Convolutional Neural Networks.
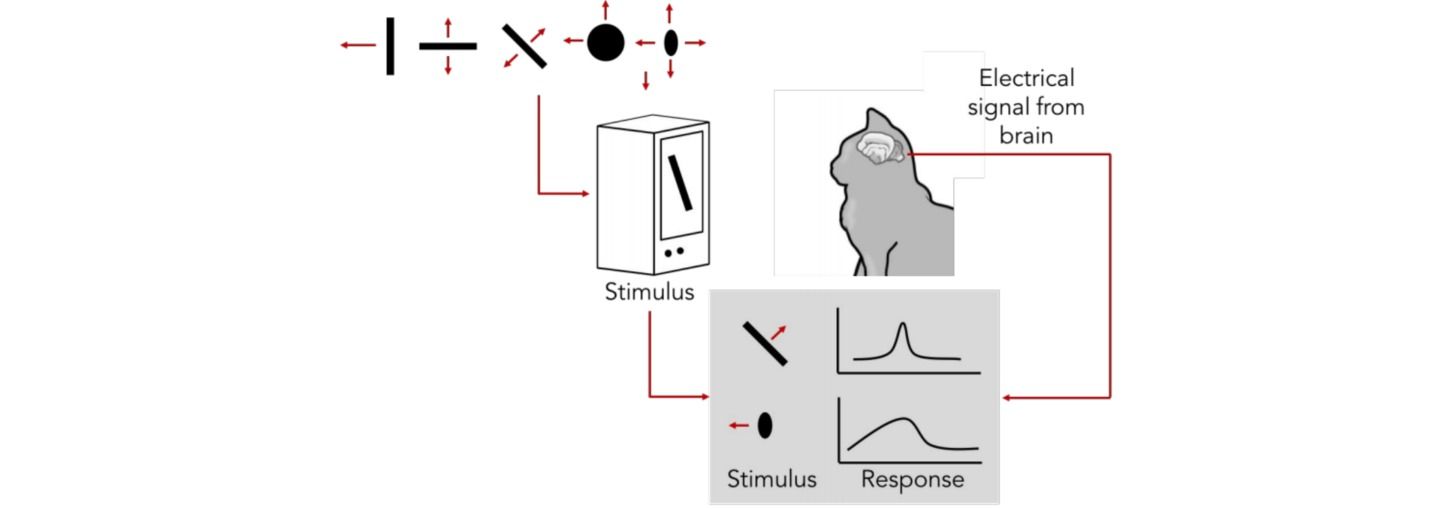
卷积神经网络(Convolutional Neural Networks, CNN)是一种为计算机视觉任务设计的深度网络,其结构设计灵感来自Hubel和Wiesel的工作,因此在很大程度上遵循了灵长类动物视觉皮层的基本结构。
卷积神经网络的学习过程与灵长类动物的视觉皮层腹侧通路(V1-V2-V4-IT/VTC)非常相似。灵长类动物的视觉皮层首先从视网膜位区域接收输入,在该区域通过外侧膝状核执行多尺度高通滤波和对比度归一化。然后通过分类为V1,V2,V3和V4的视觉皮层的不同区域执行检测。实际上视觉皮层的V1和V2部分类似于卷积层和下采样层,而颞下区类似于更深的层,最终对图像进行推断。
典型的卷积神经网络通常是由卷积层、激活函数和池化层堆叠构成,用于从图像中自适应地提取特征图(feature map),并进一步用于下游任务中。本文专注于卷积神经网络中的卷积算子本身:它的数学定义、归纳偏置、超参数与形态,以及近十年来针对采样位置、卷积核权重、聚合方式、感受野、位置信息这五个维度所做的各种改进,最后给出工程实现要点。
- 卷积的定义与性质
- (1) 从数学卷积到卷积层
- (2) 卷积层的计算
- (3) 卷积层的三个归纳偏置
- (4) 卷积层的感受野
- (5) 参数量与计算量
- ⭐ 讨论:卷积核到底学到了什么
- 卷积层的基本超参数与形态
- (1) $1\times 1$ 卷积
- (2) 扩张卷积 Dilated Convolution
- (3) 转置卷积 Transposed Convolution
- (4) 子像素卷积 Sub-Pixel Convolution
- (5) 分组卷积与深度卷积
- 常见的卷积算子改进
- 3.1 改变采样位置:几何自适应
- 3.2 动态生成卷积核权重
- 3.3 改变聚合方式:差分、掩码与稀疏
- 3.4 分解与重参数化卷积核
- 3.5 扩大感受野:大核、多尺度与频域
- 3.6 注入位置与坐标信息
- 卷积的高效实现
- (1) im2col + GEMM
- (2) FFT 卷积
- (3) Winograd 卷积
- (4) 深度卷积与大核卷积的实现要点
符号约定:本文用$X \in \Bbb{R}^{H \times W \times C}$表示输入特征图,$x(\cdot)$表示取某个空间位置上的特征向量,$y(\cdot)$表示输出特征;$w$表示卷积核权重,$b$表示偏置;$\mathcal{R}$表示卷积核覆盖的相对位置集合,$p_0$表示输出特征上的空间位置,$p_n \in \mathcal{R}$表示卷积核内部的相对偏移,$\Delta p_n$表示学习到的额外偏移量。卷积层的超参数中,$f$表示卷积核的空间尺寸,$s$表示步长,$d$表示扩张率,$g$表示分组数,$c$(或$c_{in}$)与$c’$(或$c_{out}$)分别表示输入与输出通道数,$n$表示输入特征的空间边长。
与卷积算子紧密相关但属于其它主题的内容,本文只做一句话定位并给出站内链接:
- 激活函数:卷积层之后的非线性变换,决定网络的非线性表示能力;
- 池化与下采样:与卷积并列的空间尺寸缩减算子(最大池化、平均池化、可学习下采样等);
- 轻量级卷积神经网络:MobileNet/ShuffleNet/EfficientNet等如何用深度卷积、组卷积搭建轻量网络(本文只负责这些算子的定义,不负责网络设计);
- 图像分类模型:VGG/ResNet/DenseNet/ConvNeXt等骨干网络的宏观架构设计;
- 卷积神经网络中的注意力机制与卷积神经网络中的自注意力机制:SE/CBAM式的特征重加权与Non-local式的长程建模(本文只收录那些直接改写卷积核本身的动态卷积);
- 模型压缩:剪枝、量化、知识蒸馏(本文只讨论算子层面的低成本设计)。
1. 卷积的定义与性质
卷积层(convolutional layer)的目的是从输入图像中提取对下游任务有用的特征。卷积层的基本单位是卷积核(kernel),也叫滤波器(filter)。
在传统图像处理方法中,图像滤波器算子通常是人工设计的,比如通过高斯滤波器可以进行噪声过滤,通过Sobel算子进行轮廓提取等等。而卷积层中的滤波器参数是从数据集中学习得到的,可以根据下游任务自适应地学习到最合适的参数。
(1) 从数学卷积到卷积层
在信号处理中,两个函数$x$和$w$的卷积(convolution)定义为:
\[(x*w)(t) = \int x(\tau)w(t-\tau)d\tau\]对于离散信号则写作求和形式:
\[(x*w)(t) = \sum_{\tau} x(\tau)w(t-\tau)\]注意$w$的自变量是$t-\tau$,即参与运算前卷积核被翻转(flip)了。翻转的意义在于使卷积运算满足可交换性(commutativity) $xw=wx$,以及与傅里叶变换之间的乘积关系(卷积定理)。
而卷积神经网络中实际实现的运算是互相关(cross-correlation),即不翻转卷积核:
\[(x \star w)(t) = \sum_{\tau} x(\tau)w(t+\tau)\]由于卷积层的参数是从数据中自动学习的,网络完全可以学到“已经翻转好”的一组权重,因此显式翻转对表示能力没有任何影响。深度学习社区沿用了“卷积”这个名字,但我们应当记住:卷积层做的是互相关,不满足数学卷积的可交换性描述。这个区别在推导频域卷积、FFT加速时会重新变得重要。
(2) 卷积层的计算
卷积层是一种局部操作,下面以二维卷积为例。假设输入图像(或特征图) $X\in \Bbb{R}^{H \times W \times C}$,其中$H,W$是图像的高度和宽度,$C$是图像的通道(channel)数(对于输入图像指代颜色通道,对于特征图指代深度)。
对于一个卷积核$K \in \Bbb{R}^{f \times f \times C}$,在图像上按照光栅扫描顺序(raster scanning order)滑动。当滑动到空间点$p_0$时,该点的输出值通过局部仿射变换计算:
\[y(p_0) = \sum_{p_n \in \mathcal{R}} w(p_n) \cdot x(p_0+p_n) + b\]其中$\mathcal{R} = [-\lfloor\frac{f}{2}\rfloor,…,\lfloor\frac{f}{2}\rfloor] \times [-\lfloor\frac{f}{2}\rfloor,…,\lfloor\frac{f}{2}\rfloor]$。因此一个卷积核共有$f \times f \times C+1$个参数(权重+偏置)。
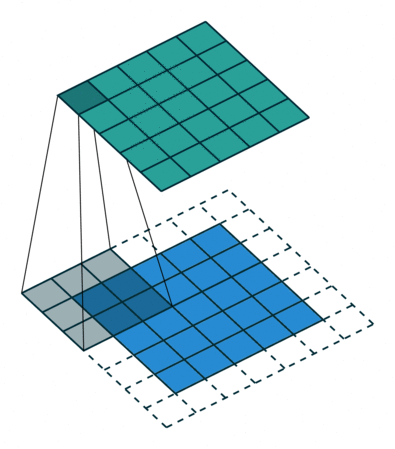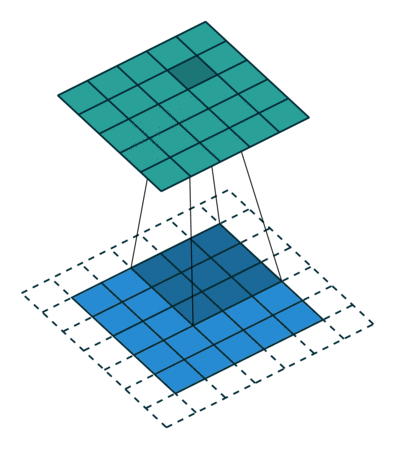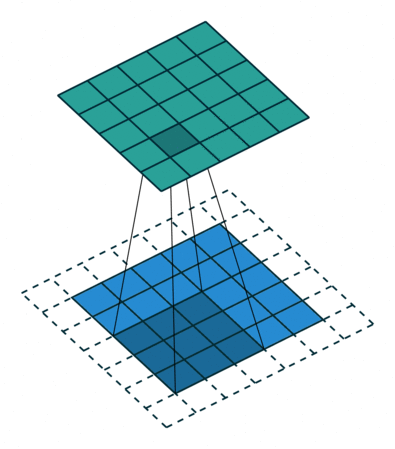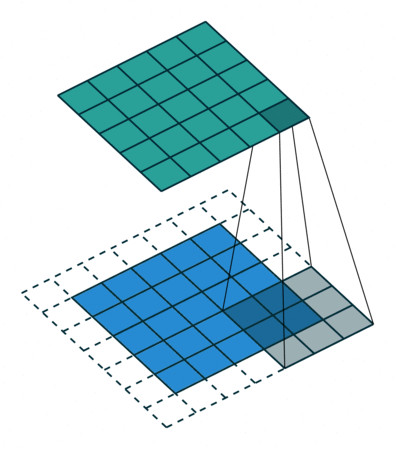
上式是本文的基准形式,后续几乎所有卷积算子的改进都可以看作是对它的某一个部分做修改:修改采样位置$p_0+p_n$(第3.1节)、修改权重$w(p_n)$的来源(第3.2节)、修改聚合方式(第3.3节)、修改$\mathcal{R}$的形状与尺度(第3.5节)、或者往$x$里注入额外信息(第3.6节)。
卷积层还具有步长(stride)参数和填充(padding)参数。步长是指卷积核在图像上进行一次滑动时所移动的像素数量,步长$s>1$会导致特征图的空间尺寸变小;填充参数是指在图像的四周填充像素,具有三种模式:
- full:对图像四周填充像素直至卷积核滑动的初始位置恰好与原图像相交,此时输出特征的空间尺寸变大;
- same:对图像四周填充像素直至卷积核滑动的初始中心位置恰好与原图像相交,此时卷积层不改变特征的空间尺寸;
- valid:不填充像素,此时输出特征的空间尺寸变小。
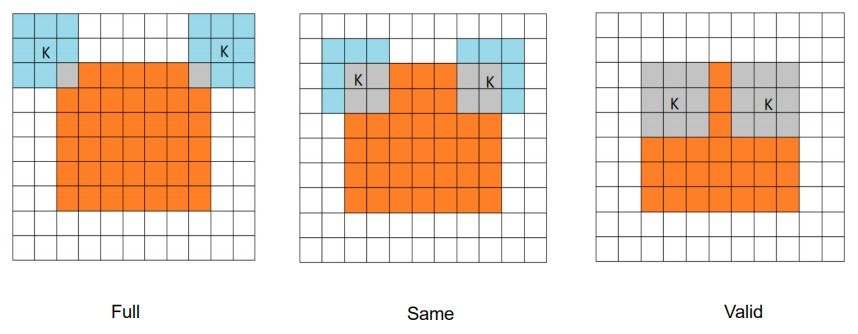
若输入图像尺寸为$n\times n\times c$,使用卷积核的尺寸为$f\times f\times c$,步长为$s$,填充为$p$,则单个卷积核对应的输出特征的尺寸是:
\[\lfloor \frac{n+2p-f}{s}\rfloor +1 \times \lfloor\frac{n+2p-f}{s}\rfloor +1\]通常认为一个卷积核只捕捉输入图像中的一种特定的局部特征。因此通过使用多个卷积核提取包含不同语义信息的特征,其中每个卷积核对应输出特征的一个通道。
下图给出了一个步长为$2$、填充为$1$的$3 \times 3$卷积核的示意图:
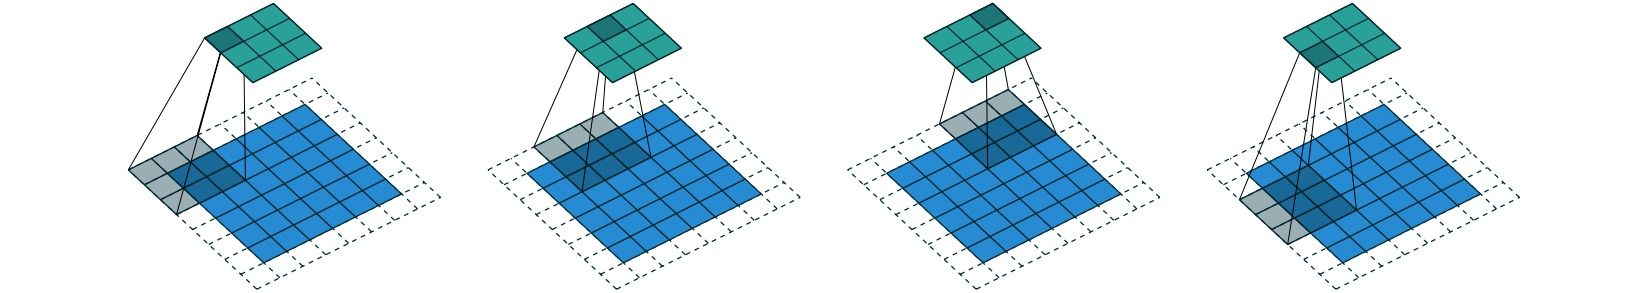
可以通过torch.nn.Conv2d在Pytorch中定义二维卷积层:
点击展开代码
conv_layer = torch.nn.Conv2d(
    in_channels,  # 输入图像/特征的通道数量
    out_channels, # 输出特征的通道数量(所使用的卷积核数量)
    kernel_size,  # 卷积核的空间尺寸
    stride=1, padding=0, # 步长和填充参数
    dilation=1, groups=1, # 实现空洞卷积和组卷积
    bias=True, # 是否使用偏置项
    padding_mode='zeros', # 填充模式,可选'zeros', 'reflect', 'replicate', 'circular'
    device=None, dtype=None)
(3) 卷积层的三个归纳偏置
相比于全连接神经网络,卷积层引入了三条针对自然图像的归纳偏置(inductive bias):稀疏连接、权值共享和平移等变性。它们既是卷积高效的原因,也是后续各种改进工作试图调整的对象。
⚪ 稀疏连接 (sparse connectivity)
全连接神经网络中的神经元与上一层的所有神经元连接,参数量较大;而卷积层的输出特征中的每一个元素都只和上一层特征对应位置的局部邻域内的元素相连,构成一个局部连接网络。这条偏置对应“自然图像中的强相关性是局部的”这一先验。
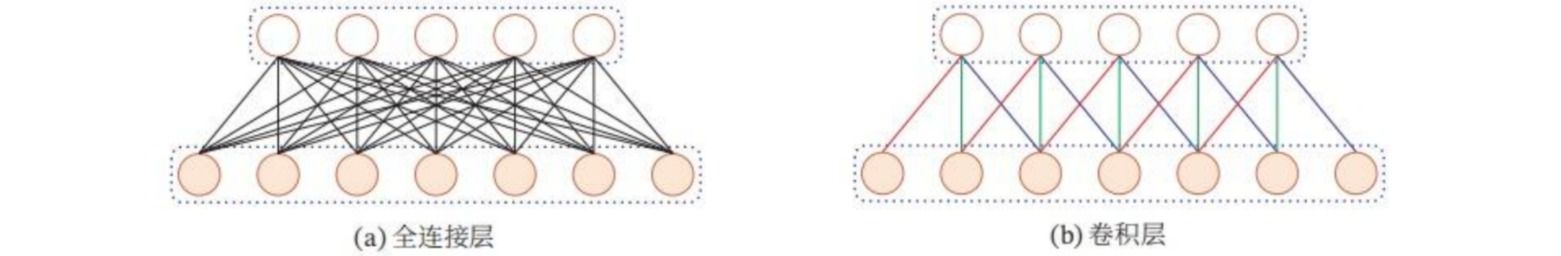
稀疏连接的代价是单层的建模范围有限,必须靠堆叠层数(或扩张、大核)来换取全局视野;这也是第3.5节各种扩大感受野方法的出发点。
⚪ 权值共享 (parameter sharing)
权值共享是指卷积层的每一个卷积核在特征的不同位置上是共享参数的。权值共享能够进一步减少卷积层的参数量,此时每一个卷积核可以提取具有某种固定模式的特征(比如水平线段或竖直线段),通过使用复数个卷积核能够提取不同语义信息的特征。
权值共享隐含了“同一种模式可能出现在图像的任何位置”的假设。这个假设在很多场景下过强:人脸图像的不同区域统计特性差异很大,遥感图像的不同区域尺度差异也很大。第3.2节的动态卷积、DRConv、Involution正是通过让卷积核逐样本甚至逐位置变化来放松这条偏置。
⚪ 平移等变性 (translation equivariance)
平移变换是指把一幅图像或一个空间中的每一个点沿相同方向移动相同的距离。平移等变性是指对输入进行平移变换时,系统在不同位置的工作原理相同,但它的响应随着目标位置的变化而变化。用算子语言写作:若$T$为平移算子、$\mathcal{C}$为卷积算子,则
\[\mathcal{C}(T(x)) = T(\mathcal{C}(x))\]对于卷积层,输入图像经过平移后,输出特征图上的对应特征表达也是平移的。
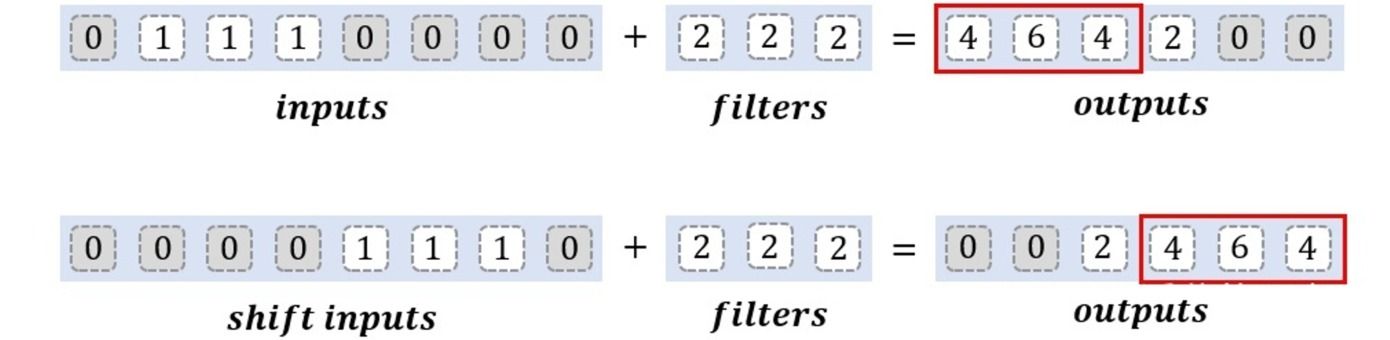
进一步地,如果卷积层之后应用池化层、全局池化、全连接层等结构,则整个网络近似具有平移不变性(translation invariance)。此时无论目标出现在图像中的哪个位置,它都会检测到相同的特征,输出同样的响应。
需要注意,严格的平移等变性只在忽略边界填充和步长下采样时成立:$s>1$的步长把等变群从“任意平移”缩小到“$s$的整数倍平移”,而零填充会在特征图边界引入位置相关的响应。有趣的是,这些“泄漏”出来的位置信息在实践中往往是有用的(见第3.6节);而当任务本身就需要显式坐标时,平移等变性反而成为缺陷,这正是CoordConv的动机。
(4) 卷积层的感受野
卷积层的特征提取能力可以用感受野(receptive field)衡量。感受野定义为每一层输出特征上的像素点对应输入图像上的区域大小。第$n$层卷积层的感受野计算为第$n$层输出特征图中的一个像素对应输入图像的像素数。
令网络第$n$层卷积层的卷积核大小为$f_n$,步长参数为$s_n$。则第$n$层卷积层的感受野$RF_n$可以递归地计算为:
\[RF_n = RF_{n-1} + (f_{n}-1)\cdot \prod_{i=1}^{n-1} {s_i}\]第$n$层特征的每个像素对应第$n-1$层特征的$f_n$个像素,其中中间像素具有相对于输入图像的感受野$RF_{n-1}$,而最边缘的像素使得第$n-1$层感受野相对于第$n-2$层增大了$(f_{n}-1)\cdot s_{n-1}$,递归地等价于相对于输入图像增大了$(f_{n}-1)\cdot \prod_{i=1}^{n-1} {s_i}$。
下面给出了一个应用步长为$2$的$3 \times 3$卷积层堆叠两层的感受野情况。则第一层卷积层具有$3 \times 3$的感受野;第二层卷积层相对于第一层卷积层具有$3 \times 3$的感受野,相对于输入图像扩展了$(3-1)\cdot 2$个像素。
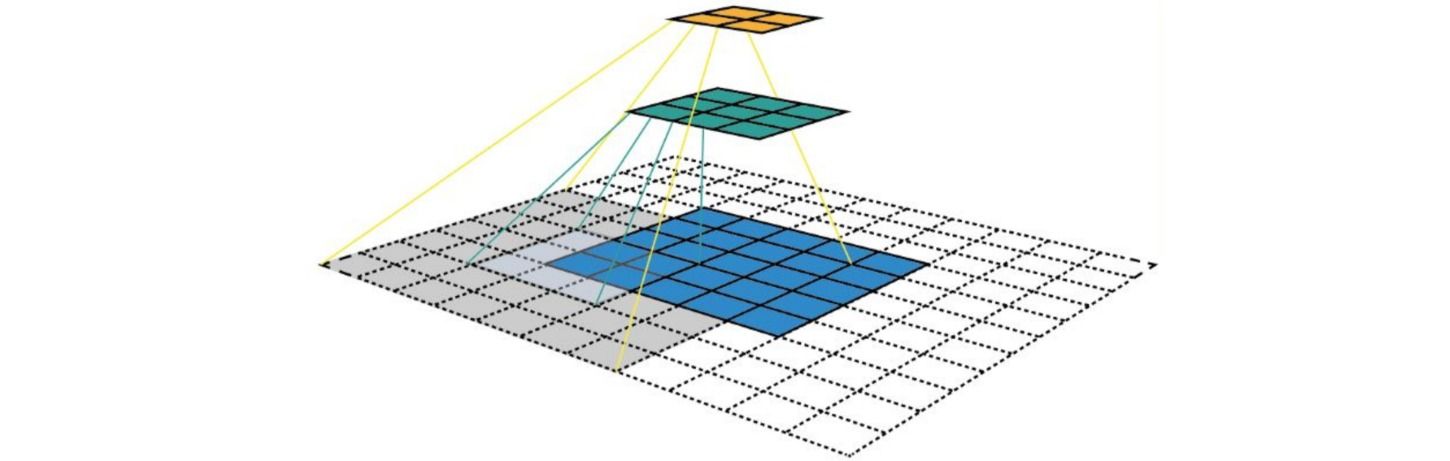
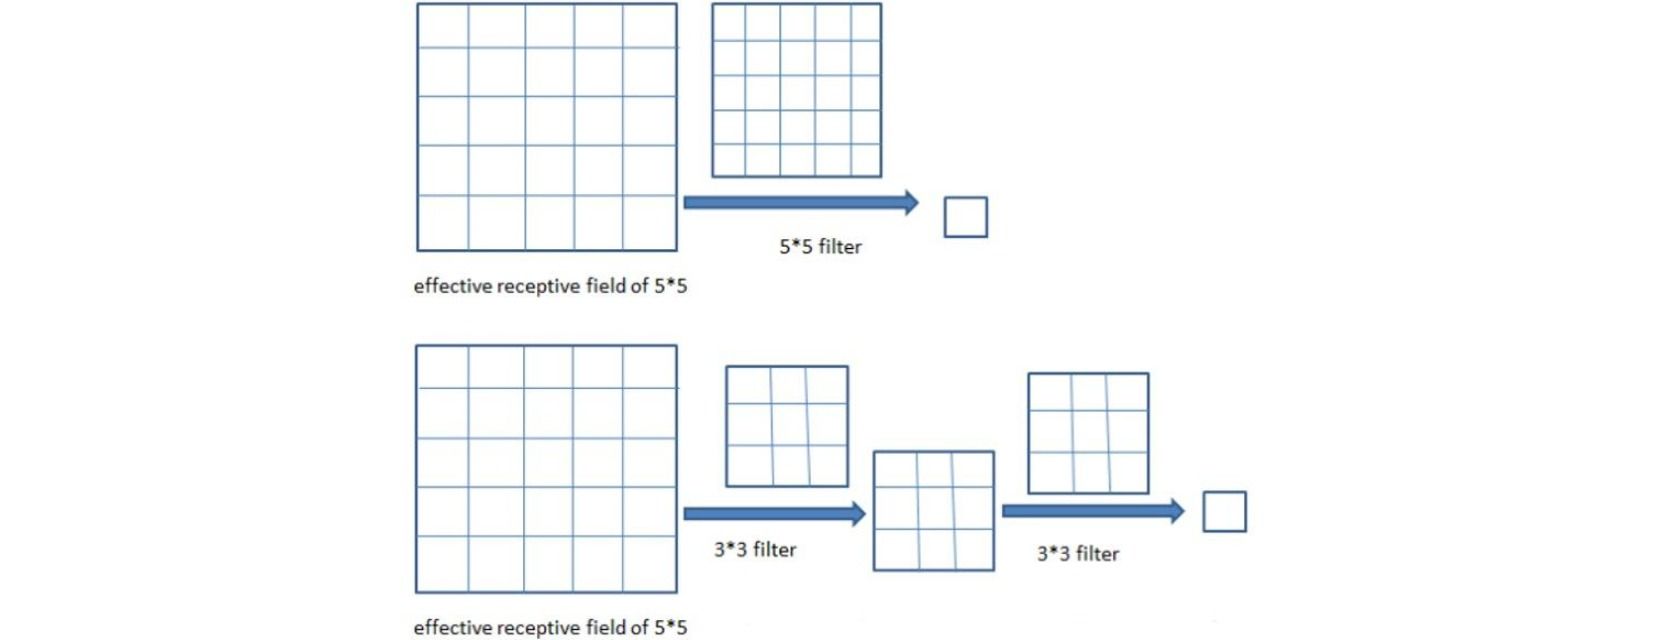
在构建卷积神经网络时,通常采用更小的卷积核堆叠更多层数来实现较大的感受野,以减少网络参数量。比如两层$3\times 3$的卷积层和一层$5\times 5$的卷积层具有相同的感受野,但前者的参数量更小($2\cdot 3^2<5^2$):
⚪ 有效感受野 (Effective Receptive Field, ERF)
上面递归公式给出的是理论感受野:它只回答“哪些输入像素在计算图上可达”,而不回答“这些像素各自贡献了多少”。若把输出对输入的梯度$\partial y(p_0)/\partial x(p)$当作贡献度,可以发现:
- 贡献度在理论感受野内部呈近似高斯分布,中心像素的影响远大于边缘像素;
- 堆叠$n$层$f\times f$卷积时,理论感受野线性增长为$O(nf)$,但有效感受野只以$O(\sqrt{n}f)$的速度增长(多层独立随机贡献的叠加近似为随机游走);
- 因此“用小卷积核堆很多层”虽然理论感受野很大,实际能利用的空间范围却被显著折扣。
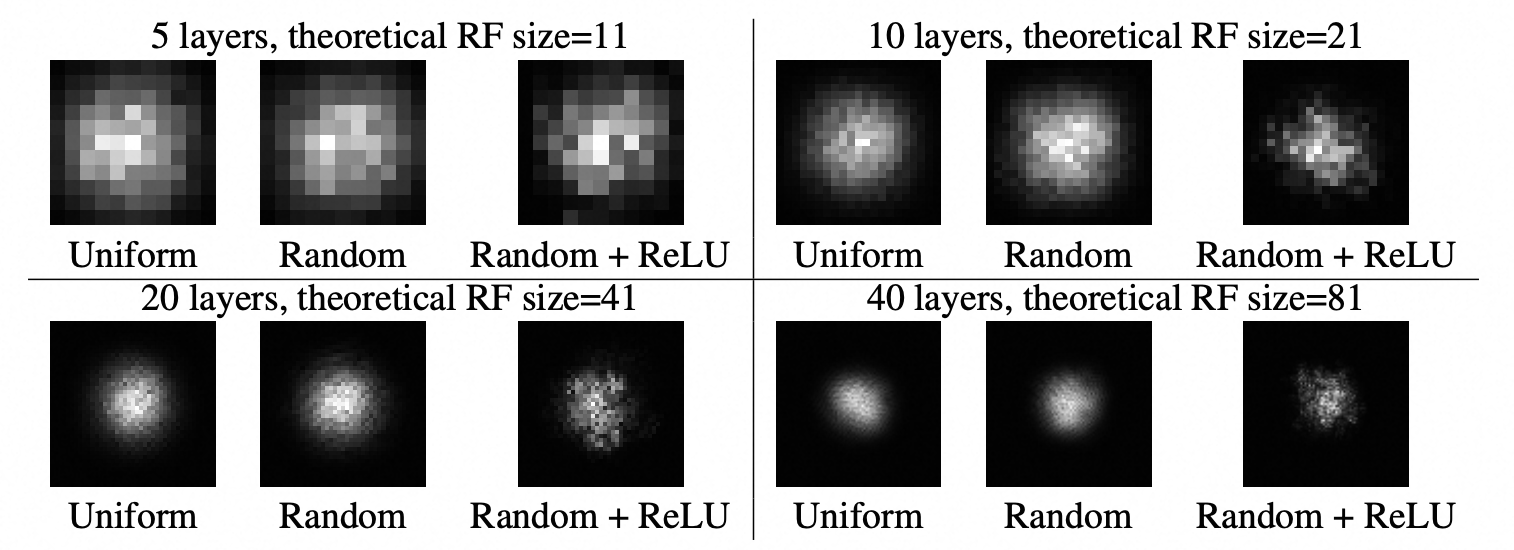
这个结论解释了两件事:为什么语义分割、目标检测这类需要大范围上下文的任务偏爱扩张卷积和金字塔结构;以及为什么2022年之后大核卷积($7\times 7$乃至$51\times 51$)会重新流行:直接把有效感受野做大,比靠深度间接积累更有效。
(5) 参数量与计算量
评价一个卷积算子的成本至少要看三个指标。设输入为$n\times n\times c$,输出为$n’\times n’\times c’$,卷积核为$f\times f$,分组数为$g$:
\[\begin{aligned} \text{Params} &= \frac{f^2 c c'}{g} + c' \\ \text{FLOPs (Mult-Adds)} &= n'^2 \cdot \frac{f^2 c c'}{g} \\ \text{MAC} &\approx n^2c + n'^2c' + \frac{f^2cc'}{g} \end{aligned}\]其中MAC (Memory Access Cost)表示访存量,即读入输入、写出输出、读入权重所涉及的数据量。三者的关系可以用算术强度(arithmetic intensity)刻画:
\[I = \frac{\text{FLOPs}}{\text{MAC}}\]- 标准$3\times 3$卷积的$I$很大(每读一个数要做几百次乘加),属于计算受限(compute-bound)算子,能充分利用GPU算力;
- 深度卷积、$1\times 1$卷积的$I$很小,属于访存受限(memory-bound)算子。这就是“FLOPs降低$8$倍,实测只快$2$倍”这类现象的根源,也是第3.4节PConv、第3.5节大核卷积在设计时必须考虑的约束。
因此评价卷积算子时,不能只看参数量和FLOPs。一个更贴近实际的经验顺序是:先看时延(在目标硬件上实测),再看MAC,最后看FLOPs与参数量。
⭐ 讨论:卷积核到底学到了什么
卷积层的可解释性研究可以从三个互补的角度切入:单个卷积核的语义、整个网络与生物视觉表征的对应、以及卷积网络偏好的频率成分。
⚪ 单个卷积核承担了可命名的语义角色
该工作提出了网络解剖(network dissection)方法:把某个卷积核(unit)在验证集上的激活图二值化,与人工标注的语义分割掩码计算交并比
\[\text{IoU}_{u,c} = \frac{\lvert M_u \cap L_c \rvert}{\lvert M_u \cup L_c \rvert}\]若$\text{IoU}_{u,c}$超过阈值,就认为卷积核$u$是概念$c$的检测器。在Places365场景分类任务上训练的VGG-16中,可以发现明确对应“天空”、“树木”、“人”、“座位”等概念的卷积核,且越深的层对应越高层的语义:浅层是颜色与纹理,中层是材质与部件,深层才是物体与场景元素。
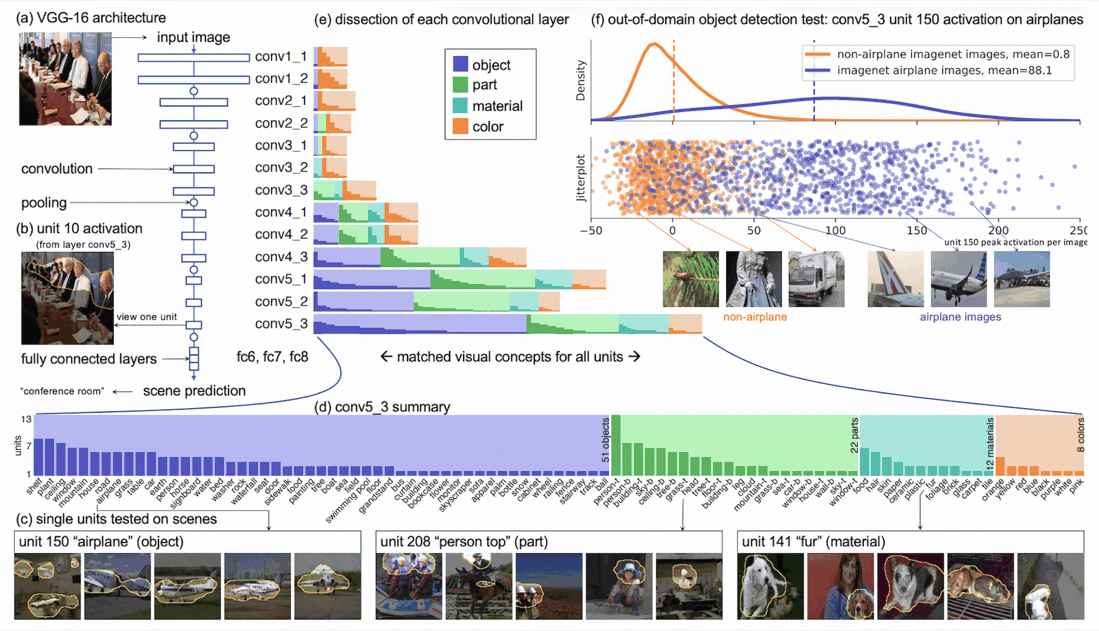
更重要的是因果性验证:把某一类的$20$个高IoU卷积核置零,该类别精度会显著下降,而对其它类别影响很小;反过来只保留少量关键卷积核仍能维持相当的精度。在生成对抗网络里做同样的实验(删除对应“树”的卷积核),生成图像中的树会消失而背景保持一致,说明这些卷积核确实因果地承担了对应概念的表示。
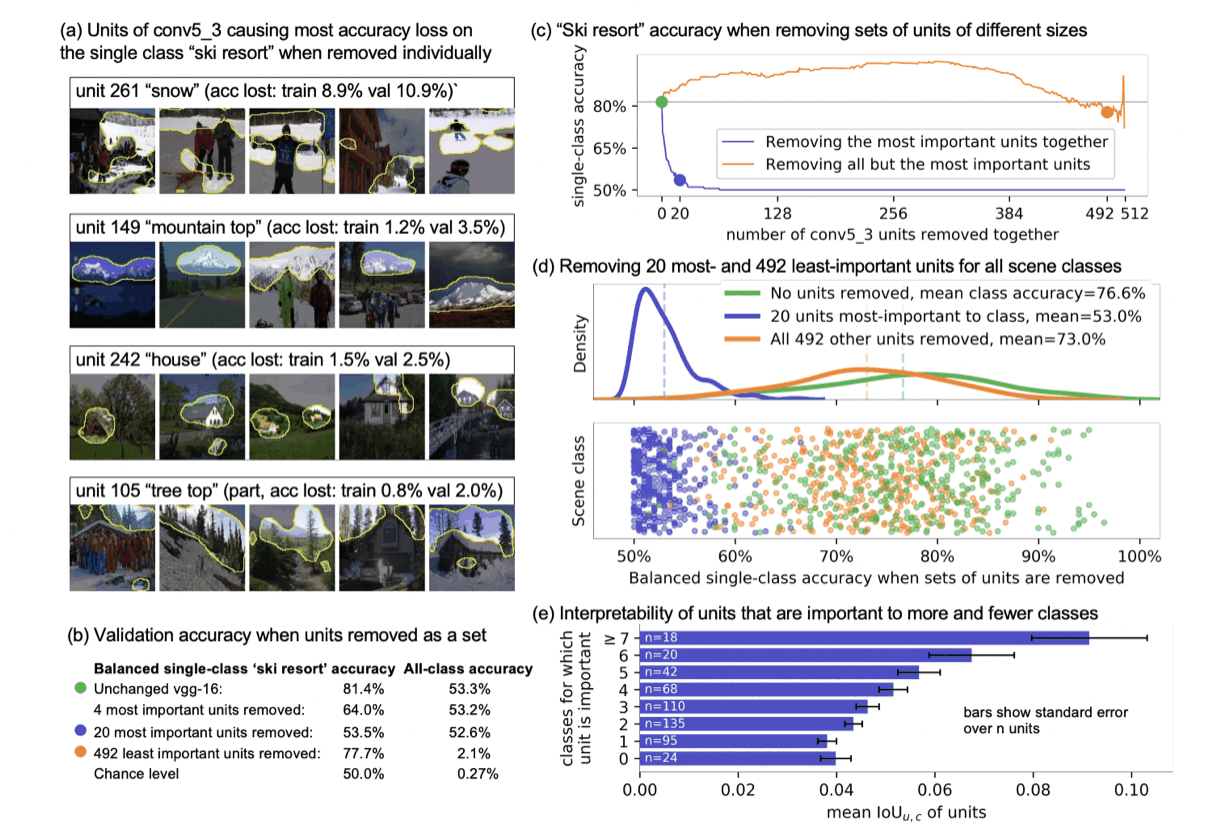
这为“卷积核=特定局部模式的检测器”这一直觉提供了定量证据,也解释了模型压缩中通道剪枝为什么可行:绝大多数卷积核对给定任务是冗余的。
⚪ 卷积特征与人脑视觉表征存在层级对应
该工作先用fMRI记录被试观看图像时的大脑活动,训练一组线性解码器把体素信号映射到预训练CNN各层的特征,再以“生成图像的CNN特征应当匹配解码出的特征”为目标,配合生成式先验做迭代优化,从而重建被试看到的图像。
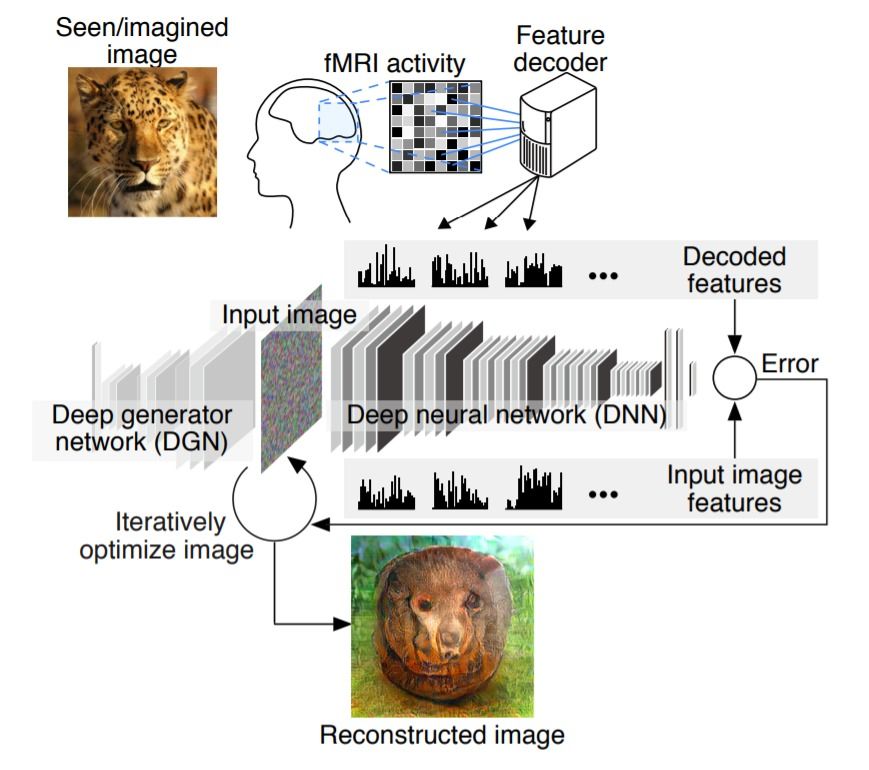
关键观察是:使用的CNN层数越多、层次越丰富,重建图像的质量越高;且低级视觉区(V1-V2)的信号更容易解码出浅层卷积特征,高级视觉区(V4-VTC)的信号更容易解码出深层特征。这一层级对应关系从表征相似性的角度支持了本文开头的类比:卷积网络的逐层抽象与灵长类视觉皮层腹侧通路是同构的。
⚪ 卷积网络对高频成分格外敏感
把输入图像做傅里叶变换$z=\mathcal{F}(x)$,按半径$r$把频谱拆成低频与高频两部分$z_l,z_h=t(z;r)$,再分别逆变换回图像域:
\[x_l = \mathcal{F}^{-1}(z_l), \quad x_h = \mathcal{F}^{-1}(z_h), \quad x = x_l + x_h\]实验发现:人类只能识别$x_l$,而卷积网络在$x_h$上仍能给出远高于随机的预测。也就是说,网络会利用人类感知不到的高频成分来降低训练损失,这些成分与语义的关联往往是数据集特有的巧合。
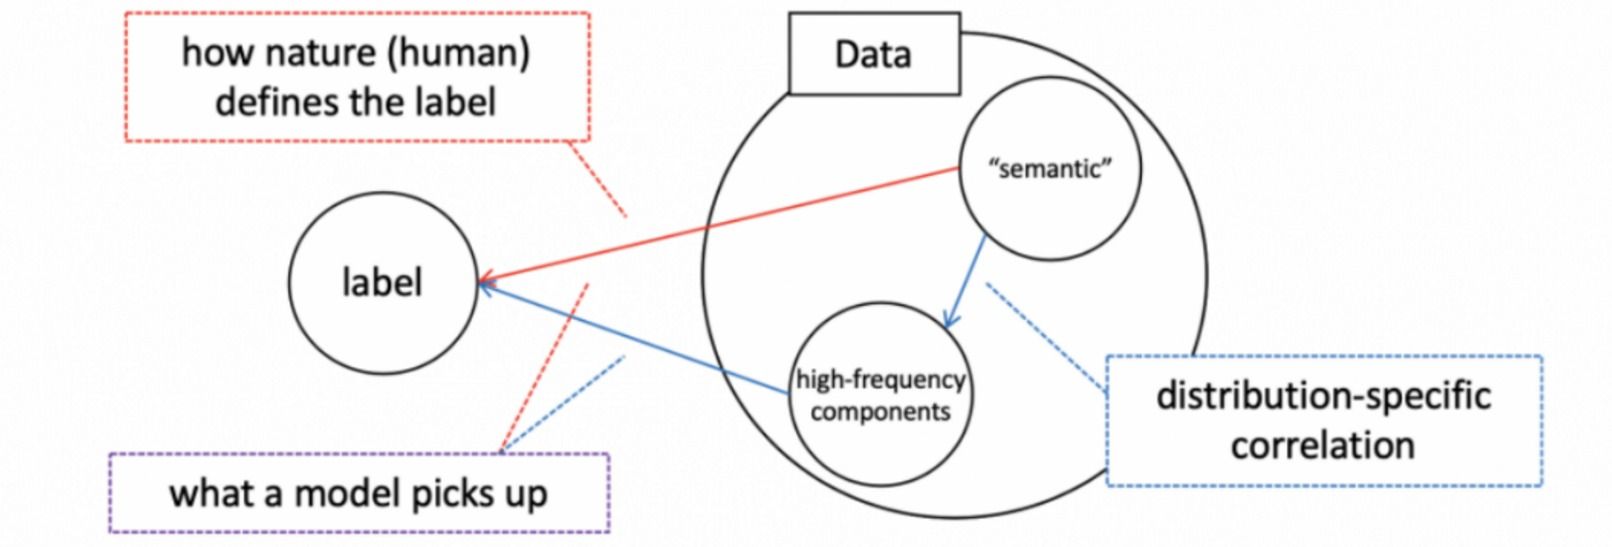
由此可以统一解释若干现象:模型在训练集上“抓住高频捷径”会带来泛化间隙;对抗样本本质上是对高频方向的扰动;因此精度与鲁棒性之间存在权衡:过度拟合高频成分提升了干净精度却损害了鲁棒性。
一个直接的推论是对卷积核做平滑正则:让第一层卷积核的相邻权重彼此靠近,等价于抑制它对高频的响应,
\[\tilde{w}_{i,j} = w_{i,j} + \sum_{(h,k) \in N(i,j)} \rho \cdot w_{h,k}\]其中$N(i,j)$是权重$w_{i,j}$的空间邻域,$\rho$控制平滑强度。这一操作会略微降低干净精度,但显著提升对抗鲁棒性,与上述权衡关系一致。这也提示我们:第3.5节的频域卷积并非只是“另一种实现”,显式地分离并分别处理不同频段,本身就是一种有意义的归纳偏置。
2. 卷积层的基本超参数与形态
标准卷积的超参数(卷积核尺寸$f$、步长$s$、填充$p$、扩张率$d$、分组数$g$)在取到边界值时会退化出若干具有独立名称的算子形态。本节按“改变通道、改变感受野、改变空间尺寸、改变连接结构”四条线索梳理这些形态,它们是后续所有改进工作的公共语言。
(1) $1\times 1$ 卷积
- paper:Network In Network
$1\times 1$卷积也叫逐点卷积(Pointwise Convolution),是卷积核尺寸取$f=1$时的退化形态。此时$\mathcal{R}={(0,0)}$,卷积公式退化为对每个空间位置独立作用的线性变换:
\[y(p_0) = W x(p_0) + b, \quad W \in \Bbb{R}^{c' \times c}\]即$1\times 1$卷积等价于在所有空间位置上共享权重的全连接层,因此它是空间独立、通道交互的算子(与空间交互、通道独立的深度卷积恰好互补)。它的作用包括:
- 通道升降维:把$c$通道映射为$c’$通道,是ResNet bottleneck、Inception降维分支的基本手段;参数量仅$cc’$,与空间尺寸无关;
- 跨通道信息融合:标准卷积在通道方向是全连接的,而深度卷积、组卷积破坏了通道间的交互,需要$1\times 1$卷积把通道重新混合起来;
- 增加非线性:配合激活函数使用时,$1\times 1$卷积等价于对每个像素的特征向量做一次MLP,这是Network In Network的原始动机;
- 作为注意力/门控的投影层:几乎所有通道注意力、动态卷积的权重生成分支都由$1\times 1$卷积(或等价的全连接层)实现。
需要注意$1\times 1$卷积是典型的访存受限算子:它的算术强度只有$O(\min(c,c’))$量级,在轻量网络里往往占据大部分实际时延。
(2) 扩张卷积 Dilated Convolution
扩张卷积 (Dilated Convolution)也称为膨胀卷积、空洞卷积 (Atrous Convolution),能够在不增加参数数量的前提下增大网络的感受野。
扩张卷积引入了膨胀/扩张率(Dilation Rate) $d$,是指在卷积核的相邻元素之间插入$d-1$个空洞,等价于把采样位置集合放大$d$倍:
\[y(p_0) = \sum_{p_n \in \mathcal{R}} w(p_n) \cdot x(p_0+d \cdot p_n)\]当$d=1$时扩张卷积退化为标准的卷积。对于尺寸为$f\times f$的扩张卷积核,若扩张率为$d$,则等效为$f’=d(f-1)+1$的标准卷积核,对应的输出特征的空间尺寸是(步长为$s$,填充为$p$):
\[n' = \lfloor \frac{n+2p-f'}{s}\rfloor +1\]下图给出了一个使用扩张率$d=2$的$3 \times 3$扩张卷积处理空间尺寸为$7 \times 7$的输入特征的例子,得到$3 \times 3$的输出特征。
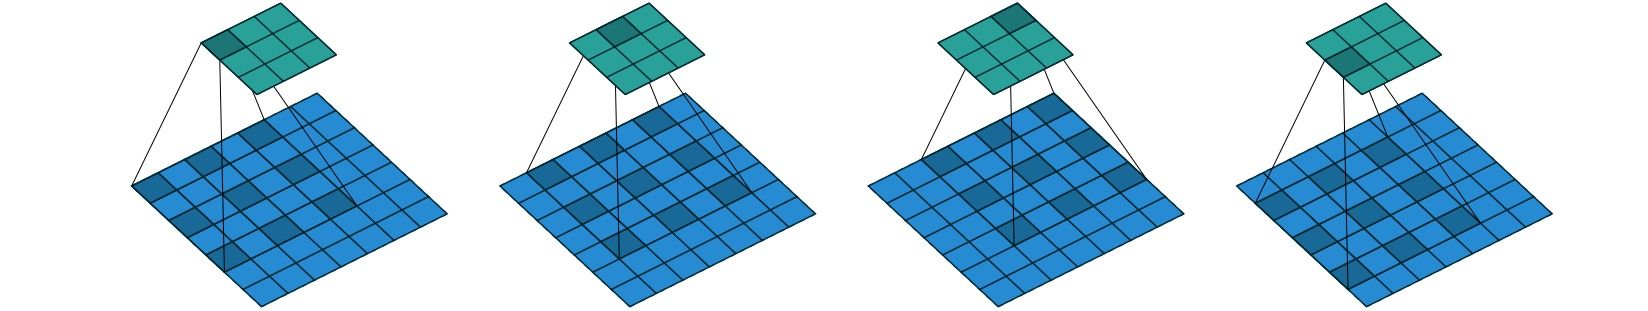
扩张卷积通过等效地增大卷积核尺寸,使网络具有更大的感受野,但没有额外增加卷积核的参数量,因此在语义分割等需要保持高分辨率同时获取大范围上下文的任务中被广泛使用(见图像语义分割中的DeepLab与ASPP)。
扩张卷积存在的问题包括:
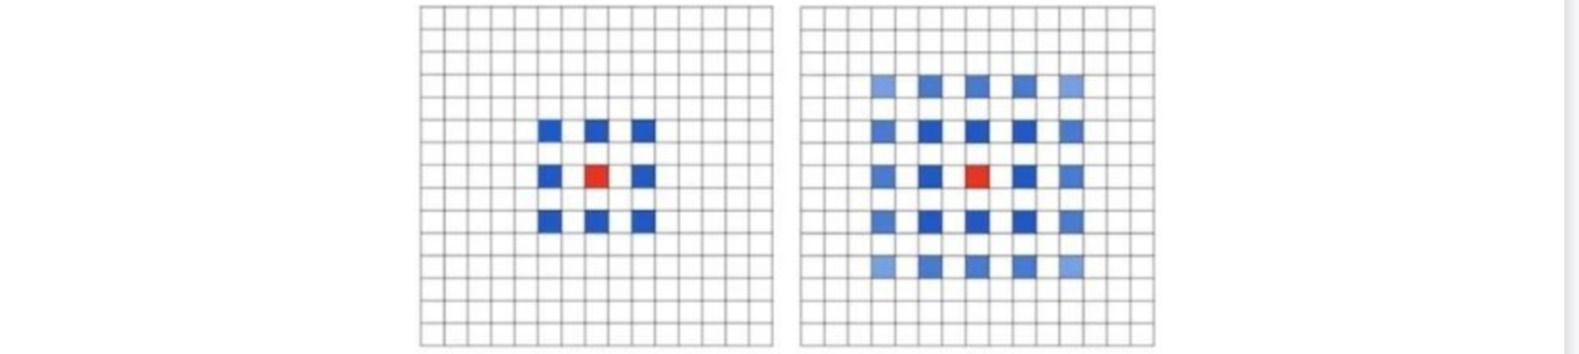
- 网格效应 (Gridding Effect):如果简单地多次叠加具有相同扩张率的扩张卷积,会导致卷积核采样的像素并不连续,并没有利用所有的像素进行计算;因此朴素堆叠的扩张卷积不适合像素级的密集预测任务。下图给出了连续使用两层扩张率相同的$3\times 3$扩张卷积对应的中心点感受野。
- 不适合小目标:扩张卷积可以捕捉长距离(long-ranged)信息,然而较大的扩张率适合捕捉大物体的信息,而对小物体来说可能有消极的作用。
可以通过torch.nn.Conv2d中的dilation参数构建扩张卷积:
点击展开代码
conv_layer = torch.nn.Conv2d(
    in_channels,  # 输入图像/特征的通道数量
    out_channels, # 输出特征的通道数量(所使用的卷积核数量)
    kernel_size,  # 卷积核的空间尺寸
    stride=1, padding=0, # 步长和填充参数
    dilation=1,   # 扩张卷积的扩张率
    bias=True, # 是否使用偏置项
    padding_mode='zeros', # 填充模式,可选'zeros', 'reflect', 'replicate', 'circular'
    device=None, dtype=None)
⚪ 混合扩张卷积 Hybrid Dilated Convolution (HDC)
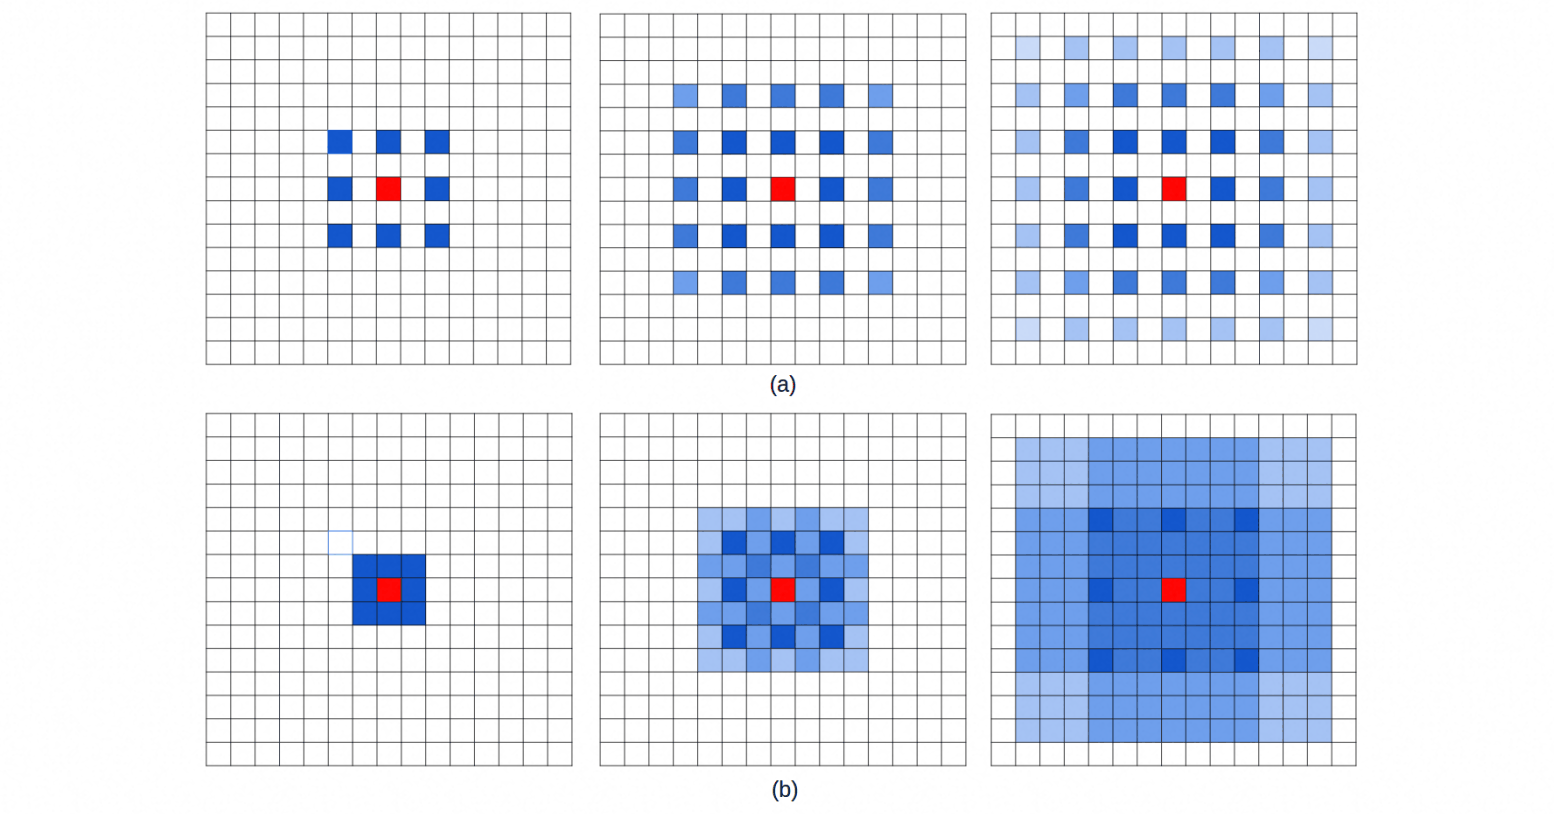
HDC是缓解网格效应的经典设计准则:不要在连续的若干层使用同一个扩张率,而应使用一组互质、锯齿状递增的扩张率(如$d=1,2,3$而非$d=2,2,2$),使连续层的采样位置互补覆盖整个感受野。
定量地,定义连续$n$层扩张卷积中第$i$层的两个非零元素之间的最大距离
\[M_i = \max\left[M_{i+1}-2d_i,\ 2d_i - M_{i+1},\ d_i\right], \quad M_n = d_n\]设计目标是使$M_2 \leq f$($f$为卷积核尺寸),此时最终感受野内没有空洞。以$f=3$、$d={1,2,3}$为例可以满足该条件(图b),而$d={2,2,2}$则不能(图a)。
⚪ Inception Convolution (IC-Conv):把扩张率交给搜索算法
HDC是人工设定的启发式规则,IC-Conv则把扩张率彻底放开:独立定义每个轴、每个通道和每个卷积层的扩张率,从而提供一个密集的有效感受野范围。
\[d = \{ d_x^i,d_y^i \mid d_x^i,d_y^i \in 1,2,...,d_{\max},\ i=1,2,...,c_{out} \}\]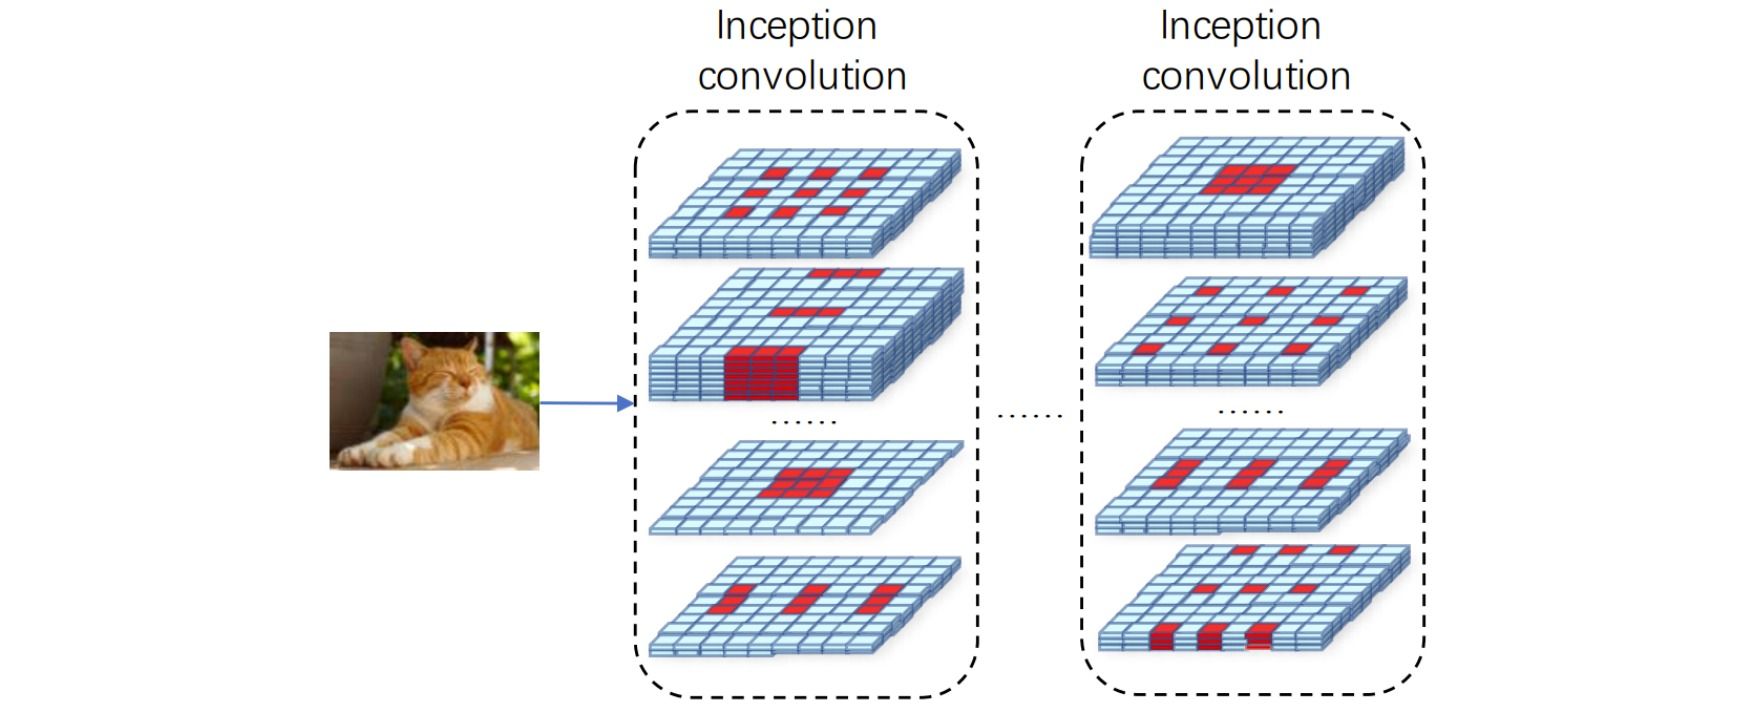
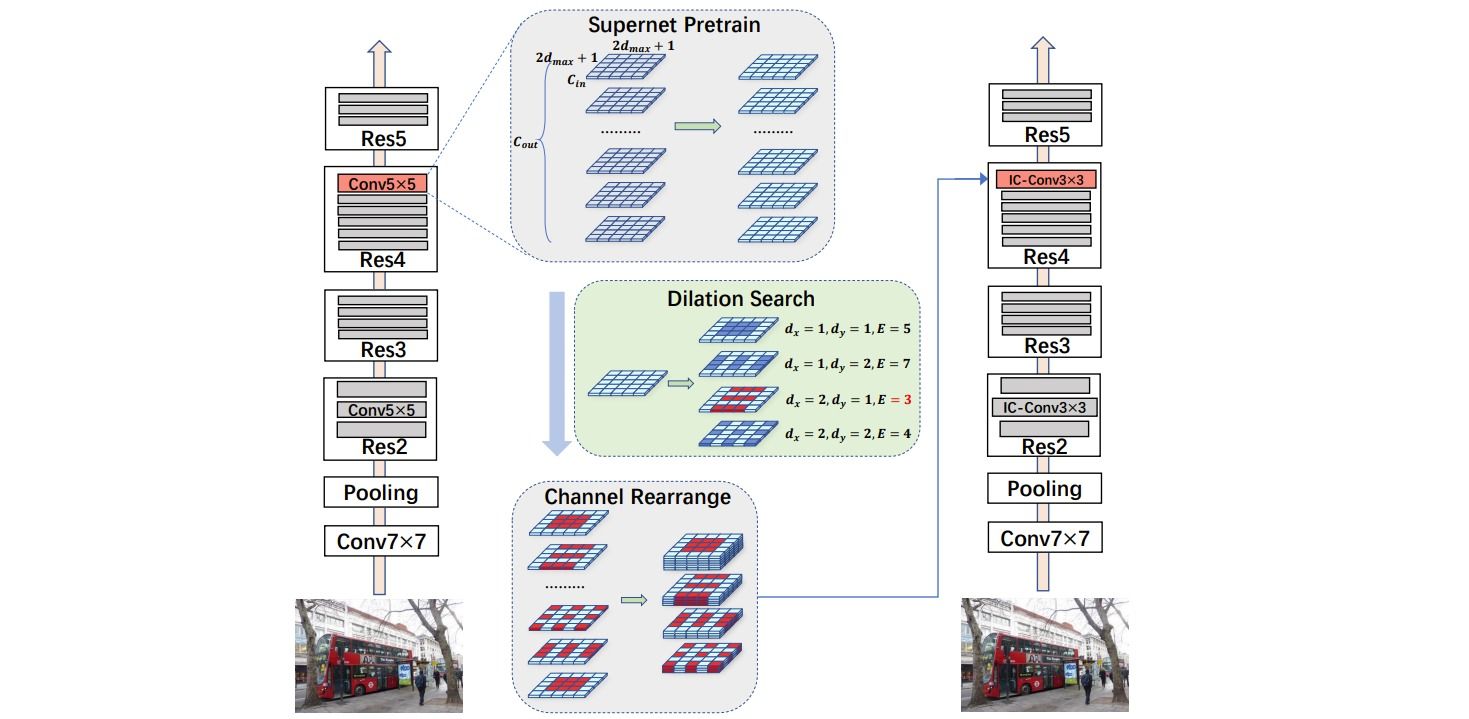
这个搜索空间大小为$d_{\max}^{2c_{out}}$,无法穷举。IC-Conv提出高效扩张搜索(Efficient Dilation Optimization, EDO):先预训练一个每层卷积核都覆盖所有可能扩张率的超网络,然后对每一层求解一个L1回归问题:从超网络的大卷积核里裁剪出一组扩张卷积核,使其输出与原始(稠密)卷积层的输出误差最小:
\[\mathop{\arg \min}_{d} \left\Vert W_{\text{dense}} * X - W_{d} * X \right\Vert_1\]由于L1目标天然倾向稀疏解,求解过程可以逐层独立、并行完成,搜索代价远低于常规的NAS。
(3) 转置卷积 Transposed Convolution
转置卷积 (Transposed Convolution)也叫解卷积(Deconvolution),能够对特征图的空间尺寸进行上采样,把低维特征映射到高维特征。
转置卷积是通过自动地对输入特征进行full填充实现的。若输入图像的空间尺寸为$n\times n$,设置$f\times f$的转置卷积核,则会自动对输入特征填充$f-1$层零像素,从而使得卷积核滑动的初始位置恰好与原图像的一个像素点相交,保证特征提取过程是有意义的。此时输出特征的空间尺寸为:
\[n' = n+(f-1)\]下图给出了通过一个$3\times 3$转置卷积把$2\times 2$特征转换成$4\times 4$特征的过程。
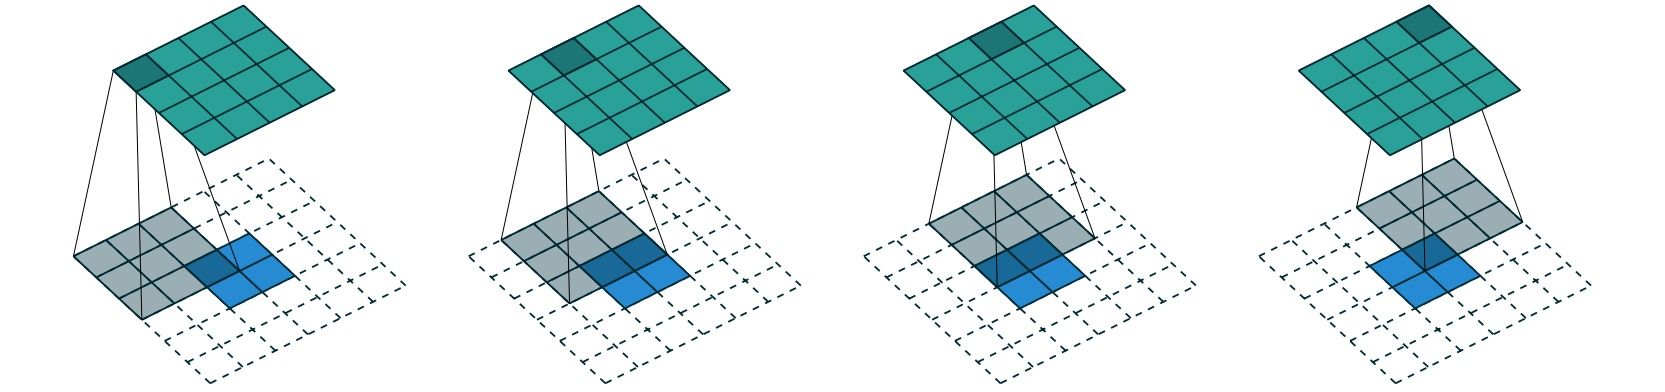
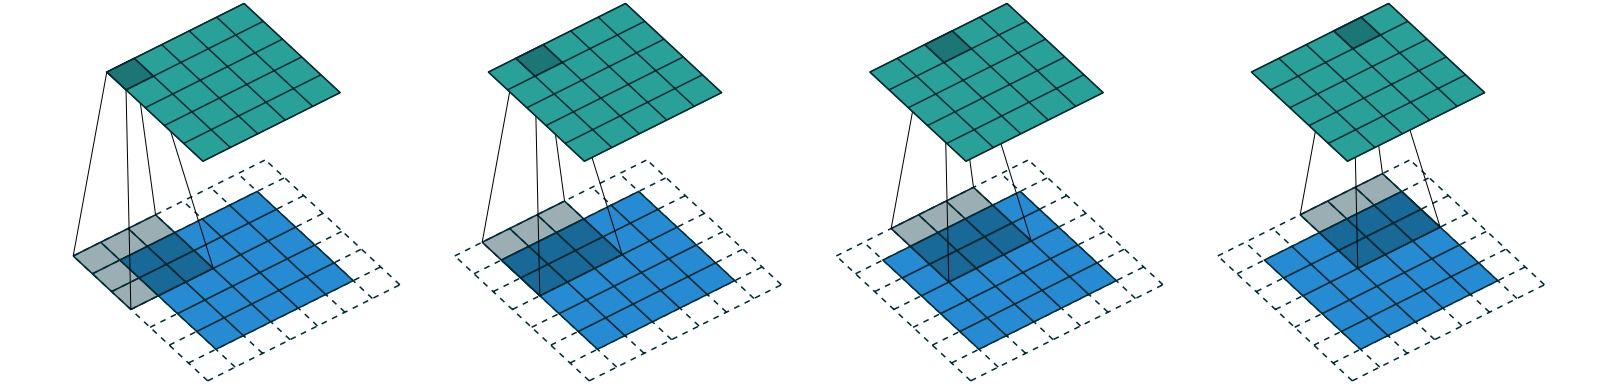
在转置卷积中,也可以人为地设置填充参数$p$。当设置填充参数$p>0$时,相当于指定输入特征的最外$p$层为填充像素,此时特征的有效尺寸为$n-2p$,$f\times f$的转置卷积核所产生的输出特征的空间尺寸为:
\[n' = n+(f-1)-2p\]填充参数$p$相当于转置卷积核自动对输入特征填充的零像素层数减少$p$层。下图给出了通过一个填充为$p=1$的$3\times 3$转置卷积把$5\times 5$特征转换成$5\times 5$特征的过程。
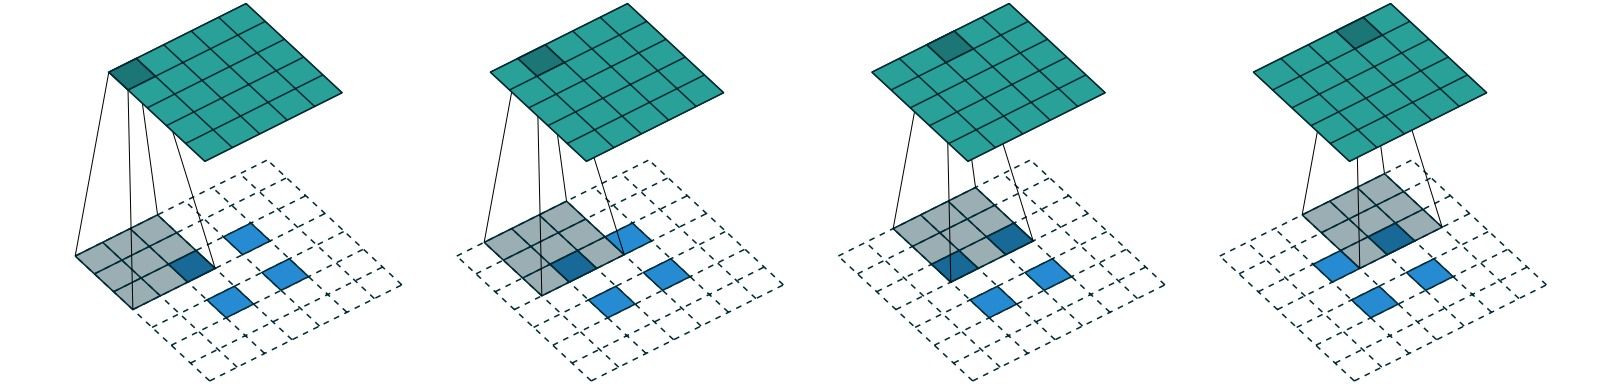
转置卷积也可以设置步长参数$s$ (实现上采样的主要参数)。步长参数$s>1$相当于对输入特征的相邻像素之间插入$s-1$个空洞,对应的卷积也叫做微步长卷积 (Fractionally-Strided Convolution),此时输入特征的空间尺寸等效为$s(n-1)+1$,$f\times f$的转置卷积核对应的输出特征的空间尺寸为:
\[n' = s(n-1)+1+(f-1) = s(n-1) + f\]下图给出了通过一个步长为$s=2$的$3\times 3$转置卷积把$2\times 2$特征转换成$5\times 5$特征的过程。
综上所述,若输入图像尺寸为$n\times n\times c$,使用$c’$个尺寸为$f\times f\times c$的卷积核,步长为$s$,填充为$p$,输出图像尺寸为$n’\times n’\times c’$,则存在如下关系:
\[n' = s(n-1) + f -2p\]可以通过torch.nn.ConvTranspose2d在Pytorch中定义二维转置卷积层:
点击展开代码
deconv_layer = torch.nn.ConvTranspose2d(
    in_channels,  # 输入图像/特征的通道数量
    out_channels, # 输出特征的通道数量(所使用的卷积核数量)
    kernel_size,  # 卷积核的空间尺寸
    stride=1, padding=0, # 步长和填充参数
    bias=True, # 是否使用偏置项
    )
⚪ 转置卷积的由来
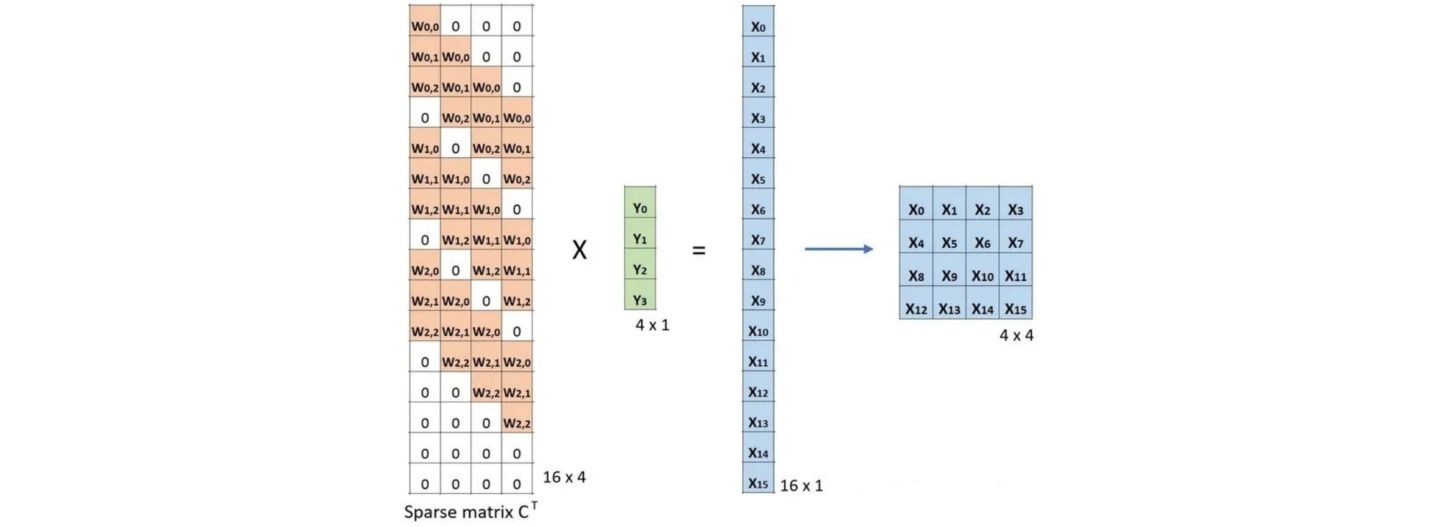
在计算机内的卷积操作是通过矩阵运算实现的(im2col)。把输入特征展平为列向量,把卷积核转换为一个稀疏矩阵。通过稀疏矩阵和列向量的矩阵乘法可以得到输出列向量,再调整为输出尺寸即可:
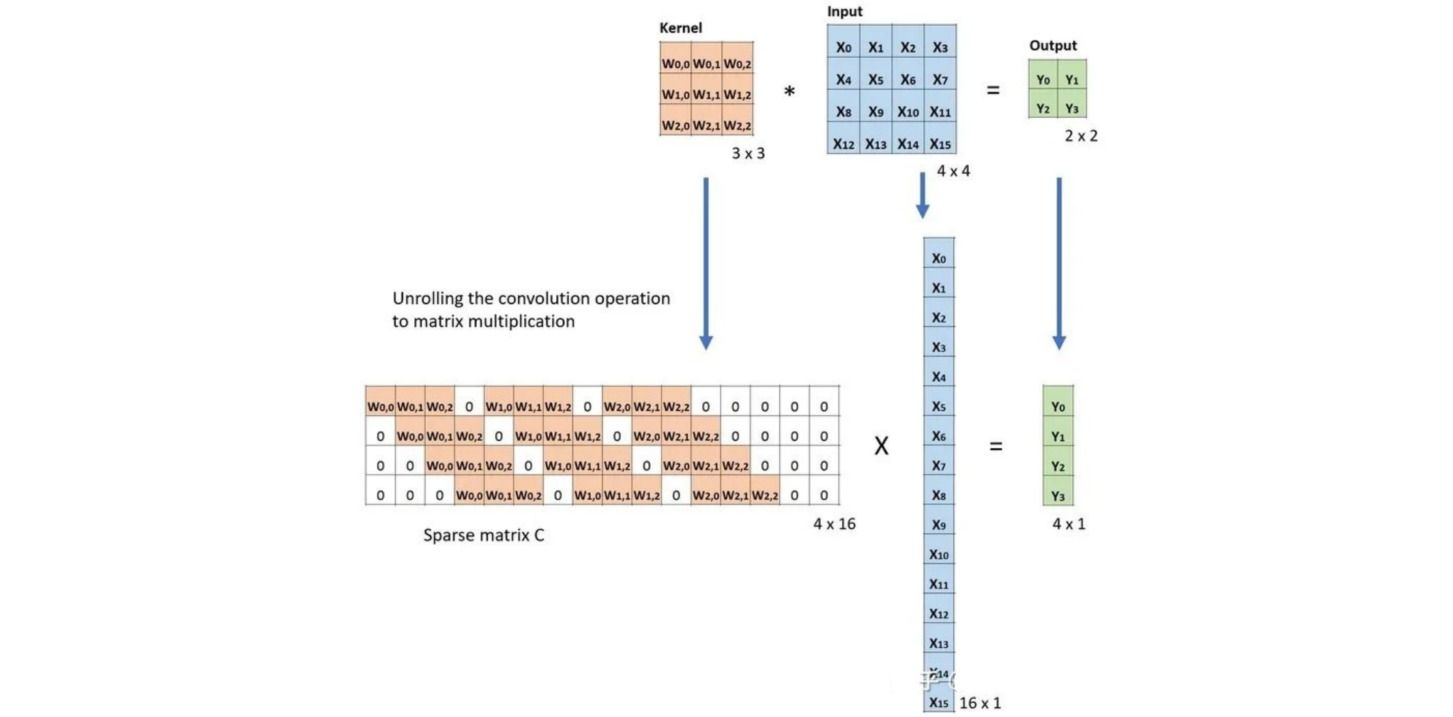
若对卷积核对应的稀疏矩阵进行转置,再与输出列向量做矩阵乘法,则可以得到与原始输入相同形状的向量。值得一提的是,由于稀疏矩阵并不是正交矩阵,因此转置之后的矩阵乘法并不能恢复到原始的数值,而是仅仅保留原始的形状,即上述的两次操作并不具备可逆关系。这也是转置卷积的由来。
⚪ 棋盘效应
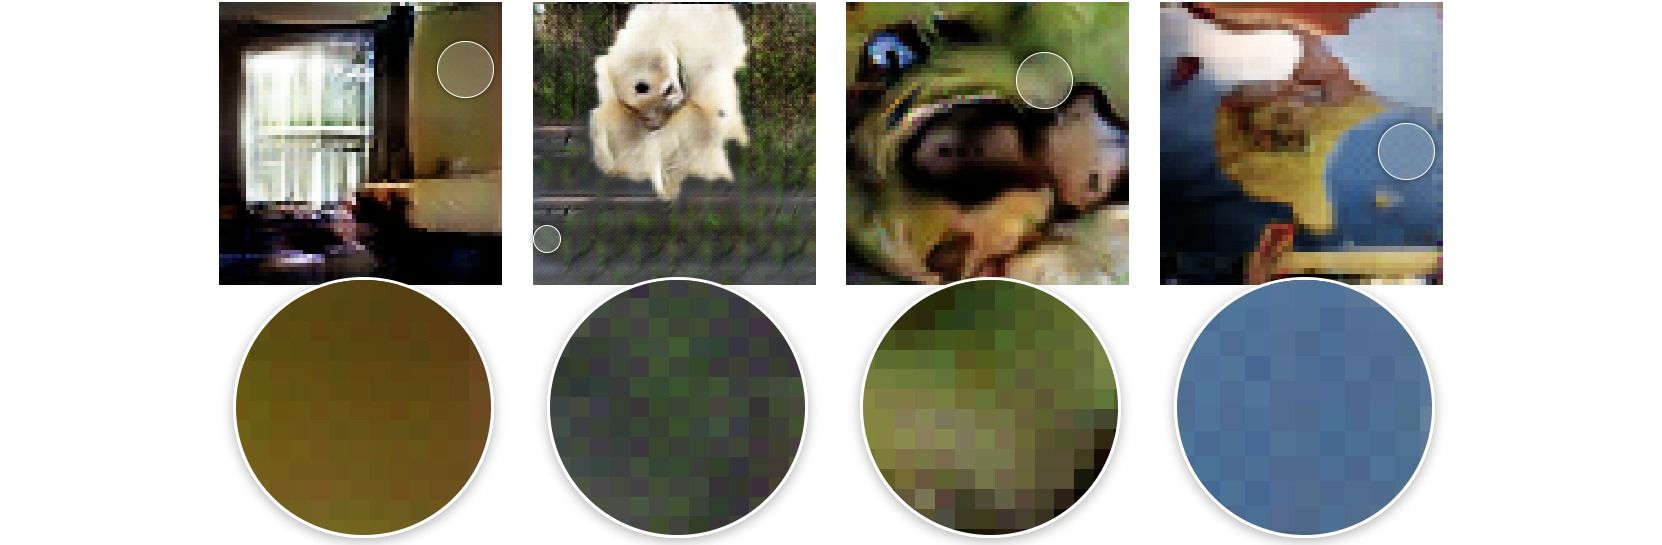
使用转置卷积时会出现棋盘效应(Checkboard Artifact),即图像中会出现棋盘格状的伪影。这是因为转置卷积中通常设置步长$s>1$,当卷积核大小$f$不能被步长$s$整除时,转置卷积的计算会不均匀重叠,使图像中某个部位的颜色比其他部位更深。
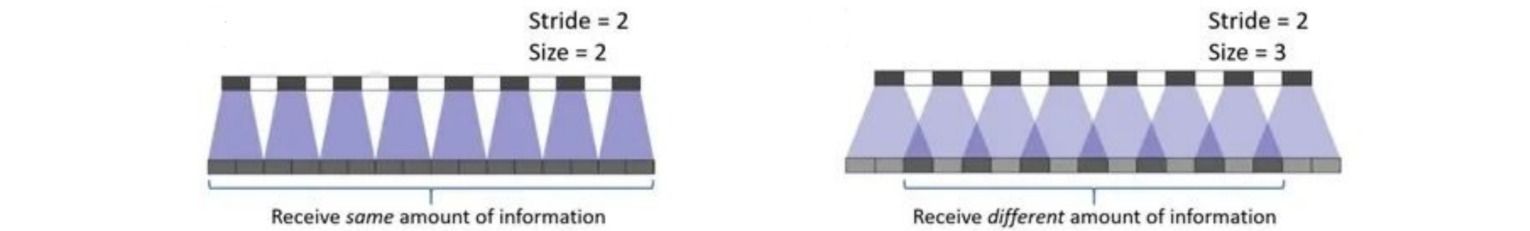
下面以一维转置卷积为例说明棋盘效应。对于卷积核尺寸为$2 \times 2$、步长为$2$的转置卷积,输入特征中的一个像素会映射到输出特征上连续的两个像素并且之间没有重叠。当卷积核尺寸调整为$3 \times 3$时,每一个输入像素映射到输出特征的三个像素区域,且之间会有重叠。这会导致输出特征上的每个像素接收的信息量与相邻像素不同,从而产生棋盘效应。
一些避免棋盘效应的做法:
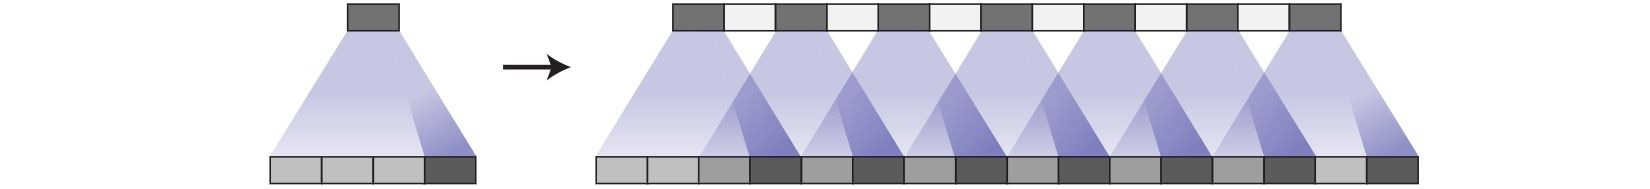
- 采取可以被步长整除的卷积核尺寸。此时如果卷积核学习的参数不均匀,依旧会产生棋盘效应:
- 在对图像质量要求较高的任务中(如图像生成、超分辨率),如果需要上采样操作,应避免使用转置卷积,而是直接使用插值上采样+常规卷积的形式。
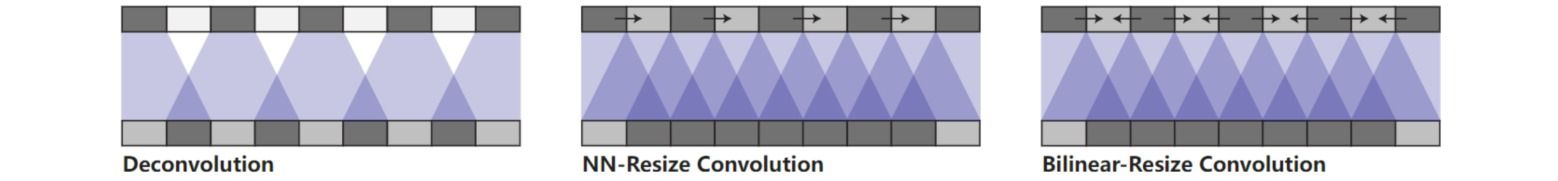
- 使用下面介绍的子像素卷积,它把上采样过程转化为纯粹的通道重排,从结构上不存在不均匀重叠。
(4) 子像素卷积 Sub-Pixel Convolution
子像素卷积 (Sub-Pixel Convolution)也叫像素重排(PixelShuffle),是图像超分辨率任务中提出的上采样算子。它的做法是:先用标准卷积把通道数扩大$r^2$倍,得到$r^2c’ \times n \times n$的特征,再把通道维度上的$r^2$个值周期性地重排到$r\times r$的空间邻域中,得到$c’ \times rn \times rn$的输出:
\[y(c', r \cdot h + i,\ r \cdot w + j) = x\left(c' \cdot r^2 + r \cdot i + j,\ h,\ w\right)\]其中$i,j \in {0,1,…,r-1}$为子像素在放大后邻域内的位置。
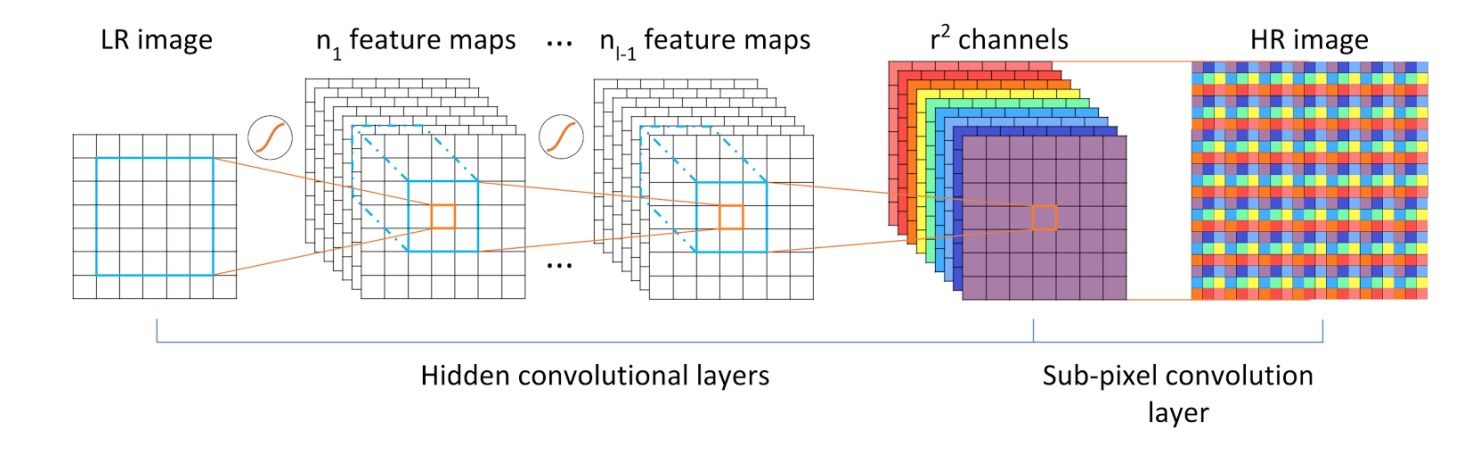
子像素卷积与转置卷积的关系值得强调:一个形状为$(r^2c’,c,f,f)$的标准卷积加PixelShuffle,与一个形状为$(c’,c,rf,rf)$、步长为$r$的转置卷积在表达能力上是等价的(前者只是后者权重的一种重排参数化)。二者的差别在于:
- 计算位置不同:子像素卷积在低分辨率特征上做卷积再重排,转置卷积等价于在高分辨率上卷积,因此子像素卷积的计算量约为$1/r^2$;
- 伪影行为不同:子像素卷积不存在“不均匀重叠”,但如果$r^2$个通道的初始化彼此独立,重排后相邻子像素会不一致,仍会看到类似棋盘的高频噪声。解决办法是ICNR初始化:让同一空间位置对应的$r^2$个卷积核初始化为相同的值,使上采样在训练初期等价于最近邻插值。
(5) 分组卷积与深度卷积
组卷积 (Grouped Convolution)把输入特征沿通道维度分成$g$个组,对每个组分别应用标准的卷积操作,然后把$g$组输出沿通道拼接。它最早出现在AlexNet中(为了把模型拆到两块显存有限的GPU上),后来成为ResNeXt、ShuffleNet等结构的基础算子。
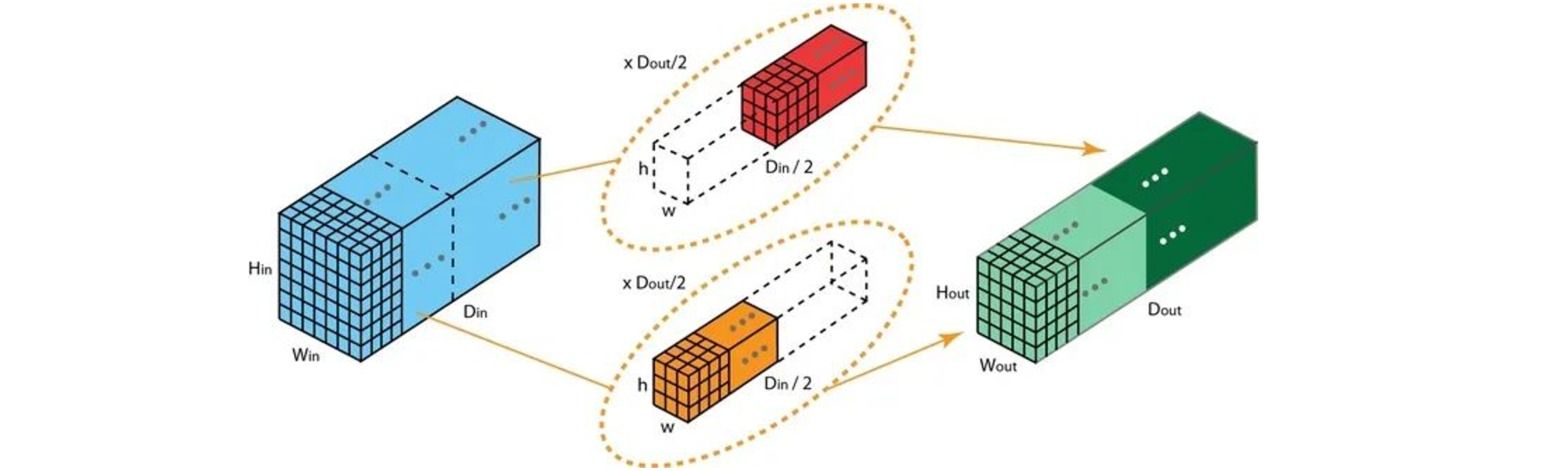
组卷积的主要优点包括:
- 高效训练:组卷积把卷积操作分为多个路径,每个路径可以由不同的GPU进行处理,因此可以实现模型并行化。
- 高效模型:标准卷积的参数量为$c’ \times (f \times f\times c)$,而$g$个组的组卷积的参数量为$g \times \frac{c’}{g} \times (f \times f\times \frac{c}{g})$,参数量之比为$1/g$。
- 正则化:组卷积通过对卷积核分组在通道维度上学习块对角结构的稀疏性,使卷积核分组以一种结构化的方式学习特征,具有正则化的效果。如图所示的两个分组的卷积核似乎结构性地组织成两个不同的分组:黑白过滤器和彩色过滤器。
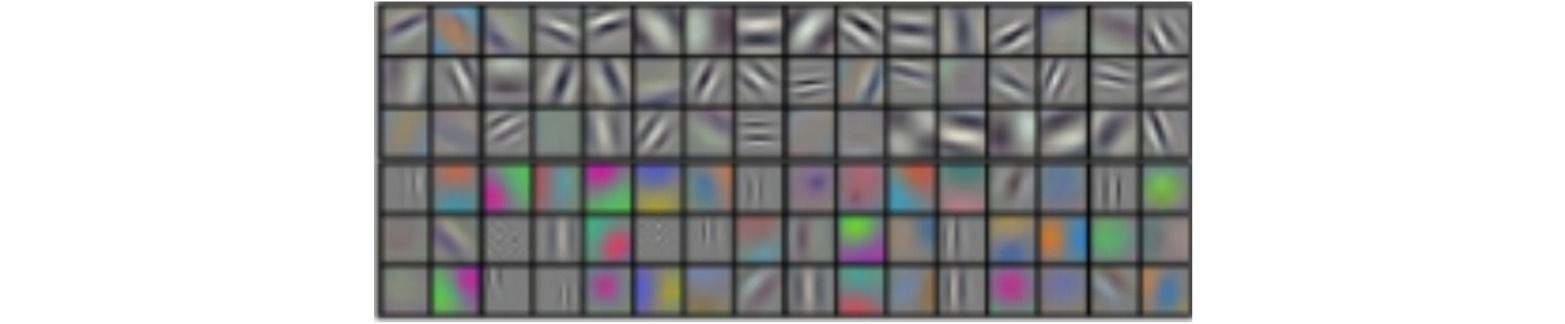
组卷积的代价是通道间信息被切断:不同组之间不存在任何交互,堆叠多层组卷积会导致特征在通道方向上分裂。常见的补救手段是在组卷积之后插入$1\times 1$卷积,或者使用ShuffleNet的通道混洗(Channel Shuffle)操作(详见轻量级卷积神经网络)。
深度卷积 (Depthwise Convolution)是组卷积取$g=c$(每个通道自成一组)的极限形态:对输入特征图的每一个通道使用一个单通道卷积核进行处理,从而实现通道独立、空间交互的卷积操作,与$1\times 1$卷积的空间独立、通道交互恰好互补。深度卷积的参数量仅为$f^2c$,与输出通道数无关。
\[y_k(p_0) = \sum_{p_n \in \mathcal{R}} w_k(p_n) \cdot x_k(p_0+p_n), \quad k=1,2,...,c\]需要提醒的是,深度卷积的FLOPs极低但算术强度也极低(每个权重只被复用$n’^2$次,且没有通道方向的复用),属于典型的访存受限算子,实测加速比通常远小于FLOPs的下降比例。
可以通过torch.nn.Conv2d中的groups参数构建组卷积与深度卷积:
点击展开代码
# 组卷积:groups = g
conv_layer = torch.nn.Conv2d(in_channels, out_channels, kernel_size, groups=g)
# 深度卷积:groups = in_channels = out_channels
dwconv_layer = torch.nn.Conv2d(in_channels, in_channels, kernel_size, groups=in_channels)
3. 常见的卷积算子改进
回顾卷积算子的基准公式$y(p_0)=\sum_{p_n \in \mathcal{R}} w(p_n) \cdot x(p_0+p_n)$,几乎所有针对卷积算子的改进都可以归入以下五个维度之一:
| 改进维度 | 修改对象 | 代表方法 |
|---|---|---|
| 采样位置自适应 | $p_0+p_n \to p_0+p_n+\Delta p_n$ | Deformable Conv, DCNv2/v3/v4, 圆形卷积 |
| 卷积核权重动态化 | $w(p_n) \to w(p_n \mid x)$ | CondConv, ODConv, Involution |
| 聚合方式改变 | $\sum w \cdot x \to \sum w \cdot g(x)$ | 差分卷积、部分卷积、稀疏卷积 |
| 卷积核结构分解 | $w \to w_1 \otimes w_2 \otimes \cdots$ | 深度可分离卷积、PConv、结构重参数化 |
| 感受野形状与尺度 | 改变$\mathcal{R}$ | 大核卷积、八度卷积、小波卷积 |
| 输入信息增强 | $x \to [x; \text{coord}]$ | CoordConv |
3.1 改变采样位置:几何自适应
标准卷积的采样位置集合$\mathcal{R}$是一个固定的正方形网格,这意味着它对几何形变(尺度、旋转、非刚性变形)没有任何适应能力。传统做法是靠数据增强和足够深的网络记住各种形变,本节的方法则直接让采样位置本身可学习。
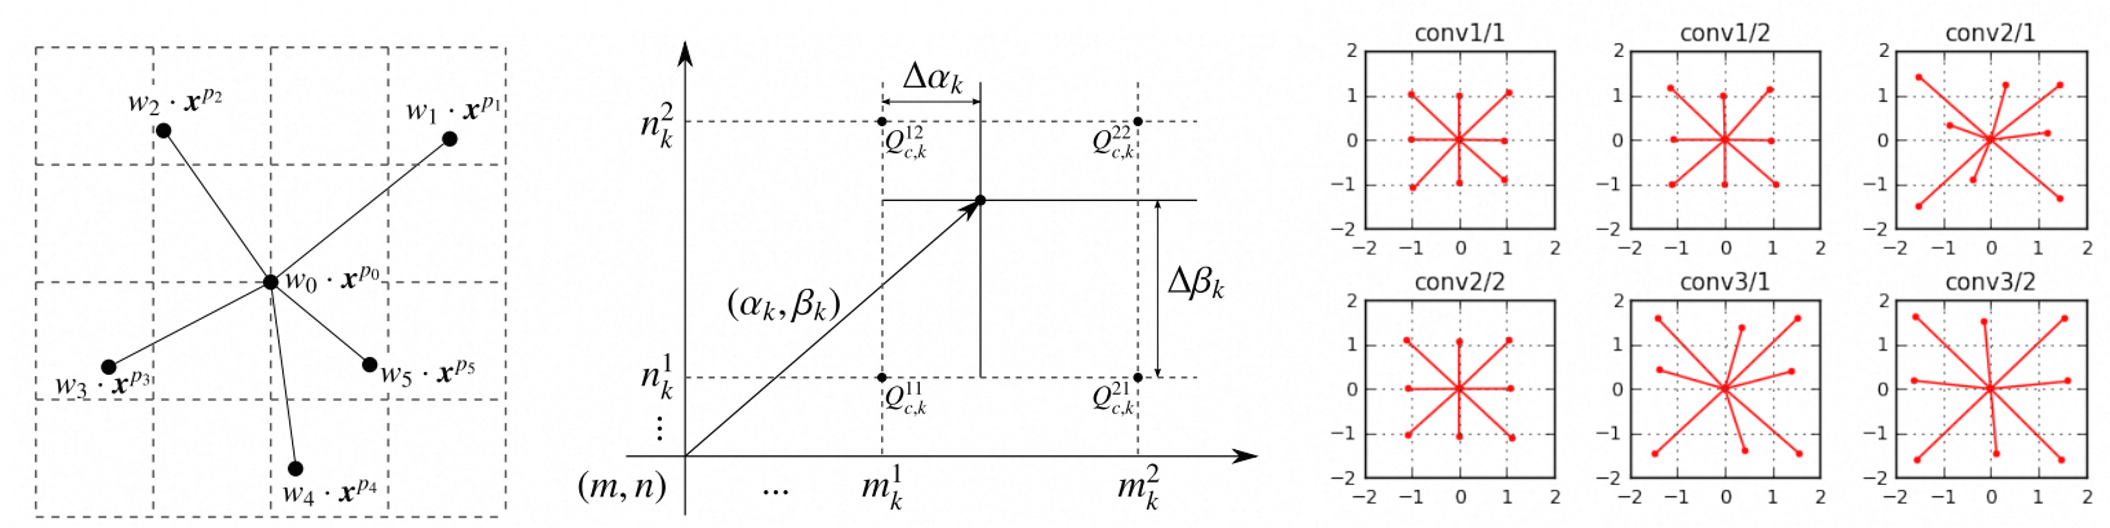
⚪ 主动卷积 Active Convolution Unit (ACU):让采样位置成为可学习参数
ACU把卷积核第$n$个元素的位置参数化为一对连续实数$(\alpha_n, \beta_n)$(相对于中心的水平、垂直位移),并与权重一起用反向传播学习:
\[y(p_0) = \sum_{n} w_n \cdot x(p_0 + \delta_n), \quad \delta_n = (\alpha_n, \beta_n) \in \Bbb{R}^2\]由于$\delta_n$是浮点数,取值通过双线性插值得到,从而对$\alpha_n,\beta_n$可导。ACU中的位置参数在整个卷积层内是共享的(与输入无关),因此它学到的是“这一层应该用什么形状的卷积核”,可以看作卷积核形状的一种连续化搜索;它同时也把扩张卷积、标准卷积统一为该参数空间中的特例。
⚪ 可变形卷积 Deformable Convolution:逐位置预测采样偏移
可变形卷积(Deformable Convolution)把ACU的“层级共享位置”进一步放松为“逐样本、逐空间位置预测的位置”:对输入特征的每个采样位置增加偏移项$\Delta p_n$:
\[y(p_0) = \sum_{p_n \in \mathcal{R}} w(p_n) \cdot x(p_0+p_n+\Delta p_n)\]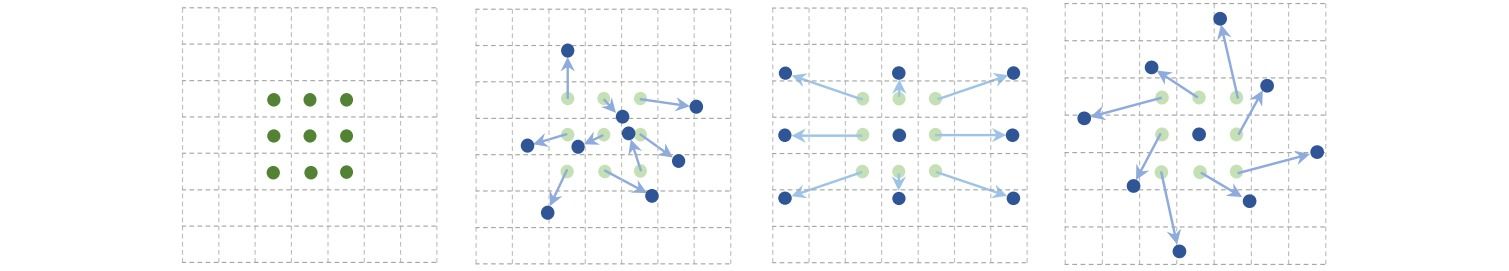
可变形卷积具有任意形状的感受野。当尺寸为$f \times f$的可变形卷积核作用于中心位置$p_0$的局部特征时,通过一个并行的标准卷积分支从同一份输入特征上学习$2f^2$个偏移项(分别控制水平和垂直方向的偏移),因此偏移场与输入特征具有相同的空间分辨率。
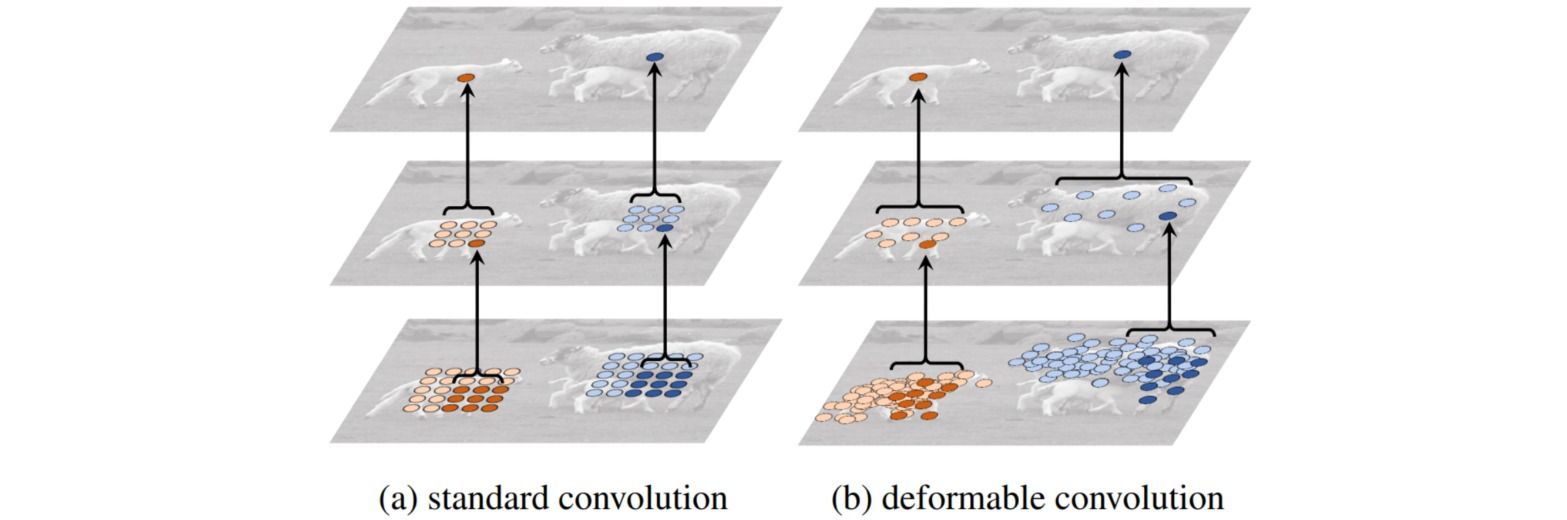
偏移项的学习结果为浮点数,因此通过双线性插值计算其对应的像素值:
\[x(p) = \sum_{q} \max(0, 1-\lvert q_x - p_x \rvert) \cdot \max(0, 1-\lvert q_y - p_y \rvert) \cdot x(q)\]其中$q$遍历特征图上的所有整数位置(实际只有$p$的四个邻居贡献非零权重)。双线性插值对$p$可导,因此偏移分支可以和主干一起端到端训练。偏移分支通常初始化为零,使网络在训练初期退化为标准卷积。
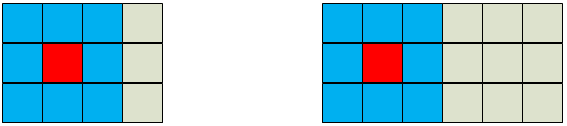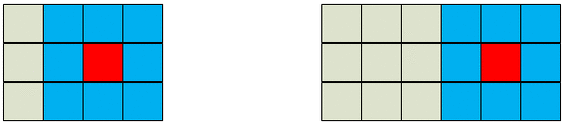
同样的思想可以用于池化,即可变形RoI池化:对RoI的每个bin预测一个偏移,使得目标检测中的区域特征提取也具备形变适应能力。
⚪ Deformable Convolution v2:为采样点增加幅度调制
v1的问题是采样点虽然移动了,却无法拒绝一个不相关的采样点(例如偏移到了背景上)。Deformable Convolution v2进一步对每个偏移位置$\Delta p_n$额外学习一个调制标量(modulation scalar) $\Delta m_n \in [0,1]$,用于评估该特征位置的重要性程度:
\[y(p_0) = \sum_{p_n \in \mathcal{R}} w(p_n) \cdot x(p_0+p_n+\Delta p_n) \cdot \Delta m_n\]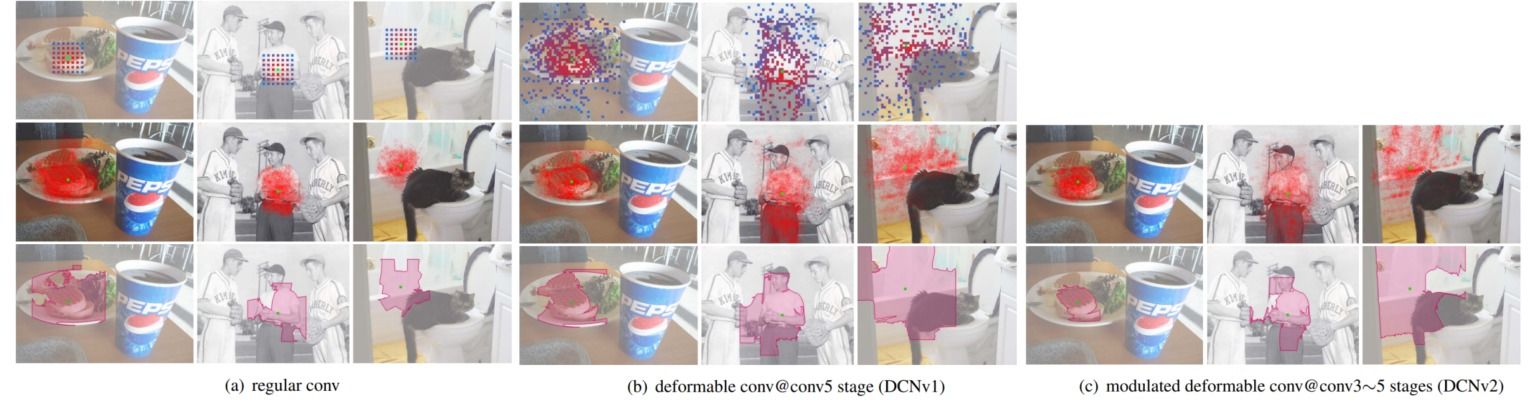
$\Delta m_n$由与偏移分支相同的卷积输出、经Sigmoid得到,共$3f^2$个输出通道($2f^2$个偏移 + $f^2$个调制)。由于$\Delta m_n$是由数据学习得到的、随输入变化,因此不能与卷积核权重$w(p_n)$离线合并。v2还引入了更多可变形层、以及用R-CNN输出的特征图作为教师的特征模仿损失,使采样点更集中于目标区域。
Pytorch中可以用torchvision.ops.deform_conv2d实现,也可以按下面的方式手写(modulation=True时对应v2):
点击展开代码
class DeformConv2d(nn.Module):
    def __init__(self, inc, outc, kernel_size=3, padding=1, stride=1, modulation=False):
        super().__init__()
        self.kernel_size, self.padding, self.stride = kernel_size, padding, stride
        self.conv = nn.Conv2d(inc, outc, kernel_size, stride=kernel_size, bias=False)
        # 偏移分支:输出 2*f*f 个通道
        self.p_conv = nn.Conv2d(inc, 2*kernel_size*kernel_size, 3, padding=1, stride=stride)
        nn.init.constant_(self.p_conv.weight, 0)  # 零初始化,初期退化为标准卷积
        self.modulation = modulation
        if modulation:  # v2:额外输出 f*f 个调制标量
            self.m_conv = nn.Conv2d(inc, kernel_size*kernel_size, 3, padding=1, stride=stride)
            nn.init.constant_(self.m_conv.weight, 0)
⚪ DCNv3:把可变形卷积深度可分离化并引入多组机制
DCNv2难以扩展到大模型:它的$w(p_n)$仍然是$c_{in}\times c_{out}$的稠密权重,参数量与显存开销随通道数平方增长。DCNv3(InternImage的核心算子)借鉴多头自注意力的设计做了三处修改:
\[y(p_0) = \sum_{g=1}^{G} \sum_{n=1}^{f^2} w_g \cdot m_{gn} \cdot x_g(p_0+p_n+\Delta p_{gn})\]- 深度可分离化:把原来的稠密权重拆成“与位置无关的$1\times 1$投影$w_g$”和“与位置有关的标量$m_{gn}$”,即空间聚合部分只保留标量权重(类似深度卷积),通道混合交给$1\times 1$卷积;
- 多组机制:把通道分成$G$组,每组独立预测自己的偏移$\Delta p_{gn}$与调制$m_{gn}$,从而在同一层内表达多种不同的形变模式;
- 调制标量归一化:把v2的Sigmoid换成沿采样点维度的Softmax,使$\sum_n m_{gn}=1$,从而在大深度下稳定训练。
在此基础上搭建的InternImage证明了:基于卷积的模型同样可以扩展到十亿参数规模并具备“大感受野 + 输入自适应”的能力,与视觉Transformer竞争。
⚪ DCNv4:去掉归一化并优化访存
DCNv4指出DCNv3的两处冗余:
- Softmax归一化是多余的:卷积本身是无界聚合算子,强行把权重限制成和为$1$的凸组合会削弱其动态范围与收敛速度。DCNv4直接使用无界的$m_{gn}$,实践中收敛更快;
- 实现是访存受限的:DCNv3的CUDA核对每个采样点重复读取输入。DCNv4让同一空间位置、不同通道组的线程复用已读入的偏移与输入,并把多个内存访问合并,前向速度相比DCNv3提升约$3$倍。
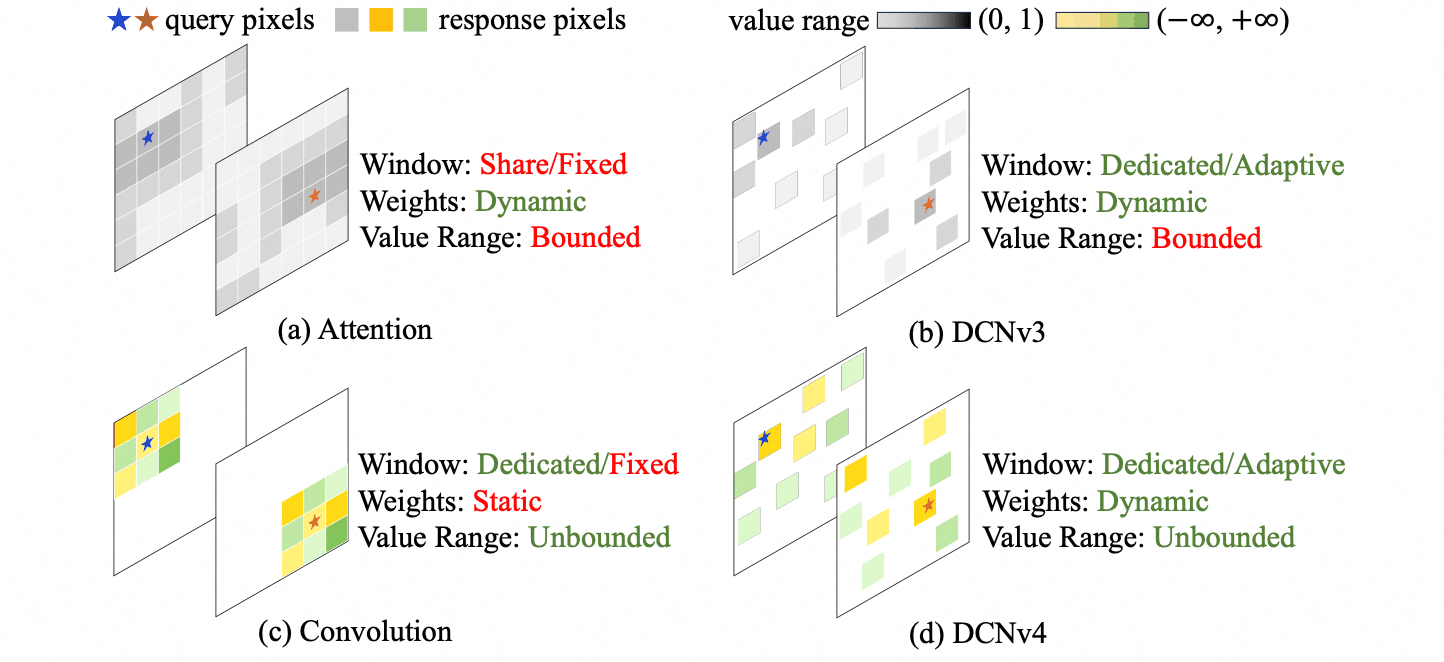
这使可变形卷积从“精度好但慢”变成在时延上可与窗口注意力正面竞争的算子。
⚪ LDConv:任意参数量、任意采样形状的可变形卷积
标准卷积和可变形卷积的采样点数都被锁死为$f^2$($1,4,9,16,\dots$),参数量随$f$平方增长。LDConv放松了这一限制:
- 提出一个初始采样坐标生成算法,对任意给定的采样点数$K$(不必是完全平方数)生成一组合理的初始采样位置;
- 与可变形卷积一样为每个采样点预测偏移$\Delta p_n$,用双线性插值取值;
- 由于采样点数可以任取,参数量随$K$线性增长,从而在参数预算与感受野之间提供了细粒度的折中。
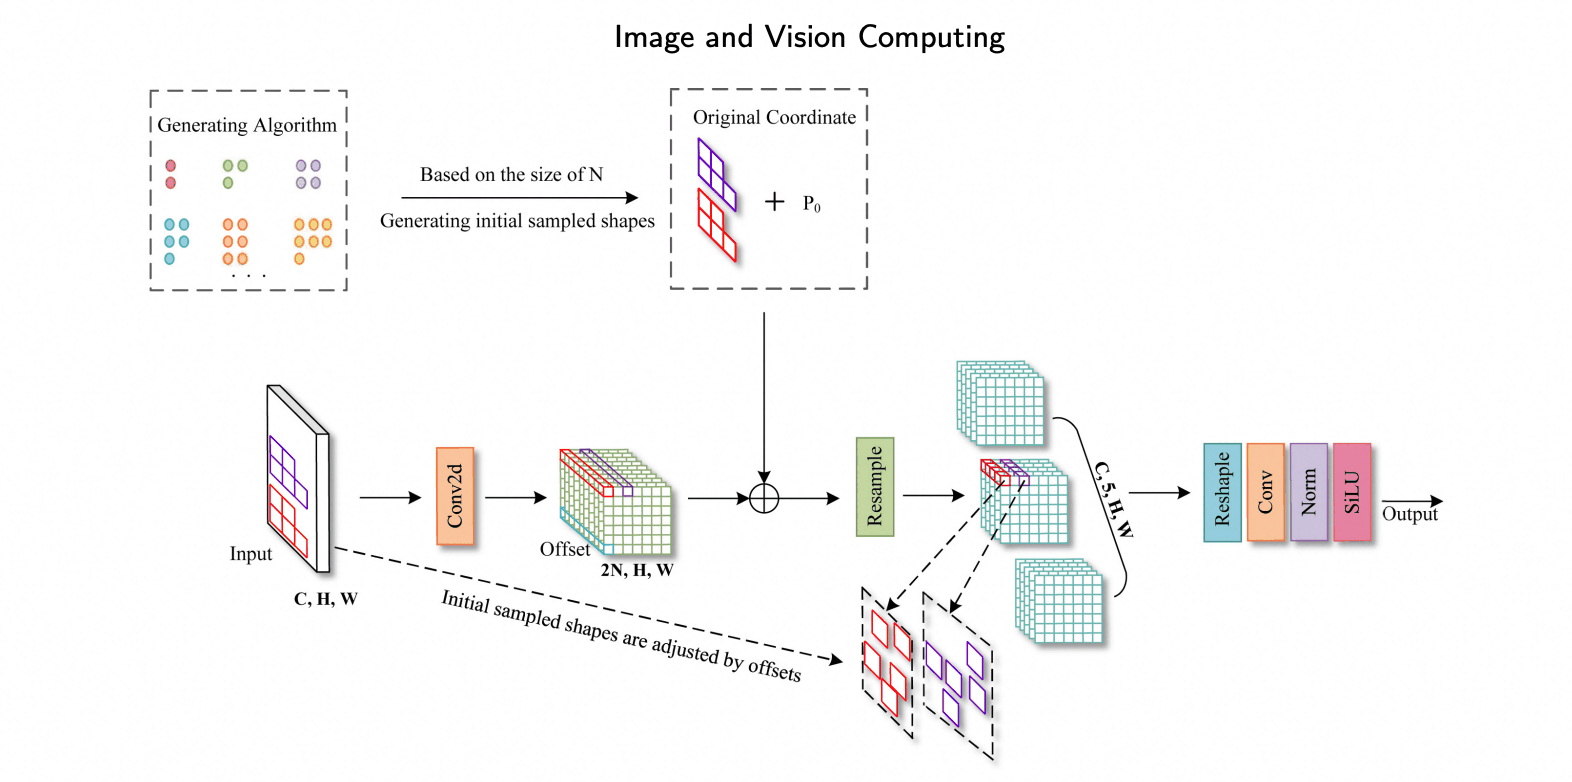
⚪ 圆形卷积 Circle Convolution:可离线合并的固定形变
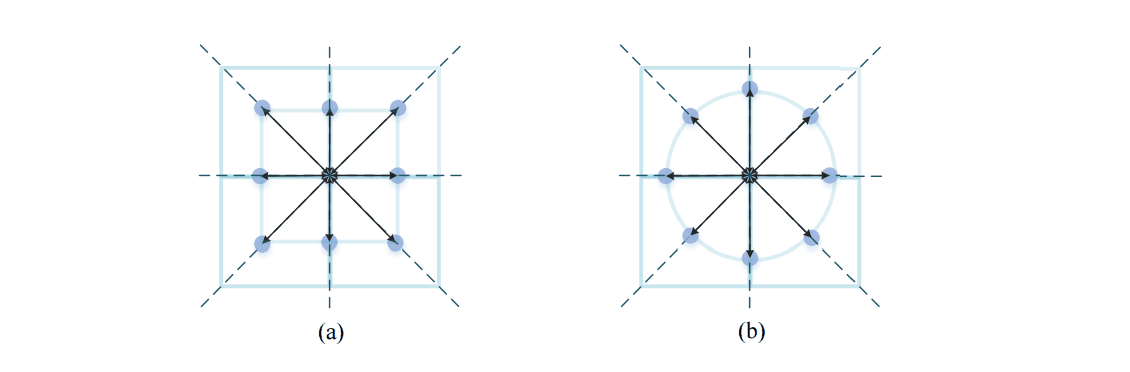
圆形卷积的设计受生物视觉系统的感受野启发,通过各向同性的圆形感受野适应全局或局部输入特征在不同方向上的信息变化。以$3\times 3$为例,它把方形网格上的$8$个邻域点替换为半径为$1$的圆周上的$8$个等分点,对角方向的坐标为$(\pm \frac{\sqrt{2}}{2}, \pm \frac{\sqrt{2}}{2})$:
\[\mathcal{R}_{\text{circle}} = \left\{ \left(\cos \frac{k\pi}{4},\ \sin\frac{k\pi}{4}\right) \mid k=0,1,...,7 \right\} \cup \{(0,0)\}\]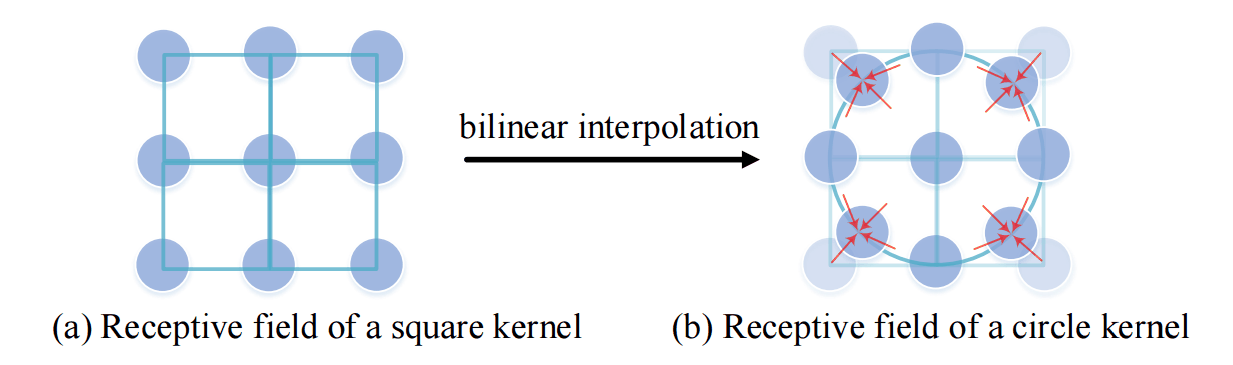
圆形卷积可以看作是一种特殊的可变形卷积,但采样位置是固定且与输入无关的。可变形卷积引入额外的参数和计算量,增加了推理复杂度;圆形卷积则通过对特征的双线性插值构造,由于双线性插值是一种线性变换,可以写成一个稀疏矩阵$B$与原权重的乘积,因此能够通过重参数化技巧与卷积的权值矩阵合并:
\[\tilde{w} = B^\top w \quad \Longrightarrow \quad y(p_0) = \sum_{p_n \in \mathcal{R}} \tilde{w}(p_n) \cdot x(p_0+p_n)\]在推理时直接使用新的卷积核$\tilde{w}$进行常规卷积操作,零额外开销。
进一步地,作者提出把方形核$S$与圆形核$R$按伯努利分布随机组合成集成核$E \sim \text{Ber}(S,R,0.5)$,或者引入可学习的缩放系数$\alpha$对两种核加权,让网络自行决定每一层偏好哪种感受野形状:
⭐ 讨论:采样位置自适应的三种粒度
采样位置自适应的关键区分维度是“偏移量在什么粒度上变化”,这直接决定了推理开销:
| 粒度 | 偏移量依赖于 | 代表方法 | 推理开销 |
|---|---|---|---|
| 全层共享(静态) | 无(训练后固定) | 扩张卷积、圆形卷积、ACU | 零额外开销,可重参数化合并 |
| 逐层逐通道搜索 | 无(搜索后固定) | IC-Conv | 零额外开销,搜索成本一次性 |
| 逐样本逐位置(动态) | 输入特征$x$ | Deformable Conv v1-v4, LDConv | 需要额外分支 + 插值采样 |
由此可以给出实用建议:如果任务中的几何形变是“数据集级”的(例如遥感图像整体尺度偏大),优先用静态方案,零成本;如果形变是“实例级”的(例如人体姿态、非刚性目标),才值得付出动态方案的开销。
3.2 动态生成卷积核权重
上一节改的是“从哪里采样”,本节改的是“用什么权重聚合”。标准卷积的权重$w$在训练结束后就是一组固定的常数,对所有输入图像、所有空间位置一视同仁(权值共享)。动态卷积(Dynamic Convolution)让权重成为输入的函数$w(\cdot \mid x)$,从而在几乎不增加FLOPs的前提下大幅提升模型容量。
按“权重随什么变化”可以分成两大类:核融合类方法让权重随样本变化(同一张图的所有位置共享一组核),逐位置生成类方法让权重随空间位置变化。
(1) 输入条件的卷积核融合
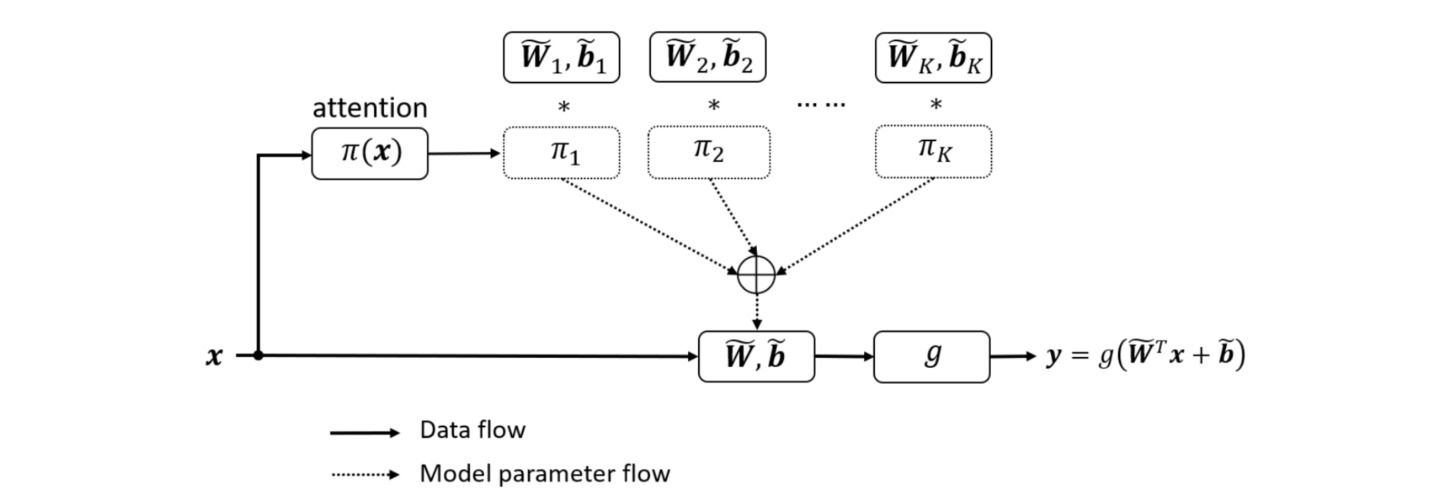
这一类方法的统一形式是:预先定义$K$个并行的卷积核$w_1,…,w_K$(称为专家),再由一个轻量分支根据输入生成融合系数$\pi_k(x)$,把它们线性组合成一个动态核:
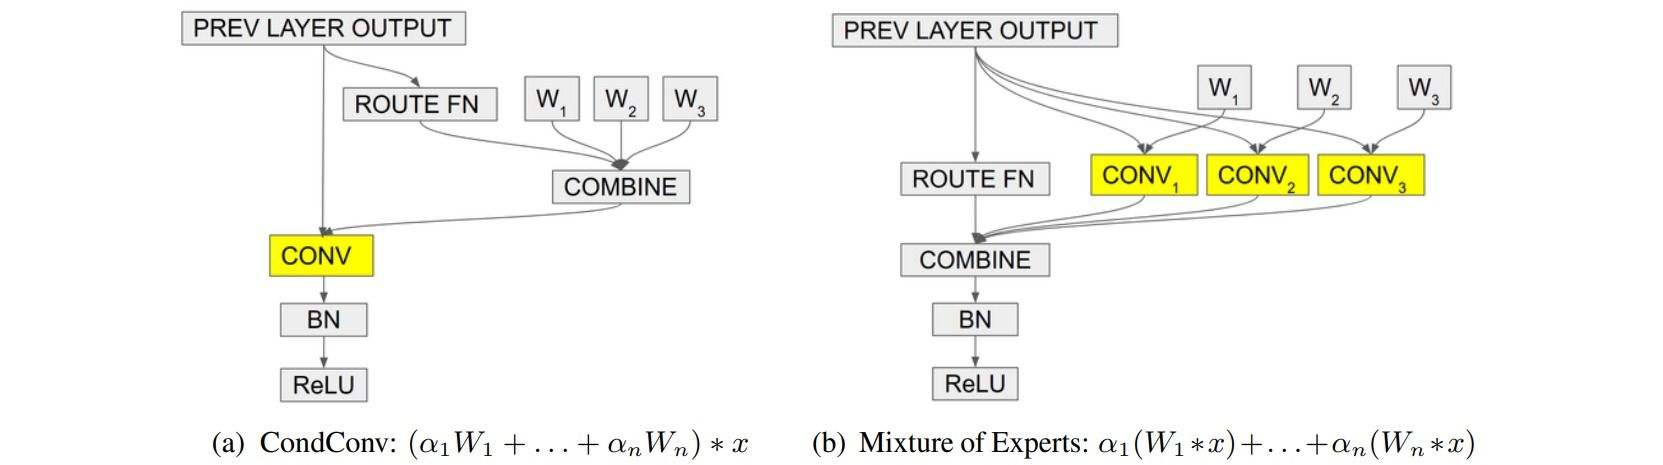
\[y(p_0) = \sum_{p_n \in \mathcal{R}} \left(\sum_{k=1}^K \pi_k(x)\, w_k(p_n)\right) \cdot x(p_0+p_n)\]它的高效性来自一个关键的顺序交换:由于卷积对权重是线性的,“先融合核、再卷积”与“先分别卷积、再融合输出”数学上等价,而前者只需做一次卷积。因此参数量增大$K$倍,FLOPs却几乎不变(只多出生成$\pi_k$的开销)。
⚪ CondConv:条件参数化卷积
CondConv把卷积层显式地看作一个混合专家(Mixture of Experts)模型。融合系数由通道注意力式的路由函数生成:全局平均池化 + 全连接 + Sigmoid:
\[\pi(x) = \text{Sigmoid}\left(R \cdot \text{GAP}(x)\right), \quad 0 \leq \pi_k(x) \leq 1\]注意这里用的是Sigmoid而非Softmax:作者认为专家之间不应该互相竞争,允许多个专家同时被激活(甚至全部接近$0$)能提供更大的表示灵活性。
工程实现上有一个细节:核融合是逐样本的,因此一个批次内不同样本的卷积核不同,无法直接调用常规卷积。CondConv的做法是把批维度折叠进通道维度:把批大小为$B$的输入reshape成$1 \times (Bc) \times n \times n$,把$B$个动态核拼成一个分组数为$B$的组卷积核,用一次组卷积完成整批计算。
⚪ DynamicConv:注意力式的核融合
DynamicConv与CondConv形式几乎相同,但把路由函数换成了带温度的Softmax:
\[\pi_k = \frac{\exp(z_k/\tau)}{\sum_j \exp(z_j/\tau)} \quad \text{s.t. } 0\leq \pi_k(x) \leq 1,\ \sum_{k=1}^K \pi_k(x)=1\]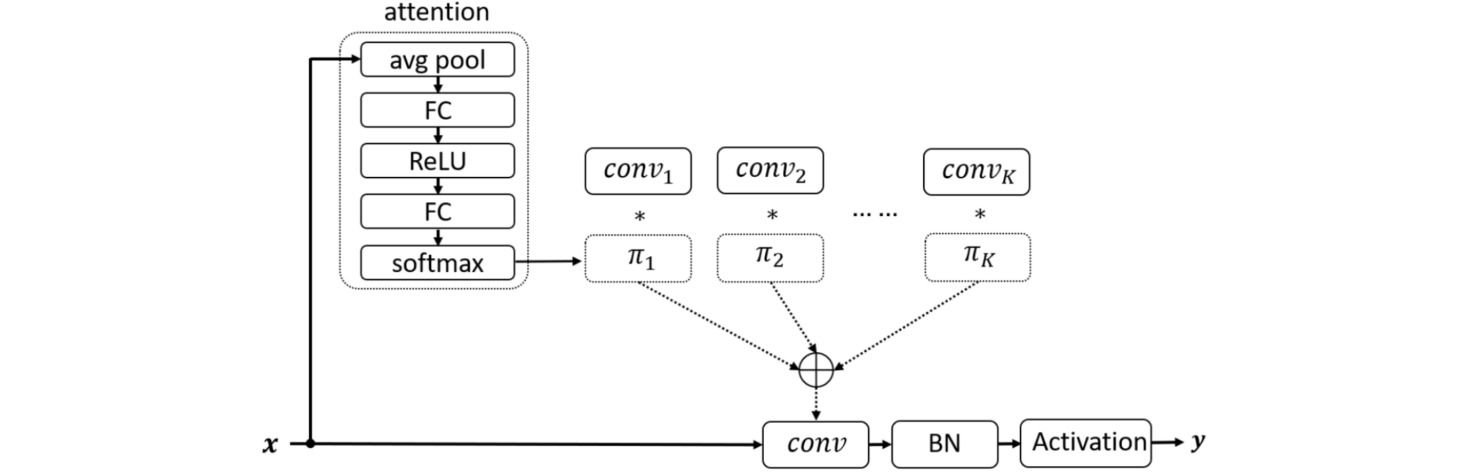
作者指出动态卷积难训练的两个原因:其一,注意力输出被$\text{Softmax}$压缩后,需要所有$K$个核同时被优化才有效;其二,训练初期的稀疏注意力会让大部分专家收不到梯度。对应的解决办法是:
- 约束注意力输出之和为$1$,压缩了动态核的取值空间,使优化更容易;
- 温度退火:训练初期使用较大的温度(论文取$\tau=30$)让注意力接近均匀分布,使所有专家都能得到梯度,随后在前$10$个epoch内把温度线性降到$1$。
⚪ DyNet:在输出通道维度上分别融合
DyNet的实现过程与CondConv类似,主要区别在于核融合过程是分别在每个输出通道上进行的。若特征的输出通道数为$c_{out}$,对每个输出通道应用$K$个卷积核,则系数向量$\pi$的长度为$K c_{out}$而非$K$,动态性的粒度更细。
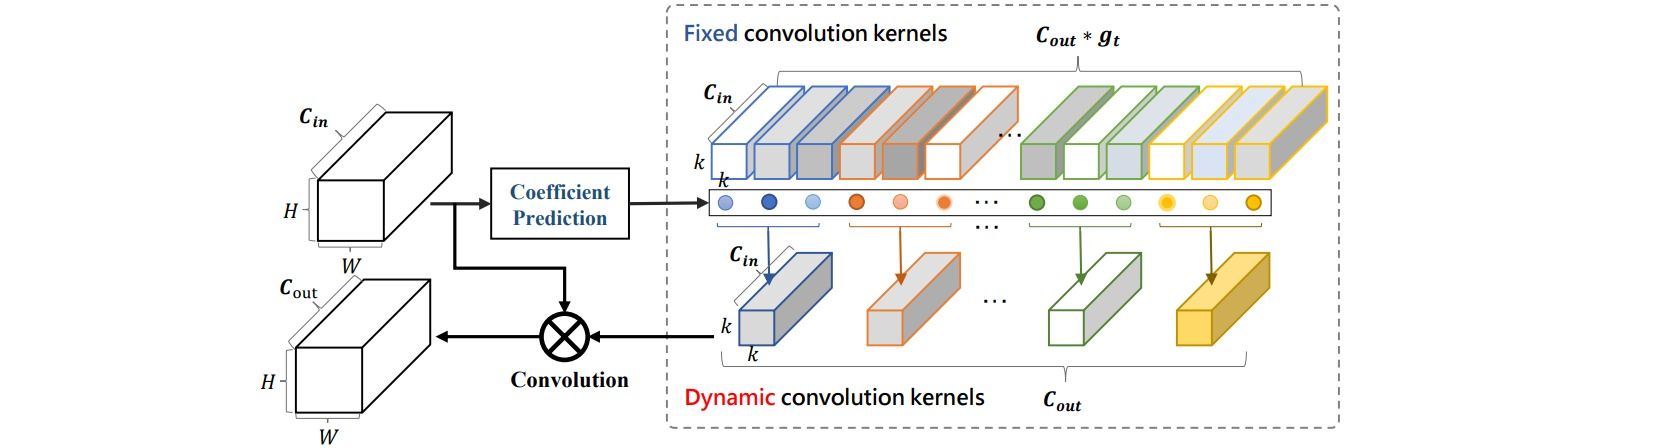
DyNet还清楚地写出了本小节开头提到的等价关系。记第$j$个输出通道的动态核为\(\tilde{w}_j = \sum_{k=1}^K \pi_{jk}(x) w_{jk}\),则
\[\begin{aligned} y_j &= \tilde{w}_j * x = \left(\sum_{k=1}^K \pi_{jk}(x) w_{jk}\right) * x \\ &= \sum_{k=1}^K \pi_{jk}(x) \left(w_{jk} * x\right) \end{aligned}\]即核融合与输出融合完全等价。这一恒等式解释了动态卷积为什么有效:它在功能上相当于一个$K$分支的多路集成网络(因此容量大),在计算上却只付一次卷积的代价(因此高效)。DyNet据此把动态卷积用于替换深度可分离网络中冗余的通道,进一步压缩计算量。
⚪ ODConv:全维动态卷积
CondConv、DynamicConv只在“第几个专家”这一个维度上做动态加权,而一个卷积核张量$w \in \Bbb{R}^{K \times c_{out} \times c_{in} \times f \times f}$总共有四个维度可以调制。ODConv把融合卷积核的注意力机制扩展为多维形式:
\[\tilde{w} = \sum_{k=1}^K \alpha_{wk} \cdot \left( \alpha_{sk} \odot \alpha_{ck} \odot \alpha_{fk} \odot w_k \right)\]- 标量注意力$\alpha_w \in \Bbb{R}^{K}$对$K$个整体卷积核赋予不同的注意力值(即CondConv的做法);
- 空间注意力$\alpha_s \in \Bbb{R}^{f \times f}$对每个卷积核的不同空间位置赋予不同的注意力值;
- 输入通道注意力$\alpha_c \in \Bbb{R}^{c_{in}}$对每个卷积核的不同输入通道赋予不同的注意力值;
- 输出通道注意力$\alpha_f \in \Bbb{R}^{c_{out}}$对不同输出通道的卷积核赋予不同的注意力值。
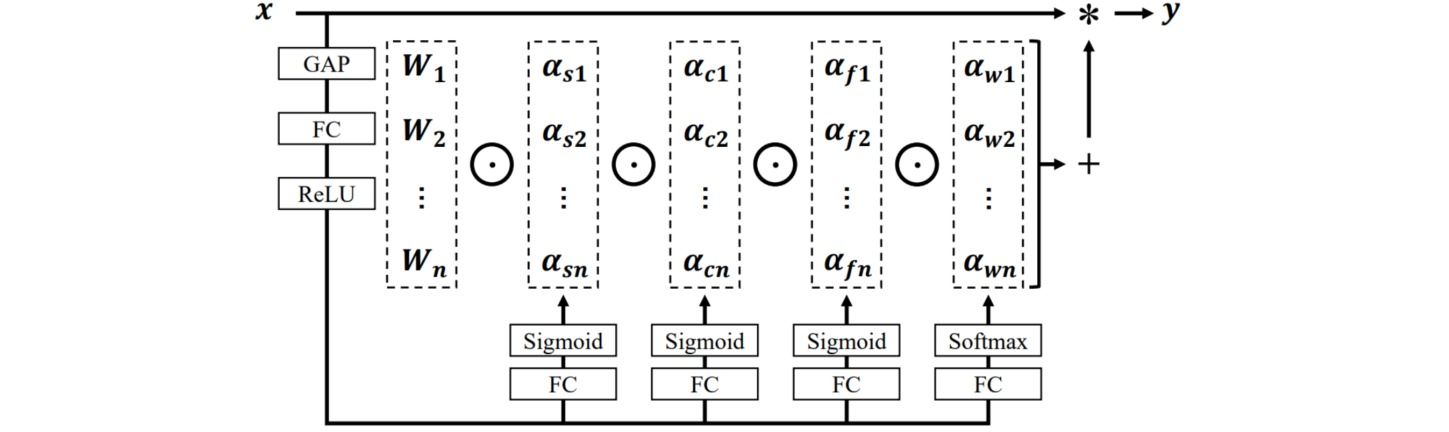
四组注意力由同一个“全局平均池化 + 全连接 + ReLU”主干经四个并行的全连接头产生,其中$\alpha_w$用Softmax、其余三组用Sigmoid:
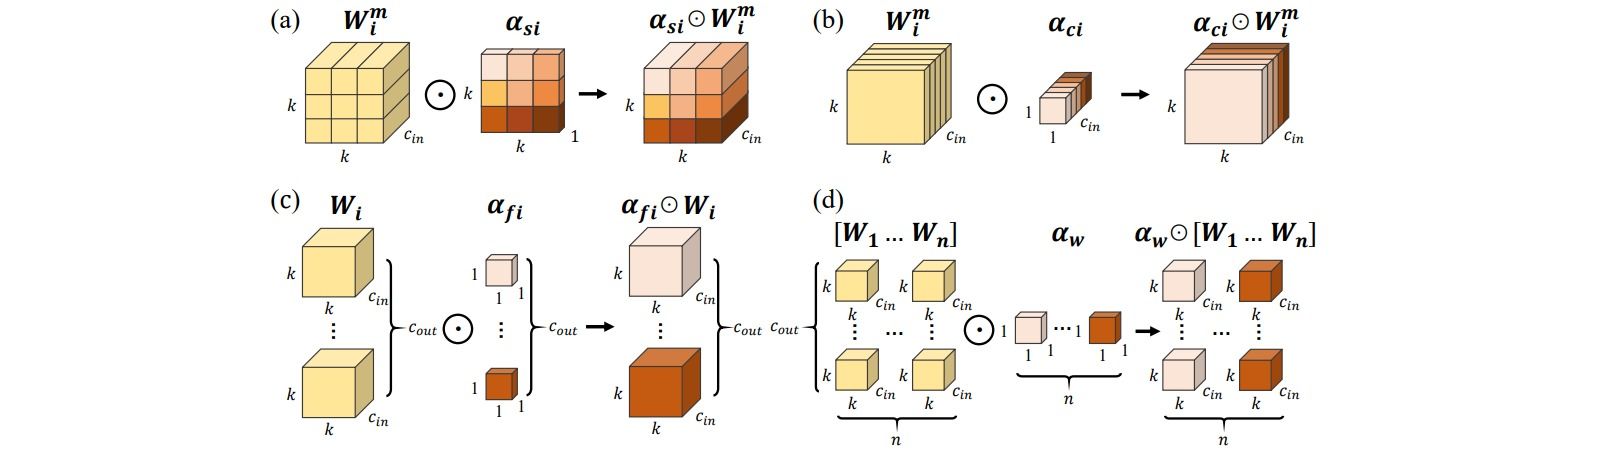
一个重要的实践结论是:由于四个维度的调制是互补的,即使只用$K=1$个专家核,ODConv也能取得显著增益;此时它退化为“对唯一一个卷积核做空间/输入通道/输出通道三重重加权”,参数量几乎不增加。这使ODConv成为轻量网络中性价比很高的即插即用模块。
点击展开代码
class ODConv2d(nn.Module):
    def __init__(self, in_planes, out_planes, kernel_size, K=4, reduction=0.0625):
        super().__init__()
        hidden = max(int(in_planes * reduction), 16)
        self.avgpool = nn.AdaptiveAvgPool2d(1)
        self.fc = nn.Conv2d(in_planes, hidden, 1, bias=False)
        self.relu = nn.ReLU(inplace=True)
        self.fc_ac = nn.Conv2d(hidden, in_planes, 1)                 # 输入通道注意力
        self.fc_af = nn.Conv2d(hidden, out_planes, 1)                # 输出通道注意力
        self.fc_as = nn.Conv2d(hidden, kernel_size * kernel_size, 1) # 空间注意力
        self.fc_aw = nn.Conv2d(hidden, K, 1)                         # 卷积核注意力
        self.weight = nn.Parameter(torch.randn(
            K, out_planes, in_planes, kernel_size, kernel_size), requires_grad=True)
(2) 逐位置生成卷积核
上面的方法虽然让核随输入变化,但在同一张特征图内部仍然是权值共享的。本小节的方法进一步打破空间共享:让每个空间位置(或每个区域)使用不同的卷积核。
⚪ DRConv:动态区域感知卷积
对每个像素都单独生成一个完整卷积核的开销是不可接受的。DRConv取了一个折中:把特征图划分为$m$个语义区域,每个区域共享一个动态生成的卷积核。它由两个模块组成:
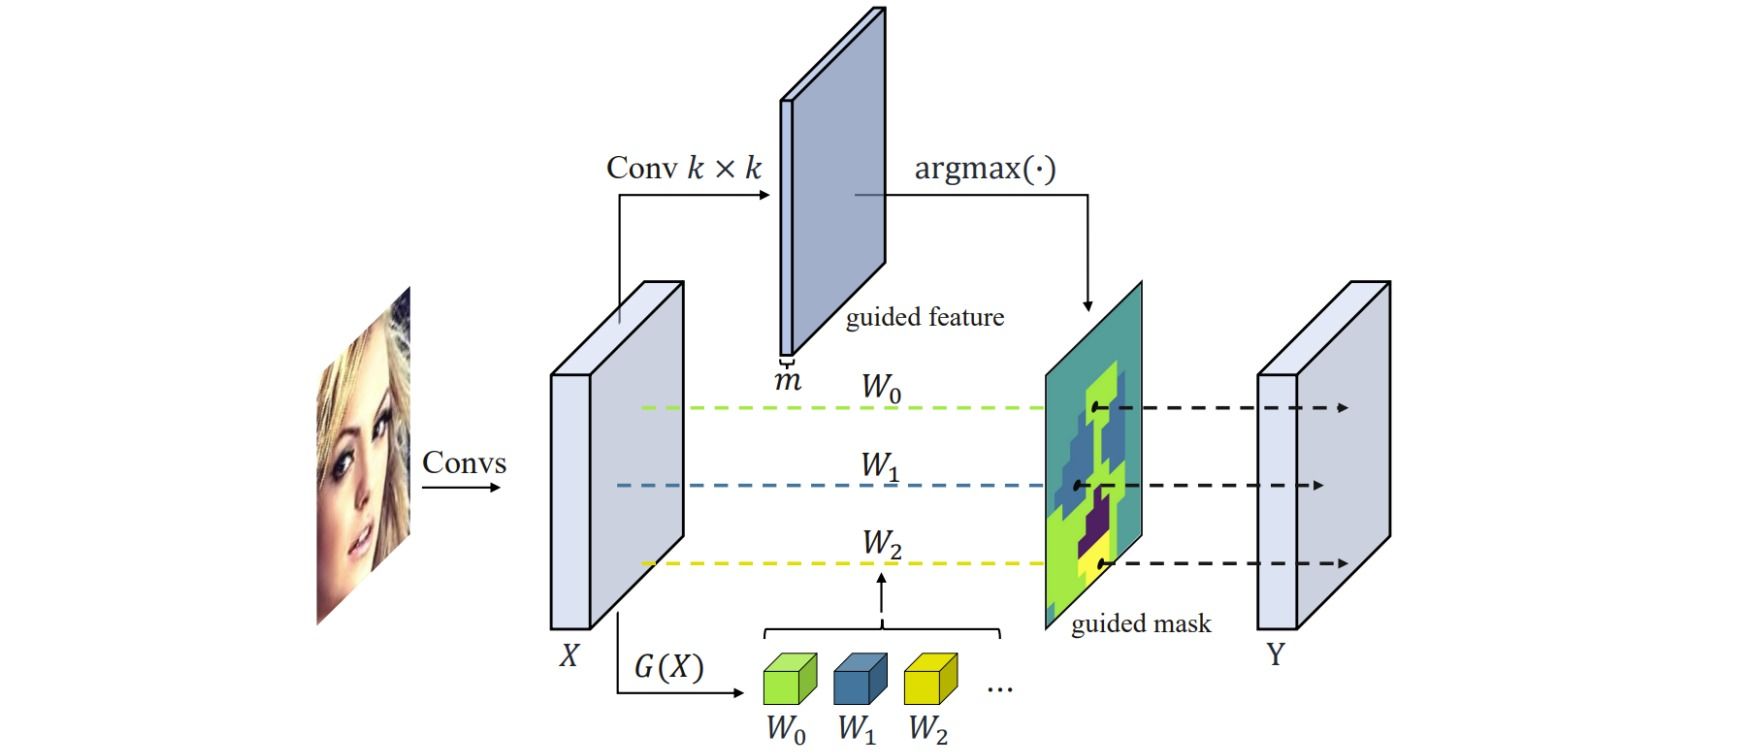
- 可学习的引导掩码(learnable guided mask):用一个标准卷积把输入映射为$m$通道的引导特征$F$,然后逐像素取通道方向的最大值下标,得到区域划分\(M(p_0) = \mathop{\arg\max}_{k} F_k(p_0)\) 由于$\arg\max$不可导,前向用hardmax、反向按softmax近似传播梯度,使区域划分本身可以端到端学习;
- 卷积核生成模块(filter generator):由自适应平均池化把输入压成$m$个空间位置,再经两层$1\times 1$卷积生成$m$组卷积核。
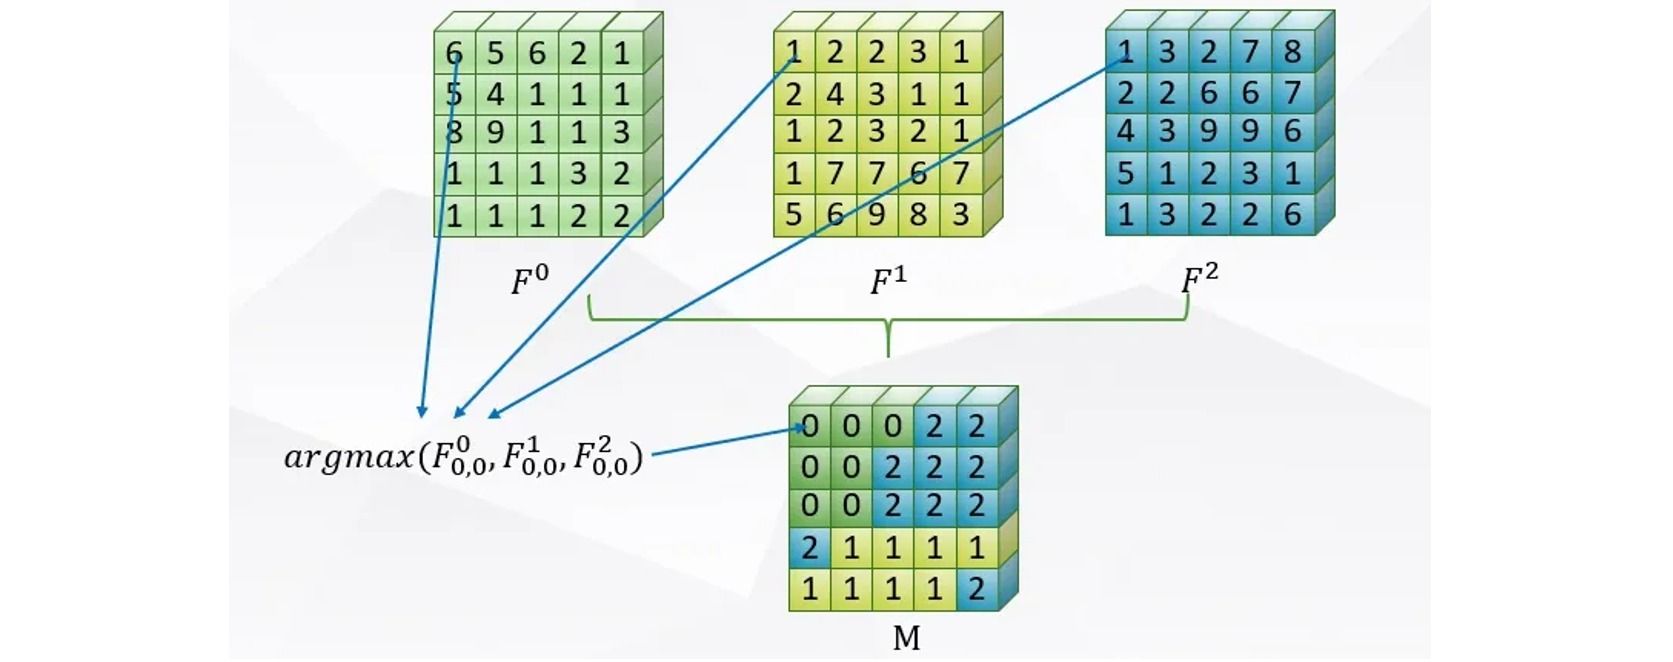
最终每个像素使用其所属区域的卷积核。与“逐像素生成核”相比,DRConv的开销只与区域数$m$有关;与“全图一个动态核”相比,它又能表达空间上的差异。这种设计尤其适合语义布局稳定的任务(如人脸、场景理解)。
⚪ Involution:把卷积的两个性质反转
标准的卷积操作具有两个特点:空间参数共享和通道参数独立。空间参数共享是指在不同的空间位置共享卷积核,有助于捕捉与空间位置无关的视觉特征;通道参数独立是指卷积在不同通道具有不同的值,用于收集不同的语义信息。
Involution则是一种空间参数独立、通道参数共享的卷积核,恰好把上述两个性质反转过来:空间参数独立使得卷积核能在不同空间位置适应不同的视觉模式,通道参数共享能够减少通道间冗余的影响。
\[y_{i,j,k} = \sum_{(u,v) \in \Delta_K} H_{i,j,u+\lfloor K/2 \rfloor, v+\lfloor K/2 \rfloor, \lceil kG/C \rceil} \cdot x_{i+u,j+v,k}\]其中$H \in \Bbb{R}^{H\times W\times K\times K\times G}$是逐位置生成的核,$G$为通道分组数($G \ll C$,同一组内的通道共享核,$G=1$时全部通道共享)。核由一个轻量的两层瓶颈结构从同一位置的特征向量生成:
\[H_{i,j} = W_1 \sigma\left(W_0 \, x_{i,j}\right)\]其中$W_0 \in \Bbb{R}^{\frac{C}{r}\times C}$、$W_1 \in \Bbb{R}^{(K^2 G) \times \frac{C}{r}}$,$\sigma$为BN + ReLU。
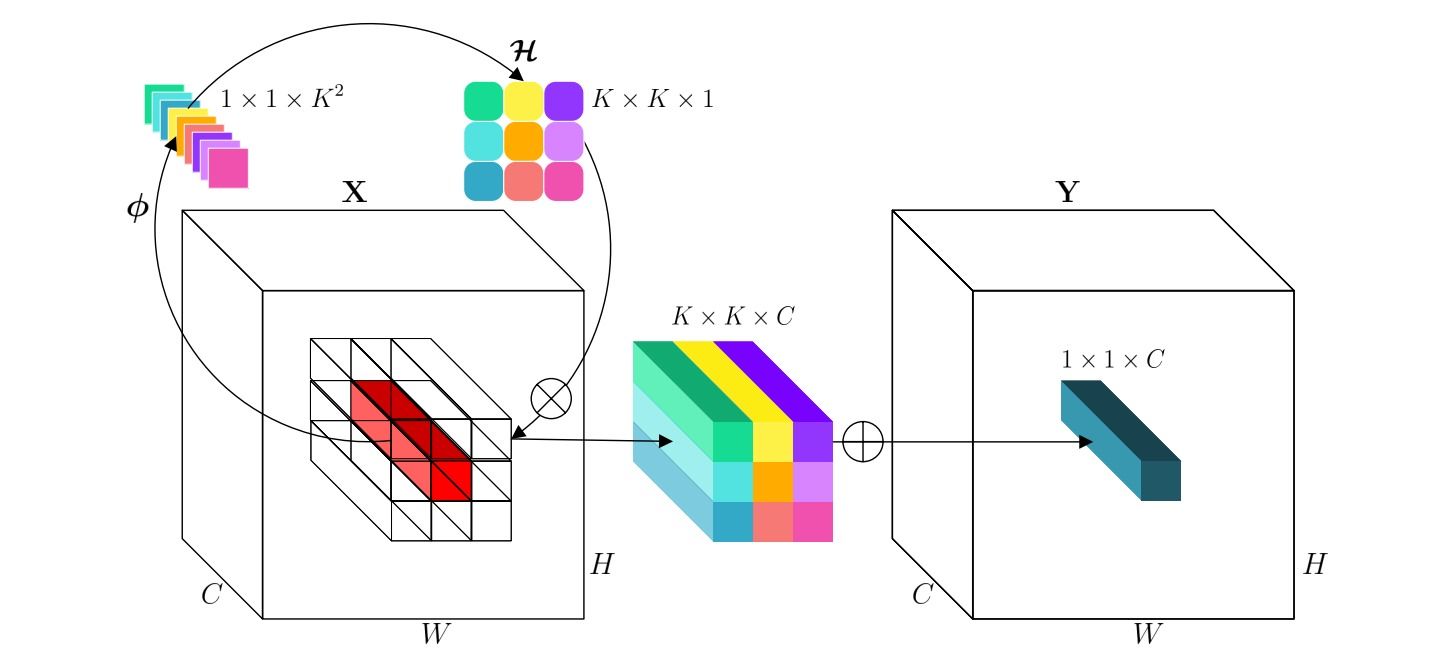
Involution的参数量为$O(C^2/r)$(与核尺寸$K$无关),因此可以廉价地使用$7\times 7$乃至更大的核。作者用它替换ResNet中所有的$3\times 3$卷积得到RedNet,在参数量更少的情况下取得更高精度。
从形式上看,Involution处于卷积与自注意力之间:它像自注意力一样让权重随位置和内容变化,但只用查询位置自身的特征生成权重(不与邻域做点积交互),因此复杂度是线性的。
⚪ Local Relation Network:用查询-键相似度生成局部权重
LR-Net把局部聚合权重定义为查询像素与邻域像素之间的关系,再加上一个可学习的几何先验:
\[w(p_0, p) = \frac{\exp\left(\Phi\left(\theta_q(x(p_0)),\ \theta_k(x(p))\right) + \Psi(p - p_0)\right)}{\sum_{p' \in \Omega(p_0)} \exp\left(\Phi\left(\theta_q(x(p_0)),\ \theta_k(x(p'))\right) + \Psi(p' - p_0)\right)}\]其中$\theta_q,\theta_k$是$1\times 1$卷积实现的查询/键变换,$\Phi$是相似度函数(论文使用小型网络而非点积),$\Psi$是只依赖相对位置的几何先验项,$\Omega(p_0)$为$p_0$的局部窗口。
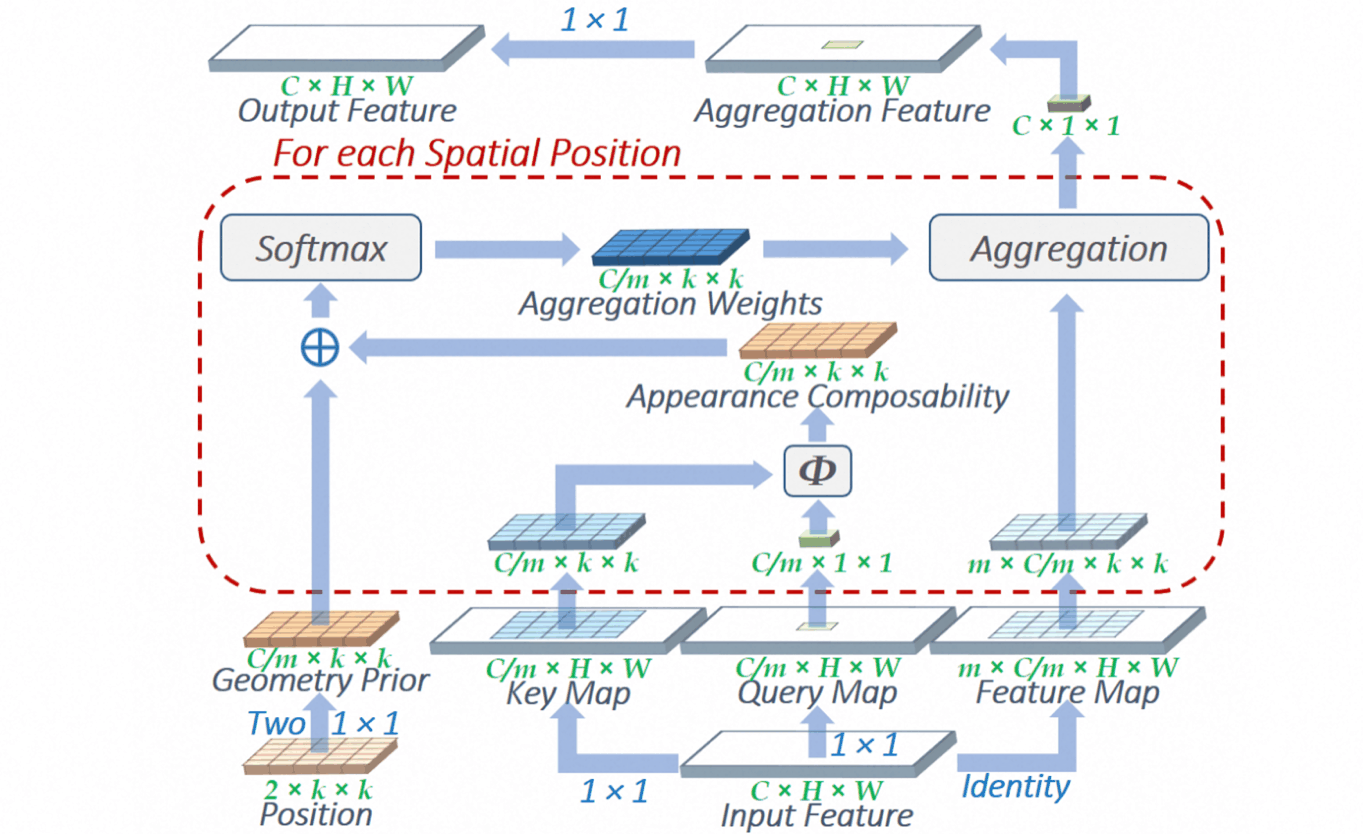
与Involution相比,LR-Net的权重同时依赖查询与键(成对交互),因此更接近局部自注意力;把$\Phi$取为点积、$\Psi$取为相对位置编码,就得到了后来Swin Transformer中的窗口注意力。这条线索的详细展开见卷积神经网络中的自注意力机制。
⚪ Conv2Former:用大核深度卷积做调制
Conv2Former指出自注意力的核心不一定是点积相似度,而是用一个内容相关的张量去调制值。它把这一操作用卷积重写为卷积调制(convolutional modulation):
\[\begin{aligned} A &= \text{DWConv}_{k\times k}\left(W_1 X\right) \\ V &= W_2 X \\ Z &= W_3 \left( A \odot V \right) \end{aligned}\]其中$W_1,W_2,W_3$均为$1\times 1$卷积,$\text{DWConv}_{k\times k}$为大核(如$11\times 11$)深度卷积,$\odot$为Hadamard积。$A$充当注意力图的角色,但它由深度卷积而非成对点积得到,因此复杂度对分辨率是线性的。
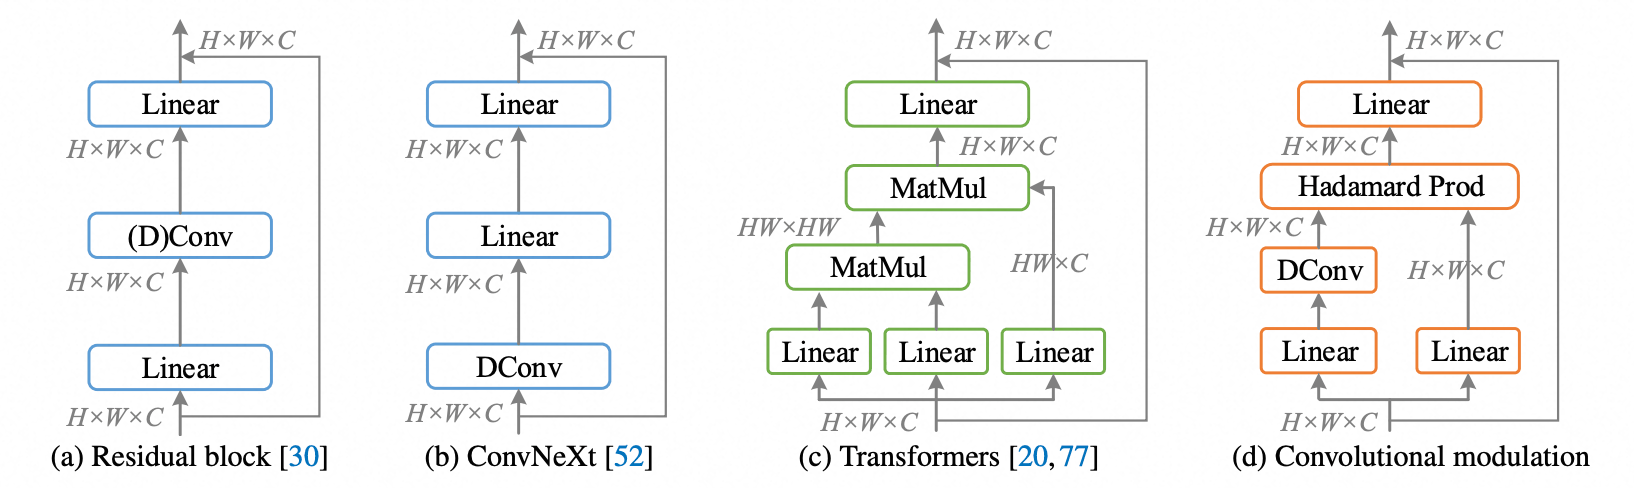
这个形式非常清晰地展示了动态卷积与注意力的连续谱:把$A \odot V$展开就会发现,输出的每个通道都是$V$按空间位置逐点重加权的结果,与逐位置生成核的效果一致,只是权重生成方式换成了大核深度卷积。
⭐ 讨论:动态卷积、注意力与自注意力的边界
动态卷积、通道/空间注意力、自注意力这三族方法在文献中经常混用,容易造成困惑。一个统一的模板是:
\[y(p_0) = \sum_{p \in \Omega(p_0)} \underbrace{w\big(p_0, p \mid x\big)}_{\text{聚合权重}} \cdot \underbrace{g\big(x(p)\big)}_{\text{值变换}}\]三族方法的差别完全体现在$w$依赖什么:
| 方法族 | 聚合权重$w$依赖 | 是否改写卷积核 | 代表方法 | 归属主题 |
|---|---|---|---|---|
| 静态卷积 | 仅$p-p_0$ | — | 标准卷积 | 本文 |
| 核融合动态卷积 | $p-p_0$ 与全局统计$\text{GAP}(x)$ | 是 | CondConv, DynamicConv, DyNet, ODConv | 本文 3.2(1) |
| 逐位置动态卷积 | $p-p_0$ 与$x(p_0)$ | 是 | DRConv, Involution, Conv2Former | 本文 3.2(2) |
| 通道/空间注意力 | 不改权重,改特征幅度 | 否 | SE, CBAM, ECA | 注意力机制 |
| 自注意力 | $x(p_0)$ 与 $x(p)$ 的成对交互 | 否 | Non-local, LR-Net, Swin | 自注意力机制 |
需要提醒的是:动态卷积的共同代价是参数量膨胀$K$倍且批内不可共享权重,这会导致训练显存上升、部署时无法离线折叠。若目标平台对参数量或算子支持度敏感,第3.4节的结构重参数化是更友好的替代方案;它同样在训练时用多分支提升容量,但推理时可以完全折叠回一个标准卷积。
3.3 改变聚合方式:差分、掩码与稀疏
前两节改的是“从哪采”和“用什么权重”,本节改的是“聚合什么量”:把$x$本身换成$x$的差分、把无效位置屏蔽掉、或者干脆跳过零像素不算。
⚪ 差分卷积 Difference Convolution
差分卷积 (Difference Convolution)起源于局部二值模式 (Local Binary Pattern, LBP)。
LBP定义在图像的$3\times 3$邻域内,以中心像素为阈值,将相邻$8$个像素的灰度值与其进行差分比较:若大于中心像素值被标记为$1$,否则为$0$;可产生$8$位二进制数(通常转换为十进制数即LBP码,共$256$种),即得到该中心像素点的LBP值,并用这个值来聚合邻域内的差分信息。
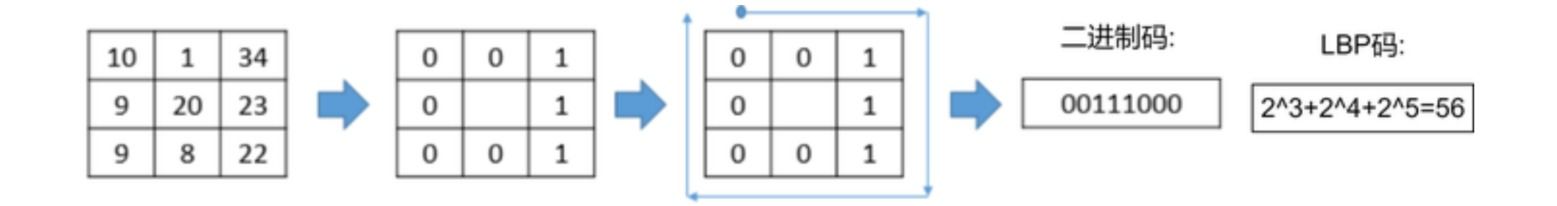
差分卷积则是用卷积处理输入图像或特征的差分信息,能较好地描述细粒度的纹理信息,经常应用在纹理识别、人脸活体检测、边缘检测等领域。
中心差分卷积 (Central Difference Convolution, CDC)是指对邻域特征进行中心差分,其关键性质是计算过程可以分解为标准卷积和一个中心差分项:
\[\begin{aligned} y(p_0) &= \sum_{p_n \in \mathcal{R}} w(p_n) \cdot [x(p_0+p_n)-x(p_0)] \\ &= \sum_{p_n \in \mathcal{R}} w(p_n) \cdot x(p_0+p_n)-x(p_0) \cdot \sum_{p_n \in \mathcal{R}} w(p_n) \end{aligned}\]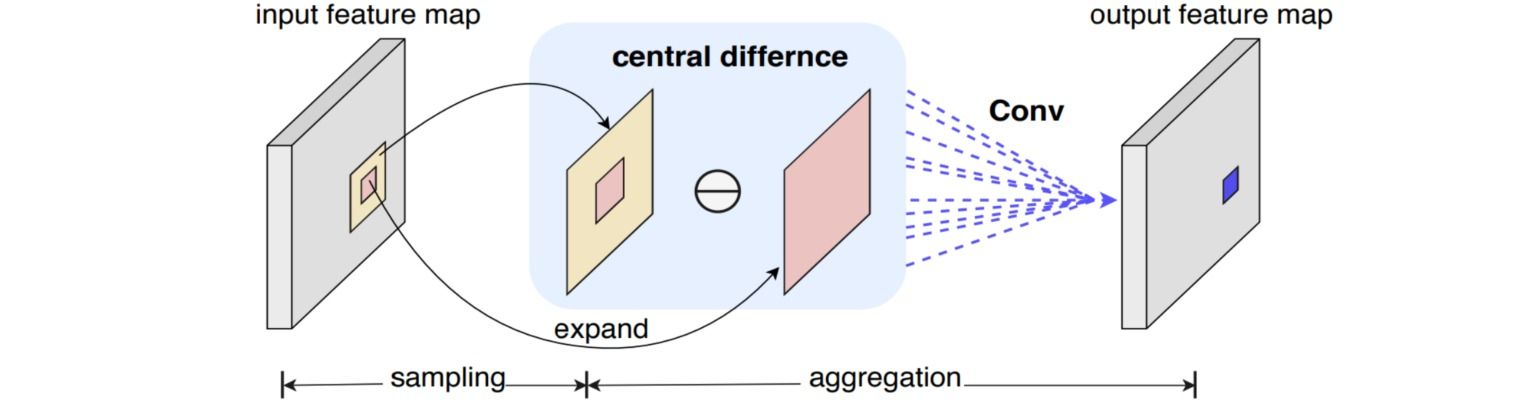
实践中通常引入超参数$\theta \in [0,1]$在“强度信息”与“梯度信息”之间插值:
\[y(p_0) = \underbrace{\sum_{p_n \in \mathcal{R}} w(p_n) \cdot x(p_0+p_n)}_{\text{标准卷积}} - \theta \cdot x(p_0) \cdot \underbrace{\sum_{p_n \in \mathcal{R}} w(p_n)}_{\text{权重之和}}\]由于第二项只需要卷积核权重之和(一个可离线计算的标量),CDC可以被完整折叠进一个等效的标准卷积核中(把中心位置的权重减去$\theta \sum_{p_n} w(p_n)$),因此推理时零额外开销。
交叉中心差分卷积 (Cross-CDC)把CDC解耦成水平垂直和对角线两个对称交叉的子算子,以减少对所有邻域特征都进行差分操作带来的较大的冗余。
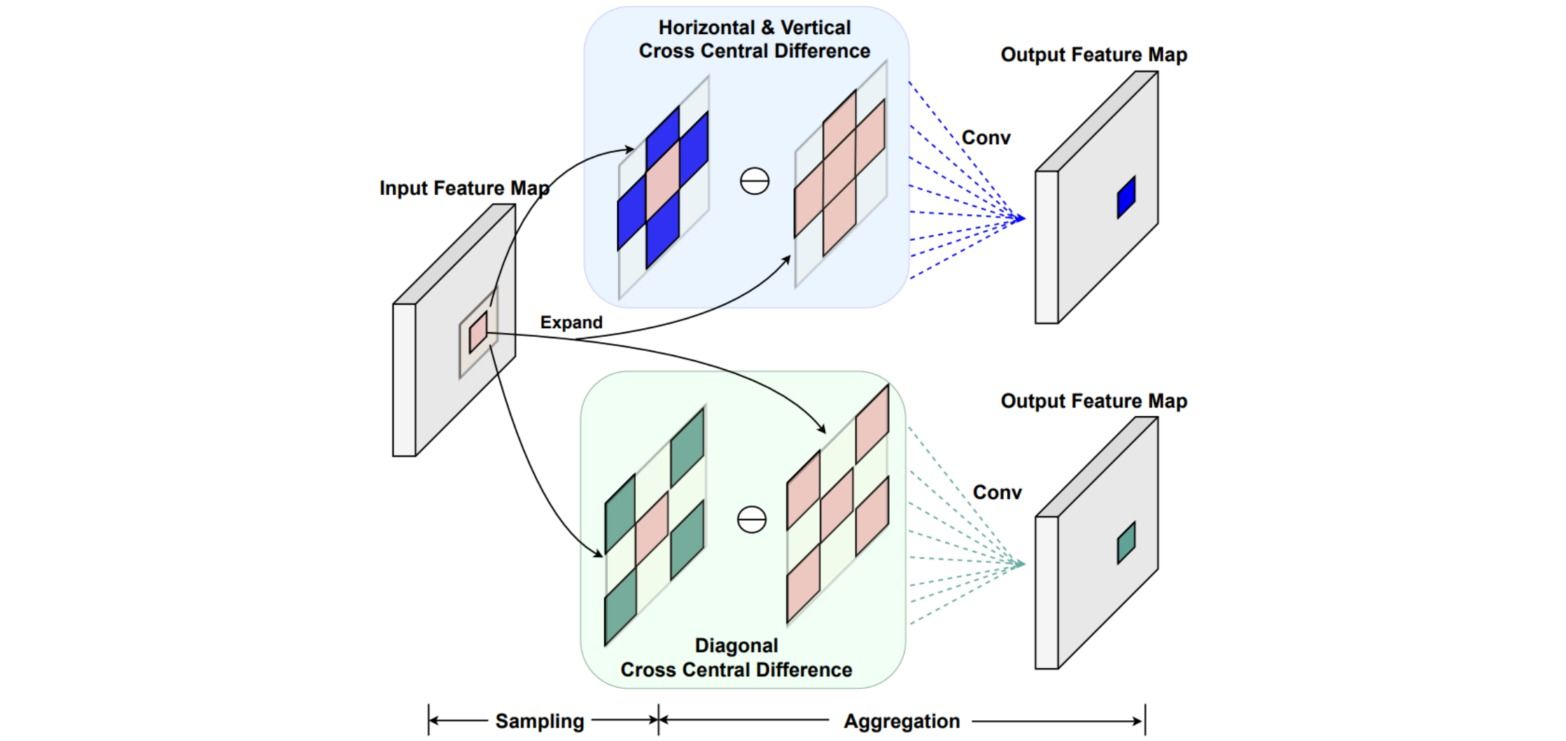
像素差分卷积 (Pixel Difference Convolution, PDC)则聚合了三种差分模式:对邻域特征进行中心差分(CPDC)、对邻域进行顺时针方向的两两差分(APDC)、以及对更大感受野的$5\times 5$邻域进行外环与内环差分(RPDC)。
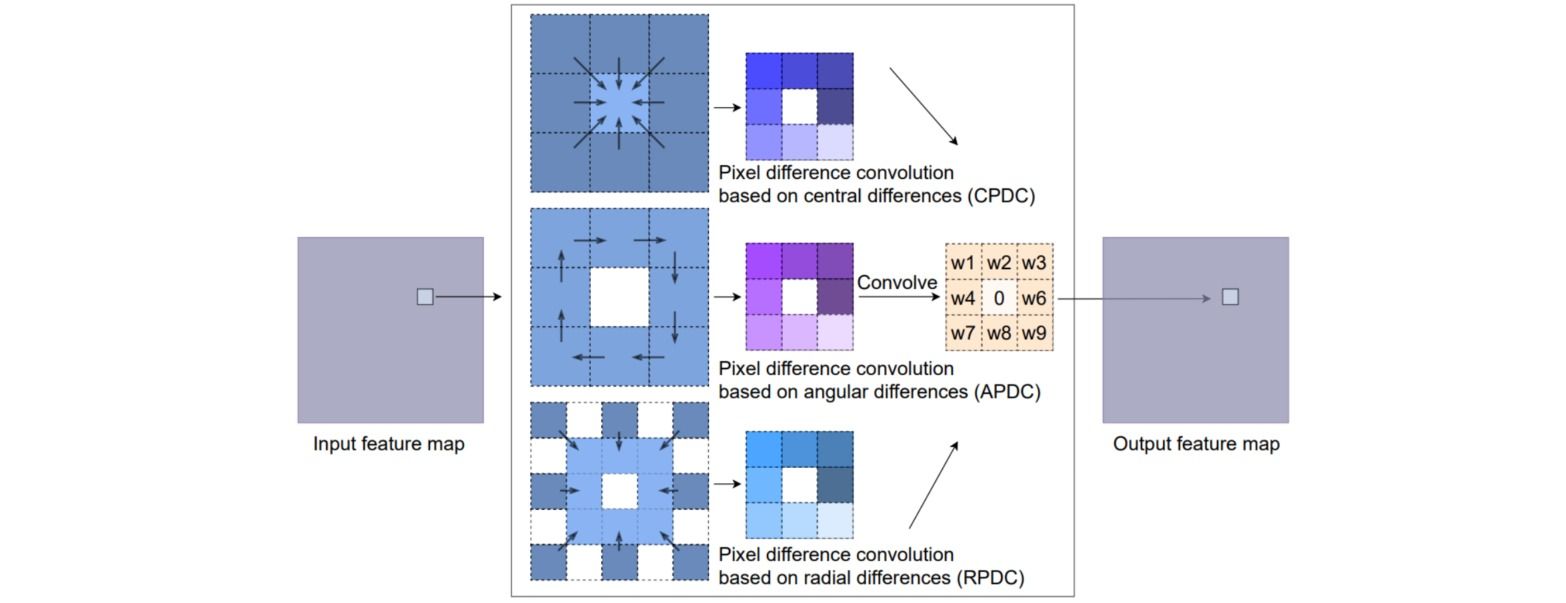
⚪ 部分卷积 Partial Convolution:只在有效像素上聚合
图像修复任务的输入带有不规则的空洞。若直接用标准卷积处理,空洞里的填充值(通常是$0$或均值)会被当作真实像素参与聚合,产生颜色偏差与伪影。部分卷积引入一个二值掩码$M$($1$表示有效像素),只在有效像素上聚合并做重归一化:
\[y(p_0) = \begin{cases} \sum_{p_n \in \mathcal{R}} w(p_n) \cdot \left[x \odot M\right](p_0+p_n) \cdot \dfrac{\lvert \mathcal{R} \rvert}{\text{sum}\left(M_{\mathcal{R}(p_0)}\right)} + b, & \text{sum}\left(M_{\mathcal{R}(p_0)}\right) > 0 \\ 0, & \text{otherwise} \end{cases}\]其中$\lvert \mathcal{R} \rvert = f^2$为窗口内像素总数,$\text{sum}(M_{\mathcal{R}(p_0)})$为窗口内有效像素数,缩放因子$\lvert \mathcal{R} \rvert / \text{sum}(M)$使得不同有效像素数的窗口输出幅度可比。每层之后掩码按下式更新(只要窗口内有一个有效像素,输出位置就变为有效):
\[m'(p_0) = \begin{cases} 1, & \text{sum}\left(M_{\mathcal{R}(p_0)}\right) > 0 \\ 0, & \text{otherwise} \end{cases}\]因此随着层数加深,空洞会从边缘向内逐层愈合,最终整张掩码全为$1$。
⚪ 门控卷积 Gated Convolution:把硬掩码换成可学习软门
部分卷积的掩码是人为规定的硬二值,且所有通道共享同一个掩码,这带来两个问题:无法表达“部分可信”的中间状态;也无法处理用户草图等额外的条件输入。门控卷积把掩码替换为从数据中学习的软门(soft gating):
\[\begin{aligned} G &= W_g * x \quad &&\text{(门控分支)} \\ F &= W_f * x \quad &&\text{(特征分支)} \\ y &= \phi(F) \odot \sigma(G) \end{aligned}\]其中$\sigma$为Sigmoid(把门限制到$[0,1]$),$\phi$为任意激活函数。由于$G$是逐通道、逐位置学习的,网络可以为每个通道自动学出不同的有效性定义,因此在自由形状掩码、带草图引导的修复任务上显著优于部分卷积。
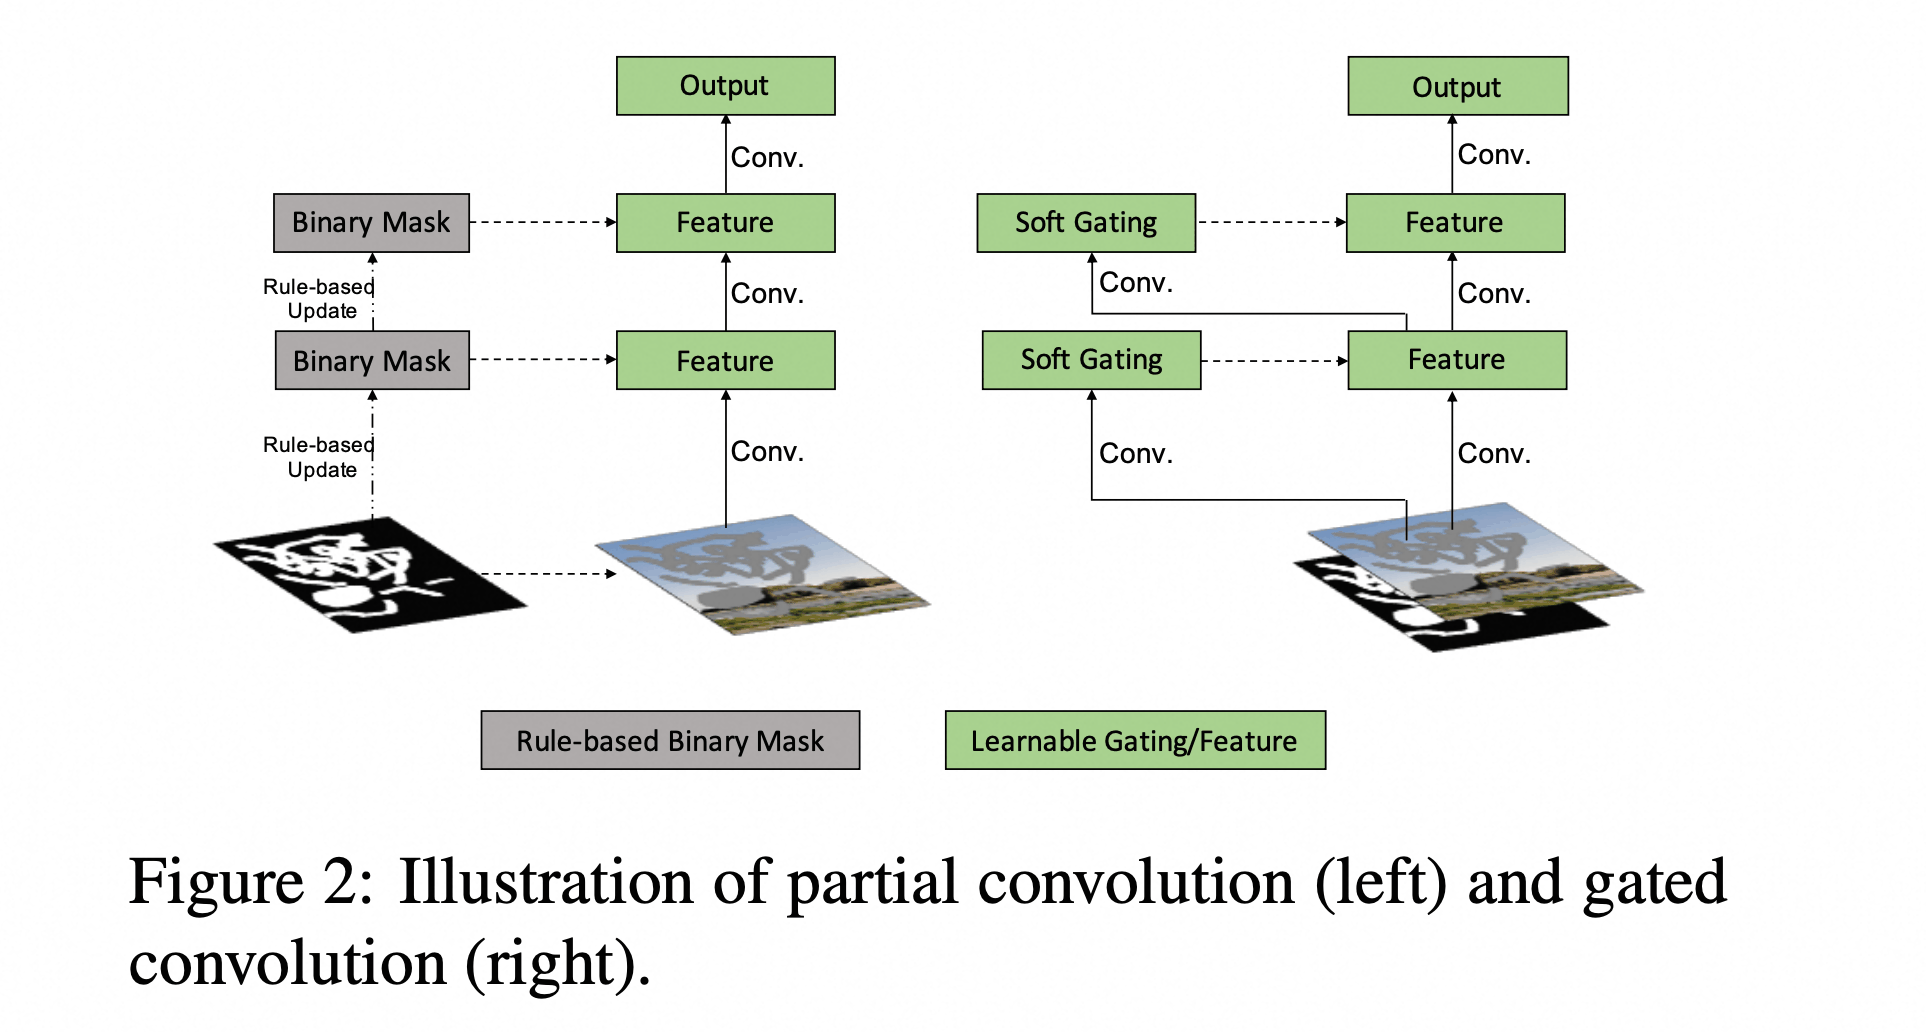
从形式上看,门控卷积与Conv2Former的卷积调制、以及激活函数中的GLU族属于同一个“乘性门控”家族,差别只在门的生成方式与作用范围。
⚪ 稀疏卷积 Sparse Convolution
对于稀疏的输入图像,如三维点云体素,其中存在大量的空白区域(像素为$0$),此时使用卷积操作滑动扫描所有像素将会产生大量的无效计算量。
稀疏卷积 (Sparse Convolution)只对输入图像/特征中的非零像素进行卷积操作,从而实现了稀疏数据的高效计算。把输入图像中的非零像素称为active input site,则稀疏卷积具有两种形式:
- 空间稀疏卷积 (Spatially Sparse Convolution):卷积核在滑动过程中,只要覆盖一个active input site,则计算一次输出。
- 子流形稀疏卷积 (Submanifold Sparse Convolution):卷积核在滑动过程中,只有卷积核中心覆盖一个active input site,才计算一次输出。
两者的关键差别在于稀疏度是否随层数衰减:空间稀疏卷积每层都会让非零区域向外膨胀$\lfloor f/2 \rfloor$圈,堆叠若干层后特征就变稠密了(称为稀疏度膨胀(submanifold dilation)问题);子流形稀疏卷积严格保持非零位置集合不变,因此可以堆叠很多层,代价是无法连接原本不连通的区域(通常靠间插的下采样层来解决)。
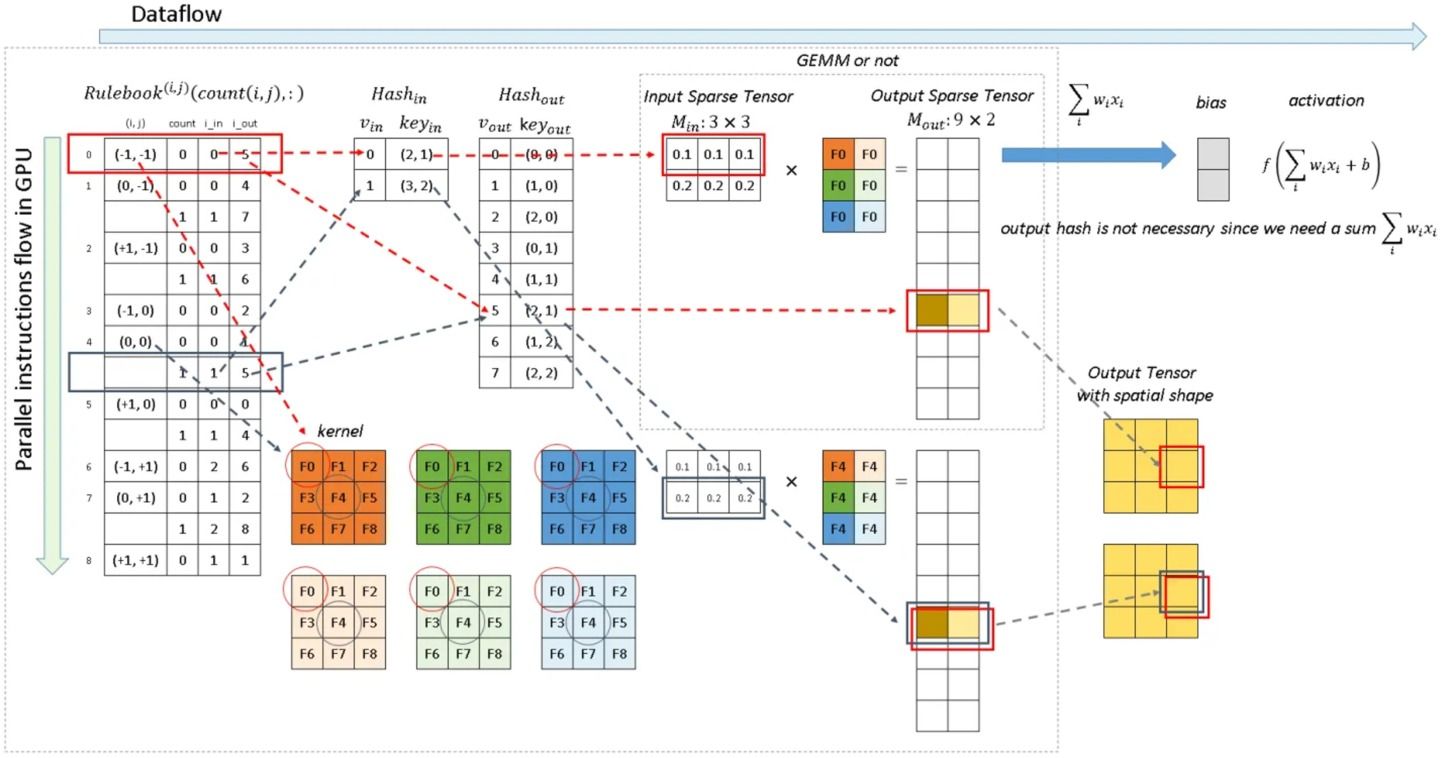
稀疏卷积的实现过程如下,首先根据输入和输出特征构建哈希表(Hash Table)。对于输入图像中的每一个非零像素$P_{in}$,根据其对应输入图像中的坐标位置$key_{in}$和顺序编号$v_{in}$构建输入哈希$Hash_{in}$;然后对每一个非零的输入像素$P_{in}$计算其所有能影响到的输出特征像素$P_{out}$,根据对应输出特征中的坐标位置$key_{out}$和顺序编号$v_{out}$构建输出哈希$Hash_{out}$。
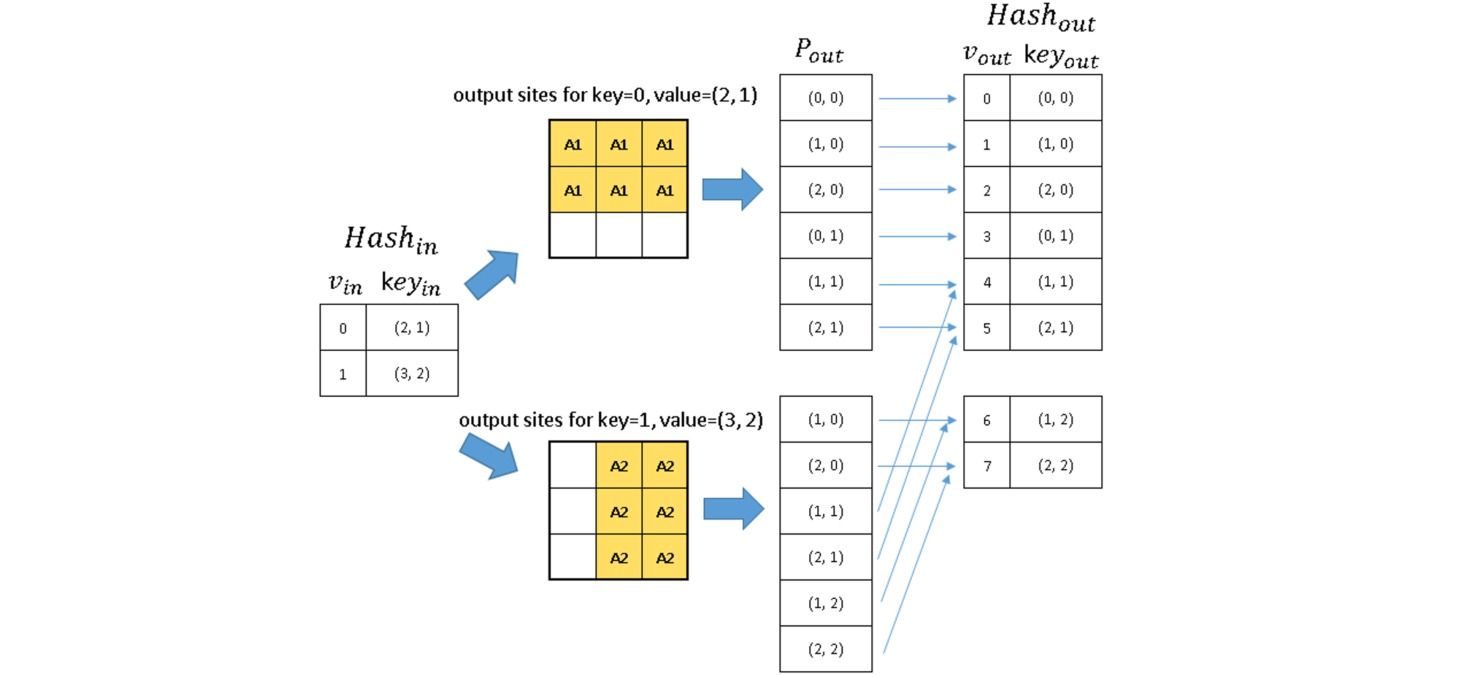
然后根据输入和输出哈希建立规则手册(Rule Book),把稀疏卷积中所有的原子计算(atomic operation)关联到对应的卷积核元素上,从而把卷积转换为有效的可编程形式。
对于任意输入像素$P_{in}$,对应的每一个输出像素$P_{out}$是通过卷积核中某个元素与输入相乘得到的,因此记录卷积核中对应的偏置坐标$(i,j)$。根据偏置坐标$(i,j)$建立规则手册,分别记录每个坐标元素使用的次数$count$,对应的输入像素编号$v_{in}$和输出像素编号$v_{out}$。
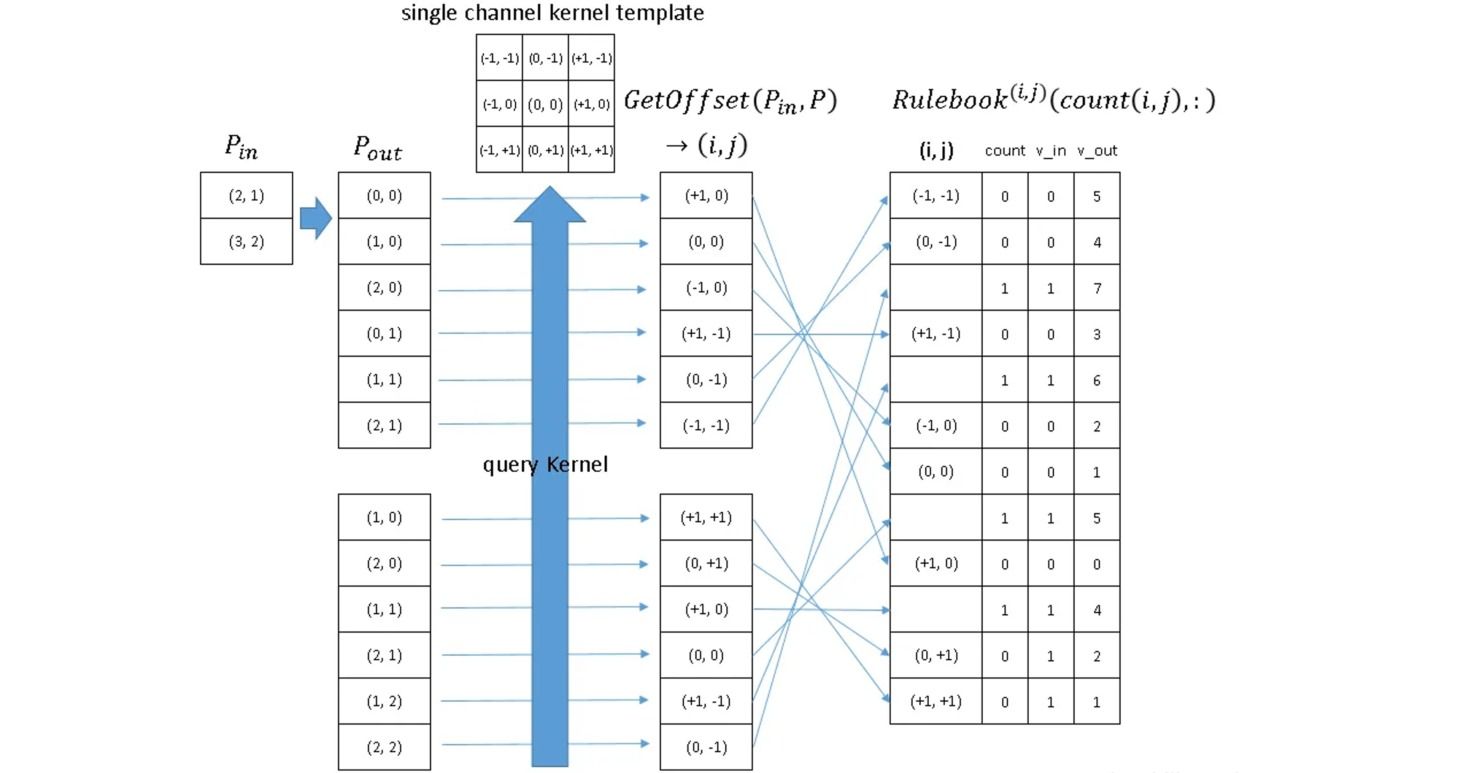
根据输入和输出哈希表以及规则手册可以实现稀疏卷积计算。首先根据规则手册查询卷积核的每个元素$(i,j)$作用的输入像素编号$v_{in}$以及对应的输出像素编号$v_{out}$,根据输入像素编号$v_{in}$对应的输入像素坐标$key_{in}$上的像素值构建稀疏的输入张量,并与卷积核元素对应相乘后把结果累积到输出像素编号$v_{out}$对应的输出像素坐标$key_{out}$上。
3.4 分解与重参数化卷积核
本节的方法不改变卷积的语义(采样位置、权重来源、聚合方式都是标准的),只改变卷积核的参数化方式。它们分成两类:低秩分解在推理时也保持分解形态以省算力;结构重参数化只在训练时使用复杂结构,推理时折叠回单个标准卷积。
(1) 卷积核的低秩分解
⚪ 空间可分离卷积 Spatially Separable Convolution
空间可分离卷积 (Spatially Separable Convolution)是指把$f \times f$的卷积核分解成两个独立的卷积核$f \times 1$和$1 \times f$,然后分别对图像的高度方向和宽度方向进行操作。这等价于假设卷积核矩阵是秩$1$的,即$W = u v^\top$。
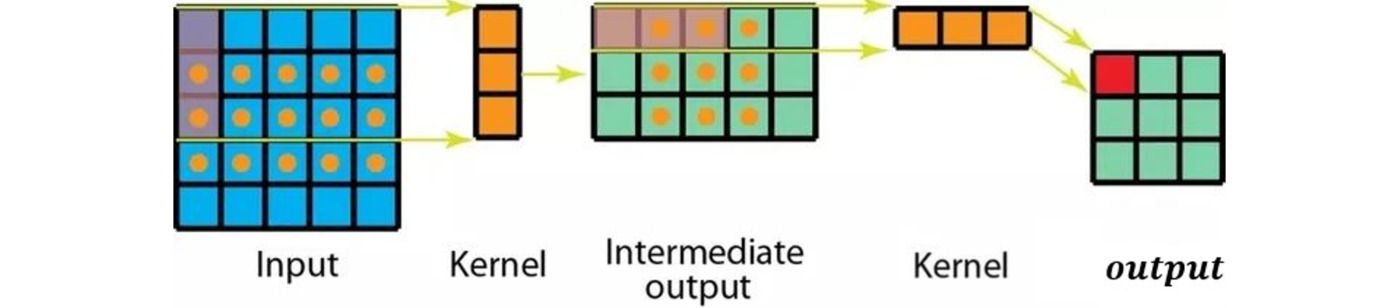
空间可分离卷积能够有效地降低卷积的计算成本。对于$f \times f$的卷积核,若特征的空间尺寸为$n \times n$且在计算过程中没有改变,并且不考虑偏置项,则标准卷积和空间可分离卷积的参数量和计算量分别为:
| 标准卷积 | 空间可分离卷积 | 比值 | |
|---|---|---|---|
| 参数量(Params) | $f \times f$ | $f \times 1 + 1 \times f$ | $\frac{2}{f}$ |
| 乘加运算量(Mult-Adds) | $(n \times n) \times (f \times f)$ | $(n \times n) \times (f \times 1) + (n \times n) \times (1 \times f)$ | $\frac{2}{f}$ |
深度学习中通常很少单独使用空间可分离卷积,这是因为并非所有卷积核都可以拆分成两个较小的卷积核,强制拆分则会阻碍在训练期间搜索所有可能的卷积核。但在大核卷积中它重新变得重要:当$f=51$时秩$1$假设造成的损失远小于$f^2$的计算量收益,见第3.5节的SLaK与InceptionNeXt。
⚪ 深度可分离卷积 Depthwise Separable Convolution
深度可分离卷积 (Depthwise Separable Convolution)是由第2.5节介绍的深度卷积和逐点卷积级联构成的:先用深度卷积做“空间交互、通道独立”的聚合,再用$1\times 1$卷积做“空间独立、通道交互”的混合。它对应的假设是卷积核在空间维度与通道维度上是可分离的。
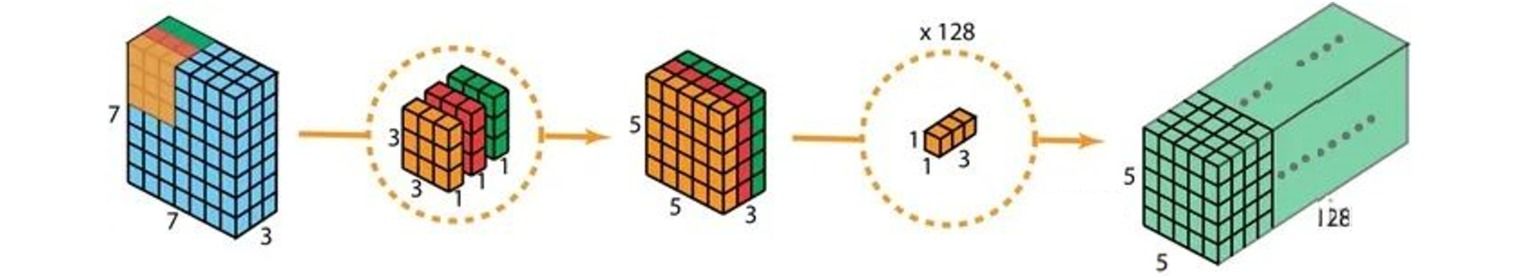
对于$f \times f\times c$的卷积核,若特征的空间尺寸为$n \times n$且在计算过程中没有改变,并且不考虑偏置项,共采用$c’$个卷积核,则标准卷积和深度可分离卷积的参数量和计算量分别为:
| 标准卷积 | 深度卷积 | 逐点卷积 | 比值 | |
|---|---|---|---|---|
| 参数量(Params) | $c’ \times (f \times f\times c)$ | $c \times (f \times f \times 1)$ | $c’ \times (1 \times 1\times c)$ | $\frac{1}{c’}+\frac{1}{f^2}$ |
| 乘加运算量(Mult-Adds) | $(n \times n\times c’) \times (f \times f\times c)$ | $(n \times n\times c) \times (f \times f\times 1)$ | $(n \times n\times c’) \times (1 \times 1\times c)$ | $\frac{1}{c’}+\frac{1}{f^2}$ |
深度可分离卷积大幅度减少卷积的参数,其主要缺点是对于规模较小的模型,模型容量可能会显著降低,拟合能力变弱,训练得到的模型可能是次优的。它是轻量级卷积神经网络的核心构件。
深度可分离卷积可以通过torch.nn.Conv2d实现:
点击展开代码
class DSConv(nn.Module):
    def __init__(self, in_channels, out_channels):
        super().__init__()
        self.depthwise_separable_conv = nn.Sequential(
            torch.nn.Conv2d(in_channels, in_channels, kernel_size=3, padding=1, groups=in_channels),
            torch.nn.Conv2d(in_channels, out_channels, kernel_size=1, padding=0),
        )

    def forward(self, x):
        return self.depthwise_separable_conv(x)
⚪ 平展卷积 Flattened Convolution
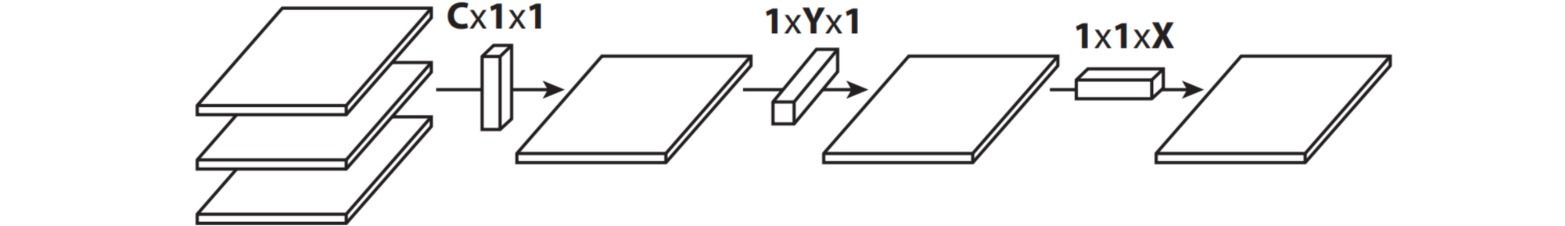
平展卷积 (Flattened Convolution)把上面两种分解推到极致:同时沿着通道维度和两个空间维度分离,即假设卷积核为rank-1三阶张量,从而可以分解为三个一维向量的外积$W = \alpha \otimes u \otimes v$,用三次一维卷积级联实现。
⚪ PConv:只对部分通道做卷积
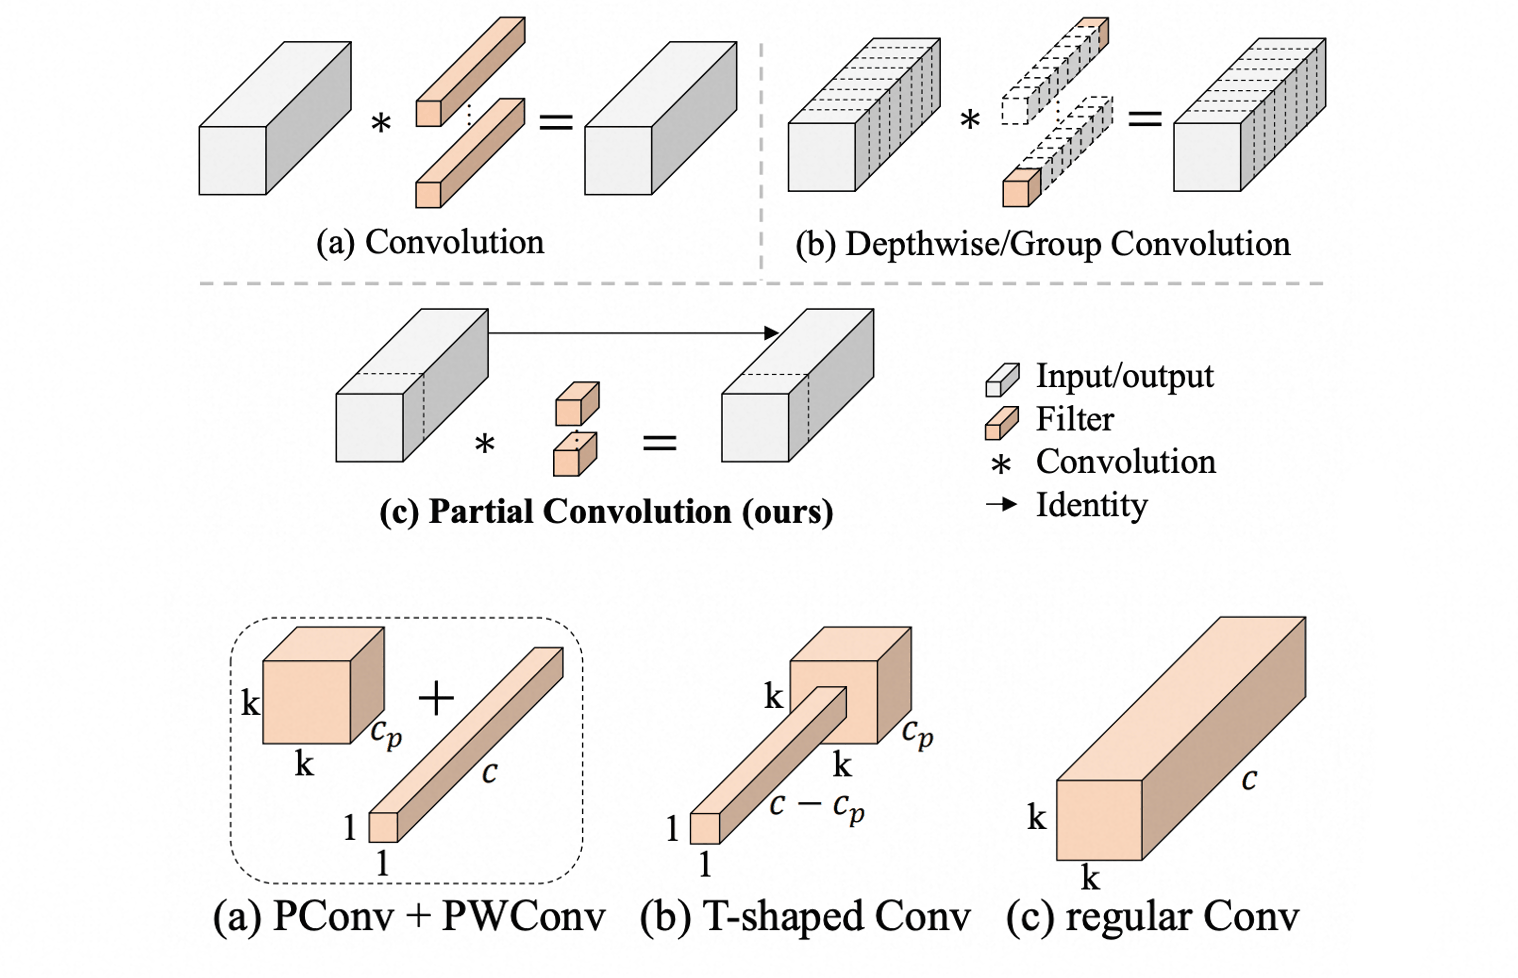
FasterNet指出:深度可分离卷积虽然把FLOPs降下来了,但深度卷积和$1\times 1$卷积都是访存受限算子,实测时延并没有同比例下降(正是第1.5节讨论的算术强度问题)。它提出部分卷积(Partial Convolution, PConv):只在前$c_p$个通道上做标准的$f\times f$卷积,其余$c-c_p$个通道原样恒等传递:
\[y = \left[\ \underbrace{W * x_{1:c_p}}_{\text{标准卷积}}\ ;\ \underbrace{x_{c_p+1:c}}_{\text{恒等}}\ \right]\]取$c_p = c/4$时(即$r=1/4$):
\[\frac{\text{FLOPs}_{\text{PConv}}}{\text{FLOPs}_{\text{Conv}}} = r^2 = \frac{1}{16}, \qquad \frac{\text{MAC}_{\text{PConv}}}{\text{MAC}_{\text{Conv}}} \approx r = \frac{1}{4}\]即FLOPs降到$1/16$而访存量只降到$1/4$,算术强度反而比深度卷积高得多,因此实测速度提升接近理论值。配合后接的$1\times 1$卷积(把信息从被卷积的通道扩散到所有通道),PConv + PWConv的等效感受野呈“T形”:在被处理的通道上有完整的$f\times f$视野,在其余通道上依赖$1\times 1$的跨通道传播。
⚪ DO-Conv:深度过参数化卷积
DO-Conv走的是与低秩分解相反的方向:训练时故意增加参数量。它在标准卷积核$W$之外额外引入一个深度卷积核$D$,并把两者复合成一个卷积核:
\[y = \left(W \circ D\right) * x\]其中$\circ$表示按通道的核复合(把$D$作用在$W$的空间维度上)。由于两个线性算子的复合仍是线性算子,训练完成后可以把$W \circ D$离线计算成一个等价的标准卷积核,因此推理时的结构、参数量、计算量与原始卷积完全一致。实现这种组合有两种数学上等价的方法: 特征组合 (a) 和卷积核组合 (b)。
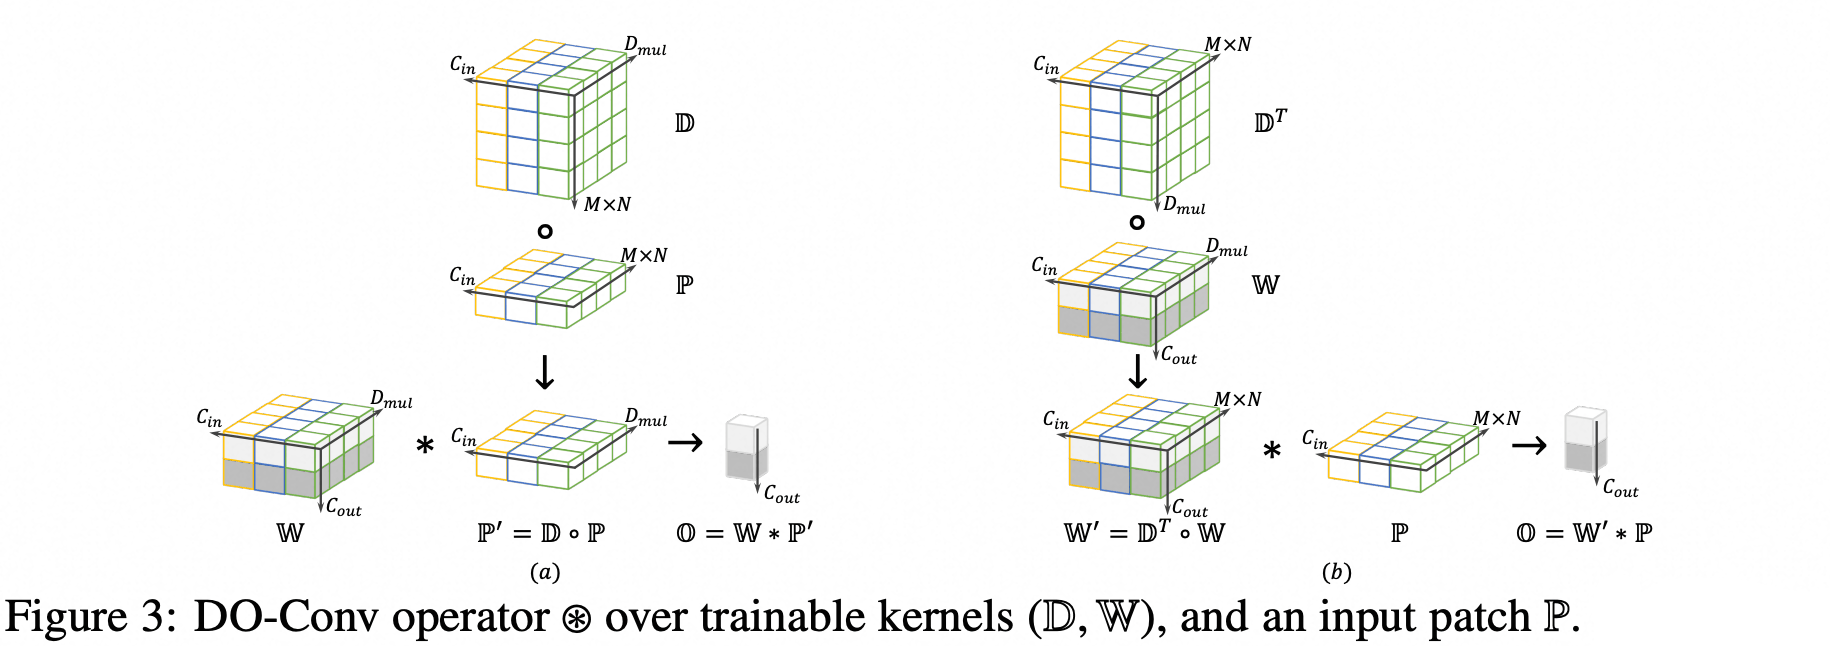
DO-Conv揭示了一个有点反直觉但非常有用的经验:过参数化能改善优化景观,从而在不改变推理成本的前提下提升精度。这一思想的系统化就是下面的结构重参数化。
(2) 结构重参数化
结构重参数化的理论基础是卷积的两条线性性质。设$*$表示卷积,则对任意标量$\lambda$与同形状的核$F_1,F_2$:
\[\begin{aligned} \text{齐次性:}\quad & x * (\lambda F) = \lambda (x * F) \\ \text{可加性:}\quad & x * F_1 + x * F_2 = x * (F_1 + F_2) \end{aligned}\]可加性要求两个卷积核兼容(相同的空间尺寸、步长与填充)。小核可以通过零填充扩充成大核尺寸,因此$1\times 1$、$1\times f$、$f\times 1$、恒等映射都可以被吸收进一个$f\times f$核中。
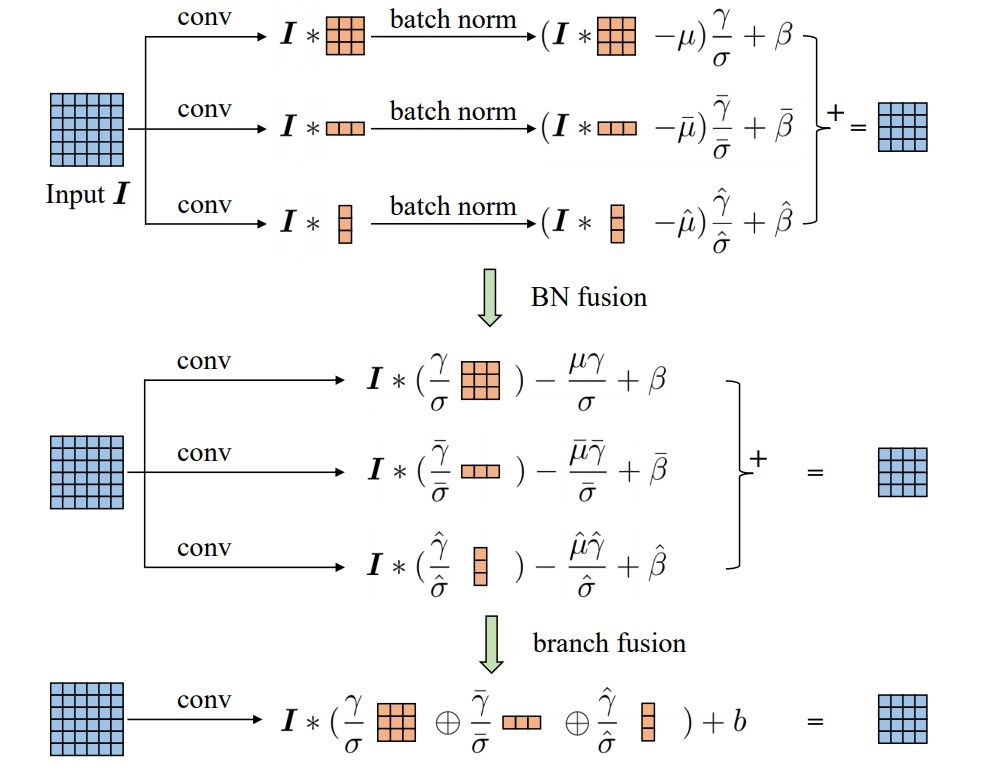
另一个必备工具是BN折叠:推理阶段的批归一化是一个逐通道的仿射变换,可以合并进前一个卷积的权重与偏置:
\[w_i' = \frac{\gamma_i}{\sqrt{\sigma_i^2+\epsilon}} w_i, \qquad b_i' = \beta_i - \frac{\mu_i \gamma_i}{\sqrt{\sigma_i^2+\epsilon}}\]其中$\mu_i,\sigma_i^2$为第$i$个通道的滑动均值与方差,$\gamma_i,\beta_i$为BN的可学习缩放与偏移。有了这两个工具,就可以做到训练时多分支、推理时单分支。
⚪ ACNet:非对称卷积块
ACNet在训练时把每个$3\times 3$卷积替换为$3\times 3$、$1\times 3$、$3\times 1$三个并行分支(各自带BN)之和:
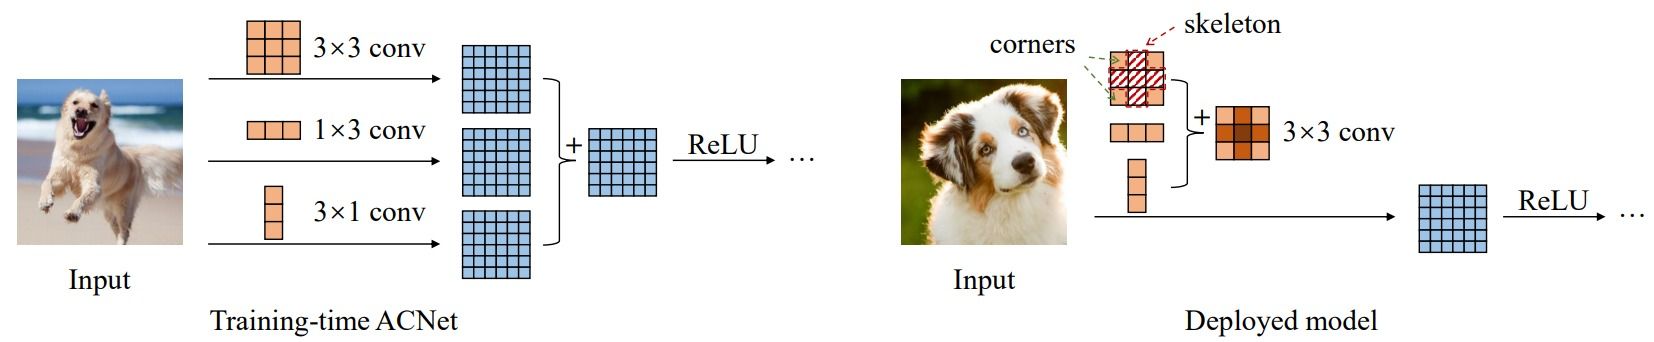
推理时先对每个分支做BN折叠,再把$1\times 3$与$3\times 1$的权重零填充到$3\times 3$后直接相加,得到一个等价的$3\times 3$卷积核:
由于水平/垂直分支只增强了卷积核的骨架(中间十字形位置)的权重,ACNet还带来了对上下翻转、左右翻转等形变的鲁棒性提升。
⚪ RepVGG:把残差结构折叠成直筒网络
RepVGG把重参数化用在了更激进的地方:训练时使用$3\times 3$卷积 + $1\times 1$卷积 + 恒等映射三分支(类似残差块),推理时全部折叠为单个$3\times 3$卷积,得到一个没有任何分支、只有“卷积 + ReLU”的直筒结构。
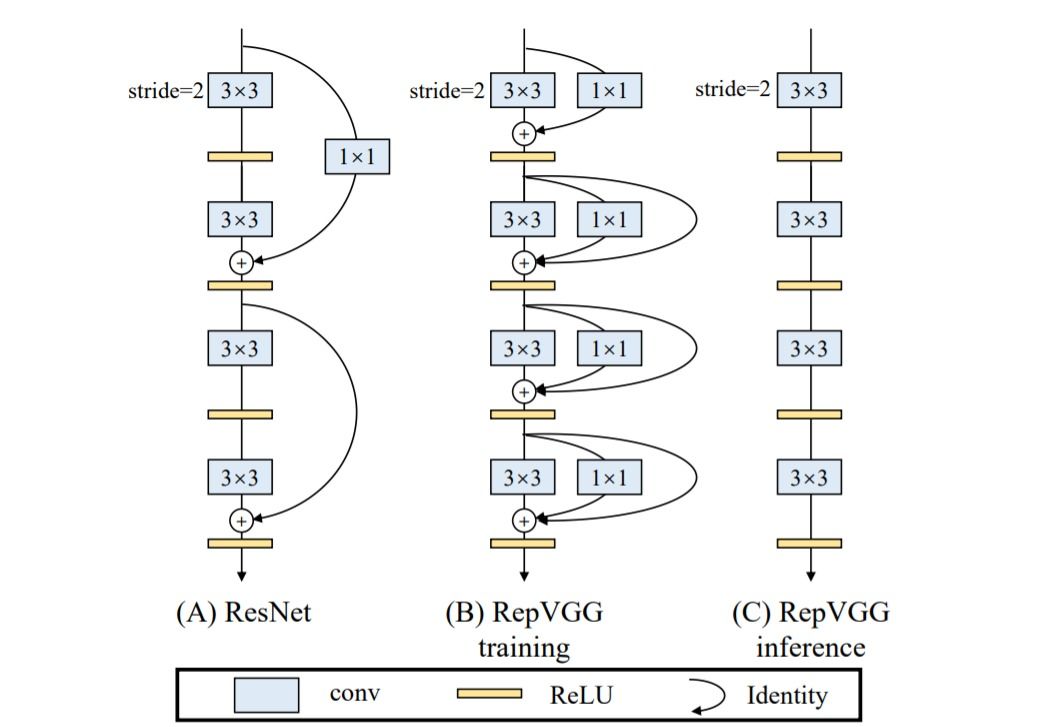
折叠时把恒等映射视为一个中心为$1$、其余为$0$的$1\times 1$卷积(即单位矩阵形式的核),再零填充到$3\times 3$。这种设计的价值在于部署友好:多分支结构的显存占用高、访存密集、且对推理引擎的算子融合不友好,而单路$3\times 3$卷积在GPU上有高度优化的实现(Winograd、cuDNN专用核),因此RepVGG在同等精度下实测速度远高于同级别的多分支网络。
⚪ DBB:多样化分支块
DBB把可折叠的变换总结为六条等价规则,从而可以把一个卷积替换成任意复杂的“Inception式”训练结构,再无损折叠回去:
| 等价变换 | 说明 |
|---|---|
| Conv + BN | BN折叠进卷积权重与偏置 |
| 多分支相加 | 兼容的卷积核直接相加(可加性) |
| 序列 $1\times 1$ + $f\times f$ | 两个卷积级联可合并为一个(沿通道做矩阵乘) |
| $1\times 1$ + 平均池化 | 平均池化等价于固定权重的深度卷积 |
| 多尺度卷积 | $1\times 1$、$1\times f$、$f\times 1$ 零填充到 $f\times f$ |
| 分组卷积 | 补零成稠密卷积核 |
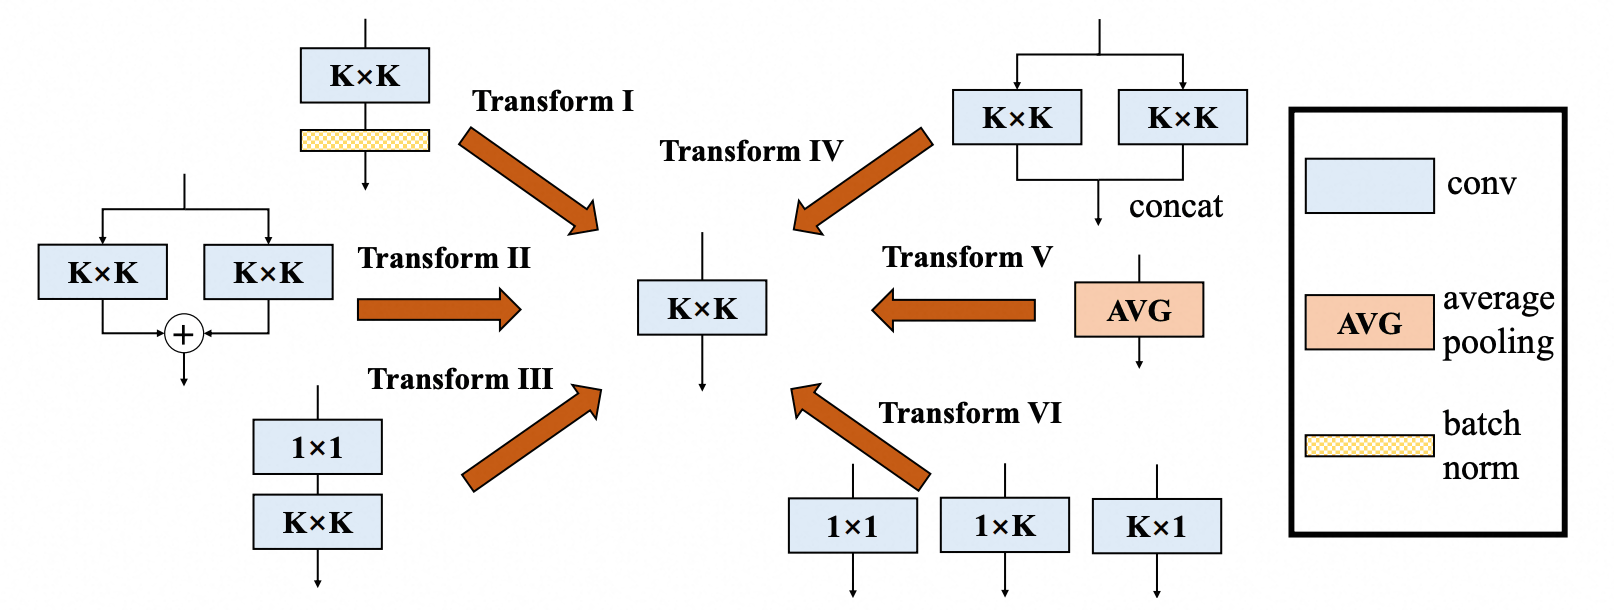
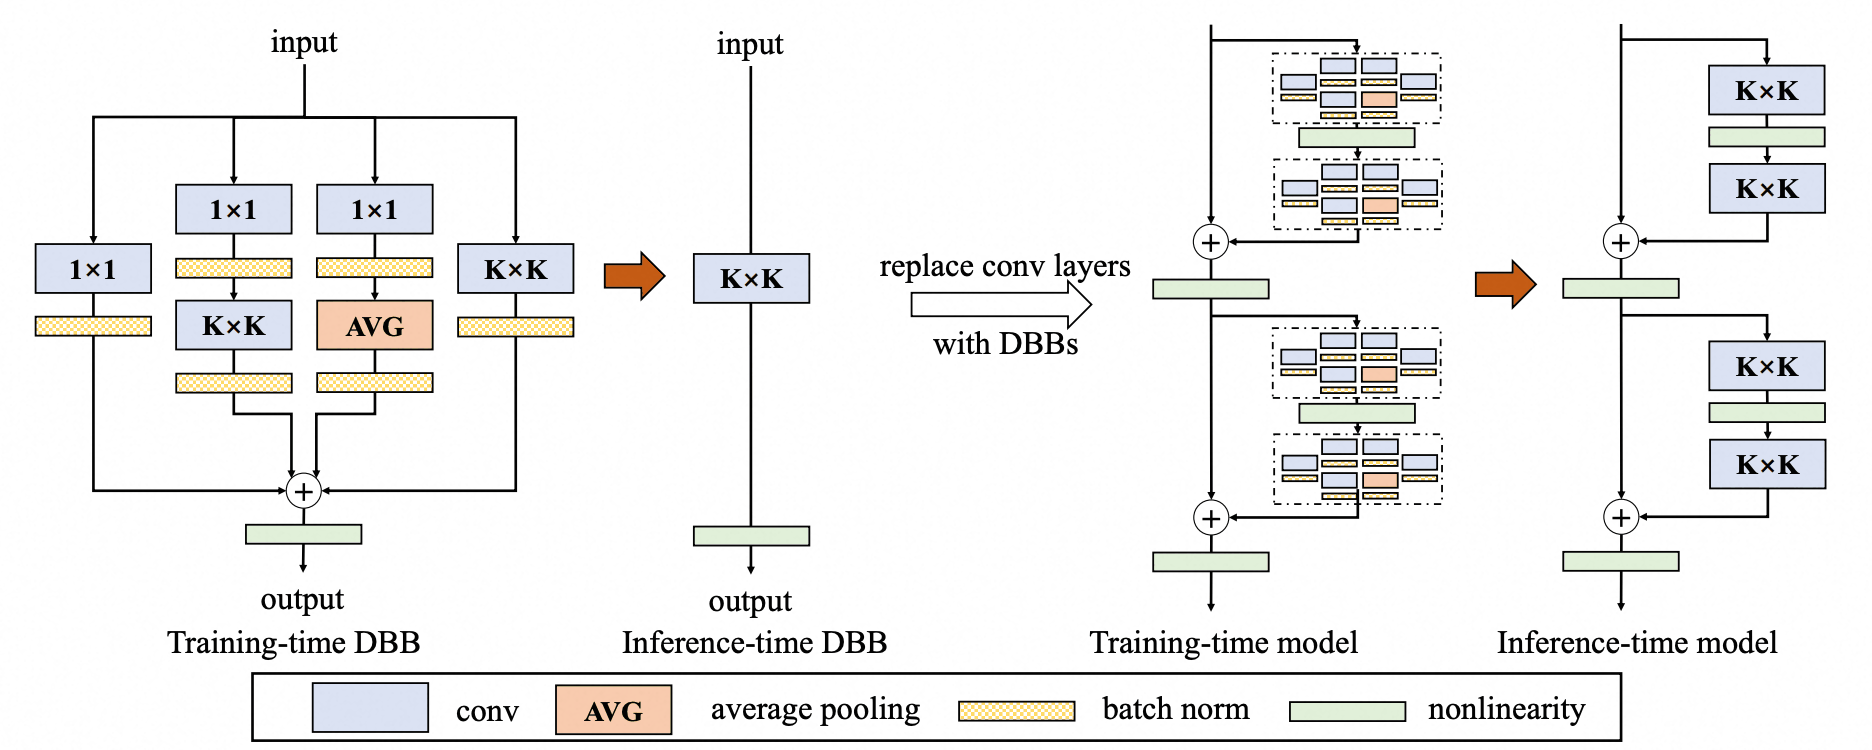
利用这些规则,DBB在训练时使用“$f\times f$ + $1\times 1$ + $1\times 1 \to f\times f$ + $1\times 1 \to$ 平均池化”四分支结构,推理时折叠为单个$f\times f$卷积,可作为任意网络中卷积层的即插即用替换,不改变推理架构。
3.5 扩大感受野:大核、多尺度与频域
第1.4节指出,靠堆叠小核积累的有效感受野只以$O(\sqrt{n})$增长。本节的三条路线分别从“直接把核做大”、“在多个尺度上分别卷积”、“在频域上操作”三个角度解决这个问题。
(1) 大核卷积
2020年之前,用多层$3\times 3$替代大核是社区的常规操作(VGG确立)。视觉Transformer的成功促使社区重新审视这一点:自注意力的优势可能主要来自大感受野而非注意力本身。ConvNeXt首先把深度卷积核放大到$7\times 7$并配合宏观架构调整追平了Swin Transformer,此后一系列工作把核尺寸继续推向极端。
⚪ RepLKNet:$31\times 31$ 大核的五条设计准则
RepLKNet系统研究了大核卷积,给出五条设计准则:
- 大核必须是深度卷积:$f\times f$稠密卷积的成本随$f^2$增长不可接受,而深度卷积的成本仅为$f^2 c$;配合合适的底层实现(按块加载的CUDA核),$31\times 31$深度卷积的实际时延可以只占整个网络的很小一部分;
- 恒等映射(shortcut)不可或缺:没有残差连接时,把核从$3$放大到$13$会降低精度;有残差连接时才能获得增益。原因是残差连接让网络隐式地包含了多种不同感受野的路径;
- 用小核做结构重参数化来补偿优化困难:训练时在$f\times f$大核旁并联一个$5\times 5$小核分支,推理时按第3.4节的规则折叠。这一步对小数据集尤其关键;
- 大核对下游任务的收益远大于分类:在ImageNet上把核从$3$放大到$31$可能只涨零点几个点,但在语义分割、目标检测上增益显著。这说明分类精度不能反映有效感受野的大小;
- 大核在小特征图上依然有效:即使核尺寸已经超过特征图尺寸(如$13\times 13$的核作用在$7\times 7$的特征图上),仍能带来增益;此时大核实际起到了编码位置相关的空间模式的作用(因为填充打破了平移等变性)。
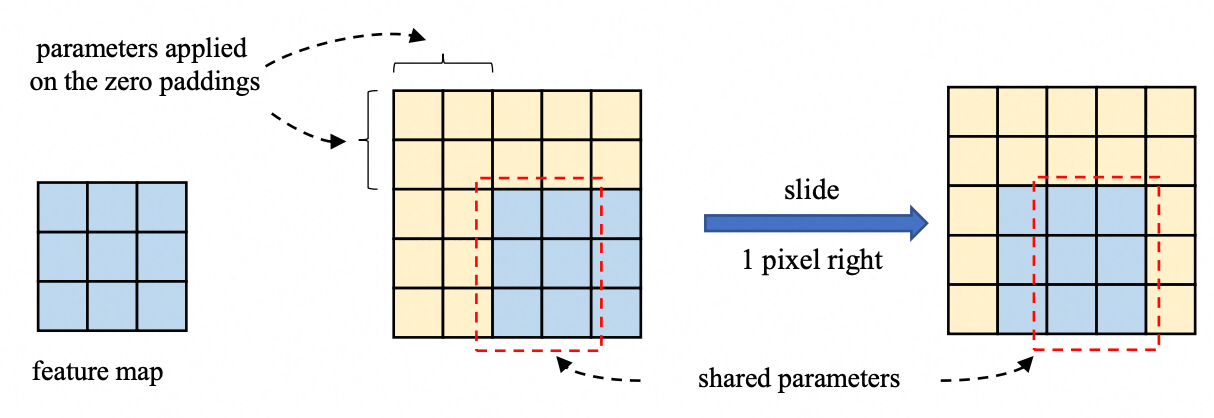
据此构建的RepLKNet用少数几个$31\times 31$深度卷积就获得了极大的有效感受野,在检测与分割上超越了同规模的Swin Transformer。
⚪ SLaK:用条形核与稀疏性突破 $51\times 51$
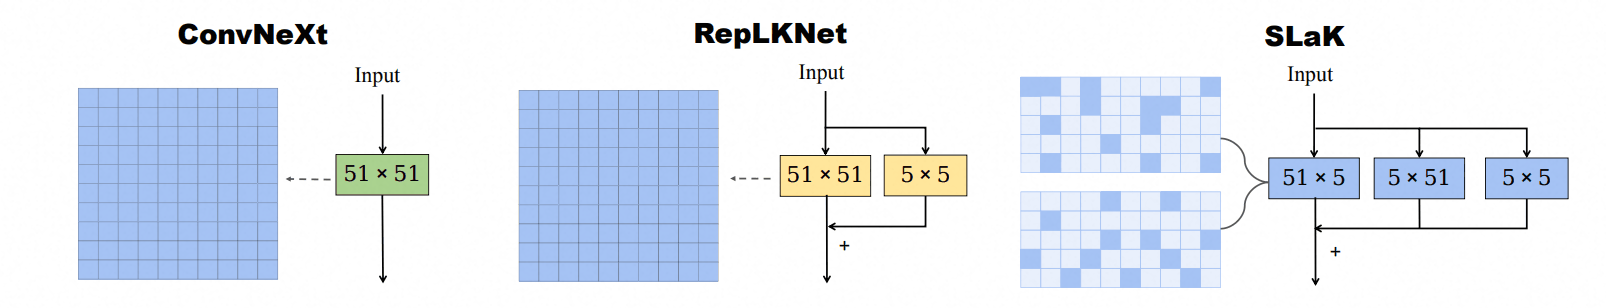
RepLKNet式的方形大核在$31\times 31$之后就开始退化。SLaK指出两个瓶颈并分别用两种稀疏性解决:
- 空间稀疏(条形核分解):把一个$f\times f$的核分解为两个并行的条形核 $f\times 5$ 与 $5\times f$(再加一个$5\times 5$分支),三者输出相加。这实际上是第3.4节空间可分离思想的并联版,参数量从$O(f^2)$降到$O(f)$,使$51\times 51$在计算上变得可行;
- 通道稀疏(动态稀疏性):把稠密的卷积核替换为稀疏核,并在训练中动态调整稀疏连接的位置(prune-and-grow);省下来的参数预算用于扩大网络宽度,从而在同等参数量下同时获得大核与宽通道。
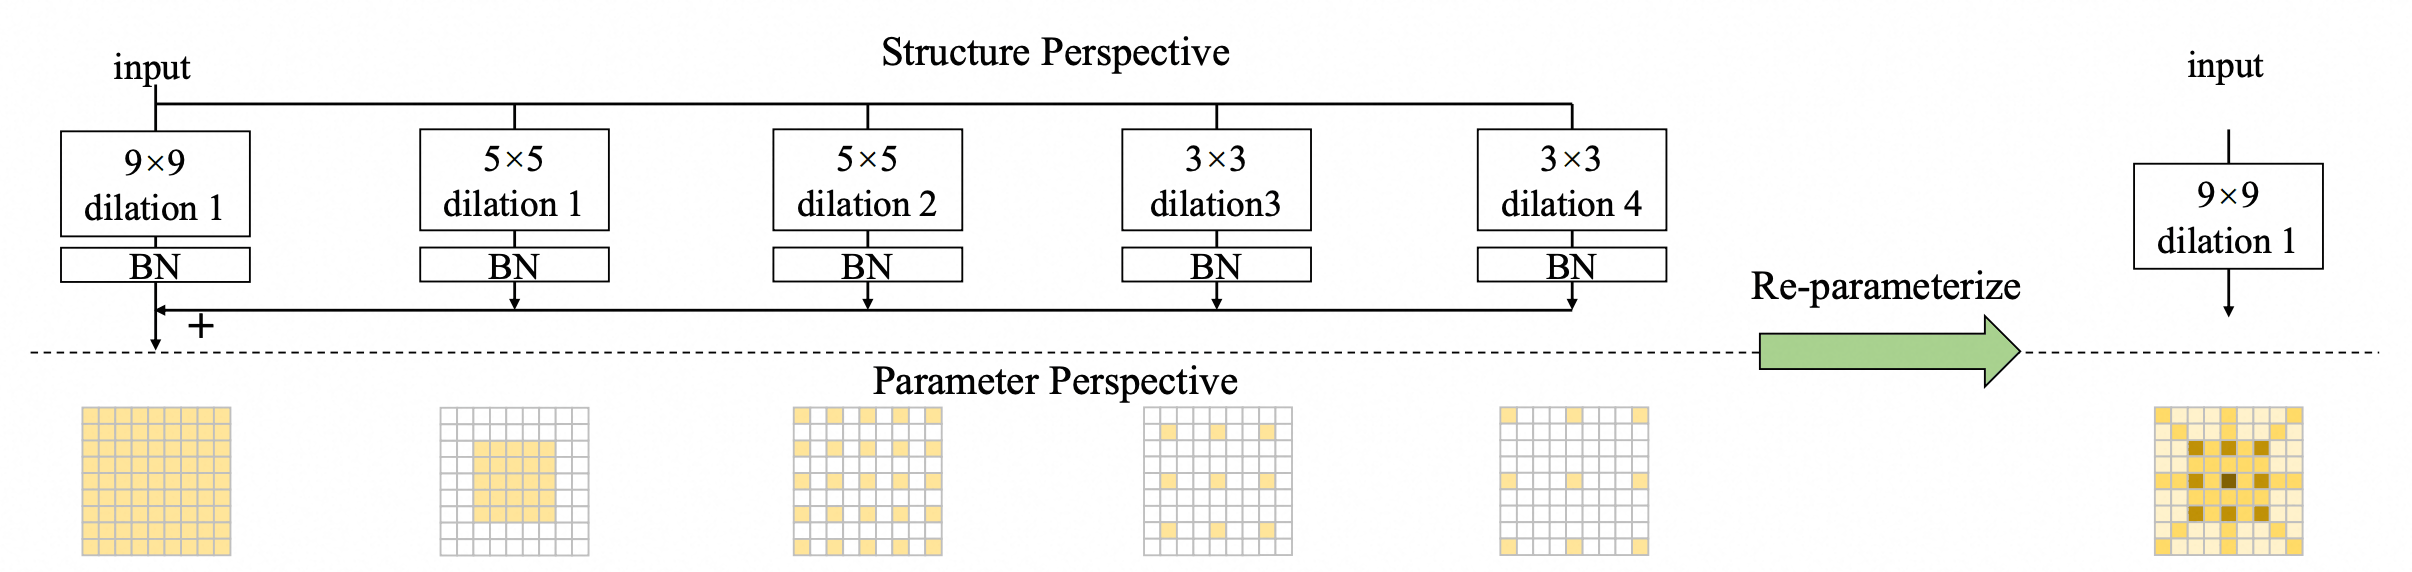
⚪ UniRepLKNet:用扩张重参数化模块合成大核
UniRepLKNet的核心贡献是扩张重参数化模块(Dilated Reparam Block)。它利用一个精确的等价关系:一个核尺寸为$k$、扩张率为$r$的扩张卷积,等价于一个尺寸为$(k-1)r+1$的稀疏大核卷积(把扩张核的元素之间插入零即可):
\[W_{\text{eq}} = \text{insert-zeros}\left(W_{k\times k},\ r\right) \in \Bbb{R}^{[(k-1)r+1] \times [(k-1)r+1]}\]因此训练时可以在一个大核分支旁并联多个“小核 + 不同扩张率”的分支(如$k=5,r=4$;$k=3,r=3$;$k=3,r=1$等),它们各自捕捉不同尺度的稀疏模式;推理时把所有分支零插值扩充到同一大核尺寸并相加,折叠成单个大核卷积。相比RepLKNet只并联一个$5\times 5$小核,这种做法在同等推理成本下注入了更丰富的多尺度先验。
UniRepLKNet还给出四条架构准则:用SE式模块补充局部/通道建模能力;用扩张重参数化模块实现大核;核尺寸应按下游任务决定(而非一味放大);扩大模型规模时增加$3\times 3$卷积的深度而不是继续放大核。它把同一套结构成功迁移到音频、视频、点云、时间序列等模态,说明“大核 + 少量层”是一种通用的感知骨架。
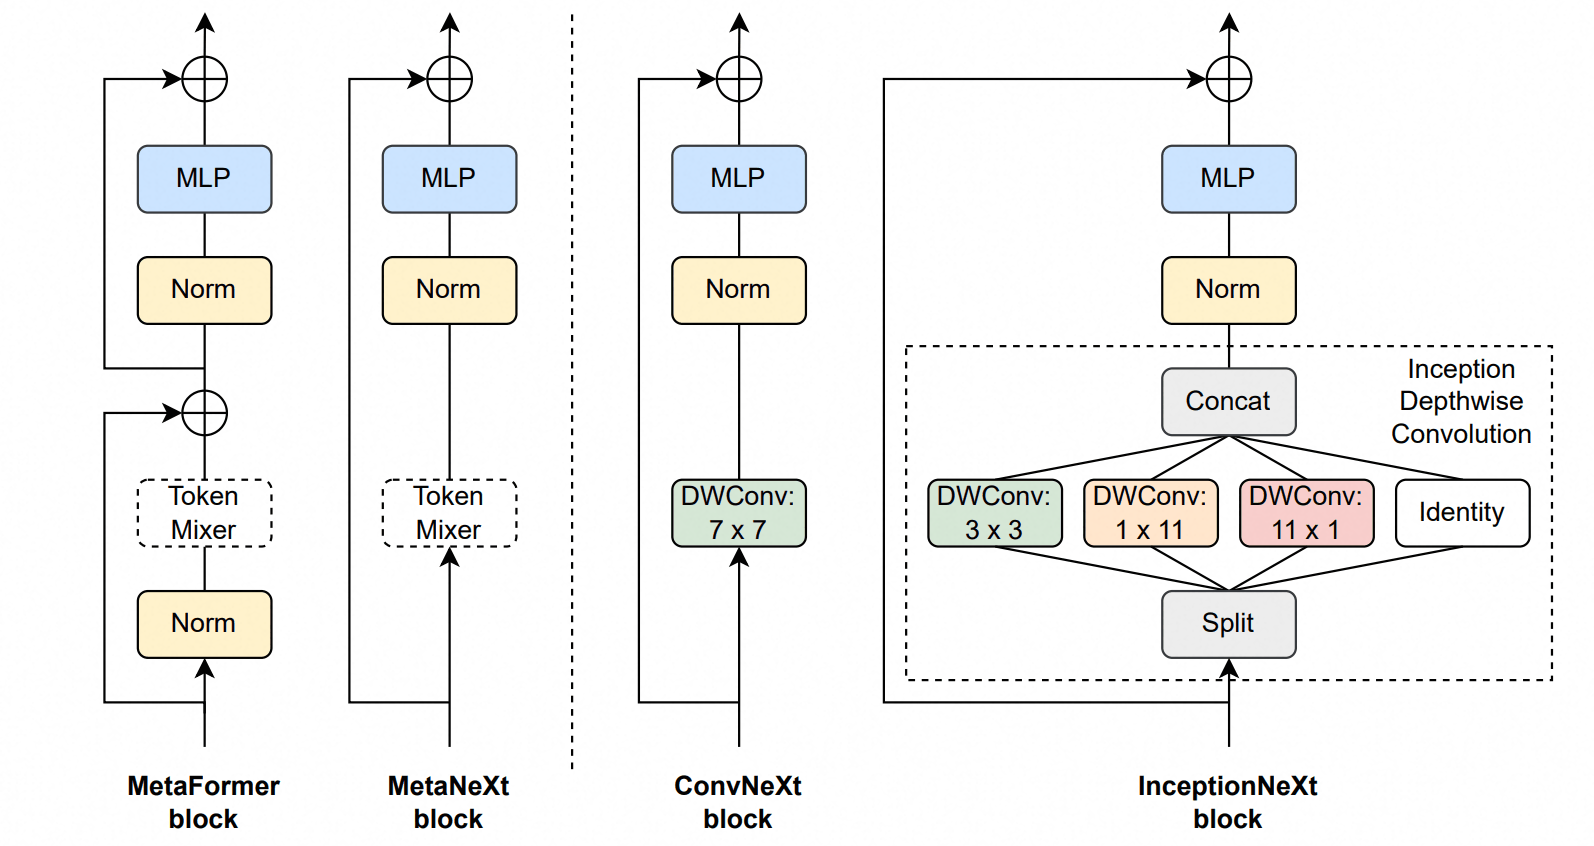
⚪ InceptionNeXt:把大核深度卷积按通道拆成四路
ConvNeXt的$7\times 7$深度卷积虽然FLOPs占比很低,却因访存受限而占据了相当比例的实际时延。InceptionNeXt借鉴Inception的分组思想,把输入通道沿通道维拆成四份,只对其中三份小分支做卷积:
\[\begin{aligned} &\left[x_{hw}, x_{w}, x_{h}, x_{id}\right] = \text{Split}(x) \\ &y = \text{Concat}\left(\text{DWConv}_{3\times 3}(x_{hw}),\ \text{DWConv}_{1\times k}(x_{w}),\ \text{DWConv}_{k\times 1}(x_{h}),\ x_{id}\right) \end{aligned}\]其中三个卷积分支各占很小的通道比例(论文取$1/8$左右),剩余大部分通道走恒等分支。这样既保留了$k\times k$级别的感受野(由$1\times k$与$k\times 1$条形核提供),又把访存量大幅降低,在GPU上取得了明显的实测加速。可以看出InceptionNeXt同时用到了第3.4节的PConv(部分通道卷积)与空间可分离(条形核)两个思想。
(2) 频域与多尺度卷积
通常的卷积操作是对时域(或称空间域)的数据执行的。频域卷积是指首先把数据转换到频率域,再在频率域中执行操作。这类方法的共同优势是:频域上的一次逐点操作对应空间域上的一次全局操作,因此能以极低的代价获得全局感受野。
⚪ 八度卷积 Octave Convolution (OctConv)
- paper:Drop an Octave: Reducing Spatial Redundancy in Convolutional Neural Networks with Octave Convolution
卷积层的特征图中存在高、低频分量。其中低频分量支撑的是图像的整体特征,是存在冗余的,在编码过程中可以节省。Octave Convolution首先构造图像特征图的线性尺度空间(scale-space)表示:
\[L(x,y;t) = g(x,y;t) * f(x,y)\]其中$g(\cdot;t)$为方差为$t$的高斯核。OctConv把原始特征的$1-\alpha$通道看作高频分量,剩余$\alpha \in [0,1]$通道经过$t=2$的高斯滤波后作为低频分量。由于低频分量是冗余的,因此把低频分量的空间尺寸设置为高频分量空间尺寸的一半(降低一个八度)。
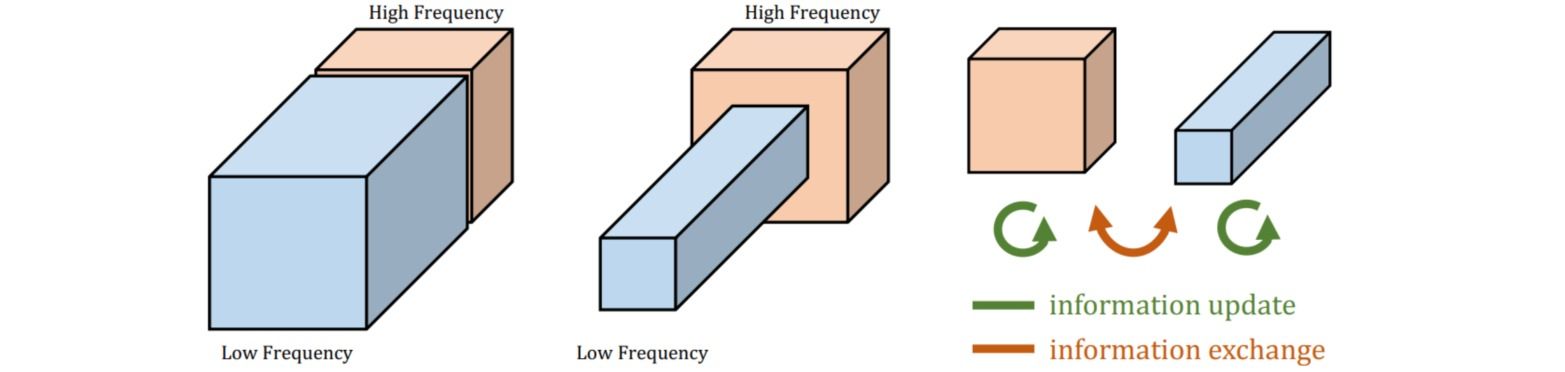
由于高/低频特征的空间尺寸不一致,把标准卷积的卷积核$W \in \Bbb{R}^{c_{in}\times c_{out} \times f \times f}$拆分成四部分:$W^{H\to H},W^{L\to L},W^{L\to H},W^{H\to L}$实现不同频率分量内部的更新和相互交互。$W^{H\to H},W^{L\to L}$处理的特征尺寸不变,因此采用标准卷积操作;$W^{H\to L}$先对特征进行平均池化,再执行标准卷积;$W^{L\to H}$则是先执行标准卷积,再对特征进行空间上采样。
\[\begin{aligned} y^H(p_0)& = \sum_{p_n \in \mathcal{R}} w^{H\to H}(p_n) \cdot x^H(p_0+p_n) \\&+ \sum_{p_n \in \mathcal{R}} w^{L\to H}(p_n) \cdot x^L\left(\lfloor \frac{p_0}{2} \rfloor +p_n\right) \\ y^L(p_0)& = \sum_{p_n \in \mathcal{R}} w^{L\to L}(p_n) \cdot x^L(p_0+p_n) \\&+ \sum_{p_n \in \mathcal{R}} w^{H\to L}(p_n) \cdot x^H\left(2 p_0+0.5 +p_n\right) \end{aligned}\]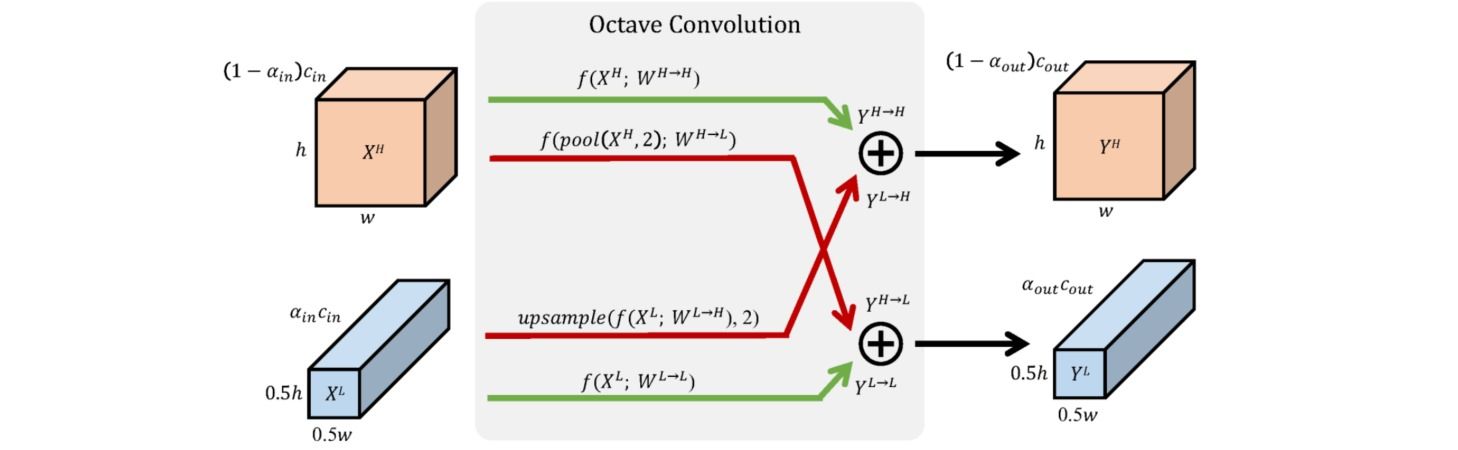
由于低频分支在半分辨率上计算,OctConv在减少约$\alpha$比例计算量的同时,还扩大了低频分支的等效感受野(同样的$f\times f$核在半分辨率上覆盖两倍的原图范围)。它是即插即用的:只需把网络中的标准卷积逐个替换,无需改动架构。
⚪ 快速傅里叶卷积 Fast Fourier Convolution (FFC)
- paper:Fast Fourier Convolution
FFC将卷积操作同时扩展到空间域和频域。其中空间域的常规卷积具有局部性和固定尺度的特性,而频域中的一个点的更新能够影响所有输入位置。FFC由两条相互连接的路径组成:一条是空间(局部)路径,负责在输入特征的部分通道上执行普通卷积;另一条是频谱(全局)路径,负责在频谱域中操作。
按比例$\alpha_{in},\alpha_{out}$把输入/输出通道划分为局部部分$X^l$与全局部分$X^g$,两条路径之间存在交叉连接:
\[\begin{aligned} Y^l &= f_l\left(X^l\right) + f_{g \to l}\left(X^g\right) \\ Y^g &= f_g\left(X^g\right) + f_{l \to g}\left(X^l\right) \end{aligned}\]其中$f_l,f_{g\to l},f_{l\to g}$都是常规卷积,而$f_g$是频谱变换单元(Spectral Transform):
\[f_g(X) = \mathcal{F}^{-1}\left(\text{ReLU}\left(\text{BN}\left(W_{1\times 1} * \mathcal{F}(X)\right)\right)\right)\]具体实现为:对输入做实数二维FFT,把复数的实部与虚部沿通道维拼接成实张量,用$1\times 1$卷积 + BN + ReLU在频域上做逐频率点的通道混合,最后做逆FFT回到空间域。由于实信号的频谱满足Hermitian对称性,只需存储一半频谱即可无损还原。
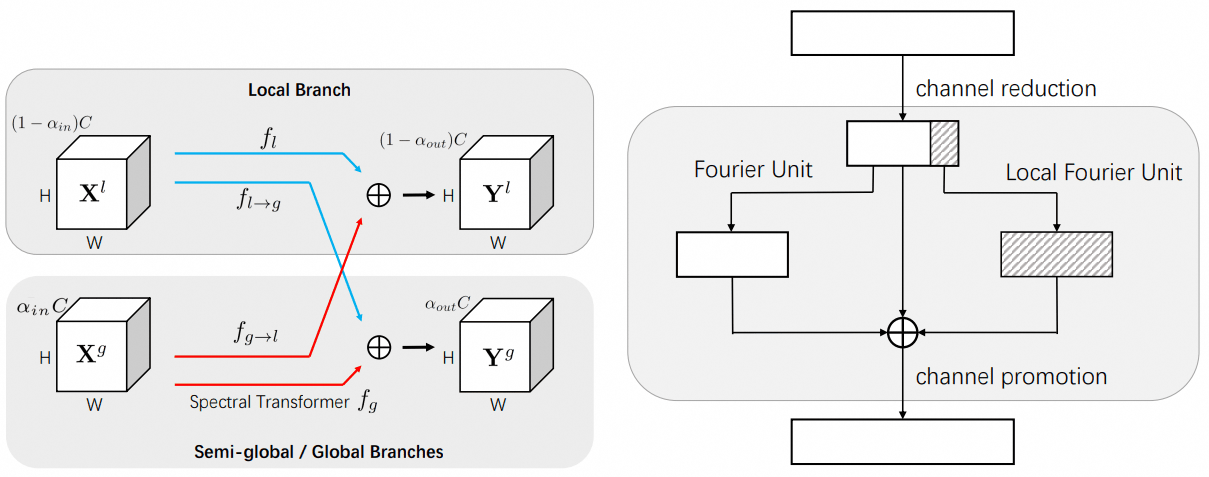
FFC还提出局部傅里叶单元(Local Fourier Unit, LFU):把特征图划分成若干块,对每块分别做频谱变换后再拼接,从而获得“半全局”的感受野,作为全局频谱路径与局部空间路径之间的过渡。
一个重要应用是图像修复:LaMa用FFC作为骨干,凭借单层即覆盖全图的感受野,在大面积掩码修复与周期性纹理(砖墙、栅栏)上取得了显著优势。
⚪ 小波卷积 Wavelet Convolution (WTConv)
傅里叶变换是全局的,完全丢失了空间定位信息;而小波变换同时具有频率与空间定位能力,更适合与卷积结合。WTConv先对输入进行Haar小波变换,将输入分解为不同频率的分量,然后在这些分量上分别进行小卷积核的深度卷积,最后通过逆小波变换将结果重构:
\[Y = \text{IWT}\left(\text{Conv}\left(W,\ \text{WT}(X)\right)\right)\]Haar小波变换用四个$2\times 2$、步长为$2$的固定深度卷积核实现,分别提取低频与三个方向的高频分量:
\[f_{LL} = \frac{1}{2}\begin{bmatrix} 1 & 1 \\ 1 & 1 \end{bmatrix},\quad f_{LH} = \frac{1}{2}\begin{bmatrix} 1 & 1 \\ -1 & -1 \end{bmatrix}\\ f_{HL} = \frac{1}{2}\begin{bmatrix} 1 & -1 \\ 1 & -1 \end{bmatrix},\quad f_{HH} = \frac{1}{2}\begin{bmatrix} 1 & -1 \\ -1 & 1 \end{bmatrix}\]由于逆变换是转置卷积、且$\text{IWT}(\text{WT}(X))=X$,整个算子是良定义的。关键性质是:每做一级小波变换,空间尺寸减半,因此同一个$f\times f$核在第$\ell$级上的等效感受野扩大$2^{\ell}$倍:感受野随级数指数增长,而参数量只线性增长。多级情形下对低频分量递归分解,各级结果按逆变换逐级重构相加。
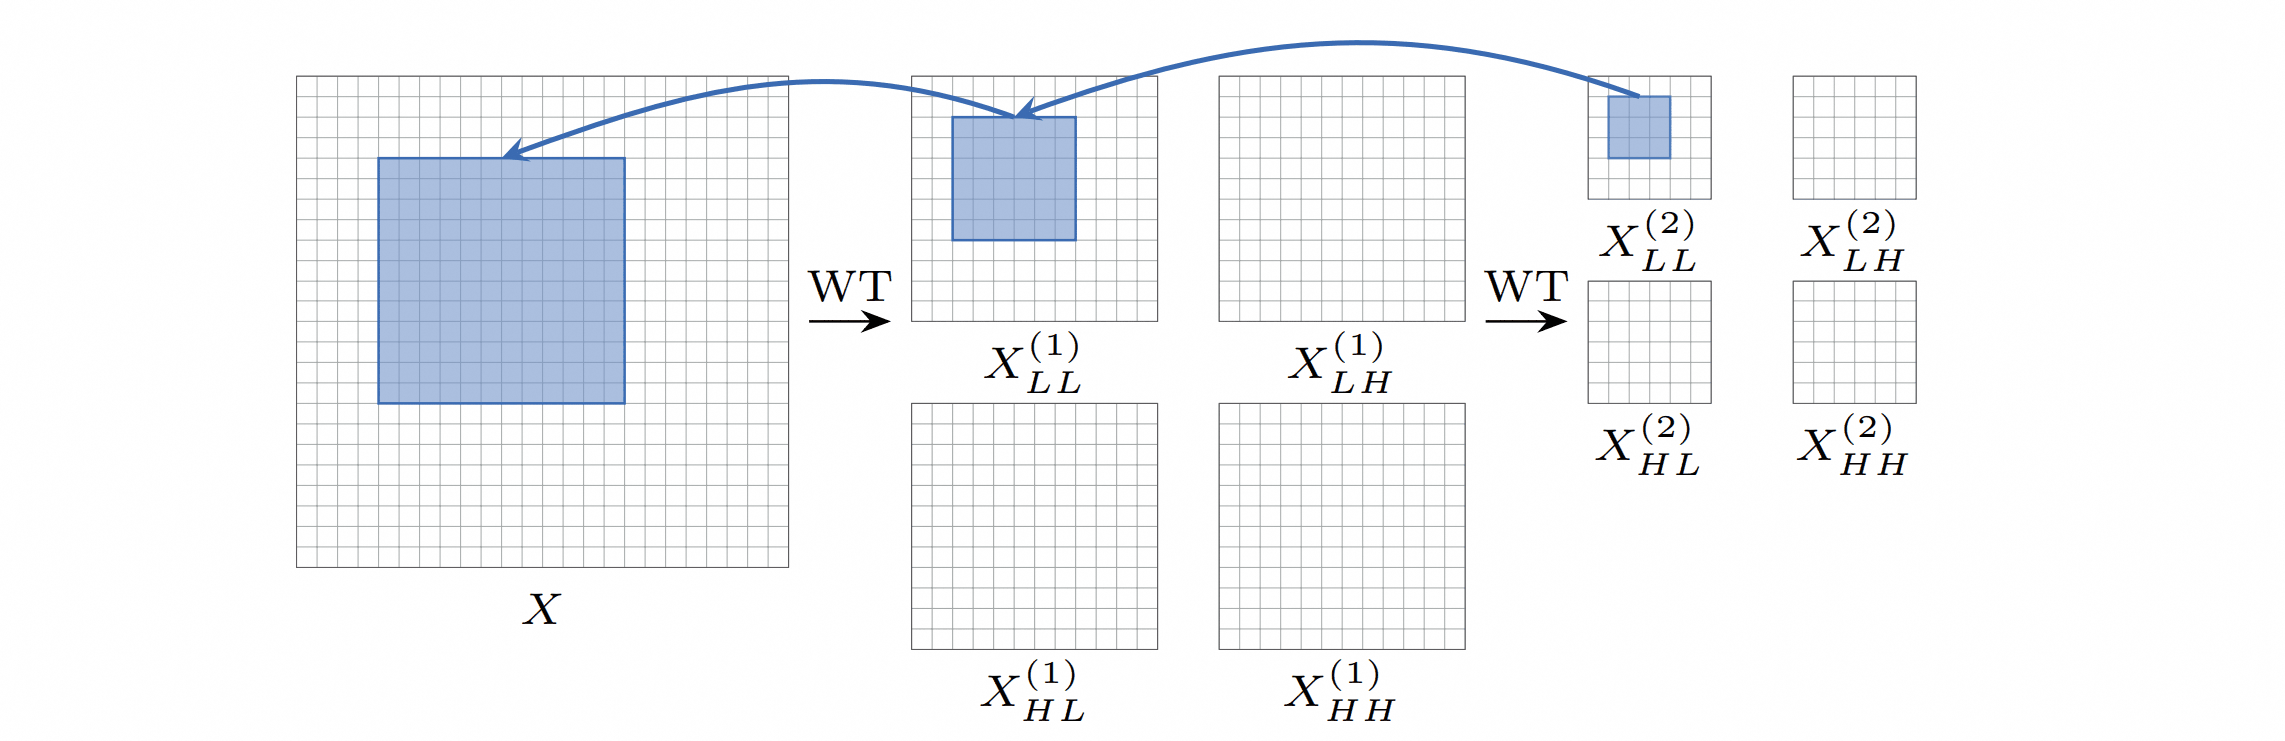
$\ell$级WTConv的计算量为:
\[\text{FLOPs} = C \cdot f_W \cdot f_H \cdot \left(N_W N_H + \sum_{i=1}^{\ell} 4 \cdot \frac{N_W}{2^i}\cdot \frac{N_H}{2^i}\right)\]由于$\sum_i 4/4^i < 4/3$,多级分解带来的额外计算量是有界的(不超过原始的$4/3$倍)。WTConv可以直接替换ConvNeXt、MobileNetV2中的深度卷积,在几乎不增加成本的前提下提升精度、增强对形状(而非纹理)的偏好与对图像退化的鲁棒性。
⭐ 讨论:三条扩大感受野的路线
| 路线 | 机制 | 感受野增长 | 参数量增长 | 代表方法 |
|---|---|---|---|---|
| 稀疏采样 | 在核内插入空洞 | 线性于$d$ | 不增长 | 扩张卷积、HDC、IC-Conv |
| 直接放大核 | 增大$\mathcal{R}$ | 线性于$f$ | 线性(条形/深度)至平方(稠密) | RepLKNet, SLaK, UniRepLKNet, InceptionNeXt |
| 变换域操作 | 在低分辨率/频域上卷积 | 指数于级数$\ell$ | 线性于$\ell$ | OctConv, FFC, WTConv |
三条路线并不互斥,且各有明确的适用条件:
- 扩张卷积成本最低,但存在网格效应,适合密集预测中作为保持分辨率的手段,需配合HDC准则;
- 大核卷积能提供密集且各向同性的有效感受野,是目前分类/检测/分割骨干网络的主流选择,但必须配合残差连接与小核重参数化,且依赖高效的深度卷积实现;
- 变换域方法在感受野/参数量的权衡上最优(指数 vs 线性),且天然带有频率先验,特别适合纹理、周期性结构与图像修复;代价是引入了变换算子,对部署引擎的支持度要求更高。
需要提醒的是,“感受野越大越好”并不成立:RepLKNet的第$4$条准则说明分类任务对感受野并不敏感,而UniRepLKNet明确建议核尺寸应由下游任务决定。过大的感受野会稀释局部细节,因此现代设计几乎都采用“大核提供全局上下文 + 小核/SE提供局部细节”的混合结构。
3.6 注入位置与坐标信息
⚪ CoordConv:把坐标作为额外输入通道
卷积层具有平移等变性,这在分类任务中是优点,但在需要坐标变换的任务中是缺陷:论文构造了一个极简的“Supervised Coordinate Classification”任务:把笛卡尔坐标$(i,j)$映射为一张只有该位置为$1$的one-hot图像,结果标准卷积网络甚至无法拟合训练集。原因是平移等变性使卷积原则上无法区分在图像的哪个位置。
CoordConv的解决方案极其简单:在卷积之前,把两个(或三个)常量通道拼接到输入特征上:分别是归一化到$[-1,1]$的$x$坐标、$y$坐标,以及可选的极坐标半径
\[r = \sqrt{\left(x - x_c\right)^2 + \left(y - y_c\right)^2}\]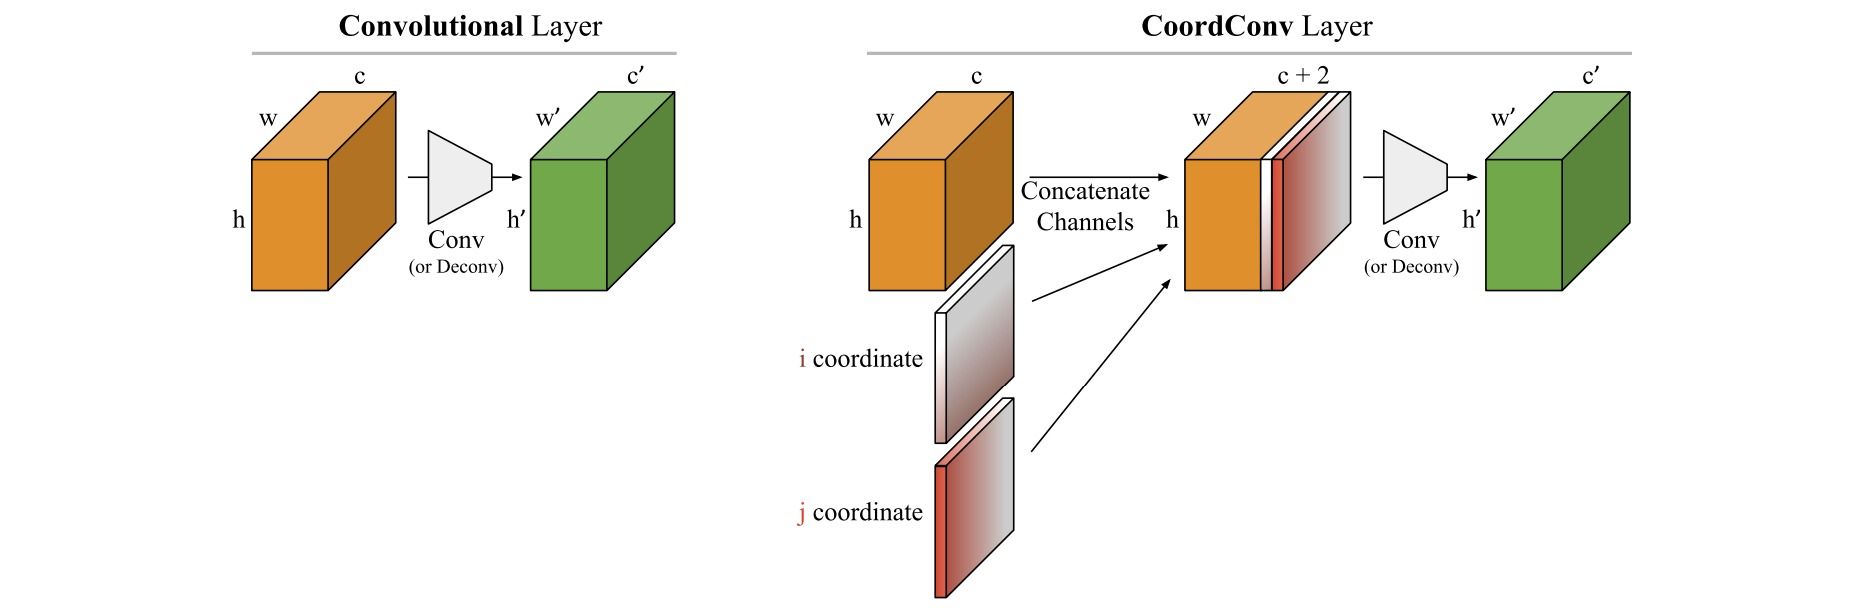
拼接之后再做标准卷积。若坐标通道对应的权重被学成$0$,CoordConv就退化为标准卷积(保留平移等变性);若权重非零,则网络获得了显式的位置感知能力。它的额外参数量仅为$f^2 c’ \cdot 2$,可以忽略。
点击展开代码
class AddCoords(nn.Module):
    def forward(self, x):
        b, _, h, w = x.size()
        # 归一化到 [-1, 1] 的坐标通道
        yy = torch.linspace(-1, 1, h, device=x.device).view(1, 1, h, 1).expand(b, 1, h, w)
        xx = torch.linspace(-1, 1, w, device=x.device).view(1, 1, 1, w).expand(b, 1, h, w)
        return torch.cat([x, xx, yy], dim=1)

class CoordConv(nn.Module):
    def __init__(self, in_channels, out_channels, **kwargs):
        super().__init__()
        self.addcoords = AddCoords()
        self.conv = nn.Conv2d(in_channels + 2, out_channels, **kwargs)

    def forward(self, x):
        return self.conv(self.addcoords(x))
CoordConv在坐标回归、目标检测的框回归、图像翻译与生成模型中都有明显收益;在纯分类任务上收益很小,因为分类恰恰需要平移不变性。
⚪ 卷积网络中的隐式位置信息
值得注意的是,即使不用CoordConv,卷积网络也并非完全没有位置感知能力。位置信息通过两条“泄漏”路径进入特征:
- 零填充:边界处的卷积会看到人为补入的零,其响应模式与图像内部不同。这个信号会在深层被逐步放大,使网络能够粗略推断“距离边界有多远”。这也解释了第3.5节RepLKNet准则$5$的现象:当核尺寸接近特征图尺寸时,几乎每个输出位置的填充模式都不同,大核实际上编码了绝对位置;
- 全局池化前的空间偏置:若网络在训练集上遇到的目标位置分布不均匀(如天空总在上方),卷积核会隐式地学习到这种统计偏置。
因此在需要严格平移等变性的场景(如全卷积的图像复原)中,反而应当避免零填充(使用反射/复制填充),或采用无填充的设计。
4. 卷积的高效实现
前面讨论的都是“卷积算什么”,本章简述“卷积怎么算得快”。理解这些实现细节有助于解释很多看似矛盾的现象(例如为什么$3\times 3$卷积在GPU上高效,而FLOPs更低的深度卷积却很慢)。
(1) im2col + GEMM
这是最通用的实现方式,也是本文第2.3节介绍转置卷积时用到的视角。im2col把卷积转化为矩阵乘法:
- 把输入特征中每个滑动窗口覆盖的$f^2 c$个元素展平为一列,所有$n’^2$个窗口拼成一个$\left(f^2c\right)\times n’^2$的矩阵;
- 把$c’$个卷积核各自展平为一行,拼成一个$c’ \times \left(f^2c\right)$的矩阵;
- 两者做一次通用矩阵乘法(GEMM),得到$c’ \times n’^2$的输出,再reshape回特征图形状。
它的优势是可以直接复用高度优化的BLAS库(GEMM是计算机体系结构中被优化得最彻底的算子)。代价是内存膨胀:展开后的矩阵$\tilde{X}$比原输入大$f^2$倍(相邻窗口的重叠元素被重复存储)。因此实际库中会使用隐式im2col(implicit GEMM):不真正物化\(\tilde{X}\),而是在GEMM的取数阶段按索引直接从原始张量读取。
(2) FFT 卷积
根据卷积定理,空间域的卷积等价于频域的逐点乘积:
\[x * w = \mathcal{F}^{-1}\left(\mathcal{F}(x) \odot \mathcal{F}(w)\right)\]因此可以先对输入与卷积核做零填充到相同尺寸、各做一次FFT,逐点相乘后再做一次逆FFT。复杂度从直接计算的$O\left(HW f^2\right)$降为$O\left(HW \log HW\right)$,与卷积核尺寸无关。
实用要点:
- 卷积层实际做的是互相关(第1.1节),因此频域相乘时需要对核的频谱取共轭,或先把核在空间上翻转;
- 需要零填充到$H+f-1$以避免循环卷积产生的环绕效应;
- FFT引入的常数因子与复数运算开销较大,只有当$f$足够大(经验上$f \geq 9 \sim 11$)时才真正划算,因此它在深度学习中主要用于大核卷积与频域卷积(第3.5节的FFC);
- 多通道情形下,各输入通道的频谱只需计算一次,因此通道数越多FFT越划算。
详细推导见快速傅里叶变换与卷积定理。
(3) Winograd 卷积
Winograd算法用“增加加法、减少乘法”的方式加速小核卷积(正好覆盖FFT不划算的区间),是cuDNN中$3\times 3$卷积的默认实现之一。
Winograd算法的核心思想源于多项式求值与插值的技巧,其理论基础是中国剩余定理(CRT)在多项式环上的应用。该定理指出,两个多项式$g(x)$和$d(x)$的乘积$y(x)=g(x)d(x)$,可以通过以下三步计算:
- 求值 (Evaluation):选取一组互不相同的点${p_0, p_1, \dots, p_k}$,分别计算$g(p_i)$和$d(p_i)$。
- 点积 (Point-wise Product):计算$y(p_i) = g(p_i) \cdot d(p_i)$。
- 插值 (Interpolation):根据点对${(p_0, y(p_0)), \dots, (p_k, y(p_k))}$,通过拉格朗日插值或其他方法重构出唯一的结果多项式$y(x)$。
线性卷积运算在数学上等价于多项式乘法。Winograd算法利用这一性质,通过线性变换将卷积核$g$和输入数据$d$投影到一个Winograd域。在这个域中,原先的卷积运算被简化为代价极低的逐元素乘积$\odot$。最后,通过一次逆变换,将逐元素乘积的结果投影回正常空间,得到最终的卷积输出$Y$。
🌰 一维示例:$F(2, 3)$
以一维卷积$F(m, r)$为例,其中输出块大小$m=2$,卷积核大小$r=3$。该配置表示使用长度为3的核在长度为4的输入上滑动,产生2个输出。
- 输入: $d = [d_0, d_1, d_2, d_3]^\top$
- 卷积核: $g = [g_0, g_1, g_2]^\top$
- 输出: $y = [y_0, y_1]^\top$
直接卷积计算如下,需要 $2 \times 3 = 6$ 次乘法: \(\begin{aligned} y_0 &= d_0g_0 + d_1g_1 + d_2g_2 \\ y_1 &= d_1g_0 + d_2g_1 + d_3g_2 \end{aligned}\)
Winograd $F(2,3)$ 算法将计算过程重构为矩阵形式,需要 $m+r-1 = 4$ 个中间点。
\[Y = A^\top \left[ (Gg) \odot (B^\top d) \right]\]其中,变换矩阵$G, B^\top, A^\top$由算法推导得出:
\[B^\top = \begin{bmatrix} 1 & 0 & -1 & 0 \\ 0 & 1 & 1 & 0 \\ 0 & -1 & 1 & 0 \\ 0 & 1 & 0 & -1 \end{bmatrix}, \quad G = \begin{bmatrix} 1 & 0 & 0 \\ 1/2 & 1/2 & 1/2 \\ 1/2 & -1/2 & 1/2 \\ 0 & 0 & 1 \end{bmatrix}, \quad A^\top = \begin{bmatrix} 1 & 1 & 1 & 0 \\ 0 & 1 & -1 & -1 \end{bmatrix}\]计算步骤分解:
- 变换 (Evaluation):计算卷积核和输入的Winograd域表示。 \(u = Gg = \begin{bmatrix} g_0 \\ (g_0+g_1+g_2)/2 \\ (g_0-g_1+g_2)/2 \\ g_2 \end{bmatrix}, \quad v = B^\top d = \begin{bmatrix} d_0-d_2 \\ d_1+d_2 \\ d_1-d_2 \\ d_1-d_3 \end{bmatrix}\)
- 点积 (Point-wise Product):执行逐元素乘积,这是算法中仅有的4次乘法。 \(u \odot v = \begin{bmatrix} g_0(d_0-d_2) \\ \frac{1}{4}(g_0+g_1+g_2)(d_1+d_2) \\ \frac{1}{4}(g_0-g_1+g_2)(d_1-d_2) \\ g_2(d_1-d_3) \end{bmatrix}\)
- 逆变换 (Interpolation):通过$A^\top$矩阵将结果还原。 \(Y = A^\top (u \odot v)\)
此过程将6次乘法和2次加法,转化为了4次乘法和11次加法/减法(不计常数缩放)。在现代处理器中,加法和常数位移(如除以2)的延迟和吞吐量远优于浮点乘法,因此总体计算效率得到提升。
🌰 二维示例:$F(2\times 2, 3\times 3)$
二维Winograd算法利用了变换的可分离性,可以将二维卷积的变换分解为沿两个维度的一维变换。对于$F(m\times m, r\times r)$,其矩阵形式为: \(Y = A^\top\left[\left(G\, g\, G^\top\right) \odot \left(B^\top d\, B\right)\right] A\) 其中 $g$ 为 $r\times r$ 卷积核,$d$ 为 $(m+r-1)\times(m+r-1)$ 的输入块。
对于$F(2\times 2, 3\times 3)$,输入块大小为 $4\times 4$,输出块大小为 $2\times 2$。
- 核变换 $U = G g G^T$: $g$ 是 $3\times 3$ 卷积核。首先计算 $Gg$,将$3\times 3$的 $G$ 矩阵应用于$g$的每一列,得到一个$4\times 3$的中间矩阵。再计算 $(Gg)G^T$,将$3\times 4$的 $G^T$ 矩阵应用于中间矩阵的每一行,得到最终的 $4\times 4$ 矩阵 $U$。
- 输入变换 $V = B^T d B$: $d$ 是 $4\times 4$ 输入块。通过类似的两次矩阵乘法,将$d$变换为 $4\times 4$ 的矩阵 $V$。
- 点积 $U ⊙ V$: 将两个 $4\times 4$ 矩阵 $U$ 和 $V$ 进行逐元素相乘,共需 $4\times 4 = 16$ 次浮点乘法。
- 输出变换 $Y = A^T (U ⊙ V) A$: 通过两次逆变换,将 $4\times 4$ 的点积结果还原为 $2\times 2$ 的输出块 $Y$。
直接卷积每个输出点需要 $3\times 3=9$ 次乘法,总计 $2^2 \times 3^2 = \mathbf{36}$ 次乘法。 Winograd核心计算仅需 $\mathbf{16}$ 次乘法。理论乘法加速比: $36 / 16 = \mathbf{2.25}$。
实用要点:
- 输出块越大(如$F(4\times 4, 3\times 3)$)理论加速比越高,但变换矩阵中会出现更多分数,数值误差随之增大,因此实际库通常只用到$F(2\times 2,3\times 3)$或$F(4\times 4,3\times 3)$;
- Winograd只适用于步长为$1$、扩张率为$1$的小核卷积。这解释了为什么RepVGG(第3.4节)坚持只用$3\times 3$卷积:它是Winograd支持最好的算子,实测吞吐远高于FLOPs相当的其它结构。
(4) 深度卷积与大核卷积的实现要点
- 深度卷积无法用im2col + GEMM高效实现(每个通道的GEMM都退化为矩阵-向量乘,算术强度极低)。高效实现需要专用核:把整个通道的特征块加载到片上内存后一次性完成所有窗口的计算,从而把访存量从$O(f^2 n^2)$降到$O(n^2)$;
- 大核深度卷积在通用库中支持很差(cuDNN对$f>7$几乎没有优化),这正是“大核很慢”这一误解的来源。RepLKNet作者提供的块级实现(后被并入MMCV等库)使$31\times 31$深度卷积的时延接近于其FLOPs应有的水平;
- 动态卷积(第3.2节)由于批内权重不同,只能通过“折叠批维度为分组”的技巧调用组卷积,这会显著降低GEMM效率,是它实测收益低于理论预期的主要原因;
- 可变形卷积的瓶颈在于不规则访存(双线性插值的四个邻居位置随输入变化,无法预取)。DCNv4的主要贡献正是通过复用线程内已读入的数据把访存量降下来。