Regularization in Deep Learning.
深度神经网络几乎总是过参数化的:参数量往往数倍甚至数千倍于训练样本数。这样的模型有能力把训练集完全记住(哪怕标签是随机打乱的),因此单纯最小化训练误差并不能保证在未见数据上表现良好。正则化(regularization)就是为了弥合训练误差与泛化误差之间的这道缝隙而存在的一整套技术。
本文首先讨论正则化要解决的问题以及它起作用的两条基本路径,然后按“约束目标函数 / 约束网络结构 / 约束优化过程”三条线索系统梳理主流方法,并在最后讨论这些方法之间的内在联系。
- 什么是正则化
- (1) 过拟合与泛化
- (2) 偏差-方差分解
- (3) 正则化的两条路径
- 正则化方法
- 2.1 约束目标函数
- 2.2 约束网络结构
- 2.3 约束优化过程
- 2.4 正则化方法之间的关系
符号约定:全文用$\theta$表示模型的全体参数,用$w$表示参数向量、$W$表示参数矩阵($W_l$为第$l$层的权重);用\(\mathcal{L}\)表示损失函数(\(\mathcal{L}(x,y;\theta)\)为单样本损失,\(L(\theta)\)为数据集上的平均损失);用$\lambda$表示正则化强度系数、$\eta$或$\alpha$表示学习率;用$N$表示样本数、$K$表示类别数、$L$表示网络层数;用$p$统一表示“丢弃”概率(保留概率为$1-p$);用\(\|\cdot\|\)表示$L_2$范数,\(\|\cdot\|_F\)表示矩阵的Frobenius范数,\(\|\cdot\|_2\)在作用于矩阵时表示谱范数;用$\odot$表示逐元素乘法。
1. 什么是正则化
(1) 过拟合与泛化
深度学习所处理的问题可以拆成两个:优化(optimization)问题是指在已有的数据集上实现最小的训练误差;泛化(generalization)问题是指在未经过训练的数据集(通常假设与训练集同分布)上实现最小的泛化误差(generalization error)。
记数据的真实分布为\(\mathcal{D}\),训练集\(\{(x_n,y_n)\}_{n=1}^N\)是从\(\mathcal{D}\)中独立采样得到的。优化过程最小化的是经验风险:
\[L(\theta) = \frac{1}{N}\sum_{n=1}^N \mathcal{L}(x_n,y_n;\theta)\]而真正关心的是期望风险:
\[R(\theta) = \mathbb{E}_{(x,y)\sim \mathcal{D}}\left[\mathcal{L}(x,y;\theta)\right]\]两者之差\(R(\theta)-L(\theta)\)称为泛化间隙(generalization gap)。深度神经网络具有很强的拟合能力,因此$L(\theta)$可以被压得很低,但泛化间隙可能很大,这种现象就是过拟合(overfitting)。
一个关键的实验事实是:Understanding deep learning requires rethinking generalization指出,标准的卷积网络可以把带完全随机标签的CIFAR-10训练到零训练误差。这说明经典的容量度量(VC维、Rademacher复杂度)无法解释深度网络的泛化行为,也说明显式正则化项不是泛化的必要条件——去掉权重衰减、Dropout和数据增强后网络依然能泛化,只是变差一些。因此现代观点认为:真正的泛化能力主要来自优化算法的隐式偏好(见第2.4节),显式正则化只是在此之上的调节手段。
(2) 偏差-方差分解
对于平方损失,期望风险可以做经典的偏差-方差分解。记\(\bar{f}(x)=\mathbb{E}_{\mathcal{D}}[f_{\theta}(x)]\)为在所有可能训练集上模型预测的平均,$f^{*}(x)$为最优预测,则:
\[\begin{aligned} \mathbb{E}_{\mathcal{D}}\left[\left(f_{\theta}(x)-f^*(x)\right)^2\right] &= \underbrace{\left(\bar{f}(x)-f^*(x)\right)^2}_{\text{偏差}^2} + \underbrace{\mathbb{E}_{\mathcal{D}}\left[\left(f_{\theta}(x)-\bar{f}(x)\right)^2\right]}_{\text{方差}} \end{aligned}\]- 偏差(bias)衡量模型假设空间与真实函数的系统性差距,模型容量不足时偏差大(欠拟合);
- 方差(variance)衡量模型对训练集随机性的敏感程度,模型容量过大时方差大(过拟合)。
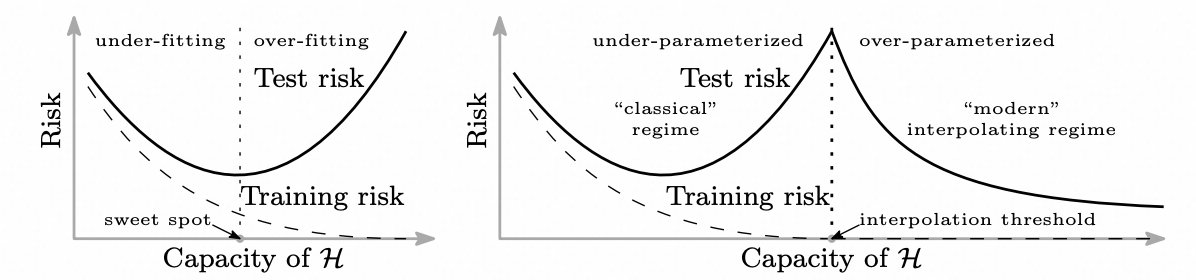
绝大多数正则化方法的作用机制都可以概括为:以少量偏差的增加换取方差的显著下降。这个视角也解释了为什么正则化过强反而有害:一旦偏差的增量超过方差的减量,泛化误差就会回升。
需要注意的是,经典的“U型”偏差-方差曲线在深度学习中并不完整。双下降(double descent)现象表明,当模型容量继续增大越过插值阈值后,测试误差会再次下降,这也是“更大的模型往往泛化更好”的经验来源。
(3) 正则化的两条路径
尽管正则化方法数量众多,它们起作用的机制基本只有两条路径:
- 限制模型复杂度:直接缩小假设空间,或让优化器偏好简单的解。典型代表是各种范数惩罚($L_1$、$L_2$、$L_0$、谱范数)、参数共享、Early Stop。这条路径对应“结构风险最小化”的经典思想:
- 引入噪声:在输入、隐藏层、参数、标签或梯度上注入随机扰动,迫使模型对扰动不敏感。典型代表是数据增强、Dropout、标签平滑、随机深度、SGD本身的采样噪声。这条路径可以统一写成对扰动分布\(\mathcal{P}\)求期望:
这两条路径在数学上常常是等价的:对扰动求期望做Taylor展开后,一阶项通常消失,二阶项就变成了一个复杂度惩罚。第2.4节会给出几个具体的等价关系(Dropout$\Leftrightarrow L_2$、对抗训练$\Leftrightarrow$梯度惩罚、Early Stop$\Leftrightarrow L_2$)。
2. 正则化方法
本文按正则化作用的位置将方法分为三类:
- 约束目标函数:在目标函数中增加关于模型参数(或其函数)的正则化项,包括$L_2$正则化、$L_1$正则化、弹性网络正则化、$L_0$正则化、谱正则化、正交与自正交性正则化、WEISSI正则化、梯度惩罚(Jacobian/Hessian正则化)。
- 约束网络结构:在网络的前向计算中引入随机性或结构限制,包括Dropout及其系列方法(Gaussian Dropout、DropConnect、Spatial Dropout、DropBlock、WCD、R-Drop)、随机深度与随机路径(DropPath、LayerDrop、ShakeDrop、Token Dropping)。
- 约束优化过程:在优化过程中施加额外步骤,包括数据增强(Cutout、Mixup、CutMix、RandAugment)、梯度裁剪、Early Stop、标签平滑、权重衰减(AdamW)、变分信息瓶颈、虚拟对抗训练、Flooding、SAM、权重平均。
此外还有一类隐式正则化(implicit regularization),它并不由使用者主动添加,而是优化算法本身自带的偏好,将在第2.4节集中讨论。
2.1 约束目标函数
这一族方法在损失函数上追加一个只与参数(或参数的函数)有关的惩罚项$\Omega(\theta)$,是最古典、也最容易分析的正则化形式。它们的差别在于用什么来度量参数的大小:向量范数、矩阵范数、还是参数之间的几何关系。
⚪ L2正则化:最常用的范数惩罚
$L_2$正则化通过约束参数的$L_2$范数(L2-norm)减小过拟合。带有$L_2$正则化的优化问题可写作:
\[\theta^*= \mathop{\arg\min}_{\theta} \frac{1}{N} \sum_{n=1}^{N} {\mathcal{L}(x_n,y_n;\theta)}+\lambda ||w||_2^2\]$L_2$正则化把参数往原点方向拉,使参数整体变小但通常不会精确等于零,因此得到的解是稠密的。从函数的角度看,参数更小意味着网络的Lipschitz常数更小,输出对输入扰动更不敏感。
在实践中要注意两点:偏置项通常不做正则化(偏置只有一个自由度、不与输入相乘,惩罚它容易引入欠拟合);归一化层的缩放/平移参数通常也不做正则化。
下面从三个角度理解$L_2$正则化。
⭐ 讨论:L2正则化等价于约束参数矩阵的Frobenius范数
若将模型参数表示为矩阵$W$,则$L_2$正则化等价于约束矩阵$W$的Frobenius范数:
\[\sum_{i,j} w_{ij}^2 = ||W||_F^2\]矩阵$W$的Frobenius范数\(\|W\|_F\)是矩阵的谱范数\(\|W\|_2\)的一个上界。约束Frobenius范数能够使网络更好地满足Lipschitz连续性,从而降低模型对输入扰动的敏感性,增强模型的泛化能力。
下面证明Frobenius范数是谱范数的上界。对于矩阵$W$和向量$x$,根据柯西不等式:
\[||Wx|| \leq ||W||_F \cdot ||x||\]而谱范数的定义:
\[||W||_2 = \mathop{\max}_{x \neq 0} \frac{||Wx||}{||x||}\]因此有:
\[||W||_2 \leq ||W||_F\]这说明$L_2$正则化是谱正则化的一个“更粗糙但更廉价”的替身:它惩罚了所有奇异值的平方和,而谱正则化只惩罚最大的那一个。
⭐ 讨论:L2正则化等价于参数服从正态分布的最大后验估计
从贝叶斯角度出发,把参数$w$看作随机变量,假设其先验概率$p(w)$服从正态分布\(\mathcal{N}(0,\sigma_0^2)\)。
由贝叶斯定理可得参数$w$的后验概率$p(w|x,y)$:
\[p(w |x, y) = \frac{p(x,y | w)p(w)}{p(y)} \propto p(x,y | w)p(w)\]参数$w$的最大后验估计为:
\[\begin{aligned} \hat{w} &= \mathop{\arg \max}_{w}\log p(w |x, y) = \mathop{\arg \max}_{w}\log p(x,y | w)p(w) \\ &= \mathop{\arg \max}_{w} \log p(x,y | w) +\log\frac{1}{\sqrt{2\pi}\sigma_0} \exp(-\frac{w^Tw}{2\sigma_0^2}) \\ &\propto \mathop{\arg \max}_{w} \log p(x,y | w)-\frac{w^Tw}{2\sigma_0^2} \\ &= \mathop{\arg \min}_{w} -\log p(x,y | w)+\frac{1}{2\sigma_0^2}||w||_2^2 \end{aligned}\]因此参数服从正态分布的最大后验估计等价于引入$L_2$正则化,且正则化强度$\lambda=1/(2\sigma_0^2)$与先验方差成反比:先验越集中($\sigma_0$越小),惩罚越强。
⭐ 讨论:L2正则化与权重衰减
在标准的梯度下降算法中,应用$L_2$正则化后参数的更新过程为:
\[\begin{aligned} w^{(t+1)} &\leftarrow w^{(t)} - \alpha \nabla_w\left[L(w)+\lambda ||w||_2^2\right] \\ &\leftarrow (1-2\alpha \lambda)w^{(t)} - \alpha \nabla_w L(w) \end{aligned}\]上式相当于在每步参数更新前先把参数按系数$1-2\alpha\lambda$收缩一次,因此在SGD中$L_2$正则化也被等价地称为权重衰减(Weight Decay)正则化。
但这种等价性只在标准SGD中成立。在Adam等自适应学习率算法中,更新量被梯度二阶矩$\sqrt{\hat{v}}$缩放,而$L_2$正则化项$2\lambda w$会同时进入一阶矩和二阶矩:
\[w^{(t+1)} \leftarrow w^{(t)} - \alpha \frac{\hat{m}^{(t)}\left(\nabla_w L+2\lambda w^{(t)}\right)}{\sqrt{\hat{v}^{(t)}\left(\nabla_w L+2\lambda w^{(t)}\right)}+\epsilon}\]对于损失梯度较大的权重,$\sqrt{\hat v}$较大,其$L_2$惩罚项被缩得更小——梯度大的权重反而被正则化得更弱,这恰好与“惩罚大权重”的初衷相反。一个粗糙但直观的近似是:当$L_2$项主导二阶矩时,$2\lambda w/\sqrt{(2\lambda w)^2}=\text{sign}(w)$,即衰减变得与$|w|$无关:
\[w^{(t+1)} \leftarrow w^{(t)} -2\alpha \lambda \,\text{sign}(w^{(t)}) - \alpha \nabla_w L(w)\]此时每个元素的惩罚都很均匀,而不是绝对值更大的元素惩罚更大,这部分抵消了$L_2$正则的作用。解决办法是把权重衰减从梯度更新中解耦,即AdamW,详见第2.3节。
⚪ L1正则化:诱导稀疏性
$L_1$正则化通过约束参数的$L_1$范数(L1-norm)减小过拟合。带有$L_1$正则化的优化问题可写作:
\[\theta^*= \mathop{\arg\min}_{\theta} \frac{1}{N} \sum_{n=1}^{N} {\mathcal{L}(x_n,y_n;\theta)}+\lambda ||w||_1\]如下图所示,蓝圈为优化函数的等高线,棕色区域为满足$L_2/L_1$正则化约束的可行域。$L_1$的可行域是带尖角的菱形(高维下是超八面体),当等高线与可行域相交时,$L_1$正则化会优先相交于坐标轴上,故$L_1$正则化会使参数具有稀疏性(sparse)。
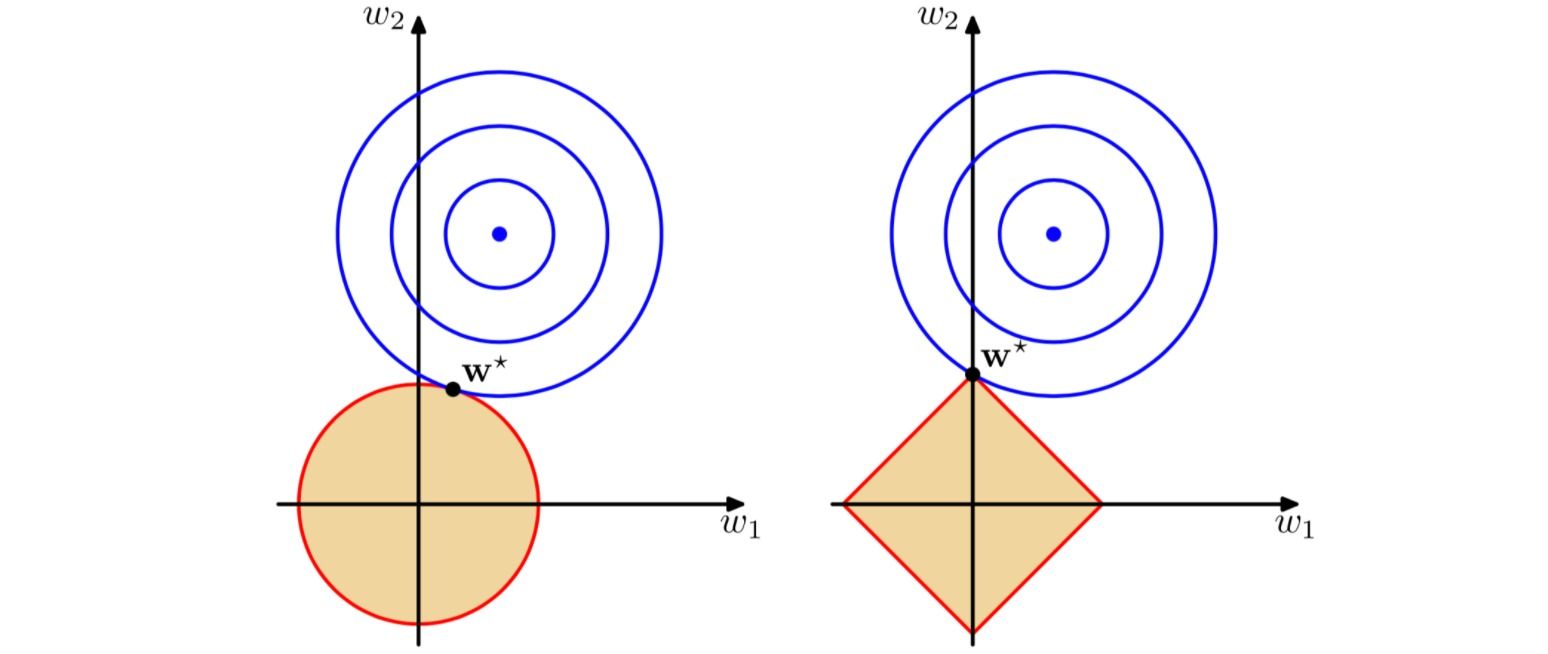
从梯度的角度看差别更直接:$L_2$项的梯度$2\lambda w$在$w\to 0$时也趋于$0$,因此参数只会无限接近零;而$L_1$项的(次)梯度$\lambda\,\text{sign}(w)$在零点附近仍是常数$\pm\lambda$,足以把参数推过零点并钉在那里。$L_1$正则化因此常被用于特征选择与网络剪枝。
⭐ 讨论:L1正则化等价于参数服从拉普拉斯分布的最大后验估计
从贝叶斯角度出发,把参数$w$看作随机变量,假设其先验概率$p(w)$服从拉普拉斯分布:
\[p(w) = \frac{1}{2\sigma_0^2} \exp\left(-\frac{|w|}{\sigma_0^2}\right)\]由贝叶斯定理可得参数$w$的后验概率$p(w|x,y)$:
\[p(w |x, y) = \frac{p(x,y | w)p(w)}{p(y)} \propto p(x,y | w)p(w)\]参数$w$的最大后验估计为:
\[\begin{aligned} \hat{w} &= \mathop{\arg \max}_{w}\log p(w |x, y) = \mathop{\arg \max}_{w}\log p(x,y | w)p(w) \\ &= \mathop{\arg \max}_{w} \log p(x,y | w) +\log \frac{1}{2\sigma_0^2} \exp(-\frac{|w|}{\sigma_0^2}) \\ &\propto \mathop{\arg \max}_{w} \log p(x,y | w)-\frac{|w|}{\sigma_0^2} \\ &= \mathop{\arg \min}_{w} -\log p(x,y | w)+\frac{1}{\sigma_0^2}||w||_1 \end{aligned}\]因此参数服从拉普拉斯分布的最大后验估计等价于引入$L_1$正则化。拉普拉斯分布在零点处有一个尖峰,这从先验的角度解释了$L_1$为什么产生稀疏解。
⚪ 弹性网络正则化 Elastic Net Regularization
弹性网络正则化(Elastic Net Regularization)是指同时约束参数的$L_2$范数和$L_1$范数:
\[\theta^*= \mathop{\arg\min}_{\theta} \frac{1}{N} \sum_{n=1}^{N} {\mathcal{L}(x_n,y_n;\theta)}+\lambda_2 ||w||_2^2+\lambda_1 ||w||_1\]弹性网络的动机是:纯$L_1$在存在强相关特征组时表现不稳定(它会随机地只保留组内的一个特征),而$L_2$项会让相关特征的系数彼此靠近,从而实现“整组一起保留或一起丢弃”的分组选择(grouping effect)效果。
⚪ L0正则化 L0 Regularization
如果目标就是稀疏,最直接的正则项是参数的$L_0$范数(不为零的参数数量):
\[\begin{aligned} \theta^*&= \mathop{\arg\min}_{\theta} \frac{1}{N} \sum_{n=1}^{N} {\mathcal{L}(x_n,y_n;\theta)}+\lambda_0 ||\theta||_0 \\ ||\theta||_0 &= \sum_{j=1}^{|\theta|} \mathbb{I}\left[\theta_j \neq 0\right] \end{aligned}\]$L_0$范数不可微、也不是凸函数,无法直接用梯度下降优化。本文的核心贡献是给出一个可微的连续近似。
第一步是门控重参数化:为每个参数引入一个二元门控标量$z_j$,
\[\theta_j = \tilde{\theta}_jz_j,\quad z_j \in \{0,1\},\quad ||\theta||_0 = \sum_{j=1}^{|\theta|} z_j\]于是$L_0$范数等于“开启的门的数量”。第二步是把门看作随机变量并对期望求梯度:给定任意连续随机变量$s$,构造$z = \min(1, \max(0, s))$,则门被打开的概率可以由$s$的累积分布函数$Q(\cdot)$解析地写出:
\[q(z\neq 0) = 1-Q(s \leq 0)\]此时正则项变成了一个关于分布参数的光滑函数:
\[\mathcal{R}(\tilde{\theta}) = \frac{1}{N} \sum_{i=1}^N\mathcal{L}\left(x_i,y_i;\tilde{\theta} \odot \min(1, \max(0, s))\right)+\lambda_0 \sum_{j=1}^{|\theta|} \left(1-Q(s_j \leq 0)\right)\]第三步是给$s$指定一个便于重参数化的分布——hard concrete分布:从均匀分布中采样$u$,经过一系列变换得到$s$与$z$:
\[\begin{aligned} u & \sim U[0,1] \\ s &= \text{sigmoid}\left(\left(\log u - \log(1-u) + \log \alpha\right)/\beta\right) \\ \overline{s} &= s(\zeta - \gamma) + \gamma \\ z &= \min(1, \max(0, \overline{s})) \end{aligned}\]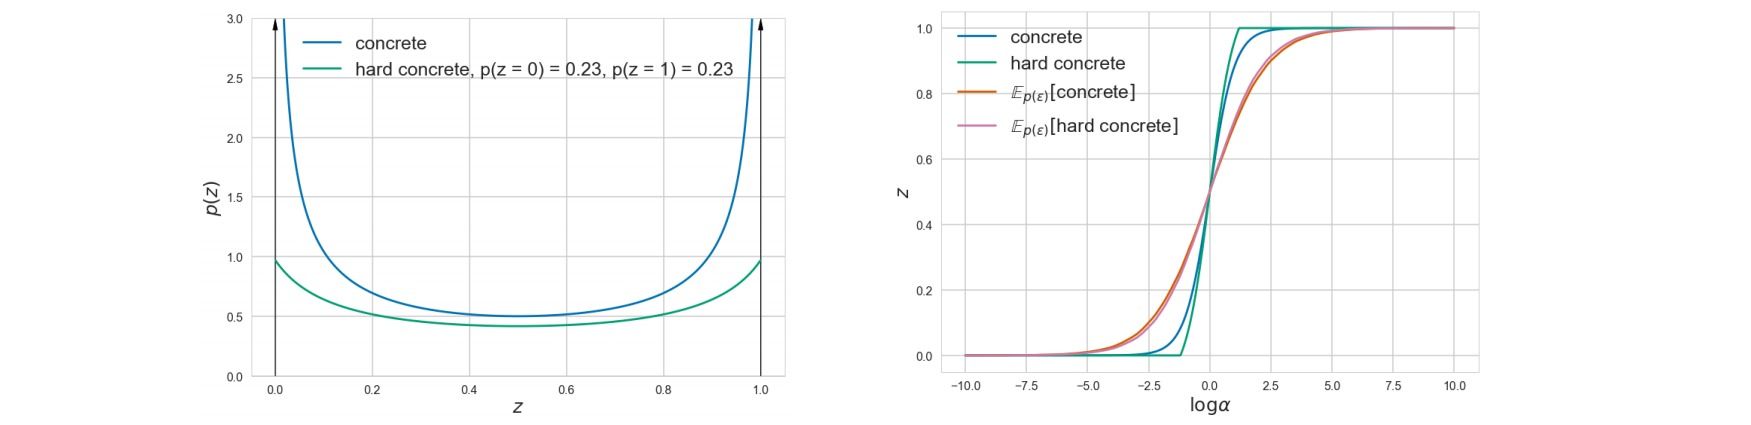
其中$\log \alpha$是位置参数(可学习),$\beta$是温度参数,$\beta \to 0$时$s$退化为伯努利分布;$\gamma < 0, \zeta > 1$把分布的取值区间拉伸到$[\gamma,\zeta]$,再用hard-sigmoid截断,从而让$z$能够精确取到$0$和$1$(这是“hard”的含义,也是真正产生稀疏的关键)。
把上述分布代入$1-Q(\overline{s}\leq 0)$可以得到闭式解:
\[\begin{aligned} 1-Q(\overline{s} \leq 0) &= Q\left(s(\zeta - \gamma) + \gamma > 0\right) = Q\left(s > \frac{- \gamma}{\zeta-\gamma}\right) \\ &= Q\left(u > \left(1+e^{\log \alpha - \beta \log \frac{-\gamma}{\zeta}}\right)^{-1}\right) \\ &= \text{sigmoid}\left(\log \alpha - \beta \log \frac{-\gamma}{\zeta}\right) \end{aligned}\]至此$L_0$正则化完全可微:
\[\mathcal{R}(\tilde{\theta}) = \frac{1}{N} \sum_{i=1}^N\mathcal{L}\left(x_i,y_i;\tilde{\theta} \odot z\right)+\lambda_0 \sum_{j=1}^{|\theta|} \text{sigmoid}\left(\log \alpha_j - \beta \log \frac{-\gamma}{\zeta}\right)\]值得注意的是,正则项只依赖于门的分布参数而不依赖采样值,因此这一项没有采样方差;而似然项通过重参数化获得低方差梯度。测试时用门的期望值(或直接把$\log\alpha<0$的门置零)得到一个真正稀疏的网络。
⚪ 谱正则化 Spectral Norm Regularization
$L_2$正则化惩罚的是所有奇异值的平方和,但决定网络对最坏方向输入扰动敏感程度的是最大奇异值。谱正则化(Spectral Norm Regularization)因此把谱范数的平方作为正则项:
\[\mathcal{L}(x,y;W) + \lambda ||W||_2^2\]其动机来自Lipschitz约束。考虑单层全连接层$f_W(x)=\sigma(Wx)$,对其做一阶Taylor展开:
\[\left|\left| \frac{\partial \sigma}{\partial (Wx)} W(x_1-x_2) \right|\right| \leq K(W) \cdot || x_1-x_2 ||\]常用激活函数的导数是有界的(如ReLU的导数取值于$[0,1]$),因此该项可以被忽略,Lipschitz约束归结为对$W$的一个矩阵范数问题:
\[||W||_2 = \mathop{\max}_{x \neq 0} \frac{||Wx||}{||x||},\qquad || W(x_1-x_2) || \leq ||W||_2 \cdot || x_1-x_2 ||\]由向量范数诱导出的这个矩阵范数就是谱范数(spectral norm)。它的平方等于$W^TW$的最大特征值:
\[||W||_2^2 = \mathop{\max}_{x \neq 0} \frac{x^TW^TWx}{x^Tx} = \lambda_{\max}\left(W^TW\right)\]上式右端是瑞利商(Rayleigh Quotient),其取值范围为\([\lambda_{\min},\lambda_{\max}]\),故最大值即最大特征值。
实践中不需要真的做特征分解,用幂迭代(power iteration)几步即可得到足够精确的估计:
\[v \leftarrow \frac{W^Tu}{||W^Tu||},\quad u \leftarrow \frac{Wv}{||Wv||},\quad ||W||_2 \approx u^TWv\]迭代收敛的原因是:把初始向量在$W^TW$的特征向量基下展开$u^{(0)} = \sum_i c_iv_i$,反复左乘后各分量按$\lambda_i^t$放大,
\[\frac{\left(W^TW\right)^tu^{(0)}}{\lambda_1^t} = c_1v_1+c_2\left(\frac{\lambda_2}{\lambda_1}\right)^tv_2+\cdots + c_n\left(\frac{\lambda_n}{\lambda_1}\right)^tv_n \to c_1v_1\]即最大特征值对应的方向指数级地压倒其余方向。
点击展开代码
def spectral_norm(w, t=5):
    w = w.view(-1, w.shape[-1]) # [m, n]
    u = torch.ones(1, w.shape[0]) # [1, m]
    for i in range(t):
        v = torch.mm(u, w) # [1, n]
        v = v/torch.norm(v)
        u = torch.mm(v, w.T) # [1, m]
        u = u/torch.norm(u)
    return torch.sum(torch.mm(torch.mm(u, w), v.T))
谱正则化是软约束(加在损失里);与之对应的硬约束做法是直接把权重除以其谱范数,即谱归一化(spectral normalization),详见深度学习中的归一化方法。前者更灵活,后者对Lipschitz常数的控制更严格,是GAN判别器的标准配置。
⚪ 正交正则化 Orthogonal Regularization
给全连接或者卷积模型的核加上带有正交化倾向的正则项,是不少模型的需求。核参数的正交化意味着参数的各个视角互不相关,能够减少视角的冗余,更充分地利用所有视角的参数;同时正交矩阵的所有奇异值都等于$1$,这使得梯度在层间传播时既不放大也不衰减。
最直接的做法是利用正交矩阵满足$W^\top W=I$,添加正则项:
\[\left|\left| W^TW - I \right|\right|_F^2\]上面这个正则项不仅希望正交化($w_i^Tw_j=0,i\neq j$),而且同时还希望归一化$w_i^Tw_i = 1$。如果只需要正交化,则可以把对角线部分mask掉:
\[\left|\left|\left( W^TW - I\right) \odot (1-I) \right|\right|_F^2\]在$W$为“高瘦”矩阵(输出维度小于输入维度)时,还可以用互相干性(mutual coherence)或谱限制等距(SRIP,即\(\|W^TW-I\|_2\)的谱范数版本)作为更强的替代,实践中SRIP的表现通常最好。
⚪ 自正交性正则化 Self-Orthogonality Regularization
本文作者指出上述基于$W^TW$的正交正则项并不能有效提高模型准确率,进而从几何角度重新定义了正交的度量:不去看参数矩阵的内积,而是看两个参数向量对实际输入的响应符号是否相关。
根据基于余弦相似度的局部敏感哈希理论,给定两个参数向量\(w_i,w_j \in \mathbb{R}^d\),记\(\theta_{i,j} \in [0, \pi]\)为它们的夹角,\(x \sim \mathcal{X}\)是$d$维单位超球面上的随机向量,则有:
\[\mathcal{V}_{i,j} = \mathbb{E}_{x \sim \mathcal{X}}\left[ \text{sign}\left(x^Tw_i\right)\text{sign}\left(x^Tw_j\right) \right] = 1 - \frac{2\theta_{i,j}}{\pi}\]若两个参数向量正交(\(\theta_{i,j}=\pi/2\)),则\(\mathcal{V}_{i,j}=0\)。因此可以构造正交正则项:
\[\mathcal{R}_{\mathcal{V}} = \lambda_1 \left(\sum_{i \neq j}\mathcal{V}_{i,j}\right)^2 + \lambda_2 \sum_{i \neq j} \mathcal{V}_{i,j}^2\]其中$\lambda_1$控制的正则项比较柔和,只希望\(\mathcal{V}_{i,j}\)的均值为$0$;而$\lambda_2$则强硬一些,希望每一个\(\mathcal{V}_{i,j}\)都等于$0$。考虑到实际问题比较复杂,不宜对模型施加过于强硬的约束,推荐取$\lambda_1=100, \lambda_2=1$。
\(\mathcal{V}_{i,j}\)的估算非常廉价。假设采样$B$个样本$X = [x_1,…,x_B]$,则:
\[\begin{aligned} \mathcal{V}_{i,j}&\approx \frac{1}{B}\sum_{b=1}^B \text{sign}\left(x_b^Tw_i\right)\text{sign}\left(x_b^Tw_j\right) = \left(\frac{y_i}{||y_i||_2}\right)^T\left(\frac{y_j}{||y_j||_2}\right) \\ y &= \text{sign}\left(X^Tw\right) \end{aligned}\]由于\(\text{sign}(\cdot)\)不可导,采用光滑近似\(\text{sign}(x) \approx \tanh(\gamma x)\)(实践中取$\gamma=10$)。而$X$既可以随机采样构造,也可以直接取当前层的真实输入——此时$X^\top W$恰好就是该层的输出,正则项几乎零额外开销,故称为自正交化:
- 对于当前层输入$X$与核矩阵$W$,做矩阵乘法得到输出$Y$(不经过激活函数);
- 用\(\tanh(\gamma Y)\)激活,沿批量维度$B$做$L_2$归一化;
- 计算$Y^TY$近似\(\mathcal{V}\),进而估算正则项\(\mathcal{R}_{\mathcal{V}}\)。
⚪ WEISSI正则化 Weight-Scale-Shift-Invariance Regularization
常见的深度学习模型中往往存在权重尺度偏移(Weight Scale Shift)现象,它会让$L_2$正则化的作用大打折扣。
问题的根源在于ReLU的正齐次性:对于$\varepsilon \geq 0$有$\varepsilon f(x)=f(\varepsilon x)$。因此对一个$L$层网络的每层参数引入偏移\(W_l=\gamma_l\tilde{W}_l,b_l=\gamma_l\tilde{b}_l\),网络输出只是被整体缩放了\(\prod_l\gamma_l\)倍:
\[\begin{aligned} h_L &= f\left(W_Lf\left(W_{L-1}f(\cdots f\left(W_1x+b_1\right)\cdots)+b_{L-1}\right)+b_L\right) \\ &= \left( \prod_{l=1}^L \gamma_l \right) f\left(\tilde{W}_Lf\left(\tilde{W}_{L-1}f\left(\cdots f\left(\tilde{W}_1x+\tilde{b}_1\right)\cdots\right)+\tilde{b}_{L-1}\right)+\tilde{b}_L\right) \\ \end{aligned}\]当\(\prod_{l=1}^L \gamma_l=1\)时两组参数对应的模型完全等价,这称为权重尺度偏移不变性(WEIght-Scale-Shift-Invariance,WEISSI)。然而$L_2$正则化项并不具有这种不变性:
\[\sum_{l=1}^L || W_l||_2^2 = \sum_{l=1}^L \gamma_l^2|| \tilde{W}_l||_2^2 \neq \sum_{l=1}^L || \tilde{W}_l||_2^2\]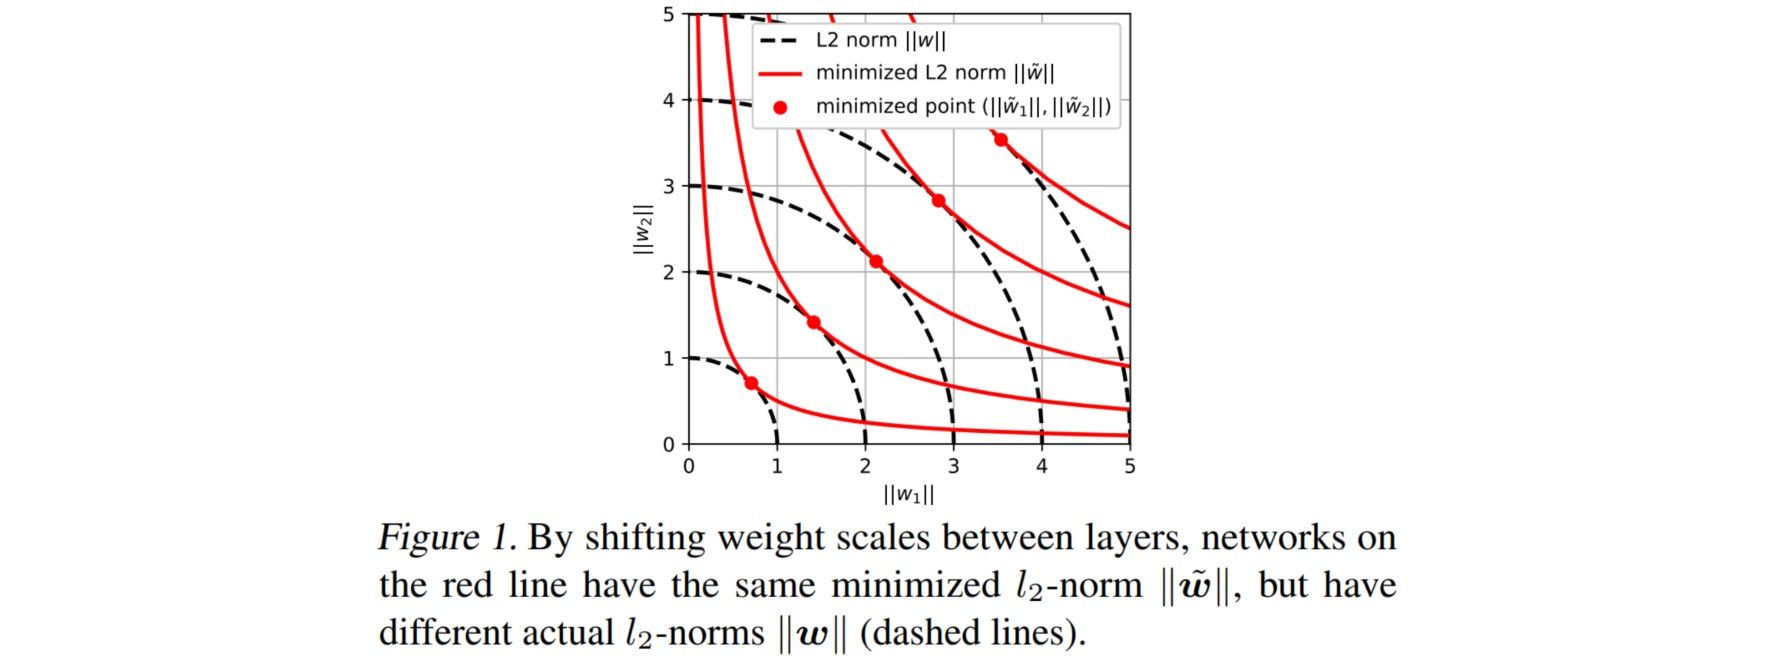
这体现了$L_2$正则化的低效性:模型完全可以找到一组新参数\(\{\tilde{W}_l,\tilde{b}_l\}\),它与原参数的模型完全等价(没有任何泛化性提升),但$L_2$正则项更小。事实上在约束\(\prod_l \gamma_l=1\)下,\(\sum_l \|\tilde{W}_l\|_2^2\)的最小值取在各层范数相等处:
\[|| \tilde{W}_1||_2=|| \tilde{W}_2||_2=\cdots = || \tilde{W}_L||_2 = \left(\prod_{l=1}^L || W_l||_2\right)^{1/L}\]也就是说,优化器可以通过“把范数在各层之间重新分配”这种廉价手段来降低$L_2$损失,而不必真正简化模型。
因此希望找到一个既有类似$L_2$作用、又对权重尺度偏移不变的正则项。考虑一般形式\(\mathcal{L}_{reg} = \sum_{l=1}^L f(\|W_l\|_2)\)($L_2$对应$f(x)=x^2$)。只要$f$在$[0,+\infty)$上单调递增,优化目标就是缩小\(\|W_l\|\);而由于优化过程只用到正则项的梯度,尺度偏移不变性要求:
\[\frac{d}{dx} f(\gamma x) = \frac{d}{dx} f( x)\]满足上式的一个解是对数函数$f(x) =\log(x)$。因此对应的正则项为:
\[\mathcal{L}_{reg} = \sum_{l=1}^L \log\left(||W_l||_2\right) = \log\left(\prod_{l=1}^L||W_l||_2\right)\]它惩罚的是各层范数的乘积(恰好是网络Lipschitz上界的形式),因此对\(\prod_l\gamma_l=1\)的重新分配完全免疫。若惩罚力度还不够,可以再对参数的方向加一个$L_1$惩罚:
\[\mathcal{L}_{reg} = \lambda_1 \sum_{l=1}^L \log\left(||W_l||_2\right) + \lambda_2 \sum_{l=1}^L \left|\left|\frac{W_l}{||W_l||_2}\right|\right|_1\]⚪ 梯度惩罚 Gradient Penalty
前面的正则项都直接作用于参数。另一类思路是惩罚损失(或输出)的导数,直接约束函数的光滑程度。梯度惩罚有两个方向:对参数求导和对输入求导。
(1) 对参数的梯度惩罚
一个有趣的事实是:梯度下降本身就隐式地在损失中加入了对参数的梯度惩罚。梯度下降的更新\(\theta_{t+\gamma} = \theta_t - \gamma g(\theta_t)\)可以看作某个连续流的离散化,把\(\theta_{t+\gamma}\)展开为微分算子的指数:
\[\begin{aligned} \theta_{t+\gamma} &= \left( 1+ \gamma \nabla +\frac{1}{2}\gamma^2 \nabla^2 + \frac{1}{6}\gamma^3 \nabla^3 + \cdots\right)\theta_{t} = e^{\gamma \nabla}\theta_{t} \end{aligned}\]于是梯度下降公式可写作\(\left( e^{\gamma \nabla}-1\right)\theta_t = - \gamma g(\theta_t)\),反解出连续流所对应的有效梯度:
\[\begin{aligned} \nabla \theta_t &= - \frac{\gamma\nabla}{e^{\gamma \nabla}-1} g(\theta_t) = - \left( 1-\frac{1}{2}\gamma \nabla + \frac{1}{12} \gamma^2 \nabla^2- \cdots \right) g(\theta_t) \\ &\approx -g(\theta_t) + \frac{1}{2}\gamma \nabla_{\theta_t} g(\theta_t) \nabla \theta_t \\ &\approx -g(\theta_t) - \frac{1}{2}\gamma \nabla_{\theta_t} g(\theta_t)g(\theta_t) = -g(\theta_t) - \frac{1}{4}\gamma \nabla_{\theta_t} ||g(\theta_t)||^2 \end{aligned}\]因此实际被优化的有效目标是:
\[\begin{aligned} \tilde{g}(\theta) & \approx g(\theta) + \frac{1}{4}\gamma \nabla_{\theta} ||g(\theta)||^2 = \nabla_{\theta} \left( L(\theta) + \frac{1}{4}\gamma ||\nabla_{\theta} L(\theta)||^2 \right) \end{aligned}\]梯度惩罚项\(\|\nabla_\theta L\|^2\)有助于模型到达损失曲面上更加平缓的区域,有利于提高泛化性能。注意惩罚强度与学习率$\gamma$成正比:如果$\gamma \to 0$,这个隐式正则化就会消失。这给出了一个反直觉但重要的实践结论——学习率不宜设得过小,较大的学习率不仅加速收敛,还自带泛化收益。
当然也可以显式地把梯度惩罚加入损失:
\[\mathcal{L}(x,y;\theta) + \lambda ||\nabla_{\theta} \mathcal{L}(x,y;\theta)||^2\](2) 对输入的梯度惩罚
在对抗训练中,对输入样本施加\(\epsilon \nabla_x \mathcal{L}(x,y;\theta)\)的对抗扰动,等价于向损失函数中加入对输入的梯度惩罚:
\[\begin{aligned} \mathcal{L}(x+\Delta x,y;\theta) &\approx \mathcal{L}(x,y;\theta)+\epsilon ||\nabla_x\mathcal{L}(x,y;\theta)||^2 \end{aligned}\]此时梯度惩罚(或对抗训练)使得模型对于较小的输入扰动具有鲁棒性。这类正则化历史悠久:最早的形式是double backpropagation,现代形式是Jacobian正则化,即惩罚网络输出对输入的Jacobian矩阵的Frobenius范数:
\[\mathcal{L}(x,y;\theta) + \frac{\lambda}{2} \left|\left| \frac{\partial f_\theta(x)}{\partial x} \right|\right|_F^2\]由于完整的Jacobian需要按输出维度做多次反向传播,实践中用随机投影做无偏估计:采样单位随机向量$v$,用\(\|v^\top \partial f/\partial x\|^2\)的期望乘以输出维度来近似\(\|\partial f/\partial x\|_F^2\),每步只需一次额外的反向传播。
如果进一步惩罚二阶导数,就得到Hessian正则化(惩罚\(\|\nabla_x^2 f\|\)),它约束的是函数的曲率而非斜率;VAT(见第2.3节)本质上就是一种沿Hessian主特征方向的各向异性版本。
对输入的梯度惩罚也被用于约束模型的Lipschitz连续性(WGAN-GP的核心)。此外,对输入的梯度惩罚跟Dirichlet能量有关,而Dirichlet能量可以作为模型复杂度的表征;所以施加对输入的梯度惩罚,会倾向于选择复杂度比较小的模型。
⭐ 讨论:两种梯度惩罚的关系
两种梯度惩罚并非独立:对参数的梯度惩罚一定程度上已经包含了对输入的梯度惩罚。对于一个$L$层的MLP \(h^{(l+1)} = g^{(l)}(W^{(l)}h^{(l)}+b^{(l)})\),记全体参数为\(\theta = (W^{(1)},b^{(1)},...,W^{(L)},b^{(L)})\),设$f$是任意标量函数(如损失函数),则存在不等式:
\[||\nabla_x f||^2 \left( \frac{1+||h^{(1)}||^2}{||W^{(1)}||^2||\nabla_x h^{(1)}||^2}+\cdots + \frac{1+||h^{(L)}||^2}{||W^{(L)}||^2||\nabla_x h^{(L)}||^2} \right) \leq ||\nabla_{\theta} f||^2\]只需对每一层证明\(\|\nabla_x f\|^2 \left( \|h^{(l)}\|^2/(\|W^{(l)}\|^2\|\nabla_x h^{(l)}\|^2) \right) \leq \|\nabla_{W^{(l)}} f\|^2\)即可。记\(z^{(l)}=W^{(l)}h^{(l)}+b^{(l)}\),由链式法则:
\[\begin{aligned} \nabla_x f = \frac{\partial f}{\partial z^{(l)}}\frac{\partial z^{(l)}}{\partial h^{(l)}} \frac{\partial h^{(l)}}{\partial x} = \frac{\partial f}{\partial z^{(l)}} W^{(l)} \frac{\partial h^{(l)}}{\partial x} \end{aligned}\]又由\(W^{(l)}=(z^{(l)}-b^{(l)})(h^{(l)})^{-1}\)可得\(\partial f/\partial z^{(l)} = \nabla_{W^{(l)}} f \cdot (h^{(l)})^{-1}\),代入并取范数:
\[\begin{aligned} ||\nabla_x f || &= ||\nabla_{W^{(l)}} f \cdot (h^{(l)})^{-1}W^{(l)} \nabla_x h^{(l)}|| \\ & \leq ||\nabla_{W^{(l)}} f|| \cdot ||h^{(l)}||^{-1}\cdot ||W^{(l)}||\cdot ||\nabla_x h^{(l)}|| \end{aligned}\]整理即得所需不等式,对$b^{(l)}$同理。
把三个结论串起来就得到一条完整的逻辑链:SGD隐式地包含了对参数的梯度惩罚 $\Rightarrow$ 对参数的梯度惩罚隐式地包含了对输入的梯度惩罚 $\Rightarrow$ 对输入的梯度惩罚与Dirichlet能量(模型复杂度的表征)相关。因此梯度下降本身就是一把“几何奥卡姆剃刀”,天然倾向于选择复杂度较小的模型。
2.2 约束网络结构
这一族方法不改变损失函数,而是在前向计算中引入随机性:每次前向传播实际使用的是原网络的一个随机子网络。它们的共同特点是“训练时随机、测试时确定”,因此都需要处理训练与测试的不一致性问题。
按丢弃的粒度可以分成两类:丢弃神经元/连接/通道(Dropout族)和丢弃整层/整条路径(随机深度族)。
(1) Dropout及其变体
⚪ Dropout:随机丢弃神经元
Dropout是指在训练深度神经网络时,随机丢弃一部分神经元。即对某一层设置丢弃概率$p$,该层的每个神经元独立地以概率$p$被置零,也就是为每个神经元采样一个伯努利掩码\(m_i \sim \text{Bernoulli}(1-p)\):
\[\tilde{h} = m \odot h,\qquad m_i \sim \text{Bernoulli}(1-p)\]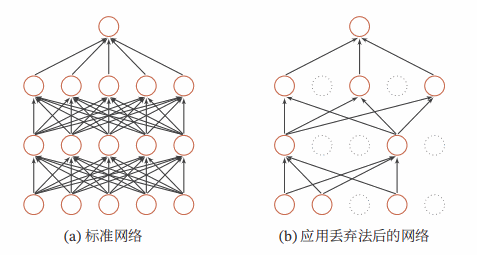
推理期缩放是Dropout实现中最容易出错的地方。训练时激活神经元的平均数量是原来的$1-p$倍,即\(\mathbb{E}[\tilde h_i] = (1-p)h_i\);而测试时所有神经元都被激活。为了让测试时每个神经元接收到的输入期望与训练时一致,有两种等价做法:
- 原始Dropout:训练时直接使用\(\tilde h = m\odot h\),测试时把该层输出乘以保留概率$1-p$;
- Inverted Dropout(现代框架的默认实现):训练时使用\(\tilde h = (m\odot h)/(1-p)\),测试时不做任何处理。
后者的好处是推理路径与不使用Dropout时完全相同,便于部署,也便于在训练中动态调整$p$。
点击展开代码
def dropout(x, level):
    if level < 0. or level >= 1:
        raise Exception('Dropout level must be in interval [0, 1].')
    retain_prob = 1. - level
    sample = np.random.binomial(n=1, p=retain_prob, size=x.shape)
    x *= sample
    x /= retain_prob   # inverted dropout
    return x
从不同角度理解Dropout:
- 正则化(Regularization)角度:每一次Dropout相当于为原网络引入乘性噪声,测试时通过平均抵消掉噪声;每次训练不会过度依赖于个别神经元的输出(抑制co-adaptation),增强网络的泛化能力。第2.4节会证明,作用在线性模型输入上的Dropout精确等价于一个带特征加权的$L_2$正则项。
- 集成(Ensemble)角度:每一次Dropout相当于从原网络中采样一个子网络,一个有$n$个神经元的层共有$2^n$个可能的子网络,每次迭代相当于训练其中一个(且它们共享参数);最终的网络可以看作这些子网络的几何平均集成。推理期的权重缩放正是这个几何平均在单层线性网络下的精确解,在深层非线性网络下则是一个很好的近似。
- 贝叶斯(Bayesian)角度:贝叶斯学习假设参数$w$为随机变量、先验分布为$q(w)$,其预测为如下积分。其中的近似由Monte Carlo方法得到,$w_m$是第$m$次Dropout的网络参数,看作对全部参数$w$的一次采样。这也是MC Dropout做不确定性估计的依据:推理时保持Dropout开启、前向多次,用预测的方差衡量模型的认知不确定性。
实践要点:Dropout通常只加在全连接层($p=0.5$)或较深的层上;卷积层参数量小、且空间相关性强,直接用Dropout效果有限(应改用Spatial Dropout或DropBlock);Dropout与BatchNorm同时使用时可能因为训练/测试的方差不一致而互相干扰,故现代CNN中常常只保留BatchNorm。
⚪ Gaussian Dropout:乘性高斯噪声
Dropout的本质是乘性噪声,噪声的具体分布并不重要,重要的是它的均值和方差。因此可以把伯努利掩码替换为均值为$1$的高斯噪声:
\[\tilde{h} = \xi \odot h,\qquad \xi_i \sim \mathcal{N}\left(1, \frac{p}{1-p}\right)\]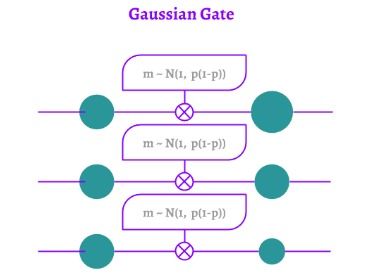
方差的取值来自与Inverted Dropout的匹配:\(m_i/(1-p)\)的均值为$1$、方差为\(p/(1-p)\)。(若使用未缩放的原始掩码$m_i$,则其均值为$1-p$、方差为$p(1-p)$。)
Gaussian Dropout的优点是噪声连续可导、无需在训练/测试间切换缩放,且往往比伯努利版本收敛更快;缺点是不产生真正的零,无法带来稀疏性。把噪声方差$\alpha=p/(1-p)$本身变成可学习参数,就得到了Variational Dropout(Variational Dropout and the Local Reparameterization Trick),它把Dropout率纳入变分推断框架,从而自动为每个权重选择合适的丢弃概率;进一步允许$\alpha \to \infty$则可以把权重彻底剪掉(Variational Dropout Sparsifies Deep Neural Networks)。
⚪ DropConnect:随机丢弃连接
DropConnect把随机性从激活值移到了权重上:不丢弃神经元,而是独立地丢弃每一条连接。
\[\tilde{h} = g\left(\left(M \odot W\right)x\right),\qquad M_{ij} \sim \text{Bernoulli}(1-p)\]Dropout相当于DropConnect的一个特例(丢弃某个神经元等于同时丢弃它的所有出边),因此DropConnect的子模型空间更大($2^{|W|}$而非$2^n$),正则化更强。代价是无法直接用“权重缩放”做推理近似:作者的做法是注意到\(u = (M\odot W)x\)在随机掩码下近似服从高斯分布,用矩匹配求出其均值\((1-p)Wx\)与方差\(p(1-p)(W\odot W)(x\odot x)\),然后采样若干次$u$再取平均。这个额外开销是DropConnect在实践中不如Dropout流行的主要原因。
⚪ Spatial Dropout:按通道丢弃
标准Dropout作用在卷积特征图上效果很差,原因是相邻像素高度相关:即使某个位置被置零,它的信息仍然可以从邻居那里恢复,噪声几乎不起作用。
Spatial Dropout(PyTorch中的nn.Dropout2d)把丢弃的单位从“像素”改为“整个通道”:对形状为$(N,C,H,W)$的特征图采样$(N,C,1,1)$的掩码,一个通道要么整体保留、要么整体置零。
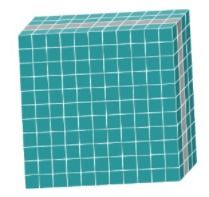
这样丢弃的是一整个特征检测器的响应,噪声无法被空间邻居补偿,因此正则化真正生效。它也是CNN中最常用的Dropout变体。
⚪ DropBlock:丢弃连续的空间区域
Spatial Dropout是“整通道全丢”,DropBlock则走另一条路:保留通道,但在空间上丢弃连续的方块区域。
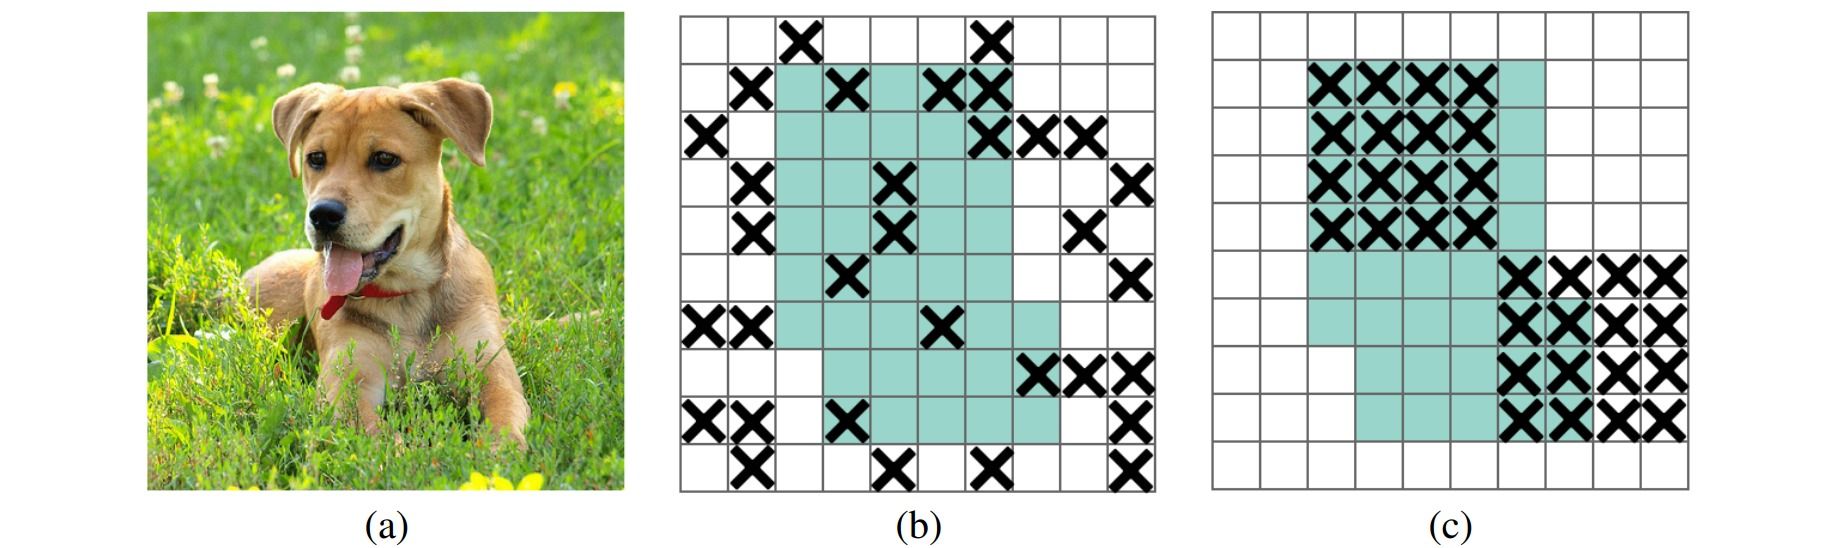
图像是一个2D结构,像素或者特征点之间在空间上存在依赖关系,普通的Dropout在屏蔽语义上不够有效;而DropBlock屏蔽连续区域块就能有效移除某些语义信息(比如狗的头),从而起到有效的正则化作用。DropBlock与Cutout思路类似,只不过Cutout是作用于输入图像的数据增强方法,而DropBlock是作用于CNN中间特征、且作用于所有特征层的正则化手段。
DropBlock有两个主要参数:block_size(方块区域的边长)和$\gamma$(控制被屏蔽的特征数量)。具体流程是:先用参数为$\gamma$的伯努利分布生成一个center mask,标记出要屏蔽的block的中心点;然后把每个中心点扩展成block_size大小的方块,得到最终的block mask。
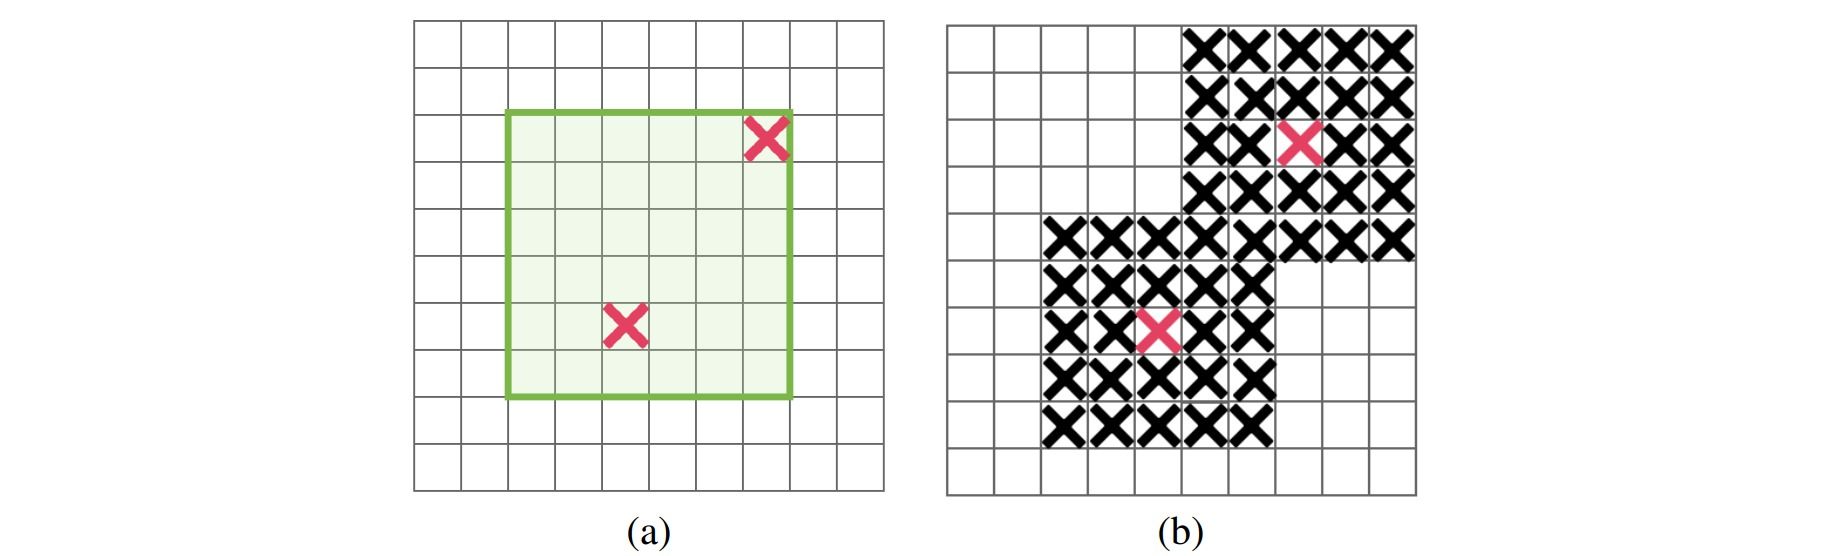
假定输入特征大小为$(N,C,H,W)$,那么center mask的大小为\((N,C,H-\text{block size}+1,W-\text{block size}+1)\)(避免方块越界),而每个方块的大小为\(\text{block size}\times \text{block size}\)。
实际使用时往往像Dropout那样指定一个keep_prob,因此需要把它换算成$\gamma$。要求两者屏蔽的特征数量相等:
\[(1- \text{keep prob}) \times \text{feat size}^2 = \gamma \times \text{block size}^2 \times (\text{feat size}-\text{block size}+1)^2\]于是:
\[\gamma = \frac{(1- \text{keep prob}) \times \text{feat size}^2}{\text{block size}^2 \times (\text{feat size}-\text{block size}+1)^2}\]注意这个换算忽略了方块之间的重叠,因此实际丢弃比例会略低于设定值。实践建议:block_size取$7$、keep_prob取较大的值(如$0.9$);此外对keep_prob采用线性递减的调度(从$1.0$逐渐降到设定值)可以进一步提升效果——这一点很关键,因为在训练初期就施加强噪声会让网络难以收敛。
在实现上,可以先对center mask做padding,然后用kernel_size为block_size的最大池化把中心点膨胀为方块。最后将特征乘以block mask,并按“总元素数/保留元素数”做归一化以保持训练测试的一致性:
点击展开代码
class DropBlock2d(nn.Module):
    def __init__(self, p: float, block_size: int) -> None:
        super().__init__()
        self.p = p
        self.block_size = block_size

    def forward(self, input):
        if not self.training:
            return input
        N, C, H, W = input.size()
        # 由 drop_prob 换算伯努利分布的 gamma
        gamma = (self.p * H * W) / ((self.block_size ** 2) *
                 ((H - self.block_size + 1) * (W - self.block_size + 1)))
        mask_shape = (N, C, H - self.block_size + 1, W - self.block_size + 1)
        mask = torch.bernoulli(torch.full(mask_shape, gamma, device=input.device))
        # 用最大池化把中心点膨胀成方块
        mask = F.pad(mask, [self.block_size // 2] * 4, value=0)
        mask = F.max_pool2d(mask, stride=(1, 1),
                            kernel_size=(self.block_size, self.block_size),
                            padding=self.block_size // 2)
        mask = 1 - mask
        normalize_scale = mask.numel() / (1e-6 + mask.sum())
        return input * mask * normalize_scale
⚪ Weighted Channel Dropout:按激活幅度加权地丢弃通道
卷积神经网络的深层特征具有明显的稀疏性:对于每张输入图像,更深的卷积层中仅有少量通道被强激活,其它通道的响应接近于零。均匀随机地丢弃通道(Spatial Dropout)会大量丢在本就接近零的通道上,等于什么都没做。
加权通道丢弃(Weighted Channel Dropout, WCD)因此根据激活的相对幅度来选择通道:分数更高的通道有更高的概率被保留。
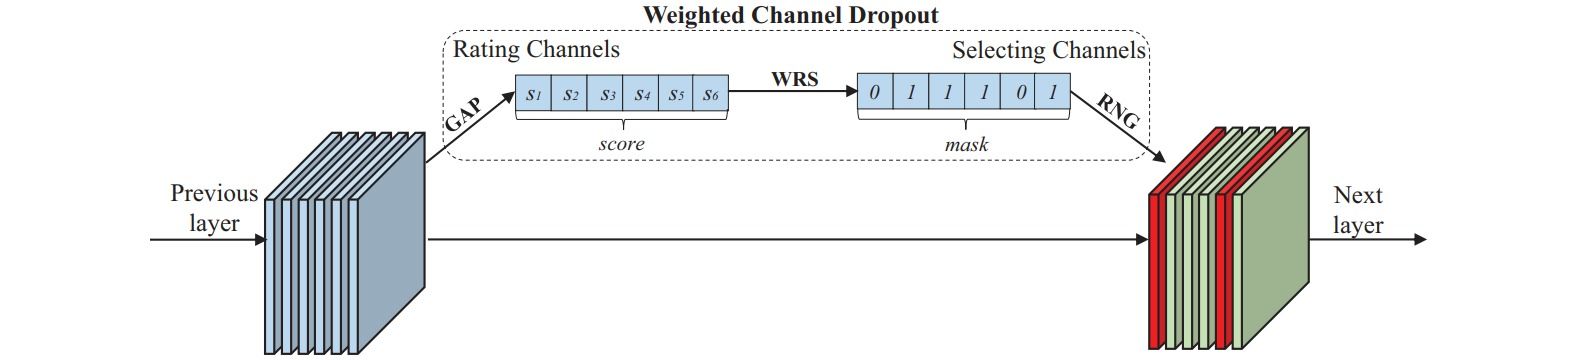
WCD分三步:
- 通过全局平均池化GAP为输入特征的每个通道分配一个分数$score_i$;
- 用加权式随机选择(Weighted Random Selection, WRS)生成二元掩码:为每个通道生成一个随机数\(r_i \sim U[0,1]\),计算键值\(key_i = r_i^{1/score_i}\),取键值最大的$M$个通道,把对应的$mask_i$置为$1$;
- (可选)使用一个额外的随机数生成器进一步过滤通道:即使$mask_i$已被置为$1$,该通道仍有一定概率不被选择。
第三步的动机是:对于预训练模型,深层中只有少量通道有较大激活值,如果仅根据分数选择通道,那么对于每张图像被选中的通道序列在每次前向传播时几乎都一样,随机性丧失、正则化失效。这一步在小数据集上尤其重要。
WCD使得网络在收敛前的训练误差更高、收敛更慢,但测试误差更低,即有效降低了训练阶段的过拟合。
⚪ R-Drop:约束两次Dropout的输出一致
Dropout有一个内在缺陷:训练与测试的不一致性。训练时每次前向都用一个随机子模型(“模型平均”的一次采样),而测试时直接关闭Dropout做确定性预测(“权重平均”)。理论上正确的做法是多次开启Dropout前向后取平均,但这在推理时代价太高。
R-Drop的思路是从训练侧消除这个差距:显式约束不同Dropout采样下的输出落入同一分布,那么“权重平均”自然就接近“模型平均”。
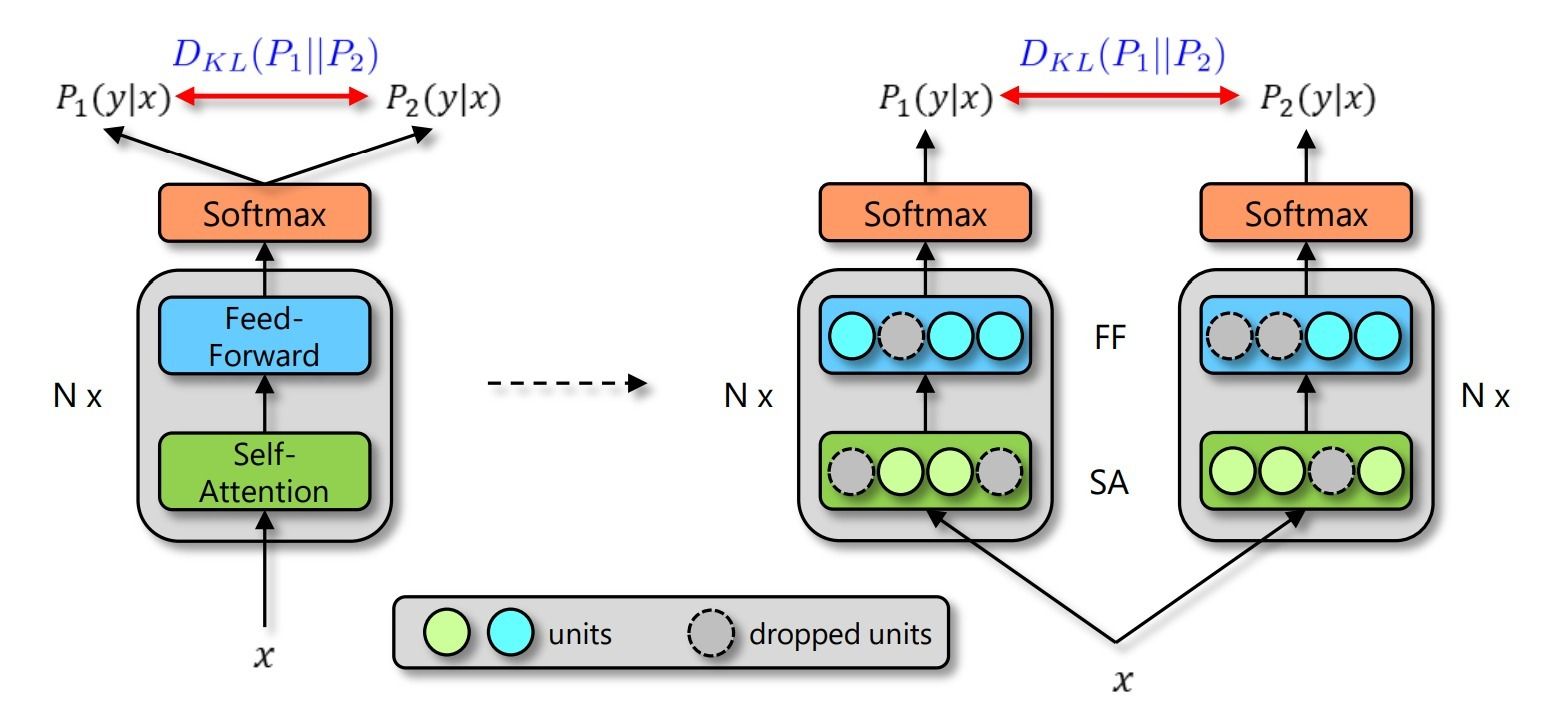
具体地,把同一个输入$x_i$两次送入带Dropout的模型,得到两个输出分布$P_1(y|x_i)$和$P_2(y|x_i)$。它们相当于两个共享参数的子模型。损失函数包含两项:两次前向的负对数似然,以及两个输出分布之间的对称KL散度:
\[\begin{aligned} \mathcal{L}_{NLL}^i &= -\log P_1(y_i|x_i) -\log P_2(y_i|x_i) \\ \mathcal{L}_{KL}^i &= \frac{1}{2}\left(\mathcal{D}_{KL}\left(P_1(y_i|x_i) || P_2(y_i|x_i)\right)+\mathcal{D}_{KL}\left(P_2(y_i|x_i) || P_1(y_i|x_i)\right)\right) \\ \mathcal{L}^i &= \mathcal{L}_{NLL}^i + \alpha \mathcal{L}_{KL}^i \end{aligned}\]R-Drop只需把一个批量在批维度上复制一份即可实现,代价是每步计算量翻倍,但在机器翻译、文本摘要、语言理解、语言建模和图像分类上都能稳定提升,是NLP微调中性价比很高的一个技巧。
⚪ 其他Dropout变体速览
| Dropout方法 | 说明 |
|---|---|
| Standout (NeurIPS2013) |
神经元的丢弃概率$p$不再是超参数,而是通过一个叠加的信念网络根据输入自适应地建模 |
| Max-Pooling Dropout (arXiv1512) |
在最大池化之前对池化窗口内的元素做Dropout,使池化结果变为按激活值大小的多项式采样 |
| Max-Drop (ACCV2016) |
沿通道或空间维度选出激活值最大的特征并丢弃它,迫使网络不依赖单个最强响应 |
| MaxDropout (arXiv2007) |
对输入特征归一化到$[0,1]$,然后把大于给定阈值$p$的位置置零(确定性地丢弃最强激活) |
| Concrete Dropout (NeurIPS2017) |
用Concrete(Gumbel-Softmax)分布松弛伯努利掩码,使丢弃概率$p$可由梯度下降直接学习 |
| Zoneout (arXiv1606) |
循环网络专用:不把隐状态置零,而是随机地保持上一时刻的隐状态,从而不破坏梯度沿时间的传播 |
| Variational RNN Dropout (NeurIPS2016) |
循环网络中在所有时间步共享同一个掩码,而非每步重新采样 |
(2) 随机深度与随机路径
如果把丢弃的粒度进一步放大到“整个模块”,就得到了随机深度一族。它们只对带残差连接的网络有意义:因为丢弃一个残差分支后,恒等映射仍然保证了信息与梯度的通路。
⚪ 随机深度 Stochastic Depth
随机深度是指在训练时以概率$p_l$丢弃第$l$个残差模块(令其退化为恒等变换):
\[h^{(l+1)} = h^{(l)} + b_l \cdot \mathcal{F}\left(h^{(l)}\right),\qquad b_l \sim \text{Bernoulli}(1-p_l)\]测试时使用完整的网络,并按保留概率对各个模块的输出加权:\(h^{(l+1)} = h^{(l)} + (1-p_l)\mathcal{F}(h^{(l)})\)。
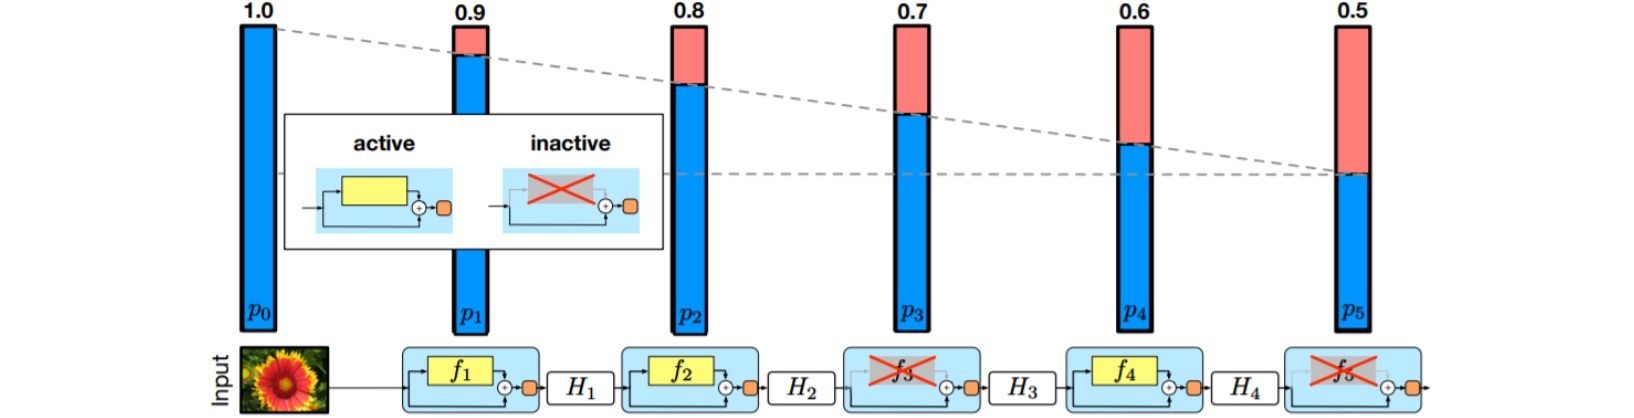
丢弃概率通常采用线性递增的调度:\(p_l = \frac{l}{L}p_L\),即浅层几乎总是保留(它们提取的低级特征不可替代),深层丢弃概率最大(通常$p_L=0.5$)。这样做的额外收益是训练期望深度变短,训练速度提升约$25\%$。
在Transformer中,随机深度(此时通常称为stochastic depth或drop path)已经成为标准配置:DeiT(Training data-efficient image transformers)证明了它是ViT在中等规模数据上能训起来的关键正则化之一;ConvNeXt、Swin等现代架构也都按模型规模调整drop path rate(tiny约$0.1$、base约$0.5$)。可以说在现代视觉骨干网络中,drop path取代了Dropout成为首选的结构性正则化。
⚪ DropPath 与 Scheduled DropPath
- paper:FractalNet: Ultra-Deep Neural Networks without Residuals
- paper:Learning Transferable Architectures for Scalable Image Recognition
DropPath最早出现在FractalNet中,用于在多分支结构中随机丢弃部分路径,并区分两种模式:
- local 丢弃:每个join点独立地随机丢弃输入分支,但保证至少保留一条
- global 丢弃:整个网络只保留一条完整路径
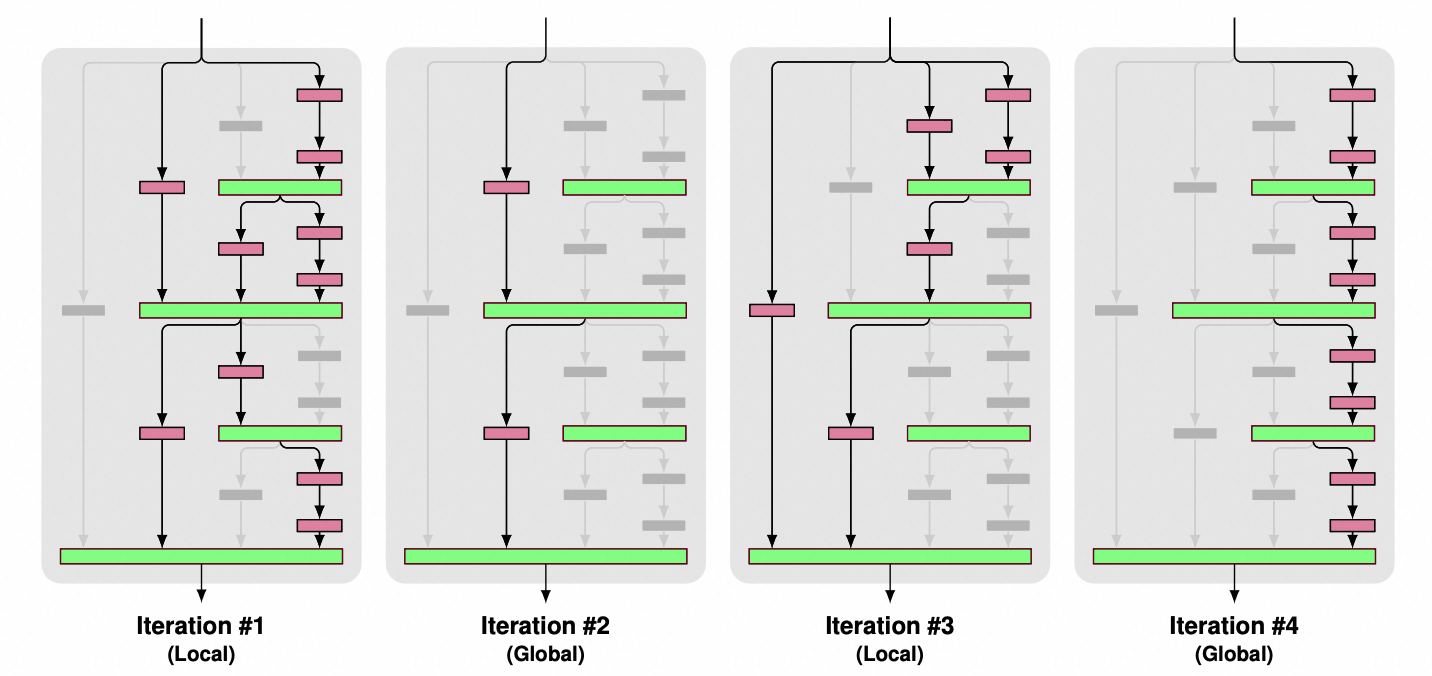
NASNet把它改造成Scheduled DropPath:路径的保留概率不再固定,而是在训练过程中从$1$线性衰减到目标值。作者发现固定的DropPath对搜索出的cell结构效果不佳,而这个简单的调度带来了显著提升。这一从弱到强的噪声调度思想在DropBlock、随机深度中反复出现,可以看作结构性正则化的一条通用经验。
⚪ LayerDrop:结构化的层丢弃
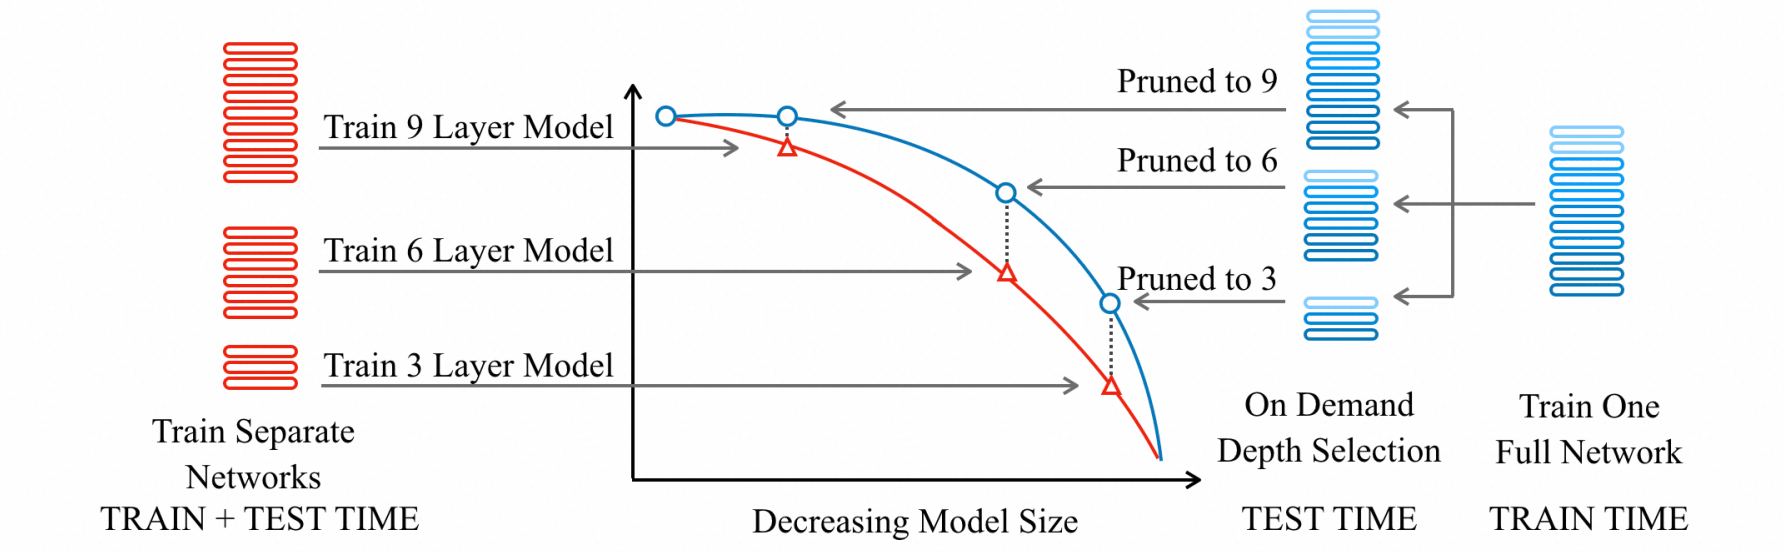
LayerDrop是随机深度在Transformer上的直接应用:训练时随机丢弃整个Transformer层。它的独特价值在于推理时的弹性——由于训练时网络已经见过各种深度的子网络,推理时可以直接丢掉若干层得到一个更小的模型而无需微调,实现一次训练、按需裁剪。
⚪ Shake-Shake 与 ShakeDrop:随机加权多分支
Shake-Shake作用于双分支残差块:前向时用随机系数\(\alpha \sim U[0,1]\)对两条分支加权,反向时换一个独立的随机系数\(\beta \sim U[0,1]\);前向反向使用不同系数意味着梯度是错误的,这本身就是一种极强的噪声:
\[\begin{aligned} \text{forward:}\quad & h^{(l+1)} = h^{(l)} + \alpha \mathcal{F}_1\left(h^{(l)}\right) + (1-\alpha)\mathcal{F}_2\left(h^{(l)}\right) \\ \text{backward:}\quad & \text{用 } \beta,\ 1-\beta \text{ 替代 } \alpha,\ 1-\alpha \end{aligned}\]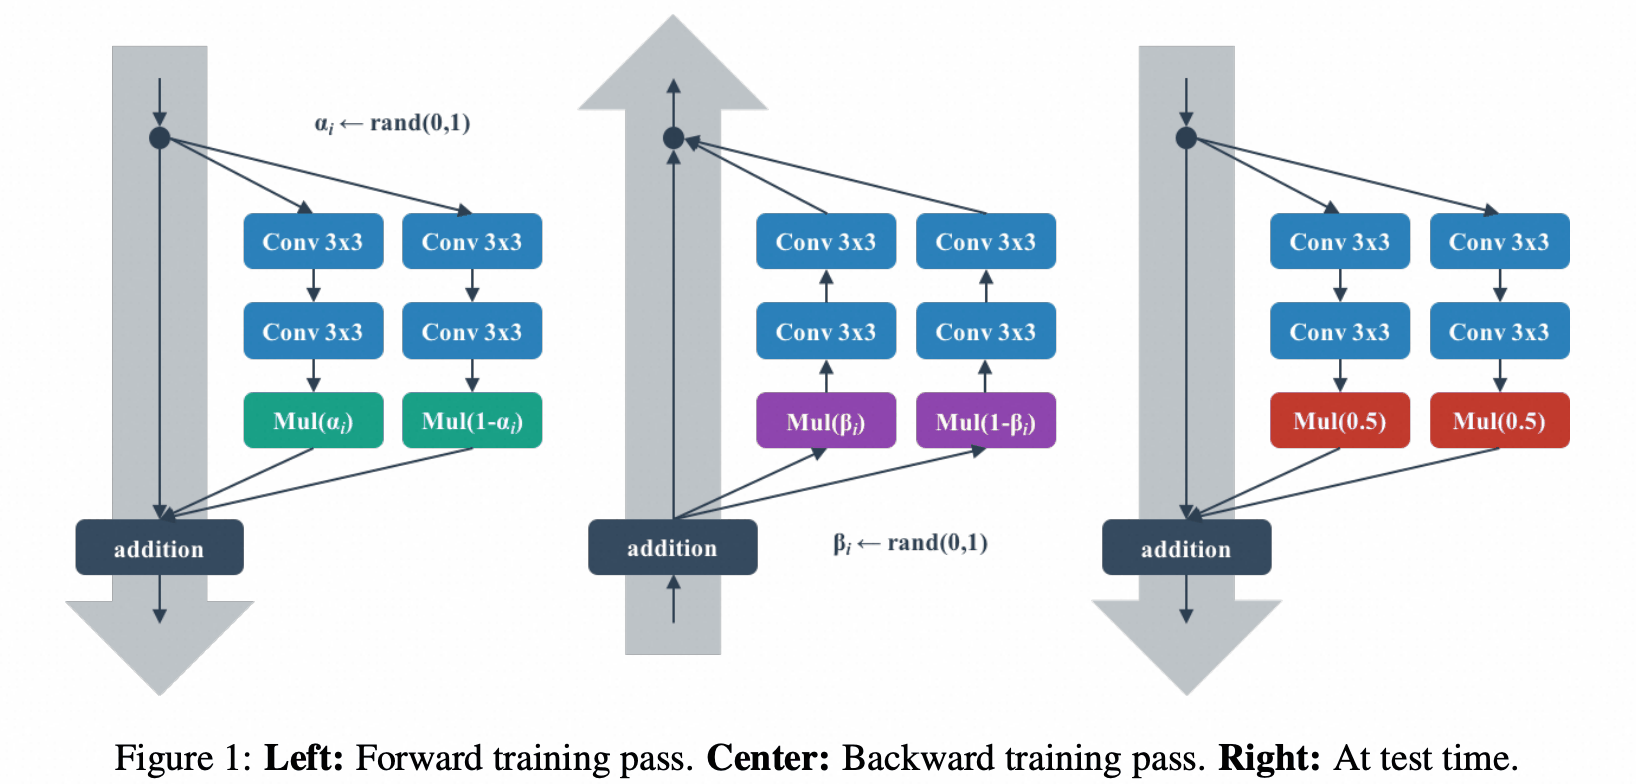
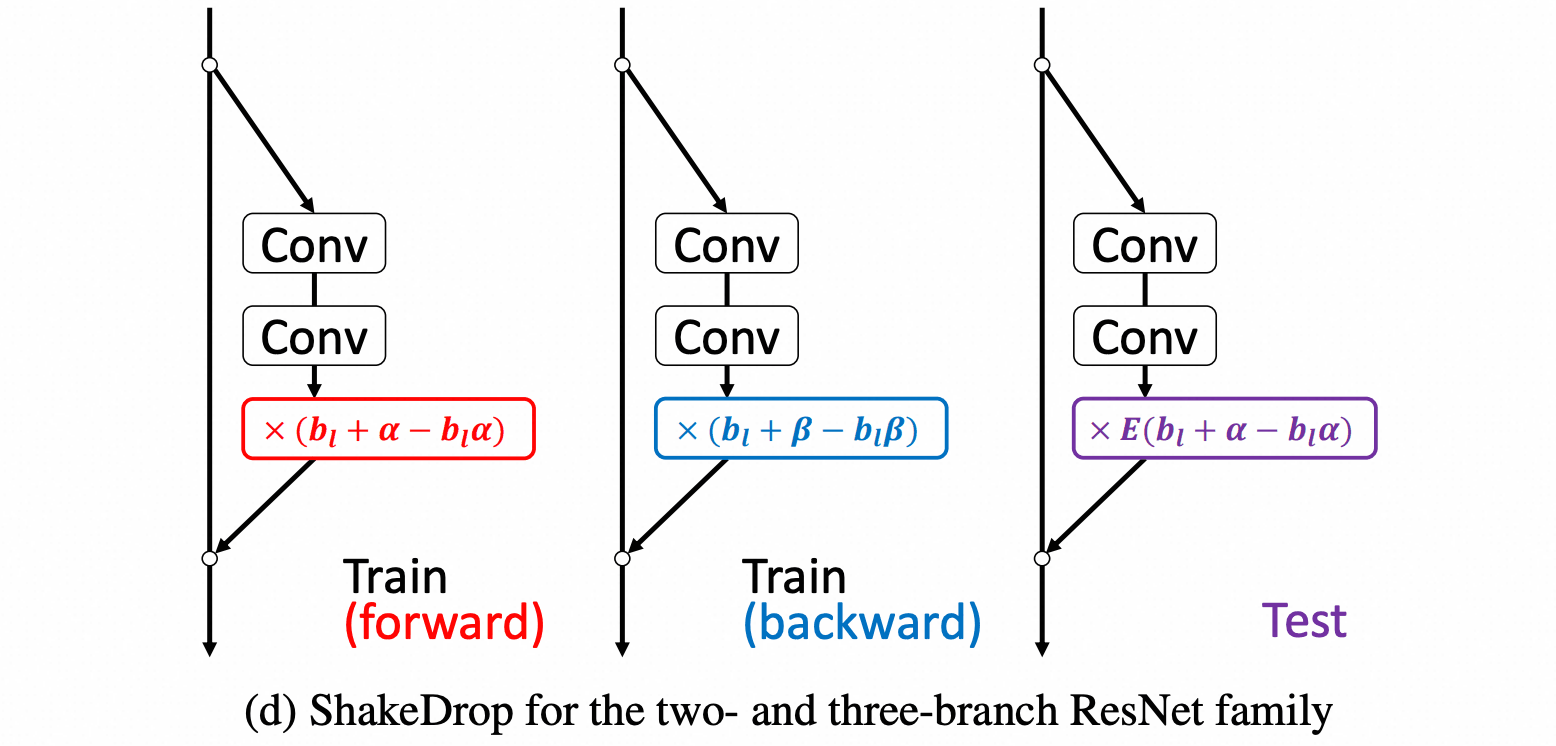
ShakeDrop把它推广到单分支残差块(如ResNet、PyramidNet),并用一个伯努利门控($b_l$)在正常残差块和shake之间切换,从而避免了训练崩溃。这两种方法在长训练预算的CIFAR任务上非常有效,但需要的训练轮数很多(通常$1800$轮),在大规模数据上并不常用。
⚪ Token Dropping:丢弃序列中的token
在Transformer中还有一个独特的丢弃维度:序列长度。Token Dropping在预训练的中间层丢弃不重要的token(用masked LM损失衡量重要性),让它们跳过中间若干层、在最后一层再重新接入。
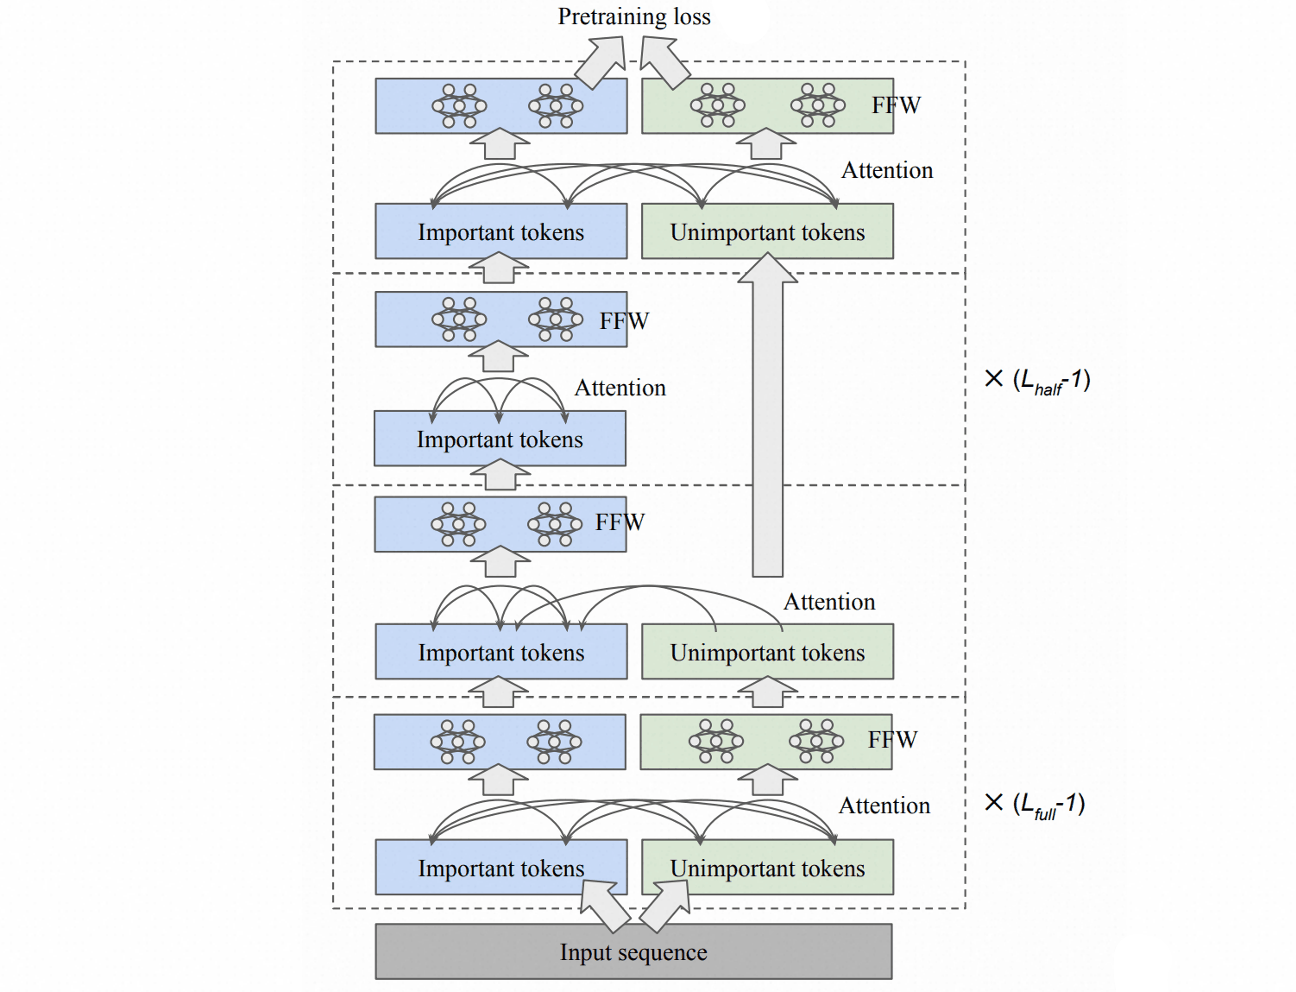
严格来说它的主要动机是效率(预训练加速约$25\%$而不损失下游性能),但它同时也起到了正则化作用:网络不能依赖任何特定token在所有层都存在。MAE式的高比例掩码预训练、以及视觉Transformer中的token pruning/merging都可以看作同一思想的变体。
⭐ 讨论:结构约束的其他形式
BatchNorm除了加速优化外还自带正则化效应:每个样本的归一化统计量依赖于同批次的其他样本,因此引入了与批量采样相关的噪声,等价于对激活值施加了乘性与加性随机扰动。这也解释了为什么使用BatchNorm后往往可以减小甚至去掉Dropout,以及为什么BatchNorm的正则化强度随批量增大而减弱。LayerNorm、GroupNorm等不跨样本的归一化没有这种噪声,因此不具备该效应。详见深度学习中的归一化方法。
此外,参数共享也是一种“硬”的结构正则化:卷积的权重共享、循环网络沿时间的权重共享、Transformer的跨层参数共享(ALBERT)都通过直接减少自由参数来限制模型复杂度。它们不引入噪声,属于第1.3节中“限制复杂度”那条路径。
2.3 约束优化过程
这一族方法既不修改损失中的参数惩罚项,也不修改网络的前向结构,而是在训练流程上做手脚:改造输入数据、改造标签、改造梯度、改造停止条件、或者改造被优化的目标本身。
⚪ 数据增强 Data Augmentation
数据增强(data augmentation)通过保持任务语义的随机变换、样本混合或条件生成扩展训练分布,是视觉任务中性价比最高的正则化手段之一。设$t\sim\mathcal{T}$为随机增强,$\tau_t$为标签的对应变换,则训练目标为:
\[L_{\mathrm{aug}}(\theta)=\frac{1}{N}\sum_{i=1}^{N}\mathbb{E}_{t\sim\mathcal{T}} \left[\mathcal{L}\left(f_{\theta}(t(x_i)),\tau_t(y_i)\right)\right]\]它把每个离散训练样本扩展成一个局部邻域,并将任务先验编码为不变性或等变性约束。增强不是越强越好:一旦变换越过类别边界,就会从降低方差变成引入标签偏差。分类增强、结构化标注同步、混合标签公式、自动策略、生成式增强、训练配方与常见错误统一整理在《图像的数据增强》中。
⚪ 梯度裁剪 Gradient Clipping
梯度裁剪(gradient clipping)用来防止梯度爆炸,尤其是在训练深度网络、循环网络和大语言模型时。它根据梯度的模长对更新量做缩放,控制更新量的模长不超过一个常数$\gamma$:
\[\theta \leftarrow \theta - \eta \nabla_{\theta}f(\theta) \times \min \left\{ 1, \frac{\gamma}{||\nabla_{\theta}f(\theta)||} \right\}\]上式也常用一个光滑的等价形式代替(避免在阈值处不连续):
\[\theta \leftarrow \theta - \eta \nabla_{\theta}f(\theta) \times \frac{\gamma}{||\nabla_{\theta}f(\theta)||+\gamma}\]梯度裁剪之所以有效,是因为它对应一个比Lipschitz约束更宽松、也更符合实际的光滑性假设。作者观察到损失函数的光滑程度与梯度模长近似线性相关,据此提出$(L_0,L_1)$-Smooth条件:
\[||\nabla_{\theta}f(\theta+\Delta \theta) - \nabla_{\theta}f(\theta)|| \leq \left(L_0+L_1 ||\nabla_{\theta}f(\theta)||\right) ||\Delta \theta||\]在这个条件下,构造辅助函数\(f(\theta+t\Delta\theta),t\in[0,1]\)可得下降量的上界:
\[\begin{aligned} f(\theta+\Delta \theta) - f(\theta) &= \int_0^1 \left< \nabla_{\theta} f(\theta+t\Delta \theta), \Delta \theta\right> dt \\ & = \left<\nabla_{\theta} f(\theta), \Delta \theta\right>+\int_0^1 \left<\nabla_{\theta} f(\theta+t\Delta \theta)-\nabla_{\theta} f(\theta), \Delta \theta\right> dt \\ & \leq \left<\nabla_{\theta} f(\theta), \Delta \theta\right>+\int_0^1 \left(L_0+L_1 ||\nabla_{\theta}f(\theta)||\right) \cdot t\,|| \Delta \theta||^2 dt \\ & = \left<\nabla_{\theta} f(\theta), \Delta \theta\right>+ \frac{1}{2}\left(L_0+L_1 ||\nabla_{\theta}f(\theta)||\right) \cdot || \Delta \theta||^2 \\ \end{aligned}\]代入梯度下降公式\(\Delta\theta= - \eta \nabla_{\theta}f(\theta)\)得到:
\[\begin{aligned} f(\theta+\Delta \theta) - f(\theta) & \leq \left(\frac{1}{2}\left(L_0+L_1 ||\nabla_{\theta}f(\theta)||\right)\eta^2-\eta \right) \cdot || \nabla_{\theta}f(\theta)||^2 \\ \end{aligned}\]要保证损失下降需\(\eta < 2/(L_0+L_1 \|\nabla_{\theta}f(\theta)\|)\),而使上界最小的学习率为:
\[\eta = \frac{1}{L_0+L_1 ||\nabla_{\theta}f(\theta)||}\]此时更新过程为:
\[\theta \leftarrow \theta - \nabla_{\theta}f(\theta) \times \frac{1}{L_0+L_1 ||\nabla_{\theta}f(\theta)||}\]这与梯度裁剪的形式完全一致。因此梯度裁剪是在$(L_0,L_1)$-Smooth假设下自适应地选取了最优步长,使更新近似为损失下降最快的方向;这也解释了为什么梯度裁剪能加速训练。
梯度裁剪有两种常见实现:
(1) 数值裁剪 clip_grad_value
直接将每个梯度分量裁剪到给定范围内:
\[\theta \leftarrow \theta - \eta \,\text{Clip} \left( \nabla_{\theta}f(\theta) , - \text{maxVal}, \text{maxVal} \right)\]点击展开代码
losses.backward()
torch.nn.utils.clip_grad_value_(model.parameters(), clip_value)
optimizer.step()
数值裁剪会改变梯度方向(不同分量被不同程度地压缩),因此一般不如范数裁剪常用。
(2) 范数裁剪 clip_grad_norm
通过把全体梯度的$L_2$范数裁剪到最大值 maxNorm 来控制梯度大小。首先计算所有参数梯度拼接后的$L_2$范数:
\[\text{totalNorm} = \sqrt{\sum_i ||\text{grad}_i||_2^2}\]如果 totalNorm 不超过 maxNorm 则梯度保持不变;否则按比例统一缩放,使新梯度的整体范数等于 maxNorm:
\[\text{grad}_i \leftarrow \text{grad}_i \times \min\left(1, \frac{\text{maxNorm}}{\text{totalNorm}}\right)\]点击展开代码
losses.backward()
torch.nn.utils.clip_grad_norm_(
    model.parameters(),
    clip_max_norm,
    norm_type=2.0,             # 所用 p 范数的类型
    error_if_nonfinite=False,  # 梯度总范数为 nan/inf 时是否抛出错误
)
optimizer.step()
范数裁剪保持梯度方向不变,是大模型训练的默认配置(常取\(\text{maxNorm}=1.0\))。注意必须在backward()之后、step()之前调用;若使用混合精度训练,还需先对梯度做unscale。
⚪ Early Stopping:用迭代次数控制复杂度
Early Stop是指训练时当观察到验证集上的误差不再下降就停止迭代。它是最简单也最有效的正则化方法:不需要修改模型、不需要额外计算,只需要一个验证集。具体停止时机的判据可参考Early stopping-but when?。
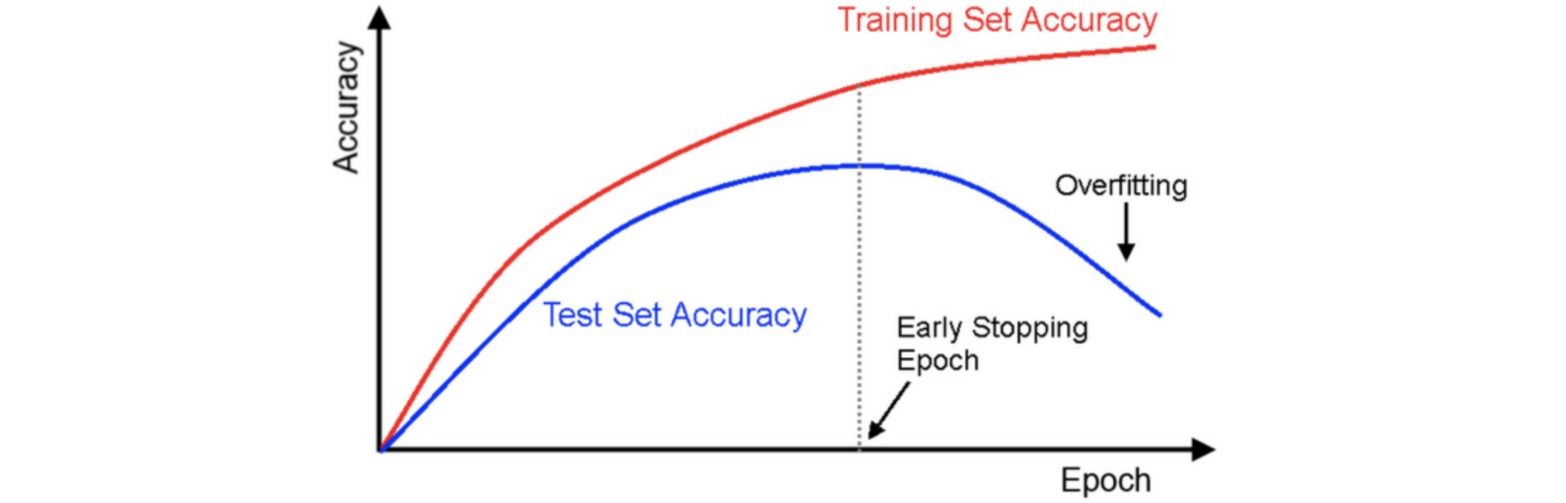
Early Stop可以理解为把“训练步数”当成一个超参数来做模型选择:迭代步数越多,参数能够偏离初始化的距离越远,模型的有效容量越大。第2.4节将证明它与$L_2$正则化在二次近似下是定量等价的。
实践要点:patience(容忍多少轮不改善)不宜过小,否则容易在损失曲线的正常波动中提前停止;应当保存验证指标最优的检查点而非最后一个检查点;在存在双下降或grokking现象的任务上,过早停止可能错过第二次下降。
⚪ 标签平滑 Label Smoothing
前面的方法都在输入侧或参数侧引入噪声,标签平滑(Label Smoothing)则在标签上引入噪声。
在分类任务中,网络输出长度为类别数$K$的logits $z$,经softmax转化为概率分布$\hat{y}$:
\[\hat{y}_i = \frac{\exp(z_i)}{\sum_{j=1}^{K} \exp(z_j)}\]以交叉熵为损失:
\[\mathcal{l}(\hat{y},y) = - \sum_{i=1}^{K} y_i\log\hat{y}_i = - \sum_{i=1}^{K} y_i\left[z_i - \log\left(\sum_{j=1}^{K} \exp(z_j)\right)\right]\]当标签采用one-hot编码(\(y_{\text{true}}=1\),\(y_{\text{false}}=0\))时,令损失对logits的导数为零可知最优解要求\(\hat{y}_{\text{true}} \to 1\),即\(z_{\text{true}}-z_{\text{false}} \to +\infty\)。这带来两个问题:
- 过拟合:网络把全部概率质量赋给真值类别,输出过度自信,泛化能力和校准性下降;若标签本身有噪声,这种“死记硬背”的危害更大;
- 优化困难:目标值是无穷大而梯度是有界的,需要非常多次更新才能接近,训练后期收益很低。
标签平滑把Hard Target替换为Soft Target,即假设样本以$\epsilon$的概率被错误标注为其他类别:
\[y_i' = \begin{cases} 1- \epsilon, & i=\text{true} \\ \dfrac{\epsilon}{K-1}, & \text{otherwise} \end{cases}\]此时网络输出logits的学习目标满足:
\[\frac{\exp(z_{\text{true}})}{\sum_{j} \exp(z_j)} = 1- \epsilon,\qquad \frac{\exp(z_{\text{false}})}{\sum_{j} \exp(z_j)} = \frac{\epsilon}{K-1}\]两式相除并取对数,得到正确类与错误类logits之间的有限间隔:
\[z_{\text{true}} - z_{\text{false}} = \log\left(\frac{(1- \epsilon)(K-1)}{\epsilon}\right)\]记\(z_{\text{false}}=\alpha\),则网络输出logits的目标值为:
\[z_i^* = \begin{cases} \log\left(\dfrac{(1- \epsilon)(K-1)}{\epsilon}\right) + \alpha, & i=\text{true} \\ \alpha, & \text{otherwise} \end{cases}\]也就是说,应用标签平滑后logits的目标值是有限的,且这个间隔只取决于类别数$K$和超参数$\epsilon$(实践中常取$\epsilon=0.1$)。等价地,标签平滑可以写成原损失加上一个“预测分布与均匀分布的KL散度”惩罚项,因此它也是一种熵正则化:鼓励模型输出保持一定的熵。
When Does Label Smoothing Help?对标签平滑的深入分析给出了三个重要结论:
- 表示层面的几何效应:标签平滑使倒数第二层的表示形成更紧致的类簇,且各类簇到其他类别模板的距离更均等。one-hot训练只要求“正确类的logit足够大”,对错误类之间的相对距离没有约束;标签平滑则显式要求所有错误类的logit相等,从而抹平了类别之间的相似性差异。
- 改善校准:标签平滑显著降低了模型的期望校准误差(ECE),效果与温度缩放相当,但无需事后调参。这对需要可靠置信度的任务很有价值。
- 损害知识蒸馏:正是因为标签平滑抹平了类别间的相似性结构,用标签平滑训练的教师模型蒸馏出的学生反而更差:教师logits中携带的类间相似性信息(蒸馏真正依赖的暗知识)被破坏了。作者用互信息定量验证了这一点。
因此实践建议是:直接部署的模型可以用标签平滑;作为蒸馏教师的模型不要用。此外在细粒度分类、度量学习等依赖类间相似结构的任务上也应谨慎。
⚪ 权重衰减与AdamW:解耦L2正则化
第2.1节已经指出:$L_2$正则化与权重衰减只在标准SGD中等价。本文系统地分析了这一问题并给出解法。
在损失函数中引入$L_2$正则化的形式为:
\[f_t^{reg}(\theta) = f_t(\theta)+\frac{\lambda}{2\alpha} ||\theta_t||_2^2\]应用标准SGD时参数更新为:
\[\theta_{t+1} = \theta_t-\alpha\nabla f_t^{reg}(\theta_t) = \theta_t-\alpha\nabla f_t(\theta_t)- \lambda \theta_t = (1-\lambda)\theta_t-\alpha\nabla f_t(\theta_t)\]即“损失中的$L_2$项”与“更新时的权重收缩”是同一回事。但在Adam等自适应梯度算法中,更新量被梯度二阶矩缩放,$L_2$项也一并被缩放,导致梯度大的权重被正则化得更弱,与正则化的初衷相悖。
解决办法是把权重衰减从梯度更新中解耦,即在最后的参数更新步骤中单独施加衰减,使所有权重以相同的相对幅度衰减,这就是AdamW:
\[\theta_{t+1} \leftarrow \theta_t - \alpha \left(\frac{\hat{m}_t}{\sqrt{\hat{v}_t}+\epsilon}+\lambda \theta_t\right)\](对SGD做同样的解耦得到SGDW,其形式与原始SGD+$L_2$一致,说明这里的问题确实只出在自适应算法上。)本文的主要结论包括:
- $L_2$正则化与权重衰减不等价(在自适应算法中);
- $L_2$正则化对Adam基本无效,而解耦的权重衰减有效;
- 解耦后学习率$\alpha$与正则化系数$\lambda$的超参数空间近似可分离,大大简化了调参;
- 最优的权重衰减值取决于总的权重更新次数(训练更久应使用更小的$\lambda$)。
AdamW如今是Transformer与大模型训练的默认优化器;关于优化器本身的完整讨论见深度学习中的优化算法。
⭐ 讨论:权重衰减到底在做什么
在现代网络中,“权重衰减 = 惩罚模型复杂度”这个朴素解释其实站不住脚。原因很直接:只要网络中有归一化层(BatchNorm、LayerNorm),把某一层权重整体缩放$\gamma$倍并不改变网络的函数(归一化会把缩放抵消掉),因此\(\|W\|\)本身并不度量函数复杂度。
那么权重衰减为什么还有效?至少有三种机制:
- 在没有归一化层时,它确实起到经典的$L_2$正则化(缩小假设空间)作用;
- 在有归一化层时,它主要通过缩小权重范数来放大有效学习率——因为归一化层后梯度的有效步长与\(1/\|W\|\)成正比,衰减权重等于隐式地提高学习率,从而增强SGD噪声带来的隐式正则化;
- 在使用二阶或自适应优化时,它还会影响损失曲面的条件数(Hessian的谱),起到类似阻尼的作用。
这个结论有很强的实践含义:权重衰减与学习率、归一化层是耦合在一起的,不能独立调节;而且对归一化层的缩放/平移参数施加权重衰减通常是有害的,应当从衰减列表中排除。
⚪ 变分信息瓶颈 Variational Information Bottleneck
变分信息瓶颈(Variational Information Bottleneck, VIB)的出发点是用尽可能少的信息完成任务:如果中间表示只保留了对预测标签有用的信息、丢掉了输入中的其余细节,那么模型自然无法记住训练样本的个体特征,泛化能力更好。
深度学习模型可以拆分成编码+预测两个步骤:先把$x$编码为隐变量$z$,再把$z$预测为标签$y$。
\[x \to z \to y\]VIB希望尽可能减少隐变量$z$中关于$x$的信息量,这由互信息$I(x,z)$衡量:
\[I(x,z) = \mathbb{E}_{p(x,z)} \left[ \log \frac{p(x,z)}{p(x)p(z)} \right] = \iint p(x,z)\log \frac{p(x,z)}{p(x)p(z)} dxdz\]但$p(z)$(隐变量的边缘分布)通常是未知且难以计算的。引入一个形式已知的分布$q(z)$即可得到一个变分上界:
\[\begin{aligned} I(x,z) &= \iint p(x,z)\log \frac{p(z|x)q(z)}{p(z)q(z)} dxdz \\ &= \iint p(x,z)\log \frac{p(z|x)}{q(z)} dxdz + \iint p(x,z)\log \frac{q(z)}{p(z)} dxdz \\ &= \int p(x) KL\left[ p(z|x) \mid\mid q(z)\right]dx - KL\left[ p(z) \mid\mid q(z)\right] \\ &\leq \mathbb{E}_{p(x)} \left[ KL\left[ p(z|x) \mid\mid q(z)\right] \right] \\ \end{aligned}\]最后一步用到了KL散度非负。因此对于分类任务,引入变分信息瓶颈后的总损失函数为:
\[\begin{aligned} \mathcal{L} &= \mathbb{E}_{p(x)} \left[ \mathbb{E}_{p(z|x)} \left[ -\log p(y|z) \right] + \lambda KL\left[ p(z|x) \mid\mid q(z)\right] \right] \\ \end{aligned}\]相比原始的监督学习任务,变分信息瓶颈的改动只有两处:
- 使用编码器$p(z|x)$输出特征分布的均值和方差,并加入重参数化操作;
- 加入后验分布$p(z|x)$与给定先验$q(z)$之间的KL散度作为额外的损失项。
其形式与变分自编码器非常类似。取\(q(z)=\mathcal{N}(0,1)\)、\(p(z\mid x)=\mathcal{N}(\mu, \sigma^2)\)时KL散度有闭式解:
\[\begin{aligned} KL\left[\mathcal{N}(\mu,\sigma^{2})||\mathcal{N}(0,1)\right] &= \frac{1}{2} \left(-\log \sigma^2 + \mu^2+\sigma^2-1\right) \end{aligned}\]点击展开代码
(mu, std), logit = self.model(x)
class_loss = F.cross_entropy(logit, y)
info_loss = -0.5*(1+2*std.log()-mu.pow(2)-std.pow(2)).sum(1).mean()
total_loss = class_loss + self.lambd*info_loss
从噪声的视角看,VIB其实是“在隐层加高斯噪声”的一个有原则的版本:KL项迫使$\sigma$不能太小(噪声不能太弱)、$\mu$不能太大(信号不能太强),信噪比因此被显式地控制住。
⚪ 虚拟对抗训练 Virtual Adversarial Training
- paper:Virtual Adversarial Training: A Regularization Method for Supervised and Semi-Supervised Learning
标准的对抗训练求解一个极小极大问题,需要用到标签$y$:
\[\mathop{\min}_{\theta} \mathbb{E}_{(x,y)\sim \mathcal{D}} \left[ \mathop{\max}_{\Delta x \in \Omega} \mathcal{L}(x+\Delta x,y;\theta) \right]\]虚拟对抗训练(Virtual Adversarial Training, VAT)把标签换成模型自身的预测,从而不需要标签(因此可以用于半监督学习):寻找使得输出分布变化\(l(f(x+\epsilon),f(x))\)尽可能大的扰动$\epsilon$,再最小化这个变化量,从而增强网络对扰动的鲁棒性。
关键问题是如何高效地找到最坏方向。对\(l(f(x+\epsilon),f_{sg}(x))\)在$\epsilon=0$处做Taylor展开(下标$sg$表示梯度截断):
\[l(f(x+\epsilon),f_{sg}(x)) \approx l(f(x),f_{sg}(x)) + \epsilon^T\nabla_xl + \frac{1}{2}\epsilon^T\nabla_x^2l\,\epsilon\]对于一般的距离型损失有$l(x,x)=0$,且$x$是$l$的极小点,故零阶项和一阶项都为零:
\[l(f(x+\epsilon),f(x)) \approx \frac{1}{2}\epsilon^T\mathcal{H}\epsilon,\qquad \mathcal{H}=\nabla_x^2l\left(f(x),f_{sg}(x)\right)\]这一点非常重要:VAT与FGSM式的对抗训练本质不同:后者靠一阶梯度确定方向,而VAT的一阶项恒为零,必须借助二阶信息。由瑞利商可知,最大化\(\epsilon^T \mathcal{H} \epsilon\)的方向是\(\mathcal{H}\)的主特征向量,可用幂迭代求解:\(u \leftarrow \mathcal{H}u/\|\mathcal{H}u\|\)。
而幂迭代并不需要显式构造\(\mathcal{H}\),只需要计算矩阵向量积\(\mathcal{H}u\),这可以用有限差分近似:
\[\begin{aligned} \mathcal{H}u &= \nabla_x\left(u \cdot \nabla_xl\left(f(x),f_{sg}(x)\right)\right) \\ &\approx \nabla_x\left( \frac{l\left(f(x+\xi u),f_{sg}(x)\right)-l\left(f(x),f_{sg}(x)\right)}{\xi} \right) = \frac{1}{\xi} \nabla_x l\left(f(x+\xi u),f_{sg}(x)\right) \\ \end{aligned}\]因此VAT的完整流程如下:
- 初始化向量\(u\sim \mathcal{N}(0,1)\)、标量$\epsilon, \xi$;
- 迭代$r$次:\(\begin{aligned} u &\leftarrow \frac{u}{\| u \|} \\ u &\leftarrow \nabla_x l\left(f(x+\xi u),f_{sg}(x)\right) \end{aligned}\)
- \(u \leftarrow u/\| u \|\);
- 用\(l\left(f(x+\epsilon u),f_{sg}(x)\right)\)作为额外的正则化损失执行梯度下降。
注意当$r=0$时相当于向输入添加各向同性的高斯噪声;VAT通过$r \geq 1$次迭代把噪声“聚焦”到模型最脆弱的方向上,因此比随机噪声有效得多。实践中$r=1$就足够,每步的额外代价是一次前向和一次反向。
点击展开代码
class VATLoss(nn.Module):
    def __init__(self, xi=10.0, eps=1.0, ip=1):
        super().__init__()
        self.xi, self.eps, self.ip = xi, eps, ip

    def forward(self, model, x):
        with torch.no_grad():
            pred = F.softmax(model(x), dim=1)
        d = _l2_normalize(torch.rand(x.shape).sub(0.5).to(x.device))
        with _disable_tracking_bn_stats(model):
            for _ in range(self.ip):        # 幂迭代寻找最坏方向
                d.requires_grad_()
                logp_hat = F.log_softmax(model(x + self.xi * d), dim=1)
                adv_distance = F.kl_div(logp_hat, pred, reduction='batchmean')
                adv_distance.backward()
                d = _l2_normalize(d.grad)
                model.zero_grad()
            logp_hat = F.log_softmax(model(x + self.eps * d), dim=1)
            lds = F.kl_div(logp_hat, pred, reduction='batchmean')
        return lds
注意实现中需要临时关闭BatchNorm的统计量更新,否则对抗样本会污染运行均值方差。
⚪ 对抗训练作为正则化
标准的对抗训练(FGSM-AT、PGD-AT)虽然以提升鲁棒性为主要目标,但它同时也是一种强力的正则化:第2.1节已经说明,单步对抗训练在一阶近似下等价于对输入的梯度惩罚。
不过在自然精度上,对抗训练通常是有害的:存在明确的鲁棒性-精度权衡,$L_\infty$约束下的PGD-AT往往会降低干净样本的准确率。真正把对抗训练当作纯正则化手段来用而且成功的例子主要在NLP领域(如FreeLB、SMART),那里的扰动加在词嵌入上、幅度很小,效果类似于VAT。关于攻击与防御方法的完整讨论见分类任务中的对抗攻击。
⚪ Flooding:不要让训练损失降到零
过参数化的深度网络能够实现零训练误差,此时它会继续把训练损失往零推,也就是继续“记忆”训练数据;尽管训练损失接近$0$,测试精度反而下降。Flooding为损失函数指定一个合理的较小值$b$(flood level),使其在优化时在该值附近波动而不至于继续下降:
\[\tilde{\mathcal{L}}(\theta) = \left| \mathcal{L}(\theta) -b\right| + b\]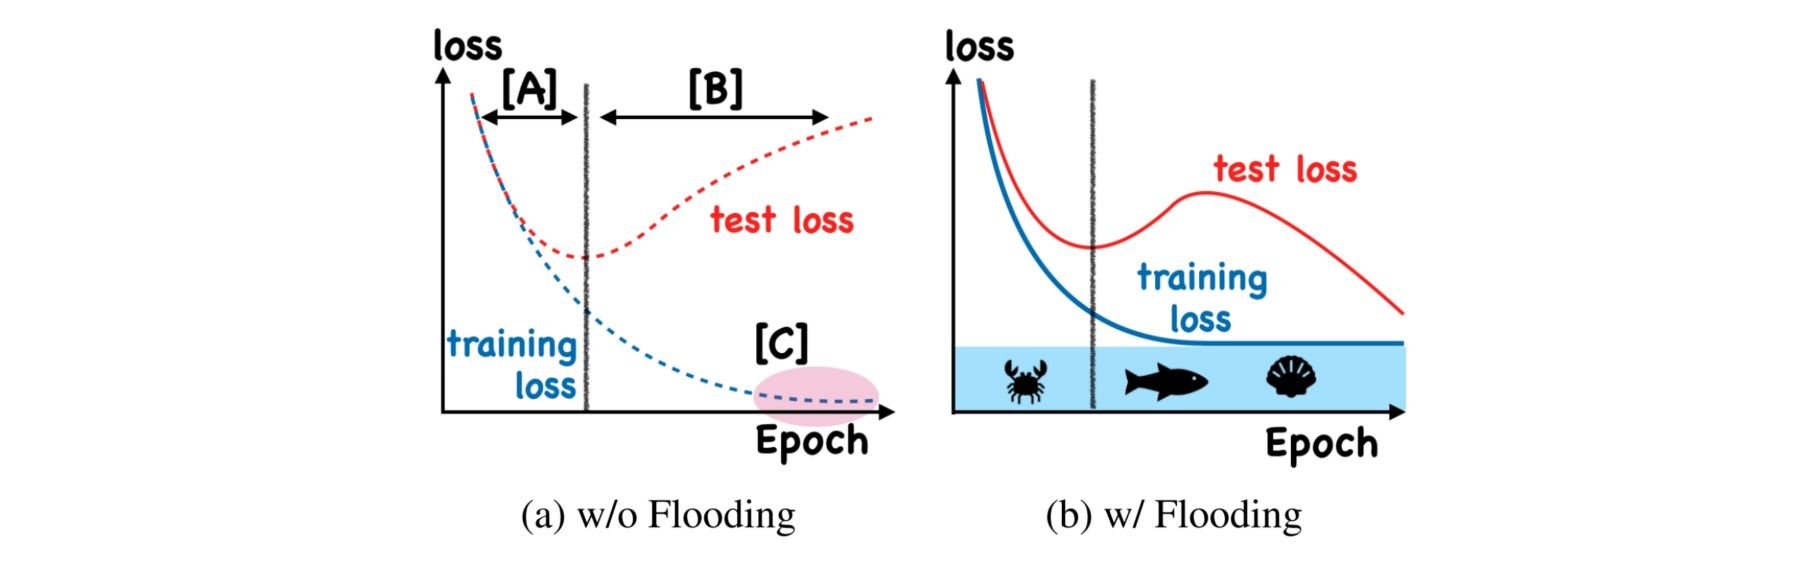
实现只需一行代码:
点击展开代码
loss = (loss - b).abs() + b
当\(\mathcal{L}(\theta)>b\)时\(\tilde{\mathcal{L}}=\mathcal{L}\),执行正常的梯度下降;当\(\mathcal{L}(\theta)<b\)时\(\tilde{\mathcal{L}}=2b-\mathcal{L}\),损失变号,执行梯度上升。
有意思的是,这种“下降-上升”的交替并非在原地打转,而是等价于对梯度范数做梯度下降。假设学习率为$\eta$,参数先下降一次再上升一次:
\[\begin{aligned} \theta_{t} &= \theta_{t-1}-\eta g(\theta_{t-1}) \\ \theta_{t+1} &= \theta_{t}+\eta g(\theta_{t}) = \theta_{t-1}-\eta g(\theta_{t-1})+\eta g\left(\theta_{t-1}-\eta g(\theta_{t-1})\right) \\ &\approx \theta_{t-1}-\eta g(\theta_{t-1})+\eta \left[g(\theta_{t-1})-\eta \nabla_{\theta}g(\theta_{t-1}) g(\theta_{t-1})\right] \\ &= \theta_{t-1}-\eta^2 \nabla_{\theta}g(\theta_{t-1}) g(\theta_{t-1}) = \theta_{t-1}-\frac{\eta^2}{2} \nabla_{\theta}|| g(\theta_{t-1})||^2 \end{aligned}\]其中\(g(\theta)=\nabla_{\theta}\mathcal{L}(\theta)\),第三步用到了Taylor展开。可见Flooding的净效果相当于以学习率$\eta^2/2$对梯度惩罚项\(\|\nabla_{\theta}\mathcal{L}(\theta)\|^2\)做梯度下降:当损失降到$b$附近后,优化目标自动切换成“寻找更平坦的极小点”。这与第2.1节的梯度惩罚、下面的SAM是同一件事的不同实现。
实践中$b$的选取需要一些试探(通常按验证集网格搜索),且$b$取得过大会导致欠拟合。
⚪ SAM:显式地寻找平坦极小点
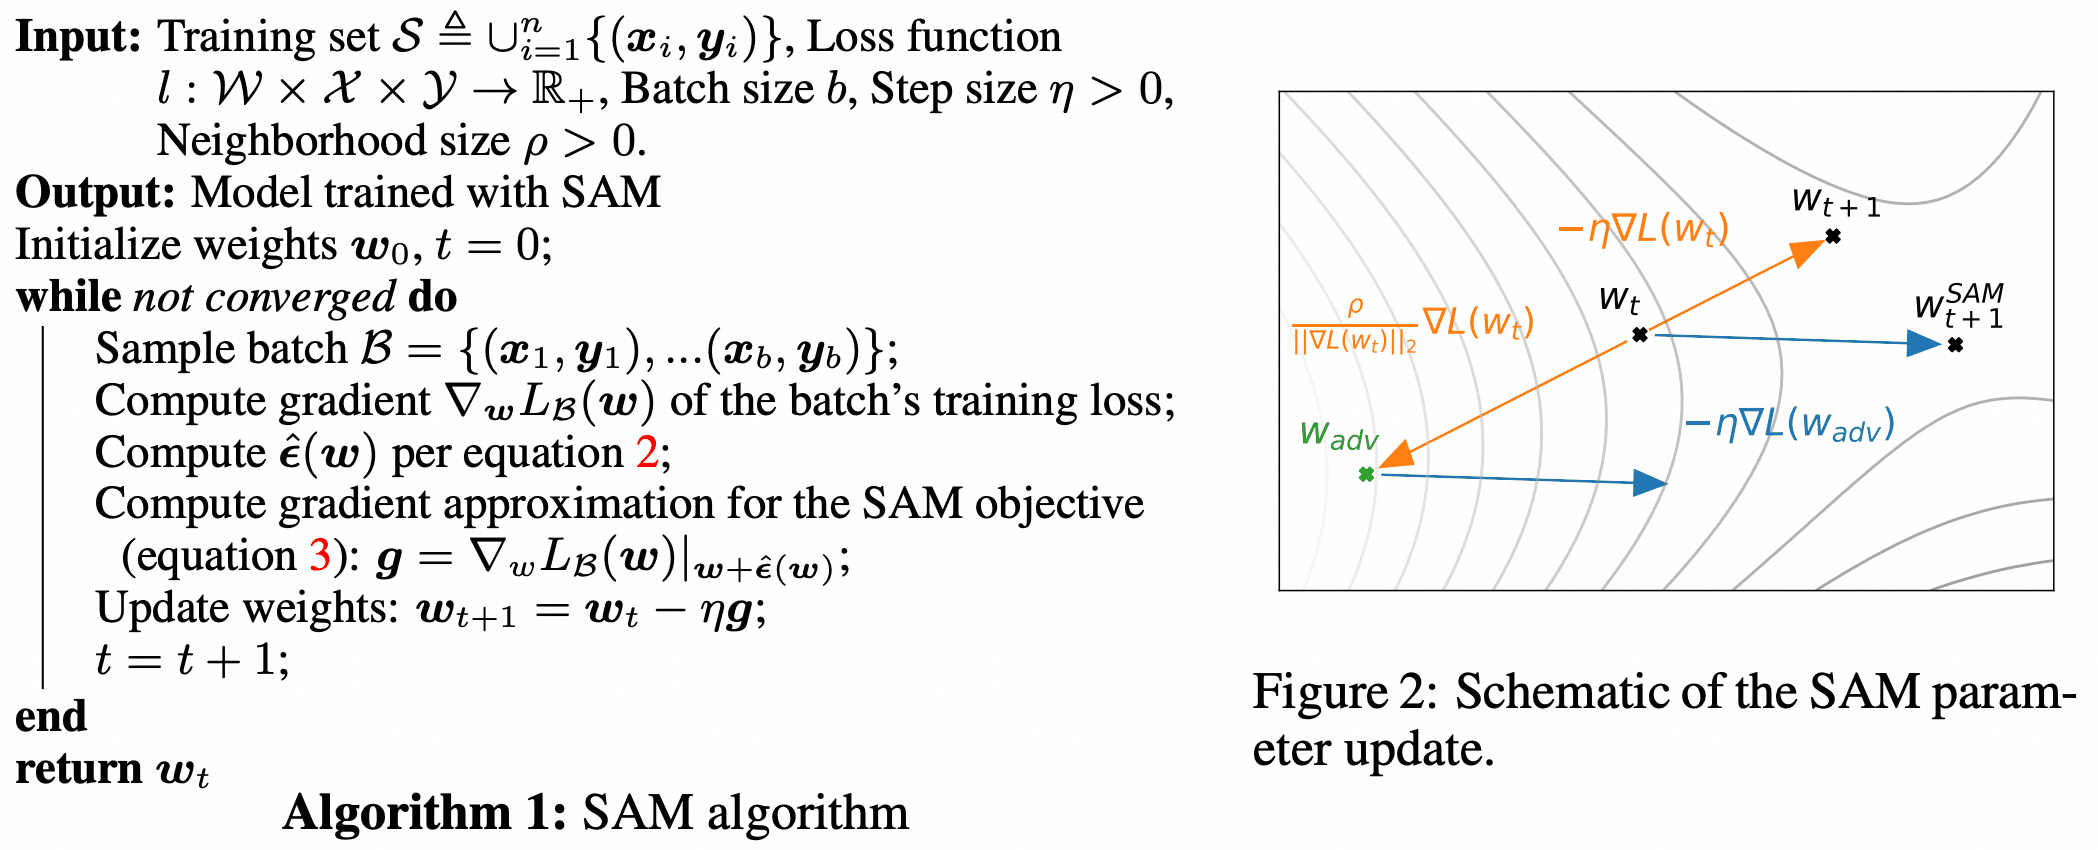
前面反复出现的一个主题是“平坦的极小点泛化更好”。SAM(Sharpness-Aware Minimization)把这个直觉变成显式的优化目标:不最小化当前点的损失,而最小化邻域内最坏点的损失。
\[\mathop{\min}_{\theta} \mathop{\max}_{||\epsilon||_2\leq \rho} \mathcal{L}(\theta+\epsilon)\]这与对抗训练的形式完全一致,只不过扰动加在参数上而不是输入上。内层的最大化用一阶近似求解:
\[\hat{\epsilon}(\theta) = \rho \frac{\nabla_{\theta} \mathcal{L}(\theta)}{||\nabla_{\theta} \mathcal{L}(\theta)||}\]然后用扰动点处的梯度更新原参数:
\[\theta \leftarrow \theta - \eta \nabla_{\theta} \mathcal{L}\left(\theta+\hat{\epsilon}(\theta)\right)\]因此每步需要两次前向反向传播(一次求$\hat\epsilon$、一次求更新梯度),计算量约为基线的两倍。SAM在视觉分类、ViT训练、噪声标签学习上都有稳定收益,在ViT上尤其明显(它在一定程度上可以替代大规模预训练)。
⚪ SAM的高效变体
SAM的两倍开销是它在大规模训练中最大的障碍,随后出现了一系列改进:
- ASAM:ASAM: Adaptive Sharpness-Aware Minimization for Scale-Invariant Learning of Deep Neural Networks。SAM定义的“锐度”不是尺度不变的(对权重重新缩放会改变锐度但不改变函数)。ASAM用逐元素的归一化算子\(T_\theta = \text{diag}(\mid \theta \mid+\eta)\)重新定义邻域,使锐度对权重缩放不变:\(\hat\epsilon = \rho T_\theta^2\nabla\mathcal{L}/\|T_\theta\nabla\mathcal{L}\|\)。
- ESAM:Efficient Sharpness-aware Minimization for Improved Training of Neural Networks。用两个技巧降低开销:随机权重扰动(只扰动一部分权重)和锐度敏感的数据选择(只用对锐度贡献大的样本计算第二次梯度),把额外开销从$100\%$降到约$40\%$。
- LookSAM:Towards Efficient and Scalable Sharpness-Aware Minimization。观察到SAM梯度中“垂直于普通梯度”的那个分量变化很慢,因此只需每$k$步(如$k=5$)计算一次完整的SAM梯度,中间步骤复用缓存的垂直分量,把平均开销摊薄到接近基线。
- GSAM:Surrogate Gap Minimization Improves Sharpness-Aware Training。指出\(\max_\epsilon \mathcal{L}(\theta+\epsilon)\)在损失很小时未必反映锐度,改为同时最小化损失和“代理间隙”\(\max_\epsilon\mathcal{L}(\theta+\epsilon)-\mathcal{L}(\theta)\)。
⭐ 讨论:锐度与泛化的争论
SAM有效已经过大量实验证明,但“它有效是因为找到了更平坦的极小点”这个解释近年受到了严肃质疑。
- A Modern Look at the Relationship between Sharpness and Generalization在大量模型上系统测量了各种锐度指标与泛化间隙的相关性,结论是:锐度与泛化的相关性很弱,甚至常常是反的。锐度更多地反映了训练超参数(学习率、批量大小、训练时长),而这些超参数本身与泛化相关,造成了虚假关联。
- 另一条线的工作指出SAM的收益可能来自其他机制:它对噪声标签特别鲁棒(早期训练阶段抑制了对错误样本的记忆)、它隐式地平衡了各层的梯度范数、它偏好特定的特征学习动力学。
- 还有工作发现即使把SAM的扰动改成完全随机的方向,也能获得部分收益,这进一步说明“最坏方向”并非全部原因。
实践上的态度应当是:SAM(尤其是它的高效变体)是一个值得尝试的技巧,在ViT训练和噪声标签场景下收益明确;但不应该把“平坦极小点”当成已经证实的解释,也不要用锐度指标去预测模型的泛化能力。
⚪ 权重平均:SWA、EMA与Model Soup
- paper:Averaging Weights Leads to Wider Optima and Better Generalization
- paper:Model soups: averaging weights of multiple fine-tuned models improves accuracy without increasing inference time
如果“平坦”确实有价值,那么有一个几乎免费的获得方式:对权重取平均。
- EMA(Exponential Moving Average):在训练过程中维护参数的指数滑动平均\(\bar\theta \leftarrow \beta\bar\theta + (1-\beta)\theta_t\)($\beta$通常取$0.999$以上),用$\bar\theta$做推理。它平滑掉了SGD后期的随机振荡,几乎总是能带来小幅提升,是扩散模型、自监督学习(BYOL、MoCo)和现代分类训练配方中的标准操作。
- SWA(Stochastic Weight Averaging):在训练后期使用周期性(或常数)学习率,把每个周期末的参数做等权平均。由于较大的学习率让参数在极小点盆地的边缘游走,等权平均得到的点更接近盆地的中心,因此更平坦。
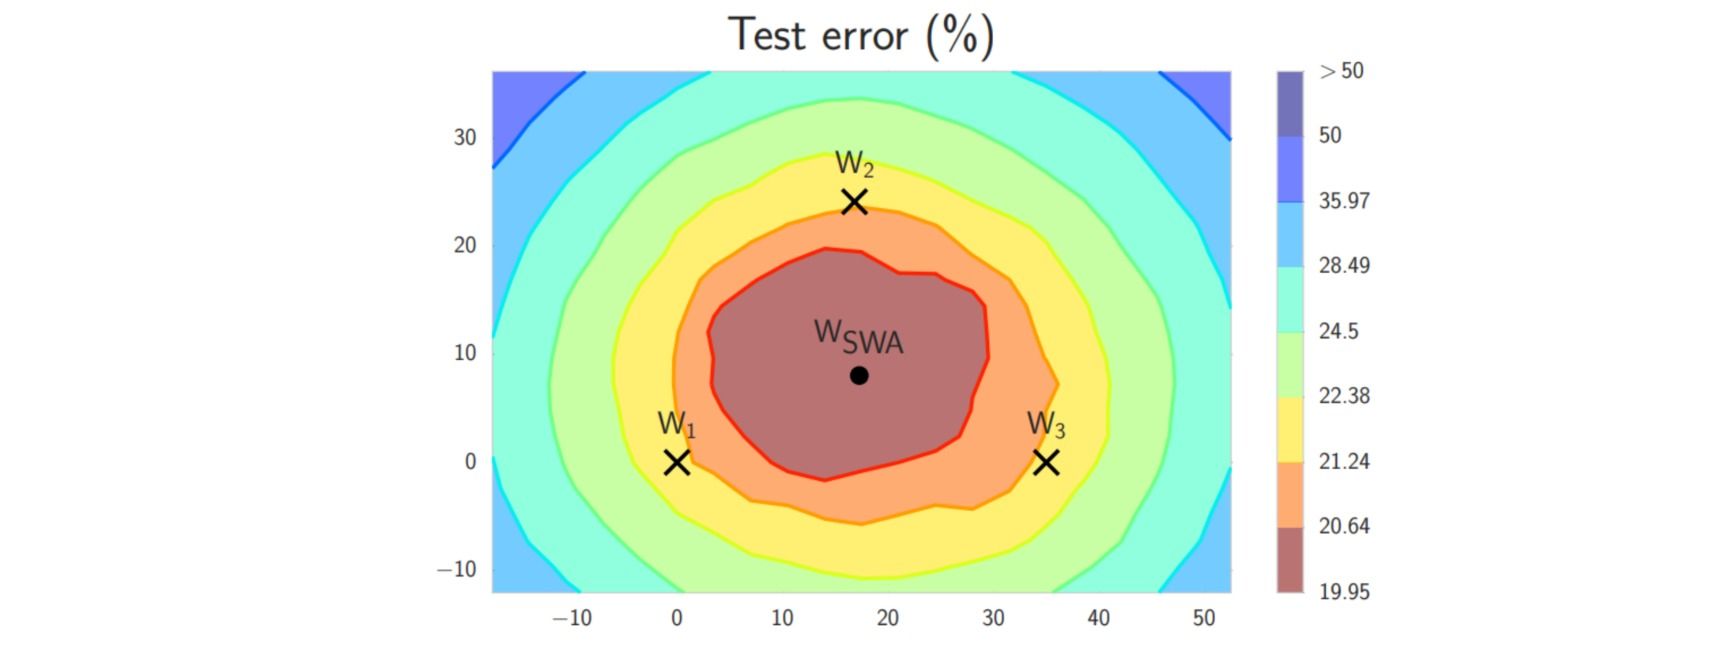
- Model Soup:把用不同超参数(学习率、增强、随机种子)微调出的多个模型的权重直接平均。这听起来不该有效;不同模型可能落在不同的损失盆地里,平均会得到一个高损失的点。但从同一个预训练权重出发微调的模型往往落在同一个线性连通的低损失区域内,因此可以平均。Model Soup在CLIP/ViT微调上刷新了ImageNet记录,且推理成本与单模型完全相同(这是它相对于模型集成的关键优势)。
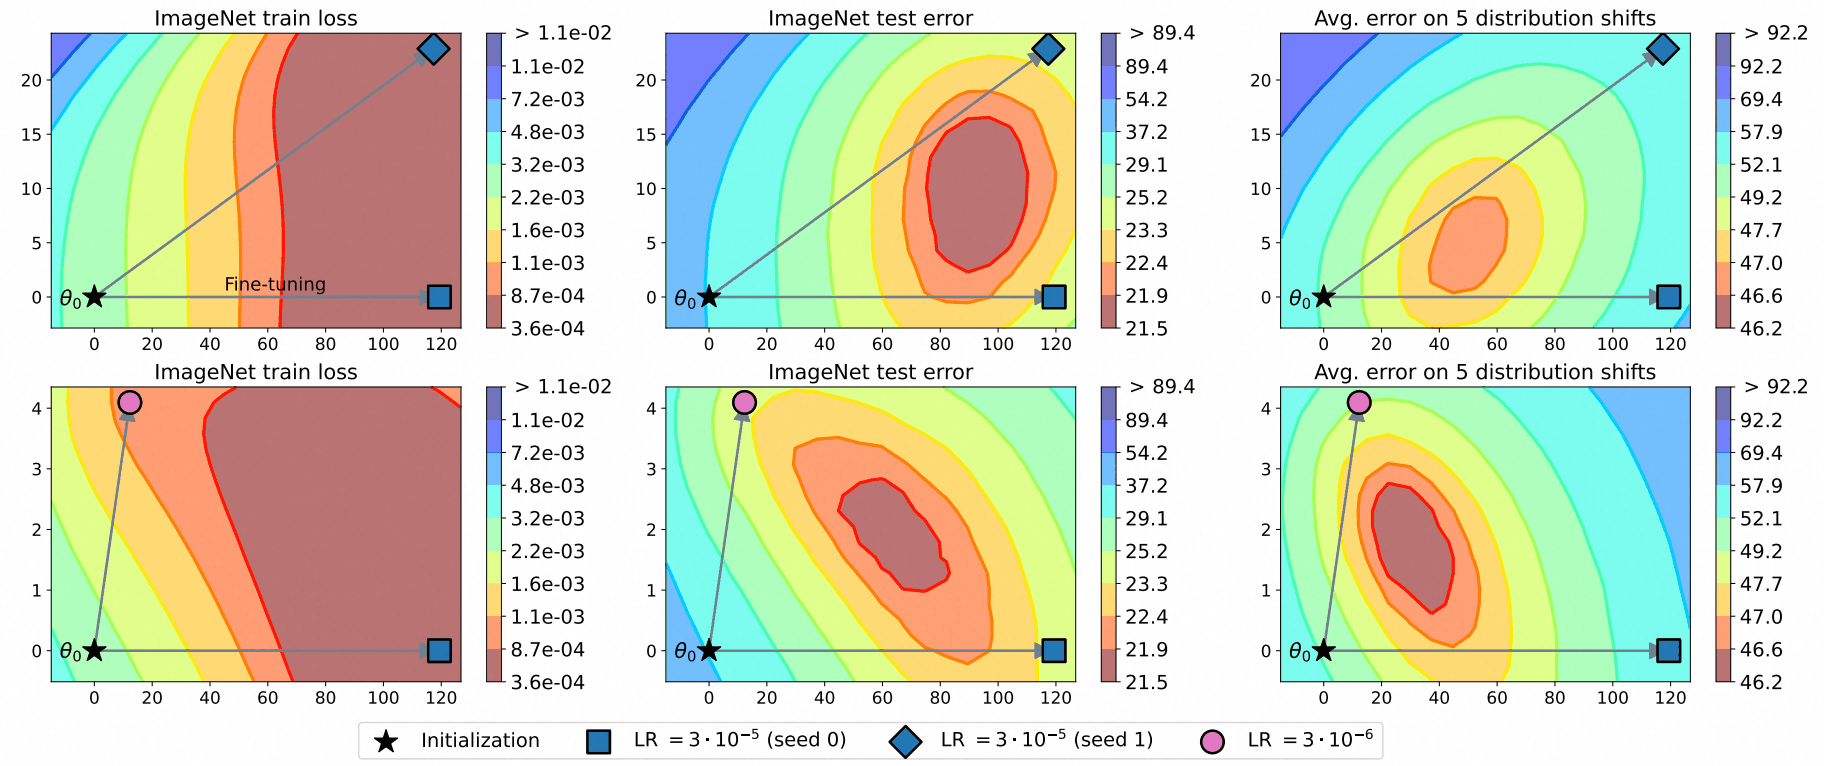
从正则化的角度看,权重平均是降低方差的最直接手段:它不改变偏差(各模型都拟合了训练集),却显著降低了参数估计的方差。
⚪ 噪声标签下的正则化
当训练标签本身含有错误时,过参数化网络的记忆能力反而成为灾难:网络会先学习“干净的模式”(此时测试精度上升),随后开始记忆错误标签(测试精度下降),这一现象称为early learning。此时正则化的目标从“防止拟合噪声输入”转变为“防止记忆错误标签”。
- 鲁棒损失函数:把交叉熵替换为对离群点不敏感的形式。Generalized Cross Entropy(Generalized Cross Entropy Loss for Training Deep Neural Networks with Noisy Labels)用一个参数$q\in(0,1]$在MAE(鲁棒但难优化)和CE(易优化但不鲁棒)之间插值($q\to 0$时退化为交叉熵,$q=1$时为MAE):
- Early-Learning Regularization:Early-Learning Regularization Prevents Memorization of Noisy Labels利用early learning阶段的预测(用时序集成维护一个目标$t_i$)作为“半可信标签”,加一个正则项把当前预测拉向它,从而在网络开始记忆噪声之前把它“钉住”。
- 样本选择类方法:Co-teaching等方法让两个网络互相挑选“损失较小”的样本喂给对方,利用两个网络的分歧过滤噪声。
- 此外,标签平滑、Mixup和SAM在噪声标签下都表现出明显的额外收益,这也是这三种方法被广泛使用的原因之一。
2.4 正则化方法之间的关系
前面按“作用位置”把正则化方法分成了三类,但这些方法在数学上有大量的交叉与等价。本节集中讨论这些联系,特别是隐式正则化:不由使用者添加、而由优化算法自带的正则化效应。
⭐ 讨论:Dropout等价于L2正则化
考虑最简单的情形:一个线性模型\(\hat{y}=\sum_i w_i x_i\),在输入上施加Inverted Dropout,即\(\hat{y}=\sum_i w_i z_i x_i\),其中\(z_i = m_i/(1-p)\)、\(m_i\sim\text{Bernoulli}(1-p)\)。于是\(\mathbb{E}[z_i]=1\)、\(\text{Var}[z_i]=p/(1-p)\)。
对掩码求期望的平方损失为:
\[\begin{aligned} \mathbb{E}_{m}\left[\left(y-\sum_i w_i z_i x_i\right)^2\right] &= \left(y-\sum_i w_i x_i\right)^2 + \text{Var}_m\left[\sum_i w_i z_i x_i\right] \\ &= \left(y-\hat{y}\right)^2 + \frac{p}{1-p}\sum_i w_i^2 x_i^2 \end{aligned}\]第二个等号用到各$z_i$相互独立。因此Dropout精确等价于一个带特征加权的$L_2$正则项,正则化强度为$p/(1-p)$,且每个权重的惩罚系数与对应输入的能量$x_i^2$成正比。这个结论有两个有价值的推论:
- Dropout的正则化强度随$p$单调递增,且在$p\to 1$时发散,这解释了为什么$p$过大会导致严重欠拟合;
- Dropout是“自适应”的$L_2$:它对活跃特征($x_i^2$大)的权重惩罚更重,相当于对输入做了归一化。这也从另一个角度说明为什么Dropout通常比朴素$L_2$更有效。
对于非线性网络这个等价只是近似(需要对损失做二阶展开),但结论的定性部分依然成立。同样的推导方式也适用于Gaussian Dropout、标签平滑(等价于熵正则)和输入加高斯噪声(等价于Jacobian正则)。
⭐ 讨论:Early Stopping等价于L2正则化
在极小点附近对损失做二次近似:\(\hat{L}(\theta) = L(\theta^*) + \frac{1}{2}(\theta-\theta^*)^\top H (\theta-\theta^*)\),其中$H$是Hessian矩阵(半正定),$\theta^*$是无正则化的最优解。
从\(\theta^{(0)}=0\)出发做$t$步梯度下降(学习率$\eta$),在$H$的特征基下(特征值$\lambda_i$)可解得:
\[\theta^{(t)}_i = \left[1-\left(1-\eta \lambda_i\right)^t\right]\theta^*_i\]而带$L_2$正则化(系数$\alpha$)的解析解为:
\[\tilde{\theta}_i = \frac{\lambda_i}{\lambda_i+\alpha}\theta^*_i\]两者都是对\(\theta^*\)在各特征方向上做收缩,只是收缩因子的形式不同。令两个收缩因子相等,在\(\eta\lambda_i \ll 1\)时对\(\left(1-\eta\lambda_i\right)^t \approx e^{-\eta\lambda_i t}\)做展开可得:
\[\alpha \approx \frac{1}{\eta t}\]即迭代步数$t$的倒数扮演了$L_2$正则化系数的角色:训练越久,等效的正则化越弱。这个结果解释了几个常见现象:Early Stop为什么有效(它就是$L_2$);为什么“$L_2$系数的最优值随训练轮数增加而减小”(AdamW论文的结论4);以及为什么$L_2$和Early Stop同时用到很强时容易欠拟合(两者的作用重复了)。
需要注意的是,这个等价依赖二次近似和从零初始化,在深度网络上只是一个启发式的类比,但它给出的“训练时长本身就是一个正则化超参数”这一洞察是普适的。
⭐ 讨论:SGD的隐式正则化
- paper:On the Origin of Implicit Regularization in Stochastic Gradient Descent
- paper:Towards Explaining the Regularization Effect of Initial Large Learning Rate in Training Neural Networks
第2.1节已经证明,有限学习率的梯度下降隐式地在损失中加入了梯度惩罚项\(\frac{\eta}{4}\|\nabla_\theta L\|^2\)。把这个分析推广到随机梯度下降(随机重排、每轮遍历$m$个小批量),平均迭代所跟随的有效目标为:
\[\tilde{L}_{SGD}(\theta) = L(\theta) + \frac{\eta}{4}\cdot\frac{1}{m}\sum_{k=1}^m \left|\left|\nabla_{\theta} L_k(\theta)\right|\right|^2\]其中\(L_k\)是第$k$个小批量的损失。注意到\(\frac{1}{m}\sum_k\|\nabla L_k\|^2 = \|\nabla L\|^2 + \frac{1}{m}\sum_k\|\nabla L_k-\nabla L\|^2\),于是:
\[\tilde{L}_{SGD}(\theta) = L(\theta) + \underbrace{\frac{\eta}{4}\left|\left|\nabla_{\theta} L(\theta)\right|\right|^2}_{\text{全批量GD也有}} + \underbrace{\frac{\eta}{4}\cdot\frac{1}{m}\sum_{k=1}^m\left|\left|\nabla_{\theta} L_k(\theta)-\nabla_{\theta} L(\theta)\right|\right|^2}_{\text{SGD特有:惩罚梯度方差}}\]SGD比全批量GD多出的那一项惩罚的是小批量梯度的方差,它偏好“所有小批量都同意”的解。这解释了几个关键的经验规律:
- 学习率与批量大小的耦合:正则化强度正比于$\eta$、反比于批量大小(批量越大梯度方差越小)。因此增大批量时必须相应增大学习率(线性缩放律),否则会丢失这部分隐式正则化;这是“大批量训练泛化变差”的一个主要解释。
- 不要用过小的学习率:小学习率虽然训练损失下降更平稳,但隐式正则化随$\eta\to 0$消失。
- 初始大学习率的特殊作用:Towards Explaining the Regularization Effect of Initial Large Learning Rate指出,初期的大学习率会让网络先学习“易学但泛化好”的模式,而小学习率会让网络过早地拟合“难学且不易泛化”的模式。这为“先大学习率、后衰减”的调度提供了理论支持,也说明学习率调度本身就是一种正则化设计。
除了SGD噪声,隐式正则化还有其他多种来源:梯度下降在可分数据上的逻辑回归会收敛到最大间隔解(隐式的$L_2$偏好);矩阵分解中的梯度下降隐式偏好低核范数解;过参数化本身也会改变优化轨迹的偏好。
⭐ 讨论:一条贯穿全文的主线——梯度惩罚
回看全文会发现一个反复出现的结构:大量看起来毫不相干的正则化方法,最终都归结为对梯度范数的惩罚。
| 方法 | 等价的惩罚项 |
|---|---|
| 有限学习率的梯度下降 | \(\frac{\eta}{4}|\nabla_{\theta} L|^2\) |
| SGD的小批量噪声 | 上式 $+$ 小批量梯度的方差 |
| Flooding(损失降到$b$以下后) | \(\frac{\eta}{2}|\nabla_{\theta} L|^2\) |
| 单步对抗训练 / FGSM-AT | \(\epsilon |\nabla_x \mathcal{L}|^2\) |
| 输入加高斯噪声 | \(\frac{\sigma^2}{2}|\partial f/\partial x|_F^2\) |
| VAT | 沿Hessian主特征方向的二阶惩罚\(\epsilon^\top\nabla_x^2 l\,\epsilon\) |
| SAM | \(\rho|\nabla_{\theta} \mathcal{L}|\)(一阶展开) |
| 谱正则化 / Lipschitz约束 | 逐层的\(|\partial h^{(l+1)}/\partial h^{(l)}|\)上界 |
再加上第2.1节证明的“对参数的梯度惩罚$\supseteq$对输入的梯度惩罚$\to$Dirichlet能量$\to$模型复杂度”这条链,就得到了一幅统一的图景:
几乎所有正则化方法都在做同一件事:让模型落在损失曲面更平坦、函数对输入更光滑的区域。它们的差别只在于:惩罚的是参数梯度还是输入梯度、用一阶还是二阶信息、是显式加在损失里还是隐式来自优化算法、是各向同性还是沿最坏方向。
这个统一视角有很实际的价值:它解释了为什么正则化方法之间常常是“重复”而非“叠加”的。同时使用强$L_2$、强Dropout、强增强、SAM和Flooding,往往不会得到五份收益,而是过度正则化导致欠拟合。反过来,如果某个技巧在你的任务上没有效果,很可能是因为已有的配置中已经存在等价的正则化了。