Normalization in Deep Learning.
归一化(Normalization)泛指把数据特征的不同维度转换到相同尺度的方法。它看起来只是在网络中间插入了一个“减均值、除标准差、再乘一个可学习系数”的简单算子,但正是这个算子让深层网络从“需要精心调参才能收敛”变成了“默认就能训起来”,并因此深刻塑造了过去十年的网络结构设计。
归一化方法的差别几乎全部集中在同一个问题上:在哪些维度上统计均值与方差?批量维度、通道维度、空间维度、序列维度、甚至权重维度的不同组合,就产生了BN/LN/IN/GN/RMSNorm这一整个家族;把统计量换成外部条件预测的仿射参数,就得到条件归一化;把归一化对象从激活值换成权重,就得到参数归一化。本文按这个思路组织:
- 为什么需要归一化
- (1) 特征尺度差异使优化变难
- (2) 内部协变量偏移及其争议
- (3) 损失曲面的平滑化
- (4) 尺度不变性与有效学习率
- (5) 隐式正则化效应
- (6) 归一化的代价
- 归一化方法
- 2.1 统一形式与统计维度
- 2.2 数据层面的归一化
- 2.3 激活值归一化(逐层归一化)
- 2.4 条件归一化与自适应归一化
- 2.5 参数归一化
- 2.6 归一化在Transformer中的位置
- 2.7 去掉归一化
符号约定:全文用$x$表示待归一化的输入激活、$y$表示归一化层的输出、\(\hat{x}\)表示标准化后(未做仿射变换)的中间量;用$\mu$与$\sigma^2$表示均值与方差统计量,用下标标注统计量沿哪些维度被共享(例如$\mu_c$表示每个通道一个统计量);用$\gamma,\beta$表示可学习的仿射参数(分别称为re-scale与re-shift);用$\epsilon$表示防止除零的数值稳定项。卷积特征图记为\(X=(x_{nchw}) \in \mathbb{R}^{N\times C\times H\times W}\),其中$N$为批量维度、$C$为通道维度、$H,W$为空间维度;序列特征记为\(X \in \mathbb{R}^{N\times L\times D}\),$L$为序列长度、$D$为特征维度。用$W$表示权重矩阵,$F_t(\cdot)$表示第$t$个残差分支。
一份系统的综述可参考Normalization Techniques in Training DNNs: Methodology, Analysis and Application。
1. 为什么需要归一化
(1) 特征尺度差异使优化变难
输入数据的特征通常具有不同的量纲和取值范围,使得不同特征的尺度(scale)差异很大。不同机器学习模型对数据特征尺度的敏感程度不同。如果一个机器学习算法在数据特征缩放前后不影响其学习和预测,则称该算法具有尺度不变性(scale invariance),表示为$f(\lambda x)=f(x)$。理论上神经网络具有尺度不变性,但是输入特征的不同尺度会增加训练的困难:
- 参数初始化困难:当使用具有饱和区的激活函数$a=f(Wx)$时,若特征$x$的不同维度尺度不同,对参数$W$的初始化不合适容易使激活函数陷入饱和区,产生vanishing gradient现象。
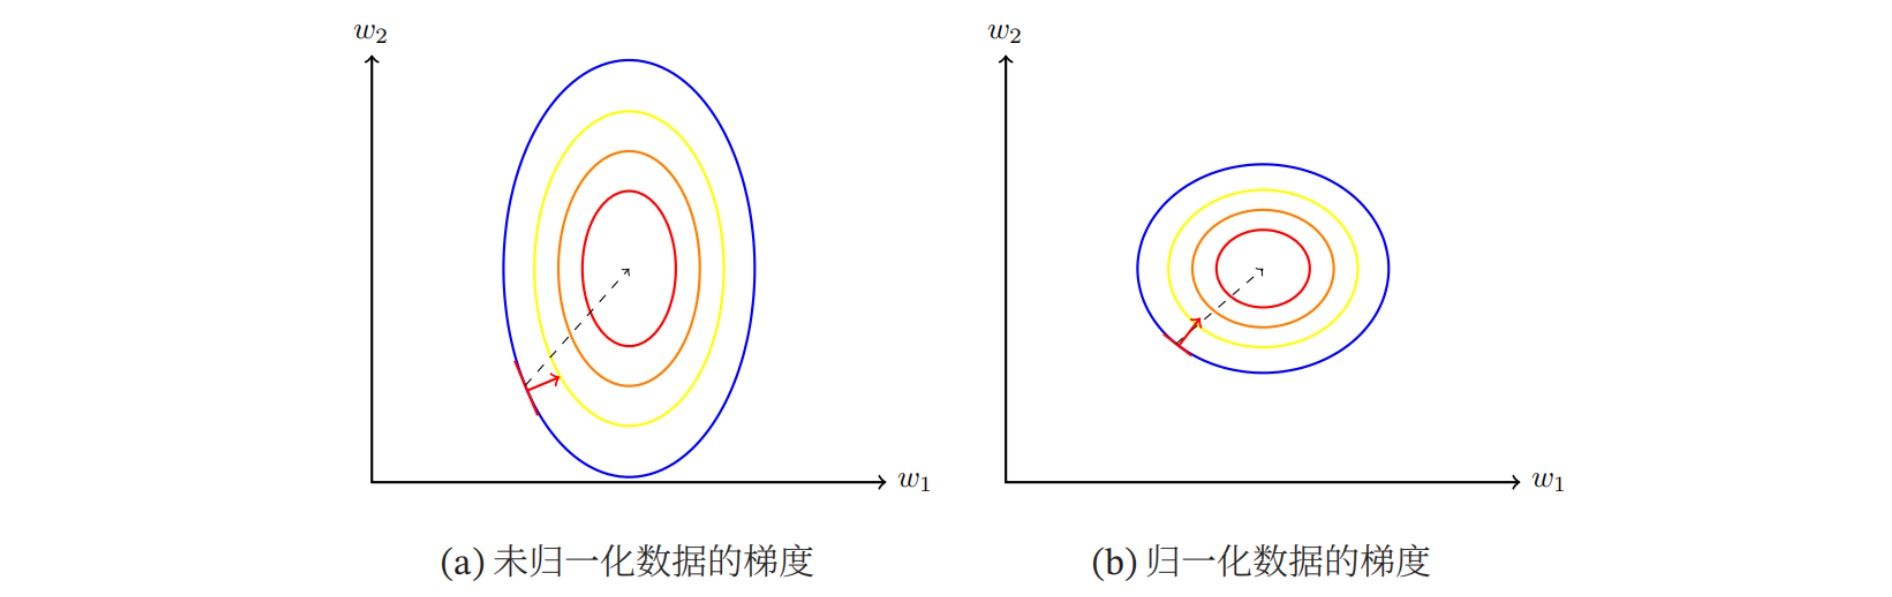
- 梯度下降法的效率下降:如下图所示,左图是数据特征尺度不同的损失函数等高线,右图是数据特征尺度相同的损失函数等高线。由图可以看出,前者计算得到的梯度方向并不是最优的方向,需要迭代很多次才能收敛;后者的梯度方向近似于最优方向,大大提高了训练效率。
这一节的论证只依赖于“输入特征”,因此它直接推出的是数据层面的归一化($2.2$节)。深度学习真正的问题在于:即使把输入数据标准化好了,网络中间层的激活值分布仍然会在训练过程中不断漂移;这就需要把归一化操作搬进网络内部。
(2) 内部协变量偏移及其争议
内部协变量偏移(Internal Covariate Shift, ICS):训练深度网络时,神经网络隐层参数更新会导致网络输出层输出数据的分布发生变化,而且随着层数的增加,这种偏移现象会逐渐被放大。神经网络本质学习的是数据分布,如果数据分布变化了,神经网络又不得不学习新的分布,当前后的要求不同时,可能会影响结果。
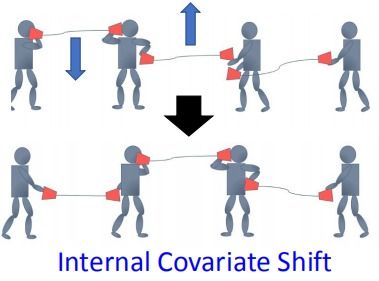
ICS是Batch Normalization原论文给出的解释,也是“归一化”这个概念在深度学习中最广为流传的动机。但需要指出,这个解释后来受到了严重质疑。How Does Batch Normalization Help Optimization?的作者做了两个关键实验:
- 直接测量带BN与不带BN网络中各层输入分布的漂移量,发现BN并没有显著减少ICS;
- 在BN层之后人为注入随时间变化的随机噪声(即刻意制造严重的ICS),网络依然训练得又快又好。
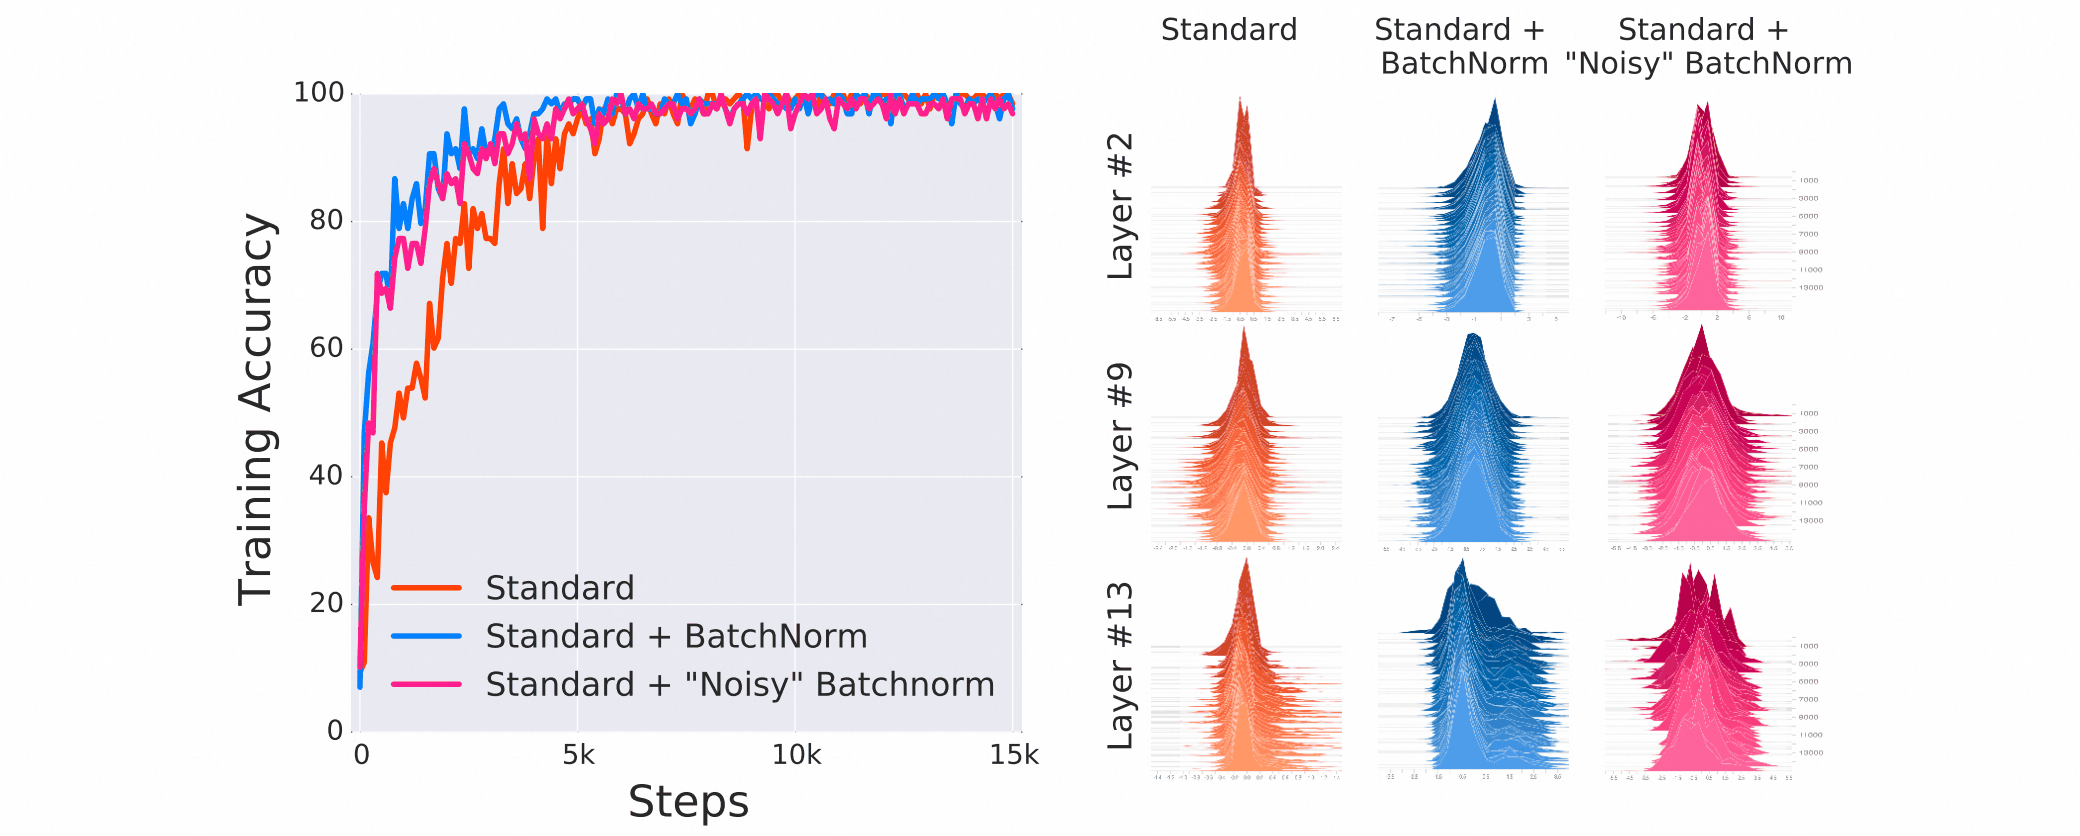
因此ICS至多是一个方便的直觉,而不是归一化生效的原因。今天更被接受的解释是下面两条:损失曲面的平滑化,以及对权重尺度的不变性。
(3) 损失曲面的平滑化
How Does Batch Normalization Help Optimization?进一步证明了:插入BN后,损失函数关于参数的Lipschitz常数与梯度的Lipschitz常数(即$\beta$-光滑性)都被显著改善。直观后果是:
\[\begin{aligned} \text{梯度的模长更小、方向更一致} &\Longrightarrow \text{可以使用更大的学习率} \\ \text{梯度对当前位置的敏感度更低} &\Longrightarrow \text{单步更新的“可预测性”更强} \end{aligned}\]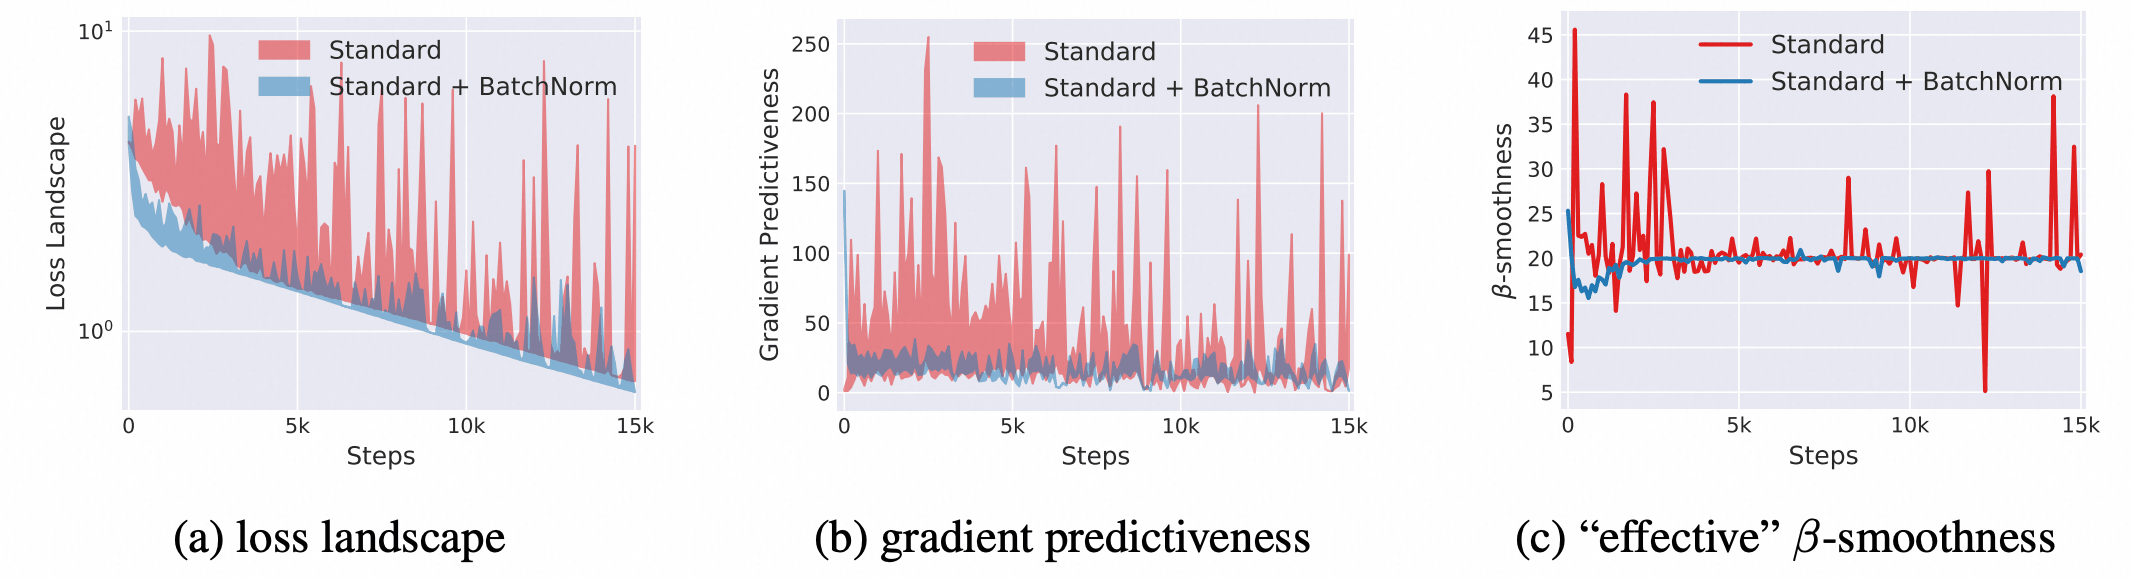
这也解释了为什么归一化网络对学习率和初始化都不那么挑剔。另一条互补的理论路线是Exponential convergence rates for Batch Normalization:归一化把参数隐式分解成了长度与方向两部分,这种解耦在非凸问题上能给出指数收敛率。
(4) 尺度不变性与有效学习率
归一化最坚实的性质是权重缩放不变性。以BN为例,把某层权重放大$\lambda$倍,标准化会把这个倍数完全抵消:
\[\text{BN}\left((\lambda W)x\right) = \text{BN}\left(Wx\right)\]由此可得两个重要推论:
- 前置层的bias可以省略:因为$f(\text{BN}(Wx+b))=f(\text{BN}(Wx))$,归一化层自带的$\beta$已经承担了偏置的作用。这也是PyTorch中卷积层接BN时习惯写
bias=False的原因。 - 有效学习率是自适应的:由于$\partial \text{BN}(\lambda Wx)/\partial(\lambda W) = \frac{1}{\lambda}\cdot \partial \text{BN}(Wx)/\partial W$,权重范数$||W||$越大,梯度越小。训练中$||W||$通常单调增长,于是有效学习率$\eta/||W||^2$自动衰减,形成一种隐式的学习率调度。反过来说,此时weight decay的作用也从“限制模型容量”变成了“通过压制$||W||$来抬高有效学习率”,参考L2 Regularization versus Batch and Weight Normalization与Norm matters: efficient and accurate normalization schemes in deep networks。
(5) 隐式正则化效应
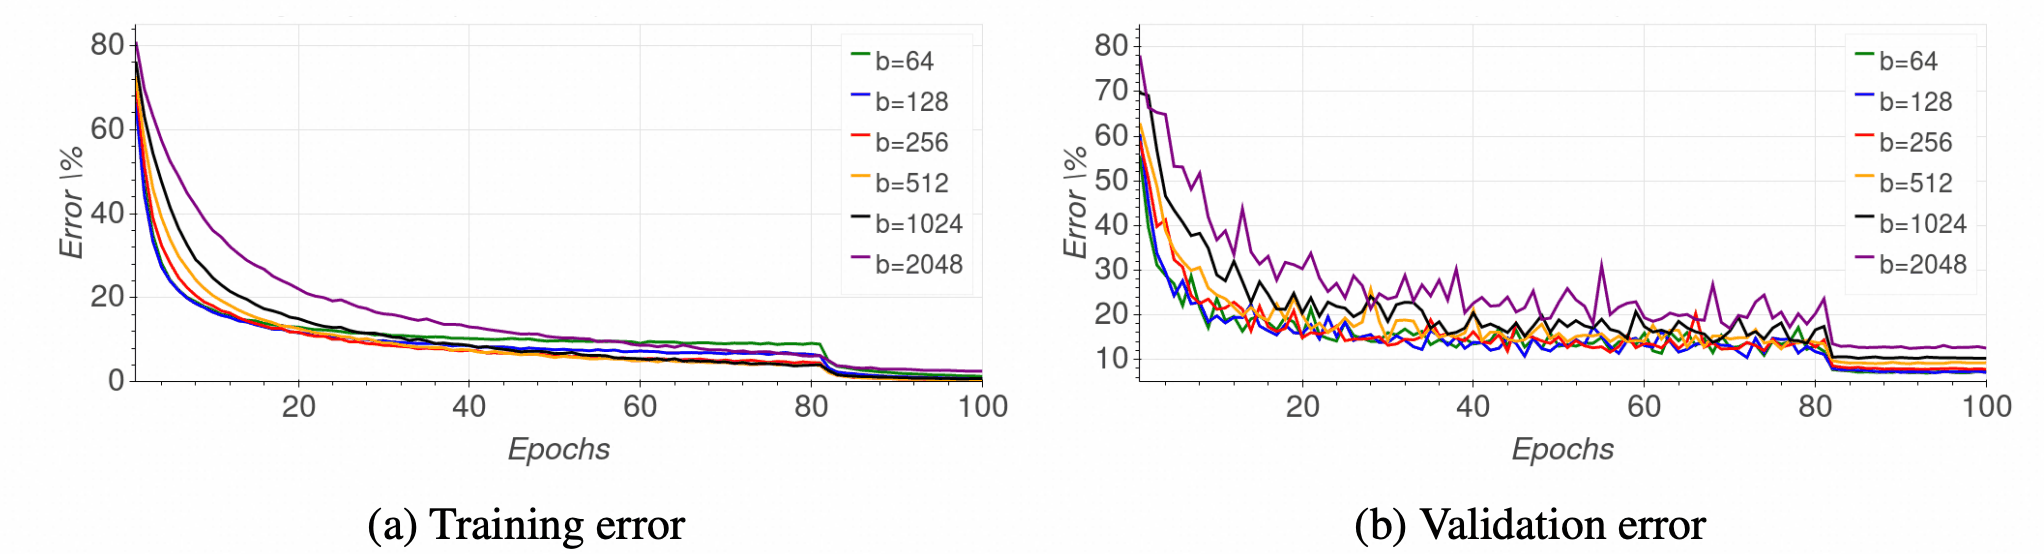
对依赖批量统计的方法(BN及其变体)而言,每个样本的归一化结果都取决于同一mini batch中的其他样本。与总体分布存在差距的mini batch统计量相当于给训练注入了噪声,因此带有正则化效果,可以提高鲁棒性与泛化能力,参考Towards Understanding Regularization in Batch Normalization。
这个效应有两个副作用值得注意:批量越大、噪声越小、正则化越弱(这是Ghost BN的动机);而不依赖批量的方法(LN/IN/GN)本身没有这种噪声,因此往往需要额外的正则化手段来补偿。
(6) 归一化的代价
归一化并非没有成本,后面各族方法的分歧几乎都可以追溯到这几条代价:
- 批量依赖:BN要求mini batch足够大且与总体近似同分布,因此在检测、分割等大分辨率小批量任务、online learning(batchsize = 1)以及动态网络结构中会失效;
- 训练与推理不一致:BN训练时用批统计量、推理时用滑动平均,这种不一致是domain shift、微调、目标检测中许多bug的来源;
- 分布式与并行开销:批统计量需要跨卡同步(SyncBN),成为通信瓶颈;
- 序列与自回归场景不适用:变长序列的填充位置使批统计量失去意义,这是LN取代BN主导NLP的直接原因;
- 访存与延迟:归一化是典型的memory-bound算子,在LLM推理中占比不低,这是RMSNorm乃至彻底去掉归一化($2.7$节)的动力;
- 量化不友好:需要在推理期把BN折叠进卷积才能高效部署。
2. 归一化方法
2.1 统一形式与统计维度
除少数例外,本文涉及的激活值归一化方法都可以写成同一个模板。设\(\mathcal{S}\)是一组张量元素的下标集合(称为统计集合),则:
\[\begin{aligned} \mu_{\mathcal{S}} &= \frac{1}{|\mathcal{S}|}\sum_{i \in \mathcal{S}} x_i \\ \sigma_{\mathcal{S}}^2 &= \frac{1}{|\mathcal{S}|}\sum_{i \in \mathcal{S}} \left(x_i-\mu_{\mathcal{S}}\right)^2 \\ \hat{x}_i &= \frac{x_i-\mu_{\mathcal{S}}}{\sqrt{\sigma_{\mathcal{S}}^2+\epsilon}} ,\quad i \in \mathcal{S}\\ y_i &= \gamma \hat{x}_i + \beta \end{aligned}\]一切差别都在\(\mathcal{S}\)怎么取,即“沿哪些维度归约求统计量”。对卷积特征图\(X \in \mathbb{R}^{N\times C\times H\times W}\),主流方法的选择如下图所示(蓝色部分为共享同一组统计量的元素):
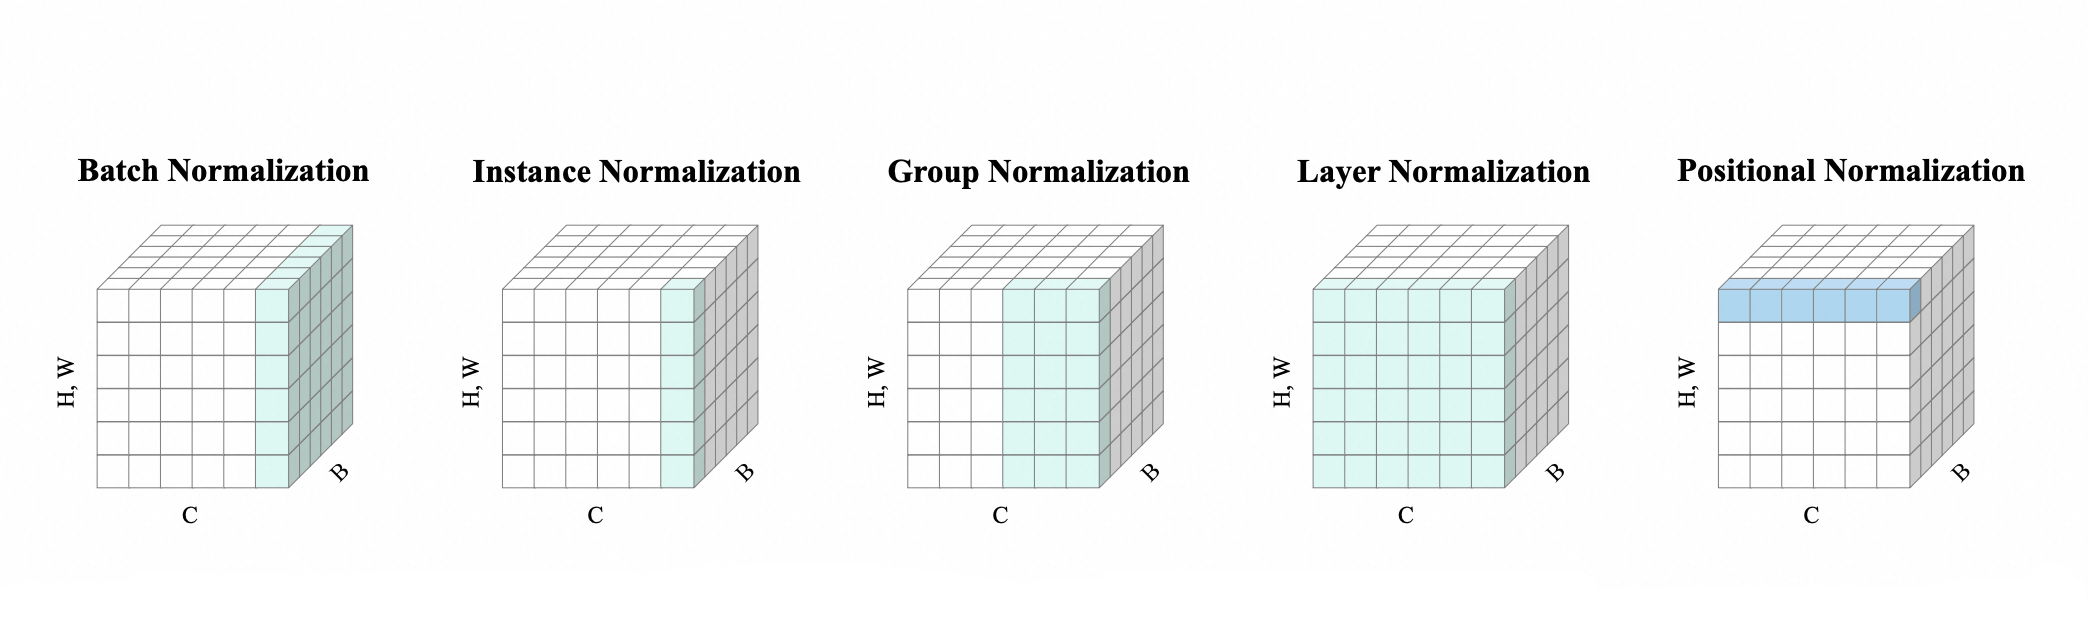
写成表格更便于对照。“归约维度”指统计量对这些维度求和取平均(因此统计量在这些维度上被共享),“统计量个数”指整个张量上一共算出多少组$(\mu,\sigma^2)$:
| 方法 | 归约维度 | 统计量个数 | 依赖batch |
|---|---|---|---|
| BatchNorm | $N,H,W$ | $C$ | 是 |
| LayerNorm(视觉写法) | $C,H,W$ | $N$ | 否 |
| LayerNorm(序列写法) | $D$(最后一维) | $N\times L$ | 否 |
| RMSNorm | 同LayerNorm,但只统计二阶矩 | $N\times L$ | 否 |
| InstanceNorm | $H,W$ | $N\times C$ | 否 |
| GroupNorm | $C/G,H,W$ | $N\times G$ | 否 |
| FRN | $H,W$,只统计二阶矩 | $N\times C$ | 否 |
| PONO | $C$ | $N\times H\times W$ | 否 |
| LRN | 邻近的$n$个通道 | $N\times C\times H\times W$ | 否 |
| Region Norm | 区域内的$H,W$ | $N\times C\times$区域数 | 否 |
| Weight Norm / WS | 权重张量的输入维度 | 输出通道数 | 否 |
三个容易混淆的实现细节:
- 仿射参数的形状:BN/IN/GN的$\gamma,\beta$是per-channel的(形状$C$);LN在PyTorch中默认是per-element的(形状等于
normalized_shape),这意味着视觉任务里对\([C,H,W]\)做LN会引入$2CHW$个参数,而NLP里对最后一维做LN只引入$2D$个参数。 - 有偏方差:所有归一化层计算方差时都用$1/|\mathcal{S}|$(有偏估计),只有BN维护滑动平均时会转成无偏估计。
- $\epsilon$的位置:$\sqrt{\sigma^2+\epsilon}$与$\sqrt{\sigma^2}+\epsilon$在低精度训练下差别显著,主流实现均采用前者。
按“归一化对象”来看,本节余下部分的组织是:$2.2$节归一化输入数据;$2.3$节归一化中间激活值(统计量由数据自身决定);$2.4$节归一化激活值但仿射参数由外部条件给出;$2.5$节归一化权重;$2.6$节讨论归一化层在Transformer中的摆放位置;$2.7$节讨论如何不用归一化。
2.2 数据层面的归一化
⚪ 最小-最大值归一化 Min-Max Normalization
最小-最大值归一化是指将每个特征的取值范围归一到$[0,1]$之间。记共有$N$个样本,每个样本含有$D$个特征,其中第$n$个样本表示为$x_n=(x_{n1},…,x_{nD})$;则最小-最大值归一化表示为:
\[x_{nd}\leftarrow \frac{x_{nd}-\min_d(x_{nd})}{\max_d(x_{nd})-\min_d(x_{nd})}\]这种归一化保留了原始分布的形状,但对异常值非常敏感(一个离群点就能把其余样本压缩到极小的区间内)。图像处理中把像素值除以$255$就是它最常见的特例。
⚪ 标准化 Standardization
标准化又叫Z值归一化(Z-Score Normalization),是指将每个特征调整为均值为0,方差为1:
\[\begin{aligned} \mu_d&= \frac{1}{N} \sum_{n=1}^{N} {x_{nd}} \\ \sigma_d^2&= \frac{1}{N} \sum_{n=1}^{N} {(x_{nd}-\mu_d)^2}\\ x_{nd}&\leftarrow \frac{x_{nd}-\mu_d}{\sigma_d} \end{aligned}\]标准化不限定输出范围,因此对异常值比最小-最大值归一化稳健,是深度学习中数据预处理的默认选择。注意统计量必须在训练集上计算,并原样应用到验证集与测试集,否则会造成信息泄漏。
⚪ 白化 Whitening
白化在调整特征取值范围的基础上消除了不同特征之间的相关性,降低输入数据特征的冗余。具体地,将输入数据在特征方向上被特征值相除,使数据独立同分布(i.i.d.),实现输入数据的零均值(zero mean)、单位方差(unit variance)、去相关(decorrelated)。
实现步骤:
- 零均值: $ \hat{X}=X-E(X) $
- 计算协方差: $ Cov(X)=E(XX^T)-E(X)(E(X))^T $
- 去相关: $ Cov(X)^ {-\frac{1}{2}} \hat{X} $
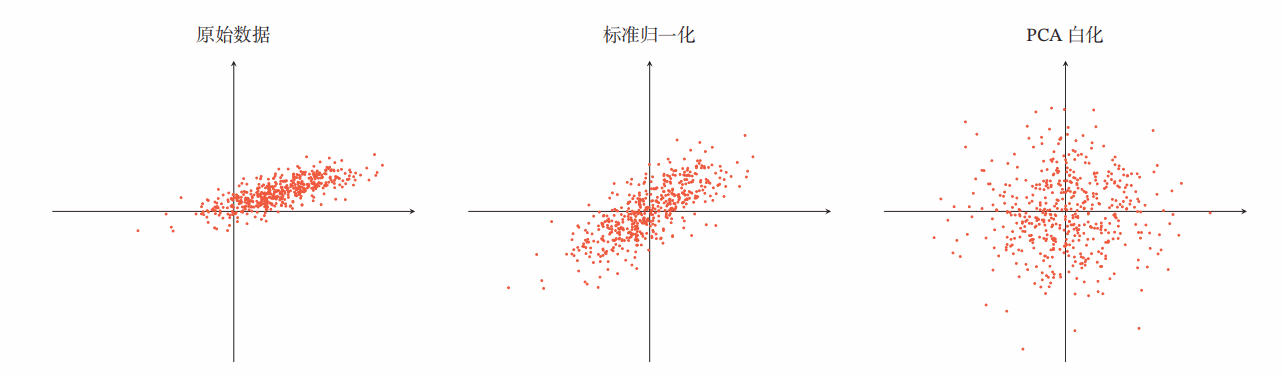
上述$Cov(X)^{-1/2}$的取法并不唯一:取协方差矩阵特征分解$Cov(X)=U\Lambda U^\top$后用$\Lambda^{-1/2}U^\top$,得到PCA白化(同时完成了降维与旋转);再左乘$U$转回原坐标系,即$U\Lambda^{-1/2}U^\top$,得到ZCA白化(zero-phase 白化,保持数据的空间结构,视觉上仍像原图,常用于图像)。
白化的主要缺点是对所有特征一视同仁,可能会放大不重要的特征和噪声;此外,对于深度学习,隐藏层使用白化时反向传播困难。
⚪ 分位数归一化 Quantile Normalization
- A comparison of normalization methods for high density oligonucleotide array data based on variance and bias
- How to do quantile normalization correctly for gene expression data analyses
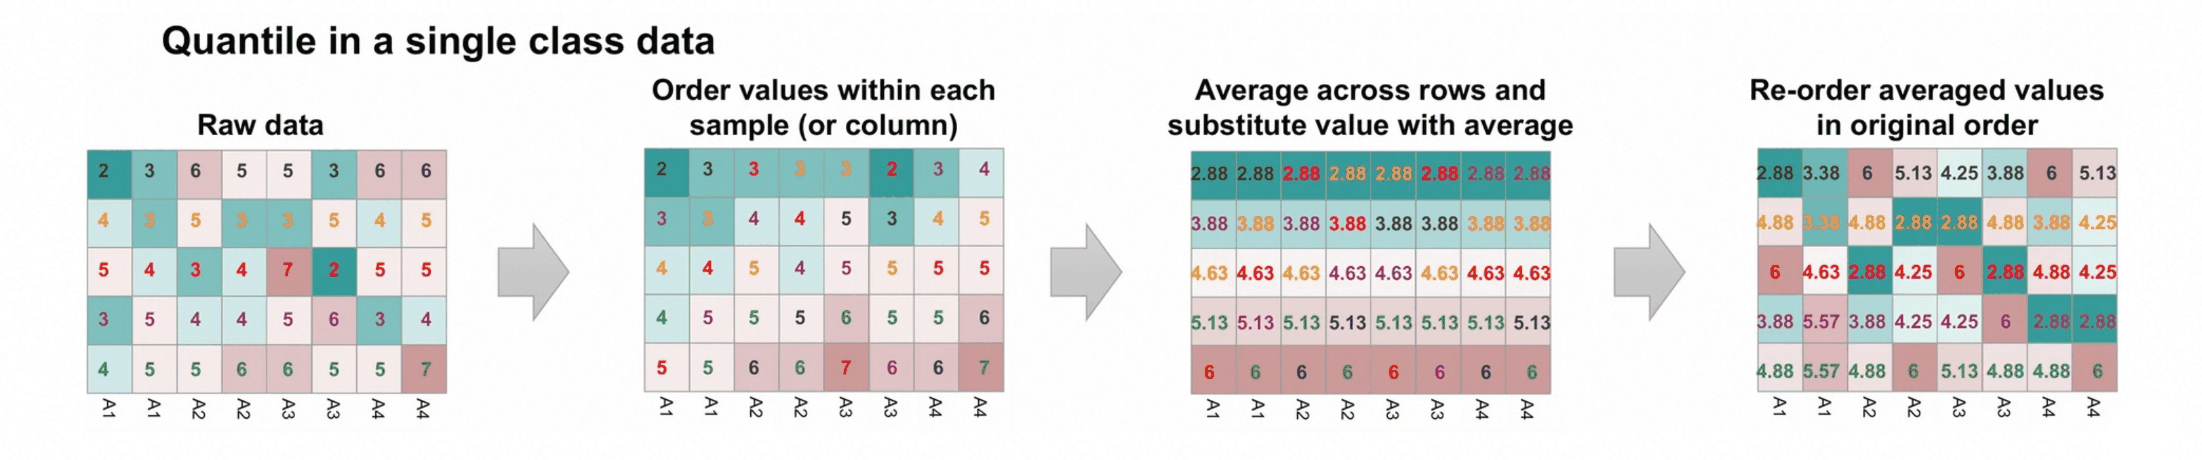
在处理生物高通量数据(如基因、甲基化、RNA-Seq等)时,通常会同时测量成千上万个探针/基因在多个样本中的信号值。然而,这些原始数据除了包含真正的生物学差异外,还混杂了大量的技术性噪音(批次效应,Batch Effect)。分位数归一化通过改变原始数据的绝对值、只保留值的排序信息,强制使每个样本的数据分布完全一致,来校正样本间的技术性变异。
分位数归一化的步骤是:首先根据特征的数值大小对每个样本中的特征进行排序;然后计算排名相同的特征的数值平均值;最后将该排名中所有特征的数值替换为该平均值,并是将每个样本中的特征按其原始顺序重新排序。
2.3 激活值归一化(逐层归一化)
逐层归一化(Layer-wise Normalization)是指将归一化方法应用于深度神经网络中,对神经网络每一个隐藏层的输入特征都进行归一化,从而提高训练效率。它的优点已在第$1$节展开,此处按结论汇总:
- 更好的尺度不变性:通过对每一层的输入进行归一化,不论低层的参数如何变化,高层的输入保持相对稳定,网络具有更好的尺度不变性,可以更高效地进行参数初始化和超参数选择。
- 更平滑的损失函数:可以使神经网络的损失函数更平滑,使梯度变得更稳定,可以使用更大的学习率,提高收敛速度。
- 隐形的正则化方法:可以提高网络的泛化能力,避免过拟合。
本节按“统计量是否依赖批量维度”分成两组,最后一组是让网络自己决定用哪种归一化的自动化方案。
(1) 依赖批量统计的方法
⚪ 批归一化 Batch Normalization
批归一化(BN)是指对神经网络每一个隐藏层的输入特征使用每一批次数据的统计量进行标准化。BN独立的对每一个特征维度计算统计量,并用mini batch的统计量作为总体统计量的估计(假设每一mini batch和总体数据近似同分布)。对每一个mini batch,计算每个特征维度的均值和(有偏的)方差,并对输入做标准化操作,其中$\epsilon$保证了数值稳定性:
\[y = \frac{x - E[x]}{\sqrt{Var[x]+\epsilon}}*\gamma + \beta\]注意到当使用具有饱和性质的激活函数(如Sigmoid)时,标准化操作会将几乎所有数据映射到激活函数的非饱和区(线性区),从而降低了神经网络的非线性表达能力。为了保证模型的表达能力不因标准化而下降,引入可学习的rescale和reshift操作$\gamma,\beta$。
BN一般应用在网络层(通常是仿射变换)后、激活函数前,此时仿射变换不再需要bias参数($f(BN(Wx+b))=f(BN(Wx))$);测试时,使用总体均值和方差的无偏估计进行标准化(有时也用训练时均值和方差的滑动平均值代替):
\[\begin{aligned} \overline{\mu} &\leftarrow (1-m)*\overline{\mu}+m*E[x]\\ &+= m*(E[x]-\overline{\mu}) \qquad \text{in-place form} \\ \overline{\sigma}^2 &\leftarrow (1-m)*\overline{\sigma}^2+m*Var[x]\\ &+= m*(Var[x]-\overline{\sigma}^2) \quad \text{in-place form}\\ \end{aligned}\]BN的作用包括:
- 调整每一层输入特征的分布,减缓了vanishing gradient,可以使用更大的学习率;
- BN具有权重缩放不变性,减少对参数初始化的敏感程度: $BN((\lambda W)x) = BN(Wx)$
- 与总体分布差距较小的mini batch分布可以看作为模型训练引入了噪声,可以增加模型的鲁棒性,带有正则化效果;
- How Does Batch Normalization Help Optimization?: 对损失函数的landscape增加了平滑约束,从而可以更平稳地进行训练。
BN适用于mini batch比较大、与总体数据分布比较接近的场合。在进行训练之前,要做好充分的shuffle。BN在运行过程中需要计算每个mini batch的统计量,因此不适用于动态的网络结构和RNN网络,也不适合Online Learning(batchsize = 1)。
⚪ BatchNorm1d:应用于MLP
记网络某一层的输入\(X=(x_{nd}) \in \mathbb{R}^{N\times D}\),$N$为batch维度,$D$为该层特征数(神经元个数),则BN表示为:
\[\begin{aligned} \mu_d &= \frac{1}{N} \sum_{n=1}^{N} {x_{nd}} \\ \sigma_d^2&= \frac{1}{N} \sum_{n=1}^{N} {(x_{nd}-\mu_d)^2} \\ \hat{x}_{nd}&= \frac{x_{nd}-\mu_d}{\sqrt{\sigma_d^2+\epsilon}} \\ y_{nd} &= \gamma \hat{x}_{nd} + \beta \end{aligned}\]点击展开代码
torch.nn.BatchNorm1d(
    num_features, eps=1e-05,
    momentum=0.1, affine=True,
    track_running_stats=True,
    device=None, dtype=None)
此时BN沿着特征维度$D$进行归一化,沿着批量维度$N$计算统计量因此也被称为时序BN(Temporal Batch Normalization)。
⚪ BatchNorm2d:应用于CNN
记网络某一层的输入\(X=(x_{nchw}) \in \mathbb{R}^{N\times C\times H\times W}\),$N$为batch维度,$C$为通道维度,$H,W$为空间维度,则BN表示为:
\[\begin{aligned} \mu_c&= \frac{1}{NHW} \sum_{n=1}^{N} \sum_{h=1}^{H} {\sum_{w=1}^{W} {x_{nchw}}} \\ \sigma_c^2&= \frac{1}{NHW} \sum_{n=1}^{N} {\sum_{h=1}^{H} {\sum_{w=1}^{W} {(x_{nchw}-\mu_c)^2}}}\\ \hat{x}_{nchw}&= \frac{x_{nchw}-\mu_c}{\sqrt{\sigma_c^2+\epsilon}}\\ y_{nchw} &= \gamma \hat{x}_{nchw} + \beta \end{aligned}\]点击展开代码
torch.nn.BatchNorm2d(
    num_features, eps=1e-05,
    momentum=0.1, affine=True,
    track_running_stats=True,
    device=None, dtype=None)
⚪ BatchNorm2d from sctratch
如果要实现类似 BN 滑动平均的操作,在 forward 函数中要使用原地(inplace)操作给滑动平均赋值。
点击展开代码
class BatchNorm2d(nn.Module):
    def __init__(self, dim, eps = 1e-5, momentum=0.1,):
        super(BatchNorm2d, self).__init__()\
        self.dim = dim
        self.eps = eps
        self.m = momentum
        self.gamma = nn.Parameter(torch.ones(1, dim, 1, 1))
        self.beta = nn.Parameter(torch.zeros(1, dim, 1, 1))
        self.register_buffer("running_mean", torch.zeros(dim))
        self.register_buffer("running_var", torch.ones(dim))

    def forward(self, x):
        if self.training:
            mean = x.mean([0, 2, 3])
            var = x.var([0, 2, 3], unbiased=False)
            with torch.no_grad():
                self.running_mean += self.m * (mean - self.running_mean)
                self.running_var += self.m * (var * self.dim/(self.dim-1) - self.running_var)
        else:
            mean = self.running_mean
            var = self.running_var
        x_norm = (x - mean[None, :, None, None]) / (var[None, :, None, None] + self.eps).sqrt()
        return x_norm * self.gamma + self.beta
⚪ Synchronized-BatchNorm (SyncBN)
当使用torch.nn.DataParallel将代码运行在多张 GPU 卡上时,PyTorch 的 BN 层默认操作是各卡上数据独立地计算均值和标准差。同步BN (SyncBatchNorm)使用所有卡上的数据一起计算 BN 层的均值和标准差,缓解了当批量大小比较小时对均值和标准差估计不准的情况,是在目标检测等任务中一个有效的提升性能的技巧。
实现上不需要传输整个特征图,只需在卡间同步两个标量统计量(Cross-GPU BN的做法):先各卡分别累加$\sum x$与$\sum x^2$,all-reduce后再合成全局均值与方差:
\[\begin{aligned} \mu &= \frac{1}{M}\sum_{k}\left(\sum_{i \in \text{card } k} x_i\right) \\ \sigma^2 &= \frac{1}{M}\sum_{k}\left(\sum_{i \in \text{card } k} x_i^2\right) - \mu^2 \end{aligned}\]点击展开代码
torch.nn.SyncBatchNorm(
    num_features, eps=1e-05,
    momentum=0.1, affine=True,
    track_running_stats=True,
    process_group=None,
    device=None, dtype=None
    )
⚪ Ghost Batch Normalization (Ghost BN)
SyncBN解决的是批量太小的问题,Ghost BN解决的是相反的问题:批量太大时,BN统计量过于准确,第$1.5$节的噪声正则化效应消失,导致大批量训练的泛化性下降(generalization gap)。
Ghost BN(也叫virtual batch size)把大批量切成若干个大小为$B_G$(如$32$)的虚拟子批量,在每个子批量内独立计算统计量:
\[\mu^{(k)},\ \left(\sigma^{(k)}\right)^2 = \text{stats}\left(x^{(k)}\right),\quad k=1,\cdots,\frac{B}{B_G}\]滑动平均则按子批量数量相应加快更新。这个技巧几乎是免费的,是大批量训练与许多表格数据模型(如TabNet)的标准配置。
⚪ Batch Renormalization
BN假设每一mini batch和总体数据近似同分布,用mini batch的统计量作为总体统计量的估计。实际上mini batch和总体的分布存在偏差,Batch Renormalization用一个仿射变换修正这一偏差。
记总体均值为$\mu$,方差为$\sigma^2$;某一mini batch计算的均值为$\mu_B$,方差为$\sigma_B^2$,引入仿射变换:
\[\frac{x-\mu}{\sigma}=\frac{x-\mu_B}{\sigma_B} r+d\]可以得到一组变换参数为:
\[r=\frac{\sigma_B}{\sigma} , d=\frac{\mu_B-\mu}{\sigma}\]当$\sigma=E(\sigma_B),\mu=E(\mu_B)$时,有$E(r)=1,E(d)=0$,这便是BN的假设。注意$r$和$d$是与mini batch有关的常数,并不参与训练,并对上下限进行了裁剪:
\[\begin{aligned} r&=\text{Clip}_{[1/r_{max},r_{max}]}(\frac{\sigma_B}{\sigma})\\ d&=\text{Clip}_{[-d_{max},d_{max}]}(\frac{\mu_B-\mu}{\sigma}) \end{aligned}\]在实际使用时,先使用BN(设置$r=1,d=0$)训练得到一个相对稳定的滑动平均,作为总体均值$\mu$和方差$\sigma^2$的近似,再逐渐放松约束。这样做的另一个好处是消除了训练与推理阶段的行为差异。
⚪ Adaptive Batch Normalization (AdaBN)
Domain adaptation (transfer learning)希望能够将在一个训练集上训练的模型应用到一个类似的测试集上。此时训练集和测试集的分布是不同的,应用BN时由训练集得到的统计量不再适合测试集。
AdaBN的思想是用所有测试集数据计算预训练网络每一层的BN统计量(均值和方差),测试时用这些统计量代替由训练得到的原BN统计量:
\[\begin{aligned} \mu^l &= \frac{1}{N} \sum_{n=1}^{N} {x^l_{test,n}}\\ \sigma^l &= \sqrt{\frac{1}{N} \sum_{n=1}^{N} {(x^l_{test,n}-\mu^l)^2}+\epsilon} \end{aligned}\]这是一个不需要任何标签、不需要反向传播的域适应方法,也是test-time adaptation这一整条研究线的起点。
⚪ L1-Norm Batch Normalization (L1-Norm BN)
BN中存在平方和开根号运算,增加了计算量,需要额外的内存,减慢训练的速度;部署到资源限制的硬件系统(如FPGA)时有困难。
L1-norm BN把BN运算中的L2-norm variance替换成L1-norm variance:
\[\sigma_B= \frac{1}{N} \sum_{n=1}^{N} \lvert x_n-\mu_B \rvert\]可以证明,(在正态分布假设下)通过L1-norm计算得到的\(\sigma'=E(\lvert X-E(X)\rvert)\)和通过L2-norm计算得到的$\sigma$仅相差一常数:
\[\frac{\sigma}{E(\lvert X-E(X) \rvert)}=\sqrt{\frac{\pi}{2}}\]这个常数可以由rescale时的$\gamma$参数学习到,所以不显式地引入算法中。
⚪ Generalized Batch Normalization (Generalized BN)
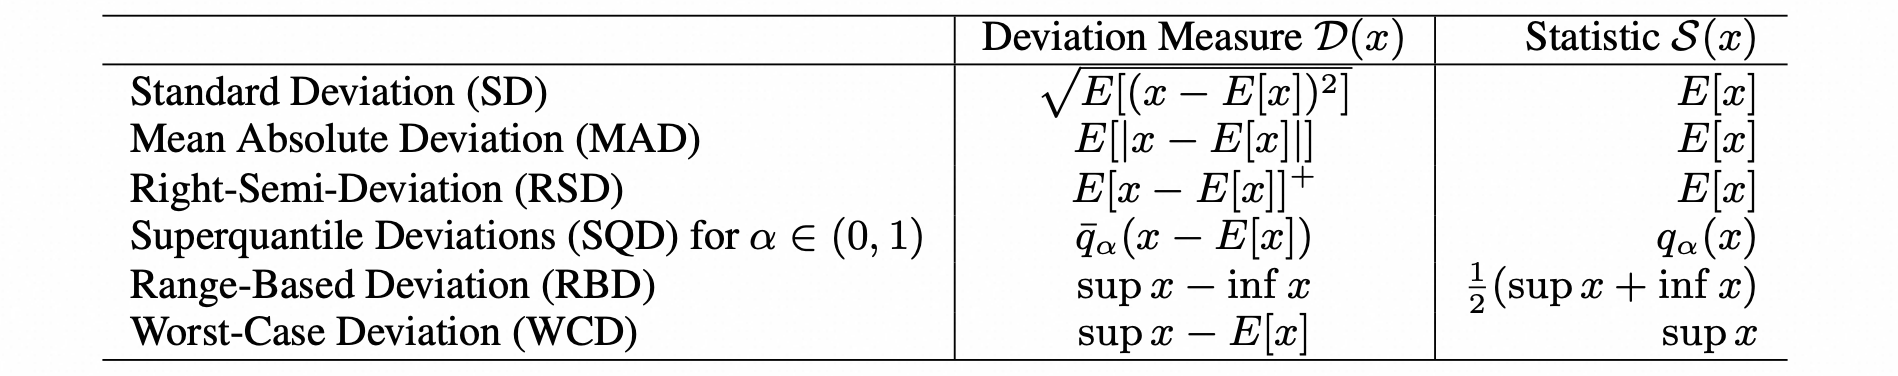
BN使用的是均值和方差统计量,在Generalized BN中使用更一般的统计量$S$和$D$:
\[\hat{x}_n= \frac{x_n-S(x_n)}{D(x_n)}\]广义偏差测度(Generalized deviation measures)提供了选择$D$和相关统计量$S$的方法。上一节的L1-norm BN就是取$D$为平均绝对偏差的特例,取中位数与中位数绝对偏差则得到对离群值更稳健的版本。
⚪ Decorrelated BN 与 IterNorm:网络内部的白化
- paper:Decorrelated Batch Normalization
- paper:Iterative Normalization: Beyond Standardization towards Efficient Whitening
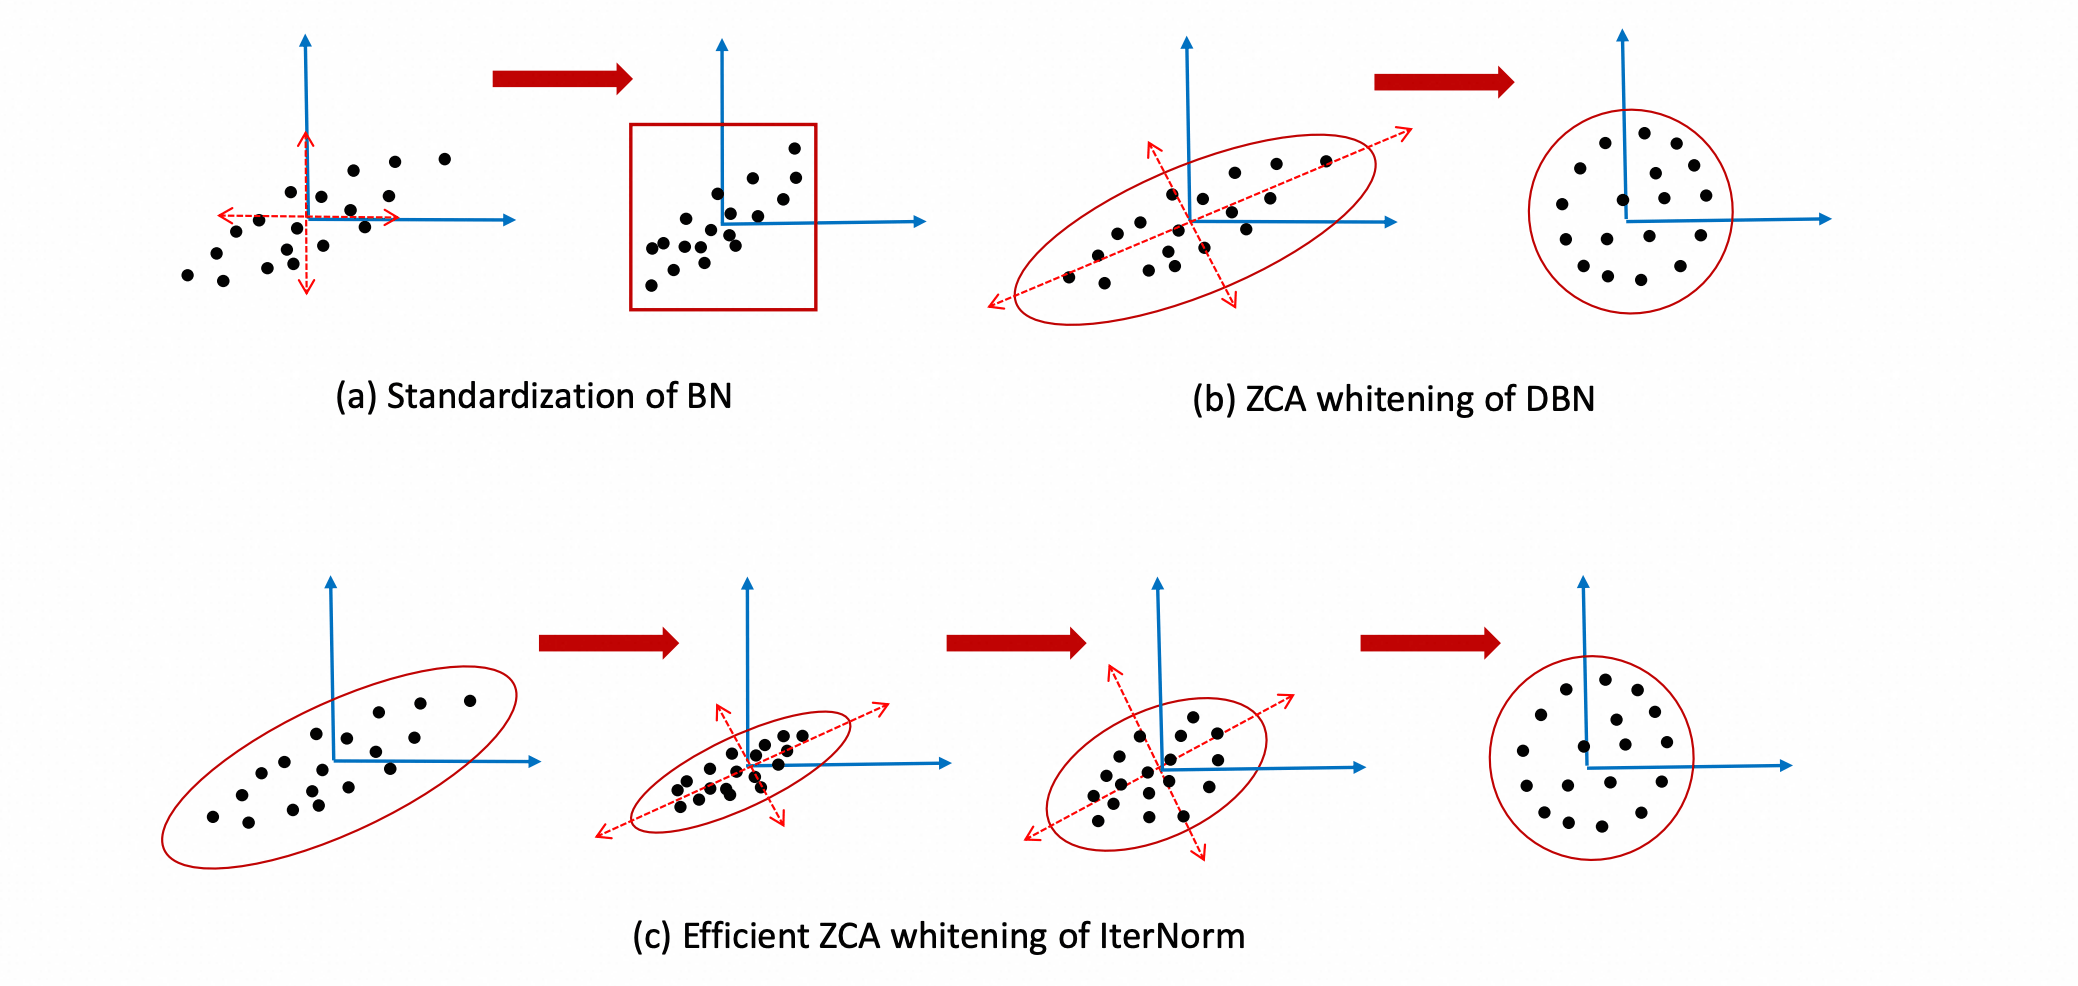
BN只做了标准化(每个通道独立地零均值、单位方差),并没有消除通道之间的相关性,即它只完成了$2.2$节白化的一半。Decorrelated BN把BN升级为完整的ZCA白化:对mini batch求协方差矩阵$\Sigma$,特征分解后作用$\Sigma^{-1/2}$:
\[\hat{x} = \Sigma^{-\frac{1}{2}}\left(x-\mu\right),\quad \Sigma = \frac{1}{N}\sum_{n=1}^N \left(x_n-\mu\right)\left(x_n-\mu\right)^\top + \epsilon I\]关键贡献在于给出了$\Sigma^{-1/2}$的反向传播公式,从而使“隐藏层白化”变得可训练。但特征分解在GPU上很慢且数值不稳定;IterNorm改用Newton迭代近似$\Sigma^{-1/2}$,只需矩阵乘法:
\[\begin{aligned} \Sigma_N &= \frac{\Sigma}{\text{tr}(\Sigma)},\quad P_0 = I \\ P_k &= \frac{1}{2}\left(3P_{k-1}-P_{k-1}^3\Sigma_N\right) ,\quad k=1,\cdots,T\\ \Sigma^{-\frac{1}{2}} &\approx \frac{P_T}{\sqrt{\text{tr}(\Sigma)}} \end{aligned}\]迭代次数$T$给出了“只标准化($T=0$)”到“完全白化($T\to \infty$)”之间的连续调节,实践中$T=5$即可。这类方法在GAN判别器与需要良好条件数的场景中有用,但在通用识别任务上收益有限、开销明显,未能成为主流。
⭐ 讨论:推理期的BN折叠
推理时BN的统计量已固定为常数,因此整个BN层退化为一个逐通道的线性变换,可以被吸收进前置的卷积或全连接层,做到零推理开销。设前置层为$y=Wx+b$,BN参数为$(\overline{\mu},\overline{\sigma}^2,\gamma,\beta)$,则折叠后的等效权重与偏置为:
\[\begin{aligned} W' &= \frac{\gamma}{\sqrt{\overline{\sigma}^2+\epsilon}}\odot W \\ b' &= \frac{\gamma\left(b-\overline{\mu}\right)}{\sqrt{\overline{\sigma}^2+\epsilon}}+\beta \end{aligned}\]其中$\odot$表示按输出通道逐行缩放。这是所有部署框架的标准优化(TensorRT、ONNX Runtime、PyTorch的torch.ao.quantization.fuse_modules)。需要注意的是,量化感知训练必须模拟折叠后的权重再量化,否则训练与部署的数值行为不一致;这也是BN在低比特部署中被视为麻烦、而GN + Weight Standardization($2.5$节)在这类场景更受欢迎的原因之一。
(2) 不依赖批量统计的方法
⚪ 局部响应归一化 Local Response Normalization
局部响应归一化受生物学中“侧抑制”的启发,即活跃的神经元对于相邻的神经元具有抑制的作用。
LRN通常应用在CNN中,且作用于激活函数之后,对邻近的特征映射(表现为邻近的通道)进行归一化。假设一个卷积层的特征图为\(X \in \mathbb{R}^{C\times H\times W}\),$H$和$W$是特征图的高度和宽度,$C$为通道数。指定$n$为归一化考虑的邻域通道数量,则LRN表示为:
\[X^c \leftarrow \frac{X^c}{\left(k+\frac{\alpha}{n}\sum_{c'=\max(1,c-\frac{n}{2})}^{\min(C,c+\frac{n}{2})} (X^{c'})^2\right)^\beta}\]超参数的取值:$k=1, \alpha=0.0001, \beta=0.75$。
点击展开代码
torch.nn.LocalResponseNorm(size, alpha=0.0001, beta=0.75, k=1.0)
LRN是AlexNet时代的产物,它只做除法(不减均值)、只在局部通道邻域内统计、且不含可学习参数,因此更像一种“竞争机制”而不是分布校正。VGG的论文已经报告LRN不带来提升只增加开销,BN出现后它就彻底退出了实践,但作为“归一化=局部竞争”的最早形态仍有历史价值。
⚪ 层归一化 Layer Normalization
- paper:Layer Normalizaiton
层归一化(LN)适用于序列模型(如RNN,LSTM,Transformer),最初提出是用来解决BN无法应用在RNN网络的问题。
BN沿batch维度计算统计量;而在RNN网络中,每一个样本句子的长度不固定,需要补零来统一长度,此时对于某个特征维度,有些样本可能是无意义的零填充,因此沿batch维度计算统计量是没有意义的。LN针对每一个训练样本计算统计量,即计算每个样本所有特征的均值和方差。
记网络某一层的输入\(X=(x_{nd}) \in \mathbb{R}^{N\times D}\),$N$为batch维度,$D$为该层特征数(神经元个数),则LN表示为:
\[\begin{aligned} \mu_n &= \frac{1}{D} \sum_{d=1}^{D} {x_{nd}} \\ \sigma_n^2&= \frac{1}{D} \sum_{d=1}^{D} {(x_{nd}-\mu_n)^2} \\ \hat{x}_{nd}&= \frac{x_{nd}-\mu_n}{\sqrt{\sigma_n^2+\epsilon}} \\ y_{nd} &= \gamma \hat{x}_{nd} + \beta \end{aligned}\]LN也包含可学习的re-scale和re-center参数$\gamma,\beta$,并且参数与单个样本的特征维度相同(作用于每个特征位置);此外LN不需要在训练过程中动态地保存mini batch的均值和方差,节省了额外的存储空间。
LN的适用场合如下:
- LN针对单个训练样本进行,不依赖于其他样本,适用小mini batch、动态网络和RNN,特别是NLP领域;可以Online Learning;
- LN对同一个样本的所有特征进行相同的转换,如果不同输入特征含义不同(比如颜色和大小),那么LN的处理可能会降低模型的表达能力;
- LN假设同一层的所有channel对结果具有相似的贡献,而CNN中每个通道提取不同模式的特征,因此LN不适用于CNN。
点击展开代码
class LayerNorm(nn.Module):
    def __init__(self, normalized_shape, eps = 1e-5):
        super().__init__()
        dim, H, W = normalized_shape
        self.eps = eps
        self.g = nn.Parameter(torch.ones(1, dim, H, W))
        self.b = nn.Parameter(torch.zeros(1, dim, H, W))

    def forward(self, x):
        mean = x.mean([1, 2, 3], keepdim = True)
        var = x.var([1, 2, 3], unbiased = False, keepdim = True)
        return (x - mean) / (var + self.eps).sqrt() * self.g + self.b

torch.nn.LayerNorm(
    normalized_shape, eps=1e-05, # normalized_shape指定计算统计量的维度,如[C,H,W]
    elementwise_affine=True,     # 仿射参数默认作用于每个元素
    device=None, dtype=None
    )
值得强调的是,Transformer中的LN与上面视觉写法的LN统计维度并不相同:前者只沿最后一维$D$(即每个token独立)统计,因此一共有$N\times L$组统计量;这也是ConvNeXt等现代卷积网络里“对\([N,H,W,C]\)的最后一维做LN”这种写法能奏效的原因;它其实等价于$G=1$以外的另一种切法(相当于$2.1$节表格中的PONO)。
⚪ Root Mean Square Layer Normalization (RMSNorm)
RMS Norm去掉了LN中的均值和reshift操作,相当于对每个样本进行了L2归一化,相比于LN减少了计算负担,并且具有相似的效果。
\[\begin{aligned} \sigma_n^2&= \frac{1}{D} \sum_{d=1}^{D} {x_{nd}^2} \\ \hat{x}_{nd}&= \frac{x_{nd}}{\sqrt{\sigma_n^2+\epsilon}} \\ y_{nd} &= \gamma \hat{x}_{nd} \end{aligned}\]center操作(减均值或reshift操作)类似于全连接层的bias项,储存到的是关于预训练任务的一种先验分布信息;而把这种先验分布信息直接储存在模型中,反而可能会导致模型的迁移能力下降。
RMSNorm如今是大语言模型中事实上的标准归一化层:LLaMA采用Pre-RMSNorm之后,LLaMA 2/3、Mistral、Qwen、Gemma、DeepSeek等主流开源模型几乎全部沿用。原因有三:省掉求均值这一趟归约后,访存量与kernel数量都减少(归一化是memory-bound算子,这个收益在推理时相当可观);只做缩放使它天然与残差流的“方向语义”一致;实证上去掉re-center没有任何性能损失。
点击展开代码
class RMSNorm(nn.Module):
    def __init__(self, dim, eps=1e-6):
        super().__init__()
        self.eps = eps
        self.g = nn.Parameter(torch.ones(dim))

    def forward(self, x):
        rms = x.pow(2).mean(-1, keepdim=True).add(self.eps).rsqrt()
        return x * rms * self.g
⚪ 实例归一化 Instance Normalization
实例归一化(IN)适用于生成模型(GAN),最初是在图像风格迁移任务中提出的。
在生成模型中,每一个样本实例之间是独立的,对batch维度计算统计量是不合适的;并且每个图像样本的每个通道之间通常也是独立的。IN计算每个样本在每个通道上的统计量,不仅可以加速模型收敛,并且可以保持每个实例及其通道之间的独立性。
记网络某一层的输入\(X=(x_{nchw}) \in \mathbb{R}^{N\times C\times H\times W}\),$N$为batch维度,$C$为通道维度,$H,W$为空间维度,则IN表示为:
\[\begin{aligned} \mu_{nc}&= \frac{1}{HW} \sum_{h=1}^{H} {\sum_{w=1}^{W} {x_{nchw}}} \\ \sigma_{nc}^2&= \frac{1}{HW} {\sum_{h=1}^{H} {\sum_{w=1}^{W} {(x_{nchw}-\mu_{nc})^2}}}\\ \hat{x}_{nchw}&= \frac{x_{nchw}-\mu_{nc}}{\sqrt{\sigma_{nc}^2+\epsilon}}\\ \end{aligned}\]IN通常不引入额外的仿射变换。IN应用于CNN时假设每个样本的每个通道是独立的,这可能会忽略部分通道之间的相关性。
IN在风格迁移中格外有效的原因值得单独一提:单个样本单个通道的均值与方差恰好编码了图像的风格信息(而空间结构编码内容),因此把这组统计量抹掉就等于抹掉风格。这个观察直接催生了$2.4$节的AdaIN:既然$\mu,\sigma$携带风格,那么把它们替换成目标风格的统计量即可完成风格迁移。
点击展开代码
class InstanceNorm2d(nn.Module):
    def __init__(self, dim, affine=False, eps = 1e-5):
        super().__init__()
        self.eps = eps
        self.g = nn.Parameter(torch.ones(1, dim, 1, 1))
        self.b = nn.Parameter(torch.zeros(1, dim, 1, 1))

    def forward(self, x):
        mean = x.mean([2, 3], keepdim = True)
        var = x.var([2, 3], unbiased = False, keepdim = True)
        x_norm = (x - mean) / (var + self.eps).sqrt()
        if affine:
            return x_norm * self.g + self.b
        else:
            return x_norm

torch.nn.InstanceNorm2d(
    num_features, eps=1e-05, # normalized_shape指定计算统计量的维度,如[H,W]
    momentum=0.1, affine=False,
    track_running_stats=False,
    device=None, dtype=None
    )
⚪ 组归一化 Group Normalization
- paper:Group Normalization
组归一化(GN)是LN和IN的一般形式:LN认为所有通道对输出的贡献是相似的,对每个样本的所有通道一起计算统计量;IN认为每个通道是独立的,对每个样本的每个通道分别计算统计量。
GN将每个样本的通道分成若干组$G$(默认$G=32$),假设组内通道具有相关性、组间通道是独立的,在每组通道内计算统计量。当$G=1$时GN退化为LN,当$G=C$时GN退化为IN。
记网络某一层的输入\(X=(x_{nchw}) \in \mathbb{R}^{N\times C\times H\times W}\),$N$为batch维度,$C$为通道维度,将$C$分成$G$个组,$H,W$为空间维度,则GN表示为:
\[\begin{aligned} \mu_{ng}&= \frac{1}{HWC/G} \sum_{c \in g} \sum_{h=1}^{H} {\sum_{w=1}^{W} {x_{nchw}}} \\ \sigma_{ng}^2&= \frac{1}{HWC/G} \sum_{c \in g} {\sum_{h=1}^{H} {\sum_{w=1}^{W} {(x_{nchw}-\mu_{ng})^2}}}\\ \hat{x}_{nchw}&= \frac{x_{nchw}-\mu_{ng}}{\sqrt{\sigma_{ng}^2+\epsilon}}\\ y_{nchw} &= \gamma \hat{x}_{nchw} + \beta \end{aligned}\]作者通过实验发现GN相比于BN更容易优化,但损失了一定的正则化能力。GN对不同batch size具有很好的鲁棒性,尤其适合batch size较小的计算机视觉任务中(如目标检测,分割)。GN的分组思想在传统视觉特征中早有先例:SIFT、HOG都是按block分组做直方图归一化的。
点击展开代码
torch.nn.GroupNorm(
    num_groups, num_channels,
    eps=1e-05, affine=True,
    device=None, dtype=None
    )
⚪ Filter Response Normalization (FRN)
FRN类似于IN,也是对每个样本的每个通道进行的操作。不同于IN,FRN使用二阶矩代替了方差统计量,即计算方差时没有考虑均值。
记网络某一层的输入\(X=(x_{nchw}) \in \mathbb{R}^{N\times C\times H\times W}\),$N$为batch维度,$C$为通道维度,$H,W$为空间维度,则FRN表示为:
\[\begin{aligned} v^2&= \frac{1}{HW} {\sum_{h=1}^{H} {\sum_{w=1}^{W} {x_{nchw}^2}}}\\ \hat{x}_{nchw}&= \frac{x_{nchw}}{\sqrt{v^2+\epsilon}}\\ y_{nchw} &= \gamma \hat{x}_{nchw} + \beta \end{aligned}\]由于不做re-center,归一化后的激活值不再是零均值的,直接接ReLU会导致大量通道被整体截断。因此FRN必须配合一个带可学习阈值的TLU(Thresholded Linear Unit)使用:
\[\text{TLU}(y) = \max(y,\tau)\]FRN + TLU是“IN式统计 + 只做缩放”的组合,可以看作RMSNorm在视觉领域的对应物。
⚪ Positional Normalization (PONO)
- paper:Positional Normalization
PONO把统计维度转了$90$度:它在每个空间位置上沿通道维度计算统计量,因此统计量本身是一张与特征图同分辨率的“图”:
\[\begin{aligned} \mu_{nhw}&= \frac{1}{C} \sum_{c=1}^{C} x_{nchw} \\ \sigma_{nhw}^2&= \frac{1}{C} \sum_{c=1}^{C} \left(x_{nchw}-\mu_{nhw}\right)^2\\ \hat{x}_{nchw}&= \frac{x_{nchw}-\mu_{nhw}}{\sqrt{\sigma_{nhw}^2+\epsilon}} \end{aligned}\]
作者指出,被PONO移除的这组$(\mu_{nhw},\sigma_{nhw})$恰好携带了图像的结构与形状信息(与IN移除风格信息互补)。因此配套提出了Moment Shortcut (MS):在生成式网络的编码器-解码器之间,把浅层的$(\mu,\sigma)$直接旁路传给深层并重新注入,从而保留结构信息:
\[y = \sigma^{\text{enc}}_{nhw}\cdot \hat{x}^{\text{dec}}_{nchw} + \mu^{\text{enc}}_{nhw}\]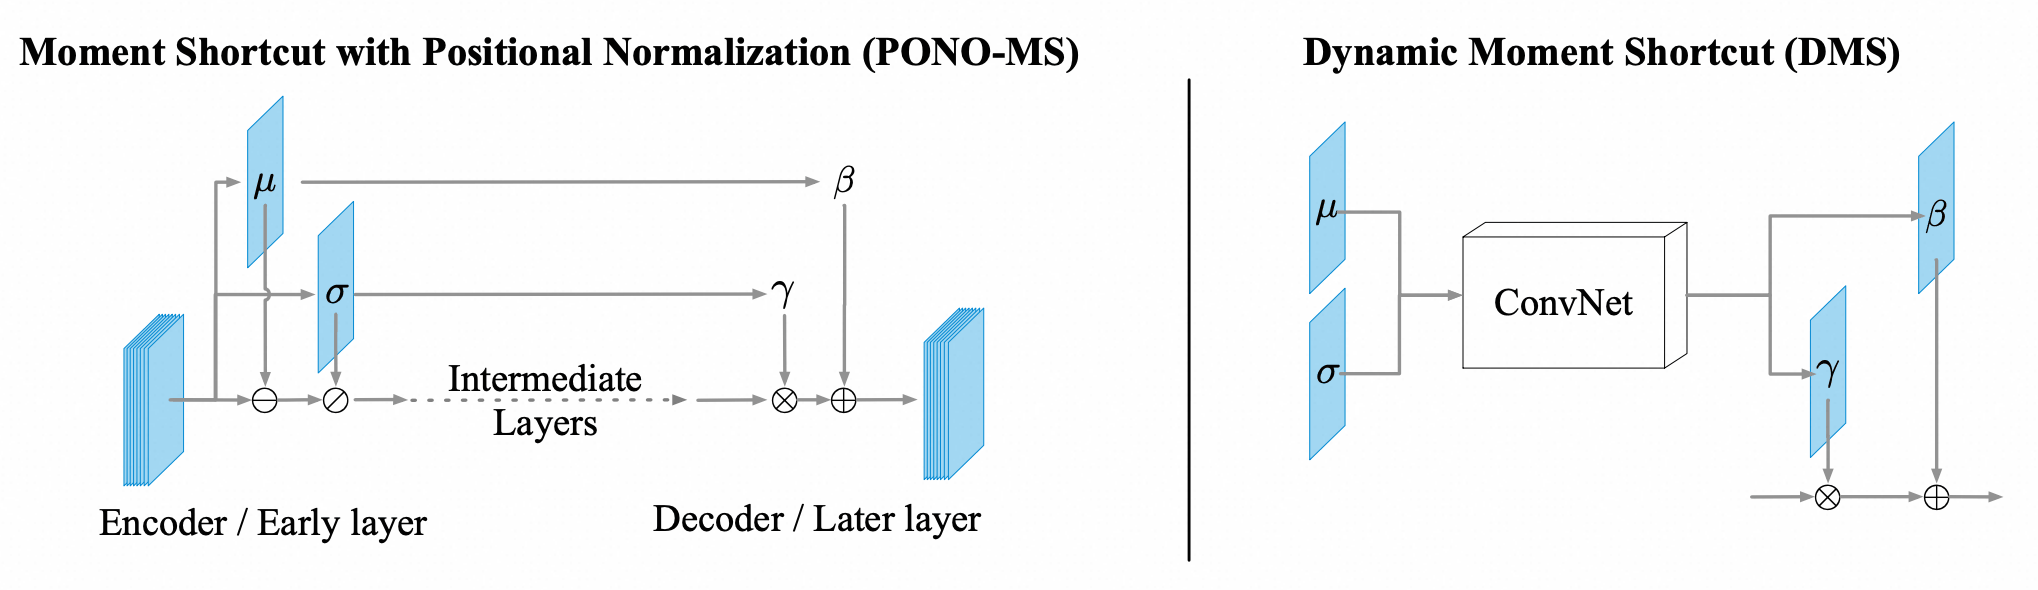
⚪ Region Normalization (RN)
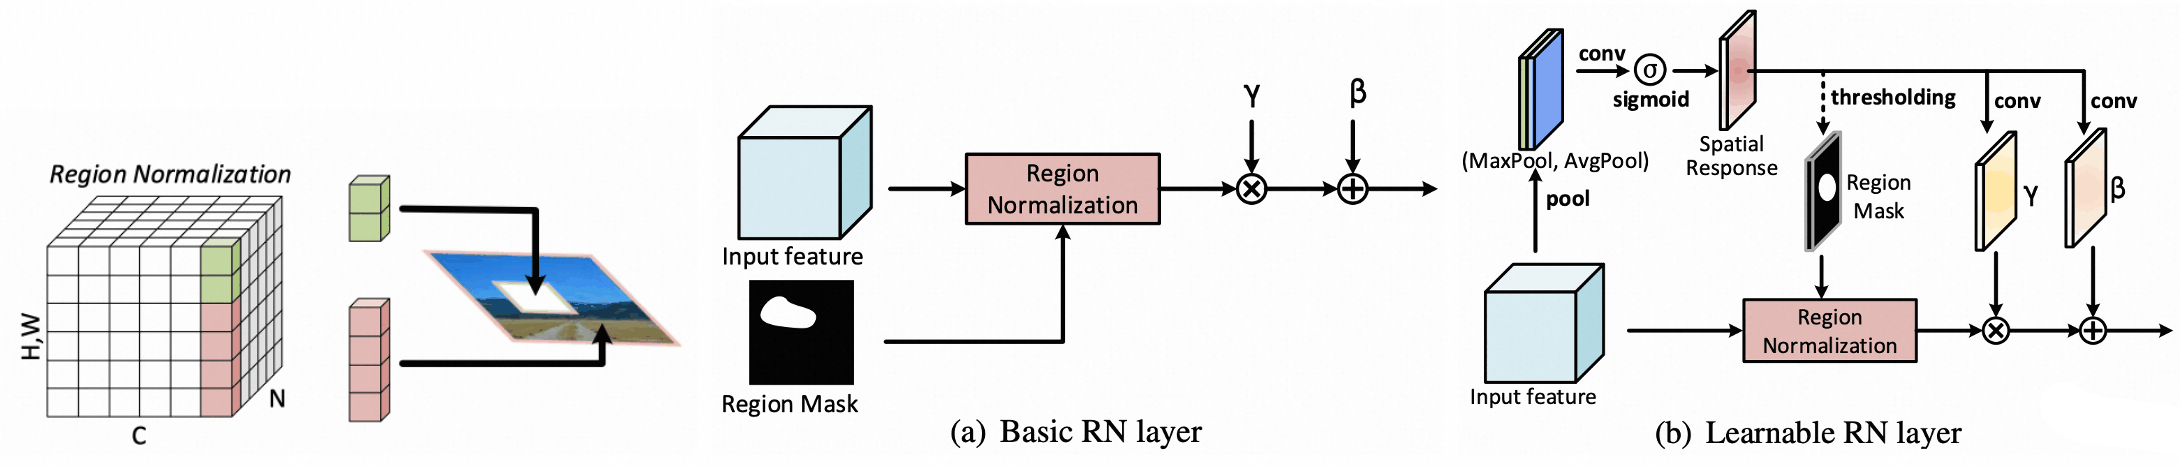
图像修复任务的输入包含破损区域(通常填$0$),如果对整张特征图统一计算统计量,破损区域的无意义数值会污染统计量,即所谓的mean and variance shift。
RN按空间掩码把特征图切成若干区域,在每个区域内独立地计算统计量:
\[y_{nchw} = \gamma_k \frac{x_{nchw}-\mu_{nck}}{\sqrt{\sigma^2_{nck}+\epsilon}}+\beta_k ,\quad (h,w)\in R_k\]其中$R_k$为第$k$个区域。论文给出两种形式:Basic RN用输入掩码显式划分区域(用于网络浅层),Learnable RN让网络自己预测区域划分(用于深层,此时破损区域已被逐步填充、掩码不再准确)。这个思路对任何“输入中存在无效像素”的任务(修复、去遮挡、点云投影、遥感缺值)都适用。
⭐ 讨论:为什么LN在CNN上不如BN,而GN可以
把$2.1$节的表格与实践结论对照,可以总结出一条经验规律:统计集合应当与“语义上同质”的元素集合对齐。
- BN沿$(N,H,W)$统计,每个通道一组统计量。卷积的每个通道对应一个滤波器,其响应在整张图上是同分布的,因此这组统计量语义清晰、样本量大($NHW$个)、估计准确;这解释了BN在视觉任务上的强势。
- LN沿$(C,H,W)$统计,把一个样本内所有通道混在一起。但不同通道检测的是不同模式(边缘、颜色、纹理),量纲不可比,强行共享统计量会损失表达能力。
- GN沿$(C/G,H,W)$统计,是二者的折中:只假设组内通道同质。它既不依赖批量($N=1$也能用),统计量样本数$HWC/G$又足够大,因此成为小批量视觉任务的默认替代。
- Transformer中的LN沿最后一维统计,此时被混在一起的是同一个token的$D$个特征通道。它之所以可行,是因为残差流中各维度本来就没有固定语义(它们是被自由旋转的坐标),同质性假设反而成立。
一个直接的推论:当batch size小于$16$时应放弃BN。此时批统计量的噪声大到会伤害性能(而不是提供正则化),实测上$N=2$时BN的误差可以比GN差一倍以上。
(3) 可学习与自动搜索的归一化
前两组方法都是人手工指定统计维度的。既然选择这么多,自然会想到让网络自己去选。
⚪ 切换归一化 Switchable Normalization (SN)
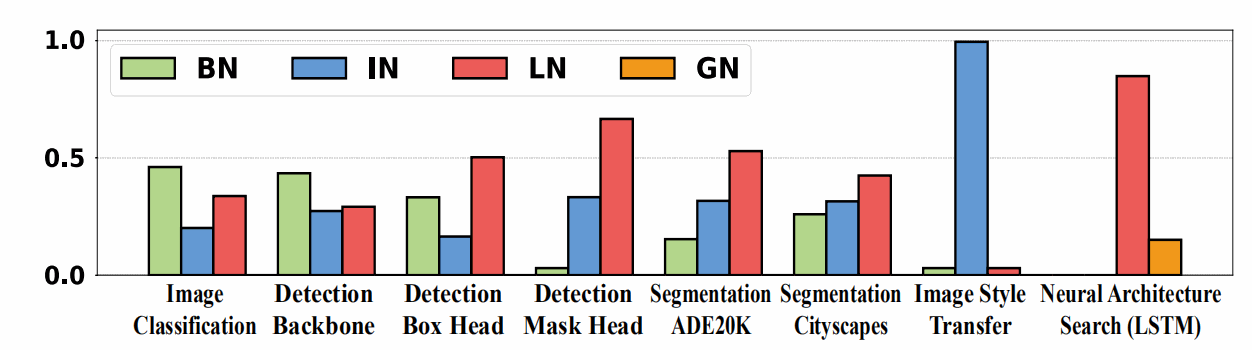
BN、LN、IN分别是minibatch-wise、layer-wise和channel-wise的归一化操作。切换归一化(SN)同时应用这三种方法,学习三种方法的权重,从而适应各种深度学习任务。
如下图所示,不同的深度学习任务具有不同的权重,代表不同归一化方法对不同任务的适合程度。
SN的实现:
\[y_{nchw}=\frac{x_{nchw}-\sum_{k \in \Omega} w_k\mu_k}{\sqrt{\sum_{k \in \Omega} w'_k\sigma^2_k+\epsilon}}\cdot \gamma+\beta\]其中\(\Omega=\{in,ln,bn\}\),注意到三种方法的统计量是相关的,可计算如下:
\[\begin{aligned} \mu_{in} &= \frac{1}{HW}\sum_{h,w}^{H,W} x_{nchw}, & \sigma^2_{in} &= \frac{1}{HW}\sum_{h,w}^{H,W} (x_{nchw}-\mu_{in})^2 \\ \mu_{ln} &= \frac{1}{C}\sum_{c=1}^{C} \mu_{in}, & \sigma^2_{ln} &= \frac{1}{C}\sum_{c=1}^{C} (\sigma^2_{in}+\mu^2_{in})-\mu^2_{ln} \\ \mu_{bn} &= \frac{1}{N}\sum_{n=1}^{N} \mu_{in}, & \sigma^2_{bn} &= \frac{1}{N}\sum_{n=1}^{N} (\sigma^2_{in}+\mu^2_{in})-\mu^2_{bn} \end{aligned}\]$w_k$和$w_k’$是三种方法对应的权重系数,用参数\(\lambda_{in},\lambda_{ln},\lambda_{bn},\lambda'_{in},\lambda'_{ln},\lambda'_{bn}\)控制:
\[w_k=\frac{e^{\lambda_k}}{\sum_{z \in \Omega} e^{\lambda_z}},\quad w'_k=\frac{e^{\lambda'_k}}{\sum_{z \in \Omega} e^{\lambda'_z}}\]注意到上面的统计量复用关系很重要:$\mu_{ln},\mu_{bn}$都可以由$\mu_{in}$廉价地聚合出来,因此SN的额外开销远小于“并行跑三种归一化”。
⚪ EvoNorm
EvoNorm用进化搜索在“归一化 + 激活函数”组成的计算图空间中直接搜索整个层,而不是只搜索统计维度。它的重要结论是:归一化与激活函数不应被分开设计,最优解往往把两者纠缠在一起。搜索出的两个代表性层(用$s_{\cdot}(x)$表示沿下标维度计算的标准差):
\[\begin{aligned} \text{EvoNorm-B0}(x) &= \frac{x}{\max\left(\sqrt{s^2_{n,h,w}(x)+\epsilon},\ v_1 x + s_{h,w}(x)\right)}\gamma + \beta \\ \text{EvoNorm-S0}(x) &= \frac{x\,\sigma\left(v_1 x\right)}{s_{h,w,c/g}(x)}\gamma + \beta \end{aligned}\]其中$v_1$是可学习标量,$\sigma$为Sigmoid。可以看出:B0是批量相关的(分母含批统计量),且用$\max$把归一化与一个类似ReLU的门控合并;S0是批量无关的,分子$x\sigma(v_1x)$正是Swish/SiLU,分母是GN式的组标准差:即“Swish 除以组标准差”。EvoNorm-S0在小批量下尤其稳健,是GN+SiLU的一个有竞争力的替代。
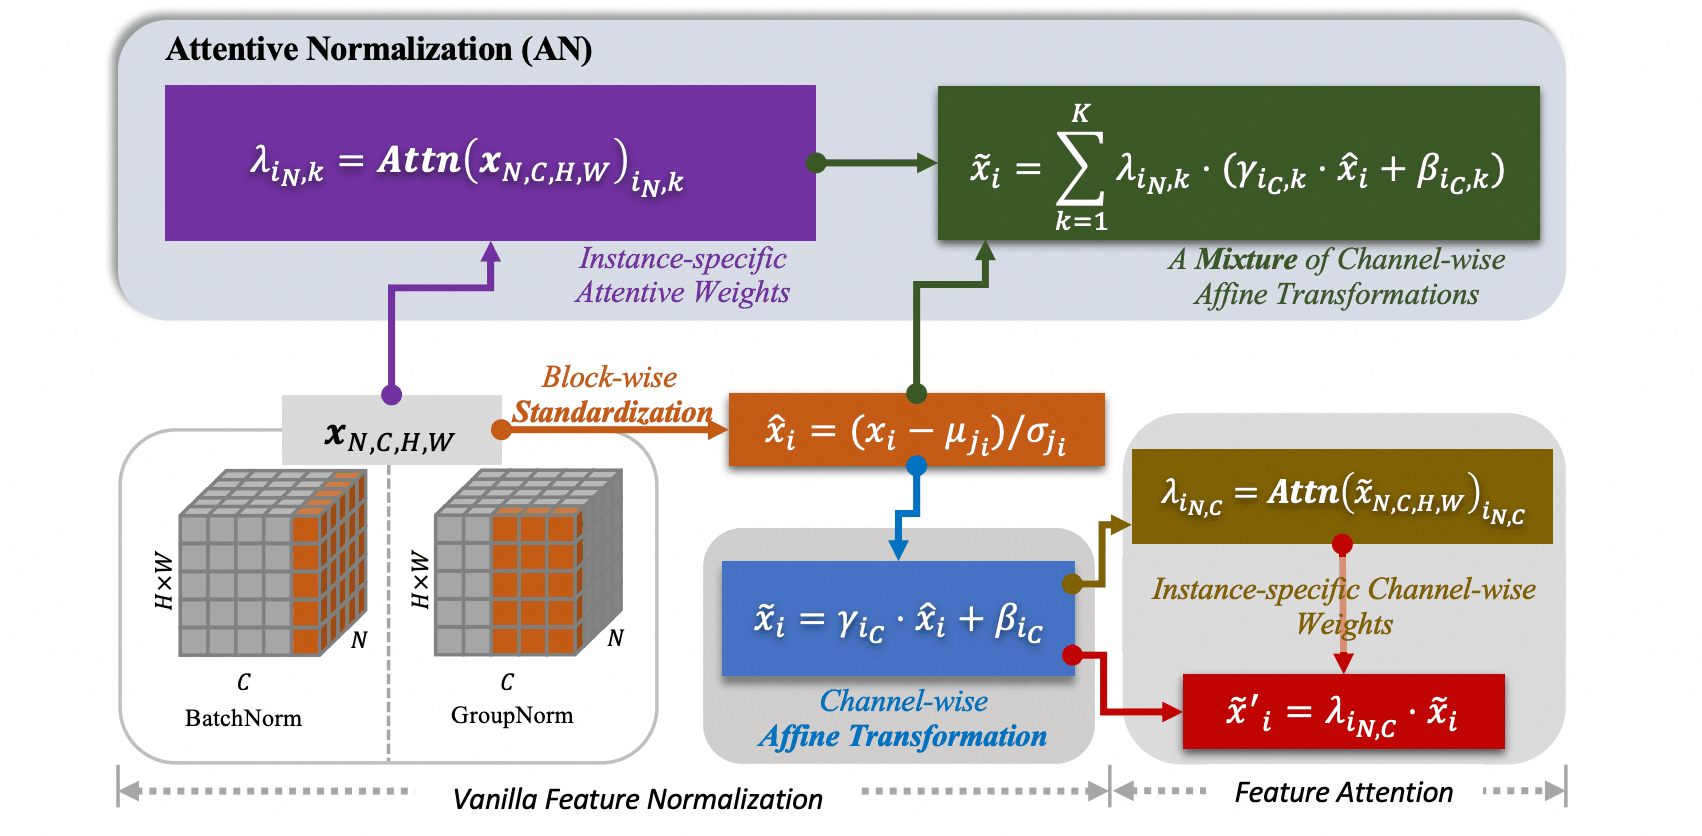
⚪ Attentive Normalization (AN)
- paper:Attentive Normalization
标准归一化层的仿射参数$\gamma,\beta$是静态的:训练完成后对所有输入都用同一组值。AN把仿射变换换成$K$组仿射参数的输入自适应加权组合,权重由通道注意力(SE式的全局池化加全连接)给出:
\[\begin{aligned} \lambda &= \text{Sigmoid}\left(\text{BN}\left(W\,\text{GAP}(x)\right)\right) \in \mathbb{R}^K \\ y &= \sum_{k=1}^{K}\lambda_k\left(\gamma_k \hat{x} + \beta_k\right) \end{aligned}\]其中$\hat{x}$是任意归一化方式(BN/GN均可)标准化后的结果。这相当于把Squeeze-and-Excitation模块融合进了归一化层的仿射步骤,几乎不增加计算量(只多$K$组逐通道参数),可以作为BN的直接替换。
2.4 条件归一化与自适应归一化
前面所有方法的仿射参数$\gamma,\beta$都是网络自身的可学习参数。条件归一化(Conditional Normalization)的思想是:先用数据自身的统计量把特征标准化(洗掉原有的风格/分布信息),再用由外部条件$z$预测出的仿射参数把信息注入回去。一般形式为:
\[y = \gamma(z) \cdot \frac{x - \mu(x)}{\sigma(x)}+\beta(z)\]条件$z$可以是类别标签、风格图像、文本嵌入、语义分割mask、噪声向量、时间步等等。这一族方法是可控图像生成的核心工具,在生成对抗网络、图像翻译与扩散模型中被大量使用。区别只在于$z$是什么、$\gamma(z),\beta(z)$的形状是什么(标量、逐通道向量、还是逐空间位置的张量)。
⚪ Conditional Instance Normalization (CIN)
最早的条件归一化形式。作者发现:一个训练好的风格迁移网络,只需为每种风格保存一组独立的$(\gamma_s,\beta_s)$,就可以用同一套卷积权重生成$N$种不同风格:
\[y = \gamma_s \cdot \frac{x - \mu_{nc}(x)}{\sigma_{nc}(x)}+\beta_s\]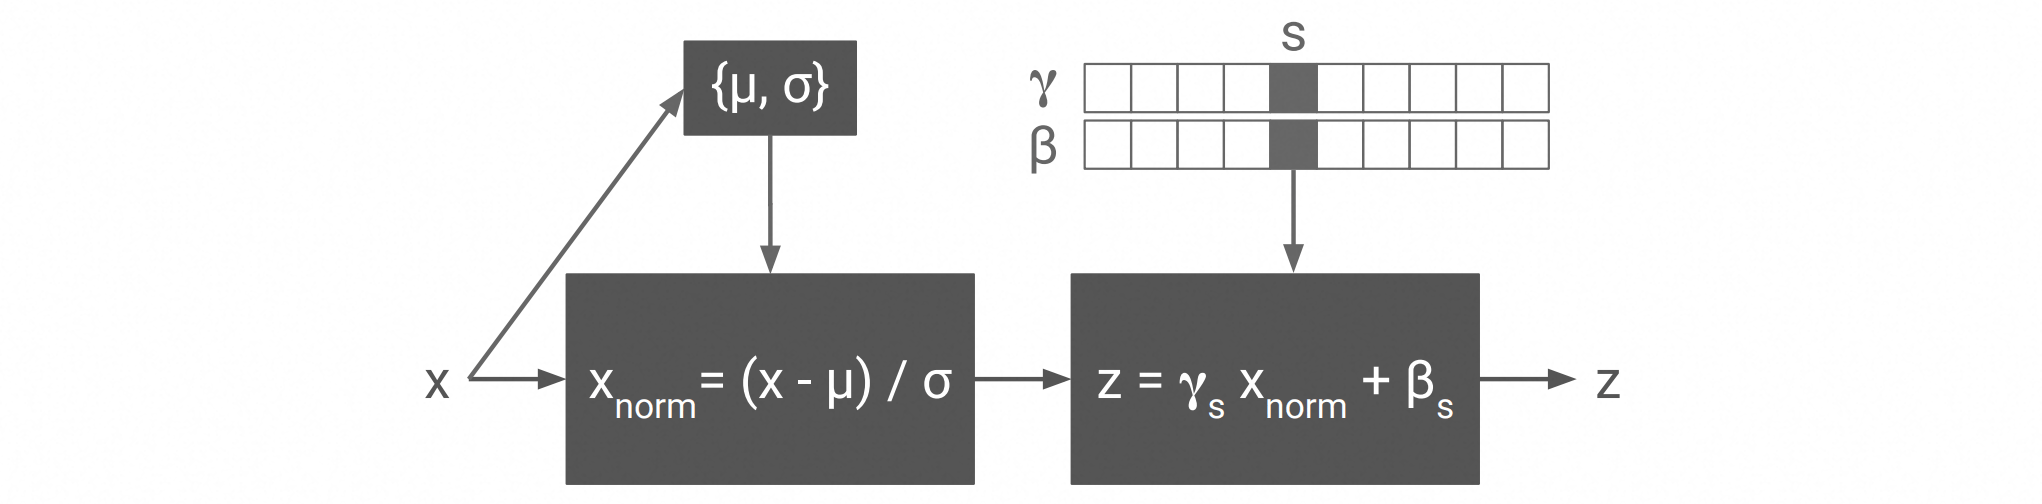
这个结果非常强:风格这样一个“全局的、语义丰富的”属性,竟然可以完全由每层几百个仿射参数编码。它是$2.3$节“IN的统计量携带风格”这一观察的直接实证,也是后续AdaIN、StyleGAN的思想源头。局限是风格数量必须预先固定。
⚪ Conditional Batch Normalization (CBN)
CBN把条件从“离散风格id”推广到任意向量(论文中是问题文本的LSTM嵌入),用一个小MLP预测仿射参数的增量:
\[\begin{aligned} \gamma(z) &= \gamma_0 + \Delta\gamma(z),\quad \Delta\gamma(z) = \text{MLP}(z) \\ \beta(z) &= \beta_0 + \Delta\beta(z),\quad \Delta\beta(z) = \text{MLP}(z) \end{aligned}\]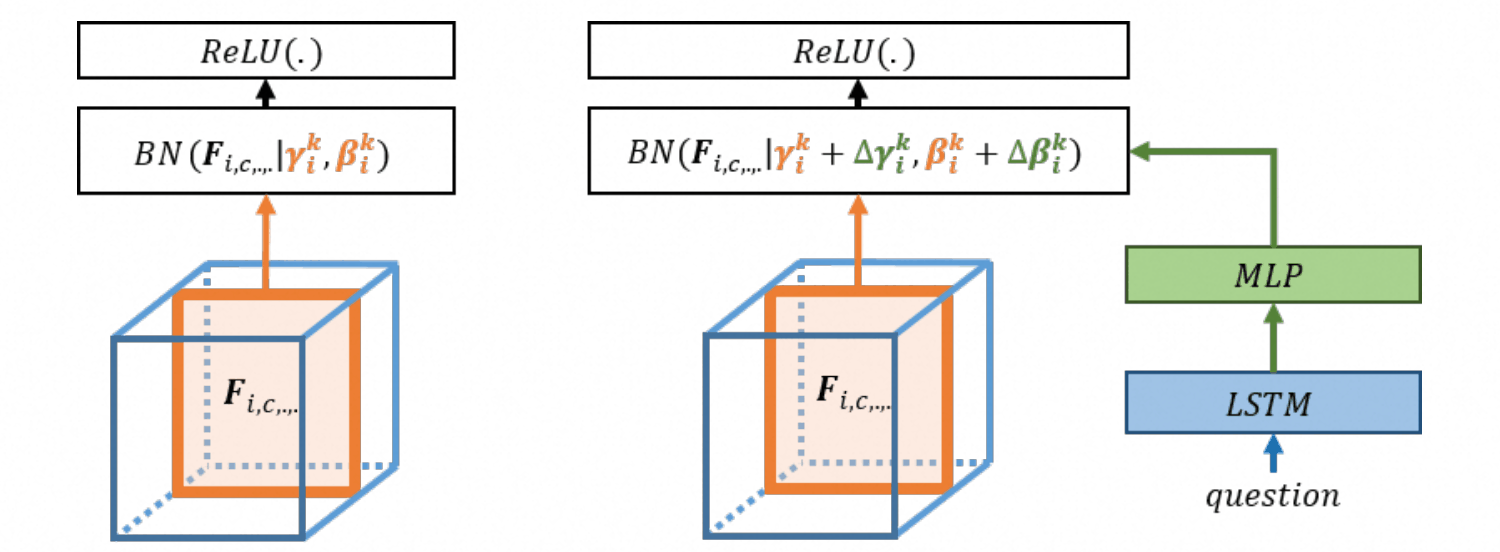
预测增量而非直接预测参数是一个重要的工程细节:$\Delta$初始化为$0$时网络退化为普通BN,因此可以安全地在预训练模型上微调。CBN后来成为类别条件GAN(SN-GAN、BigGAN)的标准组件:把类别标签的嵌入向量作为$z$即可实现类别可控生成。
⚪ Adaptive Instance Normalization (AdaIN)
本文作者指出,IN通过将特征统计量标准化来实现图像风格的标准化,即IN的仿射参数$\gamma,\beta$设置不同的值可以将特征统计信息标准化到不同的分布,从而将输出图像转换到不同的风格。AdaIN可以实现从内容图像$c$到风格图像$s$的风格迁移:
\[\text{AdaIN}(x_c,x_s) = \sigma(x_s)\cdot \frac{x_c-\mu(x_c)}{\sigma(x_c)}+\mu(x_s)\]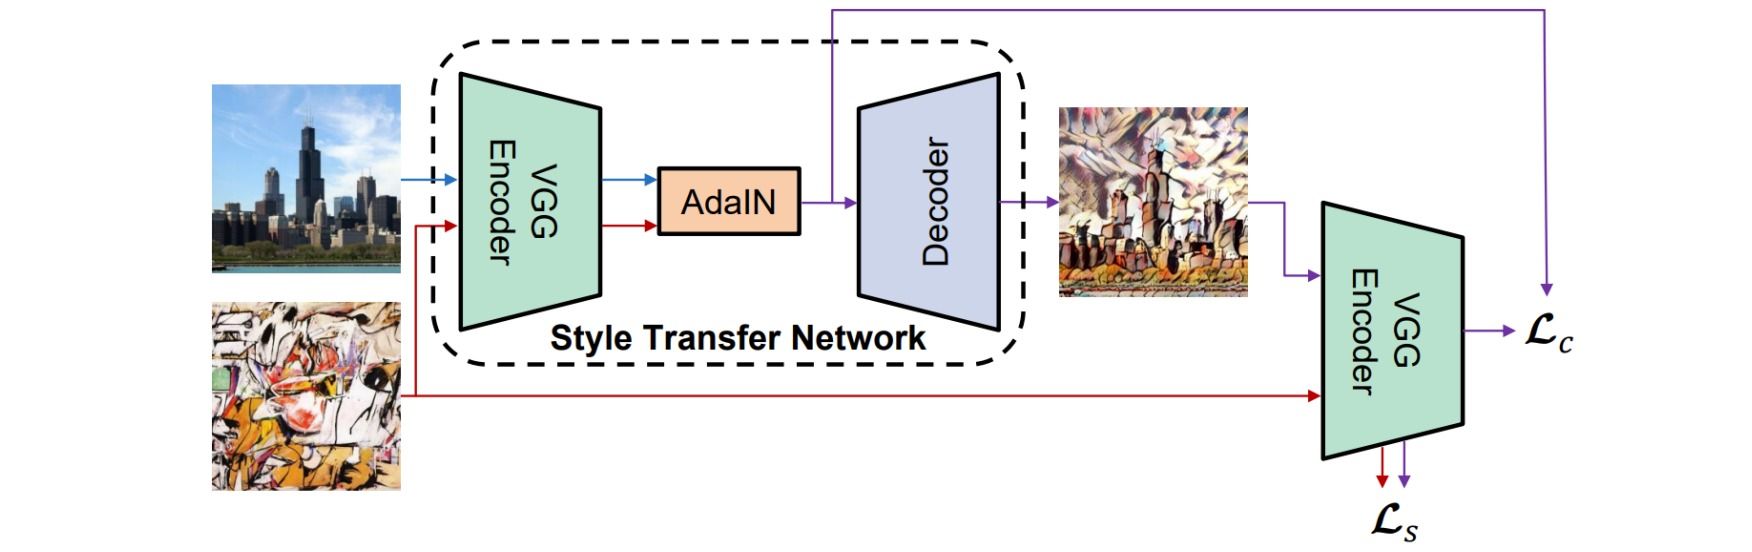
AdaIN最漂亮的地方是它完全没有可学习参数:仿射参数直接取自风格图像特征的均值与标准差。这使得它可以处理任意(训练时未见过的)风格,突破了CIN风格数固定的限制。StyleGAN把这个机制反过来用:$\gamma,\beta$不再来自风格图像,而是由隐编码$w$经仿射层预测,从而实现了对生成图像不同尺度属性的解耦控制。
向网络中加入**AdaIN**层的参考代码实现
#   AdaIN module
class AdaptiveInstanceNorm2d(nn.Module):
    def __init__(self, num_features, eps=1e-5, momentum=1):
        super(AdaptiveInstanceNorm2d, self).__init__()
        self.eps = eps
        self.momentum = momentum
        # fixed init
        self.register_buffer("running_mean", torch.zeros(num_features))
        self.register_buffer("running_var", torch.ones(num_features))

    def forward(self, x):
        b, c, h, w = x.size()
        running_mean = self.running_mean.repeat(b)
        running_var = self.running_var.repeat(b)
        # Apply instance norm
        x_reshaped = x.contiguous().view(1, b * c, h, w)
        out = F.batch_norm(
            x_reshaped, running_mean, running_var,
            None, None, True,
            self.momentum, self.eps
        )
        return out

#            Model
class Model(nn.Module):
    def __init__(self, ):
        super(Model, self).__init__()
        # 定义包含AdaIN的主体网络
        self.model = nn.Sequential()
        # 定义生成AdaIN参数的网络
        num_adain_params = self.get_num_adain_params()
        self.conv = nn.Conv2d(input_channel, num_adain_params, 1)

    def get_num_adain_params(self):
        """Return the number of AdaIN parameters needed by the model"""
        num_adain_params = 0
        for m in self.modules():
            if m.__class__.__name__ == "AdaptiveInstanceNorm2d":
                num_adain_params += 2 * m.num_features
        return num_adain_params

    def assign_adain_params(self, adain_params):
        """Assign the adain_params to the AdaIN layers in model"""
        for m in self.modules():
            if m.__class__.__name__ == "AdaptiveInstanceNorm2d":
                # Extract weight and bias predictions
                weight = adain_params[:, : m.num_features]
                bias = adain_params[:, m.num_features : 2 * m.num_features]
                # Update bias and weight
                m.bias = bias.contiguous().view(-1)
                m.weight = weight.contiguous().view(-1)
                # Move pointer
                if adain_params.size(1) > 2 * m.num_features:
                    adain_params = adain_params[:, 2 * m.num_features :]

    def forward(self, main_input, cond_input):
        # Update AdaIN parameters by ConvLayer prediction based off conditional input
        self.assign_adain_params(self.conv(cond_input))
        out = self.model(main_input)
        return out
⚪ Spatially-Adaptive Denormalization (SPADE)
前面几种条件归一化的$\gamma,\beta$都是逐通道的标量,因此注入的信息在空间上是均匀的。这对语义图像合成(把分割mask转成真实图像)是致命的:作者发现通常的归一化层倾向于“洗掉”输入语义mask中的信息;如果mask由几个均匀区域组成,直接对其使用InstanceNorm会让整个区域的信息退化为一个常数。
SPADE (Spatially-adaptive denormalization)采用的归一化形式为BatchNorm,即沿着特征的每一个通道维度进行归一化。仿射变换参数$\gamma,\beta$不是标量,而是与空间位置有关的向量$\gamma_{c,h,w},\beta_{c,h,w}$,并由输入语义mask图像通过两层卷积层构造:
\[y_{nchw} = \gamma_{chw}(m)\cdot \frac{x_{nchw}-\mu_c}{\sqrt{\sigma_c^2+\epsilon}}+\beta_{chw}(m)\]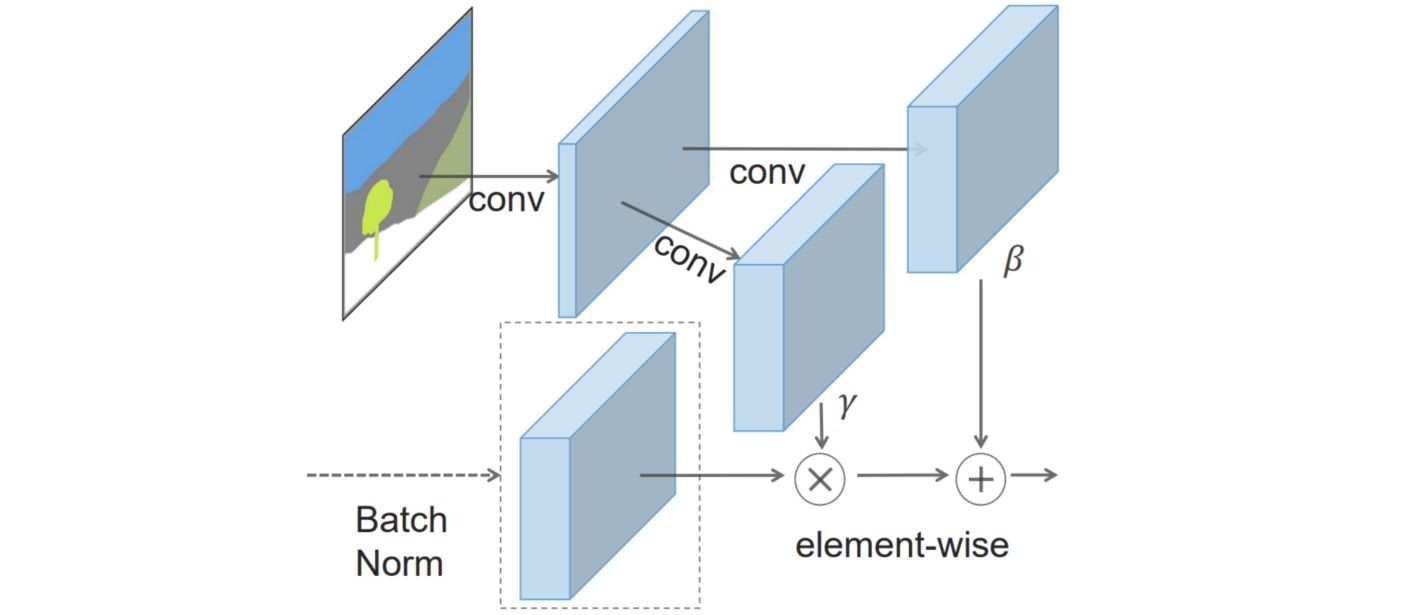
关键在于:语义mask $m$ 只经过仿射变换这条路径提供,从未被归一化,被归一化的只有前一层特征。因此SPADE能够更好地保留语义信息。它是GauGAN的核心模块,也是后来各类空间条件注入机制(ControlNet式的条件注入在精神上与之一致)的先驱。
向网络中加入SPADE层的参考代码实现:
点击展开代码
#   SPADE module
class SPADE2d(nn.Module):
    def __init__(self, num_features, eps=1e-5, momentum=0.1):
        super(SPADE2d, self).__init__()
        self.num_features = num_features
        self.eps = eps
        self.momentum = momentum
        # weight and bias are dynamically assigned
        self.weight = None # [1, c, h, w]
        self.bias = None # [1, c, h, w]
        self.bn = nn.BatchNorm2d(
            self.num_features, eps=1e-5,
            momentum=0.1, affine=False,
            )

    def forward(self, x):
        # Apply batch norm
        out = self.bn(out)
        return out*self.weight + self.bias


#            Model
class Model(nn.Module):
    def __init__(self, ):
        super(Model, self).__init__()
        # 定义包含SPADE的主体网络
        self.model = nn.Sequential()
        # 定义生成SPADE参数的网络
        num_spade_params = self.get_num_spade_params()
        self.conv = ConvLayer(input_channel, num_spade_params)

    def get_num_spade_params(self):
        """Return the number of SPADE parameters needed by the model"""
        num_spade_params = 0
        for m in self.modules():
            if m.__class__.__name__ == "SPADE2d":
                num_spade_params += 2 * m.num_features
        return num_spade_params

    def assign_spade_params(self, spade_params):
        """Assign the spade_params to the SPADE layers in model"""
        for m in self.modules():
            if m.__class__.__name__ == "SPADE2d":
                # Extract weight and bias predictions
                m.weight = spade_params[:, : m.num_features, :, :].contiguous()
                m.bias = spade_params[:, m.num_features : 2 * m.num_features, :, :].contiguous()
                # Move pointer
                if spade_params.size(1) > 2*m.num_features:
                    spade_params = spade_params[:, 2*m.num_features:, :, :]

    def forward(self, main_input, cond_input):
        # Update SPADE parameters by ConvLayer prediction based off conditional input
        self.assign_spade_params(self.conv(cond_input))
        out = self.model(main_input)
        return out
SPADE在生成对抗网络中的完整用法(生成器结构、多尺度判别器、VAE风格编码器)可参考生成对抗网络。
⚪ FiLM:去掉归一化的条件仿射
FiLM (Feature-wise Linear Modulation)把上面这些方法抽象成了一个独立的算子,并且明确指出归一化步骤不是必需的:
\[\text{FiLM}(x \mid z) = \gamma(z)\odot x + \beta(z)\]即只保留“由条件预测逐通道缩放与偏移”这一步。因此FiLM可以插在网络的任意位置(不必与归一化绑定),也可以理解为条件归一化的“公因式”。它在视觉问答、强化学习、扩散模型的时间步嵌入注入(DiT的adaLN就是LN + FiLM)中被广泛使用。
⭐ 讨论:adaLN 与 adaLN-Zero
现代扩散Transformer(DiT、SD3等)使用的adaLN是本节机制的直接产物:把时间步$t$与类别/文本条件$c$的嵌入相加后经一个MLP预测$\gamma,\beta$,作用在LayerNorm之后:
\[y = \gamma(t,c)\odot \text{LayerNorm}(x)+\beta(t,c)\]其中LayerNorm取elementwise_affine=False(自带的仿射参数被条件预测的参数取代)。adaLN-Zero进一步为每个残差分支额外预测一个门控$\alpha(t,c)$,并把预测$\alpha$的那一层初始化为零:
这样在训练开始时每个块都是恒等映射,这正是$2.7$节ReZero/SkipInit的思想,说明“条件注入”与“稳定初始化”这两条线在这里汇合了。
⚪ Modulated Convolution:把条件归一化搬到权重上
StyleGAN2的作者发现,AdaIN式的逐实例统计量操作会产生water droplet伪影:生成器为了绕过AdaIN对特征幅值的强制归一化,会故意制造一个局部强峰去“携带”幅值信息。
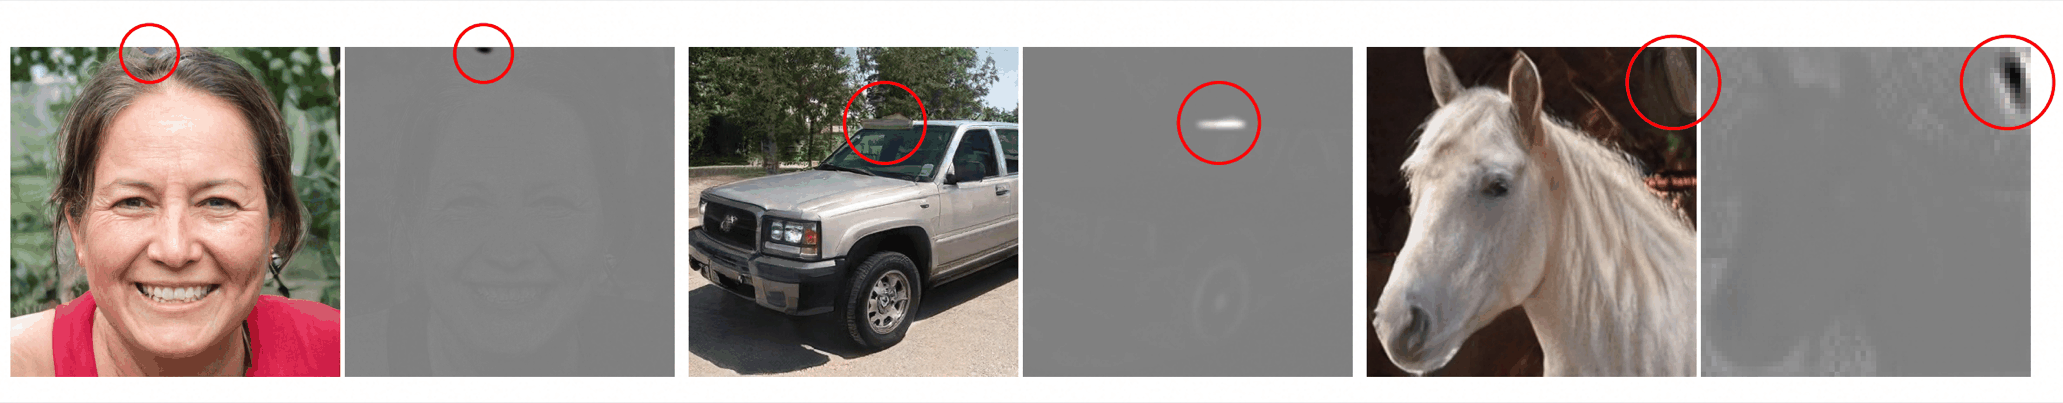
解决方案是把作用在激活值上的调制搬到卷积权重上,从而避免了对单个样本的统计量操作。设风格向量给出逐输入通道的缩放$s_i$,卷积核为$w_{ijk}$($i$为输入通道、$j$为输出通道、$k$为空间位置),则调制(modulation)与解调(demodulation)分别为:
\[\begin{aligned} w'_{ijk} &= s_i\cdot w_{ijk} \\ w''_{ijk} &= \frac{w'_{ijk}}{\sqrt{\sum_{i,k}\left(w'_{ijk}\right)^2+\epsilon}} \end{aligned}\]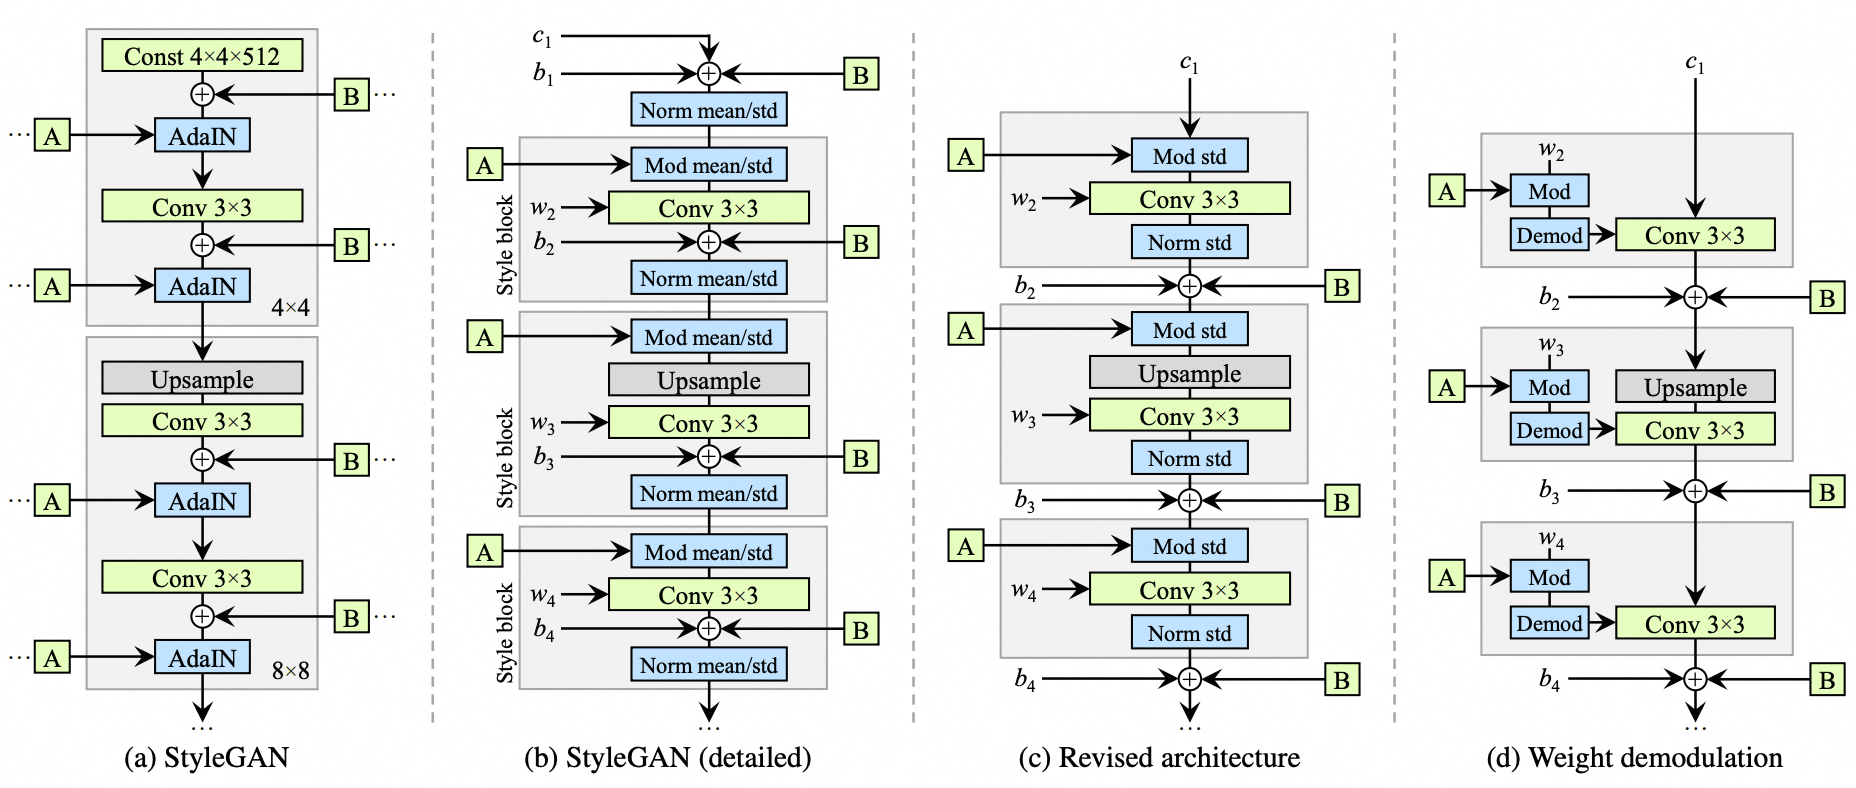
解调步骤基于一个统计假设:若输入是独立同分布的单位方差信号,则输出方差为$\sum_{i,k}(w’_{ijk})^2$,因此除以它的平方根即可恢复单位方差。这实际上是$2.5$节参数归一化的思路:用权重的范数代替激活值的统计量,从而在保留风格控制能力的同时消除了实例统计量带来的伪影。
2.5 参数归一化
之前介绍的归一化方法都是针对网络层中的特征进行的操作,也可以把归一化应用到网络权重上。参数归一化的共同优点是:不依赖任何数据统计量,因此完全没有批量依赖、没有训练/推理不一致问题;由于神经网络中权重经常是共享的(一个卷积核作用于所有空间位置),其计算开销也远小于对特征进行归一化的方法。
⚪ 权重归一化 Weight Normalization
- paper:Weight Normalization: A Simple Reparameterization to Accelerate Training of Deep Neural Networks
权重归一化(WN)对权重$W$使用长度标量$g$和方向向量$v$进行重参数化:
\[W=g\frac{v}{\Vert v \Vert}\]其中$g= \Vert W \Vert$,向量$v$由反向传播更新。
这个重参数化把“长度”与“方向”解耦,使梯度下降在两个子空间上分别进行,从而改善了优化的条件数(这与第$1.3$节引用的长度-方向解耦分析是同一件事)。WN在RNN、强化学习、生成模型等BN不适用的场合曾被广泛使用,PyTorch提供torch.nn.utils.parametrizations.weight_norm。
⚪ 中心化权重归一化 Centered Weight Normalization
WN只约束了权重的长度,没有约束其均值。Centered WN在归一化之前先把权重向量中心化:
\[W = g\cdot \frac{v-\overline{v}}{\|v-\overline{v}\|},\quad \overline{v} = \frac{1}{d}\sum_{i=1}^d v_i\]零均值的权重向量意味着$W^\top \mathbf{1}=0$,即该神经元对输入中的直流分量不敏感。作者证明这等价于对输入做了隐式的中心化,因此能取得类似BN减均值的效果,同时保持BN所不具备的批量独立性。
⚪ 权重标准化 Weight Standardization (WS)
WS把BN那套“减均值除标准差”原封不动地搬到权重上。对权重\(W \in \mathbb{R}^{O\times I}\)($O$为输出通道数,$I=C_{in}\times k\times k$为每个滤波器的元素数),逐输出通道标准化:
\[\begin{aligned} \mu_{W_j} &= \frac{1}{I}\sum_{i=1}^{I} W_{j,i} ,\quad \sigma_{W_j} = \sqrt{\frac{1}{I}\sum_{i=1}^{I}\left(W_{j,i}-\mu_{W_j}\right)^2} \\ \hat{W}_{j,i} &= \frac{W_{j,i}-\mu_{W_j}}{\sigma_{W_j}+\epsilon} \end{aligned}\]WS的作用机制与WN不同:它主要平滑损失曲面(减小了损失关于权重的Lipschitz常数),因此与激活值归一化是互补的而不是替代关系。
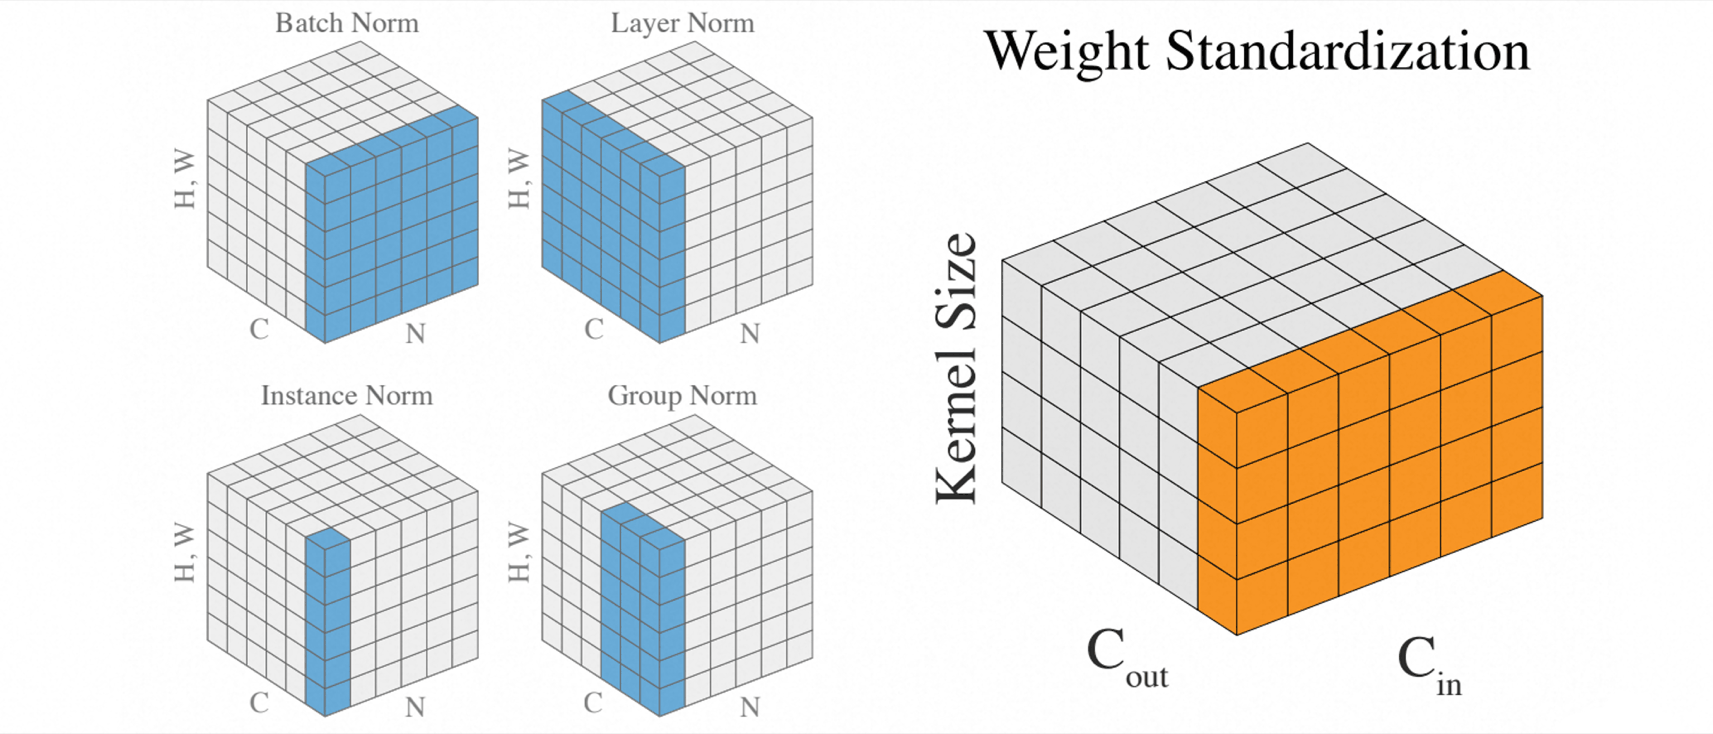
最重要的实践结论是GN + WS这个组合:它在batch size = 1的极端小批量下仍能匹配甚至超过BN的性能,被Big Transfer (BiT)采纳为大规模预训练的标准配置。BiT选择它的理由很具体:大规模预训练需要跨多设备切分批量,BN的跨设备统计量同步既昂贵又会让“预训练用的批统计量”无法迁移到下游小数据集,而GN+WS完全没有这个问题。
⚪ 余弦归一化 Cosine Normalization
对数据进行归一化的原因是因为数据经过神经网络的计算后可能变得很大,导致分布的方差爆炸,而这一问题的根源就是采用的计算方式(点积),向量点积是无界的。
向量点积是衡量两个向量相似度的方法之一。类似的度量方式还有很多。夹角余弦就是其中一个且有确定界。余弦归一化将点积运算替换为计算余弦相似度,将输出控制在$[-1,1]$之间。
\[Norm(W\cdot x) = \frac{W\cdot x}{\Vert W \Vert \cdot \Vert x \Vert}\]余弦归一化同时归一化了权重与输入,因此是本节唯一一个“双边”方法。它的代价是丢失了幅值信息,通常需要额外引入一个可学习的温度系数来恢复表达能力(ArcFace等度量学习方法中的归一化Softmax、以及$2.6$节的QK-Norm都可以看作这一思路的延续)。
⚪ 谱归一化 Spectral Normalization
谱归一化(Spectral Normalization)是指使用谱范数(spectral norm)对网络参数进行归一化:
\[W \leftarrow \frac{W}{||W||_2}\]谱归一化精确地使网络满足Lipschitz连续性。Lipschitz连续性保证了函数对于输入扰动的稳定性,即函数的输出变化相对输入变化是缓慢的。
谱范数是一种由向量范数诱导出来的矩阵范数,作用相当于向量的模长:
\[||W||_2 = \mathop{\max}_{x \neq 0} \frac{||Wx||}{||x||}\]谱范数$||W||_2$的取值为$W^TW$的最大特征值的平方根。这个结论可以由瑞利商得到:
\[||W||_2^2 = \mathop{\max}_{x \neq 0} \frac{x^TW^TWx}{x^Tx} = \lambda_{\max}\left(W^TW\right)\]为什么这能约束整个网络? 考虑单层全连接$D_W(x)=\sigma(Wx)$,对其作一阶Taylor展开:
\[|| \sigma(Wx_1)-\sigma(Wx_2) || \approx \left|\left| \frac{\partial \sigma}{\partial Wx} W(x_1-x_2) \right|\right| \leq K(W) || x_1-x_2 ||\]由于常用激活函数的导数有界(如ReLU的导数范围是$[0,1]$),这一项可以被忽略,于是Lipschitz约束完全落在$W$上,即\(\|W(x_1-x_2)\|\leq \|W\|_2\cdot\|x_1-x_2\|\)。卷积层、循环层都可以写成特殊的全连接层,因此该分析具有一般性。
如何高效计算谱范数? 每步训练都做一次特征分解显然不可行,实践中使用幂迭代(power iteration),且每次前向只迭代一步(复用上一步的$u,v$作为初值):
\[v \leftarrow \frac{W^Tu}{||W^Tu||},\quad u \leftarrow \frac{Wv}{||Wv||},\quad ||W||_2 \approx u^TWv\]幂迭代收敛的原因是:把初值在$A=W^TW$的特征向量基下展开$u^{(0)}=\sum_i c_iv_i$,迭代$t$步后$A^tu^{(0)}=\sum_i c_i\lambda_i^tv_i$,除以$\lambda_1^t$后除主特征向量外的所有项都按$(\lambda_i/\lambda_1)^t\to 0$衰减,因此$A^tu^{(0)}$的方向趋于主特征向量。
点击展开代码
model = Model()
def add_sn(m):
        for name, layer in m.named_children():
             m.add_module(name, add_sn(layer))
        if isinstance(m, (nn.Conv2d, nn.Linear)):
             return nn.utils.spectral_norm(m)
        else:
             return m
model = add_sn(model)
值得一提的是,谱归一化是对模型的每一层权重都进行的操作,使得网络的每一层都满足Lipschitz约束;这种约束有时太过硬,通常只希望整个模型满足Lipschitz约束,而不必强求每一层都满足。
谱归一化最著名的应用是SN-GAN:把它施加于判别器后,WGAN所需的\(\|D\|_L\leq K\)约束自动成立,从而可以去掉weight clipping与梯度惩罚。这部分内容(以及配套的hinge损失)属于生成对抗网络的范畴,详见生成对抗网络。此外,谱归一化也被用于稳定强化学习的价值网络与扩散模型的训练。
2.6 归一化在Transformer中的位置
前面几节关心“归一化怎么算”,本节关心一个看起来更琐碎、实际影响却更大的问题:归一化层放在残差块的哪个位置。在深度Transformer与大语言模型中,这个选择直接决定了能不能训得起来、要不要warm-up、深层是否有效、以及会不会出现loss spike。
统一记号:$x_t$为第$t$块的输入,$F_t(\cdot)$为该块的子层(自注意力或前馈网络),$L$为总层数。
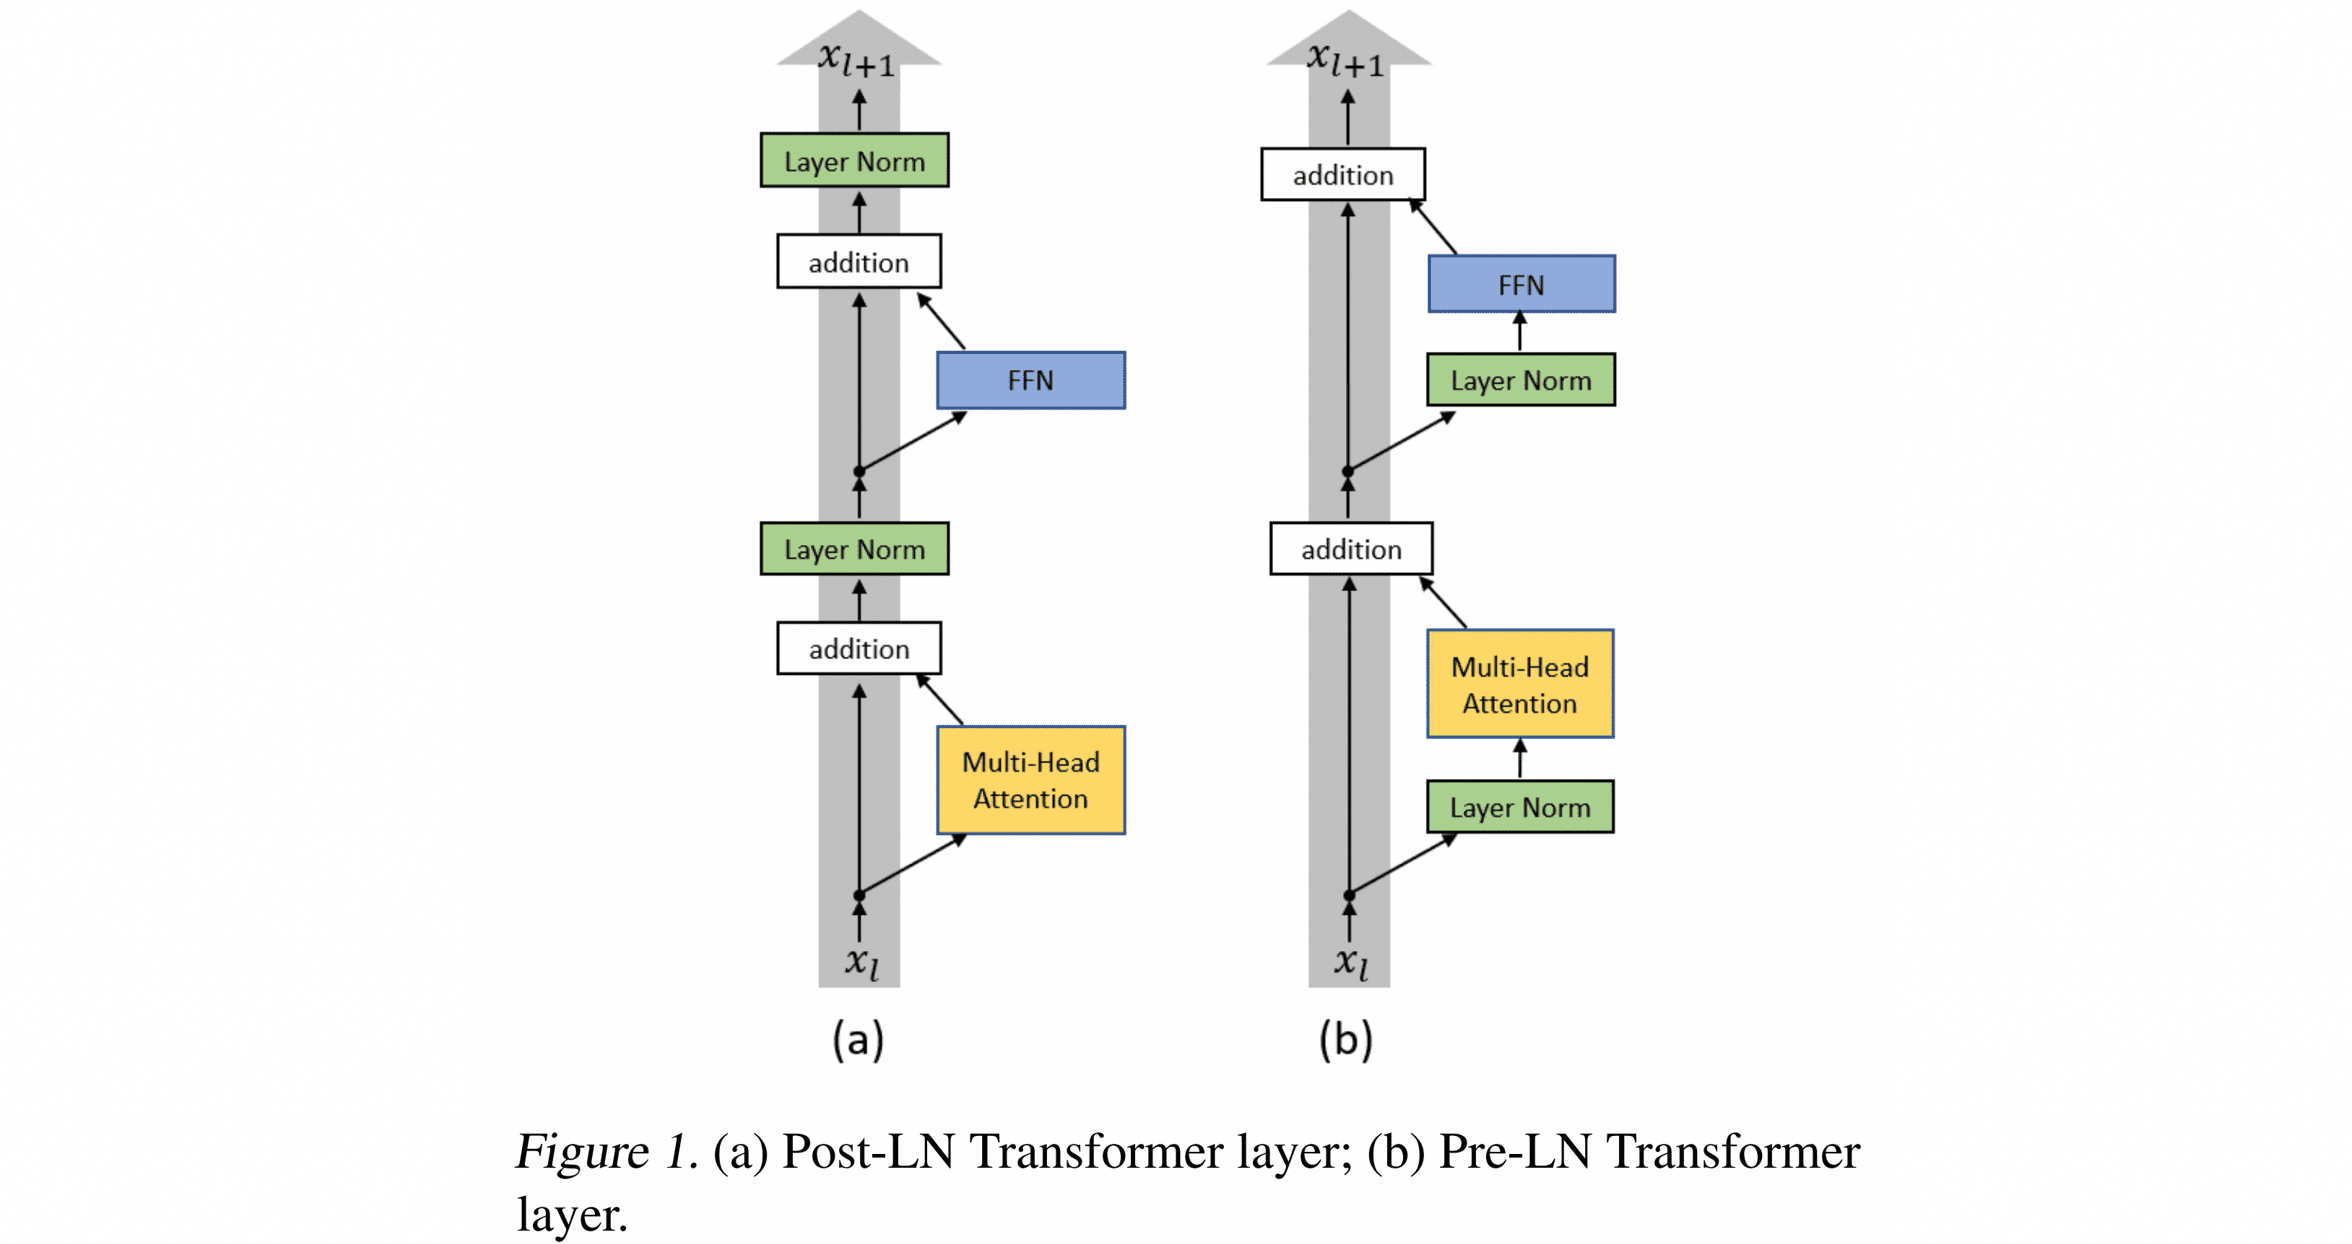
⚪ Post-LN
原始Transformer采用的方案,把LayerNorm放在残差相加之后:
\[x_{t+1} = \text{LayerNorm}(x_t + F_t(x_t))\]Post-LN的优点:
① 稳定了前向传播的方差。 如果$x$的方差为$\sigma^2_1$而$F(x)$的方差为$\sigma_2^2$,并且假设两者相互独立,则$x+F(x)$的方差为$\sigma^2_1+\sigma_2^2$,即残差会进一步放大方差。通过引入Post-LN能够稳定前向传播的数值,并且保持了每个模块的一致性。
② 微调性能更好。 在微调阶段,通常希望优先调整靠近输出层的参数,不要过度调整靠近输入层的参数,以免严重破坏预训练效果。由于Post-LN会带来一定的梯度消失问题(本质是削弱了残差,见下文),越靠近输入层的结果对最终输出的影响越弱,这正是微调时所希望的。所以预训练好的Post-LN会比Pre-LN有更好的微调性能。
Post-LN的主要缺点是削弱了残差的恒等分支。不失一般性地假设$\sigma_1=\sigma_2=1$,则$x+F(x)$的方差为$2$。LayerNorm将方差重新缩放到$1$,相当于在初始阶段进行操作:
\[\begin{aligned} x_{t+1} &= \frac{x_t+F(x_t)}{\sqrt{2}} \\ &= \frac{x_{t-1}+F(x_{t-1})}{(\sqrt{2})^2} + \frac{F(x_t)}{\sqrt{2}} \\ &= \cdots \\ &= \frac{x_0}{(\sqrt{2})^{t+1}} + \sum_{i=0}^t \frac{F(x_i)}{(\sqrt{2})^{t+1-i}} \\ \end{aligned}\]此时残差的恒等分支以幂函数的形式被削弱了,因此Post-LN失去了残差“易于训练”的优点,通常需要Warm-Up并设置足够小的学习率才能使训练过程收敛。
⚪ Pre-LN
Pre-LN把LayerNorm移到子层之前(即残差分支内部):
\[x_{t+1} = x_t + F_t(\text{LayerNorm}(x_t))\]本文的核心结论是:Post-LN在初始化时输出层附近的梯度期望与$\sqrt{L}$成正比(因此必须用warm-up把初期学习率压住),而Pre-LN的梯度与深度无关,因此无需warm-up即可稳定训练。
Pre-LN的优点是突出了残差路径的作用,它可以展开为:
\[\begin{aligned} x_{t+1} &= x_t + F_t(\text{LayerNorm}(x_t)) \\ &= x_{t-1} + F_{t-1}(\text{LayerNorm}(x_{t-1})) + F_t(\text{LayerNorm}(x_t))\\ &= \cdots \\ &= x_0 + \sum_{i=0}^t F_i(\text{LayerNorm}(x_i)) \\ \end{aligned}\]恒等分支被完整保留,所以Pre-LN更好优化。但是最后的$x_t$方差将会很大(若各项方差为$1$且独立,则$x_t$的方差为$t$),所以在接预测层之前$x_t$还要加一个LayerNorm(称为final LN)。
Pre-LN的主要缺点是实际等效层数减少。随着层数的加深,$x_t$和$x_{t+1}$之间的差异减小,因此近似有:
\[\begin{aligned} & F_{t+1}(\text{LayerNorm}(x_{t+1})) + F_t(\text{LayerNorm}(x_t)) \\ \approx & F_{t+1}(\text{LayerNorm}(x_t)) + F_t(\text{LayerNorm}(x_t)) \\ = &\begin{pmatrix} 1 & 1 \end{pmatrix}\begin{pmatrix} F_{t+1} \\ F_t \end{pmatrix} \begin{pmatrix}\text{LayerNorm}(x_t) \end{pmatrix} \end{aligned}\]当$t$比较大时,$x_t,x_{t+1}$相差较小,所以原本一个$t$层的模型与$t+1$层的模型的和,近似等效于一个更宽的$t$层模型。Pre-LN增加了模型的宽度而降低了模型的深度,由于深度通常比宽度更重要,因此Pre-LN在同等层数下的最终训练效果通常不如Post-LN。
尽管如此,由于稳定性压倒一切,Pre-LN(更准确地说是Pre-RMSNorm)成为了GPT、LLaMA等几乎所有大语言模型的选择。
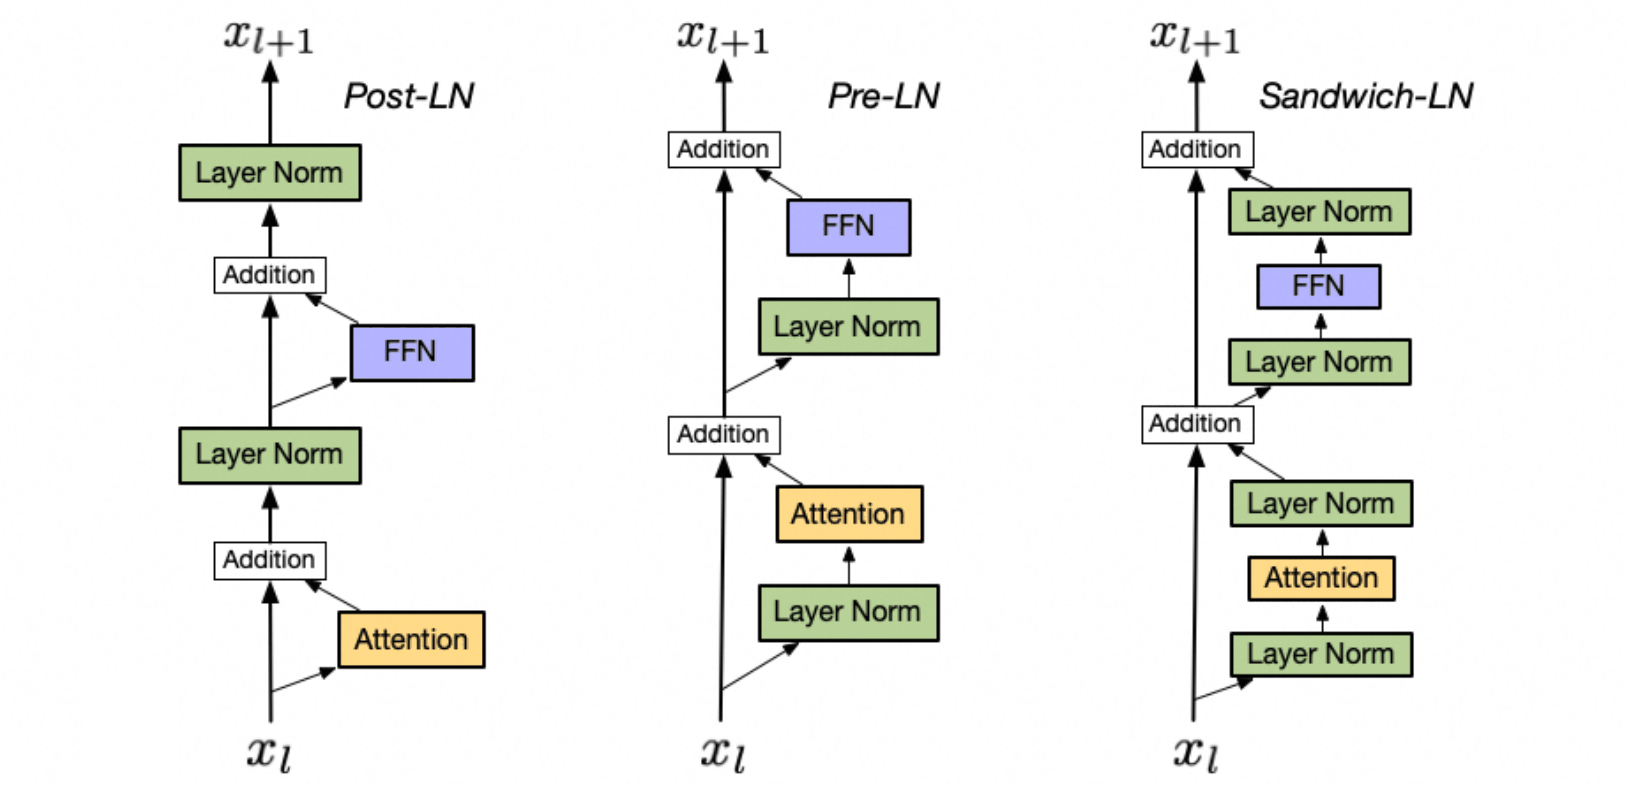
⚪ Sandwich-LN 与 Peri-LN
- paper:CogView: Mastering Text-to-Image Generation via Transformers
- paper:Peri-LN: Revisiting Normalization Layer in the Transformer Architecture
既然Post-LN的问题是归一化压制了恒等分支、Pre-LN的问题是残差流方差无界增长,一个自然的想法是在残差分支的两端各放一个归一化层,而恒等分支保持干净:
\[x_{t+1} = x_t + \text{LayerNorm}_2\left(F_t\left(\text{LayerNorm}_1(x_t)\right)\right)\]CogView最早以Sandwich-LN的名字提出这一结构,用于解决文本到图像生成训练中的数值溢出问题;Peri-LN(“peripheral”,即归一化层位于子层的外围)对同一结构做了系统的理论与实证分析,指出它能同时获得Pre-LN的梯度性质与有界的残差流方差,从而显著降低训练中出现loss spike与massive activation的概率。这一结构已被Gemma 2、OLMo 2等模型采用。
⚪ DeepNorm
DeepNorm保留了Post-LN(因而保留了它更好的最终效果),但在残差相加时给恒等分支乘一个大于$1$的常数$\alpha$来对抗归一化对它的压制:
\[x_{t+1} = \text{LayerNorm}\left(\alpha x_t + F_t(x_t)\right)\]同时配套一个初始化缩放$\beta$:把前馈层、注意力的$v$投影与输出投影的初始化按$\beta$缩小,即缩放$F_t(x_t)$的权重。推导 $α$ 和 $β$ 与网络深度 $N$ 的关系,主要源于两个相互制约的核心原则:
- 保证模型更新的有效性 (Effective Updates):为了在训练的初始阶段就建立一个稳定的关系,要求$\alpha x_t$与$F_t(x_t)$的方差的几何平均值保持为一个与深度无关的常数。这确保了两者都不会压倒对方:
- 保证梯度在N层网络中的稳定传播 (Stable Gradient Flow):对于一个 $N$ 层的深度网络,梯度在反向传播时会连乘 $N$ 次雅可比矩阵。为了让 $N$ 层网络的梯度保持稳定,需要让每一层的计算分支 $F_t(x_t)$ 的影响能够抵消掉随深度 $N$ 累积的潜在不稳定趋势。作者推导给出了一个约束:
求解关于 $α$ 和 $β$ 的方程组得到 $α$ 和 $β$ 与 $N$ 的关系:
\[\begin{aligned} α &= \sqrt{C_1 C_2} \cdot N^{1/4} \\ β &= \sqrt{C_1 / C_2} \cdot N^{-1/4} \end{aligned}\]推导出了正确的指数关系后,通过对 Transformer 具体结构的方差分析得到具体的常数项:
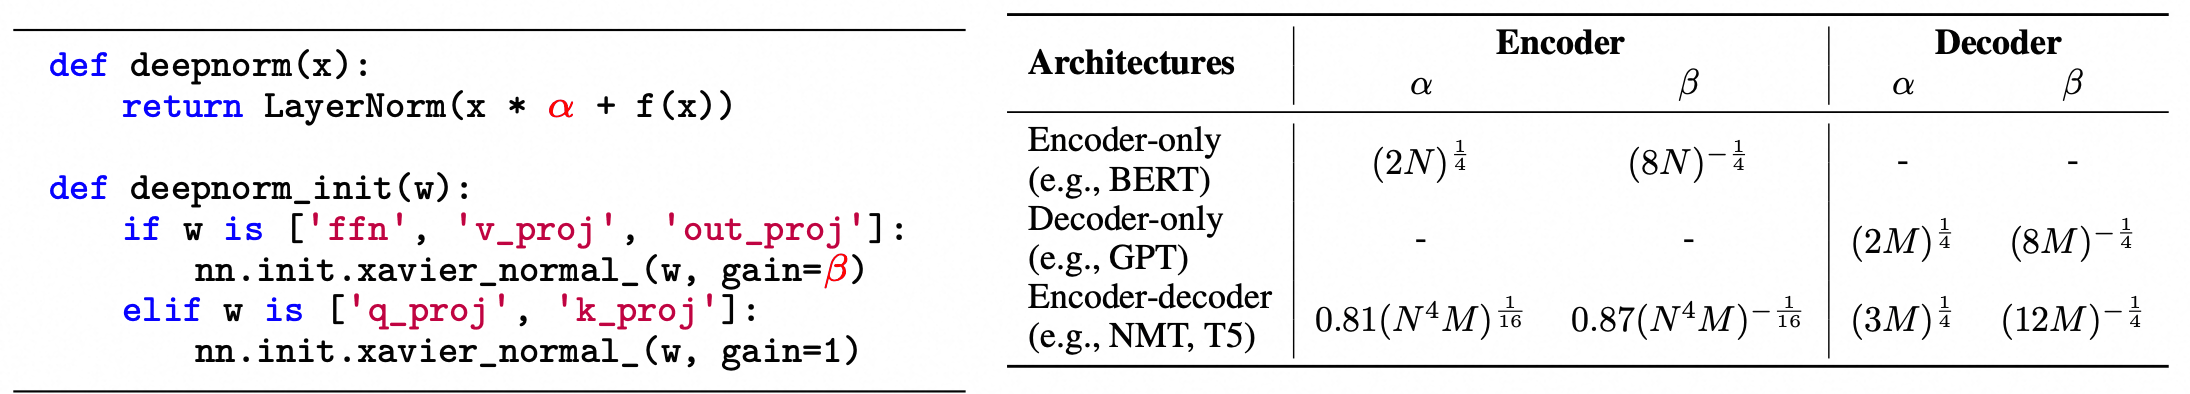
⚪ Mix-LN
大语言模型中一个被反复观察到的现象是:深层贡献很小,甚至可以整块剪掉而几乎不损失性能。这一度被视为模型压缩的机会,Mix-LN的作者则认为它反映的是训练不充分:Pre-LN使深层的梯度越来越小,而Post-LN恰好相反,它保住了深层梯度但让浅层梯度消失。
Mix-LN在模型的早期层(前$aL$层)应用Post-LN,在深度层(后$(1-a)L$层)应用Pre-LN。
这样做的目的是利用Post-LN在深度层增强梯度流动的优势,同时利用Pre-LN在早期层稳定梯度的优势。通过这种方式,Mix-LN在中间和深度层实现了更健康的梯度范数,促进了整个网络的平衡训练,从而提高了模型的整体性能。
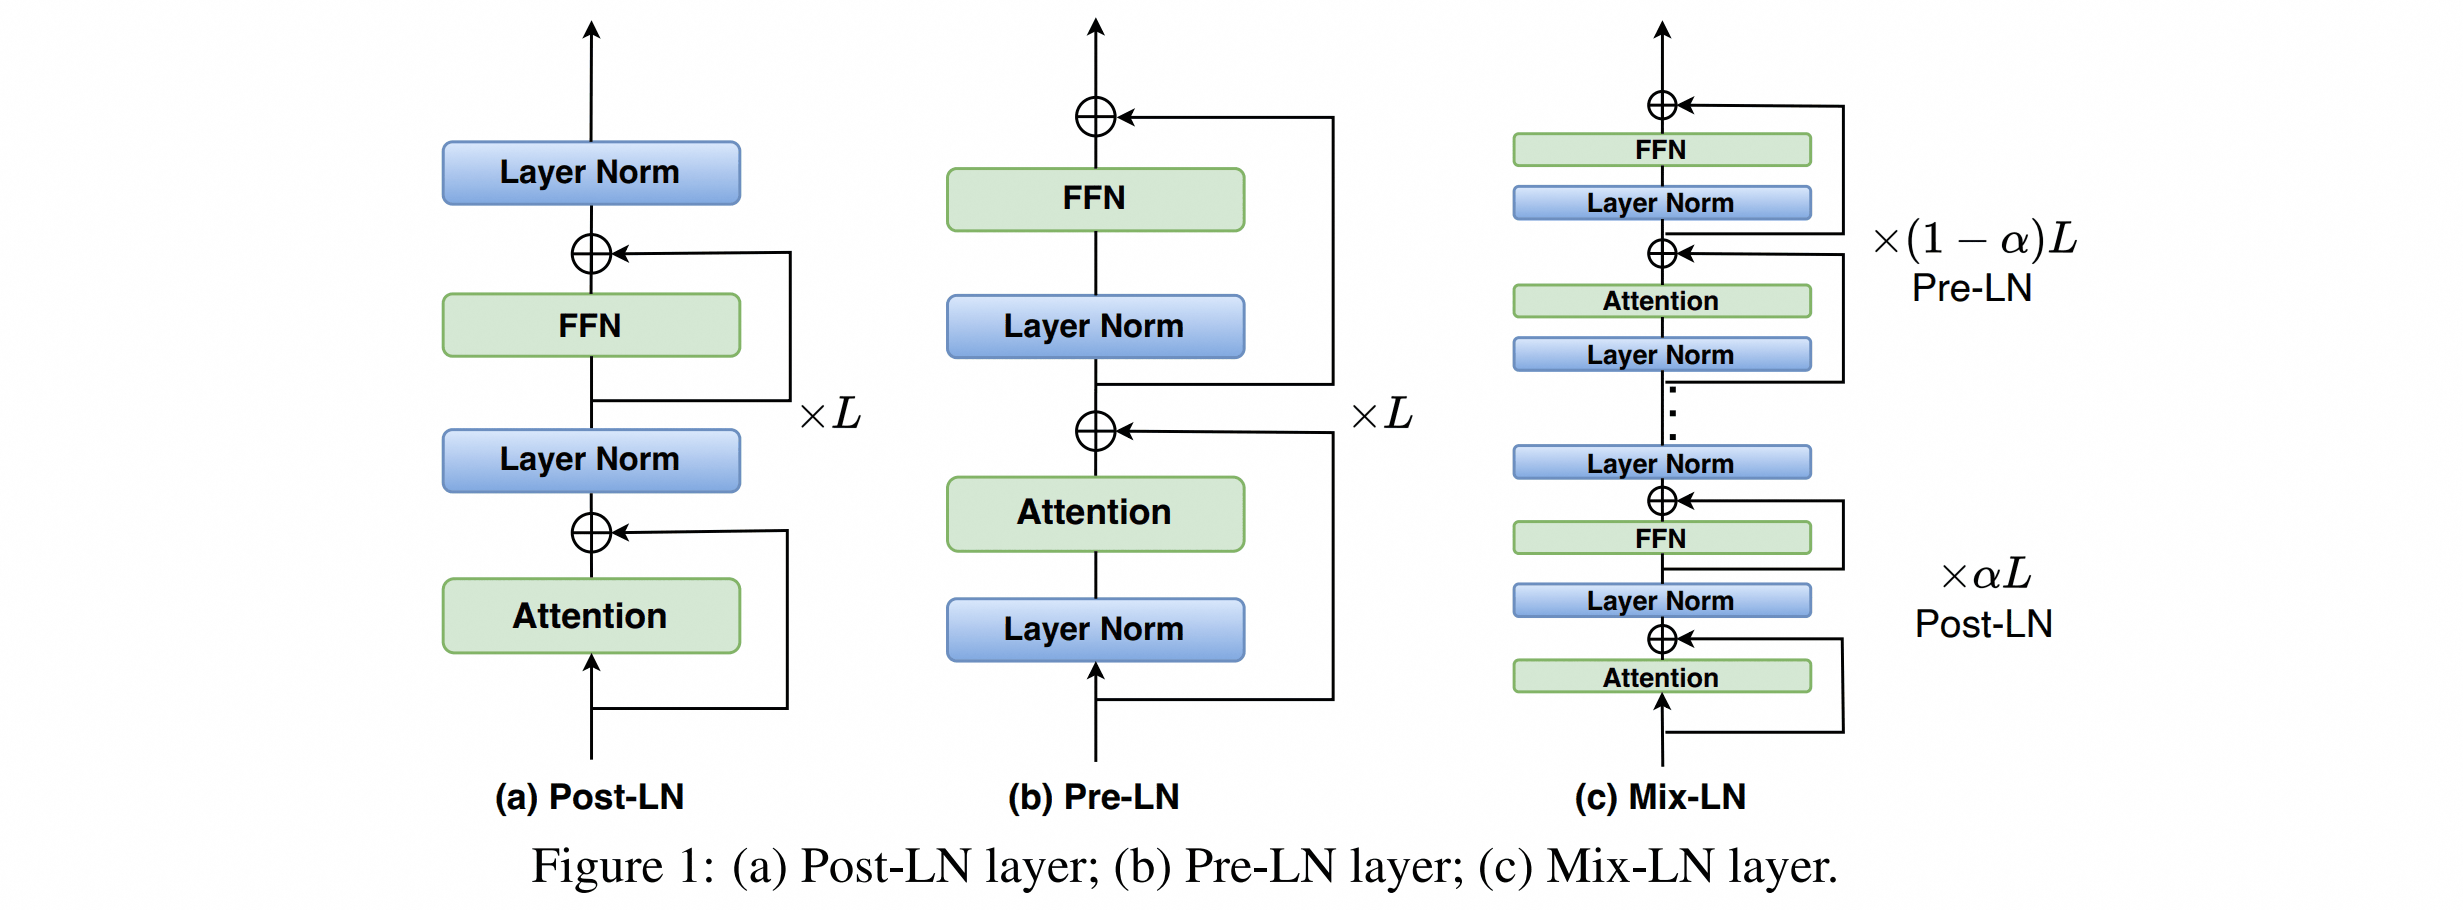
超参数$a$控制应用Post-LN的层的比例,作者在LLaMA-1B上搜索得到$a=0.25$,并在所有模型尺寸上沿用该值。
⚪ LayerNorm Scaling
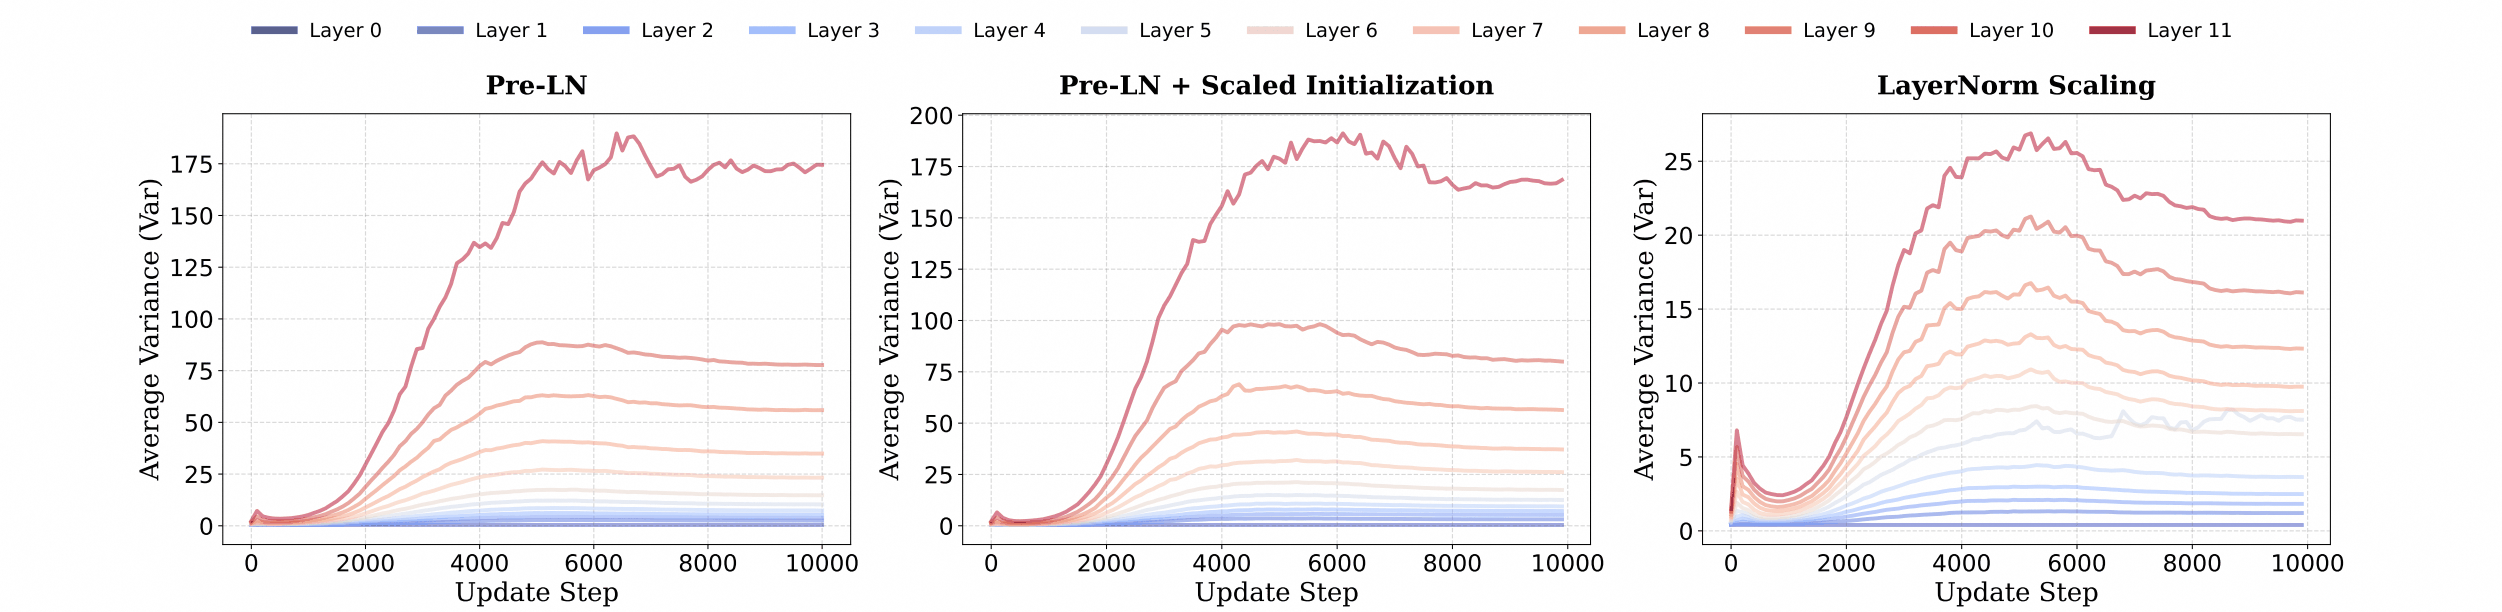
这篇工作把上述“深层无效”现象命名为深度诅咒(Curse of Depth),并给出了更明确的归因:Pre-LN的输出方差随深度指数增长(由前面的展开式可知残差流方差按层数累积),当$\text{Var}[x_t]$很大时,$\text{LayerNorm}(x_t)$对$x_t$的导数趋于$0$,整个子层的雅可比矩阵退化为单位矩阵;深层因此变成了恒等映射,不再学习任何东西。
LayerNorm Scaling的修正极其简单:按深度的平方根缩放第$l$层LayerNorm的输出:
\[x_l \leftarrow \text{LayerNorm}(x_l) \cdot \frac{1}{\sqrt{l}}\]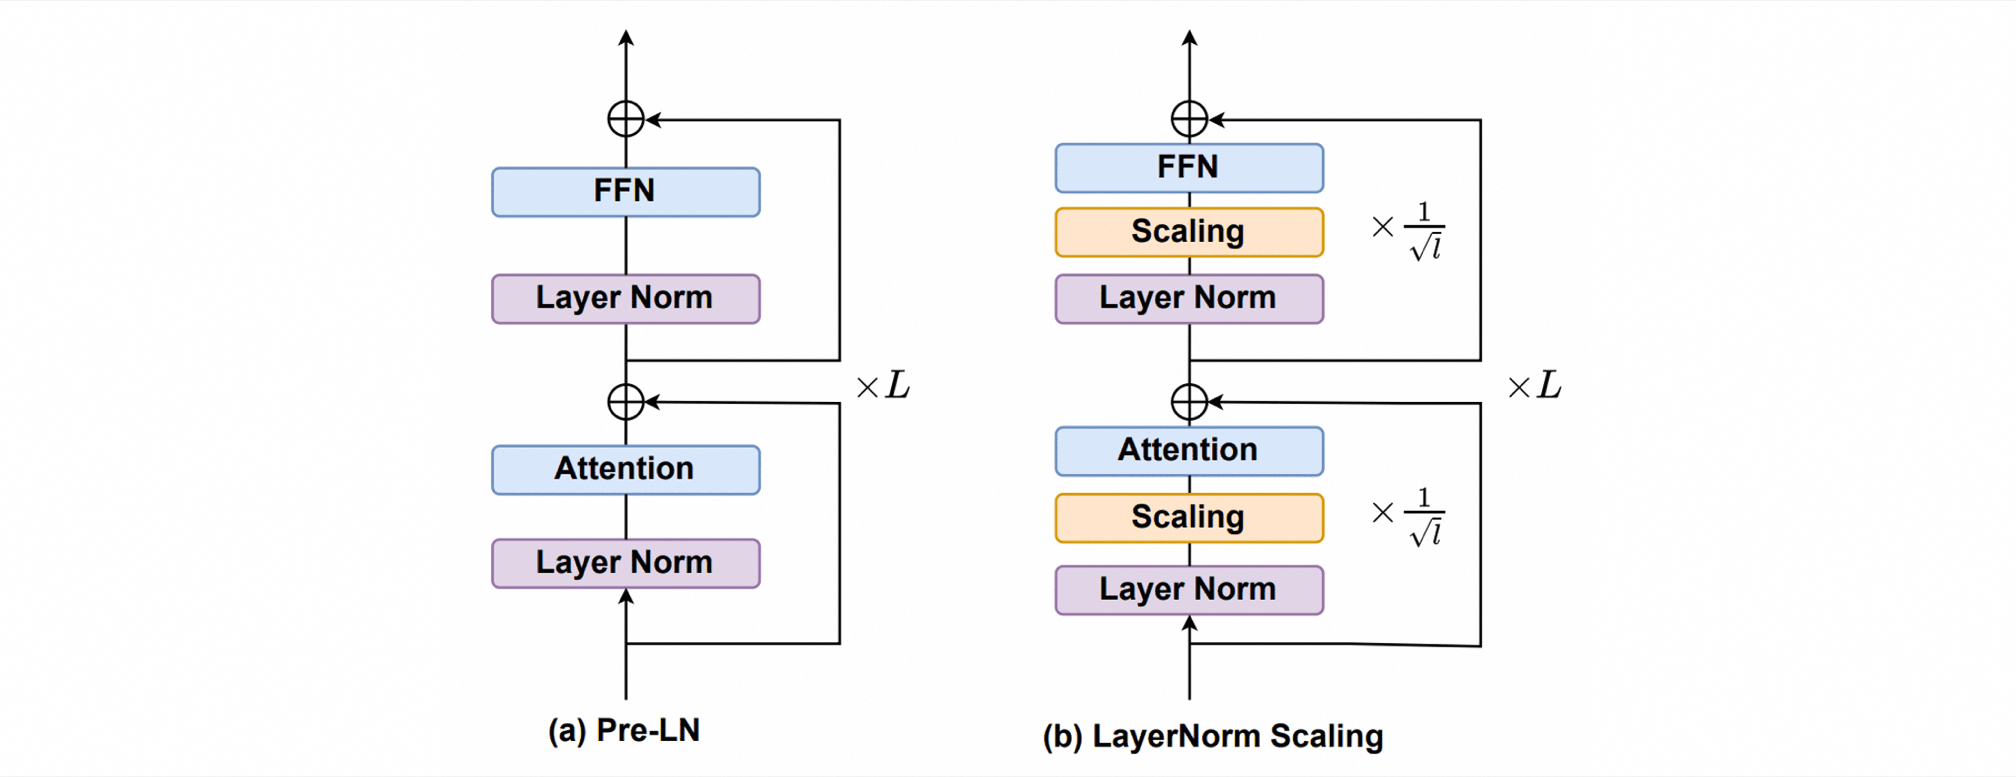
这种缩放方式不仅抑制了输出方差的爆炸性增长,还提高了深度层在训练中的贡献,确保了所有层都能有效地参与学习。它不引入任何新参数,也不改变推理成本。
⚪ ScaleNorm 与 FixNorm
这篇工作在Pre-LN的基础上进一步简化归一化本身。ScaleNorm把LayerNorm替换为“投影到半径为$g$的球面上”,全层只有一个可学习标量:
\[\text{ScaleNorm}(x) = g\cdot \frac{x}{\|x\|}\]FixNorm则把词嵌入固定在单位球面上($||e||=1$)。作者的观点是:LayerNorm的$2D$个逐维仿射参数大多是冗余的,真正重要的只是把激活值的尺度控制住、把方向保留下来。ScaleNorm可以看作RMSNorm的极简版($\gamma$退化为标量),也是本节末尾nGPT“一切都在超球面上”这一想法的先声。
⚪ QK-Norm:把归一化放进注意力内部
- paper:Query-Key Normalization for Transformers
- paper:Scaling Vision Transformers to 22 Billion Parameters
大模型训练不稳定的一个具体机制是注意力logit爆炸:$q^\top k$的量级随训练增长,使softmax饱和到接近one-hot,梯度趋近于$0$且对扰动极度敏感,这是loss spike的常见触发点。
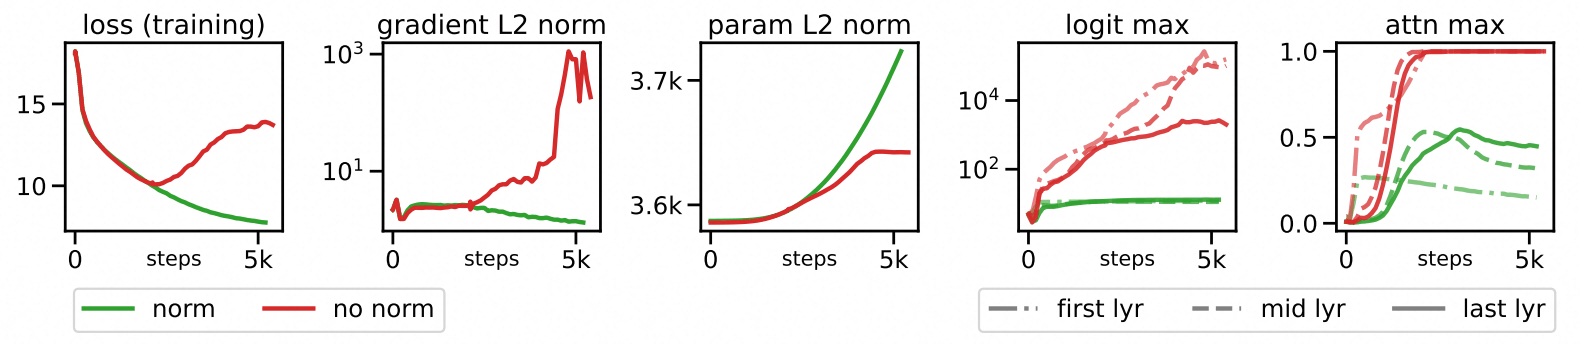
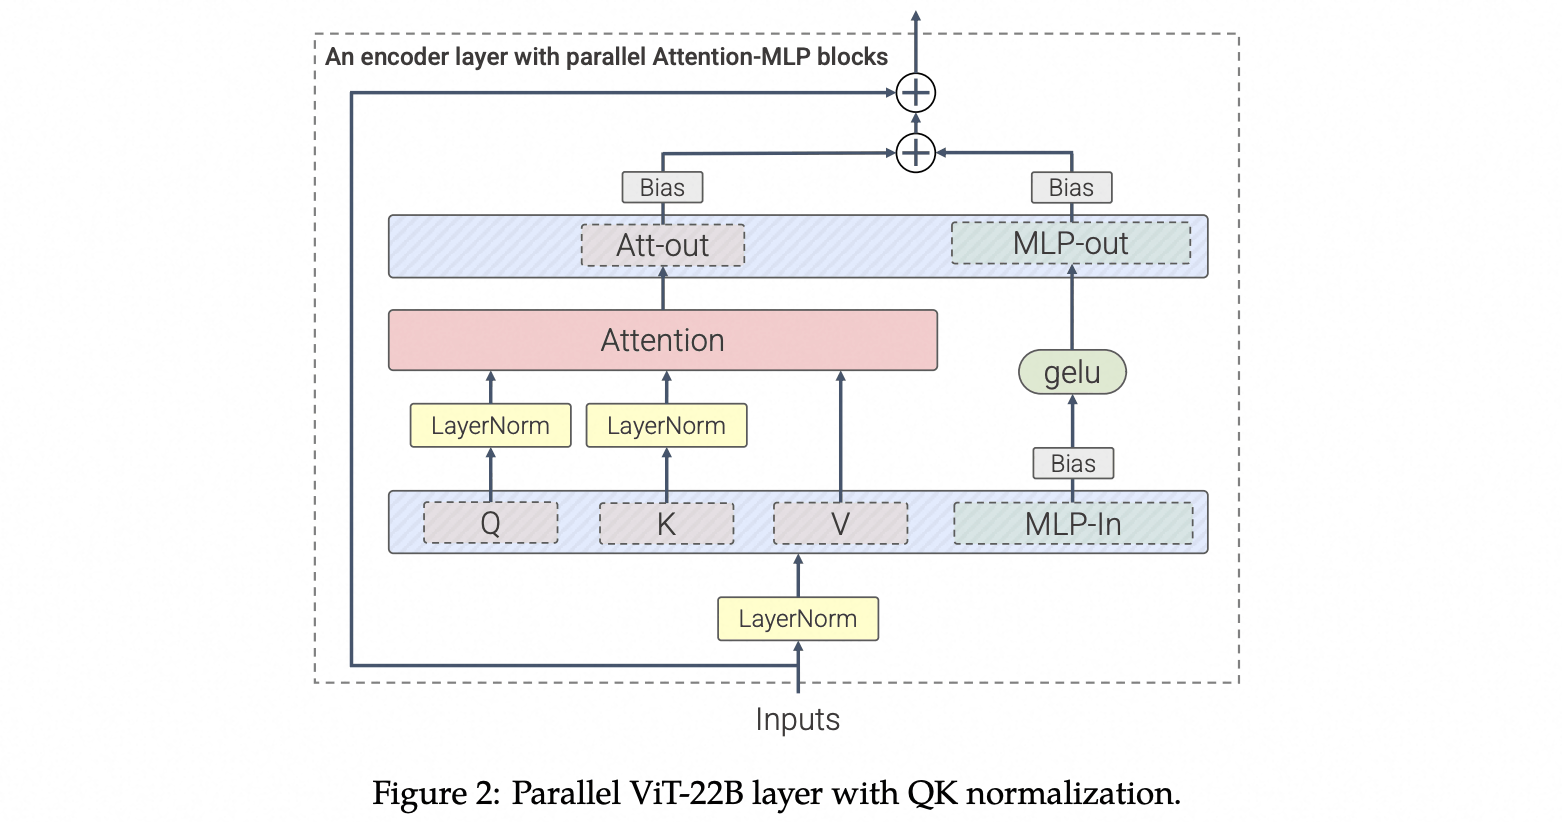
QK-Norm在计算注意力分数之前先归一化查询与键:
\[A = \text{softmax}\left(\frac{\text{Norm}(Q)\,\text{Norm}(K)^\top}{\tau}\right)\]原始论文取\(\text{Norm}\)为L2归一化并用一个可学习的温度$\tau$(此时$q^\top k$退化为余弦相似度,天然有界于$[-1,1]$,与$2.5$节的余弦归一化同源);ViT-22B采用的变体则对$Q,K$分别施加LayerNorm、保留标准的$1/\sqrt{d}$缩放。后者已成为ViT-22B、Gemma 2、Chameleon、SD3等大模型的标准配置,也是当前抑制loss spike最有效的单点改动之一。
⚪ nGPT:超球面上的归一化Transformer
nGPT把归一化从“插在若干位置的算子”推到极致:所有向量都始终位于单位超球面上。具体做法是把嵌入矩阵、注意力与前馈的所有权重矩阵的行/列都归一化为单位范数,并把残差更新从“加法”改为球面插值(LERP):
\[\begin{aligned} h &\leftarrow \text{Norm}\left(h + \alpha_A\left(\text{Norm}\left(\text{Attn}(h)\right) - h\right)\right) \\ h &\leftarrow \text{Norm}\left(h + \alpha_M\left(\text{Norm}\left(\text{MLP}(h)\right) - h\right)\right) \end{aligned}\]其中$\alpha_A,\alpha_M$是可学习的逐维“eigen learning rate”。这种形式的意义在于:残差流上的每一步都变成了从当前点$h$朝目标点移动一小段距离的插值,因此模型的隐状态永远不会爆炸,$\alpha$就是显式的、可学习的“每层步长”。作为代价,所有LayerNorm/RMSNorm层都被移除,同时训练所需的步数据报可减少$4$到$20$倍。
⭐ 讨论:归一化与训练稳定性、loss spike
- paper:Small-scale proxies for large-scale Transformer training instabilities
- paper:Spike No More: Stabilizing the Pre-training of Large Language Models
把本节的方法串起来看,大模型预训练中的loss spike(损失突然飙升,有时能恢复、有时直接崩溃)几乎总能归结到两条通路,而每条通路都有对应的归一化补丁:
- 通路一:注意力logit增长 $\to$ softmax饱和。 症状是注意力熵坍缩到接近$0$。补丁是QK-Norm,或对输出logits加z-loss(惩罚$\log Z$偏离$0$)。
- 通路二:残差流范数增长 $\to$ 梯度尖峰。 症状是深层出现massive activation(某些维度的激活值达到常规值的成百上千倍),且梯度范数的spike先于损失spike出现。补丁是Peri-LN/Sandwich-LN(给残差分支输出套一层归一化)、LayerNorm Scaling、DeepNorm的$\alpha$缩放,以及$2.7$节把残差分支初始化为零的一族方法。
两篇工作给出的可操作结论值得记住:
- 不稳定性可以在小模型上复现。只要把学习率调到足够大,$100\text{M}$参数的模型就会表现出与$70\text{B}$模型相同的失稳模式,因此稳定性方案不必在大模型上才能验证;
- 判断稳定性的正确指标不是损失曲线,而是“梯度范数的上界随深度如何增长”。Spike No More据此给出的设计准则是:既要保证梯度范数有界(避免spike),又要避免它过小(否则退化为不学习);Pre-LN加上适当缩小的初始化标准差就能同时满足这两点。
- warm-up、梯度裁剪、$\epsilon$的取值、乃至优化器的数值精度都会与归一化的选择耦合。例如Pre-LN下$\text{Adam}$的$\epsilon$若过大,会在梯度变小的深层引入额外的更新衰减。
2.7 去掉归一化
归一化层带来了额外的算子、批量依赖与训练/推理不一致,因此近些年有一系列方法尝试不引入归一化策略来训练深度学习模型。它们的思路可以分成两类:(一)用初始化或缩放使残差分支在初始时刻近乎为零(Fixup、SkipInit、ReZero、NF-Net),从而复现“归一化使残差块近似恒等映射”这一关键效果;(二)用一个逐元素函数直接拟合归一化层的输入输出映射(DyT、DyISRU)。
⚪ Fixup
在没有归一化的残差网络中,输出方差会随着深度呈指数增长,从而导致梯度爆炸。对于残差网络$x_l = x_0 + \sum_{i=0}^{l-1} F_i(x_i)$,若每个残差分支的输出方差与输入方差相近,则输出方差随深度指数增长。
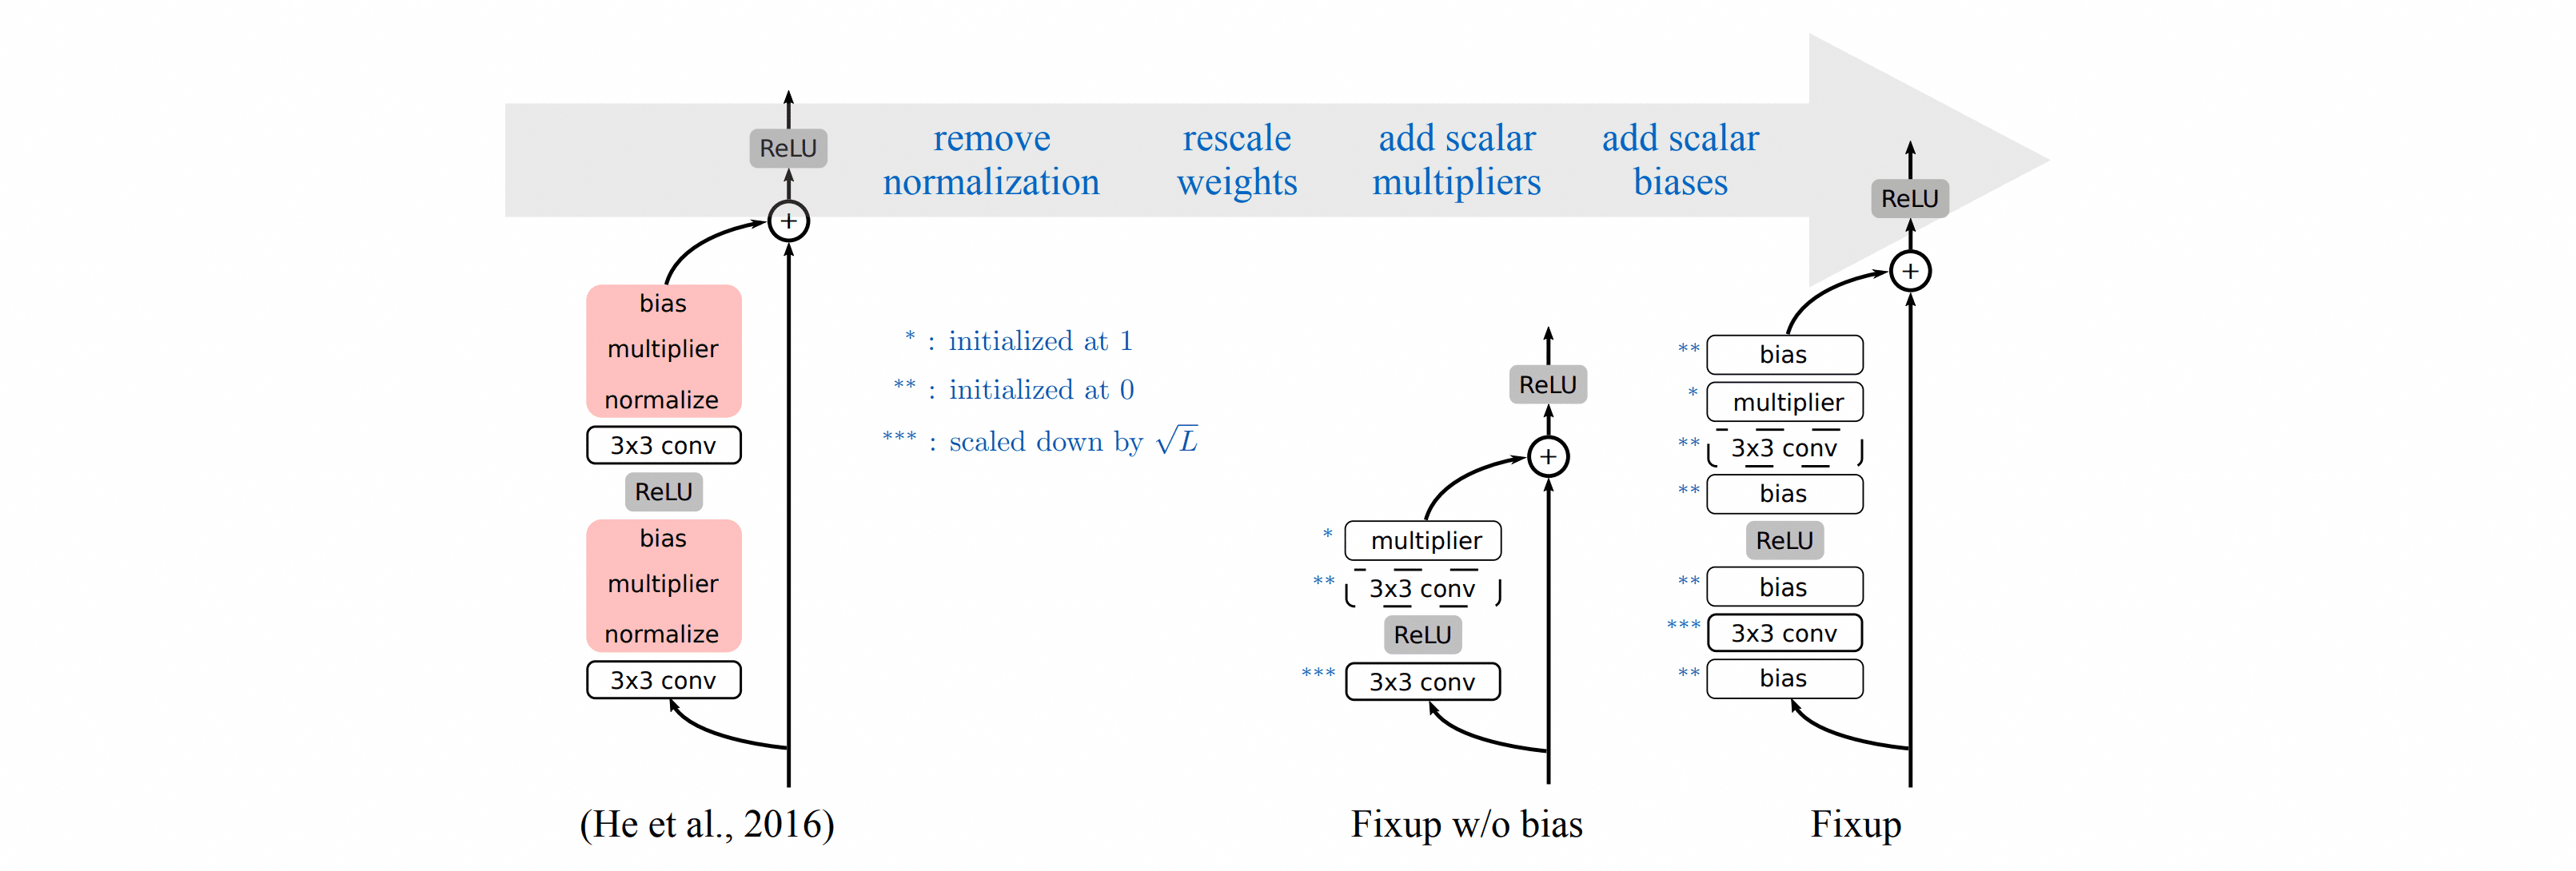
Fixup的核心思想是通过重新调整残差分支的权重初始化,使得每个残差分支对网络输出的更新幅度与网络深度无关。具体步骤如下(此处$L$表示网络深度):
- 初始化分类层和残差分支的最后一层权重为$0$:这有助于稳定训练初期的输出。
- 对残差分支内的权重层进行重新缩放:具体来说,将残差分支内的权重层按 $L^{-\frac{1}{2(m-2)}}$ 缩放,其中 $L$ 是网络深度,$m$ 是残差分支内的层数。这种缩放方式可以确保每个残差分支对网络输出的更新幅度为 $\Theta(\eta/L)$,从而使得整个网络的更新幅度为 $\Theta(\eta)$。
- 添加标量乘数和偏置:在每个残差分支中添加一个标量乘数(初始化为$1$),并在每个卷积层、线性层和激活层前添加一个标量偏置(初始化为$0$)。这些参数有助于进一步调整网络的表示能力。
Fixup可以稳定训练上万层的残差网络,但它去掉的不只是归一化的优化作用,还有归一化的正则化作用,因此需要额外配合更强的正则化(如Mixup、更大的weight decay)才能匹配BN的泛化性能。
⚪ SkipInit
这篇工作给出了归一化为何有效的另一个解释:由于归一化操作,残差分支的输出方差被抑制到接近$1$,而恒等分支的方差随深度累积,因此残差块的输出主要由跳跃连接决定,即网络函数在初始化时接近恒等函数。这种特性确保了网络在初始化时具有良好的梯度传播,便于训练。
基于上述分析,作者提出了SkipInit初始化方法。该方法的核心思想是在每个残差分支的末尾引入一个可学习的标量乘数$\alpha$,并在初始化时将其设置为$0$或一个较小的常数$1/\sqrt{d}$($d$是残差块的数量)。这样在初始化时,残差分支的贡献被显著缩小,使得残差块的输出接近跳跃连接,从而实现了与批归一化类似的效果。
\[x_{t+1} = x_t + \alpha \cdot F_t(x_t)\]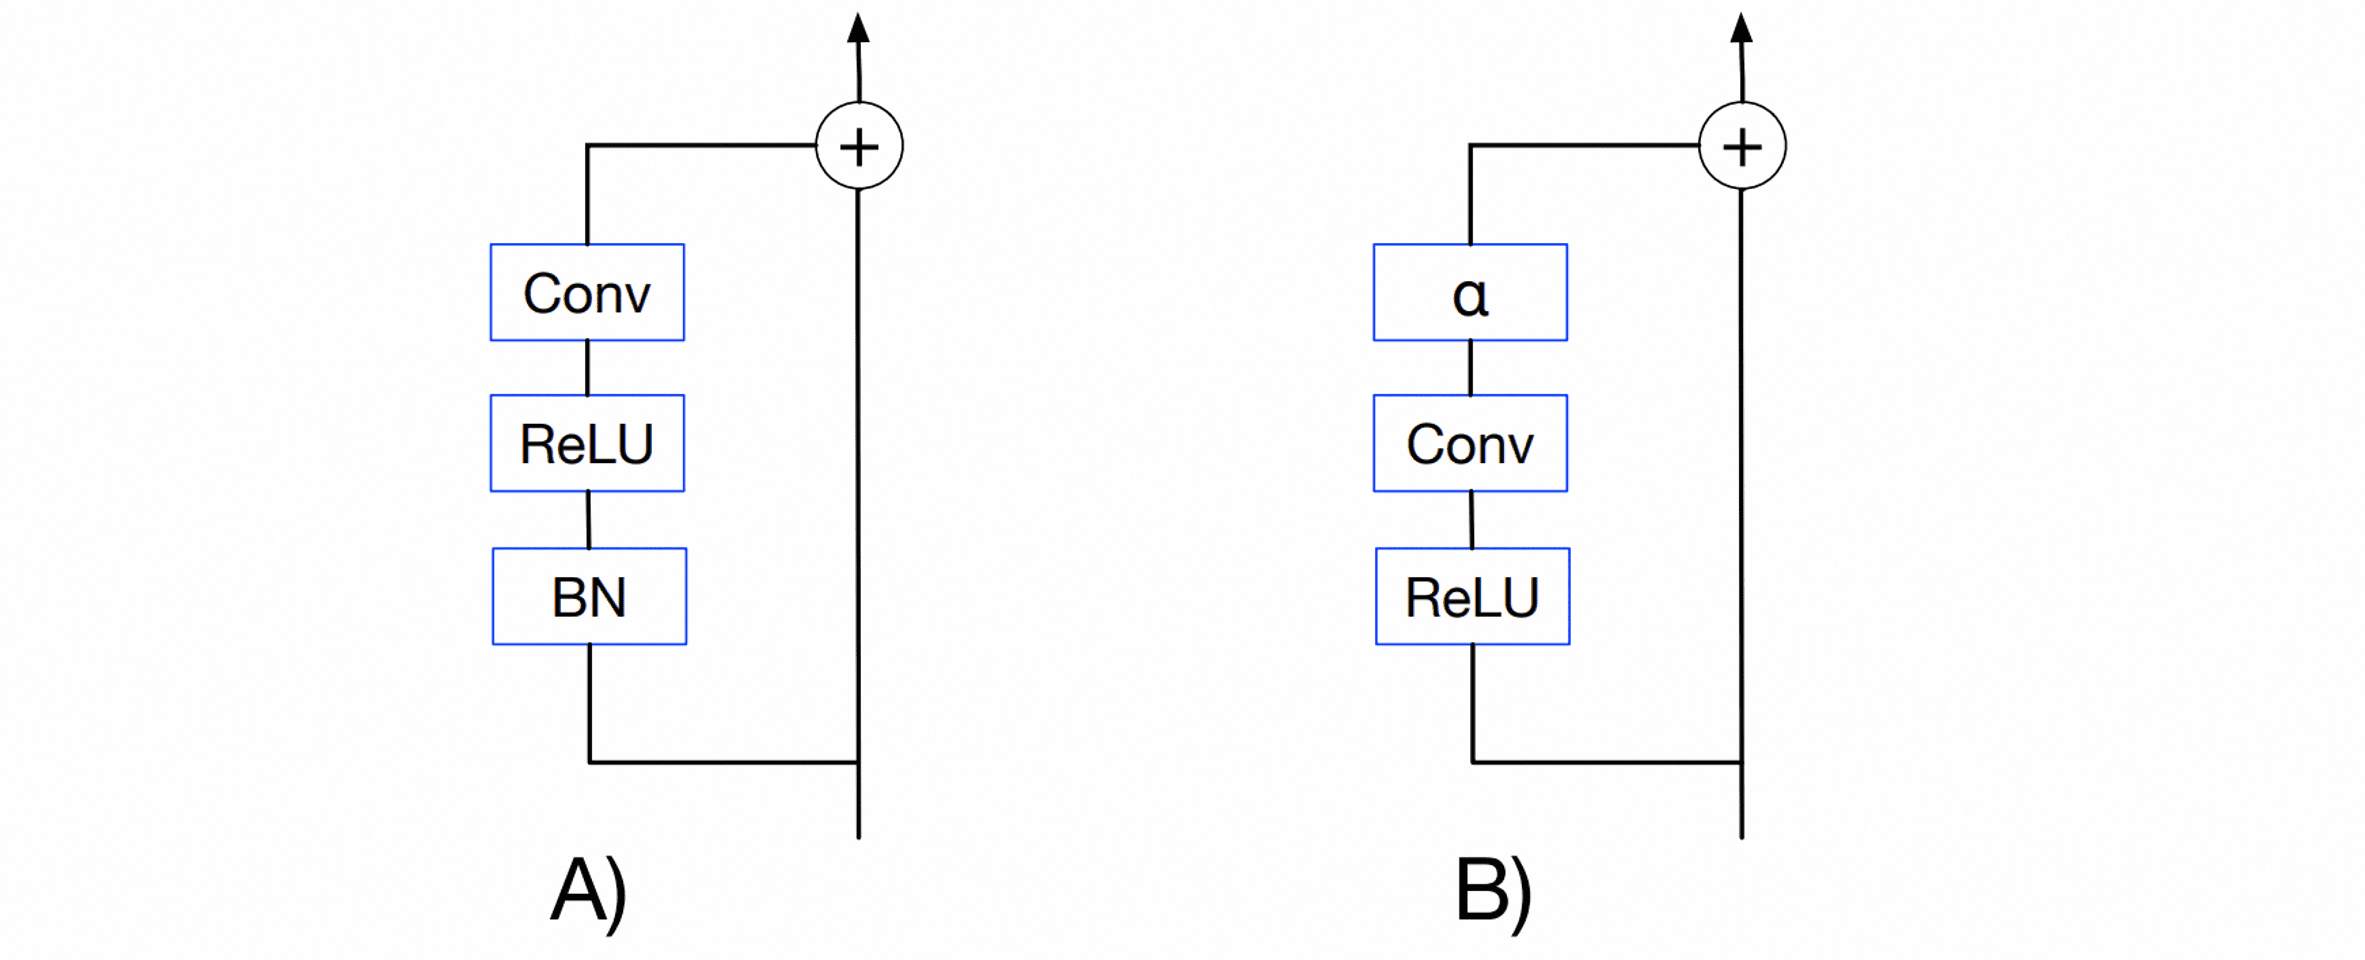
SkipInit的实现比Fixup更简单(只加一个标量),代价是同样丢失了正则化效应。这篇工作的另一个重要副产品是澄清了“BN允许更大学习率”这一常见说法的适用范围:在小批量下BN与SkipInit的最优学习率相近,BN提高最大稳定学习率的优势只在大批量训练中才转化为实际收益。
⚪ ReZero
与SkipInit类似,ReZero通过在每个残差连接处引入一个初始化为零的逐层可训练参数,实现了动态等距性,从而显著加速了深度网络的训练。
\[x_{t+1} = x_t + \alpha_t \cdot F_t(x_t)\]动态等距性(dynamical isometry)要求网络的输入-输出雅可比矩阵的所有奇异值接近$1$,即输入信号的所有扰动都能在网络中以相似的方式传播。ReZero通过将每个残差块的初始输出设置为输入本身,确保了在训练开始时网络的雅可比矩阵的奇异值为$1$。
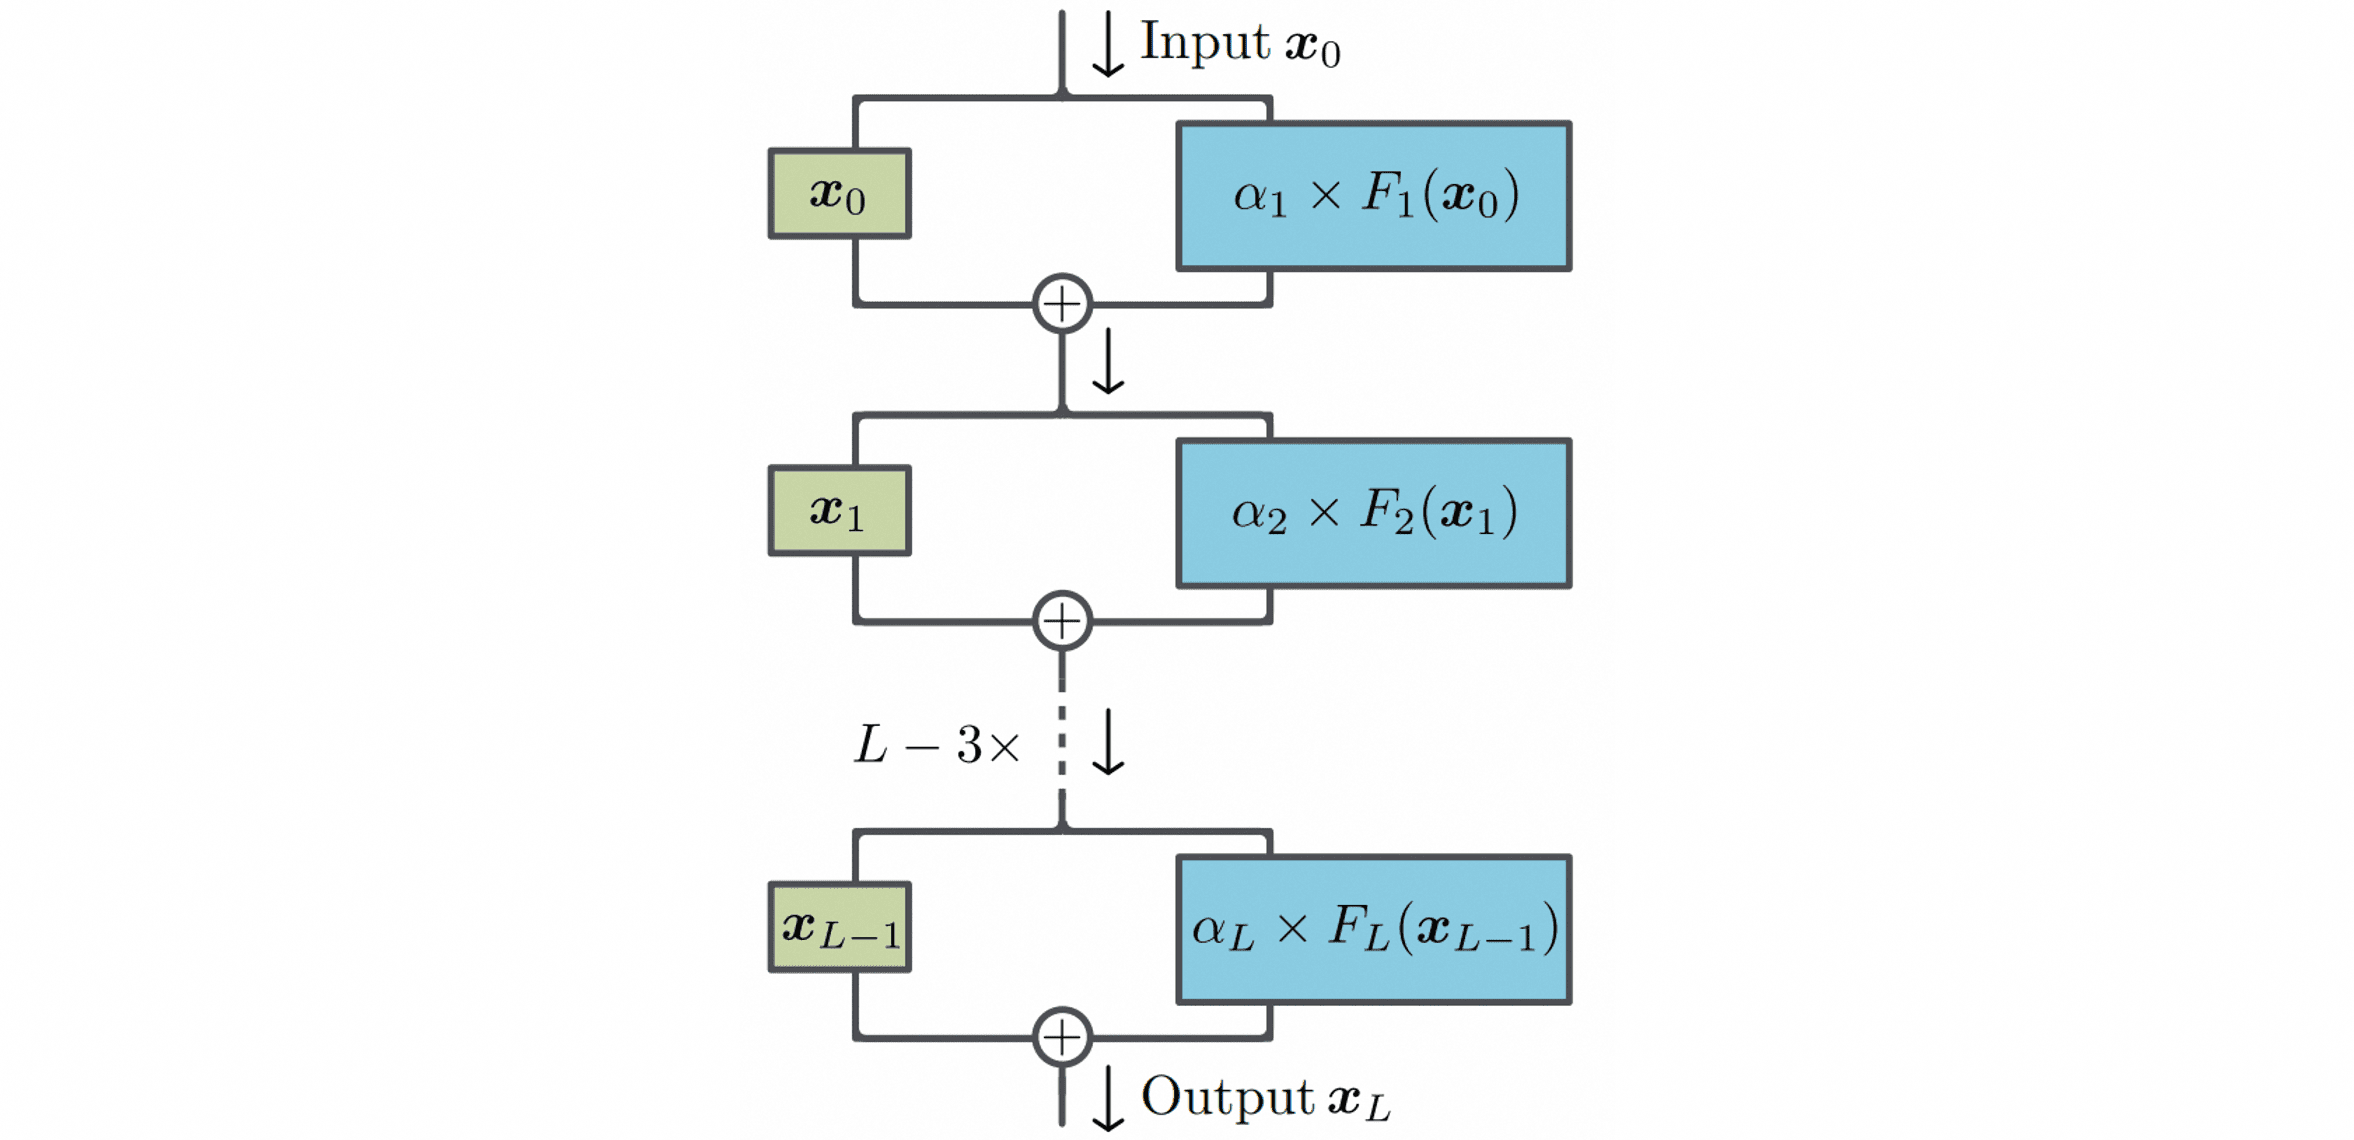
ReZero的意义超出了“去掉归一化”这一目标:这个“零初始化的残差门控”被广泛复用于需要稳定注入新模块的场合:LoRA的$B$矩阵零初始化、ControlNet的zero convolution、DiT的adaLN-Zero、以及Vision Transformer中的LayerScale都是同一模式的变体。
⚪ NF-Net:Scaled Weight Standardization + 自适应梯度裁剪
- paper:Characterizing signal propagation to close the performance gap in unnormalized ResNets
- paper:High-Performance Large-Scale Image Recognition Without Normalization
上述方法都只在初始化时刻保证信号传播良好,训练过程中的尺度漂移仍无人管理。Normalizer-Free Network (NF-Net)给出了一套完整的替代方案,是目前唯一在ImageNet上超越BN基线的无归一化方法:
① Scaled Weight Standardization:在$2.5$节的WS基础上乘一个增益,使层的输出方差在ReLU后仍保持为$1$:
\[\hat{W}_{j,i} = \gamma\cdot\frac{W_{j,i}-\mu_{W_j}}{\sigma_{W_j}\sqrt{I}}\]其中$\gamma$是与激活函数相关的解析常数(例如ReLU取$\gamma=\sqrt{2/(1-1/\pi)}$),用于抵消激活函数对方差的衰减。
② 显式的信号传播设计:残差块写作$x_{t+1}=x_t+\alpha F_t(x_t/\beta_t)$,其中$\beta_t=\sqrt{\text{Var}[x_t]}$为解析预测(而非实测)的方差,$\alpha\approx 0.2$为固定的分支缩放。由于方差可以逐层解析推算,网络的信号传播特性在设计阶段就完全已知,不需要任何运行时统计量。
③ 自适应梯度裁剪(AGC):无归一化网络对大批量与大学习率更敏感,AGC按参数与梯度的范数比值逐单元裁剪:
\[G_i \leftarrow \begin{cases} \lambda \frac{\|W_i\|_F^{\star}}{\|G_i\|_F}G_i, & \frac{\|G_i\|_F}{\|W_i\|_F^{\star}} > \lambda \\ G_i, & \text{其他} \end{cases}\]其中\(\|\cdot\|_F^{\star}=\max(\|\cdot\|_F,\epsilon)\)。这三者合起来使NF-Net能用$4096$的批量稳定训练,并取得当时的SOTA。
⚪ Dynamic Tanh(DyT)
前面几种方法都在“绕开归一化”,DyT则选择直接拟合归一化层的输入输出关系。作者发现,在训练好的Transformer模型中,归一化层的输入-输出映射呈现出类似tanh函数的S形曲线。这种映射不仅对输入激活值进行了缩放,还对极端值进行了压缩。
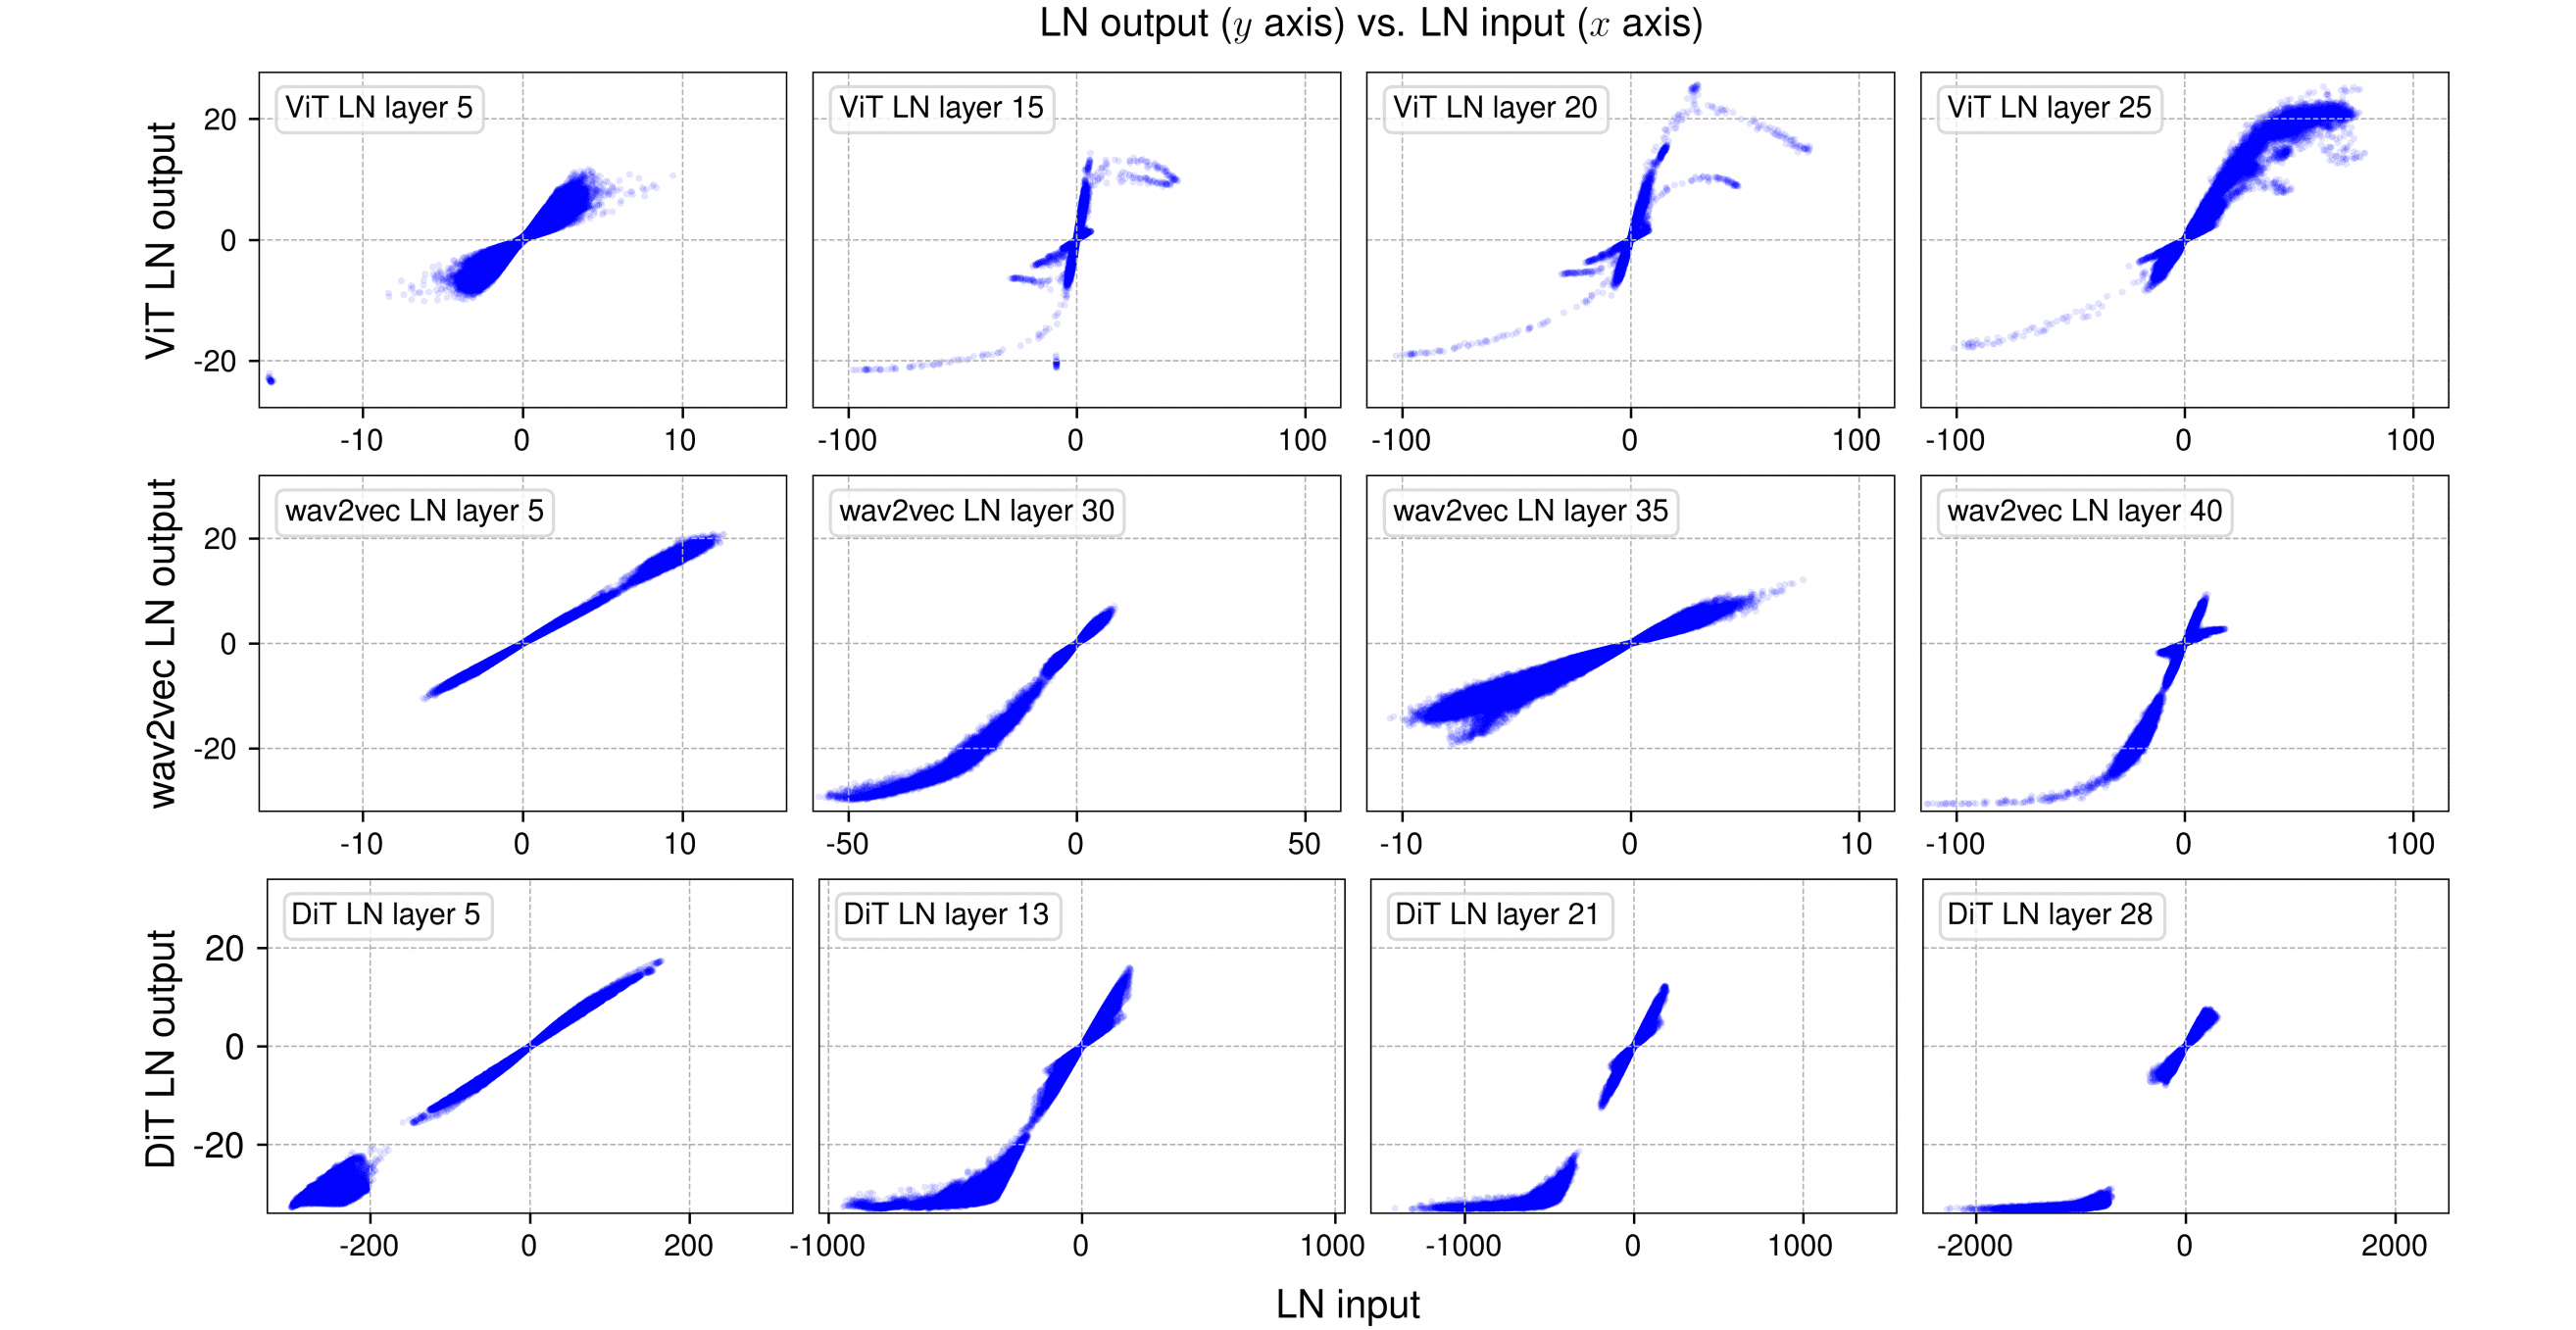
DyT的核心思想是通过一个可学习的标量参数$\alpha$和tanh函数来动态调整输入激活值,以代替网络中的LayerNorm:
\[\text{DyT}(x)=\gamma⋅\tanh(\alpha x)+\beta\]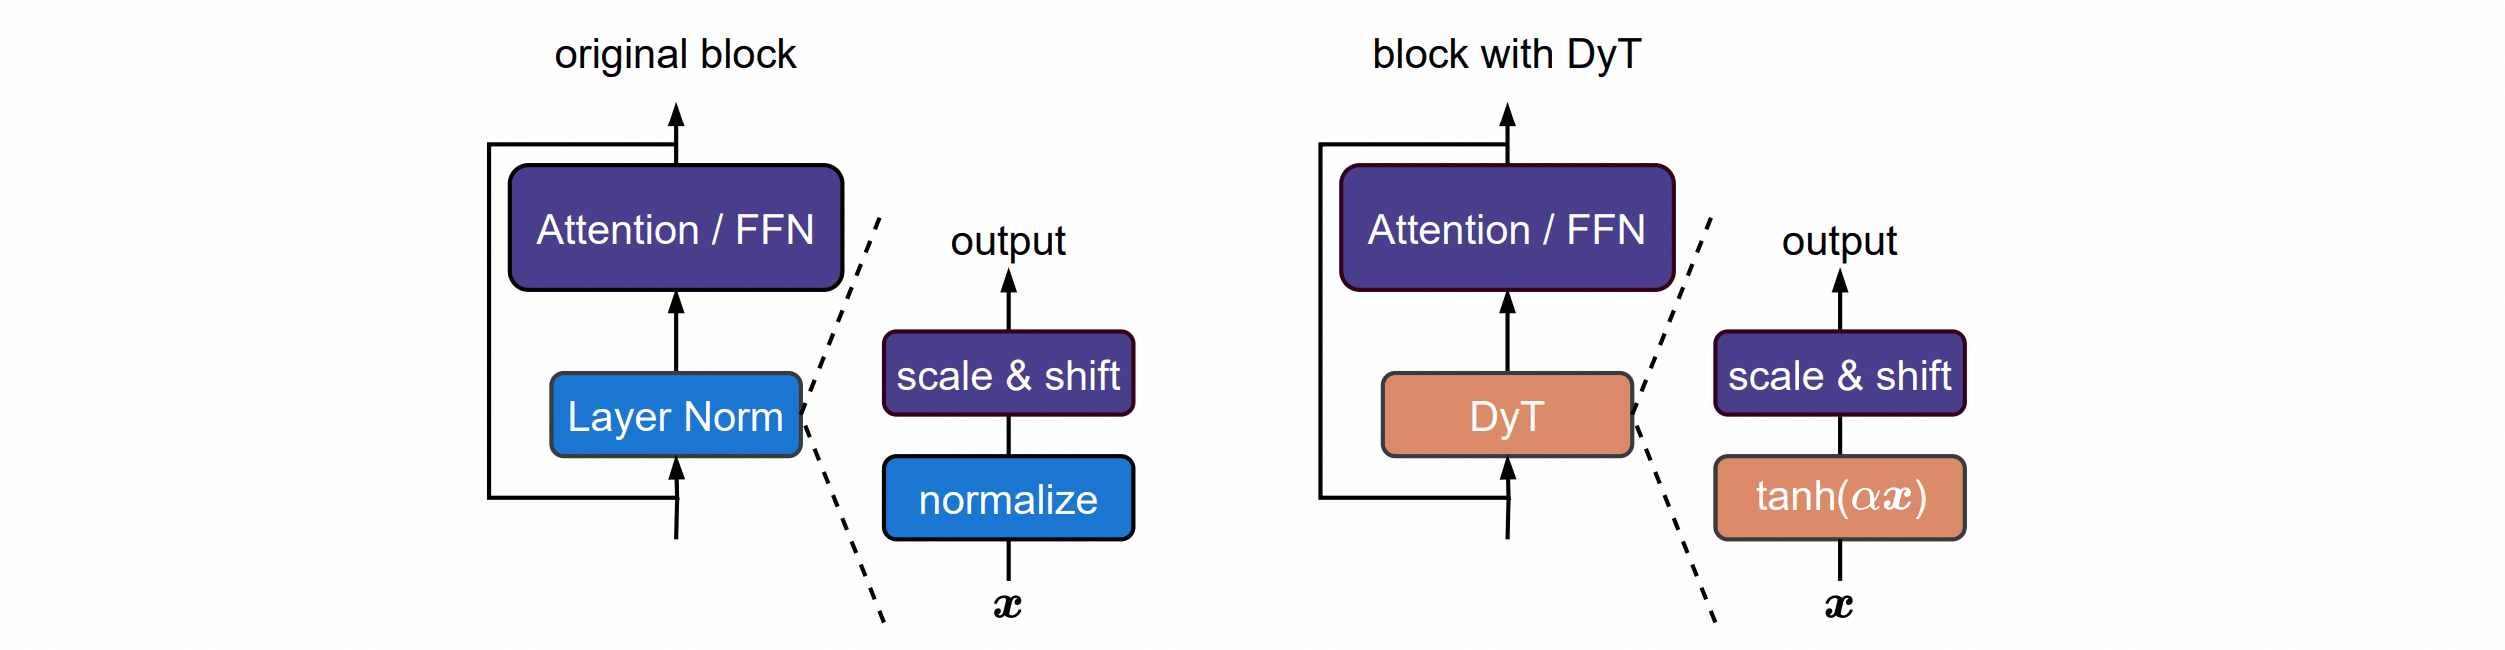
其中$\alpha$是可学习的标量(负责整体缩放,替代$1/\sigma$的作用),$\gamma,\beta$是逐通道的可学习向量。DyT是彻底的逐元素操作,不需要任何归约,因此消除了归一化层的访存瓶颈:在LLaMA-7B上推理阶段的归一化耗时下降超过一半。它可以直接替换LN/RMSNorm而无需改动其他部分,在图像分类、自监督学习、扩散模型、语言模型、语音与DNA序列建模上都能匹配归一化基线。需要注意的一个实践细节是:LLM中$\alpha$的初始值对稳定性影响较大,较大的模型需要较小的初值。
⚪ Dynamic Inverse Square Root Unit (DyISRU)
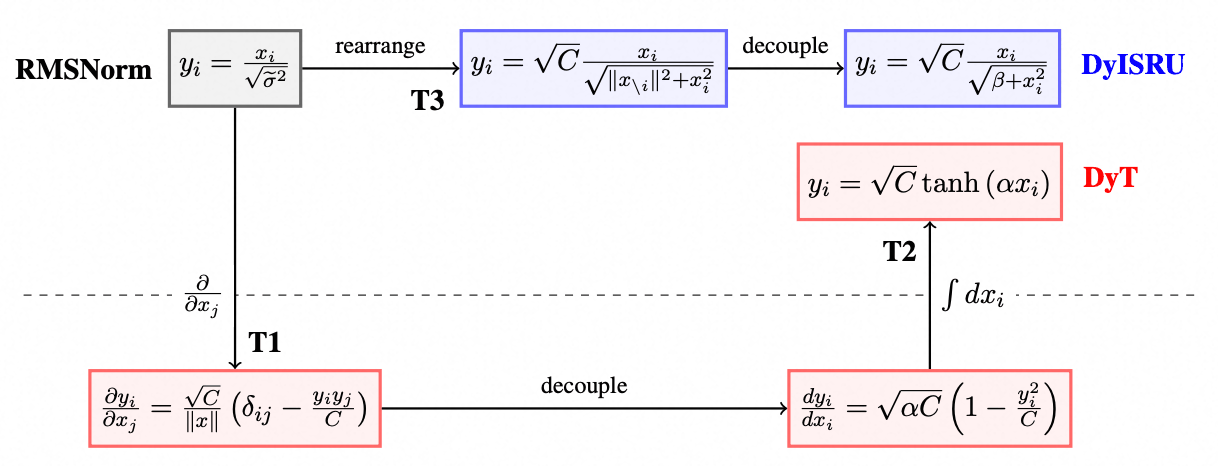
DyT的tanh形式是从经验观察中得来的。这篇工作从梯度近似的角度给出了严格推导,并指出tanh只是其中一个特例。首先,RMSNorm可写作$\mathbf{y}=\sqrt{d}\,\mathbf{x}/|\mathbf{x}|$,其梯度为:
\[\begin{aligned} \nabla_{\mathbf{x}} \mathbf{y} &= \sqrt{d}\left( \frac{I}{||\mathbf{x}||} - \frac{\mathbf{x} \mathbf{x}^\top}{||\mathbf{x}||^3} \right) = \frac{\sqrt{d}}{||\mathbf{x}||}\left(I - \frac{\mathbf{y} \mathbf{y}^\top}{d} \right) \end{aligned}\]寻找一个函数$\mathbf{y}=f(\mathbf{x})$近似RMSNorm的梯度,则$f$能够替代归一化层的使用,从而实现在网络中去掉归一化层的目标。假设$\mathbf{y}=f(\mathbf{x})$是逐元素操作,即$y_i=f(x_i)$,则$f$的梯度需满足:
\[\frac{d y_i}{d x_i} = \rho \left( 1 - \frac{y_i^2}{d} \right),\quad \rho=\frac{\sqrt{d}}{||\mathbf{x}||}\]若假设$\rho$为常数,求解上述微分方程即得到DyT的形式:
\[y_i = \sqrt{d} \tanh \left( \frac{x_i}{\rho \sqrt{d}} \right)\]而$\rho$实际上并非常数。注意到:
\[\rho=\frac{\sqrt{d}}{||\mathbf{x}||}= \frac{y_i}{x_i}\]代回后$f$的梯度需满足一个不含额外假设的微分方程:
\[\frac{d y_i}{d x_i} = \frac{y_i}{x_i} \left( 1 - \frac{y_i^2}{d} \right)\]直接求解可得到:
\[y_i = \frac{\sqrt{d}\, x_i}{\sqrt{x_i^2+C}}\]其中$C$为常数。上式形如逆平方根单元(ISRU),因此被称为DyISRU。它与DyT的关系恰好复刻了激活函数领域中ISRU与Tanh的关系:同为S型曲线,但一个用代数式、一个用指数式,且DyISRU是在不额外假设$\rho$为常数的情况下推出的,因此对极端值的抑制更贴近RMSNorm的真实行为。
⭐ 讨论:去掉归一化的两条路线
把本节六种方法并列,可以看到一个清晰的分野,也能看到它们各自付出的代价:
路线一(Fixup / SkipInit / ReZero / NF-Net):让残差分支在初始时刻消失。 它们其实都在复现SkipInit揭示的那个机制:归一化的关键作用是让残差块在初始化时近似恒等映射。共同形式都是$x_{t+1}=x_t+\alpha F_t(x_t)$,区别只在$\alpha$是常数(Fixup的深度相关缩放、NF-Net的$\alpha\approx 0.2$)还是可学习标量(SkipInit的全局$\alpha$、ReZero的逐层$\alpha_t$)。这条路线的通病是:它只处理了优化问题,没有替代归一化的正则化作用,因此几乎都需要额外增强正则化;而且只保证初始时刻的信号传播良好,训练中的漂移需要NF-Net那样的额外机制(Scaled WS + AGC)才能管住。
路线二(DyT / DyISRU):用逐元素函数拟合归一化层本身。 它们不改动网络的连接结构,只把LN/RMSNorm替换成一个S型曲线,因此可以对已有架构做drop-in替换。这条路线的真正卖点是效率:归一化层需要沿特征维归约(一次同步、一次额外访存),而逐元素函数不需要,这在LLM推理这种memory-bound场景下是实打实的收益。代价是失去了归一化“自动适配输入尺度”的能力;$\alpha$是学出来的固定值,因此对初值敏感,且在极大模型上仍需谨慎调参。
一个值得注意的共性是:两条路线都没有真正取消“把尺度控制住”这件事,它们只是把这件事从“运行时统计”换成了“初始化时的解析设计”或“训练时学到的常数”。这也从反面印证了归一化的本质:重要的不是减均值除方差这个动作,而是让每一层输出的尺度可控。