Optimization in Deep Learning.
优化(optimization)是深度学习能够学习的基础。网络结构、损失函数、数据增强都只是给出了一个高维非凸的损失曲面,而优化算法决定了我们究竟能在这个曲面上走到哪里、走得多快、以及最终落在的那个点是否具有好的泛化性。一个不恰当的优化器或学习率调度,可能会让一个设计良好的模型完全训练不起来。
本文首先讨论深度学习中优化问题的形式与困难,然后按改进思路把主流优化算法组织成不同族系统梳理,接着单独讨论学习率与批量的调度策略、以及与优化器正交的一批训练技巧。
- 深度学习中的优化问题
- (1) 问题定义:经验风险最小化
- (2) 优化深度网络的困难
- (3) 从不同角度理解梯度下降
- (4) 梯度下降的隐式偏好
- 常见的梯度优化方法
- 2.1 动量
- 2.2 自适应学习率
- 2.3 动量与自适应的结合:Adam族
- 2.4 二阶信息与矩阵型预条件
- 2.5 降低显存占用
- 2.6 层级自适应与大批量训练
- 2.7 免调参与步长自适应
- 2.8 不依赖反向传播的梯度估计
- 学习率与批量的调度策略
- (1) 学习率调度
- (2) 梯度裁剪
- (3) 批量大小与学习率的关系
- 与优化器正交的训练技巧
- (1) 权重平均
- (2) 快慢权重插值
- (3) 数据流水线加速
在选择优化器时可以参考一份大规模的基准测试Descending through a Crowded Valley - Benchmarking Deep Learning Optimizers,它对$14$种常用优化器在$8$个任务上进行了约$35000$次实验;主流优化器的PyTorch实现可参考官方文档。
符号约定:全文统一使用下列记号,同一个符号在全文只表示一个含义。
- $\theta$表示待优化参数,$\theta_t$表示第$t$步更新后的参数,$\theta_0$为初始值,$\theta^{*}$为最优参数;
- $l(x;\theta)$表示单样本损失,$L(\theta)$表示在数据集上的总损失(经验风险);
- $g_t$表示第$t$步在小批量上估计的梯度$g_t=\nabla_{\theta}L(\theta_{t-1})$;
- $m_t$表示一阶动量(梯度的累积/滑动平均),初值$m_0=0$;
- $v_t$表示二阶动量(平方梯度的累积/滑动平均),初值$v_0=0$;
- $\hat{m}_t,\hat{v}_t$表示偏差修正后的一阶、二阶动量;
- $h_t$表示由历史梯度算出的修正更新量,即$\theta_t=\theta_{t-1}-\gamma h_t$中的$h_t$;
- $\gamma$表示学习率,随更新步变化时记作$\gamma_t$;
- $\mu$表示经典动量的衰减率(缺省$0.9$);$\beta_1,\beta_2$表示指数滑动平均的衰减率(缺省$0.9$与$0.999$);
- $\epsilon$表示防止除零的数值稳定项(缺省$10^{-8}$);$\lambda$表示权重衰减率;
- $\mathcal{B}$表示一个数据批量,$B=|\mathcal{B}|$表示批量大小,$N$表示训练集样本总数;
- 上标$(i)$表示网络的第$i$层或第$i$个参数块,$L$表示层数;
- $\odot$表示逐元素乘法,$g_t^2$表示逐元素平方,$||\cdot||$默认为L2范数。
1. 深度学习中的优化问题
(1) 问题定义:经验风险最小化
深度学习中的优化问题通常指在已有数据集上最小化训练误差(training error)。记深度网络的待优化参数为$\theta$,包含$N$个训练样本$x$的数据集为$X$,单样本损失度量为$l(x;\theta)$,则损失函数(经验风险)定义为:
\[L(\theta)= \frac{1}{N}\sum_{x \in X}l(x;\theta)\]优化问题建模为寻找使损失函数取得全局最小(global minima)的参数$\theta^{*}$:
\[\theta^{*}=\mathop{\arg\min}_{\theta} L(\theta)\]需要强调的是,优化问题与机器学习问题并不等价:我们真正关心的是期望风险(在数据分布上的泛化误差),而优化算法只能看到经验风险。这一错位是本文中很多方法(SWA、隐式梯度正则化、平坦极小值的讨论)存在的根本原因;有时把训练损失降得更低反而是有害的。
(2) 优化深度网络的困难
在实践中,优化深度网络存在以下困难:
- 网络结构多样性:深度网络是高度非线性的模型,结构的多样性阻碍了构造通用的优化方法;参数量通常极大,难以使用二阶方法。
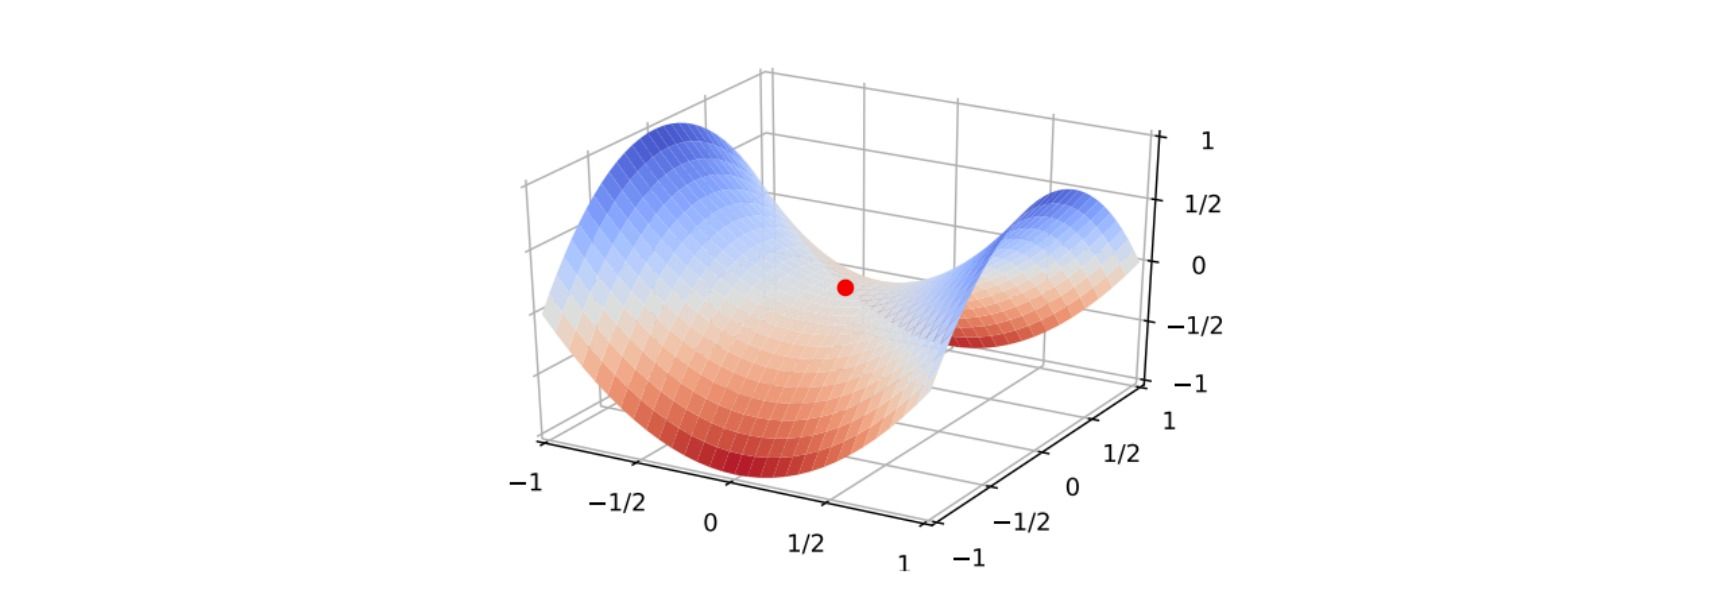
- 非凸优化:深度网络的损失函数是高维空间中的非凸函数,其损失曲面存在大量局部极小(local minima)和鞍点(saddle point),这些点也满足梯度为$0$。目前常用的优化方法大多基于梯度,因此在寻找全局最小值的过程中有可能落入局部极小值点或鞍点(如下图所示,鞍点是指梯度为$0$但Hessian矩阵不是半正定的点)。
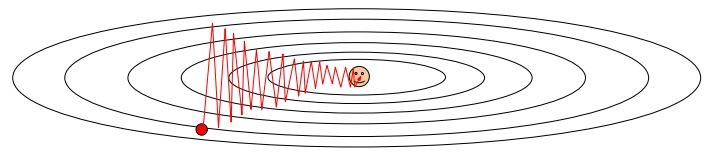
- 病态曲率(ill-conditioned curvature):参数不同维度上的梯度大小差异巨大,导致参数更新时在梯度大的方向来回震荡、在梯度小的方向前进缓慢。损失函数的条件数(condition number,即Hessian矩阵最大奇异值与最小奇异值之比)越大,这一现象越严重。这是全部自适应学习率方法的出发点。
- 梯度的噪声:小批量梯度只是全量梯度的一个无偏估计,批量越小噪声越大。噪声既是训练不稳定的来源,也是逃离尖锐极小值、获得泛化性的来源。
- 超参数敏感:学习率、批量大小、动量系数、权重衰减之间存在强耦合,缺乏理论指导时只能依赖经验。
目前深度学习中的优化问题尚没有通用的解决方法,有许多工作尝试给出优化过程和损失曲面的直觉解释:
- Identifying and attacking the saddle point problem in high-dimensional non-convex optimization:极小值点要求在特征的每个维度上都是极小点,这种情况概率比较低。在实践中,损失曲面上大部分梯度为零的点都是鞍点。
- The Loss Surfaces of Multilayer Networks:在非常大的神经网络中,大部分局部极小点和全局最小点是近似的;因此在训练神经网络时通常没有必要找全局最小点,这反而可能过拟合。
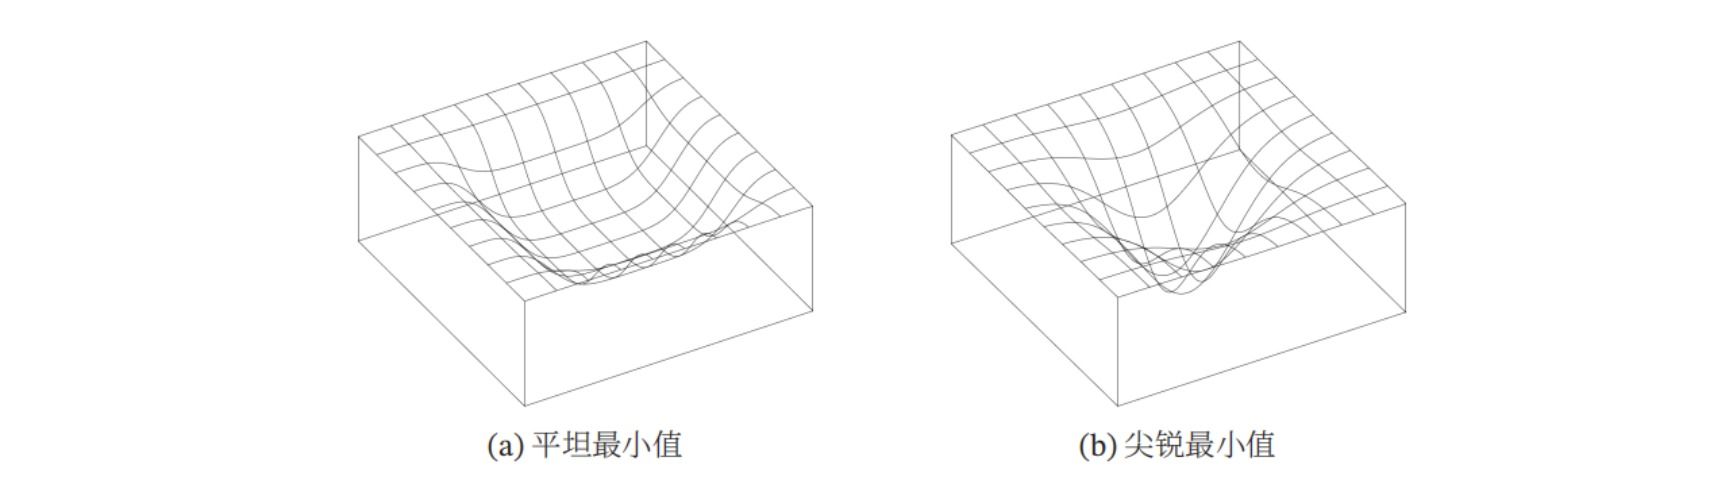
- Visualizing the Loss Landscape of Neural Nets:由于深度网络的参数非常多且有一定的冗余性,每个参数对总损失的影响非常小。这使得损失函数在局部极小点附近通常是一个平坦的区域,即平坦最小值(flat minima)而不是尖锐最小值(sharp minima)。这使得模型收敛于局部极小值时更加robust,即微小的参数变动不会剧烈地影响模型能力。
(3) 从不同角度理解梯度下降
深度学习中的优化问题通常用梯度下降(Gradient Descent, GD)算法求解,它是一种一阶近似方法。将参数$\theta$初始化为$\theta_0$,对损失函数$L(\theta)$在$\theta_0$处进行一阶Taylor展开:
\[L(\theta)=L(\theta_0)+\nabla_{\theta} L(\theta_0)^\top(\theta-\theta_0)+o\left(||\theta-\theta_0||^2\right)\]注意到若使损失函数$L(\theta)$减小,需要满足$\nabla_{\theta} L(\theta_0)^\top(\theta-\theta_0)<0$:当梯度大于零时应减小$\theta$,当梯度小于零时应增大$\theta$。综上所述,应沿梯度的负方向更新参数:
\[\begin{aligned} g_t&=\frac{1}{B}\sum_{x \in \mathcal{B}_t}\nabla_{\theta} l(x;\theta_{t-1}) \\ \theta_t&=\theta_{t-1}-\gamma g_t \end{aligned}\]下面从三个不同角度重新推导这一更新式,它们分别解释了梯度噪声的作用、步长的含义与更新方向的最优性。
⚪ 动力学角度
把神经网络建模为一个动力系统(dynamical system),则梯度下降算法描述了参数$\theta$随时间(即更新步数)的演化。该动力系统的规则是参数$\theta$的变化率为损失梯度$g=\nabla_{\theta}L(\theta)$的负值:
\[\dot{\theta} =-g\]该动力系统是一个保守动力系统,因此它最终可以收敛到一个不动点($\dot{\theta} = 0$),并可以进一步证明该稳定的不动点是一个极小值点。求解上述常微分方程ODE可以采用欧拉解法(该方法是指将方程$dy/dx=f(x,y)$转化为$y_{n+1}-y_n\approx f(x_n,y_n)h$),于是有$\theta_t-\theta_{t-1}=-\gamma g$,即为梯度下降算法的更新公式。
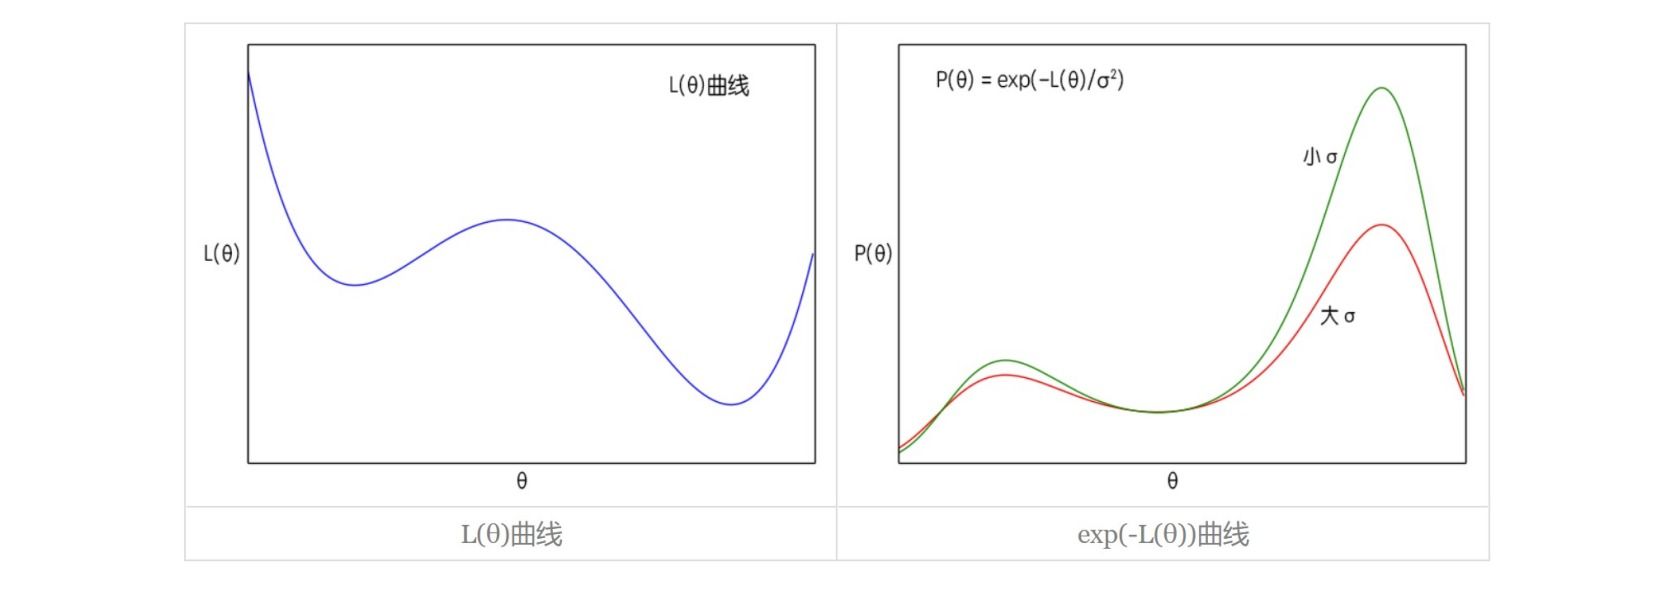
对于小批量梯度下降,每一批量上的梯度是全量梯度的近似估计,假设梯度估计的误差服从方差为$\sigma^2$的正态分布,则相当于在动力系统中引入高斯噪声:
\[\dot{\theta} =-g+\sigma \xi\]该系统用随机微分方程SDE描述,称为朗之万方程。该方程的解可以用平衡状态下的概率分布描述:
\[P(\theta) \sim \exp\left(-\frac{L(\theta)}{\sigma^2}\right)\]从上式中可以看出:当$\sigma^2$越大时,$P(\theta)$越接近均匀分布,此时参数$\theta$可能的取值范围也越大,允许探索更大比例的参数空间;当$\sigma^2$越小时,$P(\theta)$在极大值点(对应$L(\theta)$的极小值点)附近的区域越突出,则参数$\theta$落入极值点附近。在实践中,批量大小$B$越小,则$\sigma^2$越大。
⚪ 逼近角度
深度学习的损失函数$L(\theta)$通常是复杂的非线性函数。根据逼近理论,在$L(\theta)$上的任意一点$\theta_{t-1}$处可以用一条近似的曲线逼近原函数;如果近似曲线容易求得最小值,则可以用该最小值近似替代原函数的最小值。
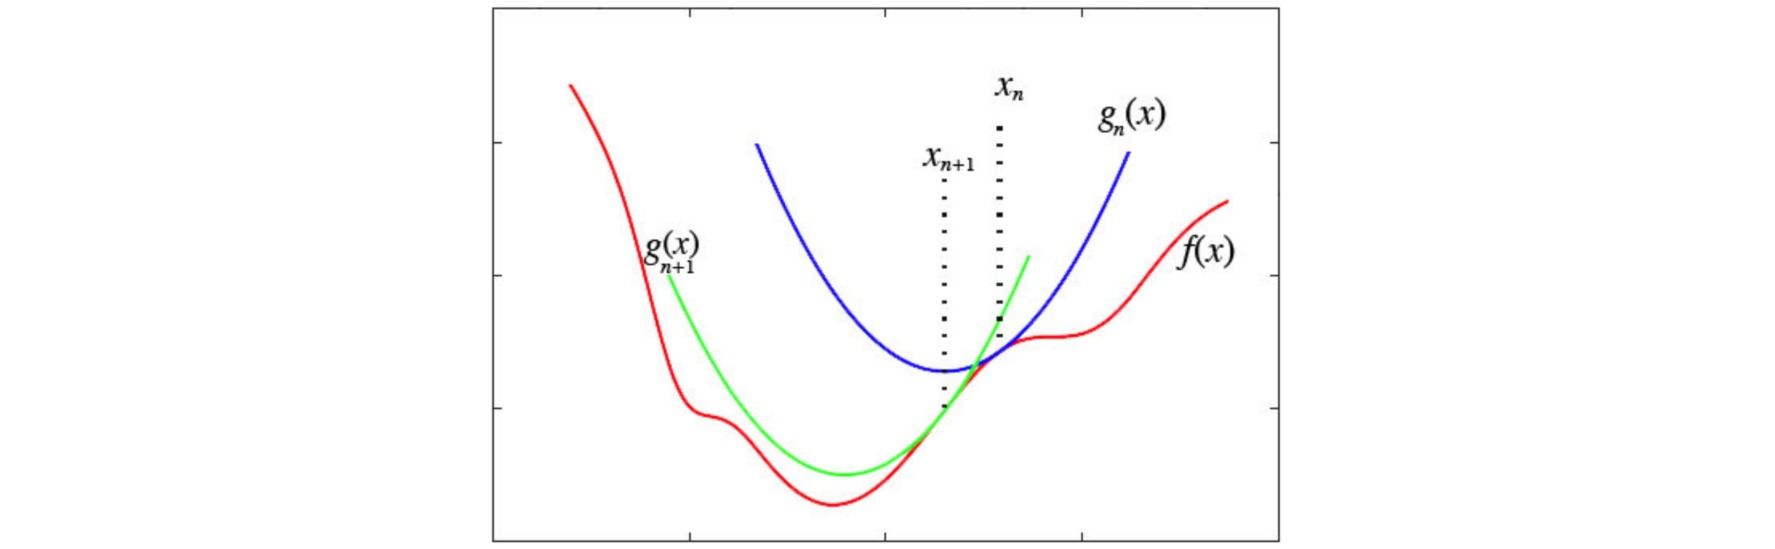
注意到所求极值为最小值,因此在$\theta_{t-1}$处采用一个开口向上的抛物线$q(\theta)$近似替代原函数:
\[q(\theta) = L(\theta_{t-1}) + \nabla_{\theta}L(\theta_{t-1})^\top(\theta-\theta_{t-1}) + \frac{1}{2\gamma}||\theta-\theta_{t-1}||^2\]该抛物线与原曲线在$\theta_{t-1}$处具有相同的数值和一阶导数,且具有容易求得的极小值点$\theta_{t-1} - \gamma \nabla_{\theta}L(\theta_{t-1})$,即为梯度下降算法的基本形式。这一视角说明学习率$\gamma$的倒数扮演了代理曲率的角色:$1/\gamma$越大,代理抛物线越陡、越保守;这也解释了为什么当真实曲率$\lambda_{\max}$超过$2/\gamma$时训练会发散。
⚪ 概率角度
从概率视角建模优化问题:记当前参数为$\theta$,优化目标为$L(\theta)$,将下一步的更新量$\Delta \theta$看作随机变量。则使得$L(\theta+\Delta \theta)$的数值越小的$\Delta \theta$出现的概率越大,用下面的分布表示:
\[p(\Delta \theta | \theta) =\frac{e^{-[L(\theta+\Delta \theta)-L(\theta)] / \alpha}}{Z(\theta)}, \quad Z(\theta)=\int e^{-[L(\theta+\Delta \theta)-L(\theta)] / \alpha}d(\Delta \theta)\]式中$Z(\theta)$是归一化因子,参数$\alpha>0$调整分布的形状:当$\alpha \to \infty$时分布趋近于均匀分布,参数可以向任意方向变化;当$\alpha \to 0$时只有使$L(\theta+\Delta \theta)$最小的$\Delta \theta$概率不为$0$,因此将选择损失下降最快的方向。参数的实际更新量取该分布的期望:
\[\Delta \theta^{*} = \Bbb{E}_{\Delta \theta \sim p(\Delta \theta | \theta)}[\Delta \theta] = \int p(\Delta \theta | \theta) \Delta \theta \, d (\Delta \theta)\]假设$L(\theta)$是一阶可导的,由Taylor展开得$L(\theta+\Delta \theta) - L(\theta) \approx \Delta \theta^\top g$。若约束参数更新的步长不超过$\epsilon$,即$|\Delta \theta| \leq \epsilon$,则有:
\[\begin{aligned} p(\Delta \theta | \theta) &=\frac{e^{-\Delta \theta^\top g / \alpha}}{Z(g)}, \quad Z(g)=\int_{||\Delta \theta|| \leq \epsilon} e^{-\Delta \theta^\top g / \alpha}d(\Delta \theta) \\ \Delta \theta^{*} &= \int_{||\Delta \theta|| \leq \epsilon} \frac{e^{-\Delta \theta^\top g / \alpha}}{Z(g)} \Delta \theta \, d (\Delta \theta) = -\nabla_g \ln Z(g) \end{aligned}\]假设更新量$\Delta \theta$与梯度$g$的夹角为$\eta$,则$Z(g)$表示为:
\[Z(g)=\int_{||\Delta \theta|| \leq \epsilon} e^{-||\Delta \theta|| \cdot ||g|| \cdot \cos \eta / \alpha}d(\Delta \theta)\]上式表示一个高维球体内的积分,由于积分空间具有各向同性,因此该积分只和梯度的模长$||g||$有关,将其记为$Z(||g||)$,则有:
\[\Delta \theta^{*} = -\nabla_g \ln Z(||g||) = -\frac{Z'(||g||)}{Z(||g||)} \nabla_g ||g|| = -\frac{Z'(||g||)}{Z(||g||)} \frac{g}{||g||}\]上式表示参数更新的最佳方向与梯度方向相反,即为梯度下降算法。
(4) 梯度下降的隐式偏好
梯度下降并不是一个“中性”的求解器:离散化的梯度下降本身携带了正则化效应,并且它得到的解具有很强的结构性。理解这一点有助于解释为什么较大的学习率往往泛化更好。
⚪ 隐式梯度正则化
梯度下降的连续形式是$\dot{\theta} = -g(\theta)$,而实际执行的是离散差分$\theta_{t} = \theta_{t-1} - \gamma g(\theta_{t-1})$。这两者存在差异,直接衡量离散解与精确解的误差比较困难,因此采用后向误差分析(backward error analysis):把离散迭代得到的序列看作另一个微分方程$\dot{\theta} = -\tilde{g}(\theta)$的精确解,转而分析$g$与$\tilde{g}$的差异。
对$\theta_{t+\gamma}$进行Taylor展开:
\[\begin{aligned} \theta_{t+\gamma} &= \theta_t+\gamma \nabla_t \theta_{t}+\frac{1}{2}\gamma^2 \nabla^2_t \theta_{t} + \frac{1}{6}\gamma^3 \nabla^3_t \theta_{t} + \cdots \\ &= \left(1+\gamma \nabla_t+\frac{1}{2}\gamma^2 \nabla^2_t +\frac{1}{6}\gamma^3 \nabla^3_t +\cdots\right)\theta_{t} = e^{\gamma \nabla_t}\theta_t \end{aligned}\]因此离散迭代对应的差分方程可写作$(e^{\gamma \nabla_t}-1)\theta_t = - \gamma g(\theta_t)$,通过算符运算调整为:
\[\begin{aligned} \nabla_t \theta_t &= - \left(\frac{\gamma \nabla_t}{e^{\gamma \nabla_t}-1}\right) g(\theta_t) \\ \dot{\theta}_t &= - \left(1-\frac{\gamma \nabla_t}{2}+\frac{\gamma^2 \nabla_t^2}{12}-\frac{\gamma^4 \nabla_t^4}{720}+\cdots\right) g(\theta_t) \end{aligned}\]对上式保留一阶项:
\[\begin{aligned} \dot{\theta}_t &= - \left(1-\frac{\gamma \nabla_t}{2}\right) g(\theta_t) = -g(\theta_t)+\frac{1}{2}\gamma \nabla_tg(\theta_t) \\ &\approx -g(\theta_t)-\frac{1}{2}\gamma \nabla_{\theta}g(\theta_t)\,g(\theta_t) =-g(\theta_t)-\frac{1}{4}\gamma \nabla_{\theta}||g(\theta_t)||^2 \end{aligned}\]对照$\dot{\theta} = -\tilde{g}(\theta)$,则有:
\[\begin{aligned} \tilde{g}(\theta_t) &= \nabla_{\theta}L(\theta_t)+\frac{1}{4}\gamma \nabla_{\theta}||\nabla_{\theta}L(\theta_t)||^2 = \nabla_{\theta}\left[L(\theta_t)+\frac{1}{4}\gamma ||\nabla_{\theta}L(\theta_t)||^2\right] \end{aligned}\]这说明梯度下降实际上并不是沿$L$的梯度负方向更新,而是沿一个修正损失$\tilde{L}$的梯度负方向更新:
\[\tilde{L}(\theta) = L(\theta)+\frac{1}{4}\gamma ||\nabla_{\theta}L(\theta)||^2\]其中$\frac{1}{4}\gamma||\nabla_{\theta}L(\theta)||^2$相当于一个正则化项,称为隐式梯度正则化(implicit gradient regularization)。它对具有较大梯度值的损失平面进行惩罚,有助于模型到达更加平缓的区域,有利于提高泛化性能。该项的强度正比于学习率$\gamma$:学习率过小会弱化这种隐式正则化,导致泛化性能不佳;而学习率过大会导致训练不稳定。因此也可以把它显式地加入损失函数,构造显式梯度正则化$\tilde{L}(\theta) = L(\theta)+ \mu ||\nabla_{\theta}L(\theta)||^2$。
⚪ 梯度下降与核方法的联系
通常认为深度学习的成功在于它能自动从数据中学习特征表示。但作者证明:通过标准梯度下降训练得到的深度网络,在数学上近似等价于一个核方法(kernel machine),即记录所有训练数据并通过一个相似性函数直接进行预测。这为网络权重提供了一种可解释性:权重是所有训练样本的叠加态(superposition)。
两个数据点的路径核(path kernel)定义为它们对应的网络输出关于权重的梯度点积沿梯度下降路径$c(t)$的积分(假设学习率无穷小,梯度下降是连续过程):
\[K_{f,c}^{p}(x,x') = \int_{c(t)} \nabla_{\theta}f_{\theta}(x) \cdot \nabla_{\theta}f_{\theta}(x')\, dt\]被积函数正是正切核(tangent kernel)。直观上,路径核衡量模型在这两个数据点上训练时变化的相似性。
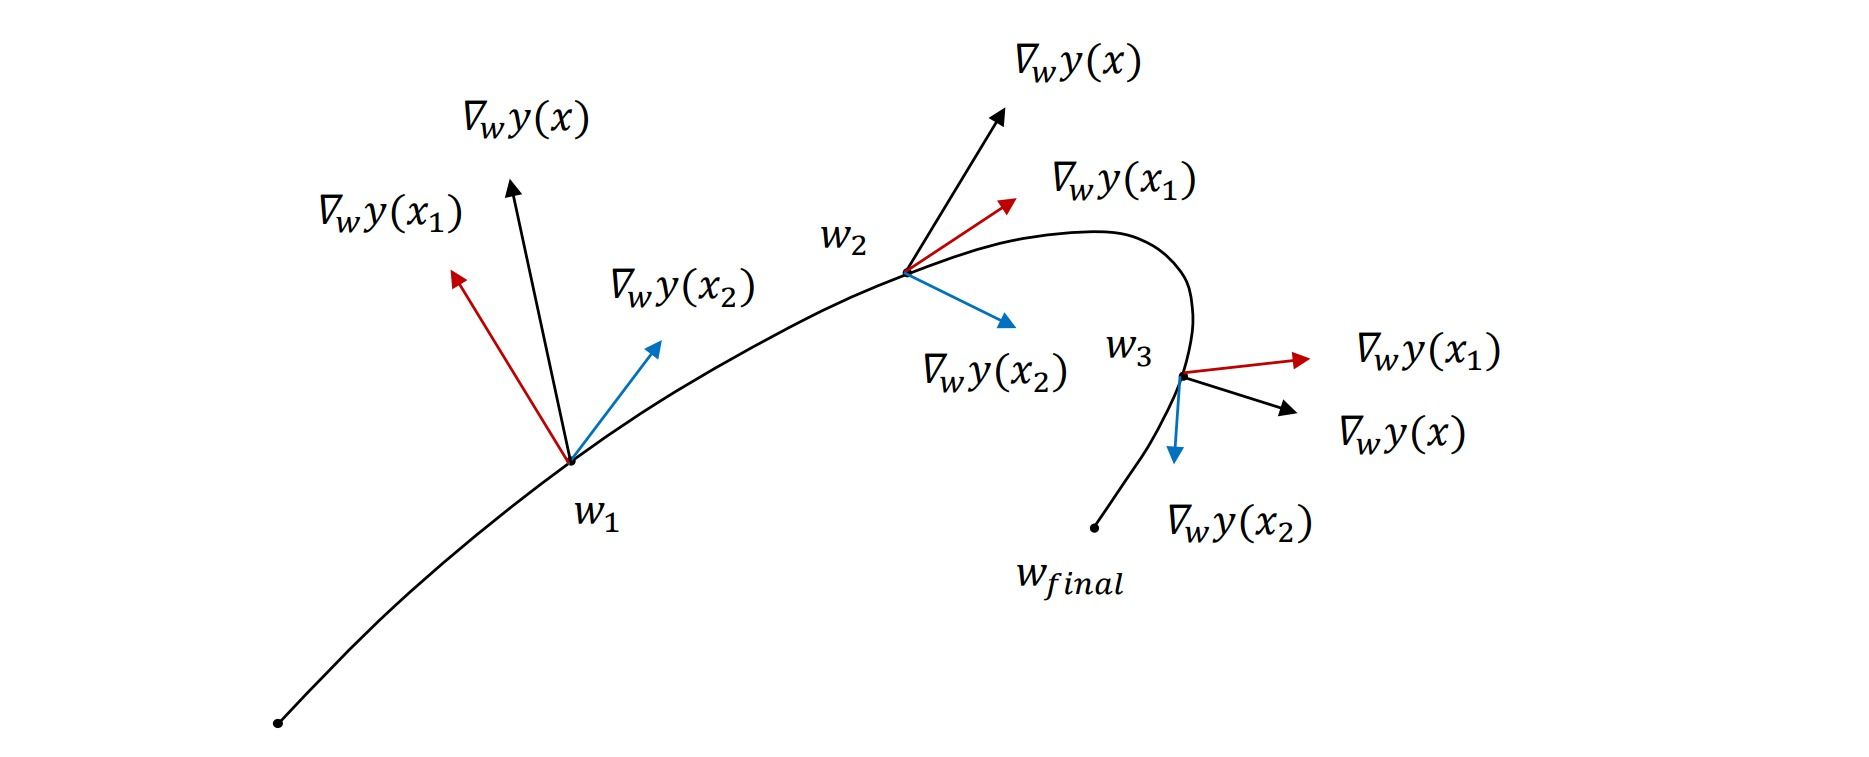
假设模型$y=f_{\theta}(x)$在训练集\(\{(x_i,y_i^{*})\}_{i=1}^m\)上通过梯度下降优化,损失为$L=\sum_i L(y_i^{*},y_i)$,学习率为$\gamma$。由链式法则:
\[\begin{aligned} \frac{dy}{dt} &= \sum_{j} \frac{\partial y}{\partial \theta_j} \frac{\partial \theta_j}{\partial t} = -\sum_{j} \frac{\partial y}{\partial \theta_j}\frac{\partial L}{\partial \theta_j} \\ &= -\sum_{i=1}^{m} \frac{\partial L}{\partial y_i} \sum_{j} \frac{\partial y}{\partial \theta_j} \frac{\partial y_i}{\partial \theta_j} = -\sum_{i=1}^{m} L'(y_i^{*},y_i) K_{f,\theta(t)}^{g} (x,x_i) \end{aligned}\]解上述微分方程并把积分整理成加权平均的形式,得到:
\[\mathop{\lim}_{\gamma \to 0} y = \sum_{i=1}^{m} a_i K_{f,c}^{p}(x,x_i)+b\]其中$a_i$是沿路径由正切核加权平均的损失对输出的负梯度,$b$是初始模型的输出。这一结论把深度学习与核方法、神经正切核理论联系了起来。
⚪ 深度集成与损失曲面
损失曲面上存在许多表现相近但彼此相距很远的局部极小值。
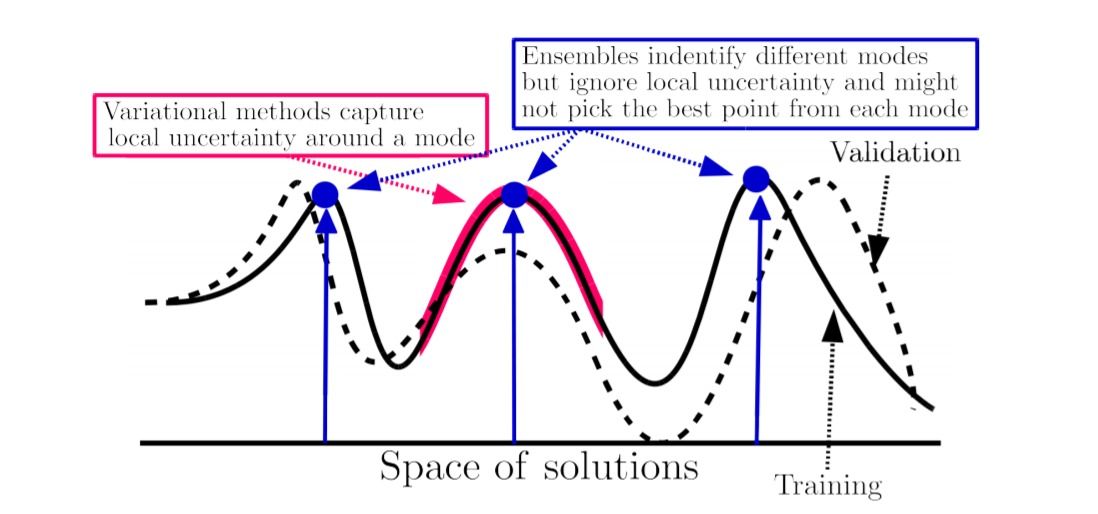
作者比较了两类“多模型”的构造方式:一是完全独立的随机初始化训练出的多个模型,二是在单个极小值附近做扰动得到的子模型(随机子空间采样、Monte Carlo dropout子空间、对角高斯子空间、低秩高斯子空间)。
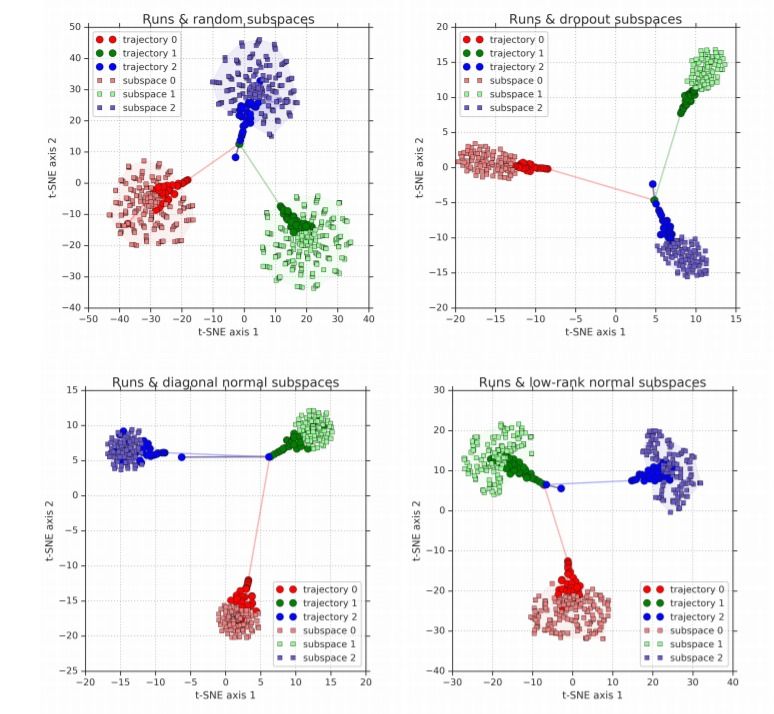
结论是:不同随机初始化训练出的模型即使都收敛到相似的损失值,其参数差异与预测差异仍然很大,因此把它们集成起来(deep ensemble)能显著提升效果;而在同一极小值附近扰动得到的子模型预测高度相关,集成收益很小。这从损失曲面的角度解释了深度集成为何是一个如此强的基线,也提示我们:优化过程的随机性本身是一种可利用的资源。
2. 常见的梯度优化方法
损失函数$L(\theta)$是在整个训练集上定义的,严格计算梯度需要考虑所有训练数据,这称为全量梯度下降($B=N$)。但训练集规模通常很大且数据高度冗余,因此实践中把训练集分成若干互补的批次(batch),每次在一个批次上计算梯度并更新参数,即小批量梯度下降(mini-batch gradient descent)($B<N$)。特别地,$B=1$时称为随机梯度下降(stochastic gradient descent, SGD)。如今SGD一般泛指小批量梯度下降:
\[\theta_t=\theta_{t-1}-\gamma g_t\]每一批量数据的梯度都是全体数据梯度的近似,由于小批量的数据分布和总体分布有所差异,且批量越小差异越大;因此批量越小,梯度估计的方差越大,引入的噪声越大,训练可能不稳定,但也带来更强的探索能力。
标准的小批量梯度下降存在若干缺陷,本节把主流优化算法按“如何弥补这些缺陷”分成八族:
- 更新过程中容易在鞍点与病态方向上停滞 → 引入动量(2.1);
- 参数不同维度的梯度尺度差异巨大 → 自适应学习率(2.2);
- 两者可以正交地结合 → Adam族(2.3);
- 一阶信息不足以描述曲率 → 二阶信息与矩阵型预条件(2.4);
- 优化器状态与参数同样大,显存吃紧 → 降低显存占用(2.5);
- 分布式训练中整体批量过大导致精度崩塌 → 层级自适应(2.6);
- 学习率本身难以选择 → 免调参方法(2.7);
- 反向传播的显存与串行性受限 → 不依赖反向传播的梯度估计(2.8)。
2.1 动量
动量的核心思想是:用历史梯度的累积代替瞬时梯度作为更新方向。这既在梯度方向一致的维度上放大步长(加速穿越平坦区与鞍点),又在梯度方向反复振荡的维度上相互抵消(抑制震荡)。
⚪ Momentum:引入动量
动量法在参数更新的过程中不断累积梯度值:
\[\begin{aligned} m_t &= \mu m_{t-1} + g_t \\ \theta_t&=\theta_{t-1}-\gamma m_t \end{aligned}\]上式是PyTorch采用的形式(学习率在动量之外)。原始论文采用把学习率吸收进动量的等价形式$m_t = \mu m_{t-1} + \gamma g_t,\ \theta_t=\theta_{t-1}- m_t$;两者在学习率恒定时完全等价,但在学习率变化时不等价(见3.3节的动量修正)。
由于$m_t=\sum_{i=1}^{t}\mu^{t-i}g_i$,当各步梯度方向一致时动量的模长趋于$1/(1-\mu)$倍的梯度模长。因此$\mu=0.9$意味着有效学习率被放大约$10$倍:修改动量系数后必须重新调整学习率。有些实现(如Adam的一阶动量)采用滑动平均形式$m_t = \beta_1 m_{t-1} + (1-\beta_1)g_t$,此时动量的尺度与梯度一致,不存在这个放大效应。
⚪ NAG:Nesterov动量
Nesterov加速梯度(Nesterov accelerated gradient, NAG)同样是一阶方法,但通常具有更好的收敛速率。它的更新公式为:
\[\begin{aligned} m_t &= \mu m_{t-1} + \nabla_{\theta} L(\theta_{t-1}-\gamma\mu m_{t-1}) \\ \theta_t&=\theta_{t-1}-\gamma m_t \end{aligned}\]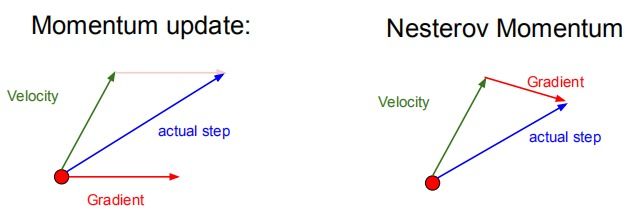
Momentum的更新方向是当前动量方向与当前点梯度方向的矢量和;而NAG的更新方向是当前动量方向与沿动量方向前进一步后的梯度方向的矢量和。直观来看,NAG赋予算法一定的前瞻能力:不直接使用当前位置的梯度,而是计算参数被当前动量修正后的位置处的梯度。
在主流框架中,计算$\nabla_{\theta} L(\theta_{t-1}-\gamma\mu m_{t-1})$比计算$\nabla_{\theta} L(\theta_{t-1})$繁琐得多,因此做如下变量代换。把NAG的更新式写作(此处采用学习率吸收进动量的写法,记$v_t=\gamma m_t$):
\[\theta_{t} = \theta_{t-1} - \mu v_{t-1} - \gamma \nabla_{\theta} L(\theta_{t-1}-\mu v_{t-1})\]等式两端减去$\mu v_{t}$,并定义$\Theta_t = \theta_t-\mu v_t$,则迭代公式可写作:
\[\begin{aligned} v_{t} &= \mu v_{t-1} + \gamma \nabla_{\theta} L(\Theta_{t-1}) \\ \Theta_{t} &= \Theta_{t-1} - \mu v_{t} - \gamma \nabla_{\theta} L(\Theta_{t-1}) \end{aligned}\]此时梯度是在同一个变量$\Theta$上计算的,避免了求梯度时的自变量偏移。随着迭代逐渐靠近极值点,动量$v$逐渐减小,从而使$\Theta$和$\theta$趋于等价。因此实践中(PyTorch风格)NAG的更新公式为:
\[\begin{aligned} m_t &= \mu m_{t-1} + g_t \\ \theta_t&=\theta_{t-1}-\gamma\left(\mu m_t + g_t\right) \end{aligned}\]⚪ signSGD 与 Signum:只用梯度的符号
signSGD把更新量压缩为梯度的符号,每个分量的更新幅度都等于$\gamma$:
\[\theta_t=\theta_{t-1}-\gamma\,\text{sign}(g_t)\]加上动量后称为Signum:
\[\begin{aligned} m_t &= \beta_1 m_{t-1} + (1-\beta_1)g_t \\ \theta_t&=\theta_{t-1}-\gamma\,\text{sign}(m_t) \end{aligned}\]符号化有三个后果:一是通信量可以压缩到$1$比特,天然适合分布式训练;二是它可以看作一种极端的自适应学习率(等价于用$|g_t|$归一化梯度),因此对梯度尺度完全不敏感;三是符号化引入了额外的噪声,倾向于把模型推向更平坦的区域。Signum是理解2.3节中Lion的关键前身:Lion基本上就是“Signum + 解耦权重衰减 + 两个不同的$\beta$”。
⭐ 讨论:动量的连续极限与“重球法”
带动量的梯度下降对应二阶微分方程$\ddot{\theta}+\frac{1-\mu}{\gamma}\dot{\theta}+\nabla L(\theta)=0$,即重球法(heavy ball method):参数像一个有质量、受摩擦力的小球在损失曲面上滚动。$\mu$控制惯性,$1-\mu$控制阻尼。
这个图像解释了动量的两个作用:惯性帮助小球冲过平坦区域和小的局部起伏,阻尼保证它最终停下来。在凸二次问题上,最优调参的重球法把收敛速率从$O(\kappa)$改进到$O(\sqrt{\kappa})$($\kappa$为条件数),这也是NAG在凸情形下达到一阶方法最优速率$O(1/t^2)$的来源。
但需要注意的是,这些加速结论都建立在凸性与精确梯度之上,在带噪声的非凸深度学习中并不严格成立;动量在深度学习里更多是作为一个方差缩减与尺度自适应的工具在起作用。
2.2 自适应学习率
自适应学习率方法为参数的每个维度单独维护步长,以缓解病态曲率带来的问题。它们的代价是改变了更新方向(不再严格沿负梯度),因此在某些任务上会带来一定的精度损失。
⚪ RProp:只根据梯度符号调整步长
RProp(resilient propagation)是最早的逐坐标自适应方法之一,它完全抛弃梯度的幅值,只用符号信息决定方向,并用一个独立维护的弹性步长$\eta_t$决定幅度:
\[\begin{aligned} \eta_t &= \begin{cases} \min(\eta_{t-1}\eta_+,\Gamma_{\max}), & g_{t-1}g_t>0 \\ \max(\eta_{t-1}\eta_-,\Gamma_{\min}), & g_{t-1}g_t<0 \\ \eta_{t-1}, & g_{t-1}g_t=0 \end{cases} \\ \theta_{t} &= \theta_{t-1} -\eta_t \odot \text{sign}(g_t) \end{aligned}\]其中$\eta_+>1$(缺省$1.2$)、$0<\eta_-<1$(缺省$0.5$)。规则的含义是:如果偏导数改变了符号,说明上一步跨过了极小值,步长太大,因此收缩步长(并且可以选择性地撤销上一步的更新$\theta_t=\theta_{t-1}$);如果符号没有改变,说明还在往下走,因此放大步长以加速收敛。
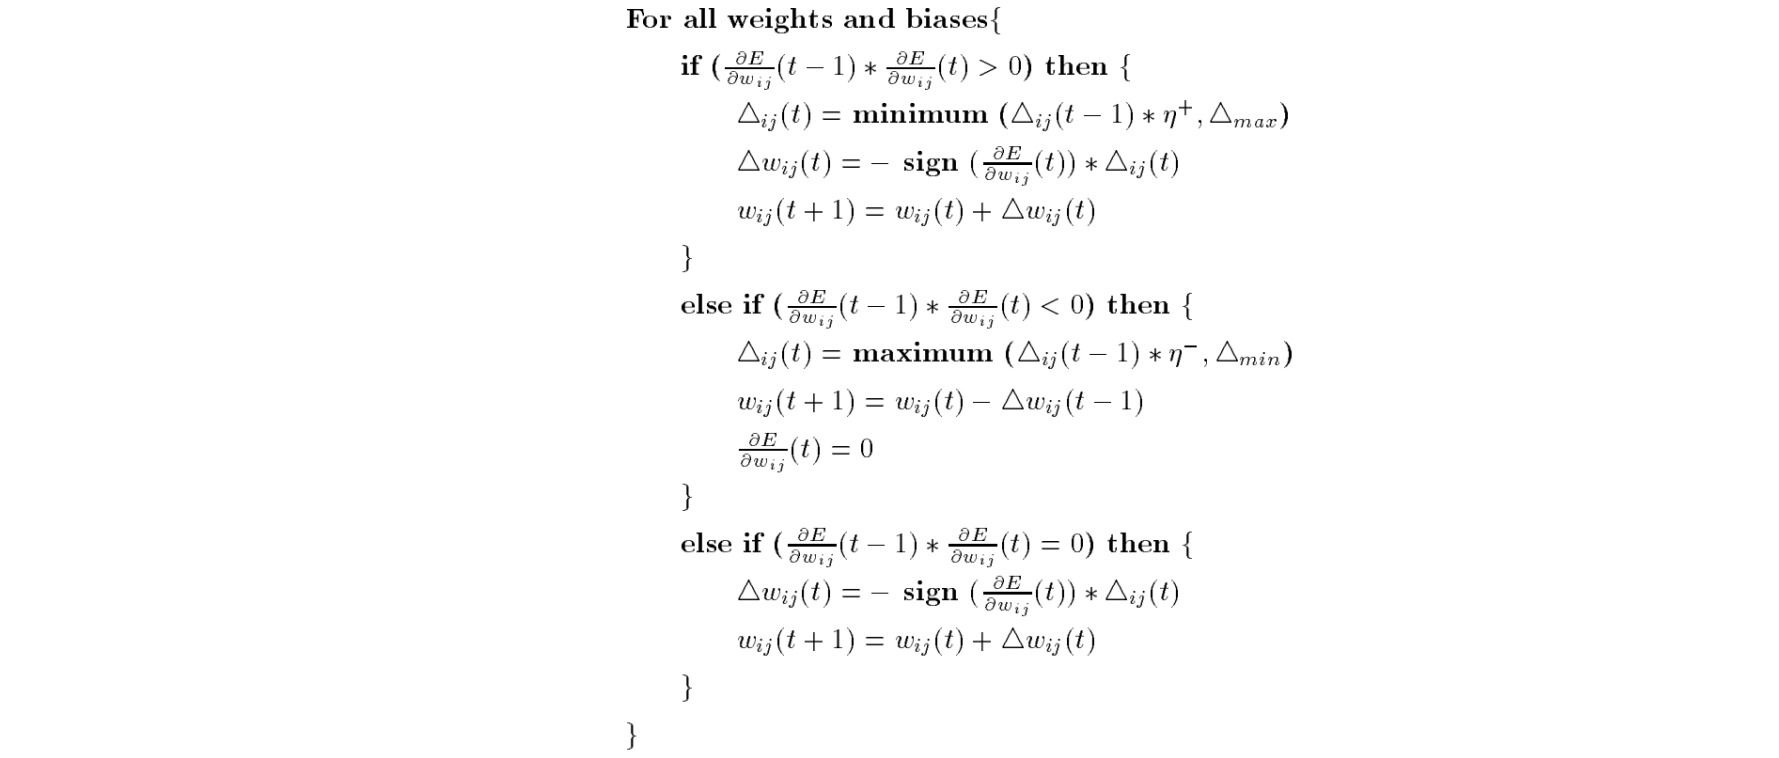
RProp对参数初始化和梯度尺度都不敏感,且几乎不需要调超参数。但它有一个致命限制:符号比较要求梯度是确定性的,因此它只适用于全量梯度下降。在小批量训练中相邻两步的梯度符号变化主要由采样噪声决定,RProp会失效;RMSProp正是为了把RProp“改造成可用于小批量”而提出的。
⚪ AdaGrad:累积平方梯度
AdaGrad累积全部历史平方梯度,用其平方根的倒数缩放学习率:
\[\begin{aligned} v_t &= v_{t-1} + g_t^2 \\ \theta_{t} &= \theta_{t-1} -\gamma \frac{g_t}{\sqrt{v_t}+\epsilon} \end{aligned}\]梯度较大的维度获得较小的学习率,梯度较小的维度获得较大的学习率,从而平衡不同维度上的更新幅度。AdaGrad在稀疏特征(如词嵌入)上效果尤其好,因为罕见特征的累积梯度小、有效学习率大。它也有明确的在线学习理论保证。
AdaGrad的缺点是:由于分母中的累积单调不减,有效学习率在整个训练过程中持续衰减并最终趋于$0$,导致训练在收敛之前就停滞;且它对初始梯度的大小非常敏感(初期梯度大会永久压低学习率)。
⚪ RMSProp:把累积换成指数滑动平均
RMSProp把AdaGrad的无限累积替换为指数滑动平均,从而只保留近期梯度的信息:
\[\begin{aligned} v_t &= \beta_2 v_{t-1} + (1-\beta_2)g_t^2 \\ \theta_{t} &= \theta_{t-1} -\gamma \frac{g_t}{\sqrt{v_t}+\epsilon} \end{aligned}\]由于$v_t$不再单调递增,有效学习率不会持续衰减到$0$,因此RMSProp可以稳定地长时间训练。这个改动看似微小,却是从AdaGrad通向Adam的关键一步;但它也正是2.3节中Adam收敛性争议的根源($v_t$可能减小,导致有效步长增大)。
⚪ AdaDelta:修正参数更新的单位
AdaDelta在RMSProp的基础上做了第二个改进:让参数更新量具有正确的单位,从而彻底去掉手工设置的全局学习率。
注意到一阶方法的更新量与参数的单位并不一致:
\[\Delta \theta \propto g = \frac{\partial L}{\partial \theta} \propto \frac{1}{\theta}\]而使用Hessian矩阵的二阶方法(如牛顿法)具有正确的单位:
\[\Delta \theta \propto H^{-1}g = \frac{\partial L/\partial \theta}{\partial^2 L/\partial \theta^2} \propto \theta\]由于$\frac{1}{\partial^2 L/\partial \theta^2} = \frac{\Delta \theta}{\partial L/\partial \theta}$,且分母上的梯度方均根已经由RMSProp提供,因此只需在分子上补一个参数更新量的方均根。为此额外维护平方更新量的滑动平均$\Delta_t$:
\[\begin{aligned} v_t &= \beta_2 v_{t-1} + (1-\beta_2)g_t^2 \\ \Delta_{t-1} &= \beta_2 \Delta_{t-2} + (1-\beta_2)\left(\theta_{t-1}-\theta_{t-2}\right)^2 \\ \theta_{t} &= \theta_{t-1} -\frac{\sqrt{\Delta_{t-1}+\epsilon}}{\sqrt{v_t+\epsilon}} g_t \end{aligned}\]AdaDelta不需要设置学习率、对超参数不敏感、对大梯度与噪声具有鲁棒性,且几乎不增加计算量。它在实践中的表现并不总是最好(在上文提到的基准测试中,AdaDelta是默认超参数最不合适的优化器之一),但“用更新量自身的尺度充当学习率”这一思路后来反复出现:LARS、LAMB、Adafactor的层自适应、Amos都是它的变体。
2.3 动量与自适应的结合:Adam族
动量(改进方向)与自适应学习率(改进步长)是两个正交的改进,把它们结合起来就得到了当今最主流的优化器族。这一族方法都需要同时存储与参数同样大的$m_t$和$v_t$,因此显存开销是SGD的三倍(参数 + 两组状态)。
⚪ Adam:自适应矩估计
Adam(adaptive moment estimation)是Momentum与RMSProp的结合:前者使用梯度的一阶矩估计,适用于在线学习和非平稳环境;后者使用二阶矩估计,适用于稀疏梯度的情况。
\[\begin{aligned} m_t &= \beta_1 m_{t-1} + (1-\beta_1)g_t \\ v_t &= \beta_2 v_{t-1} + (1-\beta_2)g_t^2 \\ \hat{m}_t &= \frac{m_t}{1-\beta_1^t} \\ \hat{v}_t &= \frac{v_t}{1-\beta_2^t} \\ \theta_t&=\theta_{t-1}-\gamma \frac{\hat{m}_t}{\sqrt{\hat{v}_t}+\epsilon} \end{aligned}\]其中$m_t$是一阶矩(均值)的估计,$v_t$是二阶矩(未中心化的方差)的估计。
初始化偏差修正是Adam的一个关键细节。由于滑动平均初始化为$0$,矩估计在训练初期是有偏的,尤其当$\beta_1,\beta_2$接近$1$时估计值接近$0$,会使更新步长异常。以二阶矩为例,展开递推式得:
\[\begin{aligned} v_t =& \beta_2^tv_0 + \beta_2^{t-1} (1-\beta_2) g_{1}^2 + \cdots \\ &+ (1-\beta_2) g_t^2 = (1-\beta_2)\sum_{i=1}^{t}\beta_2^{t-i}g_{i}^2 \\ \Bbb{E}[v_t] =& \Bbb{E}[g_{t}^2] \cdot (1-\beta_2)\sum_{i=1}^{t}\beta_2^{t-i}+\zeta \\ =& \Bbb{E}[g_{t}^2] \cdot (1-\beta_2^t)+\zeta \end{aligned}\]当真实二阶矩$\Bbb{E}[g_t^2]$是固定值时$\zeta=0$,否则可以通过选择合适的$\beta_2$使其保持较小。因此$\Bbb{E}[v_t]$与$\Bbb{E}[g_t^2]$之间存在$(1-\beta_2^t)$倍的系统偏差,除以该系数即可修正。
在实现上可以把两个修正因子合并到学习率里以提高效率:
\[\gamma_t = \gamma \cdot \frac{\sqrt{1-\beta_2^t}}{1-\beta_1^t}, \quad \theta_t = \theta_{t-1} - \gamma_t \frac{m_t}{\sqrt{v_t}+\hat{\epsilon}}\]在凸的在线优化设定下,Adam具有遗憾上界$R(T)=O(\sqrt{T})$,即$R(T)/T = O(1/\sqrt{T})$。(这一收敛性证明后来被AMSGrad指出存在漏洞,详见本节末的讨论。)
⚪ Adamax:用L-∞范数缩放
Adam使用梯度的L2范数缩放更新量,可以推广到Lp范数。Lp范数梯度的滑动平均为(注意衰减率使用$\beta_2^p$):
\[v_t = \beta_2^p v_{t-1} + (1-\beta_2^p)|g_t|^p = (1-\beta_2^p)\sum_{i=1}^{t}\beta_2^{p(t-i)}|g_i|^p\]当$p \to \infty$时:
\[\begin{aligned} \mathop{\lim}_{p \to \infty} (v_t)^{1/p} &= \mathop{\lim}_{p \to \infty} \left(\sum_{i=1}^{t}\left(\beta_2^{t-i}|g_i|\right)^p\right)^{1/p} \\ &= \max\left(\beta_2^{t-1}|g_1|,\beta_2^{t-2}|g_2|,\cdots,|g_t|\right) \end{aligned}\]上式具有简洁的递归形式,得到Adamax(注意此时$v_t$本身就是幅值量纲,不需要开方也不需要偏差修正):
\[\begin{aligned} m_t &= \beta_1 m_{t-1} + (1-\beta_1)g_t \\ v_t &= \max\left(\beta_2 v_{t-1}, |g_t|\right) \\ \theta_t&=\theta_{t-1}-\gamma \frac{\hat{m}_t}{v_t+\epsilon} \end{aligned}\]Adamax对梯度中的稀疏离群值更稳定,因为$\max$操作不会像平方平均那样被单个大梯度长期污染。
⚪ AdamW:解耦权重衰减
在标准SGD中,L2正则化与权重衰减是等价的。在损失函数中引入L2正则化项$\frac{\lambda}{2\gamma}||\theta||^2$,则SGD的更新过程为:
\[\begin{aligned} \theta_{t} &= \theta_{t-1}-\gamma\nabla L(\theta_{t-1})- \lambda \theta_{t-1} \\ &= (1-\lambda)\theta_{t-1}-\gamma\nabla L(\theta_{t-1}) \end{aligned}\]即“在损失里加L2项”与“每步把参数乘以$(1-\lambda)$”是同一件事,这正是权重衰减这一名称的来源。
然而这种等价性在自适应梯度算法中不成立:Adam用二阶矩对更新量进行缩放,因此L2正则化项的梯度$\lambda\theta$也会被$\sqrt{\hat v_t}$缩放——梯度大的权重,其正则化强度反而被缩小了,这与权重衰减“所有权重以相同比例收缩”的意图完全相反。AdamW把权重衰减从梯度更新过程中解耦出来,直接作用在参数上:
\[\begin{aligned} m_t &= \beta_1 m_{t-1} + (1-\beta_1)g_t, \quad v_t = \beta_2 v_{t-1} + (1-\beta_2)g_t^2 \\ \theta_t&=\theta_{t-1}-\gamma \left(\frac{\hat{m}_t}{\sqrt{\hat{v}_t}+\epsilon}+\lambda \theta_{t-1}\right) \end{aligned}\]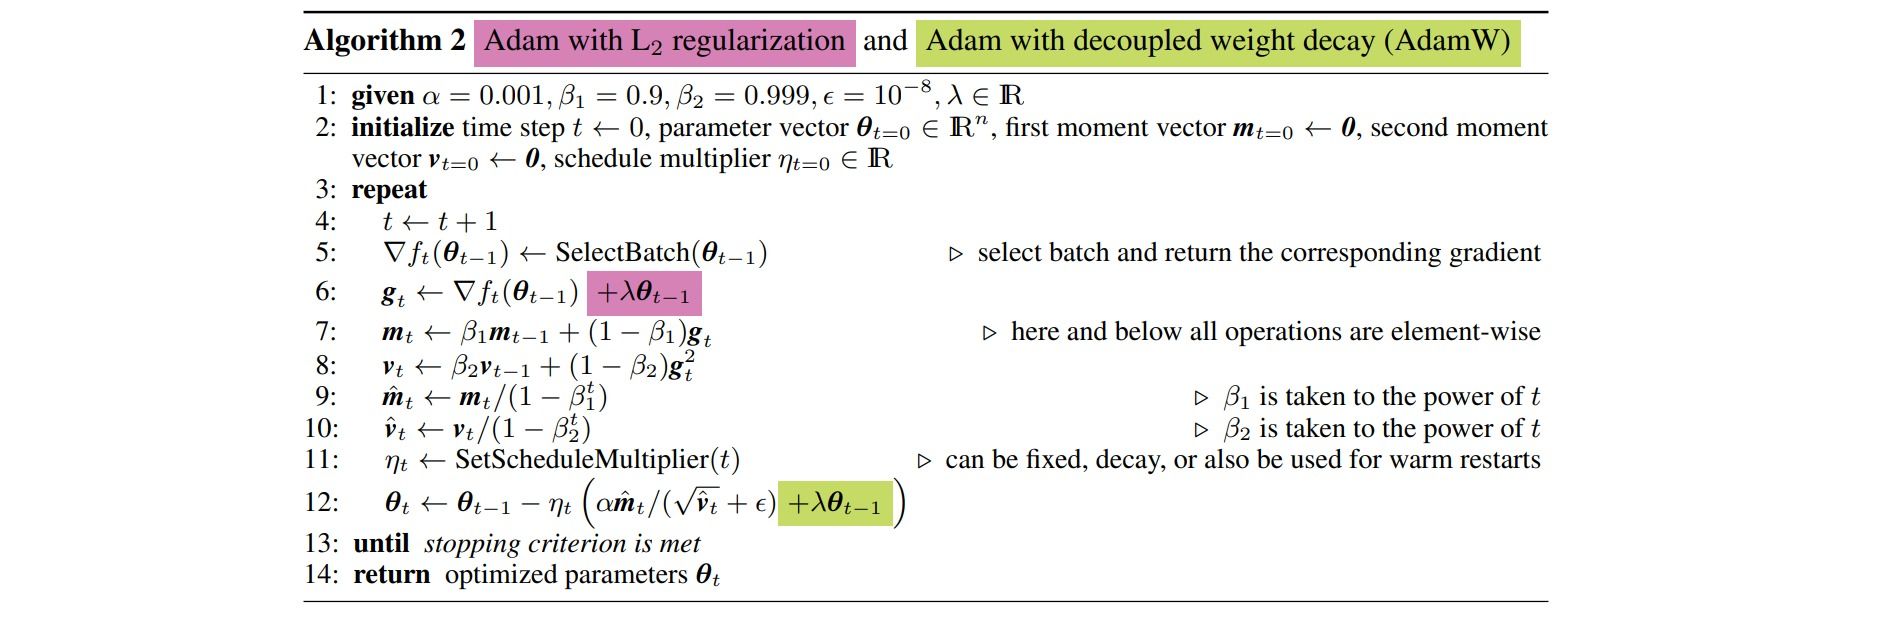
解耦带来的实际好处是学习率$\gamma$与权重衰减率$\lambda$的超参数空间可分离,可以独立调节(若采用L2形式,两者的最优值强相关,网格搜索会呈斜条带状)。AdamW已经成为Transformer与大语言模型训练的事实标准优化器。关于权重衰减作为正则化手段的完整讨论可参考深度学习中的正则化方法。
值得一提的是,解耦后的$\lambda$含义变成了“每步的相对收缩比例”,因此最优权重衰减值取决于总更新次数:训练更久时应当使用更小的$\lambda$。
⚪ Nadam:把Nesterov动量引入Adam
忽略自适应学习率部分,Adam的动量更新可以展开为“沿前一个动量方向走一步 + 沿当前梯度方向走一步”:
\[\theta_t = \theta_{t-1} - \gamma \left(\frac{\beta_1 m_{t-1}}{1-\beta_1^t}+\frac{(1-\beta_1) g_t}{1-\beta_1^t}\right)\]对照2.1节中Momentum与NAG的差别(前者沿$\mu m_{t-1}$,后者沿$\mu m_{t}$),把Nesterov动量引入Adam只需把动量项从$\beta_1 m_{t-1}$替换为$\beta_1 m_{t}$。作者同时引入了随更新步递增的动态衰减率$\mu_t$($\psi=0.004$):
\[\begin{aligned} \mu_t &= \beta_1\left(1-\frac{1}{2}\cdot 0.96^{t\psi}\right) \\ m_t &= \beta_1 m_{t-1} + (1-\beta_1)g_t, \quad v_t = \beta_2 v_{t-1} + (1-\beta_2)g_t^2 \\ \hat{m}_t &= \frac{\mu_{t+1} m_{t}}{1-\prod_{i=1}^{t+1}\mu_i}+\frac{(1-\mu_t) g_t}{1-\prod_{i=1}^{t}\mu_i} \\ \hat{v}_t &= \frac{v_t}{1-\beta_2^t} \\ \theta_t&=\theta_{t-1}-\gamma \frac{\hat{m}_t}{\sqrt{\hat{v}_t}+\epsilon} \end{aligned}\]需要注意:动态衰减率$\mu_t$使得偏差修正的分母变成累乘$\prod_i\mu_i$而不是$\beta_1^t$,这是Nadam实现中最容易出错的地方;PyTorch的NAdam实现即采用上述形式(其超参数momentum_decay对应$\psi$)。若只需要Adam + Nesterov而不需要动态衰减率,可以简单地使用$\hat m_t’ = \beta_1\hat m_t + (1-\beta_1)g_t/(1-\beta_1^t)$。
⚪ AMSGrad:修补Adam的收敛性
作者指出Adam原论文的收敛性证明有误,并给出了一个反例:即使在一维凸问题上,Adam也可能不收敛到最优解。
为便于讨论,假设$\beta_1=0$(不使用动量),则有效学习率为$\gamma/\sqrt{v_t}$。考察其倒数的变化:
\[\Gamma_{t+1} = \frac{\sqrt{v_{t+1}}}{\gamma}-\frac{\sqrt{v_t}}{\gamma}\]对于SGD和AdaGrad,$v_t$单调不减,因此$\Gamma_{t} \geq 0$,有效步长单调收缩,算法收敛。但引入指数滑动平均后$v_{t+1} = \beta_2 v_{t} + (1-\beta_2) g_{t+1}^2$无法保证$v_{t+1} \geq v_t$,可能出现$\Gamma_{t}<0$即有效步长突然放大的情况。
反例构造如下:设$\theta\in[-1,1]$,损失函数为
\[L_t(\theta) = \begin{cases} C\theta, & t\bmod 3=1 \\ -\theta, & \text{其他} \end{cases}\]其中$C>2$。该函数是凸的,最优解在$\theta=-1$。每三步中有一步提供一个大梯度$C$(把参数推向最优),另两步提供梯度$-1$(把参数推向错误方向)。取$\beta_2 = 1/(1+C^2)$,可以算出三步之后参数反而增大了:那个信息量最大的大梯度经过指数滑动平均后被迅速遗忘,而两个小而频繁的错误梯度累积起来占据主导。
AMSGrad的修补是让分母使用二阶矩的历史最大值,从而保证有效步长不会增加:
\[\begin{aligned} m_t &= \beta_1 m_{t-1} + (1-\beta_1)g_t, \quad v_t = \beta_2 v_{t-1} + (1-\beta_2)g_t^2 \\ \hat{m}_t &= \frac{m_t}{1-\beta_1^t}, \quad \hat{v}_t = \frac{v_t}{1-\beta_2^t} \\ \hat{v}_t^{\max} &= \max\left(\hat{v}_{t-1}^{\max},\hat{v}_t\right) \\ \theta_t&=\theta_{t-1}-\gamma \frac{\hat{m}_t}{\sqrt{\hat{v}_t^{\max}}+\epsilon} \end{aligned}\]代价是它重新引入了类似AdaGrad的单调收缩,在实践中往往过于保守,因此并未取代Adam。
⚪ RAdam:修正自适应学习率的早期方差
对于Adam等自适应算法,学习率warmup(最初几步使用较小的学习率)能够稳定训练、加速收敛。作者指出其根本原因是:自适应学习率在训练早期具有过大甚至发散的方差。
把偏差修正后的自适应学习率记作
\[l_t = \sqrt{\frac{1-\beta_2^t}{(1-\beta_2)\sum_{i=1}^{t}\beta_2^{t-i}g_{i}^2}}\]以$t=1$为例,$l_1 = 1/|g_1|$;若$g_1 \sim \mathcal{N}(0,\sigma^2)$,则$\text{Var}[l_1]$是发散的。这解释了两个经验现象:Adam-2k(只在前$2000$步更新$v_t$而不更新参数)和Adam-eps(把$\epsilon$放大到$10^{-4}$)都能替代warmup,因为它们都降低了早期方差。
为了定量修正,作者用简单平均近似指数滑动平均,则$l_t^2$近似服从scaled inverse chi-square分布$\chi^{-2}(\rho_t,1/\sigma^2)$,通过匹配两个分布得到“等效自由度”:
\[\rho_t = \frac{2}{1-\beta_2} - 1 - \frac{2t\beta_2^t}{1-\beta_2^t}, \quad \rho_\infty = \frac{2}{1-\beta_2} - 1\]$\text{Var}[l_t]$随$\rho_t$增加而单调减少,在$\rho_t = \rho_\infty$处取得最小值。引入修正系数$r_t$使每步的$\text{Var}[r_tl_t]$都等于该最小方差,并对方差使用一阶近似$\text{Var}[l_t] \approx \frac{\rho_t}{2(\rho_t-2)(\rho_t-4)\sigma^2}$,得到:
\[r_t = \sqrt{\frac{(\rho_t-4)(\rho_t-2)\rho_\infty}{(\rho_\infty-4)(\rho_\infty-2)\rho_t}}\]上式仅在$\rho_t>4$时成立,因此RAdam在早期($\rho_t\leq 4$)退化为带动量的SGD,之后才启用自适应学习率:
\[\begin{aligned} m_t &= \beta_1 m_{t-1} + (1-\beta_1)g_t, \quad v_t = \beta_2 v_{t-1} + (1-\beta_2)g_t^2 \\ \hat{m}_t &= \frac{m_t}{1-\beta_1^t}, \quad \hat{v}_t = \frac{v_t}{1-\beta_2^t} \\ \theta_t&=\begin{cases} \theta_{t-1}-\gamma r_t \dfrac{\hat{m}_t}{\sqrt{\hat{v}_t}+\epsilon}, & \rho_t>4 \\ \theta_{t-1}-\gamma \hat{m}_t, & \rho_t\leq 4 \end{cases} \end{aligned}\]RAdam的实际价值在于它把warmup这个纯经验技巧变成了一个自动、无需调参的机制,并显著提高了模型对学习率取值的鲁棒性。
⚪ AdaBound:从Adam平滑过渡到SGD
Adam收敛快但泛化常不如SGD,一个流行的经验做法是“先用Adam再切换到SGD”。AdaBound把这个切换变成连续的:对逐元素的有效学习率施加一个随时间收紧的上下界,
\[\begin{aligned} \hat{\gamma}_t &= \text{Clip}\left(\frac{\gamma}{\sqrt{\hat{v}_t}+\epsilon},\ \gamma_l(t),\ \gamma_u(t)\right) \\ \theta_t &= \theta_{t-1}-\hat{\gamma}_t \odot \hat{m}_t \end{aligned}\]其中界随$t$增大分别单调递增/递减并收敛到同一个常数$\gamma^{*}$(如$\gamma_l(t)=\gamma^{*}\left(1-\frac{1}{(1-\beta_2)t+1}\right)$、$\gamma_u(t)=\gamma^{*}\left(1+\frac{1}{(1-\beta_2)t}\right)$)。因此算法在早期是Adam(界很宽,不起作用),后期所有维度的学习率都被夹到$\gamma^{*}$,退化为带动量的SGD。这一“上下界”视角也直接回应了AMSGrad关心的问题:不收敛的根源是极端的有效学习率,而裁剪比取历史最大值更温和。
⚪ AdaBelief:按“梯度是否符合预期”调整步长
Adam用$g_t^2$(二阶原点矩)作为分母,而AdaBelief只改一行:用梯度偏离动量预测的程度$(g_t-m_t)^2$(即中心化的二阶矩,梯度的方差估计)作为分母:
\[\begin{aligned} m_t &= \beta_1 m_{t-1} + (1-\beta_1)g_t \\ v_t &= \beta_2 v_{t-1} + (1-\beta_2)\left(g_t-m_t\right)^2 \\ \theta_t&=\theta_{t-1}-\gamma \frac{\hat{m}_t}{\sqrt{\hat{v}_t}+\epsilon} \end{aligned}\]含义是把$m_t$看作对梯度的预测:当实际梯度与预测一致(可信)时$v_t$小、步长大;当梯度剧烈波动时$v_t$大、步长小。这修正了Adam的一个反直觉行为:在梯度大但方向一致的区域(例如一条陡峭而平直的峡谷底部),Adam会因为分母大而缩小步长,而AdaBelief会放大步长。它在保持Adam收敛速度的同时改善了泛化,且不增加任何显存开销。
⚪ AdaX:引入二阶矩的指数长期记忆
把Adam的二阶矩偏差修正合并进递推式,可以得到一个等价的“时变衰减率”形式:
\[\begin{aligned} \hat{v}_t &= \frac{v_t}{1-\beta_2^t} = \beta_2\frac{1-\beta_2^{t-1}}{1-\beta_2^t}\hat{v}_{t-1} +\left(1-\beta_2\frac{1-\beta_2^{t-1}}{1-\beta_2^t}\right)g_t^2 \end{aligned}\]记\(\hat{\beta}_{2,t}=\beta_2\frac{1-\beta_2^{t-1}}{1-\beta_2^t}\),则\(\hat{v}_t = \hat{\beta}_{2,t}\hat{v}_{t-1} +(1-\hat{\beta}_{2,t})g_t^2\)。当$t=1$时\(\hat{\beta}_{2,1}=0\),即用实时梯度校正学习率;当$t \to \infty$时\(\hat{\beta}_{2,t}\to\beta_2<1\),即始终保留对当前梯度的敏感性。作者认为这是不合适的:训练后期梯度本身很小,继续用它校正学习率会改变更新方向、导致不稳定。理想的行为是训练后期\(\hat{\beta}_{2,t}\to 1\),算法退化为SGD。
AdaX因此把二阶矩的累积改为指数长期记忆形式(并去掉了一阶动量的偏差修正):
\[\begin{aligned} m_t &= \beta_1 m_{t-1} + (1-\beta_1)g_t \\ v_t &= (1+\beta_2)v_{t-1}+\beta_2 g_t^2 \\ \hat{v}_t &= \frac{v_t}{(1+\beta_2)^t-1} \\ \theta_t&=\theta_{t-1}-\gamma \frac{m_t}{\sqrt{\hat{v}_t}+\epsilon} \end{aligned}\]此时等效衰减率为\(\hat{\beta}_{2,t}=1- \frac{\beta_2}{(1+\beta_2)^t-1}\),满足\(\hat{\beta}_{2,1}=0\)且\(\hat{\beta}_{2,\infty}=1\),即历史二阶矩的比重越来越大。通常取$\beta_2=10^{-4}$。
⚪ Amos:自适应设置学习率与权重衰减
Amos从“参数应该收缩到什么尺度”出发,同时给出学习率$\alpha_t$和权重衰减率$\rho_t$的解析调度。带权重衰减的更新写作:
\[\theta_{t} = \theta_{t-1} - \left(\alpha_t h_t+\rho_t\theta_{t-1}\right)\]记最优参数为$\theta^{*}$、当前误差为$\epsilon_t=\theta_t-\theta^{*}$,则:
\[\begin{aligned} ||\epsilon_{t+1}||^2 & = ||\epsilon_t - (\alpha_th_t+\rho_t\theta_t)||^2 \\ & \approx ||\epsilon_t||^2 - 2\alpha_t h_t \cdot \epsilon_t +\left(\alpha_t^2||h_t||^2-2\rho_t\theta_t \cdot \epsilon_t\right) \end{aligned}\]要求权重衰减带来的更新量始终比主目标高一阶($\mathcal{O}(\alpha_t^2) = \mathcal{O}(\rho_t)$),即令括号内为零:$\alpha_t^2||h_t||^2=2\rho_t\theta_t \cdot \epsilon_t\approx 2\rho_t q||\epsilon_t||^2$。代入并用$\cos(h_t,\epsilon_t)\approx p$近似,得到误差的递推:
\[\begin{aligned} ||\epsilon_{t+1}||^2 & \approx ||\epsilon_t||^2\left(1 - 2 p \sqrt{2\rho_tq} \right) \approx ||\epsilon_t||^2 \exp\left(- 2 p \sqrt{2\rho_tq}\right) \end{aligned}\]再令$2\rho_tq = \lambda^2|\epsilon_t|^2$使两者同步衰减,并取$p_t = p_0 \exp(-S_t)$($S_t$为指数求和项),解相应的微分方程可得$\exp(-2S_t) = \frac{1}{2 \alpha_0 p_0 t+1}$,最终:
\[\begin{aligned} \alpha_t &\approx \frac{\alpha_0 ||\epsilon_0||}{||h_t||} \cdot \frac{1}{2 \alpha_0 p_0 t+1} \\ \rho_t &\approx \frac{\alpha_0^2}{2q} \cdot \frac{1}{2 \alpha_0 p_0 t+1} \end{aligned}\]即学习率与权重衰减都采用逆时间衰减(inverse time decay)。这里$\alpha_0$是全局相对更新幅度(一般取$10^{-3}$),$q=1$,而$||\epsilon_0||=||\theta_0-\theta^{*}||$代表参数的变化尺度:若参数按$0$均值、$\sigma^2$方差初始化,则对$\theta \in \Bbb{R}^k$有$||\epsilon_0||^2\approx k\sigma^2$(训练前后参数的整体尺度不会剧烈变化);对全零或全一初始化的参数(偏置、归一化层的rescale/reshift)可取$\sigma=0.5$。Amos的意义在于它把“学习率调度”从超参数搜索问题变成了一个可以由模型结构与初始化推算出来的量。
⚪ Lion:自动搜索出的符号动量优化器
作者用数千TPU小时在程序空间中搜索优化算法,并结合人工简化,得到了Lion(EvoLved Sign Momentum):
\[\begin{aligned} u_t &= \text{sign}\left( \beta_1m_{t-1}+(1-\beta_1)g_t \right) + \lambda\theta_{t-1} \\ \theta_t&=\theta_{t-1}-\gamma u_t \\ m_t &= \beta_2m_{t-1}+(1-\beta_2)g_t \end{aligned}\]相比AdamW,Lion有三个特点:一是只缓存一组状态$m_t$(不需要二阶矩),显存更省;二是去掉了除法与开方,计算更快;三是动量的更新放在参数更新之后,并且参数更新用的插值系数$\beta_1$与动量累积用的$\beta_2$是两个不同的值(相当于在更新时使用了一个更新鲜的动量,与NAG的前瞻思想同源),这在大量实验中显示出优越性。
使用Lion时必须注意超参数的换算:由于$\text{sign}$使更新量每个分量的绝对值都是$1$,更新幅度显著大于其他优化器,因此学习率$\gamma$要缩小(通常比AdamW小$3\sim 10$倍);而为了让权重衰减的实际幅度$\gamma\lambda$保持不变,$\lambda$应相应放大(通常放大同样的倍数)。视觉任务推荐$\beta_1=0.9,\beta_2=0.99$,语言任务推荐$\beta_1=0.95,\beta_2=0.98$。此外,符号化引入的噪声在批量较小时(小于$64$)可能过量而导致效果恶化甚至发散。
⚪ Adan:自适应的Nesterov动量估计
Adan用一个“重写过的Nesterov”来避免NAG中额外的前瞻梯度计算:额外维护梯度差分的动量$d_t$,并用$g_t+\beta_2 d_t$(对前瞻梯度的一阶外推)来同时驱动一阶与二阶动量:
\[\begin{aligned} m_t &= \beta_1 m_{t-1} + (1-\beta_1)g_t \\ d_t &= \beta_2 d_{t-1} + (1-\beta_2)\left(g_t-g_{t-1}\right) \\ v_t &= \beta_3 v_{t-1} + (1-\beta_3)\left[g_t+\beta_2\left(g_t-g_{t-1}\right)\right]^2 \\ \theta_t&=\frac{\theta_{t-1}-\gamma \left(\hat{m}_t+\beta_2 \hat{d}_t\right)/\left(\sqrt{\hat{v}_t}+\epsilon\right)}{1+\lambda\gamma} \end{aligned}\]代价是多缓存一组$d_t$与$g_{t-1}$。Adan在视觉、语言、强化学习的多个基线上都能用更少的训练轮数达到同等精度,且对学习率的容忍范围较宽。
⭐ 讨论:Adam的收敛性到底有没有问题
AMSGrad的反例曾一度被理解为“Adam不收敛”,但后续工作给出了更细致的图景:
- A Simple Convergence Proof of Adam and Adagrad:在有界梯度与光滑性假设下,只要$\beta_2$随问题恰当选取,Adam(含偏差修正)在非凸光滑目标上具有$O(\log T/\sqrt{T})$的梯度范数收敛速率。
- Adam Can Converge Without Any Modification On Update Rules:AMSGrad的反例本质上是先给定$\beta_2$再构造问题。反过来,对任意固定问题,只要$\beta_2$足够大,Adam就能收敛;存在一个明确的$\beta_2$分界线。这解释了为什么实践中$\beta_2=0.999$几乎从不出问题,而在梯度分布重尾的大模型训练里偶尔需要把$\beta_2$调到$0.95$以下时反而容易出现损失尖峰;两者是同一个现象的两端。
- Why Transformers Need Adam: A Hessian Perspective:从Hessian谱的角度解释了为什么Transformer上SGD远不如Adam:不同参数块(Attention、MLP、Embedding、LayerNorm)的Hessian谱差异极大(“块异质性”),单一学习率无法同时适配,而Adam的逐坐标缩放天然处理了这一点。
实践结论是:Adam/AdamW的收敛性在深度学习中不是一个真实的痛点,$\beta_2$与$\epsilon$才是需要关注的旋钮。
2.4 二阶信息与矩阵型预条件
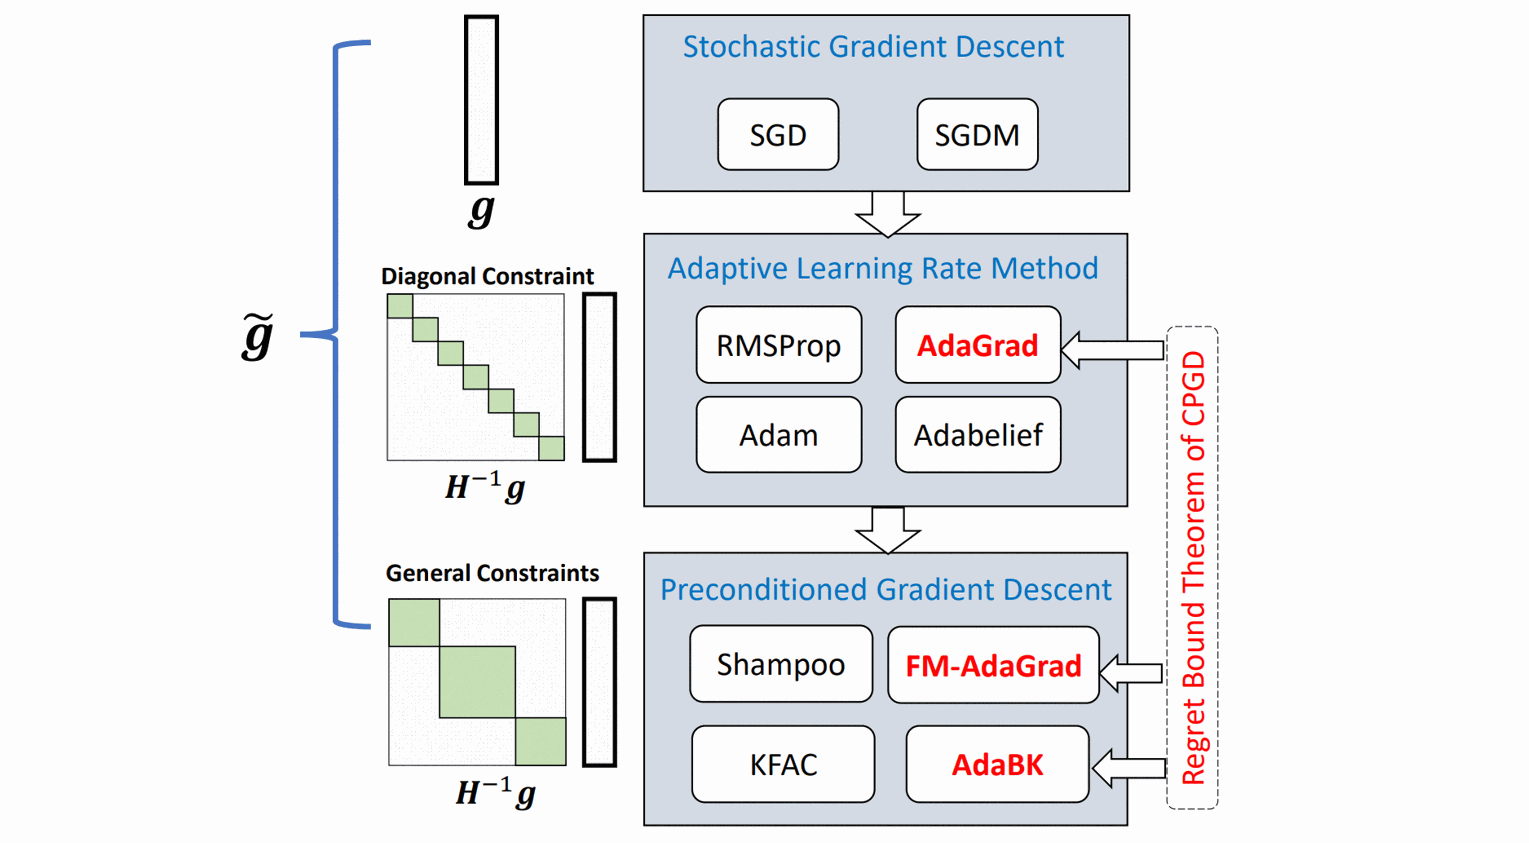
梯度自适应的方法可以总结为:在实际应用SGD时,把当前步$t$的梯度信息$g_{t}$(或累计历史梯度的动量$m_{t}$)送入一个预条件算子(Preconditioner)$\mathcal{P}_t$,输出真正的更新方向$h_t$:
\[\theta_t=\theta_{t-1}-\gamma \mathcal{P}_t(g_{t})\]预条件算子的作用是对原始梯度做一次线性变换:用局部曲率的(近似)逆来重新缩放各个方向,把病态、各向异性的损失曲面在变换后拉得更接近各向同性,从而让梯度下降用更少的迭代收敛。常见的设置为:
| 方法 | 预条件矩阵 $P_t$ |
|---|---|
| SGD / Momentum | $P_t=I$ |
| AdaGrad | $v_t=\sum_{s\le t}g_s\odot g_s,\; P_t=\big(\operatorname{diag}(v_t)^{1/2}+\epsilon I\big)^{-1}$ |
| RMSProp / Adam | $v_t=\beta_2v_{t-1}+(1-\beta_2)g_t\odot g_t,\;P_t=\big(\operatorname{diag}(v_t)^{1/2}+\epsilon I\big)^{-1}$ |
上面所有方法的预条件算子$\mathcal{P}_t$都是对角矩阵(即每个参数独立更新)。而真实的曲率是有耦合的,用矩阵型预条件能显著减少迭代次数;从梯度向量到更新向量的矩阵乘法代表了任意线性变换。问题在于$d\times d$的矩阵在深度学习中完全无法存储。本节的方法都在回答同一个问题:如何用结构化近似把二阶信息塞进可接受的显存与计算预算。
⚪ 牛顿法与拟牛顿法
牛顿法用Hessian矩阵的逆作为预条件:
\[\theta_t=\theta_{t-1}-\gamma H_{t-1}^{-1}g_t, \quad H = \nabla^2_{\theta}L(\theta)\]它在极小值附近具有二次收敛速率,且天然是“单位正确”的(见2.2节AdaDelta的讨论)。但$H$的存储是$O(d^2)$、求逆是$O(d^3)$,在深度学习中不可行;且非凸问题中$H$可能不正定,牛顿方向可能是上升方向。
L-BFGS是最常用的拟牛顿法:它不存储$H^{-1}$,而是保留最近$k$组$\left(s_i,y_i\right)=\left(\theta_{i}-\theta_{i-1},\ g_{i}-g_{i-1}\right)$,通过两重循环递归隐式计算$H^{-1}g$,内存为$O(kd)$。共轭梯度法则完全不显式构造$H$,只需要Hessian向量积$Hv$(可以由两次自动微分得到)。
这些方法在深度学习中很少使用,根本原因是它们都依赖确定性的梯度:曲率估计$y_i=g_i-g_{i-1}$在小批量噪声下几乎没有意义,而线搜索也无法在随机目标上进行。它们的适用场合是全批量的小规模问题,例如物理信息神经网络(PINN)、风格迁移的图像优化、隐式神经表示的微调。
⚪ K-FAC:Kronecker分解的Fisher近似
自然梯度法用Fisher信息矩阵$F=\Bbb{E}\left[\nabla_{\theta}\log p\,\nabla_{\theta}\log p^\top\right]$代替Hessian,其优点是它总是半正定的,且对参数化方式不变。K-FAC对每一层的Fisher块做Kronecker分解:
\[F^{(i)} \approx A^{(i-1)} \otimes G^{(i)}, \quad A^{(i-1)}=\Bbb{E}\left[a^{(i-1)}{a^{(i-1)}}^\top\right],\ G^{(i)}=\Bbb{E}\left[\delta^{(i)}{\delta^{(i)}}^\top\right]\]其中$a^{(i-1)}$是第$i$层的输入激活,$\delta^{(i)}$是该层输出的梯度。利用$\left(A \otimes G\right)^{-1}=A^{-1} \otimes G^{-1}$,第$i$层的更新量可以写成两个小矩阵的乘法:
\[\Delta W^{(i)} = {G^{(i)}}^{-1}\left(\nabla_{W^{(i)}}L\right){A^{(i-1)}}^{-1}\]若第$i$层的权重是$m\times n$的,则只需存储$m\times m$与$n\times n$的两个因子,把$O(m^2n^2)$降到$O(m^2+n^2)$。逆矩阵每隔若干步才重算一次以摊销开销。K-FAC是“矩阵型预条件在深度学习中可行”的第一个有力证据。
⚪ PSGD:在李群上拟合预条件矩阵
PSGD不显式估计Hessian,而是直接学习一个预条件矩阵$P=Q^\top Q$,使其满足割线条件$P\,\delta g=\delta\theta$(其中$(\delta\theta,\delta g)$是一对匹配的参数扰动与梯度扰动,即Hessian向量积对)。它通过最小化如下拟合准则来在线更新$Q$:
\[c(Q)=\Bbb{E}\left[\delta g^\top P\,\delta g + \delta\theta^\top P^{-1}\delta\theta\right]\]该准则的极小点恰好给出$P\approx H^{-1}$,参数更新为$\theta \leftarrow \theta-\mu\,P g$。关键技巧是把$Q$约束在一个李群上并做乘法式更新,从而始终保持正定、且更新代价可控。现代实现(PSGD-Kron)把$Q$做Kronecker分解$Q=Q_L\otimes Q_R$以适配矩阵参数;其白化(whitening)变体用原始梯度代替$\delta g$、用随机噪声代替$\delta\theta$,使$P$估计梯度协方差的逆,让预条件后的梯度被白化。相比Adam,它以更少的调参获得曲率/白化级别的预条件效果。
⚪ Shampoo:对张量的每个维度分别预条件
Shampoo不依赖概率模型(不需要Fisher),而是直接对梯度张量的每个维度累积一个预条件矩阵。对于矩阵参数$W \in \Bbb{R}^{m\times n}$与其梯度$G_t$:
\[\begin{aligned} P_t &= P_{t-1} + G_tG_t^\top \quad (m\times m) \\ Q_t &= Q_{t-1} + G_t^\top G_t \quad (n\times n) \\ W_t &= W_{t-1} - \gamma\, P_t^{-1/4}G_tQ_t^{-1/4} \end{aligned}\]可以验证:当$m=n=1$时它退化为AdaGrad。$-1/4$次幂是为了让两侧预条件的总强度匹配$\text{AdaGrad}$的$-1/2$。Shampoo的主要开销是矩阵的$-1/4$次幂(需要特征分解),实践中每隔上百步才更新一次;分布式实现(Scalable Second Order Optimization for Deep Learning)把这些分解分散到不同的CPU上。Shampoo在AlgoPerf等公开优化器竞赛中取得了领先成绩,是目前最有竞争力的非对角优化器之一。
⚪ SOAP:在Shampoo的特征基里跑Adam
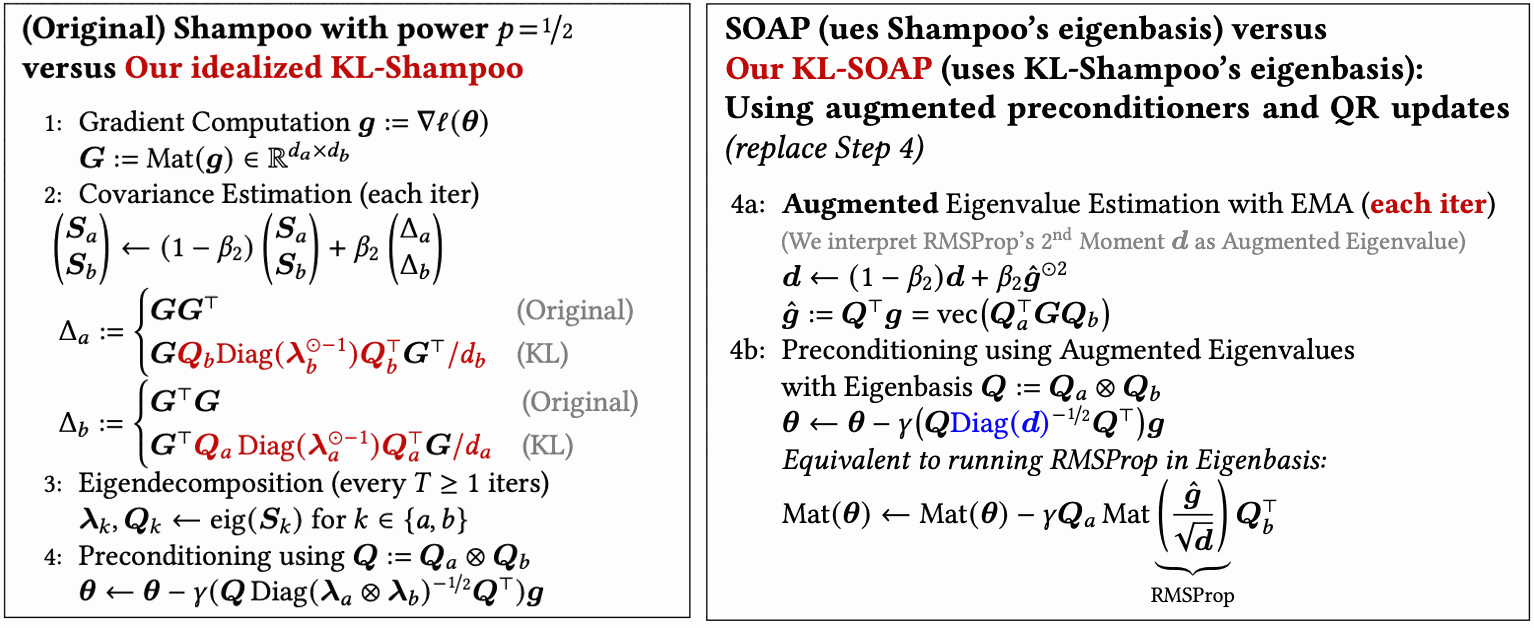
作者证明了一个漂亮的等价性:Shampoo(取$-1/2$次幂时)等价于“在其预条件矩阵的特征基中运行Adafactor”。既然如此,不如在这组特征基中直接运行完整的Adam;这就是SOAP:
\[\begin{aligned} &P_t=U\Lambda U^\top,\quad Q_t=V\Sigma V^\top \quad (\text{每 } T \text{ 步更新一次特征基}) \\ &\tilde{g}_t = U^\top G_t V \\ &\tilde{h}_t = \text{Adam}\left(\tilde{g}_t\right) \\ &W_t = W_{t-1}-\gamma\, U\tilde{h}_t V^\top \end{aligned}\]由于特征基更新可以低频摊销,而基内的Adam是逐元素的(廉价且自带偏差修正与动量),SOAP比Shampoo少一个超参数、每步开销更低,且训练更稳定。
⚪ KL-Shampoo:用KL散度拟合预条件
Shampoo用Frobenius范数拟合梯度协方差来估计其Kronecker因子,它常常需要Adam grafting(借用Adam的步长)才稳定。KL-Shampoo把预条件因子的估计重新表述为高斯分布之间的KL散度最小化(协方差拟合)问题。在这一视角下得到的更新在同等(SOAP级别的)单步开销下匹配甚至超过Shampoo,并且无需再做Adam grafting,从而省去了额外维护一组Adam状态的显存开销。
⚪ Sophia:轻量级的对角Hessian预条件
Sophia回到对角预条件,但把分母从“二阶矩”换成“对角Hessian估计”,并用裁剪保证在非凸区域的安全性:
\[\begin{aligned} m_t &= \beta_1 m_{t-1} + (1-\beta_1)g_t \\ H_t &= \beta_2 H_{t-k} + (1-\beta_2)\hat{H}_t \quad (\text{每 } k \text{ 步更新一次}) \\ \theta_t &= \theta_{t-1}-\gamma \cdot \text{clip}\left(\frac{m_t}{\max\left(\rho H_t,\epsilon\right)},1\right) \end{aligned}\]其中对角Hessian用Gauss-Newton-Bartlett估计量给出:从模型自身的预测分布中采样标签$\hat{y}\sim p_{\theta}(\cdot|x)$,在这些采样标签上计算小批量梯度$\hat{g}_t$,则$\hat{H}_t = B \cdot \hat{g}_t\odot \hat{g}_t$。这个估计量只需要一次额外的反向传播(每$k=10$步一次,摊销开销约$5\%$),并且保证非负,因此不需要额外处理负曲率。
裁剪是Sophia的关键安全阀:在曲率估计不可靠或曲率很小的方向上,$m_t/(\rho H_t)$会很大,裁剪把每个坐标的更新幅度限制在$\gamma$以内,行为退化为signSGD。这使得Sophia在语言模型预训练中相比AdamW能减少约一半的迭代步数。
⚪ AdaBK:块对角与Kronecker约束下的全矩阵预条件
AdaBK从在线学习的regret上界出发推导预条件矩阵:理想的全矩阵预条件(逐层梯度协方差)能收紧regret界,但存储与求逆不可行。作者对其施加块对角(Block-diagonal) + Kronecker分解(K)的结构约束(即BK),把逐层协方差近似为左右两个小矩阵的Kronecker积,从而以可接受的开销逼近全矩阵预条件。Ada系列(AdaBK分别套在SGD与Adam上)把这一预条件以低成本的方式加入到已有优化器中,在图像分类等任务上加速收敛。
⚪ Muon:对动量做正交化
Muon(MomentUm Orthogonalized by Newton-Schulz)是针对矩阵参数$\theta \in \mathbb{R}^{m\times n}$的优化器。它的更新极其简洁:对Momentum的结果做正交化,再用于更新参数。
\[\begin{aligned} m_t &= \mu m_{t-1} + g_t \\ O_t &= \text{msgn}(m_t) = UV^\top, \quad \text{其中 } m_t = U\Sigma V^\top \\ \theta_t &= \theta_{t-1}-\gamma\, O_t \end{aligned}\]即把动量矩阵的(非零)奇异值全部置为$1$(保留$U,V$而$\Sigma \to I$)。这一操作的动机是:神经网络的动量矩阵在实践中往往接近低秩,少数几个大奇异值方向主导了更新,其余方向几乎得不到更新;正交化让所有方向获得同等大小的更新。
这一操作可以严格地解释为在谱范数意义下的最速下降。所谓在范数 $|\cdot|$ 下的(归一化)最速下降方向,是指在单位范数球内使一阶下降量最大的方向:
\[O_t = \mathop{\arg\min}_{\|O\|_2 \le 1} \langle m_t, O\rangle\]对动量做SVD $m_t = U\Sigma V^\top$($\Sigma=\operatorname{diag}(\sigma_i)$,$\sigma_i\ge 0$)。对任意满足 $|O|_2\le 1$ 的 $O$,利用迹的循环性有
\[\langle m_t, O\rangle = \operatorname{tr}(m_t^\top O) = \operatorname{tr}(\Sigma\, U^\top O V) = \sum_i \sigma_i\,(U^\top O V)_{ii}\]由于 $U,V$ 正交,$\lvert U^\top O V\rvert_2 = \lvert O\rvert_2 \le 1$,因此每个对角元满足 $\lvert (U^\top O V)_{ii}\rvert \le 1$,从而
\[\langle m_t, O\rangle \ge -\sum_i \sigma_i = -\|m_t\|_*\]其中 $|\cdot|_*$ 是核范数(谱范数的对偶范数)。等号在 $U^\top O V = -I$,即 $O = -UV^\top$ 时取得。因此谱范数下的最速下降方向恰好是 $-UV^\top = -\text{mSign}(m_t)$,正是Muon的更新方向。这也解释了为什么更新的RMS依赖矩阵形状、需要按 $\sqrt{\max(m,n)}$ 一类因子重新缩放:谱范数最速下降给出的单位是“谱范数为 $1$”,而非逐元素的RMS为 $1$。
关键的工程细节:精确SVD太慢,因此用五次Newton-Schulz迭代$X \leftarrow aX+b\,XX^\top X+c\left(XX^\top\right)^2X$在bfloat16下近似(系数经过调优,允许奇异值只收敛到$[0.7,1.3]$区间内,实践中足够)。Muon只用于二维隐藏层权重;标量与向量参数(偏置、归一化层的增益)、嵌入层与输出头仍然使用AdamW,因为这些参数的“矩阵结构”并不对应线性映射。
Muon的额外显存只有一组动量(与SGD-M相同,是AdamW的一半),却在同等FLOPs下显著优于AdamW;Muon is Scalable for LLM Training进一步验证了它在数十亿参数规模上的有效性(需要配合权重衰减与逐参数更新尺度调整)。
⚪ Newton-Muon:补上输入侧的二阶矩
Muon对动量做正交化,等价于只在输出侧做谱范数意义的预条件,而忽略了输入侧(激活)的二阶矩。Newton-Muon在Muon的矩阵符号函数$\text{msgn}(\cdot)$(由Newton-Schulz迭代实现)之外,额外右乘输入二阶矩矩阵$ZZ^\top$的逆:
\[W \leftarrow W-\eta\,\text{msgn}\left(G\,(ZZ^\top)^{-1}\right)\]其中$Z$是该层的输入激活。这相当于把Muon补成一个更完整的二次(牛顿型)近似,兼顾输入协方差带来的各向异性。
⚪ Pion:保持谱的正交等价变换
Adam、Muon等优化器都是对权重做加性更新,会不受控地改变权重矩阵的奇异值分布(谱)。Pion改为对权重施加正交等价变换$W \leftarrow U W V$($U,V$正交),由于正交变换不改变奇异值,更新过程严格保持权重矩阵的谱,只旋转其左右奇异向量。其动机是通过谱保持来获得更稳定的训练动态。
Pion的更新规则是:首先对两个单位因子 $I_{d_{out}}, I_{d_{in}}$ 应用链式法则,得到相应的梯度 $G_tW_t^\top, W_t^\top G_t$;然后强制斜对称性,将这些梯度投影到李代数上,从而由这两个单位因子生成李代数元素;最后通过矩阵指数将这些元素映射回李群,得到有效的正交变换。
\[\begin{aligned} G_t^{in} &= W_t^\top G_t - (W_t^\top G_t)^\top \\ G_t^{out} &= G_tW_t^\top - (G_tW_t^\top)^\top \\ W_{t+1} &= \exp(-\eta G_t^{out})W_t\exp(-\eta G_t^{in}) \end{aligned}\]⚪ DeltaMomentum:用Delta规则做各向异性动量
普通动量对所有方向一视同仁(各向同性)。DeltaMomentum(论文称AK-Momentum)借用联想记忆中的键-值(key-value)结构与Delta规则来更新动量,使其成为各向异性的:动量按激活(键)的方向被有选择地增强或抑制。其效果类似于Muon式的条件化预条件,但无需显式的矩阵求逆或正交化,因而更轻量。动量的更新规则如下:
\[\begin{aligned} M_t &= \beta M_{t-1} + \eta(\nabla_t-M_{t-1}x_t)x_t^\top \\ &= M_{t-1}(\beta I_n - \eta x_tx_t^\top) + \eta g_t \end{aligned}\]2.5 降低显存占用
Adam族需要为每个参数额外存储$m_t$与$v_t$,在混合精度训练中优化器状态(fp32的参数副本 + 两组动量)往往是显存的最大消耗项。本节的方法通过分解、共享或融合来压缩这部分开销。
⚪ Adafactor:对二阶矩做低秩分解
Adafactor通过四个改动把Adam的$O(mn)$状态降到$O(m+n)$。
(1) 移除动量。 在自然语言处理模型中自适应学习率比动量更重要,因此直接丢弃$m_t$,省掉一半状态:
\[\theta_t=\theta_{t-1}-\gamma \frac{g_t}{\sqrt{\hat{v}_t}+\epsilon}\](2) 低秩分解二阶矩。 把$v_t$看作$m \times n$的非负矩阵$C$,用秩$1$分解$a_ib_j \approx c_{i,j}$近似。求解时使用广义KL散度(I散度),它衡量两组非负变量的相似程度而不要求归一化为概率分布。由$x \log x \geq x-1$($x>0$)令$x=p/q$并两端乘$q$得$p \log \frac{p}{q} -p +q \geq 0$,因此目标为:
\[\ell = \sum_{i,j}\left( c_{i,j} \log \frac{c_{i,j}}{a_ib_j} -c_{i,j} + a_ib_j \right)\]令偏导数为零得$a_i \sum_{j}b_j = \sum_{j}c_{i,j}$与$b_j \sum_{i}a_i = \sum_{i}c_{i,j}$。注意到若$(a_i,b_j)$是一组解则$(\kappa a_i,b_j/\kappa)$也是,不妨令$\sum_j b_j =1$,得到:
\[a_i = \sum_{j}c_{i,j}, \quad b_j = \frac{\sum_{i}c_{i,j}}{\sum_{i,j}c_{i,j}}\]即分别按行求和与按列求和,相乘后再除以全体的和;形式上正是从联合分布恢复两个边缘分布。因此只需维护行向量$v^{(r)}$与列向量$v^{(c)}$。
(3) 时变的滑动权重。 把偏差修正合并进递推式得到等效衰减率\(\hat{\beta}_{2,t}=\beta_2\frac{1-\beta_2^{t-1}}{1-\beta_2^t}\)(推导同2.3节AdaX)。作者希望训练后期算法退化为SGD(\(\hat{\beta}_{2,t}\to 1\)),因此直接令
\[\hat{\beta}_{2,t} = 1-\frac{1}{t^c}\]当$c=1$时\(\hat{v}_t = \frac{1}{t} \sum_{i=1}^{t}g_i^2\),即所有历史梯度平方的算术平均;通常希望越久远的梯度权重越低,故取$c<1$(实验中$c=0.8$)。
(4) 更新量裁剪与参数尺度自适应。 借鉴LARS,把更新量的RMS归一化后乘以参数自身的RMS:
\[\begin{aligned} u_t&= \frac{g_t}{\sqrt{\hat{v}_t}} \\ \hat{u}_t &= u_t \cdot \frac{\max\left(\epsilon_2,\text{RMS}(\theta_{t-1})\right)}{\max\left(1,\text{RMS}(u_t)/d\right)} \\ \theta_t&=\theta_{t-1}-\gamma \hat{u}_t \end{aligned}\]其中分母只在$\text{RMS}(u_t)$超过阈值$d$时才生效(缺省$d=1$)。此时学习率$\gamma$的含义变成“相对更新比例”,因此Adafactor可以使用与模型规模无关的相对步长。
综合以上四点即为Adafactor:
\[\begin{aligned} \hat{\beta}_{2,t} &= 1-\frac{1}{t^c} \\ v_{i;t}^{(r)} &= \hat{\beta}_{2,t}v_{i;t-1}^{(r)} + \left(1-\hat{\beta}_{2,t}\right)\sum_{j} \left(g_{i,j;t}^2+\epsilon_1\right) \\ v_{j;t}^{(c)} &= \hat{\beta}_{2,t}v_{j;t-1}^{(c)} + \left(1-\hat{\beta}_{2,t}\right)\sum_{i} \left(g_{i,j;t}^2+\epsilon_1\right) \\ \hat{v}_{i,j;t} &= \frac{v_{i;t}^{(r)} v_{j;t}^{(c)} }{\sum_{j} v_{j;t}^{(c)} } \\ u_t &= \frac{g_t}{\sqrt{\hat{v}_t}}, \quad \hat{u}_t = u_t \frac{\max\left(\epsilon_2,\text{RMS}(\theta_{t-1})\right)}{\max\left(1,\text{RMS}(u_t)/d\right)} \\ \theta_t&=\theta_{t-1}-\gamma \hat{u}_t \end{aligned}\]关于Adafactor在大模型训练中的实际用法,有几点值得说明:T5采用了完整配置(无动量、因子化二阶矩、相对步长、更新量裁剪$d=1$),代价是相比AdamW有可观的精度损失;PaLM则采用了“Adafactor without factorization”,即保留$\beta_1=0.9$的动量和完整的$v_t$,只借用了参数尺度自适应与更新量裁剪,这实际上是“AdamW + 参数尺度化学习率”,说明Adafactor贡献最大的部分未必是低秩分解。如今在超大模型上,低秩分解带来的显存收益常常被ZeRO/张量并行等分布式切分手段以更无损的方式取代,但Adafactor的更新量裁剪与相对步长仍被广泛沿用。
⚪ SM3:用集合共享二阶矩
SM3从另一个角度压缩状态:不为每个参数存一个二阶矩,而是把$d$个参数索引划分到$k$个(可重叠的)非空集合\(\{S_r\}_{r=1}^k\)中,每个集合只存一个标量,因此状态从$O(d)$降到$O(k)$。
对每个集合$S_r$维护累积项$\mu_t(r)$,累积该集合内所有参数在本步的最大平方梯度;对每个参数取其所属集合中累积值的最小者作为分母:
\[\begin{aligned} \mu_{t}(r) &= \mu_{t-1}(r)+\mathop{\max}_{j \in S_r}g_t^2(j) \\ v_t(i) &= \mathop{\min}_{r:\, S_r\ni i} \mu_{t}(r) \\ \theta_{t}(i) &= \theta_{t-1}(i) - \gamma \frac{g_t(i)}{\sqrt{v_t(i)}}, \quad \forall i \in [d] \end{aligned}\]算法名来源于它计算的是平方梯度(squared-gradient)的最大值(maxima)的和(sums)的最小值(minima)的平方根(square-root)。取$\max$保证了$v_t(i)$始终是真实AdaGrad累积量的上界,因此有效学习率被压小而不是放大,这是它保留AdaGrad收敛保证的关键;取$\min$则尽可能收紧这个上界。当$k=d$、\(S_i=\{i\}\)时算法精确退化为AdaGrad。
对尺寸为$m \times n$的矩阵参数,按行和列划分共得到$m+n$个集合,显存从$O(mn)$降至$O(m+n)$,此时与Adafactor的因子化形式非常接近(区别是SM3用$\max/\min$而Adafactor用KL最优的乘积近似)。
⚪ Adam-mini:按参数块共享学习率
Adam-mini的出发点是Hessian的块结构:Transformer的Hessian近似呈块对角,同一块(例如一个注意力头、一个神经元的输入权重)内部的曲率相近,因此没必要为块内每个参数各存一个二阶矩。做法是把参数按这种结构切分成块,每块只维护一个标量二阶矩,取块内平方梯度的均值:
\[\begin{aligned} v_t^{(i)} &= \beta_2 v_{t-1}^{(i)} + (1-\beta_2)\,\text{mean}\left(g_t^{(i)}\odot g_t^{(i)}\right) \\ \theta_t^{(i)}&=\theta_{t-1}^{(i)}-\gamma \frac{\hat{m}_t^{(i)}}{\sqrt{\hat{v}_t^{(i)}}+\epsilon} \end{aligned}\]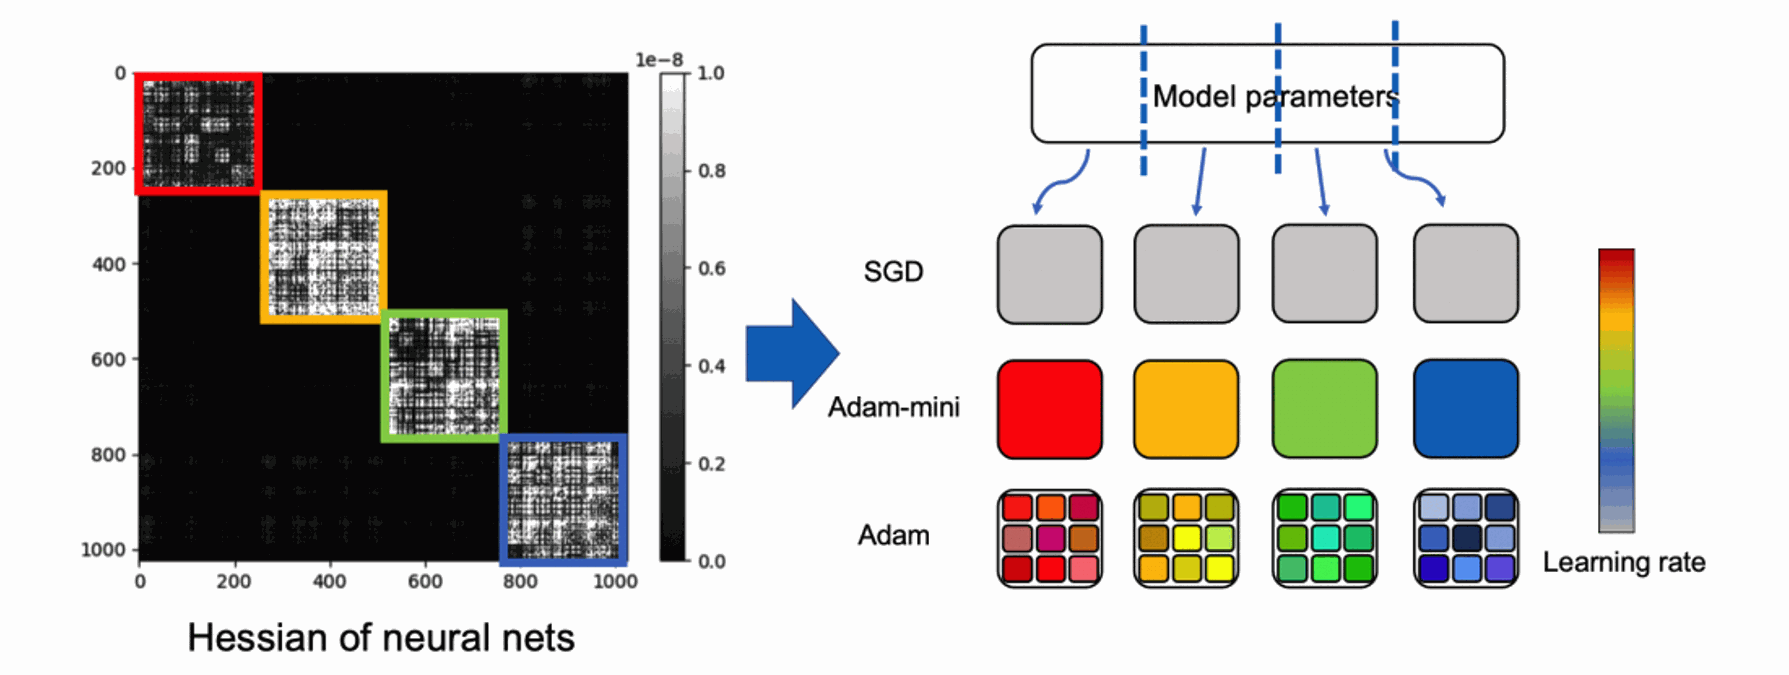
这可以省去$v_t$的$90\%$以上(整体优化器状态减少约$45\%\sim50\%$),同时在语言模型预训练中达到与AdamW相当甚至更好的效果。它与Adafactor、SM3的差别在于分块依据来自Hessian结构,因此块的划分需要一点模型特定的知识。
⚪ GaLore:在梯度的低秩子空间中优化
LoRA通过限制权重更新为低秩来省显存,但也限制了表达能力。GaLore观察到:训练中梯度矩阵本身逐渐变成低秩的,因此可以把梯度投影到低秩子空间、在子空间里运行Adam、再投影回全参数空间;权重更新仍然是满秩的:
\[\begin{aligned} &P_t = \text{SVD}_r\left(g_t\right) \in \Bbb{R}^{m\times r} \quad (\text{every } T \text{ steps}) \\ &\tilde{g}_t = P_t^\top g_t \in \Bbb{R}^{r\times n} \\ &\tilde{h}_t = \text{Adam}\left(\tilde{g}_t\right) \\ &\theta_t = \theta_{t-1}-\gamma\, P_t \tilde{h}_t \end{aligned}\]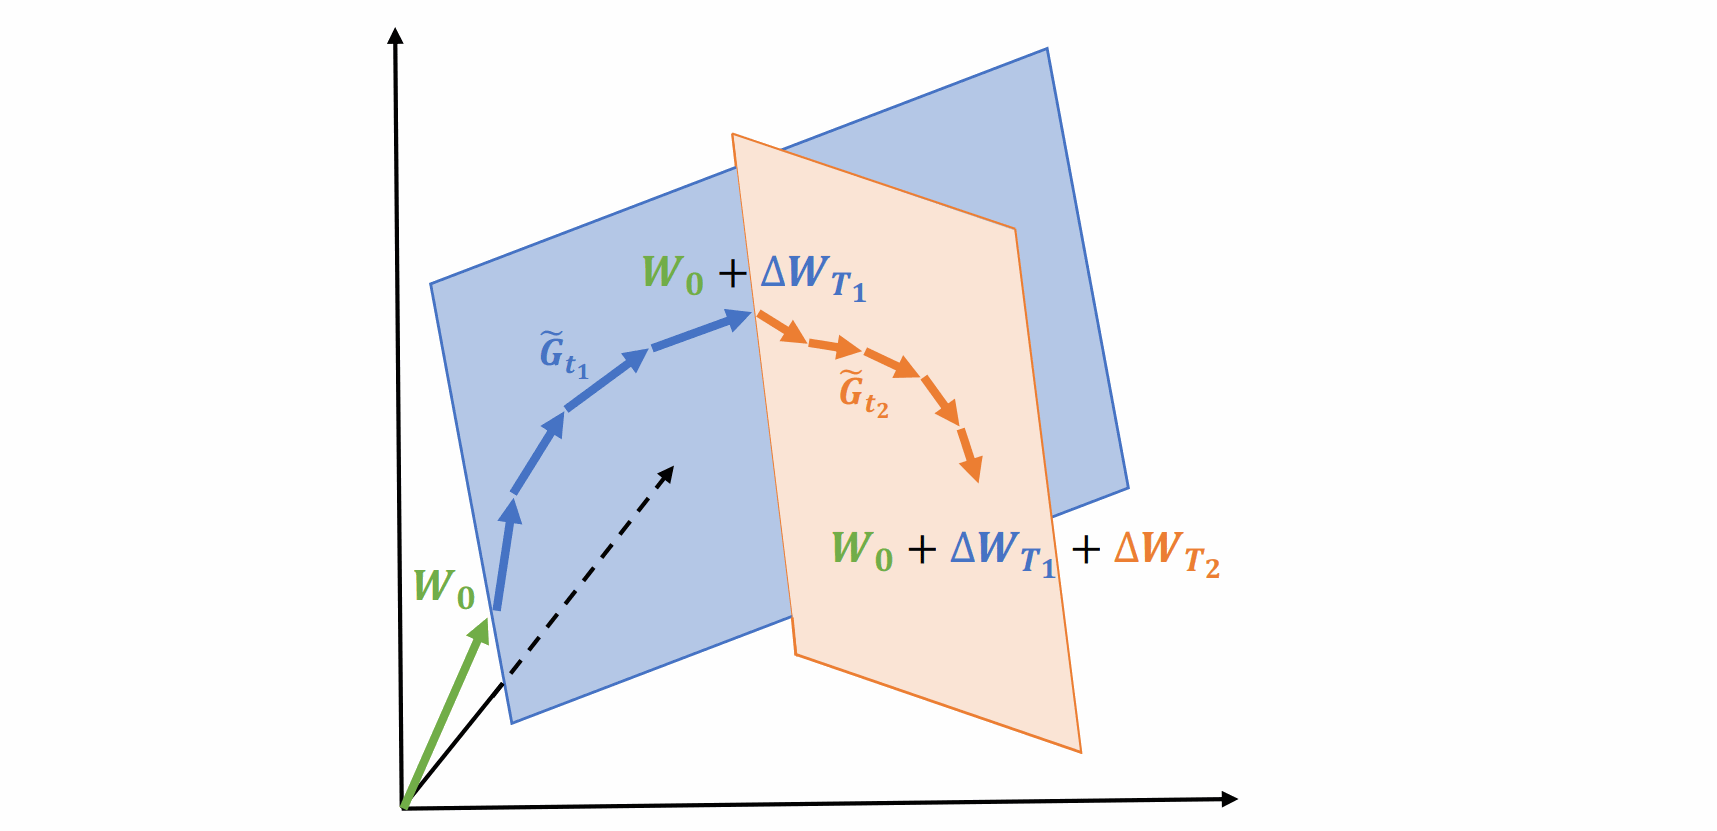
优化器状态从$O(mn)$降到$O(r(m+n))$($r\ll \min(m,n)$)。它使得在单张$24$GB消费级显卡上从零预训练$7$B级模型成为可能。代价是需要周期性地做SVD,以及子空间切换时刻的更新方向不连续。
⚪ LoMo 与 AdaLomo:把梯度计算与参数更新融合
- paper:Full Parameter Fine-tuning for Large Language Models with Limited Resources
- paper:AdaLomo: Low-memory Optimization with Adaptive Learning Rate
LoMo(LOw-Memory Optimization)从工程角度消除显存:注意到SGD的更新$\theta\leftarrow\theta-\gamma g$只需要该参数自己的梯度,因此可以在反向传播过程中,一旦某个参数的梯度算出就立即完成更新并释放该梯度(通过反向传播的钩子函数实现)。这样既不需要保存完整的梯度张量,也不需要任何优化器状态,把微调的显存降到接近推理的水平。
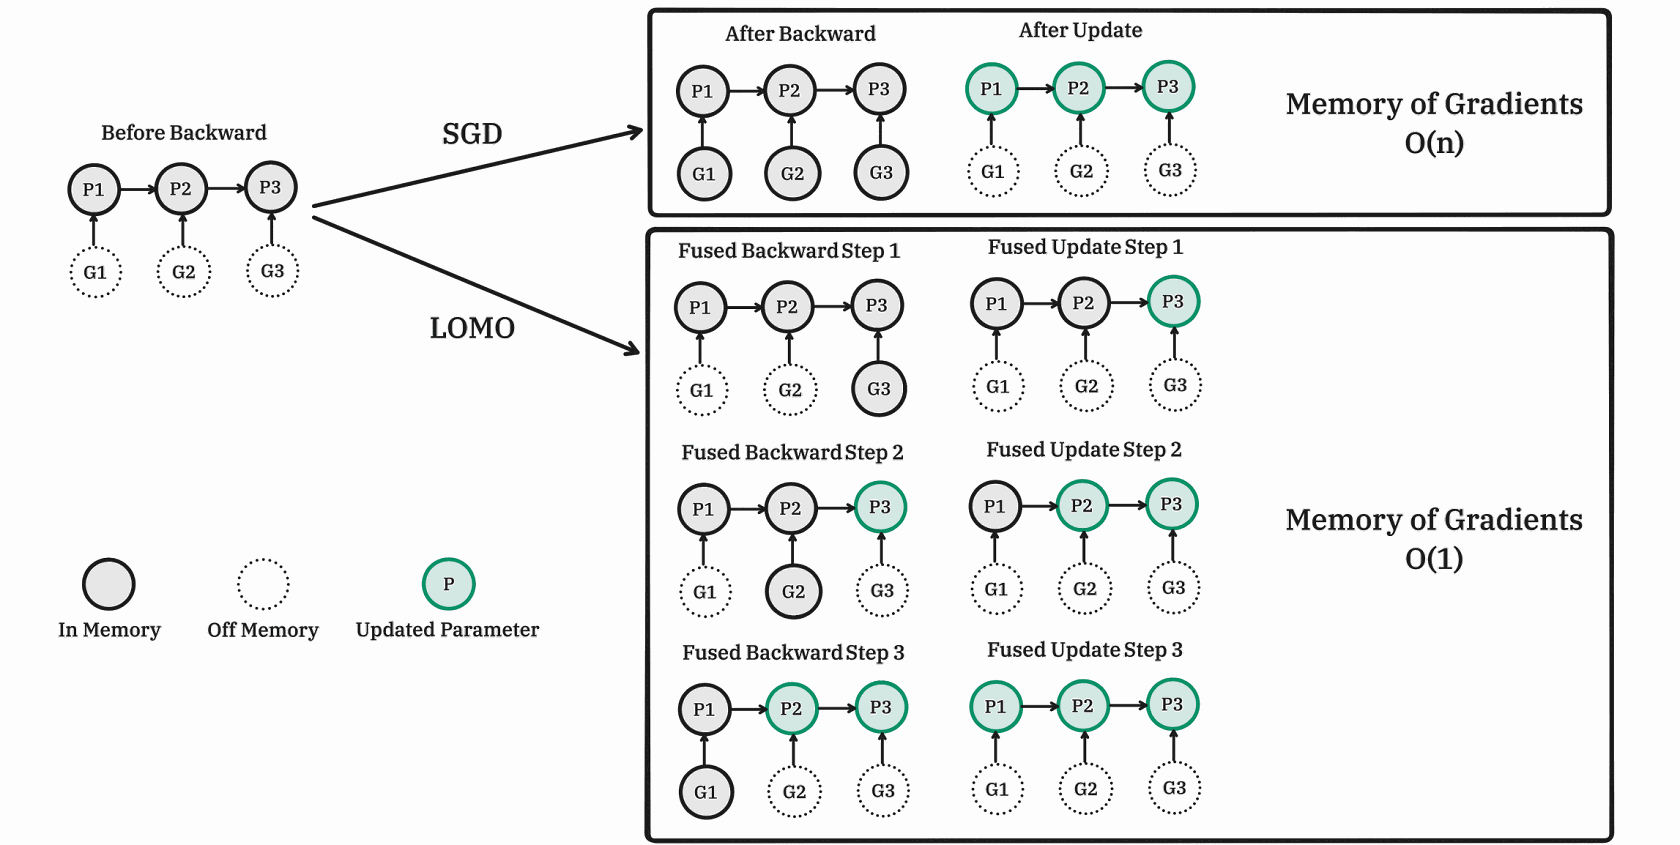
LoMo的问题是纯SGD在语言模型上表现不佳。AdaLomo在同样的融合更新框架内加入了Adafactor式的非负矩阵分解二阶矩($O(m+n)$状态)与分组的更新量裁剪,从而在保持极低显存的同时达到接近AdamW的微调效果。
2.6 层级自适应与大批量训练
在分布式训练中,整体批量随计算节点数线性增大。当总训练轮数不变时,批量增大意味着参数更新次数减少,同时较大的批量使网络倾向于收敛到尖锐极小值(见On Large-Batch Training for Deep Learning: Generalization Gap and Sharp Minima),因此模型精度会显著降低。3.3节的线性缩放律与warmup能部分缓解,但并不充分。本节方法的共同思路是:让每一层的更新幅度只取决于该层参数自身的尺度,而与梯度的绝对大小无关。
⚪ LARS:层级自适应学习率缩放
标准梯度下降对每一层使用相同的学习率。当学习率过大时,某些层的更新量$\gamma||g_t^{(i)}||$可能比参数本身$||\theta^{(i)}||$还大,从而导致不收敛;而作者发现每层参数与其梯度的范数之比$||\theta^{(i)}|| / ||g_t^{(i)}||$在不同层之间差异巨大(可达几个数量级)。如果全局学习率显著大于某层的这个比值,该层就会不稳定;显著小于则该层几乎不更新。
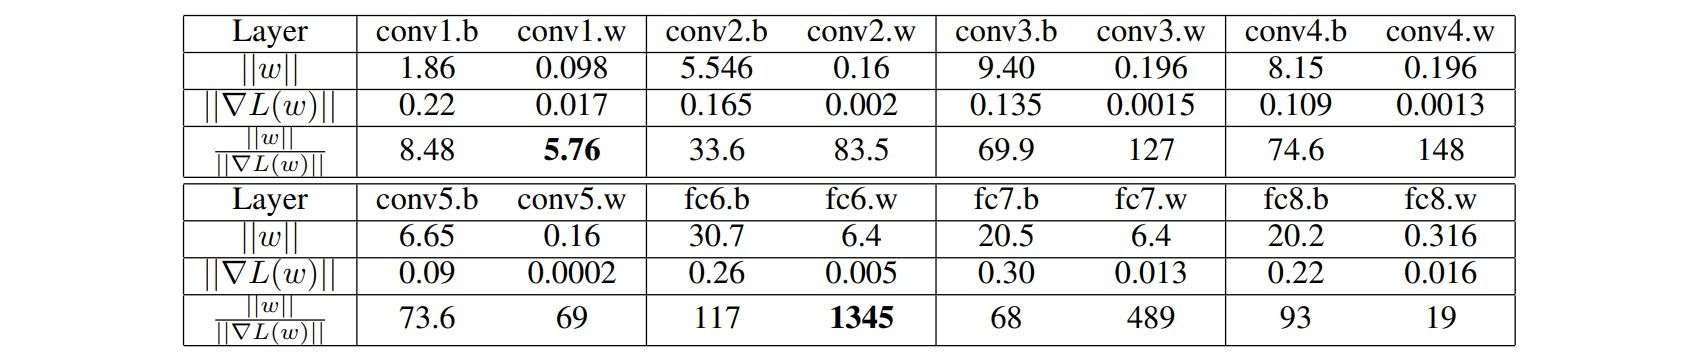
因此LARS为每一层引入局部学习率,等于该比值乘以一个信任系数$\eta$:
\[\begin{aligned} m_t &= \mu m_{t-1} + \left(g_t+\lambda \theta_{t-1}\right) \\ \theta_t^{(i)}&=\theta_{t-1}^{(i)}-\gamma \eta \frac{|| \theta_{t-1}^{(i)} ||}{|| m_t^{(i)} ||} m_t^{(i)}, \quad \forall i \in [L] \end{aligned}\]此时参数更新的幅值与梯度幅值完全无关,只由参数自身尺度与全局学习率决定;梯度只决定更新的方向。这使LARS天然免疫梯度爆炸/消失。作者用它把AlexNet的训练扩展到$8$k批量、ResNet-50扩展到$32$k批量而精度几乎不降。
⚪ LAMB:层级自适应 + Adam
LARS在训练BERT等自注意力模型时表现较差,说明“momentum + 层级自适应”的组合并不通用。LAMB把层级自适应与Adam结合,其自适应体现在两个层次:逐坐标的二阶矩归一化,以及逐层的更新量归一化:
\[\begin{aligned} m_t &= \beta_1 m_{t-1} + (1-\beta_1)g_t, \quad v_t = \beta_2 v_{t-1} + (1-\beta_2)g_t^2 \\ \hat{m}_t &= \frac{m_t}{1-\beta_1^t}, \quad \hat{v}_t = \frac{v_t}{1-\beta_2^t} \\ h_t &= \frac{\hat{m}_t}{\sqrt{\hat{v}_t}+\epsilon}+\lambda \theta_{t-1} \\ \theta_t^{(i)}&=\theta_{t-1}^{(i)}-\gamma \frac{\phi\left(|| \theta_{t-1}^{(i)} ||\right)}{|| h_t^{(i)} ||} h_t^{(i)}, \quad \forall i \in [L] \end{aligned}\]其中$\phi(\cdot)$是一个可选的缩放函数,实践中取$\phi(z)=z$或$\phi(z)=\min\left(\max(z,\gamma_l),\gamma_u\right)$(后者对参数范数做上下截断,避免范数极端的层获得离谱的步长)。作者用LAMB把BERT的批量增大到$32$k(TPU v3内存上限),在$76$分钟内完成预训练。
⚪ NovoGrad:层级二阶矩 + 梯度归一化
NovoGrad把Adam的二阶矩改成逐层的标量(每层只存一个数),并且在计算一阶动量之前就先用二阶矩归一化梯度,而不是在最后归一化更新步长(这是与LARS/LAMB最本质的区别):
\[\begin{aligned} v_t^{(i)} &= \beta_2 v_{t-1}^{(i)} + (1-\beta_2) ||g_t^{(i)}||^2 \\ m_t^{(i)} &= \beta_1 m_{t-1}^{(i)} + \left(\frac{g_t^{(i)}}{\sqrt{v_t^{(i)}}+\epsilon}+\lambda \theta_{t-1}^{(i)}\right) \\ \theta_t^{(i)}&=\theta_{t-1}^{(i)}-\gamma m_t^{(i)}, \quad \forall i \in [L] \end{aligned}\]初始化为$v_1^{(i)}=||g_1^{(i)}||^2$、$m_1^{(i)}=\frac{g_1^{(i)}}{\sqrt{v_1^{(i)}}}+\lambda \theta_1^{(i)}$以消除偏差。先归一化再累积动量的好处是:极端的梯度“异常值”在进入动量之前就被压缩了,因此不会污染后续多步的更新。NovoGrad的显存占用只有Adam的一半(二阶矩退化为$L$个标量),对学习率与初始化的选择也更鲁棒。
2.7 免调参与步长自适应
学习率是深度学习中最重要的超参数。本节的方法试图从优化过程本身推断出合适的步长,从而消除(或大幅减轻)对学习率与调度的调参需求。
⚪ 步长自适应:指数梯度更新
若把步长本身当作待优化参数,由于它必须非负,适合使用指数梯度更新(exponentiated gradient update, EGU):
\[\theta_{t} = \theta_{t-1} \odot \exp\left(-\gamma \nabla_{\theta}L(\theta_{t-1})\right)\]EGU等价于对指数变换后的变量做普通梯度更新:令$\theta = e^{\phi}$,则
\[\begin{aligned} \phi_{t} &= \phi_{t-1}-\gamma \nabla_{\phi}L\left(e^{\phi_{t-1}}\right) = \phi_{t-1}-\gamma e^{\phi_{t-1}} \nabla_{\theta}L\left(e^{\phi_{t-1}}\right) \\ &\Downarrow \\ e^{\phi_{t}} &= e^{\phi_{t-1}}\exp\left(-\gamma' \nabla_{\theta}L\left(e^{\phi_{t-1}}\right)\right) \end{aligned}\]现在引入一个与梯度同尺寸的非负步长增益$\nu$,逐点作用于梯度:$\theta_{t} = \theta_{t-1}-\gamma \nu_{t} \odot g_t$。对$\nu$使用EGU,由链式法则$\nabla_{\nu_{t-1}}L = \nabla_{\theta_{t-1}}L \odot \nabla_{\nu_{t-1}}\theta_{t-1} = -\gamma g_{t-1} \odot g_t$,得到:
\[\nu_{t} = \nu_{t-1} \odot \exp\left(\gamma_\nu\, g_{t-1} \odot g_t\right)\]若初始化$\nu_0=1$,则展开得$\nu_{t} = \exp\left(\gamma_\nu \sum_{k=1}^{t}g_{k-1}\odot g_k\right)$:如果某分量相邻两步的梯度经常同号,累加项为正、增益大于$1$,学习率被放大;反之被缩小。这正是RProp规则的连续、可微版本。
基于此,作者构造了带动量的漏斗型(funnelled) SGDM,同时维护逐坐标增益$p_t$与全局步长尺度$s_t$(两者都用EGU更新):
\[\begin{aligned} p_{t} &= p_{t-1} \odot \exp\left(\gamma_p\, m_{t-1} \odot g_t\right) \\ s_{t} &= s_{t-1} \cdot \exp\left(\gamma_s\, h_{t-1} \cdot g_t\right) \\ m_{t} &= \beta_1 m_{t-1}+(1-\beta_1)g_t \\ h_{t} &= \mu h_{t-1}+\gamma\left(p_{t}\odot g_t\right) \\ \theta_{t} &= \theta_{t-1}-s_{t} h_{t} \end{aligned}\]这类方法在非平稳环境(数据分布随时间漂移,如推荐系统)中价值最大:它能自动重新放大学习率以适应新的分布,而固定的衰减调度做不到这一点。
⚪ D-Adaptation:估计到最优解的距离
对于凸Lipschitz问题,最优的SGD步长是$\gamma^{*}=\frac{D}{G\sqrt{T}}$,其中$D=||\theta_0-\theta^{*}||$是初始点到最优解的距离,$G$是梯度范数上界。$G$容易在线估计,而$D$未知;这正是必须手工调学习率的根本原因。D-Adaptation的贡献是给出了一个只用已观测量就能算出的$D$的下界,并在训练中不断收紧它。
记$\lambda_t = \gamma_t d_t$为实际步长,$s_t = \sum_{i\le t}\lambda_i g_i$为累积的加权梯度(于是$\theta_t=\theta_0-s_t$)。由凸性$\sum_i \lambda_i\langle g_i, \theta_{i-1}-\theta^{*}\rangle \geq 0$,代入$\theta_{i-1}=\theta_0-s_{i-1}$得$\langle s_t, \theta_0-\theta^{*}\rangle \geq \sum_i \lambda_i\langle g_i, s_{i-1}\rangle$。另一方面展开$||s_t||^2$的递推可得$\sum_i \lambda_i\langle g_i, s_{i-1}\rangle = \frac{1}{2}\left(||s_t||^2 - \sum_i\lambda_i^2||g_i||^2\right)$。结合Cauchy-Schwarz不等式$D|s_t| \geq \langle s_t, \theta_0-\theta^{*}\rangle$,得到:
\[\begin{aligned} \hat{d}_{t+1} &= \frac{||s_t||^2-\sum_{i=1}^{t}\lambda_i^2||g_i||^2}{2||s_t||} \leq D \\ d_{t+1} &= \max\left(d_t, \hat{d}_{t+1}\right) \\ \theta_t &= \theta_{t-1}-\lambda_t g_t \end{aligned}\]即维护一个单调递增的下界$d_t$作为$D$的代用品。理论上该方法在凸情形下达到与已知最优步长相同的渐近速率,不含任何需要调节的学习率;实践中把它套在SGD与Adam上,在十余个深度学习任务上能匹配精调过的基线。
⚪ Prodigy:更快地逼近D
D-Adaptation的下界$\hat d_t$增长偏慢,导致训练初期步长过小、浪费预算。Prodigy保持整个框架不变,但修改$\hat d$的估计方式:分子直接累积$\lambda_i\langle g_i, \theta_0-\theta_{i-1}\rangle$(去掉那个使估计变保守的负项),分母改用$||s_t||_1$,并在$\lambda_i$的权重中额外乘入$d_i$。
论文证明这些改动使收敛速率相比D-Adaptation改善了$O\left(\sqrt{\log(D/d_0)}\right)$倍(其中$d_0$是$d$的初值),实践上使$d_t$逼近$D$的速度快出一个量级。Prodigy(配合AdamW基座)是目前“开箱即用、不调学习率”这一路线中最实用的选择,在扩散模型微调等社区场景中被广泛使用。
⚪ Schedule-Free:用平均代替调度
- paper:The Road Less Scheduled
学习率衰减调度的一个麻烦是它必须预先知道总训练步数$T$:一旦提前停止或延长训练,调度就失配了。Schedule-Free方法指出,衰减调度的作用可以由迭代平均来替代,从而完全去掉调度。它维护三个序列:
\[\begin{aligned} y_{t} &= (1-\beta)z_{t} + \beta x_{t} \\ z_{t+1} &= z_{t}-\gamma\nabla_{\theta} L(y_{t}) \\ x_{t+1} &= \left(1-c_{t+1}\right)x_{t}+c_{t+1}z_{t+1}, \quad c_{t+1}=\frac{\gamma_{t+1}^2}{\sum_{i\le t+1}\gamma_i^2} \end{aligned}\]其中$z$是基础的SGD(或AdamW)序列,$x$是$z$的加权平均、也是用于评测和部署的参数,而梯度在两者的插值点$y$上计算。恒定学习率时$c_{t+1}=1/(t+1)$,即$x$就是$z$的算术平均(Polyak-Ruppert平均)。
关键在于$\beta$(缺省$0.9$)的作用:$\beta=0$退化为纯SGD(快但终点噪声大),$\beta=1$退化为在平均点求梯度(稳但慢),插值取得了两者的折中。Schedule-Free在AlgoPerf竞赛的自调优赛道上取得第一,其实践意义是:可以在训练的任意时刻取出一个高质量的检查点,而不必等到调度走完。
⚪ ScheduleFree+:面向大语言模型的规模化
朴素的Schedule-Free在大语言模型的训练规模上会失效:在大批量下发散,且它与权重衰减的相互作用会引起梯度范数漂移、权重范数持续收缩,从而破坏长时训练的稳定性。ScheduleFree+保持“用平均代替调度”的核心不变,针对这些问题做了若干工程化修正,使这条免调参路线能扩展到十亿参数级别的LLM:
- 重新引入内层动量:朴素Schedule-Free去掉了动量,ScheduleFree+在基础序列$z$上恢复动量($\beta_1\approx 0.75$),以抑制大批量下的方差。
- 梯度范数倒数加权:把迭代平均的权重取为$\gamma_t \propto 1/||g_t||_1$,让梯度范数大的步少贡献于平均,缓解范数漂移。
- 退火平均系数:把Polyak平均中的$\beta$从约$0.9$逐步退火到约$0.965$,并取平均指数$r=1$。
- 完全解耦的权重衰减:采用AdamC式的解耦权重衰减,并配合异常大的衰减系数(约$5\sim 50$),专门修正权重范数收缩的问题。
论文报告:在约1000 tokens/参数的预算下,达到目标损失比当前最优的调度方案快约$31\%$;在120M–1B参数的LLM上,最终损失优于Warmup-Stable-Decay(WSD)与线性衰减,同时仍然保持免学习率、可做模型平均的特性。
2.8 不依赖反向传播的梯度估计
反向传播需要保存全部前向中间激活(空间复杂度高),而且严格串行。本节的方法尝试绕开它,其现实意义主要在超大模型微调、不可导目标(如离散决策、黑盒API)与硬件受限场景。
⚪ 前向梯度
自动微分(automatic differentiation, AD)有两种实现方式。对于$f:\Bbb{R}^{n} \to \Bbb{R}^{m}$,其导数是$n\times m$的Jacobian矩阵$J_f$:
- 前向模式:给定扰动向量$v \in \Bbb{R}^{n}$,在一次前向传播中同时得到$f(\theta)$与Jacobian矢量积$J_f(\theta)v$。每次只能得到关于一个方向的信息,需要$n$次才能拼出完整Jacobian。
- 反向模式:给定伴随向量$v \in \Bbb{R}^{m}$,先前向计算$f(\theta)$,再反向计算矢量Jacobian积$v^\top J_f(\theta)$。需要$m$次。
深度学习中损失是标量($m=1$)而参数维度$n$极大,因此反向模式(即反向传播)时间复杂度更低;代价是必须把前向的中间节点全部存到栈中,空间复杂度高。
前向梯度的思路是:只做一次前向模式微分,用随机方向的方向导数构造梯度的无偏估计。定义
\[g(\theta) = \left(\nabla_{\theta} L(\theta)\cdot v\right) v, \quad v \sim \mathcal{N}(0,I)\]即把标量的方向导数$\nabla_{\theta}L(\theta)\cdot v = \sum_{i}\frac{\partial L}{\partial \theta_i}v_i$按权重向量$v$“归还”给每个参数分量。
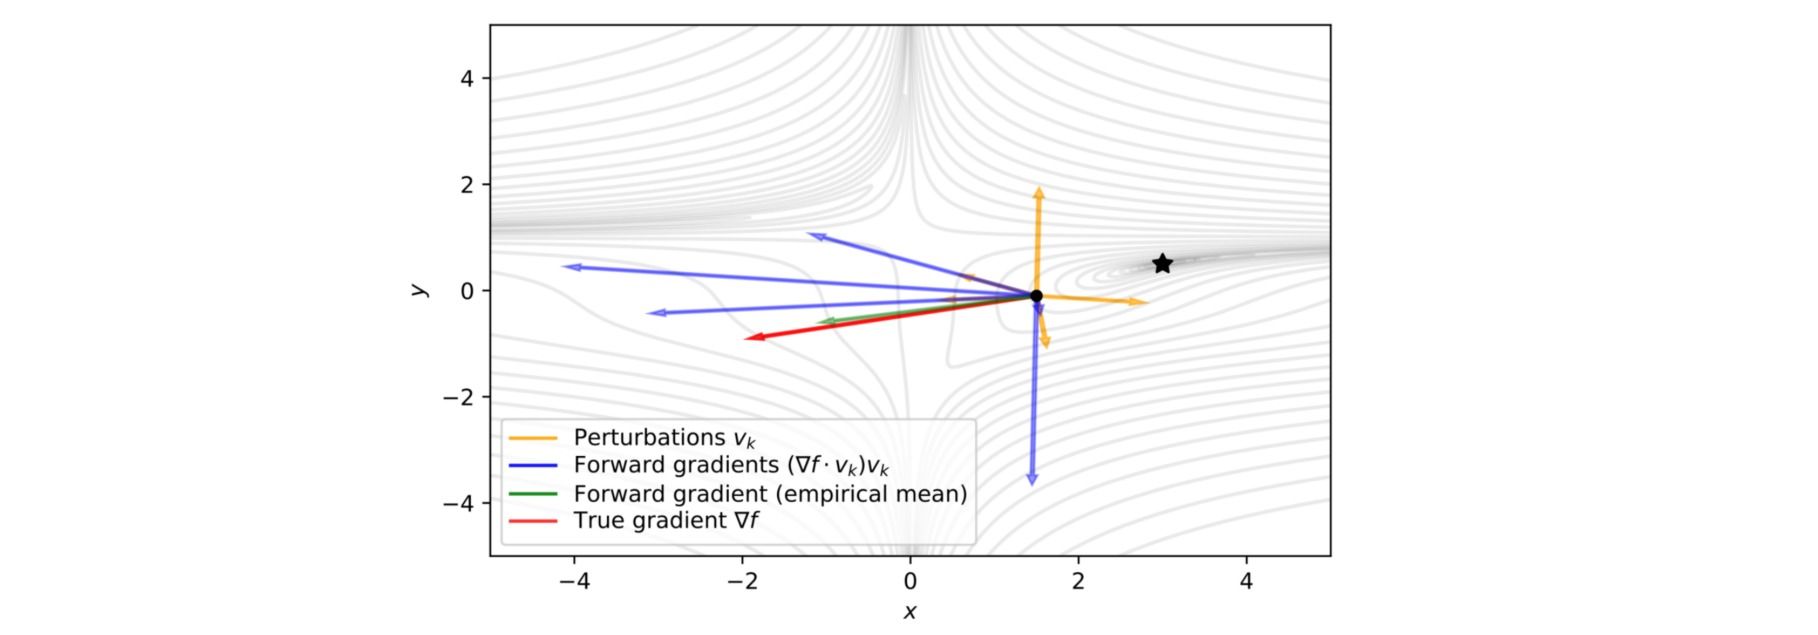
它是真实梯度的无偏估计。考察第$i$个分量$g_i(\theta) = \frac{\partial L}{\partial \theta_i}v_i^2 + \sum_{j\neq i}\frac{\partial L}{\partial \theta_j}v_iv_j$,由$v$的各分量独立且$\Bbb{E}[v]=0,\text{Var}[v]=1$,有$\Bbb{E}[v_i^2]=1$、$\Bbb{E}[v_iv_j]=0\ (i\neq j)$,因此:
\[\Bbb{E}[g_i(\theta)] = \frac{\partial L}{\partial \theta_i} \quad \Rightarrow \quad \Bbb{E}[g(\theta)] = \nabla_{\theta} L(\theta)\]用它替代反向传播的梯度即得前向梯度下降(forward gradient descent, FGD)。需要清醒认识到它的局限:无偏但方差随参数维度$n$线性增长,因此在真实规模的网络上单次前向梯度的信噪比极低。它在小模型上的加速(约$2$倍)无法直接外推,目前主要价值在于理论意义与“生物可实现性”的讨论。
⚪ 零阶优化
零阶(zeroth-order)优化又称无梯度(gradient-free)优化或土匪(bandit)优化,泛指不需要梯度信息、只需要函数值的优化方法。
基于差分的零阶优化通过采样估计梯度:
\[\tilde{\nabla}_{\theta}L(\theta) = \Bbb{E}_{u \sim p(u)}\left[\frac{L(\theta+\epsilon u)-L(\theta)}{\epsilon} u\right]\]其中$\epsilon$是小正数,$p(u)$具有零均值和单位协方差矩阵(通常取标准正态分布)。若$L$可导,由Taylor展开$L(\theta+\epsilon u) = L(\theta) + \epsilon u^\top\nabla_{\theta}L(\theta) + \mathcal{O}(\epsilon^2)$可验证该估计是无偏的:
\[\tilde{\nabla}_{\theta}L(\theta) = \Bbb{E}_{u}\left[u u^\top\nabla_{\theta}L(\theta)\right] = \nabla_{\theta}L(\theta)\]基于采样的零阶优化(无梯度下降)则完全是一种搜索:给定采样分布$\mathcal{D}$和初值$\theta_0$,在第$t$轮设置标量半径$r_t$,从以$\theta_{t-1}$为中心的分布$r_t\mathcal{D}$中采样候选$y_t$;若$L(y_t)<L(\theta_{t-1})$则接受$\theta_t=y_t$,否则$\theta_t=\theta_{t-1}$。采样分布通常固定为均匀分布,而半径$r_t$可以按二分搜索的方式在一组尺度间轮换;若目标函数的条件数有良好上界,还可以随迭代逐渐缩小半径以降低方差。
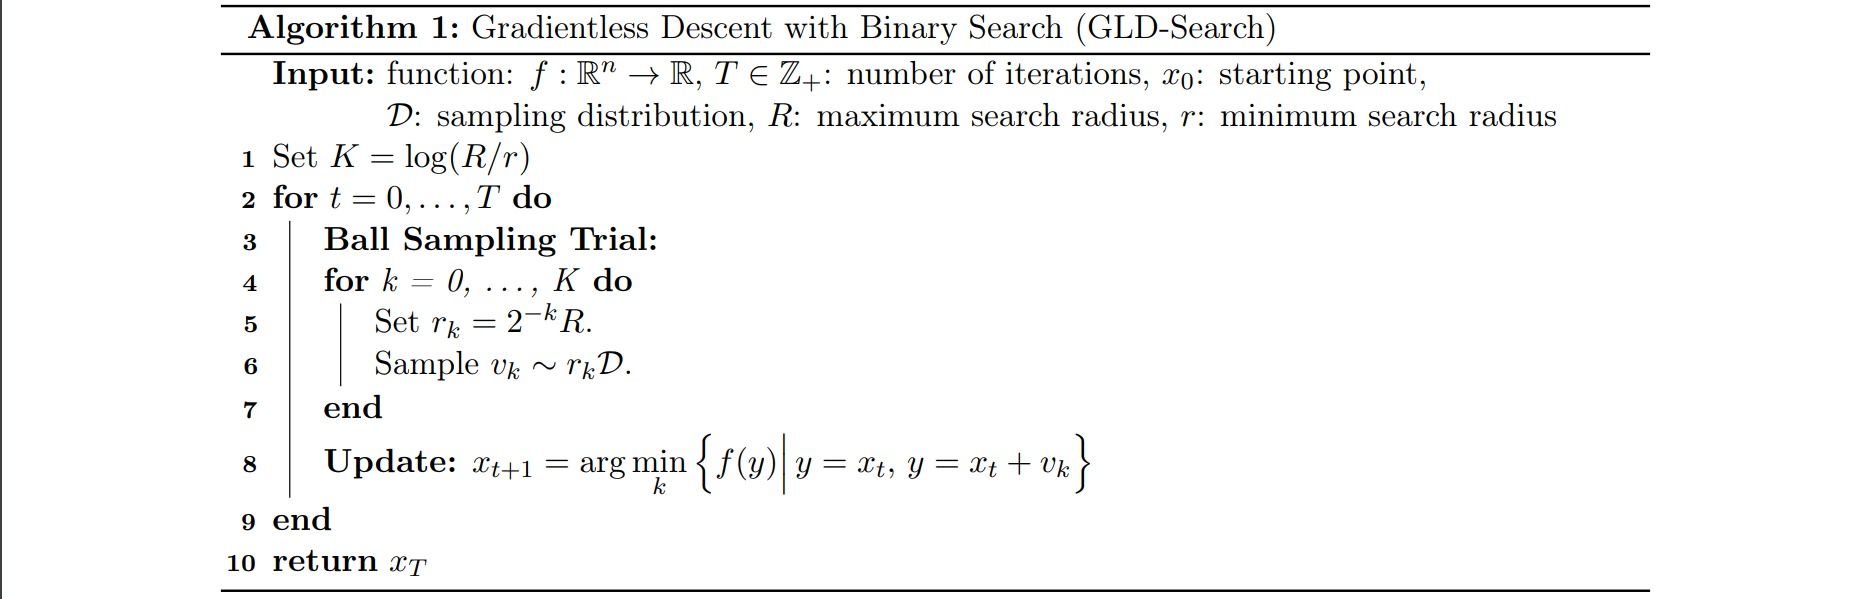
零阶方法的根本困难是方差随维度增长。但在两个场景下它非常有竞争力:一是超参数/结构搜索这类低维黑盒问题;二是MeZO: Fine-Tuning Language Models with Just Forward Passes所展示的大模型微调:通过复用随机数种子重新生成扰动$u$而不存储它,把零阶SGD的显存降到与推理相同,从而能在单卡上微调数百亿参数的模型。它之所以可行,是因为预训练模型的微调实际上发生在一个极低有效维度的子空间中。
3. 学习率与批量的调度策略
优化器决定了更新的方向与相对幅度,而学习率调度与批量策略决定了绝对幅度如何随时间变化。经验上,调度往往比优化器的选择更影响最终结果。
(1) 学习率调度
学习率$\gamma$决定了更新步长:过大会使更新不收敛甚至发散,过小会导致收敛缓慢并弱化隐式梯度正则化。常用的调度方案如下($T$为总步数,$T_w$为warmup步数):
\[\begin{aligned} \text{阶梯衰减} \quad & \gamma_t = \gamma_0 \cdot c^{\lfloor t/T_s \rfloor}, \quad c<1 \\ \text{指数衰减} \quad & \gamma_t = \gamma_0 \cdot c^{t} \\ \text{逆时衰减} \quad & \gamma_t = \frac{\gamma_0}{1+kt} \\ \text{线性warmup} \quad & \gamma_t = \gamma_0 \cdot \min\left(1, t/T_w\right) \\ \text{逆平方根} \quad & \gamma_t = \gamma_0 \cdot \min\left(t/T_w, \sqrt{T_w/t}\right) \\ \text{余弦退火} \quad & \gamma_t = \gamma_{\min}+\frac{1}{2}\left(\gamma_{\max}-\gamma_{\min}\right)\left(1+\cos\frac{\pi T_{\text{cur}}}{T_i}\right) \end{aligned}\]- 余弦退火:由SGDR: Stochastic Gradient Descent with Warm Restarts提出,$T_{\text{cur}}$是自上次重启以来的步数,$T_i$是第$i$个周期的长度。原论文强调热重启(周期性把学习率跳回$\gamma_{\max}$,$T_{i+1}=\eta T_i$);但在实践中更常用的是单周期余弦($T_i=T$),它是ResNet、ViT、Chinchilla等训练配方的默认选择。周期性重启的版本在与SWA结合时特别有用(4节)。
- 逆平方根:Transformer原论文的Noam调度,语言模型训练的经典选择。
- WSD(Warmup-Stable-Decay):由MiniCPM推广,先warmup、然后长期保持恒定学习率、最后在训练末尾$10\%\sim20\%$的步数内快速衰减到接近$0$。它的优势是恒定阶段的任意检查点都可以作为继续训练的起点(不需要预先确定$T$),因此对持续预训练与数据配比实验极为友好,已成为当前大模型预训练的主流调度。
⭐ 讨论:为什么需要warmup
warmup(训练开始时使用较小的学习率,再线性增大到目标值)几乎是所有大规模训练的标准配置。它为什么有效,目前有三种互补的解释:
- 自适应学习率的方差:如2.3节RAdam所分析,$v_t$在早期样本量不足,导致自适应学习率$1/\sqrt{\hat v_t}$的方差发散,个别参数会获得极大的更新。
- 曲率与稳定性:从1.3节的逼近视角看,稳定训练要求$\gamma < 2/\lambda_{\max}$($\lambda_{\max}$为Hessian最大特征值)。随机初始化点的$\lambda_{\max}$通常很大,直接使用目标学习率会立即发散;warmup让网络先用小步长走到锐度较小的区域,之后才能承受大学习率。Why Warmup the Learning Rate? Underlying Mechanisms and Improvements系统验证了这一机制,并指出warmup的真正作用是“把网络送到一个能容忍目标学习率的位置”,因此warmup的终点学习率比其形状重要得多。
- 线性缩放律的失效:如3.3节所述,线性缩放律的推导假设相邻若干步的梯度近似不变,而训练早期梯度变化极快,该假设不成立。因此大批量训练必须配合warmup。
实践建议:warmup步数通常取总步数的$1\%\sim5\%$,或按经验取一个固定值(如$2000$步);对Adam类优化器,$T_w$的下界与$\beta_2$有关(大致$T_w \gtrsim 2/(1-\beta_2)$)。
(2) 梯度裁剪
梯度裁剪是与优化器正交的一道安全阀,尤其在循环网络与语言模型中不可缺少。常见形式为:
\[\begin{aligned} \text{按值裁剪} \quad & g \leftarrow \text{clip}(g,-c,c) \\ \text{按范数裁剪} \quad & g \leftarrow g \cdot \min\left(1, \frac{c}{||g||}\right) \\ \text{自适应裁剪} \quad & g^{(i)} \leftarrow g^{(i)} \cdot \min\left(1, \kappa\frac{|| \theta^{(i)} ||_F}{|| g^{(i)} ||_F}\right) \end{aligned}\]按范数裁剪(PyTorch的clip_grad_norm_)保持梯度方向不变,只在整体范数超过阈值$c$时按比例缩小,是最常用的形式(大模型训练通常取$c=1.0$)。
裁剪不只是工程技巧,它有清晰的理论支撑。Why Gradient Clipping Accelerates Training指出,语言模型的损失并不满足经典的$L$-光滑假设,而满足更弱的relaxed smoothness:
\[||\nabla^2 L(\theta)|| \leq L_0 + L_1||\nabla L(\theta)||\]即曲率随梯度大小增长。在这一假设下,固定步长的梯度下降必须用最坏情况的曲率来选步长(因此极慢),而裁剪后的梯度下降可以达到显著更快的收敛速率;这解释了为什么裁剪不仅防止发散,还能加速训练。
自适应梯度裁剪(AGC)由High-Performance Large-Scale Image Recognition Without Normalization提出,它逐层按“梯度范数与参数范数之比”裁剪(与2.6节LARS的思想同源),是NFNet得以在无BatchNorm的情况下稳定训练大批量的关键。关于梯度裁剪与归一化层的关系可参考深度学习中的归一化方法。
(3) 批量大小与学习率的关系
⚪ 线性缩放律与分布式训练的细节
学习率的线性缩放规则(linear scaling rule)是指:当批量大小增大$k$倍时,学习率也增大$k$倍,并保持其它超参数不变。
其推导如下。对于通常的梯度更新,经过$k$步后参数为:
\[\theta_{t+k} = \theta_t - \gamma \frac{1}{B}\sum_{j<k}\sum_{x \in \mathcal{B}_j} \nabla l(x;\theta_{t+j})\]如果把这$k$个批量合并为一个大批量$\cup_j\mathcal{B}_j$做单次更新:
\[\hat{\theta}_{t+1} = \theta_t - \hat{\gamma} \frac{1}{kB}\sum_{j<k}\sum_{x \in \mathcal{B}_j} \nabla l(x;\theta_t)\]若假设$\nabla l(x;\theta_{t+j})\approx\nabla l(x;\theta_t)$(即$k$步内参数变化不大、梯度近似不变),则两者等价的条件为$\hat{\gamma}=k\gamma$。这个假设在训练初期梯度剧烈变化时不成立,因此必须配合warmup(原论文使用gradual warmup:从$\gamma$线性增大到$k\gamma$,历时$5$个epoch);批量也不能无限扩大,超过某个规模后精度会迅速下降。
在实现分布式训练时,有几个容易出错的细节:
- 权重衰减:梯度更新中权重衰减项$\gamma\lambda\theta_t$与批量无关。由于对学习率的缩放等价于对损失的缩放,而权重衰减项不参与批量平均,因此“缩放学习率”与“缩放损失函数”在使用权重衰减时不再等价,必须分别处理。
- 梯度聚合:$k$个设备的梯度必须求平均而非求和。一个简洁的做法是把$1/k$放进每个设备的损失里(即用$\frac{1}{kB}$而不是$\frac{1}{B}$做归一化),这样只需对分布式梯度求和。
- 数据打乱:每个epoch都应对整个数据集重新打乱,再划分给$k$个设备,而不是让每个设备固定持有一个数据分片。
- 动量修正:动量有两种等价写法,$h_t = \mu h_{t-1}+ g_t;\ \theta_t = \theta_{t-1} - \gamma_t h_t$(动量与学习率无关)与$v_t = \mu v_{t-1}+ \gamma_t g_t;\ \theta_t = \theta_{t-1} - v_t$(学习率被吸收进动量)。当学习率随时间变化时,后者必须引入动量修正因子$\gamma_{t}/\gamma_{t-1}$:
当$\gamma_{t} \gg \gamma_{t-1}$(例如warmup阶段)时这一修正很重要,否则会导致训练不稳定。
⚪ 增大批量代替衰减学习率
既然学习率与批量大小之间存在线性关系,那么衰减学习率与增大批量应当是等效的。作者从随机梯度的噪声尺度出发论证了这一点。
在强凸问题的优化中,学习率应满足$\sum_i\gamma_i = \infty$(保证无论初始化在哪里都能到达最小值)与$\sum_i\gamma_i^2 < \infty$(保证衰减足够快、收敛到最小值而不是在附近震荡)。把参数演化建模为随机微分方程
\[\frac{d\theta}{dt} = -\nabla_{\theta}L(\theta) + \xi(t)\]其中$\xi(t)$是由小批量估计全量梯度造成的高斯噪声,则噪声尺度为:
\[\sigma_{\text{noise}} = \gamma\left(\frac{N}{B}-1\right)\]引入动量后为$\sigma_{\text{noise}} = \frac{\gamma}{1-\mu}\left(\frac{N}{B}-1\right)$。
从上式可以看出:衰减学习率$\gamma$与增大批量$B$对噪声尺度的影响是等价的,都使噪声减小、从而收敛到极小值。因此在训练期间可以固定学习率、逐渐增大批量,直到$B \approx N/10$后再改用学习率衰减(因为$B$接近$N$时$N/B-1$不再随$B$线性变化)。这两种策略在相同的训练轮数下取得几乎完全相同的学习曲线与测试精度,但增大批量所需的参数更新次数更少、并行度更好,因此墙上时间显著缩短。同理也可以协调地调整动量系数$\mu$与批量$B$,不过实验发现这会轻微降低精度。
⭐ 讨论:批量大小到底该怎么选
综合本节的几项工作,可以给出一个相对完整的图景:
- 存在一个临界批量$B_{\text{crit}}$:小于它时,增大批量几乎线性地减少所需的更新步数(完美的数据并行);大于它时收益迅速饱和,只是在浪费算力。$B_{\text{crit}}$由梯度噪声尺度决定,与模型规模、任务难度和训练阶段相关(训练后期梯度噪声更大,$B_{\text{crit}}$更大),详见An Empirical Model of Large-Batch Training。
- 线性缩放律$\gamma \propto B$在$B<B_{\text{crit}}$的范围内是可靠的,但需要配合warmup,且在$B$很大时会失效(此时最优学习率不再随$B$增长,反而需要回调);对Adam族这类自适应方法,由于更新量已被$\sqrt{v_t}$归一化,经验上$\gamma \propto \sqrt{B}$比线性缩放更稳。
- 学习率衰减与增大批量在“降低梯度噪声尺度”这一点上是等价的,因此二者只需选其一为主:受显存与并行度限制时用学习率衰减,追求墙上时间时用增大批量(或梯度累积的反向操作:减少累积步数)。
- 实践建议:先用能吃满显存的批量作为起点,按线性/平方根缩放律外推学习率并加$5\%\sim10\%$步数的warmup;如果增大批量后精度掉了,优先怀疑学习率没有相应放大、warmup太短、或权重衰减/正则强度没有随更新次数减少而调整。
4. 与优化器正交的训练技巧
本节讨论的技巧都不修改优化器内部的更新规则,因此可以叠加在任意优化器之上:对优化轨迹上的权重取平均(SWA、EMA)、在快慢两组权重之间插值(Lookahead),以及在数据流水线层面提升优化的吞吐(Data Echoing)。
(1) 权重平均
⚪ SWA:随机权重平均
由第$1$章的概率角度可知,以恒定(或周期性)学习率运行SGD近似于在以极小值为中心的高斯分布中采样。而高维高斯分布的概率质量几乎全部集中在球面附近,因此单次采样得到的权重总是落在球面上;对多次采样取平均,才能得到球体内部的解。
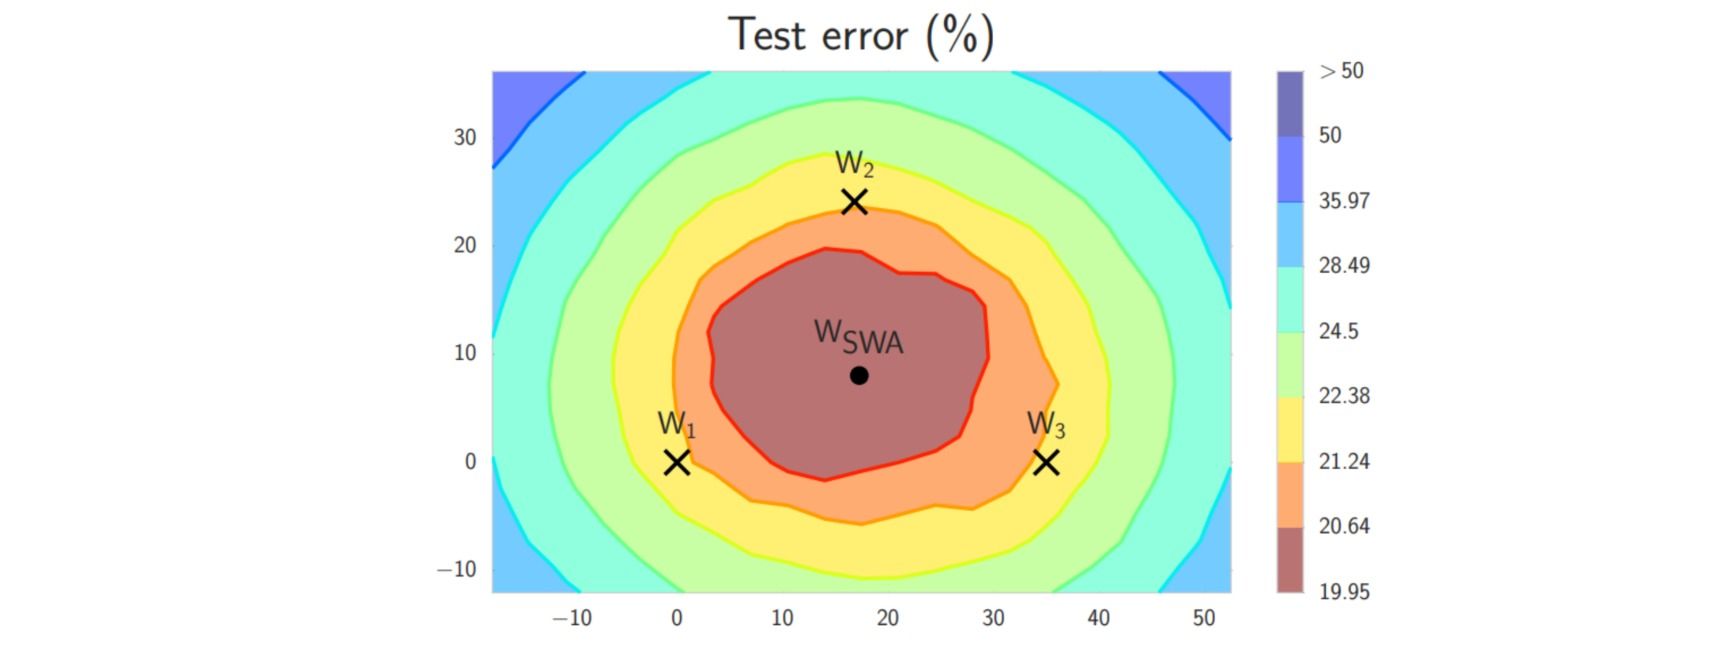
随机权重平均(stochastic weight averaging, SWA)据此在训练后期采用周期为$c$的循环学习率(每个周期内学习率从$\gamma_1$线性下降到$\gamma_2$):
\[\begin{aligned} t(i)&=\frac{1}{c}\left(\text{mod}(i-1,c)+1\right) \\ \gamma(i)&=\left(1-t(i)\right)\gamma_1+t(i)\gamma_2 \end{aligned}\]每完成一个周期(即$\text{mod}(i,c)=0$;使用恒定学习率时取$c=1$)就把当前权重$\theta_i$累积进平均权重,其中$n=i/c$为已累积的模型数:
\[\theta_{\text{SWA}} \leftarrow \frac{n \cdot \theta_{\text{SWA}}+\theta_i}{n+1}\]需要注意:$\theta_{\text{SWA}}$在训练过程中不参与前向传播,因此不会累积BatchNorm所需的滑动统计量。如果网络含有BatchNorm,训练结束后必须用$\theta_{\text{SWA}}$在训练数据上额外跑一遍前向传播,重新估计每一层的均值与方差。
作者分别以$\theta_{\text{SWA}}$和$\theta_{\text{SGD}}$为中心沿不同方向采样参数点,发现随着采样距离增大,SWA的训练损失与测试误差都上升得更慢,即它收敛到了更宽的平坦极小值,也直接解释了SWA为何几乎零成本地提升泛化性。
PyTorch在torch.optim.swa_utils中提供了实现:
点击展开代码
from torch.optim.swa_utils import AveragedModel, SWALR, update_bn

swa_model = AveragedModel(model)                    # 维护平均权重的副本
swa_scheduler = SWALR(optimizer, swa_lr=0.05)       # 后期切换到恒定/循环学习率

for epoch in range(epochs):
    for x, y in loader:
        optimizer.zero_grad()
        loss_fn(model(x), y).backward()
        optimizer.step()
    if epoch > swa_start:
        swa_model.update_parameters(model)          # 累积平均权重
        swa_scheduler.step()
    else:
        scheduler.step()

update_bn(loader, swa_model)                        # 重新估计BatchNorm统计量
⚪ EMA:权重的指数滑动平均
更常用的变体是对权重直接做指数滑动平均(即经典的Polyak-Ruppert averaging):
\[\theta_{\text{EMA}} \leftarrow \beta\theta_{\text{EMA}}+(1-\beta)\theta_t\]其中$\beta$通常取$0.999 \sim 0.9999$。它与SWA的差别在于:SWA给窗口内所有采样点相同的权重,通常只在训练后期开启并需要配合较大的恒定/循环学习率;EMA给近期权重更高的权重,可以全程开启且不要求特定的学习率调度。EMA权重是扩散模型、半监督学习(Mean Teacher)以及大模型训练中的标准配置,同样需要在评估前同步BatchNorm统计量。
(2) 快慢权重插值
⚪ Lookahead:快权重前进k步,慢权重后退1步
Lookahead与“自适应学习率”、“动量”这两类改进是正交的,可以套在任意优化算法$A$的外面。它维护两组权重:慢权重(slow weight) $\phi$与快权重(fast weight) $\theta$。第$t$轮先把快权重初始化为上一轮的慢权重$\theta_{t,0}=\phi_{t-1}$,用$A$更新$k$次;随后慢权重朝最终快权重的方向做一次线性插值:
\[\begin{aligned} \theta_{t,i} &= \theta_{t,i-1}+A\left(L,\theta_{t,i-1},\mathcal{B}\right),\quad i=1,\cdots,k \\ \phi_{t} &= \phi_{t-1}+\alpha\left(\theta_{t,k}-\phi_{t-1}\right) \end{aligned}\]展开慢权重的递推式,可以看出它其实是每$k$步快权重的指数滑动平均:
\[\begin{aligned} \phi_{t} &= (1-\alpha)\phi_{t-1}+\alpha\theta_{t,k} \\ &= (1-\alpha)\left[(1-\alpha)\phi_{t-2}+\alpha\theta_{t-1,k}\right]+\alpha\theta_{t,k} \\ &= (1-\alpha)^t\phi_0+\sum_{i=1}^{t}\alpha(1-\alpha)^{t-i}\theta_{i,k} \end{aligned}\]因此Lookahead与EMA的关键区别是:它不仅平均权重,还把平均结果写回优化轨迹,让后续探索从平滑后的点重新出发。当快权重沿低曲率方向来回振荡时,慢权重的插值把振荡“剪掉”,从而在保留探索能力的同时降低了优化器的方差。下图是在CIFAR-100上优化ResNet-32时两组权重的轨迹:快权重在极小值附近探索,慢权重的一次更新把参数推向测试精度更高的区域。
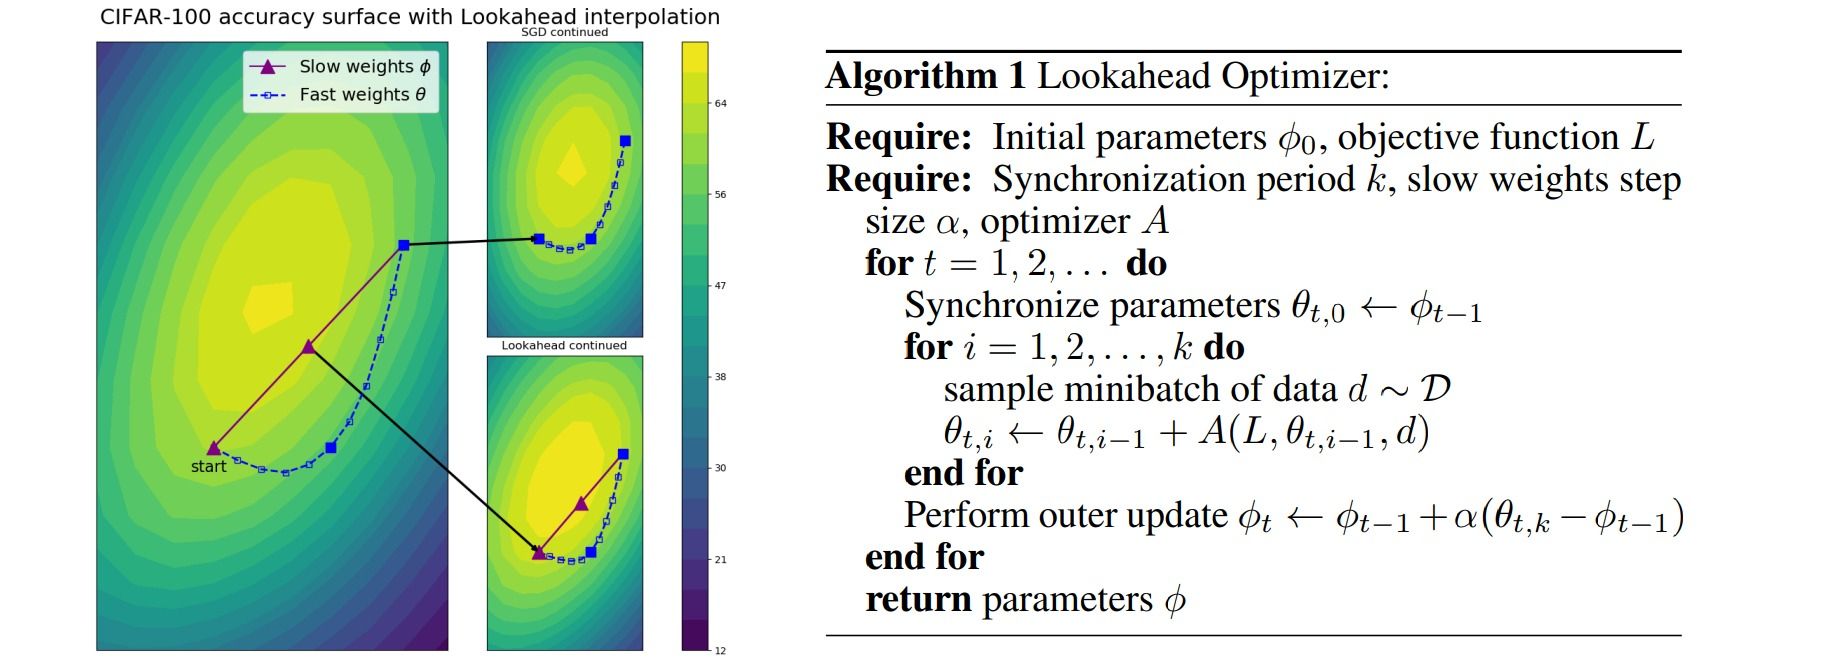
相比直接用$A$更新$k$次,额外开销只有$O(\frac{k+1}{k})$倍的运算量与一份参数的显存。两个超参数(快权重步数$k$与慢权重步长$\alpha$)都相当鲁棒,实践中直接取$k=5,\alpha=0.5$即可。
(3) 数据流水线加速
⚪ Data Echoing:重复利用已预处理的数据
前面讨论的都是“拿到一个批量之后如何更新参数”,但真实训练中每一步的墙上时间往往并不由参数更新决定。典型的训练流水线是:读取数据并张量化$\to$打乱$\to$数据增强$\to$取出一个批量$\to$梯度更新。其中前几步(upstream)在CPU上执行,最后一步(downstream)在GPU/TPU上执行;随着加速器越来越快,预处理反而成为瓶颈,加速器有相当比例的时间在空转。
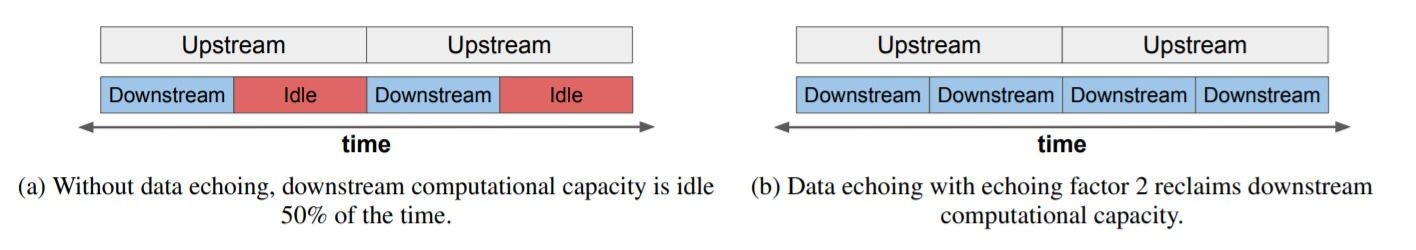
Data Echoing在流水线的瓶颈处插入一个buffer:upstream把预处理好的数据放进buffer,downstream反复从buffer中采样批量做参数更新,直到upstream准备好新数据再刷新buffer。每份数据被重复使用的次数称为echoing factor $e$。几个实践要点:
- 插入位置要选在瓶颈处。越靠前插入(如在数据增强之前做example echoing),重复样本经过后续随机增强后差异越大、越接近独立同分布,达到目标精度所需的等效样本数越少,但节省的upstream计算也越少;越靠后插入(batch echoing)则相反。
- 从buffer采样前一定要打乱。打乱能显著降低同一批次内重复样本的相关性,所需样本量明显下降。
- $e$不宜过大,且大批量更友好。$e=2$理论上只需一半的新样本,但重复使用破坏了独立同分布假设,实际需要的样本数总是多于理论值;批量越大,重复样本落进同一批次的概率越低,Data Echoing的收益也越明显。
这类工作提醒我们:优化的“每步代价”不只是梯度计算,端到端的训练速度必须把数据流水线一起纳入考虑。