Genome Foundation Model part IV: Decoder Architectures.
基因组基础模型(Genome Foundation Model, gFM),又称基因组语言模型(Genomic Language Model, gLM),将 DNA 序列映射为长度为 $T$ 的离散词元序列 $z_{1:T}$,通过在大规模无标注基因组语料上拟合边缘概率或条件概率分布 $p_\theta(z)$,学习具备跨任务迁移能力的通用基因组表征。
本文是基因组基础模型系列的第四篇。全系列按“分词 → 预训练 → 编码器 → 解码器 → 多模态”的脉络组织:
- I. DNA 分词策略:如何将碱基序列切分为词元。
- II. 预训练策略:如何构造自监督信号从无标注基因组中学习。
- III. 编码器框架:模型如何在长序列上混合上下文信息。
- IV. 解码器框架:模型如何评估序列似然并生成新序列。
- V. 多模态模型:如何联合建模基因组序列、其他生物分子与人类自然语言。
解码器框架(Decoder Architecture)通常以自回归方式将序列联合概率分解为条件概率乘积 $p_\theta(x) = \prod_{t=1}^T p_\theta(x_t \mid x_{<t})$。与仅能计算局部伪似然的掩码编码器不同,解码器不仅能直接评估任意完整序列或复杂插入缺失突变(Indel)的对数似然差 $\log p_\theta(x^{\mathrm{alt}}) - \log p_\theta(x^{\mathrm{ref}})$,还具备从头(de novo)生成调控元件与人工基因组、或基于上下文提示补全序列的能力;其深层隐状态同样可通过线性探针或微调迁移至判别式任务。
- 1. Transformer 解码器框架(Transformer Decoders)
- megaDNA:三级多尺度因果 Transformer 的噬菌体语言模型
- GENERator:功能基因座长上下文预训练的真核生成式模型
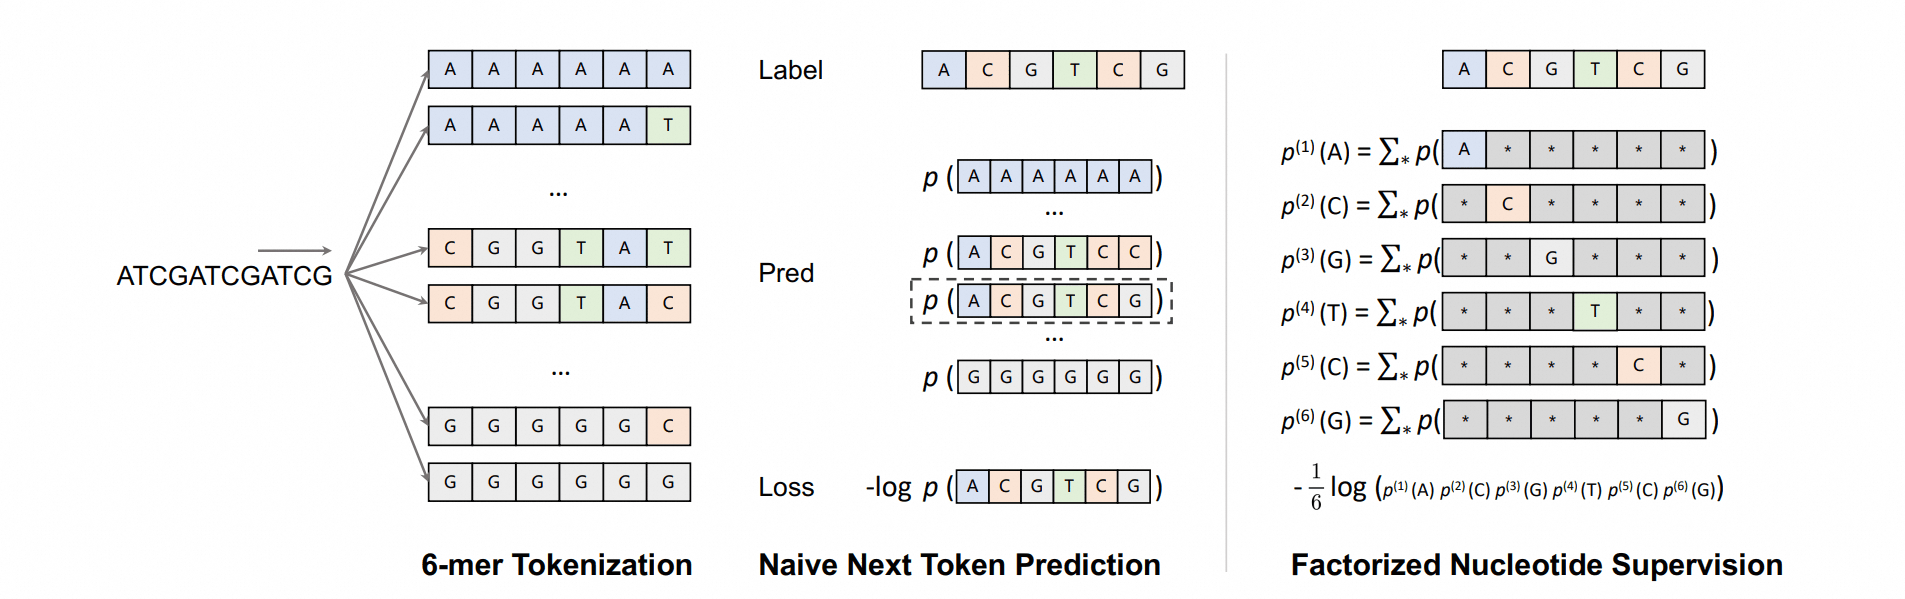
- GENERator-v2:分解式单核苷酸监督与基因组压缩预训练
- OmniReg-GPT:局部滑窗-全局混合注意力与多尺度顺式调控解码器
- Genos:基于泛基因组与稀疏混合专家的百万碱基级模型
- Gene42:基于渐进式持续预训练与稠密注意力的长程模型
- AntigenLM:全基因组八节段保序预训练的流感演化预测模型
- DeepD:系统发育感知稀疏混合专家与上下文-锚点-主体染色体级生成模型
- Carbon:高信噪比注释语料与 CE-FNS 阶段切换的高效长上下文解码器
- 2. 隐式长卷积与混合框架(Convolutional & Hybrid Decoders)
- 3. 状态空间混合框架(State-Space Hybrid Decoders)
- 4. 其他框架(Other Architectures)
1. Transformer 解码器框架(Transformer Decoders)
自回归 Transformer 解码器通过下三角因果注意力掩码 \(M \in \{0, -\infty\}^{T \times T}\)(当 $j > i$ 时 $M_{ij} = -\infty$)严格阻断未来信息回流,使位置 $i$ 的隐状态仅聚合前缀上下文 $x_{\le i}$:
\[\mathrm{CausalAttn}(Q, K, V) = \mathrm{Softmax}\!\left(\frac{QK^\top}{\sqrt{d_k}} + M\right)V.\]在基因组建模中,直接套用标准自回归 Transformer 面临三项核心矛盾:(1)单碱基分辨率下,全基因组或长基因座序列极易触发二次方复杂度与键值缓存(KV Cache)显存瓶颈;(2)真核基因组中大段低复杂度非编码背景序列会主导自回归交叉熵损失,稀释编码区与顺式调控元件的梯度信号;(3)若采用 $k$-mer 分词压缩序列长度,扁平的 $4^k$ 词表分类损失会忽略近邻词元间的碱基重叠相似性,且难以直接导出单核苷酸分辨率的突变似然。
针对上述问题,基因组 Transformer 解码器发展出多尺度层次化注意力(MegaByte 架构)、分组查询注意力(GQA)配合稀疏混合专家(MoE)、基因中心语料压缩拼接,以及将 $k$-mer 预测分布边缘化投影回单碱基空间的分解式监督机制。
⚪ megaDNA:三级多尺度因果 Transformer 的噬菌体语言模型
- paper:A long-context language model for deciphering and generating bacteriophage genomes(Nature Communications 2024)
megaDNA 采用三级多尺度因果 Transformer 架构,在无注释完整噬菌体基因组上进行自回归预训练,实现高达 $96\text{ kbp}$ 的全基因组从头生成、零样本必需基因识别与跨尺度功能表征提取。
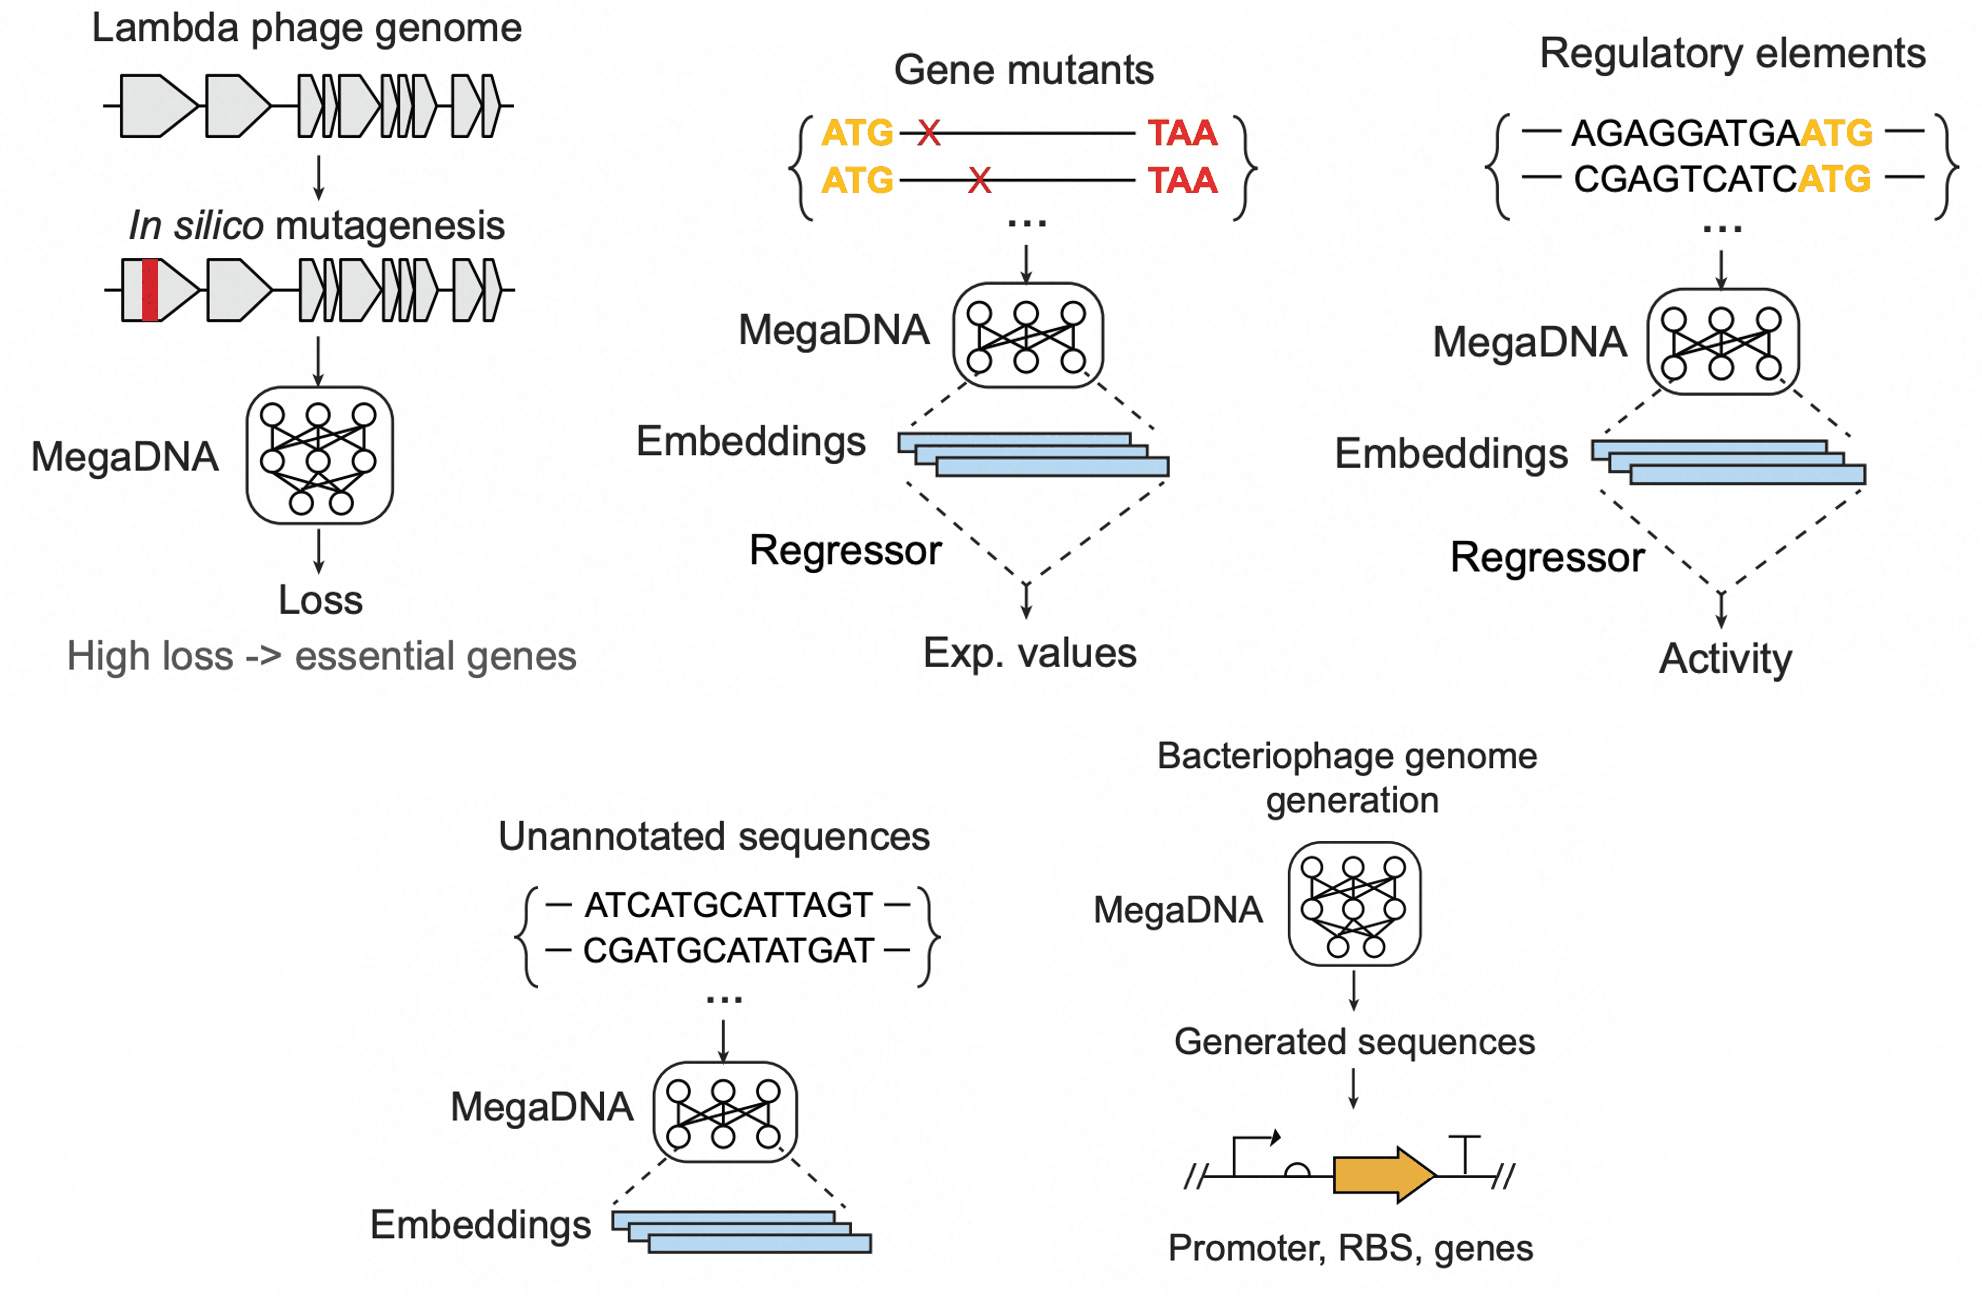
单核苷酸分词与三级多尺度解码器: 模型直接采用单核苷酸分词。为克服单碱基长序列的自注意力瓶颈,主干网络引入 MegaByte 式三级层次化解码器架构,各级配置递增的隐藏维度与感受野尺度:
- 局部层(Local Layer):在 $16\text{ bp}$ 局部窗口内处理单核苷酸嵌入,捕获密码子与短调控基序等细粒度特征;
- 中间层(Middle Layer):接收局部层输出,将有效感受野扩展至 $1{,}024\text{ bp}$,建模单个开放阅读框与顺式调控区的基因级结构;
- 全局层(Global Layer):汇总中间层特征,将上下文窗口扩展至整个输入序列(最高达 $96\text{ kbp}$),捕获全基因组尺度的长程依赖。
零样本计算机诱变与多尺度探针: 推理阶段可通过温度采样从头生成包含启动子、核糖体结合位点与蛋白编码区的完整候选噬菌体基因组。在零样本必需基因预测中,模型通过计算突变序列相对于野生型序列的自回归损失增量评估位点功能必需性;在有监督任务中,则拼接局部、中间与全局三层激活向量输入线性探针。
⚪ GENERator:功能基因座长上下文预训练的真核生成式模型
- paper:GENERator: A Long-Context Generative Genomic Foundation Model(arXiv 2025)
GENERator 在真核生物基因中心功能语料上结合随机相位偏移的 $6$-mer 分词与 LLaMA 因果解码器架构,在 $98\text{k}$ 碱基窗口内实现序列恢复、词元概率边缘化的单碱基零样本变异效应预测以及提示词引导的顺式调控元件设计。
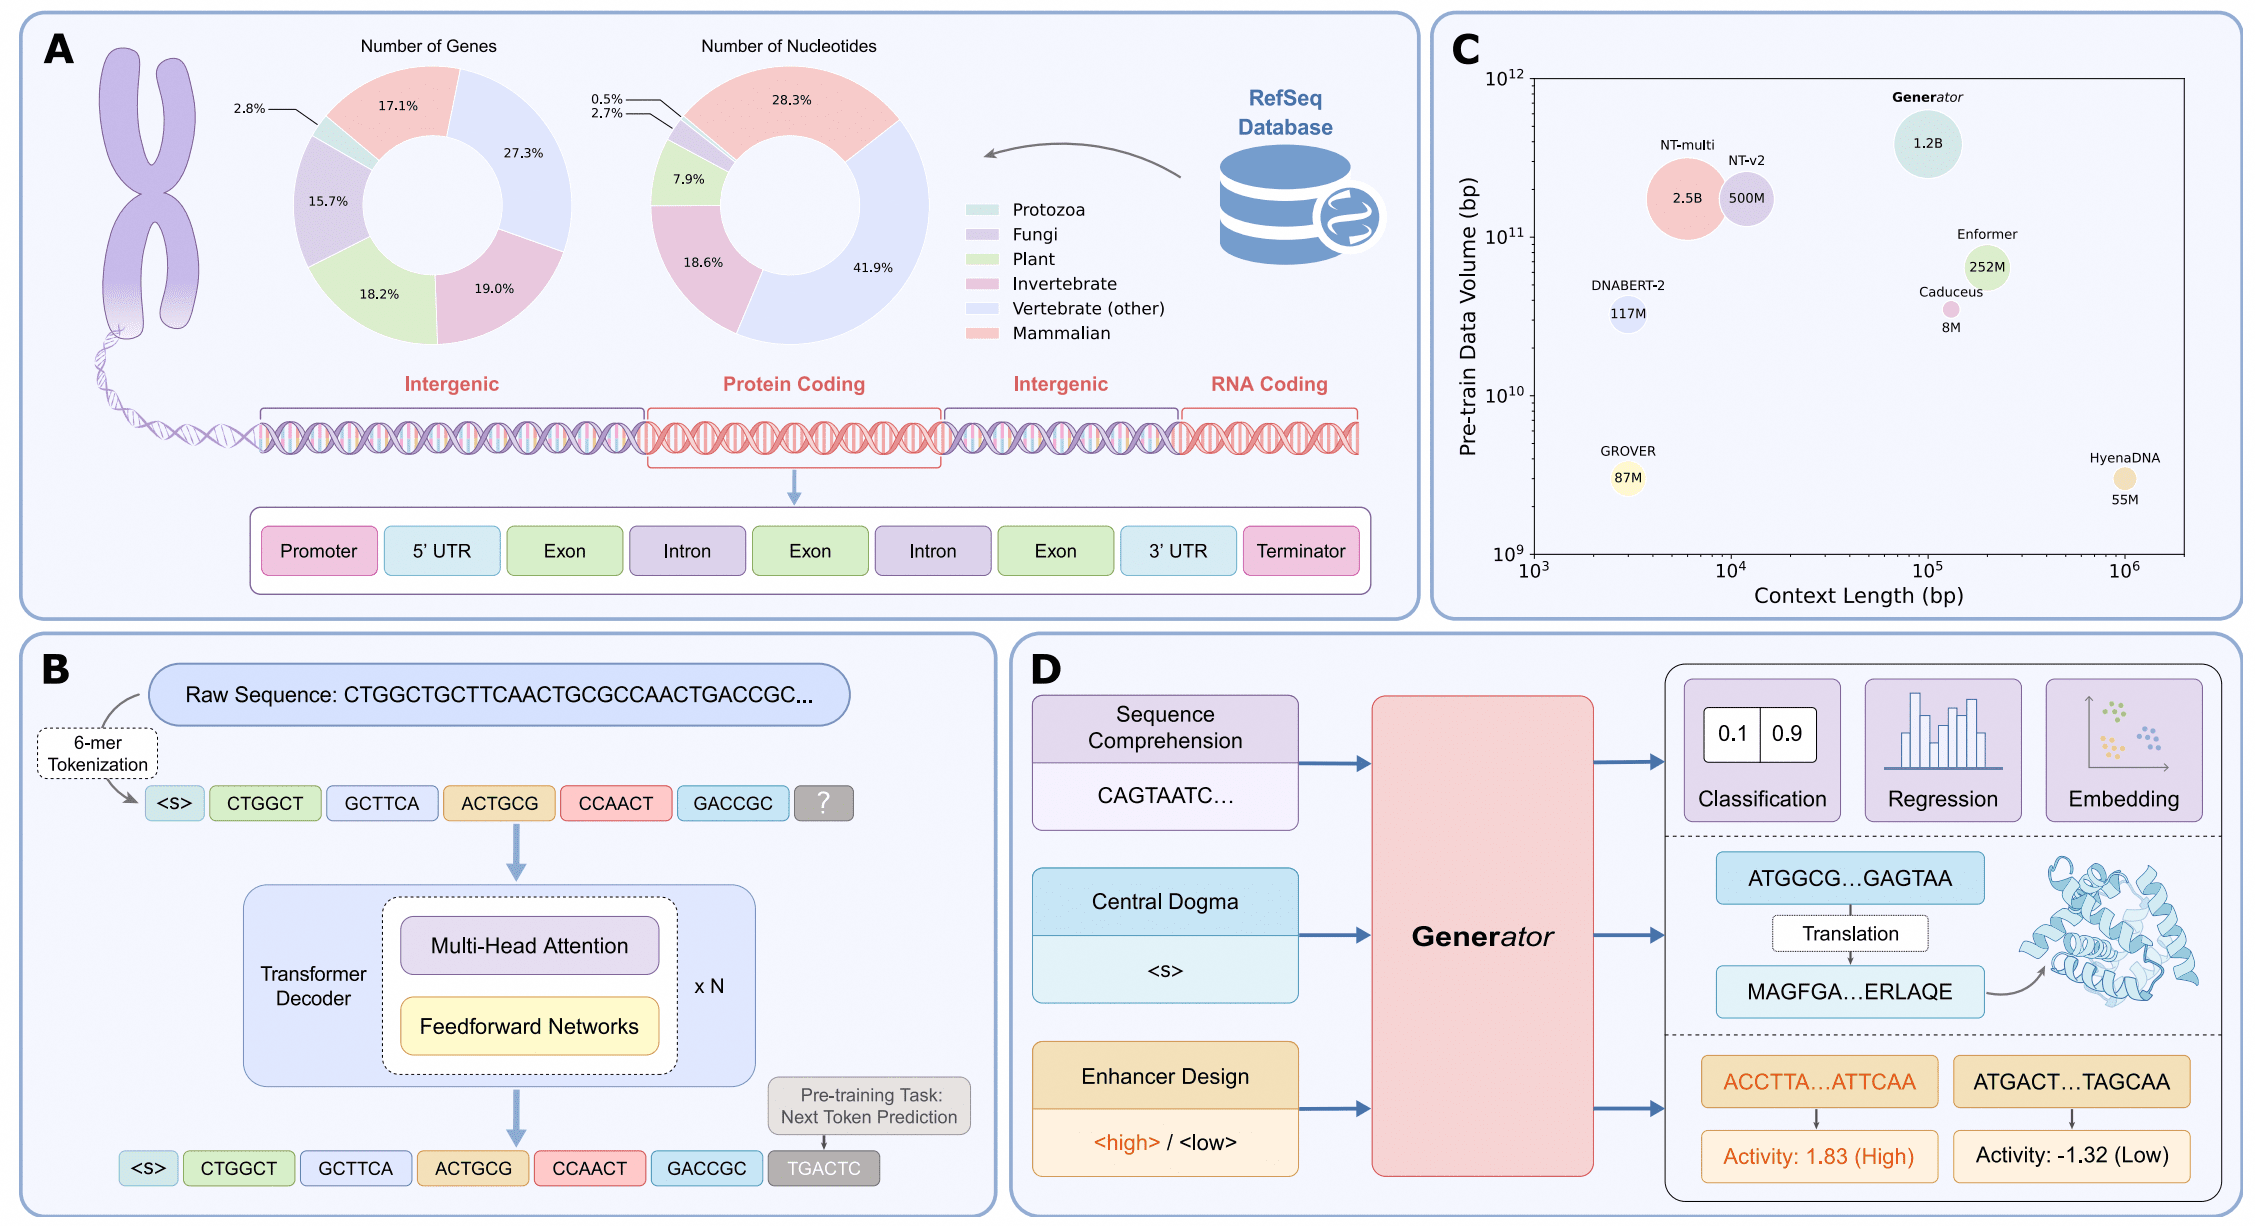
基因中心功能语料与随机相位 $6$-mer 分词: 为防止自回归预训练过拟合基因间区低复杂度重复背景,模型仅提取注释基因边界内的完整功能基因座构建跨物种真核语料。模型采用定长 $6$-mer 分词,主干采用配备 RoPE 与分组查询注意力(GQA)的 LLaMA 解码器;预训练时在每个周期为每条序列在 $[0, 5]\text{ nt}$ 内均匀随机采样起始截断偏移量,使模型遍历同一底层序列的不同 $6$-mer 切分相位。
词元概率边缘化的单碱基变异评估与可控设计: 在零样本单核苷酸变异评估中,为解决 $6$-mer 词表与单碱基突变的粒度失配,模型将变异位点置于因果序列末端,聚合覆盖位点 $i$ 的所有词元集合 $\mathcal{T}_i$ 的预测概率($j$ 为位点 $i$ 在词元 $t$ 内的相对偏移),边缘化投影回单核苷酸空间以计算参考等位基因 $R$ 与替代等位基因 $A$ 的对数似然比:
\[p(s_i = X) = \sum_{t \in \mathcal{T}_i} p(t)\,\mathbb{I}(t_j = X), \quad \mathrm{VEP}(R \to A) = \log \frac{p(s_i = R \mid S_{\setminus i})}{p(s_i = A \mid S_{\setminus i})}.\]在顺式调控元件设计中,模型将训练集按活性分位数离散化并拼接专用前缀提示词元微调生成,同时将主干微调为定量回归器 $f(\cdot)$ 筛选候选序列并评估单碱基突变活性贡献度。
⚪ GENERator-v2:分解式单核苷酸监督与基因组压缩预训练
- paper:Functional In-Context Learning in Genomic Language Models with Nucleotide-Level Supervision and Genome Compression(bioRxiv 2026)
GENERator-v2 在保持 Transformer 解码器与 $6$-mer 分词高吞吐量的基础上,提出分解式单核苷酸监督(FNS)与基因组压缩预训练(GCP),解决了非重叠 $k$-mer 分类损失忽略近邻碱基相似性以及真核基因组功能元件稀疏导致跨基因互作欠拟合的问题。
分解式单核苷酸监督(FNS)与相位不变训练: 标准 $k$-mer 下一词元预测将大小为 $4^k$ 的词表视为无结构原子类别。FNS 在不改变分词器或输出维度的前提下,将词元分布 $p(v)$ 边缘化投影为块内各相对位点 \(j \in \{1, \ldots, k\}\) 的单碱基条件分布 $p^{(j)}(b)$,并计算真实目标 $y = (y^{(1)}, \ldots, y^{(k)})$ 的分解式损失:
\[p^{(j)}(b) = \sum_{v \in \mathcal{V}:\, v^{(j)} = b} p(v), \quad \mathcal{L}_{\mathrm{FNS}} = -\sum_{j=1}^k \log p^{(j)}\!\big(y^{(j)}\big).\]配合遍历全部偏移量 \(\delta \in \{0, \ldots, k-1\}\) 的分词移位增强,除序列两端边界位点外,聚合后的总单碱基监督信号对分词相位完全不变。
基因组压缩预训练(GCP)与双层语义解耦: 为使有限的上下文窗口覆盖多个真核功能单元,模型提取每条染色体 $C$ 上的注释功能区间(编码基因座、非编码 RNA 与调控区),剔除基因间背景后按原始坐标顺序以特殊分隔词元 <s> 拼接为连续压缩流(屏蔽 <s> 位置的损失):
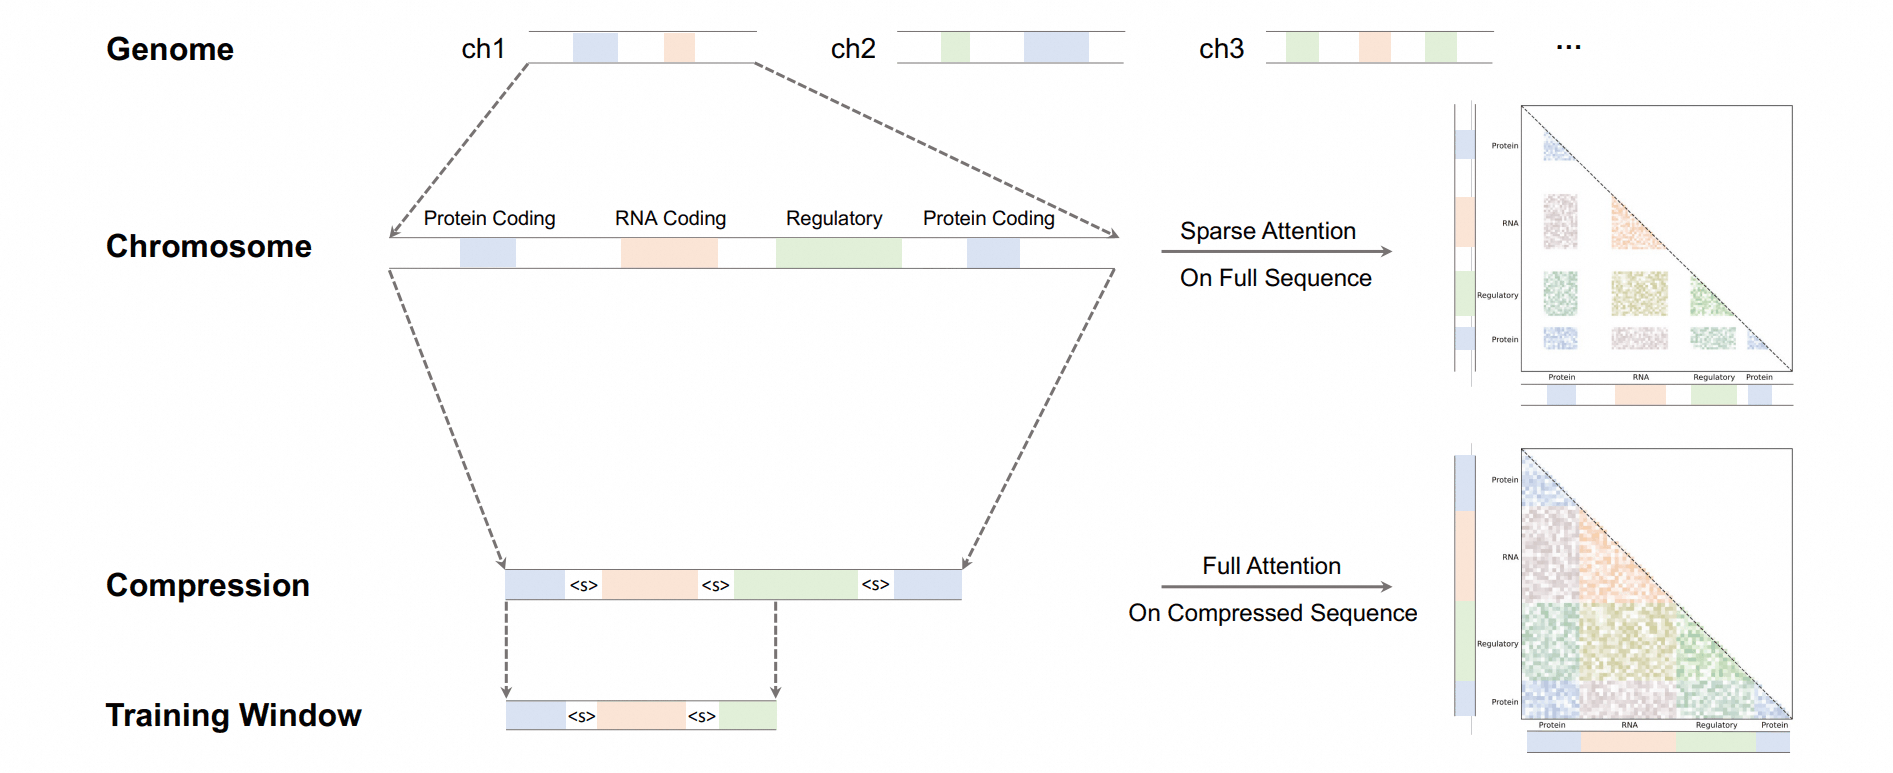
推理时,提取序列末位内容词元的隐状态可编码正反链方向与密码子相位;而提取序列末端分隔符 <s> 的隐状态,则会自动坍缩局部相位差异,聚合出基因级分类学摘要表征。
⚪ OmniReg-GPT:局部滑窗-全局混合注意力与多尺度顺式调控解码器
- paper:Omnireg-gpt: a high-efficiency foundation model for comprehensive genomic sequence understanding(Nature Communications 2025)
OmniReg-GPT($270\text{M}$ 参数)结合 BPE 分词与“$12$ 层局部滑窗注意力 + $2$ 层全局注意力”混合解码器架构,在单张 $32\text{ GB}$ 显存 GPU 上支持最长 $200\text{ kb}$ 序列预训练,统一赋能跨尺度顺式调控理解与细胞类型特异增强子从头生成。
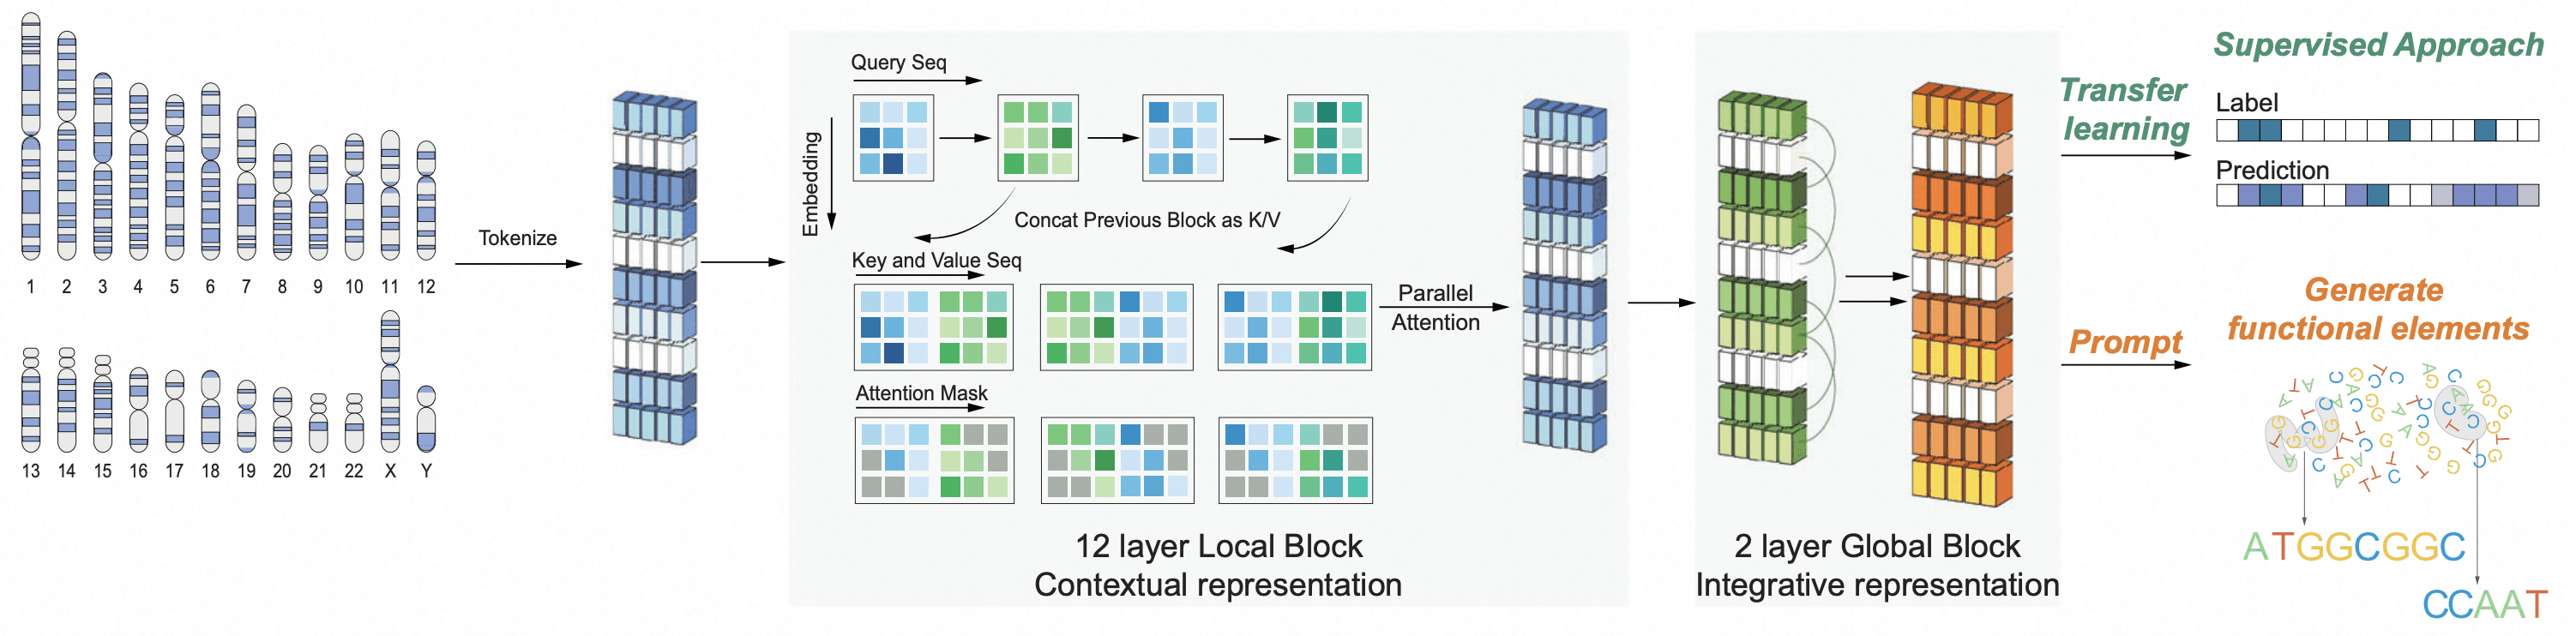
局部—全局混合注意力与隐维词元移位: 模型在人类 T2T v2 参考基因组切分的 $20\text{ kb}$ 片段(共约 $5\text{B}$ 词元)上优化因果下一词元预测损失。主干网络由 $12$ 个局部块与 $2$ 个全局块堆叠而成(隐藏层维数 $d=1{,}024$,均配备 FlashAttention 与 RoPE 旋转位置编码):
-
局部块(Local Blocks):将长度为 $L$ 的查询序列切分为大小为 $w$ 的非重叠窗口,并将当前窗口与前序相邻窗口拼接作为键值序列(把窗口维并入批次维 $\mathrm{bs} \to \mathrm{bs}\cdot L/w$ 并行计算),将注意力复杂度从 $\mathcal{O}(\mathrm{bs}\cdot L^2 d)$ 降至线性 $\mathcal{O}(Lwd)$:
\[Q = h_l^{(i)} W_q, \quad K_j = h_l^{(j)} W_k,\;\; V_j = h_l^{(j)} W_v \quad \big(j \in [\max(0, i-w+1),\, i]\big)\]同时沿隐藏层维度施加词元移位并与注意力输出拼接后送入前馈网络;
-
全局块(Global Blocks):在顶部 $2$ 层执行全序列注意力以聚合跨窗口长程调控依赖,末层通过全词元均值池化导出序列级表征。
跨尺度调控迁移与渐进提示增强子设计: 预训练表征与生成接口支持从百碱基到兆碱基的三类下游应用:(1)表达与单细胞染色质预测:提取 TSS 周围 $20\text{ kb}$ 均值嵌入回归基因表达,或通过单层线性探针预测跨物种单细胞基因活性与 scATAC-seq 可及性,其分类头权重矩阵可直接充当细胞类型嵌入;(2)$2\text{ Mb}$ 染色质三维构象建模:利用 RoPE 外推能力直接编码 $2\text{ Mb}$ 序列并接入 C.Origami 解码器,仅凭纯 DNA 序列预测 $8{,}192\text{ bp}$ 分辨率 Hi-C 接触矩阵;(3)零样本增强子评估与两轮提示生成:以质粒序列对数似然零样本拟合 STARR-seq 增强子—启动子兼容性($\mathrm{Score} \sim \mathrm{Gamma}(\exp(P+E))$),并结合 CODA 评分执行两轮渐进式前缀提示生成从头设计高特异性合成增强子。
⚪ Genos:基于泛基因组与稀疏混合专家的百万碱基级模型
- paper:Genos: a human-centric genomic foundation model(GigaScience 2025)
Genos 基于人类泛基因组单倍型解析组装构建两阶段渐进式语料,并在集成超大基频 RoPE 与 GQA 的 Transformer 解码器中引入稀疏混合专家(MoE)架构,实现兼顾人类群体多样性与条件计算效率的百万碱基级($1\text{ Mb}$)基因组建模。
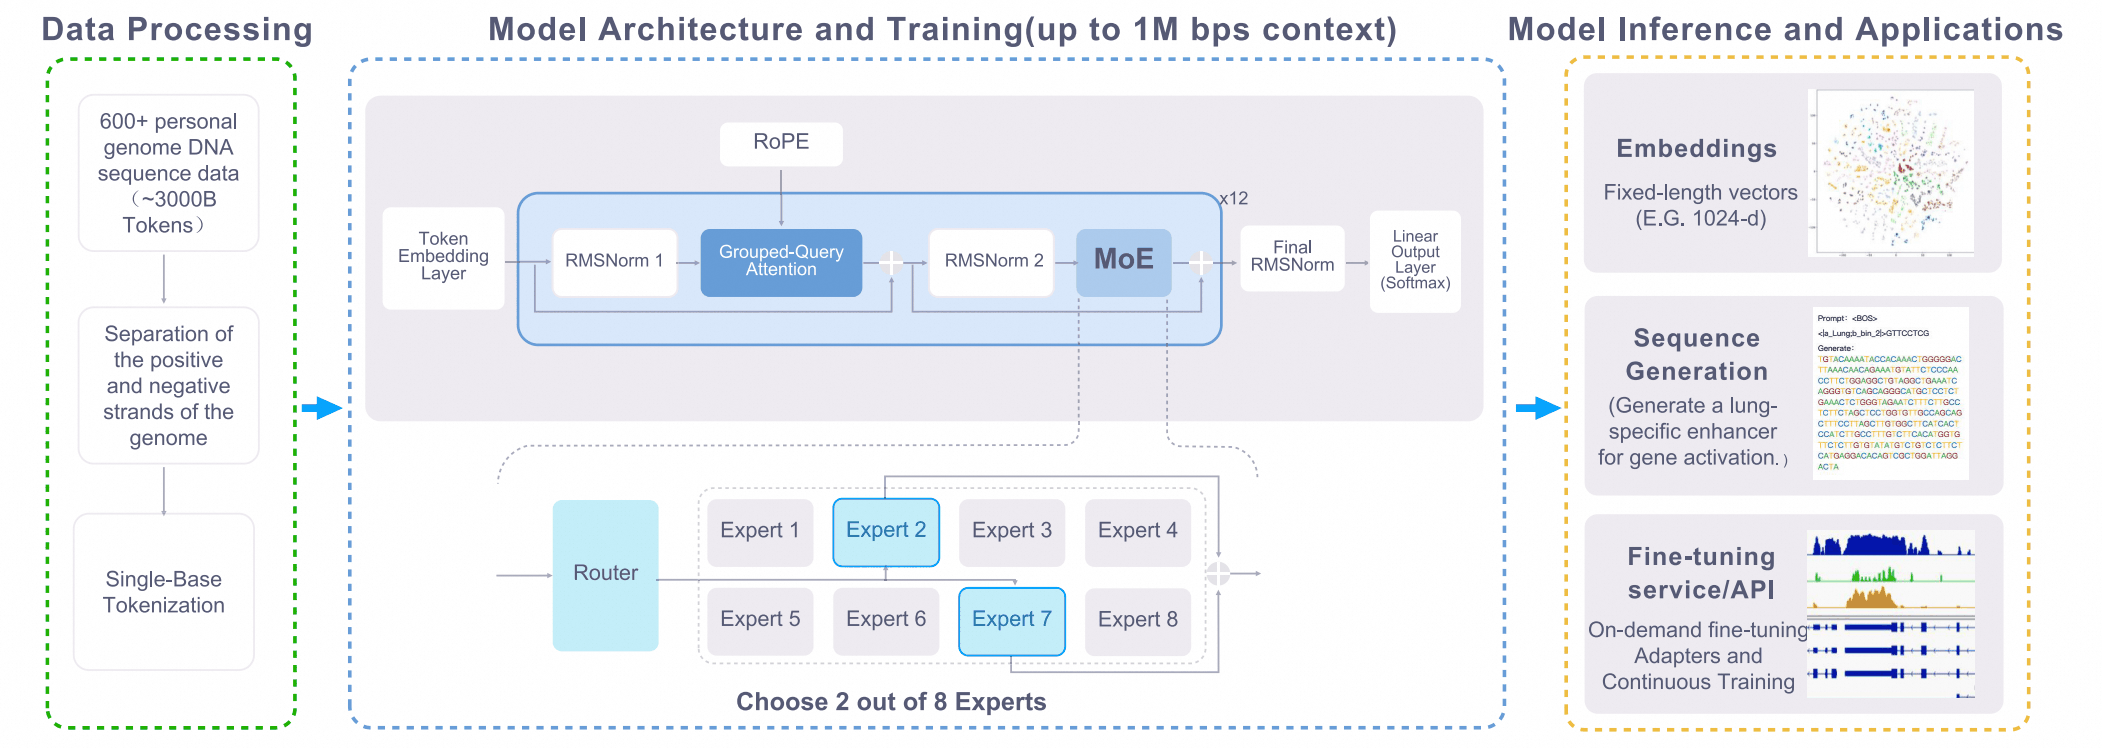
人类泛基因组组装与两阶段渐进式语料: 模型采用单核苷酸分词,训练语料整合自人类泛基因组参考联盟(HPRC)、结构变异联盟(HGSVC)的高质量单倍型从头组装及参考基因组。数据流遵循两阶段策略:(1)第一阶段将样本切分为 $8\text{k}$ 至 $1\text{M}\text{ bp}$ 四个尺度,在短尺度片段中剔除远离基因边界的基因间区序列,并按长度由短至长渐进训练;(2)第二阶段(持续预训练)取消基因间区过滤,将全尺度与正反链样本混合,使模型充分学习远端基因间区、片段重复与转座元件等背景结构。
稀疏混合专家(MoE)与百万碱基解码器: 为支撑 $1\text{ Mb}$ 单碱基窗口,注意力层集成基频达 $5\times 10^7$ 的旋转位置编码与分组查询注意力(GQA)。前馈网络升级为稀疏 MoE 层,路由器根据当前序列上下文为每个词元动态激活 Top-$2$ 个 $\mathrm{SwiGLU}$ 专家子网络,自适应分配算力以区分简单重复区域与复杂调控元件。针对仅有 $4$ 类碱基词元易引发的路由坍缩,训练目标联合优化下一词元预测损失、专家负载均衡损失与路由器对数几率 Z-loss 惩罚。
⚪ Gene42:基于渐进式持续预训练与稠密注意力的长程模型
- paper:Gene42: Long-Range Genomic Foundation Model With Dense Attention(NeurIPS 2025 Workshop AI4D3)
Gene42 采用不引入稀疏近似或卷积替代的标准 LLaMA 稠密自注意力解码器架构,结合单核苷酸分词、旋转位置编码基频缩放与多阶段渐进式持续预训练,将单碱基分辨率下的全注意力上下文窗口扩展至 $192\text{ kbp}$。
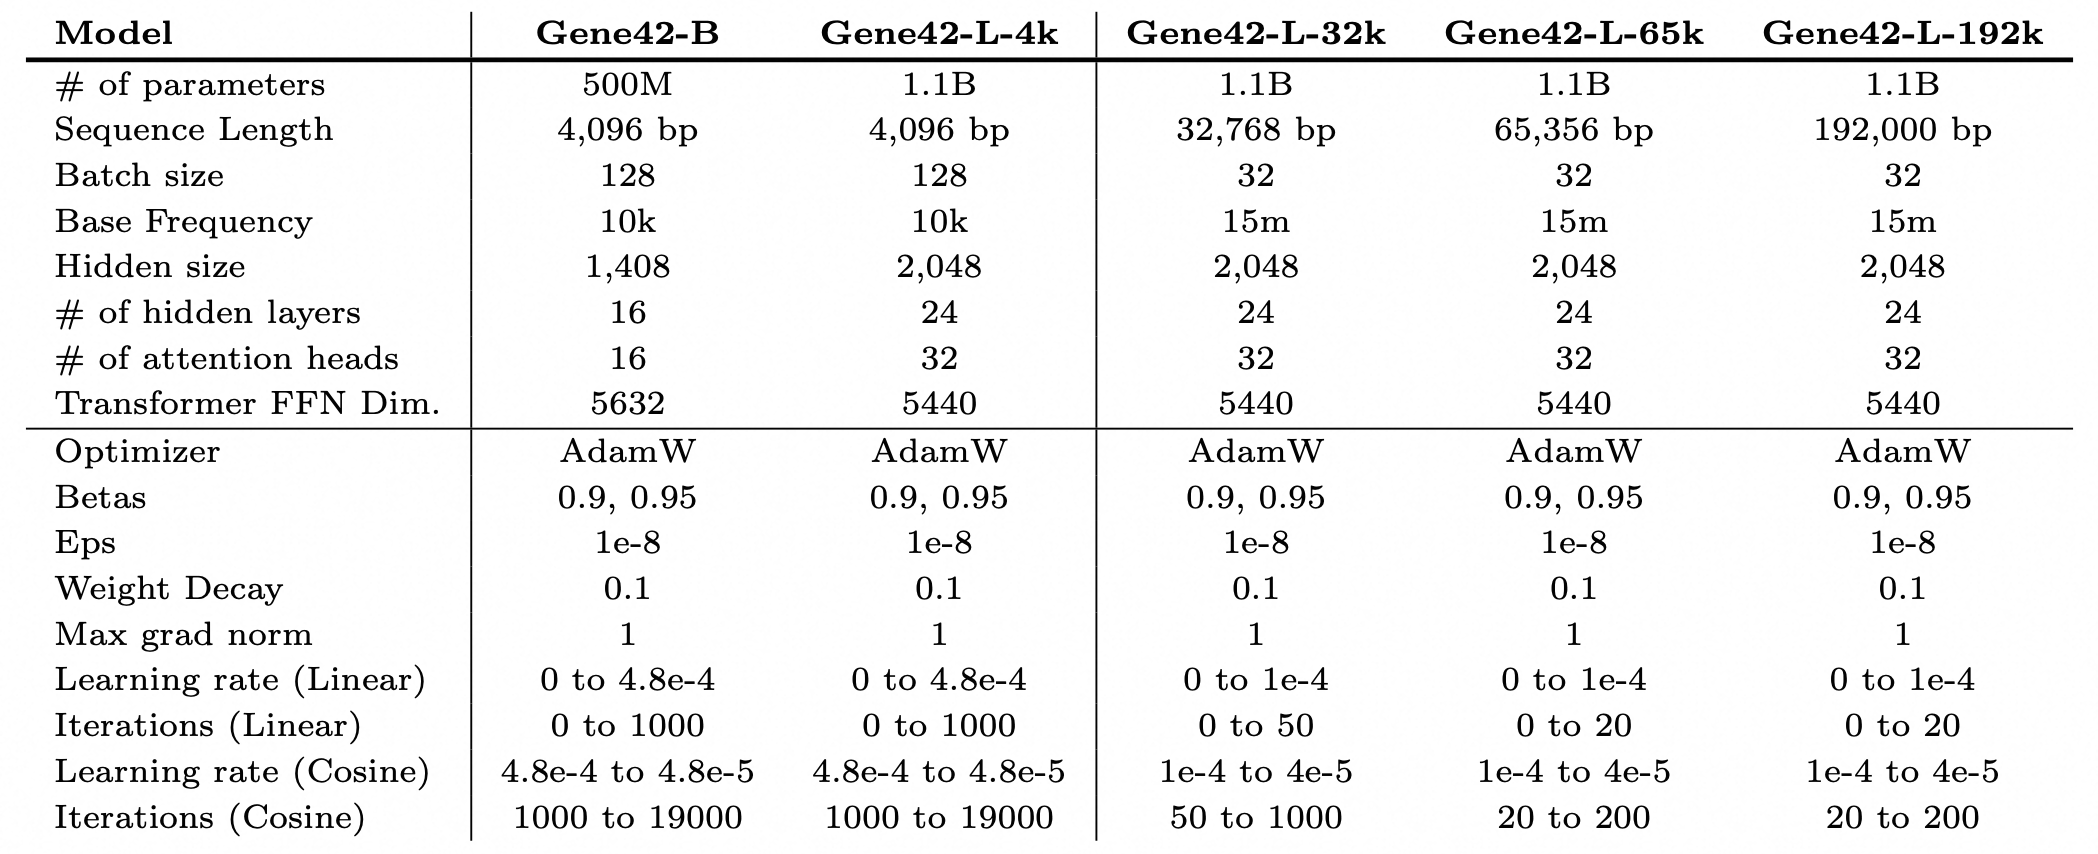
单核苷酸分词与渐进式长上下文持续预训练: 模型采用单字符分词,主干遵循集成前置 RMSNorm、SwiGLU 与稠密多头因果自注意力的 LLaMA 解码器设计,在人类与 $14$ 种脊椎动物基因组上优化下一词元预测损失。为克服直接从头训练超长稠密注意力的高昂开销,模型先在 $4{,}096\text{ bp}$ 短窗口与默认 RoPE 基频($\theta = 10^4$)下完成基础预训练;随后在持续预训练阶段,将 RoPE 基频调大至 $\theta = 1.5 \times 10^7$ 以减小旋转角并缓解位置编码对远端词元的衰减效应,同时将上下文窗口按 $4\text{k} \to 8\text{k} \to \cdots \to 192\text{k bp}$ 分多阶段翻倍拓宽。得益于稠密注意力对全局上下文的无损检索,长窗口模型在长程序列困惑度评估上显著优于隐式长卷积基线:
\[\mathrm{PPL}(X) = \exp\!\left\{-\frac{1}{t}\sum_{i=1}^t \log p_\theta(x_i \mid x_{<i})\right\}.\]⚪ AntigenLM:全基因组八节段保序预训练的流感演化预测模型
- paper:AntigenLM: Structure-Aware DNA Language Modeling for Influenza(ICLR 2026)
AntigenLM 在长上下文 GPT-2 解码器架构下提出两阶段功能单元编码策略,通过在无截断完整甲型流感基因组上执行保序自回归预训练,并结合多时间窗口时序提示与哨兵词元微调,统一实现未来流行株抗原序列预测与病毒亚型判别。
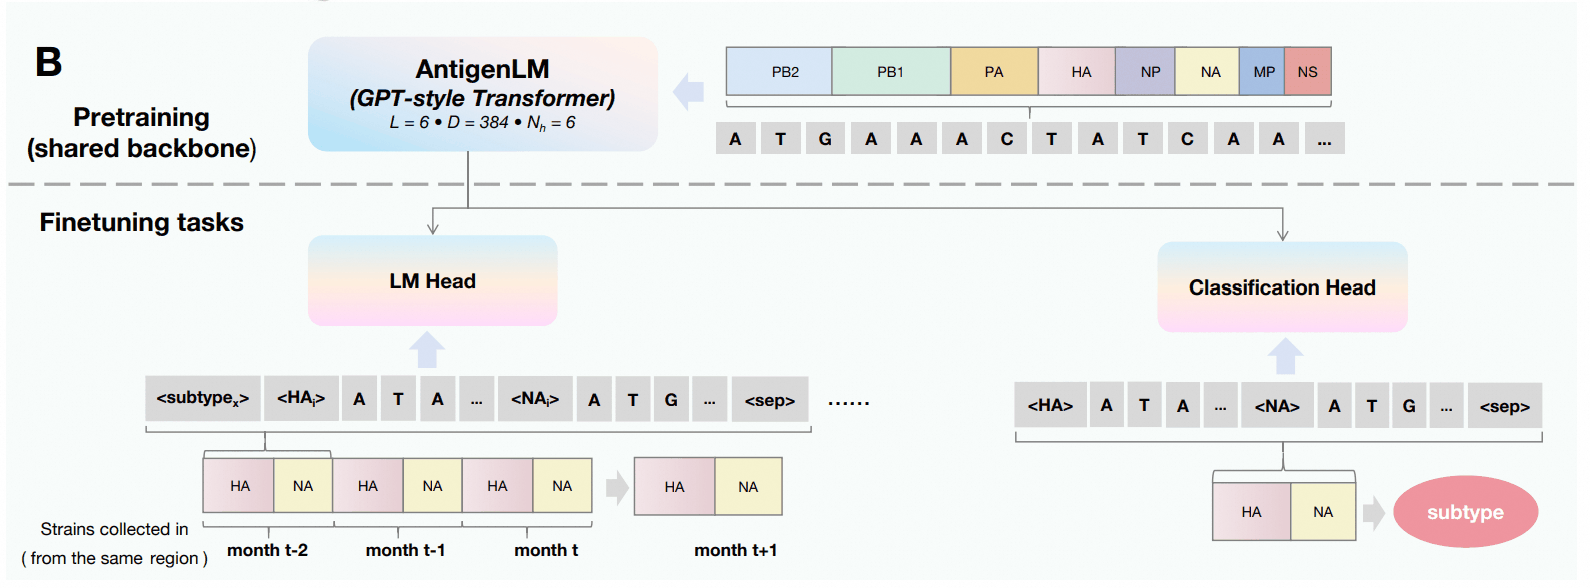
全基因组八节段保序拼接预训练: 模型采用单核苷酸分词。预训练阶段严格保留各基因节段编码序列(CDS)的完整性,将同一分离株的全部八个基因节段按由长至短的固定顺序($\mathrm{PB2}\to\mathrm{PB1}\to\mathrm{PA}\to\mathrm{HA}\to\mathrm{NP}\to\mathrm{NA}\to\mathrm{MP}\to\mathrm{NS}$)无间隔拼接为单条连续序列(约 $13\text{k}$ 词元),使自注意力在全基因组尺度捕获聚合酶复合体与表面抗原之间的跨节段共进化及代偿突变信号,优化标准因果语言建模损失 $\mathcal{L}_{\mathrm{CLM}}$。
时序块提示与哨兵词元引导的演化预测: 下游适配阶段引入界定功能区边界的哨兵词元(如 <subtype>、<HA>、<NA>、<sep>)。在未来优势毒株预测任务中,模型将同一地理区域内连续三个历史时间窗口的血凝素($\mathrm{HA}$)与神经氨酸酶($\mathrm{NA}$)序列块与待预测未来时间块拼接为单条时序提示序列:
其中未来目标块 $\mathrm{block}^{(\star)}$ 省略前导 <subtype> 词元。推理时输入前三个历史块并从目标 <HA> 词元触发自回归解码,直至生成 <sep> 终止符,直接输出未来流行株的完整 $\mathrm{HA}$ 与 $\mathrm{NA}$ 序列。
⚪ DeepD:系统发育感知稀疏混合专家与上下文-锚点-主体染色体级生成模型
- paper:DeepD enables efficient genome modeling and controllable long-context sequence generation across domains of life(bioRxiv 2026)
DeepD 在单核苷酸分辨率与百万词元($1\text{M}$)上下文窗口下,构建了融合多尺度门控注意力与系统发育感知稀疏混合专家的自回归基础模型,通过在跨越全生命域的未筛选全基因组语料上预训练,统一支持跨物种零样本变异评估与染色体级可控生成。
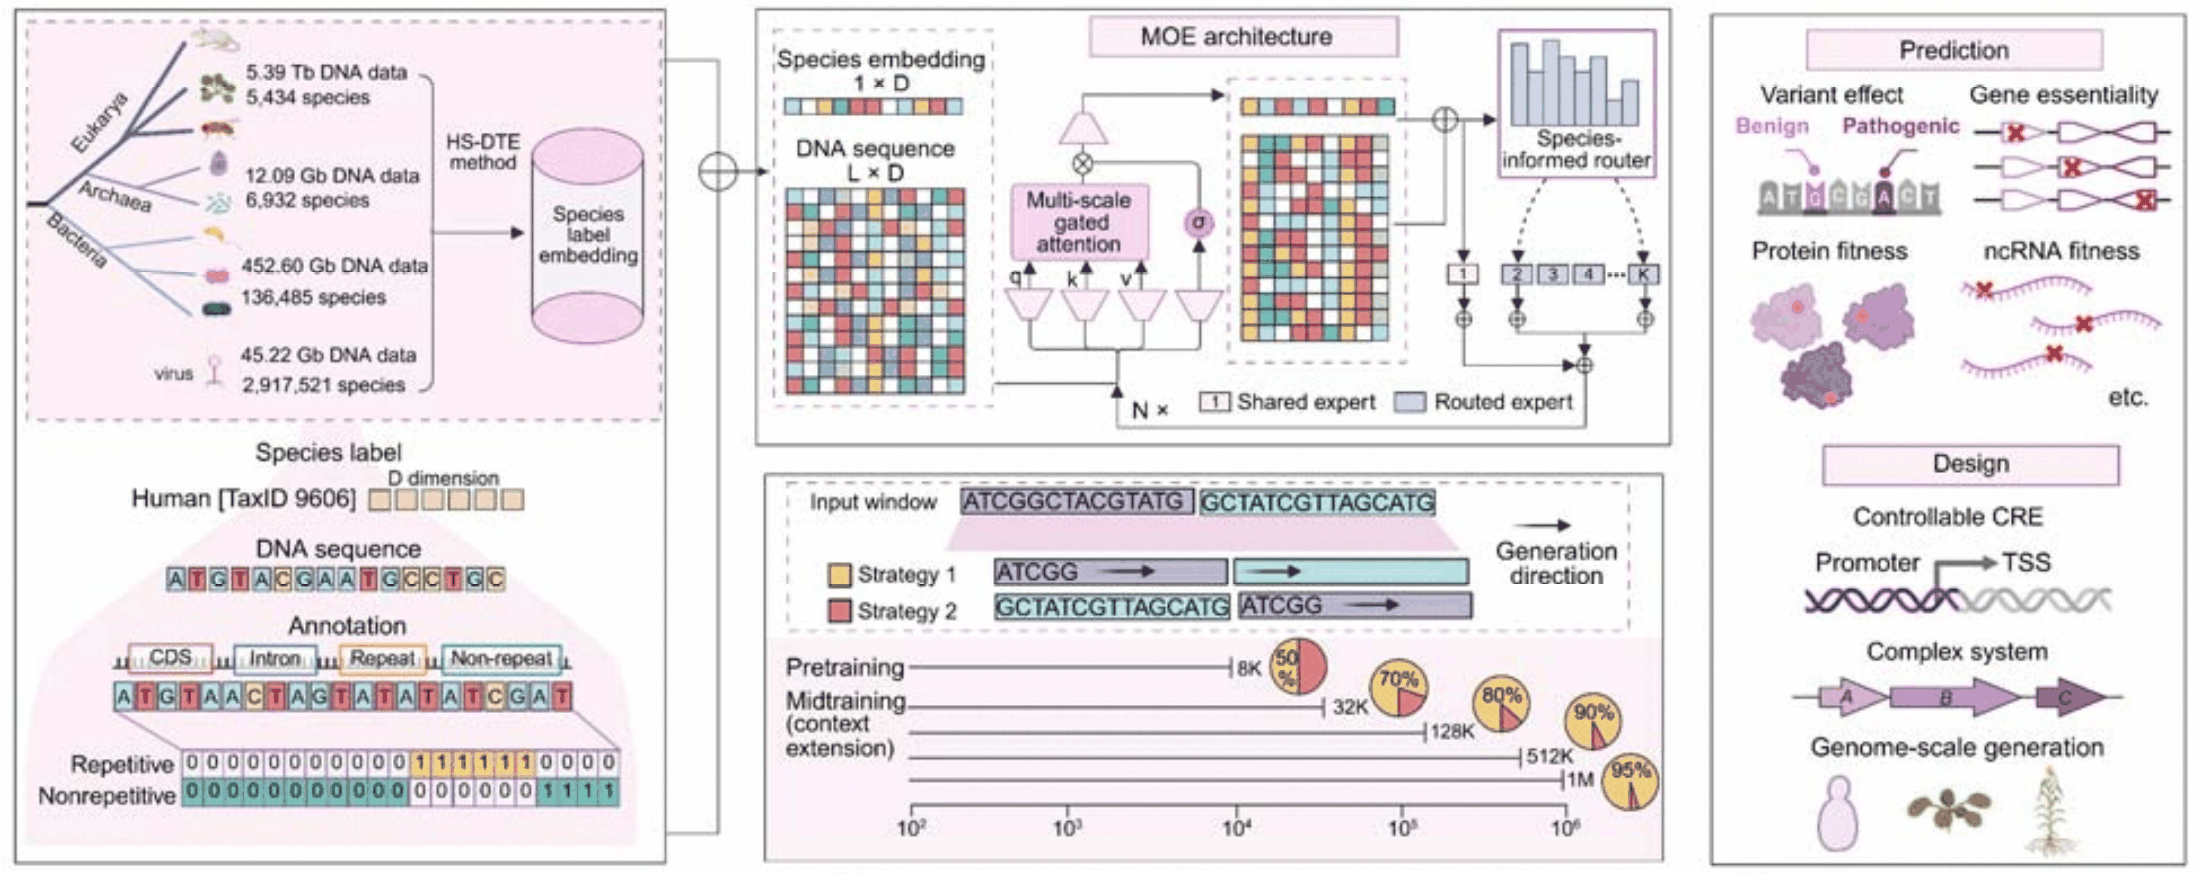
未筛选全基因组语料与系统发育感知稀疏 MoE: 预训练语料涵盖真核生物、古菌、细菌与病毒的未筛选完整基因组,在原生语境中完整保留编码区、内含子、转座子及全空间基因间区(仅对软掩码重复碱基降低损失权重),并将上下文窗口从 $8\text{K}$ 逐级扩展至 $1\text{M}$。每个解码块在输入端整合序列、物种分类学标签嵌入与注释特征:(1)多尺度门控注意力混合分配局部滑动窗口注意力头(占比 $3/4$)与全局全注意力头(占比 $1/4$);(2)系统发育感知专家路由采用由物种信息引导的路由器动态激活稀疏专家子集——浅层专家自发分化为响应高 AT 与高 GC 的组成传感器,中深层路由门控权重则直接编码了外显子边界、转座子家族及远端顺式调控元件。
上下文–锚点–主体(CAB)兆碱基级接力生成: 针对常规自回归长程续写中早期误差累积以及初始提示滑出窗口后丧失全局基因排布控制的问题,DeepD 提出受条件填充启发的 CAB 接力生成策略:将下游参考序列作为上下文(Context)、上游序列作为锚点(Anchor),条件化生成夹在二者之间的定长($8\text{ kb}$)主体(Body)片段;推理时采用滑动窗口迭代接力,将每一轮新生成的片段作为下一轮的锚点向前推进,从而将总输出长度与单次窗口解耦,支持从头生成保持天然基因共线性的全长真核染色体及兆碱基级区段。
⚪ Carbon:高信噪比注释语料与 CE-FNS 阶段切换的高效长上下文解码器
- paper:Carbon: Decoding the Language of Life(bioRxiv 2026)
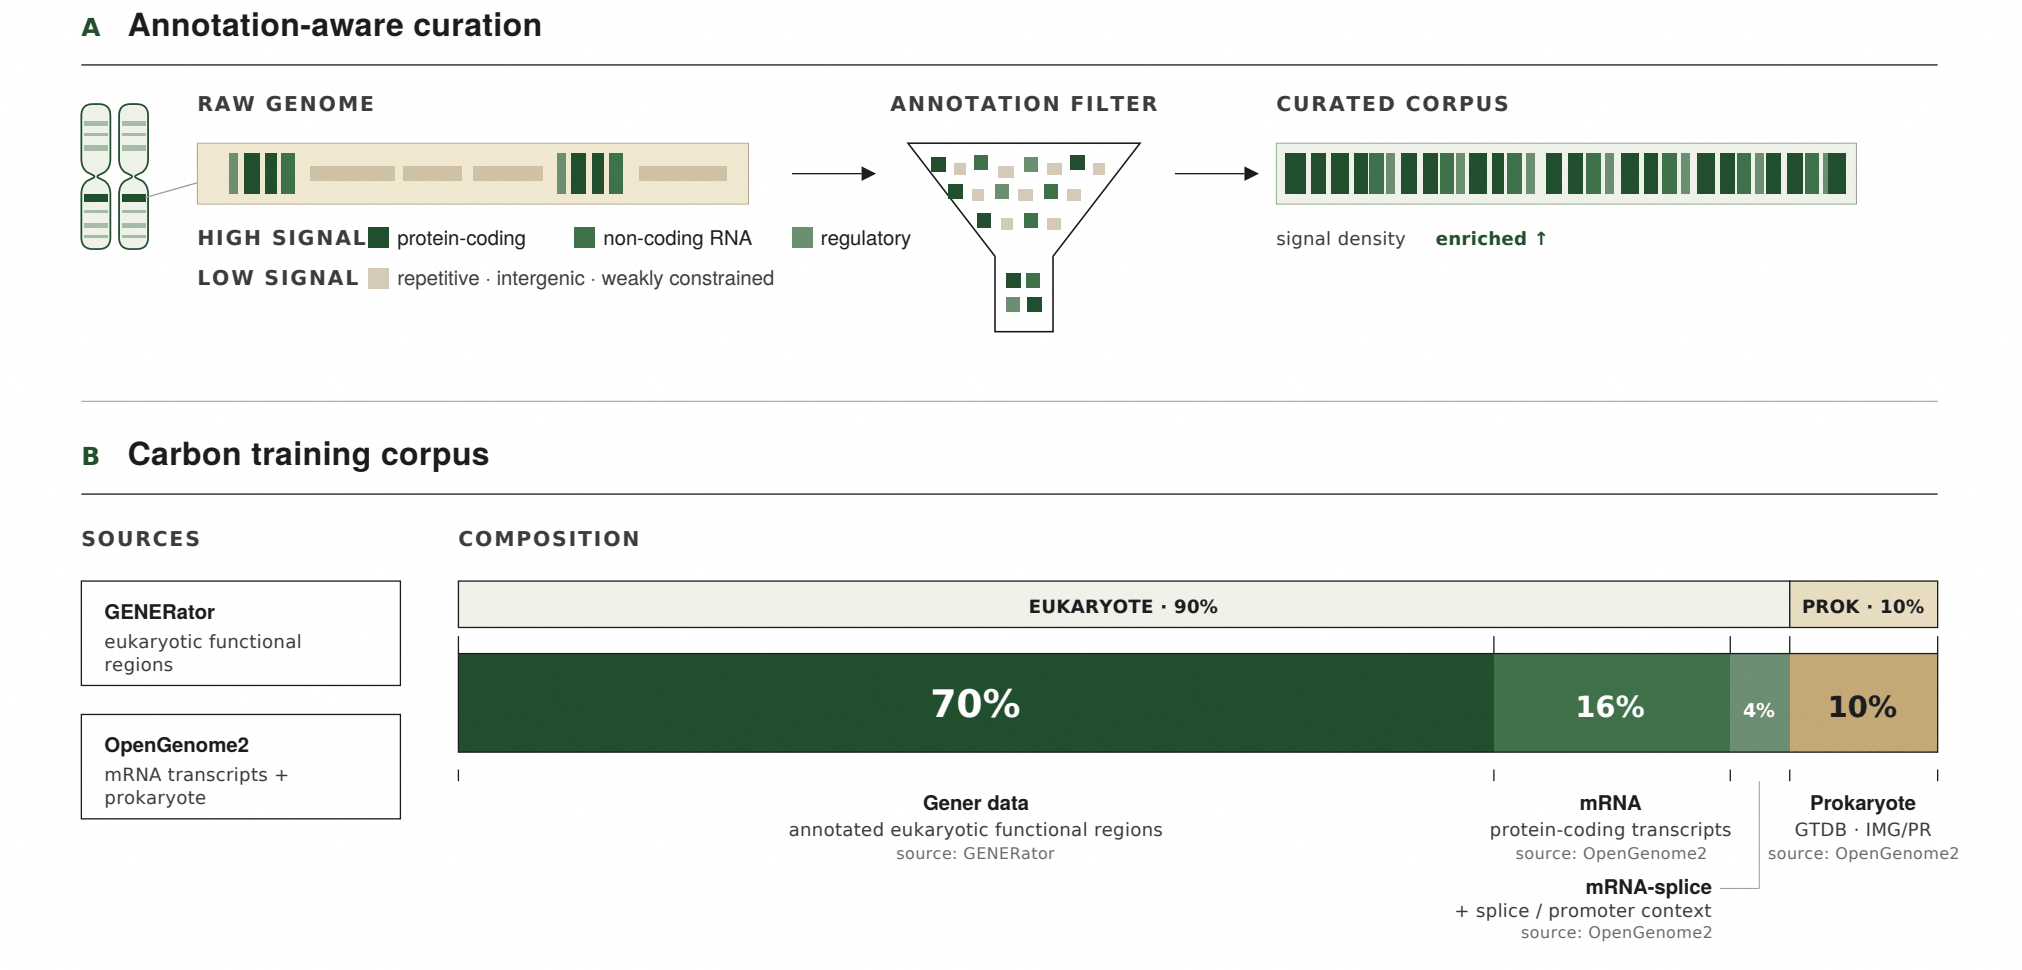
Carbon($3\text{B}/8\text{B}$)在标准 Llama 3 解码器架构上结合高信噪比注释感知语料、非重叠 $6$-mer 分词与“CE 转分解核苷酸监督(FNS)”两阶段目标调度,在维持最高 $786\text{ kbp}$ 有效上下文与单碱基分辨率的同时实现了数十倍的推理加速。
基因组信噪比建模与注释感知语料配比: 针对原始基因组中大量弱约束重复背景(占比 $1-\rho$、梯度方差 $\sigma_N^2$)稀释功能区梯度信号(占比 $\rho$、期望对齐度 $\mu$)的问题,研究从全基因组有效信噪比出发指导语料清洗:
\[\mathrm{SNR}_{\mathrm{all}} \propto \frac{\rho\mu}{\sqrt{\rho\sigma_S^2 + (1-\rho)\sigma_N^2}}, \quad \rho_{\mathrm{curated}} = \frac{r\rho}{r\rho + \epsilon(1-\rho)}.\]通过滤除 $>100\text{ kbp}$ 的长背景序列并富集功能元件(保留率 $r \gg \epsilon$),模型构建了由 $70\%$ 真核注释功能区(GENERator-v2)、$16\%$ mRNA 转录本、$4\%$ 剪接与启动子上下文以及 $10\%$ 原核基因组(OpenGenome2)组成的高密度预训练语料,并在 $50\%$ 样本前随机冠以 <species type> 与 <gene type> 元数据控制标签以支持条件生成。
非重叠 $6$-mer 分词与 CE $\to$ FNS 两阶段目标切换: 模型在 <dna>...</dna> 块内采用步长为 $6$ 的确定性 $6$-mer 分词。针对纯 CE 训练后期强制区分简并近似词元引发梯度范数攀升、损失阶梯式跳变及 BF16/FP32 精度差距扩大的现象,Carbon 先在前 $100\text{B}$ 词元使用标准 CE 学习 $6$-mer 内部联合依赖,随后降低学习率并在剩余 $900\text{B}$ 词元切换至分解核苷酸监督(FNS),通过对包含特定碱基的词元概率求和导出块内 $6$ 个位置的单碱基边缘分布以提供结构化部分奖励:
长上下文扩展与免训练单碱基评估: 预训练后期将 RoPE 基频由 $5\times 10^5$ 缩放至 $5\times 10^6$ 并混入同重叠群功能区拼接序列,将原生窗口从 $8{,}192$ 扩展至 $32{,}768$ 词元(约 $197\text{ kbp}$),推理时进一步通过 YaRN 外推至 $65{,}536$(3B,约 $393\text{ kbp}$)与 $131{,}072$ 词元(8B,约 $786\text{ kbp}$)。推理端同样利用 FNS 边缘分布直接执行单碱基对数似然打分与逐碱基重组采样,并在序列恢复、临床变异效应预测、三核苷酸重复扩张/同义密码子替换扰动以及真实基因组大海捞针检索(Genomic-NIAH)等免训练基准上验证了表征的分类学聚类(</dna> 分隔符嵌入)与三相位密码子阅读框几何结构(内容词元嵌入)。
2. 隐式长卷积与混合框架(Convolutional & Hybrid Decoders)
为在保持单核苷酸分辨率的同时突破二次方注意力瓶颈,隐式长卷积框架(Implicit Long Convolution)利用参数化的全局因果卷积核替代自注意力矩阵。给定输入投影序列 $v \in \mathbb{R}^L$ 与由小型神经网络隐式生成的因果滤波器 $h \in \mathbb{R}^L$,其核心操作由下三角 Toeplitz 矩阵乘法与逐元素数据门控交替构成,并可通过快速傅里叶变换(FFT)在 $\mathcal{O}(L \log_2 L)$ 时间内完成全局上下文聚合:
\[y_t = (h * v)_t = \sum_{\tau=0}^{t} h_{t-\tau} v_\tau = \mathrm{iFFT}\big(\mathrm{FFT}(h) \odot \mathrm{FFT}(v)\big)_t.\]尽管纯隐式长卷积在百万碱基尺度上具备显著的吞吐量优势,但在需要精确跨位置信息检索的复杂序列生成中仍存在容量瓶颈。因此,新一代全基因组生成基础模型(如 Evo 与 Evo 2)演进为多尺度卷积—注意力混合架构(StripedHyena):以占多数比例的多尺度输入依赖卷积层高效处理局部基序与长程背景信号,同时周期性交错插入少量配备旋转位置编码(RoPE)的自注意力层,兼顾百万碱基上下文效率与高保真序列设计。
⚪ HyenaDNA:基于隐式长卷积与数据门控的单核苷酸模型
- paper:HyenaDNA: Long-Range Genomic Sequence Modeling at Single Nucleotide Resolution(NeurIPS 2023)
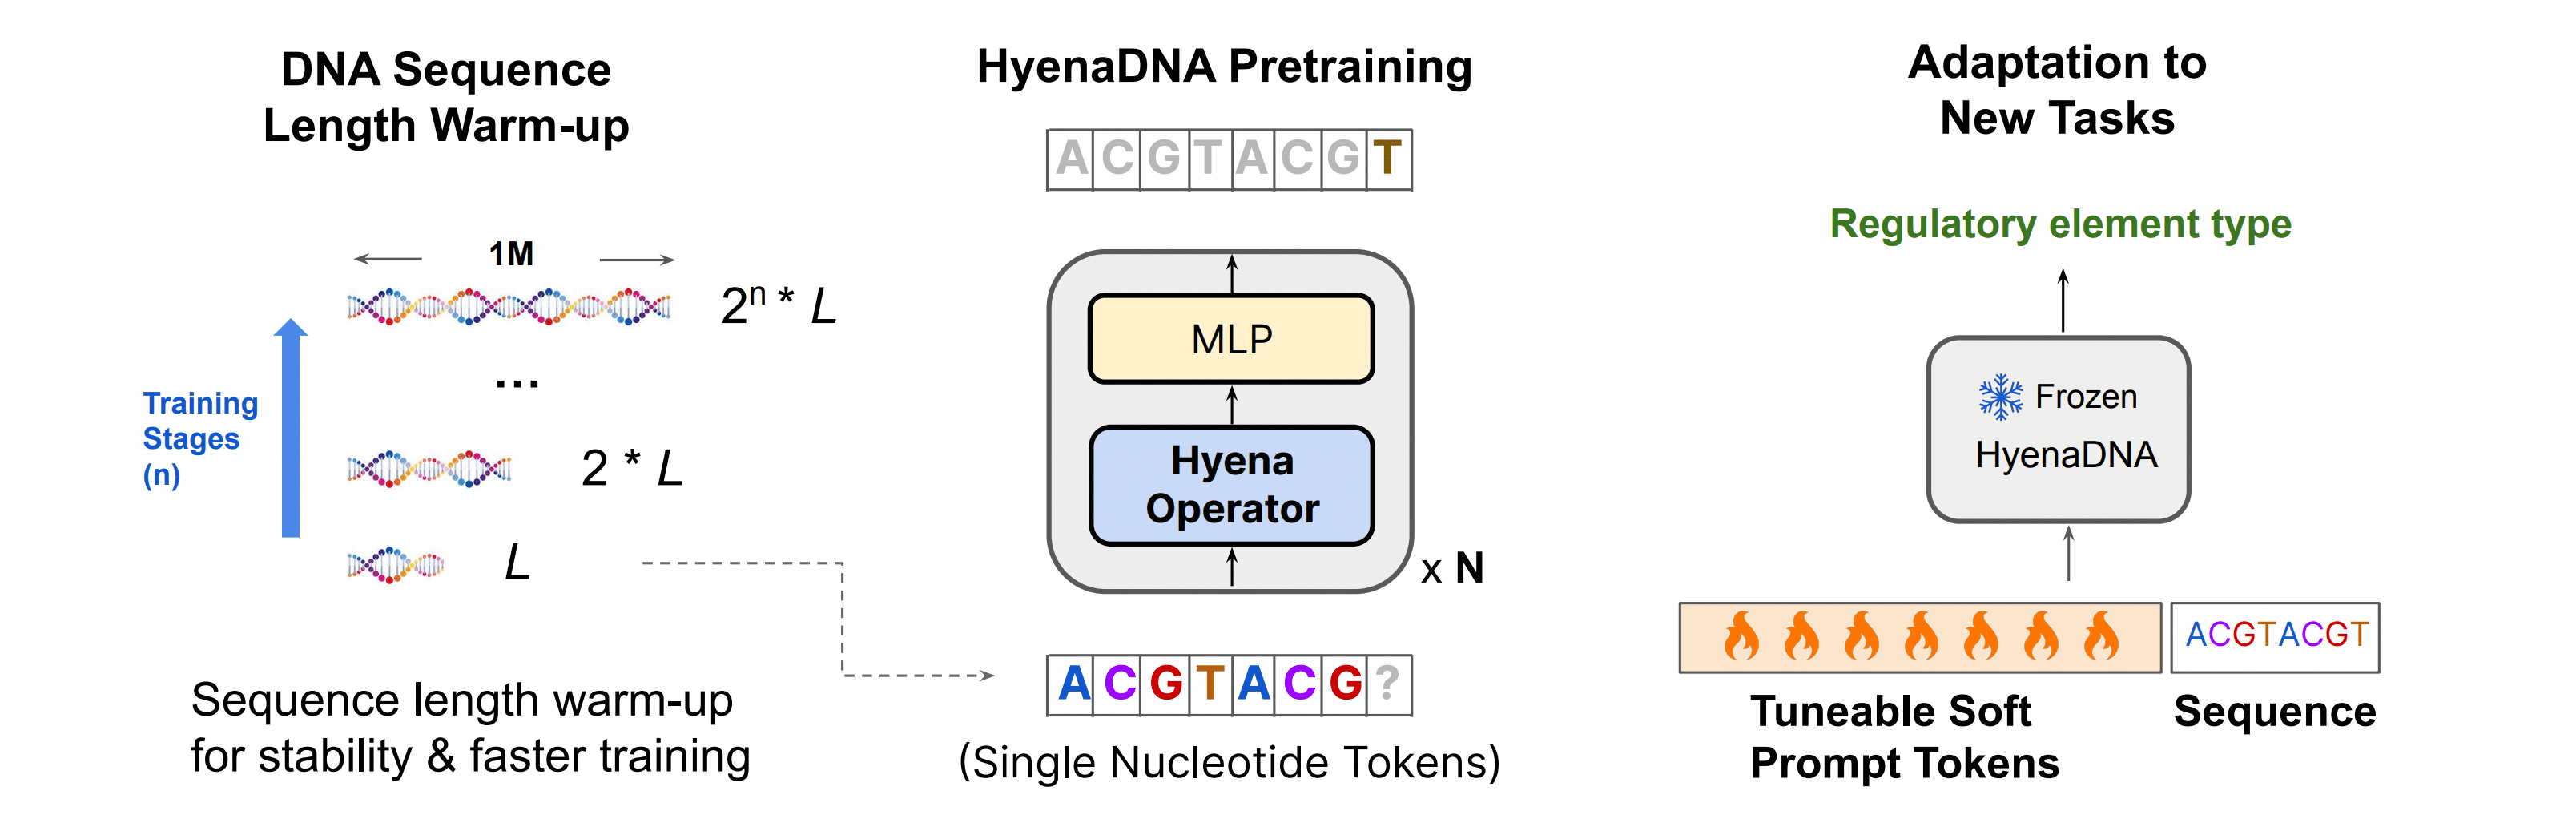
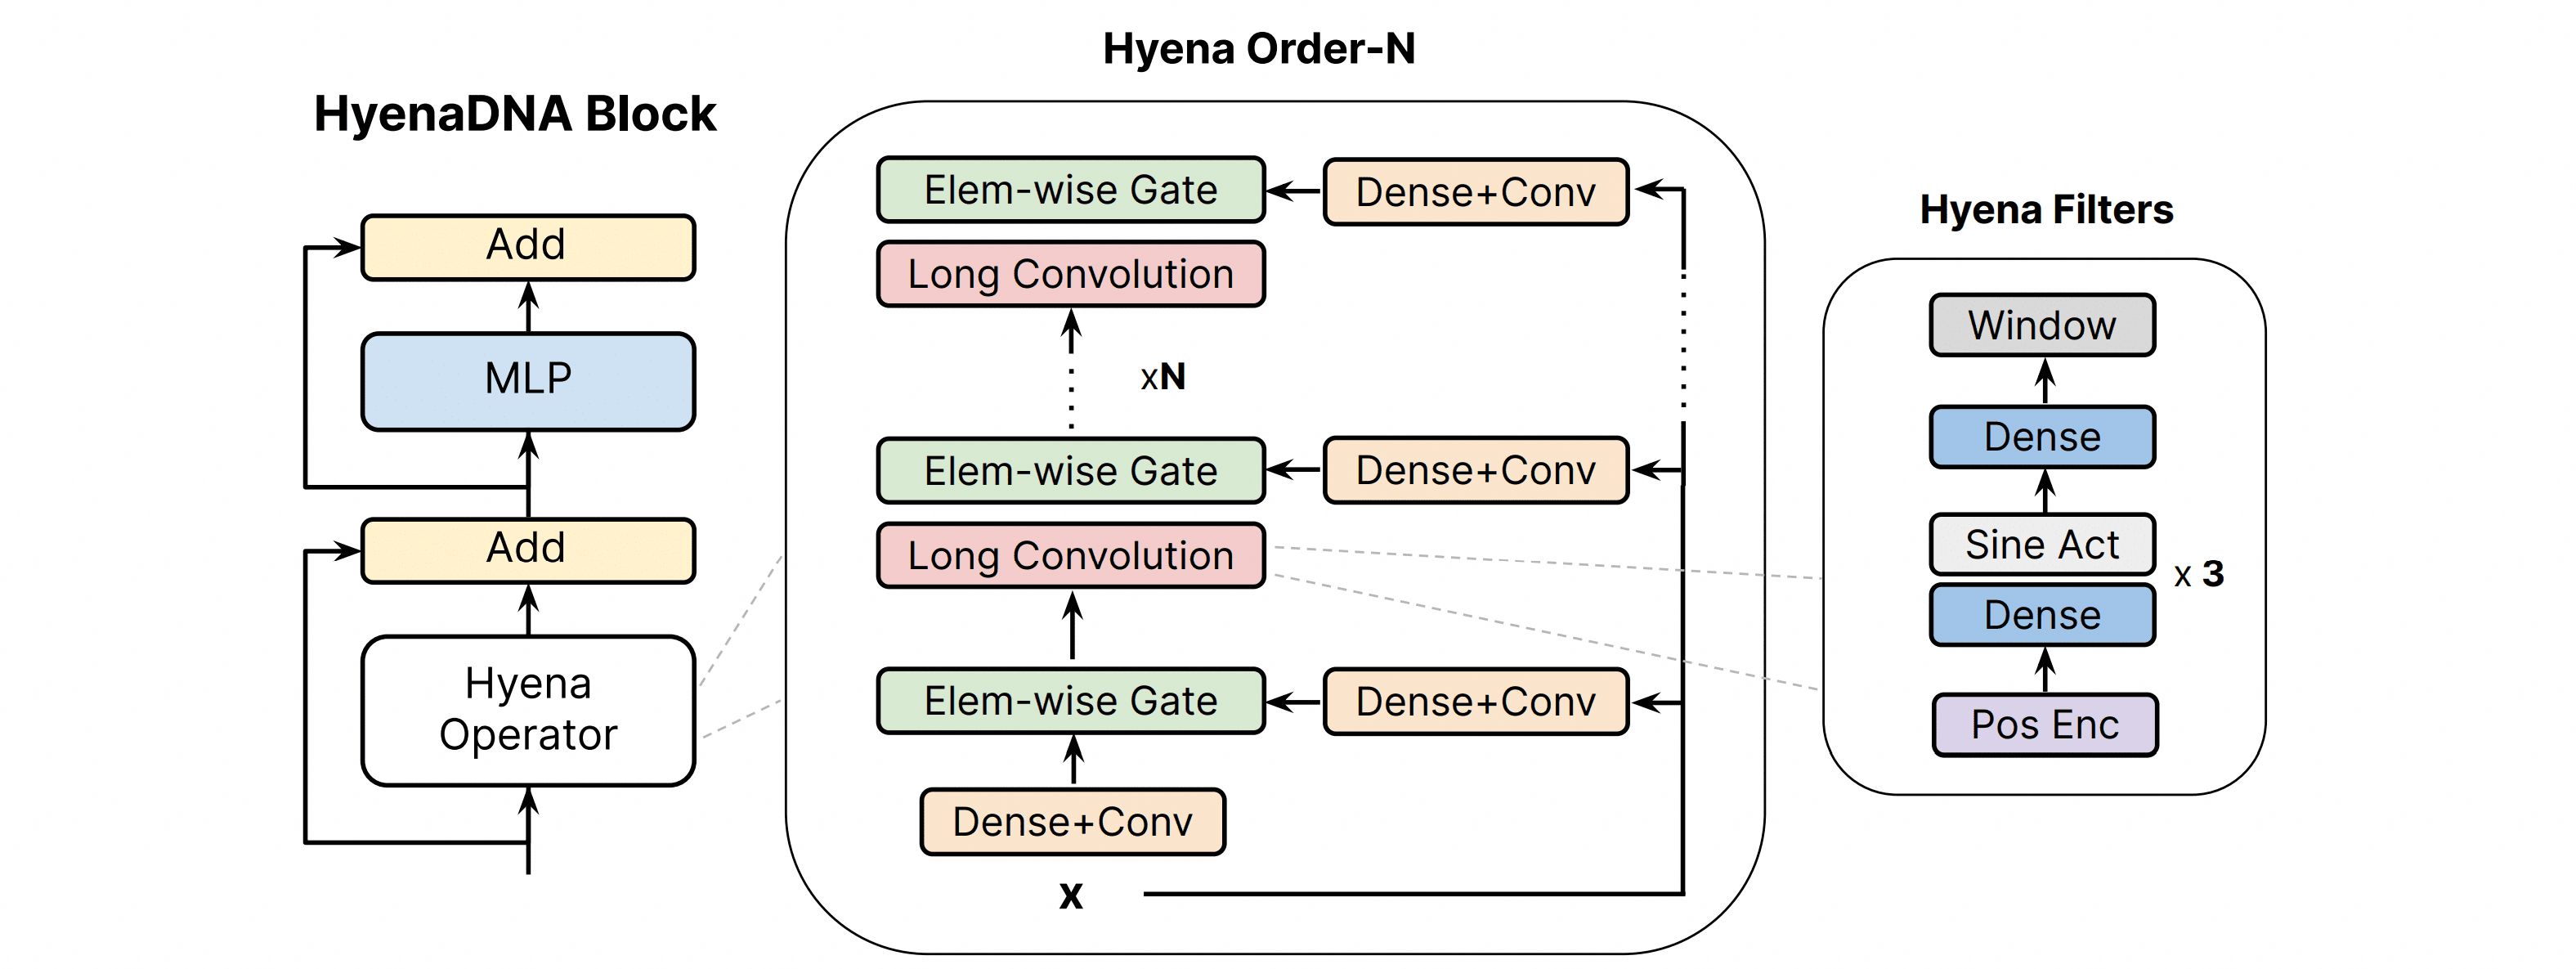
HyenaDNA 以隐式长卷积与数据控制门控构成的 Hyena 算子完全替代稠密自注意力,结合序列长度渐进预热与软提示上下文学习,在 $\mathcal{O}(L\log_2 L)$ 复杂度下实现百万词元级单碱基自回归建模。
隐式长卷积与数据门控 Hyena 算子: 模型采用单核苷酸分词。给定长度为 $L$ 的输入序列,单通道 $2$ 阶 Hyena 算子先通过线性层与短卷积将输入映射为三个分支投影 $x_1, x_2, v \in \mathbb{R}^L$,随后交替施加逐元素数据门控与全局因果长卷积:
\[(x_1, x_2, v) \mapsto H(x_1, x_2)v, \quad H(x_1, x_2) = D_{x_2} T_h D_{x_1},\]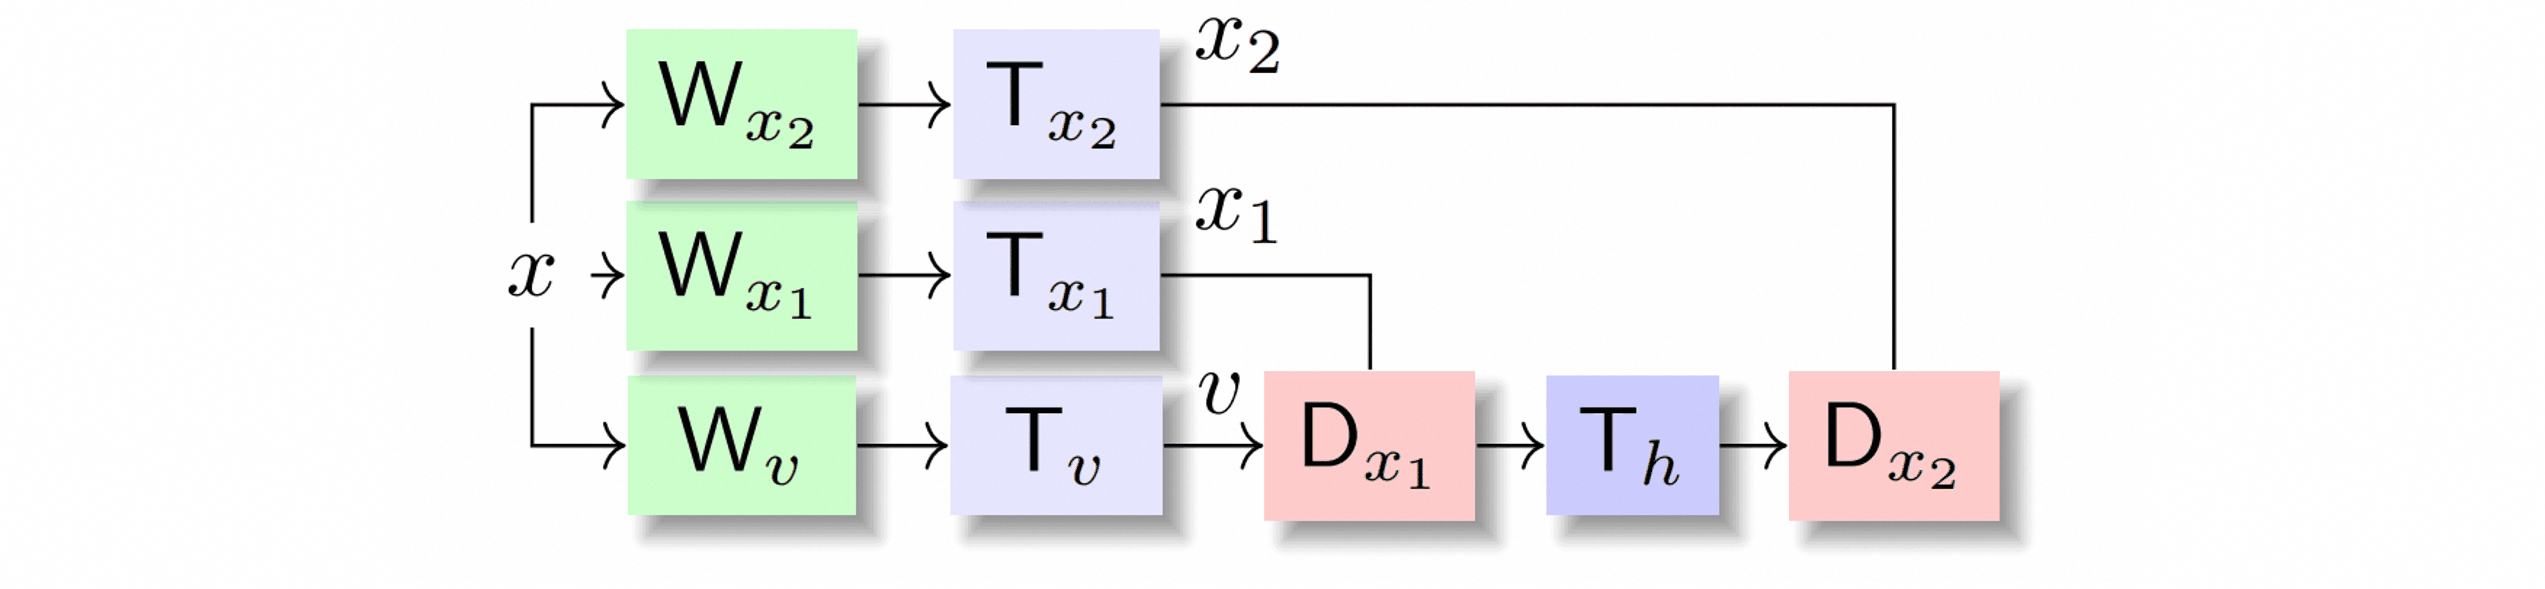
其中 $D_{x_1}, D_{x_2}$ 为对角门控矩阵,$T_h$ 为由因果长卷积核 $h$ 构造的下三角 Toeplitz 矩阵。为使参数量与序列长度 $L$ 解耦,滤波器 $h_t = \gamma_\theta(t)$ 由接收位置编码、带正弦激活与窗口调制的小型 MLP 隐式生成,并通过 FFT 高效计算。
长度渐进预热与软提示上下文学习: 预训练采用从短窗口($L=64$)逐级翻倍至百万碱基的序列长度预热调度。依托宽裕的上下文窗口,模型支持免更新主干权重的可调软提示(Soft Prompting):在下游任务序列 $x_p$ 前端拼接 $N$ 个可学习软提示向量 $\theta \in \mathbb{R}^{N \times D}$,冻结主干仅优化 $\theta$,并直接借用单碱基字符映射分类标签:
\[x \leftarrow \mathrm{concat}[\mathrm{embed}(x_p),\, \theta], \quad x \in \mathbb{R}^{D \times (T+N)}.\]⚪ Evo:长卷积与注意力混合架构的全基因组生成基础模型
- paper:Sequence modeling and design from molecular to genome scale with Evo(Science 2024)
Evo 采用将模态范式 Hyena 算子与旋转位置编码自注意力交错堆叠的 StripedHyena 混合架构,在大规模原核与噬菌体全基因组语料(OpenGenome)上以单核苷酸分辨率训练,实现了跨 DNA、RNA 与蛋白质模态的零样本功能预测与多组件系统生成。
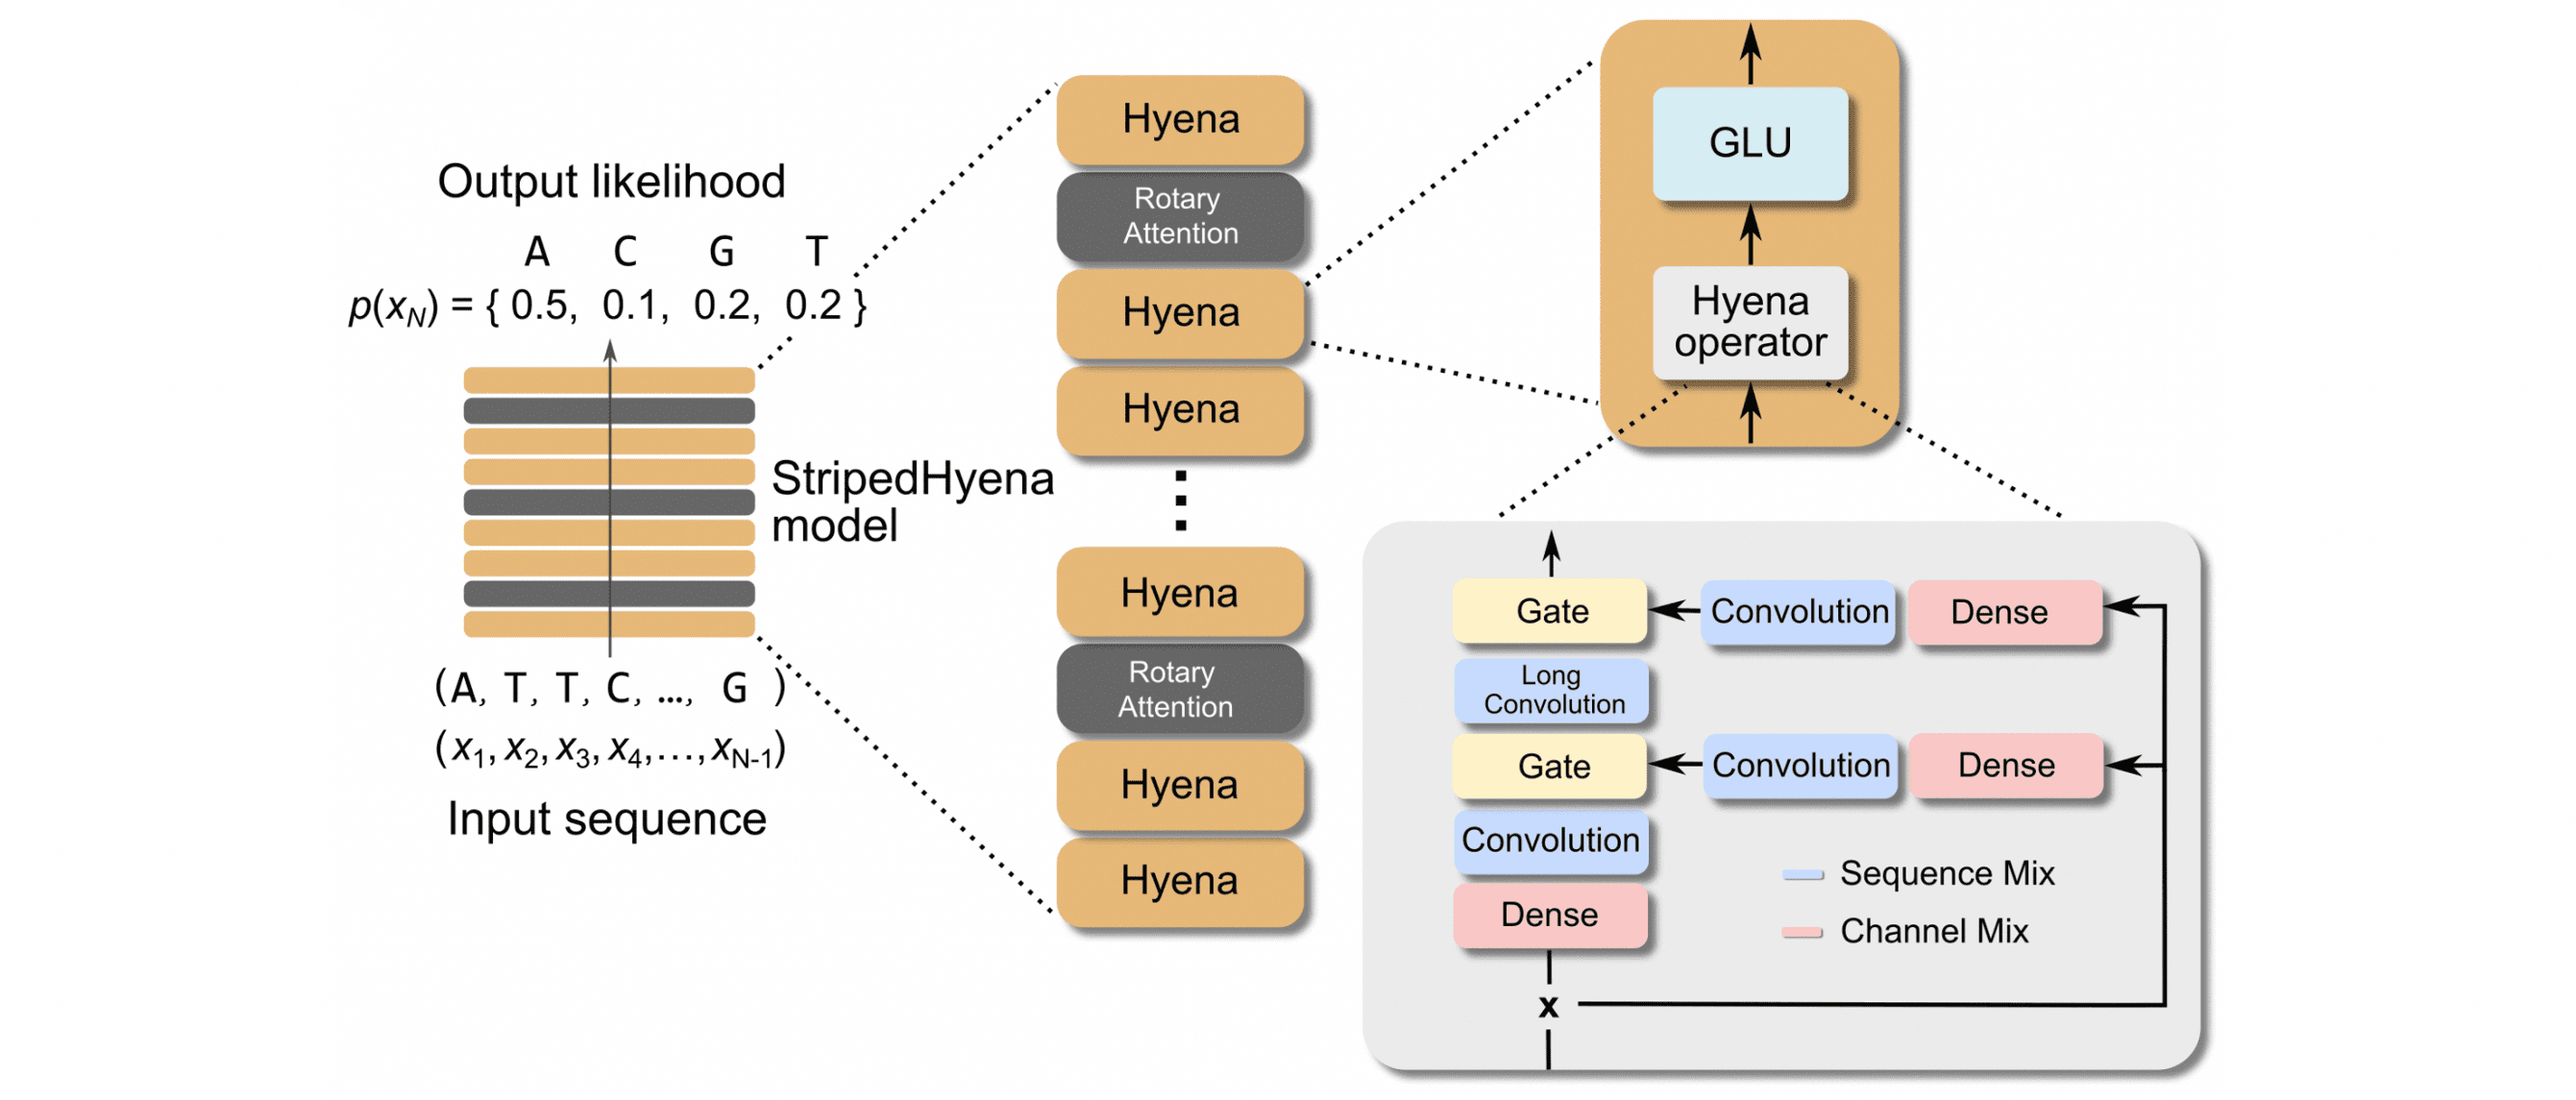
StripedHyena 混合架构与两阶段上下文扩展: 模型采用单核苷酸分词。主干由数据控制 Hyena 层与等间隔插入的少量(占比约 $10\%$)RoPE 自注意力层交错构成。在 Hyena 层中,输入经线性投影与短卷积生成 $q, k, v$,随后通过模态范式状态空间隐式生成全局滤波器 $h = \mathrm{ImplicitFilter}(L)$,依次执行逐元素门控与 FFT 长卷积:
\[v \leftarrow k \odot v, \quad v_t \leftarrow \mathrm{FFTConv}(h, v)_t, \quad y \leftarrow q \odot v.\]训练先在 $8\text{k}$ 窗口内完成基础自回归预训练,再通过对 RoPE 施加缩放因子为 $16$ 的线性位置插值将窗口平滑扩展至 $131\text{k}$。
跨中心法则零样本推断与多组件生成: 依托原核基因组操纵子共定位特性,模型直接计算突变型与野生型序列的自回归对数似然比 $\log [p(x_{\mathrm{mut}}) / p(x_{\mathrm{wt}})]$,即可零样本评估蛋白质、非编码 RNA 突变效应及全基因组必需基因;经控制符微调后可协同生成 CRISPR-Cas 蛋白—RNA 复合物及数百 kb 的人工原核基因组。
⚪ Evo 2:多尺度卷积混合架构的跨生命域基因组基础模型
- paper:Genome modelling and design across all domains of life with Evo 2(Nature 2026)
Evo 2 将训练语料扩展至跨越全生命域的 OpenGenome2,提出由短显式、中正则化与长隐式卷积及旋转注意力交错构成的 StripedHyena 2 多重混合架构,在单核苷酸分辨率与百万碱基($1\text{ Mb}$)窗口下统一实现全谱系变异评估、稀疏自编码器可解释性解析与推理时引导的表观遗传设计。
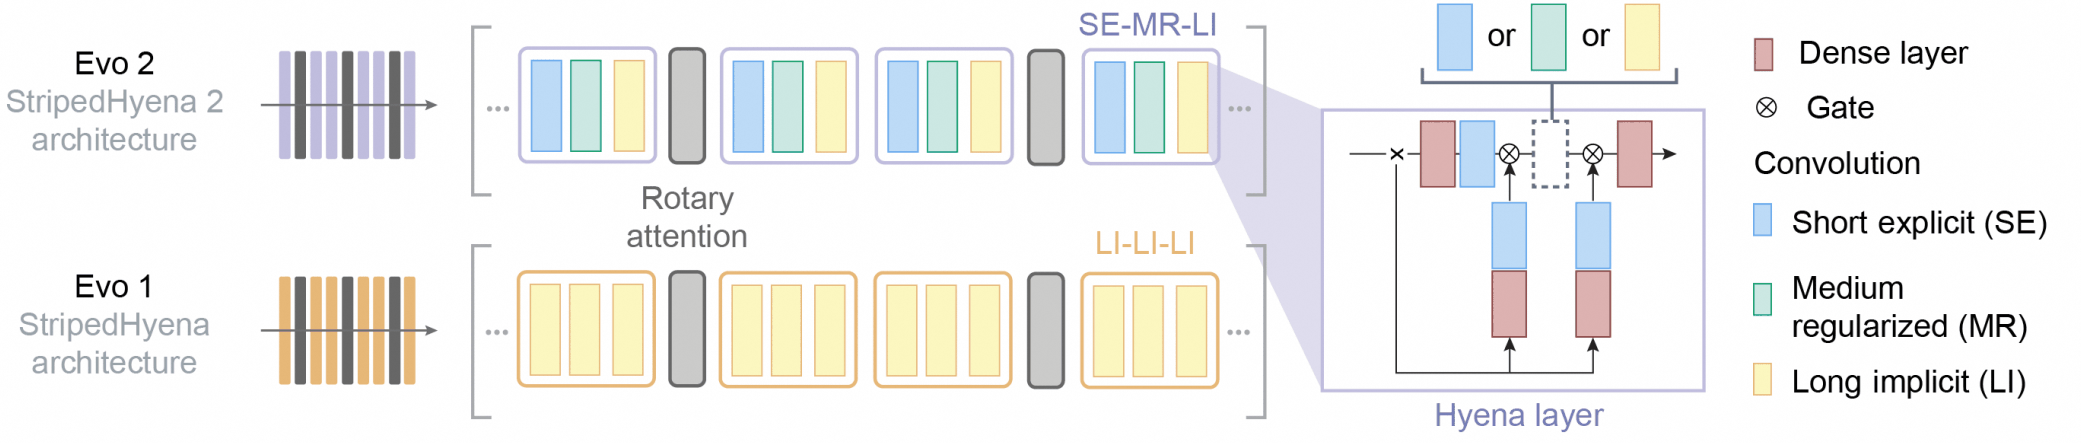
StripedHyena 2 多重混合架构与百万碱基训练: StripedHyena 2 将输入依赖卷积拆解为针对不同距离尺度的三类算子:短显式卷积(SE)、中距离正则化卷积(MR)与长隐式卷积(LI),并以 SE-MR-LI 组合块与 RoPE 自注意力层周期性交错堆叠。训练遵循两阶段范式:(1)先在 $8\text{k}$ 短窗口内优先采样真核启动子、外显子与基因中心窗口学习核心遗传语法;(2)随后在多阶段长上下文中期训练(Midtraining)中将窗口从 $8\text{k}$ 分级扩展至 $1\text{M}$ 单核苷酸词元,纳入完整染色体级长序列。
零样本变异评估、SAE 解析与推理时引导设计: 模型无需多序列比对,直接通过自回归对数似然变化统一评估编码与非编码区的 SNV 及复杂结构变异;同时在中间层激活上训练 Batch-TopK 稀疏自编码器(SAE),无监督解耦出对齐外显子剪接边界、移码突变与转录因子基序的稀疏特征。在染色质可及性从头设计中,Evo 2 作为先验提议分布与序列到功能预测器(Enformer / Borzoi)结合,按每 $128\text{ bp}$ 块执行束搜索引导采样,可编程生成匹配目标开闭峰值模式的序列。
3. 状态空间混合框架(State-Space Hybrid Decoders)
状态空间解码器(State-Space Decoders)利用选择性状态空间模型(如 Mamba2)的线性递归形式,在自回归生成中以 $\mathcal{O}(1)$ 的常数级单步显存与计算开销维护无限长历史上下文,消除了 Transformer 解码器随生成长度线性膨胀的 KV Cache 瓶颈。基于结构化状态空间对偶性(Structured State Space Duality, SSD),其线性状态递推可精确等价为半可分矩阵(Semiseparable Matrix)对偶变换:
\[h_t = a_t h_{t-1} + B_t x_t, \quad y_t = C_t^\top h_t \quad \Longleftrightarrow \quad y = M x, \quad M_{ij} = \mathbb{I}(j \le i)\, C_i^\top A_{j:i+1} B_j.\]然而,两项固有限制制约了纯状态空间解码器在基因组中的通用性:一是固定维度的递归隐状态对超长距离下的单核苷酸精细互作存在有损压缩,需交错混入少量自注意力层以恢复精确上下文检索;二是单向因果掩码使词元表征缺失右侧下游序列信息,在迁移至启动子或增强子分类等判别式理解任务时存在结构性劣势,需配合序列重放(如回声嵌入)等机制补全双向视野。
⚪ HybriDNA:结构化状态空间对偶与因果注意力混合的长程模型
- paper:HybriDNA: A Hybrid Transformer-Mamba2 Long-Range DNA Language Model(ICLR 2025 Workshop)
HybriDNA 将 Mamba2 结构化状态空间对偶块与标准 Transformer 因果自注意力块按 $7:1$ 比例交错堆叠,并结合序列重复的回声嵌入(Echo Embedding)判别式微调与指令提示生成式微调,在 $131\text{ kb}$ 单核苷酸窗口下统一支持长程基因组理解与顺式调控元件设计。
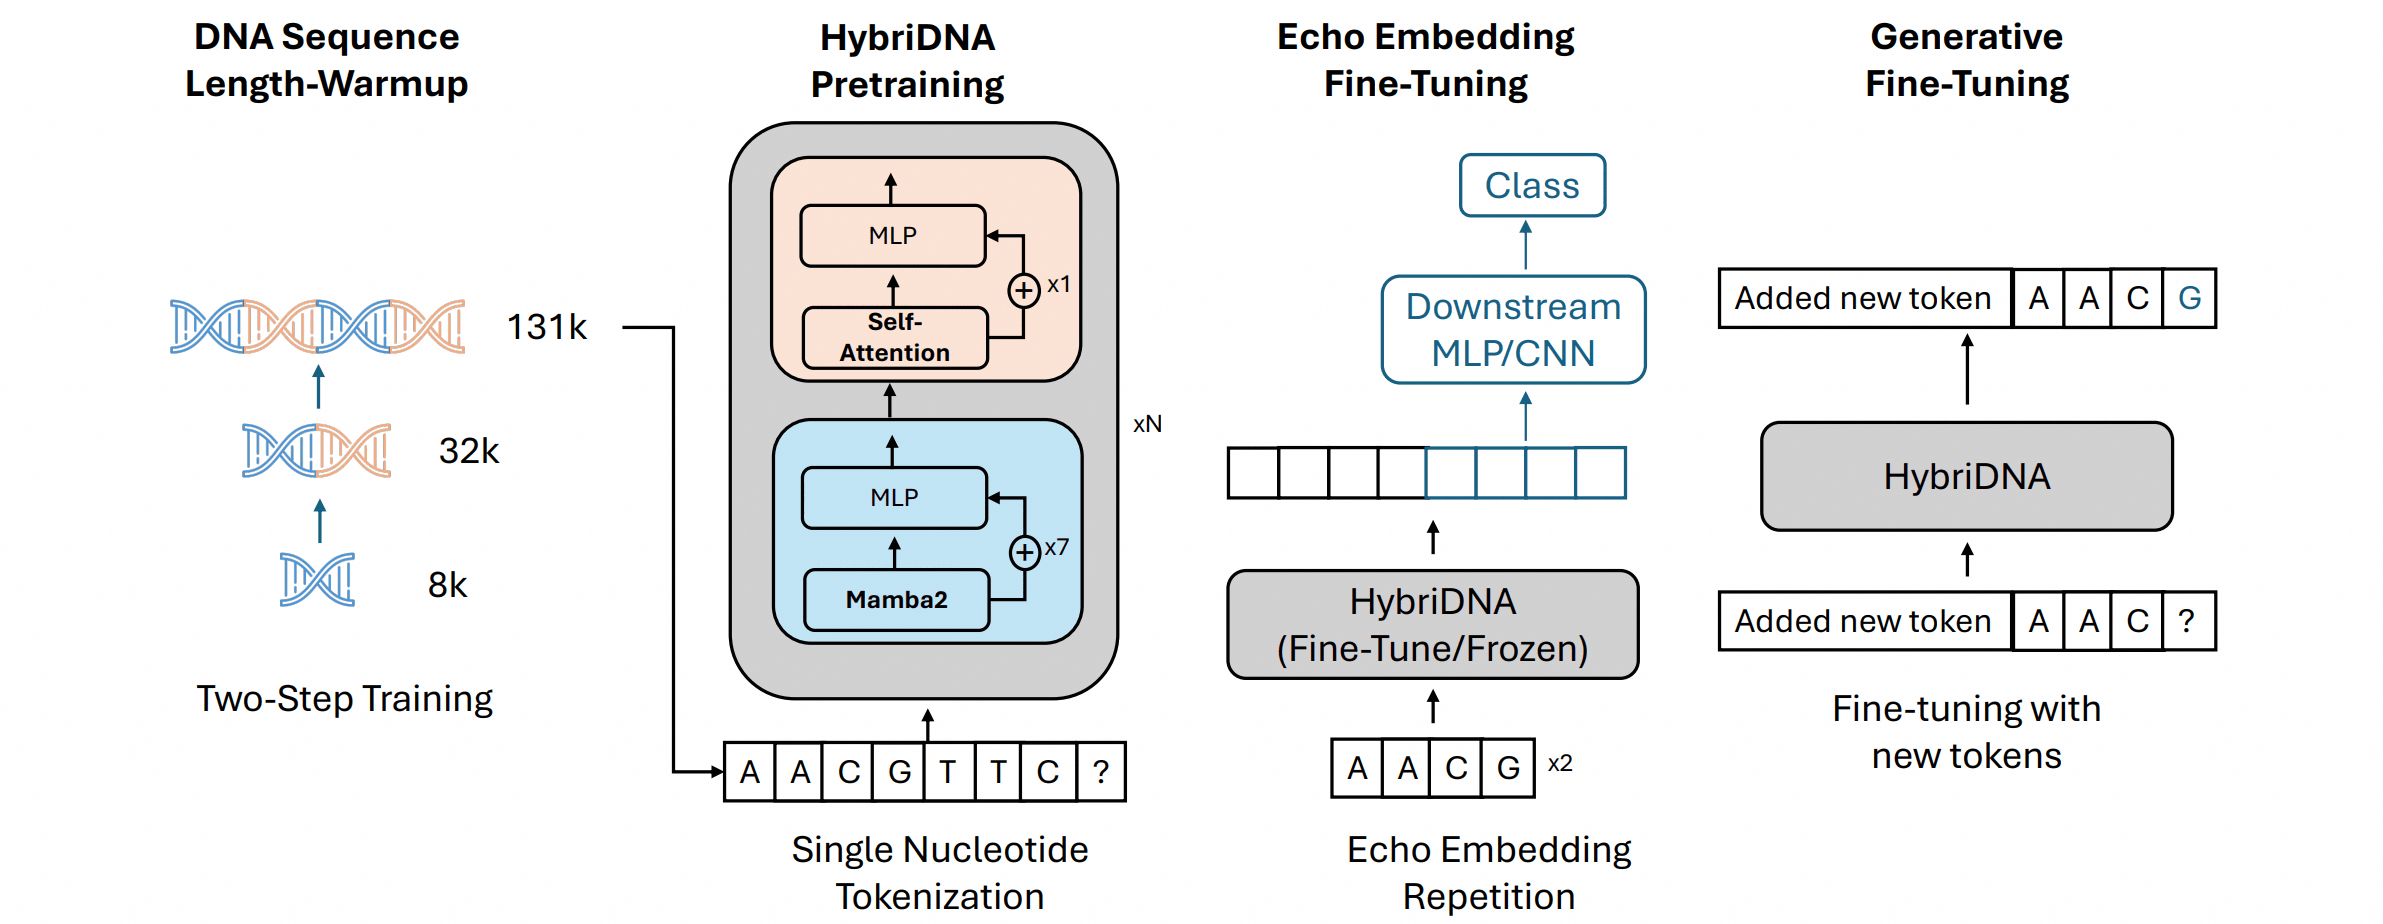
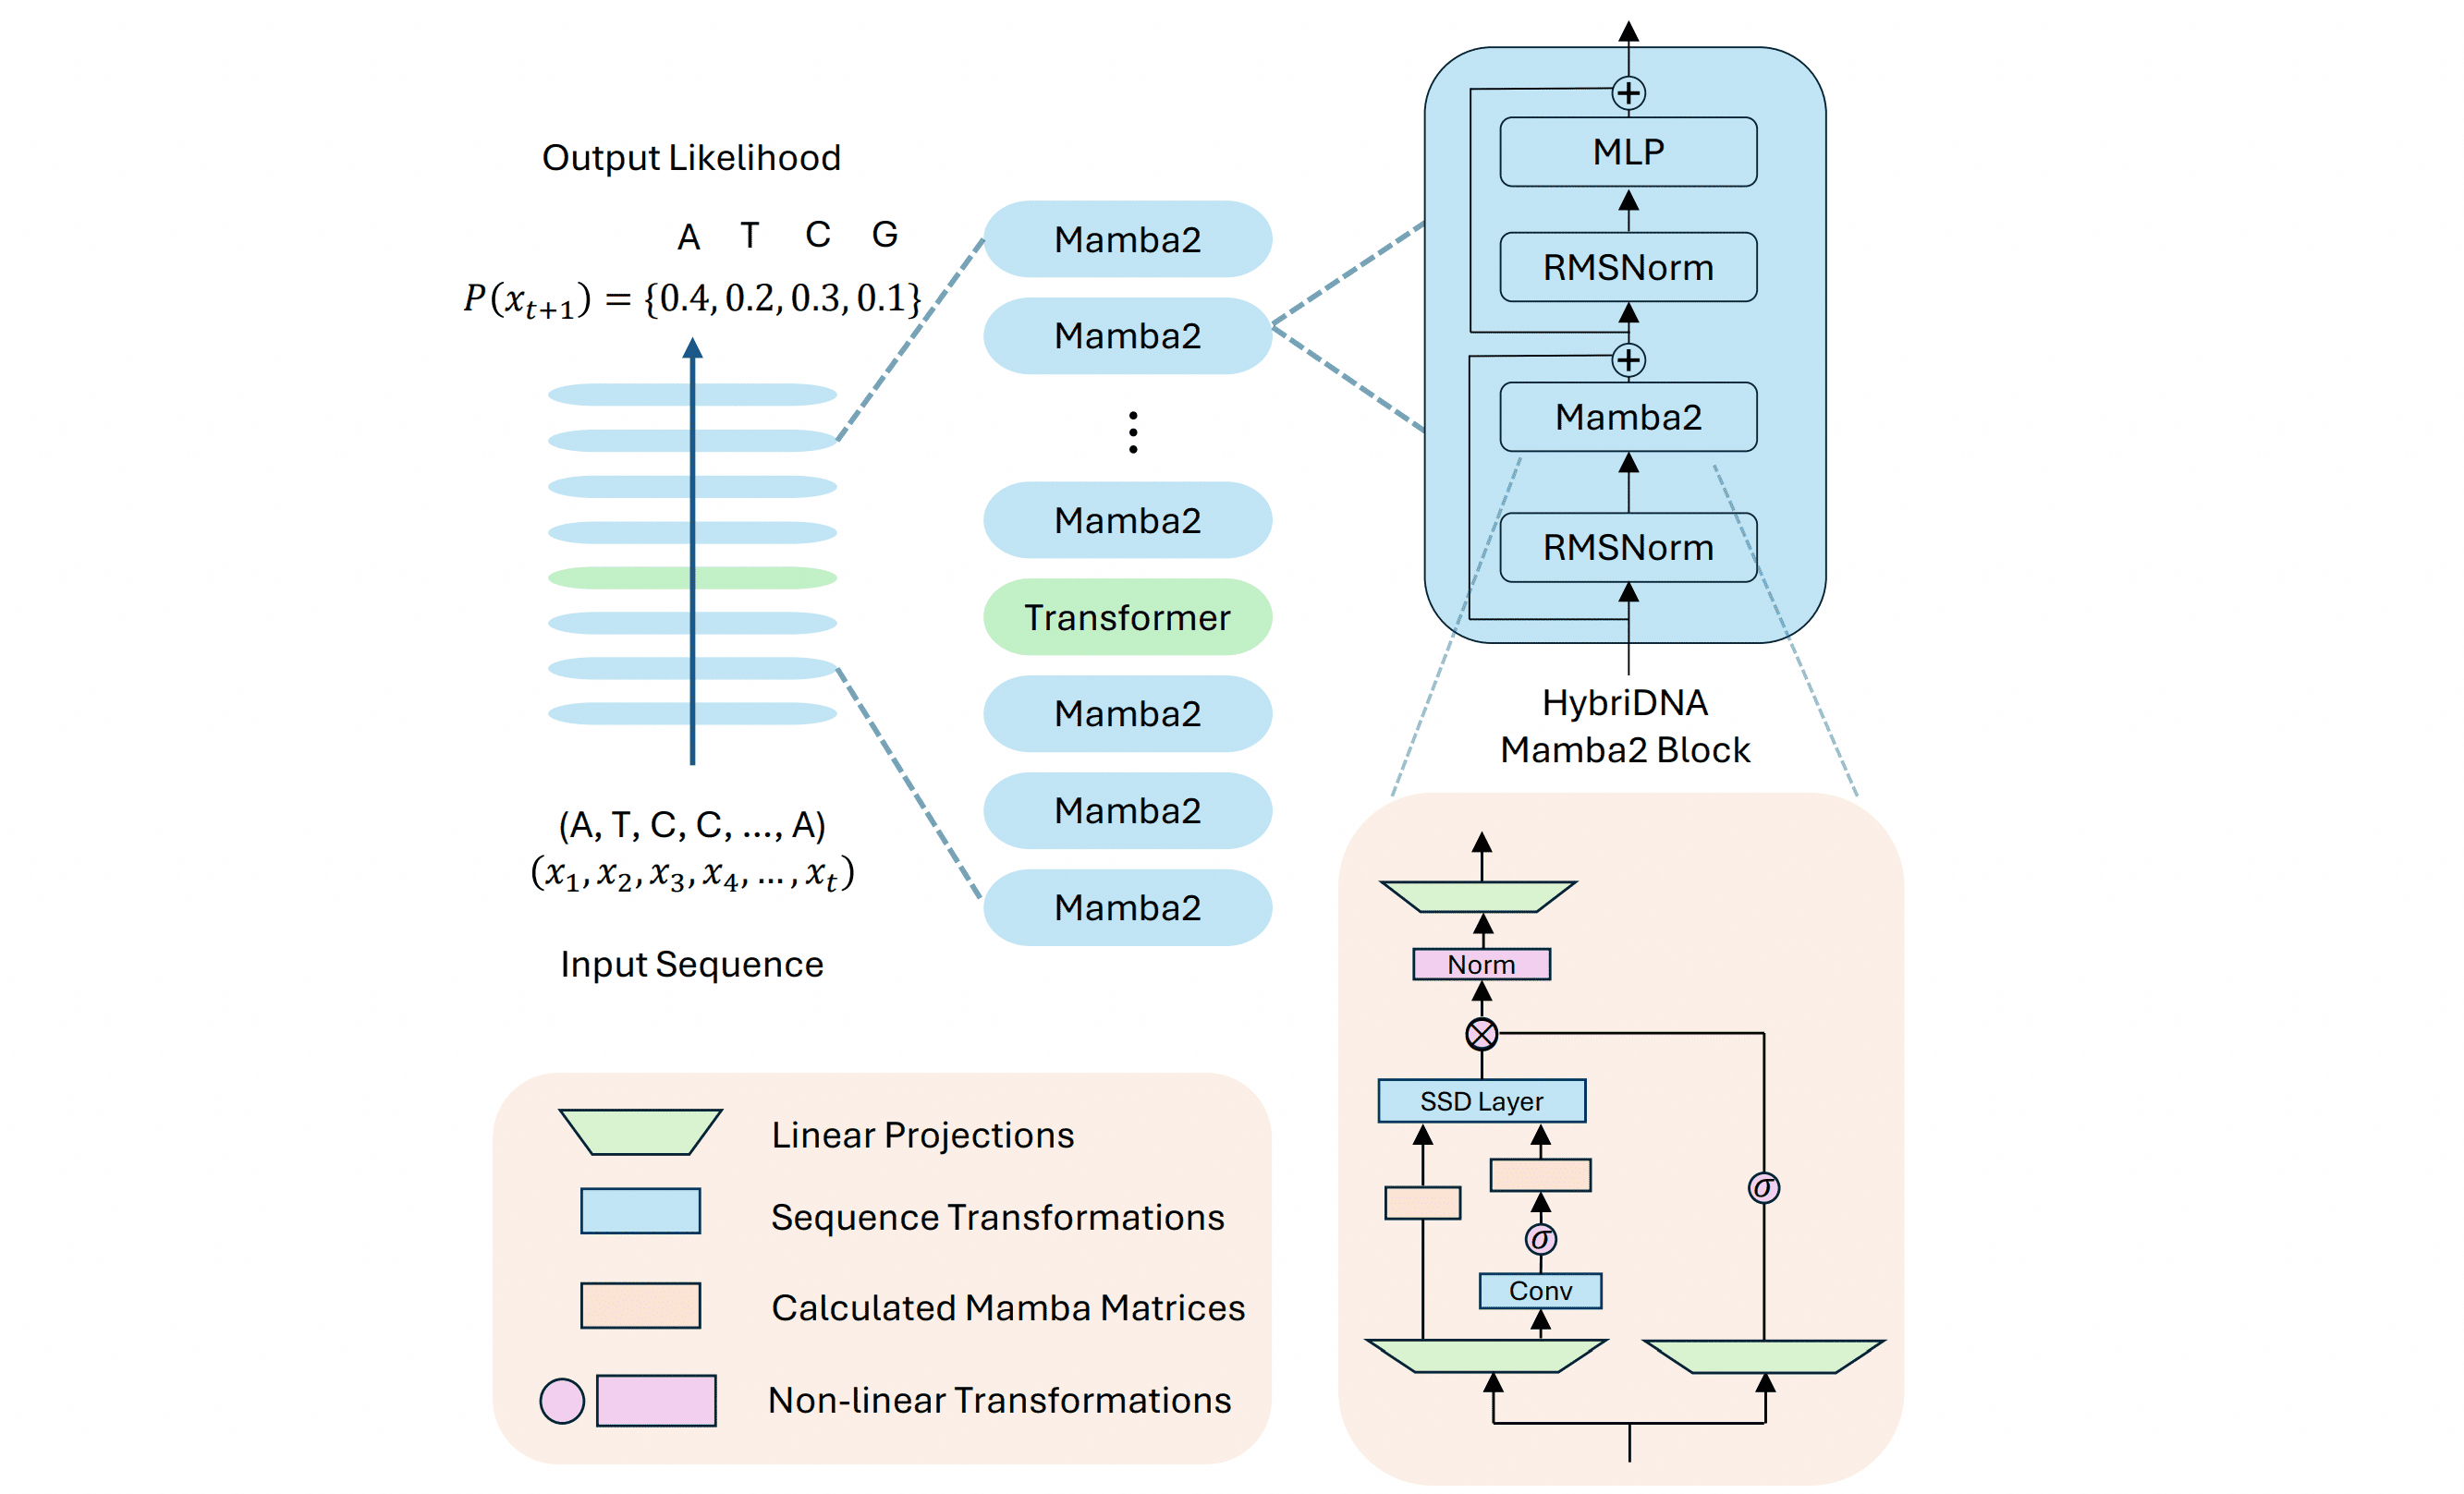
7:1 交错混合架构与 SSD 算子: 模型采用单核苷酸分词且省略显式位置编码,每 $8$ 层由 $7$ 个 Mamba2 块与 $1$ 个 Transformer 解码器块交错构成。Mamba2 内部的多头结构化状态空间对偶(SSD)层将状态转移矩阵简化为标量与单位阵的乘积 $A_t = a_t I$,其半可分矩阵可分解为低秩项与下三角项之和 $M = U V^\top + K$,在 $\mathcal{O}(NL)$ 线性复杂度下完成全局上下文聚合。
回声嵌入判别式微调与提示生成微调: 为弥补因果解码器无法感知右侧上下文的缺陷,模型在分类任务中将输入序列重复拼接构造回声输入 $x_{\mathrm{echo}} = [x, x]$,使后半段重复序列完整关注前半段全部上下文,仅提取后半段末层隐状态均值池化得到 $h_\theta(x_{\mathrm{echo}})$ 送入分类头;在调控元件生成任务中,则在序列前端拼接活性等级提示词元 $z_{0:k-1}$ 最小化条件自回归损失:
\[\begin{aligned} &P(y \mid x) = \mathrm{Softmax}\big(h_\theta(x_{\mathrm{echo}})W + b\big), \\ &\mathcal{L}_{\mathrm{gen}}(\theta) = -\frac{1}{T}\sum_{t=1}^T \log p_\theta(x_t \mid z_{0:k-1}, x_{<t}). \end{aligned}\]⚪ SparseDNA:嵌入轻量线性共享-路由专家的状态空间模型
- paper:SparseDNA: Efficient Genomic Sequence Modeling via Sparse Experts in State Spaces(DASFAA 2026)
SparseDNA 将包含共享专家与路由专家的轻量级混合专家模块直接嵌入 Mamba 块的输入投影阶段,在保持状态空间模型 $\mathcal{O}(L)$ 线性复杂度与低激活开销的同时,为异质性基因组信号提供条件化特征特化能力。
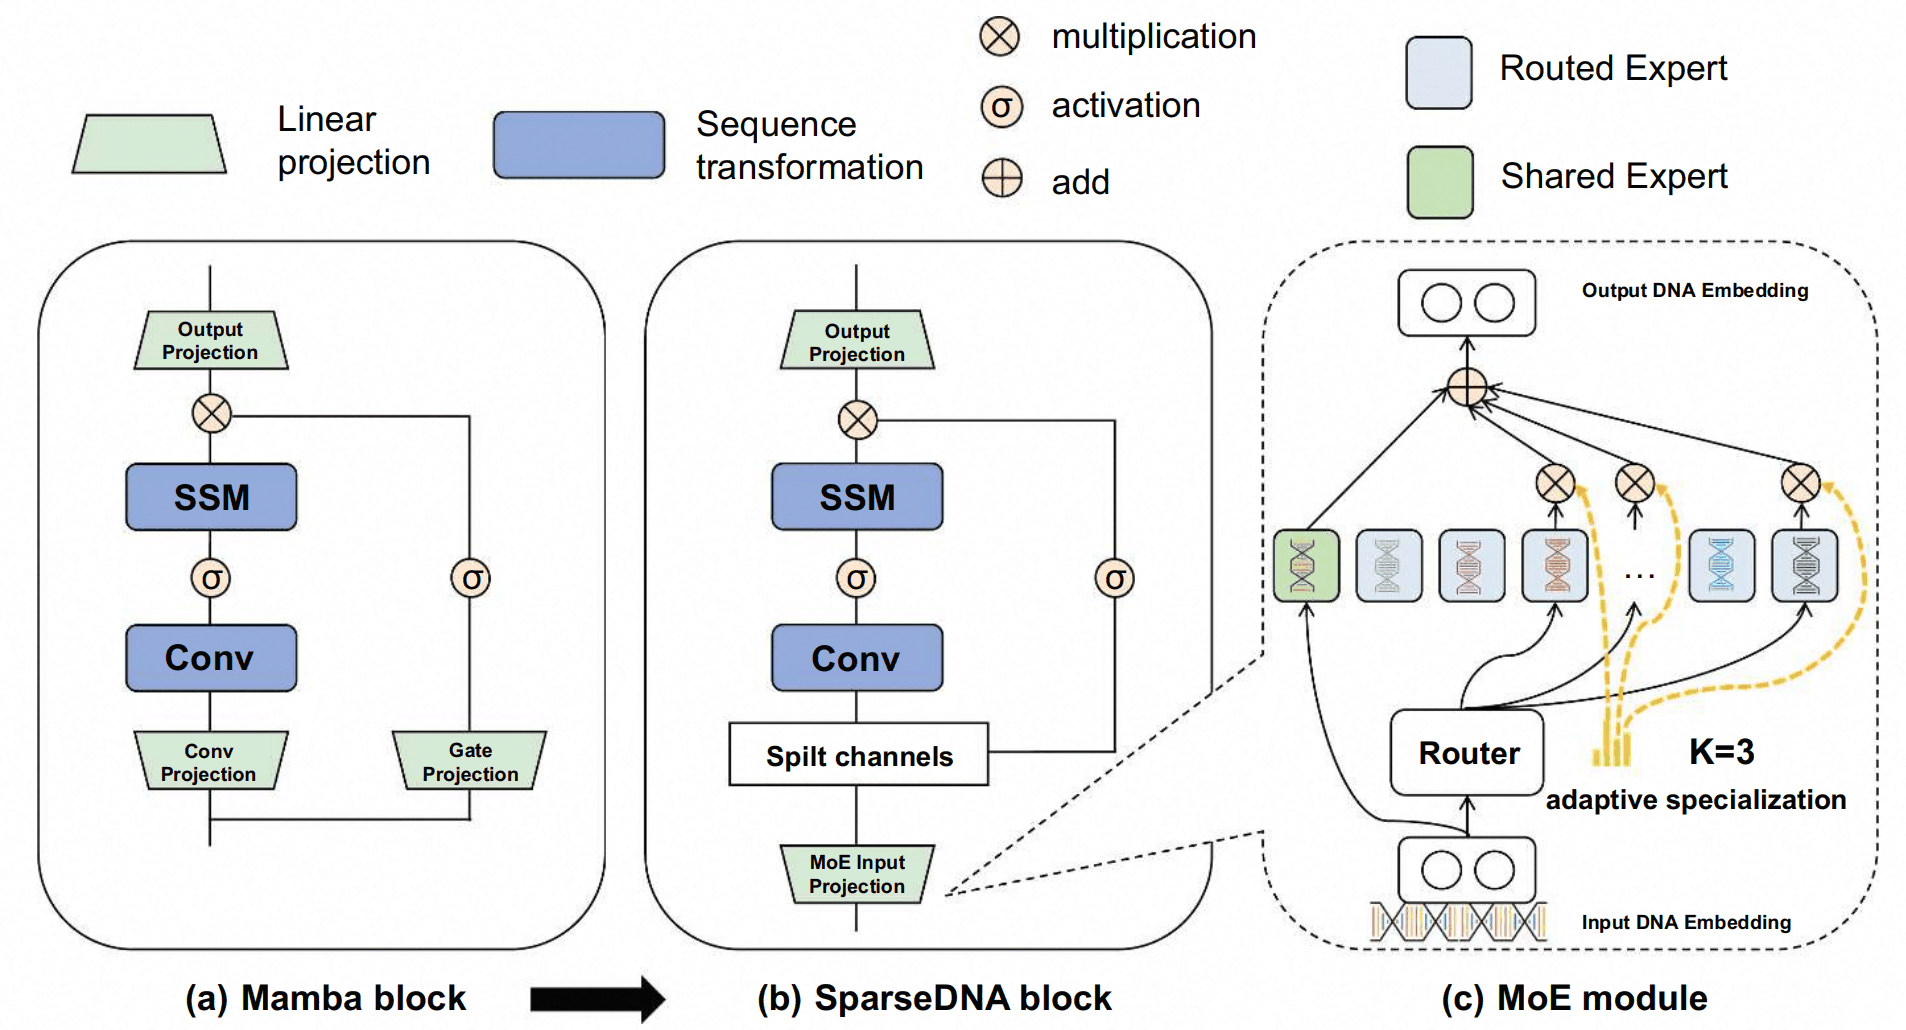
轻量级共享-路由线性专家与内嵌投影: 模型将每个专家参数化为单层线性投影 $E_k(x) = W_k x + b_k$,并同时配置 $1$ 个始终激活的共享专家 $E_{\mathrm{shared}}$ 与 $N_e$ 个按 Top-$K$ 策略稀疏激活的候选路由专家。该混合专家函数 $f_{\mathrm{MoE}}(\cdot)$ 直接替代标准 Mamba 块的前置稠密输入投影,其输出沿通道维对半切分为卷积输入 $X_c$ 与门控输入 $X_g$:
\[\begin{aligned} &\tilde{X} = f_{\mathrm{MoE}}(X) = \sum_{k=1}^{N_e} \mathrm{Softmax}(W_r X)_k E_k(X) + E_{\mathrm{shared}}(X), \\ &[X_c, X_g] = \mathrm{Split}(\tilde{X}), \quad H_c = \mathrm{Conv1D}(X_c), \quad H_g = \sigma(X_g). \end{aligned}\]随后 $H_c$ 进入选择性状态空间算子进行线性状态递推,并与 $H_g$ 逐元素相乘融合。该设计仅在进入状态空间前引入稀疏条件计算,不改变底层 SSM 的线性动态递推机制。
4. 其他框架(Other Architectures)
⚪ ENBED:字节级精度与亚二次注意力的非对称编码-解码器
- paper:Understanding the natural language of DNA using encoder–decoder foundation models with byte-level precision(Bioinformatics Advances 2024)
ENBED 采用层数比为 $2:1$ 的非对称编码器—解码器 Transformer 架构,结合单核苷酸字节级分词与滑动窗口—全局块聚合混合注意力,在单碱基分辨率下将上下文扩展至 $16{,}384\text{ bp}$,统一支持序列分类、测序噪声识别与序列到序列的病毒突变生成。
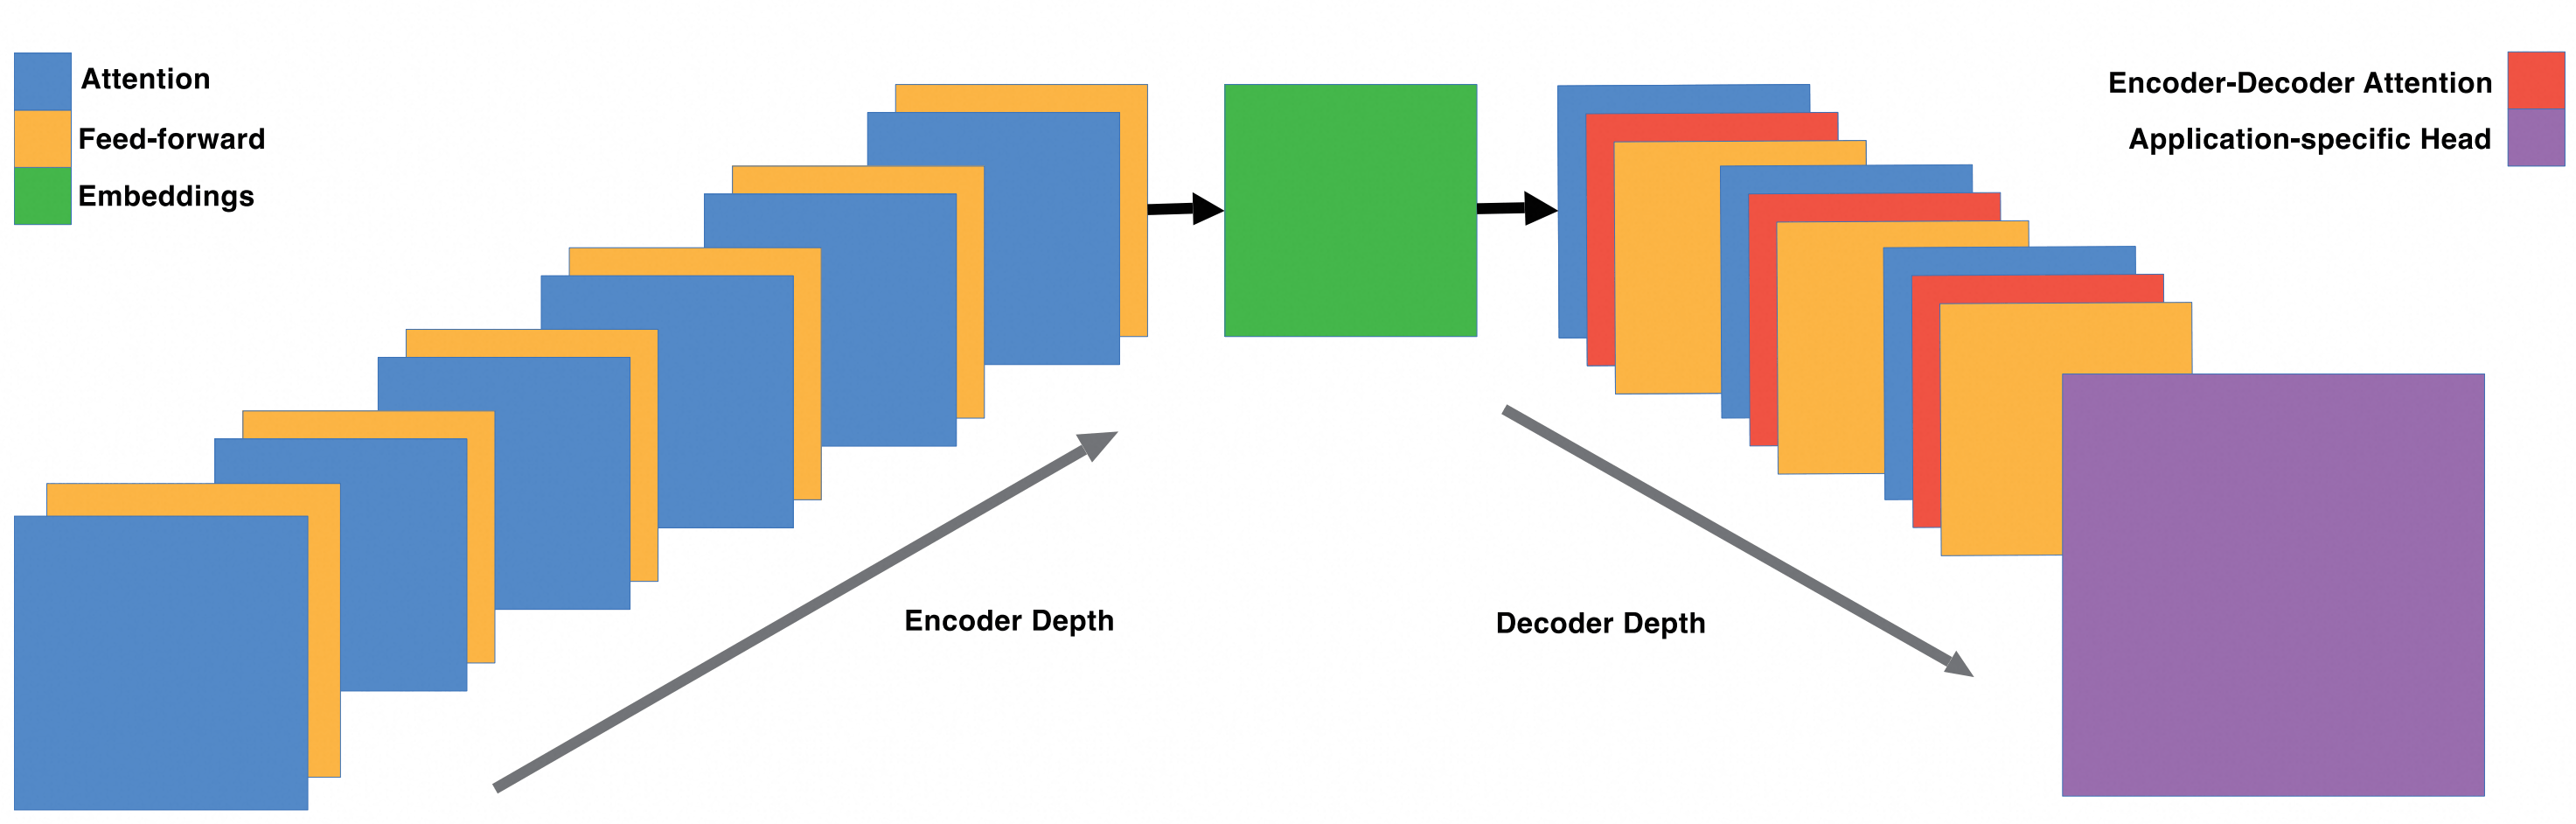
2:1 重编码器架构与亚二次混合注意力: 模型采用单核苷酸字节级分词,将主要参数容量分配给双向编码器,解码器则通过交叉注意力读取编码器表征。为将注意力复杂度降至亚二次方,模型组合两类稀疏注意力:(1)滑动窗口注意力限制每个词元仅关注半径为 $r$ 的局部邻域,复杂度为 $\mathcal{O}(L \times r)$;(2)块聚合全局注意力将序列均分为 $k$ 个连续块,对块内词元嵌入求和归一化构造 $k$ 个全局词元,令每个输入词元同时关注局部邻居与全部 $k$ 个全局词元,使总复杂度控制在 $\mathcal{O}\big(L(r + k)\big)$。模型在多物种语料上执行短跨度掩码预训练,判别任务直接提取编码器末层输出,病毒抗原演化预测则由解码器自回归生成候选子代序列。
⚪ OpticalDNA:基于多模态文档渲染与 OCR 的基因组视觉建模
- paper:Rethinking Genomic Modeling Through Optical Character Recognition(ICML 2026)
针对一维序列模型处理长基因组时需逐词元扫描大段低信息密度背景区域的问题,OpticalDNA 将一维 DNA 序列转化为二维图像文档,利用高压缩比视觉 token 实现区域级阅读、定位与检索。

DNA 文档渲染与视觉压缩编解码: 模型将长序列按行连续光栅化为多页固定分辨率 RGB 图像文档 \(D(S)=(\{\text{page}_p\}_{p=0}^{P-1},\{B^{(p)}\}_{p=0}^{P-1})\),建立从一维序列区间到二维像素边界框的双射映射,并围绕全文转录、感兴趣区域(ROI)框转录、涂白补全与子序列检索定位等六类光学字符识别(OCR)问答任务进行预训练。视觉编码器 $E_\theta$ 提取每页图像 patch 特征,经卷积 $16\times$ 下采样、投影器 $\Pi_\theta$ 与多页融合模块 $F_\theta$ 聚合成文档级视觉表示 $Z$;随后由混合专家(MoE)自回归解码器 $G_\psi$ 在指令 $q$ 条件下生成输出序列 $\hat Y$:
\[Z = F_\theta\big(\Pi_\theta(V(\{\text{page}_p\}))\big) \in \mathbb{R}^{L\times d}, \quad P_\psi(\hat Y\mid Z,q)=\prod_{t=1}^{T}P_\psi(\hat y_t\mid\hat y_{<t},Z,q).\]下游任务直接丢弃解码器,利用冻结的视觉编码器提取多页特征并池化输入轻量分类头。
⚪ D3LM:连续掩码率加权去噪的离散扩散基因组语言模型
- paper:D3LM: A Discrete DNA Diffusion Language Model for Bidirectional DNA Understanding and Generation(ICLR 2026 Workshop)
D3LM 在双向 Transformer 架构下引入离散掩码扩散语言建模范式,通过连续掩码率加权交叉熵目标,将双向基因组表征学习与非顺序迭代去噪生成统一于单一模型。
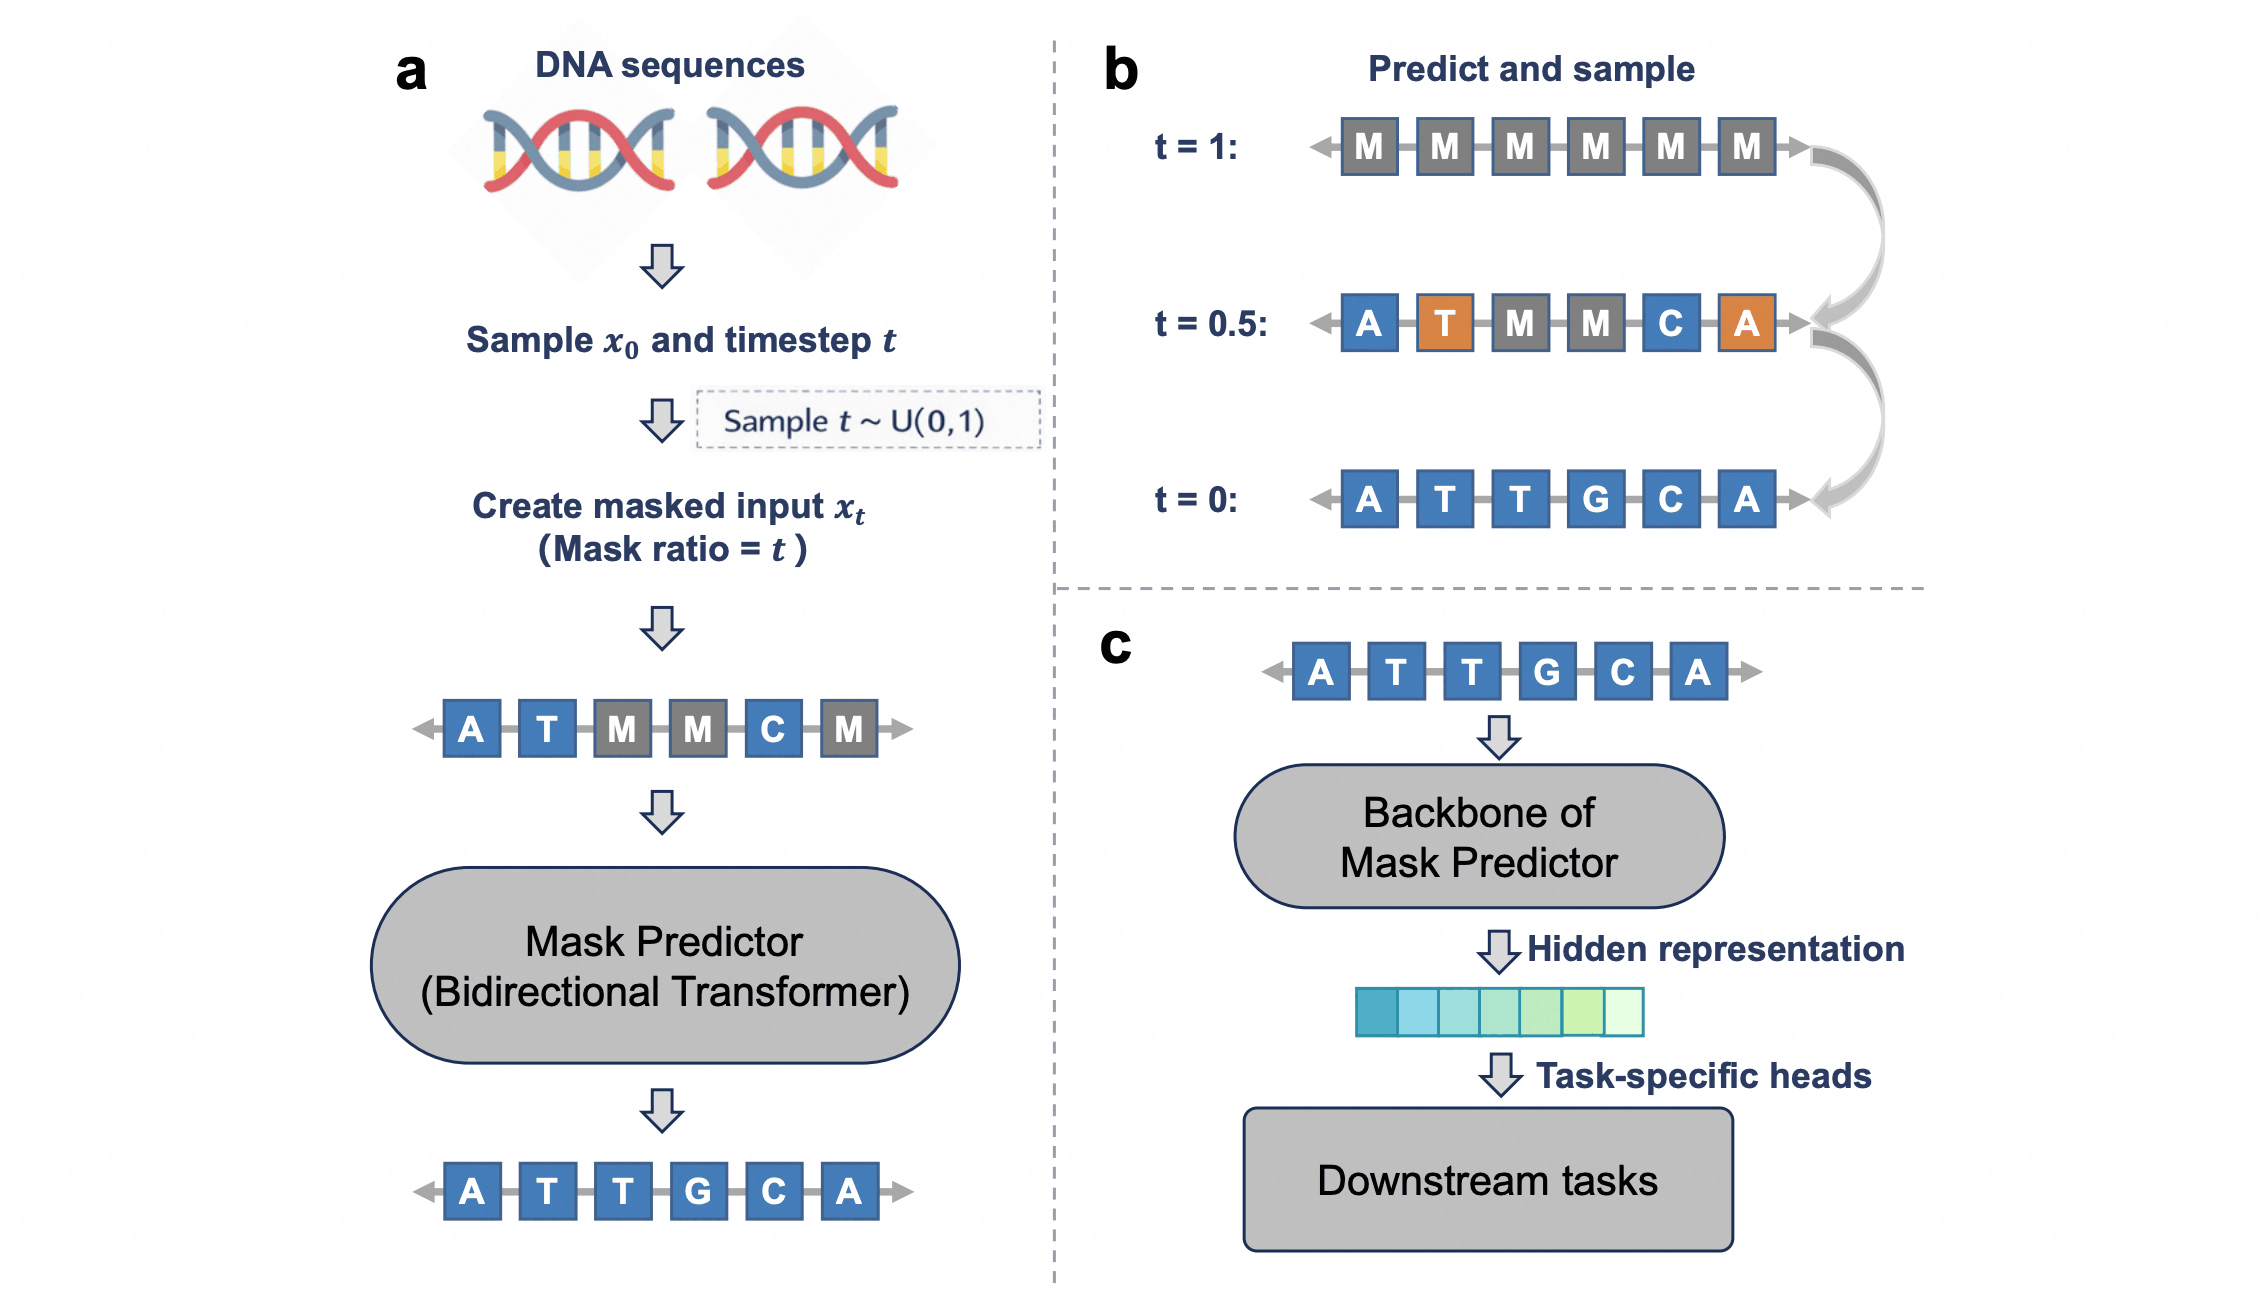
连续掩码率扩散训练与逆向去掩码采样: 模型复用 NT-v2 双向 Transformer 主干与非重叠 $6$-mer 分词。前向加噪过程从 $t \in [0, 1]$ 均匀采样掩码率,将干净序列 $x_0$ 的每个位置独立以概率 $t$ 替换为 [M] 得到 $x_t$;反向过程通过双向网络同步预测被遮蔽词元,优化 $1/t$ 加权交叉熵变分上界:
\[\mathcal{L}(\theta) = -\mathbb{E}_{t, x_0, x_t}\!\left[\frac{1}{t}\sum_{i=1}^L \mathbb{I}[x_t^i = \mathrm{[M]}]\log p_\theta(x_0^i \mid x_t)\right].\]从头生成时,模型从全掩码序列 $x_1$ 出发离散化为 $T$ 步迭代恢复:在每步 $t$ 对当前掩码集合 \(\mathcal{M}_t\) 预测带温度 $\tau$ 缩放的分布 \(p_\theta^{\mathrm{temp}}(x_0^i \mid x_t) \propto p_\theta(x_0^i \mid x_t)^{1/\tau}\),并按置信度或熵调度选取子集 \(\mathcal{U}_t \subset \mathcal{M}_t\) 执行并行去掩码转移:
\[x_{t-1}^i = \begin{cases} \text{sample from } p_\theta^{\mathrm{temp}}(x_0^i \mid x_t), & \text{if } i \in \mathcal{U}_t, \\ \mathrm{[M]}, & \text{if } i \in \mathcal{M}_t \setminus \mathcal{U}_t, \\ x_t^i, & \text{otherwise}. \end{cases}\]由于训练覆盖了 $t \to 0$ 的全连续谱掩码水平,推理时可直接输入未加噪序列($t=0$)提取无偏移的双向表征进行判别式微调。