Genome Foundation Model part III: Encoder Architectures.
基因组基础模型(Genome Foundation Model, gFM),又称基因组语言模型(Genomic Language Model, gLM),将 DNA 序列映射为长度为 $T$ 的离散词元序列 $z_{1:T}$,通过在大规模无标注基因组语料上拟合边缘概率或条件概率分布 $p_\theta(z)$,学习具备跨任务迁移能力的通用基因组表征。
本文是基因组基础模型系列的第三篇。全系列按“分词 → 预训练 → 编码器 → 解码器 → 多模态”的脉络组织:
- I. DNA 分词策略:如何将碱基序列切分为词元。
- II. 预训练策略:如何构造自监督信号从无标注基因组中学习。
- III. 编码器框架:模型如何在长序列上混合上下文信息。
- IV. 解码器框架:模型如何评估序列似然并生成新序列。
- V. 多模态模型:如何联合建模基因组序列、其他生物分子与人类自然语言。
真核生物基因组序列跨越 $10^2$ 至 $10^9\text{ bp}$ 量级,远端增强子与靶基因启动子可相距数十至数百 kb,而中间穿插着大段与该调控互作无关的基因间区背景。编码器框架(Encoder Architecture)的设计主线是:在维持单核苷酸级分辨率与双向上下文可见性的同时,以更低复杂度的序列混合算子换取更长的有效感受野,并将 DNA 双链反向互补(Reverse Complement, RC)对称性等物理先验嵌入网络结构。
- 1. Transformer 框架(Transformer Architectures)
- DNABERT:重叠 $k$-mer 分词的基因组双向编码器
- DNABERT-2:字节对编码与线性偏置注意力的多物种编码器
- Nucleotide Transformer:跨物种与群体多态性预训练的规模化编码器
- NTv3:卷积-Transformer 混合 U-Net 与功能-生成联合建模
- dnaGrinder:序列长度预热与双亲本变异去重语料的轻量编码器
- AIDO.DNA:基于单核苷酸分词与依赖图谱的规模化多物种编码器
- DeepGene:基于泛基因组变异图序列化的双向编码器
- GENA-LM:块稀疏注意力与循环记忆机制的长序列编码器
- ModernGENA:融合局部-全局交替注意力与无填充打包的高效基线
- TrinityDNA:多尺度沟槽卷积与滑动多窗口注意力的长序列编码器
- 2. 卷积网络框架(Convolutional Architectures)
- 3. 状态空间框架(State-Space Architectures)
- 4. 循环与记忆网络框架(Recurrent & Memory Architectures)
1. Transformer 框架(Transformer Architectures)
Transformer 编码器通过自注意力机制,在单层内直接建立序列任意两个位置间的交互通道。给定隐状态矩阵 $H \in \mathbb{R}^{T \times d}$,其核心算子定义为缩放点积注意力:
\[\mathrm{Attention}(Q, K, V) = \mathrm{Softmax}\!\left(\frac{QK^\top}{\sqrt{d_k}} + B\right)V,\]其中 $B \in \mathbb{R}^{T \times T}$ 为相对位置偏置或稀疏掩码矩阵。这种无视物理距离的直接路由机制,契合了基因组三维染色质折叠下远端顺式调控元件(如增强子与启动子)跨越长距离发生物理接触的生物学特性。
然而,标准自注意力在基因组建模中受制于 $\mathcal{O}(T^2)$ 的时间与显存复杂度。在单碱基分辨率下,数万至百万碱基的基因组窗口会迅速耗尽硬件显存,且过长的序列会导致注意力权重分布趋于平缓(过平滑现象)。为此,基因组 Transformer 编码器沿着三条路径演进:(1)通过 $k$-mer、BPE 分词或卷积 U-Net 下采样缩短进入注意力层的有效词元数 $T$;(2)引入块稀疏注意力、局部—全局交替滑动窗口或跨片段循环记忆,将复杂度降低至近线性;(3)采用旋转位置编码(RoPE)或线性距离偏置(ALiBi)替代绝对位置嵌入,赋予模型测试时的长度外推能力。
⚪ DNABERT:重叠 $k$-mer 分词的基因组双向编码器
- paper:DNABERT: pre-trained Bidirectional Encoder Representations from Transformers model for DNA-language in genome(Bioinformatics 2021)
DNABERT 是早期将 BERT 架构直接迁移至基因组领域的代表性工作,通过重叠 $k$-mer 分词将局部碱基上下文融入单个词元,并配合连续跨度掩码在人类参考基因组上提取双向上下文表征。
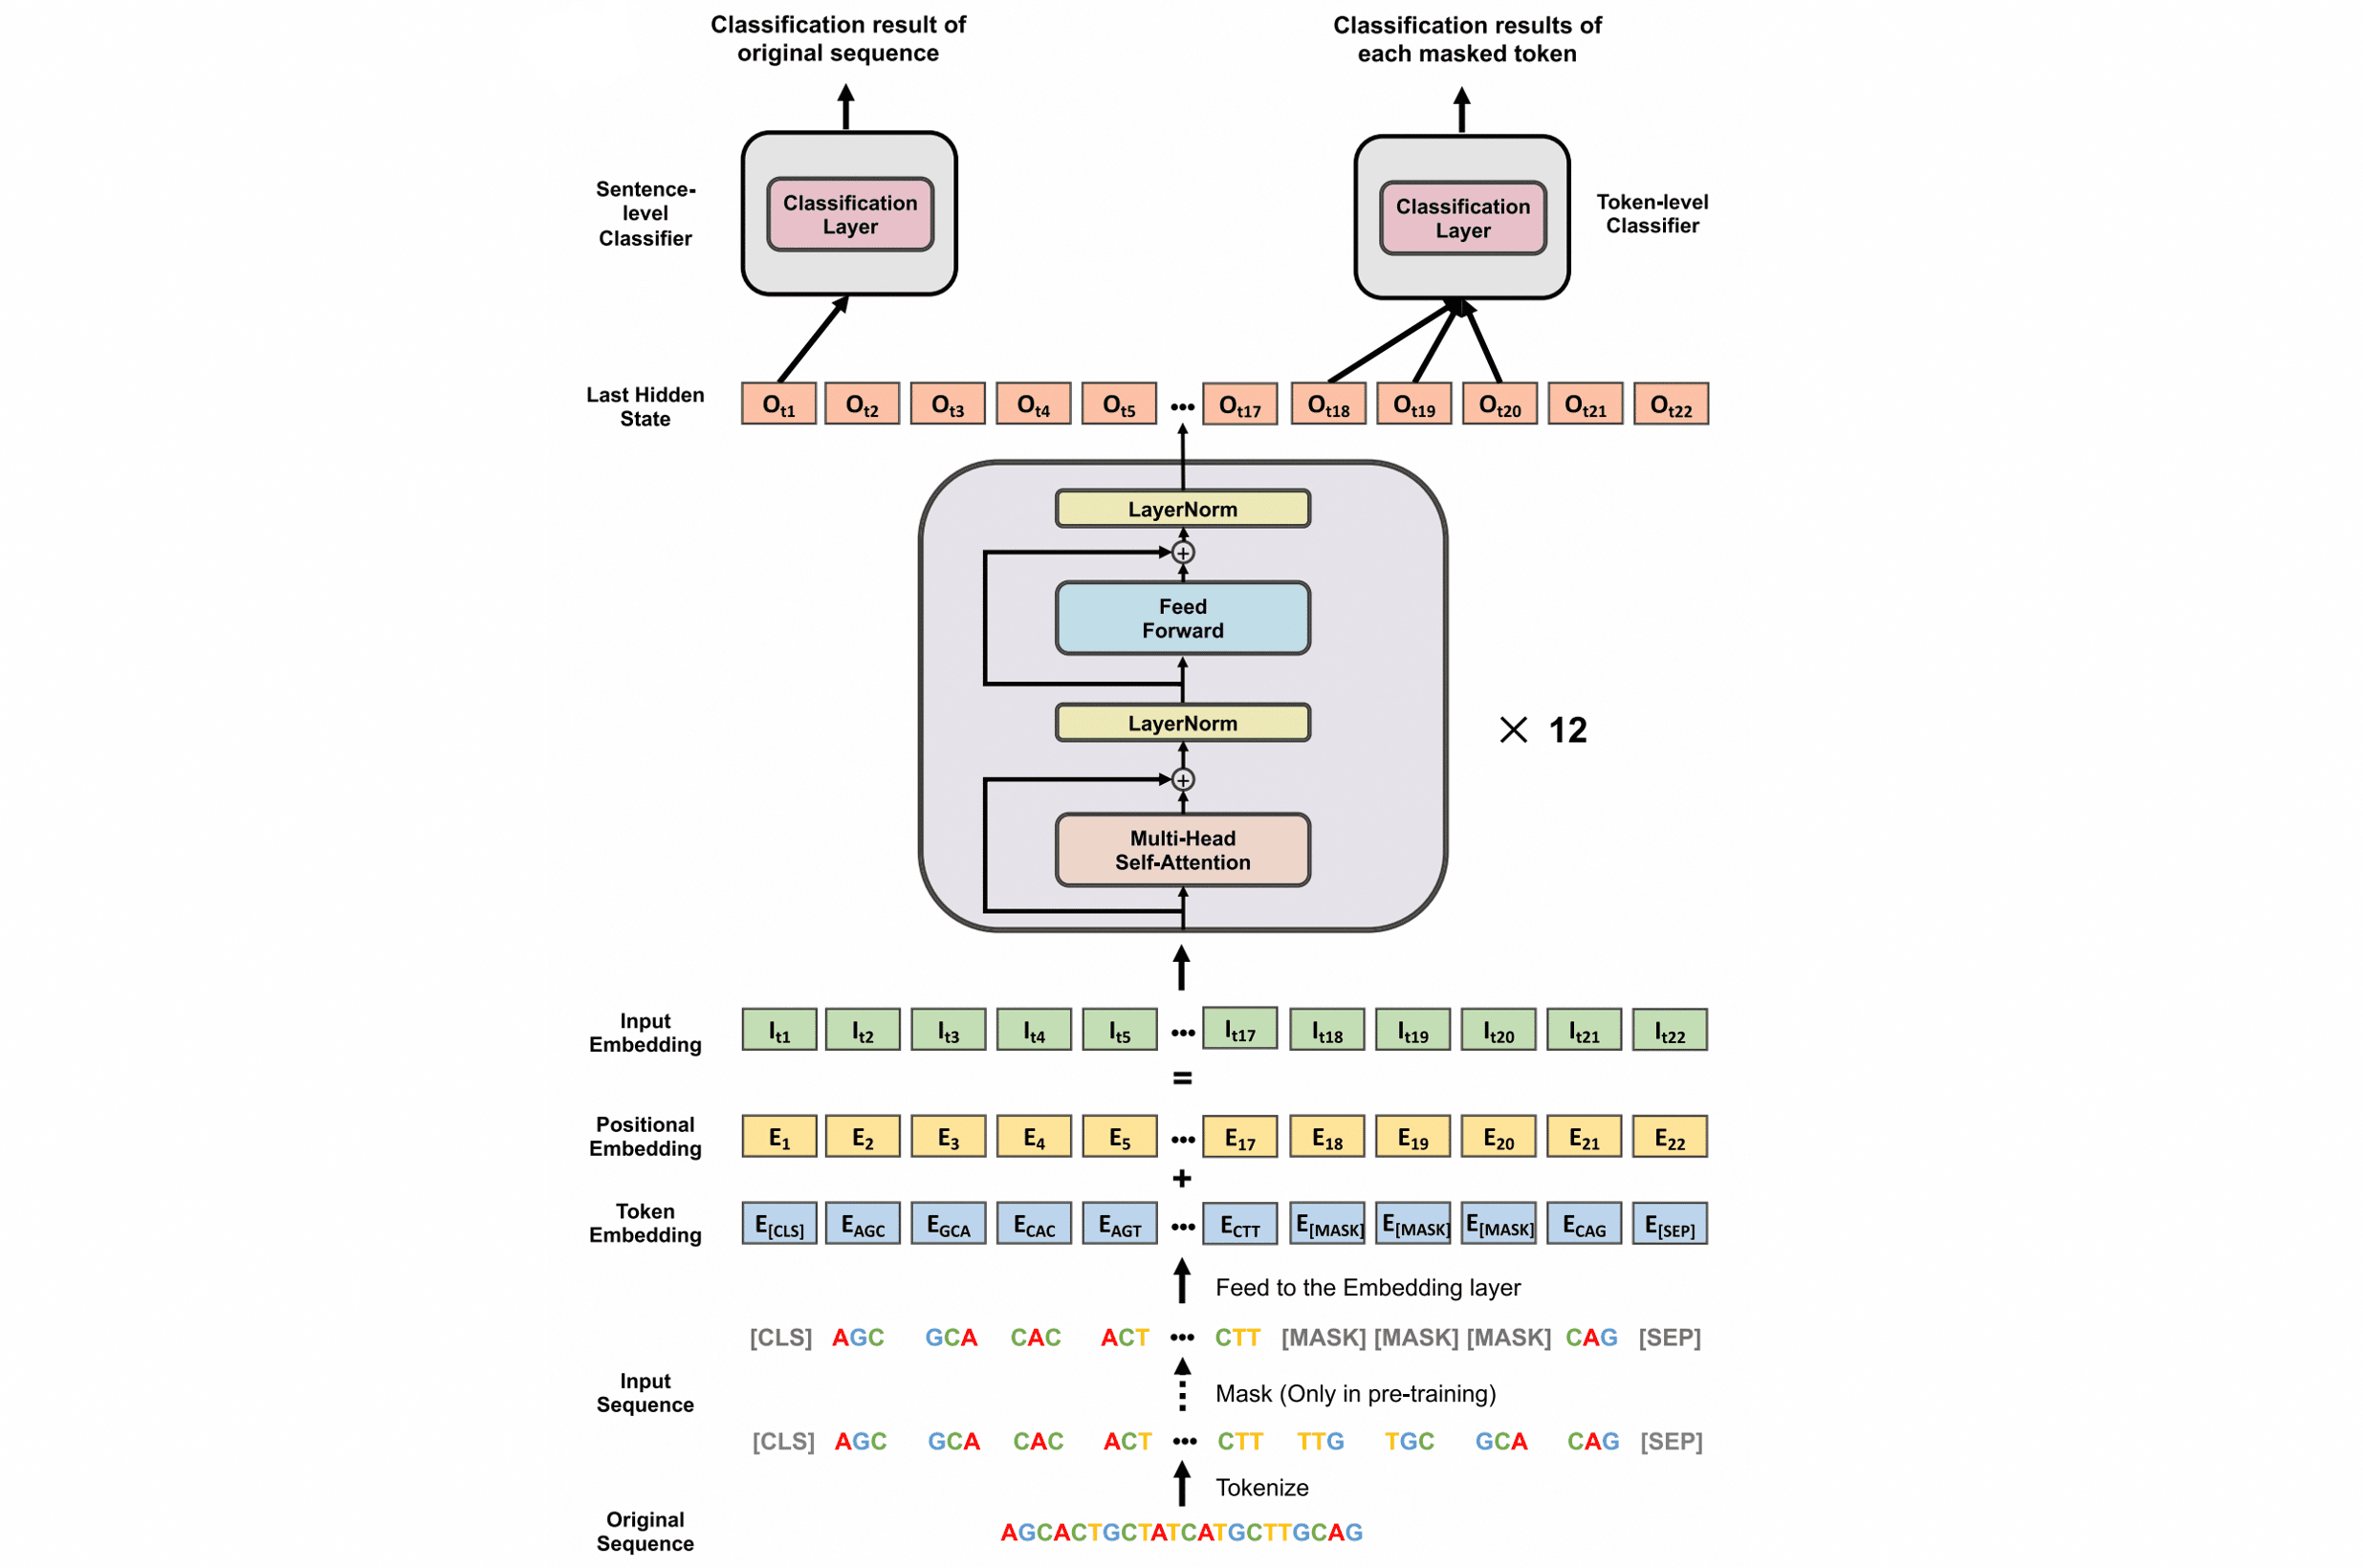
重叠 $k$-mer 分词与连续跨度掩码: 模型采用步长为 $1$ 的滑动窗口,将长度为 $L$ 的 DNA 序列转化为 $T = L - k + 1$ 个重叠 $k$-mer 词元($k \in {3, 4, 5, 6}$),词表由全部 $4^k$ 种碱基排列及 $5$ 个特殊控制符构成。词元嵌入与可学习绝对位置嵌入相加后输入双向 Transformer。由于重叠 $k$-mer 与左右相邻词元共享 $k-1$ 个碱基,独立遮蔽单个词元会被平凡恢复。为此,预训练引入连续跨度掩码,每次连续遮蔽 $k$ 个相邻词元以阻断局部信息泄漏,在被遮蔽位置集合 $\mathcal{M}$ 上最小化多分类交叉熵损失:
\[\mathcal{L}_{\mathrm{MLM}} = -\sum_{i \in \mathcal{M}}\sum_{c=1}^{\vert\mathcal{V}\vert} y'_{i,c} \log y_{i,c}.\]下游微调与分块扩展: 下游微调时,模型利用首位置 [CLS] 隐状态执行序列分类,并可通过聚合末层自注意力权重定位功能基序(DNABERT-viz)。针对超出最大窗口的长序列,扩展变体 DNABERT-XL 将序列切分为多个子片段独立编码,拼接各片段输出后再送入顶层分类器。
⚪ DNABERT-2:字节对编码与线性偏置注意力的多物种编码器
DNABERT-2 放弃了易造成长度膨胀与信息泄漏的重叠 $k$-mer 分词,在双向 Transformer 中引入字节对编码(BPE)可变长分词与线性注意力距离偏置(ALiBi),在多物种基因组语料上实现了高效的表征学习。
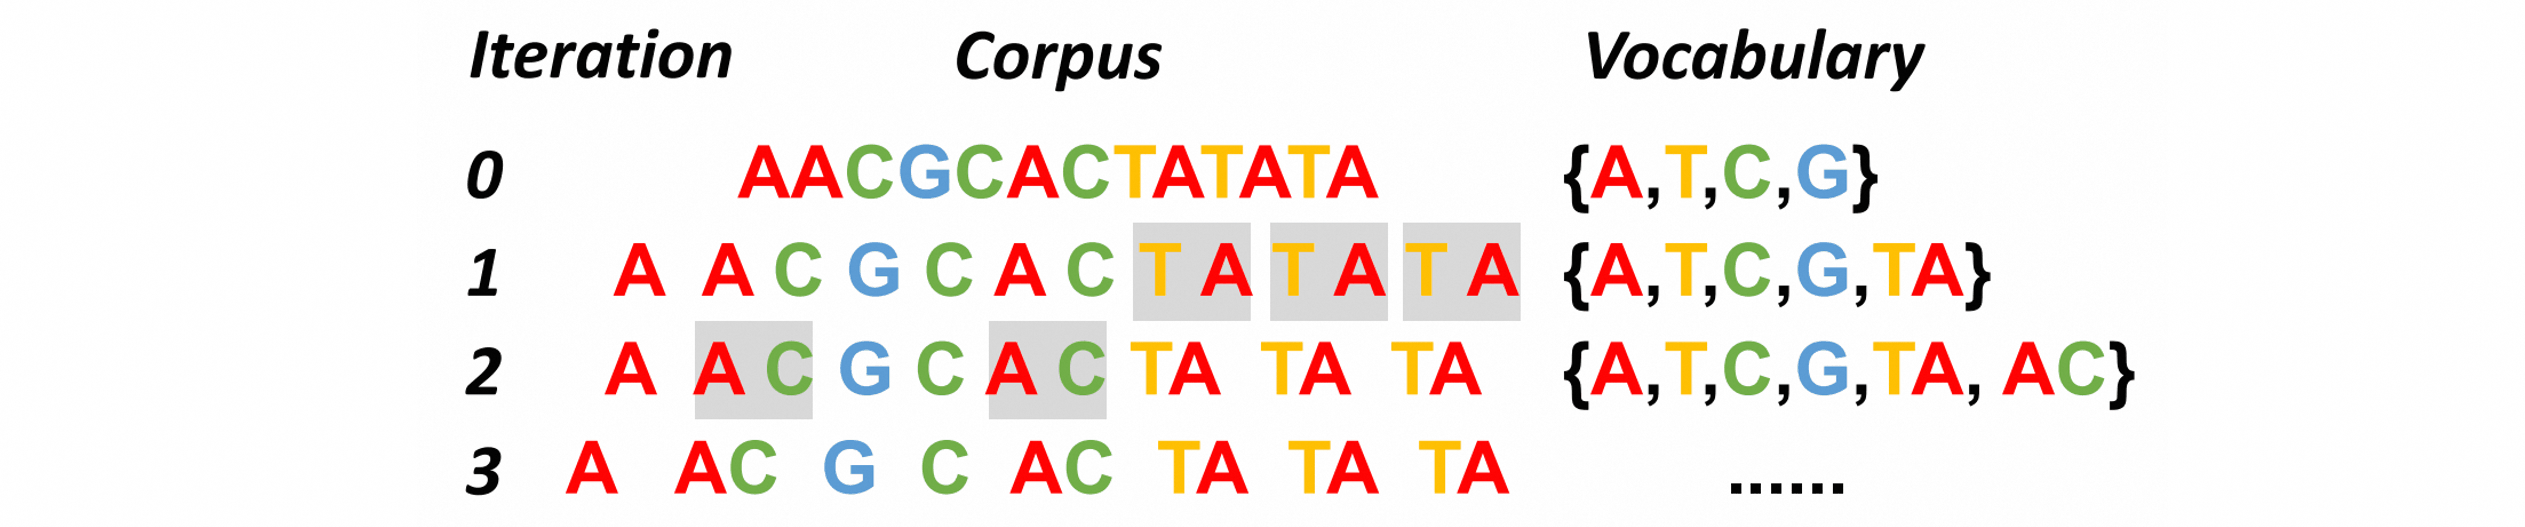
BPE 可变长分词与独立掩码: 模型从四个单碱基出发,迭代合并语料中共现频率最高的相邻片段,构建大小为 $4{,}096$ 的无重叠 BPE 词表,平均将原始碱基序列长度压缩约 $5$ 倍。由于非重叠分词消除了邻接词元的碱基共享,预训练可直接以 $15\%$ 的比例独立随机遮蔽词元(等价于在原序列上执行可变长跨度掩码),优化标准掩码语言建模损失:
\[\mathcal{L}_{\mathrm{MLM}}=-\sum_{i\in\mathcal{M}}\log p_\theta(x_i\mid x_{\setminus\mathcal{M}}).\]线性偏置注意力(ALiBi)与长度外推: 编码器移除了定长的绝对位置嵌入,在注意力得分矩阵中直接减去与词元相对距离成正比的惩罚项。设第 $h$ 个注意力头在位置 $i, j$ 处的查询与键向量为 $q_i, k_j \in \mathbb{R}^{d_k}$,未归一化的注意力分数定义为:
\[e_{ij}^{(h)}=\frac{q_i\cdot k_j}{\sqrt{d_k}}-m_h\vert i-j\vert,\]其中 $m_h$ 为预设的头特异固定斜率。该设计使位置感知摆脱了预训练窗口长度的限制,支持模型在微调与推理阶段直接外推处理更长的基因组序列。
⚪ Nucleotide Transformer:跨物种与群体多态性预训练的规模化编码器
- paper:Nucleotide Transformer: building and evaluating robust foundation models for human genomics(Nature Methods 2025)
Nucleotide Transformer(NT) 探索了基因组编码器的参数规模缩放规律,采用非重叠 $6$-mer 分词与随机阅读框偏移增强,系统整合人类参考基因组、千人基因组群体变异及跨物种基因组语料进行大规模预训练。
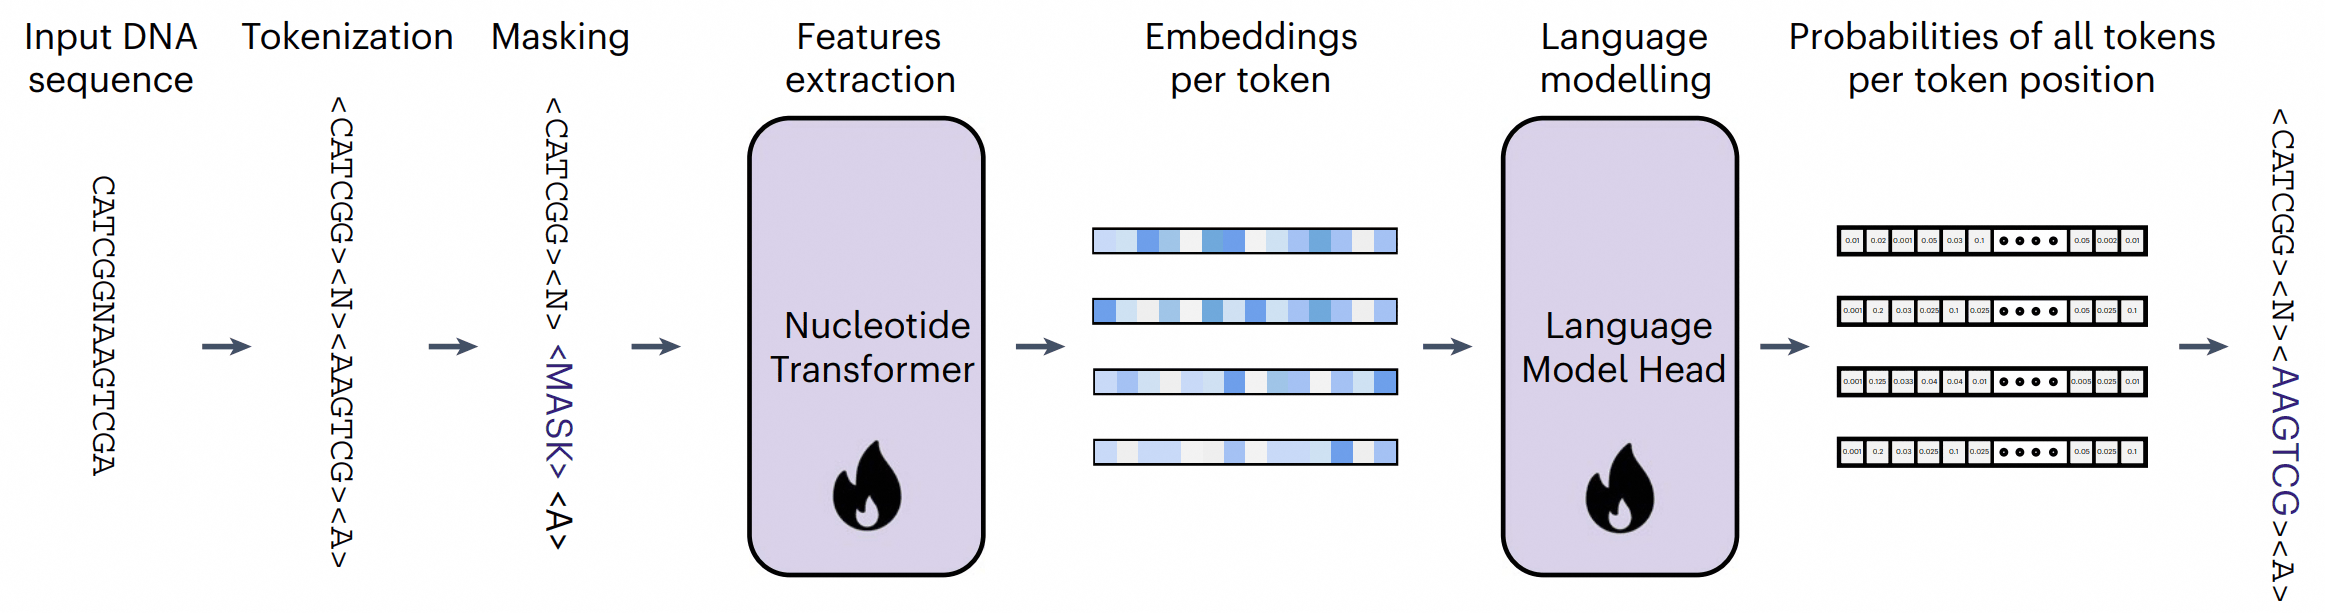
非重叠 $6$-mer 分词与群体变异注入: 模型采用步长为 $6$ 的非重叠滑动窗口切分序列(遇到未知碱基 N 或尾部不足 $6$ 个碱基时回退至单字符切分),并在数据加载时引入随机起始点偏移以实现阅读框相位增强。预训练语料涵盖人类参考基因组、千人基因组计划分相群体基因组(1000G)与多物种参考基因组。针对 1000G 群体数据,训练流在参考序列上动态替换目标个体的 SNP 与 Indel 变异,并在掩码预训练中移除“$10\%$ 随机词元替换”操作,防止人为噪声干扰低频天然多态性位点的似然估计。
架构演进与单碱基解包微调: 第一代 NT-v1 采用绝对位置嵌入;第二代 NT-v2 引入旋转位置编码(RoPE)与无偏置 SwiGLU 前馈层,将上下文窗口扩展至 $12\text{ kb}$。
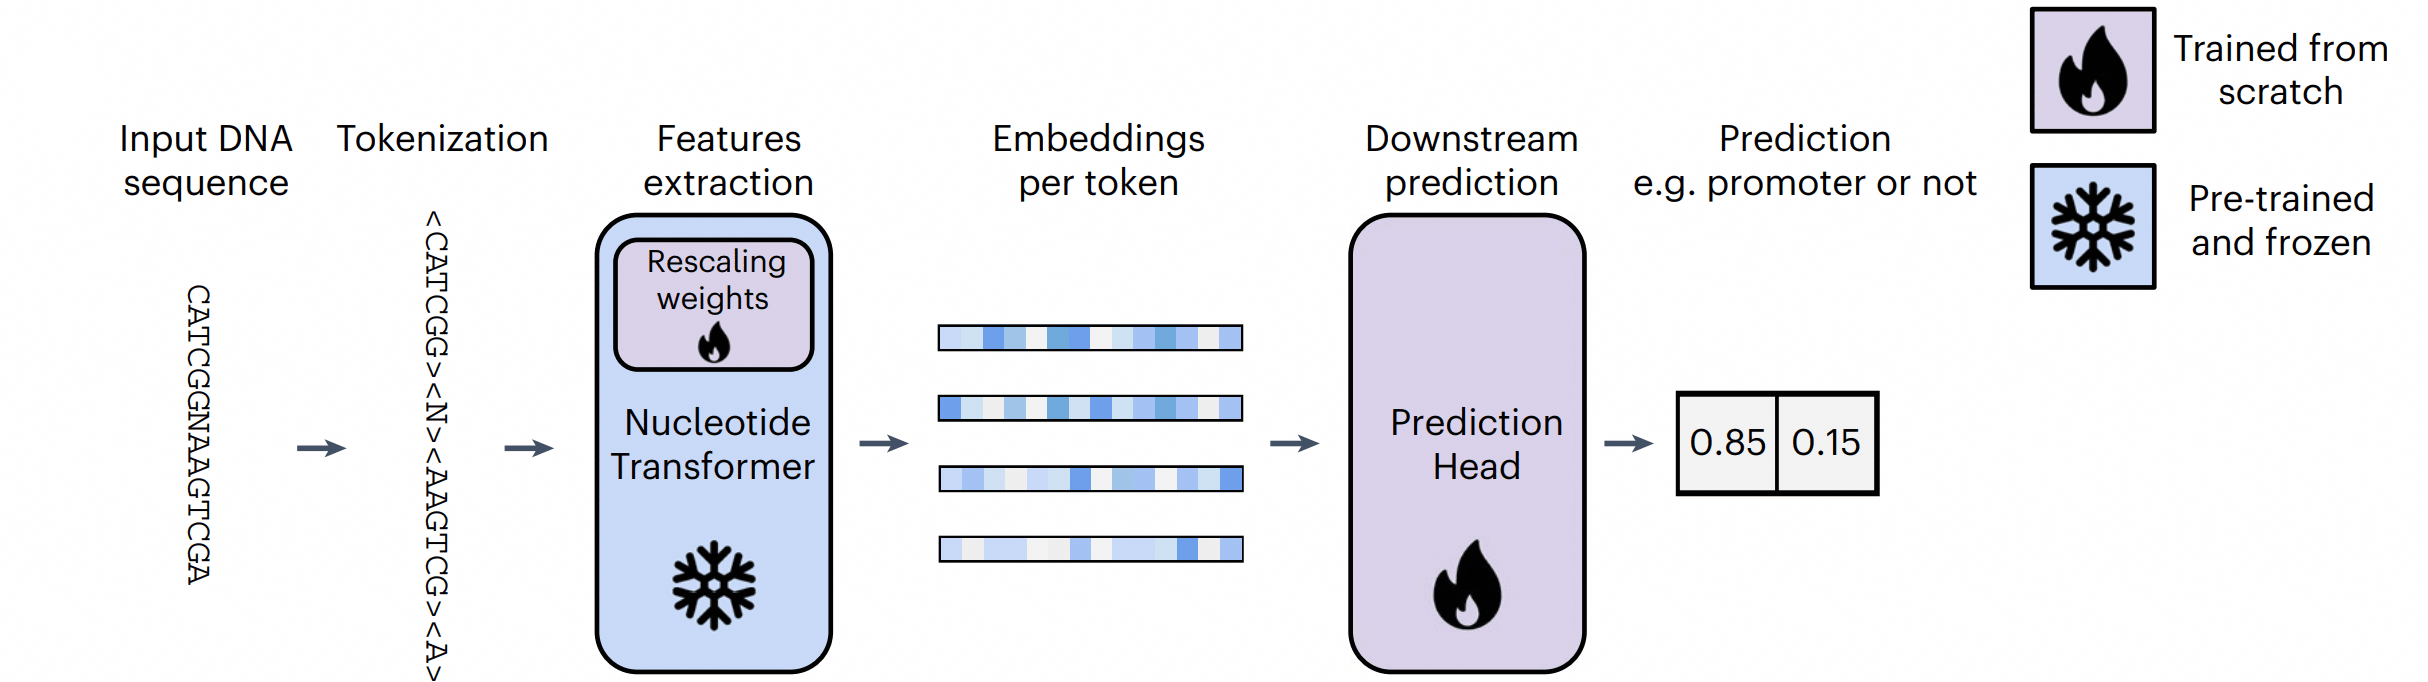
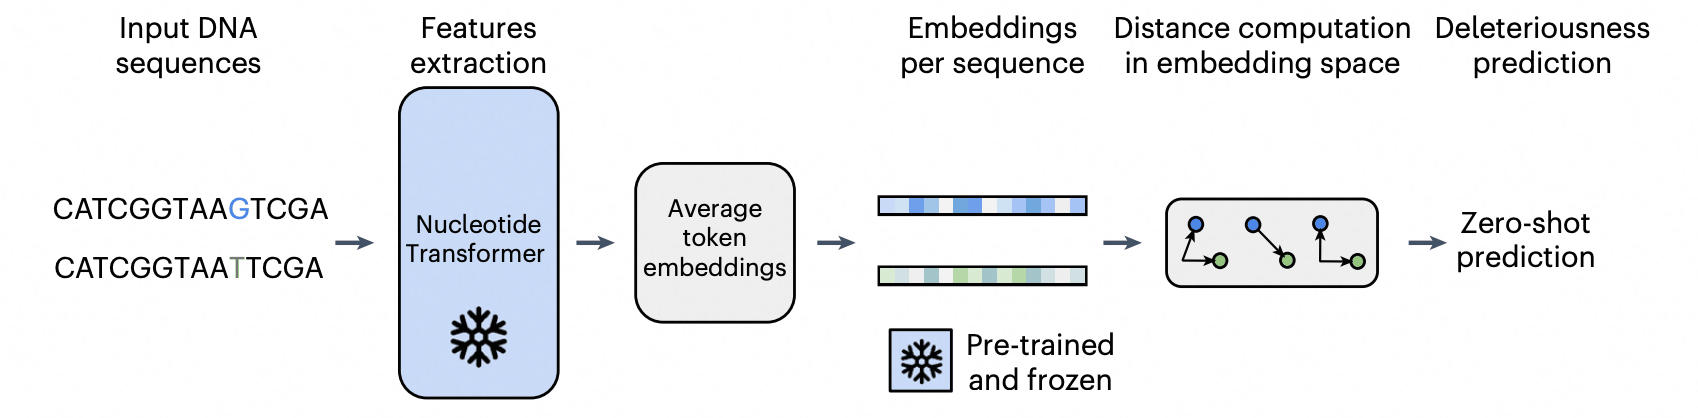
下游适配支持分层探针或 IA3 参数高效微调。对于剪接位点等单碱基分辨率任务,顶层线性头直接将单个 $6$-mer 词元嵌入解包映射为 $6$ 个碱基位置各自的类别概率分布;零样本变异效应预测则通过计算参考与突变序列中间层嵌入的余弦距离或掩码重建损失差来量化突变破坏性。
⚪ NTv3:卷积-Transformer 混合 U-Net 与功能-生成联合建模
- paper:A foundational model for joint sequence-function multi-species modeling at scale for long-range genomic prediction(bioRxiv 2025)
NTv3 采用多尺度卷积—Transformer 混合 U-Net 架构,结合自适应层归一化(AdaLN)物种条件调制与掩码扩散语言建模,在 $1\text{ Mb}$ 超长上下文窗口内统一了单碱基表征学习、多物种序列到功能轨道预测与条件序列生成。
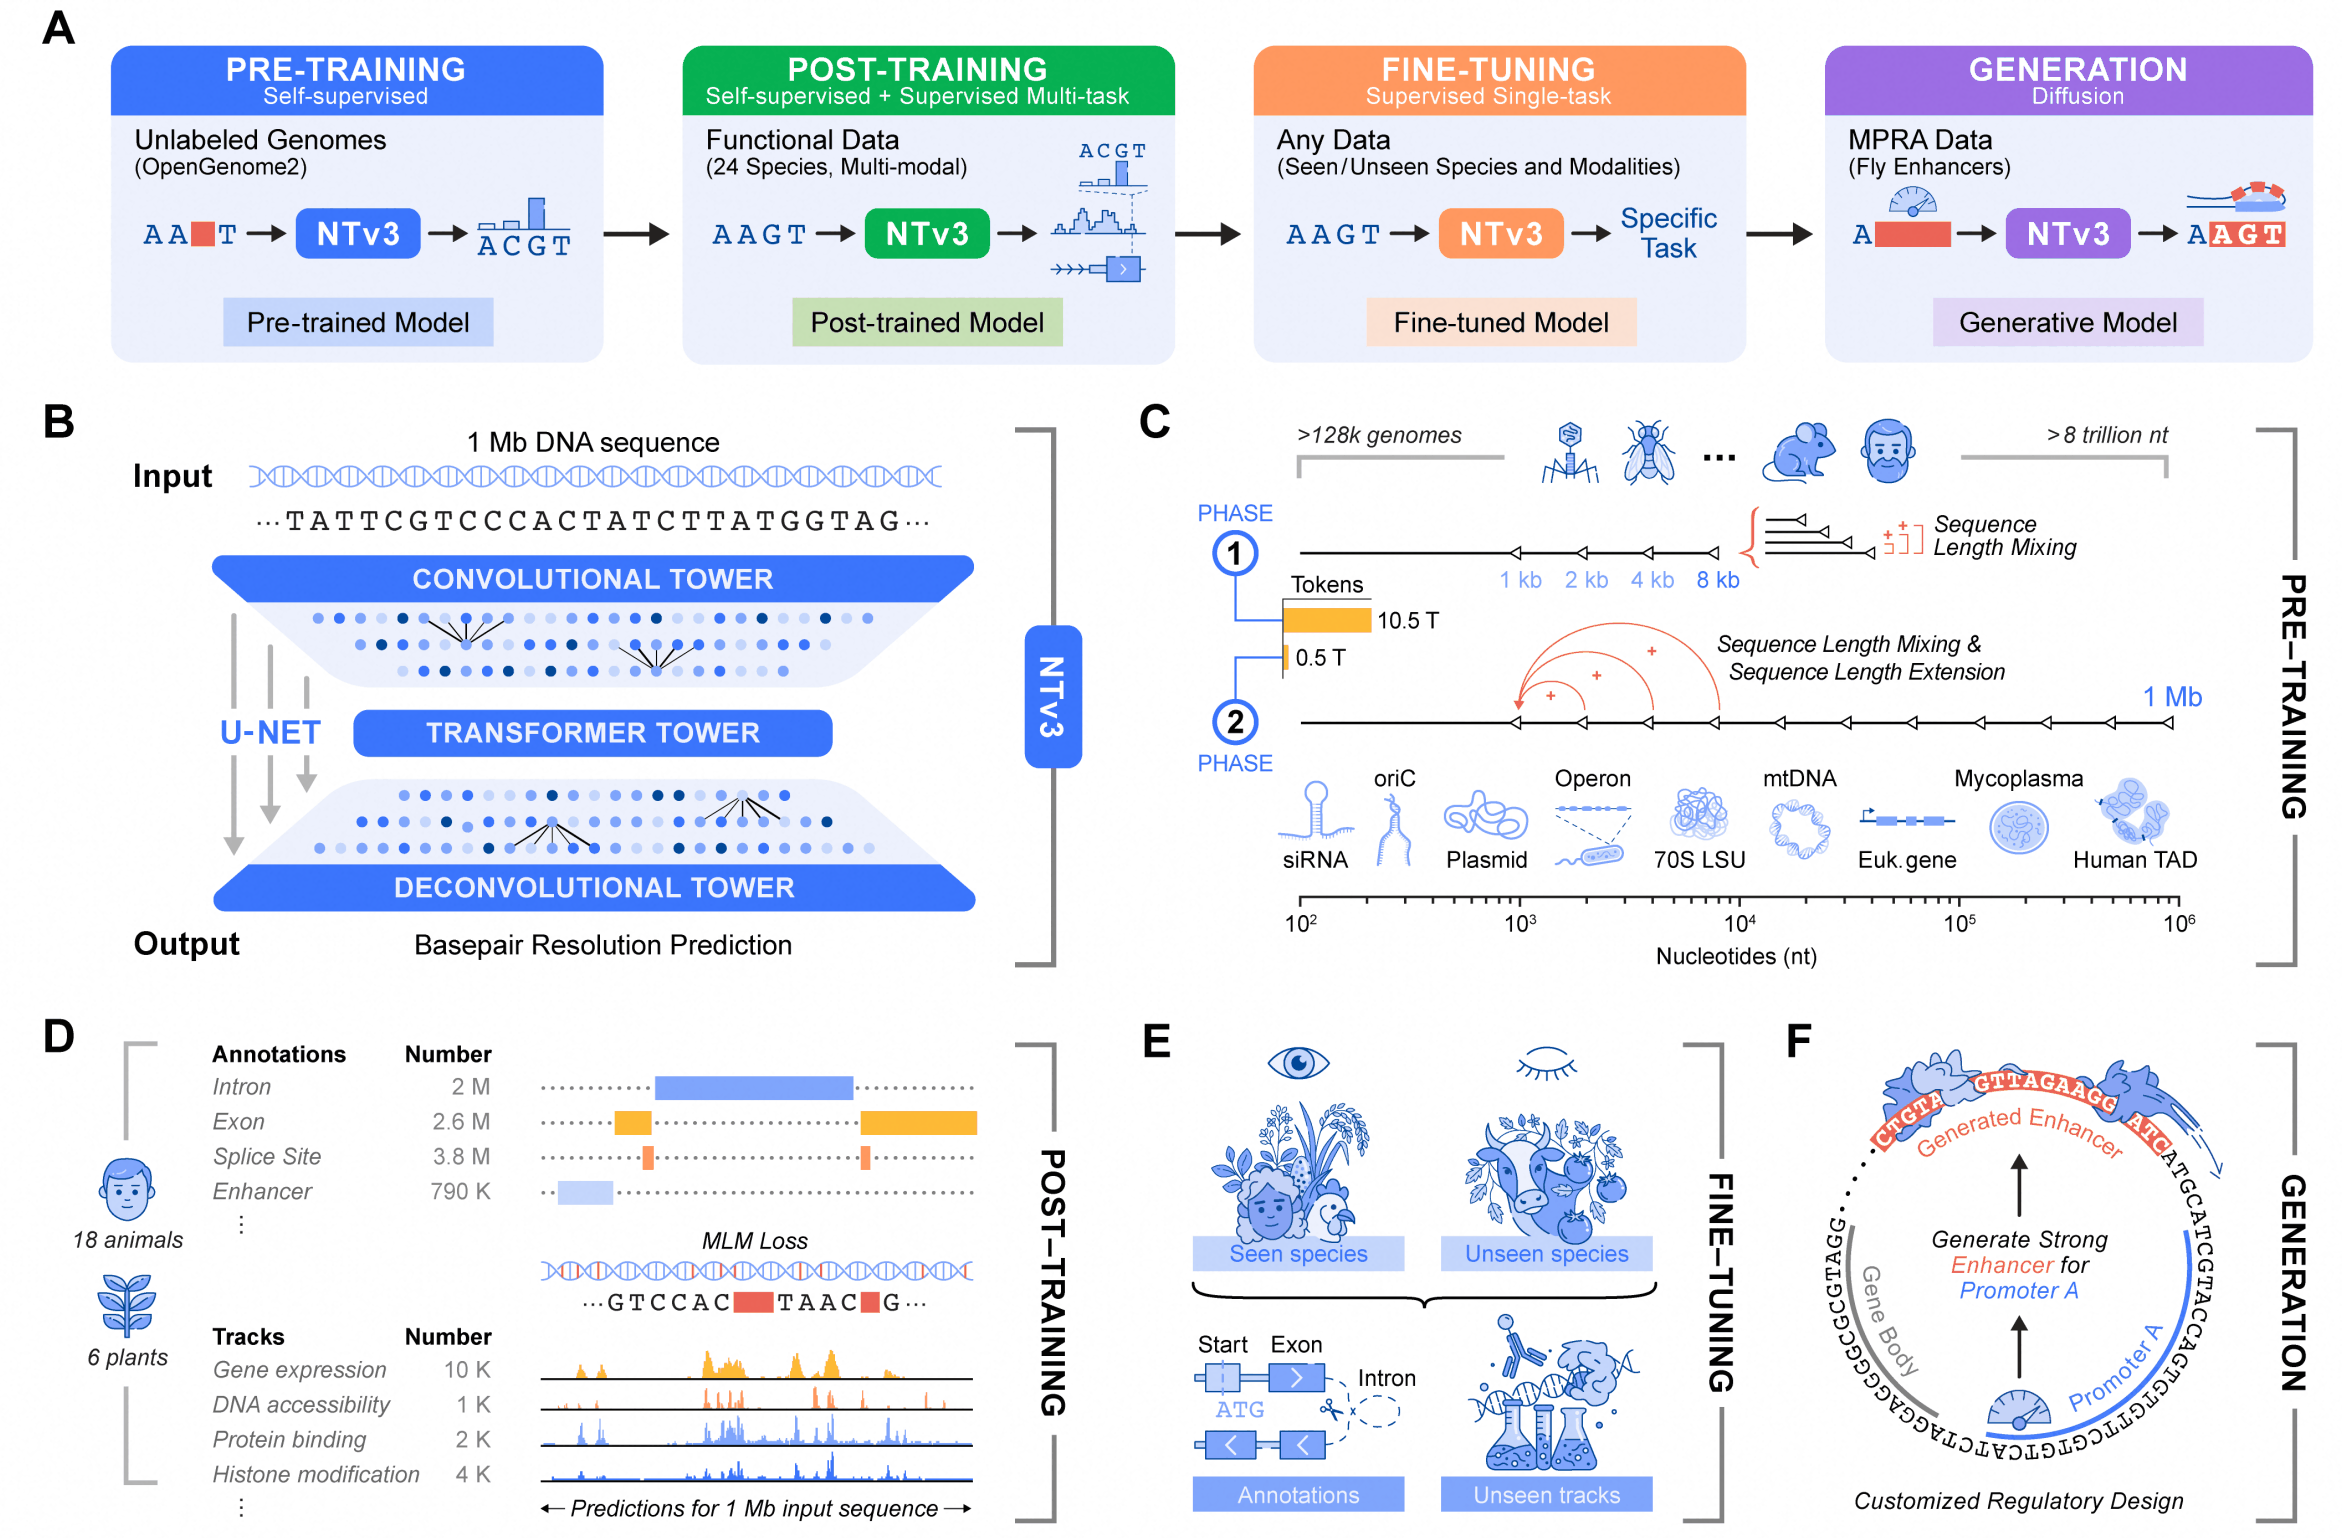
多尺度 U-Net 骨架与物种条件调制: 模型以单核苷酸为词元。为避免在百万碱基上直接计算全局注意力,编码端通过 $7$ 级残差一维卷积与池化将序列长度逐级压缩 $128$ 倍;瓶颈层利用带 RoPE 与 SwiGLU 的中心 Transformer 捕获长程依赖;解码端通过 $7$ 级上采样与跳跃连接恢复至单碱基分辨率。在多物种适配阶段,可学习物种嵌入 $s$ 被映射为零初始化的 AdaLN 与残差支路调制参数:
\[\mathrm{AdaLN}(x,s)=(1+\gamma(s))\odot\mathrm{LayerNorm}(x)+\beta(s),\quad x_{\mathrm{out}}=x+(1+\alpha(s))\odot f(x).\]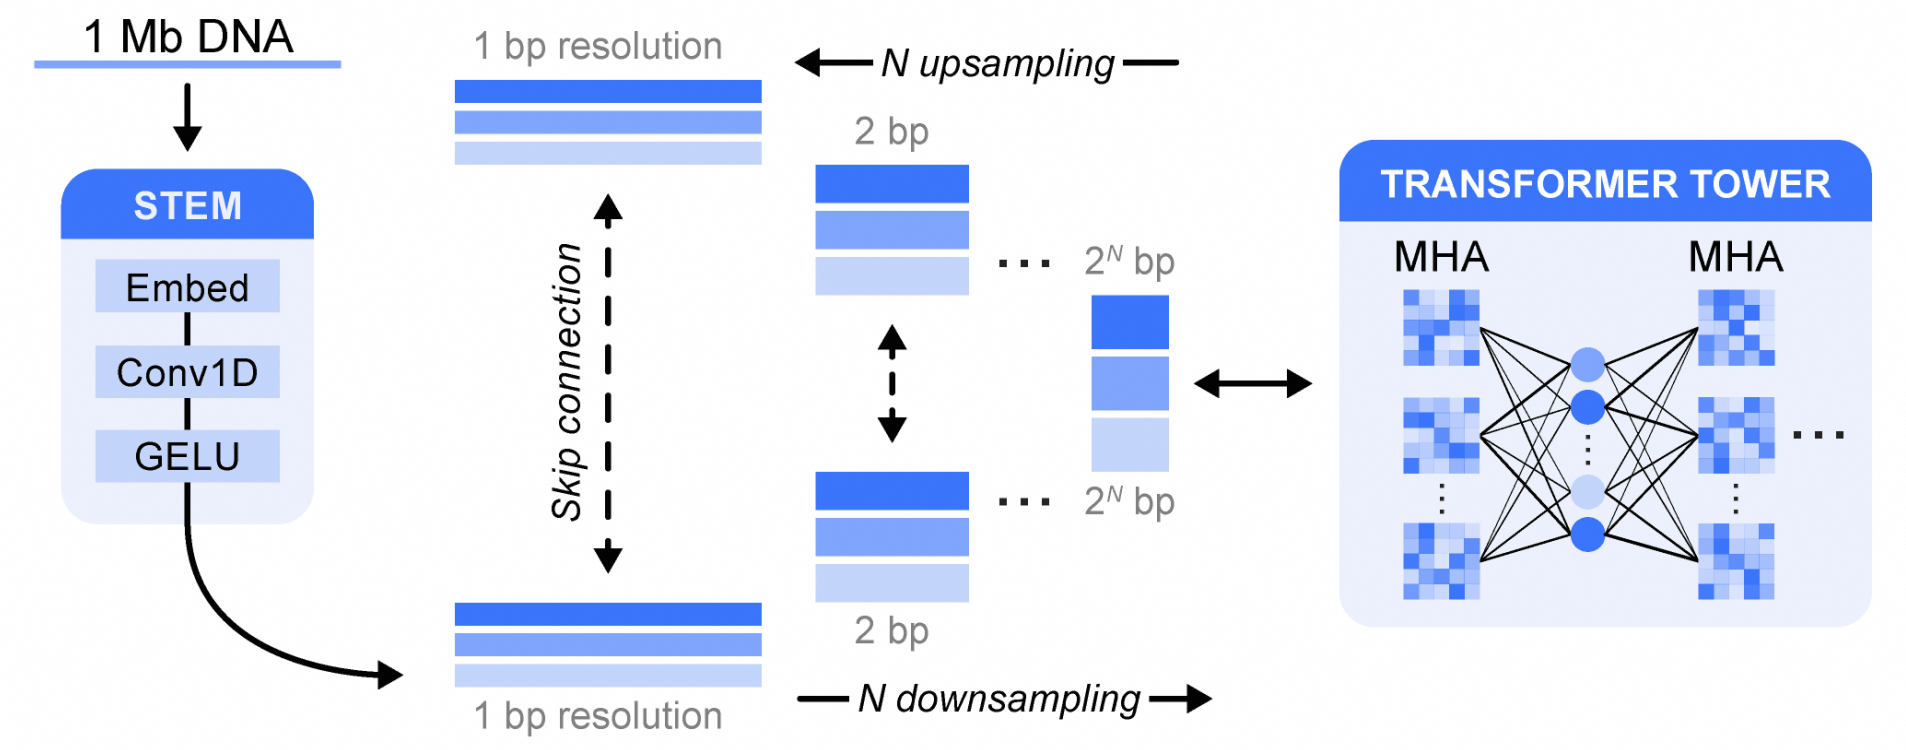
功能联合后训练与掩码扩散条件生成: 自监督阶段通过长度课程将窗口扩展至 $1\text{ Mb}$ 优化 $\mathcal{L}_{\mathrm{MLM}}$。后训练阶段联合优化跨物种实验功能轨道(位置 $i$ 真实信号为 $x_i$、预测值为 $y_i$)与基因组元件分割注释,将总覆盖度泊松损失与局部轮廓多项式损失解耦:
\[\begin{aligned} &\mathcal{L}_{\mathrm{Poisson}}=\sum_i y_i-\left(\sum_i x_i\right)\log\left(\sum_i y_i\right),\quad \mathcal{L}_{\mathrm{multinomial}}=-\sum_i x_i\log\left(\frac{y_i}{\sum_j y_j}\right),\\ &\mathcal{L}_{\mathrm{post}}=\lambda_{\mathrm{P}}\mathcal{L}_{\mathrm{Poisson}}+\mathcal{L}_{\mathrm{multinomial}}+\mathcal{L}_{\mathrm{focal}}+\mathcal{L}_{\mathrm{MLM}}. \end{aligned}\]基于双向主干,模型可进一步通过掩码扩散语言建模(MDLM)微调为生成模型(设干净碱基独热向量为 $\mathbf{x}$、掩码噪声调度为 $\alpha_t=1-t$、去噪预测为 \(\mathbf{x}_\theta(\mathbf{z}_t)\)),并结合强度为 $\gamma>1$ 的无分类器引导(CFG)按目标活性 $y_{\mathrm{target}}$ 从头设计调控元件:
\[\begin{aligned} &\mathcal{L}_{\mathrm{MDLM}}=\int_0^1\frac{-\alpha'_t}{1-\alpha_t}\,\mathbb{E}_{\mathbf{x},\mathbf{z}_t}\!\left[\sum_{\ell=1}^{L}-\log\left\langle\mathbf{x}_\theta^\ell(\mathbf{z}_t),\mathbf{x}^\ell\right\rangle\right]\mathrm{d}t,\\ &p_\gamma(\mathbf{z}_s\mid\mathbf{z}_t)\propto p_\theta(\mathbf{z}_s\mid\mathbf{z}_t,y_{\mathrm{target}})^\gamma\,p_\theta(\mathbf{z}_s\mid\mathbf{z}_t,y_{\mathrm{bg}})^{1-\gamma}. \end{aligned}\]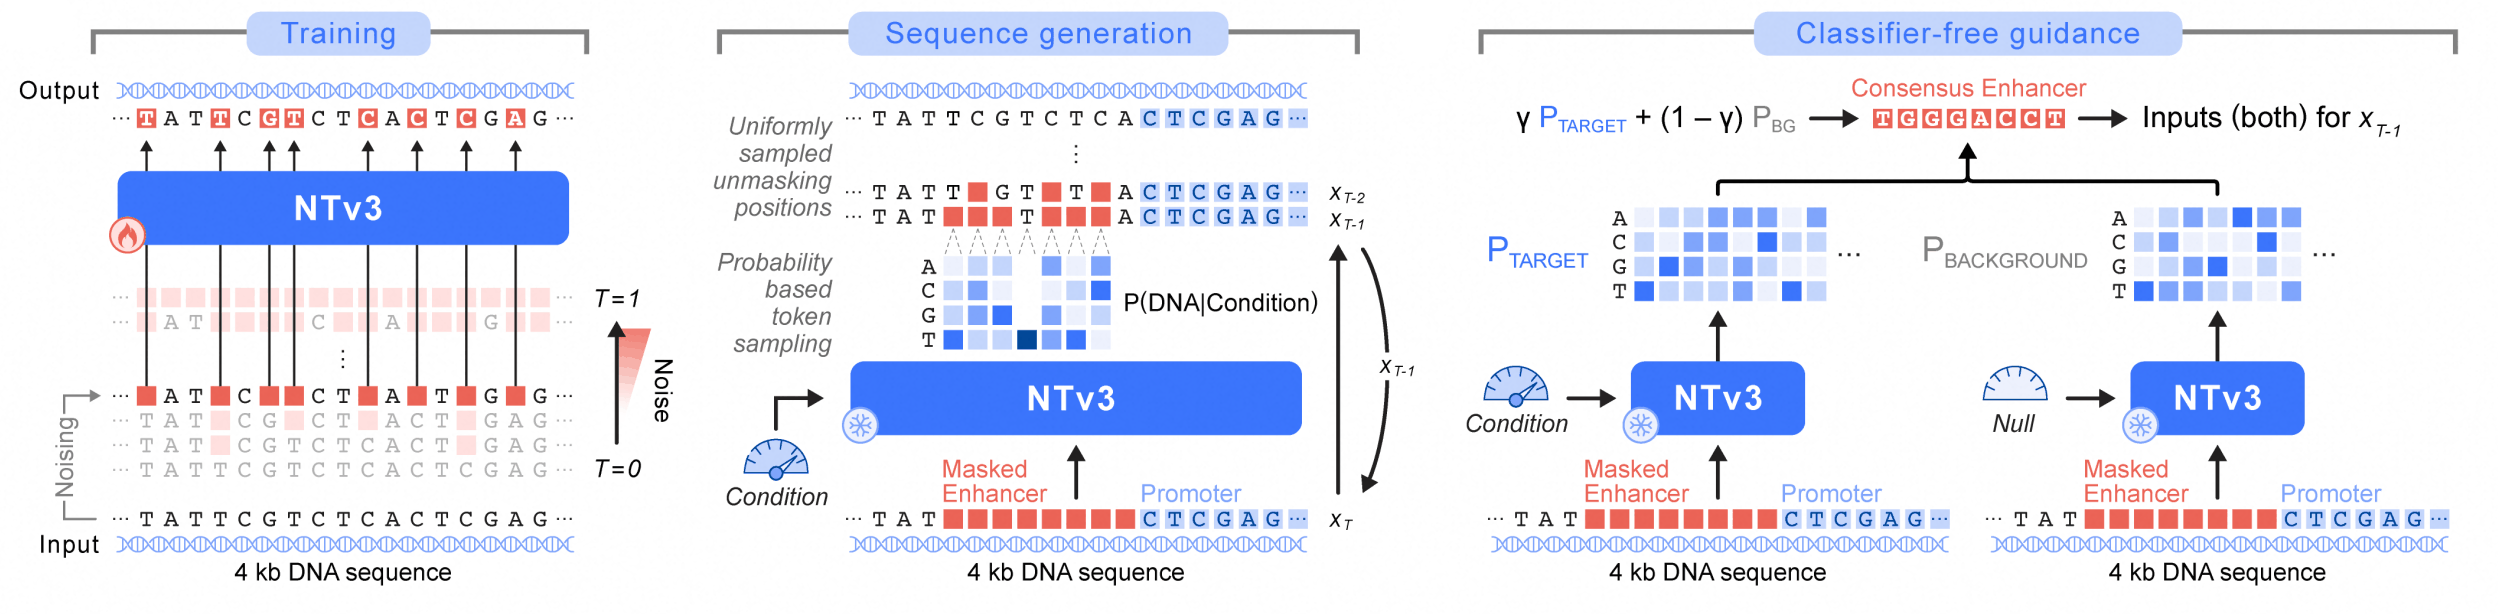
⚪ dnaGrinder:序列长度预热与双亲本变异去重语料的轻量编码器
- paper:dnaGrinder: A Lightweight and High-Capacity Genomic Foundation Model(arXiv 2024)
dnaGrinder 在集成 FlashAttention-2、线性注意力偏置(ALiBi)与 SwiGLU 的轻量双向 Transformer 编码器中,引入流式 BPE 分词、序列长度预热(SLW)以及融合千人基因组双亲本结构变异与非重复区扩展的语料,支持从 $12\text{ kbp}$ 预训练窗口外推至 $120\text{ kbp}$ 以上的超长序列推理。
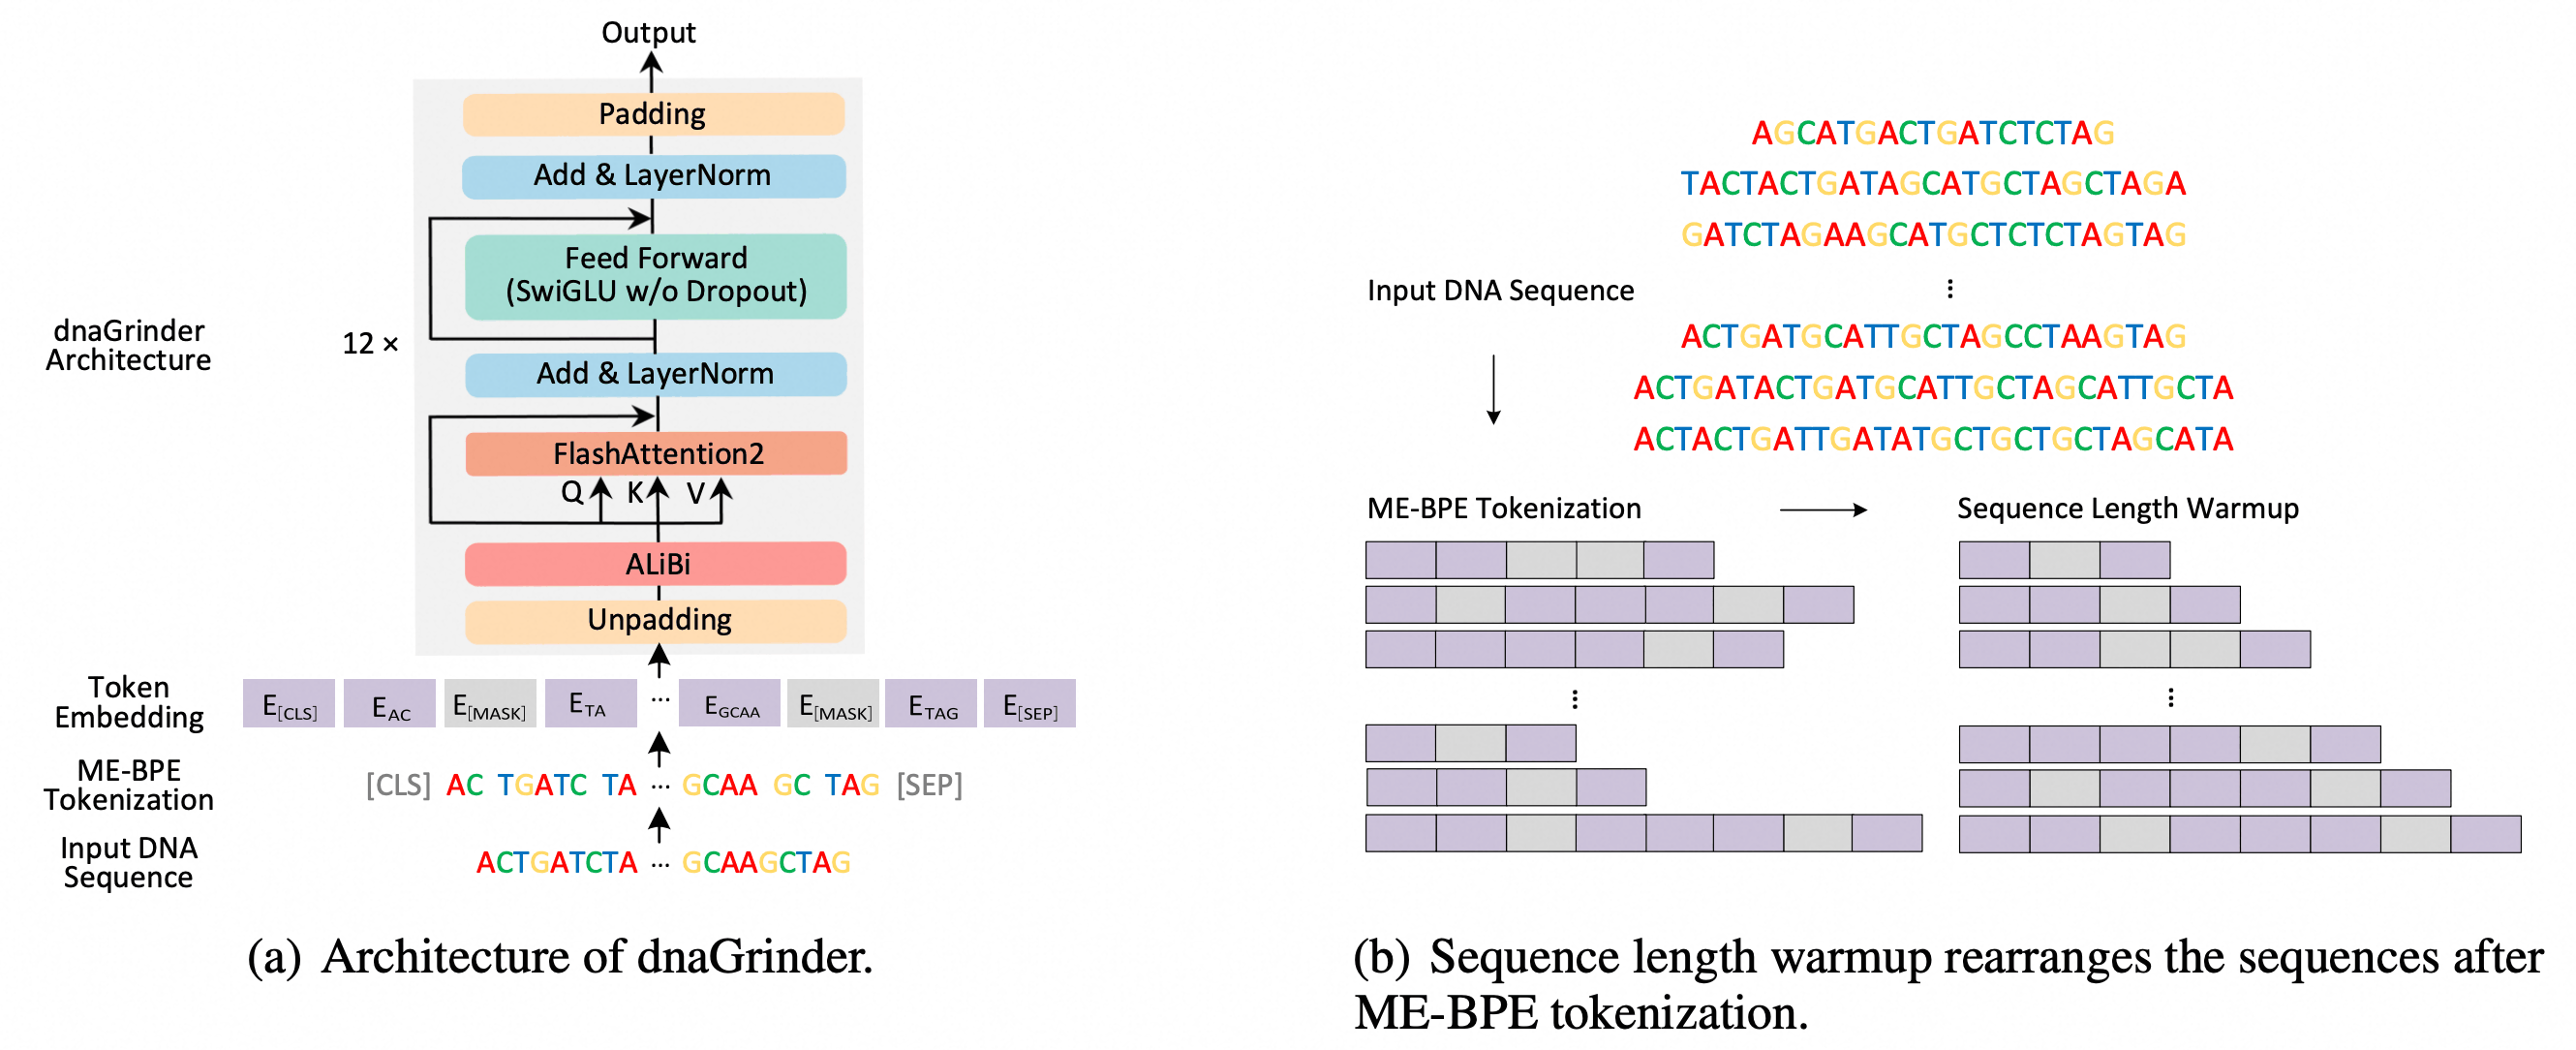
非重复区过滤扩展与双亲本变异替换: 预处理首先利用 RepeatMasker 滤除人类参考基因组中的低信息量重复区与过短碎片,以有效非重复区为锚点延伸并截取 $12{,}000\text{ bp}$ 片段;随后注入千人基因组个体的 SNV、INDEL 与长结构变异(SV),同时生成父源与母源两条平行等位基因序列,最后与多物种参考基因组混合构成预训练语料。
流式 BPE、序列长度预热(SLW)与 ALiBi 外推: 模型将大规模语料拆分为子文件,采用流式贪婪策略迭代更新容量为 $4{,}096$ 的 BPE 词表。由于 $12\text{ kbp}$ 序列分词后的词元数波动较大,模型将序列按词元数量升序排列以执行序列长度预热(SLW):富含简单重复模式的低复杂度序列被压缩为更短的词元序列,在减少填充浪费的同时自然构成了由简入繁的课程学习。主干采用无 Dropout 的双向 Transformer,结合 SwiGLU 与 ALiBi 线性距离惩罚($m$ 为头特异斜率):
\[\mathrm{Attention}(q_i, K, V) = \mathrm{Softmax}\!\big(q_i K^\top + m \cdot [-(i-1), \ldots, -2, -1, 0]\big)V,\]使模型在完成 $15\%$ 动态 MLM 预训练后,无需微调位置参数即可直接外推处理十倍于预训练长度的超长基因组序列。
⚪ AIDO.DNA:基于单核苷酸分词与依赖图谱的规模化多物种编码器
- paper:Accurate and General DNA Representations Emerge from Genome Foundation Models at Scale(NeurIPS 2024 Workshop)
AIDO.DNA 在引入 RoPE 与 SwiGLU 的稠密双向 Transformer 架构下直接采用单核苷酸分词,将模型参数规模扩展至十亿级,在不损失单碱基分辨率的前提下学习跨物种通用表征。
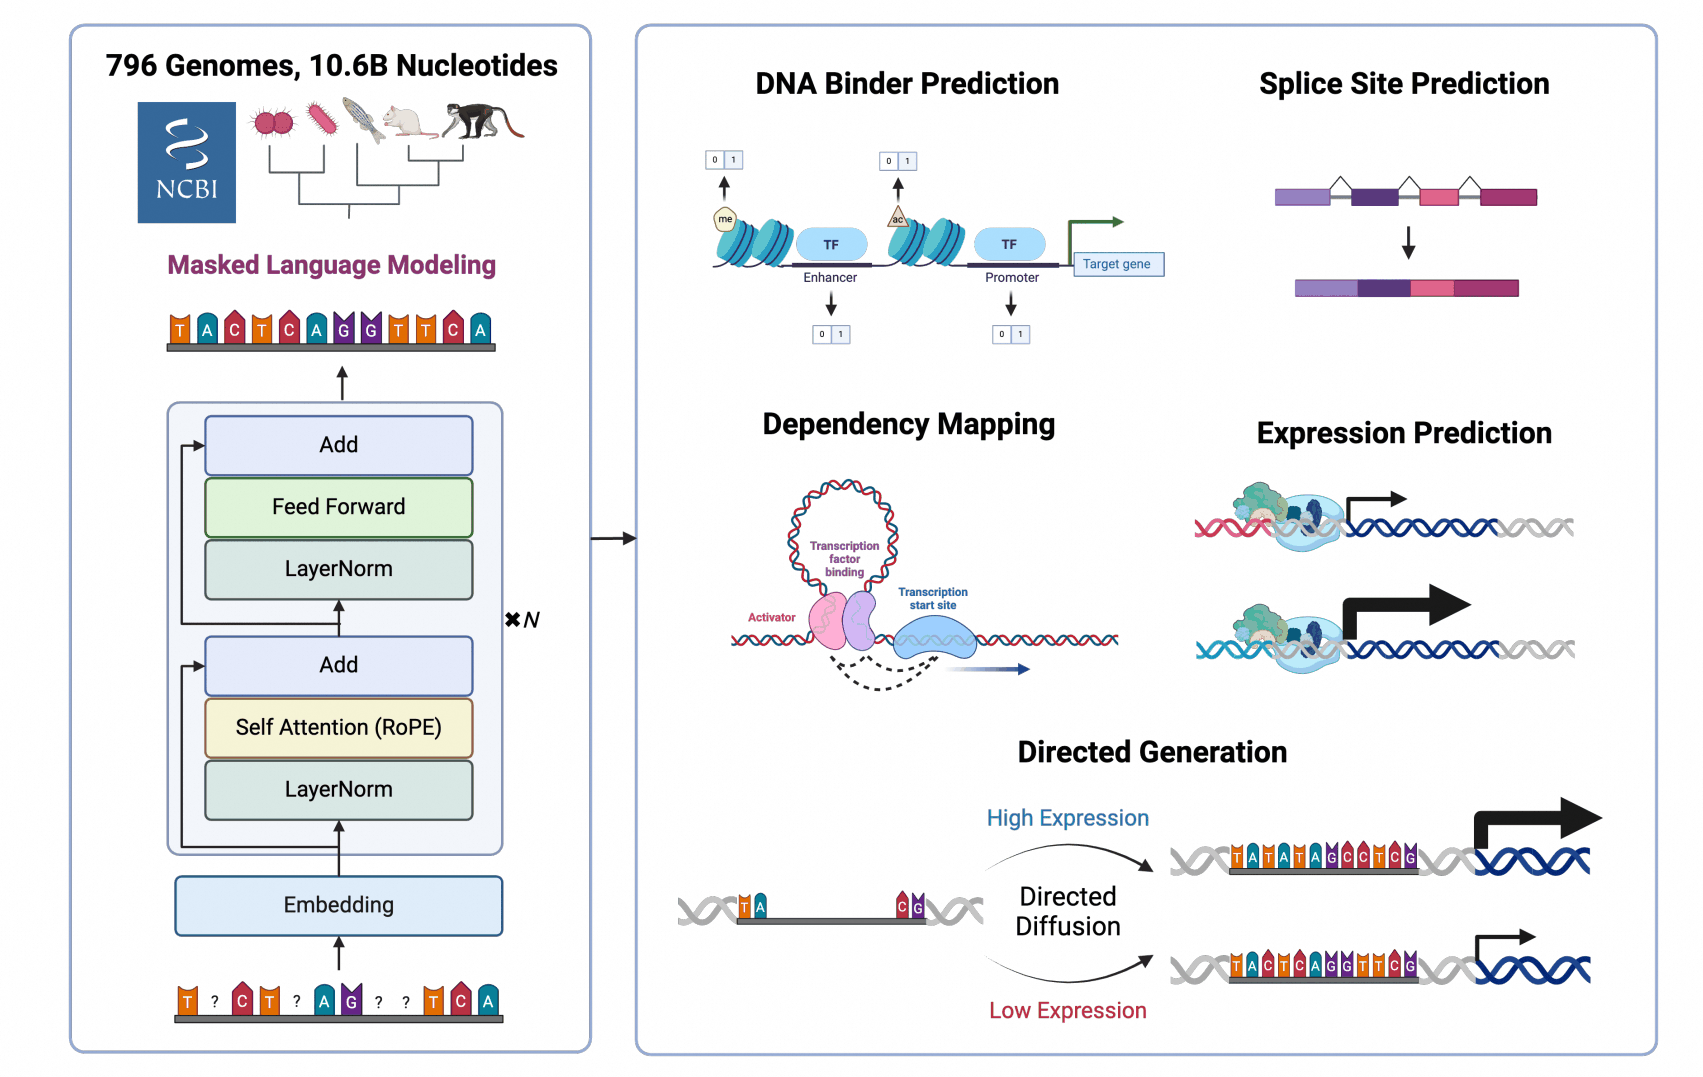
单核苷酸预训练与无监督核苷酸依赖图谱: 模型以单字符 A, T, C, G, N 为基本词元,在跨物种非重叠基因组切片上执行 $15\%$ 掩码预训练。为探测模型捕获的顺式调控语法与共进化信号,可冻结预训练权重,通过逐位点计算机饱和突变(In-silico Mutagenesis)构建二维核苷酸依赖图谱。设原始序列为 $n_1,\ldots,n_L$,将位置 $i$ 的碱基突变为 $q$ 后,位置 $j$ 对位置 $i$ 的预测依赖强度定义为遍历所有突变碱基 $q$ 与目标候选碱基 $k$ 时的最大对数优势比(Odds Ratio)绝对变化量:
\[e_{i,j}=\max_{k,q\in\lbrace \mathrm{A,T,C,G}\rbrace }\left\vert\log_2\frac{\widehat{\mathrm{odds}}(n_j=k\mid n_1,\ldots,n_i=q,\ldots,n_L)}{\widehat{\mathrm{odds}}(n_j=k\mid n_1,\ldots,n_L)}\right\vert,\]其中 $\widehat{\mathrm{odds}}=p/(1-p)$,$p$ 为模型在位置 $j$ 预测碱基为 $k$ 的条件概率。
域对齐微调与条件扩散生成: 针对存在分布偏移的下游任务,模型支持先在目标测试集无标签序列上继续执行 MLM 预训练以对齐输入分布,再进行有监督微调。在调控序列生成任务中,模型在编码器与解码头之间插入带跳跃连接的轻量条件扩散头,将词元表征与投影后的目标表达量相加,基于掩码扩散目标微调后即可按指定表达水平生成候选启动子序列。
⚪ DeepGene:基于泛基因组变异图序列化的双向编码器
- paper:DeepGene: An Efficient Foundation Model for Genomics Based on Pan-Genome Graph Transformer(IEEE TCBB 2025)
DeepGene 引入人类泛基因组 Minigraph 变异图表示,通过有向无环图(DAG)去环、拓扑位置递归编码与子图序列化,在集成旋转位置编码的双向 Transformer 编码器上消除群体线性序列拼接的高冗余,实现兼顾群体多态性建模与跨长度外推的紧凑预训练。
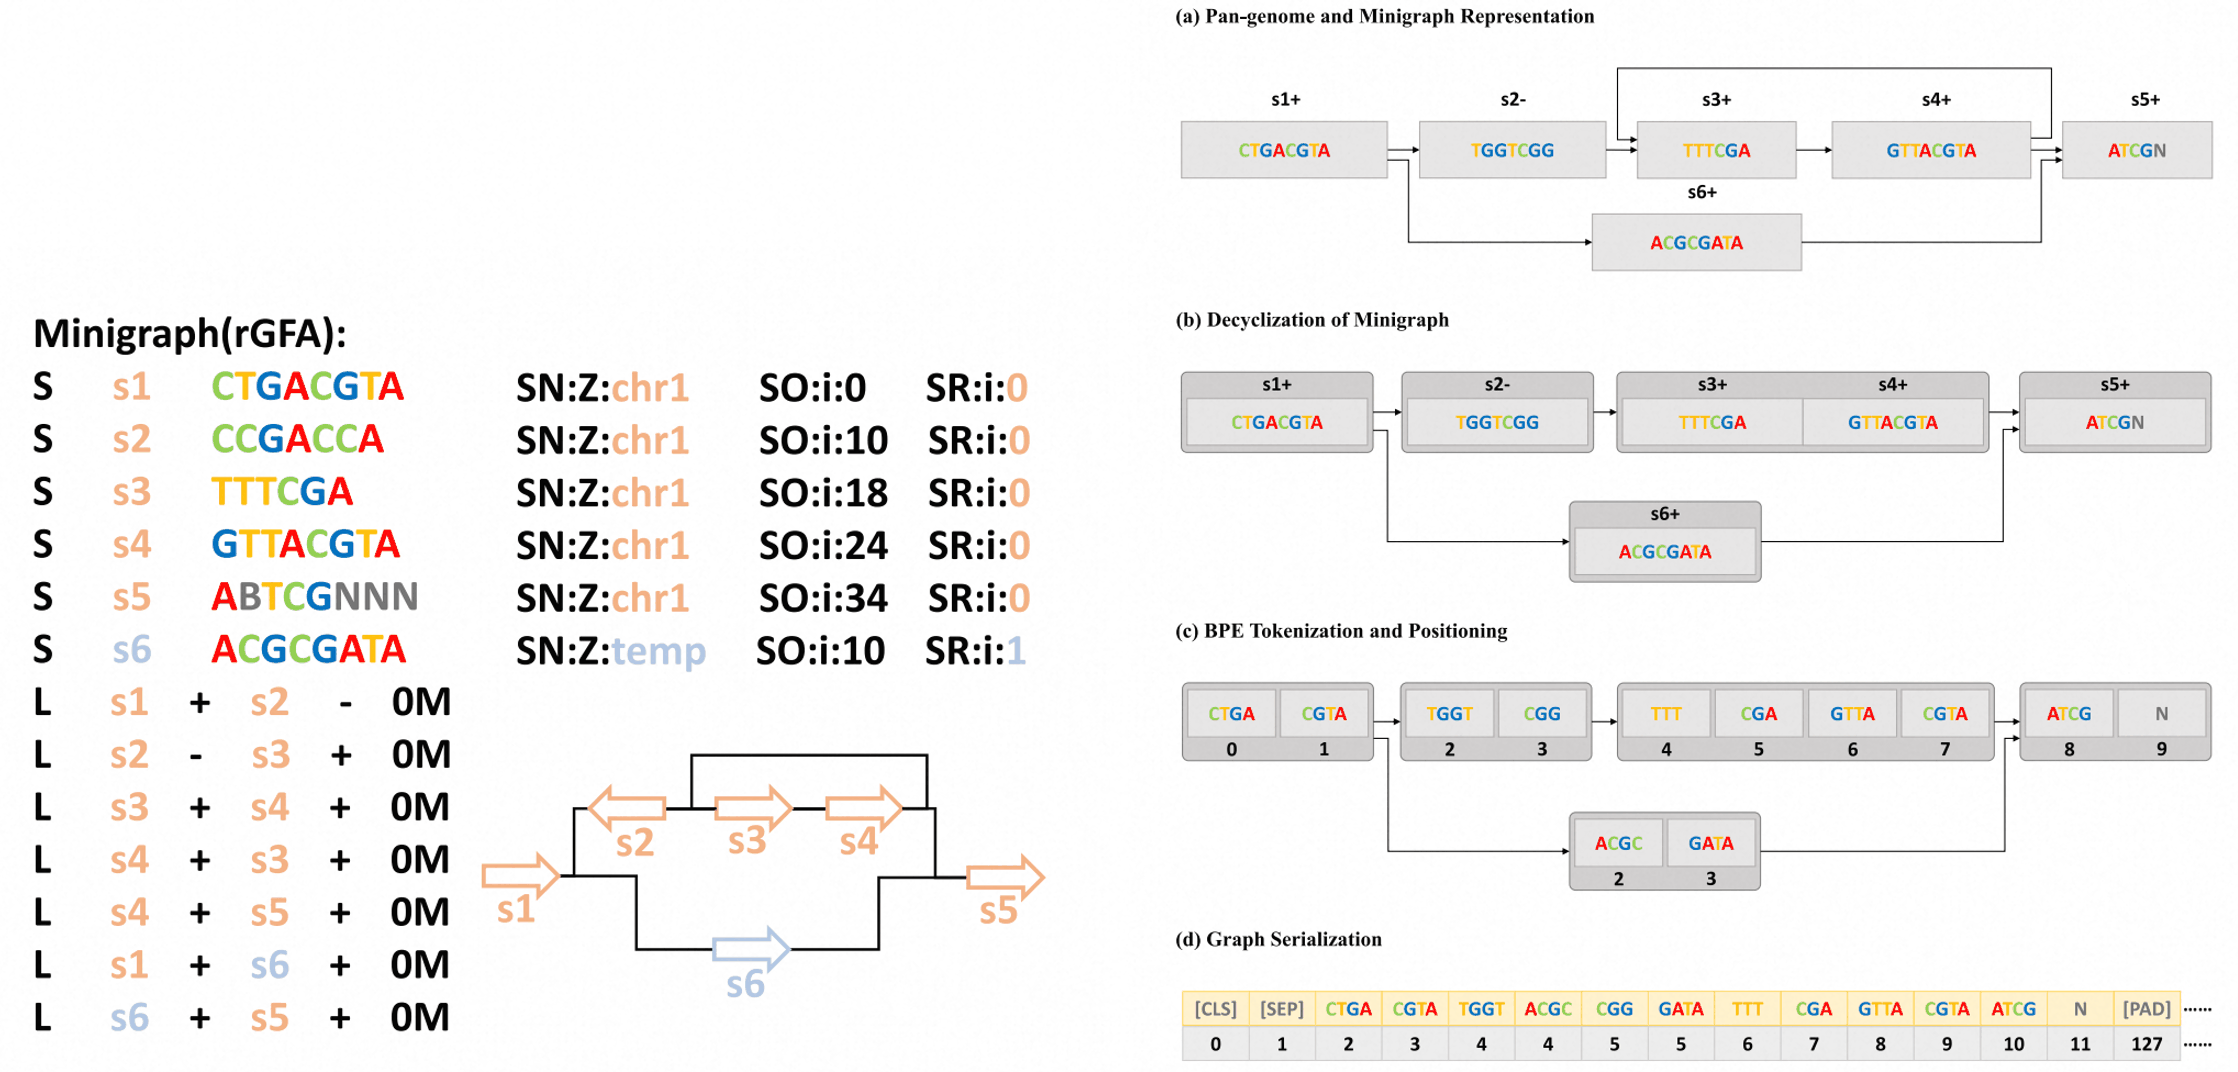
泛基因组 Minigraph 去环与拓扑位置编码: 预训练语料取自人类泛基因组参考联盟(HPRC)的 Minigraph 变异图(rGFA 格式),其中节点表示非重叠核苷酸序列,有向边连接不同单倍型路径上的相邻节点。模型先采用强连通分量算法消去图中的少量环路以转化为严格的有向无环图(DAG),随后在每个节点内执行无重叠 BPE 分词。记节点 $i$ 的前驱节点集为 $P$、节点 $k$ 的词元总数为 $\mathrm{len}(k)$,节点 $i$ 内第 $j$ 个词元的全局拓扑位置递归定义为(无前驱起始节点初始位置设为 $0$):
\[\mathrm{position}(i, j) = \begin{cases} \min_{k \in P} \big(\mathrm{position}(k, 0) + \mathrm{len}(k)\big), & j = 0, \\ \mathrm{position}(i, 0) + j, & j \neq 0. \end{cases}\]RoPE 相对位置感知与长度外推微调: 所有词元按拓扑位置升序排列并切分为定长子图样本。主干双向 Transformer 弃用绝对位置嵌入,对拓扑位置为 $m, n$ 的词元隐状态 $x_m, x_n$ 施加 RoPE 相位旋转,使注意力内积直接依赖于两词元在泛基因组图中的相对拓扑距离 $m - n$:
\[q_m = R_m^d W_q x_m, \quad k_n = R_n^d W_k x_n, \quad q_m^\top k_n = x_m^\top W_q R_{m-n}^d W_k x_n.\]预训练在序列化子图样本上执行 $15\%$ 掩码语言建模,下游微调时直接输入常规线性 DNA 序列并提取 [CLS] 表征,支持从短预训练窗口外推至长程启动子识别。
⚪ GENA-LM:块稀疏注意力与循环记忆机制的长序列编码器
- paper:GENA-LM: a family of open-source foundational DNA language models for long sequences(Nucleic Acids Research 2025)
GENA-LM 在双向编码器中结合 BPE 分词、BigBird 块稀疏注意力与循环记忆机制(RMT),将有效上下文感受野从数千碱基扩展至数十万碱基。
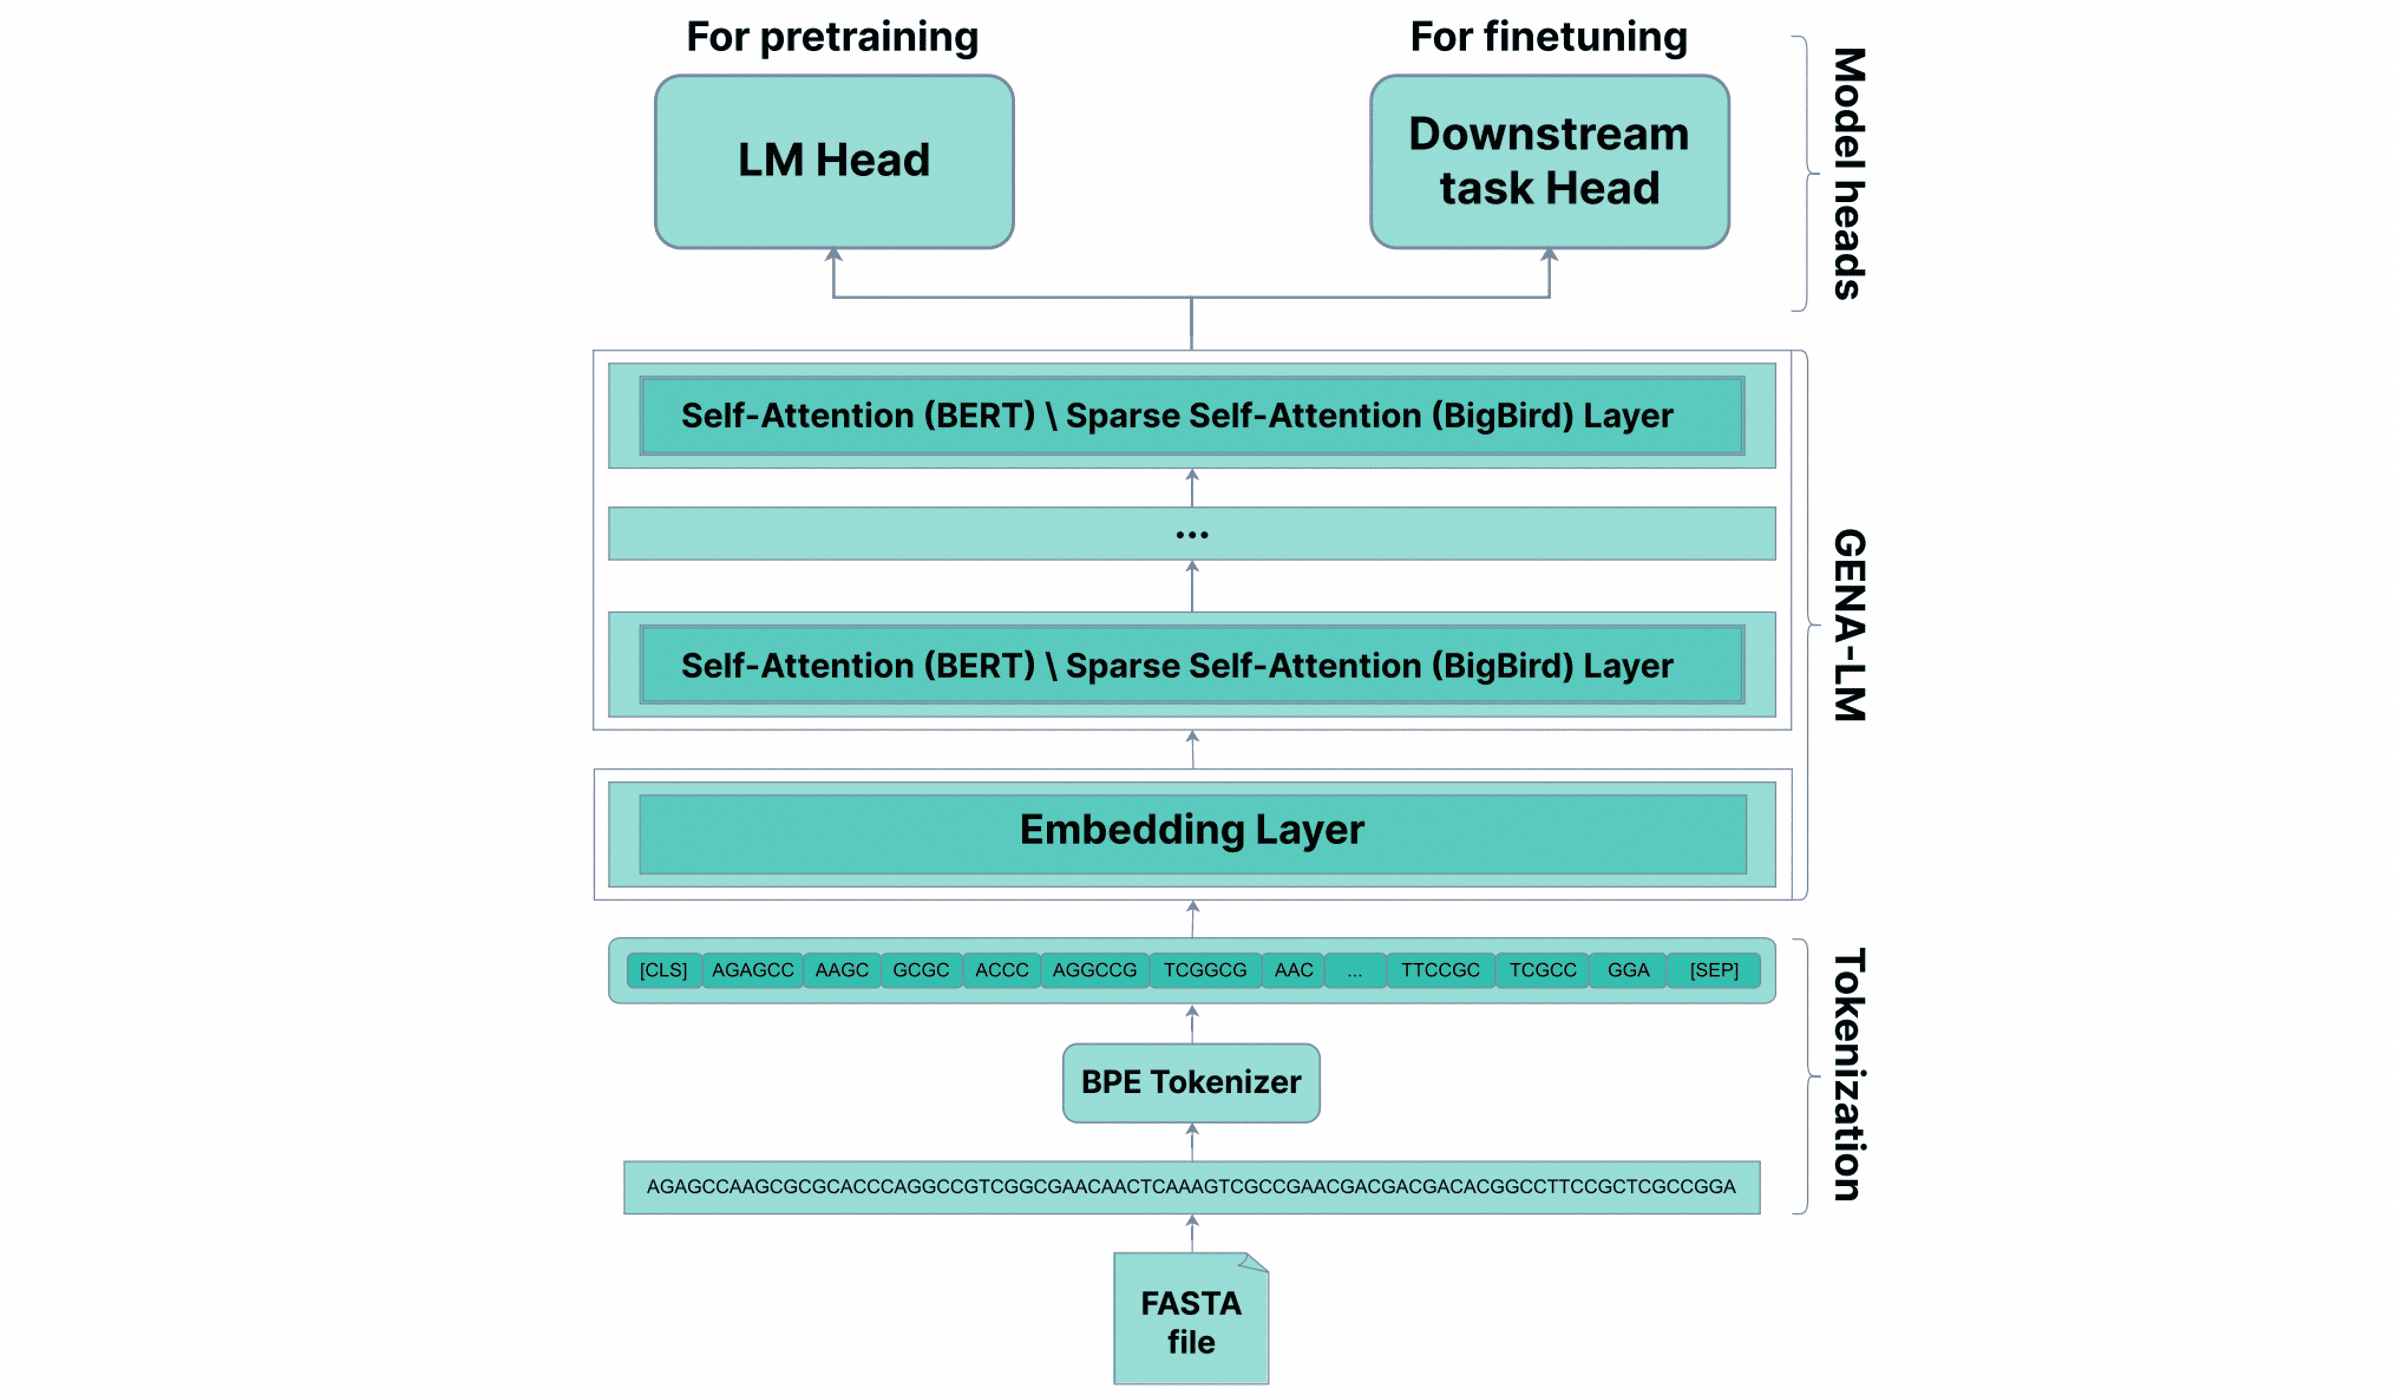
单倍型感知语料与块稀疏注意力: 模型构建了大小为 $32{,}000$ 的 BPE 词表,预训练语料融合了千人基因组与 gnomAD 个体单倍型变异的 T2T 人类参考基因组及多物种基因组。长序列主干采用 BigBird 块稀疏注意力,将局部滑动窗口注意力、随机块注意力与全局词元注意力相结合,使计算复杂度降为序列长度的线性函数。
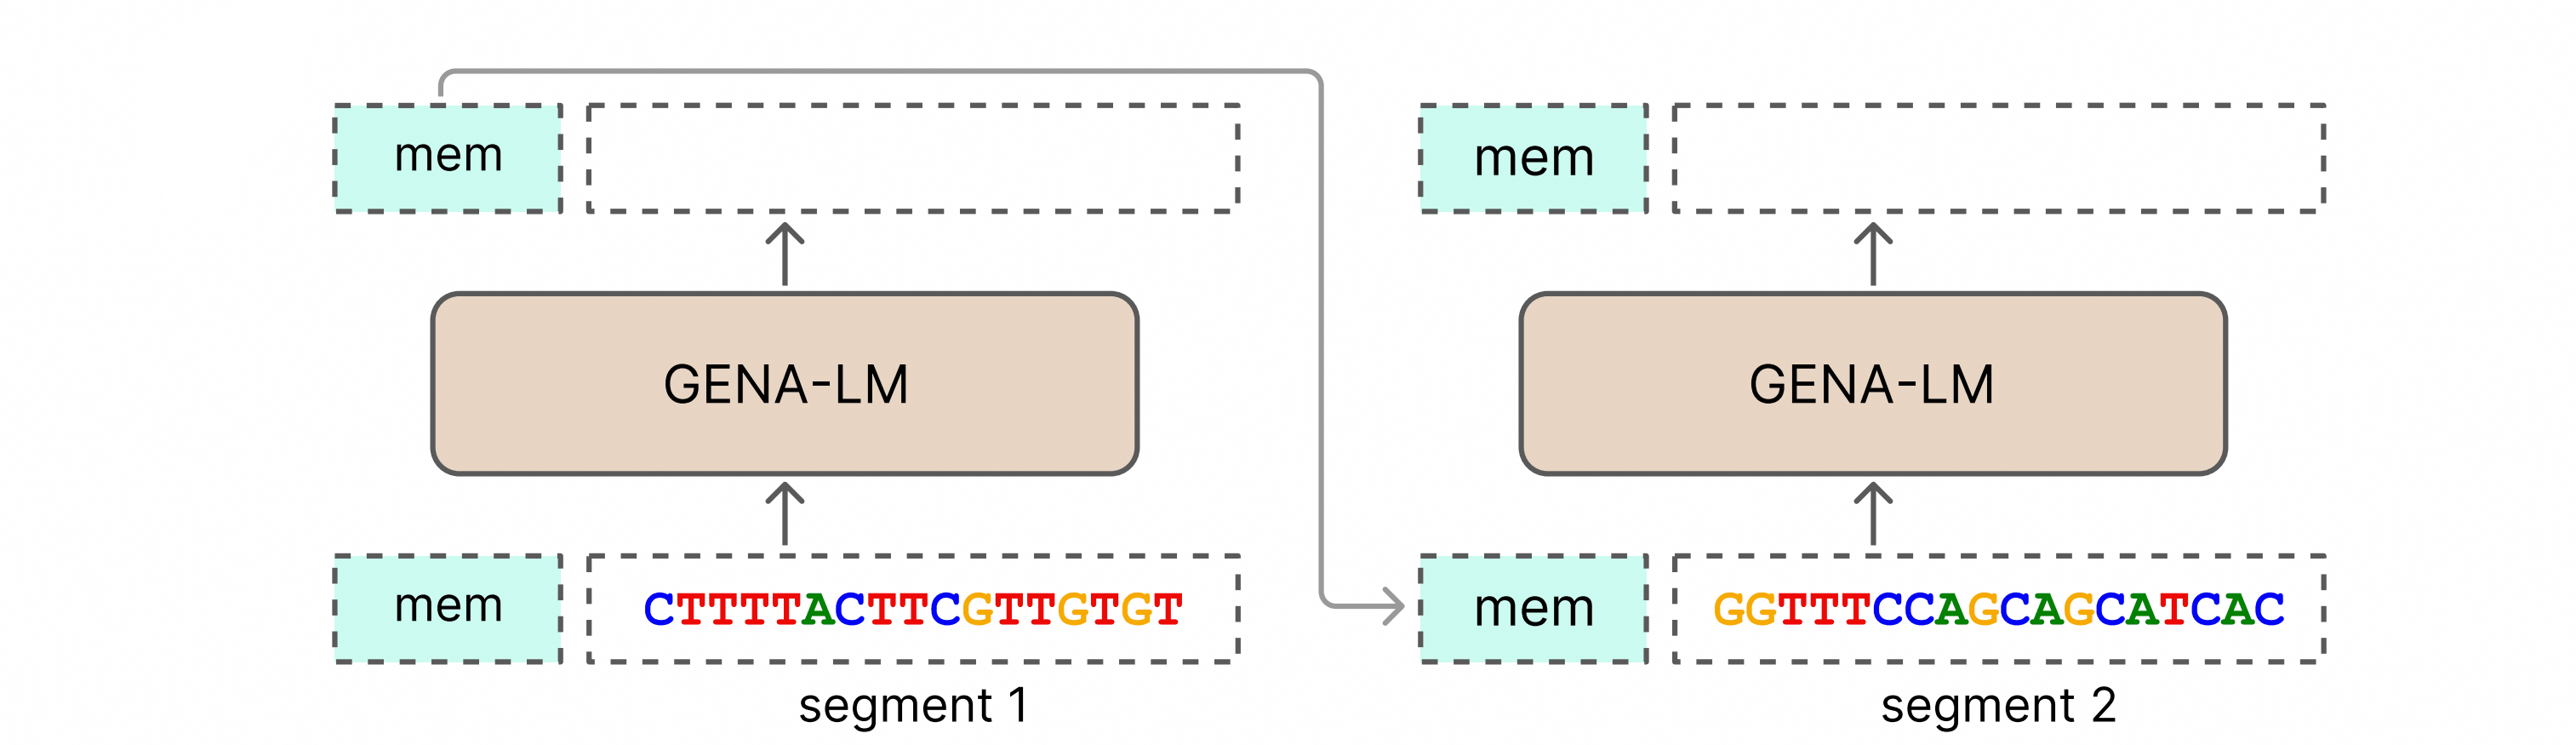
循环记忆跨片段传递与边界对齐微调: 为突破单次注意力窗口上限,模型引入循环记忆 Transformer(RMT),将超长序列切分为连续片段 $S^{(k)}$,并在每个片段输入端拼接一组可学习的记忆词元。前一片段输出的记忆隐状态 $M^{(k-1)}$ 直接作为下一片段的前缀输入,通过随时间反向传播(BPTT)实现跨片段上下文递推:
\[[H^{(k)},M^{(k)}]=\mathrm{GENA\text{-}LM}([M^{(k-1)},S^{(k)}]).\]针对剪接位点等边界敏感的词元级任务,微调时将左上下文、中央目标区与右上下文分别独立执行 BPE 分词后再拼接,防止可变长词元跨越目标区域边界。
⚪ ModernGENA:融合局部-全局交替注意力与无填充打包的高效基线
- paper:Back to BERT in 2026: ModernGENA as a Strong, Efficient Baseline for DNA Foundation Models(ICLR 2026 Workshop)
ModernGENA 在保留 BPE 分词与双向编码器范式的基础上,系统引入 ModernBERT 的局部—全局交替注意力、旋转位置编码与端到端无填充序列打包(Unpadding)机制,构建了高吞吐量的基因组表征基线。
TSS 邻近语料与局部-全局交替注意力: 为富集顺式调控信号,预训练语料围绕跨脊椎动物基因组的每个转录起始位点(TSS)截取 $[-16\text{ kbp}, +8\text{ kbp}]$ 的邻近窗口,采用 $32\text{k}$ 词表的 BPE 分词。主干网络采用局部滑动窗口注意力与全局自注意力交替堆叠的模式(每 $3$ 层局部注意力后插入 $1$ 层全局注意力),并为局部层与全局层配置独立的 RoPE 参数化,在捕获局部调控基序的同时周期性整合长程上下文。网络同时引入前置归一化(Pre-Norm)与无偏置 GeGLU 前馈层以提升训练稳定性。
无填充动态序列打包: 预训练阶段采用动态序列打包策略,对变长序列执行端到端无填充解包,仅在有效词元上计算注意力与 MLM 损失,消除了传统定长 [PAD] 填充带来的显存与算力浪费。
⚪ TrinityDNA:多尺度沟槽卷积与滑动多窗口注意力的长序列编码器
- paper:TrinityDNA: A Bio-Inspired Foundational Model for Efficient Long-Sequence DNA Modeling(AAAI 2026)
TrinityDNA 在单核苷酸双向编码器中集成了多尺度局部卷积、滑动多窗口注意力与门控反向互补机制,并配合从原核向真核过渡的两阶段演化训练策略,实现十万碱基级长序列建模。
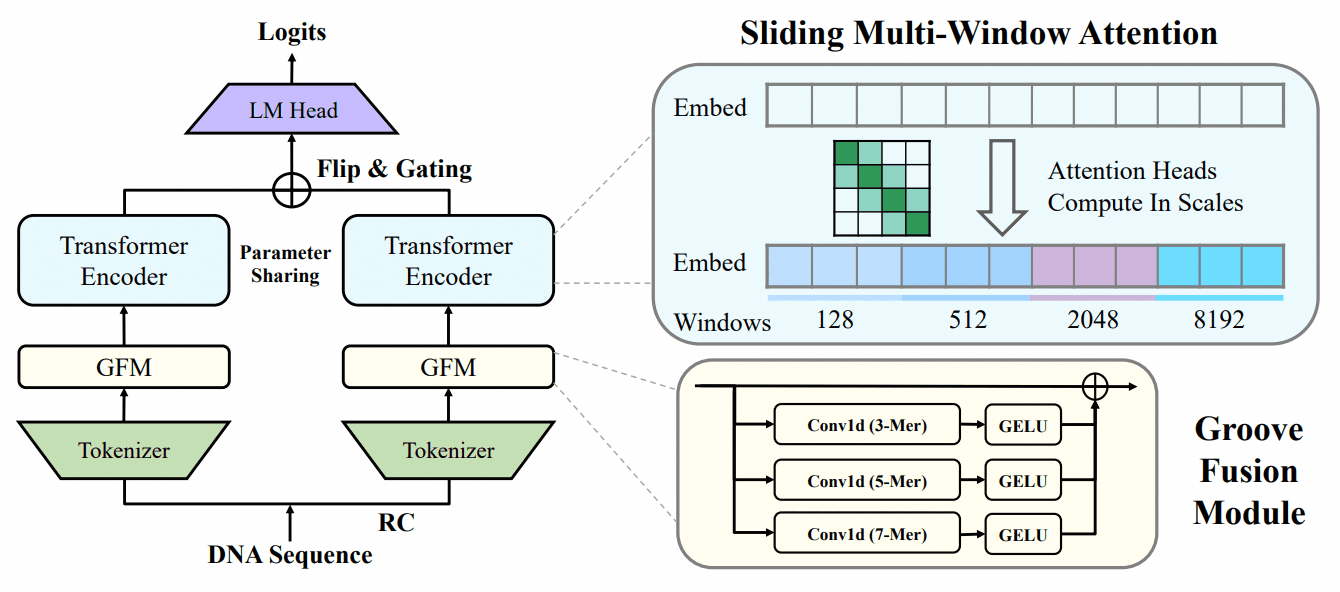
沟槽卷积、多窗口注意力与门控反向互补: 模型以单核苷酸为输入,主干包含三项核心算子:
-
沟槽融合模块(GFM):受 DNA 双螺旋大沟与小沟空间尺度启发,输入序列 $S$ 并行通过核宽 $k\in\lbrace 3,5,7\rbrace$ 的一维卷积提取多尺度局部基序:
\[\mathrm{GrooveFusion}(S)=\sum_{k\in\lbrace 3,5,7\rbrace }\mathrm{GELU}(\mathrm{Conv}_k(S)).\] - 滑动多窗口注意力(SMWA):为不同注意力头分配差异化的局部窗口半径 $L_h\in\lbrace 128,512,2048,8192\rbrace$,使第 $h$ 个头在位置 $i$ 仅计算 $[i-L_h,i+L_h]$ 内的键值交互,以线性复杂度同步捕获近端与远端上下文。
- 门控反向互补(GRC):正链序列与其反向互补序列并行通过参数共享的编码器;随后将反向互补分支输出沿长度轴翻转以对齐正链坐标,通过可学习门控单元与正链特征逐位点融合。
原核至真核演化训练与动态掩码: 模型采用两阶段演化训练策略(ETS):先在基因高密度的细菌、古菌等原核短序列上预训练以捕获紧凑编码语法,再迁移至包含真核生物的跨物种语料并将窗口扩展至 $102.4\text{ kb}$。预训练在 $15\%$ 掩码位点上优化交叉熵损失,并以一定概率在 $[0,80\%]$ 区间内动态采样 [mask] 词元的实际替换比例,缓解预训练与无掩码微调之间的分布偏移。
2. 卷积网络框架(Convolutional Architectures)
一维卷积网络(1D CNN)利用局部感受野算子沿基因组序列滑动提取特征,天然具备平移等变性(Translation Equivariance)——即调控基序在序列中的微小位置平移不会改变其提取出的特征模式,这与转录因子扫描识别局部 DNA 基序的生物物理过程高度契合。
为在不引入池化下采样(以严格保持单碱基分辨率)的前提下捕获长程顺式调控依赖,基因组卷积编码器普遍采用扩张卷积(Dilated Convolution)。设第 $l$ 层卷积核大小为 $K$、扩张率为 $d_l$,位置 $t$ 的输出特征计算为:
\[h_t^{(l)} = \sum_{k=0}^{K-1} W_k^{(l)} h_{t - d_l \cdot k}^{(l-1)}.\]通过令扩张率 $d_l$ 随网络深度按指数规律递增(如 $d_l = 2^{l-1}$),模型的有效感受野可在 $\mathcal{O}(L)$ 线性复杂度下呈指数级扩张。在此基础上,现代基因组卷积框架进一步引入了独立门控通路(抑制大段非编码背景噪声)或快速傅里叶变换(FFT)与小波变换,将纯时域局部卷积拓展至时频双域全局卷积。
⚪ GPN:基于指数循环扩张卷积的无监督基因组编码器
GPN(Genomic Pre-trained Network) 采用纯一维扩张卷积架构,结合功能区富集采样与重复序列损失降权策略,直接从近缘物种未比对参考基因组中无监督学习顺式调控语法与单碱基演化约束。
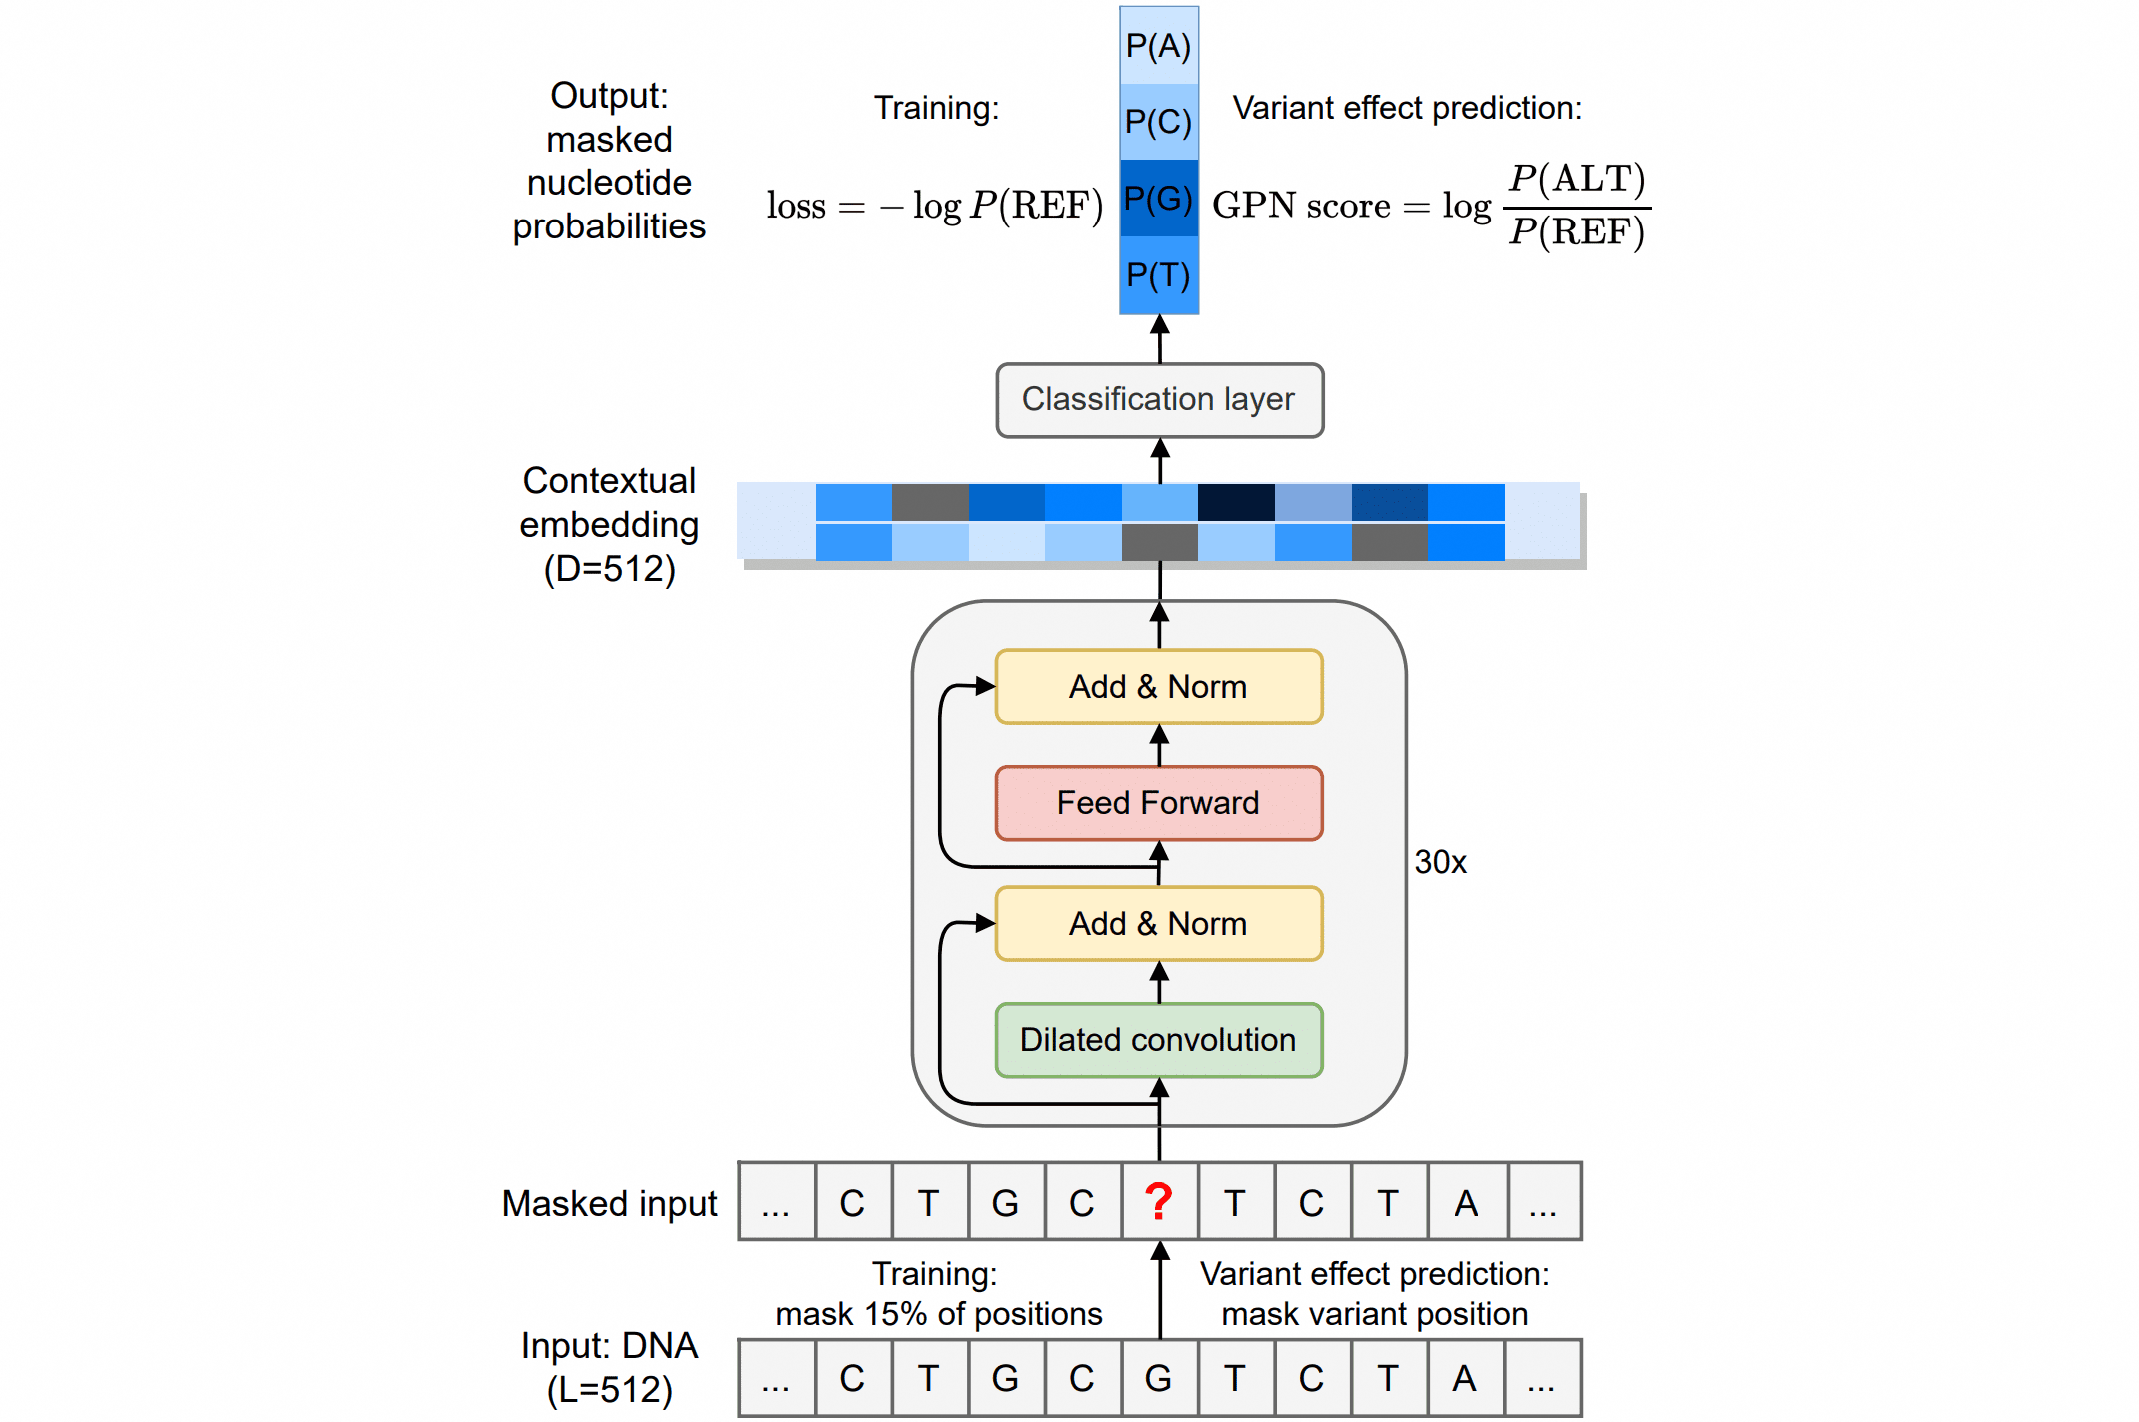
指数循环扩张卷积与重复区降权预训练: 模型输入单核苷酸独热编码序列,主干由多级一维扩张卷积块与前馈层串联堆叠而成。卷积扩张率按指数递增至预设上限后循环往复,在保持恒定序列长度与 $\mathcal{O}(L)$ 复杂度的同时逐层扩大感受野。预训练语料取自十字花目近缘植物参考基因组,混合了外显子、启动子富集窗口与全基因组随机窗口。模型在 $15\%$ 掩码位点上计算交叉熵损失,并对软屏蔽重复序列区域施加损失降权,防止模型过拟合低复杂度重复元件。
零样本变异效应评分与连锁不平衡校正: 推理时取正反双链输出概率的算术平均。在零样本变异效应预测中,模型遮蔽突变位点,计算替代等位基因($\mathrm{ALT}$)相对于参考等位基因($\mathrm{REF}$)的边际对数似然比;在 GWAS 精细定位中,进一步将目标位点 $i$ 邻近窗口内各变异位点 $j$ 的分数绝对值按连锁不平衡相关系数平方 $r_{ij}^2$ 加权求和:
\[\text{GPN Score}=\log\frac{P(\text{Allele}_{\mathrm{ALT}}\mid\text{Context})}{P(\text{Allele}_{\mathrm{REF}}\mid\text{Context})},\quad \mathrm{GPN}\times\mathrm{LD}_i=-\sum_j\vert\mathrm{GPN}_j\vert\cdot r_{ij}^2.\]⚪ ConvNova:非对称双分支门控扩张卷积的基因组编码器
ConvNova 在纯一维扩张卷积架构下引入非对称双分支门控机制,通过独立演化的门控通路在单碱基分辨率下实现内容依赖的动态特征筛选。
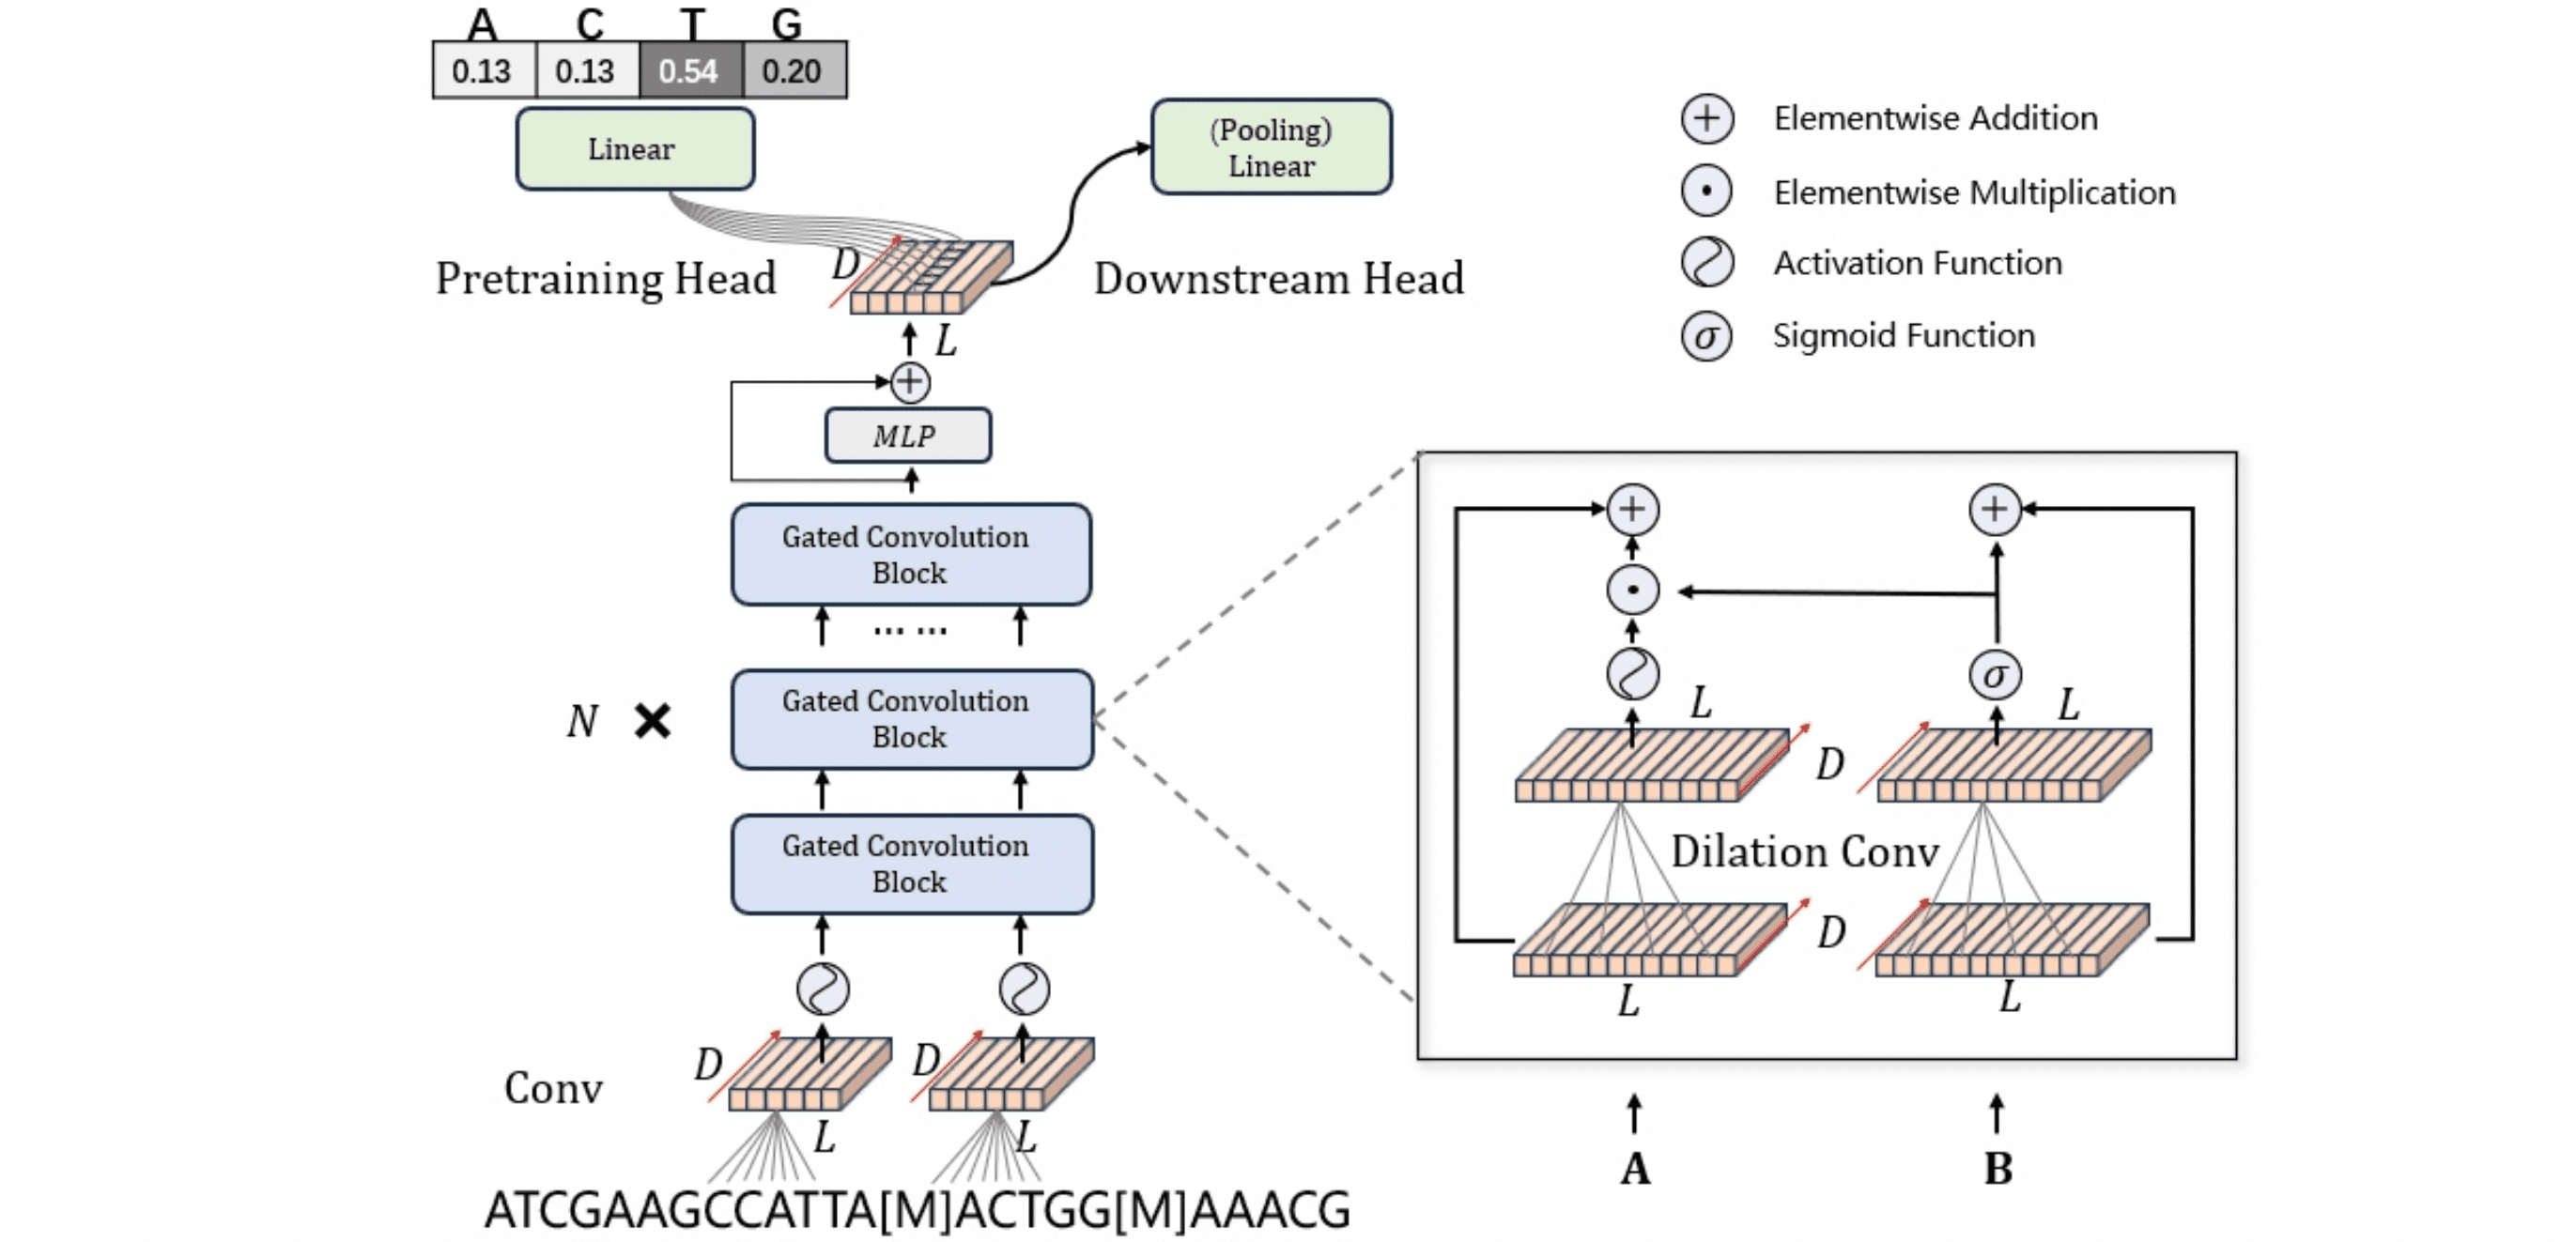
非对称双分支门控扩张卷积块(GCB): 模型采用单核苷酸分词,输入正反双链序列,全程不使用池化下采样,通过循环递增卷积扩张率扩大感受野。不同于在单一路径内临时分出激活与门控的常规门控卷积,GCB 维护两条参数独立的演化通路:左分支为特征提取流 $A$,右分支为独立门控信号流 $B$。在每一层中,两分支分别经层归一化与一维扩张卷积后,左分支生成候选特征 $h$,右分支生成动态门控权重 $g$:
\[\begin{aligned} h&=\mathrm{GELU}\!\left(\mathrm{DilatedConv}_1(\mathrm{LayerNorm}(A))\right),\\ g&=\sigma\!\left(\mathrm{DilatedConv}_2(\mathrm{LayerNorm}(B))\right),\\ A&\leftarrow A+h\odot g,\quad B\leftarrow B+g. \end{aligned}\]左分支利用门控加权特征 $h\odot g$ 执行残差更新,以保留调控基序并抑制低信息背景;右分支则通过残差累加 $g$ 独立维护跨层的门控上下文状态。预训练在人类参考基因组上随机将 $10\%$ 的单核苷酸替换为字符 N,优化掩码重建交叉熵损失。
⚪ SPU-DNA:协同可塑性单元与时频双域多分辨率建模
- paper:Adaptive DNA Sequence Modeling via Synergistic Plasticity Units(ICML 2026)
针对静态卷积难以同时兼顾局部基序、长程依赖与核小体定位等周期性信号的问题,SPU-DNA 提出协同可塑性单元(SPU),将局部可塑性层(LPL)、域可塑性层(DPL)与显著性可塑性层(SPL)组合为单一算子,以 $\mathcal{O}(L\log L)$ 复杂度实现局部—全局、时域—频域的多分辨率表征。

局部与时频双域特征提取(LPL & DPL): 给定输入 $E\in\mathbb{R}^{B\times L\times D}$,LPL 使用 $T=4$ 个核宽为 ${1,3,5,7}$ 的卷积提取多尺度特征 $F_i=\mathrm{Conv}(k_i,E)$,同时由 $1\times1$ 卷积生成位点相关的混合权重 $m_{j,i}$,逐位置动态聚合局部感受野 $F_{\mathrm{lpl},j}=\sum_{i=0}^{T-1}m_{j,i}F_{i,j}$。DPL 并行包含时域与频域两条路径:时域路径以 $F_{\mathrm{lpl}}$ 为条件生成带指数衰减窗的长卷积核 $p$,利用快速傅里叶变换(FFT)执行非因果全局卷积 $\hat F_{\mathrm{lpl}}$;频域路径对 $F_{\mathrm{lpl}}$ 逐级做小波分解 $(P_i^l,P_i^h)=\mathrm{WT}(P_{i-1}^l)$,在各子带上执行全局卷积后,以可学习尺度 $\gamma_i$ 逐级逆变换($\mathrm{IWT}$)重构并累加回时域特征:
\[\begin{aligned} &\hat F_{\mathrm{lpl}}=\mathrm{CenterCrop}_L\!\left(\mathrm{iFFT}\big(\mathrm{FFT}(F_{\mathrm{lpl}})\odot\mathrm{FFT}(p)\big)\right),\\ &F_{\mathrm{dpl}}=\hat F_{\mathrm{lpl}}+\mathrm{IWT}(\gamma_0\tilde P_1^l,\hat P_1^h). \end{aligned}\]显著性门控调制(SPL): SPL 从通道和空间位置两个维度计算门控权重:通道分支沿位置轴均值池化后经 MLP 得到 $S_c$,位置分支沿通道轴拼接均值与最大值后经深度可分离卷积得到 $S_p$,逐元素调制输出 $F_{\mathrm{out}}=F_{\mathrm{dpl}}\odot S_c\odot S_p$。
3. 状态空间框架(State-Space Architectures)
选择性状态空间模型(Selective State Space Models, SSMs,如 Mamba)将一维连续动态系统离散化,通过线性隐状态递推捕获长程依赖:
\[h_t = \bar{A}_t h_{t-1} + \bar{B}_t x_t, \quad y_t = C_t h_t,\]其中离散化状态转移矩阵 $\bar{A}_t$、输入矩阵 $\bar{B}_t$ 与输出矩阵 $C_t$ 均为当前输入 $x_t$ 的函数。这种输入依赖的选择性机制允许模型在处理数十万碱基序列时,动态过滤非编码背景冗余并将关键调控基序压缩入隐状态,同时利用并行关联扫描(Parallel Associative Scan)或结构化状态空间对偶(SSD)实现 $\mathcal{O}(T)$ 线性时间复杂度的训练。
然而,原生 Mamba 是单向因果算子,且不具备对 DNA 双螺旋物理对称性的归纳偏置。在基因组双链中,正链序列与其反向互补(Reverse Complement, RC)链承载着完全等价的分子结构信息。因此,基因组状态空间编码器的核心设计在于:通过正反向权重共享扫描实现双向上下文聚合(BiMamba),并通过通道拆分与对偶置换构造严格满足 $\mathcal{F}(\mathrm{RC}(X)) = \mathrm{RC}(\mathcal{F}(X))$ 的反向互补等变算子。
⚪ Species-aware DSS:逐碱基物种嵌入注入与对角状态空间的非编码区编码器
- paper:Species-aware DNA language modeling(bioRxiv 2023)
Species-aware DSS(约 $97.6\text{k}$ 参数)将对角状态空间模型(Diagonal State Space, DSS)引入跨物种非编码区掩码核苷酸建模,通过在跨越 $5$ 亿年演化史的 $806$ 种真菌基因 $3’$ 侧翼区语料(约 $3.9\text{B}$ 核苷酸)中逐碱基注入物种标签嵌入,在无需序列比对且参数量仅为 DNABERT 百分之一的条件下,捕获了快速演化且位置游移的顺式调控基序与跨物种密码演化。
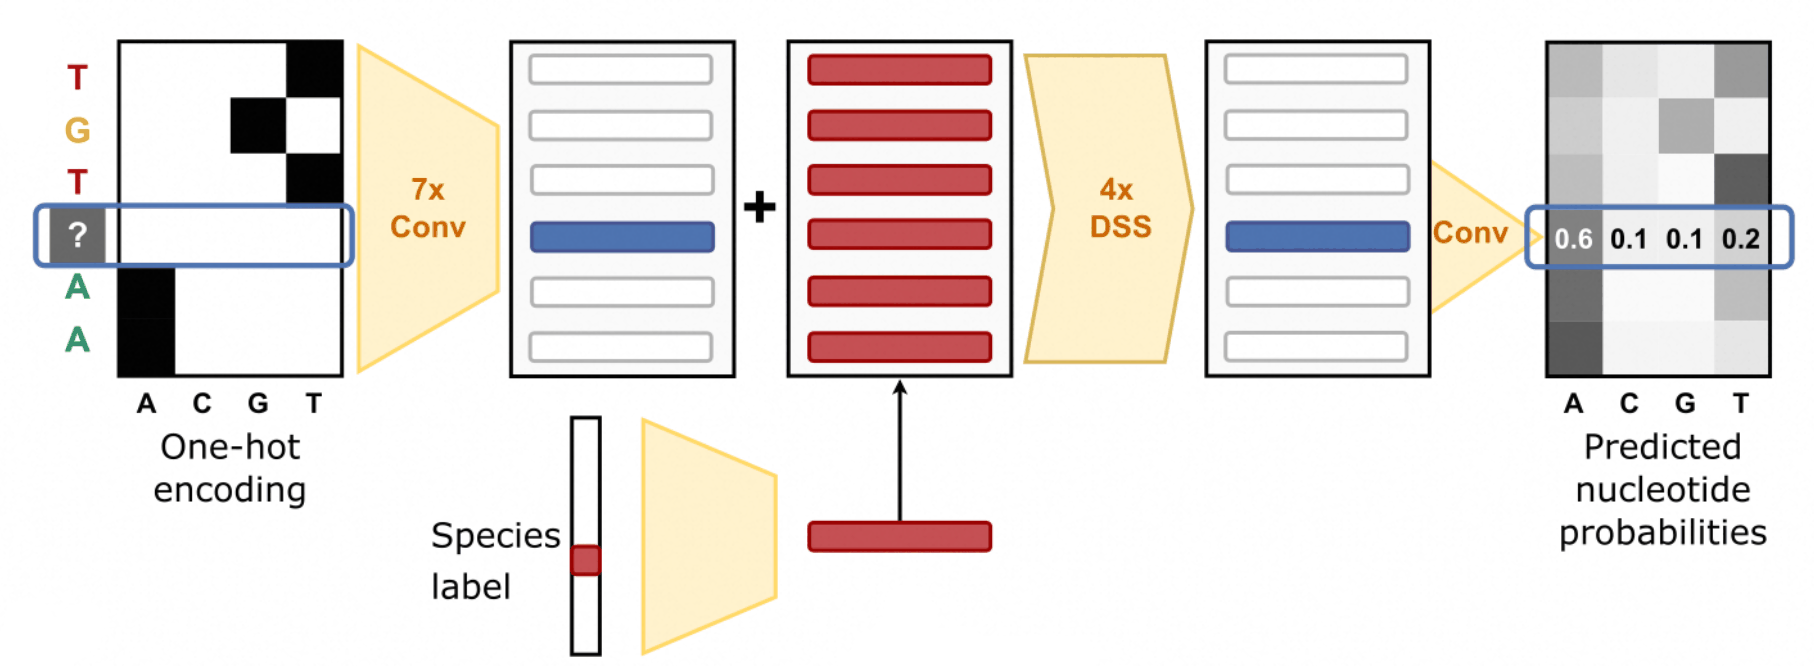
基因 $3’$ 区定向语料与物种感知对角状态空间主干: 鉴于真核 $3’$ 非翻译区($3’$ UTR)演化迅速且调控基序位置高度游移导致跨属比对失效,预训练语料专门截取 $1{,}500$ 个真菌基因组中所有蛋白质编码基因终止密码子下游 $300\text{ bp}$ 的非编码序列(严格留出整个酿酒酵母属 Saccharomyces 作为零样本测试集)。输入单碱基独热编码序列 $x_{1:L}$ 先经首层卷积与 $3$ 个双核残差卷积块映射至高维隐空间,并在每个碱基位置 $i$ 直接叠加对应物种标识符 $s$ 的可学习嵌入向量 $e_{\mathrm{sp}}(s)$;随后特征流经 $4$ 层具有 $\mathcal{O}(L)$ 线性复杂度的对角状态空间(DSS)层捕获长程依赖,最后由单层卷积解码器输出单核苷酸概率分布,在 $15\%$ 标准 BERT 掩码位置集 $\mathcal{M}$ 上优化条件交叉熵损失:
\[\mathcal{L}_{\mathrm{MLM}} = -\sum_{i \in \mathcal{M}} \log P_\theta\big(x_i \mid \tilde{x}, s\big).\]近缘代理零样本基序探测与逐位掩码表征提取: 在未见测试物种(如酿酒酵母 S. cerevisiae)的推理阶段,模型以训练集中演化距离最近的近缘物种(光滑念珠菌 C. glabrata)作为代理物种标签 $s^*$,不仅能通过切换物种标签还原同一 RNA 结合蛋白(如 Puf3)在不同真菌谱系间的结合基序第 $5$ 位碱基偏好演化($\mathrm{TGTAAATA} \leftrightarrow \mathrm{TGTACATA}$),还可直接利用目标区间 $\Omega$ 的平均掩码核苷酸重建概率 $S_{\mathrm{rec}}(\Omega)$ 零样本识别 gPAR-CLIP 实验验证的蛋白质结合位点。在有监督 mRNA 半衰期与报告基因表达量预测中,模型依次遮蔽序列中的每个核苷酸 $i$,提取末层 DSS 在该掩码位点的隐状态并沿序列求均值得到定长 $3’$ UTR 表征 $\bar{z}$,仅需配合岭回归线性探针即可达到或超越依赖复杂手工特征工程的专用模型:
\[S_{\mathrm{rec}}(\Omega) = \frac{1}{\lvert\Omega\rvert}\sum_{i \in \Omega} P_\theta\big(x_i \mid x_{\setminus i}, s^*\big), \quad \bar{z} = \frac{1}{L}\sum_{i=1}^{L} \mathrm{DSS}_{\mathrm{last}}\big(x_{\setminus i}, s^*\big)_i.\]⚪ Caduceus:反向互补等变的双向选择性状态空间模型
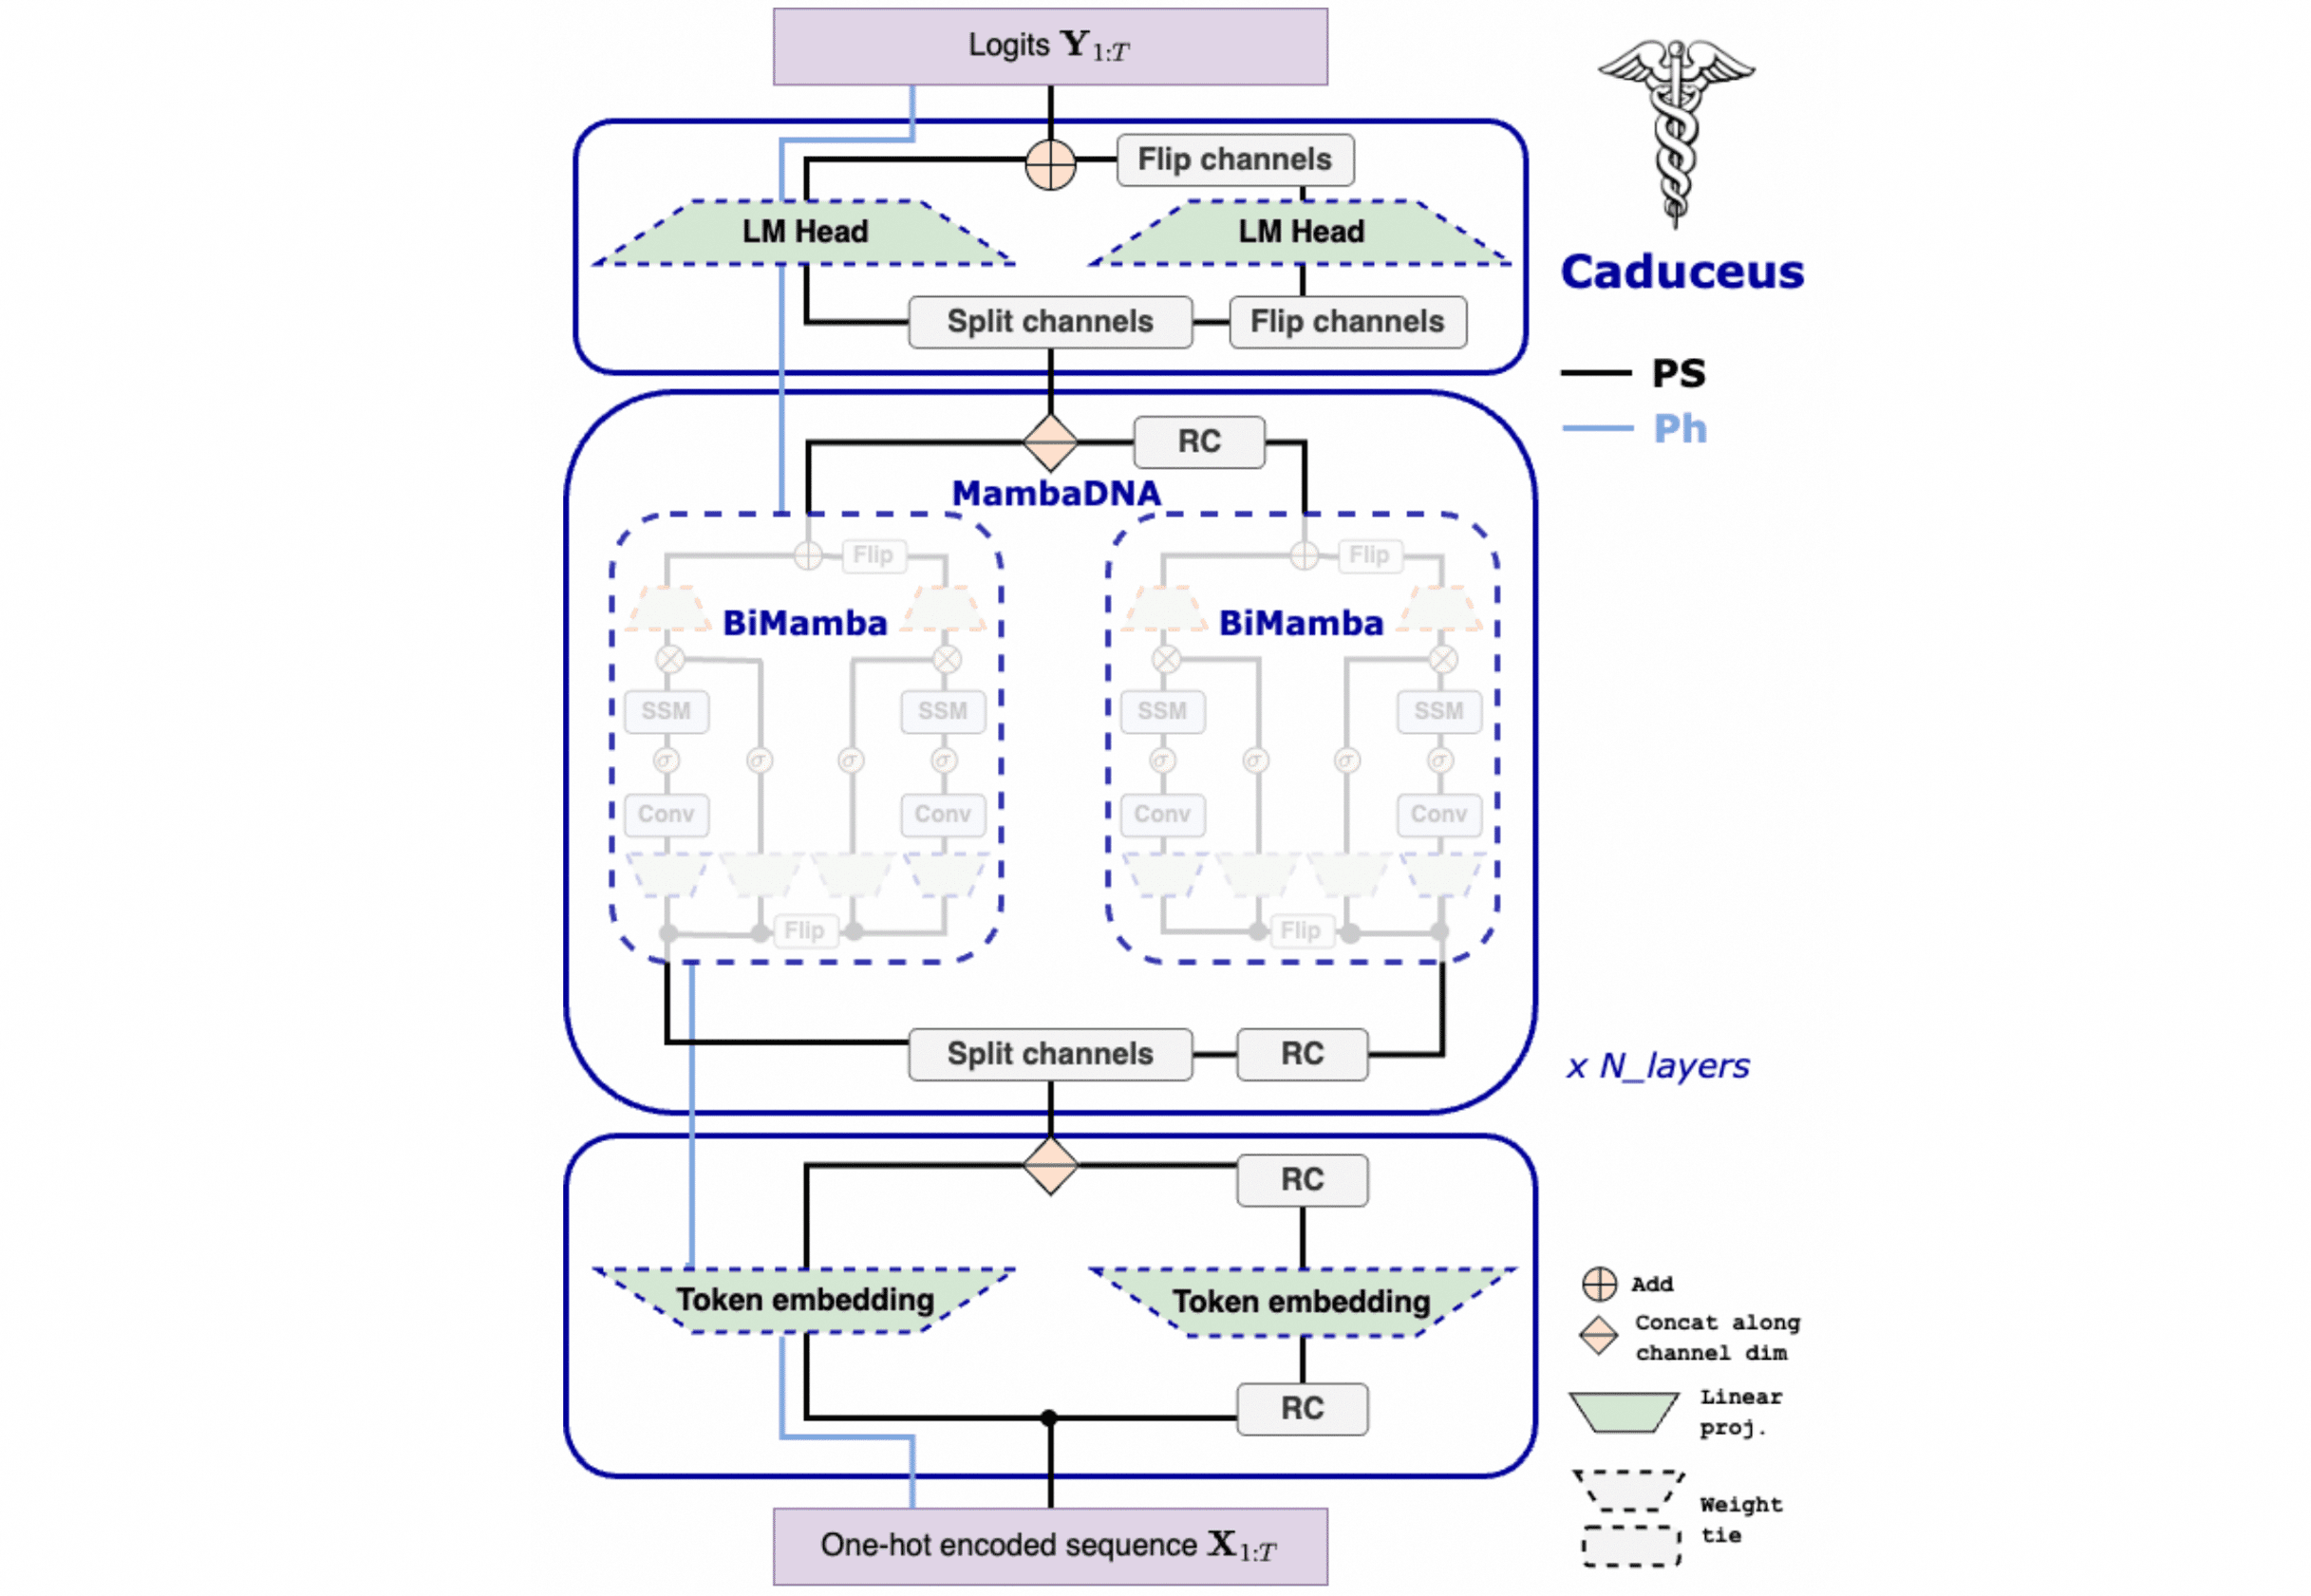
Caduceus 将单向 Mamba 拓展至双链基因组建模,构建了参数共享的双向组件 BiMamba 与反向互补等变组件 MambaDNA,在单核苷酸分辨率下实现 $131\text{k}$ 窗口的长程双向等变建模。
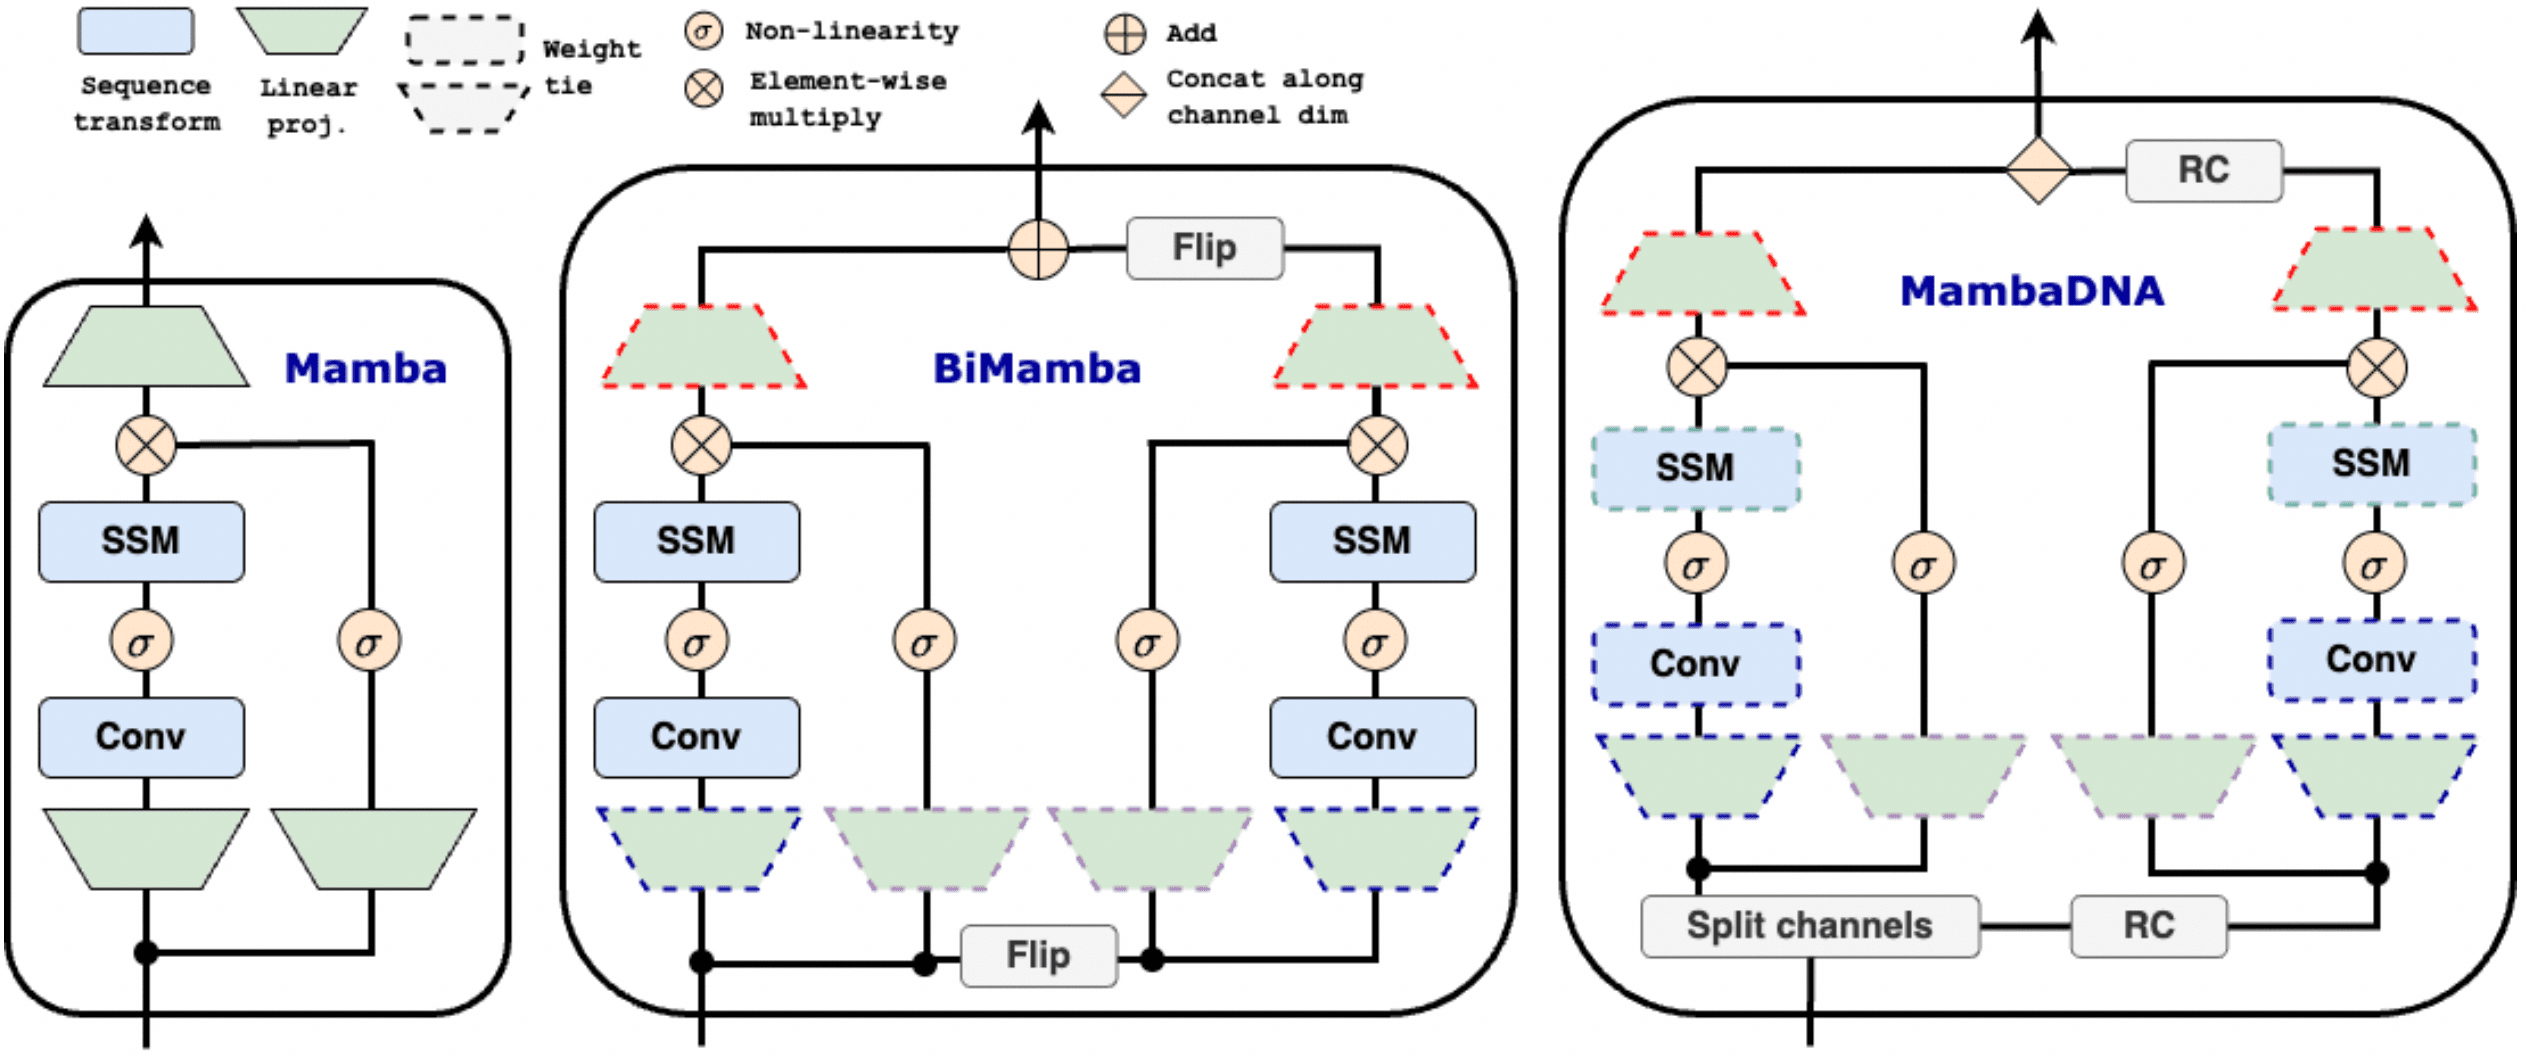
双向状态空间与反向互补等变算子: 模型设计了两层核心组件:
- BiMamba:分别沿正向与位置反转方向扫描输入序列,在正反两个分支间共享输入与输出线性投影权重;反向分支输出经翻转对齐回原始坐标后与正向输出相加。
-
MambaDNA:将通道维度为 $D$ 的隐状态 $X$ 沿通道轴对半切分为两路,共享同一底层模块 $M_\theta$(即 BiMamba)。其中第二路特征先施加隐空间反向互补变换 $\mathrm{RC}(\cdot)$(对应序列长度轴反转与互补通道置换),经 $M_\theta$ 处理后再执行一次逆向 $\mathrm{RC}(\cdot)$ 变换并与第一路输出沿通道拼接:
\[\mathrm{MambaDNA}(X)=\mathrm{concat}\!\left(M_\theta(X_{1:D/2}),\;\mathrm{RC}\!\left(M_\theta(\mathrm{RC}(X_{D/2+1:D}))\right)\right).\]该设计严格满足等变关系 $\mathrm{MambaDNA}(\mathrm{RC}(X))=\mathrm{RC}(\mathrm{MambaDNA}(X))$。
参数共享等变与事后双链联合变体: 模型衍生出两类变体:Caduceus-PS(参数共享等变)将 BiMamba 封装于 MambaDNA 内部,配合等变词嵌入层与对偶输出头,无需数据增强即可在端到端保证反向互补等变性;Caduceus-Ph(事后双链联合)主干仅堆叠非等变的 BiMamba 模块,训练期施加 RC 数据增强,推理期分别输入正反双链并将输出对齐平均。
⚪ PlantCaduceus:面向被子植物基因组的跨物种等变状态空间模型
- paper:Cross-species modeling of plant genomes at single-nucleotide resolution using a pretrained DNA language model(PNAS 2025)
针对植物基因组中非编码背景膨胀与高比例转座子重复序列干扰表征学习的问题,PlantCaduceus 在 Caduceus 双向等变架构下结合非编码区下采样与重复序列损失降权策略,从多物种被子植物基因组中学习单碱基分辨率的跨物种演化约束。
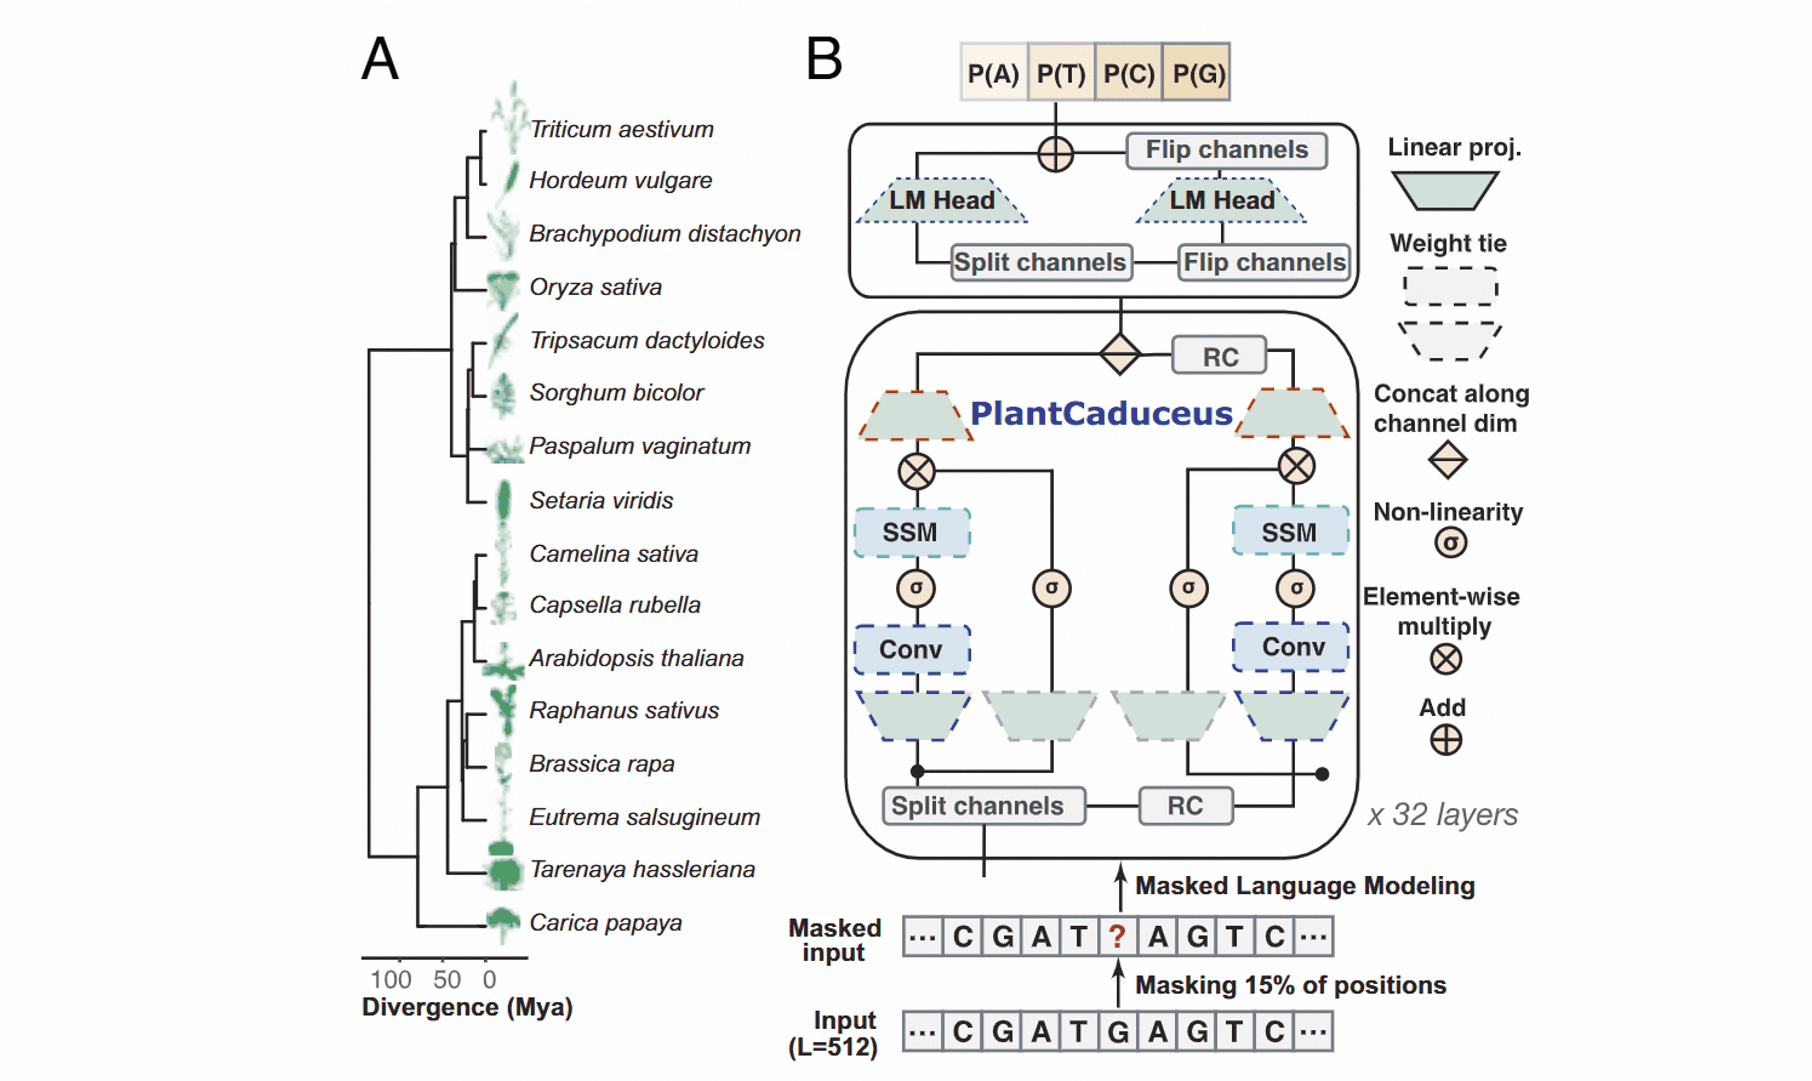
功能区重采样与重复降权预训练: 模型沿用 Caduceus 的双向 RC 等变主干与单核苷酸分词。预训练语料构建于横跨禾本科与十字花目的多物种参考基因组;为抑制海量转座子与基因间区背景噪声,数据流通过主动下采样压缩非编码区与重复序列的样本占比,使训练分布聚焦于基因编码区及近端调控区。在 $15\%$ 掩码语言建模中,模型进一步对落入软掩码重复区域的被遮蔽位点施加损失降权。
跨物种零样本迁移与变异评分: 下游基因结构预测任务可直接冻结主干,提取末层隐状态训练轻量分类器实现跨物种零样本迁移。在零样本变异效应预测中,模型根据突变位点的双向上下文计算替代等位基因相对于参考等位基因的条件概率对数似然比:
\[\text{Score}=\log\frac{P(\text{Allele}_{\mathrm{ALT}}\mid\text{Context})}{P(\text{Allele}_{\mathrm{REF}}\mid\text{Context})}.\]⚪ PlantCAD2:基于结构化状态空间对偶的长上下文植物基因组编码器
- paper:PlantCAD2: A DNA foundation model for interpreting genomes across flowering plants(Cell Genomics 2026)
PlantCAD2 在双向反向互补等变编码器中将底层序列算子升级为 Mamba2,结合基因侧翼长窗口采样与重复序列损失降权策略,在 $8{,}192\text{ bp}$ 上下文窗口内建模跨物种被子植物基因组。
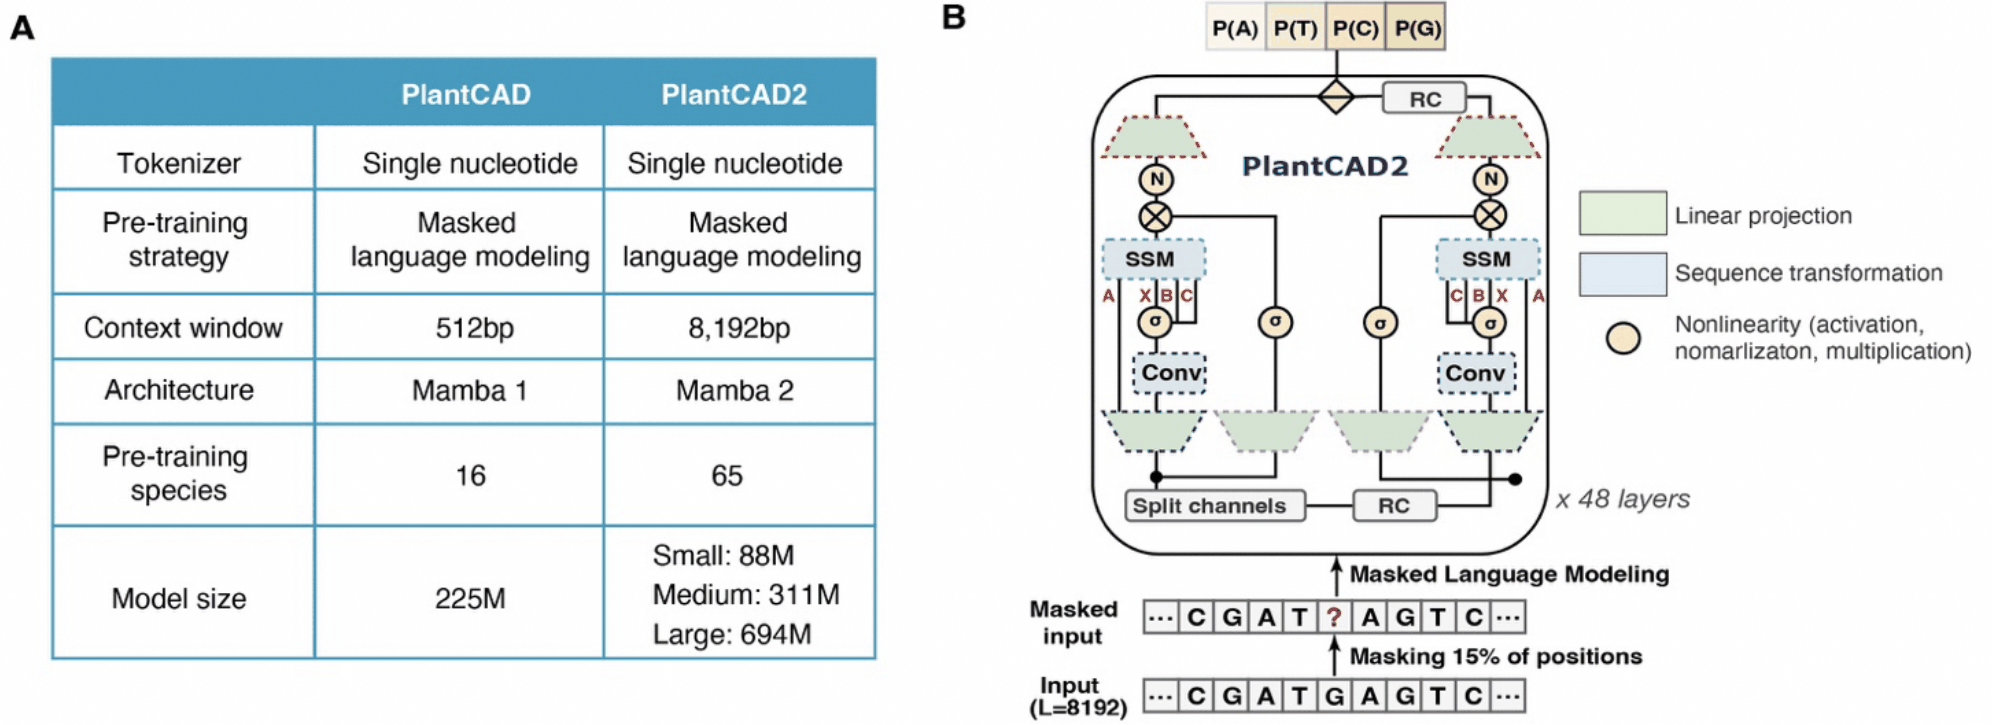
双向等变 Mamba2 架构与侧翼长窗口语料: 模型采用单核苷酸分词,围绕跨属代表性被子植物的每个注释基因及其上下游各 $5\text{ kb}$ 侧翼调控区提取长序列窗口。主干沿用双向与 RC 等变设计,并将内部状态空间模块替换为 Mamba2——利用结构化状态空间对偶性(SSD),在保持输入依赖动态筛选机制的同时,将线性状态递推转化为块状结构化矩阵乘法以提升长序列并行训练效率。预训练同样采用对注释重复区施加损失降权的 $15\%$ 掩码语言建模目标,支持单碱基保守性评分与小片段缺失等结构变异的零样本似然评估。
⚪ Wisteria:基于 BiMamba 与傅里叶注意力的多尺度编码器
- paper:Wisteria: A Unified Multi-Scale Feature Learning Framework for DNA Language Model(Pattern Recognition 2026)
Wisteria 构建了单核苷酸分辨率的自底向上多尺度双向编码器:浅层通过门控扩张卷积—BiMamba 模块(GCMB)捕获局部调控基序,中深层通过 BiMamba 与门控 MLP 精炼长程上下文,顶层引入傅里叶位置嵌入(FoPE)自注意力建模基因组内在的频域周期性信号。
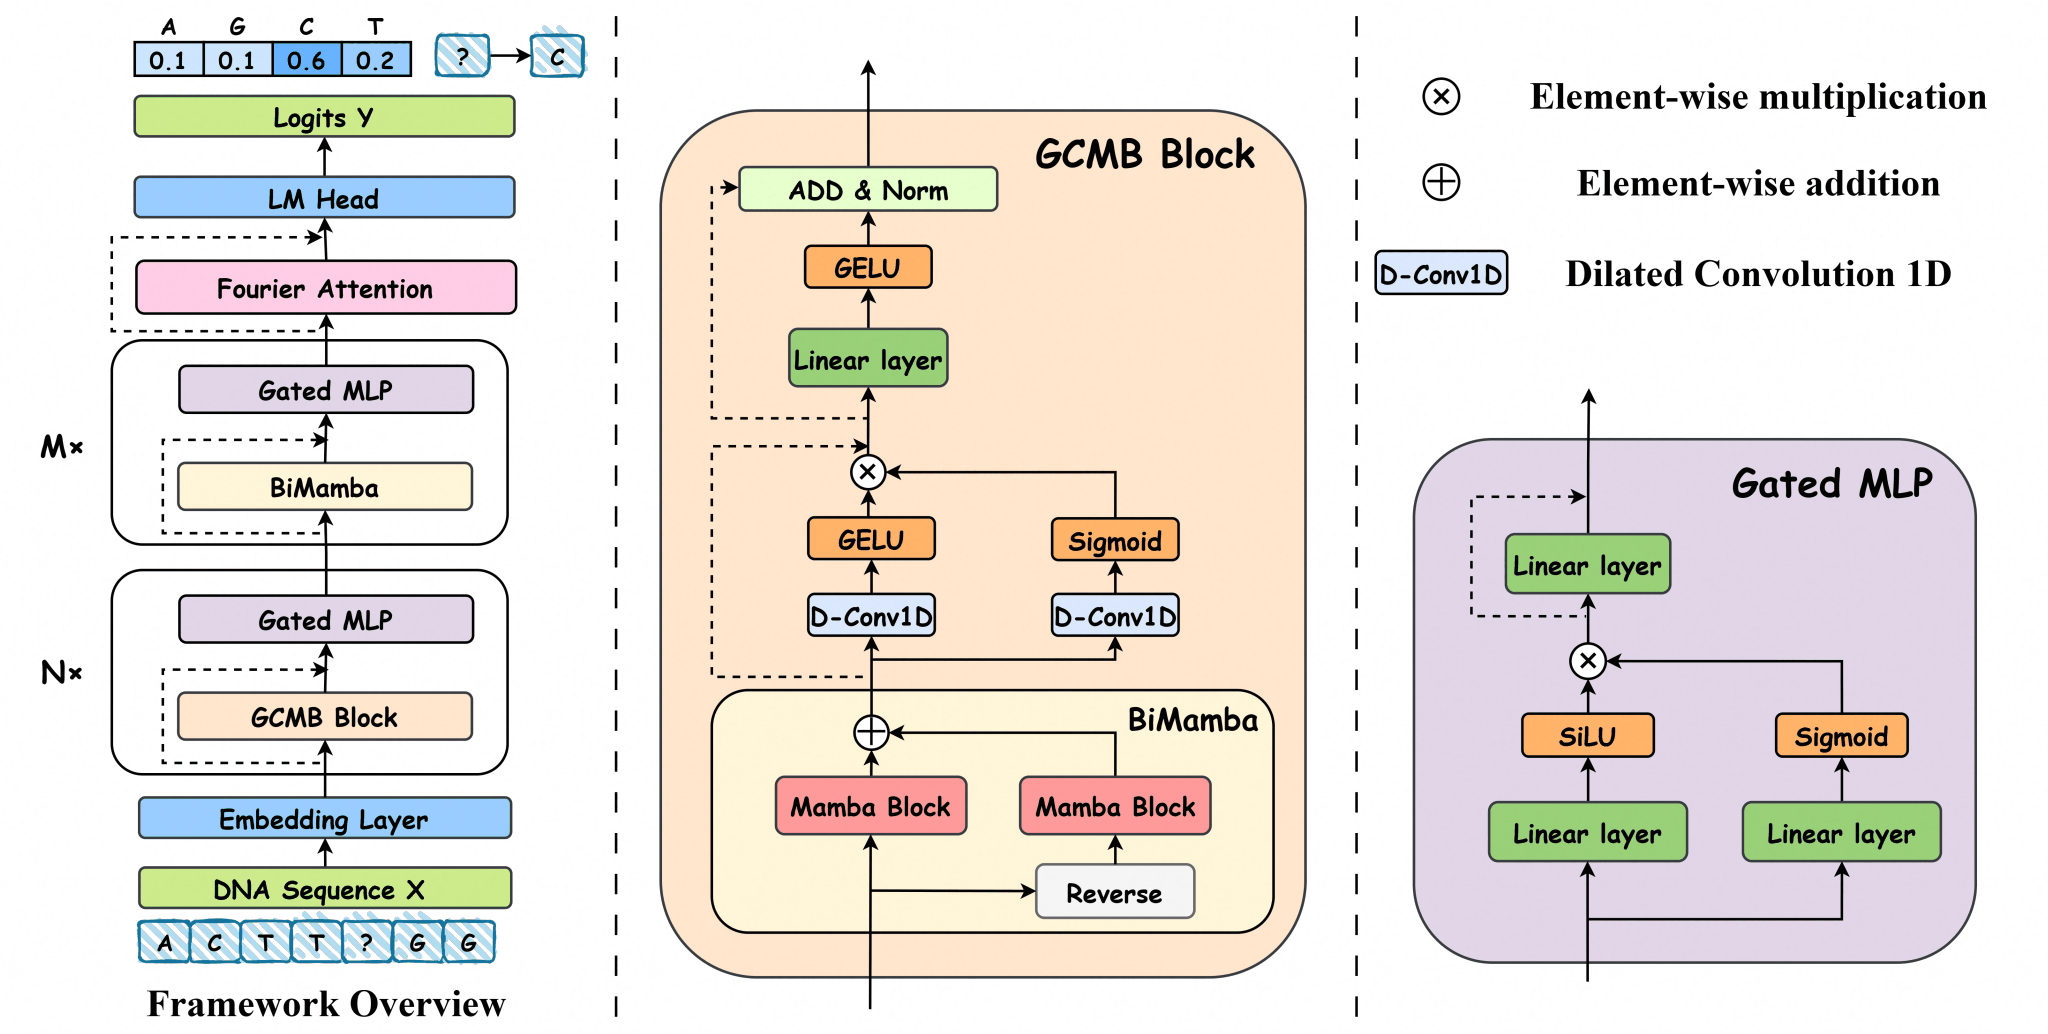
浅层门控扩张卷积–BiMamba 模块(GCMB)与门控 MLP: 模型采用单核苷酸分词且不设输入位置编码。在前 $N=5$ 个浅层中,BiMamba 首先提取正反向状态空间双向上下文均值 $H$;随后并行通过两个不同扩张率的深度一维扩张卷积分支生成局部特征 $h$ 与门控权重 $g$:
\[\begin{aligned} &H = \frac{1}{2}\Big(\mathrm{Mamba}_{\mathrm{fwd}}(X) + \mathrm{Flip}\big(\mathrm{Mamba}_{\mathrm{bwd}}(\mathrm{Flip}(X))\big)\Big),\\ &h = \mathrm{GeLU}\big(\mathrm{Conv}_A(H)\big),\quad g = \sigma\big(\mathrm{Conv}_B(H)\big),\\ &Y = \mathrm{LayerNorm}\big(\mathrm{MLP}(H + h \odot g)\big). \end{aligned}\]在每个 GCMB(或深层纯 BiMamba)之后,特征 $Y$ 经门控 MLP 对半切分为 $U, G$,通过双门控融合 $\tilde{U} = \mathrm{SiLU}(U) \odot \sigma(G)$ 完成残差更新。
顶层傅里叶位置注意力(FoPE): 为捕获与核小体定位相关的频域周期性(如 $10\sim 11\text{ bp}$ 振荡)并避免 RoPE 在长上下文延拓时的频谱损伤,末层自注意力采用 FoPE,将位置 $n$ 的响应表示为含可学习谐波系数 $a_\omega$ 的多频傅里叶级数,并对低于截止频率 $\omega_l = 2\pi / N$ 的分量施加截断门控:
\[\begin{aligned} &f(\omega_m) = \begin{cases} 1, & \omega_m < \omega_l, \\ e^{i\omega_m n} + \sum_\omega a_\omega e^{i\omega n}, & \omega_m \ge \omega_l, \end{cases}\\ &\mathrm{Attn}(q, k) = \mathrm{Softmax}\!\left(\frac{\big(q f(\omega)\big)\big(k f(\omega)\big)^\top}{\sqrt{D}}\right). \end{aligned}\]⚪ eccDNAMamba:超长环状 DNA 的循环增强双向 Mamba-2 编码器
- paper:eccDNAMamba: A Pre-Trained Model for Ultra-Long eccDNA Sequence Analysis(ICML 2025 Workshop GenBio)
针对染色体外环状 DNA(eccDNA)在任意断点线性化时会破坏首尾成环接合区依赖、且超长序列受限于二次方注意力瓶颈的问题,eccDNAMamba 结合字节对编码分词、首尾循环数据增强与双向 Mamba-2 状态空间编码器,通过连续跨度掩码语言建模实现长达 $200\text{ kbp}$ 的环状基因组序列全长表征。
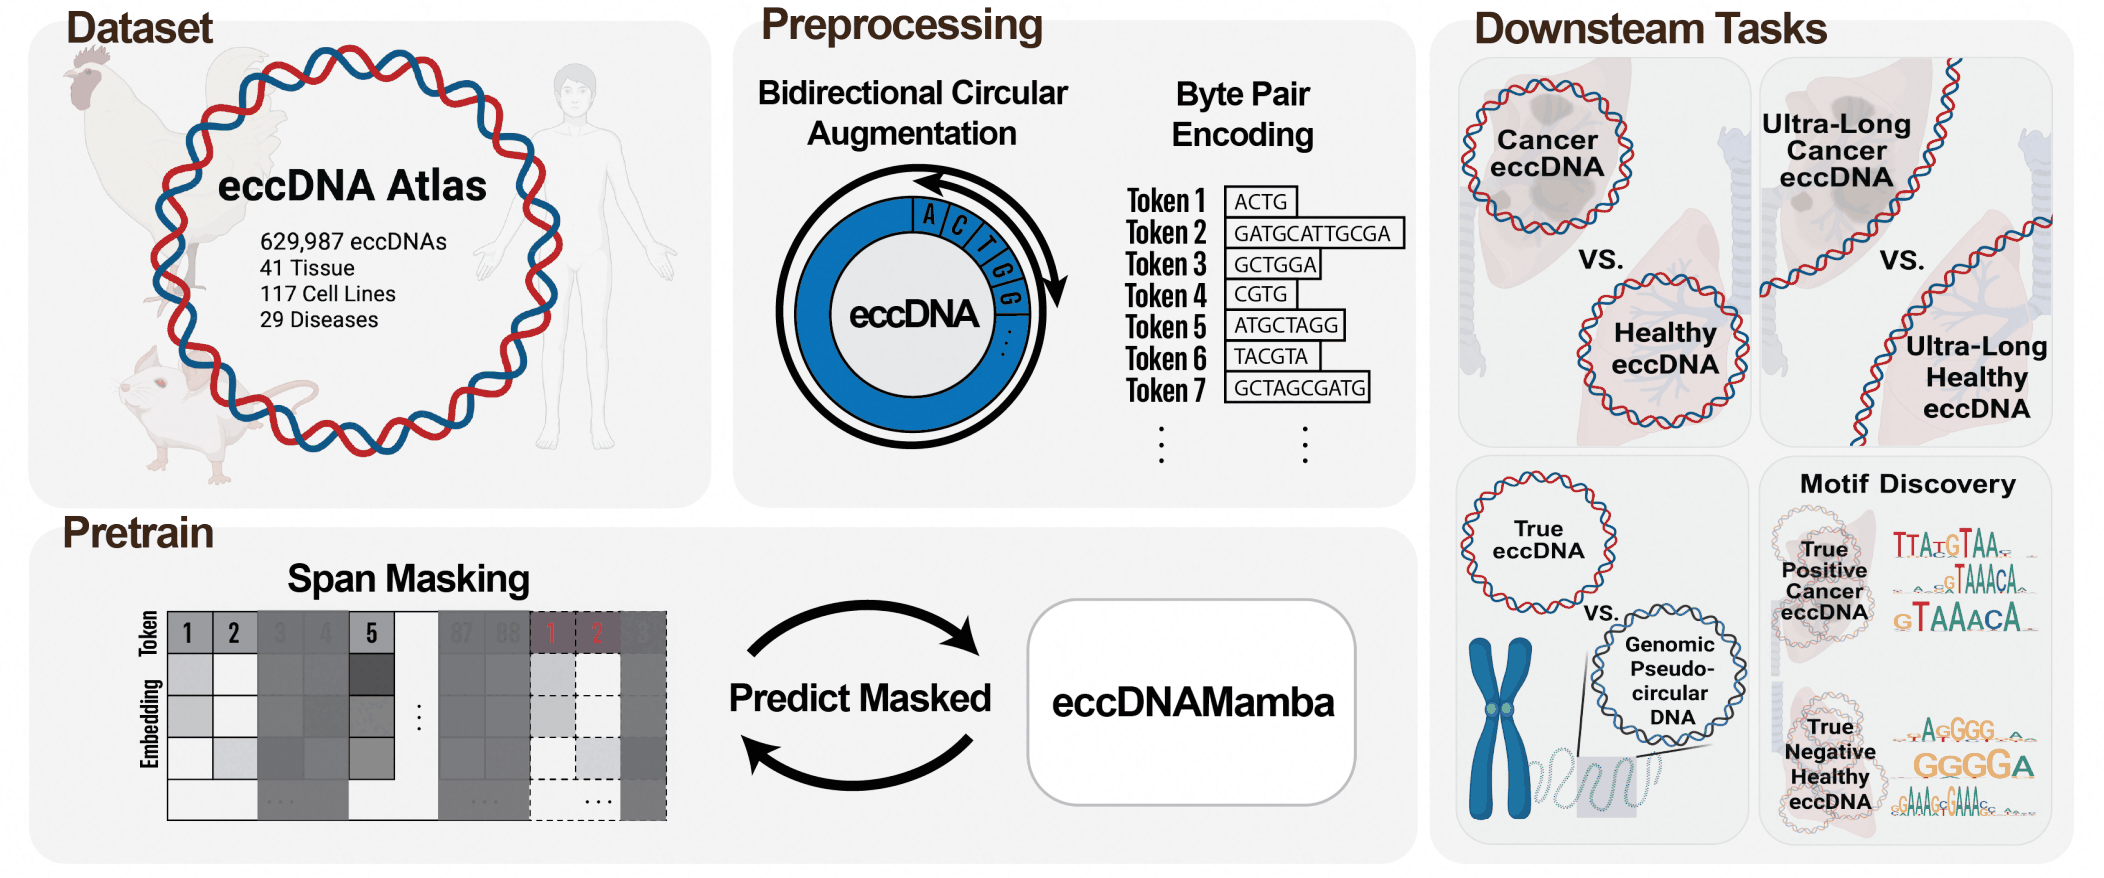
BPE 分词与首尾循环拓扑增强: 模型在跨物种 eccDNA 语料上构建 BPE 子词词表以压缩序列长度。由于 eccDNA 为闭合环状分子且两端常富集介导成环的重复元件,直接线性化会割裂首尾交互。为此,给定长度为 $L$ 的分词序列 $x = (x_1, \ldots, x_L)$,模型在前端附加 [CLS],并将起始端的前 $s=64$ 个词元复制追加至序列尾部,构造跨越断点的循环增强输入 $\tilde{x} = (\mathrm{[CLS]}, x_1, \ldots, x_L, x_1, \ldots, x_s)$。
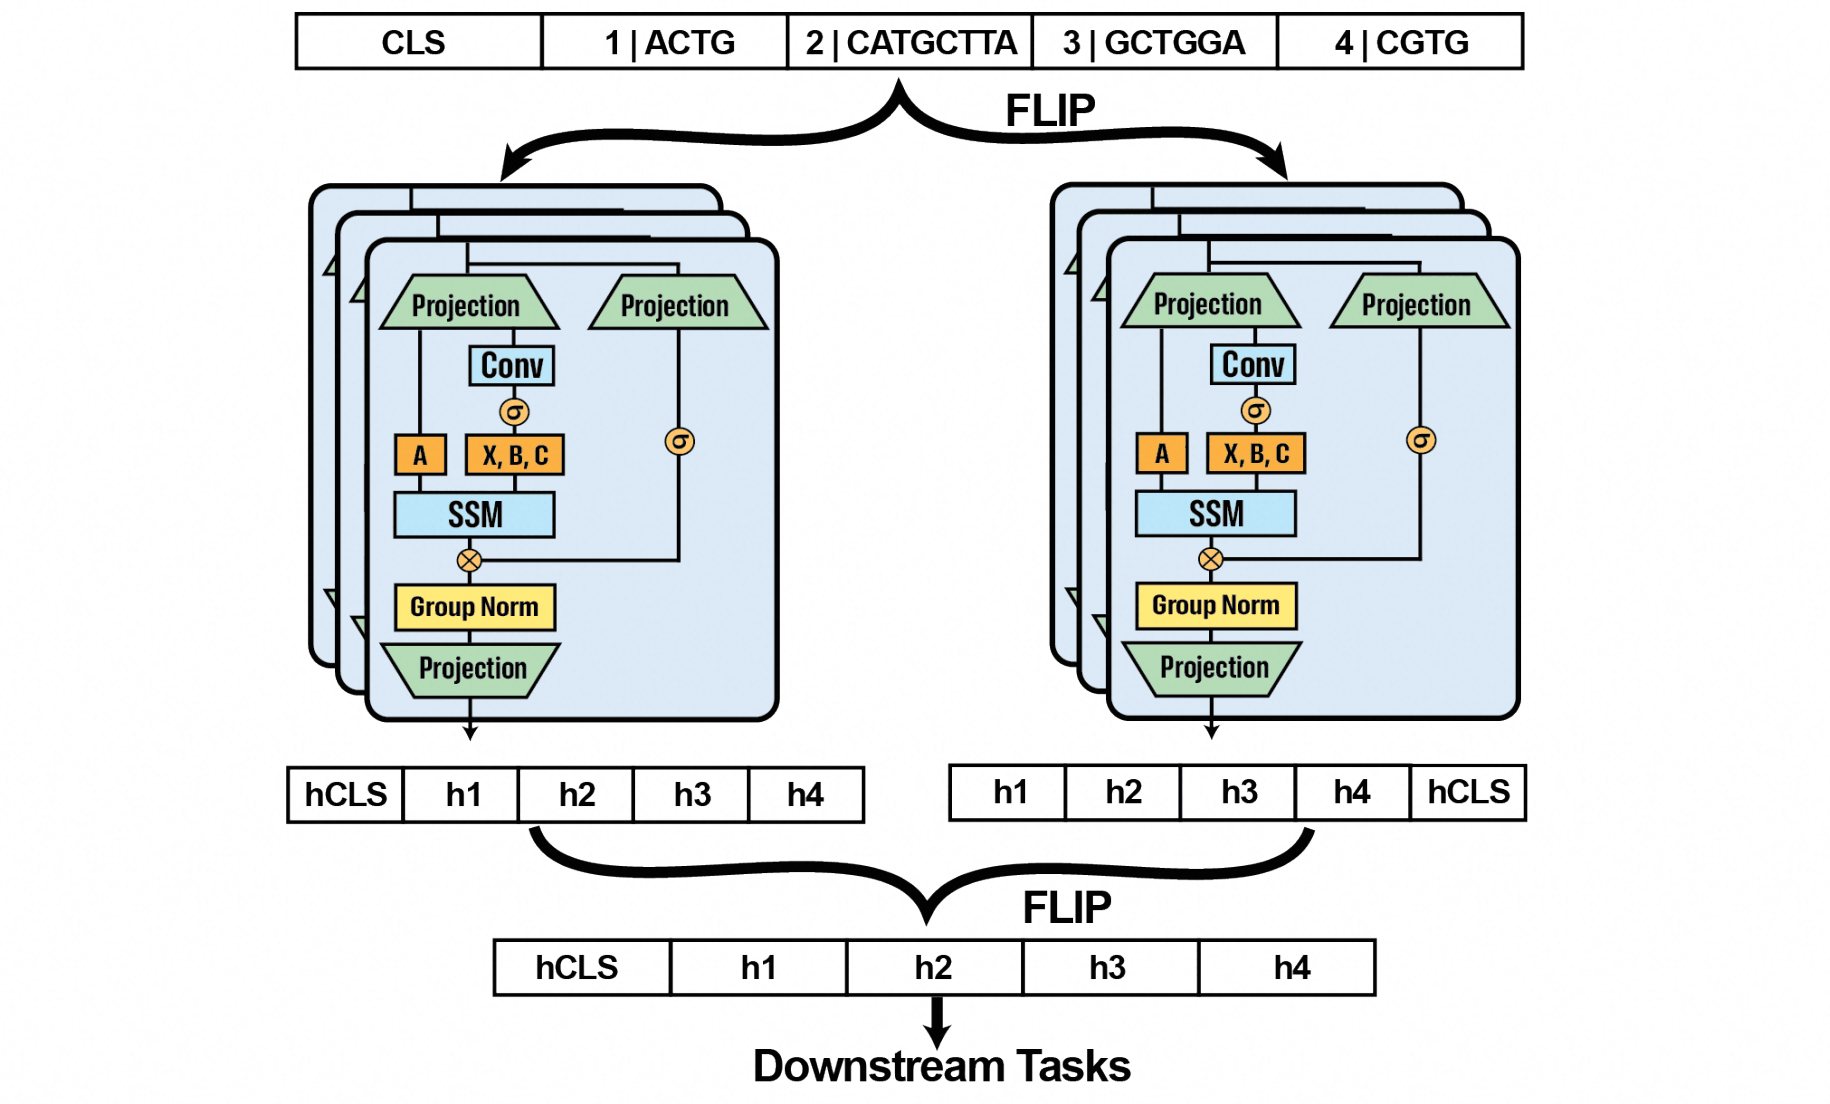
双向 Mamba-2 编码与连续跨度掩码: 模型并行实例化前向与后向两个 Mamba-2 分支,分别扫描正向序列 $\overrightarrow{\tilde{x}}$ 与反转序列 $\overleftarrow{\tilde{x}}$:
\[\overrightarrow{h} = \overrightarrow{\mathrm{Mamba}}(\overrightarrow{\tilde{x}}) = [\overrightarrow{h}_{\mathrm{cls}}, \overrightarrow{h}_1, \ldots, \overrightarrow{h}_L], \\ \overleftarrow{h} = \overleftarrow{\mathrm{Mamba}}(\overleftarrow{\tilde{x}}) = [\overleftarrow{h}_L, \ldots, \overleftarrow{h}_1, \overleftarrow{h}_{\mathrm{cls}}].\]后向输出对齐后与前向输出拼接,经共享 MLP 融合为双向表征;同时将 [PAD] 词元的嵌入及各层对应的隐状态与残差显式置零以阻断填充噪声。预训练采用连续跨度掩码(SpanMLM,随机遮蔽总占比 $15\%$、平均长 $3$ 词元的连续跨度),下游微调时无需截断即可直接提取 $200\text{ kbp}$ 全长序列的 [CLS] 表征进行分类。
4. 循环与记忆网络框架(Recurrent & Memory Architectures)
传统循环神经网络(如标准 LSTM)受限于 $\mathrm{sigmoid}$ 门控饱和、标量细胞状态容量瓶颈以及非线性隐状态依赖导致的无法并行训练,难以直接应用于长程基因组建模。现代循环与快权重记忆网络(Extended RNNs & Fast-Weight Memory)通过两项关键改进复兴了循环范式:
- 消除非线性隐状态递归:移除门控对上一时刻输出 $h_{t-1}$ 的非线性依赖,使循环更新在时间轴上呈线性,从而支持训练阶段的分块矩阵并行计算与推理阶段 $\mathcal{O}(1)$ 显存开销的常数级状态递推;
- 高维矩阵记忆与测试时训练(TTT / Fast Weights):将固定维度的标量向量记忆升级为键值外积构成的矩阵记忆(Matrix Memory) $C_t \in \mathbb{R}^{d \times d}$ 或参数化子网络 $f_M(\cdot)$,利用协方差更新规则或块内多步梯度下降写入上下文:
在基因组编码器中,这类高容量循环记忆常与局部滑动窗口注意力结合:由局部注意力精确解析邻近基序语法,再通过跨链通信、正反向变点差异写入等机制,将长程拓扑结构与调控信号压缩进全局记忆状态中。
⚪ Bio-xLSTM (DNA-xLSTM):指数门控与矩阵记忆的基因组扩展长短期记忆网络
- paper:Bio-xLSTM: Generative Modeling, Representation and In-Context Learning of Biological and Chemical Sequences(ICLR 2025)
DNA-xLSTM 在单核苷酸分辨率下引入指数门控与矩阵记忆原语(sLSTM 与 mLSTM),结合双向扫描与反向互补等变架构,统一支持基因组掩码表征学习与自回归生成建模。
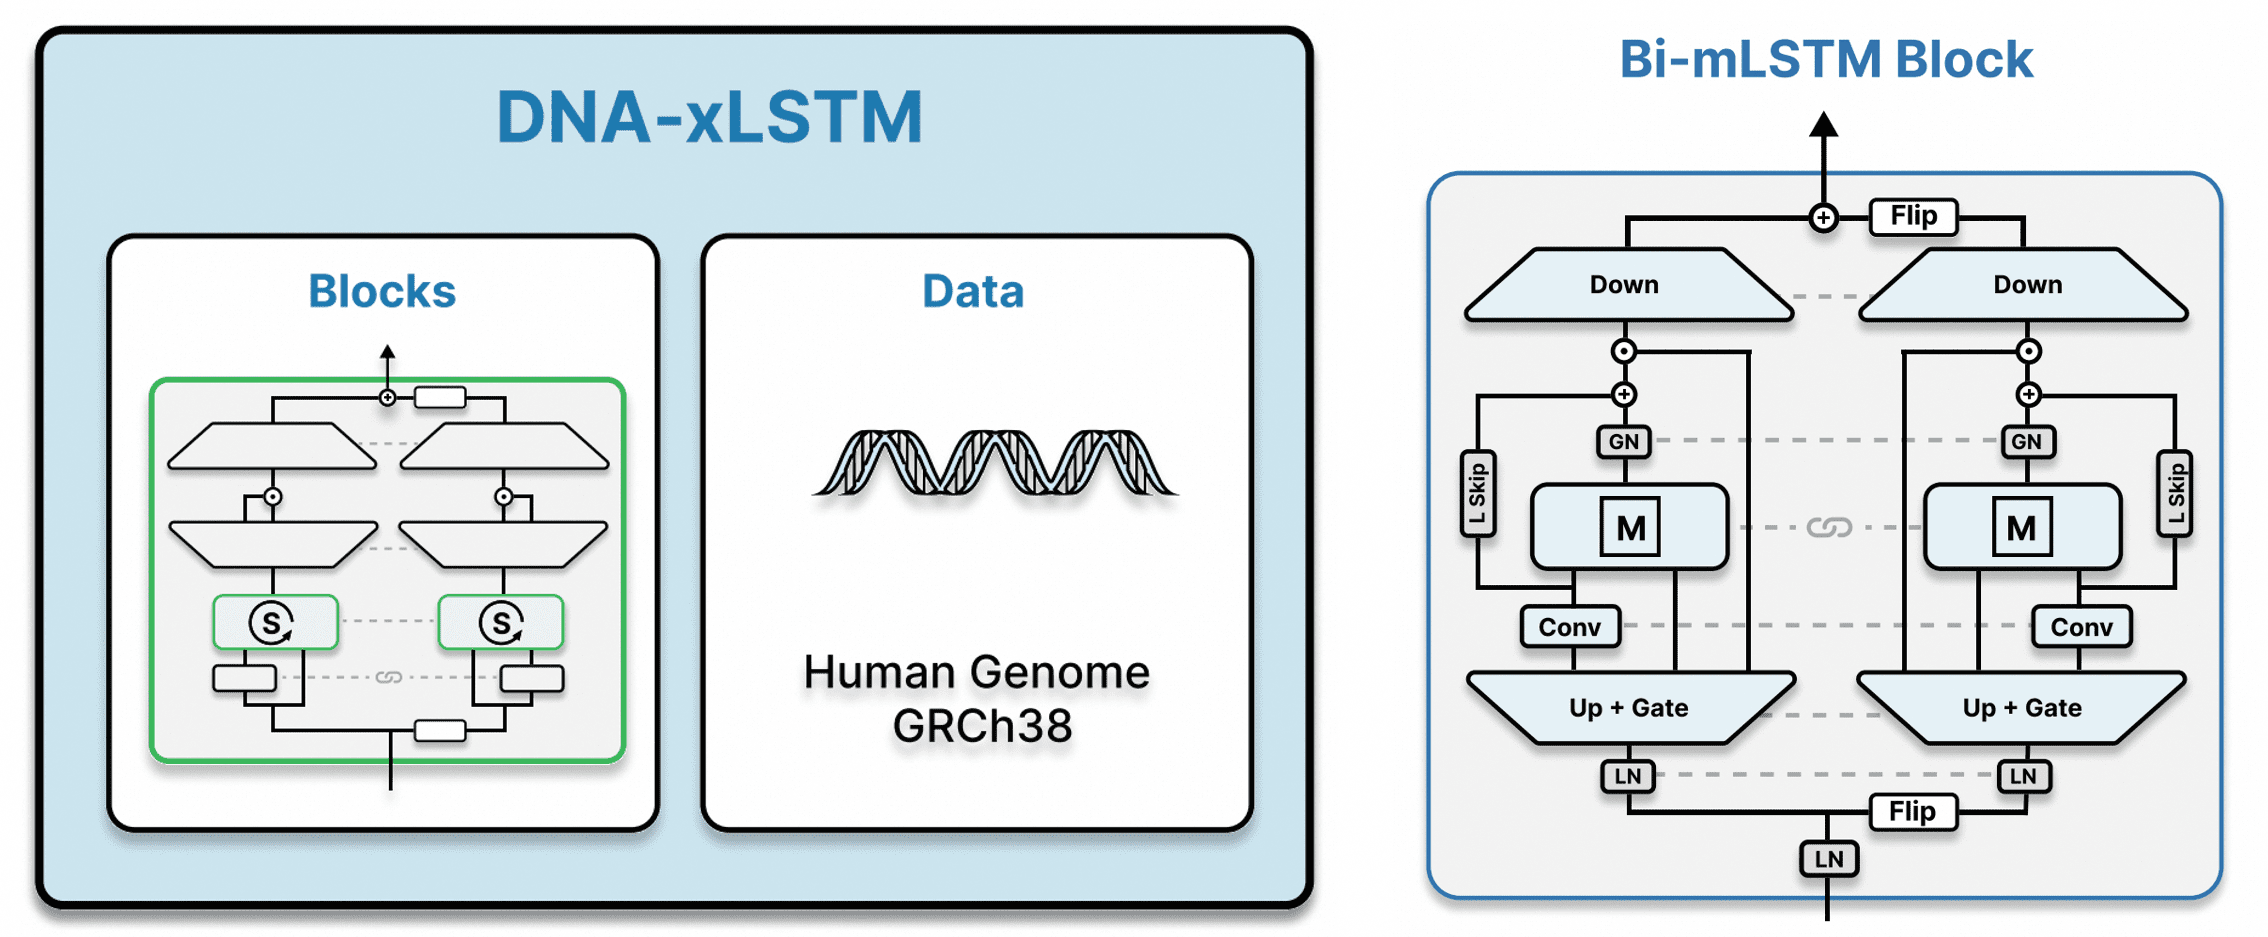
标量与矩阵扩展记忆循环原语: 给定输入序列 $x_t \in \mathbb{R}^D$,模型构建于两类核心算子之上:
-
标量记忆(sLSTM):保留逐通道标量记忆 $c_t$ 与隐状态递归连接,引入指数激活输入门 $i_t$ 与累积归一化器状态 $n_t$ 以动态修订历史记忆($z_t$ 为候选记忆,$f_t, o_t$ 为遗忘门与输出门):
\[c_t=f_t\odot c_{t-1}+i_t\odot z_t,\quad n_t=f_t\odot n_{t-1}+i_t,\quad h_t=o_t\odot(c_t\odot n_t^{-1}).\] -
矩阵记忆(mLSTM):移除隐状态递归依赖,将输入经短卷积映射为查询 $q_t$、键 $k_t$、值 $v_t$,通过键值外积更新矩阵记忆 $C_t \in \mathbb{R}^{d \times d}$ 并由查询向量读取,支持训练期分块并行与推理期常数显存递推:
\[C_t=f_t C_{t-1}+i_t v_t k_t^\top,\quad n_t=f_t n_{t-1}+i_t k_t,\quad h_t=o_t\odot\frac{C_t q_t}{\max\!\big(\vert n_t^\top q_t\vert,1\big)}.\]
双向聚合与反向互补等变设计: 为适配双链 DNA,模型通过块内共享参数 $w$ 分别扫描正向与反转序列并相加来实现双向化;同时提供参数共享等变变体(DNA-xLSTM-PS),将隐状态通道对半切分为 $[X_a, X_b]$,共享底层循环块 $\mathrm{block}(\cdot)$ 并对第二路施加隐空间反向互补变换 $\mathcal{R}$:
\[H=\mathrm{xLSTM}(X_{1:T};w)+\mathrm{xLSTM}(X_{T:1};w)_{T:1},\quad [H_a,H_b]=\big[\mathrm{block}(X_a),\;\mathcal{R}\big(\mathrm{block}(\mathcal{R}(X_b))\big)\big].\]⚪ CrossDNA:跨链动态交互与自蒸馏的双链循环记忆模型
- paper:Explicit Dynamic Cross-Strand Interactions for DNA Sequence Language Modeling(Nature Machine Intelligence 2026)
CrossDNA 提出双分支动态跨链架构,结合闭环双线性循环记忆单元与词元级跨链通信模块,在保持双链语义等价性的同时构建低方向敏感性的基因组表征。
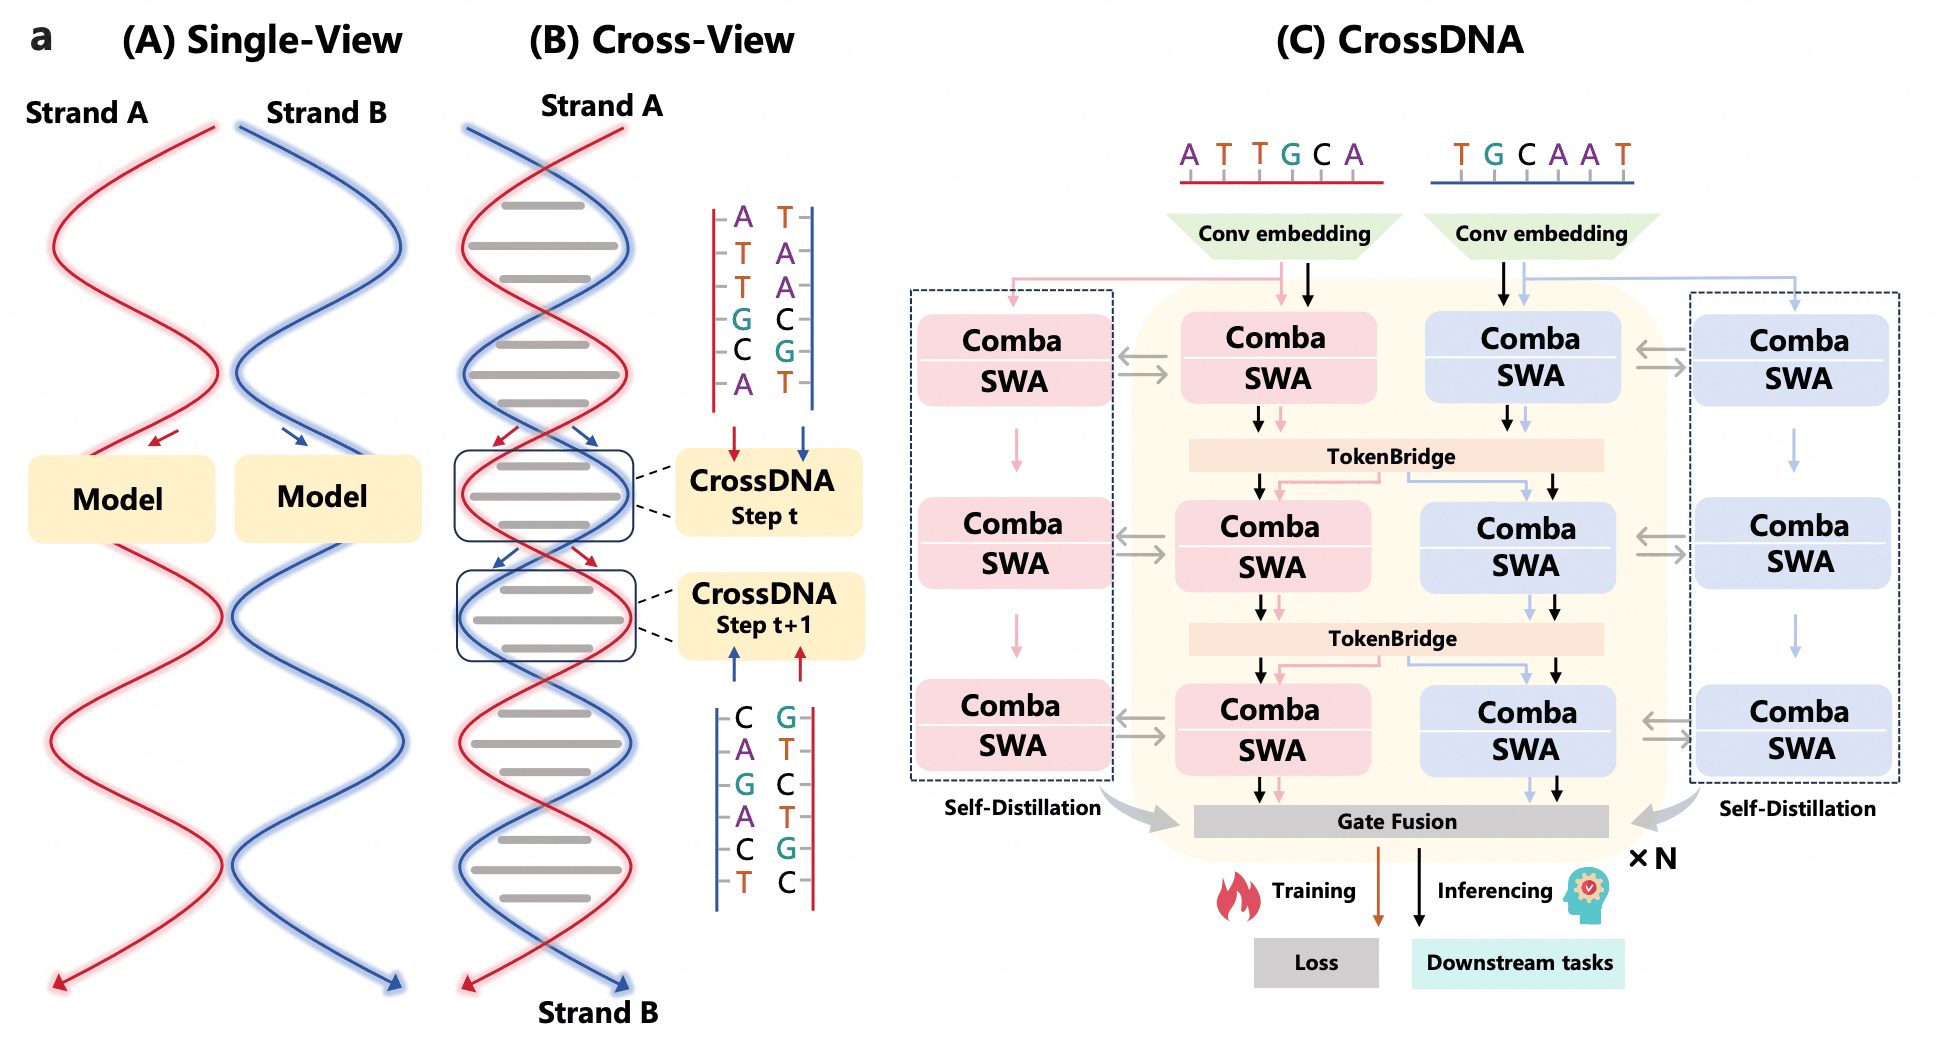
跨视角双链轮换与 Comba–SWA 记忆骨干: 模型采用单碱基分词。输入正链与反向互补链被切分为长度为 $\ell$ 的片段,按指示变量 \(\sigma_t \in \{0,1\}\) 交替送入两个结构对称的学生分支($X_A^t = (1-\sigma_t)X_{\mathrm{fwd}}^t + \sigma_t X_{\mathrm{rc}}^t$),编码后翻转 RC 分支以对齐回正链坐标系。各分支主干由闭环双线性循环单元 Comba 与局部滑动窗口注意力交替组成;Comba 维护矩阵状态 $S_i$ 并引入双重负反馈项以抑制远距离噪声干扰:
\[S_i = S_{i-1}\left(\alpha_i I - \tilde{\beta}_i k_i k_i^\top\right) + \beta_i v_i k_i^\top, \quad o_i = S_i(q_i - d k_i),\]其中 $\alpha_i, \beta_i$ 为遗忘门与写入门,$\tilde{\beta}_i$ 为状态校正因子,$d$ 为可学习缩放标量。
TokenBridge 跨链通信与教师自蒸馏: 两分支对齐后的特征 $\tilde{H}_A, \tilde{H}_B$ 经 TokenBridge 模块(拼接 $[\tilde{H}_A, \tilde{H}_B, \tilde{H}_A - \tilde{H}_B, \tilde{H}_A \odot \tilde{H}_B]$ 计算门控)进行词元级双链信息交换,生成 $F_A, F_B$ 后加权融合为最终表征。针对分段轮换输入导致的单链语义断裂问题,模型引入由学生参数 EMA 更新的教师模型接收未切分的连续序列以提供平滑目标表征 $R_A^\star, R_B^\star$,与 MLM 损失联合优化:
\[\mathcal{L} = \mathcal{L}_{\mathrm{MLM}} + w_{\mathrm{sem}} \cdot \frac{1}{\ell}\sum_{u=1}^{\ell}\left(\|F_A(u) - R_A^\star(u)\|_2^2 + \|F_B(u) - R_B^\star(u)\|_2^2\right).\]⚪ Double-Take:局部注意力与双向快权重记忆混合的长上下文架构
- paper:Double-Take: Improving Capacity, Binding, and Selectivity in Long-Context within Bidirectional Memory(arXiv 2026)
针对测试时训练(TTT / LaCT)快权重记忆在超长序列上存在跨块串扰、缺乏跨位置绑定以及背景信号淹没结构边界的问题,Double-Take(DT) 在结合局部滑动窗口注意力的单核苷酸双向编码器中,引入多步正交化更新、因果跨位置混合与双向变点差异写入机制,实现百万碱基尺度的选择性记忆建模。
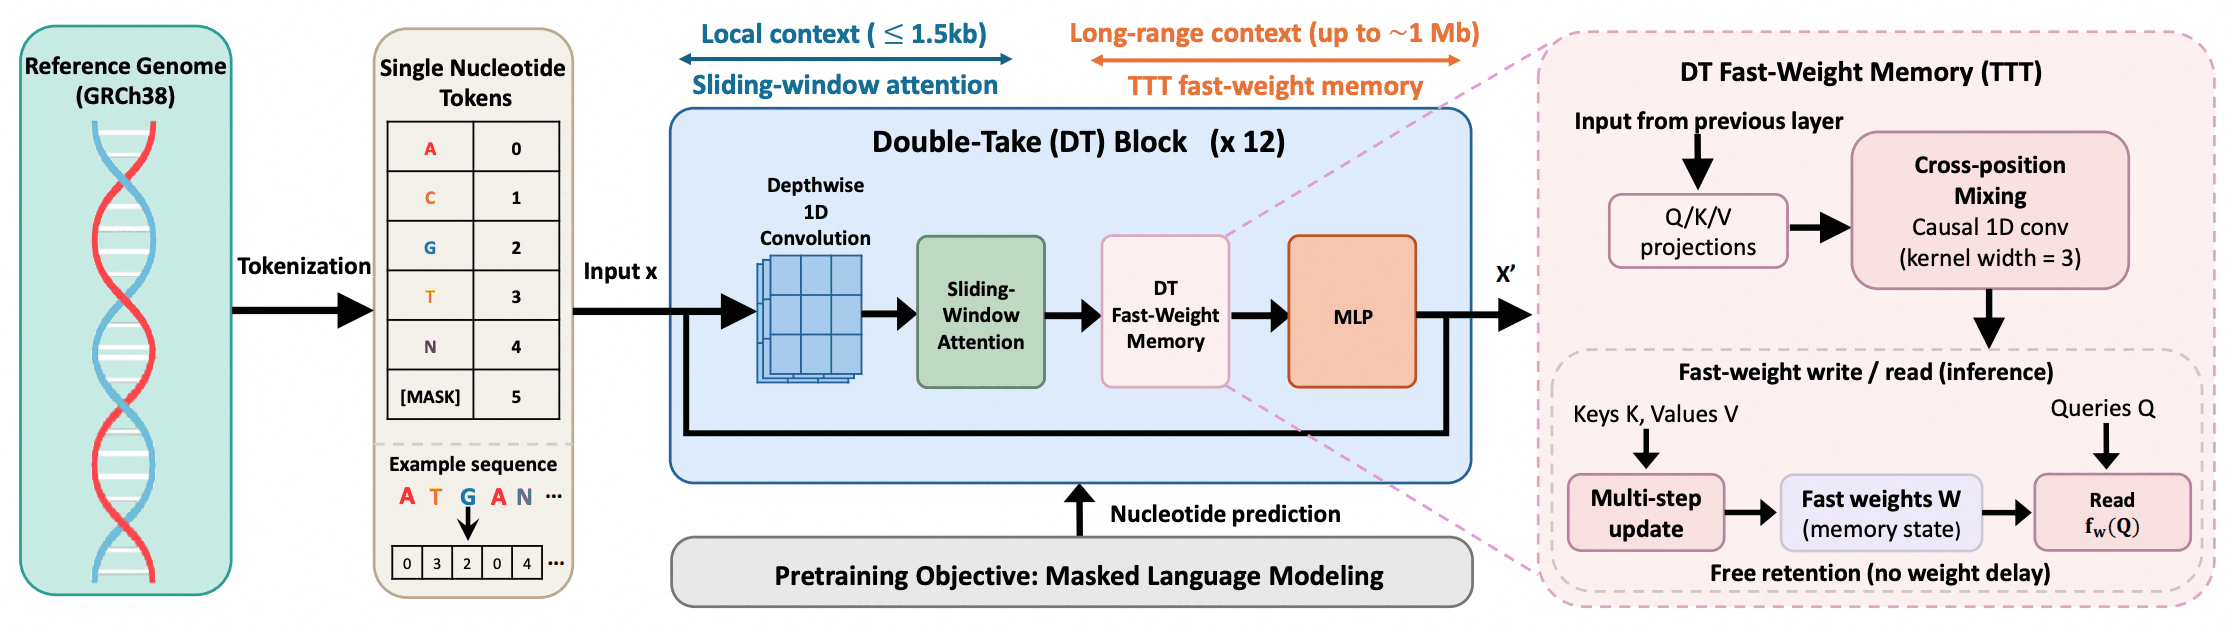
多步正交化更新与因果跨位置绑定: 每个编码块串联深度卷积、局部滑动窗口注意力与快权重记忆模块(每个记忆头参数化为三矩阵 SwiGLU 子网络 $f_M(x) = M_1(\mathrm{SiLU}(M_0 x) \odot M_2 x)$)。序列切分为连续块,在第 $m$ 块内以 \(\mathcal{L}_{\mathrm{mem}} = -\sum_i \langle f_M(k_i), v_i \rangle\) 为内层目标执行 $S$ 步正交化梯度更新以消除键值串扰;同时在写入前对键流施加核宽为 $c$ 的因果卷积 \(\tilde{k}_i = \sum_{r=0}^{c-1} \alpha_r^{(k)} k_{i-r}\),建立跨位点局部绑定关系:
\[M_m^{(s+1)} = M_m^{(s)} - \eta_s\,\mathrm{NS}\!\left(\nabla_M \mathcal{L}_{\mathrm{mem}}(M_m^{(s)}; K, V)\right), \quad \sum_i v_i \tilde{k}_i^\top = \sum_i \sum_{r=0}^{c-1} \alpha_r^{(k)} v_i k_{i-r}^\top,\]其中 $\mathrm{NS}(\cdot)$ 为将梯度方向正交化的 Newton–Schulz 算子。
双向变点差异写入与选择性读取: 为从均质背景序列中筛选出拓扑结构边界等关键信号,模型并行处理正反向序列,将位置 $i$ 的左侧前置上下文摘要 $\mu_i^L$ 与右侧上下文摘要 $\mu_i^R$ 之差作为记忆写入目标:
\[y_i = \mu_i^L - \mu_i^R.\]均质背景区两侧抵消使写入趋近于零,而在结构转换边界处则保留高对比度写入。读取阶段对齐正反向读取结果 $o_i^L, o_i^R$,同时保留均值分量 $(o_i^L + o_i^R)/2$ 与方向差分分量 $o_i^L - o_i^R$。
⚪ Mnemos-DNA:门控 Delta 规则线性注意力与 $k$-mer 寻址快权重记忆模型
- paper:Mnemos-DNA: Gated Delta-Rule Linear Attention with k-mer Fast-Weight Memory for Edge-Scale DNA Modeling(Preprint 2026)
针对门控 Delta 规则线性注意力(KDA)受限于固定大小的递归状态矩阵、无法在长程基因组背景下精确召回远端重复基序的问题,Mnemos-DNA 在边缘级单核苷酸架构中为每个 KDA 层并行挂载一个以精确 $8$-mer 内容寻址的快权重矩阵记忆表,以仅增加 $2.9\%$ 参数量的代价换取 $\mathcal{O}(N)$ 复杂度下跨 $64\text{ kbp}$ 的长程精确召回。
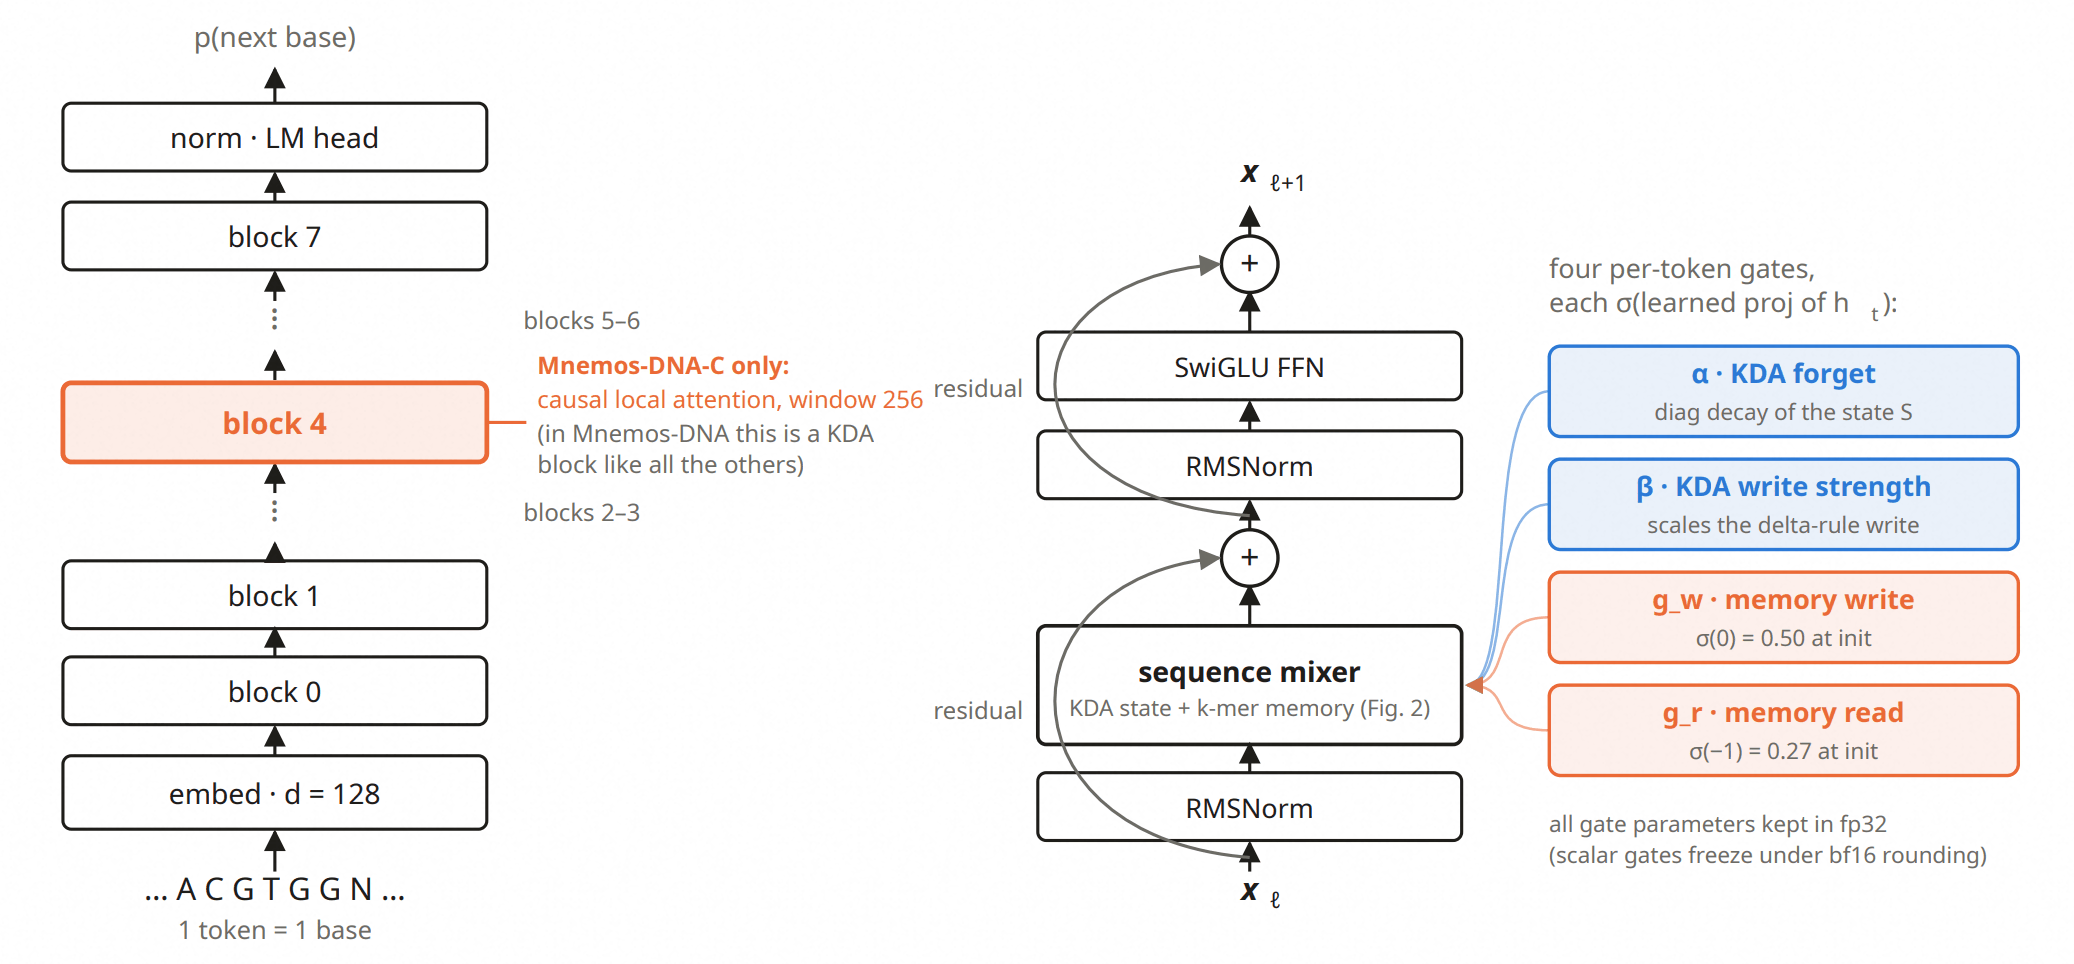
门控 Delta 规则递归与 $k$-mer 内容寻址快权重表: 模型采用单核苷酸分词且不设位置编码。在每个混合层中,输入经短因果卷积与 $\ell_2$ 归一化生成查询、键、值向量,并由两个并行的记忆系统同时读取:
-
全局共享 KDA 递归状态:每个头维护单一固定状态矩阵 $S_t \in \mathbb{R}^{d_v \times d_k}$,通过遗忘门 $\alpha_t$ 与写入强度 $\beta_t$ 执行纠错式 Delta 外积更新:
\[S_t = \mathrm{diag}(\alpha_t)S_{t-1} + \beta_t(v_t - S_{t-1}k_t)k_t^\top, \quad o_t^{\mathrm{KDA}} = S_t q_t.\] -
逐 8-mer 私有快权重表:每层额外维护 $4^8 = 65{,}536$ 个独立的快权重矩阵槽位 $W_a \in \mathbb{R}^{16 \times 16}$,由当前位置最近 $8$ 个核苷酸的精确序列哈希寻址至槽位 $a$,在写入门 $g_w$ 与读取门 $g_r$ 控制下执行局部 Delta 更新与读取:
\[W_a \leftarrow W_a + g_w(v - W_a k)k^\top, \quad o_t = S_t q_t + g_r W_a q.\]
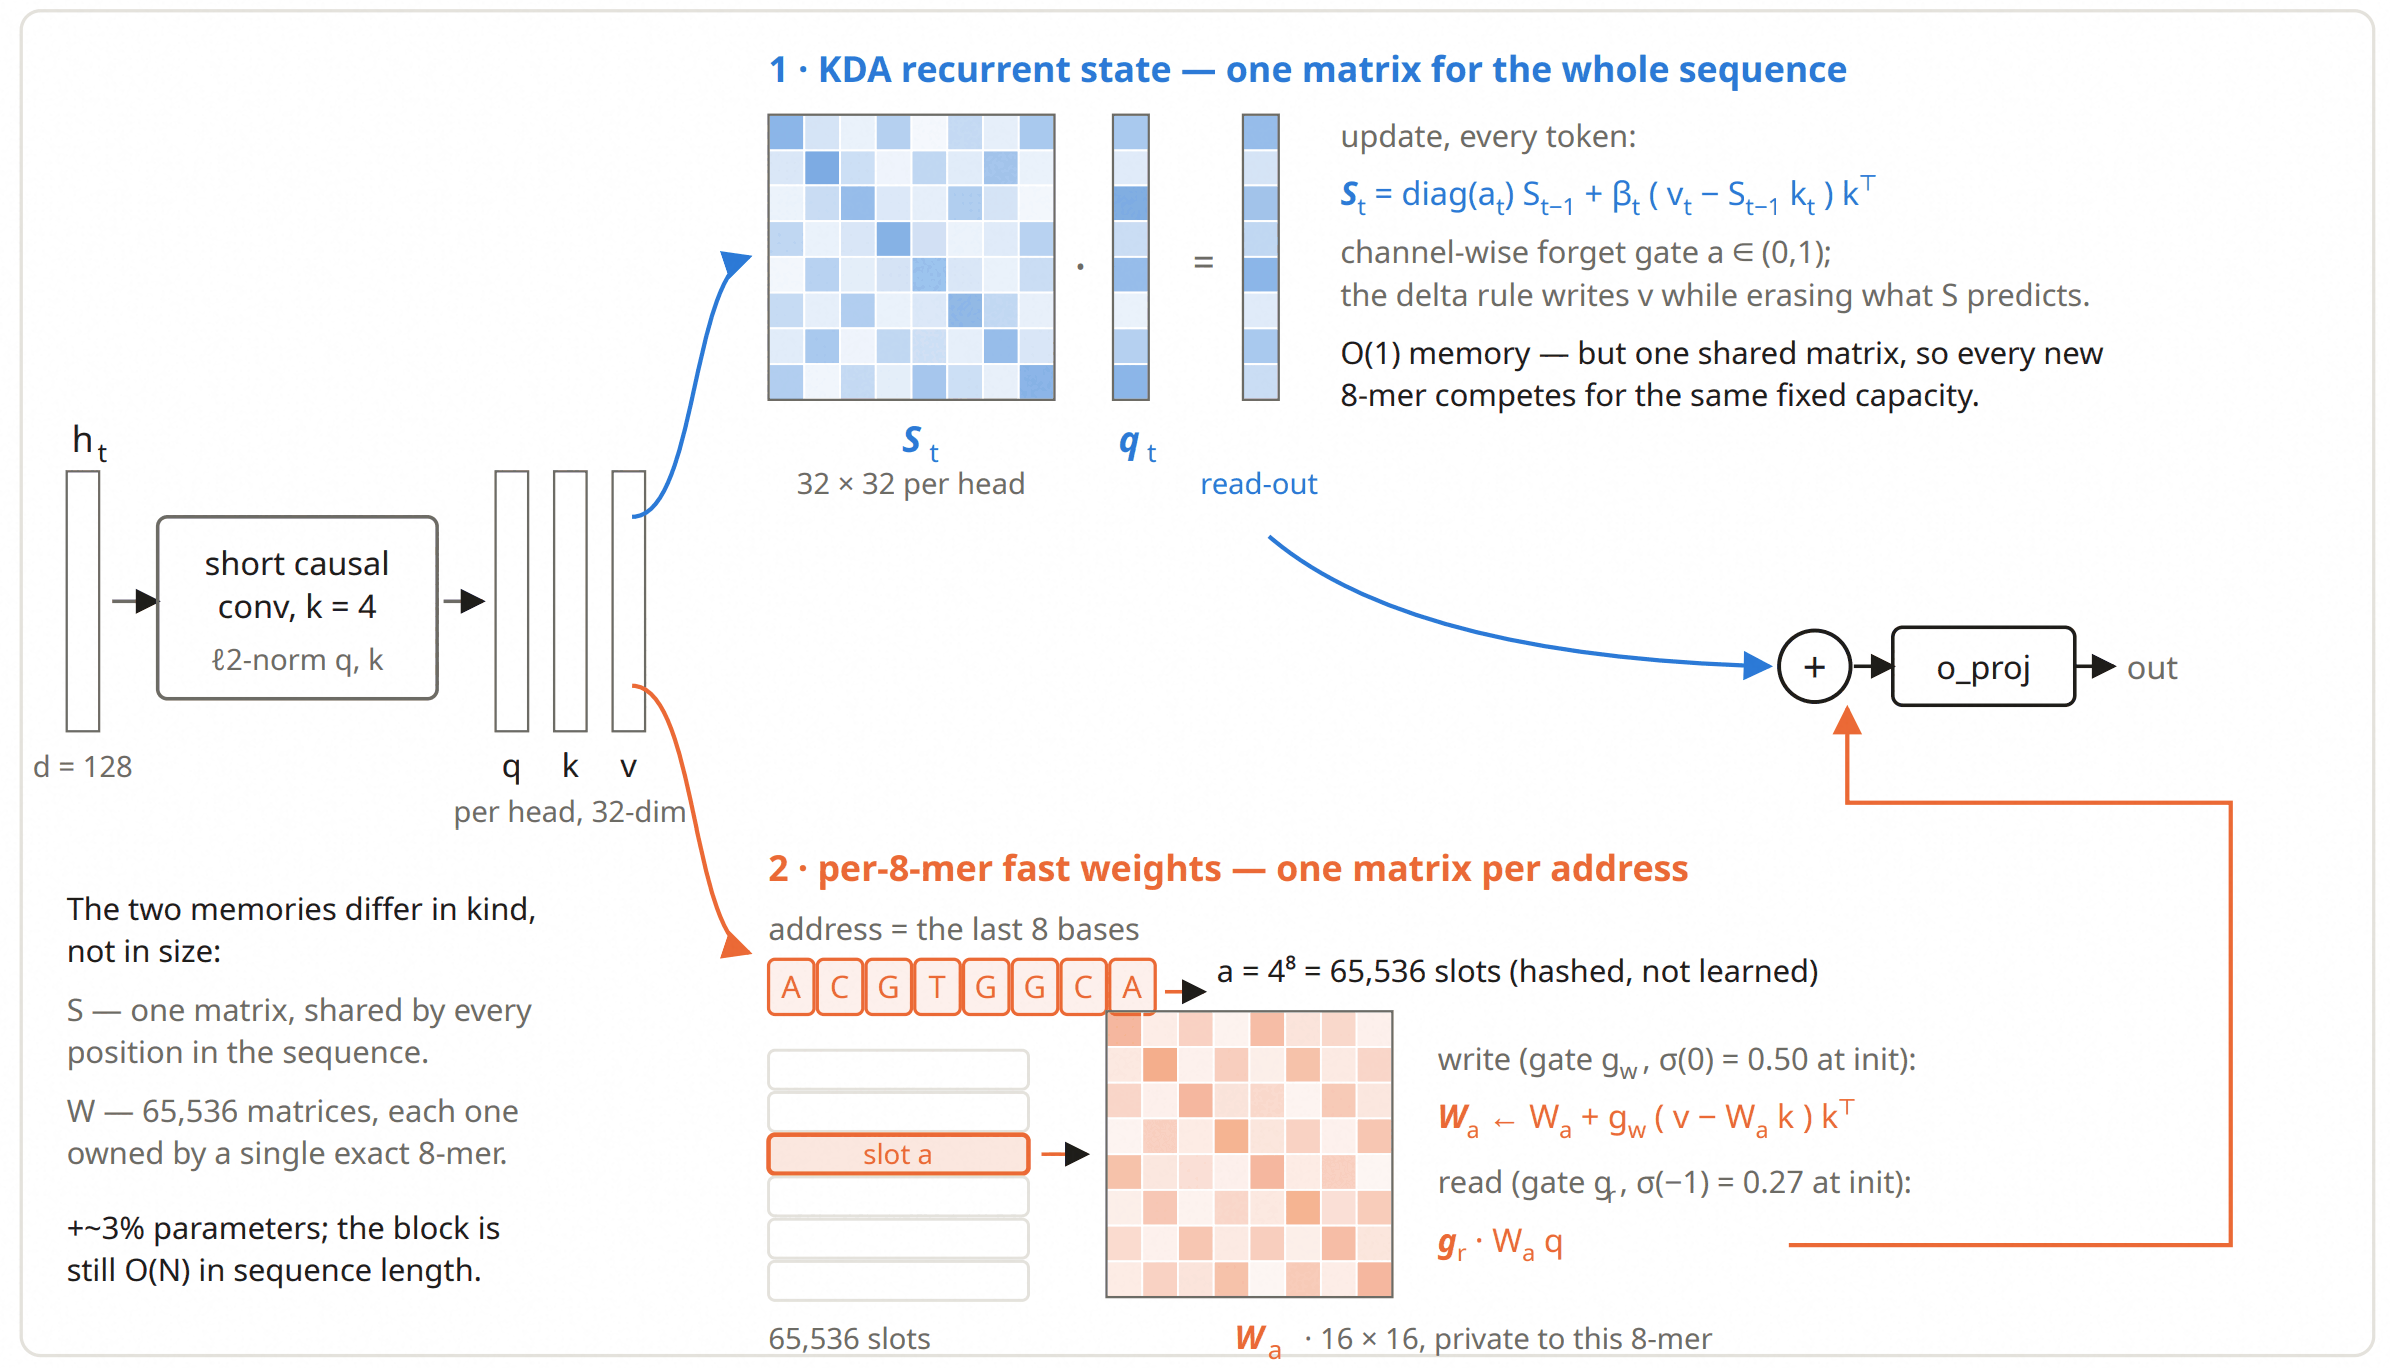
碰撞动力学与参数—状态空间权衡: 当槽位 $a$ 经历多次碰撞写入时,递归更新满足 $W_a^{(i)} = W_a^{(i-1)}(I - g_i k_i k_i^\top) + g_i v_i k_i^\top$:若重复写入的键方向相同,槽位退化为指数移动平均;若键方向相互正交,单槽位最多可无干扰并存 $16$ 个关联映射。该机制将精确召回的代价从参数量($+2.9\%$)转移至流式推理携带的递归状态体积(扩大 $4{,}096$ 倍),同时消融揭示了固定在 $131\text{ kbp}$ 超长窗口上预训练会导致模型将容量优先分配给长程统计,从而在强位置敏感的亚千碱基局部语法任务(如剪接位点)上引发性能退化。