Genome Foundation Model part I: DNA Tokenization.
生物体的基因组(Genome)是其完整的遗传物质集合。细胞生物通常以双链 DNA 为载体,其序列可形式化为定义在四元离散字母表 $\mathcal{B} = \lbrace \mathrm{A}, \mathrm{C}, \mathrm{G}, \mathrm{T}\rbrace$ 上的超长一维符号序列 $x = (x_1, x_2, \ldots, x_L) \in \mathcal{B}^L$。
基因组基础模型(Genome Foundation Model, gFM),又称基因组语言模型(Genomic Language Model, gLM),将 DNA 序列映射为长度为 $T$ 的离散词元序列 $z_{1:T}$,通过在大规模无标注基因组语料上拟合边缘概率或条件概率分布 $p_\theta(z)$,学习具备跨任务迁移能力的通用基因组表征。
本文是基因组基础模型系列的第一篇。全系列按“分词 → 预训练 → 编码器 → 解码器 → 多模态”的脉络组织:
- I. DNA 分词策略:如何将碱基序列切分为词元。
- II. 预训练策略:如何构造自监督信号从无标注基因组中学习。
- III. 编码器框架:模型如何在长序列上混合上下文信息。
- IV. 解码器框架:模型如何评估序列似然并生成新序列。
- V. 多模态模型:如何联合建模基因组序列、其他生物分子与人类自然语言。
分词(Tokenization)将碱基序列切分为离散词元(Token),直接决定了模型的输入粒度、词表规模以及序列压缩率。现有的基因组分词方案主要分为固定窗口分词、统计子词分词、学习式分词与动态自适应分词四类。
- 1. 固定窗口分词(Fixed-Window Tokenization)
- 1.1 单碱基分词
- 1.2 $k$-mer 分词
- 1.3 密码子分词
- 1.4 基因级分词
- 2. 统计子词分词(Statistical Tokenization)
- 3. 学习式分词(Learned Tokenization)
- 4. 动态自适应分词(Dynamic Tokenization)
1. 固定窗口分词(Fixed-Window Tokenization)
固定窗口分词按照预定义的几何跨度或生物学注释边界切分序列,是最直观的词元化方式。根据切分尺度的由小到大,可分为单碱基、$k$-mer、密码子与基因四个层级。
1.1 单碱基分词
单碱基分词(Single-nucleotide Tokenization)直接将单个核苷酸映射为基础词元,词表仅由 ${\mathrm{A,C,G,T}}$(外加未知字符 $\mathrm{N}$ 与特殊控制符)构成,分词后序列长度保持 $T=L$。
- 优势:具备最高的空间分辨率(1 bp),保持局部平移等变性,直接支持单核苷酸变异(SNV)位点似然评估与逐碱基功能轨道预测。
- 局限:无法压缩序列长度,且单个词元缺乏局部邻域语义,通常需配合线性注意力或状态空间模型等亚二次方算子以扩展感受野。
⚪ BioToken / BioFM:为单碱基词表引入变异与基因结构边界
- paper:BioToken and BioFM – Biologically-Informed Tokenization Enables Accurate and Efficient Genomic Foundation Models(ICML 2026)
常规基因组语言模型将 DNA 视为纯核苷酸序列,忽略了诠释遗传变异所需的基因结构与调控上下文。该工作提出生物注释感知的分词框架 BioToken,将遗传变异与功能结构注释编码进一个包含 23 个词元的统一词表,并训练了自回归模型 BioFM。

词表设计: 在 BioToken 词表中,SNV 和插入使用特殊变异词元 $\check{\mathrm{A}},\check{\mathrm{G}},\check{\mathrm{C}},\check{\mathrm{T}}$ 替换原碱基;基于 GENCODE 的基因结构注释则通过成对的起止特殊词元([START/END TRANSCRIPT]、[START/END EXON] 和 [START/END CDS])直接插入序列的对应边界。
模型预训练:BioFM 基于 Mistral 的自回归 Transformer 架构,通过调大 RoPE 基频扩展长上下文能力。预训练数据取自千人基因组计划(1000 Genomes Project)的真实个体全基因组测序数据,将个体的分相变异与注释写入参考基因组,采用标准下一词元预测目标:
\[\mathcal L=-\sum_t\log p_\theta(x_t\mid x_{<t}),\]其中 $x_t$ 可为普通核苷酸、变异词元或注释词元。训练时对输入序列随机执行反向互补增强,同时翻转并仅保留链特异的注释边界。
1.2 $k$-mer 分词
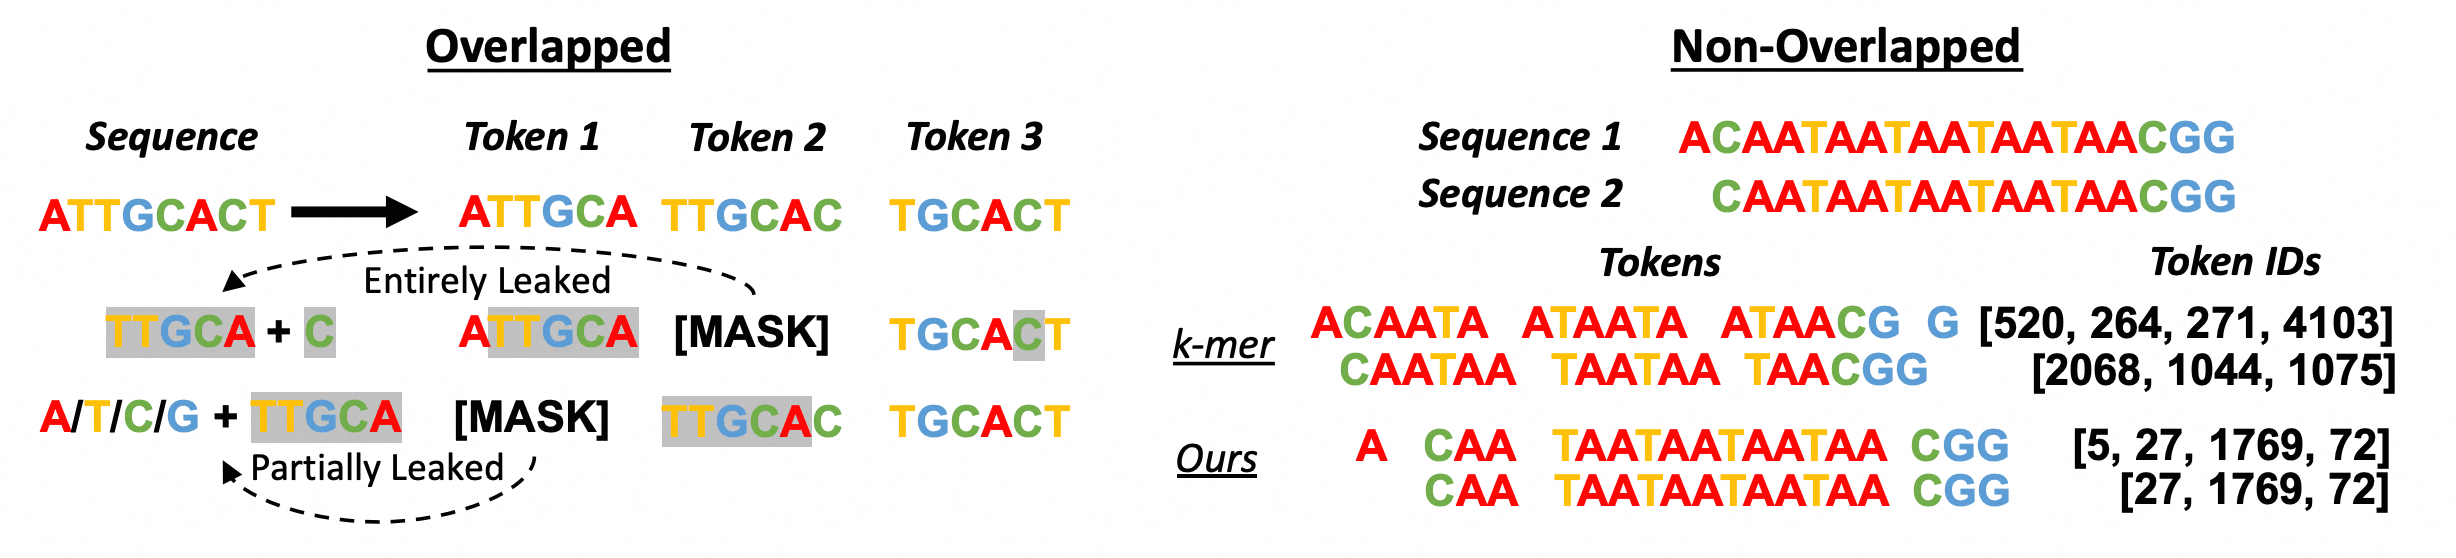
$k$-mer 分词将长度为 $k$ 的连续核苷酸片段映射为单个离散词元。超参数 $k$ 需要在局部感受野、词表规模($4^k$)与序列压缩率之间权衡。根据滑动窗口步长 $t$ 的不同,固定 $k$-mer 分词分为两类设置,但二者均存在固有缺陷:
-
重叠 $k$-mer(步长 $t=1$): 设原始碱基序列为 $x_{1:L}$,步长 $t=1$ 时第 $i$ 个词元覆盖区间 $z_i = x_{i : i+k-1}$,分词后序列总长度为 $T = L - k + 1$(未实现有效长度压缩),且相距 $d < k$ 步的两个词元共享 $k - d$ 个重叠碱基。在掩码语言建模中,这种重叠会导致严重的上下文信息泄漏(Information Leakage)。设位置 $i$ 的被遮蔽词元 $z_i$ 距离左侧最近未遮蔽词元 $z_{i-l}$ 为 $l$ 步($l \ge 1$),距离右侧最近未遮蔽词元 $z_{i+r}$ 为 $r$ 步($r \ge 1$),则左邻居限制其未知碱基数至多为 $\min(l, k)$,右邻居限制其至多为 $\min(r, k)$,双侧同时向内夹逼则仅剩 $\max(0, l+r-k)$ 个自由碱基,使其有效候选词表搜索空间从 $4^k$ 坍缩至:
\[4^{u(l,r,k)} = 4^{\min\big(l,\; r,\; k,\; \max(0,\, l+r-k)\big)}.\]若仅独立遮蔽单个词元($l=1, r=1, k\ge 2$),即有 $u=0$,词元被左右邻居唯一确定;即便连续遮蔽 $k$ 个相邻词元,跨度边缘词元($l=1, r=k$)的候选空间仍退化为 $4^1 = 4$,降低了预训练样本效率。
-
非重叠 $k$-mer(步长 $t=k$): 以步长 $t=k$ 进行无重叠切分可将序列长度压缩至 $\lfloor L/k \rfloor$ 并消除邻接重叠($u \equiv k$),但破坏了模型对局部模式的平移不变性(Translation Invariance)。当序列首部发生单碱基插入或缺失(1-bp Indel)或切分起点偏移 1 bp 时,后续所有 $k$-mer 的切分边界均发生全局错位,迫使模型消耗额外容量去学习同一基序在 $k$ 种不同切分相位下的等价性。
⚪ LOGO:多相位步长 $k$-mer 分组与单碱基分辨率等位基因交错编码
- paper:Integrating convolution and self-attention improves language model of human genome for interpreting non-coding regions at base-resolution(Nucleic Acids Research 2022)
LOGO 在基于 ALBERT 参数共享与词嵌入因式分解的轻量双向编码器之上,围绕 $k$-mer 分词提出了多相位无重叠分组训练、先验知识嵌入以及多流交错等位基因编码。
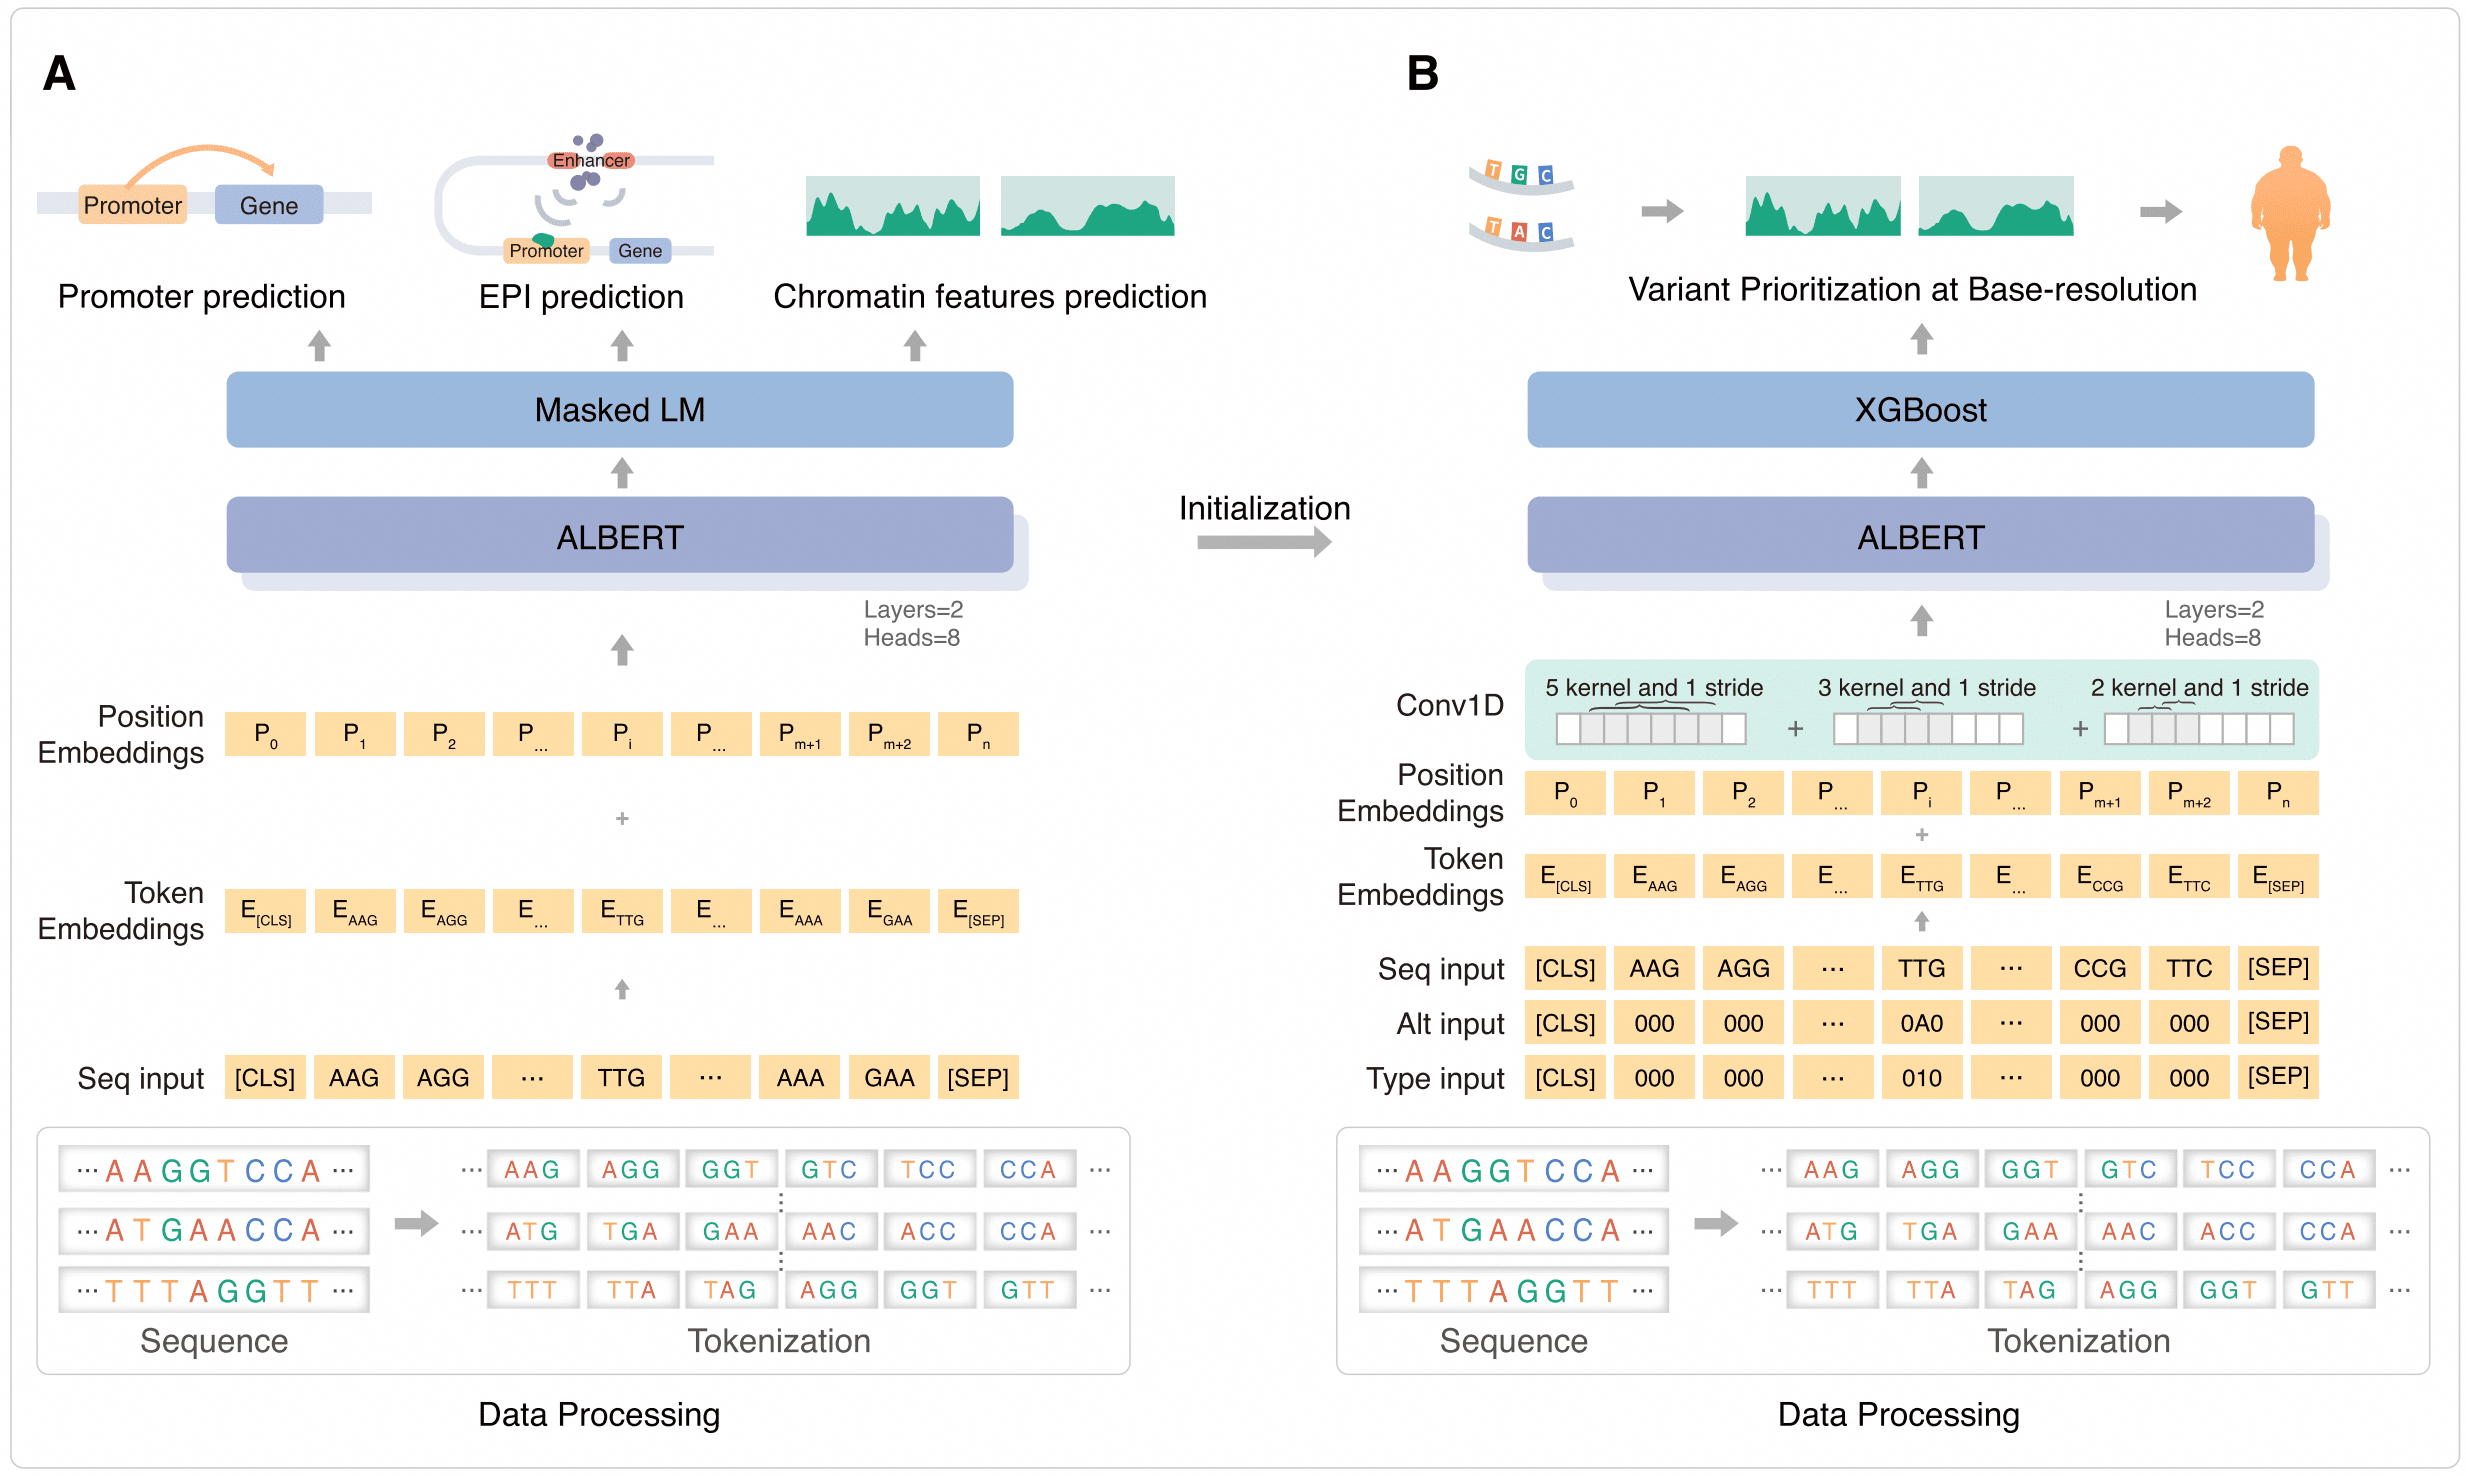
多相位无重叠分组分词: 模型采用跨层参数共享的 ALBERT 编码器,并对词嵌入矩阵进行低秩因式分解。为同时消除切分起点偏置与相邻词元重叠泄漏,模型将序列的切分起点依次右移 $s \in \lbrace 0, 1, \ldots, k-1\rbrace\text{ bp}$,拆解为 $k$ 条独立的非重叠 $k$-mer 序列(长度压缩为 $T_k = \lfloor (L - s)/k \rfloor$):
\[z^{(s)} = \left(x_{1+s \,:\, k+s},\; x_{1+k+s \,:\, 2k+s},\; \ldots,\; x_{1+(T_k-1)k+s \,:\, T_k k+s}\right), \quad s = 0, 1, \ldots, k-1.\]预训练时,这 $k$ 条序列作为独立样本分别送入模型:单条序列内部相邻词元互不重叠,支持直接执行随机独立遮蔽而无邻接泄漏;跨序列联合则完整覆盖了全部 $k$ 种切分相位。
先验知识注入与交错等位基因编码(LOGO-E2E): 微调阶段,模型可将 GenBank 基因注释编码为独热向量并映射为知识嵌入,与词元和位置嵌入相加。针对单碱基变异致病性预测,LOGO-E2E 构造三层多流词元矩阵:(1)参考层将全部 $6$ 个相位的 6-mer 序列交错拼接为单条序列输入;(2)替代层仅在突变位点填入突变 6-mer 词元,其余位置置 0 以突出有向突变;(3)类型层在突变位点置 1 标识 SNV/Indel。三路嵌入随后经多尺度一维卷积注入局部敏感性。
⚪ ProkBERT:可调步长部分重叠 LCA 分词的微生物组编码器
- paper:ProkBERT family: genomic language models for microbiome applications(Frontiers in Microbiology 2024)
ProkBERT(约 $20\text{M}\sim 27\text{M}$ 参数,基于配备可学习相对键值位置嵌入的 $6$ 层 MegatronBERT 架构)在跨越细菌、古菌、病毒与真菌的 $3{,}882$ 个属(约 $2{,}066$ 亿词元)微生物基因组语料上预训练,通过局部上下文感知(LCA)可调步长分词与全序列注意力加权池化,实现原核基因组特征无监督聚类、跨物种启动子识别与噬菌体序列鉴定。
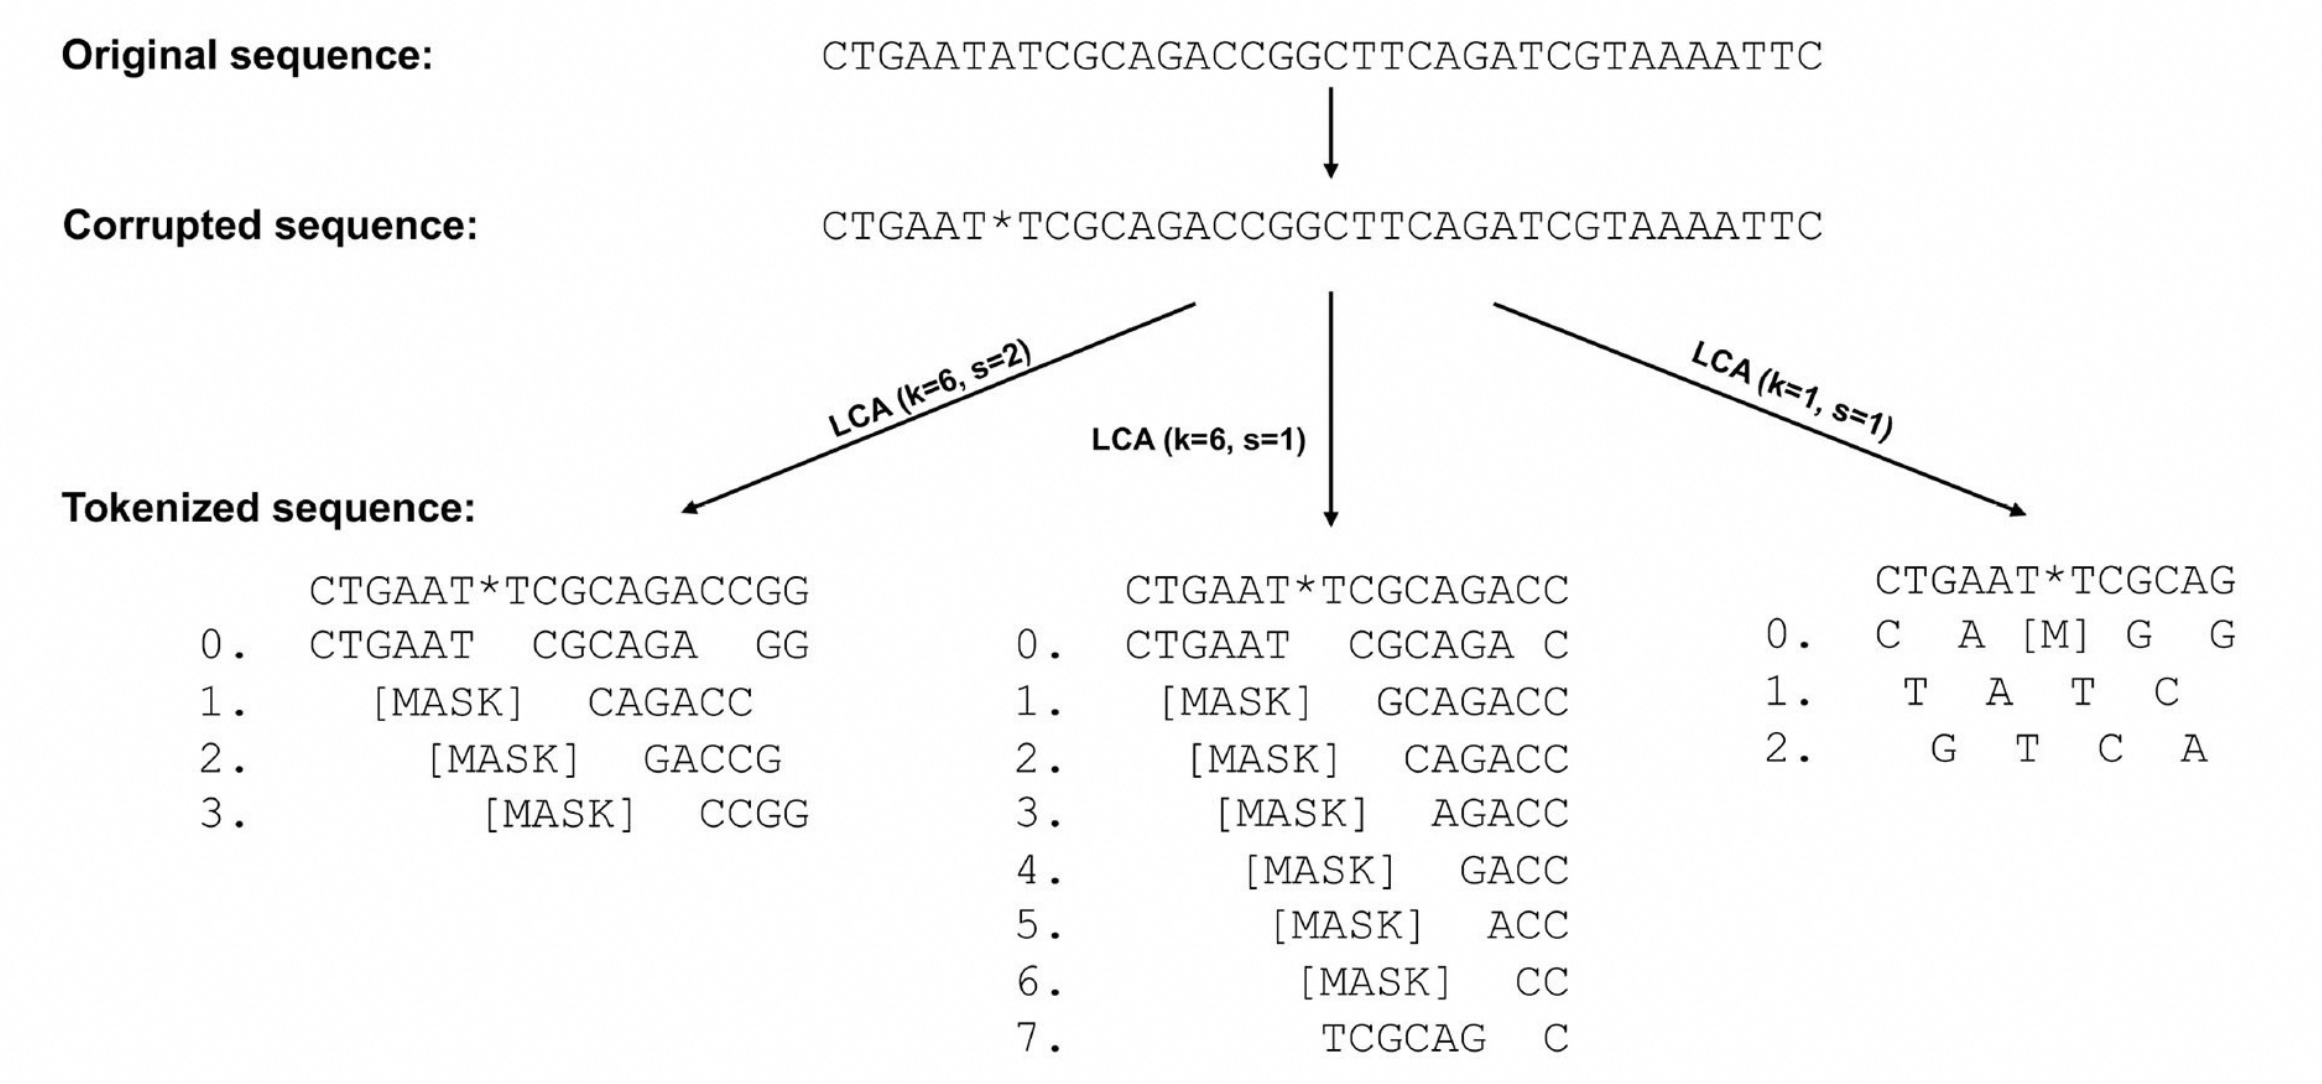
局部上下文感知分词(LCA)与防泄漏跨度掩码: LCA 分词由窗口长度 $k$ 与滑动步长 $s$ 两个参数控制,将原始序列切分为部分重叠的 $k$-mer 词元序列并衍生出三类变体:(1)ProkBERT-mini($k=6, s=1$,词表 $4{,}101$,窗口 $1{,}024\text{ bp}$)采用最大重叠切分以保留精细局部上下文;(2)ProkBERT-mini-c($k=1, s=1$,词表 $9$)退化为单核苷酸字符级分词;(3)ProkBERT-mini-long($k=6, s=2$,窗口扩展至 $2{,}048\text{ bp}$)通过步长 $s=2$ 的半重叠切分,在维持局部邻域信息的同时将相同词元预算下的上下文覆盖范围翻倍。由于重叠分词下遮蔽单个词元会被相邻词元泄漏恢复,预训练将所有覆盖受扰动碱基的重叠 $k$-mer 同步替换为 [MASK](如 $k=6$ 时连续遮蔽至少 $5\sim 6$ 个相邻词元),并按定长短片段向变长片段过渡的两阶段课程最小化掩码位置 $m_i=1$ 的负对数似然:
\[\mathcal{L}_{\mathrm{MLM}}(x, m, l) = -\sum_{i:\, m_i=1} \log y_i[l_i].\]全序列注意力加权池化与分阶段微调: 在下游二分类微调中,模型摒弃仅依赖单一 [CLS] 词元的常规做法,通过可学习线性层将全序列 $T$ 个位置的编码器输出隐状态 $S = [s_1, \dots, s_T]^\top \in \mathbb{R}^{T \times d}$ 映射为归一化注意力权重 $W$,并执行加权求和池化得到定长序列表示 $P$:
\[W = \mathrm{Softmax}(W_1 S^\top + b_1), \quad P = \sum_{i=1}^{T} w_i s_i.\]针对跨物种细菌启动子识别,微调训练集结合编码区(CDS)与保持天然启动子富含 AT 组成特征的三阶马尔可夫链合成序列 $P(x_i \mid x_{i-3}, x_{i-2}, x_{i-1})$ 构造高难度负样本;针对噬菌体序列鉴定,则按 $660$ 个细菌宿主属分层平衡采样,并沿 $256 \to 512 \to 1{,}024/2{,}048\text{ bp}$ 执行三阶段长度递增课程微调。
1.3 密码子分词
密码子分词(Codon Tokenization)是专为蛋白质编码序列(CDS / cDNA)或 mRNA 设计的分词策略。它遵循分子生物学中心法则的翻译机制,从起始密码子(如 ATG/AUG)开始,按照开放阅读框(ORF)的相位,以步长为 3、窗口长度为 3 的非重叠方式(Non-overlapping 3-mer),将连续的三个核苷酸切分为一个独立词元。
⚪ GenSLMs:密码子级原核预训练与潜空间扩散层次规划
GenSLMs 采用密码子级分词在跨属原核生物基因上预训练 GPT 解码器,并结合潜空间连续扩散高层规划与奖励引导束搜索,在全基因组尺度建模并预测 SARS-CoV-2 变异株的演化轨迹。
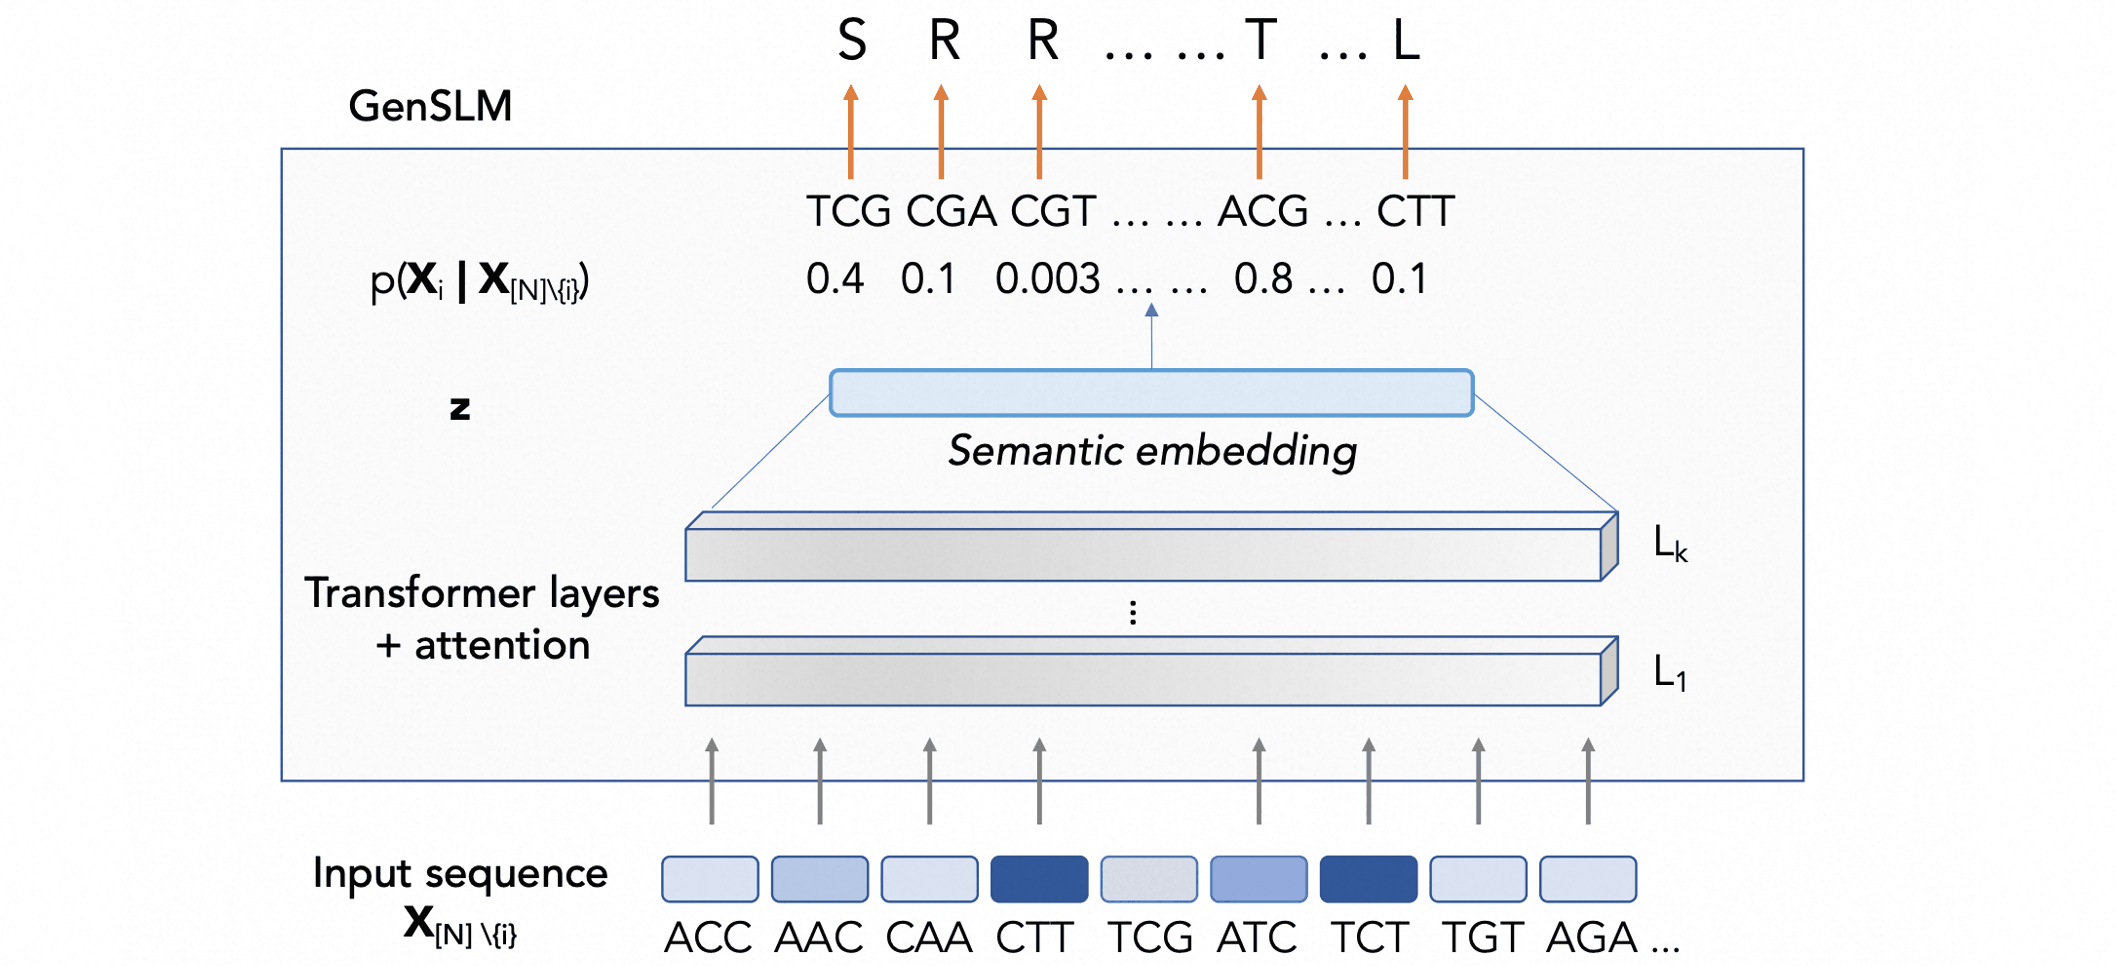
密码子级两阶段迁移与潜空间扩散规划: 模型将每三个连续核苷酸编码为一个密码子词元(词表大小 $64$),先在跨属原核生物单基因序列上预训练基础自回归模型,再将窗口扩展至 $10{,}240$ 个密码子,在完整 SARS-CoV-2 基因组上微调以捕获跨开放阅读框(ORF)的共进化耦合。为防止超长序列生成丢失全局连贯性,模型将全基因组每 $512$ 个密码子切分为一个“句子”:(1)利用对比损失训练句子编码器提取句子级潜表征;(2)在潜表征序列上训练去噪扩散模型,从高斯噪声恢复全局高层规划序列 $z_0$;(3)令自回归解码器同时以前置局部密码子窗口 $r$ 与全局规划 $z_0$ 为条件建模 $p(x_t \mid r, z_0)$。
奖励引导束搜索: 为定向生成具有特定属性(如比对得分 $R(x) = \sum_{t=1}^L r_t(x_t)$)的候选突变株,模型在束搜索中融合语言模型似然与阶段性奖励($\alpha$ 为长度惩罚,$\mu \in [0, 1]$ 为由高斯过程贝叶斯优化调优的混合系数):
\[S(x) = \frac{\mu}{L^\alpha}\sum_{t=1}^L \log p_\theta(x_t \mid x_{<t}, c) + (1-\mu)R(x), \quad s_t(x_t) = \mu\, p_\theta(x_t \mid \mathcal{X}_{\mathrm{beams}}^i, c) + (1-\mu)\, r_t(x_t).\]⚪ NT-v2-3mer:面向蛋白质下游任务的密码子分词
- paper:Are genomic language models all you need? Exploring genomic language models on protein downstream tasks(Bioinformatics 2024)
该工作评估了基因组语言模型在蛋白质编码序列(CDS)上的表征能力,训练了对齐密码子尺度的非重叠 $3$-mer 模型 NT-v2-3mer,并构建了融合 CDS 与氨基酸表征的双模态联合模型。
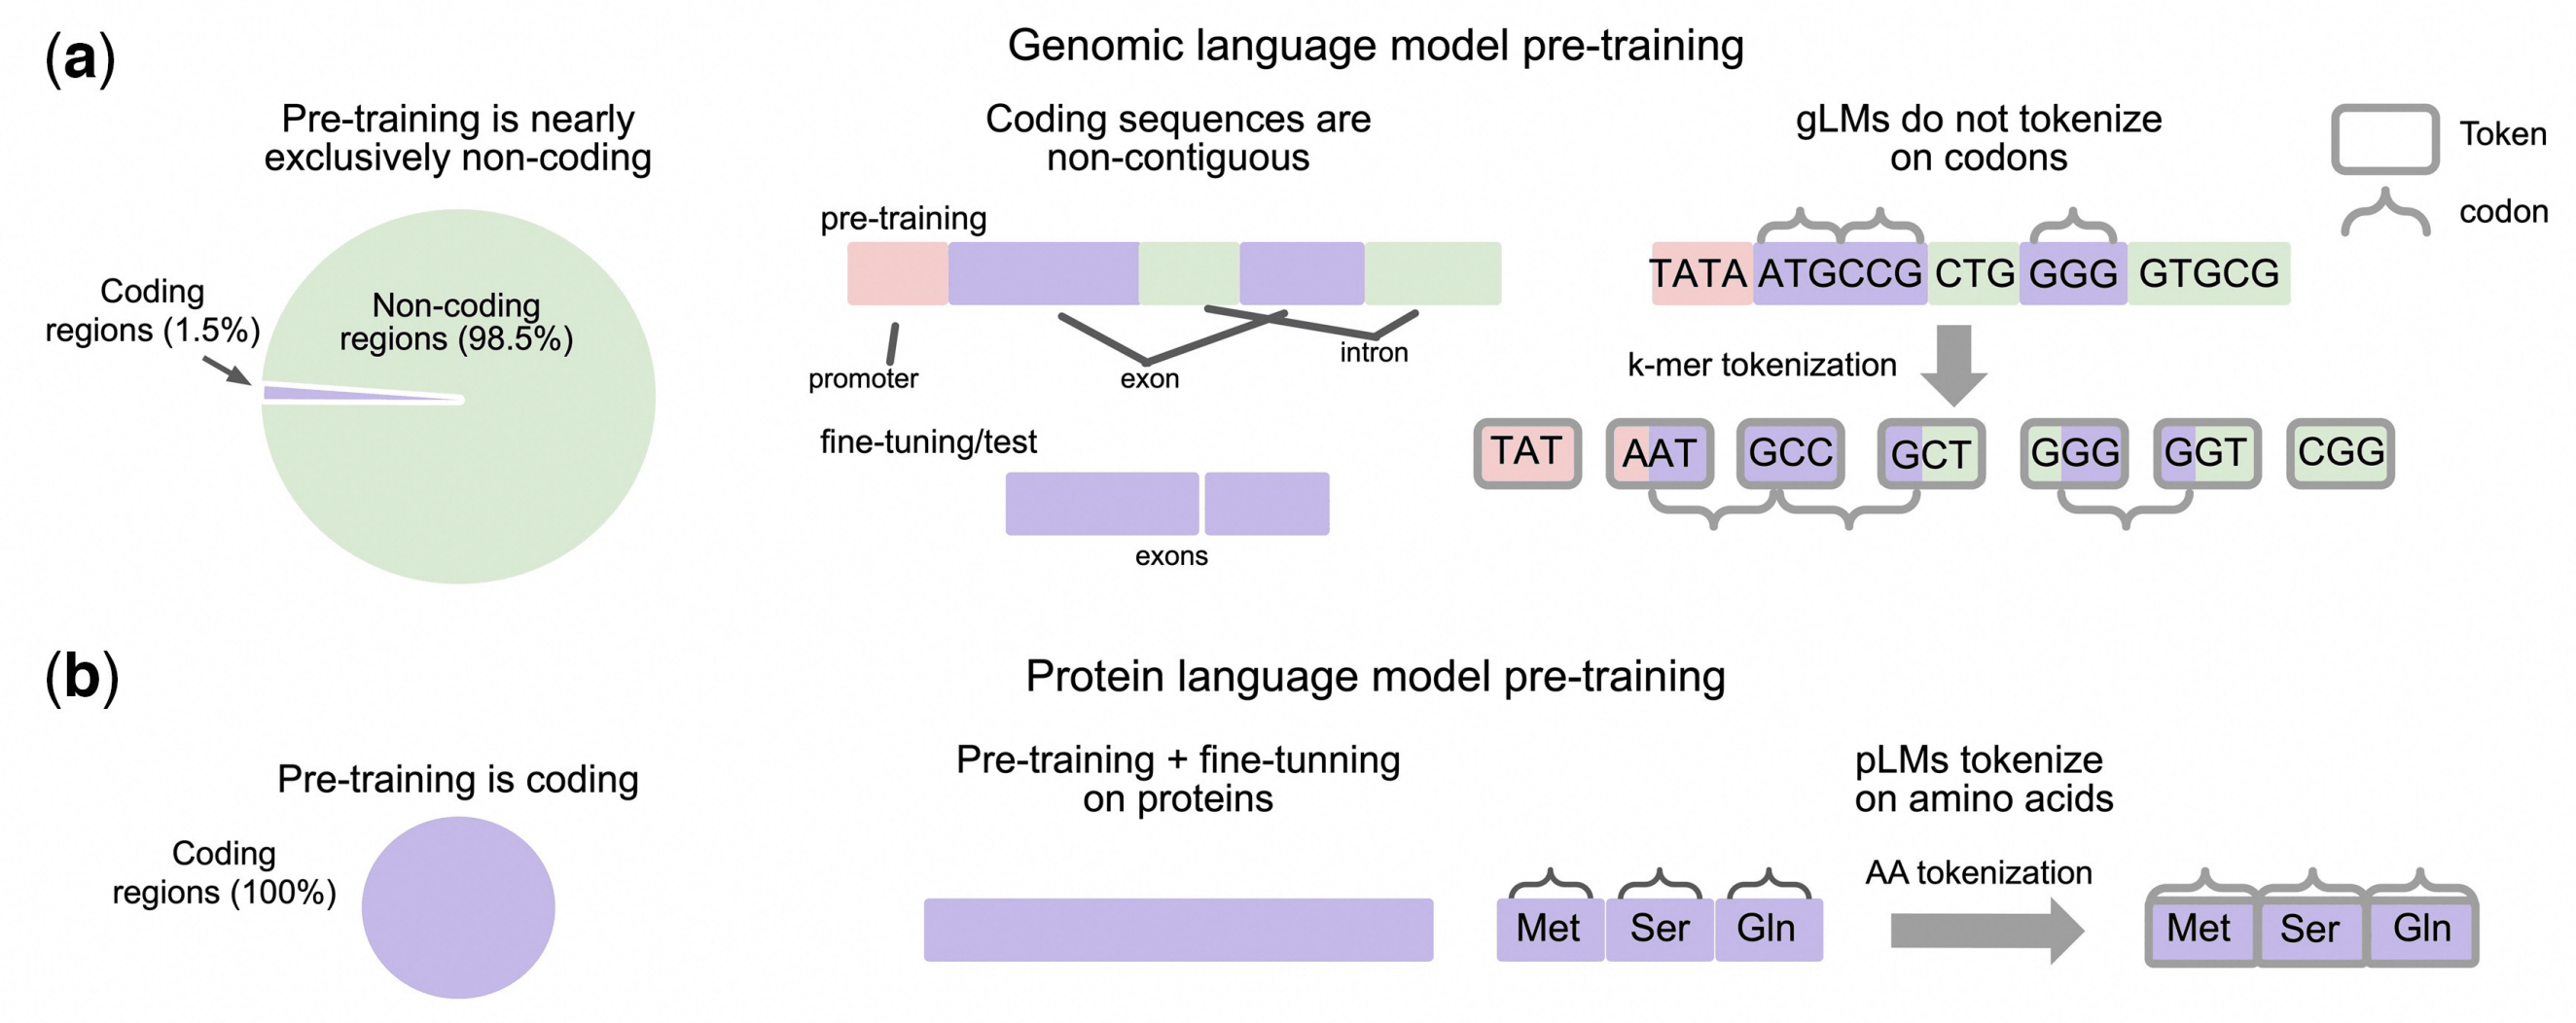
密码子分词与 $3$-mer 粒度对齐: 遗传密码具有简并性($18$ 种氨基酸由多个同义密码子编码)。密码子分词采用步长 $t=3$ 的非重叠 $3$-mer(词表大小 $4^3=64$),使每个词元严格对应一个三联体密码子与单个氨基酸残基。论文将 NT-v2 的非重叠 $6$-mer 替换为非重叠 $3$-mer 分词,从头预训练了 NT-v2-3mer,在不损失基因组基准性能的前提下实现了单密码子分辨率对齐。
隐空间几何解耦与双模态拼接: 设编码器映射为 $f_\theta : V^m \to \mathbb{R}^d$。在隐空间 $k$-近邻探测下,两类模型呈现出互补的局部组织原则:输入真实 CDS 的 gLM 倾向于按突变在序列中的物理位置聚类,而输入氨基酸序列的蛋白质语言模型 pLM(ESM-2) 倾向于按突变后的氨基酸类型聚类。基于这一互补性,论文将 NT-v2 对 CDS 的序列平均池化嵌入与 ESM-2 对氨基酸序列的平均池化嵌入直接拼接,送入线性头并配合 $\text{IA}^3$ 进行参数高效微调:
\[\mathbf{h}_{\mathrm{joint}} = \operatorname{Concat}\!\Big(\frac{1}{T_{\mathrm{CDS}}}\sum_{i=1}^{T_{\mathrm{CDS}}} f_{\mathrm{gLM}}(x_{\mathrm{CDS}})_i,\; \frac{1}{T_{\mathrm{AA}}}\sum_{j=1}^{T_{\mathrm{AA}}} f_{\mathrm{pLM}}(x_{\mathrm{AA}})_j\Big), \quad \hat{y} = W\mathbf{h}_{\mathrm{joint}} + b.\]⚪ CaLM:密码子阅读框感知的编码区掩码语言建模
- paper:Codon language embeddings provide strong signals for use in protein engineering(Nature Machine Intelligence 2024)
CaLM 利用密码子到氨基酸的满射非单射性质,直接在蛋白质编码序列(cDNA)的三联体阅读框粒度上执行掩码语言建模,从同义密码子偏好性中提取纯氨基酸模型无法观测的翻译动力学与物种演化特征。
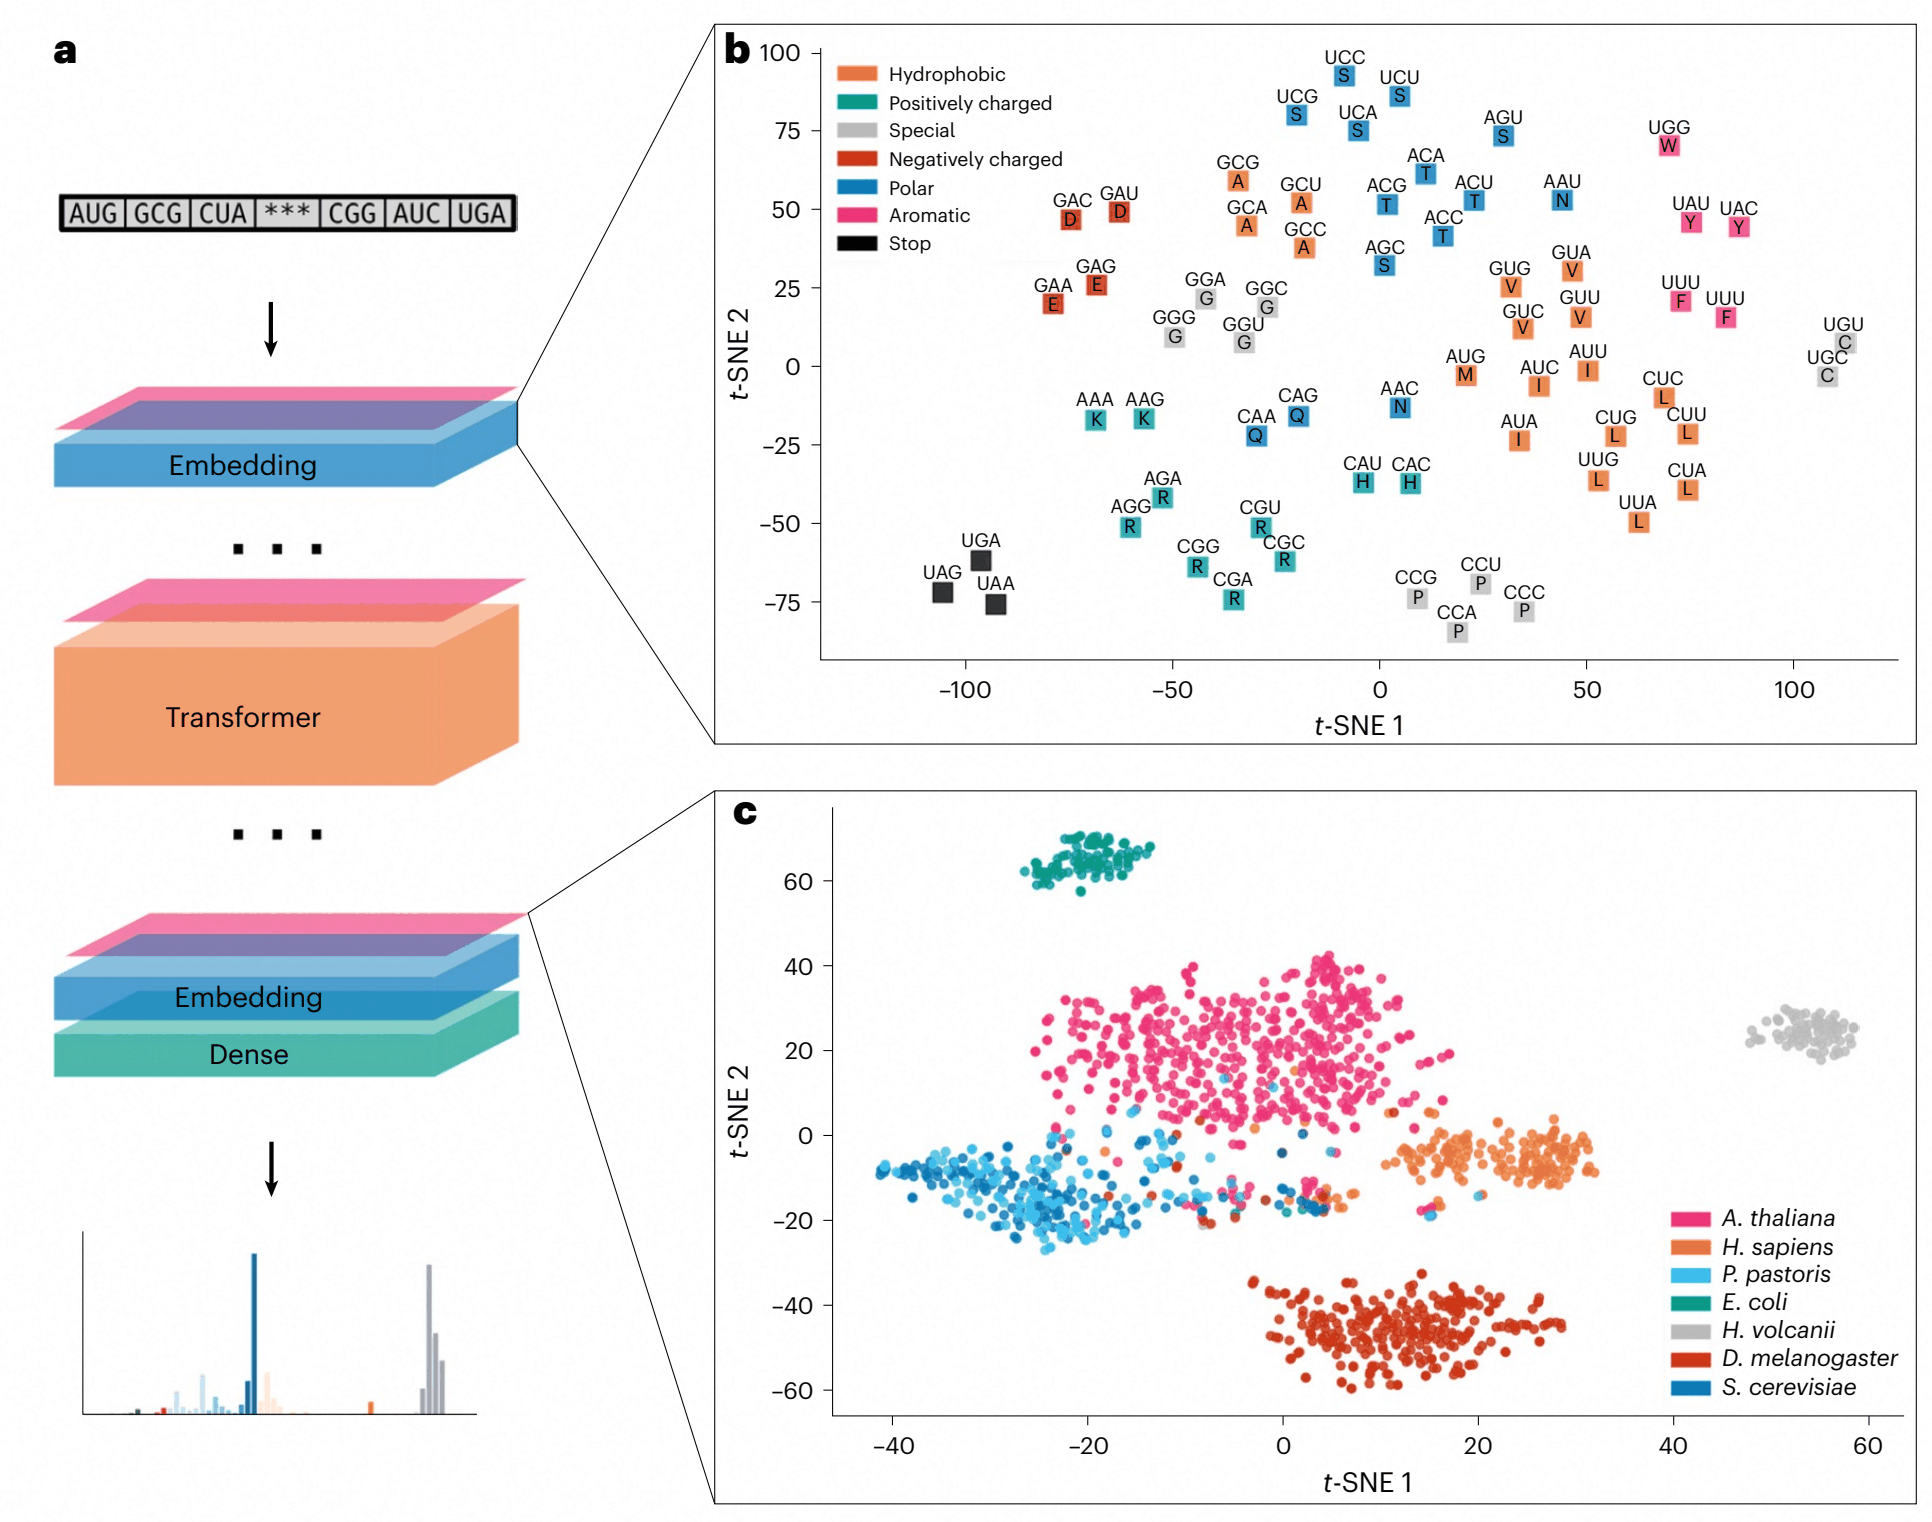
非冗余 cDNA 语料与三联体密码子词表: 语料取自欧洲核苷酸档案库(ENA)的组装基因组编码序列,滤除含简并碱基、非 ATG 起始、含内部终止密码子或长度非 $3$ 的整数倍的异常片段,并通过序列一致性聚类去除冗余。分词严格对齐开放阅读框(ORF),采用步长为 $3\text{ nt}$ 的非重叠三联体切分;词表包含 $64$ 个标准遗传密码子与 $5$ 个特殊控制符。各密码子映射为独立的离散索引,不向模型注入关于单核苷酸组成或氨基酸翻译表的先验特征。
RoPE 双向编码器与动态密码子掩码: 模型主干沿用 ESM 架构的预归一化双向 Transformer,通过旋转位置编码注入阅读框内的相对顺序信息,语言建模头与输入嵌入矩阵共享权重。预训练采用动态掩码策略,将掩码率提升至 $25\%$:在每个批次中随机抽取 $25\%$ 的密码子位置集合 $\mathcal{M}$($80\%$ 替换为掩码符、$10\%$ 随机替换、$10\%$ 保持不变),最小化掩码位置真实密码子的条件负对数似然:
\[\mathcal{L}_{\mathrm{MLM}} = -\sum_{i \in \mathcal{M}} \log P_\theta(x_i \mid x_{\setminus\mathcal{M}}).\]⚪ CodonFM (EnCodon):密码子频率加权掩码与同义密码子语法建模
- paper:Learning the Language of Codon Translation with CodonFM(Preprint 2025)
CodonFM 中的 EnCodon 系列模型在跨生命域的蛋白质编码序列(CDS)上采用三联体密码子分词与双向 Transformer 编码器,并引入密码子频率加权掩码策略(CDWT),从同义密码子简并性中学习调控翻译延伸速率、mRNA 稳定性与蛋白质表达的上下文语法。
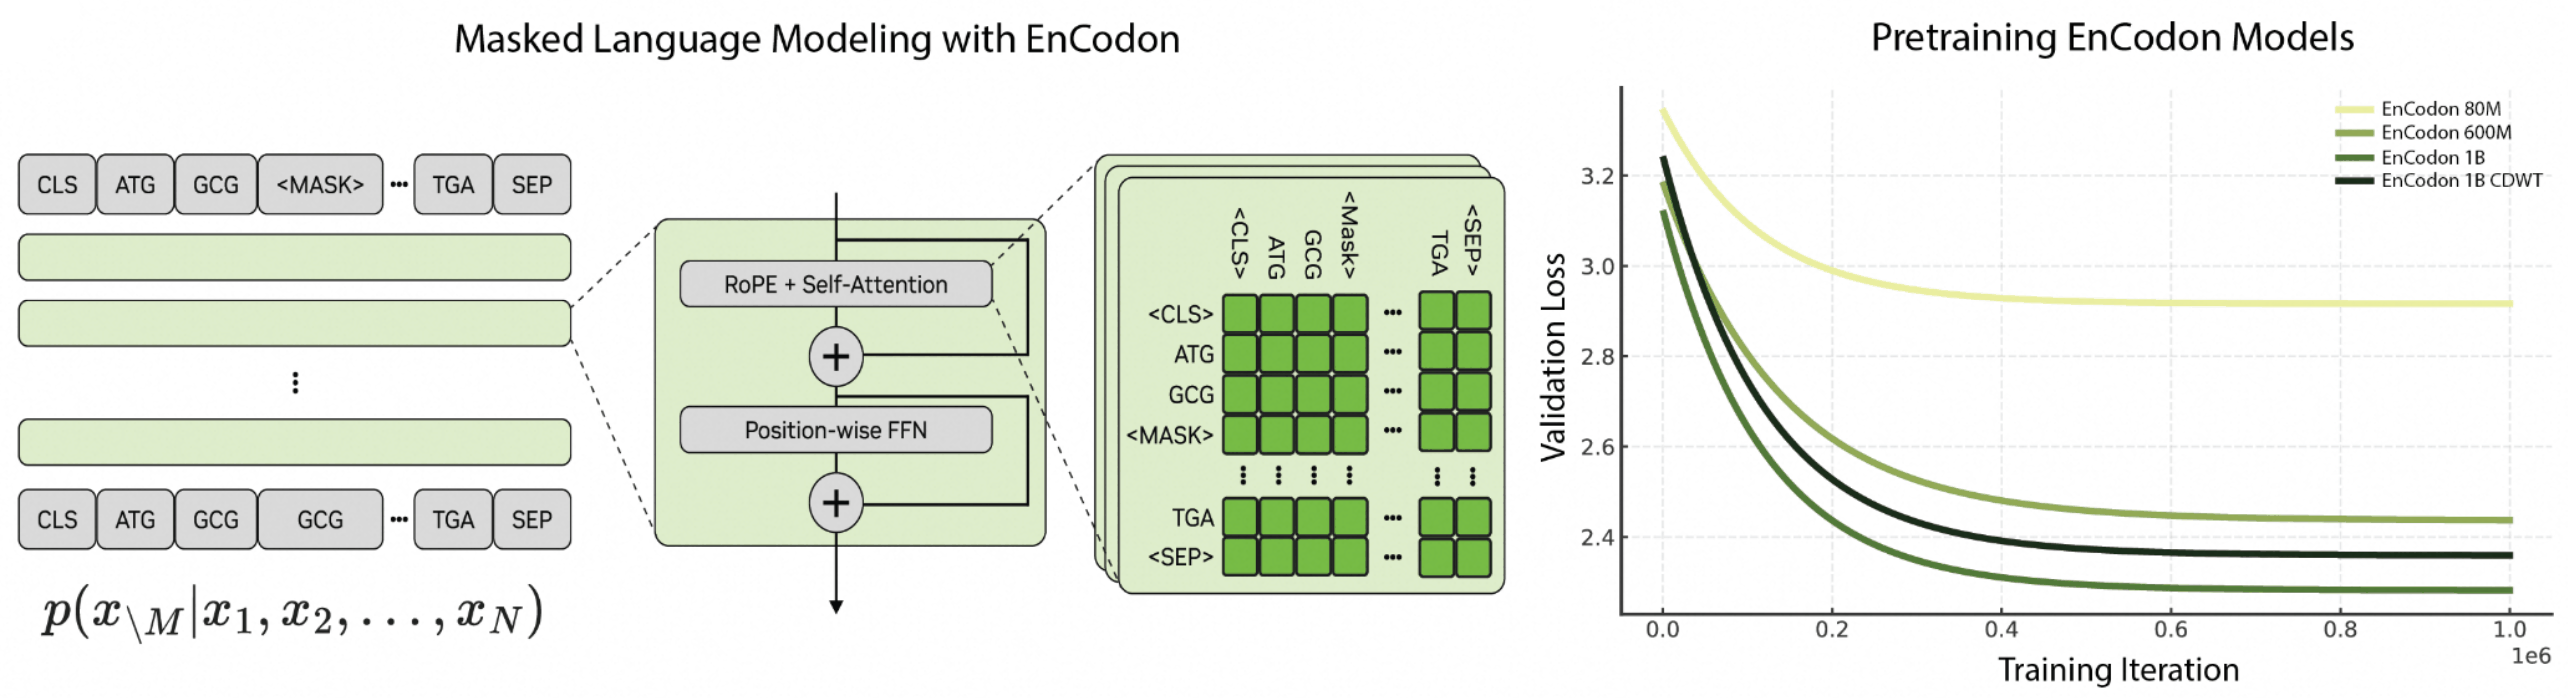
跨物种 ORF 语料与密码子频率加权掩码(CDWT): 语料整合自 NCBI RefSeq 中跨越原核与真核生物的 $1.3$ 亿余条完整开放阅读框(ORF)序列,严格按阅读框相位切分为非重叠三联体密码子词元(最大窗口为 $2{,}046$ 个密码子)。主干采用双向 Transformer 编码器执行掩码密码子预测。在标准均匀掩码($w(c_i)=1$)之外,变体 EnCodon 1B-CDWT 引入密码子频率加权掩码策略:提高稀有同义密码子在掩码采样或损失计算中的权重 $w(c_i)$,防止高频常见密码子主导梯度更新,迫使模型捕获稀有密码子与同源 tRNA 丰度适配及局部二级结构之间的耦合:
\[\mathcal{L}_{\mathrm{MLM}} = -\sum_{i \in \mathcal{M}} w(c_i) \log p_\theta(c_i \mid c_{\setminus \mathcal{M}}).\]零样本同义/错义变异评估: 在下游零样本变异效应预测中,模型直接计算突变密码子 $c_i^{\mathrm{alt}}$ 与参考密码子 $c_i^{\mathrm{ref}}$ 在双向上下文下的条件对数似然差:
\[\Delta \mathrm{LL}_i = \log p_\theta(c_i^{\mathrm{alt}} \mid c_{\setminus i}) - \log p_\theta(c_i^{\mathrm{ref}} \mid c_{\setminus i}),\]在无需氨基酸序列或结构先验的条件下,即可同时评估错义突变致病性、纯氨基酸模型无法感知的临床同义突变效应以及 mRNA 翻译效率。
1.4 基因级分词
基因级分词跳过单碱基的局部细节,直接以“基因”或“编码序列单元”作为基本词元,在宏基因组或多基因尺度上建模基因共调控与功能协同。
⚪ gLM:基于蛋白质语言模型的基因分词
- paper:Genomic language model predicts protein co-regulation and function(Nature Communications 2024)
gLM 将基因组视为“句子”、将基因视为“词元”,直接输入蛋白质语言模型提取的连续语义向量与转录方向,在宏基因组重叠群(Contigs)上进行掩码预训练,捕获基因在染色体邻域中的共调控句法与功能语义。
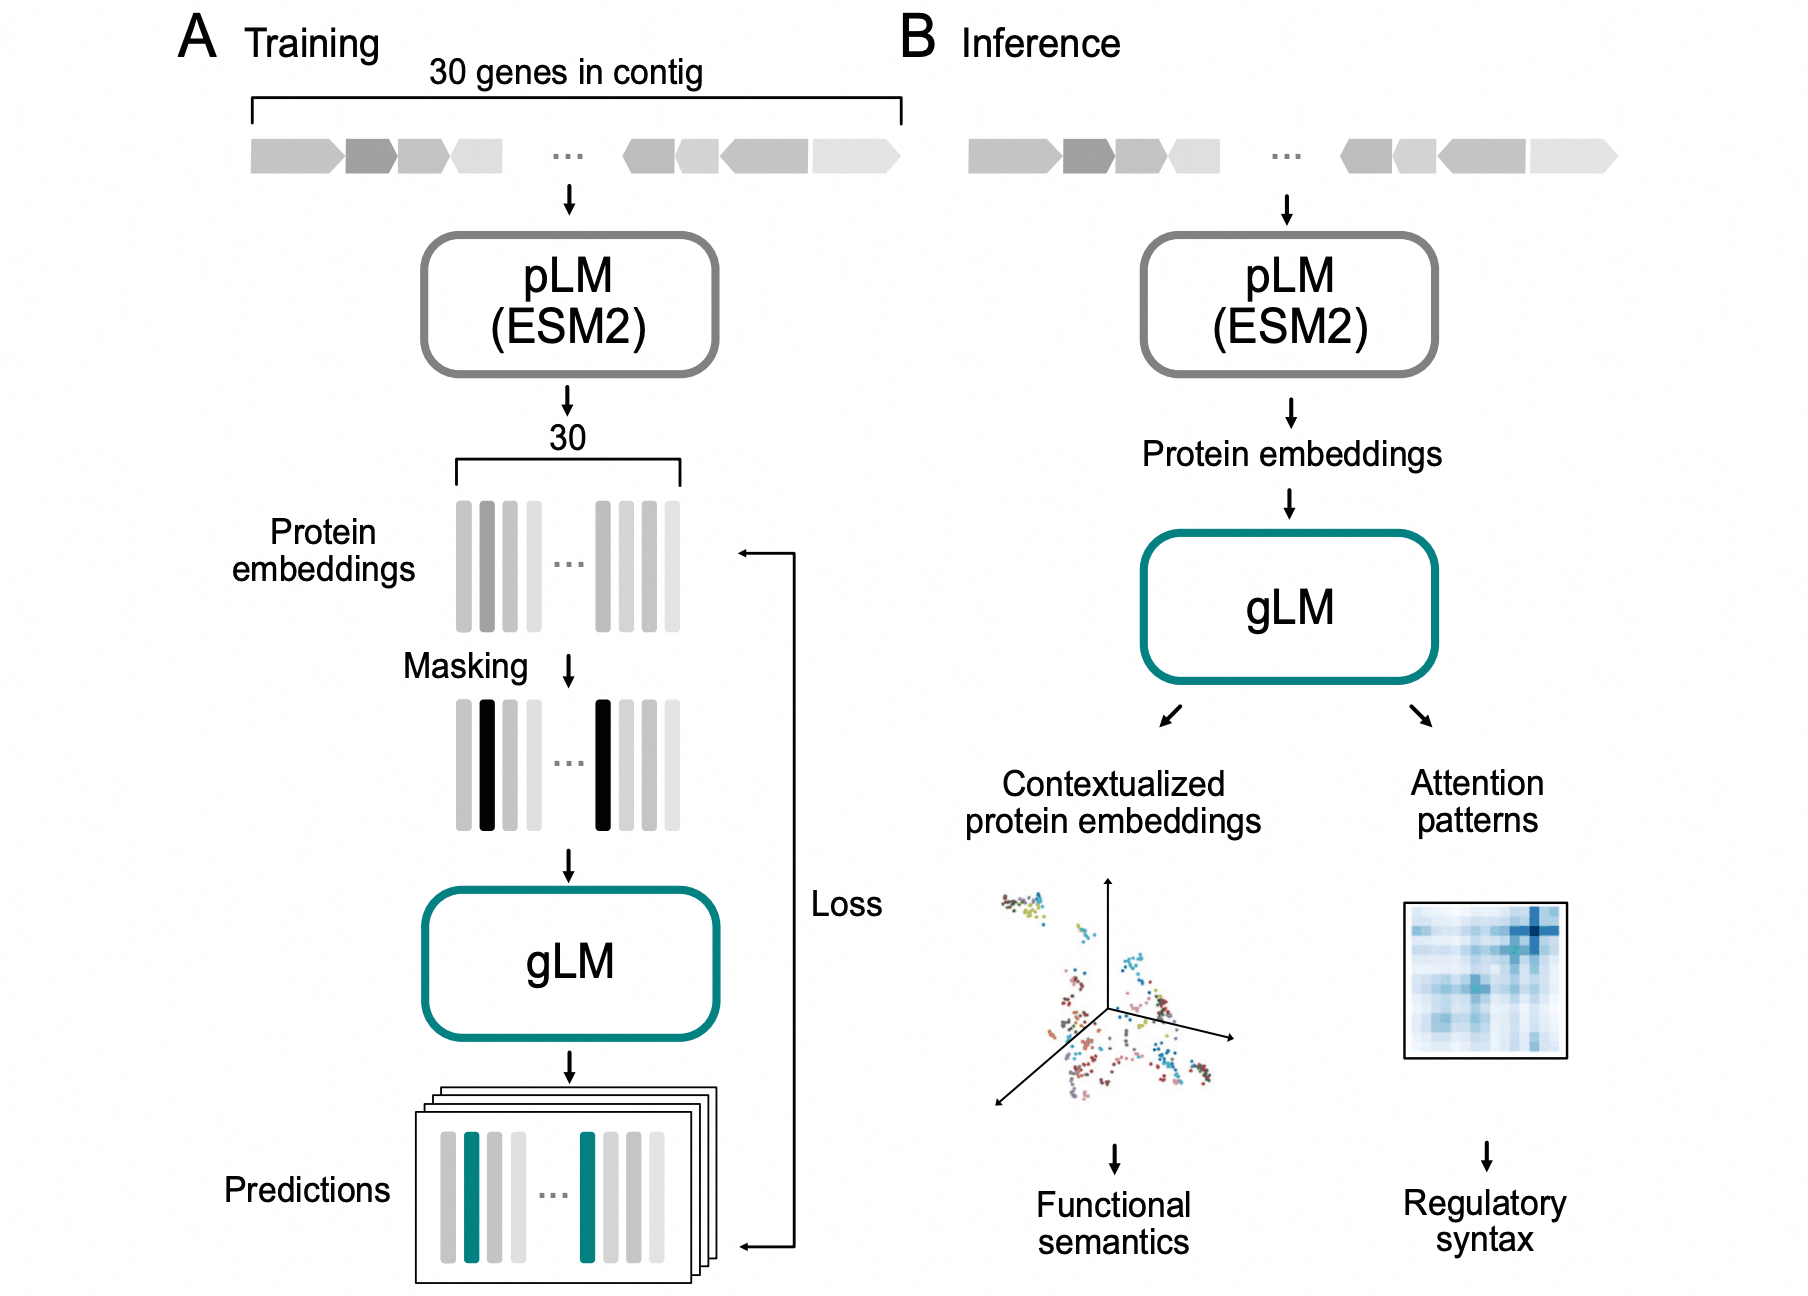
连续空间基因词元构建: 模型基于 MGnify 数据库将宏基因组切分为包含 $15\sim30$ 个基因的子重叠群。gLM 的基础词元直接采用预训练蛋白质语言模型 ESM-2 输出的均值池化向量,并拼接标量方向编码(标识正负链转录方向),形成连续词元嵌入,同时保留蛋白质序列特征与基因组转录拓扑。
多峰分布重构预训练: 骨干网络采用引入相对位置编码的 RoBERTa 编码器,预训练随机遮蔽 $15\%$ 的基因位点。考虑到同一基因组上下文中可能存在多种同工或可替代基因,模型将目标真值经 PCA 降维后,通过线性输出头同时预测 4 个候选表示及其置信概率分布 $\mathbf{p}$:
\[\mathcal{L} = \mathrm{MSE}(\hat{y}_{\mathrm{closest}}, y) + \alpha \cdot \mathrm{CrossEntropy}(\mathbf{p}, \mathrm{idx}_{\mathrm{closest}}),\]其中 $\hat{y}_{\mathrm{closest}}$ 为与真实目标 $L_2$ 距离最近的候选向量。模型通过联合优化逼近特定基因组生态位下的潜在多峰基因分布。
⚪ gLM2 / OMG:混合模态基因组语言模型与宏基因组去重语料
- paper:The OMG dataset: An Open MetaGenomic corpus for mixed-modality genomic language modeling(ICLR 2025)
gLM2 依托大规模宏基因组数据集 OMG,构建了交替融合蛋白质氨基酸与基因间区核苷酸的混合模态基因组语言模型,在多基因上下文中同时捕获蛋白质功能与残基级共进化特征。
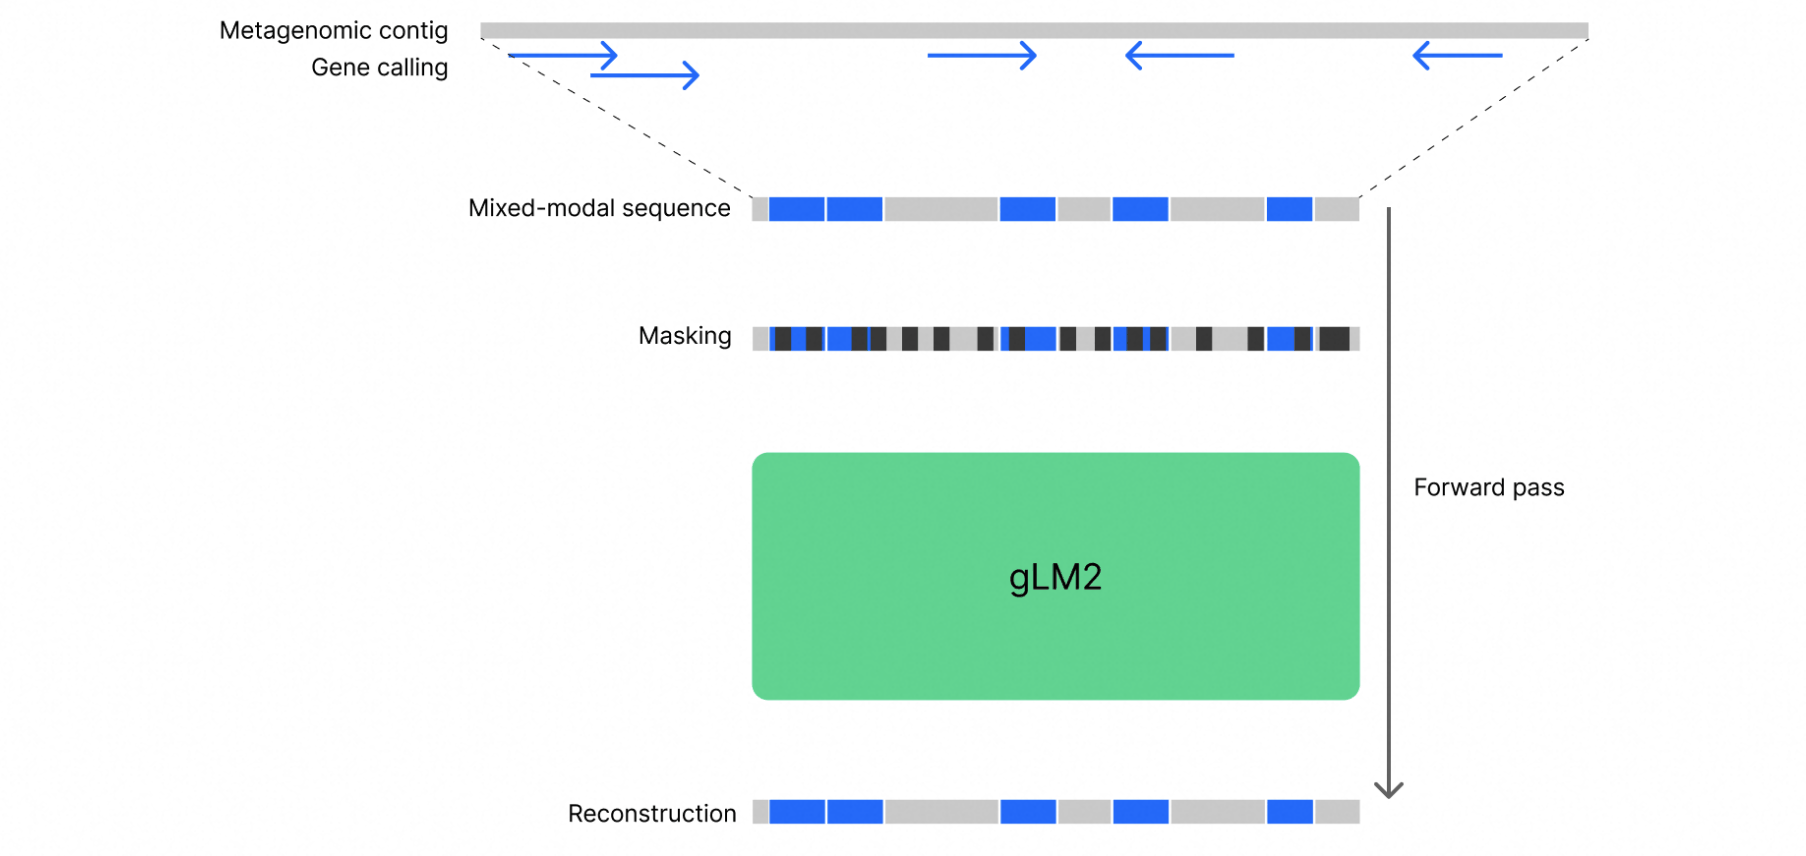
OMG 语料清洗与嵌入空间语义去重: 研究整合 MGnify 与 IMG 数据库构建了宏基因组语料库,剔除边缘不完整编码序列(CDS)、过短重叠群以及含高比例模糊字符的异常片段。由于宏基因组缺乏分类学标签且序列长度可变,作者利用初步训练的 gLM2 提取重叠群均值池化表征,在嵌入空间中剪除余弦距离极小的高度稠密样本(Genomic SemDeDup),平抑常见菌群的过采样偏差。
混合模态分词与掩码语言建模: 模型将基因组重叠群表示为 CDS 单元与基因间区(IGS)单元交错排列的序列:CDS 以单氨基酸为词元并在前端拼接正反链方向控制符($+ / -$);IGS 保留原始非编码核酸序列并采用字节对编码(BPE)分词;基于 Transformer 编码器,在 $30\%$ 掩码率下联合对氨基酸与核酸两类模态的掩码词元进行重建训练。
2. 统计子词分词(Statistical Tokenization)
自然基因组的核苷酸组成并非均匀分布,而是呈现出显著的局部异质性:转座子衍生序列、微卫星串联重复与 $\mathrm{poly(A)/poly(T)}$ 尾高频富集;而受胞嘧啶甲基化脱氨基突变($\mathrm{C}\to\mathrm{T}$)影响,$\mathrm{CpG}$ 二核苷酸在脊椎动物基因组中显著缺失。若采用定长 $k$-mer 分词,词表内部频次呈严重的长尾分布,高频重复词元主导梯度更新,而携带调控信息的低频词元则面临训练不充分的问题。
统计子词分词利用字节对编码(BPE)或 Unigram 语言模型,将高频重复片段合并为长词元,将低频复杂序列保留为短词元,在缩短有效序列长度的同时拉平词表频率分布。
⚪ GROVER:基于下一 $k$-mer 预测的频率平衡 BPE 词表
- paper:DNA language model GROVER learns sequence context in the human genome(Nature Machine Intelligence 2024)
GROVER 利用 BPE 构建频率平衡词表,并通过与词表大小解耦的下一 $k$-mer 预测任务确定最优合并轮数,基于 BERT 架构学习人类基因组上下文。
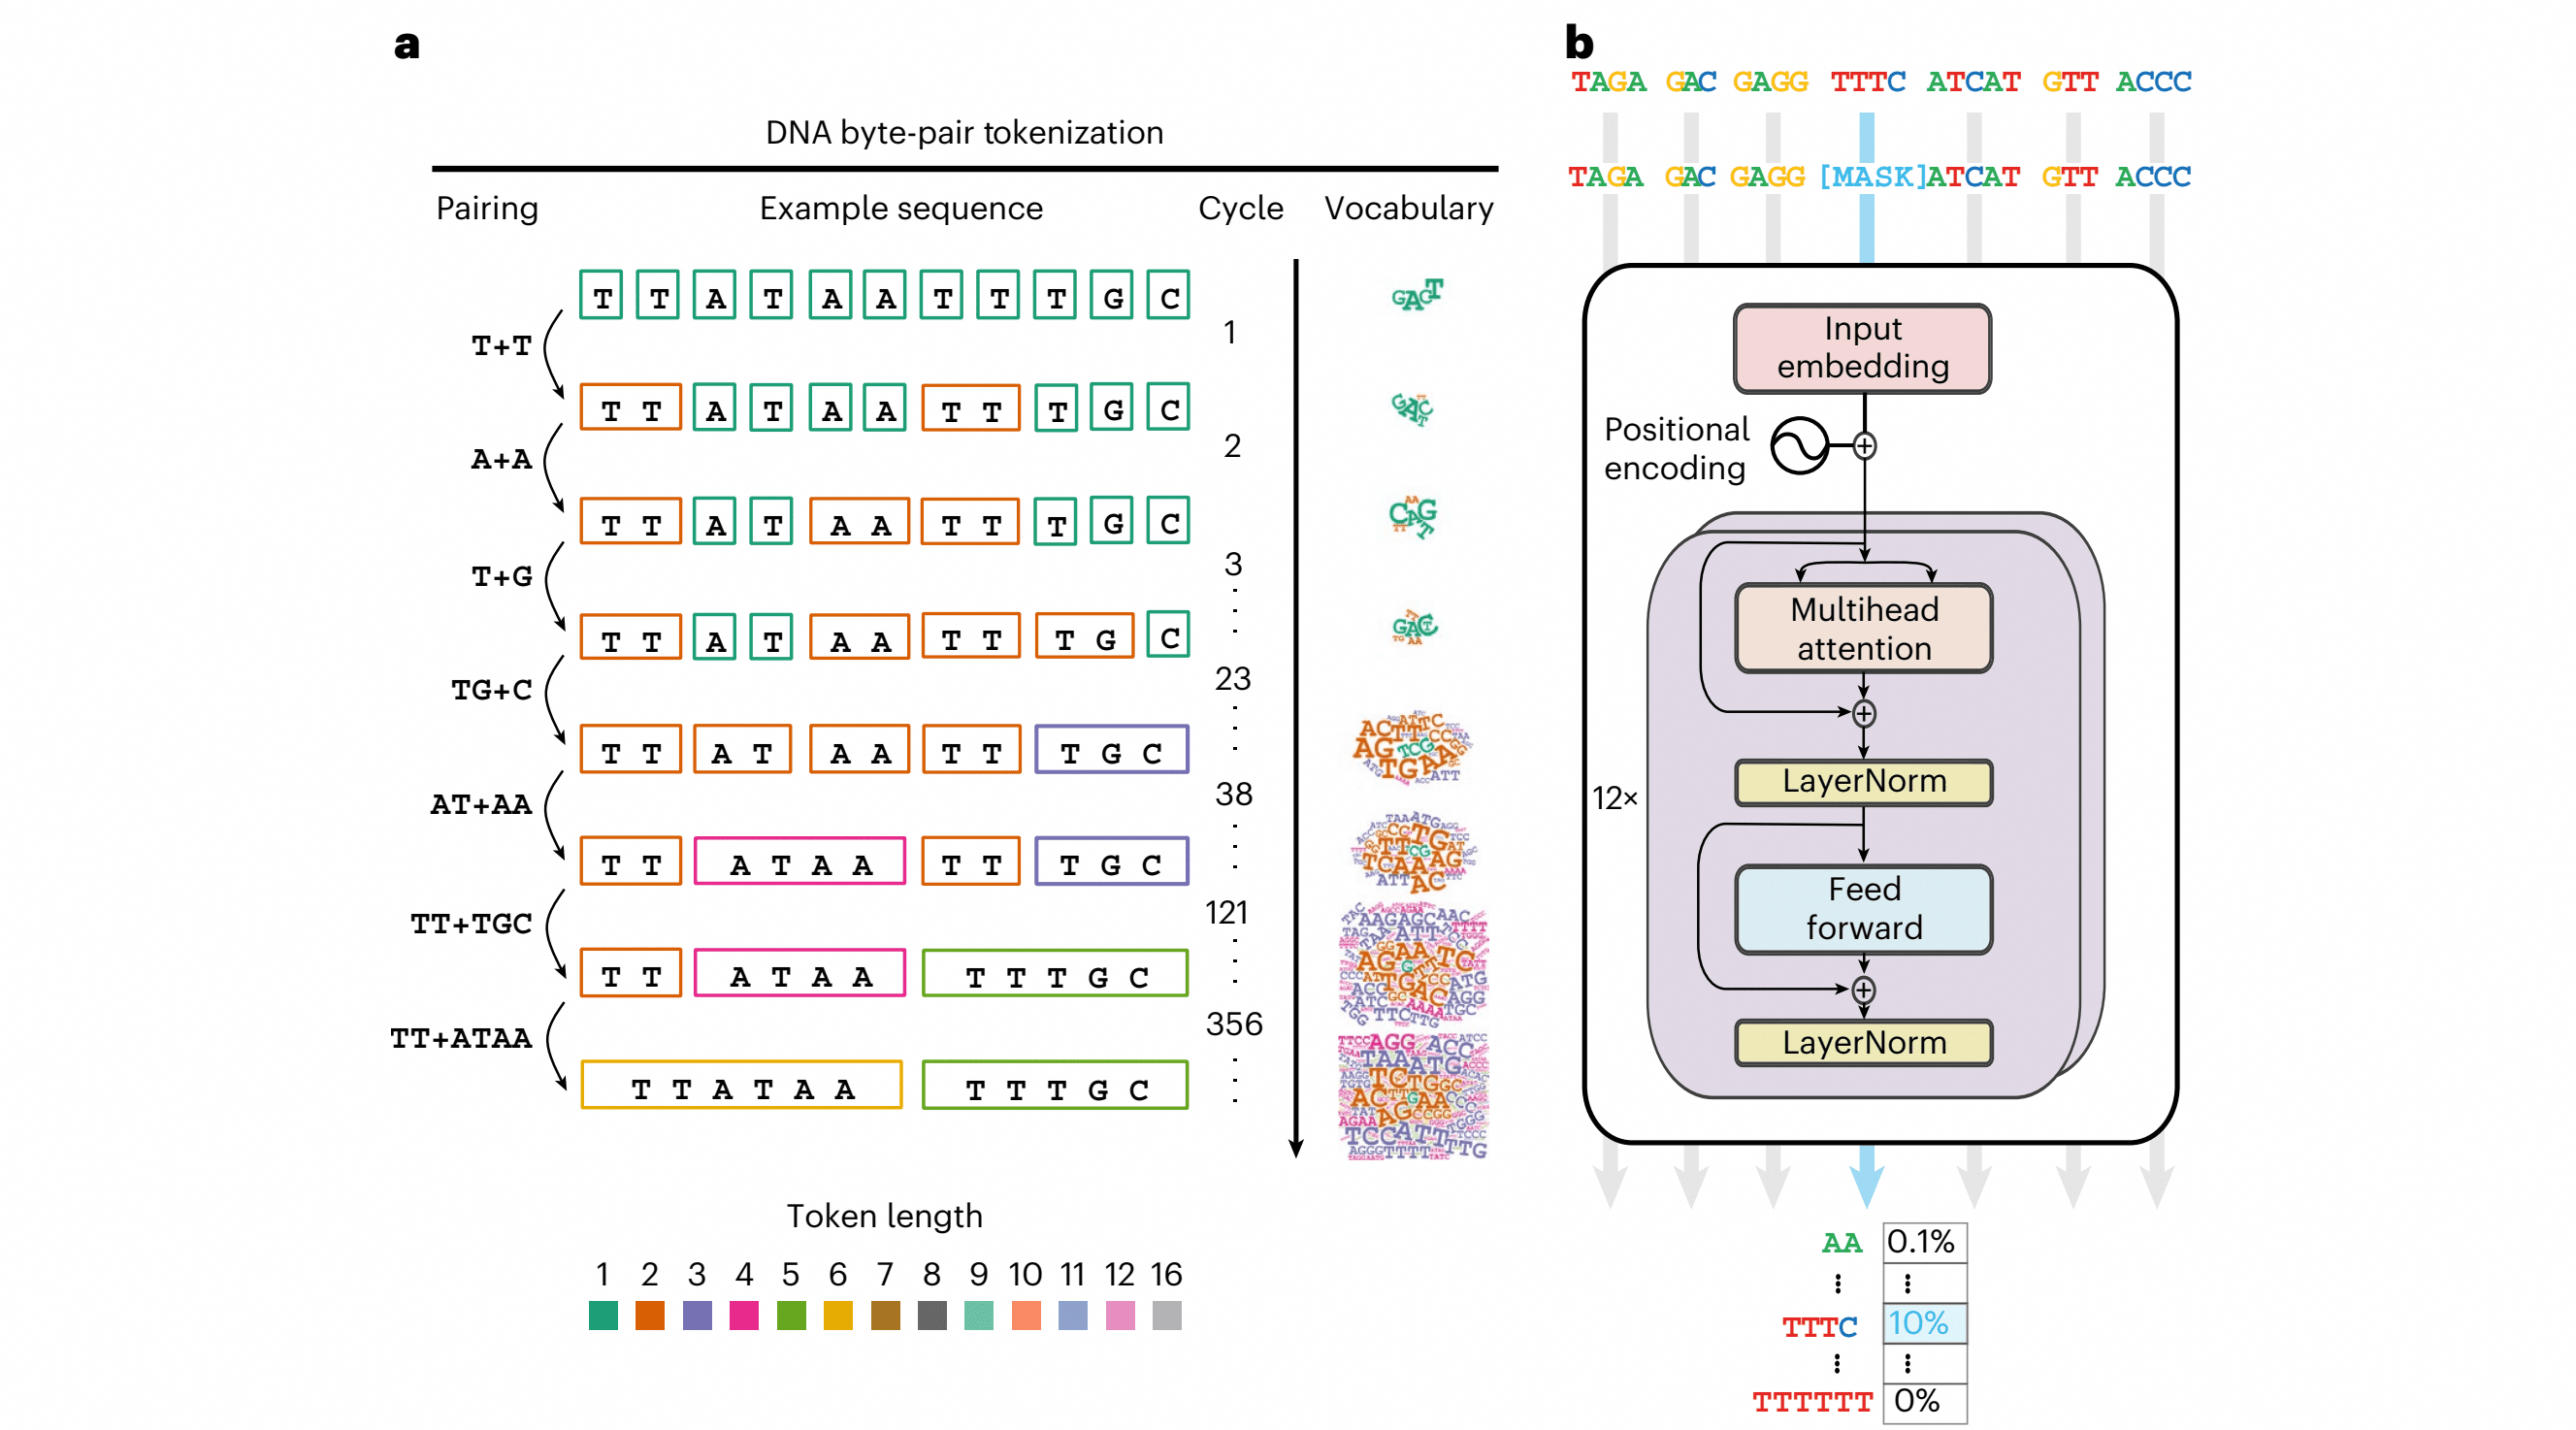
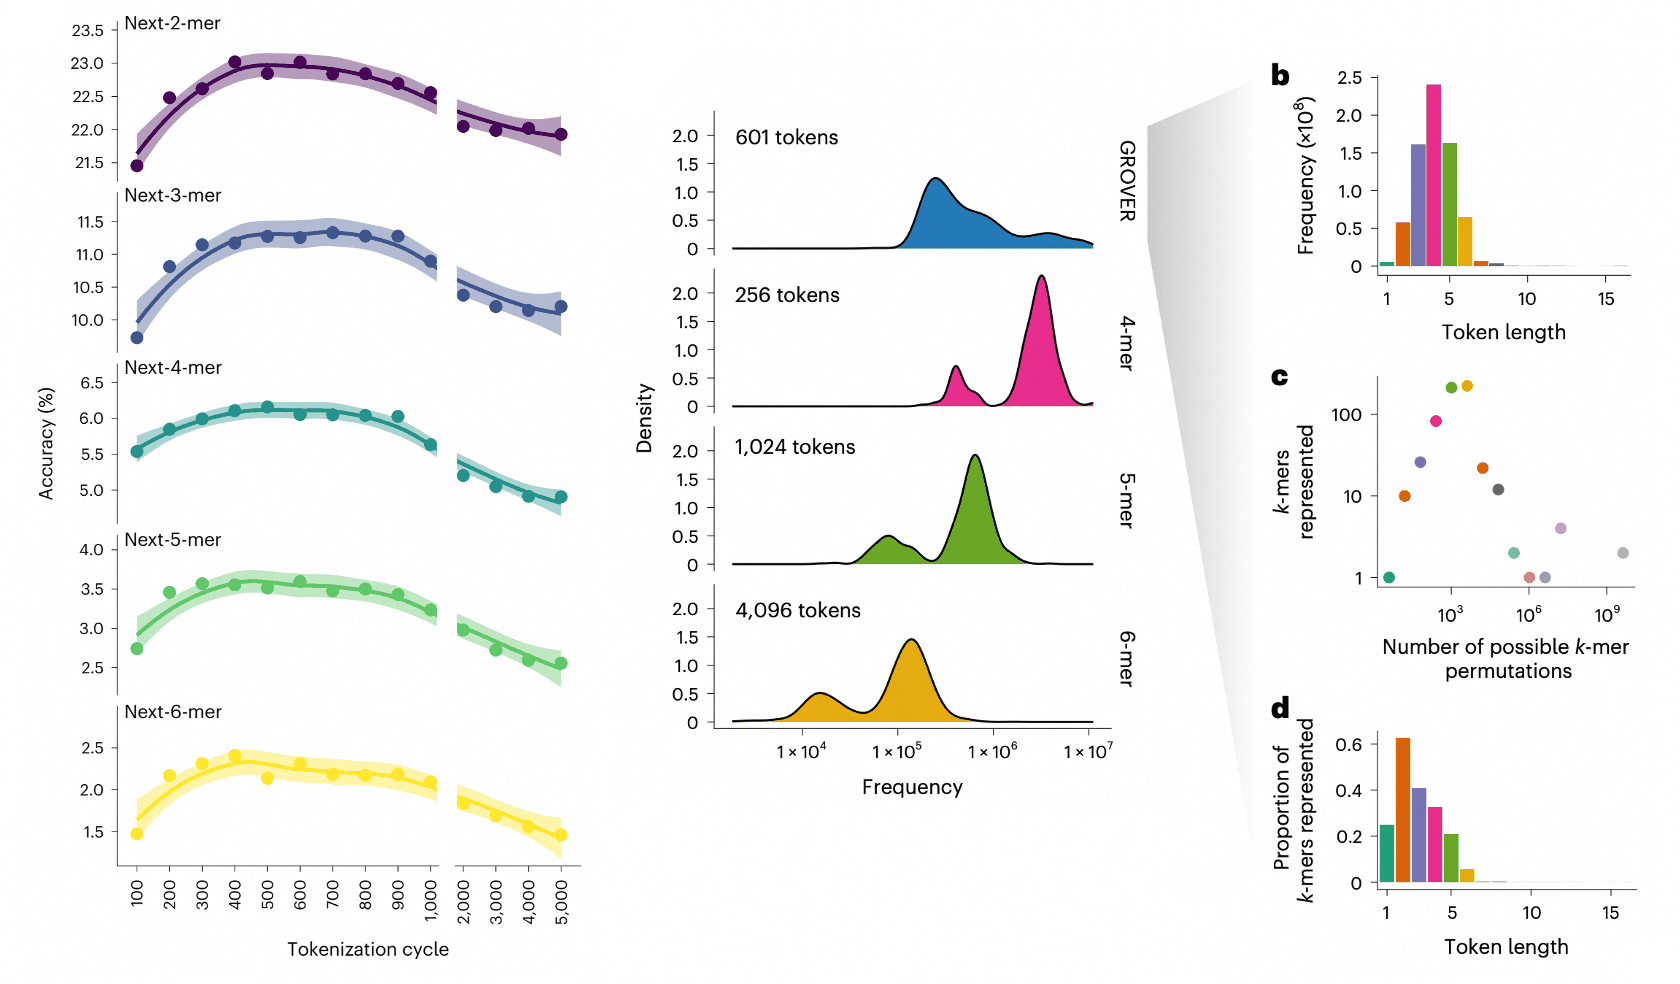
频率平衡 BPE 与词表寻优: BPE 从单碱基出发反复合并最高频的相邻词元。由于标准掩码困惑度与词表规模耦合,无法直接跨词表比较,论文设计了下一 $k$-mer 预测作为验证指标:以前 $50\text{ nt}$ 为上下文,监督预测紧随其后的 $k \in \lbrace 2,3,4,5,6\rbrace$ 个碱基(对应 $4^k$ 类分类),据此选定最优的 $600$ 轮合并(BPE-600)。最终词表包含 $601$ 个序列词元,长度跨度为 $1\sim 16\text{ nt}$(平均约 $4\text{ nt}$)。
低掩码率预训练: 人类参考基因组经 BPE-600 分词后切分为动态长度窗口,输入双向 BERT 编码器。由于单个词元平均长约 $4\text{ nt}$,为避免局部上下文过度缺失,预训练在每条序列中仅随机选择 $2.2\%$ 的词元位置进行掩码预测,最小化多分类交叉熵损失。
⚪ DNAZEN:混合粒度 G-gram 与整单元掩码重建
- paper:DNAZEN: Enhanced Gene Sequence Representations via Mixed Granularities of Coding Units(arXiv 2025)
DNAZEN 在 BPE 分词之上动态抽取统计显著的大粒度 G-gram,通过双路编码与整单元掩码预训练,兼顾细粒度序列分辨率与长程保守模式的建模。
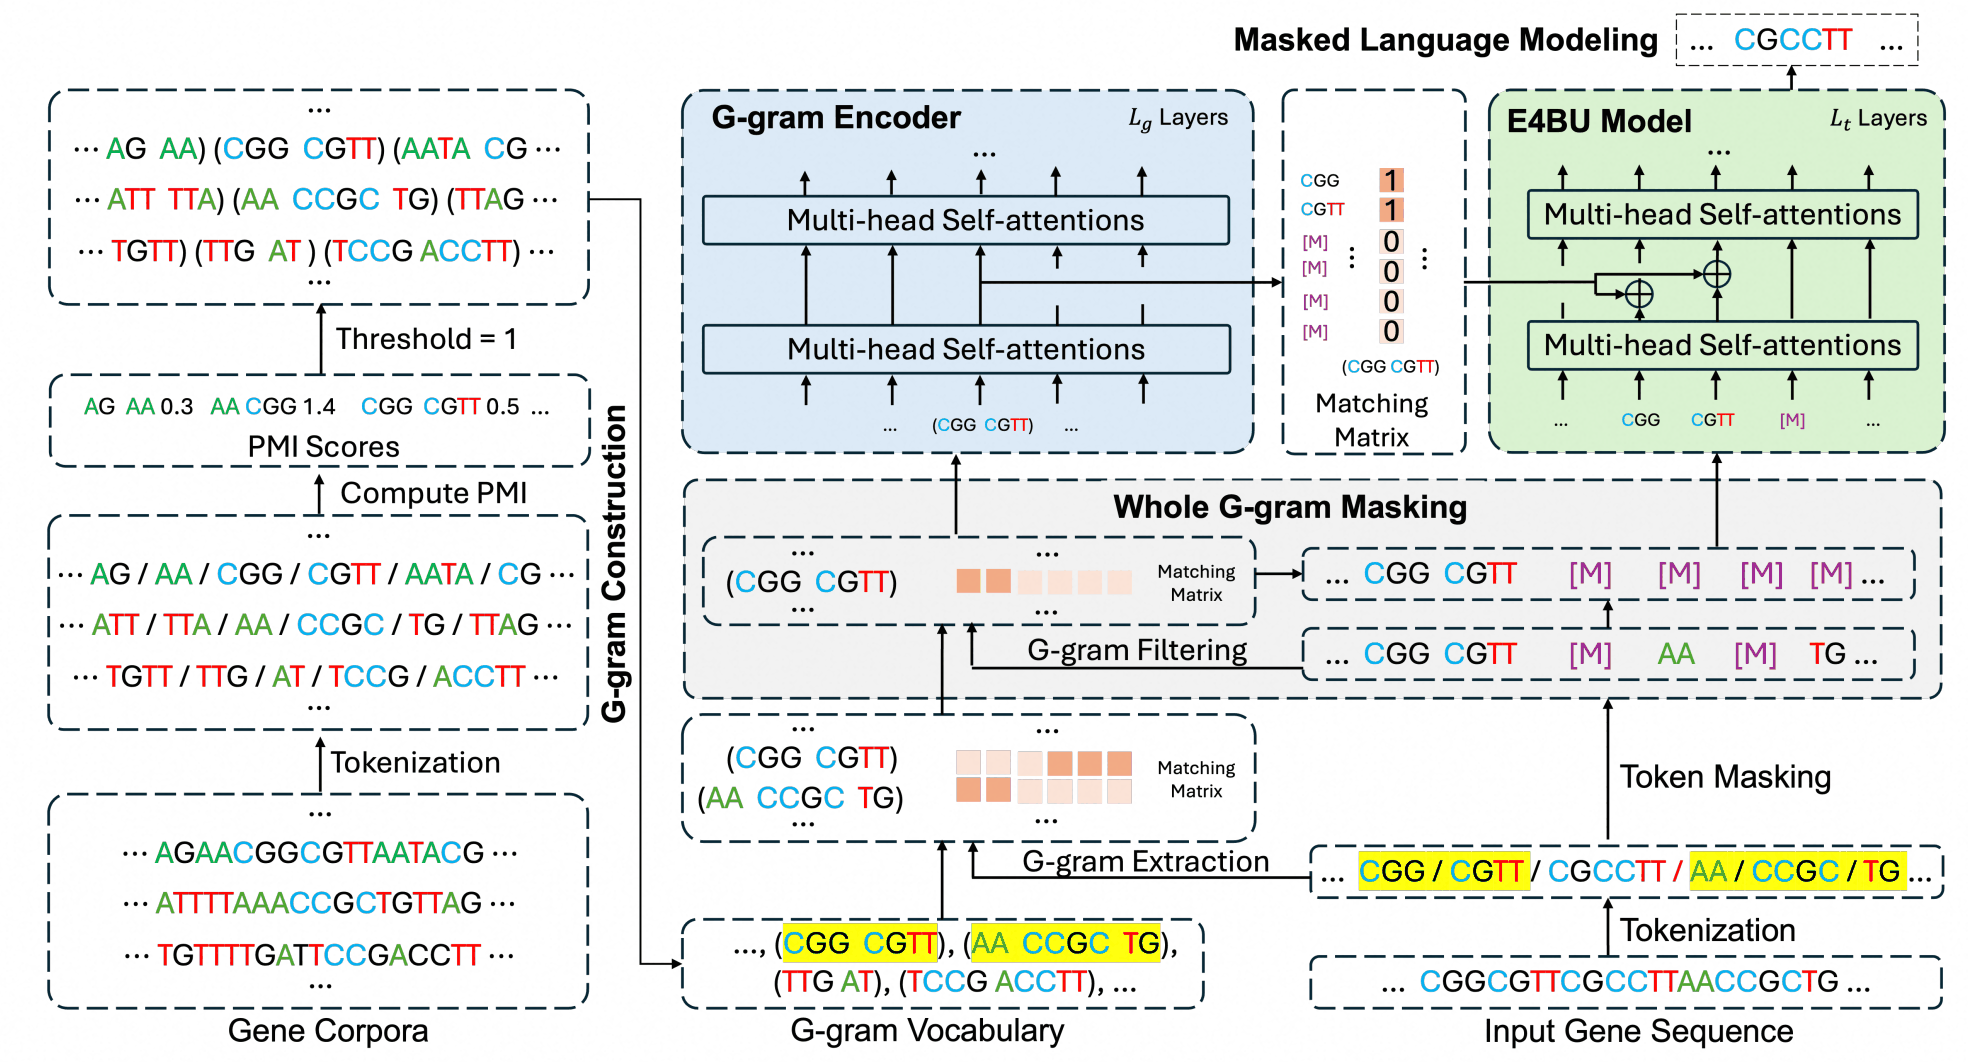
PMI 驱动的 G-gram 词表: 基础分词沿用 BPE 词表。模型在跨物种基因组语料中计算相邻词元 $x’$ 与 $x’’$ 的点互信息(PMI):
\[\mathrm{PMI}(x',x'')=\log\frac{p(x'x'')}{p(x')p(x'')}.\]在 $\mathrm{PMI}$ 低于阈值处阻断合并,保留长度在 $2\sim5$ 个 BPE 词元之间的连续高互信息片段,构建 G-gram 词表。训练和推理时,输入序列 $X=(x_1,\ldots,x_N)$ 在此词表中动态匹配,抽取得到允许重叠的 G-gram 集合 $C=(c_1,\ldots,c_T)$。
双路编码与整单元掩码: 模型包含基础单元编码器(E4BU)与不设位置编码的大粒度分支(G-gram encoder)。匹配矩阵 $M \in \lbrace 0,1\rbrace^{N\times T}$ 记录基础词元 $x_n$ 是否属于片段 $c_t$。记第 $l$ 层的基础表示为 $\nu_n^{(l)}$、大粒度表示为 $\mu_t^{(l)}$,在前 $L_g$ 层中 E4BU 逐层叠加覆盖该词元的所有 G-gram 表示:
\[\begin{aligned} &\mu_1^{(l)},\ldots,\mu_T^{(l)} = f_g^{(l)}\big(\mu_1^{(l-1)},\ldots,\mu_T^{(l-1)}\big), \\ &\nu_n^{*(l)}=\nu_n^{(l)}+\sum_{t=1}^{T}m_{n,t}\mu_t^{(l)}, \quad l=1,\ldots,L_g. \end{aligned}\]预训练执行整单元掩码(Whole G-gram Masking):随机选中的基础词元若命中任意 G-gram,则掩码范围扩展至该单元内的全部基础词元,并同步从大粒度分支中剔除该单元以防泄漏。
⚪ Genomics-FM:集成基因组词表预训练与任务自适应词表激活
- paper:Genomics-FM: Universal Foundation Model for Versatile and Data-Efficient Functional Genomic Analysis(bioRxiv 2024)
针对单一固定分词器难以同时兼顾局部高分辨率位点识别与全局长序列语义建模的矛盾,Genomics-FM 提出“集成基因组词表预训练 + 任务特定词表选择性激活微调”的范式,显著提升少样本标签效率与跨领域泛化能力。
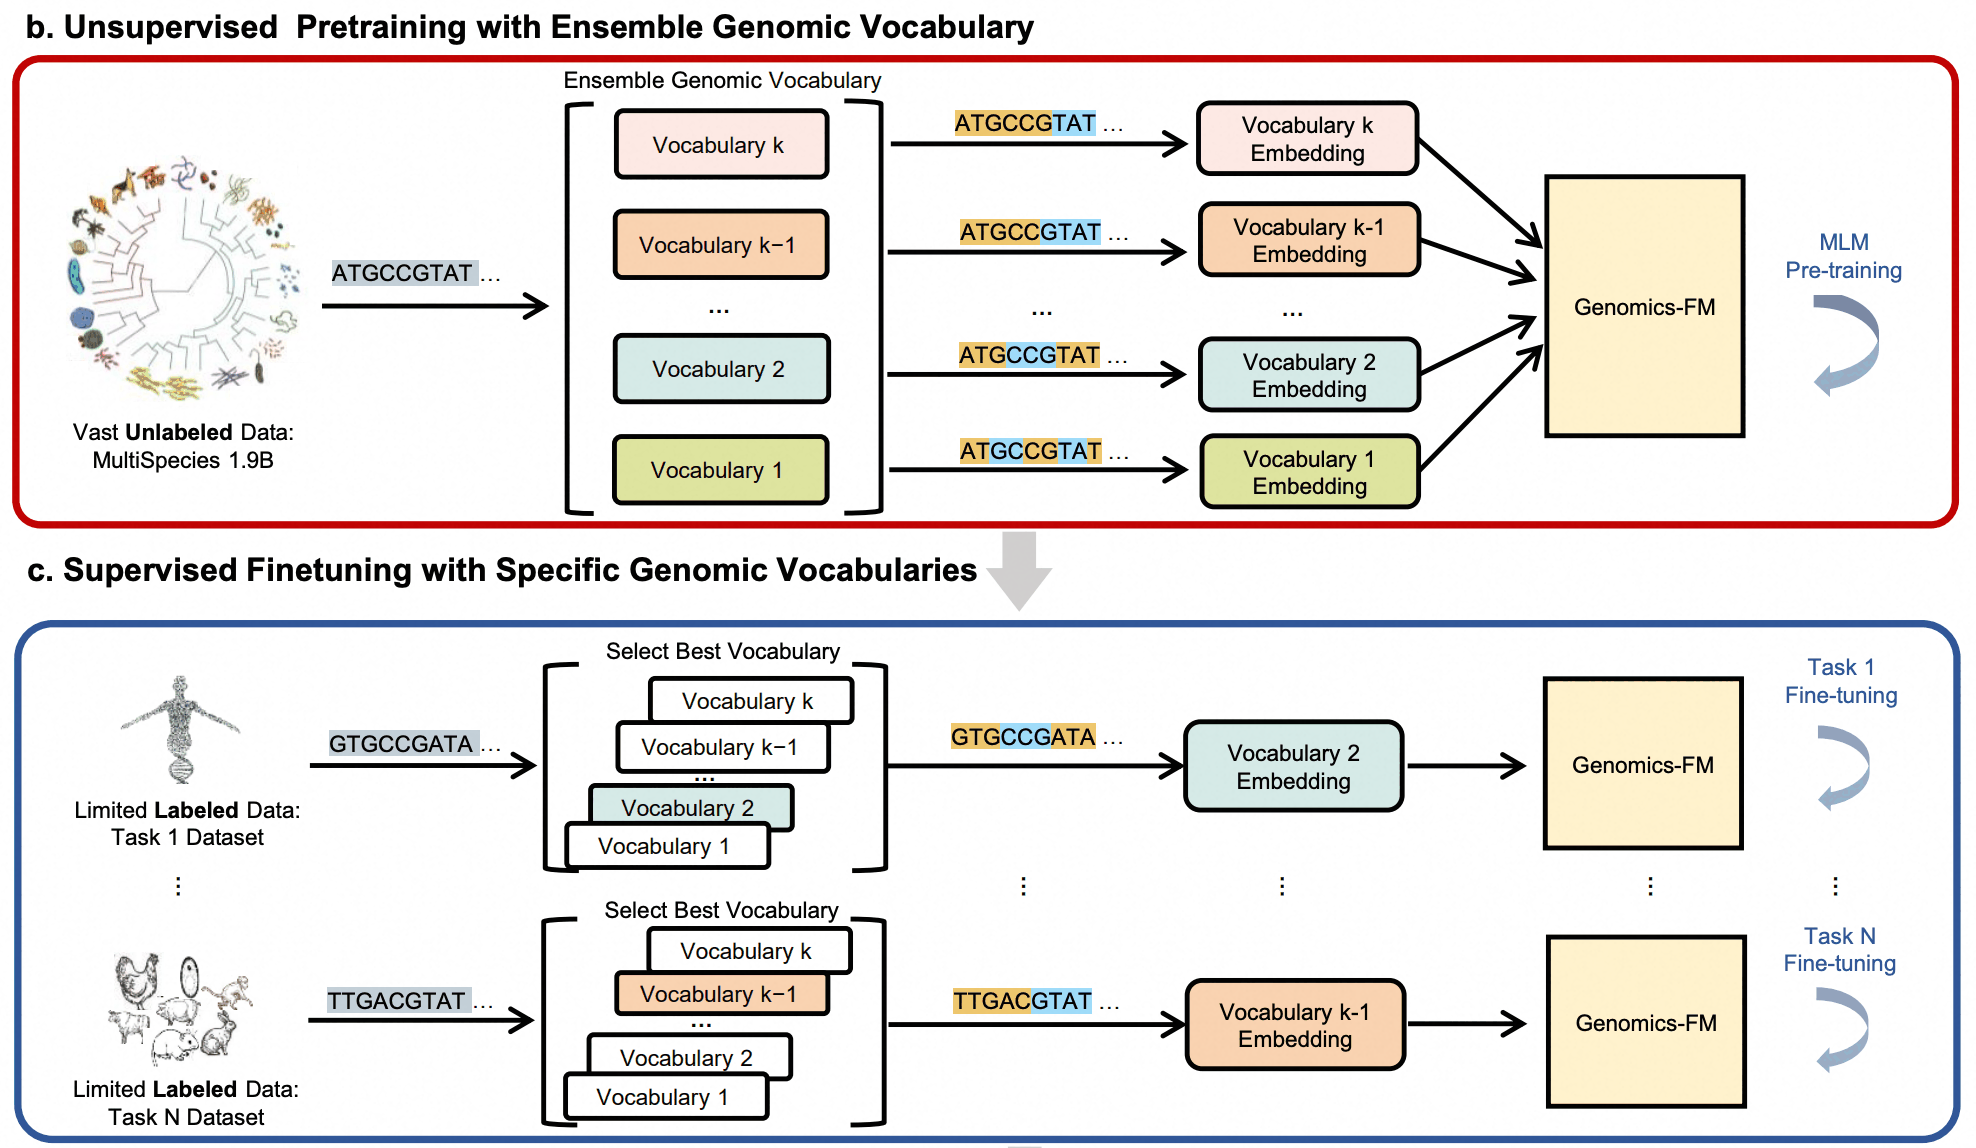
集成词表构建与提示符引导预训练: 模型整合两类互补词表:擅长编码长全局上下文的非重叠 BPE 词表,以及保留单核苷酸分辨率的步长为 $1$ 的重叠 $6$-mer 词表。模型将多个词表去重合并为统一的集成词表初始化嵌入层,并在每条输入序列前端附加指示当前分词方式的专用提示词元 $p_k$:
\[X_k = \big[\mathrm{[CLS]}, p_k, \mathrm{Tokenize}_{\mathcal{V}_k}(S), \mathrm{[SEP]}\big].\]主干采用集成 ALiBi 的双向 Transformer 编码器,在多物种与千人基因组变异语料上执行掩码预训练(对 BPE 随机孤立掩码,对重叠 $6$-mer 连续遮蔽至少 $6$ 个相邻词元)。
基于词表重叠度的任务特定激活微调: 不同任务对分词粒度具有显著偏好(如位点识别偏好 $6$-mer,表达预测偏好 BPE)。微调阶段无需遍历所有词表,而是从下游任务的训练正样本中提取子串频率统计构造任务特征词集 $\mathcal{V}_{\mathrm{task}}$,选出与预训练词表 $\mathcal{V}_k$ 交集最大的最优词表 $k^*$:
\[k^* = \operatorname*{arg\,max}_{k} \lvert \mathcal{V}_{\mathrm{task}} \cap \mathcal{V}_k \rvert,\]微调时仅激活与 \(\mathcal{V}_{k^*}\) 关联的提示词元 \(p_{k^*}\) 及对应词表嵌入,仅需 $10\%\sim 20\%$ 的标注样本即可匹敌全量数据训练的单词表基线。
⚪ genomicBERT:基于受限词元长度 Unigram 模型的轻量编码器
- paper:genomicBERT: A Light-weight Foundation Model for Genome Analysis using Unigram Tokenization and Specialized DNA Vocabulary(bioRxiv 2025)
genomicBERT 采用自顶向下的 Unigram 语言模型构建概率子词分词器,并将最大词元长度限制在 $16\text{ bp}$ 以内,配合 MosaicBERT 架构构建了轻量级基因组基础模型。
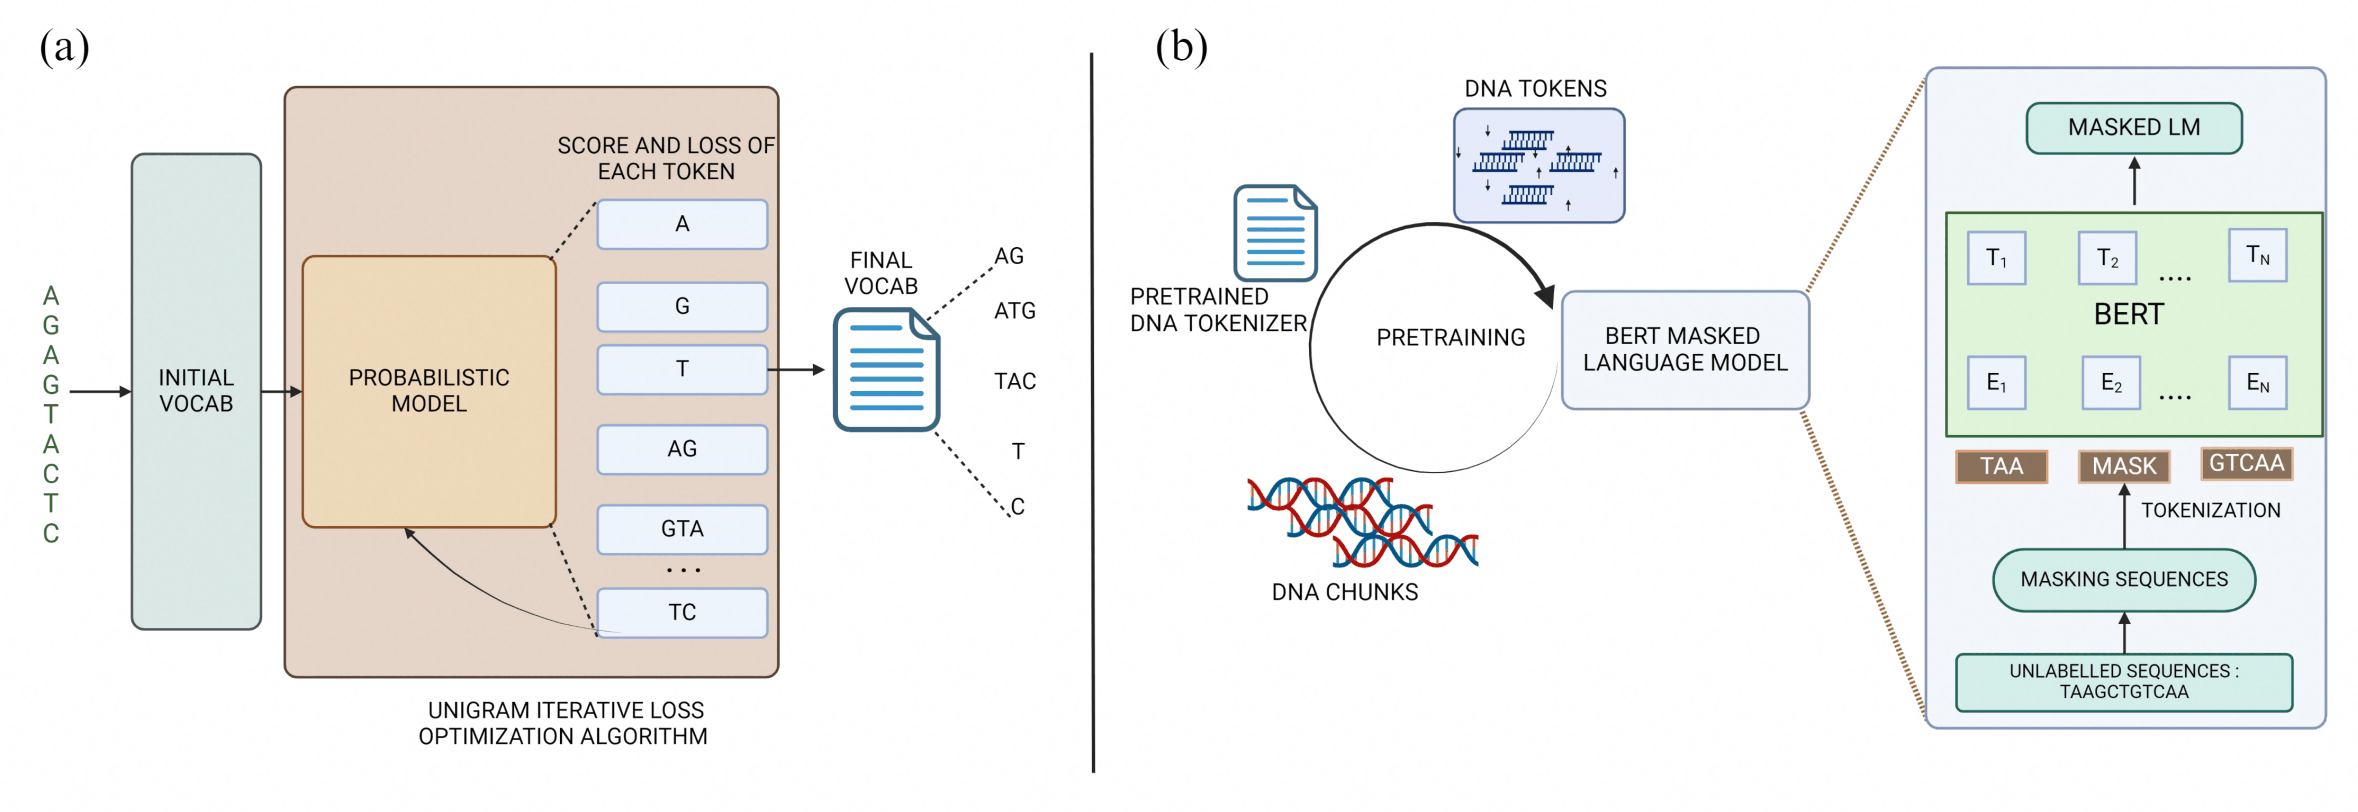
Unigram 概率分词与长度受限词表: 模型将序列的子词切分视为概率混合。设候选词表为 $V$,切分序列 $x = (x_1, \ldots, x_M)$ 的生成概率定义为独立子词概率的乘积,并通过 EM 算法在语料库 $\mathcal{D}$ 上最大化所有合法切分集合 $S(X^{(s)})$ 的对数边缘似然,迭代剪除使总似然损失最小的冗余子词:
\[P(x) = \prod_{i=1}^{M} p(x_i) \;\;\Big(\sum_{x \in V} p(x) = 1\Big), \quad \mathcal{L} = \sum_{s=1}^{\vert\mathcal{D}\vert} \log\!\left(\sum_{x \in S(X^{(s)})} P(x)\right).\]分词器在人类参考基因组正反链上跨染色体迭代更新,设定词表容量为 $4{,}096$、最大词元长度为 $16\text{ bp}$。所得词元长度集中在 $5\sim 9\text{ bp}$,平均将序列压缩约 $5$ 倍,随后送入集成 ALiBi 与 FlashAttention 的编码器进行掩码预训练。
⚪ DNAMotifTokenizer:融合转录因子基序词典的知识驱动分词
- paper:DNAMotifTokenizer: Towards Biologically Informed Tokenization of Genomic Sequences(arXiv 2025)
DNAMotifTokenizer 直接将实验验证的转录因子(TF)结合基序词典嵌入多粒度静态词表,并配合带局部偏移容差的前缀树贪婪扫描算法,防止功能基序在分词时被割裂。
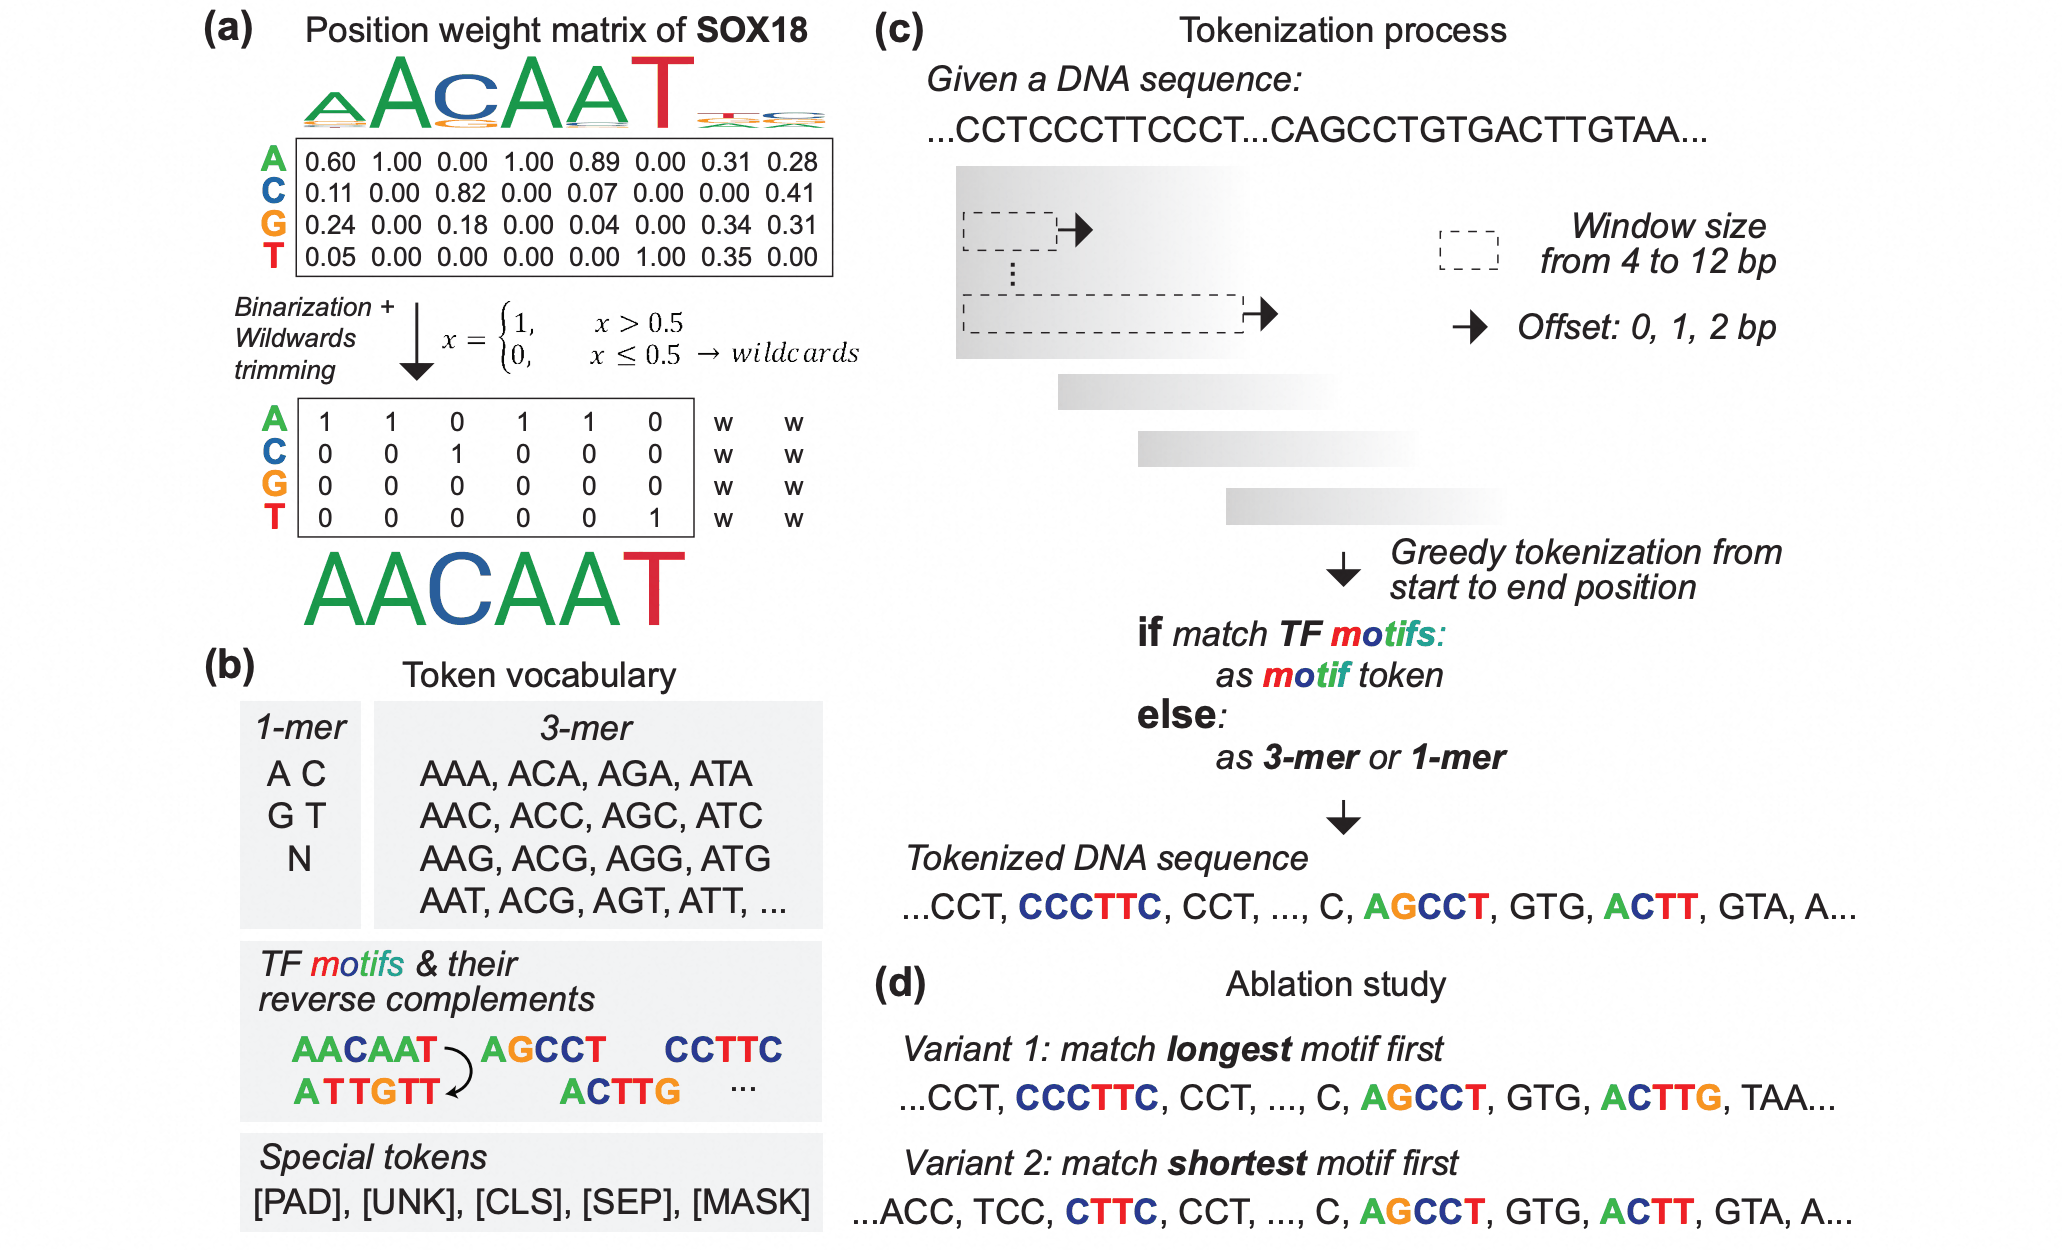
JASPAR 混合词表构建: 消融实验表明,盲目扩大全基因组 BPE 词表会引入统计冗余,而在调控富集区构建紧凑词表更为有效。模型从 JASPAR 脊椎动物库出发,对位置权重矩阵(PWM)二值化并修剪边缘通配符,提取高概率共识序列。最终构建的多粒度词表包含:$827$ 个 TF 基序词元(长 $4\sim 12\text{ bp}$)、$64$ 个 $3$-mer 词元、$5$ 个单碱基词元与 $5$ 个特殊控制符。
带局部偏移容差的前缀树分词: 为缓解单碱基偏移引发的切分错位,算法将基序词元存入前缀树。在位置 $p$ 检索匹配基序集:若命中则从中随机抽取一个基序作为 $t_p$,若未命中则依次回退为 $3$-mer 或 $1$-mer,记匹配得分为词元长度 $\operatorname{score}(p) = \vert t_p\vert$。主指针 $i$ 向右试探偏移量 $\delta \in \lbrace 0, 1, 2\rbrace\text{ bp}$,选取能产生最长有效词元的偏移方案推进:
\[\delta^\star = \operatorname*{arg\,max}_{\delta \in \lbrace 0, 1, 2\rbrace} \operatorname{score}(i + \delta), \quad t^\star = t_{i + \delta^\star}, \quad i \leftarrow (i + \delta^\star) + \vert t^\star\vert.\]⚪ EvoLen:演化保守性分层与长度感知动态规划分词
- paper:EvoLen: Evolution-Guided Tokenization for DNA Language Model(COLM 2026)
EvoLen 将单碱基跨物种演化保守性分数(phyloP)引入子词分词器构建,通过“演化分层训练 BPE $\to$ 保守性优先词表合并 $\to$ 动态规划全局解码”三阶段流程,在不改变模型架构的前提下保护功能基序并注入演化先验。
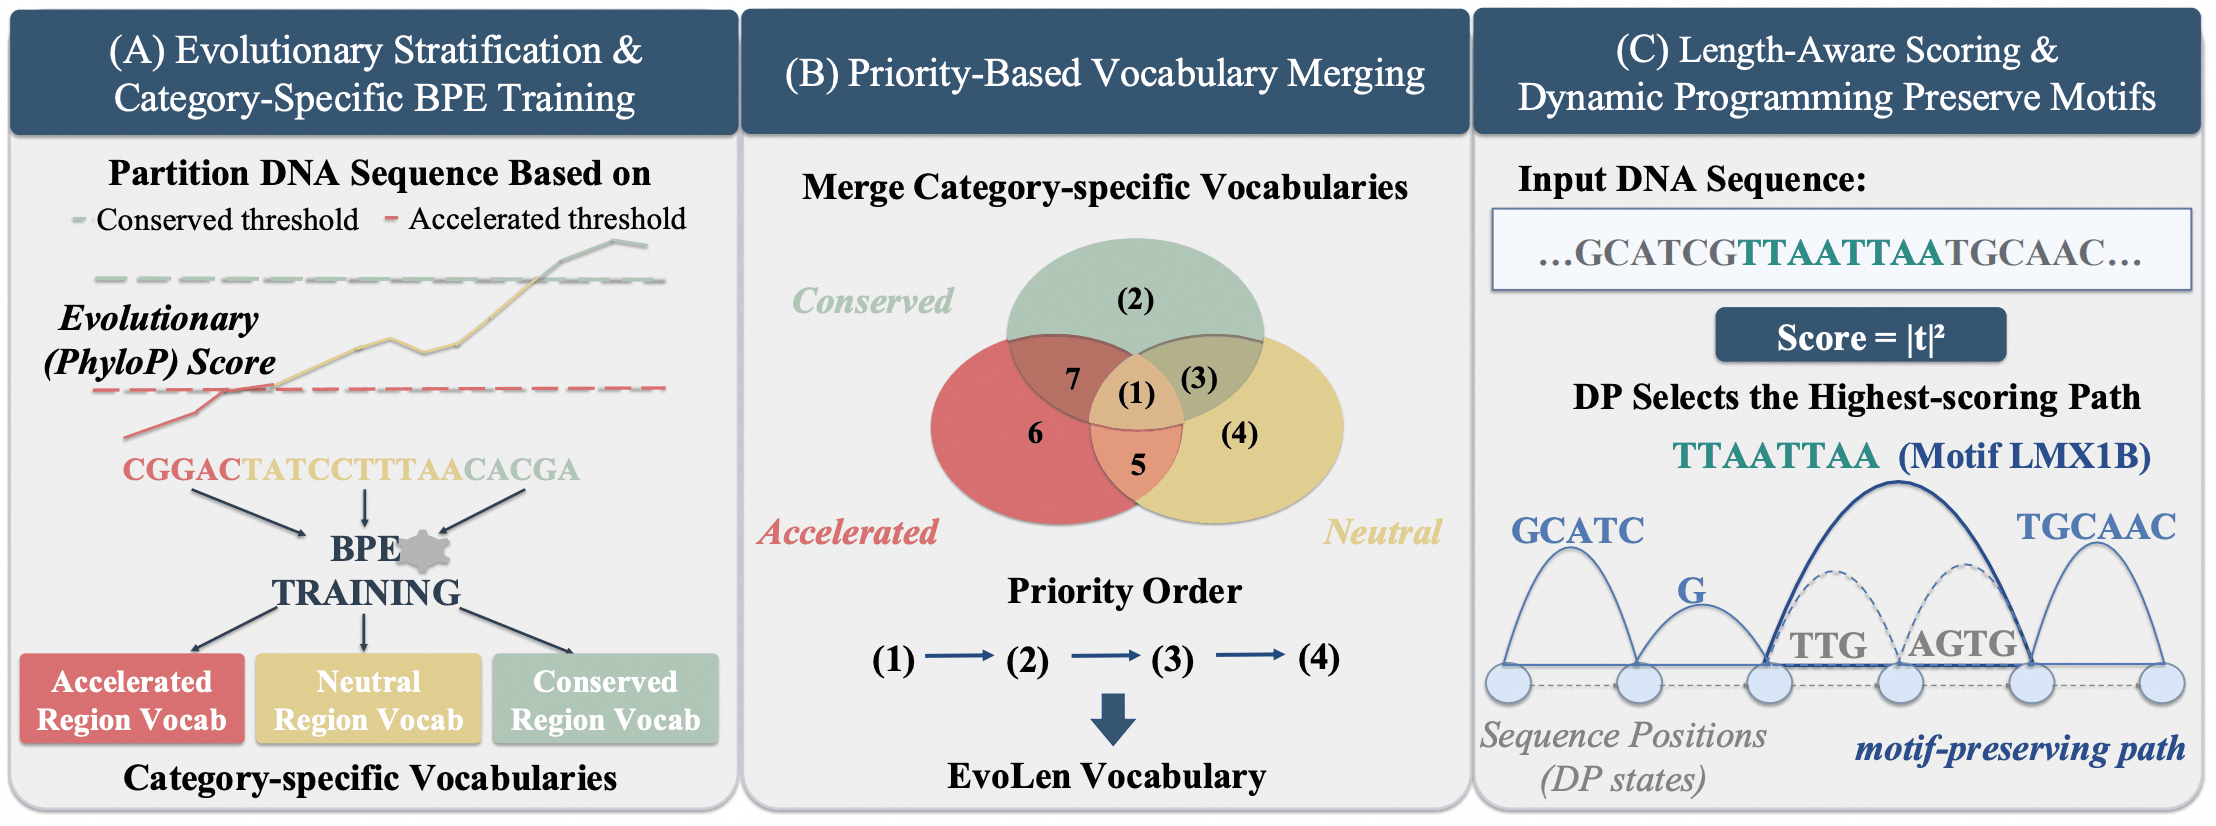
phyloP 演化分层与词表合并: EvoLen 将人类基因组切分为 $100\text{ bp}$ 的非重叠分箱,根据箱内平均 phyloP 分数的 Z-score 划分为三个序列池:保守区(con)、中性区(neu)与加速演化区(acc),并在各池上独立训练 BPE 得到候选词表 $V_{\mathrm{con}}, V_{\mathrm{neu}}, V_{\mathrm{acc}}$。随后按四级优先级抽取词元直至填满目标词表容量:(1)三区共享词元 $V_{\mathrm{con}} \cap V_{\mathrm{neu}} \cap V_{\mathrm{acc}}$ $\to$(2)保守区特异词元 $V_{\mathrm{con}} \setminus (V_{\mathrm{neu}} \cup V_{\mathrm{acc}})$ $\to$(3)保守与中性共享但排除加速区的词元 $(V_{\mathrm{con}} \cap V_{\mathrm{neu}}) \setminus V_{\mathrm{acc}}$ $\to$(4)中性区特异词元。
长度平方打分与动态规划解码: 为防止解码器因局部高频短子串得分更高而将词表中已收录的完整功能基序拆碎,EvoLen 为每个词元 $t \in V$ 赋予长度平方静态分 $\operatorname{score}(t) = \vert t\vert^2$,并通过动态规划求解序列 $s_{1:n}$ 的全局最优非重叠切分(初始化 $\mathrm{DP}\lbrack 0\rbrack = 0$):
\[\mathrm{DP}\lbrack i\rbrack = \max_{0 \le j < i,\; s_{j+1:i} \in V} \Big(\mathrm{DP}\lbrack j\rbrack + \vert s_{j+1:i}\vert^2\Big), \quad i = 1, \ldots, n.\]由于 $(a+b)^2 > a^2 + b^2$($a,b \ge 1$),只要词表中存在匹配的完整长基序词元,动态规划回溯必定优先保留完整单元。
3. 学习式分词(Learned Tokenization)
固定步长的 $k$-mer 与基于共现统计的 BPE 均依赖预定义的静态字符串切分规则:分词过程独立于神经网络,无法根据局部上下文动态感知基序边界,导致相同的碱基子串在不同基因组语境下被固定映射为同一词元。
学习式分词将分词转化为端到端的表征学习问题:先由编码器聚合局部邻域上下文,再通过向量量化(Vector Quantization, VQ)将连续隐状态映射为离散码本(Codebook)中的原型向量,由序列重构目标直接驱动词表更新。
⚪ VQDNA:学习式离散词表与层次残差量化
- paper:VQDNA: Unleashing the Power of Vector Quantization for Multi-Species Genomic Sequence Modeling(ICML 2024)
VQDNA 将基因组分词重构为基于 VQ-VAE 的端到端可学习词表优化,并通过沿编码器深度构建的层次残差量化(HRQ)捕获由粗到细的多尺度序列特征。
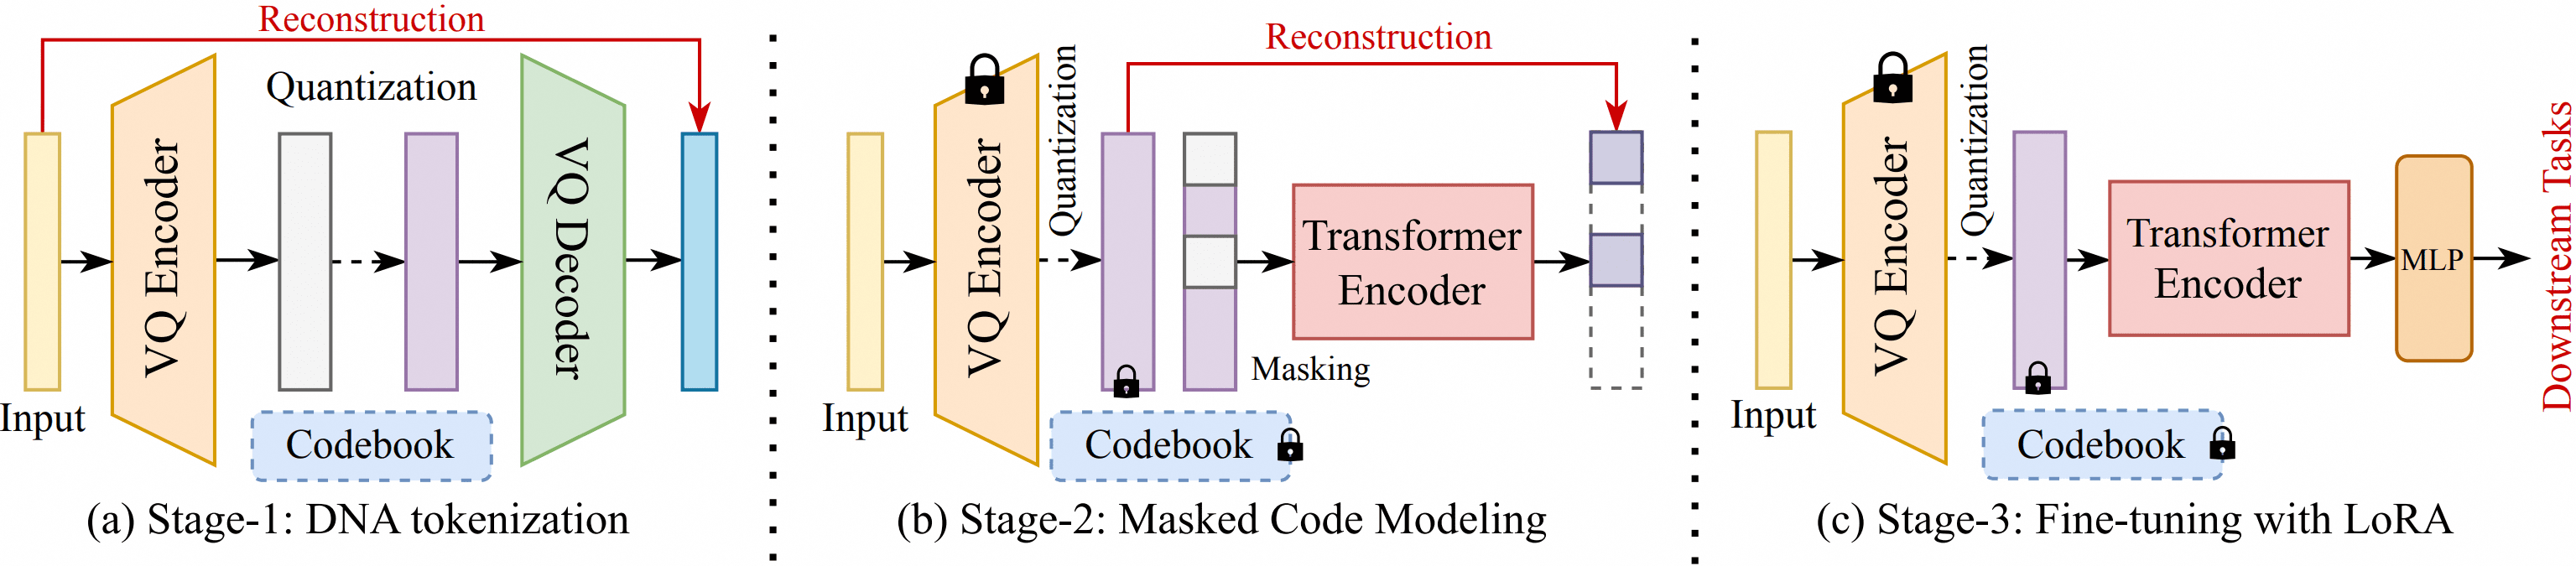
基于 VQ-VAE 的离散词表: 单碱基独热输入 $X\in\mathbb{R}^{L\times d}$ 经 ConvNeXt 编码器提取等长潜表示 $Z\in\mathbb{R}^{L\times D}$,在包含 $K$ 个原型向量 $e(k)$ 的码本中执行最近邻量化 $M_i=\arg\min_{k\in[K]}\lVert Z_i-e(k)\rVert_2$(通过直通估计器 STE 回传梯度,并用 EMA 更新码字)。
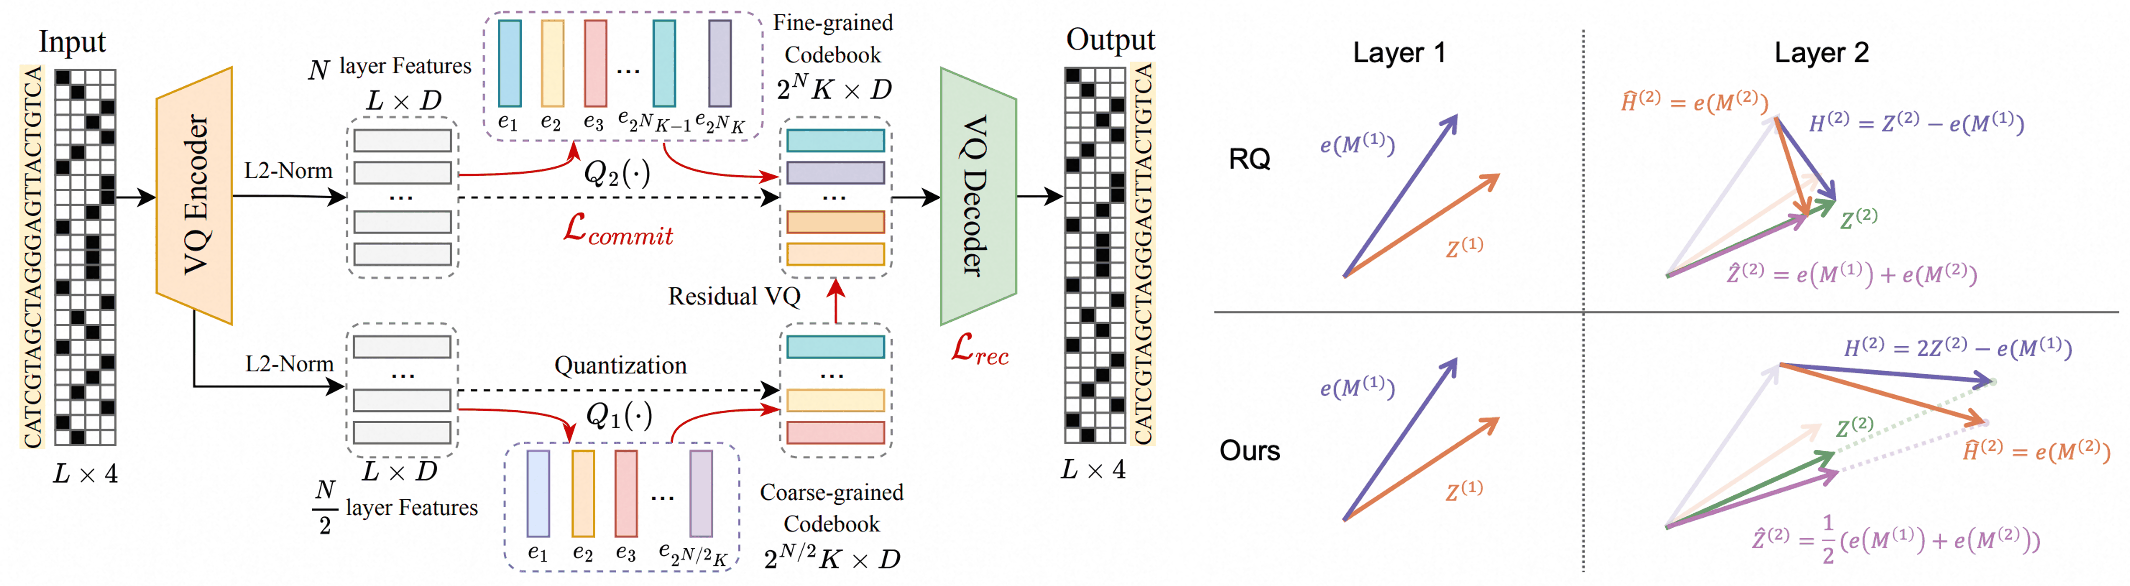
层次残差量化(HRQ): 为解耦多尺度局部细节,HRQ 沿编码器不同深度构造 $N$ 级码本(第 $n$ 级容量设为 $2^nK$)。首层直接量化编码特征 $H_i^{(1)} = Z_i^{(1)}$ 得到 $e(M_i^{(1)})$;后续层结合更深层编码特征 $Z_i^{(n)}$ 与上一层量化码字构造二倍跨层特征残差:
\[\begin{aligned} &H_i^{(n)} = 2Z_i^{(n)} - e(M_i^{(n-1)}), \\ &M_i^{(n)} = \arg\min_{k\in[2^nK]}\big\lVert H_i^{(n)}-e(k^{(n)})\big\rVert_2, \\ &\hat H_i^{(n)} = e(M_i^{(n)}). \end{aligned}\]最终输出取各级量化向量的均值 $\hat Z_i = N^{-1}\sum_{n=1}^{N}\hat H_i^{(n)}$ 由解码器重构序列 $\hat X$,并联合优化交叉熵重构与各级承诺损失($\mathrm{sg}[\cdot]$ 为停止梯度):
\[\mathcal{L}_{\mathrm{HRQ}}=\mathcal{L}_{\mathrm{CE}}(X,\hat X)+\beta\sum_{n=1}^{N}\lVert Z^{(n)}-\mathrm{sg}[\hat Z^{(n)}]\rVert_2^2.\]4. 动态自适应分词(Dynamic Tokenization)
基因组不同区域的信息密度高度不均:启动子与外显子富含精细调控和编码语法,而大段内含子、基因间区与重复元件则存在大量信息冗余。若对整条序列施加均匀切分,有限的词元预算会被低信息背景大量消耗。
动态自适应分词将边界划分改造为依赖序列内容或功能先验的动态过程,根据局部语义变化率、进化保守性或基因组区域注释自适应分配分辨率:在功能密集区保留细粒度词元,在冗余背景区合并为粗粒度长分块(Chunks / Patches)。
⚪ MxDNA:基于稀疏卷积专家混合与可变形卷积的自适应分词
- paper:Model Decides How to Tokenize: Adaptive DNA Sequence Tokenization with MxDNA(NeurIPS 2024)
MxDNA 在 Transformer 主干内部嵌入可微分词模块,通过“稀疏卷积专家混合识别连续基本单元 $\to$ 一维可变形卷积跨距组装词元”两阶段机制,使学习到的基因组词元具备非连续性(跨越间隔碱基组合协同片段)、重叠性(跨词元复用基础单元)与语境多义性。
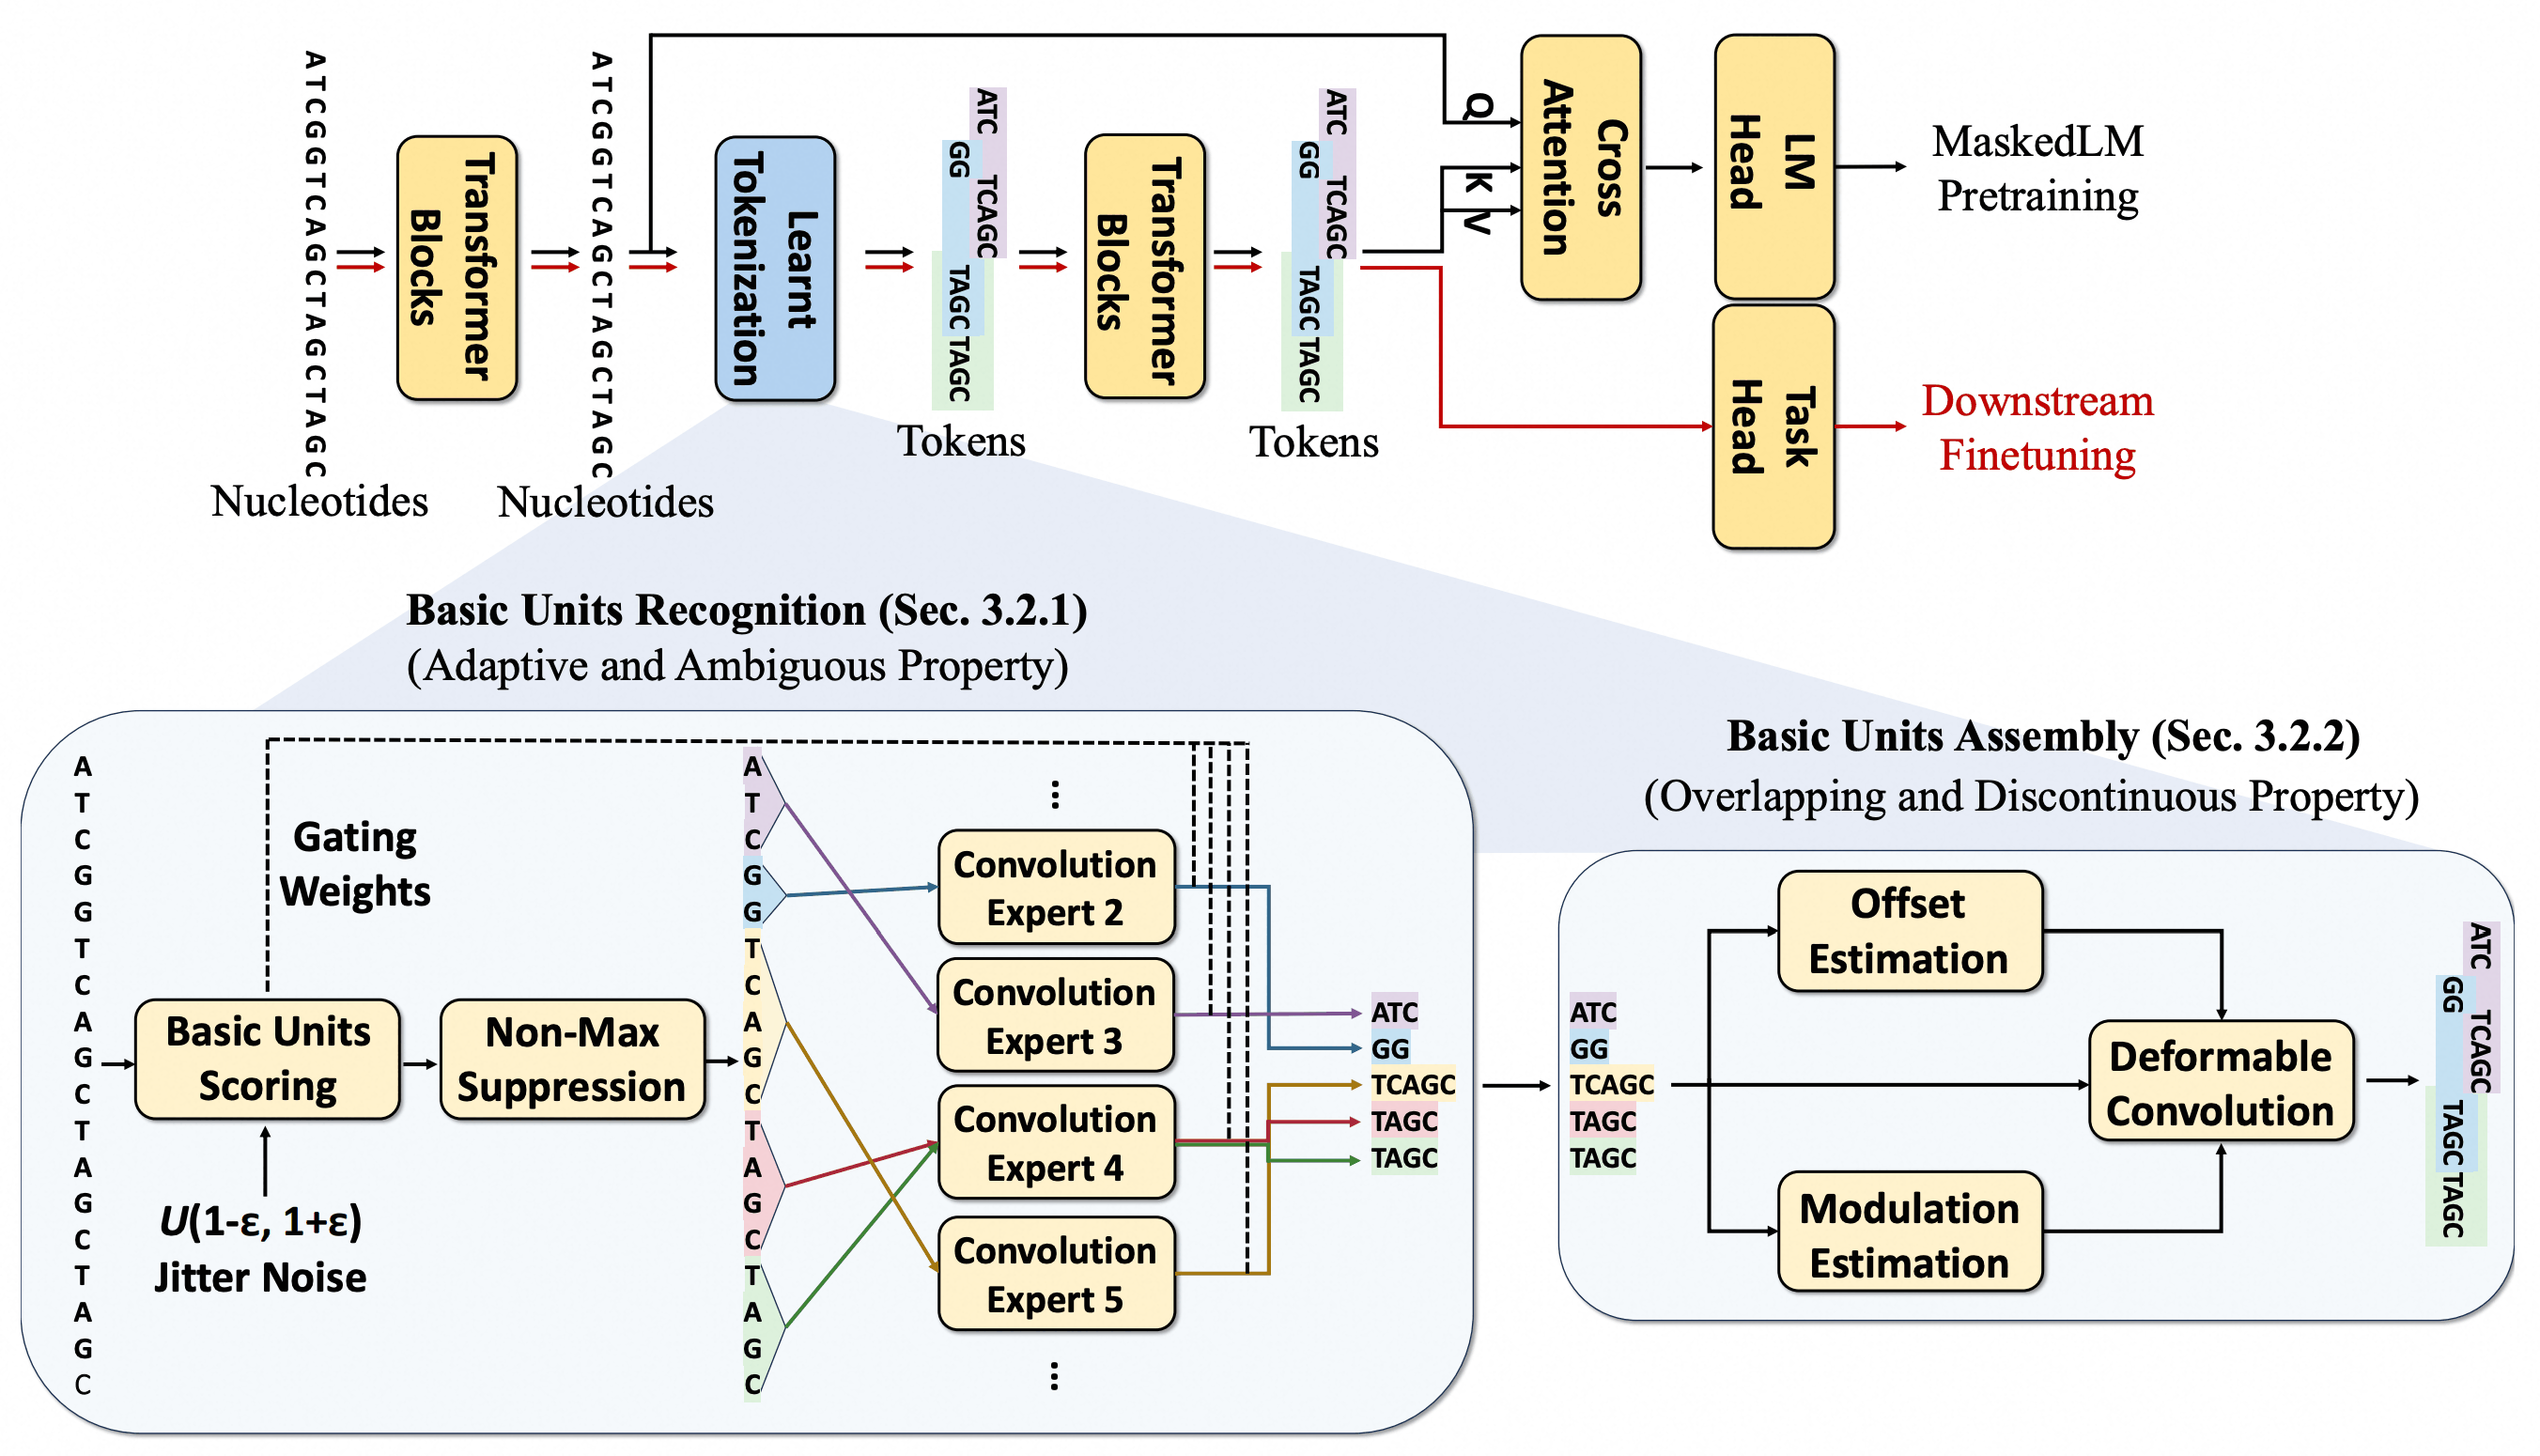
基本单元识别(稀疏卷积 MoE + 1D NMS): 模型将底层提取的单碱基特征 $X \in \mathbb{R}^{l \times d}$ 经线性门控打分,得到对应不同核宽 $L = \lbrace 1, \ldots, 10\rbrace$ 的一维分组卷积专家 $E_j$ 的置信度矩阵 $S$。接着按得分降序执行贪婪一维非极大值抑制(1D NMS)筛选互不重叠的片段中心,在掩码 $M \in \mathbb{N}^l$ 中记录选中核宽 $M_i = L_j$(未选中置 $0$),仅在 $M_i > 0$ 处稀疏激活对应专家并剔除零条目,得到 $k$ 个紧凑基本单元 $U \in \mathbb{R}^{k \times d}$:
\[U_i = E_j\!\left(X_{\lbrack i - \lceil M_i/2\rceil + 1 \,:\, i + \lfloor M_i/2\rfloor\rbrack}\right) \cdot \operatorname{softmax}(S_i)_j \quad (L_j = M_i > 0).\]可变形卷积跨距组装: 为组合远端片段并允许基本单元复用,模型在基本单元序列 $U$ 上施加核宽为 $3$ 的一维可变形卷积,预测实值空间偏移 $\Delta P$ 与调制权重 $\Delta M$,通过线性插值采样偏移位置 $p’ = i + p + \Delta p$ 组装出最终词元 $T \in \mathbb{R}^{k \times d}$ 送入后续 Transformer 层:
\[U_{p'} = \sum_{q=1}^{k} \max\big(0,\; 1 - \vert p' - q\vert\big) \cdot U_q, \quad T_i = \sum_{p \in \lbrace -1, 0, 1\rbrace} w_p \cdot U_{i + p + \Delta p} \cdot \Delta m.\]在 MLM 预训练时,顶层词元输出作为键与值(K/V)、分词前的单碱基特征 $X$ 作为查询(Q),经单层交叉注意力还原至单碱基分辨率进行重建。
⚪ MergeDNA:局部窗口可微词元合并与上下文感知掩码建模
- paper:MergeDNA: Context-aware Genome Modeling with Dynamic Tokenization through Token Merging(AAAI 2026)
MergeDNA 将可微分的词元合并(Token Merging, ToMe)引入层次化自编码 Transformer 架构,联合优化合并词元重构(MTR)与自适应掩码词元建模(AMTM),实现词元分辨率与掩码概率的自适应分配。
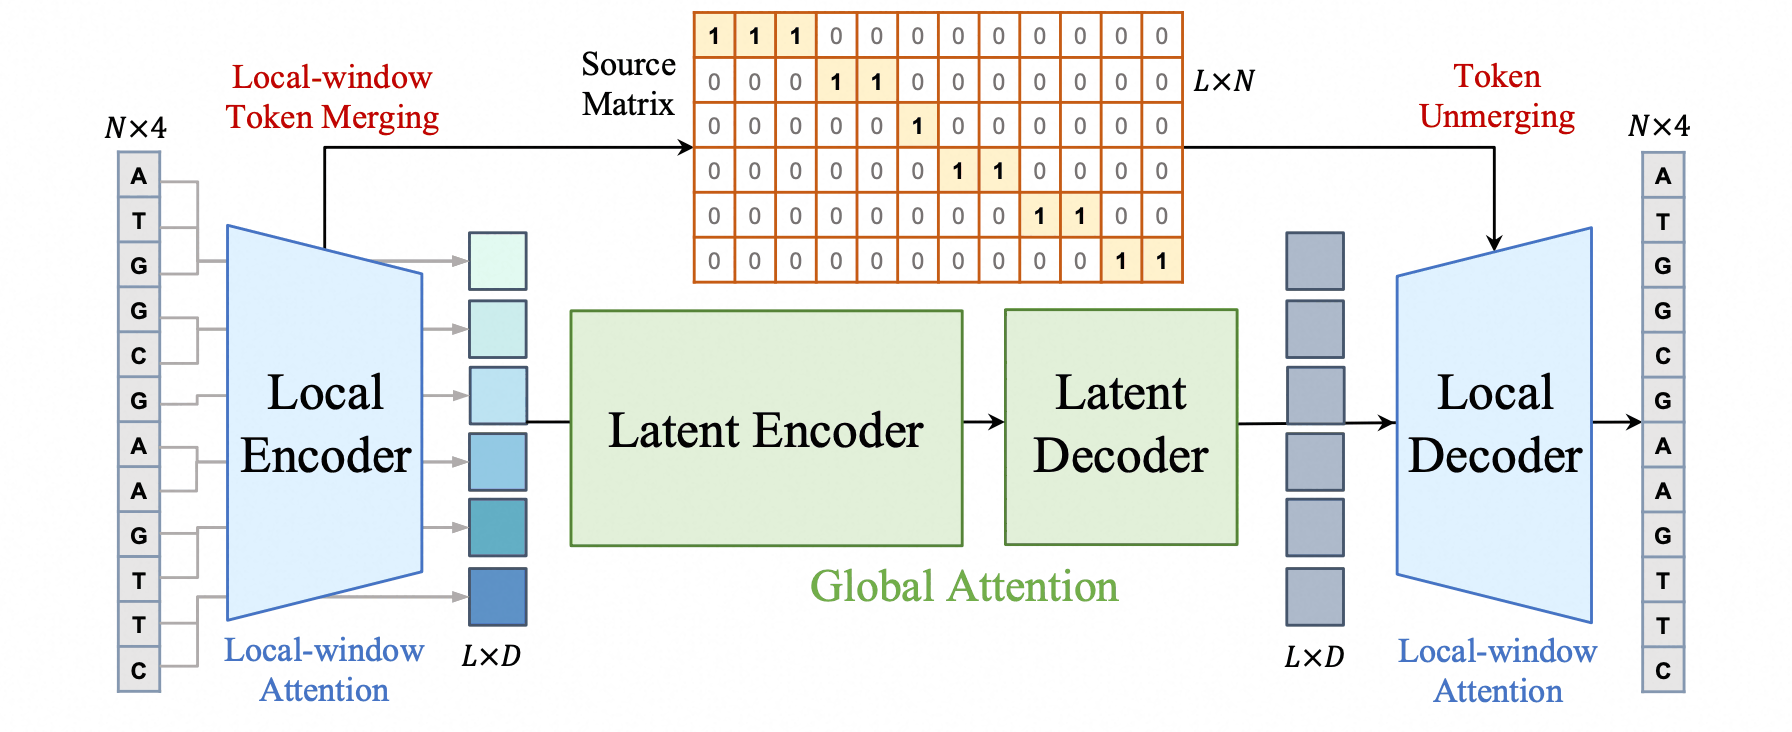
局部窗口词元合并与源矩阵解合并: 模型采用四阶段对称自编码结构。局部编码器 $E_\phi$ 在每层局部注意力后计算窗口内相邻词元对的相似度,将最相似的词元对加权平均软合并,把长度为 $N$ 的单碱基序列 $X$ 动态压缩为 $L$ 个可变长词元 $Z_L \in \mathbb{R}^{L \times D}$,并维护二值源矩阵 $S \in \lbrace 0, 1\rbrace^{L \times N}$($S_{i,j}=1$ 标识第 $i$ 个合并词元覆盖原始碱基 $j$)。压缩词元经潜空间全局编码器 $E_\psi$ 与潜空间解码器 $E_\omega$ 得到 \(\hat{Z}_L\) 后,由局部解码器 $E_\zeta$ 利用源矩阵转置执行无参数解合并(Token Unmerging),还原至原始长度 $N$:
\[Z_L, S = E_\phi(X), \quad \bar{Z}_N = S^\top \hat{Z}_L \in \mathbb{R}^{N \times D}, \quad \hat{X} = E_\zeta(\bar{Z}_N).\]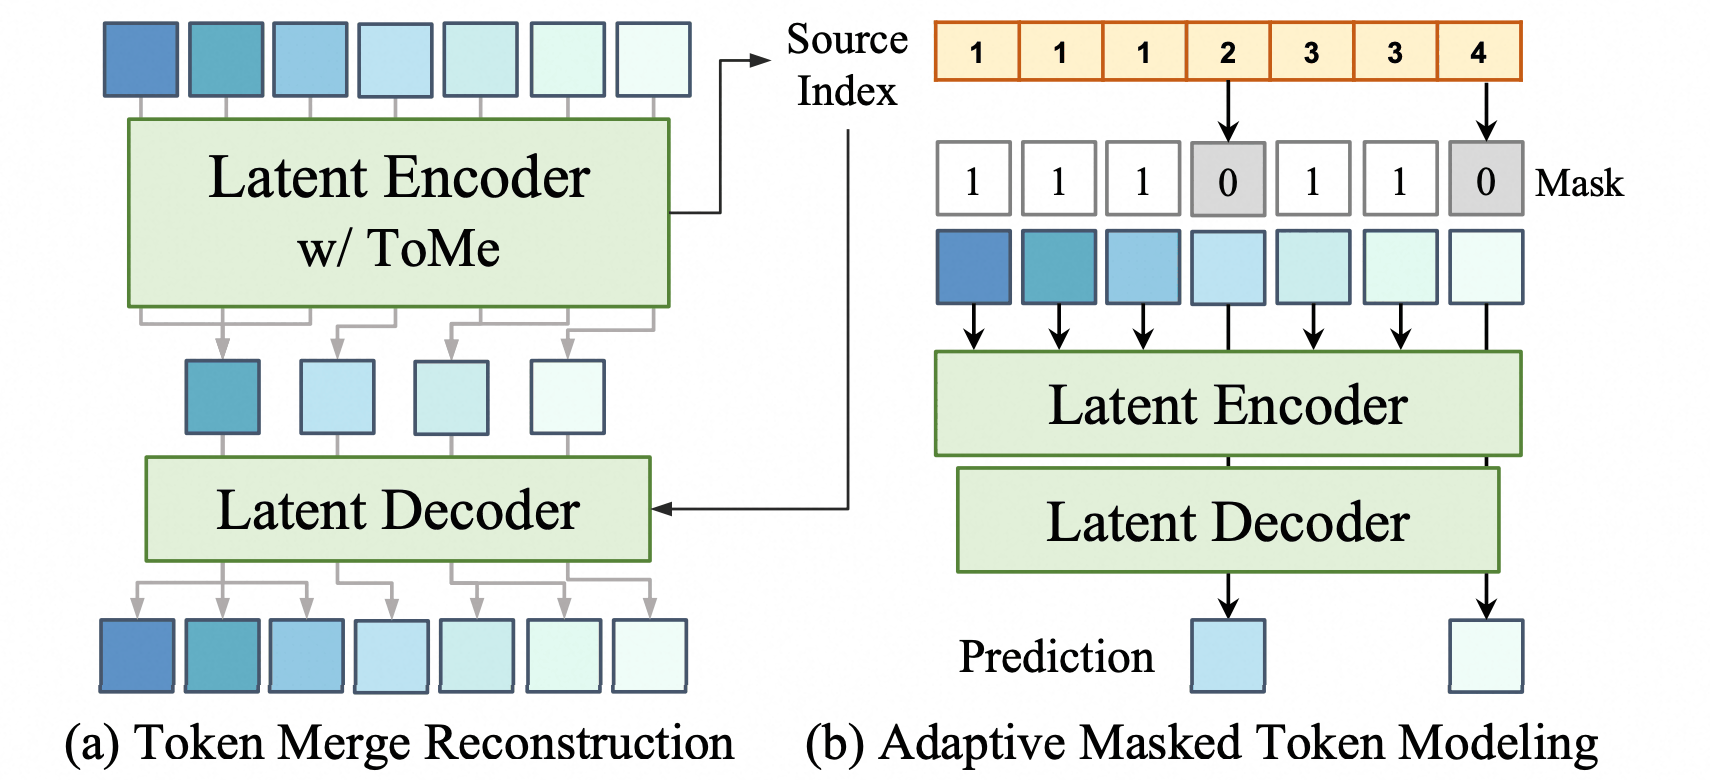
上下文感知预训练(MTR + AMTM): 预训练联合优化:(1)合并词元重构与潜空间显著词元重构(在 $E_\psi$ 中启用全局 ToMe 将 $L$ 个局部词元二次合并为 $K$ 个潜词元,记录潜源矩阵 $S’ \in \lbrace 0, 1\rbrace^{K \times L}$ 后解合并重构);(2)自适应掩码词元建模统计第 $i$ 个潜词元组归并的局部词元数 $g_i = \sum_{j=1}^L S’_{i,j}$,对独立或小规模合并的高信息量局部词元赋予与 $g_i^2$ 成反比的遮蔽采样概率,生成掩码 $M_L$ 并通过 $M_N = S^\top M_L$ 整块遮蔽对应的原始碱基。
⚪ GenART:基于多尺度卷积的 Gumbel-Softmax 动态分词
- paper:GenART: Reading the genome’s language with adaptive ‘‘words’’(Cell Reports Methods 2026)
GenART 构建了“核苷酸编码器 $\to$ 多尺度卷积自适应分词层 $\to$ 词元编码器”的层次化双向 Transformer 架构,端到端推断可变长词元边界,并在微调阶段引入由目标密度与簇集因子控制的拓扑正则项。
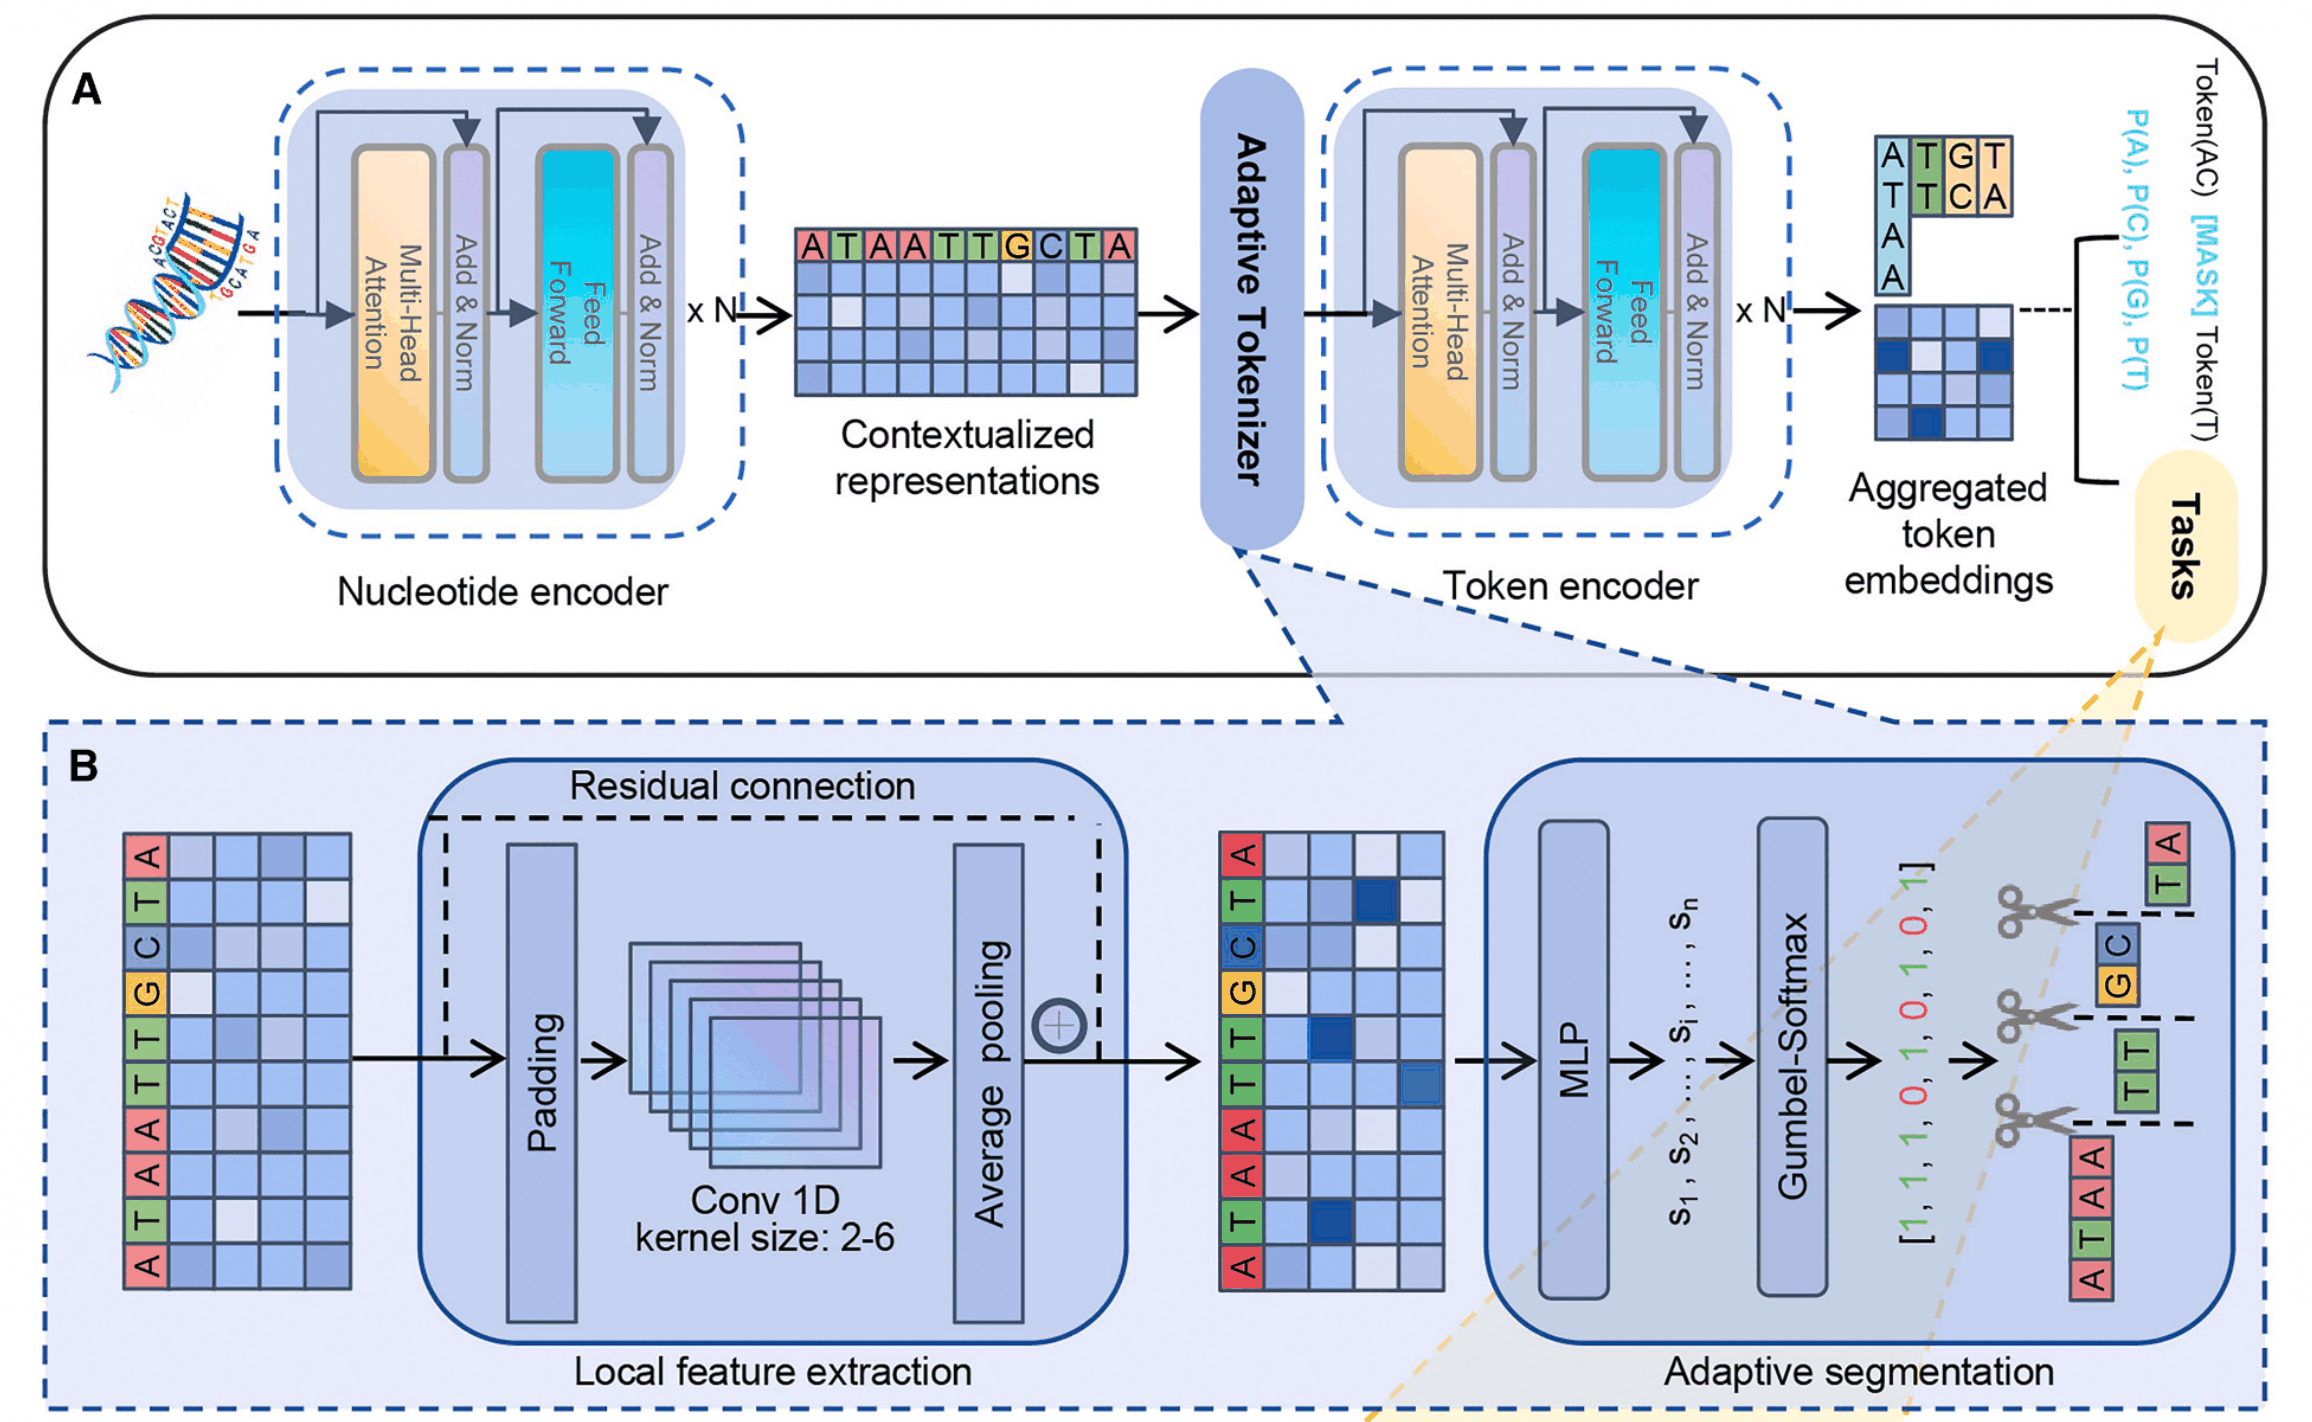
多尺度卷积与 Gumbel-Softmax 动态分词: 单碱基序列先经底层编码器提取隐状态 $H_{\mathrm{nuc}} \in \mathbb{R}^{B \times N \times D}$;自适应分词层将其并行输入核宽为 $k \in \lbrace 2, 3, 4, 5, 6\rbrace$ 的一维卷积层提取多尺度局部特征并做残差叠加,随后经 MLP 为每个位置预测标量分 $s_i$,以相邻位置得分之和 \(s'_i = s_i + s_{i+1}\) 构造“切分/合并”对数几率,通过 Gumbel-Softmax 采样可微二元边界决策 $P_{\mathrm{model}} \in \lbrace 0, 1\rbrace^{N-1}$。同一连续片段内的核苷酸隐状态按片段长度做分段平均,压缩为可变长词元序列送入顶层编码器。预训练时通过单层交叉注意力解码器恢复至单碱基分辨率。
任务拓扑精炼(Refining): 下游微调时,自适应分词层保持可训练,并引入长度正则项引导边界分布 $P_{\mathrm{model}}$ 对齐目标信号的空间拓扑:由目标词元密度 $\rho$ 与目标簇集因子(高斯平滑带宽)生成空间聚簇的理想边界模式 $P_{\mathrm{ideal}}$,最小化 $L_1$ 归一化后的均方误差:
\[\mathcal{L}_{\mathrm{total}} = \mathcal{L}_{\mathrm{task}} + \lambda \cdot \operatorname{MSE}\!\left(\frac{P_{\mathrm{model}}}{\lVert P_{\mathrm{model}}\rVert_1},\; \frac{P_{\mathrm{ideal}}}{\lVert P_{\mathrm{ideal}}\rVert_1}\right).\]⚪ PatchDNA:基于演化保守性的无词表分块与预训练后动态重分块
PatchDNA 利用单碱基演化保守性分数(PhyloP)将序列动态划分为可变长连续分块(Patches)以聚焦功能受限区;得益于无词表的交叉注意力架构,模型支持在预训练后无需重训即可直接切换分块函数(Re-patching),动态注入细胞特异的表观遗传信号。
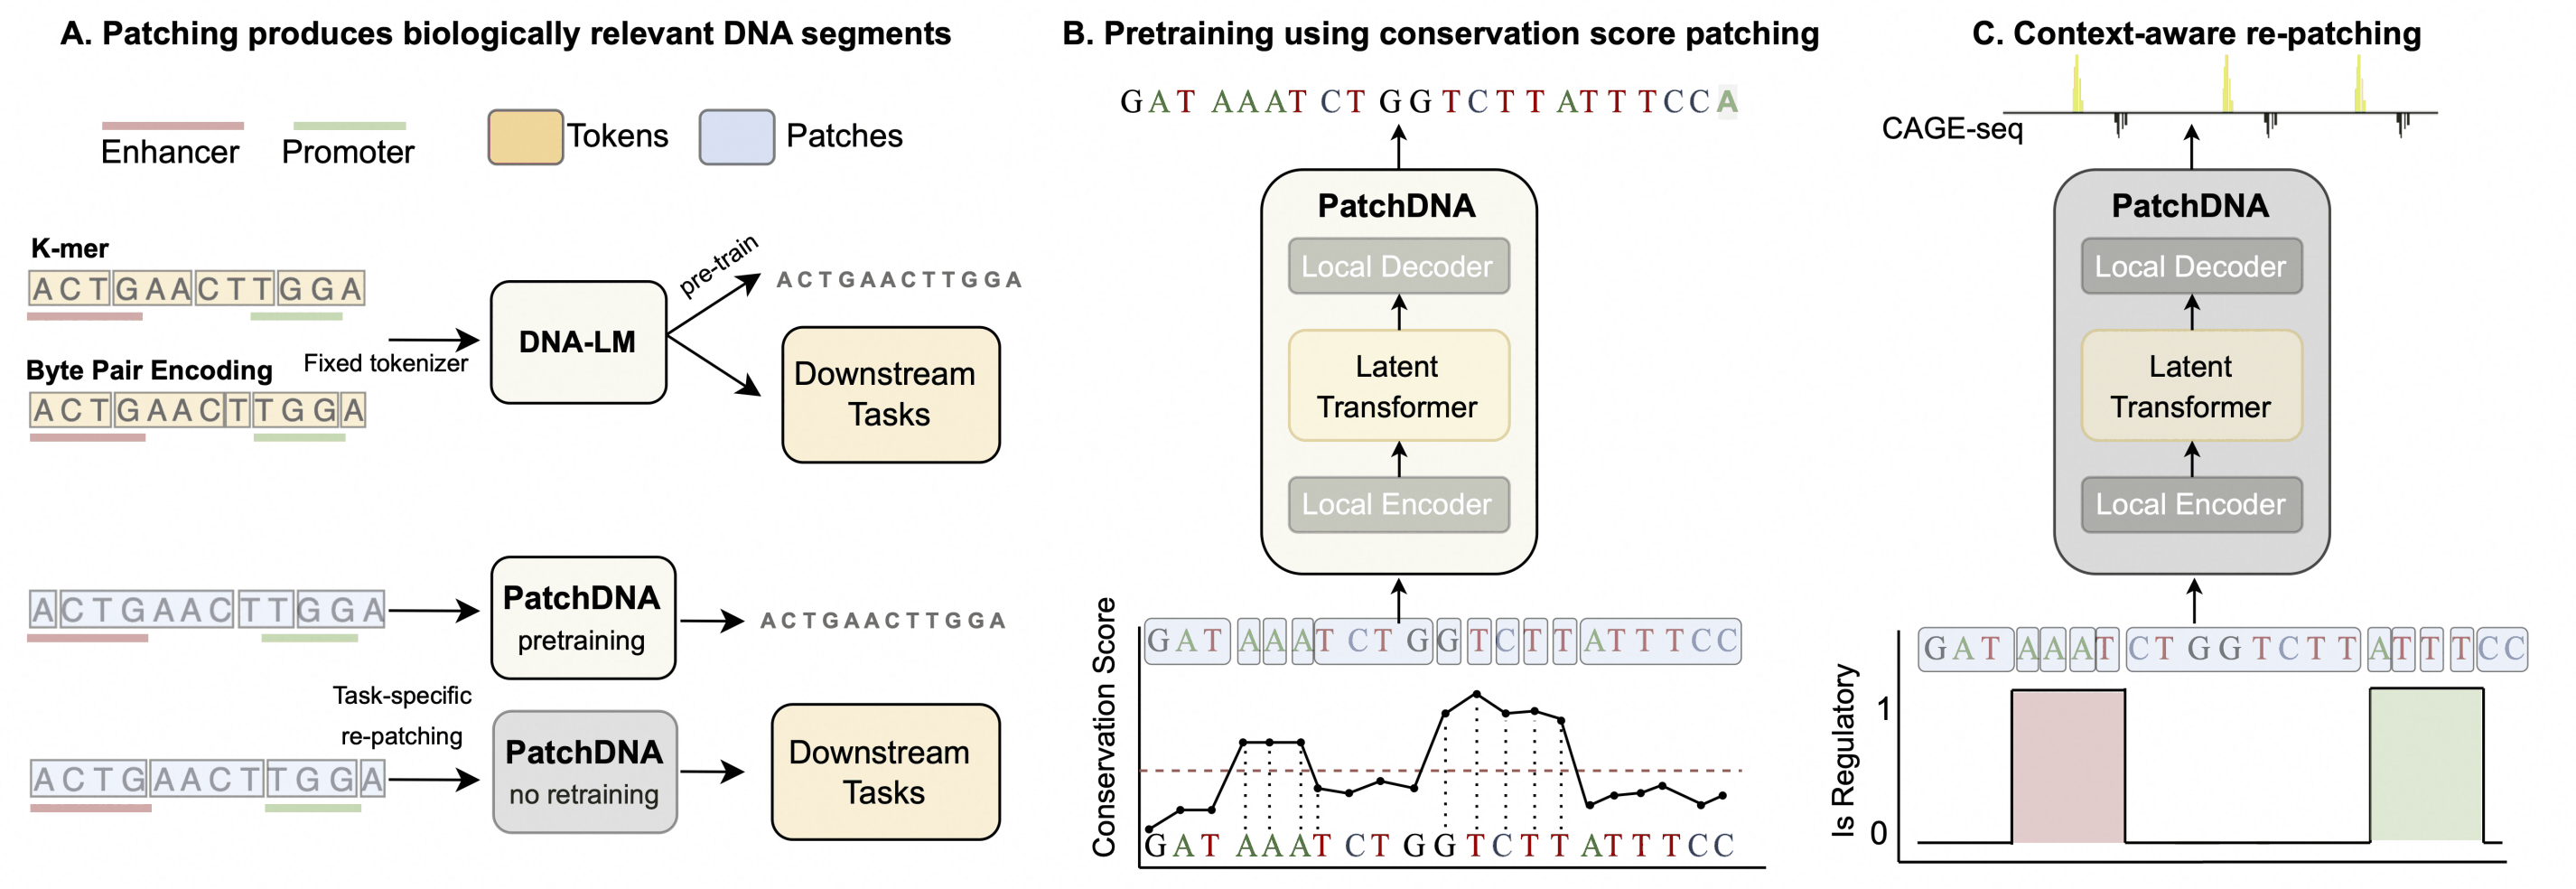
演化保守性驱动分块与跨注意力架构: 模型利用逐位置评分函数 $g_p(x_i)$ 与阈值 $\theta_p$ 将序列动态划分为连续分块:当 $g_p(x_i) > \theta_p$ 时,下一位置触发新分块边界 $f_p(x_{i+1}) = \mathbb{1}\lbrack g_p(x_i) > \theta_p\rbrack$。预训练以单碱基 PhyloP 分数作为 $g_p(x_i)$,将 $\theta_p$ 设为全基因组 PhyloP 的 $95\%$ 分位数,使高保守区密集切分为短块、中性背景合并为长块。模型采用三阶段自回归架构:局部编码器交替执行滑窗自注意力与分块内部的交叉注意力;潜空间全局 Transformer 在分块序列上建模长程依赖;局部解码器再以单核苷酸为查询、全局分块表征为键值还原单碱基分辨率。
免重训动态重分块(Re-patching): 由于编解码器仅通过交叉注意力掩码感知分块边界而无固定词表绑定,模型在预训练后可直接按任务需求替换分块函数 $(g_p, \theta_p)$:例如在剪接位点任务上重分块为 $1\text{ bp}$ 分辨率,在长程表达预测中代入 $g_p(x_i) = \mathbb{1}\lbrace x_i \in \mathrm{cCRE}\rbrace$ 聚焦顺式调控元件,或直接以目标细胞类型的 DNase-seq 染色质开放性信号作为 $g_p$ 将注意力集中于细胞特异激活区。
⚪ dnaHNet:基于余弦路由与比例损失的层级动态分块
- paper:dnaHNet: A Scalable and Hierarchical Foundation Model for Genomic Sequence Learning(ICML 2026)
dnaHNet 采用可微的“编码器—主网络—解码器”递归层级结构(H-Net 范式),利用相邻隐状态的余弦不相似度路由与比例损失约束,端到端地将原始核苷酸动态压缩为多级潜在分块。

余弦动态路由与平滑解码: 混合编码器(Mamba + 滑窗 Transformer)提取隐状态 $h_t \in \mathbb{R}^D$ 后,路由模块将其投影为查询与键($q_t = W_q h_t,\; k_t = W_k h_t$),通过相邻位置的余弦不相似度预测边界概率 $p_t$,并按硬阈值 $b_t$ 抽取分块代表向量送入主网络。解码端先以边界概率 $P_j$ 对主网络输出 $\hat e_j$ 做递归插值平滑,再按覆盖跨度复制回原始碱基位置(前向硬掩码通过 STE 回传梯度):
\[\begin{aligned} &p_t = \frac{1}{2}\left(1 - \frac{q_t^\top k_{t-1}}{\lVert q_t\rVert_2 \lVert k_{t-1}\rVert_2}\right), \quad b_t = \mathbb{1}\lbrack p_t \ge 0.5\rbrack, \\ &\bar e_j = P_j\hat e_j + (1 - P_j)\bar e_{j-1}. \end{aligned}\]自回归训练与比例损失(Ratio Loss): 模型联合优化自回归负对数似然与约束各级目标压缩率 $R_s$ 的比例损失。设实际硬保留比例为 $F_s=\frac{1}{L}\sum_{t=1}^L b_t^{(s)}$,平均软边界概率为 $G_s=\frac{1}{L}\sum_{t=1}^L p_t^{(s)}$:
\[\begin{aligned} &\mathcal{L}_{\mathrm{rate}}^{(s)} = \frac{R_s}{R_s-1}\Big((R_s-1)F_sG_s + (1-F_s)(1-G_s)\Big), \\ &\mathcal L = -\sum_{t=1}^L\log P_\theta(x_t\mid x_{<t}) + \alpha \sum_s \mathcal{L}_{\mathrm{rate}}^{(s)}. \end{aligned}\]视 $F_s$ 为停止梯度常数时,$\frac{\partial \mathcal L_{\mathrm{rate}}^{(s)}}{\partial G_s} \propto R_s F_s - 1$,当且仅当达到目标保留率 $F_s = G_s = 1/R_s$ 时梯度归零。后续的 GeneZip、DNAChunker 与 LDARNet 均建立在这一路由框架之上。
⚪ GeneZip:基因结构比例监督与有界路由的长程自适应压缩
- paper:GeneZip: Region-Aware Compression for Long Context DNA Modeling(ICML 2026 Workshop)
GeneZip 在两级 Mamba2 动态分块自回归架构上提出区域感知比例损失(RAR)与有界路由投影,在训练阶段利用静态基因结构注释引导各功能区达到差异化的压缩率目标,从而在推理阶段无需外部注释即可对长程 DNA 执行百倍级非均匀压缩。
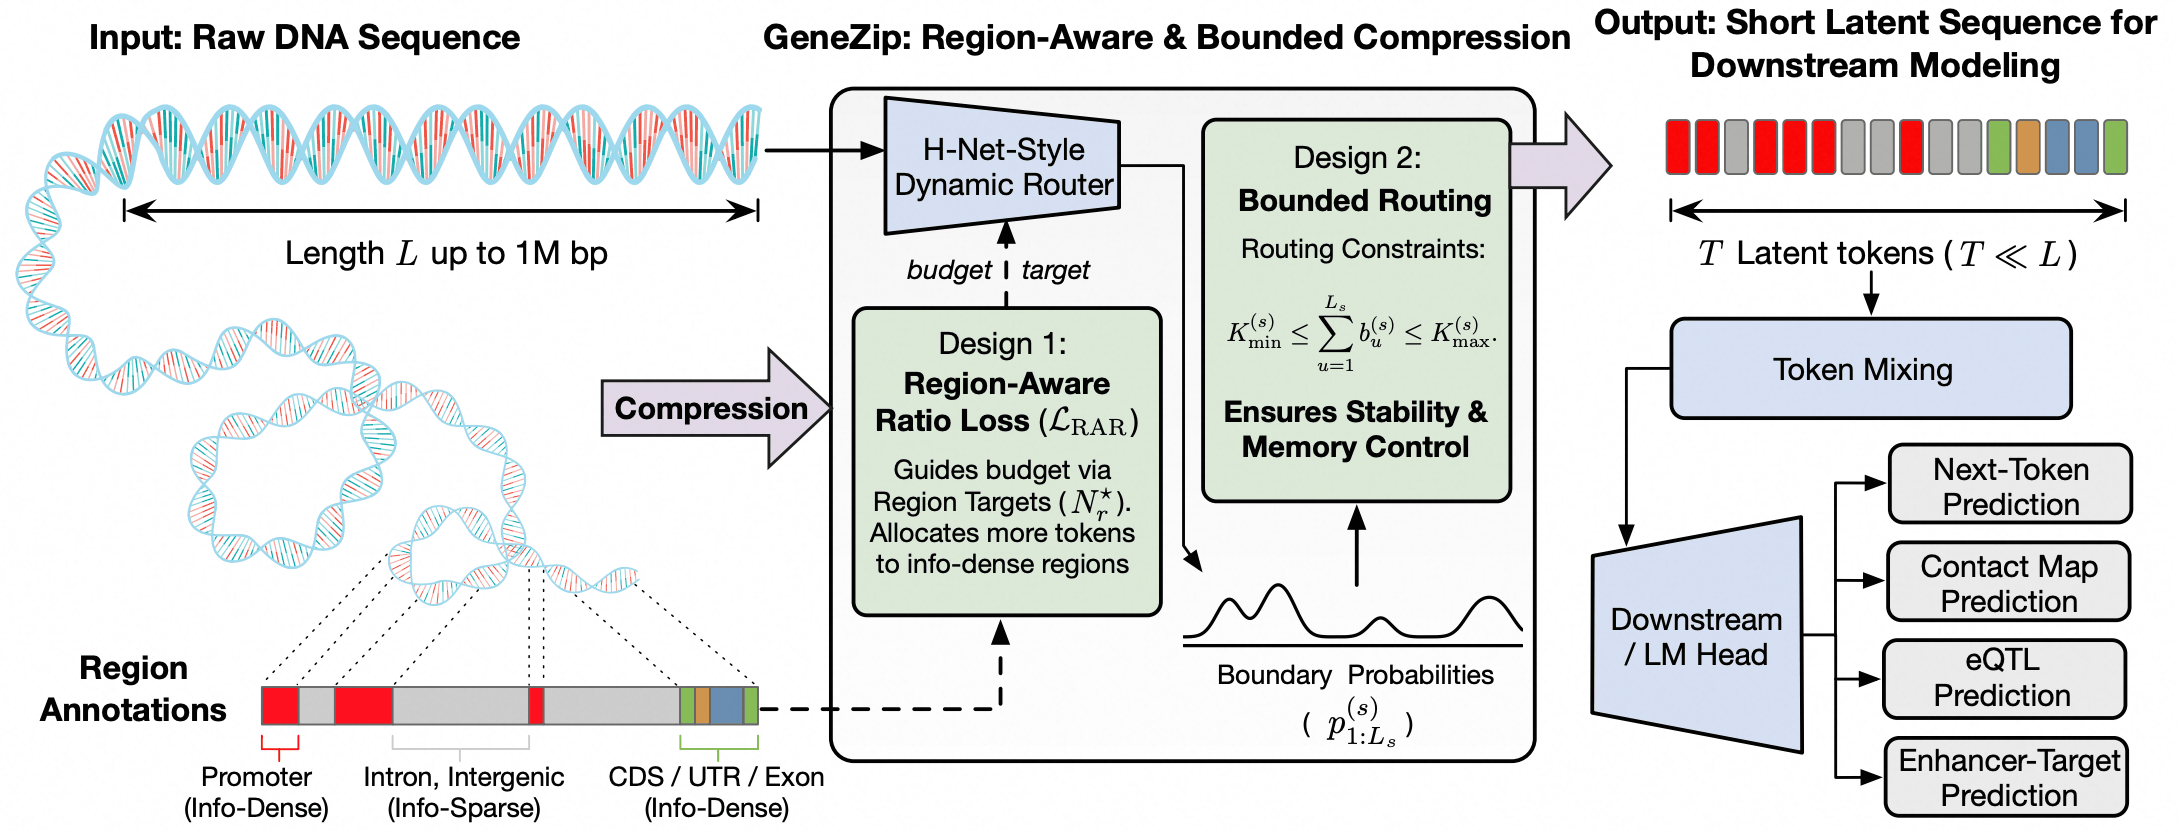
基因结构标注与有界路由投影: 预训练阶段按功能优先级(启动子 $>$ 编码区 $>$ 非翻译区 $>$ 外显子 $>$ 内含子 $>$ 基因间区)为每个碱基赋予区域标签 $r(t) \in \mathcal{R}$。为防止训练早期出现显存溢出或路由坍缩,第 $s$ 阶段在初始硬掩码 \(\tilde{b}_t^{(s)} = \mathbb{1}\lbrack p_t^{(s)} \ge 0.5\rbrack\) 上施加有界投影算子 \(b^{(s)} = \Pi(\tilde{b}^{(s)};\, p^{(s)})\),以 $p_t^{(s)}$ 为置信度翻转最少数量的边界决策,强制输出词元数满足 \(K_{\min}^{(s)} \le \sum_{t=1}^{L_s} b_t^{(s)} \le K_{\max}^{(s)}\)。
区域感知比例损失: 模型为每个区域 $r \in \mathcal{R}$ 设定基准锚点 $N$ 与差异化的区域乘子 $\mu_r$(对启动子和编码区赋予低压缩率,对内含子和基因间区赋予高压缩率),定义各阶段区域目标压缩率 $N_r^{\star(s)} = (N \cdot \mu_r)^{1/S}$。设区域 $r$ 的长度占比为 $\pi_r^{(s)}$、区域内硬保留率为 $F_r^{(s)}$、软保留率为 $G_r^{(s)}$,加权汇总区域比例损失并与自回归交叉熵 $\mathcal{L}_{\mathrm{NTP}}$ 联合优化:
\[\begin{aligned} &\mathcal{L}_{\mathrm{RAR}}^{(r,s)} = \frac{N_r^{\star(s)}}{N_r^{\star(s)} - 1}\left\lbrack \left(N_r^{\star(s)} - 1\right) F_r^{(s)} G_r^{(s)} + \left(1 - F_r^{(s)}\right)\left(1 - G_r^{(s)}\right)\right\rbrack, \\ &\mathcal{L} = \mathcal{L}_{\mathrm{NTP}} + \alpha \sum_{s=1}^{S}\sum_{r \in \mathcal{R}} \pi_r^{(s)} \mathcal{L}_{\mathrm{RAR}}^{(r,s)}. \end{aligned}\]⚪ DNAChunker:掩码边界保护与残差门控的双向动态分块建模
- paper:DNAChunker: Learnable Tokenization for DNA Language Models(ICML 2026)
DNAChunker 将层级动态分块迁移至双向掩码语言模型,通过两级 BiMamba 编解码器与 Transformer 主干,提出掩码保护分段与掩码残差门控,消除了 [MASK] 词元对余弦路由的干扰及跳跃残差的信息泄漏。

掩码保护分段(Mask Protection): 编码器采用两级轻量 BiMamba 提取双侧上下文并执行余弦路由分块,压缩序列随后送入深层 Transformer 主干(其 RoPE 位置编码直接取各分块覆盖碱基的平均索引)。为防止路由器利用预训练特有的 [MASK] 符号走捷径,编码器在每个 [MASK] 位置的前后强制插入硬边界,使其在每一级都保持为孤立的单例分块,不与相邻可见碱基合并。
双向扫描解块与掩码残差门控: 解码器分两级将压缩表征按累计边界计数复制回原管辖位置 \(\tilde z_t^{(s+1)}=z^{(s)}_{\sum_{k=1}^t b_k^{(S-s)}}\),并以边界概率 $p$ 为门控执行前后向线性递归扫描均值平滑:
\[z_t^{(s+1)} = \frac{1}{2}\Big(\mathrm{SCAN}_\rightarrow(\tilde z^{(s+1)},p)_t + \mathrm{SCAN}_\leftarrow(\tilde z^{(s+1)},p)_t\Big).\]随后在融合同层编码器跳跃残差时施加掩码残差门控——凡是包含 [MASK] 的分段,其对应的编码器残差连接一律置零,迫使模型依赖深层主网络重建掩码碱基。模型联合优化对重复区降权的 MLM 损失与保留率比例损失:
\[\mathcal L = \sum_{t\in\mathcal M} w_t \mathcal L_{\mathrm{CE}}(t) + \lambda \sum_{s\in\{0,1\}} \left( \frac{\bar b^{(s)}\bar p^{(s)}}{\alpha^{(s)}} + \frac{(1-\bar b^{(s)})(1-\bar p^{(s)})}{1-\alpha^{(s)}} \right).\]⚪ LDARNet:基于 BiMamba-2 与双向对称余弦路由的自适应分块
- paper:LDARNet: DNA Adaptive Representation Network with Learnable Tokenization for Genomic Modeling(ICML 2026)
LDARNet 以权重共享的双向状态空间算子 BiMamba-2 构建非对称动态分块掩码语言模型,通过前后向对称余弦路由、双向指数移动平均解块以及外层学习率缩放,缓解 MLM 掩码对局部相似度的扰动与分块下采样引发的梯度衰减。

BiMamba-2 骨干与双向对称余弦路由: 模型采用外窄内宽的非对称维度布局(外层编解码器维度 $d_{\text{outer}}$ 小于内层主干维度 $d_{\text{back}}$)。核心算子 BiMamba-2 在前向与时间翻转分支间共享输入/输出投影权重并取均值输出。为降低 [MASK] 词元对单向余弦相似度的扰动,路由模块同时计算相邻位置的前向与后向余弦相似度并取平均,导出边界概率 $p_t$:
\[\begin{aligned} &s_t^{\mathrm{fwd}} = \cos(q_{t-1},k_t), \quad s_t^{\mathrm{bwd}} = \cos(q_t,k_{t-1}), \\ &p_t = \frac{1}{2}\left(1 - \frac{s_t^{\mathrm{fwd}}+s_t^{\mathrm{bwd}}}{2}\right). \end{aligned}\]双向 EMA 解块与外层学习率缩放: 解块模块采用双向指数移动平均从左右两侧同时向掩码位置传播上下文,再按累计边界索引广播回原序列长度;同时为补偿分块下采样(目标压缩率 $N$)与通道维度变化引起的外层梯度衰减,外层编解码器采用按压缩率与维度比缩放的学习率放大策略:
\[\begin{aligned} &\bar z_j^{\mathrm{fwd}} = p_jz_j + (1-p_j)\bar z_{j-1}^{\mathrm{fwd}},\quad \bar z_j^{\mathrm{bwd}} = p_jz_j + (1-p_j)\bar z_{j+1}^{\mathrm{bwd}},\\ &\eta_{\text{outer}} = \eta_{\text{base}}\sqrt{N\cdot \frac{d_{\text{back}}}{d_{\text{outer}}}}. \end{aligned}\]