Image Recognition.
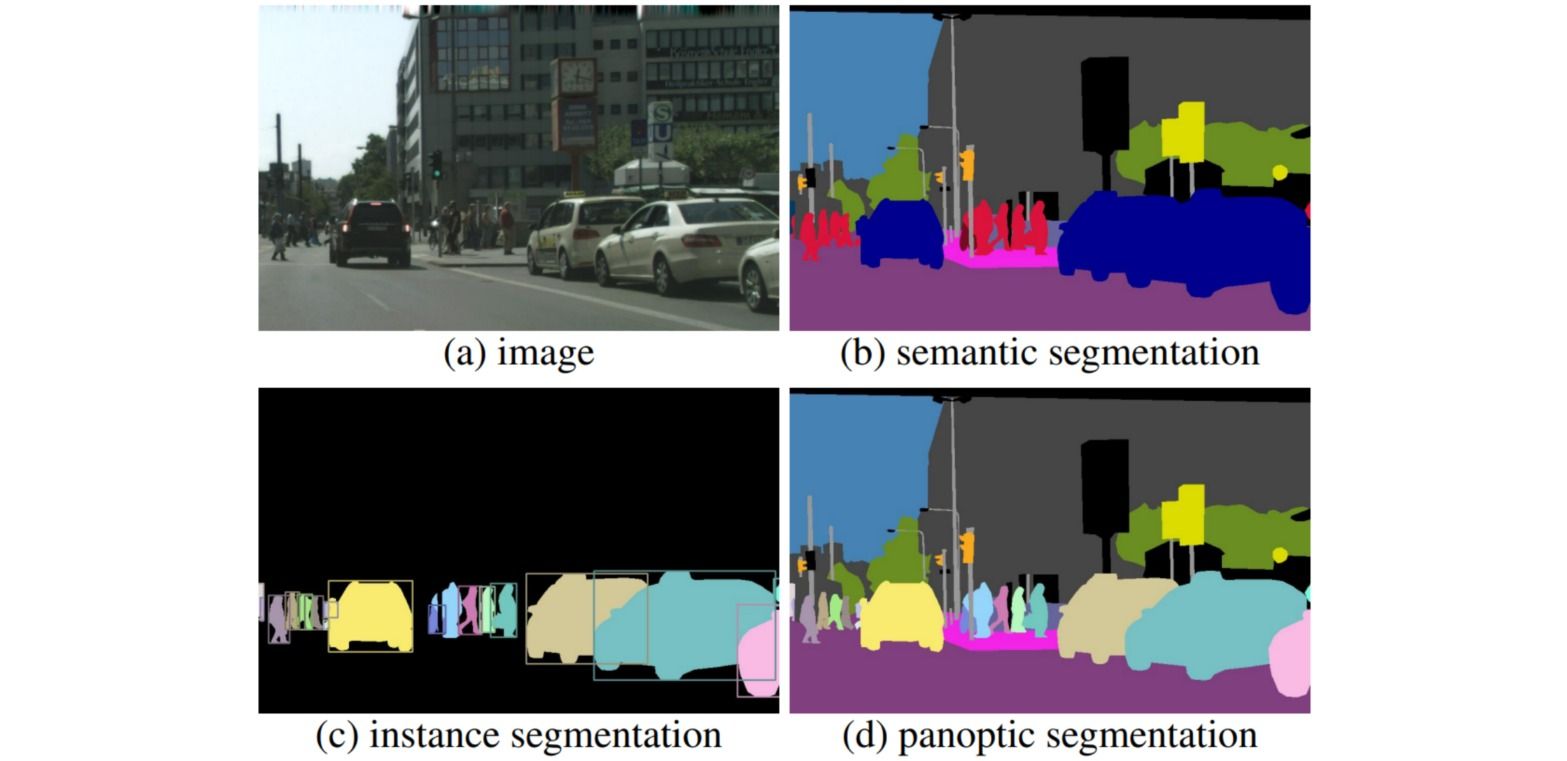
图像识别(Image Recognition)也叫图像分类(Image Classification),是计算机视觉(computer vision)的基本任务,旨在对每张图像内出现的物体进行类别区分。
图像识别任务面临的主要问题是语义鸿沟(semantic gap),表现在:不同图像的低级视觉特征(low-level visual features)相似,但高级语义(high-level concepts)差别很大;反之不同图像的低级视觉特征差距很大,但高级语义相同。传统的图像处理先对图像手工提取特征,再根据特征分类;深度学习方法则用卷积神经网络端到端地自动提取特征并分类。
图像识别是深度视觉的“试金石”:几乎所有主干网络(backbone)的设计思想都是先在图像分类上验证,再迁移到检测、分割等下游任务。本文首先按设计思想梳理图像识别模型,然后介绍常用训练基准与分布外测试集。
- 图像识别模型:早期探索、深度化设计、模块化设计、缩放与架构搜索
- 图像识别技巧:训练配方与稳定性、少标注学习范式
- 图像识别基准:常用训练基准(MNIST / CIFAR / ImageNet等)与分布外测试集(ImageNet-V2/-A/-R/-Sketch/-C)
1. 图像识别模型
本节介绍应用于图像识别任务的卷积神经网络(Convolutional Neural Network, CNN),并按照结构与训练的发展脉络组织。
(1) 早期探索
卷积神经网络结构设计的早期探索过程,奠定了“卷积层-下采样层-全连接层”的拓扑结构,并通过实践与理论分析总结出使用小尺寸卷积核(如$3 \times 3$)并增加网络深度的设计思想。
⚪ LeNet5
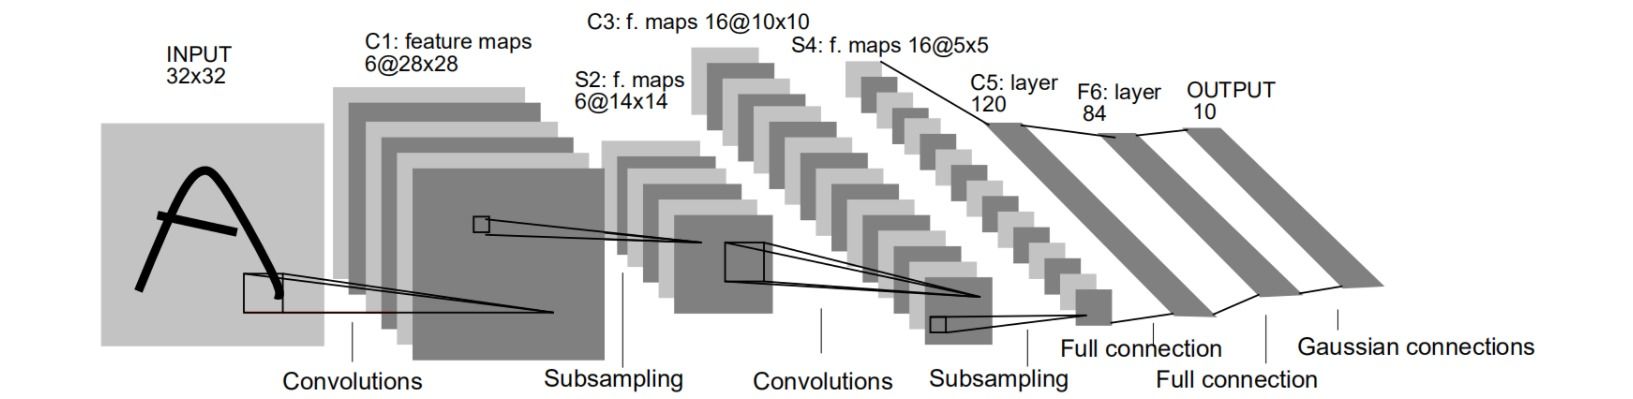
LeNet由LeCun在$1998$年提出,是历史上最早的卷积网络之一,被用于手写字符识别。该网络由五层交替的卷积和下采样层组成,后接全连接层,大约有$6$万个参数,能够对数字进行分类且不易受到较小的失真、旋转以及位置和比例变化的影响。
当时GPU尚未广泛用于加速训练,传统的多层全连接网络计算负担大;卷积神经网络利用了图像的潜在结构(相邻像素彼此相关),不仅减少了参数量和计算量,还能自动学习特征。原始LeNet使用了带参数的下采样层与高斯径向基连接,这些设计今天已很少使用,但它奠定的“卷积层-下采样层-全连接层”拓扑结构影响深远。
⚪ AlexNet
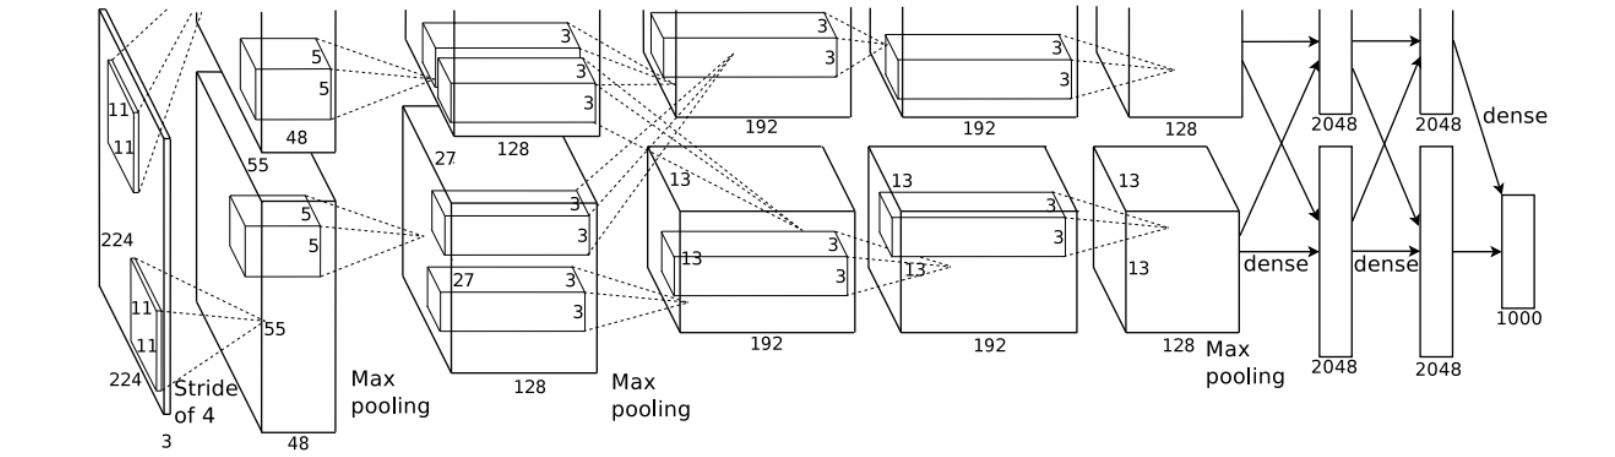
AlexNet被认为是第一个深层卷积神经网络,设计了一个八层结构,大约有$6000$万个参数。网络使用了Dropout帮助训练,使用ReLU作为激活函数提高收敛速度,并使用了最大池化和局部响应归一化。它获得了$2012$年ImageNet图像分类竞赛的冠军,此后的网络大多在其基础上演变。
值得一提的是,受当时显存限制,网络在两块GPU上并行训练,只在部分层交互——这种做法后来被进一步研究,演变成如今“组卷积(group convolution)”的概念。
⚪ ZFNet
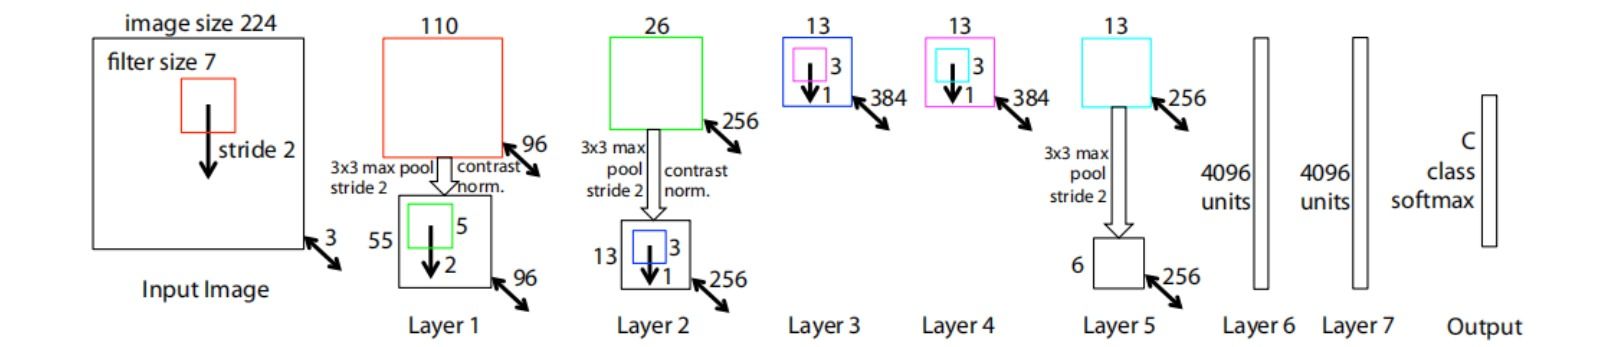
早期网络的超参数主要靠反复试验确定,缺乏对“为什么有效”的理解,限制了网络在复杂图像上的性能。$2013$年Zeiler和Fergus提出ZFNet,其初衷是定量地可视化网络性能:通过解释神经元的激活来监视网络行为。实验发现,减小卷积核尺寸和步幅能够保留更多特征,从而最大化学习能力。这表明特征可视化可用于识别设计缺陷并及时调整参数。
⚪ NIN:Network In Network
- paper:Network In Network
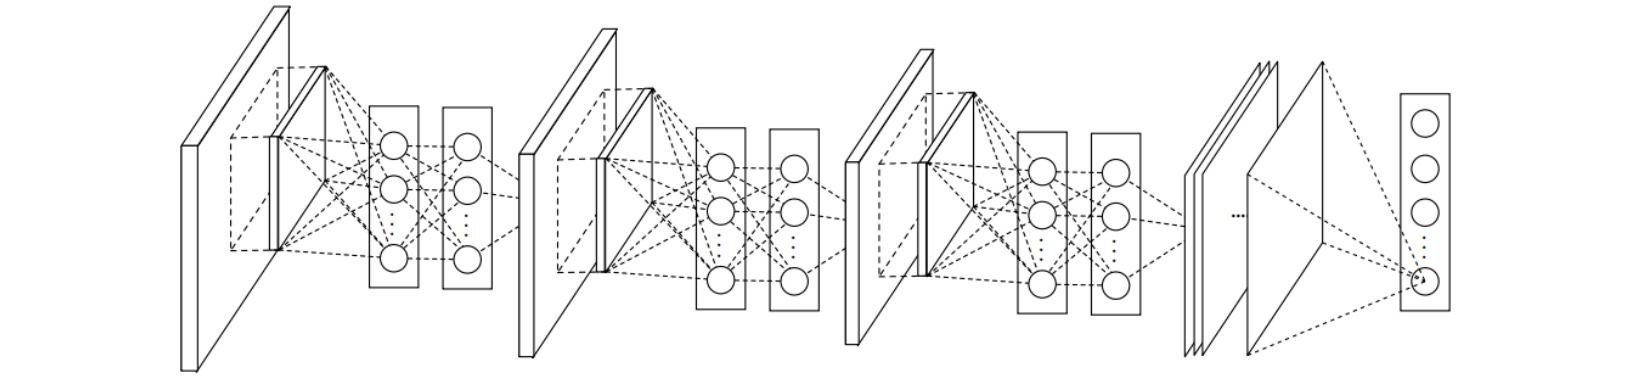
NIN提出用非线性函数($1\times 1$卷积)增强卷积层提取的局部特征,同时使用全局平均池化(Global Average Pooling)层替代全连接层作为网络尾部的分类部分。这两点后来被广泛采纳:$1\times 1$卷积成为通道变换与瓶颈设计的基础,全局平均池化则成为分类头的默认选择。
⚪ SPP-net:空间金字塔池化网络
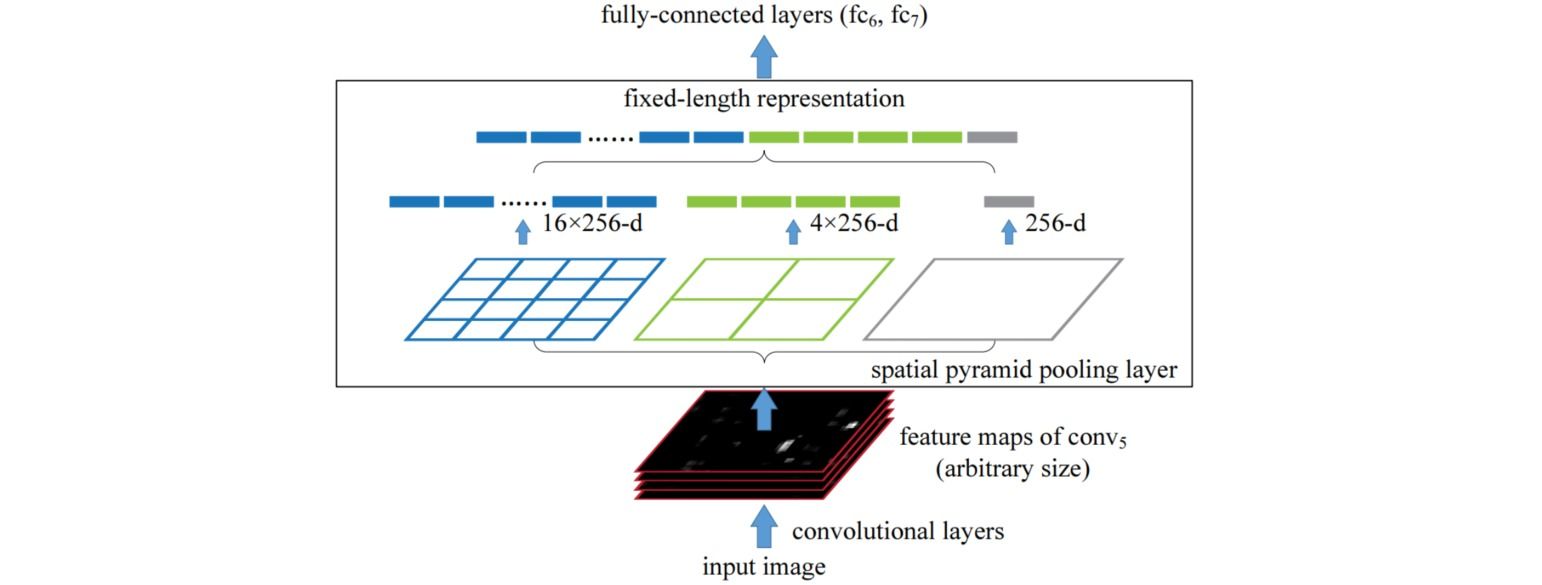
通常的卷积网络包含卷积层和全连接层,后者要求固定数量的输入特征,因此在输入时需把图像裁剪或拉伸为固定大小,从而改变图像尺寸和纵横比并扭曲信息。SPP-net在卷积层和全连接层之间引入空间金字塔池化(spatial pyramid pooling)结构,能把任意尺寸、任意纵横比的特征转换为固定尺寸的输出向量。
⚪ VGGNet
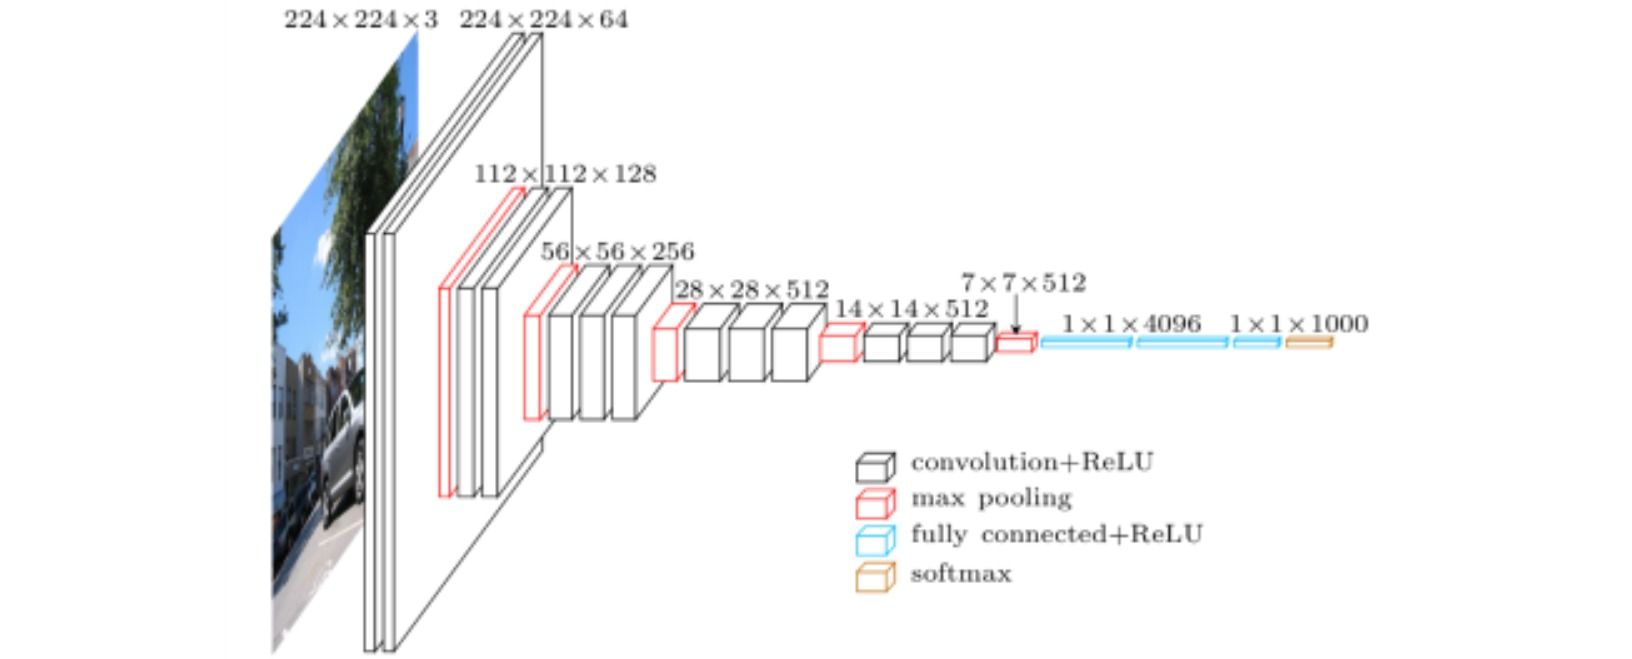
VGGNet提出了一种简单有效的结构设计原则:用多层$3\times 3$卷积代替$11\times 11$和$5\times 5$卷积。实验证明,堆叠多层$3\times 3$卷积可以达到大卷积核的感受野,同时减少参数量。VGGNet的主要缺点是计算成本高,$16$层的版本即使使用小卷积核也有约$1.4$亿个参数。
(2) 深度化设计
深度化设计的思路是通过增加堆叠卷积层的数量来增强模型的非线性表示能力,其核心难点是如何让梯度在很深的网络中稳定回传。
⚪ Highway Network
- paper:Highway Networks
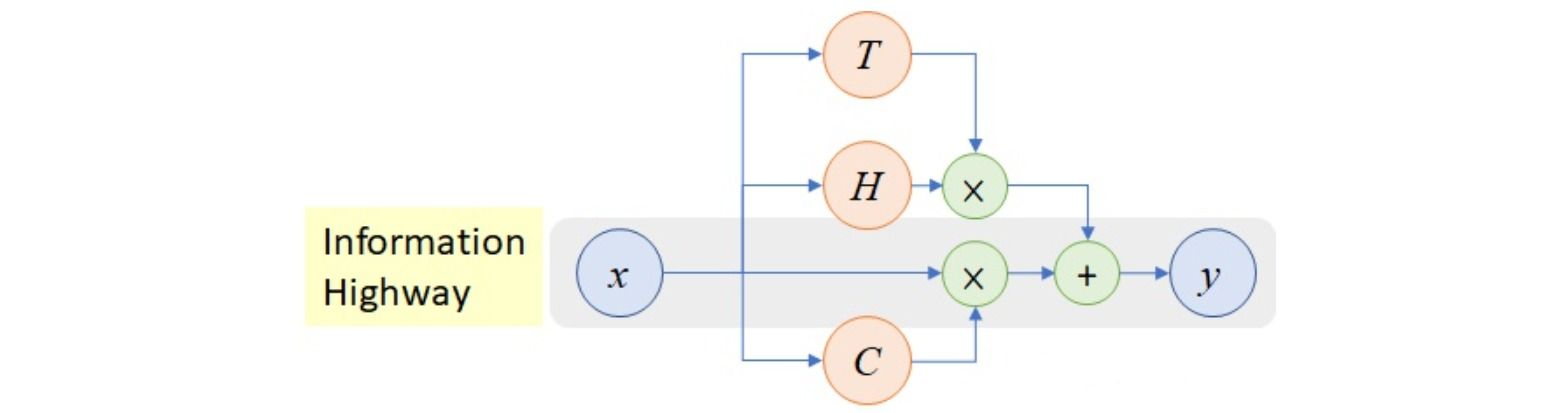
Highway Network通过门控机制引入新的跨层连接。设变换$H(x)$与门控$T(x)$,输出为:
\[y = H(x) \cdot T(x) + x \cdot (1-T(x))\]当门$T(x)\to 0$时,该层退化为恒等映射,信息可以“畅通无阻”地流过。实验表明,即使深度达$900$层,Highway Network的收敛速度也远快于普通网络。
⚪ ResNet:残差网络
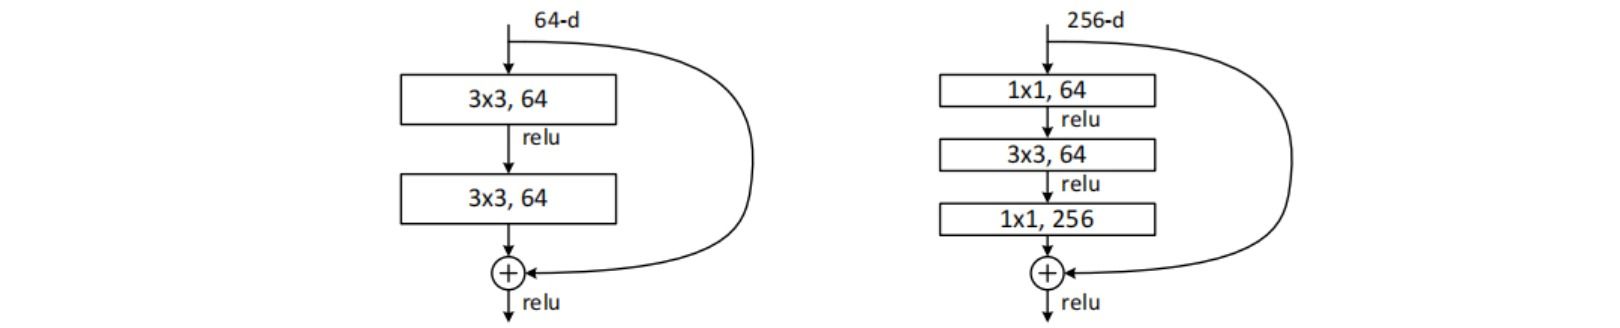
ResNet通过引入残差学习(residual learning)使训练极深卷积网络成为可能。它在若干卷积层前后用一个恒等映射相连,使主路径学习的是信号的残差$F(x)=H(x)-x$:
\[y = F(x) + x\]由于恒等映射的存在,反向传播时梯度可以更容易地回传,从而降低了训练难度。作者训练了超过$100$层的网络并在分类挑战赛中取得优异成绩。残差连接从此成为几乎所有现代深层网络的标准组件。
⚪ Stochastic Depth:随机深度
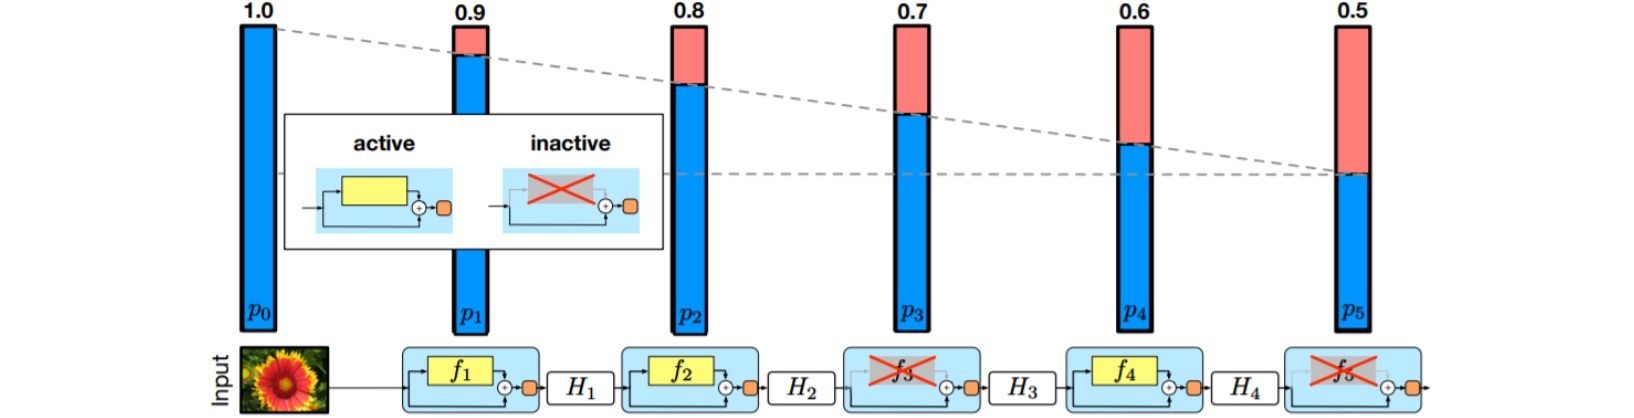
随机深度是指在训练时以一定概率丢弃网络中的残差模块(此时该模块退化为恒等变换);测试时使用完整网络,并按丢弃概率对各模块特征进行加权。它既缩短了训练时的期望深度、缓解了梯度消失,又起到类似Dropout的正则化作用,是训练超深残差网络的常用技巧。实践中常让第$l$个模块的存活概率随深度线性衰减:
\[p_l = 1 - \frac{l}{L}\left(1 - p_L\right)\]其中$L$为总模块数、$p_L$为最后一个模块的存活概率(如$0.5$)。浅层几乎总被保留、深层更易被丢弃,从而在保证底层特征稳定的同时显著缩短期望训练深度。
⚪ DenseNet:密集连接网络
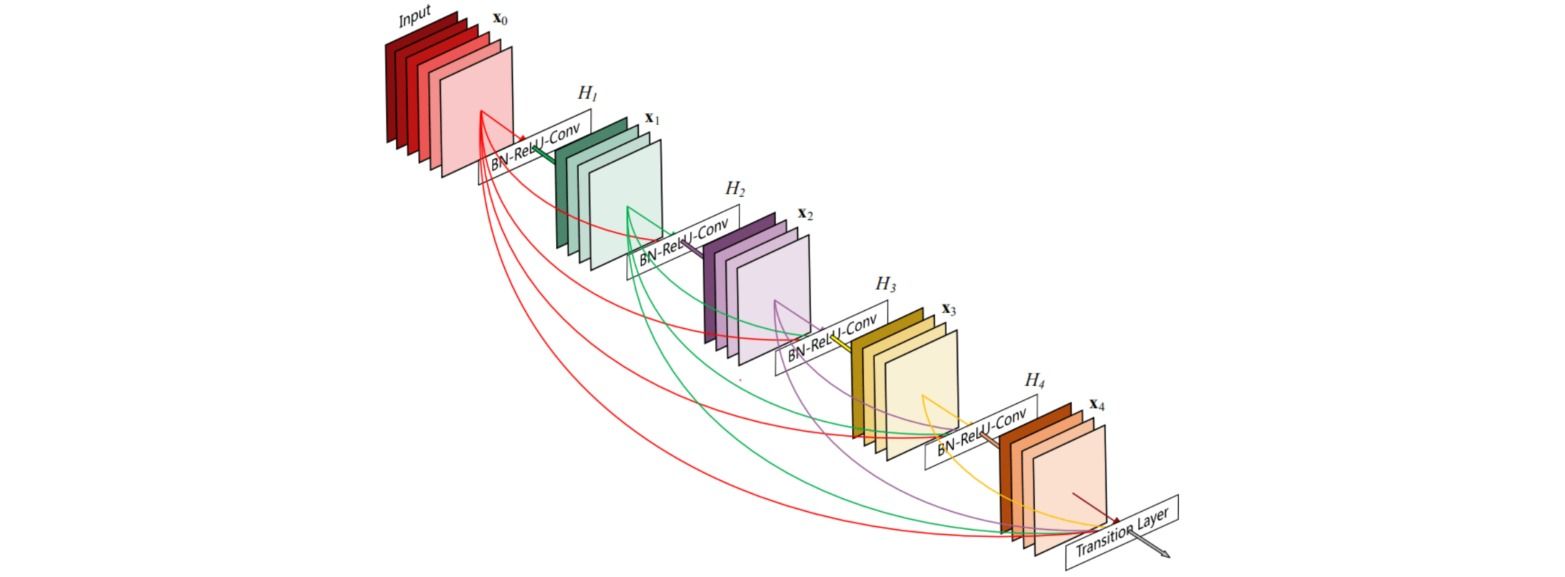
ResNet训练了很深的网络,但其中许多层可能贡献很少甚至没有信息。DenseNet以前馈的方式将每一层连接到之后的所有层:若网络有$L$层,则建立了$L(L+1)/2$个直接连接,并且对先前层的特征使用级联(concatenation),从而显式区分不同深度的信息,鼓励特征复用、减少参数量。
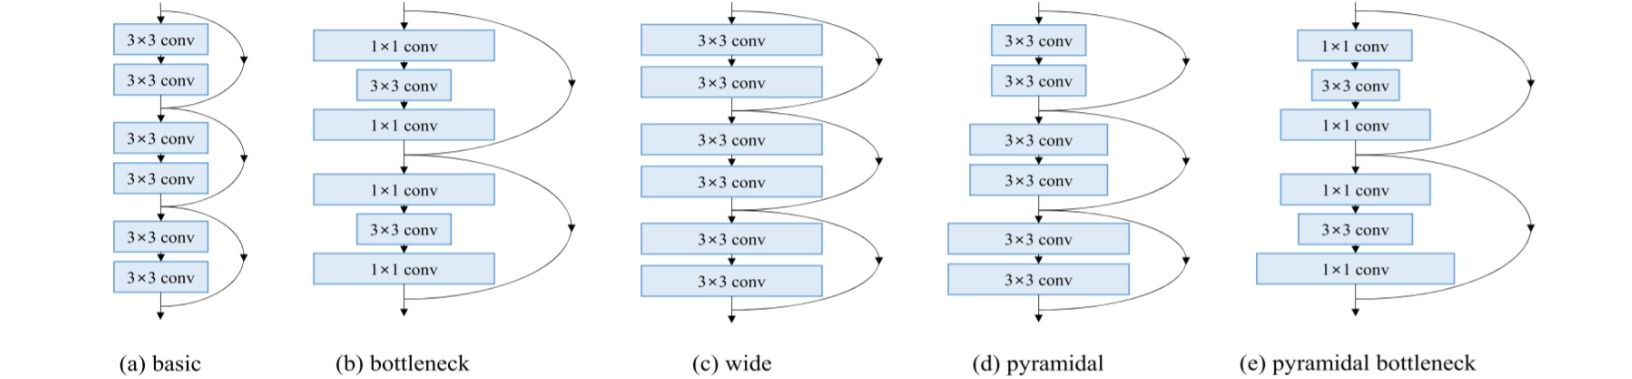
⚪ Pyramidal ResNet:金字塔残差网络
一般残差网络在每个下采样处“阶跃式”地成倍增加通道数。Pyramidal ResNet改为在整个网络中逐层平缓地增加通道数(形成金字塔形),把通道扩增的“负担”分摊到每一层,从而提升了泛化能力,也让删除单个模块时性能更稳健。
⚪ SpineNet:尺度置换主干
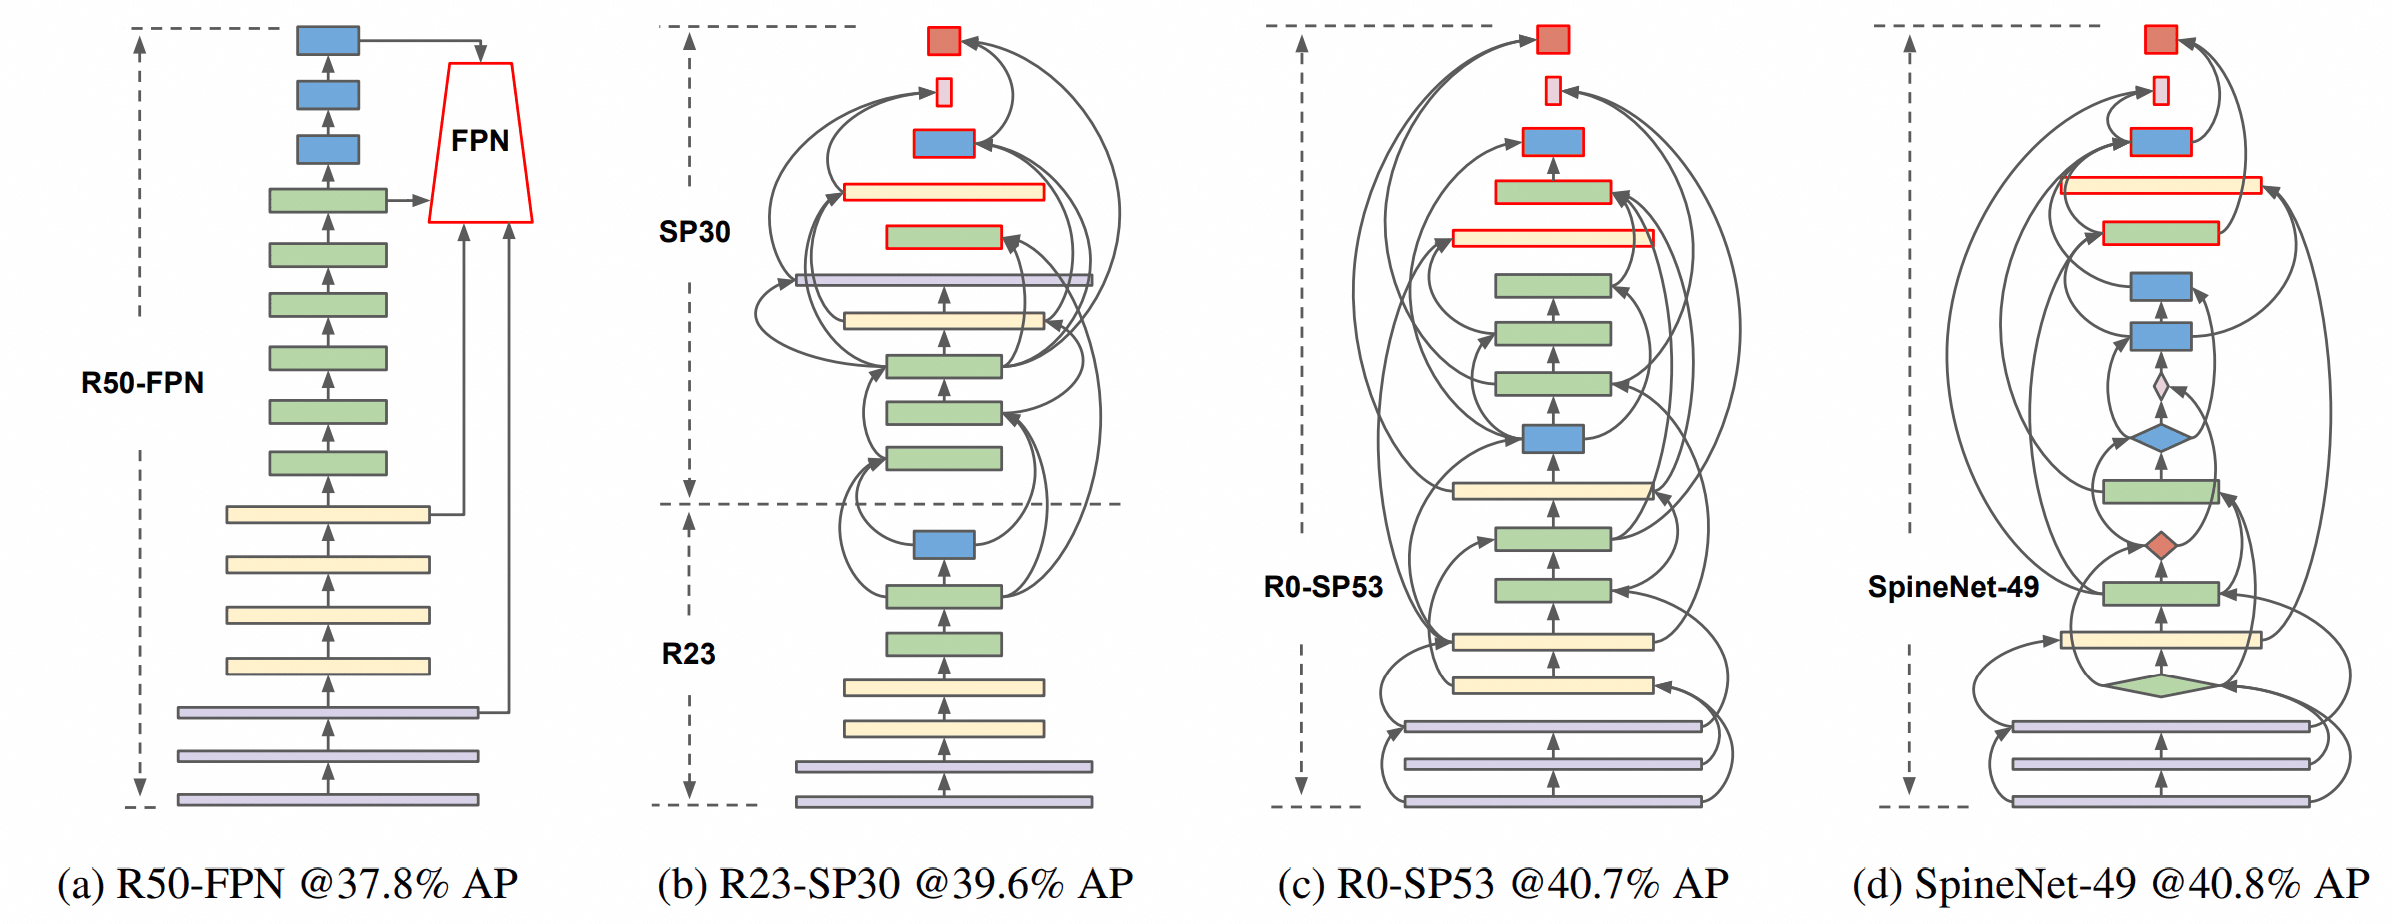
传统主干网络遵循尺度递减(scale-decreased)设计,特征分辨率随深度单调下降;这对同时需要识别与定位的任务(检测、分割)并不友好,因为下采样丢弃的空间信息很难由解码器完全恢复。SpineNet提出尺度置换(scale-permuted)元架构:中间特征的尺度可以随时增大或减小,且允许跨尺度连接。由于设计空间巨大,作者用神经架构搜索(Neural Architecture Search, NAS)在COCO检测任务上自动学习最优拓扑。
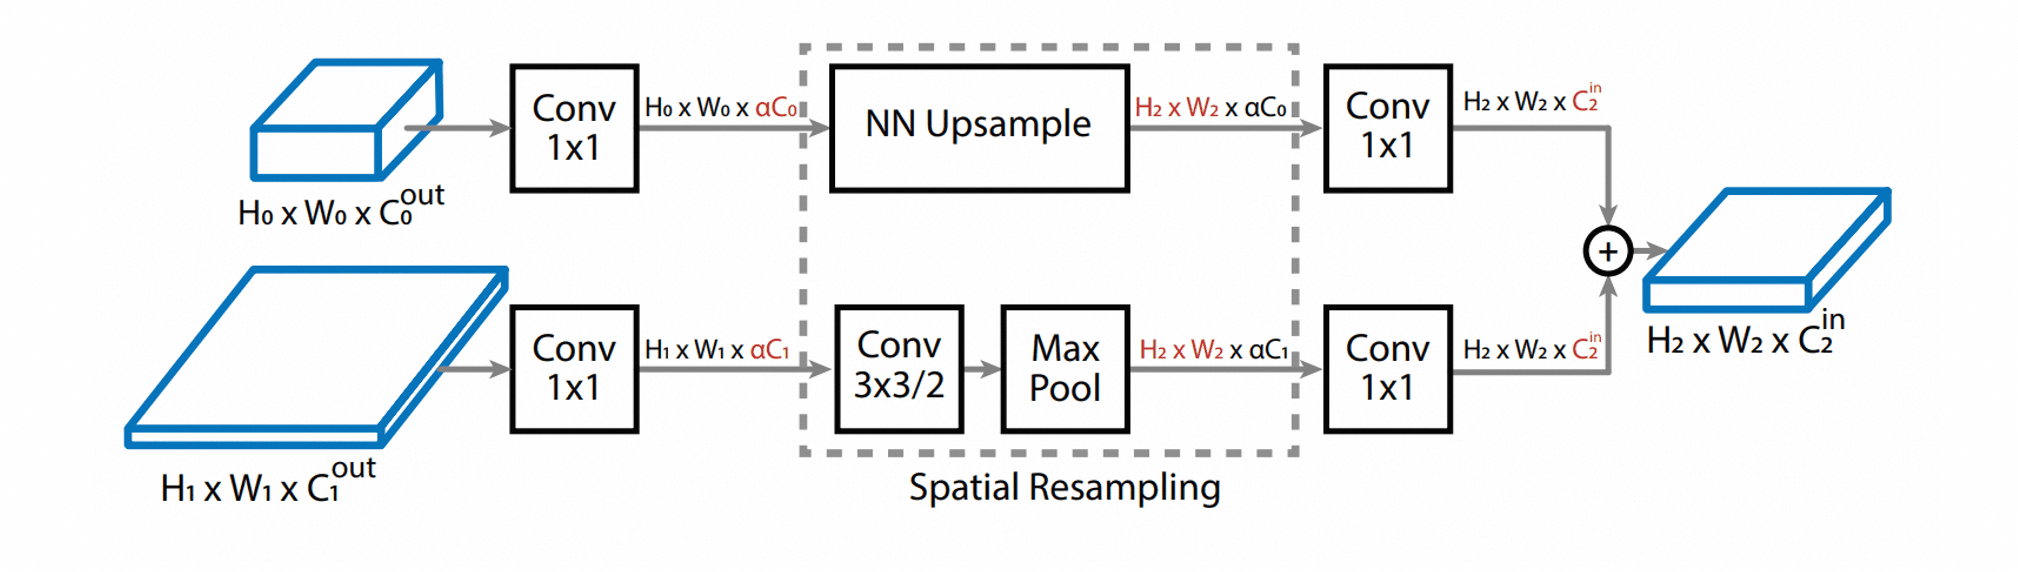
跨尺度连接时需要重采样以匹配分辨率和通道:上采样用最近邻插值,下采样用步长为$2$的$3\times 3$卷积(必要时后接最大池化),并用$1\times 1$卷积匹配通道,最后逐元素相加融合。
从学习到的架构可以观察到:中间特征经历了持续的上采样和下采样,中间块之间以短距离连接形成深度通路,输出块则倾向于使用更长距离的连接。虽然为检测而生,SpineNet在ImageNet上以更少计算量取得了与ResNet相当的精度,在细粒度的iNaturalist上更高出约$5\%$。
⚪ SpinalNet:渐进输入网络
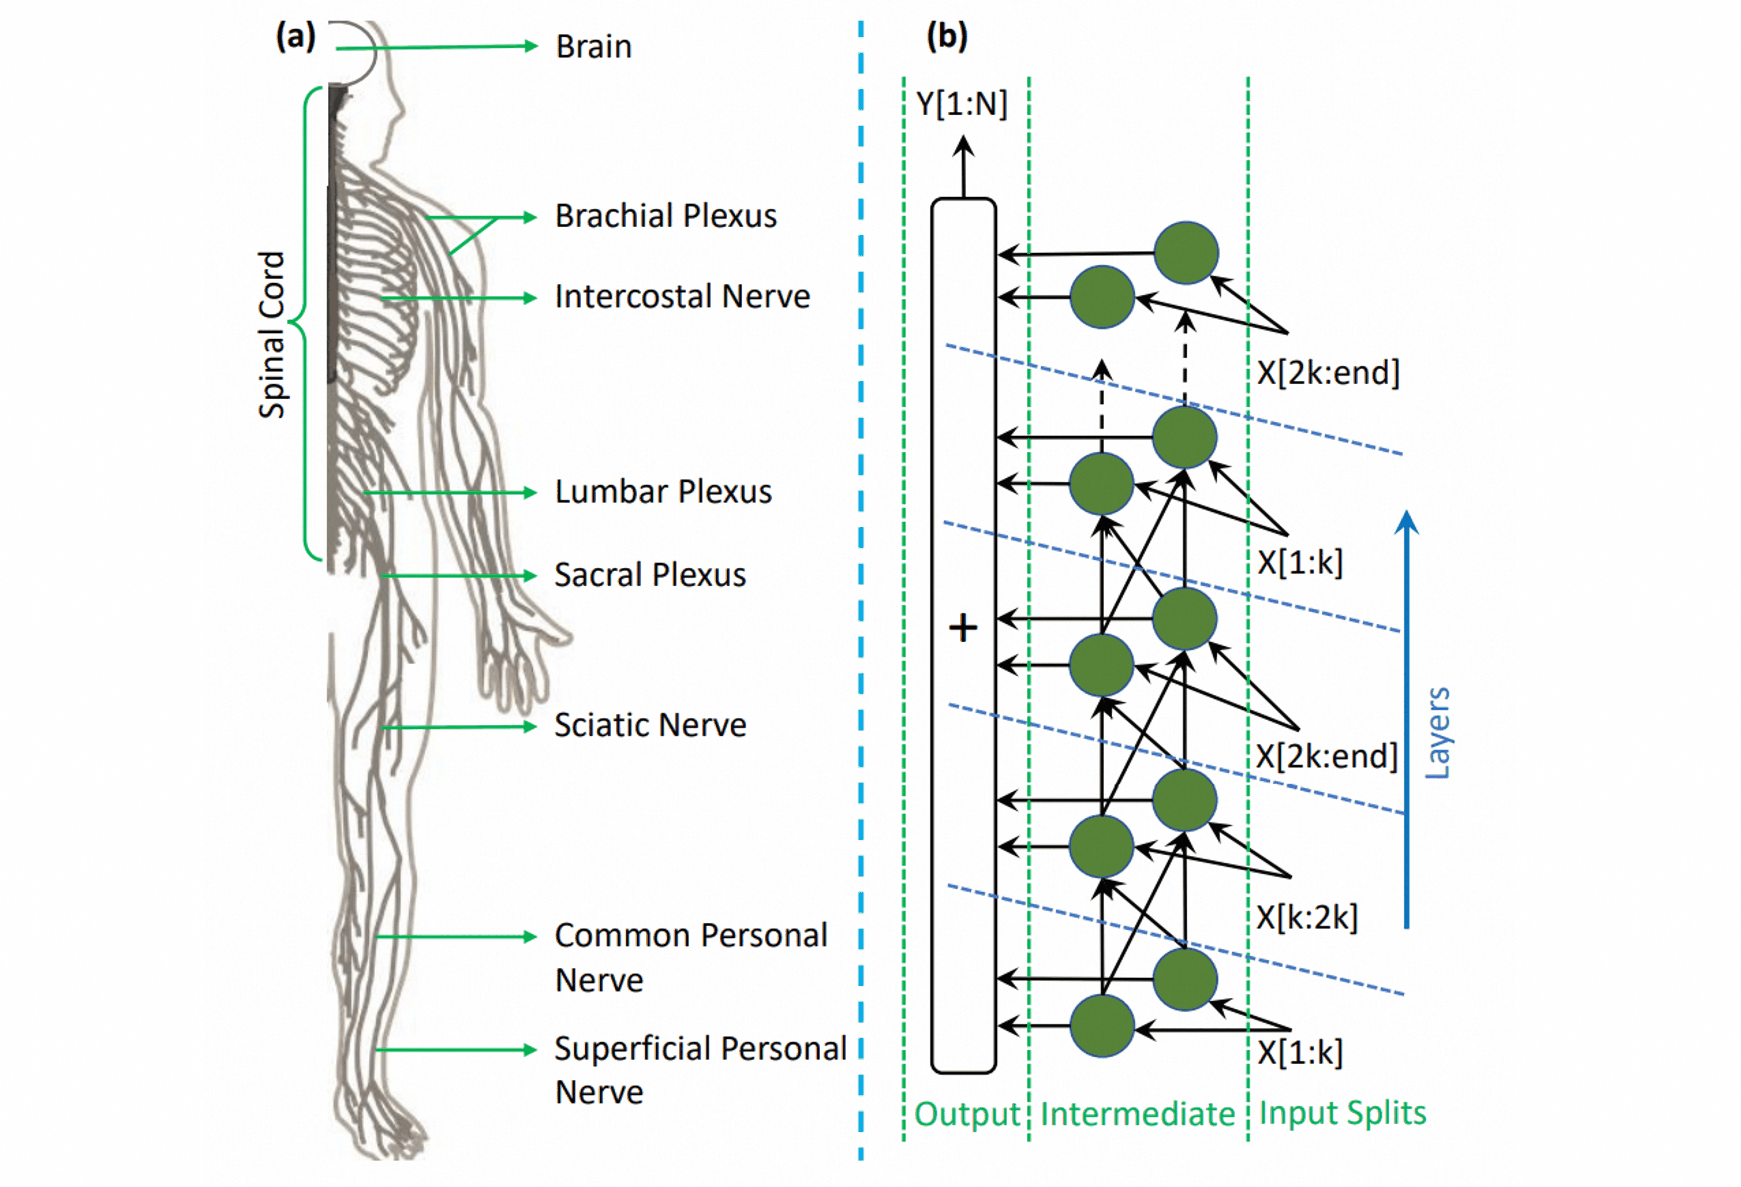
SpinalNet的设计灵感来源于人类体感神经系统处理信息的方式,主要用于替换大型CNN中的全连接分类层。网络由多个“脊髓层”组成,每层包含三部分:
- 输入部分(input split):总输入$X$被分割成多段$X[1:k], X[k:2k], \dots$,每层只接收其中一段;
- 中间部分(intermediate split):第一层只接收第一段输入,从第二层起同时接收“前一层中间部分的输出”与“当前层的输入段”;
- 输出部分(output split):将所有中间部分的输出加权求和得到最终输出。
由于每层中间神经元只接收一部分原始输入和前一层输出,其输入维度远小于传统全连接层,因而显著减少了乘法运算与参数量。作者还证明了足够深的SpinalNet可等价于一个足够宽的单隐藏层网络,因而具有通用近似能力。
(3) 模块化设计
模块化设计的思想是先设计一个包含若干卷积层的网络模块,再通过堆叠相同模块构造深度网络。它的优点是泛化性和可替代性好——新方法只需替换基本模块即可提升性能。
⚪ Inception (GoogLeNet)
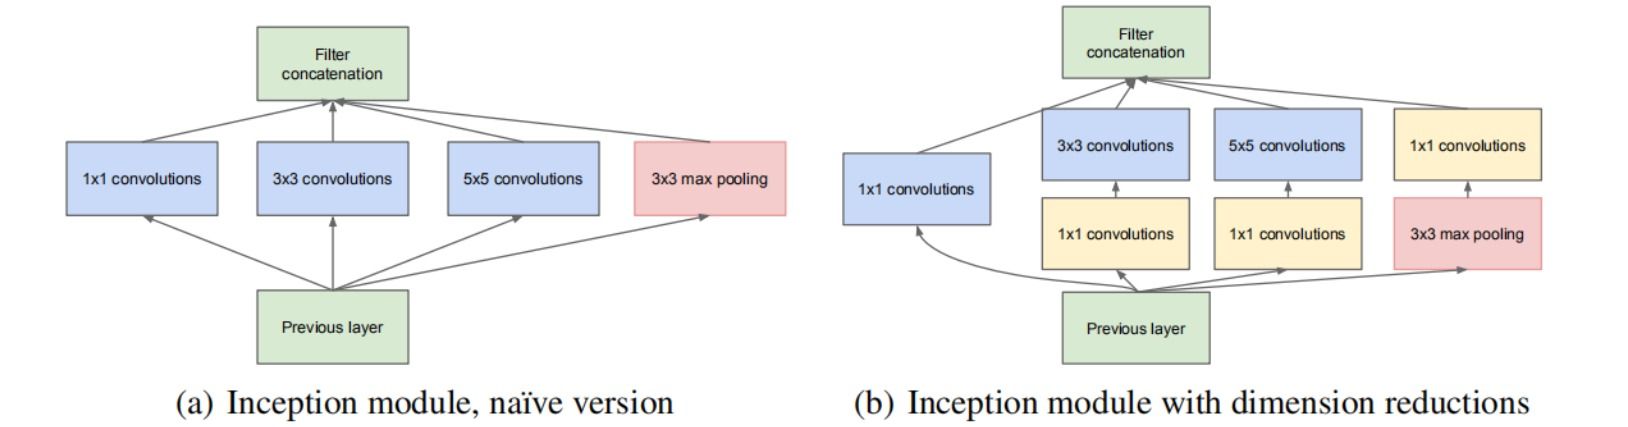
GoogLeNet提出了模块设计的基本思想——拆分-变换-融合(split-transform-merge)。inception模块把上一层输出拆分成$4$路,分别通过$1\times 1$、$3\times 3$、$5\times 5$卷积和一个$3\times 3$最大池化进行变换,再把结果拼接作为输出,从而在同一模块内捕获不同尺度的空间信息。在大卷积核之前使用$1\times 1$卷积作为瓶颈层,显著减小了参数量。
⚪ Inception-V2, Inception-V3
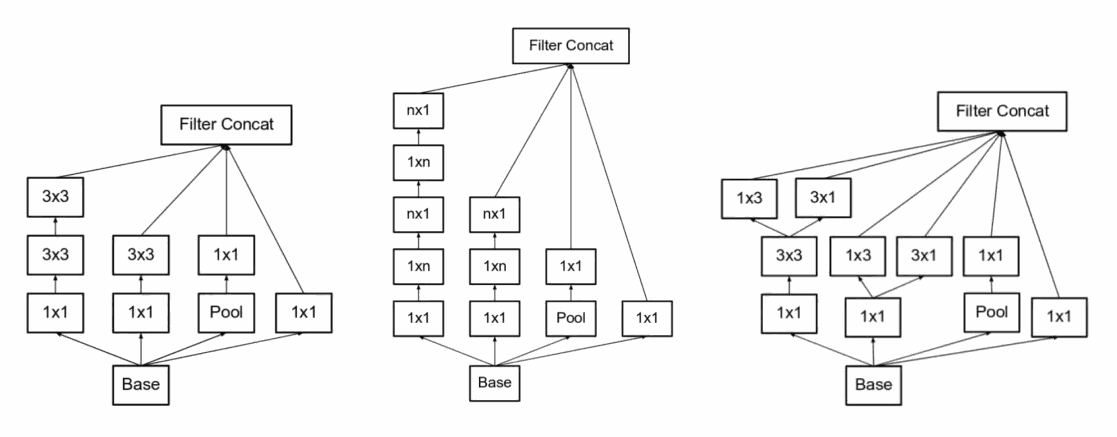
Inception-V2主要引入了BatchNorm优化训练。Inception-V3进一步做了卷积分解:先把一个$5\times 5$卷积拆成两层$3\times 3$卷积(相同感受野、更少参数),再把$n\times n$卷积拆成$n\times 1$与$1\times n$卷积的串联或并联形式,从而进一步降低计算量。
⚪ Inception-V4, Inception-ResNet
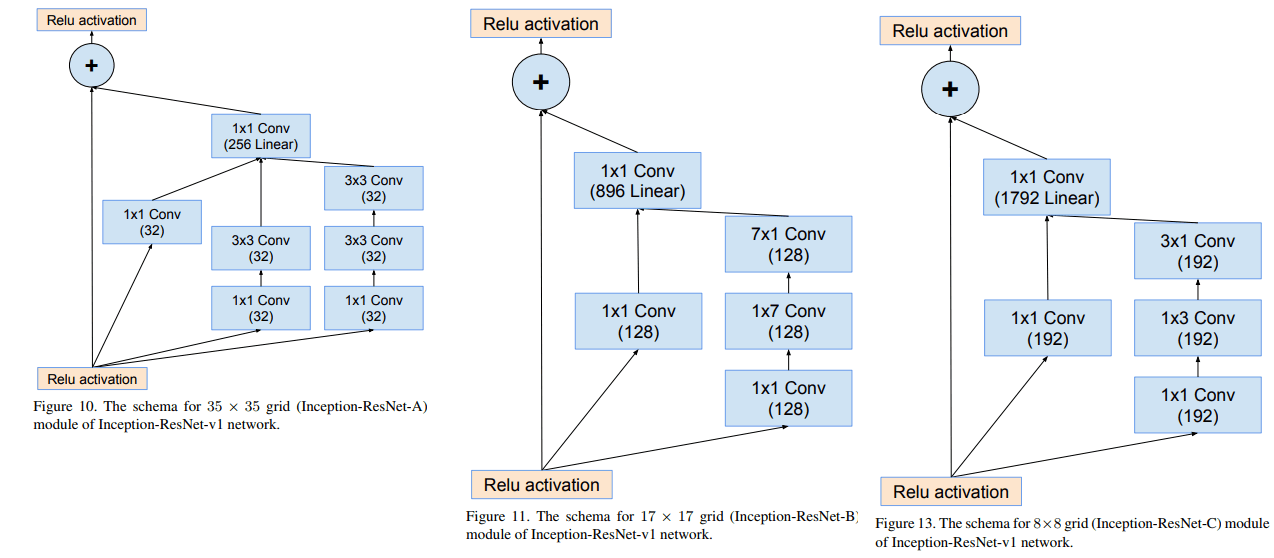
Inception-V4统一并简化了各阶段的模块设计;Inception-ResNet则在Inception模块中引入残差连接,显著加快了训练收敛速度,说明残差连接与多分支模块可以正交叠加。
⚪ WideResNet:宽残差网络
- paper:Wide Residual Networks
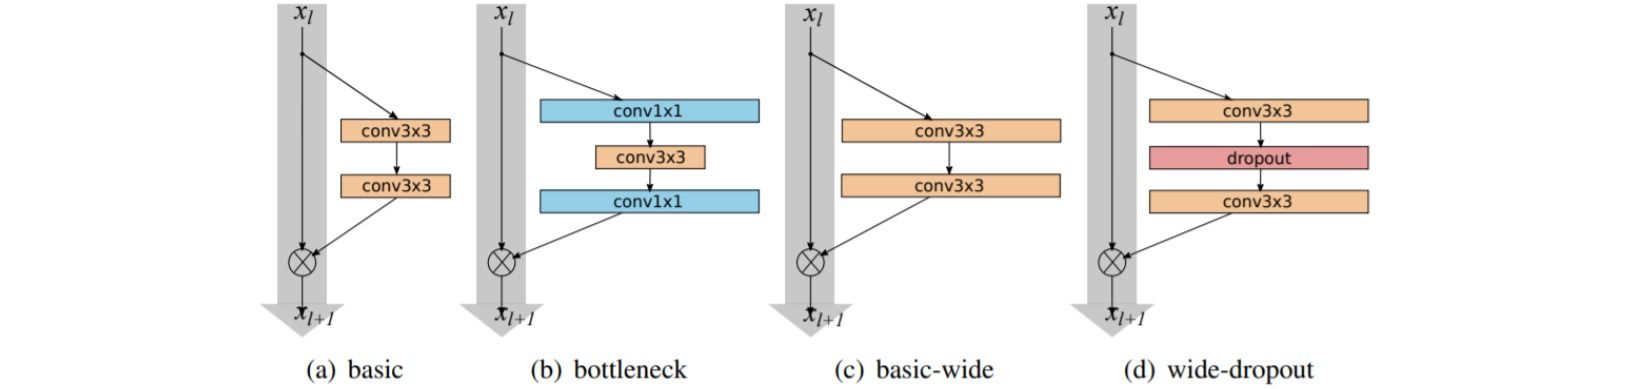
WideResNet指出与其一味加深,不如适当加宽(增大特征通道数)。它通过增大宽度改善性能,并在卷积层之间引入Dropout正则化,实现了用较浅的网络获得与很深网络相当的精度,同时因并行度更高而训练更快。
⚪ Xception:极致的Inception
Xception可视为一种极端(eXtreme)的Inception结构。它把Inception的思想推向极限,设计了深度可分离卷积(depthwise separable convolution):先用$1\times 1$卷积混合通道信息,再对每个通道独立做$3\times 3$空间卷积。这一算子后来成为轻量化网络的基石。相比把空间与通道相关性一次性建模的标准卷积,深度可分离卷积把二者解耦,其计算量之比约为:
\[\frac{\text{depthwise separable}}{\text{standard}} \approx \frac{1}{C_{out}} + \frac{1}{k^2}\]其中$C_{out}$为输出通道数、$k$为卷积核尺寸。当通道数较大时该比值主要由$1/k^2$决定,因此$3\times 3$核可把计算量降到标准卷积的约$1/9$,这正是它在移动端广泛使用的原因。
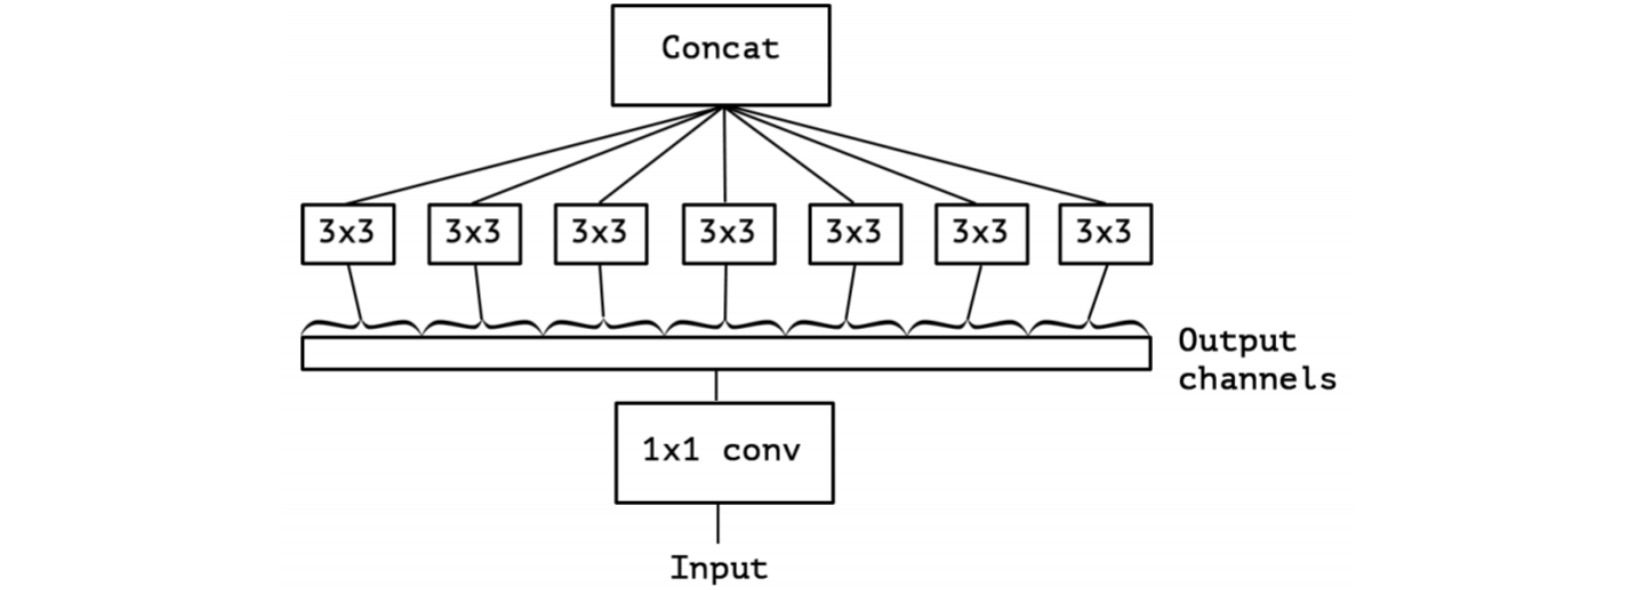
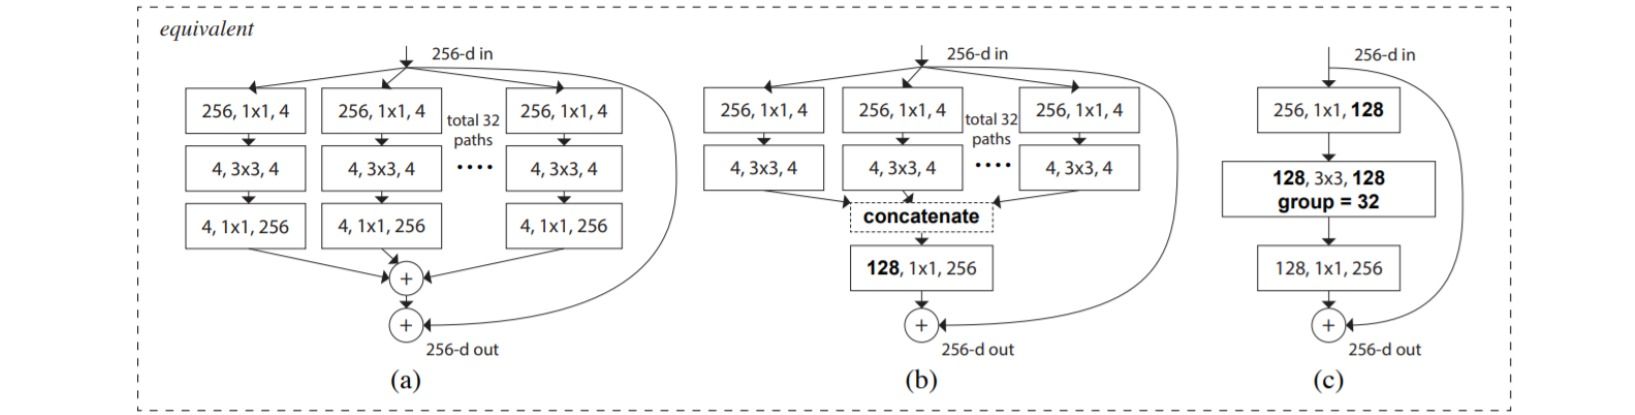
⚪ ResNeXt:聚合变换
ResNeXt引入基数(cardinality)这一维度,表示对特征进行拆分变换时的路径数目。图中把输入拆分成$32$条结构相同的路径(基数为$32$),再相加融合。实验表明,在计算量相当的前提下,增大基数比单纯加深或加宽更有效。基数本质上是“组卷积”的一种规整化表达。
⚪ Res2Net:粒度化的多尺度残差
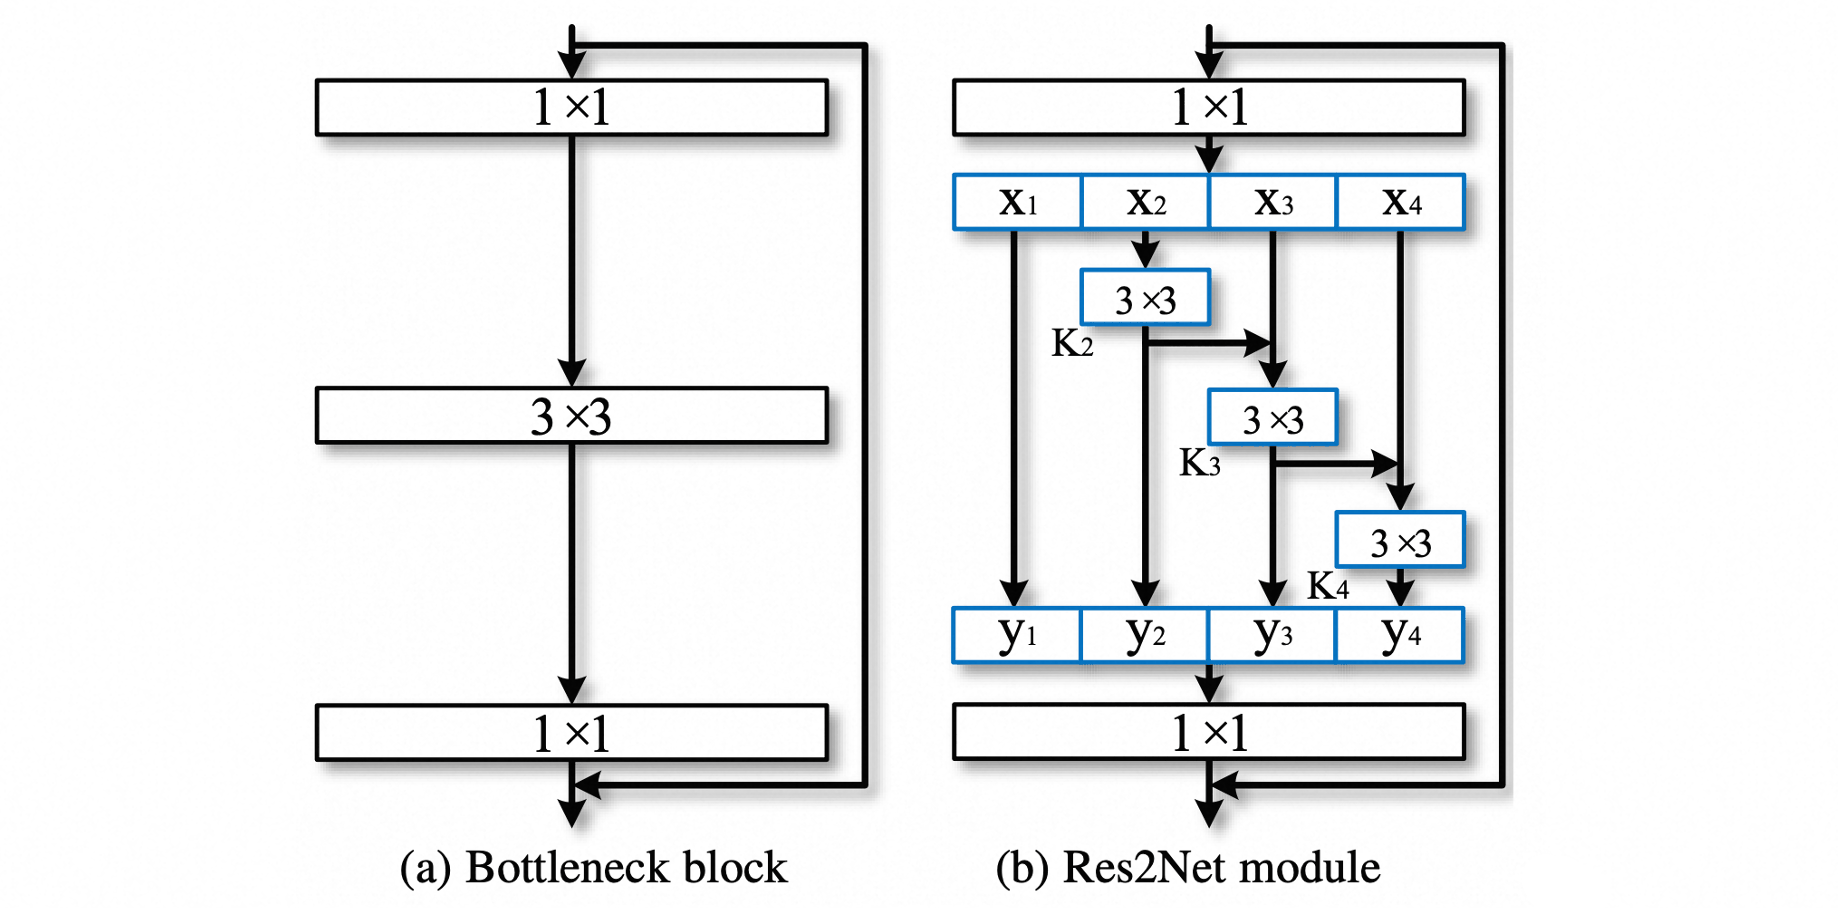
Res2Net在单个残差块内部构造多尺度表示:把瓶颈内的特征沿通道分成$s$组$x_1,\dots,x_s$,各组的$3\times 3$卷积$K_i$以级联(hierarchical)方式相连,后一组接收前一组的输出再卷积:
\[y_i = \begin{cases} x_i, & i=1 \\ K_i(x_i), & i=2 \\ K_i\left(x_i + y_{i-1}\right), & 2 < i \leq s \end{cases}\]由于$y_i$累积经过了$i-1$次卷积,不同分组对应不同的等效感受野,从而在一个模块内形成多种尺度的表示;分组数$s$被称为尺度维度(scale dimension),是继深度、宽度、基数之后的又一条正交维度。
⚪ DPN:双路径网络
- paper:Dual Path Networks
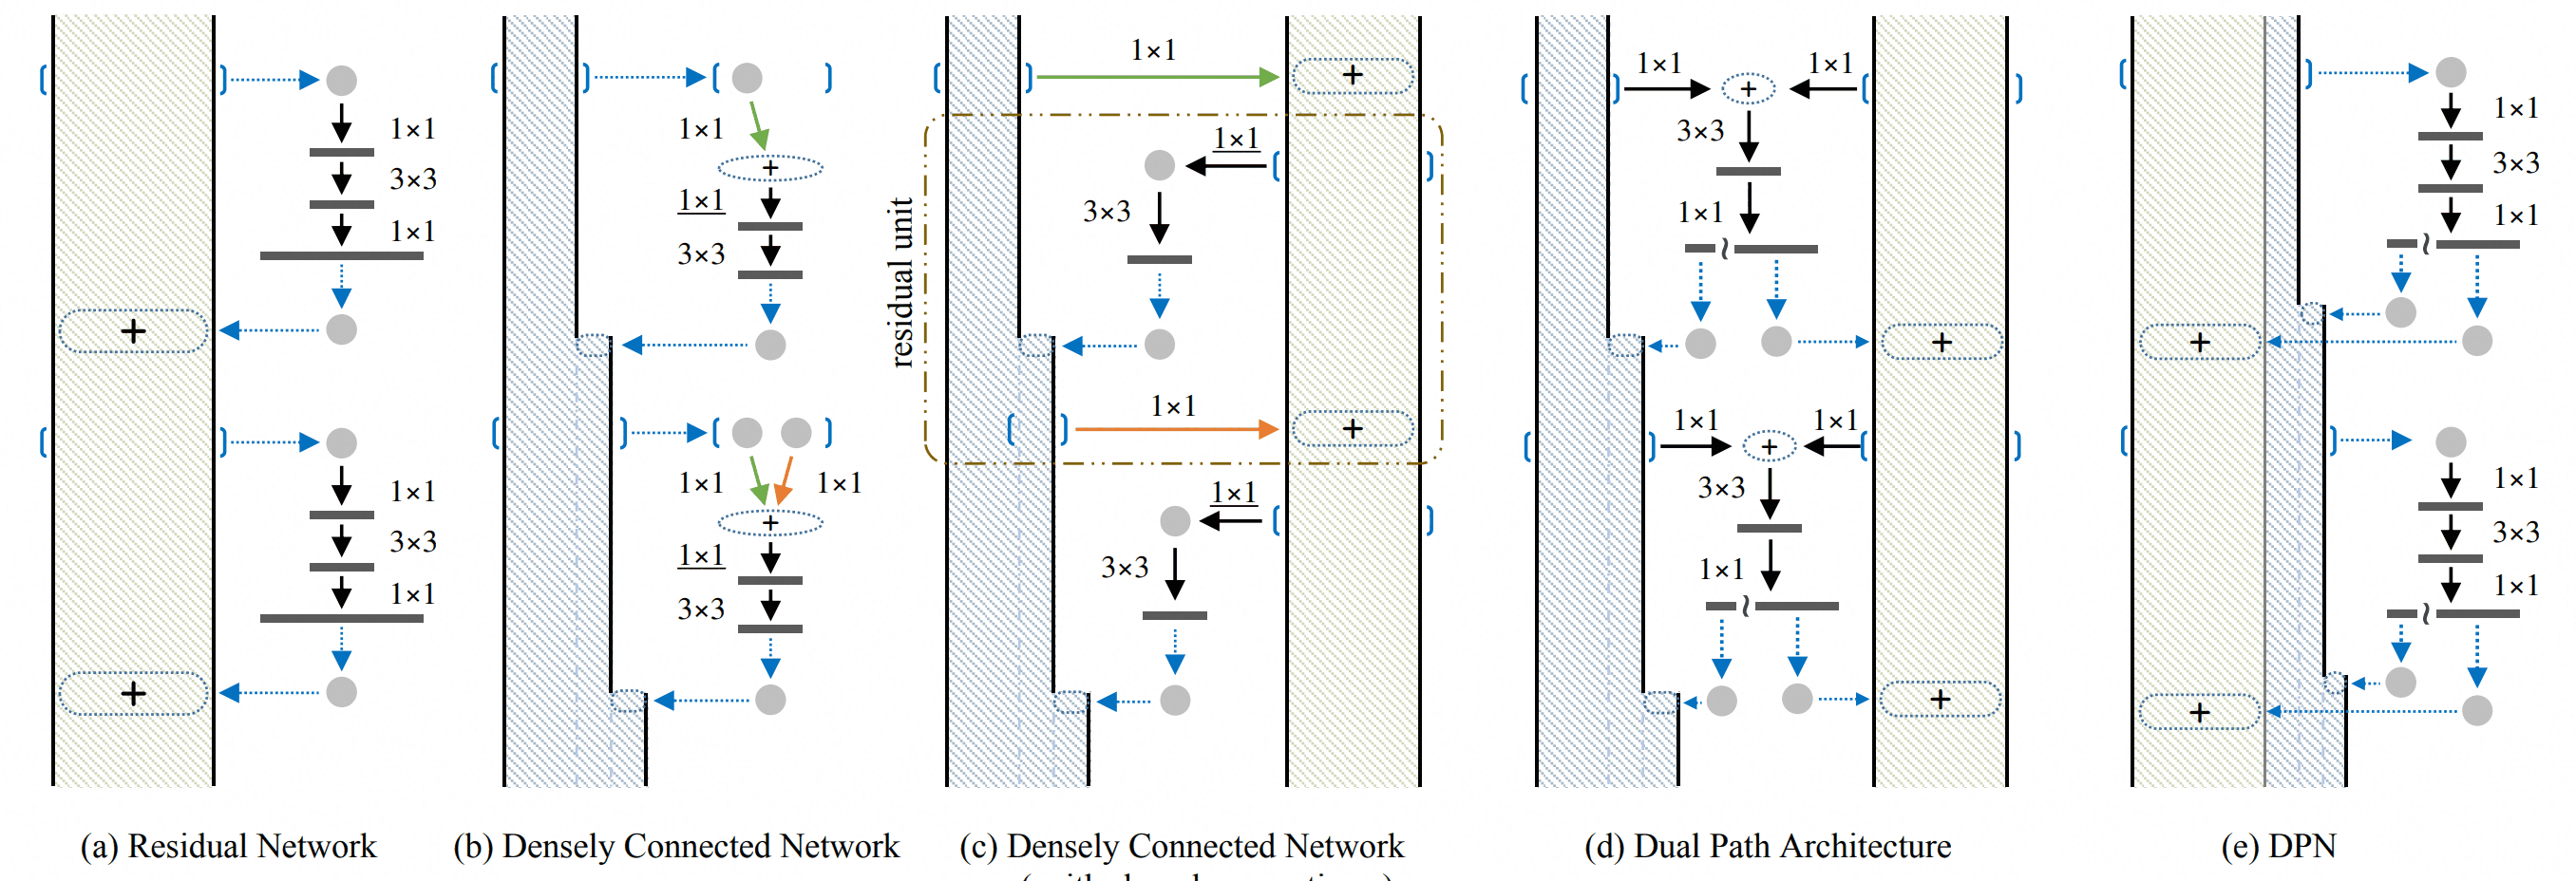
DPN从高阶递归网络的视角统一了ResNet与DenseNet:前者利于特征复用,后者利于探索新特征。DPN用一条残差路径(相加)与一条密集路径(级联)并行,兼取两者之长,在参数量和计算量更小的情况下取得了更好的分类与检测性能。其每一步的输出可写成“相加复用”与“级联新增”两部分的组合:
\[y_k = \underbrace{\sum_{t=1}^{k} f_t(x)}_{\text{残差路径:特征复用}} \ \oplus \ \underbrace{[g_1(x), \dots, g_k(x)]}_{\text{密集路径:探索新特征}}\]其中$\oplus$表示两条路径在通道维的拼接。这样每个块既通过相加复用已有特征,又通过级联为后续层引入新特征。
⚪ ResNeSt:拆分注意力网络
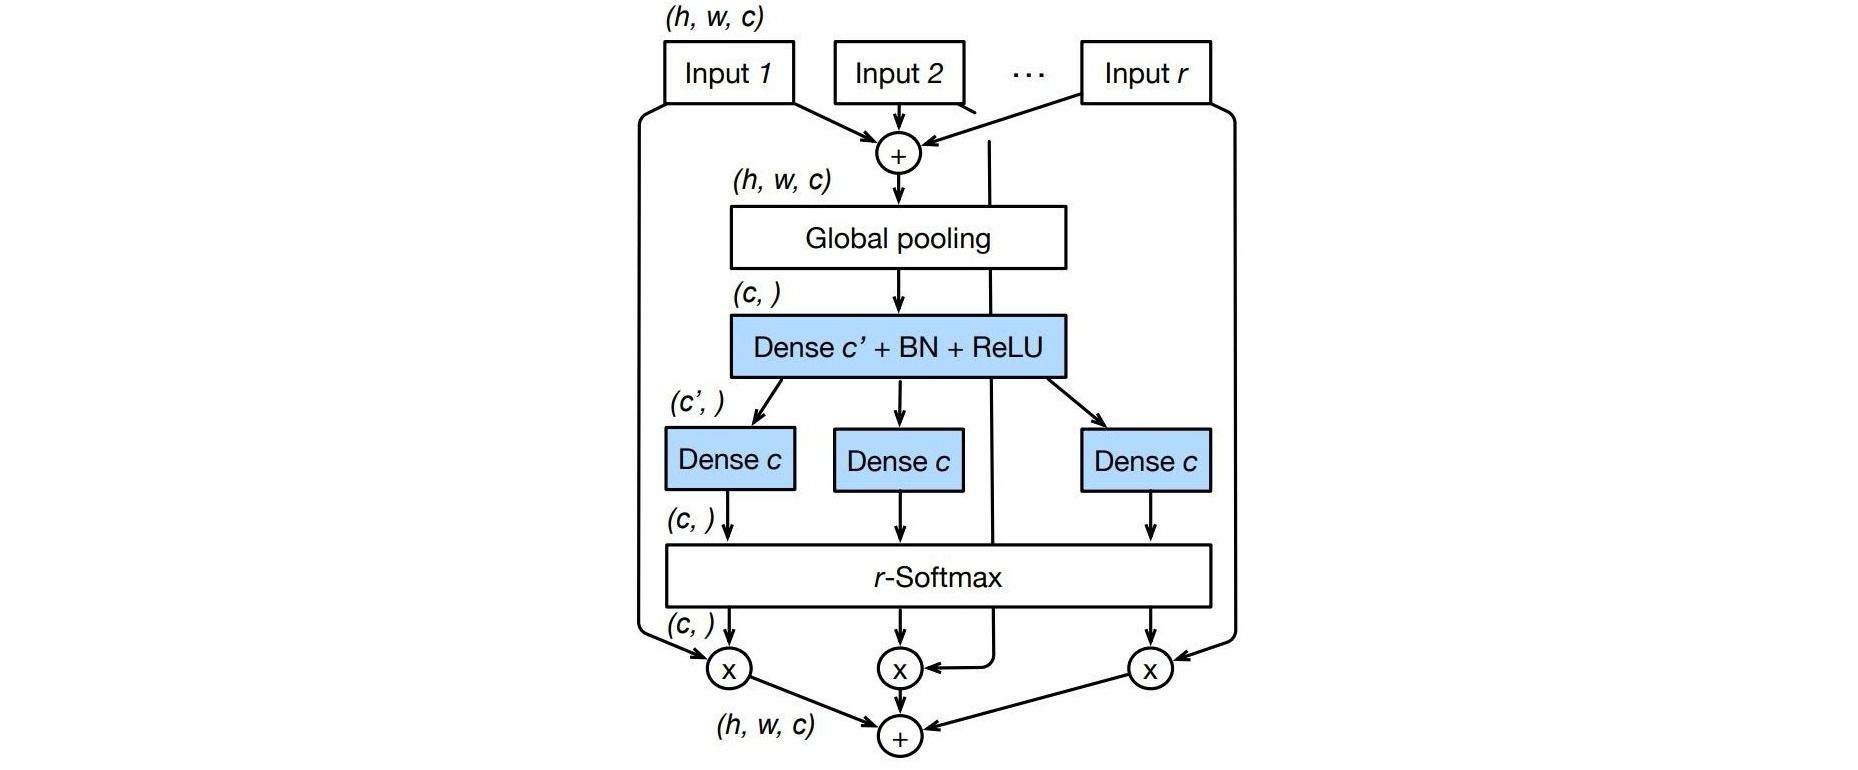
ResNeSt把通道注意力与多路径设计结合起来,试图在不依赖架构搜索、保持通用性的前提下刷新精度。它的两个核心是multi-path与channel attention:前者参考ResNeXt引入基数$k$控制分组卷积的分支数,后者参考SKNet引入radix $r$控制注意力计算的分支数。
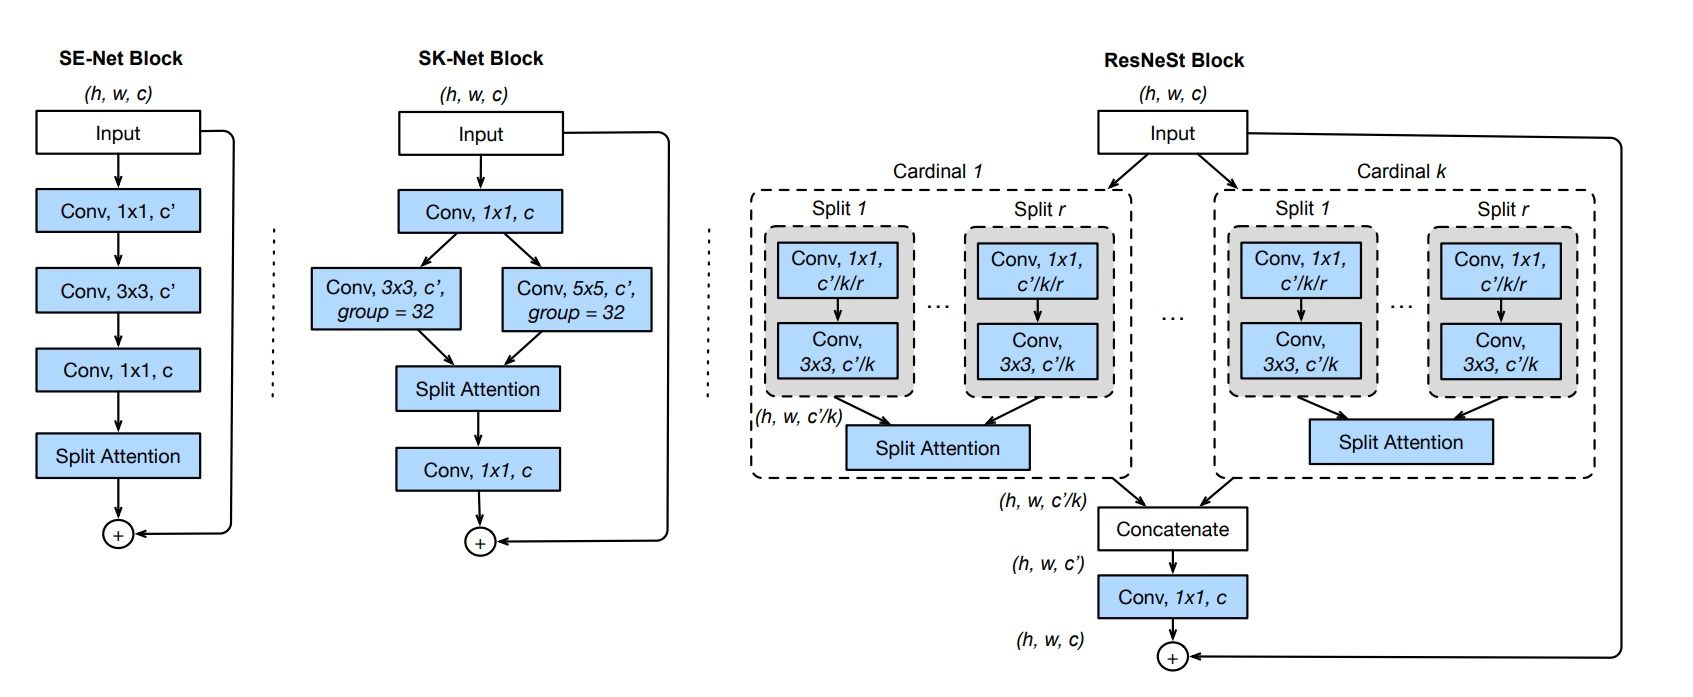
其拆分注意力(split-attention)先在$r$个分支上做特征变换,再用类似SE的方式计算跨分支的软注意力并加权求和。作者给出了cardinality-major与radix-major两种等价实现,后者便于并行、加速训练。
⚪ ConvNeXt:面向2020年代的卷积网络
- paper:A ConvNet for the 2020s
当视觉Transformer逐渐超越卷积网络时,ConvNeXt反问:纯卷积网络的极限在哪里?作者把标准ResNet-50沿着Swin Transformer的方向逐步“现代化”,逐项验证每个改动的收益:调整阶段计算比为$(3,3,9,3)$、把stem换成步长$4$的$4\times 4$非重叠卷积、改用深度可分离卷积+反向瓶颈、把卷积核增大到$7\times 7$、把ReLU/BatchNorm换成GELU/LayerNorm并减少其数量、把下采样独立出来。这些改动叠加后,纯卷积网络重新超过了同量级的Swin。
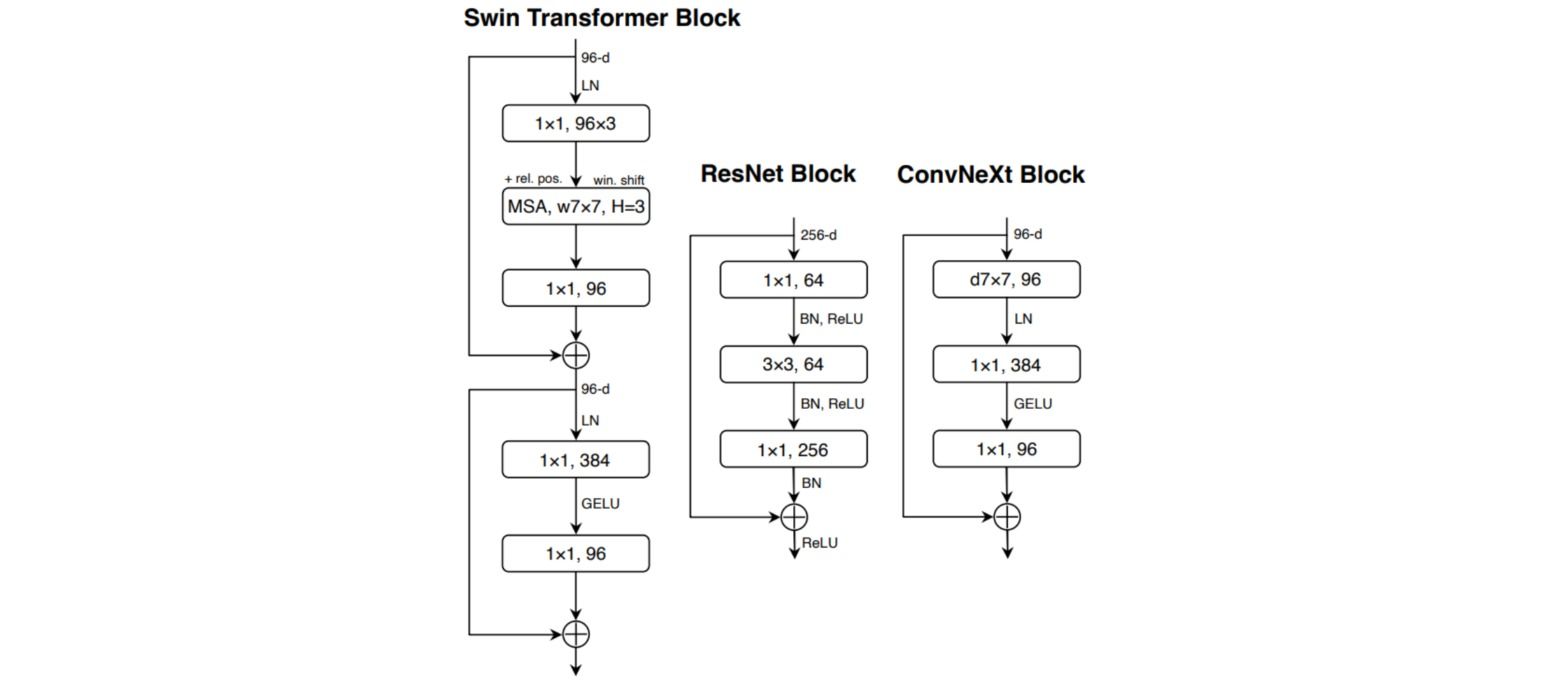
值得强调的是,其中一个关键发现是:仅仅把训练配方从旧的$90$轮换成现代的$300$轮(AdamW、Mixup/CutMix/RandAugment/Random Erasing、Stochastic Depth/Label Smoothing),就把ResNet-50的精度从$76.1\%$提高到$78.8\%$——Transformer相对卷积的“结构优势”里有相当一部分其实来自训练方式。
⚪ ConvNeXt V2:与掩蔽自编码器协同设计
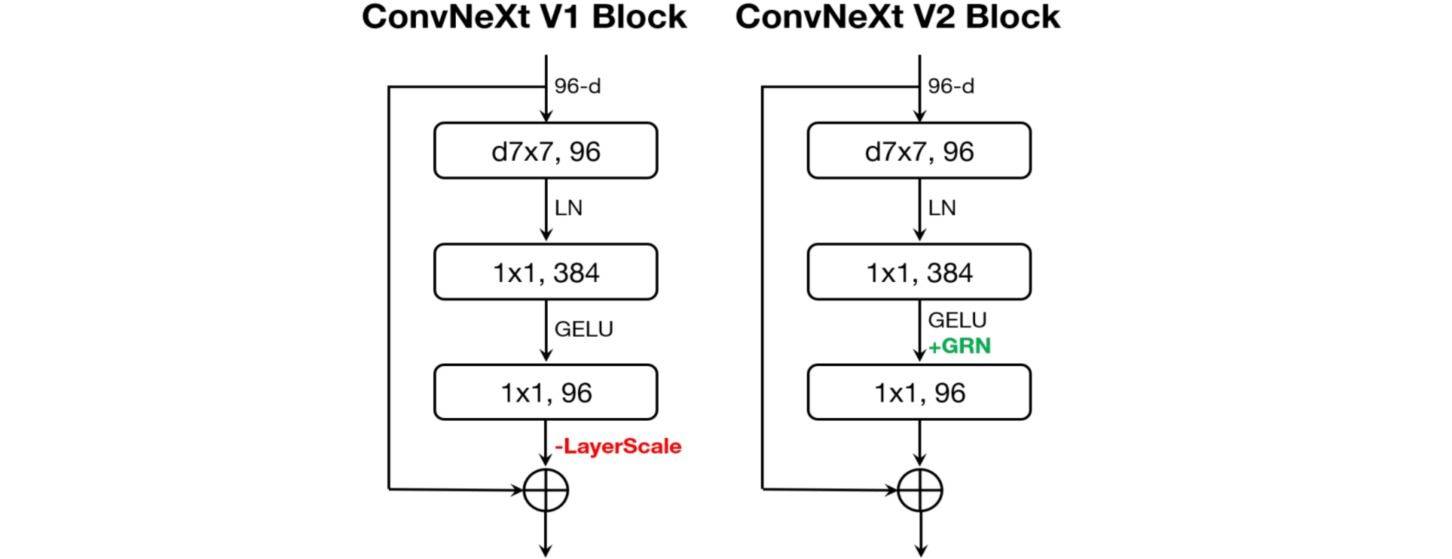
ConvNeXt V2把视觉自监督预训练引入卷积网络。它设计了全卷积掩蔽自编码器(Fully Convolutional Masked AutoEncoder, FCMAE):预训练时用子流形稀疏卷积只在可见图像块上运算(微调时再转回标准卷积),编码器-解码器均用ConvNeXt,以被掩蔽区域的重建误差为损失。
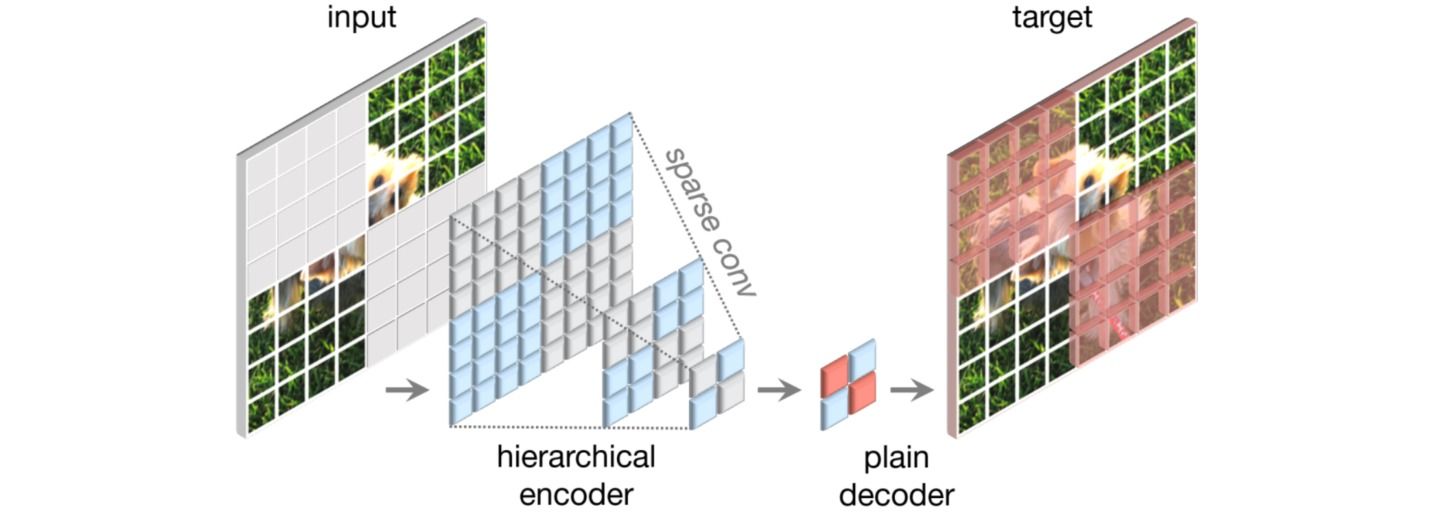
然而直接掩蔽预训练会导致特征collapse(大量通道饱和、冗余度高)。作者据此提出全局响应归一化(Global Response Normalization, GRN):先用全局聚合$G(\cdot)$得到每个通道的范数,再做通道间相对归一化$N(\cdot)$,最后校准原特征并加入可学习缩放$\gamma,\beta$与残差:
\[X_i = \gamma \cdot X_i \cdot N\left(G(X)_i\right) + \beta + X_i\]把GRN加入ConvNeXt模块(置于每个模块最后一个$1\times 1$卷积之前),配合FCMAE预训练,性能显著超过纯监督训练。
(4) 缩放与架构搜索
有了好的模块,下一个问题是如何把它放大到不同的算力预算。这条线索关心的不再是“单个模块长什么样”,而是“深度、宽度、分辨率如何配比”以及“能否让机器自动决定这些配比”。
⚪ NASNet:可迁移的搜索单元
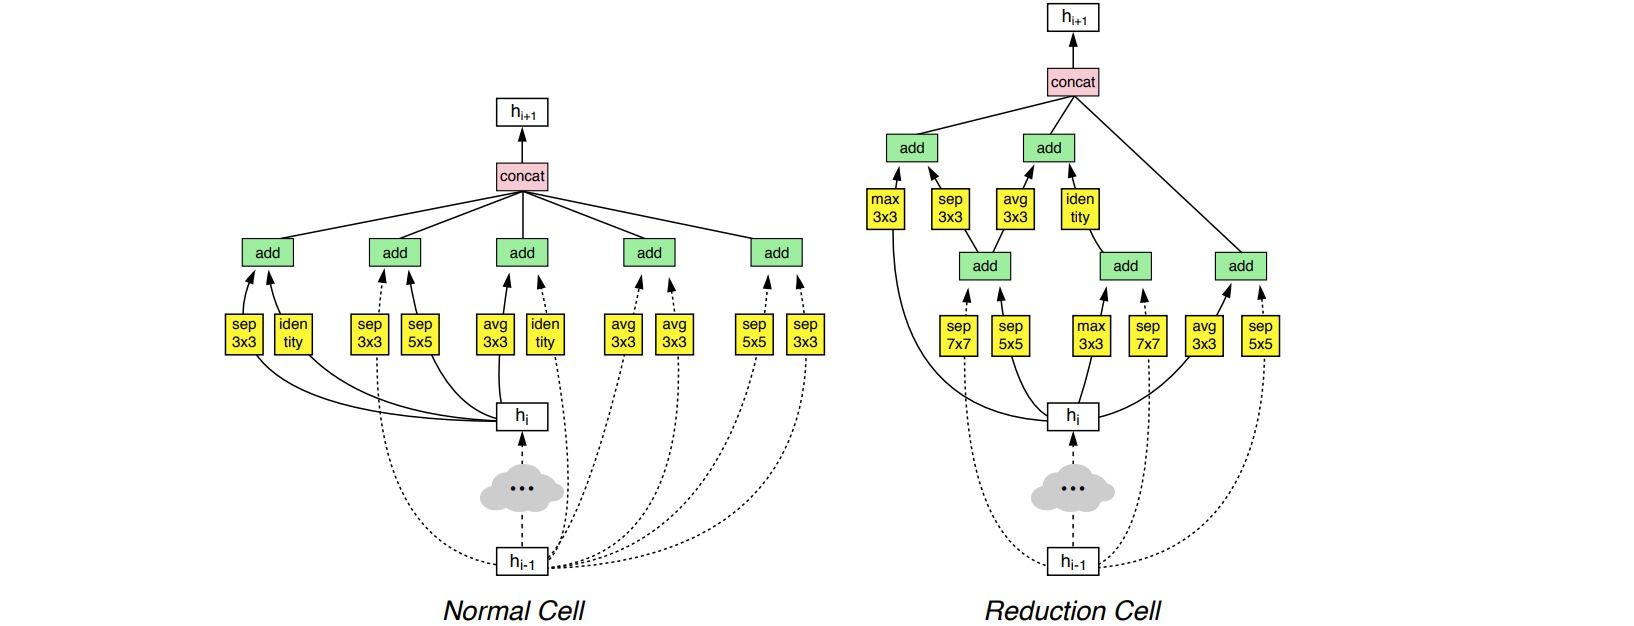
直接在大数据集上搜索完整网络代价过高,NASNet改为在小数据集(CIFAR-10)上搜索一个可堆叠的单元(cell),再迁移堆叠到ImageNet。搜索时预设了一组基本操作(不同尺寸卷积、池化、空洞卷积、深度可分离卷积),由控制器自动组合寻找最优拓扑。它验证了“搜索单元+堆叠”的范式,但搜索成本极高(约$500$块GPU)。
⚪ MnasNet:面向平台的架构搜索
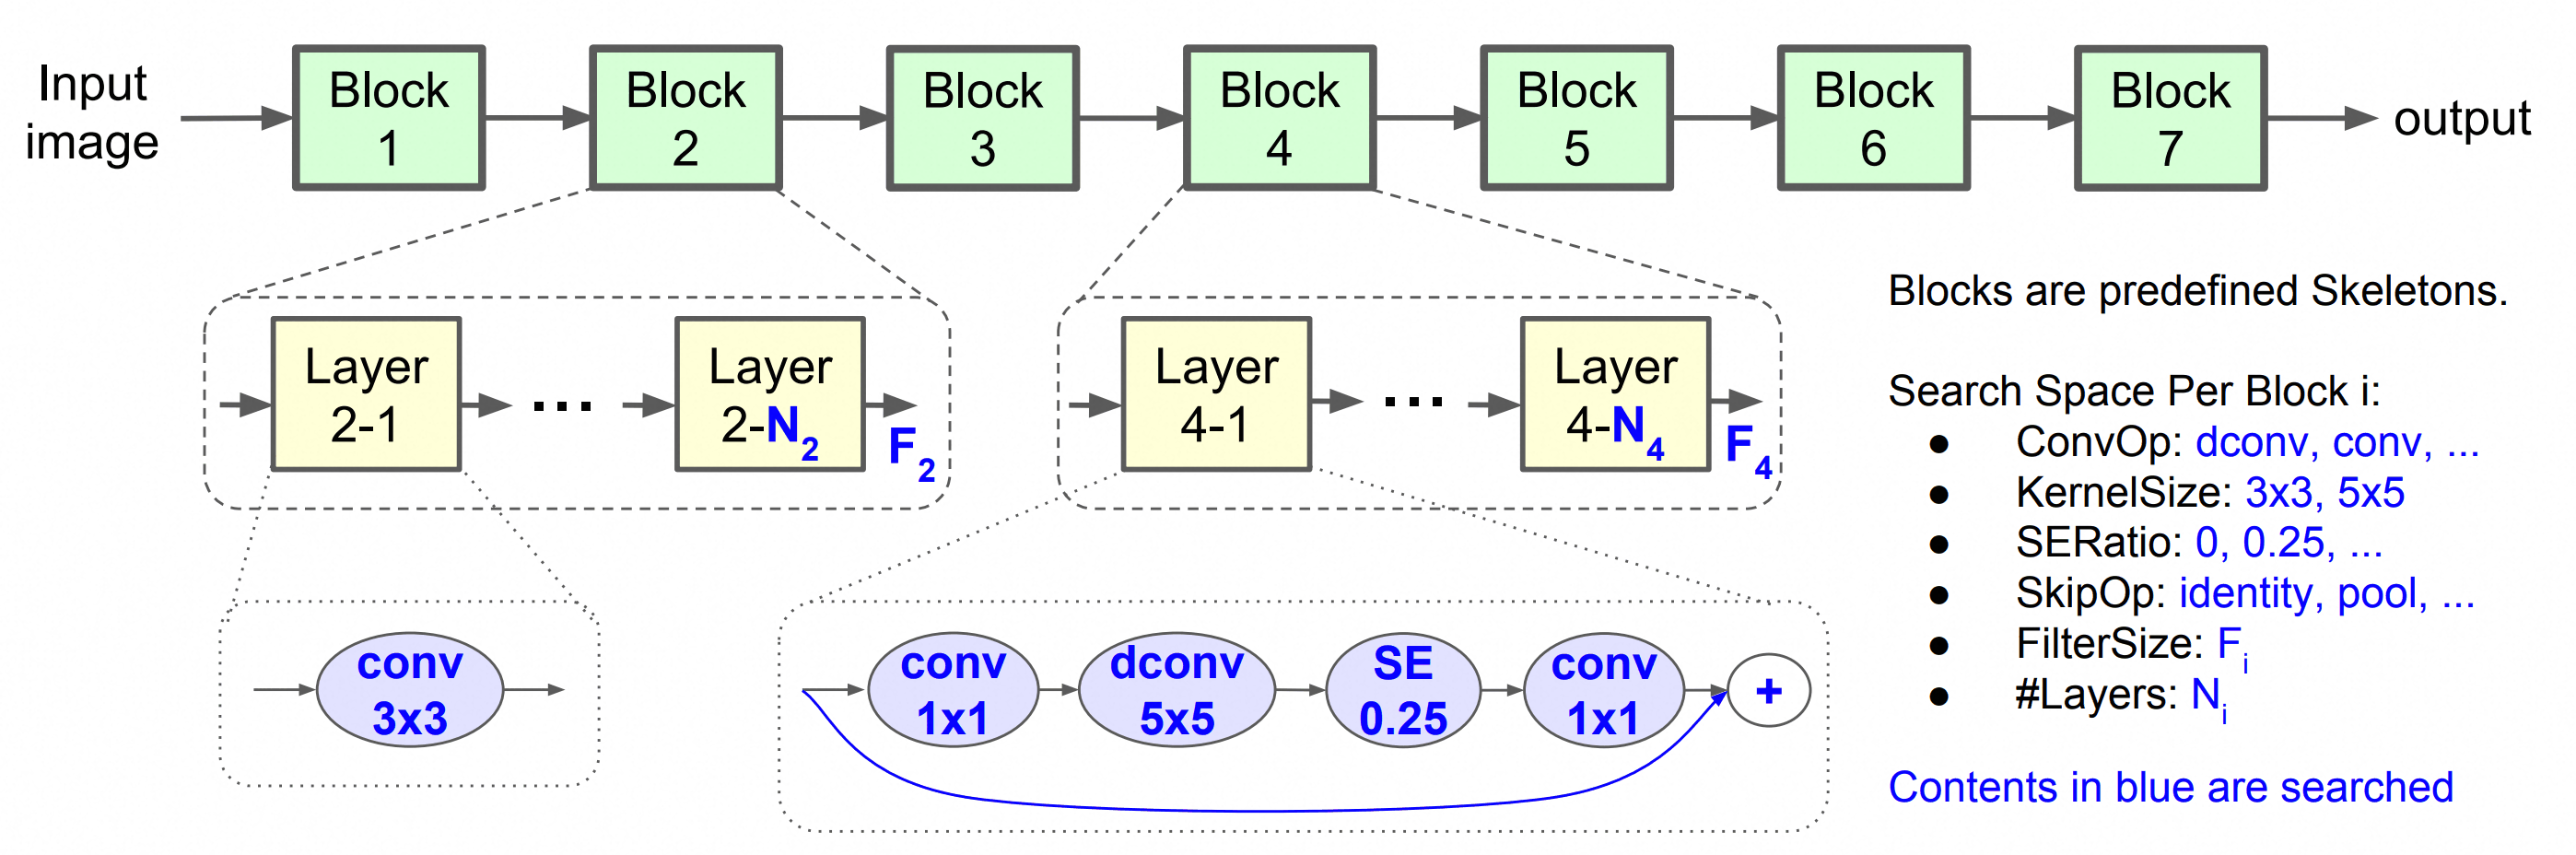
MnasNet把真实设备上的推理延迟直接写进搜索目标(而非用FLOPs近似),并采用分层的搜索空间允许不同阶段有不同结构。它搜出的移动端模型在精度-延迟权衡上明显优于人工设计,其搜索到的MBConv(带SE的倒残差块)也成为后续EfficientNet的基本构件。其多目标奖励把精度$ACC(m)$与延迟$LAT(m)$用软约束联合起来:
\[\mathop{\max}_{m} \ ACC(m) \times \left[\frac{LAT(m)}{T}\right]^{w}\]其中$T$是目标延迟,指数$w$控制精度与延迟的权衡(当$w<0$时超出目标延迟会被惩罚)。这样搜索出的模型不是一味追求最高精度,而是在给定延迟预算下取得最佳精度。
⚪ DARTS:可微架构搜索
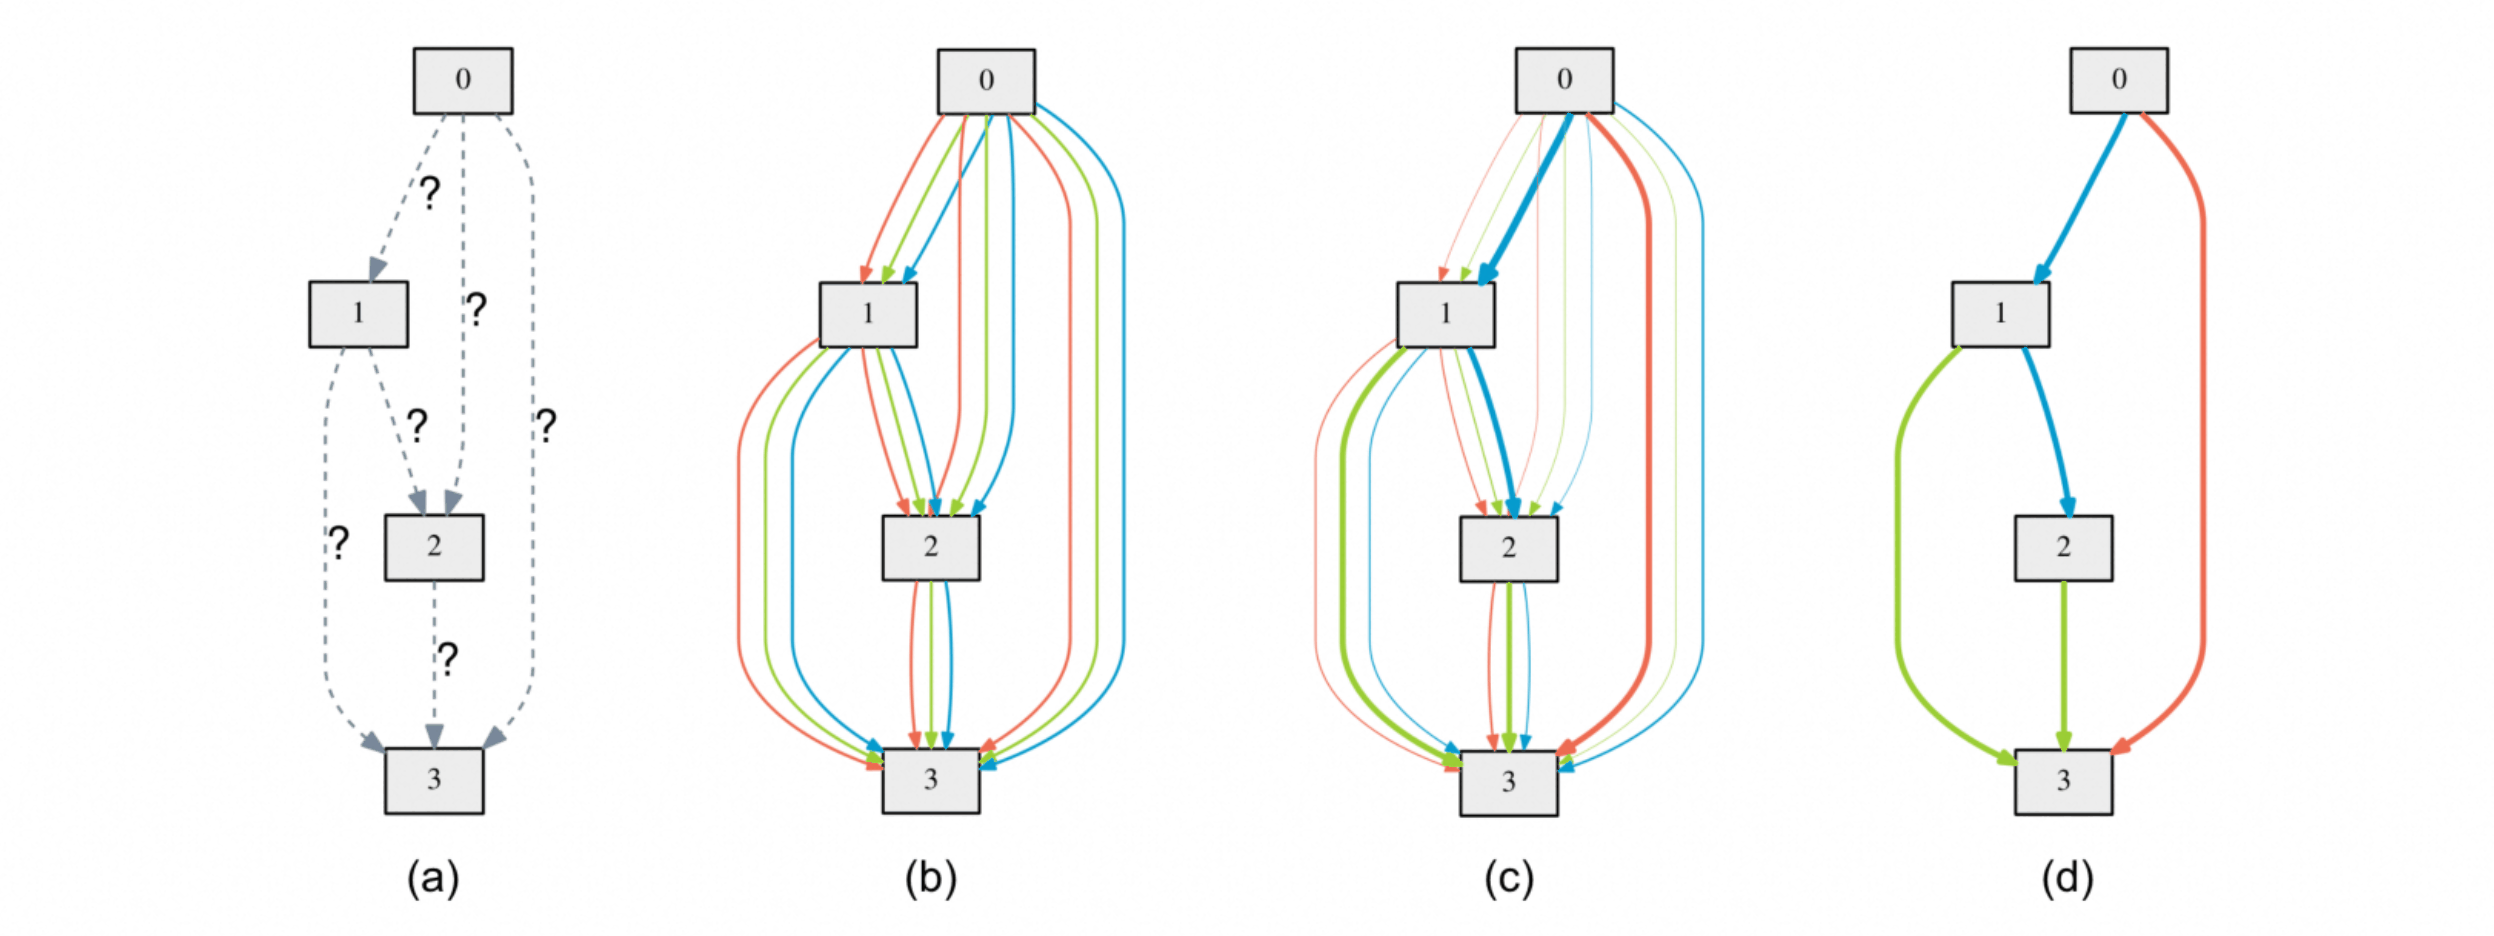
早期NAS依赖强化学习或进化算法,需要成百上千GPU天。DARTS把离散的“选哪个操作”连续松弛为对候选操作的加权(权重经softmax归一化),从而可以用梯度下降在一个超网络(supernet)上联合优化结构参数与权重参数,把搜索成本降到单卡数天量级。它开启了可微/权重共享 NAS的方向。
⚪ EfficientNet:复合缩放
EfficientNet指出,深度$d$、宽度$w$、分辨率$r$三个维度不应孤立缩放——单独放大任一维度都会较快遇到收益递减。作者提出复合缩放(compound scaling):用一个系数$\phi$按固定比例同时缩放三者,
\[d = \alpha^\phi, \quad w = \beta^\phi, \quad r = \gamma^\phi, \\ \text{s.t. } \alpha \cdot \beta^2 \cdot \gamma^2 \approx 2,\ \alpha,\beta,\gamma \geq 1\]其中$\alpha,\beta,\gamma$通过在小模型上做一次网格搜索确定(约束保证每增大一个单位的$\phi$、总FLOPs约翻倍)。以NAS搜出的EfficientNet-B0为基线,按$\phi$放大得到B1–B7系列,在当时以远更少的参数和计算量取得了SOTA精度。
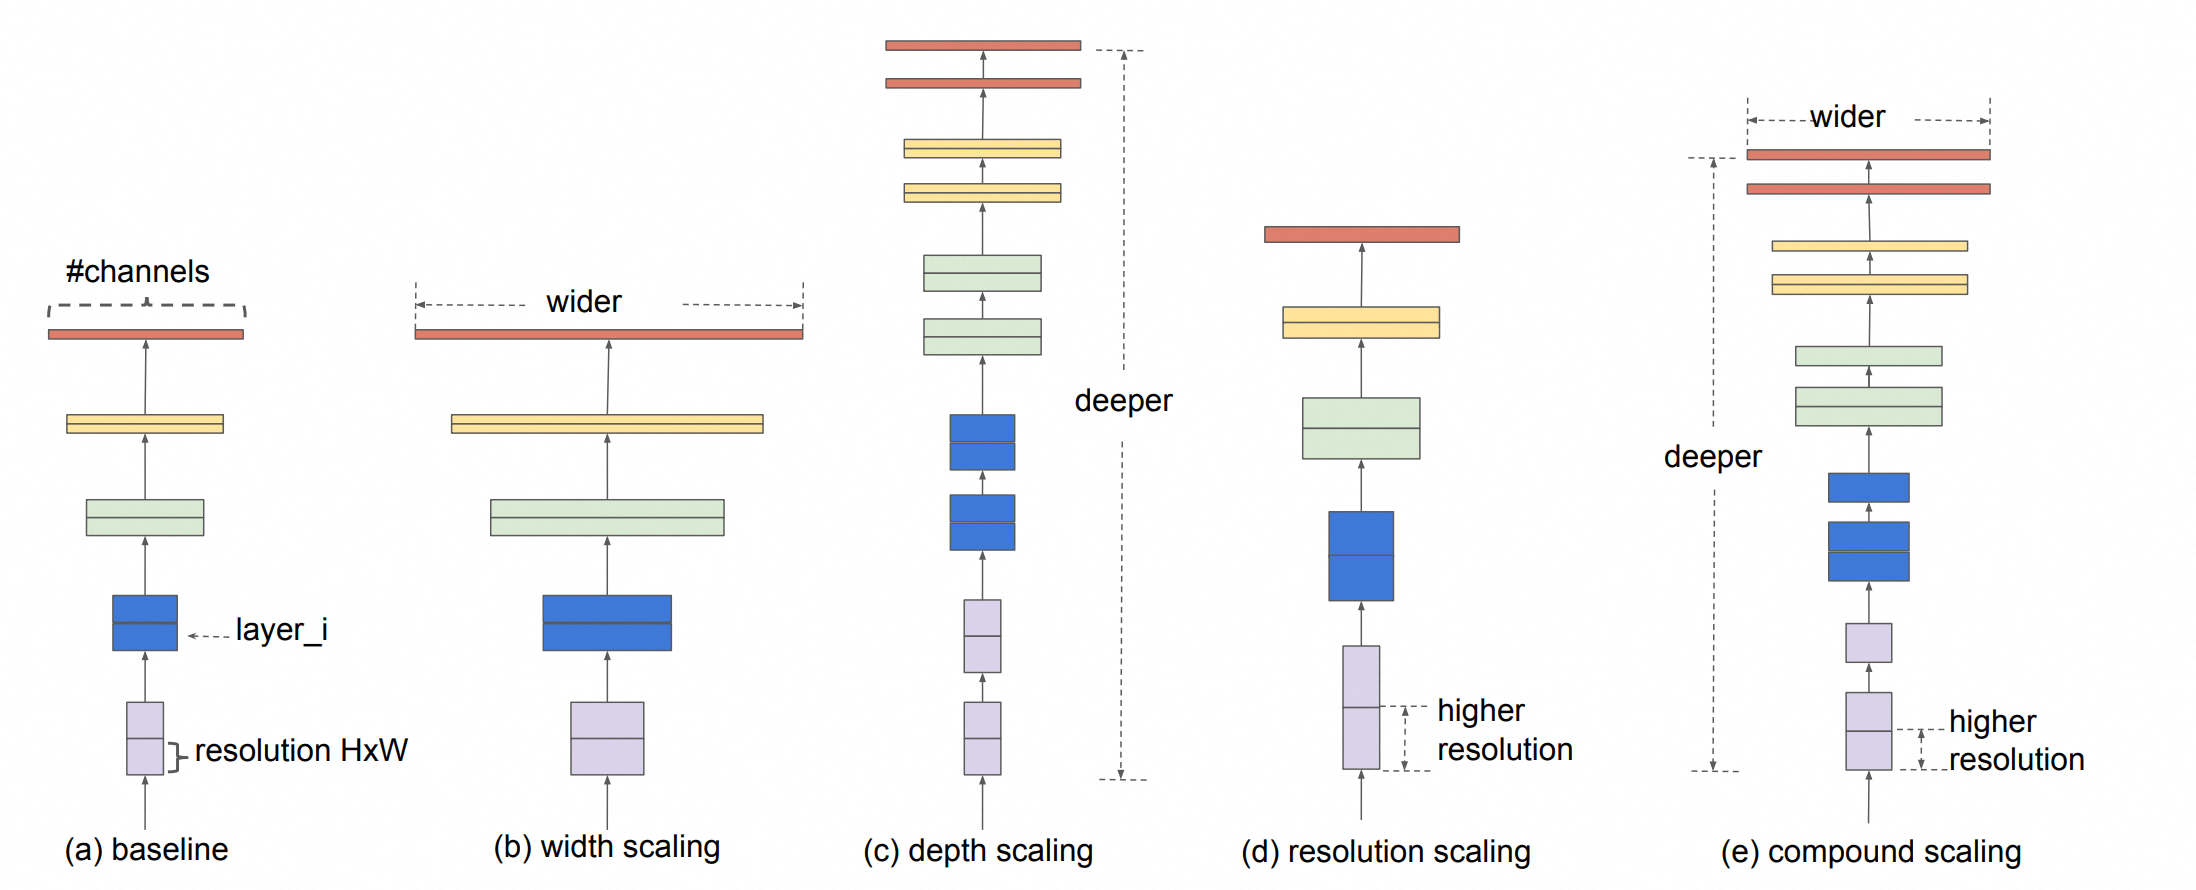
联合缩放的直觉在于三个维度彼此耦合:
- 分辨率$r$增大后,需要更深的网络(更大$d$)才能覆盖更大的感受野,也需要更宽的网络(更大$w$)才能捕获更细粒度的特征;
- 单独放大任一维度都会较快饱和:更深易受梯度与优化难度限制,更宽难以学到高层语义,更高分辨率则边际收益递减;
- 因此在给定算力预算下,按固定比例同时放大三者,往往比把预算全押在单一维度更优。
⚪ EfficientNetV2:训练感知的缩放
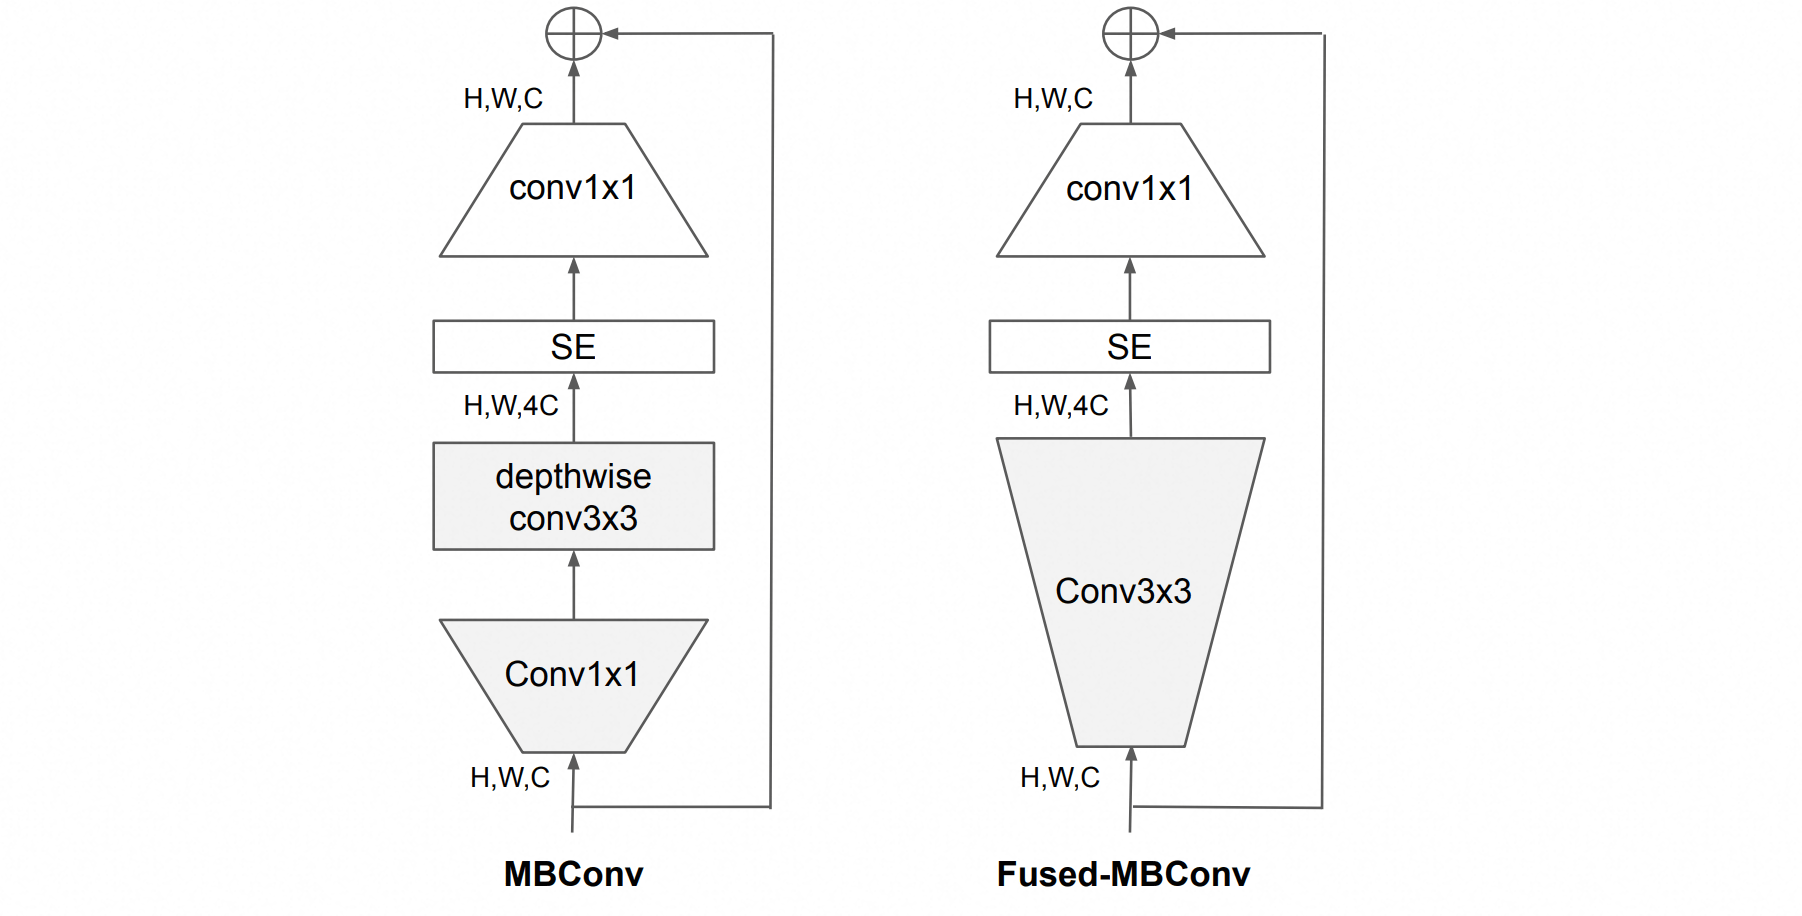
EfficientNetV2发现原版存在两个训练瓶颈:超大分辨率下的深度可分离卷积在浅层反而很慢,且大分辨率训练占用巨大显存。为此它在训练感知的 NAS中引入Fused-MBConv(把倒残差里的深度卷积与扩张$1\times 1$卷积融合成一个普通$3\times 3$卷积)用于浅层,并提出渐进式学习(progressive learning):训练早期用小分辨率+弱正则、后期逐步增大分辨率并同步增强正则。二者结合使训练速度和精度同时提升。
⚪ RegNet:量化的设计空间
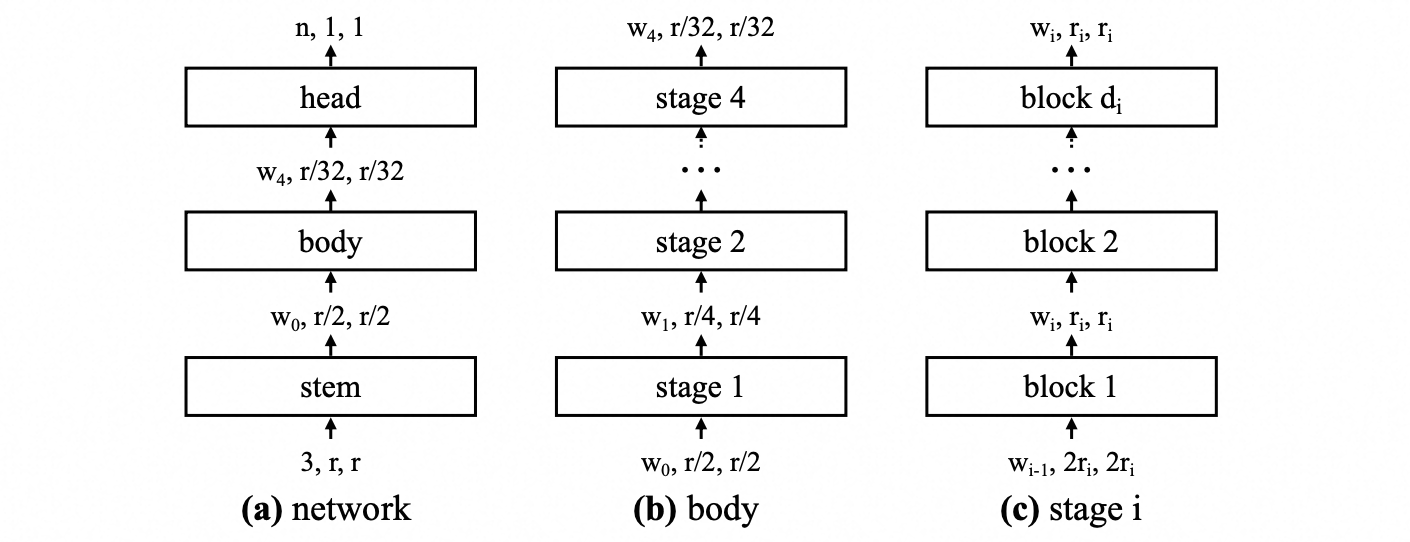
与其搜索“单个最优网络”,RegNet主张设计更好的设计空间(design space)。作者从一个宽松的空间出发,通过统计分析不断施加约束、逐步收缩到高质量子空间RegNet,并得到一个简洁结论:好网络各阶段的宽度与深度可以用一个量化的线性函数描述。具体地,第$j$个块的宽度先由一条线性规律给出,再量化到若干离散档位:
\[u_j = w_0 + w_a \cdot j, \quad 0 \leq j < d\]其中$w_0$为初始宽度、$w_a$为斜率、$d$为总深度;随后把$u_j$按公比$w_m$量化并分组,得到每个阶段常数的宽度。
2. 图像识别技巧
(1)分类的训练配方与稳定性
同一个架构,在不同训练配方下的精度可能相差好几个百分点。因此“训练配方(training recipe)”本身就是一个独立且极其重要的研究视角——它决定了我们能否公平地判断一个结构改进的真实收益。
⚪ Bag of Tricks:图像分类的训练技巧
这篇工作系统整理了在几乎不改变模型复杂度的前提下提升精度的技巧,分三类:
- 高效训练:大 batch 下的线性缩放学习率、学习率warmup、把残差块末尾BatchNorm的$\gamma$初始化为$0$、只对权重做衰减而不衰减偏置;以及float16混合精度训练。
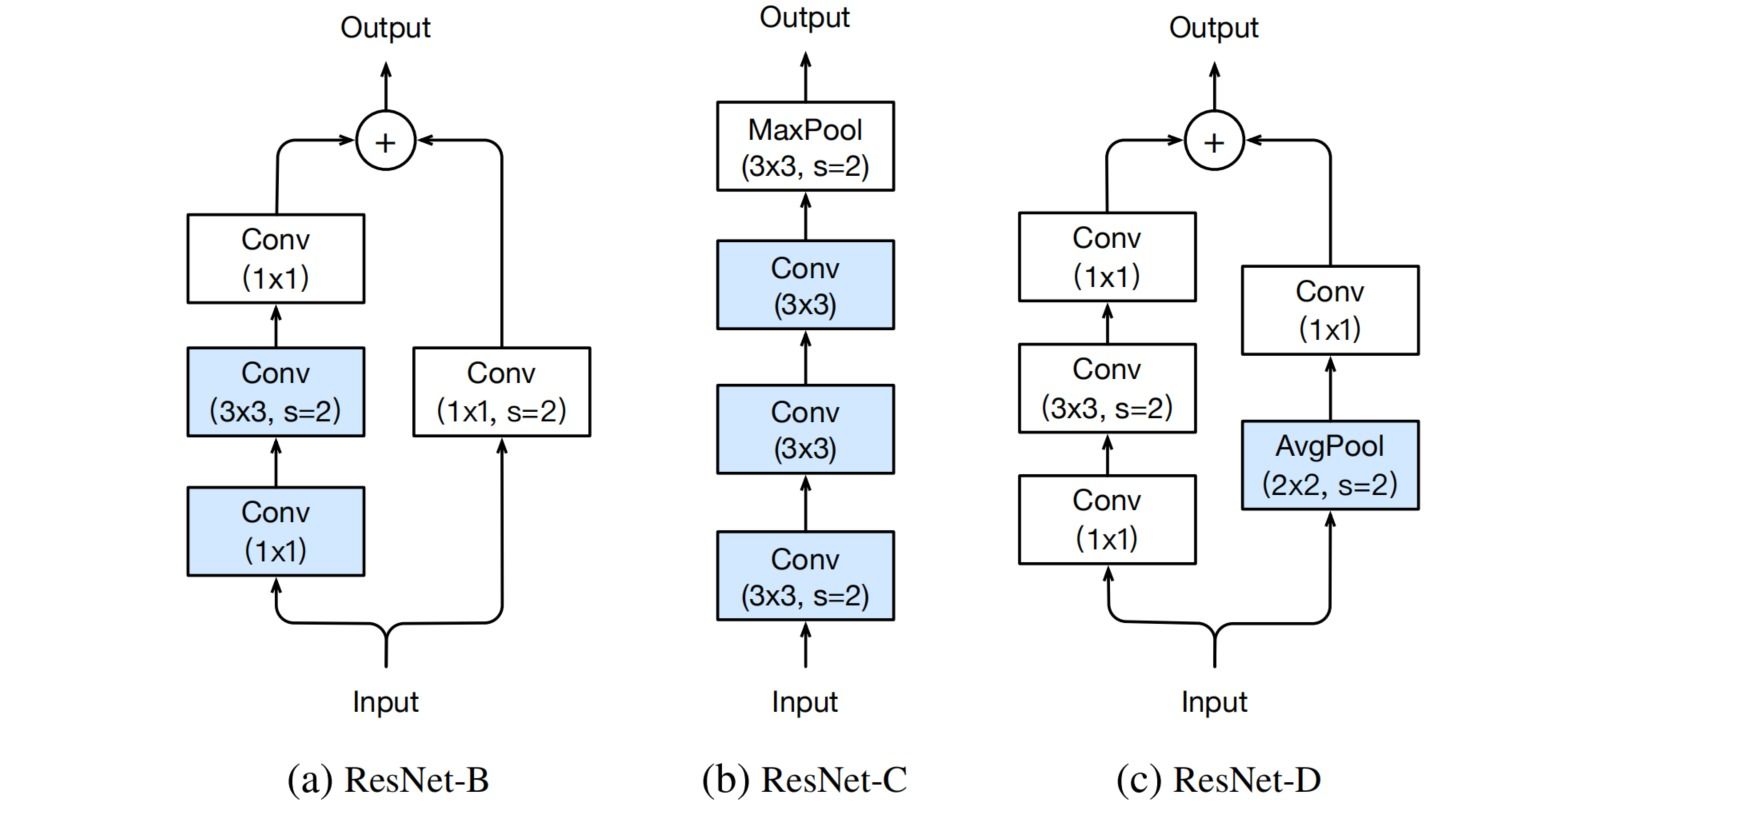
- 模型微调:对ResNet下采样模块的几处小改动(ResNet-B/C/D),如把损失信息的步长$2$的$1\times 1$卷积改为步长$1$、把$7\times 7$stem拆成三个$3\times 3$、在跳连中用$2\times 2$平均池化替代步长$2$的$1\times 1$卷积——几乎不增加计算量却明显提升精度。
- 训练改进:余弦学习率衰减、标签平滑(label smoothing)、知识蒸馏、Mixup。其中标签平滑把硬标签$q_y=1$改为:
从而缩小正确类与错误类得分间的gap、避免过度自信,提升泛化。这些技巧叠加可把ResNet-50的精度提升数个百分点,并能迁移到检测、分割等下游任务。
⚪ ResNet strikes back:现代配方下的ResNet
这项工作用一套现代训练流程(LAMB/AdamW优化、强数据增强RandAugment/Mixup/CutMix、Binary Cross-Entropy损失、重复增强、长训练等)重新训练原始结构不变的 ResNet-50,把其ImageNet top-1 从经典的约$76\%$提升到$80\%$以上。
它给出了一个极具警示意义的结论:很多号称超越 ResNet 的新架构,其增益可能只是因为使用了更好的训练配方;只有把ResNet也放在同样的配方下,比较才有意义。
⚪ ResNet-RS:把缩放与训练分开评估
一个模型的综合性能由网络结构、训练方法、缩放策略三者共同决定,但许多工作把新结构与旧训练配方下的经典模型(如ResNet)对比,这并不公平。
ResNet-RS给经典ResNet加上现代训练/正则方法(把精度从$79.0\%$提到$82.2\%$)和微小结构改进(如ResNet-D式下采样、加入SE,再提到$83.4\%$),并系统研究缩放:
- 不同训练轮数下最优缩放策略不同:大训练轮数下优先加深,小训练轮数下优先加宽;
- 增大分辨率存在收益递减,应缓慢扩大;
- 用小模型、短训练估计最终精度并不安全。
结论是:经典ResNet在公平的训练与缩放下,速度-精度权衡可全面超过由NAS搜出的EfficientNet。
⚪ NFNet:无归一化的高性能网络
BatchNorm虽是训练稳定性的常用手段,却带来计算/显存开销、训练-推理差异、以及打破样本间独立性等问题。NFNet去掉了BatchNorm,转而用自适应梯度裁剪(Adaptive Gradient Clipping, AGC)保证大batch训练的稳定性——它裁剪的是梯度范数与参数范数之比:
\[\begin{aligned} G \leftarrow \begin{cases} \lambda \dfrac{\Vert W \Vert}{\Vert G \Vert} G, & \dfrac{\Vert G \Vert}{\Vert W \Vert} \geq \lambda \\ G, & \text{otherwise} \end{cases} \end{aligned}\]配合精心设计的无归一化残差块,NFNet在ImageNet上取得了当时SOTA的精度,说明归一化并非高性能的必要条件。
(2) 少标注学习范式
前面的方法都假设有大量带标注的ImageNet数据。当标注稀缺时,还有另一条提升识别性能的路径:利用无标注数据。
⚪ Noisy Student:带噪声的自训练
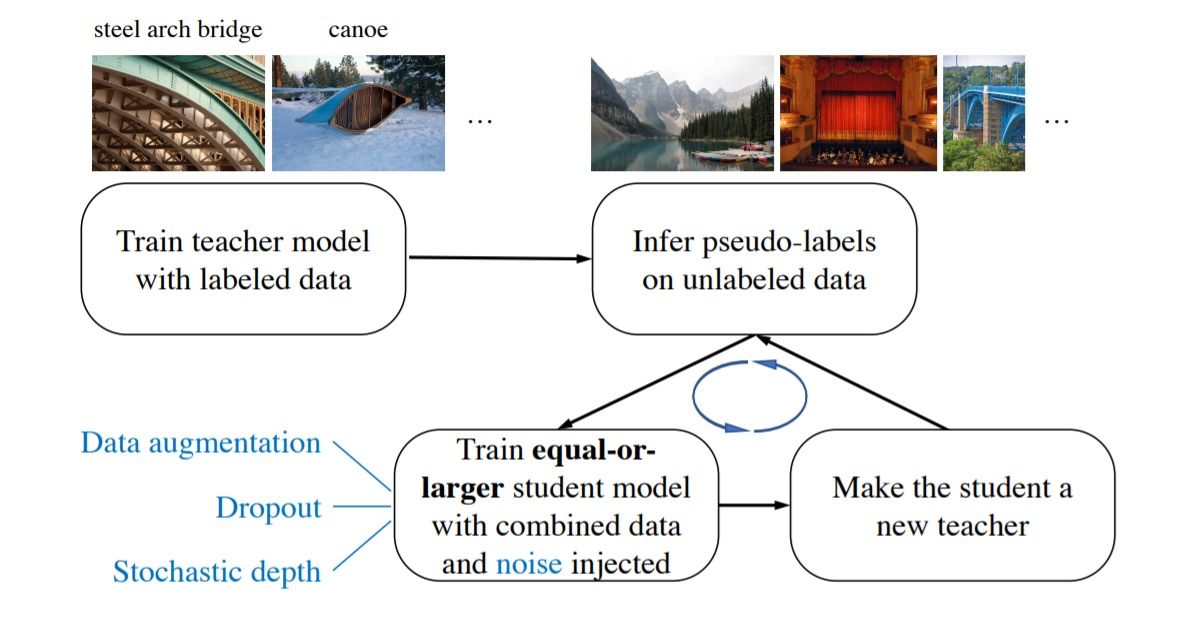
Noisy Student是一种半监督方法,通过“自训练(self-training)”的迭代放大无标注数据的价值:
- 用标注数据训练一个教师网络;
- 用(无噪声的)教师对大量无标注数据打伪标签;
- 训练一个容量相等或更大的学生网络同时学习标注数据与伪标签数据,并在学生端注入噪声(数据增强、Dropout、随机深度);
- 把训练好的学生作为新教师,重复上述过程。
关键在于“学生更大”与“给学生加噪”:教师给出干净伪标签,学生在更难的条件下学习,因而能超过教师。以EfficientNet为骨干,它在当时刷新了ImageNet精度。
⚪ Meta Pseudo Labels:让教师被学生反馈优化
- paper:Meta Pseudo Labels
普通伪标签方法中,教师是固定的,如果它的伪标签有偏差,学生会一直被带偏。Meta Pseudo Labels让教师和学生同时训练:学生用教师的伪标签学习,而教师则根据“学生在有标注验证集上的表现”这一元目标被反过来更新。这样教师会朝着“生成对学生更有益的伪标签”的方向演化,进一步刷新了ImageNet精度。
它本质上是一个双层优化(bi-level optimization):内层用教师伪标签更新学生参数$\theta_S$,外层用更新后学生在标注数据上的损失来更新教师参数$\theta_T$:
\[\begin{aligned} \mathop{\min}_{\theta_T} &\mathcal{L}_{labeled}\left(\theta_S^{*}(\theta_T)\right), \\ \text{s.t. } &\theta_S^{*}(\theta_T) = \mathop{\arg\min}_{\theta_S} \mathcal{L}_{pseudo}(\theta_T, \theta_S) \end{aligned}\]由于严格求解内层最优代价高昂,实际实现用一步梯度近似把外层梯度回传给教师,从而让教师与学生交替更新、相互适配。
⚪ SCAN:无标注的图像聚类分类
SCAN是一种无监督图像分类方法,把任务拆成两步。第一步特征学习:用自监督表示学习让网络对图像$X$及其变换$T[X]$输出相近特征,
\[\mathop{\min}_{\theta} d\left(\Phi_\theta(X_i), \Phi_\theta(T[X_i])\right)\]第二步聚类:对每张图像在特征空间中找最近邻的$k$个样本,通过调整网络最大化图像特征与这些近邻的相似度,同时用聚类给出伪类别并最大化其归属概率。由此在完全没有人工标签的情况下得到语义上合理的分类。
3. 图像识别基准与分布外测试集
(1) 常用训练基准
常见的图像识别训练基准包括MNIST、CIFAR、Places2、Cats vs Dogs、ImageNet(及其大规模版本)、PASCAL VOC。
⚪ MNIST(Mixed National Institute of Standards and Technology)
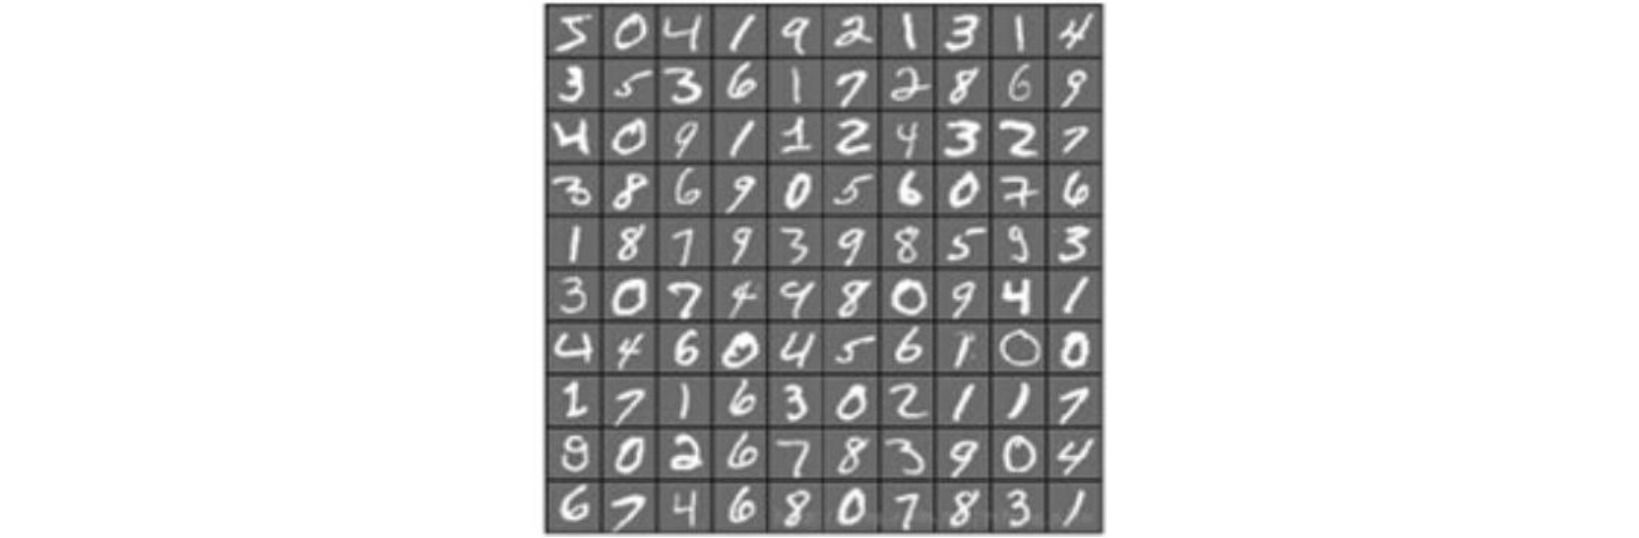
MNIST是由Yann LeCun整理的手写数字识别数据集。训练集含$60000$张图像,测试集含$10000$张,每张都做过尺度归一化和数字居中处理,固定尺寸$28\times 28$。它是验证新方法的“Hello World”,但过于简单,早已饱和。
⚪ CIFAR(Canada Institute For Advanced Research)
CIFAR是小图片数据集,含CIFAR-10与CIFAR-100两个版本。
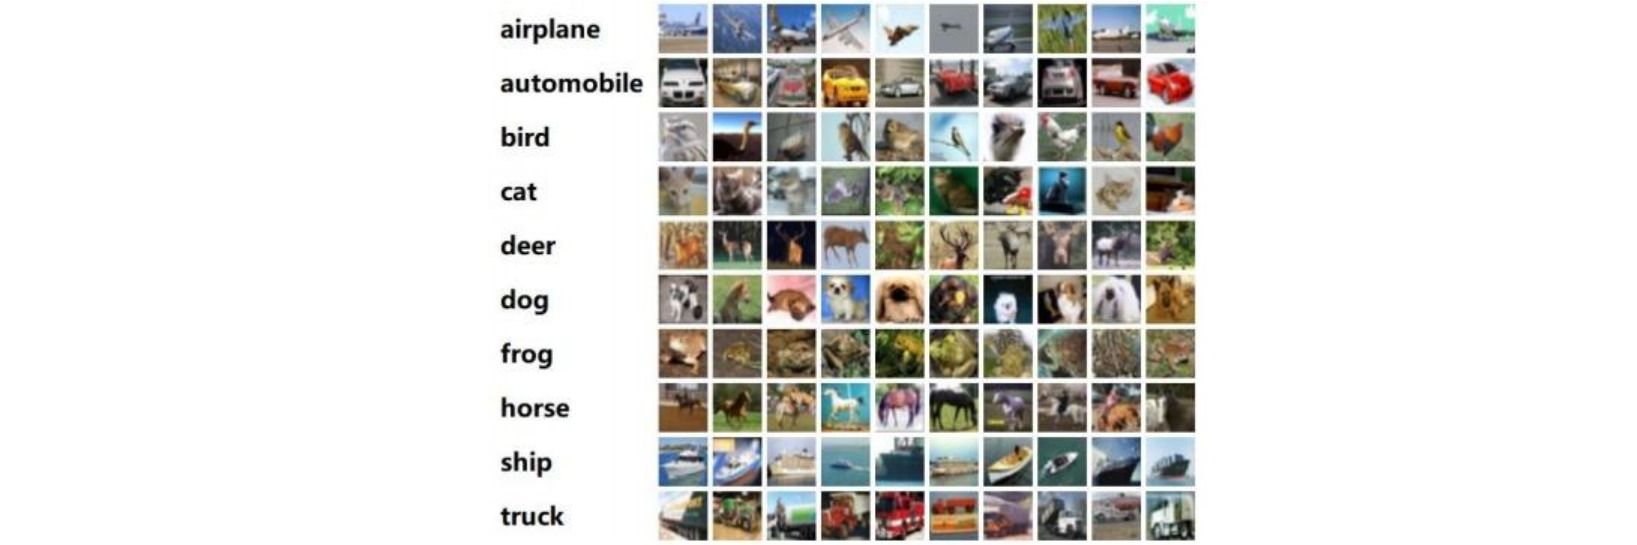
- CIFAR-10:$60000$张$32\times 32$的RGB彩色图,共$10$类,其中$50000$张训练、$10000$张测试。
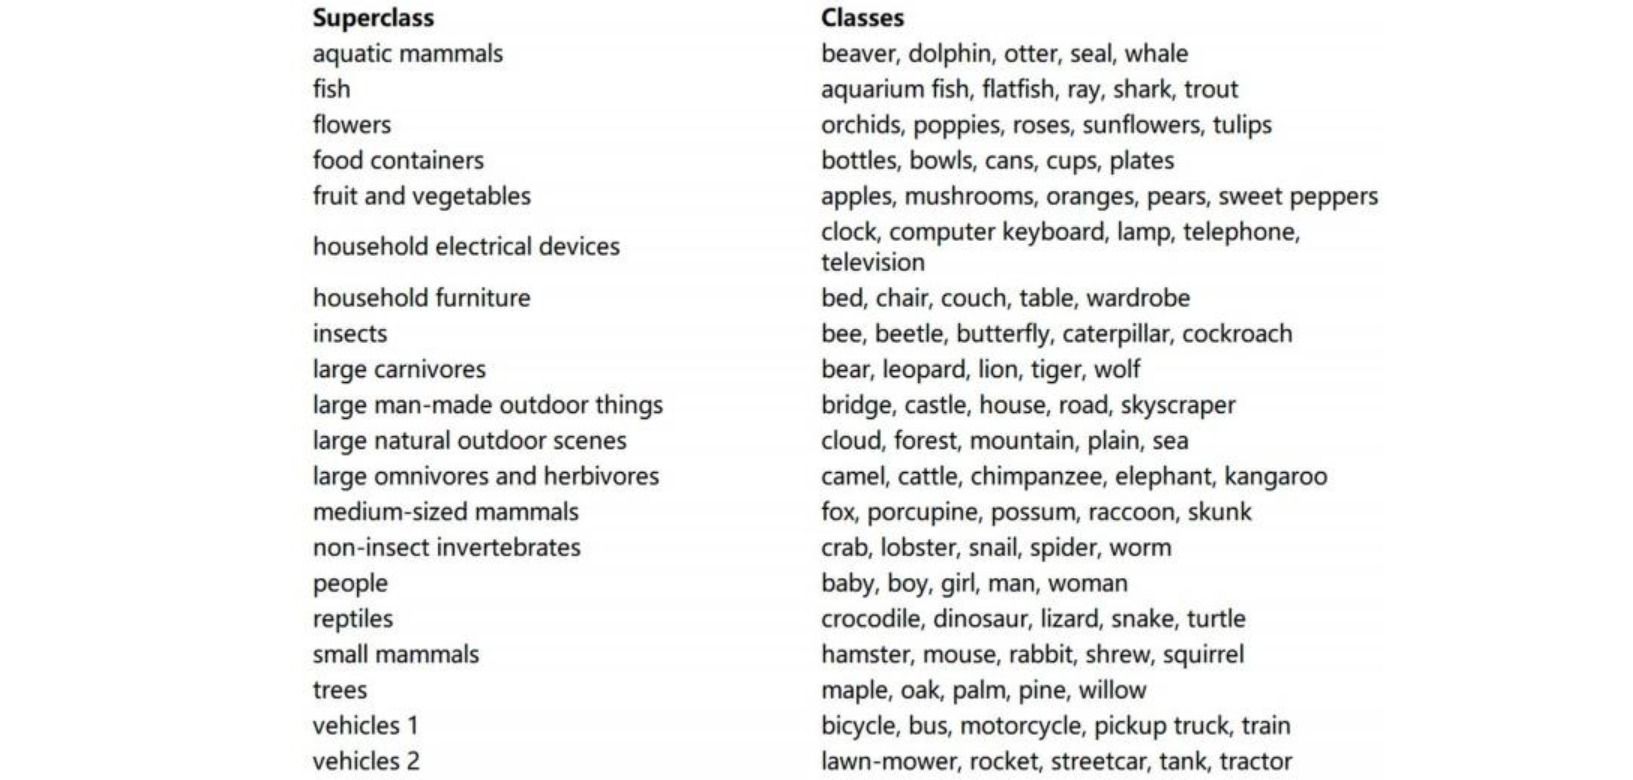
- CIFAR-100:$60000$张图,$100$个类别,每类$600$张($500$训练、$100$测试);这$100$类又归入$20$个大类,每张图带小类与大类两个标签。
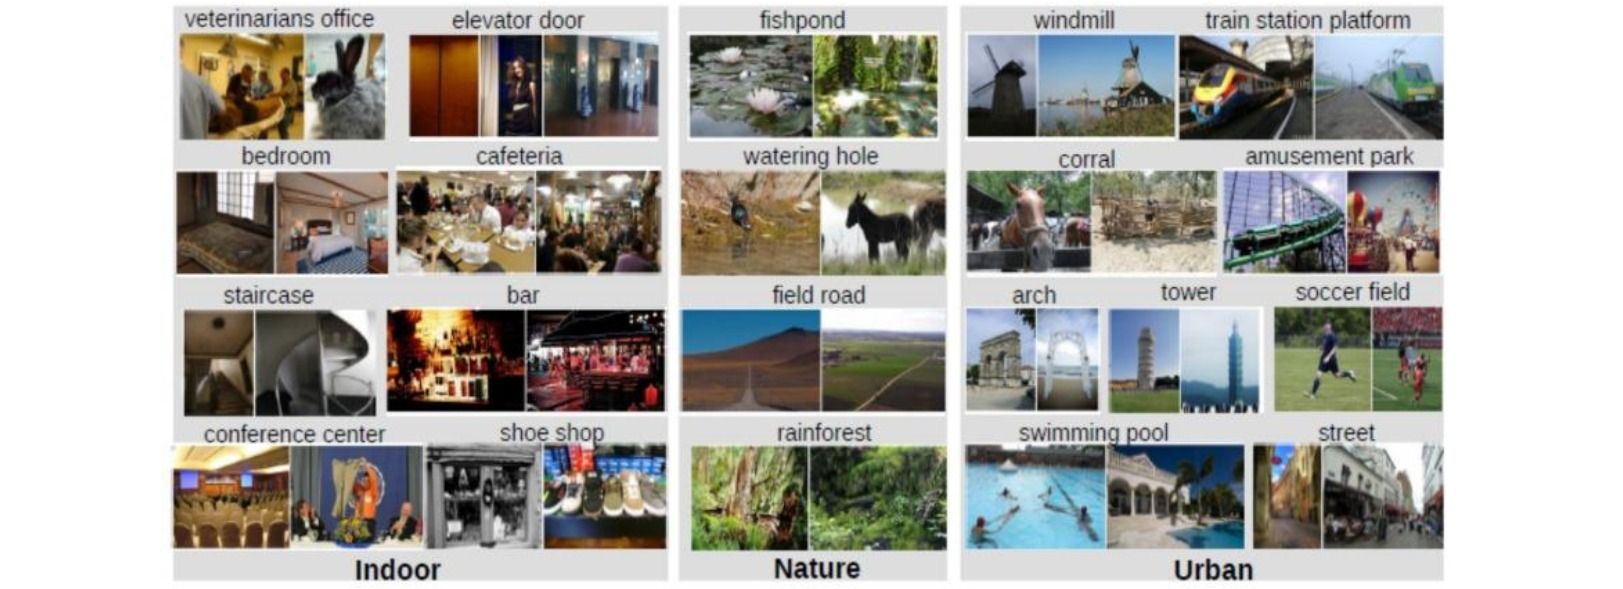
⚪ Places2
Places2是MIT开发的场景图像数据集,可用于以场景和环境为内容的视觉认知任务。它包含约一千万张图片、$400$多个场景类别,每类$5000$–$30000$张。
⚪ Cats vs Dogs
Cats vs Dogs是Kaggle上的猫狗二分类数据集,共$25000$张图片,猫、狗各$12500$张,常用于入门与快速验证。
⚪ ImageNet 与 ImageNet-21k
ImageNet是由李飞飞团队建立的大规模图像识别数据库,包含约$1400$万张图像、$2$万余个类别。基于它举办的ILSVRC(ImageNet Large-Scale Visual Recognition Challenge)是图像识别领域最重要的赛事,其常用子集ImageNet-1K有$1000$类、约$120$万张训练图像、$5$万张验证、$15$万张测试,催生了一大批著名卷积网络。
更大的ImageNet-21K(约$1400$万张、$2$万余类)近年被证明是极佳的预训练数据集。ImageNet-21K Pretraining for the Masses提供了标准化的预处理与训练流程,使普通算力也能受益于$21$K预训练;类似地,Big Transfer (BiT)也表明大规模上游预训练能显著改善下游迁移。ViT / ConvNeXt 等大模型的强表现,很大程度上依赖这类大规模预训练。
⚪ PASCAL VOC
PASCAL VOC是视觉对象分类、检测与分割的经典基准,提供了标准的图像标注和评估系统,常用版本有VOC2007与VOC2012。
(2) 分布外与鲁棒性测试集
只在与训练集同分布的验证集上刷精度是危险的:模型可能过拟合到该数据集的采样偏差。Do ImageNet Classifiers Generalize to ImageNet?按原始流程重新采集了新的ImageNet测试集(即ImageNet-V2),发现所有模型的精度都出现系统性下降(约$11$–$14$个百分点),且新旧测试集上的精度近似满足一条斜率大于$1$的线性关系。作者把差距拆分为三部分:Adaptivity gap(原测试集被反复调参带来的误差)、Distribution gap(两数据集分布不同带来的误差,是主因)与Generalization gap(新测试集采样误差)。
结论是差距主要来自分布差异。这提醒我们:同分布验证精度不能完全代表泛化能力,必须辅以分布外(out-of-distribution, OOD)评测。常用的分布外/鲁棒性测试集包括:
- ImageNet-V2:Do ImageNet Classifiers Generalize to ImageNet?,同流程复采的新测试集,度量对采样偏差的敏感度;
- ImageNet-A:Natural Adversarial Examples,收集自然界中被分类器持续误判的“自然对抗样本”,暴露模型对纹理/背景的过度依赖;
- ImageNet-R:The Many Faces of Robustness,包含艺术画、卡通、涂鸦、雕塑等多种渲染(rendition)风格,度量对语义不变的风格变化的鲁棒性;
- ImageNet-Sketch:Learning Robust Global Representations by Penalizing Local Predictive Power,全部为黑白手绘素描,考验模型是否学到了形状而非纹理;
- ImageNet-C:Benchmarking Neural Network Robustness to Common Corruptions and Perturbations,对图像施加噪声、模糊、天气、数字化等$15$类、$5$档强度的损坏(corruption),度量对常见退化的鲁棒性。