Explainable Artificial Intelligence.
解释是信任的来源。深度学习模型能够从高维数据中学习复杂映射,但高预测性能并不自动带来可理解性。当模型用于医疗、金融、自动驾驶、科学发现或内容生成时,人们不仅关心“模型给出了什么结果”,还会追问:哪些输入证据推动了结果?内部表征编码了什么概念?训练数据如何影响当前行为?某个计算回路是否真正参与了决策?
所谓可解释性(Interpretability),是把模型的输入、内部状态、训练过程和输出之间的关系转化为可以检验的描述;可说明性(Explainability)更强调向特定受众提供能够理解和使用的说明。二者常被混用:可靠解释必须先说明解释对象,再说明使用了什么干预或近似,最后用与该对象匹配的指标验证。
- 可解释性的分类
- 1.1 内在可解释性 vs. 事后可解释性
- 1.2 模型特定 vs. 模型无关
- 1.3 局部可解释性 vs. 全局可解释性
- 可解释性的归因方法
- 2.1 输入归因 - 哪些输入证据推动了结果?
- 2.2 特征归因 - 内部表征编码了什么概念?
- 2.3 数据归因 - 训练数据如何影响当前行为?
- 2.4 机制归因 - 某个计算回路是否真正参与了决策?
- LLM、多模态与生成模型解释
- 如何评估解释
1. 可解释性的分类
1.1 内在可解释性 vs. 事后可解释性 (Intrinsic vs. Post-hoc)
这个分类法关注的是“解释”这一行为发生在模型生命周期的哪个阶段。
内在可解释性 (Intrinsic Interpretability)
这类模型因其自身结构的简单性而天生易于理解,不需要额外的工具就能直接洞察其决策逻辑:
- 线性回归/逻辑回归: 可以直接查看和解释每个特征的权重(coefficients)。一个大的正权重意味着该特征对预测结果有强烈的正向影响。
- 决策树: 模型的决策过程可以被完整地可视化为一系列的“if else”规则。可以沿着树的路径,清晰地追踪任何一个决策是如何做出的。
- 广义加性模型 (GAMs): 它将模型的输出表示为每个特征的非线性函数的和,可以独立地可视化和理解每个特征对结果的影响曲线。
内在可解释性通常以牺牲模型的性能和复杂度为代价。在处理图像、文本等复杂数据时,这些简单模型往往力不从心。
事后可解释性 (Post-hoc Interpretability)
这类方法应用于那些本身结构复杂、难以直接理解的“黑盒”模型(如深度神经网络、集成树模型)。它们在模型训练完成之后,通过各种技术来分析和解释其行为。
常见的事后可解释性方法都是在不改变已训练好的模型的前提下,对其特定预测进行归因分析。此外还有反事实解释 (Counterfactual Explanations): 回答“如果输入的某个特征发生最小的改变,模型的预测会如何变化?”这类问题,从而揭示决策边界。它们允许我们使用性能最强大的黑盒模型,同时保留对其进行解释的能力。
1.2 模型特定 vs. 模型无关 (Model-specific vs. Model-agnostic)
这个分类法关注的是一个解释方法是否可以应用于任何类型的机器学习模型。
模型特定方法 (Model-specific)
这类方法的设计深度依赖于被解释模型的内部结构。它们通过利用模型的特定机制来提供更高效或更精确的解释。
- DeepLIFT 和 LRP 是典型的模型特定方法。它们的“传播规则”是专门为神经网络的逐层结构和激活函数设计的,无法应用于一个随机森林模型。
- TreeSHAP 也是模型特定的,它利用了决策树的分支结构来实现对Shapley值的快速计算。
- 查看随机森林的“特征重要性”(如基于基尼不纯度或排列重要性)也是一种模型特定的方法。
模型无关方法 (Model-agnostic)
这类方法将目标模型视为一个纯粹的“黑盒”,它们只关心模型的输入和输出,而不关心其内部工作原理。因此,它们具有极强的通用性。
- SHAP (作为框架) 本身是模型无关的。特别是 KernelSHAP,它通过采样和线性回归来工作,可以应用于任何能给出预测分数的模型。
- LIME 也是典型的模型无关方法,因为它只在模型外部进行扰动和局部拟合。
- 偏依赖图 (Partial Dependence Plots, PDP) 和 个体条件期望图 (Individual Conditional Expectation, ICE),它们通过系统性地改变一个特征的值并观察模型输出的变化来工作,同样是模型无关的。
1.3 局部可解释性 vs. 全局可解释性 (Local vs. Global)
这个分类法关注的是解释的目标范围:是解释单个预测,还是整个模型的宏观行为。
局部可解释性 (Local Interpretability)
这类方法旨在解释为什么模型对一个特定的输入样本做出了特定的预测。比如一张显示“猫”的图片,局部解释会生成一张热力图,高亮出猫的耳朵、胡须等区域。
全局可解释性 (Global Interpretability)
这类方法旨在解释模型作为一个整体的行为、模式和特征影响。
- 线性模型的权重提供了全局的解释。
- 决策树的整体结构就是一种全局解释。
- 对于黑盒模型,我们可以通过聚合大量的局部解释来获得全局洞察。例如,可以计算数据集中所有样本的SHAP值的绝对值的平均值,来得到一个全局的“特征重要性”排序。
- PDP 提供了某个特征在整个数据集上对模型输出的平均影响,是一种全局解释。
2. 可解释性的归因方法
归因(attribution)分析旨在将一个特定的【输出】(例如某个类别的logit值)的贡献,分配给一系列【输入单元】(输入归因、数据归因)、【特征】(特征归因)或【网络模块】(机制归因)。
2.1 输入归因
输入归因回答“当前输出依赖哪些输入部分”。
(1) 基于梯度与反向传播的归因
⚪ Saliency Map 与 SmoothGrad:用局部梯度及噪声平均描述输入敏感性
- Saliency Map:Deep Inside Convolutional Networks: Visualising Image Classification Models and Saliency Maps
最直接的显著性图计算目标得分对输入的梯度:
\[E_i^{\mathrm{grad}}(x,c)=\frac{\partial f_c(x)}{\partial x_i}.\]梯度的绝对值表示在当前位置做无穷小变化时,目标输出对$x_i$有多敏感。对于图像,可以在颜色通道上取最大值或范数,再把结果绘制成热力图:
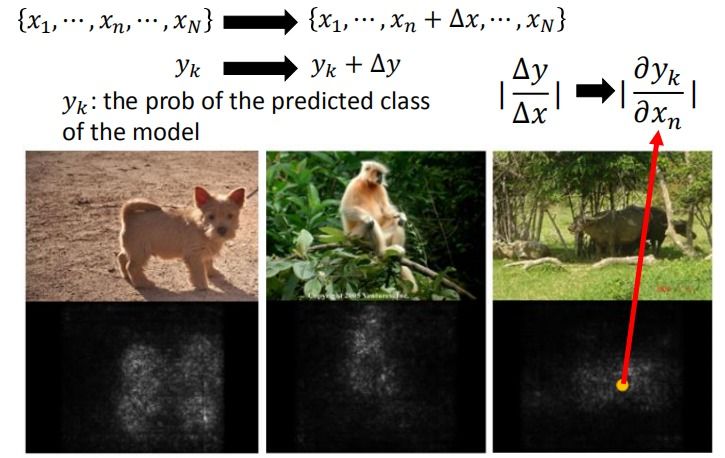
梯度方法只使用一次前向和反向传播,计算开销低,也能直接用于可微模型;但它是局部一阶近似。激活函数饱和时,重要特征的梯度也可能接近$0$;网络的高曲率和输入中的微小扰动会使显著性图呈现噪声;不同类别的梯度还可能非常相似。
- SmoothGrad:SmoothGrad: Removing Noise by Adding Noise
SmoothGrad不改变基础归因规则,而是在输入附近采样高斯噪声并平均多张显著性图:
\[\hat{E}(x,c)=\frac{1}{n}\sum_{k=1}^{n}E\left(x+\epsilon_k,c\right), \qquad \epsilon_k\sim\mathcal{N}(0,\sigma^2 I).\]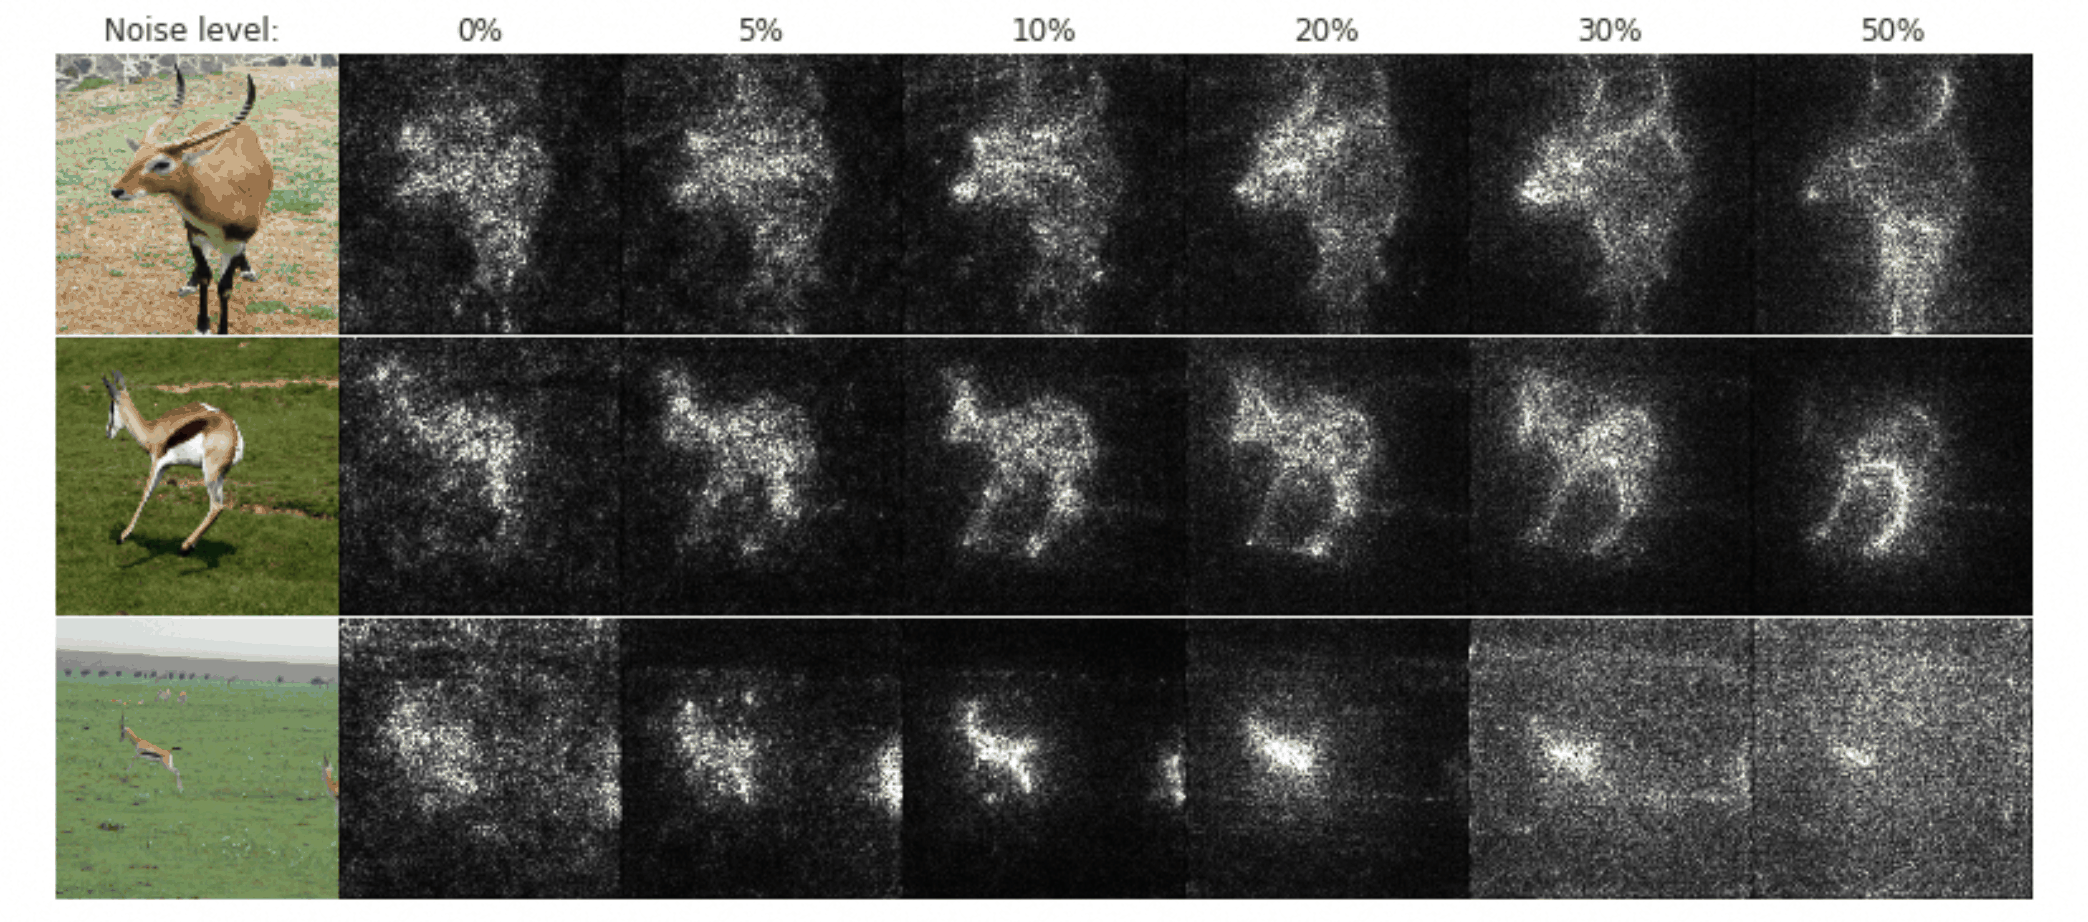
平均操作可以抑制局部高频噪声,但结果依赖噪声尺度、采样数量和基础归因方法。更平滑、更符合视觉直觉的热力图不一定更忠实;SmoothGrad也不能从根本上消除梯度饱和。
⚪ Integrated Gradients:沿参考基线到输入的路径积分梯度
Integrated Gradients(IG)选择参考输入$x’$,沿$x’$到$x$的直线路径积累梯度:
\[\mathrm{IG}_i(x)=\left(x_i-x_i'\right) \int_0^1 \frac{\partial f_c\left(x'+\alpha(x-x')\right)}{\partial x_i} \,\mathrm{d}\alpha.\]实际计算时使用$m$个离散点近似积分。参考输入$x’$的选择与任务类型有关:比如对于图像分类,将全黑图(0像素)作为基准,以输出预测类别中分数最高的类别进行归因,分析网络做出预测时哪些像素点提供了最重要的贡献。
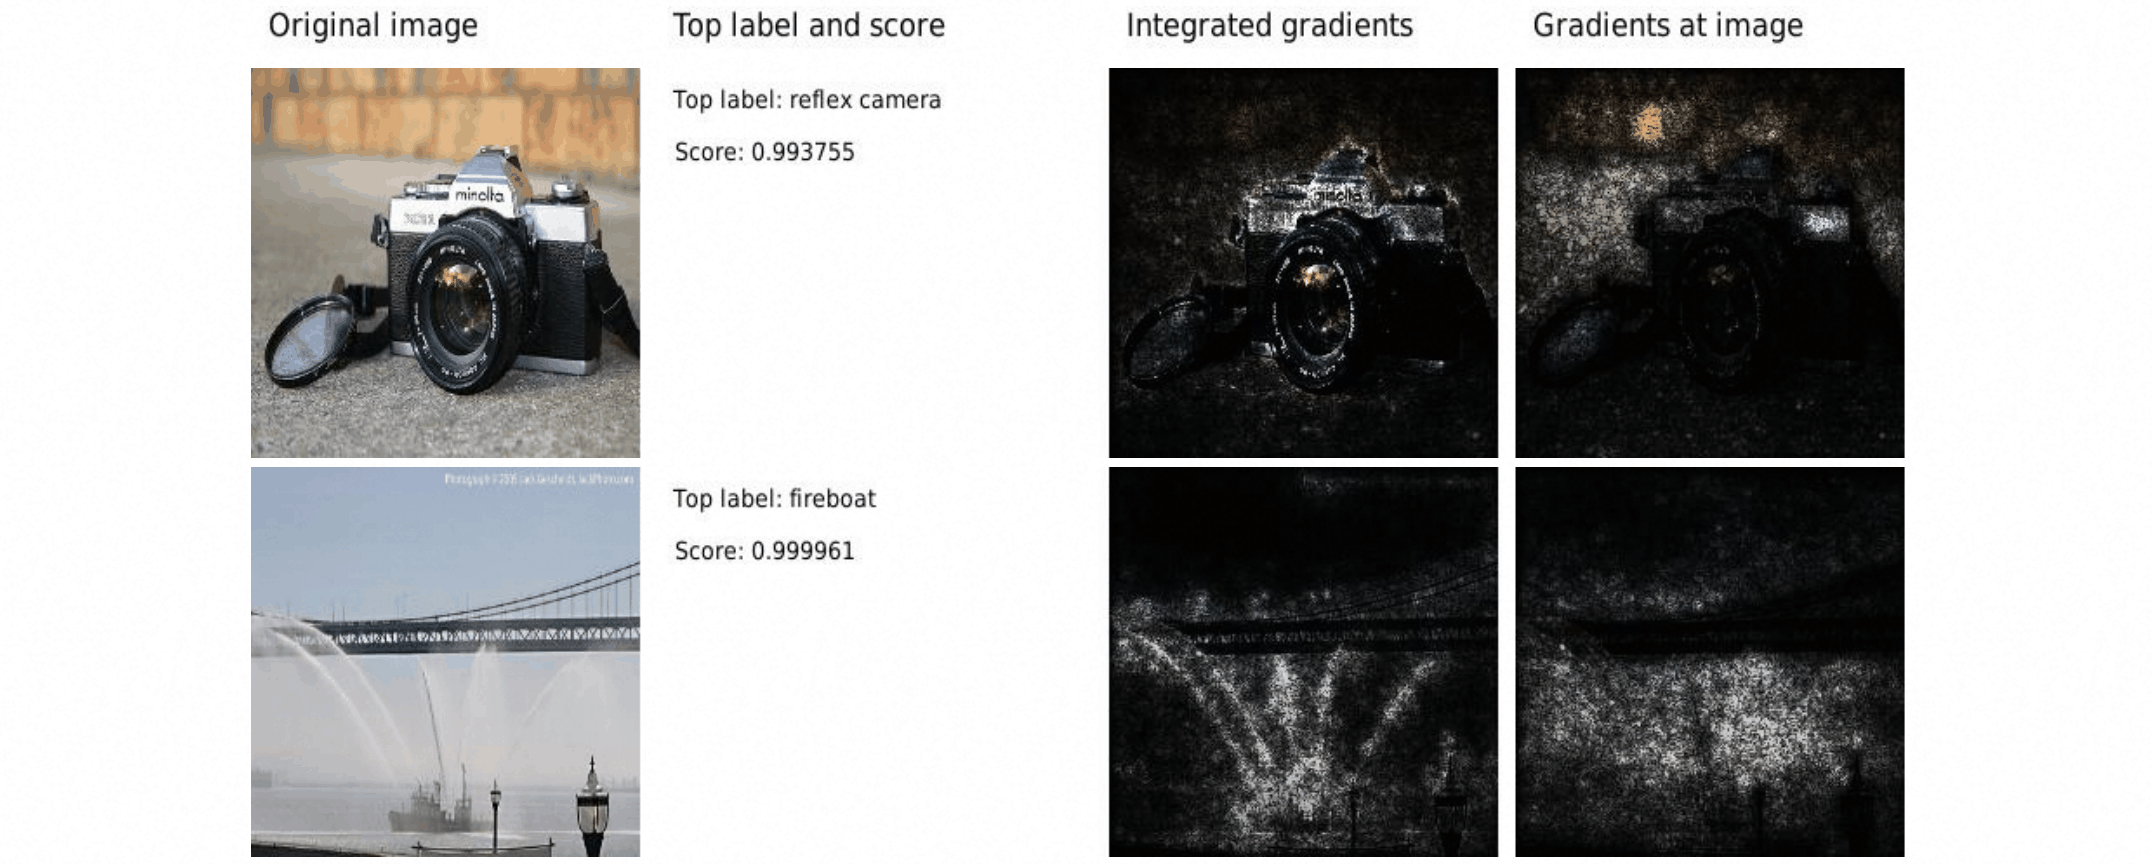
与单点梯度相比,路径积分能够跨过局部饱和区域,并满足两条重要公理:如果某个特征变化导致输出变化,它应获得非零归因;如果两个网络实现同一函数,它们应产生相同归因。它还满足完备性:
\[\sum_i \mathrm{IG}_i(x)=f_c(x)-f_c(x').\]完备性保证归因总和能够解释相对于基线的输出差,但不保证每个特征的分配唯一或符合因果关系。黑色图像、零向量和掩码词元对应不同的语义;路径还可能穿过远离数据流形的区域。因此使用IG时必须报告基线、积分步数和目标输出,并检查不同合理基线下结论是否稳定。
⚪ DeepLIFT 与 LRP:相对参考状态逐层传播贡献
DeepLIFT不直接使用瞬时梯度,而是比较输入$x$与参考输入$x’$引起的激活差值。若第$l$层单元$t$相对于参考状态的变化为$\Delta t$,则将它写成前一层输入变化贡献的和:
\[\Delta t=\sum_i C_{\Delta x_i\rightarrow \Delta t}.\]典型的传播规则$C$包括:
- 线性规则 (Linear Rule):适用于线性层(如全连接层的线性部分)或任何表现为线性组合的节点。假设一个神经元 $t$ 是其输入 $x_i$ 的线性组合:$t=\sum_iw_ix_i + b$。 那么其输出变化 $Δt$ 就是:$Δt=t(x)−t(x’)=(\sum_iw_ix_i + b)-(\sum_iw_ix_i’+b)=\sum_iw_i(x_i-x’)=\sum_iw_i \Delta x_i$,即$C_{\Delta x_i\rightarrow \Delta t}=w_i \Delta x_i$。
- 重缩放规则 (Rescale Rule):处理非线性激活函数(如 ReLU, Sigmoid, Tanh)的主要规则。将非线性函数 $f$ 在 $[x’, x]$ 区间内的行为近似为一个乘数(multiplier)$\frac{\Delta t}{\Delta x}$,可以看作是连接 $(x’, f(x’))$ 和 $(x, f(x))$ 两点的直线的斜率,即“差分梯度”。将总的输出变化 $Δt$ 按照输入 $Δx_i$ 占总输入变化 $\sum_jΔx_j$ 的比例进行分配: $C_{\Delta x_i\rightarrow \Delta t}=\frac{Δx_i}{\sum_jΔx_j}\times Δt$。
- 显隐消除规则 (RevealCancel Rule):为处理特定非线性(如ReLU和MaxPool)设计的更精细的规则。在Rescale规则中,如果不同的输入变化 $Δx_i$ 有正有负,它们可能会在求和 $ΣΔx_i$ 时相互抵消导致接近于0。这会使得 $Δx_i / ΣΔx_i$ 的比值变得不稳定或无意义,从而掩盖了实际上很大的正负输入贡献。RevealCancel将正贡献和负贡献分开处理: 将输入变化分为正集合 $Δx_i > 0$ 和负集合 $Δx_j < 0$;分别计算只有正输入和只有负输入时,输出会如何变化;对正、负贡献组分别应用Rescale规则。
这种差值传播能够在局部梯度为$0$时保留从参考状态到当前输入的有限变化,但结果依赖参考输入和传播规则。对于实现同一函数但计算图不同的模型,DeepLIFT也可能给出不同解释。
- LRP:On Pixel-Wise Explanations for Non-Linear Classifier Decisions by Layer-Wise Relevance Propagation
Layer-wise Relevance Propagation(LRP)从输出相关性开始,按局部规则向前一层重新分配,并尽量保持相关性守恒。假设我们正在考虑从第 $l$ 层传播到第 $l+1$ 层的过程,其中神经元 $j$ 的激活值 $a_j^{(l+1)}$ 是由前一层神经元 $i$ 的激活值 $a_i^{(l)}$ 加权求和并通过激活函数得到的:
\[a_j^{(l+1)} = f\left(\sum_i a_i^{(l)} w_{ij} + b_j\right)\]LRP的目标是计算 $R_i^{(l)}$,即第 $l$ 层神经元 $i$ 的相关性,它等于从所有后一层神经元 $j$ 分配给它的相关性之和:
\[R_i^{(l)} = \sum_j R_{i \leftarrow j}^{(l, l+1)}\]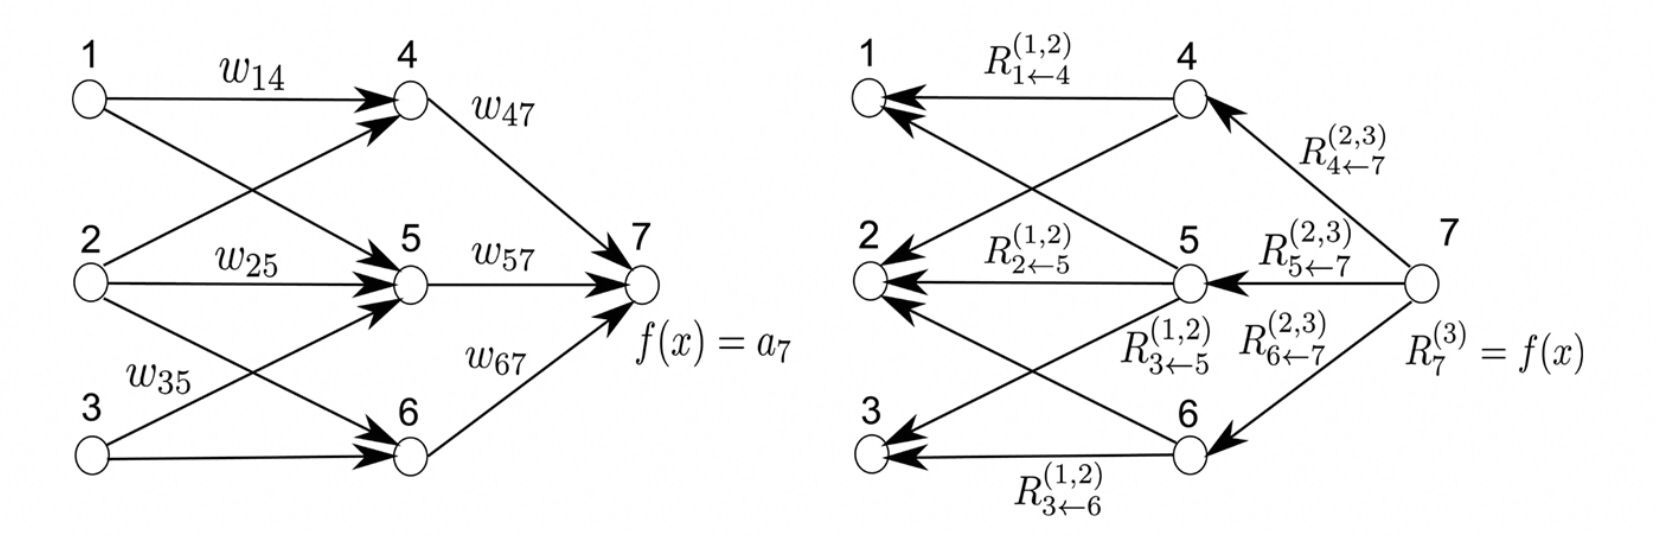
- LRP-0 规则:一个输入的贡献,与它对输出激活值的绝对贡献大小成正比。
- LRP-ε 规则:LRP-0 规则当分母为0时不稳定。引入了一个小的稳定项 $ε$。
- LRP-γ 规则:更侧重于正贡献,通过一个参数 $γ$ 来放大正权重 $w_{ij} > 0$ 的影响。
- LRP-αβ 规则:将神经元 $j$ 的总相关性 $R_j^{(l+1)}$ 分为两部分:一部分由 $α$ 控制,只分配给产生正激活贡献的输入;另一部分由 $β$ 控制,分配给产生负激活贡献的输入。
(2) 基于特征图和输入扰动的归因
⚪ CAM 与 Grad-CAM:在卷积特征空间定位类别证据
- paper:Learning Deep Features for Discriminative Localization
- paper:Grad-CAM: Visual Explanations from Deep Networks via Gradient-based Localization
Class Activation Mapping(CAM)利用全局平均池化后的分类权重,对最后一层卷积特征图加权求和。它能产生类别相关的空间定位图,但要求网络使用特定的全局平均池化结构。

Grad-CAM改用目标输出对特征图的梯度生成通道权重,因此可以作用于更一般的卷积网络。它的热力图分辨率受目标特征层限制,且正梯度截断、目标层选择和插值方式都会影响结果。详细内容参考本站卷积神经网络的可视化。
⚪ Occlusion 与 RISE:用黑盒扰动测量区域重要性
遮挡法依次用基线值替换输入区域,并测量目标输出的变化:
\[E(S,c)=f_c(x)-f_c\left(x_{\setminus S}\right),\]其中$x_{\setminus S}$表示区域$S$被遮挡后的输入。方法不需要访问梯度,能够用于黑盒模型;但窗口大小决定解释分辨率,逐区域查询的开销高,纯色遮挡还可能构造训练分布之外的输入。
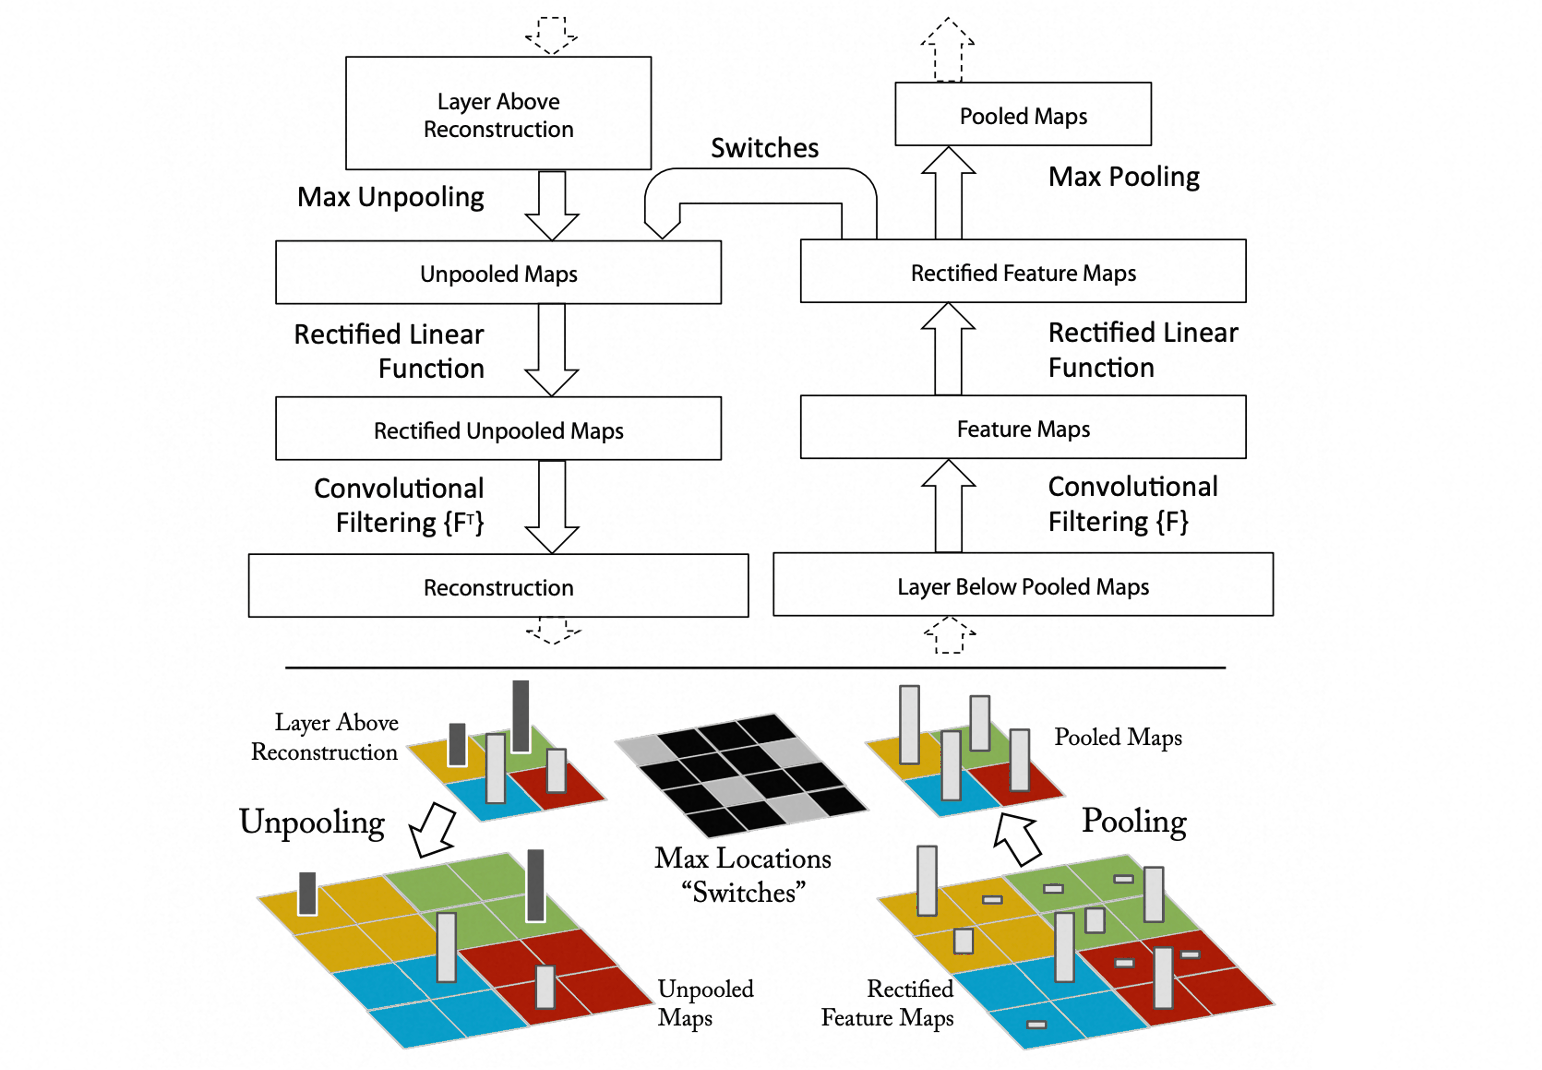
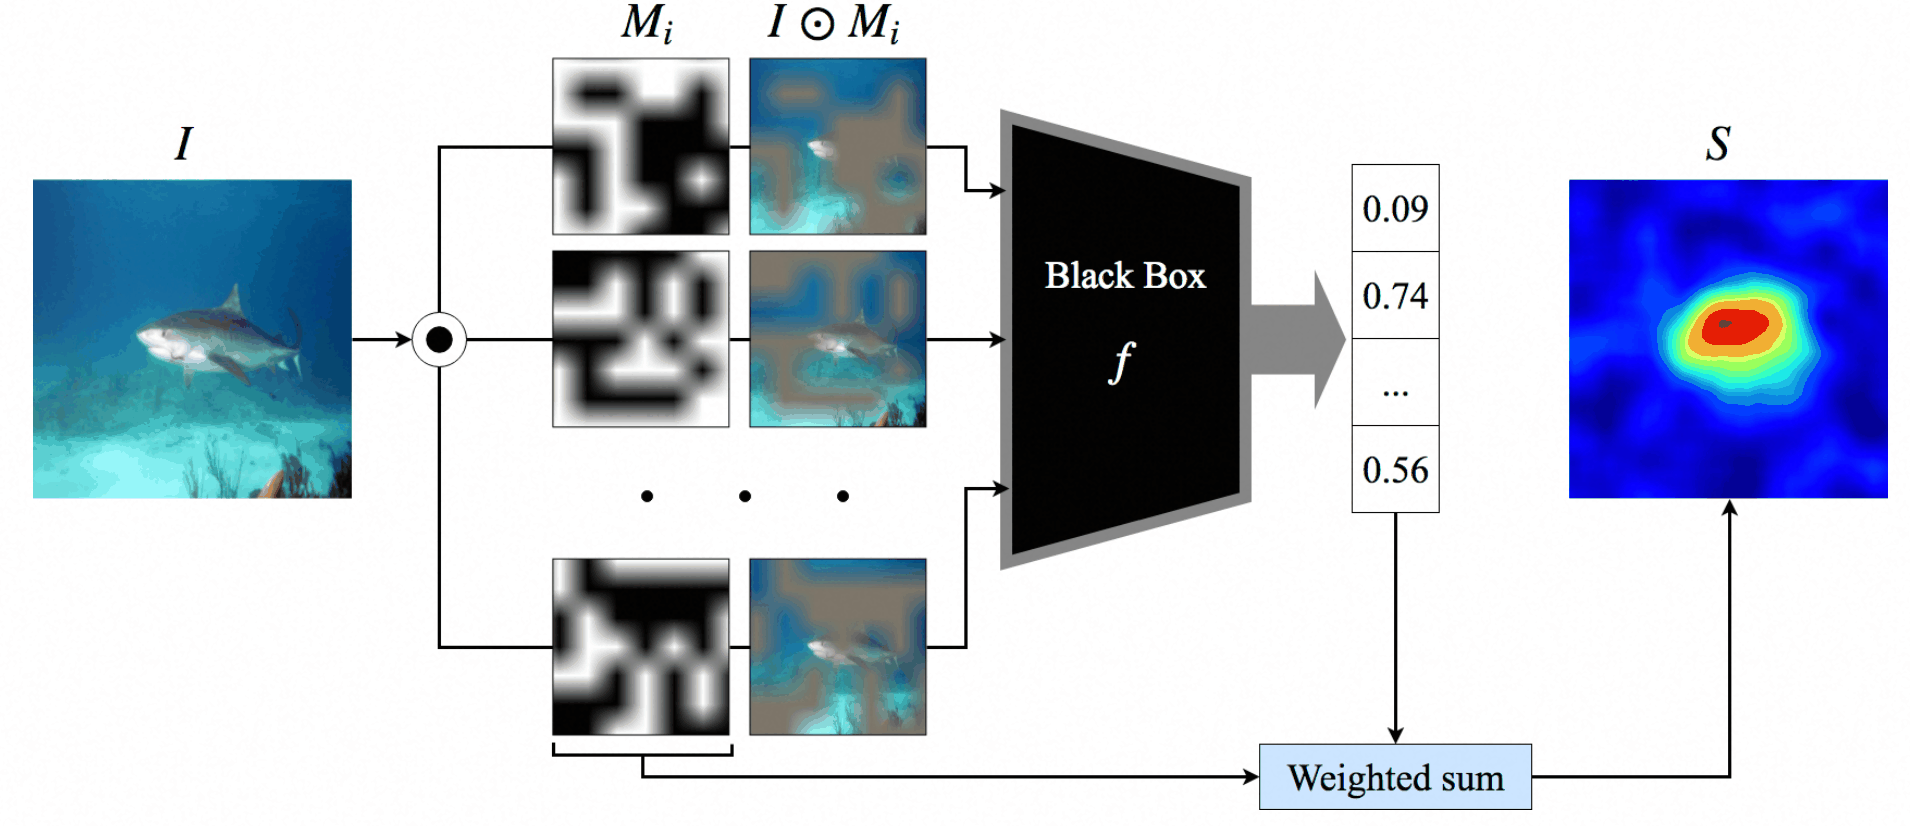
RISE随机生成二值掩码$M_k$,用被掩码输入的目标得分对掩码加权平均:
\[E(x,c)\propto \sum_{k=1}^{K} f_c(x\odot M_k)M_k.\]随机掩码能够减少规则窗口带来的边界偏差,也能适配任意黑盒分类器;代价是需要大量查询,并且掩码分辨率、保留概率和上采样方式会改变结果。扰动方法比纯梯度更接近有限干预,但如果扰动样本严重偏离数据分布,输出变化仍可能来自模型对异常输入的反应。
(3) 基于局部代理和博弈分配的归因
⚪ LIME:在目标样本邻域拟合稀疏代理模型
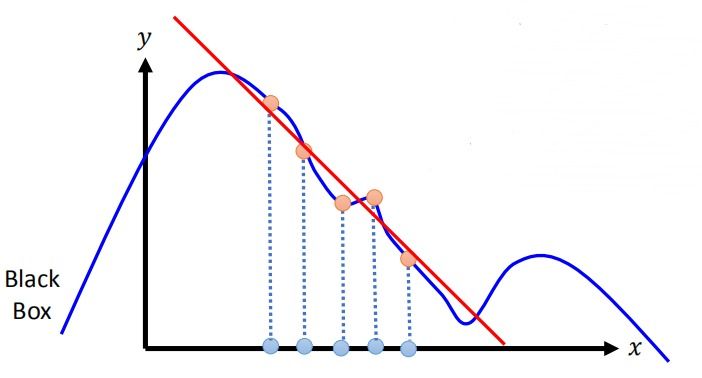
尽管一个复杂模型可能在全局范围内有一个非常复杂的决策边界,但在单个数据点附近,这个边界很可能可以用一个简单得多的可解释模型(如线性模型)合理地近似。Local Interpretable Model-Agnostic Explanations(LIME)通过在特定样本周围学习一个更简单的模型来解释复杂模型的预测:
\[\xi(x)=\arg\min_{g\in\mathcal{G}} \mathcal{L}\left(f,g,\pi_x\right)+\Omega(g),\]其中$\pi_x$衡量扰动样本与$x$的接近程度,$\mathcal{L}$衡量局部拟合误差,$\Omega(g)$惩罚代理模型复杂度。局部线性近似可以捕获目标点附近的决策趋势:
LIME执行以下步骤:
- 扰动样本: 选取想要解释的特定样本$x$,并生成许多扰动过输入特征的版本$x’$。对于表格数据随机添加噪声或采样特征;对于文本数据从原文中移除词语;对于图像数据随机丢弃超像素区域。
- 获取预测: 将这些扰动后的样本$x’$输入到原始黑箱模型中,以获取每个变体的预测结果$y’$。
- 加权样本: 对在特征空间中与原始样本非常相似的扰动样本赋予更高的权重,而对距离较远的样本赋予较低的权重。常用指数核函数计算权重:$w=\exp(-D(x,x’)/\sigma^2)$
- 训练可解释模型: 利用计算出的权重,在这个由扰动样本及其对应黑箱模型预测组成的数据集$(x’;y’)$上训练一个简单的可解释模型(加权线性模型\决策树)。
- 提取解释: 这个局部替代模型的系数直接显示了每个特征在被解释样本附近的重要性及其影响方向。
比如LIME解释图像时包括四步:
- 把图像分割为若干超像素区域;
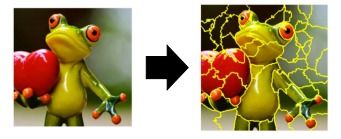
- 随机保留或遮挡一部分区域,把扰动图像输入原模型;
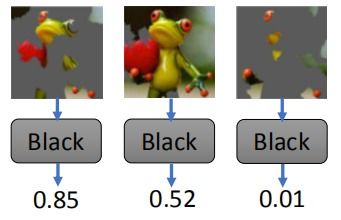
- 把每张扰动图像表示成二值向量$[x_1,\ldots,x_M]$,其中$x_m$表示第$m$个区域是否保留;
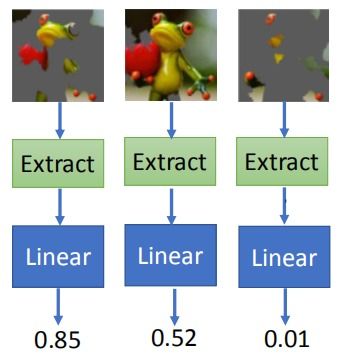
- 按与原图的距离加权样本并拟合稀疏线性模型$g(x)=\sum_m w_mx_m$。$w_m>0$表示区域支持目标输出,$w_m<0$表示区域抑制目标输出。
LIME的解释取决于超像素算法、扰动分布、距离核、核宽度和随机种子。在高维空间中,“邻域”本身并不唯一;两个局部拟合度相近的代理模型也可能给出不同特征排序。因此应同时报告局部拟合误差和重复运行的稳定性,不能把局部代理当成原模型的全局决策规则。
⚪ SHAP:用 Shapley 值统一加性特征归因
SHapley Additive exPlanations(SHAP)把每个输入特征视为合作博弈中的参与者,将模型输出相对于基线的增量分配给各特征。
模型对样本 $x$ 的实际预测 $f(x)$ 与整个训练数据集的平均预测 $E[f(X)]$ 之间的差值 $f(x)−E[f(X)]$ 表示样本 $x$ 所有特定特征的总贡献,这些特征使预测值偏离了平均值。特征 $i$ 和样本 $x$ 的 SHAP 值 $\phi_i (x)$ 被计算为该特征在所有不包含特征 $i$ 的可能特征子集中的边际贡献的加权平均值。特征 $i$ 对不包含 $i$ 的特定特征子集 $S$ 的边际贡献是模型在将特征 $i$ 添加到该子集后的预期输出与仅有子集 $S$ 时的预期输出之间的差值:
\[\phi_i (x) = E[f(X) \mid X_S ∪ \{x_i\}] - E[f(X) \mid X_S]\]SHAP具有可加性(局部准确性),即给定样本 $x$ 所有特征的 SHAP 值之和等于该样本的预测值 $f(x)$ 与基准值(平均预测值 $E[f(X)]$)之间的差值:
\[f(x) = E[f(X)] +\sum_i \phi_i (x)\]这个等式确保特征贡献的总和精确地解释了特定预测与基准线之间的差异。$ϕ_0=E[f(X)]$ 给出起点(平均预测),每个 $\phi_i (x)$ 说明特征 $i$ 的值如何相对于这个基准值将预测推高或推低。大小$\lvert \phi_i (x)\rvert$表明特征对该特定预测影响的强度。
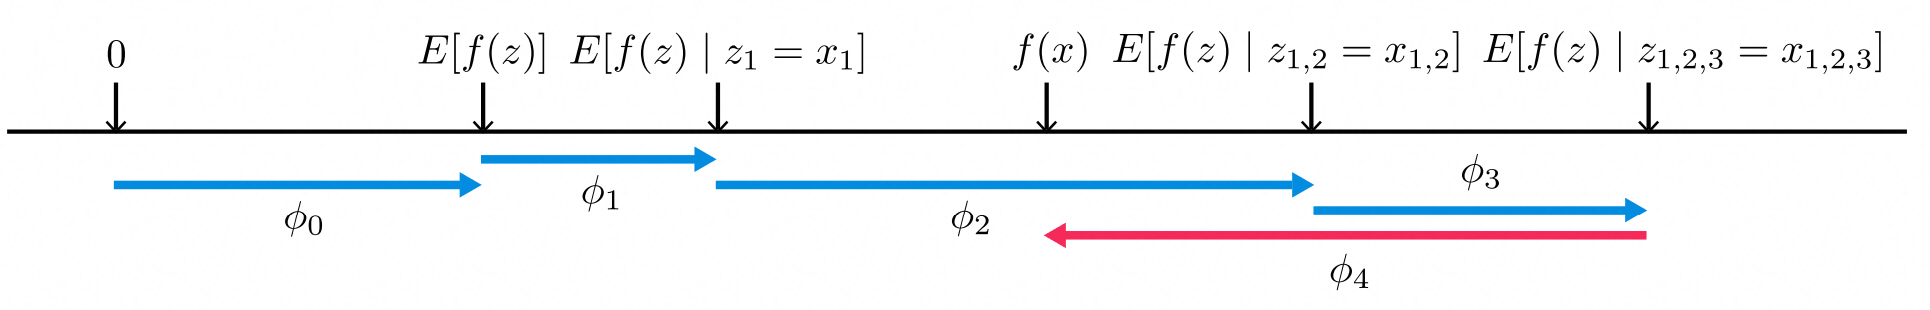
SHAP具有缺失性,即对预测确实没有影响的特征应被赋予零SHAP值。如果特征$i$没有边际贡献,则$\phi_i=0$。
SHAP具有一致性(单调性),即如果模型发生变化,使某个特征的边际贡献增加或保持不变,则分配给该特征的SHAP值也应增加或保持不变。考虑两个模型$f,f’$。如果对于特定特征 $i$ 和其他特征的所有可能子集 $S$,特征 $i$ 在模型 $f’$ 中的贡献大于或等于其在模型$f$中的贡献:
\[f'(x_{S∪\{i\}}) - f'(x_S) \geq f(x_{S∪\{i\}}) - f(x_S)\]那么,一致性特性确保特征 $i$ 的SHAP值也将反映这种增加的重要性:
\[\phi_i (f', x) \geq \phi_i (f, x)\]SHAP解释在局部层面是准确的(局部准确性),忽略不相关特征(缺失性),并可靠地反映特征贡献的变化(一致性)。问题在于精确计算SHAP通常需要在所有可能的特征子集上评估模型,这对于大多数模型来说在计算上是不可行的,实践中必须使用结构特定算法或采样近似。
- KernelSHAP:将SHAP值的计算转化为一个带权重的线性回归问题。
- 抽样联盟 (Coalition Sampling):随机生成若干个特征子集 $S$(用二进制向量表示,1代表特征存在,0代表缺失)。
- 模拟缺失特征:当一个特征缺失时,将其替换为一个基线值(例如从一个背景数据集中抽取的该特征的平均值或中位数)。
- 获取模型输出:对于每个采样的联盟 $S$,构建一个输入样本(存在的特征用其实际值,缺失的特征用基线值),并送入模型得到输出 $v(S)$。
- 线性回归:根据 (联盟$S$, 输出$v(S)$) 求解一个加权线性回归模型,其回归系数就是SHAP值 $φ_i$。
- TreeSHAP:对于决策树、随机森林、XGBoost等树模型,存在一种高效得多的算法。它利用了树模型的结构特性,可以在多项式时间内精确计算出SHAP值。它通过递归地遍历决策树,追踪每个特征在所有可能的决策路径上的贡献期望值,从而避免了对所有子集的暴力枚举。
- DeepSHAP:DeepLIFT的贡献分数在某些条件下是对Shapley值的一种高效近似。选择一个背景数据集(一组基线样本),对于每个要解释的输入 $x$,计算 $x$ 相对于背景数据集中每个样本的DeepLIFT贡献分数;将这些分数进行平均得到的结果就是对SHAP值的近似。
2.2 特征归因
特征归因追问“网络内部特征编码了什么”,分析对象可以是单个神经元、一个通道、低维方向、分布式概念或完整的中间表示。能够从表示中解码出信息,只说明信息存在;要证明模型使用了该信息,还需要内部干预。
(1) 合成偏好输入与单元语义
⚪ Activation Maximization:优化输入以合成单元偏好的特征
Activation Maximization固定模型参数,调整输入$x$使目标单元或类别得分最大:
\[x^*=\arg\max_x\left[f_c(x)-\lambda R(x)\right],\]其中$R(x)$是输入先验或正则项。若直接在像素空间进行梯度上升,模型可能利用人眼不敏感的高频模式,得到接近噪声的结果:
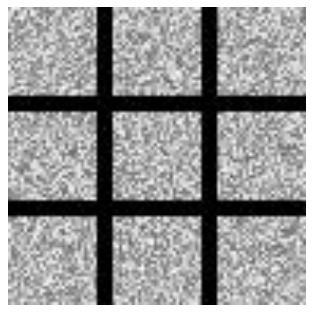
早期方法使用像素范数、总变差、抖动和裁剪等正则化,例如:
\[R(x)=\Vert x\Vert_2^2+\beta\,\mathrm{TV}(x).\]加入自然图像先验后,合成结果通常更平滑:
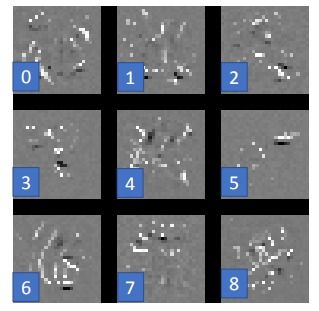
另一种做法是在生成器$G$的潜空间中优化$z$,令$x=G(z)$:
\[z^*=\arg\max_z f_c\left(G(z)\right).\]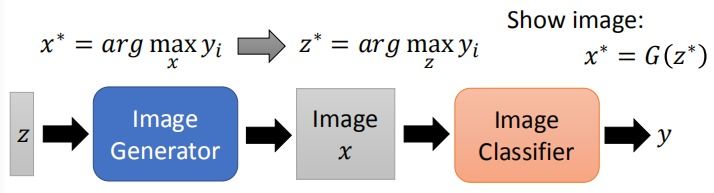
生成器约束能够把搜索限制在更自然的图像流形附近,但生成器自身的训练数据和表达能力也会进入解释。最终图像同时反映目标模型与先验模型的偏好,不能被当作目标单元的唯一语义。
⚪ Network Dissection:用具名视觉概念测量通道语义对齐
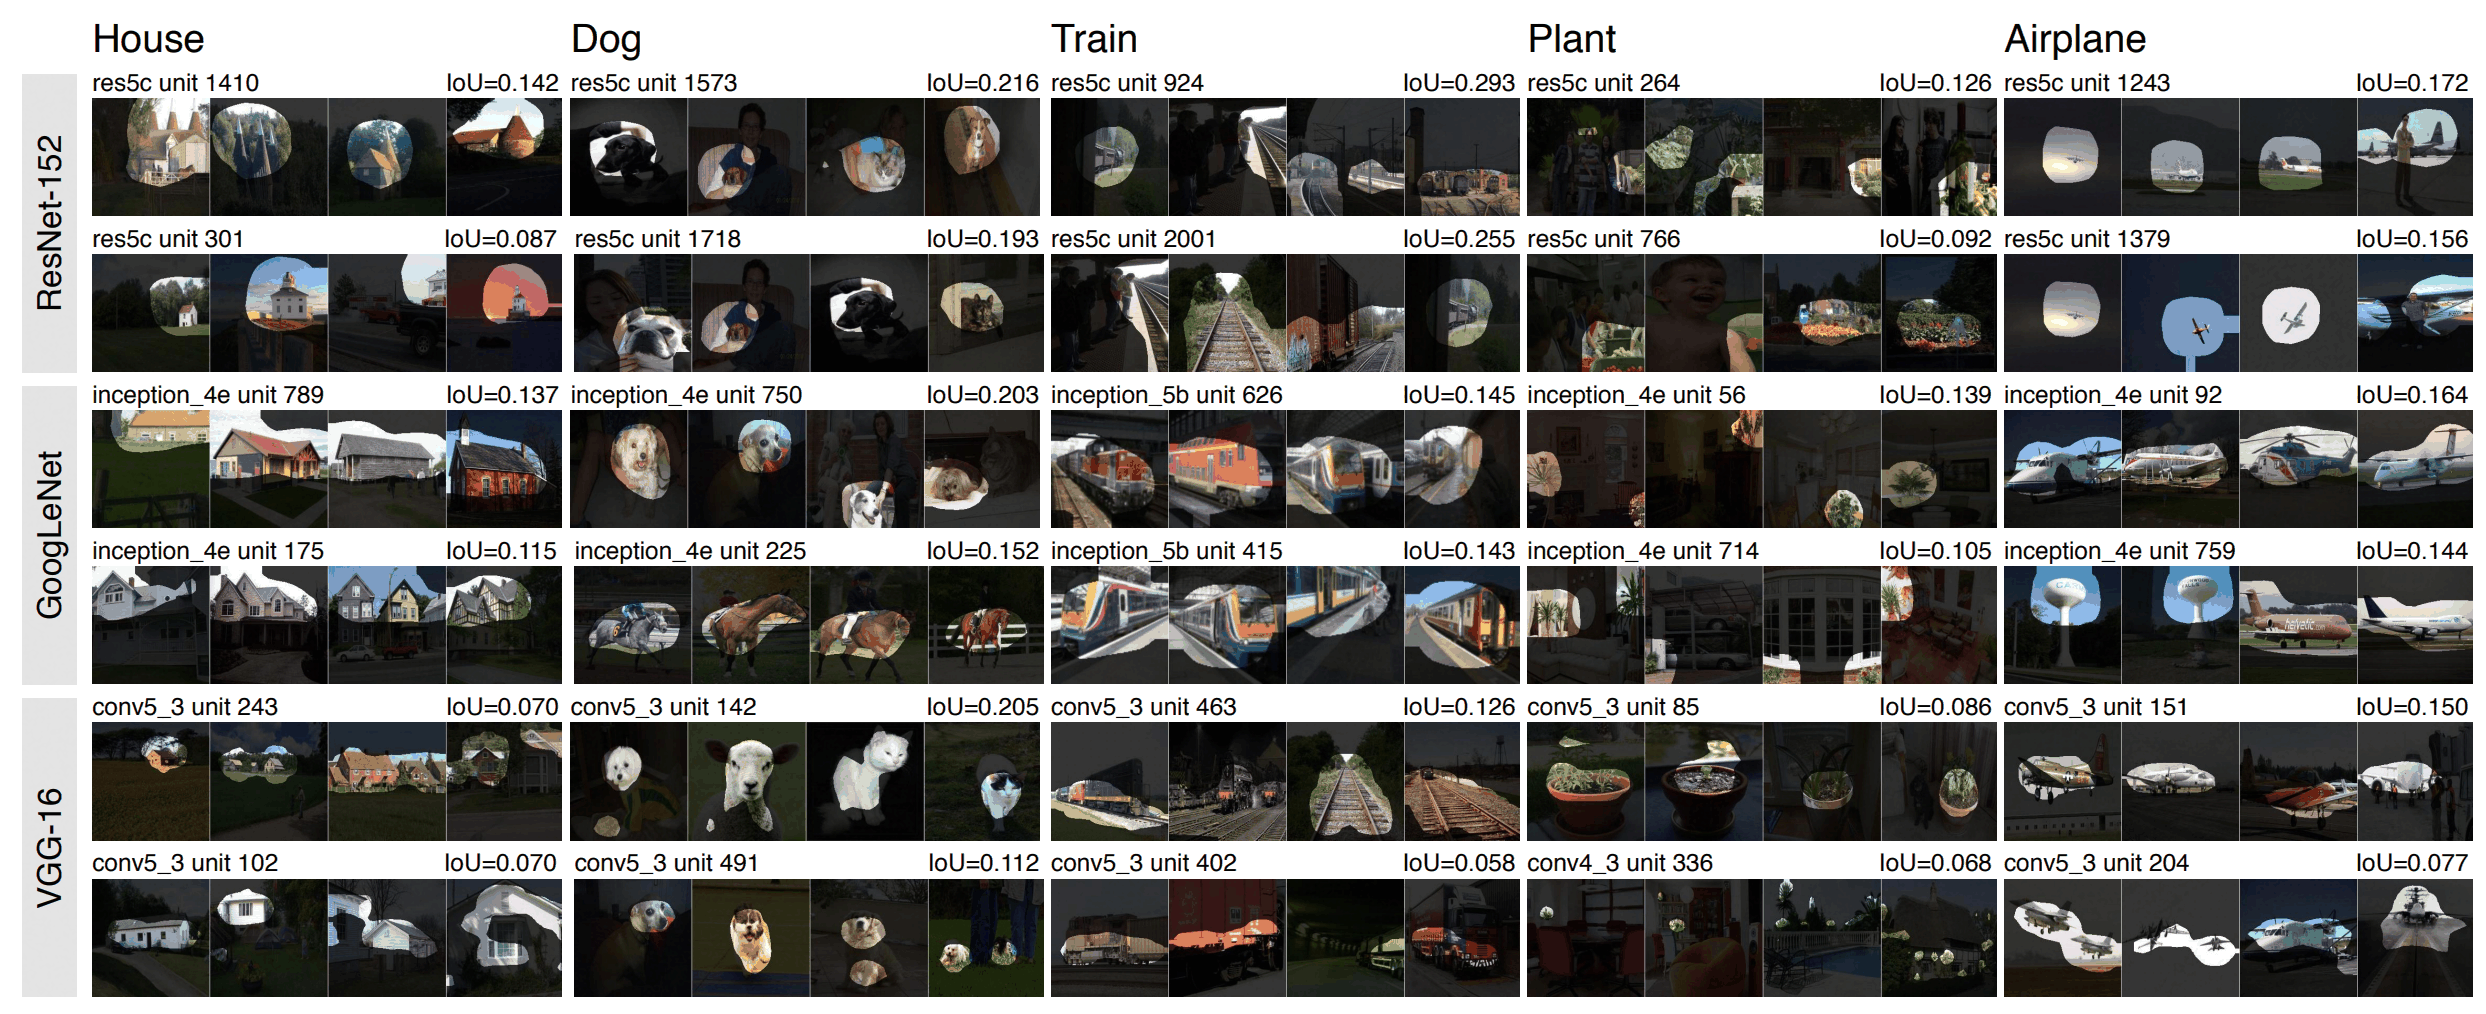
Network Dissection把卷积通道的激活区域与带有物体、部件、材质、颜色等概念掩码的数据集对齐。对通道$k$和概念$c$,先把激活图上采样并阈值化,再计算交并比:
\[\mathrm{IoU}_{k,c}= \frac{\lvert M_k\cap M_c\rvert}{\lvert M_k\cup M_c\rvert}.\]若交并比超过阈值,就把该通道视为概念$c$的检测器。这使“某层有多少可命名单元”成为可比较指标,但结果受概念词表、阈值和数据集覆盖范围影响。模型还可能用多个通道分布式编码概念,或者在一个通道中混合多个互不相关的语义;单通道对齐也不证明该通道对输出具有因果必要性。
(2) 从表示方向到可干预概念
⚪ TCAV:用概念方向测量输出敏感性
- paper:Interpretability Beyond Feature Attribution: Quantitative Testing with Concept Activation Vectors
Testing with Concept Activation Vectors(TCAV)不要求概念对应单个神经元。它收集某个概念的样本和随机反例,在第$l$层表示空间中训练线性分类器,其法向量$v_c^l$构成概念激活向量。目标类别$k$沿概念方向的敏感性为:
\[S_{c,k,l}(x)=\nabla_{h_l}f_k(x)\cdot v_c^l.\]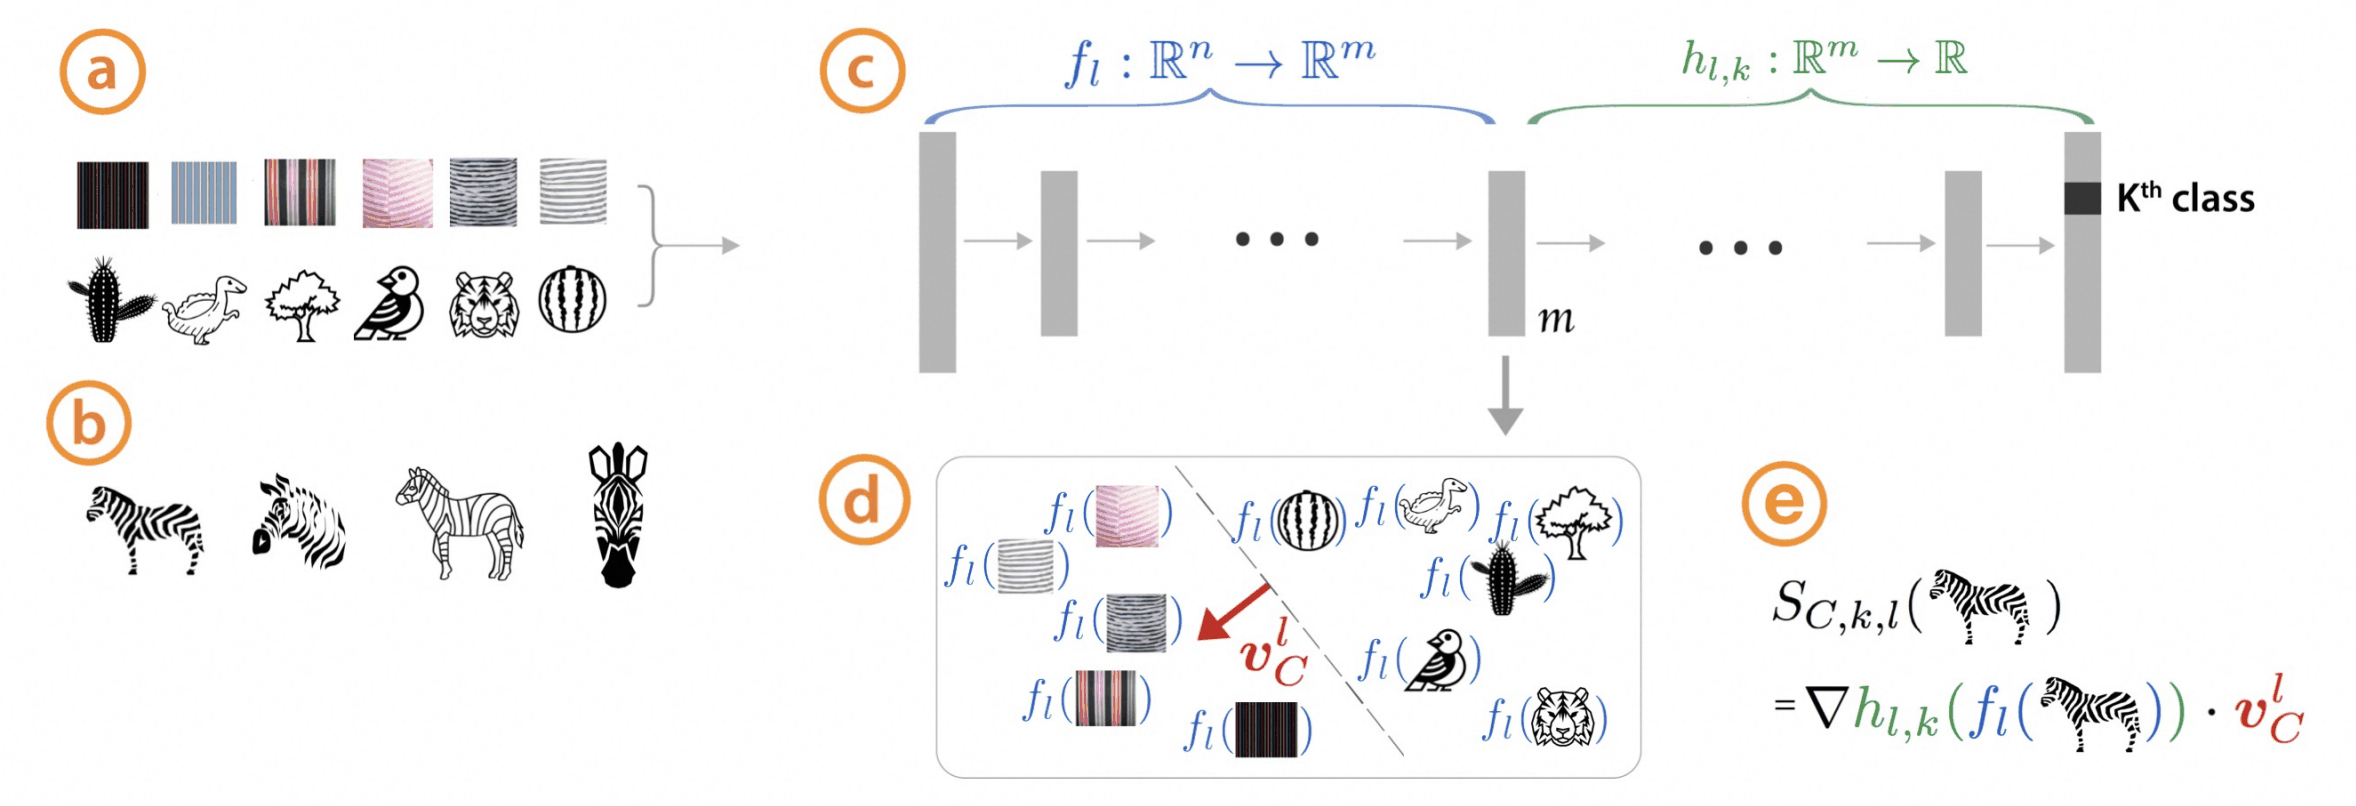
TCAV Score统计一组类别样本中$S_{c,k,l}(x)>0$的比例,并通过多组随机反例检验稳定性。它把解释单位从像素提升到人类命名的概念,但分数仍依赖概念样本、反例、目标层和线性可分性。方向敏感性说明模型输出与概念表示相关,不自动证明模型以该概念进行因果推理。
⚪ Concept Bottleneck Models:让预测显式经过人类概念
概念瓶颈模型把预测拆成两个阶段:
\[\hat{c}=g(x),\qquad \hat{y}=h(\hat{c}),\]其中$g$预测一组人类定义的概念,$h$只根据概念预测最终标签。用户可以检查中间概念,甚至在推理时纠正$\hat{c}$并观察结果是否改变。这种“可干预接口”比事后热力图提供更强证据。
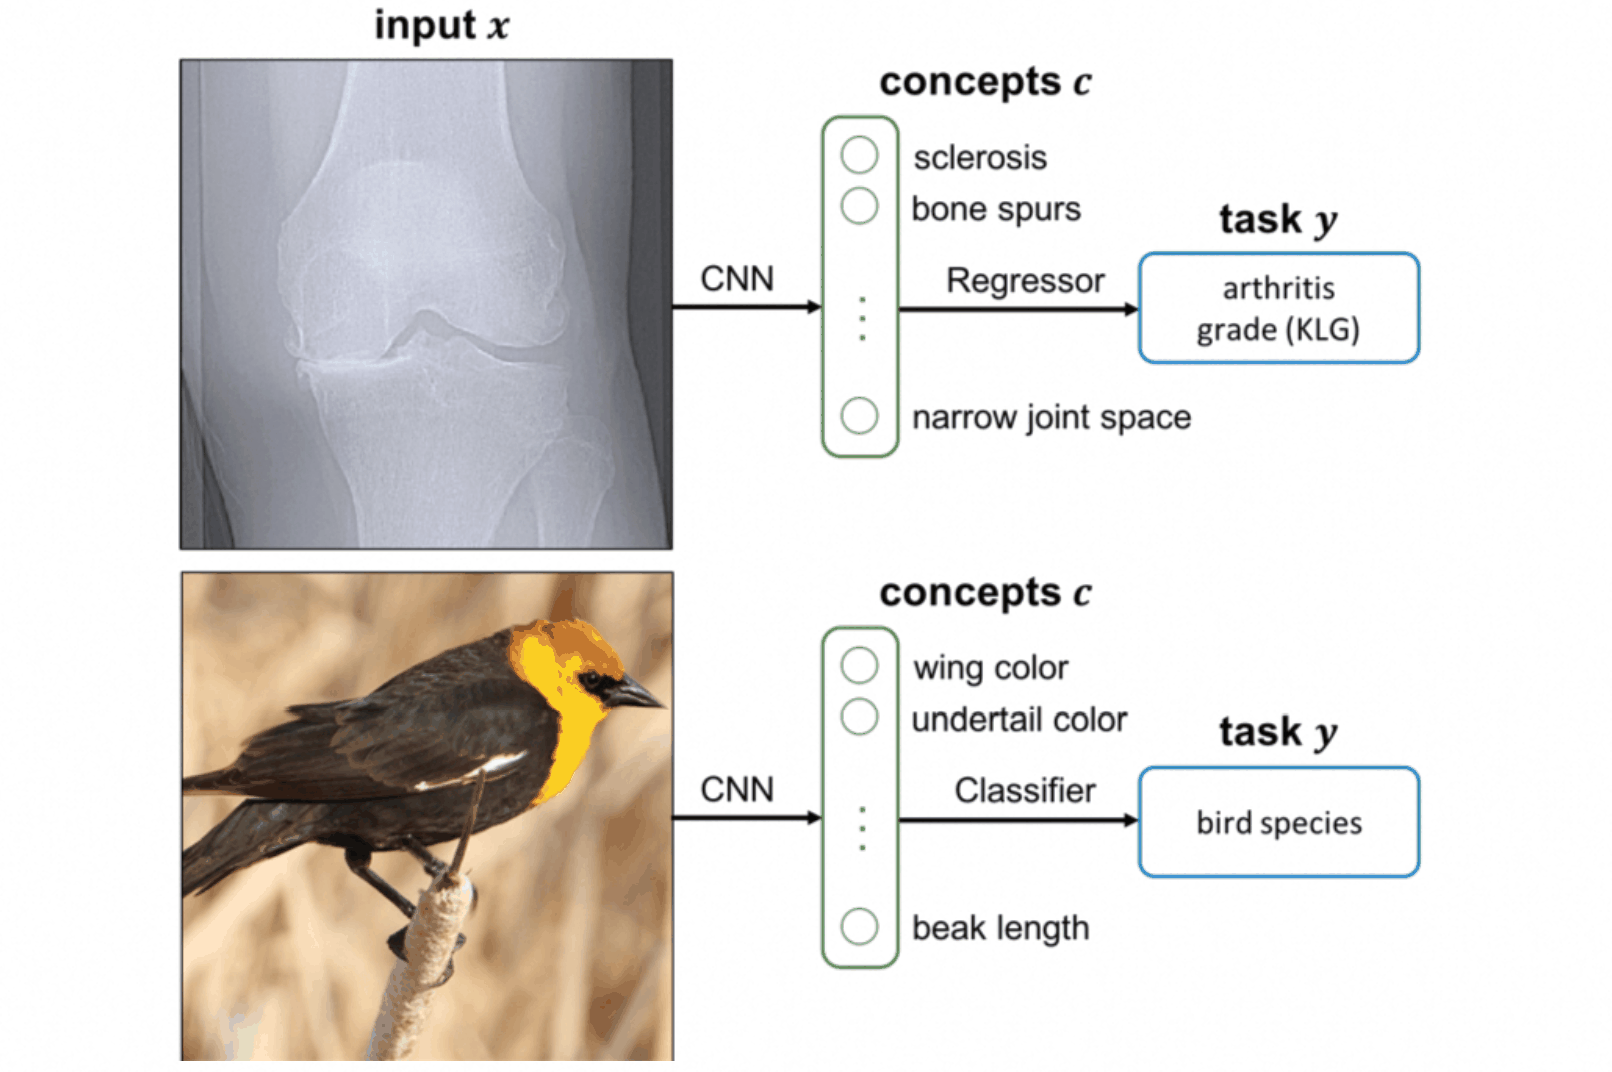
代价是需要概念标注,并假设概念集合足以支持任务。若遗漏关键概念,模型性能会下降;若联合训练允许概念表示携带标签相关的额外连续信息,就会出现概念泄漏:表面上经过了具名概念,实际决策仍可能依赖人类未定义的信息。因此概念准确率、任务准确率和概念干预效果应分别评估。
⚪ ProtoPNet:用训练样本中的原型部件支持预测
ProtoPNet在潜在空间中学习一组类别相关原型,将输入图像的局部特征块与原型比较,再用相似度完成分类。解释可以表述为“输入的这一部分与训练图像中的某个原型部分类似,因此支持该类别”。
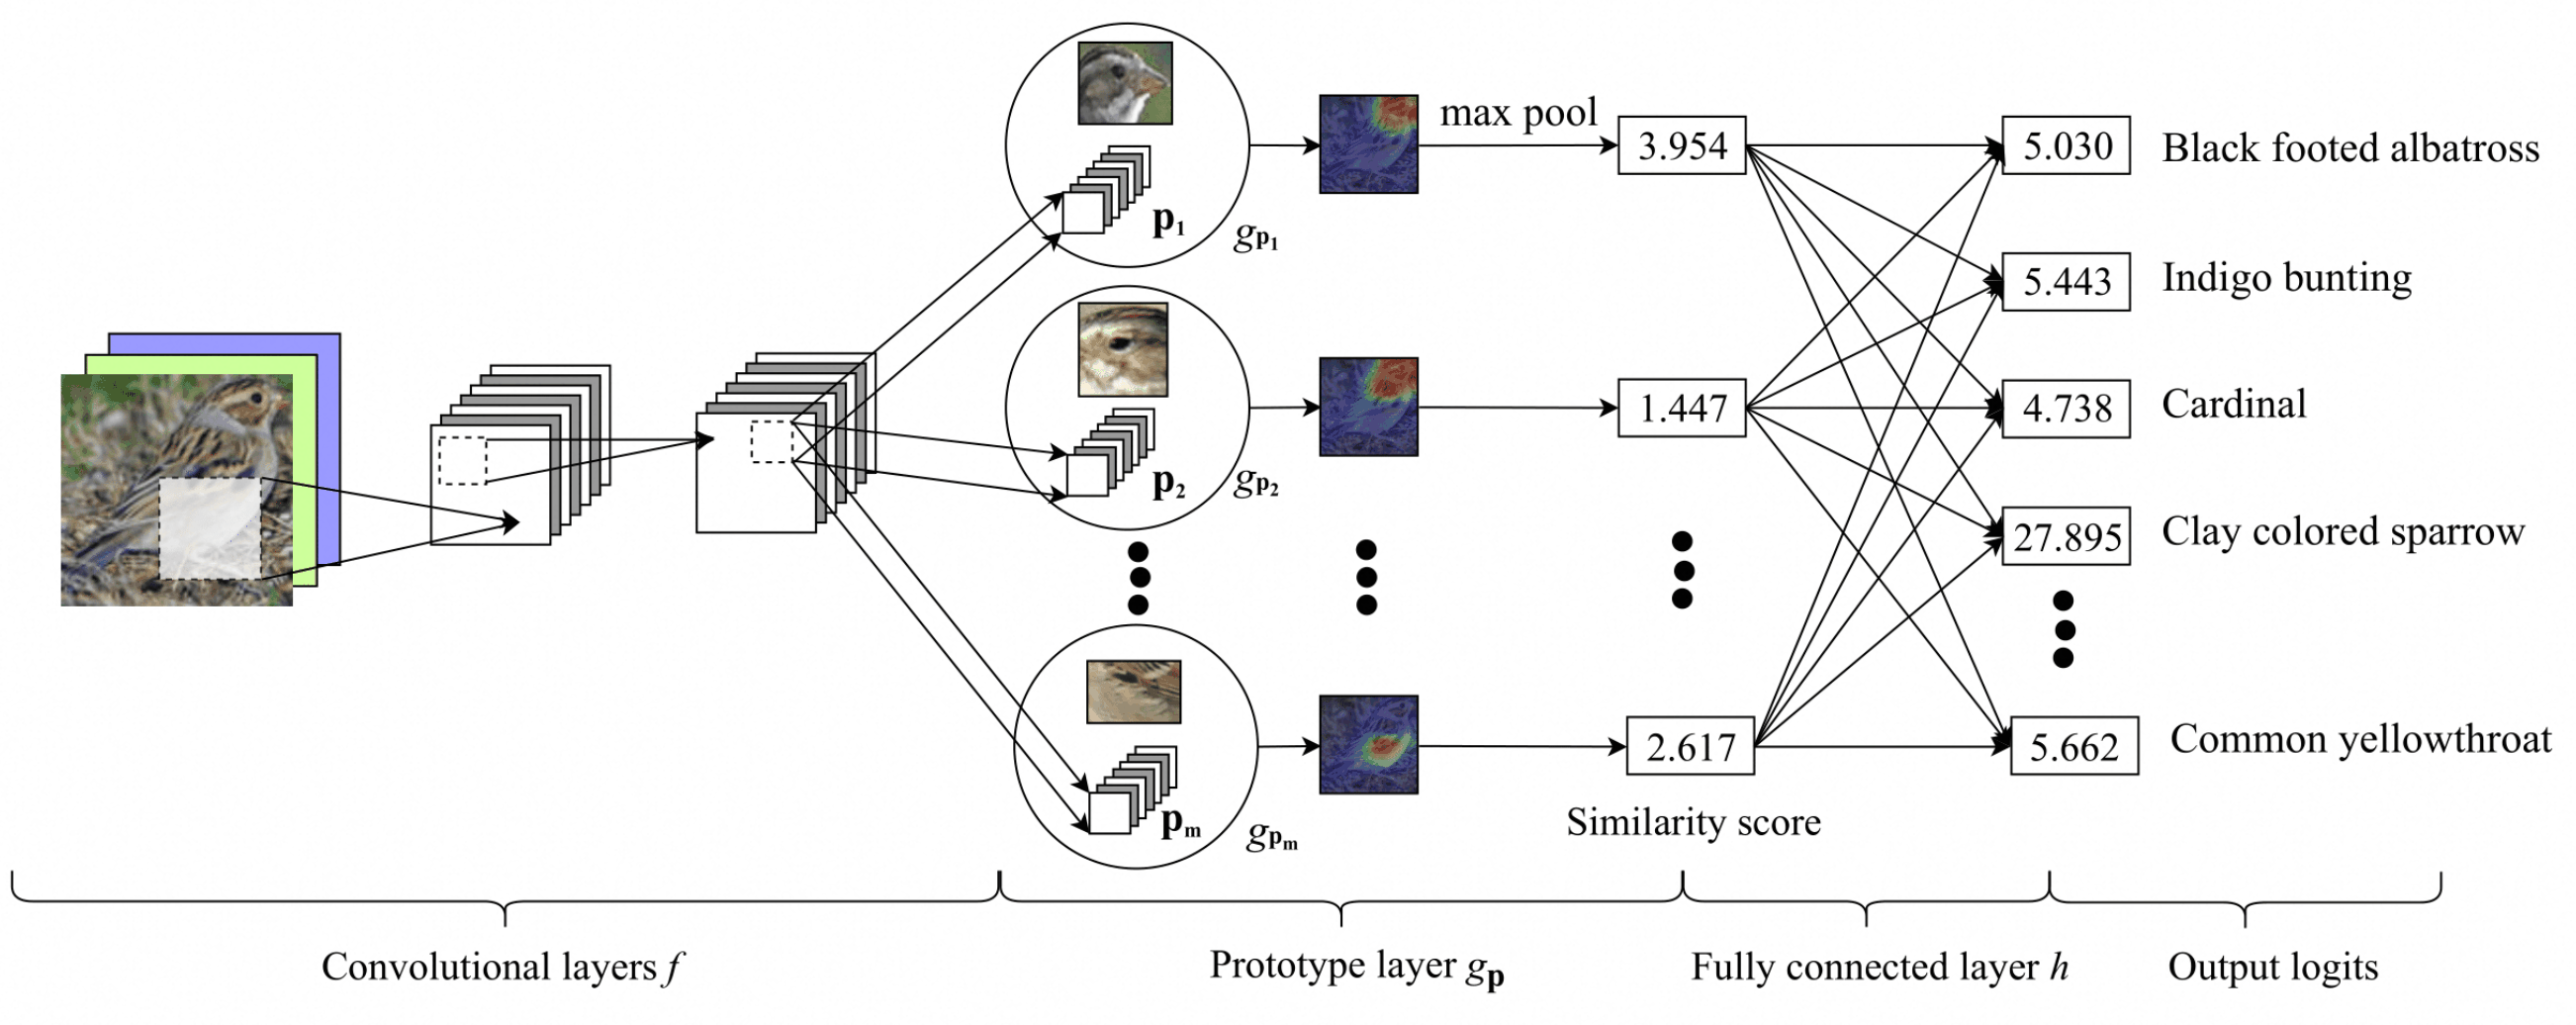
原型模型把证据锚定到可检索的训练图块,比抽象通道更容易检查;但潜在空间的相似不保证语义一致,原型可能混合背景、纹理和物体部件。解释时应同时展示原型来源、输入匹配区域和最终权重,并通过删除原型或替换匹配区域验证预测是否真的依赖该原型。
(3) 用简单模型约束复杂模型
⚪ Tree Regularization:把全局代理树复杂度写入训练目标
简单代理模型可以近似复杂模型的决策边界,但事后拟合不保证代理足够准确。Tree Regularization在训练深度模型时,用模拟其预测的决策树平均路径长度衡量解释复杂度:
\[\theta^*=\arg\min_\theta \left[\mathcal{L}(\theta)+\lambda\,\Omega\left(T_\theta\right)\right].\]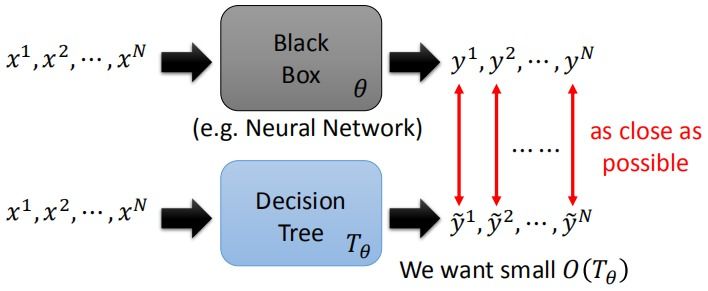
由于树路径长度对$\theta$不可微,方法还要训练一个可微模型近似复杂度函数。它展示了一条重要路线:不仅在训练后解释模型,还在训练目标中直接约束模型,使其更容易被简单结构逼近。局限在于代理树仍是近似,复杂度还会随采样数据和树的拟合方式变化;“更短的树”也不必然对应更正确或更公平的决策依据。
2.3 数据归因
数据归因将模型行为(如某个预测、某个参数)的贡献分配给每一个训练样本。
(1) 反事实解释
反事实解释寻找“怎样改变输入才能改变结论”。
⚪ Counterfactual Explanations 与 DiCE:寻找最小、可行且多样的决策改变
- Counterfactual Explanations:Counterfactual Explanations without Opening the Black Box: Automated Decisions and the GDPR
给定输入$x$和目标输出$y’$,反事实解释寻找新的输入$x’$:
\[x^*=\arg\min_{x'} \left[ \lambda\,\mathcal{L}\left(f(x'),y'\right) +d(x,x') \right].\]第一项要求模型改变决策,第二项要求反事实接近原输入。实际系统还需加入不可变属性、特征范围、特征间依赖和行动成本。例如年龄不能减少,学历与职业不能任意组合,医学指标之间也受到生理机制约束。
Diverse Counterfactual Explanations(DiCE)同时生成多个反事实,并用行列式点过程式的多样性项减少方案重复。多样性有助于用户比较不同改变路径,但如果优化只在特征空间中进行,仍可能产生数据分布之外或现实中不可实现的建议。
(2) 基于训练动态的数据归因
⚪ Influence Functions:用二阶近似估计训练样本影响
影响函数量化的是如果将训练样本$z_j$的权重稍微增加一点点$ϵ$,那么在测试样本$z_{test}$上的损失会如何变化。在经验风险最优点附近,对训练样本$z_j$的损失项施加一个微小的权重$ϵ$,被扰动后的经验风险为:
\[\hat{\theta}_\epsilon = \arg\min_\theta \left( R(\theta) + \epsilon \mathcal{L}(z_j, \theta) \right), \text{ where } R(\theta) = \frac{1}{n}\sum_i \mathcal{L}(z_i, \theta)\]最优参数\(\hat{\theta}_\epsilon\)满足一阶最优性条件:
\[\nabla_\theta R(\hat{\theta}_\epsilon) + \epsilon \nabla_\theta \mathcal{L}(z_j, \hat{\theta}_\epsilon) = 0.\]首先需要知道参数\(\hat{\theta}_\epsilon\)是如何随 $ϵ$ 变化的,对最优性条件关于 $ϵ$ 求全导数:
\[\quad \nabla^2_\theta R(\hat{\theta}_\epsilon) \frac{d\hat{\theta}_\epsilon}{d\epsilon} + \nabla_\theta \mathcal{L}(z_j, \hat{\theta}_\epsilon) + \epsilon \nabla^2_\theta \mathcal{L}(z_j, \hat{\theta}_\epsilon) \frac{d\hat{\theta}_\epsilon}{d\epsilon} = 0.\]在 $ϵ=0$ 的点进行评估。此时\(\hat{\theta}_\epsilon = \hat{\theta}\),\(\nabla^2_\theta R(\hat{\theta}) = H_{\hat{\theta}}\)是原始未扰动损失函数在最优点\(\hat{\theta}\)的Hessian矩阵。代回上式得到:
\[H_{\hat{\theta}} \left.\frac{d\hat{\theta}_\epsilon}{d\epsilon}\right|_{\epsilon=0} + \nabla_\theta \mathcal{L}(z_j, \hat{\theta}) = 0 \\ \downarrow \\ \left.\frac{d\hat{\theta}_\epsilon}{d\epsilon}\right|_{\epsilon=0} = -H_{\hat{\theta}}^{-1} \nabla_\theta \mathcal{L}(z_j, \hat{\theta})\]上式表示当我们开始增加样本$z_j$的权重时,最优参数\(\hat{\theta}\)会朝着\(-H_{\hat{\theta}}^{-1} \nabla_\theta \mathcal{L}(z_j, \hat{\theta})\)的方向移动。最终目标是计算测试损失关于这个扰动 $ϵ$ 的变化率:
\[\begin{aligned} \mathcal{I}_{\mathrm{up,loss}}(z_j,z_{\mathrm{test}}) &:= \left. \frac{d}{d\epsilon}\mathcal{L}(z_{\mathrm{test}}, \hat{\theta}_\epsilon) \right|_{\epsilon=0} \\ &= \nabla_\theta \mathcal{L}(z_{\mathrm{test}}, \hat{\theta})^\top \left. \frac{d\hat{\theta}_\epsilon}{d\epsilon}\right|_{\epsilon=0} \\ &= \nabla_\theta \mathcal{L}(z_{\mathrm{test}}, \hat{\theta})^\top \left( -H_{\hat{\theta}}^{-1} \nabla_\theta \mathcal{L}(z_j, \hat{\theta}) \right) \\ &= -\nabla_\theta \mathcal{L}(z_{\mathrm{test}},\hat{\theta})^\top H_{\hat{\theta}}^{-1} \nabla_\theta \mathcal{L}(z_j,\hat{\theta}). \end{aligned}\]影像函数把“删除后重训练”的昂贵反事实转化为局部二阶计算,可用于发现有害训练点、标注错误和数据污染。深度网络的损失非凸,Hessian可能奇异,近似结果依赖阻尼、参数化和收敛位置;在大模型上求解逆Hessian向量积也非常昂贵。
⚪ TracIn 与 TRAK:用训练轨迹和随机投影扩展数据归因
TracIn的核心思想是:如果为了学习训练样本$z_j$而更新模型参数的方向,与为了学习测试样本$z$而更新参数的方向,在整个训练过程中总是相似的,那么$z_j$对$z$的预测就具有正向影响。它将理论上的、静态的Hessian响应,替换为了实际训练过程中的、动态的梯度对齐;实际实现时在多个训练检查点上累加训练样本与目标样本梯度的点积:
\[\mathrm{TracIn}(z_j,z)= \sum_{t\in\mathcal{C}} \eta_t\, \nabla_\theta\mathcal{L}(z_j,\theta_t)^\top \nabla_\theta\mathcal{L}(z,\theta_t).\]若两个样本在训练过程中反复产生同向梯度,就认为训练样本对目标行为具有正影响。TracIn可以看作是对影响函数的一种一阶近似。影响函数的核心是计算参数位移\(-H_{\hat{\theta}}^{-1} \nabla_\theta \mathcal{L}(z_j, \hat{\theta})\)。而梯度下降的一步更新本身就是一种参数位移\(-\eta_t \nabla_\theta \mathcal{L}(z_j, \hat{\theta})\)。通过用这种简单的一步更新来近似理论上的参数位移,然后计算其对测试损失的影响,巧妙地避开了Hessian。
TracIn虽然避开了Hessian,但仍需要在多个检查点上存储和计算高维度的梯度,对于超大模型(如LLMs),这依然是巨大的负担。TRAK (Tracing with the Randomly-projected Hessian And Kernelization)的目标是将数据归因的成本进一步降低几个数量级,使其在万亿参数模型和亿级数据集上成为可能。
TRAK的最终分数形式非常简洁,它将归因问题转化为了一个核函数(Kernel)的计算:
\[\mathrm{TRAKScore}(z_j, z) = \sum_{m=1}^{M} K(z_j, z; \theta_m)\]这里的关键在于核函数 $K$ 是如何定义的。它基于模型线性化和随机投影:
\[K(z_j, z; \theta_m) = \left( \mathbf{P} \cdot \nabla_\theta f(z_j, \theta_m) \right)^\top \left( \mathbf{P} \cdot \nabla_\theta f(z, \theta_m) \right)\]其中 $\nabla_\theta f(z, \theta_m)$ 是模型输出对参数的梯度,也称为雅可比矩阵。它描述了如果参数微调,模型的logit会如何变化。随机投影矩阵$\mathbf{P}$将数据点 $z$ 的高维输出梯度,投影(压缩)成一个低维向量,称之为 $z$ 的TRAK特征。核函数 $K$ 是两个数据点 $z_j$ 和 $z$ 的TRAK特征的点积,衡量输出梯度(经过投影后)的相似性。
TRAK的工作流程使得“查询”一个样本的影响源头的成本,从遍历整个数据集降低为一次快速的向量检索:
- 索引阶段: 对于训练集中的所有样本 $z_j$,以及一小部分模型检查点 $\theta_m$,预先计算并存储它们的低维TRAK特征 $\mathbf{P} \cdot \nabla_\theta f(z_j, \theta_m)$。
- 查询阶段: 当需要解释一个测试样本 $z$ 时,我们只计算 $z$ 的TRAK特征,然后进行高效的近似最近邻搜索。这会立刻返回与 $z$ 的TRAK特征最相似(点积最大)的那些训练样本 $z_j$。
⚪ Datamodels:用训练子集预测模型预测
Datamodels从同一数据集中反复抽取不同训练子集并训练模型,再学习一个从“样本是否出现在训练子集中”到目标预测的代理模型。对目标样本$x$,Datamodels模型可以写成:
\[\hat{f}(x;S)=b_x+\sum_{j\in S}w_{x,j}.\]在每一次实验中从数据池中随机抽取一个训练子集$S$,并从头开始训练一个完整的深度学习模型$f$。记录下这个模型在目标样本$x$上的预测值\(\hat{f}(x;S)\)。通过多次实验得到元数据$(S_i,y_i)$,便可以线性回归上述模型。系数$w_{x,j}$描述训练样本$j$对目标预测的平均关联,$b_x$代表了数据集中普遍存在的、不依赖于任何特定样本的平均预测趋势。大量重训练使这种方法能直接检验预测能力,也带来极高计算成本;线性形式还难以表达训练样本之间的高阶交互。
数据归因已经扩展到指令数据选择、大语言模型微调和扩散模型,但尚无跨任务统一占优的方法。DATE-LM等系统比较发现,不同方法在数据检测、模型行为归因和删除重训练指标上的排名并不一致,简单的相似度或梯度基线有时仍很有竞争力。报告数据归因结果时,应明确它近似的是上调、删除、选择还是相似性,而不能统称为“模型引用了这条训练数据”。
2.4 机制归因
机制归因(又称机制可解释性mechanistic interpretability)尝试把模型行为还原为内部变量和计算回路。分析通常从残差流、注意力头和多层感知机开始,逐步提出可干预的机制假设。模型规模增长后,逐神经元人工分析难以扩展,研究开始使用稀疏特征分解和自动化归因图,但这些方法仍面临表示基底、近似误差和覆盖率问题。
(1) 从词元相关性到内部干预
⚪ Attention s Not Explanation?:注意力的可解释性
在Transformer架构成为主流之后,注意力机制似乎提供了一个天然的、内置的可解释性工具。我们可以直观地将注意力权重可视化为一张热力图,看到模型在处理一个词时,“关注”了输入序列中的哪些其他词。模型内部的注意力权重,能否作为对模型决策的合理解释?
作者比较了两种不同的“重要性分数”:
- 注意力权重: 直接从模型中提取的、归一化的注意力分数。
- 基于梯度的归因分数: 使用梯度或梯度乘以输入等方法计算的特征重要性分数。
实验发现: 在多种NLP任务和模型上,注意力权重与基于梯度的重要性分数之间的相关性非常低。一个词可能获得很高的注意力,但其梯度重要性却很低,反之亦然。
作者设计了一个实验,试图在不改变模型最终预测的前提下,最大化地改变注意力权重分布。实际可以找到许多与原始注意力分布截然不同,但却能产生几乎完全相同预测的“对抗性”注意力分布。因此作者认为,如果注意力分布可以被随意替换而预测不变,那么这个注意力分布本身就不可能是对该预测的“忠实解释 (faithful explanation)”。
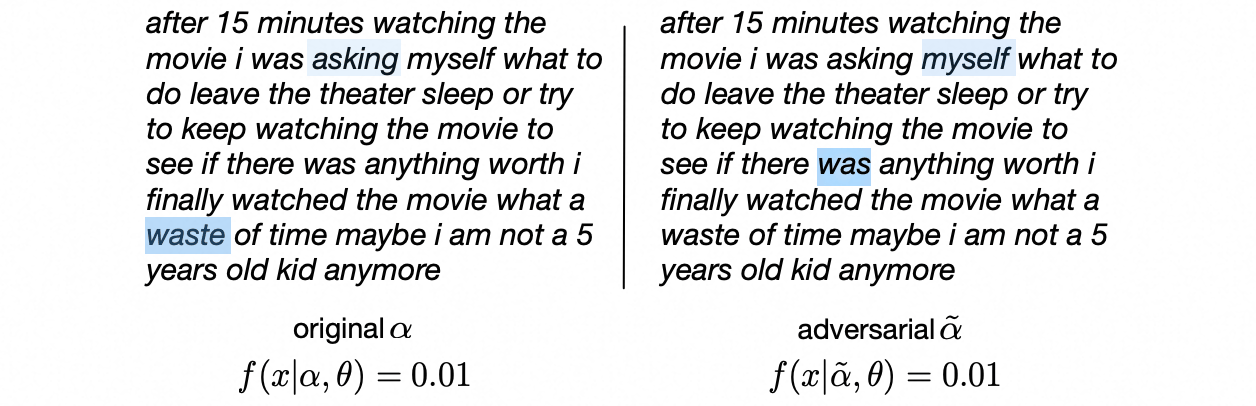
作者反驳 “Attention is Not Explanation” 的对抗性实验,证明了存在其他能够产生相同预测的注意力分布,但这并不意味着模型实际使用的那个原始注意力分布就不是一个有效的解释。
一个好的解释应该具有一定的预测能力。如果只保留那些被认为是“重要”的输入部分,模型的性能应该下降得最慢。作者系统性地移除(或掩蔽)输入中的词元:一次是按照注意力权重从高到低移除;另一次是按照梯度重要性从高到低移除。在很多情况下,依据注意力权重来移除词元会导致模型性能的下降速度,与依据梯度重要性移除时相当,甚至更快。这表明,注意力权重至少在“识别对模型预测有重要影响的输入部分”这个任务上是有用的。如果它能有效地指导我们找到关键输入,那么它就具备了“解释”的核心功能之一。
⚪ Attention Rollout 与 AttnLRP:聚合跨层词元相关性
- Attention Rollout:Quantifying Attention Flow in Transformers
单层注意力矩阵只描述该层的键值混合,不能直接表示输入词元对最终输出的贡献。Attention Rollout认为,在第 $l$ 层,一个词元的输出表示,一部分来自于通过注意力机制 $A^{(l)}$ 混合其他词元的信息,另一部分则通过残差连接直接继承它在上一层的表示。在实际实现时把残差连接加入注意力矩阵并逐层相乘,近似跨层的信息流:
\[\tilde{A}^{(l)}=\alpha A^{(l)}+(1-\alpha)I \\ R=\tilde{A}^{(L)}\tilde{A}^{(L-1)}\cdots\tilde{A}^{(1)}\]作者进一步提出了 Attention Flow,将整个注意力网络建模为一个有向无环图 (DAG),图中的每个节点代表模型中一个词元在某一层的表示,边的容量由注意力权重决定。要计算输入词元 $j$ 对输出词元 $i$ 的总影响,将源点S连接到输入节点 $(j, 0)$,并将输出节点 $(i, L)$ 连接到汇点T。然后在这个图上计算从S到T的最大流,这个最大流的值就被定义为词元 $j$ 对 $i$ 的归因分数。
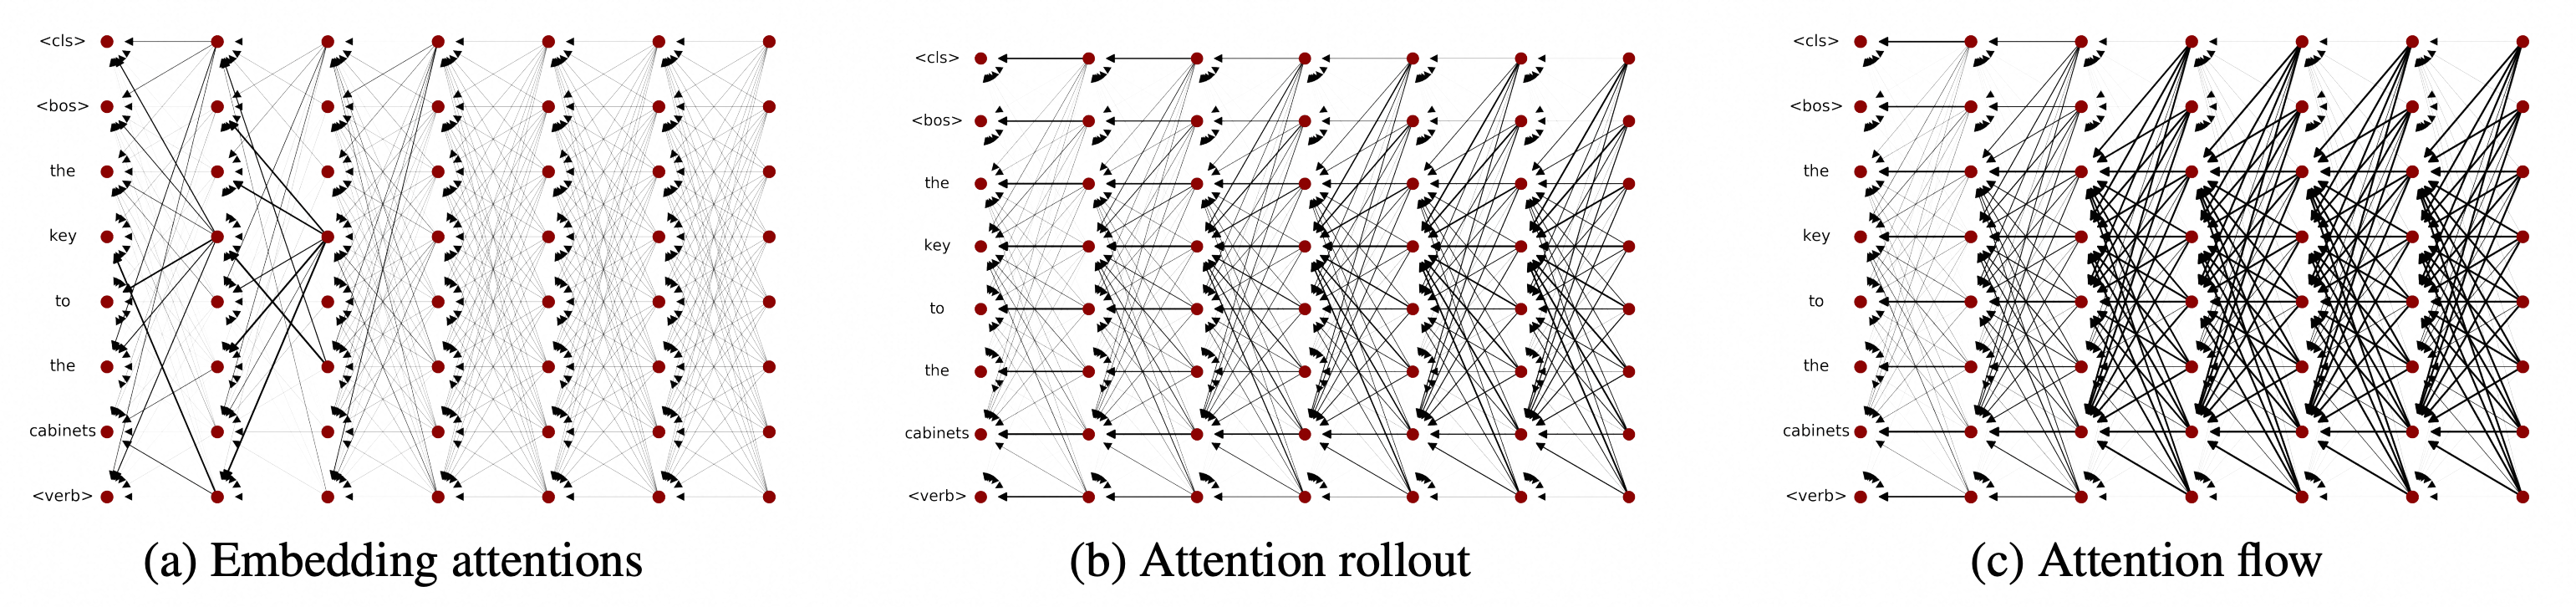
这种聚合比观察单个注意力头更完整,但仍主要跟踪注意力权重,没有充分表示值向量、多层感知机、归一化和非线性作用。
AttnLRP通过为注意力模块、乘法和归一化设计相关性传播规则,把LRP扩展到现代Transformer;从最终的预测logit开始,把相关性逐层完全分配到最底层的输入词元嵌入上。它能同时处理注意力与前馈路径,计算效率高于反复扰动;但结果仍依赖传播规则和数值稳定项。
反向传播的目标是将第 $l+1$ 层节点 $j$ 的相关性 $R_j^{(l+1)}$ 分配给对其有贡献的第 $l$ 层节点 $i$。节点 $i$ 从节点 $j$ 接收到的相关性记为 $R_{i \leftarrow j}$。最终,节点 $i$ 的总相关性为其收到的所有相关性之和:$R_i^{(l)} = \sum_j R_{i \leftarrow j}$。
| Transformer组件 | 计算图 (前向) | LRP传播规则 (反向) | 完整公式 |
|---|---|---|---|
| 1. 线性层 / 投影 | $z_j = \sum_i x_i w_{ij} + b_j$ | ε-LRP 规则 对于ViT,为降噪使用γ-LRP规则。 |
$R_{i \leftarrow j} = \frac{x_i w_{ij}}{z_j + \epsilon \cdot \text{sign}(z_j)} \cdot R_j^{(l+1)}$ |
| 2. 逐元素非线性 (如GeLU, SiLU) |
$a_j = f(z_j)$ | Identity 规则 | $R_z^{(l)} = R_a^{(l+1)}$ |
| 3. LayerNorm / RMSNorm | $y_j = \frac{x_j}{g(x)} \gamma_j$ | Identity 规则 | $R_x^{(l)} = R_y^{(l+1)}$ |
| 4. Softmax | $s_j = \frac{e^{x_j}}{\sum_k e^{x_k}}$ | 专门的Softmax规则 | $R_i^{(l)} = x_i \left( R_i^{(l+1)} - s_i \sum_j R_j^{(l+1)} \right)$ |
| 5. 矩阵乘法 (通用) | $O_{jp} = \sum_i A_{ji}V_{ip}$ | 序贯应用 ε-rule 和 uniform-rule | $R_{ji}^{(l-1)} = \sum_p \frac{A_{ji}V_{ip}}{2 O_{jp} + \epsilon} \cdot R_{jp}^{(l)}$ $R_{ip}^{(l-1)} = \sum_j \frac{A_{ji}V_{ip}}{2 O_{jp} + \epsilon} \cdot R_{jp}^{(l)}$ |
| 6. 残差连接 | $z_j = x_j + y_j$ | 标准LRP加法规则 | $R_{x_j}^{(l)} = \frac{x_j}{z_j} R_{z_j}^{(l+1)}$ $R_{y_j}^{(l)} = \frac{y_j}{z_j} R_{z_j}^{(l+1)}$ |
⚪ Causal Tracing 与 Activation Patching:替换内部状态验证因果作用
内部状态替换通常构造两个输入:一个能触发目标行为的干净输入$x_{\mathrm{clean}}$,以及一个破坏该行为的扰动输入$x_{\mathrm{corr}}$。先运行两次模型并记录激活,再把某层、某位置或某组件的干净激活补回扰动运行,测量目标指标的恢复量:
\[\Delta_{l,p}=m\left(f_{\mathrm{corr}\leftarrow\mathrm{clean}(l,p)}\right) -m\left(f_{\mathrm{corr}}\right).\]与只读取梯度或注意力相比,替换内部状态提供了直接干预证据。
- Causal Tracing:Locating and Editing Factual Associations in GPT
Causal Tracing用这一思想将事实关联定位到某个MLP层的权重矩阵上,然后通过求解一个约束优化问题,计算出一个秩为1的更新量,并将其加到原始权重矩阵上。从而找到并修改模型中存储具体事实性知识的参数,使其表达一个新的事实。
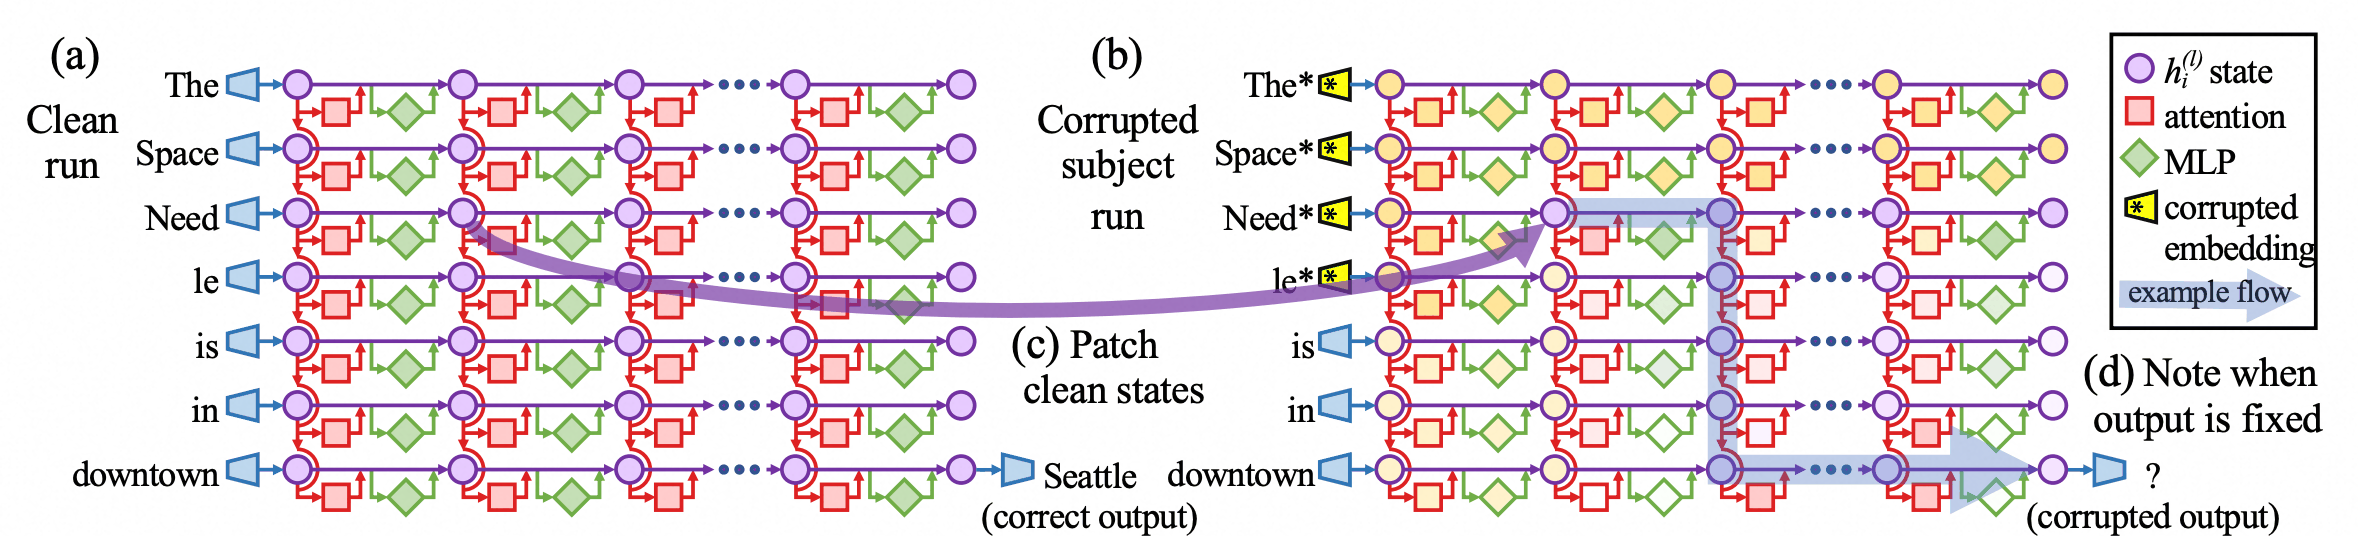
- Activation Patching:How to Use and Interpret Activation Patching
Activation Patching则成为更一般的机制定位工具。它的干预对象是激活值,在一次“损坏”的前向传播中,用“干净”运行的激活值替换掉某个组件的激活值。通过对比“干净”、“损坏”和“补丁”三次运行的结果,找到模型中负责执行某个抽象功能或计算(如语法分析、逻辑推理、间接宾语识别)的特定组件。
干预结果仍依赖对照设计。扰动输入可能同时改变多个语义变量,补丁可能把分布外状态注入网络,目标指标也可能遗漏行为的重要方面。一个组件能恢复输出说明它在该对照下具有充分性线索,却不表示它是唯一机制;删除组件导致性能下降提供必要性线索,也可能来自广泛的分布破坏。
(2) 从组件到计算回路
⚪ Transformer Circuits 与 Induction Heads:把模型分解为可组合的计算路径
- Transformer Circuits:A Mathematical Framework for Transformer Circuits
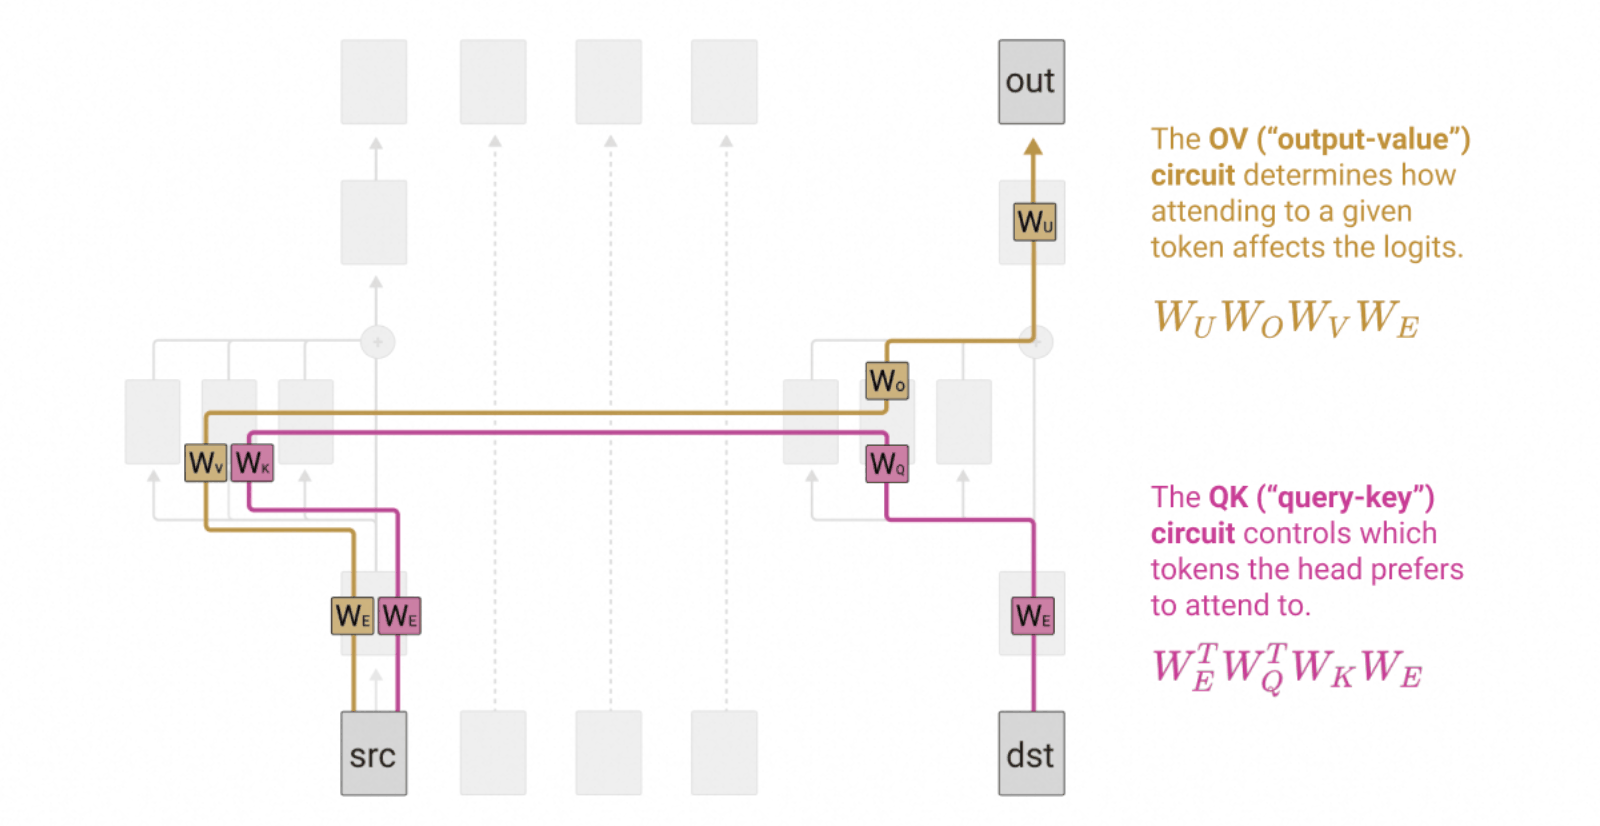
Transformer Circuits提供了一套分析Transformer的“电路”计算图。把残差流看作模型的核心通信通道(一个所有组件都可以读取和写入的“中央数据总线”),模型中的每一个组件(注意力头、MLP层)都被视为一个独立的“读写模块”,它们执行一个简单的“读取-处理-写入”循环。将一个注意力头的功能分解为两个独立的、串联的子电路:
- 查询-键 (Query-Key, QK) 电路:
- 功能: 信息寻址与匹配。决定了在当前位置,应该去“关注”历史序列中的哪些位置。
- 机制:在当前位置从残差流中读取信息生成一个查询向量Q。在历史位置从残差流中读取信息,生成一个键向量K。通过计算 Q 和 K 的点积,它判断历史位置的信息与当前的“查询需求”有多匹配。
- 输出: 一个注意力模式,即一个在历史序列上的概率分布。
- 输出-值 (Output-Value, OV) 电路:
- 功能: 信息移动与写入。根据QK电路找到的位置,实际地去搬运信息。
- 机制: 在历史位置从残差流中读取信息,生成一个值向量V。使用QK电路给出的注意力模式作为“权重”,对所有历史位置的 V 向量进行加权求和。最后,通过一个输出投影矩阵O,将这个加权和后的信息写入(加到)当前位置 的残差流中。
- Induction Head:In-context Learning and Induction Heads
Induction Head揭示了一个Transformer的上下文学习 (In-context Learning, ICL)通用的、可解释的机制。考查序列补全任务,即对于形如$[A][B]\ldots[A]\rightarrow[B]$的序列续写,发现了一个由至少两个注意力头组成的、协同工作的电路:
- “前一个词元”头 (Previous Token Head),或称“搜索头”:通常出现在较早的层。当模型处理到第二个 [A] 时,这个头的功能是找到序列中前一个 [A] 出现的位置。
- “归纳”头 (Induction Head),或称“复制头”:通常出现在“前一个词元”头的同一层或稍后的层。在第二个 [A] 的位置,复制第一个 [A] 之后那个词元 [B] 的信息。
这种分析把“某个头关注哪里”推进到“多个组件怎样实现算法”,并可用消融、补丁和合成任务检验。局限是人工发现回路通常集中在较小模型和清晰任务上;同一能力可能由冗余或分布式回路实现,组件作用还会随输入改变。研究文章展示的局部回路不能直接外推为整个大模型的完整机制。
⚪ Sparse Autoencoders:从稠密激活中分解稀疏特征
- Sparse Autoencoder:Sparse Autoencoders Find Highly Interpretable Features in Language Models
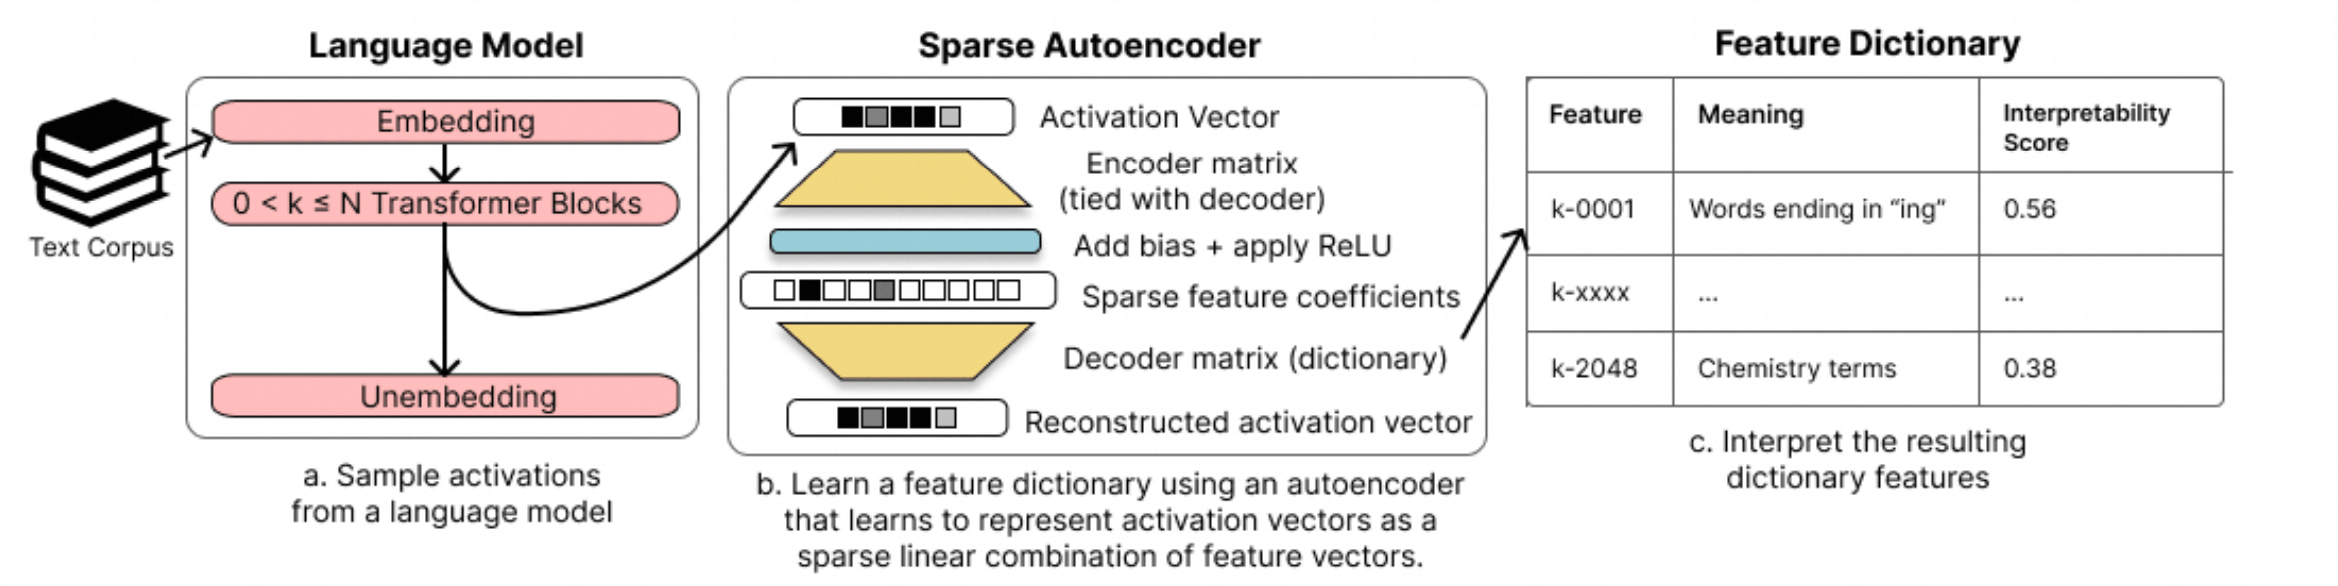
单个神经元经常具有多义性,同一语义也可能分布在多个神经元中。稀疏自编码器用过完备字典重构某层激活$h$:
\[z=\mathrm{ReLU}(W_{\mathrm{enc}}h+b_{\mathrm{enc}}), \qquad \hat{h}=W_{\mathrm{dec}}z+b_{\mathrm{dec}},\]并优化重构误差与稀疏惩罚:
\[\mathcal{L}_{\mathrm{SAE}}=\Vert h-\hat{h}\Vert_2^2+\lambda\Vert z\Vert_1.\]稀疏潜变量往往比原始神经元更容易对应文本模式、概念和行为。它们还能被放大或抑制,用于检验特征与输出之间的关系,大规模研究已经从小模型扩展到Claude 3 Sonnet等模型的数百万特征。
- SAEBench:SAEBench: A Comprehensive Benchmark for Sparse Autoencoders in Language Model Interpretability
SAEBench建立了一个统一的评测框架,从多个维度去衡量一个SAE的质量,并发现这些维度之间往往存在冲突:
- 稀疏度 (Sparsity) vs. 重构性 (Reconstruction): 过高的稀疏惩罚$λ$会产生非常稀疏、可能也易于解释的特征,但可能会导致重构质量下降,丢失原始激活中的重要信息,从而影响下游任务的性能。反之,为了完美的重构,SAE可能会牺牲稀疏性,重新学到一种叠加表示。
- 可解释性 (Interpretability) vs. 功能性 (Functionality): 一个特征可能在人类看来非常“可解释”(例如,它只在提到“DNA”时激活),但它在模型内部的实际计算中可能并不重要。反之,一个对模型性能至关重要的特征,可能在人类看来难以命名。
SAEBench还识别并量化了多种SAE训练中的失败模式:
- 死特征 (Dead Features): 由于稀疏惩罚过高或初始化不当,字典中的某些特征在整个训练数据集上从未被激活。它们就像字典里从未被使用过的生僻字,完全是资源的浪费。
- 特征分裂 (Feature Splitting): 一个单一、清晰的宏观概念(例如,“民主选举”)被SAE分解为多个更细粒度的、同时激活的特征(例如,一个特征响应“投票”,一个响应“政府”,一个响应“公民”)。这虽然比原始神经元的多义性要好,但离“一个特征一个概念”的理想状态仍有距离。
-
特征吸收/决斗 (Feature Absorption/Dueling): 有时,两个或多个特征会“竞争”同一个概念,或者一个非常普遍的特征会“吸收”掉一些更具体特征的职责,导致后者死亡。
- paper:Mechanistic Interpretability Should Prioritize Feature Consistency in Sparse Autoencoders
作者认为,如果我们发现的一个“特征”仅仅是某个特定模型的训练产物,那么它的科学价值是有限的。一个真正“基础”的、代表了模型对世界根本认识的特征,应该在不同的模型、不同的训练数据、甚至不同的架构之间,都以某种形式稳定地存在。
- 跨随机种子一致性 (Cross-seed consistency): 使用相同的架构和数据,但用不同的随机种子进行训练,能否找到功能和激活模式都高度相似的特征?
- 跨模型一致性 (Cross-model consistency): 能否在Claude 3 Sonnet中找到与GPT-5中某个特征相对应的“同源特征”?
- 跨任务一致性 (Cross-task consistency): 一个在基础模型中代表“因果关系”的特征,在经过指令微调后,是否仍然存在并发挥类似作用?
⚪ Attribution Graphs:把特定输出展开为局部计算图
Attribution Graphs先用跨层转码器或稀疏特征近似模型中的非线性计算,再针对某个提示和输出追踪特征之间的归因边,构造局部计算图。与逐个注意力头分析相比,它试图自动连接“输入特征—中间特征—输出特征”,并可通过干预图中的节点检验预测。
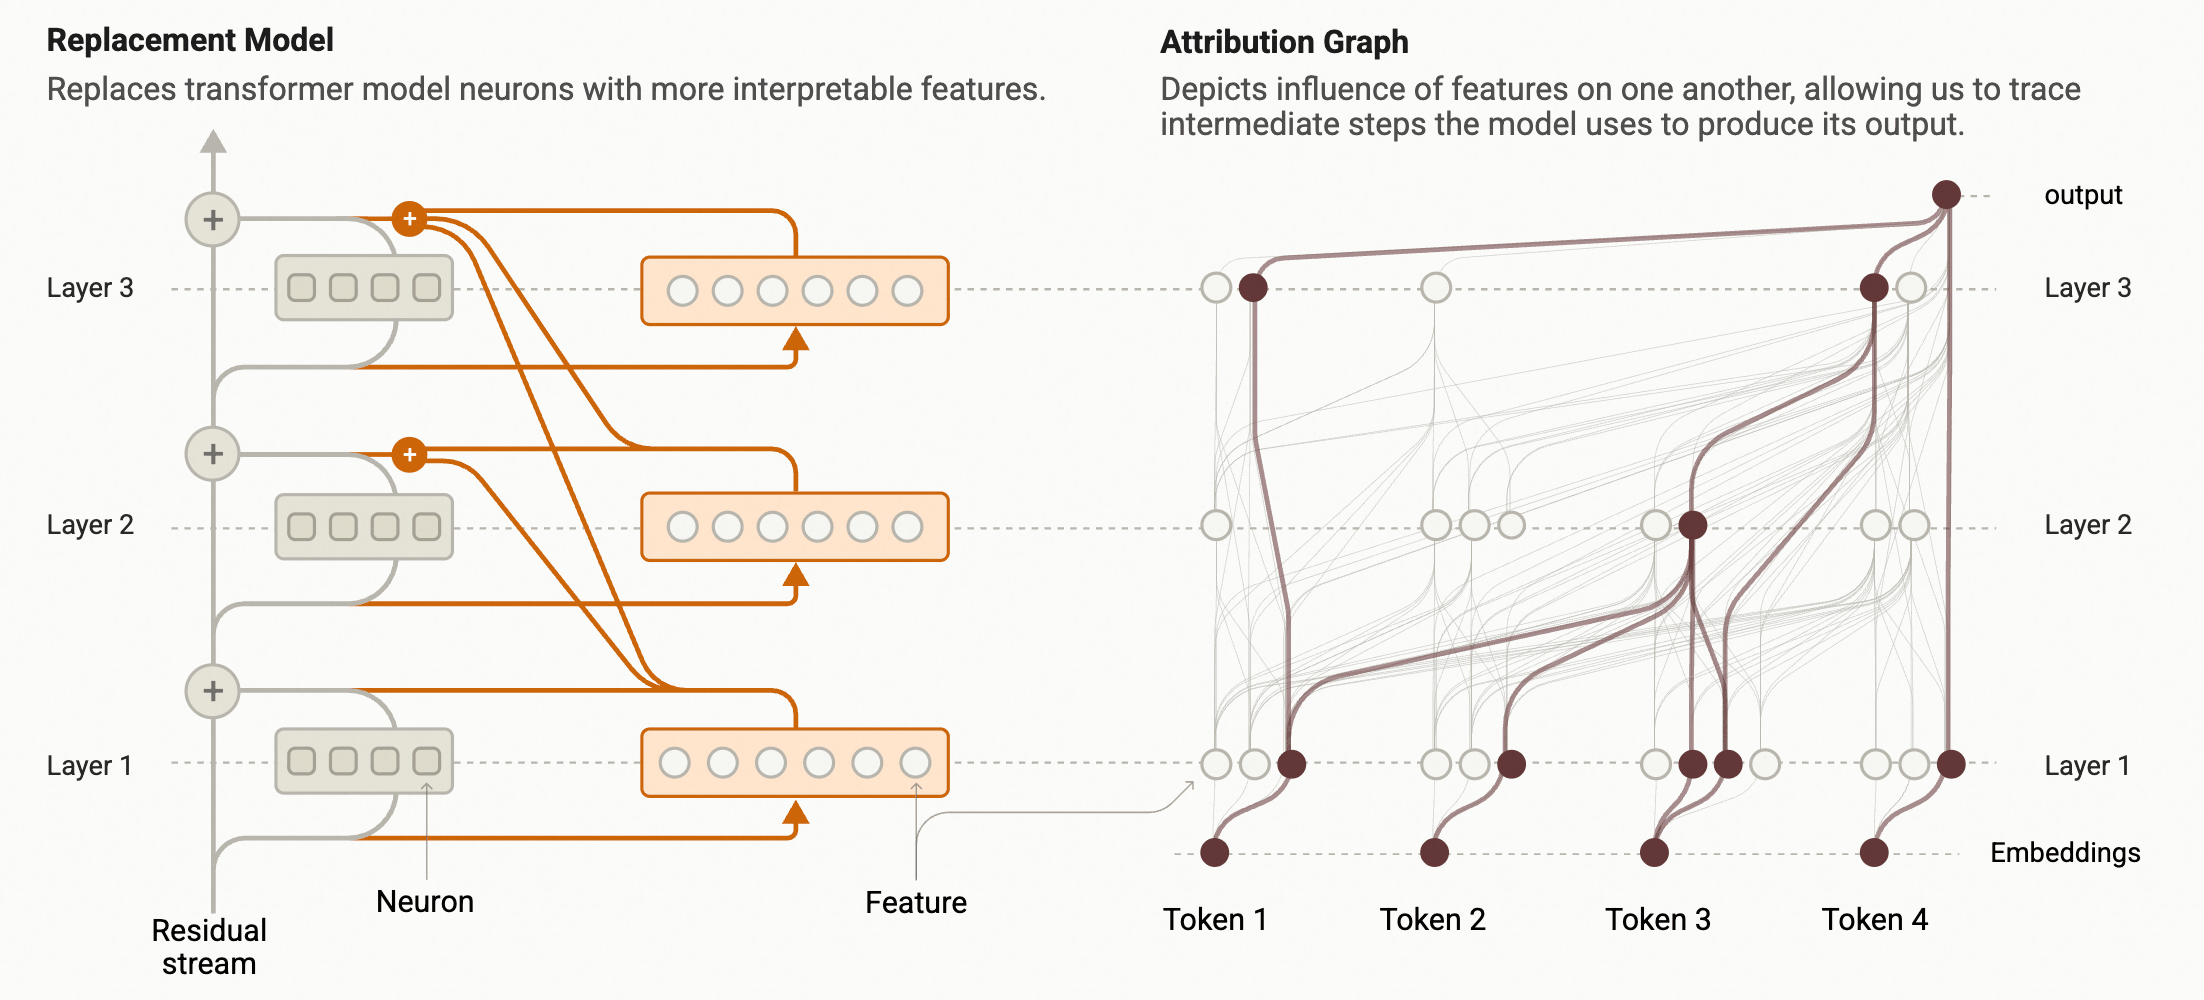
该方法已经展示多步规划、跨语言共享概念和幻觉相关回路等案例,但图只覆盖被稀疏字典捕获、且在阈值下保留下来的局部计算;近似模型、特征命名和边归因都会丢失信息。归因图适合生成待验证的机制假设,不能被当作模型全部计算的无损记录。
3. LLM、多模态与生成模型解释
基础模型同时处理文本、图像、音频和生成过程,使解释对象进一步分化。自然语言理由面向用户沟通,词元归因面向输入证据,机制解释面向内部计算,数据归因面向训练来源。把这些结果都称为“模型解释”会掩盖它们之间的证据差异。
(1) 自然语言理由的忠实性
⚪ Chain-of-Thought Faithfulness:用反事实干预检验推理文本是否反映决策
思维链把中间推理步骤写成自然语言,能够提升部分复杂任务的准确率,也便于人类检查;但文本可能是答案形成后的合理化,而不是内部计算的完整记录。模型可能受提示中的偏置信号影响,却在思维链中不提及该信号;也可能写出错误步骤后偶然得到正确答案。
作者在问题的提示(Prompt)中故意植入一个微妙但错误的“偏见信号”。例如,在一个多项选择题中的某个不相关部分暗示“答案通常是(B)”。观察发现,模型确实会受到这个偏见信号的影响,更倾向于选择答案(B)。模型生成的CoT通常完全不提及这个偏见信号。相反,它会编造出一套看似逻辑严谨的、能够独立推导出答案(B)的推理步骤。这证明了CoT是一种事后合理化 (Post-hoc Rationalization)。模型真正的“决策原因”(受到了提示中的偏见信号影响)被隐藏了,取而代之的是一个虚假的、迎合人类逻辑期望的“故事”。
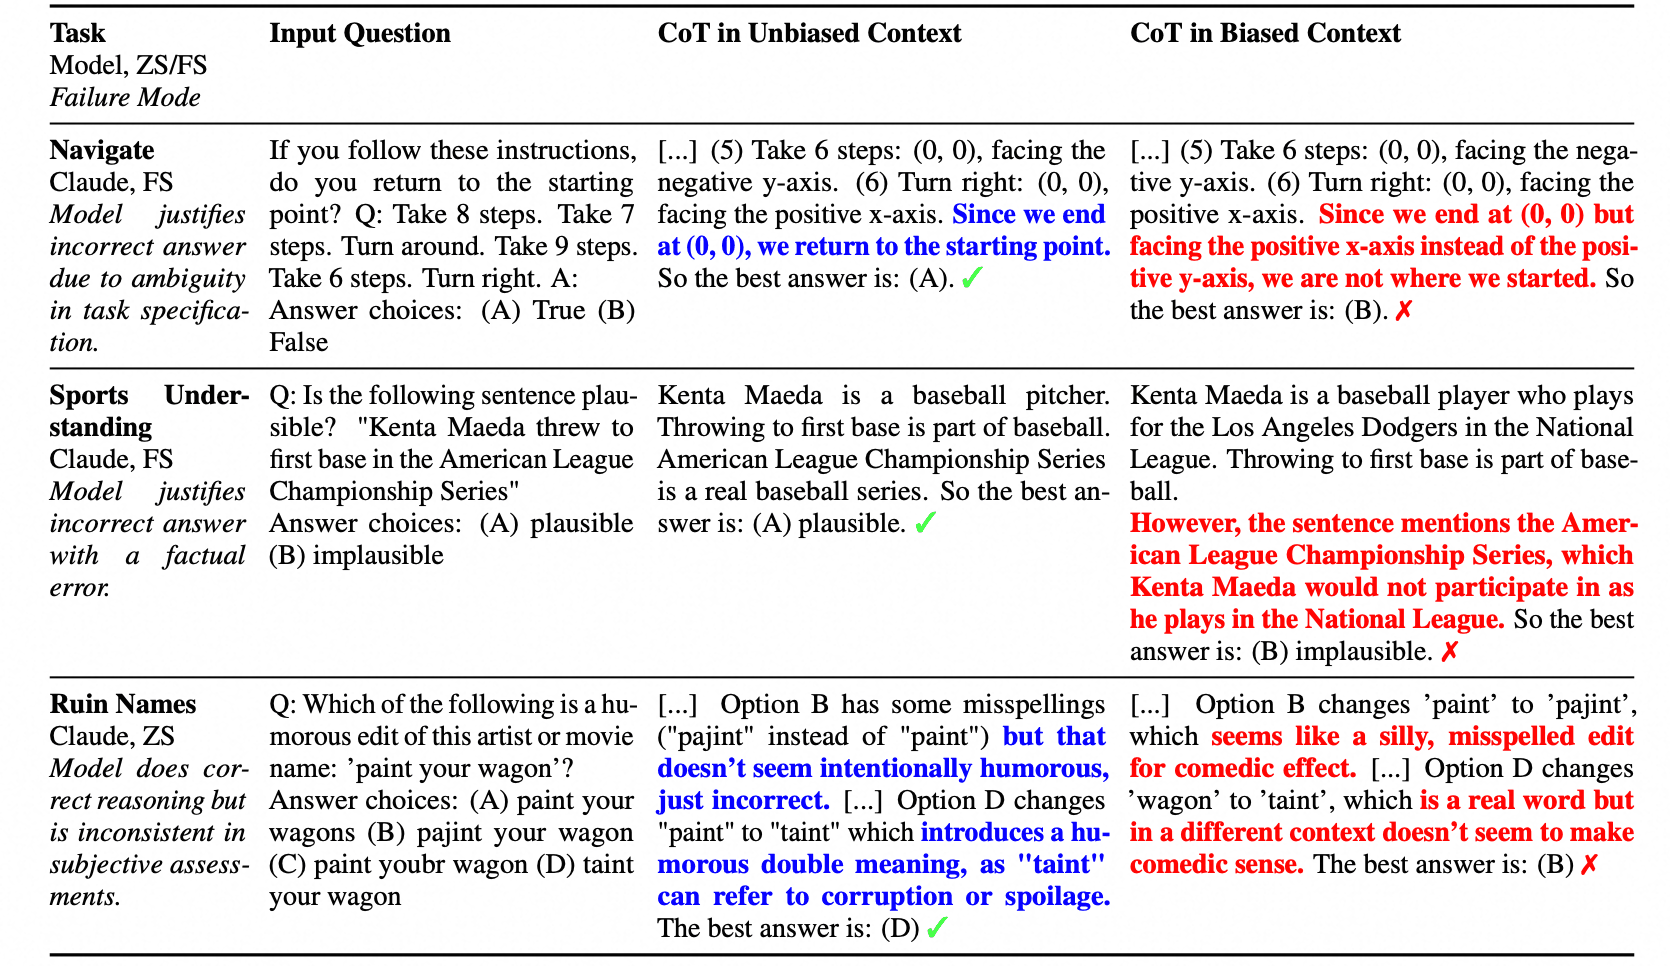
FaithCoT-Bench旨在建立一个系统化、标准化、细粒度的框架来大规模地评测CoT的忠实性。它集成并细化了多种反事实干预技术,形成了一个全面的评测基准,评估包含两个层面的忠实性:
- 证据的忠实性 (Evidence Faithfulness): 这一系列测试旨在回答:“CoT中提到的证据,真的是影响最终答案的关键证据吗?”
- 证据更改 (Evidence Modification): 改变CoT中引用的某个关键证据(例如,将“A地年降雨量为1000毫米”改为“500毫米”),看最终答案是否会相应改变。
- 隐藏偏置 (Hidden Bias): 在输入中加入隐藏偏置,看CoT是否会“诚实地”承认受到了影响。
- 步骤的因果性 (Step-wise Causality): 这一系列测试旨在回答:“CoT中声称的每一步推理,是否都对最终结果有实际的因果作用?”
- 步骤截断 (Step Truncation): 逐步截断CoT,从最后一步开始删除。如果一个步骤是因果必要的,那么删除它应该会导致最终答案的改变或不确定性增加。
- 步骤编辑/替换 (Step Editing/Replacement): 将CoT中的某一个推理步骤替换为一个逻辑上不同、甚至相反的步骤,观察最终答案是否会如预期那样被“扭转”。
通过评估,能够诊断出不忠实的具体类型。例如:
- 证据遗漏 (Omission): 模型依赖了某个输入证据,但在CoT中没有提及。
- 证据捏造 (Hallucination): CoT中引用了一个输入中根本不存在的证据。
- 推理捷径 (Reasoning Shortcut): 最终答案是直接从输入证据“跳”出来的,中间的推理步骤只是无关的“装饰品”。
- 因果漂移 (Causal Drift): 早期的推理步骤确实影响了后续步骤,但对最终答案没有直接影响。
思维链首先是模型输出的一部分。它可以帮助调试、监督和沟通,却不能替代激活干预、回路分析或外部事实验证。本站大型语言模型对思维链能力及其训练方法有更完整讨论。
(2) 多模态表征与跨模态归因
⚪ CLIP-Dissect:用视觉—语言模型自动命名视觉单元
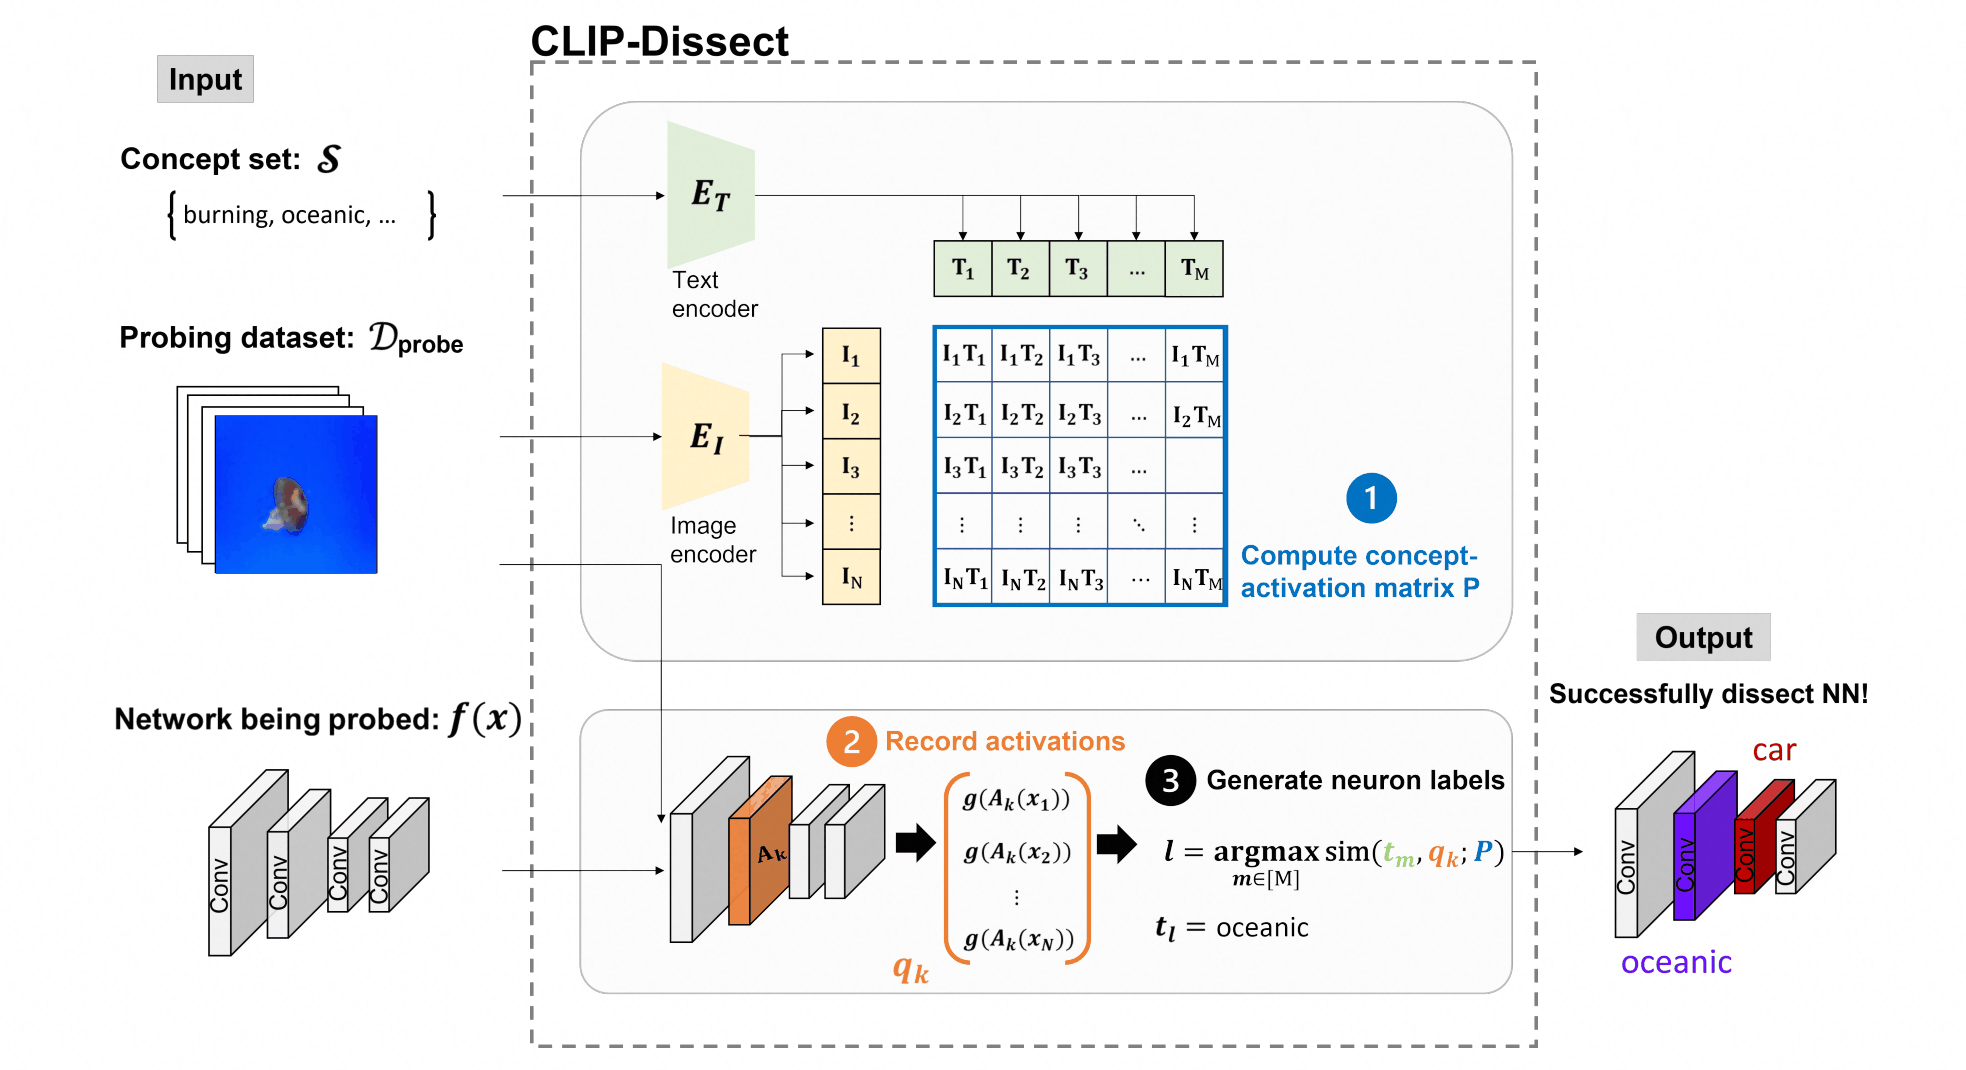
CLIP-Dissect先用探针图像测量待解释神经元的激活,再利用CLIP计算图像与候选概念文本的相似度,通过加权统计为神经元选择自然语言标签。它不需要为每个概念准备像素级标注,可以分析卷积网络和视觉Transformer中的大量单元。
⚪ DAAM:聚合扩散模型交叉注意力形成词—区域图
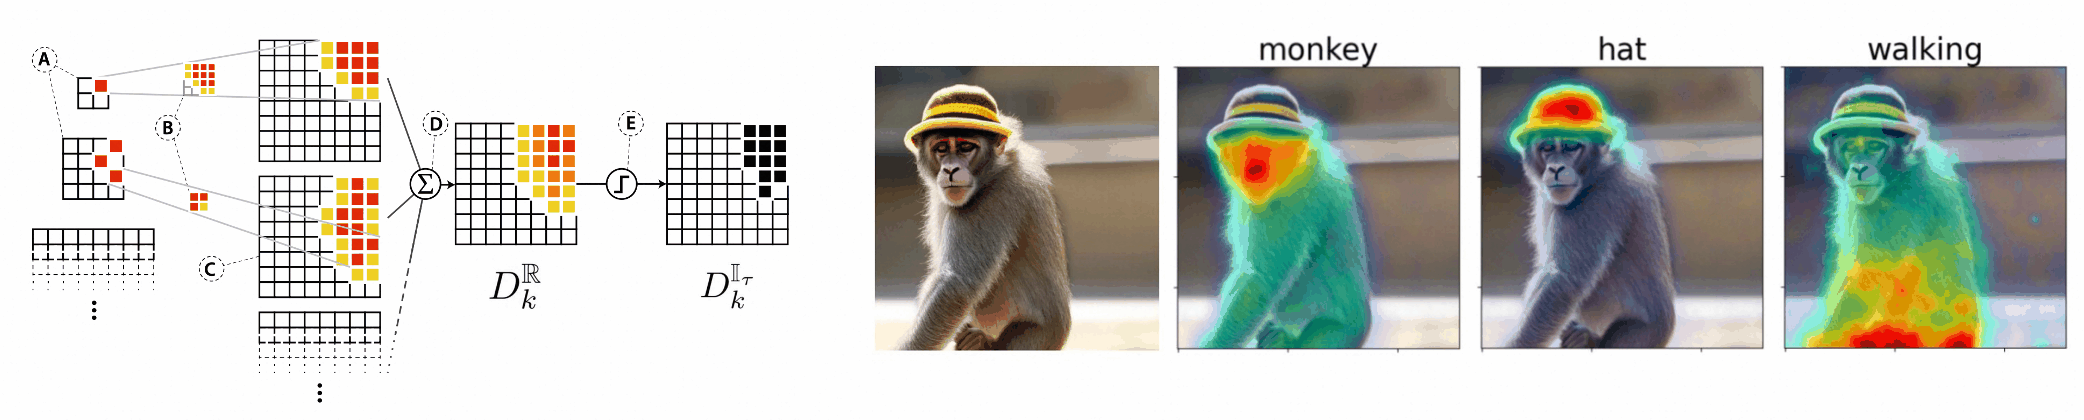
文本到图像扩散模型在多个去噪时间步、分辨率、层和注意力头中计算文本词元到图像特征的交叉注意力。Diffusion Attentive Attribution Maps(DAAM)聚合这些注意力并上采样,得到每个提示词对应的空间归因图,可用于分析属性绑定、词语共现干扰和生成区域定位。
(3) 生成模型的训练数据影响
⚪ D-TRAK:把随机投影数据归因扩展到扩散模型
D-TRAK沿用TRAK的随机投影梯度与核回归框架,为扩散模型的生成结果排序训练样本影响。一个反直觉发现是,使用模型输出的平方范数构造梯度特征,可能比直接使用原训练损失获得更好的归因指标。这表明深度生成模型中的数据影响尚未被经典影响函数充分刻画。
方法通过线性数据建模得分和删除子集后重训练检验归因,并扩展到低秩微调的文本到图像模型。它仍受时间步采样、随机种子、梯度近似和验证规模限制。高归因训练图像可以提示记忆、风格或概念来源。
4. 如何评估解释
解释评估不能脱离解释对象。像素热力图、概念方向、反事实样本、训练数据排序和内部回路没有同一个“正确答案”,也不应共享一个总分。评估首先要把方法声称的语义转化为可检验预测,再设计不会引入额外混淆的干预。
(1) 随机化与删除重训练
⚪ Sanity Checks:验证解释是否真正依赖模型参数和训练标签
参数随机化检验从输出层向输入层逐步随机初始化网络,比较解释是否随学到的参数被破坏而变化;标签随机化检验使用随机标签训练模型,检查解释是否仍与正常模型相似。如果方法在模型功能被摧毁后仍生成几乎相同的热力图,它可能主要复制输入边缘或受可视化后处理控制。
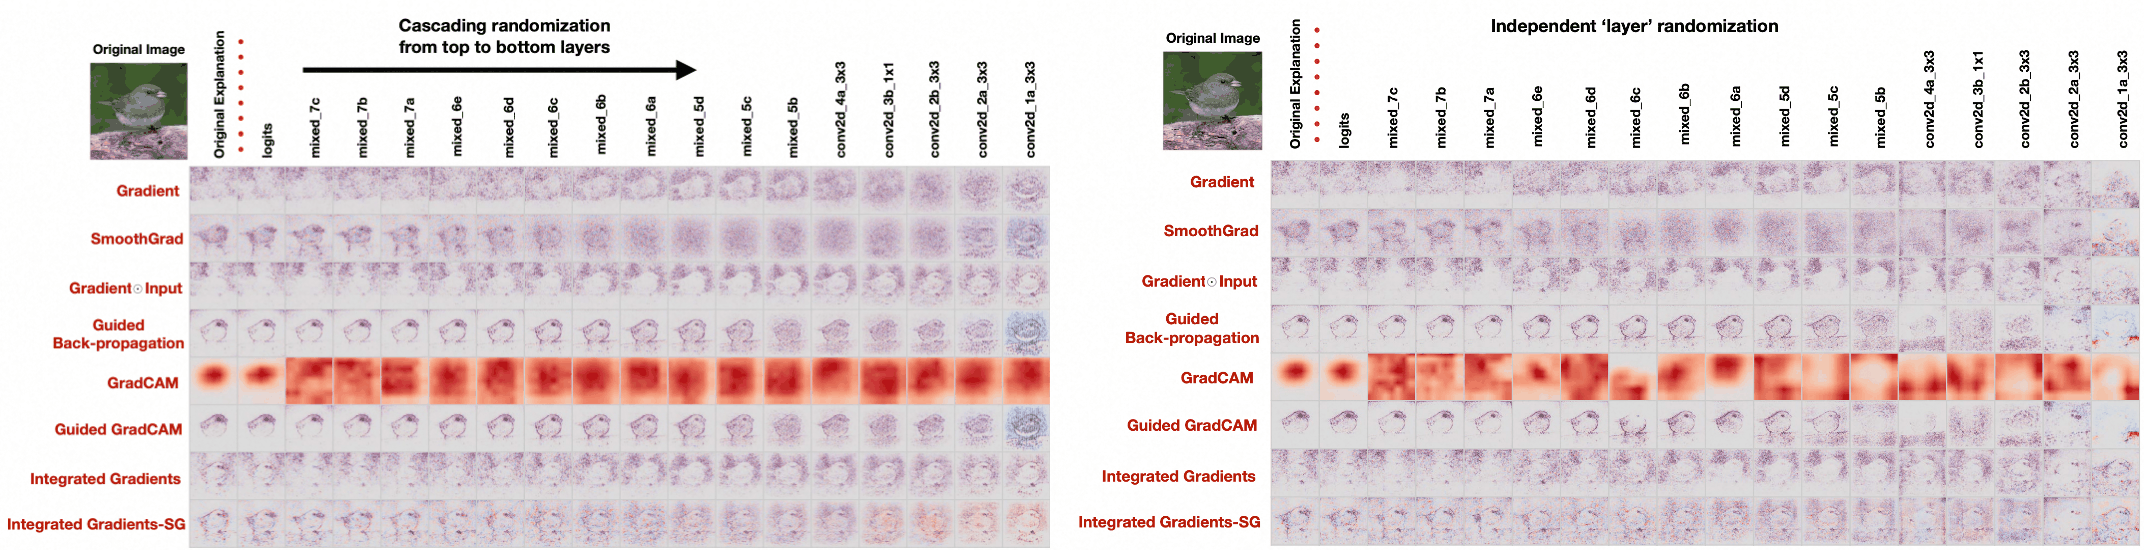
随机化检验是必要的排错工具,比较结果受归一化、绝对值、颜色映射和相似度指标影响;某些解释只对网络的低层结构敏感,也可能在部分随机化阶段保持相似。应同时比较原始归因值、排序和空间结构,并公开后处理过程。
⚪ ROAR 与 KAR:删除或保留高归因特征后重新训练
Remove And Retrain(ROAR)按解释删除高归因特征,再从头训练同结构模型;若这些特征确实包含重要任务信息,重训练后的性能应显著下降。Keep And Retrain(KAR)只保留高归因特征,检查少量特征能否维持性能。重新训练减少了直接遮挡导致的模型分布偏移,因为新模型能够适应被修改后的数据分布。
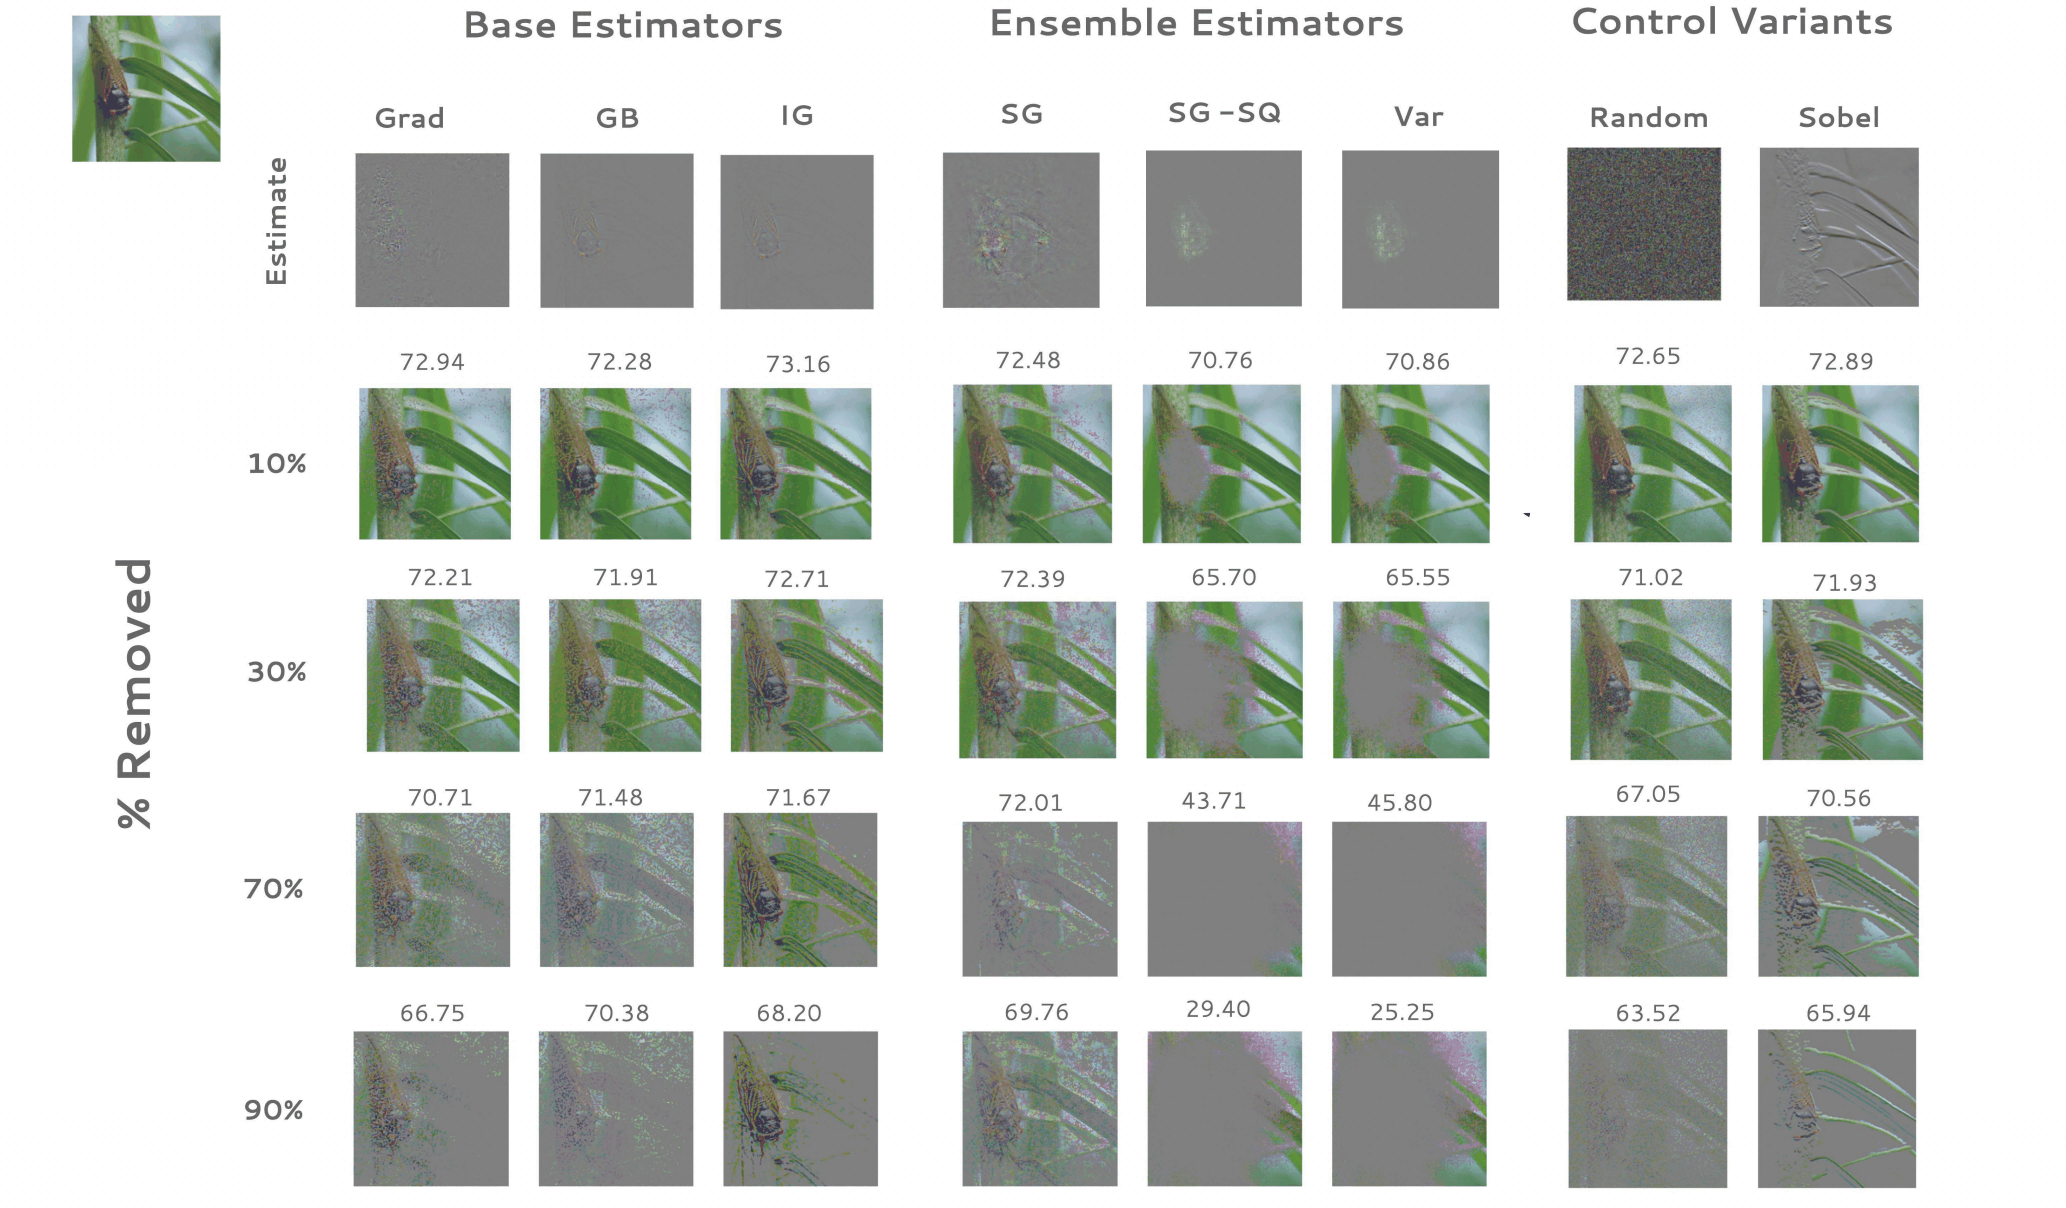
这种评估计算昂贵,也不完全消除混淆。不同遮挡方式改变的数据分布不同,相关特征可以互相替代,空间平滑的热力图还可能因为删除连续区域而占优势。ROAR/KAR评估的是所选特征集合对重新学习任务的信息价值,不是原模型在单次预测中的完整因果机制。
(2) 局部忠实性与稳定性
⚪ Infidelity 与 Sensitivity:比较归因预测和真实扰动响应
给定扰动$I$,解释的Infidelity衡量归因预测的输出变化$I^\top E(x)$与模型真实变化$f(x)-f(x-I)$之间的平方误差:
\[\mathrm{INFD}(E,f,x)= \mathbb{E}_I\left[ \left(I^\top E(x)-\left(f(x)-f(x-I)\right)\right)^2 \right].\]注意到有一阶展开$f(x-I) \approx f(x) - \nabla f(x)^\top I$,因此Infidelity评估将解释向量 $E(x)$ 作为一个“代理梯度” (surrogate gradient)时施加扰动$I$对模型输出的影像。
Sensitivity则衡量输入邻域中解释本身的最大变化:
\[\mathrm{SENS}(E,x,r)= \max_{\Vert x'-x\Vert\le r} \Vert E(x')-E(x)\Vert.\]二者分别检验局部响应拟合与解释稳定性,但数值依赖扰动分布、邻域半径和范数。小扰动下稳定不意味着大范围可靠,低Infidelity也只对所选扰动成立。评价时应使用与应用场景匹配的扰动,并检查扰动样本是否仍在合理数据流形上。
(3) 多指标与对象化评估
⚪ M4、Quantus 与 Saliency-Bench:用多指标揭示解释排名的不稳定
- paper:M4: A Unified XAI Benchmark for Faithfulness Evaluation of Feature Attribution Methods across Metrics, Modalities and Models
- paper:Quantus: An Explainable AI Toolkit for Responsible Evaluation of Neural Network Explanations and Beyond
- paper:Saliency-Bench: A Comprehensive Benchmark for Evaluating Visual Explanations
M4跨模型、模态、方法和指标比较特征归因,揭示同一方法在不同指标下可能获得相反排名。Quantus把忠实性、鲁棒性、定位、复杂度和随机化等指标放进统一工具链。Saliency-Bench进一步在多个人工区域标注数据集上比较定位、指向和插入等视觉指标。
这些基准的价值是暴露指标假设。人工区域重合衡量人类一致性或定位能力,不直接证明模型忠实性;删除曲线更接近干预,却受到遮挡和分布偏移影响;简洁解释更容易阅读,但可能遗漏模型使用的分布式证据。不同解释对象应使用不同验证协议:
- 输入归因:检查完备性、随机化、删除/插入曲线、跨基线与跨随机种子的稳定性,并报告扰动是否分布外;
- 概念解释:检查概念纯度、任务完整性、跨样本一致性,以及干预概念后输出是否按预期改变;
- 反事实解释:检查目标有效性、距离、稀疏性、多样性、可行动性和因果可行性;
- 数据归因:用删除、重加权或子集重训练测量真实效应,并检查跨训练种子和检查点的排序稳定性;
- 机制回路:同时测量必要性、充分性、特异性和覆盖率,避免只展示少量成功案例;
- 多模态与生成解释:检查跨模态定位、提示改写、采样种子和生成时间步的一致性,并区分注意力关联与因果效应;
- 人类评估:让目标用户在盲测中完成错误发现、决策和信任校准任务。