Pretrained Language Models.
预训练语言模型(Pretrained Language Model, PLM)是指先在大规模无标注语料库上通过自监督任务学习通用的语言表示,再把这份表示迁移到具体下游任务的一类模型。它之于自然语言处理,就好比backbone之于计算机视觉:模型结构本身并不神秘,真正稀缺的是”在海量文本上把语言的统计规律与世界知识压缩进参数”这一过程。使用预训练语言模型的标准流程只有两步:
- 在大规模无标签语料库上执行某个自监督的预训练(pre-training)任务;
- 在下游任务的语料上微调(fine-tuning),或者干脆不改参数、直接用提示(prompting)驱动。
这条路线经历了三次重心转移:从上下文无关的词向量(Word2Vec、GloVe)到上下文相关的特征提取器(ELMo),再到可以整体微调或直接提示的预训练网络(BERT、T5、GPT)。理解这段演化的关键是:用什么架构、用什么预训练任务、如何迁移。
本文首先梳理语言的特征表示,然后按“架构 × 预训练任务”两个维度讨论编码器、编码器-解码器与解码器三条技术路线,最后讨论预训练语言模型内部的知识如何被探测、定位与修改。
- 语言的特征表示:上下文无关的嵌入与上下文相关的嵌入,Word2Vec、GloVe 与 ELMo
- 预训练语言模型的设计空间:Encoder-Only / Decoder-Only / Encoder-Decoder 三种架构;LM / MLM / Seq2Seq MLM / PLM / Prefix-LM 五类预训练任务
- 编码器架构:BERT 及其后继(RoBERTa、SpanBERT、ERNIE、ALBERT、ELECTRA、REALM、DeBERTa、XLNet、ModernBERT)
- 编码器-解码器架构与统一预训练目标:MASS、UniLM、BART、T5 系列、GLM、UL2
- 解码器架构:GPT与GPT-2
- 理解预训练语言模型:模型学到了哪些知识、知识存储在哪里、如何修改知识(TDA、约束微调、Knowledge Neuron、MEND、ROME、MEMIT)
符号约定:全文用$x=[x_1,x_2,\cdots,x_T]$表示长度为$T$的输入词元(token)序列,$x_{<t}$表示$x_t$之前的所有词元;$e(\cdot)$表示词嵌入函数,$h_t^{(l)}$表示第$l$层第$t$个位置的隐状态,$L$表示层数,$d$表示隐藏维度;$\theta$表示模型参数,$p_\theta(\cdot)$表示模型给出的概率分布;$\mathcal{V}$表示词表,$\lvert \mathcal{V} \rvert$表示词表大小。在讨论规模化时用$N$表示模型参数量、$D$表示训练词元数、$C$表示训练总算力(以FLOPs计)。
1. 语言的特征表示
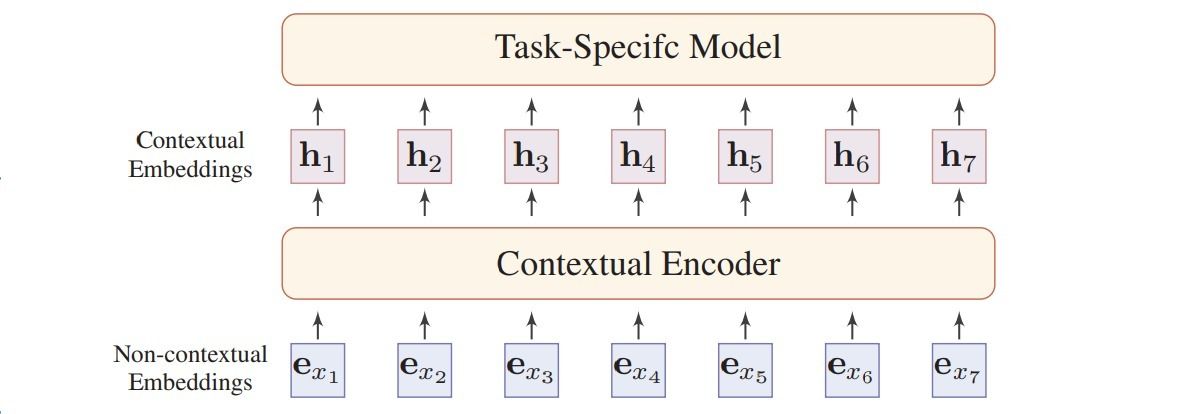
自然语言处理中对语言的特征表示,应当能从文本语料中学到内在的语言规则与常识知识,如词义、句法结构、词类、语用信息等。一种好的语言特征表示既要有与具体任务无关的通用含义,又要能为具体任务提供有用的信息。按照”同一个词在不同句子里是否得到同一个向量”这一标准,语言特征表示可以分成上下文无关的嵌入(non-contextual embedding)和上下文相关的嵌入(contextual embedding)两类。
(1) 上下文无关的嵌入
上下文无关的嵌入通常由词嵌入(word embedding)实现,即把句子中的每一个词(word)映射成一个固定的向量:$x \to e_x$。在这类方法中,不同句子里的同一个词都会被嵌入成同一个向量,然而同一个词在不同句子中可能具有完全不同的含义,例如:
- It is safest to deposit your money in the bank.
- The victim was found lying dead on the river bank.
两句话中的bank分别表示”银行”和”河岸”,固定的词向量无法解决这种多义问题。此外,由于词表是有限的,对于训练时未出现过的词无法得到嵌入向量,即词表外问题(out of vocabulary, OOV)——这也是后来BPE、WordPiece等子词(subword)切分方案被普遍采用的原因。
⚪ Word2Vec:用共现关系学习静态词向量
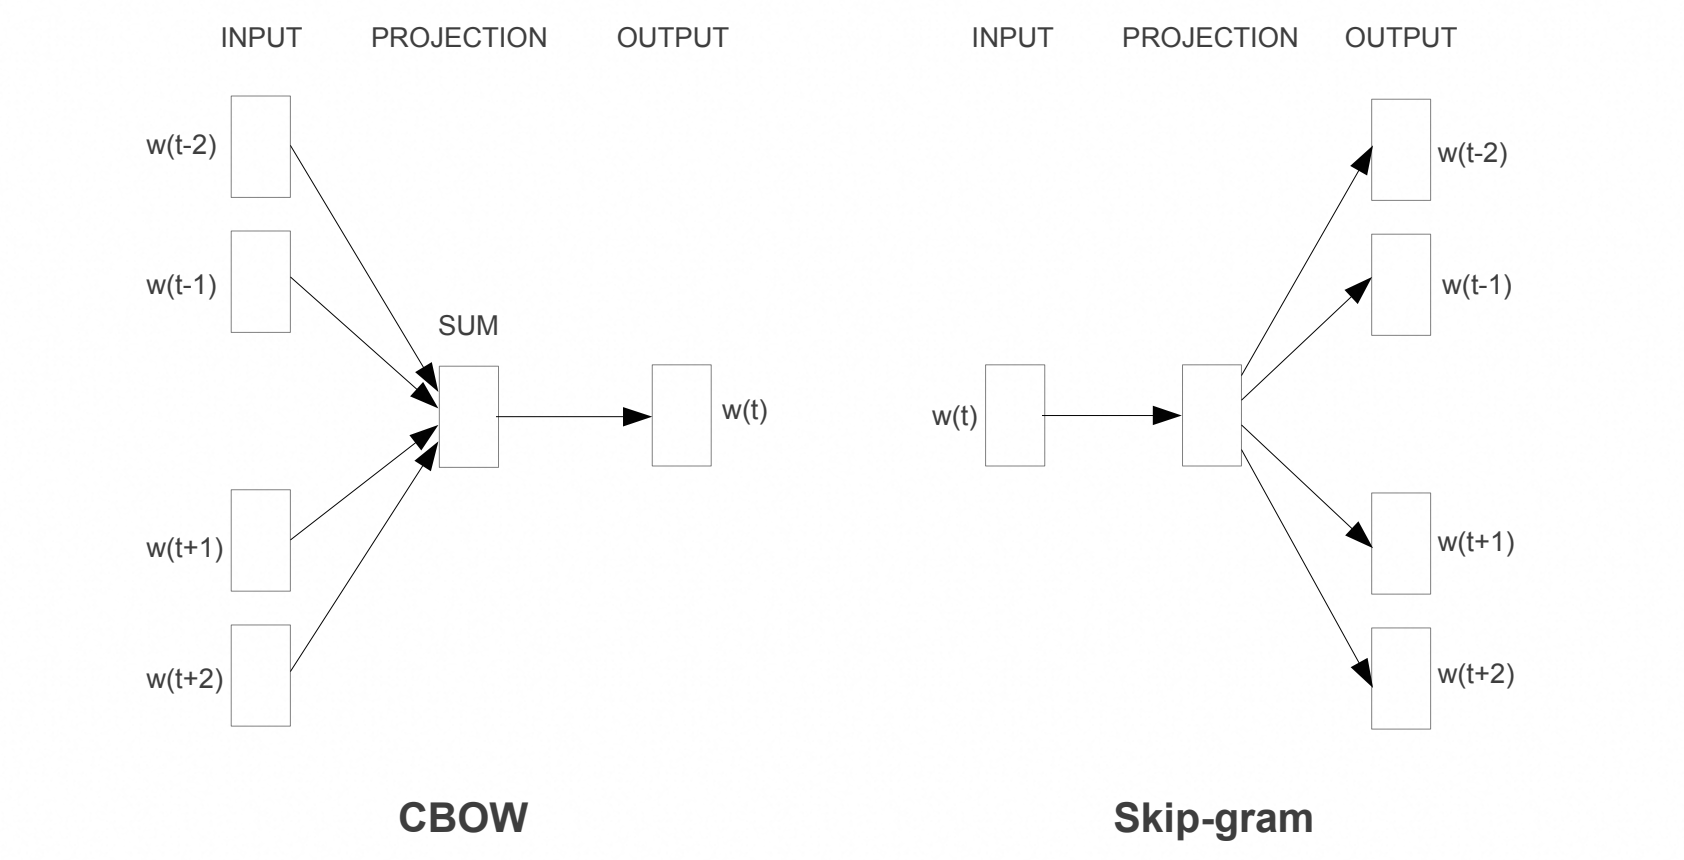
Word2Vec提出了CBOW与Skip-gram两种极简结构:前者用上下文窗口内的词预测中心词,后者用中心词预测上下文窗口内的词。以Skip-gram为例,其目标是最大化
\[\frac{1}{T} \sum_{t=1}^{T} \sum_{-c \le j \le c, j \ne 0} \log p_\theta(x_{t+j} \mid x_t)\]模型只有一个嵌入矩阵和一个输出矩阵,配合负采样或层次softmax近似归一化项,因此可以在十亿量级的语料上快速训练。它从无标注语料中获得高质量词向量,捕捉了潜在的语法与语义信息(著名的”国王 $-$ 男人 $+$ 女人 $\approx$ 女王”),但局部窗口训练只直接利用被采样的词对,没有显式拟合整个语料库的全局统计。
⚪ GloVe:分解全局词共现统计
GloVe(Global Vectors)先统计词$i$与上下文词$j$在整个语料库中的共现次数$X_{ij}$,再学习词向量$w_i,\tilde{w}_j$,使其内积拟合对数共现频率:
\[J=\sum_{i,j=1}^{|\mathcal{V}|}f(X_{ij})\left(w_i^\top\tilde{w}_j+b_i+\tilde{b}_j-\log X_{ij}\right)^2\]其中$f(X_{ij})$降低极高频词和极低频噪声的影响。与Word2Vec逐窗口采样不同,GloVe把训练写成加权矩阵分解,直接利用全局共现比率;两者最终学习到的仍是一词一向量的静态表示。FastText进一步把词表示为字符$n$元组向量之和,改善罕见词与词形变化,却仍不能让同一个词随句子改变含义。关于这一族方法的细节可参考词嵌入。
(2) 上下文相关的嵌入
上下文相关的嵌入是指根据当前文本的上下文,为每一个词元位置(注意不是每一个词)动态地生成表示;当上下文不同时,同一个词也会得到不同的向量。这通常由一个神经网络编码器$f_{enc}(\cdot)$实现:
\[[h_1,h_2,\cdots,h_T] = f_{enc}([x_1,x_2,\cdots,x_T])\]随着循环神经网络和Transformer的引入,这类模型迅速成为主流。相比静态词向量,它的优势在于:
- 可以在大规模语料中学到通用语言表示,包含词的上下文信息;
- 为下游任务提供了更好的初始化,既提高精度也加速收敛;
- 可以看作一种正则化,缓解模型在小数据集上的过拟合。
⚪ ELMo:用双向语言模型做动态词嵌入
ELMo(Embeddings from Language Model)是上下文相关表示的开创性工作。它先在大规模语料上预训练一个双向语言模型(bidirectional language model, biLM),再把该模型每一层、每个方向的隐状态看作对输入词的一种编码,加权求和后作为最终的词嵌入。
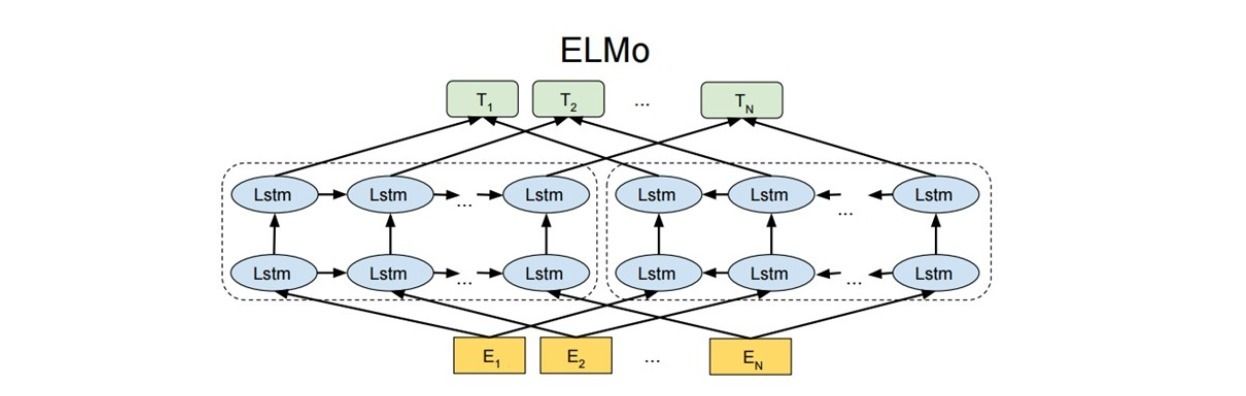
具体地,ELMo使用一个双向的多层LSTM。对于经过词嵌入的输入句子$(e_1,e_2,\cdots,e_T)$,前向语言模型假设句子概率是每个词关于其左侧所有词的条件概率之积,后向语言模型则关于右侧所有词,双向语言模型是两者的结合:
\[P(e_1,\cdots,e_T) = \prod_{t=1}^{T} P(e_t \mid e_1,\cdots,e_{t-1}) \cdot P(e_t \mid e_{t+1},\cdots,e_{T})\]注意这里的”双向”是两个独立的单向模型拼接,而不是在同一次前向计算中同时看到左右上下文——这正是后来BERT强调自己是”深度双向”的原因。若设置$L$层,则每个词元$x_t$可以获得$2L+1$个表示向量(输入词嵌入以及每层每个方向的隐状态)。将同一层的两个方向拼接,可写成$L+1$个向量:
\[R_t = \{h_{t,j}^{LM} \mid j=0,\cdots,L\}, \\ h_{t,j}^{LM} = \begin{cases} e_t^{LM}, & j=0 \\ [\overrightarrow{h}_{t,j}^{LM},\overleftarrow{h}_{t,j}^{LM}], & j=1,\cdots,L \end{cases}\]最终的表示是各层的可学习加权平均:
\[\text{ELMo}_t = \gamma^{task} \sum_{j=0}^{L} s_j^{task} h_{t,j}^{LM}\]其中$s_j^{task}$是每一层的重要性权重,$\gamma^{task}$是针对下游任务的缩放系数;两者都是随下游任务训练的,因此不同任务可以自动选择”更偏语法的低层”或”更偏语义的高层”。使用时ELMo通常与原始词向量并联后送入下游模型:
\[\{ [e_t^{LM},\text{ELMo}_t] \mid t=1,\cdots,T \}\]ELMo的使用方式仍然是”特征提取器”:下游模型是重新设计并从零训练的,预训练模型只提供输入特征。GPT与BERT把这一范式改成了”整个模型都是预训练好的、下游只加一个极薄的输出头”。
2. 预训练语言模型的设计空间
在讨论具体模型之前,先把设计空间拆成两个正交的维度:架构(每个位置能看到哪些位置)与预训练任务(监督信号如何构造)。绝大多数预训练语言模型都可以由这两个维度定位,而它们的差异也几乎全部由这两个维度解释。
(1) 三种架构
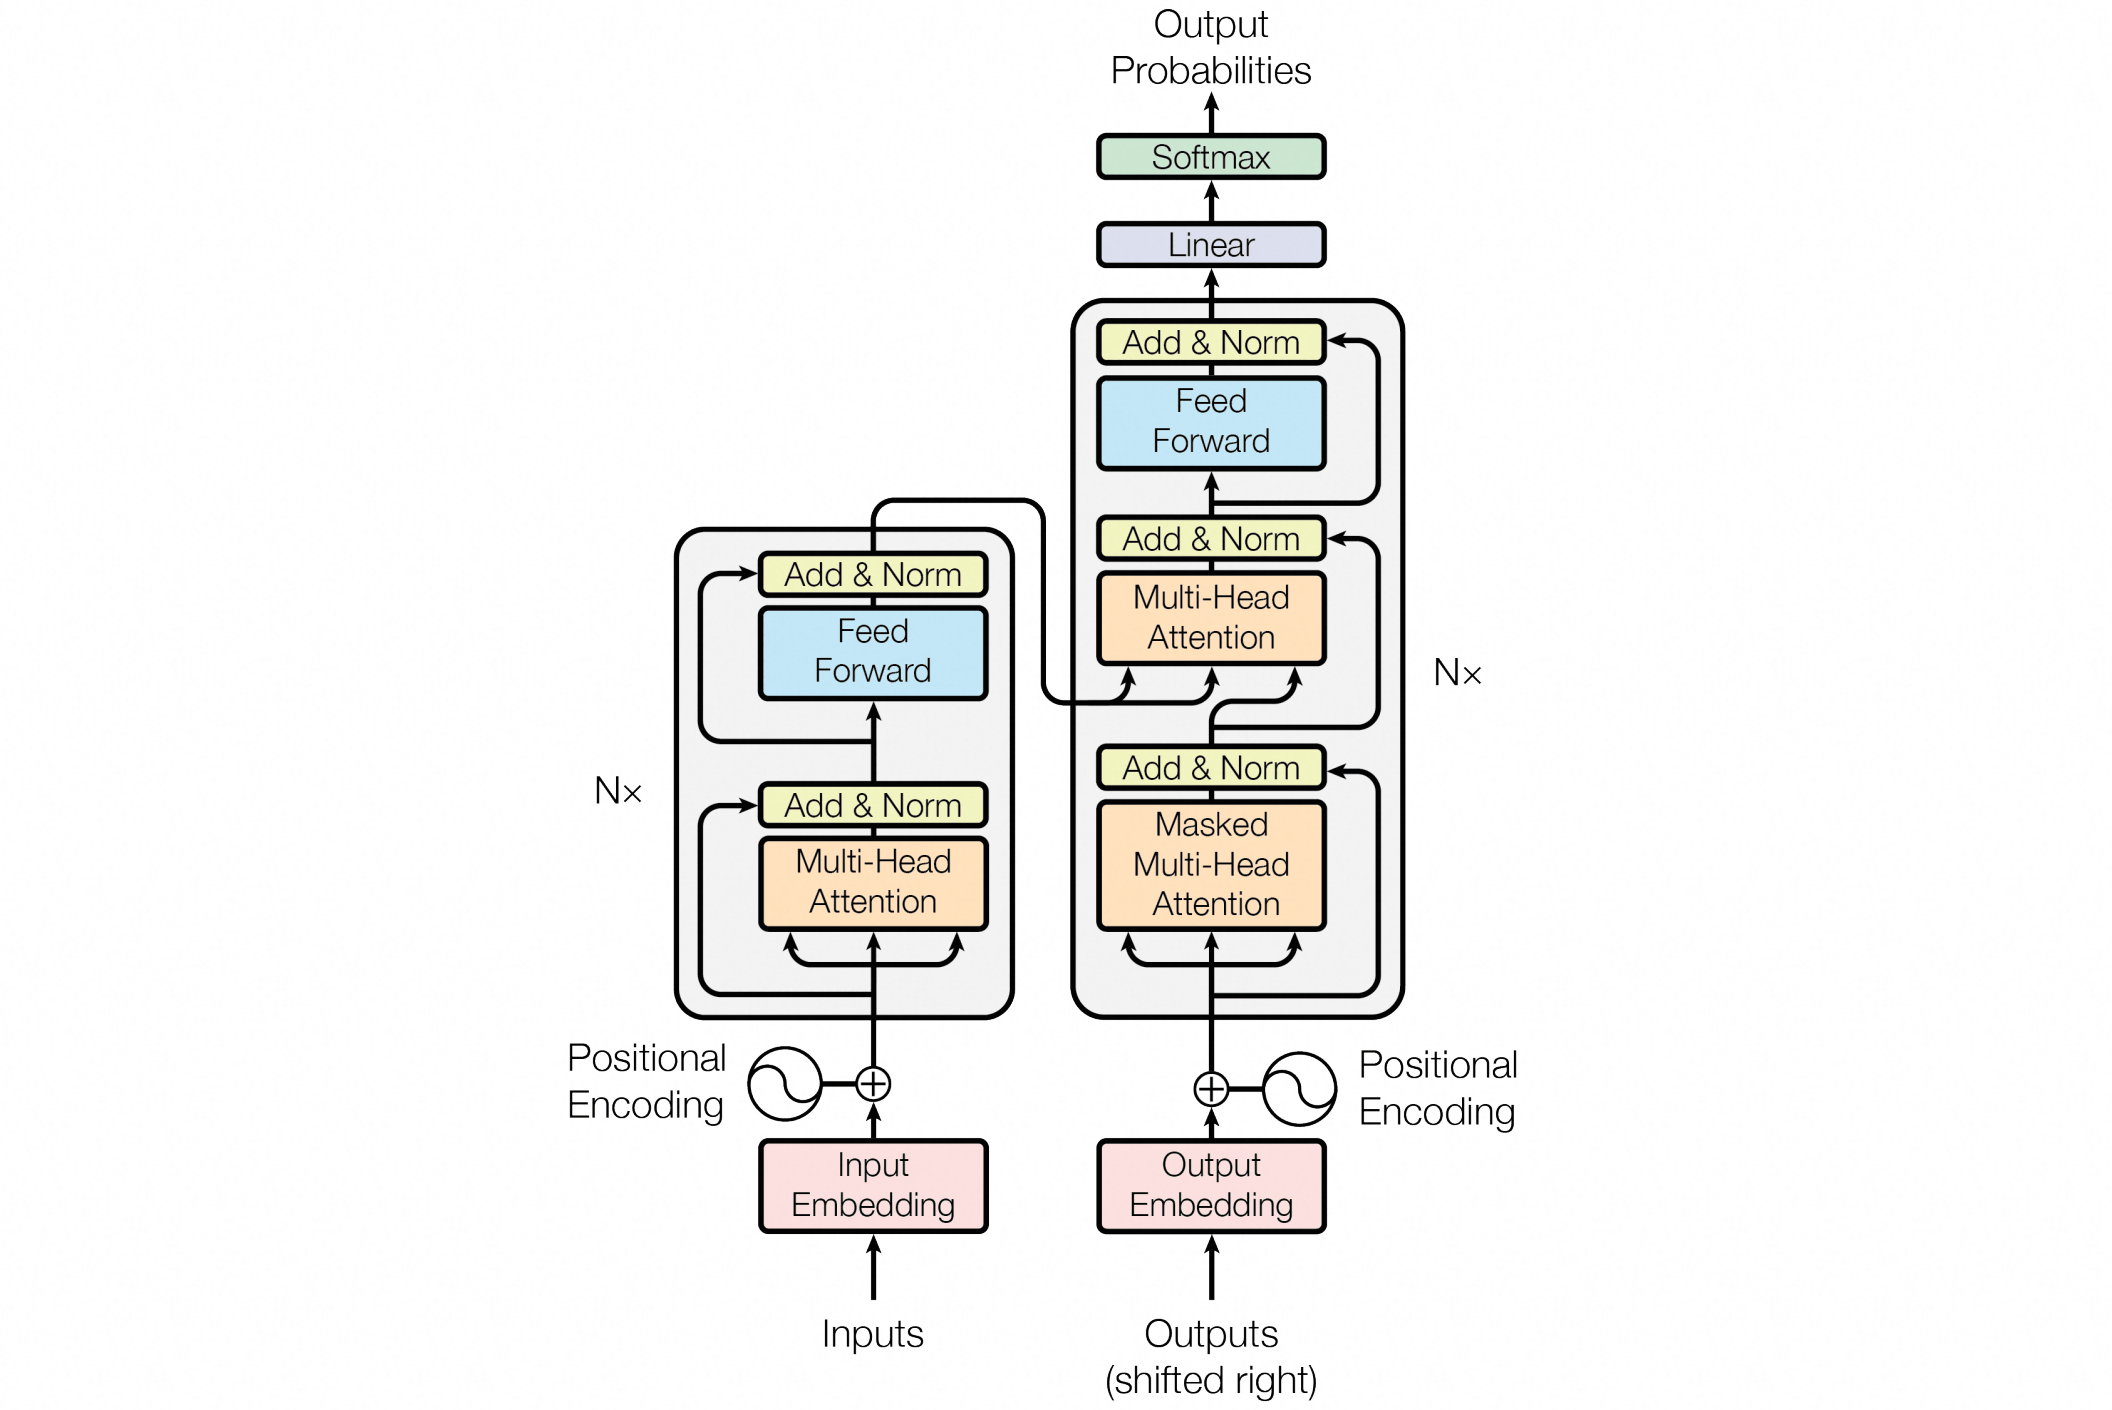
Transformer原始论文给出的是编码器-解码器架构,但当前对预训练语言模型的分类通常按”哪一半被保留”分为三类。
① 编码端(Encoder-Only)架构
编码端架构(如BERT、RoBERTa)可以生成上下文向量表征,但不能直接用于生成文本。这些表征通常用于自然语言理解任务(形式上多为分类,如文本分类、情感分类、序列标注)。其优点是对每个$x_t$,上下文表征可以双向地依赖左侧上下文$x_{<t}$和右侧上下文$x_{>t}$,因此对文本的理解更充分;缺点是不能自然地生成文本,且需要专门设计的训练目标(如掩码语言建模)。
② 解码端(Decoder-Only)架构
解码端架构(如GPT系列)是常见的自回归语言模型,通常用于自然语言生成任务:给定提示$x_{1:t}$,模型对下一个词元$x_{t+1}$给出概率分布,并递归地生成整个后续序列。它的优点是能自然地生成文本、训练目标简单(就是最大似然);缺点是对每个$x_t$,上下文表征只能单向地依赖左侧上下文$x_{<t}$。
③ 编码-解码端(Encoder-Decoder)架构
编码-解码端架构(如BART、T5)在某种程度上兼具两者优点:用双向注意力处理输入$x_{1:T}$,再自回归地生成输出$y_{1:T’}$。它对输入的理解是双向的、对输出的生成是自由的,代价是参数量与实现复杂度更高,且同样需要专门设计的去噪目标。
⚪ 双向性到底在什么时候有用
上述三类架构的对比长期停留在定性层面,因为不同模型的数据、词表、规模都不同。这项工作提出了一个统一框架,用三个可调参数把”双向性”连续地插值出来,从而在完全相同的语料与词表下比较各种配置:
- $n_{bidir}$:使用双向注意力的前缀长度,前$n_{bidir}$个词元之间双向可见,其余单向;
- $n_{mask}$:随机掩码的词元数量,被选中的词元替换为
<mask>,并把这些词元及其位置嵌入移到序列末尾; - $n_{predict}$:定义监督信号的后缀长度,只对最后$n_{predict}$个位置计算损失,其中最后$n_{mask}$个位置预测被掩码的词元,其余位置预测下一个词元。
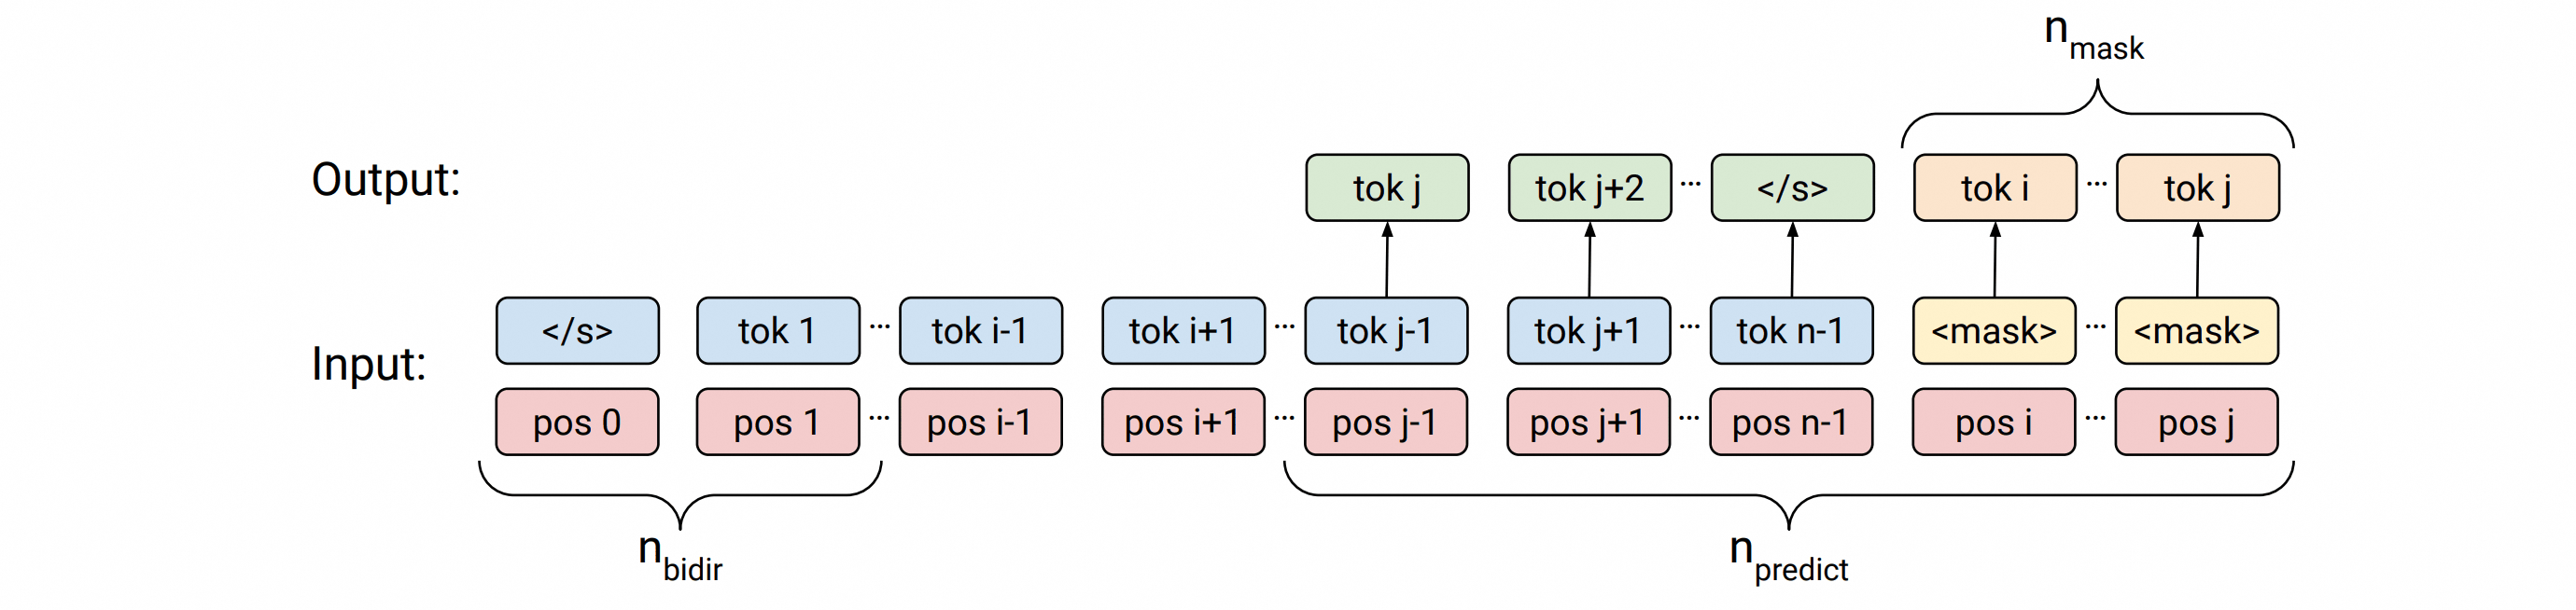
通过调节这三个参数,可以覆盖从完全单向(GPT式)到完全双向(BERT式),再到各种混合模型(前缀语言模型等)的连续谱。在$125$M 到 $6.7$B 的多个规模上,结论相当一致:
- 下一词预测与零样本提示:完全单向的配置最好。混合目标会互相干扰,且这种差距不随规模缩小,说明”预测下一词”与”填充掩码”之间存在根本冲突;单向模型能直接生成完整序列,而双向模型在零样本场景下需要额外的推理步骤来处理掩码位置。
- 文本填充与微调:双向配置显著更好,且随着规模增大,混合模型能逐渐追上纯掩码模型。微调时双向注意力可以充分利用上下文,这也解释了为什么在很长一段时间里BERT类模型是分类任务的默认选择。
换言之,架构选择不是”谁更强”的问题,而是”下游怎么用”的问题:微调范式偏好双向,提示范式偏好单向。
(2) 预训练任务的谱系
预训练任务决定了监督信号从哪里来、有多密。常见的任务可以归为以下几类。
① 概率语言建模(Language Modeling, LM)
最经典的无监督任务,通常指自回归(autoregressive)或单向语言建模,即给定前面所有词预测下一个词:
\[p_\theta(x) = \prod_{t=1}^{T} p_\theta(x_{t} \mid x_{<t})\]其最大的优点是每个位置都提供监督:一条长度为$T$的序列贡献$T$个预测目标,信号密度是$100\%$。
② 掩码语言建模(Masked Language Modeling, MLM)
从输入序列中遮盖一部分词元,训练模型用其余词元预测被遮盖的内容:
\[\max_\theta \sum_{t=1}^{T} m_t \log p_\theta(x_t \mid \hat{x}), \quad m_t \in \{0,1\}\]其中$\hat{x}$是加了掩码的序列,$m_t$指示位置$t$是否被掩码。这类方法也称为自编码(autoencoding)式语言模型。它的两个固有问题是:(a) 只有被掩码的位置(通常$15\%$)提供监督,信号密度低;(b) 预训练中引入的[MASK]在下游任务中并不存在,造成预训练与微调之间的不匹配(discrepancy)。
③ 序列到序列的掩码语言建模(Seq2Seq MLM)
MLM通常把掩码位置的表示送入分类器来预测词元,适合判别式任务。序列到序列版本改为编码器-解码器结构:把掩码序列输入编码器,由解码器自回归地顺序生成被掩码的内容。这样既保留了编码端的双向理解,又保留了解码端的生成能力。
④ 增强掩码语言建模(Enhanced MLM, E-MLM)
指在掩码语言建模基础上做各种增强,例如动态掩码(RoBERTa)、连续片段掩码(SpanBERT)、实体与短语级掩码(ERNIE)、判别式替换检测(ELECTRA)、解耦的内容-位置注意力(DeBERTa)等。这一族方法的共同动机是:让预测任务变难,从而迫使模型编码更全局的信息。
⑤ 排列语言建模(Permuted Language Modeling, PLM)
在输入序列的随机排列上做自回归语言建模:从所有可能的排列中采样一个顺序,训练模型按该顺序预测词元,同时保留词元的原始位置信息。这样每个词元在不同采样下可以看到左右两侧的不同子集,从而在不引入[MASK]的前提下获得双向上下文。
⑥ 前缀语言建模(Prefix-LM)
序列被切成前缀与后缀两段:前缀内部双向可见,后缀自回归生成并可看到整个前缀。它可以看作编码器-解码器的”参数共享版”,是UniLM、GLM、UL2 等模型的核心机制。
⭐ 讨论:用注意力掩码统一理解预训练目标
上面六类任务看起来五花八门,但它们几乎都可以用同一套 Transformer 参数 $+$ 不同形状的注意力掩码 $+$ 不同的损失位置来实现。把注意力矩阵的行看作查询(输出位置)、列看作键(输入位置),则:
| 预训练任务 | 注意力掩码形状 | 损失作用的位置 | 信号密度 | 代表模型 |
|---|---|---|---|---|
| LM(自回归) | 严格下三角 | 所有位置 | $100\%$ | GPT、GPT-2 |
| MLM(自编码) | 全连接(双向) | 被掩码位置 | $\approx 15\%$ | BERT、RoBERTa、DeBERTa |
| RTD(替换检测) | 全连接(双向) | 所有位置 | $100\%$ | ELECTRA、DeBERTaV3 |
| PLM(排列) | 打乱顺序后的下三角 | 排列后的后段位置 | 可调 | XLNet |
| Prefix-LM | 前缀块双向 $+$ 后缀下三角 | 后缀位置 | 取决于切分 | UniLM、GLM、UL2 |
| Seq2Seq MLM | 编码器双向 $+$ 解码器下三角 $+$ 交叉注意力 | 解码器输出位置 | 取决于破坏比例 | MASS、T5、BART |
这个视角带来三个有用的推论。
- “架构”和”任务”并不是完全独立的两件事:UniLM 证明了只要给注意力矩阵加合适的掩码,纯编码器就能做Seq2Seq;MASS 证明了只要调节掩码长度$k$,编码器-解码器就能在BERT式($k=1$)与GPT式($k=T$)之间连续插值。
- 信号密度是一个被长期低估的变量:MLM 每条序列只用了$15\%$的位置计算损失,这直接意味着相同算力下自回归模型见到的有效监督多出数倍——ELECTRA 的主要收益也正来自把信号密度提回$100\%$。
[MASK]这类特殊词元带来的预训练-微调不匹配,是XLNet 与 ELECTRA 各自绕开它的动机,但在实践中这个问题的严重程度远小于信号密度问题(RoBERTa 用同样的[MASK]、只靠更多数据和更长训练就大幅超过了BERT)。
3. 编码器架构:BERT 及其后继
(1) BERT:深度双向的掩码语言模型
⚪ BERT
BERT(Bidirectional Encoder Representations from Transformers)用Transformer编码器在无标注语料上做自监督学习,得到每个词元的上下文表示;下游任务只需在其上接一个极薄的输出层并整体微调。原论文给出两个规格:
- $\text{BERT}_{\text{BASE}}$:$L=12$层,$d=768$,$12$个注意力头,约$110$M参数;
- $\text{BERT}_{\text{LARGE}}$:$L=24$层,$d=1024$,$16$个注意力头,约$340$M参数。
与ELMo(两个独立单向LSTM的拼接)和GPT(严格单向)相比,只有BERT能在同一次前向计算中让每个词元直接获取左右两侧的上下文,这正是名称中bidirectional的由来。
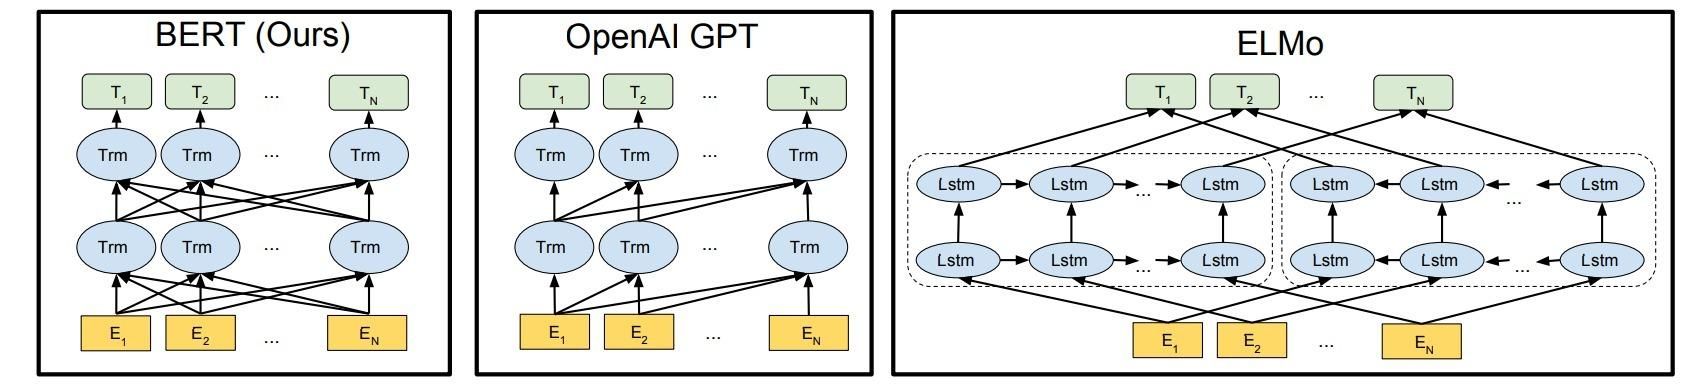
BERT的预训练由两个自监督任务组成。
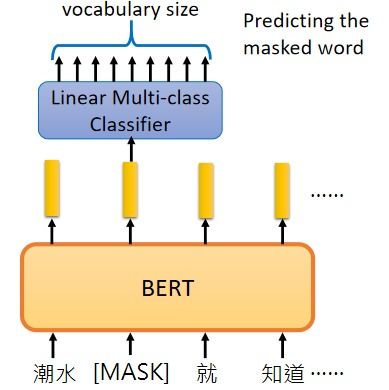
任务一:掩码语言建模(Masked Language Model, MLM)。随机选择$15\%$的词元作为预测目标;对于被选中的词元,以$80\%$的概率替换为[MASK],以$10\%$的概率替换为一个随机词,以$10\%$的概率保持原样。这个”$80/10/10$”的设计是为了缓解预训练-微调不匹配:如果总是替换成[MASK],模型就只会在看到[MASK]时才认真编码上下文。做法上是把掩码位置的输出向量送入一个简单的线性分类器,与BERT联合训练:
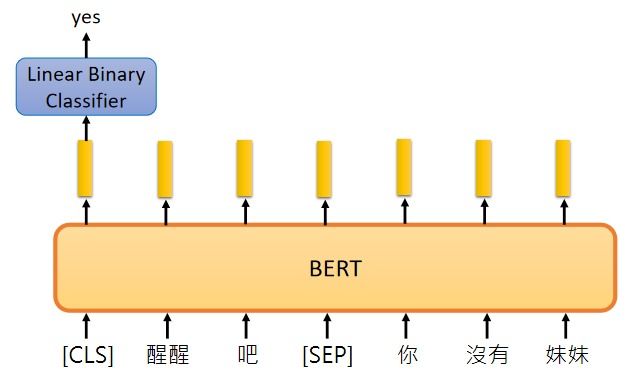
任务二:下一句预测(Next Sentence Prediction, NSP)。把两个句子用[SEP]连接、首部加[CLS],判断两句是否相邻。训练数据以$50\%$概率取语料中连续的两句(正样本),以$50\%$概率随机替换第二句(负样本)。做法是把[CLS]位置的输出向量送入一个线性二分类器:
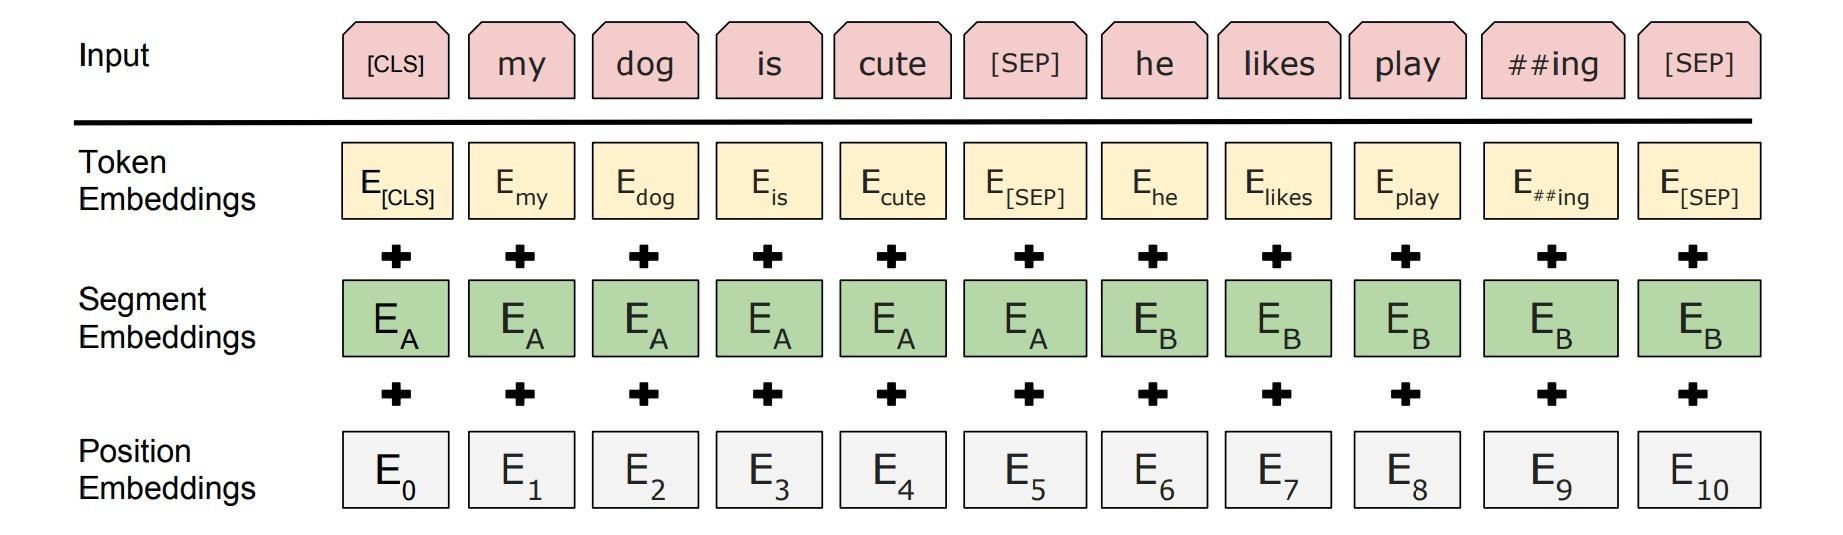
由于输入形如[CLS] 句子1 [SEP] 句子2 [SEP],BERT的输入编码是三种嵌入之和:
- 词嵌入:使用WordPiece把单词切分为有限的公共子词单元,在词的完整性与字符的灵活性之间取得平衡(例如
playing被拆成play和##ing),从而缓解OOV问题; - 段嵌入(segment embedding):区分词元属于第一句还是第二句;
- 位置嵌入:BERT使用的是可学习的绝对位置嵌入,具体形式见位置编码。
两个任务在训练时同时进行,损失相加:
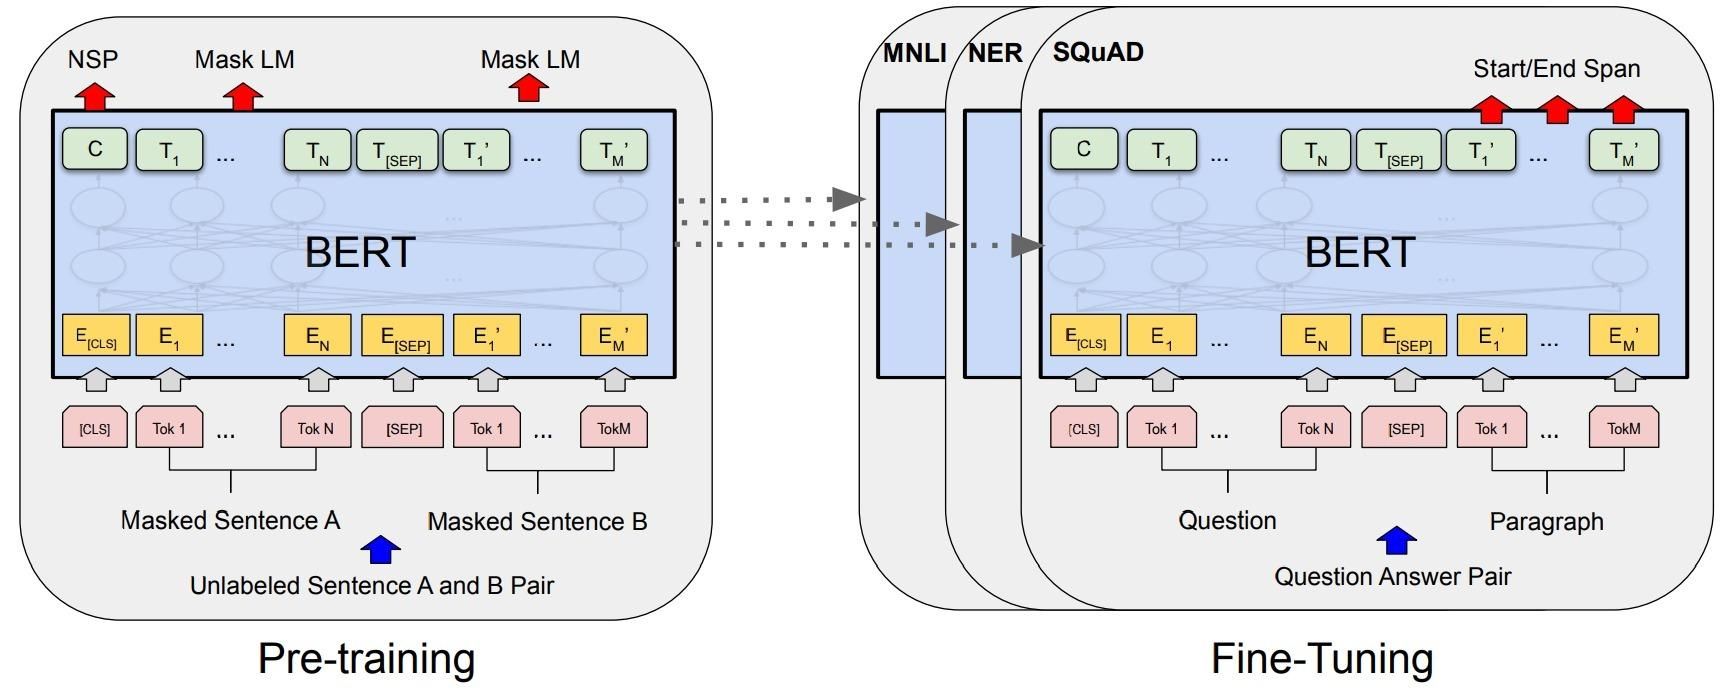
预训练完成后,BERT通过更换输出头适配各类下游任务:单句分类(用[CLS])、序列标注(用每个词元的输出)、句对分类(用[CLS])、抽取式问答(训练两个向量分别定位答案片段的起止位置)。
(2) 掩码策略与训练配方的改进
⚪ RoBERTa:把 BERT 训练充分
RoBERTa没有改动BERT的架构,只是系统性地重做了训练配方,结论是BERT被严重欠训练了。四点主要改进:
- 动态掩码(dynamic masking)。BERT在数据预处理阶段就固定了掩码位置(静态掩码),同一个句子在整个训练过程中掩码方式相同;RoBERTa改为每次输入时重新随机生成掩码,提高了输入的随机性,等价于一种数据增强。
- 移除 NSP。作者对比了四种输入构造方式(句对$+$NSP、短句对$+$NSP、跨文档的连续整句、单文档的连续整句),发现去掉NSP损失、直接用连续的长文本片段填满$512$的窗口,反而略微提升了下游表现。这说明NSP提供的”句子级连贯性”信号价值有限,甚至可能因为负样本来自不同文档而退化为简单的主题判别。
- 更大的批量。在总更新步数相同的条件下,把批量从$256$提高到$2$K-$8$K,同时按比例提高学习率,能提高训练吞吐与下游表现。
- 更多数据、更长训练。除BOOKCORPUS与英文WIKIPEDIA($16$GB)外,增加了CC-NEWS($76$GB)、OPENWEBTEXT($38$GB)、STORIES($31$GB),并显著延长训练。
RoBERTa的意义在于确立了一条至今有效的经验:在比较两个预训练目标之前,先确认两者都被训练充分了。此后所有声称”新目标更好”的工作都必须与RoBERTa式的强基线对比。
⚪ SpanBERT:掩码连续片段并从边界重建
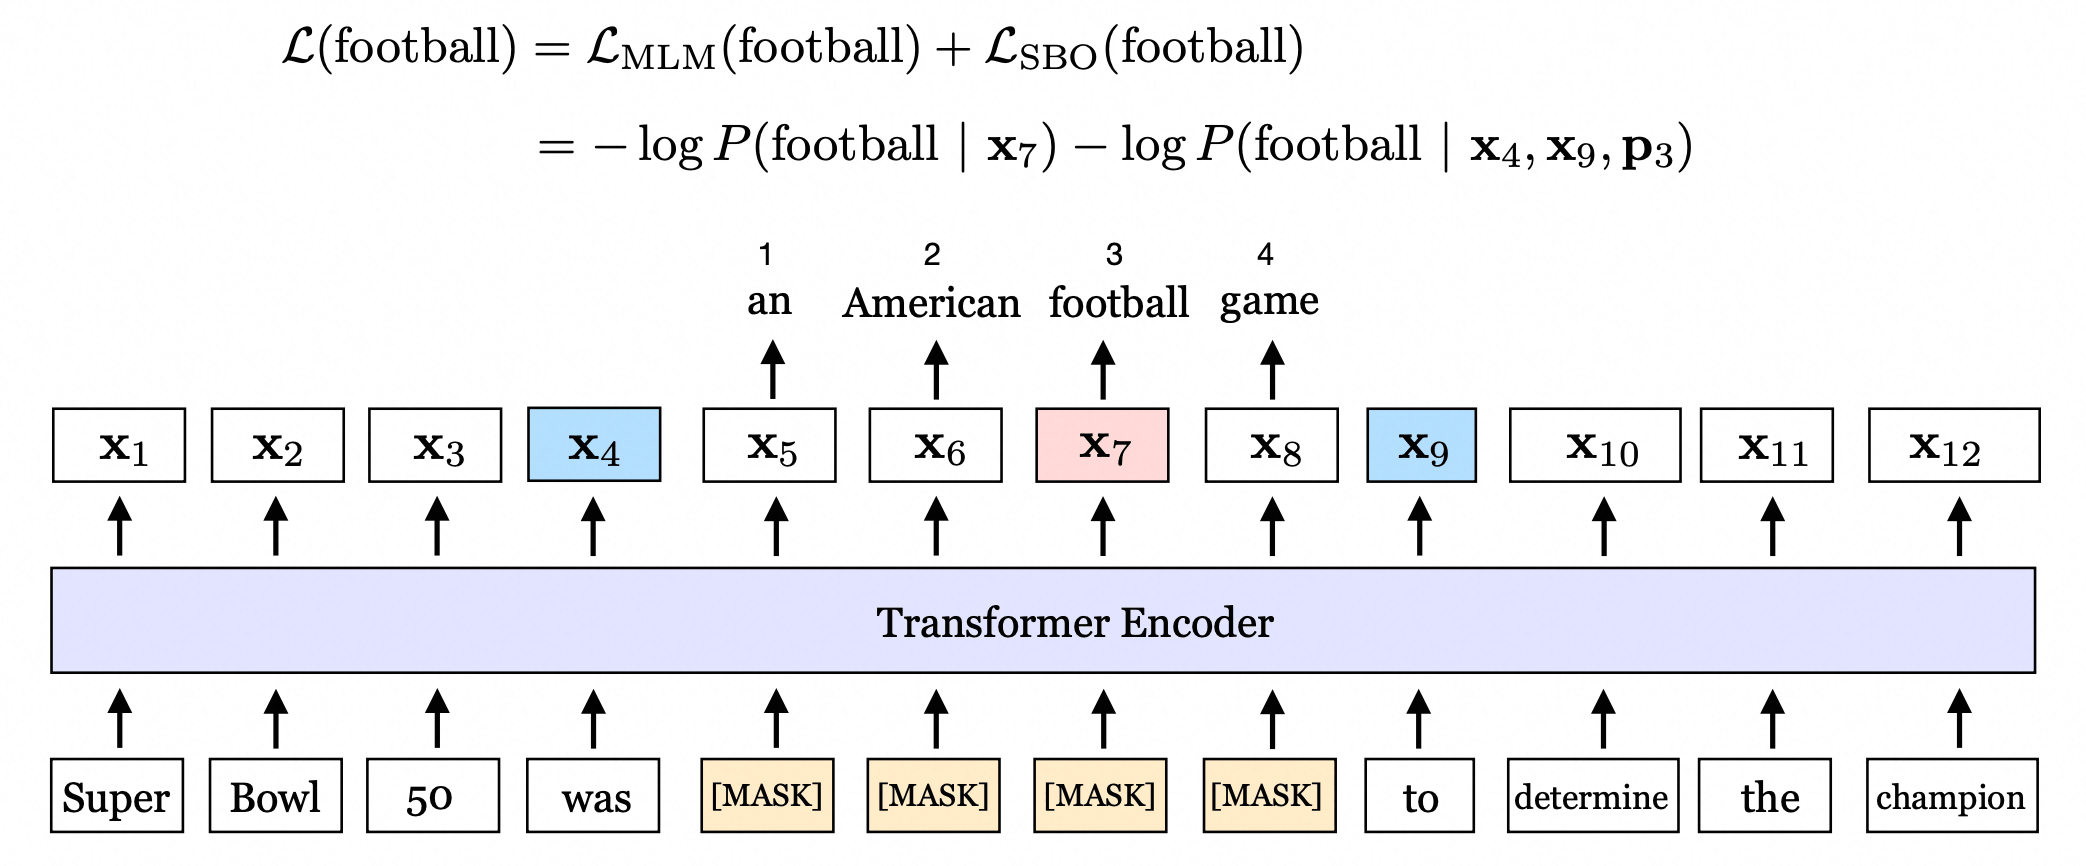
BERT的随机词元掩码有一个漏洞:当New York City中只有York被掩码时,模型可以靠局部搭配轻松猜出答案,而不必真正理解上下文。SpanBERT做了两点修改:
① 连续片段掩码。不再独立地采样单个词元,而是先从几何分布中采样片段长度$\ell \sim \text{Geo}(p)$($p=0.2$,平均长度约$3.8$),再随机选择起点,掩掉整个连续片段,直到达到$15\%$的预算。
② 片段边界目标(Span Boundary Objective, SBO)。除了在掩码位置本身预测词元,还要求仅用片段外侧两个边界词元的表示$h_{s-1},h_{e+1}$(加上目标位置的相对位置编码)来预测片段内每一个词元:
\[\mathcal{L} = \mathcal{L}_{\text{MLM}} + \mathcal{L}_{\text{SBO}}, \quad \mathcal{L}_{\text{SBO}}(x_i) = -\log p_\theta\left(x_i \mid f(h_{s-1},h_{e+1},p_{i-s+1})\right)\]这迫使边界词元把整个片段的信息压缩进自己的表示,对抽取式问答、指代消解等”需要表示一个片段”的任务收益明显。同时SpanBERT也去掉了NSP、改用单段长文本输入。
⚪ ERNIE:知识增强的掩码
ERNIE从另一个角度解决同一个问题:与其随机掩码,不如按语言单位掩码。它设计了三级掩码策略,逐阶段进行:
- 基础级掩码:与BERT相同,随机掩码子词;
- 短语级掩码:把语法分析得到的短语(如
a series of)整体掩掉; - 实体级掩码:把命名实体(人名、地名、机构名)整体掩掉。
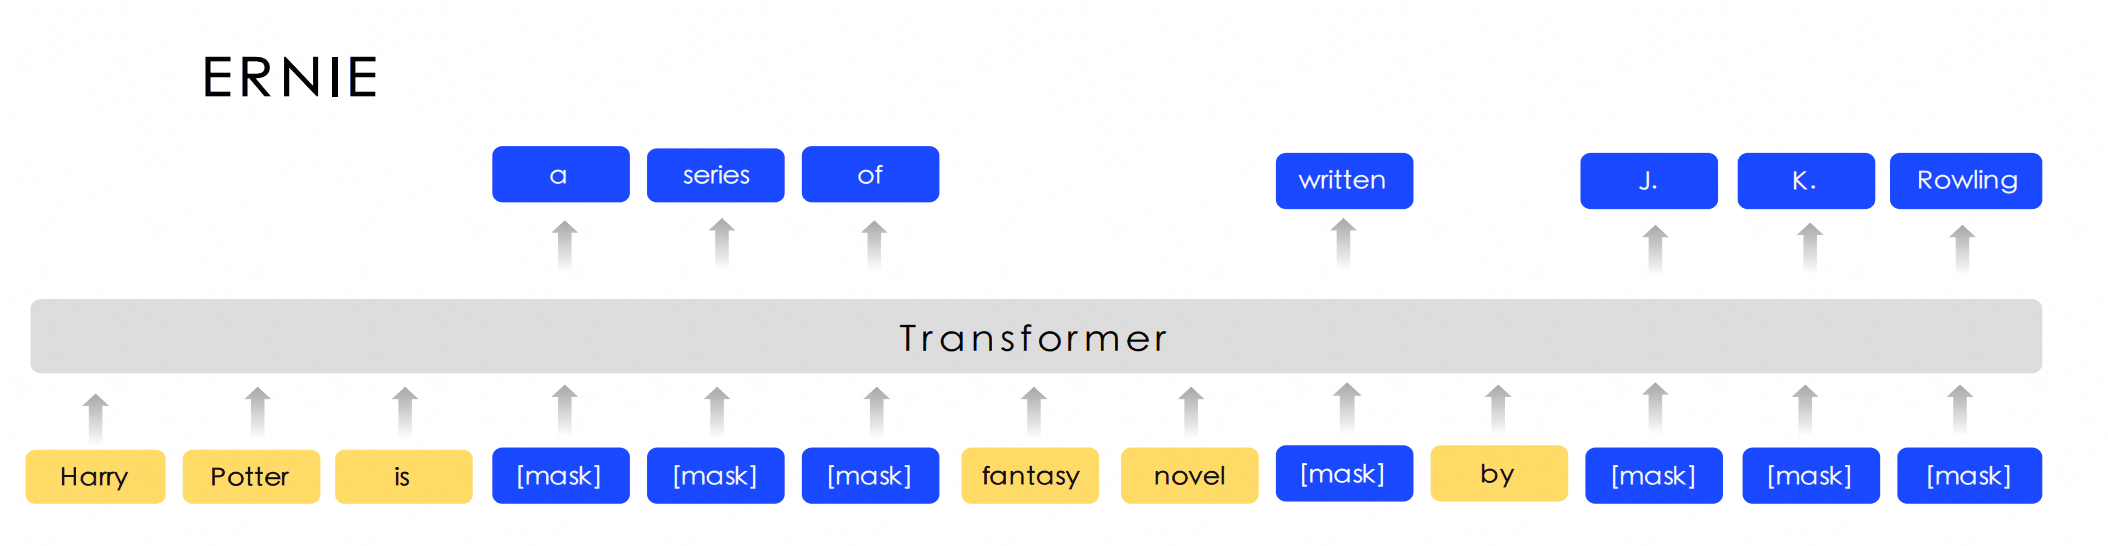
对于中文这类没有空格分词的语言,这套策略尤其重要——单字掩码的BERT很容易通过词内搭配恢复答案,而短语级与实体级掩码迫使模型利用更远的上下文。这一思路后来被BERT-wwm的全词掩码、REALM的显著片段掩码等工作继续采用。
⚪ ALBERT:参数共享与句子顺序预测
ALBERT是BERT的轻量化版本,做了三点改进:
- 嵌入矩阵分解。BERT的词嵌入维度与隐藏维度绑定(都是$768$),使得嵌入矩阵占据大量参数。ALBERT把词嵌入维度降到$128$,再用一个$128 \times 768$的矩阵投影回隐藏维度,把嵌入部分的参数量从$O(\lvert \mathcal{V} \rvert \cdot d)$降到$O(\lvert \mathcal{V} \rvert \cdot d_e + d_e \cdot d)$。
- 跨层参数共享。BERT由$12$个独立的Transformer块堆叠,可写作$y=f_{12}(f_{11}(\cdots f_1(x)))$;ALBERT让所有层共享同一组参数,写作$y=f(f(\cdots f(x)))$。
- 句子顺序预测(Sentence-Order Prediction, SOP)。把NSP换成”判断两个连续句子是否被交换了顺序”。负样本不再来自其他文档,因此模型无法靠主题差异蒙对,必须真正建模句间的话语连贯性。
参数共享同时起到了正则化作用,能抑制过拟合(ALBERT因此不使用dropout),但也限制了模型表达能力。需要特别注意一个常见误解:ALBERT减少的是参数量与显存占用,而不是计算量。同规格下ALBERT的前向计算复杂度与BERT相当(甚至多一次嵌入投影),推理时间并不占优;且在小规格下ALBERT表现弱于BERT,只有把规格放得足够大才能反超。
(3) 更换预训练信号
⚪ ELECTRA:把生成式目标换成判别式目标
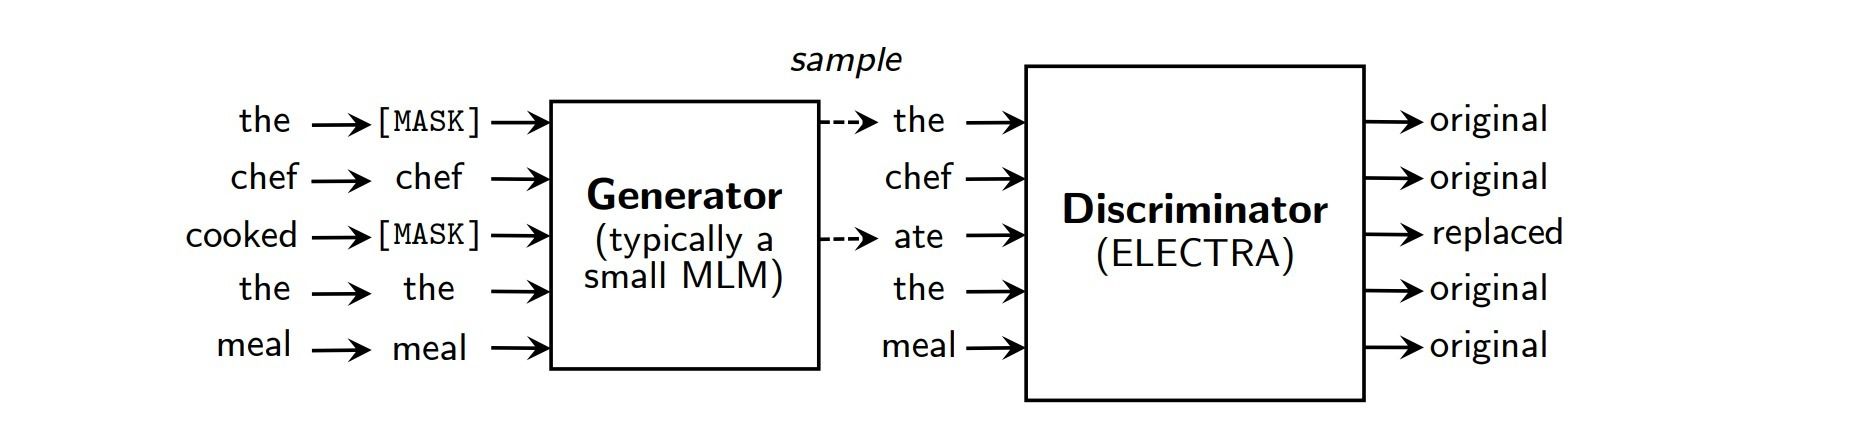
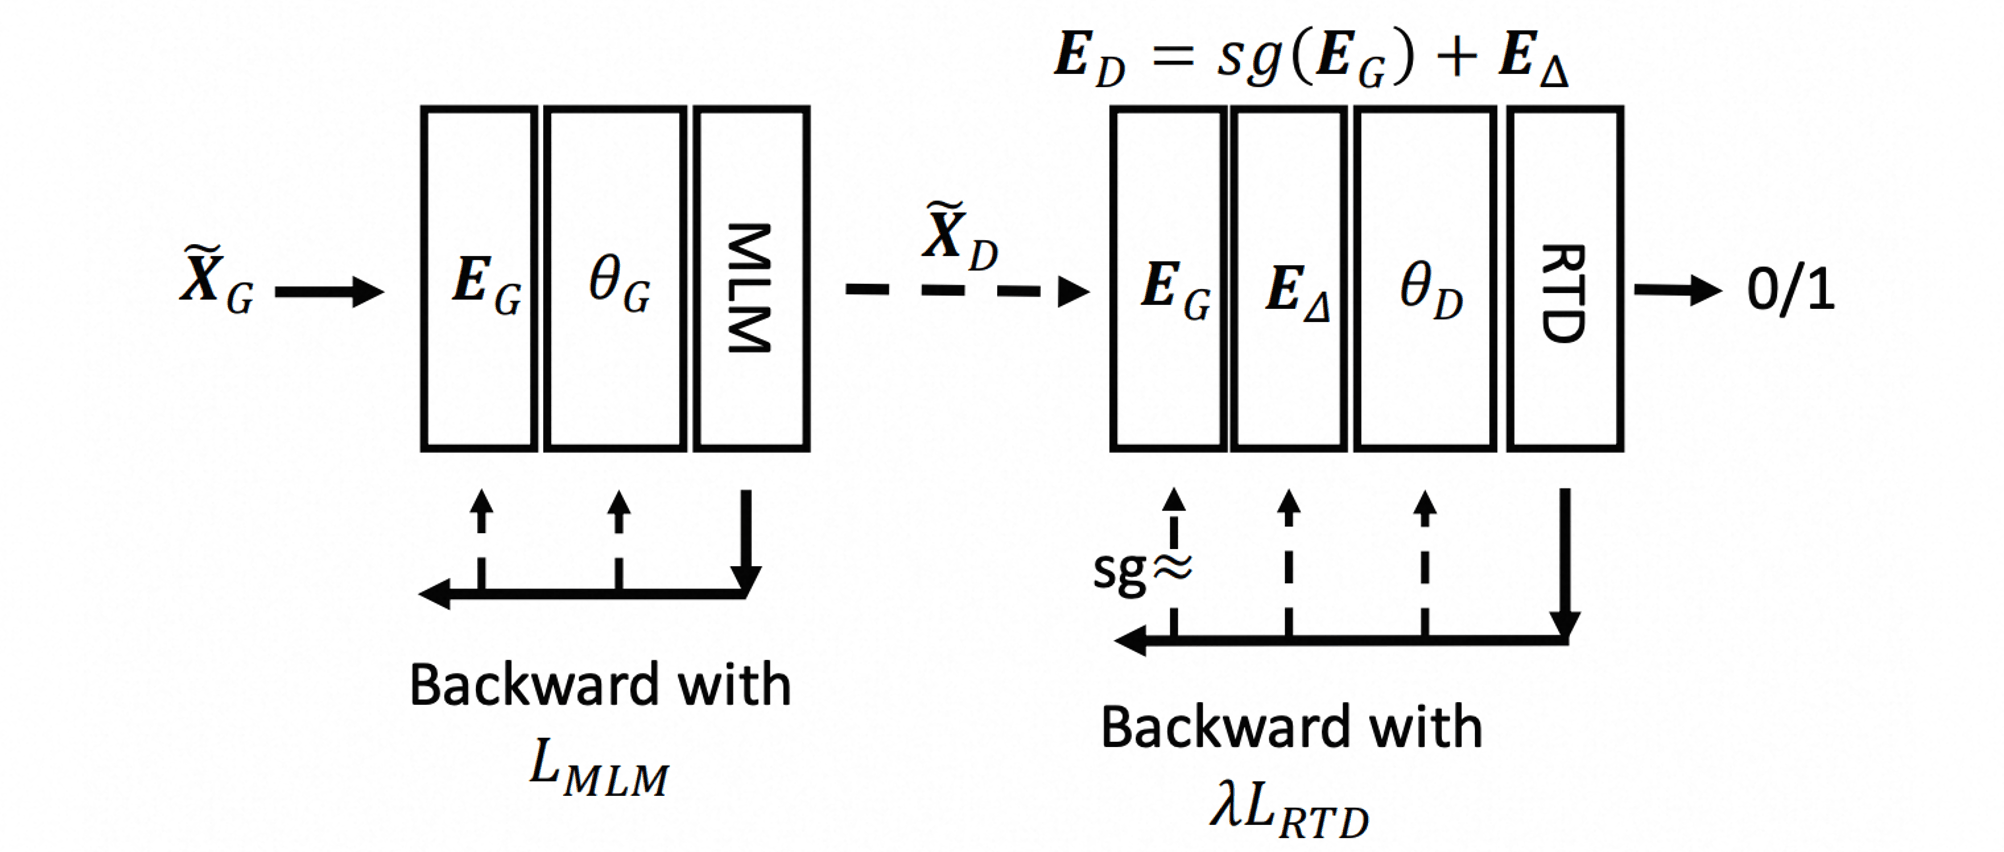
BERT用掩码语言建模训练了一个”生成式”模型,而ELECTRA借鉴生成对抗网络的思路,把预训练拆成两个模型:先用一个小的生成器做掩码语言建模并对被掩位置采样出替换词,把替换后的句子交给判别器,让它逐位置判断”这个词是原文还是被替换过的”,这一任务称为替换词检测(Replaced Token Detection, RTD)。预训练结束后丢弃生成器,只把判别器作为下游模型。
总损失为两部分加权:
\[\mathcal{L} = \mathcal{L}_{\text{MLM}}(x,\theta_G) + \lambda \, \mathcal{L}_{\text{RTD}}(x,\theta_D)\]与标准GAN不同的是,生成器并不通过对抗梯度更新(文本采样不可导),而是独立地用最大似然训练;生成器与判别器同步训练,随着生成器变强,判别任务自然变难,形成课程学习式的效果。
一个反直觉但重要的细节:生成器不能太强。在生成对抗网络中判别器的最优解是$D(x)=\frac{p(x)}{p(x)+q(x)}$,其中$p,q$分别是真假样本分布;若生成器拟合能力足够强使$q \approx p$,判别器就退化为常数$D(x)=\frac{1}{2}$,失去提取判别特征的能力。实践中生成器规模取判别器的$\frac{1}{4}$至$\frac{1}{2}$效果最好。
ELECTRA最大的贡献是把监督信号密度从$15\%$提到$100\%$:每一个位置都要做二分类。这使它在相同算力下的预训练效率远高于BERT,小模型上的优势尤为明显。
⚪ REALM:把检索作为预训练的一部分
REALM在预训练与微调两个阶段都插入了知识检索(knowledge retrieval)步骤,让模型学会”先查资料再作答”,而不是把所有世界知识硬塞进参数。
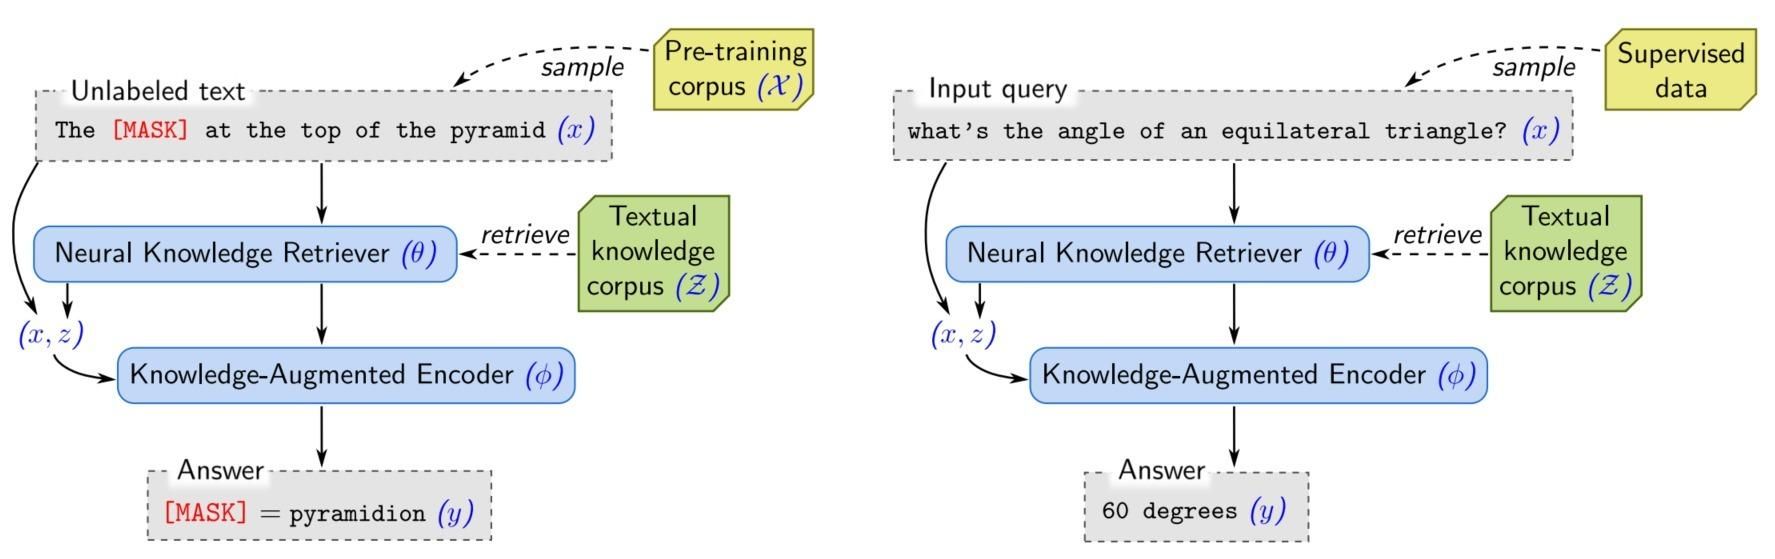
设掩码后的句子为$x$、待预测内容为$y$,标准MLM建模$p(y \mid x)$;REALM引入隐变量$z$表示检索到的文档,把问题拆成检索与阅读两步:
\[p(y \mid x) = \sum_{z \in \mathcal{Z}} p(z \mid x)\, p(y \mid x,z)\]检索模型$p(z \mid x)$与阅读模型$p(y \mid x,z)$联合训练:检索到有用文档时阅读器更容易预测正确,反向传播就会给检索器正反馈。检索本身用最大内积搜索(Maximum Inner Product Search, MIPS)实现——把句子与语料库文档都编码成向量,取内积最大的前$k$篇。
由于检索语料库(Wikipedia)规模巨大,直接检索会引入巨量计算,因此实现上采取了几项工程手段:预先计算所有文档的嵌入向量并构建索引;用内积对候选文档排序;每隔数百步再异步刷新一次文档索引(因为文档编码器在缓慢变化)。此外还引入了几项训练技巧:
- 显著片段掩码(salient span masking):与ERNIE类似,优先掩掉命名实体与日期这类”必须查资料才能填对”的片段,避免模型靠语法就能补全从而学不到检索;
- 空文档(null document):允许检索结果为空文档$\phi$,为不需要外部知识的样本提供退路;
- 禁止平凡检索:屏蔽掉与输入完全相同的文档,防止检索器学会”抄自己”;
- 检索器预热初始化:用逆完形填空任务预训练检索器,否则冷启动时检索毫无用处、梯度信号无法建立。
REALM是检索增强生成(RAG)这条技术路线的源头:它第一次说明”参数化知识”与”非参数化知识”可以联合优化,也第一次展示了让知识可替换、可审计、可更新的可能性。
(4) 注意力与位置的改进
⚪ DeBERTa:解耦内容与位置的注意力
DeBERTa提出两项技术:分解注意力(disentangled attention)与增强型掩码解码器(enhanced mask decoder)。
分解注意力的出发点是:BERT把内容嵌入与位置嵌入直接相加后再算注意力,等价于把注意力分解成”内容-内容、内容-位置、位置-内容、位置-位置”四项之和,其中”位置-位置”项与具体输入无关、贡献很小。DeBERTa为每个词元分别维护内容向量与相对位置向量,删掉位置-位置项,并把剩下两个交叉项中的绝对位置换成相对位置$R_{i,j}$:
\[\alpha_{ij} = \text{softmax}\left\{ x_iW^Q (W^K)^\top x_j^\top + x_iW^Q (W^K)^\top R_{i,j}^\top + R_{j,i}W^Q (W^K)^\top x_j^\top \right\}\]三项分别对应”内容对内容”、”内容对位置”、”位置对内容”的注意力。相对位置嵌入在所有层之间共享;相对位置的具体分桶与截断方式属于位置编码的设计问题,详见位置编码。
增强型掩码解码器处理的是另一个问题:纯相对位置无法区分”店”在”新店开在商场旁”与”商场旁开了新店”中的绝对位置,而MLM恰恰需要绝对位置来消歧。DeBERTa的做法是把整个模型分成两段:以base规格为例,共$13$层中前$11$层只用相对位置编码(称为Encoder),最后$2$层再注入绝对位置信息并预测被掩词(称为Enhanced Mask Decoder)。这样绝对位置只在必要处使用,不干扰主体的相对位置建模。
DeBERTa-v2 通过使用基于 SentencePiece 的分词器和 128K 的新词汇表改进了 DeBERTa 架构。它还在第一个 Transformer 层中添加了一个额外的卷积层,以更好地学习输入词元的局部依赖关系。并且注意力层共享位置投影矩阵和内容投影矩阵,以减少参数数量。
⚪ DeBERTaV3:把 DeBERTa 的注意力接到 ELECTRA 的目标上
DeBERTaV3保留DeBERTa的分解注意力,把预训练目标从MLM换成ELECTRA式的替换词检测。但直接组合会遇到一个隐蔽的冲突:ELECTRA中生成器与判别器共享词嵌入,而两者的梯度方向相反——生成器希望语义相近的词嵌入靠近(以便替换),判别器希望它们分开(以便区分),导致嵌入矩阵在训练中”拉锯”,作者称之为拔河(tug-of-war)。
解决方案是梯度解耦的嵌入共享(Gradient-Disentangled Embedding Sharing, GDES):生成器使用嵌入$E_G$,判别器使用$E_D = sg(E_G) + E_\Delta$,其中只有残差$E_\Delta$接收生成器的梯度,$E_G$的梯度被截断。这样两者仍然共享大部分嵌入参数(省显存、共享语义),但不再互相破坏。DeBERTaV3至今仍是同参数量级下判别式任务的最强编码器之一,也是许多竞赛与工业分类系统的默认选择。
(5) 排列语言建模
⚪ XLNet:在随机排列上做自回归
XLNet从对比自回归与自编码两类目标出发。自回归式(GPT)最大化
\[\max_{\theta} \log p_{\theta}(x) = \sum_{t=1}^{T}\log p_{\theta}(x_t \mid x_{<t}) = \sum_{t=1}^{T}\log \frac{\exp\left(h_{\theta}(x_{<t})^\top e(x_t)\right)}{\sum_{x'} \exp\left(h_{\theta}(x_{<t})^\top e(x')\right)}\]自编码式(BERT)最大化
\[\max_{\theta} \log p_{\theta}(\overline{x} \mid \hat{x}) \approx \sum_{t=1}^{T} m_t \log \frac{\exp\left(h_{\theta}(\hat{x})_t^\top e(x_t)\right)}{\sum_{x'} \exp\left(h_{\theta}(\hat{x})_t^\top e(x')\right)}\]两者的差异集中在三点:独立性假设(自编码把多个被掩位置当作条件独立,自回归通过链式法则精确分解)、输入噪声(自编码引入下游不存在的[MASK])、上下文依赖(自回归只能单向,自编码可以双向)。
排列语言建模试图同时拿到”精确分解”、”无噪声”与”双向上下文”三项。给定序列$x$,先从$T!$种排列中采样一个顺序$z$,再在该顺序下做自回归训练:
\[\max_{\theta} \, \mathbb{E}_{z \sim \mathcal{Z}_T} \left[\sum_{t=1}^{T}\log p_{\theta}(x_{z_t} \mid x_{z_{<t}})\right]\]每次采样的顺序不同,某个位置能看到的上下文子集也不同,在期望意义下每个词元都能看到左右两侧的信息。下图展示了在几种不同排列下,第$3$个词元所依赖的上下文来自不同位置:
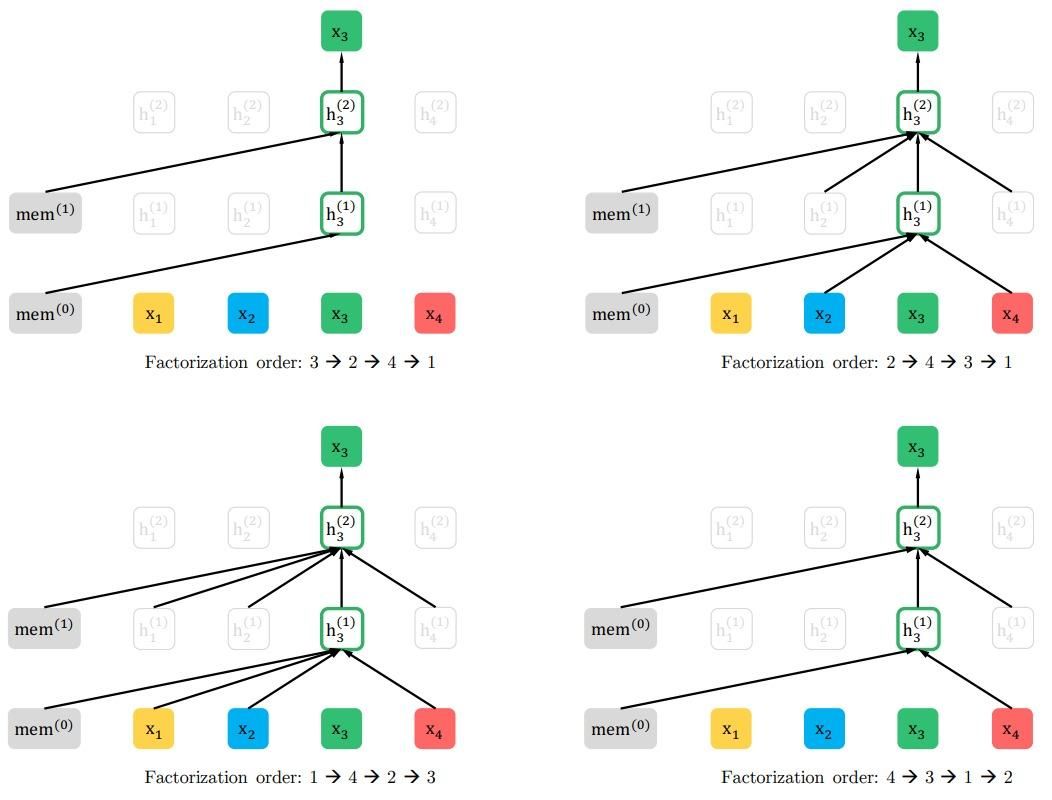
从注意力矩阵的角度看得更清楚:自编码模型的注意力矩阵处处有值,自回归模型的注意力矩阵是下三角阵,而排列语言模型相当于把下三角阵按采样顺序打乱行列。例如对序列<s> → 迎 → 京 → 你 → 欢 → 北 → <e>,几种语言模型对应的注意力掩码分别为:
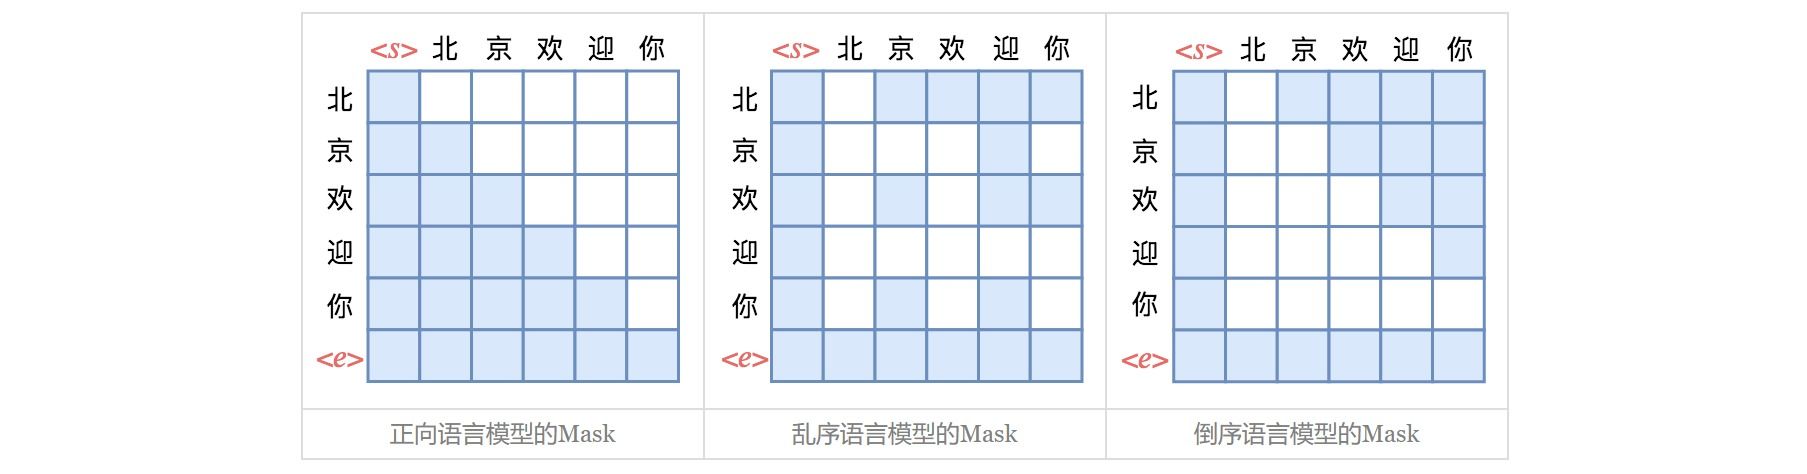
直接构造这种乱序掩码比较繁琐,但有一个等价实现:注意力机制本身是置换不变的,序列顺序完全由位置编码引入,因此只要把词元连同其原始位置 id 一起按采样顺序重排(如{(迎,4),(京,2),(你,5),(欢,3),(北,1)}),再用标准的下三角掩码训练即可。
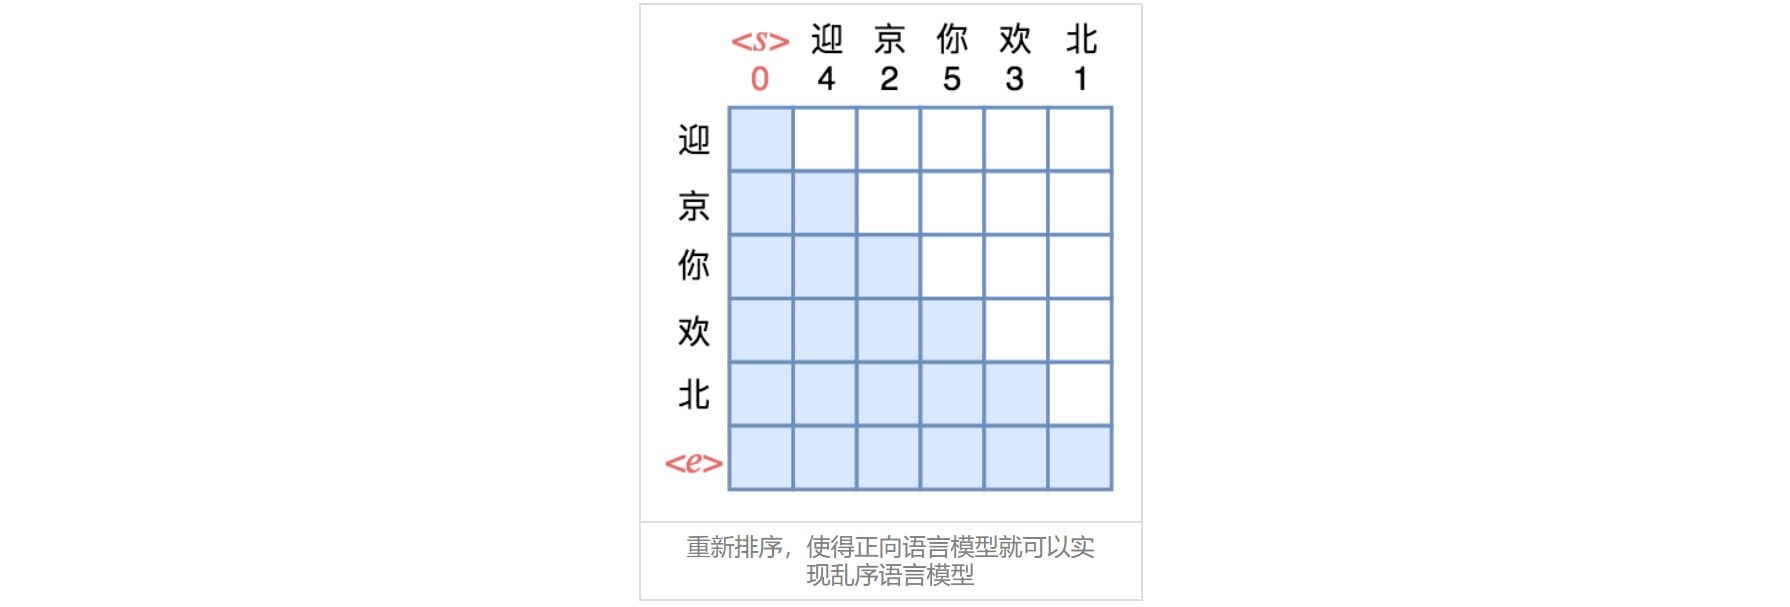
这里还有一个技术难点:预测位置$z_t$时,模型必须知道”我要预测哪个位置”(需要$z_t$的位置信息)但不能知道”那个位置是什么词”(不能用$x_{z_t}$的内容)。XLNet为此引入双流自注意力(two-stream self-attention),把每个位置的表示拆成两路:
- 内容流$h_{z_t}$:等同于标准自注意力的隐状态,可以看到包含自身在内的前$t$个位置;
- 查询流$g_{z_t}$:只携带位置信息、不含自身内容,只能看到前$t-1$个位置。
训练中$h_{z_t}^{(0)}$初始化为词嵌入$e(x_{z_t})$,$g_{z_t}^{(0)}$初始化为一个可学习向量$w$,两路交替更新:
\[\begin{aligned} h_{z_t}^{(m)} &\leftarrow \text{Attention}\left(Q=h_{z_t}^{(m-1)},\ K,V=h_{z_{\le t}}^{(m-1)}\right) \\ g_{z_t}^{(m)} &\leftarrow \text{Attention}\left(Q=g_{z_t}^{(m-1)},\ K,V=h_{z_{<t}}^{(m-1)}\right) \end{aligned}\]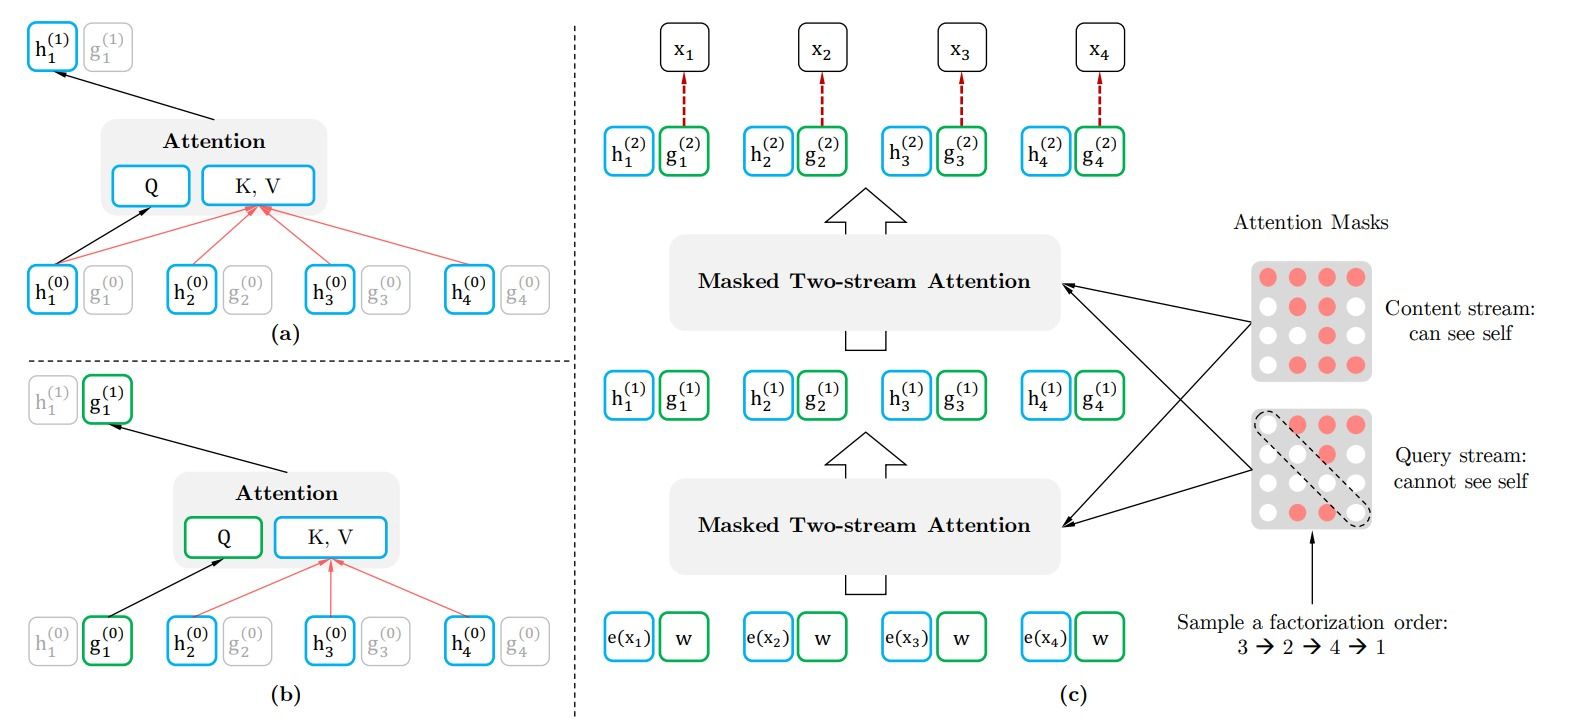
由于排列数量过多导致优化困难,XLNet只预测排列后序列的末尾一段:以长度$c$把序列切成两半,只对后半部分计算损失:
\[\max_{\theta} \, \mathbb{E}_{z \sim \mathcal{Z}_T} \left[\sum_{t=c+1}^{T}\log p_{\theta}(x_{z_t} \mid x_{z_{<t}})\right]\]XLNet还沿用了Transformer-XL的片段循环机制与三角函数形式的相对位置编码以支持长文本,相关细节见位置编码。
⚪ ModernBERT:编码器的现代化重构
ModernBERT把BERT发布后这些年在解码器上验证过的工程改进系统性地移植回编码器:用RoPE替换可学习绝对位置嵌入以支持$8192$的上下文、用GeGLU替换GELU前馈、去掉大部分偏置项、采用pre-normalization、每三层用一次全局注意力其余层用局部滑动窗口注意力、使用FlashAttention与去填充(unpadding)以提高吞吐,并在$2$万亿词元的现代语料(含大量代码)上训练。
ModernBERT的价值在于它证明了一件容易被忽略的事:“BERT 已经过时”在很大程度上是训练配方与工程实现过时,而不是双向编码器这一架构过时。在需要为海量文档生成向量、或对候选做低延迟打分的场景里,一个$150$M参数的双向编码器仍然比调用大模型划算几个数量级。
⭐ 讨论:BERT 家族的改进究竟来自哪里
把上述改进放在一起看,会发现它们的收益来源可以归为四类,而且量级差别很大。
| 改进 | 代表模型 | 机制归因 | 收益量级 |
|---|---|---|---|
| 训练更充分(数据/步数/批量) | RoBERTa | 原模型欠训练 | 大,且几乎免费 |
| 提高监督信号密度 | ELECTRA、DeBERTaV3 | $15\% \to 100\%$ | 大,小模型上尤甚 |
| 让掩码任务变难 | SpanBERT、ERNIE | 阻断局部搭配捷径 | 中,任务相关 |
| 改进位置建模 | DeBERTa、ModernBERT | 相对位置 $+$ 绝对位置分工 | 中 |
| 句子级辅助任务 | BERT(NSP)、ALBERT(SOP) | 话语连贯性 | 小,NSP 甚至有害 |
| 参数共享 | ALBERT | 正则化 $+$ 省显存 | 小,且不省计算 |
由此可以提炼三条经验。
- “更难的任务”不等于”更好的表示”,但”更密的信号”几乎总是更好:ELECTRA 的替换词检测在语言学上并不比掩码语言建模更”深刻”,它的优势主要是每个位置都参与损失。
- 句子级目标的价值被高估了:NSP 的负样本来自不同文档,使任务退化为主题判别,RoBERTa 删掉它反而更好,ALBERT 的 SOP 只是把这个漏洞补上,收益仍然有限;这提示我们设计辅助任务时必须检查”是否存在比预期更简单的解法”。
- 参数量与计算量必须分开讨论:ALBERT 的宣传语容易让人误以为它更快,实际上它只是更省显存;同样地,比较两个编码器时应该同时报告参数量、FLOPs 与吞吐。
4. 编码器-解码器架构与统一预训练目标
编码器架构擅长理解、解码器架构擅长生成,而自然语言处理中的大多数任务都可以写成序列到序列(Seq2Seq)的形式。本章讨论的这一族模型试图用一个统一的去噪目标同时获得两种能力。
(1) 序列到序列的掩码语言建模
⚪ MASS:掩掉连续片段并由解码器重建
MASS对输入序列随机掩掉连续的$k$个词元,用编码器读入被掩序列、用解码器自回归地生成这$k$个词元。
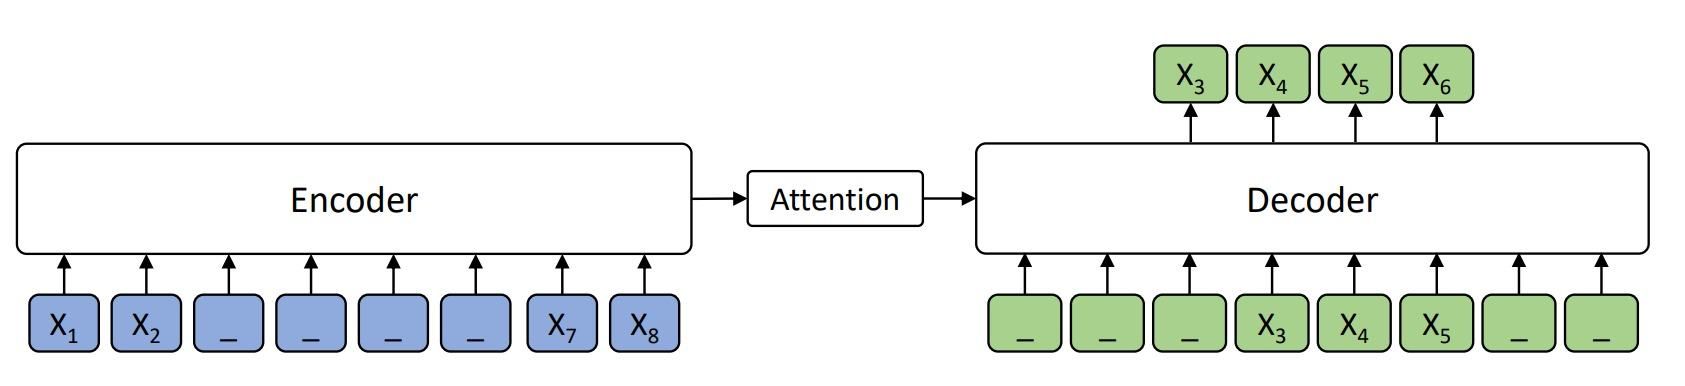
它的三个设计恰好互相配合:
- 解码器的输入中,不需要预测的词元也被掩掉,逼迫解码器从编码器输出中提取信息,而不是靠自己的语言模型硬猜;
- 编码器中被预测的词元被掩掉,提高编码器对上下文的理解能力;
- 预测的是连续片段,从而训练解码器的语言建模与流畅性。
超参数$k$使MASS成为一个统一框架:
- 当$k=1$时,编码器掩掉一个词元、解码器预测一个词元,解码器几乎没有输入信息,等价于BERT的掩码语言建模;
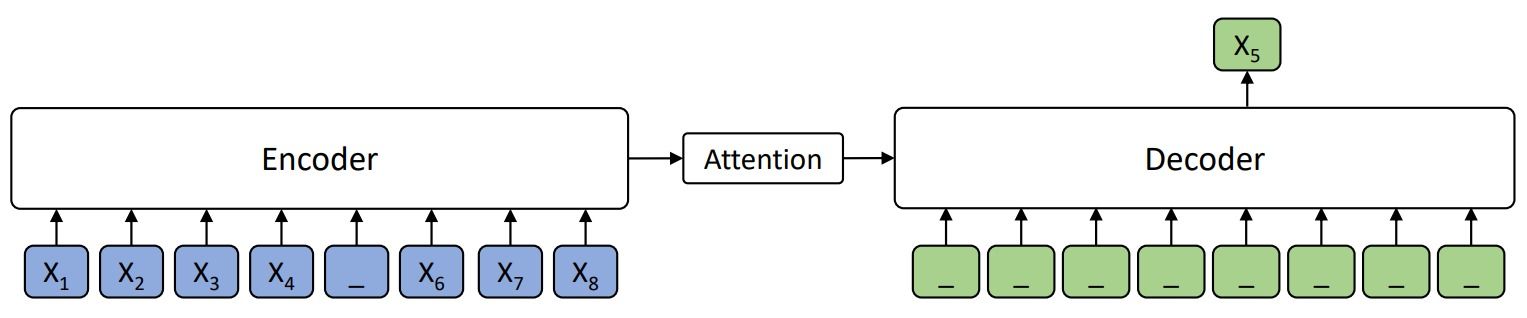
- 当$k=T$(序列长度)时,编码器掩掉全部词元、解码器预测全部词元,编码器没有任何信息,等价于GPT的自回归语言建模。
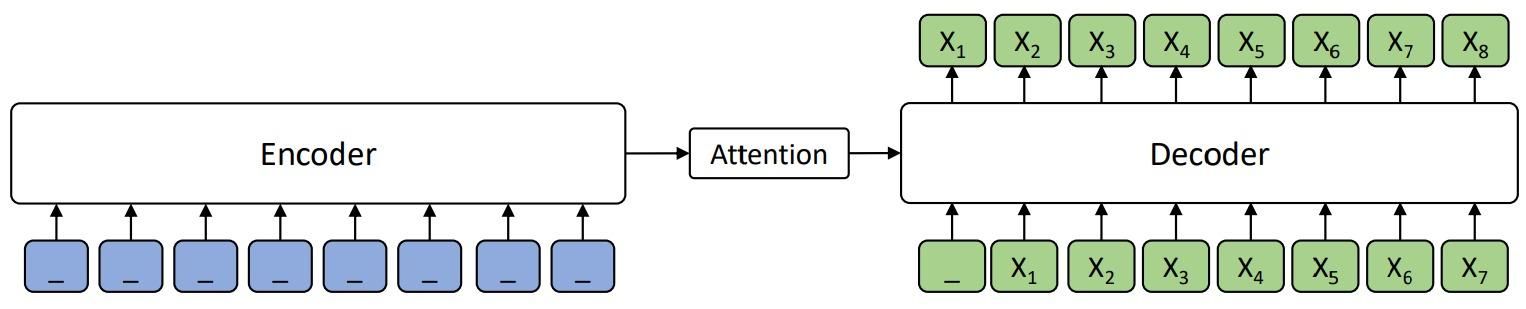
实验表明$k \approx T/2$时能较好地平衡编码器与解码器的预训练:$k$过小偏向训练编码器,$k$过大偏向训练解码器。这个”用一个超参数把 BERT 与 GPT 连起来”的观察,是后来UL2混合去噪目标的直接思想来源。
⚪ UniLM:用注意力掩码让编码器做生成
标准自注意力对输入是”无序全连接”的,直觉上不适合Seq2Seq。UniLM指出:只要给注意力矩阵加上合适形状的掩码,纯编码器(即 BERT)也能完成 Seq2Seq 任务,无需引入解码器与交叉注意力。
通过施加不同形状的掩码,同一套参数可以实现三种语言模型:
- 不加掩码:双向自编码语言模型,对应标准的BERT;
- 加严格下三角掩码:单向自回归语言模型,对应GPT;
- 加”前段双向 $+$ 后段单向”的分块掩码:前一个句子内部双向可见、后一个句子只能看到自己左侧和整个前段,这正是Seq2Seq(前缀语言模型)所需的可见性结构。
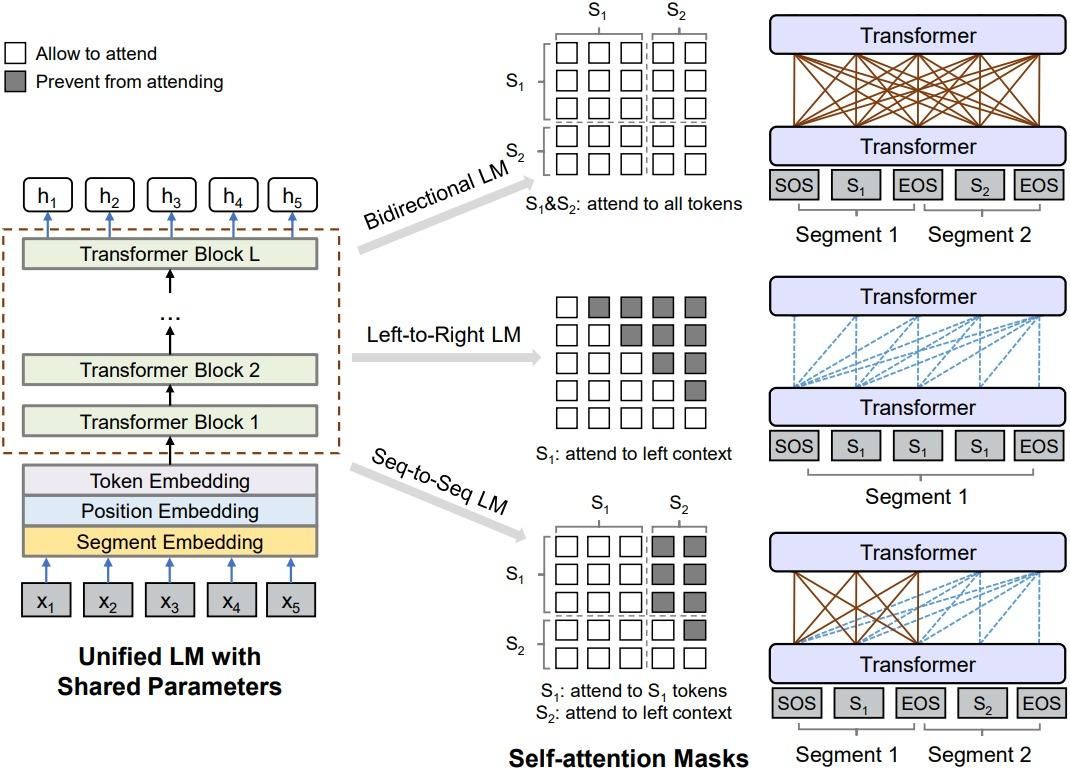
UniLM在预训练时按比例混合这三种掩码,因此一套权重同时具备理解与生成能力。这个方案的最大优势是零额外约束:不改模型结构、可以直接沿用BERT的预训练权重继续训练,收敛更快。它也是”架构其实是注意力掩码的一个特例”这一认识的关键证据。
(2) 去噪自编码
⚪ BART:任意噪声下的序列到序列去噪
BART是一个去噪自编码器:用任意噪声函数破坏原文档,再训练模型把它重建回来。结构上是标准的序列到序列Transformer,包含一个双向编码器与一个自左向右的自回归解码器;与BERT的区别是解码器每层都会对编码器最后一层做交叉注意力,且预测词元前没有额外的前馈层。
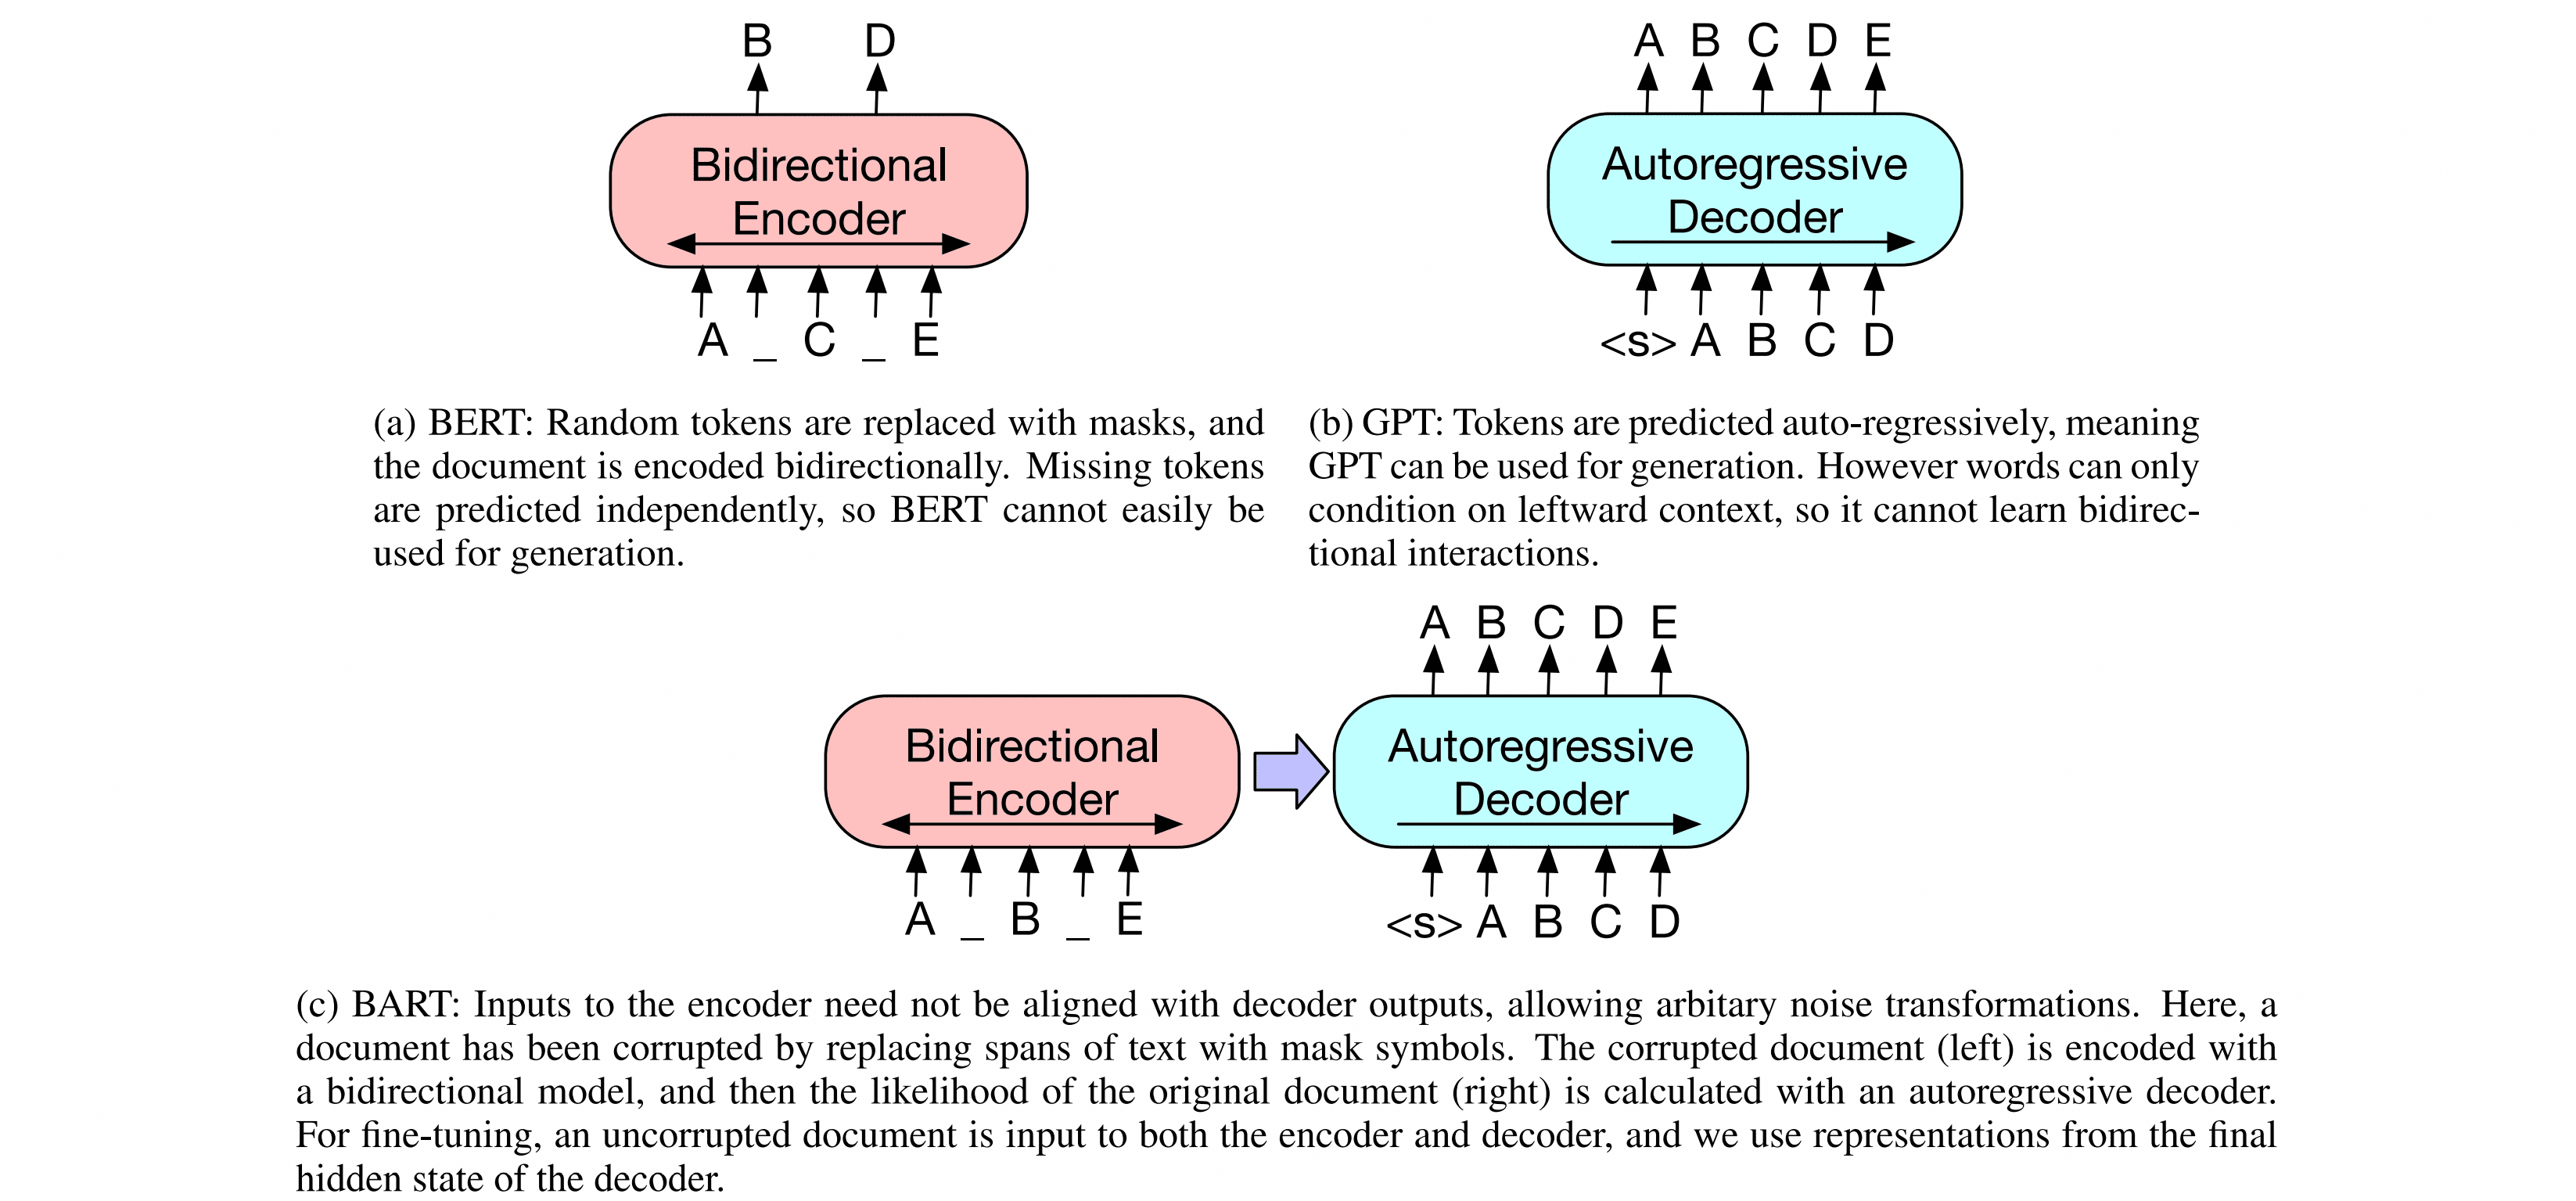
预训练目标就是最小化原文档的负对数似然。BART的关键在于它不限定噪声形式,作者系统尝试了五种破坏方式:
- 词元掩码(Token Masking):随机把词元替换为
[MASK],与BERT相同; - 词元删除(Token Deletion):随机删除词元,模型必须自己判断”哪里少了东西”;
- 文本填充(Text Infilling):把随机长度的连续片段(长度可以为$0$)替换成单个
[MASK],模型必须预测片段的长度与内容; - 句子排列(Sentence Permutation):打乱文档中句子的顺序;
- 文档旋转(Document Rotation):随机选一个词元并把文档旋转到以它开头,模型必须找出真正的文档起点。
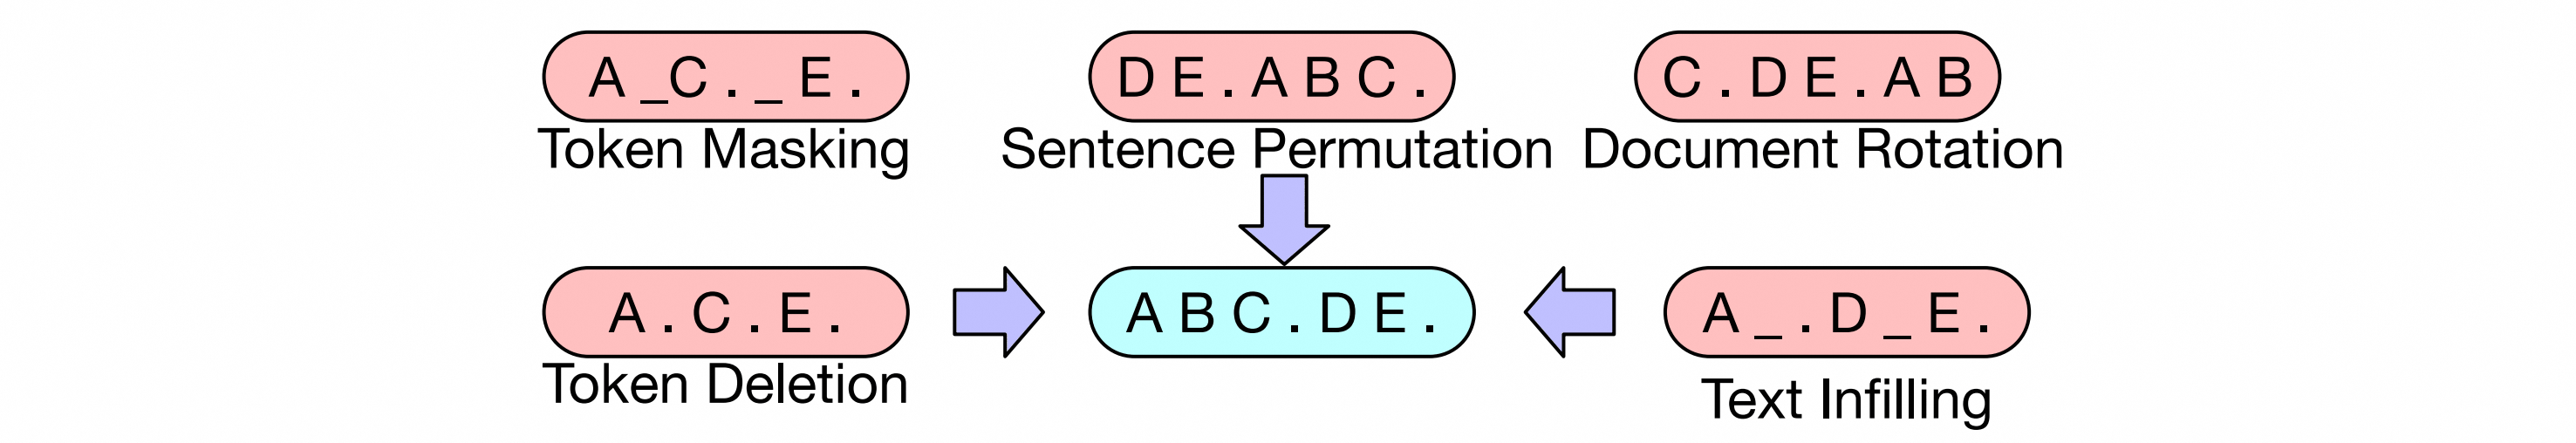
这些噪声可以组合使用;最终配方是”文本填充 $+$ 句子排列”,掩掉每篇文档约$30\%$的词元并打乱所有句子。其中文本填充是收益最大的一项,因为它同时要求模型预测”缺了多长”和”缺了什么”——这一点与MLM有本质区别(MLM的输入长度天然泄露了答案长度)。
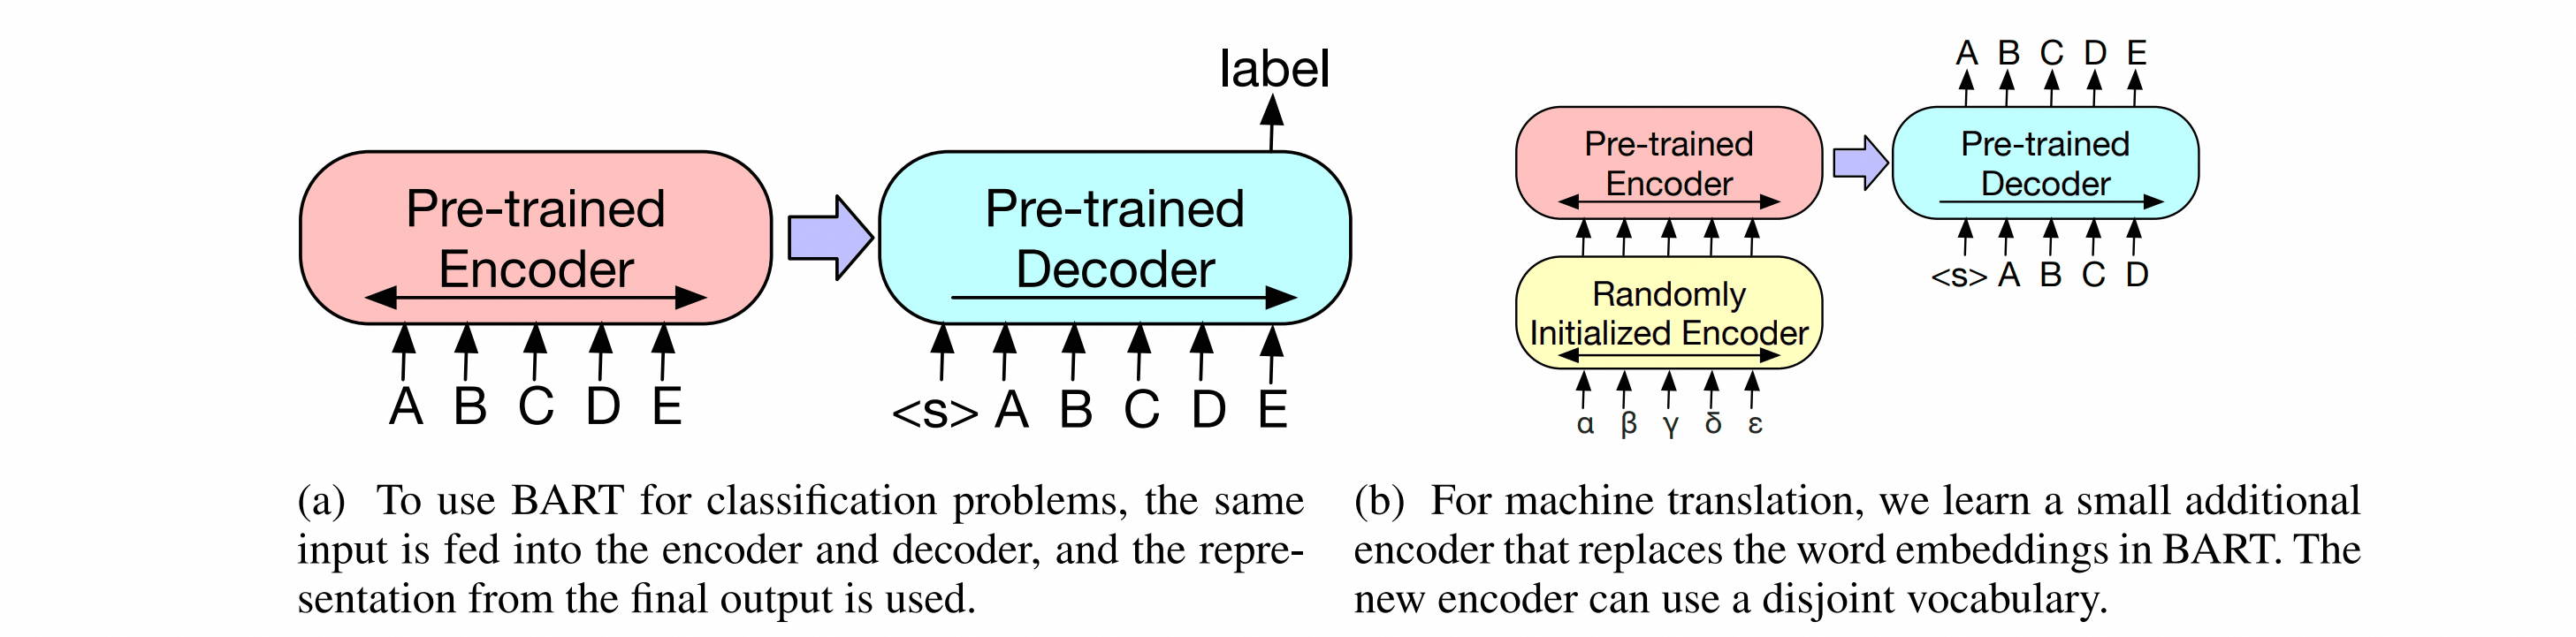
微调时BART用四种方式适配下游任务:序列分类(把同一输入喂给编码器与解码器,取解码器最后一个位置的隐状态)、词元分类(取解码器顶层每个位置的隐状态)、序列生成(直接微调)、机器翻译(把编码器的嵌入层替换为一个新的小编码器,学习把外语映射到BART能去噪的表示空间)。
(3) 文本到文本的统一
⚪ T5:把所有任务都写成文本到文本
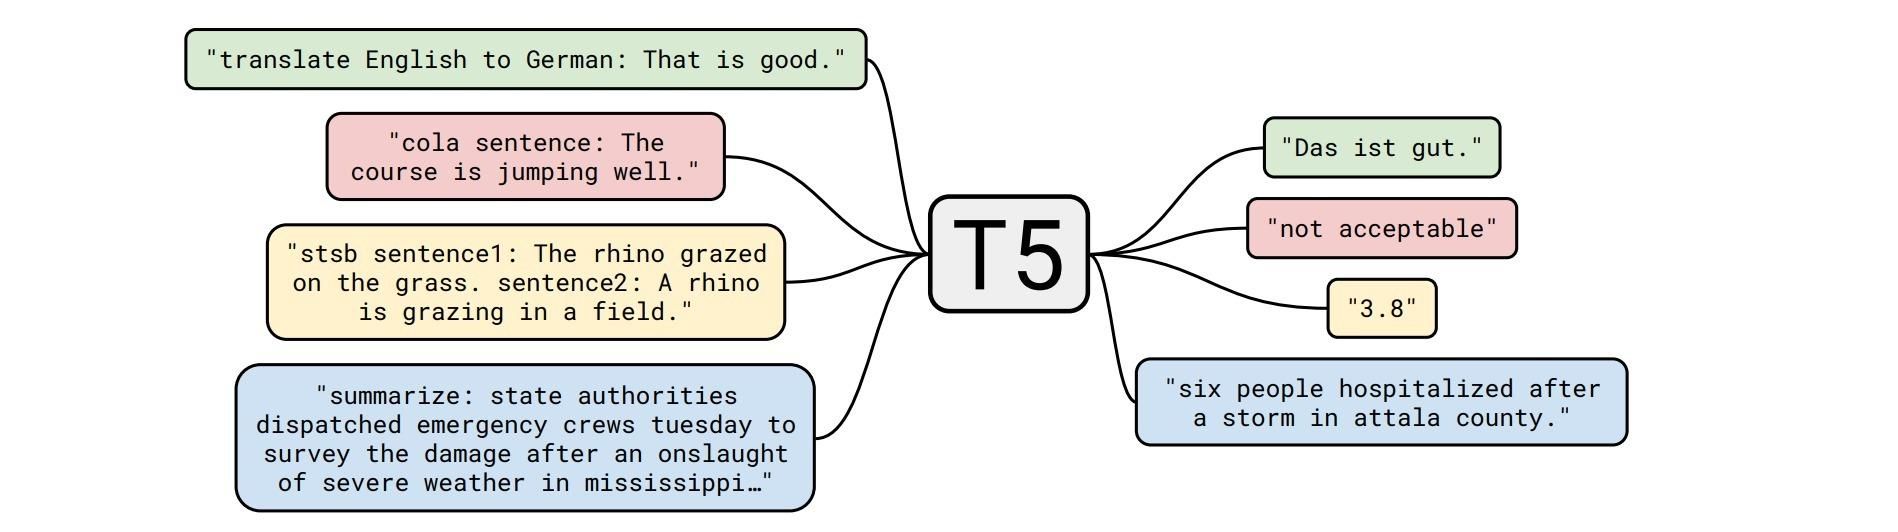
T5(Text-to-Text Transfer Transformer)使用标准的编码器-解码器结构,其核心主张是:所有自然语言处理任务都可以统一为”输入一段文本、输出一段文本”。翻译写成translate English to German: ...,分类写成cola sentence: ...并输出acceptable,回归任务甚至把分数离散化成字符串输出。
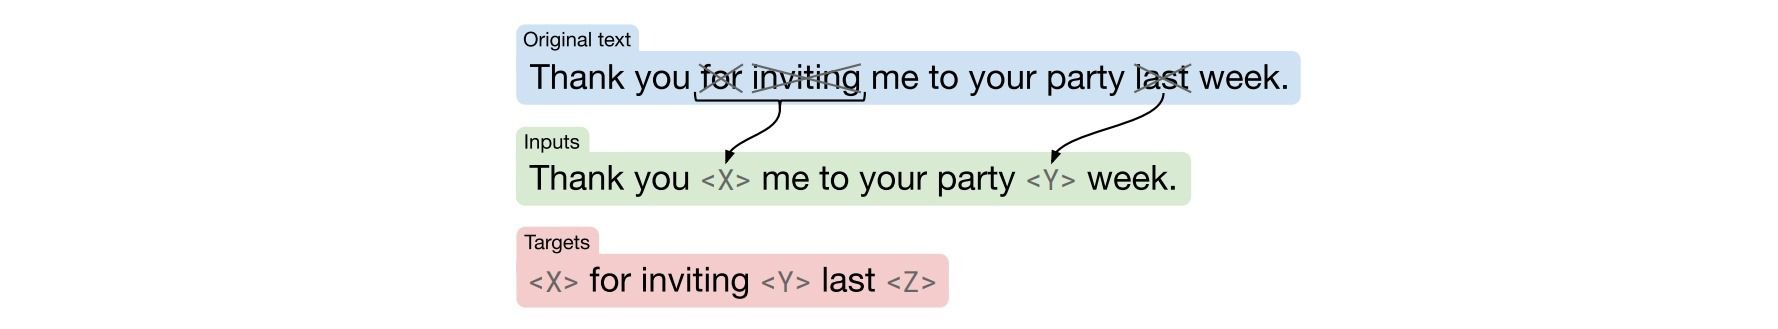
无监督部分使用作者构建的$750$GB级语料C4,训练任务是BERT式掩码语言建模的Seq2Seq版本,也称片段破坏(span corruption):把连续片段替换为唯一的哨兵词元<X>、<Y>,解码器只需按顺序输出这些哨兵及其对应内容,而不是重建整篇原文——这使目标序列大幅缩短,训练效率显著提高。
有监督部分则把多种下游任务的标注数据同样转成文本到文本的形式,与无监督任务混合训练:
T5的另一半贡献是一份极其详尽的消融实验,把架构(标准编码器-解码器、UniLM式共享参数、纯解码器)、预训练目标(语言建模、BERT式掩码、去乱序、片段破坏)、破坏比例($10\%$-$50\%$)、片段长度($2$-$10$)、数据规模与多任务混合比例逐一扫过。这份”超参数地图”至今仍是设计去噪目标时最有用的参考。T5使用了一种可训练的相对位置偏置(按距离分桶并截断),其细节见位置编码。
一个实用细节:微调T5时的学习率要比微调BERT大$10$倍以上($10^{-4}$量级而非$10^{-5}$量级),这是两者架构与预训练目标差异决定的,也是很多人第一次用T5时效果不佳的原因。
⚪ T5.1.1:用门控线性单元替换前馈激活
T5.1.1是T5的改进版,主要变化是把前馈子层的激活函数换成门控线性单元(Gated Linear Unit, GLU)的变体。标准前馈层为
\[\text{FFN}_{\text{ReLU}}(x) = \max(xW_1,0)W_2\]GLU的一般形式是用一路线性变换经激活函数后去门控另一路线性变换:
\[\text{GLU}(x,W,V) = \sigma(xW) \otimes (xV)\]把其中的sigmoid换成其他激活函数即得到一族变体,代入前馈层后为:
\[\begin{aligned} \text{FFN}_{\text{GLU}}(x) &= \left(\sigma(xW) \otimes xV\right)W_2 \\ \text{FFN}_{\text{ReGLU}}(x) &= \left(\max(0,xW) \otimes xV\right)W_2 \\ \text{FFN}_{\text{GEGLU}}(x) &= \left(\text{GELU}(xW) \otimes xV\right)W_2 \\ \text{FFN}_{\text{SwiGLU}}(x) &= \left(\text{Swish}_1(xW) \otimes xV\right)W_2 \end{aligned}\]由于引入了第三个权重矩阵$V$,为保持参数量与计算量不变需要把中间维度$d_{ff}$减少约$1/3$。实验表明GEGLU与SwiGLU在预训练困惑度与下游任务上都稳定优于ReLU/GELU。这项改动后来成为现代解码器前馈层的常见选择,更多激活函数的讨论见激活函数。
T5.1.1同时移除了嵌入层与输出层的权重共享、去掉了dropout(在大数据下不再需要),这些细节也被后续模型广泛沿用。
⚪ mT5:多语言版本的 T5
mT5采用T5.1.1的结构,配合覆盖$101$种语言的mC4语料,词表扩大到$250$K。技术路线上没有新意,但它是研究跨语言零样本迁移的重要基线:只在英语标注数据上微调、直接在其他语言上测试,模型仍能保持相当的性能,说明多语言预训练确实在不同语言之间对齐了表示空间。这类工作也暴露了多语言模型的核心张力——“维度诅咒”:在固定容量下增加语言数量会稀释每种语言的表现(高资源语言变差、低资源语言变好),因此语料的采样温度成为关键超参数。
(4) 自回归填空与混合目标
⚪ GLM:把填空任务改成自回归生成
GLM指出三类框架各有短板:自编码模型不擅长生成,自回归模型不擅长理解,编码器-解码器模型参数利用率低。它提出自回归填空(autoregressive blank infilling)作为统一目标:
- 从输入序列中采样多个连续片段并挖空,被挖掉的片段用单个
[MASK]占位,得到破坏后的序列$x_{\text{corrupt}}$; - 把被挖出的片段随机打乱顺序后拼接在序列末尾;
- 用一个前缀语言模型式的注意力掩码:破坏序列内部双向可见,待生成的片段自回归地生成、并可看到整个破坏序列以及此前已生成的片段。
优化目标可写为对片段顺序$\pi$的期望:
\[\max_\theta \, \mathbb{E}_{\pi \sim S_m} \left[ \sum_{i=1}^{m} \log p_\theta\left(s_{\pi_i} \mid x_{\text{corrupt}}, s_{\pi_{<i}}\right) \right]\]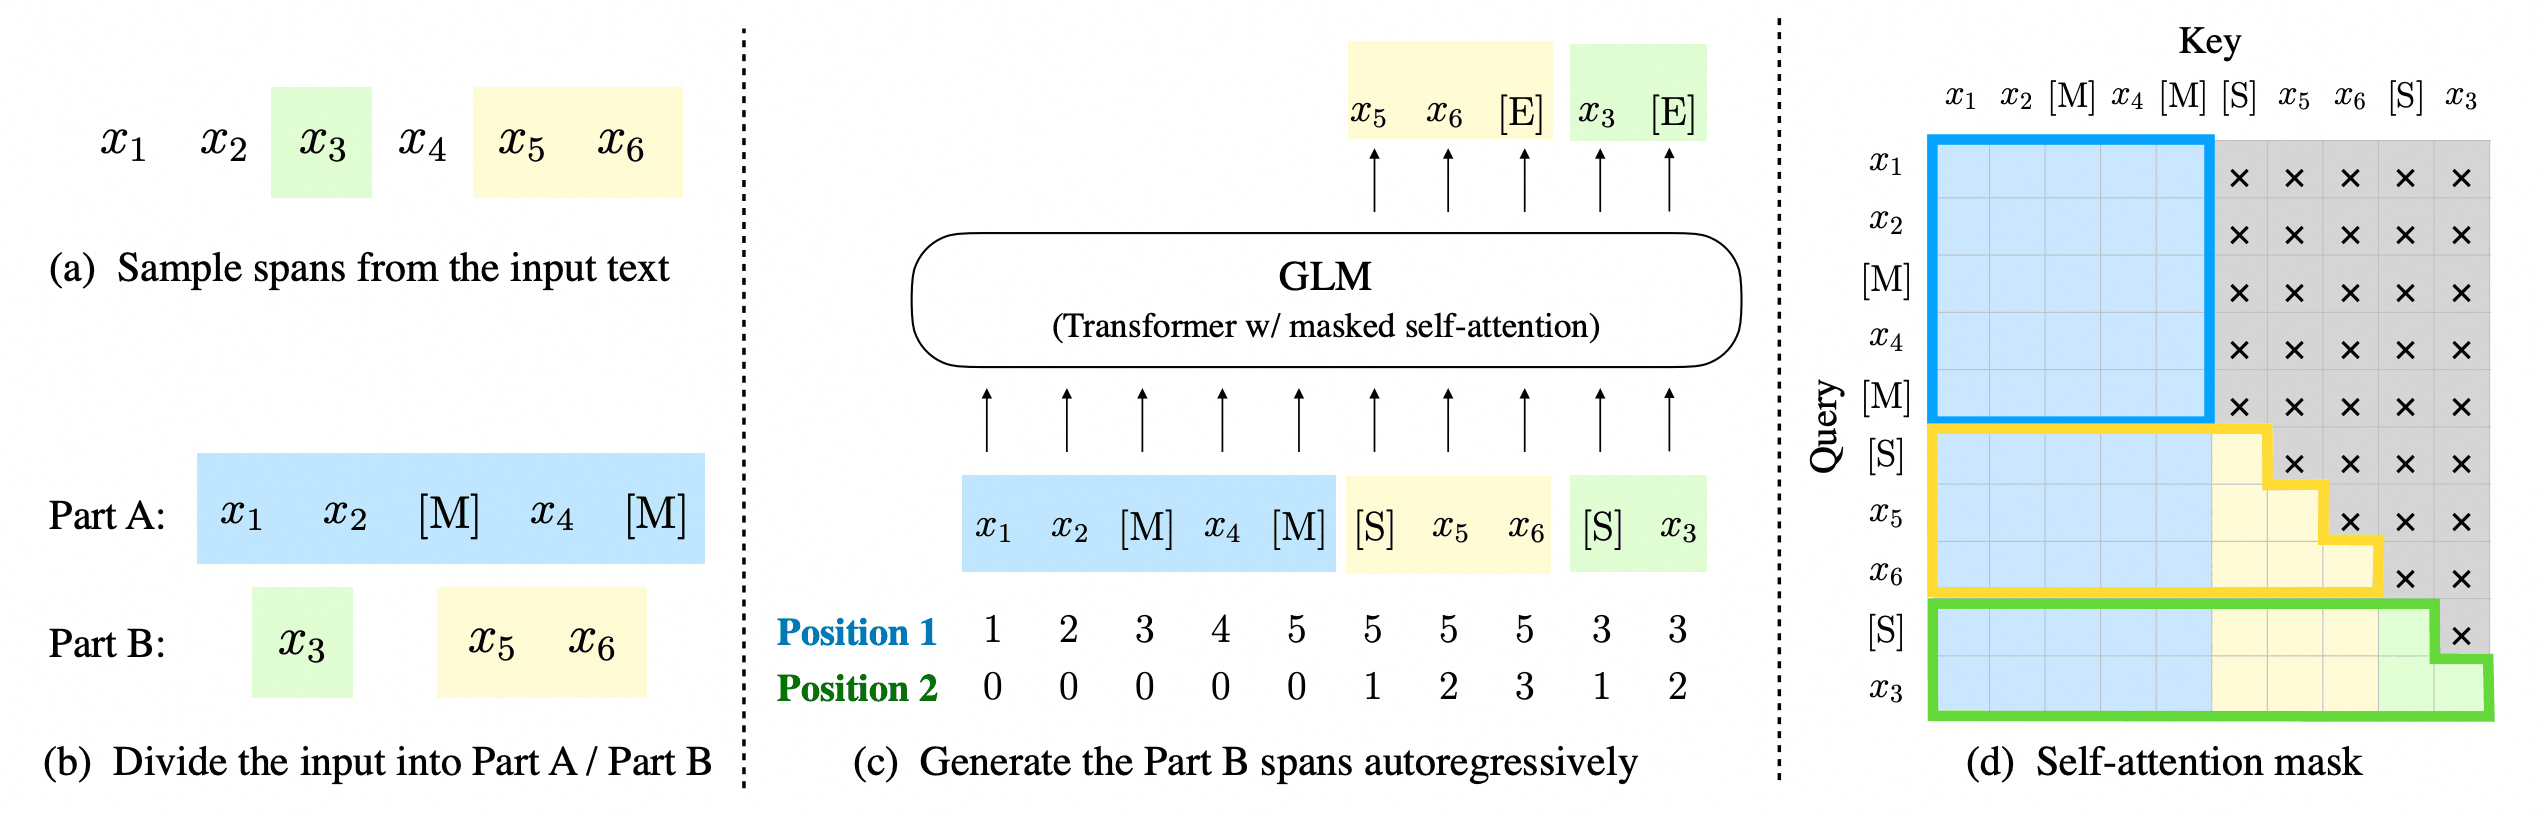
与T5的片段破坏相比,GLM有两个关键区别:片段之间的依赖被显式建模(T5的各哨兵片段在解码器中虽然顺序生成,但顺序固定;GLM通过随机打乱使模型学习任意顺序的依赖),以及只用一套参数(没有独立的解码器)。为了同时适配理解与生成,GLM混合两种片段采样策略:短片段(占原文$15\%$)用于自然语言理解,长片段(占原文$50\%$-$100\%$)用于长文本生成。GLM还使用了二维位置编码来同时表示”片段在原文中的位置”与”词元在片段内的位置”。
GLM 是中文社区最重要的开源模型谱系之一(ChatGLM 系列的基础),其”填空即生成”的思想也让它能天然处理需要在中间插入内容的任务。
⚪ UL2:混合去噪目标
UL2把”用什么去噪目标”这个问题彻底参数化。作者指出所有去噪目标都可以由三个参数刻画:破坏片段的平均长度$\mu$、破坏比例$r$、以及破坏片段的数量$n$。据此定义三类去噪器(denoiser):
- R-denoiser(常规去噪):$\mu \in {3,8}$、$r \approx 15\%$,即T5式的短片段破坏,偏向学习语言知识;
- S-denoiser(顺序去噪):只在序列中间切一刀,前段作为输入、后段作为输出,即严格的前缀语言建模,偏向学习生成能力;
- X-denoiser(极端去噪):$\mu \ge 12$或$r \ge 30\%$,长片段或高比例破坏,模型必须从很少的上下文中生成很多内容,接近开放式生成。
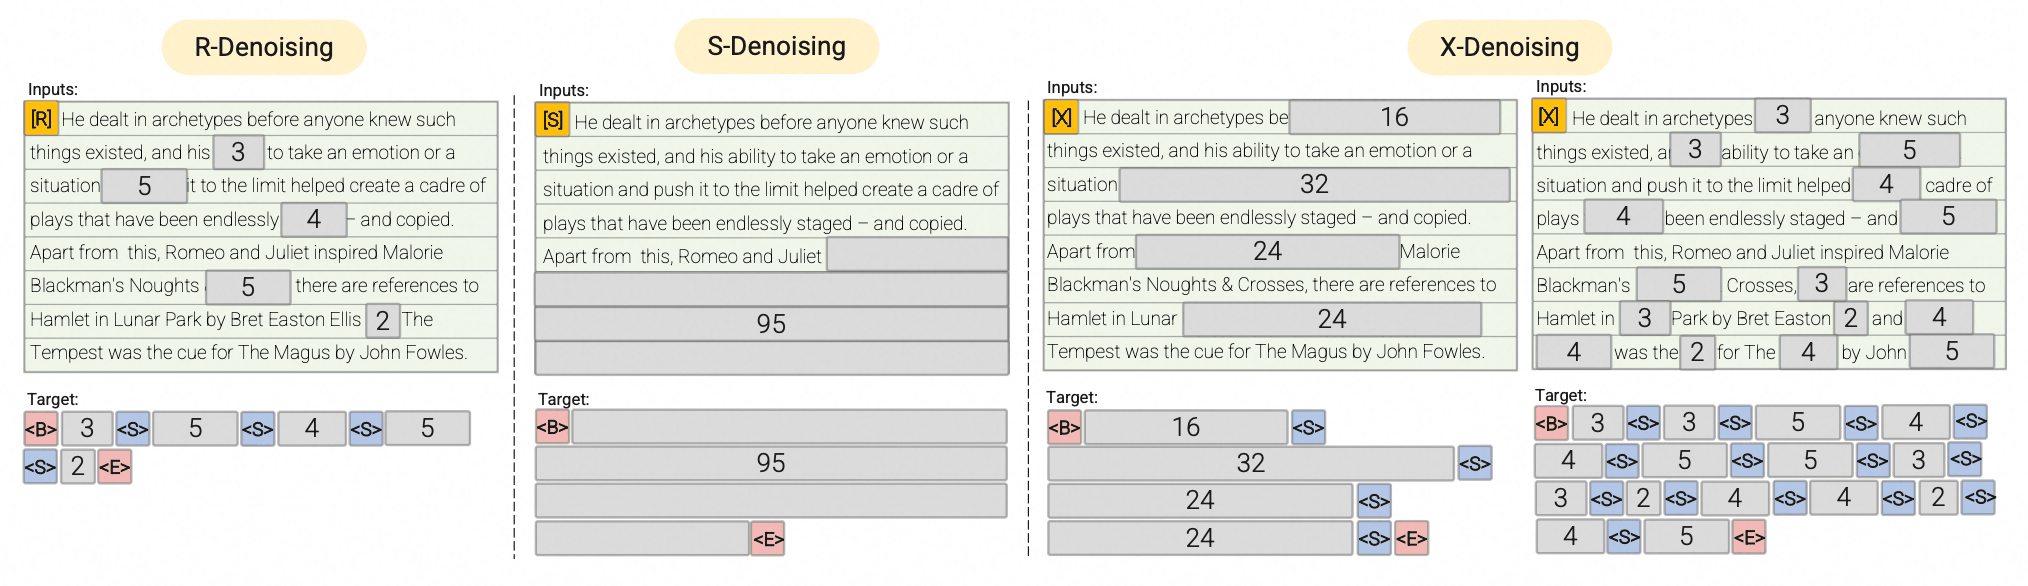
混合去噪器(Mixture-of-Denoisers, MoD)在预训练中按比例混合这七种具体配置,并在输入前加一个范式标记([R]、[S]、[X])告诉模型当前是哪种任务。推理时通过切换这个标记,同一个模型就能在”擅长微调的模式”与”擅长少样本提示的模式”之间自由切换,作者称之为模式切换(mode switching)。
UL2的价值在于把第 2 章“架构与目标是连续谱”的观察变成可操作的训练方案,也在实验上说明:与其在BERT式与GPT式目标之间二选一,不如按比例混合。类似思想也用于预训练后期混入FIM(fill-in-the-middle)等填空目标,尤其适合需要生成中间代码片段的模型。
⭐ 讨论:去噪目标的设计空间
把本章的模型放到”破坏方式 $\times$ 重建方式”的坐标系里,可以看到一个清晰的设计空间:
| 模型 | 破坏方式 | 重建目标 | 参数结构 |
|---|---|---|---|
| BERT | 独立词元替换为 [MASK],$15\%$ | 仅在掩码位置分类 | 编码器 |
| SpanBERT | 几何分布采样的连续片段 | 掩码位置 $+$ 边界重建 | 编码器 |
| MASS | 一个长度为$k$的连续片段 | 解码器生成该片段 | 编码器-解码器 |
| BART | 掩码/删除/填充/句子重排/文档旋转 | 解码器重建整篇原文 | 编码器-解码器 |
| T5 | 多个短片段替换为哨兵,$15\%$,$\mu \approx 3$ | 解码器只生成哨兵内容 | 编码器-解码器 |
| GLM | 多个片段挖空并随机排序 | 单套参数自回归生成各片段 | 前缀语言模型 |
| UL2 | R/S/X 三类去噪器按比例混合 | 随范式标记切换 | 编码器-解码器或解码器 |
沿着这张表可以读出四条设计原则。
- 破坏的粒度决定学到什么:单词元掩码留下了局部搭配捷径,片段掩码迫使模型使用远距离上下文,句子级/文档级破坏才能学到话语结构。
- 输出是否包含完整原文,直接决定训练效率:BART 重建整篇文档,目标序列与输入等长;T5 只输出哨兵内容,目标序列短了数倍,同算力下能多训练几倍的数据——这是T5式片段破坏成为主流的实际原因。
- “长度信息是否泄露”是一个常被忽视的细节:BERT 的输入里有多少个
[MASK]就有多少个待预测词,长度是白送的;BART 的文本填充与 T5 的哨兵机制都把长度也变成了需要预测的量,任务因此更难也更接近真实生成。 - 多个去噪目标可以叠加但不能随便叠加:UL2 的混合有效,前提是用范式标记显式告知模型当前任务;第 2 章提到的双向性研究已经表明,如果不加区分地把”预测下一词”与”填充掩码”混在一起,两者会互相干扰。
5. 解码器架构:从微调走向提示
编码器通过双向上下文学习表示,编码器-解码器通过去噪统一输入与输出;解码器则只依赖左侧上下文,以与生成完全一致的下一词预测目标预训练。本章保留GPT与GPT-2,用于说明自回归预训练如何从“预训练后微调”走向“直接用自然语言提示”。十亿参数以上模型的规模化、能力与使用方法统一见大型语言模型。
(1) GPT 系列:生成式预训练的范式转折
⚪ GPT:生成式预训练 $+$ 判别式微调
GPT(Generative Pre-Training)使用Transformer解码器,先在无标注语料上做自回归语言建模,再用标注数据微调下游任务。
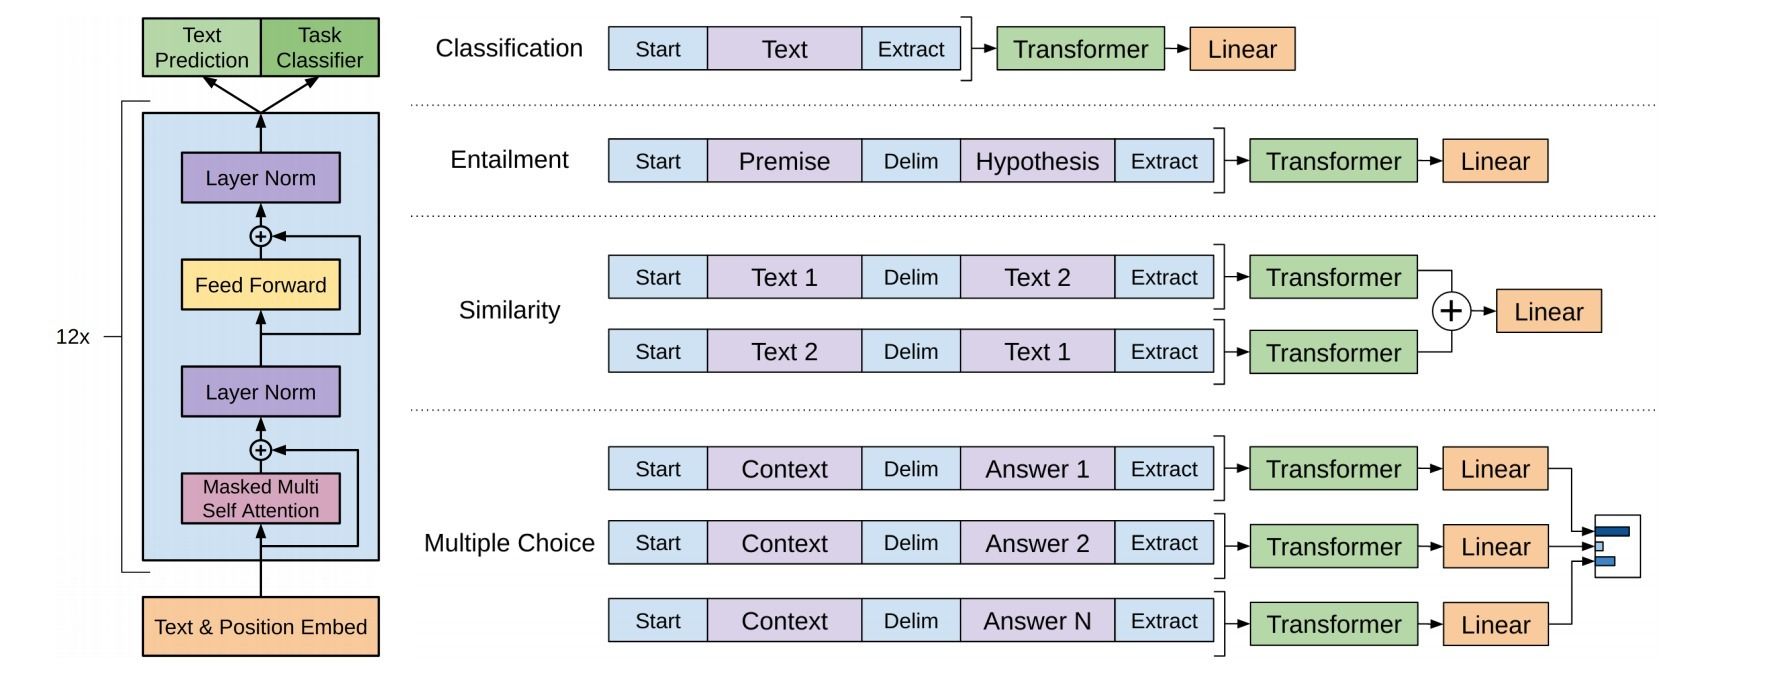
预训练阶段最大化窗口为$k$的对数似然:
\[L_1(\mathcal{U}) = \sum_{i} \log P(u_i \mid u_{i-k},\cdots,u_{i-1};\Theta)\]模型的前向计算是标准的解码器堆叠:
\[h_0 = UW_e + W_p, \quad h_l = \text{transformer\_block}(h_{l-1}), \quad P(u) = \text{softmax}(h_L W_e^\top)\]其中$U$是上下文词元的one-hot表示,$W_e$是词嵌入矩阵(输出层与之共享权重),$W_p$是位置嵌入。
微调阶段在最后一个位置的隐状态上接一个线性分类头:
\[P(y \mid x^1,\cdots,x^m) = \text{softmax}(h_L^m W_y), \quad L_2(\mathcal{C}) = \sum_{(x,y)} \log P(y \mid x^1,\cdots,x^m)\]作者发现把语言建模作为辅助目标保留在微调阶段有助于收敛与泛化,因此最终目标是两项之和:
\[L_3(\mathcal{C}) = L_2(\mathcal{C}) + \lambda \cdot L_1(\mathcal{C})\]对于输入具有结构的任务(句对、三元组),GPT不改模型结构,而是把结构化输入线性化成一个序列:文本蕴含把前提与假设用分隔符连接;语义相似度把两种句序都输入一遍再相加;问答与常识推理把文档、问题与每个候选答案拼接后分别打分。这种”用输入格式而非模型结构适配任务”的思路,正是后来提示(prompt)范式的雏形。
⚪ GPT-2:语言模型是无监督的多任务学习器
GPT-2在结构上只是GPT的放大与微调(层归一化前置到每个子块输入端、在最后一个自注意力块后再加一次层归一化、词表扩到$50257$、上下文长度从$512$增至$1024$、按层数缩放残差分支的初始化),最大规模$1.5$B参数。
真正的贡献是提出并验证了一个论断:自回归语言建模本身就是一种多任务学习。作者的论证是,自然语言处理的各类任务都可以写成$p(\text{output} \mid \text{input},\text{task})$的形式,而这种”任务描述 $+$ 输入 $+$ 输出”的三元组在自然文本中大量存在(翻译对照、问答帖、TL;DR:后面的摘要),因此单纯建模
就已经在隐式地学习这些任务。与之相对,BERT式的双向建模$p(x_t \mid x_{<t},x_{>t})$无法直接对应这种形式。
为了让这个论断成立,作者构建了WebText:抓取 Reddit 上获得至少$3$个赞的外链网页正文,用人类的点赞行为作为质量过滤器,得到$40$GB高质量、高多样性的文本。输入表示采用字节级 BPE(byte-level BPE),在字节层面做子词合并,从而在保持子词效率的同时能表示任意Unicode字符串,彻底消除OOV。
评测方式也随之改变:GPT-2在下游任务上不做任何微调,直接用零样本方式测试(例如在文章后加TL;DR:来诱导摘要)。它在$8$个语言建模数据集中的$7$个上取得零样本最佳,但在摘要、翻译等任务上仍明显弱于专用系统。重要的是,作者观察到性能随模型容量呈对数线性提升且尚未饱和,这直接推动了后续大规模自回归模型。
⭐ 讨论:自回归预训练为什么适合提示
自回归目标在每个位置都计算下一词损失,训练与开放式生成使用相同的因果掩码,因此无需引入下游不存在的[MASK],也能借助KV Cache逐词元解码。更重要的是,自然文本本身包含问答、翻译、摘要和代码示例,“任务描述 $+$ 输入 $+$ 输出”可以直接作为普通序列建模。
这并不意味着解码器在所有任务上都优于双向编码器。文本检索、重排序、序列标注和低延迟分类仍受益于一次前向即可读取完整上下文的编码器;输入很长而输出较短的条件生成也可能更适合编码器-解码器。架构选择取决于任务接口。
6. 理解预训练语言模型
(1) 预训练语言模型学到了哪些知识
预训练语言模型从文本中学到的知识大致可分两类。
- 语言类知识指词法、词性、句法、语义等有助于理解自然语言的知识,又可细分为:
- 浅层语言知识(词法、词性、句法等),通常存储在Transformer的低层与中层;
- 抽象语言知识(语义类知识),通常存储在中层与高层。
- 世界知识指真实事件与常识,又可细分为:
- 事实型知识(factual knowledge),如”某人是某国现任总统”(这类知识会过期);
- 常识性知识(common sense knowledge),如”太阳从东方升起”。 这类知识主要分布在中层与高层,尤其聚集在中层。
⚪ BERTnesia:中间层也存了大量知识,且微调会遗忘
以往的知识探测只看最后一层的输出,这项工作为每一层单独训练一个轻量级解码器(用与预训练相同的掩码语言建模目标训练),再用LAMA完形填空数据集测量各层的知识含量,指标是排名前一的精度$P@1$:
\[P@1 = \max\left(\{P_l@1 \mid \forall l \in L\}\right)\]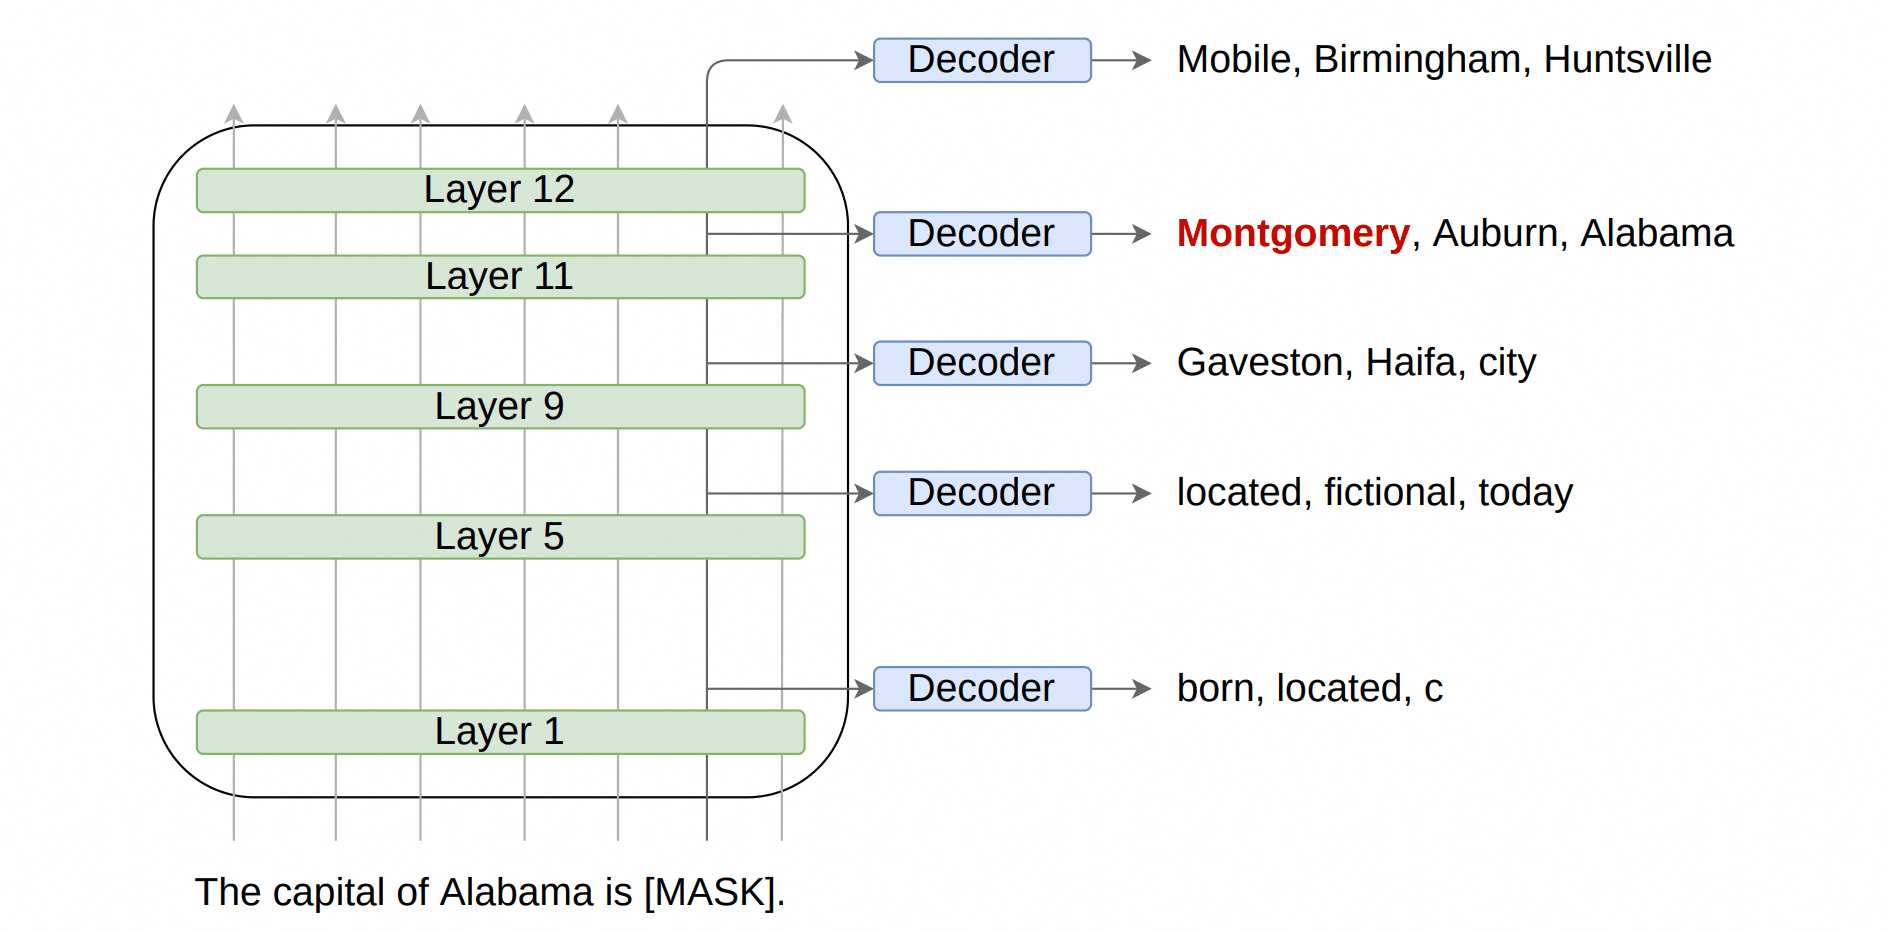
三个主要发现:① 知识不只在最后一层——中间层贡献了$17\%$-$60\%$的知识,最后一层”遗忘”了$18\%$-$33\%$在中间层已经掌握的事实,平均有$7\%$的关系类型在中间层被捕获得最好;② 层深与知识量正相关,但并非单调,某些关系类型在最后一层知识量翻倍,另一些则明显下降;③ 微调会遗忘世界知识,遗忘程度取决于微调目标——问答式微调遗忘最严重($35\%$-$53\%$),排序式微调保留得更好,而以掩码语言建模为目标的继续训练则最擅长从新数据中吸收知识。
这些结论有直接的实践含义:如果下游任务依赖事实知识,只取最后一层的表示可能是次优的(应考虑多层融合),且激进的微调会损害模型的知识库属性。
⚪ 需要多少预训练数据
这项工作用四种探测方法(冻结表示上的分类器探测、基于最小描述长度的信息论探测、BLiMP上的无监督语法可接受性判断、以及SuperGLUE上的微调)评估在$1$M、$10$M、$100$M、$1$B、$30$B词汇上预训练的一系列RoBERTa模型。
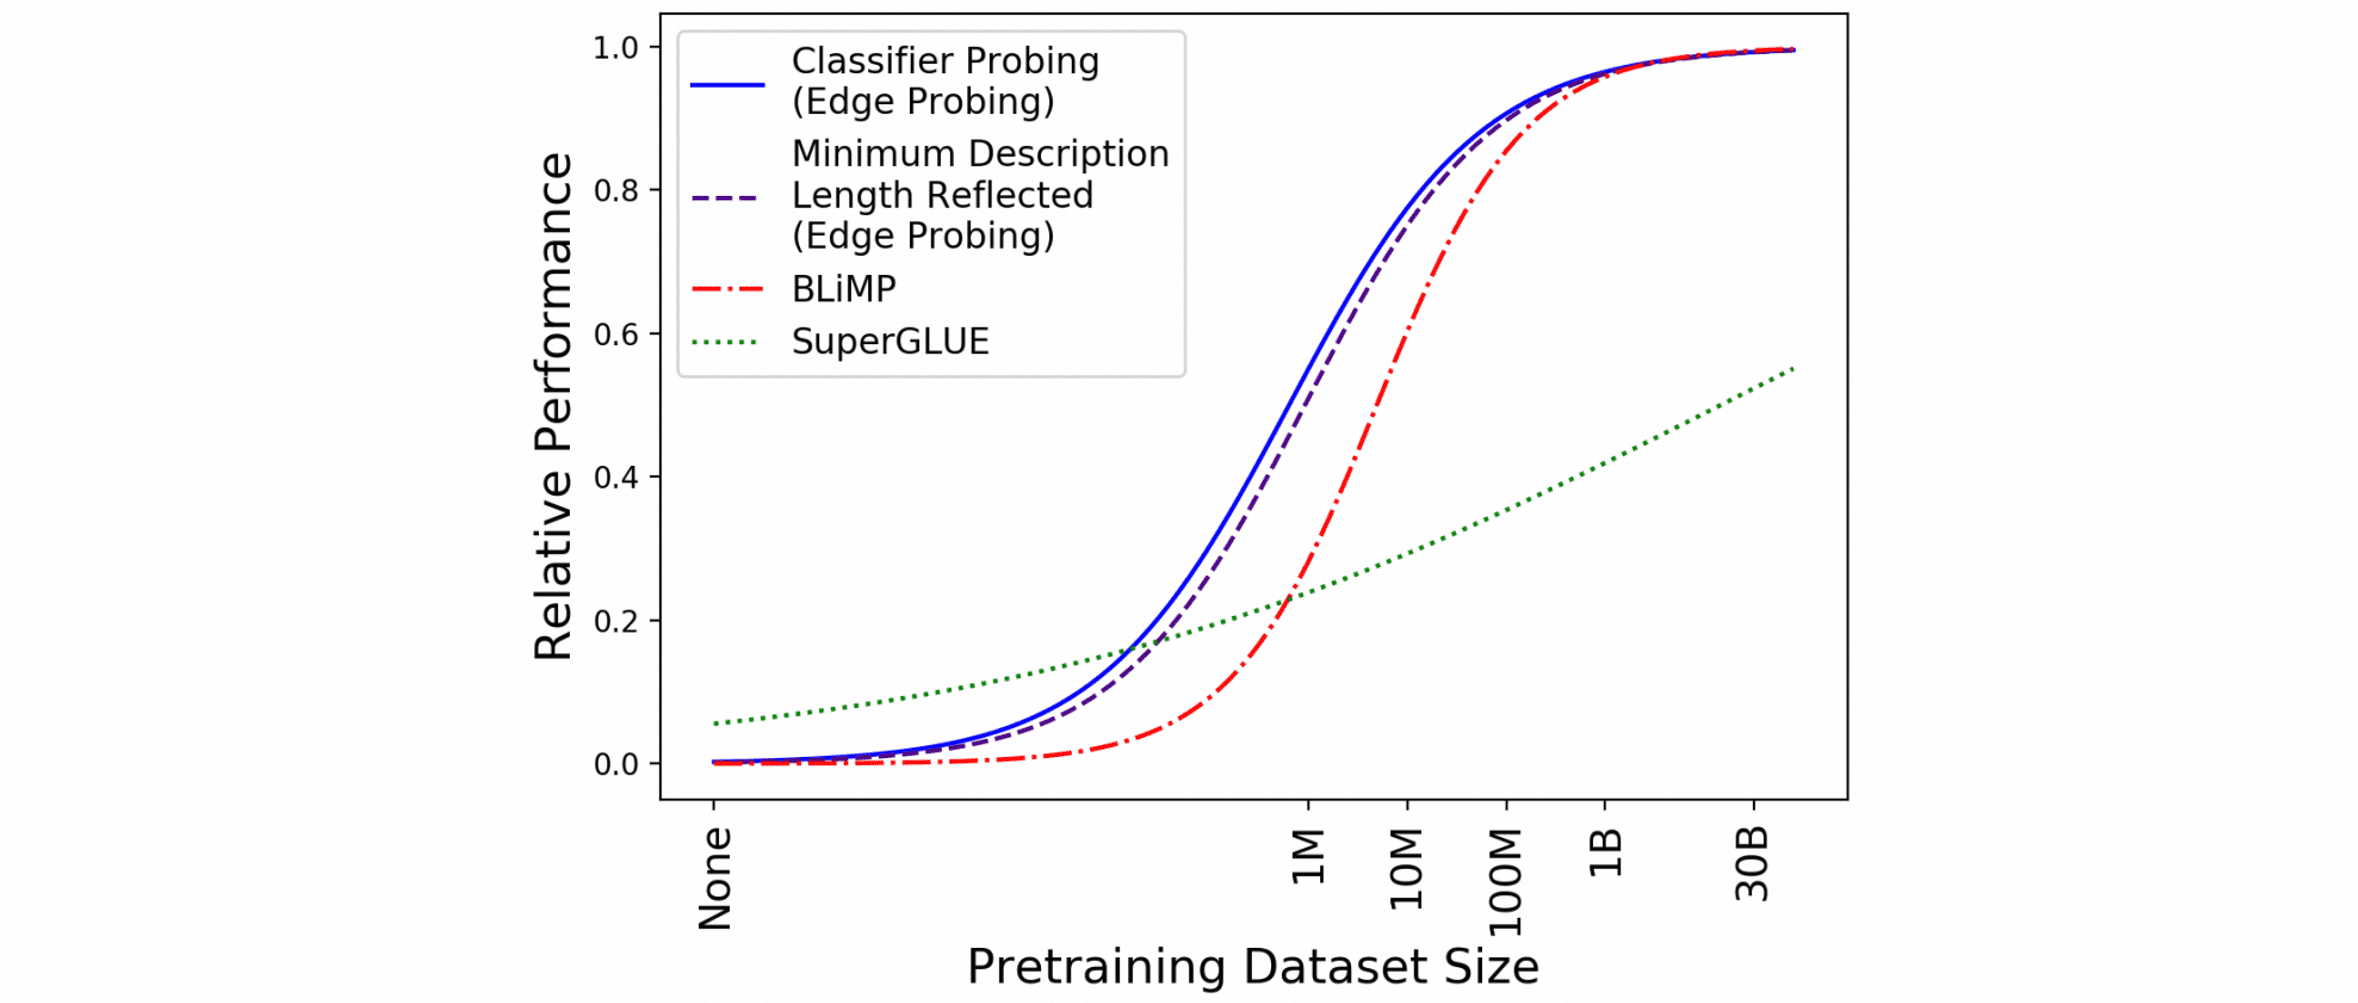
结论非常清晰:语言类知识很便宜,世界知识很贵。句法与语义特征的学习在$10$M-$100$M词汇处基本饱和($90\%$的提升在$20$M词以内完成,与人类语言学习者接触的语料量同量级),且句法比语义饱和得更早;而涉及常识与世界知识的任务(如Winograd)在$1$B-$30$B之间才出现显著提升,SuperGLUE微调性能在$30$B词汇处仍未见饱和迹象。
换言之,继续增加预训练数据时,性能提升的主要驱动力逐渐从基础语言规律转向世界知识。这也解释了为什么语言现象已经基本饱和后,扩大数据量仍能持续改善知识密集型任务;完整的规模化规律见大型语言模型。
(2) 预训练语言模型如何存储知识
预训练语言模型的知识存储在Transformer的参数里。从结构上看参数分为两部分:自注意力层(约占三分之一)与全连接层(约占三分之二)。自注意力层主要计算词元之间的相关性、整合全局信息,更像是在建立知识之间的联系;因此可以推测具体的知识点主要存储在全连接层中。
⚪ 全连接层是键值记忆单元
Transformer的前馈层可写作
\[\text{FF}(x)=f\left(x \cdot K^\top\right) \cdot V\]其中$K,V \in \mathbb{R}^{d_m \times d}$是参数矩阵,$f$是非线性函数。这与神经记忆(neural memory)的形式几乎完全相同(唯一区别是神经记忆用softmax归一化、标准前馈层不归一化):$K$的每一行是一个键,$V$的对应行是一个值。
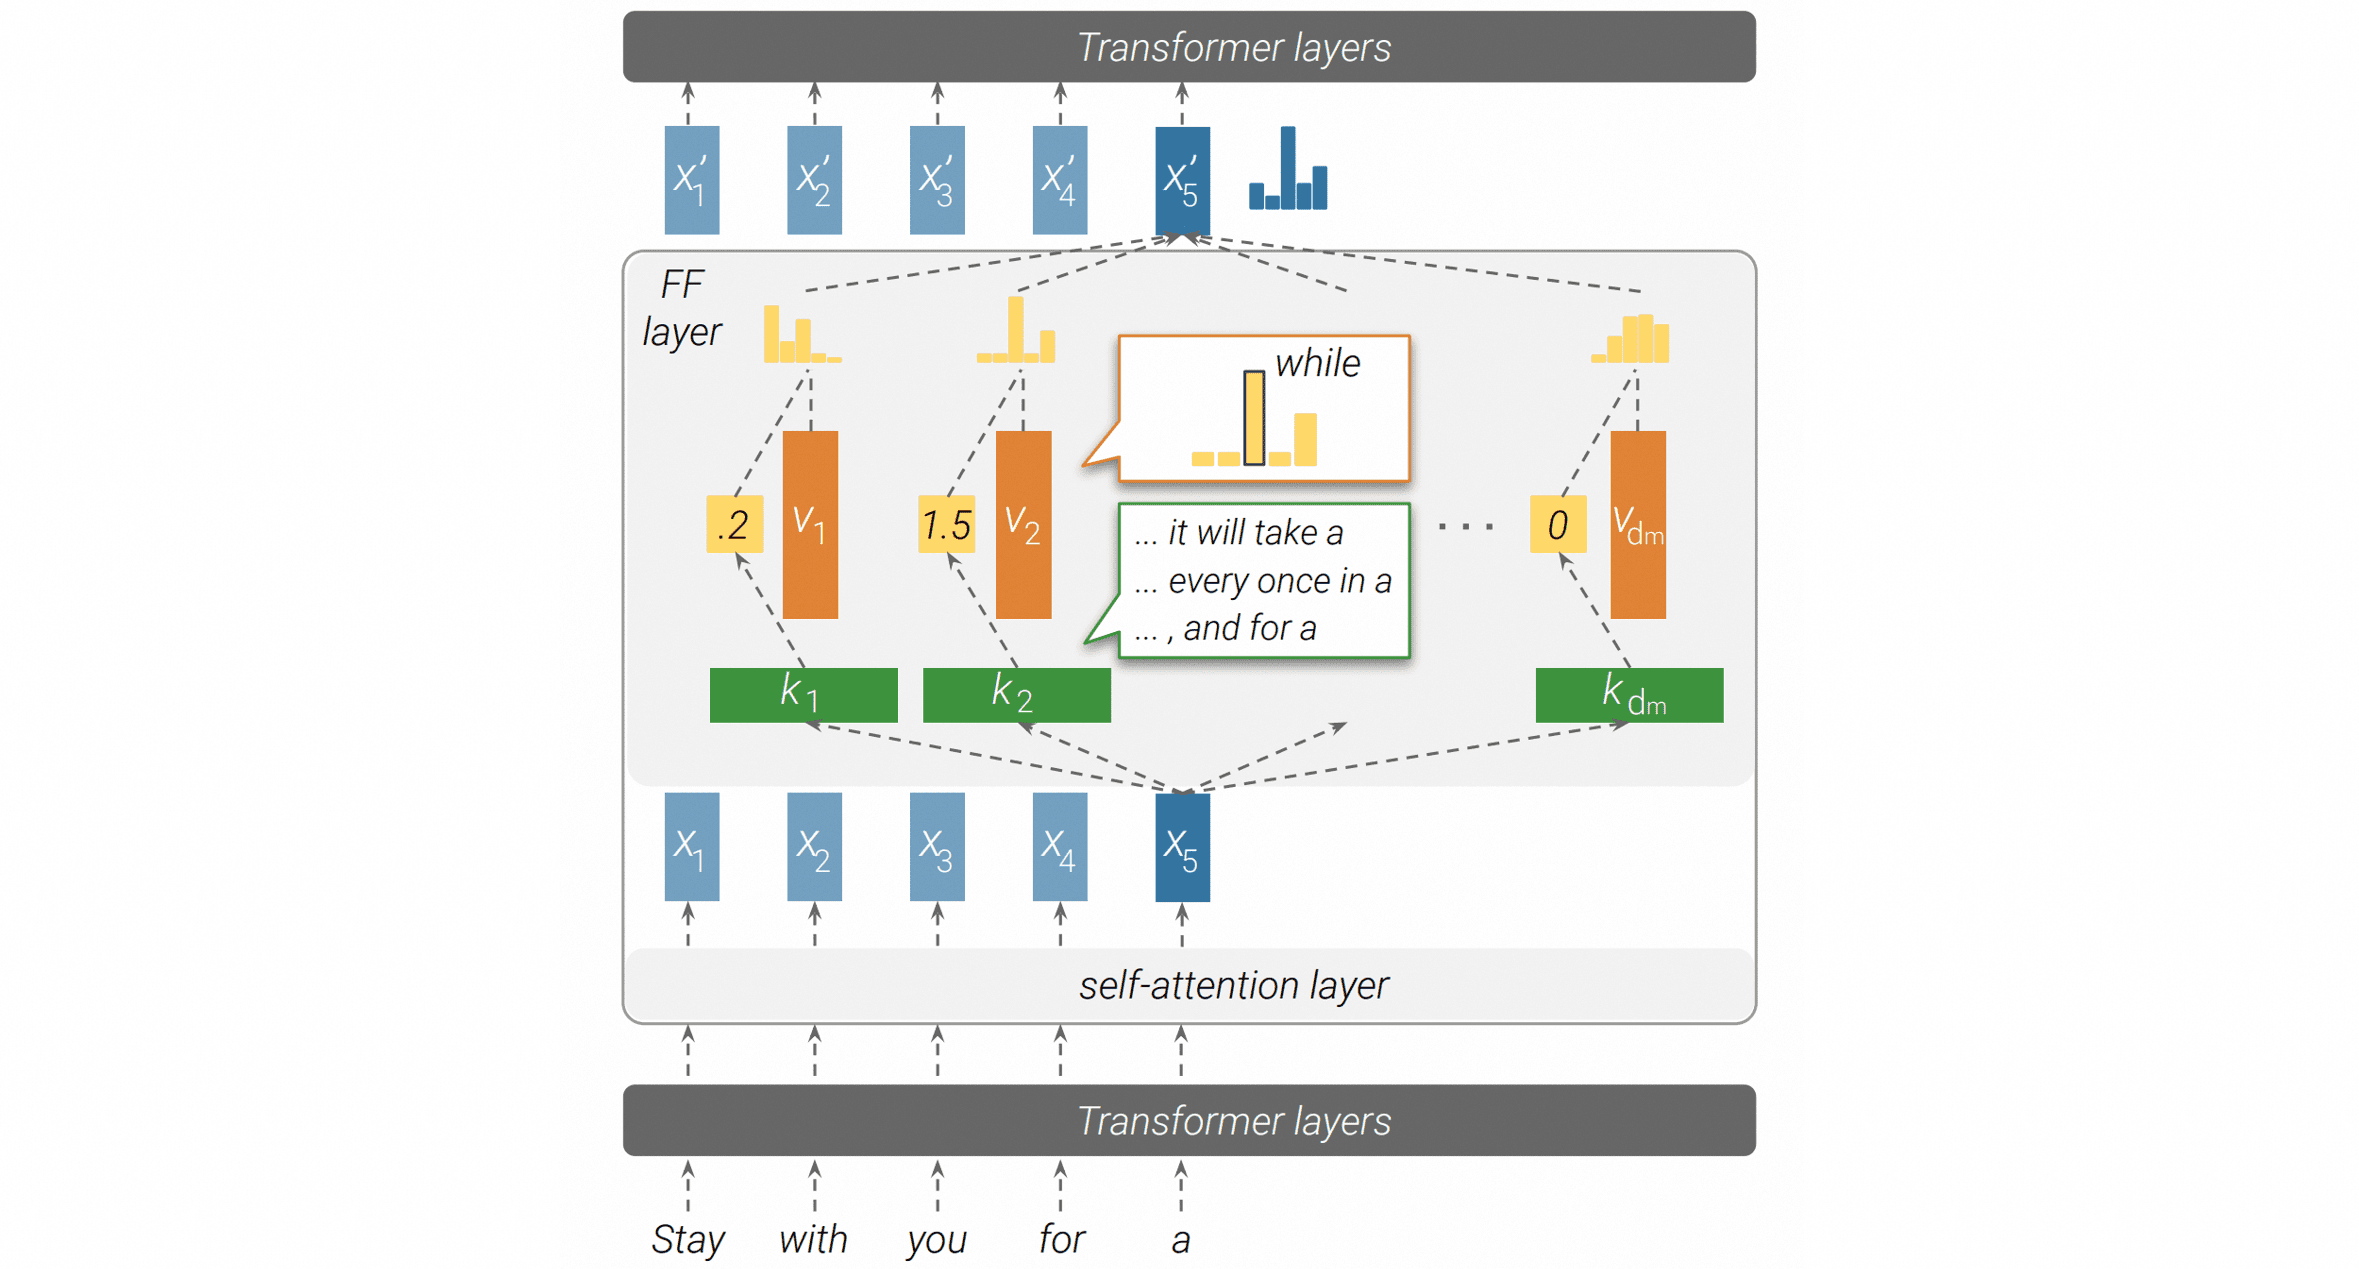
作者用一个$16$层语言模型逐个检验这些记忆单元,得到三个发现:
- 键是可解释的模式检测器——每个键都对应输入前缀中一类人类可识别的模式,低层的键倾向于捕获浅层的表面模式(n-gram、词形),高层的键捕获更语义化的模式(主题、语义角色);
- 值编码了输出分布——把每个值向量投影到词表上得到一个概率分布,高层的值倾向于给该键所对应模式的”下一个词”更高的概率;
- 输出分布是自底向上逐层精炼的——每层通过残差连接把若干记忆单元的分布聚合起来,再由后续层不断修正,最终形成模型的输出。
这项工作是后续所有“定位-编辑”式知识编辑方法的理论基础:既然知识以键值对的形式存在于特定的前馈层,那么就有可能定位并直接改写它。
⚪ Knowledge Neuron:定位表达特定事实的神经元
把前馈层视作键值记忆后,一个自然的问题是:某条具体事实由哪些中间神经元表达?
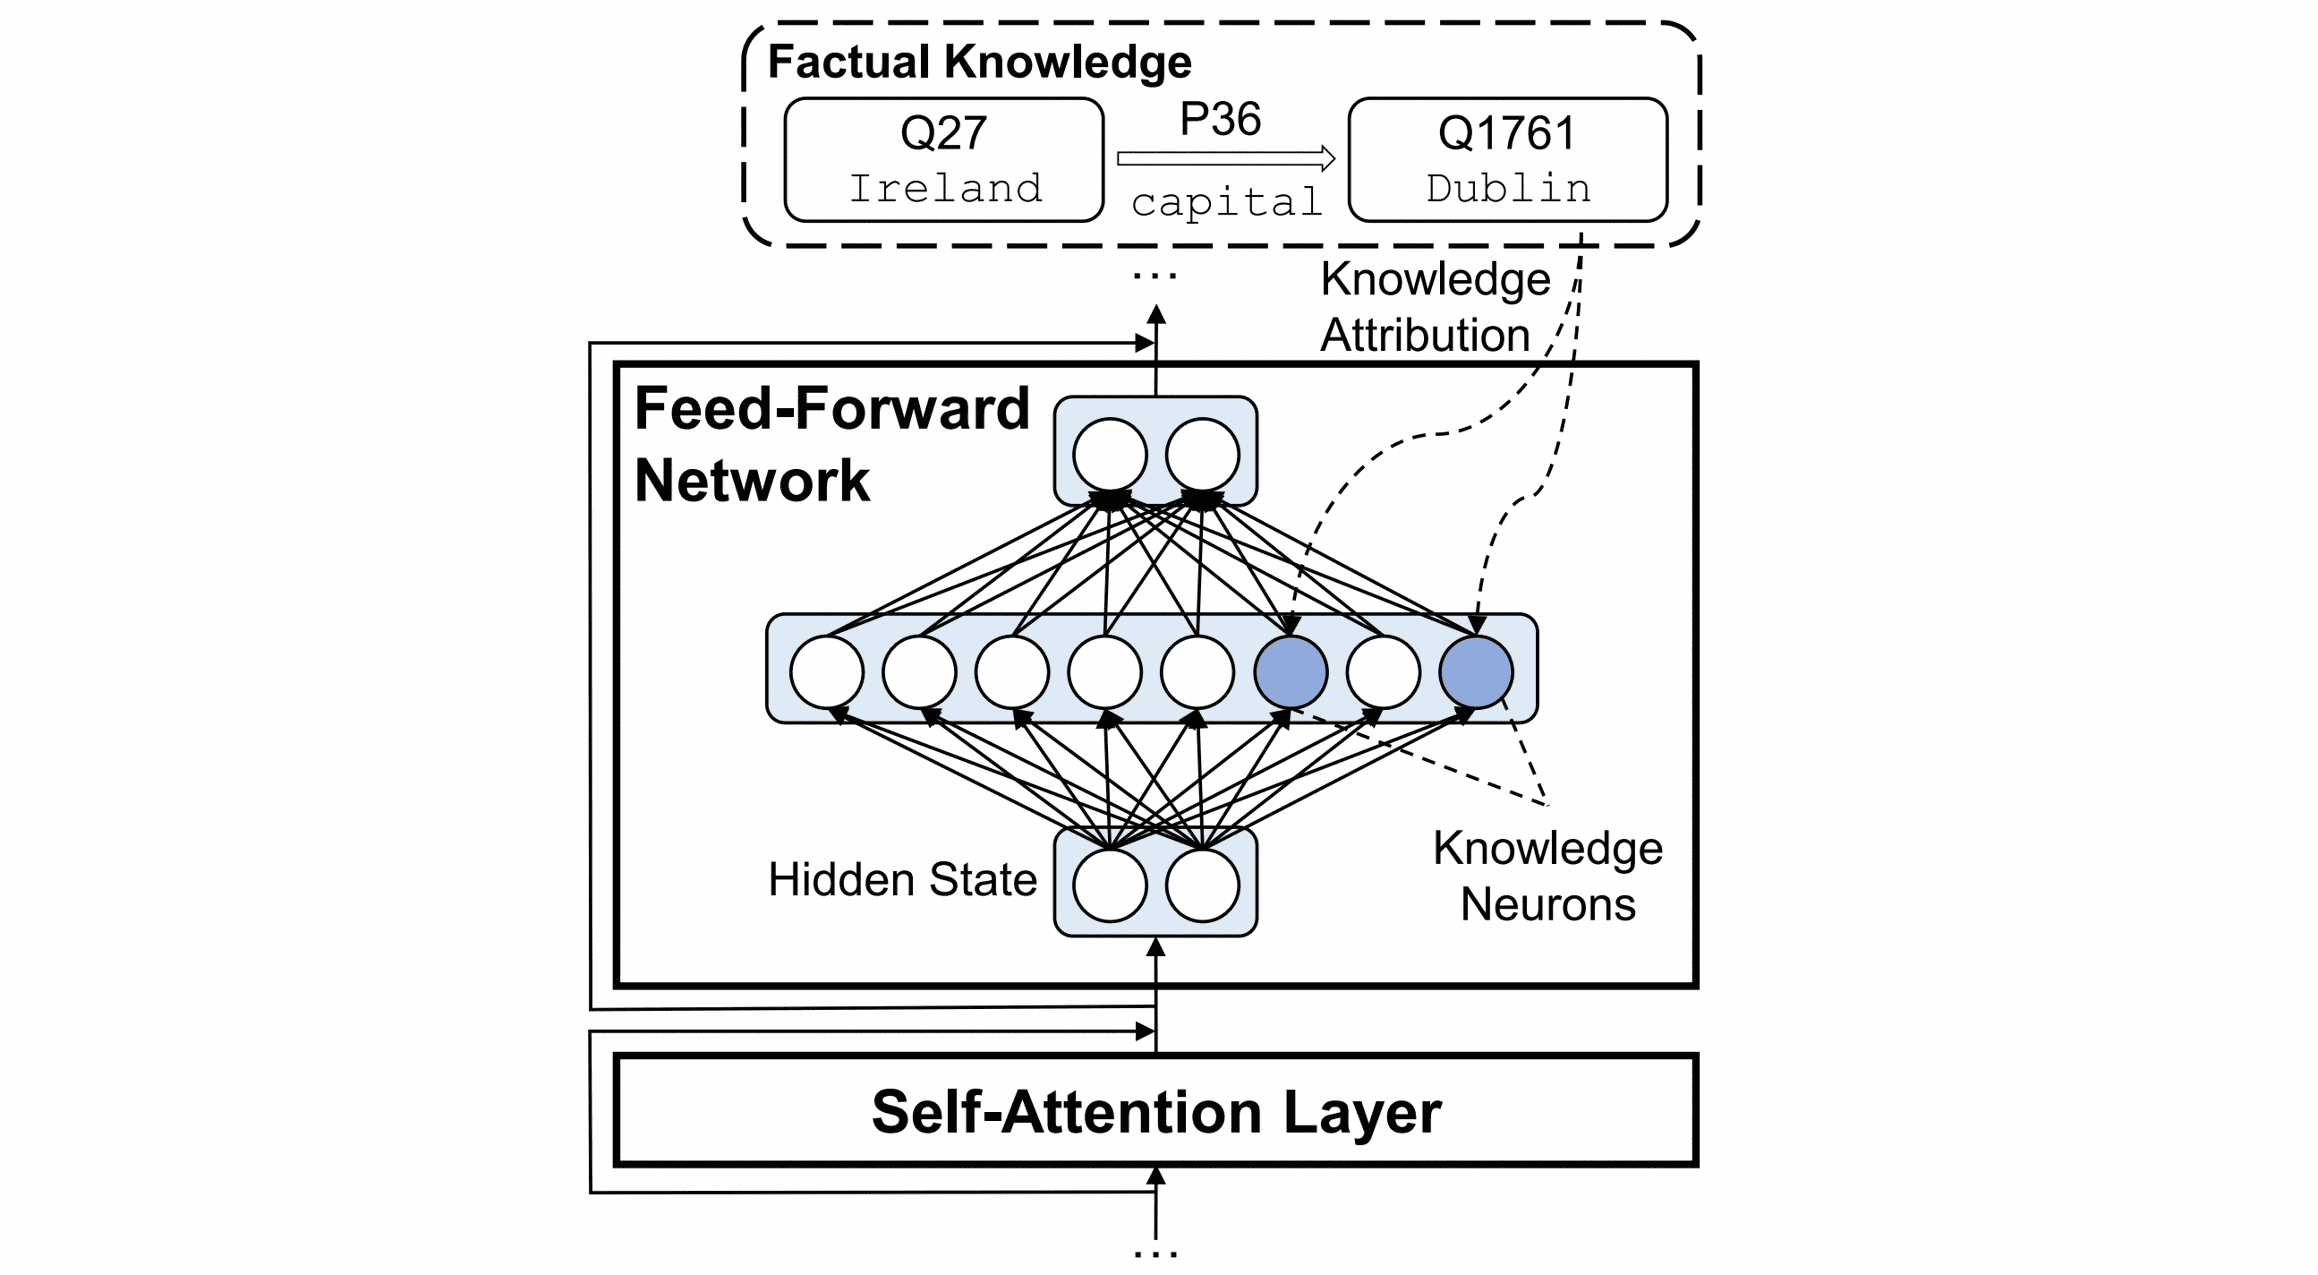
作者提出基于集成梯度(integrated gradients)的知识归因方法。给定输入提示$x$与关系事实$\langle h,r,t \rangle$,定义模型输出为预测正确答案$y^*$的概率:
\[P_x(\hat{w}^{(l)}_i) = p\left(y^* \mid x, w^{(l)}_i = \hat{w}^{(l)}_i\right)\]其中$w^{(l)}_i$是第$l$层前馈网络的第$i$个中间神经元。把该神经元的激活值从$0$连续变化到原始值,对梯度积分得到归因分数:
\[\text{Attr}(w^{(l)}_i) = w^{(l)}_i \int_{0}^{1} \frac{\partial P_x\left(\alpha w^{(l)}_i\right)}{\partial w^{(l)}_i} \, d\alpha\]实际计算用黎曼近似(取$m=20$步):
\[\tilde{\text{Attr}}(w^{(l)}_i) = \frac{w^{(l)}_i}{m} \sum_{k=1}^{m} \frac{\partial P_x\left(\frac{k}{m} w^{(l)}_i\right)}{\partial w^{(l)}_i}\]归因分数超过阈值$t$的神经元构成粗略的候选集合。为过滤假阳性,作者对同一事实生成多个不同措辞的提示,只保留被超过$p\%$的提示共同选出的神经元——真正的知识神经元应当与措辞无关。
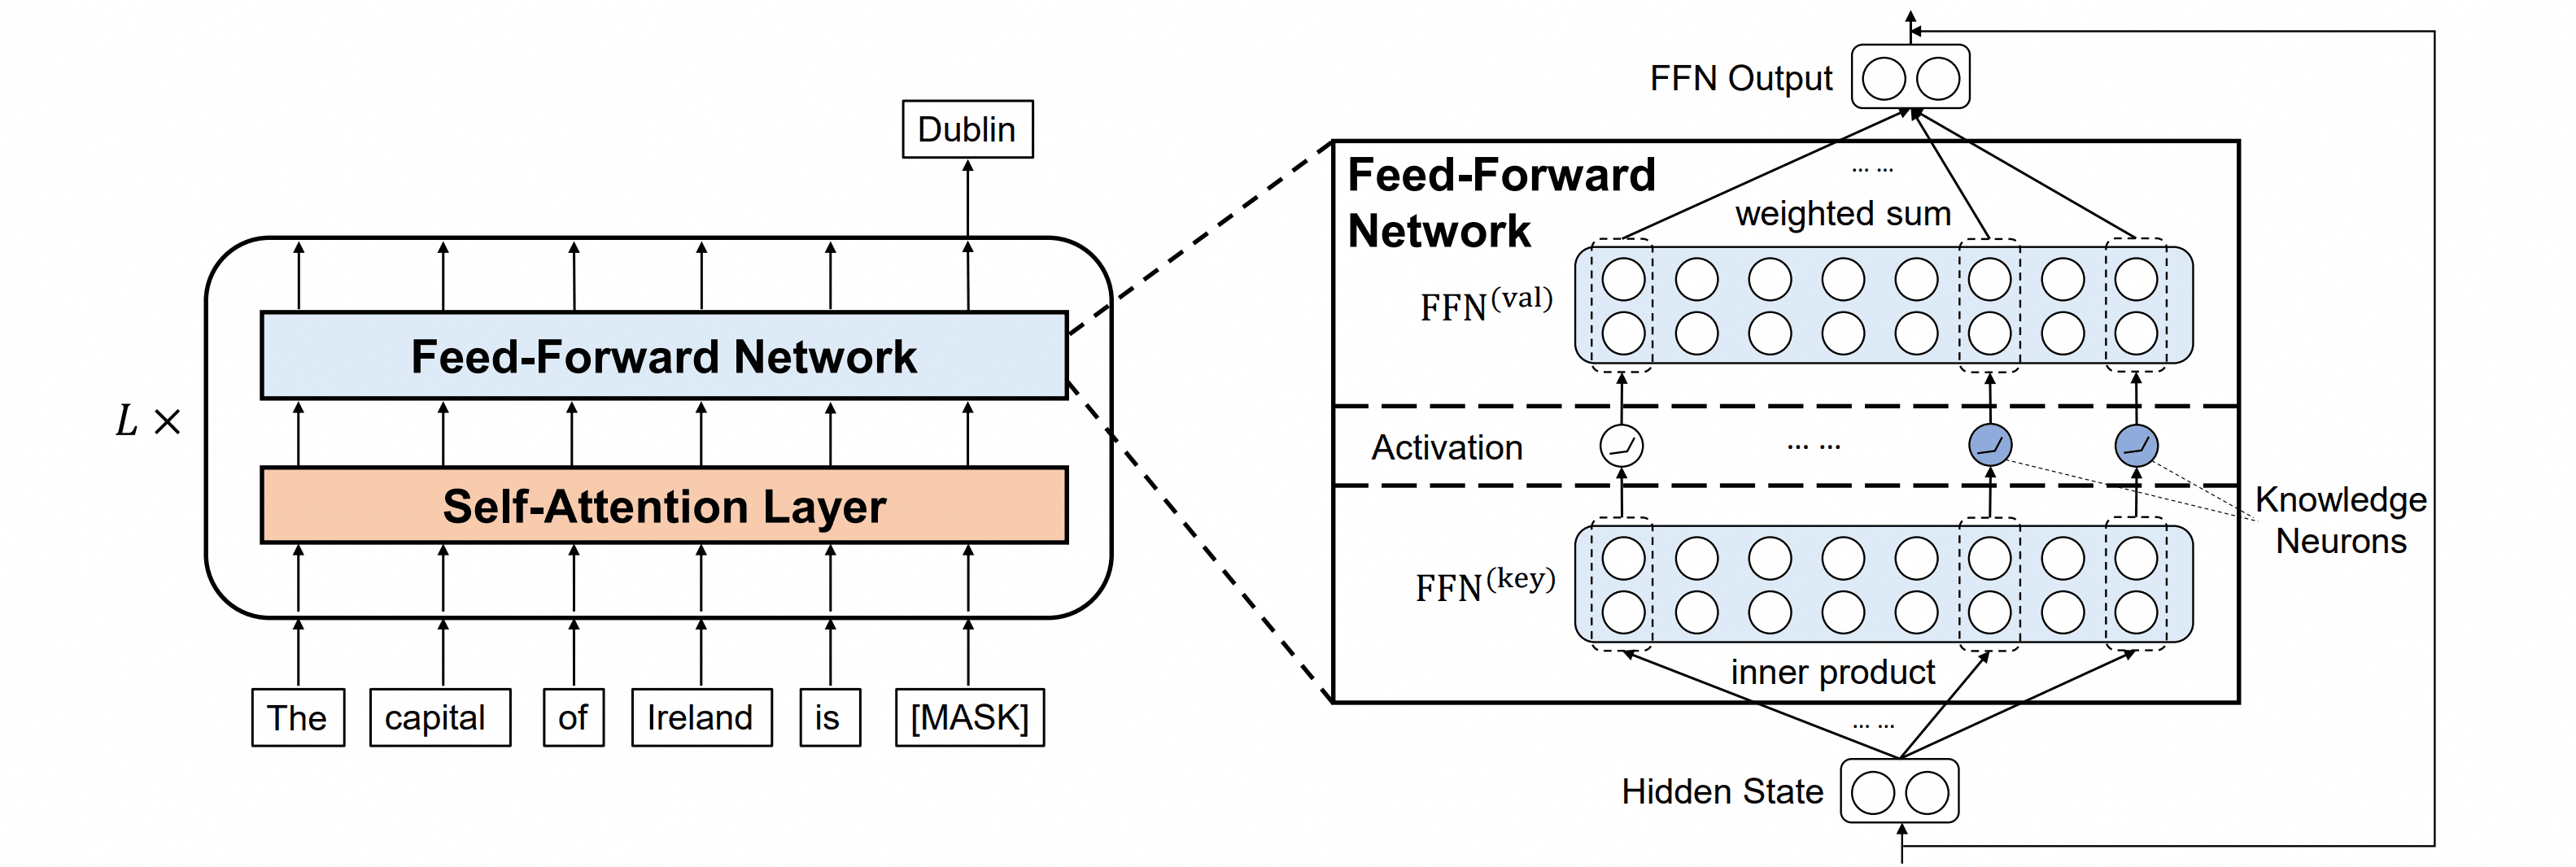
实验表明:抑制(置零)知识神经元会显著降低正确答案的概率,增强(加倍)则显著提高,两者呈正相关;平均每条关系事实只对应约$4$个知识神经元;同一关系的不同事实共享较多神经元,不同关系之间几乎不共享;且这些神经元主要分布在模型的最高层。
利用知识神经元可以在不微调的前提下编辑事实:
- 更新事实:把$\langle h,r,t \rangle$改为$\langle h,r,t’ \rangle$,其中$t,t’$为对应的词嵌入,直接修改值向量$\text{FFN} \leftarrow \text{FFN} - \lambda_1 t + \lambda_2 t’$;
- 擦除关系:把该关系对应的知识神经元置零。
(3) 预训练语言模型如何修改知识
模型中存储的事实型知识可能过时(总统换届、球员转会)或有害(隐私、偏见),因此修正这些知识是必要的。下面按代价从高到低介绍三条路线。
路线一:更换训练数据并重新预训练
如果要删除某一类知识,可以定位并删除对应的数据源,然后重新预训练。由于预训练成本极高,这种方法只适合一次性大规模删除的场合(如去除毒性内容、清理受版权保护的语料),不适合少量多次的常规知识修正。
它的前提是数据归因(data attribution)能力:对于指定的一条知识,能定位是哪些训练样本让模型学到了它。
⚪ 训练数据归因:事实追踪
这项工作定义了事实追踪(fact tracing)任务——识别哪些训练样本教会了模型生成某个事实性断言——并比较了三类方法。
① 梯度归因。经典的影响力函数通过训练样本$z$对测试样本$z_{\text{query}}$损失的边际影响来度量关联:
\[I(z, z_{\text{query}}) = - \nabla_{\theta} L(z_{\text{query}}, \hat{\theta})^\top H_{\hat{\theta}}^{-1} \nabla_{\theta} L(z, \hat{\theta})\]其中$H_{\hat{\theta}}$是Hessian矩阵。逆Hessian在大模型上不可计算,因此实际采用TracIn:在训练过程中记录每次对$z$做梯度更新时$z_{\text{query}}$的损失变化,用一阶泰勒近似取梯度内积并对所有检查点求和:
\[I(z, z_{\text{query}}) = \sum_{k=1}^{K} \nabla_{\theta} L(z_{\text{query}}, \theta_{t(k)})^\top \nabla_{\theta} L(z, \theta_{t(k)})\]实践中还需要对梯度做单位归一化,以避免梯度范数大的异常样本主导排序。
② 嵌入归因。从Transformer的中间层提取表示并对时间步平均,用余弦相似度度量关联:
\[I(z, z_{\text{query}}) = \frac{\text{LM}_{\text{inter}}(z)^\top \text{LM}_{\text{inter}}(z_{\text{query}})}{\left\Vert \text{LM}_{\text{inter}}(z) \right\Vert \left\Vert \text{LM}_{\text{inter}}(z_{\text{query}}) \right\Vert}\]③ 信息检索基线 BM25。纯粹依据词项重叠打分:
\[I(z, z_{\text{query}}) = \sum_{t \in z_{\text{query}}} \log\left(\frac{N+1}{N_t}\right) \times \frac{(k_1+1) \cdot f(z,t)}{k_1\left((1-b)+b\frac{L(z)}{L_{\text{avg}}}\right) + f(z,t) + 1}\]结果颇为尴尬:在真实事实数据集上,两种基于模型的归因方法都不如 BM25 这个纯词频基线。作者诊断出主要原因是梯度饱和——预训练模型在训练早期就已经能正确预测这些事实(因为语料中存在大量相似表述),损失几乎不变,导致TracIn信号消失;同时一条事实的影响力被分散在成百上千个样本上,每个样本的信号都很弱。在专门构造的、模型确定没见过的合成事实数据集上,梯度归因方法则显著优于BM25,验证了这一诊断。
这提醒我们:“训练数据归因”目前还不是一项可靠的工程能力,用它来做数据删除的合规性保证需要非常谨慎。
⚪ 路线二:约束微调
第二条路线是直接构造包含新知识的微调数据集去微调模型。朴素做法会导致灾难性遗忘:只在修改后的事实上微调,虽然在新事实上准确率可达$75\%$,但未修改事实的准确率会从原本的水平崩塌到$0.3\%$;把修改与未修改事实混在同一批次中微调也只能把后者恢复到不到$20\%$。
作者提出约束优化的形式化:给定参数为$\theta_0$的模型(存储事实集合$F$),目标是把其中一小部分事实$S$替换为新事实$M$,得到存储$F’=(F \backslash S) \cup M$的新参数。理想的约束是”未修改事实的损失变化足够小”:
\[\begin{aligned} \min_{\theta \in \Theta} \quad & \frac{1}{m} \sum_{x \in D_M} L(x;\theta) \\ \text{s.t.} \quad & \frac{1}{n} \sum_{x' \in D_{F \backslash S}} \left\lvert L(x';\theta) - L(x';\theta_0) \right\rvert \le \delta \end{aligned}\]这个约束需要遍历所有未修改事实,代价过高,因此用参数空间的$\ell_\infty$范数近似:
\[\begin{aligned} \min_{\theta \in \Theta} \quad & \frac{1}{m} \sum_{x \in D_M} L(x;\theta) \\ \text{s.t.} \quad & \left\Vert \theta - \theta_0 \right\Vert_\infty \le \delta \end{aligned}\]用投影梯度下降求解:从$\theta_0$出发,每步计算梯度并更新,再把参数投影回以$\theta_0$为中心、半径$\delta$的$\ell_\infty$球内。
一个有实用价值的发现是:只微调特定的少数层比微调整个模型更有效。以BERT-Base为例,只约束微调第$0$层可以在新事实上达到$71\%$准确率、同时把未修改事实保持在$46\%$;而且随着待修改事实数量增加,最优层会从最后一层向第一层迁移。
⚪ MEND:用超网络学会如何编辑
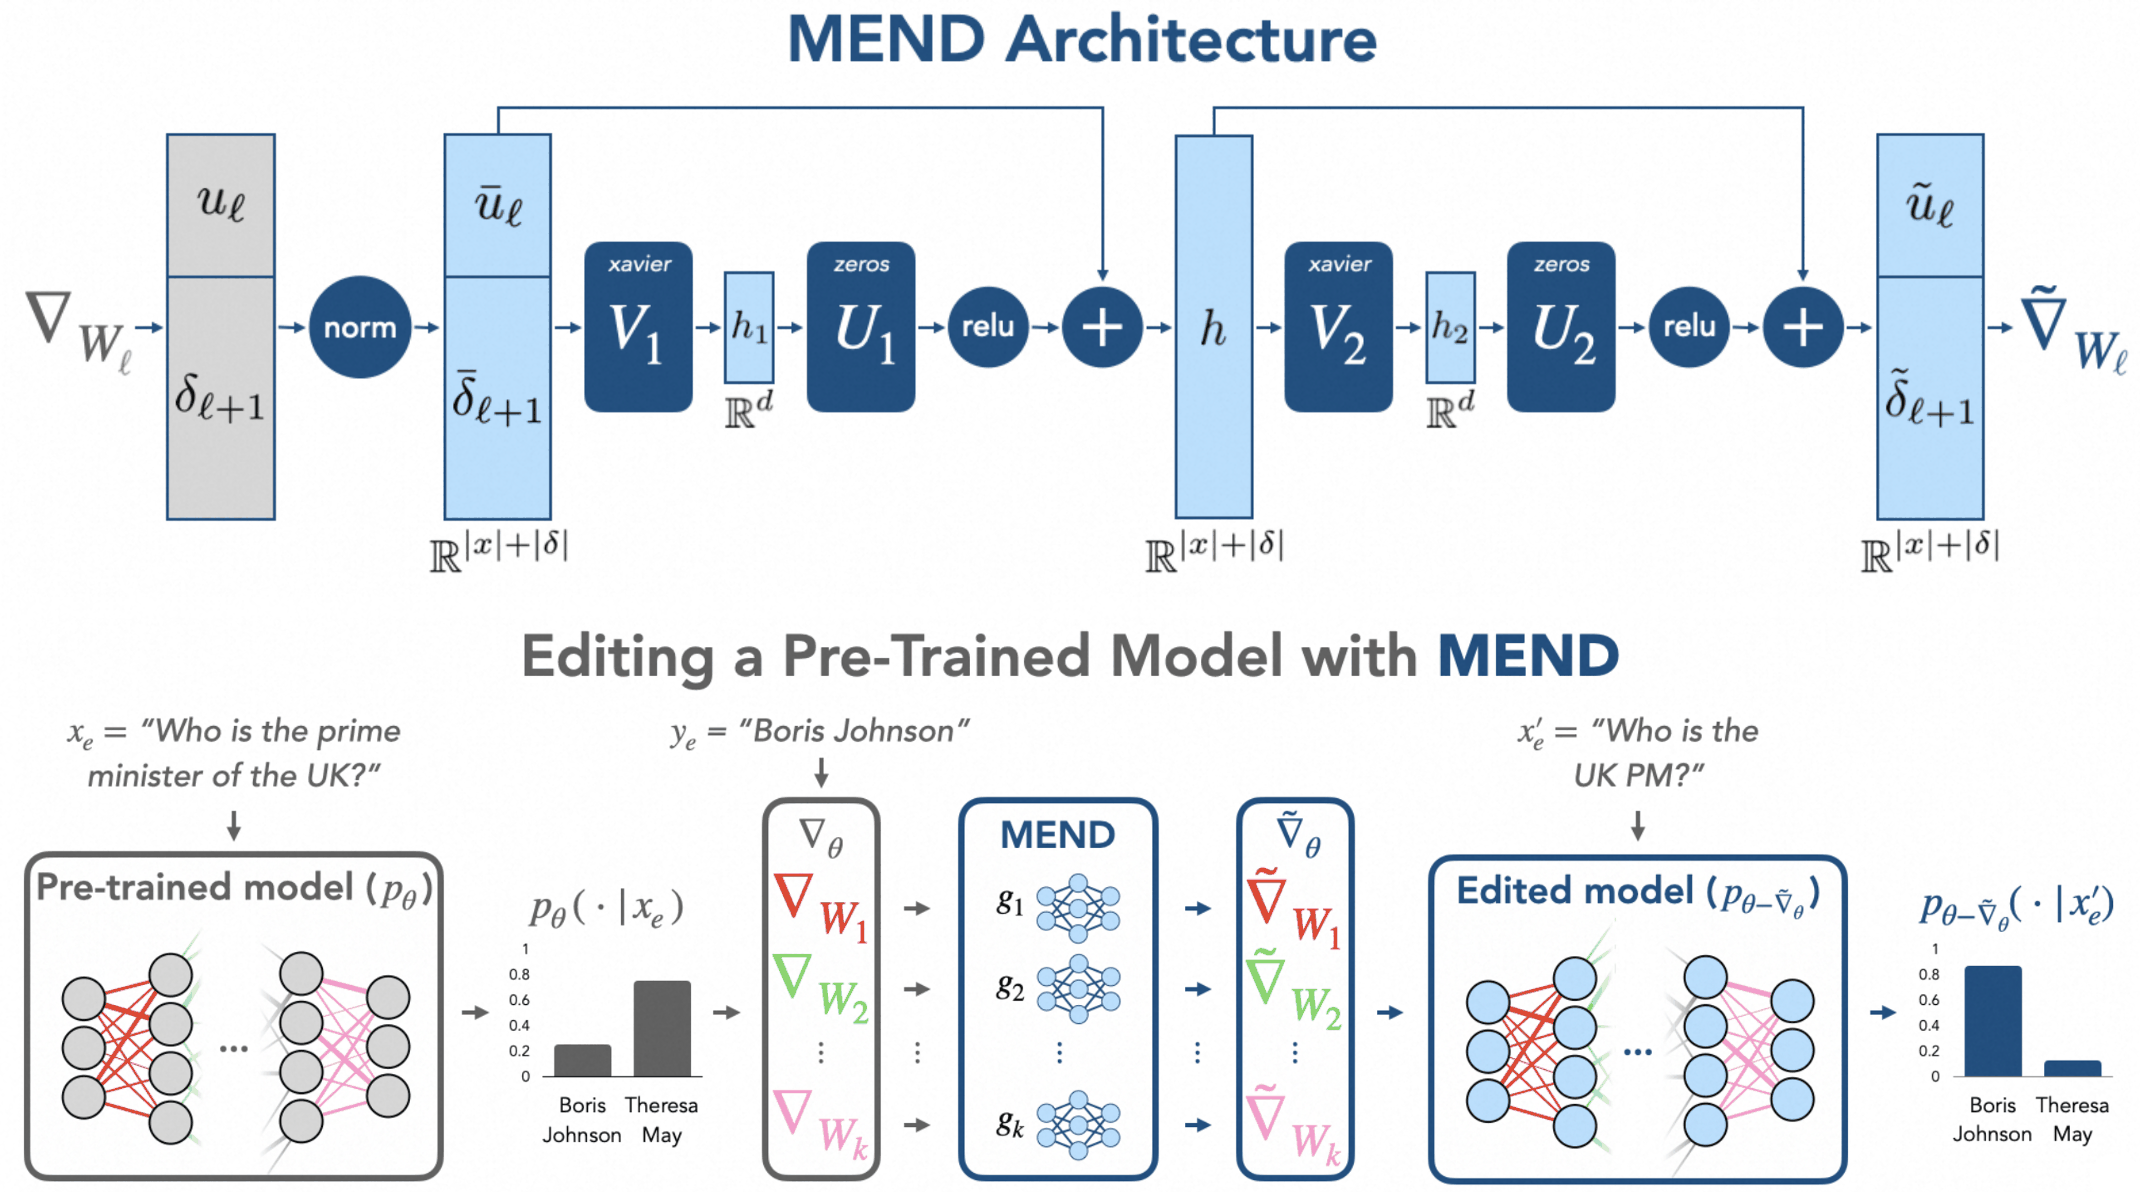
约束微调需要为每次编辑跑一遍优化,MEND则训练一个超网络(hypernetwork)来直接预测参数更新量。观察是:全连接层的梯度$\nabla_W L = \delta \, u^\top$本身是秩一的($u$是层输入,$\delta$是输出侧的反传误差),因此只需把这两个低维向量映射成新的一对向量即可:
\[\tilde{\delta},\tilde{u} = g_\psi(\delta,u), \quad \Delta W = \tilde{\delta}\,\tilde{u}^\top\]其中$g_\psi$是一个小的MLP,参数量与层维度成线性关系。训练$g_\psi$的目标同时包含”新事实及其改写要预测正确”与”未涉及的输入分布不要改变”两项,因此泛化性与特异性是被显式优化的目标。推理时一次前向即可完成编辑,可以扩展到数十亿参数的模型。
⚪ ROME:定位并做秩一编辑
ROME先解决”在哪里改”,再解决”怎么改”。
定位使用因果干预分析(causal mediation analysis),包含三次运行:
- 干净运行:输入含主语的事实性提示,记录所有隐状态;
- 损坏运行:对主语词的嵌入加噪声,破坏模型对主语的识别,记录损坏后的隐状态;
- 恢复运行:在损坏运行的基础上,逐个把某些位置某些层的隐状态替换回干净值,观察正确预测被恢复的程度。
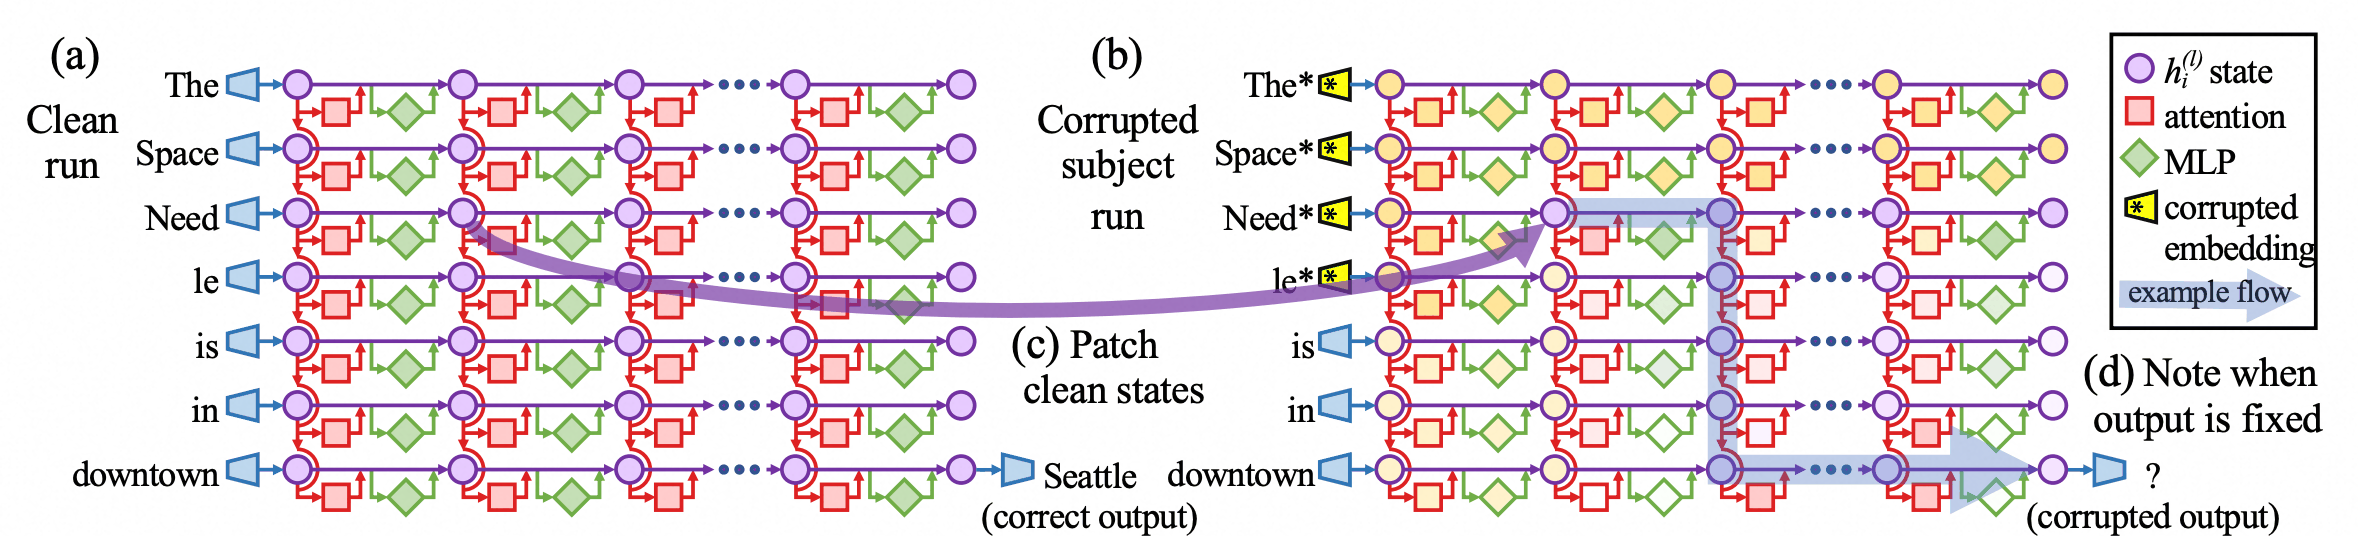
恢复效果最强的位置就是因果贡献最大的位置。结果显示:主语最后一个词元处的中间层前馈模块具有决定性的因果效应,这与”前馈层是键值记忆”的结论完全一致。
编辑则把该前馈层的第二个线性层视作线性联想记忆 $WK=V$:键$K$是主语在该层的输入表示,值$V$是输出。要插入新事实$(s,r,o^{*})$,需要计算新键值对$(k^{*},v^{*})$——$k^{*}$由主语的隐状态得到,$v^{*}$通过优化”最大化模型预测新对象$o^{*}$的概率、同时最小化对主语本质的扰动”得到。随后求解带等式约束的最小二乘问题:
\[\begin{aligned} \min_{\hat{W}} \quad & \frac{1}{2}\left\Vert \hat{W}K-V \right\Vert_F^2 \\ \text{s.t.} \quad & \hat{W}k^* = v^* \end{aligned}\]引入拉格朗日乘子$\Lambda$并令导数为零:
\[\begin{aligned} L(\hat{W},\Lambda) &= \frac{1}{2}\left\Vert \hat{W}K-V \right\Vert_F^2 - \Lambda\left(\hat{W}k^*-v^*\right) \\ \frac{\partial L}{\partial \hat{W}} &= \hat{W}KK^\top - VK^\top - \Lambda (k^*)^\top = 0 \\ (\hat{W}-W)KK^\top &= \Lambda (k^*)^\top \\ \hat{W} &= W + \Lambda \left(C^{-1}k^*\right)^\top \end{aligned}\]其中$C=KK^\top$是键向量的协方差矩阵(可由大量文本预先估计),用于把更新方向”白化”到不常用的子空间中,从而减少对其他知识的干扰。乘子$\Lambda$由约束反解:
\[\begin{aligned} \hat{W}k^* &= Wk^* + \Lambda\left(C^{-1}k^*\right)^\top k^* = v^* \\ \Lambda &= \frac{v^*-Wk^*}{\left(C^{-1}k^*\right)^\top k^*} \end{aligned}\]最终的更新$\Delta W = \Lambda (C^{-1}k^*)^\top$是一个秩一矩阵,这也是方法名称的由来。
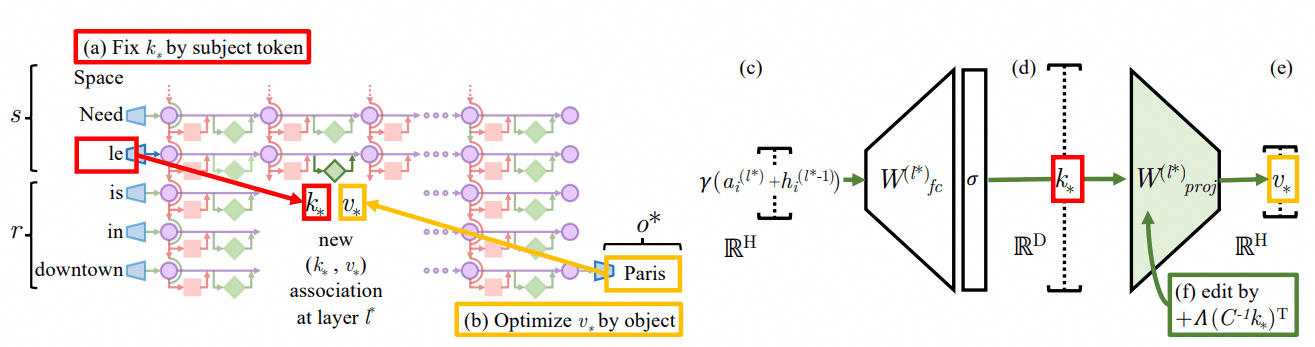
ROME的优势是编辑局部化、不需要重训练、且在改写后的提示上具有泛化性;缺点是一次只能编辑一条事实。
⚪ MEMIT:批量编辑多条记忆
MEMIT把ROME扩展到数千条事实的批量编辑。编辑目标同样是中间层前馈模块的第二个线性层。
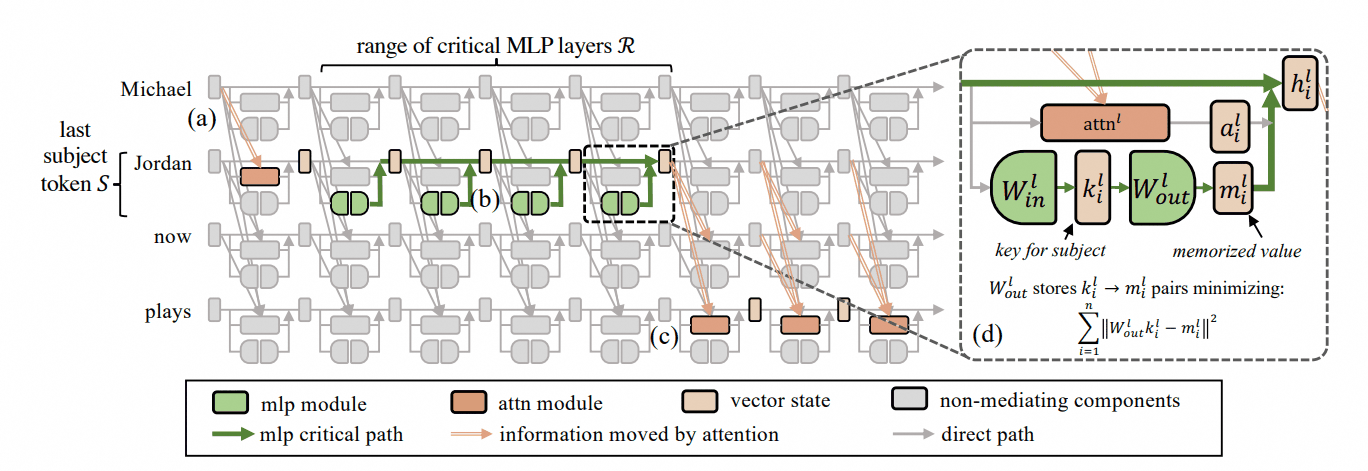
设预训练权重为$W_0$,已有记忆的键值为$(K_0,M_0)$(满足$W_0K_0=M_0$),待插入的新记忆键值为$(K_1,M_1)$,更新量为$\Delta$,则单层的优化目标为”保持旧记忆、精确写入新记忆”:
\[\begin{aligned} \min_{\Delta} \quad & \left\Vert (W_0+\Delta)K_0-M_0 \right\Vert_F^2 \\ \text{s.t.} \quad & (W_0+\Delta)K_1=M_1 \end{aligned}\]写成正规方程并求解:
\[\begin{aligned} (W_0+\Delta)\left(K_0K_0^\top+K_1K_1^\top\right) &= M_0K_0^\top+M_1K_1^\top \\ \Delta\left(K_0K_0^\top+K_1K_1^\top\right) &= M_1K_1^\top-W_0K_1K_1^\top \\ \Delta &= (M_1-M_0)K_1^\top\left(K_0K_0^\top+K_1K_1^\top\right)^{-1} \end{aligned}\]与ROME的差别是:这里用的是最小二乘而非等式约束,因此可以同时容纳大量新键值对;$K_0K_0^\top$仍由大规模文本预先估计。
MEMIT的第二个关键设计是把更新分摊到多层,而不是全部压在一层上:
- 对每条记忆$i$,先在顶层$L$优化一个目标向量$z_i$,使该位置的隐状态能完整传达新事实;
- 从顶层向下逐层传播残差,第$l$层需要承担的增量为$R_l = \frac{z_i-h_i^L}{L-l+1}$;
- 用上式$\Delta_l = R_l K_l^\top\left(C_l+K_lK_l^\top\right)^{-1}$逐层更新前馈权重。
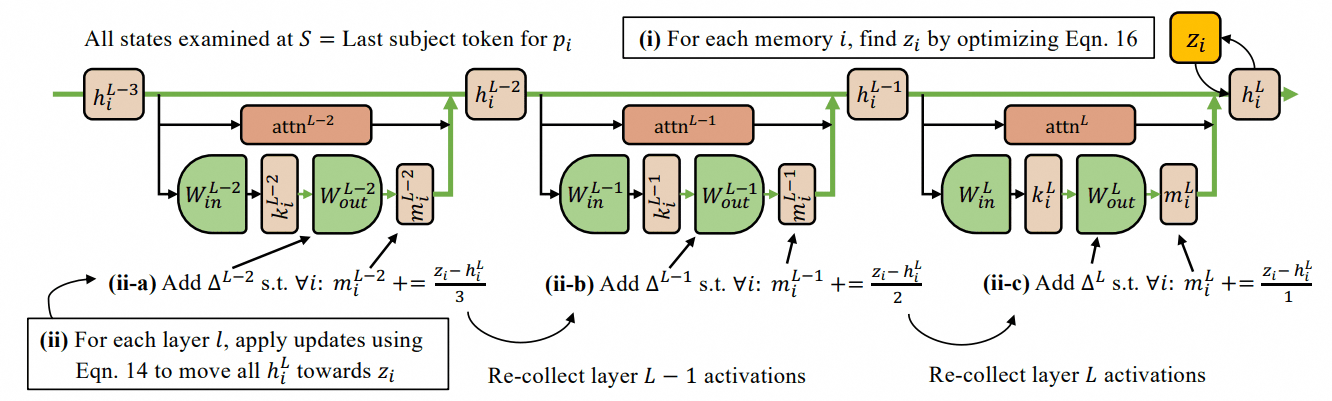
这样单层的扰动被控制在较小范围内,使得MEMIT能在GPT-J($6$B)与GPT-NeoX($20$B)上一次插入上万条事实,而ROME、MEND等方法在编辑量增大时性能会迅速崩塌。