Word Embedding.
词嵌入(Word Embedding)是把离散的语言符号映射到连续向量空间的表示方法。向量的几何关系可以编码词义、句法、主题或任务相关信息,使神经网络能够通过内积、距离和连续变换处理文本。
早期词嵌入为词表中的每个词学习一个固定向量,主要分为基于语料共现统计的计数方法(count-based methods)和通过预测任务学习表示的预测方法(prediction-based methods)。随着上下文编码器和对比学习的发展,表示单位又从词扩展到词元、句子、段落乃至文档,但核心问题没有改变:什么对象被映射为向量,哪些样本应当接近,以及这种几何结构如何被验证。
本文目录:
- 从离散符号到连续表示
- 基于计数的静态词向量
- 基于预测的静态词向量
- 从词到上下文词元表示
- 从词元到句子与检索嵌入
- 如何评估与理解嵌入空间
符号约定:用$\mathcal{V}$表示词表,$|\mathcal{V}|$表示词表大小,$d$表示嵌入维度,$E\in\mathbb{R}^{|\mathcal{V}|\times d}$表示嵌入矩阵;$w_i$表示词或词元,$e_i\in\mathbb{R}^d$表示对应嵌入,$f_\theta(\cdot)$表示文本编码器,$s(\cdot,\cdot)$表示相似度函数。
1. 从离散符号到连续表示
在自然语言处理任务中,最直接的离散表示是独热编码(one-hot encoding)。词表中的第$i$个词被表示成只有第$i$维为$1$、其余维度均为$0$的向量$x_i$:
\[x_i=[0,\ldots,0,1,0,\ldots,0]^\top\in\mathbb{R}^{|\mathcal{V}|}.\]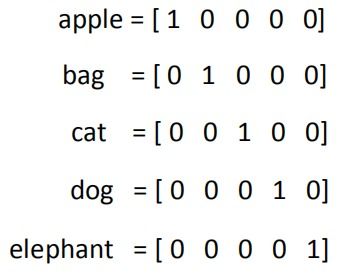
任意两个不同词的独热向量彼此正交且距离相同:
\[x_i^\top x_j=0,\qquad \|x_i-x_j\|_2=\sqrt{2},\quad i\ne j.\]因此独热编码能够区分词,却不能表达“猫”比“桌子”更接近“狗”。它的维度还会随词表线性增长,无法利用词之间共享的统计结构。
一种改进是把语义或语法相近的词划入同一个词类(word class):
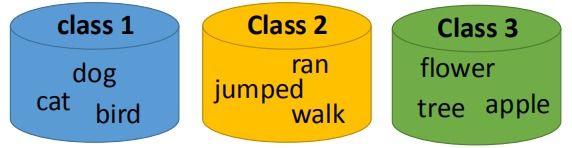
词类让同类词共享统计信息,但离散类别仍不能表达类内差异,也很难表示“相似程度”。词嵌入进一步为每个词分配一个$d$维稠密向量:
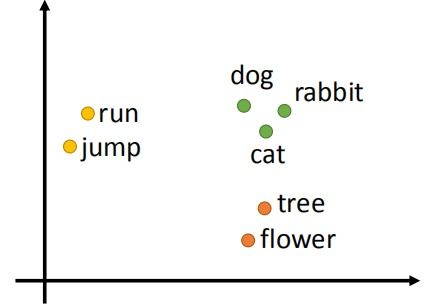
若输入是独热向量,则嵌入操作可以写成:
\[e_i=E^\top x_i=E_{i:}^\top.\]这等价于从共享嵌入矩阵$E$中取出第$i$行并写成列向量,是一次查表(lookup),并不要求额外的偏置项。实际系统通常直接输入词元编号,不显式构造高维独热向量。
词嵌入建立在分布假设(distributional hypothesis)之上:出现在相似上下文中的词往往具有相近含义。不同方法的差别主要在于如何定义“上下文”、如何从上下文构造监督信号,以及如何把这些统计关系压缩到有限维向量中。
⭐ 讨论:词嵌入是否等于无监督学习
词嵌入是一种表示形式,不是一种固定的训练范式。经典词向量通常从无标注文本中自动构造预测目标,因此更准确地说属于自监督学习(self-supervised learning);嵌入也可以随分类器接受监督训练、由多任务数据学习,或者保持冻结后供下游模型使用。
同理,嵌入空间中的“接近”并不天然等于人类理解的语义相似。它取决于训练语料、上下文窗口、目标函数和相似度函数:局部窗口更容易捕捉句法与词语替换关系,较宽窗口则更容易反映主题相关性。
2. 基于计数的静态词向量
基于计数的方法先统计词与上下文的共现关系,再对高维统计矩阵进行变换或低秩分解。设$X_{ij}$表示中心词$w_i$与上下文词$c_j$在选定窗口内的共现次数,则每一行$X_{i:}$都可以看作词$w_i$的高维分布表示。
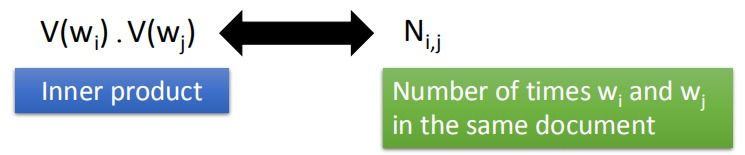
直接使用共现次数会让高频词占据主导。更常见的做法是计算点互信息(pointwise mutual information, PMI):
\[\operatorname{PMI}(i,j)=\log\frac{p(i,j)}{p(i)p(j)},\]其中$p(i,j)$是词与上下文的联合概率,$p(i)$和$p(j)$是边缘概率。正值表示二者共同出现的频率高于独立假设下的期望,负值则表示低于期望。正点互信息(positive PMI, PPMI)把负值截断为零:
\[\operatorname{PPMI}(i,j)=\max(\operatorname{PMI}(i,j),0).\]⚪ LSA 与 PPMI-SVD:分解高维共现矩阵
- paper:Indexing by Latent Semantic Analysis
- paper:From Frequency to Meaning: Vector Space Models of Semantics
若记经过频次变换的词—上下文矩阵为$M$,可通过截断奇异值分解(singular value decomposition, SVD)获得低维近似:
\[M\approx U_d\Sigma_dV_d^\top.\]词向量通常取自$U_d\Sigma_d^\alpha$,其中$d$控制压缩维度,$\alpha$决定奇异值的缩放。潜在语义分析(latent semantic analysis, LSA)最初主要分解词—文档矩阵;后续分布语义方法则常对词—上下文矩阵应用PPMI和SVD。低秩约束可以共享相似上下文中的统计信息,并抑制稀疏计数中的部分噪声。
需要注意的是,PMI会放大罕见事件,PPMI会丢弃负相关信息,而窗口大小、距离加权、上下文方向和高频词处理都会改变最终空间。所谓“共现越多,语义越接近”只是直觉,真正被建模的是经过定义和加权后的共现分布。
⚪ GloVe:用加权回归拟合全局共现统计
GloVe(Global Vectors for Word Representation)从共现概率的比值出发:若词$k$与“ice”共同出现的相对概率远高于与“steam”共同出现的概率,这个比值能够揭示$k$与两者的语义关系。模型最终用词向量$w_i$、上下文向量$\tilde{w}_j$及偏置拟合非零共现项的对数计数:
\[J=\sum_{i,j:X_{ij}>0}f(X_{ij}) \left(w_i^\top\tilde{w}_j+b_i+\tilde{b}_j-\log X_{ij}\right)^2.\]常用权重函数为:
\[f(x)= \begin{cases} (x/x_{\max})^\alpha,&x<x_{\max},\\ 1,&x\ge x_{\max}, \end{cases}\]它降低极少共现带来的噪声,同时避免极高频词完全支配目标。训练后通常使用$w_i$,或将$w_i$与$\tilde{w}_i$相加作为最终词向量。
GloVe不是直接对PPMI矩阵做SVD。它显式构造全局共现矩阵,但通过带权回归学习低维参数,因此同时具有“全局计数”和“连续优化”的特征。
⭐ 讨论:计数方法与预测方法是否真的不同
表面上,计数方法先构造矩阵再分解,预测方法则逐批优化神经网络;但二者都在压缩词与上下文的联合统计。论文Neural Word Embedding as Implicit Matrix Factorization指出,在特定噪声分布、无限维度和充分优化等假设下,带负采样的Skip-gram(SGNS)所学习的词—上下文内积对应移位后的PMI:
\[w_i^\top\tilde{w}_j\approx \operatorname{PMI}(i,j)-\log K,\]其中$K$是负样本数。有限维模型、$3/4$次幂噪声分布和实际优化过程都会改变这一关系,所以它说明的是共同的统计本质。
3. 基于预测的静态词向量
预测方法不先固定整个共现矩阵,而是在语言预测任务中把嵌入作为可学习参数。每次更新只访问当前样本涉及的词,因此可以用随机梯度方法处理大规模语料。
(1) 从语言模型到 Word2Vec
⚪ 神经概率语言模型:在下一个词预测中学习分布式表示
神经概率语言模型用前$n-1$个词预测下一个词:
\[p(w_1,\ldots,w_T)=\prod_{t=1}^{T}p_\theta(w_t\mid w_{t-n+1},\ldots,w_{t-1}).\]上下文词先通过同一个嵌入矩阵查表,再按位置拼接并送入前馈网络;嵌入矩阵与语言模型参数通过预测损失联合优化。这样,能够在相似上下文中帮助预测相同目标的词会获得相似向量。
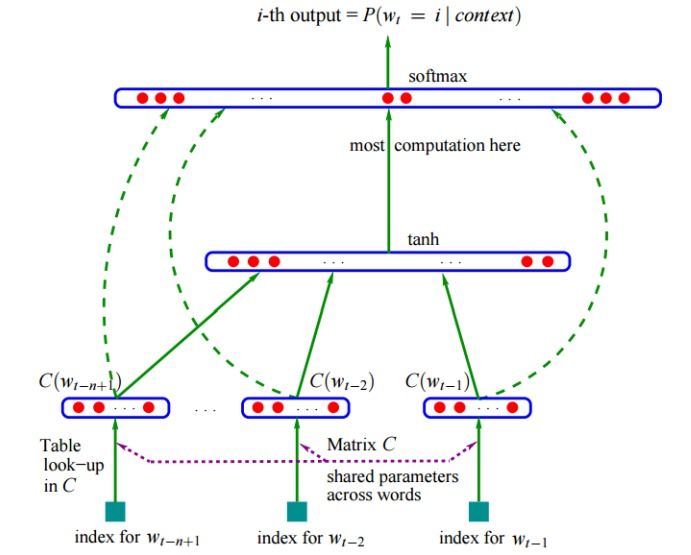
该模型仍保留上下文词的顺序,不等同于后来的CBOW。它的重要意义是用分布式表示缓解离散$n$元语言模型的组合爆炸,并把词表示与概率模型放在同一个目标中学习。
⚪ Word2Vec:用 CBOW 与 Skip-gram 学习局部共现
Word2Vec不是单个网络,而是两种高效训练结构:
- CBOW(Continuous Bag-of-Words)忽略上下文内部顺序,将窗口中的词向量求和或平均后预测中心词;
- Skip-gram反过来,用中心词预测窗口内的每个上下文词。
以Skip-gram为例,若窗口半径为$c$,目标是最大化:
\[\frac{1}{T}\sum_{t=1}^{T}\sum_{-c\le j\le c,\,j\ne 0} \log p(w_{t+j}\mid w_t).\]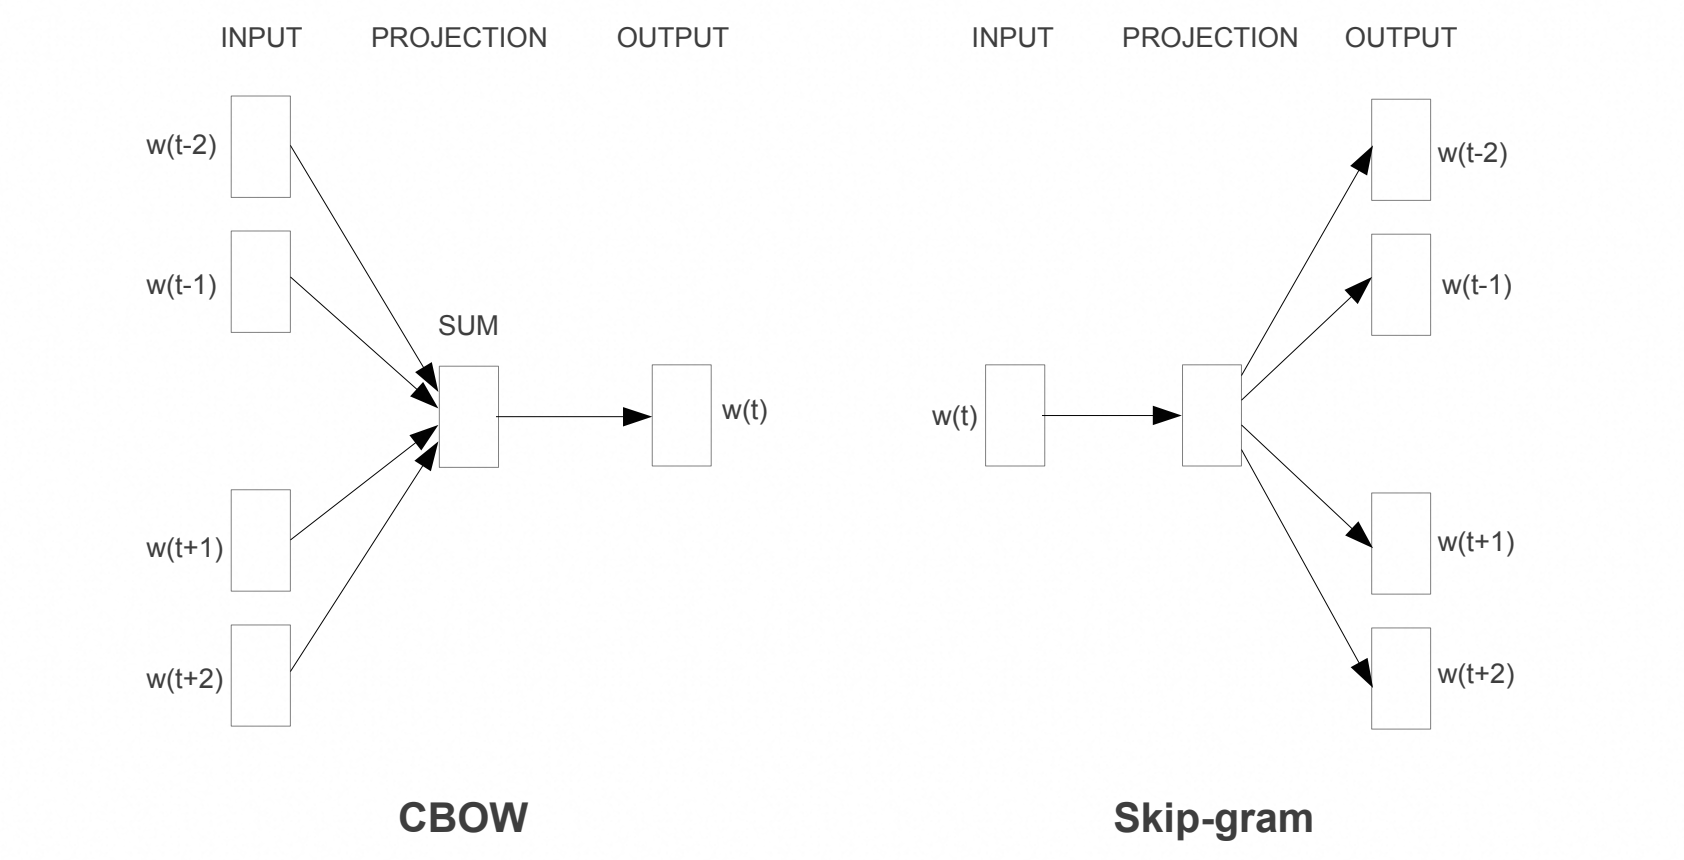
完整softmax使用输入词向量$v_w$和输出上下文向量$u_o$:
\[p(o\mid w)= \frac{\exp(u_o^\top v_w)} {\sum_{w'\in\mathcal V}\exp(u_{w'}^\top v_w)}.\]分母需要遍历整个词表,代价随$|\mathcal V|$增长。原始工作使用层次 softmax(hierarchical softmax)把词表组织成二叉树,将一次预测降为沿根到叶路径的一系列二分类。
(2) 负采样与子词信息
⚪ Negative Sampling:把词预测改写为正负词对判别
负采样(negative sampling)不计算完整词表概率,而是让真实词对$(w,o)$具有较高内积,并从噪声分布$P_n$采样$K$个负上下文$n_k$:
\[\mathcal{J}_{w,o}= \log\sigma(u_o^\top v_w)+ \sum_{k=1}^{K}\mathbb{E}_{n_k\sim P_n} \left[\log\sigma(-u_{n_k}^\top v_w)\right].\]常用$P_n(w)\propto f(w)^{3/4}$,使高频词仍较常被采样,但降低其在采样分布中相对于原始词频的占比。训练通常还会随机下采样高频词,以减少“the”“of”等词产生的大量低信息窗口。
负采样优化的是二分类目标,并不输出归一化的语言模型概率。训练结束后也要明确使用输入向量$v_w$、输出向量$u_w$还是二者组合;不同选择可能产生不同结果。
⚪ fastText:用字符 n-gram 组合词向量
fastText沿用Skip-gram训练目标,但把一个词表示成整词向量与字符$n$元组向量之和。若$\mathcal{G}_w$是词$w$包含的字符$n$元组集合,则:
\[v_w=z_w+\sum_{g\in\mathcal{G}_w}z_g.\]例如词首、词尾边界符能够区分词内部片段和完整词形;实现还用哈希桶限制$n$元组词表大小。共享字符片段让形态相近的词共享参数,因而更适合形态丰富的语言、罕见词和拼写变体,并能为未见词组合出近似表示。
但字符$n$元组不是语言学意义上的词素分析,也不能解决一词多义:同一个拼写在不同句子中仍得到同一个静态向量。
⭐ 讨论:静态词向量学到了什么,又遗漏了什么
静态词向量常表现出可解释的方向和近邻结构。例如Word2Vec展示了“king - man + woman $\approx$ queen”一类线性类比,但这不意味着所有语义关系都能由单一方向稳定表示。类比结果会受到词频、归一化、数据集构造和近邻搜索方式影响,也不能替代真实下游任务评估。
训练语料中的刻板印象同样会进入几何空间。论文Man is to Computer Programmer as Woman is to Homemaker? Debiasing Word Embeddings说明某些偏差可以沿特定方向测量和后处理,但删除一个可见方向不等于消除模型在应用中的全部偏差。
静态词向量还面临三类结构性限制:有限词表产生词表外(out-of-vocabulary, OOV)问题;一个词只有一个向量,无法区分多义词;把长文本压缩成词向量的简单平均会丢失顺序与组合语义。这些问题推动表示单位从完整词转向子词,并从固定查表转向上下文编码。
4. 从词到上下文词元表示
(1) 子词切分改变了嵌入单位
现代模型通常不再以“自然词”为唯一词表单位,而是把文本切分为字符、子词或其他词元(token)。词是语言学单位,词元则是分词器输出的计算单位;同一个词可能对应一个或多个词元。
⚪ BPE:用高频符号合并构造开放词表
字节对编码(byte pair encoding, BPE)从字符等基本符号开始,反复合并语料中最频繁的相邻符号对,得到固定大小的子词词表。高频词可能保留为一个词元,罕见词则被拆成多个片段,因此模型能用有限词表表示开放文本。
WordPiece、Unigram Language Model与字节级切分使用不同的词表学习和分词准则,但共同改变了嵌入矩阵的行所对应的对象。它们与fastText也不相同:前者先把输入序列切成子词词元,再为每个词元查表;后者通常仍以词为训练单位,只在词向量内部共享字符$n$元组参数。
(2) 上下文表示让同一词元拥有不同向量
静态嵌入可写成只依赖词元编号的$e_t=E[x_t]$;上下文表示则依赖整个输入序列:
\[h_t=f_\theta(x_1,x_2,\ldots,x_T)_t.\]因此“bank”在“river bank”和“bank account”中可以得到不同表示。此时输入嵌入仍然存在,但它只是编码器的第零层;用于下游任务的通常是经过多层上下文交互后的隐藏状态$h_t$。
⚪ ELMo:从双向语言模型提取上下文词表示
ELMo将双向多层语言模型中每一层的隐状态加权组合,为每个词位置生成依赖句子的表示。BERT随后使用深度双向Transformer与掩码语言建模,把“预训练上下文编码器—整体微调”发展为通用范式。
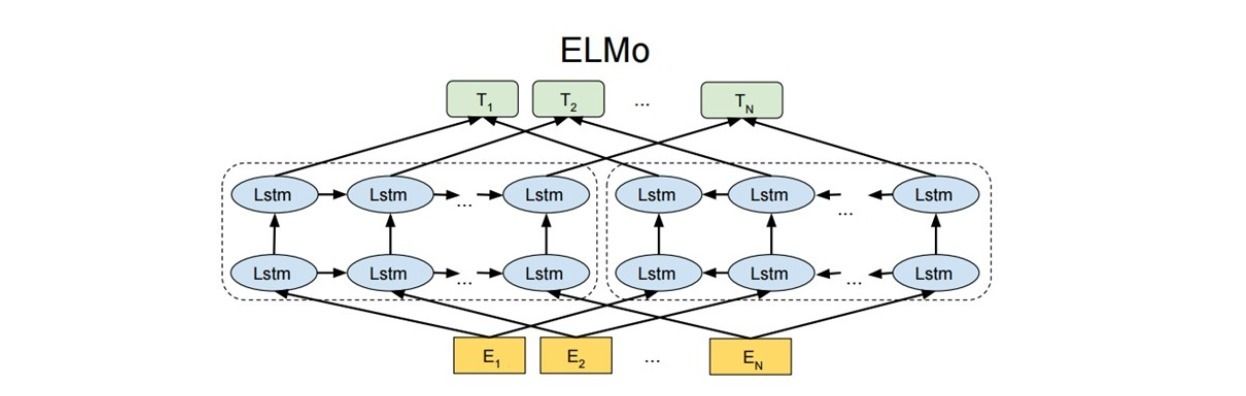
上下文表示的架构、预训练目标和迁移方式详见预训练语言模型。这里需要强调的是:词元级隐藏状态不能自动当作高质量句向量。直接取首词元或平均所有词元虽然能得到固定长度向量,但其几何空间未必经过语义相似度或检索目标训练。
⭐ 讨论:上下文表示是否取代了静态词向量
上下文编码器缓解了多义性,却没有让静态嵌入消失。模型输入层仍需把离散词元映射为连续向量,输出分类器还可能与输入嵌入共享权重;在内存受限、可解释词典、低延迟检索和小数据场景中,静态表示也仍有价值。
二者回答的问题不同:静态词向量描述“一个词表条目在总体语料中的分布”,上下文表示描述“一个词元在当前序列中的状态”。后者信息更丰富,但计算成本更高,并且向量会随模型、层和上下文改变。
5. 从词元到句子与检索嵌入
句子或文档嵌入希望把可变长度文本映射为固定长度向量$z=f_\theta(x)$,使语义相近或任务相关的文本在某种相似度下接近。常用余弦相似度为:
\[\operatorname{cos}(z_i,z_j)= \frac{z_i^\top z_j}{\|z_i\|_2\|z_j\|_2}.\]它支持预先编码语料并进行向量检索,但单向量也形成信息瓶颈:文本越长、任务越复杂,越难把所有可匹配信息压缩到一个点中。
(1) 句子嵌入
⚪ Sentence-BERT:用共享孪生编码器生成可比较的句向量
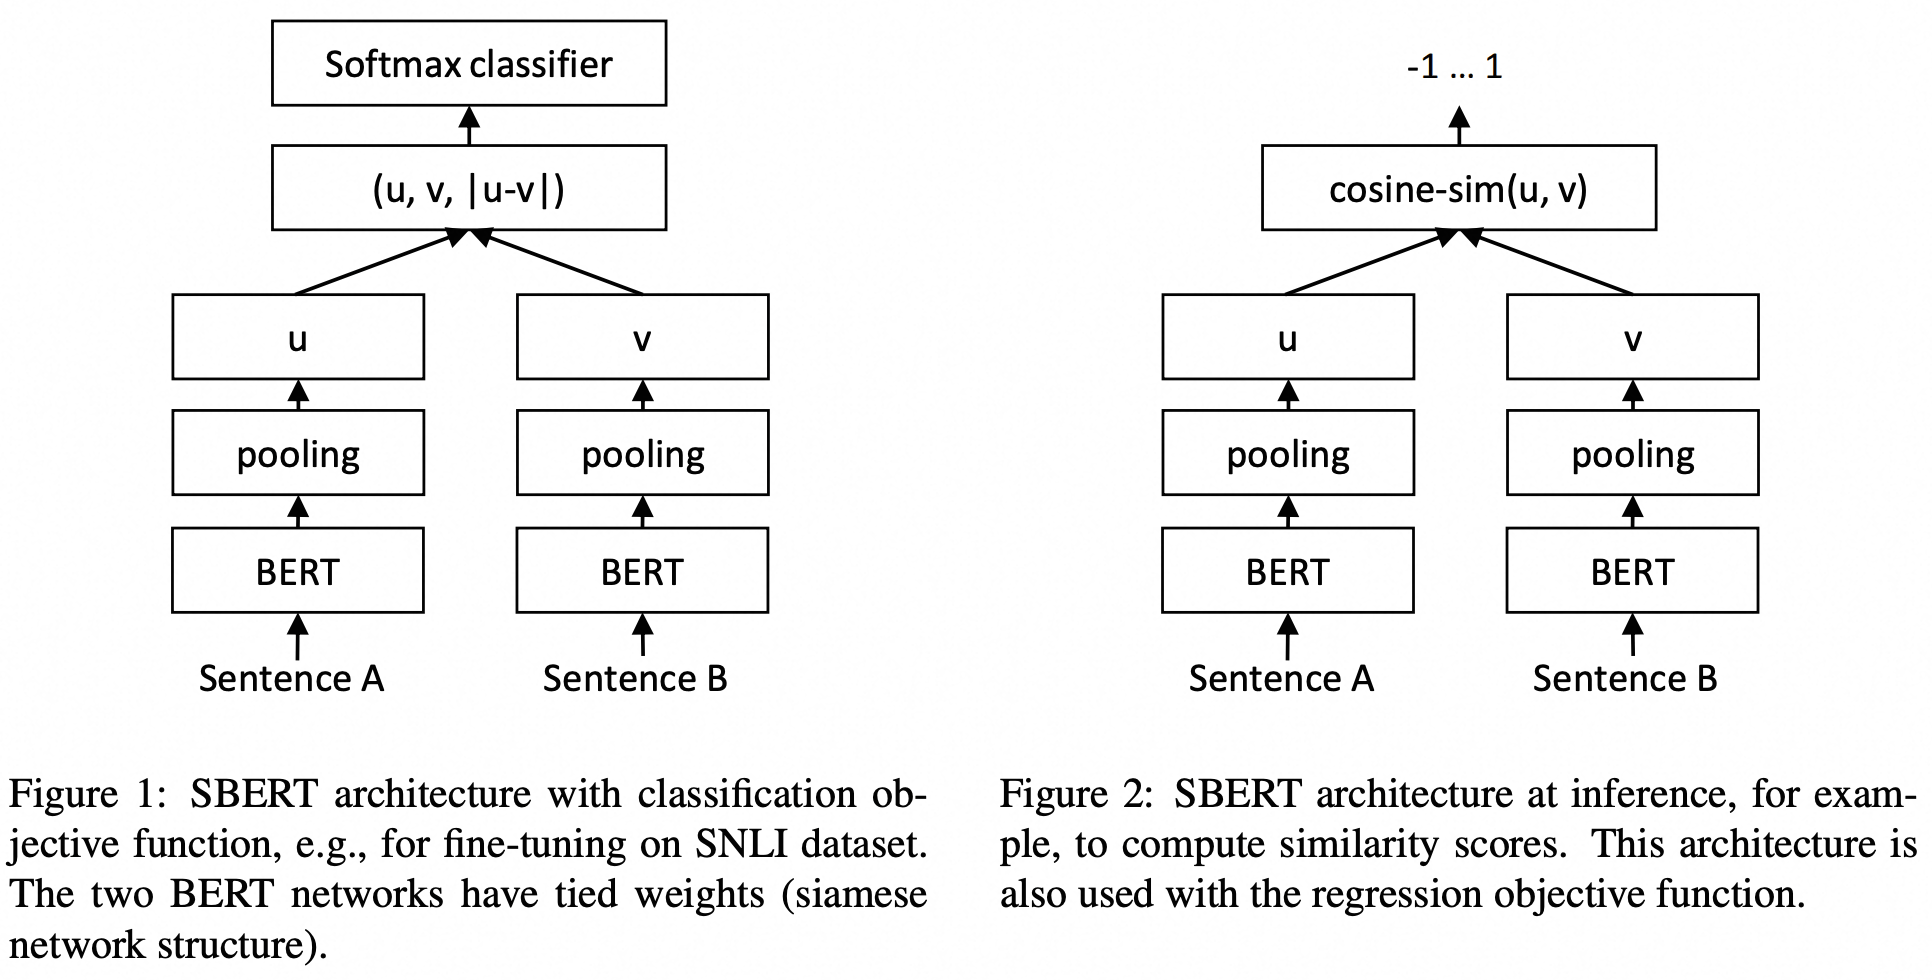
直接把两个句子拼接后送入BERT交叉编码器,可以精细建模词元交互,却必须为每一对文本重新计算。Sentence-BERT(SBERT)让两个句子分别经过参数共享的编码器和池化层,再比较两个固定长度向量。这样可以预先计算语料嵌入,把大规模相似度搜索转化为向量近邻搜索。
原论文主要先用自然语言推断数据训练分类目标,将两个句向量$u,v$及$|u-v|$拼接后分类;也实验了回归和三元组目标。
⚪ SimCSE:以不同视图进行句子级对比学习
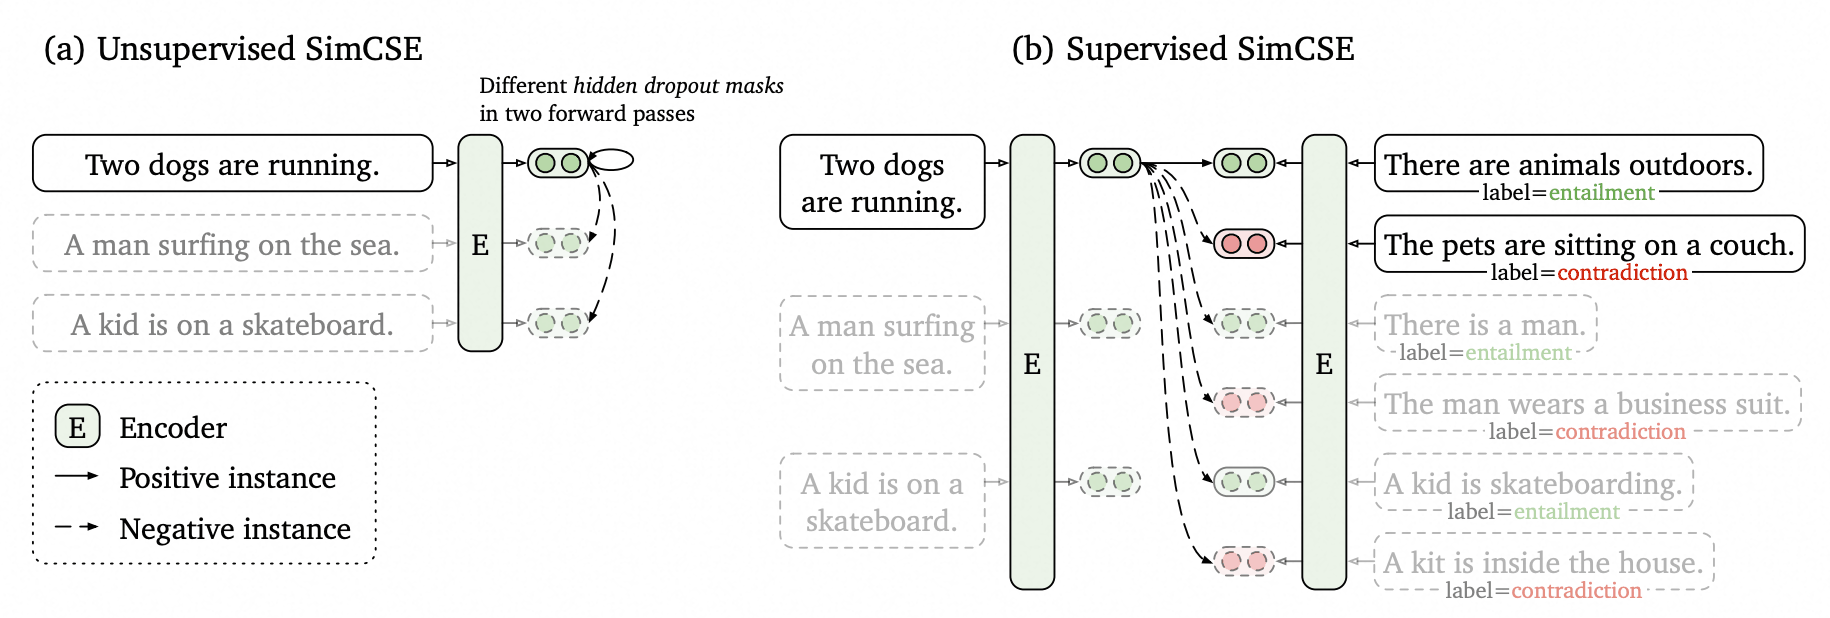
SimCSE的无监督版本把同一句子两次前向传播时产生的不同dropout掩码视为正对,把批内其他句子视为负例。监督版本则使用自然语言推断数据中的蕴含句作为正例,并把矛盾句加入难负例。对锚点$i$,典型对比损失为:
\[\mathcal{L}_i=-\log \frac{\exp(\operatorname{sim}(z_i,z_i^+)/\tau)} {\sum_j\exp(\operatorname{sim}(z_i,z_j^+)/\tau)},\]其中$\tau$是温度系数,$z_j^+$表示批内第$j$个句子的另一视图;监督版本还在分母中加入矛盾句表示作为难负例。对比目标同时要求正对齐,并让批内表示分布更均匀;但批内其他文本并不总是真负例,语义相近的假负例(false negatives)可能损害训练。
(2) 稠密检索与晚交互
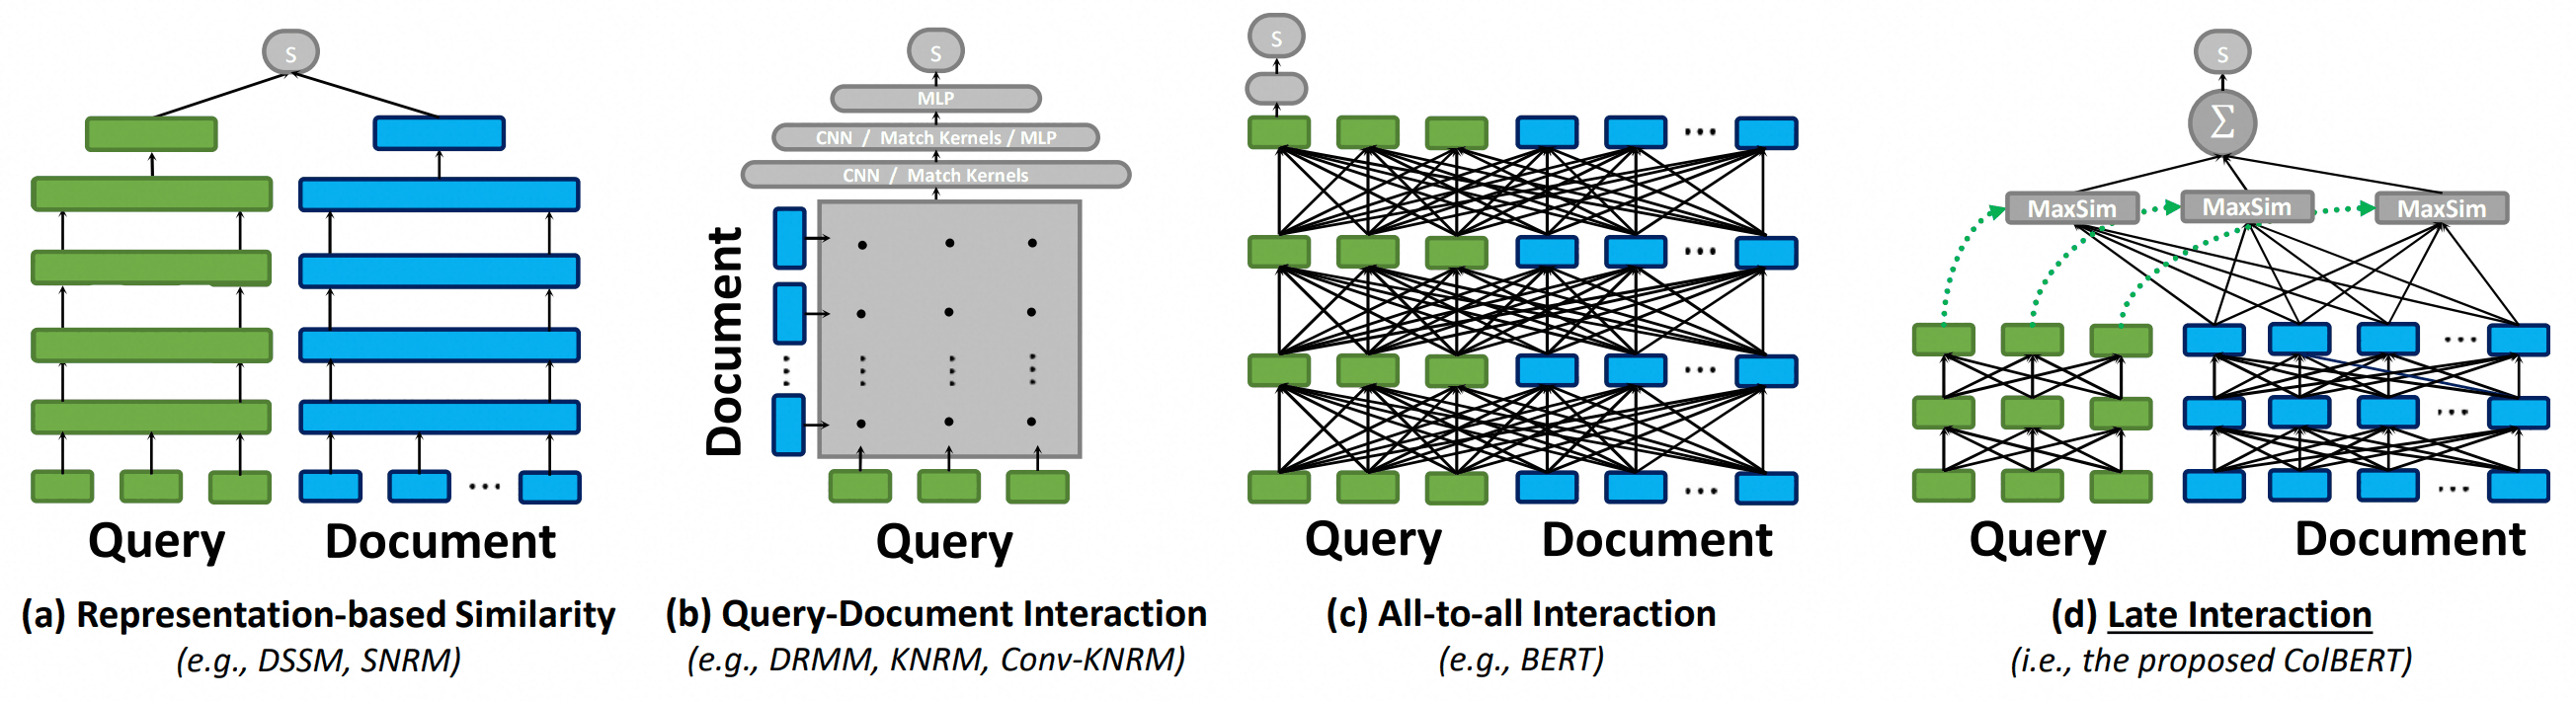
⚪ DPR:用双编码器学习查询与段落的单向量表示
DPR(Dense Passage Retrieval)使用两个参数独立的编码器分别生成查询$q$和段落$p$的向量,并以内积评分:
\[s(q,p)=E_Q(q)^\top E_P(p).\]对于正段落$p^+$和一组负段落$p_j^-$,训练目标为:
\[\mathcal{L}_q=-\log \frac{\exp s(q,p^+)} {\exp s(q,p^+)+\sum_j\exp s(q,p_j^-)}.\]负例可来自随机段落、BM25召回结果或同批其他样本。文档向量可以离线建立索引,查询时通过最大内积搜索(maximum inner product search, MIPS)召回候选。模型效果不仅取决于编码器,也高度依赖负样本难度和正例定义。
⚪ ColBERT:保留词元向量并执行晚交互
单向量双编码器的表示更紧凑,但查询与文档在编码阶段互不交互。ColBERT为查询和文档保留多组归一化词元向量,在检索阶段执行MaxSim晚交互:
\[S(q,d)=\sum_{i\in q}\max_{j\in d}E_{q_i}^\top E_{d_j}.\]每个查询词元都寻找最相似的文档词元,再对查询侧求和。它比交叉编码器更容易离线索引,又比单向量表示保留更多细粒度匹配信息,代价是更大的索引和更多在线计算。
(3) 通用、指令化与可伸缩文本嵌入
⚪ E5:用弱监督文本对预训练通用文本嵌入
E5把问答、标题—正文、引用和用户行为等异构文本对统一为对比学习数据,先进行大规模弱监督预训练,再用人工标注任务与难负例微调。输入中的“query:”和“passage:”前缀显式标明两侧角色,使同一编码器能够处理对称语义相似和非对称检索。
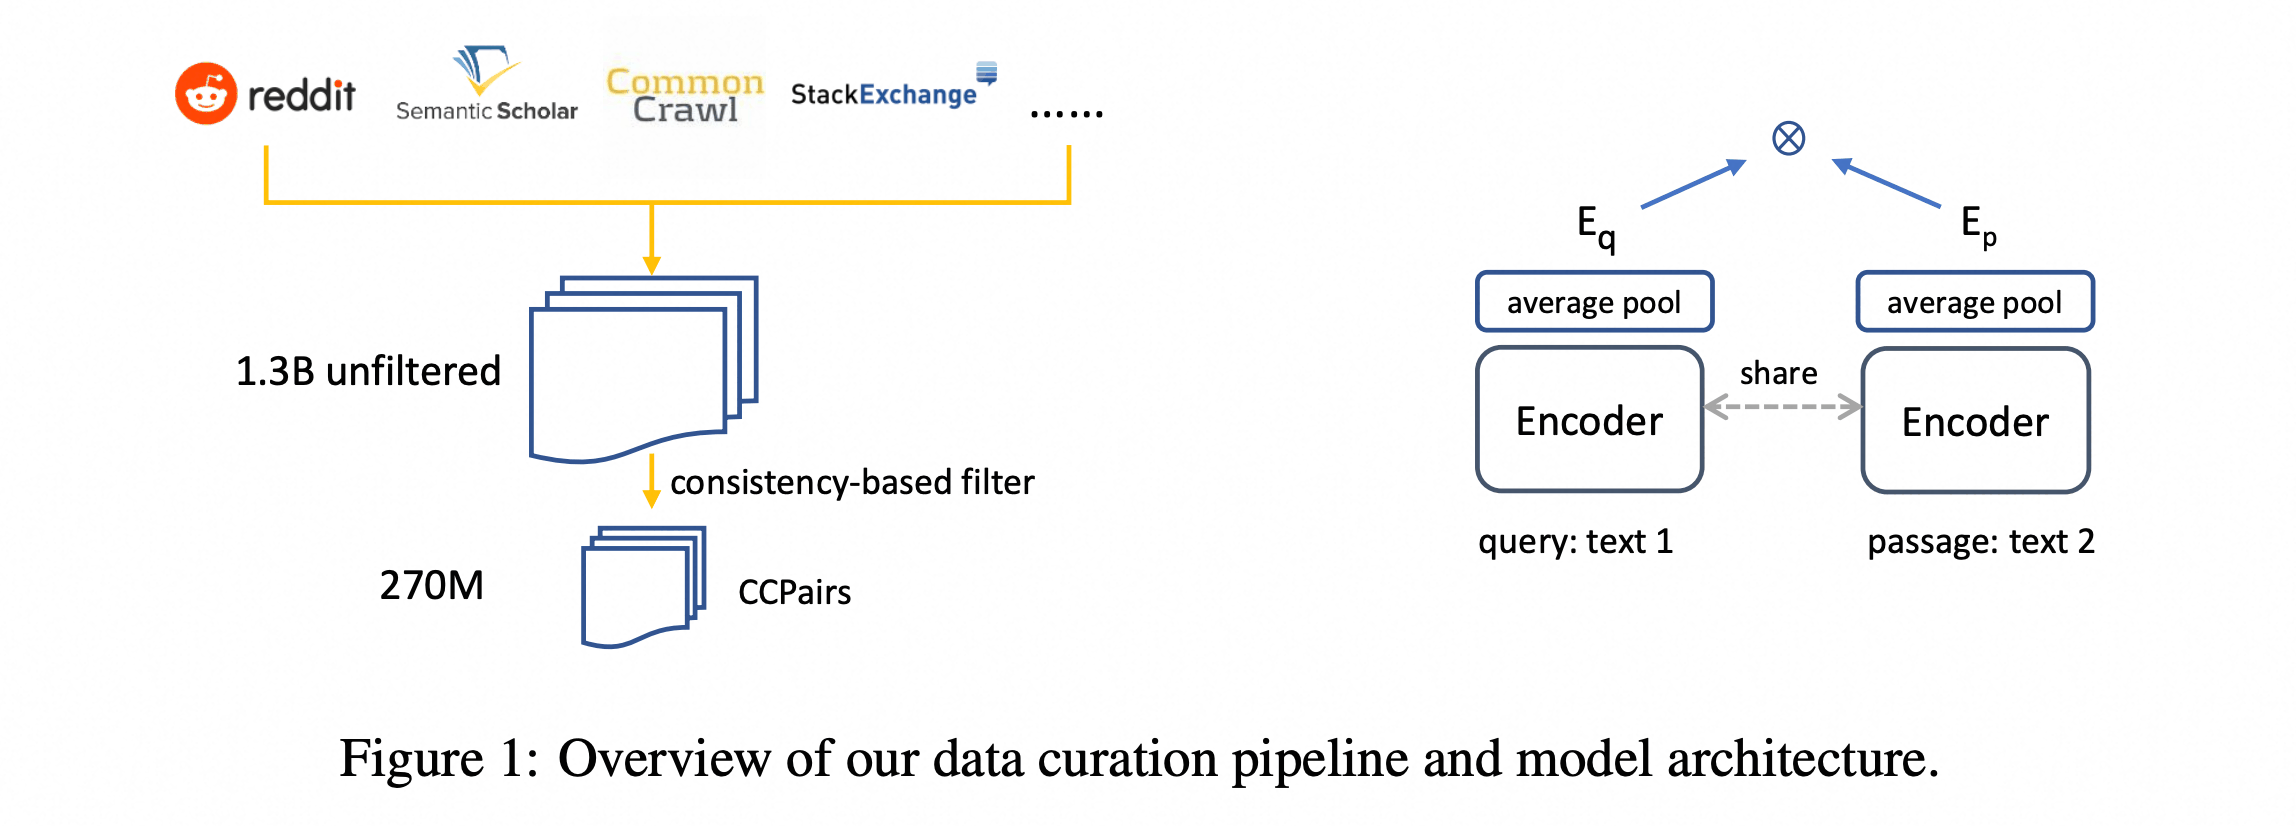
这种范式把文本嵌入从单一任务模型扩展为面向多任务的通用表示:模型不只学习“意思是否相似”,还根据训练数据中的关系学习“一个文本能否回答、支持或匹配另一个文本”。
⚪ INSTRUCTOR:用自然语言指令条件化嵌入任务
INSTRUCTOR把任务说明与待编码文本共同输入编码器,使向量依赖“为什么要编码这段文本”。同一句话在分类、检索或相似度任务中可以得到不同表示,从而把任务条件从固定前缀推广为自然语言指令。
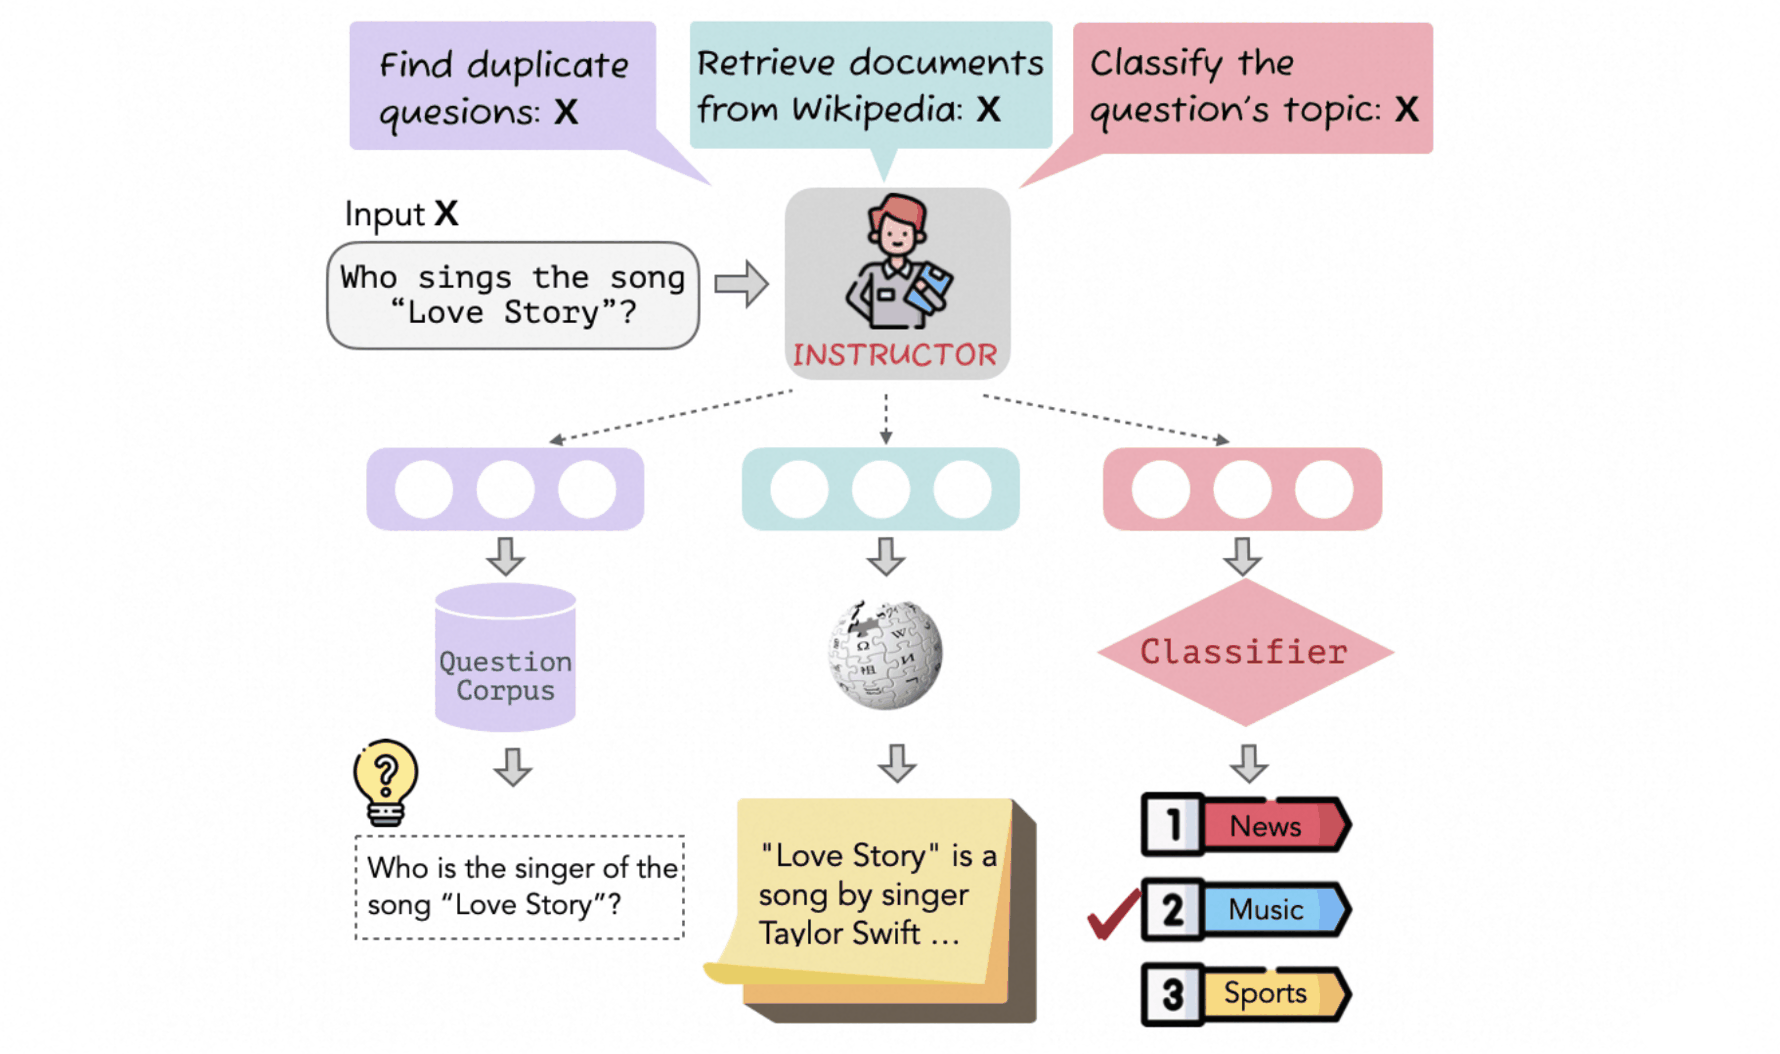
指令化提高了任务迁移能力,但也引入新的评估变量:结果可能对指令措辞敏感,模型还可能主要识别训练中见过的任务模板,而非真正理解任意指令。
⚪ BGE-M3:统一多语言、多粒度与多种检索表示
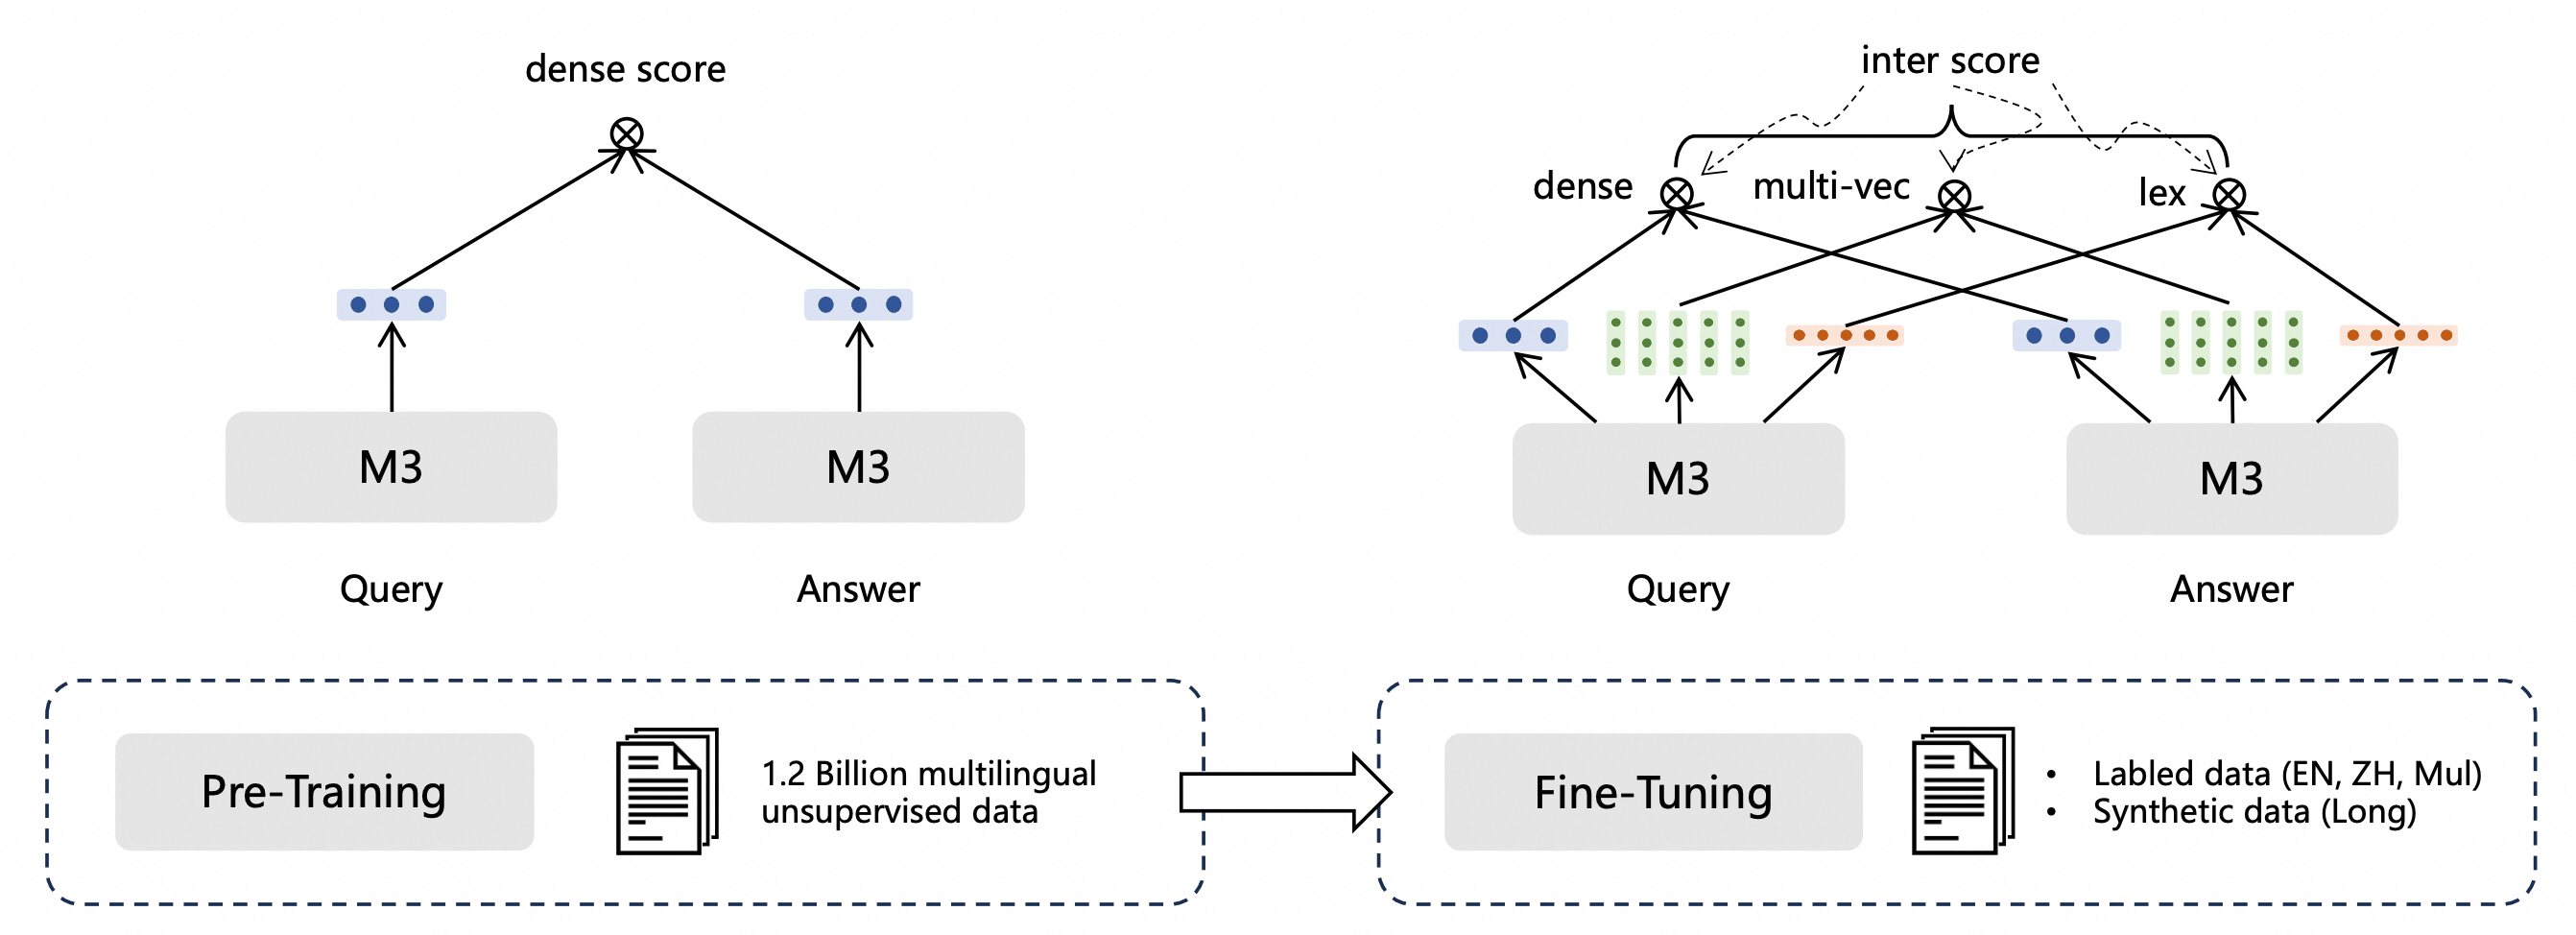
BGE-M3在一个模型中联合支持单向量稠密表示、词项级稀疏表示和多向量表示,并通过自知识蒸馏让不同检索功能相互提供监督。它在同一训练框架中覆盖多语言、从短句到长文档的多种粒度,以及不同的检索交互形式。
⚪ LLM2Vec 与 NV-Embed:把解码器语言模型改造成文本编码器
- paper:LLM2Vec: Large Language Models Are Secretly Powerful Text Encoders
- paper:NV-Embed: Improved Techniques for Training LLMs as Generalist Embedding Models
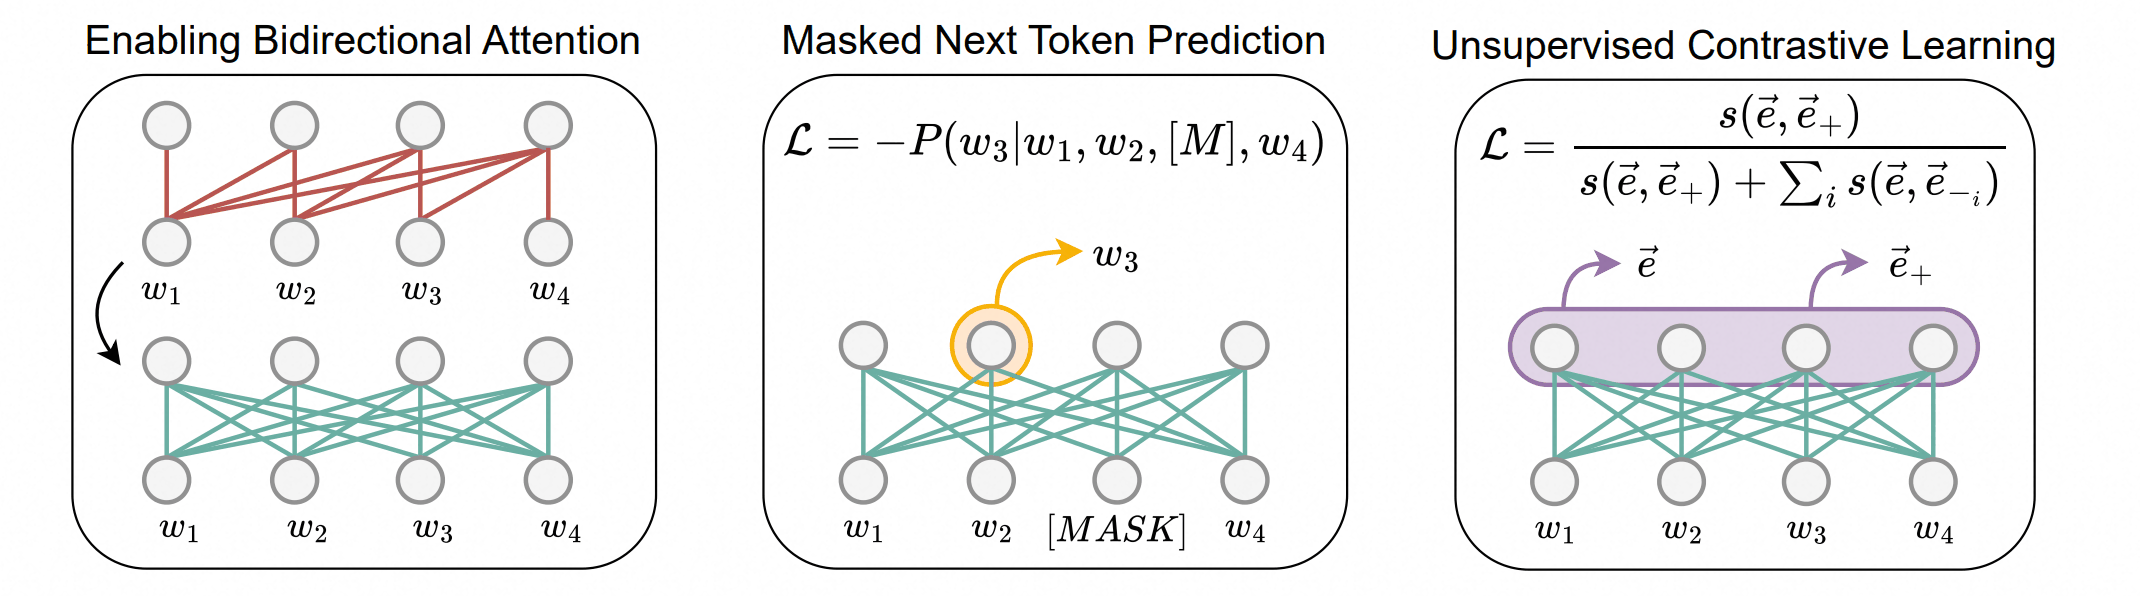
仅从因果语言模型读取最后一个隐藏状态,通常不能得到理想的通用嵌入。LLM2Vec解除单向因果掩码,并通过掩码式下一词元预测和无监督对比学习适配解码器模型:
NV-Embed同样移除因果掩码,引入潜在注意力池化,并使用两阶段对比式指令微调:
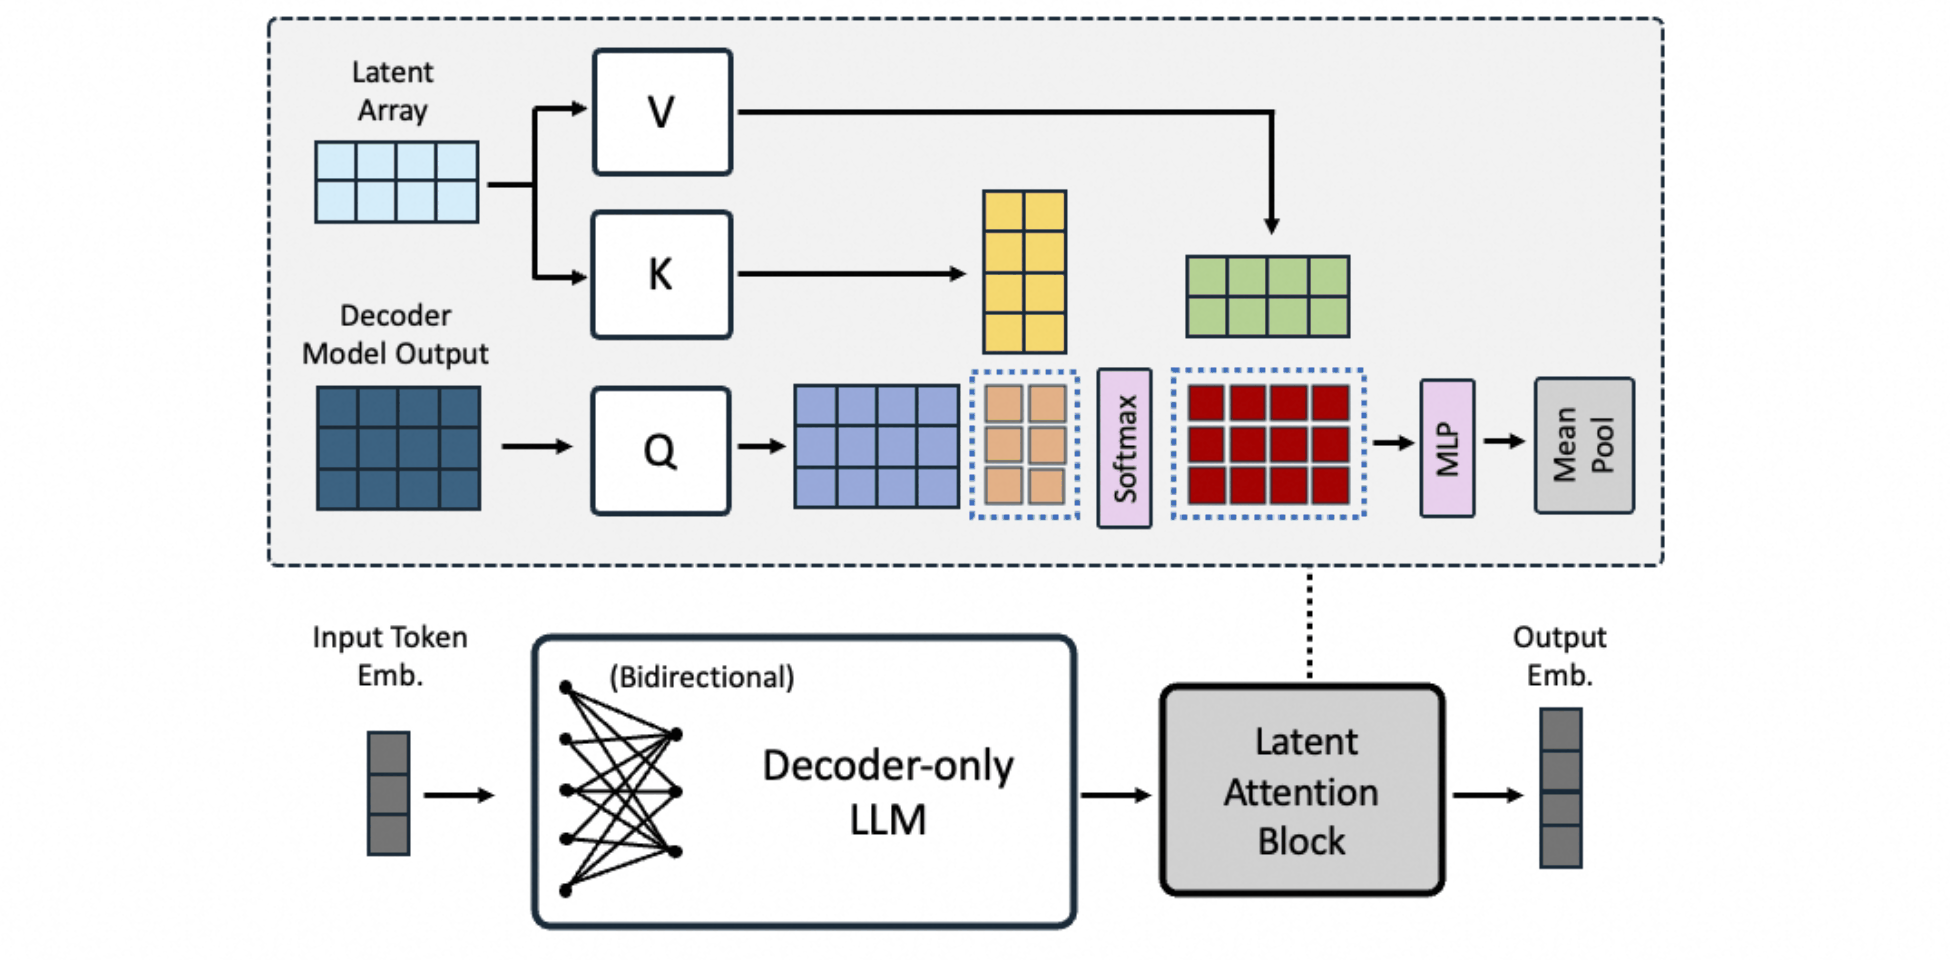
这条路线利用大型语言模型已有的语言知识与长文本能力,但高参数量会增加编码、部署和索引更新成本。“语言模型能够生成文本”也不意味着其隐藏状态天然适合余弦相似度;编码方式、池化和对比训练仍然关键。
⚪ Matryoshka Representation Learning:让嵌入前缀支持弹性维度
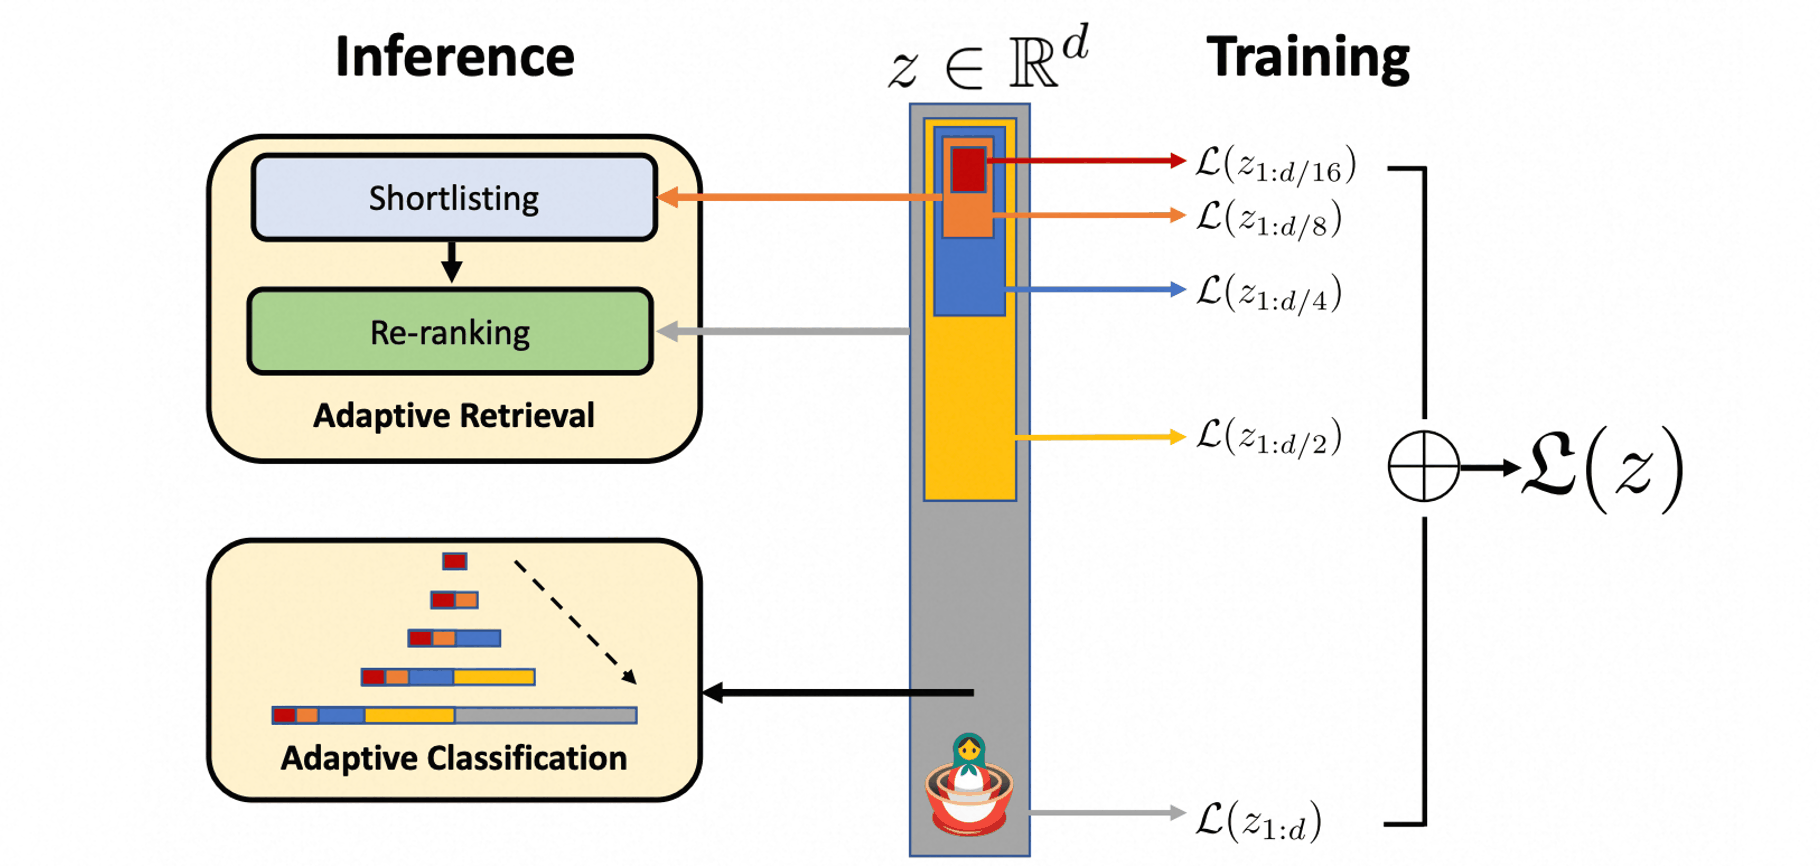
Matryoshka Representation Learning(MRL)在训练时同时约束多个嵌套维度,使高维向量的前$m$维本身也形成可用表示。部署时可以根据存储、带宽和召回阶段选择不同维度,而不必为每个维度训练独立模型。
这种可截断性来自训练目标,不能假设任意现成向量裁掉尾部后仍保持质量。维度越小通常越节省资源,但信息损失仍需针对具体任务测量。
⚪ Contextual Document Embeddings:让文档表示感知目标语料
传统双编码器独立编码每个文档,同一文档无论放在哪个语料库都得到相同向量。Contextual Document Embeddings(CDE)先从目标语料提取上下文信息,再让文档表示依赖其所在集合,从而建模领域、主题和语料内部关系。
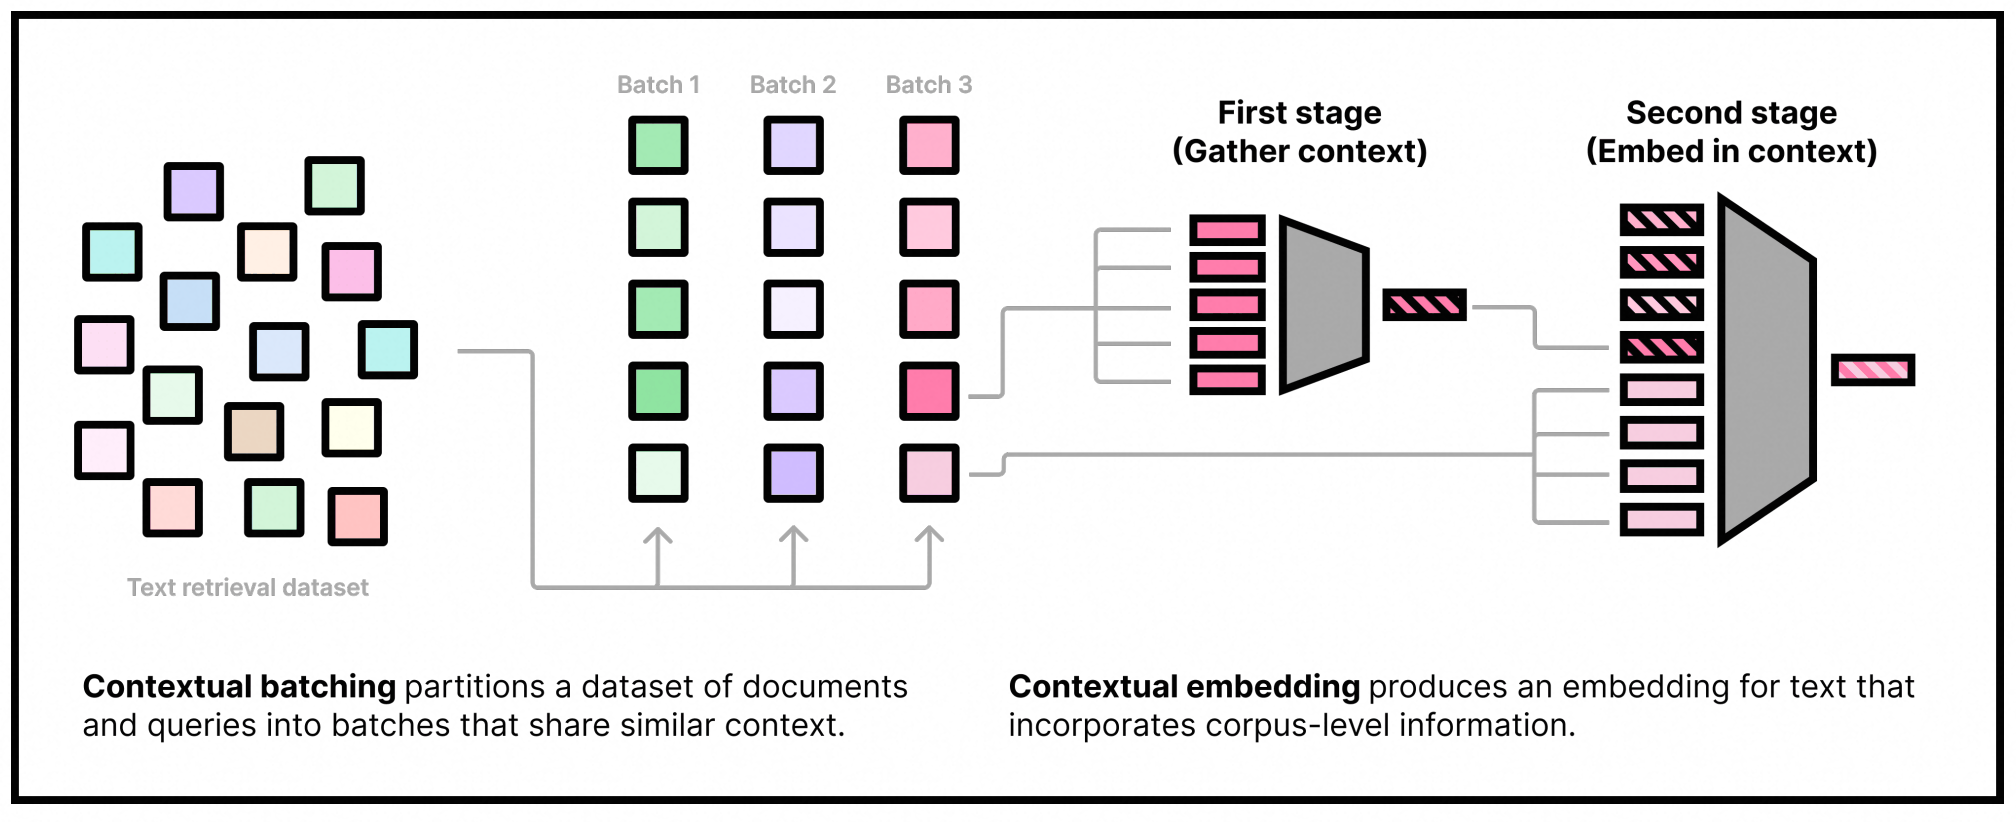
这表明“上下文”不仅可以是一个句子周围的词元,也可以是一个文档周围的语料环境。但语料感知需要额外编码阶段,并使索引随集合变化;它是独立文档嵌入的补充。
⭐ 讨论:从一个词一个向量到一个文本一个向量
嵌入的发展同时改变了四个要素:
- 表示单位从词表条目扩展到子词、上下文词元、句子、段落和文档;
- 监督关系从窗口共现扩展到蕴含、问答、点击、检索相关性与任务指令;
- 交互方式从单向量内积扩展到多向量晚交互;
- 部署约束开始直接进入训练目标,包括索引大小、向量维度、编码成本和多语言覆盖。
因此“文本嵌入”不是唯一向量空间。一个适合语义相似度的空间未必适合问答检索,一个适合英文短句的模型也未必适合多语言长文档。只有同时说明编码对象、训练关系、相似度函数和评估协议,向量距离才具有明确含义。
6. 如何评估与理解嵌入空间
(1) 词向量的内在评估与下游评估
经典词向量常用两类内在评估(intrinsic evaluation):
- 词相似度:比较模型余弦相似度与人工评分的秩相关;
- 词类比:根据$v_b-v_a+v_c$检索目标词,测试某些关系是否近似线性。
内在测试便宜且容易诊断几何结构,但数据规模小、词义和相关性标准含混,还会受到词频、词表覆盖及近邻算法影响。下游评估(extrinsic evaluation)把嵌入放入分类、标注或检索系统中测量任务指标,更接近实际用途,却同时混入模型结构、训练预算和超参数的影响。
所以内在指标与下游性能不能互相替代。好的词类比结果不保证好的句子理解,某个下游任务上的提升也不能证明整个嵌入空间更符合人类语义。
(2) 句子与检索嵌入基准
⚪ BEIR:跨领域评估零样本信息检索
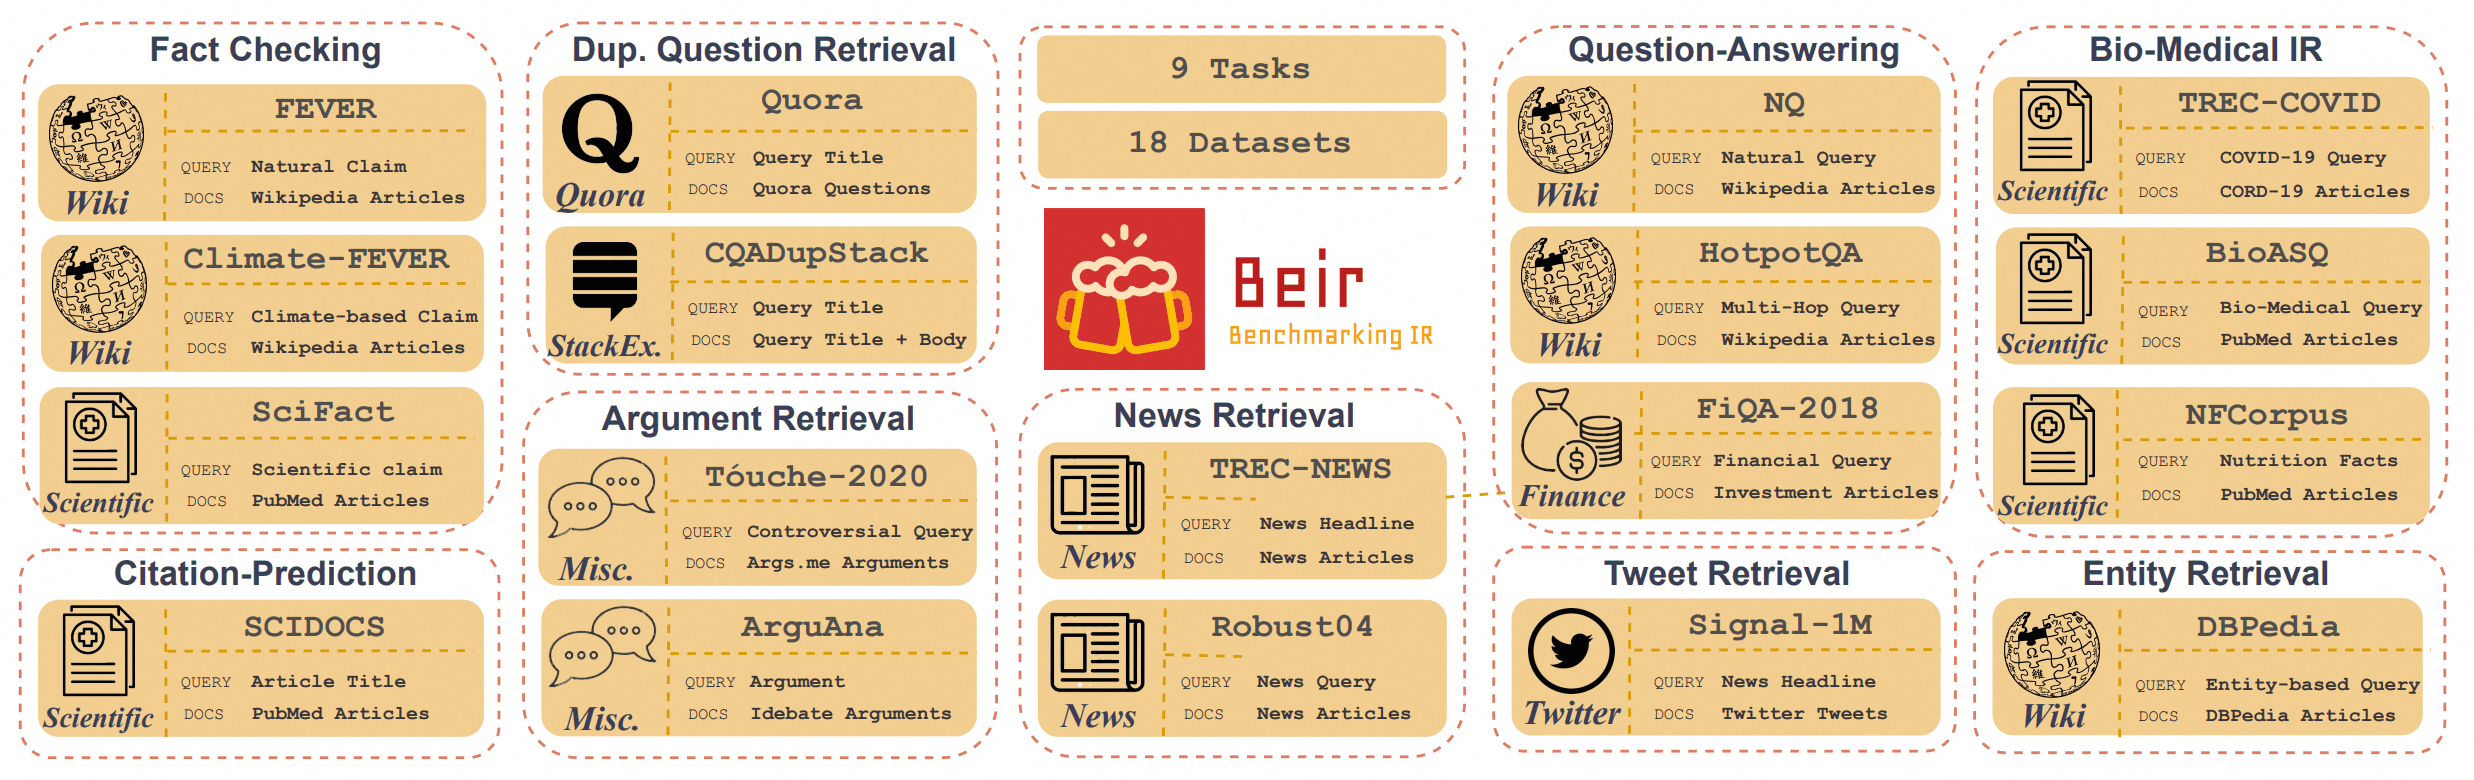
BEIR汇集问答、事实核验、引文预测、实体检索等异质数据集,用统一接口比较模型在未针对每个数据集训练时的迁移能力。它揭示词法方法、稠密双编码器、晚交互和重排序器在不同领域具有不同优势。
BEIR评估的是文本嵌入的信息检索能力;把重排序器与单阶段向量召回器直接比较时,也必须同时报告候选生成方式、延迟和索引成本。
⚪ MTEB 与 MMTEB:跨任务、跨语言评估文本嵌入
- paper:MTEB: Massive Text Embedding Benchmark
- paper:MMTEB: Massive Multilingual Text Embedding Benchmark
MTEB把平行语句挖掘、分类、聚类、句对分类、重排序、检索、语义文本相似度和摘要评价等任务放入统一框架;其结果中没有单一方法在所有任务上均占优。MMTEB进一步扩大多语言、跨语言、长文档、代码和指令遵循等覆盖。
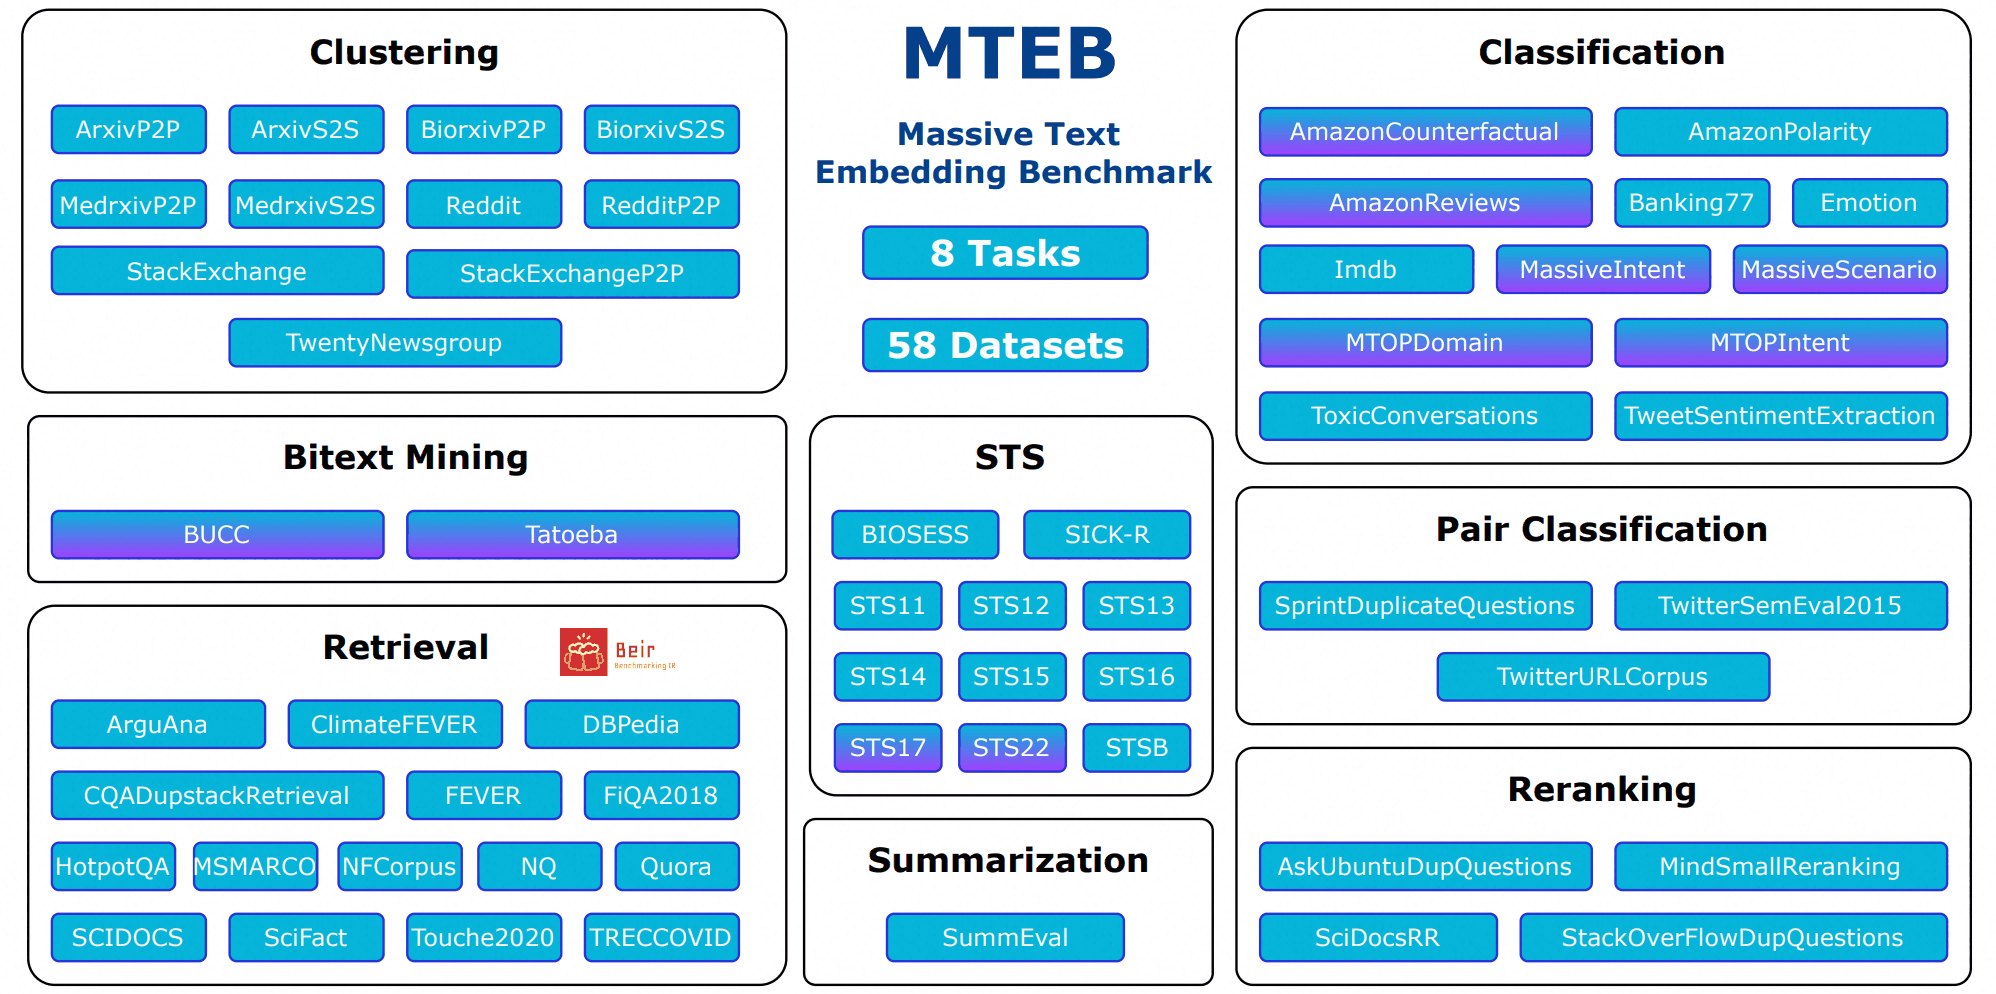
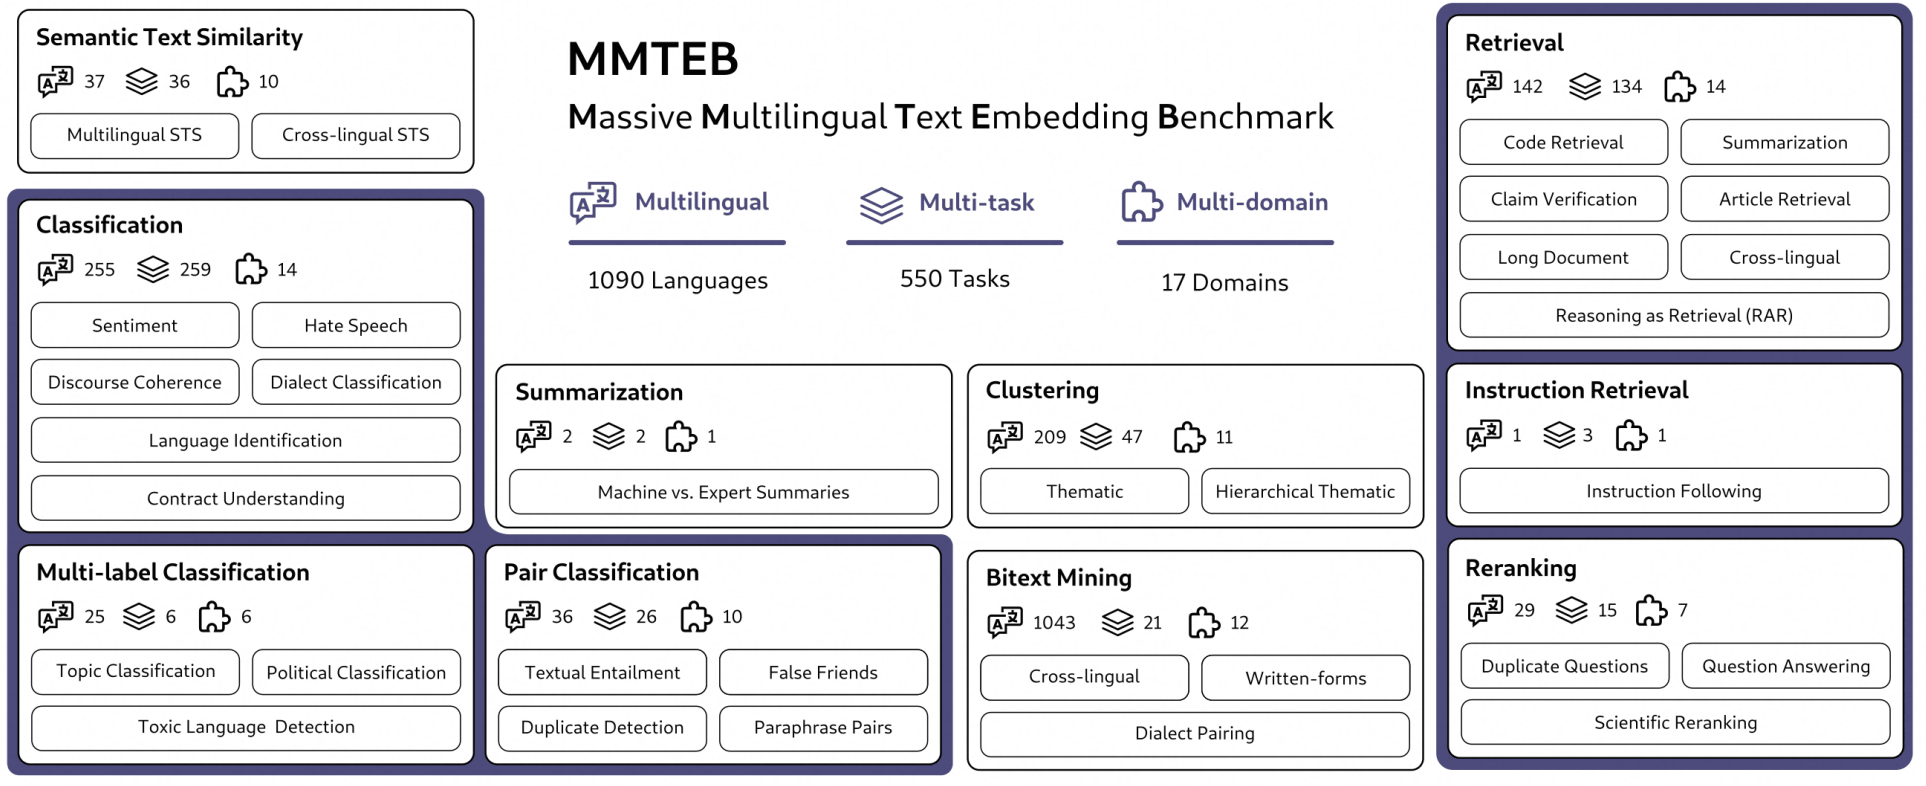
聚合总分便于观察整体迁移能力,却会掩盖任务重要性、语言覆盖、模型大小和推理成本。实际结论应落到目标任务及其指标,而不是把排行榜位置当成模型的固有属性。
(3) 嵌入空间的常见失效模式
各向异性(anisotropy)是指向量集中在狭窄方向或锥体中,导致随机文本也具有较高余弦相似度;枢纽性(hubness)是指少数向量成为大量查询的近邻。这些现象会受池化、归一化、训练目标和维度影响,不能仅靠二维降维图判断。
文本嵌入还常受到以下因素影响:
- 领域偏移:通用语料中的近邻结构未必适合医学、法律或代码检索;
- 长文本压缩:单向量可能忽略局部事实,多向量方法则增加存储与计算;
- 负样本偏差:过易负例缺乏训练信号,假负例又会把相关文本错误推远;
- 多语言不均衡:高资源语言的平均成绩可能掩盖低资源语言退化;
- 数据污染:基准样本或近重复文本进入训练集会夸大泛化能力;
- 公平性与隐私:向量会编码语料偏差,也可能保留可被探测的敏感属性。