Self-Attention Mechanism.
注意力机制最初是Seq2Seq中编码器与解码器之间的桥梁,用查询—键—值(Query-Key-Value,QKV)三元组把两条序列连接起来。自注意力(Self-Attention)机制——也称为内部注意力(Intra-Attention)——把这一模式收缩到同一条序列内部:每个位置既是查询也是键和值,用自身来查自身。它把序列建模的“递归传播”换成了“全局配对”,从而与卷积、循环并列成为处理序列的第三类基本算子。
- 从跨序列注意力到序列内注意力
- 卷积、循环与自注意力的对比
- 自注意力的QKV实现
- (1) 查询/键/值矩阵
- (2) 缩放点积注意力
- (3) 输出与残差
- 多头自注意力
- 位置编码
- (1) 为何自注意力需要位置信息
- (2) 学习式位置嵌入
- (3) Sinusoidal位置编码
- 受限自注意力与掩码
- 讨论:自注意力的能力与代价
符号约定:输入序列\(X=[x_1,\dots,x_N]\in\mathbb{R}^{N\times d}\);查询、键、值矩阵分别记为\(Q,K,V\);\(d_k\)与\(d_v\)为键与值的维度;头数记为\(h\),每个头的维度记为\(d_k/h\)。
1. 从跨序列注意力到序列内注意力
跨序列注意力处理两条序列的映射,例如把源序列\(x_{1:T}\)翻译成目标序列\(y_{1:U}\)。它引入可学习权重\(\alpha_{u,t}\),使得
\[y_u=\sum_{t=1}^{T}\alpha_{u,t}h_t.\]$\alpha_{u,t}$由查询—键得分决定,反映“目标位置\(u\)应参考源位置\(t\)的哪些内容”。它是注意力机制一节的主题。
自注意力把查询—键值全部来自同一条序列。对输入\(X=[x_1,\dots,x_N]\),输出的每个位置是同一序列的加权和:
\[b_i=\sum_{j=1}^{N}w_{ij}v_j,\qquad w_{ij}=\operatorname{softmax}_j(\operatorname{score}(q_i,k_j)).\]其中\(q_i,k_j,v_j\)都是\(x\)的线性投影。跨注意力与自注意力的主要差异如下:
- 权重来源:注意力机制的权重由查询与键的相关性决定;跨注意力查询来自另一条序列,自注意力查询来自自己。
- 序列长度:跨注意力允许输入输出长度不同;自注意力必须等长。
- 使用位置:跨注意力作为编码器—解码器之间的桥梁;自注意力可以作为网络内部的基本层重复堆叠。
- 建模目标:跨注意力捕捉“两序列之间”的关系;自注意力捕捉“一条序列内部”的关系。
正因为自注意力可以像卷积一样重复堆叠,它才被视为一种“可以替代RNN/CNN的层”。
2. 卷积、循环与自注意力的对比
自然语言序列\(X=[x_1,x_2,\dots,x_n]\in\mathbb{R}^{n\times d}\)的处理层可以分成三类:
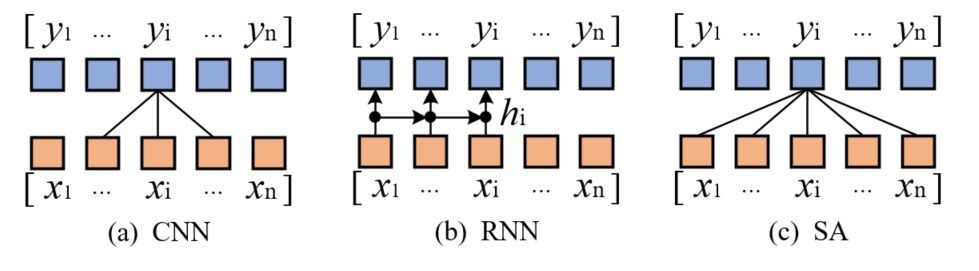
卷积神经网络用固定宽度的滑动窗口聚合局部上下文,例如宽度为\(3\)的核
\[y_i=f(x_{i-1},x_i,x_{i+1}).\]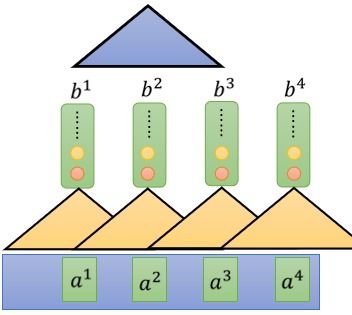
它高度并行,感受野随层数线性扩大;但要覆盖长距离依赖必须堆很深。
循环神经网络按递推关系传播:
\[y_i=f(h_{i-1},x_i).\]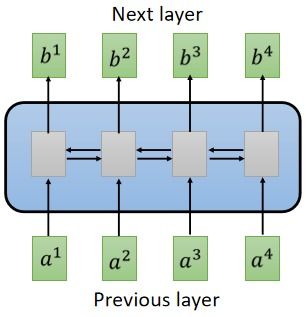
它天然对序列敏感,但每一步依赖前一步,无法并行化;且长距离依赖会被梯度消失削弱。
自注意力让每个输出直接看到所有输入:
\[y_i=f(x_1,x_2,\dots,x_n).\]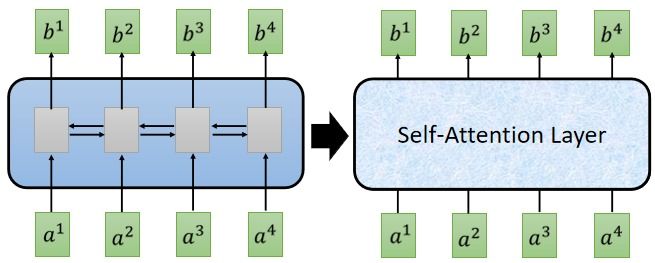
它一次前向就能把任意两个位置连起来,且计算高度并行。三者的复杂度、序列操作数与最大路径长度对比如下:
\[\begin{array}{c|ccc} \text{Layer Type} & \text{Complexity per Layer} & \text{Sequential Operations} & \text{Maximum Path Length} \\ \hline \text{Convolutional} & O(k\cdot n\cdot d^2) & O(1) & O(\log_k n) \\ \text{Recurrent} & O(n\cdot d^2) & O(n) & O(n) \\ \text{Self-Attention} & O(n^2\cdot d) & O(1) & O(1) \\ \end{array}\]三点结论值得记住:
- 卷积与循环获取全局依赖的路径长度分别是\(O(\log n)\)与\(O(n)\);自注意力是\(O(1)\)。
- 循环网络在序列维度上不能并行,卷积在核之间可以并行,自注意力则完全并行。
- 自注意力的每层计算量随\(n^2\)增长;对长序列这是主要开销来源。降低这一复杂度是后续注意力研究的核心方向,参见降低Transformer的计算复杂度。
3. 自注意力的QKV实现
自注意力的实现遵循查询—键—值(Query-Key-Value,QKV)模式:把输入映射到三个线性子空间,用查询与键计算相似度,再用相似度加权求和值向量。
(1) 查询/键/值矩阵
设输入为\(X=[x_1,\dots,x_N]^\top\in\mathbb{R}^{N\times d}\)(这里按行存放,便于矩阵表述),经过词嵌入或前一层输出得到\(A\in\mathbb{R}^{N\times d_a}\)。三个可学习矩阵\(W^Q,W^K\in\mathbb{R}^{d_a\times d_k}\)与\(W^V\in\mathbb{R}^{d_a\times d_v}\)将其投影到
\[Q=AW^Q,\quad K=AW^K,\quad V=AW^V.\]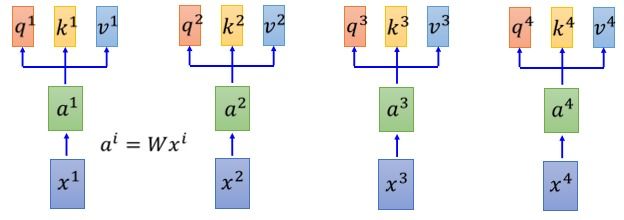
$Q,K$共享维度\(d_k\)以便做点积,\(V\)的维度\(d_v\)独立,用来控制输出通道数。三个矩阵是自注意力的全部可学习参数,与序列长度无关。
(2) 缩放点积注意力
用点积衡量查询与键的相关性,并除以\(\sqrt{d_k}\)进行缩放,防止较大内积把softmax推向饱和:
\[S=\frac{QK^\top}{\sqrt{d_k}}\in\mathbb{R}^{N\times N}.\]对\(S\)的每一行做softmax得到注意力权重矩阵:
\[\hat{A}=\operatorname{softmax}(S).\]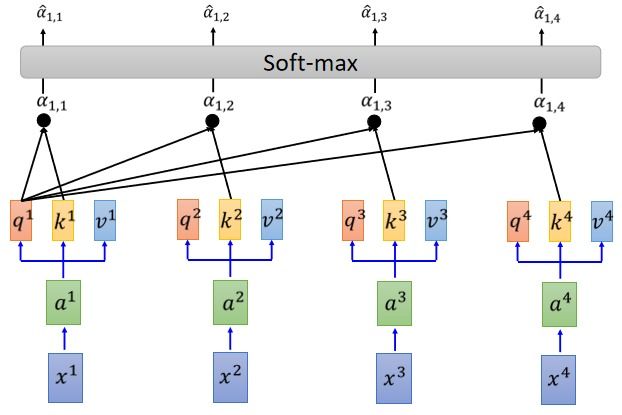
其中\(\hat{A}_{ij}\)表示第\(i\)个位置对第\(j\)个位置的注意力权重。softmax是按行归一化的,因此每个查询的权重和为\(1\)。
(3) 输出与残差
注意力权重加权求和值向量得到输出:
\[B=\hat{A}V\in\mathbb{R}^{N\times d_v}.\]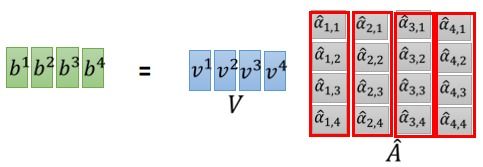
$B$的每一行仍然对应输入的一个位置,因此自注意力保持序列长度不变。工程上通常再加一层线性变换\(W^O\)与残差连接,把\(B\)映射回\(d_a\)维空间,便于堆叠。
整套流程可以浓缩成一行公式:
\[\operatorname{Attention}(Q,K,V)=\operatorname{softmax}\left(\frac{QK^\top}{\sqrt{d_k}}\right)V.\]它就是缩放点积自注意力(scaled dot-product self-attention)。整个计算只有三次矩阵乘法与一次softmax,非常适合GPU并行。
4. 多头自注意力
一次自注意力只能学到一种位置间关系。类比卷积网络里“不同卷积核捕捉不同pattern”,我们希望模型能同时关注多种关系,例如句法依赖、语义共指、指代等。做法是把注意力沿子空间维度切成\(h\)份:
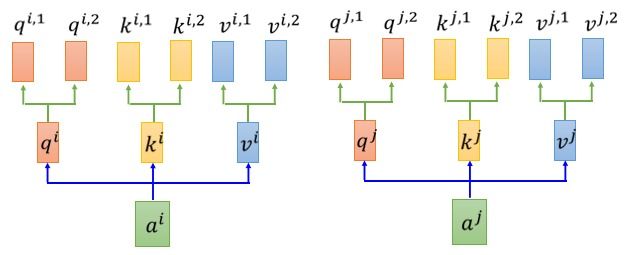
多头自注意力(Multi-Head Self-Attention)为每个头\(m=1,\dots,h\)独立学习一组投影矩阵\(W^Q_m,W^K_m,W^V_m\),各自计算缩放点积注意力:
\[B_m=\operatorname{Attention}(AW^Q_m,AW^K_m,AW^V_m).\]再把所有头的输出拼接并通过一层线性变换合并:
\[B=[B_1;B_2;\dots;B_h]W^O.\]工程实现有两种常见形式:
- 切分式(narrow):把输入按通道切成\(h\)块,每块单独做注意力。计算量与参数量都与单头相同,但每个头的通道数只有\(d/h\)。
- 重复式(wide):每个头独立投影到完整的\(d_k\)维空间,参数量与计算量按\(h\)倍增加。表达能力更强但更贵。
主流实现默认使用第一种“切分式”形式:设\(d=d_k\),每个头的键值维度为\(d/h\),\(h\)个头的总计算量与单头相同。可以证明当\(W^O\)允许任意混合时,切分式实际能覆盖重复式的所有效果(在参数共享意义下)。
5. 位置编码
(1) 为何自注意力需要位置信息
自注意力对输入序列具有置换等变性(permutation equivariance):如果把\(X\)的行随机重排列,\(\operatorname{Attention}(Q,K,V)\)的输出也会按同一置换重排,注意力权重矩阵关于两个下标同步置换。换言之,仅凭自注意力算子,模型无法区分“我吃苹果”与“苹果吃我”。语言、语音、时序信号都强烈依赖顺序,因此必须显式地把位置信息注入到输入向量里。
(2) 学习式位置嵌入
最直接的做法是把位置索引\(t\in\{1,\dots,N\}\)当成一个离散token,学习一个嵌入表\(E\in\mathbb{R}^{N_{\max}\times d}\),与词嵌入相加:
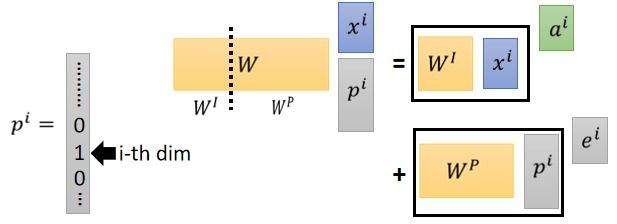
从形式上看,把位置嵌入拼到词嵌入上,再乘一个线性层,等价于把位置嵌入与词嵌入分别投影后再相加。因此文献上通常直接相加位置嵌入。学习式位置嵌入的优势是灵活,缺点是不能泛化到训练时未见过的更长位置。
(3) Sinusoidal位置编码
Sinusoidal位置编码把位置\(t\)写成一族不同频率的正余弦:
\[\begin{aligned} e_{t,2i}&=\sin\left(\dfrac{t}{10000^{2i/d}}\right),\\ e_{t,2i+1}&=\cos\left(\dfrac{t}{10000^{2i/d}}\right). \end{aligned}\]其中\(e_{t,k}\)表示位置\(t\)对应向量的第\(k\)维,\(d\)是嵌入维度。该形式的一个良好性质是:对任意偏移\(\Delta\),\(e_{t+\Delta}\)可以写成\(e_t\)的线性变换——由正余弦的加法定理
\[\begin{aligned} \sin(\alpha+\beta)&=\sin\alpha\cos\beta+\cos\alpha\sin\beta,\\ \cos(\alpha+\beta)&=\cos\alpha\cos\beta-\sin\alpha\sin\beta \end{aligned}\]即可推出。因此模型可以在权重里学到与相对位置相关的模式。Sinusoidal位置编码不需要额外参数,也可以外推到训练时没见过的更长序列。可视化后如下:
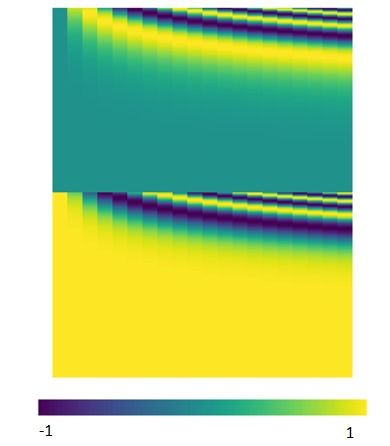
学习式与Sinusoidal在Transformer原始论文里效果接近,但两者只是位置信息的最基础版本。更丰富的相对位置编码、RoPE等方案见自注意力机制中的位置编码。
6. 受限自注意力与掩码
原始自注意力关注序列内所有位置,对长序列不够高效,且在自回归生成中会“看到未来”。两类修改被广泛使用:
- 受限自注意力(Restricted Self-Attention):每个查询只关注前后各\(r\)个位置,把复杂度从\(O(N^2)\)降至\(O(rN)\)。窗口约束把自注意力局部化,形式上接近\(1\)维卷积。
- 掩码自注意力(Masked Self-Attention):在\(S=QK^\top/\sqrt{d_k}\)上加一个\(-\infty\)掩码,把不允许查询的位置屏蔽。典型掩码包括:因果掩码只允许查询左侧位置,用于自回归解码;填充掩码忽略padding位置;双向掩码允许全部位置,用于编码器。
这两种修改本质上都是修改注意力矩阵的支撑集——即把哪些\((i,j)\)对参与计算的问题——它们与后续的稀疏注意力、局部注意力属于同一族思路。
7. 讨论:自注意力的能力与代价
自注意力给序列建模带来了两项显著的能力:
- 高度并行:所有位置的\(QK^\top\)都可以一次矩阵乘法完成,非常适合GPU加速。
- 长距离依赖:任意两个位置之间的路径长度是\(O(1)\),不需要通过多层递归才能相连。
代价则来自其结构:
- \(O(N^2)\)复杂度:每层的计算量和显存都随序列长度平方增长。对长文档、高分辨率图像等场景需要专门的降低复杂度方案。
- 位置无关:算子本身不知道顺序,必须通过位置编码把顺序信息补进来;错误的位置编码会严重影响模型能力。
- 建模选择而非学习结构:自注意力权重由数据决定,但\(W^Q,W^K,W^V\)的容量与位置编码的形式仍然是人为的设计选择。
回到本文开头的定位:自注意力是一种基本算子。它可以像卷积那样重复堆叠,加上残差、归一化和前馈子层就变成完整的Transformer编码器/解码器——这一步是Transformer的主题;把自注意力做得更快、更长的一系列改进则汇总在降低Transformer的计算复杂度。