Attention Mechanism in Seq2Seq Models.
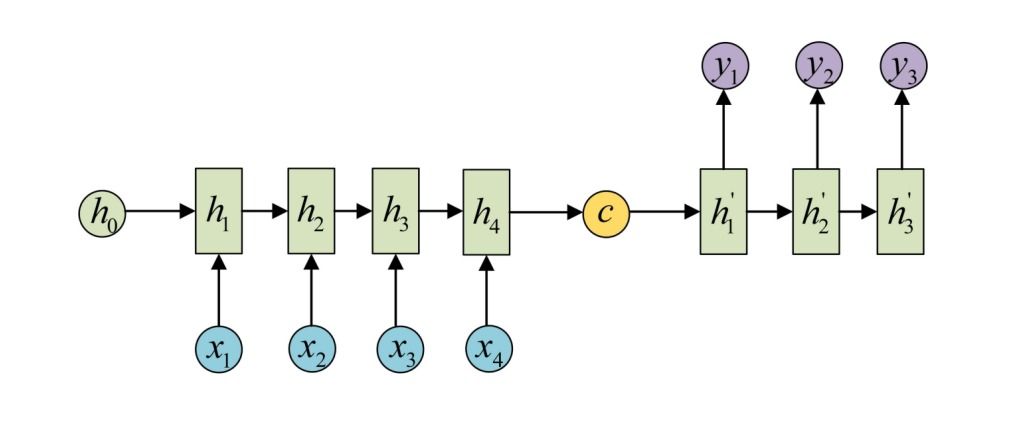
序列到序列(Seq2Seq)模型把整个源序列压缩到编码器最后一个隐状态\(c=h_T\),再由解码器逐位生成目标序列。当源序列变长,一个固定维度向量无法承载全部语义:不同目标位置需要的源信息并不相同,让所有位置共享同一个上下文向量必然造成信息稀释。Bahdanau等人在\(2014\)年的神经机器翻译中提出注意力机制(Attention Mechanism),让解码器在生成第\(u\)步时按需重新查询编码器的所有隐状态,实质上把定长的“上下文向量”换成一个内容可寻址的动态记忆。
注意力机制主要回答三个问题:
- 查询是什么(query):一般是解码器当前隐状态。
- 候选记忆是什么(key/value):编码器所有位置的隐状态。
- 如何加权聚合:先用score函数打分,再经softmax归一化,最后加权求和值向量。
本文目录:
- 从固定上下文向量到动态查询
- 加性注意力与乘性注意力
- (1) Bahdanau加性注意力
- (2) Luong乘性注意力
- 注意力得分函数汇总
- 全局注意力与局部注意力
- 软性注意力与硬性注意力
- 覆盖度与结构化注意力
- (1) 覆盖度机制
- (2) 单调注意力
- (3) 层次化注意力
- 讨论:注意力的能力边界
符号约定:源序列\(x_{1:T}\)对应编码器隐状态\(h_{1:T}\),目标序列\(y_{1:U}\)对应解码器隐状态\(s_{1:U}\);第\(u\)步解码时的查询向量记作\(q_u\)(一般取\(s_{u-1}\)或\(s_u\)),注意力权重记作\(\alpha_{u,t}\),上下文向量记作\(c_u\)。
1. 从固定上下文向量到动态查询
不使用注意力的Seq2Seq中,编码器压缩、解码器生成,两者只通过\(c=h_T\)相连:
引入注意力后,解码器每一步都会重新构造一个上下文向量\(c_u\):
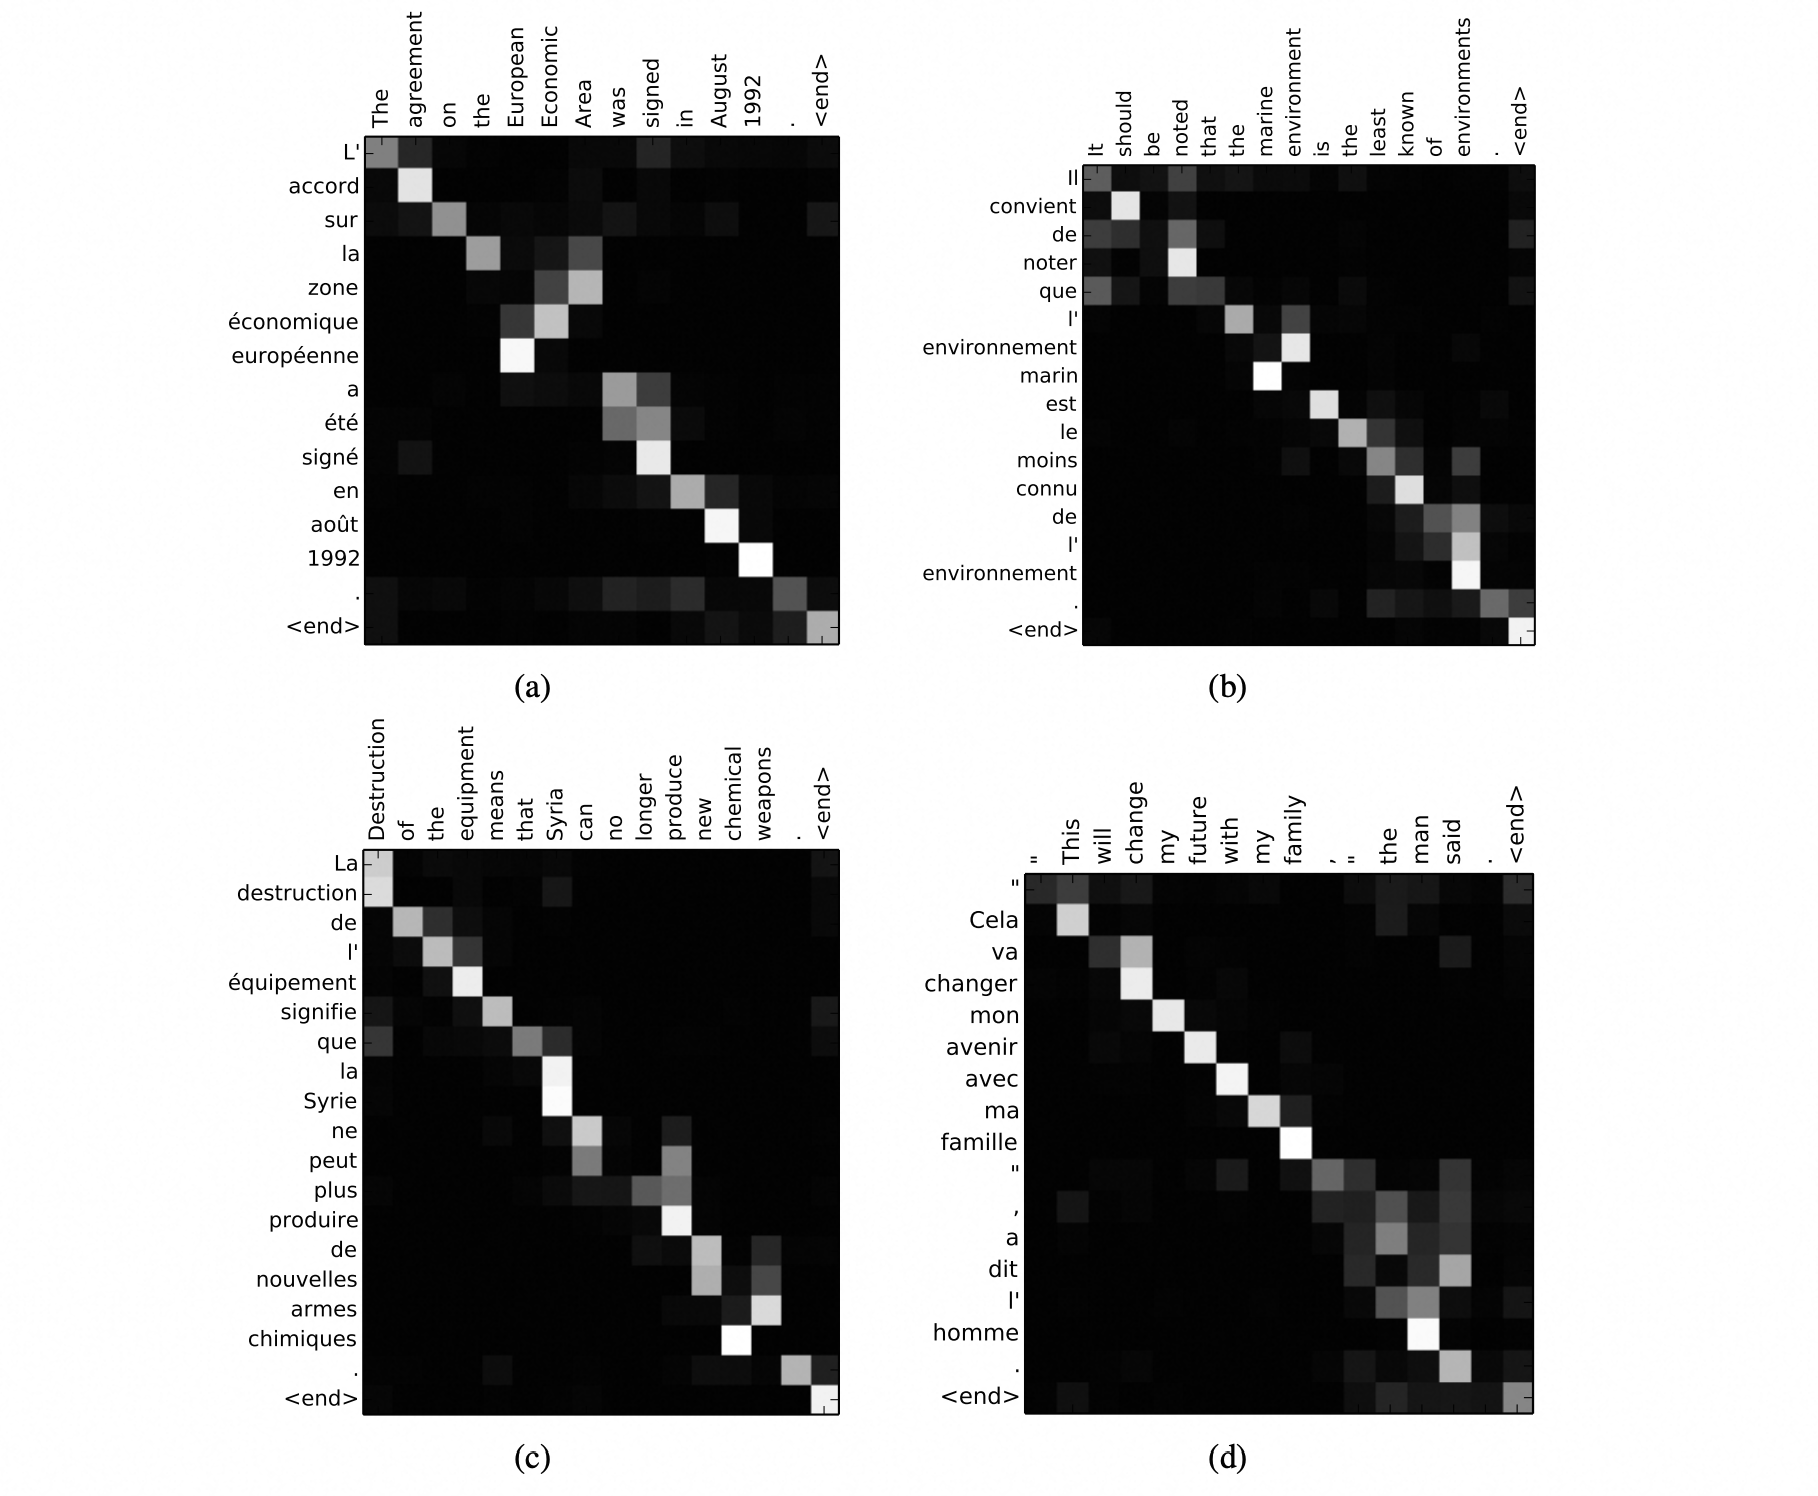
\[\begin{aligned} e_{u,t}&=\operatorname{score}(q_u,h_t),\\ \alpha_{u,t}&=\frac{\exp(e_{u,t})}{\sum_{t'=1}^{T}\exp(e_{u,t'})},\\ c_u&=\sum_{t=1}^{T}\alpha_{u,t}h_t. \end{aligned}\]$c_u$随\(u\)变化,因此解码器在不同目标位置可以“看”源序列的不同位置。\(\alpha_{u,t}\)可视化后往往呈现出对角形对齐,与传统机器翻译中的词对齐相吻合,这也是注意力最初被提出时的解释性证据。
注意力机制的实现有几个共通细节:
- 可微性:\(\alpha\)通过softmax得到,整个流程可导,可以直接与解码器一起端到端训练。
- 不依赖长度:编码器隐状态数量\(T\)变化不影响解码器结构,模型天然处理变长源序列。
- 成本:每一步注意力需要与所有\(T\)个键做点积,解码整体复杂度是\(O(UT)\)。
2. 加性注意力与乘性注意力
(1) Bahdanau加性注意力
⚪ Bahdanau Attention:注意力机制的首篇论文
Bahdanau等人在双向RNN编码器与GRU解码器之上引入了第一版注意力。它以解码器上一时刻的隐状态\(s_{u-1}\)作为查询,对每个编码器隐状态\(h_t\)计算加性得分:
\[e_{u,t}=v^\top\tanh(W_qs_{u-1}+W_kh_t),\]其中\(v\in\mathbb{R}^{d}\)、\(W_q,W_k\in\mathbb{R}^{d\times d_h}\)是可学习参数。所有位置的\(e_{u,t}\)经softmax得到\(\alpha_{u,t}\),再加权求和得到\(c_u\)。解码器把\(c_u\)与自身隐状态一起用于预测:
\[\begin{aligned} s_u&=f_{\mathrm{dec}}(y_{u-1},s_{u-1},c_u),\\ p(y_u\mid y_{<u},x)&=\operatorname{softmax}(g(s_u,y_{u-1},c_u)). \end{aligned}\]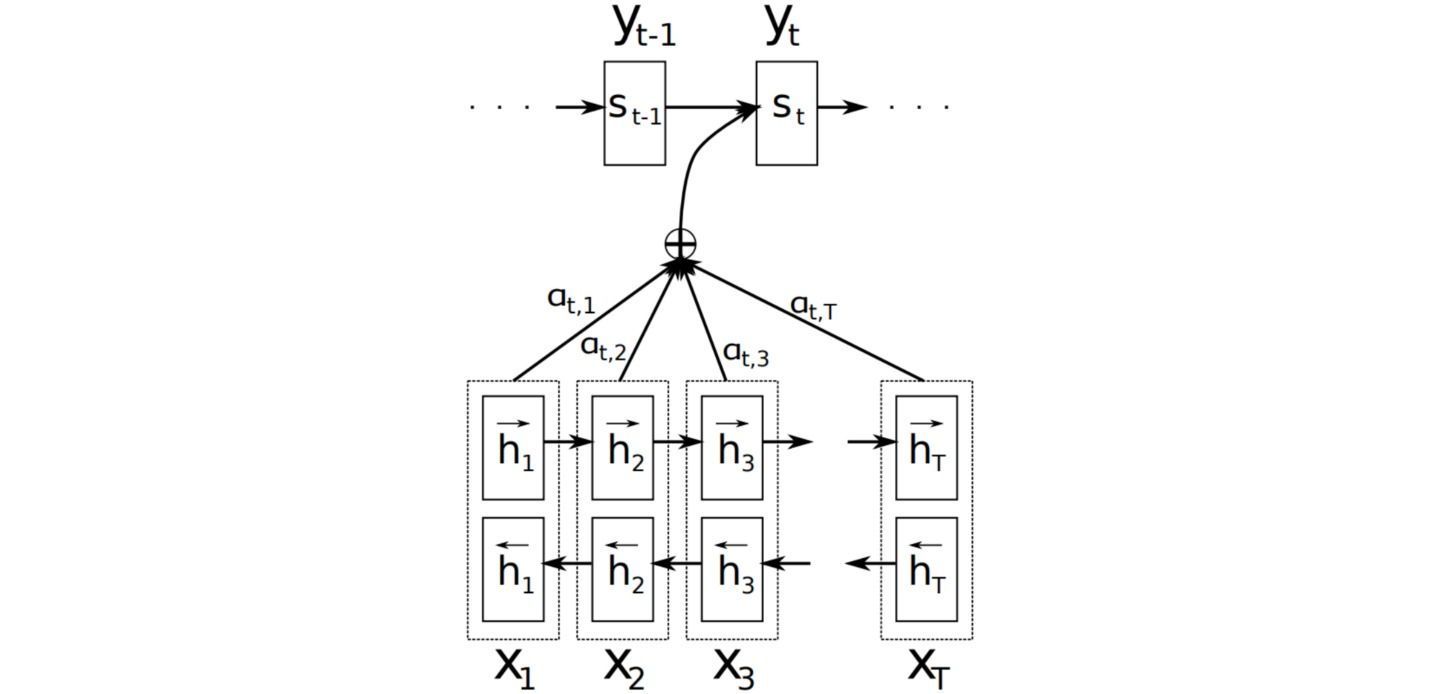
加性注意力的关键优势是\(s_{u-1}\)与\(h_t\)可以有不同维度:\(W_q\)与\(W_k\)分别把它们映射到相同的\(d\)维空间。这一版本没有依赖“查询与键同维”的假设,因此更灵活。
(2) Luong乘性注意力
⚪ Luong Attention:结构更简的乘性打分
Luong等人系统比较了多种得分函数与两种解码流程,把注意力实现简化到几乎不需要额外参数。他们的主要贡献有三点:
- 乘性得分:直接用\(s_u^\top h_t\)或\(s_u^\top W h_t\)作为得分。前者不需要额外参数,后者引入非对称性以适配不同表示空间。
- 不同的解码集成方式:他们提出dot、general、concat三种得分函数,并对比“先算注意力再更新隐状态”与“先更新隐状态再算注意力”两种流程。
- 局部注意力:仅在源序列的局部窗口内计算注意力,避免长序列上的\(O(T)\)成本,将在第\(4\)节详述。
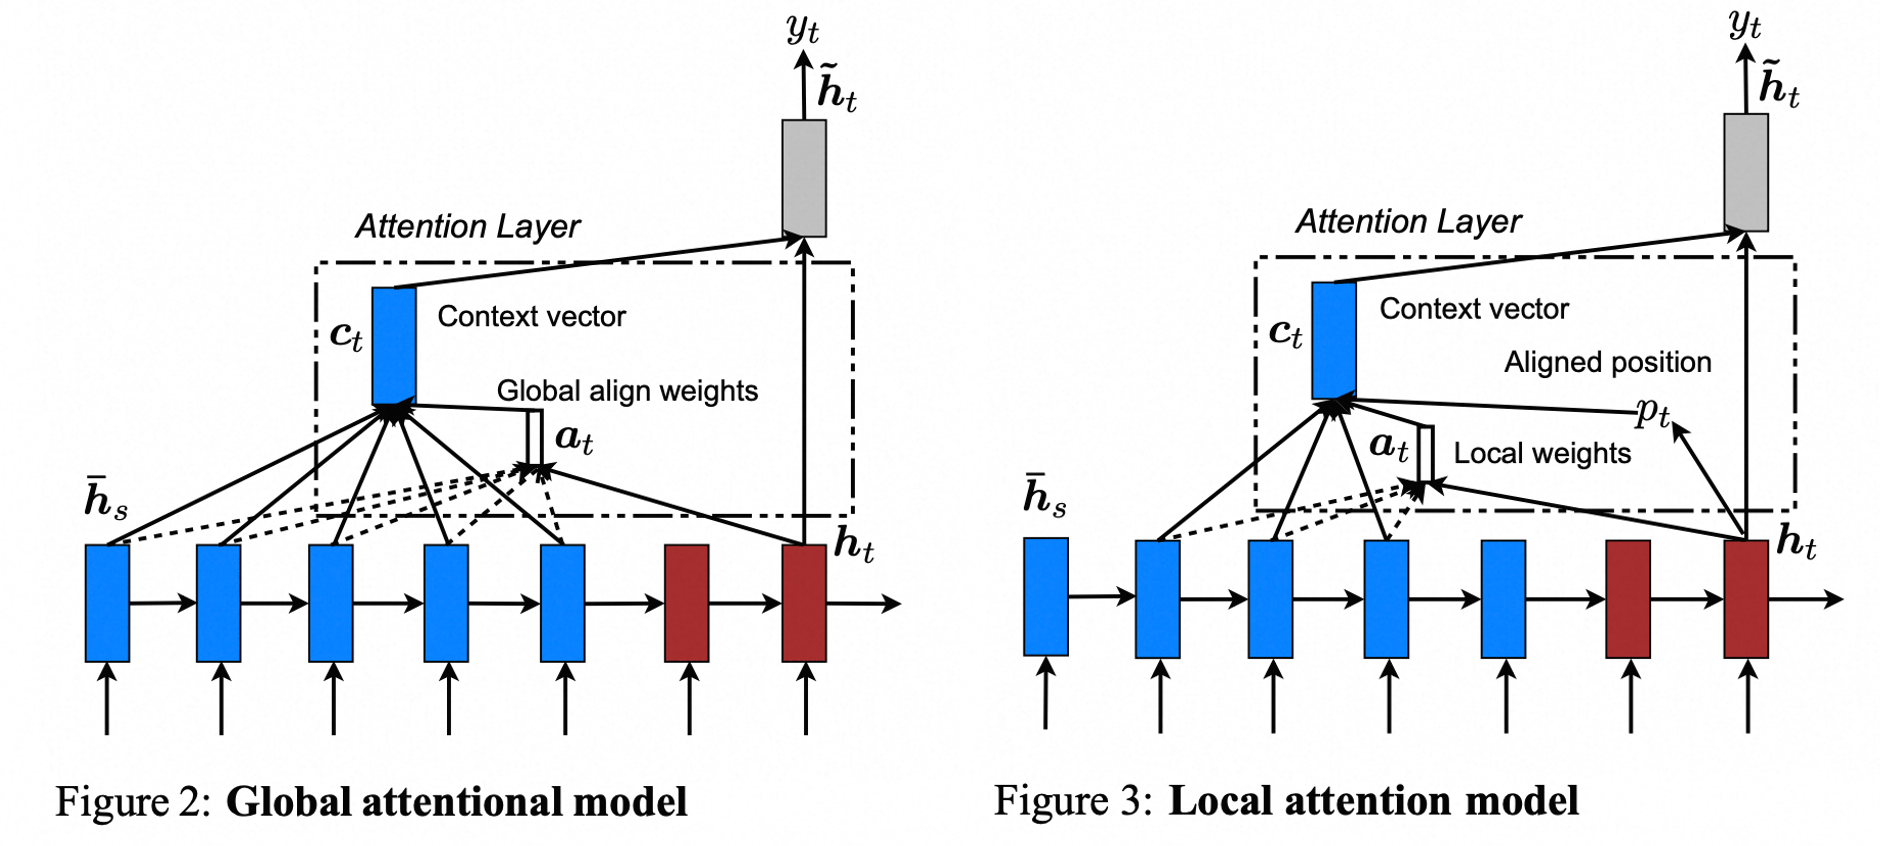
论文的经验结论是:general得分(\(s_u^\top W h_t\))在多数任务上稳定优于纯点积;对长序列,局部注意力可以在几乎不损失质量的前提下大幅降低推理开销。
3. 注意力得分函数汇总
不同注意力机制的差别主要在得分函数\(\operatorname{score}(q,k)\)。常见的几种形式如下。
| 名称 | 表达式 | 说明 |
|---|---|---|
| 加性 Additive | \(v^\top\tanh(W_qq+W_kk)\) | 引入非线性,允许\(q\)与\(k\)异维 |
| 点积 Dot-Product | \(q^\top k\) | 无额外参数,需要\(q,k\)同维 |
| 缩放点积 Scaled Dot-Product | \(q^\top k/\sqrt{d_k}\) | 缩放防止内积过大导致softmax饱和 |
| 双线性 General | \(q^\top W k\) | 引入不对称的可学习权重 |
| 基于位置 Location-based | \(W q\) | 得分只依赖查询,不看键 |
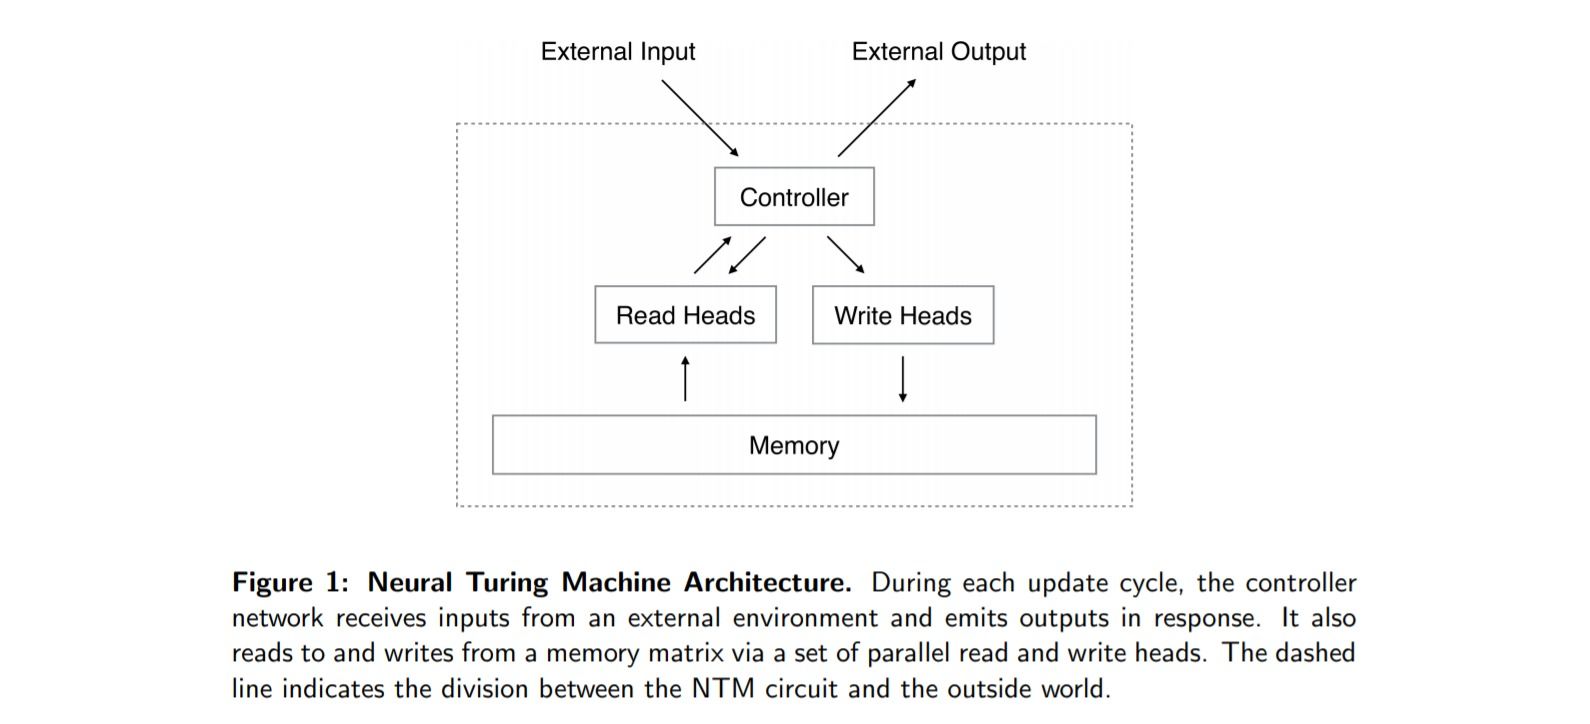
| 基于上下文 Context-based | \(\cos(q,k)\) | 余弦相似度,用于NTM等结构化记忆 |
得分函数的选择影响计算成本、数值稳定性与可解释性。乘性系列可以直接写成矩阵乘法,特别适合GPU批量加速;加性系列需要额外的\(\tanh\),但对异维查询/键更友好。
⭐ 讨论:为什么要缩放点积
当\(d_k\)较大时,两条零均值单位方差的向量点积的方差是\(d_k\),使得softmax输入变得过于集中,梯度趋近于零。除以\(\sqrt{d_k}\)把方差归一为\(1\),让softmax保持在敏感区间。在RNN式注意力里\(d_k\)通常不大,缩放的重要性没那么突出;但在多头点积注意力中它决定了训练是否可行。
4. 全局注意力与局部注意力
全局(global)注意力在整个源序列\(h_{1:T}\)上计算\(\alpha_{u,t}\),这是最早提出的形式,也称为软性注意力(Soft Attention)。它平滑可微,但每步都要处理\(T\)个键,序列很长时代价高。
局部(local)注意力只在一个宽度\(2D+1\)的窗口内做softmax,\(D\)是超参数。窗口中心\(p_u\)的选择有两种:
- 单调对齐(monotonic alignment):\(p_u=u\)。假设源序列与目标序列大致同步,例如语音识别。
- 预测对齐(predictive alignment):\(p_u=T\cdot\sigma(v^\top\tanh(Ws_u))\),把窗口中心作为可学习函数。为了让\(\alpha\)在窗口两端平滑衰减,通常在\(\alpha\)上乘一个以\(p_u\)为均值的Gaussian核。
局部注意力在长序列上明显更快,且在机器翻译和摘要上并不总是逊色于全局注意力;缺点是引入了对齐先验,非单调的语对之间会失去精度。
5. 软性注意力与硬性注意力
硬性注意力(Hard Attention)在每一步只选择一个源位置:
\[c_u=h_{\hat{t}},\qquad \hat{t}=\arg\max_{t}\alpha_{u,t}.\]或者更一般地:把\(\alpha_{u,t}\)作为一个类别分布,采样一个位置\(\hat{t}\sim\mathrm{Cat}(\alpha_{u,\cdot})\)。硬性注意力的直觉是“真实注意力就应该是尖锐的”,但\(\arg\max\)与采样都不可微,需要用REINFORCE或Straight-Through估计梯度。Xu等人在Show, Attend and Tell中用硬性注意力做图像描述并给出了变分下界的解释。
软性注意力用连续权重把所有键混合,训练稳定且完全可微,是绝大多数Seq2Seq任务的默认选择。硬性注意力的优势是推理时开销小(只取一个位置),并且注意力权重具有更强的可解释性。二者之间还存在稀疏注意力这类折中方案,比如sparsemax用可微的欧氏投影替代softmax,得到严格稀疏但仍可求梯度的权重。
6. 覆盖度与结构化注意力
(1) 覆盖度机制
⚪ Coverage Mechanism:约束注意力不要反复关注同一位置
不加约束的注意力可能反复访问同一源位置,造成翻译或摘要中的过翻译(over-translation)与漏翻译(under-translation)。Tu等人为每个源位置引入一个覆盖向量\(c_t^{\mathrm{cov}}\),累积其历史注意力:
\[c_t^{\mathrm{cov},u}=c_t^{\mathrm{cov},u-1}+\alpha_{u,t}.\]把\(c_t^{\mathrm{cov},u}\)作为额外输入送入得分函数,模型倾向避免关注已被覆盖的位置:
\[e_{u,t}=v^\top\tanh(W_qs_u+W_kh_t+W_cc_t^{\mathrm{cov},u}).\]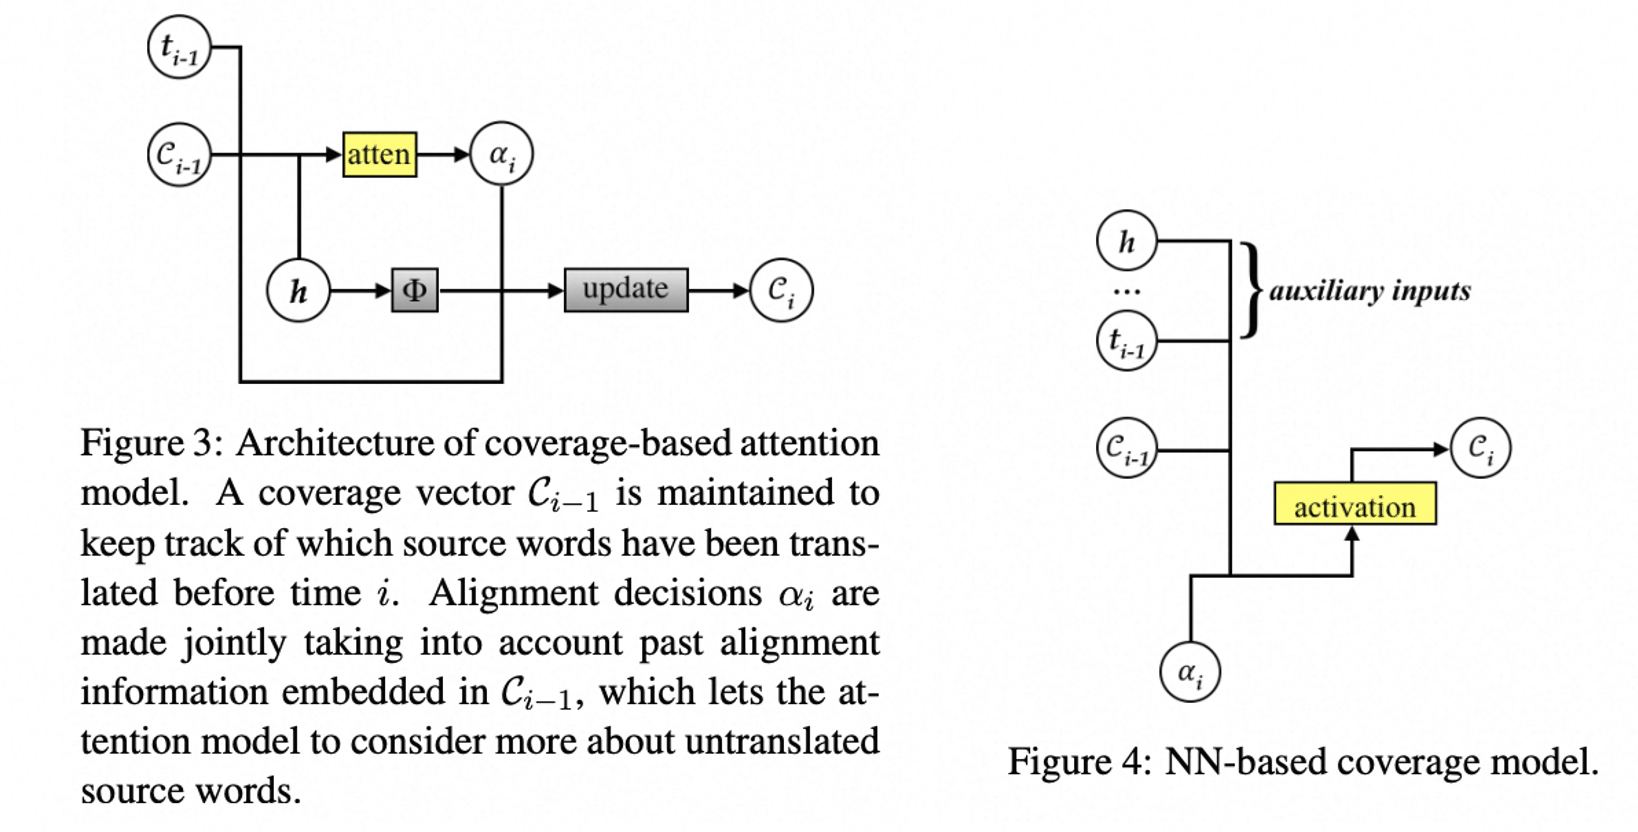
与Pointer-Generator同源的抽象式摘要工作还在损失里加入覆盖惩罚\(\sum_{u,t}\min(\alpha_{u,t},c_t^{\mathrm{cov},u})\)。两种形式都在减少重复输出上有效。
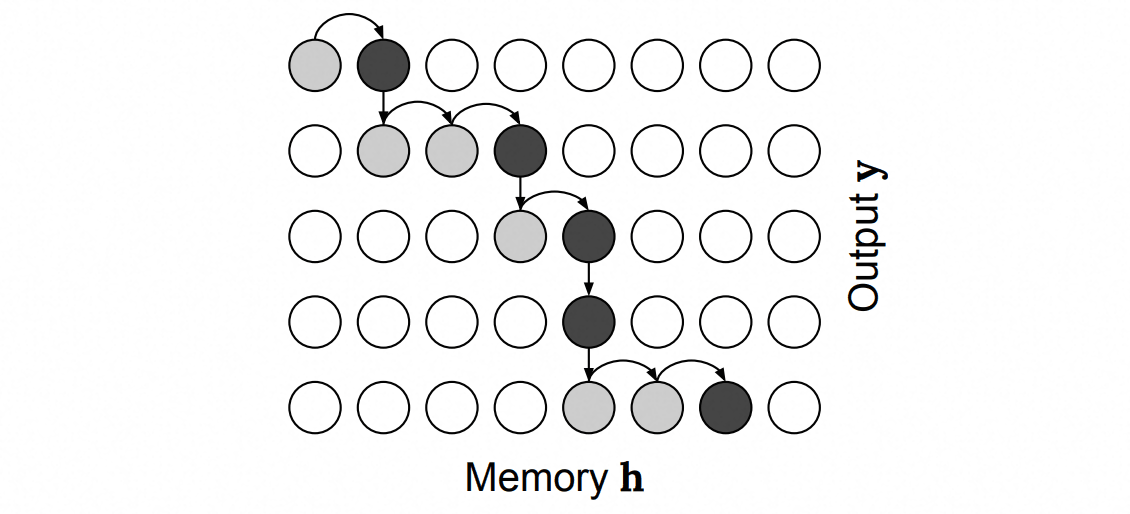
(2) 单调注意力
⚪ Monotonic Attention:适配流式解码
在语音识别、同声传译等流式(streaming)任务中,源序列是逐步到达的,解码器不能回看已处理过的位置。Raffel等人提出单调注意力:把注意力权重视为一个只能向右推进的“读取指针”,用一族Bernoulli变量决定何时停下、何时继续读入。为了训练可行,实际实现采用期望形式MoChA在每个位置上做局部软注意力。这一族方法把注意力的适用范围从离线Seq2Seq**推广到在线场景。
(3) 层次化注意力
⚪ Hierarchical Attention Network:文档级建模的两层注意力
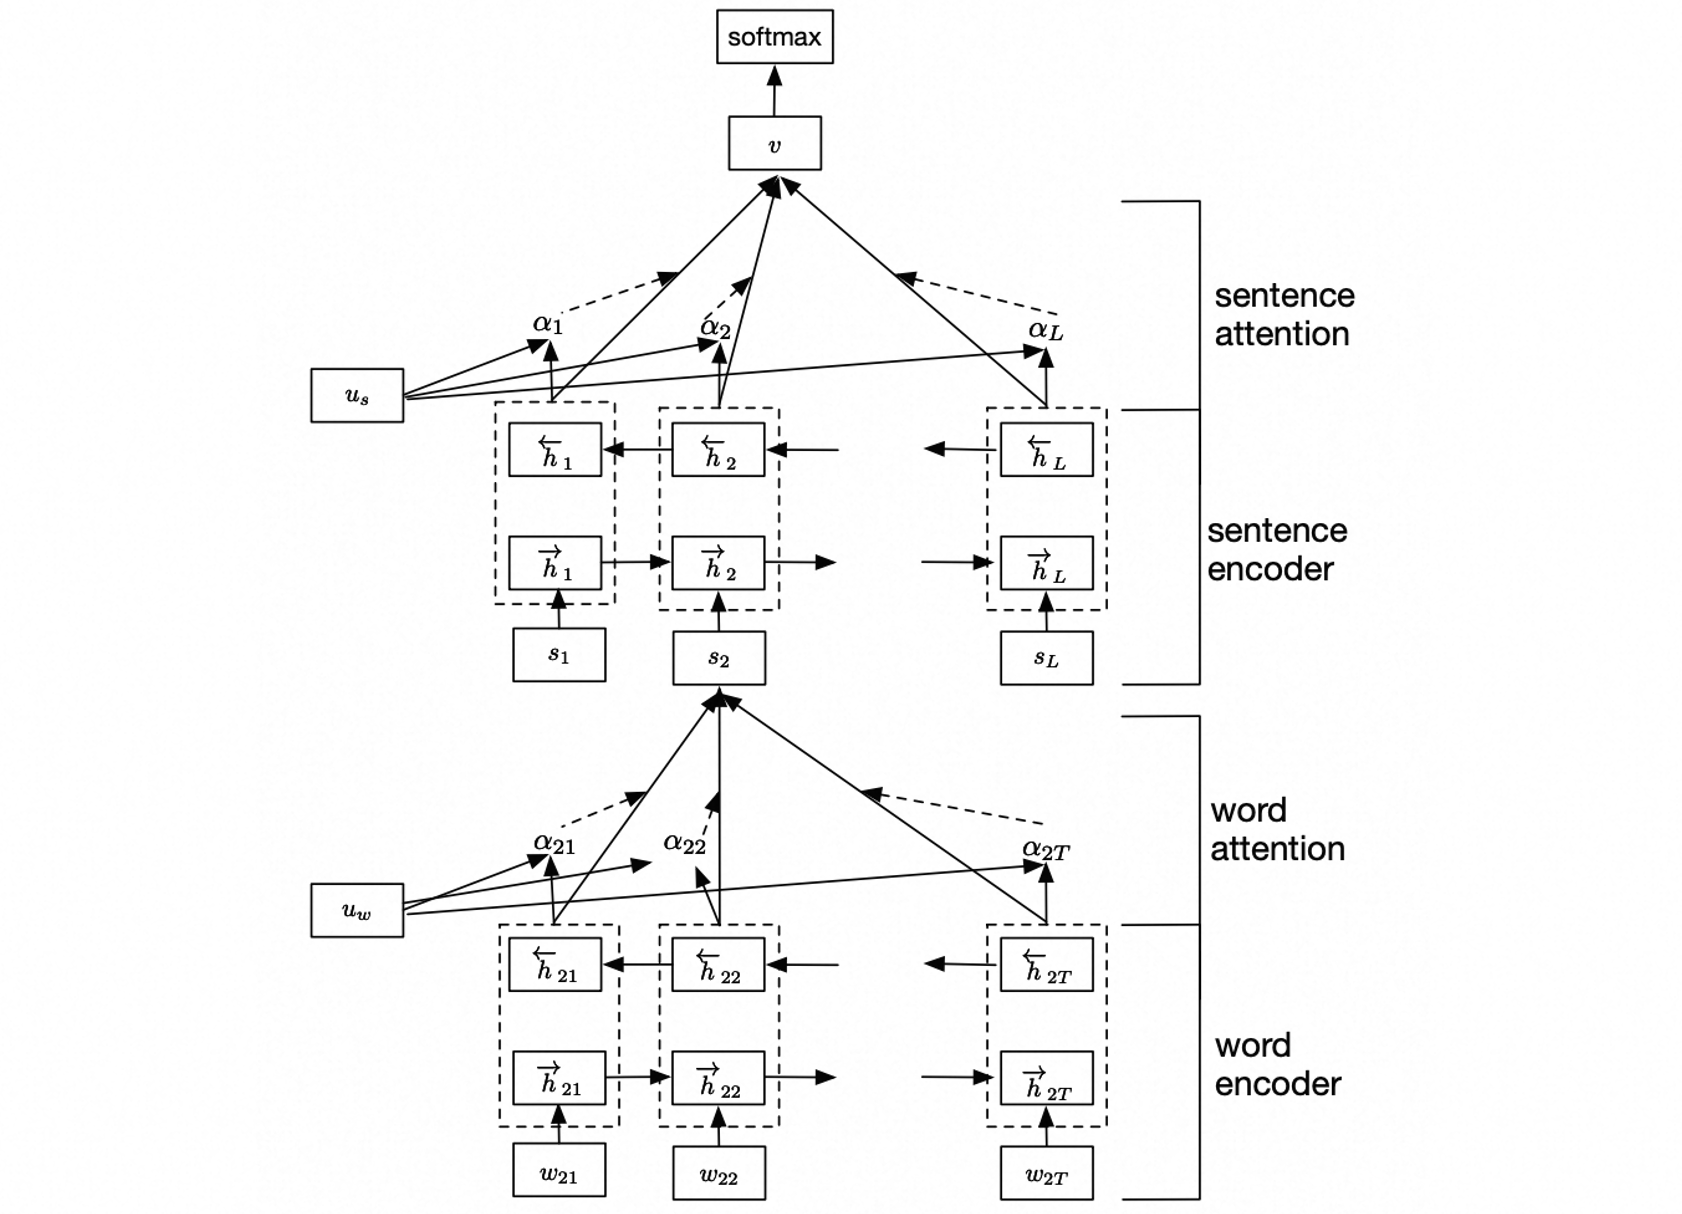
HAN面向长文档任务,先在词级用双向RNN+注意力聚合每个句子的表示,再在句子级用另一次注意力聚合成文档表示。它体现了注意力的“层次化”视角:把不同粒度的表示逐级摘要,每一级都由注意力决定重要性。这一思想在Seq2Seq框架里也常见,例如把文档的段落级、句级、词级注意力合成为多阶段结构。
7. 讨论:注意力的能力边界
回到最初的动机:注意力机制解决了固定长度上下文向量的信息瓶颈。它给Seq2Seq带来了三项能力:
- 变长记忆:源序列越长,注意力覆盖的位置越多,容量线性增长。
- 动态对齐:不同目标位置查询不同源位置,天然吻合翻译等对齐任务。
- 可解释性:\(\alpha\)可视化后能给出粗略的对齐图,是调试Seq2Seq的有用信号。
也存在一些局限:
- 注意力不是显式对齐。Koehn & Knowles指出\(\alpha\)可能与语言学对齐系统偏差较大,视觉化的“漂亮对角线”未必反映真实机制。
- 依赖底层表示。注意力权重的质量最终取决于\(h_t\)与\(q_u\)的表达力,若编码器本身不够强,加注意力也难挽救。
- 计算量线性增长。对每个解码位置都要扫过整段源序列,\(O(UT)\)在很长序列上并非“免费”。
注意力最初是Seq2Seq的一个附加模块,但一旦把它推广到“查询自己内部”,就得到了自注意力机制——Seq2Seq内部循环网络也可以被完全替换掉。这一路径最终在Transformer处交汇。