Sequence to sequence.
自然语言的翻译、摘要、对话与语音识别都要求把一个变长序列映射到另一个变长序列,输入和输出之间既没有固定的对齐关系,也没有相同的长度。传统的RNN只能把序列映射到序列或标量,无法同时生成一个长度未知的目标序列。
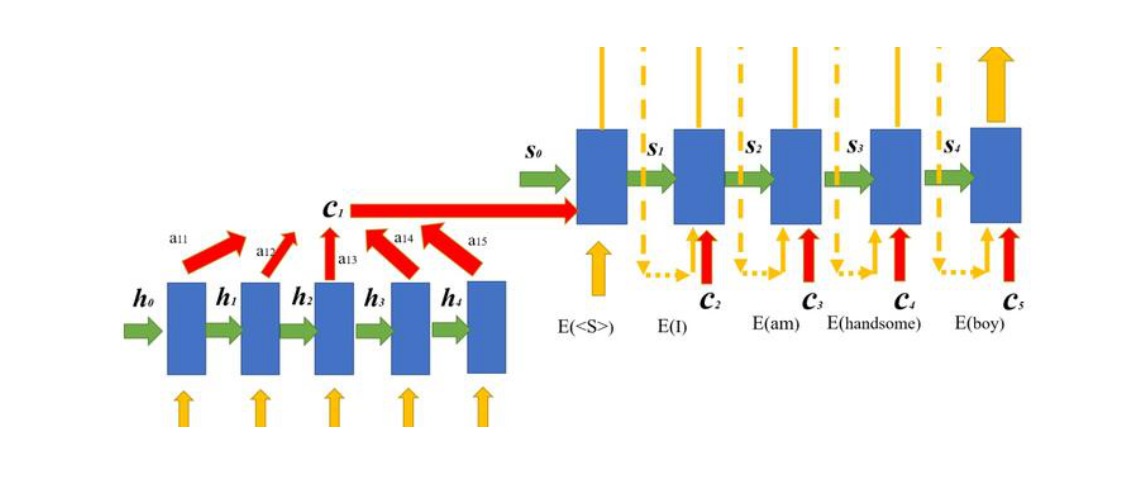
序列到序列(Sequence to Sequence,Seq2Seq)模型正是为这一类问题设计的:先用一个编码器(encoder)把整个源序列压成向量表示,再用一个解码器(decoder)以自回归方式逐位生成目标序列,直至输出终止符。它把“序列建模”和“条件语言模型”拼在同一张计算图上,成为神经机器翻译、图像描述、语音识别等任务在Transformer出现之前的主流框架。
本文目录:
- 编码器—解码器结构
- (1) RNN编码器—解码器
- (2) Sequence to Sequence Learning
- (3) 深层与双向的扩展
- 训练目标与教师强制
- 解码搜索
- (1) 贪婪搜索
- (2) 束搜索与长度归一化
- 曝光偏差与序列级训练
- (1) 计划采样
- (2) 序列级强化学习
- 条件Seq2Seq与输出词表扩展
- (1) 条件Seq2Seq
- (2) 指针网络
- (3) 拷贝机制与Pointer-Generator
- 覆盖度与重复问题
- 评估与讨论
符号约定:源序列\(x_{1:T}=(x_1,\dots,x_T)\),目标序列\(y_{1:U}=(y_1,\dots,y_U)\);编码器隐状态\(h_{1:T}\),解码器隐状态\(s_{1:U}\);\(\mathrm{BOS}\)和\(\mathrm{EOS}\)分别标识序列起始与终止。
1. 编码器—解码器结构
(1) RNN编码器—解码器
⚪ RNN Encoder-Decoder:把源序列压成上下文向量
Cho等人最早把编码器—解码器结构写成一个可端到端训练的RNN:编码器把源序列逐词读入循环单元,最终隐状态\(c=h_T\)作为上下文向量(context vector);解码器以\(c\)作为初始状态,对每个目标位置基于上一步隐状态、上一步生成的token以及\(c\)生成下一个词的分布:
\[\begin{aligned} h_t&=f_{\mathrm{enc}}(x_t,h_{t-1}),\\ s_u&=f_{\mathrm{dec}}(y_{u-1},s_{u-1},c),\\ p(y_u\mid y_{<u},x)&=\operatorname{softmax}(g(s_u,y_{u-1},c)). \end{aligned}\]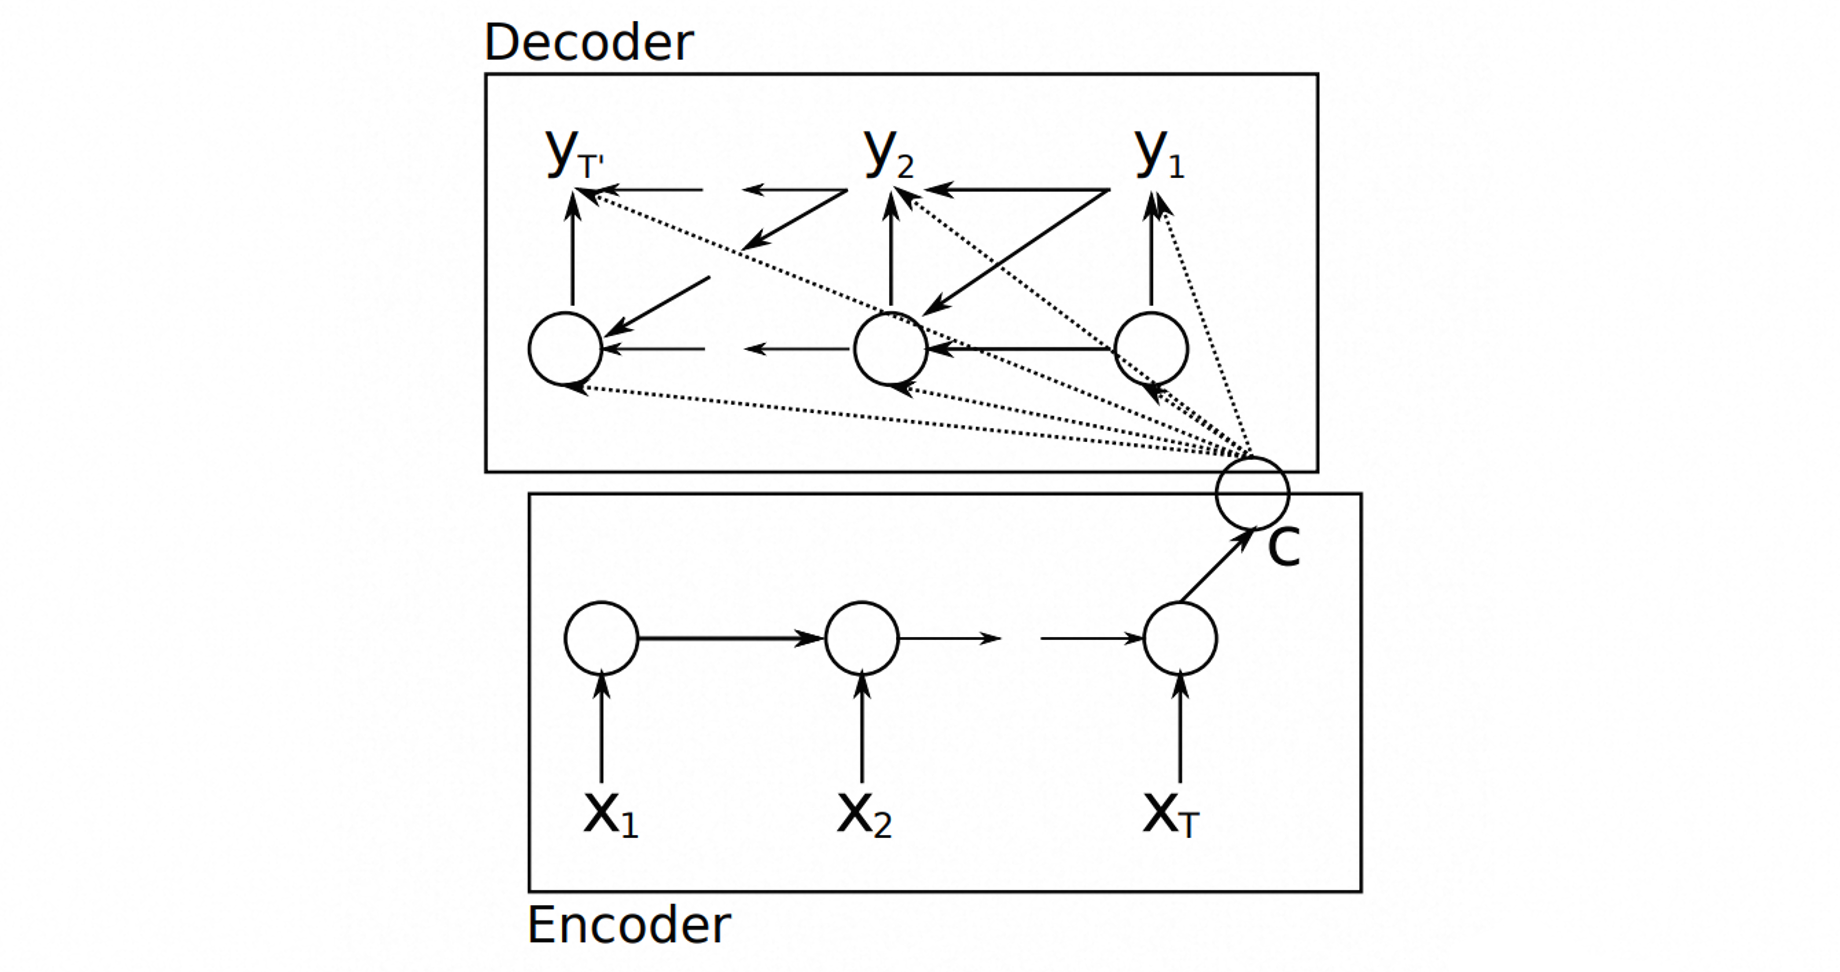
这篇论文同时提出了GRU门控单元,用于缓解长源序列上的梯度问题。RNN Encoder-Decoder最初被用作统计机器翻译的短语打分模块,之后被证明可以独立驱动神经机器翻译。
(2) Sequence to Sequence Learning
⚪ Seq2Seq:多层LSTM+反向输入
Sutskever等人给出了机器翻译上第一个纯神经网络的强基线。他们用四层LSTM做编码器,另一层LSTM做解码器;两者不共享参数,编码器最后时刻的隐状态与细胞状态一起传给解码器:
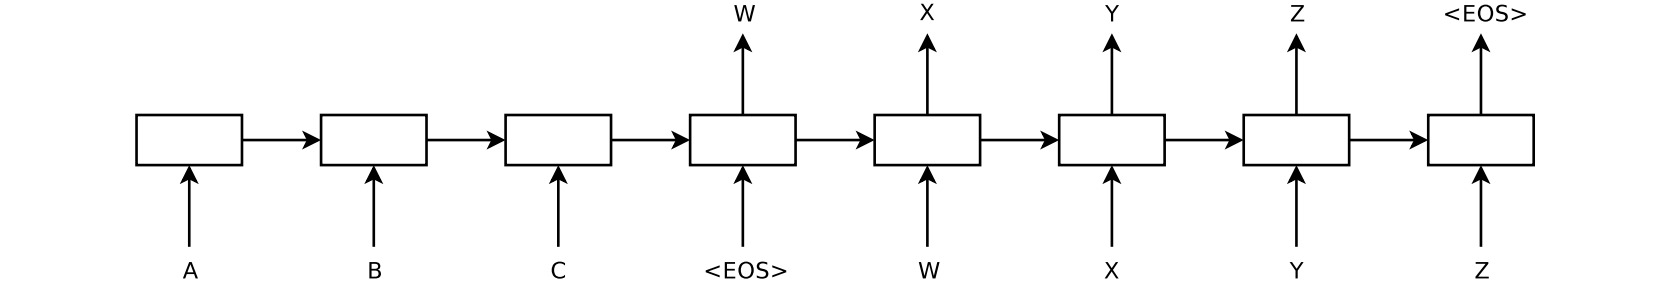
论文里有几项工程结论:
- 反向输入:把源句子颠倒顺序再喂给编码器,在英法翻译上把BLEU大幅提升。原因是源句子的前几个词离目标句子的前几个词更“近”,缓解了LSTM跨越长时间步的优化难度。
- 深层堆叠:四层LSTM明显优于一层,说明容量比反向输入更基础。
- 束搜索:解码时用beam search替代贪婪搜索能显著提高质量(见第$3$节)。
这两项工作确定了后续所有Seq2Seq变体的模板:一个把源序列压成固定长度表示的编码器,加一个基于该表示的条件语言模型解码器。
(3) 深层与双向的扩展
单向编码器只能看到左侧上下文,对翻译等任务并不理想。工程上常见的两项扩展:
- 双向编码器(bidirectional encoder):把正向与反向RNN的隐状态拼接,\(h_t=[\overrightarrow{h}_t;\overleftarrow{h}_t]\)。每个位置都携带完整上下文,且可以直接对齐到源位置;这是后续注意力机制所依赖的输入形式。
- 深层堆叠(deep stacking):编码器与解码器都堆多层LSTM/GRU。Google NMT在生产系统中使用\(8\)层LSTM并加入residual连接,用来在不损失稳定性的前提下扩大容量。
无论如何扩展,只要解码器只能依赖编码器最后一层的一个向量,就必须承担“变长源序列 → 定长向量”的信息瓶颈。
2. 训练目标与教师强制
Seq2Seq训练最大化对数似然:
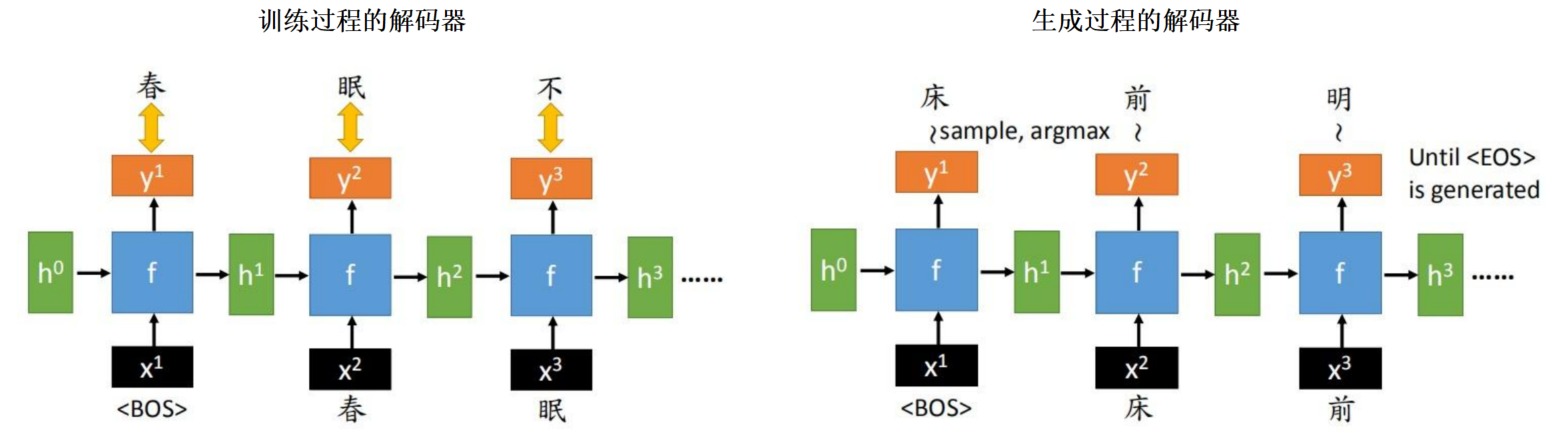
\[\mathcal{L}(\theta)=-\sum_{u=1}^{U}\log p_\theta(y_u\mid y_{<u},x).\]实现上,解码器输入的“上一步生成的token”并不来自模型自身预测,而是训练数据中的真实前缀——这就是教师强制(teacher forcing)。它把每一步的损失彼此解耦,允许并行计算所有时间步的梯度,也让训练过程稳定:模型永远看到正确的前缀,梯度不会被早期错误一路放大。
⭐ 讨论:教师强制的代价
教师强制的隐患是训练与推理的输入分布不一致。训练时前缀总是真实的,推理时前缀却是模型自己生成的;一旦某一步产生罕见词,后续状态就落到训练中没有见过的区域。这个训练—推理分布偏移被称为曝光偏差(exposure bias),将在第$4$节详述。教师强制换取的稳定收敛,代价就是把这一偏差留到解码阶段暴露。
3. 解码搜索
给定训练好的模型,生成任务的目标是找到概率最大的目标序列:
\[\hat{y}=\arg\max_{y}\prod_{u=1}^{U}p(y_u\mid y_{<u},x).\]严格求解要遍历所有可能序列,指数级复杂度不可行。实际使用启发式搜索。
(1) 贪婪搜索
贪婪搜索(greedy search)每一步选择当前概率最大的token:
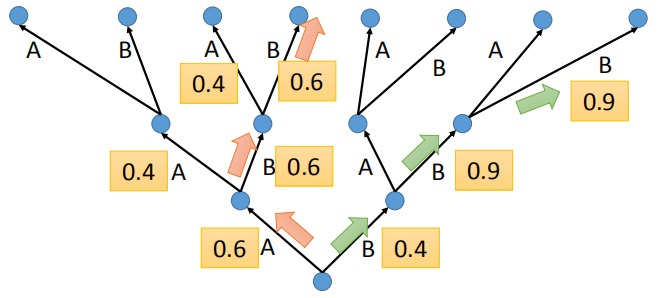
\[\hat{y}_u=\arg\max_{y_u}p(y_u\mid \hat{y}_{<u},x).\]它只需要单次前向传播,但一步的错误会一直传播下去。下图中绿色序列是全局最优,贪婪搜索却陷入红色分支:
(2) 束搜索与长度归一化
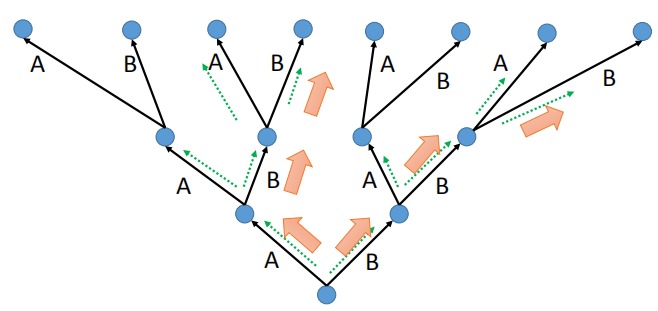
束搜索(beam search)在每一步保留概率最高的\(K\)条前缀,其中束宽(beam size)\(K\)是超参数。第\(u\)步先对束中每一条前缀扩展所有词表候选,再从\(K\cdot\lvert V\rvert\)个候选中挑出对数概率最高的\(K\)个:
束宽的权衡:\(K\)越大越有可能覆盖高概率序列,代价是\(K\)倍的计算量和显存;\(K=1\)退化为贪婪搜索;实践中翻译常用\(K\in[4,10]\),摘要或对话可能更大。
长度归一化:直接比较不同长度序列的对数概率会偏爱短序列,因为对数概率是负数、每多一步就更负。Wu等人在GNMT中提出长度惩罚:
\[\mathrm{score}(y)=\frac{\log p(y\mid x)}{\left(\dfrac{5+\lvert y\rvert}{5+1}\right)^{\alpha}},\]其中\(\alpha\in[0,1]\)是超参数,\(\lvert y\rvert\)为已生成长度。同一篇论文还提出覆盖惩罚,与第\(6\)节讨论的覆盖度相关。
⭐ 讨论:束搜索会“过度”吗
经验上\(K\)增大到一定程度反而降低质量,被称为束搜索悖论。原因是长度归一化不完美,且极大化\(p(y\mid x)\)未必等价于人类翻译偏好;模型对高概率序列的估计在tail处并不可靠。这不是搜索本身的问题,而是训练目标与评估指标之间存在系统偏差。
4. 曝光偏差与序列级训练
(1) 计划采样
⚪ Scheduled Sampling:在训练里逐步暴露自身预测
Scheduled Sampling在训练时按概率\(\varepsilon_i\)使用真实token、按\(1-\varepsilon_i\)使用模型自身采样的token作为解码器输入:
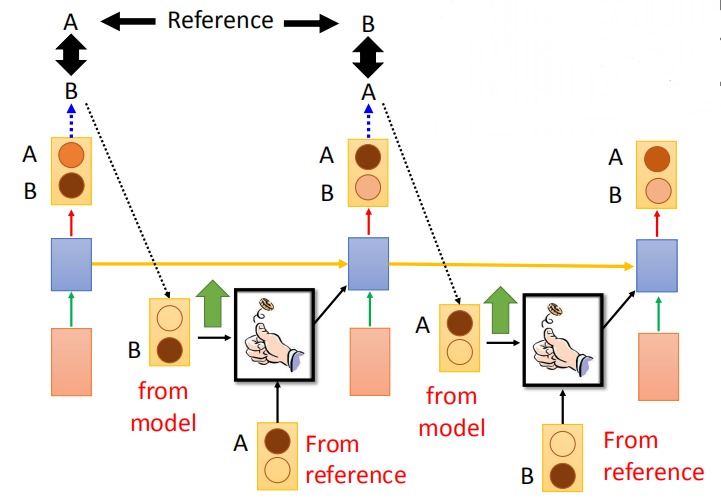
$\varepsilon_i$随训练步数逐步从\(1\)降到较小值,让模型在早期得到稳定的教师前缀,在后期越来越多地看到自身预测。它显著缓解了曝光偏差,但也引入两点缺陷:
- 过度纠正:无论输入替换成什么token,目标输出仍然是真实序列,模型可能被迫为不正确的前缀预测“正确”的下一个词。
- 梯度不一致:训练损失不再等价于对数似然,梯度沿采样操作没有显式定义(Huszár指出这带来了偏差估计)。
(2) 序列级强化学习
⚪ MIXER:把生成看成一个强化学习问题
Ranzato等人的MIXER从另一个角度解决曝光偏差:直接把序列级评价指标(如BLEU或ROUGE)当作强化学习的奖励,用REINFORCE优化。为避免从随机策略开始训练,先用交叉熵预热,再在训练过程中逐步把后缀的损失切换成策略梯度。
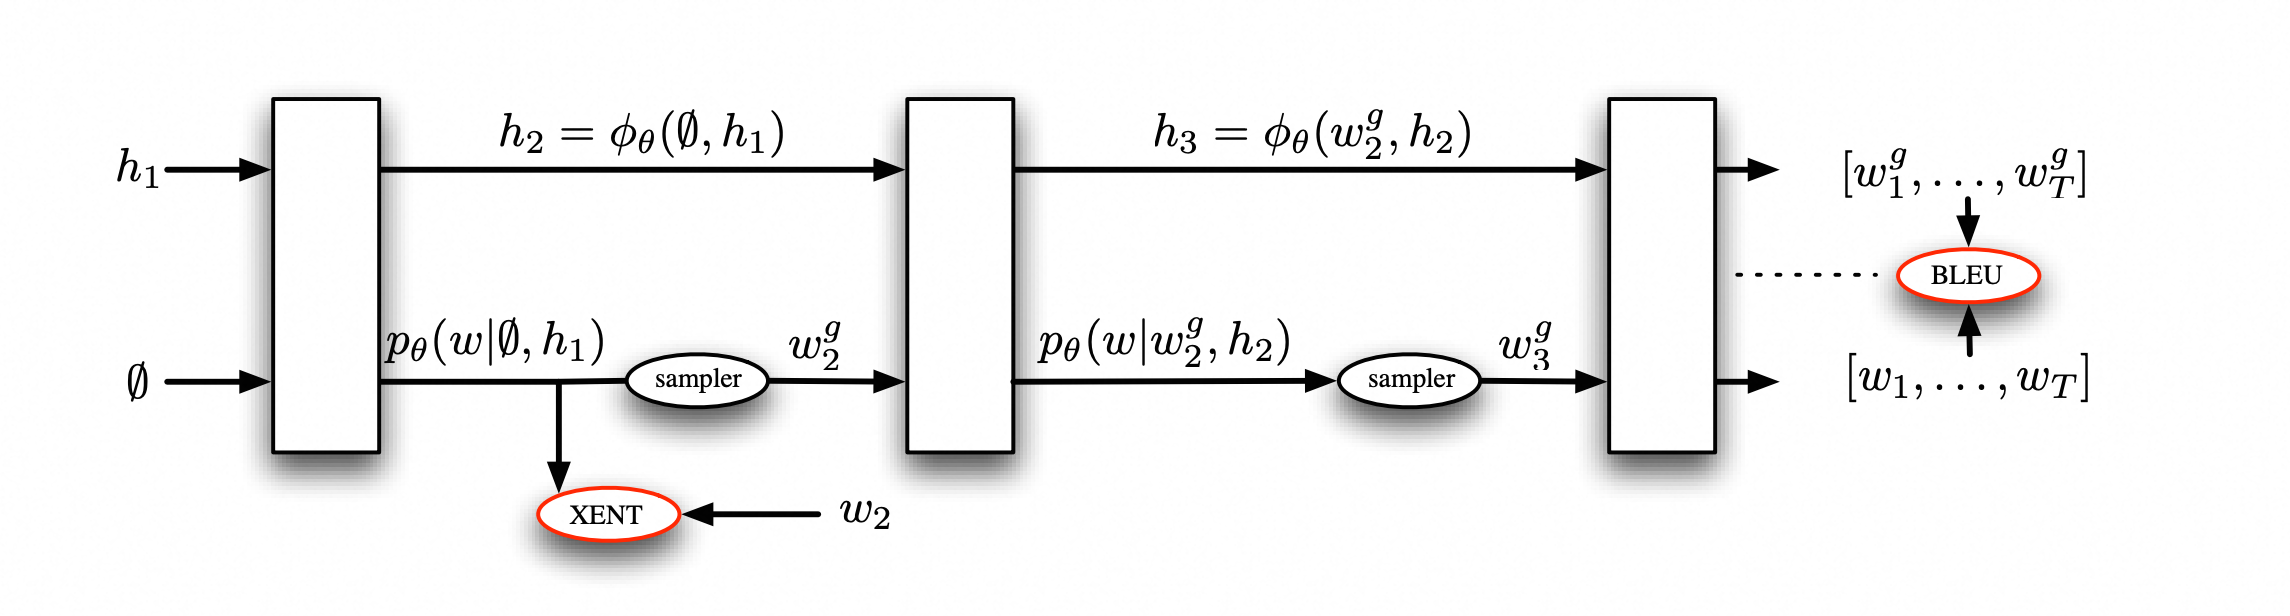
序列级训练对齐了训练目标与评估指标,也让模型在自身分布下学习。它的代价是策略梯度方差大、依赖精心设计的baseline;后续的Self-Critical Sequence Training用贪婪解码结果作为baseline进一步稳定训练。
5. 条件Seq2Seq与输出词表扩展
(1) 条件Seq2Seq
普通Seq2Seq只把源序列作为条件;很多任务还有额外条件,比如图像描述里的图像、对话中的说话人身份、机器翻译里的语气/风格标签。做法通常是把条件表示成向量\(z\),然后作为解码器每一步的额外输入:
\[s_u=f_{\mathrm{dec}}(y_{u-1},s_{u-1},c,z).\]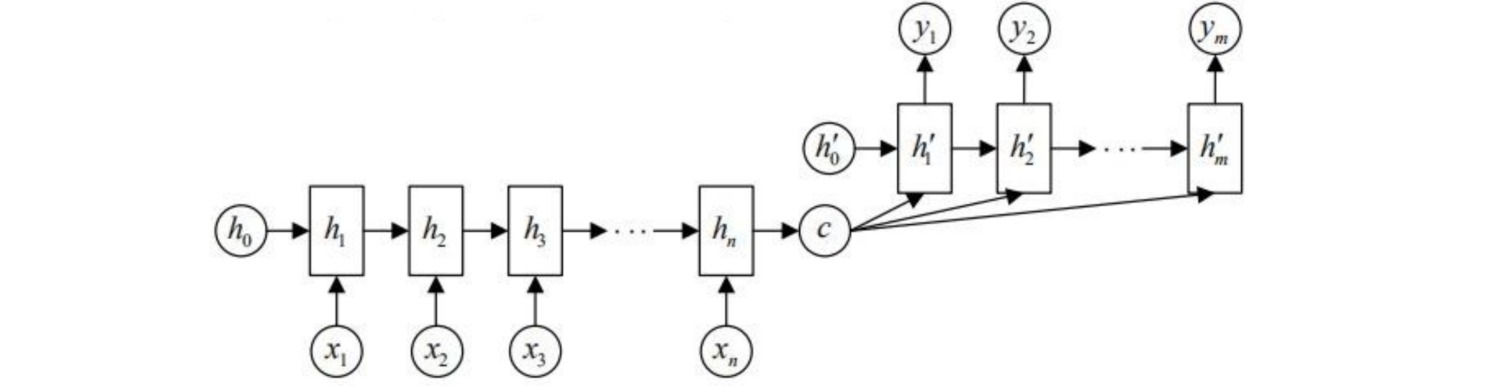
在图像描述任务中,\(z\)是CNN的图像特征;在多语言翻译中,\(z\)是目标语言标签的嵌入;在对话中,\(z\)可以是persona向量。条件Seq2Seq是引入外部信号的最简单方式。
(2) 指针网络
⚪ Pointer Network:让输出指向输入位置
- paper:Pointer Networks
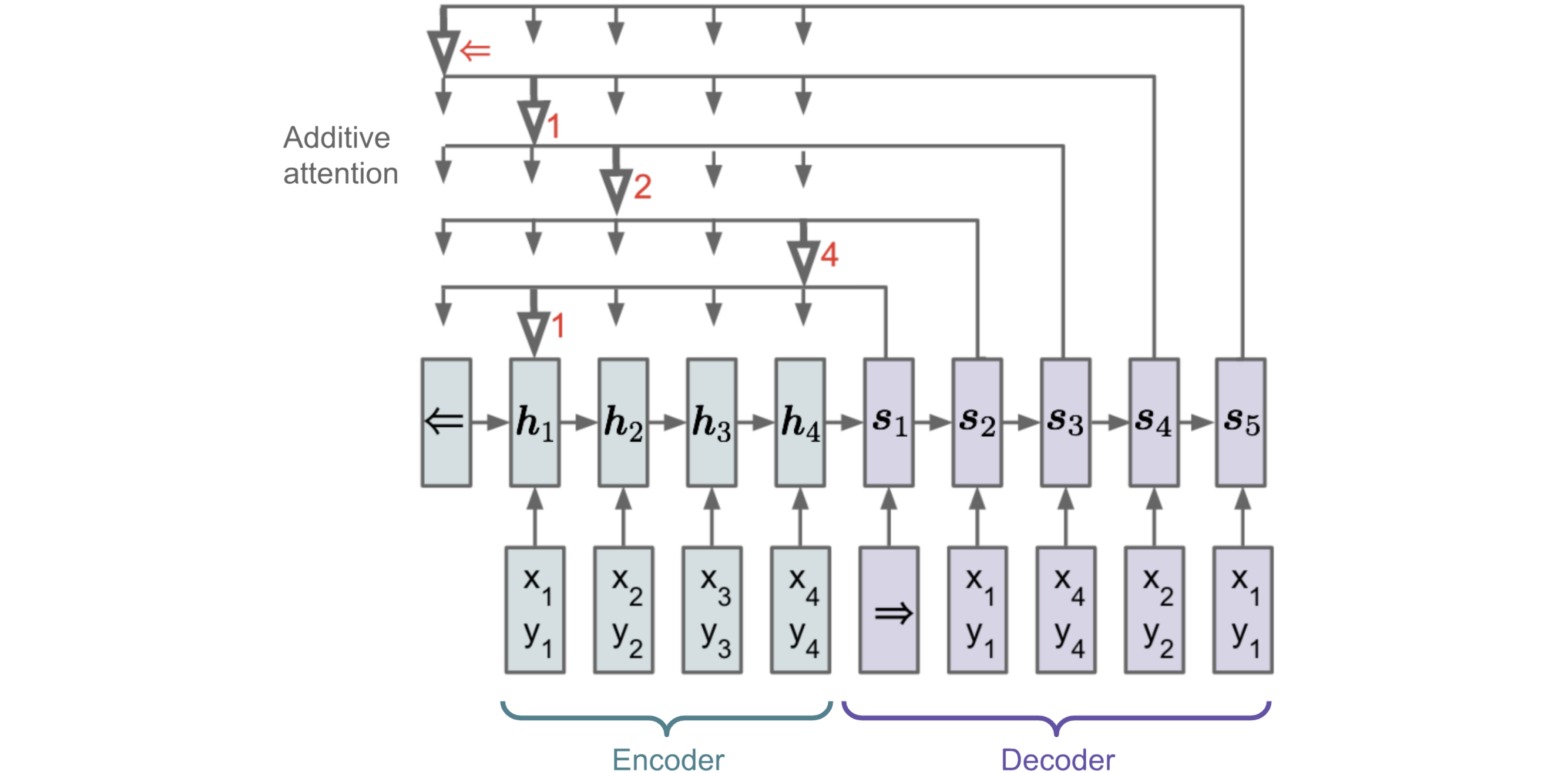
在排序、凸包、旅行商这类组合问题中,输出序列的长度由输入决定,且每个输出token都对应某个输入位置。此时词表随输入变化,无法用固定softmax层解决。
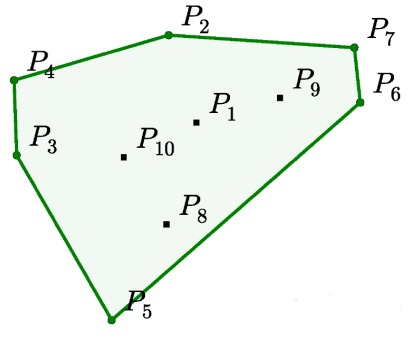
指针网络(Pointer Network)把注意力权重直接作为输出分布:解码器在第\(u\)步针对每个输入位置\(t\)计算得分\(e_{u,t}=v^\top\tanh(W_1h_t+W_2s_u)\),然后归一化得到
\[p(c_u=t\mid c_{<u},x)=\operatorname{softmax}(e_{u,t}).\]输出\(c_u\)即“指向输入的第\(t\)个位置”。这一结构把词表大小从固定值改成了输入长度\(T\),天然适应变化的输出空间。
(3) 拷贝机制与Pointer-Generator
⚪ CopyNet:混合生成与拷贝
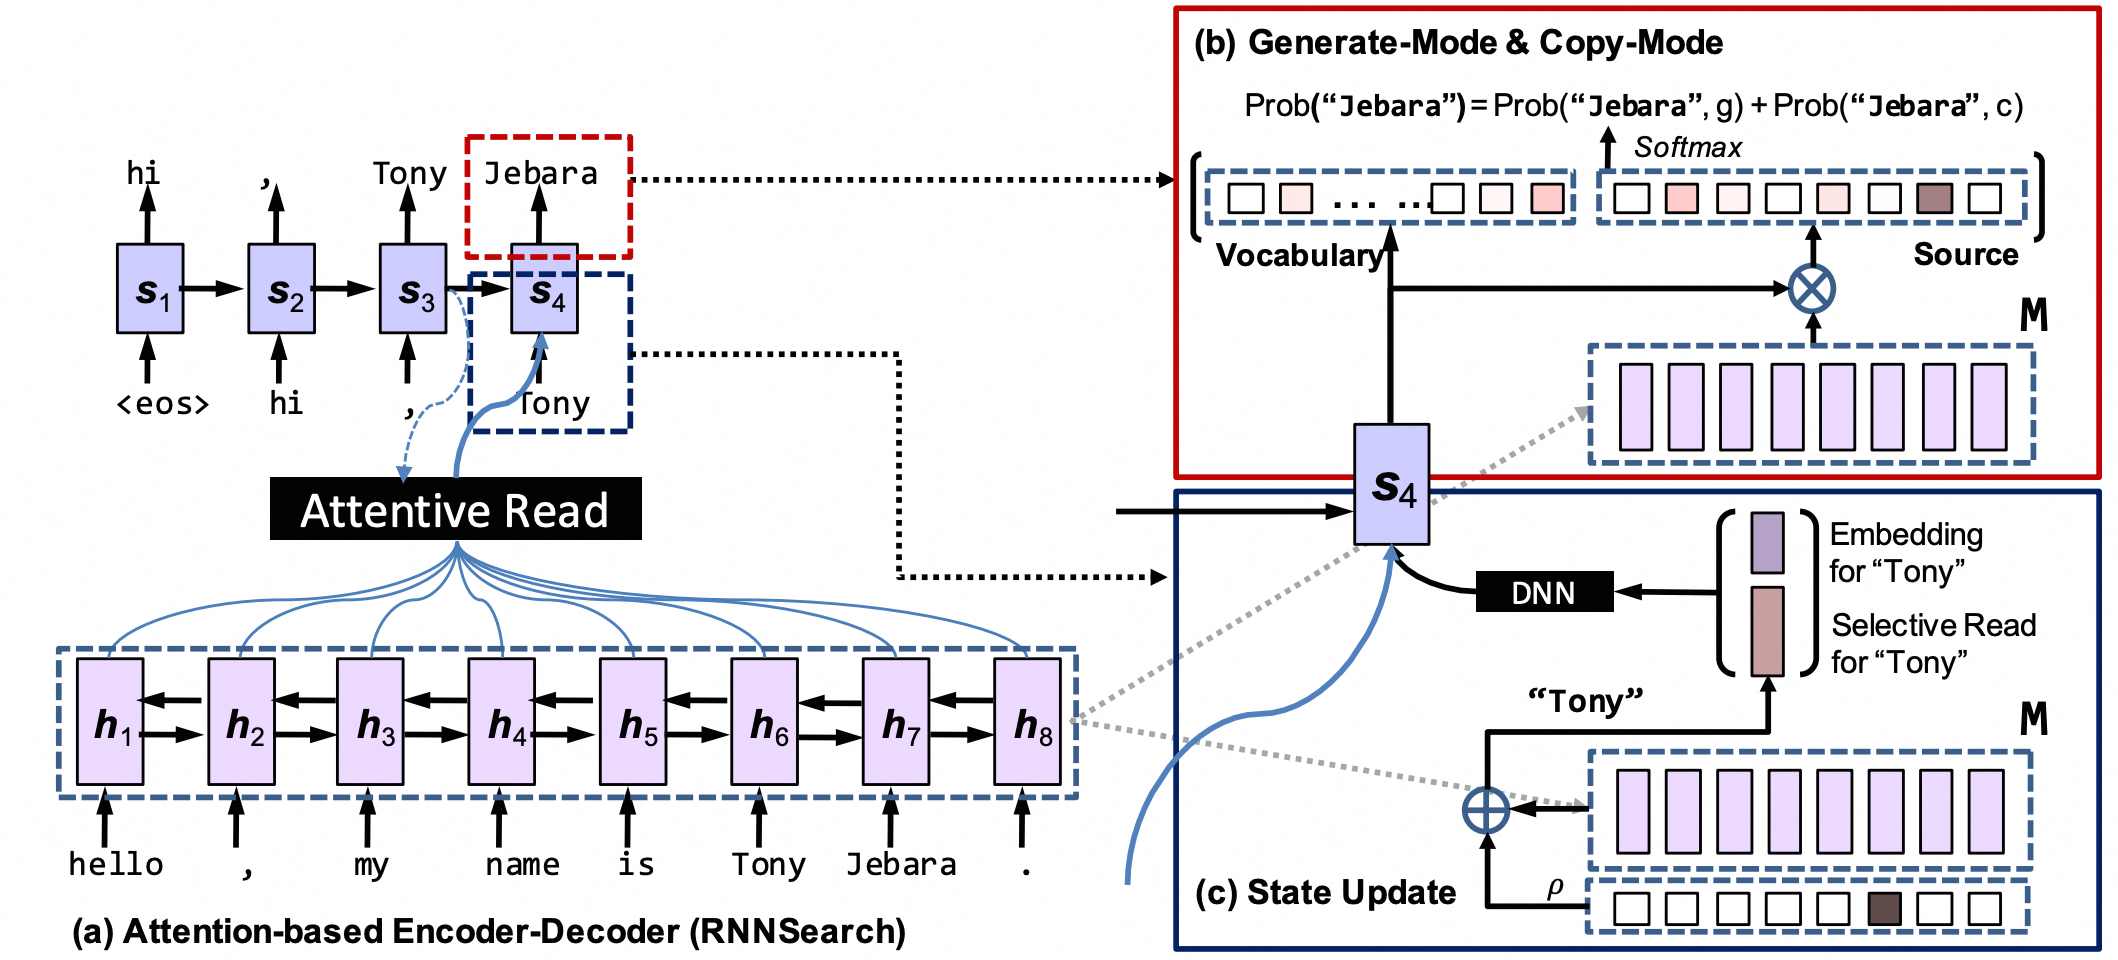
摘要、对话与问答里经常遇到罕见的实体或数字,词表里没有对应token。CopyNet引入拷贝概率\(p_{\mathrm{copy}}\),让模型在每一步选择:从固定词表生成一个词,或者从源序列拷贝一个词。词表分布与拷贝分布通过一个门控加权融合。
⚪ Pointer-Generator Network:抽象式摘要的标配
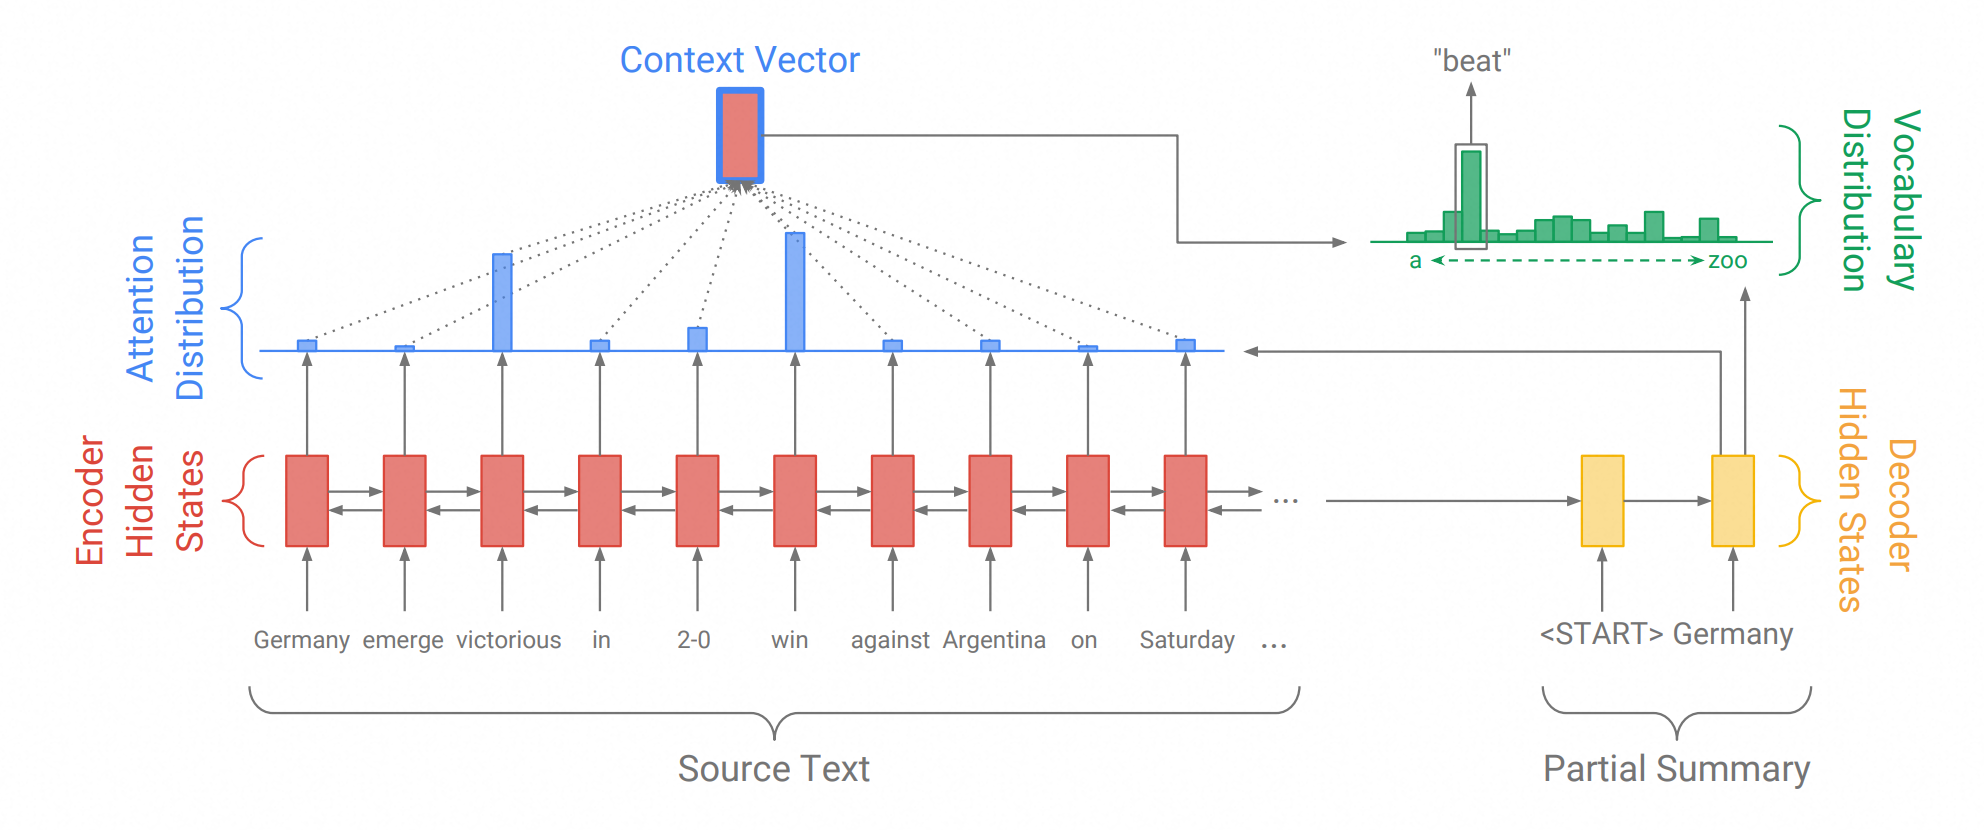
See等人的Pointer-Generator把上述思路整理成一个统一分布:
\[p(w)=p_{\mathrm{gen}}\cdot p_{\mathrm{vocab}}(w)+(1-p_{\mathrm{gen}})\sum_{t:\,x_t=w}\alpha_{u,t},\]其中\(p_{\mathrm{gen}}\in[0,1]\)由上下文向量、解码器状态和上一个token共同决定,\(\alpha_{u,t}\)是注意力权重。它兼顾了生成的表达力和拷贝的准确性,是Transformer之前抽象式摘要的强基线。
6. 覆盖度与重复问题
Seq2Seq在长序列生成中容易反复关注同一段源文本,导致输出出现重复片段(例如摘要中同一句反复出现)。Coverage Mechanism用一个累积向量记录到第\(u\)步为止每个源位置被注意力覆盖的程度:
\[\mathrm{cov}_{u,t}=\sum_{i=1}^{u-1}\alpha_{i,t}.\]把\(\mathrm{cov}_{u,t}\)作为注意力得分的额外输入,可以让模型倾向于关注还未被覆盖的源位置:
\[e_{u,t}=v^\top\tanh(W_1h_t+W_2s_u+W_3\mathrm{cov}_{u,t}).\]同时在损失中加入覆盖惩罚项\(\sum_{u,t}\min(\alpha_{u,t},\mathrm{cov}_{u,t})\),惩罚“继续关注已被覆盖的位置”。这一组合在Pointer-Generator上明显减少了重复;机器翻译中的Coverage Model(Tu等人)几乎同时提出了同样的思路。
7. 评估与讨论
Seq2Seq任务的评估在Transformer时代之前主要依赖n-gram匹配:机器翻译用BLEU、摘要用ROUGE、对话与图像描述常用METEOR、CIDEr。语言模型部分则用困惑度perplexity。这些指标都易受tokenization、大小写与参考数量影响,只能作为相对比较。
回顾整篇文章,早期Seq2Seq方法有三条共同的主线:
- 表示瓶颈:固定长度上下文向量无法承载长源序列的所有信息,这是引入注意力机制最直接的动机。
- 训练—推理错配:教师强制稳定训练,但需要计划采样或序列级强化学习来补足推理分布。
- 输出空间的可扩展性:条件Seq2Seq引入外部信号,指针网络与拷贝机制打破固定词表,覆盖机制约束解码的注意力使用。
这些机制是Seq2Seq框架配套的正交手段。它们与注意力机制一起,构成了从RNN式Seq2Seq通向Transformer之前的完整技术栈。