Recursive Neural Networks.
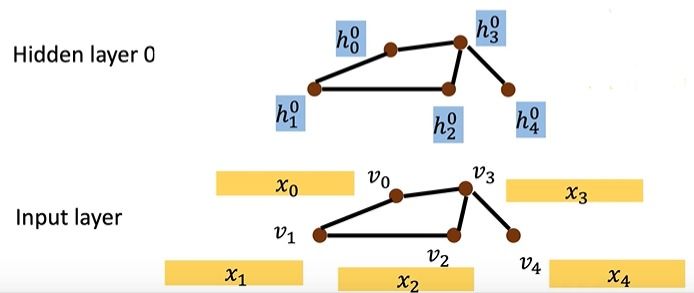
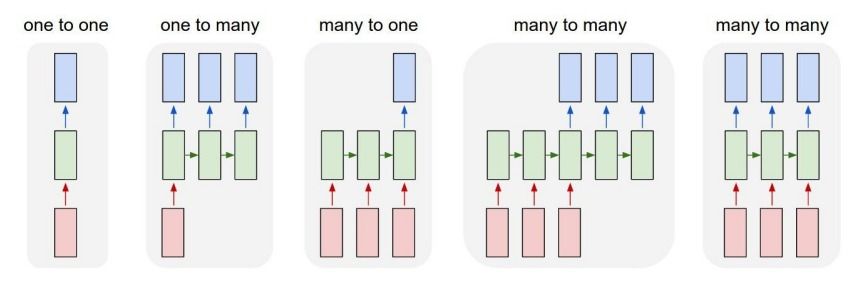
递归神经网络(Recursive Neural Network, RecNN/RvNN)把同一个神经组合函数递归地应用在树或有向无环图(DAG)的节点上:先计算叶节点,再根据子节点表示计算父节点,直到得到根节点表示。它与处理时间序列的循环神经网络(Recurrent Neural Network)计算拓扑完全不同:循环网络沿一条链传播状态,递归网络沿数据自身的层级结构传播表示。
递归神经网络最经典的应用是自然语言的组合语义(compositional semantics):词组成短语、短语组成从句、从句组成句子,父节点的语义由子节点组合得到。相同思想也适用于程序的抽象语法树、图像场景层级、知识库关系以及3D物体的部件树。
本文从基础递归组合、结构反向传播开始,依次介绍Recursive Autoencoder、MV-RNN、RNTN、Tree-LSTM、SPINN与潜在树学习,并讨论它们与循环网络、图神经网络和Transformer的关系。
- 什么是递归神经网络
- 1.1 在树与DAG上共享组合函数
- 1.2 递归网络、循环网络与图神经网络
- 1.3 常见树结构
- 基础TreeRNN的前向与训练
- 2.1 自底向上的组合
- 2.2 结构反向传播
- 2.3 树结构从哪里来
- 经典递归组合模型
- 3.1 从固定向量到内容相关组合
- 3.2 用门控记忆处理深树
- 学习树结构而不是依赖外部解析器
- 4.1 离散结构的端到端学习
- 递归网络的应用与扩展
- 5.1 自然语言处理
- 5.2 程序与抽象语法树
- 5.3 图像、场景与3D结构
- 与GNN和Transformer的关系
- 6.1 TreeRNN是树上的有向消息传递
- 6.2 Transformer为什么取代了大量TreeRNN
- 工程实现
- 7.1 后序遍历与按深度批处理
- 7.2 变长分支的处理
- 7.3 复杂度与数值稳定性
1. 什么是递归神经网络
1.1 在树与DAG上共享组合函数
设结构为有根树\(T=(V,E)\),节点$j$的子节点集合记为\(C(j)\)。每个叶节点具有输入特征$x_j$,内部节点根据子节点表示计算自身表示:
\[h_j = f_{\theta_j}\left(x_j,\{h_k:k\in C(j)\}\right).\]递归神经网络的关键约束是参数共享:相同类型的节点共用同一个组合函数$f_\theta$。因此网络参数量不随树的节点数和深度增长,而计算图会根据每个样本的结构动态展开。
对最常见的二叉树,父节点$p$由左、右子节点$l,r$组成:
\[\begin{aligned} a_p &= W_Lh_l+W_Rh_r+b \\ h_p &= \phi(a_p). \end{aligned}\]也可以把两个子节点拼接后写成:
\[h_p=\phi\left(W\begin{bmatrix}h_l\\h_r\end{bmatrix}+b\right), \qquad W=[W_L,W_R].\]若所有内部节点共享$W_L,W_R,b$,则同一个局部组合规则可以应用到任意大小、任意深度的树:
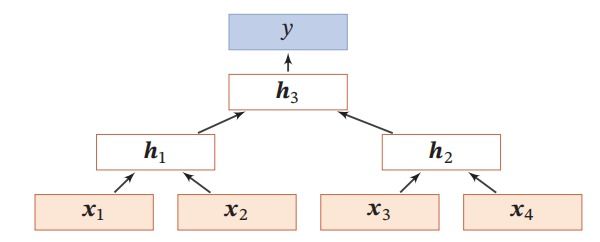
\[\begin{aligned} h_1 &= \phi\left(W[x_1;x_2]+b\right) \\ h_2 &= \phi\left(W[x_3;x_4]+b\right) \\ h_3 &= \phi\left(W[h_1;h_2]+b\right) \\ y &= g(W_oh_3+b_o). \end{aligned}\]1.2 递归网络、循环网络与图神经网络
三类网络都通过参数共享处理可变尺寸输入,但共享发生的维度不同:
| 网络 | 计算结构 | 单元的前驱 | 典型输入 |
|---|---|---|---|
| 循环神经网络 | 时间链 | 上一时刻 | 文本、语音、时间序列 |
| 递归神经网络 | 树或DAG | 一个或多个子节点 | 句法树、AST、部件层级 |
| 图神经网络 | 一般图上的迭代消息传递 | 任意邻居 | 社交图、分子图、知识图谱 |
一条链本身就是每个节点只有一个子节点的特殊树,因此递归网络可以退化成循环网络:
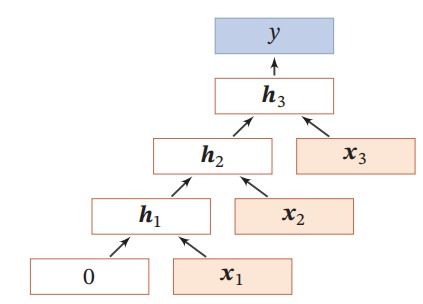
但两者的归纳偏置不同:
- 循环网络假设相邻位置最先交互,任意两个词之间的路径长度等于它们的序列距离;
- 递归网络假设树中相邻节点最先交互,句法相关但在线性序列中相距很远的词可以通过较短路径组合;
- 图神经网络通常在固定图上重复多轮消息传递,而递归网络按照拓扑序对每个节点计算一次,属于树/DAG上的动态规划。
⭐ 讨论:为什么“递归”不等于程序里的函数递归
数学上的递归指同一种组合规则反复作用于子结构;实现时不一定真的调用递归函数。为了批量化和避免Python调用开销,工程实现通常先把树按深度或拓扑序分层,再用循环、gather/scatter和批量矩阵乘法执行。
1.3 常见树结构
⚪ 成分句法树:短语逐级组合
成分句法树(constituency tree)的叶节点是词,内部节点表示名词短语、动词短语等句法成分。通常先把多叉树二值化,再用左右子节点组合父节点。根节点表示整个句子,也可以在每个短语节点上执行分类。
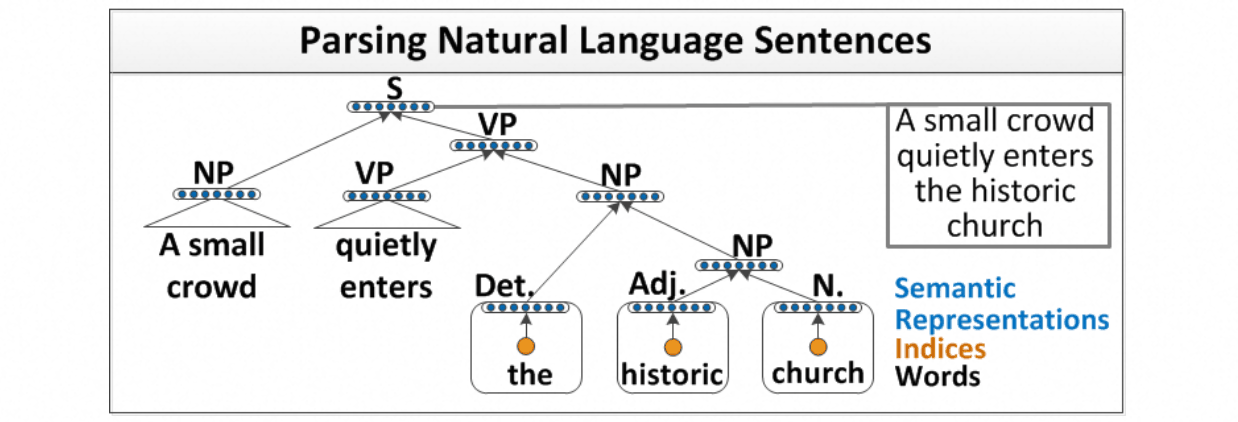
成分树明确给出“先组合谁”:例如否定词与形容词先组成短语,再与名词短语组合。这种结构非常适合建模“not very good”一类不能由词向量简单平均得到的组合语义。
⚪ 依存句法树:以中心词聚合修饰词
依存句法树(dependency tree)中的每个节点都是一个词,边表示主谓、动宾、修饰等依存关系。一个中心词可以有数量不定的子节点,因此更适合使用多叉组合或Child-Sum Tree-LSTM。
成分树强调短语边界,依存树强调词之间的语法关系。哪一种更合适取决于任务:句子分类常用成分树,关系抽取、依存分析和以中心词为核心的任务常用依存树。
⚪ 一般层级与DAG:结构不只来自语言
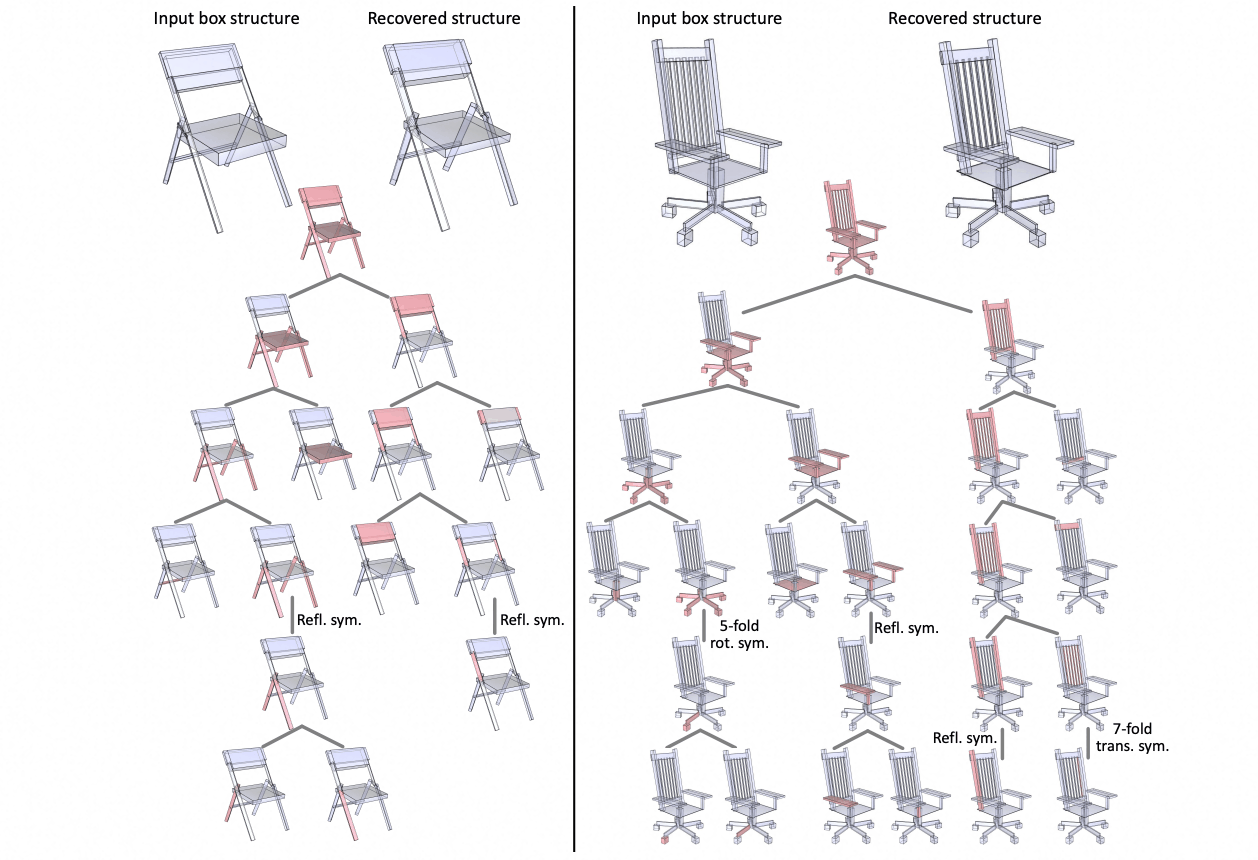
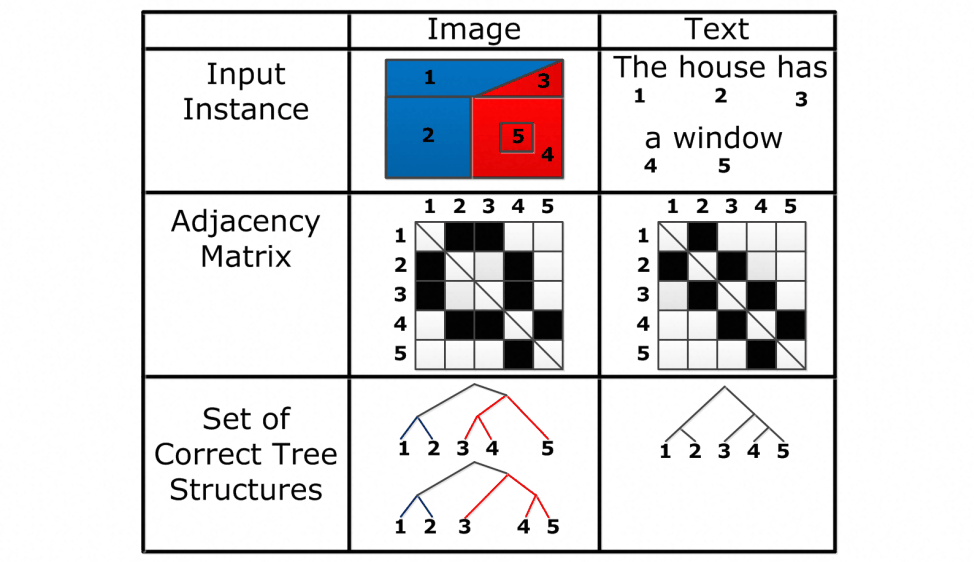
树结构也可以来自3D物体的部件层级、图像的区域合并、文件系统和程序AST。如果一个子节点被多个父节点共享,结构就从树变成DAG;此时仍可按拓扑序前向计算,只是在反向传播时要把来自所有父节点的梯度相加。
2. 基础TreeRNN的前向与训练
2.1 自底向上的组合
⚪ 基础TreeRNN:用共享仿射层组合子节点
设一棵二叉树的后序遍历顺序为\(v_1,\ldots,v_{\lvert V\rvert}\)。叶节点直接查词向量或编码输入:
\[h_j=E[x_j],\qquad j\in\mathcal{L},\]内部节点在两个子节点都计算完后执行:
\[h_j=\phi\left(W_Lh_{l(j)}+W_Rh_{r(j)}+b\right).\]如果只需要整棵树的表示,使用根节点$h_{root}$;如果每个短语都有标签,则所有内部节点都可以接预测头:
\[p_j=\operatorname{softmax}(W_sh_j+b_s).\]整体监督损失是所有有标签节点损失之和:
\[\mathcal{L}_{sup}=\sum_{j\in V_{label}}\operatorname{CE}(p_j,y_j).\]节点级监督比只监督根节点提供更短的梯度路径,也是Stanford Sentiment Treebank能有效训练深层递归模型的重要原因。
2.2 结构反向传播
递归网络的反向传播通常称为Backpropagation Through Structure(BPTS),它是时间反向传播(BPTT)在树/DAG上的推广。
定义内部节点的局部误差信号:
\[\delta_j\triangleq\frac{\partial\mathcal{L}}{\partial a_j}, \qquad a_j=W_Lh_l+W_Rh_r+b.\]节点$j$的表示既参与自身预测,也会被父节点继续使用,因此总梯度由“本节点监督”和“父节点传回”两部分组成:
\[\delta_j= \left( \frac{\partial\mathcal{L}_j}{\partial h_j} +W_{role(j)}^\top\delta_{parent(j)} \right)\odot\phi'(a_j),\]其中$W_{role(j)}$根据$j$是左子结点还是右子结点取$W_L$或$W_R$。共享参数的梯度要对所有内部节点求和:
\[\begin{aligned} \frac{\partial\mathcal{L}}{\partial W_L} &=\sum_{j\in V_{inner}}\delta_jh_{l(j)}^\top,\\ \frac{\partial\mathcal{L}}{\partial W_R} &=\sum_{j\in V_{inner}}\delta_jh_{r(j)}^\top,\\ \frac{\partial\mathcal{L}}{\partial b} &=\sum_{j\in V_{inner}}\delta_j. \end{aligned}\]树的前向使用后序遍历,反向则从根向叶执行。对DAG,一个节点可能有多个父节点,其误差信号应先累加所有父节点贡献,再乘局部导数。
⭐ 讨论:递归深度同样会造成梯度消失
从叶节点到根节点的梯度需要连续乘多个Jacobian,树很深时仍会出现梯度消失或爆炸。平衡二叉树的深度是$O(\log \lvert V\rvert)$,但极端右分支树会退化成深度$O(\lvert V\rvert)$的链。因此树的形状不仅表达语法,也直接决定优化难度。Tree-LSTM用记忆单元与门控缓解这一问题。
2.3 树结构从哪里来
递归网络需要同时回答两个问题:节点表示怎样组合,以及组合顺序由谁决定。
- 外部给定:由句法分析器、程序解析器、场景层级标注或领域规则提供树;
- 监督预测:使用树库训练解析器,再把预测树交给递归编码器;
- 联合搜索:一边构造树,一边根据重构误差、分类损失或结构分数选择合并;
- 潜在树学习:不提供树标签,只用下游任务损失学习离散组合顺序。
外部树具有可解释性,但解析错误会传递到下游模型;潜在树直接服务于任务,但学到的结构未必对应人类句法,也可能对随机种子敏感。
3. 经典递归组合模型
3.1 从固定向量到内容相关组合
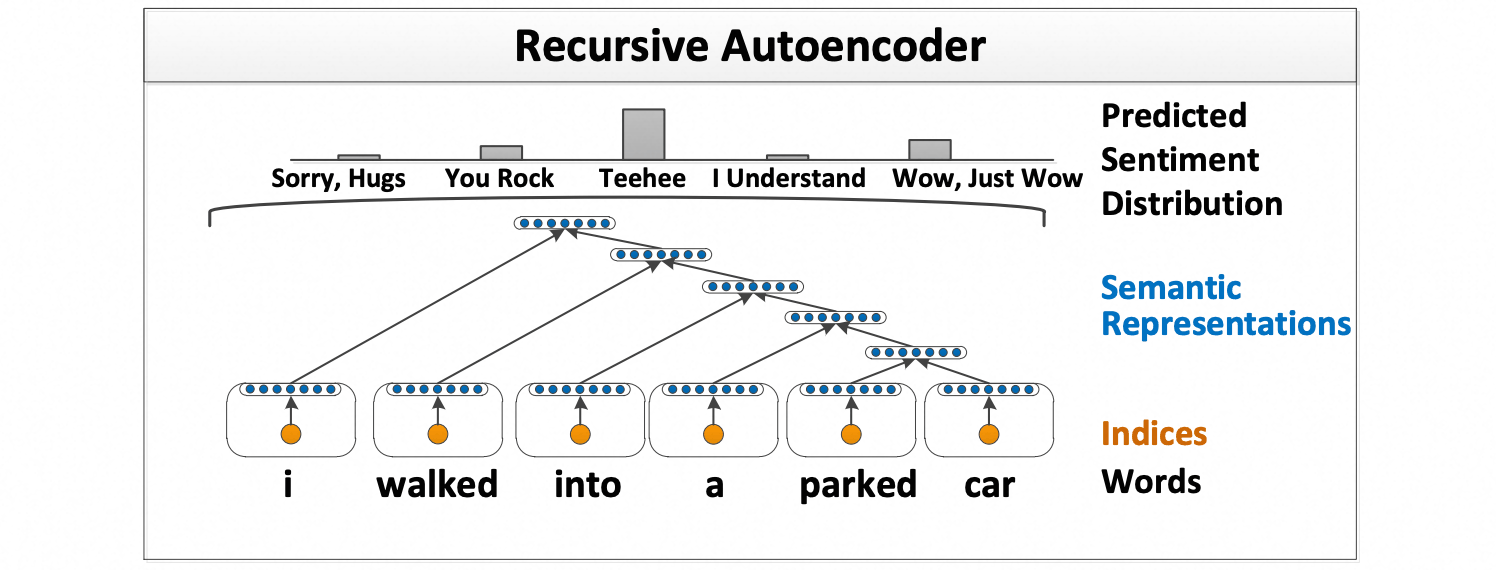
⚪ Recursive Autoencoder:用重构误差学习短语表示与树结构
Recursive Autoencoder(RAE)在每次组合后尝试重构两个子节点。编码器为
\[h_p=\phi\left(W_e[h_l;h_r]+b_e\right),\]解码器把父节点还原成两个子表示:
\[[\hat h_l;\hat h_r]=W_dh_p+b_d.\]局部重构损失为
\[\mathcal{L}_{rec}(p) =\left\|h_l-\hat h_l\right\|_2^2 +\left\|h_r-\hat h_r\right\|_2^2.\]如果没有现成句法树,可以在相邻节点对中选择重构误差最小的一对合并,反复执行直到只剩根节点。这是一种贪心的潜在树构造。半监督版本同时优化重构损失和分类损失:
\[\mathcal{L}=\mathcal{L}_{sup}+\lambda\sum_{p\in V_{inner}}\mathcal{L}_{rec}(p).\]RAE的重构目标能利用无标签文本,但欧氏重构误差不一定与下游语义一致;贪心合并一旦选错,后续无法回退。
⚪ Matrix-Vector RNN:每个词同时携带语义与组合算子
普通TreeRNN让所有词共享同一个组合矩阵,因此“very good”和“not good”只能依靠词向量内容产生差异。Matrix-Vector RNN(MV-RNN)为每个词或短语同时分配:
- 向量$v$:表示它自身的语义;
- 矩阵$M$:表示它怎样改变另一个成分的语义。
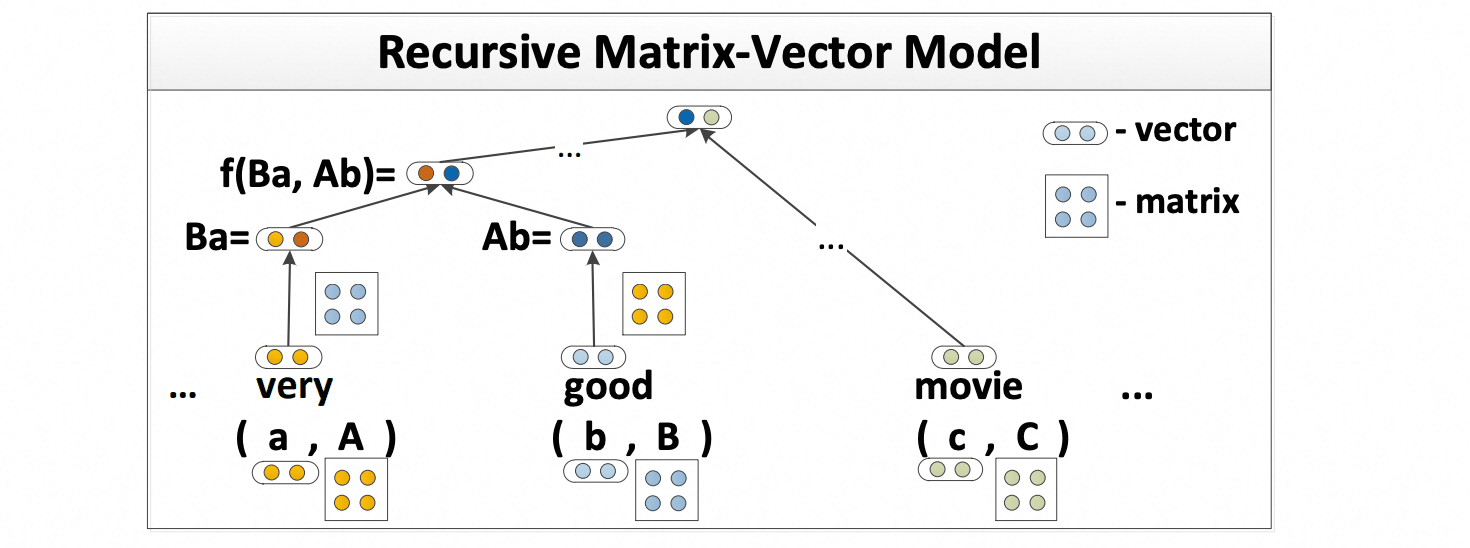
对两个子节点$(v_l,M_l)$与$(v_r,M_r)$,先让双方矩阵作用于对方向量,再进行组合:
\[v_p=\phi\left( W_v \begin{bmatrix} M_rv_l\\ M_lv_r \end{bmatrix} +b_v \right).\]父节点矩阵则由两个子矩阵组合:
\[M_p=W_M[M_l;M_r]+b_M.\]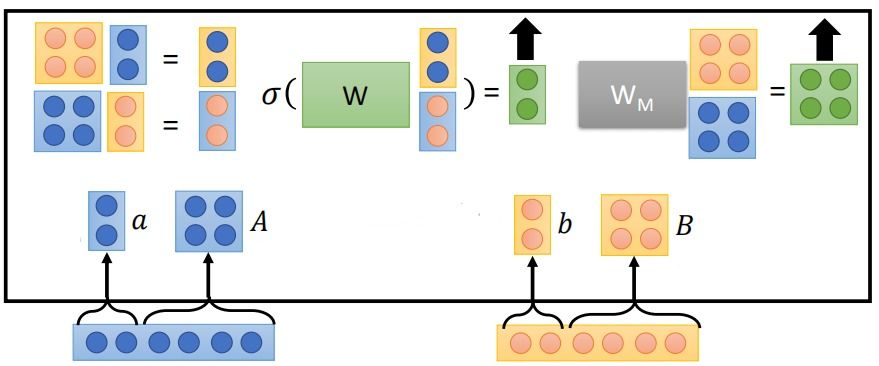
这种设计把“内容”和“函数”分开:名词更像语义载体,形容词、否定词和动词更像对邻居施加变换的函数。缺点是每个词需要一个$d\times d$矩阵,参数量和计算量都很大,低频词的矩阵也难以可靠学习。
⚪ Recursive Neural Tensor Network:显式建模子节点的双线性交互
基础TreeRNN的组合是拼接后的仿射变换,两个子节点只在线性求和后通过激活函数间接交互:
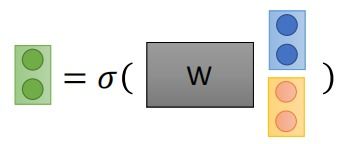
Recursive Neural Tensor Network(RNTN)增加三阶张量$V^{[1:d]}\in\mathbb{R}^{2d\times2d\times d}$。记\(z=[h_l;h_r]\),父节点为
\[h_p=\phi\left( \begin{bmatrix} z^\top V^{[1]}z\\ \vdots\\ z^\top V^{[d]}z \end{bmatrix} +Wz+b \right).\]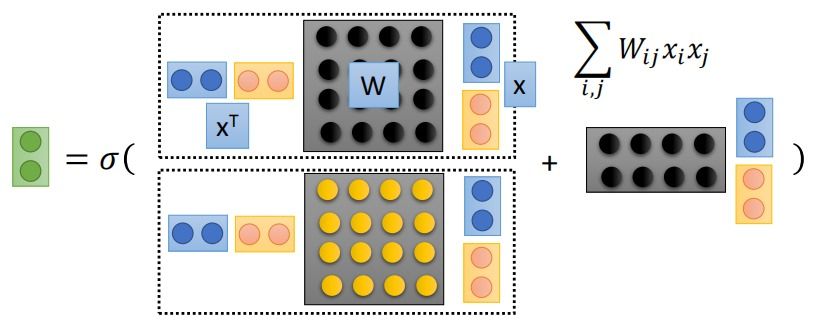
每个张量切片都计算一个双线性标量,因此能够直接表达“左成分的某个维度如何调制右成分的某个维度”。它特别适合否定、程度副词等非加性组合。
RNTN的代价是参数量与单节点计算量达到$O(d^3)$。实践中可以对张量切片做低秩分解,把双线性交互写成若干低秩因子的乘积,从而把成本降到$O(rd^2)$。
3.2 用门控记忆处理深树
⚪ Tree-LSTM:为每个子节点设置独立遗忘门
Tree-LSTM把链式LSTM推广到树。每个节点$j$同时维护隐状态$h_j$与记忆状态$c_j$,并允许多个子节点把各自记忆传给父节点:
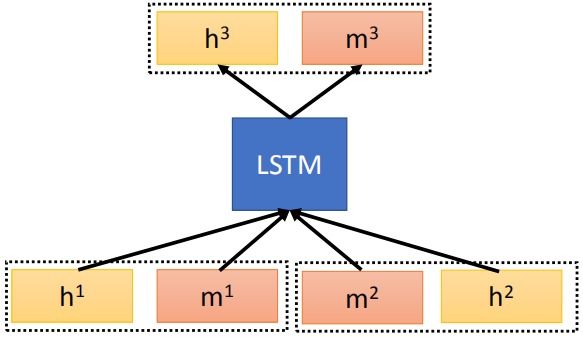
Child-Sum Tree-LSTM适合子节点数量不定、次序不重要的依存树。先聚合所有子节点隐状态:
\[\tilde h_j=\sum_{k\in C(j)}h_k.\]门控与候选状态为:
\[\begin{aligned} i_j &= \sigma(W_ix_j+U_i\tilde h_j+b_i),\\ o_j &= \sigma(W_ox_j+U_o\tilde h_j+b_o),\\ u_j &= \tanh(W_ux_j+U_u\tilde h_j+b_u),\\ f_{jk} &= \sigma(W_fx_j+U_fh_k+b_f). \end{aligned}\]每个子节点$k$都有独立遗忘门$f_{jk}$,父节点记忆和输出为:
\[\begin{aligned} c_j &= i_j\odot u_j+ \sum_{k\in C(j)}f_{jk}\odot c_k,\\ h_j &= o_j\odot\tanh(c_j). \end{aligned}\]这使父节点可以保留某些子树的长期信息,同时丢弃不相关子树。
N-ary Tree-LSTM适合子节点数量固定、位置有意义的成分树。它为第$k$个子位置使用独立参数$U_k$,还能让第$k$个遗忘门查看其他位置的隐状态,因此可以区分左、右子节点:
\[i_j=\sigma\left(W_ix_j+ \sum_{k=1}^{N}U_k^{(i)}h_{jk}+b_i\right).\]Child-Sum版本具有置换不变性,N-ary版本能够建模子节点顺序,但参数量随最大分支数增长。
⚪ SPINN:把树计算改写成可批量的SHIFT-REDUCE过程
传统TreeRNN需要先为每个句子准备树,再按不同拓扑逐节点执行,很难组成规整批量。SPINN(Stack-augmented Parser-Interpreter Neural Network)把二叉树编码改写成移进-归约(shift-reduce)动作序列:
- SHIFT:把下一个词表示压入栈;
- REDUCE:弹出栈顶两个表示,用TreeRNN/Tree-LSTM组合后压回;
- 动作结束时,栈顶表示整句。
不同句子可以在同一步同时执行SHIFT或REDUCE,并用掩码处理动作差异,因此能进行批量计算。模型还可以联合预测动作序列,从原始文本中同时学习解析与句子表示。
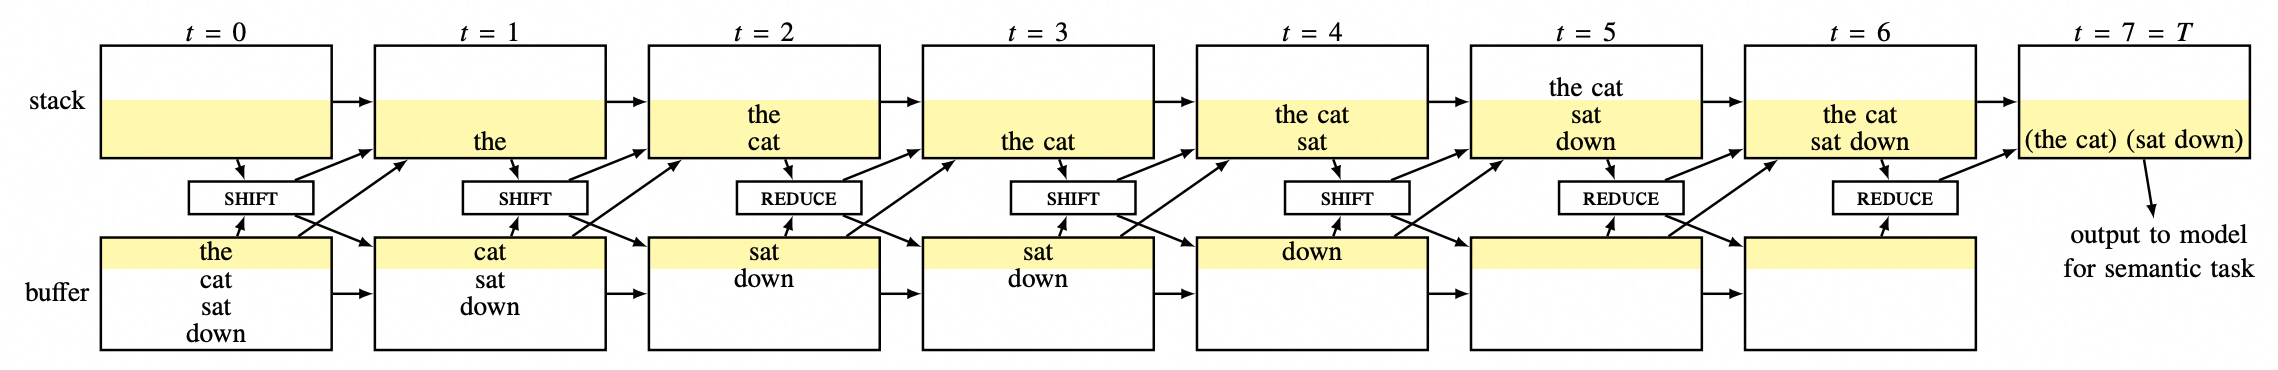
SPINN说明递归结构的计算瓶颈不一定来自树本身,而来自不规则调度;只要把树线性化成有限动作集合,就能显著提高吞吐量。
4. 学习树结构而不是依赖外部解析器
4.1 离散结构的端到端学习
⚪ RL-SPINN:用下游任务奖励学习组合顺序
离散的SHIFT/REDUCE动作不能直接反向传播。RL-SPINN把解析器看成策略,以下游分类性能作为奖励,用策略梯度学习动作序列。这样得到的树是任务特定(task-specific)的,不必与语言学句法完全一致。
优点是消除了外部解析器依赖;缺点是策略梯度方差大、训练不稳定,而且潜在树容易形成偏向左分支或右分支的退化策略。
⚪ Gumbel Tree-LSTM:用可微采样选择合并节点
Gumbel Tree-LSTM在每一层为所有相邻节点对计算合并分数,通过Straight-Through Gumbel-Softmax选择一个父节点。前向使用近似离散的one-hot决策,反向使用连续softmax梯度,从而端到端学习二叉树。
它避免了策略梯度的高方差,但每次只合并一对节点,长度为$T$的句子需要$T-1$轮选择;温度、随机种子和训练目标都会影响最终树形。
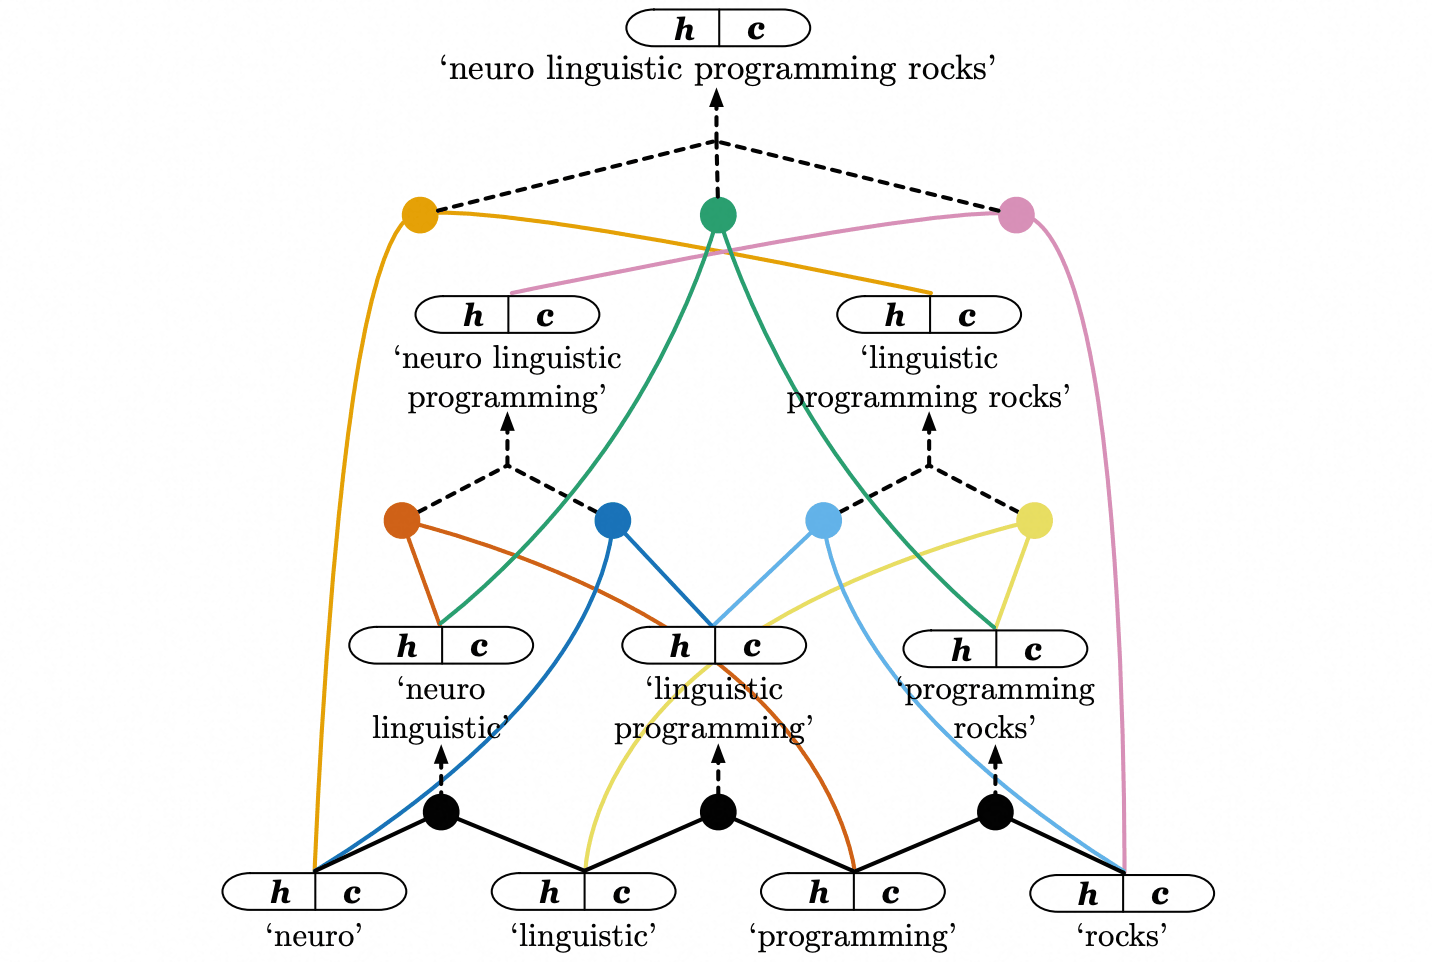
⚪ 可微Chart Parser:在所有子树划分上做动态规划
对跨度$(i,j)$,二叉树根部可能在任意位置$k$切分。可微chart parser为所有切分计算候选表示与分数,再用softmax加权:
\[h_{i:j}=\sum_{k=i}^{j-1} \alpha_{i,j,k}\operatorname{Compose}(h_{i:k},h_{k+1:j}).\]这种方法在训练时对多棵树做软边缘化,推理时再取最高分树。它比贪心合并更全面,但动态规划复杂度通常达到$O(T^3)$,长序列成本很高。
5. 递归网络的应用与扩展
5.1 自然语言处理
递归网络曾广泛用于:
- 情感分析:在词、短语和句子各级预测情感,处理否定与程度组合;
- 语义相关度与文本蕴含:比较两棵句法树的节点表示;
- 句法分析:把子树表示作为解析器状态;
- 关系抽取:沿依存树压缩两个实体之间的结构路径;
- 问答与机器阅读:按句法或篇章树聚合局部证据。
Tree-LSTM相对序列LSTM的优势来自更短的结构路径;但当大规模预训练Transformer已经编码丰富上下文后,显式树结构的边际收益往往依赖任务和数据规模。
5.2 程序与抽象语法树
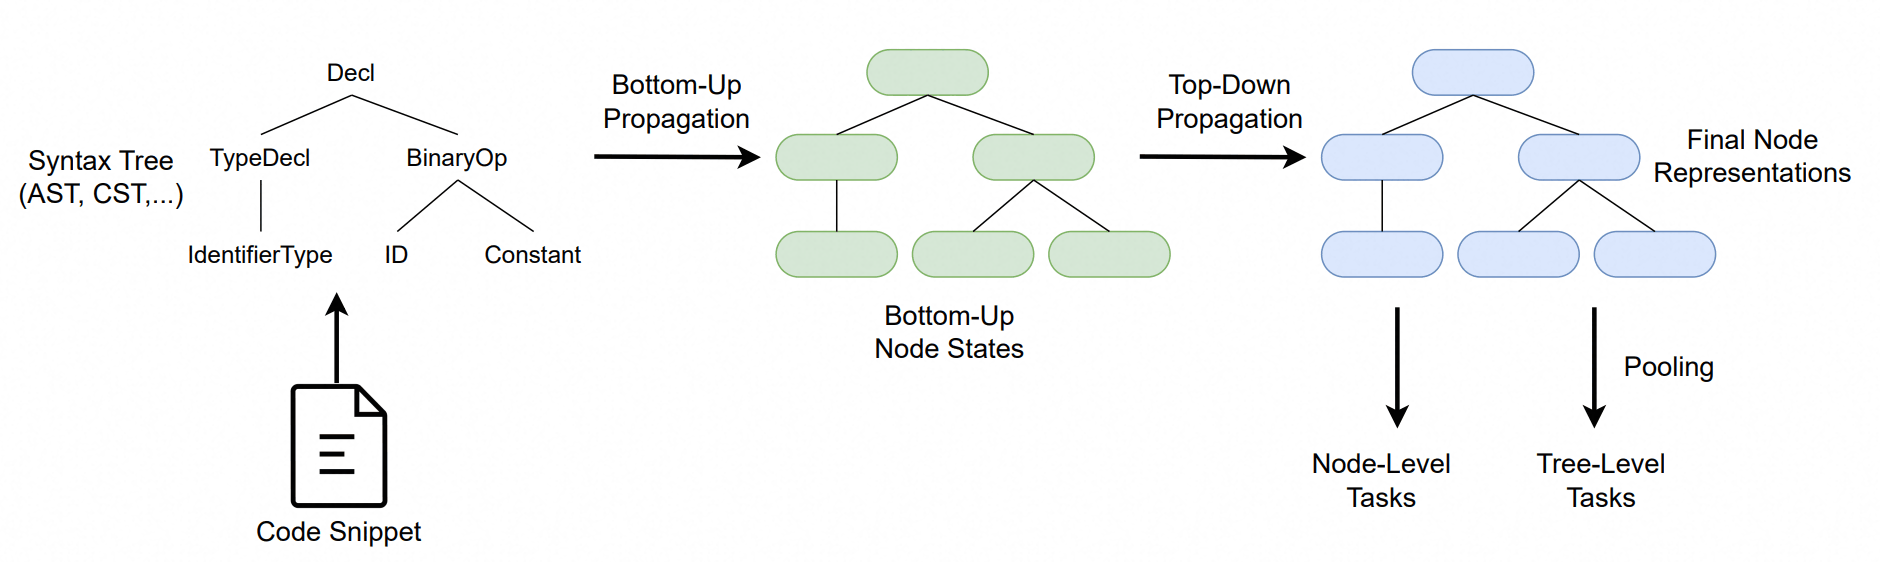
⚪ Tree-Transformer:用注意力组合AST中的父子与兄弟节点
程序天然具有抽象语法树(AST)。相比把代码完全当作token序列,树结构显式表示作用域、表达式嵌套和控制结构。
Tree-Transformer仍按树递归传播,但用多头注意力建模兄弟节点以及父子节点之间的关系,并同时执行自底向上和自顶向下传播。它可以看成TreeRNN与Transformer的结合:树决定允许交互的结构,注意力决定同一局部结构内的信息权重。
5.3 图像、场景与3D结构
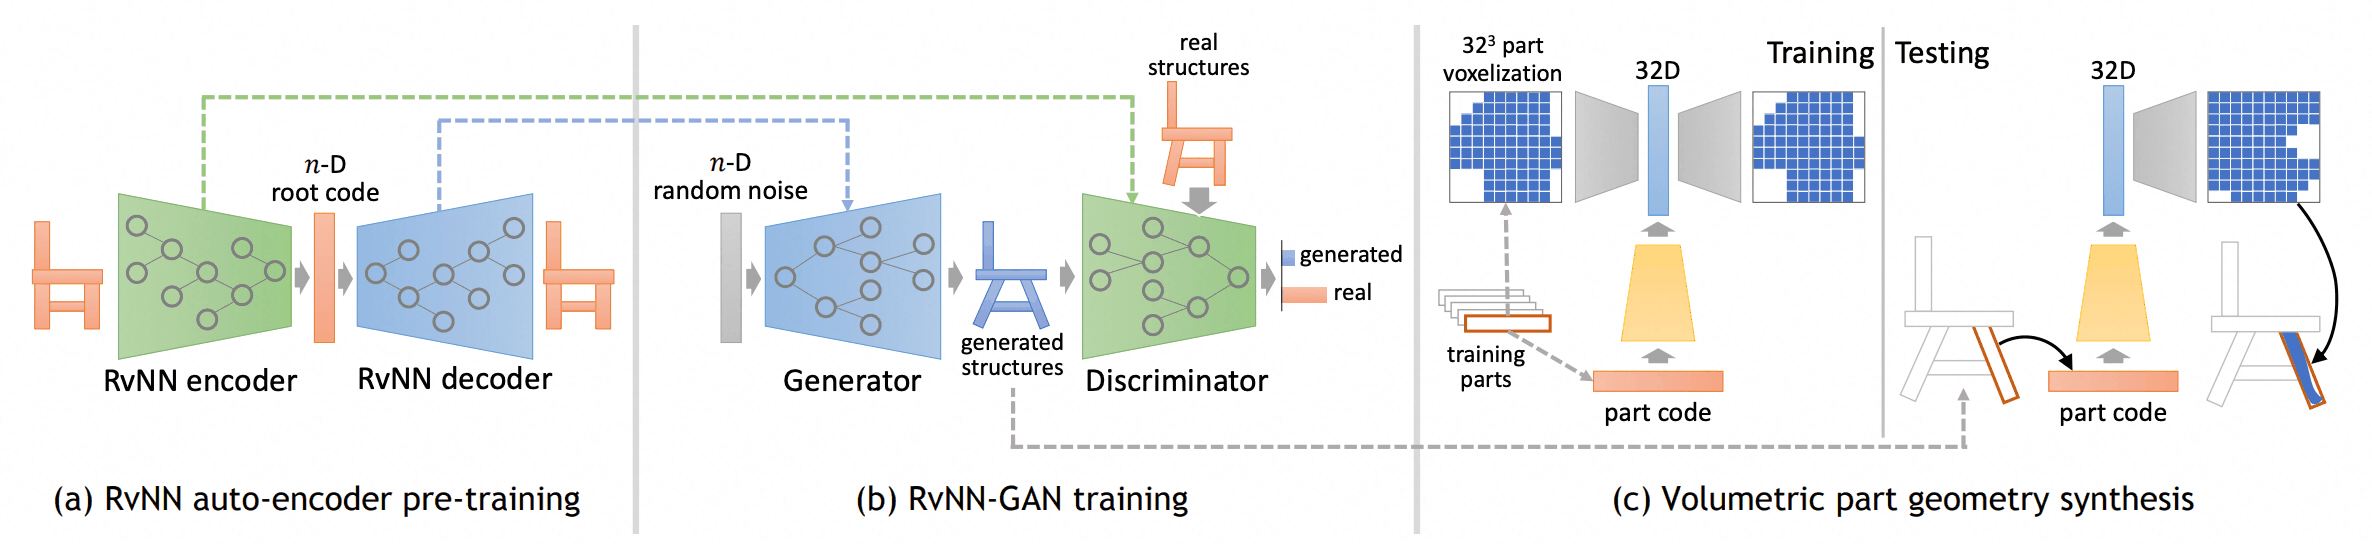
⚪ GRASS:用递归自编码器生成3D部件层级
GRASS把3D物体表示成部件树,内部节点描述相邻、对称等部件关系。编码器递归地把子部件与关系压缩成根向量,解码器再从根向量递归恢复部件和层级。
这种表示不仅建模“有哪些部件”,还建模“部件怎样组成整体”。与固定体素或点云相比,递归结构更适合编辑、插值和生成具有明确部件关系的物体。
视觉场景也可以通过区域合并形成树:叶节点是候选区域,内部节点表示更大的物体或场景组。早期递归网络正是同时在自然图像和语言解析上展示了这种通用性。
6. 与GNN和Transformer的关系
6.1 TreeRNN是树上的有向消息传递
把父节点更新写成
\[h_j=\operatorname{UPDATE}\left( x_j, \operatorname{AGG}\{\operatorname{MSG}(h_k):k\in C(j)\} \right),\]就得到现代GNN的消息传递形式。TreeRNN的特殊之处是:
- 图是无环的,可以用一次拓扑遍历完成精确传播;
- 信息通常只自底向上流动,而GNN常双向、迭代多轮;
- 节点角色和子节点顺序常有语义,因此组合函数可能不是置换不变的。
如果需要同时使用祖先和后代信息,可以先做自底向上编码,再做自顶向下传播;这相当于树上的双向网络。
6.2 Transformer为什么取代了大量TreeRNN
Transformer在NLP中的主导地位主要来自工程和预训练优势:
- 自注意力可以并行处理所有token,TreeRNN必须等待子节点完成;
- Transformer不依赖外部解析器,避免解析错误和语言迁移成本;
- 大规模预训练可以从数据中隐式学习部分句法关系;
- 规则张量更适合GPU/TPU,树批量仍需复杂调度。
但TreeRNN仍有独特价值:当输入本身就是可靠的树(AST、XML、部件层级),或任务要求强层级归纳偏置、结构可解释性和数据效率时,显式递归通常比把树强行展平成序列更自然。
⚪ Tree Transformer:把层级约束加入自注意力
现代方法不一定在TreeRNN与Transformer之间二选一。Tree Transformer通过约束注意力的组合范围逐层形成软树结构,让低层关注局部成分、高层关注更大短语。另一类方法则把已知树的距离、父子关系或路径编码成attention bias。
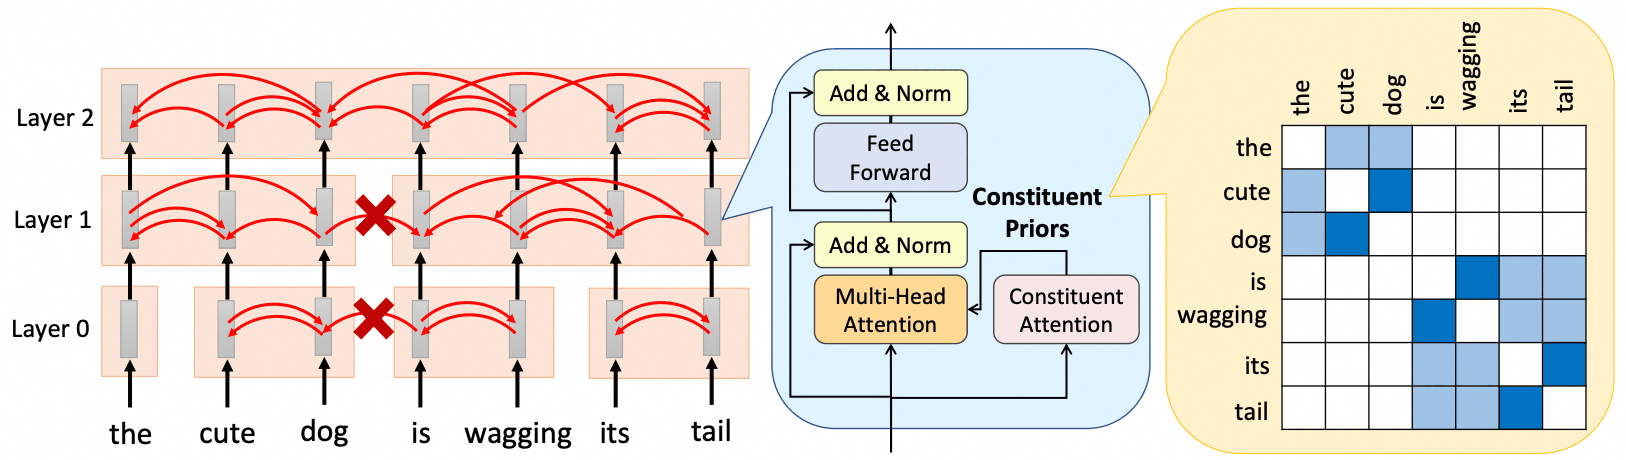
这些混合方法保留注意力的并行性,同时注入层级偏置,但树结构往往从“硬计算拓扑”变成“软注意力约束”。
⭐ 讨论:什么时候树结构真的有必要
树结构最有价值的情况通常包括:训练数据较少、组合规则需要系统泛化、远距离关系在树上距离很短、或者输入树由可靠语法/领域规则给出。反之,如果序列模型已经有双向上下文、大规模预训练和充足数据,显式树带来的收益可能不足以抵消解析与批处理成本。
7. 工程实现
7.1 后序遍历与按深度批处理
最直接的实现是递归函数:
点击展开代码
def encode(node):
    if node.is_leaf:
        return embedding(node.token)
    child_states = [encode(child) for child in node.children]
    return compose(node.feature, child_states)
这种写法清晰,但Python递归、逐节点小算子和不规则内存访问会严重拖慢训练。更高效的流程是:
- 把每棵树转换成节点数组、子节点索引和根索引;
- 计算每个节点的深度或拓扑层级;
- 把一个批次中相同深度、相同分支数的节点放在一起;
- 用
gather取出子节点状态,批量执行组合函数; - 把结果
scatter回节点状态数组。
同一深度的节点彼此没有依赖,可以并行计算。树越平衡,可并行层内节点越多;链式树则退化为循环网络的串行计算。
7.2 变长分支的处理
多叉树可以采用三种方式:
- 求和/平均聚合:简单且对子节点顺序不敏感,适合Child-Sum Tree-LSTM;
- 位置专用参数:区分第$k$个子节点,适合固定分支数的N-ary Tree-LSTM;
- 注意力聚合:对子节点内容自适应加权,兼顾变长分支和顺序信息。
若树包含不同类型的节点或边,可以为不同类型使用独立组合函数,或将类型嵌入作为条件输入。程序AST和3D部件树通常需要这种类型条件化。
7.3 复杂度与数值稳定性
设树有$|V|$个节点、隐藏维度$d$:
- 基础TreeRNN与Tree-LSTM的计算量通常为$O(|V|d^2)$;
- RNTN因三阶张量达到$O(|V|d^3)$;
- 内存需要保存所有节点状态,约为$O(|V|d)$;
- 实际速度常由树调度和小矩阵乘法决定,而不只是FLOPs。
训练深树时需要注意:
- 使用Tree-LSTM、残差连接或LayerNorm改善梯度传播;
- 对梯度做范数裁剪;
- 限制极端不平衡树的深度,或把一元链压缩;
- 对节点级损失按树大小归一化,避免大树支配批量梯度;
- 记录树形统计量,区分模型问题与解析器问题。