Graph Neural Networks.
现实世界中的关系往往不是规则网格:分子由原子和化学键组成,社交网络由用户和关系组成,交通系统由路口和道路组成,知识图谱由实体和关系组成。图神经网络(Graph Neural Network,GNN)的目标,是在保留这种关系结构的同时学习节点、边或整张图的表示。
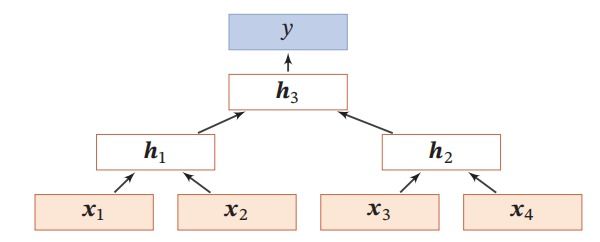
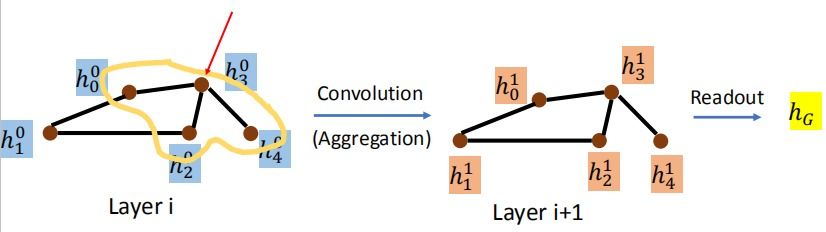
图神经网络最核心的操作是消息传递(message passing):每个节点从邻居接收消息,以排列不敏感的方式聚合,再结合自身状态完成更新。多层消息传递让信息沿图逐跳传播;图级任务还需要一个对节点排列不敏感的读出函数。谱图卷积、邻居采样、注意力、异构关系建模乃至图Transformer,都可以放进这个统一视角中理解。
本文目录:
- 图学习问题与基本归纳偏置
- (1) 图、特征与任务
- (2) 排列等变性与排列不变性
- (3) 同配性、异配性与图构建
- 消息传递神经网络的统一框架
- (1) 消息、聚合与更新
- (2) 读出与图级表示
- (3) 感受野、复杂度与归纳/直推学习
- 谱图理论与谱图卷积
- 3.1 图拉普拉斯与图傅里叶变换
- 3.2 从谱滤波到局部多项式滤波
- 3.3 一阶图卷积与传播-变换解耦
- 空间消息传递模型
- 4.1 早期递归与扩散模型
- 4.2 采样、注意力与可表达聚合
- 4.3 边特征、度信息与图池化
- 表达能力与结构编码
- (1) Weisfeiler-Lehman测试与消息传递上界
- (2) 高阶图网络
- (3) 位置编码与结构编码
- 深层图网络的三类瓶颈
- (1) 过平滑
- (2) 过压缩
- (3) 异配图上的错误平滑
- 特殊图结构
- 7.1 异构图与知识图谱
- 7.2 时空图与连续时间动态图
- 7.3 几何图与等变网络
- 图Transformer
- (1) 为什么图需要全局注意力
- (2) 结构偏置、稀疏注意力与混合架构
- 大规模训练与自监督学习
- 9.1 采样、聚类与预计算
- 9.2 对比学习、非对比学习与掩码建模
- 任务、基准与评测陷阱
- (1) 节点、边与图级任务
- (2) 数据划分、指标与信息泄漏
- (3) 从基准分数到真实部署
符号约定:记图为\(G=(V,E)\),节点数为\(n=\rvert V\rvert\),边数为\(m=\rvert E\rvert\);节点$v$的邻居集合为\(\mathcal{N}(v)\),节点特征为\(x_v\),边特征为\(e_{uv}\),第$l$层节点表示为\(h_v^{(l)}\)。邻接矩阵记为\(A\),度矩阵记为\(D\),节点特征矩阵记为\(X\)。除非另有说明,谱图理论部分讨论无向图;消息传递部分允许有向边、边特征和多种关系。
1. 图学习问题与基本归纳偏置
(1) 图、特征与任务
图把对象表示成节点,把对象之间的关系表示成边。与图像和序列相比,图数据有四个显著差异:
- 节点没有天然顺序。交换节点编号不应改变图本身,只会同步交换节点级输出的顺序。
- 邻居数量不固定。不同节点的度可以相差几个数量级,因此不能用固定长度的拼接表示邻域。
- 拓扑可能变化。训练与测试时可能出现新节点、新边甚至全新的图。
- 结构与特征共同决定语义。相同节点特征放在不同拓扑中可能代表完全不同的对象;反之,相同拓扑配上不同特征也会产生不同任务。
常见输入可以写成:
\[G=(V,E,X,E_f,U),\]其中\(X\)是节点特征,\(E_f\)是边特征,\(U\)是可选的全局特征。图可以是有向或无向、静态或动态、同构或异构;边还可以带有权重、类型、时间戳和几何坐标。
图学习任务通常按输出粒度分为三类:
- 节点级任务(node-level task):为每个节点预测标签或数值,例如论文分类、用户风险识别和蛋白质功能预测。
- 边级任务(edge-level task):预测一条边是否存在、属于哪种关系或具有多大权重,例如推荐、知识图谱补全和药物相互作用预测。
- 图级任务(graph-level task):为整张图预测性质,例如分子活性、材料性质、程序漏洞和病理切片分类。
还可以输出子图、节点集合或完整图结构,对应社区发现、组合优化和图生成。输出粒度决定最后的读出方式,却不改变中间消息传递的基本机制。
(2) 排列等变性与排列不变性
排列对称性的形式化定义
设\(P\)是任意置换矩阵,重新编号后的邻接矩阵和节点特征为:
\[A'=PAP^\top, \qquad X'=PX.\]节点级模型\(F\)应满足排列等变性(permutation equivariance):
\[F(PAP^\top,PX)=PF(A,X).\]这表示输入节点编号改变后,输出只做同样的重排。图级模型\(f\)则应满足排列不变性(permutation invariance):
\[f(PAP^\top,PX)=f(A,X).\]消息传递模型通过两个设计保证这些性质:对所有节点和边共享同一组参数;使用求和、均值、最大值等与输入顺序无关的聚合函数。若直接按邻居编号拼接特征,模型就会把任意编号误当成语义。
⭐ 讨论:图网络的归纳偏置
邻接矩阵确实是一个矩阵,但它的行列编号没有固定含义。把\(A\)展平后输入全连接网络,会让模型对同一张图的两个节点编号产生不同预测;对邻接矩阵做二维卷积,也会把编号相邻误解成图上相邻。图神经网络的归纳偏置是关系局部性、参数共享和排列对称性。
(3) 同配性、异配性与图构建
许多经典图神经网络隐含了同配性(homophily)假设:相连节点倾向于具有相似标签或特征。邻居平均在引文网络和社交网络中往往有效,正是因为局部平滑与任务目标一致。
但图也可能具有异配性(heterophily):不同类别之间反而更容易连接。例如交易网络中的买方与卖方、知识图谱中的不同实体类型、蛋白质网络中的互补功能。此时无差别聚合一跳邻居会混入相反语义,甚至比不使用图更差。
图结构也不总是客观给定。对点云、细胞、病人或图像区域,常见做法是按距离或相似度构造k近邻(k-nearest-neighbor,k-NN)图。此时建图本身就是模型的一部分:邻居数过小会让图断裂,过大会引入噪声;用全数据建图还可能把测试样本信息泄漏进训练过程。因此必须区分:
- 观测图(observed graph):边来自真实关系,如化学键、引用、道路和交易。
- 构造图(constructed graph):边由距离、相似度或可学习函数生成。
- 潜在图(latent graph):模型在训练中动态推断关系,图结构与表示共同优化。
2. 消息传递神经网络的统一框架
(1) 消息、聚合与更新
⚪ MPNN:统一消息传递框架
消息传递神经网络(Message Passing Neural Network,MPNN)把大量图模型统一为三步:
\[\begin{aligned} m_{u\to v}^{(l)} &= M^{(l)}\left(h_u^{(l)},h_v^{(l)},e_{uv}\right),\\ m_v^{(l)} &= \operatorname{AGG}^{(l)}\left(\left\{m_{u\to v}^{(l)}:u\in\mathcal{N}(v)\right\}\right),\\ h_v^{(l+1)} &= U^{(l)}\left(h_v^{(l)},m_v^{(l)}\right). \end{aligned}\]其中\(M\)构造边上的消息,\(\operatorname{AGG}\)把可变数量的邻居消息压成固定维向量,\(U\)更新中心节点。聚合必须对邻居排列不敏感;消息函数和更新函数通常由线性层、多层感知机或门控单元实现。
一层消息传递只融合一跳邻域;堆叠\(L\)层后,\(h_v^{(L)}\)最多依赖\(L\)跳邻域。这个简单事实同时解释了图网络的能力和局限:增加深度能扩大感受野,却会带来第$6$节讨论的过平滑与过压缩。
不同模型的差异主要来自四个选择:
- 消息里放什么:只用邻居表示,还是同时使用中心节点、边特征、相对位置和关系类型。
- 如何聚合:求和、均值、最大值、注意力或多个统计量的组合。
- 如何更新:直接替换、残差连接、门控更新或归一化后的组合。
- 传播与变换是否耦合:每层都做特征变换,还是先传播多步再一次性预测。
(2) 读出与图级表示
节点级任务可以直接对\(h_v^{(L)}\)分类;图级任务还需要把节点集合压成图表示:
\[h_G=R\left(\left\{h_v^{(L)}:v\in V\right\}\right),\]其中\(R\)必须满足排列不变性。求和保留节点数量信息;均值表达分布的平均状态;最大值强调是否出现某种显著模式。它们不是可以随意互换的实现细节:例如两个图的节点表示分别为\(\{a,a\}\)与\(\{a,a,a\}\),均值和最大值完全相同,求和却能区分节点重数。
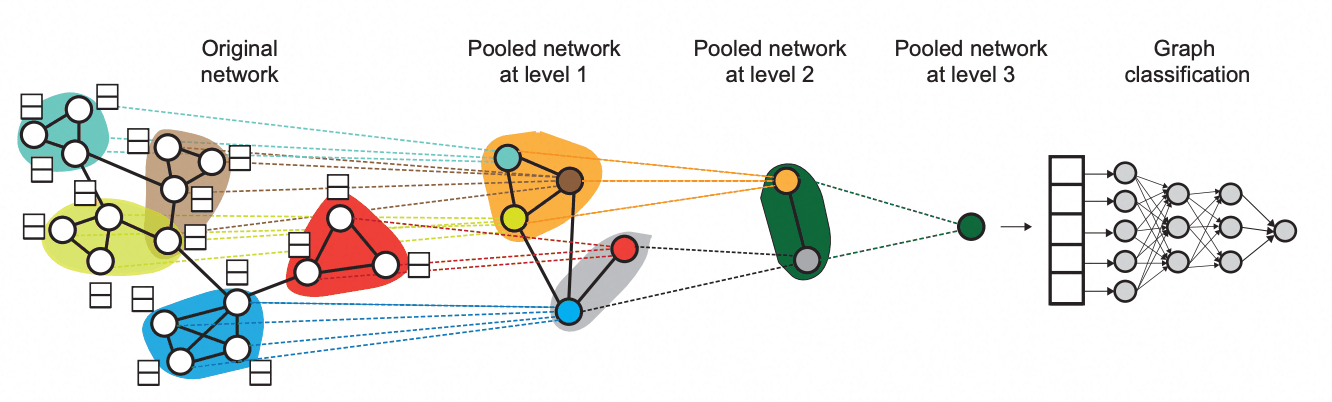
当图具有层级结构时,还可以逐层把节点聚成簇,构造更小的粗化图。池化不仅减少计算,也决定模型如何从局部基元形成图级概念。
(3) 感受野、复杂度与归纳/直推学习
对隐藏维度\(d\)的稀疏图,一层简单消息传递的传播成本约为\(O(md)\),特征变换成本约为\(O(nd^2)\)。若直接使用稠密邻接矩阵,传播会退化为\(O(n^2d)\);若使用全局注意力,则还要显式存储\(n^2\)个成对分数。
图学习还应区分两种设定:
- 直推学习(transductive learning):训练时已经看到测试节点及其连接,只是不知道测试标签。经典引文网络上的半监督节点分类属于这一设定。
- 归纳学习(inductive learning):测试时出现训练阶段从未见过的节点或整张图。模型必须学习可迁移的聚合规则,而不能把每个节点身份记进参数。
GraphSAGE等基于局部特征和共享聚合器的方法天然支持归纳推理;把每个节点直接设成可学习嵌入的方法通常只能直推。数据划分若混淆两种设定,会严重高估部署性能。
3. 谱图理论与谱图卷积
3.1 图拉普拉斯与图傅里叶变换
对无向图,邻接矩阵\(A\)是对称矩阵,度矩阵\(D\)满足\(D_{ii}=\sum_jA_{ij}\)。常用的拉普拉斯矩阵包括:
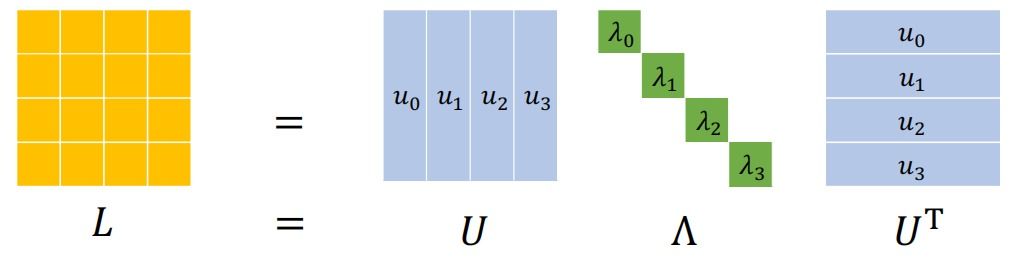
\[L=D-A, \qquad L_{\mathrm{sym}}=I-D^{-1/2}AD^{-1/2}, \qquad L_{\mathrm{rw}}=I-D^{-1}A.\]$L$和\(L_{\mathrm{sym}}\)都是对称半正定矩阵,因此可以正交分解:
\[L=U\Lambda U^\top,\]其中\(\Lambda=\operatorname{diag}(\lambda_0,\ldots,\lambda_{n-1})\)是特征值,\(U=[u_0,\ldots,u_{n-1}]\)是特征向量。
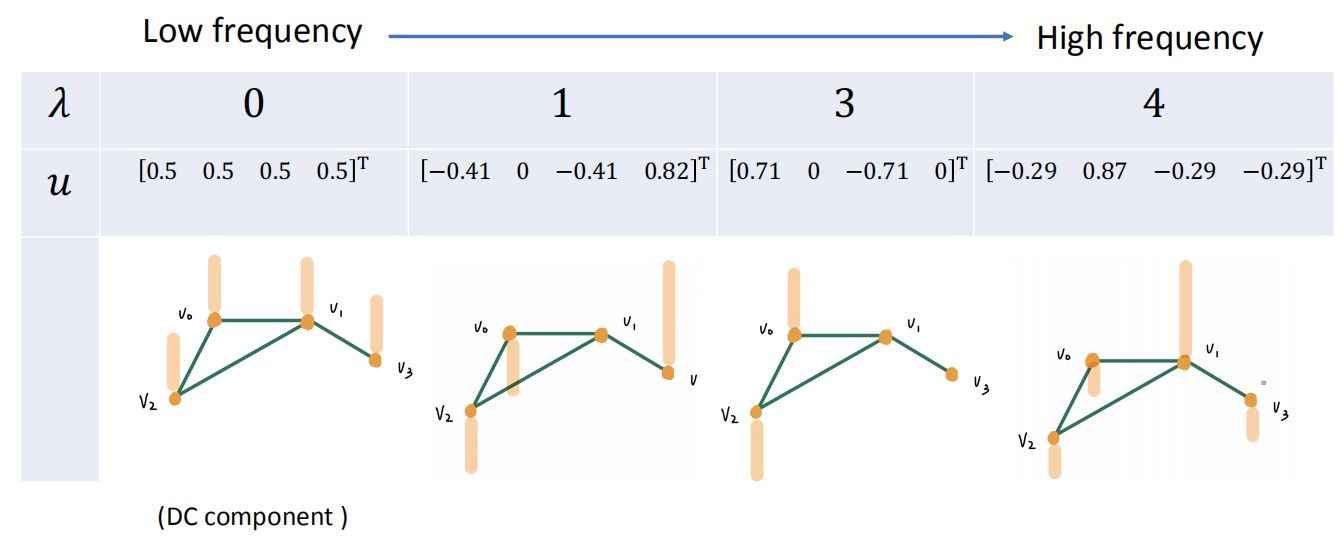
拉普拉斯二次型给出“频率”的几何意义:
\[x^\top Lx=\frac{1}{2}\sum_{(i,j)\in E}A_{ij}(x_i-x_j)^2.\]若一个特征向量在相邻节点之间变化缓慢,上式较小,对应低频;若相邻节点取值剧烈变化,则对应高频。
图信号\(x\in\mathbb{R}^n\)的图傅里叶变换(Graph Fourier Transform,GFT)与逆变换为:
\[\hat{x}=U^\top x, \qquad x=U\hat{x}.\]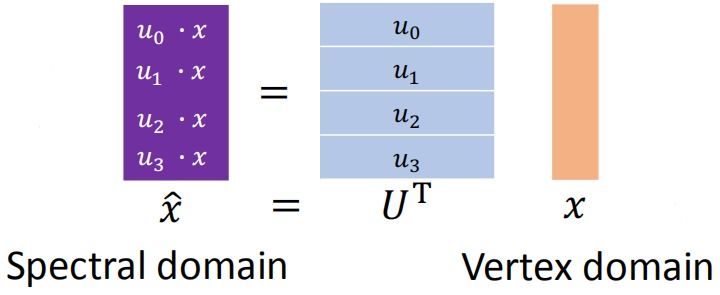
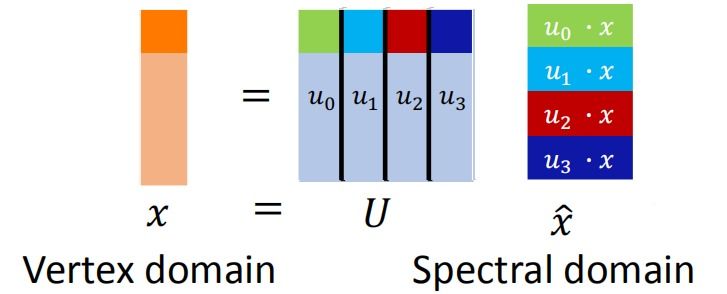
在谱域中,用滤波器\(g_\theta(\Lambda)\)逐频率缩放信号,再变回节点域:
\[y=Ug_\theta(\Lambda)U^\top x=g_\theta(L)x.\]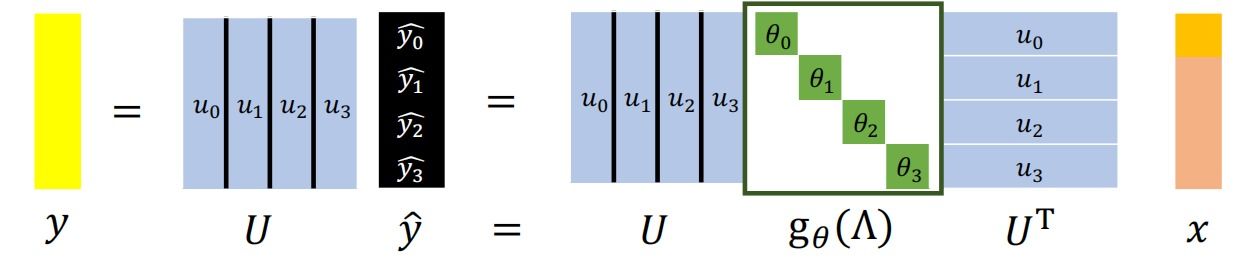
早期谱卷积直接学习每个特征值上的系数,既需要\(O(n^3)\)的特征分解,也依赖当前图的特征向量基,难以迁移到另一张图。后续方法的关键不是更精确地做特征分解,而是把谱滤波器限制成拉普拉斯的低阶多项式,从而得到局部、稀疏且可迁移的节点域计算。
3.2 从谱滤波到局部多项式滤波
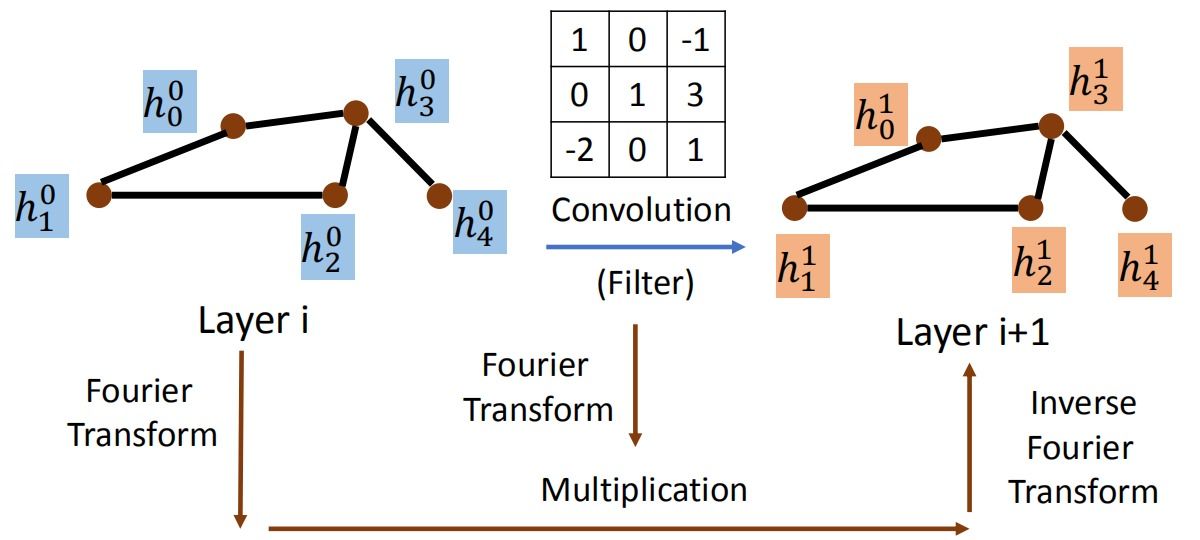
⚪ Spectral CNN:在拉普拉斯特征基上学习卷积
早期谱图卷积把卷积核定义为\(U\operatorname{diag}(\theta)U^\top\)。它建立了“图卷积等于谱域乘法”的基本联系,但每张图都要重新计算\(U\),参数也绑定于该图的谱基;当特征值接近或图结构变化时,特征向量还可能发生不稳定旋转。
⚪ ChebNet:切比雪夫多项式局部滤波
ChebNet把滤波器写成缩放拉普拉斯\(\tilde{L}=2L/\lambda_{\max}-I\)上的\(K\)阶切比雪夫多项式:
\[\begin{aligned} T_0(\tilde{L})&=I,\\ T_1(\tilde{L})&=\tilde{L},\\ T_k(\tilde{L})&=2\tilde{L}T_{k-1}(\tilde{L})-T_{k-2}(\tilde{L}),\\ g_\theta(L)x&=\sum_{k=0}^{K}\theta_kT_k(\tilde{L})x. \end{aligned}\]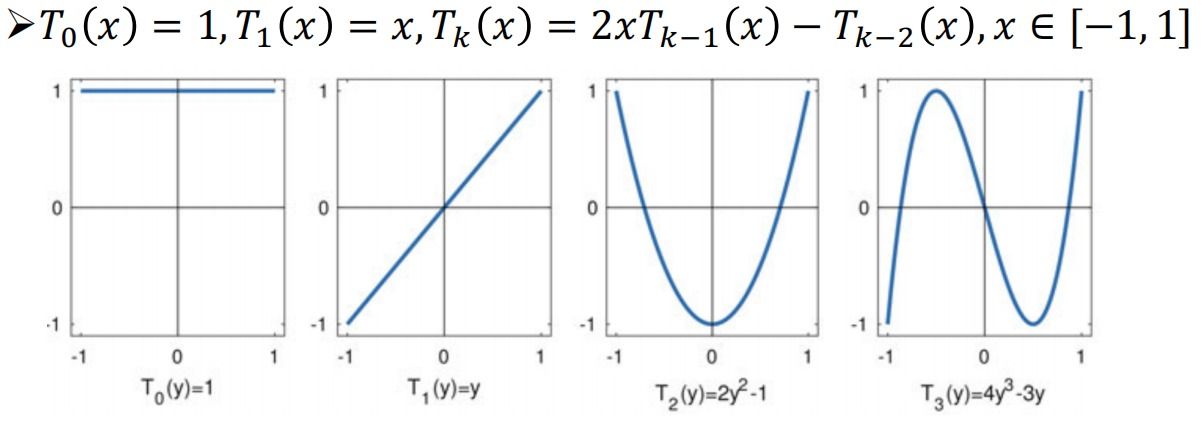
因为\(L^k\)只会连接距离不超过\(k\)跳的节点,\(K\)阶多项式滤波是\(K\)跳局部的;递推计算无需特征分解,复杂度降为\(O(Km)\)。这一步完成了从“谱域定义”到“节点域局部消息传递”的桥接。
3.3 一阶图卷积与传播-变换解耦
⚪ GCN:一阶谱近似与重归一化传播
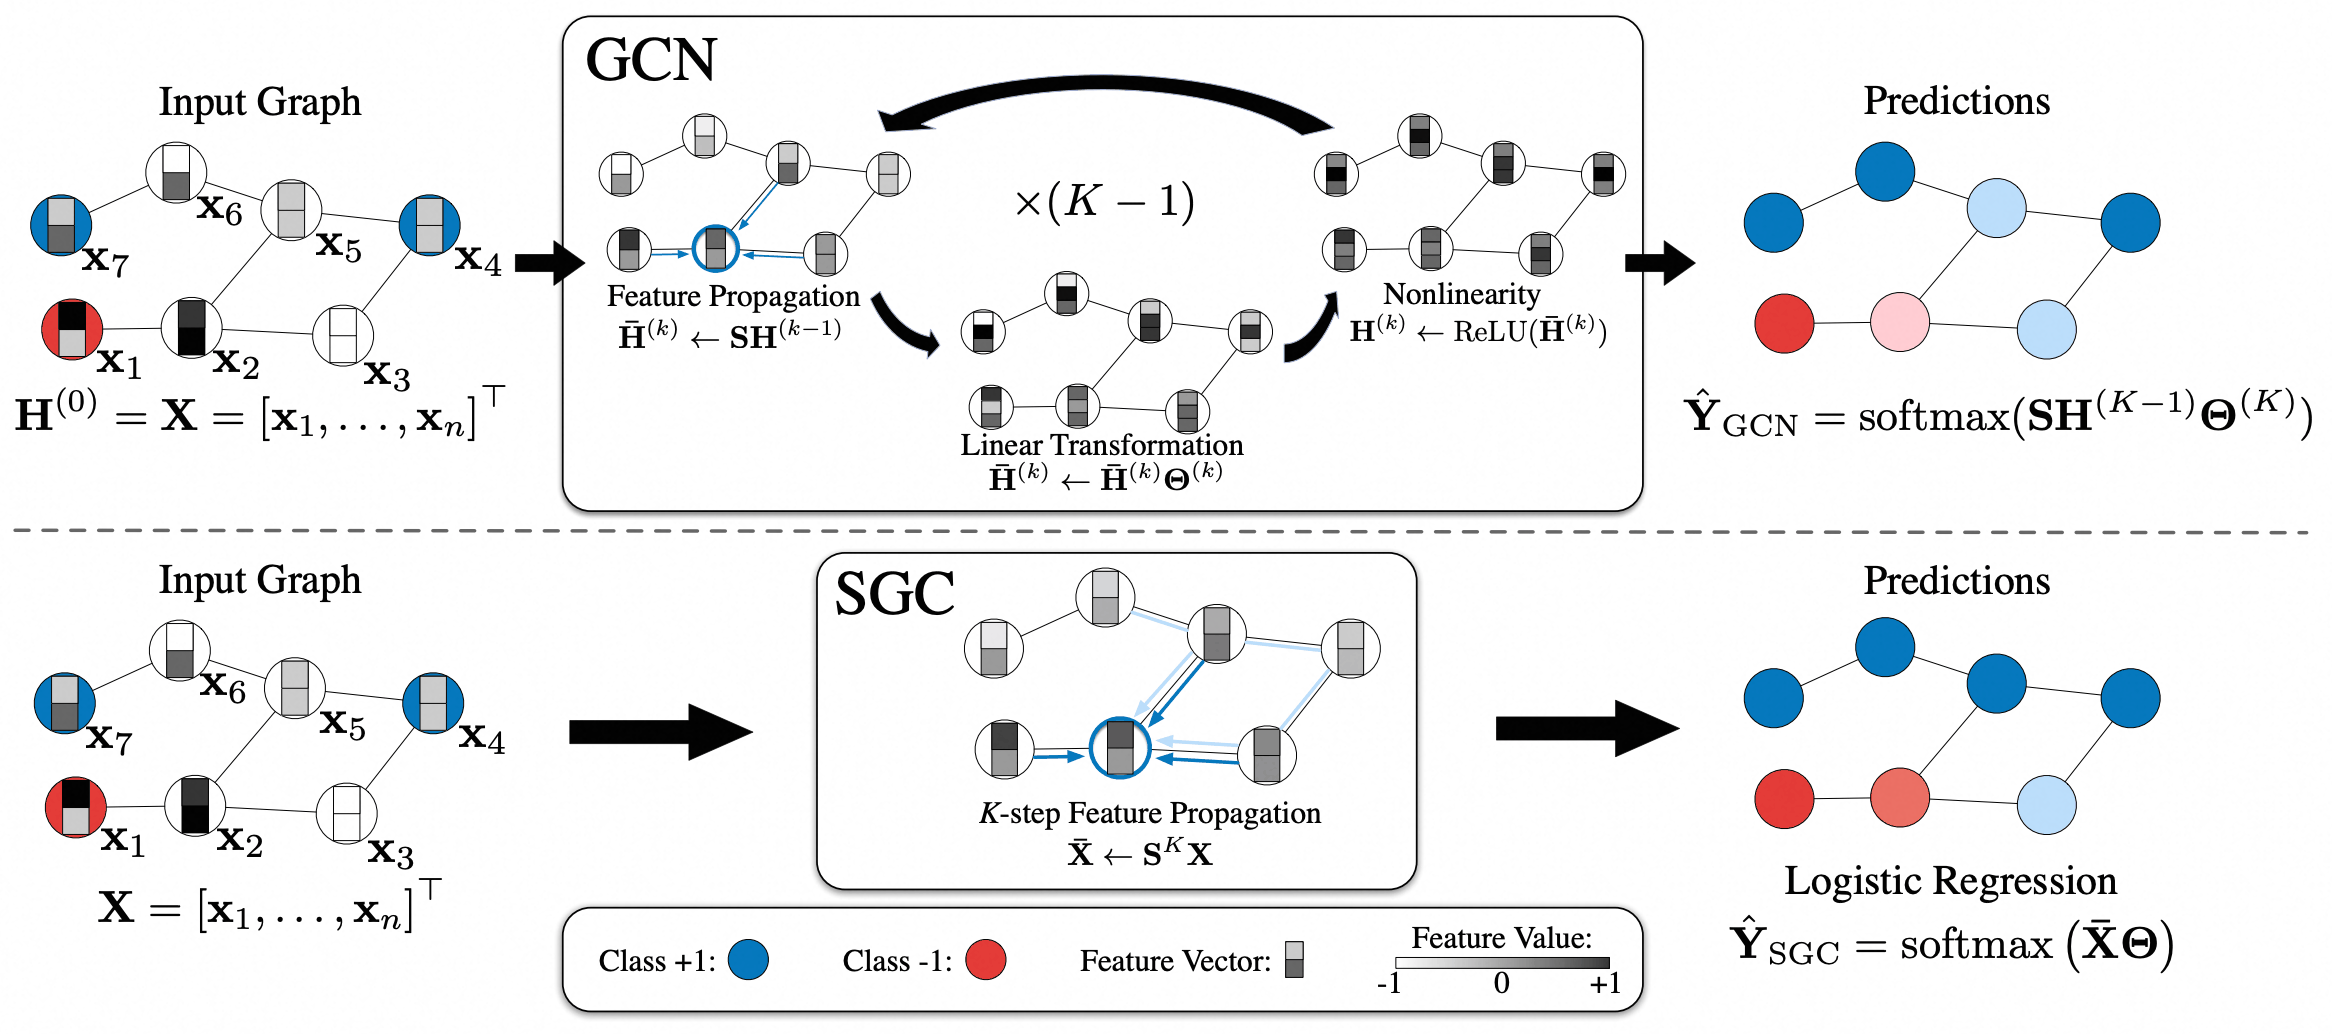
GCN(Graph Convolutional Network)把ChebNet截断到一阶,并通过参数约束与\(\lambda_{\max}\approx2\)简化滤波。为避免反复传播造成数值不稳定,加入自环并使用“重归一化技巧”:
\[\tilde{A}=A+I, \qquad \tilde{D}_{ii}=\sum_j\tilde{A}_{ij}, \qquad \hat{A}=\tilde{D}^{-1/2}\tilde{A}\tilde{D}^{-1/2}.\]一层传播写成:
\[H^{(l+1)}=\sigma\left(\hat{A}H^{(l)}W^{(l)}\right).\]\(\hat{A}H\)先按节点度对邻居特征做对称归一化聚合,\(W\)再变换特征通道。自环让节点保留自身信息;对称归一化避免高度节点在求和中支配尺度。GCN的成功使“归一化邻居聚合 + 可学习变换”成为图网络的默认基线。
⭐ 讨论:GCN既是低通滤波器,也是消息传递层
从谱视角看,\(\hat{A}\)抑制高频差异,推动相邻节点表示变得平滑;从空间视角看,它按度归一化后聚合一跳邻居。两种解释描述的是同一个线性算子。谱视角解释了平滑与过平滑,空间视角更容易扩展到有向图、边特征和归纳学习。
⚪ SGC:移除层间非线性与参数
若连续\(K\)层GCN之间不使用非线性和独立权重,传播可以合并为:
\[Z=\operatorname{softmax}\left(\hat{A}^{K}X\Theta\right).\]SGC(Simple Graph Convolution)先预计算\(\hat{A}^{K}X\),再训练线性分类器。它揭示经典引文网络上相当一部分收益来自图扩散而非深层非线性,也为第$9$节的预计算路线奠定基础。
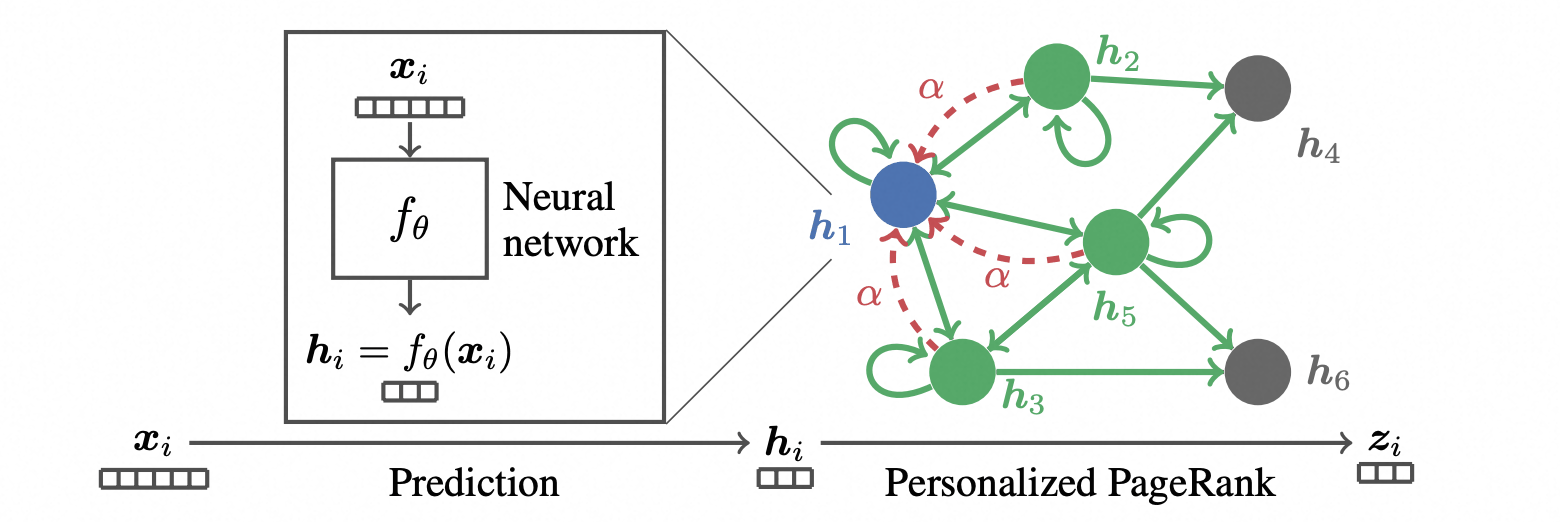
⚪ APPNP:个性化随机游走传播
APPNP先用任意神经网络得到初始预测\(H^{(0)}\),再迭代:
\[H^{(k+1)}=(1-\alpha)\hat{A}H^{(k)}+\alpha H^{(0)}.\]回注系数\(\alpha\)持续保留节点自身的初始预测,传播步数可以远大于普通GCN而不至于完全抹去个体信息。它把“特征变换”和“图传播”解耦,也把图卷积与个性化PageRank联系起来。
4. 空间消息传递模型
4.1 早期递归与扩散模型
⚪ NN4G:共享递归更新的早期图神经网络
早期图神经网络为每个节点反复应用共享更新函数,直到状态收敛到不动点,再由节点或图级读出函数生成预测。其基本形式是:
\[h_v=\sum_{u\in\mathcal{N}(v)}f_\theta(x_v,x_u,e_{uv},h_u).\]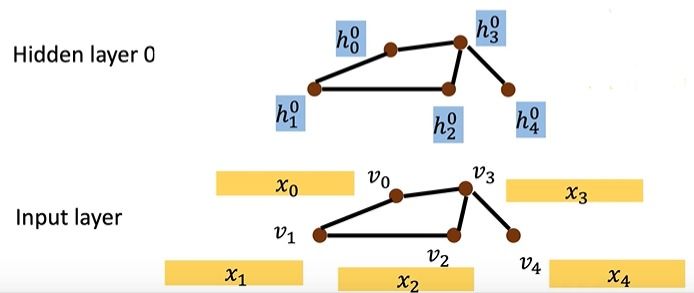
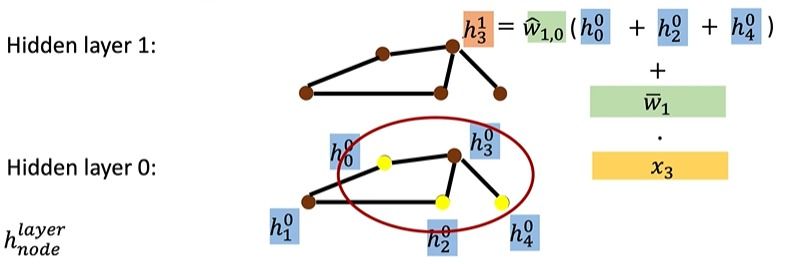
收敛约束让更新映射必须是压缩映射,训练还要对不动点求导,限制了表达能力和计算效率。现代图网络改为显式堆叠有限层,不再要求收敛;但“共享局部更新 + 不变读出”的骨架已经在这里形成。
⚪ DCNN:按随机游走距离扩散特征
DCNN(Diffusion-Convolutional Neural Network)使用随机游走转移矩阵\(P=D^{-1}A\)的幂\(P^k\)描述\(k\)步扩散,并为不同扩散步学习不同权重。与只使用一跳邻居的层不同,它在单个模块中显式收集多个扩散尺度:
\[H_{k}=\sigma\left(P^kXW_k\right),\qquad k=0,\ldots,K.\]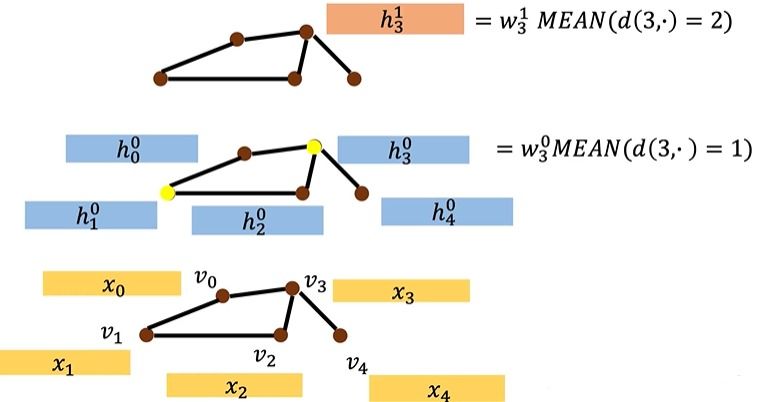
这种设计把图上的随机游走与卷积联系起来,但存储多个\(P^kX\)会随扩散阶数增长。现代方法通常通过递推传播、稀疏乘法或预计算避免显式保存稠密扩散张量。
⚪ MoNet:伪坐标上的混合模型卷积
MoNet(Mixture Model Network)为每条边构造伪坐标\(u_{uv}\),再用多个高斯核决定邻居权重:
\[w_k(u)=\exp\left(-\frac{1}{2}(u-\mu_k)^\top\Sigma_k^{-1}(u-\mu_k)\right).\]节点更新为:
\[h_v' = \sum_{k=1}^{K}\sum_{u\in\mathcal{N}(v)}w_k(u_{uv})W_kh_u.\]伪坐标可以来自节点度、流形上的相对位置或其他几何属性。MoNet表明:只要边上存在描述相对关系的坐标,规则卷积中“不同方向使用不同卷积核”的思想就可以推广到不规则图。
4.2 采样、注意力与可表达聚合
⚪ GraphSAGE:邻居采样与归纳式聚合
GraphSAGE不为节点身份学习独立向量,而是学习一个可迁移的邻居聚合器:
\[\begin{aligned} m_v^{(l)}&=\operatorname{AGG}^{(l)}\left(\left\{h_u^{(l)}:u\in\mathcal{N}(v)\right\}\right),\\ h_v^{(l+1)}&=\sigma\left(W^{(l)}[h_v^{(l)}\Vert m_v^{(l)}]\right). \end{aligned}\]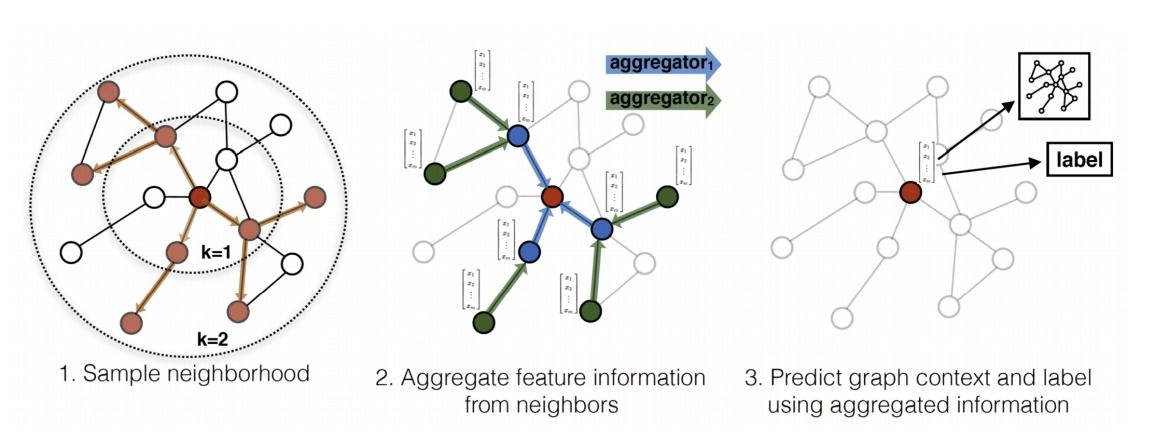
每层只采样固定数量的邻居,使一个批次的计算图大小可控,并支持未见节点的归纳推理。但若每层采样\(s\)个邻居,\(L\)层最坏仍会展开为\(s^L\)个节点;独立采样还会带来梯度方差和邻域信息损失。
⚪ GAT:邻域上的多头注意力
- paper:Graph Attention Networks
GAT(Graph Attention Network)不再只根据节点度分配固定权重,而是根据中心节点和邻居特征学习注意力:
\[\begin{aligned} e_{uv}&=\operatorname{LeakyReLU}\left(a^\top[Wh_u\Vert Wh_v]\right),\\ \alpha_{uv}&=\frac{\exp(e_{uv})}{\sum_{j\in\mathcal{N}(v)\cup\{v\}}\exp(e_{jv})},\\ h_v'&=\sigma\left(\sum_{u\in\mathcal{N}(v)\cup\{v\}}\alpha_{uv}Wh_u\right). \end{aligned}\]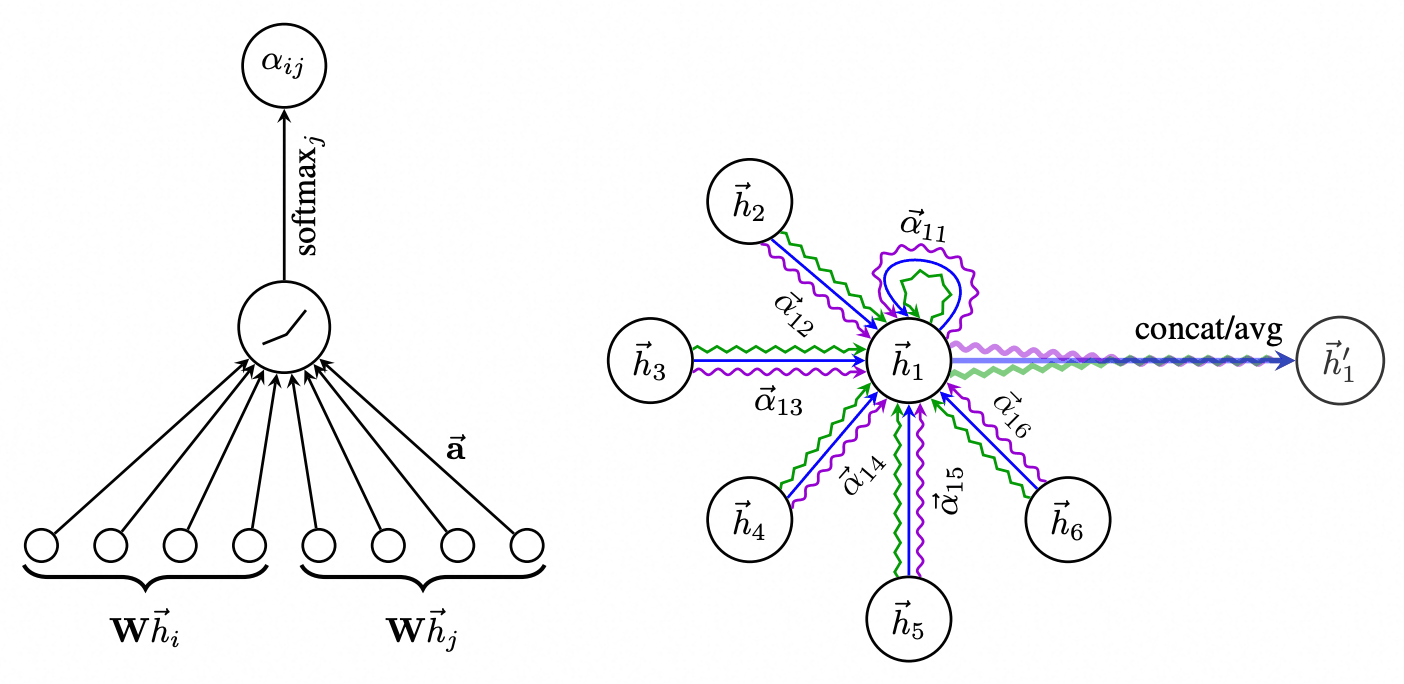
多头注意力把若干独立聚合结果拼接或平均,可以降低单头权重的方差。注意力让模型对同一节点的不同邻居赋予不同权重,但它不会自动突破局部消息传递的表达上界;注意力系数也不等同于可靠的因果解释。
⚪ GATv2:修正静态注意力排序
经典GAT先分别线性变换节点,再把两者拼接后打分。由于线性结构,给定邻居集合后,不同中心节点对邻居的排序可能被限制为相同的“静态排序”。GATv2把线性变换移到拼接之后:
\[e_{uv}=a^\top\operatorname{LeakyReLU}\left(W[h_u\Vert h_v]\right),\]从而允许查询节点真正改变邻居排序。它只改变打分顺序,却显著扩大注意力函数族。
⚪ GIN:与一维WL测试同等强的聚合
GIN(Graph Isomorphism Network)使用求和和多层感知机更新:
\[h_v^{(l+1)}=\operatorname{MLP}^{(l)}\left((1+\epsilon^{(l)})h_v^{(l)}+\sum_{u\in\mathcal{N}(v)}h_u^{(l)}\right).\]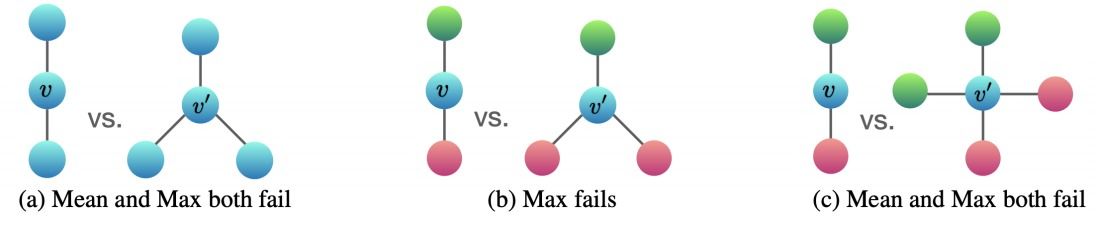
对有界大小、可数特征的多重集合,求和后接足够强的多层感知机可以构造单射;均值会丢失元素个数,最大值会丢失元素重数。因此GIN达到标准消息传递模型能够达到的一维Weisfeiler-Lehman表达上界。
4.3 边特征、度信息与图池化
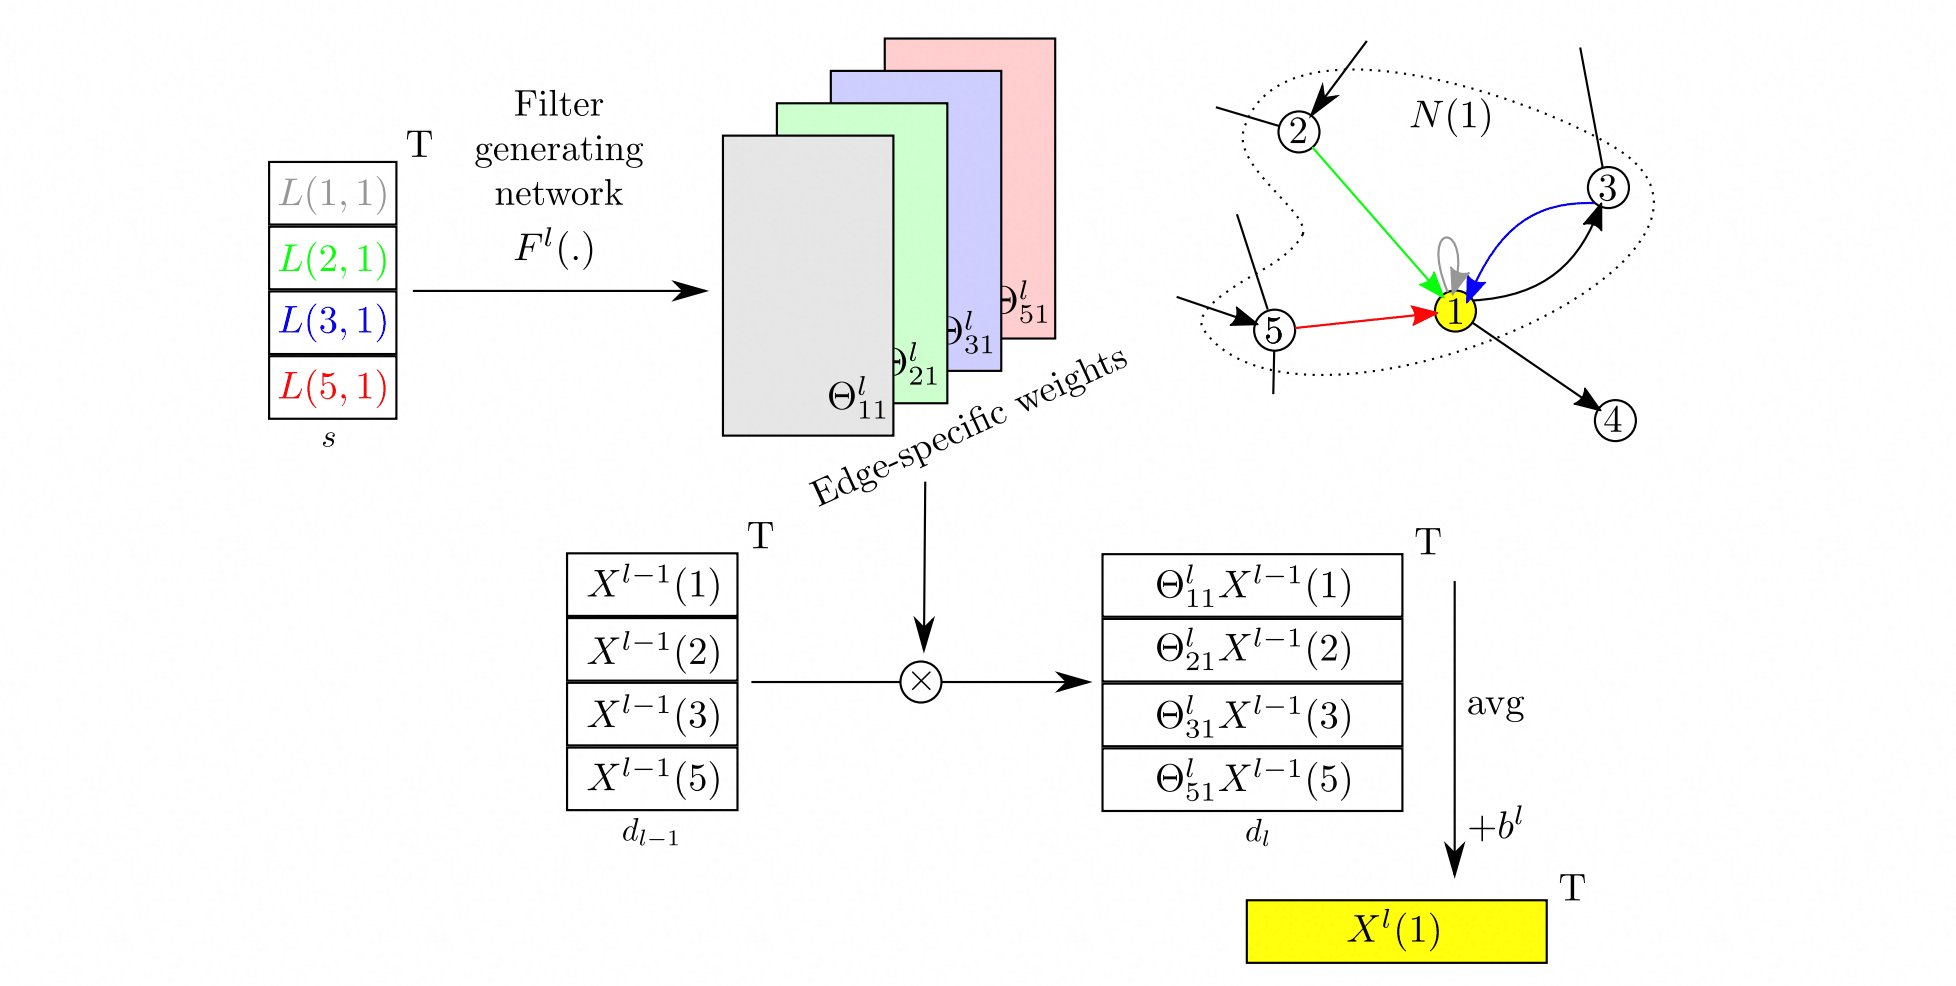
⚪ ECC与MPNN:让边决定消息变换
若边表示化学键类型、距离、方向或时间间隔,仅聚合节点特征会丢掉关键关系。ECC(Edge-Conditioned Convolution)用边特征生成变换矩阵:
\[h_v'=\sum_{u\in\mathcal{N}(v)}\Phi(e_{uv})h_u,\]其中\(\Phi\)是参数生成网络。更一般的MPNN可以同时在消息函数中使用\(h_u\)、\(h_v\)和\(e_{uv}\),并通过门控或残差更新节点。
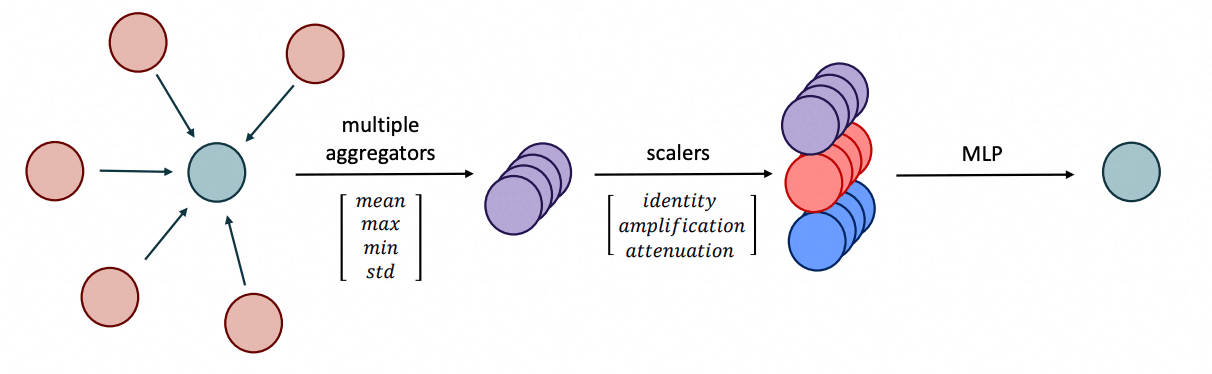
⚪ PNA:组合多个统计量与度缩放器
单一聚合器只能保留邻域的一部分统计信息。PNA(Principal Neighbourhood Aggregation)同时计算均值、最大值、最小值、标准差等统计量,再根据节点度使用放大、恒等和衰减缩放器。它把“聚合什么”和“不同度下如何校准尺度”分开,在分子图等任务上通常比单一求和或均值更稳定。
⚪ DiffPool:可微分层级图池化
DiffPool用两个图网络分别生成节点嵌入\(Z\)和软分配矩阵\(S\):
\[Z=\operatorname{GNN}_{\mathrm{embed}}(A,X), \qquad S=\operatorname{softmax}\left(\operatorname{GNN}_{\mathrm{pool}}(A,X)\right).\]粗化后的特征与邻接矩阵为:
\[X'=S^\top Z, \qquad A'=S^\top AS.\]它可以学习类似社群的层级结构,但分配矩阵通常是\(n\times k\)的稠密矩阵,内存成本高;还需要链接预测和熵正则避免所有节点塌缩到同一簇。
5. 表达能力与结构编码
(1) Weisfeiler-Lehman测试与消息传递上界
一维Weisfeiler-Lehman(1-WL)测试反复执行“节点自身颜色 + 邻居颜色多重集合”的哈希:
\[c_v^{(l+1)}=\operatorname{HASH}\left(c_v^{(l)},\left\{\!\left\{c_u^{(l)}:u\in\mathcal{N}(v)\right\}\!\right\}\right).\]若两张图在某一轮得到不同的颜色直方图,就能判定它们不同;若始终相同,测试不能证明它们同构。标准消息传递网络的更新也只依赖“自身表示 + 邻居表示多重集合”,因此最多与一维WL测试一样强。
⚪ GIN与一维WL上界
若消息、聚合、更新和读出都具有足够的单射能力,GIN可以模拟一维WL测试;反过来,一维WL无法区分的图,任何只依赖局部多重集合的普通MPNN也无法区分。典型反例包括某些正则图、环结构与高度对称图。
这个结论提醒我们:增加隐藏维度、注意力头数或训练数据,不会自动突破结构上的不可辨识性。若任务必须区分这些图,需要注入节点身份、位置编码、高阶子结构或超越一维邻域的计算。
(2) 高阶图网络
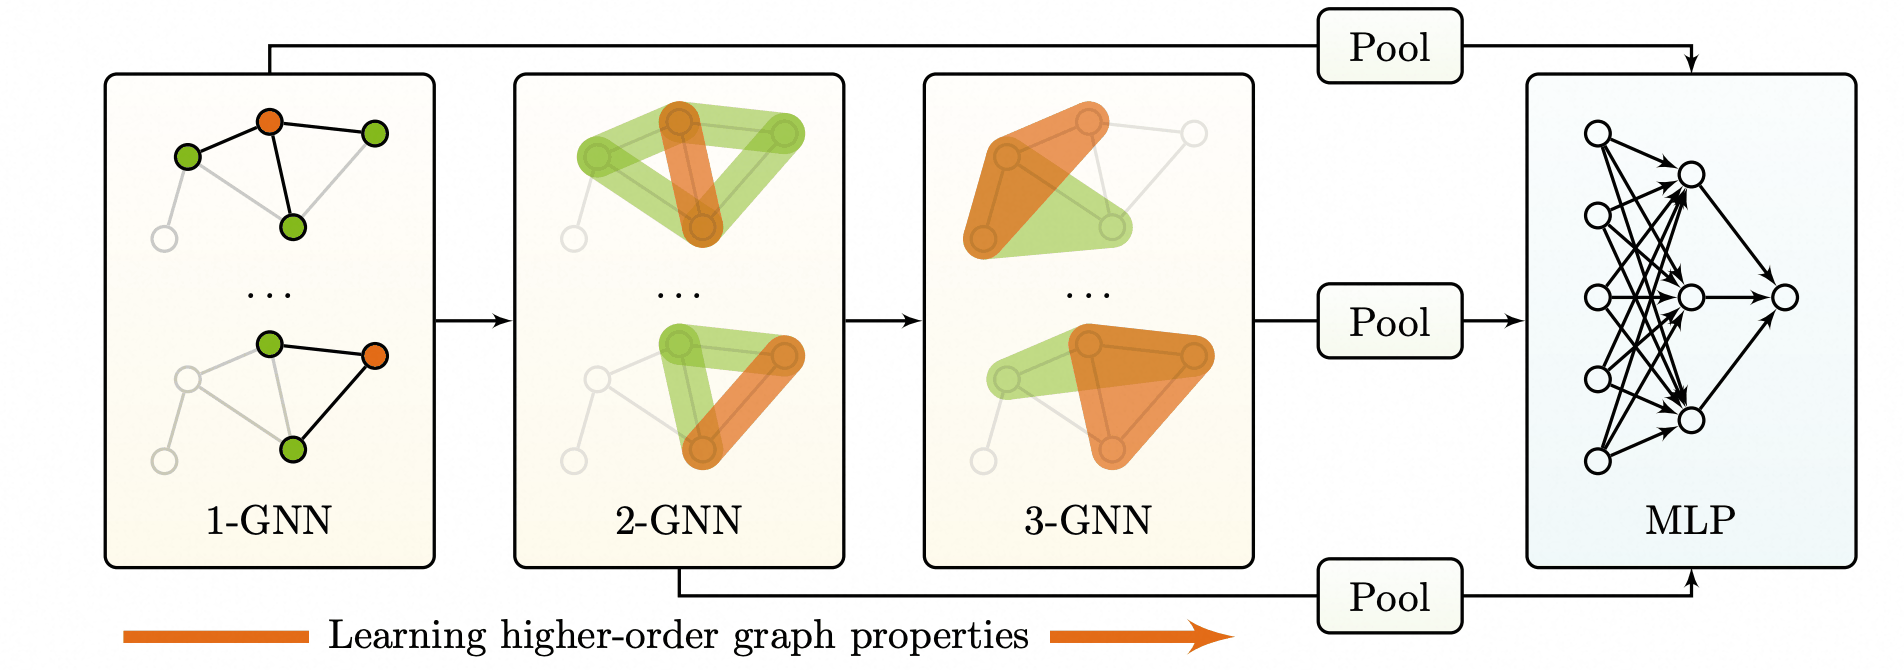
⚪ k-GNN:从节点提升到节点元组
k-GNN不只为单个节点建模,而是为\(k\)个节点组成的元组或子集学习表示,从而对应更高阶的WL测试。它能识别普通消息传递看不到的环、团和子图模式,但状态数量会从\(O(n)\)增长到\(O(n^k)\),表达力提升直接换来组合爆炸。
⚪ PPGN:二阶张量上的可证明强图网络
PPGN(Provably Powerful Graph Network)维护\(n\times n\times d\)的二阶表示,并通过矩阵乘法组合路径信息,可以达到三维WL级别的判别能力。它适合中小图和需要强结构识别的任务,但\(O(n^2d)\)内存与更高计算量限制了规模。
(3) 位置编码与结构编码
没有节点特征时,规则图中的所有节点可能从完全相同的表示开始;即使有特征,局部消息传递也难以知道节点在全图中的位置。结构编码通过额外信号打破对称性,常见形式包括:
- 拉普拉斯位置编码(Laplacian Positional Encoding,LapPE):取拉普拉斯矩阵的若干非平凡特征向量作为坐标。它包含全局谱信息,但每个特征向量存在符号不确定性,重根对应的特征子空间还可任意旋转。
- 随机游走结构编码(Random-Walk Structural Encoding,RWSE):使用\(P^k_{vv}\)等随机游走返回概率描述节点在不同尺度的局部结构,对特征向量符号不敏感。
- 最短路编码(shortest-path encoding):把节点对之间的最短距离放进注意力偏置,直接提供全局拓扑距离。
- 锚点与距离编码(anchor-based encoding):选择若干锚点,使用节点到锚点的距离或可达概率形成坐标。
结构编码不是免费的节点编号:它必须在节点重排后同步重排,并尽量在同构变换下保持一致。直接给每个节点一个固定身份嵌入虽然能打破对称性,却通常无法迁移到新图。
6. 深层图网络的三类瓶颈
(1) 过平滑
邻居聚合本质上是图上的低通滤波。以线性化GCN为例,反复传播得到\(H^{(L)}=\hat{A}^LX\Theta\);当\(L\)增大时,高频分量逐渐衰减,连通分量中的节点表示趋向低维稳定子空间。不同类别节点变得难以区分,这称为过平滑(over-smoothing)。
过平滑不是普通意义上的过拟合:训练损失可能同样变差,因为表示本身已经失去类别信息。它也不是“层数一多必然发生”的单一阈值,而取决于图谱、归一化、残差路径、激活函数和监督信号。
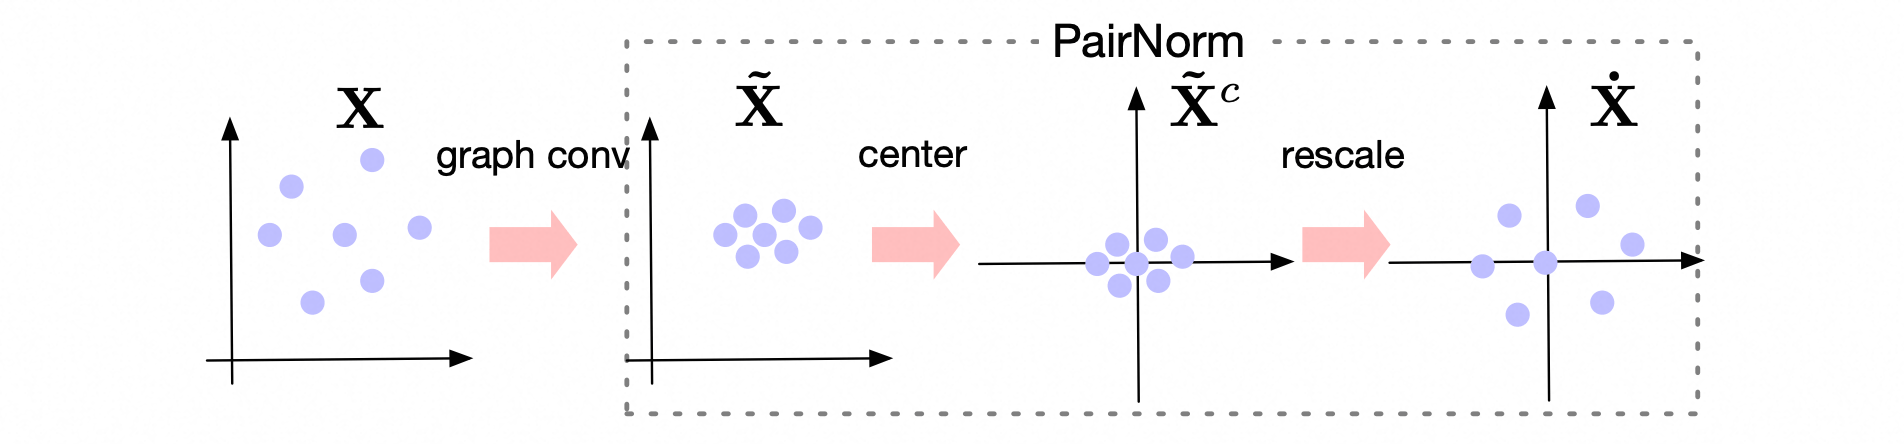
⚪ PairNorm:固定节点间总体离散度
PairNorm先把节点表示中心化,再缩放到固定总体方差,阻止所有节点向同一点塌缩。它直接控制节点间距离,却可能放大噪声或与任务需要的真实平滑冲突,因此更适合作为诊断性基线。
⚪ DropEdge:训练时随机删除边
DropEdge每轮训练随机丢弃部分边,既是结构数据增强,也减慢了图扩散的混合速度,使深层网络不那么快进入平滑极限。它简单且几乎不增加推理成本,但删除关键桥接边可能损害稀疏图。
⚪ GCNII:初始残差与恒等映射
GCNII每层重新注入初始表示,并让特征变换接近恒等映射:
\[H^{(l+1)}=\sigma\left(\left((1-\alpha_l)\hat{A}H^{(l)}+\alpha_lH^{(0)}\right) \left((1-\beta_l)I+\beta_lW^{(l)}\right)\right).\]初始残差保留节点个体信息,恒等映射改善深层优化,使数十层甚至上百层传播成为可能。
(2) 过压缩
深度不足时,远处信息到不了中心节点;简单增加深度后,半径\(L\)内可能有指数增长的节点,却必须穿过少量边并压进固定维度向量。这种“指数信息流穿过有限瓶颈”的现象称为过压缩(over-squashing)。
过平滑与过压缩不同:前者是反复平均导致表示趋同,后者是远程依赖在传播路径上被压缩或梯度衰减。残差和归一化能缓解过平滑,却不一定增加跨越图瓶颈的通信容量。
⚪ 图重连:用曲率定位瓶颈
负曲率边附近往往对应树状扩张或社群之间的狭窄桥梁。图重连方法通过添加捷径边、调整边权或删除冗余边,缩短远程依赖路径并增加瓶颈截面。代价是改变了原始图语义;在化学键、因果关系等不可随意修改的图上,需要把新增边视作计算边而非真实关系。
⚪ Jumping Knowledge:跨层选择感受野
Jumping Knowledge Network汇总节点在不同层的表示,让不同节点自行选择合适的邻域半径:
\[h_v=\operatorname{AGG}\left(h_v^{(0)},h_v^{(1)},\ldots,h_v^{(L)}\right).\]浅层保留局部细节,深层提供远程上下文;拼接、最大池化或注意力都可作为跨层聚合。这不能消除传播瓶颈,却避免所有节点被迫使用同一深度。
(3) 异配图上的错误平滑
在异配图中,邻居可能主要来自不同类别。普通GCN的低通偏置会把本应分开的类别拉近;即使没有过平滑,第一层聚合也可能已经破坏信息。解决思路包括:保留中心节点与邻居信息的独立通道、显式使用高阶邻居、学习正负传播权重、把结构与特征预测分开。
⚪ H2GCN:分离自身、一跳与二跳信息
H2GCN强调三项设计:先变换自身特征再传播;把自身与邻居表示拼接而非立即混合;显式区分一跳与严格二跳邻域。异配图中一跳邻居可能不同类,二跳邻居反而重新回到同类,因此高阶结构不是简单“堆更多层”。
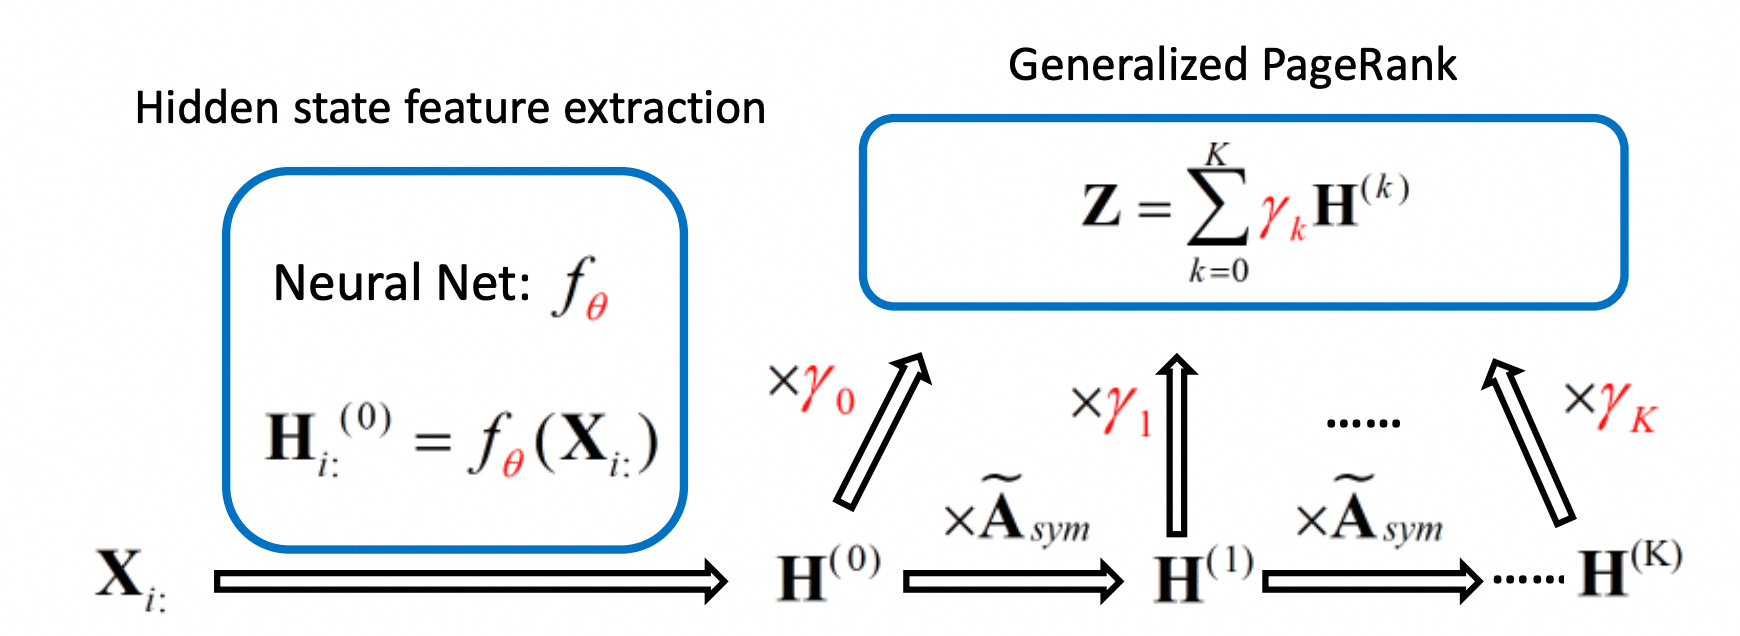
⚪ GPR-GNN:学习不同传播阶数的权重
GPR-GNN把多个传播阶数线性组合:
\[Z=\sum_{k=0}^{K}\gamma_k\hat{A}^kH,\]并学习可正可负的\(\gamma_k\)。正系数偏向低通平滑,交替符号可以表达高通成分,因此同一框架能适应同配和异配结构。
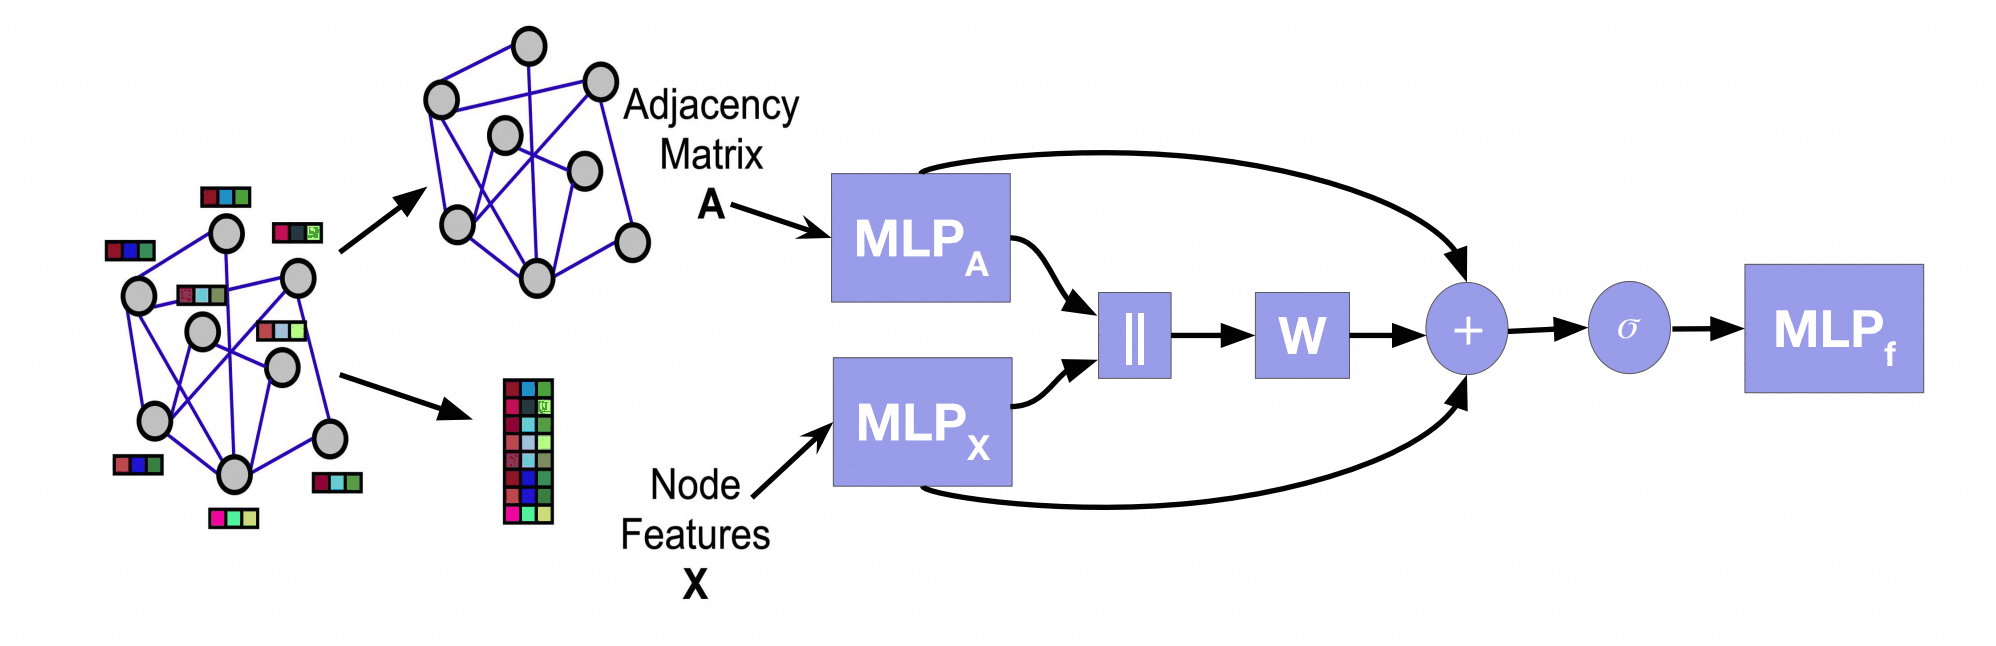
⚪ LINKX:分别编码邻接行与节点特征
LINKX先分别用多层感知机编码节点的邻接行和原始特征,再融合两者,不强迫特征沿边平滑。它说明在某些异配网络中,“谁与谁连接”的整体模式比“邻居特征平均”更有辨识力,也提醒我们始终与不传播的强基线比较。
7. 特殊图结构
7.1 异构图与知识图谱
异构图包含多种节点类型或边类型。例如知识图谱中的“作者—撰写—论文”和“论文—发表于—会议”是不同关系;把它们压成同一种边会丢失方向和语义。
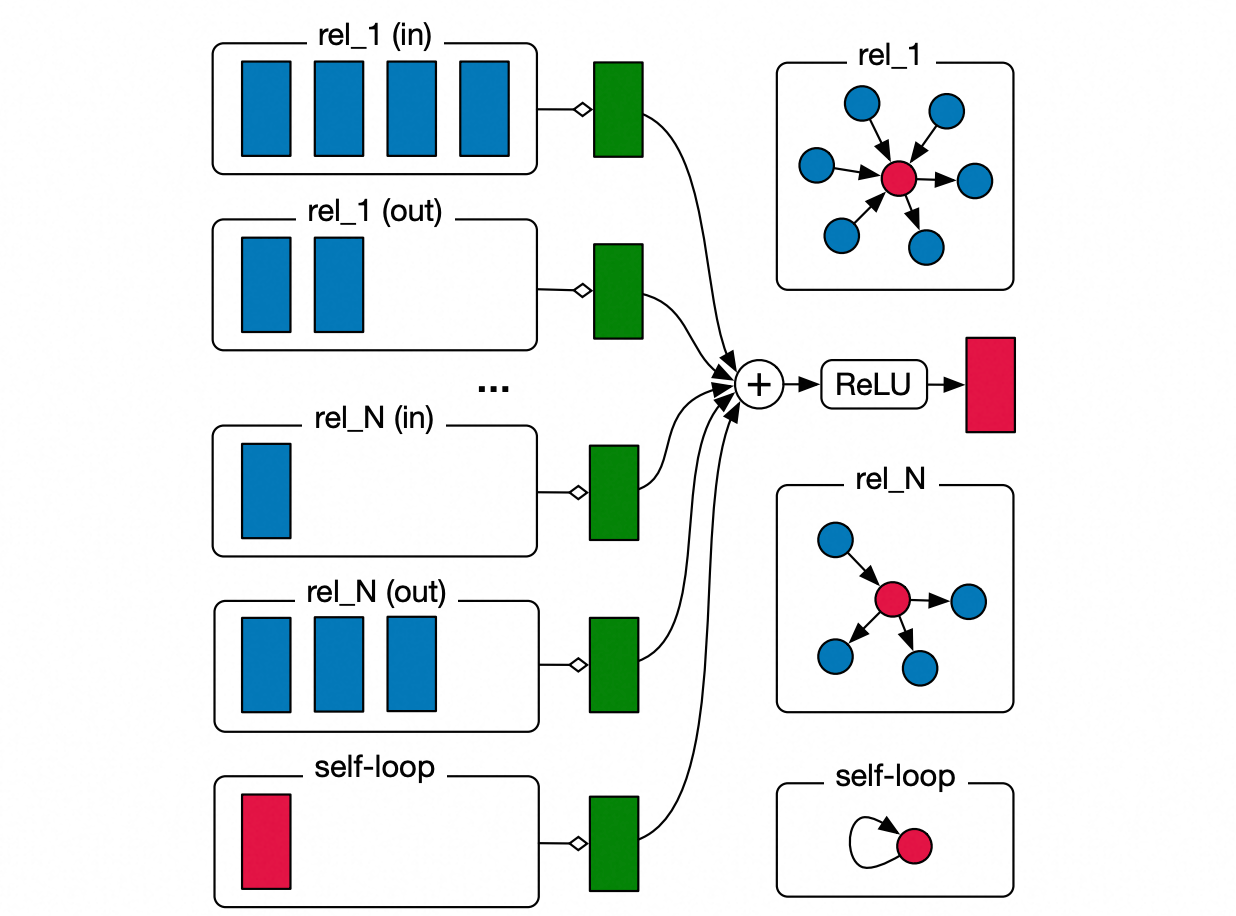
⚪ R-GCN:关系类型专用的消息变换
R-GCN(Relational Graph Convolutional Network)为每种关系\(r\)使用独立变换:
\[h_v^{(l+1)}=\sigma\left(W_0^{(l)}h_v^{(l)}+ \sum_{r\in\mathcal{R}}\sum_{u\in\N_r(v)}\frac{1}{c_{v,r}}W_r^{(l)}h_u^{(l)}\right).\]关系很多时,独立矩阵会导致参数爆炸,因此通常使用基分解或块对角分解共享参数。它是知识图谱编码器和异构消息传递的基础模型。
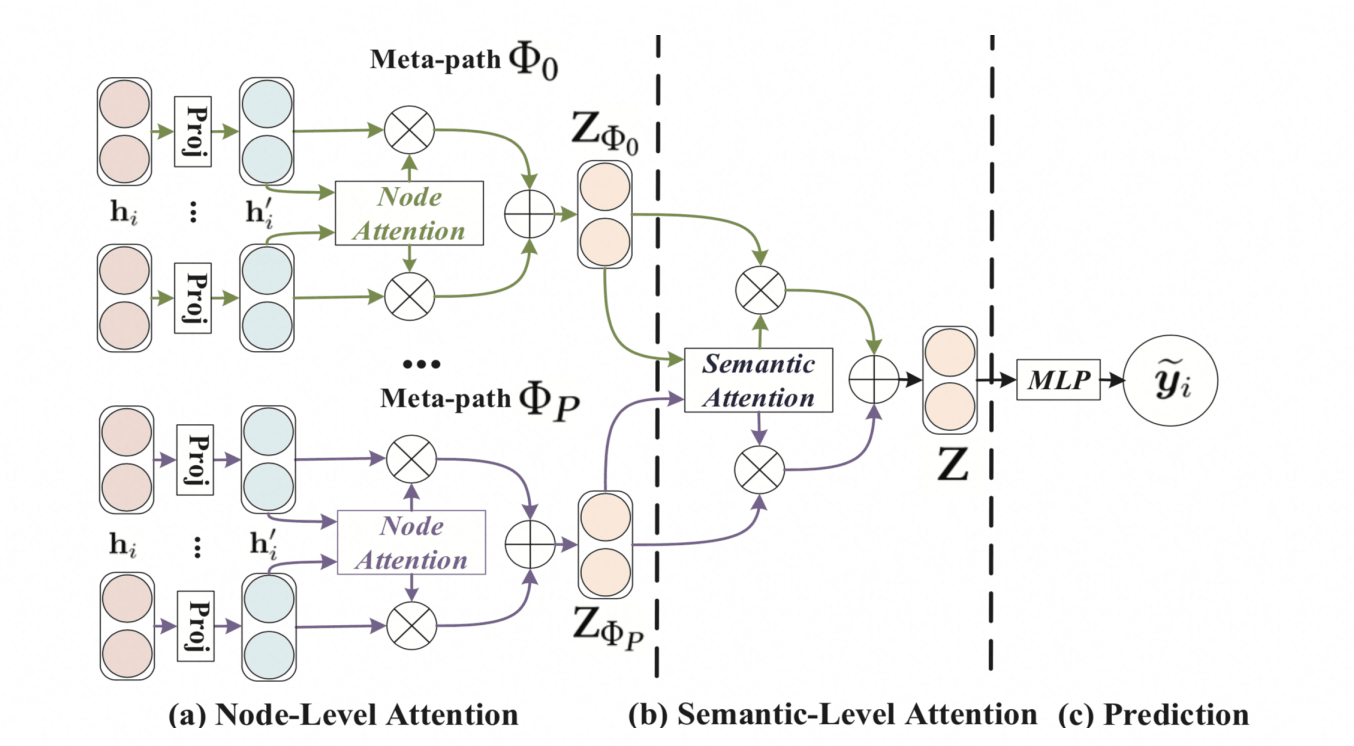
⚪ HAN:元路径上的层级注意力
HAN(Heterogeneous Graph Attention Network)先沿预先定义的元路径构造同类型节点邻域,在每条元路径内做节点级注意力,再用语义级注意力融合不同元路径。元路径提供强领域先验,但需要人工设计,且路径数量随关系组合快速增长。
⚪ HGT:类型相关的异构图Transformer
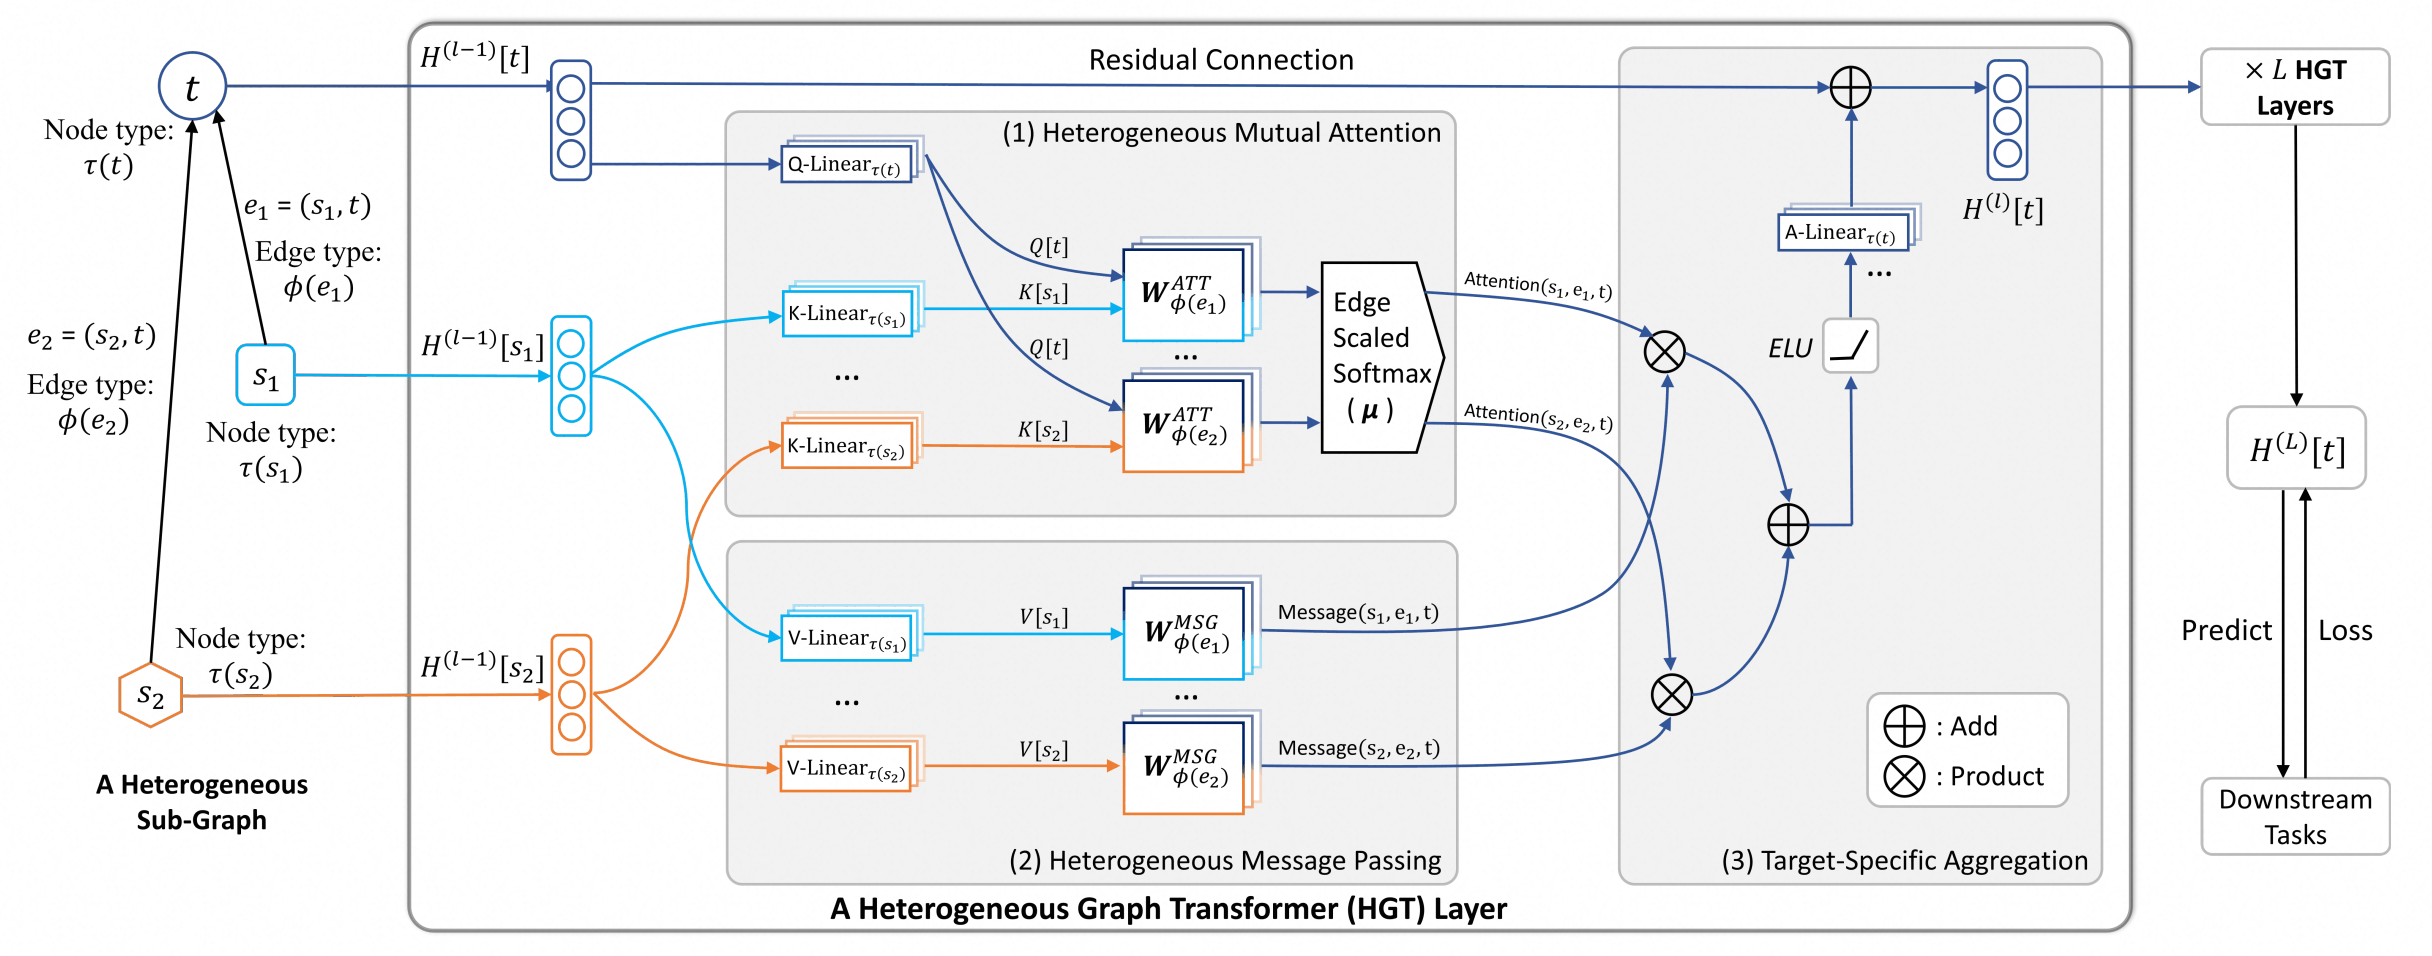
HGT(Heterogeneous Graph Transformer)让查询、键、值投影依赖节点类型,注意力和消息变换依赖边类型,并加入相对时间编码。这样不同关系共享统一架构,又保留各自语义,适合大规模学术网络和多关系动态图。
7.2 时空图与连续时间动态图
时序图有两种不同设定:离散快照图(discrete-time dynamic graph)把时间切成若干图;连续时间事件图(continuous-time event graph)把每次边出现、消息或节点更新记录成带时间戳的事件。前者适合规则采样的交通与传感器数据,后者适合交易、通信和交互日志。
⚪ DCRNN:扩散卷积与循环网络
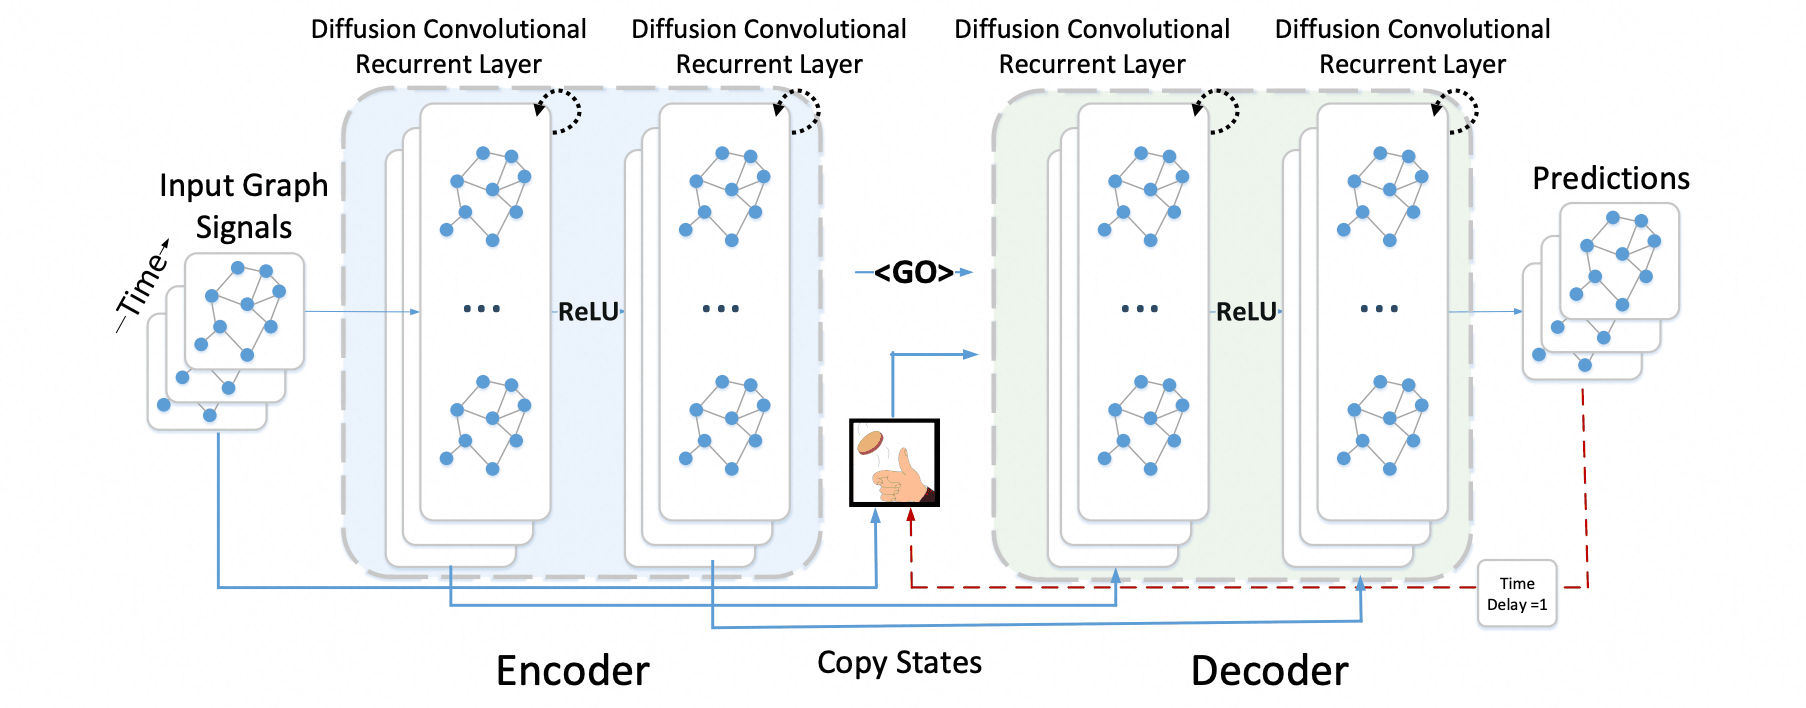
DCRNN把道路网络上的有向随机游走扩散卷积放进门控循环单元,用图传播建模空间依赖,用递归状态建模时间依赖。它还采用计划采样缓解多步预测中训练和推理输入不一致的问题。
⚪ STGCN:时间卷积与图卷积交替
- paper:Spatio-Temporal Graph Convolutional Networks: A Deep Learning Framework for Traffic Forecasting
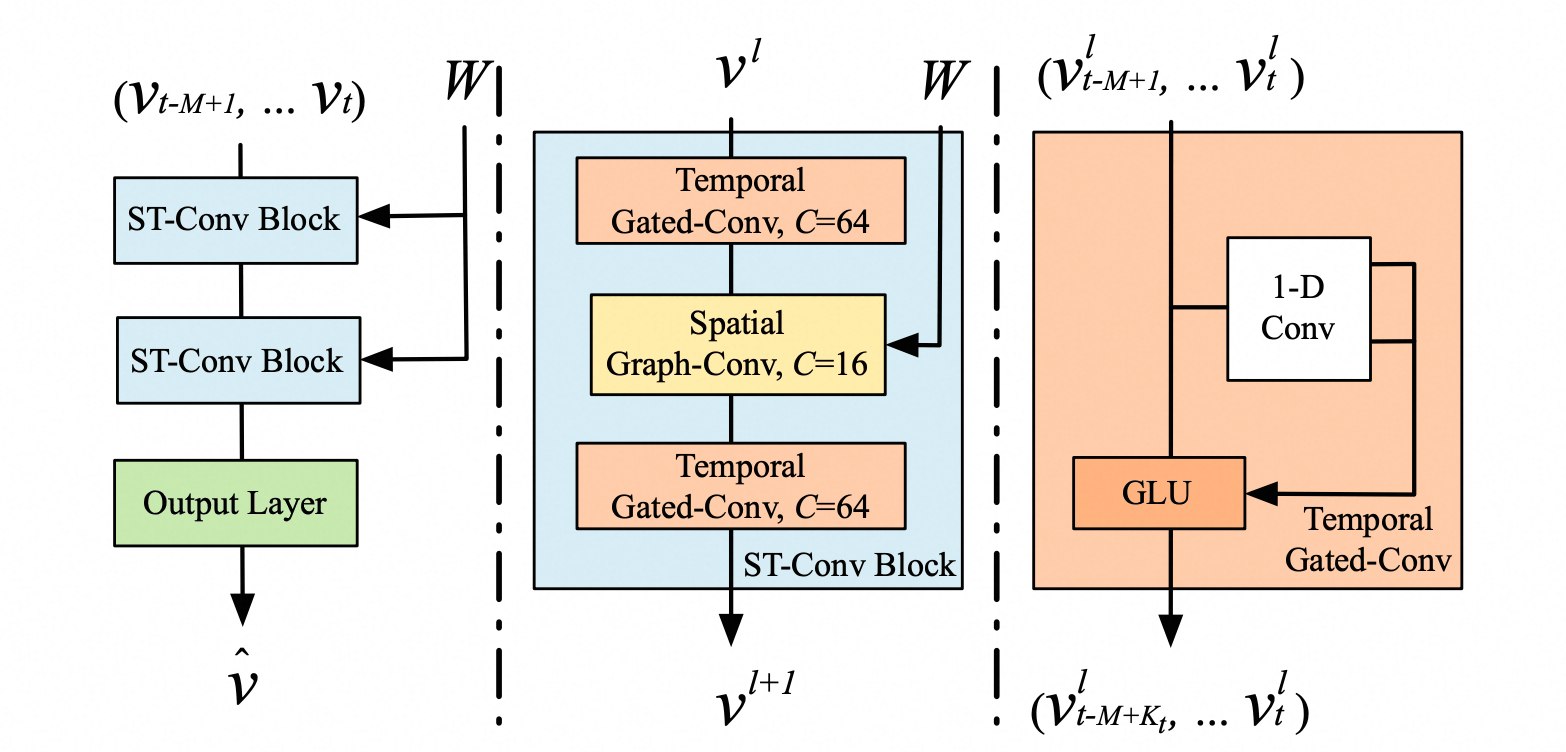
STGCN用一维时间卷积替代循环网络,并在时间卷积之间插入图卷积。整个网络可以沿时间并行训练,适合固定传感器图上的短期预测,但图结构和采样间隔通常在训练前固定。
⚪ TGAT:时间编码的邻域注意力
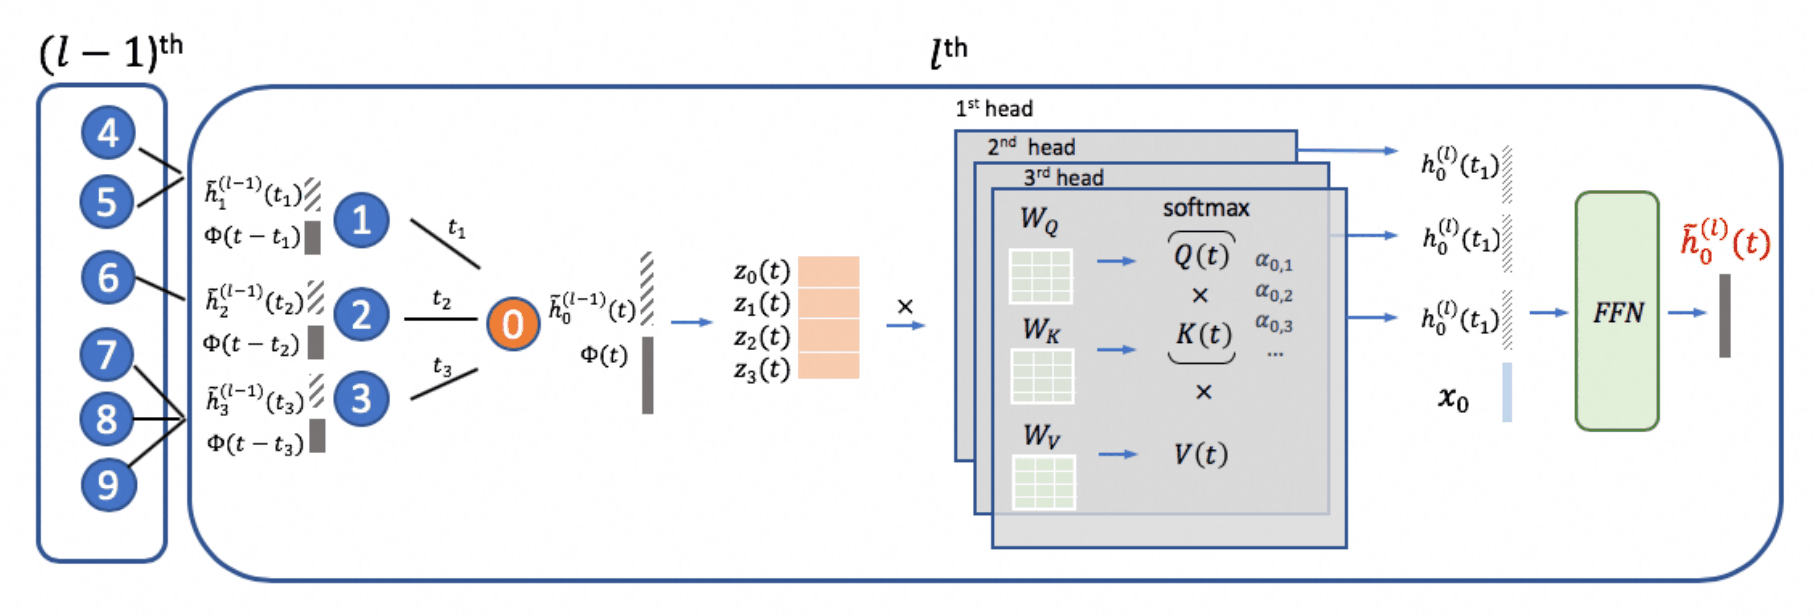
TGAT(Temporal Graph Attention Network)把时间间隔映射为一组周期基,并在历史邻居上做时间感知注意力。查询时只使用事件发生前的邻域,支持新节点的归纳表示。任何随机批处理若读取未来边,都会造成严重时间泄漏。
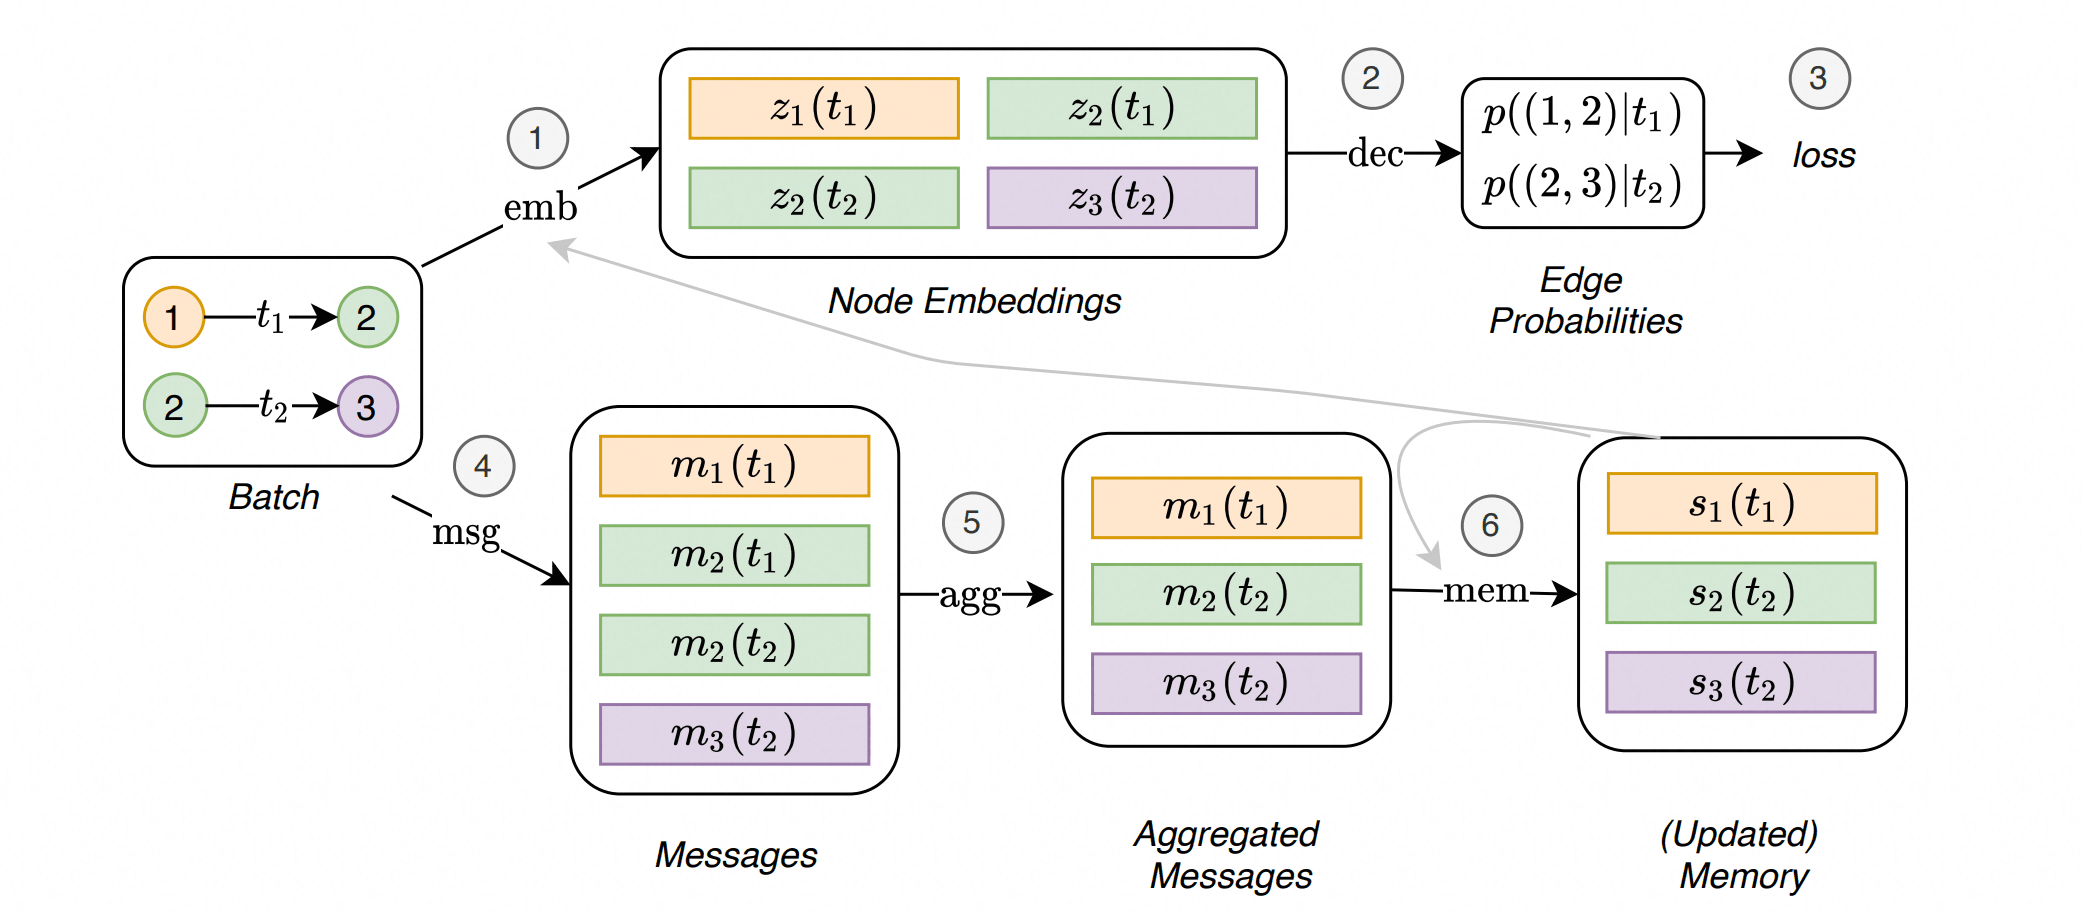
⚪ TGN:事件驱动的节点记忆
TGN(Temporal Graph Network)为每个节点维护记忆,事件到来时生成消息并更新记忆,预测时再从时间邻域聚合。它把记忆、消息、更新和嵌入拆成可替换模块,适合高频事件流;训练时必须解决同一批事件内部的时间顺序和记忆一致性。
7.3 几何图与等变网络
分子、点云和物理系统的节点带有三维坐标。模型不仅要对节点重排保持等变,还应满足平移、旋转或反射对称性。若输入整体旋转,能量等标量应保持不变,力和速度等向量应按同样方式旋转。
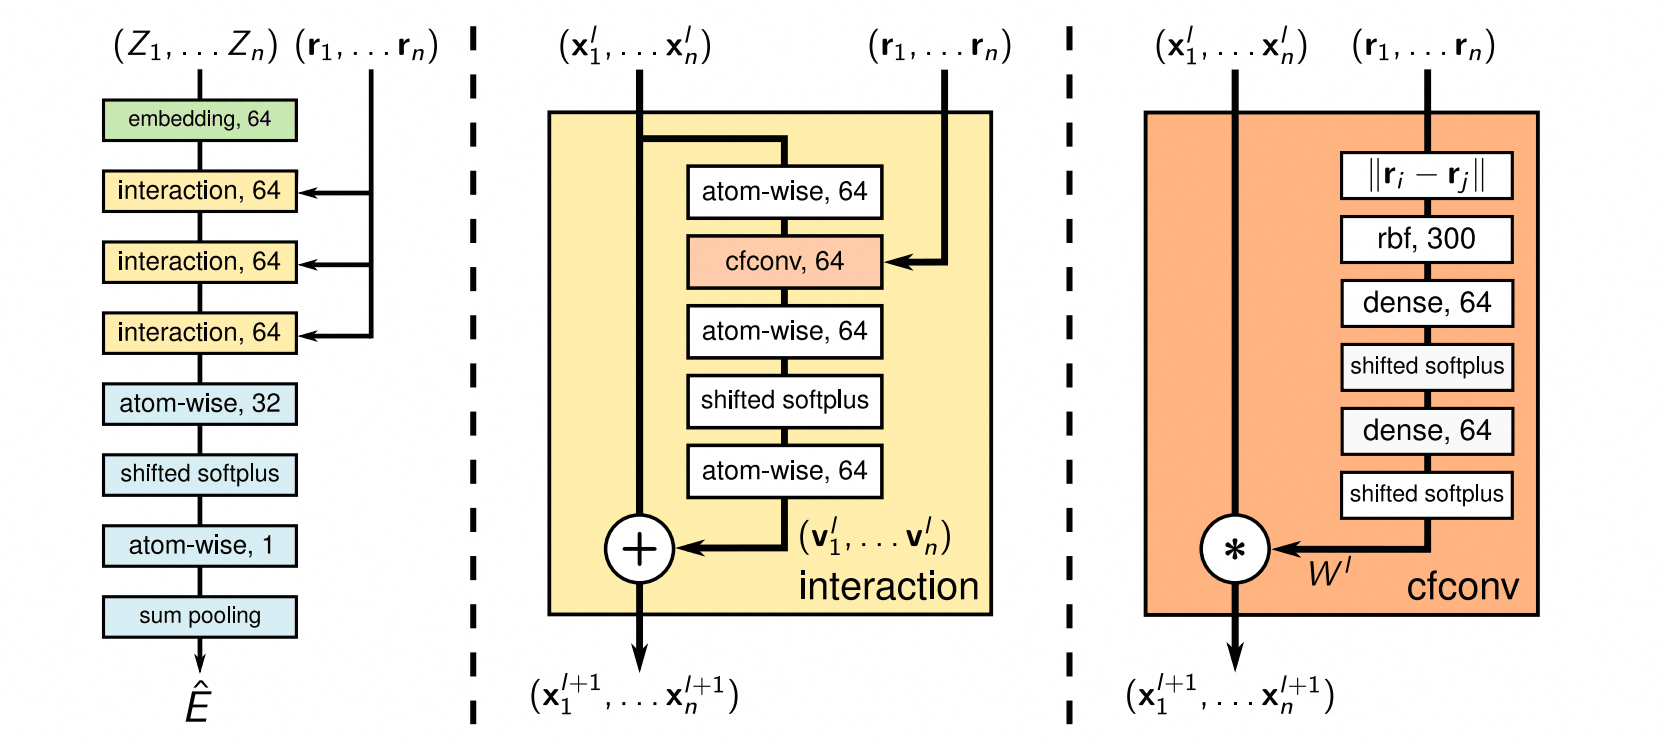
⚪ SchNet:连续滤波的分子图网络
SchNet用原子间距离生成连续滤波器,再对邻居特征加权。仅依赖距离使能量预测天然具有旋转和平移不变性,但纯距离消息难以完整表达方向和手性信息。
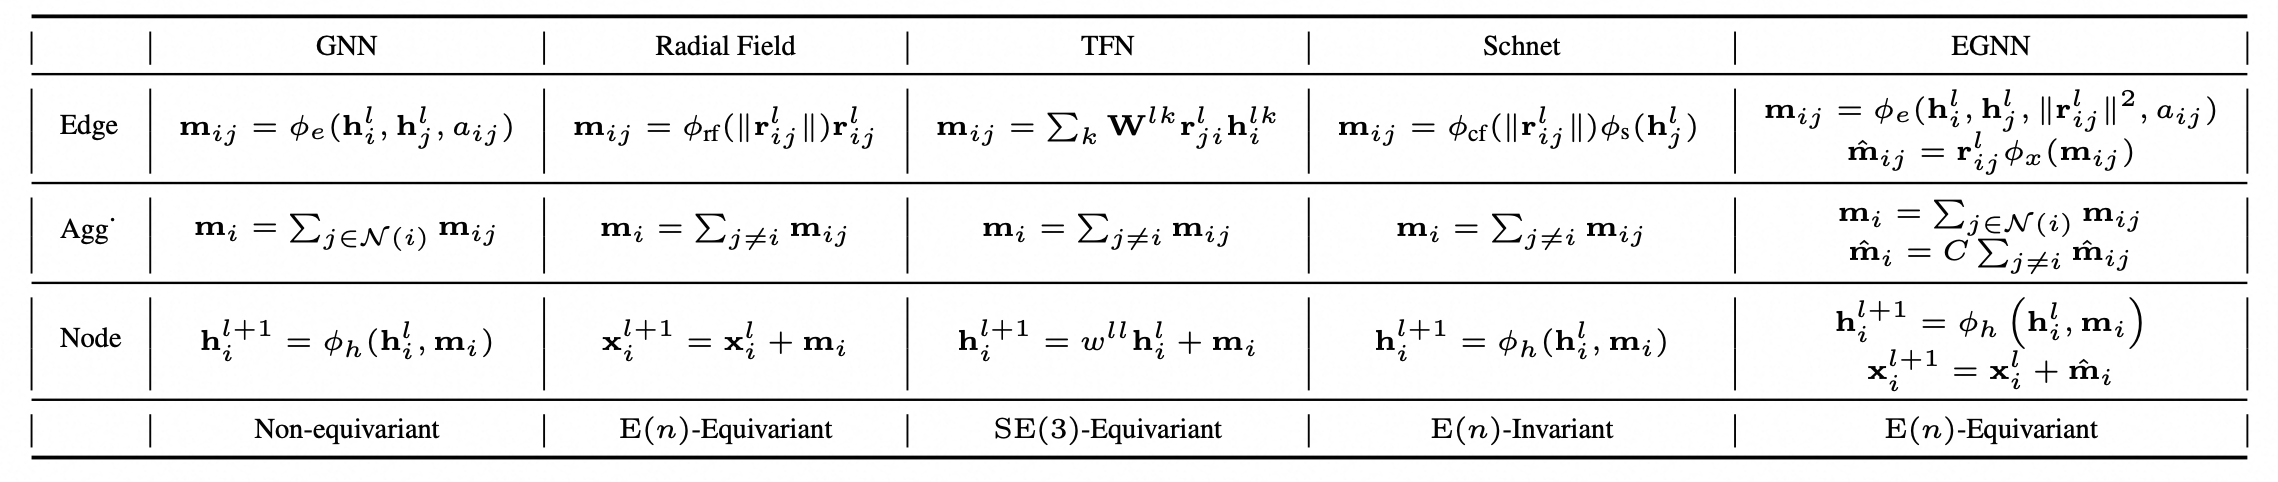
⚪ EGNN:欧氏群等变消息传递
EGNN(E(n) Equivariant Graph Neural Network)用相对坐标差和距离平方构造消息,并用标量系数更新坐标:
\[\begin{aligned} m_{ij}&=\phi_e(h_i,h_j,\Vert x_i-x_j\Vert^2,e_{ij}),\\ x_i'&=x_i+\sum_{j\ne i}(x_i-x_j)\phi_x(m_{ij}),\\ h_i'&=\phi_h\left(h_i,\sum_{j\ne i}m_{ij}\right). \end{aligned}\]由于坐标更新只由相对向量乘不变标量组成,整体变换满足平移、旋转和反射等变性,无需显式球谐函数。
8. 图Transformer
(1) 为什么图需要全局注意力
局部消息传递需要\(L\)层才能让距离\(L\)的节点通信;在直径大、存在狭窄桥梁的图上,远程信息容易过压缩。全局自注意力让任意节点一层直接交互,但也带来两个问题:
- 没有位置顺序时,纯注意力只把节点看成集合,必须额外注入图结构。
- 标准注意力的时间和内存复杂度为\(O(n^2)\),大图无法承受。
因此图Transformer的核心是回答:如何把结构编码进注意力,以及如何在局部归纳偏置与全局通信之间取舍。
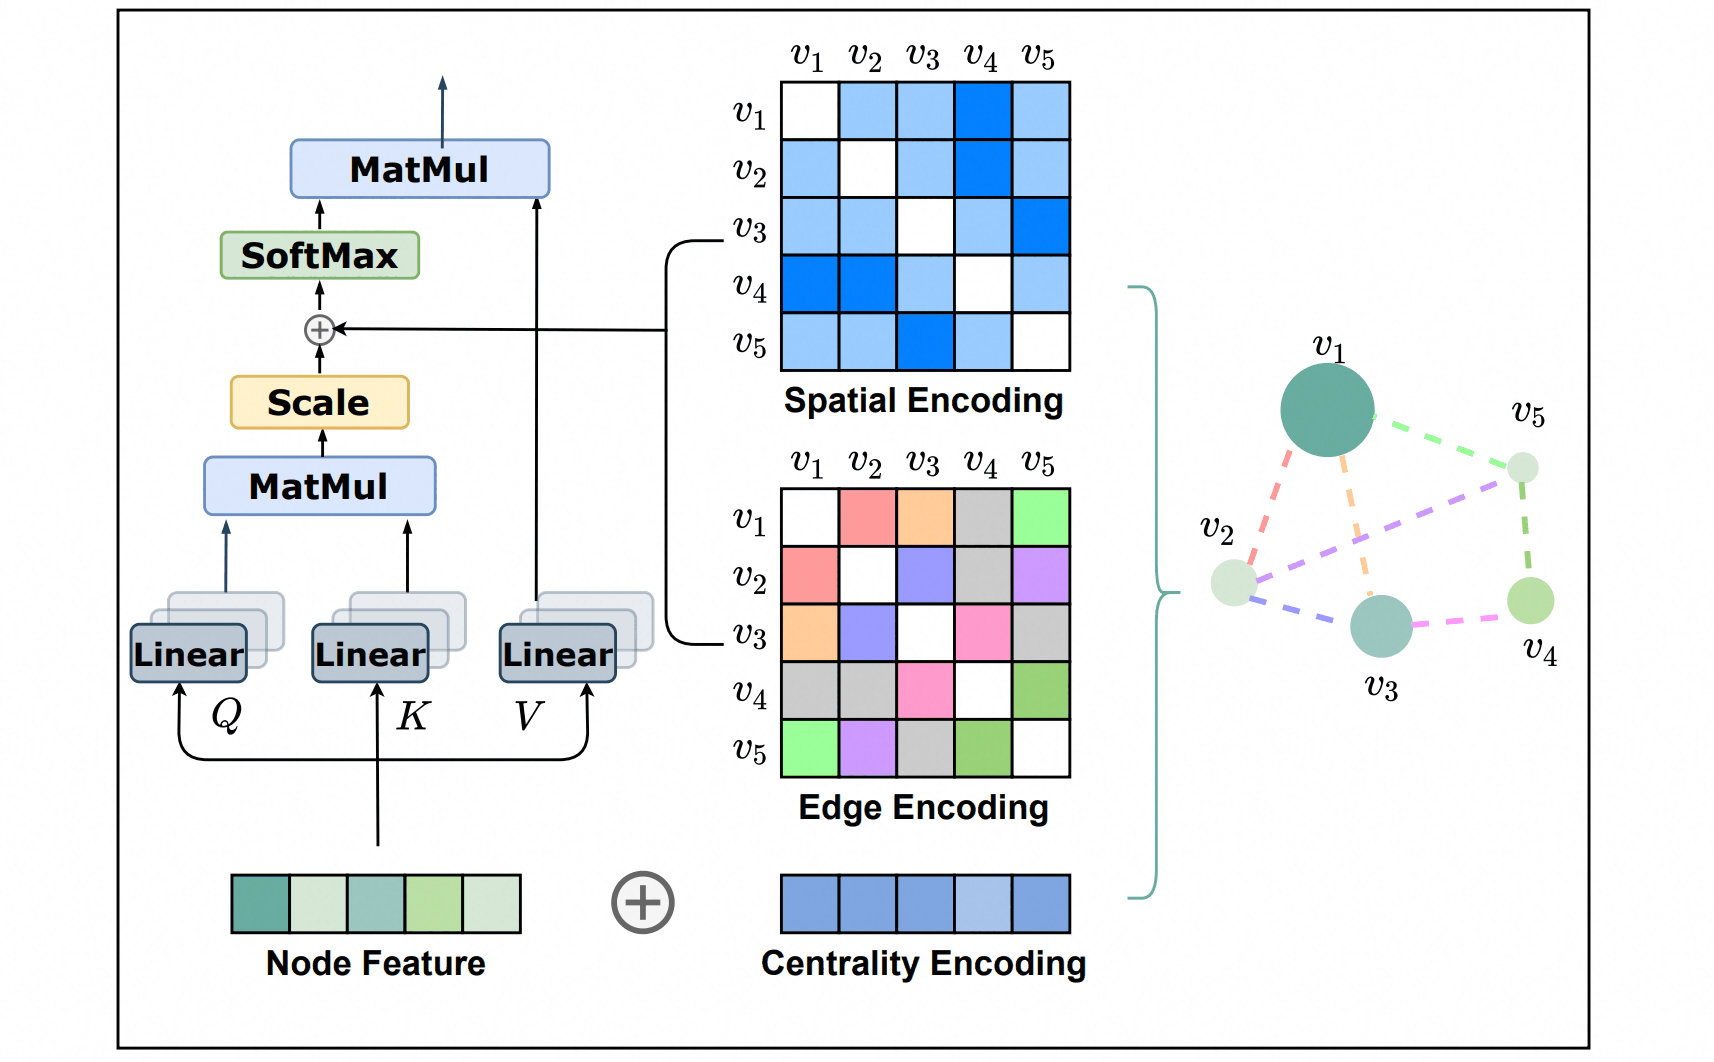
⚪ Graphormer:结构偏置的全局注意力
Graphormer在注意力分数中加入三类结构信息:节点度形成中心性编码,节点对最短路距离形成空间偏置,最短路径上的边类型形成边编码:
\[\alpha_{ij}=\operatorname{softmax}_j\left( \frac{(h_iW_Q)(h_jW_K)^\top}{\sqrt{d}}+b_{\mathrm{dist}(i,j)}+c_{ij} \right).\]全局注意力提供一跳远程通信,结构偏置告诉模型哪些节点在图上接近。代价是\(O(n^2)\)成对计算,更适合中小分子图而非百万节点网络。
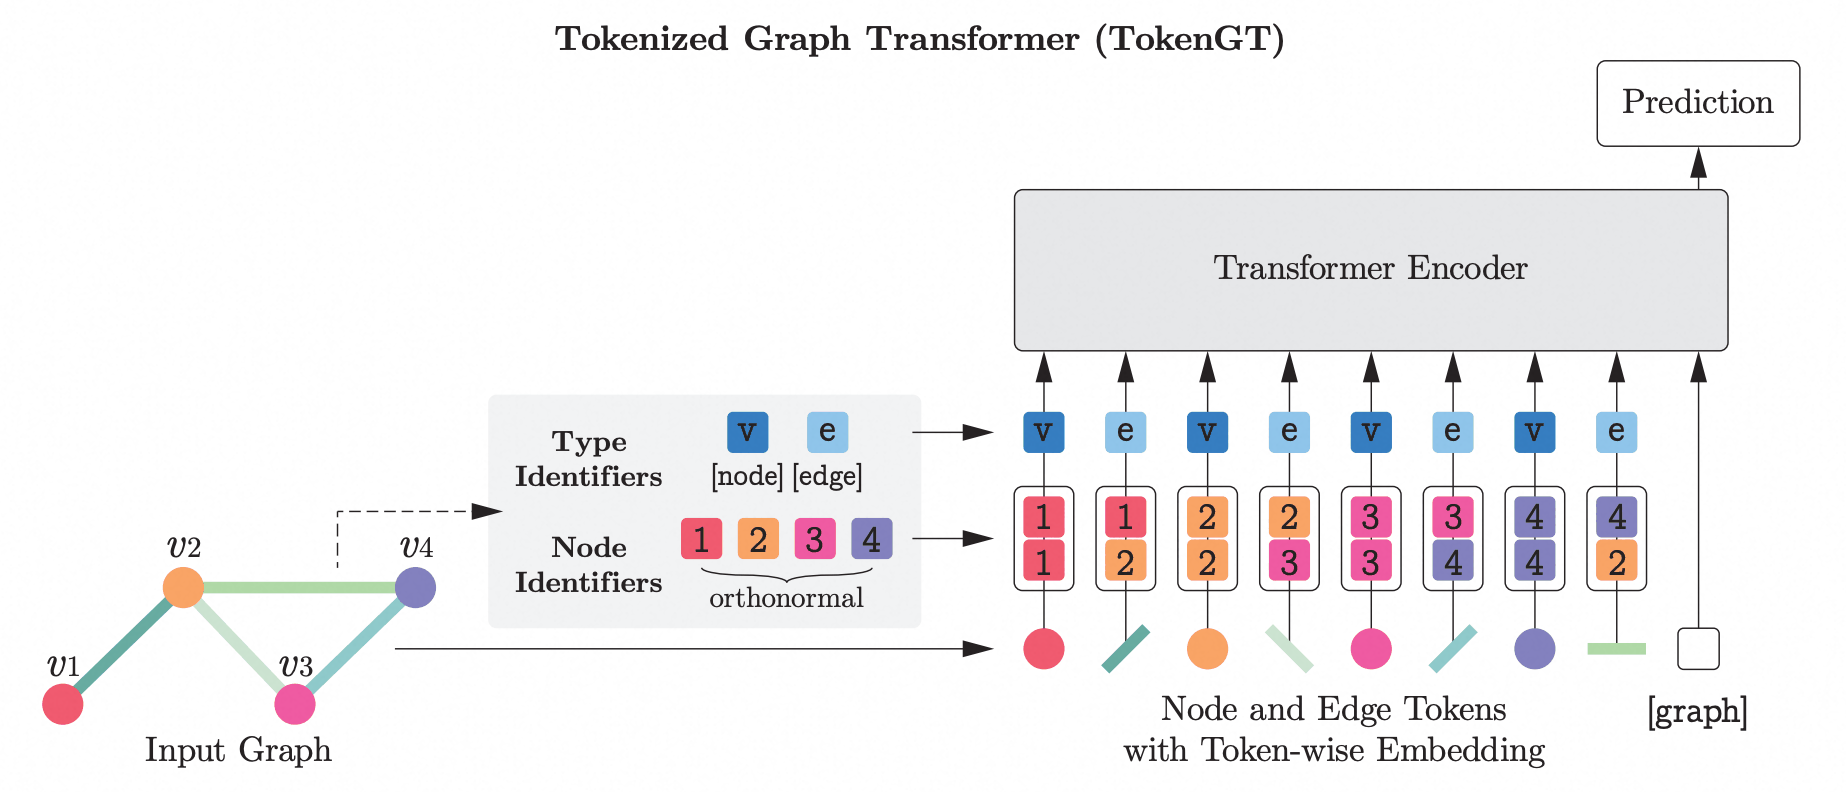
⚪ TokenGT:把节点和边都视作标记
TokenGT把节点和边都转成输入标记,并用节点标识符与类型标识符编码关联关系。它说明在合适的不变/等变标识设计下,纯Transformer也能达到强图表达能力;但标记数变为\(n+m\),全局注意力成本进一步增加。
(2) 结构偏置、稀疏注意力与混合架构
⚪ GraphGPS:局部消息传递与全局注意力并行
GraphGPS每层并行计算局部MPNN和全局注意力,再融合两条分支:
\[H^{(l+1)}=\operatorname{MLP}\left( \operatorname{MPNN}^{(l)}(H^{(l)},A)+ \operatorname{Attn}^{(l)}(H^{(l)}) \right).\]局部分支利用边和局部结构,全局分支跨越图瓶颈,拉普拉斯或随机游走编码提供节点位置。全局注意力还可以替换成线性或稀疏实现,使架构扩展到更大图。
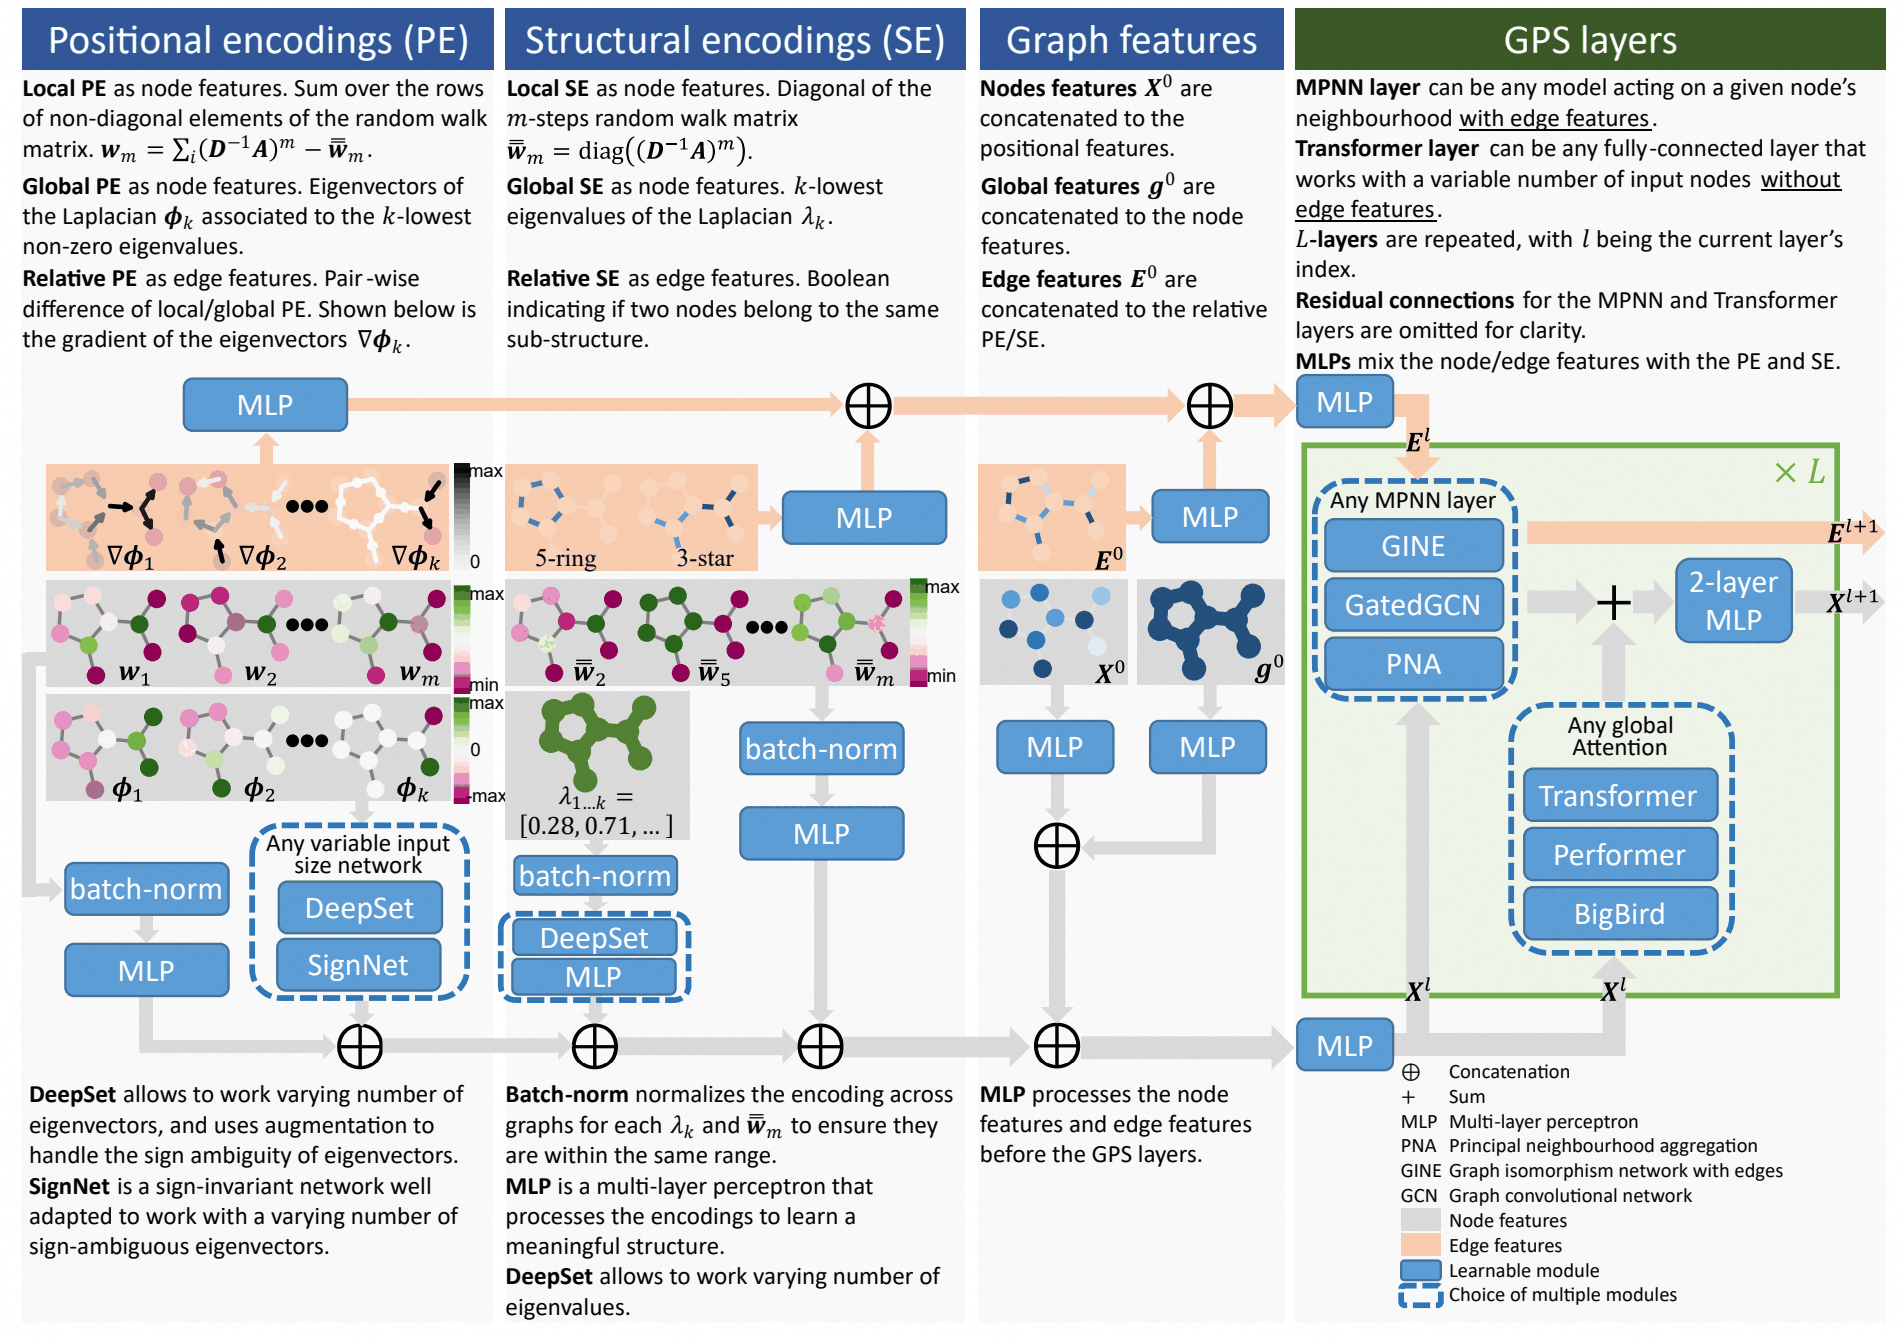
⚪ Exphormer:虚拟节点与扩展图稀疏注意力
Exphormer只在原图边、随机扩展图边和少量虚拟节点之间计算注意力。扩展图以稀疏边提供快速全局混合,虚拟节点作为全图通信枢纽,使每层成本接近线性。稀疏模式降低\(O(n^2)\)成本,但其全局通信质量取决于附加边和虚拟节点的设计。
9. 大规模训练与自监督学习
9.1 采样、聚类与预计算
全批图训练每一步都要访问整张图;即使模型只有两层,反向传播也要保存大量节点激活。小批训练的困难在于节点样本并不独立:一个目标节点会递归展开多跳邻居,形成“邻居爆炸”。
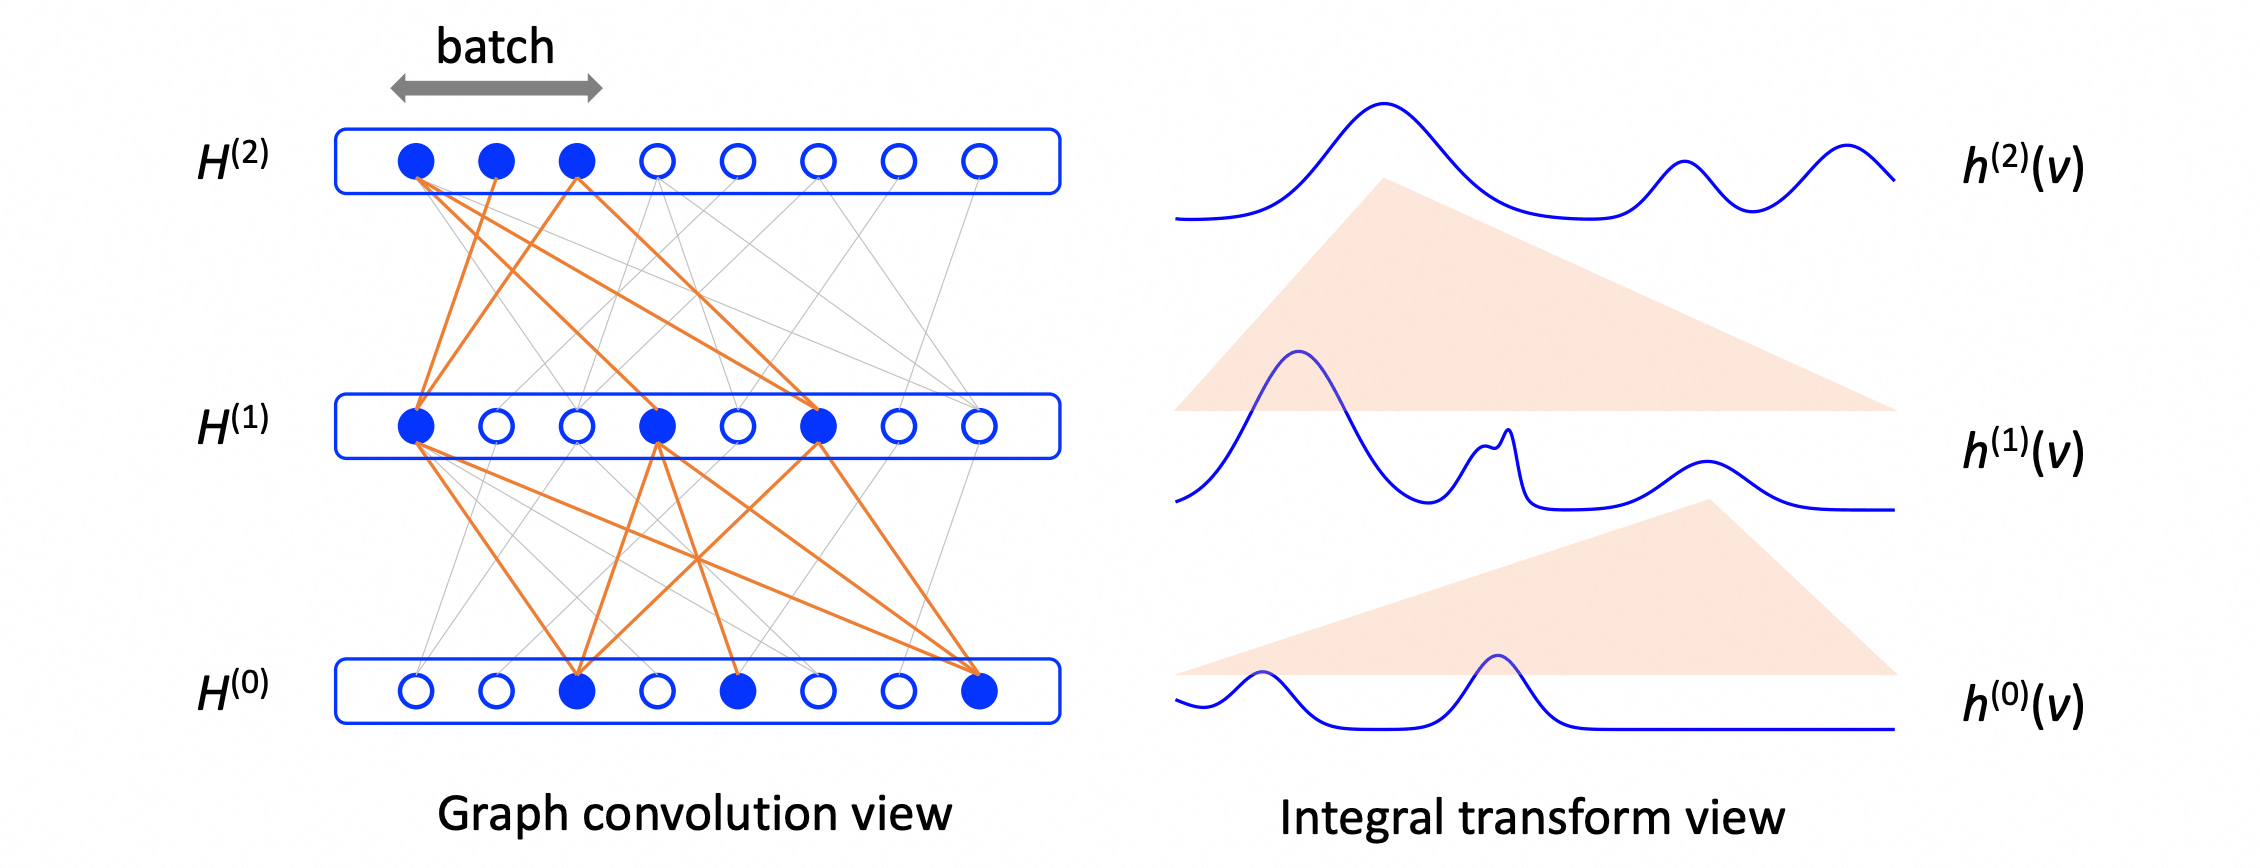
⚪ FastGCN:逐层重要性采样
FastGCN把图卷积视作积分变换,在每一层独立采样节点,并用重要性权重校正估计。它避免按目标节点递归展开邻域,但不同层独立采样会切断真实依赖,估计方差也依赖采样分布。
⚪ Cluster-GCN:按图簇构造小批次
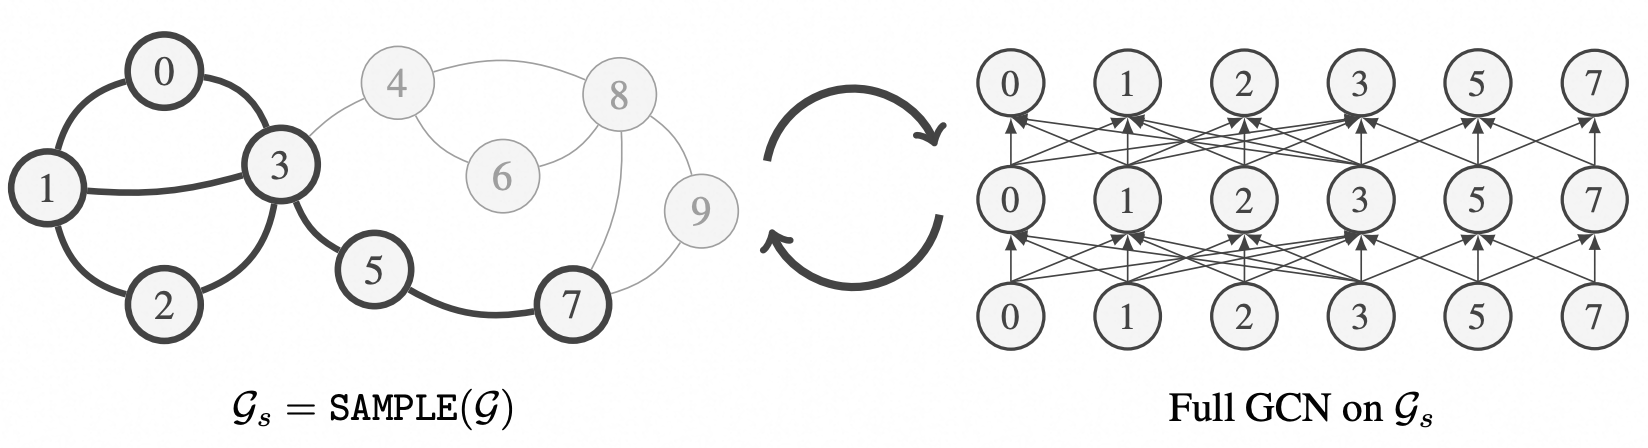
Cluster-GCN先把图划分成内部连接密集的簇,每个批次加载一个或多个簇。簇内边保留了真实局部结构,内存访问也更连续;但跨簇边在当前批次被截断,划分质量会影响偏差。
⚪ GraphSAINT:子图采样与无偏校正
GraphSAINT直接采样节点、边或随机游走诱导出的子图,再用采样概率归一化节点损失和消息。整个子图可按普通图网络处理,避免逐层采样造成不规则计算;不同采样器在覆盖长尾节点和保留局部结构之间有不同权衡。
⚪ SIGN:预计算多尺度扩散特征
SIGN离线预计算多种图算子作用后的特征:
\[X_k=A_kX, \qquad Z=\operatorname{MLP}\left([X_0\Vert X_1\Vert\cdots\Vert X_K]\right).\]训练阶段退化为普通独立样本的小批学习,不再访问图;代价是图结构和传播算子固定,无法端到端学习每层消息,也不适合边频繁变化的动态图。
9.2 对比学习、非对比学习与掩码建模
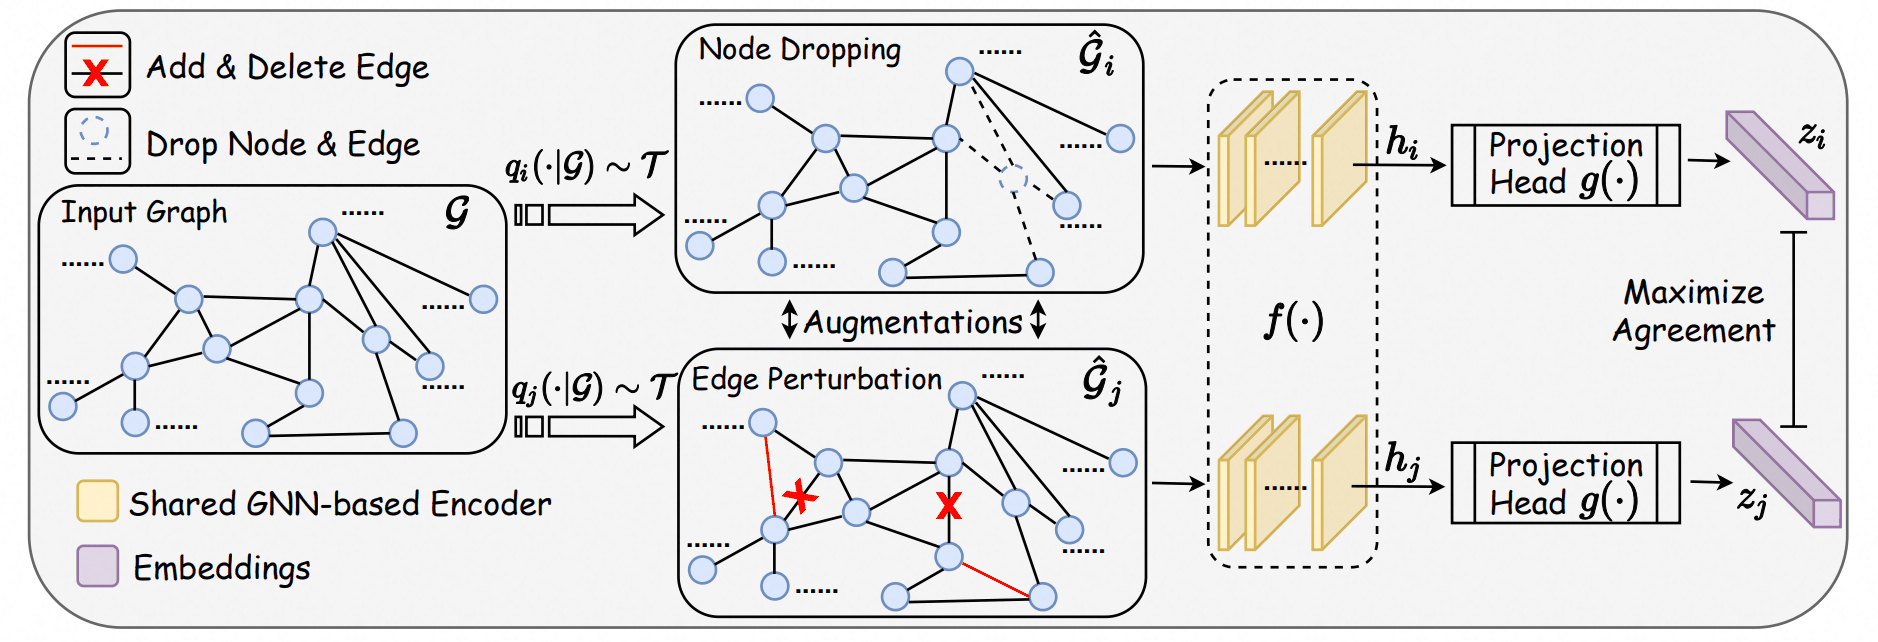
图标签昂贵,但节点特征和拓扑本身提供了自监督信号。核心难点在于增强操作:图像裁剪通常保持语义,随机删边或删节点却可能破坏分子官能团、知识图谱事实或关键桥梁。
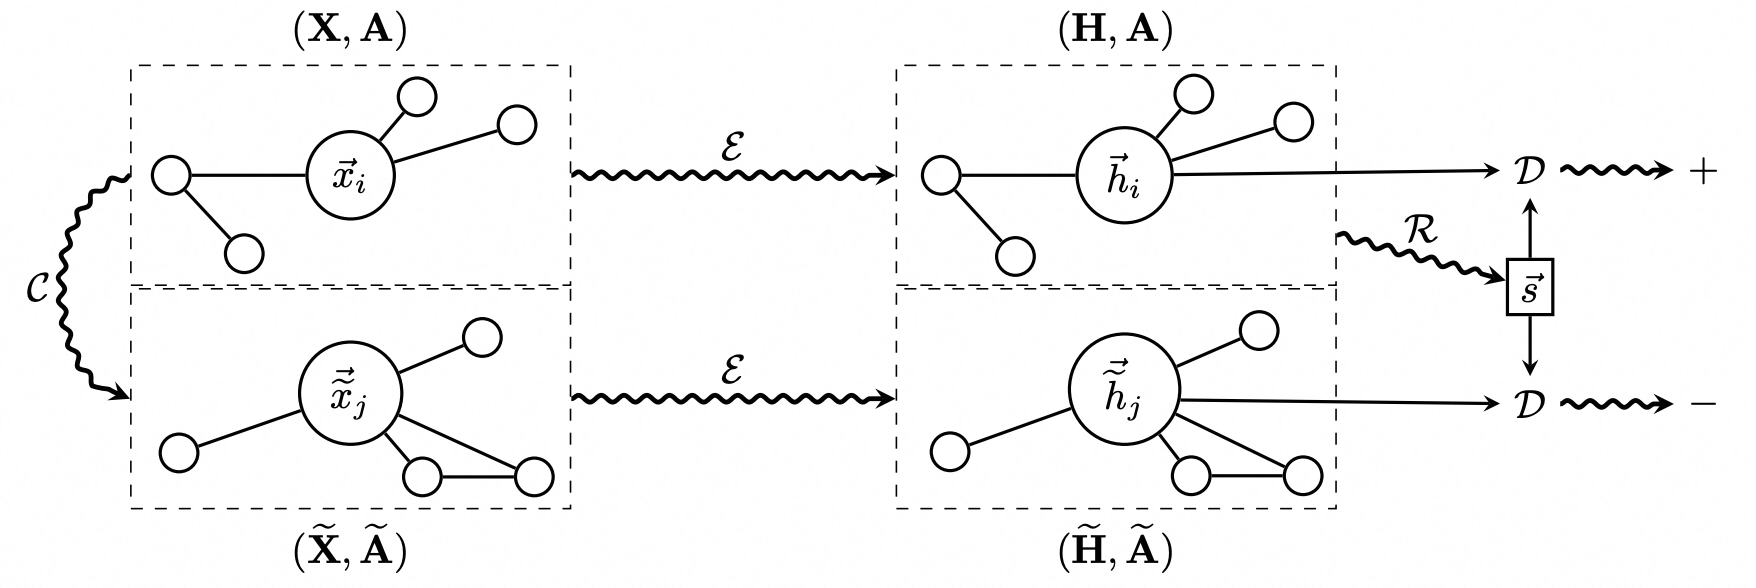
⚪ DGI:局部表示与全局摘要互信息
- paper:Deep Graph Infomax
DGI(Deep Graph Infomax)让真实图中的节点表示与全局摘要互相匹配,并把打乱特征后的图作为负样本。它不需要标签,适合单图节点表示学习;但“最大化互信息”在实现中依赖具体判别目标,打乱方式也可能产生过于容易的负样本。
⚪ GraphCL:图增强上的对比学习
GraphCL对同一张图施加节点丢弃、边扰动、属性遮蔽或子图采样,把两个视图作为正样本,不同图作为负样本。性能高度依赖增强是否保留任务语义;在分子图中随意删除化学键可能改变真实标签。
⚪ BGRL:无需负样本的自举图表示
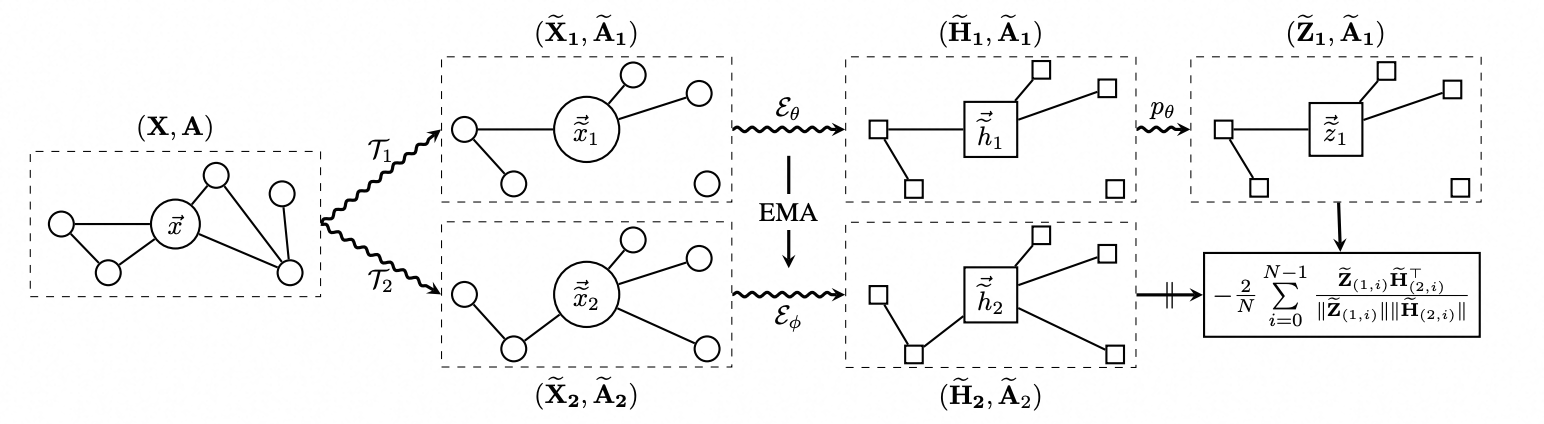
BGRL(Bootstrapped Graph Latents)使用在线编码器预测目标编码器的表示,目标参数由在线参数的指数滑动平均更新。它避免维护大量负样本,适合大图;防止表示塌缩依赖不对称预测器、停止梯度和增强差异。
⚪ GraphMAE:掩码图自编码
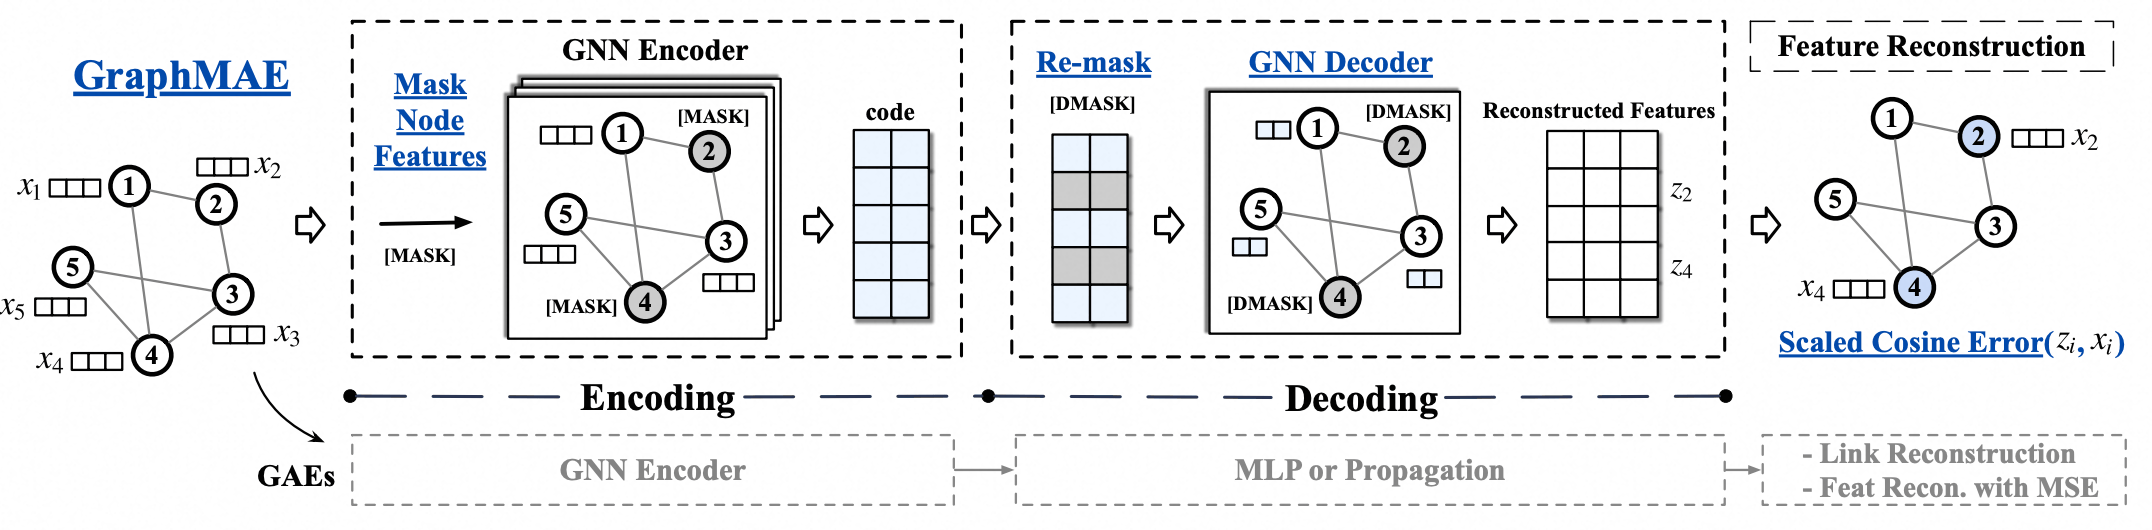
GraphMAE遮蔽部分节点属性,让编码器利用邻域上下文恢复原特征,并用重掩码策略减少解码器直接复制可见输入。与对比学习相比,它不需要负样本和复杂跨样本队列;但若原始特征噪声很大或容易由邻居平均恢复,预训练任务可能过于简单。
10. 任务、基准与评测陷阱
(1) 节点、边与图级任务
节点分类与回归
经典数据集包括引文网络Cora、CiteSeer、PubMed,以及更大、更真实的OGBN-Arxiv、OGBN-Products、Reddit。常见指标是准确率、宏平均F1或均方误差。类别不平衡时,只报告准确率会掩盖少数类失败。
链接预测与边分类
链接预测通常用正边和采样负边训练,指标包括ROC-AUC、Average Precision、MRR、Hits@K。负边不是“真实不存在的边”,而是“当前未观测到的边”;在推荐、药物发现和知识图谱中,随机负采样可能把未知正例错误标成负例。
图分类与图回归
分子性质预测常用ZINC、QM9、MoleculeNet与OGBG-MolHIV、OGBG-MolPCBA;一般图分类常见TU数据集。图级模型必须使用排列不变读出,并警惕同一来源的近重复图跨越训练/测试集。
(2) 数据划分、指标与信息泄漏
⚪ OGB:规模化且任务相关的统一基准
OGB(Open Graph Benchmark)提供统一下载、评测器和更贴近部署的数据划分。例如论文按时间划分、蛋白质按物种划分、分子按骨架划分,避免随机划分把高度相似样本同时放进训练和测试集。
可靠评测至少要回答:
- 划分单位是什么:节点、边、整图、时间还是实体群组。
- 训练时能看到哪些结构:直推节点分类允许看到测试节点的无标签连接;归纳设定不能。
- 预处理是否泄漏:标准化、特征选择、建图、负采样和位置编码都只能使用划分允许的信息。
- 负样本如何构造:随机负样本通常比按时间、类型或候选集合采样容易得多。
- 是否报告方差:图基准对随机种子、划分和初始化很敏感,应报告多个种子的均值与标准差。
(3) 从基准分数到真实部署
一个图模型的效果由图构建、输入特征、传播算子和评测协议共同决定。只比较模型层而固定其他环节,不能证明该层在真实系统中最重要。实践中尤其需要检查:
- 特征基线:只用多层感知机、不使用图结构时有多强;若差距很小,图可能没有提供有效增益。
- 结构基线:只用节点度、标签传播或随机游走时有多强;图网络的收益可能主要来自简单扩散。
- 可扩展性:除参数量和浮点运算量外,还要报告采样开销、峰值内存、预处理时间和推理时延。
- 鲁棒性:缺边、错边、新节点、度分布变化和时间漂移都会改变消息来源。
- 解释边界:注意力权重、聚合系数和显著性分数是模型内部敏感度,不自动等于因果关系。
图神经网络的真正优势在于它提供了一套把关系结构、对称性与学习目标共同编码的语言。谱滤波解释了平滑,消息传递统一了局部模型,表达能力分析指出了不可辨识边界,异构、时序和几何网络把消息扩展到更丰富的关系,图Transformer则用全局通信补足局部传播。