Data Preprocessing in Deep Learning.
在深度学习任务中,原始数据很少能直接输入网络:表格数据存在缺失值、异常值与量纲各异的特征,类别变量没有天然的数值表示;图像有不同的尺寸、颜色空间与像素格式;音频有不同的采样率、声道与响度;文本混杂着各种Unicode变体与控制字符;时间序列的采样间隔不规则、统计特性随时间漂移。
数据预处理(data preprocessing)是指在原始数据进入模型之前,对其进行清洗、变换、编码、划分与组织的一系列操作。预处理决定了模型实际看到的输入分布,因此它既是工程问题,也是统计问题。
本文首先讨论预处理的基本原则;然后介绍通用的数据清洗方法;接着介绍数值特征与离散特征的预处理;再按模态介绍图像、音频、文本、时间序列的预处理;最后讨论数据集的划分与加载。
- 数据预处理的意义与原则
- 数据清洗:缺失值处理、异常值处理、重复样本处理
- 数值特征的预处理:线性缩放、白化、幂变换、基于秩的变换、离散化与数值嵌入
- 离散特征的预处理:无监督编码、目标编码、哈希与嵌入
- 不同模态数据的预处理:图像预处理、音频与语音预处理、文本预处理、时间序列预处理
- 数据集划分与加载:数据集划分、交叉验证与数据泄露、打乱, 批处理与加载
1. 数据预处理的意义与原则
(1) 为什么需要数据预处理
数据预处理主要服务于三个目标:
- 把数据变成模型可以处理的格式:神经网络的输入通常要求固定类型、固定形状的数值张量。
- 改善优化的条件:输入特征的尺度差异会使损失曲面呈现狭长的椭圆形等高线,梯度方向偏离最优方向,同时使带饱和区的激活函数更容易进入饱和区。
- 控制数据分布的质量:预处理需要去除重复、错误与低质量样本,校正采集过程引入的技术性变异,筛选真正与目标任务相关的数据。
(2) 拟合-变换范式与数据泄露
几乎所有带统计量的预处理都可以写成拟合(fit)与变换(transform)两步:
\[\begin{aligned} \hat{\theta} &= \mathcal{A}\left(\mathcal{D}_{\text{train}}\right) \\ x' &= T_{\hat{\theta}}(x)\\ x & \in \mathcal{D}_{\text{train}}\cup\mathcal{D}_{\text{val}}\cup\mathcal{D}_{\text{test}} \end{aligned}\]其中$\mathcal{A}$是估计统计量的算法(例如求均值与方差)。核心原则是:统计量只在训练集上估计。若在全部数据上估计$\hat{\theta}$再划分数据集,测试集的信息就通过$\hat{\theta}$流入了训练过程,这称为数据泄露(data leakage)。以标准化为例,
\[\mu_{\text{all}} = \frac{N_{\text{train}}}{N}\mu_{\text{train}} + \frac{N_{\text{test}}}{N}\mu_{\text{test}}\]若用全体数据的均值$\mu_{\text{all}}$代替训练集均值$\mu_{\text{train}}$,则预处理后的训练数据中就含有测试集均值$\mu_{\text{test}}$的信息;泄露会显著抬高验证指标。
(3) 训练与推理的一致性
训练-推理偏差(training-serving skew)指模型部署时的预处理与训练时不一致,导致输入分布偏移。常见来源包括:
- 统计量不一致:推理时重新计算均值方差,或使用了不同版本的词表;
- 实现不一致:训练用PIL解码与缩放图像、部署用OpenCV,二者的通道顺序(RGB与BGR)、插值核与抗混叠行为不同;
- 随机性不一致:随机裁剪、随机翻转等数据增强只应在训练时启用,推理时应替换为确定性的对应操作。
工程上的通用做法是把预处理封装为与模型一起版本化、序列化的对象(例如scikit-learn的Pipeline、torchvision的transforms、Hugging Face的ImageProcessor与FeatureExtractor),并在训练与推理共用同一份代码与同一份统计量文件。
(4) 可逆变换与不可逆变换
预处理变换可以按是否可逆分为两类:
- 可逆变换:线性缩放、标准化、幂变换、可逆实例归一化等。当变换作用于预测目标时,模型输出必须经过逆变换回到原始尺度。
- 不可逆变换:截断、量化、缩放与裁剪、去重与过滤等。这些变换主动丢弃信息,其设计目标是丢弃与任务无关的部分。
对目标做非线性变换时还需注意逆变换的偏差。若对正值目标$y \in (0, + \infty)$取对数后训练回归模型(模型预测$\mathbb{E}[\log y\mid x]$);由Jensen不等式,$\exp(\mathbb{E}[\log y\mid x])\le\mathbb{E}[y\mid x]$,直接对预测结果取指数得到的是偏小的条件几何均值,从而引入了系统性偏差。
2. 数据清洗
数据清洗(data cleaning)处理数据中的缺失、异常、重复与错误标签。
(1) 缺失值处理
⚪ 缺失机制:MCAR、MAR与MNAR
选择缺失值处理方法之前,需要先判断数据为什么缺失。记完整数据为$X=(X_{\text{obs}},X_{\text{mis}})$,缺失指示矩阵为$R$($R_{nd}=1$表示$x_{nd}$缺失),缺失机制由条件分布$p(R\mid X)$描述。Rubin将缺失机制分为三类:
- MCAR(完全随机缺失):$p(R\mid X_{\text{obs}},X_{\text{mis}})=p(R)$;一个数据点是否缺失与观测到的任何数据都无关。
- MAR(随机缺失):$p(R\mid X_{\text{obs}},X_{\text{mis}})=p(R\mid X_{\text{obs}})$;数据是否缺失与它自身的值无关,但与观测到的其他变量有关。
- MNAR(非随机缺失):$p(R\mid X_{\text{obs}},X_{\text{mis}})$依赖于$X_{\text{mis}}$;数据是否缺失,恰恰是由它自己的值决定的。
以一份社会调查问卷为例,问卷中包含“年龄”和“年收入”两个问题。数据录入员在将纸质问卷录入电脑时,由于疲劳随机地漏掉其中一部分“年收入”信息,属于MCAR;年长者更倾向于不回答“年收入”这个问题,属于MAR;收入非常高或非常低的人选择不填,属于MNAR。
引入数据参数$\theta$描述数据的内在规律(例如包含了“年龄”和“收入”之间的真实关系),机制参数$\psi$描述数据的缺失规律(例如“年龄越大,不填收入的概率越高”这个规律)。在MAR下,观测数据$X_{\text{obs}},R$的似然可以分解为
\[\begin{aligned} p(X_{\text{obs}},R\mid\theta,\psi)&= \int p(X_{\text{obs}},X_{\text{mis}},R\mid\theta,\psi)dX_{\text{mis}} \\ &=\int \underbrace{p(X_{\text{obs}},X_{\text{mis}}\mid\theta)}_{\text{数据生成过程,省略}\psi} \cdot \underbrace{p(R\mid X_{\text{obs}},X_{\text{mis}},\psi)}_{\text{数据缺失过程,省略}\theta} dX_{\text{mis}}\\ &=\int p(X_{\text{obs}},X_{\text{mis}}\mid\theta) \cdot p(R\mid X_{\text{obs}},\psi) dX_{\text{mis}}\\ &=p(X_{\text{obs}}\mid\theta)p(R\mid X_{\text{obs}},\psi) \end{aligned}\]通过最大化似然函数来估计关心的参数$\theta$。当$\theta$与$\psi$参数相互独立时,关于数据参数$\theta$的推断可以忽略缺失机制($p(R\mid X_{\text{obs}},\psi)$与$\theta$无关),这称为缺失机制的可忽略性(ignorability)。这一结论是填补法与基于似然的方法的理论基础。
⚪ 删除法:成列删除与成对删除
成列删除(listwise deletion)丢弃任何含缺失值的样本;成对删除(pairwise deletion)在计算每一对特征的统计量(如协方差)时只使用这两个特征都被观测到的样本。
在MCAR下,删除后的样本仍是总体的随机子样本,基于它的估计是无偏的。若每个特征独立地以概率$\rho$缺失,则$D$个特征全部被观测的样本比例为$(1-\rho)^D$;例如$\rho=0.05,D=50$时只剩约$7.7\%$的样本,因此成列删除主要用于缺失比例低、特征数少的情形,或者用于删除缺失比例极高的特征(列删除)。
⚪ 统计量填补:均值、中位数、众数与常数
单一填补(single imputation)用一个在训练集上估计的统计量替换缺失值:连续特征常用均值或中位数,类别特征常用众数或一个新的“缺失”类别,也可以用领域常数(如$0$)。
均值填补会系统性地压缩方差与协方差。设特征$x_d$的缺失比例为$\rho$,观测值的均值与方差为$\mu_d,\sigma_d^2$,用$\mu_d$填补后,新的样本方差为
\[\begin{aligned} \tilde{\sigma}_d^2&=\frac{1}{N}\left[\sum_{n\in\text{obs}}(x_{nd}-\mu_d)^2+\sum_{n\in\text{mis}}(\mu_d-\mu_d)^2\right] \\ &\approx \frac{1}{N}\left[N_\text{obs}\sigma_d^2+0\right] =(1-\rho)\sigma_d^2 \end{aligned}\]同理它与其他特征$x_{d’}$的协方差也近似缩小为原来的$(1-\rho)$倍,相关系数被拉向$0$。这一性质说明单一填补把“不确定的值”当成了“确定的值”,下文的多重插补正是为了在推断中保留这部分不确定性。
⚪ 缺失指示变量:把缺失本身作为特征
缺失指示变量(missing indicator)为每个可能缺失的特征$x_d$额外增加一个二值特征
\[m_{nd}=\mathbb{1}\left[x_{nd}\text{ 缺失}\right]\]并与任意填补方法组合使用(例如$x_{nd}$用中位数填补,同时保留$m_{nd}$)。在MNAR下缺失模式本身与目标相关,指示变量使模型能够直接利用这部分信息;对神经网络而言,“填补值$+$指示变量”等价于让网络对缺失样本学习一个独立的偏置。梯度提升树(如XGBoost)在分裂时为缺失值学习一个默认方向,可以视作这一思想在树模型中的内置实现。
⚪ KNN填补:用相似样本的观测值填补
KNN填补(KNNimpute)为每个含缺失值的样本寻找$k$个在其余特征上最相似、且在目标特征上有观测值的样本,用它们的加权平均填补。由于样本本身也有缺失,距离只在双方共同观测的特征集合$\mathcal{O}$上计算,并按观测比例放缩以保持量纲可比:
\[\text{dist}(x_n,x_m)=\sqrt{\frac{D}{\lvert\mathcal{O}\rvert}\sum_{d\in\mathcal{O}}\left(x_{nd}-x_{md}\right)^2}\]设$\mathcal{N}_k(n)$为最近的$k$个邻居,填补值为距离倒数加权的平均:
\[\hat{x}_{nd}=\frac{\sum_{m\in\mathcal{N}_k(n)}w_{m}x_{md}}{\sum_{m\in\mathcal{N}_k(n)}w_{m}}\\ w_{m}=\frac{1}{\text{dist}(x_n,x_m)+\epsilon}\]原论文在基因表达芯片数据上比较了KNNimpute、基于奇异值分解的SVDimpute与行平均填补,发现KNNimpute的估计误差最低,并且在$k=10\sim20$范围内结果稳定。由于距离依赖特征尺度,KNN填补前通常需要先完成特征缩放。
⚪ MICE:链式方程多重插补
多重插补(multiple imputation)生成$M$份不同的完整数据集,在每份数据上分别分析,再合并结果,从而把填补的不确定性计入最终推断。
MICE(Multivariate Imputation by Chained Equations)又称全条件设定(fully conditional specification),它为每个含缺失的特征指定一个条件模型,并轮流更新:
- 初始化:用均值或随机抽取的观测值填补所有缺失位置;
- 对第$t$轮迭代、每个含缺失的特征$x_d$:以当前填补后的其余特征$x_{-d}$为自变量,在$x_d$被观测到的样本上拟合条件模型$p(x_d\mid x_{-d},\phi_d)$(连续变量常用贝叶斯线性回归或预测均值匹配(predictive mean matching),二值变量用逻辑回归,多类变量用多项逻辑回归);从参数后验抽取$\phi_d^{(t)}$,再从$p(x_d\mid x_{-d},\phi_d^{(t)})$中抽样填补$x_d$的缺失位置;
- 重复迭代$T$轮(mice包默认$T=5$)得到一份填补数据;用不同随机种子独立重复,得到$M$份(默认$M=5$)。
设第$m$份数据上得到的估计量为$\hat{Q}_m$、其方差估计为$U_m$,Rubin合并规则为
\[\begin{aligned} &\bar{Q}=\frac{1}{M}\sum_{m=1}^{M}\hat{Q}_m, \bar{U}=\frac{1}{M}\sum_{m=1}^{M}U_m \\ &B=\frac{1}{M-1}\sum_{m=1}^{M}\left(\hat{Q}_m-\bar{Q}\right)^2 \\ &V_{\text{total}}=\bar{U}+\left(1+\frac{1}{M}\right)B \end{aligned}\]其中$\bar{U}$是插补内方差,$B$是插补间方差,$(1+1/M)$修正了用有限个插补估计$B$带来的额外不确定性。
(2) 异常值检测与处理
异常值(outlier)指显著偏离数据主体分布的观测,可能来自录入错误、传感器故障,也可能是真实但罕见的事件。
⚪ Z值规则:以标准差为单位的偏离
Z值规则(z-score rule)计算每个观测相对于训练集均值的标准化偏离
\[z_{nd}=\frac{x_{nd}-\mu_d}{\sigma_d}\]并把$\lvert z_{nd}\rvert>\tau$的观测判为异常,常用阈值$\tau=3$。若数据服从正态分布,则$P(\lvert Z\rvert>3)=2(1-\Phi(3))\approx0.27\%$,即每$370$个正常样本中约有$1$个被误判。这一规则的统计量$\mu_d,\sigma_d$本身由全部数据(包括异常值)决定,这是下面两种稳健规则的出发点。
⚪ IQR规则:Tukey栅栏
IQR规则又称Tukey栅栏(Tukey’s fences),用四分位数代替均值与标准差。记第一、第三四分位数为$Q_1=Q_{0.25}$、$Q_3=Q_{0.75}$,四分位距(interquartile range)为$\text{IQR}=Q_3-Q_1$,则正常范围为
\[\left[Q_1-k\cdot\text{IQR},\;Q_3+k\cdot\text{IQR}\right]\]$k=1.5$时栅栏外为“温和异常”,$k=3$时为“极端异常”,这也是箱线图须线的定义。在正态分布下$Q_3=\mu+0.6745\sigma$、$\text{IQR}=1.349\sigma$,于是$k=1.5$的上栅栏位于
\[\begin{aligned} Q_3+1.5\,\text{IQR}&=\mu+(0.6745+1.5\times1.349)\sigma \\ &\approx\mu+2.698\sigma \end{aligned}\]栅栏外的概率约为$0.70\%$;$k=3$时栅栏位于约$\pm4.72\sigma$。由于四分位数只取决于中间$50\%$数据的排序位置,少量极端值几乎不影响栅栏的位置。
⚪ 稳健Z值:基于中位数绝对偏差
中位数绝对偏差(median absolute deviation, MAD)定义为
\[\text{MAD}=\text{median}_n\left(\left\lvert x_n-\tilde{x}\right\rvert\right),\quad \tilde{x}=\text{median}_n(x_n)\]在正态分布下$\lvert X-\mu\rvert$的中位数为$\Phi^{-1}(3/4)\,\sigma\approx0.6745\sigma$,因此$\hat{\sigma}=1.4826\cdot\text{MAD}$是$\sigma$的一致估计。Iglewicz与Hoaglin定义的修正Z值(modified z-score)为
\[M_n=\frac{0.6745\,(x_n-\tilde{x})}{\text{MAD}}\]推荐阈值为$\lvert M_n\rvert>3.5$。中位数与MAD的崩溃点(breakdown point)均为$50\%$,即至少一半的数据被任意污染时估计才会失控;而均值与标准差的崩溃点为$0$,单个极端值就能使其任意偏移。
⚪ Isolation Forest:基于随机划分的孤立难度
- paper:Isolation Forest
孤立森林(Isolation Forest)的出发点是:异常点“少而不同”,在随机划分下更容易被孤立。它构建$t$棵孤立树(iTree),每棵树在一个大小为$\psi$的随机子样本上递归生长:随机选择一个特征,在该特征当前节点内的最小值与最大值之间均匀随机选取分裂点,直到节点只剩一个样本或达到高度上限$\lceil\log_2\psi\rceil$。样本$x$的路径长度$h(x)$是从根到其所在叶节点的边数(叶节点未完全分裂时再加上修正项$c(\text{叶内样本数})$)。
由于iTree与二叉搜索树结构等价,含$n$个样本时一次不成功搜索的平均路径长度为
\[c(n)=2H(n-1)-\frac{2(n-1)}{n},\quad H(i)\approx\ln i+0.5772\]其中$H(i)$为调和数、$0.5772$为Euler常数。用$c(\psi)$归一化路径长度,异常分数定义为
\[s(x,\psi)=2^{-\frac{\mathbb{E}[h(x)]}{c(\psi)}}\]其中$\mathbb{E}[h(x)]$是$x$在所有树上的平均路径长度。当$\mathbb{E}[h(x)]\to0$时$s\to1$(高度异常);当$\mathbb{E}[h(x)]\to c(\psi)$时$s\to0.5$;当$\mathbb{E}[h(x)]\to\psi-1$时$s\to0$。原论文推荐$\psi=256$、$t=100$,并指出小子样本有助于缓解异常点聚集造成的掩蔽(masking)与淹没(swamping)效应;训练复杂度为$O(t\psi\log\psi)$,与数据集大小无关。
⚪ 截尾与缩尾:异常值的处理方式
检测到异常值之后,常见的处理方式包括:删除样本;把异常位置当作缺失值再填补;以及缩尾(winsorization),即把超出分位数区间$[Q_{p},Q_{1-p}]$(如$p=0.01$)的值裁剪到区间端点:
\[x'=\min\left(\max\left(x,Q_p\right),Q_{1-p}\right)\]缩尾保留了样本与其排序信息,只压缩尾部的幅度;其分位数阈值同样只在训练集上估计。深度学习中对输入做clip、对目标做截断(例如回归任务中把目标限制在合理物理范围内)都属于这一类操作。
(3) 重复样本处理
⚪ 精确重复与近重复:哈希、感知哈希与嵌入相似度
重复样本会改变训练分布中各样本的有效权重,而跨划分的重复(训练集与测试集中出现相同或近似的样本)会使测试指标不能体现真正的泛化能力。去重通常分三个层次:
- 精确重复:对规范化后的内容(如解码后的像素、去除空白差异的文本)计算加密哈希(MD5/SHA),哈希相同即视为重复;
- 近重复(感知层面):图像常用感知哈希(perceptual hash, pHash),即把图像缩放为$32\times32$灰度图、做二维DCT、取左上角$8\times8$低频系数、以其中位数为阈值二值化得到$64$位指纹,两张图的相似度用指纹的汉明距离衡量;文本常用MinHash估计$n$-gram集合的Jaccard相似度;
- 语义近重复:用预训练模型提取嵌入,余弦相似度超过阈值即视为重复,可以捕获裁剪、调色、改写等变化。
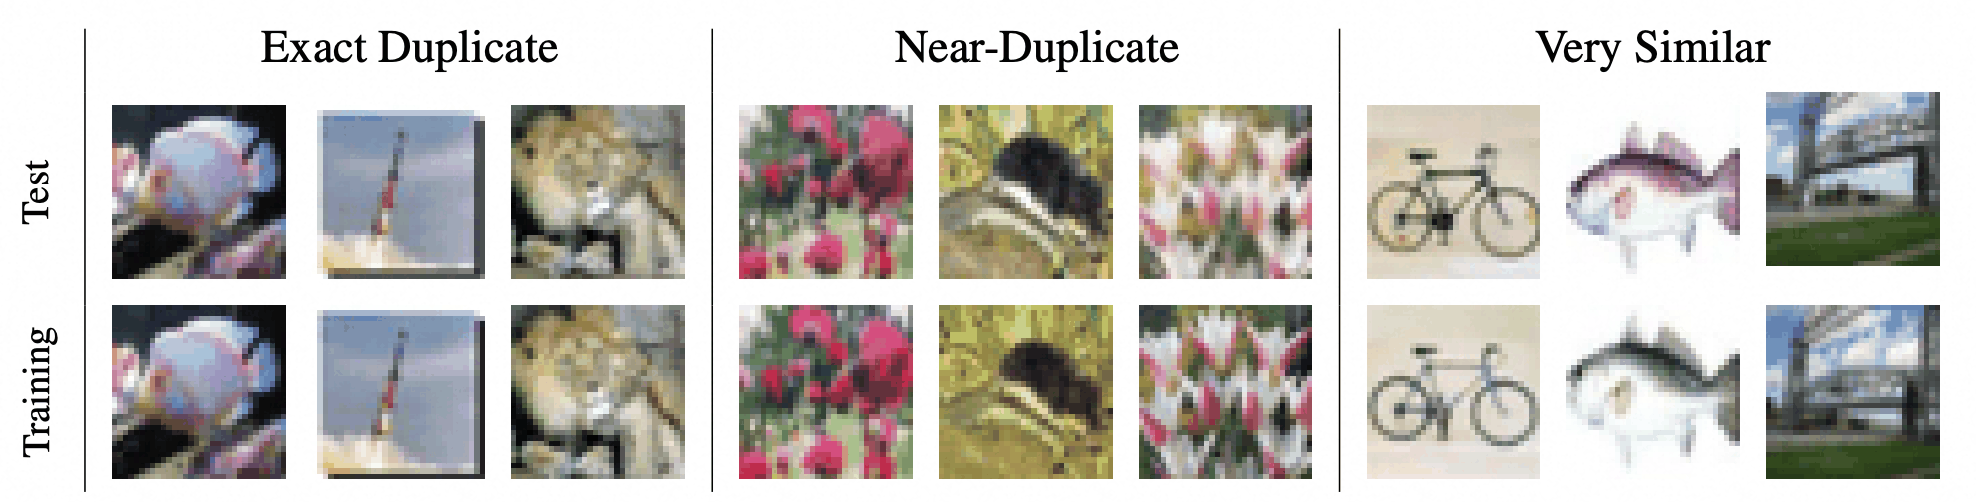
Barz与Denzler用这一思路检查CIFAR:以预训练网络特征检索每张测试图像在训练集中的最近邻并人工确认,发现CIFAR-10测试集约$3.3\%$、CIFAR-100测试集约$10\%$的图像在训练集中有近重复。他们把这些测试图像替换为新的同类图像,得到ciFAIR-10/100,并观察到各模型在新测试集上的准确率与排名发生变化。
3. 数值特征的预处理
本节的方法都作用于数值特征。不同的数值特性具有不同的取值范围与量纲,需要进行数值缩放与分布变换。
(1) 线性缩放
⚪ 最小-最大值归一化 Min-Max Normalization:映射到固定区间
最小-最大值归一化把每个特征映射到$[a,b]$。
\[x'_{nd}=a+(b-a)\frac{x_{nd}-\min_nx_{nd}}{\max_nx_{nd}-\min_nx_{nd}+\epsilon}.\]训练阶段保存$\max_nx_{nd}, \min_nx_{nd}$,验证与推理复用;$a,b,\epsilon$是关键超参数。常用$[a,b]=[0,1]$,或者$[-1,1]$以与$\tanh$输出范围匹配。推理时若出现超出训练范围的值,变换结果会落在$[a,b]$之外,可以按需在端点处截断。
⚪ 最大绝对值缩放 Max-Abs Scaling:保持稀疏性与符号
最大绝对值缩放把每个特征除以其训练集上的最大绝对值:
\[x'_{nd}=\frac{x_{nd}}{\max_{n}\lvert x_{nd}\rvert+\epsilon}\in[-1,1]\]它不做平移,因此$0$仍映射为$0$,适用于稀疏数据(如词频矩阵、独热编码拼接后的高维特征):缩放后矩阵的稀疏结构不变,可以继续用稀疏格式存储与计算;同时特征的符号保持不变。
⚪ 标准化 Standardization:零均值单位方差
标准化又叫Z值归一化(Z-Score Normalization),是指将每个特征调整为均值为0,方差为1:
\[\begin{aligned} \mu_d&= \frac{1}{N} \sum_{n=1}^{N} {x_{nd}} \\ \sigma_d^2&= \frac{1}{N} \sum_{n=1}^{N} {(x_{nd}-\mu_d)^2}\\ x_{nd}&\leftarrow \frac{x_{nd}-\mu_d}{\sigma_d} \end{aligned}\]在训练集上保存$\mu_d,\sigma_d^2$,再统一计算\(x'_{nd}=(x_{nd}-\mu_d)/\sqrt{\sigma_d^2+\epsilon}\);$\epsilon$是关键超参数,验证与测试阶段不重新估计统计量。
数据量很大或以流式到达时,均值与方差可以用Welford在线算法单遍计算,避免先求和再求平方和带来的数值抵消:
\[\begin{aligned} \mu^{(n)}&=\mu^{(n-1)}+\frac{x_n-\mu^{(n-1)}}{n} \\ M_2^{(n)}&=M_2^{(n-1)}+\left(x_n-\mu^{(n-1)}\right)\left(x_n-\mu^{(n)}\right),\quad \sigma^2=\frac{M_2^{(N)}}{N} \end{aligned}\]多个分片的统计量$(n_a,\mu_a,M_{2,a})$与$(n_b,\mu_b,M_{2,b})$可以按$\delta=\mu_b-\mu_a$合并为$n=n_a+n_b$、$\mu=\mu_a+\delta\,n_b/n$、$M_2=M_{2,a}+M_{2,b}+\delta^2n_an_b/n$,这使统计量可以在分布式环境中并行估计。
⚪ 稳健缩放 Robust Scaling:中位数与四分位距
Min-Max与标准化的统计量分别由两个极值和平方偏差决定,单个异常值即可大幅改变缩放结果。稳健缩放用第$2$节中崩溃点为$50\%$的统计量代替它们:
\[x'_{nd}=\frac{x_{nd}-\text{median}_d}{Q_{d,q_{\text{hi}}}-Q_{d,q_{\text{lo}}}}\]默认取$(q_{\text{lo}},q_{\text{hi}})=(0.25,0.75)$,即分母为四分位距$\text{IQR}_d$。由于正态分布下$\text{IQR}=1.349\sigma$,若希望结果与标准化处于同一量级,可以把分母换成$\text{IQR}_d/1.349$(或用$1.4826\cdot\text{MAD}_d$)。稳健缩放只改变尺度与位置,异常值在变换后依然是异常值,它保证的是主体数据的缩放不被异常值左右。
⚪ 样本级范数归一化 L2 Normalization:逐样本缩放到单位范数
前面的方法都是逐特征(列)估计统计量,样本级范数归一化则逐样本(行)缩放,不需要拟合任何统计量:
\[x'_n=\frac{x_n}{\lVert x_n\rVert_p+\epsilon},\quad p\in\{1,2,\infty\}\]$p=2$时,归一化后两个样本的内积等于原样本的余弦相似度,$\langle x’_n,x’_m\rangle=\cos(x_n,x_m)$,且欧氏距离与余弦相似度一一对应:$\lVert x’_n-x’_m\rVert^2=2-2\cos(x_n,x_m)$。因此它常用于文本的TF-IDF向量、检索与度量学习中的嵌入向量。$p=1$时,非负向量被归一化为概率分布(如直方图特征)。
(2) 去相关:白化
⚪ 白化 Whitening:零均值、单位方差且去相关
白化在调整特征取值范围的基础上消除了不同特征之间的相关性,降低输入数据特征的冗余。具体地,将输入数据在特征方向上被特征值相除,使数据独立同分布(i.i.d.),实现输入数据的零均值(zero mean)、单位方差(unit variance)、去相关(decorrelated)。
实现步骤:
- 零均值: $ \hat{X}=X-E(X) $
- 计算协方差: $ Cov(X)=E(XX^T)-E(X)(E(X))^T $
- 去相关: $ Cov(X)^ {-\frac{1}{2}} \hat{X} $
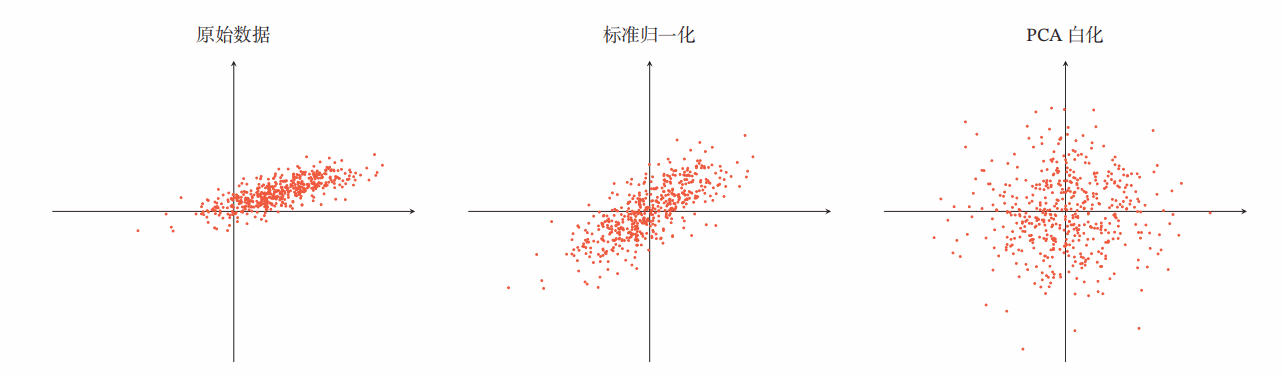
上述$Cov(X)^{-1/2}$的取法并不唯一:取协方差矩阵特征分解$Cov(X)=U\Lambda U^\top$后用$\Lambda^{-1/2}U^\top$,得到PCA白化(同时完成了降维与旋转);再左乘$U$转回原坐标系,即$U\Lambda^{-1/2}U^\top$,得到ZCA白化(zero-phase 白化,保持数据的空间结构,视觉上仍像原图,常用于图像)。
训练阶段保存$\mu,U,\Lambda$,推理阶段复用;$\epsilon$与保留的特征向量数是关键超参数。
白化矩阵不唯一的原因可以从约束条件直接看出。记$\Sigma=Cov(X)$,白化变换$z=W\hat{x}$需满足$Cov(z)=W\Sigma W^\top=I$,即$W^\top W=\Sigma^{-1}$。若$W_0$是一个解,则对任意正交矩阵$Q$,$QW_0$也是解,因为$(QW_0)\Sigma(QW_0)^\top=QQ^\top=I$。因此全部白化矩阵构成${Q\Sigma^{-1/2}:Q^\top Q=I}$,选择不同的$Q$对应不同的白化准则。Optimal whitening and decorrelation的分析给出了各准则下的最优解:
- ZCA白化($W=\Sigma^{-1/2}=U\Lambda^{-1/2}U^\top$)最小化白化前后数据的均方差异$\mathbb{E}\lVert z-\hat{x}\rVert^2$,即在所有白化变换中“改动原数据最少”;
- PCA白化($W=\Lambda^{-1/2}U^\top$)使各输出分量依次最大化地压缩原始方差,因此截断时保留前$k$个分量即可实现降维;
- ZCA-cor与PCA-cor白化先用相关矩阵$P=V^{-1/2}\Sigma V^{-1/2}$($V$为方差对角阵)代替协方差矩阵,适用于各特征尺度差异很大的情形;其中ZCA-cor最大化白化后分量与对应原始分量的平均相关。
数值上,特征值很小的方向在$\Lambda^{-1/2}$下被大幅放大,主要放大的是噪声,因此实践中用$(\Lambda+\epsilon I)^{-1/2}$代替$\Lambda^{-1/2}$。图像的ZCA白化常取$\epsilon=10^{-2}\sim10^{-1}$(像素尺度为$[0,1]$时),它在视觉上相当于一个边缘增强滤波器。
(3) 幂变换
线性缩放不改变分布的形状。当特征呈现严重偏态(如收入、计数、时长)时,常用单调非线性变换使其更接近对称或正态,以便线性模型、基于距离的方法以及对输入分布有隐含假设的网络更好地利用。
⚪ 对数与平方根变换:方差稳定化
对数变换$x’=\log(x+c)$(常用$c=1$,即log1p)把乘性关系变为加性关系,并压缩右尾。对含负值的特征,可以用对称对数(symlog)$x’=\text{sign}(x)\log(1+\lvert x\rvert)$。
这类变换的统计动机是方差稳定化(variance stabilization)。若随机变量$X$的标准差随均值变化,$\text{sd}(X)=g(\mu)$,由delta方法,对光滑函数$f$有
\[\text{Var}[f(X)]\approx f'(\mu)^2\,\text{Var}[X]=f'(\mu)^2g(\mu)^2\]令其为常数,得到$f’(\mu)\propto1/g(\mu)$:
- 若标准差与均值成正比($g(\mu)=c\mu$,乘性误差),则$f(\mu)=\log\mu$,变换后方差约为常数$c^2$;
- 若方差等于均值($g(\mu)=\sqrt{\mu}$,Poisson计数),则$f(\mu)=2\sqrt{\mu}$,变换后方差约为$1$。Anscombe变换$2\sqrt{x+3/8}$是对小计数的修正版本。
⚪ Box-Cox变换:正值数据的参数化幂变换
Box-Cox变换为正值数据$x>0$定义了一族以$\lambda$为参数的幂变换:
\[x^{(\lambda)}= \begin{cases} \dfrac{x^\lambda-1}{\lambda}, & \lambda\ne0 \\ \log x, & \lambda=0 \end{cases}\]减$1$再除以$\lambda$保证了变换在$\lambda=0$处连续:由$x^\lambda=e^{\lambda\log x}=1+\lambda\log x+O(\lambda^2)$,得$\lim_{\lambda\to0}(x^\lambda-1)/\lambda=\log x$;同时对任意$\lambda$,变换都是单调递增的(导数$x^{\lambda-1}>0$)。$\lambda=1$对应平移,$\lambda=0.5$对应平方根,$\lambda=-1$对应倒数。
$\lambda$通过极大似然估计。假设变换后的数据服从正态分布$x_n^{(\lambda)}\sim\mathcal{N}(\mu,\sigma^2)$,原始数据的密度需要乘以变换的雅可比行列式$\prod_n\lvert dx_n^{(\lambda)}/dx_n\rvert=\prod_nx_n^{\lambda-1}$,于是对数似然为
\[\begin{aligned} \ell(\lambda,\mu,\sigma^2)=&-\frac{N}{2}\log(2\pi\sigma^2)\\&-\frac{1}{2\sigma^2}\sum_{n=1}^{N}\left(x_n^{(\lambda)}-\mu\right)^2\\&+(\lambda-1)\sum_{n=1}^{N}\log x_n \end{aligned}\]对固定的$\lambda$,$\mu$与$\sigma^2$的极大似然解为变换后数据的样本均值$\hat{\mu}(\lambda)$与样本方差$\hat{\sigma}^2(\lambda)$。代回得到轮廓对数似然(profile log-likelihood):
\[\ell_{p}(\lambda)=-\frac{N}{2}\log\hat{\sigma}^2(\lambda)+(\lambda-1)\sum_{n=1}^{N}\log x_n+\text{const}\]用一维搜索(网格搜索或Brent方法)最大化$\ell_p(\lambda)$即得$\hat{\lambda}$;再由$2\left[\ell_p(\hat{\lambda})-\ell_p(\lambda)\right]\sim\chi^2_1$可以构造$\lambda$的置信区间。等价地,记几何均值$\dot{x}=\left(\prod_nx_n\right)^{1/N}$,最大化$\ell_p$等价于最小化归一化变换$x^{(\lambda)}/\dot{x}^{\lambda-1}$的残差平方和。原论文还给出了带平移参数$\lambda_2$的两参数形式$\left((x+\lambda_2)^{\lambda}-1\right)/\lambda$以处理非正数据,以及$\lambda$的贝叶斯估计。
⚪ Yeo-Johnson变换:适用于任意实数的幂变换
Box-Cox要求$x>0$。Yeo-Johnson变换把幂变换扩展到全体实数:
\[\psi(\lambda,x)= \begin{cases} \dfrac{(x+1)^\lambda-1}{\lambda}, & x\ge0,\ \lambda\ne0 \\ \log(x+1), & x\ge0,\ \lambda=0 \\ -\dfrac{(1-x)^{2-\lambda}-1}{2-\lambda}, & x<0,\ \lambda\ne2 \\ -\log(1-x), & x<0,\ \lambda=2 \end{cases}\]对非负部分,它是$x+1$上的Box-Cox变换;对负数部分,它是$1-x$上参数为$2-\lambda$的Box-Cox变换再取负号。这一构造使$\psi$在$x=0$处连续且一阶导数连续(两侧导数在$x=0$处都等于$1$),对每个$\lambda$都单调递增;$\lambda<1$时压缩右尾、拉伸左尾(纠正右偏),$\lambda>1$时相反。
其导数为:$x\ge0$时$\partial\psi/\partial x=(x+1)^{\lambda-1}$;$x<0$时$\partial\psi/\partial x=(1-x)^{1-\lambda}$。两者可以统一写成$(1+\lvert x\rvert)^{\text{sign}(x)(\lambda-1)}$,因此在正态假设下的轮廓对数似然为
\[\ell_p(\lambda)=-\frac{N}{2}\log\hat{\sigma}^2(\lambda)+(\lambda-1)\sum_{n=1}^{N}\text{sign}(x_n)\log\left(1+\lvert x_n\rvert\right)+\text{const}\]其中$\hat{\sigma}^2(\lambda)$为$\psi(\lambda,x_n)$的样本方差,同样用一维搜索求$\hat{\lambda}$。实践中(例如scikit-learn的PowerTransformer)幂变换之后通常再做一次标准化;$\hat{\lambda}$与标准化统计量一起在训练集上拟合。
(4) 基于秩的变换
⚪ 分位数变换 Quantile Transform:映射到均匀或正态分布
分位数变换以经验累积分布函数为基础,是一种非参数的单调变换。它的依据是概率积分变换(probability integral transform):若连续随机变量$X$的累积分布函数为$F$,则
\[P\left(F(X)\le u\right)=P\left(X\le F^{-1}(u)\right)=F\left(F^{-1}(u)\right)=u,\quad u\in[0,1]\]即$F(X)\sim U(0,1)$;进而$\Phi^{-1}(F(X))\sim\mathcal{N}(0,1)$。因此对每个特征$d$:
- 在训练集上估计经验分布:取$n_q$个等间隔的概率水平$p_1\lt \dots\lt p_{n_q}$(如$n_q=1000$),记录对应的样本分位数$Q_{d,p_i}$;
- 变换时对$x$在分位数表中线性插值得到$u=\hat{F}_d(x)$,输出均匀分布结果$u$,或正态分布结果$\Phi^{-1}\left(\text{clip}(u,\epsilon,1-\epsilon)\right)$(截断是为了避免$\Phi^{-1}(0)=-\infty$)。
分位数变换只依赖于样本的排序,因此对任意单调变换不变,异常值被映射到分布的尾部而不会主导尺度。它是单调但非线性的:特征内部的排序保留,而样本之间的距离被重新分配。在表格竞赛中,“排序后映射到正态分布”的做法常被称为RankGauss,用作神经网络的输入预处理。
⚪ 分位数归一化 Quantile Normalization:使各样本分布完全一致
- paper:A comparison of normalization methods for high density oligonucleotide array data based on variance and bias
- paper:How to do quantile normalization correctly for gene expression data analyses
在处理生物高通量数据(如基因、甲基化、RNA-Seq等)时,通常会同时测量成千上万个探针/基因在多个样本中的信号值。然而,这些原始数据除了包含真正的生物学差异外,还混杂了大量的技术性噪音(批次效应,Batch Effect)。分位数归一化通过改变原始数据的绝对值、只保留值的排序信息,强制使每个样本的数据分布完全一致,来校正样本间的技术性变异。
设$X\in\mathbb R^{D\times N}$每列为一个样本。排序得到$x_{(r)n}$,计算$q_r=N^{-1}\sum_nx_{(r)n}$,再把原秩为$r$的元素替换为$q_r$并恢复顺序;并列值规则与参考分布是关键设置。
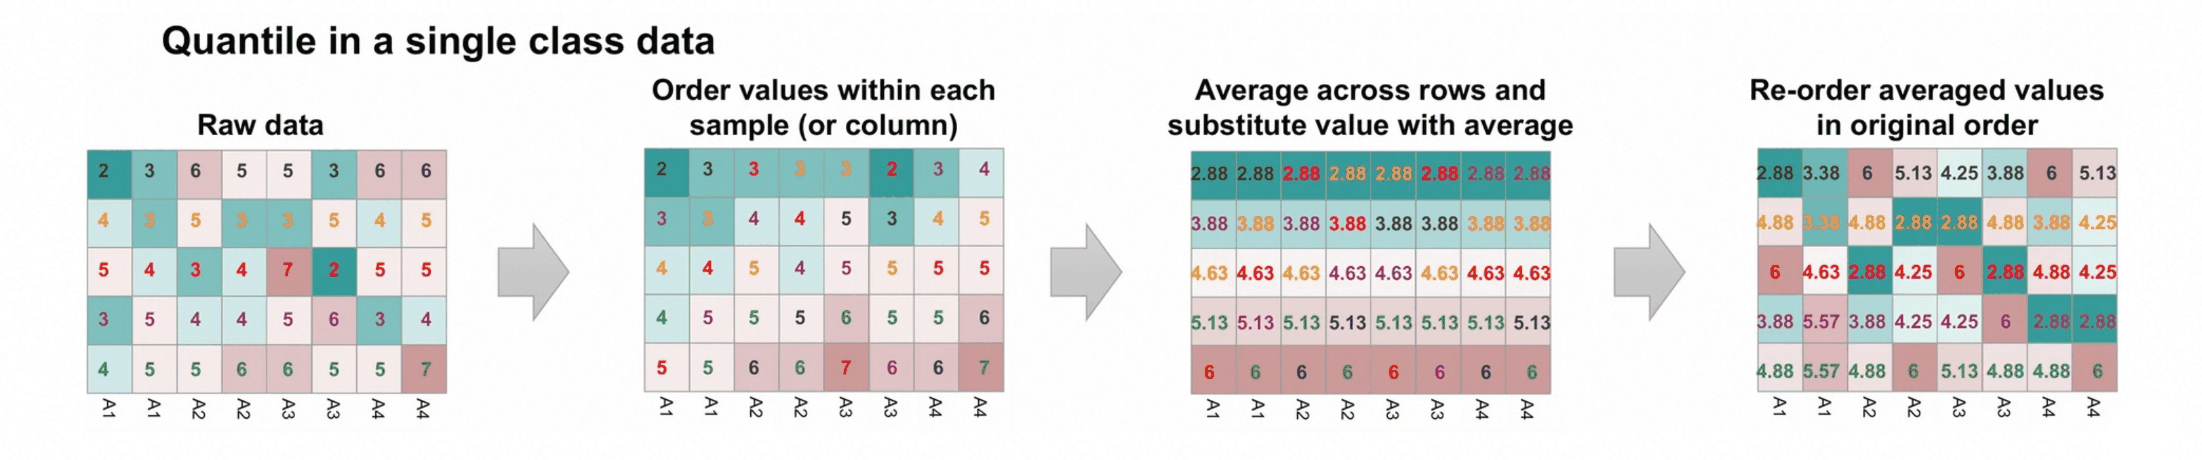
与分位数变换相比,二者都只保留排序信息,但统计方向不同:分位数变换对每个特征估计其在样本间的分布并映射到固定的参考分布;分位数归一化则让每个样本的取值分布都等于所有样本排序后求平均得到的参考分布${q_r}$。新样本到来时,可以复用训练阶段保存的参考分布${q_r}$,只对新样本自身排序后替换取值。
(5) 离散化与数值嵌入
⚪ 分箱离散化 Binning:把连续值映射为区间编号
分箱(binning)把连续特征划分为$B$个区间$[b_0,b_1),[b_1,b_2),\dots,[b_{B-1},b_B]$,用区间编号(或其独热编码)代替原值。边界的常见取法有:
- 等宽分箱:$b_i=m_d+i\,(M_d-m_d)/B$;
- 等频分箱:$b_i=Q_{d,i/B}$,每个箱内样本数相同,等价于把分位数变换的输出均匀量化;
- 聚类分箱:对一维取值做k-means,以相邻聚类中心的中点为边界;
- 有监督分箱:以与目标的信息增益或基尼指数为准则递归选择切分点,与决策树(Decision Tree)对连续特征的处理相同。
分箱把非线性关系转化为分段常数函数,使线性模型能够拟合非单调关系,同时把落在箱内的异常值与正常值同等对待。
⚪ 数值特征嵌入:分段线性编码与周期编码
在表格深度学习中,分箱的思想被推广为连续的数值嵌入(numerical embeddings),即把每个标量特征映射为一个向量再输入MLP或Transformer。Gorishniy等人提出两类方案:
分段线性编码(piecewise linear encoding, PLE):给定$B$个箱的边界$b_0\lt b_1\lt \dots\lt b_B$(由分位数或决策树得到),标量$x$被编码为$B$维向量$\text{PLE}(x)=(e_1,\dots,e_B)$:
\[e_t= \begin{cases} 0, & x\lt b_{t-1}\text{ 且 }t>1 \\ 1, & x\ge b_t\text{ 且 }t\lt B \\ \dfrac{x-b_{t-1}}{b_t-b_{t-1}}, & \text{其他} \end{cases}\]即$x$之前的箱全为$1$、之后的箱全为$0$、所在的箱取箱内的相对位置。它是分箱独热编码的连续版本:保留了箱内的位置信息,并且编码向量随$x$连续变化。
周期编码(periodic encoding):
\[\text{Periodic}(x)=\left[\sin(2\pi c_1x),\cos(2\pi c_1x),\dots,\sin(2\pi c_kx),\cos(2\pi c_kx)\right],\quad c_i\sim\mathcal{N}(0,\sigma^2)\]其中频率$c_i$初始化自正态分布并作为可学习参数,$\sigma$为关键超参数。两类编码之后都可以再接线性层与ReLU。论文在多个表格基准上观察到,配备这些嵌入的简单MLP的性能可以与基于注意力的表格模型相当,并缩小了与梯度提升树的差距。
4. 离散特征的预处理
类别特征(如城市、商品编号、用户编号)取值于一个有限集合${1,\dots,K}$,取值之间没有天然的数值关系。在输入网络前需要进行特征编码。
(1) 无监督编码
⚪ 独热编码 One-Hot Encoding:每个类别一个维度
独热编码把类别$c\in{1,\dots,K}$映射为$K$维标准基向量$e_c\in{0,1}^K$。它不引入类别之间的任何顺序或距离(任意两个不同类别的欧氏距离都是$\sqrt{2}$)。相关的工程细节有:
- 哑变量陷阱:$K$个独热列之和恒为$1$,与线性模型的截距列线性相关,因此带截距的线性模型通常只保留$K-1$列(dummy encoding),以被删除的类别为基准;带正则化的模型与神经网络通常保留全部$K$列;
- 未知类别:推理时出现训练集未见的类别,可以编码为全零向量,或映射到一个专门的“未知”类别;
- 稀有类别合并:把训练集中出现次数少于阈值的类别合并为“其他”,以控制维数并为它们共享统计强度。
在神经网络中,独热向量乘以权重矩阵$W\in\mathbb{R}^{K\times d}$等于取出$W$的第$c$行,$e_c^\top W=W_{c,:}$,因此独热编码接线性层与嵌入查表在数学上等价,后者只是避免了显式构造稀疏向量。
⚪ 序数编码与频数编码 Ordinal / Count Encoding:单列整数表示
序数编码(ordinal encoding)把类别映射为整数${0,\dots,K-1}$。当类别本身有序(如“低<中<高”、教育程度)时,应按自然顺序映射,使数值大小反映真实顺序;对无序类别,任意编号会引入虚假的顺序,但对树模型而言,只要允许足够多次分裂,任意编号都能被切分为任意子集,因此序数编码常作为树模型的紧凑输入。
频数编码(count / frequency encoding)用类别在训练集中出现的次数$n_c$或频率$n_c/N$代替类别,它把“类别有多常见”这一信息直接暴露给模型,且只占一列。
(2) 目标编码
⚪ 目标编码 Target Encoding:带平滑的类别条件均值
对高基数类别(如邮政编码、商品编号),独热编码的维数过高。目标编码(target / mean encoding)用每个类别下目标的条件均值代替类别,把$K$维压缩为$1$维。设类别$c$在训练集中出现$n_c$次、其目标均值为$\bar{y}_c$、全局目标均值为$\bar{y}$,Micci-Barreca提出的平滑估计为
\[\begin{aligned} S_c&=\lambda(n_c)\,\bar{y}_c+\left(1-\lambda(n_c)\right)\bar{y}\\ \lambda(n)&=\frac{1}{1+\exp\left(-\frac{n-k}{f}\right)} \end{aligned}\]其中$k$是“类别均值与全局均值各占一半”时的样本数,$f$控制过渡的陡峭程度。样本多的类别以自身均值为主,样本少的类别向全局均值收缩。
另一种常用的平滑是m-估计(m-estimate),它可以从贝叶斯后验均值推导出来。对二分类目标,设类别$c$中正例的概率为$\pi_c$,取先验$\pi_c\sim\text{Beta}(m\bar{y},m(1-\bar{y}))$,观测到$n_c$个样本、其中$\sum y$个正例后,后验均值为
\[\begin{aligned} \mathbb{E}[\pi_c\mid\text{data}]&=\frac{\sum_{n:x_n=c}y_n+m\bar{y}}{n_c+m}\\&=\frac{n_c}{n_c+m}\bar{y}_c+\frac{m}{n_c+m}\bar{y} \end{aligned}\]即以$\lambda(n)=n/(n+m)$为权重的收缩,$m$相当于“先验样本数”。多分类目标为每个类别(除一个基准类外)各生成一列,回归目标直接使用均值。
目标编码直接使用了标签,若用包含样本自身标签的统计量编码该样本,会产生目标泄露(target leakage):极端情况下,每个类别只出现一次时,编码值就等于样本自己的标签。标准做法是K折外编码(out-of-fold encoding):把训练集分为$K$折,第$k$折样本的编码只用其余$K-1$折的统计量计算;验证集、测试集与推理时使用全部训练集的统计量。
⚪ 有序目标统计 Ordered Target Statistics:按排列顺序只用历史样本
CatBoost把目标泄露形式化为条件偏移(conditional shift):对训练样本$x_n$,若其编码$\hat{x}_n$的计算用到了$y_n$,则$\hat{x}_n\mid y$在训练集与测试集上的分布不同。论文给出的例子是:类别特征的每个取值都唯一时,带先验的贪心目标统计给出$\hat{x}_n=(y_n+ap)/(1+a)$,训练集上一个阈值就能完美区分正负例,而测试集上所有样本的编码都等于先验$p$。
有序目标统计借鉴在线学习的思想:随机生成一个排列$\sigma$,每个样本只用排列中排在它之前的样本计算统计量:
\[\hat{x}_n=\frac{\sum_{m:\,\sigma(m)<\sigma(n),\,x_m=x_n}y_m+a\,p}{\sum_{m:\,\sigma(m)<\sigma(n)}\mathbb{1}[x_m=x_n]+a}\]其中$p$为先验(如全局正例比例),$a>0$为先验权重。这样每个样本的编码都不依赖自身标签,训练与测试的编码分布一致,同时所有训练样本都参与了统计(不同于留出部分样本的做法)。为降低排列靠前样本统计量的方差,CatBoost使用多个随机排列,并与其有序提升(ordered boosting)共用同一组排列;它还在建树过程中贪心地构造类别特征的组合,并对组合同样计算有序目标统计。
(3) 哈希与嵌入
⚪ 哈希技巧 Hashing Trick:用哈希函数固定特征维数
当类别取值的集合很大或无法事先枚举(如文本中的词、用户与商品的组合特征)时,哈希技巧(feature hashing)用哈希函数$h:\mathcal{J}\to{1,\dots,m}$把原始特征索引映射到固定的$m$维空间,并用第二个哈希函数$\xi:\mathcal{J}\to{\pm1}$给出符号:
\[\phi_i^{(h,\xi)}(x)=\sum_{j:\,h(j)=i}\xi(j)\,x_j\]它不需要存储类别到索引的映射表,新类别可以直接哈希。Weinberger等人证明了带符号的哈希核是无偏的。对两个输入$x,x’$,
\[\left\langle\phi(x),\phi(x')\right\rangle=\sum_{j,j'}\xi(j)\xi(j')\,x_jx'_{j'}\,\mathbb{1}\left[h(j)=h(j')\right]\]由于$\xi$与$h$独立,且$\mathbb{E}_\xi[\xi(j)\xi(j’)]=\mathbb{1}[j=j’]$,求期望后只剩$j=j’$的项:
\[\mathbb{E}_{\phi}\left[\left\langle\phi(x),\phi(x')\right\rangle\right]=\sum_{j}x_jx'_j=\left\langle x,x'\right\rangle\]方差随$m$按$O(1/m)$减小,论文还给出了哈希后范数保持的指数型集中不等式。若不用符号函数,碰撞的特征值只会相加,内积估计偏大;符号使碰撞产生的误差正负抵消。任意两个特征发生碰撞的概率为$1/m$,$n$个活跃特征中期望的碰撞对数约为$n^2/(2m)$。
论文的主要应用是多任务个性化:在垃圾邮件过滤中,为每个用户$u$构造个性化特征(把“用户$u$与词$w$”的组合哈希到同一空间),与全局特征共享一个$m$维参数向量;即使用户数巨大,参数量也只由$m$决定,并且实验中个性化模型显著优于只用全局特征的模型。
⚪ 实体嵌入 Entity Embeddings:为类别学习稠密向量
实体嵌入为每个类别特征$j$(含$K_j$个取值)学习一个嵌入矩阵$E_j\in\mathbb{R}^{K_j\times d_j}$,样本中各类别特征的嵌入向量与数值特征拼接后输入网络,与网络其余部分一起端到端训练:
\[h_0=\left[E_1[c_1];E_2[c_2];\dots;E_J[c_J];x_{\text{num}}\right]\]由前文的等价性,这相当于对独热编码接一个无偏置、无激活的线性层,但它把相似的类别映射到嵌入空间中相近的位置,使网络能够在类别之间共享统计强度。
嵌入维度$d_j$是关键超参数,论文中按经验为每个特征手动选取;工程上常用随基数次线性增长的经验规则(例如fastai采用$\min(600,\text{round}(1.6K_j^{0.56}))$)。
Guo与Berkhahn在Kaggle的Rossmann门店销量预测竞赛中用这一方法获得第三名。他们观察到:学习到的德国各州嵌入在降维可视化后呈现出与地理位置相似的布局,星期与月份的嵌入也呈现出有意义的结构;并且把训练好的嵌入作为特征输入KNN、随机森林与梯度提升树时,这些模型的性能也得到提升。
5. 不同模态数据的预处理
5.1 图像预处理
图像预处理把以各种格式存储的图像变成形状固定、数值范围固定的浮点张量。
(1) 解码与颜色空间
⚪ 解码、通道顺序与颜色空间转换
图像文件(JPEG、PNG、WebP等)首先被解码为$H\times W\times C$的uint8数组。这一步涉及的约定有:
- 通道顺序:PIL与torchvision输出RGB,OpenCV的
imread输出BGR;早期Caffe模型也以BGR顺序训练。混用时需显式转换。 - 内存布局:解码结果为HWC(通道在最后),PyTorch的卷积期望CHW,需要转置;TensorFlow默认NHWC。
- 方向:手机拍摄的JPEG常把旋转信息写在EXIF的
Orientation字段中,像素本身未旋转,解码后需按该字段转正。 - 通道数:灰度图需复制为三通道或修改第一层;带透明通道的RGBA图像需与背景色合成,$C_{\text{out}}=\alpha C_{\text{fg}}+(1-\alpha)C_{\text{bg}}$;调色板模式(P模式)需先展开为RGB。
- 解码器差异:不同的JPEG解码库(如libjpeg与libjpeg-turbo的不同IDCT实现、色度上采样方式)会产生逐像素的微小差异,训练与部署应使用同一解码实现。
常用的颜色空间转换包括:YCbCr(JPEG内部表示,按ITU-R BT.601,$Y=0.299R+0.587G+0.114B$为亮度,超分辨率等任务常只在$Y$通道上计算)、HSV(便于调整色相与饱和度)、CIE Lab(感知均匀,常用于图像着色)。另外,标准图像的像素值是经过sRGB伽马编码的,涉及物理光照的计算(如线性混合、色彩恒常)需要先转换到线性空间:
\[C_{\text{lin}}= \begin{cases} C/12.92, & C\le0.04045 \\ \left(\dfrac{C+0.055}{1.055}\right)^{2.4}, & C>0.04045 \end{cases}\]其中$C\in[0,1]$为归一化后的sRGB分量。
⚪ 强度窗:医学与高动态范围图像的值域映射
医学影像(CT、MRI)与遥感、HDR图像通常以$12\sim16$位或浮点数存储,取值范围远大于$[0,255]$。以CT为例,像素值为Hounsfield单位(HU,水为$0$、空气约为$-1000$),预处理用窗位(window level)$L$与窗宽(window width)$W$把关注的组织范围线性映射到$[0,1]$:
\[x'=\text{clip}\left(\frac{x-(L-W/2)}{W},\,0,\,1\right)\]例如肺窗常取$L=-600,W=1500$,软组织窗常取$L=40,W=400$;也可以把多个窗口的结果作为不同通道输入网络。MRI没有绝对的物理单位,常用逐图像的分位数截断加标准化(如截断到$[Q_{0.5\%},Q_{99.5\%}]$后做z-score)。
(2) 尺寸调整与插值
⚪ 插值核:最近邻、双线性、双三次、Lanczos与区域平均
把尺寸为$W_{\text{in}}$的图像缩放到$W_{\text{out}}$(以一维为例,二维按行列可分地进行),缩放因子$r=W_{\text{out}}/W_{\text{in}}$。输出像素$u$对应的输入坐标有两种约定:
- 像素中心对齐 align_corners=False:$u_{\text{src}}=\frac{u+0.5}{r}-0.5$
- 角点对齐 align_corners=True:$u_{\text{src}}=u\cdot\frac{W_{\text{in}}-1}{W_{\text{out}}-1}$
前者把像素视为面积单元,是PIL与OpenCV的默认行为;后者让两端像素严格对齐,在分割与关键点任务中需要与标注坐标的约定保持一致。输出值由插值核$k(\cdot)$对邻近输入像素加权:
\[I_{\text{out}}(u)=\frac{\sum_{i}I_{\text{in}}(i)\,k(u_{\text{src}}-i)}{\sum_{i}k(u_{\text{src}}-i)}\]常用的插值核为:
- 最近邻(nearest):取最近的输入像素,不产生新的像素值,适用于分割掩码、类别图等离散标签;
- 双线性(bilinear):三角核$k(t)=\max(0,1-\lvert t\rvert)$,支撑区间为$[-1,1]$;
- 双三次(bicubic):Keys三次卷积核
PIL取$a=-0.5$,OpenCV取$a=-0.75$,二者的输出因此不同;双三次插值可能产生超出$[0,255]$的过冲,需要截断;
- Lanczos:$k(t)=\text{sinc}(t)\,\text{sinc}(t/a)$($\lvert t\rvert\lt a$),常取$a=3$,它是对理想低通滤波器$\text{sinc}$的加窗截断;
- 区域平均(area / box):缩小时对每个输出像素覆盖的输入区域求平均,等价于盒式滤波后采样。
⚪ 抗混叠缩放:下采样时按缩放因子扩展滤波器支撑
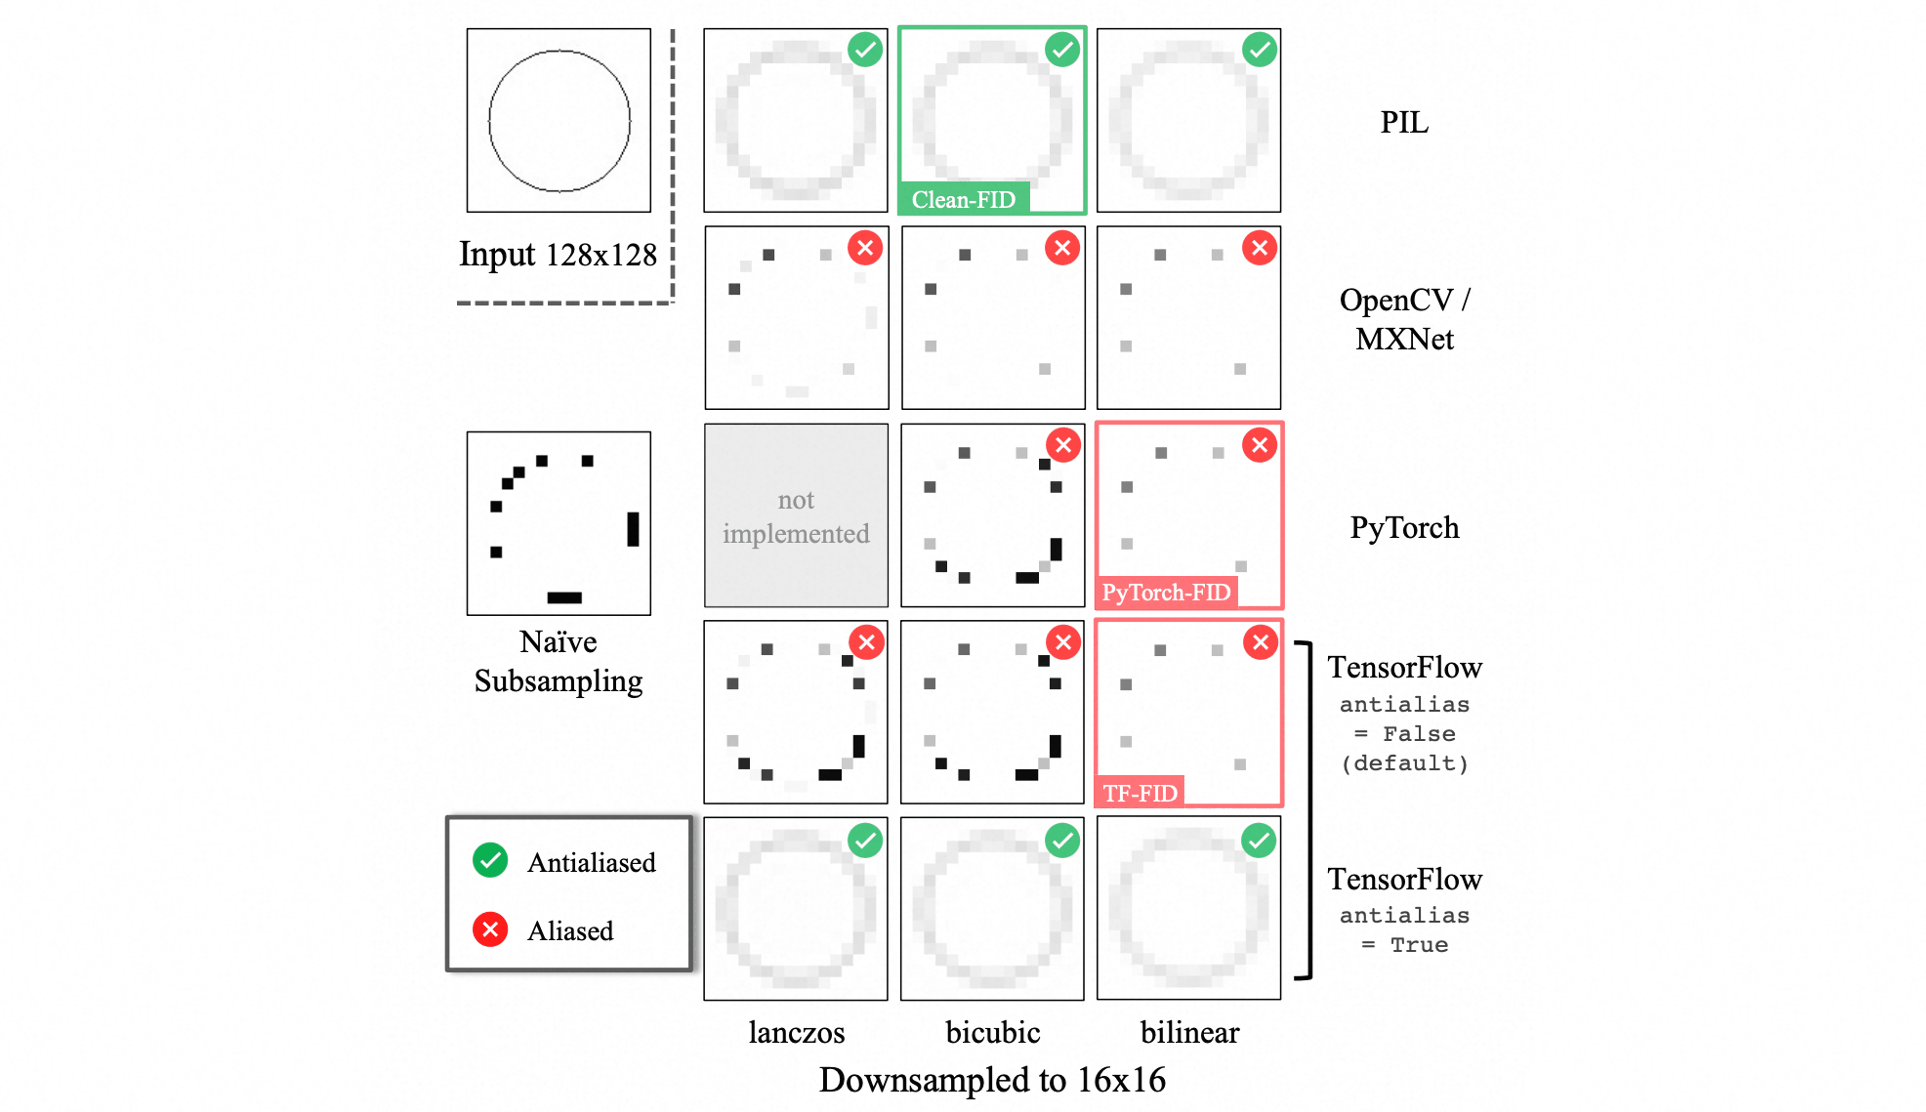
由采样定理,下采样($r<1$)后新的奈奎斯特频率降为原来的$r$倍,高于该频率的成分会混叠为低频伪影。正确的做法是先用截止频率与$r$成比例的低通滤波器滤波再采样,即把插值核在输入坐标上拉伸为$k(rt)$、支撑区间扩大为原来的$1/r$倍,并相应地按$r$归一化权重。PIL的缩放实现就是这样做的;而许多深度学习框架中默认的双线性下采样(例如PyTorch的F.interpolate在antialias=False时、早期TensorFlow的tf.image.resize)对任意缩放因子都只取邻近的$2\times2$个像素,下采样倍数较大时会出现混叠。
Parmar等人系统比较了不同库的缩放实现对FID的影响:对同一组图像,仅改变FID计算前的缩放函数,结果差异可以超过不同生成模型之间的差距;JPEG压缩质量的变化也会显著改变FID。他们据此提出clean-fid,统一使用抗混叠的PIL双三次缩放。这一结论同样适用于训练与部署:两侧应使用同一缩放实现,现代框架中可以通过antialias=True启用抗混叠。
(3) 裁剪与填充协议
⚪ 短边缩放与中心裁剪:分类模型的标准评估协议
ImageNet分类的标准评估协议是:把图像的短边缩放到$S$(保持宽高比),再从中心裁剪出$K\times K$的区域。缩放比例为$s=S/\min(H,W)$;最常见的配置是$S=256,K=224$,即裁剪比例$K/S=0.875$。一些模型使用不同的裁剪比例(如$0.9$、$0.95$或$1.0$),通常是与模型权重配套发布的超参数。
早期工作还使用多裁剪评估:例如10-crop取四个角与中心的五个裁剪及其水平翻转,对十个预测取平均。训练时则通常使用随机缩放裁剪(RandomResizedCrop)等增强,这使训练与测试时物体的视在尺寸不同。
⚪ FixRes:训练与测试分辨率差异的校正
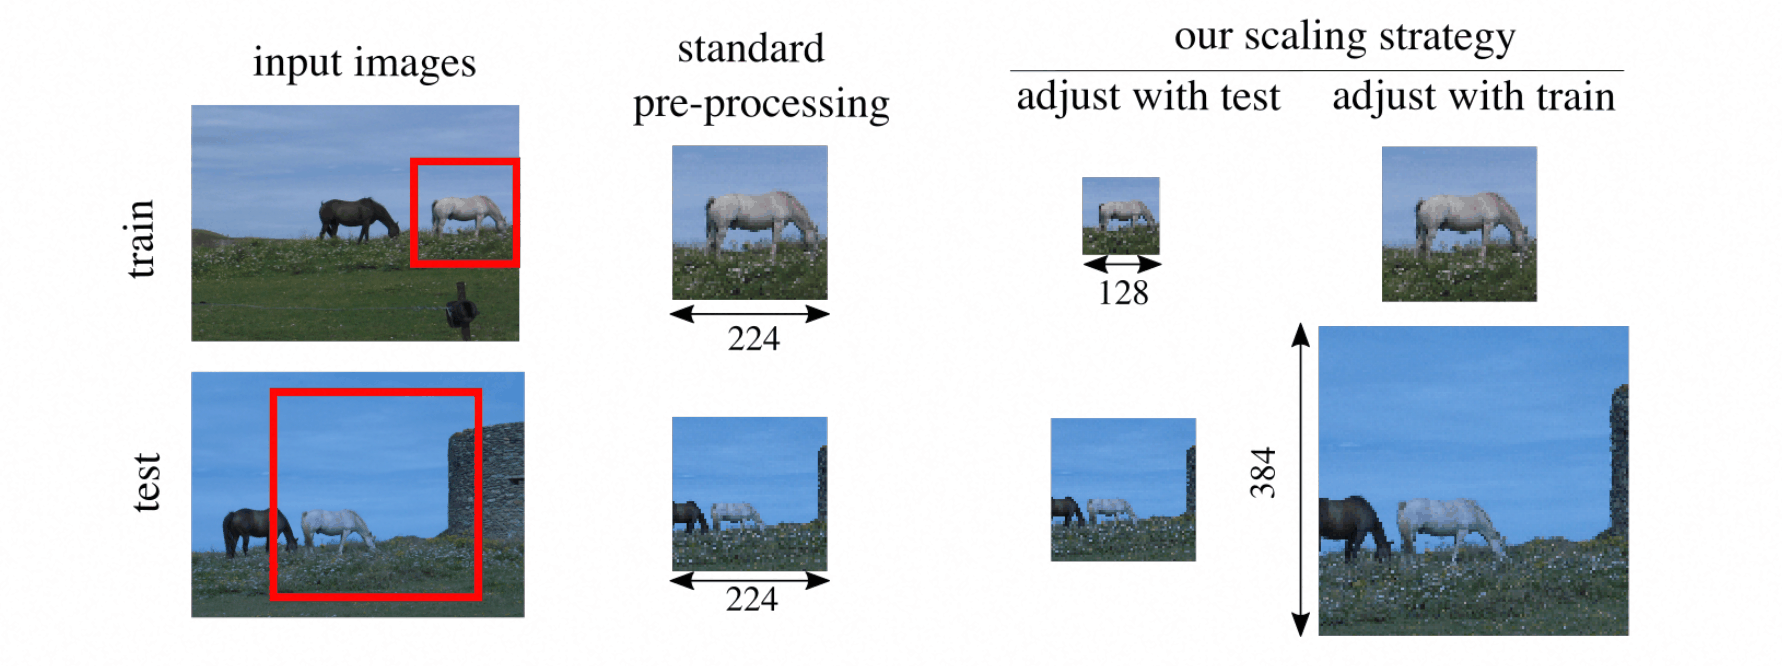
FixRes指出,训练时的RandomResizedCrop与测试时的中心裁剪会导致物体的视在尺寸(apparent object size)不一致。
做一个简化的推导:设原图的尺度为$\sqrt{HW}$,训练时随机裁剪出面积占比为$\sigma$的区域再缩放到$K_{\text{train}}$,物体的放大倍数约为$K_{\text{train}}/(\sqrt{\sigma}\sqrt{HW})$;测试时短边缩放到$K_{\text{test}}/0.875$再裁剪,放大倍数约为$K_{\text{test}}/(0.875\sqrt{HW})$。
RandomResizedCrop的默认设定为$\sigma\sim U(0.08,1)$,于是
\[\mathbb{E}\left[\sqrt{\sigma}\right]=\frac{1}{1-0.08}\int_{0.08}^{1}\sqrt{\sigma}\,d\sigma=\frac{2}{3}\cdot\frac{1-0.08^{3/2}}{0.92}\approx0.71\]两者相等需要$K_{\text{test}}\approx K_{\text{train}}\cdot0.875/0.71\approx1.24K_{\text{train}}$,即在相同分辨率下,训练时看到的物体平均比测试时更大,测试时应使用更高的分辨率。但直接提高测试分辨率会改变网络激活值的统计分布(尤其是全局池化之前特征图的尺寸与激活幅度)。
FixRes在目标测试分辨率下用测试时的预处理重新生成训练数据,并对模型做一次轻量微调:只更新分类器与最后的BN层参数(或只重新估计BN统计量)。论文报告:ResNet-50以$128\times128$训练、$224\times224$测试,达到$77.1\%$的ImageNet top-1准确率;在大规模弱监督预训练的ResNeXt-101 32x48d上应用该方法,以$320$的测试分辨率达到$86.4\%$的top-1准确率。
⚪ Letterbox:保持宽高比的缩放加填充
目标检测等对几何形状敏感的任务通常不做裁剪(以免截掉目标),也不做各向异性拉伸(以免改变物体形状),而是使用letterbox:按较长边等比缩放到目标尺寸$S$,再在较短边两侧填充常数:
\[\begin{aligned} r&=\min\left(\frac{S}{H},\frac{S}{W}\right),\\ (H',W')&=(\text{round}(rH),\text{round}(rW)),\\ p_y&=\frac{S-H'}{2},\ p_x=\frac{S-W'}{2} \end{aligned}\]YOLO系列的开源实现普遍采用这一方式,填充值常为灰色(如YOLOv5中的$114$)。标注框坐标随之变换为$x’=rx+p_x$、$y’=ry+p_y$,推理输出再经逆变换$x=(x’-p_x)/r$、$y=(y’-p_y)/r$映射回原图坐标。推理时还可以使用矩形推理:不填充到正方形,而只把两条边各自填充到网络总步长(如$32$)的最小整数倍,以减少无效计算。
(4) 像素值归一化
⚪ 像素值缩放与逐通道均值方差归一化
解码后的uint8像素首先被转换为浮点数并缩放到$[0,1]$,即$x/255$。之后常见的归一化约定有三类:
- 逐通道标准化(ImageNet统计量):$x’_c=(x_c-\mu_c)/\sigma_c$,其中$\mu=(0.485,0.456,0.406)$、$\sigma=(0.229,0.224,0.225)$(RGB顺序、像素范围$[0,1]$)是在ImageNet训练集上估计的通道统计量。CLIP等模型使用在自身训练数据上估计的统计量,如$\mu=(0.4815,0.4578,0.4082)$、$\sigma=(0.2686,0.2613,0.2758)$。
- 映射到$[-1,1]$:$x’=x/127.5-1$,用于Inception系列与许多生成模型(与$\tanh$输出层匹配)。
- 只减均值:早期Caffe模型在$[0,255]$尺度、BGR顺序下减去通道均值$(103.94,116.78,123.68)$,不除标准差。
这些约定是模型权重的一部分:使用预训练模型时必须采用与其训练时相同的约定,否则输入分布会整体偏移。
逐通道归一化是一个逐通道的仿射变换,因此可以合并进第一层卷积。设第一层卷积权重为$W_{o,c,i,j}$、偏置为$b_o$,则
\[\sum_{c,i,j}W_{o,c,i,j}\frac{x_{c}-\mu_c}{\sigma_c}+b_o=\sum_{c,i,j}\underbrace{\frac{W_{o,c,i,j}}{\sigma_c}}_{W'_{o,c,i,j}}x_c+\underbrace{b_o-\sum_{c,i,j}\frac{W_{o,c,i,j}\,\mu_c}{\sigma_c}}_{b'_o}\]这一等式在不考虑零填充边界时严格成立(零填充位置在归一化前后对应不同的像素值)。部署时把归一化折叠进卷积,可以省去一次逐元素运算。
⚪ 图像块整除与位置编码插值:ViT的输入约束
ViT把图像切分为$P\times P$的不重叠图像块,因此要求$H$与$W$都是$P$的整数倍,图像块数为$N_p=HW/P^2$(例如$224\times224$、$P=16$时$N_p=196$)。尺寸不满足整除条件时,可以缩放到$P$的整数倍,或在右侧与下侧补零到$\lceil H/P\rceil P\times\lceil W/P\rceil P$。
ViT的位置编码是与图像块网格一一对应的可学习参数$E_{\text{pos}}\in\mathbb{R}^{N_p\times d}$。论文在更高分辨率下微调时保持$P$不变,因此图像块数增加;此时把预训练的位置编码按其二维网格排列,用二维插值(如双三次插值)缩放到新的网格尺寸。这与FixRes的观察一致:在高于预训练的分辨率上微调通常能提升准确率。
5.2 音频与语音预处理
音频信号是采样率为$f_s$的一维时间序列$s[t]$。语音识别、说话人识别、音频分类等任务的标准前端把波形变换为对数梅尔谱或梅尔频率倒谱系数;自监督语音模型与神经编解码器则常直接以归一化后的波形为输入。
(1) 波形级处理
⚪ 解码、声道合并与重采样
音频文件解码后通常为整数PCM(如int16),先转换为浮点数$s[t]/2^{15}\in[-1,1)$;多声道音频常取各声道的平均合并为单声道。
不同来源的音频采样率不同(如$8\,\text{kHz}$电话语音、$16\,\text{kHz}$语音识别、$44.1/48\,\text{kHz}$音乐),需要统一重采样。由Shannon采样定理,带宽受限于$f_s/2$的信号可以由采样值完全重建:
\[s(\tau)=\sum_{t}s[t]\,\text{sinc}\left(f_s\tau-t\right),\quad \text{sinc}(u)=\frac{\sin(\pi u)}{\pi u}\]把采样率从$f_s$变为$f’_s$,即在新的时刻$\tau=t’/f’_s$上对上式求值。降采样时还必须先去除高于$f’_s/2$的成分以免混叠,因此实际使用的低通截止频率为$f_c=\min(f_s,f’_s)/2$(乘以略小于$1$的滚降系数)。无限长的$\text{sinc}$核在实现中被截断并加窗(常用Kaiser窗,其参数$\beta$控制阻带衰减与过渡带宽度的权衡),即加窗sinc插值。
当$f’_s/f_s=L/M$为有理数时(如$44.1\,\text{kHz}\to16\,\text{kHz}$对应$L/M=160/441$),可以用多相(polyphase)实现:概念上先插入$L-1$个零做$L$倍上采样,再用低通滤波器滤波,最后每$M$个采样取一个;多相分解把滤波器拆成$L$个子滤波器,只计算最终被保留的输出点,避免对插入的零做乘法。
⚪ 预加重:一阶高通滤波补偿频谱倾斜
预加重(pre-emphasis)对波形施加一阶高通滤波:
\[y[t]=s[t]-\alpha\,s[t-1],\quad H(z)=1-\alpha z^{-1}\]常取$\alpha=0.97$($0.95\sim0.97$)。其幅频响应为
\[\left\lvert H(e^{j\omega})\right\rvert^2=1-2\alpha\cos\omega+\alpha^2\]在$\omega=0$处为$(1-\alpha)^2$,在$\omega=\pi$处为$(1+\alpha)^2$,即高频相对低频被提升约$20\log_{10}\frac{1+\alpha}{1-\alpha}\approx36\,\text{dB}$($\alpha=0.97$时)。浊音的频谱由于声门激励而随频率升高衰减,预加重把这一倾斜大致拉平,使高频共振峰在后续的对数谱与倒谱中得到与低频相当的权重。
(2) 时频表示
⚪ 分帧与加窗:短时平稳假设
语音在$10\sim30\,\text{ms}$的尺度上近似平稳,因此把信号切分为重叠的短帧分别分析。设帧长为$N_w$个采样、帧移为$R$个采样,第$m$帧为$s_m[n]=s[mR+n]\,w[n]$,$n=0,\dots,N_w-1$,帧数为$1+\lfloor(T-N_w)/R\rfloor$。语音中最常用的设置是帧长$25\,\text{ms}$、帧移$10\,\text{ms}$,$16\,\text{kHz}$时即$N_w=400$、$R=160$。
加窗是为了减小帧两端的截断造成的频谱泄漏(spectral leakage):截断相当于乘以矩形窗,在频域与窗函数的频谱卷积。常用窗函数为
\[\begin{aligned} \text{Hann}:&\quad w[n]=0.5-0.5\cos\left(\frac{2\pi n}{N_w-1}\right) \\ \text{Hamming}:&\quad w[n]=0.54-0.46\cos\left(\frac{2\pi n}{N_w-1}\right) \end{aligned}\]三种窗的最高旁瓣电平约为:矩形窗$-13\,\text{dB}$、Hann窗$-31\,\text{dB}$、Hamming窗$-43\,\text{dB}$;Hann窗在两端降为$0$,旁瓣以$18\,\text{dB}$每倍频程衰减,Hamming窗两端不为$0$,第一旁瓣更低。短时傅里叶变换的实现中常使用周期型(periodic)窗,即把上式分母中的$N_w-1$换成$N_w$,以满足下文的重叠相加条件。
⚪ 短时傅里叶变换 STFT:语谱图
短时傅里叶变换(short-time Fourier transform, STFT)对每一帧做长度为$N_{\text{fft}}\ge N_w$的离散傅里叶变换(不足部分补零):
\[X[m,k]=\sum_{n=0}^{N_w-1}s[mR+n]\,w[n]\,e^{-j2\pi kn/N_{\text{fft}}},\quad k=0,\dots,\frac{N_{\text{fft}}}{2}\]实信号的频谱共轭对称,因此只保留$N_{\text{fft}}/2+1$个频点;第$k$个频点对应频率$f_k=kf_s/N_{\text{fft}}$,频率分辨率为$f_s/N_{\text{fft}}$。功率谱为$P[m,k]=\lvert X[m,k]\rvert^2$(有时再除以$N_{\text{fft}}$),幅度谱为$\lvert X[m,k]\rvert$。帧长决定了时间分辨率与频率分辨率的权衡:帧越长,频率分辨率越高、时间分辨率越低。
当窗函数满足恒定重叠相加(constant overlap-add, COLA)条件$\sum_mw[n-mR]=\text{const}$(例如周期型Hann窗在$R=N_w/2$或$N_w/4$时)时,逆STFT可以用重叠相加精确重建信号。只保留幅度谱则丢弃了相位,波形需要用Griffin-Lim等相位估计算法或神经声码器重建,因此幅度谱特征是一种不可逆的预处理。
⚪ 梅尔滤波器组 Mel Filterbank:按听觉感知刻度汇聚频谱
人耳对音高的感知在低频近似线性、在高频近似对数。Stevens、Volkmann与Newman通过心理声学实验建立了梅尔刻度(mel scale),使梅尔值上相等的间隔对应感知上相等的音高差。工程上最常用的拟合公式(HTK公式)为
\[\begin{aligned} m&=2595\log_{10}\left(1+\frac{f}{700}\right)=1127\ln\left(1+\frac{f}{700}\right)\\ f&=700\left(10^{m/2595}-1\right) \end{aligned}\]另一种常用的Slaney公式(librosa默认)在$1000\,\text{Hz}$以下取线性关系、以上取对数关系,两种公式数值不同,训练与推理需保持一致。
梅尔滤波器组由$M$个三角滤波器构成(语音常取$M=40$或$80$,音乐与通用音频常取$128$):在梅尔刻度上把$[m(f_{\min}),m(f_{\max})]$等分为$M+1$段,得到$M+2$个边界点,换算回赫兹为$f_0\lt f_1\lt \dots\lt f_{M+1}$。第$i$个滤波器在频率$f$处的响应为
\[H_i(f)= \begin{cases} \dfrac{f-f_{i-1}}{f_i-f_{i-1}}, & f_{i-1}\le f\le f_i \\ \dfrac{f_{i+1}-f}{f_{i+1}-f_i}, & f_i\lt f\le f_{i+1} \\ 0, & \text{其他} \end{cases}\]梅尔谱为功率谱在各滤波器上的加权和$S[m,i]=\sum_kH_i(f_k)P[m,k]$。三角滤波器在高频处更宽,若希望每个滤波器的能量贡献相当,可以对其做面积归一化,乘以$2/(f_{i+1}-f_{i-1})$(Slaney归一化)。
⚪ 对数梅尔谱 Log-Mel Spectrogram:深度模型的标准声学输入
对梅尔谱取对数得到对数梅尔谱(log-mel spectrogram / filterbank, Fbank):
\[\begin{aligned} F[m,i]&=\log\left(S[m,i]+\epsilon\right)\\ F_{\text{dB}}[m,i]&=10\log_{10}\max\left(S[m,i],\epsilon\right) \end{aligned}\]取对数的作用有二:一是与响度感知的近似对数关系相符,压缩动态范围;二是把信号与信道(或声道响应与激励)在频域上的乘性关系变为加性关系,为下面的倒谱分析与均值归一化提供基础。以分贝为单位时,常用top_db(如$80\,\text{dB}$)把低于最大值一定范围的部分截断。
Robust Speech Recognition via Large-Scale Weak Supervision(Whisper)的前端是一个典型配置:音频重采样到$16\,\text{kHz}$,用$25\,\text{ms}$窗长、$10\,\text{ms}$帧移计算$80$通道的对数幅度梅尔谱,并整体缩放到$[-1,1]$附近、近似零均值。其开源实现中具体为:对梅尔功率谱取$\log_{10}$,把低于全局最大值$8$个单位(即$80\,\text{dB}$)的部分截断,再计算$(F+4)/4$;输入统一填充或截断为$30$秒。
⚪ 梅尔频率倒谱系数 MFCC:对数滤波器组能量的离散余弦变换
梅尔频率倒谱系数(Mel-Frequency Cepstral Coefficients, MFCC)对每一帧的$M$个对数滤波器组能量$F_i=\log S_i$做离散余弦变换(DCT-II),取前$C$个系数(常取$C=13$):
\[c_n=\sum_{i=1}^{M}F_i\cos\left[\frac{\pi n}{M}\left(i-\frac{1}{2}\right)\right],\quad n=0,\dots,C-1\]推导上,倒谱是“对数谱的谱”:语音可以建模为激励$e$与声道响应$v$的卷积,$s=e\ast v$,频域上为乘积,对数域上为相加$\log\lvert S\rvert=\log\lvert E\rvert+\log\lvert V\rvert$;声道响应(决定共振峰与音色)是频谱的缓变包络,集中在低阶倒谱系数,而激励的谐波结构是快变分量,落在高阶系数中。因此保留低阶系数相当于对频谱包络做平滑,提取了与音素相关的信息。DCT还近似地对相邻滤波器组的强相关能量做了去相关,使对角协方差的高斯混合模型能够有效建模。$c_0$与帧的对数能量成正比,常被替换为单独计算的对数能量。
Davis与Mermelstein比较了MFCC、线性频率倒谱系数、线性预测系数与线性预测倒谱系数、反射系数等参数化表示在连续语句中单音节词识别上的表现,发现MFCC的识别率最高,此后它成为语音识别的标准特征。常见的附加处理有:
- 倒谱提升(liftering):$c’_n=\left(1+\frac{L}{2}\sin\frac{\pi n}{L}\right)c_n$,常取$L=22$,放大中阶系数使各维幅度相近;
- 差分特征:一阶差分$\Delta c_t=\frac{\sum_{\theta=1}^{\Theta}\theta\left(c_{t+\theta}-c_{t-\theta}\right)}{2\sum_{\theta=1}^{\Theta}\theta^2}$(常取$\Theta=2$),再对$\Delta c_t$做同样运算得到二阶差分;$13$维静态系数加一阶与二阶差分构成经典的$39$维特征。
(3) 特征归一化
⚪ 倒谱均值方差归一化 CMVN:消除信道的平稳偏移
倒谱均值方差归一化(Cepstral Mean and Variance Normalization, CMVN)在时间轴上对每一维特征做标准化:
\[\hat{c}_{t,n}=\frac{c_{t,n}-\mu_n}{\sigma_n},\quad \mu_n=\frac{1}{T}\sum_{t=1}^{T}c_{t,n},\quad \sigma_n^2=\frac{1}{T}\sum_{t=1}^{T}\left(c_{t,n}-\mu_n\right)^2\]其中只减均值的版本称为倒谱均值减法(CMS/CMN)。其动机来自上文的对数域可加性:若录音信道(麦克风、电话线路)是一个时不变的线性滤波器$g$,观测为$y=x\ast g$,则在对数谱与倒谱域中$c_y=c_x+c_g$,信道表现为一个与时间无关的常数偏移,减去时间均值即可将其消除。
按统计量的作用范围,CMVN分为:逐句(per-utterance)、逐说话人(per-speaker)、全局(global)(在训练集上估计、推理时复用,许多端到端语音识别工具包采用这一方式),以及用于流式识别的滑动窗口(sliding-window)版本,即只用过去一段时间(如数秒)的帧估计统计量。它同样适用于对数梅尔谱。直接以波形为输入的模型使用类似的逐句标准化,例如wav2vec 2.0的部分配置把每段输入波形归一化为零均值单位方差。
⚪ PCEN:逐通道能量归一化
对数压缩对所有能量水平施加相同的变换,远场与音量变化较大的场景中信号的整体增益随时间变化。逐通道能量归一化(Per-Channel Energy Normalization, PCEN)用一个自适应增益控制代替对数:
\[\begin{aligned} M(t,f)&=(1-s)\,M(t-1,f)+s\,E(t,f) \\ \text{PCEN}(t,f)&=\left(\frac{E(t,f)}{\left(\epsilon+M(t,f)\right)^{\alpha}}+\delta\right)^{r}-\delta^{r} \end{aligned}\]其中$E(t,f)$为滤波器组能量,$M(t,f)$是其沿时间的一阶IIR平滑(平滑系数$s$),作为“近期能量水平”的估计;除以$M^\alpha$($\alpha\le1$)实现自动增益控制,使输出对输入的整体增益近似不变;随后的$(\cdot+\delta)^r-\delta^r$($r<1$)是一种动态范围压缩,在$\delta$附近近似线性、远大于$\delta$时近似幂律。常用取值为$\alpha=0.98$、$\delta=2$、$r=0.5$、$\epsilon=10^{-6}$,$s$对应约数百毫秒的时间常数。
PCEN的各项运算都可微,因此$\alpha,\delta,r$(乃至每个频率通道各自的参数)可以作为网络参数与模型联合训练。论文在远场与带噪的关键词检测任务上观察到,以PCEN代替对数梅尔谱显著降低了错误率。
⚪ 响度归一化:基于ITU-R BS.1770的节目响度
不同来源的音频整体音量差异很大。最简单的归一化是峰值归一化$s’=s\cdot a_{\text{peak}}/\max_t\lvert s[t]\rvert$或RMS归一化$s’=s\cdot a_{\text{rms}}/\sqrt{\frac{1}{T}\sum_ts[t]^2}$;但人耳感知的响度依赖于频率,ITU-R BS.1770定义了与感知更一致的节目响度,单位为LKFS(与LUFS等同):
- K加权:先经过一个高频搁架滤波器(模拟头部的声学效应),再经过一个高通滤波器(RLB加权,衰减低频);
- 分块均方:对每个声道$c$,在长$400\,\text{ms}$、重叠$75\%$的块上计算均方值$z_{c,j}$,块响度为$\ell_j=-0.691+10\log_{10}\sum_cG_cz_{c,j}$,其中$G_c$为声道权重(左、右、中置为$1$,环绕声道约为$1.41$);
- 门限:先丢弃$\ell_j<-70\,\text{LKFS}$的块(绝对门限),对剩余块求平均响度,再丢弃比该平均值低$10\,\text{LU}$以上的块(相对门限),用剩余块的平均均方计算最终响度$L$。
归一化到目标响度$L_{\text{target}}$(如广播标准EBU R128规定的$-23\,\text{LUFS}$)只需乘以增益
\[g=10^{\left(L_{\text{target}}-L\right)/20}\]由于响度定义在均方的对数上,$20\log_{10}g$恰好等于需要调整的分贝数。增益放大后若峰值超过$1$,还需配合限幅。
5.3 文本预处理
本节讨论从原始文档中抽取文本、在字符层面做规范化与清洗、识别语言。
(1) 文本抽取
⚪ Trafilatura:网页正文抽取
网页语料的原始形式是HTML,其中导航栏、页脚、广告、评论区、版权声明等模板内容(boilerplate)占了很大比例。Common Crawl提供的WET文件是对整页HTML的简单文本化,保留了这些模板内容;正文抽取则试图只保留主体内容。
Trafilatura结合了基于规则的DOM树启发式(按标签类型、类名、文本密度与链接密度判断节点是否为正文,剪除常见的模板节点)与回退算法(在主算法失败时调用readability、jusText等通用抽取器并比较结果),同时抽取标题、作者、日期等元数据。RefinedWeb与FineWeb都以Trafilatura从WARC中的原始HTML抽取文本,FineWeb的消融实验显示这比直接使用WET文本得到的模型更好。
(2) 字符级规范化与清洗
⚪ Unicode规范化:NFC、NFD、NFKC与NFKD
同一段可见文本在Unicode中可能有多种码点序列表示。Unicode标准定义了两种等价关系:
- 规范等价(canonical equivalence):表示相同的抽象字符,在显示与语义上都应视为相同。例如“é”可以是单个预组合码点
U+00E9,也可以是“e”U+0065加组合重音符U+0301;韩文音节可以是预组合形式或字母序列。 - 兼容等价(compatibility equivalence):表示相同的抽象字符但外观或用途不同。例如连字“fi”(
U+FB01)与“fi”、全角“A”(U+FF21)与“A”、带圈数字“①”与“1”、上标“²”与“2”、罗马数字“Ⅳ”与“IV”。
由此定义四种规范化形式(normalization form):
- NFD:规范分解,把预组合字符拆成基本字符加组合符号,并按规范组合类排序组合符号;
- NFC:规范分解后再做规范组合,得到尽可能短的预组合形式,是网页与文件存储最常用的形式;
- NFKD:兼容分解,在规范分解的基础上把兼容字符替换为其兼容等价形式;
- NFKC:兼容分解后再做规范组合。
所有形式都是幂等的(再次规范化不改变结果),且两个字符串规范等价当且仅当它们的NFC(或NFD)形式逐码点相同。对NLP而言,NFC只消除编码上的差异而不改变外观,适合需要保留原文的场景;NFKC进一步合并了全角半角、连字等外观变体,是SentencePiece的默认规范化规则(nmt_nfkc),在中日韩文本中尤其常用。NFKC会把“²”变为“2”、“fi”变为“fi”,对数学公式、化学式等对上标和特殊符号敏感的文本需要按需选择。
⚪ 空白、控制字符与编码错误清洗
在规范化之外,文本清洗通常还包括:
- 控制字符与格式字符:删除Unicode类别为Cc(控制字符,保留制表符与换行符)与部分Cf(格式字符)的码点,如零宽空格
U+200B、字节顺序标记U+FEFF、替换字符U+FFFD(表示此前的解码已经出错);BERT的基础分词器即在切分前删除码点$0$、U+FFFD与控制字符。 - 空白统一:把不间断空格
U+00A0、全角空格U+3000、各种宽度的空格(U+2000至U+200A)统一为普通空格U+0020,合并连续空白,把CRLF与CR换行统一为LF。 - 编码错误修复:以错误的编码解读UTF-8字节会产生乱码(mojibake),例如“é”被显示为“é”;可以检测典型的乱码模式并逆向修复(如ftfy库)。
- 标记语言残留:反转义HTML实体(如
&、 ),去除残余标签与脚本。
这些规则同样必须在训练与推理两侧一致地执行。
⚪ 大小写折叠与去重音
小写化(lowercasing)把大写字母映射为小写,以减少词表中的大小写变体(uncased模型)。严格意义上的大小写折叠(case folding)按Unicode的CaseFolding.txt进行,它与简单的小写映射不同:例如德语“ß”在完全折叠下变为“ss”,希腊语词尾形式“ς”折叠为“σ”。大小写映射还有语言相关的特例,如土耳其语中“I”的小写是无点的“ı”、“İ”的小写才是“i”。
去重音(accent stripping)先做NFD分解,再删除Unicode类别为Mn(非间距组合标记)的码点,例如“café”变为“cafe”。BERT的uncased模型即“小写化$+$NFD$+$去除Mn”。去重音把某些语言中有区别的词映射为同一形式(如西班牙语“año”与“ano”),因此多语言模型通常保留重音。
(3) 语言识别
⚪ fastText语言识别:基于字符n-gram的线性分类器
- paper:Bag of Tricks for Efficient Text Classification
- paper:FastText.zip: Compressing text classification models
多语言语料的过滤与采样都需要逐文档(或逐行)的语言标签。fastText分类器把文本表示为词与字符$n$-gram 的集合,每个$n$-gram 通过哈希映射到$B$个桶之一并查得一个嵌入,对所有嵌入取平均后接一个线性层与softmax:
\[p(y\mid x)=\text{softmax}\left(B_{\text{out}}\frac{1}{\lvert G(x)\rvert}\sum_{g\in G(x)}A_g\right)\]其中$G(x)$是$x$的$n$-gram 集合,$A$为嵌入矩阵,$B_{\text{out}}$为输出矩阵;类别数很大时用层次softmax加速。模型只有一层隐藏表示,可以在CPU上每秒处理大量文档。基于FastText.zip中的量化压缩方法,官方发布了支持$176$种语言的语言识别模型(lid.176,压缩版不足$1\,\text{MB}$),它以字符$n$-gram 为主要特征,因此对短文本与未登录词也能给出可靠预测。
语言识别模型输出的最大类别概率常被用作过滤阈值,例如CCNet取$0.5$,RefinedWeb与FineWeb对英文取$0.65$;C4则使用langdetect工具并要求英语概率至少为$0.99$。代码、数学公式与多语混排文本的语言概率分布与单语自然文本不同,这类数据通常设置单独的处理分支。
5.4 时间序列预处理
时间序列$x_{1:T}$(可以是多变量的,$x_t\in\mathbb{R}^{D}$)的预处理需要额外遵守因果性:任何在时刻$t$使用的变换都只能依赖于$t$及之前的信息,否则会在预测任务中引入未来信息。
(1) 重采样与对齐
⚪ 重采样、对齐与因果填补
原始时间序列常以不规则的时间戳记录(事件日志、传感器上报),或者多条序列的采样频率不同。预处理首先把它们映射到统一的规则时间网格:
- 降采样(聚合):把一个时间桶内的观测聚合为一个值,聚合函数取决于变量的语义:流量型变量(销量、降雨量)用求和,状态型变量(温度、价格)用均值或最后一个值,金融行情常用开高低收(OHLC)四个值;
- 升采样(填补):网格点上没有观测时,可用前向填充(forward fill)$x_t=x_{t’}$($t’$为$t$之前最近的观测时刻)或插值;
- 对齐:多条序列按时间戳连接到同一网格,并统一时区与夏令时处理。
前向填充只使用过去的信息,是因果的;线性插值$x_t=x_{t_1}+\frac{t-t_1}{t_2-t_1}(x_{t_2}-x_{t_1})$使用了之后的观测$x_{t_2}$,在构造预测任务的输入时会泄露未来信息,只适用于离线分析或插值本身就是任务的场景。另一种做法是保留缺失并附加缺失指示与“距上次观测的时间间隔”特征,交给模型处理。
(2) 平稳化与分解
⚪ 差分:消除趋势与单位根
许多经典模型与深度模型都在近似平稳(统计特性不随时间变化)的序列上表现更稳定。一阶差分与季节差分分别为
\[\nabla x_t=x_t-x_{t-1},\quad \nabla_px_t=x_t-x_{t-p}\]其中$p$为季节周期(如日数据中的周周期$p=7$)。$d$阶差分$\nabla^dx_t$可以消除$d$次多项式趋势:例如线性趋势$x_t=a+bt+\varepsilon_t$满足$\nabla x_t=b+\varepsilon_t-\varepsilon_{t-1}$,均值不再随时间变化;随机游走$x_t=x_{t-1}+\varepsilon_t$含有单位根,其方差$\text{Var}(x_t)=t\sigma^2$随时间增长,而$\nabla x_t=\varepsilon_t$是平稳的白噪声。季节差分以同样的方式消除周期为$p$的确定性季节模式。
差分在保留初值时可逆:模型预测差分序列\(\nabla\hat{x}_{t+1:t+S}\)后,用累加还原\(\hat{x}_{t+h}=x_t+\sum_{i=1}^{h}\nabla\hat{x}_{t+i}\)。对乘性增长的序列,常先取对数再差分,此时\(\nabla\log x_t\approx(x_t-x_{t-1})/x_{t-1}\)近似为增长率。
⚪ STL分解:基于局部加权回归的季节-趋势分解
STL把序列加性地分解为趋势、季节与残差三部分:
\[x_t=\mathcal{T}_t+\mathcal{S}_t+\mathcal{R}_t\](乘性的情形可以先取对数)。它以LOESS(局部加权多项式回归)为基本平滑器,由内外两层循环构成。内循环的第$k$次迭代为:
- 去趋势:$x_t-\mathcal{T}_t^{(k)}$(初始$\mathcal{T}^{(0)}=0$);
- 周期子序列平滑:把去趋势序列按周期位置拆成$p$条子序列(如所有“周一”的值组成一条),对每条子序列用平滑参数为$n_s$的LOESS平滑并向两端各外推一个周期,得到临时季节序列$C_t$;
- 低通滤波:对$C_t$依次做长度为$p,p,3$的移动平均,再做一次LOESS,得到$L_t$,它表示$C_t$中混入的低频成分;
- 去除季节中的趋势:$\mathcal{S}_t^{(k+1)}=C_t-L_t$;
- 去季节:$x_t-\mathcal{S}_t^{(k+1)}$;
- 趋势平滑:对去季节序列用平滑参数为$n_t$的LOESS平滑,得到$\mathcal{T}_t^{(k+1)}$。
外循环根据残差$\mathcal{R}_t=x_t-\mathcal{T}_t-\mathcal{S}_t$计算稳健权重
\[\begin{aligned} \rho_t&=B\left(\frac{\lvert\mathcal{R}_t\rvert}{6\cdot\text{median}\lvert\mathcal{R}\rvert}\right),\\ B(u)&= \begin{cases} (1-u^2)^2, & 0\le u<1 \\ 0, & u\ge1 \end{cases} \end{aligned}\]($B$为bisquare函数),并在下一轮内循环的所有LOESS中把邻域权重乘以$\rho_t$,从而使异常值不影响趋势与季节的估计。关键参数为周期$p$、季节平滑参数$n_s$(奇数,至少为$7$)与趋势平滑参数$n_t$(论文建议取大于等于$1.5p/(1-1.5/n_s)$的最小奇数);使用稳健外循环时,内循环迭代次数常取$1\sim2$。分解后,模型可以分别预测各分量或只对残差建模。
⚪ 移动平均分解:DLinear中的趋势-季节拆分
深度预测模型中常用一种更轻量的分解,作为模型的第一步:用移动平均提取趋势,原序列减去趋势作为季节(余项)部分。对回看窗口$X\in\mathbb{R}^{L\times D}$:
\[X_{\text{trend}}=\text{AvgPool}\left(\text{Padding}(X)\right),\quad X_{\text{season}}=X-X_{\text{trend}}\]其中平均池化的核长为$k$(DLinear取$k=25$)、步长为$1$,两端用边界值复制填充以保持长度。DLinear对两个分量各用一个沿时间维的线性层预测未来$S$步并相加,$\hat{X}=W_tX_{\text{trend}}+W_sX_{\text{season}}$;同文的NLinear则先减去回看窗口的最后一个值$x_L$、线性预测后再加回,用以应对分布偏移。论文在多个长期预测基准上观察到,这些单层线性模型的表现超过了当时多种基于Transformer的预测模型,并据此提出应重新审视长期预测中的建模假设。
(3) 窗口化与归一化
⚪ 滑动窗口:把序列转化为监督样本
预测任务把一条长序列切分为大量“输入-目标”样本对:以长度为$L$的回看窗口为输入、之后长度为$S$的片段为目标,窗口以步长$\Delta$滑动:
\[\left(x_{t-L+1:t},\;x_{t+1:t+S}\right),\quad t=L,\,L+\Delta,\,\dots,\quad \text{样本数}=\left\lfloor\frac{T-L-S}{\Delta}\right\rfloor+1\]相邻窗口高度重叠($\Delta=1$时只差一个时间步),因此训练、验证与测试必须按时间切分整条序列,再在各段内部分别构造窗口;划分边界处应留出至少$L+S-1$步的间隔,以免同一段观测同时出现在训练窗口的目标与测试窗口的输入中。分类任务(如传感器活动识别)同样用固定长度、可重叠的窗口切分,并以窗口内多数标签或终点标签为窗口标签。
⚪ 逐序列与逐窗口缩放:全局统计量与局部统计量
时间序列的归一化需要先确定统计量的作用范围:
- 全局逐变量标准化:在训练段上为每个变量估计$\mu_d,\sigma_d$并用于全部数据,是许多长期预测基准的标准设置;
- 逐序列缩放:多条序列(如成千上万个商品的销量)的量级差异可达数个数量级,为每条序列单独估计尺度。DeepAR为每条序列计算尺度$\nu_i=1+\frac{1}{L}\sum_{t}x_{i,t}$(对回看窗口求平均),输入除以$\nu_i$,输出分布的参数再乘回$\nu_i$;
- 逐窗口归一化:每个输入窗口用自身的统计量归一化,并用同一统计量还原预测,下面的RevIN是这一思路的代表。
全局统计量保留了序列之间与时间段之间的绝对水平差异,逐窗口统计量则把每个窗口变换到相同的尺度,使模型专注于局部形状;后者需要把被移除的统计量在输出端加回。
⚪ RevIN:可逆实例归一化
- paper:Reversible Instance Normalization for Accurate Time-Series Forecasting against Distribution Shift
时间序列的均值与方差常随时间变化,训练窗口与测试窗口的统计量不同(分布偏移)。可逆实例归一化(Reversible Instance Normalization, RevIN)在模型的输入端与输出端放置一对对称的归一化与反归一化层。对第$i$个样本的第$d$个变量,先在其回看窗口上计算实例统计量:
\[\mu_{i,d}=\frac{1}{L}\sum_{t=1}^{L}x_{i,t,d},\quad \sigma_{i,d}^2=\frac{1}{L}\sum_{t=1}^{L}\left(x_{i,t,d}-\mu_{i,d}\right)^2\]归一化并施加可学习的逐变量仿射参数$\gamma_d,\beta_d$:
\[\hat{x}_{i,t,d}=\gamma_d\left(\frac{x_{i,t,d}-\mu_{i,d}}{\sqrt{\sigma_{i,d}^2+\epsilon}}\right)+\beta_d\]模型$f$以$\hat{x}_{i}$为输入输出预测$\tilde{y}_i=f(\hat{x}_i)$,反归一化用同一组统计量与参数做精确的逆变换:
\[\hat{y}_{i,t,d}=\sqrt{\sigma_{i,d}^2+\epsilon}\cdot\left(\frac{\tilde{y}_{i,t,d}-\beta_d}{\gamma_d}\right)+\mu_{i,d}\]于是模型只需预测归一化空间中的“形状”,而窗口的水平与尺度由输入窗口的统计量直接传递到输出。由于两端是严格互逆的,若模型输出恰好是输入的延续,则反归一化后在原始尺度上也保持连续。RevIN与模型结构无关,可以作为插件加到任意预测模型上;论文在ETT、Electricity等数据集上为Informer、N-BEATS、SCINet等模型加上RevIN,在多数设置下显著降低了预测误差,长预测长度时改善尤为明显。之后的许多预测模型(如PatchTST)都默认使用这一归一化。
⚪ 序列平稳化:Non-stationary Transformers
Non-stationary Transformers的序列平稳化(Series Stationarization)模块采用与RevIN相同的不带仿射参数的逐窗口归一化$x’=(x-\mu_x)/\sigma_x$与反归一化$\hat{y}=\sigma_x\odot y’+\mu_x$。它进一步指出,平稳化之后注意力只能看到归一化后的序列,原序列的非平稳信息(不同窗口的注意力模式本应不同)被抹去了,这一现象被称为过度平稳化(over-stationarization),并提出去平稳注意力(De-stationary Attention)从数学上恢复原序列上的注意力。
推导如下:假设嵌入层与投影是线性的,则原序列上的查询与键可以写成$Q=\sigma_xQ’+\mathbf{1}\mu_Q^\top$、$K=\sigma_xK’+\mathbf{1}\mu_K^\top$,其中$Q’,K’$为平稳化序列上的查询与键,$\mu_Q,\mu_K$为均值项。展开
\[QK^\top=\sigma_x^2Q'K'^\top+\sigma_x\,Q'\mu_K\mathbf{1}^\top+\sigma_x\,\mathbf{1}\mu_Q^\top K'^\top+\mathbf{1}\mu_Q^\top\mu_K\mathbf{1}^\top\]softmax按行归一化,对每一行加上同一常数不改变结果;第二项$Q’\mu_K\mathbf{1}^\top$与第四项在每一行内都是常数,可以去掉。于是
\[\text{softmax}\left(\frac{QK^\top}{\sqrt{d_k}}\right)=\text{softmax}\left(\frac{\sigma_x^2\,Q'K'^\top+\mathbf{1}(\sigma_xK'\mu_Q))^\top}{\sqrt{d_k}}\right)\]由于$\tau=\sigma_x^2$与$\Delta=\sigma_xK’\mu_Q$依赖于原序列的统计量,论文用两个以原始序列$x$及其统计量$\mu_x,\sigma_x$为输入的MLP预测$\log\tau$与$\Delta$,在所有注意力层中共享。论文报告该框架使Transformer、Informer与Reformer的平均MSE分别降低$49.43\%$、$47.34\%$与$46.89\%$。
6. 数据集划分、采样与加载
(1) 数据集划分
⚪ 随机划分与分层划分
随机划分把样本随机打乱后按比例(如$8:1:1$)切分为训练、验证与测试集,它要求样本之间近似独立同分布。
分层划分(stratified split)在每个类别内部分别按比例切分,使各划分中的类别比例与总体一致;对类别不平衡的数据,它避免了少数类在验证或测试集中的比例因随机波动而偏离总体。回归任务可以先对目标值分箱再按箱分层;多标签任务的分层需要同时平衡多个标签的比例,常用迭代分层(iterative stratification)贪心地把样本分配给最缺少其稀有标签的划分。
⚪ 分组划分:同源样本不跨划分
当样本之间存在分组结构时(同一病人的多张影像、同一用户的多条记录、同一视频的多帧、同一文档的多个片段、同一说话人的多段录音),随机划分会把同组样本分到不同划分中,模型可以通过记住组的特征(如病人的解剖结构、说话人的音色)在测试集上取得虚高的指标。
分组划分(group split)以组为单位划分,保证每个组的全部样本都在同一划分中。若测试目标是“对新组的泛化”,分组划分是与目标一致的评估方式。
⚪ 时间划分:训练在前、测试在后
对时间相关的数据(时间序列预测、推荐、金融、按时间收集的日志),时间划分以时间点$t_1\lt t_2$切分:$t\lt t_1$为训练集,$t_1\le t\lt t_2$为验证集,$t\ge t_2$为测试集,与部署时“用过去预测未来”的方式一致。常用的扩展有:
- 滚动起点评估(rolling-origin / walk-forward):依次把切分点向后移动,每次用切分点之前的数据训练(扩展窗口)或只用最近一段数据训练(滑动窗口),在之后的一段上评估,再平均各次的结果;
- 间隔(gap / embargo):在训练段与测试段之间留出一段不使用的时间,以免特征或标签的时间窗口跨越边界(例如标签定义为“未来$7$天是否流失”时,训练段最后$7$天样本的标签已经使用了测试段的信息)。
(2) 交叉验证与数据泄露
⚪ K折交叉验证与嵌套交叉验证
K折交叉验证(K-fold cross-validation)把训练数据划分为$K$个大小相近的折$\mathcal{D}_1,\dots,\mathcal{D}_K$,第$k$次以$\mathcal{D}_k$为验证集、其余为训练集,泛化误差估计为
\[\widehat{\text{Err}}_{\text{CV}}=\frac{1}{K}\sum_{k=1}^{K}\frac{1}{\lvert\mathcal{D}_k\rvert}\sum_{(x,y)\in\mathcal{D}_k}\ell\left(f^{(-k)}(x),y\right)\]其中$f^{(-k)}$为在除第$k$折外的数据上训练的模型。常取$K=5$或$10$;$K=N$时为留一法。分层、分组与时间划分都有对应的交叉验证版本(分层K折、分组K折、时间序列的滚动起点评估)。
在交叉验证中选择超参数后,$\widehat{\text{Err}}_{\text{CV}}$的最小值是对所选模型泛化误差的乐观估计,因为选择本身利用了验证折。嵌套交叉验证(nested cross-validation)用外层$K$折估计泛化误差,在每个外层训练集内部再做一次内层交叉验证选择超参数,使外层验证折完全不参与任何选择。
每一个需要拟合的预处理步骤(填补、缩放、目标编码、特征选择、过采样)都必须在每一折的训练部分上单独拟合。以scikit-learn为例,把预处理与模型组合成一个Pipeline再交给交叉验证函数,就能自动保证这一点:
from sklearn.pipeline import Pipeline
from sklearn.compose import ColumnTransformer
from sklearn.impute import SimpleImputer
from sklearn.preprocessing import StandardScaler, OneHotEncoder
from sklearn.linear_model import LogisticRegression
from sklearn.model_selection import StratifiedKFold, cross_val_score

preprocess = ColumnTransformer([
    ("num", Pipeline([("impute", SimpleImputer(strategy="median", add_indicator=True)),
                      ("scale", StandardScaler())]), num_cols),
    ("cat", OneHotEncoder(handle_unknown="ignore", min_frequency=10), cat_cols),
])
model = Pipeline([("prep", preprocess), ("clf", LogisticRegression(max_iter=1000))])
# 每一折都只在该折的训练部分上拟合 imputer / scaler / encoder
scores = cross_val_score(model, X, y, cv=StratifiedKFold(n_splits=5, shuffle=True, random_state=0))
⚪ 数据泄露的形式化:学习-预测分离
Kaufman等人把数据泄露定义为:模型在训练时使用了在真实预测时刻不合法地可得的信息。他们以学习-预测分离(learn-predict separation)为准则:对每个待预测样本,存在一个“预测时刻”,只有在该时刻之前合法可得的信息才能进入特征与训练样本。据此泄露分为两类:
- 特征泄露:特征中包含了目标本身或目标的代理(例如用“是否开具了某种药物的处方”预测“是否患有该病”,而处方是诊断之后的结果);
- 训练样本泄露:训练样本中包含了预测时刻之后的样本,或与测试样本存在依赖(时间上的重叠、同一实体、近重复)。
论文分析了若干数据挖掘竞赛中出现的泄露案例(例如样本编号或数据来源的字段与标签相关),并讨论了检测方法:检查对模型贡献异常大的特征、检查验证性能是否“好得不合常理”、按时间戳追溯每个特征的生成过程。他们的建议是在数据收集阶段就为每个字段记录其产生时间,在预处理阶段按预测时刻截断。
(3) 打乱、批处理与加载
⚪ 打乱:全局排列与打乱缓冲区
随机梯度下降的分析通常假设每个小批量是从训练分布中独立抽取的。数据集能够随机访问时,每个epoch生成一个全局随机排列即可(无放回采样)。对存储为顺序文件、无法随机访问的超大数据集,常用两级近似:
- 分片级打乱:把数据预先写成大量分片(shard),每个epoch随机排列分片的顺序,并把分片分配给不同的数据加载进程与设备;
- 缓冲区打乱:维护一个容量为$B$的缓冲区,每读入一个样本就从缓冲区中随机取出一个输出、并把新样本放入其位置。
缓冲区打乱的范围由$B$决定:第$i$个读入的样本最早在第$i-B$个位置被输出(缓冲区被填满之前不输出),因此若原始顺序存在聚集(如同一来源的样本连续存放),$B$需要远大于聚集的长度;这也是数据在写入分片之前通常先做一次全局打乱的原因。
⚪ 长度分桶与按标记数组批
变长序列(文本、语音、视频)组成批次时,需要填充到批内最大长度$l_{\max}$。批大小为$b$、各序列长度为$l_1,\dots,l_b$时,填充所占的比例为
\[\text{padding ratio}=1-\frac{\sum_{i=1}^{b}l_i}{b\cdot l_{\max}}\]长度分桶(length bucketing)按长度把样本分到若干桶中(或在一个较大的随机池内按长度排序后再切成批),每个批次只从同一桶中取样本,使批内长度相近、填充比例接近$0$;批次的顺序再随机打乱,以保持随机性。与之配套的是按标记数组批(token-based batching):不固定样本数$b$,而是固定每批的标记总数上限($b\cdot l_{\max}\le N_{\text{tok}}$),使每个批次的计算量与显存占用近似恒定,这是机器翻译与语音识别工具包中的常见做法。
⚪ 序列打包:拼接、切块与文档掩码
语言模型预训练常用序列打包(sequence packing)代替填充:把文档依次拼接,文档之间插入结束标记<eos>,再把这条长流切成长度恰为$L$的块,于是没有任何填充。这种做法下一个块可能包含多篇文档的片段,注意力会跨越文档边界。若要避免跨文档的注意力,可以使用文档掩码:注意力掩码取块对角形式,并在每篇文档的起点重置位置编号,
其中$\text{doc}(i)$为第$i$个标记所属的文档。微调数据(如指令数据)长度分布很宽时,可以把若干条完整样本按装箱问题打包进长度为$L$的块,例如用最优适配递减(best-fit decreasing)启发式:按长度从长到短依次把样本放入剩余空间最小且放得下的块。Efficient Sequence Packing without Cross-contamination分析了BERT预训练数据的长度分布,结合装箱打包与防止跨样本污染的掩码和位置编号调整,在保持精度的同时获得了约两倍的预训练加速。
⚪ 预取、并行解码与流式分片
当数据解码与预处理的速度跟不上加速器时,训练会被输入流水线阻塞。常用的工程手段包括:
- 多进程并行:用多个工作进程并行地读取、解码与变换样本(如PyTorch
DataLoader的num_workers),并预先准备好若干个批次(prefetch_factor),使数据准备与模型计算重叠; - 锁页内存与异步拷贝:把批次放在锁页内存(
pin_memory)中,以便用非阻塞方式拷贝到GPU; - 硬件解码:把JPEG解码、缩放等操作放到GPU上执行(如NVIDIA DALI);
- 流式分片格式:把大量小文件打包成较大的顺序分片(WebDataset使用POSIX tar文件,同一样本的各个模态以相同的文件名前缀存放,如
000123.jpg与000123.json;分片大小常为数百MB),使读取变为对对象存储或网络文件系统的顺序大块读取,并配合分片级打乱与缓冲区打乱; - 可恢复性:记录当前epoch、随机种子与每个工作进程已消费的样本偏移,使训练从检查点恢复时数据顺序可以精确复现。
🤔 讨论:统计量的作用范围
本文的大部分方法都可以用“在哪个范围上估计统计量”来对照:
| 作用范围 | 代表方法 | 统计量的来源 |
|---|---|---|
| 训练集全局、逐特征 | Min-Max、标准化、稳健缩放、幂变换、分位数变换、目标编码 | 训练集,推理时复用 |
| 训练集全局、跨特征 | 白化 | 训练集协方差,推理时复用 |
| 逐样本 | L2归一化、分位数归一化(使用共享参考分布)、逐图像强度截断 | 样本自身 |
| 逐序列或逐片段 | CMVN、DeepAR缩放、RevIN、序列平稳化 | 当前输入的时间窗口 |
| 固定常数 | ImageNet均值方差、像素$/255$、梅尔刻度 | 外部约定,与模型权重绑定 |
统计量的作用范围越大,变换后保留的跨样本绝对信息越多(例如两个窗口的整体水平差异);作用范围越小,变换后的输入在样本之间越可比,被移除的信息则需要在输出端加回或另行提供给模型。逐样本与逐窗口的方法不需要在训练集上拟合,因此天然没有拟合-变换范式中的泄露问题。