Slutsky Theorem and Delta Method.
数理统计的许多核心结论都是以“极限”形式出现的:大数定律告诉我们样本均值会逼近总体均值,中心极限定理则给出了标准化样本均值的极限分布。
然而,这些基础定理往往只针对单个、形式简单的统计量。在实际的统计推断中,我们几乎总是需要把多个统计量组合起来(例如用样本标准差替换未知的总体标准差),或者对统计量做非线性变换(例如求对数、求倒数)。
组合或变换之后的统计量,还能保持原来的极限性质吗? 这就是 Slutsky定理 与 Delta方法 要解决的核心问题:
- Slutsky定理:处理“依概率收敛的量”与“依分布收敛的量”之间的四则运算(为“参数替换”提供合法性)。
- Delta方法:处理光滑非线性函数作用在渐近正态统计量上的误差传播(本质是统计量的泰勒展开)。
1. 两种收敛及其关系
1.1 依概率收敛:刻画“位置”的稳定
依概率收敛(Convergence in probability) 的直觉是:当样本量 $n$ 足够大时,随机估计量会以极高的概率紧紧包裹住真实值(常数或目标随机变量),偏离它的可能性趋近于零:
\[X_n \xrightarrow{P} X \iff \forall \varepsilon>0:\ \lim_{n\to\infty} P\left(\vert X_n-X\vert >\varepsilon\right)=0\]最经典的依概率收敛例子就是大数定律(LLN)。设独立同分布样本 $X_1,X_2,\cdots$ 的均值 $\mu$ 有限:
- 按 Kolmogorov 强大数定律,样本均值 $\bar{X}_n\xrightarrow{a.s.}\mu$。由于几乎处处收敛(a.s.)强于依概率收敛,故 $\bar{X}_n\xrightarrow{P}\mu$。
- 若方差 $\sigma^2$ 有限,直接用 Chebyshev 不等式 也能看出依概率收敛:
1.2 依分布收敛:刻画“形状”的逼近
依分布收敛(Convergence in distribution) 不关心随机变量具体落在哪个值,而是关心当样本量足够大时,它的整体概率分布形状(CDF)是否趋近于某个已知的分布模型:
\[X_n \xrightarrow{d} X \iff \lim_{n\to\infty}F_{X_n}(x)=F_X(x),\quad \forall x\in C(F_X)\]其中 $C(F_X)$ 是极限分布函数 $F_X$ 的连续点集合。
为什么只要求在连续点上收敛? 考虑退化序列 $X_n\equiv \frac{1}{n}$,它显然应该收敛到常数 $X\equiv 0$。但如果在 $x=0$ 处考察分布函数:对一切 $n$ 都有 $F_{X_n}(0)=P(1/n \le 0)=0$,而极限分布 $F_X(0)=P(0\le 0)=1$。在跳跃点 $x=0$ 处极限并不相等!因此,剔除不连续点是为了避免这种边界跳跃带来的伪反例。
在现代概率论中,判断依分布收敛的方法是 Portmanteau 定理(以下四个条件完全等价):
- $X_n\xrightarrow{d}X$;
- 对所有有界连续函数 $h$,期望收敛:$\mathbb{E}[h(X_n)]\to \mathbb{E}[h(X)]$;
- 对所有闭集 $C$,$\limsup_n P(X_n\in C)\leq P(X\in C)$;
- 对所有开集 $G$,$\liminf_n P(X_n\in G)\geq P(X\in G)$。
最经典的依分布收敛例子就是 中心极限定理(CLT):设 $X_i$ 独立同分布,$\mathbb{E}[X_i]=\mu$,$\text{Var}(X_i)=\sigma^2<\infty$,则
\[\frac{\sqrt{n}\left(\bar{X}_n-\mu\right)}{\sigma}\xrightarrow{d}Z\sim N(0,1)\]1.3 二者的关系
- 依概率收敛强于依分布收敛:$X_n\xrightarrow{P}X\Rightarrow X_n\xrightarrow{d}X$。
- 直觉:如果两个随机变量的取值都已经几乎一模一样了,它们的分布形状自然也一模一样。
- 证明:任取有界连续函数 $h$ 与 $\varepsilon>0$,将期望按 $\vert X_n-X\vert \leq\varepsilon$ 与否拆开: \(\left\vert \mathbb{E}h(X_n)-\mathbb{E}h(X)\right\vert \leq 2\vert \vert h\vert \vert _{\infty}P(\vert X_n-X\vert >\varepsilon)+\sup_{\vert x-y\vert \leq\varepsilon}\vert h(x)-h(y)\vert\) 先令 $n\to\infty$(第一项由依概率收敛消失),再令 $\varepsilon\to 0$(第二项由一致连续性消失),即满足 Portmanteau 定理的条件 2。
- 反之不成立:设 $X\sim N(0,1)$,令 $X_n = -X$。显然 $X_n$ 也是标准正态分布,故 $X_n\xrightarrow{d}X$。但 $\vert X_n - X\vert = 2\vert X\vert$,它们在数值上南辕北辙,绝不依概率收敛。
- 特例:当极限是常数时,两种收敛等价
\(X_n\xrightarrow{d}c \iff X_n\xrightarrow{P}c\)
- 证明($\Rightarrow$):若分布收敛到常数 $c$,说明所有的概率质量都集中到了点 $c$ 附近。对任意 $\varepsilon>0$,取 $x_1=c-\varepsilon$、$x_2=c+\varepsilon$(均为 $F_c$ 的连续点),有:
1.4 连续映射定理
如果一个序列收敛,把它套进一个连续函数里,收敛性保持不变。
连续映射定理(Continuous Mapping Theorem):设函数 $g:\mathbb{R}^d\to\mathbb{R}^s$ 在集合 $D$ 上连续,且极限随机变量落在 $D$ 上的概率为 1(即 $P(X\in D)=1$),则:
- $X_n\xrightarrow{d}X \implies g(X_n)\xrightarrow{d}g(X)$
- $X_n\xrightarrow{P}X \implies g(X_n)\xrightarrow{P}g(X)$
证明思路:对任意有界连续函数 $h$,复合函数 $h\circ g$ 依然有界连续,因此 $\mathbb{E}[h(g(X_n))] = \mathbb{E}[(h\circ g)(X_n)] \to \mathbb{E}[(h\circ g)(X)] = \mathbb{E}[h(g(X))]$。
说明:定理不要求 $g$ 处处连续,只要求在极限 $X$ 的支撑集上连续即可。例如 $g(x)=1/x$ 在 $x=0$ 处间断,但只要极限常数 $c \neq 0$(即 $P(X=0)=0$),若 $X_n\xrightarrow{P}c$,则依然可以直接得出 $1/X_n\xrightarrow{P}1/c$。
2. Slutsky定理
2.1 为什么需要 Slutsky 定理?
在微积分中,极限的四则运算是理所当然的。但在概率论中,如果 $X_n\xrightarrow{d}X$ 且 $Y_n\xrightarrow{d}Y$,通常推不出 $X_n+Y_n\xrightarrow{d}X+Y$! 因为我们不知道 $X_n$ 和 $Y_n$ 之间的相关性(除非已知它们独立,或者联合收敛)。
Slutsky 定理指出:当样本量很大时,一个趋近于常数 $c$ 的随机变量,在四则运算里可以直接被当成常数 $c$ 来用。
定理陈述(Slutsky定理):设 $X_n\xrightarrow{d}X$,$Y_n\xrightarrow{P}c$,其中 $c$ 为常数($X_n,Y_n$ 可任意相依),则: \(\boxed{\begin{aligned} 1.\quad &X_n+Y_n \xrightarrow{d} X+c\\ 2.\quad &X_nY_n \xrightarrow{d} cX\\ 3.\quad &\frac{X_n}{Y_n}\xrightarrow{d}\frac{X}{c}\quad (c\neq 0) \end{aligned}}\)
2.2 定理证明
证明思路:当 $Y_n$ 收敛到常数 $c$ 时,$Y_n$ 的随机性消失了,它无法再与 $X_n$ 产生复杂的尾部联动。因此,我们只需:
- 第一步:证明联合收敛 $(X_n,Y_n)\xrightarrow{d}(X,c)$。
- 第二步:对二维向量 $(X_n, Y_n)$ 应用连续映射定理(因为加、减、乘、除都是二元连续函数)。
证明: 第一步(证联合收敛): 由 $X_n\xrightarrow{d}X$ 知序列 ${X_n}$ 是一致紧(tight)的,即质量不会逃逸到无穷远:对任意 $\eta>0$,存在足够大的正数 $M$,使得对所有 $n$ 都有 $\sup_n P(\vert X_n\vert >M)<\eta$。
任取二元有界连续函数 $h:\mathbb{R}^2\to\mathbb{R}$,我们要证 $\mathbb{E}h(X_n,Y_n)\to\mathbb{E}h(X,c)$。利用三角不等式拆分为两项:
\[\left\vert \mathbb{E}h(X_n,Y_n)-\mathbb{E}h(X,c)\right\vert \leq \underbrace{\mathbb{E}\left[\left\vert h(X_n,Y_n)-h(X_n,c)\right\vert \right]}_{\text{I: 将 } Y_n \text{ 替换为 } c \text{ 的代价}} + \underbrace{\left\vert \mathbb{E}h(X_n,c)-\mathbb{E}h(X,c)\right\vert }_{\text{II: 一元分布收敛}}\]- 对于第 II 项:固定 $c$ 后,$x\mapsto h(x,c)$ 是一元有界连续函数,由 $X_n\xrightarrow{d}X$ 知当 $n\to\infty$ 时第 II 项趋于 $0$。
- 对于第 I 项:固定 $M,\varepsilon>0$,构造“好事件”集合 $A_n={\vert X_n\vert \leq M}\cap{\vert Y_n-c\vert \leq\varepsilon}$。
- 在集合 $A_n$ 内部,$(X_n, Y_n)$ 被限制在有界闭矩形 $[-M,M]\times[c-\varepsilon,c+\varepsilon]$ 内。由于连续函数在紧集上一致连续,当 $\varepsilon$ 很小时,$\vert h(X_n,Y_n)-h(X_n,c)\vert $ 存在微小上界 $\delta(M,\varepsilon)$(随 $\varepsilon\to 0$ 而趋于 $0$)。
- 在集合 $A_n^c$(坏事件)上,函数差被 $2\vert \vert h\vert \vert _\infty$ 控制,且坏事件发生的概率极小: \(\limsup_{n\to\infty} P\left(A_n^c\right)\leq \sup_n P(\vert X_n\vert >M)+\lim_{n\to\infty} P(\vert Y_n-c\vert >\varepsilon)\leq \eta + 0 = \eta\)
- 综合可得:$\limsup_n \text{第 I 项} \leq \delta(M,\varepsilon)+2\vert \vert h\vert \vert _\infty\eta$。先令 $\varepsilon\to0$,再令 $M\to\infty$(即 $\eta\to0$),第 I 项亦趋于 $0$。
由 Portmanteau 定理,联合收敛 $(X_n,Y_n)\xrightarrow{d}(X,c)$ 得证。
第二步(应用连续映射): 映射 $(x,y)\mapsto x+y$ 与 $(x,y)\mapsto xy$ 在 $\mathbb{R}^2$ 上处处连续;对于除法,映射 $(x,y)\mapsto x/y$ 在极限点 $(X,c)$ 处连续(因为 $c\neq 0$)。直接应用 1.4 节的连续映射定理,三条结论全部得证。$\blacksquare$
2.3 应用:未知参数的“Plug-in(代入)”合法性
在中心极限定理中,$\frac{\sqrt{n}(\bar{X}_n-\mu)}{\sigma}\xrightarrow{d} N(0,1)$。但在实际做置信区间或假设检验时,总体标准差 $\sigma$ 是未知的,我们只能用样本标准差 $S_n = \sqrt{\frac{1}{n-1}\sum(X_i-\bar{X}_n)^2}$ 强行代入(Plug-in)。
为什么把常数 $\sigma$ 换成随机变量 $S_n$ 后,极限依然是标准正态分布? 因为样本方差是相合估计量($S_n^2\xrightarrow{P}\sigma^2$),由连续映射定理知 $\frac{\sigma}{S_n}\xrightarrow{P}1$。于是:
\[t_n = \frac{\sqrt{n}\left(\bar{X}_n-\mu\right)}{S_n} = \underbrace{\frac{\sqrt{n}(\bar{X}_n-\mu)}{\sigma}}_{\xrightarrow{d} N(0,1)} \cdot \underbrace{\frac{\sigma}{S_n}}_{\xrightarrow{P} 1} \xrightarrow{d} N(0,1)\]这就是为什么当样本量 $n\to\infty$ 时,学生 $t$ 统计量会渐近服从标准正态分布。
一般化法则:任何满足渐近正态性的估计量 \(\sqrt{n}(\hat{\theta}_n-\theta)\xrightarrow{d}N(0,\tau^2)\),只要我们能找到其渐近方差的相合估计量 \(\hat{\tau}_n^2\xrightarrow{P}\tau^2>0\),由 Slutsky 定理就有:
\[\frac{\sqrt{n}\left(\hat{\theta}_n-\theta\right)}{\hat{\tau}_n}\xrightarrow{d}N(0,1)\]从而可以直接构造渐近 $1-\alpha$ 置信区间:\(\hat{\theta}_n\pm z_{\alpha/2}\frac{\hat{\tau}_n}{\sqrt{n}}\)。统计学中绝大多数“代入型(Plug-in)”检验(如两样本不等方差的 Welch $t$ 检验、Wald 检验等)的合法性皆源于此。
如果我们需要对估计量做非线性变换 $g(\hat{\theta}_n)$,由连续映射定理可知 $g(\hat{\theta}_n)\xrightarrow{P}g(\theta)$。但这只是一个退化的常数极限,变换之后的误差波动(渐近方差)变成了多少? 这就需要 Delta 方法。
3. Delta方法
3.1 动机与一元情形
Slutsky 定理处理的是四则运算,而在实际建模中,我们经常对参数做非线性变换:比如对相关系数做 Fisher-$z$ 变换、在逻辑回归中对概率求对数赔率(Log-odds)、或者对均值取倒数。
假设已知估计量满足渐近正态性:
\[\sqrt{n}\left(\hat{\theta}_n-\theta\right)\xrightarrow{d}N\left(0,\tau^2\right)\]我们希望知道变换后的统计量 $\sqrt{n}\left(g(\hat{\theta}_n)-g(\theta)\right)$ 服从什么极限分布。
💡 出发点(以直代曲): 当样本量 $n$ 很大时,$\hat{\theta}_n$ 已经极其贴近真值 $\theta$(距离仅为 $O_p(n^{-1/2})$ 量级)。不管函数 $g(x)$ 在全局上多么弯曲复杂,只要我们在 $\theta$ 附近无限放大,这段曲线看起来就几乎是一条直线(一阶泰勒展开,斜率为导数 $g’(\theta)$)。 而概率论的基本常识告诉我们:正态分布经过线性变换后,依然是正态分布。只不过标准差被放大了 $\vert g’(\theta)\vert $ 倍(方差放大了 $[g’(\theta)]^2$ 倍)。
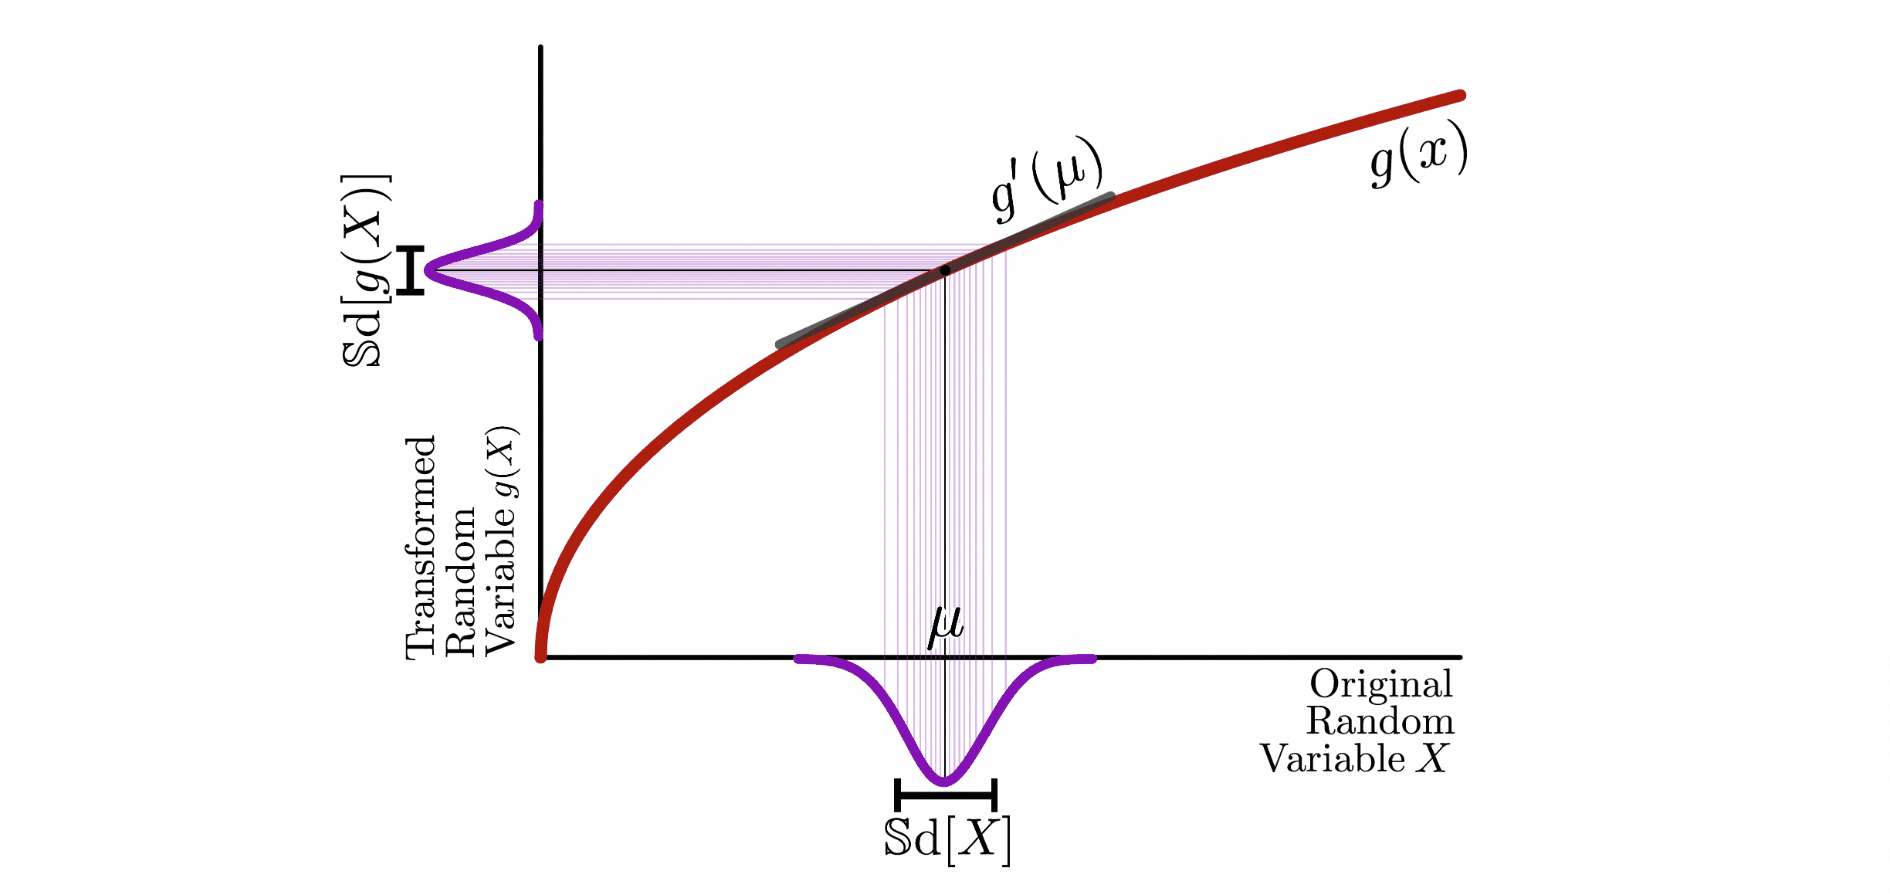
定理(一元 Delta 方法):设函数 $g:\mathbb{R}\to\mathbb{R}$ 在点 $\theta$ 处可导,且导数 $g’(\theta)\neq 0$。若 $\sqrt{n}(\hat{\theta}_n-\theta)\xrightarrow{d}N(0,\tau^2)$,则:
\[\boxed{\sqrt{n}\left(g(\hat{\theta}_n)-g(\theta)\right)\xrightarrow{d}N\left(0,\ \tau^2\left[g'(\theta)\right]^2\right)}\]证明: 将 $g(\hat{\theta}_n)$ 在真值 $\theta$ 处进行一阶 Taylor 展开(采用 Lagrange 余项形式):存在介于 $\hat{\theta}_n$ 与 $\theta$ 之间的随机点 $\theta_n^{*}$,使得
\[g(\hat{\theta}_n)-g(\theta) = g'(\theta_n^{*})\left(\hat{\theta}_n-\theta\right)\]两边同乘以 $\sqrt{n}$:
\[\sqrt{n}\left(g(\hat{\theta}_n)-g(\theta)\right) = g'(\theta_n^{*})\cdot\left[\sqrt{n}\left(\hat{\theta}_n-\theta\right)\right]\]- 因为 $\sqrt{n}(\hat{\theta}_n-\theta)$ 依分布收敛,所以 $\hat{\theta}_n - \theta = \frac{1}{\sqrt{n}}\cdot O_p(1) \xrightarrow{P} 0$,即 $\hat{\theta}_n\xrightarrow{P}\theta$。
- 由于 $\theta_n^{*}$ 被夹在 $\hat{\theta}_n$ 与 $\theta$ 之间,由夹逼性可知 $\theta_n^{*}\xrightarrow{P}\theta$。
- 由导函数在 $\theta$ 处的连续性及连续映射定理,可得系数项依概率收敛到常数:$g’(\theta_n^{*})\xrightarrow{P}g’(\theta)$。
现在,式子右侧变成了一个“依概率收敛到常数的项”乘以一个“依分布收敛到正态的项”。直接调用 Slutsky 定理的乘法法则:
\[g'(\theta_n^{*})\cdot\sqrt{n}\left(\hat{\theta}_n-\theta\right)\xrightarrow{d}g'(\theta)\cdot N\left(0,\tau^2\right) = N\left(0,\ \tau^2 [g'(\theta)]^2\right) \quad \blacksquare\]🌰 经典算例:抛硬币算赔率(Odds)
设硬币正面朝上的真实概率为 $p\in(0,1)$,抛 $n$ 次后正面的样本比例为 $\hat{p}_n$。由中心极限定理知: \(\sqrt{n}(\hat{p}_n - p) \xrightarrow{d} N\big(0, \, p(1-p)\big)\) 在生物统计或博彩中,我们更关心“赔率” $\text{Odds} = g(p) = \frac{p}{1-p}$。如果我们用 $\frac{\hat{p}_n}{1-\hat{p}_n}$ 去估计真赔率,它的渐近分布是什么?
- 求导数:$g’(p) = \left(\frac{p}{1-p}\right)’ = \frac{1}{(1-p)^2}$。
- 算新方差:$\tau^2 [g’(p)]^2 = p(1-p) \cdot \left[\frac{1}{(1-p)^2}\right]^2 = \frac{p}{(1-p)^3}$。
- 得结论:由一元 Delta 方法,立即得到赔率估计量的渐近正态分布: \(\sqrt{n}\left(\frac{\hat{p}_n}{1-\hat{p}_n} - \frac{p}{1-p}\right) \xrightarrow{d} N\left(0, \, \frac{p}{(1-p)^3}\right)\)
3.2 多元Delta方法
当参数是高维向量时,逻辑完全一致:只需将一元的“导数”替换为多元的“Jacobi 矩阵(梯度)”,将方差的“平方放大”替换为协方差矩阵的“二次型变换”。
定理(多元 Delta 方法):设 $m$ 维随机向量 $\hat{\boldsymbol{\theta}}_n\in\mathbb{R}^m$ 满足渐近多元正态性:
\[\sqrt{n}\left(\hat{\boldsymbol{\theta}}_n-\boldsymbol{\theta}\right)\xrightarrow{d}N_m\left(\mathbf{0},\ \boldsymbol{\Sigma}\right)\]其中 $\boldsymbol{\Sigma}\in\mathbb{R}^{m\times m}$ 为半正定协方差矩阵。设映射 $g:\ \mathbb{R}^m\to\mathbb{R}^s$ 在 $\boldsymbol{\theta}$ 的某邻域内连续可微,记其在真值处的 Jacobi 矩阵为 $G=\left.\frac{\partial g}{\partial\boldsymbol{\theta}^{\top}}\right\vert _{\boldsymbol{\theta}}\in\mathbb{R}^{s\times m}$,则:
\[\boxed{\sqrt{n}\left(g(\hat{\boldsymbol{\theta}}_n)-g(\boldsymbol{\theta})\right)\xrightarrow{d}N_s\left(\mathbf{0},\ G\boldsymbol{\Sigma} G^{\top}\right)}\]证明: 对向量函数 $g$ 的每一个分量分别做多元一阶 Taylor 展开,拼成矩阵形式:存在位于 $\hat{\boldsymbol{\theta}}_n$ 与 $\boldsymbol{\theta}$ 连线上的点列,构成矩阵 $G(\boldsymbol{\theta}_n^{*})$,使得:
\[\sqrt{n}\left(g(\hat{\boldsymbol{\theta}}_n)-g(\boldsymbol{\theta})\right)=G\left(\boldsymbol{\theta}_n^{*}\right)\cdot\sqrt{n}\left(\hat{\boldsymbol{\theta}}_n-\boldsymbol{\theta}\right)\]由 $\hat{\boldsymbol{\theta}}_n\xrightarrow{P}\boldsymbol{\theta}$ 及偏导数的连续性,随机矩阵 $G(\boldsymbol{\theta}_n^{*})$ 按元素依概率收敛到常数矩阵 $G$。
为了证明高维向量的依分布收敛,我们使用 Cramér-Wold 定理(即:高维向量依分布收敛 $\iff$ 它在任意方向上的线性投影作为一维随机变量依分布收敛)。 任取固定非零向量 $\mathbf{a}\in\mathbb{R}^s$,考察一维投影:
\[\mathbf{a}^\top \sqrt{n}\left(g(\hat{\boldsymbol{\theta}}_n)-g(\boldsymbol{\theta})\right) = \left[\mathbf{a}^\top G(\boldsymbol{\theta}_n^{*})\right]\cdot \sqrt{n}\left(\hat{\boldsymbol{\theta}}_n-\boldsymbol{\theta}\right)\]由于行向量 $\mathbf{a}^\top G(\boldsymbol{\theta}_n^{*})\xrightarrow{P}\mathbf{a}^\top G$,这本质上是有限个分量的线性组合,系数均依概率收敛到常数。反复应用一元 Slutsky 定理,可得该一维投影的极限分布为:
\[\mathbf{a}^\top G \cdot N_m(\mathbf{0},\boldsymbol{\Sigma}) \sim N\left(0,\ \mathbf{a}^\top (G\boldsymbol{\Sigma} G^\top)\mathbf{a}\right)\]这恰好是多元正态分布 $N_s(\mathbf{0}, G\boldsymbol{\Sigma} G^\top)$ 在 $\mathbf{a}$ 方向上的投影分布。由 Cramér-Wold 定理,原结论成立。$\blacksquare$
3.3 二阶Delta方法:当一阶导数为 0 时怎么办?
一元 Delta 方法要求一个关键前提:$g’(\theta)\neq 0$。 如果恰好碰上极值点,使得 $g’(\theta)=0$,一阶展开项就会彻底消失,套用原公式会得出渐近方差为 $0$ 的退化结果。此时“以直代曲”失效了,必须用抛物线去逼近曲线——即把 Taylor 展开推进到二阶。
定理(二阶 Delta 方法):设 $g$ 在 $\theta$ 处二阶连续可导,且 $g’(\theta)=0$、$g’’(\theta)\neq 0$。若 $\sqrt{n}(\hat{\theta}_n-\theta)\xrightarrow{d}N(0,\tau^2)$,则:
\[\boxed{n\left(g(\hat{\theta}_n)-g(\theta)\right)\xrightarrow{d}\frac{g''(\theta)}{2}\cdot\tau^2\chi_1^2}\]其中 $\chi_1^2$ 为自由度为 1 的卡方分布。
证明: 将 $g(\hat{\theta}_n)$ 在 $\theta$ 处做二阶 Taylor 展开,因一阶项 $g’(\theta)=0$,直接得到:
\[g(\hat{\theta}_n)-g(\theta)=\frac{1}{2}g''(\theta_n^{*})\left(\hat{\theta}_n-\theta\right)^2,\qquad \theta_n^{*}\xrightarrow{P}\theta\]注意由于右边是 $(\hat{\theta}_n-\theta)$ 的平方,为了凑出 $\sqrt{n}(\hat{\theta}_n-\theta)$,需要在等式两边同乘以 $n$:
\[n\left(g(\hat{\theta}_n)-g(\theta)\right)=\frac{g''(\theta_n^{*})}{2}\cdot\left[\sqrt{n}\left(\hat{\theta}_n-\theta\right)\right]^2\]- 方括号内部 $\sqrt{n}(\hat{\theta}_n-\theta)\xrightarrow{d} \tau Z$(其中 $Z\sim N(0,1)$)。由连续映射定理(函数 $x\mapsto x^2$ 连续),其平方项依分布收敛到 $\tau^2 Z^2 = \tau^2\chi_1^2$。
- 前面的系数项由连续映射定理知 $\frac{g’’(\theta_n^{*})}{2}\xrightarrow{P}\frac{g’’(\theta)}{2}$。
- 再次调用 Slutsky 定理,两者相乘即得最终结论。$\blacksquare$
当一阶导数消失、被迫进入二阶展开时,统计量的渐近行为发生了根本性的改变:
- 收敛速度变快(放大尺度从 $\sqrt{n}$ 变为 $n$):因为在极值点附近函数极其平坦,$O_p(n^{-1/2})$ 的参数误差经过平方后缩小到了 $O_p(n^{-1})$ 量级,必须乘以 $n$ 才能看到非退化的波动。
- 分布形状改变(从正态分布变为卡方分布):线性变换保持正态性,但二次型变换(平方)会把正态分布折叠成单侧有界的卡方分布 $\chi_1^2$。
- 估计产生渐近偏误(均值不再为 0):正态分布均值为 0,但 $\chi_1^2$ 的期望是 $1$。这意味着 $g(\hat{\theta}_n)$ 总是倾向于落在 $g(\theta)$ 的单侧(取决于凹凸性 $g’’(\theta)$ 的正负),在大样本下呈现出系统性的二阶渐近偏误。