Survival Analysis and Cox Proportional-Hazards Model.
1. 生存分析
在医学研究、可靠性工程、精算科学等众多领域,我们常常需要分析从某个起始时间点到某个特定“事件”发生所经历的时间长度。这种类型的数据被称为生存数据(Survival Data)或事件时间数据(Time-to-Event Data),而研究和建模这类数据的方法则被称为生存分析(Survival Analysis)。
1.1 生存时间 (Survival Time) 与事件 (Event)
生存时间 (T)是一个非负的随机变量,表示从一个明确定义的起始点(如疾病诊断、手术开始)到终点事件发生所经过的时间。
事件 (Event)是我们感兴趣的终点,例如死亡、疾病复发、设备故障等。对于每个观测个体$i$,我们记录两个量:观测时间$T_i$和删失指示变量 $\delta_i \in {0,1}$,其中$\delta_i=1$表示在$T_i$时刻确实观测到了事件(非删失),$\delta_i=0$表示在$T_i$时刻未观测到事件而被删失。
1.2 删失 (Censoring)
删失是生存分析区别于标准回归分析的一个核心特征。它指的是我们未能观察到个体的确切事件时间。由于生存数据的特殊性,有时候很难获取对象完整的生存时间,此时数据的标注信息往往是不完整的。
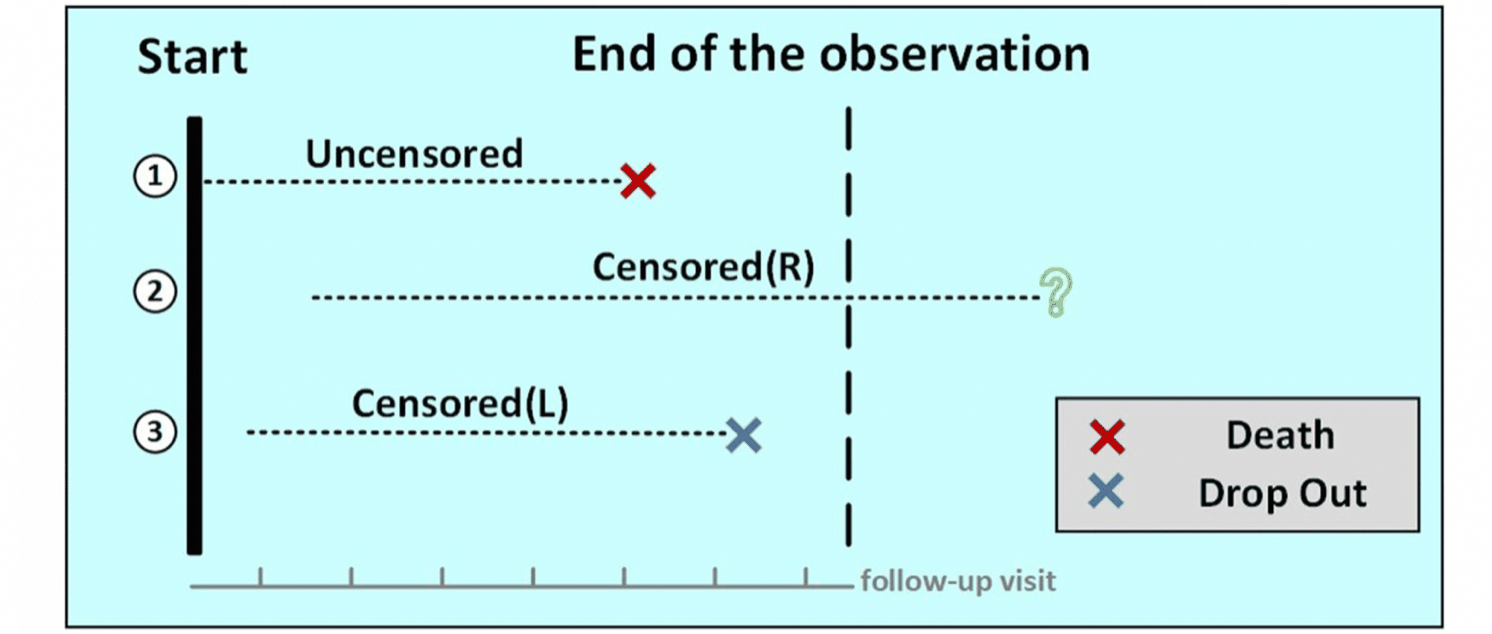
对一组实验,从患者的确诊时间开始观测,每隔一定的时间进行一次随访,直到实验的观测结束。删失主要有三种类型:
- 右删失(Right Censoring):最常见的一种。实验结束时患者仍然存活,或者在随访过程中失去联系,导致我们只知道该个体的生存时间大于其最后的观测时间,但不知道确切的事件时间。
- 左删失(Left Censoring):事件在观测开始之前就已经发生了,我们只知道该个体的事件时间小于某个已知时间。例如,在一项检测疾病感染的研究中,患者入组时已经被感染,无法确定最初的感染时刻。
- 区间删失(Interval Censoring):我们只知道事件发生在两次随访之间的某个区间$(t_L, t_R)$内,但不知道确切时间。例如,上一次随访时患者健康,下一次随访时发现疾病复发。
在Cox模型的标准框架中,我们通常假设删失是右删失且删失机制与事件独立。
1.3 生存函数 (Survival Function)
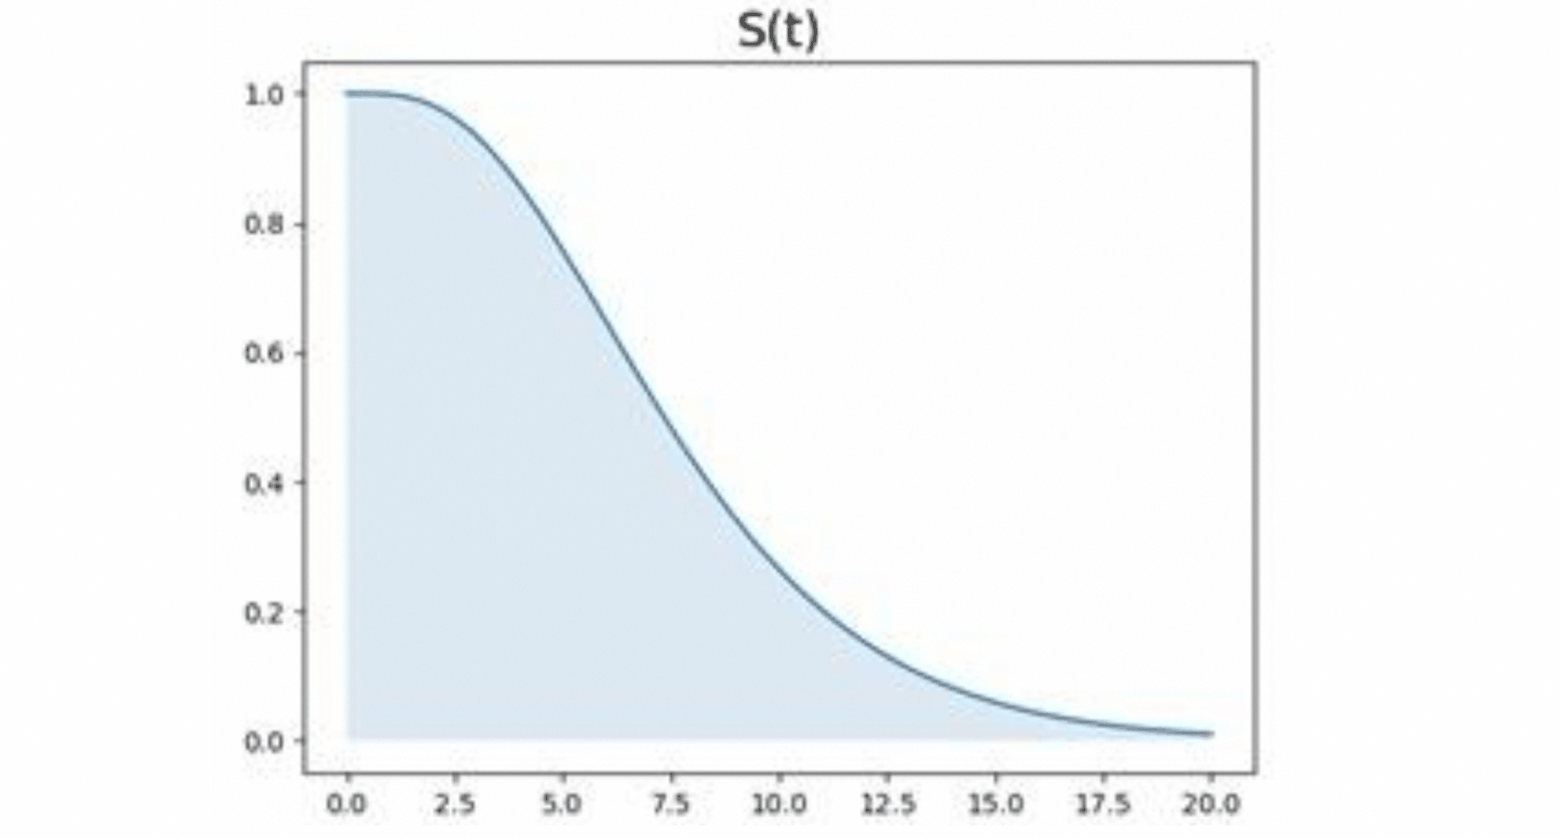
生存函数 $S(t)$,定义为个体生存时间$T$超过某个特定时间点$t$的概率:
\[S(t) = P(T > t) = \int_{t}^{\infty} f(u) \, du = 1-F(t)\]其中$f$是概率密度函数,$F$是分布函数。$S(t)$是一个非增单调函数,其值域为$[0, 1]$,且$S(0)=1$。在标准假设下$\lim_{t\to\infty}S(t)=0$(即事件迟早会发生);但在”治愈率模型”等特殊框架下,部分个体可能永远不会经历事件,此时$S(\infty)>0$。$S(t)$直观地描绘了随着时间的推移,群体中存活个体的比例。
1.4 风险函数 (Hazard Function)
风险函数(Hazard Function),也称为风险率(Hazard Rate)或瞬时失效率(Instantaneous Failure Rate),记作$h(t)$。它描述了在时间$t$存活的个体,在下一个极小时间间隔$[t, t+\Delta t)$内发生事件的瞬时概率。其数学定义为:
\[h(t) = \lim_{\Delta t \to 0} \frac{P(t \le T < t + \Delta t | T \ge t)}{\Delta t}\]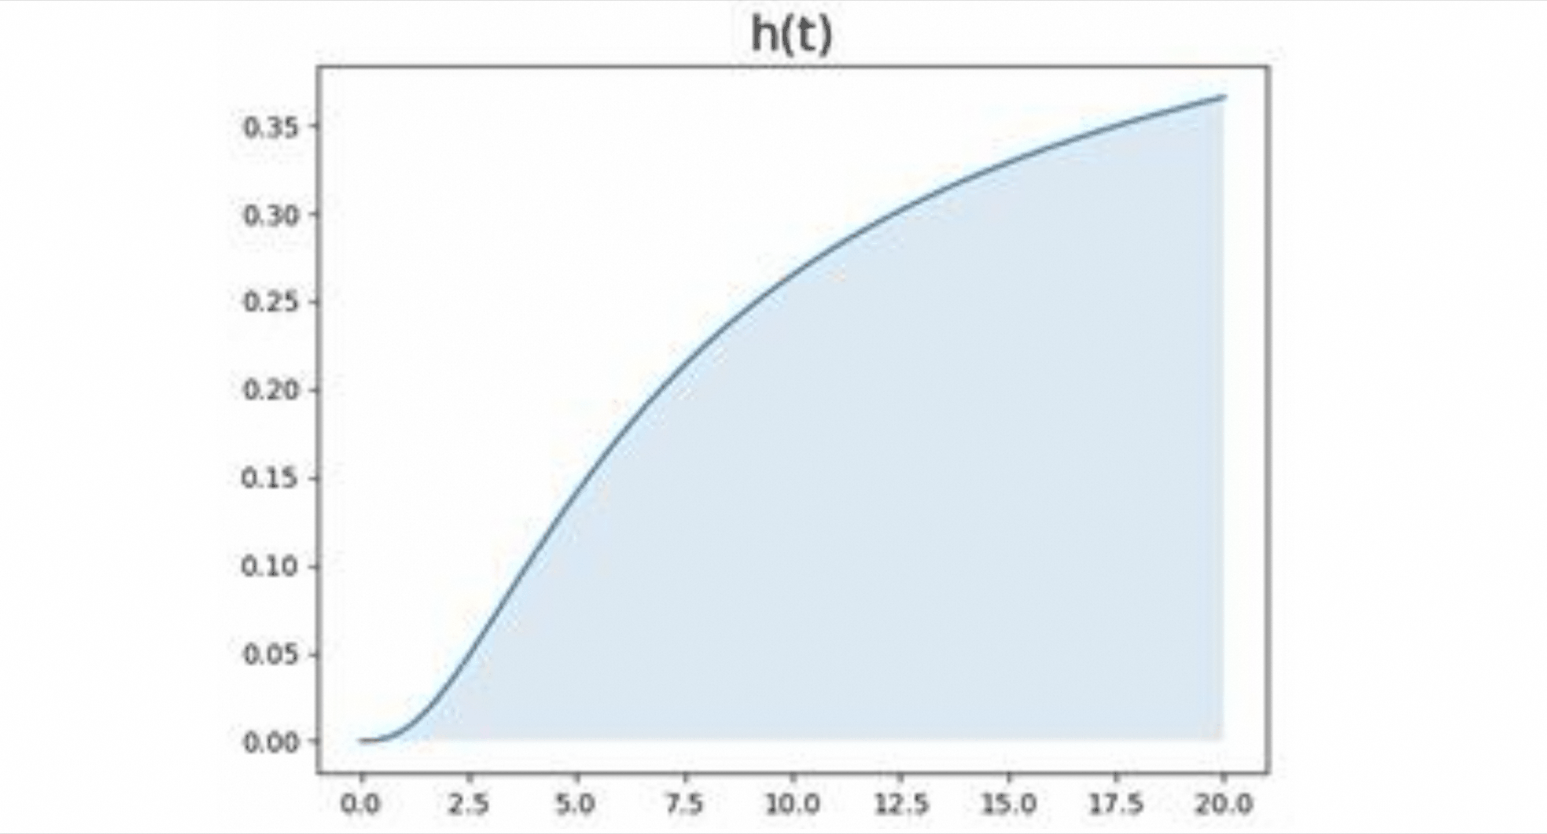
风险函数$h(t)$(描述了在t时刻发生事件的“瞬时风险”)与生存函数$S(t)$(描述了“到t时刻还未发生事件”的累积概率)之间存在着密切的数学关系。令$f(t)$为生存时间的概率密度函数,则风险函数等价于概率密度函数除以生存函数:
\[\begin{aligned} h(t) &= \lim_{\Delta t \to 0} \frac{P(t \le T < t + \Delta t | T \ge t)}{\Delta t} \\ &= \lim_{\Delta t \to 0} \frac{P(t \le T < t + \Delta t)}{P(T \ge t)\Delta t} \\ &= \lim_{\Delta t \to 0} \frac{\int_{t}^{t+\Delta t} f(u) \, du}{S(t)\Delta t} \\ &= \lim_{\Delta t \to 0} \frac{f(\xi) \Delta t}{S(t)\Delta t}, \xi \in (t,t+\Delta t) \\ &= \frac{f(t)}{S(t)} \end{aligned}\]由于概率密度函数$f(t) = -S’(t)$(生存函数的导数取负),代入上式可以得到风险函数的另一个等价形式:
\[h(t) = \frac{-S'(t)}{S(t)} = -\frac{d}{dt}\ln S(t)\]这一表达式揭示了风险函数与生存函数之间的微分关系。对两边从$0$到$t$积分,定义累积风险函数(Cumulative Hazard Function)$H(t)$:
\[H(t) = \int_0^t h(u)\,du = -\ln S(t)\]因此,生存函数与累积风险函数之间具有指数关系:
\[\boxed{S(t) = \exp\left(-H(t)\right) = \exp\left(-\int_0^t h(u)\,du\right)}\]这个关系表明,只要知道风险函数$h(t)$,就可以通过积分得到完整的生存曲线$S(t)$。这也是Cox模型能够从风险函数出发进行预测的理论基础。
2. Cox比例风险模型
1972年,英国统计学家David R. Cox提出了一种半参数回归模型,它能够在不预设基准风险函数具体形式的情况下,评估多个协变量(covariates)对生存风险的影响。这个模型就是Cox比例风险模型。Cox模型是统计学史上引用最高的文章之一。
2.1 模型定义
Cox模型的核心思想是将风险函数$h(t)$分解为两个部分:一个与时间相关但与个体病例无关的基准风险函数(baseline hazard function)$h_0(t)$,和一个与时间无关、仅与患者特征有关、依赖于一组协变量$X = (X_1, X_2, …, X_p)$的比例系数。
对于一个具有协变量向量$X$的个体,其在时间$t$的风险函数$h(t|X)$被建模为:
\[\boxed{h(t|X) = h_0(t) \exp\left(\sum_{i=1}^{p} \beta_i X_i\right) = h_0(t) \exp(\beta^T X)}\]- $h_0(t)$:基准风险函数。它代表了当所有协变量$X_i$都为0时,个体的风险函数。它是一个任意的、非负的时变函数,其形式无需预先指定,这是Cox模型被称为半参数模型(semi-parametric model)的原因。
- $\exp(\beta^T X)$:非时变的风险比例部分。它描述了协变量$X$如何以乘法的方式调整基准风险。$\beta = (\beta_1, \beta_2, …, \beta_p)$是回归系数向量,是模型需要估计的参数。
2.2 比例风险假设 (Proportional Hazards Assumption)
Cox模型之所以被称为“比例风险”模型,是因为它基于一个核心假设:任意两个不同个体之间的风险比(Hazard Ratio, HR)是一个不随时间变化的常数。
考虑两个具有不同协变量向量$X_1$和$X_2$的个体,它们在时间$t$的风险比为:
\[\boxed{\frac{h(t|X_1)}{h(t|X_2)} = \frac{h_0(t) \exp(\beta^T X_1)}{h_0(t) \exp(\beta^T X_2)} = \exp[\beta^T (X_1 - X_2)]}\]可以看到,基准风险函数$h_0(t)$被消去了,风险比仅依赖于协变量的差异,与时间$t$无关。这就是比例风险假设。这个假设是Cox模型有效性的基石,在应用模型后需要对其进行检验。
2.3 回归系数$\beta$的解释
在Cox模型中,系数$\beta_i$的解释是基于风险比(Hazard Ratio, HR)的。考虑一个协变量$X_i$,当其值增加一个单位,而其他协变量保持不变时,新的风险与原始风险之比为:
\[\boxed{HR = \frac{h(t|X_i+1, ...)}{h(t|X_i, ...)} = \frac{h_0(t)\exp(\beta_i(X_i+1) + ...)}{h_0(t)\exp(\beta_i X_i + ...)} = \exp(\beta_i)}\]因此:
- 如果$\beta_i > 0$,则$\exp(\beta_i) > 1$,$X_i$是一个风险因素,其值的增加会导致事件发生的风险增加。
- 如果$\beta_i < 0$,则$\exp(\beta_i) < 1$,$X_i$是一个保护因素,其值的增加会导致事件发生的风险降低。
- 如果$\beta_i = 0$,则$\exp(\beta_i) = 1$,$X_i$对风险没有影响。
$\exp(\beta_i)$即为协变量$X_i$的风险比 (HR)。
3. Cox模型的参数估计:偏似然法
由于基准风险函数$h_0(t)$是未知的,传统的最大似然法无法直接应用。Cox提出了一种称为偏似然法(Partial Likelihood)的方法来估计回归系数$\beta$。
3.1 偏似然函数的构建
偏似然法的核心思想是,不考虑事件发生的具体时间,只考虑在每个事件发生时间点,事件实际发生在特定个体上的条件概率。
假设我们有$n$个个体,其中有$k$个不同的、已观察到的事件发生时间,按升序排列为$t_{(1)} < t_{(2)} < … < t_{(k)}$。 在任意一个事件时间点$t_{(j)}$,假设事件发生在个体$j$上。此时,我们定义一个风险集(Risk Set)$R(t_{(j)})$,它包含了在时间$t_{(j)}$时仍然存活且处于“风险中”的所有个体(包括个体$j$)。
那么,在给定一个事件在时间$t_{(j)}$发生,并且该事件发生在风险集$R(t_{(j)})$中的某一个个体上的条件下,这个事件恰好发生在个体j身上的概率可以表示为:
\[P(\text{事件发生在个体} j | \text{事件在} t_{(j)} \text{发生于} R(t_{(j)})) = \frac{h(t_{(j)}|X_j)}{\sum_{i \in R(t_{(j)})} h(t_{(j)}|X_i)}\]代入Cox模型的定义,我们得到:
\[P= \frac{h_0(t_{(j)}) \exp(\beta^T X_j)}{\sum_{i \in R(t_{(j)})} h_0(t_{(j)}) \exp(\beta^T X_i)} = \frac{\exp(\beta^T X_j)}{\sum_{i \in R(t_{(j)})} \exp(\beta^T X_i)}\]偏似然函数$L(\beta)$就是将所有事件时间点的这种条件概率连乘起来:
\[\boxed{L(\beta) = \prod_{j=1}^{k} \frac{\exp(\beta^T X_j)}{\sum_{i \in R(t_{(j)})} \exp(\beta^T X_i)}}\]下面通过一个患者统计图来解释该目标。$U$表示非删失的患者数据,$S$表示删失的患者数据,$T$表示患者所统计的生存时间或最后存活时间(对删失数据而言)。
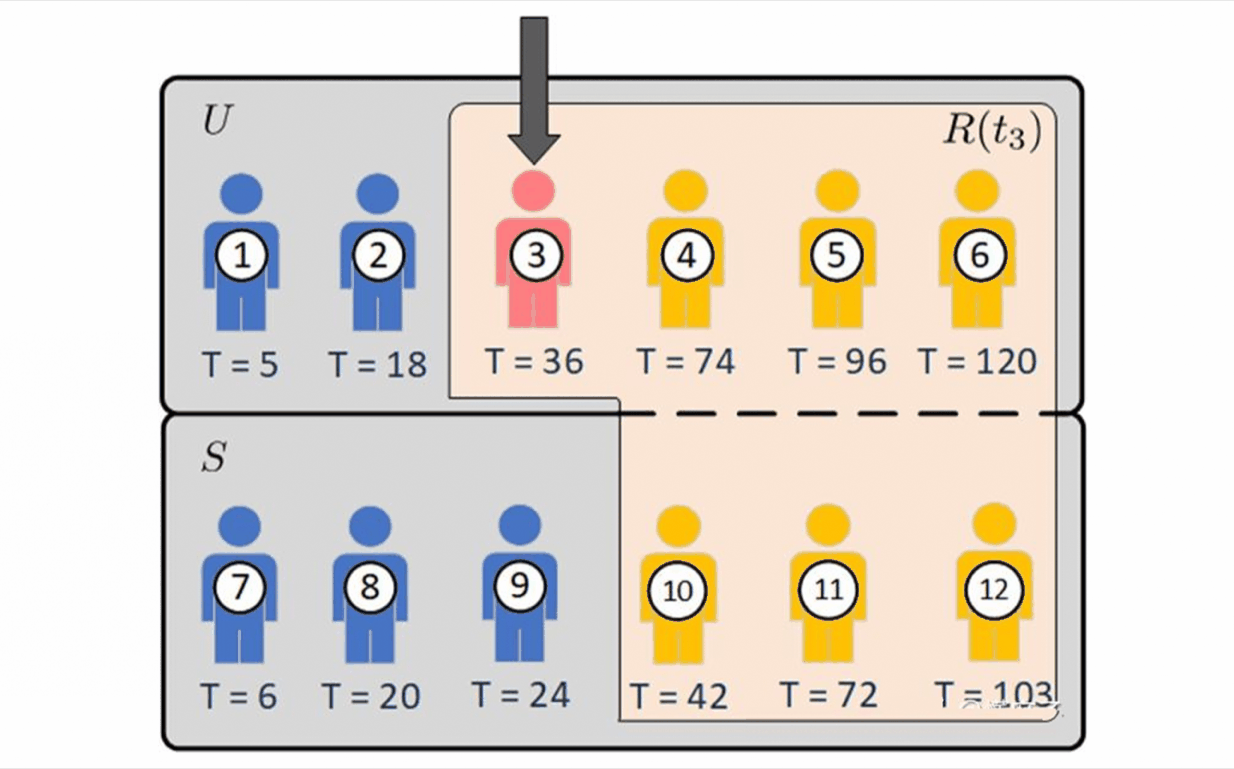
针对患者3建立似然函数时,我们希望患者3在观测统计时刻(T=36)死亡的风险最大,而其余的患者在该时刻死亡的风险最小。对于事件或删失时间小于T=36的患者(患者1在T=5死亡、患者2在T=18死亡、患者7在T=6删失、患者8在T=20删失、患者9在T=24删失)而言,它们在T=36时已不再处于”风险中”。因此,此时$R(t_3)$包括的人群是在T=36时仍然存活且处于观测中的所有个体,即患者3本人以及患者(4、5、6、10、11、12),共7人。注意删失个体在被删失之前也贡献于风险集——它们虽然未观测到事件,但在其最后观测时间点之前确实”处于风险中”。此时最大化该似然函数,即最大化患者3在$R(t_3)$中被选中死亡的概率。
3.2 对数偏似然与参数求解
为了计算方便,通常对偏似然函数取对数,得到对数偏似然函数(Log Partial Likelihood)$LL(\beta)$:
\[LL(\beta) = \sum_{j=1}^{k} \left[ \beta^T X_j - \log\left(\sum_{i \in R(t_{(j)})} \exp(\beta^T X_i)\right) \right]\]现在,估计$\beta$的问题就转化为了一个标准的最优化问题:找到一组$\beta$使得$LL(\beta)$最大化。这可以通过牛顿-拉弗森法(Newton-Raphson method)等数值优化算法来求解。上述目标也被称为Cox Loss。
牛顿-拉弗森法的每一步更新需要计算对数偏似然的一阶导(Score 函数)和二阶导(观测信息矩阵)。Score函数为:
\[U(\beta) = \frac{\partial LL(\beta)}{\partial \beta} = \sum_{j=1}^{k} \left[ X_j - \frac{\sum_{i \in R(t_{(j)})} X_i \exp(\beta^T X_i)}{\sum_{i \in R(t_{(j)})} \exp(\beta^T X_i)} \right]\]直觉上,每一项是”实际发生事件的个体的协变量”减去”风险集中所有个体的协变量的加权平均”,权重正比于$\exp(\beta^T X_i)$。观测信息矩阵为:
\[\begin{aligned} I(\beta) &= -\frac{\partial^2 LL(\beta)}{\partial \beta \partial \beta^T} \\&= \sum_{j=1}^{k} \left[ \frac{\sum_{i \in R(t_{(j)})} X_i X_i^T \exp(\beta^T X_i)}{\sum_{i \in R(t_{(j)})} \exp(\beta^T X_i)} - \bar{X}_j(\beta) \bar{X}_j(\beta)^T \right] \end{aligned}\]其中$\bar{X}_j(\beta)$是风险集内的加权平均协变量。参数更新为$\beta^{(m+1)} = \beta^{(m)} + I(\beta^{(m)})^{-1}U(\beta^{(m)})$。
回归系数$\hat{\beta}$的标准误从信息矩阵获得:$\text{Var}(\hat{\beta}) \approx I(\hat{\beta})^{-1}$,这也是后续Wald检验统计量$(\hat{\beta}_i / SE(\hat{\beta}_i))^2$的理论来源。
Cox(1975)和后续的Andersen & Gill(1982)证明,偏似然函数虽然不是完整的似然,但在一定的正则条件下,其最大化估计量$\hat{\beta}$具有与真实最大似然估计量相同的渐近性质——$\hat{\beta}$是一致的、渐近正态的,且$I(\hat{\beta})$给出了有效的方差估计。
3.3 处理时间并存 (Ties)
在实际数据中,可能会有多个事件在同一时间点发生,这被称为时间并存(Ties)。处理这种情况有多种近似方法,最常用的是Breslow近似和Efron近似。
设在时间$t_{(j)}$有$d_j$个个体同时发生事件,记这组个体集合为$D_j$,其协变量之和为$s_j = \sum_{i \in D_j} X_i$。
Breslow近似假设并存事件的个体在该时刻都处于风险集中,对数偏似然修正为:
\[LL_B(\beta) = \sum_{j=1}^{k} \left[ \beta^T s_j - d_j \log\left(\sum_{i \in R(t_{(j)})} \exp(\beta^T X_i)\right) \right]\]当$d_j=1$时退化为无并存情形的标准偏似然。Breslow近似计算简便,但在并存事件较多时会产生向下的偏差(因为风险集的分母被重复使用了$d_j$次)。
Efron近似对此进行了修正,在分母中逐步移除部分已发生事件的个体风险,对数偏似然为:
\[LL_E(\beta) = \sum_{j=1}^{k} \left[ \beta^T s_j - \sum_{m=0}^{d_j-1} \log\left(\sum_{i \in R(t_{(j)})} \exp(\beta^T X_i) - \frac{m}{d_j}\sum_{i \in D_j} \exp(\beta^T X_i)\right) \right]\]Efron近似在并存比例较高时更加精确,是大多数统计软件(如R的survival包)的默认选项。当$d_j=1$时,两种近似完全一致。
4. 基准风险的估计与生存预测
偏似然法只估计了回归系数$\beta$,而基准风险函数$h_0(t)$仍然未知。为了进行完整的生存预测,我们需要估计基准累积风险函数$H_0(t)$。
4.1 Breslow估计量
Breslow估计量是基准累积风险函数$H_0(t)$的非参数估计,其形式为:
\[\boxed{\hat{H}_0(t) = \sum_{t_{(j)} \le t} \frac{d_j}{\sum_{i \in R(t_{(j)})} \exp(\hat{\beta}^T X_i)}}\]其中$d_j$是在时间$t_{(j)}$发生事件的个体数目。直觉上,$\hat{H}_0(t)$在每个事件时间点上增加一个”跳跃”,跳跃的大小等于该时刻发生的事件数除以风险集中所有个体的加权风险之和。这是对Nelson-Aalen累积风险估计量的推广。
基准生存函数的估计为:
\[\hat{S}_0(t) = \exp\left(-\hat{H}_0(t)\right)\]4.2 个体化生存预测
利用$\hat{S}_0(t)$和估计的系数$\hat{\beta}$,可以对具有任意协变量向量$X$的个体给出生存函数的预测。由$S(t)=\exp(-H(t))$以及Cox模型的乘法结构$h(t|X)=h_0(t)\exp(\beta^T X)$,可以推导出:
\[\boxed{\begin{aligned} S(t|X) &= \exp\left(-\int_0^t h(u|X)\,du\right) \\ &= \exp\left(-\exp(\beta^T X)\int_0^t h_0(u)\,du\right) \\ &= \exp\left(-H_0(t)\exp(\beta^T X)\right) \\ &= \left[S_0(t)\right]^{\exp(\beta^T X)} \end{aligned}}\]代入估计值即可:$\hat{S}(t|X) = \left[\hat{S}_0(t)\right]^{\exp(\hat{\beta}^T X)}$。这表明,协变量对生存曲线的作用是以基准生存函数为底、以$\exp(\beta^T X)$为指数的幂变换:风险比越大($\exp(\beta^T X)>1$),生存曲线下降越快。
5. 模型评估与应用
在构建了Cox模型并估计出参数后,需要对其进行评估和解释。
5.1 模型显著性检验
- 似然比检验 (Likelihood Ratio Test):比较包含所有协变量的全模型与不包含任何协变量的零模型(即所有$\beta_i=0$)的对数偏似然。检验统计量$-2[LL(0) - LL(\hat{\beta})]$近似服从自由度为$p$的$\chi^2$分布,用于评估整个模型的显著性。
- Wald检验 (Wald Test):对单个回归系数$\beta_i$进行显著性检验。检验统计量$(\hat{\beta}_i / SE(\hat{\beta}_i))^2$近似服从自由度为1的$\chi^2$分布,其中$SE(\hat{\beta}_i)$是$\beta_i$的标准误。
- Score检验 (Score Test):在零假设($\beta=0$)下评估对数偏似然函数的一阶导数(score function),计算成本较低。
5.2 模型预测能力的评估
一致性指数 (Concordance Index, C-index) 是评估生存模型预测准确性的最常用指标。它衡量了模型预测的风险排序与实际生存时间排序的一致性。C-index的取值范围为$[0, 1]$:$0.5$表示随机猜测,$>0.5$表示模型的风险排序与实际生存顺序正相关,$1$表示完美预测,而$<0.5$则表明模型的预测与实际相反。它计算的是所有可比较的患者对中,预测风险高的患者比预测风险低的患者更早发生事件的比例。
5.3 比例风险假设的检验
检验比例风险假设是应用Cox模型后必不可少的一步。常用的方法有:
- Schoenfeld残差检验:这是最经典和最常用的方法。其思想是,如果比例风险假设成立,那么Schoenfeld残差应该与时间无关。通过检验残差与时间的(零)相关性,可以判断假设是否被违背。
- 图形法:例如,绘制log-log生存曲线图。如果对于一个分类协变量的不同水平,其log[-log(S(t))] 曲线相互平行,则表明比例风险假设成立。
如果假设不成立,可以考虑使用含时依变协变量的Cox模型(Time-Dependent Covariate Cox Model)或分层Cox模型(Stratified Cox Model)等扩展模型。
5.4 残差诊断
除了检验比例风险假设外,还需要通过残差来评估模型的其他方面:
- 鞅残差(Martingale Residuals):定义为$\hat{M}_i = \delta_i - \hat{H}_0(T_i)\exp(\hat{\beta}^T X_i)$,即”实际发生事件的次数”(0或1)减去”模型预期的累积风险”。将鞅残差对某个协变量作散点图并拟合平滑曲线,可以检测该协变量是否需要进行非线性变换(如取对数、多项式等)。如果曲线偏离零水平线,说明当前的线性假设不合适。
- 偏差残差(Deviance Residuals):是对鞅残差的归一化变换:$\hat{d}_i = \text{sgn}(\hat{M}_i)\left[-2\left(\hat{M}_i + \delta_i \log(\delta_i - \hat{M}_i)\right)\right]^{1/2}$。偏差残差的分布更加对称,适合用来识别离群点和高影响力观测。绝对值较大的偏差残差提示对应个体未被模型很好地拟合。