Network Compression.
深度神经网络通常具有大量参数和计算操作,直接部署到手机、边缘设备或高并发服务时,会受到存储、内存带宽、延迟和能耗限制。网络压缩(network compression)通过删除冗余参数、迁移教师知识、降低数值精度、分解权重或按输入分配计算,在尽量保持任务性能的前提下降低模型成本。
网络压缩并不等同于“模型文件变小”。参数量、位宽、理论计算量和真实延迟分别描述不同资源;一种方法只有被目标硬件、运行时和算子内核支持,理论节省才能转化为实际收益。本文从统一效率指标出发,按照压缩机制讨论经典方法及其在大模型中的演化。
- 压缩目标与效率口径
- 网络剪枝与稀疏化
- 知识蒸馏
- 参数量化与编码
- 低秩分解与结构压缩
- 动态计算与条件计算
1. 压缩目标与效率口径
模型压缩可以减少一种或多种资源,但这些目标并不等价:
- 参数量(parameter count)描述可学习标量的数量;它影响模型体积,却不能直接决定推理速度;
- 模型体积(model size)还取决于参数位宽、稀疏索引、量化码本和元数据;
- MACs/FLOPs估计算术操作数,但不包括访存、内核启动、同步和数据格式转换;
- 峰值内存(peak memory)由权重、激活、工作空间及生成模型的KV Cache共同决定;
- 延迟(latency)描述单个请求耗时,吞吐(throughput)描述单位时间处理量,二者随批量和并发变化;
- 能耗(energy)同时受计算、片外内存访问、设备利用率和散热约束影响。
若第$l$层有$P_l$个参数、平均位宽为$b_l$,模型的静态存储近似为:
\[S_{\text{model}}\approx \sum_l\frac{P_lb_l}{8}+S_{\text{metadata}},\]其中$S_{\text{metadata}}$包括稀疏索引、量化缩放因子和零点等附加信息。压缩率应基于实际字节数:
\[\text{Compression Ratio}= \frac{S_{\text{baseline}}}{S_{\text{compressed}}}.\]生成式大模型还需要区分预填充(prefill)和解码(decode)。预填充并行处理提示,长上下文时计算量较大;解码逐词元读取权重和不断增长的缓存,常受内存带宽约束。因此权重量化、激活量化和缓存量化解决的是不同瓶颈,评估时应分别报告首词元延迟、词间延迟和吞吐。
⭐ 讨论:参数量、FLOPs 与真实延迟为什么不等价
参数量减少主要降低存储与权重读取;FLOPs减少只说明理论算术工作变少。非结构化稀疏需要额外索引,低秩分解把一个大算子拆成两个小算子,动态路由会引入分支与同步,低比特参数也可能在计算前被反量化。若运行时没有对应的稀疏或低比特内核,这些方法甚至可能比原始稠密模型更慢。因此压缩结果必须绑定硬件型号、数据类型、批量、输入形状、推理框架和测量协议。
2. 网络剪枝与稀疏化
网络剪枝(network pruning)通过掩码删除部分连接、通道、层或其他结构。给定参数$W$和二值掩码$M$,剪枝后的权重为:
\[\widetilde{W}=W\odot M,\]典型目标是在稀疏预算$K$下最小化任务损失:
\[\min_{W,M}\mathcal{L}(W\odot M), \qquad \|M\|_0\le K.\]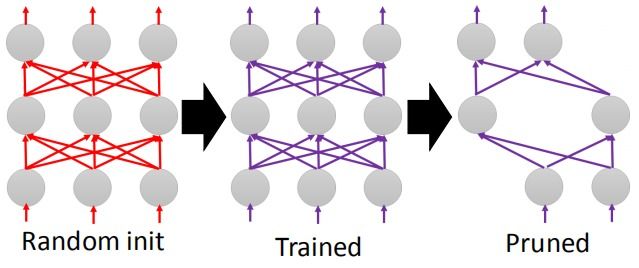
剪枝可以按被删除结构分为三类:
- 非结构化剪枝(unstructured pruning)删除单个权重,精度通常较容易保持,但产生不规则稀疏矩阵;
- 结构化剪枝(structured pruning)删除整个通道、滤波器、注意力头或层,可以直接重建较小的稠密模型;
- 半结构化剪枝(semi-structured pruning)在固定小组内保留规定数量的权重,例如2:4 sparsity,在灵活性和硬件规则性之间折中。
按发生时机又可分为训练后剪枝、训练中逐步剪枝和从头维持固定稀疏度的动态稀疏训练。
(1) 幅值剪枝与结构化剪枝
⚪ Deep Compression:把剪枝、量化与熵编码串成压缩流水线
经典迭代幅值剪枝先训练稠密网络,再删除绝对值低于阈值的连接并重新训练:
\[M_i=\mathbb{I}(|W_i|>\tau).\]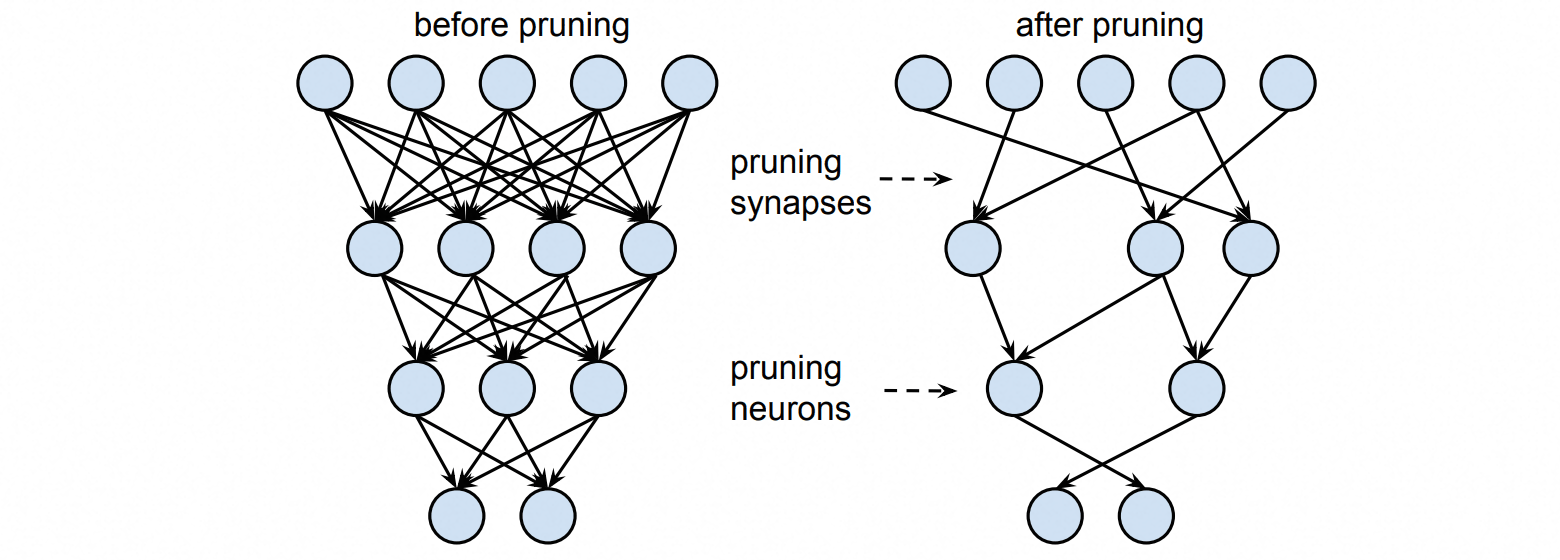
对单个权重,最简单的重要性指标是$|W_i|$。更一般的一阶近似考虑删除权重对损失的影响:
\[s_i^{\text{Taylor}}=\left|W_i\frac{\partial\mathcal{L}}{\partial W_i}\right|.\]早期的Optimal Brain Damage/Surgeon进一步利用二阶曲率估计损失变化;现代一次性大模型剪枝也重新采用局部二阶近似。
删除卷积层的输出通道时,还必须同步删除下一层对应的输入通道,并处理残差分支、归一化层和分组约束。结构化结果更容易在通用硬件上兑现加速,但同样稀疏率下通常比非结构化剪枝损失更多自由度。
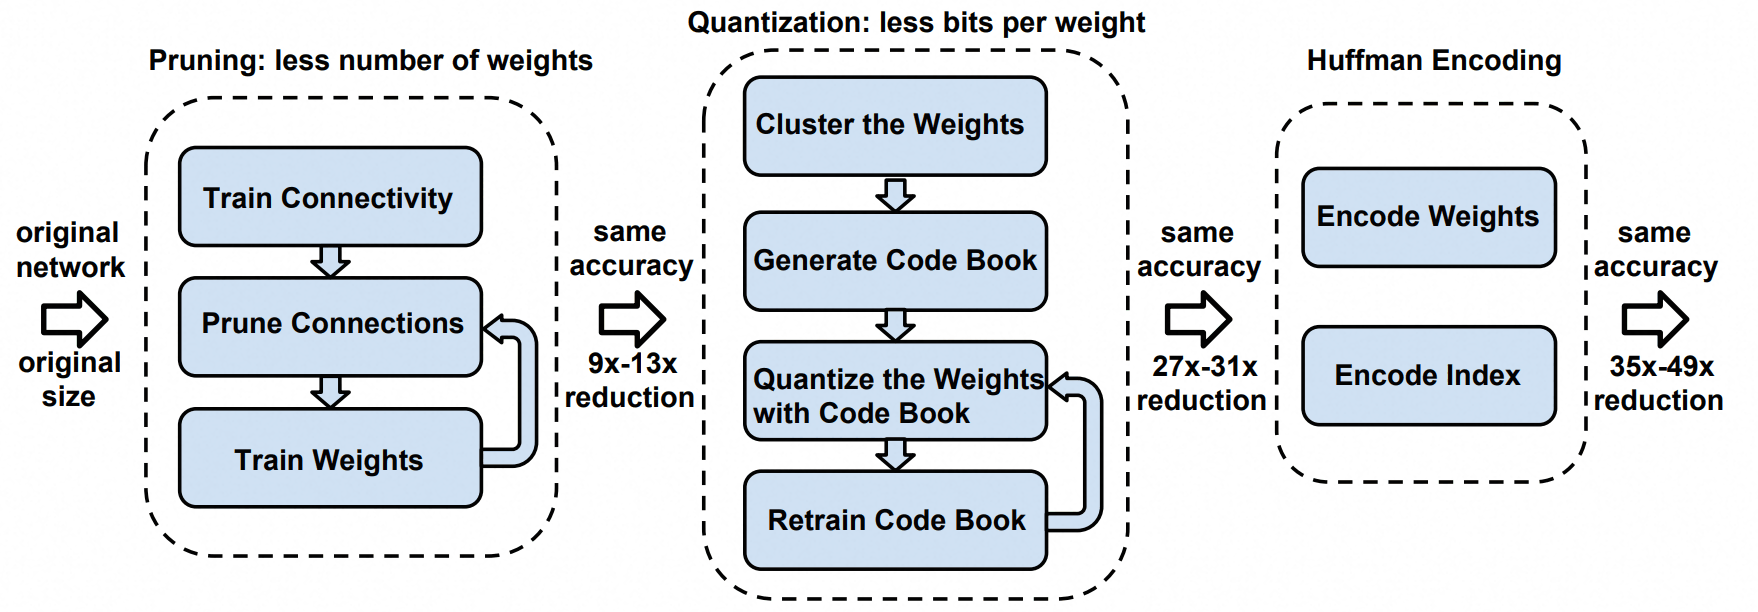
Deep Compression进一步组合连接剪枝、权重聚类/共享和Huffman编码。它显著减少模型存储,但“不规则权重被置零”不等于模型已经加速:若仍调用稠密矩阵乘,零值仍会参与计算;稀疏格式还需存储位置索引,并依赖专用内核和足够高的稀疏度。
⚪ Network Slimming:用归一化缩放因子选择通道
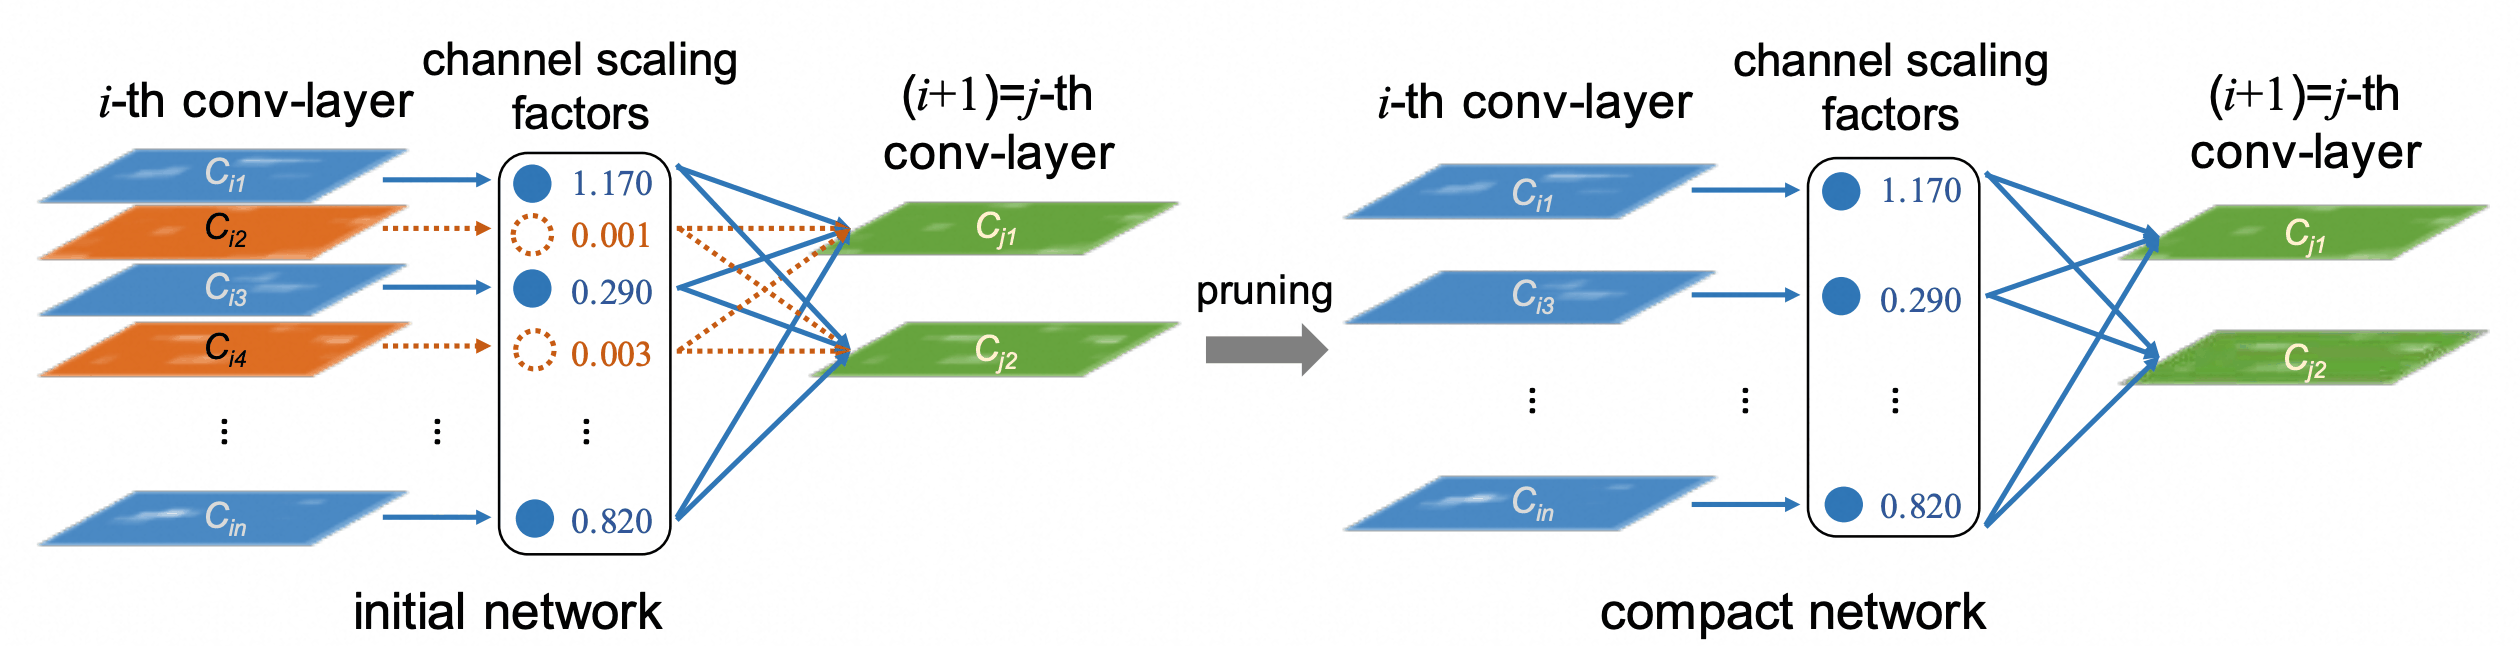
卷积通道常接BatchNorm缩放因子$\gamma_c$。Network Slimming在训练目标中对这些缩放因子加入$L_1$正则:
\[\mathcal{L}=\mathcal{L}_{\text{task}}+ \lambda\sum_c|\gamma_c|.\]训练后删除$|\gamma_c|$较小的通道,再进行微调。这个方法把通道选择嵌入训练过程,得到可直接转成较窄稠密网络的结构。
另一类数据依赖指标是APoZ(Average Percentage of Zeros):统计ReLU后某个神经元在校准数据上的零激活比例。高APoZ表示它很少被激活,可作为剪枝候选。
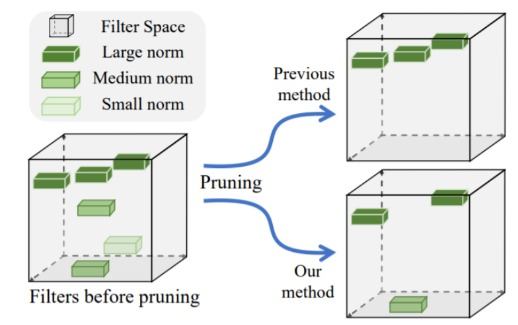
⚪ FPGM:剪除靠近几何中位数的冗余滤波器
只按滤波器范数剪枝默认“小范数即不重要”。FPGM改为寻找最靠近其余滤波器几何中位数的滤波器:
\[i^*=\arg\min_i\sum_j\|F_i-F_j\|_2.\]靠近几何中位数意味着该滤波器更容易由同层其他滤波器近似,因此优先删除它。
(2) 稀疏训练与硬件规则稀疏
⚪ RigL:在固定预算下动态更新稀疏连接
传统剪枝先承担一次完整稠密训练。RigL从稀疏网络开始训练,周期性删除幅值最小的活跃连接,再在当前为零的连接中选择梯度绝对值最大的部分重新生长。非零参数总量近似固定,但连接拓扑随训练变化。
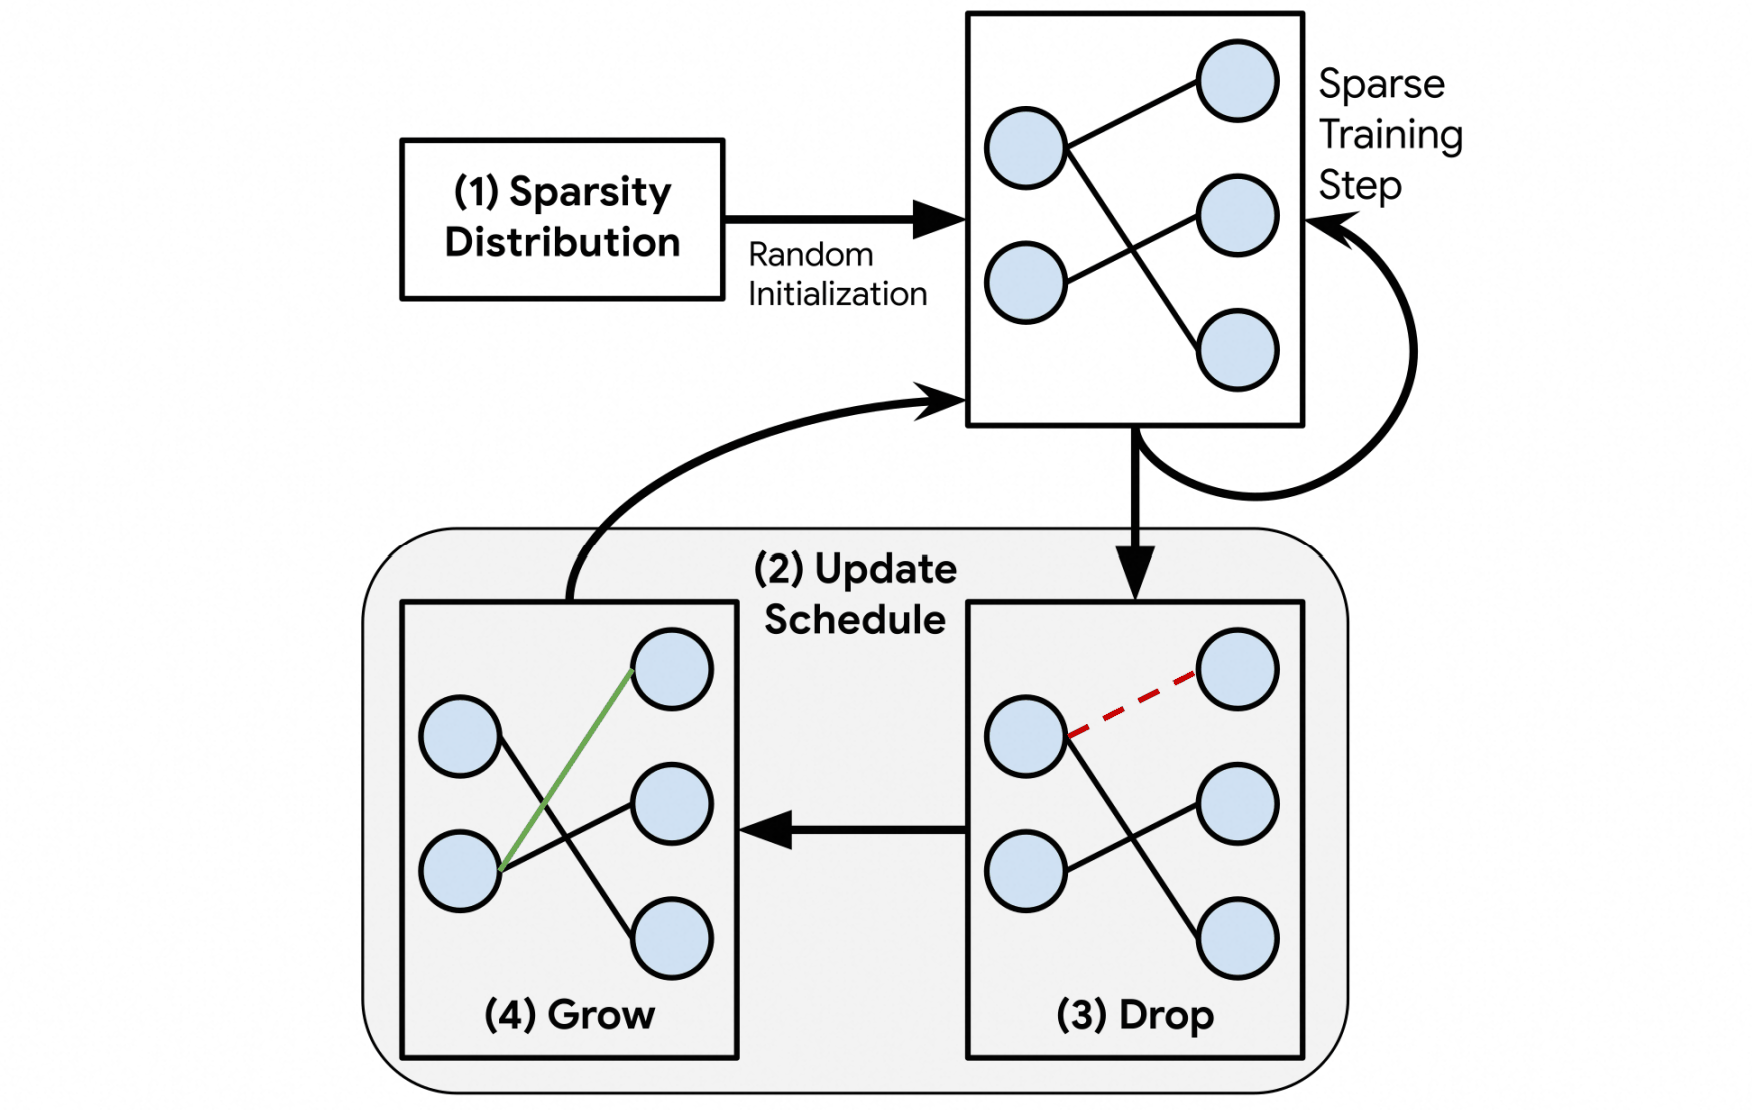
RigL减少的是训练过程中需要保留的连接;只有稀疏前向、反向和优化器内核都得到支持时,理论稀疏训练才会带来端到端收益。用稠密张量保存掩码并执行计算,只会得到算法稀疏而非系统稀疏。
⚪ N:M Sparsity:在固定小组内约束非零权重
N:M稀疏要求每组连续$M$个权重最多保留$N$个非零值。例如2:4模式在每四个权重中保留两个:
\[\|M_{g}\|_0\le N,\qquad |M_g|=M.\]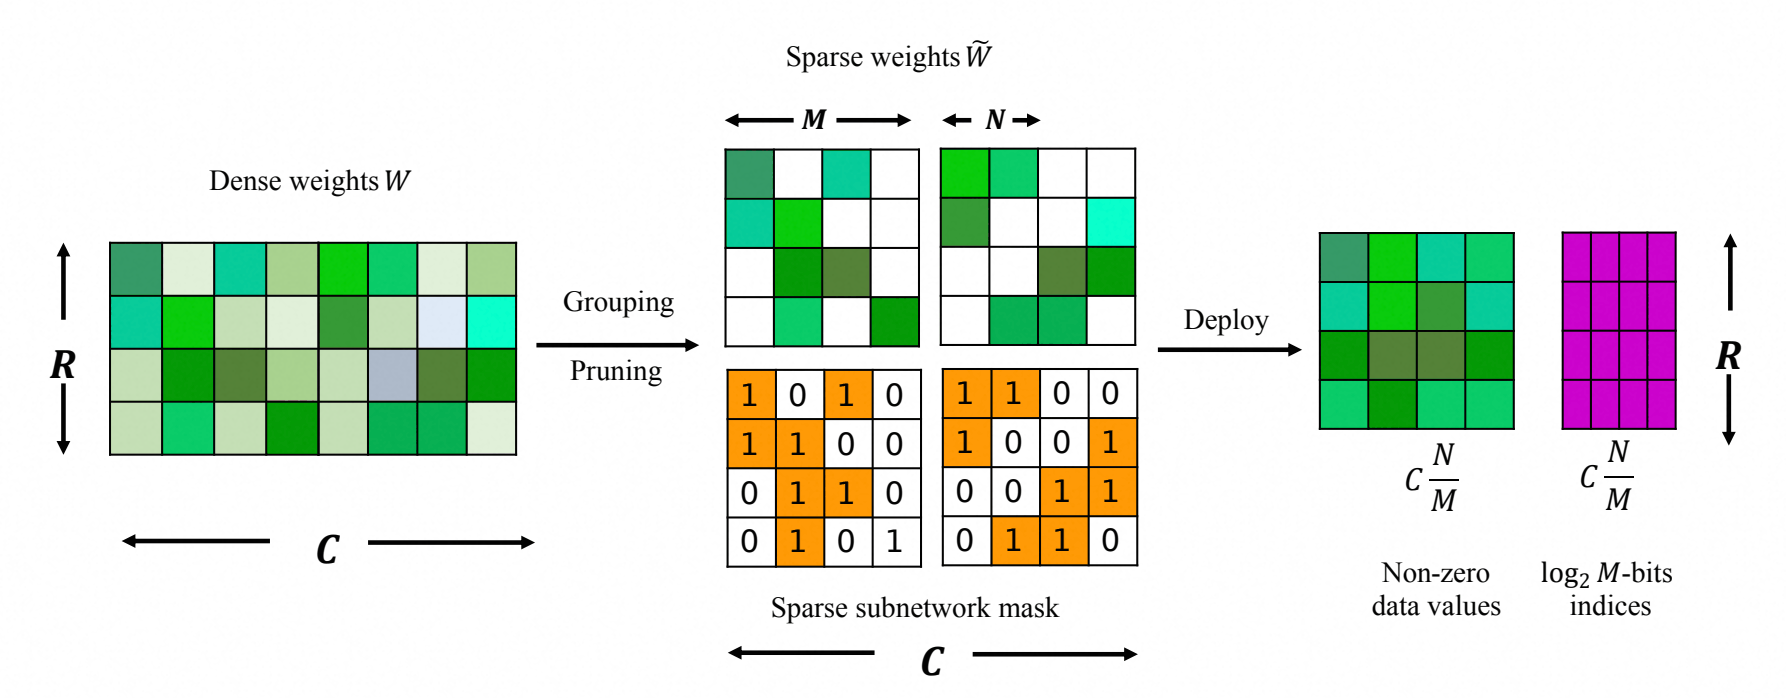
它比任意非结构化稀疏更规则,又比删除整行整列更细粒度。支持对应布局和数据类型的硬件可以跳过被掩蔽乘法;若设备或库不支持该模式,规则掩码仍不会自动加速。
(3) 大模型的一次性剪枝
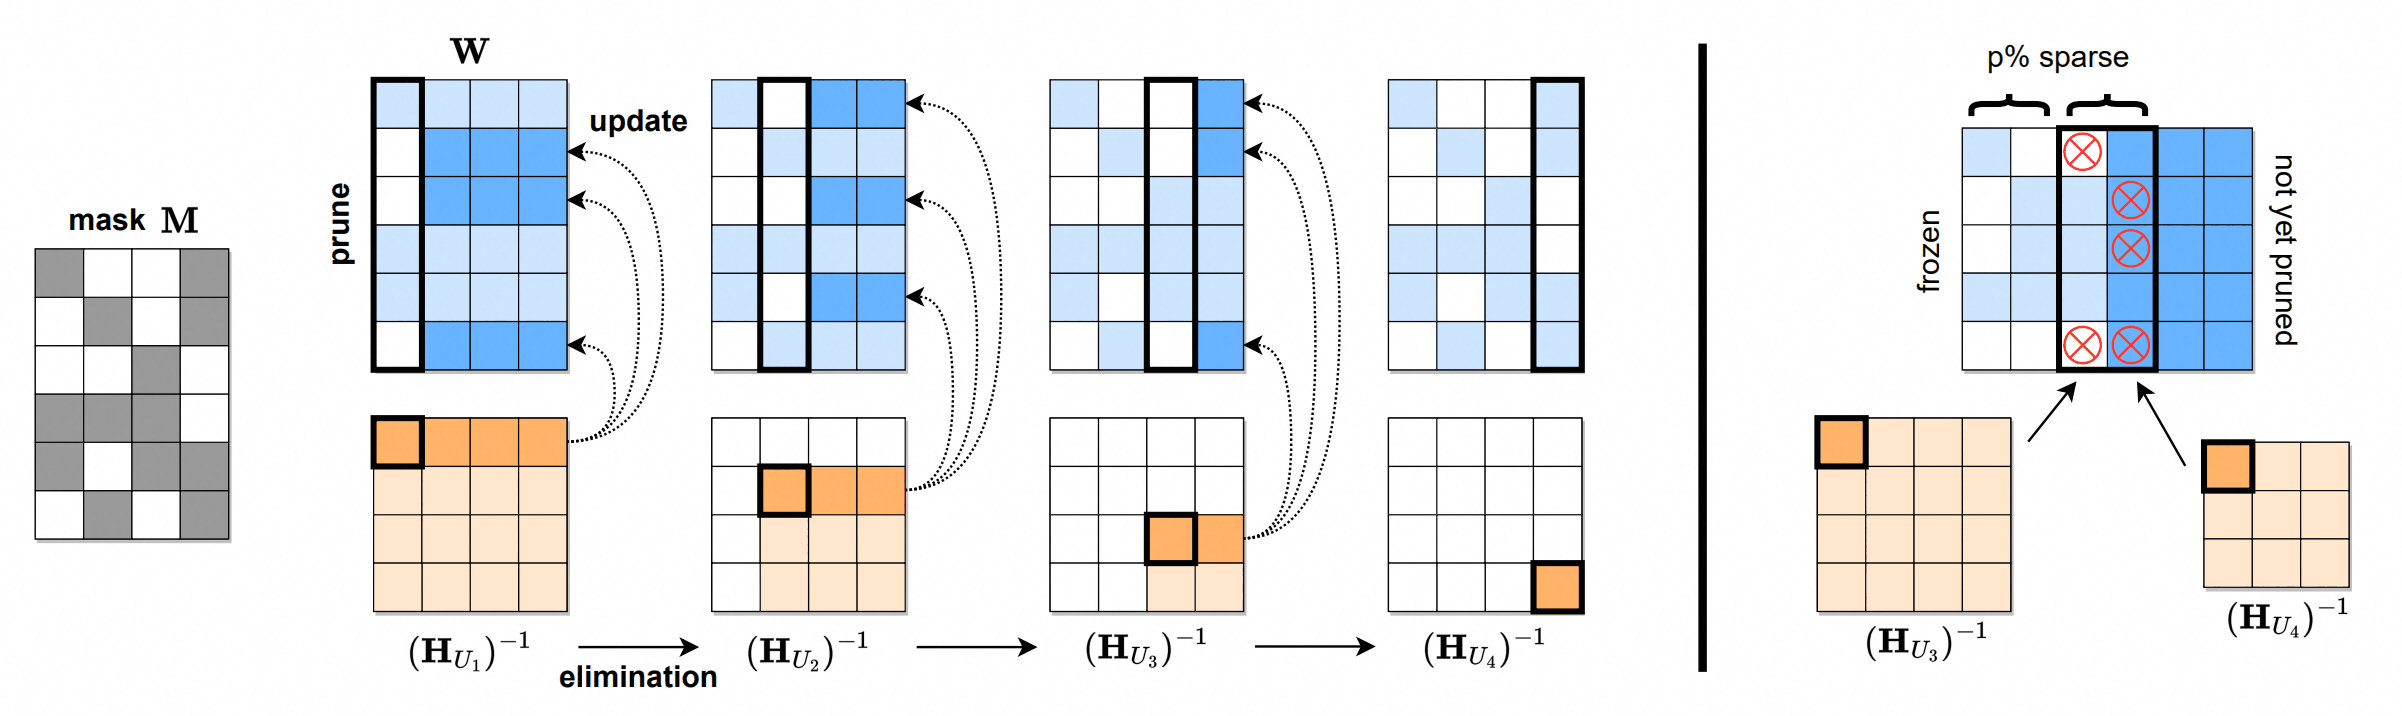
⚪ SparseGPT:用局部二阶补偿完成一次性剪枝
SparseGPT逐层用少量校准输入$X$近似保持原层输出:
\[\min_{\widehat{W}}\|WX-\widehat{W}X\|_F^2, \qquad \|\widehat{W}\|_0\le K.\]如果定义权重改变量为 $\Delta w = \hat{w} - w$,那么目标就是最小化:
\[\| -\Delta w X \|_2^2 = (\Delta w X)(\Delta w X)^\top = \Delta w (XX^\top) \Delta w^\top\]矩阵 $\mathbf{H} = XX^\top$ 是输入的Hessian矩阵。它是一个对称矩阵,捕捉了所有输入特征之间的二阶相关性。误差函数变成了一个关于 $\Delta w$ 的简洁二次型 $\Delta w \mathbf{H} \Delta w^\top$。
在贪心剪枝的每一步,都将权重分为两组:
- 待剪枝权重 ($F$): 将这些权重置零。因此它们的改变量是固定的:$\Delta w_F = -w_F$。
- 保留权重 ($S$): 调整这些权重来补偿剪枝带来的误差。它们的改变量 $\Delta w_S$ 是要求解的变量。
将扰动向量 $\Delta w$ 和Hessian矩阵 $\mathbf{H}$ 按 $S$ 和 $F$ 进行分块:
\[\Delta w = \begin{pmatrix} \Delta w_S & \Delta w_F \end{pmatrix} \qquad \mathbf{H} = \begin{pmatrix} \mathbf{H}_{SS} & \mathbf{H}_{SF} \\ \mathbf{H}_{FS} & \mathbf{H}_{FF} \end{pmatrix}\]其中 $\Delta w_F$ 是已知量(由 $-w_F$ 构成),$\Delta w_S$ 是待求量。将分块矩阵代入误差函数:
\[\begin{aligned} E &= \begin{pmatrix} \Delta w_S & \Delta w_F \end{pmatrix} \begin{pmatrix} \mathbf{H}_{SS} & \mathbf{H}_{SF} \\ \mathbf{H}_{FS} & \mathbf{H}_{FF} \end{pmatrix} \begin{pmatrix} \Delta w_S^\top \\ \Delta w_F^\top \end{pmatrix} \\ &= \Delta w_S \mathbf{H}_{SS} \Delta w_S^\top + 2 \Delta w_S \mathbf{H}_{SF} \Delta w_F^\top + \Delta w_F \mathbf{H}_{FF} \Delta w_F^\top \end{aligned}\]这是一个关于 $\Delta w_S$ 的二次函数。为了找到最小值,对 $\Delta w_S$ 求导并令其为零:
\[\frac{\partial E}{\partial (\Delta w_S)} = 2 \Delta w_S \mathbf{H}_{SS} + 2 \Delta w_F \mathbf{H}_{FS} = 0\]解出最优的 $\Delta w_S$:
\[\begin{aligned} \Delta w_S &= - \Delta w_F \mathbf{H}_{FS} \mathbf{H}_{SS}^{-1} \\ &= -(-w_F) \mathbf{H}_{FS} \mathbf{H}_{SS}^{-1} \\ &= w_F \mathbf{H}_{FS} \mathbf{H}_{SS}^{-1} \end{aligned}\]该公式表明,对剩余权重 $S$ 的最优补偿更新 $\Delta w_S^{*}$,可以直接通过被剪枝的权重值 $w_F$ 和Hessian矩阵 $\mathbf{H} = XX^\top$ 的相应子块(\(\mathbf{H}_{FS}\) 和 \(\mathbf{H}_{SS}^{-1}\))一次性计算出来。这避免了任何迭代优化,是其“一次性”高效更新的核心。
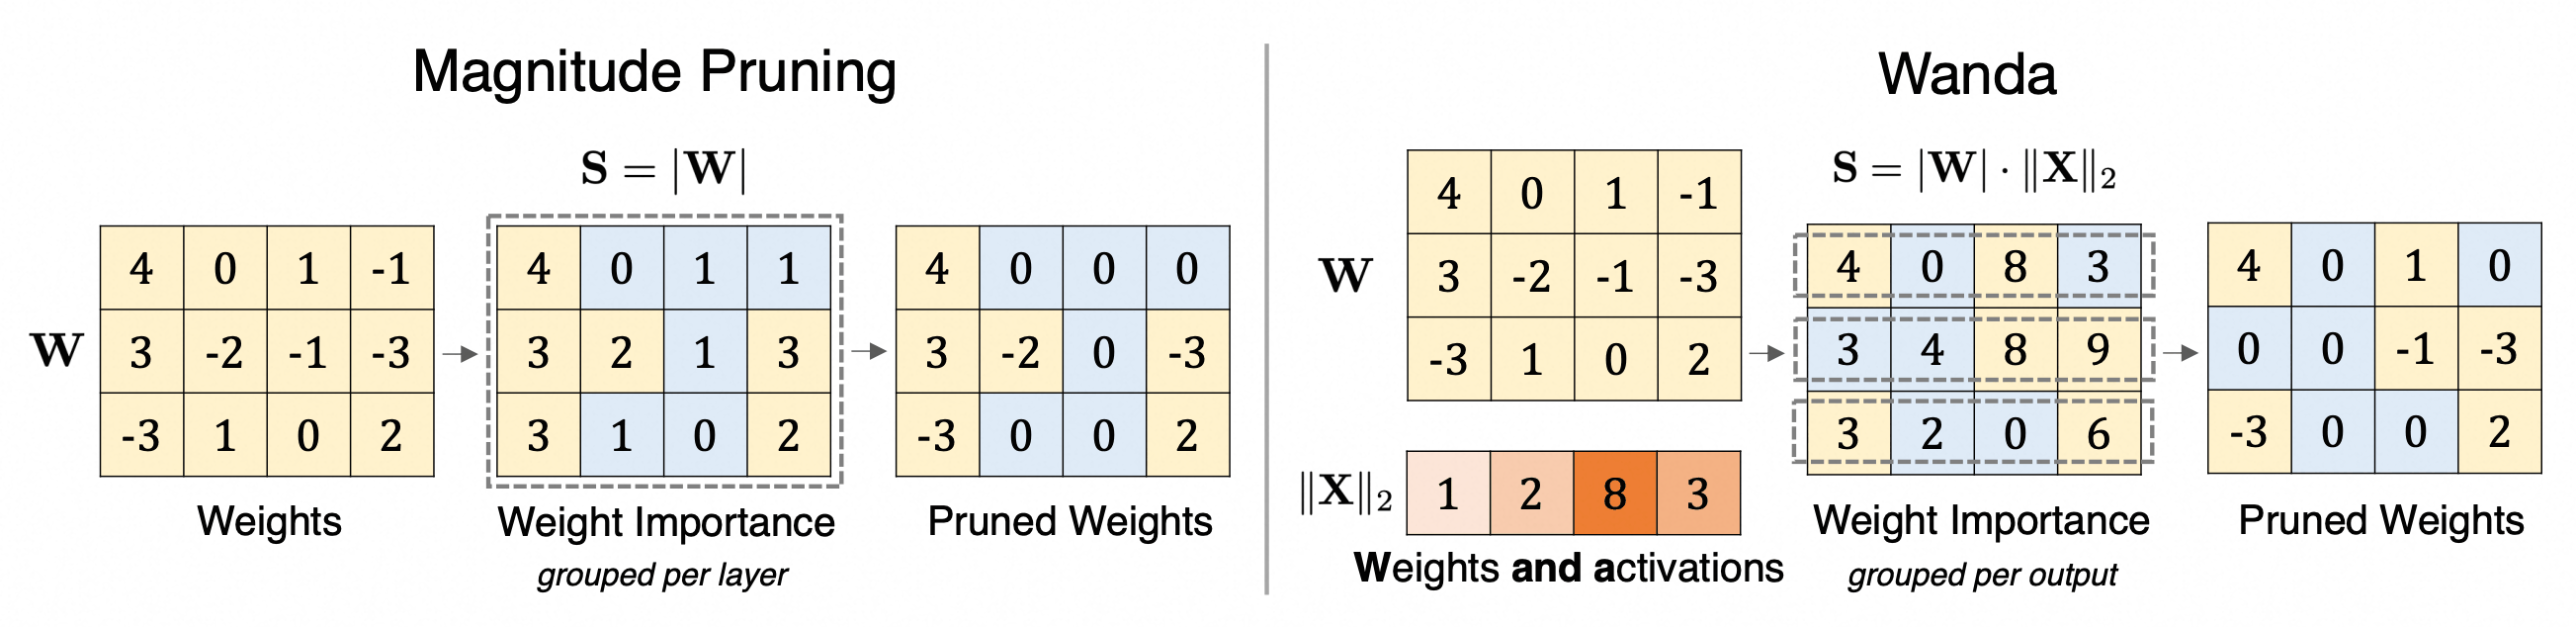
⚪ Wanda:用权重幅值与输入激活联合评分
Wanda(Pruning by Weights and Activations)为权重$W_{ij}$定义:
\[s_{ij}=|W_{ij}|\cdot\|X_{:j}\|_2,\]并在每个输出行内删除得分较小的权重。它不计算梯度,也不更新保留权重,因而比二阶补偿更简单;校准激活让同样幅值的权重按输入通道重要性获得不同评分。
⭐ 讨论:为什么不直接训练剪枝后的小模型
Lottery Ticket Hypothesis指出,随机初始化网络中可能存在带特定初始权重的稀疏子网,单独训练即可在相近训练步数内达到完整网络的性能。它并不是说训练后的大模型“包含若干已经最优的小模型”,寻找中奖彩票本身也需要反复训练和剪枝。
Rethinking the Value of Network Pruning发现,许多结构化剪枝得到的架构从头训练即可匹敌继承权重后的结果,说明部分收益来自架构搜索;但该结论不应外推到所有非结构化剪枝、大规模任务和训练预算。大模型可能更容易优化、提供更好的表示或暴露更优子结构,是否保留权重必须由具体设置验证。
3. 知识蒸馏
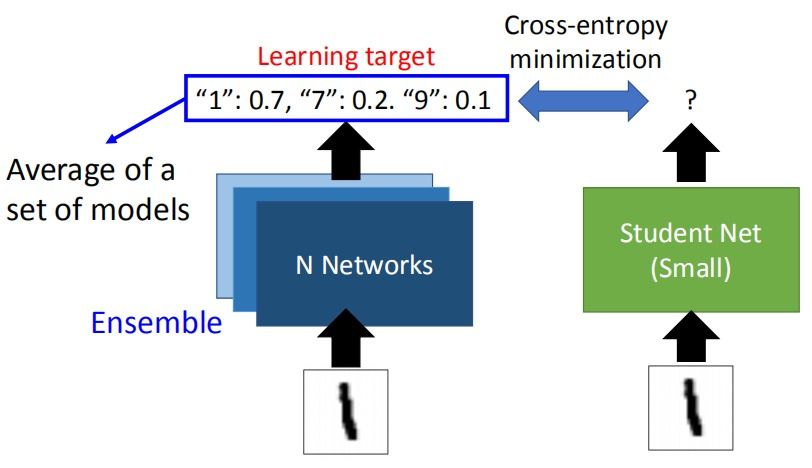
知识蒸馏(knowledge distillation, KD)让较小的学生模型(student)模仿较强的教师模型(teacher)。教师提供的监督可以是输出概率、中间特征、样本关系,也可以是生成序列或推理轨迹。
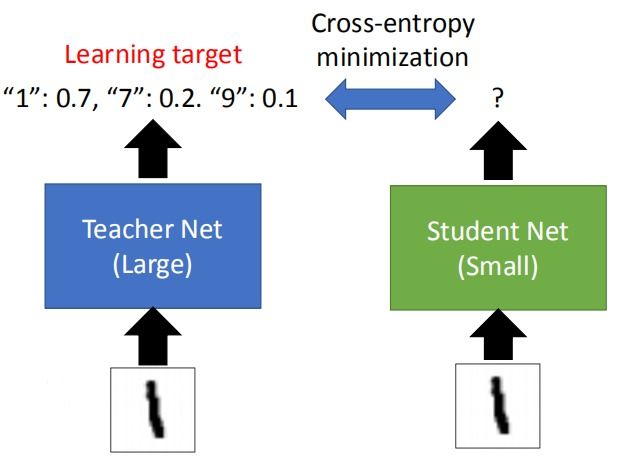
一个典型应用是把多个模型的集成知识迁移到单个学生中,以降低部署成本:
(1) 输出分布蒸馏
⚪ Knowledge Distillation:用温度化类别分布传递暗知识
设教师和学生的logits分别为$z^t,z^s$,温度$T$下的概率为:
\[p_t^{(T)}(c|x)= \frac{\exp(z_c^t/T)}{\sum_j\exp(z_j^t/T)}, \\ p_s^{(T)}(c|x)= \frac{\exp(z_c^s/T)}{\sum_j\exp(z_j^s/T)}.\]$T>1$会使类别分布更平滑,让学生看到教师如何分配非目标类别的概率。常见损失同时包含硬标签和软目标:
\[\mathcal{L}=(1-\alpha) \operatorname{CE}(y,p_s^{(1)})+ \alpha T^2D_{\mathrm{KL}} \left(p_t^{(T)}\|p_s^{(T)}\right).\]KL散度作用于经过softmax的温度化概率,而不是“除以温度的 logits”。乘$T^2$用于补偿高温下软目标梯度量级约按$1/T^2$缩小,使软目标与硬标签的相对权重更稳定。
⚪ DML、BAN 与 TAKD:改变教师的来源与容量路径
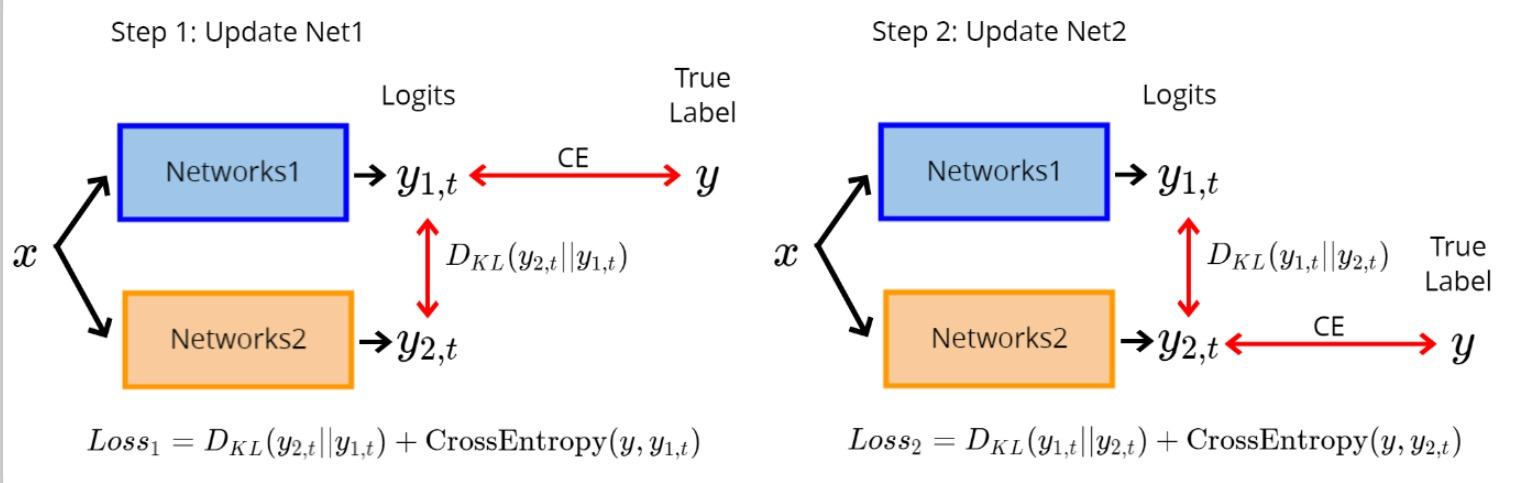
Deep Mutual Learning(DML)不需要预训练好的固定教师,而是让多个模型同步训练并相互匹配输出分布:
Born Again Networks(BAN)使用与教师同构的学生逐代蒸馏,说明蒸馏也可能改善相同容量模型的优化与泛化:
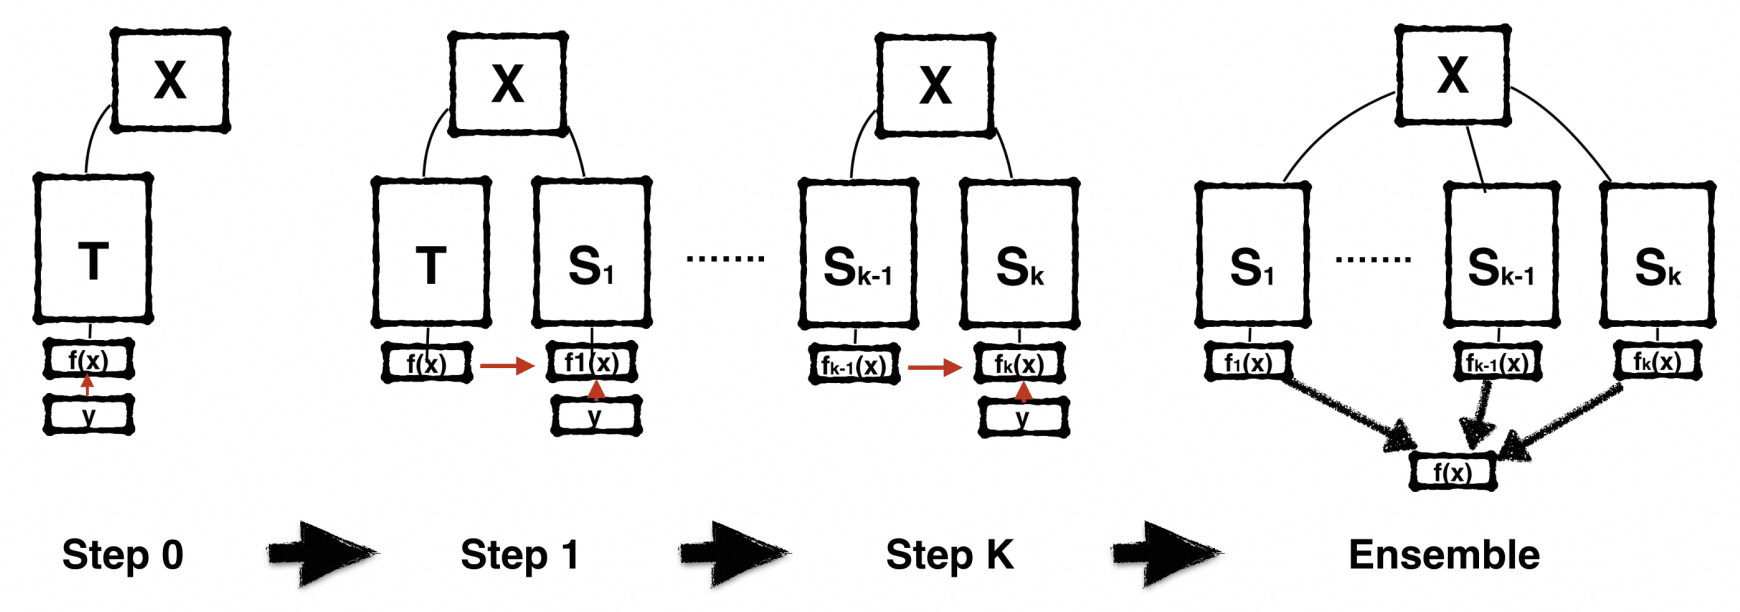
当教师与学生容量差距过大时,学生可能难以拟合教师分布。Teacher Assistant Knowledge Distillation(TAKD)在两者之间加入一个或多个容量递减的教师助理:
\[T\rightarrow TA_1\rightarrow\cdots\rightarrow S.\]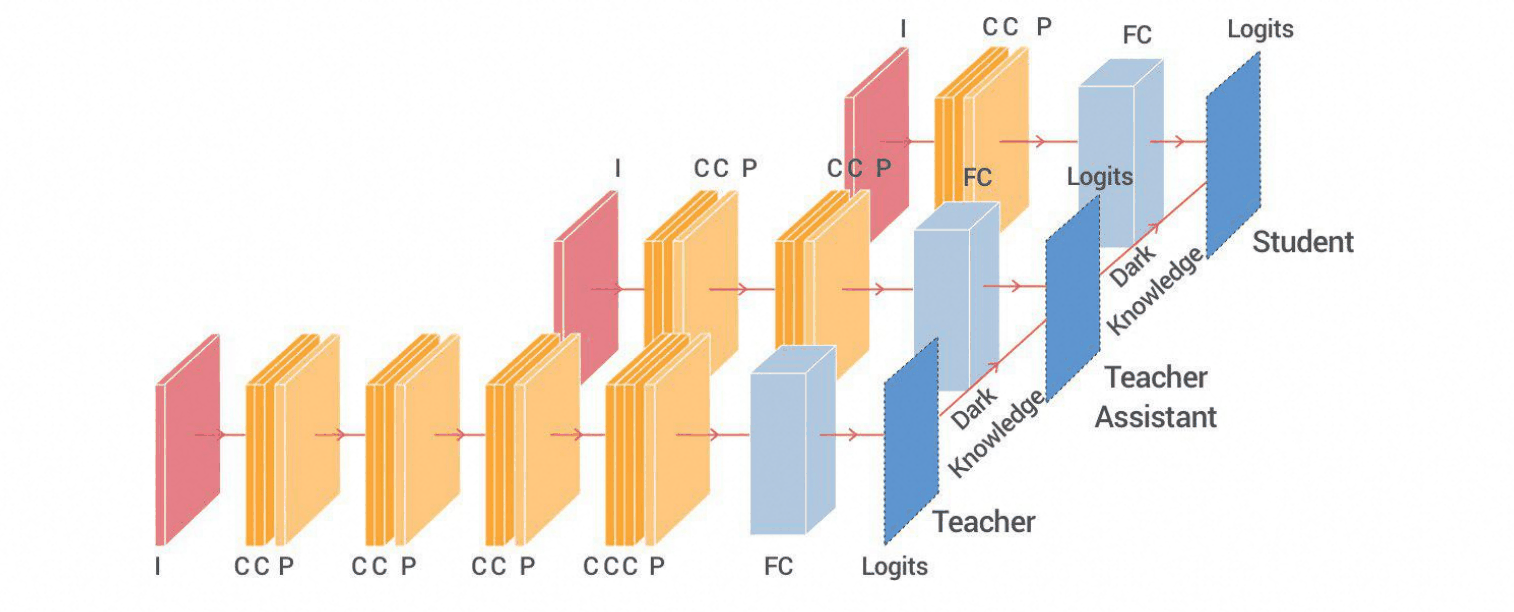
这些方法说明“教师越强,学生一定越好”并不成立。教师分布过尖、任务偏差过大或表示复杂度超出学生容量时,增加教师规模可能反而降低可学习性。
(2) 特征与关系蒸馏
⚪ FitNets:用提示层对齐教师与学生的中间表示
FitNets选择教师的提示层和学生的引导层,通过可学习映射调整学生特征的形状,再最小化中间表示差异:
\[\mathcal{L}_{\text{hint}}= \|h_t-r(h_s)\|_2^2.\]完成提示训练后,再结合输出分布和标签训练学生:
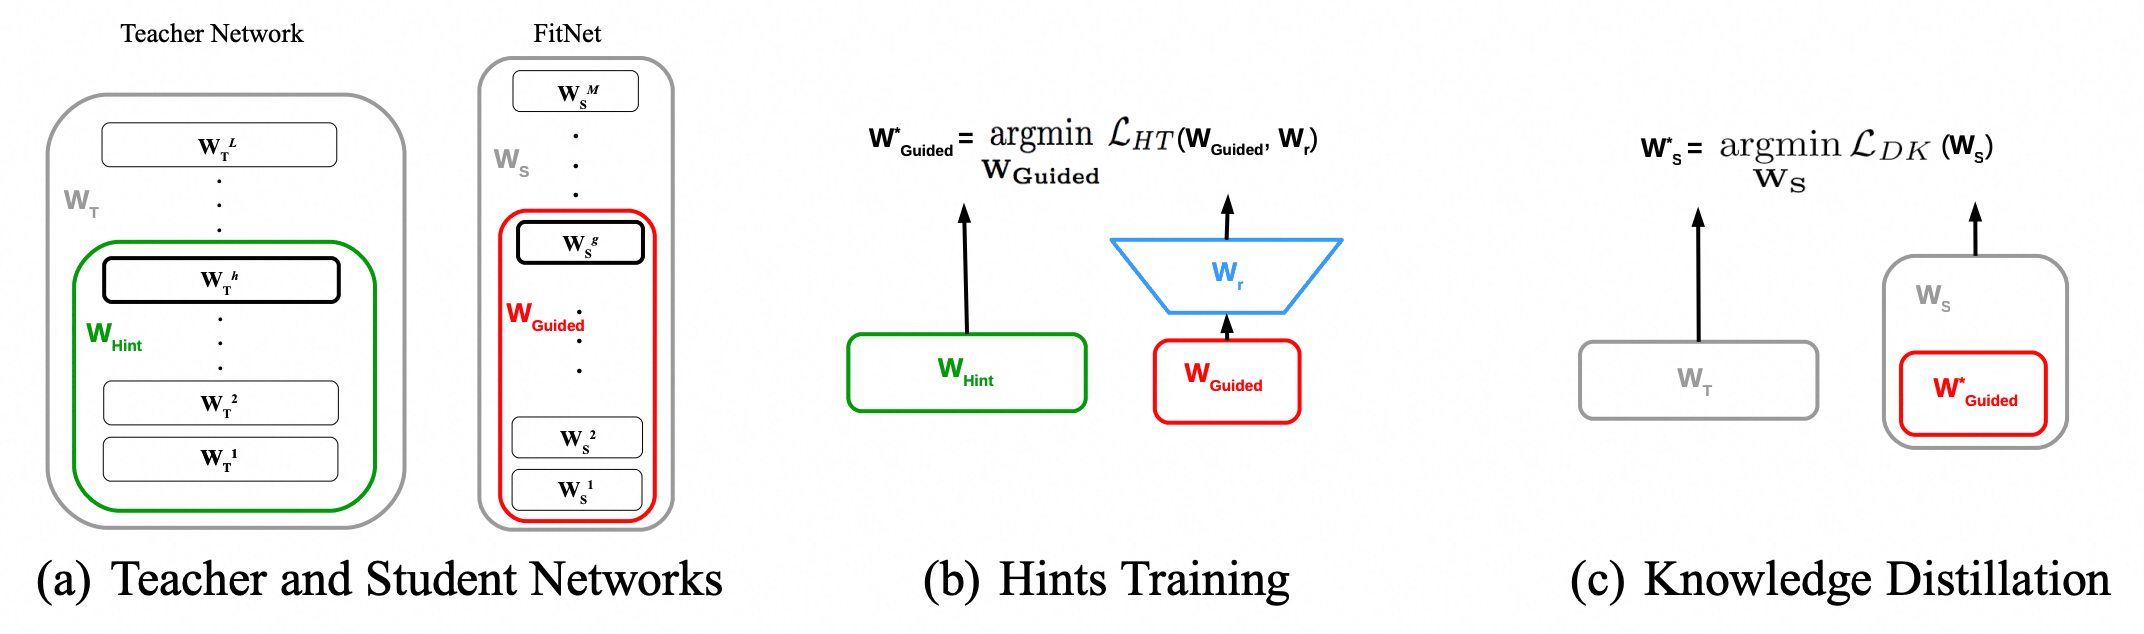
教师与学生的层数、通道数和空间尺寸可能不同,因此中间层配对和转换器$r(\cdot)$会直接影响效果。逐元素强制复制教师特征也可能把冗余信息一并传给学生。
⚪ Attention Transfer:对齐压缩后的空间注意图
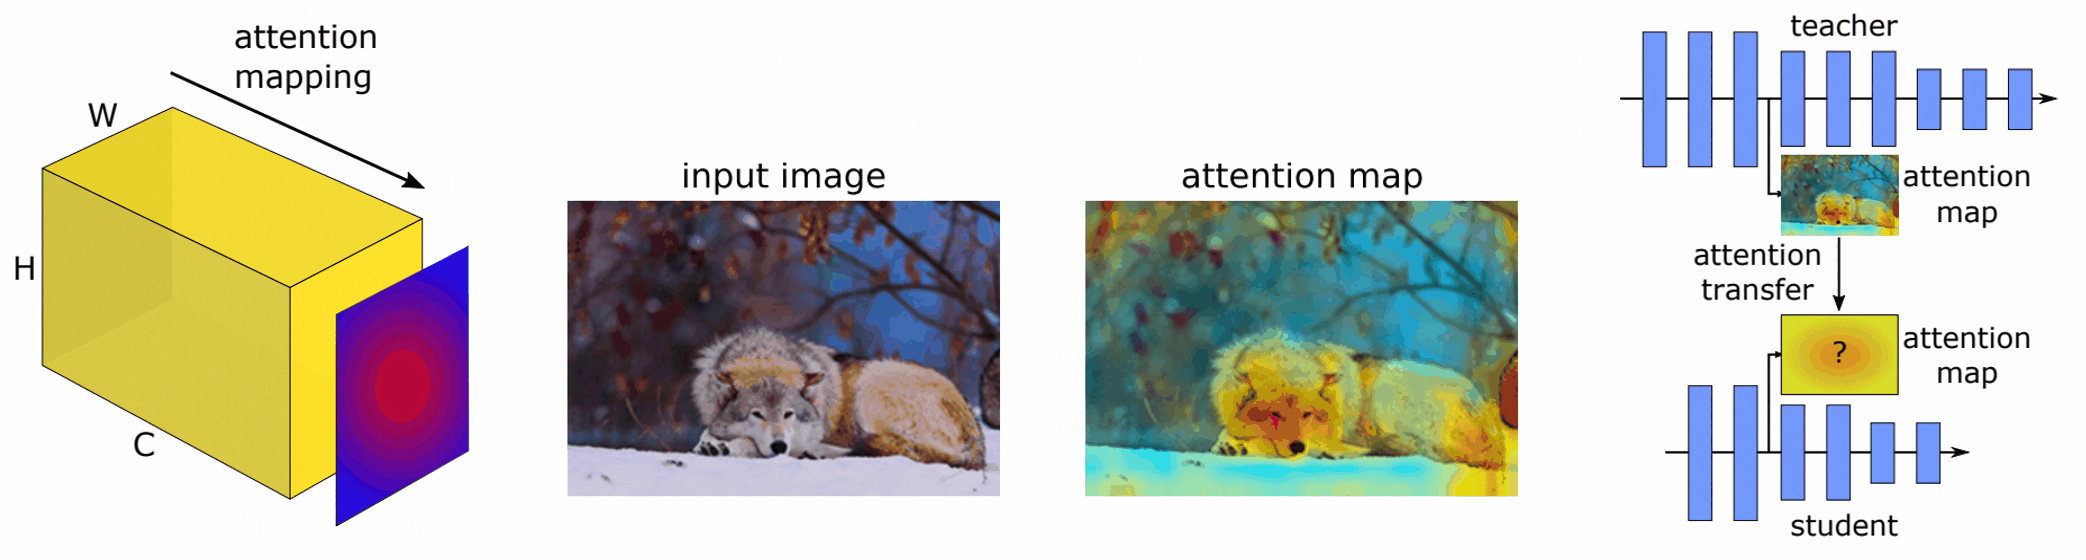
Attention Transfer不逐元素复制全部特征,而是沿通道聚合得到空间注意图。对于特征$F\in\mathbb{R}^{C\times H\times W}$,一种定义为:
\[A(F)_{h,w}=\sum_{c=1}^{C}|F_{c,h,w}|^2.\]将教师和学生的注意图归一化后对齐,可以在通道数不同的网络之间传递“模型关注哪里”的信息:
⚪ RKD 与 SPKD:蒸馏样本之间的几何关系
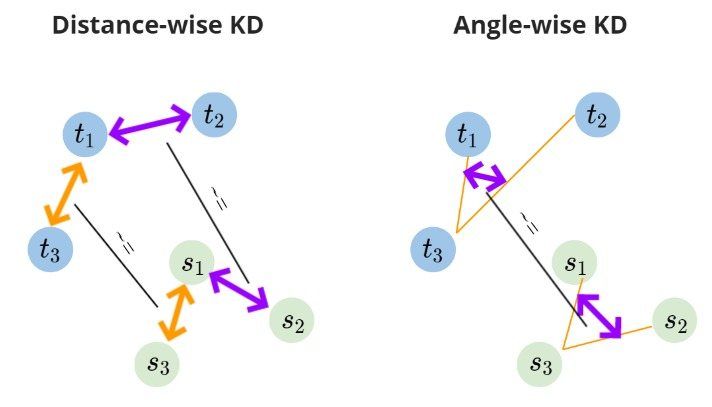
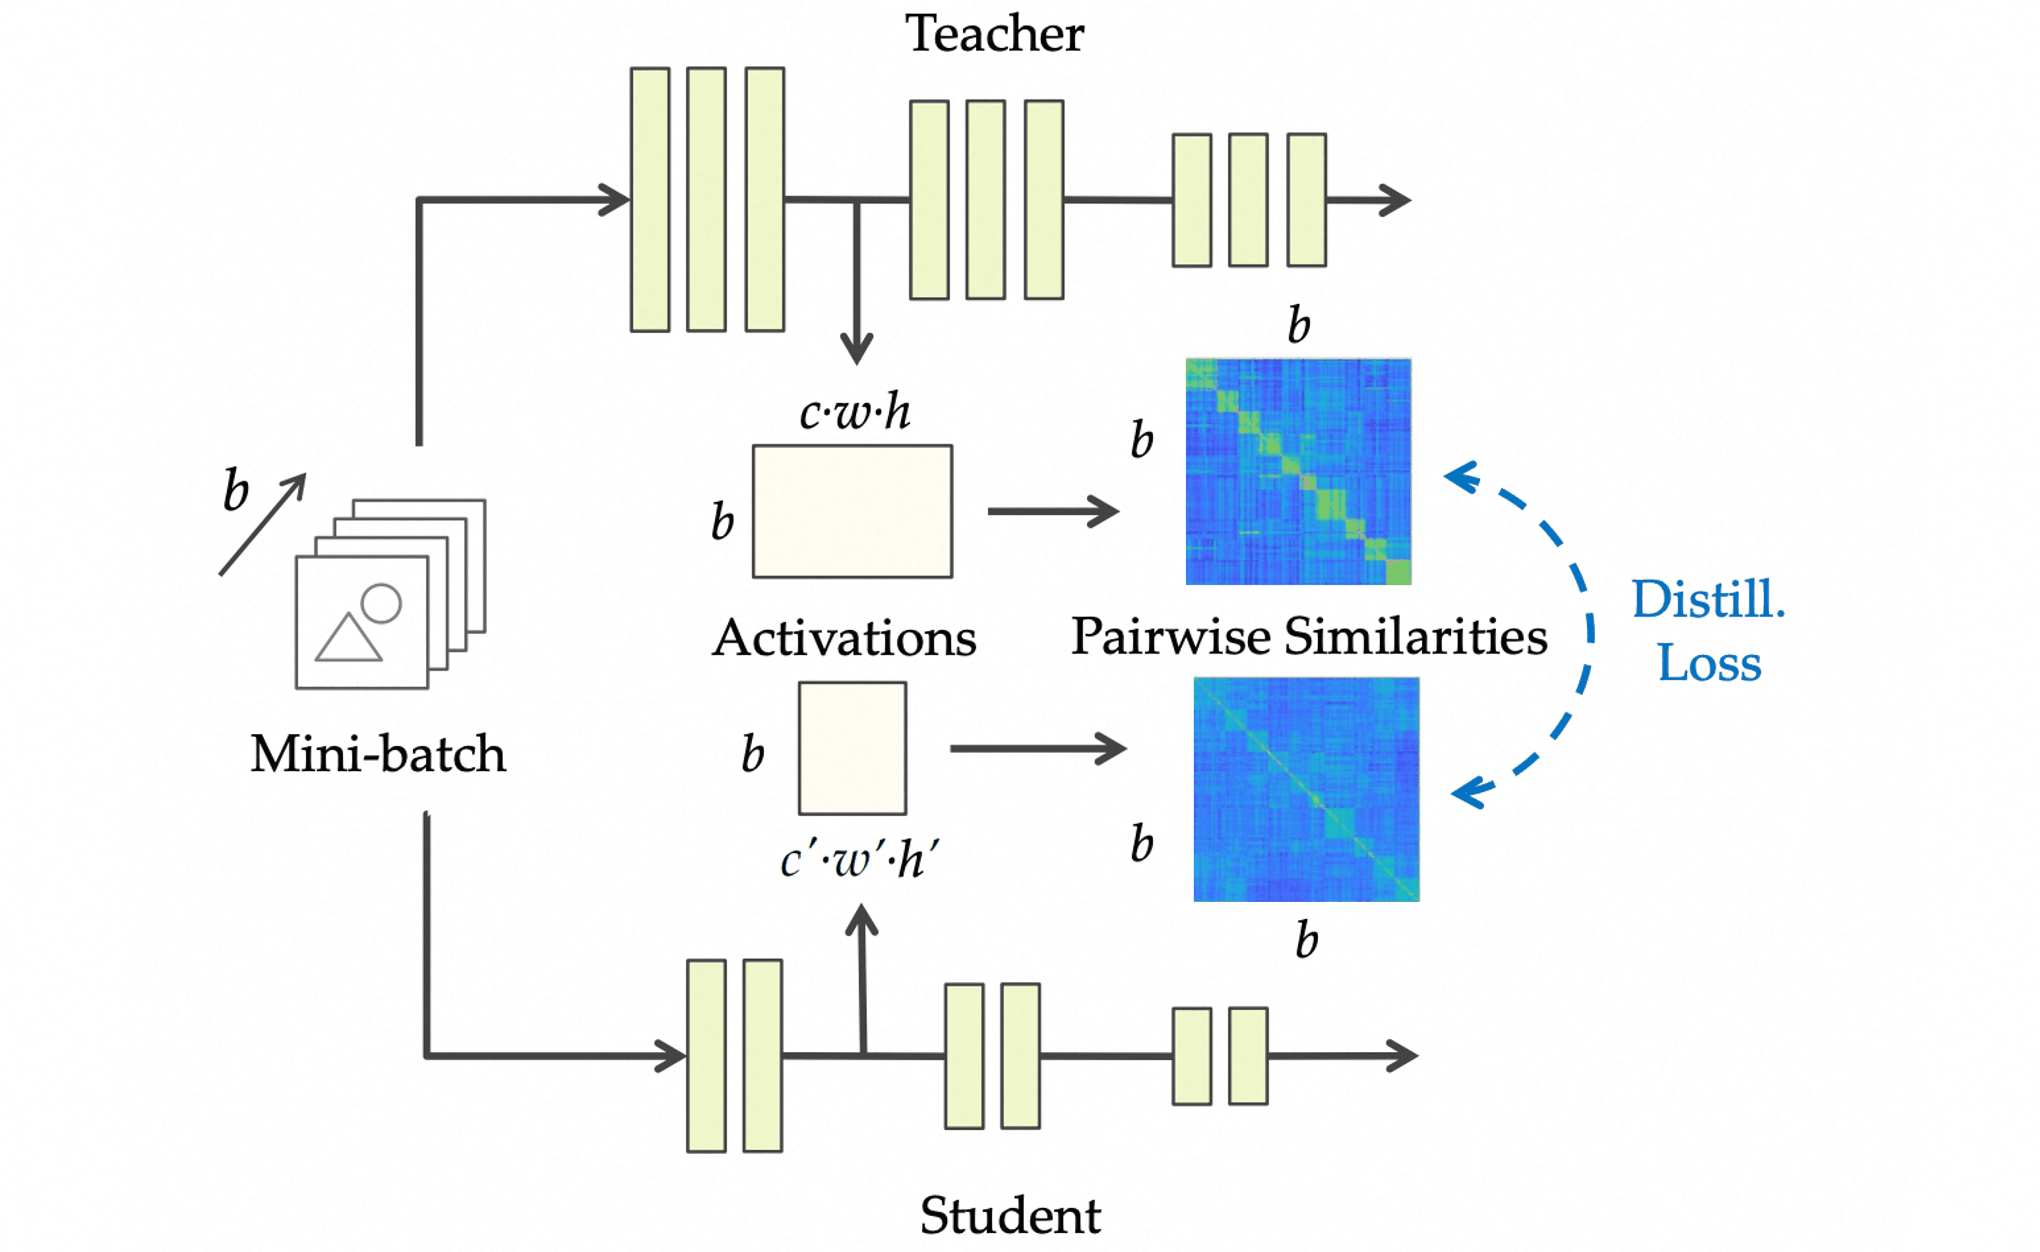
输出和特征蒸馏都以单个样本为主要单位,关系蒸馏则让学生重现教师嵌入空间中的样本间结构:
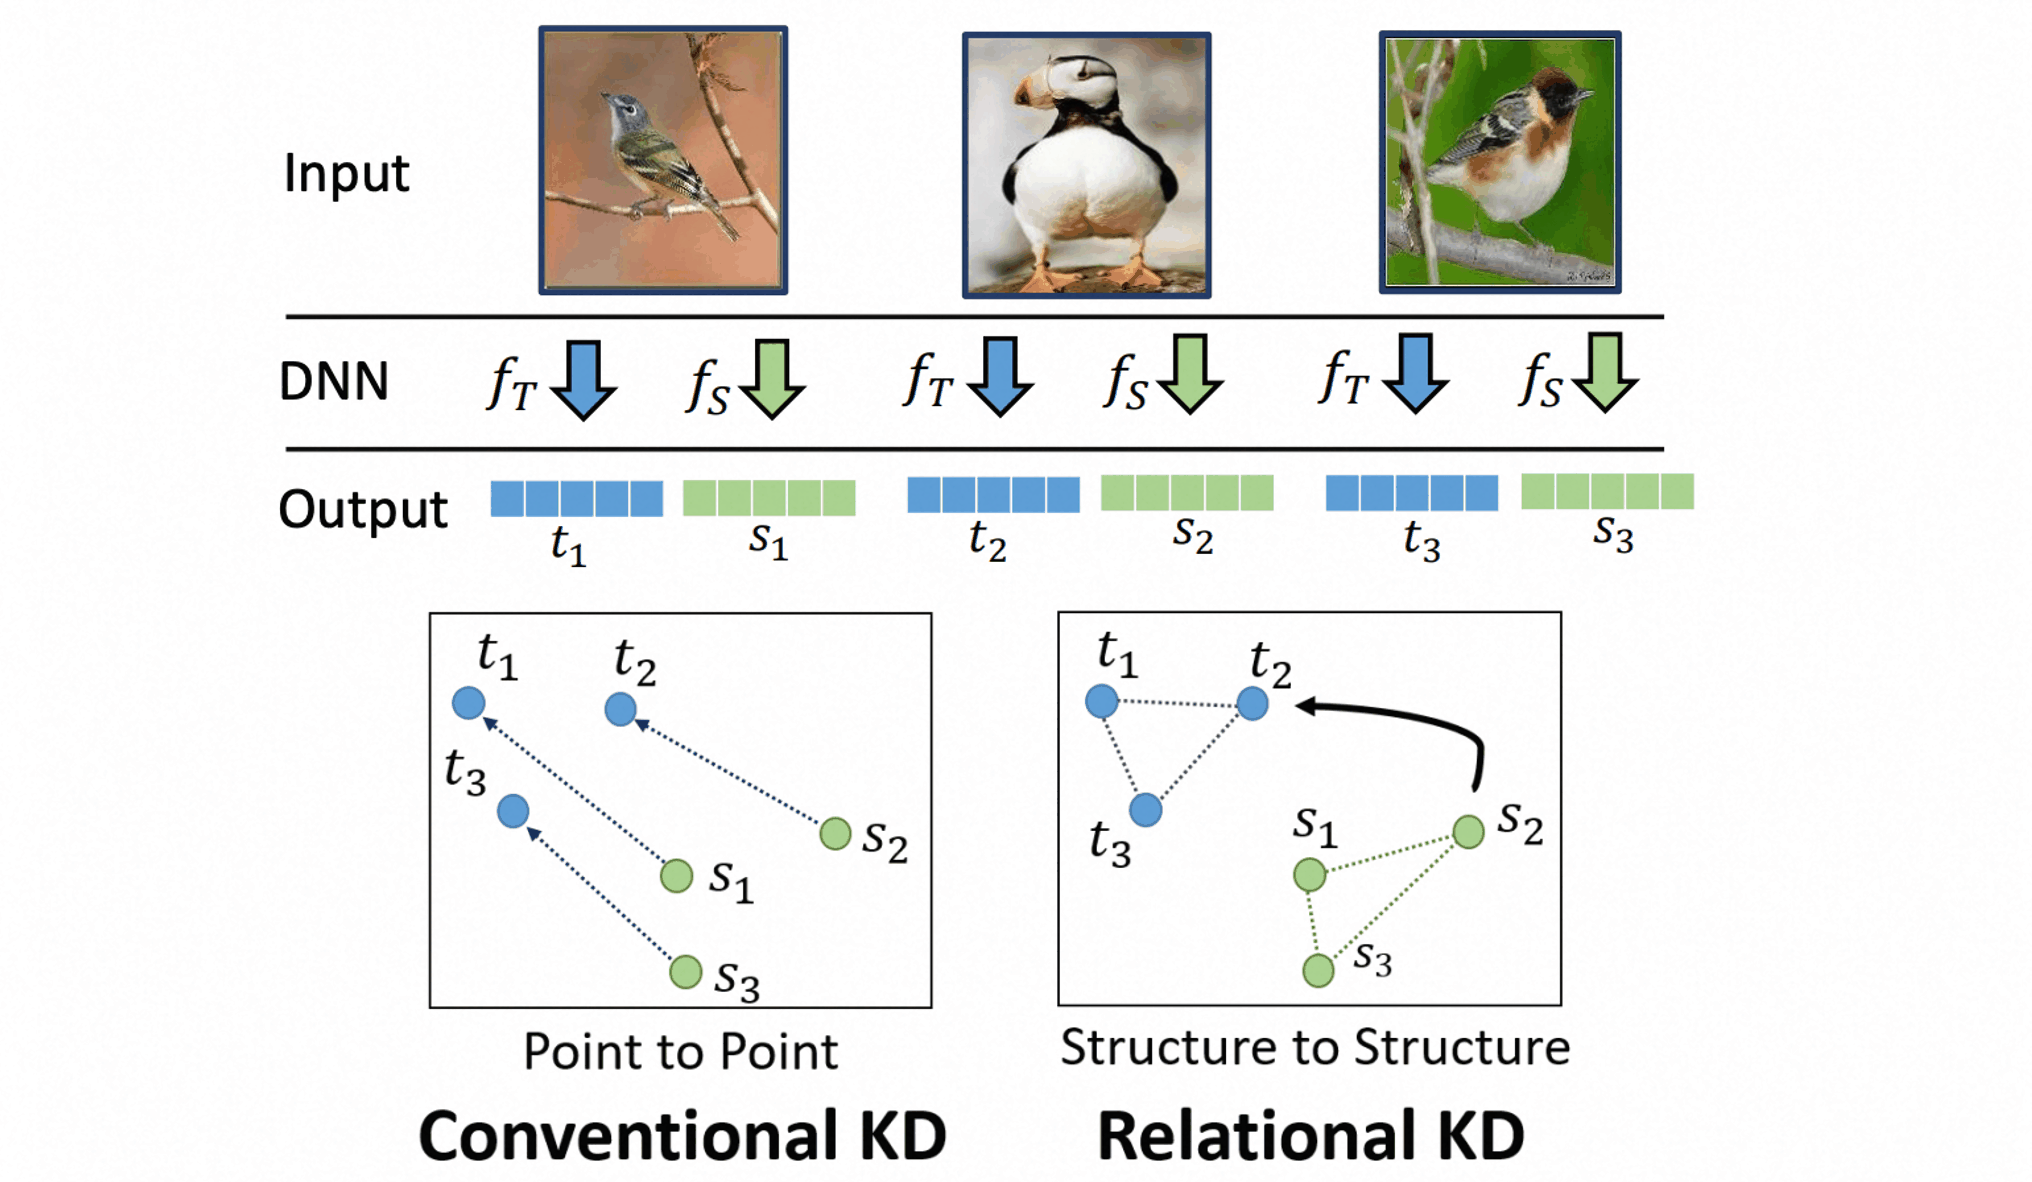
Relational Knowledge Distillation(RKD)对齐样本对的归一化距离和样本三元组的夹角:
Similarity-Preserving Knowledge Distillation(SPKD)则对齐一个批次内的归一化Gram矩阵,使教师与学生保留相似的成对关系:
(3) 序列与生成模型蒸馏
⚪ Sequence-Level Knowledge Distillation:用教师生成序列训练学生
序列模型的输出空间随长度指数增长,逐词元匹配不能直接保证完整序列质量。Sequence-Level Knowledge Distillation先用教师搜索得到伪目标$\widehat{y}$,再训练学生最大化:
\[\log p_s(\widehat{y}|x)= \sum_t\log p_s(\widehat{y}_t|\widehat{y}_{<t},x).\]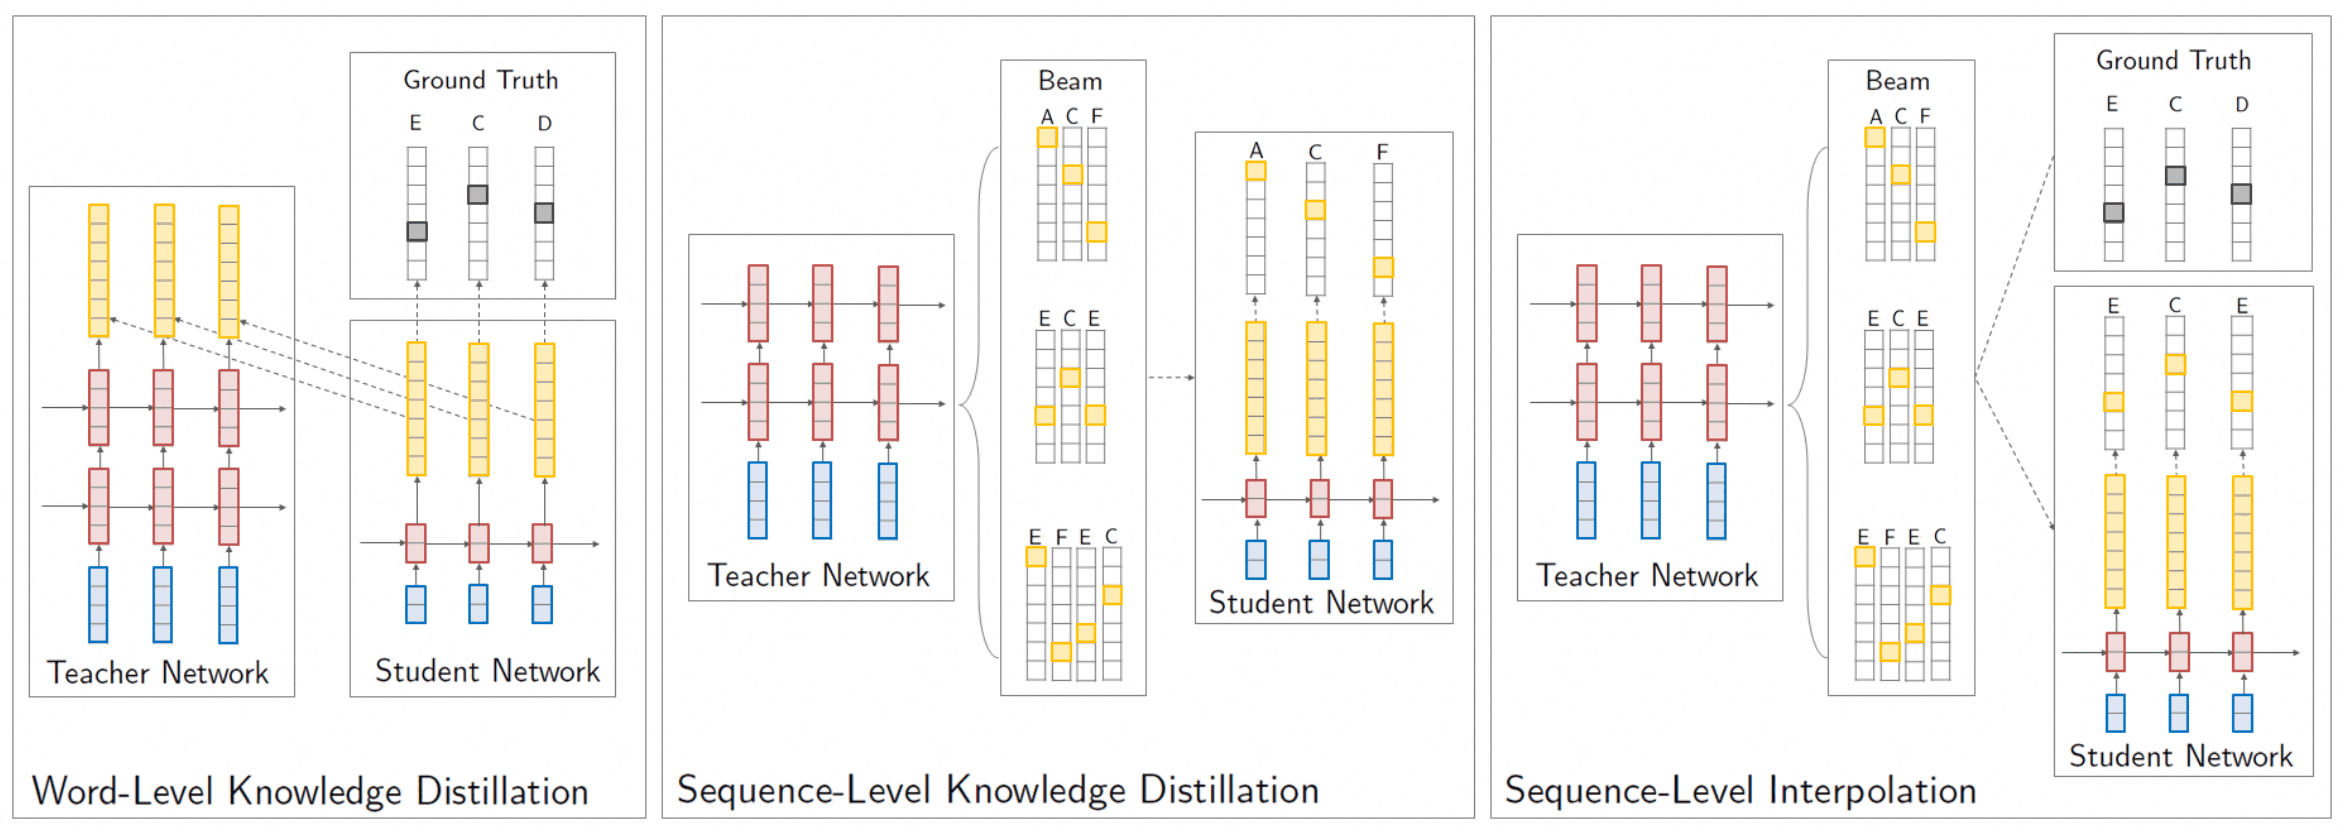
它把教师偏好的复杂输出分布压缩成较简单的硬序列,能减少训练目标的多模态性,但会丢失教师在其他候选上的概率信息,并继承教师搜索偏差。
⚪ MiniLLM 与 On-Policy Distillation:在学生生成分布上学习教师
传统生成蒸馏常在真实答案或教师前缀上比较逐词元分布,学生自由生成时却会访问不同前缀,形成暴露偏差(exposure bias)。MiniLLM优化序列级反向散度:
\[D_{\mathrm{KL}}(p_s(y|x)\|p_t(y|x)),\]并在学生采样的序列上估计目标。
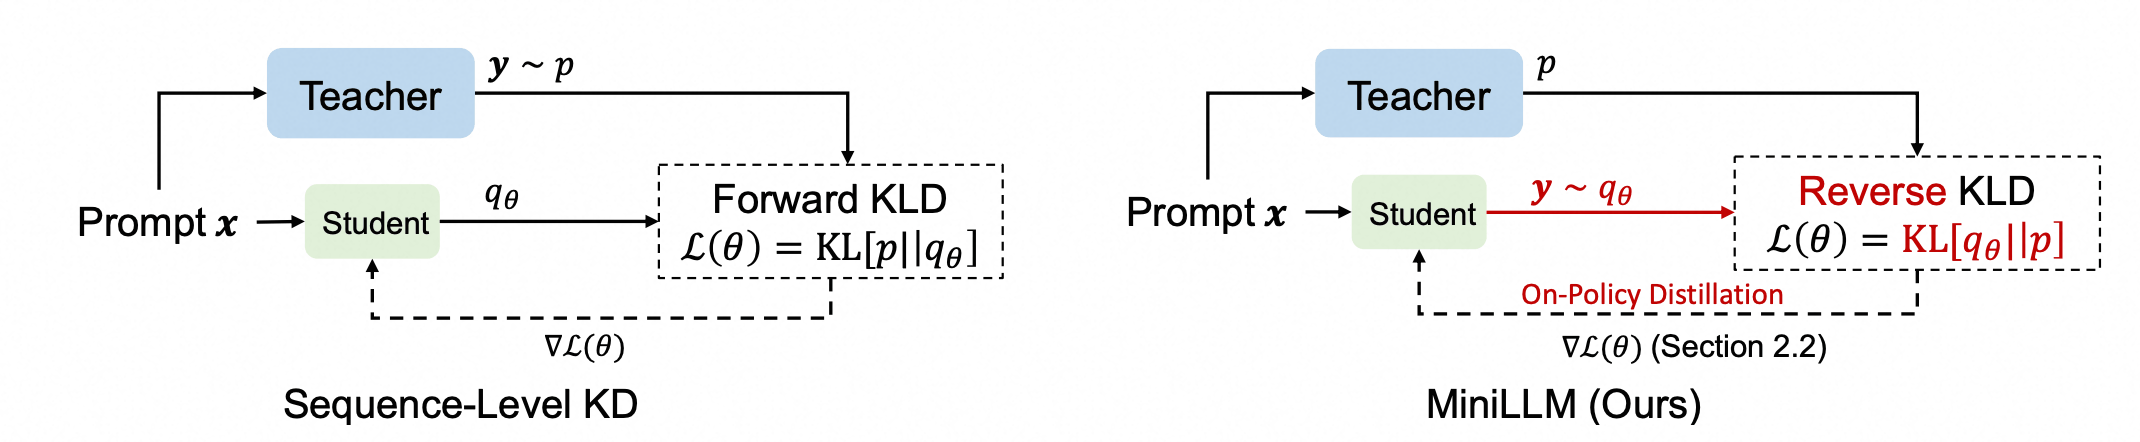
- On-Policy Distillation:On-Policy Distillation of Language Models: Learning from Self-Generated Mistakes
On-Policy Distillation同样让学生先生成轨迹,再在这些前缀上查询教师,可选择正向/反向KL或广义Jensen-Shannon散度。
⭐ 讨论:蒸馏传递的究竟是什么
蒸馏目标决定了学生接收到的信息:硬标签只给最终答案,软分布提供类别间相对关系,中间特征传递表示,关系蒸馏传递几何结构,序列蒸馏提供教师选择的完整输出。
蒸馏不保证压缩。若学生与教师同构,目标可能是正则化或自蒸馏;若生成大量教师数据,训练成本甚至会上升。部署收益最终仍由学生结构、精度、位宽和运行时决定。
4. 参数量化与编码
参数量化(quantization)用有限离散值近似连续权重或激活。它既能降低存储和内存带宽,也可能让整数或低精度浮点单元获得更高吞吐。
(1) 统一量化表示
对均匀仿射量化,实数$x$与整数$q$之间的映射为:
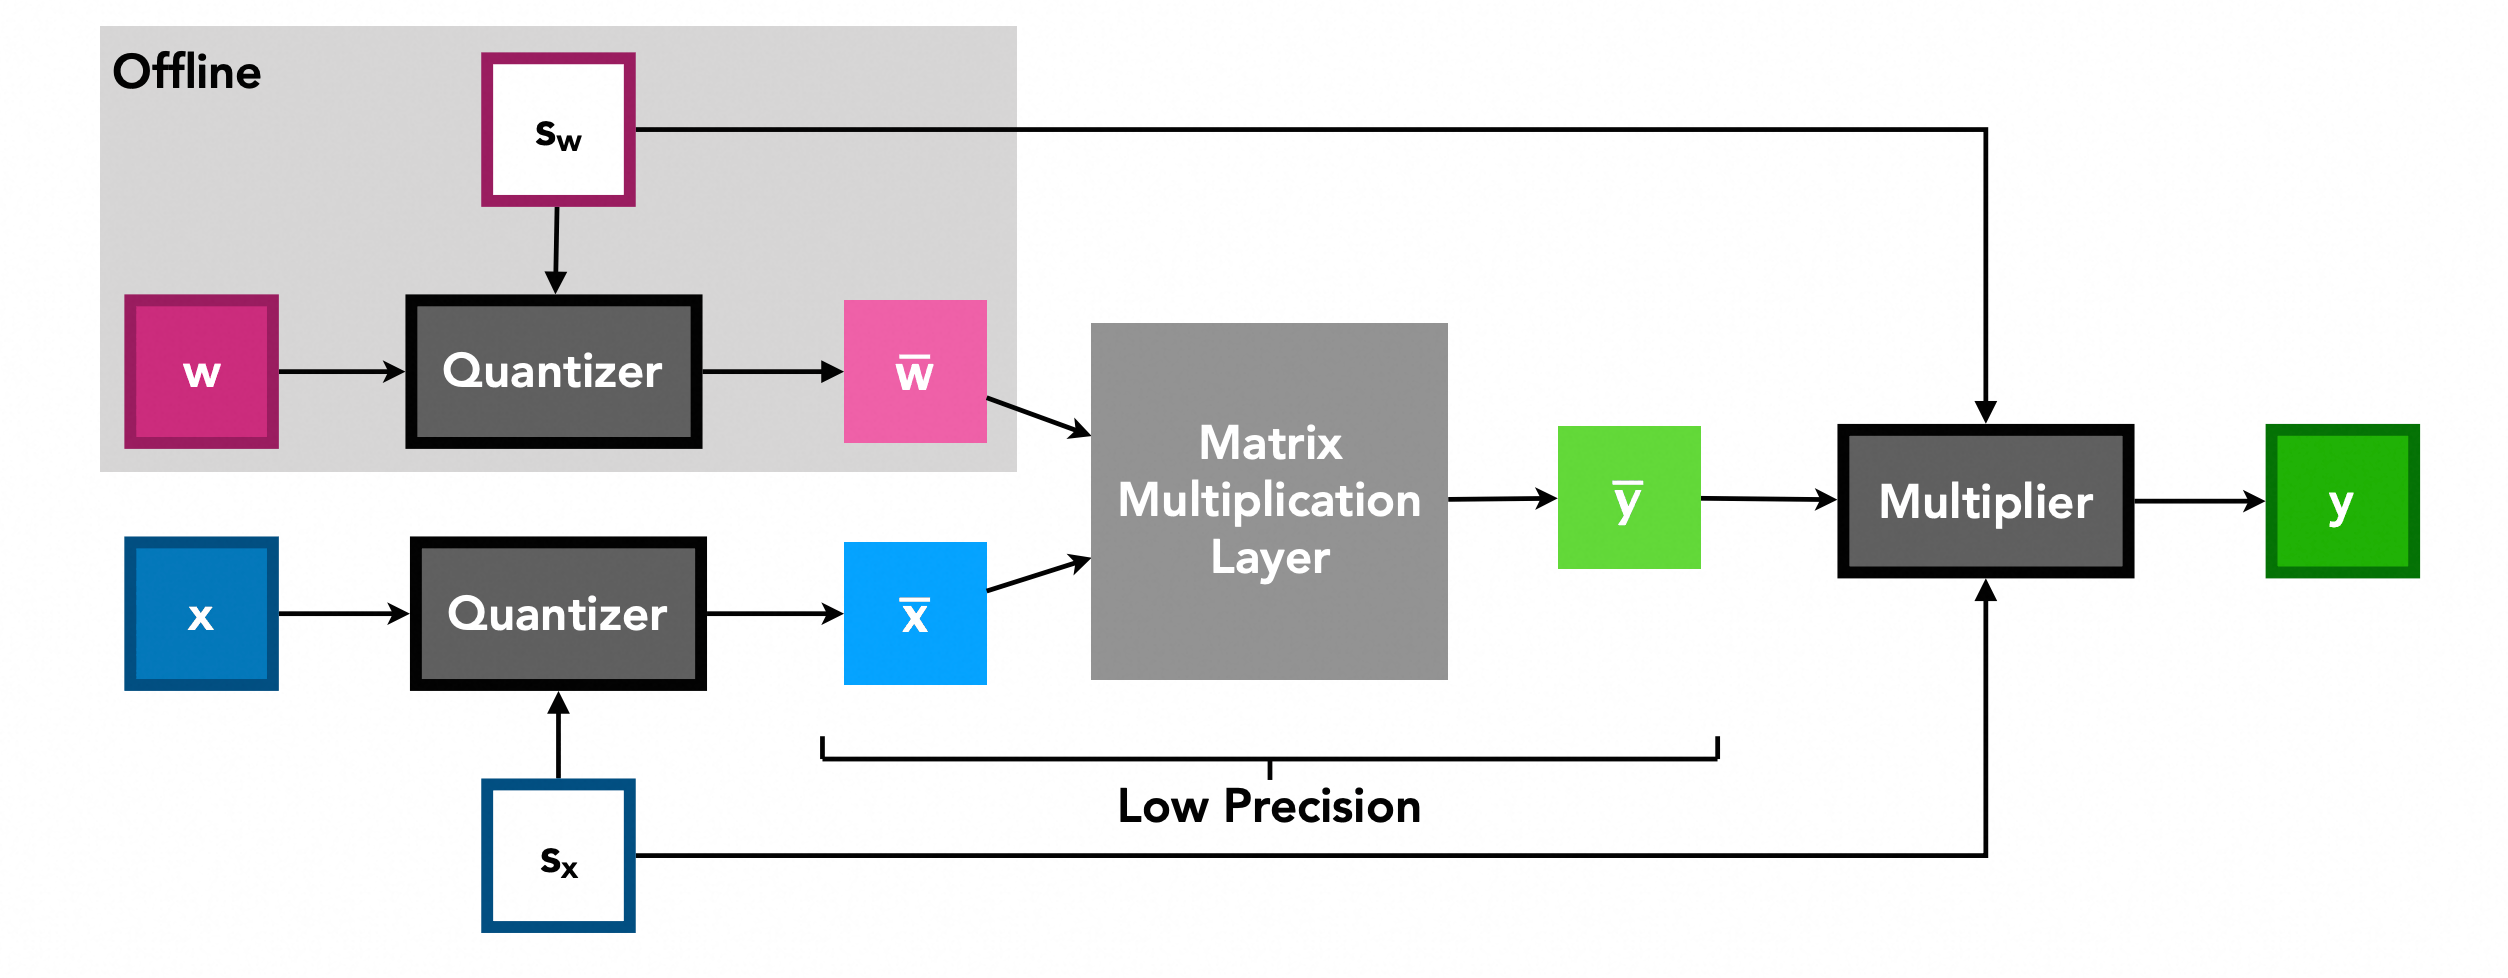
\[q=\operatorname{clip}\left( \operatorname{round}\left(\frac{x}{s}\right)+z, q_{\min},q_{\max} \right), \qquad \widehat{x}=s(q-z),\]其中$s>0$是缩放因子,$z$是表示实数零点的整数。对称量化通常令$z=0$,实现简单;非对称量化可以更充分利用偏斜数据的整数范围。
量化还应说明三个维度:
- 训练方式:训练后量化(PTQ)只使用少量校准数据,量化感知训练(QAT)在训练中模拟量化误差;
- 量化粒度:逐张量共享一个尺度,逐通道、逐组或逐词元使用更细尺度,精度更高但元数据和内核更复杂;
- 量化对象:仅量化权重、同时量化权重和激活,或单独量化生成模型的KV Cache。
⚪ Integer-Only Quantization:用仿射量化连接训练与整数推理
该方法在训练中插入伪量化节点,使模型适应权重和激活的离散误差;部署时以INT8乘法、INT32累加和整数重定标执行受支持算子。舍入函数几乎处处梯度为零,因此QAT通常用直通估计器(straight-through estimator, STE)近似反向梯度。
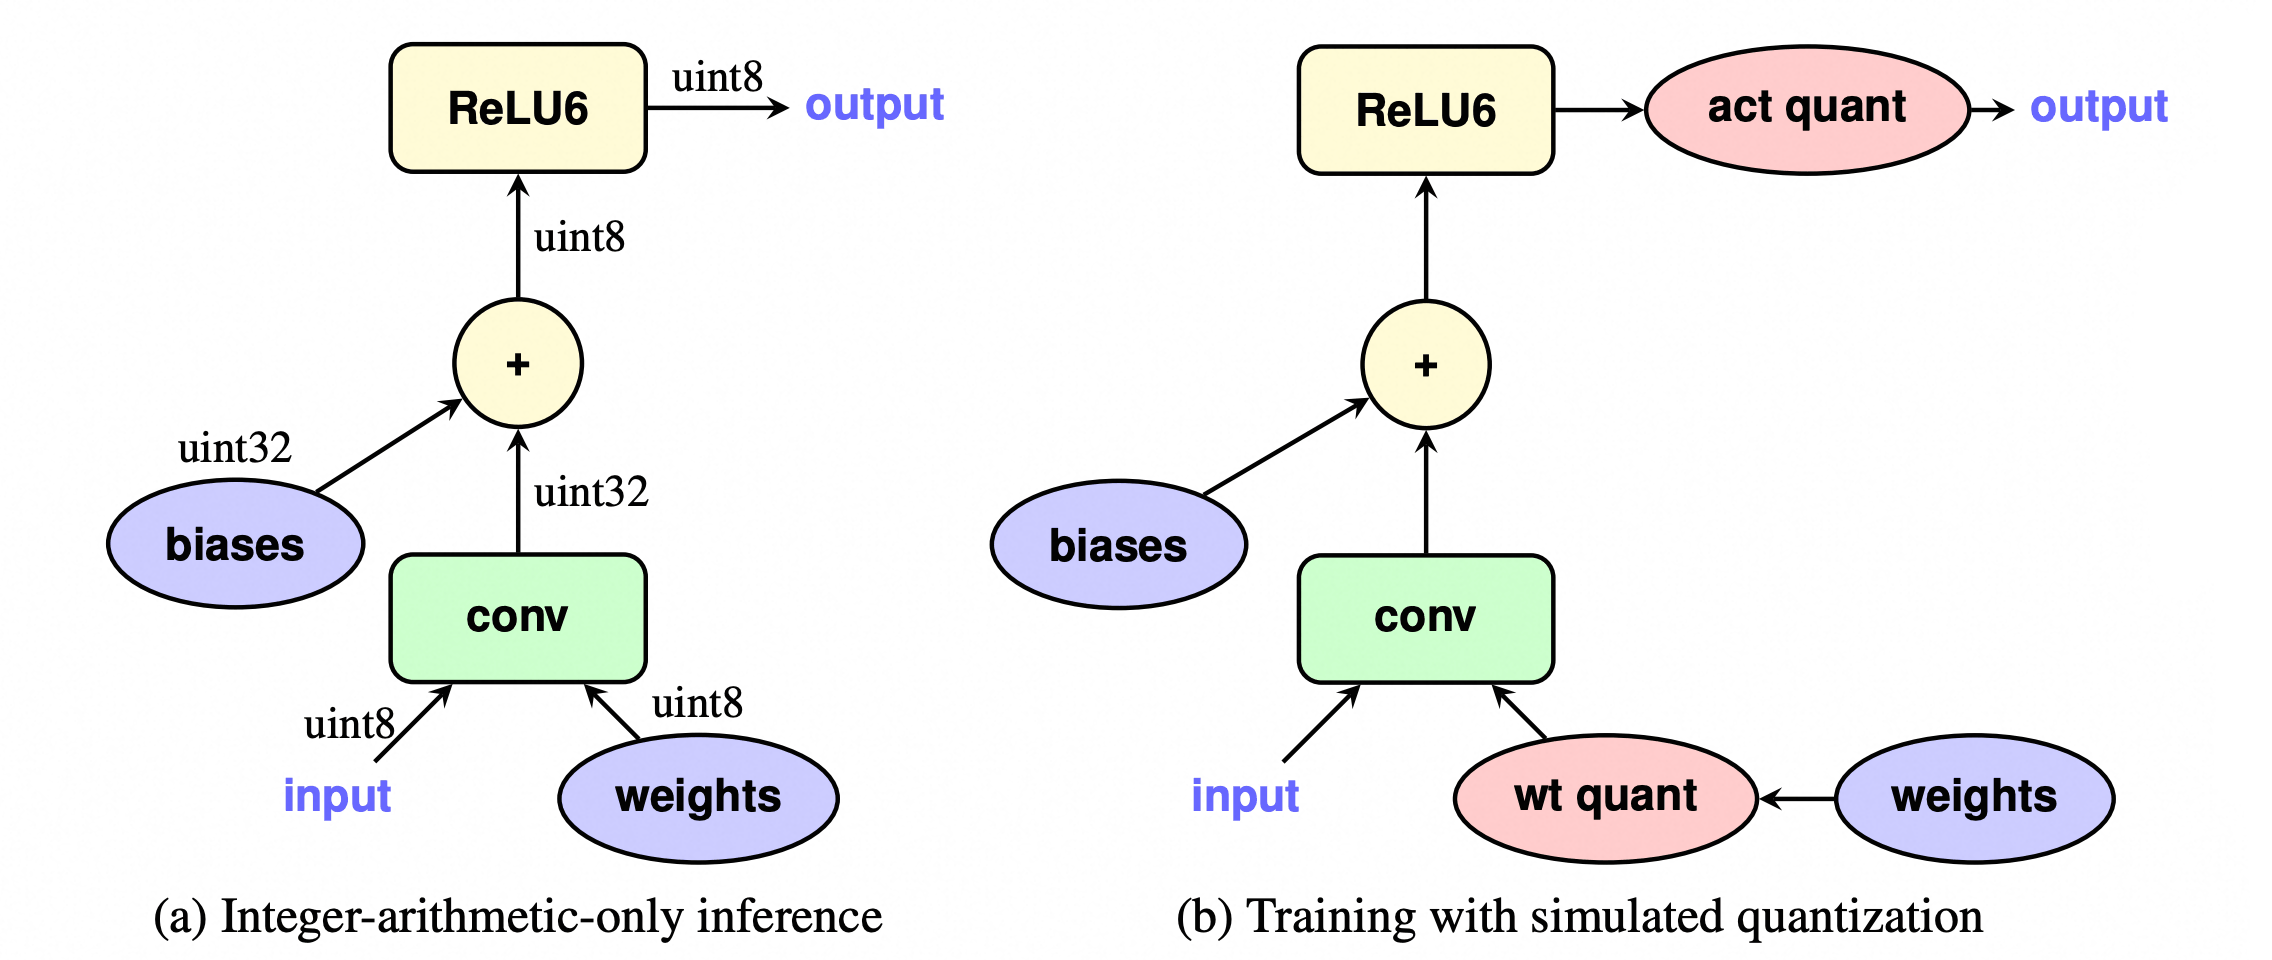
整数推理的收益要求计算图大部分算子都能保持量化格式。若不支持的层频繁回到浮点,再量化回整数,格式转换成本可能抵消加速。
(2) 权重共享与极低比特网络
⚪ Deep Compression:权重聚类与码本共享
Deep Compression提出了权重共享,其核心思想是:一个神经网络中并不需要数百万个独一无二的32位浮点权重,许多权重的值其实非常接近。通过一个三步流程实现这一点:
- 权重聚类(Clustering): 使用K-Means等算法将所有权重值聚类成k个簇。每个簇的中心点(centroid)就成为了一个“代表值”。
- 码本共享(Codebook Sharing): 创建一个包含这 k 个代表值的“码本”(codebook)。然后,原始权重矩阵被一个低比特的“索引矩阵”所替代,每个索引指向码本中的一个值。例如,如果使用256个簇,每个权重只需要一个8-bit整数来存储其索引,相比32-bit浮点数实现了4倍的压缩。
- 进一步压缩(Huffman Coding): 为了极致地压缩模型文件的大小,对索引矩阵应用了霍夫曼编码。频繁出现的权重(索引)用更短的码表示,不常用的则用更长的码。
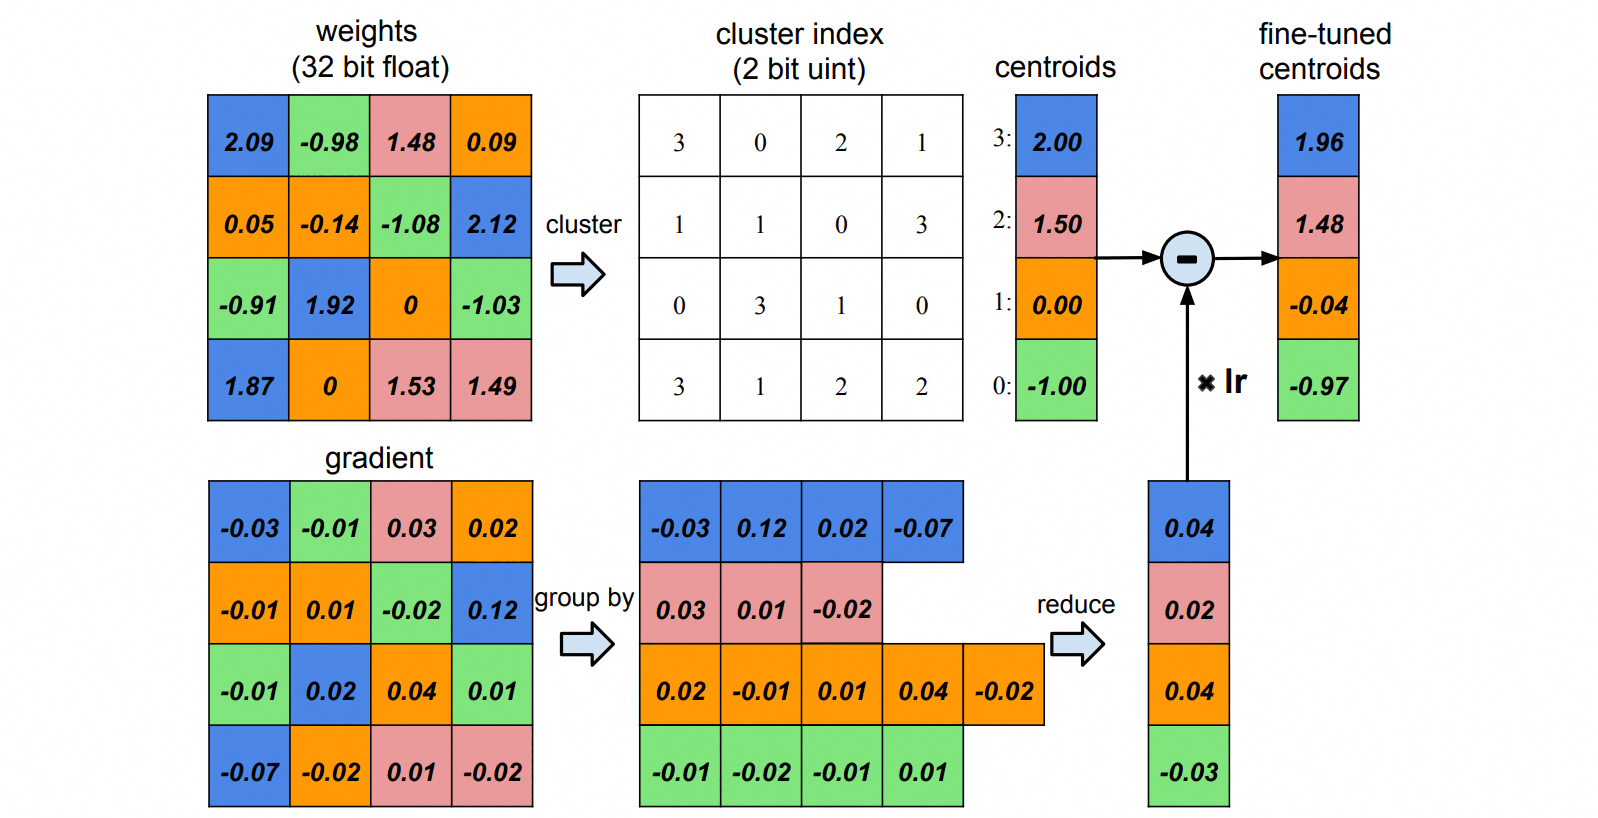
霍夫曼编码这种变长编码方案虽然极大地减小了模型的磁盘占用,却给硬件加速带来了巨大挑战。现代GPU和AI加速器专为处理规整、定长的稠密数据而设计。在推理时需要实时解码变长编码,会引入无法被并行计算单元隐藏的巨大开销。
⚪ BinaryConnect、BNN 与 XNOR-Net:把乘加降为二值逻辑操作
二值化网络将权重压缩成两个值:$-1$和$+1$。用硬件层面最高效的位运算(XNOR和popcount)来彻底取代昂贵的浮点乘加(MAC)运算,从而实现数量级的能效和速度提升。二值化常用:
\[W_b=\operatorname{sign}(W_r)\in\{-1,+1\}.\]BinaryConnect在前向和反向传播中使用二值权重,但训练期间保留实值影子权重$W_r$用于累积梯度更新;计算时权重被动态二值化。
BNN进一步二值化激活值,层与层之间的矩阵乘法完全变成了XNOR和popcount(比特计数)操作,实现了逻辑运算替代算术运算。
BNN的一个关键问题是纯粹的$±1$表示丢失了原始权重和激活的尺度信息。XNOR-Net通过引入一个全精度的缩放因子$\alpha$来解决这个问题。它将全精度卷积近似为:
\[W⊗X≈(αB)⊗(βH)\]其中 $B,H$ 是二值矩阵。这可以重新组织为 $(αβ)×(B⊛H)$,即先进行高效的XNOR+popcount二值卷积,再用一个高精度标量进行缩放。这一改进显著提升了二值网络的准确率。
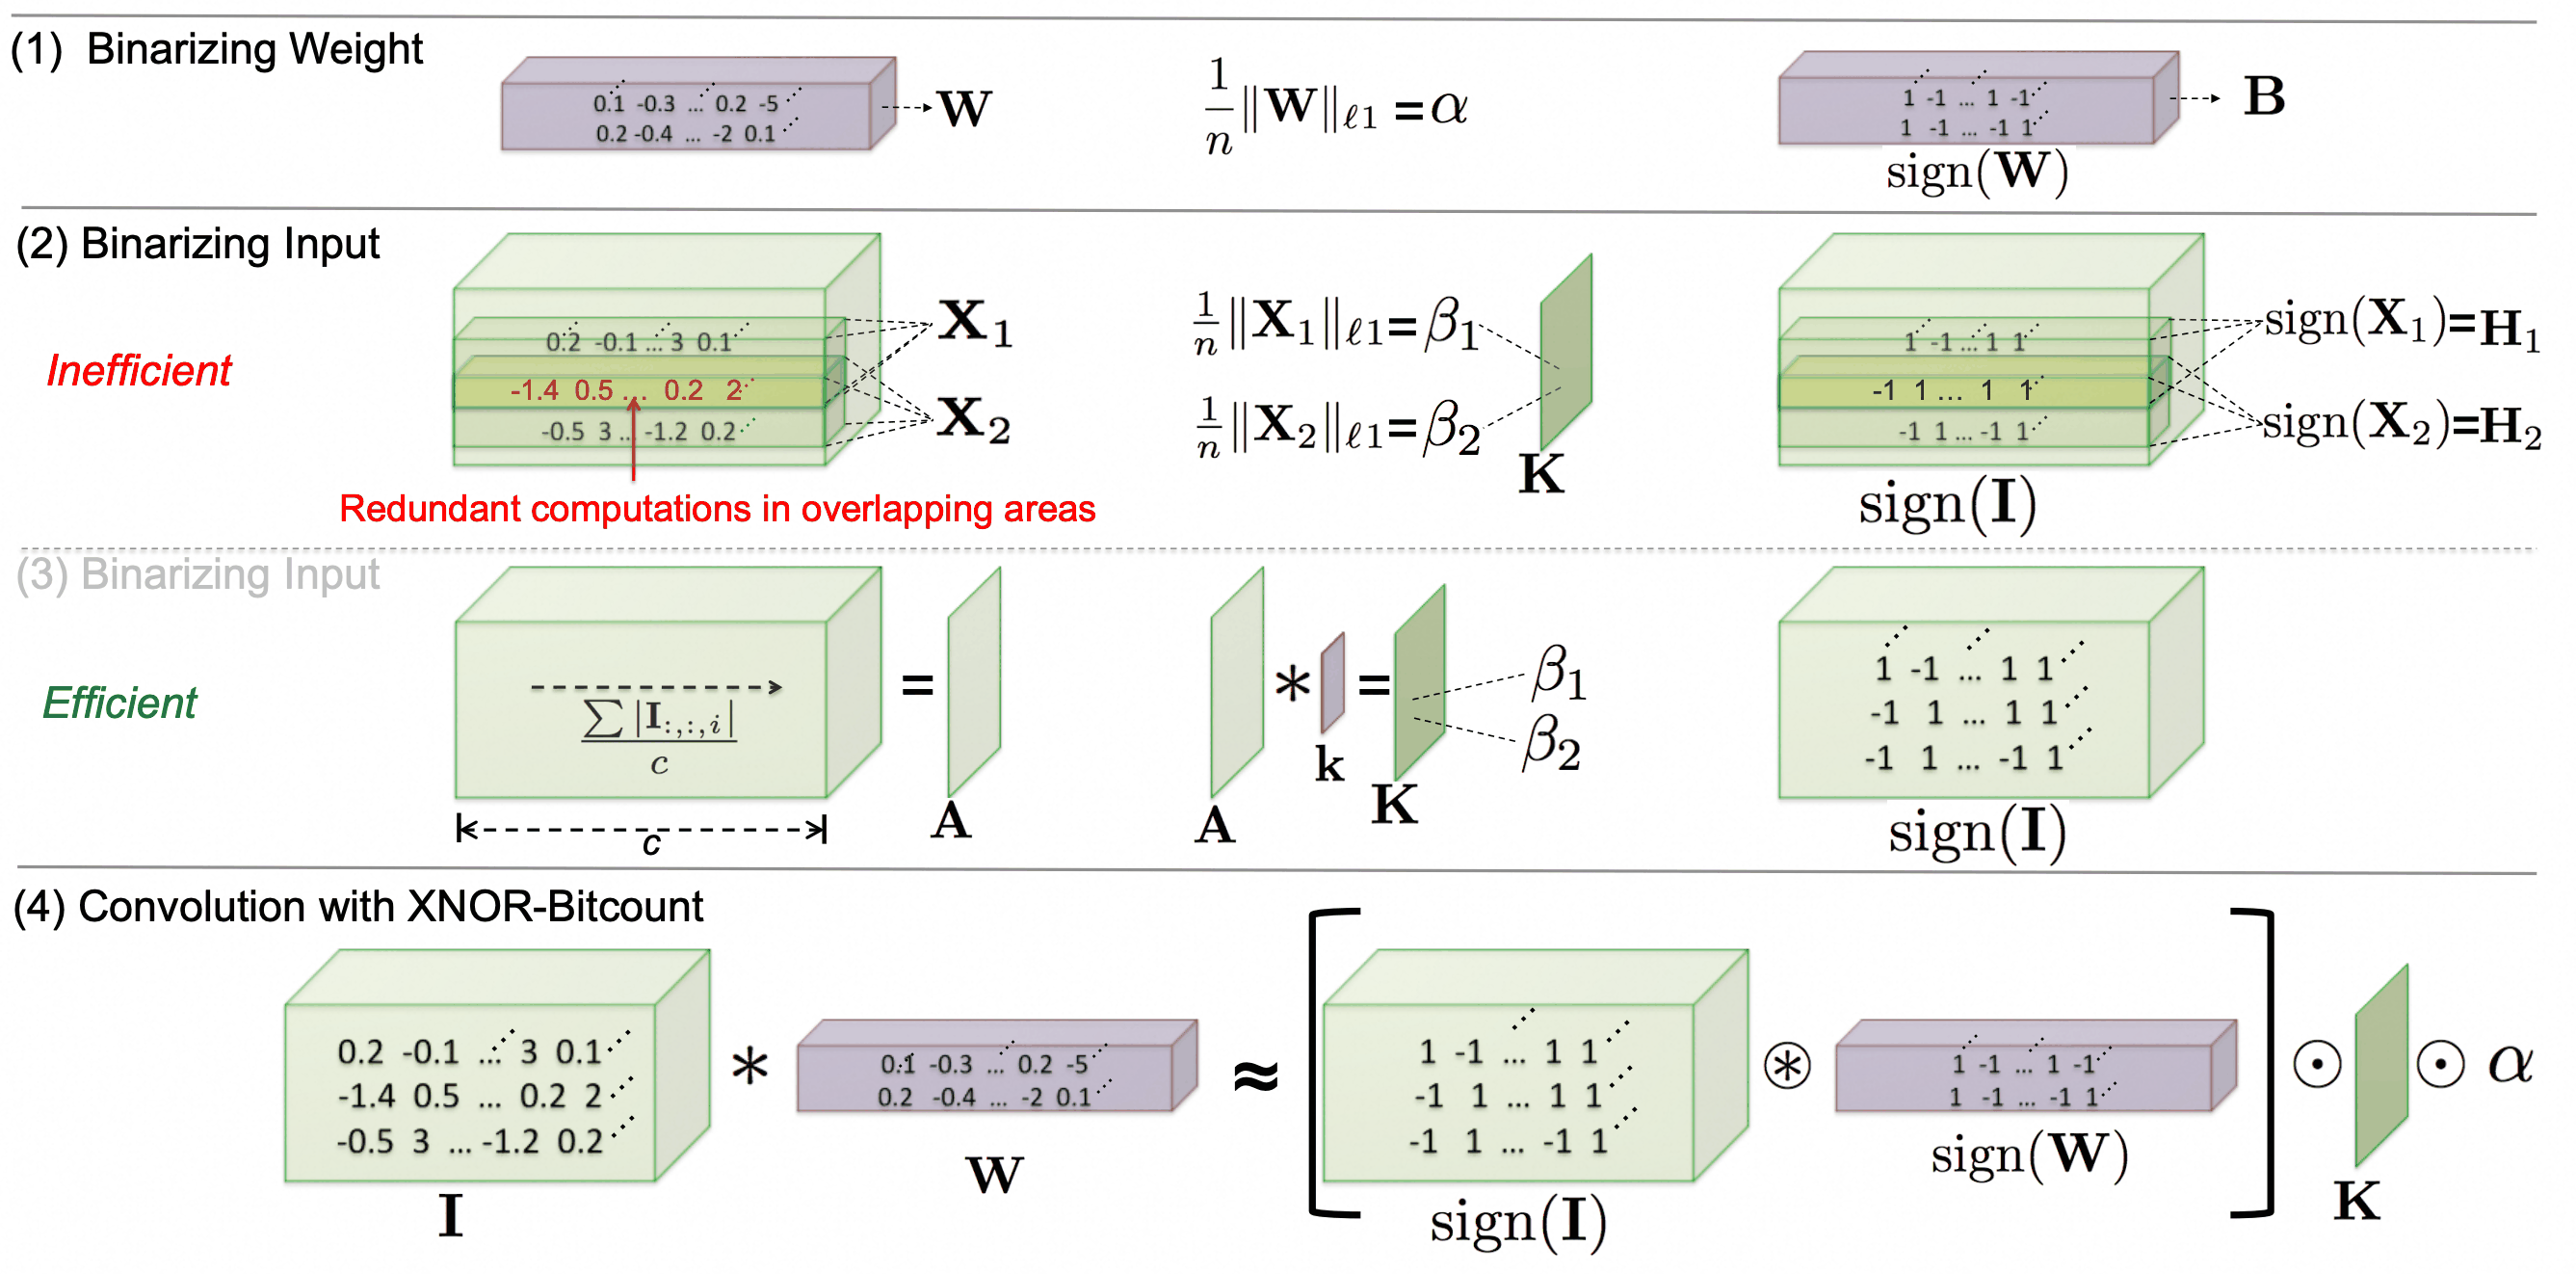
二值网络在实践中遇到了三大挑战:首先是显著的精度损失,在大型复杂任务上尤为明显;其次是对定制硬件的强依赖,如果没有专门的位运算加速内核,在通用GPU上模拟二值运算甚至可能比原生INT8更慢;最后,网络的首尾层、归一化层和残差连接通常需要保持较高精度才能稳定训练,使得整个系统并非“完全二值化”。
⚪ LSQ:通过任务损失学习量化步长
在极端的二值化和常规的float32之间,存在着广阔的低比特量化空间(如2/4/8-bit)。一个核心问题是:如何为每一层的权重和激活值确定最佳的量化范围和精度?LSQ把量化步长$s$设为可学习参数。对于一个输入值$v$,其量化过程如下:
\[\widehat{v}=s\cdot \operatorname{clip}\left(\operatorname{round}(v/s),Q_N,Q_P\right),\]$Q_N,Q_P$定义了量化比特数对应的整数范围(例如对于4-bit,范围是$[-8, 7]$)。并对$s$使用与张量元素数和量化范围相关的梯度缩放。由于round函数是不可导的,LSQ使用直通估计器(Straight-Through Estimator, STE)来近似其梯度,从而允许步长$s$通过标准的反向传播和梯度下降进行端到端的优化。
(3) 大模型训练后量化
⚪ GPTQ:用二阶误差补偿进行低比特权重量化
GPTQ逐层最小化校准输入上的输出重建误差:
\[\min_{\widehat{W}}\|WX-\widehat{W}X\|_F^2.\]模型用近似$H=2XX^\top$的逆矩阵,在逐列量化后更新尚未量化的权重以补偿误差。它主要是weight-only PTQ:权重可降至低比特,激活通常仍以半精度计算。
权重更小能降低内存占用和解码阶段的权重带宽,但实际加速依赖融合反量化与矩阵乘内核;在计算受限的大批量场景中,收益可能小于低批量解码。
⚪ SmoothQuant:把激活离群难度迁移到权重
大模型激活的少数通道可能长期出现离群值,使统一INT8尺度牺牲大部分普通值的分辨率。对线性层$Y=XW$,SmoothQuant利用逐通道缩放等价性:
\[Y=(X\operatorname{diag}(s)^{-1}) (\operatorname{diag}(s)W).\]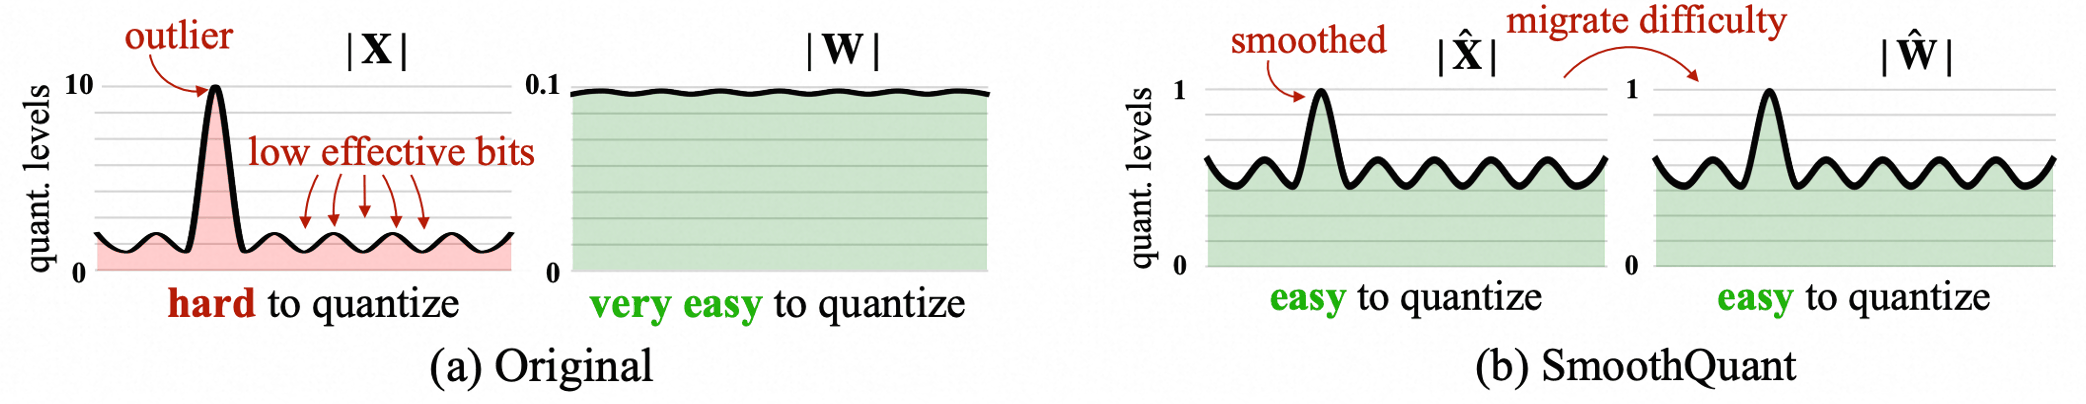
它离线缩小难量化的激活通道,并反向放大对应权重,把量化难度从动态激活迁移到静态权重,实现W8A8 PTQ。缩放参数来自校准数据,因此领域变化仍可能影响范围估计。
⚪ AWQ:用激活统计保护显著权重
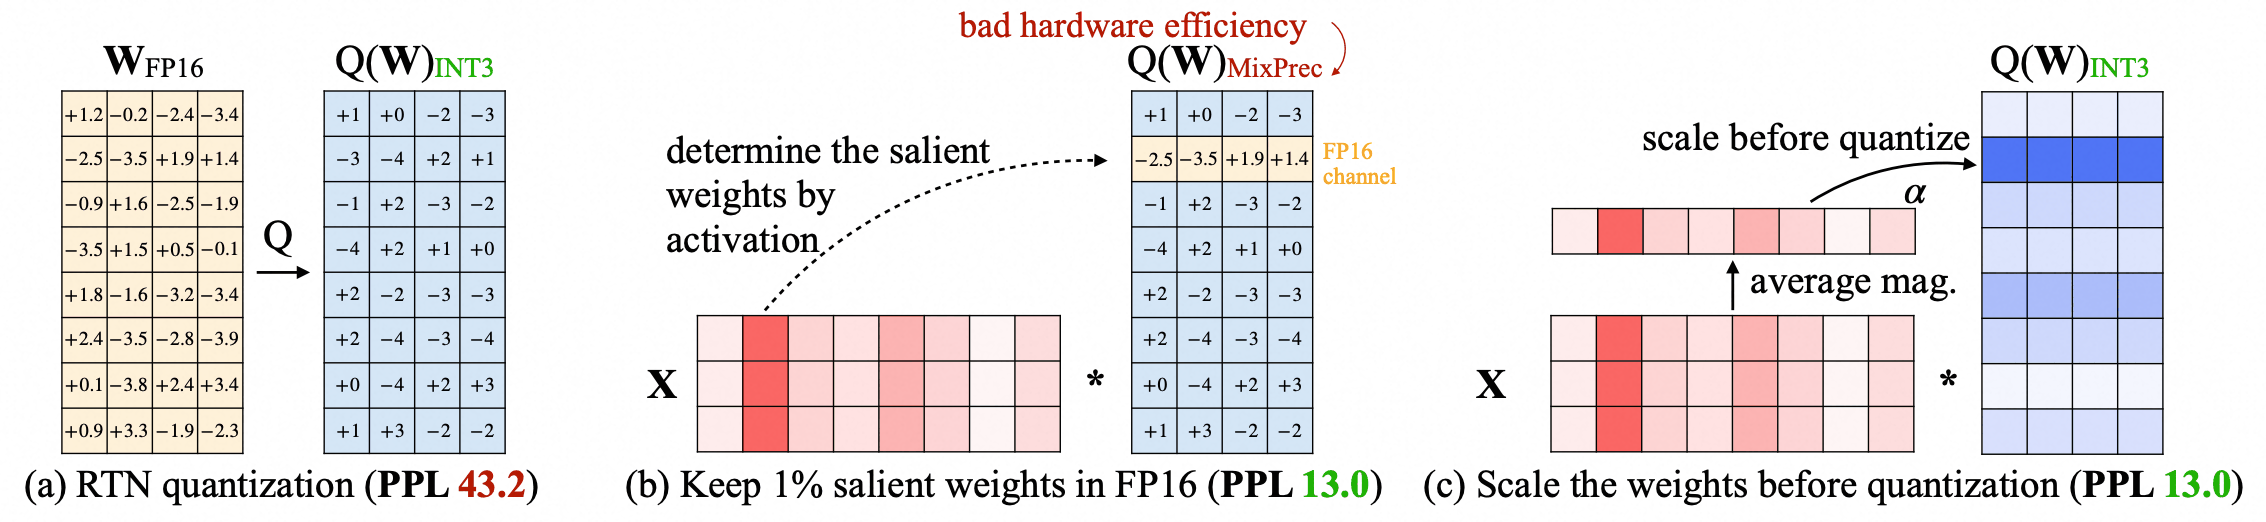
AWQ观察到少量权重通道对大模型输出格外重要,并用校准激活识别这些通道。它搜索逐通道缩放,在不进行反向传播的情况下减小显著权重的相对量化误差,再执行低比特权重量化。AWQ通常对应W4A16:权重低比特存储,激活仍为高精度。
⚪ KIVI:按键和值的分布差异量化 KV Cache
自回归解码时,每层历史键和值持续增长。KIVI根据分布差异对键采用逐通道量化、对值采用逐词元量化,并保留近期词元的高精度残差窗口,实现无需微调的非对称低比特缓存。
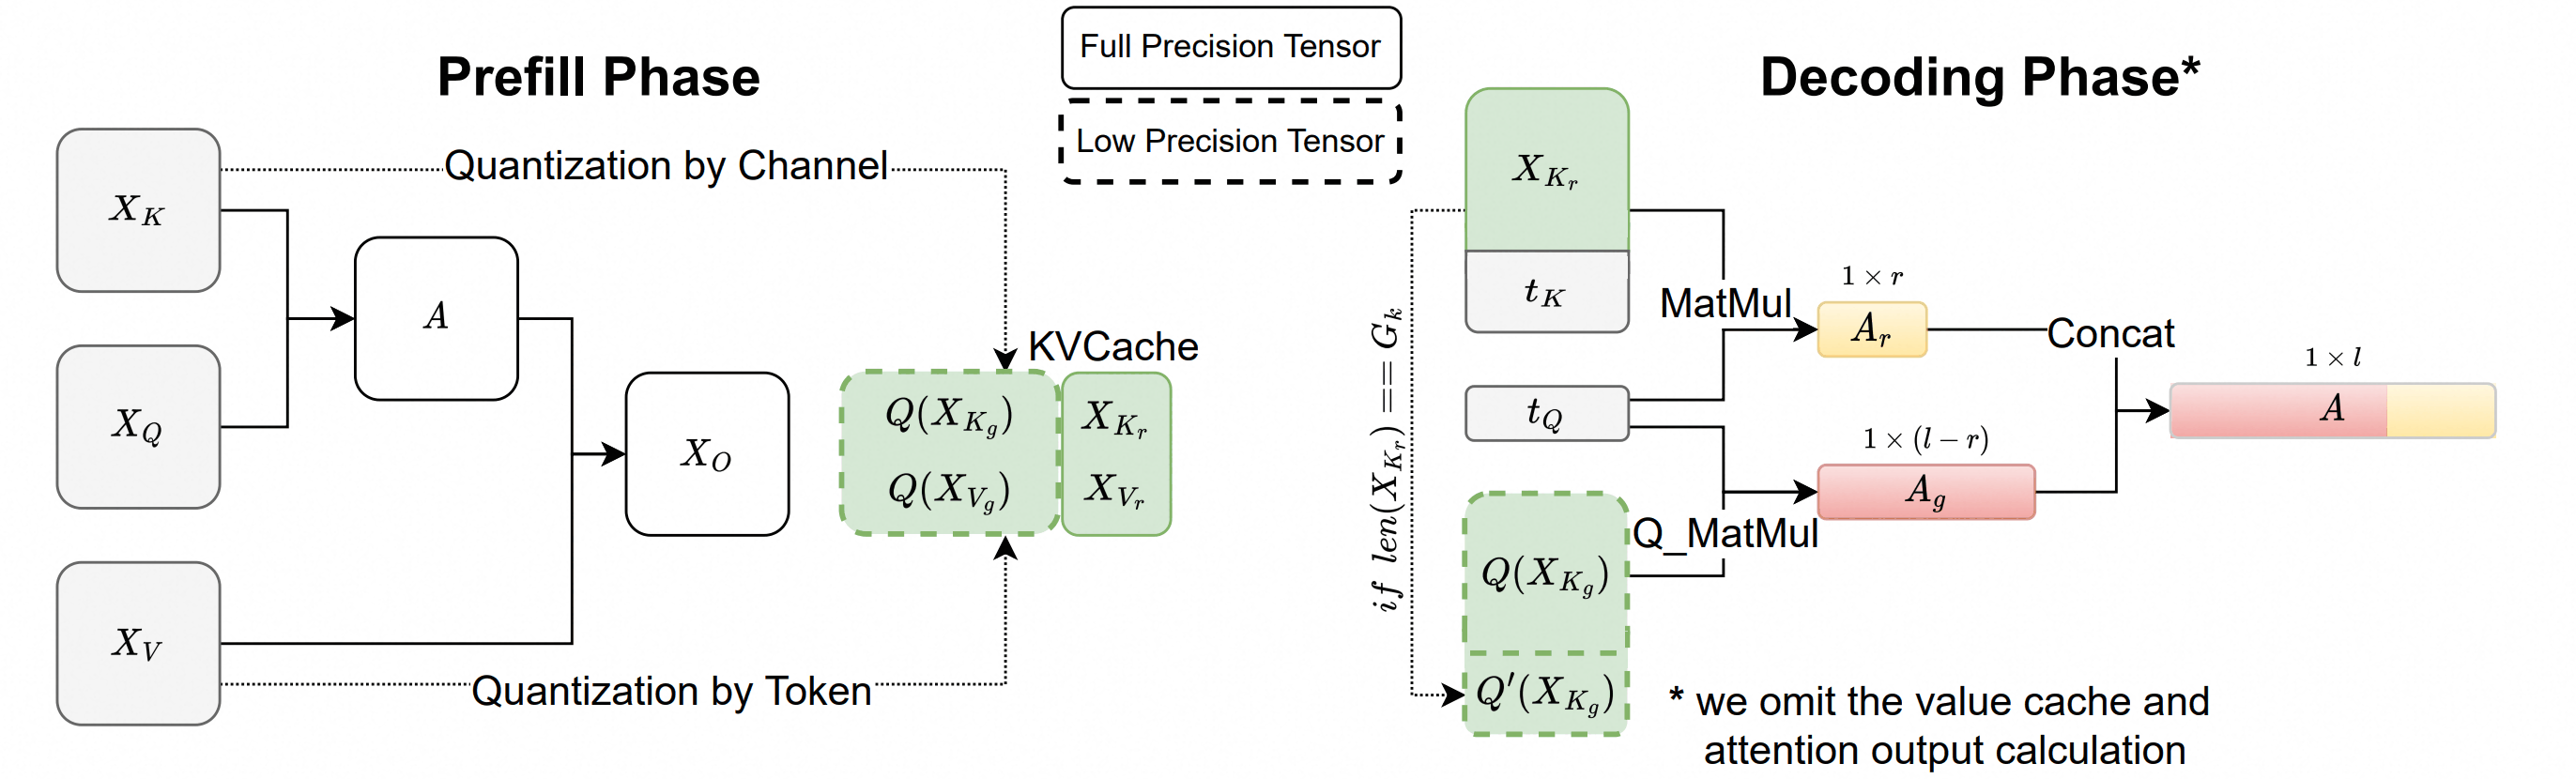
缓存量化不改变模型权重,也不直接减少前馈网络计算。它主要缓解长上下文和大批量解码的缓存容量与带宽压力,收益取决于上下文长度、批量、缓存读写占比和融合内核。
5. 低秩分解与结构压缩
(1) 权重矩阵的低秩近似
对$W\in\mathbb{R}^{M\times N}$进行截断SVD:
\[W\approx U_r\Sigma_rV_r^\top,\]其中$U_r\in\mathbb{R}^{M\times r}$、$\Sigma_r\in\mathbb{R}^{r\times r}$、$V_r\in\mathbb{R}^{N\times r}$。把奇异值吸收到两侧矩阵后,可以用两个连续线性层近似原映射:
\[Wx\approx A(Bx), \qquad A\in\mathbb{R}^{M\times r}, \quad B\in\mathbb{R}^{r\times N}.\]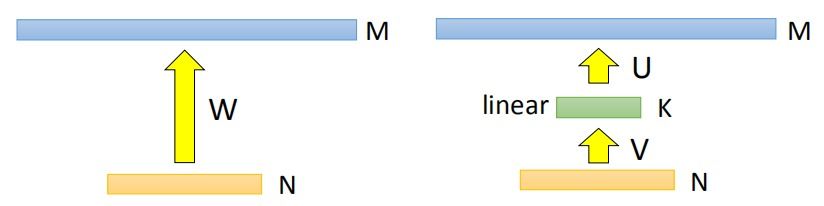
原矩阵有$MN$个参数,分解后约有$r(M+N)$个参数。只有满足:
\[r(M+N)<MN\]时才真正减少参数。近似矩阵的秩不超过$r$;若$r\ge\operatorname{rank}(W)$并保留全部非零奇异值,则可以精确重构,而不是任何分解都会损失信息。
⚪ Low-Rank CNN Compression:分解卷积映射降低计算
卷积核也可以沿空间维、输入通道或输出通道分解为连续的小卷积。分解可以由已训练权重的低秩近似得到,再通过微调恢复精度;CP、Tucker、Tensor Train等张量分解则施加不同的多维低秩结构。
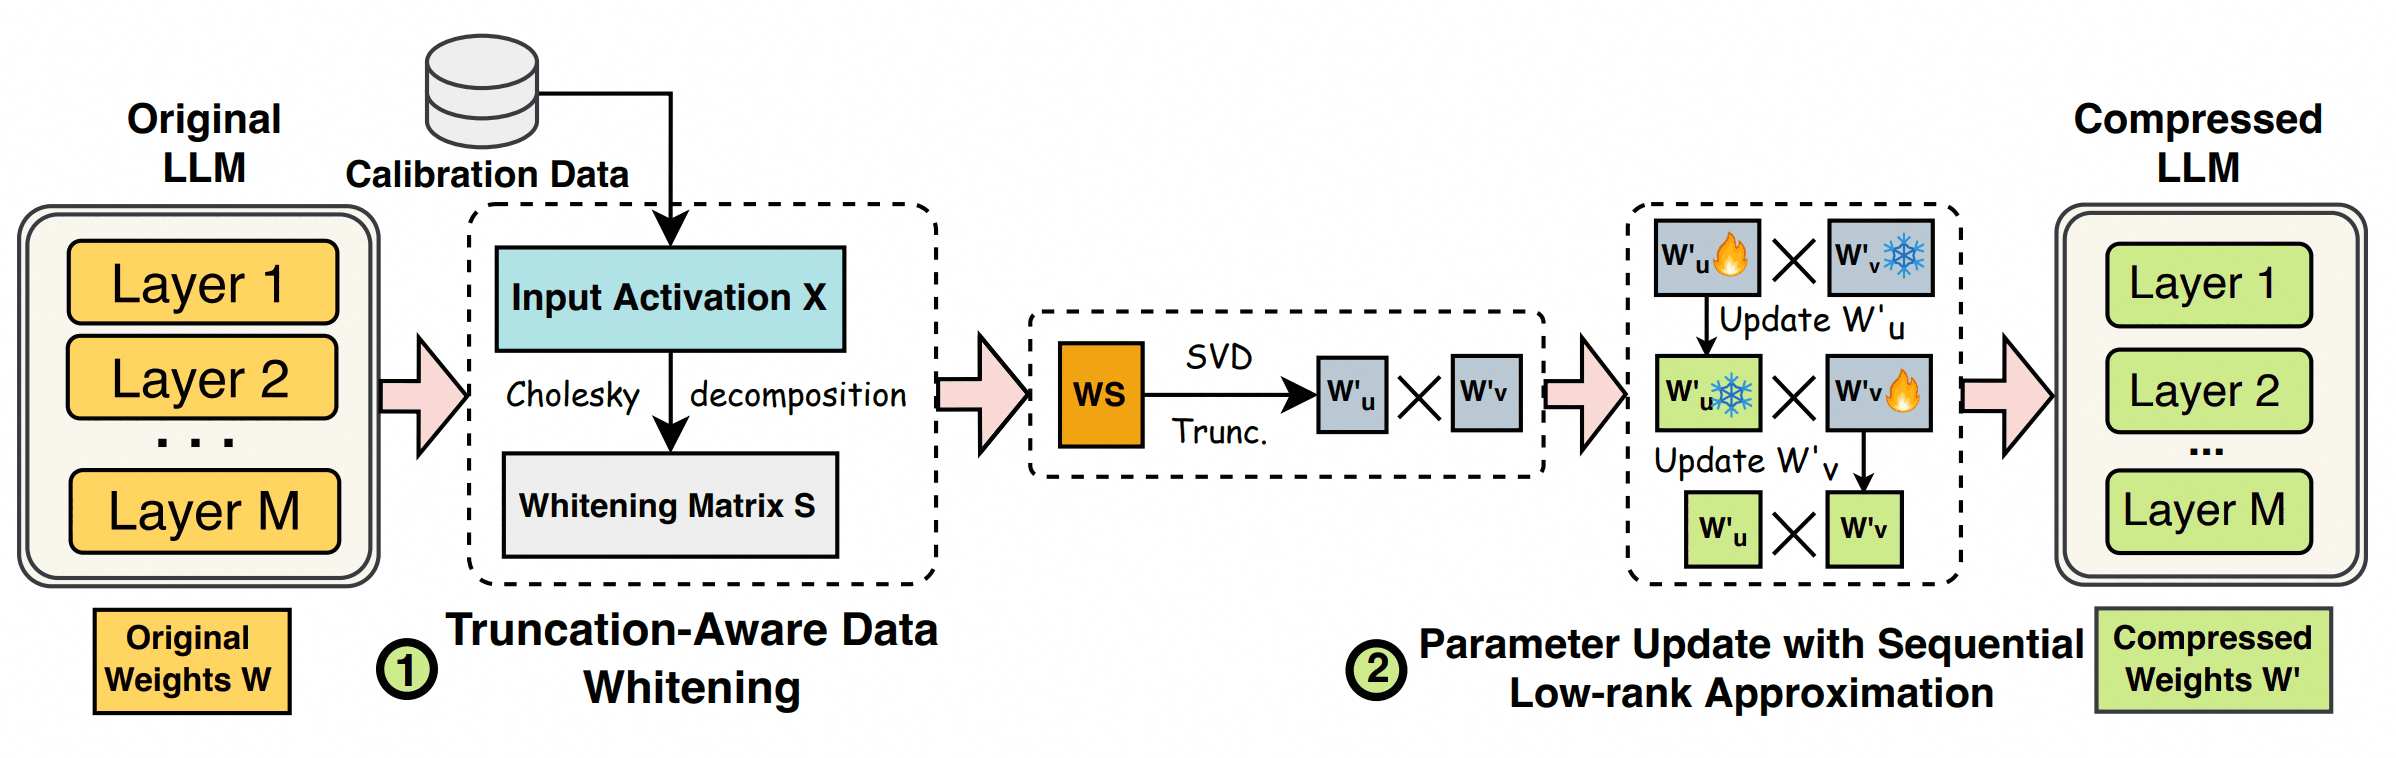
⚪ SVD-LLM:让大模型低秩截断感知激活分布
直接对大模型权重做SVD只最小化权重重建误差,却不一定最小化层输出误差。SVD-LLM利用校准激活对白化后的权重进行截断,再顺序更新后续层以补偿误差,使保留的低秩方向更贴合实际输入分布。
(2) 结构分解与轻量网络
深度可分离卷积把标准卷积分为逐通道空间卷积和$1\times1$逐点卷积:
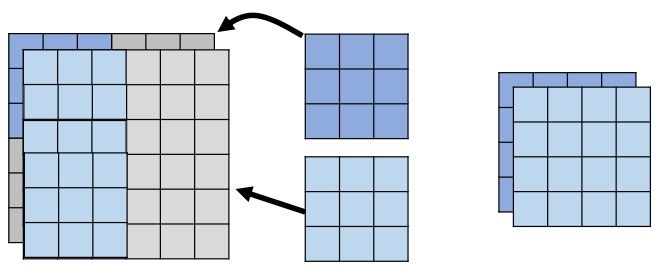
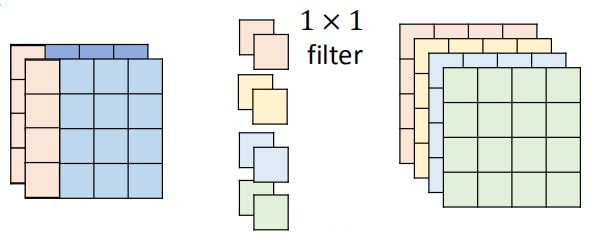
对卷积核大小$k\times k$、输入通道$I$和输出通道$O$,忽略偏置且深度乘子为$1$时,标准卷积与深度可分离卷积的参数量分别为:
\[P_{\text{conv}}=k^2IO, \qquad P_{\text{sep}}=k^2I+IO.\]二者比值为:
\[\frac{P_{\text{sep}}}{P_{\text{conv}}} =\frac{1}{O}+\frac{1}{k^2}.\]深度卷积、组卷积和结构重参数化的完整推导见卷积神经网络,MobileNet、ShuffleNet、GhostNet等架构见轻量级卷积神经网络。
6. 动态计算与条件计算
静态压缩让每个输入经过相同的小模型;动态计算(dynamic computation)则根据样本难度、当前状态或资源预算,只激活部分层、词元、通道或专家。若输入在第$k$个出口停止的概率为$P(e=k)$、累计计算量为$C_k$,平均计算量为:
\[\mathbb{E}[C]=\sum_kP(e=k)C_k.\](1) 早退
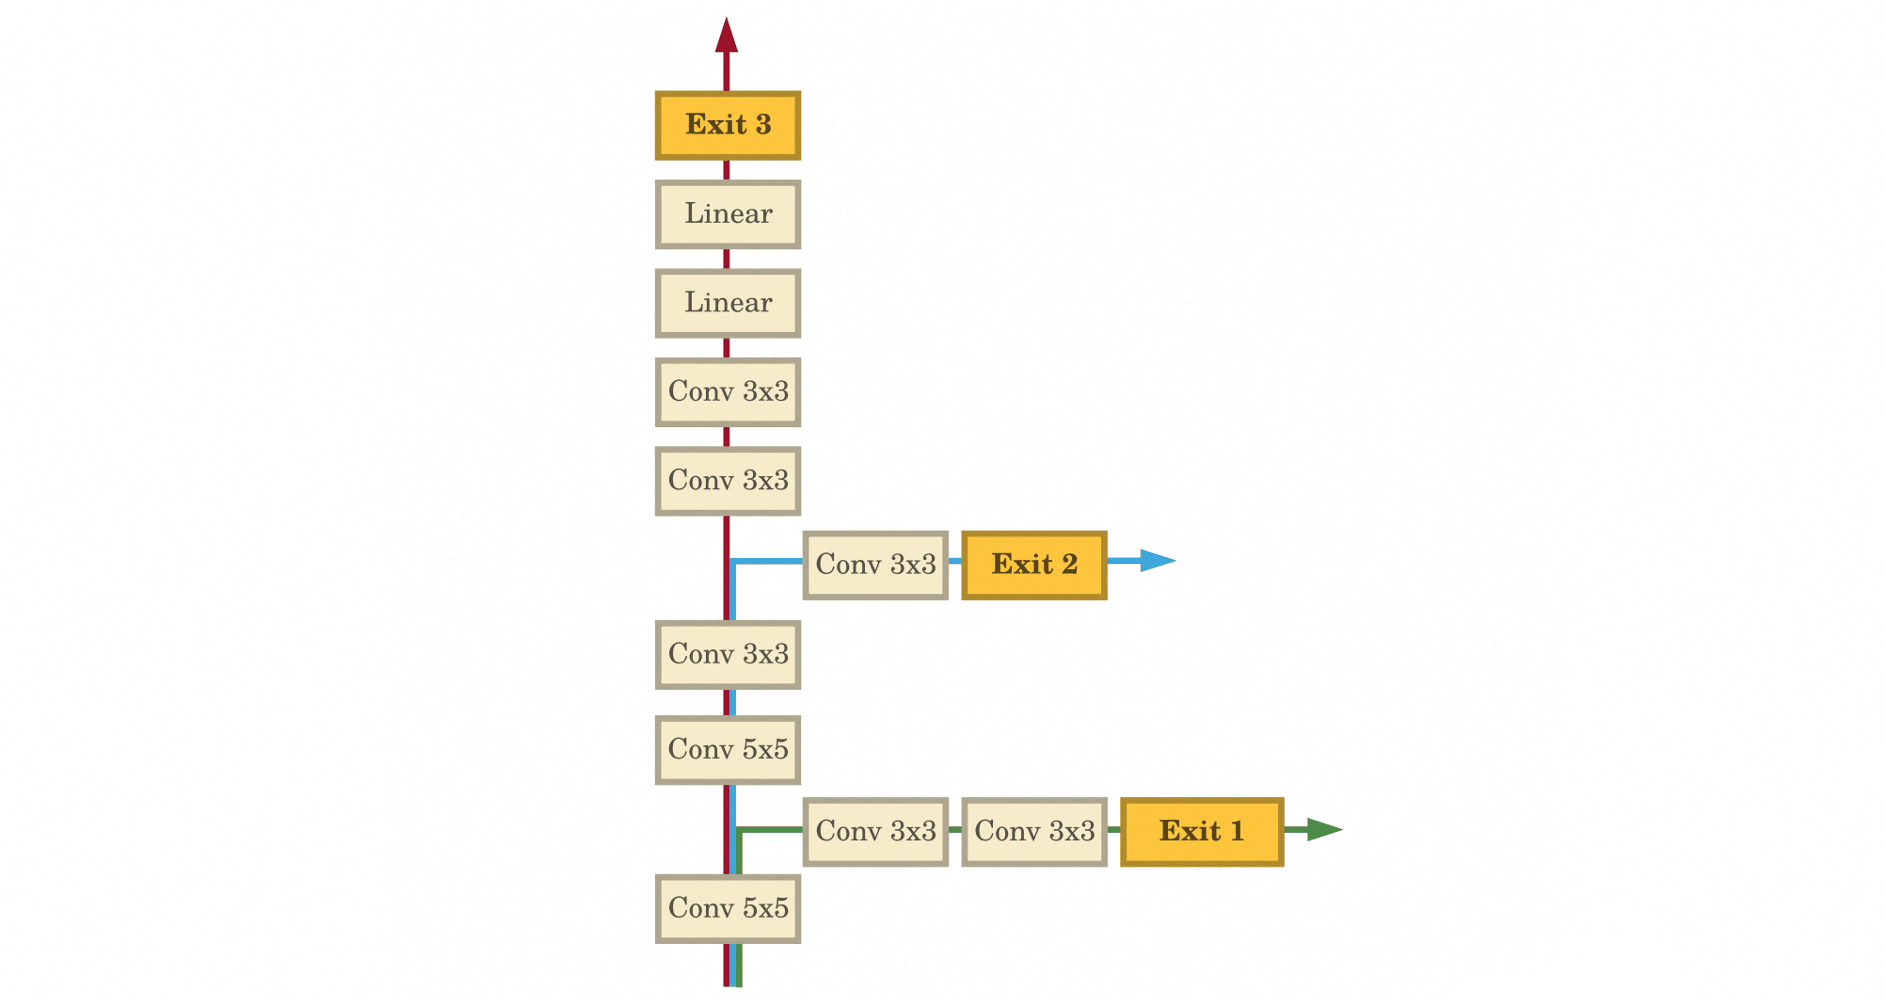
早退(Early Exiting)模型在多个深度设置分类器。简单的样本不需要走完整个网络的深度计算流程,模型在中间层设置“出口”(classifiers),一旦对某个样本的预测达到足够的置信度,就提前输出结果;困难样本则继续计算。
⚪ BranchyNet:“早退”概念的朴素实现
BranchyNet直接在AlexNet、ResNet等经典网络的主干上附加分类“分支”。如果某个分支的预测置信度超过阈值,则提前返回结果。
⚪ MSDNet:用多尺度特征支持任意时刻预测
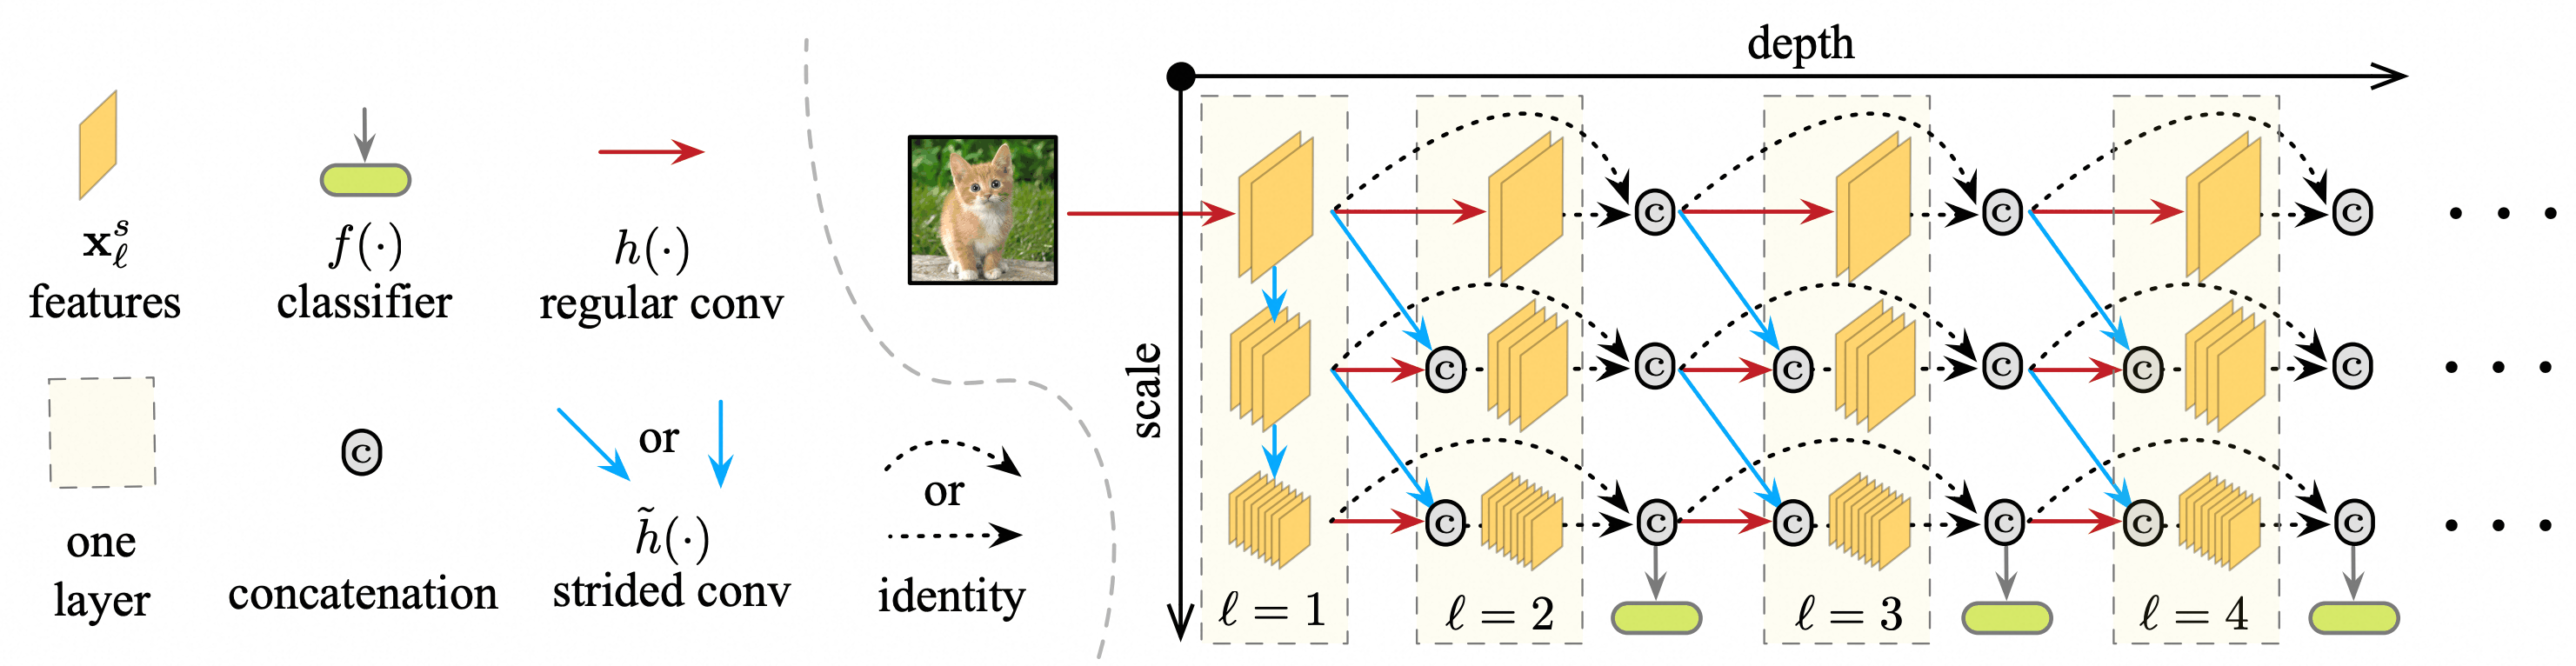
普通网络浅层特征分辨率高但语义弱,直接加分类器可能降低早期出口质量并干扰主干训练。MSDNet(Multi-Scale Dense Network)在网络中并行维护多个不同尺度(分辨率)的特征图,并在层内和跨尺度之间都建立了稠密的连接,使中间层同时获得粗粒度语义和细粒度信息,支持按样本预算或任意时间预测。
⚪ DeeBERT:早退的Transformer模型
DeeBERT在BERT的每一层之后,都附加一个轻量级分类器。通过检查[CLS] token输出的熵或置信度,模型可以判断是否已经获得了足够的信息来做出决策。
(2) 超网络模型
超网络(Supernetwork)的核心思想是构建一个包含海量子网络的“超网络”,并高效地训练它,使得从中采样出的任何子网络都具备良好的性能;从而得到一个可以适应不同硬件设备和延迟要求的模型家族。
⚪ Slimmable Networks:具有可切换批量归一化的共享网络
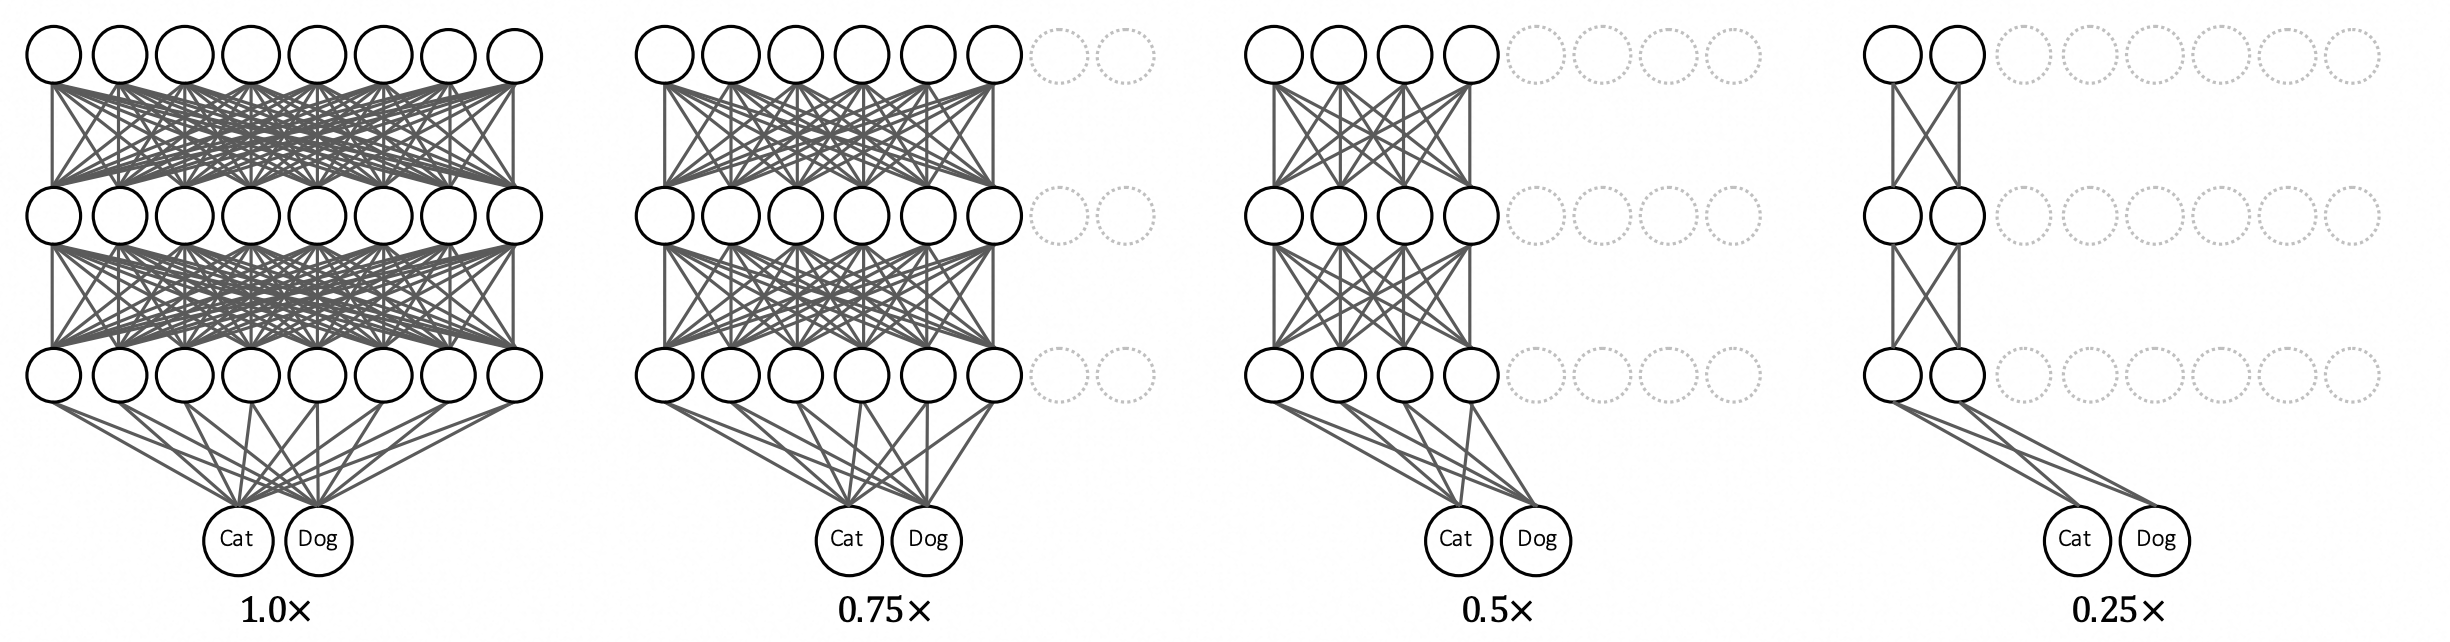
Slimmable Networks训练一个单一网络,但使其权重能够支持在推理时动态切换不同的“宽度”(即通道数)。其关键技术是可切换批归一化(Switchable Batch Normalization),为每个宽度配置(如1.0x, 0.75x, 0.5x)维护独立的BN统计量,从而避免了不同宽度配置在训练时的相互干扰。这使得同一个模型文件可以无缝部署在从高端到低端的不同设备上,只需在运行时选择合适的宽度即可。
⚪ OFA:渐进式收缩的超网络训练
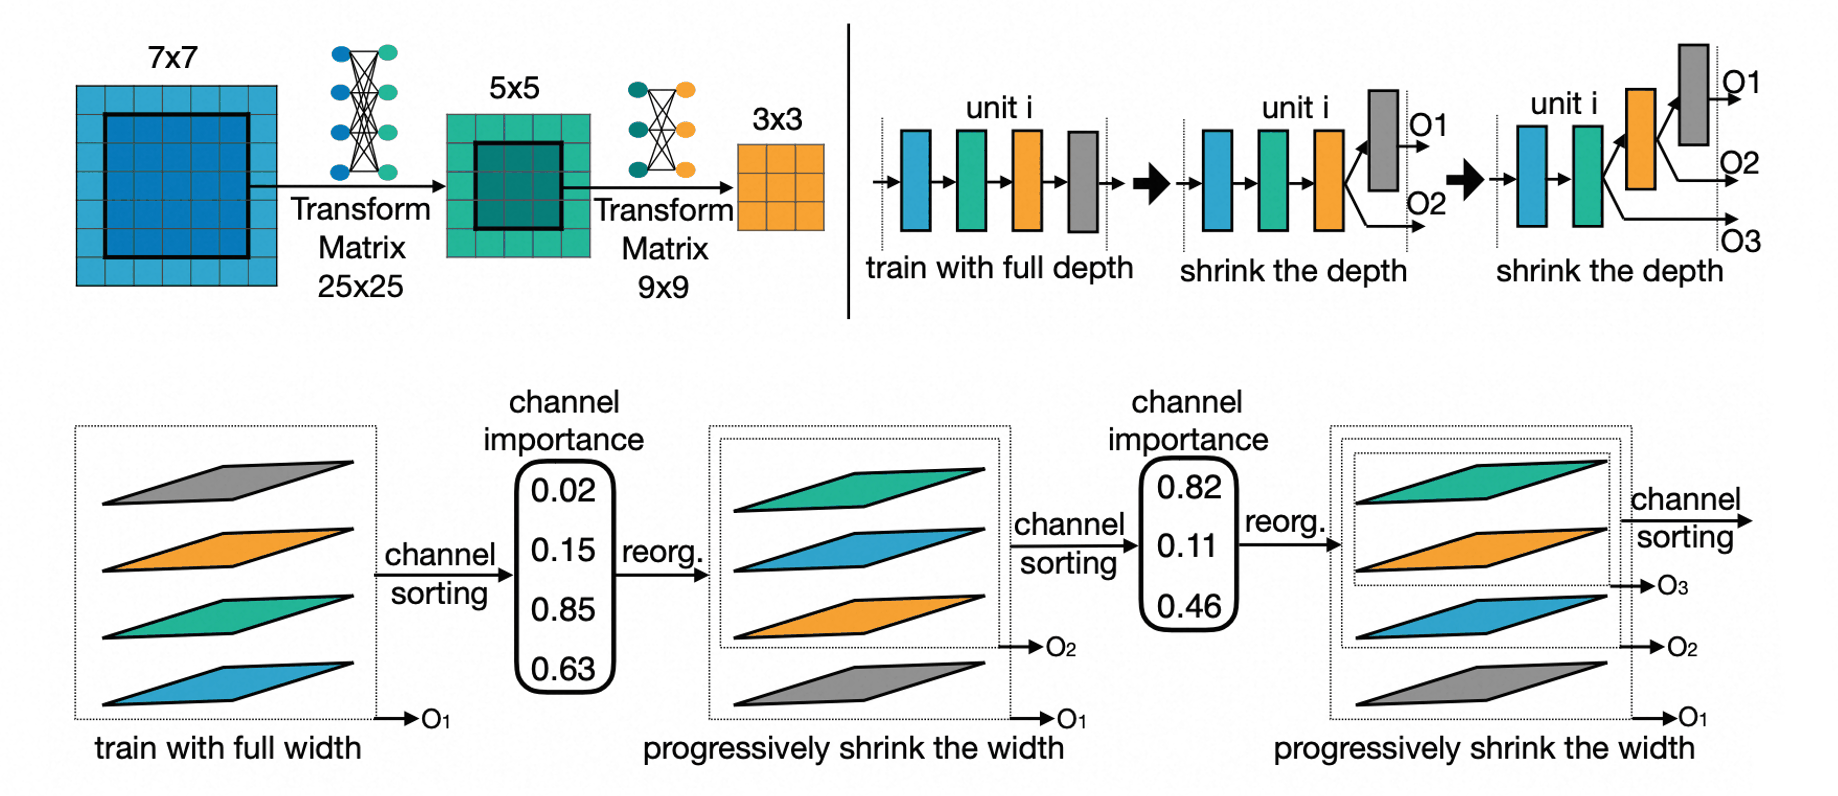
OFA的核心是构建并训练一个巨大的超网络,这个超网络包含了搜索空间中所有可能的子网络架构。推理时,可以从中“采样”出一个特定的子网络来执行任务,而无需任何重新训练。这个超网络在多个维度上都是“弹性”的:
- 深度(Depth): 可以选择性地跳过某些层。
- 宽度(Width): 每一层可以有不同数量的通道(channels)。
- 卷积核大小(Kernel Size): 每一层可以使用不同大小的卷积核(如3x3, 5x5, 7x7)。
- 输入分辨率(Resolution): 可以处理不同尺寸的输入图像。
OFA的训练方法是渐进式收缩(Progressive Shrinking):
- 训练全尺寸网络: 首先,训练一个具有最大深度、最大宽度和最大卷积核的完整超网络,确保其达到SOTA性能。
- 弹性卷积核训练: 在保持网络尺寸不变的情况下,开始在训练中引入弹性卷积核。在每个训练批次中,除了更新最大的核(如7x7),也随机选择并更新较小的核(如5x5, 3x3)。为了让不同尺寸的卷积核共享权重,作者设计了一种方法,即小核的权重由大核中心部分的权重通过一个变换矩阵得到。这样,训练大核的同时也间接训练了小核。
- 弹性深度与宽度训练: 接下来,逐步引入弹性的深度和宽度。在每个训练批次,随机从超网络中采样一个具有不同深度和宽度的子网络。关键点在于,梯度只在被采样的子网络的权重上传播。通过在训练中遍历各种尺寸的子网络,模型学会了让不同尺寸的架构都能协同工作。
一旦OFA超网络训练完成,它就变成了一个巨大的、即取即用的“模型库”。实际应用时的架构搜索阶段变得极其廉价:确定部署目标后,使用一个简单的搜索算法(如进化算法或随机搜索)在这个训练好的OFA网络中进行采样。随机选择一个子网络架构(确定其深度、宽度、核大小等),在验证集上运行一次前向传播,立即得到其准确率(无需训练);将该子网络部署到目标硬件上,直接测量其延迟、功耗等指标。重复上述过程数千次(由于无需训练,这个过程非常快),记录下所有满足硬件约束且性能最优的架构。
(3) 动态词元计算
对于标准自注意力,第$l$层词元数为$n_l$时,注意力计算量近似满足:
\[C_{\text{attn}}\propto\sum_l n_l^2d.\]越早减少无关词元,后续层节省越大;但词元重要性会随层和任务变化,过早删除的信息可能无法恢复。
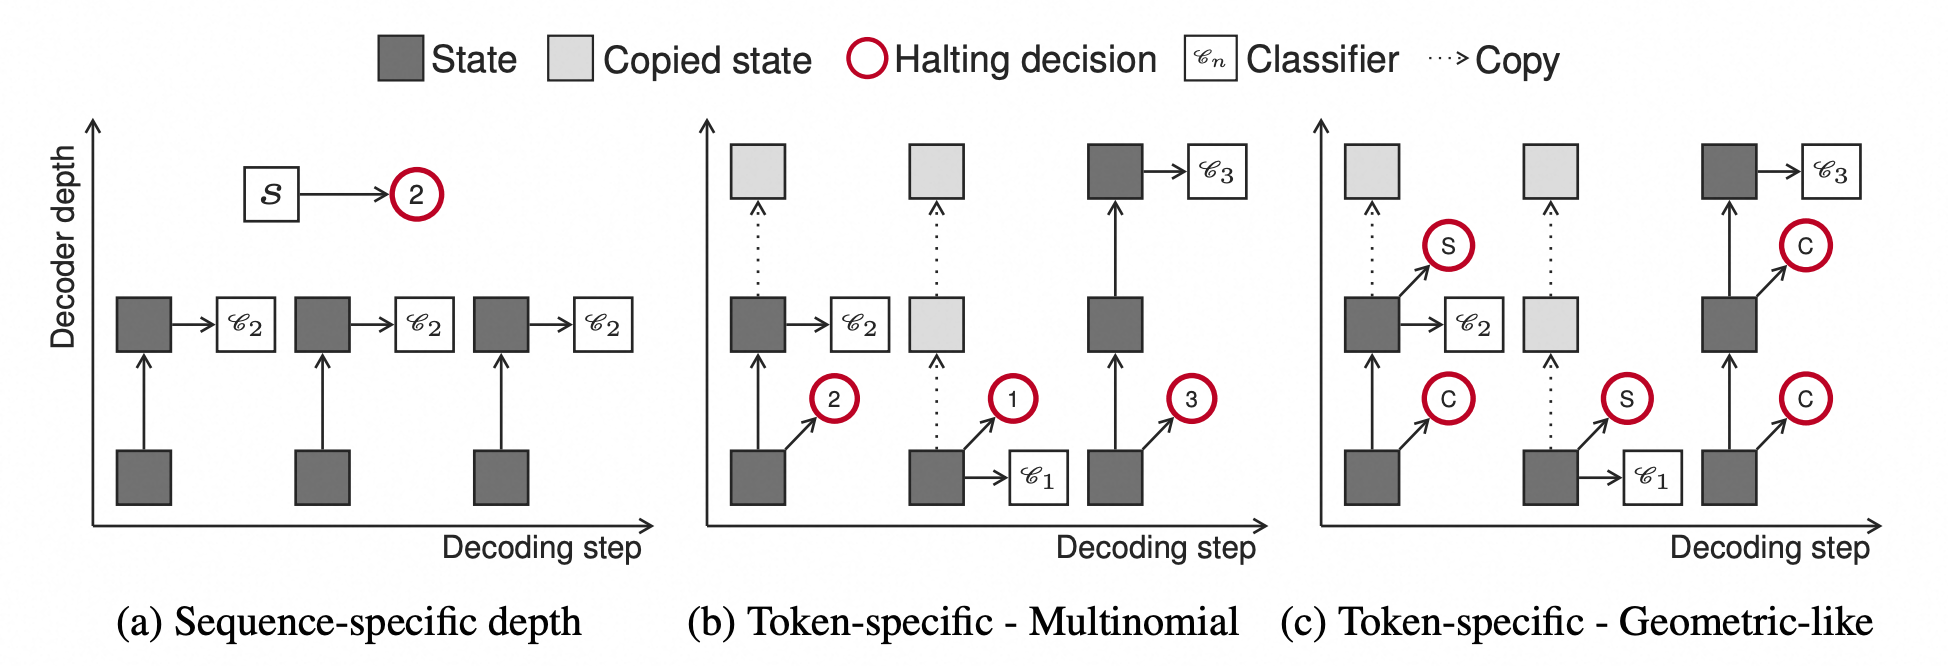
⚪ DAT:暂停成熟Token的更新
在处理一个句子时,DAT允许每个Token独立决定是否继续参与后续层的计算。对于“the”、“a”这类简单的Token,可能几层之后其表示就已“成熟”(不再发生大的变化),从而可以跳过后续昂贵的自注意力计算。
为了实现这一目标,作者设计了一个“暂停模块”(Halting Module)。在Transformer的每个标准层之后,都附加一个非常轻量级的模块。这个模块通常就是一个简单的线性层加上Sigmoid激活函数。它的输入是当前层计算出的token隐状态$h_t^{(l)}$,输出是一个暂停概率(halting probability)$p_t^{(l)}$。这个概率值代表了token $t$在第$l$层“决定停下来”的可能性。
一个token在第 $l$ 层实际停留的概率,是它在当前层决定暂停(概率$p_t^{(l)}$),并且在之前所有层都没有暂停的概率之积。最终,一个token的最终输出表示 $h_t^{\text{final}}$,是它在每一层可能停留的表示的加权期望。权重就是它在该层实际停留的概率。
\[h_t^{\text{final}} = \sum_{l=1}^{L} P(\text{halt at layer } l) \cdot h_t^{(l)}\]在训练时使用概率混合是为了梯度的平滑传播。在推理时,为了真正节省计算,会采用一个更直接的策略:累积暂停概率。当一个token从第一层开始累积的暂停概率总和超过一个预设阈值(例如0.9)时,它就立即停止计算。
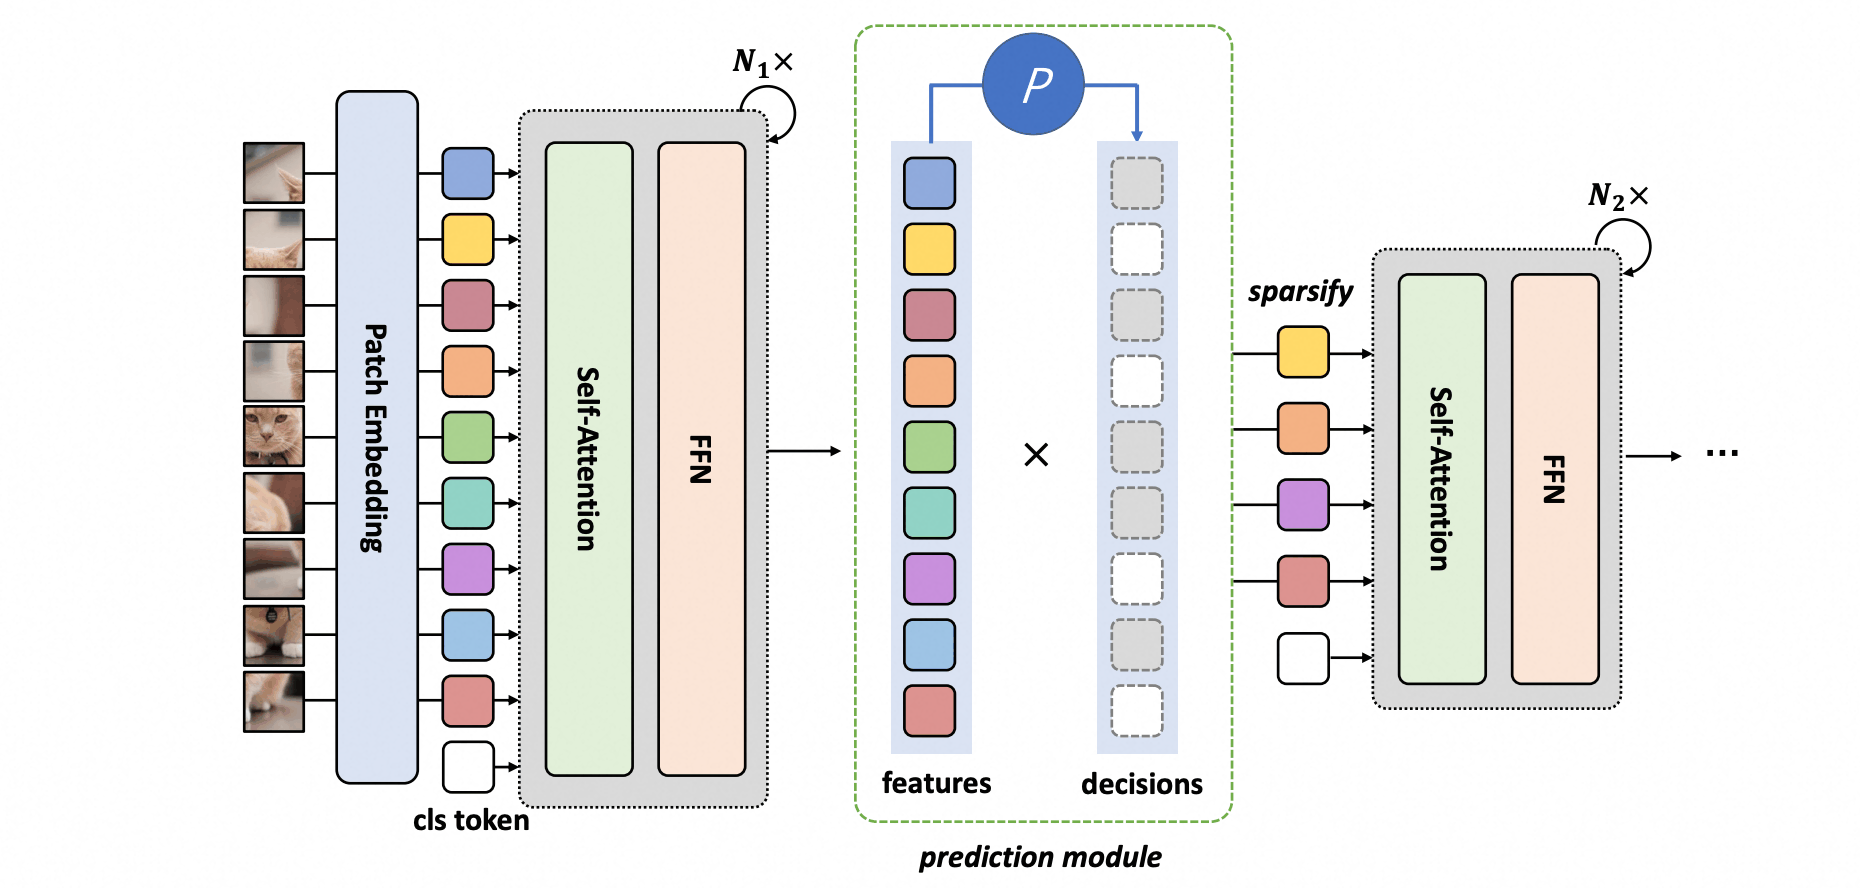
⚪ DynamicViT:逐层预测并裁剪视觉词元
DynamicViT在多层插入轻量预测器,根据局部词元和全局上下文估计保留概率,并通过注意力掩码和可微近似训练。它让后续层只处理被保留词元,从而降低二次注意力和前馈计算。
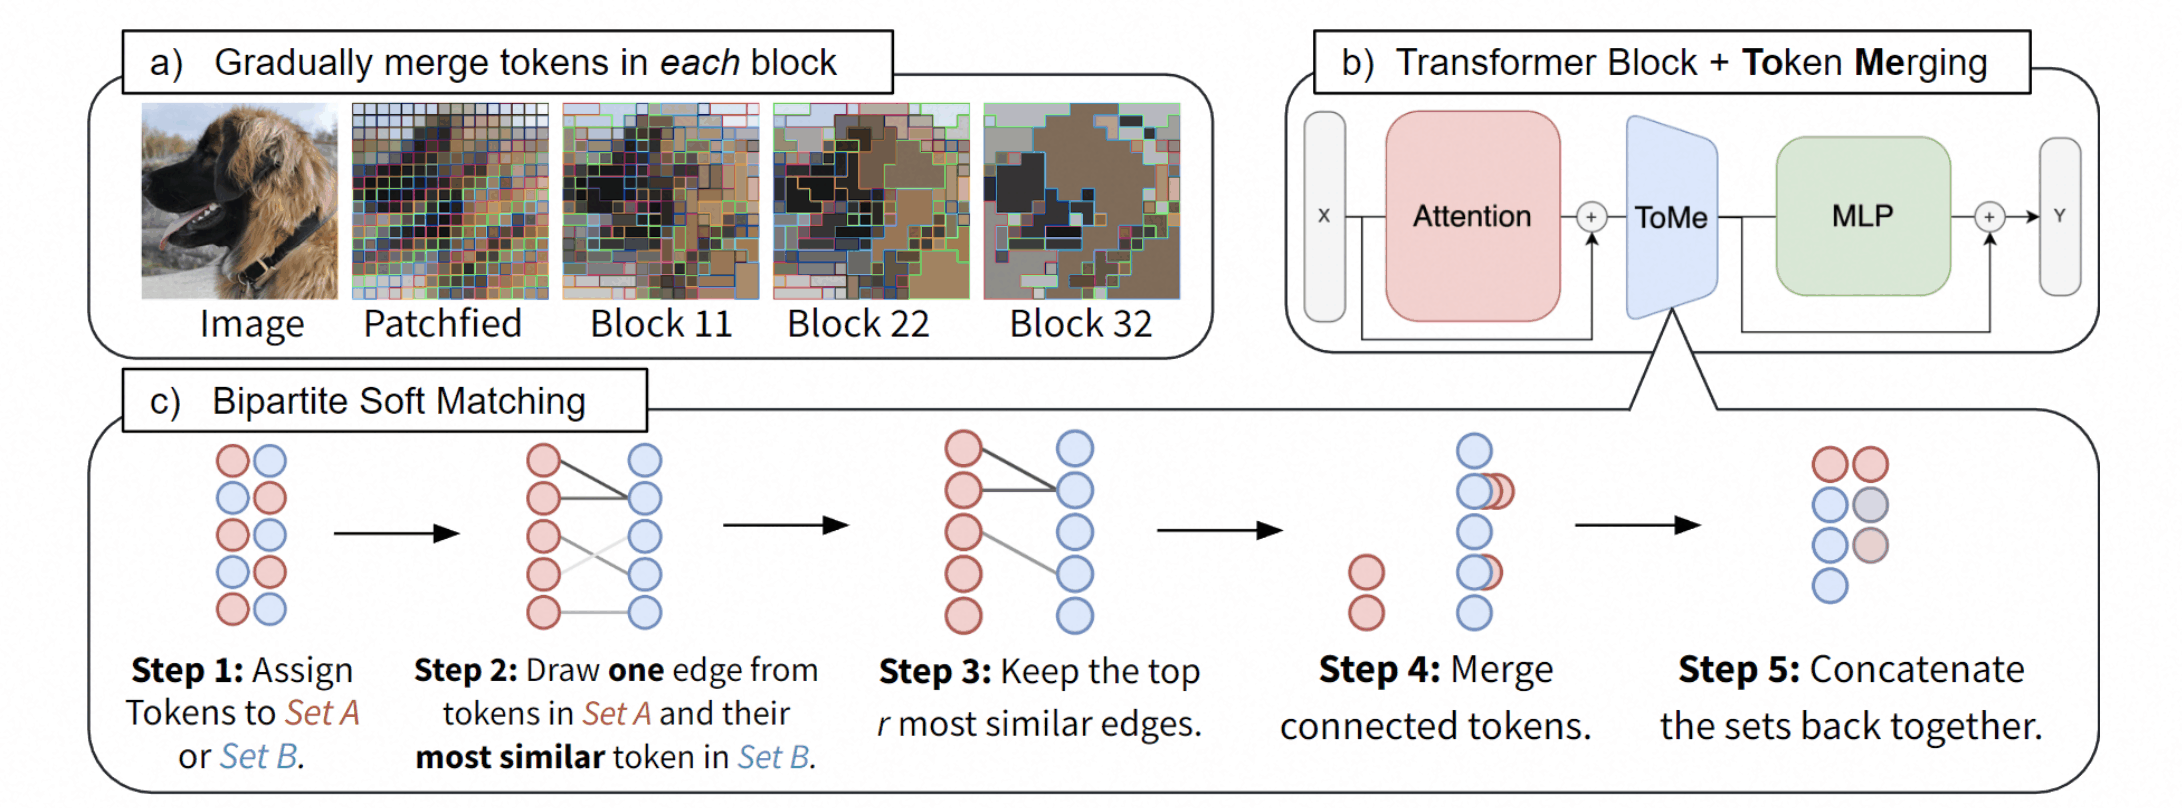
⚪ Token Merging(ToMe):合并相似词元
在一个序列中,尤其是在经过几层Transformer的计算之后,许多token的表示会变得非常相似。例如,在图像中背景里的多片天空或草地对应的token;在文本中连续的停用词或同一实体的不同部分。这些相似的token携带了大量冗余信息。将它们合并成一个单一的token可以显著缩短序列长度。
ToMe可以在不进行任何重新训练的情况下,直接应用于预训练好的Transformer模型。其合并过程如下:
- 相似度计算: 在一个要进行合并的层,模型会计算所有token对之间的相似度。这个相似度通常使用简单的余弦相似度来衡量它们的隐状态向量。
- 双向匹配 (Bipartite Matching): 为了决定哪些token应该被合并,从序列中随机选择一部分token作为“源”,另一部分作为“目标”,然后进行匹配,确保每个token最多只参与一次合并。
- 加权平均与路由: 新token的表示是原始两个token表示的加权平均。这个权重通常与它们在原始序列中的“重要性”或“注意力得分”相关。在后续的注意力计算中,原本应该流向原始两个token的注意力,现在都会被路由到这个新的合并后的token上。
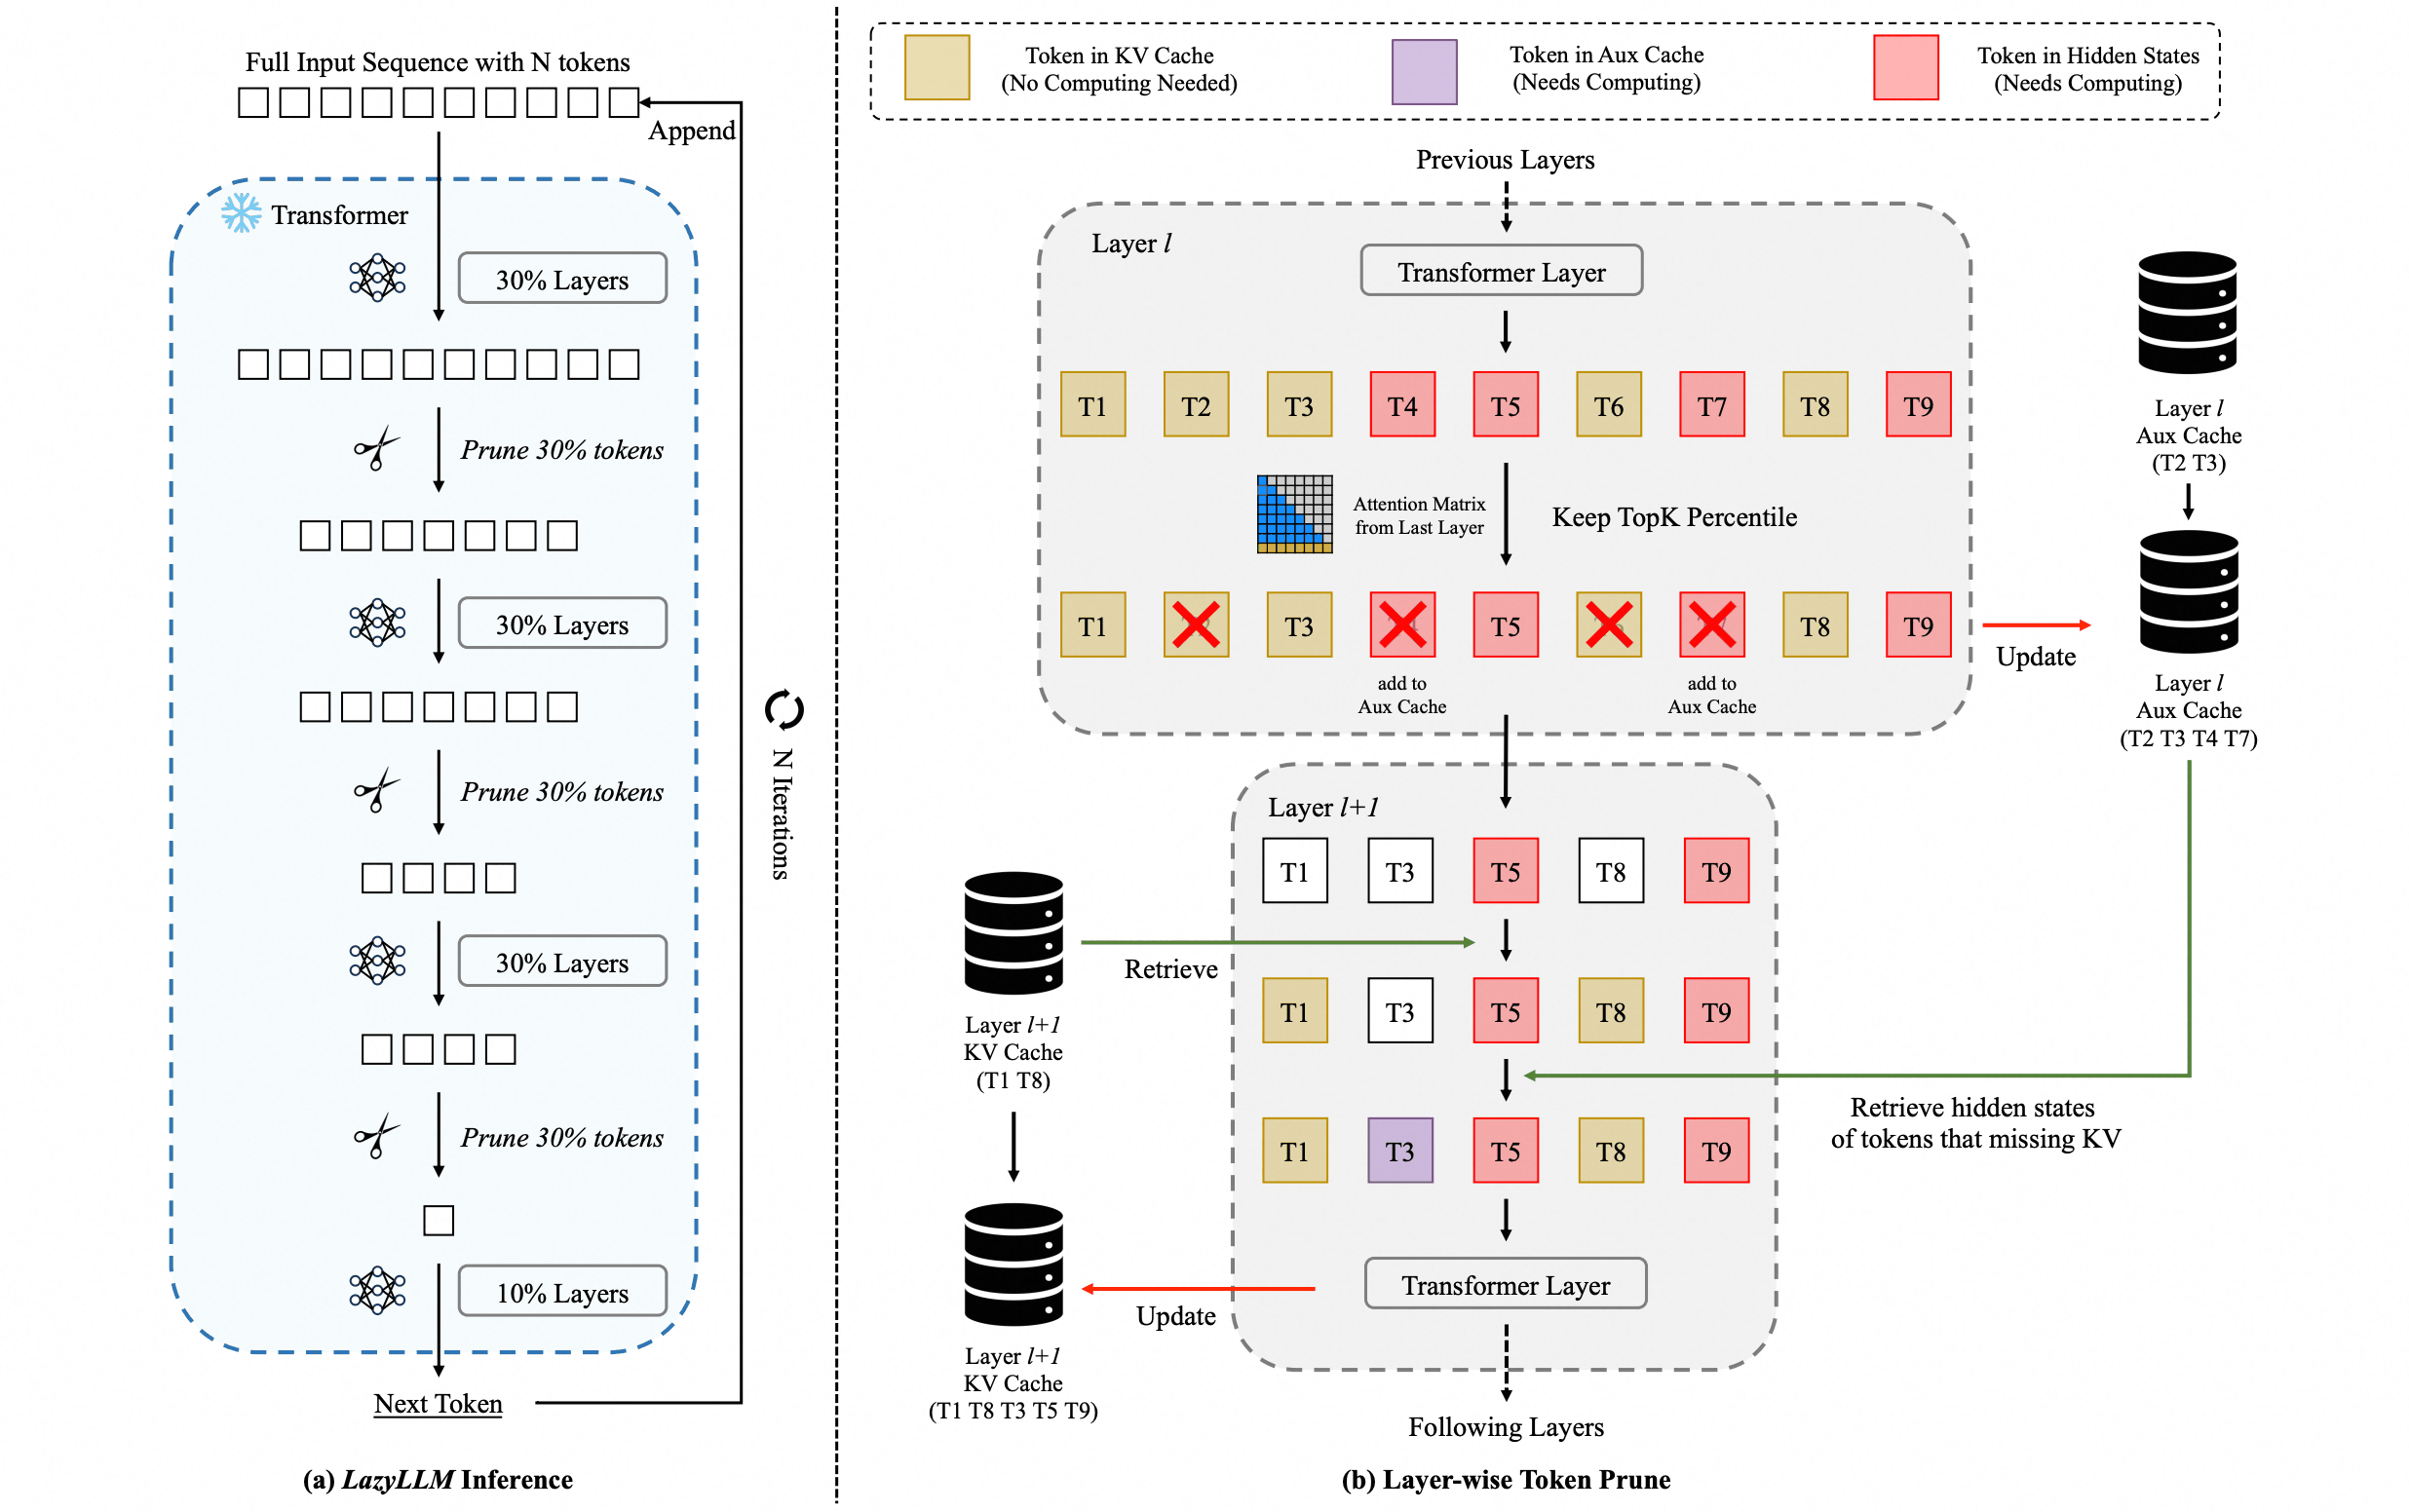
⚪ LazyLLM:面向长上下文生成动态裁剪并恢复词元
语言生成中,不同上下文词元对下一个输出的作用不同。在生成下一个词元时,模型并不需要关注全部的历史上下文,而只需要关注其中一小部分最相关的片段。LazyLLM按当前生成步骤动态选择上下文词元,在每一步生成时只将当前最相关的上下文加载到“工作区”(Active Cache)进行计算,暂时不相关的上下文则被放入一个“归档区”(Lazy Cache),并在后续步骤恢复。
在生成每一个新token时,LazyLLM都会执行以下循环:
- 注意力计算: 当前的查询只与活跃缓存中的键(keys)进行注意力计算。
- 重要性重新评估: 在生成新token的隐状态后,模型会利用这个新的状态,重新评估全部历史token的重要性。这个评估通常基于部分注意力得分的近似。
- 缓存更新: 根据新的重要性排名,模型动态地更新工作区与归档区两个缓存。
(4) 稀疏专家路由
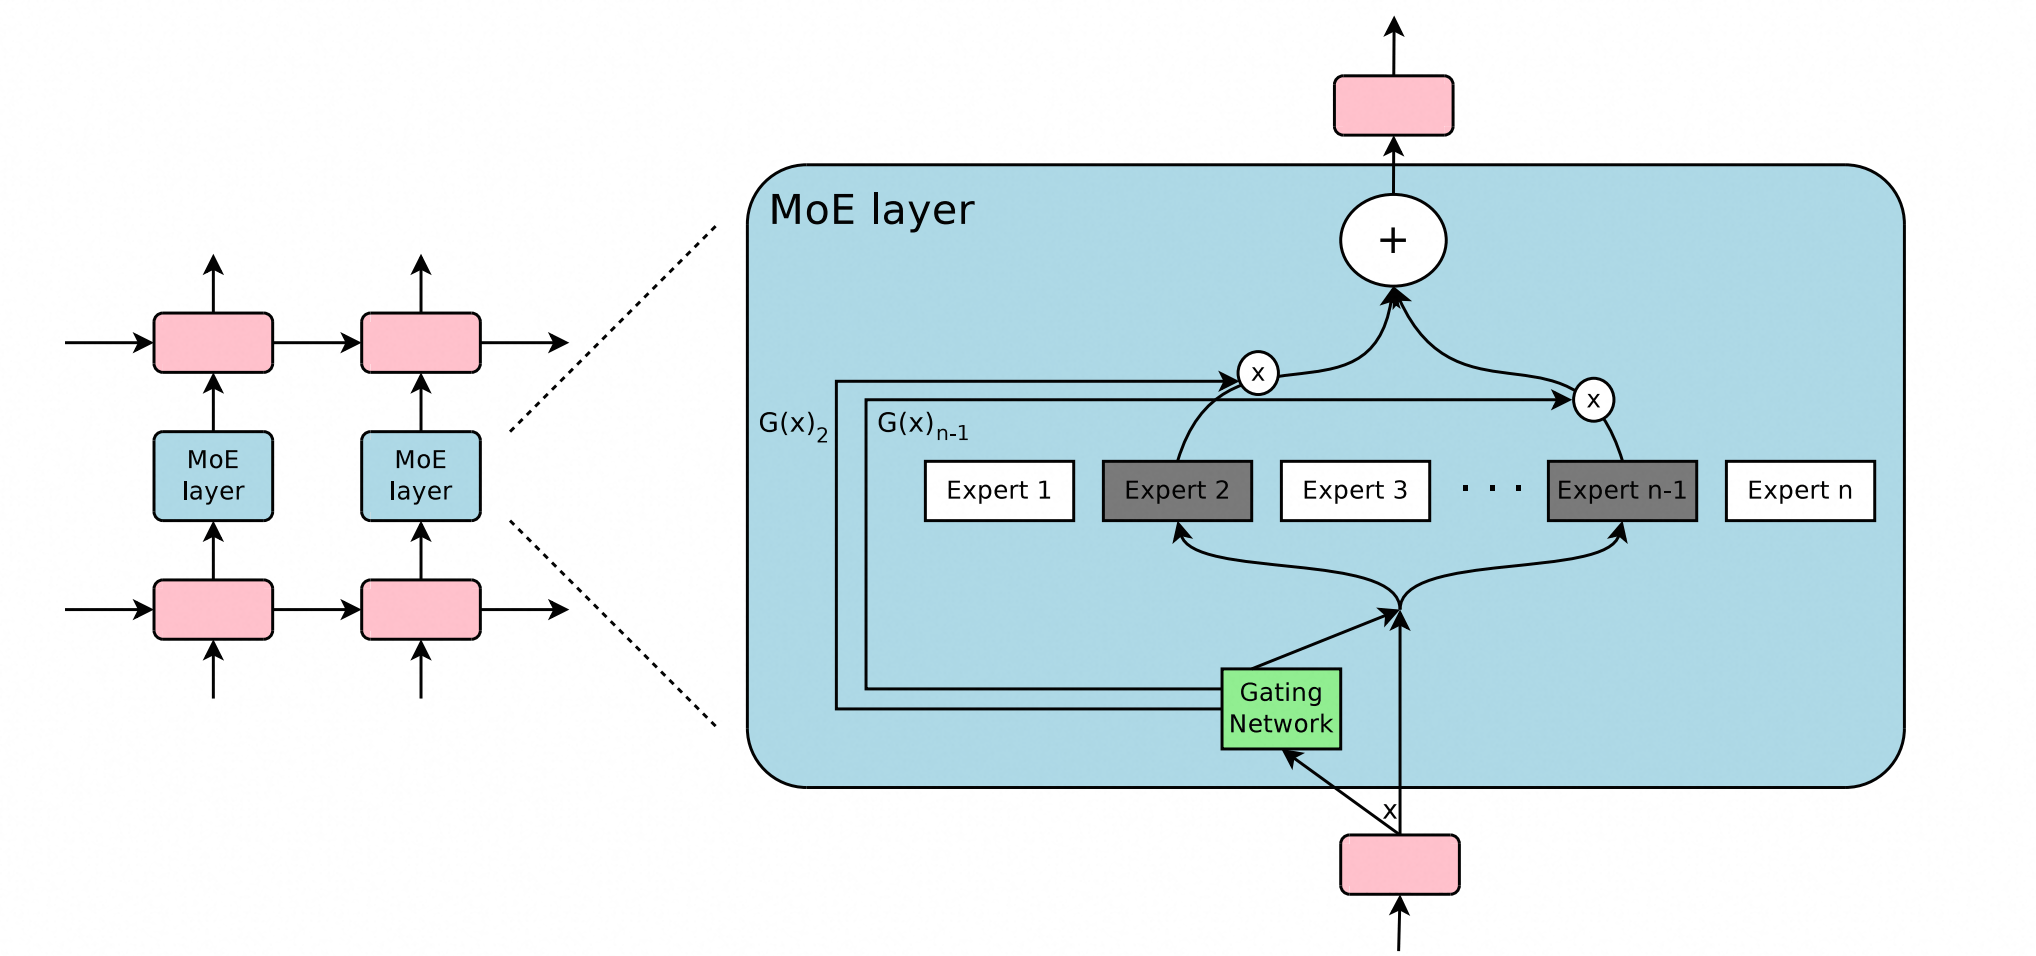
⚪ Sparsely-Gated MoE:每个输入只激活少数专家
稀疏混合专家(mixture of experts, MoE)用门控函数为输入选择少量专家:
\[y(x)=\sum_{i\in\operatorname{TopK}(g(x))} p_i(x)f_i(x).\]模型总参数可以随专家数增长,但每个词元只经过少数专家,所以活跃计算保持相对有限。负载均衡损失用于避免所有输入集中到少数专家;分布式部署还需承担专家间all-to-all通信和容量溢出。