Initialization in Deep Learning.
考察一个典型的深度神经网络层。记上一层的输出激活值为$x^{(l-1)} \in \mathbb{R}^{n_{in}}$,本层参数为$W^{(l)} \in \mathbb{R}^{n_{out}\times n_{in}}$,激活函数为$f(\cdot)$,则本层输出(未经过激活函数)为:
\[\begin{aligned} z^{(l)} &= W^{(l)}x^{(l-1)}= W^{(l)}f\left(z^{(l-1)}\right) \end{aligned}\]参数$W^{(l)}$需要进行初始化(initialization):它只在训练的第$0$步起作用,却决定了后面所有步能否顺利进行。糟糕的初始化不仅让模型精度变差,还可能使网络根本训练不动、不收敛。
本文首先从对称性破坏、方差传播、梯度消失与爆炸的角度讨论初始化为什么重要,然后按设计思路把主流初始化方法组织成不同族系统梳理,并在最后给出PyTorch中的初始化实践。
- 为什么初始化重要
- 1.1 对称性破坏
- 1.2 前向激活值与反向梯度的方差传播
- 1.3 梯度消失与梯度爆炸的初始化视角
- 1.4 初始化与激活函数、归一化、学习率的相互作用
- 常见的初始化方法:
- 2.1 固定分布初始化
- 2.2 方差缩放初始化
- 2.3 正交, 恒等与等距初始化
- 2.4 残差网络的初始化
- 2.5 大模型的初始化
- 2.6 数据驱动与学习式初始化
- PyTorch中的初始化实践
1. 为什么初始化重要
1.1 对称性破坏
在传统的机器学习算法(比如感知机和Logistic回归)中,一般将参数全部初始化为$0$。但这在神经网络中会带来致命问题:如果一层内所有参数都相同($W_1^{(l)}=W_2^{(l)}=\cdots=W_n^{(l)}$),则第一次前向计算时该层所有隐藏神经元的输出都相同($z_1^{(l)}=z_2^{(l)}=\cdots=z_n^{(l)}$);激活值也都相同(不一定为$0$,取决于激活函数在$0$处的值);反向传播时它们收到的梯度也完全相同,因此更新之后依然相同。无论训练多久,这一层实际上只有一个“有效神经元”,网络的表达能力被彻底浪费。这种现象称为对称权重(symmetric weights)。因此权重的初始化必须引入某种非对称性,这称为对称性破坏(symmetry breaking)。
1.2 前向激活值与反向梯度的方差传播
在打破对称性的前提下,初始化的核心问题变成了取多大的尺度。分析工具是方差传播:假设权重元素$W_{ij}$独立同分布、均值为$0$,且与输入独立,偏置初始化为$0$,则前向传播$z=Wx$满足
\[\begin{aligned} \text{Var}\left[z^{(l)}\right] &= \text{Var}\left[\sum_{i=1}^{n_{in}} W_{i}^{(l)}x_i^{(l-1)}\right] \\&= \sum_{i=1}^{n_{in}}\text{Var}\left[W_{i}^{(l)}x_i^{(l-1)}\right] \\ &= n_{in}\text{Var}\left[W^{(l)}\right]\mathbb{E}\left[\left(x^{(l-1)}\right)^2\right] \end{aligned}\]最后一步用到了\(\text{Var}[AB]=\mathbb{E}[A^2]\mathbb{E}[B^2]-(\mathbb{E}[A]\mathbb{E}[B])^2=\text{Var}[A]\mathbb{E}[B^2]\)(当\(\mathbb{E}[A]=0\))。注意这里出现的是激活值的二阶原点矩\(\mathbb{E}[x^2]\)而不是方差\(\text{Var}[x]\):只有当激活值均值为$0$时两者才相等(\(\mathbb{E}[x]=0\)需激活函数均值为0),这个细节正是Xavier初始化与Kaiming初始化分道扬镳的地方。
同理,反向传播的误差项满足\(\delta_i^{(l-1)} = f'\left(z_i^{(l-1)}\right)\sum_{j=1}^{n_{out}}W_{ji}^{(l)}\delta_j^{(l)}\),因此
\[\begin{aligned} \text{Var}\left[\delta^{(l-1)}\right] &= \text{Var}\left[f'\left(z^{(l-1)}\right) \sum_{j=1}^{n_{out}}W_{ji}^{(l)}\delta_j^{(l)}\right] \\ &= n_{out}\text{Var}\left[W^{(l)}\right]\text{Var}\left[\delta^{(l)}\right]\mathbb{E}\left[f'\left(z^{(l-1)}\right)^2\right] \end{aligned}\]这一步用到了\(\text{Var}[AB]=\mathbb{E}[A^2]\mathbb{E}[B^2]-(\mathbb{E}[A]\mathbb{E}[B])^2=\text{Var}[B]\mathbb{E}[A^2]\)(当\(\mathbb{E}[B]=0\))。
前向的缩放因子由扇入(fan-in)$n_{in}$决定,反向的缩放因子由扇出(fan-out)$n_{out}$决定,这是所有方差缩放初始化的出发点。而权重本身的梯度是两者的乘积:
\[\frac{\partial \mathcal{L}}{\partial W^{(l)}} = \delta^{(l)}\left(x^{(l-1)}\right)^\top\]即\(\text{Var}[\partial \mathcal{L}/\partial W^{(l)}] \propto \text{Var}[\delta^{(l)}]\cdot \mathbb{E}[(x^{(l-1)})^2]\)。所以前向激活值的尺度和反向误差的尺度必须同时被控制:任何一侧失控,权重更新量就会失控。
1.3 梯度消失与梯度爆炸的初始化视角
记每层对方差的缩放倍率为$\rho = n_{in}\sigma^2$(前向)或$\rho’ = n_{out}\sigma^2$(反向,暂设$f$为恒等映射)。经过$L$层后,激活值与梯度的尺度分别被放大$\rho^L$与$\rho’^L$倍。这是一个指数关系:只要$\rho \neq 1$,深度稍大就会失控。
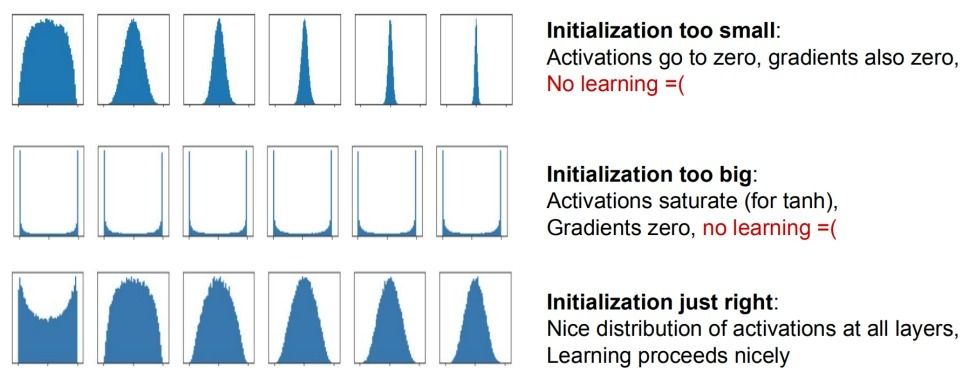
- 若参数初始化数值过小($\rho<1$),Sigmoid型激活函数被限制在原点附近的线性区($f(x)\approx x$),网络丧失非线性能力;随着层数加深输出激活值\(x^{(l)}\approx W^{(l)}x^{(l-1)}\)趋近于$0$,反向梯度(与激活值成正比)也趋近于$0$,网络无法学习;
- 若参数初始化数值过大($\rho>1$),激活值逐层放大,经过带饱和区的激活函数(如Sigmoid、Tanh)后进入饱和区($f’\to 0$),反而产生梯度消失(vanishing gradient);对于不饱和的ReLU,则直接表现为激活值与梯度的指数爆炸。
因此初始化的目标可以概括为一句话:让方差的逐层缩放倍率尽可能等于$1$,或者更强地,让输入-输出雅可比矩阵的所有奇异值都接近$1$(动力等距)。
1.4 初始化与激活函数、归一化、学习率的相互作用
初始化从来不是一个孤立的选择:
- 与激活函数耦合:方差传播公式里的\(\mathbb{E}[x^2]\)与\(\mathbb{E}[f'(z)^2]\)都由激活函数决定(下文会进行讨论)。ReLU丢掉一半的方差,于是需要额外的因子$2$(Kaiming初始化);Tanh在原点斜率为$1$但很快饱和,于是需要$g=5/3$的增益;SELU干脆反过来设计激活函数,使$(0,1)$成为方差映射的不动点;SIREN的正弦激活则必须配套专门的初始化,否则完全无法训练。换激活函数就必须重新核对初始化。
- 与归一化层耦合:BatchNorm / LayerNorm在每层强制把激活值的均值方差重新标定,等价于在每一层重新执行一次初始化。这使得网络对权重的初始尺度变得不敏感(把权重整体乘以常数,BatchNorm的输出不变),这也是“有了归一化就不必精细调初始化”这一实践经验的来源。反过来只要初始化足够聪明(把残差分支缩小到接近$0$),归一化层是可以被去掉的。
- 与学习率、warmup耦合:初始化决定了损失曲面在起点处的局部曲率与梯度尺度,因而直接决定了可用的最大学习率。warmup之所以有效,很大程度上是因为它在补偿一个“不够好”的初始化;而muP则说明,只要按宽度正确地缩放初始化与学习率,最优学习率甚至可以在不同规模的模型之间直接迁移。
2. 常见的初始化方法
2.1 固定分布初始化
固定分布初始化只关心“取什么分布”,不关心方差与网络结构的关系。它们大多不能单独用于深层网络的权重,但在偏置、归一化层参数以及浅层模型中依然是标准做法。
⚪ 零初始化与常数初始化
零初始化用于表达“该参数在第$0$步不贡献增量”;常数初始化用于给门控、偏置或仿射尺度指定先验状态。这些固定值通常用于以下特殊参数:
- 偏置通常用$0$初始化(权重的随机性已经足够破坏对称性);
- BatchNorm / LayerNorm的缩放参数$\gamma$初始化为$1$、平移参数$\beta$初始化为$0$,使归一化层在初始时是恒等映射;
- 对于使用ReLU的神经元,也可以把偏置设为$0.01$等小正数,使神经元在训练初期更容易被激活;
- 残差分支的最后一层权重(或其$\gamma$)初始化为$0$,有助于训练深层网络。
点击展开代码
torch.nn.init.zeros_(tensor)         # 初始化为0
torch.nn.init.ones_(tensor)          # 初始化为1
torch.nn.init.constant_(tensor, val) # 初始化为常数val
⚪ 随机正态与随机均匀初始化
随机初始化从均值$\mu$、方差$\sigma^2$的分布采样。通常选择正态、均匀或截尾正态分布;$\mu,\sigma$与截断区间是关键超参数。
(1) 正态分布初始化:使用\(\mathcal{N}(0,\sigma^2)\)采样。
点击展开代码
torch.nn.init.normal_(tensor, mean=0.0, std=1.0)
(2) 均匀分布初始化:使用$U(a,b)$采样,其均值$\mu$与方差$\sigma^2$满足
\[\begin{aligned} \mu &= \frac{a+b}{2}\\ \sigma^2 &= \frac{(b-a)^2}{12} \end{aligned}\]因此若要指定均值$\mu$与方差$\sigma^2$,对应的均匀分布为\(U(\mu-\sqrt{3}\sigma,\mu+\sqrt{3}\sigma)\)。
点击展开代码
torch.nn.init.uniform_(tensor, a=0.0, b=1.0)
(3) 截尾正态分布初始化:正态分布的采样结果更加多样化,但理论上无界,采样到绝对值过大的结果可能不利于优化;均匀分布有界,但采样结果通常更单一。截尾正态分布(truncated normal)结合两者优点:从\(\mathcal{N}(\mu,\sigma^2)\)采样并把数值截断在$[a,b]$内(通常取$\pm 2\sigma$)。
点击展开代码
torch.nn.init.trunc_normal_(tensor, mean=0.0, std=1.0, a=-2.0, b=2.0)
⚪ 稀疏初始化 Sparse Initialization
稀疏初始化把权重矩阵中的大部分元素置零,只保留少量非零连接:
\[\widetilde W_{ij}\sim\mathcal N(0,\sigma^2),\quad B_{ij}\sim\operatorname{Bernoulli}(\rho),\quad W=B\odot\widetilde W.\]其中$\rho$是非零连接比例,常从$0.1$或$0.01$起调;非零权重标准差常取$\sigma=0.01$。实现时逐输出单元选择零元素,再采样其余元素;$\rho,\sigma$是关键超参数。
点击展开代码
torch.nn.init.sparse_(tensor, sparsity, std=0.01)
⚪ 偏置的初始化惯例
偏置的默认选择是$0$,但在若干场景下有意设置一个非零偏置能显著改善训练初期的行为。这类技巧成本极低、收益明确,却经常被忽略:
- LSTM的遗忘门偏置:初始化为$1$或$2$(而非$0$)。遗忘门经过Sigmoid后接近$1$,使记忆单元在初始时倾向于保留历史状态,时序上的梯度因而更容易传播到远处。这一技巧由Learning to Forget提出,并被An Empirical Exploration of Recurrent Network Architectures确认为最有效的LSTM改动之一。
- 检测头的先验偏置:在Focal Loss中,单阶段检测器的分类分支存在极端的正负样本不平衡。把分类层的偏置初始化为$b = -\log\frac{1-\pi}{\pi},\quad \pi = 0.01$,使模型在第一次前向时对每个anchor输出的前景概率就等于先验$\pi=0.01$,避免了训练最初若干次迭代中巨大的、由背景主导的损失影响网络训练。同理,在类别不平衡的分类任务中,把输出层偏置初始化为各类别的对数先验$\log p_c$、在回归任务中把输出层偏置初始化为目标的均值,都是同一思想。
- 归一化层的$\gamma,\beta$:默认$\gamma=1,\beta=0$;残差块中最后一个归一化层的$\gamma$初始化为$0$则是Zero-$\gamma$技巧。
2.2 方差缩放初始化
方差缩放(variance scaling)初始化是深度神经网络初始化的主流:它不改变分布形式(正态或均匀),而是让方差$\sigma^2$随扇入扇出自动调整,使方差缩放倍率等于$1$。这一族方法的差别只在于保守前向还是保守反向,以及如何补偿激活函数。
⚪ LeCun初始化
- paper:Efficient BackProp
最早的方差缩放方案只考虑前向传播。由$1.2$节的前向递推式,若激活值$x$均值为$0$、方差为$\text{Var}[x]$,则
\[\text{Var}[z] = n_{in}\text{Var}[W]\text{Var}[x]\]要求$\text{Var}[z]=\text{Var}[x]$,立即得到
\[\text{Var}[W] = \frac{1}{n_{in}}\]即LeCun初始化:\(W \sim \mathcal{N}(0, 1/n_{in})\)(LeCun Normal)或\(W\sim U(-\sqrt{3/n_{in}},\sqrt{3/n_{in}})\)(LeCun Uniform)。
值得一提的是,PyTorch中nn.Linear与nn.Conv2d的默认初始化kaiming_uniform_(w, a=math.sqrt(5))展开后正好是
即方差为$1/(3n_{in})$的LeCun Uniform变体(比标准LeCun Uniform小$3$倍)。这解释了一个常见现象:不显式初始化的PyTorch网络其实并没有使用Kaiming初始化,深层ReLU网络往往需要手动重新初始化。
⚪ Xavier初始化 Xavier Initialization
初始化一个神经网络时,为了缓解梯度消失或爆炸问题,应尽可能保持每个神经元输入和输出的方差一致。Xavier初始化由Xavier Glorot提出(因此也称Glorot初始化),它的贡献在于同时考虑前向与反向两个方向,并给出一个折中方案。假设参数初始化均值为$0$、激活函数在原点附近近似线性($f(z)\approx z, f’(z)\approx 1$),偏置初始化为$0$。
(1) 前向:激活值方差守恒
考察第$l$层的一个神经元,它接收前一层$n_{in}$个神经元的输出。方差推导结论与LeCun初始化相同,即:
\[n_{in}\text{Var}\left[W\right] = 1 \quad \Longrightarrow \quad \text{Var}\left[W\right] = \frac{1}{n_{in}}\](2) 反向:梯度方差守恒
在反向传播中,误差项满足
\[\delta_i^{(l-1)} = f'\left(z_i^{(l-1)}\right)\sum_{j=1}^{n_{out}}W_{ji}^{(l)}\delta_j^{(l)} \approx \sum_{j=1}^{n_{out}}W_{ji}^{(l)}\delta_j^{(l)}\]注意这里的求和下标$j$遍历的是第$l$层的$n_{out}$个输出神经元,即$W^{(l)}$的扇出。完全同理地展开方差:
\[\text{Var}\left[\delta^{(l-1)}\right] = n_{out}\text{Var}\left[W^{(l)}\right]\text{Var}\left[\delta^{(l)}\right]\]为使误差信号在反向传播中也不被放大或缩小,应有
\[n_{out}\text{Var}\left[W\right] = 1 \quad \Longrightarrow \quad \text{Var}\left[W\right] = \frac{1}{n_{out}}\](3) 折中:调和平均
除非$n_{in}=n_{out}$,两个条件不可能同时满足。Xavier初始化取两者的调和平均(即对候选方差$1/n_{in}$与$1/n_{out}$取调和平均$\frac{2ab}{a+b}$):
\[\text{Var}\left[W\right] = \frac{2}{n_{in}+n_{out}}\]若采用正态分布\(\mathcal{N}(0,\sigma^2)\),则标准差为
\[\sigma = g \cdot \sqrt{\frac{2}{n_{in}+n_{out}}}\]若采用均匀分布$U(-a,a)$,由$2.1$节的均值方差换算$\sigma^2=(2a)^2/12=a^2/3$,得
\[\begin{aligned} \sigma = \sqrt{\frac{(a-(-a))^2}{12}} &= \frac{a}{\sqrt{3}} = g \cdot \sqrt{\frac{2}{n_{in}+n_{out}}} \\ &\Downarrow \\ a &= g \cdot \sqrt{\frac{6}{n_{in}+n_{out}}} \end{aligned}\]其中$g$是补偿激活函数的增益值(见下方讨论),无激活函数时$g=1$。
点击展开代码
torch.nn.init.xavier_normal_(tensor, gain=1.0)
torch.nn.init.xavier_uniform_(tensor, gain=1.0)
Xavier初始化适用于无激活函数、以及激活函数为Sigmoid、Tanh的场合(此时神经元的参数与输入绝对值较小,处于激活函数的线性区间)。例如Sigmoid在线性区的斜率约为$\frac{1}{4}$,为补偿这一衰减需要增益$g=4$,即方差调整为
\[\text{Var}\left[W\right] = 16 \times \frac{2}{n_{in}+n_{out}}\]⭐ 讨论:一般激活函数的增益值
上述推导假设激活函数为恒等映射。对于一般的激活函数$f(\cdot)$,它会改变输入分布的形式;当$f$能够近似线性化时不改变均值(仍为$0$),此时只需考虑方差的变化:
\[\begin{aligned} \text{Var}\left[z^{(l)}\right] &= \sum_{i=1}^{n_{in}} \text{Var}\left[{W_i^{(l)}f\left(z_i^{(l-1)}\right)}\right]\\ &= \sum_{i=1}^{n_{in}} \mathbb{E}\left[(W_i^{(l)})^2\right]\mathbb{E}\left[f^2\left(z_i^{(l-1)}\right)\right] -\left(\mathbb{E}\left[W_i^{(l)}\right]\mathbb{E}\left[f\left(z_i^{(l-1)}\right)\right]\right)^2 \\ &= \sum_{i=1}^{n_{in}} \text{Var}\left[W_i^{(l)}\right]\text{Var}\left[f\left(z_i^{(l-1)}\right)\right] \\ &= n_{in}\text{Var}\left[W^{(l)}\right]\text{Var}\left[f\left(z^{(l-1)}\right)\right] \end{aligned}\]上述推导用到了\(\mathbb{E}[W]=\mathbb{E}[f(\cdot)]=0\)。
参考SELU的自标准化思想:假设输入方差为$1$,希望经过激活函数后仍然方差为$1$,则可为激活函数引入一个增益值(gain value) $\lambda$,使输出满足二阶统计量(方差$=1$)对应的积分方程:
\[\int_{-\infty}^{+\infty} \frac{1}{\sqrt{2\pi}}e^{-\frac{x^2}{2}} \cdot \left(\lambda f(x)\right)^2dx = 1\]使用sympy库可以快速求解该方程:
点击展开代码
import sympy
from sympy import Symbol, nsolve, integrate

x = Symbol('x')
l = Symbol('l')
integal = integrate(sympy.exp(-x**2/2)*(f(x))**2, (x,-sympy.oo,sympy.oo))
fn = l**2/sympy.sqrt(2*sympy.pi)*integal - 1
ans = nsolve(fn, l, 1)
为激活函数引入增益值$\lambda$,等价于为权重引入增益值$g=1/\lambda$:
\[\text{Var}\left[z^{(l)}\right] \approx n_{in}\text{Var}\left[\frac{1}{\lambda}W_i^{(l)}\right]\text{Var}\left[\lambda f\left(z_i^{(l-1)}\right)\right]\]因此对于一般的激活函数,权重初始化时会额外引入一个增益值$g$。PyTorch内置了常见激活函数的增益值:
| 激活函数 | Linear / Sigmoid | Tanh | ReLU | Leaky ReLU(负斜率$\alpha$) | SELU |
|---|---|---|---|---|---|
| 增益值$g$ | \(1\) | \(5/3\) | \(\sqrt{2}\) | \(\sqrt{2/(1+\alpha^2)}\) | \(3/4\) |
点击展开代码
gain = nn.init.calculate_gain('leaky_relu', 0.2) # leaky_relu with negative_slope=0.2
⚪ Kaiming初始化 Kaiming Initialization
Xavier初始化的推导要求激活值均值为零:\(\mathbb{E}[x]=0\),因此仅适用于线性激活函数或在零值附近具有线性区域的激活函数$f(\cdot)$。
对于ReLU族激活函数,输出恒非负,均值不再为$0$,Xavier的条件被破坏。Kaiming He给出了针对整流函数的修正(因此也称He初始化),其关键在于**不再假设\(\mathbb{E}[x]=0\),而是直接追踪二阶原点矩:
\[\begin{aligned} \text{Var}\left[z^{(l)}\right] &= \sum_{i=1}^{n_{in}} \text{Var}\left[{W_i^{(l)}f\left(z_i^{(l-1)}\right)}\right]\\ &= \sum_{i=1}^{n_{in}} \text{Var}\left[W_i^{(l)}\right]\mathbb{E}\left[f^2\left(z_i^{(l-1)}\right)\right] \\ &= n_{in}\text{Var}\left[W^{(l)}\right]\mathbb{E}\left[f^2\left(z^{(l-1)}\right)\right] \end{aligned}\]第二步仍然用到了\(\text{Var}[AB]=\mathbb{E}[A^2]\mathbb{E}[B^2]-(\mathbb{E}[A]\mathbb{E}[B])^2=\text{Var}[A]\mathbb{E}[B^2]\)(当\(\mathbb{E}[A]=0\))。
(1) ReLU激活函数:因子2的来源
对于ReLU $f(x)=\max(0,x)$,若$x$的分布关于原点对称,则
\[\begin{aligned} \mathbb{E}\left[f^2\left(x\right)\right] &= \int_{-\infty}^{+\infty} \left(\max(0,x)\right)^2p(x)dx = \int_{0}^{+\infty} x^2p(x)dx \\ &= \frac{1}{2}\int_{-\infty}^{+\infty} x^2p(x)dx = \frac{1}{2}\mathbb{E}\left[x^2\right] = \frac{1}{2}\left(\text{Var}[x]+\left(\mathbb{E}[x]\right)^2\right) \end{aligned}\]即ReLU因为丢弃了一半的分布,恰好把二阶矩减半,这就是因子$2$的来源。代回方差表达式(注意到$z^{(l-1)}=W^{(l-1)}x^{(l-2)}$的均值为$0$):
\[\begin{aligned} \text{Var}\left[z^{(l)}\right] &= n_{in}\text{Var}\left[W^{(l)}\right]\mathbb{E}\left[f^2\left(z^{(l-1)}\right)\right] \\ &= \frac{n_{in}}{2}\text{Var}\left[W^{(l)}\right]\text{Var}\left[z^{(l-1)}\right] \end{aligned}\]要求缩放倍率为$1$,得到Kaiming初始化的fan_in版本:
\[\text{Var}\left[W\right] = \frac{2}{n_{in}}\]若采用正态分布,则\(\sigma = g\sqrt{2/n_{in}}\);若采用均匀分布$U(-a,a)$,则\(a = g\sqrt{6/n_{in}}\)(推导同Xavier)。
点击展开代码
torch.nn.init.kaiming_normal_(tensor, a=0, mode='fan_in', nonlinearity='relu')
torch.nn.init.kaiming_uniform_(tensor, a=0, mode='fan_in', nonlinearity='relu')
# a:leaky ReLU的负斜率
# mode:fan_in考虑前向传播,fan_out考虑反向传播
(2) fan_in还是fan_out
对反向传播做同样的分析:ReLU的导数$f’(z)$以概率$\frac{1}{2}$为$1$、以概率$\frac{1}{2}$为$0$,因此
\[\text{Var}\left[\delta^{(l-1)}\right] = \frac{n_{out}}{2}\text{Var}\left[W^{(l)}\right]\text{Var}\left[\delta^{(l)}\right] \quad \Longrightarrow \quad \text{Var}\left[W\right] = \frac{2}{n_{out}}\]与Xavier不同,Kaiming初始化没有采用折中,而是指出两个版本都可以用。原因是二者的比值在深度上会望远镜式相消:若采用fan_in版本,则反向的累积缩放倍率为
\[\prod_{l=2}^{L}\frac{n_{out}^{(l)}}{n_{in}^{(l)}} = \prod_{l=2}^{L}\frac{n_{l}}{n_{l-1}} = \frac{n_L}{n_1}\]这是一个与深度无关的常数(而非指数量级),因此不会导致梯度爆炸或消失。实践中的惯例是:前馈网络与卷积网络用fan_in(保证前向激活值稳定,这也是PyTorch默认值),转置卷积、生成器上采样路径常用fan_out。
(3) Leaky ReLU激活函数
若激活函数为Leaky ReLU $f(x)=\max(\alpha x,x)$,则
\[\begin{aligned} \mathbb{E}\left[f^2\left(x\right)\right] &= \int_{-\infty}^{0} \alpha^2x^2p(x)dx+ \int_{0}^{+\infty} x^2p(x)dx \\ &= \frac{\alpha^2+1}{2}\int_{-\infty}^{+\infty} x^2p(x)dx = \frac{\alpha^2+1}{2}\mathbb{E}\left[x^2\right] \end{aligned}\]代回得到缩放倍率\(\frac{(\alpha^2+1)n_{in}}{2}\text{Var}[W]\),于是
\[\text{Var}\left[W\right] = \frac{2}{(1+\alpha^2)n_{in}}\]当$\alpha=0$时退化为ReLU的结果,当$\alpha=1$时退化为线性情形的LeCun初始化。PReLU、RReLU可以用相同公式(取$\alpha$的期望);对于GELU、Swish这类光滑近似,实践中直接沿用ReLU的$g=\sqrt{2}$即可,误差很小。
⭐ 讨论:卷积层与注意力层的扇入扇出
方差缩放初始化的所有公式都依赖$n_{in},n_{out}$,而对于非全连接层,“扇入扇出”需要按一个输出元素实际连接了多少个输入元素来计算:
- 卷积层(核大小$k_h\times k_w$,输入输出通道$C_{in},C_{out}$):\(n_{in}=k_hk_wC_{in}\),\(n_{out}=k_hk_wC_{out}\);
- 分组卷积($G$组):\(n_{in}=k_hk_wC_{in}/G\);深度可分离卷积是$G=C_{in}$的特例,其扇入只有$k_hk_w$,因此按公式算出的方差很大,实践中往往需要额外收敛;
- 转置卷积:
fan_in与fan_out的角色互换; - 注意力层:$W_Q,W_K,W_V$与输出投影都是$d\times d$的线性层,\(n_{in}=n_{out}=d\)。但要注意注意力打分已经除以$\sqrt{d_k}$,这个缩放本身就是为了让$q^\top k$在标准初始化下方差为$1$,属于在架构里内置的初始化补偿;
- 嵌入层:扇入没有意义(one-hot输入的有效扇入为$1$),因此嵌入层不使用方差缩放,而是直接指定标准差。
2.3 正交、恒等与等距初始化
方差缩放只约束了权重矩阵的平均奇异值(二阶矩),而没有约束奇异值的分布。即使\(n_{in}\text{Var}[W]=1\),随机高斯矩阵的奇异值仍然散布在一个宽区间内,深层复合后会使某些方向被指数放大、另一些被指数压缩。本节的方法进一步要求所有奇异值都接近$1$。
⭐ 讨论:高维随机矩阵为何近似正交
从一个固定均值$\mu$、方差$\sigma^2$的分布$p(x)$中随机采样两个$n$维向量$x=(x_1,…,x_n), y=(y_1,…,y_n)$,则有
\[\begin{aligned} \langle x,y\rangle &= \sum_{i=1}^nx_iy_i = n\times \frac{1}{n}\sum_{i=1}^nx_iy_i\\ &\approx n\times\mathbb{E}_{x\sim p(x),y\sim p(x)} \left[ xy \right] \\ &= n\times\mathbb{E}_{x\sim p(x)} \left[ x \right]\mathbb{E}_{y\sim p(x)} \left[ y \right] = n\mu^2 \\ \|x\|^2 &= \sum_{i=1}^nx_i^2 = n\times \frac{1}{n}\sum_{i=1}^nx_i^2 \\ &\approx n\times\mathbb{E}_{x\sim p(x)} \left[ x^2 \right] = n\times \left(\mu^2+\sigma^2\right) \end{aligned}\]当设置$\mu=0,\sigma^2=1/n$时,从$p(x)$中随机采样的任意两个向量都近似正交且归一化,此时采样构造的矩阵近似正交矩阵,相当于把参数矩阵初始化为一个保持模长的正交变换。这既解释了$\text{Var}[W]=1/n$这一取值的几何含义,也说明了为什么“直接使用严格正交矩阵”是一个自然的下一步:随机高斯只是近似正交,且近似的误差随维度降低而增大。
⚪ 正交初始化 Orthogonal Initialization
正交初始化把参数矩阵$W^{(l)}$初始化为正交矩阵:
\[W^{(l)}{W^{(l)}}^\top = I\]实现过程为:$1)$用标准高斯分布\(\mathcal{N}(0,1)\)初始化一个矩阵;$2)$对其做奇异值分解(或QR分解),取得到的正交矩阵作为权重。非方阵情形取半正交矩阵(行或列正交)。
点击展开代码
torch.nn.init.orthogonal_(tensor, gain=1)
正交初始化使前向信号与反向误差项都具有严格的范数保持性(norm-preserving)。对于误差项\(\delta^{(l-1)} = {W^{(l)}}^\top \delta^{(l)}\),有
\[\|\delta^{(l-1)}\|^2 = \|{W^{(l)}}^\top \delta^{(l)}\|^2 = \|\delta^{(l)}\|^2\]这一性质与深度无关:无论多少层复合,范数都不变。原论文用深度线性网络的精确解说明,正交初始化使学习动力学中所有模态以相近的速率收敛,从而实现深度无关的训练时间。
当在非线性网络中应用正交初始化时,通常需要乘以一个缩放系数$g$来补偿激活函数。比如ReLU在$0$附近的平均平方增益为$\frac{1}{2}$,为保持范数应取$g=\sqrt{2}$。正交初始化最经典的用途是循环神经网络中循环边上的权重矩阵:循环矩阵会被复合$T$次($T$为序列长度),任何偏离$1$的奇异值都会被放大到$T$次幂。
⚪ 恒等初始化 Identity Initialization
正交矩阵中最特殊的一个就是单位矩阵。恒等初始化把权重层初始化为单位矩阵,使网络层的输出与输入完全相等,各层之间的方差自然不会发生变化。
点击展开代码
torch.nn.init.eye_(tensor)            # 二维参数(全连接层)
torch.nn.init.dirac_(tensor, groups=1) # 高维参数(卷积层,Dirac-delta核)
恒等初始化具有动力等距(dynamical isometry)性质(所有奇异值严格为$1$),使网络具有稳定的信号传播与梯度下降行为。它在循环网络中还有一个专门的应用:A Simple Way to Initialize Recurrent Networks of Rectified Linear Units提出的IRNN把ReLU循环网络的循环矩阵初始化为单位矩阵、偏置初始化为$0$,使网络在初始时等价于一个“累加器”,从而在长序列任务上逼近LSTM的表现。
⚪ ZerO初始化:只用0和1的确定性初始化
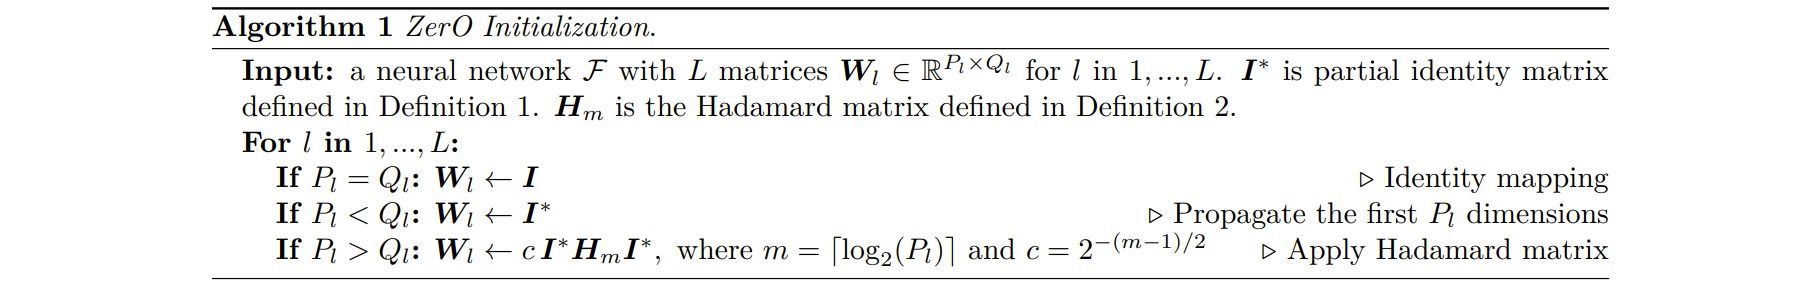
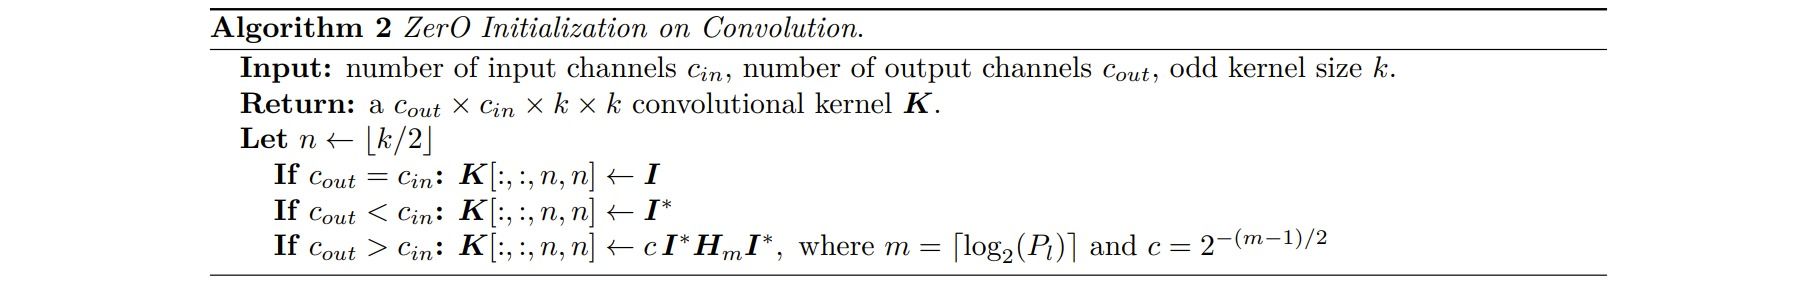
作为恒等初始化的后继动机,输入输出维度不等时部分单位矩阵需要补零,使额外通道初始为零。ZerO据此对部分单位矩阵应用哈达玛变换(Hadamard transform),用$H$旋转基向量。哈达玛矩阵由$+1$与$-1$构成,满足\(H_nH_n^\top=nI_n\),可以递归构造(设$H_0=1$):
\[H_m = \begin{pmatrix} H_{m-1} & H_{m-1}\\ H_{m-1} & -H_{m-1}\\ \end{pmatrix} = \begin{pmatrix} 1 & 1 & 1& 1 & \cdots\\ 1 & -1 & 1& -1 & \cdots\\ 1 & 1 & -1& -1 & \cdots\\ 1 & -1 & -1& 1 & \cdots\\ \vdots & \vdots & \vdots & \vdots & \ddots \end{pmatrix}\]在二维平面中,哈达玛变换相当于把标准坐标轴旋转$45$度。论文证明:当初始化\(W_1,W_L = H\hat I, W_l = I\)时,有
\[\dim\left(\text{span}\left(z_l(x)\right)\right) \geq N_x\]即训练衰减被打破。本质上,部分单位矩阵的训练衰减源自补零操作使这些位置的输入在激活函数阶段无法生效,而哈达玛变换通过旋转基向量打破了传递过程中零元素的对称性。完整算法如下(分别对应全连接网络与残差网络):
由于部分单位矩阵与哈达玛矩阵都是确定性的,ZerO初始化完全不含随机数,因此训练结果的可复现性显著提高,因此打破对称性不必依赖随机性。此外ZerO初始化的网络具有低秩学习轨迹(low-rank learning trajectory):训练从一个秩很低的简单网络开始,权重矩阵的秩随训练逐渐增加,这与贪心低秩学习(greedy low-rank learning, GLRL)理论相符,即梯度下降隐含地偏好按秩递增的顺序搜索解空间,这也为神经网络的泛化能力提供了一种解释。
⚪ Delta-Orthogonal初始化:把正交性推广到卷积
对卷积层直接把展平后的权重矩阵正交化,并不能保证空间维度上的等距性。Delta-Orthogonal初始化的做法是让卷积核在空间上只保留中心一个抽头(一个空间Dirac-delta函数),并把该抽头上的通道混合矩阵取为正交矩阵$H$:
\[W[:,:,i,j] = \begin{cases} H, & (i,j)=(\lceil k/2\rceil,\lceil k/2\rceil),\quad HH^\top = g^2 I \\ \mathbf{0}, & \text{其他} \end{cases}\]此时卷积层在初始时是一个严格等距的逐点线性变换,整个网络的输入-输出雅可比矩阵的奇异值都集中在$1$附近。借助这一初始化,作者成功训练了10000层的朴素卷积网络(无残差连接、无归一化层)。
2.4 残差网络的初始化
残差网络的初始化有它独特的困难。考察
\[x^{(l)} = x^{(l-1)} + F_l\left(x^{(l-1)}\right)\]若按$2.2$节初始化使残差分支保持方差(\(\text{Var}[F_l(x)]\approx\text{Var}[x]\)),且分支输出与恒等路径近似独立,则
\[\text{Var}\left[x^{(l)}\right] \approx 2\,\text{Var}\left[x^{(l-1)}\right] \\ \downarrow \\ \text{Var}\left[x^{(L)}\right]\approx 2^L\text{Var}\left[x^{(0)}\right]\]即激活值方差随深度指数增长。逐层的方差缩放初始化对此完全无能为力,因为问题不在单层内部,而在$L$个分支的累加。归一化层恰好抑制了这一增长(这是BatchNorm能训练超深残差网络的关键原因之一);而本节的方法给出了另一条路:在初始化时把残差分支缩小到接近$0$,让网络起点是一个(近似)恒等映射。
⚪ Zero-γ:把最后一个BN的γ置零
把每个残差块最后一个BatchNorm设为$\gamma_l=0,\beta_l=0$:$x^{(l)}=x^{(l-1)}+\gamma_l\widehat F_l(x^{(l-1)})$。第$0$步分支输出为零,训练中$\gamma_l$与分支权重联合更新;torchvision对应zero_init_residual=True。
⚪ Fixup:无归一化的残差学习
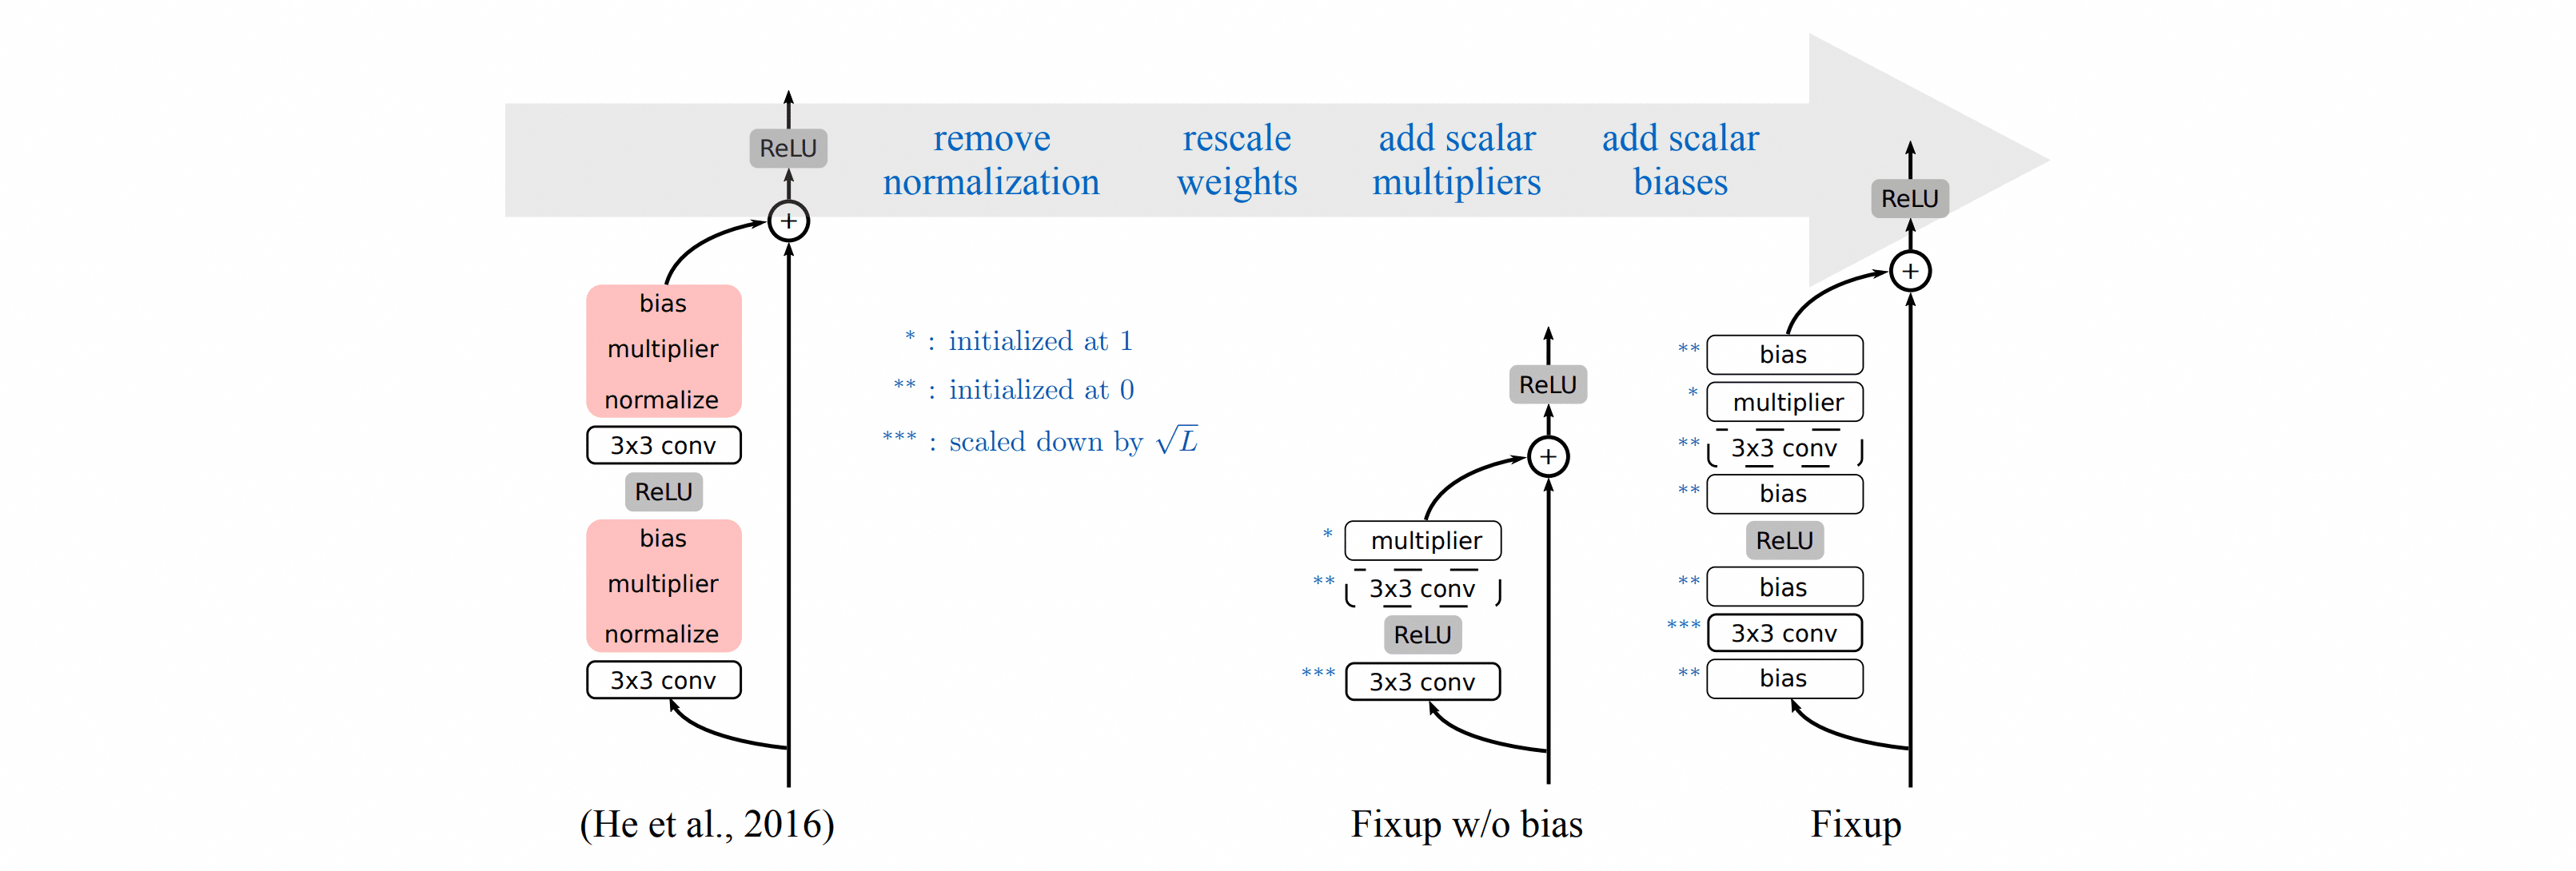
Fixup的目标更彻底:完全去掉归一化层,只靠初始化训练深层残差网络。作者分析出,标准初始化下残差网络在初始时的梯度范数下界随深度增长,因此必然梯度爆炸;解决办法是让每个残差分支对网络输出的更新幅度与深度无关:若单次更新使每个分支贡献$\Theta(\eta/L)$,则$L$个分支合起来正好是$\Theta(\eta)$。具体做法:
- 把分类层与每个残差分支的最后一层权重初始化为$0$;
- 分支内其余权重层用标准方法(如Kaiming)初始化后,再统一乘以缩放因子$L^{-\frac{1}{2m-2}}$,其中$L$是残差块个数,$m$是单个残差分支内的权重层数(例如$m=2$时缩放为$L^{-1/2}$,$m=3$时为$L^{-1/4}$);
- 在每个残差分支中加入一个标量乘子(初始化为$1$)、在每个卷积层/线性层/激活层前加入一个标量偏置(初始化为$0$),以补偿去掉归一化层后损失的表达能力。
⚪ SkipInit:一个标量就够了
这篇工作指出,BatchNorm在残差网络中最关键的作用就是在初始化时把残差分支相对于跳跃连接缩小,使网络函数接近恒等。既然如此,直接在每个残差分支末尾乘一个可学习标量$\alpha$即可:
\[x^{(l)} = x^{(l-1)} + \alpha\cdot F_l\left(x^{(l-1)}\right)\]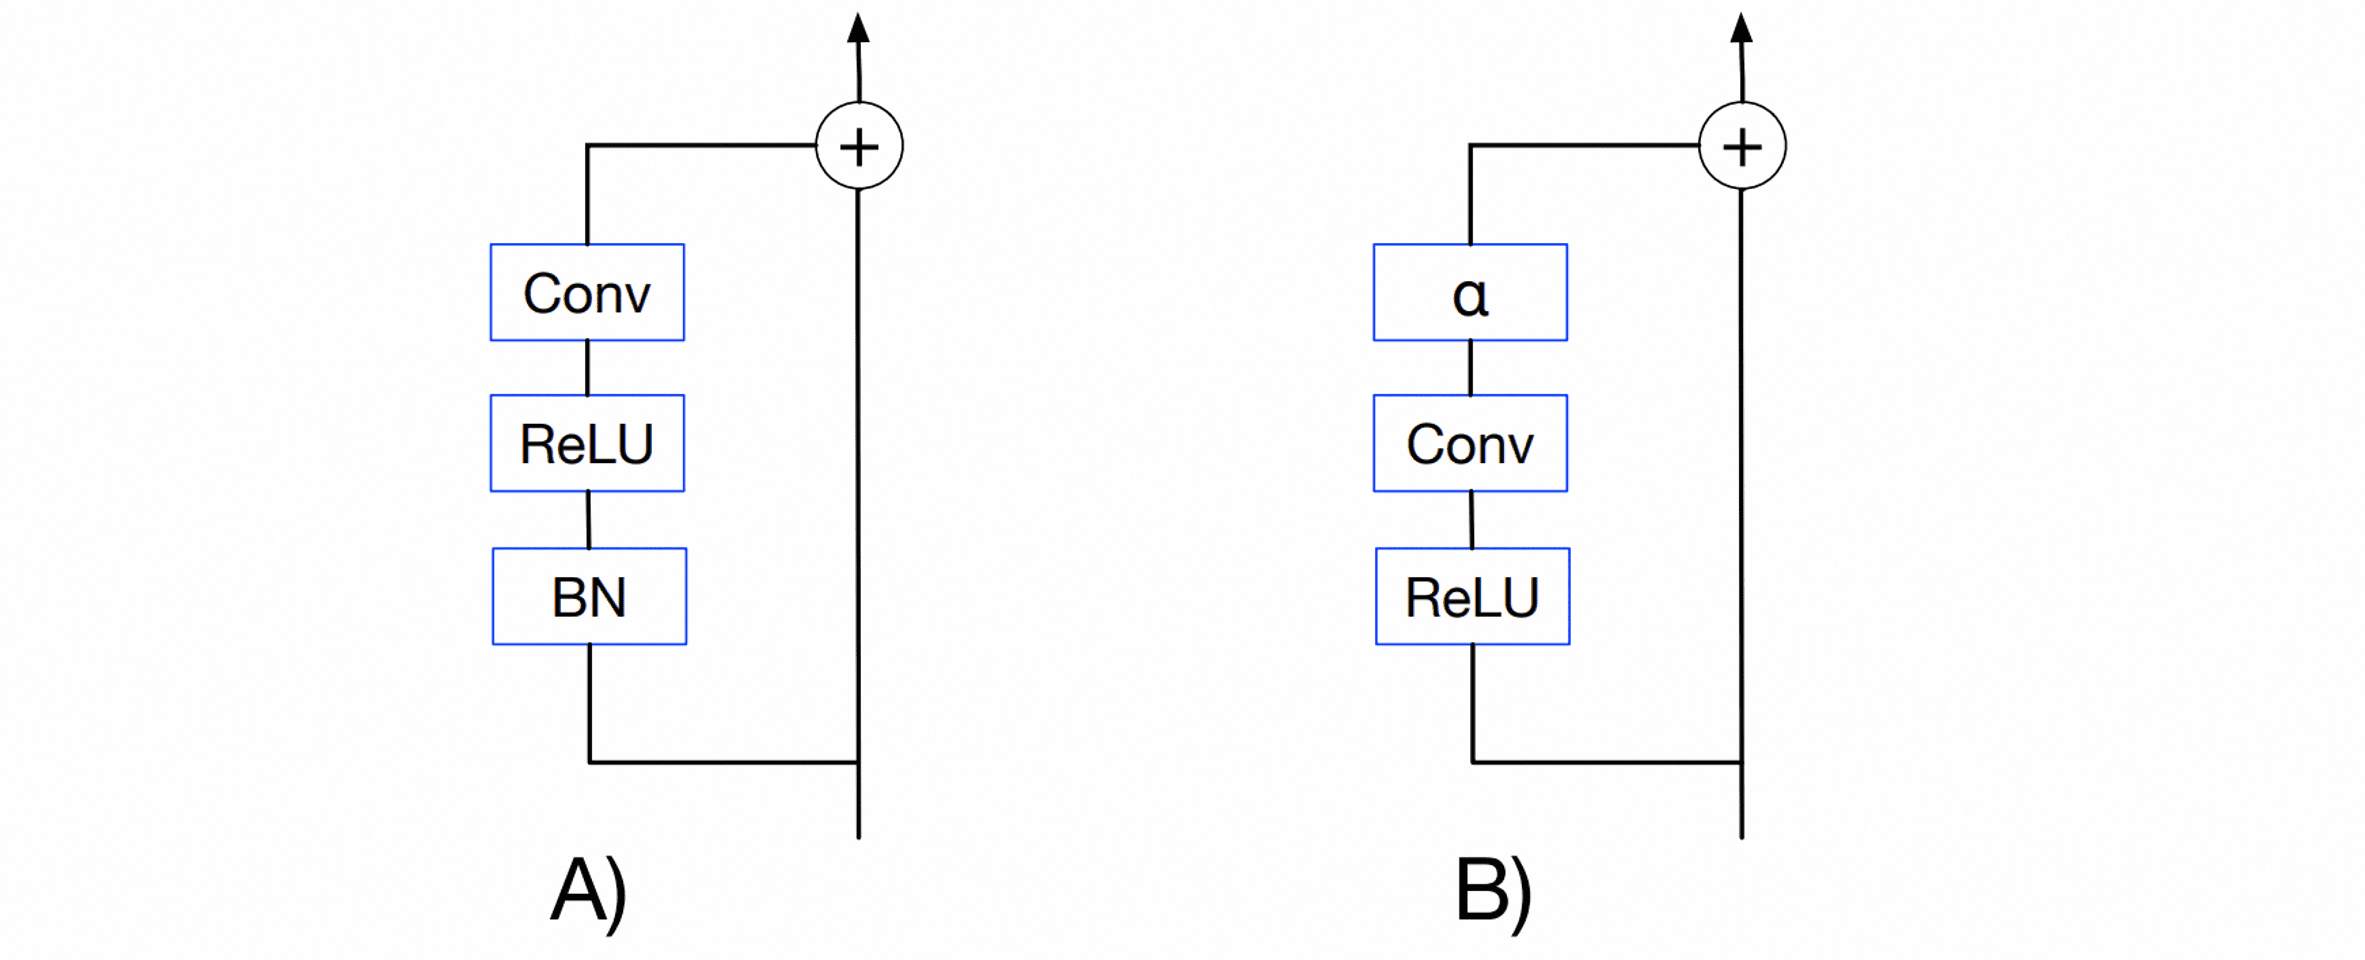
其中$\alpha$初始化为$0$或一个小常数$1/\sqrt{L}$。这个方案称为SkipInit,实现只需一行,却能在无归一化的情况下训练上千层的残差网络。该工作还给出了一个重要的补充结论:BatchNorm在小批量下并不带来学习率优势,它的真正优势在于提高了大批量训练时的最大稳定学习率。
⚪ ReZero:零初始化的残差门控
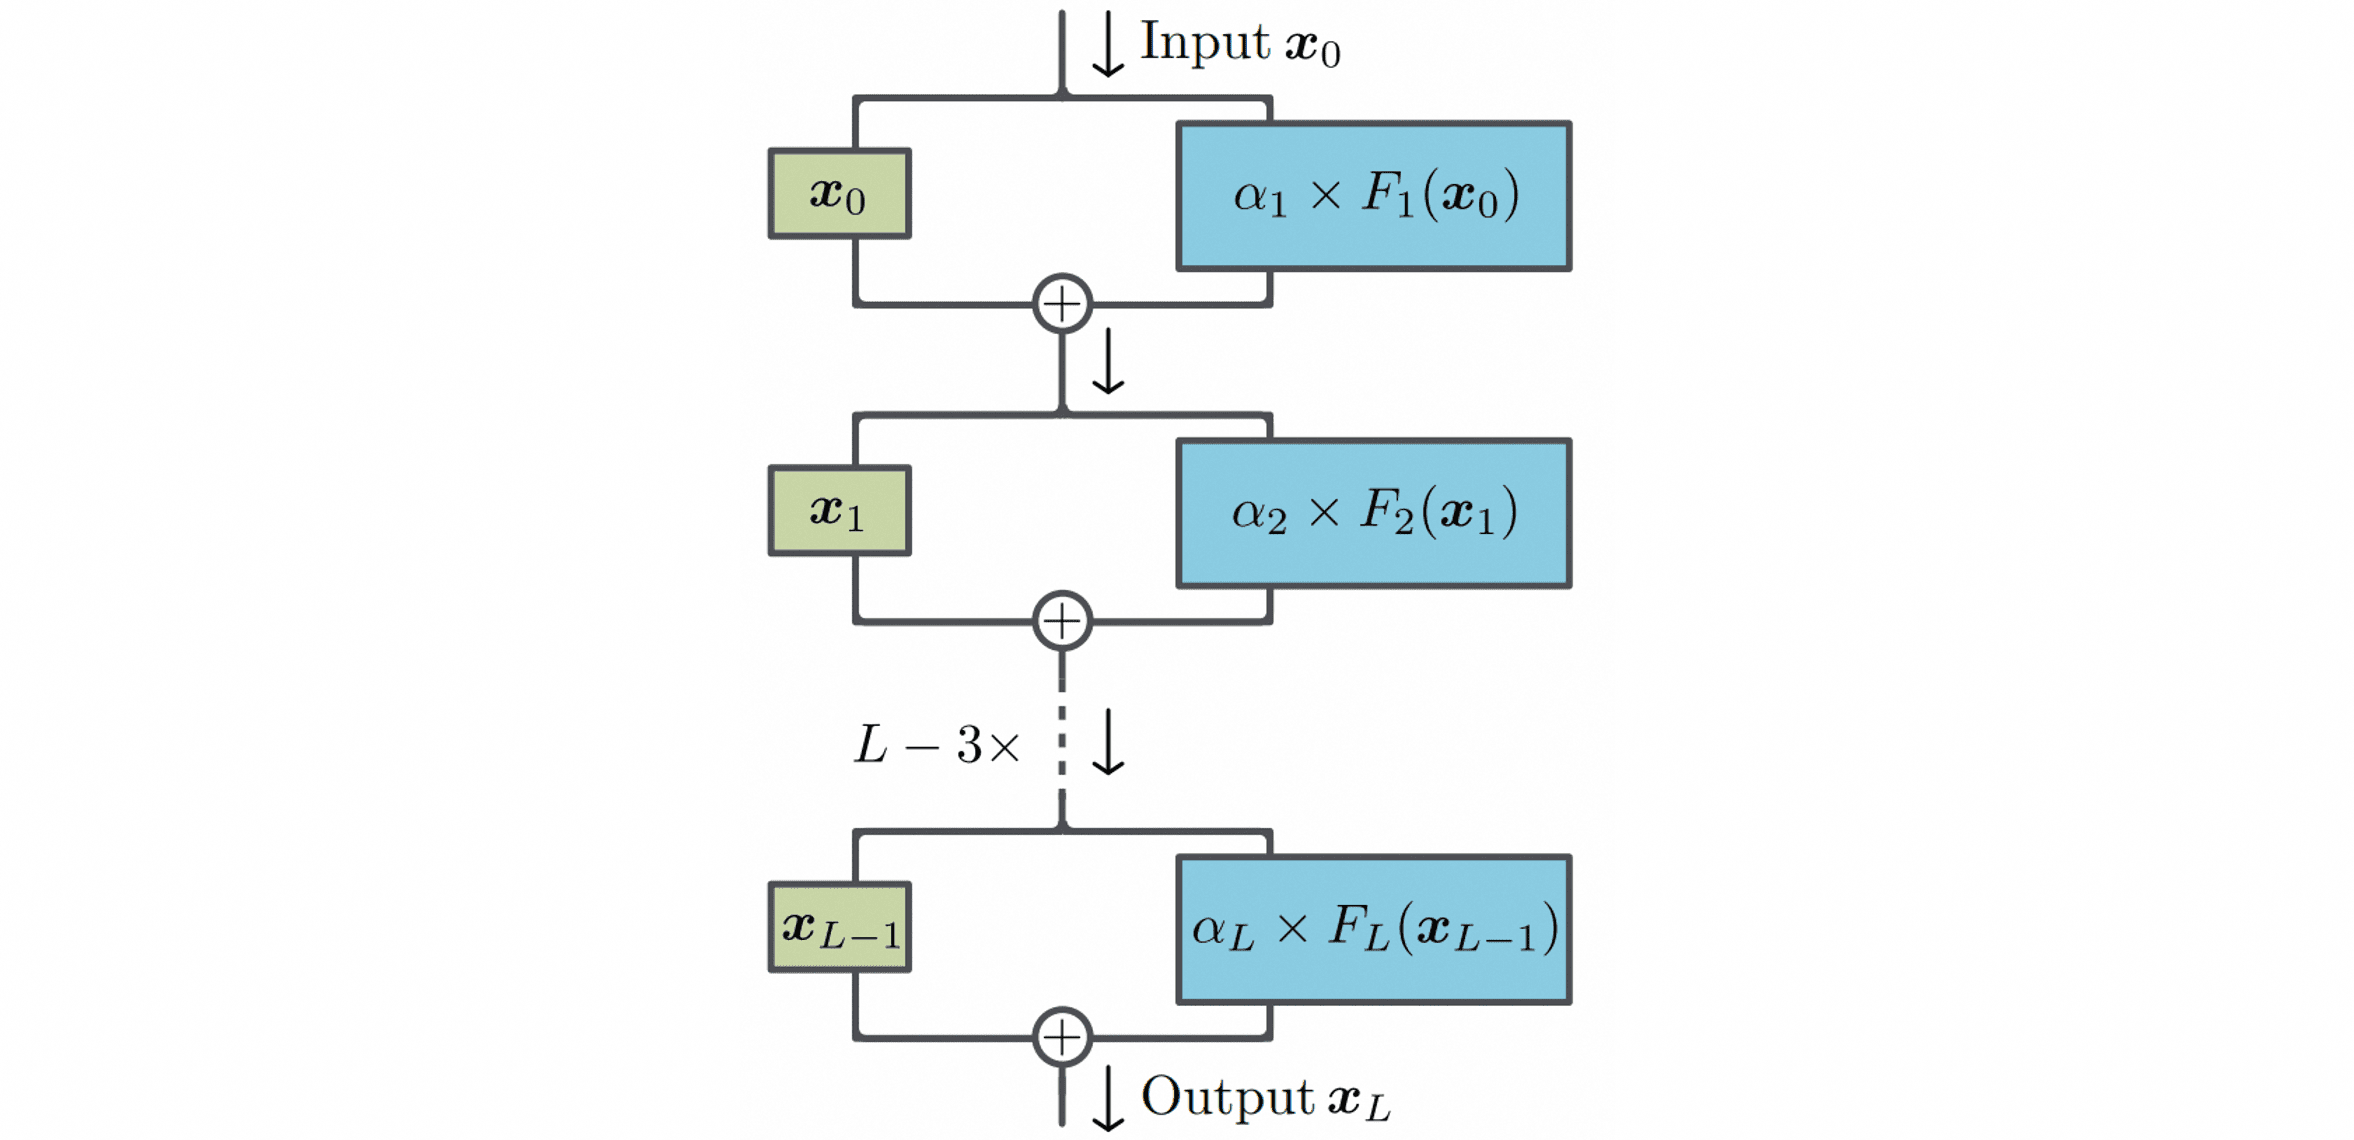
ReZero(residual with zero initialization)与SkipInit形式相同(每个残差连接引入可训练标量$\alpha_t$并初始化为$0$),但从动力等距的角度给出了解释:当$\alpha_t=0$时网络严格等于恒等映射,其输入-输出雅可比矩阵就是单位矩阵,所有奇异值为$1$,天然满足动力等距;随着训练进行$\alpha_t$逐渐增大,网络按需引入非线性。这一视角解释了为什么零初始化的门控对自注意力这类难以实现动力等距的模块尤其有效:ReZero可以在不使用LayerNorm的情况下训练超过$100$层的Transformer,并在全连接网络上取得$7$到$15$倍的收敛加速。
零初始化门控后来成为一种通用手段,例如LLaMA-Adapter的零初始化注意力、ControlNet的零卷积、LoRA的$B=0$,本质上都是同一个思想:让新增模块在初始时是恒等(或零)映射,从而不破坏已有网络的行为。
⚪ LayerScale:视觉Transformer的小尺度门控
LayerScale是ReZero的逐通道版本:在每个残差分支输出上乘一个可学习的对角矩阵
\[x^{(l)} = x^{(l-1)} + \text{diag}\left(\lambda_1,...,\lambda_d\right)F_l\left(x^{(l-1)}\right)\]其中$\lambda_i$初始化为一个很小的常数$\epsilon$($18$层以内取$0.1$,$24$层取$10^{-5}$,更深取$10^{-6}$)。相比纯零初始化,逐通道的$\lambda$给了不同通道不同的开启速度,是深层ViT的标准配置。
⚪ T-Fixup与Admin:Transformer的初始化修正
- paper:Improving Transformer Optimization Through Better Initialization
- paper:Understanding the Difficulty of Training Transformers
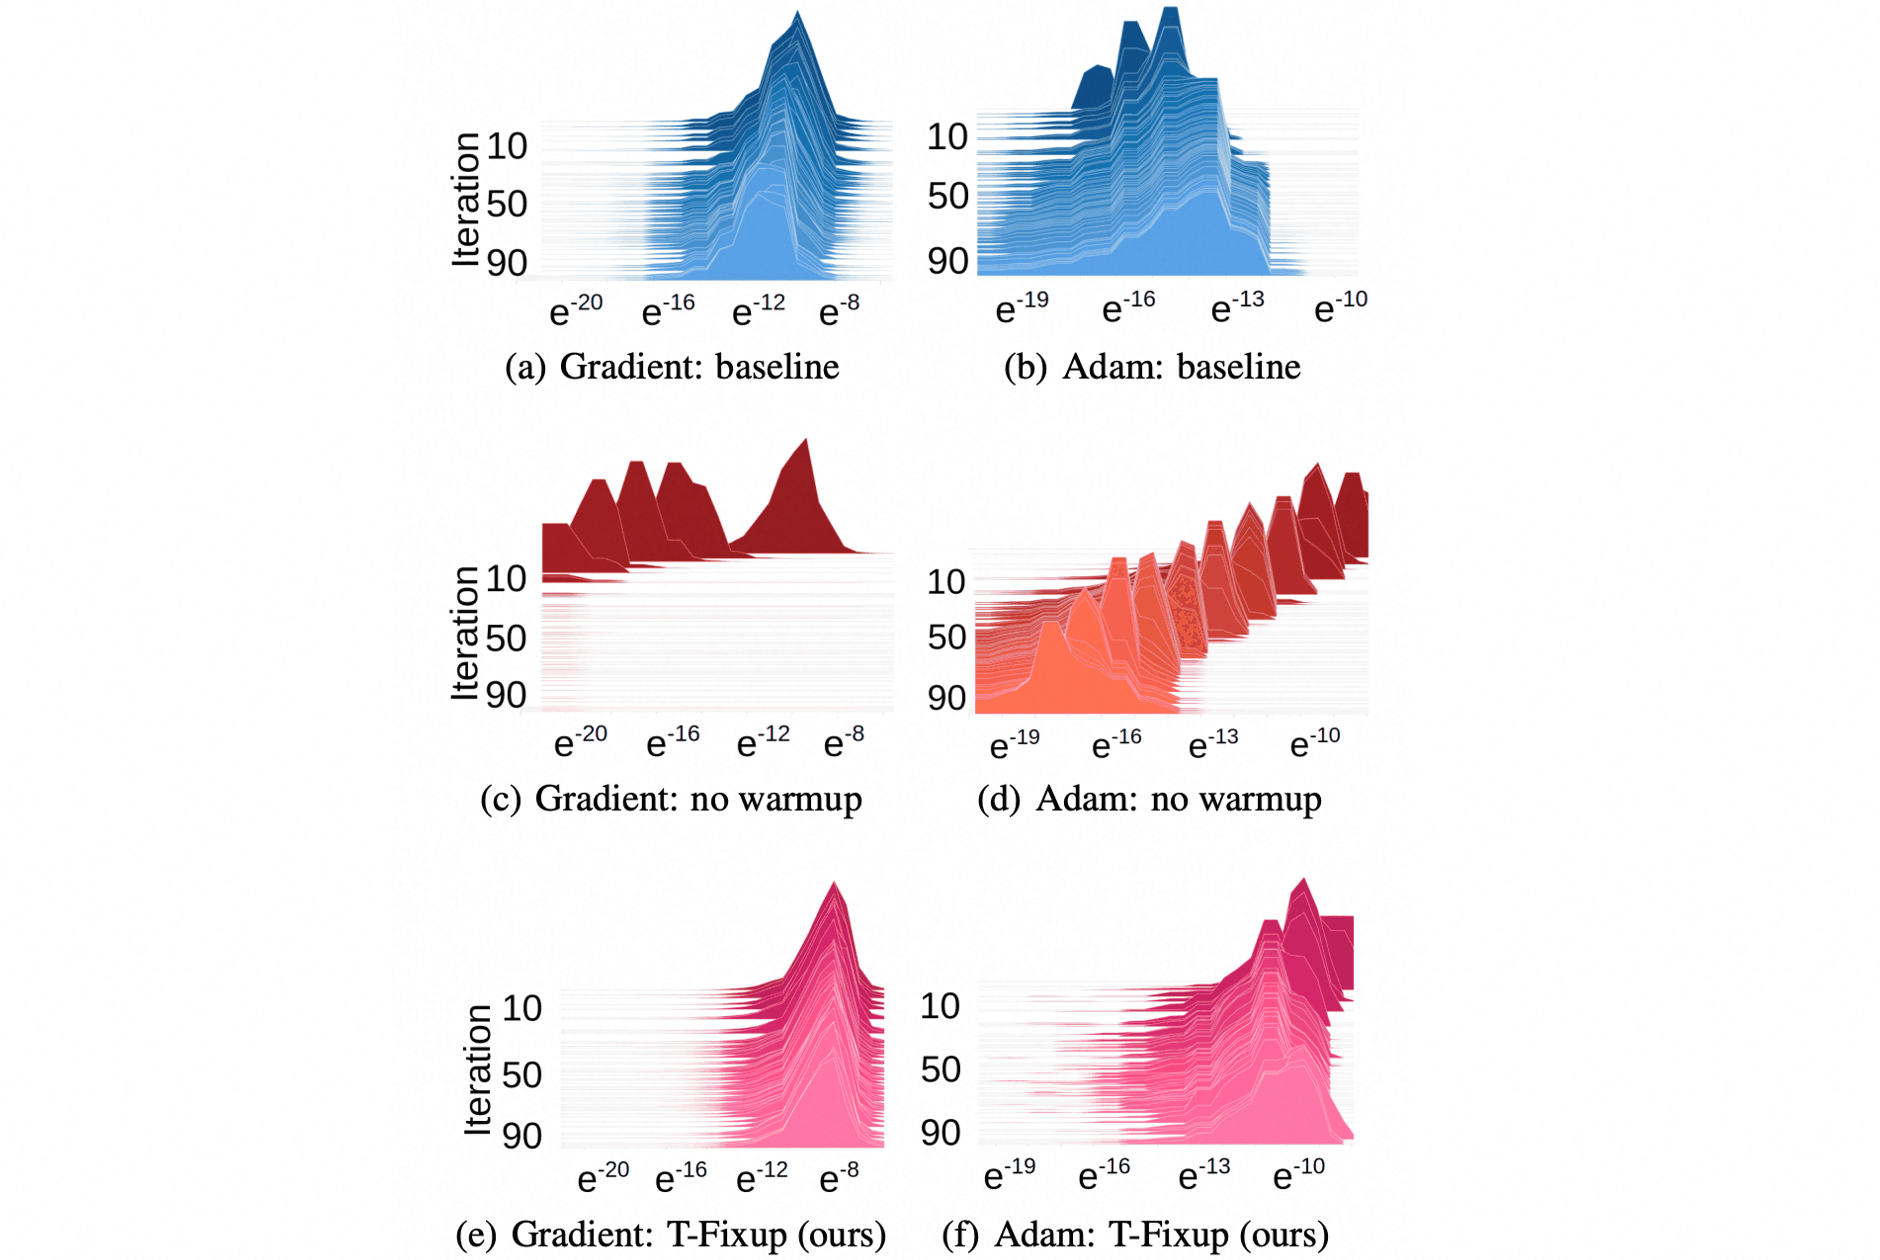
T-Fixup把Fixup的思路搬到Transformer:作者论证Post-LN Transformer必须使用warmup的根本原因是初始化时Adam的更新量方差无界,进而使LayerNorm的梯度爆炸。通过按\(\Theta\left(L^{-1/4}\right)\)的比例缩小编码器/解码器中各权重矩阵(并对嵌入层做相应缩放),T-Fixup可以同时去掉LayerNorm与warmup并稳定训练。
Admin(adaptive model initialization)给出了另一种更工程化的方案:先用一次前向传播测量每个残差分支输出的方差,据此为每个残差连接计算一个常数$\omega_l$:
\[x^{(l)} = \omega_l\cdot x^{(l-1)} + F_l\left(x^{(l-1)}\right)\]使各层输出方差在初始时保持一致,从而稳定$1000$层量级的Transformer训练。它的贡献还包括识别出Post-LN训练不稳定的机制:浅层的梯度依赖于深层的放大,形成放大效应(amplification effect)。
⚪ DeepNorm:用α与β同时缩放残差和初始化
DeepNorm把残差缩放与初始化缩放这两个旋钮联合起来:
\[x^{(l)} = \text{LN}\left(\alpha\cdot x^{(l-1)} + F_l\left(x^{(l-1)}\right)\right)\]其中恒等路径被放大$\alpha>1$倍(等价于相对缩小残差分支),同时把前馈层与注意力的$W_V,W_{out}$的初始化按$\beta<1$缩小($W_Q,W_K$不缩放,因为注意力打分对尺度不敏感)。以$N$层的仅编码器(或仅解码器)结构为例:
\[\alpha = (2N)^{\frac{1}{4}}, \qquad \beta = (8N)^{-\frac{1}{4}}\]编码器-解码器结构有一组更复杂的取值。理论依据是把模型更新量\(\|\Delta \mathcal{F}\|\)的界控制为$O(1)$。详情可参考归一化方法。
2.5 大模型的初始化
大模型时代,初始化的关注点从“能否训练”转向了两个新问题:如何避免loss spike,以及如何让小模型上调好的超参数迁移到大模型。
⚪ 小标准差初始化与残差缩放
- paper:Language Models are Unsupervised Multitask Learners
- paper:Transformers without Tears: Improving the Normalization of Self-Attention
GPT-2确立了两条至今仍在使用的惯例:
(1) 统一的小标准差。所有权重使用\(\mathcal{N}(0,0.02^2)\)初始化(GPT-2、BERT、GPT-3、LLaMA同源实现都沿用$0.02$)。注意$0.02$与宽度无关;Megatron / GPT-NeoX采用显式依赖宽度$d$的small init:
\[\sigma = \sqrt{\frac{2}{5d}}\]这是显式与宽度相关的版本。
(2) 残差分支的$1/\sqrt{N}$缩放。GPT-2把残差分支输出投影的权重按\(1/\sqrt{N}\)缩小,其中$N$是残差分支的总数。推导很直接:$N$个方差为$v$的独立分支累加得到方差$Nv$;把分支权重乘以\(1/\sqrt{N}\)使每个分支贡献$v/N$,总方差回到$v$,与深度无关。由于每个Transformer块含两个残差分支(注意力与前馈),实现中\(N=2L\),即
\[\sigma_{\text{proj}} = \frac{0.02}{\sqrt{2L}}\]GPT-NeoX使用的Wang init是同一思想的另一个取值\(\sigma_{\text{proj}}=\frac{2}{L\sqrt{d}}\)。
⚪ 嵌入层初始化与权重绑定
嵌入层的输入是one-hot,扇入的概念失效,因此不能套用方差缩放公式,只能直接指定标准差。两种常见选择:
- $\sigma=0.02$(GPT/BERT惯例):此时嵌入向量的模长约为\(0.02\sqrt{d}\),远小于$1$,需要紧接一个LayerNorm(BERT)或依赖后续层放大;
- $\sigma=1/\sqrt{d}$:使嵌入向量模长约为$1$。Transformer原始实现则采用\(\sigma=1\)配合前向时乘以\(\sqrt{d}\)的缩放。
权重绑定(weight tying)令输入嵌入$E\in\mathbb R^{V\times d}$与输出投影共享,即$z=hE^\top$。只初始化一次$E$并让两处引用同一参数;标准差、输入侧缩放与输出温度是关键设置。
⚪ muP:最大更新参数化
标准参数化下,最优学习率随网络宽度$n$漂移,因此每换一个模型尺寸都要重新调参。muP(maximal update parametrization)的出发点是:通过初始化和学习率设置让每一层的激活值与其参数的单步更新量都保持$\Theta(1)$(不随模型尺度$n$变化,故称“最大更新”)。满足这一条件后,最优学习率等超参数在宽度上不再漂移,于是可以在小代理模型上调参、零样本迁移到大模型(称为muTransfer)。
引入符号 $\Theta(\cdot)$ 代表“量级”(即随隐藏层宽度 $n$ 变化的缩放比例);$\Theta(1)$代表理想状态:数值稳定,既不随 $n$ 变大而爆炸,也不随 $n$ 变小而消失。
Step1: 让初始前向传播 = $\Theta(1)$)
考虑一个三层线性网络:
- 输入层:$Z_{in} = X W_{in}$ (求和维度是固定的 $n_{in}=\Theta(1)$)
- 隐藏层:$Z_{hid} = Z_{in} W_{hid}$ (求和维度是宽度 $n$)
- 输出层:$Z_{out} = Z_{hid} W_{out}$ (求和维度是宽度 $n$)
现在要决定三个权重矩阵的初始化标准差(即每个元素的量级):
- 对于 $W_{in}$ 和 $W_{hid}$:为了保证初始激活值 $Z_{in}$ 和 $Z_{hid}$ 的每个元素都是 $\Theta(1)$,应设置:
- \((W_{in})_{ij} = \Theta(1/\sqrt{n_{in}})\) (即方差为 \(\Theta(1/n_{in})\))
- $(W_{hid})_{ij} = \Theta(1/\sqrt{n})$ (即方差为 $\Theta(1/n)$)
- 对于输出层 $W_{out}$:先假设它的元素量级是未知的 $s_{out}$。
Step2: 解出输出层初始化 $s_{out}$
现在的核心目标是:训练更新一步之后,隐藏层特征的变化量 $\Delta Z_{hid}$ 必须恰好是 $\Theta(1)$,而且此时隐藏层用的是不随宽度变化的标准学习率 $\eta_{hid} = \Theta(1)$。
-
先看反向传播到隐藏层的梯度 $\frac{\partial \mathcal{L}}{\partial Z_{hid}}$: 因为 $\frac{\partial \mathcal{L}}{\partial Z_{hid}} = \frac{\partial \mathcal{L}}{\partial Z_{out}} W_{out}^\top$(求和维度是固定的 $n_{out}=\Theta(1)$),损失对输出的梯度 $\frac{\partial \mathcal{L}}{\partial Z_{out}}$ 是 $\Theta(1)$,而 $W_{out}$ 的量级是 $s_{out}$,所以:
\[\frac{\partial \mathcal{L}}{\partial Z_{hid}} = \Theta(1) \cdot \Theta(s_{out}) = \Theta(s_{out})\] -
再看隐藏层权重 $W_{hid}$ 的梯度:
\[\frac{\partial \mathcal{L}}{\partial W_{hid}} = Z_{in}^\top \frac{\partial \mathcal{L}}{\partial Z_{hid}} = \Theta(1) \cdot \Theta(s_{out}) = \Theta(s_{out})\] -
最后看隐藏层特征的一步变化量 $\Delta Z_{hid}$: 用 SGD 更新权重:$\Delta W_{hid} = -\eta_{hid} \frac{\partial \mathcal{L}}{\partial W_{hid}} = \Theta(\eta_{hid} \cdot s_{out})$。 那么更新权重后,特征的变化量是($n$个相关项相加,量级放大$n$倍):
\[\Delta Z_{hid} = Z_{in} \Delta W_{hid} = n \cdot \underbrace{\Theta(1)}_{Z_{in}} \cdot \underbrace{\Theta(\eta_{hid} s_{out})}_{\Delta W_{hid}} = \Theta(n \cdot \eta_{hid} \cdot s_{out})\] -
解方程求 $s_{out}$: 我们要求学习率 $\eta_{hid} = \Theta(1)$,且特征变化量 $\Delta Z_{hid} = \Theta(1)$。代入上式:
\[n \cdot 1 \cdot s_{out} = 1 \implies \mathbf{s_{out} = \Theta(1/n)}\]
因此输出层权重 $W_{out}$ 的初始化标准差必须设为 $\Theta(1/n)$(即初始化方差为 $\Theta(1/n^2)$)。
Step3: 算出所有层的梯度和更新量
把 $s_{out} = \Theta(1/n)$ 代回去,立刻得到三个权重矩阵的梯度量级,以及为了保证各层特征变化 $\Delta Z = \Theta(1)$ 所需要的权重理想更新量 $\Delta W$:
- 输入层 $W_{in}$:
- 传到输入层的梯度:$\frac{\partial \mathcal{L}}{\partial Z_{in}} = \frac{\partial \mathcal{L}}{\partial Z_{hid}} W_{hid}^\top$。这是 $n$ 项独立随机求和(量级乘 $\sqrt{n}$),所以量级是 $\sqrt{n} \cdot \Theta(1/n) \cdot \Theta(1/\sqrt{n}) = \Theta(1/n)$。
- 权重梯度:$\frac{\partial \mathcal{L}}{\partial W_{in}} = X^\top \frac{\partial \mathcal{L}}{\partial Z_{in}} = \Theta(1) \cdot \Theta(1/n) = \mathbf{\Theta(1/n)}$。
- 理想更新量 $\Delta W_{in}$ 需要是多少? 因为 $\Delta Z_{in} = X \Delta W_{in}$(求和维度是固定的 $n_{in}=\Theta(1)$),要让 $\Delta Z_{in} = \Theta(1)$,就必须让 $\Delta W_{in} = \Theta(1)$。
- 隐藏层 $W_{hid}$:
- 权重梯度:$\frac{\partial \mathcal{L}}{\partial W_{hid}} = \Theta(s_{out}) = \mathbf{\Theta(1/n)}$。
- 理想更新量 $\Delta W_{hid}$ 需要是多少? 因为 $\Delta Z_{hid} = Z_{in} \Delta W_{hid}$($n$ 项相关求和,放大 $n$ 倍),要让 $\Delta Z_{hid} = \Theta(1)$,就必须让 $\Delta W_{hid} = \Theta(1/n)$。
- 输出层 $W_{out}$:
- 权重梯度:$\frac{\partial \mathcal{L}}{\partial W_{out}} = Z_{hid}^\top \frac{\partial \mathcal{L}}{\partial Z_{out}} = \Theta(1) \cdot \Theta(1) = \mathbf{\Theta(1)}$。
- 理想更新量 $\Delta W_{out}$ 需要是多少? 因为 $\Delta Z_{out} = Z_{hid} \Delta W_{out}$($n$ 项相关求和,放大 $n$ 倍),要让 $\Delta Z_{out} = \Theta(1)$,就必须让 $\Delta W_{out} = \Theta(1/n)$。
Step4:算出 SGD 和 Adam 的学习率
1. 对于 SGD:因为 $\Delta W = \eta_{SGD} \times \text{梯度}$,所以 $\eta_{SGD} = \frac{\text{理想 }\Delta W}{\text{梯度}}$
- 输入层 $W_{in}$:理想 $\Delta W_{in} = \Theta(1)$,但梯度只有 $\Theta(1/n)$ $\implies$ 学习率必须放大 $n$ 倍补回来:$\eta_{in}^{SGD} = \Theta(n)$。
- 隐藏层 $W_{hid}$:理想 $\Delta W_{hid} = \Theta(1/n)$,梯度刚好也是 $\Theta(1/n)$ $\implies$ 学习率保持不变:$\eta_{hid}^{SGD} = \Theta(1)$。
- 输出层 $W_{out}$:理想 $\Delta W_{out} = \Theta(1/n)$,但梯度是 $\Theta(1)$ $\implies$ 学习率必须缩小 $1/n$ 倍压住它:$\eta_{out}^{SGD} = \Theta(1/n)$。
2. 对于 Adam
Adam 的更新公式是 $\Delta W = -\eta \frac{m}{\sqrt{v}}$。分子 $m$ 是梯度的一阶矩(均值),分母 $\sqrt{v}$ 是梯度的二阶矩开根号(标准差)。 分子分母同除,把梯度的量级归一化成了 $\Theta(1)$。所以理想更新量 $\Delta W$ 是多少,Adam 的学习率就设成多少:
- 输入层 $W_{in}$:理想 $\Delta W_{in} = \Theta(1) \implies \mathbf{\eta_{in}^{Adam} = \Theta(1)}$
- 隐藏层 $W_{hid}$:理想 $\Delta W_{hid} = \Theta(1/n) \implies \mathbf{\eta_{hid}^{Adam} = \Theta(1/n)}$
- 输出层 $W_{out}$:理想 $\Delta W_{out} = \Theta(1/n) \implies \mathbf{\eta_{out}^{Adam} = \Theta(1/n)}$
因此,对当前三层网络直接参数化后的规则是:
| 参数类型 | 初始化方差 | SGD学习率 | Adam学习率 |
|---|---|---|---|
| 输入层$W_{in}$ | $\Theta(1/n_{in})$ | $\Theta(n)$ | $\Theta(1)$ |
| 隐藏层$W_{hid}$ | $\Theta(1/n)$ | $\Theta(1)$ | $\Theta(1/n)$ |
| 输出层$W_{out}$ | $\Theta(1/n^2)$ | $\Theta(1/n)$ | $\Theta(1/n)$ |
对于输出维度为$n$的隐藏偏置,其梯度是\(\Theta(1/n)\),因此学习率与输入型参数相同:SGD取\(\Theta(n)\)、Adam取\(\Theta(1)\);固定维度的输出偏置则两者都取\(\Theta(1)\)。偏置通常初始化为$0$,不能和权重矩阵共用\(1/n_{in}\)的初始化方差。嵌入矩阵可以视为one-hot输入层,因此在词表大小固定时属于输入型参数。
muP可以看成“把初始化、学习率、前向乘子三者作为一个整体来设计”,这是初始化研究在大模型时代的范式转变。后续工作u-muP: The Unit-Scaled Maximal Update Parametrization把muP与unit scaling结合,使所有张量(含激活值与梯度)在初始时都是单位尺度,从而天然适配FP8等低精度训练,并让超参数之间更加解耦。
⚪ A Spectral Condition for Feature Learning:用谱范数统一muP规则
前面的推导逐层跟踪了权重元素、梯度元素和学习率关于宽度$n$的量级。这样可以得到正确规则,但输入层、隐藏层和输出层看起来各不相同。Spectral Condition提供了一个与参数类型无关的统一描述:不要比较单个权重元素的大小,而要比较整个权重矩阵及其更新的谱范数(算子范数)。
考虑一层\(Z_{out}=Z_{in}W,W\in\mathbb{R}^{n_{in}\times n_{out}}\),若输入、输出的每个特征分量都是\(\Theta(1)\),则单个样本的特征向量满足
\[\left\|Z_{in}\right\|_2=\Theta\left(\sqrt{n_{in}}\right), \qquad \left\|Z_{out}\right\|_2=\Theta\left(\sqrt{n_{out}}\right).\]由算子范数不等式
\[\left\|Z_{in}W\right\|_2 \leq \left\|Z_{in}\right\|_2\left\|W\right\|_2,\]为了让该层把\(\Theta(\sqrt{n_{in}})\)尺度的输入映射成\(\Theta(\sqrt{n_{out}})\)尺度的输出,权重矩阵需要满足
\[\boxed{ \left\|W\right\|_2 =\Theta\left(\sqrt{\frac{n_{out}}{n_{in}}}\right) }.\]同理,一步参数更新引起的特征变化为
\[\Delta Z_{out}=Z_{in}\Delta W.\]若希望每个输出特征都发生\(\Theta(1)\)的非平凡变化,即\(\left\|\Delta Z_{out}\right\|_2=\Theta(\sqrt{n_{out}})\),则参数更新应满足相同的谱尺度:
\[\boxed{ \left\|\Delta W\right\|_2 =\Theta\left(\sqrt{\frac{n_{out}}{n_{in}}}\right) }.\]这就是用于特征学习的谱条件。梯度更新天然与当前特征方向对齐;以单个样本为例,
\[\Delta W=-\eta Z_{in}^{\top}\frac{\partial \mathcal{L}}{\partial Z_{out}}\]是一个秩$1$外积,其输入侧奇异向量正是$Z_{in}$的方向;批量训练时更新秩至多为$b$。因此对梯度更新而言,上面的谱范数上界通常能够达到正确量级。
⭐ 讨论:谱条件如何还原前面的muP规则
把该条件应用到前面的三层网络:
| 参数 | 矩阵形状 | 目标谱范数 |
|---|---|---|
| $W_{in}$ | $n_{in}\times n$ | \(\Theta\left(\sqrt{n/n_{in}}\right)=\Theta(\sqrt{n})\) |
| $W_{hid}$ | $n\times n$ | \(\Theta\left(\sqrt{n/n}\right)=\Theta(1)\) |
| $W_{out}$ | $n\times n_{out}$ | \(\Theta\left(\sqrt{n_{out}/n}\right)=\Theta(1/\sqrt{n})\) |
对于元素独立、零均值的随机初始化,矩阵谱范数的量级为
\[\left\|W\right\|_2 =\Theta\left(\sigma\left(\sqrt{n_{in}}+\sqrt{n_{out}}\right)\right),\]其中$\sigma$是权重元素的标准差。因此:
- 输入层取\(\sigma_{in}=\Theta(1/\sqrt{n_{in}})\),得到\(\left\|W_{in}\right\|_2=\Theta(\sqrt{n})\);
- 隐藏层取\(\sigma_{hid}=\Theta(1/\sqrt{n})\),得到\(\left\|W_{hid}\right\|_2=\Theta(1)\);
- 输出层取\(\sigma_{out}=\Theta(1/n)\),得到\(\left\|W_{out}\right\|_2=\Theta(1/\sqrt{n})\)。
这恰好给出前面推导的初始化方差\(1/n_{in}\)、\(1/n\)和\(1/n^2\)。
再看一步更新。批量梯度是至多秩$b$的低秩矩阵,因此其谱范数与Frobenius范数具有相同量级。前面得到
\[(\Delta W_{in})_{ij}=\Theta(1), \qquad (\Delta W_{hid})_{ij}=\Theta(1/n), \qquad (\Delta W_{out})_{ij}=\Theta(1/n),\]对应的谱范数分别为
\[\left\|\Delta W_{in}\right\|_2=\Theta(\sqrt{n}), \qquad \left\|\Delta W_{hid}\right\|_2=\Theta(1), \qquad \left\|\Delta W_{out}\right\|_2=\Theta(1/\sqrt{n}),\]也逐层满足同一个谱条件。因此,muP的逐元素初始化与学习率表,本质上是谱条件在不同矩阵形状下的坐标表达。
⭐ 讨论:为什么不能只比较Frobenius范数
随机初始化的隐藏权重通常是高秩矩阵,而一次小批量梯度更新至多只有秩$b$。定义稳定秩
\[\operatorname{srank}(A) =\frac{\left\|A\right\|_F^2}{\left\|A\right\|_2^2}.\]对$n\times n$隐藏矩阵,初始化时\(\left\|W_{hid}\right\|_F=\Theta(\sqrt{n})\)、\(\left\|W_{hid}\right\|_2=\Theta(1)\),稳定秩为\(\Theta(n)\);而一步更新满足\(\left\|\Delta W_{hid}\right\|_F=\Theta(1)\)、\(\left\|\Delta W_{hid}\right\|_2=\Theta(1)\),稳定秩只有\(\Theta(1)\)。
所以即使更新的Frobenius范数比权重小\(\sqrt{n}\)倍,它仍然可以在某个与数据对齐的方向上产生与权重同阶的作用。谱范数恰好测量这种“最强方向上的变化”,比逐元素尺度或Frobenius范数更直接地对应特征是否真正发生学习。
⚪ Depth-muP与CompleteP:把缩放律推广到深度
- paper:Tensor Programs VI: Feature Learning in Infinite-Depth Neural Networks
- paper:Don’t be lazy: CompleteP enables compute-efficient deep transformers
muP只解决了宽度方向的迁移。Depth-muP进一步处理深度$L$:对于残差网络,需要把残差分支乘以\(1/\sqrt{L}\),并把分支内参数的学习率同样按\(1/\sqrt{L}\)缩放;论文证明这是唯一能在$L\to\infty$时保持特征学习(而非退化为核区域)的缩放方式,此时超参数可以同时跨宽度与深度迁移。
CompleteP指出\(1/\sqrt{L}\)的缩放会让深层网络中的各个模块逐渐进入惰性(lazy)区域(每层只做线性化的微小更新)。它改用$1/L$的分支缩放并配合相应的逐层学习率调整,使每一层都保持完备的特征学习,在深宽比较大的Transformer上取得了$12\%$至$34\%$的计算效率提升,同时让最优超参数在深度方向上也保持稳定。
⚪ 训练不稳定的初始化视角
- paper:Spike No More: Stabilizing the Pre-training of Large Language Models
- paper:The Curse of Depth in Large Language Models
大模型预训练中的loss spike(损失突然飙升且难以恢复)常常可以追溯到初始化。Spike No More分析了嵌入层子雅可比矩阵的范数,给出了避免spike的两个充分条件:小的梯度范数上界与足够大的嵌入层输出,并据此说明为什么“小标准差初始化 + 嵌入层后接LayerNorm”这一组合在实践中如此可靠。
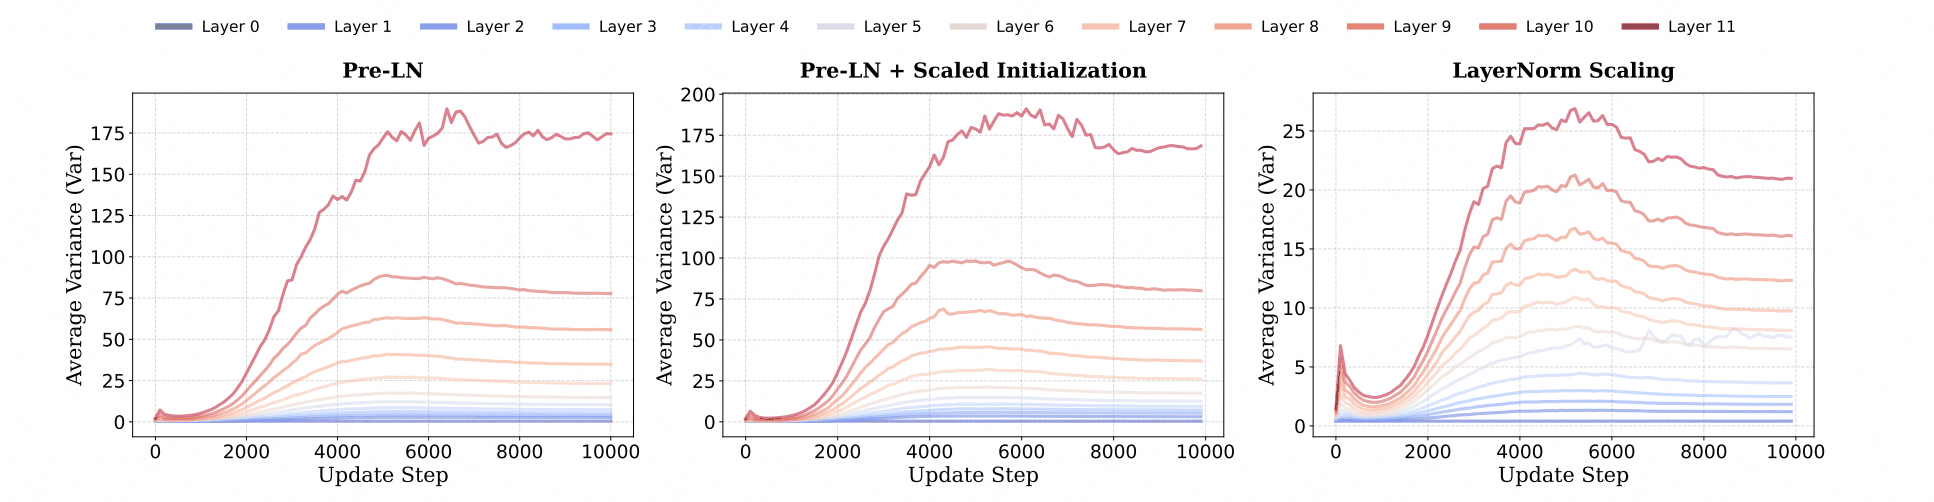
The Curse of Depth则揭示了Pre-LN Transformer的一个结构性缺陷:输出方差随深度累积增长,导致深层块的雅可比矩阵趋于恒等,深层因而近乎无效(这解释了大模型剪掉深层几乎不掉点的现象)。其解法LayerNorm Scaling把第$l$层归一化的输出乘以\(1/\sqrt{l}\),使深层重新参与学习。这类工作说明:初始化时的方差分析同样适用于分析训练后的网络行为,具体讨论可参考归一化方法。
2.6 数据驱动与学习式初始化
前面所有方法都基于解析推导:假设输入独立同分布、激活函数可近似线性化、层与层之间独立。真实网络(含BatchNorm、注意力、复杂连接)往往不满足这些假设。本节的方法干脆放弃解析推导,直接用数据或优化过程来标定初始尺度。
⚪ LSUV:逐层单位方差初始化
LSUV(layer-sequential unit-variance)分两步:
- 用正交矩阵初始化所有权重(保证等距);
- 取一个mini-batch数据做前向传播,从第一层开始逐层迭代:计算该层输出\(z^{(l)}\)的方差,并把权重除以\(\sqrt{\text{Var}[z^{(l)}]}\),重复直到方差落入\(1\pm\epsilon\):
LSUV的优点是它对架构完全无假设:无论中间有什么奇怪的模块,最终测得的方差都是真实值。它相当于“只在第$0$步执行一次的BatchNorm”,成本极低(一次前向传播),却能让VGG这类深网络在没有归一化层时也顺利收敛。
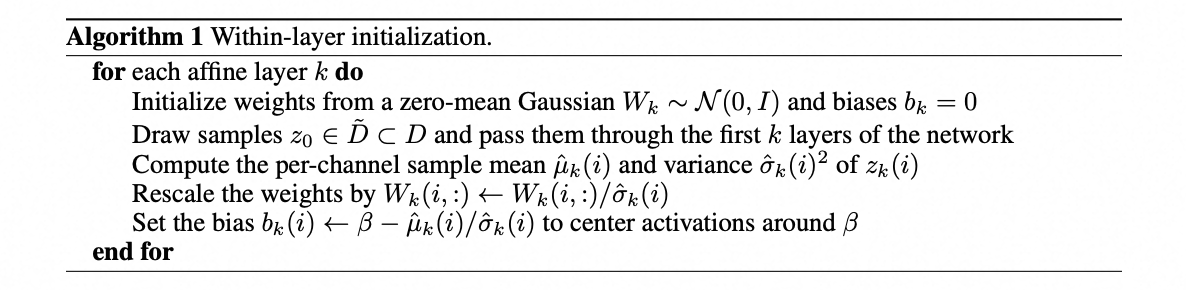
⚪ 数据依赖初始化
该方法同时标定均值与方差。对通道$c$测得$\mu_c,\sigma_c$后执行$W_c\leftarrow W_c/\sigma_c$、$b_c\leftarrow(b_c-\mu_c)/\sigma_c$。
⚪ MetaInit:以梯度量为目标学习初始化
MetaInit完全不使用真实数据(可以用随机噪声输入),而是把初始化本身当作一个优化问题。它的目标是让损失曲面在起点处尽可能平坦,具体度量为梯度商(gradient quotient):
\[GQ = \frac{\left\|\dfrac{g\left(\theta - g(\theta)\right)}{g(\theta)}-\mathbf{1}\right\|_1}{\dim(\theta)}\]其中$g(\theta)$是梯度。$GQ$衡量走一步梯度之后梯度本身变化了多少,$GQ\to 0$意味着损失局部近似线性、曲率很小。
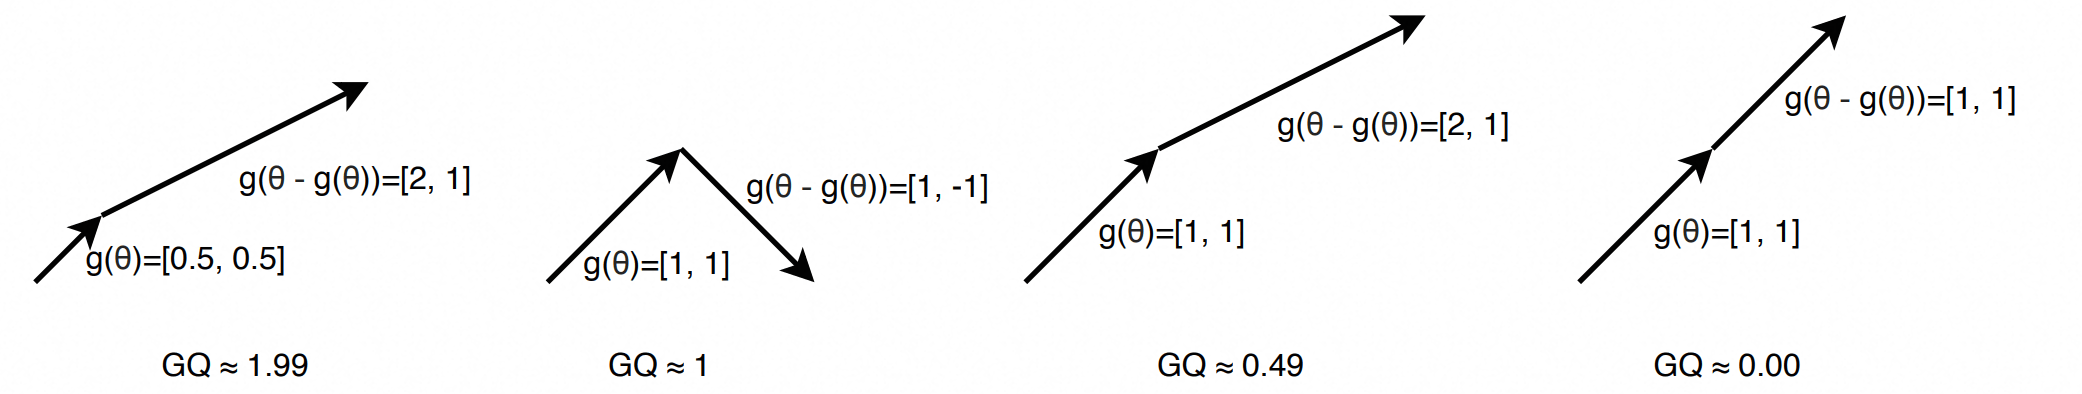
MetaInit只优化每个权重矩阵的范数(不改变方向),用少量梯度步把$GQ$降下来。它能自动重新发现针对具体架构的合适尺度,在没有归一化层的网络上尤其有效。
⚪ GradInit:以可训练性为目标学习初始化
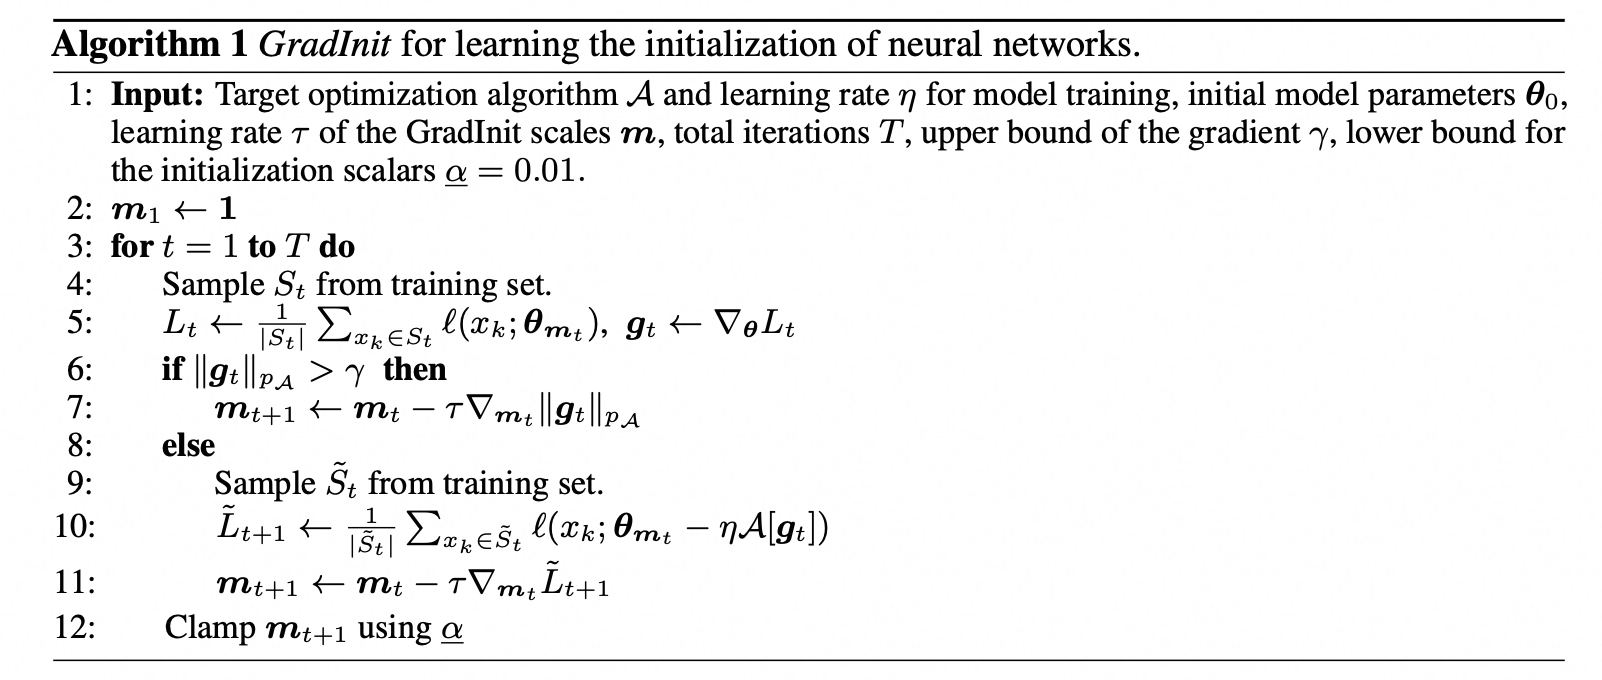
GradInit为每层学习正缩放$\alpha_l$,求解$\min_\alpha\mathcal L(\alpha\odot\theta-\eta U(g))$且$|g|\leq\gamma$,其中$U$是目标优化器的一步更新。流程是初始化$\alpha_l=1$,采样批量、模拟更新并对$\alpha$反向传播,完成元初始化步数后固定缩放。
⚪ 模仿初始化 Mimetic Initialization
Transformer在大规模预训练中表现出色,却很难在小数据集上从头训练。模仿初始化的思路是:既然预训练权重里存在稳定的结构,那么不做预训练、直接把这种结构“模仿”到初始权重里,或许就能获得一部分收益。
记自注意力层的查询、键、值矩阵为\(W_Q,W_K \in \mathbb{R}^{d \times k}, W_V \in \mathbb{R}^{d \times d}\),多头输出投影为\(W_{proj} \in \mathbb{R}^{d \times d}\),则注意力分布与单头输出为
\[\begin{aligned} A &= \text{softmax}\left(\frac{1}{\sqrt{k}}XW_QW_K^\top X^\top\right) \in \mathbb{R}^{n \times n} \\ O &= AXW_VW_{proj} \in \mathbb{R}^{n \times d} \end{aligned}\]作者观察ImageNet上预训练的ViT-Tiny,发现\(W_QW_K^\top\)的对角线显著为正,而\(W_VW_{proj}\)的对角线显著为负:
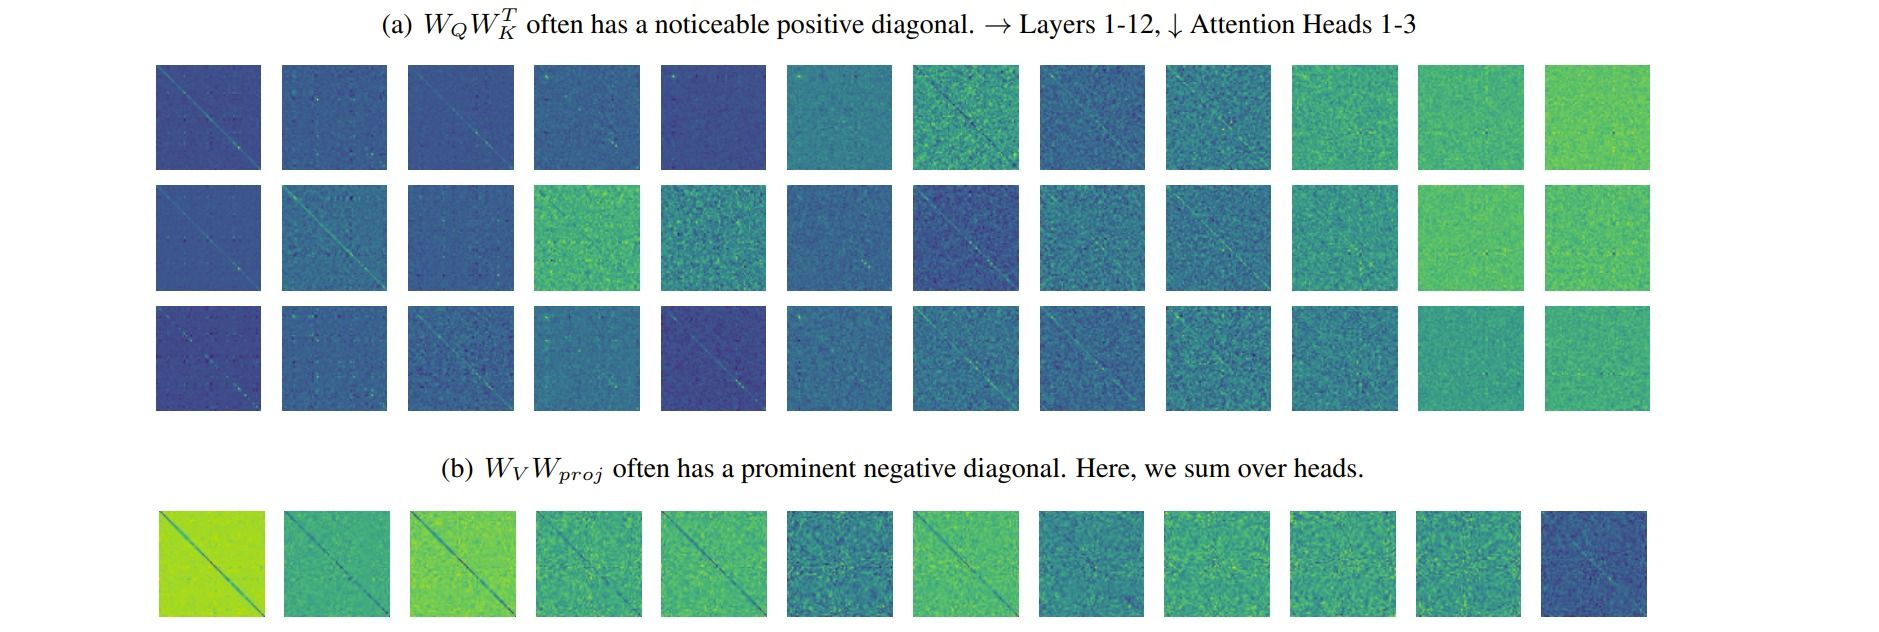
前者意味着注意力倾向于“关注自身”(近似恒等),后者意味着输出倾向于减去自身(配合残差连接近似恒等)。据此可以把两个乘积模仿为单位矩阵的正负倍数:
\[\begin{aligned} W_QW_K^\top &\approx \alpha_1Z_1+\beta_1 I, \quad Z_1 \sim \mathcal{N}(0, I/k)\\ W_VW_{proj} &\approx \alpha_2Z_2-\beta_2 I, \quad Z_2 \sim \mathcal{N}(0, I/d) \end{aligned}\]其中\(\alpha_i,\beta_i\in[0,1]\)分别控制噪声与对角线的强度(引入$\alpha,\beta$是因为直接令\(W_Q=W_K\sim \mathcal{N}(0,I/k)\)虽然由$2.3$节的近似正交性可得\(W_QW_K^\top\approx I\),但无论如何缩放,对角线与非对角噪声的比值都是固定的)。为了从乘积恢复单个矩阵,对目标矩阵做奇异值分解:
\[\begin{aligned} \alpha_2Z_2-\beta_2 I = U_2\Sigma_2V_2^\top,\quad &W_V=U_2\Sigma_2^{1/2},\ W_{proj}=\Sigma_2^{1/2}V_2^\top \\ \alpha_1Z_1+\beta_1 I = U_1\Sigma_1V_1^\top,\quad &W_Q=U_1[:,:k]\Sigma_1[:k,:k]^{1/2},\\ \quad &W_K=V_1[:,:k]\Sigma_1[:k,:k]^{1/2} \end{aligned}\]后者截断前$k$个奇异值以恢复低秩形式。超参数搜索给出\(\alpha_1=\beta_1=0.7,\alpha_2=\beta_2=0.4\)。这种“零成本模仿预训练结构”的初始化在小规模图像识别任务上尤其有效。
3. PyTorch中的初始化实践
在PyTorch中,可以在定义网络时为每个模块(如卷积层、BatchNorm)指定初始化类型:
class Model(nn.Module):
    def __init__(self, ):
        super(Model, self).__init__()
        # 定义模型

        for m in self.modules():
            if isinstance(m, nn.Conv2d):
                n = m.kernel_size[0] * m.kernel_size[1] * m.out_channels
                m.weight.data.normal_(0, math.sqrt(2. / n))  # Kaiming, fan_out
            elif isinstance(m, nn.BatchNorm2d):
                m.weight.data.fill_(1)
                m.bias.data.zero_()

    def forward(self, x):
        # 前向传播
也可以在实例化网络后,对其中的模块统一进行初始化:
def weights_init(net, init_type='normal', init_gain = 0.02):
    def init_func(m):
        classname = m.__class__.__name__
        if hasattr(m, 'weight') and classname.find('Conv') != -1:
            if init_type == 'normal':
                torch.nn.init.normal_(m.weight.data, 0.0, init_gain)
            elif init_type == 'xavier':
                torch.nn.init.xavier_normal_(m.weight.data, gain=init_gain)
            elif init_type == 'kaiming':
                torch.nn.init.kaiming_normal_(m.weight.data, a=0, mode='fan_in')
            elif init_type == 'orthogonal':
                torch.nn.init.orthogonal_(m.weight.data, gain=init_gain)
            else:
                raise NotImplementedError('initialization method [%s] is not implemented' % init_type)
        elif classname.find('BatchNorm2d') != -1:
            torch.nn.init.normal_(m.weight.data, 1.0, 0.02)
            torch.nn.init.constant_(m.bias.data, 0.0)
    print('initialize network with %s type' % init_type)
    net.apply(init_func)

model = Model()
weights_init(model)
若需要实现残差分支的零初始化(Zero-$\gamma$)与GPT-2式的残差缩放,只需在遍历模块时按名称筛选:
for name, p in model.named_parameters():
    if name.endswith('proj.weight'):   # 残差分支的输出投影
        torch.nn.init.normal_(p, mean=0.0, std=0.02/math.sqrt(2*n_layer))

for m in model.modules():              # Zero-gamma
    if isinstance(m, Bottleneck):
        torch.nn.init.zeros_(m.bn3.weight)