Data Tokenization in Deep Learning.
标记化(tokenization)是把文本、图像、视频等原始数据分割成基本单元、并映射为标记(token)的预处理技术,它是模型与原始数据之间的接口。
本文首先讨论标记化的问题形式、设计权衡与评价指标;然后按模态介绍文本、图像、视频、音频、科学数据与其他模态的标记化;最后介绍多模态统一标记化。
本文目录:
- 标记化的问题与视角:为什么需要标记化、设计权衡、统一形式化与评价指标
- 文本的标记化:字符级与字节级、词级与中文分词、子词级、大模型时代的词表工程
- 图像的标记化:非学习式标记化、学习式离散量化、量化机制的改进、语义视觉标记、一维与多尺度标记、连续视觉标记
- 视频的标记化:时空图像块、离散视频分词器、连续视频隐空间
- 音频的标记化:信号级量化、神经音频编解码器、自监督语义标记、语义与声学标记的融合
- 科学数据的标记化:分子、蛋白质、基因组DNA
- 其他模态的标记化:时间序列、机器人动作、点云、图与推荐系统
- 多模态统一标记化:早期融合的统一词表、理解与生成统一的视觉分词器、离散与连续混合接口
1. 标记化的问题与视角
(1) 为什么需要标记化
在图像分类这样的简单深度学习任务中,一张图像经过缩放、归一化等简单预处理后,以原始像素张量的形式直接进入卷积网络,最终输出一个类别标签。从原始数据到模型输入的转换由网络结构自身完成。并没有“标记化”的步骤。
如今在深度学习中,标记化越来越重要;主要原因是几个研究趋势的变化。
其一是Transformer取代专用架构成为通用骨干。 自注意力对数据结构并不敏感:它只输入“一组标记”。使用Transformer的前提是对数据进行显式标记化:视觉需要图像块化,音频需要帧级特征,文本需要子词词表。
其二是生成式任务的统一。 自回归与掩码预训练把训练目标统一为“预测下一个或被遮住的标记”,这要求一个可枚举的输出空间:模型在$|\mathcal{V}|$维softmax上定义条件分布$p(z_t\mid z_{<t})$。一旦各模态都表示为标记,生成就成了分类:文本、图像、音频的生成共享同一个“下一标记预测”目标。
标记化的第三个作用是压缩。注意力的计算量随序列长度二次增长,而原始数据的长度往往极大:一张$256\times256$的RGB图像有$196608$个子像素,一秒$24$kHz音频有$24000$个采样点,一部百万字的中文书有约$300$万个UTF-8字节。标记化把这些长度压缩一到三个数量级,使序列模型能在合理算力下覆盖完整的语义单元。
(2) 标记化的设计权衡
标记化的设计权衡包括:
- 粒度:以文本为例,从细到粗存在一个谱系:字节$\to$字符$\to$子词$\to$词$\to$短语(超词)。粒度越细,词表越小、越不会有未知词,但序列越长、单个标记承载的语义越弱;粒度越粗则相反。图像与音频同理:单个像素/采样点是极细的粒度,图像块、视频管块与音频帧是较粗的粒度。
- 覆盖性与可逆性:理想情况下任何输入都应能被编码(无OOV),且能从标记序列无损还原(可逆)。字节级方法天然满足这两条;子词方法通过把未知词拆成已知子词满足前者;图像与音频的学习式分词器一般是有损的,其“可逆性”以重构质量衡量。
- 规则式与学习式的取舍:规则式(空白切分、图像块化、mu-law量化、$k$-mer切分)简单可预测、无需训练;学习式(子词统计、向量量化、动态分块)从数据中学习标记边界与取值,通常在同等序列长度下承载更多信息。学习式又可分为与下游模型解耦(先训练分词器、再冻结使用,如BPE与VQGAN)和与下游模型端到端联合训练(如Charformer、H-Net)两类。
- 离散与连续的取舍:文本天然离散;图像与音频既可以直接以连续张量输入网络(如ViT的图像块嵌入、Stable Diffusion的连续隐空间),也可以先离散化为标记(如VQ-VAE)。离散接口把生成统一为分类问题,并支持先验建模与码本复用;连续接口保留更多信息,需要配合扩散、流匹配等连续分布建模方法。
- 语义与重构的取舍:为重构训练的标记(如VQGAN码)保留像素细节,为语义训练的标记(如HuBERT聚类单元、BEiT v2的知识蒸馏码)对齐高层语义;理解任务与生成任务对两者的偏好不同。
(3) 标记化的统一形式化
把标记化写成算子:
\[x \xrightarrow{\ \text{tok}\ } (z_1,z_2,\dots,z_n),\quad z_i\in\mathcal{V}=\{1,\dots,|\mathcal{V}|\}\]模型一侧通过嵌入查询把离散索引变成连续向量$E[z_i]\in\mathbb{R}^{d}$;生成一侧则在词表上定义分布;去标记化(detokenization)算子$\text{detok}(\cdot)$把标记序列还原为数据,可逆分词器满足$\text{detok}(\text{tok}(x))=x$。
词表大小$|\mathcal{V}|$、序列长度$n$与单标记平均信息量构成一条帕累托前沿:增大$|\mathcal{V}|$可以缩短$n$,但嵌入与输出层的参数量、softmax的竞争难度随之上升。几乎所有标记化方法都可以理解为在这条前沿上选择一个工作点,并回答三个问题:边界怎么切(规则或学习)、离散值怎么定(查表、统计或量化)、反变换怎么还原。
(4) 标记化的评价指标
对文本分词器,常用的内在指标有:
- 压缩率:平均每个标记覆盖的字节数(bytes per token)或字符数(characters per token),越大表示序列越短;
- 繁殖率(fertility):平均每个词被切成的标记数,常用于比较不同语言在同一分词器下的切分程度;
- 词表利用率:在语料中实际出现的标记占词表的比例;
- 信息论效率:标记分布的熵与最大熵之比。
比较不同分词器下训练的语言模型时,标记级困惑度不可直接比较(同一段文本的标记数不同),通常换算为每字节比特数(bits per byte, BPB):若文本共$N_B$个字节、模型给出的总负对数似然(以自然对数计)为\(\mathcal{L}_{\text{tot}}=-\sum_{t=1}^{n}\ln p(z_t\mid z_{<t})\),则
\[\text{BPB}=\frac{\mathcal{L}_{\text{tot}}}{N_B\ln 2}\]它把损失归一化到与分词无关的字节数上。严格地说,若一段文本有多种切分,$p(x)=\sum_{\mathbf{z}:\,\text{detok}(\mathbf{z})=x}p(\mathbf{z})$应对所有切分求和;确定性分词器只取规范切分$\mathbf{z}^{\ast}$,由于$p(x)\ge p(\mathbf{z}^{\ast})$,以规范切分计算的似然是$p(x)$的一个下界。
对图像、视频与音频的学习式分词器,评价分为两部分。
- 重构质量:图像常用rFID(重构图像与原图之间的Fréchet Inception Distance)、PSNR、SSIM与LPIPS;视频用rFVD;音频用ViSQOL、PESQ、STOI、UTMOS与主观的MUSHRA评分。
- 可建模性:在该分词器上训练生成模型后的生成质量(gFID、FVD)或理解性能。
此外还要统计码本利用率(被实际使用的码字比例)与码本困惑度$\exp(-\sum_k \bar{p}_k\log\bar{p}_k)$($\bar{p}_k$为码字$k$在数据集上的使用频率,困惑度越接近$K$表示码字使用越均匀)。音频分词器的码率(bitrate)由帧率$f_r$、每帧码本数$N_q$与码本大小$K$决定:
\[\text{bitrate}=f_r\cdot N_q\cdot\log_2 K\quad(\text{bit/s})\]例如$75$Hz帧率、$8$个大小为$1024$的码本对应$75\times8\times10=6000$bit/s,即$6$kbps。图像分词器则常用每像素比特数$n\log_2 K/(HW)$衡量压缩程度。
2. 文本的标记化
文本是离散符号序列,标记化的问题是“以什么单元切分”。按粒度从细到粗分为字符/字节级、词级(含中文分词)与子词级方法;最后介绍大模型时代的词表工程。
(1) 字符级与字节级
最细的文本粒度是字符级(character-level):词表为全体可见字符(几千到几万),彻底消除未知词,但序列极长、单字符语义稀疏。更彻底的字节级(byte-level)以UTF-8字节为最小单元:词表仅$256$个,任何合法文本(乃至任意二进制数据)都能编码,天然跨语言统一;同等文本的字节序列约为子词序列的$3\sim5$倍长(UTF-8中拉丁字母占$1$个字节,汉字占$3$个字节,部分表情符号占$4$个字节)。介于两者之间的折中是在字节之上再做子词合并,即字节级子词。
⚪ 字节级BPE:GPT-2的字节表示
GPT-2在字节序列上运行BPE,基础词表就是$256$个字节值,再通过学习到的合并规则把常见字节组合合并成子词。这样任何Unicode字符串都能被编码而不会出现未知标记(未知字符回落到字节序列),多语言文本在字节层面天然共享表示。GPT-2的词表大小为$50257$,即$256$个基础字节、$50000$次合并产生的子词与$1$个文本结束标记<|endoftext|>。
实现上,为了让字节序列能以可读字符串的形式参与合并与存储,GPT-2先用一个固定的双射把$256$个字节值映射到$256$个可打印的Unicode字符(可打印的ASCII字节映射到自身,控制字符与空白等映射到偏移后的码点,如空格显示为Ġ),合并规则就定义在这些字符上;解码时逆映射回字节再按UTF-8解码。
一个关键工程细节是预切分(pre-tokenization):先用正则表达式把文本切成“词”,BPE只在词内进行,防止合并跨越词边界(例如避免产生dog.、dog!、dog?这类把词与标点合在一起的冗余标记)。GPT-2使用的模式为:
pat = re.compile(r"""'s|'t|'re|'ve|'m|'ll|'d| ?\p{L}+| ?\p{N}+| ?[^\s\p{L}\p{N}]+|\s+(?!\S)|\s+""")
它把英文缩写、带前导空格的字母串、带前导空格的数字串、标点串与空白分别切开。GPT-4/gpt-4o 的cl100k/o200k词表在此基础上做了两处修改:数字按最多$3$位一组切分(利于算术),连续空格与换行合并成整块(利于代码缩进)。cl100k_base的预切分模式为:
pat = r"""(?i:'s|'t|'re|'ve|'m|'ll|'d)|[^\r\n\p{L}\p{N}]?\p{L}+|\p{N}{1,3}| ?[^\s\p{L}\p{N}]+[\r\n]*|\s*[\r\n]+|\s+(?!\S)|\s+"""
其中\p{N}{1,3}限定数字串至多$3$位一组,(?i:...)让缩写匹配大小写不敏感,\s*[\r\n]+把连续换行(及其前的空白)合成一块。
⚪ BBPE:字节级子词的机器翻译
字节级BPE(Byte-level BPE, BBPE)系统研究了字节级子词在机器翻译中的作用。动机是:中文、日文等字符丰富的语言以及含噪文本中有大量稀有字符,字符级子词表必须为它们预留词表位置,使词表难以紧凑;而纯字节序列又过长。BBPE在UTF-8字节序列上学习BPE合并,使高频字符与字符组合成为完整标记、稀有字符拆为字节,从而兼得“无未知词”与“词表紧凑”。
BBPE的一个特性是合并后的标记可能是不完整的字符(例如一个汉字的$3$个字节中前$2$个被合并为一个标记),单个标记的嵌入因此缺乏独立含义。论文提出对BBPE嵌入做上下文化(contextualization):在嵌入层之后加一层卷积或双向GRU,让每个字节级标记的表示融合邻近标记的信息,再送入Transformer。
解码时,模型输出的字节序列可能不是合法的UTF-8。论文给出一个动态规划的恢复算法:设$f(k)$为前$k$个字节能解码出的最大合法字符数,则
\[f(k)=\max_{t=1,\dots,4}\left\{f(k-t)+g(k-t+1,k)\right\}\]其中$g(i,j)=1$当且仅当字节$i\sim j$构成一个合法字符,否则为$0$;沿最优路径回溯即可恢复尽可能多的合法字符。实验表明BBPE在词表只有BPE的约$1/8$时取得与之相当的翻译质量;在多语言设置下它最大化了跨语言的词表共享,并能在字符集互不重叠的语言之间迁移模型。
(2) 词级与中文分词
词级(word-level)以自然语言的词为标记:英语等以空白与标点即可切分(配合词典把每个词映射为索引);词的语义完整、序列最短,但词表随语料开放增长,训练中未见过的词只能映射为专门的<UNK>标记。中文、日文等语言没有天然的词边界,分词(word segmentation)本身就是标记化。
⚪ 最大匹配法:基于词典的机械分词
最大匹配法(maximum matching)是最经典的机械分词:给定一部词典与最大词长$L$,从当前位置开始取最多$L$个字,若能在词典中找到则切出该词并后移,否则缩短一个字继续匹配;匹配失败到单字时切出单字。
按扫描方向分为正向最大匹配、逆向最大匹配与双向最大匹配(两种方向分别匹配,按“词数更少、单字词更少”等启发式选取其中一种)。对长度为$m$的句子,正向最大匹配的时间复杂度为$O(mL)$(每个位置至多做$L$次词典查询)。
最大匹配法只需要一部词典,速度快、可解释;它的边界完全由词典决定,词典外的词与真实歧义需要更强的模型来处理(如“结婚的和尚未结婚的”在正向匹配下被切为“结婚/的/和尚/未/结婚/的”),这直接推动了基于统计与序列标注的分词方法。
⚪ 基于序列标注的分词:HMM、CRF与BiLSTM-CRF
把分词形式化为序列标注问题:给每个字打上${B,M,E,S}$标签(词首/词中/词尾/单字词),标签序列的唯一解码即分词结果。记字符序列为$\mathbf{c}=(c_1,\dots,c_m)$、标签序列为$\mathbf{s}=(s_1,\dots,s_m)$。三类代表性模型按建模能力递进:
- HMM是生成式模型:联合分布分解为标签转移与字符发射$p(\mathbf{c},\mathbf{s})=\prod_t p(s_t\mid s_{t-1})p(c_t\mid s_t)$,参数通过标注语料的计数估计;解码用Viterbi动态规划,定义$\delta_t(s)$为以标签$s$结尾的前$t$个字的最大联合概率,则$\delta_t(s)=\max_{s’}\delta_{t-1}(s’)\,p(s\mid s’)\,p(c_t\mid s)$,回溯得到全局最优标签序列,复杂度$O(m\cdot4^2)$。
- CRF是判别式模型:直接建模标签序列的(给定观测下的)条件分布
其中$f$为特征函数(可以任意设计:字符组合、词典命中、上下文窗口),$\mathbf{w}$为权重,配分函数$Z(\mathbf{c})$由前向算法在$O(m\cdot4^2)$时间内求出;参数通过最大化条件对数似然训练,同样用Viterbi解码。
- BiLSTM-CRF用双向LSTM自动提取字符的上下文表示,接CRF层做标签解码,免去人工特征。其打分函数为$\text{score}(\mathbf{c},\mathbf{s})=\sum_{t=1}^{m}\left(A_{s_{t-1},s_t}+P_{t,s_t}\right)$,其中$P\in\mathbb{R}^{m\times4}$是BiLSTM输出经线性层得到的发射分数,$A\in\mathbb{R}^{4\times4}$是可学习的标签转移矩阵(能学到“$B$之后不能接$S$”之类的约束),$p(\mathbf{s}\mid\mathbf{c})=\text{softmax}_{\mathbf{s}}(\text{score})$。它对未登录词(人名、新术语)的泛化显著更好。
工程实现(如jieba)常把词典与统计模型组合:先用词典构建切分有向无环图(DAG),按词频估计的概率用动态规划求最大概率路径,对路径中连续的单字串再用HMM识别未登录词,兼顾速度与召回。
⚪ 日文形态分析:基于词格的最小代价路径
日文分词通常与词性标注一起完成,称为形态分析(morphological analysis),代表工具是MeCab。它先用词典在输入字符串上找出所有可能的词,构成一张词格(lattice):节点是候选词(附带词性等信息),边连接相邻的候选词。每个节点有生成代价$c_w(w)$,每条边有依赖左右两词词性上下文的连接代价$c_t(\ell,r)$,一条切分路径$w_1,\dots,w_k$的总代价为
\[\text{cost}(w_{1:k})=\sum_{i=1}^{k}c_w(w_i)+\sum_{i=1}^{k-1}c_t\left(\text{ctx}(w_i),\text{ctx}(w_{i+1})\right)\]其中$\text{ctx}(\cdot)$表示词的词性上下文类别。分析结果是代价最小的路径,用Viterbi算法在词格上求解;代价参数由CRF在标注语料上学习(代价即负的对数势函数)。PathPiece最短切分以及Lattice LSTM的共同结构基础。
⚪ Lattice LSTM:把词典信息融入字级模型
先分词、再在词序列上建模的流水线会把分词错误传播到下游任务。Lattice LSTM采用另一种思路:以字为基本标记,但把词典匹配到的所有词作为额外路径注入字级LSTM,让模型自己决定利用哪些词边界。
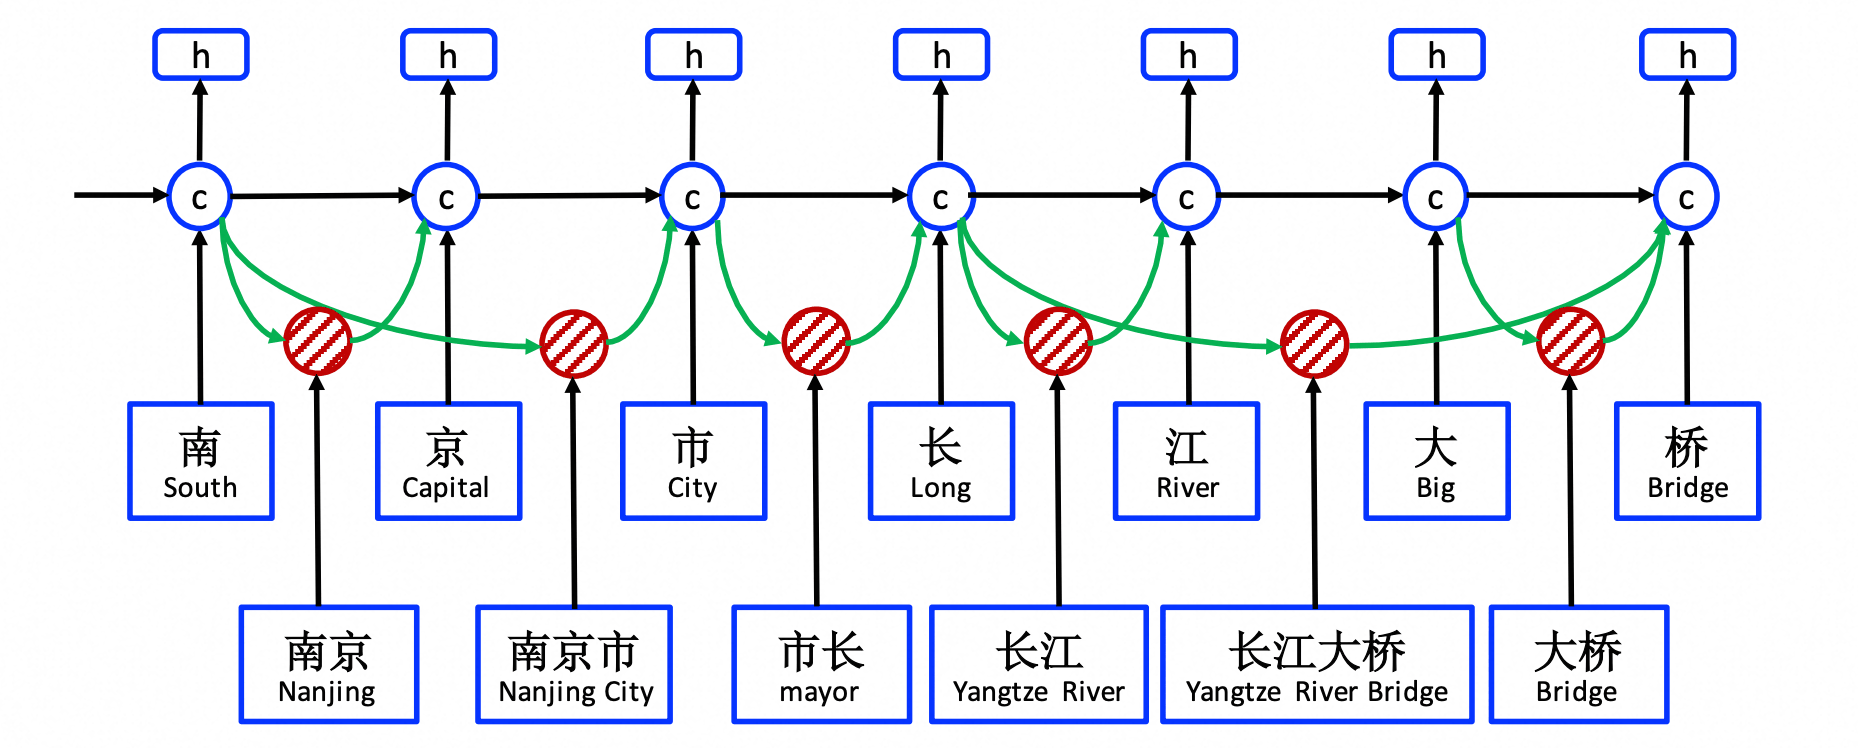
记字符序列$c_1,\dots,c_m$,对词典中匹配到的每个词$w_{b,e}$(从第$b$个字到第$e$个字),先用起始字的隐状态$h^c_b$与词嵌入$x^w_{b,e}$计算一个词单元$c^w_{b,e}$(结构同LSTM单元但没有输出门);在第$e$个字处,字单元的记忆$c^c_e$由所有以$e$结尾的词单元与当前字的候选记忆$\tilde{c}^c_e$加权融合:
\[c^c_e=\sum_{b\in\{b'\mid w_{b',e}\in\mathbb{D}\}}\alpha^c_{b,e}\odot c^w_{b,e}+\alpha^c_e\odot\tilde{c}^c_e\]其中$\mathbb{D}$为词典,权重$\alpha^c_{b,e}$与$\alpha^c_e$由各自的门控向量经softmax式归一化得到(对每一维满足$\sum_b\alpha^c_{b,e}+\alpha^c_e=1$),$\odot$为逐元素乘。这样字级模型既不受单一切分的约束,又能利用全部潜在词的信息;在OntoNotes、MSRA、微博等中文NER数据集上,它优于基于字和基于词的LSTM-CRF基线。
⚪ 中文是否需要分词:字级表示的实证研究
这项工作直接追问分词对神经中文NLP的必要性:在语言建模、机器翻译、句子匹配/复述与文本分类四类端到端任务上,系统比较依赖分词的词级模型与不分词的字级模型。结论是字级模型一致地优于词级模型。
进一步分析表明,原因在于词级模型面临更严重的数据稀疏与未登录词问题(词表大、长尾词出现次数少),因而更容易过拟合;字级词表规模小(几千个常用汉字)、每个字都有充足的训练样本。
⚪ SubChar:利用字形与读音的亚字符标记化
汉字之下仍有语言信息:字形由部件与笔画构成,读音由拼音与声调构成。亚字符标记化(SubChar)先把每个汉字转写为一个短符号序列,再在转写文本上做子词切分:
- 编码:基于字形的变体用五笔、仓颉、笔画等输入法编码(如“好”$\to$五笔码
vbg),基于读音的变体用带声调的拼音(如“好”$\to$hao3);每个字的编码之后加一个分隔符,以保证编码可逆、不同字的编码不会混淆; - 子词切分:在转写后的语料上训练Unigram或BPE词表(借助SentencePiece实现),高频的字、词与部件组合成为完整标记;
- 建模:预训练与下游任务都在亚字符标记序列上进行,输出时逆转写回汉字。
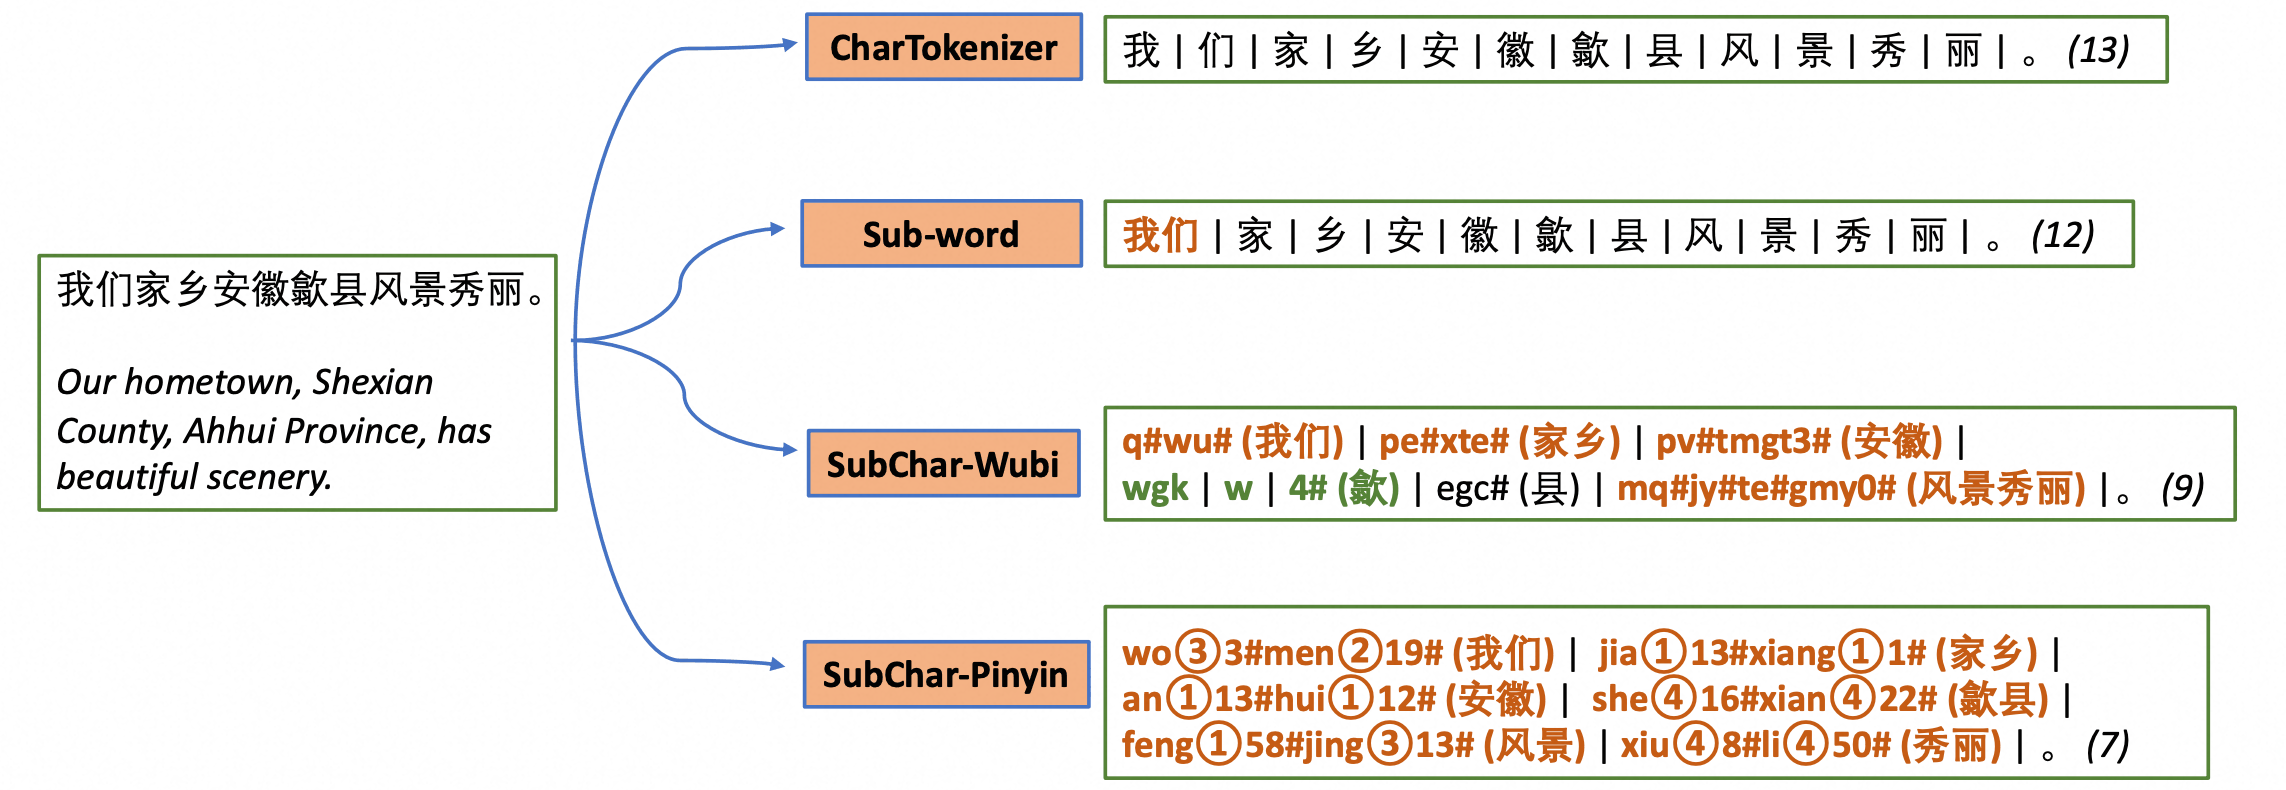
SubChar的两个性质来自转写:一是序列更短——转写后高频的多字词可以合并为单个标记,同等词表下序列长度低于字级标记,提升了计算效率;二是同音鲁棒性——基于读音的变体把同音字编码为同一序列,因而对同音错别字天然鲁棒。在中文下游任务上,使用SubChar的模型与字级、子词级基线表现相当。
(3) 子词级
子词(subword)在字符与词之间取折中:让高频词保持完整、低频词拆成有意义的片段,从而在固定词表大小下同时控制序列长度与未知词率。
⚪ Morfessor:基于最小描述长度的语素发现
Morfessor的目标是从无标注语料中发现语素(morph),例如把unbreakable切为un+break+able。它把切分看作一个模型选择问题:模型由一部语素词典(lexicon)$\mathcal{M}$与语料在该词典下的切分组成,按最小描述长度(MDL)或等价的最大后验(MAP)准则选择总编码长度最短的模型:
其中$m_j$遍历语料切分后的全部语素出现,$p(m_j)$为语素的出现频率;$-\log P(\mathcal{M})$为编码词典本身的代价(与词典中语素的总字符数相关)。第一项惩罚大词典(倾向切得更碎、复用更多),第二项惩罚长的语料编码(倾向保留完整高频词),两者的平衡自动决定切分粒度。
搜索采用贪心的递归二分:依次对每个词尝试所有二分切点(及不切分),选择使总代价最小的方案并递归处理两个子串,反复遍历语料直到代价收敛。Morfessor是形态丰富语言(芬兰语、土耳其语等)上的经典基线。
⚪ BPE:字节对编码
字节对编码(Byte Pair Encoding, BPE)原是一种简单的数据压缩算法,被引入神经机器翻译中解决稀有词问题。训练过程从一个“字符级”词表出发,迭代地合并语料中频率最高的相邻符号对:
- 把语料中每个词切分为字符序列,并在词尾加结束符$\langle/\text{w}\rangle$(防止合并跨越词边界),统计词频;
- 统计所有相邻符号对$(a,b)$的频率,选择频率最高的一对合并为新符号,加入合并表;
- 重复步骤$2$共$M$次($M$即目标词表大小与字符表大小之差)。
形式化地,记语料的词频表为${(w,\text{cnt}(w))}$,当前每个词被表示为符号序列$w=(a_1,\dots,a_{\ell_w})$,则相邻对的频率为
\[\text{freq}(a,b)=\sum_{w}\text{cnt}(w)\cdot\left|\left\{i: a_i=a,\ a_{i+1}=b\right\}\right|\]每步选择$(a^{\ast},b^{\ast})=\mathop{\arg\max}_{(a,b)}\text{freq}(a,b)$,把所有词中的相邻$a^{\ast}b^{\ast}$替换为新符号。从压缩的角度看,每次合并使语料的符号总数减少$\text{freq}(a^{\ast},b^{\ast})$,因此BPE是“每步贪心地最大化压缩量”的算法。朴素实现每步需重新扫描全部词,复杂度为$O(M\cdot N_w)$($N_w$为不同词的总长度);实用实现维护“符号对$\to$出现位置”的索引与按频率排序的优先队列,每次合并只增量更新受影响的相邻对。
以语料${\text{low}:5,\ \text{lower}:2,\ \text{newest}:6,\ \text{widest}:3}$为例,前几步合并为:
| 步骤 | 最高频对 | 频次 | 合并结果 |
|---|---|---|---|
| $1$ | (e,s) | $9$ | es |
| $2$ | (es,t) | $9$ | est |
| $3$ | (est,⟨/w⟩) | $9$ | est⟨/w⟩ |
| $4$ | (l,o) | $7$ | lo |
| $5$ | (lo,w) | $7$ | low |
编码新文本时,按合并表中学习到的顺序依次应用每条合并规则;等价的高效做法是:反复在当前符号序列中找出合并表排名最靠前(最早学到)的相邻对并合并,直到没有可合并的对。于是“newest”会被切为“n/ew/est⟨/w⟩”之类的子词组合(具体取决于最终保留的规则)。BPE是确定性贪心的:同一输入永远得到同一组子词。它只需词频统计,训练极快。原论文在英德、英俄翻译上用联合BPE(源语言与目标语言共享合并表)处理稀有词与未登录词,显著改善了稀有词的翻译。
⚪ WordPiece:按似然增益合并的子词
WordPiece与BPE的整体流程相同(初始字符词表、迭代合并),差别在合并对的选取准则:BPE选频率最高的对,WordPiece选使语言模型似然增益最大的对。
设当前语料在一元语言模型下的对数似然为$\mathcal{L}=\sum_{u}\text{freq}(u)\log p(u)$,把符号$f$与$g$合并为$fg$后,似然的变化近似正比于$\text{freq}(fg)\log\frac{p(fg)}{p(f)p(g)}$,即合并对的点互信息;实践中常用的选择准则为:
\[\text{score}(f,g)=\frac{\text{freq}(fg)}{\text{freq}(f)\cdot\text{freq}(g)}\]即优先合并“组合后相对频率提升最大”的对,而不是绝对次数最多的对:两个本身就很常见的符号偶然相邻不会被优先合并,而几乎总是一起出现的符号会被优先合并。
WordPiece用##前缀标记词内延续片段(如playing切为play与##ing),是BERT所用的分词器(英文词表约$3$万)。与BPE按合并顺序编码不同,WordPiece编码采用最长匹配优先(MaxMatch):对每个词从左到右,每次取词表中能匹配的最长前缀(非首片段需带##),若某一步找不到任何匹配则整个词输出[UNK]。在相同词表大小下,它与BPE的分词结果通常只有少量差异,主要来自上述选取准则与编码方式。
⚪ Fast WordPiece:线性时间的最长匹配
WordPiece的最长匹配优先编码若朴素实现,每个位置都要尝试从长到短的所有前缀,复杂度为$O(n^2)$或$O(nm)$($n$为输入长度,$m$为词表中最长标记的长度)。Fast WordPiece借鉴Aho-Corasick多模式串匹配算法,提出严格$O(n)$的LinMaxMatch:
- 用词表建一棵字典树(trie),从根出发沿字符走到的节点对应一个前缀;
- 为每个节点$v$预计算失败链接$f(v)$与失败弹出$F(v)$:当在$v$处无法继续匹配下一个字符时,$F(v)$给出此时应当输出的最长匹配标记序列,$f(v)$给出输出这些标记后应跳转到的节点(对应剩余后缀以
##开头的匹配状态); - 编码时沿字典树前进,匹配失败就沿失败链接跳转并输出$F(v)$中的标记,而不回退输入指针。
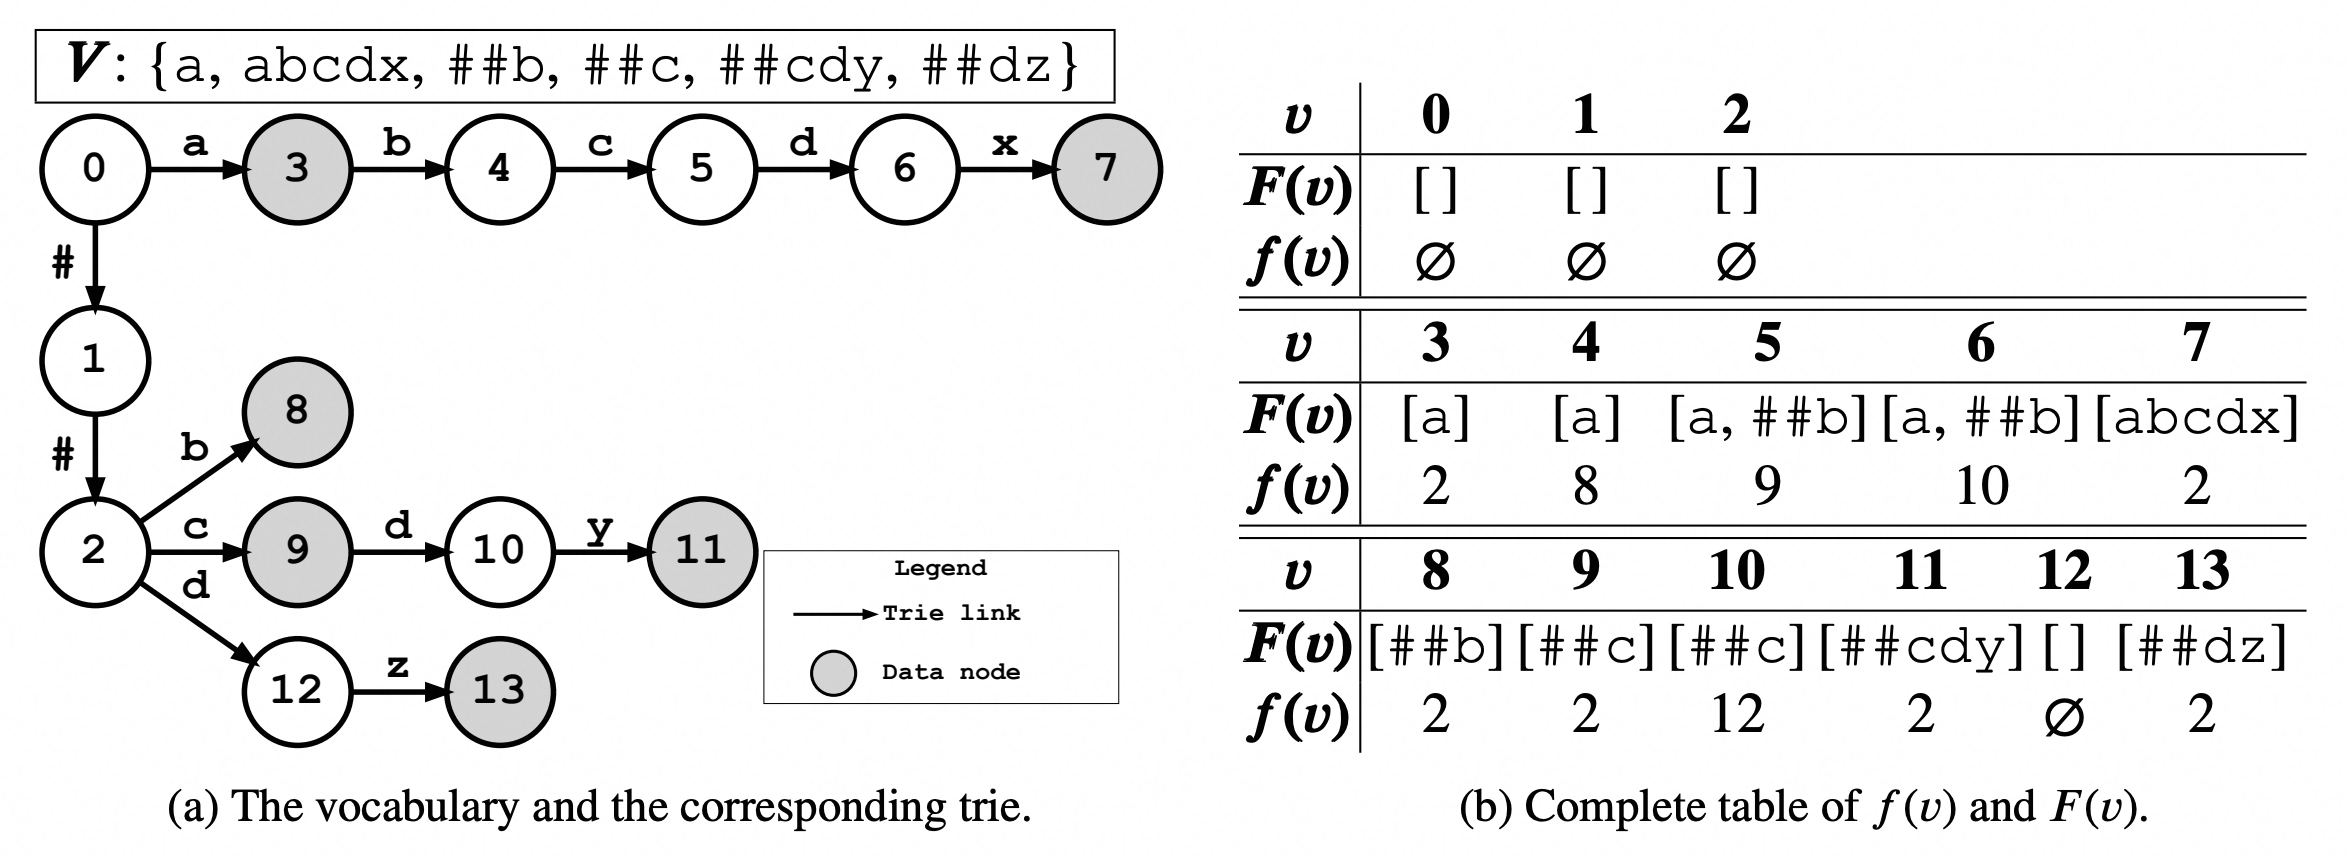
由于输入中每个字符只被读取一次、失败跳转的总次数也被输入长度摊还界定,总复杂度为$O(n)$。论文进一步把预切分(按空白与标点切词)与LinMaxMatch融合为对整段文本的单遍扫描(E2E WordPiece)。在通用文本上,该实现平均比HuggingFace Tokenizers快$8.2$倍、比TensorFlow Text快$5.1$倍。
⚪ Unigram语言模型与子词正则化:概率切分与采样增强
- paper:Subword Regularization: Improving Neural Network Translation Models with Multiple Subword Candidates
Unigram方法从概率生成模型出发:假设每个词(或句子)的子词切分$S=(s_1,\dots,s_k)$由一个Unigram语言模型生成,各子词独立、概率为$p(s)$且$\sum_{s\in\mathcal{V}}p(s)=1$,则切分的概率为$P(S)=\prod_{i}p(s_i)$,文本$x$的概率为所有可能切分的边缘概率:
\[P(x)=\sum_{S\in\mathcal{S}(x)} \prod_{s_i\in S} p(s_i)\]其中$\mathcal{S}(x)$为$x$在当前词表下的全部切分。给定语料$\mathcal{D}$,训练目标是最大化边缘对数似然$\mathcal{L}=\sum_{x\in\mathcal{D}}\log P(x)$。由于切分是隐变量,用EM算法求解:
- E步:对每个$x$,在其切分词格上用前向-后向算法计算每个子词$s$的期望出现次数$\mathbb{E}[c(s)]=\sum_{x}\sum_{S\in\mathcal{S}(x)}P(S\mid x)\,c_S(s)$,其中$P(S\mid x)=P(S)/P(x)$,$c_S(s)$为$s$在切分$S$中出现的次数;
- M步:更新$p(s)=\mathbb{E}[c(s)]/\sum_{s’}\mathbb{E}[c(s’)]$。
词表的确定采用自顶向下剪枝:先用后缀数组等方法取足够大的种子词表(如全部高频子串),然后循环执行“EM估计$p(s)$ $\to$ 对每个子词$s_i$计算移除它后似然的下降量\(\text{loss}_i=\mathcal{L}-\mathcal{L}_{-s_i} \to\) 保留\(\text{loss}_i\)最大的前$80\%$左右的子词”(始终保留全部单字符以保证任何文本可切分),直到词表缩减到目标大小。推断时用Viterbi取概率最大的切分\(S^{\ast}=\mathop{\arg\max}_{S\in\mathcal{S}(x)}P(S)\)。
与BPE的确定性不同,Unigram天然给出多个候选切分及其概率,这带来子词正则化(subword regularization):训练时从候选中按
\[P(S\mid x)\approx\frac{P(S)^{\alpha}}{\sum_{S'\in\mathcal{S}_l(x)}P(S')^{\alpha}}\]采样切分($\mathcal{S}_l(x)$为前$l$个最优切分,或在全部切分上用前向滤波-后向采样精确采样),让同一词在不同batch中呈现不同子词形式,相当于对分词做数据增强。$\alpha$为平滑超参数:$\alpha\to\infty$时退化为确定性的Viterbi最优切分,$\alpha\to0$时趋于在候选中均匀采样。在多个低资源与跨领域翻译任务上,子词正则化带来稳定的BLEU提升。
⚪ BPE-dropout:随机化的BPE
BPE-dropout指出BPE本身就蕴含产生多种切分的能力,无需换用Unigram即可实现子词正则化。方法极其简单:编码一个词时,照常按合并表的优先级迭代合并,但在每一步,当前候选的每个合并都以概率$p$被随机丢弃(这一步不可用);从剩余的合并中选优先级最高者执行,直到无可用合并为止。
- $p=0$时退化为标准BPE;$p=1$时所有合并都被丢弃,输出纯字符序列;
- 中间的$p$使同一个词在不同训练样本中呈现粗细不同的切分,例如
unrelated可能被切为un/related、un/rel/ated、u/n/re/l/ated等; - 合并表与词表完全不变,推断时使用标准BPE($p=0$)。
论文推荐大多数语言取$p=0.1$(对中文、日文等以字符为主的语言取更大的$p$)。在多个机器翻译基准上,训练时用BPE-dropout、推断时用标准BPE,相比BPE最多提升$3$ BLEU,相比Unigram子词正则化最多提升$0.9$ BLEU;模型对拼写错误等切分扰动也更鲁棒,学到的子词嵌入更能反映词的组合结构。
⚪ SentencePiece:语言无关的子词框架
SentencePiece是一个语言无关的分词框架,把BPE与Unigram实现为可替换的后端,并对分词的工程问题给出统一处理:
- 不依赖语言的预切分:传统流程先用空白切词再在词内做子词切分,这对无空格语言(中文、日语)需要额外的分词预处理;SentencePiece把空白本身当作普通字符
▁(U+2581)处理,整个文本直接是一个字符流,BPE/Unigram直接在字符流上运行; - 可逆性:由于空白被显式保留为
▁,标记序列可以无损还原回原始文本(去标记化只需把▁换回空格并拼接),即$\text{detok}(\text{tok}(x))=x$,这在生成任务的解码端是必要的; - 内置归一化:如NFKC归一化、大小写折叠、多余空白收缩等规则被写入模型文件,在训练与编码时保持一致;
- 字节回退(byte fallback):词表中额外保留$256$个字节标记
<0x00>$\sim$<0xFF>,遇到词表外字符时把它拆成UTF-8字节标记,从而在字符级词表上也做到无未知词; - 高效实现:BPE训练用优先队列在$O(N\log N)$时间内完成,Unigram训练用后缀数组初始化种子词表,并直接支持子词正则化采样。
(4) 大模型时代的词表工程
大语言模型的分词器在算法上仍以字节级BPE与SentencePiece为主,但在词表规模、预切分规则、数字与代码处理上形成了一套新的工程共识。
⚪ 现代大模型的词表:cl100k、o200k与Llama 3
早期GPT-2/GPT-3使用约$5$万的字节级BPE词表,LLaMA$1$/$2$使用$32000$的SentencePiece BPE词表(单个数字切为独立标记、启用字节回退)。此后主流模型的词表普遍扩大到$10$万以上:
| 模型/词表 | 算法 | 词表大小 | 备注 |
|---|---|---|---|
cl100k_base(GPT-3.5、GPT-4) |
字节级BPE(tiktoken) | 约$10$万 | 数字至多$3$位一组;空白与换行成块 |
o200k_base(GPT-4o) |
字节级BPE(tiktoken) | 约$20$万 | 更多非英语标记 |
| Llama 3 | 字节级BPE(tiktoken) | $128000$ | $10$万来自tiktoken,另加$2.8$万非英语标记 |
| Qwen系列 | 字节级BPE | 约$15$万 | 多语言与代码 |
| Gemma | SentencePiece | 约$25.6$万 | 字节回退,数字逐位切分 |
Llama 3的技术报告给出了扩大词表的直接收益:与Llama 2的$32$k词表相比,$128$k词表在英文数据上的压缩率从平均每标记$3.17$个字符提升到$3.94$个字符,使同样的训练算力能“看到”更多文本,且新增的非英语标记改善了多语言能力而不损害英语分词。
这类工程选择的共同逻辑是:词表扩大带来的嵌入层参数增长相对模型主体已经很小(例如$128$k词表在隐藏维度$8192$的模型上对应约$10$亿参数的嵌入矩阵,相对$700$亿参数的模型约占$1.5\%$),而序列缩短带来的训练与推理节省是全局性的。
⚪ 数字的切分:从左到右与从右到左
数字如何切分是影响算术能力的归纳偏置。主流方案有三类:LLaMA、PaLM把每个数字切为单独标记;GPT-3.5/GPT-4的cl100k为$1\sim3$位数字各设独立标记,并按预切分正则从左到右(left-to-right, L2R)每$3$位一组;早期GPT-2式BPE则按语料频率任意合并数字。
对一个$m$位数字串$d_1d_2\cdots d_m$,L2R分组为$(d_1d_2d_3)(d_4d_5d_6)\cdots$,最后一组长度为$m\bmod3$(为$0$时取$3$);从右到左(right-to-left, R2L)分组则让最后一组恰为$3$位、第一组长度为$m\bmod3$,于是每个标记与“个/千/百万……”的数位严格对齐。例如$1234567$在L2R下切为123、456、7,在R2L下切为1、234、567。
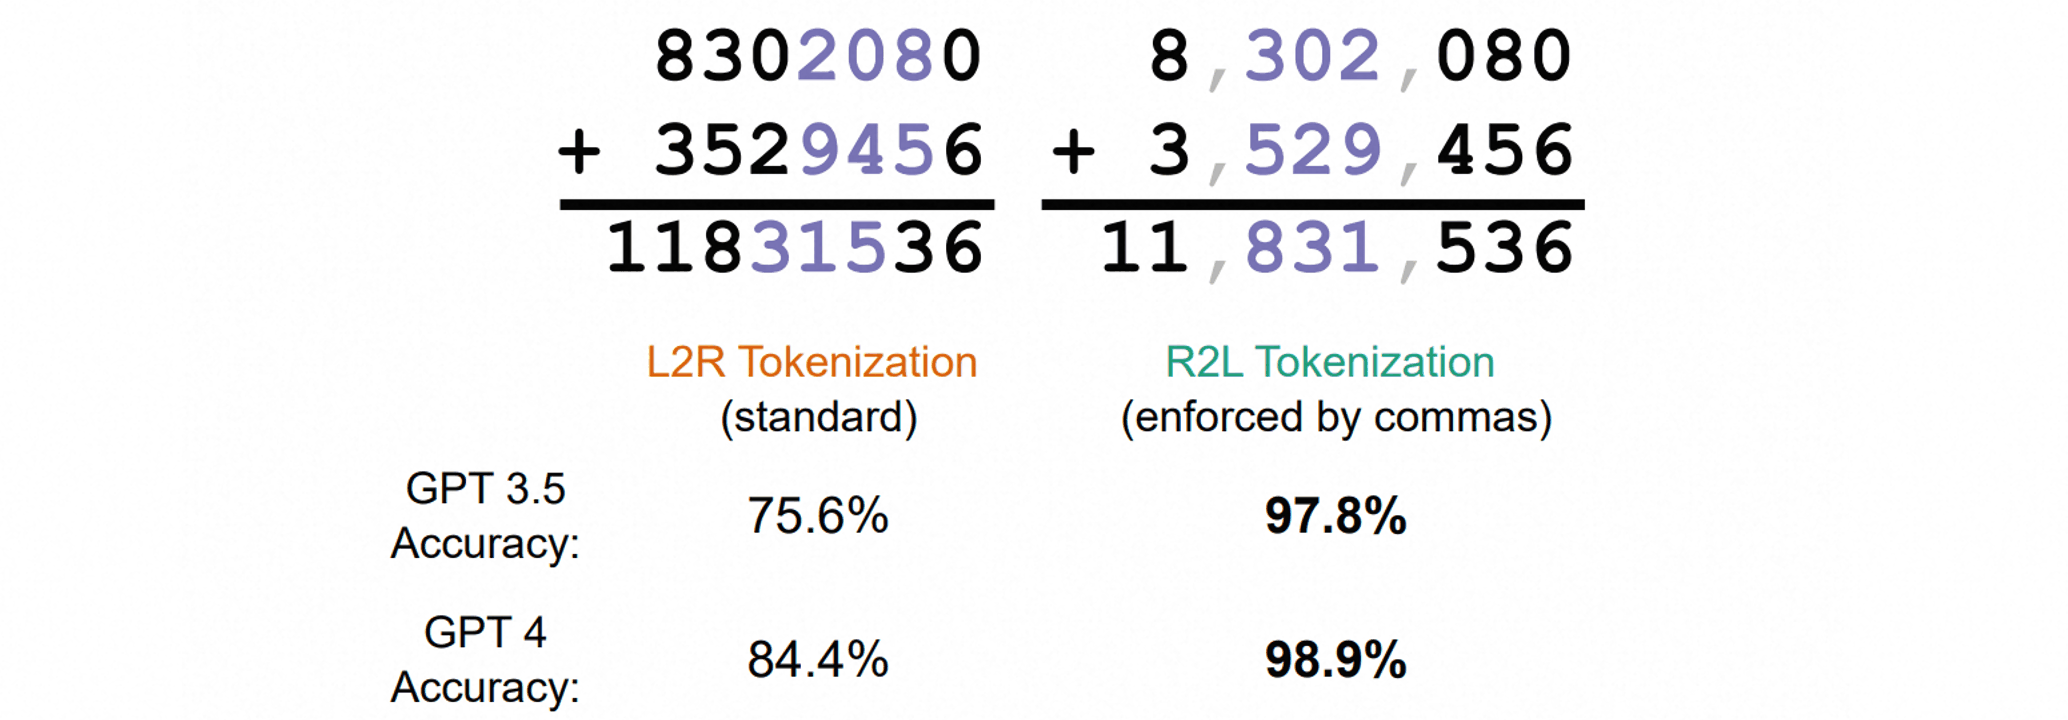
论文在推理时用千位逗号(1,234,567)强制GPT-3.5与GPT-4采用R2L切分,发现加法等算术任务的准确率大幅提升;L2R下的错误呈现高度规律的模式(集中出现在答案位数多于加数、数位对齐被打乱的情形)。模型也能在两种切分之间相互转换,因此先把数字改写为R2L格式再计算(类似思维链)即可恢复性能;随着模型规模增大,两种方向的差距缩小。这一发现使“数字切分方向”成为分词器设计中需要显式消融的选项。
3. 图像的标记化
图像的标记化有两条路线:非学习式直接按规则切分或量化;学习式训练一个编码器把图像映射为离散码本索引,即向量量化(vector quantization),或映射为低维连续隐变量。
(1) 非学习式标记化
最细的图像“标记”是单个像素:$8$位RGB像素本身就是一个$2^{24}$的离散空间,但这个隐含词表过大、且像素值几乎没有语义。把像素值聚类成调色板是像素级的显式标记化,更常用的非学习式粒度则是空间上的图像块。
⚪ iGPT:基于调色板的像素标记
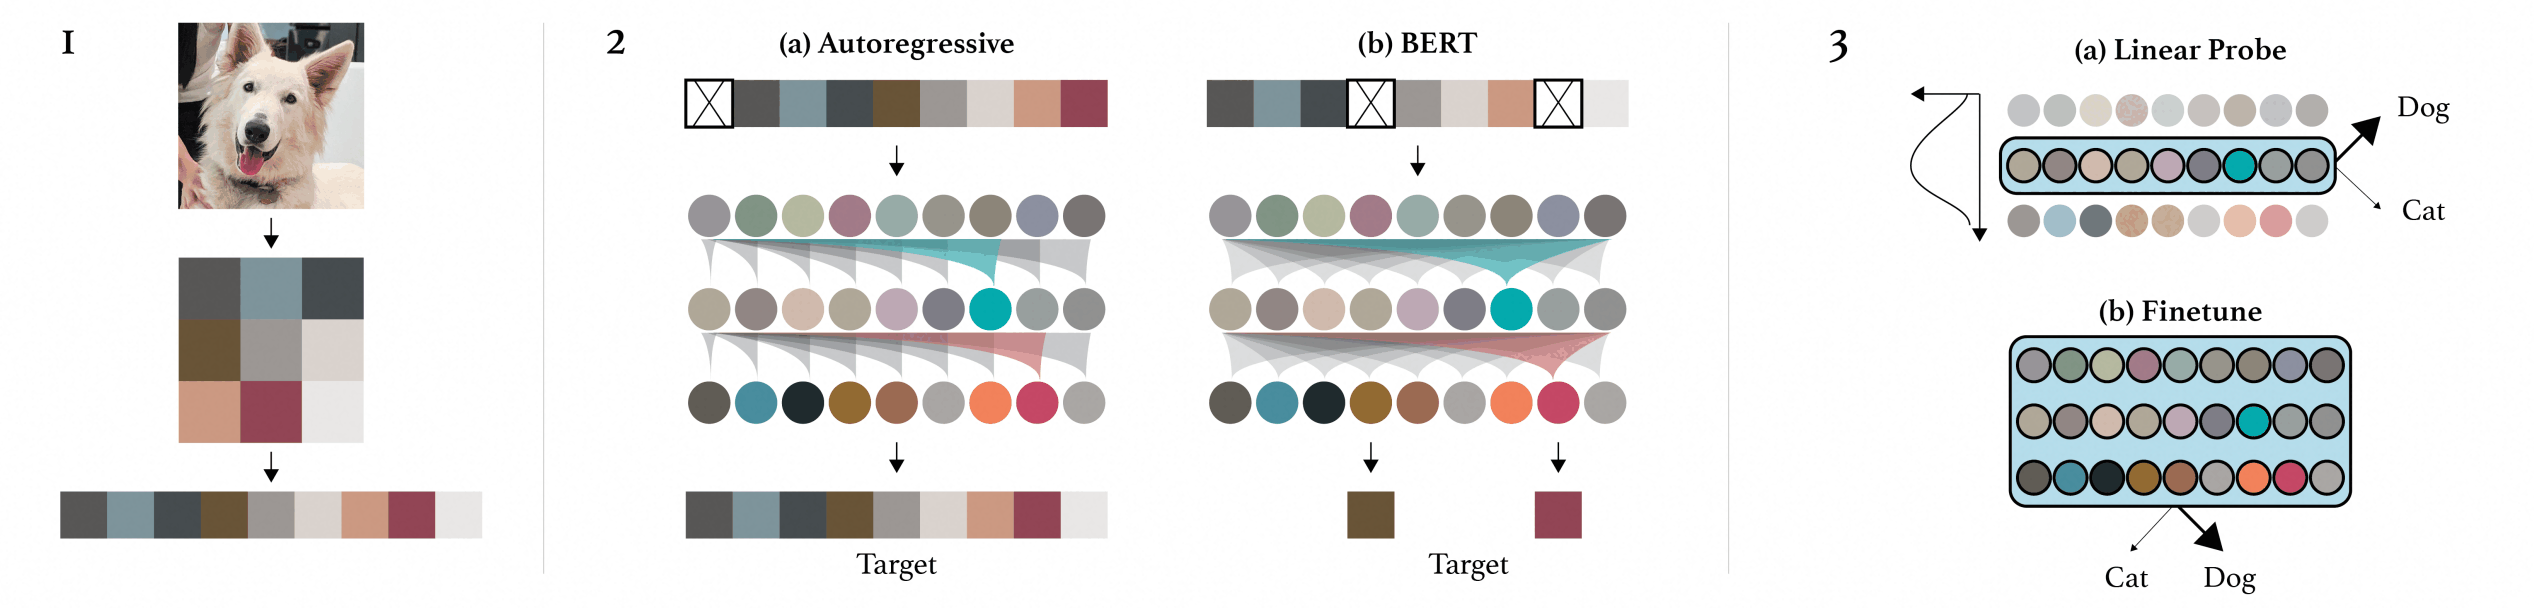
iGPT(Image GPT)检验了“不引入任何二维先验、直接把图像当作一维像素序列做语言模型式预训练”能否学到好的视觉表示。
为了把像素变成有限词表,它对训练集的RGB值做$k$均值聚类得到$512$色的调色板(palette)(即$9$位颜色),把每个像素量化到最近的调色板色,图像即成为调色板索引序列;同时把图像降采样到$32\times32$、$48\times48$或$64\times64$,对应$1024$、$2304$或$4096$长度的序列。每个像素的标记取值为\(\mathop{\arg\min}_{k}\|x_{ij}-\mu_k\|_2\),$\mu_k\in\mathbb{R}^3$为第$k$个聚类中心。
在这个标记序列上,iGPT训练GPT-2结构的Transformer,目标为自回归的下一像素预测$-\sum_t\log p(z_t\mid z_{<t})$或BERT式的掩码像素预测(掩码约$15\%$的像素)。
预训练后用中间层特征做线性探测:在CIFAR-10上达到$96.3\%$,在ImageNet上(拼接多层特征)达到$72.0\%$,证明了在像素级离散标记上做生成式预训练可以学到与当时的自监督方法竞争的表示。
⚪ 图像块化 Patchify:ViT的连续图像块标记
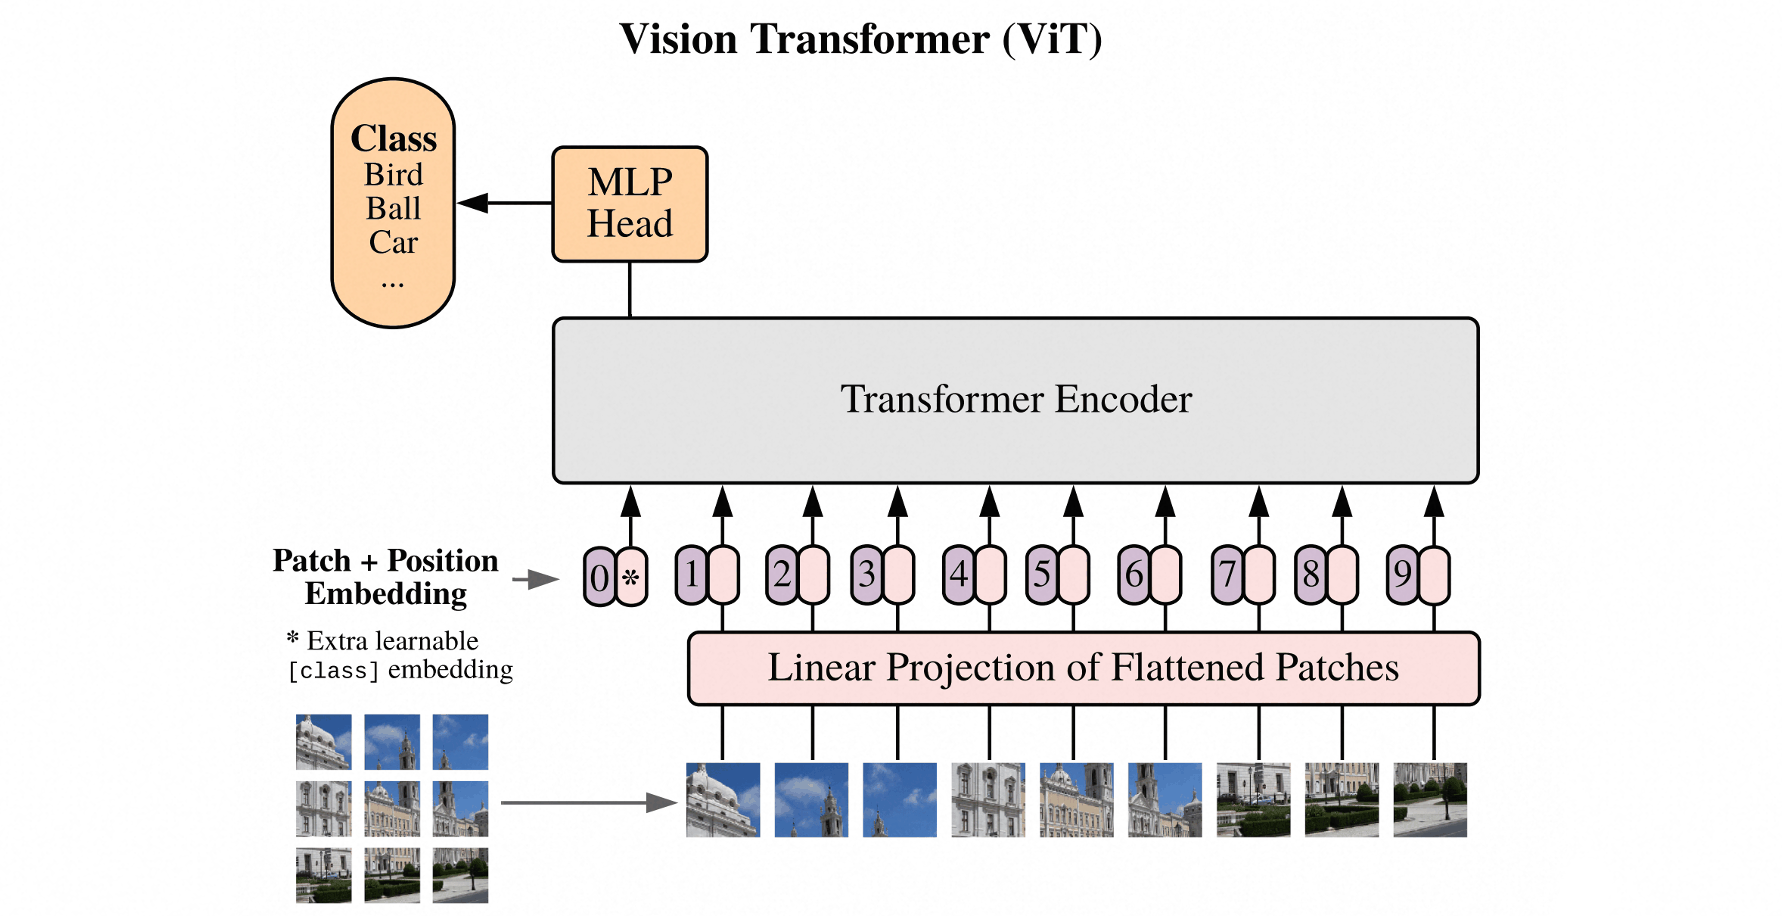
ViT把图像切成不重叠的$P\times P$小块并线性投影为标记:
\[N=\frac{HW}{P^2},\quad z_i=\text{Linear}\left(\text{flatten}(x_p^{i})\right),\quad x_p^{i}\in\mathbb{R}^{P^2 c}\]例如$224\times224$的输入用$16\times16$的块得到$196$个标记。线性投影等价于一个卷积核大小与步长都为$P$的卷积;投影后再加上可学习的一维位置编码,并在序列前拼接一个分类标记[CLS]。图像块是连续标记(线性投影后的向量,不查表),它解决了Transformer处理图像的输入接口问题。
(2) 学习式离散量化
⚪ VQ-VAE:神经离散表示学习
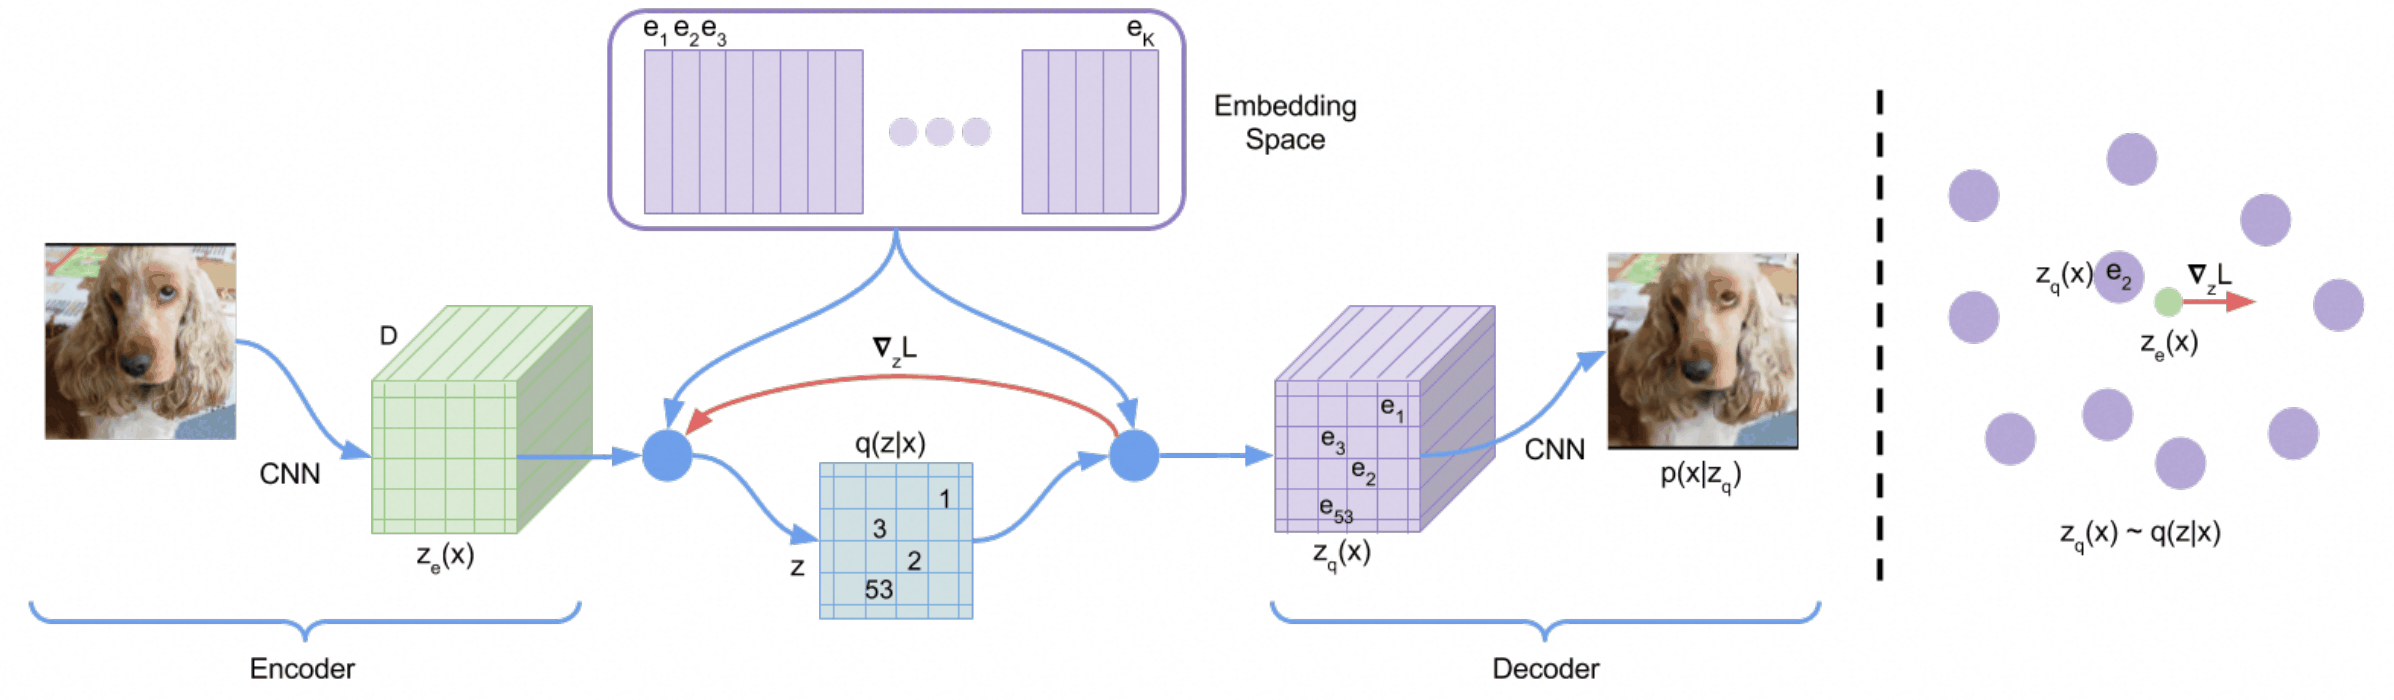
VQ-VAE(Vector Quantized Variational AutoEncoder)用一个可学习的码本$\mathcal{C}={e_1,\dots,e_K},\ e_k\in\mathbb{R}^{D}$把编码器输出量化为离散码。编码器把图像$x$映射为$H’\times W’$个$D$维向量$z_e(x)$,每个向量独立地替换为最近的码字:
\[z_e^{(i)}(x)\to e_k,\quad k=\mathop{\arg\min}_{j}\left\|z_e^{(i)}(x)-e_j\right\|_2\]因此图像被编码为一个$H’\times W’$的整数矩阵,即离散标记序列(词表大小$K$)。从变分推断的角度看,后验$q(z=k\mid x)$是在最近码字处取值为$1$的独热分布,先验$p(z)$取为$K$类均匀分布,于是ELBO中的KL项为常数:
\[\text{KL}\left(q(z\mid x)\,\|\,p(z)\right)=\sum_{k}q(z=k\mid x)\log\frac{q(z=k\mid x)}{1/K}=\log K\]训练时可以忽略。训练损失为(重构项写成负对数似然,最小化):
\[\mathcal{L}=-\log p(x|z_q)+\left\|\text{sg}[z_e]-e\right\|_2^2+\beta\left\|z_e-\text{sg}[e]\right\|_2^2\]其中$z_q$为量化后的隐表示,$e$为被选中的码字:重构项训练编码器与解码器;第二项(码本损失)把码字拉向编码器输出(只更新码本);第三项(承诺损失,commitment loss)把编码器输出拉向码字(只更新编码器),防止编码器输出无限增长,$\beta$通常取$0.25$。量化本身不可导,梯度用直通估计器(straight-through estimator)近似:
\[z_q=z_e+\text{sg}\left[z_q-z_e\right]\quad\Rightarrow\quad \frac{\partial\mathcal{L}}{\partial z_e}\approx\frac{\partial\mathcal{L}}{\partial z_q}\]即前向用量化值、反向把解码器输入处的梯度原样传给$z_e$。工程上常用EMA更新码本以替代码本损失、提高稳定性与码字利用率:记一个批次中被分配到码字$k$的编码器输出为${z_{e,j}}_{j=1}^{n_k}$,则
\[\begin{aligned} N_k&\leftarrow\gamma N_k+(1-\gamma)n_k\\ m_k&\leftarrow\gamma m_k+(1-\gamma)\sum_{j=1}^{n_k}z_{e,j}\\ e_k&=\frac{m_k}{N_k} \end{aligned}\]衰减率$\gamma$通常取$0.99$,即码字为分配给它的编码器输出的滑动平均(相当于在线$k$均值)。从未被选中的死码字不会被更新,大量码字闲置的现象称为码本坍缩(codebook collapse);常见对策包括用$k$均值初始化码本、把长期未使用的码字重新初始化为随机的编码器输出(随机重启)。
VQ-VAE是两阶段的:先训练自编码器与码本,再单独训练一个先验模型(原论文用PixelCNN)对码索引做自回归建模;采样时从先验采码、经解码器还原图像。原论文在ImageNet上把$128\times128\times3$的图像编码为$32\times32$个码($K=512$),在语音上把波形下采样$64$倍编码为离散码,并发现这些码与音素高度相关。
⚪ VQ-VAE-2:分层向量量化
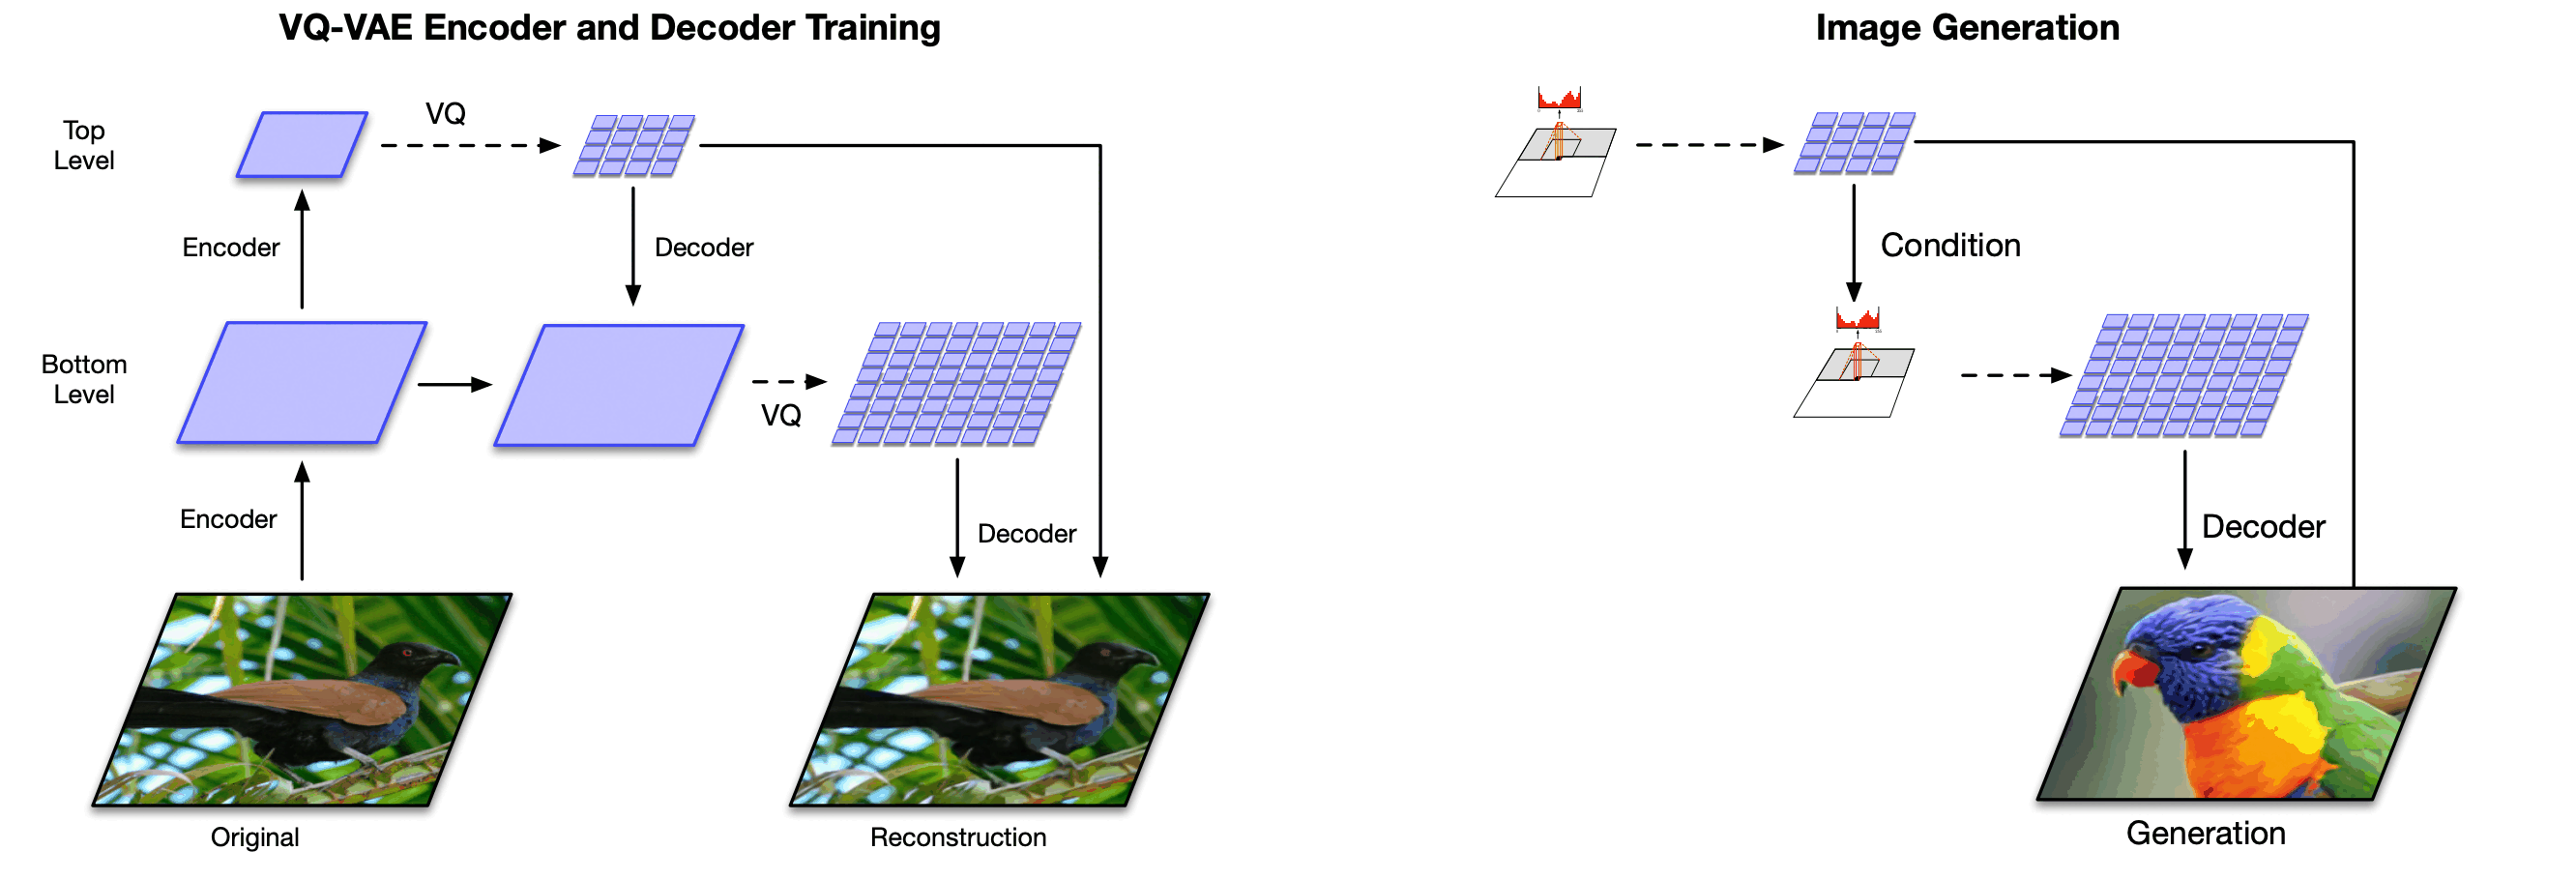
VQ-VAE-2把单一码本扩展为分层结构:编码器输出顶层(粗尺度,捕捉全局布局与形状)与底层(细尺度,捕捉纹理等局部细节)两级码索引,底层编码以顶层量化结果为条件,解码器同时以两级码为输入。在$256\times256$的ImageNet上,顶层为$32\times32$、底层为$64\times64$个码;在$1024\times1024$的FFHQ人脸上扩展为三级($32\times32$、$64\times64$、$128\times128$)。
先验相应地分级建模:顶层用PixelCNN自回归生成全局结构,底层用以顶层码为条件的PixelCNN生成细节,把生成分辨率提升到$1024\times1024$量级。
⚪ dVAE:DALL-E的Gumbel-Softmax离散变分自编码器
DALL-E的第一阶段把VQ-VAE中的最近邻量化替换为Gumbel-Softmax松弛:把码本选择看作$K$类分类,编码器对每个位置输出码字上的类别分布$\pi\in\Delta^{K-1}$,训练时用温度$\tau$下的Gumbel-Softmax产生“软”的独热向量
\[y_k=\frac{\exp\left((\log\pi_k+g_k)/\tau\right)}{\sum_{j=1}^{K}\exp\left((\log\pi_j+g_j)/\tau\right)}\\ g_k=-\log(-\log u_k),\ u_k\sim\mathcal{U}(0,1)\]解码器的输入为码字的加权组合$\sum_k y_k e_k$。Gumbel-Max技巧保证$\mathop{\arg\max}_k(\log\pi_k+g_k)$恰好服从类别分布$\pi$,softmax把argmax松弛为可导函数;$\tau\to0$时$y$趋于独热向量,因此训练中$\tau$从$1$逐渐退火到$1/16$以逼近离散选择;训练结束后取argmax得到精确的离散码。训练目标是ELBO,其中KL项的权重$\beta$在训练初期从$0$逐渐增大(最终约$6.6$)以提高码本利用率,重构似然采用适合像素值有界性的logit-Laplace分布。
dVAE把$256\times256$的图像编码为$32\times32=1024$个码,词表大小为$8192$。第二阶段把最多$256$个文本BPE标记(文本词表$16384$)与$1024$个图像码拼接成长度$1280$的序列,用一个$120$亿参数的自回归Transformer联合建模。该dVAE作为公开的图像分词器,随后也被BEiT用作掩码图像建模的目标。
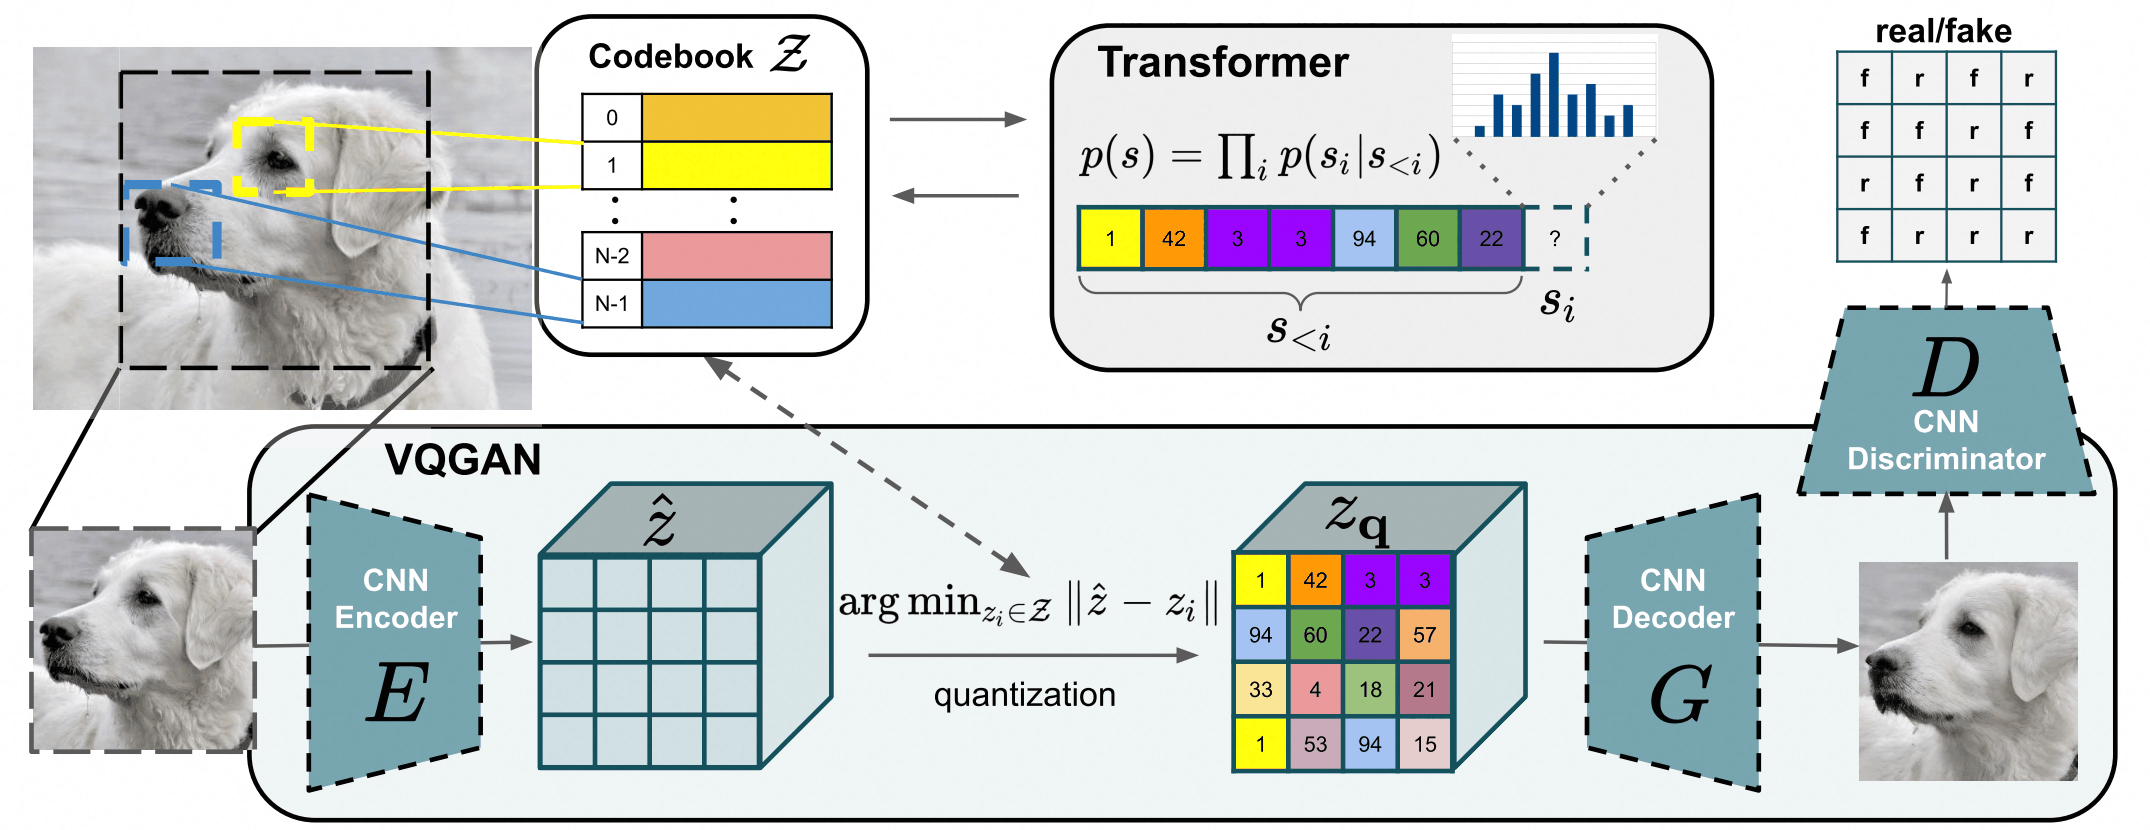
⚪ VQGAN:感知量化的Transformer图像合成
VQGAN在VQ-VAE的量化骨架上引入两项改造,使离散标记足够好以支撑Transformer生成:
- 感知重构损失:把像素级$L_2$重构换成像素$L_1$与感知相似度(LPIPS)之和,使量化损失集中在对人眼不敏感的高频细节上;
- 对抗训练:接一个PatchGAN判别器$D$评估每个局部子区域的真实性,$\mathcal{L}_{GAN}=\log D(x)+\log\left(1-D(\hat{x})\right)$,总目标为:
其中$E$、$G$分别为编码器与解码器,$\nabla_{G_L}$表示对解码器最后一层参数求梯度:$\lambda$按感知重构损失$\mathcal{L}_{rec}$与对抗损失的梯度范数相对大小自适应调节,保持两路贡献的平衡。损失包含感知重构与码本两项。
\[\mathcal{L}_{VQ}=\mathcal{L}_{rec}+||\text{sg}[E(x)]-z_q||_2^2+\beta||\text{sg}[z_q]-E(x)||_2^2\]VQGAN的编码器是带下采样的卷积残差网络,最低分辨率处加入自注意力层;典型配置为下采样率$f=16$($256\times256$图像得到$16\times16=256$个码)、码本大小$1024$或$16384$。高分辨率图像用滑动注意力窗口在码索引上自回归生成;条件生成时类别标签、语义分割图或另一幅图像的码作为条件前缀。
⚪ ViT-VQGAN:基于ViT的因子化码本
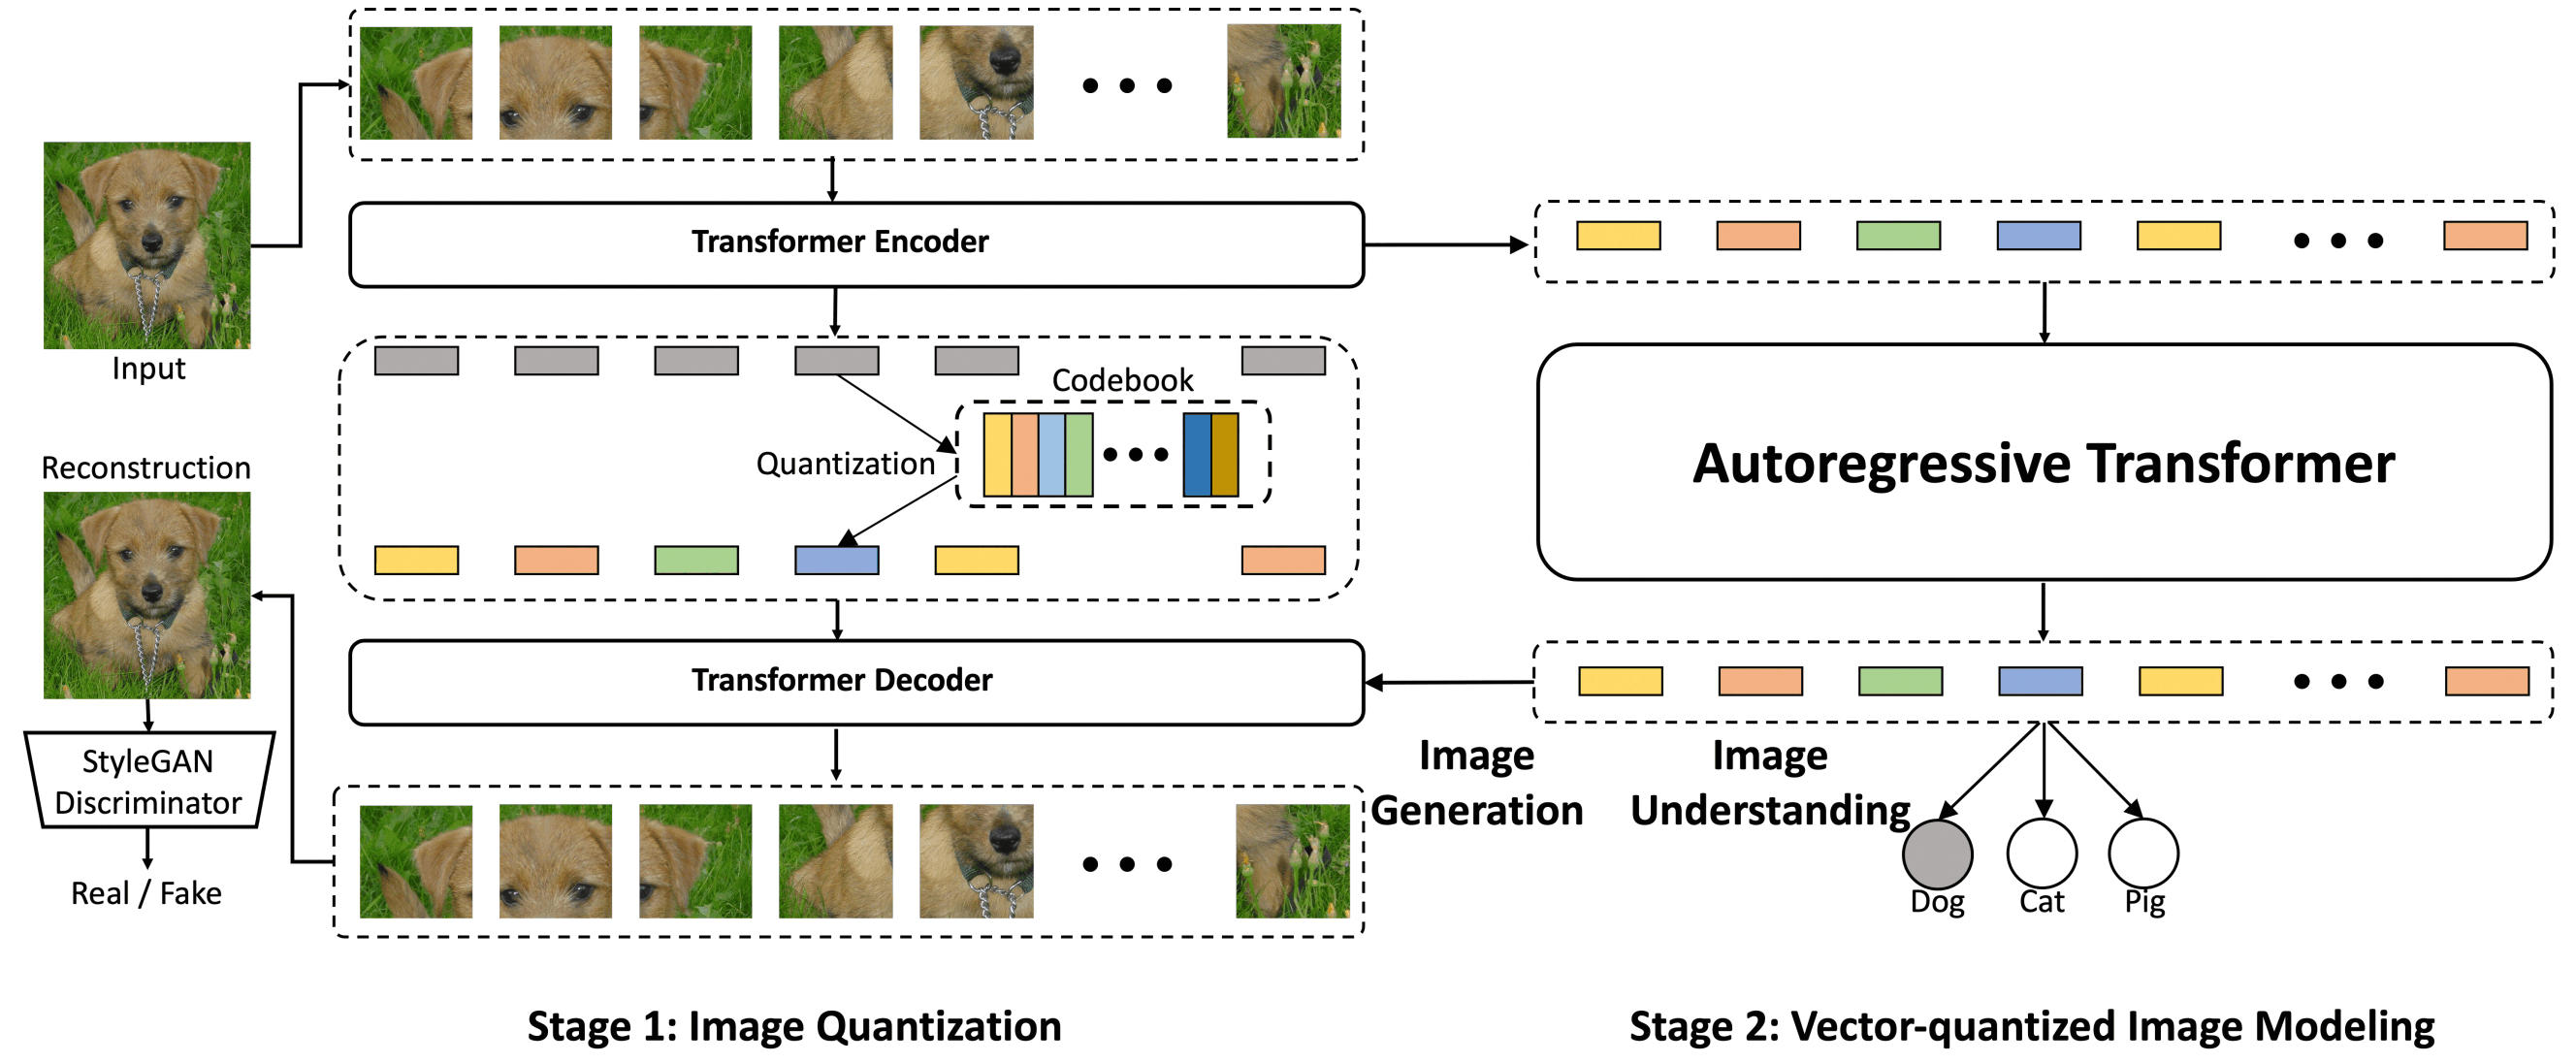
ViT-VQGAN把VQGAN的卷积编码器/解码器替换为ViT:编码器把$256\times256$图像切成$8\times8$的不重叠图像块,得到$32\times32=1024$个标记,码本大小为$8192$。它对码本做两点改进以提高利用率:
- 因子化码(factorized codes):先用一个线性投影把编码器输出从高维降到低维查找空间(如$32$维或$8$维),在低维空间做最近邻检索,再投影回高维送入解码器;把“检索”与“表示”解耦后,低维空间中码字更容易被均匀使用;
- L2归一化码:对低维编码与码字都做L2归一化,使最近邻检索在余弦意义上进行,消除范数差异造成的少数码字垄断。
判别器采用StyleGAN判别器。这些改动把码本利用率提高到$96\%$,并提升了重构质量与训练效率。在此分词器上训练的自回归模型,其中间特征的线性探测性能显著优于iGPT,说明码本利用率的提高也改善了码的表示质量。
(3) 量化机制的改进
向量量化的两个长期问题是码本利用率(大量码字从未被使用,实际词表远小于$K$)与梯度估计与辅助损失的复杂性(直通估计、commitment、EMA、熵正则等都是为了把编码器输出与码字“对上”)。
⚪ RQ-VAE与RQ-Transformer:残差量化
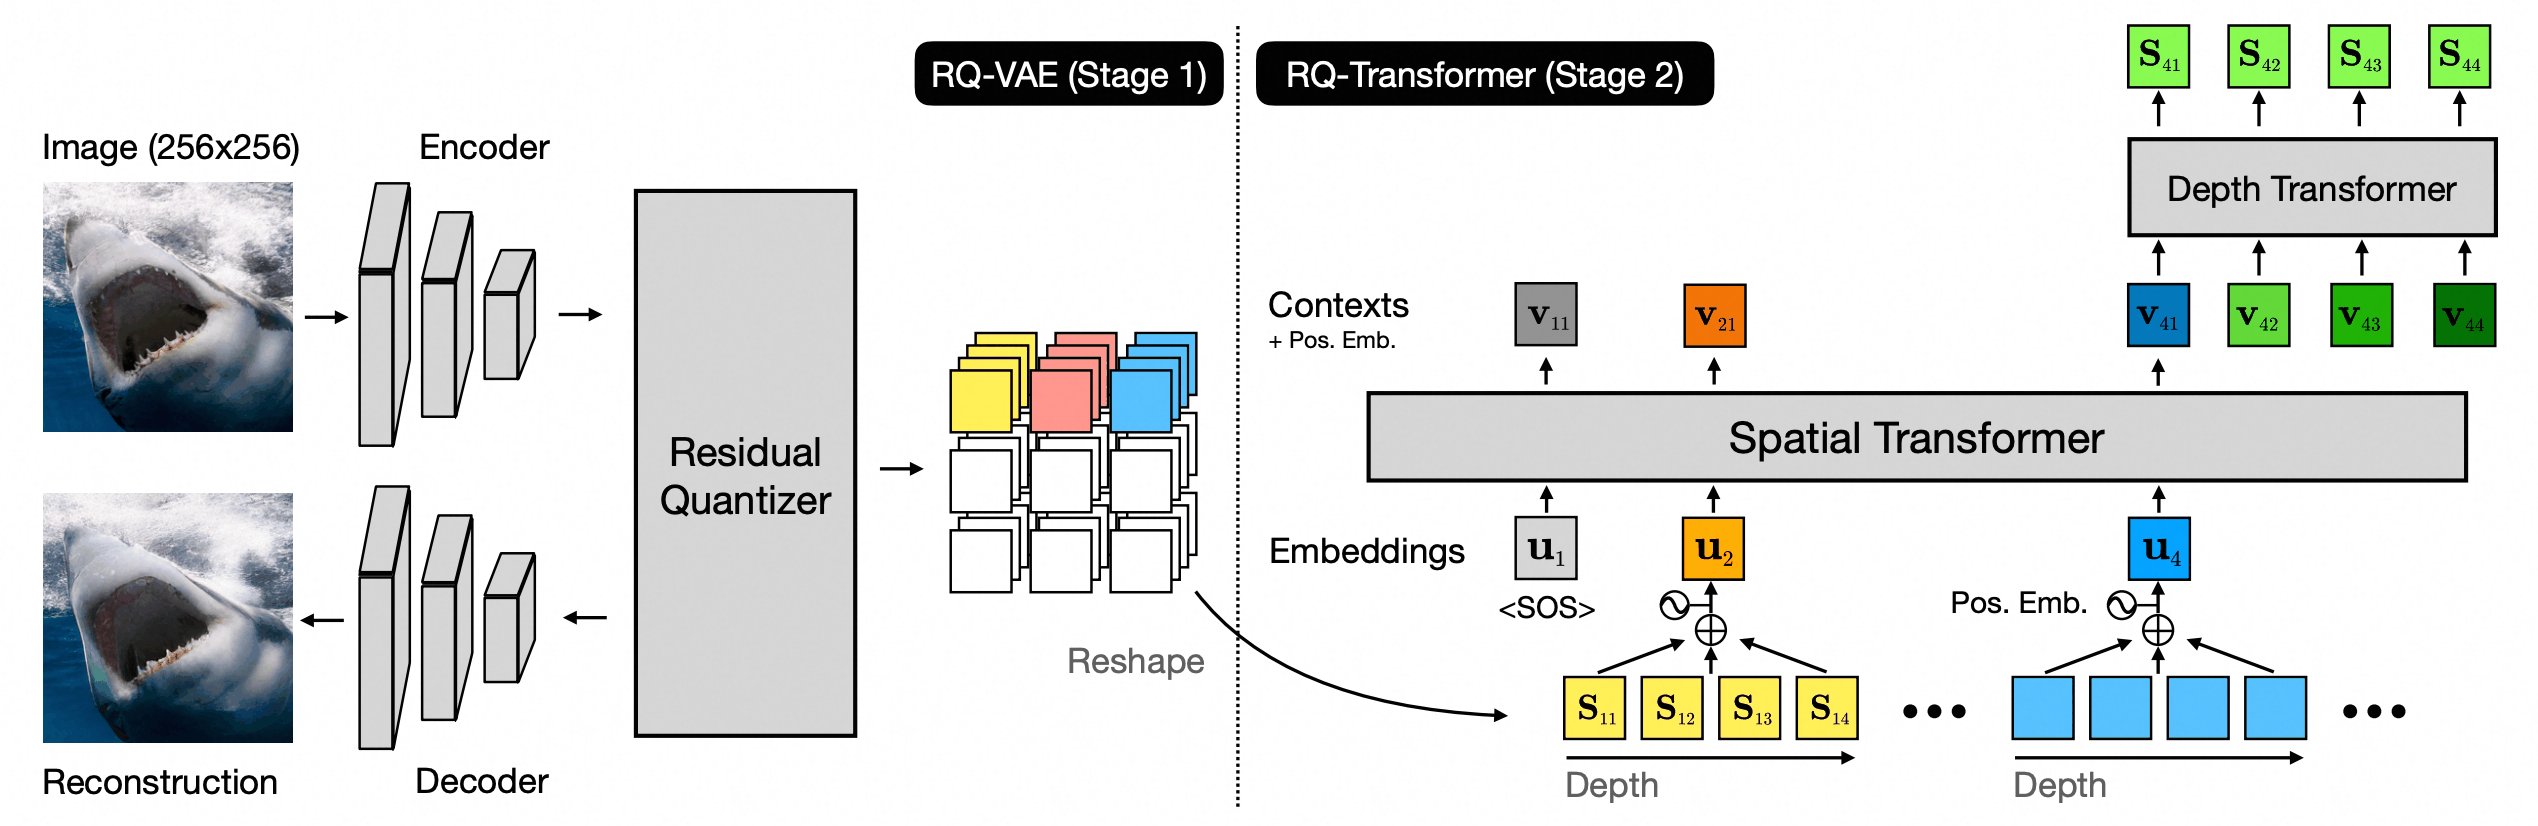
残差量化(Residual Quantization, RQ)不再要求单个码字逼近编码,而是用共享码本逐级量化残差(论文称级数为深度$D$,这里记为$N_q$以与码字维度区分):
\[r_0=z_e,\quad q_j=Q\left(r_{j-1}\right),\\ r_j=r_{j-1}-q_j,\quad z_e\approx\hat{z}^{(N_q)}=\sum_{j=1}^{N_q} q_j\]其中$Q(\cdot)$为在共享码本上的最近邻量化。第一级码本量化粗略近似,其后每一级量化上一级的残差,部分和$\hat{z}^{(d)}=\sum_{j\le d}q_j$构成由粗到细的逐级逼近。每个空间位置产生$N_q$个码索引,可表示的组合数为$K^{N_q}$,因此单个码本无需很大。训练损失为\(\mathcal{L}=\|x-\hat{x}\|_2^2+\beta\sum_{d=1}^{N_q}\left\|z_e-\text{sg}[\hat{z}^{(d)}]\right\|_2^2\)(对每一级部分和都施加承诺损失),再加上感知与对抗损失。由于每个位置可以用多级码精确表示,RQ-VAE能把$256\times256$图像压缩到$8\times8\times4$的码(下采样率$32$、$N_q=4$、码本$16384$),而不明显损失重构质量。
RQ-Transformer配套两级结构建模$N_q$个码:空间Transformer按光栅顺序在$H’W’$个位置上做因果建模,深度Transformer在每个位置自回归地依次预测该位置的$N_q$个码。相比把$N_q$个码摊平成长度$H’W’N_q$的长序列,这把序列模型的长度压缩为$H’W’$,使高分辨率自回归建模可行。
⚪ FSQ:有限标量量化
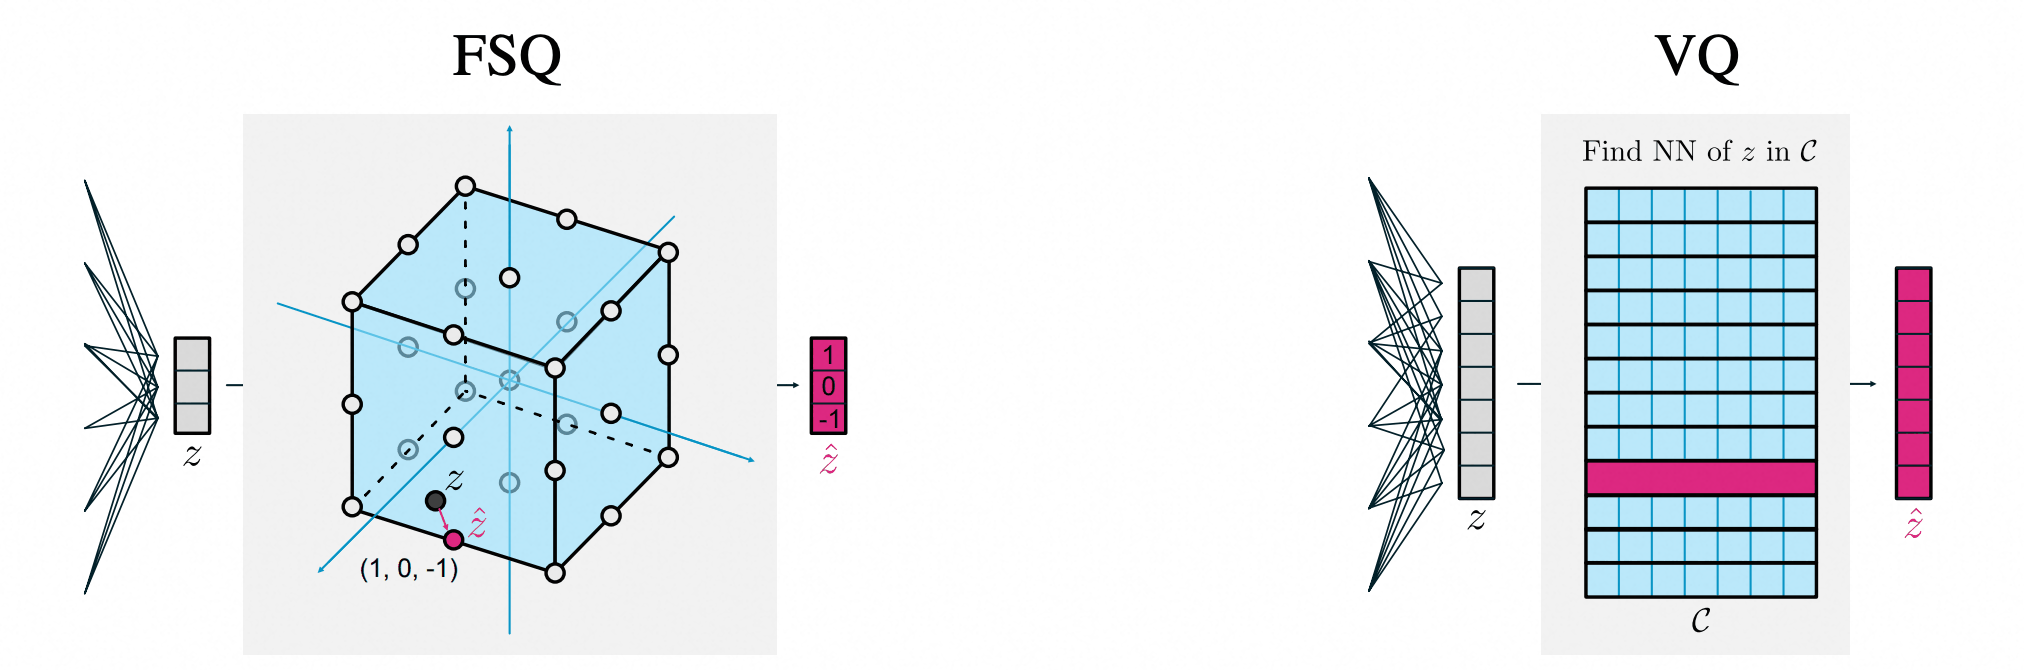
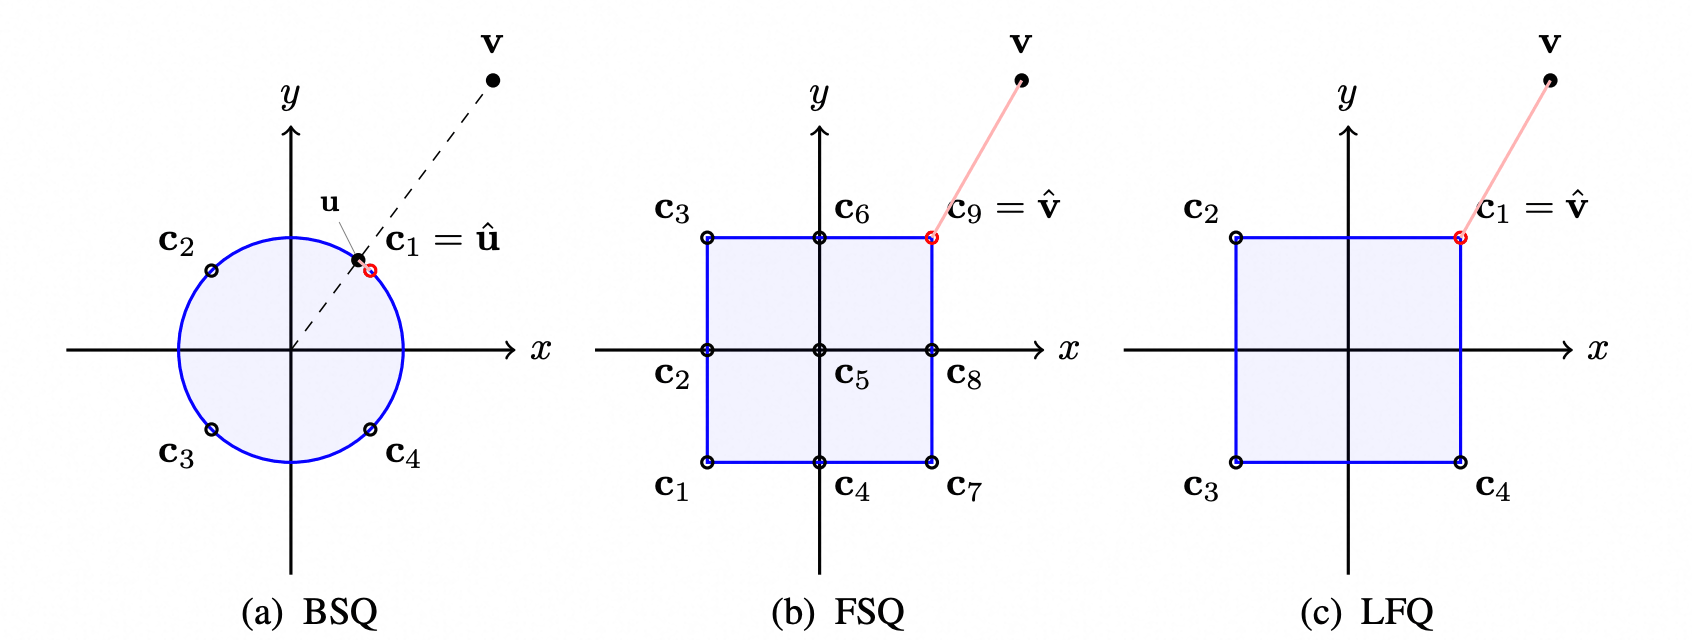
有限标量量化(Finite Scalar Quantization, FSQ)完全去掉显式码本与全部辅助损失:编码器输出一个很低维(如$d=3\sim10$)的向量$z$,先用有界函数把每一维压到有限区间,再把每一维独立地四舍五入到$L_i$个等距整数档位之一:
\[\hat{z}_i=\text{round}\left(\left\lfloor\frac{L_i}{2}\right\rfloor\tanh(z_i)\right)\]$\tanh$把$z_i$映射到$[-1,1]$,乘以$\lfloor L_i/2\rfloor$后四舍五入,$L_i$为奇数时恰好得到${-\lfloor L_i/2\rfloor,\dots,\lfloor L_i/2\rfloor}$共$L_i$个整数($L_i$为偶数时加半格偏移使取值数为$L_i$)。梯度经直通估计器回传:$\hat{z}=z+\text{sg}[\text{round}(z)-z]$。词表隐式地由各维档位的笛卡尔积定义:
\[|\mathcal{V}|=\prod_{i=1}^{d} L_i\]例如档位$[8,6,5]$给出词表$240$,$[8,5,5,5]$给出$1000$,$[7,5,5,5,5]$给出$4375$,$[8,8,8,6,5]$给出$15360$,$[8,8,8,5,5,5]$给出$64000$(同理$[8,5,5,5,5,5]$给出$25000$)。由于每个码字对应一个明确的网格点,且编码器输出总会落入某个网格单元,不存在码本初始化与码字未使用问题,码本利用率接近$100\%$。
⚪ LFQ:无查找量化
无查找量化(Lookup-Free Quantization, LFQ)把FSQ的每维档位进一步压缩为二值:把编码器输出的每个维度按符号二值化为$\pm1$,即\(\hat{z}_i=\text{sign}(z_i)\),$d$维隐向量即一个$d$位二进制码,其索引为\(k=\sum_{i=1}^{d}2^{i-1}\mathbb{1}[\hat{z}_i>0]\),词表大小恰为$2^{d}$(如$d=18$对应$2^{18}=262144$)。训练时对中间值做直通估计器,并对码字分布施加熵正则以用满词表:
\[\mathcal{L}_{\text{entropy}}=\mathbb{E}_{z}\left[H\left(q(z)\right)\right]-H\left(\mathbb{E}_{z}\left[q(z)\right]\right)\]其中$q(z)$是$z$在全部$2^{d}$个码字上的软分配分布(按到各码字距离的softmax计算)。第一项鼓励每个样本的分配确定(低熵),第二项鼓励整体使用分布均匀(高熵)。由于LFQ的码字是超立方体顶点,$q(z)$可以分解为$d$个独立的二值分布之积,熵按维度分解计算,复杂度从$O(2^d)$降为$O(d)$。由于任何码字都可以由位运算直接得到,无需维护与查询码本。
⚪ BSQ:二值球面量化
二值球面量化(Binary Spherical Quantization, BSQ)在二值化之前先把隐向量投影到单位超球面上。设编码器输出经线性投影得到$v\in\mathbb{R}^{L}$,则
\[u=\frac{v}{\|v\|_2},\quad \hat{u}=\frac{1}{\sqrt{L}}\text{sign}(u)\]$\hat{u}$是超球面上$2^{L}$个点之一,即隐式码本大小为$2^{L}$,梯度用直通估计器传回。投影到球面带来一个有界的量化误差:由于$u$与$\hat{u}$都是单位向量且$u^{\top}\hat{u}=\frac{1}{\sqrt{L}}\sum_i|u_i|\ge\frac{1}{\sqrt{L}}||u||_2=\frac{1}{\sqrt{L}}$,有
\[\|u-\hat{u}\|_2^2=2-2u^{\top}\hat{u}\le2-\frac{2}{\sqrt{L}}\]即误差上界与输入无关、只随维度缓慢变化,这使训练更稳定;同时码字范数恒定,熵正则可以按维度分解为高效的近似。
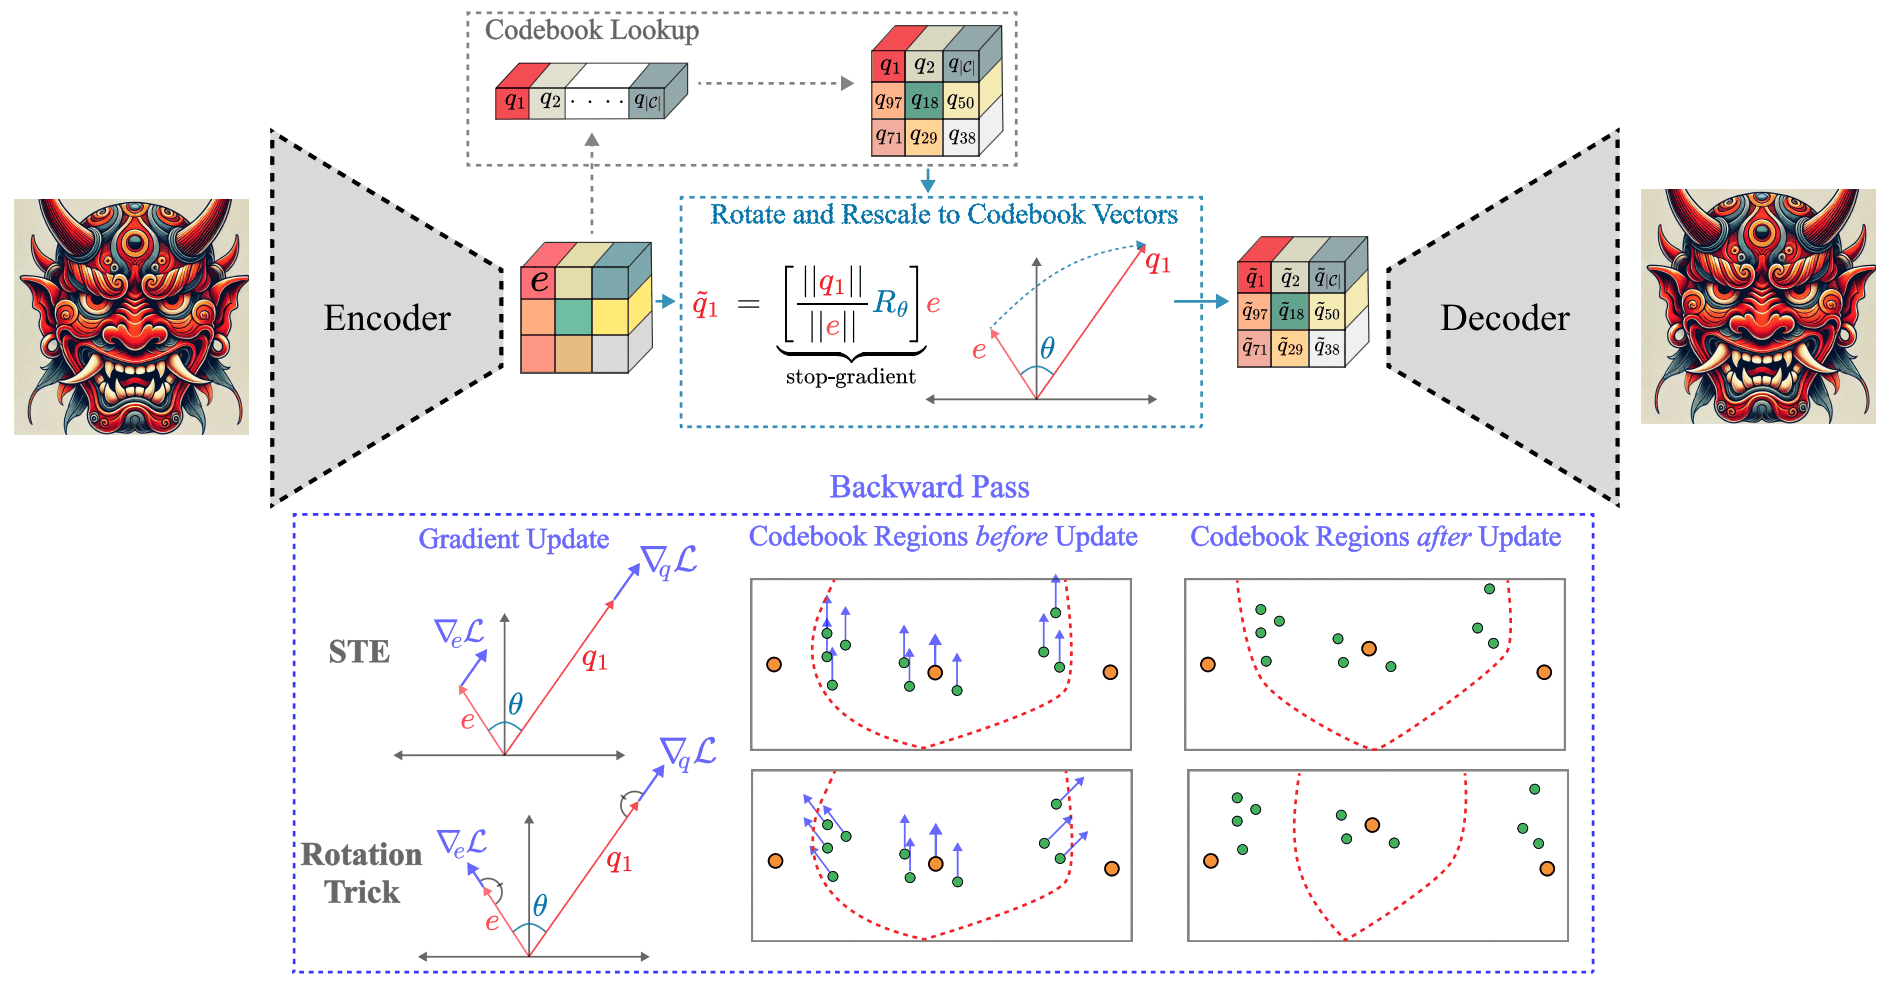
⚪ 旋转技巧:穿过量化层传播梯度
直通估计器把解码器输入处的梯度原样复制给编码器输出,梯度“绕过”了量化层:无论编码器输出$e$与码字$q$相距多远、方向如何,回传的梯度都一样,量化操作的信息完全丢失。
旋转技巧(rotation trick)用一个旋转加缩放的线性变换把$e$光滑地变为$q$,并在反向传播时把这个变换视为常数:
\[\begin{aligned} \tilde{q}&=\text{sg}\left[\frac{\|q\|}{\|e\|}R\right]e\\ R&=I-2rr^{\top}+2\hat{q}\hat{e}^{\top}\\ r&=\frac{\hat{e}+\hat{q}}{\|\hat{e}+\hat{q}\|} \end{aligned}\]其中\(\hat{e}=e/\|e\|\)、\(\hat{q}=q/\|q\|\),$R$是把$\hat{e}$旋转到$\hat{q}$的正交矩阵(由Householder反射构造,作用在$\hat{e}$与$\hat{q}$张成的平面内)。
前向时\(\tilde{q}=\frac{\|q\|}{\|e\|}R e=q\),与原量化输出完全相同;反向时\(\frac{\partial\mathcal{L}}{\partial e}=\frac{\|q\|}{\|e\|}R^{\top}\frac{\partial\mathcal{L}}{\partial\tilde{q}}\),即解码器梯度被旋转并缩放后才传给编码器,$e$与$q$之间的相对角度与模长被编码进梯度。直观地,若梯度会把$q$推向某个方向,同一簇内与$q$方向不同的编码器输出会相应地被推向不同方向,从而在训练中拉开或聚拢码字簇。
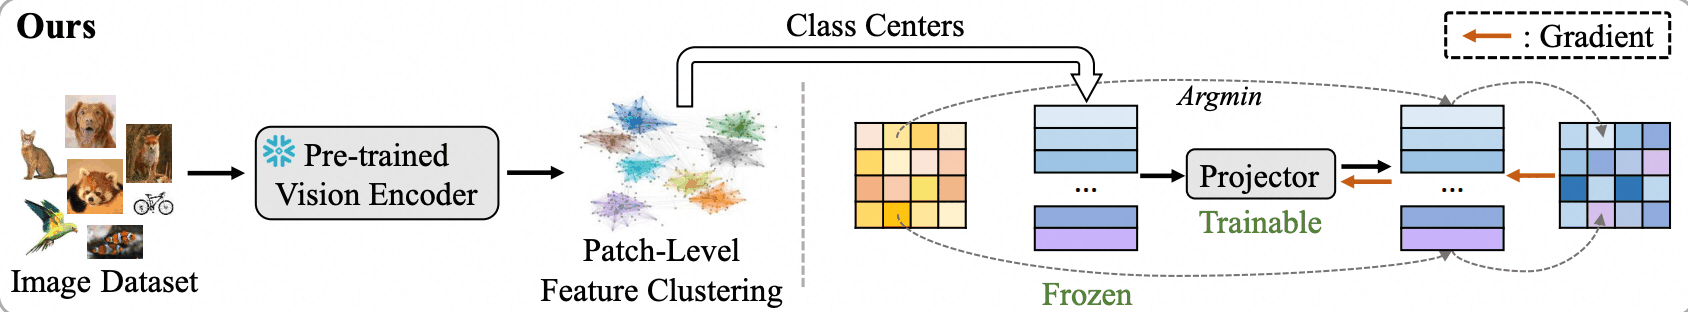
⚪ VQGAN-LC:用预训练特征初始化的十万级码本
受Llama 3扩大词表获益的启发,VQGAN-LC(Large Codebook)尝试把图像码本扩大到$10$万。此前的VQGAN-FC(因子化码)最大只能学到$16384$的码本,在ImageNet上利用率通常低于$12\%$;问题在于每次只有被选中的码字得到更新,码本越大闲置越多。VQGAN-LC改为:
- 初始化:用预训练视觉编码器(如CLIP)提取大量图像块特征,通过聚类得到$10$万个中心作为初始码本$\mathcal{C}_{\text{init}}$,并在训练中冻结;
- 投影器:只训练一个投影器$P$,实际码本为$\mathcal{C}=P(\mathcal{C}_{\text{init}})$,即用同一组参数把整个码本整体对齐到VQGAN编码器的特征分布;
- 其余部分与VQGAN相同。
由于投影器的每次更新都作用于全部码字,码本整体随编码器特征分布移动,利用率超过$99\%$。
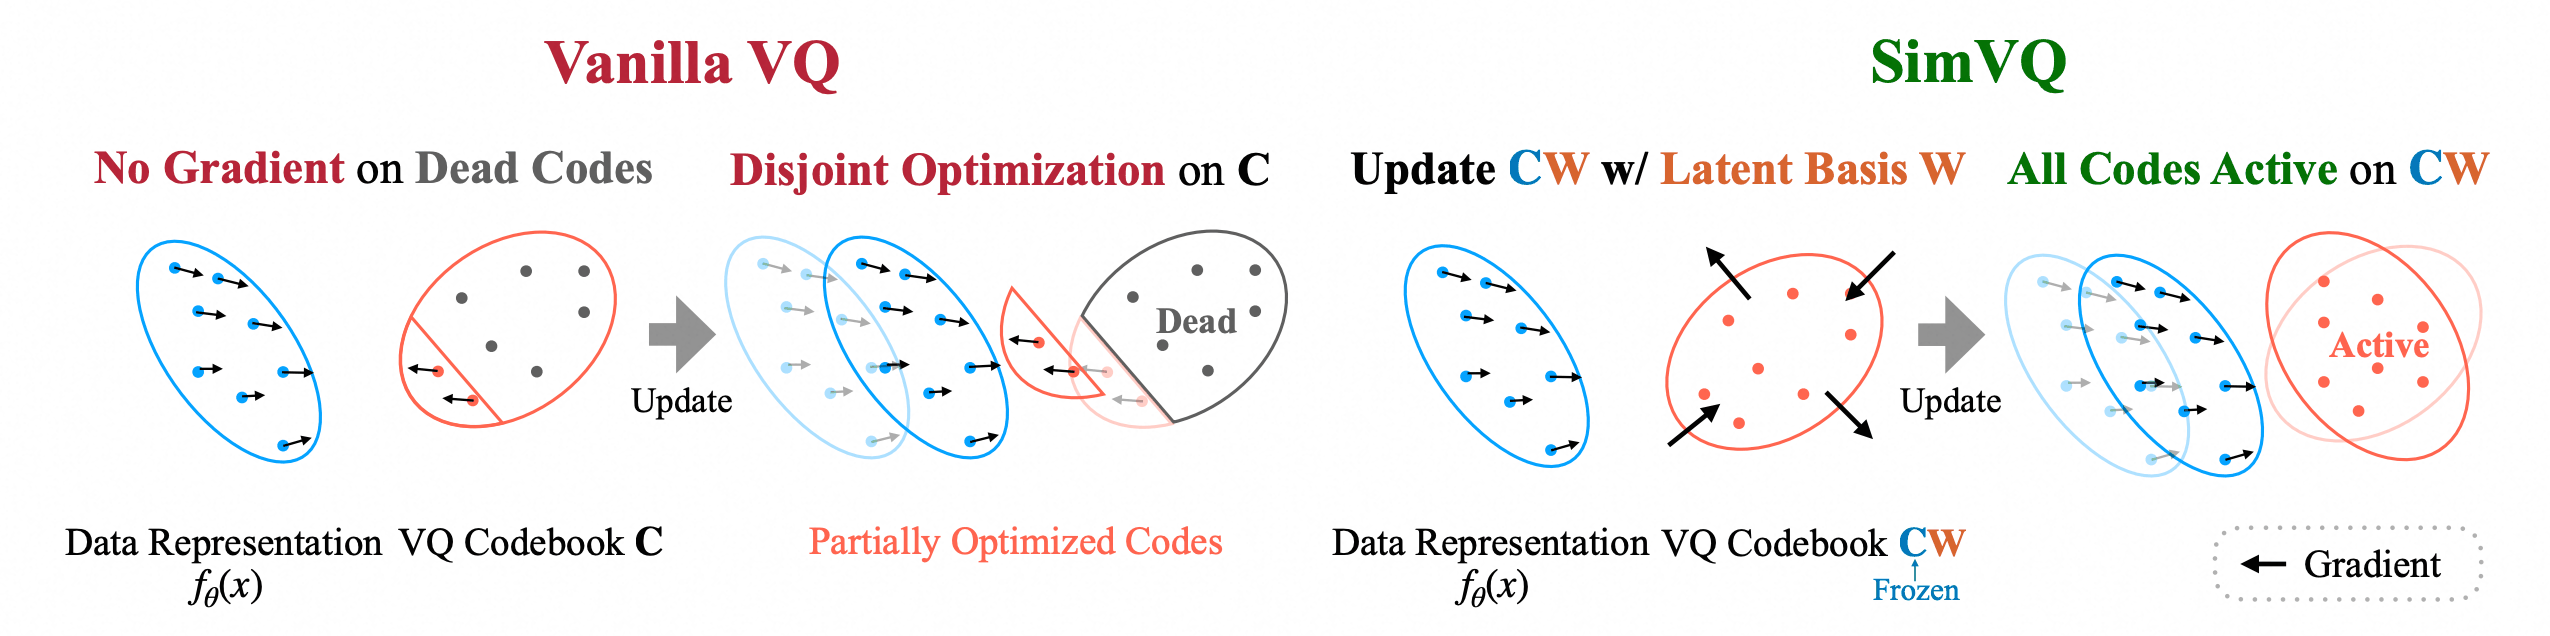
⚪ SimVQ:用一个线性层避免表示坍缩
SimVQ把码本坍缩的根源归结为不相交的码本优化:梯度下降每次只更新被最近邻选中的少数码字,其余码字停滞,最终只有一小部分码字被使用。其解法是对码字做重参数化:
\[e_k=w_kW,\quad k=1,\dots,K\]其中${w_k}$为随机初始化后冻结的隐基向量,$W\in\mathbb{R}^{D\times D}$为可学习的线性变换。量化、码本损失与承诺损失的形式与VQ-VAE相同,但码本损失的梯度不再只更新被选中的码字,而是更新共享的$W$,从而优化整个码字所张成的线性空间,所有码字随之一起移动。尽管两个线性矩阵相乘在表达能力上等价于单个线性层;这种参数化改变了优化动力学,有效防止了坍缩。
⚪ IBQ:索引反向传播量化
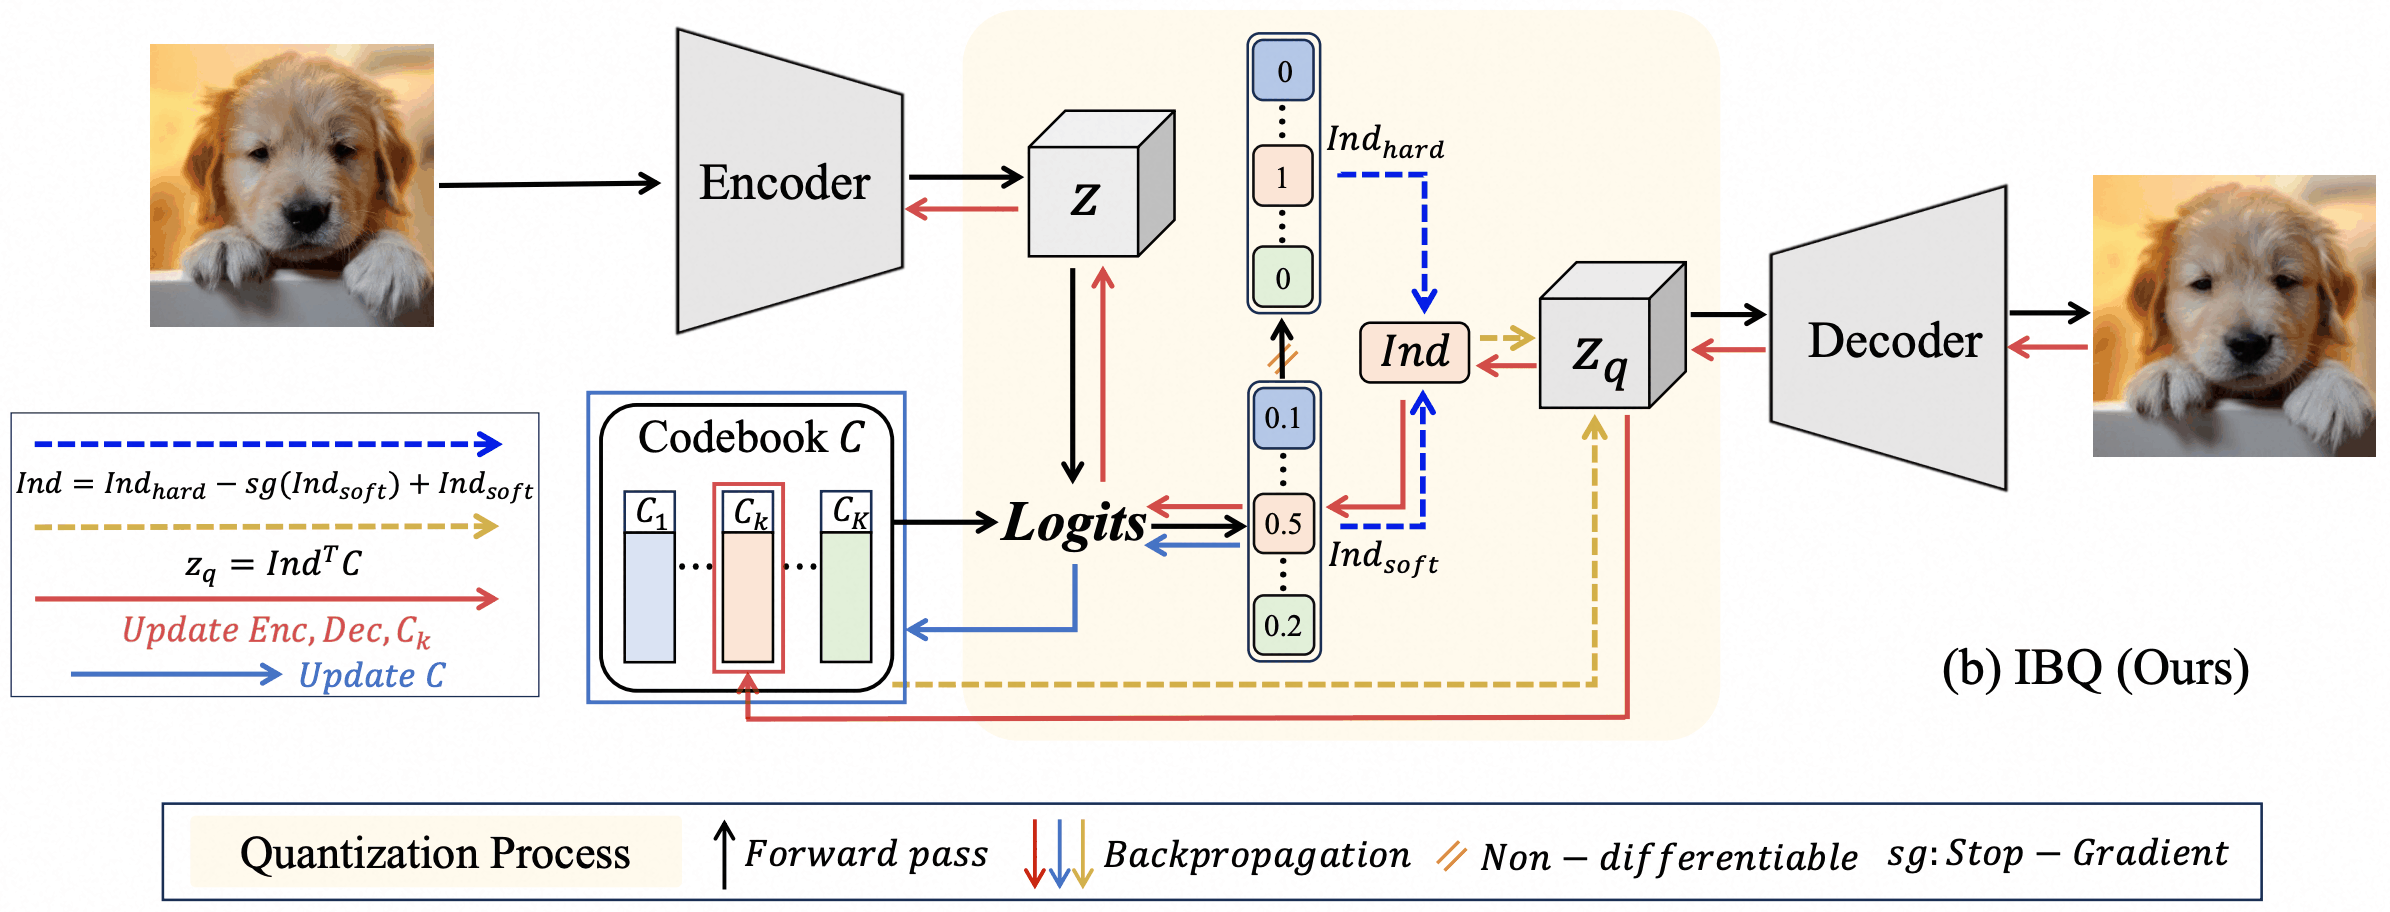
IBQ(Index Backpropagation Quantization)同样针对“部分更新导致未激活码字与视觉特征之间分布差距逐渐扩大、最终坍缩”的问题,让全部码字与编码器联合优化。设编码器特征为$z$,码本矩阵为$\mathcal{C}\in\mathbb{R}^{K\times D}$:
\[\begin{aligned} &\ell=z\,\mathcal{C}^{\top}\in\mathbb{R}^{K},\quad p=\text{softmax}(\ell)\\ &\text{ind}=\text{onehot}\left(\mathop{\arg\max}_k p_k\right)\\ &\text{ind}_{ST}=\text{ind}-\text{sg}[p]+p,\quad z_q=\text{ind}_{ST}\,\mathcal{C} \end{aligned}\]前向时$\text{ind}_{ST}=\text{ind}$,$z_q$就是被选中的码字;反向时梯度经$p$流向所有码字的logits,因而每个码字都会被更新,并与编码器保持一致的隐空间。
(4) 语义视觉标记
基于图像重构任务训练的码字偏重像素细节。用作掩码图像建模(Masked Image Modeling, MIM)的预测目标或多模态理解的输入时,人们希望视觉标记更像携带高层语义的“词”。
⚪ BEiT:以视觉标记为掩码预测目标
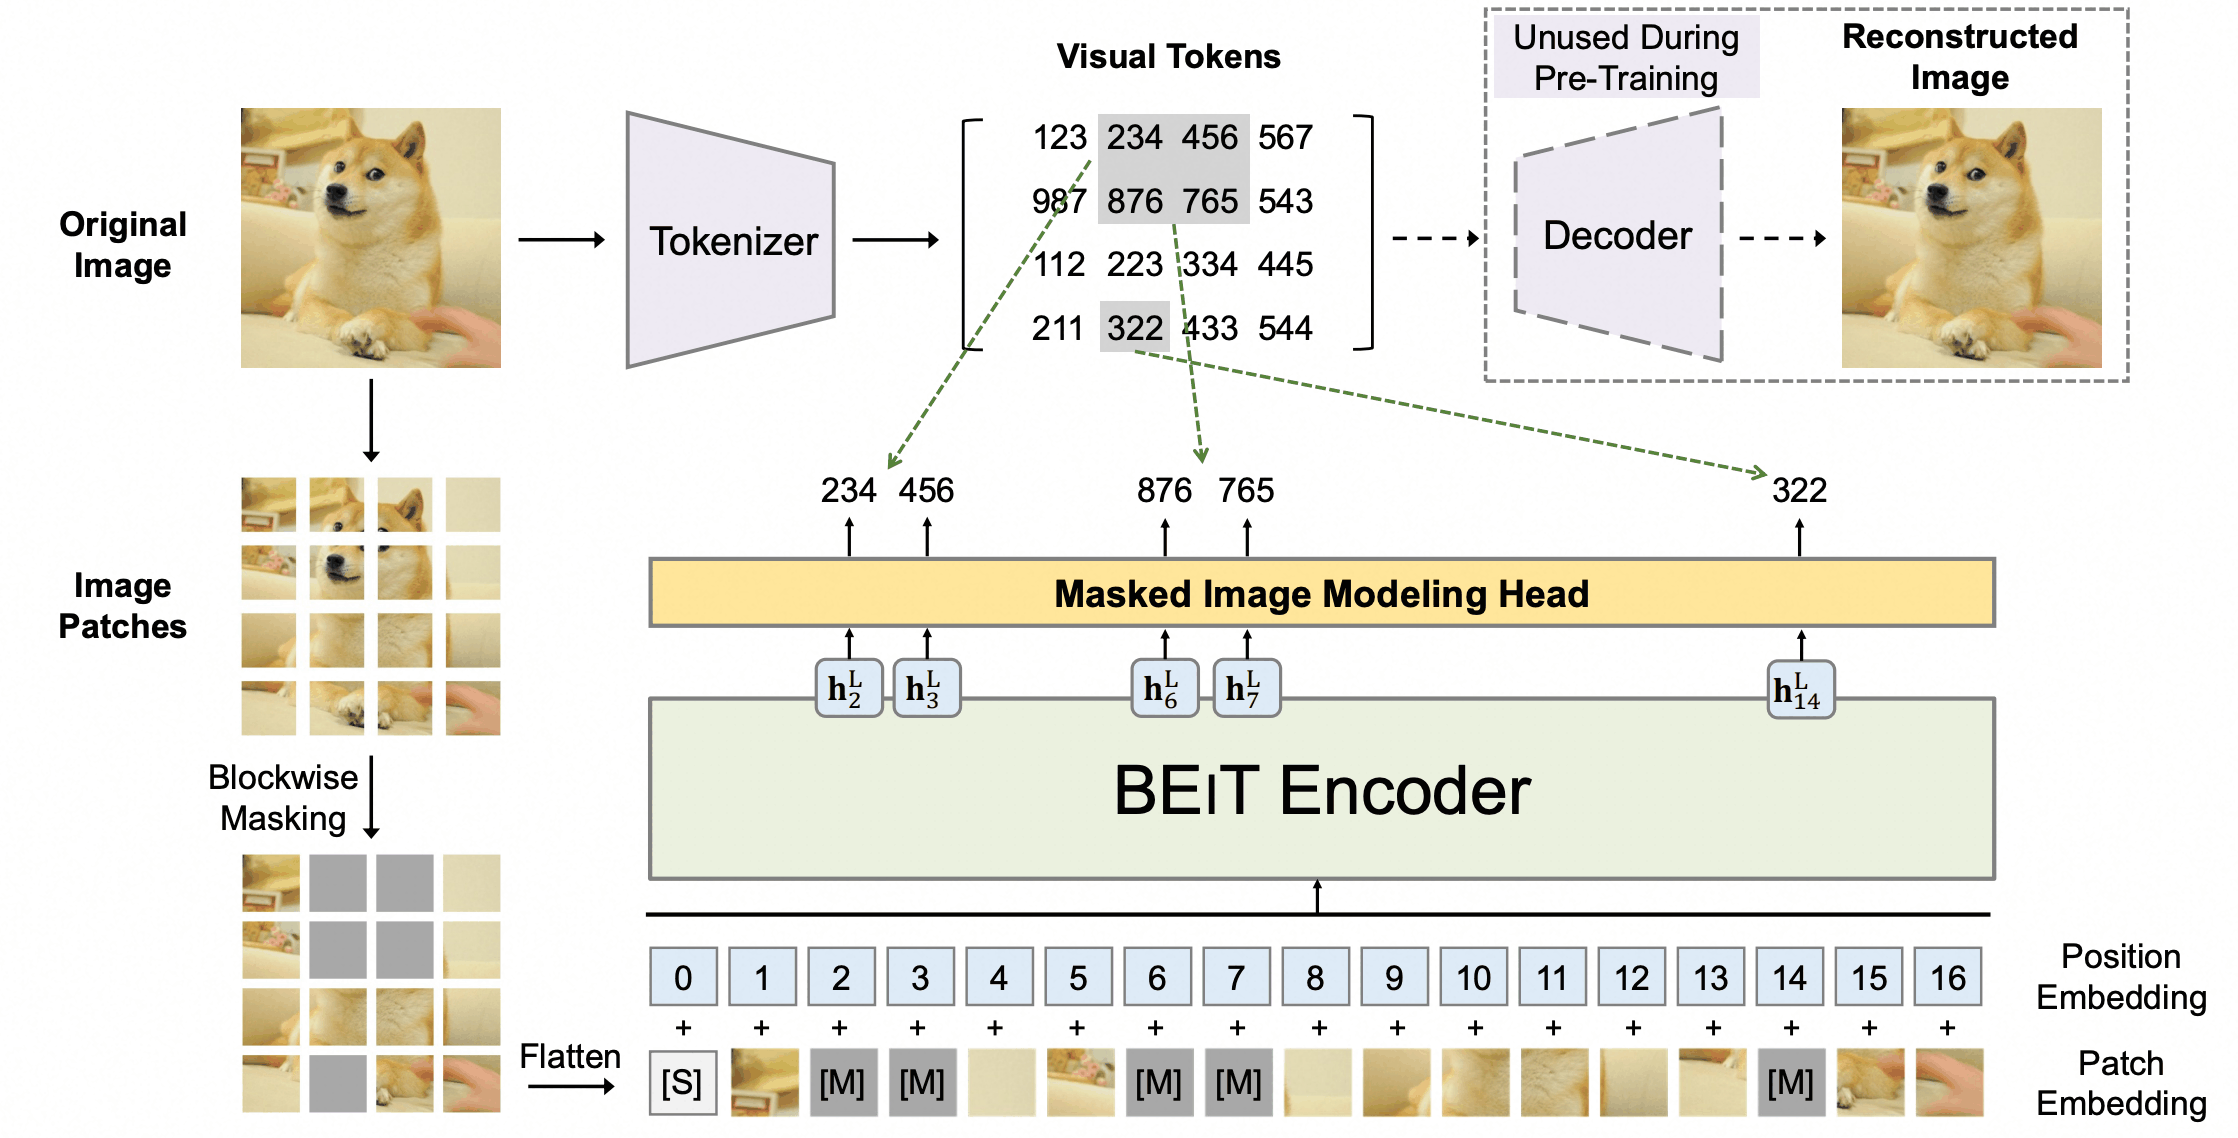
BEiT把BERT的掩码语言建模迁移到图像:图像有两种视图——图像块(输入)与视觉标记(预测目标)。视觉标记由DALL-E公开的dVAE分词器给出:把图像编码为$14\times14$的码网格(词表$8192$),恰与$224\times224$图像的$14\times14$个$16\times16$图像块一一对应。预训练流程为:
- 把输入图像切成$N=196$个图像块$x^p$,同时用分词器得到视觉标记$z=[z_1,\dots,z_N]$;
- 用块状掩码(blockwise masking)随机遮住约$40\%$的图像块:每次随机采样一个面积不小于$16$个块、长宽比随机的矩形区域加入掩码集合$\mathcal{M}$,直到掩码比例达到$40\%$;被遮住的块替换为可学习的掩码嵌入;
- ViT编码器处理带掩码的序列,在被遮位置上用线性分类器预测对应的视觉标记,目标为$\max\sum_{i\in\mathcal{M}}\log p_{\text{MIM}}(z_i\mid x^{\mathcal{M}})$。
从变分自编码器的角度,整个过程可以看作两阶段优化ELBO:第一阶段(分词器训练)最大化视觉标记的重构似然\(\mathbb{E}_{z\sim q_\phi(z\mid x)}\log p_\psi(x\mid z)\),第二阶段(MIM)学习以掩码图像为条件的标记先验\(\log p_\theta(\hat{z}\mid\tilde{x})\)。消融显示:预测离散视觉标记优于直接回归被遮像素,块状掩码对分类与分割都有利。
⚪ PeCo:感知码本
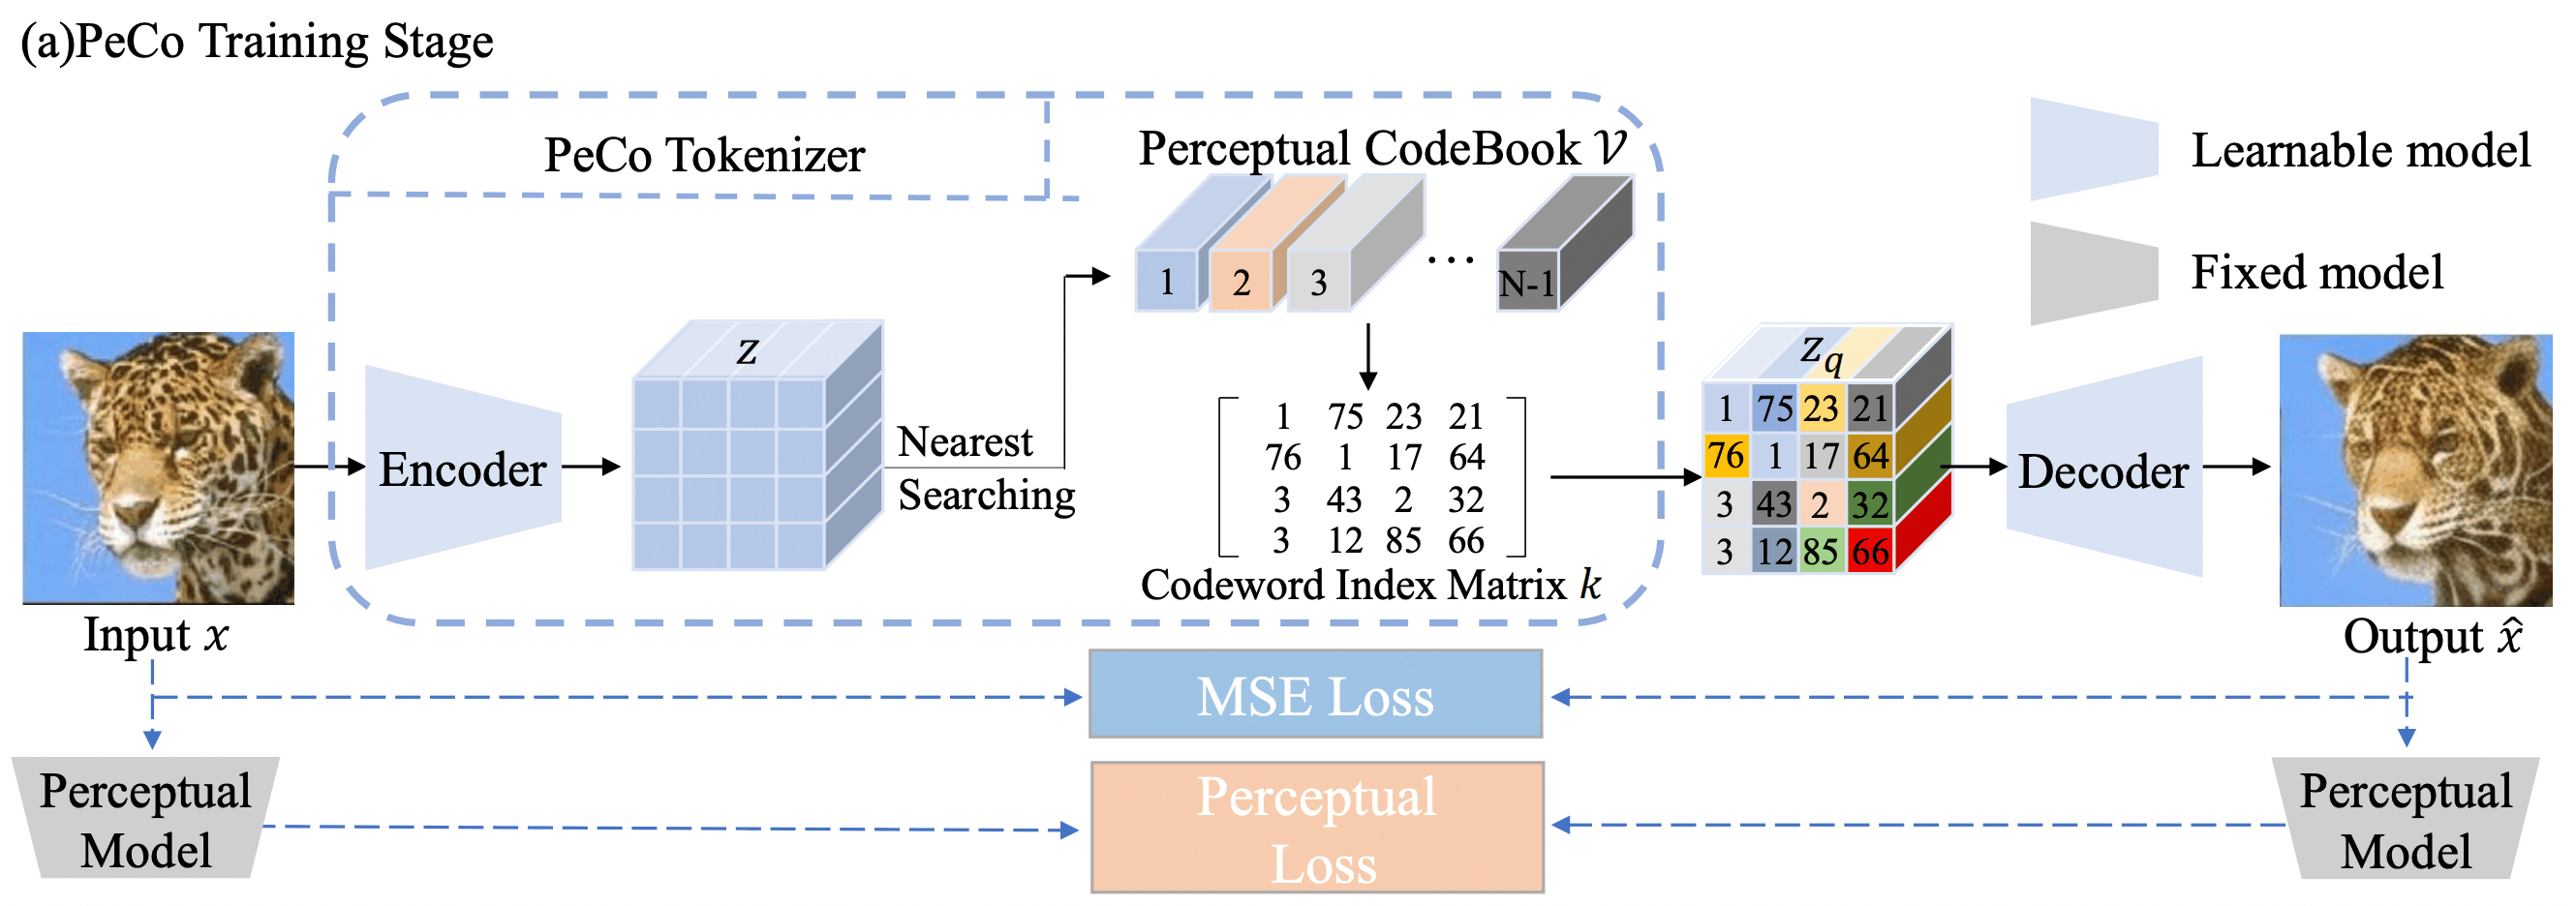
PeCo观察到,BEiT所用视觉标记的相似性与人类感知判断并不一致:感知上相似的图像可能得到差异很大的标记。它主张感知相似的图像在预测目标空间中也应彼此靠近,并给出一个简单有效的做法:在训练dVAE(VQGAN式结构)时加入感知损失,用一个自监督训练的ViT(MoCo v3)的深层特征衡量重构图像与原图之间的感知距离:
\[\mathcal{L}_{\text{percep}}=\sum_{l\in\mathcal{S}}\frac{1}{C_lH_lW_l}\left\|\phi_l(x)-\phi_l(\hat{x})\right\|_2^2\]其中$\phi_l$为该ViT第$l$层的特征,$\mathcal{S}$为选取的若干层,$C_l$、$H_l$、$W_l$为特征维度。总损失为像素重构、感知损失、对抗损失与量化损失之和,码本大小$8192$。这样学到的视觉标记具有更好的语义,作为BEiT式预训练的目标带来更好的迁移性能。
⚪ BEiT v2:向量量化知识蒸馏 VQ-KD
BEiT v2把视觉分词器的训练目标从“重构像素”换成“重构教师模型的语义特征”,提出向量量化知识蒸馏(Vector-Quantized Knowledge Distillation, VQ-KD),把连续的语义空间离散化为紧凑的码:
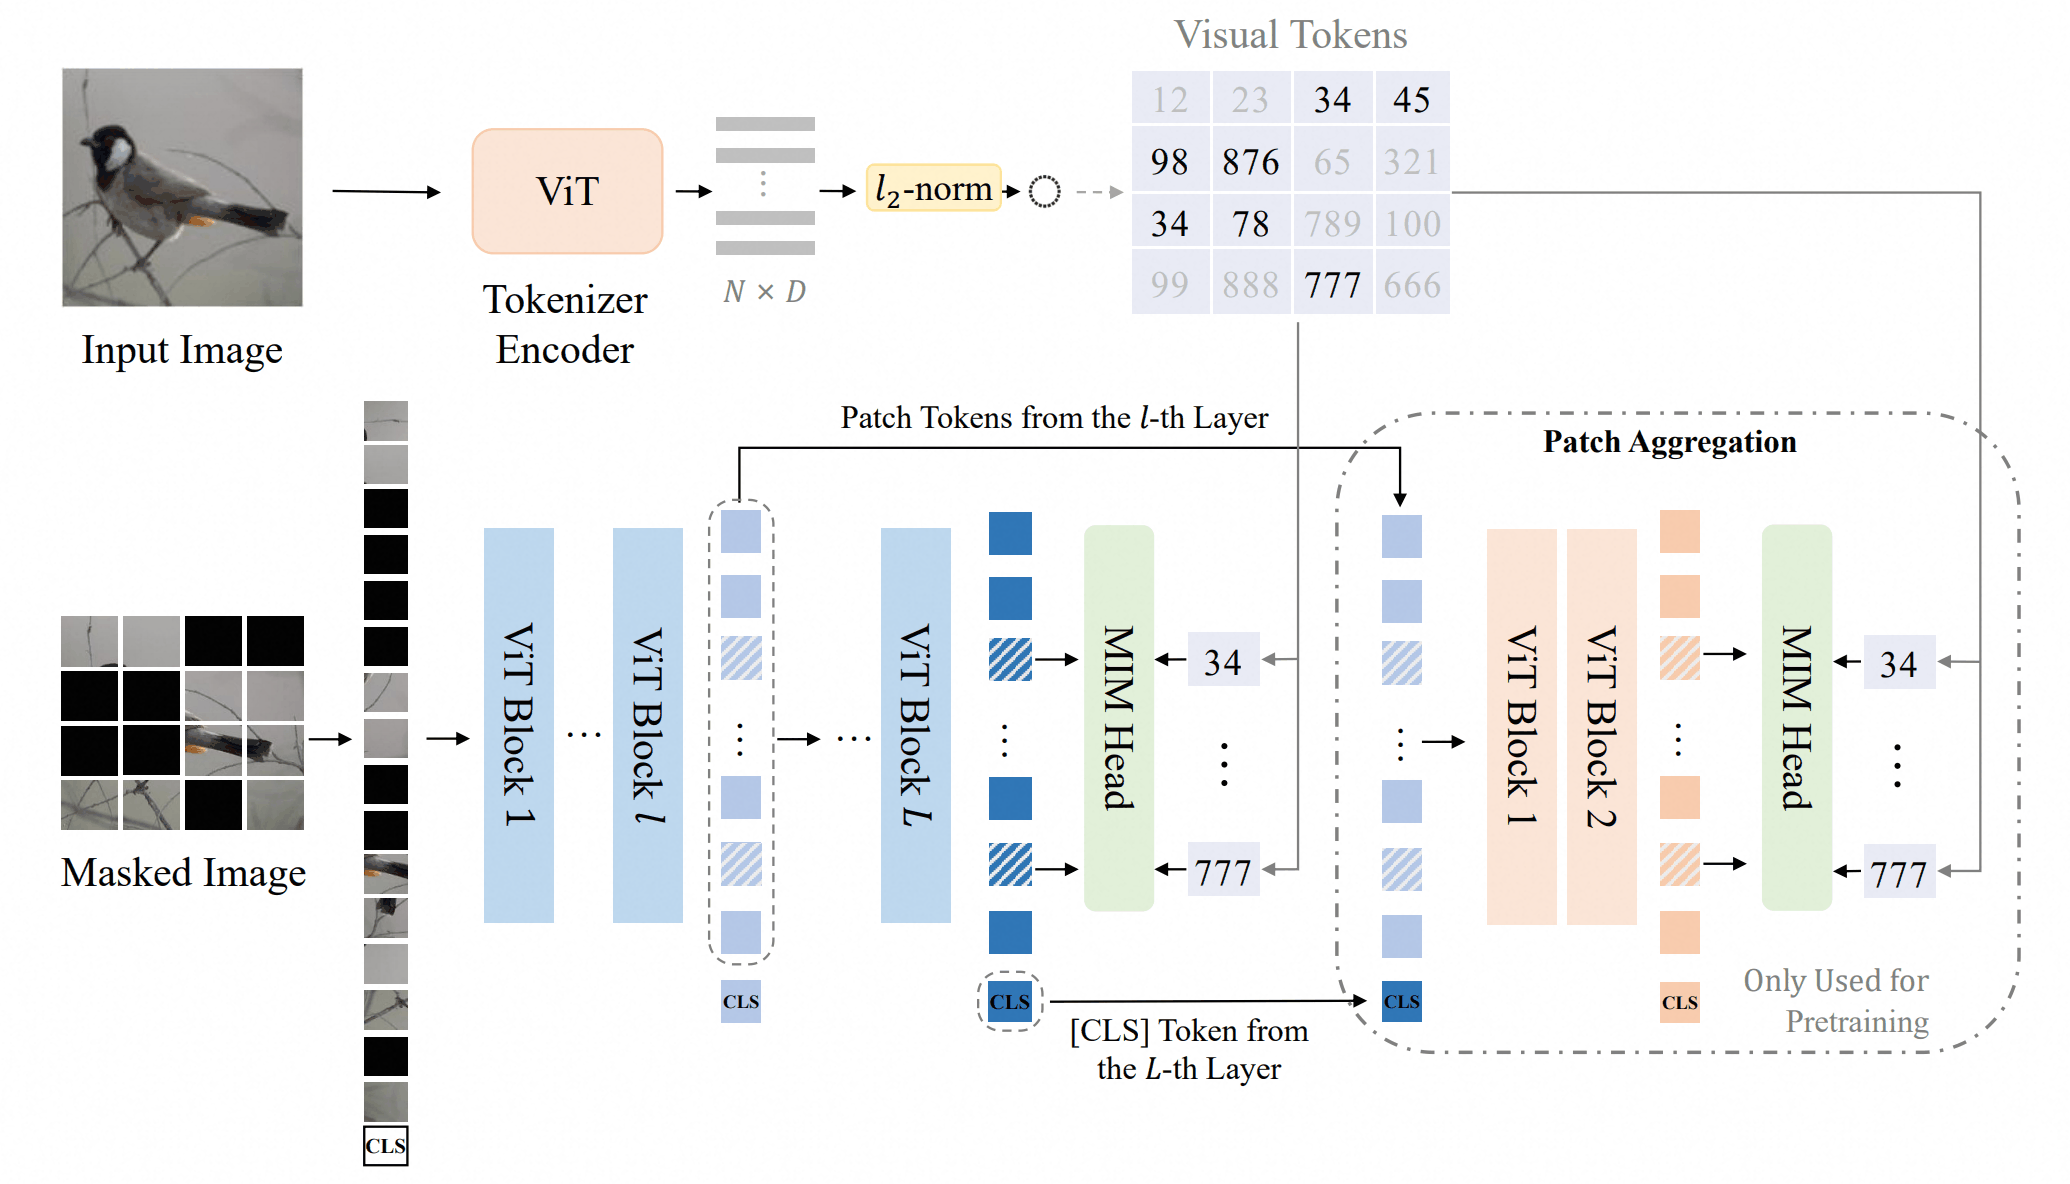
- ViT编码器把图像编码为块特征$h_i$;
- 在L2归一化后做最近邻量化$z_i=\mathop{\arg\min}_{j}||\ell_2(h_i)-\ell_2(v_j)||_2$,$v_j$为码字,$\ell_2(\cdot)$表示L2归一化;
- 一个浅层Transformer解码器以量化后的码字为输入,输出$o_i$,要求其逼近教师模型(CLIP-B/16)在同一块上的特征$t_i$。
训练目标为
\[\max\sum_{i}\cos\left(o_i,t_i\right)-\left\|\text{sg}[\ell_2(h_i)]-\ell_2(v_{z_i})\right\|_2^2-\left\|\ell_2(h_i)-\text{sg}[\ell_2(v_{z_i})]\right\|_2^2\]码本大小为$8192$、码字维度$32$,用EMA更新码字以提高利用率。由于目标是语义特征,同一码字倾向于对应语义一致的图像区域(如同一类物体的部件)。预训练时BEiT v2以这些视觉标记为MIM目标,并提出块聚合(patch aggregation)策略:用[CLS]标记与中间层块特征拼接后送入一个浅层网络完成MIM,迫使[CLS]汇聚全局语义。
(5) 一维与多尺度标记
VQGAN类分词器输出与图像空间位置一一对应的二维网格,标记数由下采样率固定决定,且相邻标记高度冗余。这类工作改变标记的组织方式:按尺度由粗到细排列,或脱离二维网格、用少量一维标记表示整张图像。
⚪ VAR:多尺度残差分词器与下一尺度预测
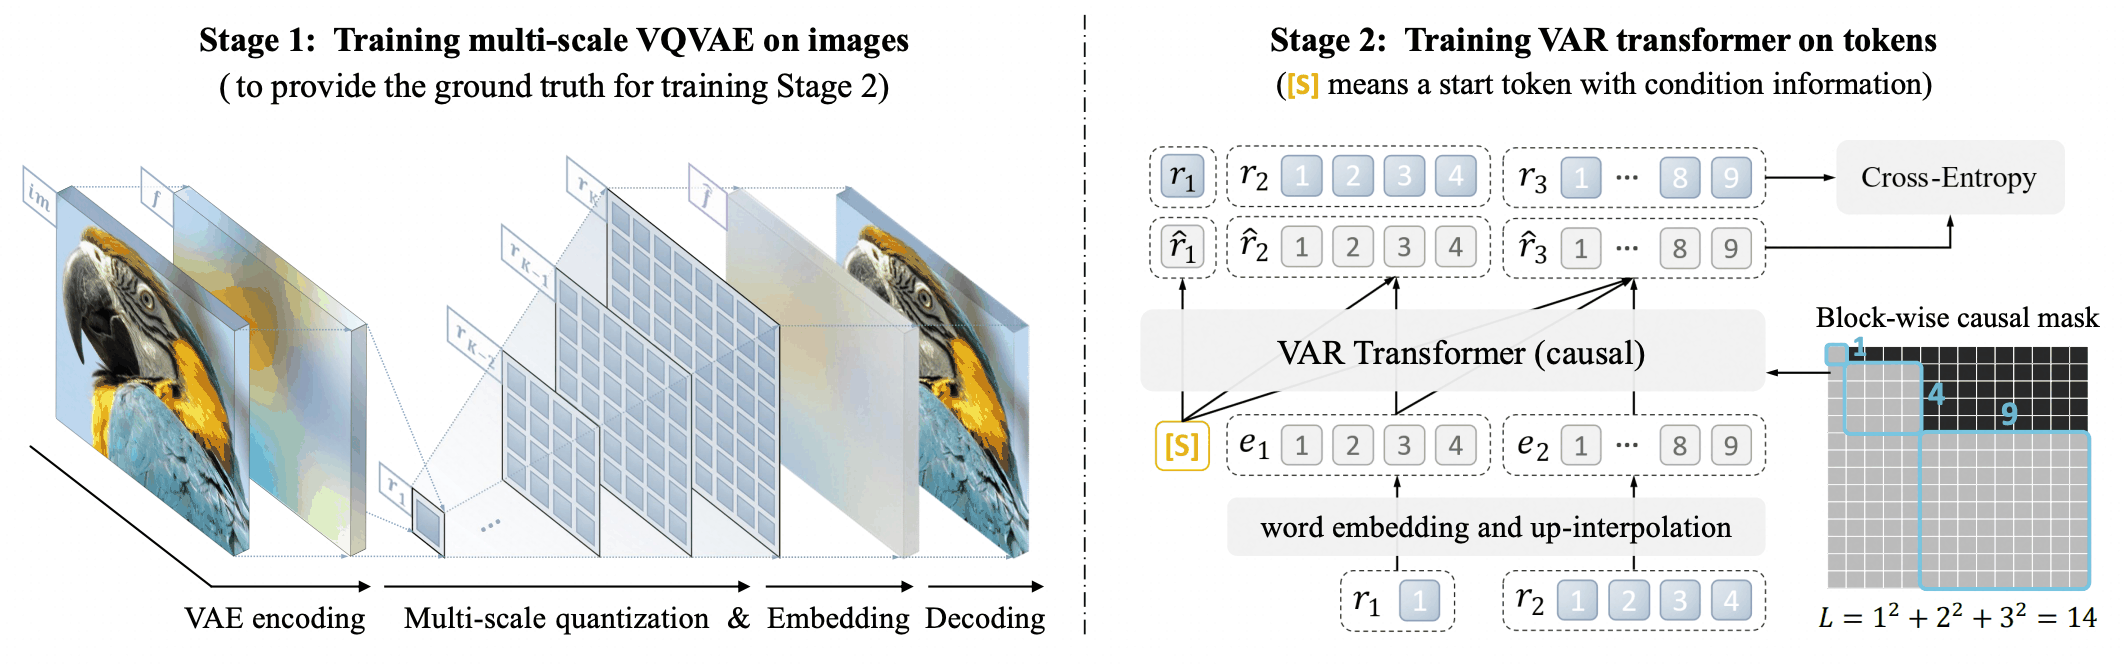
视觉自回归建模(Visual AutoRegressive modeling, VAR)把图像上的自回归从光栅扫描的“下一标记预测”改为由粗到细的“下一尺度预测”,并为此设计了多尺度残差量化分词器。
设编码器输出特征图$f\in\mathbb{R}^{h\times w\times C}$,预设$K$个尺度$(h_1,w_1),\dots,(h_K,w_K)$($256$分辨率下为$1,2,3,4,5,6,8,10,13,16$的方形尺度),编码过程为:
\[\begin{aligned} &r_k=\mathcal{Q}\left(\text{interpolate}(f,\,h_k\times w_k)\right)\\ &z_k=\text{lookup}(\mathcal{C},r_k)\\ &f\leftarrow f-\phi_k\left(\text{interpolate}(z_k,\,h\times w)\right) \end{aligned}\]即在第$k$个尺度上把当前残差特征下采样到$h_k\times w_k$并量化得到标记图$r_k$,查表得到码字图$z_k$,再上采样回$h\times w$、经卷积$\phi_k$后从残差中减去;解码端的重建特征为$\hat{f}=\sum_{k=1}^{K}\phi_k\left(\text{interpolate}(z_k,h\times w)\right)$。所有尺度共享一个大小为$4096$的码本,一张$256\times256$图像共有$1+4+9+\cdots+256=680$个标记。
生成模型按尺度自回归:$p(r_1,\dots,r_K)=\prod_{k=1}^{K}p(r_k\mid r_1,\dots,r_{k-1})$,同一尺度内的$h_kw_k$个标记在一步内并行生成(块状因果注意力掩码:每个尺度的标记可看到所有更粗尺度的标记)。
⚪ TiTok:用32个一维标记表示图像
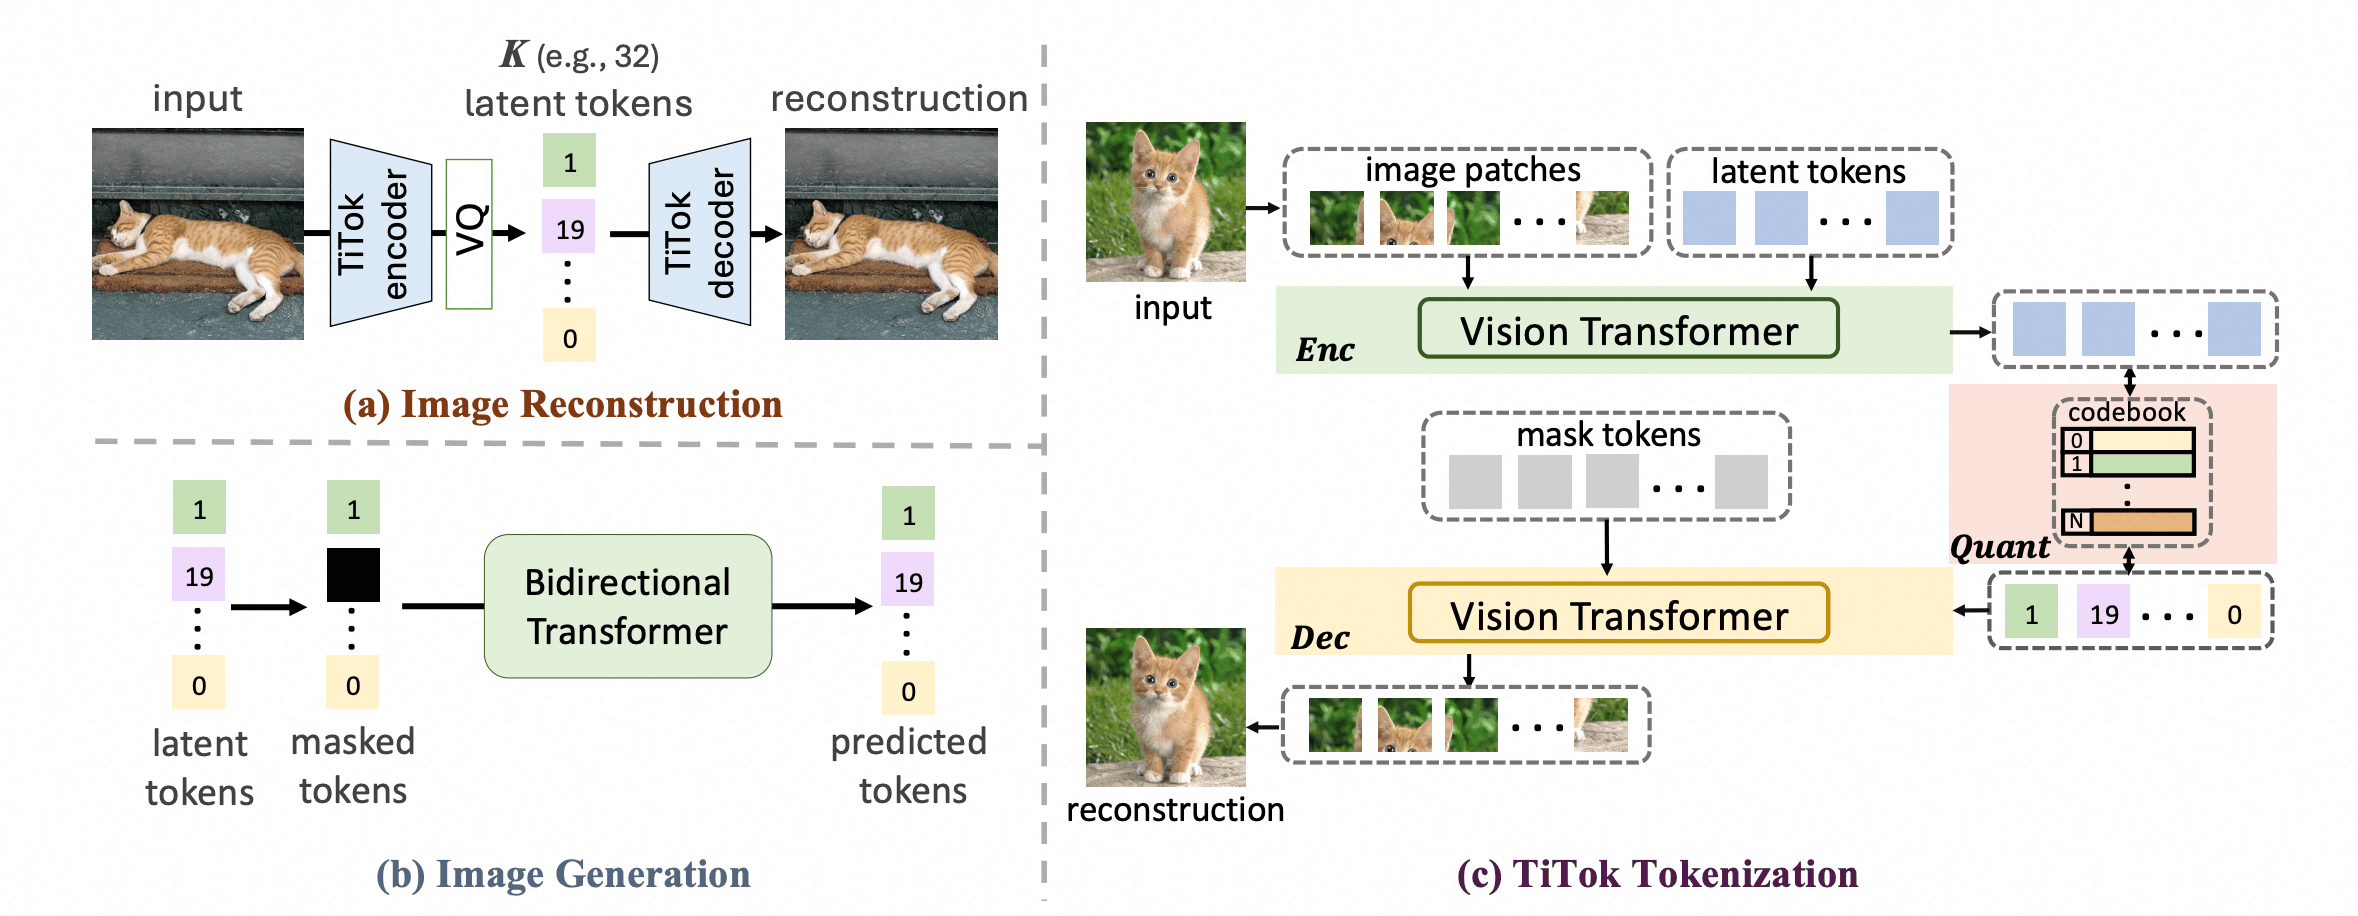
TiTok(Transformer-based 1-Dimensional Tokenizer)认为二维网格标记难以消除图像中相邻区域的冗余,转而把图像编码为一个短的一维潜在序列:
- 编码:把图像切成图像块($256\times256$图像、$16\times16$的块得到$256$个块嵌入),与$K$个可学习的潜在标记拼接后送入ViT编码器;编码器输出中只保留潜在标记部分,得到$K$个向量;
- 量化:对$K$个向量做向量量化(码本大小$4096$),得到$K$个离散标记;
- 解码:把量化后的潜在标记与$256$个掩码标记拼接送入ViT解码器,在掩码标记位置输出重建结果。
由于潜在标记不与任何空间位置绑定,编码器可以把全局信息自由分配给它们,$K$可以远小于网格标记数,例如$K=32$。训练采用两阶段方案:先以一个现成VQGAN的码作为“代理码”,训练TiTok预测这些代理码;再微调解码器直接重建像素。
(6) 连续视觉标记
不经量化的连续隐变量同样可以看作标记:自编码器把图像压缩为低分辨率、低通道的连续隐空间,再按图像块切成连续标记。
⚪ LDM与Stable Diffusion的VAE:感知压缩的连续隐空间
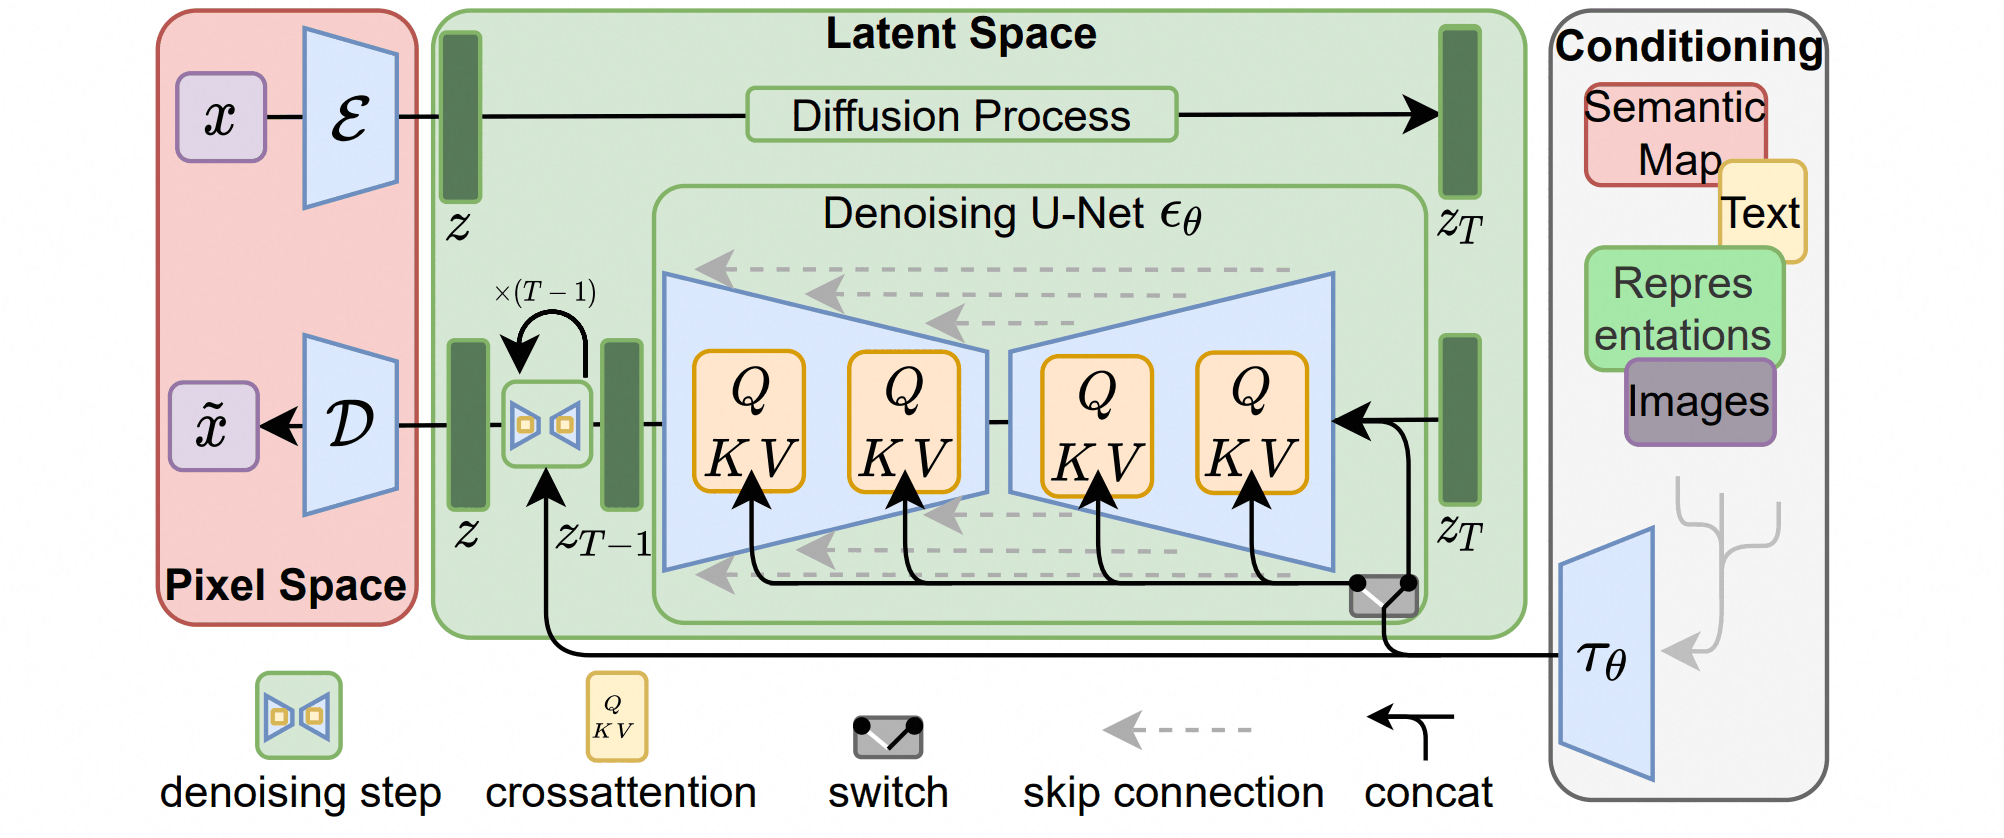
扩散模型的隐变量通常与原图同维,直接在像素空间训练的计算量极大:一张$512\times512$的RGB图像有$786432$维。隐扩散模型(Latent Diffusion Model, LDM)观察到图像的大部分比特用于描述人眼不敏感的感知细节,因此把生成建模拆为两步:先用自编码器做感知压缩(perceptual compression)去除像素级冗余,再在隐空间中用扩散模型学习语义压缩(semantic compression)。
编码器$\mathcal{E}$把$x\in\mathbb{R}^{H\times W\times3}$压缩为$z=\mathcal{E}(x)\in\mathbb{R}^{h\times w\times c}$,下采样率$f=H/h=W/w=2^m$;解码器$\mathcal{D}$恢复$\tilde{x}=\mathcal{D}(z)$。自编码器以感知损失与基于图像块的对抗损失训练,
\[\begin{aligned} \mathcal{L}_{\text{AE}}=\mathop{\min}_{\mathcal{E},\mathcal{D}}\mathop{\max}_{\psi}\Big(\mathcal{L}_{rec}\left(x,\mathcal{D}(\mathcal{E}(x))\right)-\mathcal{L}_{adv}\left(\mathcal{D}(\mathcal{E}(x))\right)\\+\log D_{\psi}(x)+\mathcal{L}_{reg}\left(x;\mathcal{E},\mathcal{D}\right)\Big) \end{aligned}\]其中$D_\psi$为判别器,$\mathcal{L}_{reg}$为隐空间正则,有两种选择:KL正则(对隐变量施加权重极小(约$10^{-6}$)的标准正态KL惩罚,类似VAE)与VQ正则(在解码器中加入一个向量量化层,相当于把量化吸收进解码器)。与VQGAN不同,扩散模型直接建模连续的$z$,因此隐空间保留了二维结构,压缩率可以较温和。
⚪ DiT:隐空间的图像块化
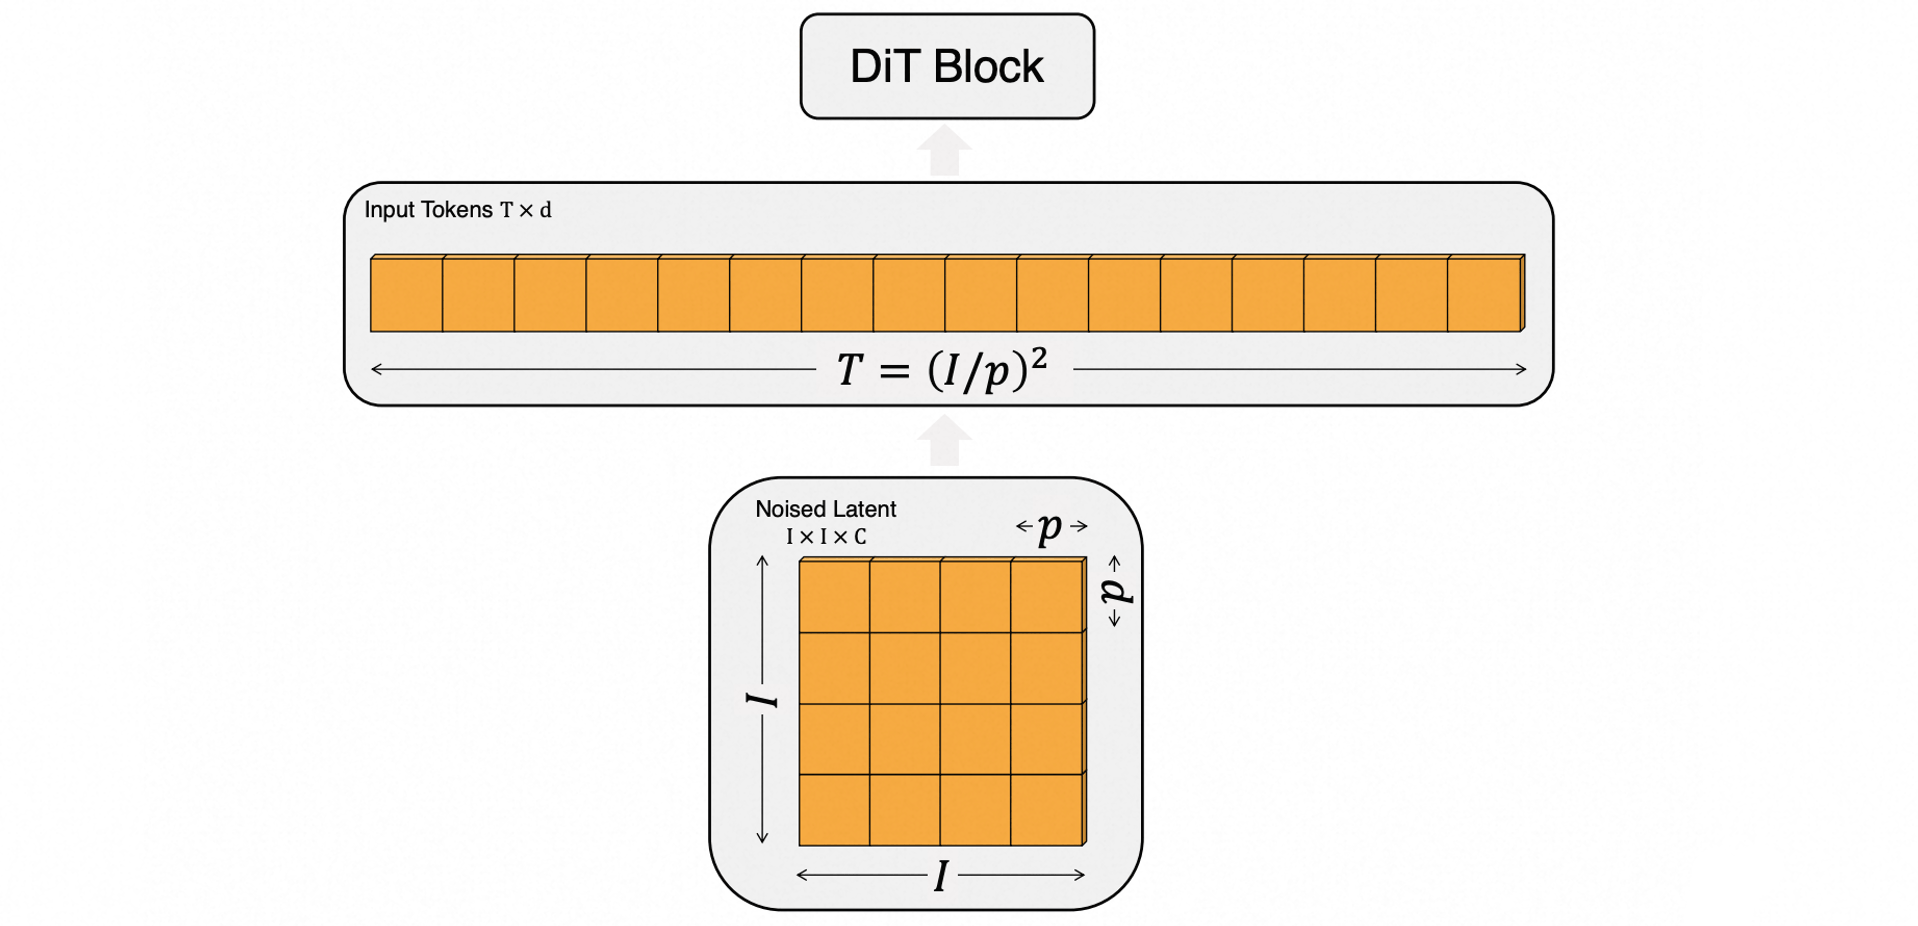
DiT(Diffusion Transformer)把ViT的图像块化直接用在LDM的连续隐空间上,使扩散模型可以用标准Transformer作为骨干。对$256\times256$图像,SD自编码器给出$32\times32\times4$的隐变量$z$;DiT以块大小$p$把$z$切成$T=(32/p)^2$个块,每块线性投影为$d$维标记并加上正弦位置编码:
\[T=\left(\frac{I}{p}\right)^2,\quad p\in\{2,4,8\}\]其中$I$为隐变量的空间边长。$p=2$时得到$256$个标记,$p$每减半标记数增至$4$倍;由于Transformer的计算量主要由标记数决定,块大小成为控制模型Gflops的关键。
⚪ VA-VAE:与视觉基础模型对齐的隐空间
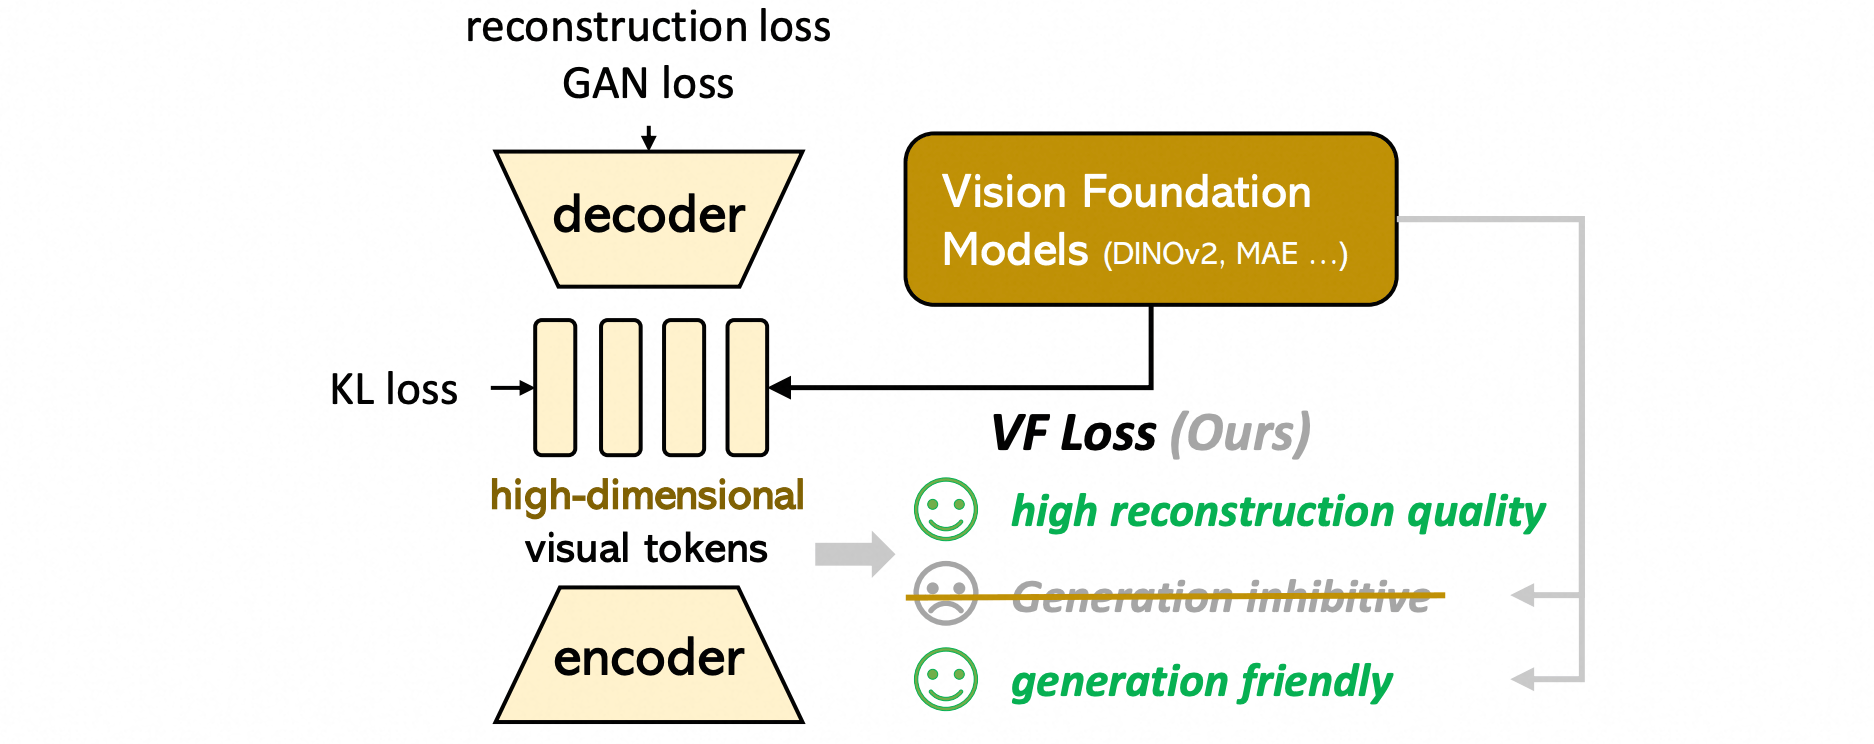
连续分词器存在与离散分词器类似的两难:增大每个标记的特征维度能改善重构,但需要大得多的扩散模型与更多训练迭代才能达到相当的生成质量。论文认为根源在于无约束的高维隐空间难以学习,提出VA-VAE(Vision foundation model Aligned VAE):在训练自编码器时,把隐变量与预训练视觉基础模型(如DINOv2)的特征对齐,损失称为VF损失,由两部分组成。设隐变量经线性投影后的第$(i,j)$个位置为\(z'_{ij}\),基础模型特征为$f_{ij}$:
\[\mathcal{L}_{\text{mcos}}=\frac{1}{hw}\sum_{i,j}\text{ReLU}\left(1-m_1-\cos(z'_{ij},f_{ij})\right)\\ \mathcal{L}_{\text{mdms}}=\frac{1}{N^2}\sum_{a,b}\text{ReLU}\left(\left|\cos(z_a,z_b)-\cos(f_a,f_b)\right|-m_2\right)\]\(\mathcal{L}_{\text{mcos}}\)是带间隔$m_1$的逐位置余弦相似度损失,\(\mathcal{L}_{\text{mdms}}\)要求隐变量内部各位置之间的相似度矩阵与基础模型特征的相似度矩阵一致($a,b$遍历全部$N=hw$个位置,间隔$m_2$),两者都只在差距超过间隔时起作用,以免过度约束重构;两项损失按梯度范数自适应加权。VA-VAE显著扩展了隐扩散模型的“重构-生成”前沿,使扩散Transformer在高维隐空间(如$f16d32$)中也能快速收敛。
4. 视频的标记化
视频在图像的两个空间维之外多了时间维,相邻帧之间高度冗余,原始数据量极大:一段$10$秒、$24$帧每秒、$512\times512$的视频有约$1.9$亿个子像素。视频标记化的核心是同时在时间与空间上压缩。
(1) 时空图像块
⚪ ViViT:管块嵌入
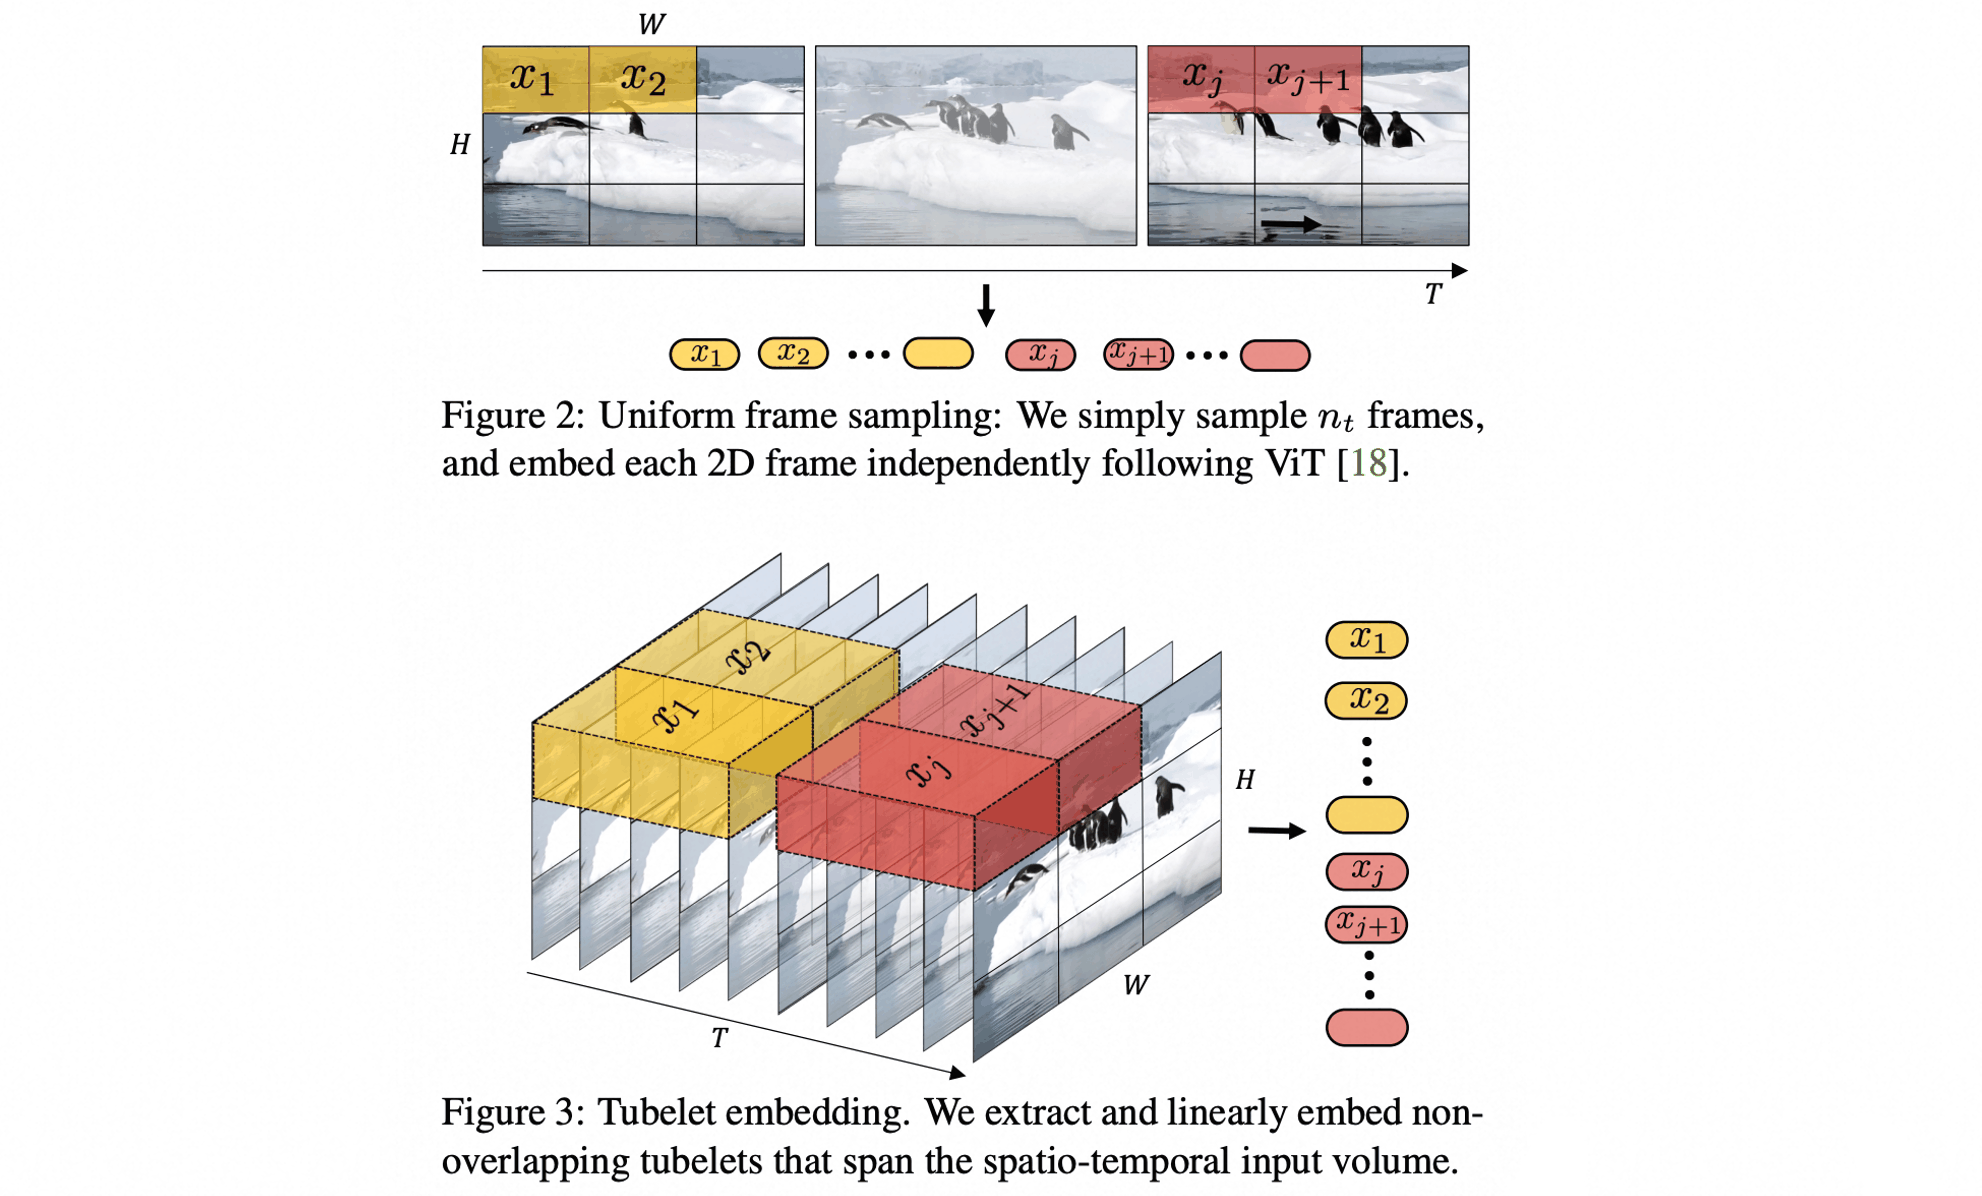
ViViT研究了把视频变成Transformer标记序列的两种方式。设视频$V\in\mathbb{R}^{T\times H\times W\times c}$:
- 均匀帧采样(uniform frame sampling):均匀采样$n_t$帧,每帧按ViT的方式切成$n_h\times n_w$个二维图像块并独立嵌入,所有帧的标记拼接成一个序列;
- 管块嵌入(tubelet embedding):从视频中切出不重叠的时空管块,每个管块大小为$t\times h\times w$,线性投影为一个标记,标记数为
管块嵌入等价于核大小与步长都为$t\times h\times w$的三维卷积,它在标记化阶段就融合了时空信息,并把序列长度相对逐帧切块缩短$t$倍。管块是后续几乎所有视频分词器的基本单元。
⚪ Sora:压缩隐空间中的时空图像块
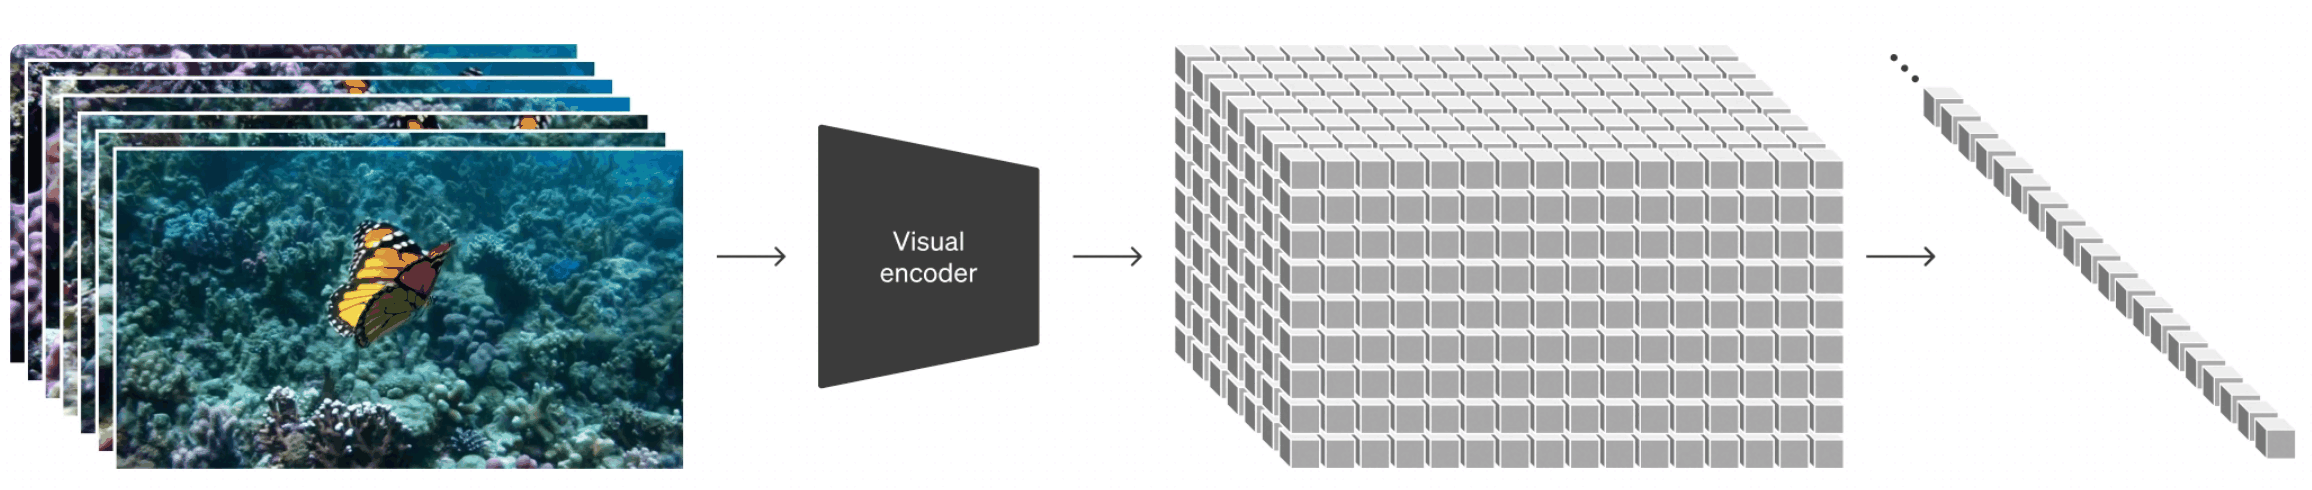
Sora把时空图像块(spacetime patches)明确作为视频生成模型的标记:先用一个视频压缩网络把原始视频在时间与空间上同时压缩到低维的连续隐空间,再从压缩后的隐视频中切出时空图像块,作为扩散Transformer的输入标记;生成的隐变量由对应的解码器还原为像素视频。
作者这一接口的灵活性:由于图像块只是隐空间网格上的局部单元,不同分辨率、时长与宽高比的视频(以及作为单帧视频的图像)都可以表示为数量不同的图像块序列,因此模型可以直接在原始尺寸的数据上训练,推理时通过把随机初始化的图像块排成相应大小的网格来控制输出视频的尺寸。
(2) 离散视频分词器
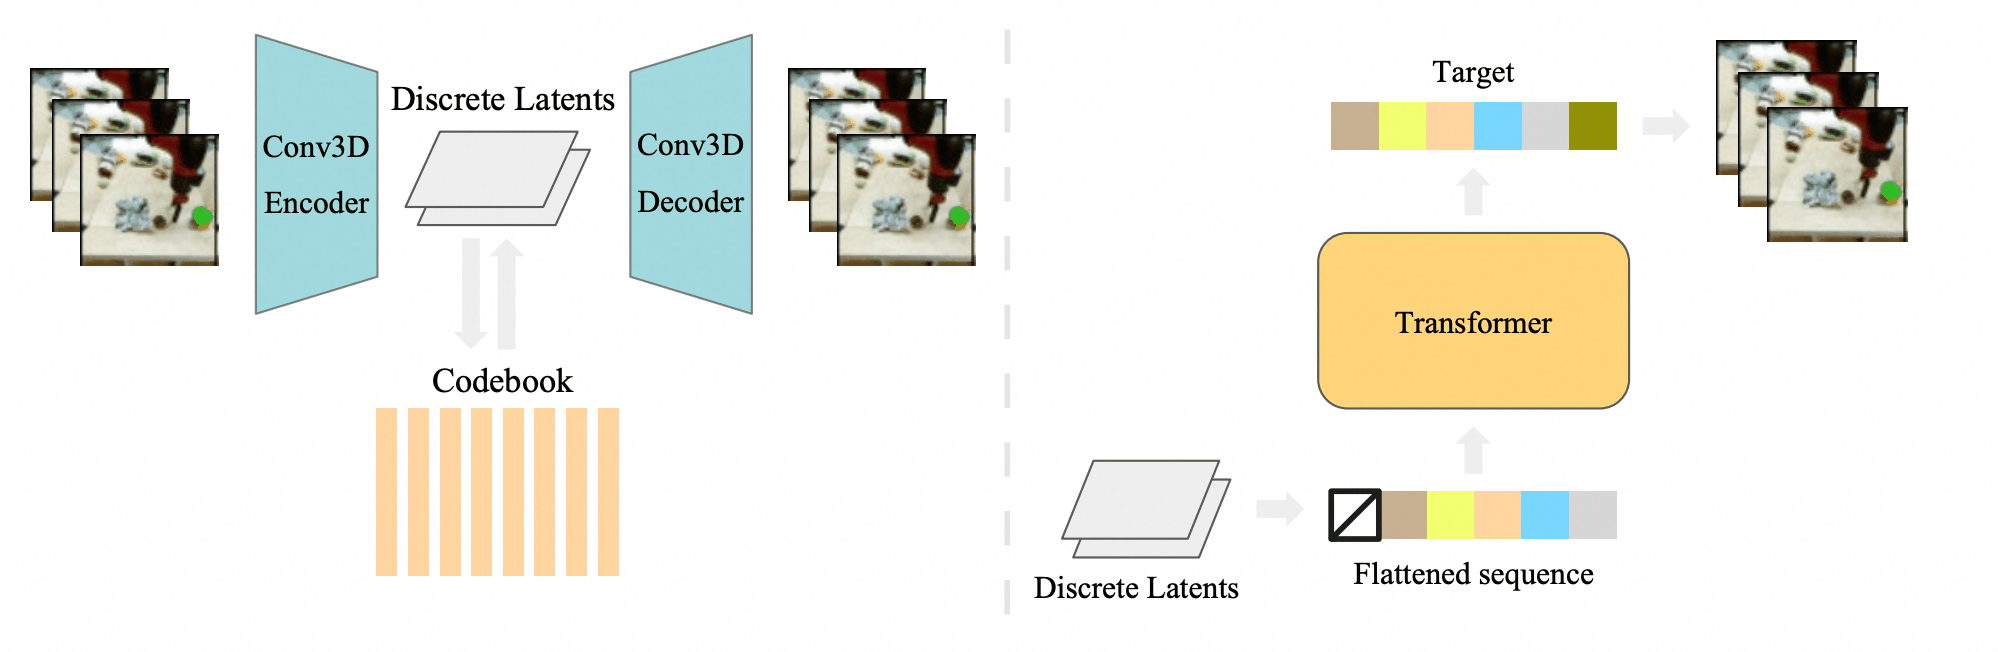
⚪ VideoGPT:三维VQ-VAE与GPT
VideoGPT是“VQ-VAE$+$GPT”范式在视频上的极简实现。
- 第一阶段的VQ-VAE用三维卷积同时在时间与空间上下采样原始视频,并在残差块中加入轴向自注意力(axial attention)(分别沿时间、高度、宽度三个轴做注意力)以扩大感受野,输出一个三维的离散码网格;码本用EMA更新,训练损失与VQ-VAE相同。
- 第二阶段用一个GPT式Transformer在展平的三维码序列上做自回归建模,使用时空位置编码;条件生成时(如以首帧为条件)把条件帧的编码通过交叉注意力或条件归一化注入。
⚪ MAGVIT:三维VQGAN与掩码视频生成
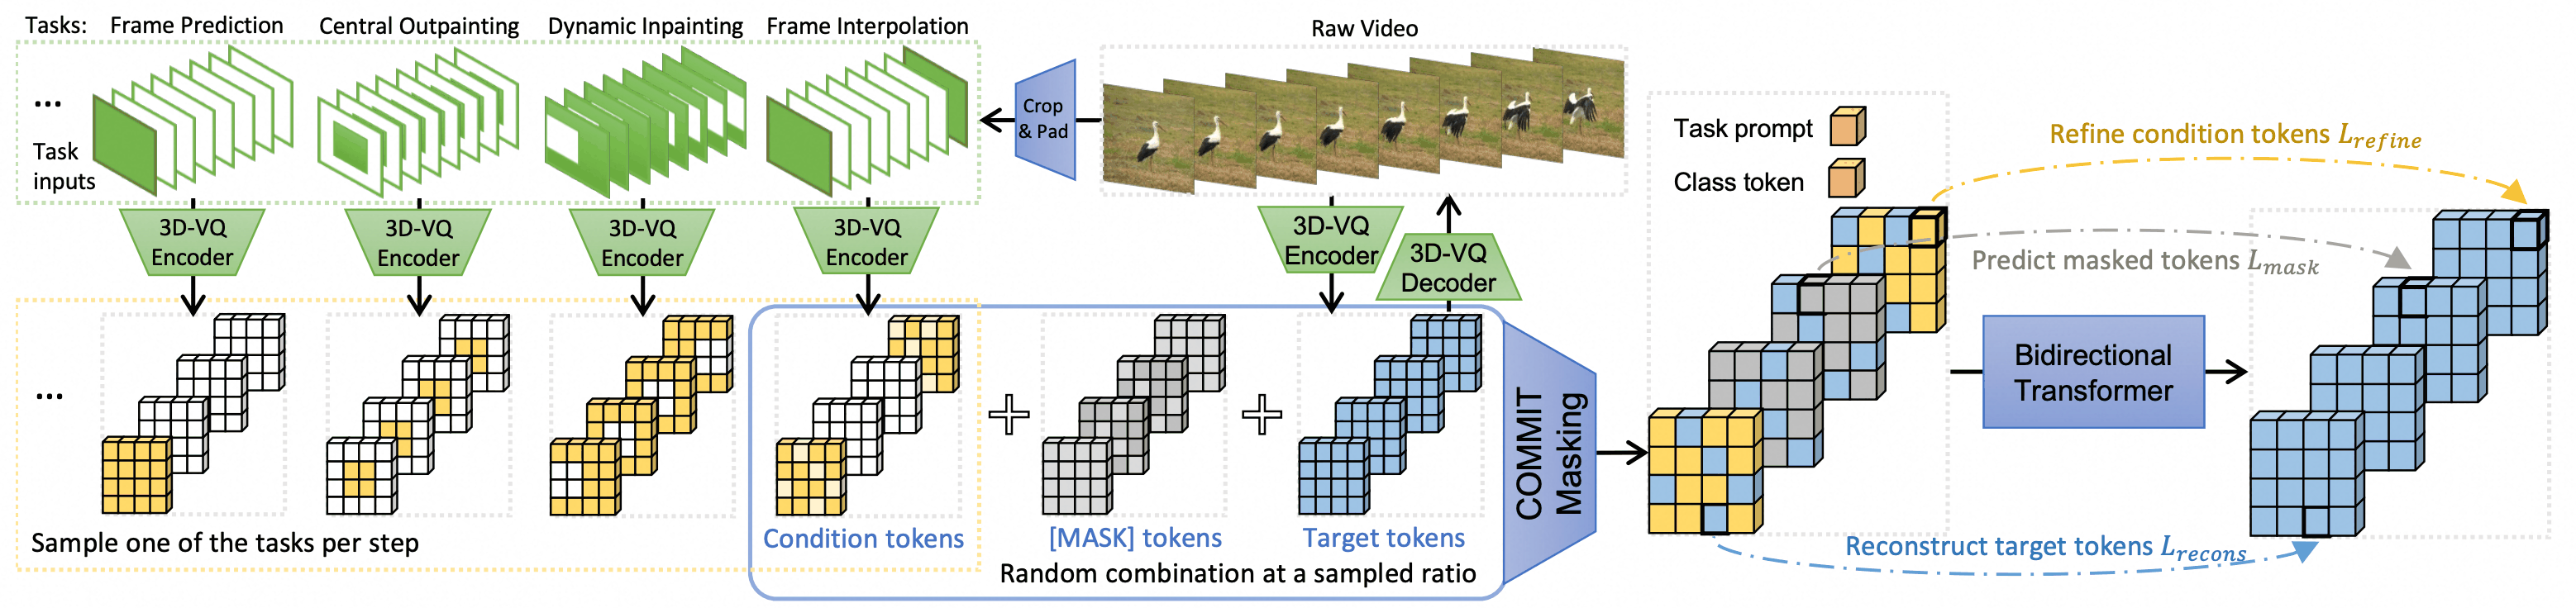
MAGVIT提出一个三维VQ分词器,把视频量化为时空视觉标记:它把VQGAN的二维卷积膨胀为三维卷积,把$16$帧$128\times128$的视频片段量化为$4\times16\times16$个标记(时间下采样$4$倍、空间下采样$8$倍,码本大小$1024$);训练时除VQGAN的感知与对抗损失外,还使用三维判别器与LeCAM正则以稳定GAN训练。三维分词器能利用帧间冗余,相比逐帧图像分词显著减少了标记数。
在这些标记上,MAGVIT沿用MaskGIT的双向掩码生成,并提出面向多任务的COMMIT条件掩码嵌入:对于帧预测、插帧、外扩、修复等任务,条件区域(如已知帧)的视觉信息不是直接以原始标记给出,而是把条件像素编码后的标记嵌入与掩码嵌入按条件区域组合作为输入,使同一个模型可以通过不同的条件掩码完成十种生成任务。
⚪ Phenaki的C-ViViT:时间因果的视频分词器
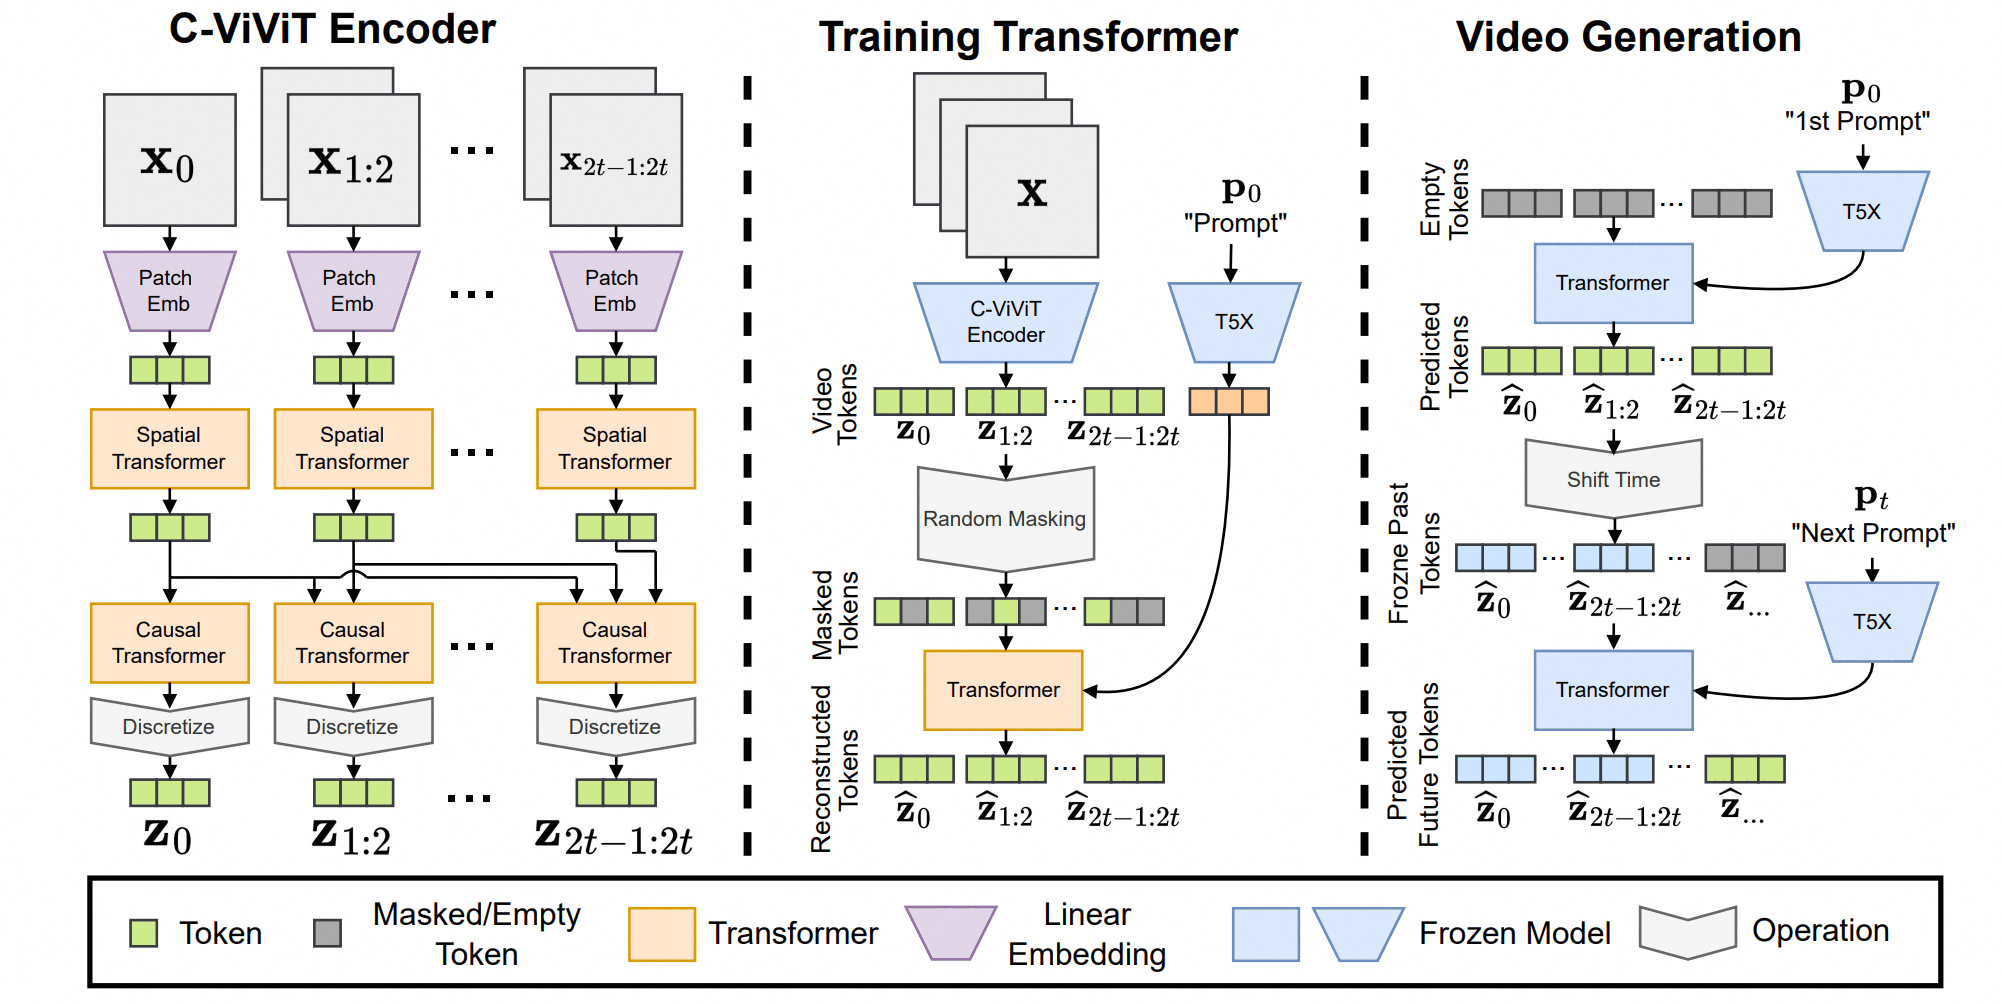
Phenaki面向任意长度、由一串文本提示驱动的视频生成,为此设计了C-ViViT分词器,其关键是在时间维上使用因果注意力:
- 块化:视频的第一帧单独切成空间图像块,其后的帧按若干帧一组切成时空管块;这样第一帧的编码不依赖后续帧,图像可以看作只有一帧的视频,与视频共用同一个分词器;
- 编码:先在每个时刻内部做空间Transformer,再沿时间做因果Transformer(每个时刻只看过去与当前),输出经向量量化为离散标记;
- 解码:对称的时间因果与空间Transformer还原像素,训练损失包括VQ损失、像素重构损失、图像与视频的感知损失以及对抗损失。
时间因果性使编码器天然支持可变长度的视频,并允许在已有标记之后继续编码新帧。生成端,Phenaki用一个以预计算文本嵌入为条件的双向掩码Transformer生成视频标记,再由解码器还原;生成长视频时,以上一段末尾帧的标记为条件、配合新的文本提示继续生成,从而实现随时间变化的文本(故事)驱动的长视频生成。
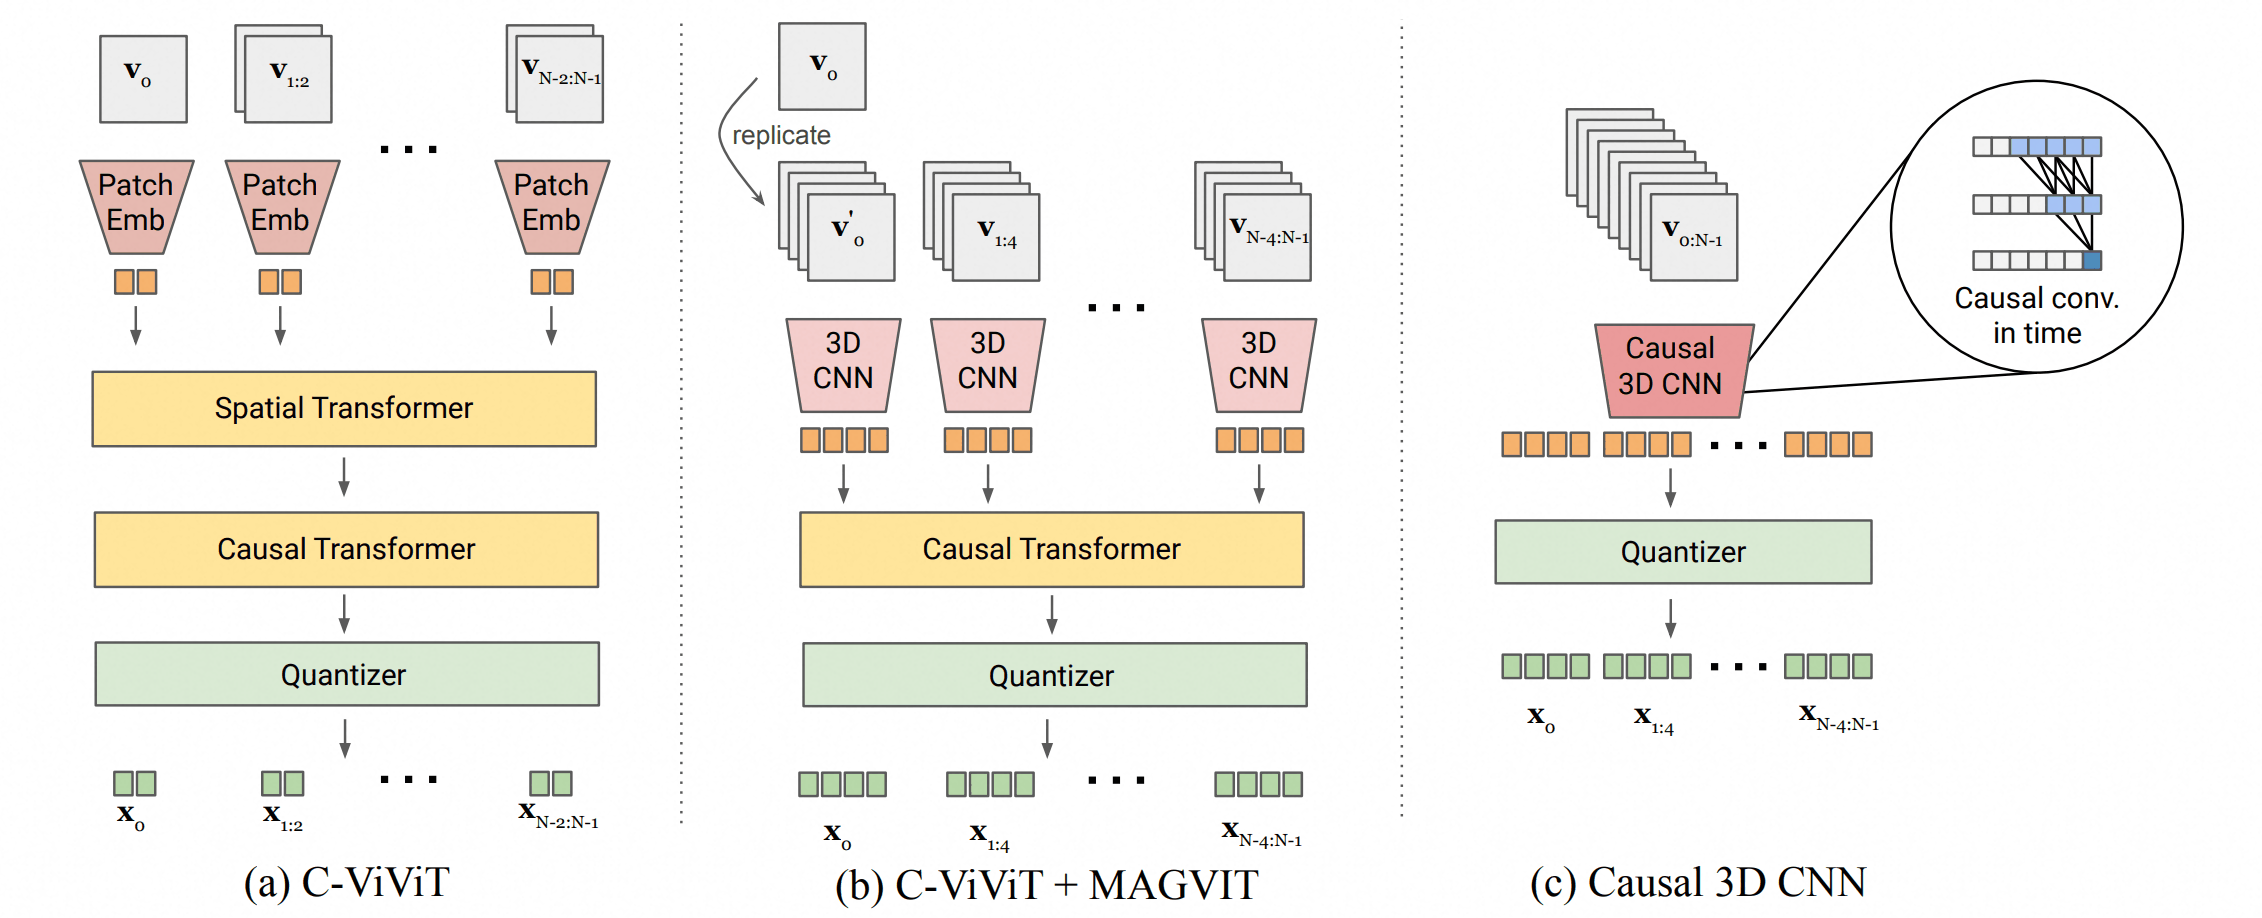
⚪ MAGVIT-v2:因果三维CNN的图像-视频联合分词器
MAGVIT-v2的分词器在量化上采用LFQ,在结构上采用因果三维卷积,使同一个分词器能同时编码图像与视频。普通三维卷积在时间维两侧对称填充,输出依赖未来帧;因果三维卷积只在时间维的前方填充$k_t-1$帧($k_t$为时间核大小),第$\tau$个输出时刻只依赖输入的第$1\sim\tau$帧。于是第一帧的编码只依赖它自身:
- 图像被当作单帧视频编码,得到与图像分词器相同形式的标记;
- 一段$1+4m$帧的视频被编码为$1+m$个时间步的隐变量(例如$17$帧对应$5$个时间步),第一个时间步就是第一帧的图像标记,其余每个时间步压缩$4$帧;空间下采样$8$倍。
结构上还做了若干改进:用带步长的卷积代替平均池化做下采样,在解码器中使用自适应组归一化等。配合$2^{18}$的LFQ词表,MAGVIT-v2在图像(ImageNet)与视频(UCF-101、Kinetics-600)生成上都超过同期扩散模型。
(3) 连续视频隐空间
⚪ CogVideoX:三维因果VAE
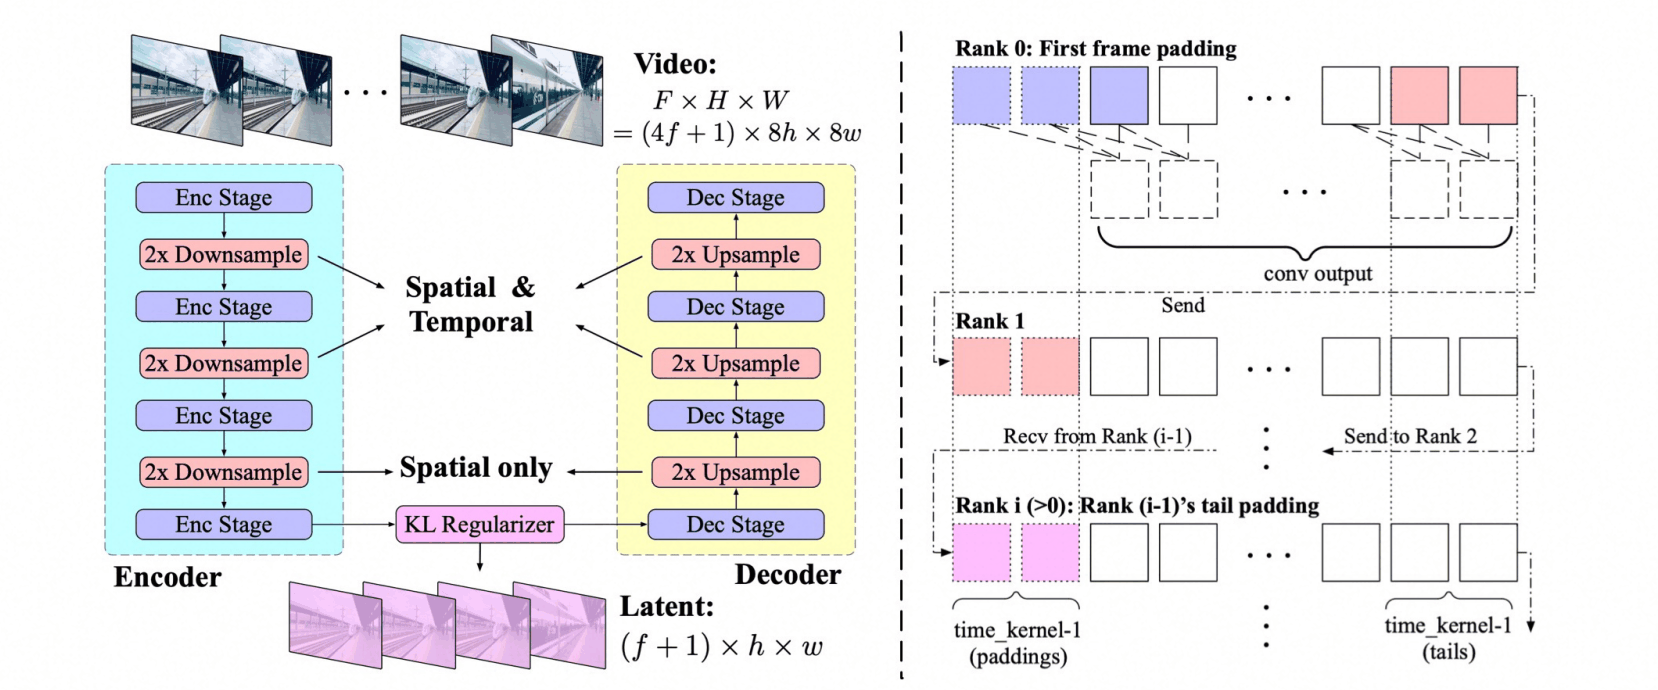
CogVideoX用一个三维因果VAE同时在时间与空间上压缩视频,作为扩散Transformer的连续标记来源:编码器在时间上压缩$4$倍、空间上压缩$8\times8$倍,隐通道数为$16$;卷积在时间维上只向过去填充(因果),因此第一帧单独编码,$49$帧的视频被压缩为$1+48/4=13$个隐帧。训练损失包括像素$L_1$、LPIPS感知损失、KL正则与三维判别器的对抗损失。
为了编码长视频,三维卷积沿时间维做上下文并行:把视频按时间切成若干段分配到不同设备,每段只需从前一段接收因果卷积所需的少量边界帧。相比逐帧的二维VAE,三维压缩显著提高了压缩率并减少了帧间闪烁。
扩散Transformer再把隐视频沿空间做$2\times2$块化得到时空标记,与文本标记拼接后做三维全注意力,并用专家自适应LayerNorm分别调制文本与视频两种模态的标记。配合渐进训练与多分辨率帧打包,CogVideoX可以生成$10$秒、$16$帧每秒、$768\times1360$分辨率、与文本对齐的连贯视频。
⚪ Cosmos分词器:连续与离散的因果视频分词器
Cosmos世界基础模型平台为物理智能构建了一组同时支持图像与视频的分词器,分为连续(CV,用于扩散模型)与离散(DV,用于自回归模型)两类,结构相同、只在瓶颈处不同:
- 小波变换:输入先经两级Haar小波变换,把输入下采样$4$倍,把冗余的像素信息重排到通道维,使后续网络专注于语义压缩;
- 因果编码器:由因果的因子化三维卷积(空间二维卷积与时间一维因果卷积交替)与因子化的因果注意力组成,每一阶段只处理当前与过去的帧,因此第一帧可以独立编码,图像与视频共享同一模型;
- 瓶颈:连续分词器的隐维度为$16$;离散分词器使用FSQ,档位为$(8,8,8,5,5,5)$,词表大小为$8\times8\times8\times5\times5\times5=64000$;
- 解码器:与编码器对称,最后做逆小波变换还原像素。
压缩配置以“时间$\times$高度$\times$宽度”的压缩倍数命名,如CV$4\times8\times8$、CV$8\times8\times8$、CV$8\times16\times16$与DV$4\times8\times8$、DV$8\times8\times8$、DV$8\times16\times16$。
训练分两阶段:先用像素$L_1$与感知损失训练,再加入光流损失(约束重构视频的时间平滑性)与Gram矩阵损失(增强纹理锐度),并在微调中使用对抗损失。与已有分词器相比,Cosmos分词器在相同压缩率下重构质量显著更好(PSNR提升约$4$ dB),运行速度最快提高$12$倍。平台中的扩散世界模型使用连续分词器的隐空间,自回归世界模型使用离散分词器的标记。
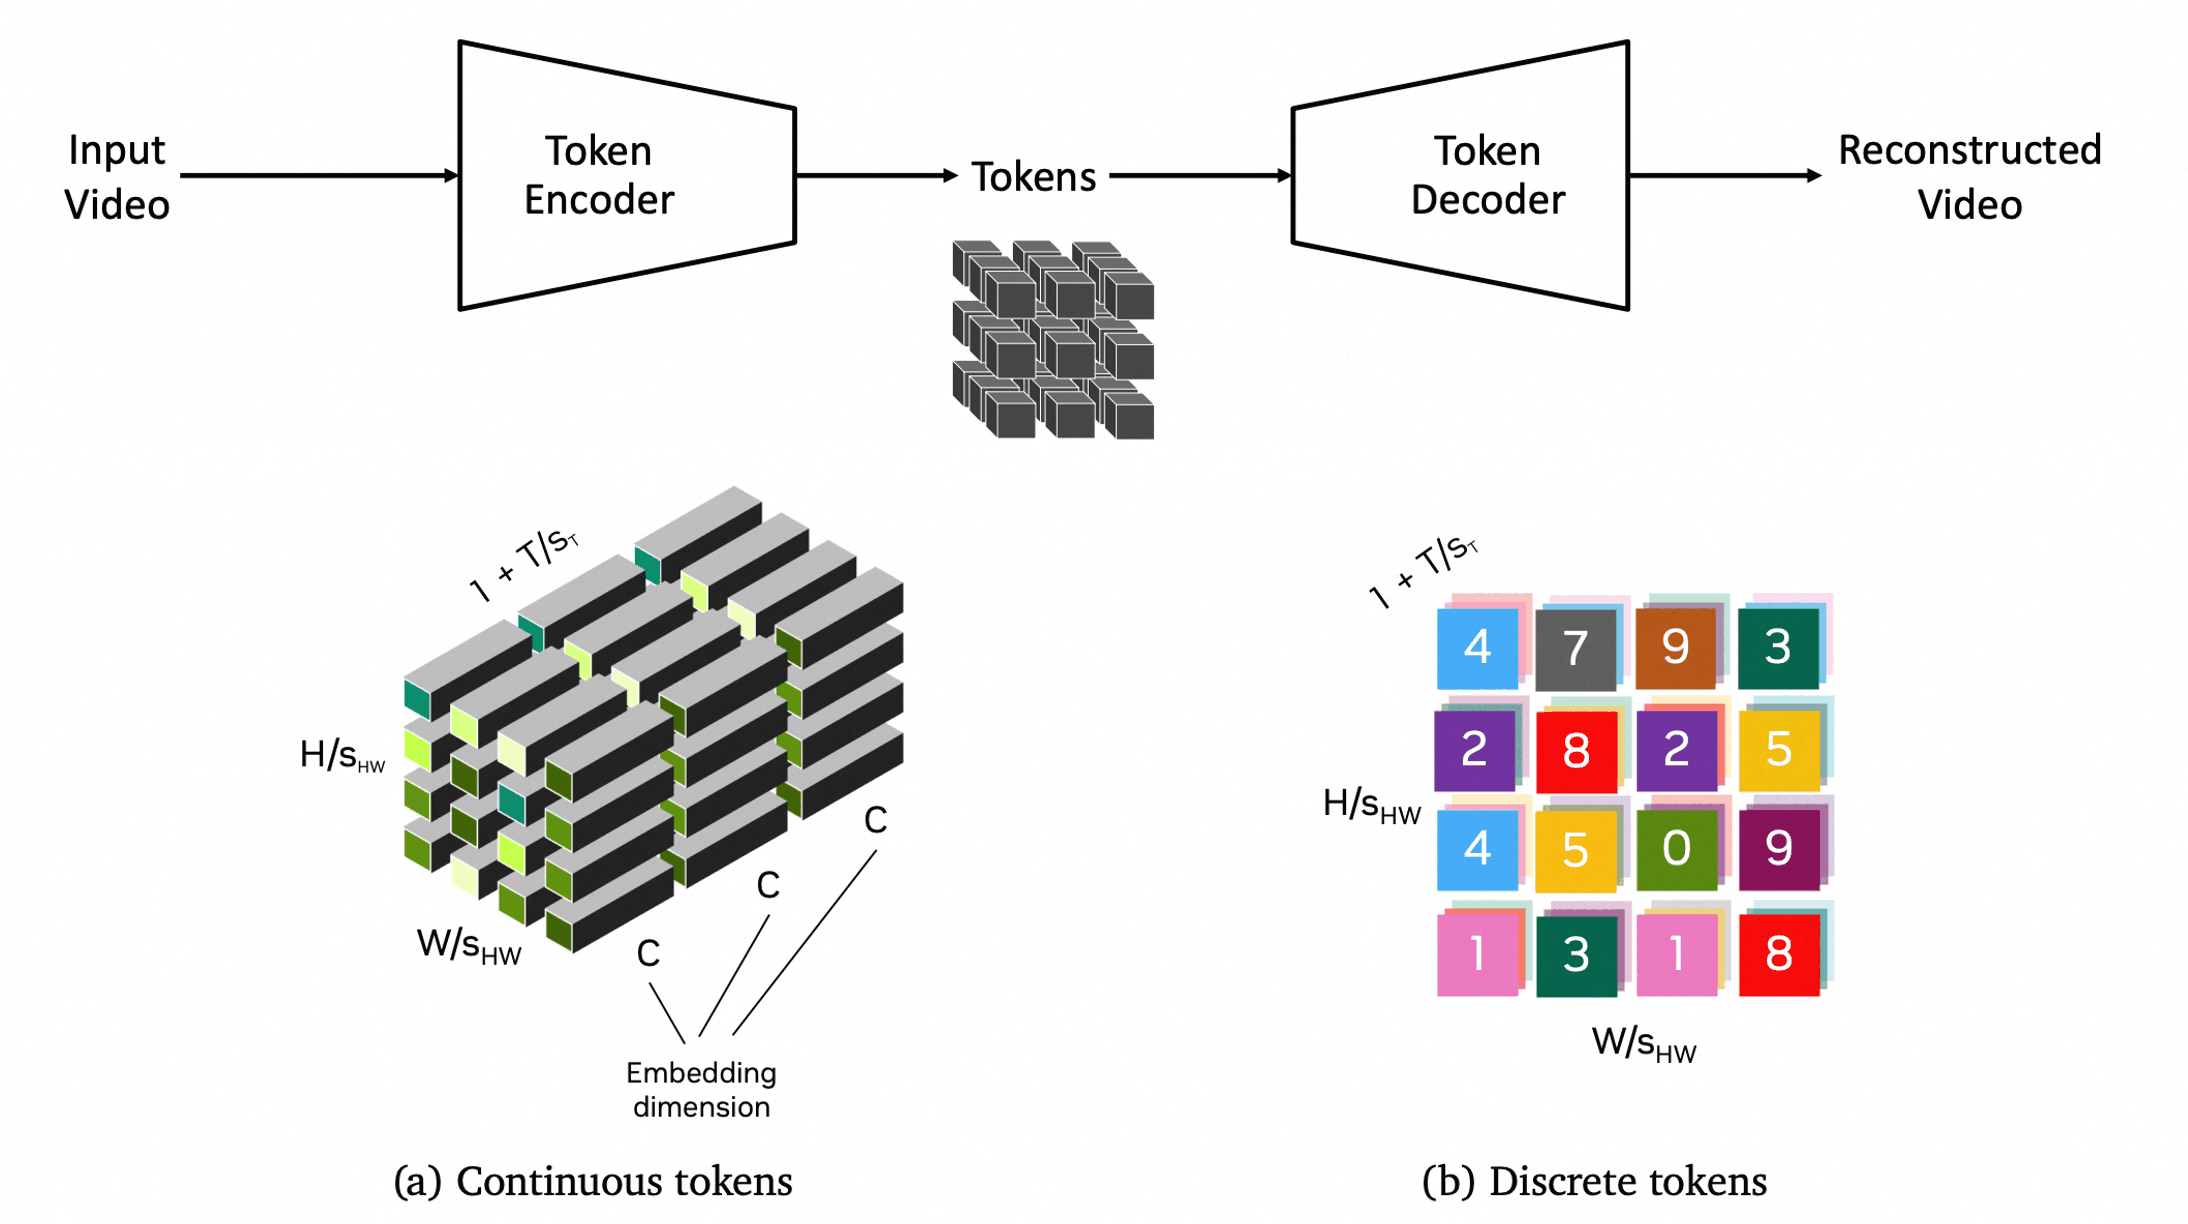
5. 音频的标记化
音频是连续一维信号,其标记化同样从细粒度走向学习式:从对采样值做非线性量化,到神经编解码器的多级码本,再到自监督表示聚类出的“语义”标记,以及把语义与声学信息融合进同一套标记的统一语音分词器。
音频分词器有两类主要用途:声学标记(acoustic token)以高保真重构为目标,服务于压缩与生成的最终波形;语义标记(semantic token)以语言内容为目标,服务于理解与长程结构建模。
(1) 信号级量化
⚪ mu-law量化:对数压扩的波形标量量化
对原始波形最直接的离散化是标量量化。语音信号的能量集中在中低幅度,线性量化把比特平均花在很少出现的大幅度上;mu-law压扩(源自电话通信)先用非线性函数压缩动态范围,再均匀量化:
\[f(x)=\text{sign}(x)\frac{\ln\left(1+\mu|x|\right)}{\ln(1+\mu)},\quad \mu=255,\ x\in[-1,1]\]$f$把$[-1,1]$单调映射到$[-1,1]$,小幅度被放大、大幅度被压缩,等价于对响度做对数感知:其在原点处的斜率为$f’(0)=\frac{\mu}{\ln(1+\mu)}\approx46$,即小信号的量化间隔约为线性量化的$1/46$,而在$|x|\to1$处斜率约为$\frac{\mu}{(1+\mu)\ln(1+\mu)}\approx0.18$。这样不同幅度信号的相对量化误差大致恒定,在同样的比特数下获得更好的感知质量。量化与反量化为
\[\begin{aligned} &q=\left\lfloor\frac{f(x)+1}{2}\cdot\mu+\frac{1}{2}\right\rfloor\in\{0,\dots,255\}\\ &x=\text{sign}(y)\frac{(1+\mu)^{|y|}-1}{\mu}\\& y=\frac{2q}{\mu}-1 \end{aligned}\]WaveNet对$16$kHz采样先做mu-law压扩再量化为$8$位($256$档),在这个$256$词表上用PixelCNN式的扩张因果卷积做逐采样点自回归建模,输出层是$256$类的softmax;论文发现即使数据本身是连续的,这种类别分布也比混合密度模型更灵活、效果更好。语音波形合成的后续工作长期沿用这一离散化。
(2) 神经音频编解码器
⚪ Jukebox:多尺度VQ-VAE的音乐标记
Jukebox把VQ-VAE用于$44.1$kHz的原始音乐波形。由于音乐的时间跨度极长(一首歌有上千万个采样点),它训练了三个独立的VQ-VAE,跳步长度(hop length)分别为$8$、$32$与$128$,即把波形分别压缩$8$倍、$32$倍与$128$倍,每级码本大小为$2048$;最顶层每秒约$344$个标记,保留旋律与结构,底层保留音色细节。三个自编码器彼此独立训练,以免顶层把信息全部交给底层。训练损失为
\[\mathcal{L}=\mathcal{L}_{\text{recons}}+\mathcal{L}_{\text{codebook}}+\beta\mathcal{L}_{\text{commit}}+\mathcal{L}_{\text{spec}}\]前三项同VQ-VAE,其中码本项通过EMA实现;频谱损失$\mathcal{L}_{\text{spec}}=|| |\text{STFT}(x)|-|\text{STFT}(\hat{x})| ||_2$(在多个STFT分辨率上求和)用于补偿波形$L_2$损失对高频的忽视。为了避免码本坍缩,Jukebox使用随机重启:当某个码字的平均使用率低于阈值时,把它重置为当前批次中随机的一个编码器输出。
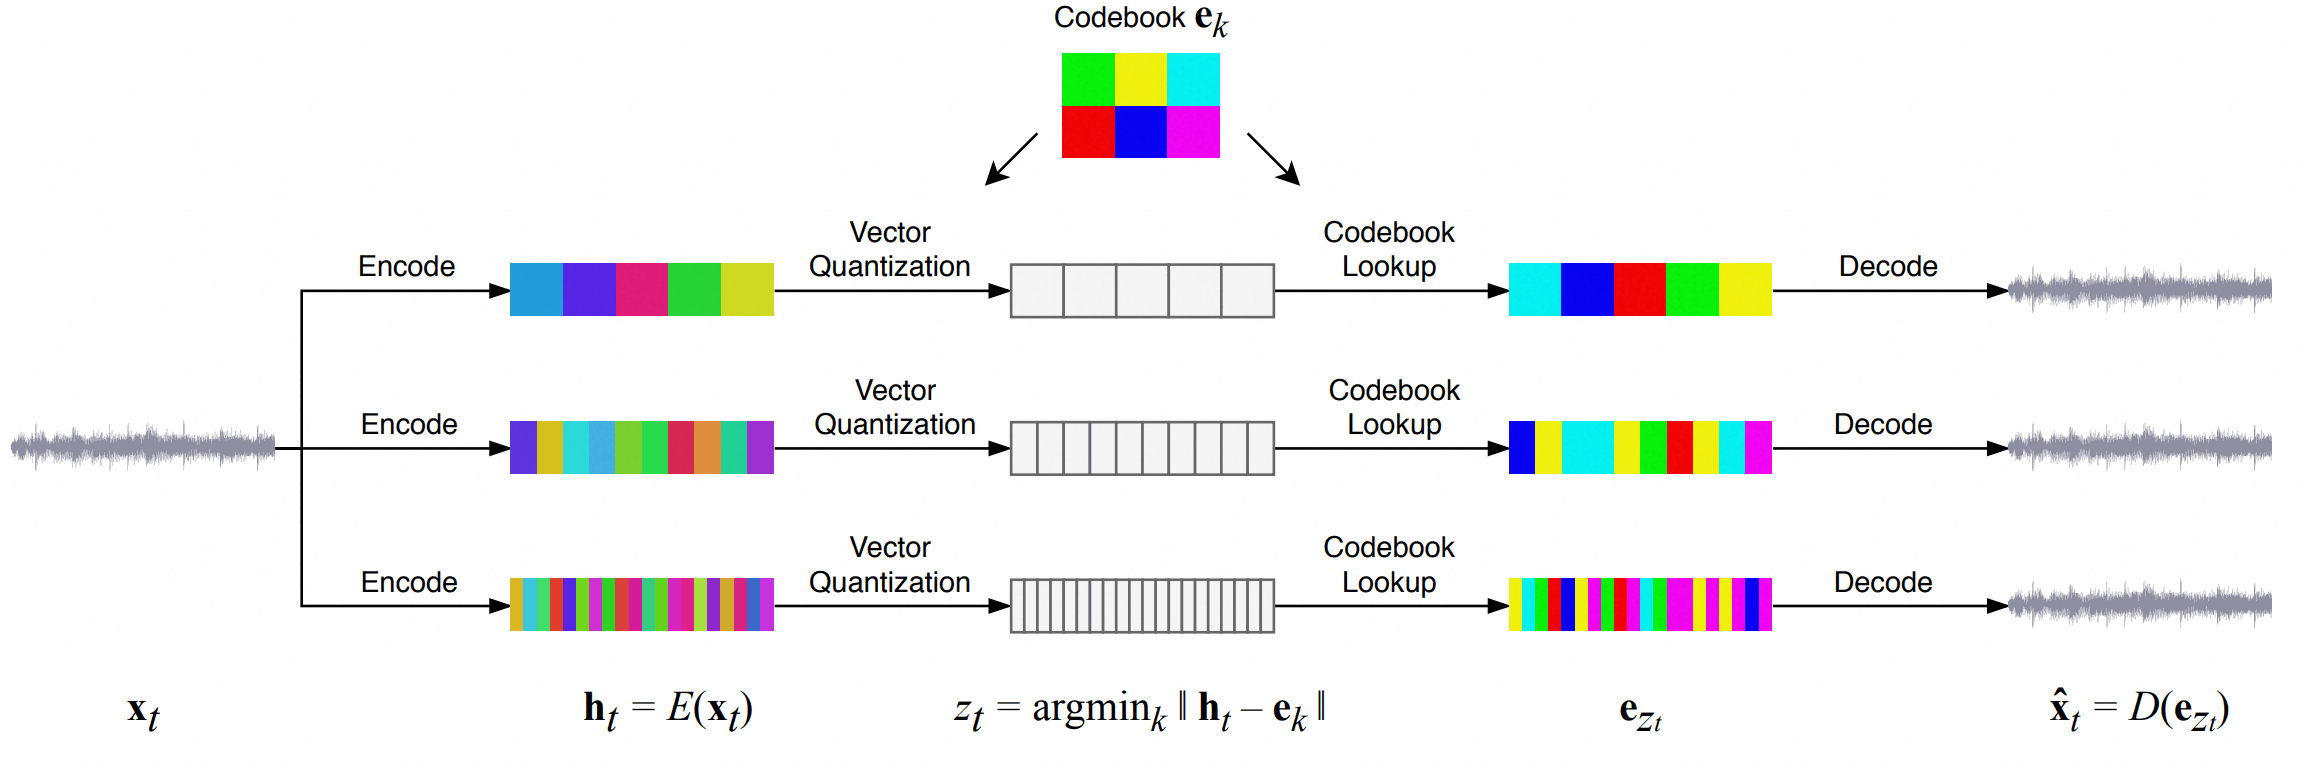
⚪ SoundStream:残差向量量化RVQ的神经编解码器
SoundStream是一个端到端训练的神经编解码器:全卷积编码器把$24$kHz波形压成低帧率的连续隐表示,经量化后再由对称的卷积解码器还原波形。编码器由若干带步长的卷积块组成,步长为$(2,4,5,8)$,总下采样$2\times4\times5\times8=320$倍,即每秒$24000/320=75$帧。量化的关键是残差向量量化(Residual Vector Quantization, RVQ)——把向量量化串成$N_q$级,逐级量化残差:
\[r_0=z_e,\quad q_j=Q_j\left(r_{j-1}\right)\\ r_j=r_{j-1}-q_j,\quad \hat{z}\approx\sum_{j=1}^{N_q} q_j\]每级是一个小码本(如$1024$个码字,即$10$比特);级数越多失真越小、码率越高:$75$Hz帧率下$N_q$级对应$750N_q$ bit/s,例如$N_q=8$对应$6$kbps。如果用单级VQ达到同样的$80$比特每帧,码本需要$2^{80}$个码字,RVQ把它分解为$8$个$2^{10}$的码本之和。训练时随机丢弃后面的量化级(quantizer dropout):对每个样本均匀采样$n_q\in{1,\dots,N_q}$,只使用前$n_q$级,使同一模型能在推理时按需增减级数、在$3\sim18$kbps间切换码率。码本用第一个批次的$k$均值初始化,以EMA更新,并把连续多个批次未被使用的码字替换为随机的编码器输出。
训练损失由三部分组成:基于多分辨率波形判别器与STFT判别器的对抗损失、判别器中间特征上的特征匹配损失,以及多尺度频谱重构损失
\[\begin{aligned} \mathcal{L}_{\text{rec}}=\sum_{s\in\{2^6,\dots,2^{11}\}}&\sum_{t}\left\|S^{s}_t(x)-S^{s}_t(\hat{x})\right\|_1\\&+\alpha_s\sum_{t}\left\|\log S^{s}_t(x)-\log S^{s}_t(\hat{x})\right\|_2 \end{aligned}\]其中$S^{s}_t$为窗长$s$的梅尔谱第$t$帧,$\alpha_s=\sqrt{s/2}$。SoundStream还通过FiLM条件层把降噪与压缩合并在同一模型中,并能在智能手机CPU上实时流式运行。主观评测中,$3$kbps的SoundStream优于$12$kbps的Opus,接近$9.6$kbps的EVS。RVQ给出的多级码索引序列(每帧$N_q$个标记)成为语音生成模型的通用“声学标记”。
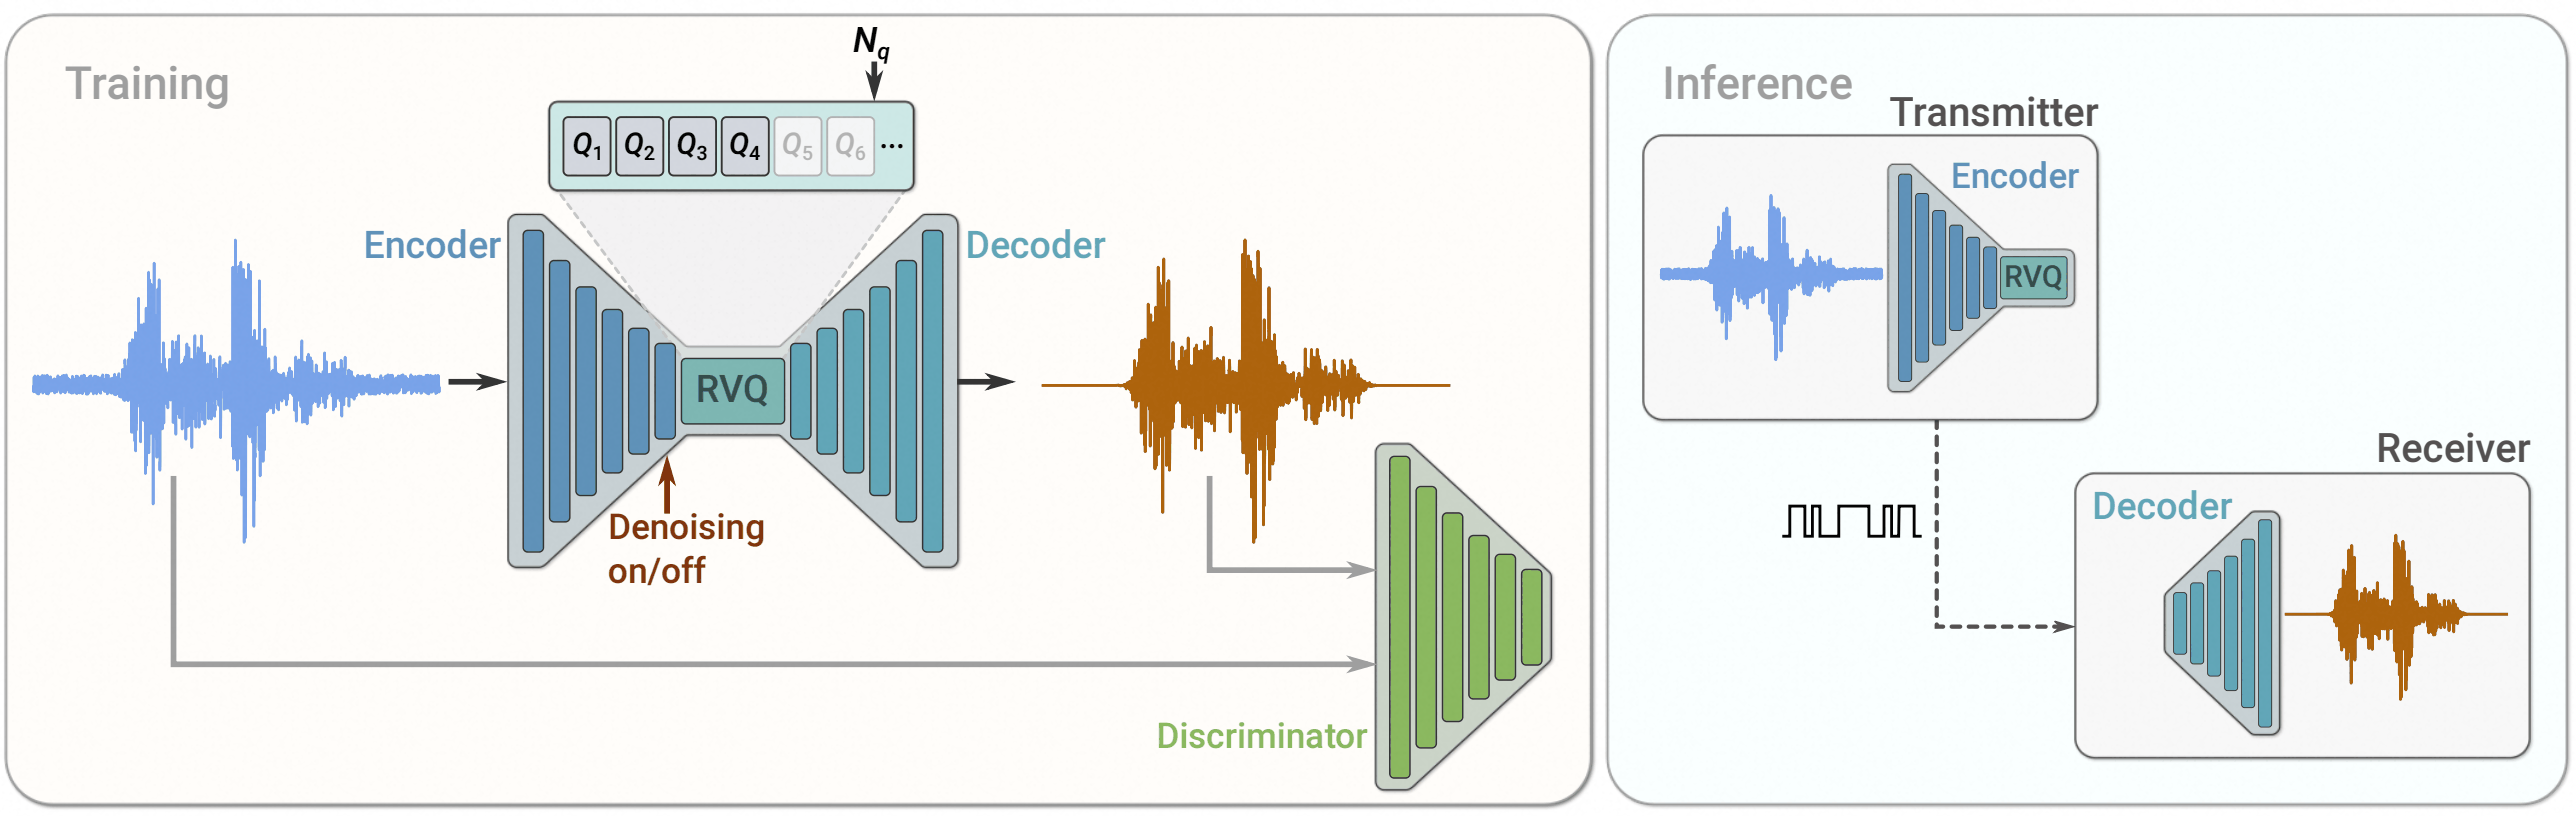
⚪ EnCodec:损失平衡与熵编码的流式编解码器
EnCodec沿SoundStream的编解码器$+$RVQ路线并强化训练目标。结构上,编码器为SEANet式卷积网络(步长同为$(2,4,5,8)$,$24$kHz下$75$Hz帧率)后接两层LSTM,支持因果流式的变体;RVQ码本大小为$1024$,用$2$、$4$、$8$、$16$、$32$个码本分别对应$1.5$、$3$、$6$、$12$、$24$kbps的码率;另有支持$48$kHz立体声音乐的模型。
损失由时域$L_1$重构、多个窗长上的梅尔谱$L_1+L_2$重构、多尺度STFT判别器(MS-STFTD)的对抗与特征匹配损失以及承诺损失组成。为避免手工调权,EnCodec提出损失平衡器(balancer):对各损失$\ell_i$只考虑其对解码器输出$\hat{x}$的梯度$g_i=\partial\ell_i/\partial\hat{x}$,按
\[\tilde{g}_i=R\,\frac{\lambda_i}{\sum_j\lambda_j}\cdot\frac{g_i}{\left\langle\|g_i\|_2\right\rangle_{\beta}}\]重新缩放后求和回传,其中$\langle\cdot\rangle_\beta$为梯度范数的指数滑动平均,$R$为参考范数。这样权重$\lambda_i$直接等于该损失在总梯度中所占的比例,与损失本身的数值尺度无关。量化码流还可以再经一个小型Transformer语言模型做算术编码的无损压缩,进一步降低$25\%\sim40\%$的码率。
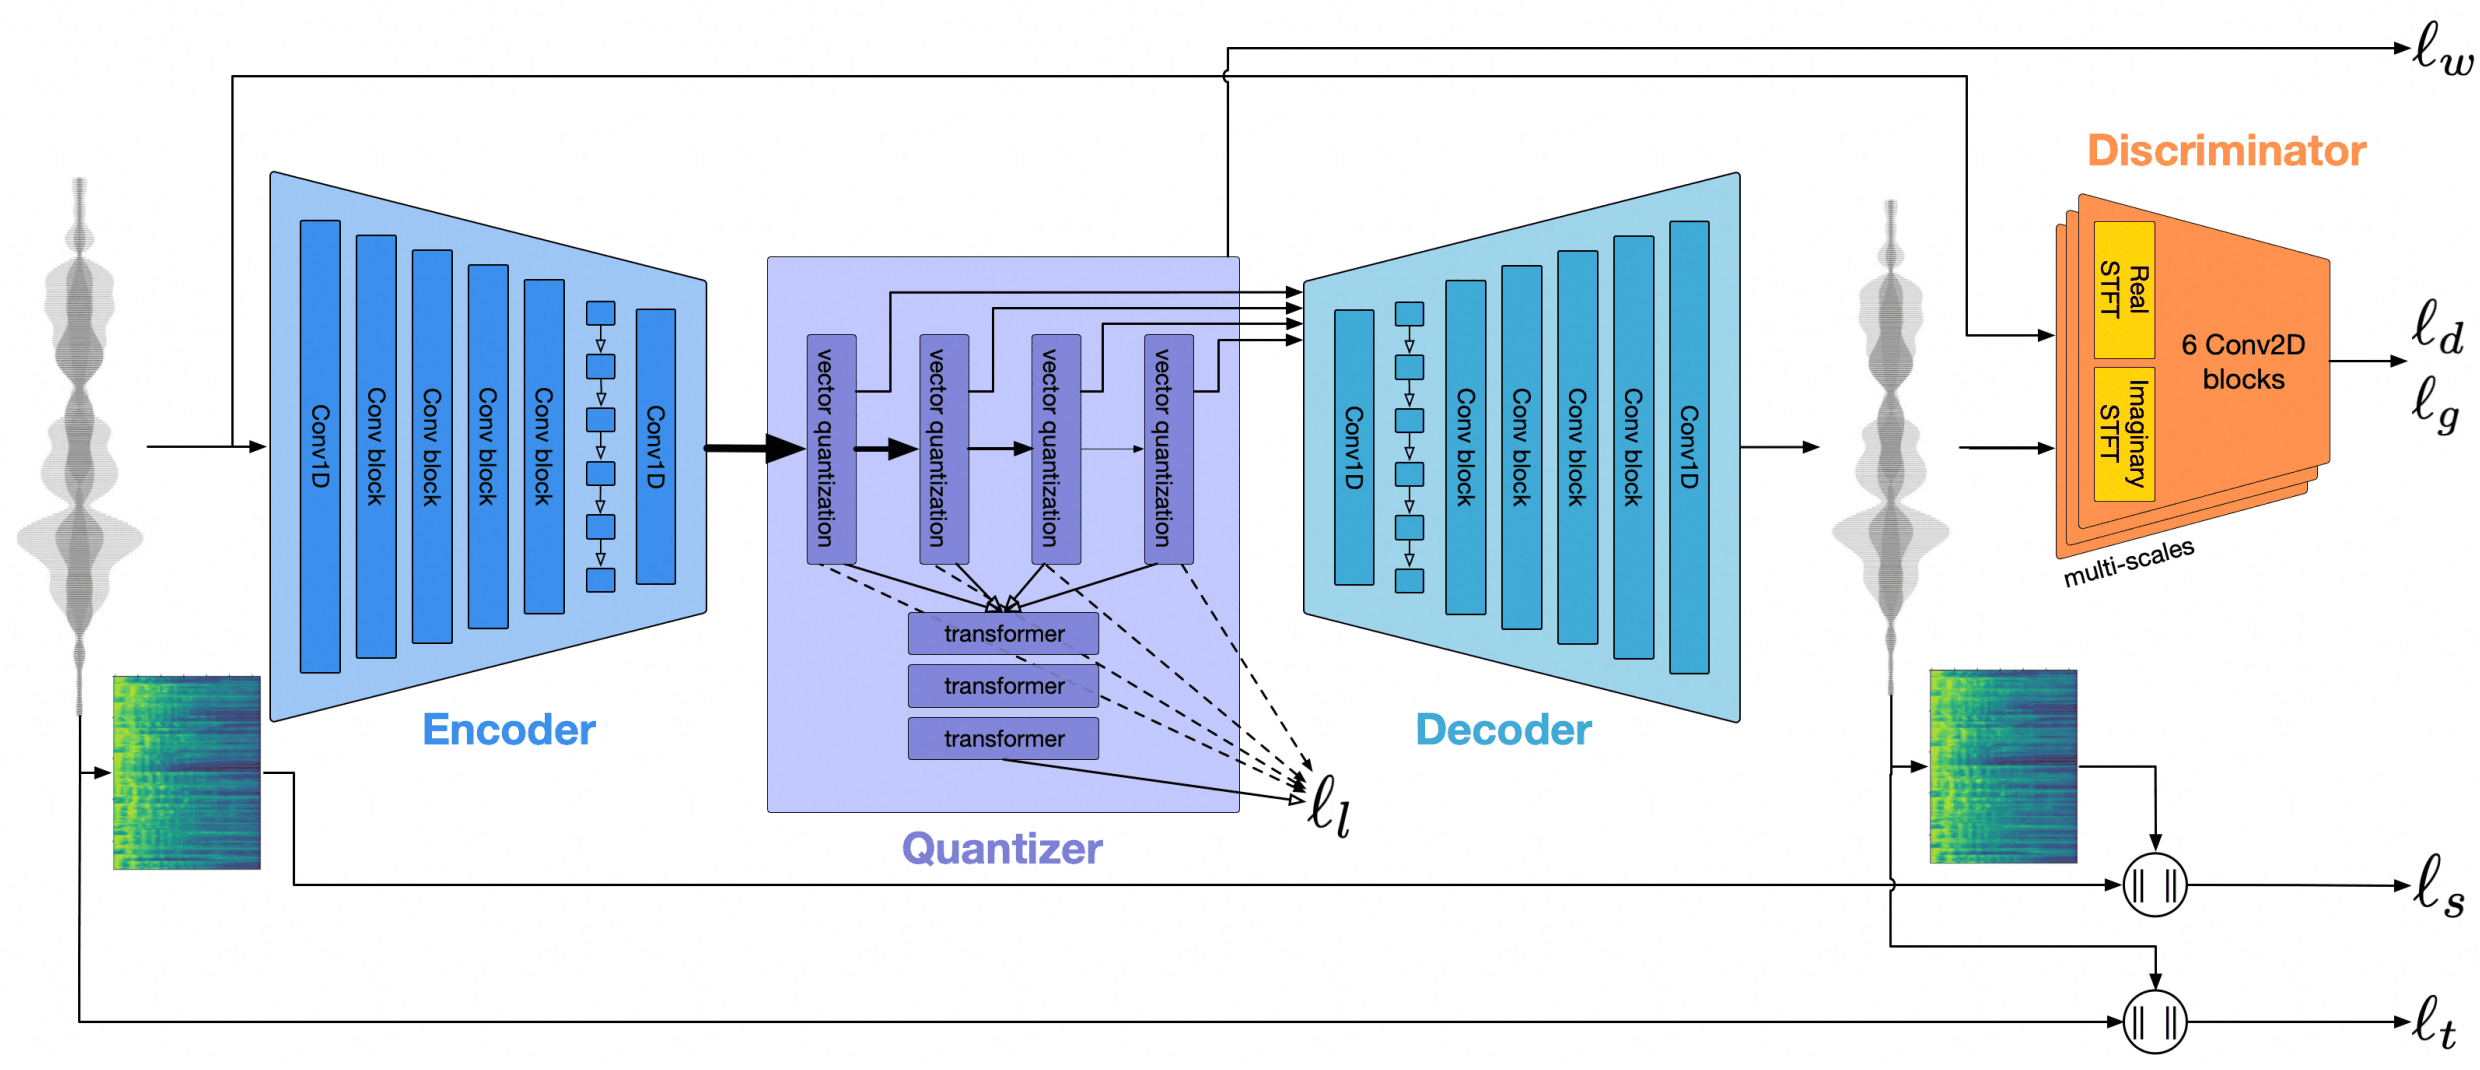
⚪ DAC:改进的RVQGAN
DAC(Descript Audio Codec)把$44.1$kHz音频以仅$8$kbps的码率压缩约$90$倍($44.1$kHz、$16$位单声道原始码率约$705.6$kbps),用同一个通用模型处理语音、环境声与音乐等全部领域。它在SoundStream/EnCodec式的RVQGAN基础上做了几项关键改进:
- 周期激活:用Snake激活函数$\text{snake}(x)=x+\frac{1}{\alpha}\sin^2(\alpha x)$($\alpha$为可学习的逐通道参数)替代Leaky ReLU,为波形的周期结构提供归纳偏置;
- 借鉴图像的码本技术:采用ViT-VQGAN的因子化码(把编码投影到$8$维的低维空间做最近邻查找)与L2归一化码,使码本利用率接近$100\%$;
- 量化器丢弃的改进:只以$0.5$的概率对样本施加量化器丢弃,其余样本使用全部码本,从而兼顾可变码率与满码率下的重构质量;
- 判别器与损失:使用多周期判别器(MPD)与在复数STFT上按子频带划分的多频带多尺度STFT判别器,配合多尺度梅尔谱损失(窗长从$32$到$2048$)与特征匹配损失。
$44.1$kHz模型的总下采样为$512$倍,帧率约$86$Hz,使用$9$个大小为$1024$的码本,码率约$86\times9\times10\approx7.7$kbps。在相同码率下,DAC显著优于EnCodec等已有编解码器。
⚪ WavTokenizer:单码本的极致压缩
多级RVQ让每帧产生多个标记,下游语言模型需要额外处理码本之间的依赖。WavTokenizer追求极致压缩:在量化器层数与时间维两方面同时压缩,$24$kHz采样率的一秒音频只用单个量化器的$40$或$75$个标记表示。码本大小为$4096$($12$比特),因此码率分别约为$40\times12=480$ bit/s与$75\times12=900$ bit/s。它通过以下设计弥补单码本的容量:
- 更大的VQ空间:使用更大的码本,并配合$k$均值初始化与随机唤醒(重置长期未使用的码字)保证利用率;
- 更长的上下文窗口与改进的注意力网络:在解码器中加入注意力模块,提升对长程依赖与语义信息的建模;
- 傅里叶域解码:解码器不再用转置卷积逐级上采样,而是Vocos式地预测短时傅里叶变换的幅度与相位,再经逆STFT得到波形;
- 强判别器:多尺度判别器与复数STFT判别器。
尽管标记数大幅减少,WavTokenizer在语音、一般音频与音乐上都取得了当时最好的重构质量(主观质量指标UTMOS表现突出),其标记也包含更丰富的语义信息,便于下游音频语言模型建模。
(3) 自监督语义标记
⚪ vq-wav2vec:可量化的自监督语音表示
vq-wav2vec在wav2vec式的自监督上下文预测任务中学习离散的语音表示,使NLP中依赖离散输入的算法(如BERT)可以直接用于语音。模型由三部分组成:卷积编码器$f$把波形映射为稠密表示$z$(约$10$ms一帧),量化器$q$把$z$离散化为$\hat{z}$,上下文网络$g$在$\hat{z}$上汇聚得到$c$;训练目标是用$c_i$区分$k$步之后的真实$\hat{z}_{i+k}$与随机采样的负样本($k=1,\dots,K$):
\[\mathcal{L}_k=-\sum_{i}\left(\log\sigma\left(\hat{z}_{i+k}^{\top}h_k(c_i)\right)+\lambda\,\mathbb{E}_{\tilde{z}\sim p_n}\left[\log\sigma\left(-\tilde{z}^{\top}h_k(c_i)\right)\right]\right)\]其中$h_k$为第$k$步的仿射变换,$\sigma$为sigmoid,$p_n$为负样本分布,$\lambda$为负样本数。量化器有两种选择:
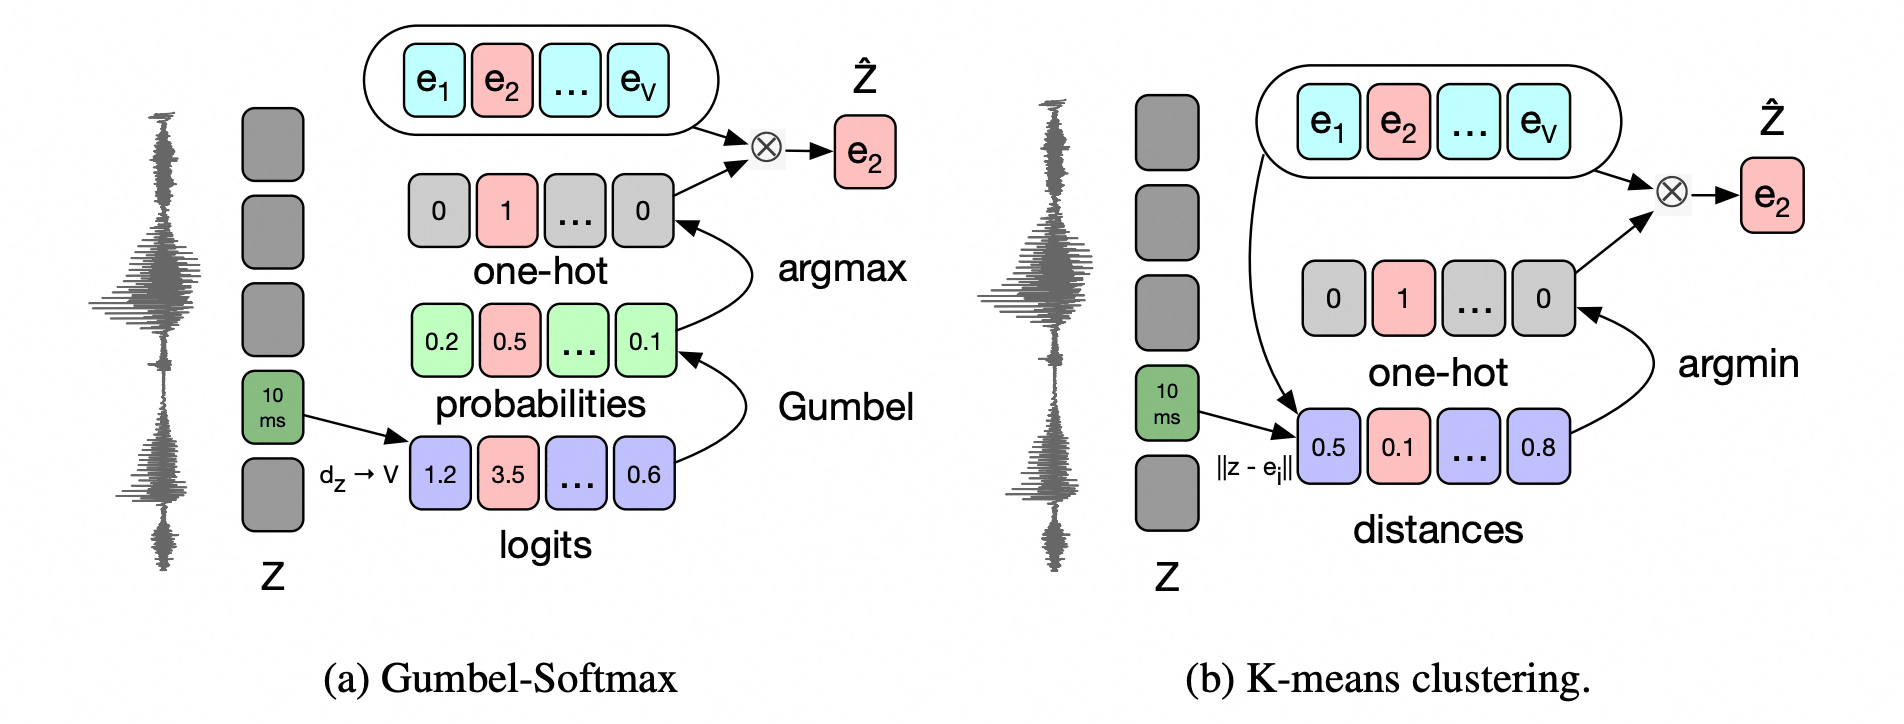
- Gumbel-Softmax:线性层输出$V$个码字的logits,前向取argmax,反向用温度$\tau$的Gumbel-Softmax梯度(直通Gumbel估计),$\tau$在训练中从$2$退火到$0.5$;
- 在线$k$均值:选取欧氏距离最近的码字,损失中加入$||\text{sg}[z]-\hat{z}||^2+\gamma||z-\text{sg}[\hat{z}]||^2$($\gamma=0.25$),与VQ-VAE的码本与承诺损失相同。
为了避免模式坍缩,$z$被分为$G=2$组,每组独立量化(各$V=320$个码字),理论上可表示$320^2=102400$种组合,实际被使用的约$1.35$万种。量化后的离散序列作为“语音单词”送入BERT做掩码预训练,BERT特征再用于声学模型,在TIMIT音素分类与WSJ语音识别上取得当时最好的结果。
⚪ wav2vec 2.0:对比学习中的乘积量化器
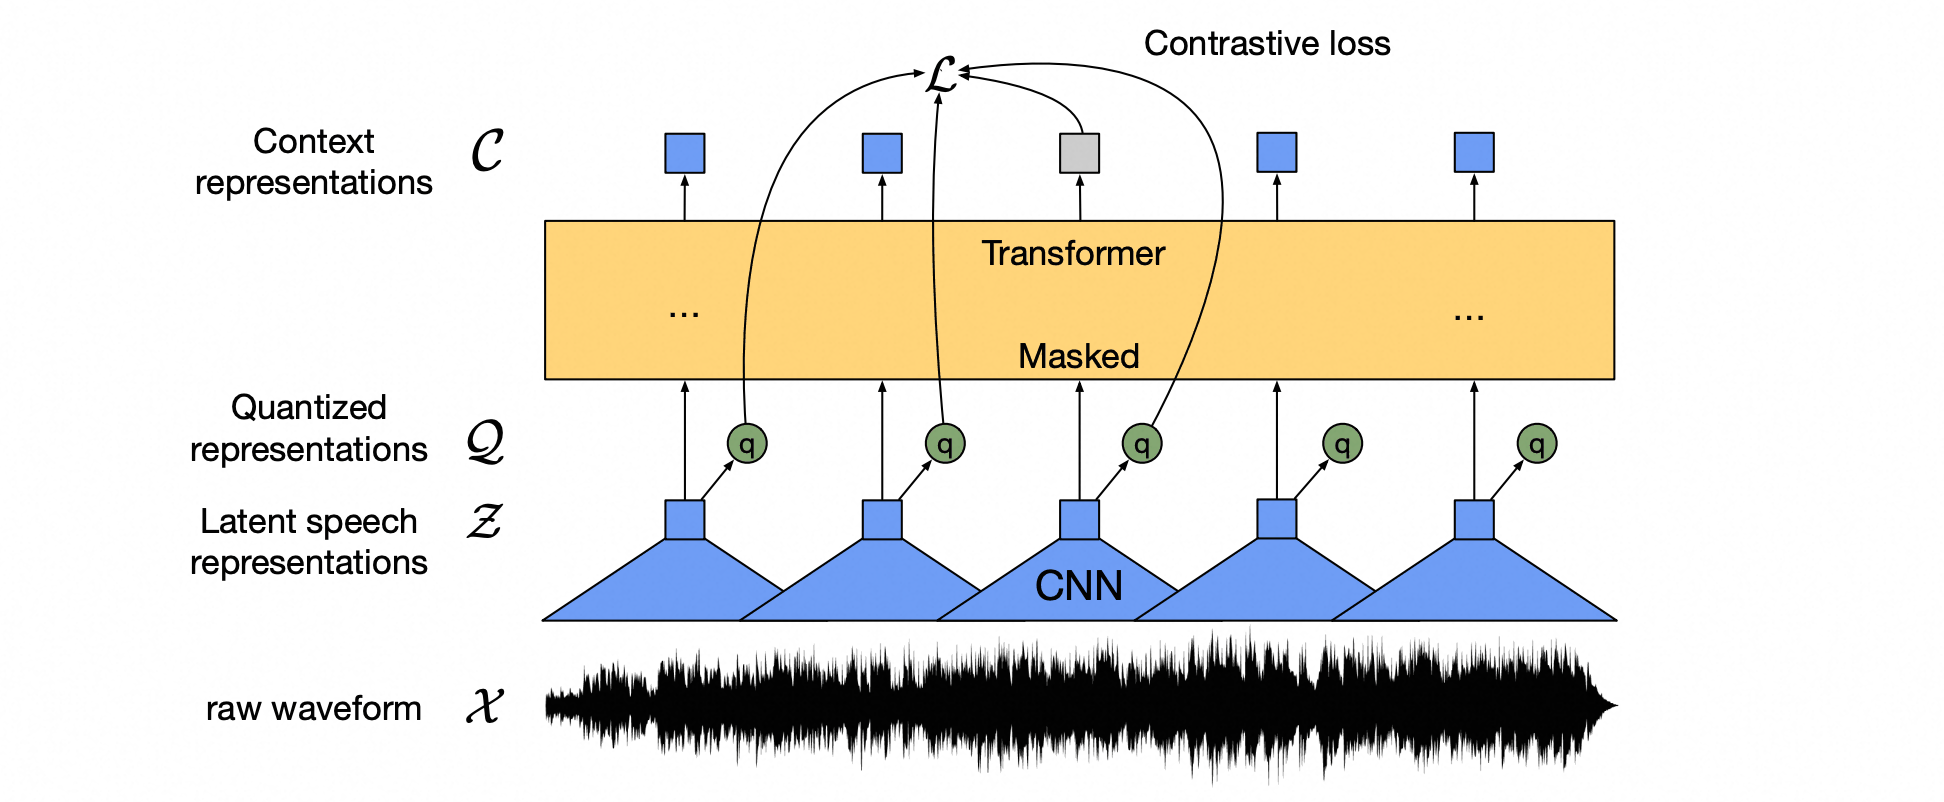
wav2vec 2.0把量化与上下文表示的学习合并为一个端到端的模型。卷积特征编码器由$7$层卷积组成(步长$(5,2,2,2,2,2,2)$,总步长$320$),在$16$kHz音频上每$20$ms输出一帧隐表示$z_t$(感受野$25$ms);随机以$p=0.065$的比例选取起点并掩码其后$M=10$帧(约$49\%$的帧被掩码),送入Transformer得到上下文表示$c_t$。
量化模块采用乘积量化(product quantization):有$G=2$个码本,每个含$V=320$个码字;对每个码本用Gumbel-Softmax(直通估计)选出一个码字,把$G$个码字拼接后经线性变换得到量化表示$q_t$,可表示的离散单元共$V^G=102400$种。训练目标为
\[\mathcal{L}=\mathcal{L}_m+\alpha\mathcal{L}_d,\quad \mathcal{L}_m=-\log\frac{\exp\left(\text{sim}(c_t,q_t)/\kappa\right)}{\sum_{\tilde{q}\in Q_t}\exp\left(\text{sim}(c_t,\tilde{q})/\kappa\right)}\]其中$\mathcal{L}_m$为对比损失:对被掩码的时刻$t$,要求$c_t$在候选集合$Q_t$(真实的$q_t$与从同一语音其他被掩码时刻采样的$K=100$个干扰项)中识别出$q_t$,$\text{sim}$为余弦相似度,温度$\kappa=0.1$。$\mathcal{L}_d$为多样性损失,鼓励每个码本的码字被均匀使用:
\[\mathcal{L}_d=\frac{1}{GV}\sum_{g=1}^{G}-H(\bar{p}_g)=\frac{1}{GV}\sum_{g=1}^{G}\sum_{v=1}^{V}\bar{p}_{g,v}\log\bar{p}_{g,v}\]$\bar{p}_g$为一个批次内第$g$个码本上的平均softmax分布(不含Gumbel噪声),$\alpha=0.1$。量化单元只作为对比学习的目标,下游微调使用连续的$c_t$;但它学到的离散单元与音素高度相关,后续工作也直接把它们作为离散语音标记使用。
⚪ 自监督语音表示的聚类标记:HuBERT units
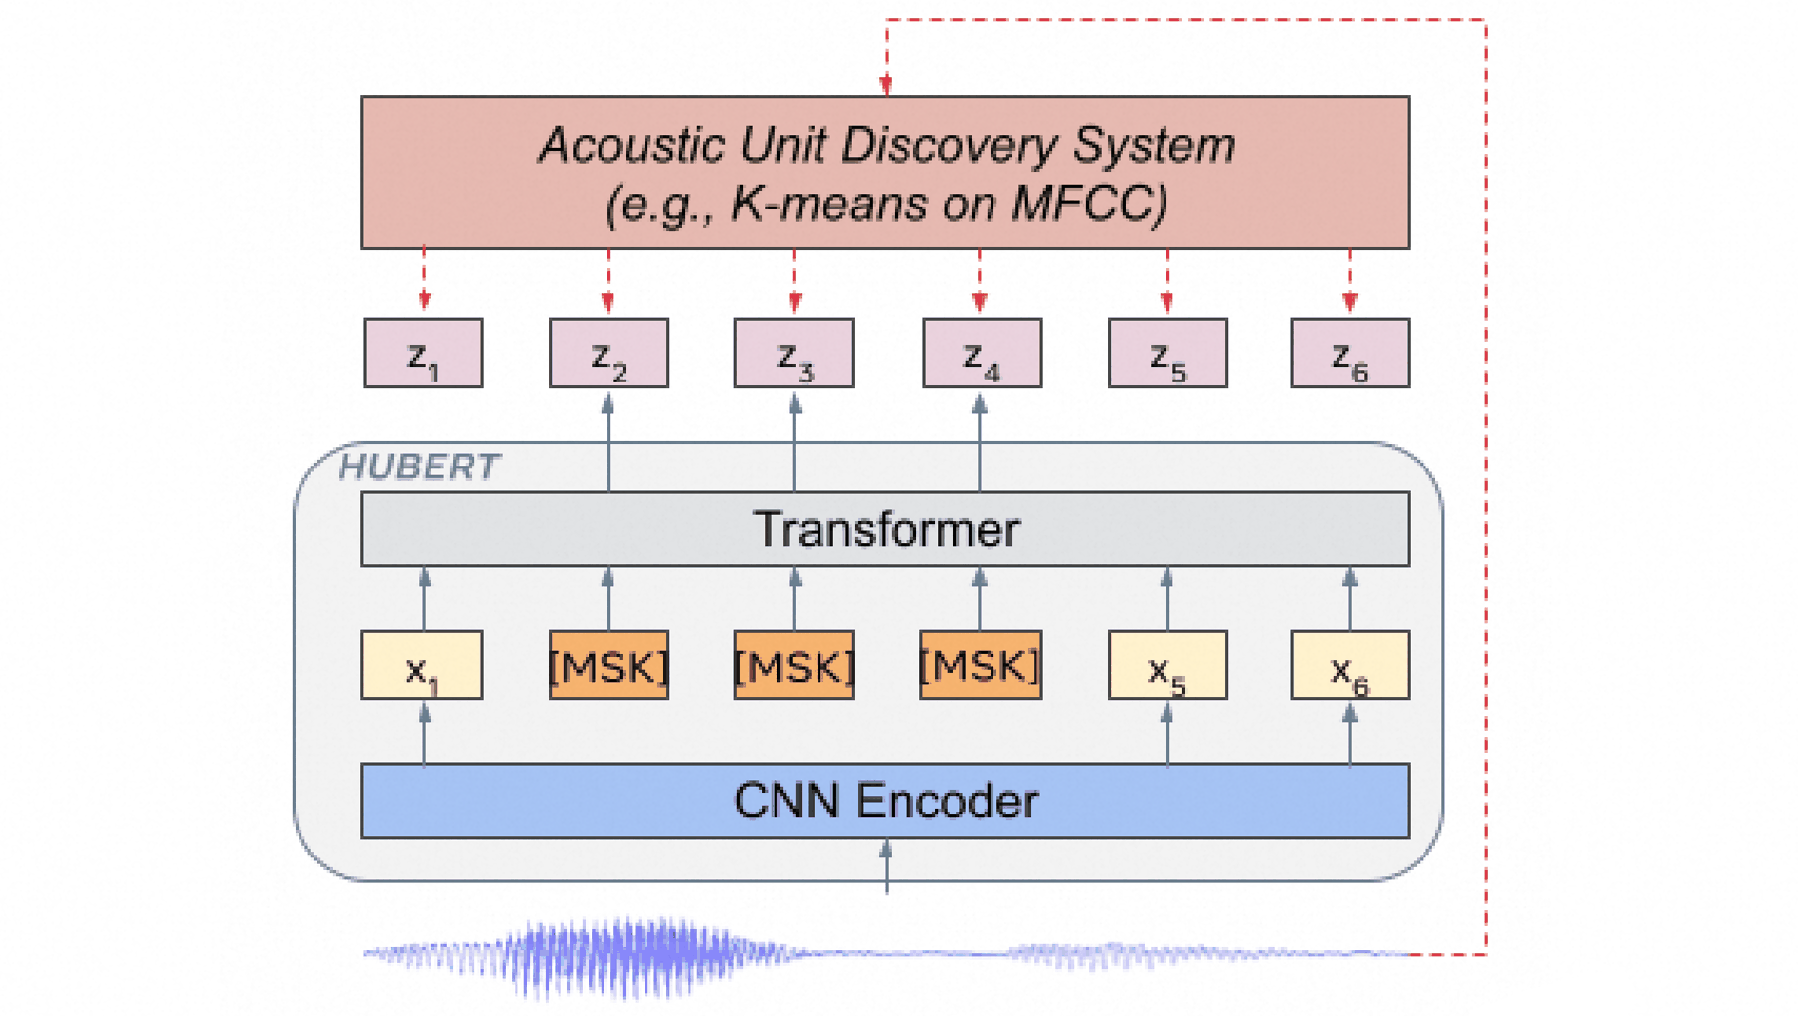
编解码器标记保留声学细节但不含高层语义;另一族标记从自监督表示中提取。HuBERT的预训练目标就是对“聚类标记”做掩码预测:先对语音特征做$k$均值聚类(第一轮对MFCC聚类,后续轮对上一轮模型的中间层隐状态聚类),把每帧的聚类编号作为伪标签$z_t$;再训练一个Transformer预测被掩码位置的标签。模型的卷积编码器与wav2vec 2.0相同($20$ms一帧),掩码策略为以$8\%$的比例选取起点、每段掩码$10$帧。对被掩码的帧$t$,预测分布为
\[p\left(c\mid\tilde{X},t\right)=\frac{\exp\left(\text{sim}(Ao_t,e_c)/\tau\right)}{\sum_{c'=1}^{C}\exp\left(\text{sim}(Ao_t,e_{c'})/\tau\right)}\]其中$o_t$为Transformer输出,$A$为投影矩阵,$e_c$为第$c$个聚类的嵌入,$\text{sim}$为余弦相似度,$\tau=0.1$,$C$为聚类数。损失为$\mathcal{L}=\alpha\mathcal{L}_m+(1-\alpha)\mathcal{L}_u$,$\mathcal{L}_m$与$\mathcal{L}_u$分别为掩码与未掩码位置的交叉熵,$\alpha=1$(只在掩码位置计算损失)效果最好——这迫使模型利用上下文推断被遮内容,而不仅是对局部声学做聚类映射。
HuBERT的关键在于迭代精炼标签:第一轮在$39$维MFCC上聚成$100$类,第二轮在第一轮BASE模型第$6$层的特征上聚成$500$类;LARGE与X-LARGE模型使用第二轮BASE模型第$9$层特征的聚类。即使初始的MFCC聚类质量不高,掩码预测也能学到更好的表示,下一轮的聚类质量随之提升。在LibriSpeech与Libri-Light的各种微调数据量设置下,HuBERT与wav2vec 2.0持平或更优。
聚类标签(簇数数百量级)构成一种离散的语义标记(units):它们丢弃说话人音色等声学细节,保留音素与内容信息,因此可以直接作为语音生成的中间表示——先建模语义标记、再在语义条件下生成声学标记。
⚪ w2v-BERT:对比学习与掩码语言建模的结合
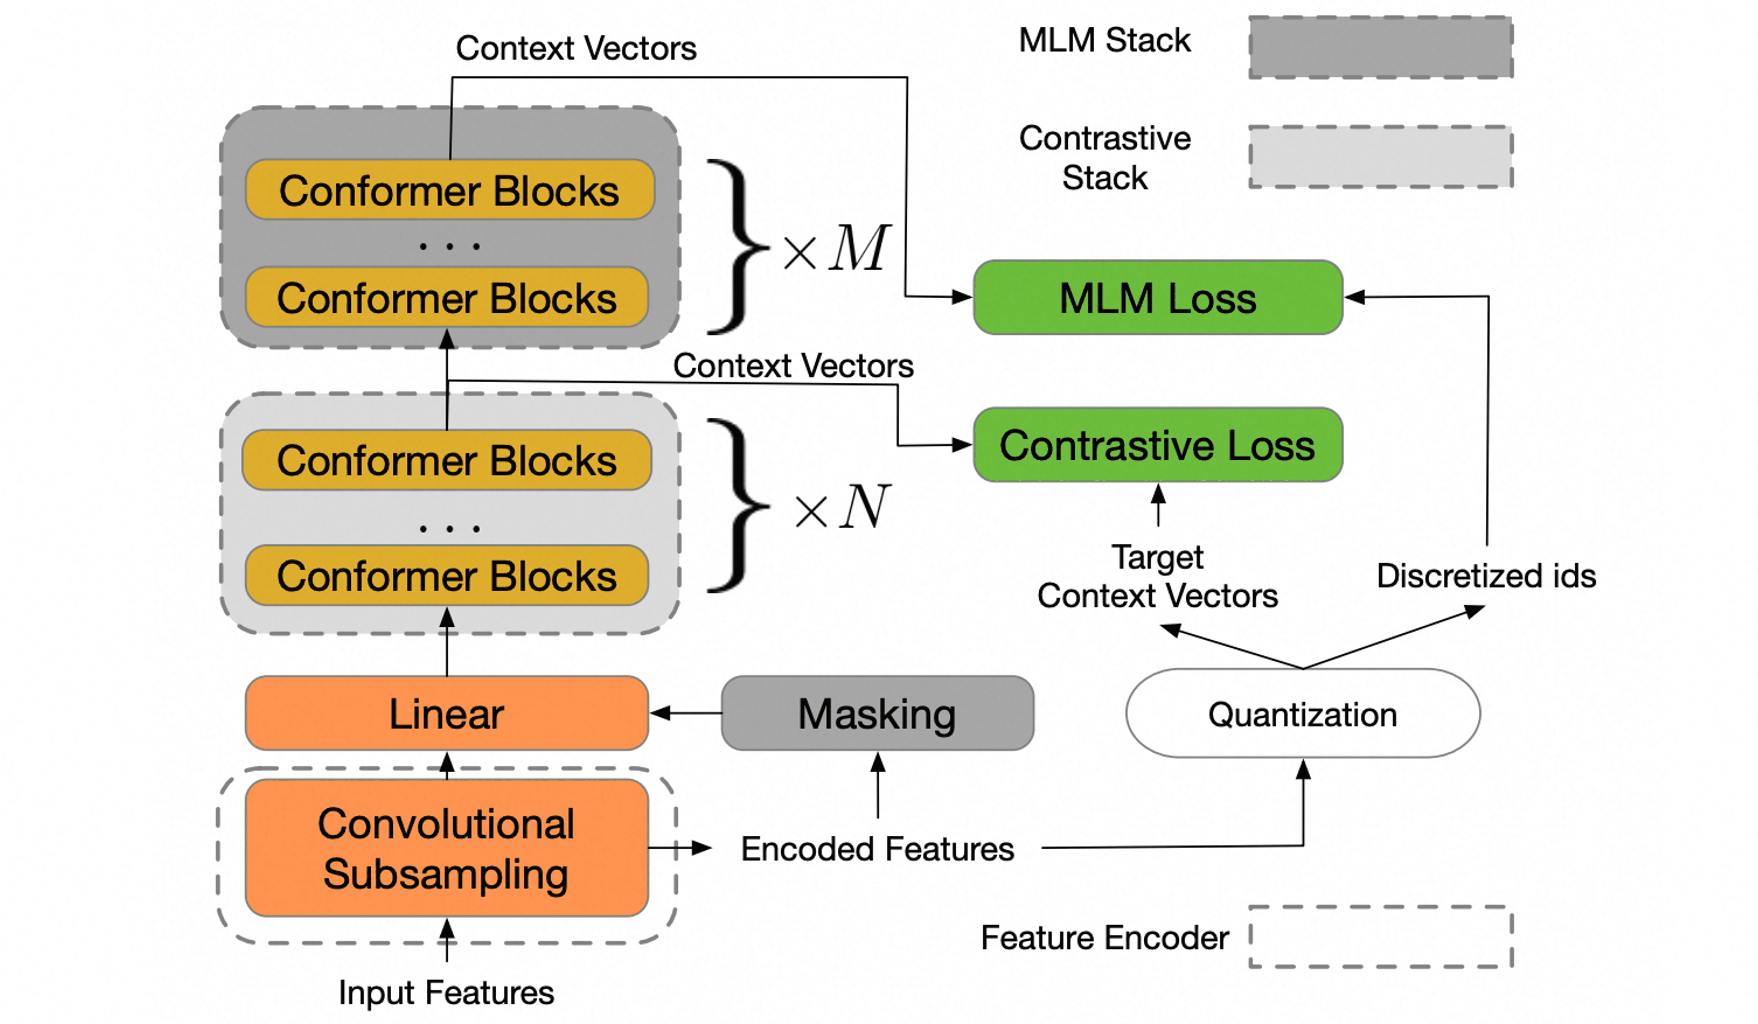
HuBERT需要“聚类—重新训练”的迭代,vq-wav2vec则把量化与BERT分两阶段训练。w2v-BERT把两者合并为一次端到端训练:
- 特征编码器:卷积下采样层把对数梅尔谱压缩为帧序列;
- 对比模块:若干Conformer层输出上下文向量,同时一个量化器把(掩码前的)特征离散化为一组有限的判别性语音标记,以wav2vec 2.0式的对比损失$\mathcal{L}_c$(加多样性损失)训练,作用是把连续语音“切成”离散标记;
- 掩码预测模块:更深的Conformer层以对比模块的输出为输入,在被掩码位置预测对应的离散标记ID,损失为交叉熵$\mathcal{L}_m$。
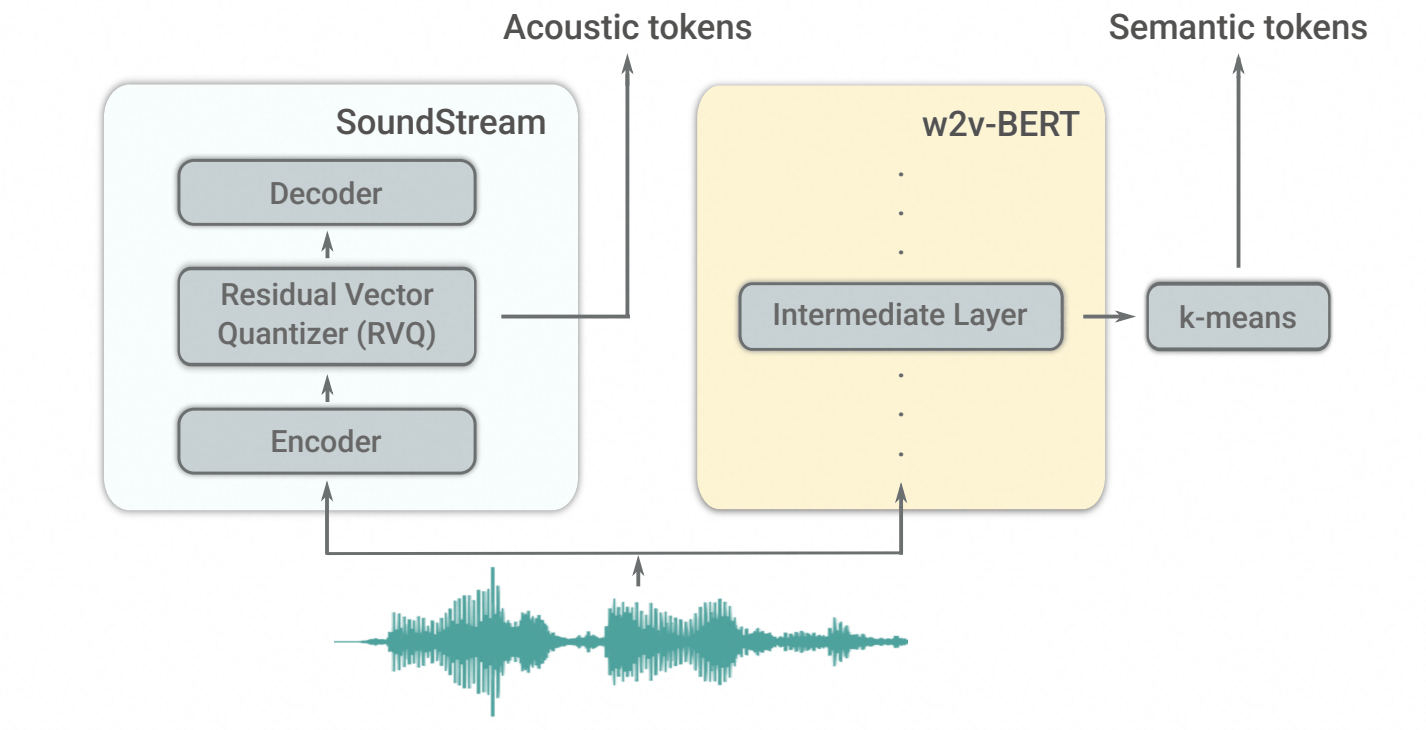
总损失为$\mathcal{L}=\mathcal{L}_c+\mathcal{L}_m$,两个自监督任务同时优化:对比任务提供离散目标,掩码语言建模在这些目标上学习上下文表示。其掩码预测模块中间层特征的$k$均值聚类,就是AudioLM的语义标记。
(4) 语义与声学标记的融合
⚪ AudioLM:语义标记与声学标记的层次化建模
AudioLM确立了层次化的音频标记路线:语义标记建模“说了什么”,声学标记建模“听起来怎样”,两级都由语言模型自回归生成。
- 语义标记:取$6$亿参数的w2v-BERT掩码预测模块中间层(第$7$层)的嵌入,做$k$均值聚类($K=1024$),得到$25$Hz的离散序列;
- 声学标记:$16$kHz的SoundStream编解码器,帧率$50$Hz,$Q=12$级RVQ、每级$1024$个码字,码率$50\times12\times10=6$kbps。
生成分为三个阶段,每个阶段是一个独立的Transformer:
- 语义建模对语义标记做自回归$p(z_t\mid z_{<t})$,捕捉长程的语言与旋律结构;
- 粗声学建模以语义标记为条件,生成前$Q’=4$级的RVQ码(各级码按“时间优先、级别次之”展平为一个序列),确定说话人、录音条件等全局声学属性;
- 精细声学建模以粗声学标记为条件生成剩余$8$级码,补全细节,最后由SoundStream解码器还原波形。
给定几秒钟的语音提示,AudioLM能续写出语法与语义合理、且保持说话人音色与韵律的语音;人类评测者区分真实语音与其续写的成功率约为$51.2\%$,接近随机。它同样适用于钢琴音乐等非语音音频。
⚪ VALL-E:基于编解码器标记的语言模型TTS
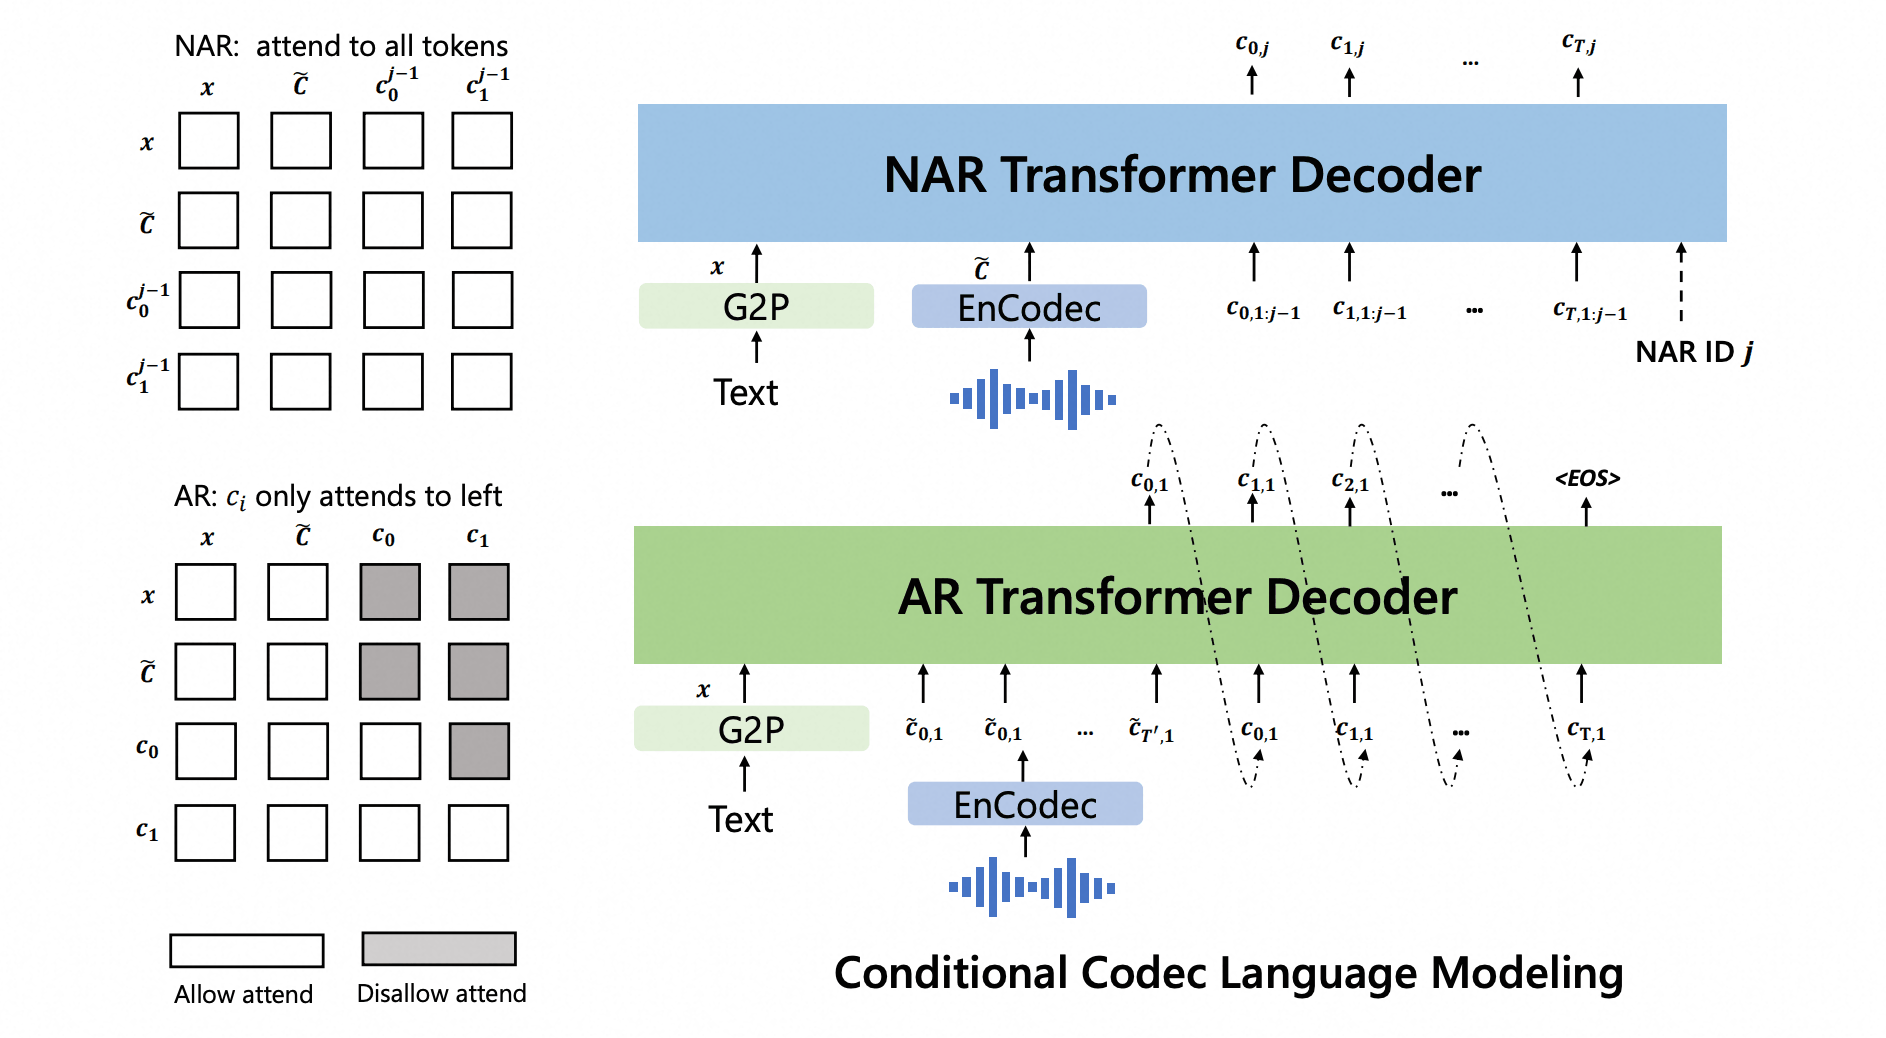
VALL-E把文本到语音合成视为条件语言建模:不再回归梅尔谱,而是生成EnCodec的离散声学标记。EnCodec在$24$kHz、$6$kbps设置下每帧产生$8$级RVQ码(帧率$75$Hz、每级$1024$个码字),记为矩阵$C\in{1,\dots,1024}^{T\times8}$。模型分两部分:
- 自回归模型(AR):以音素序列$\mathbf{x}$与$3$秒语音提示的声学标记$\tilde{C}$为条件,逐帧自回归生成第一级码$c_{:,1}$,即\(p(c_{:,1}\mid\mathbf{x},\tilde{C}_{:,1})=\prod_t p(c_{t,1}\mid c_{<t,1},\tilde{c}_{:,1},\mathbf{x})\),它决定内容与时长;
- 非自回归模型(NAR):对第$j=2,\dots,8$级,在一次前向中并行生成整段的第$j$级码,条件为音素、提示的全部$8$级码与已生成的前$j-1$级码,即$p(c_{:,j}\mid c_{:,<j},\mathbf{x},\tilde{C})$。
由于RVQ的第一级承载最多信息、后续级是残差细节,这种“首级自回归、其余级非自回归”的分解兼顾了质量与速度。
⚪ SpeechTokenizer:语义蒸馏的统一语音分词器
现有语音标记要么是语义标记(如HuBERT units,内容好但丢失音色、无法高质量重构),要么是声学标记(如EnCodec,重构好但内容与声学信息纠缠,对语言模型不友好)。论文先建立基准SLMTokBench,从“与文本的对齐程度”(标记与文本之间的互信息)和“信息保留程度”两方面评估语音标记,表明两类标记都不理想。
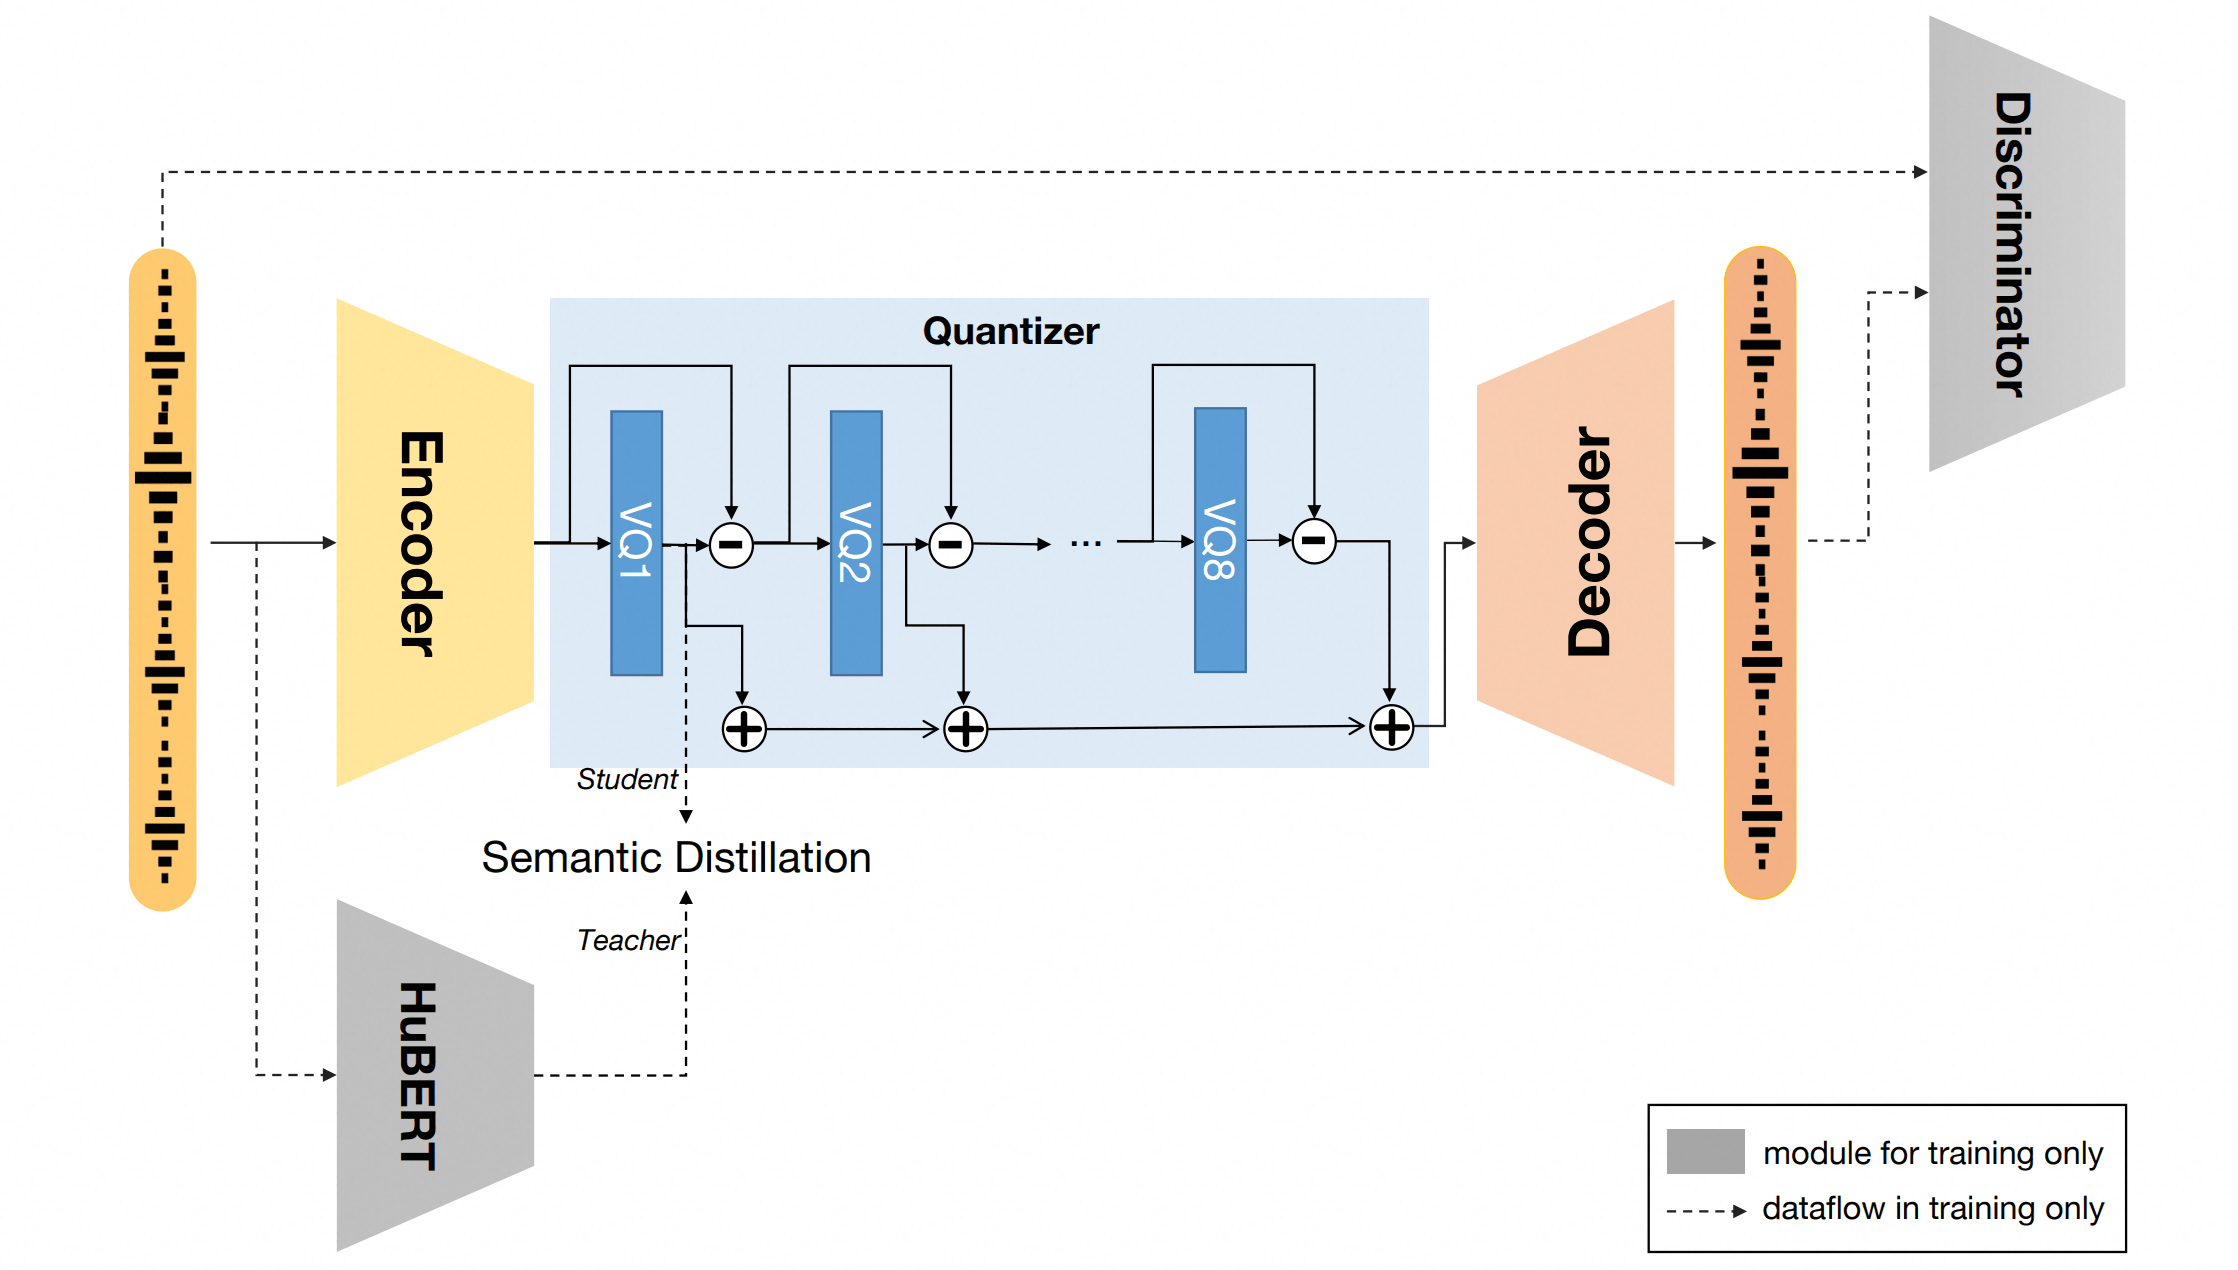
SpeechTokenizer采用EnCodec式的编码器-解码器与$8$级RVQ($16$kHz、$50$Hz帧率、每级$1024$个码字),编码器中的LSTM换为双向LSTM以增强语义建模;关键是对第一级RVQ做语义蒸馏:以HuBERT为教师,要求第一级量化输出$Q_1$在经投影$A$后与教师表示$S$在每一个特征维度上都相似,
\[\mathcal{L}_{\text{distill}}=-\frac{1}{D}\sum_{d=1}^{D}\log\sigma\left(\cos\left(AQ_1^{(:,d)},S^{(:,d)}\right)\right)\]其中$Q_1^{(:,d)}$与$S^{(:,d)}$分别为第$d$维特征在所有时间帧上组成的向量,$\sigma$为sigmoid。这样语音信息在RVQ的层级间被分层解耦:第一级承载内容(语义),后续各级在残差中补充音色、韵律等副语言与声学信息。交换两段语音的第一级与后续级标记即可实现音色转换。在其上构建的统一语音语言模型(USLM)由自回归模型生成第一级标记、非自回归模型生成其余各级标记;SpeechTokenizer的重构质量与EnCodec相当,在SLMTokBench上表现出色,USLM在零样本TTS上优于VALL-E。
⚪ Mimi:Moshi的语义-声学分离编解码器
Moshi是一个全双工的实时语音对话基础模型,其语音标记来自专门设计的流式编解码器Mimi:
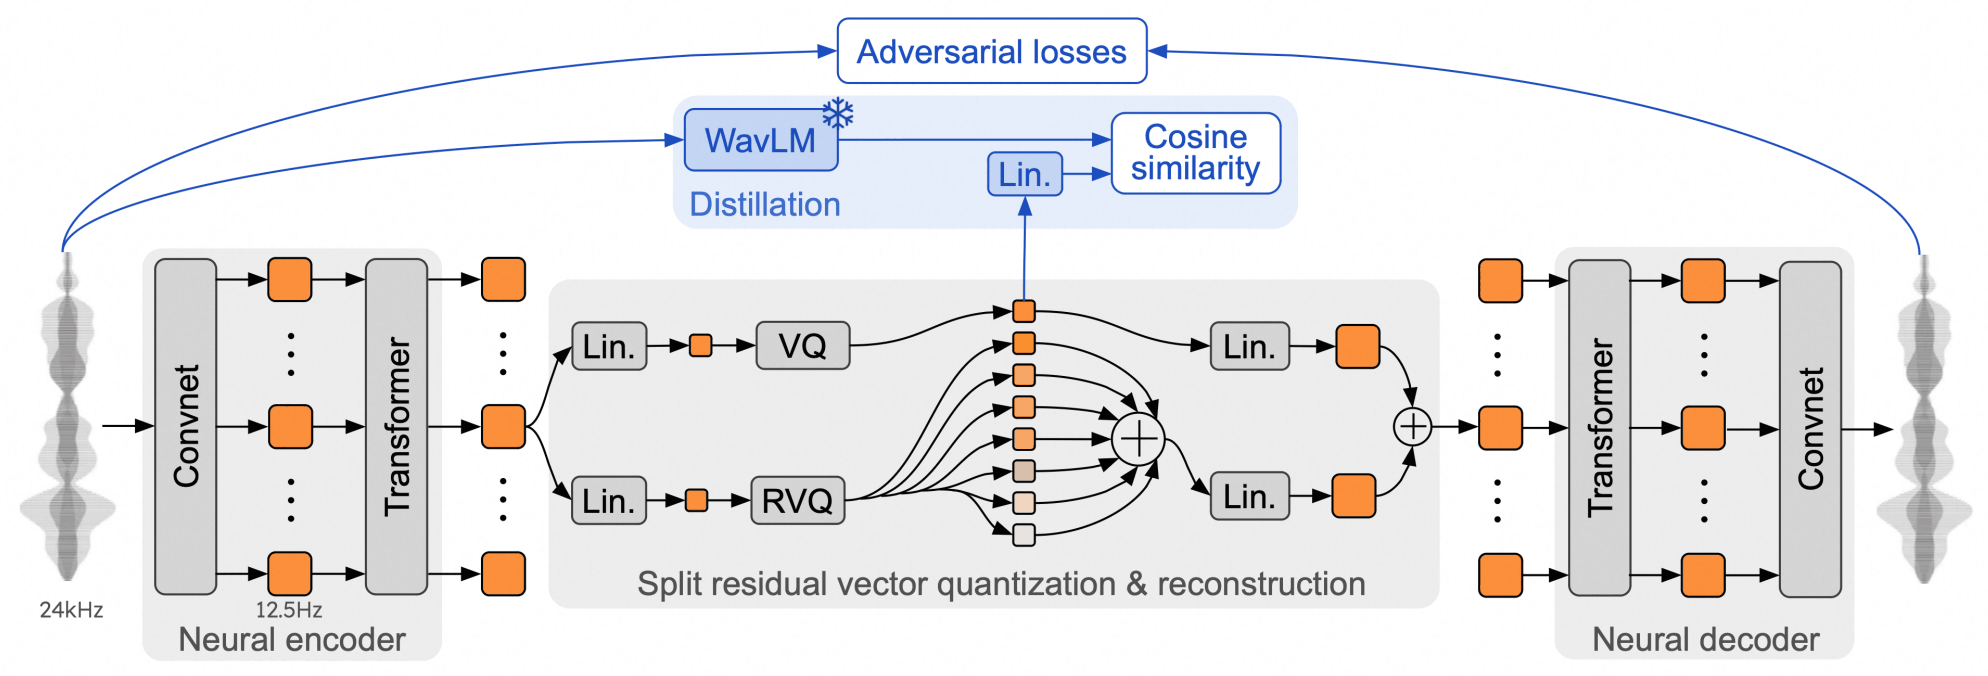
- 低帧率:$24$kHz的输入被压缩为$12.5$Hz的帧序列(每帧$80$ms),每帧用$8$个大小为$2048$的码本量化,码率为 $12.5\times 8\times 11=1.1$ kbps;
- 结构:SeaNet式的卷积编码器与解码器,在编码器与解码器的瓶颈处各加入Transformer层,全部为因果结构以支持流式;
- 分离式RVQ(split RVQ):一个普通VQ(语义码本)与一个$7$级RVQ(声学码本)并行量化同一编码,两者输出相加;对语义码本的输出做语义蒸馏——经线性投影后与非因果的WavLM教师表示(降采样到$12.5$Hz)计算余弦距离,从而在因果的编解码器中注入非因果模型的语义信息;分离式结构避免了蒸馏目标与声学重构在同一RVQ残差链上相互干扰;
- 训练:训练中只在$50\%$的时间施加量化,并且只用对抗损失(特征匹配损失与判别器损失)而不用重构损失,主观质量显著提升。
建模上,Moshi使用RQ-Transformer:大的时间Transformer(基于$70$亿参数的文本语言模型Helium)在时间步上自回归,小的深度Transformer在每个时间步内依次生成该帧的$8$个码;声学码相对语义码延迟$1\sim2$步生成,以便声学细节可以依赖已确定的语义。
模型同时建模用户与自身的两路语音流,从而无需显式的说话轮次;并引入“内心独白”——在语音标记之前先预测时间对齐的文本标记作为前缀,显著提升生成语音的语言质量,同时还能用于流式识别与合成。Moshi的理论延迟为$160$ms($80$ms帧长加$80$ms声学延迟),实际约$200$ms。
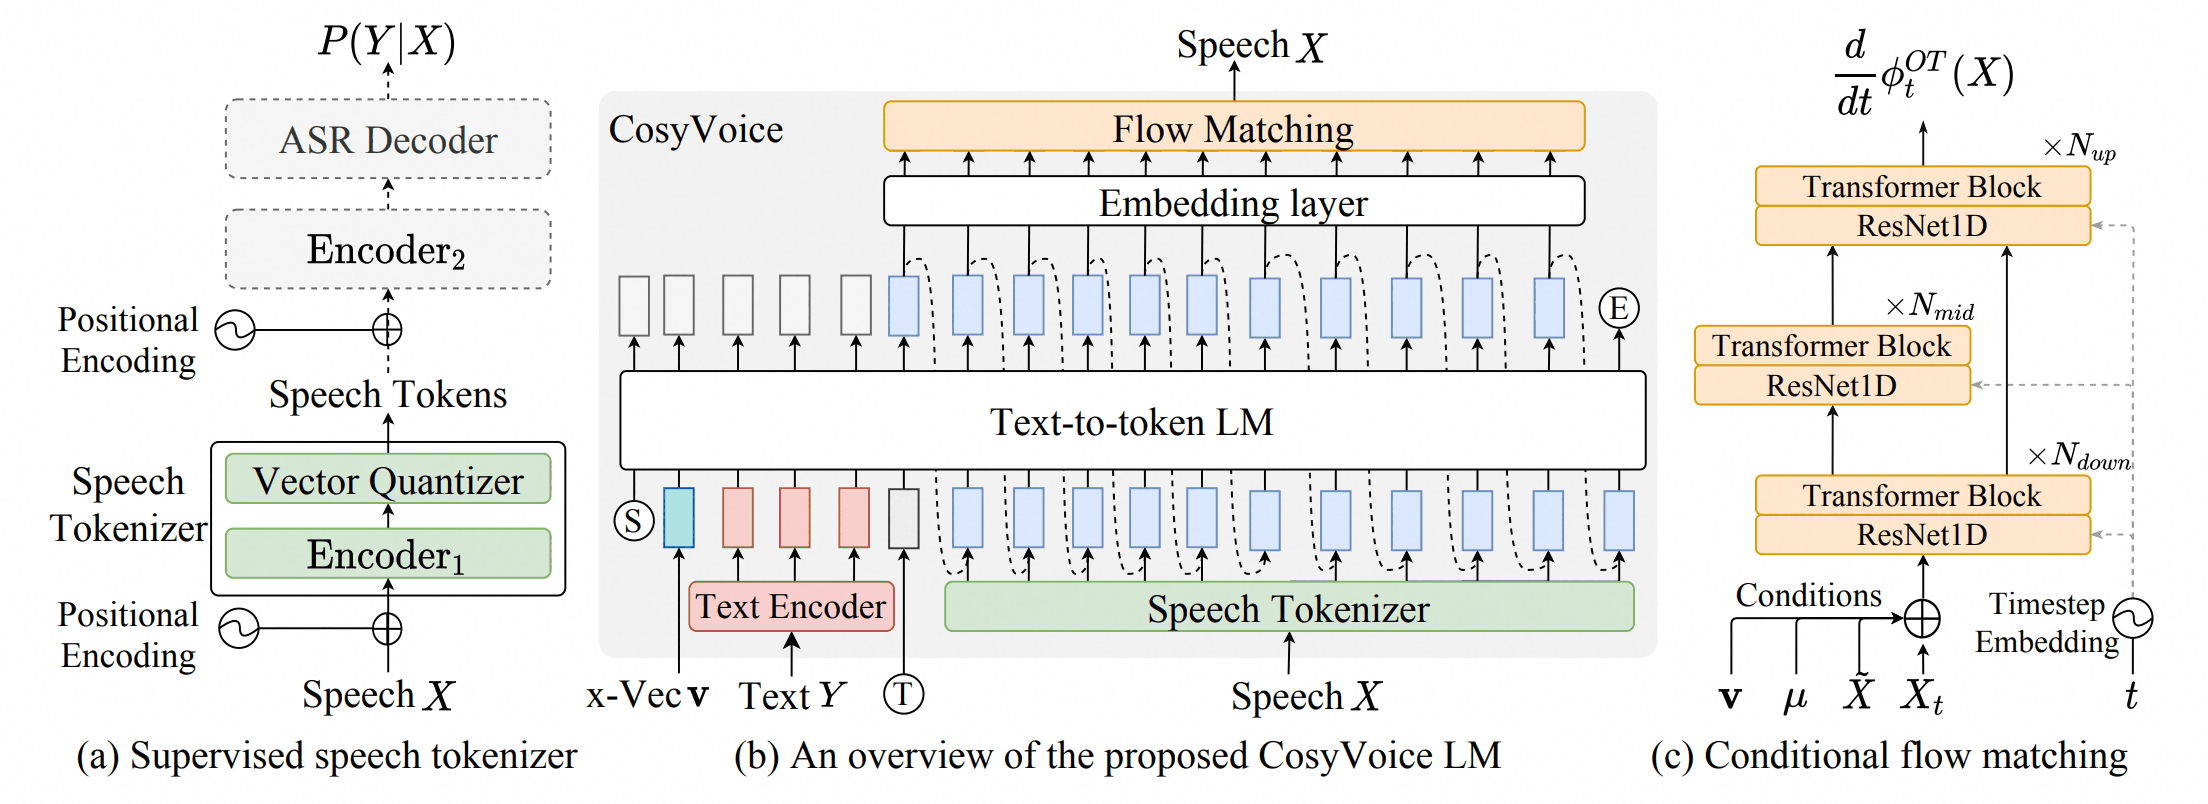
⚪ CosyVoice:有监督的语义语音标记
基于大语言模型的TTS把语音离散化为标记序列,以文本为提示由语言模型生成,再由基于标记的声码器还原波形。此前的语音标记都是无监督学到的,缺乏显式的语义信息与文本对齐。
CosyVoice提出有监督语义语音标记(supervised semantic speech tokens, S3):在一个多语言语音识别模型(SenseVoice)的编码器中插入向量量化——量化层位于前$6$层编码器之后,码本含$4096$个码字、用EMA更新;整个模型以语音识别损失训练,于是量化后的标记被迫保留识别文本所需的内容信息,天然与文本对齐,而说话人等信息被大量丢弃。
合成系统由两部分组成:文本到标记的大语言模型以文本编码与说话人嵌入为条件,自回归生成S3标记;标记到语音的条件流匹配模型以标记、说话人嵌入与提示语音的梅尔谱为条件生成梅尔谱,再经声码器得到波形。实验表明,在零样本声音克隆中,有监督语义标记在内容一致性(WER)与说话人相似度上显著优于已有的无监督标记,扩大训练数据还能持续提升合成性能。
6. 科学数据的标记化
分子、蛋白质与基因组都可以写成符号序列,因而能直接借用语言建模的工具;但这些“语言”的基本单元、语法约束与信息密度与自然语言很不相同,标记化需要尊重其化学与生物学结构。
(1) 分子
⚪ 分子标记化:SMILES与SELFIES
- SMILES:SMILES, a chemical language and information system. 1. Introduction to methodology and encoding rules
- SELFIES:Self-Referencing Embedded Strings (SELFIES): A 100% robust molecular string representation
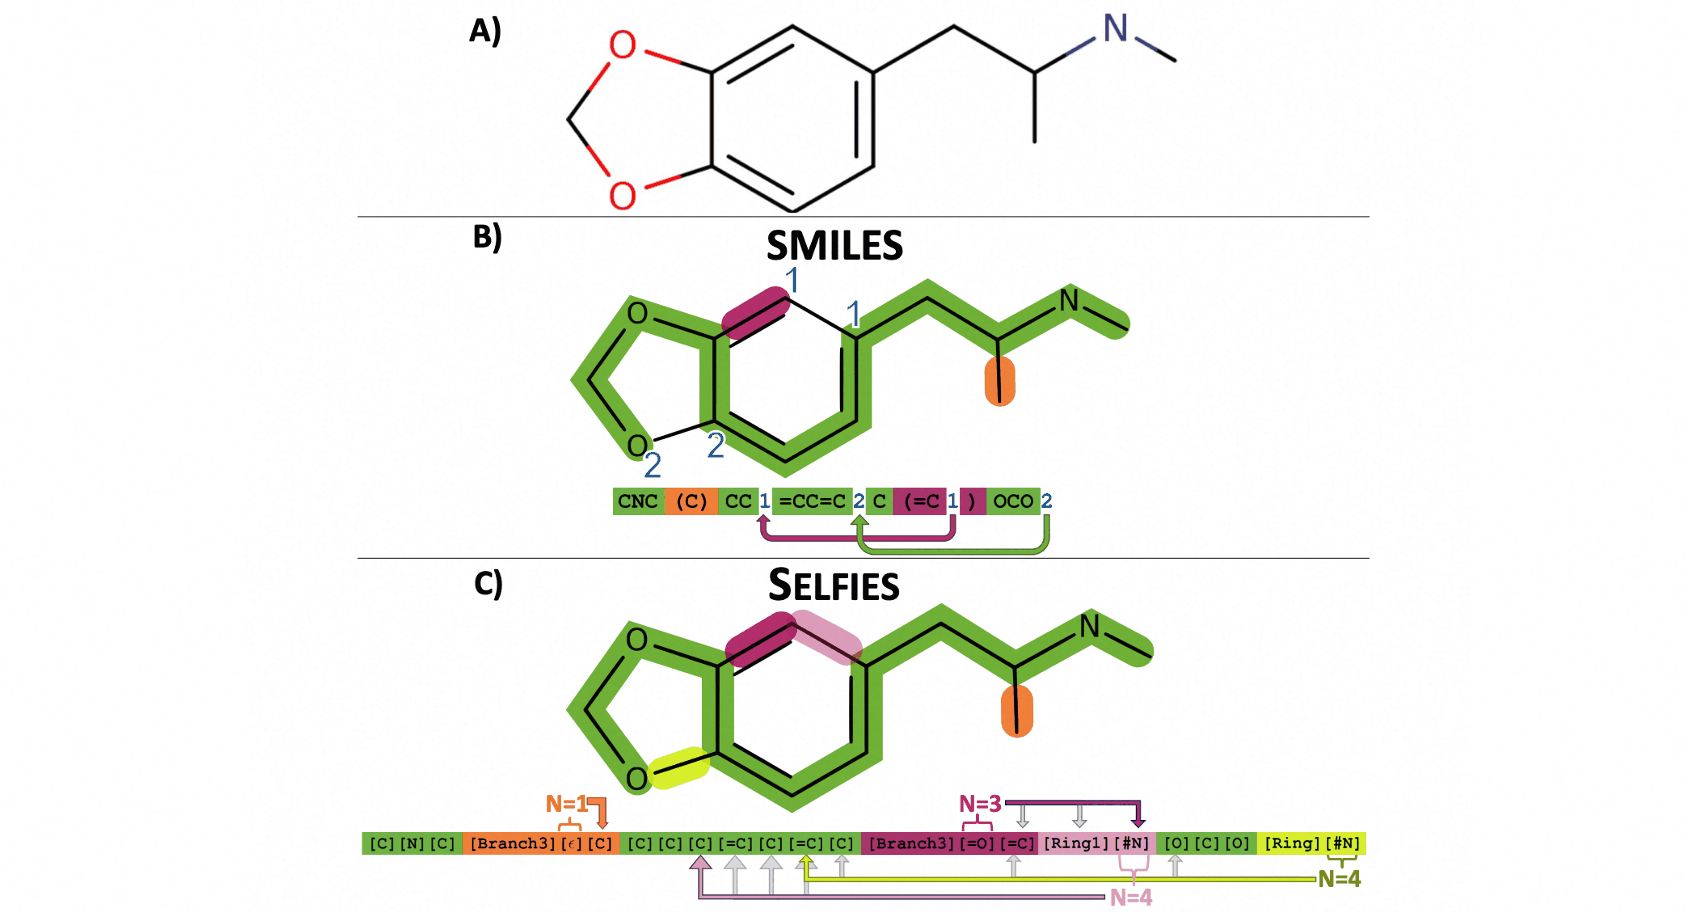
图结构数据的标记化同样有“字符串化”路线。分子可以用SMILES(Simplified Molecular Input Line Entry System)表示:按深度优先遍历把分子图写成线性字符串,规则包括:原子用元素符号表示(有机子集B、C、N、O、P、S、F、Cl、Br、I可直接书写,其他原子或带电荷、同位素的原子写在方括号中,如[Fe+2]、[NH4+]),芳香原子用小写字母;键用-、=、#、:表示(单键可省略);分支写在圆括号中;环用成对的数字标记闭合位置。例如乙醇为CCO,苯为c1ccccc1,阿司匹林为CC(=O)Oc1ccccc1C(=O)O。同一分子可以从不同原子出发、按不同顺序遍历,因而有多个合法的SMILES;规范化SMILES为每个分子选出唯一的写法,而随机枚举的SMILES常被用作数据增强。于是分子建模变成字符串建模,字符级与子词级方法可以直接套用。实践中常用的是原子级标记化:用正则表达式把方括号原子、双字母元素(Cl、Br)、键、括号与环编号各自切为一个标记,例如:
pattern = r"(\[[^\]]+]|Br?|Cl?|N|O|S|P|F|I|b|c|n|o|s|p|\(|\)|\.|=|#|-|\+|\\|\/|:|~|@|\?|>|\*|\$|\%[0-9]{2}|[0-9])"
但SMILES的字符串只有满足文法约束(括号与环编号配对、原子价合法)才对应合法分子,任意修改一个字符(例如由生成模型采样)常产生无效结构。SELFIES为此重新设计文法:它把每个符号定义为一个自引用的状态转移函数——推导过程维护一个“当前原子剩余可用价”的状态,每个符号(如[C]、[=O]、[Branch1]、[Ring1])的含义由当前状态决定:键级超过剩余价时自动降级,分支与环的长度由其后的符号按索引表解释,因而不存在括号不匹配或环不闭合的情况。从任意当前状态出发,任何符号串都能被确定性地解释为一个(语义合法的)分子——即$100\%$鲁棒。这使遗传算法式的随机变异与语言模型的自由采样都能保证有效性。
⚪ SMILES Pair Encoding:数据驱动的子结构标记
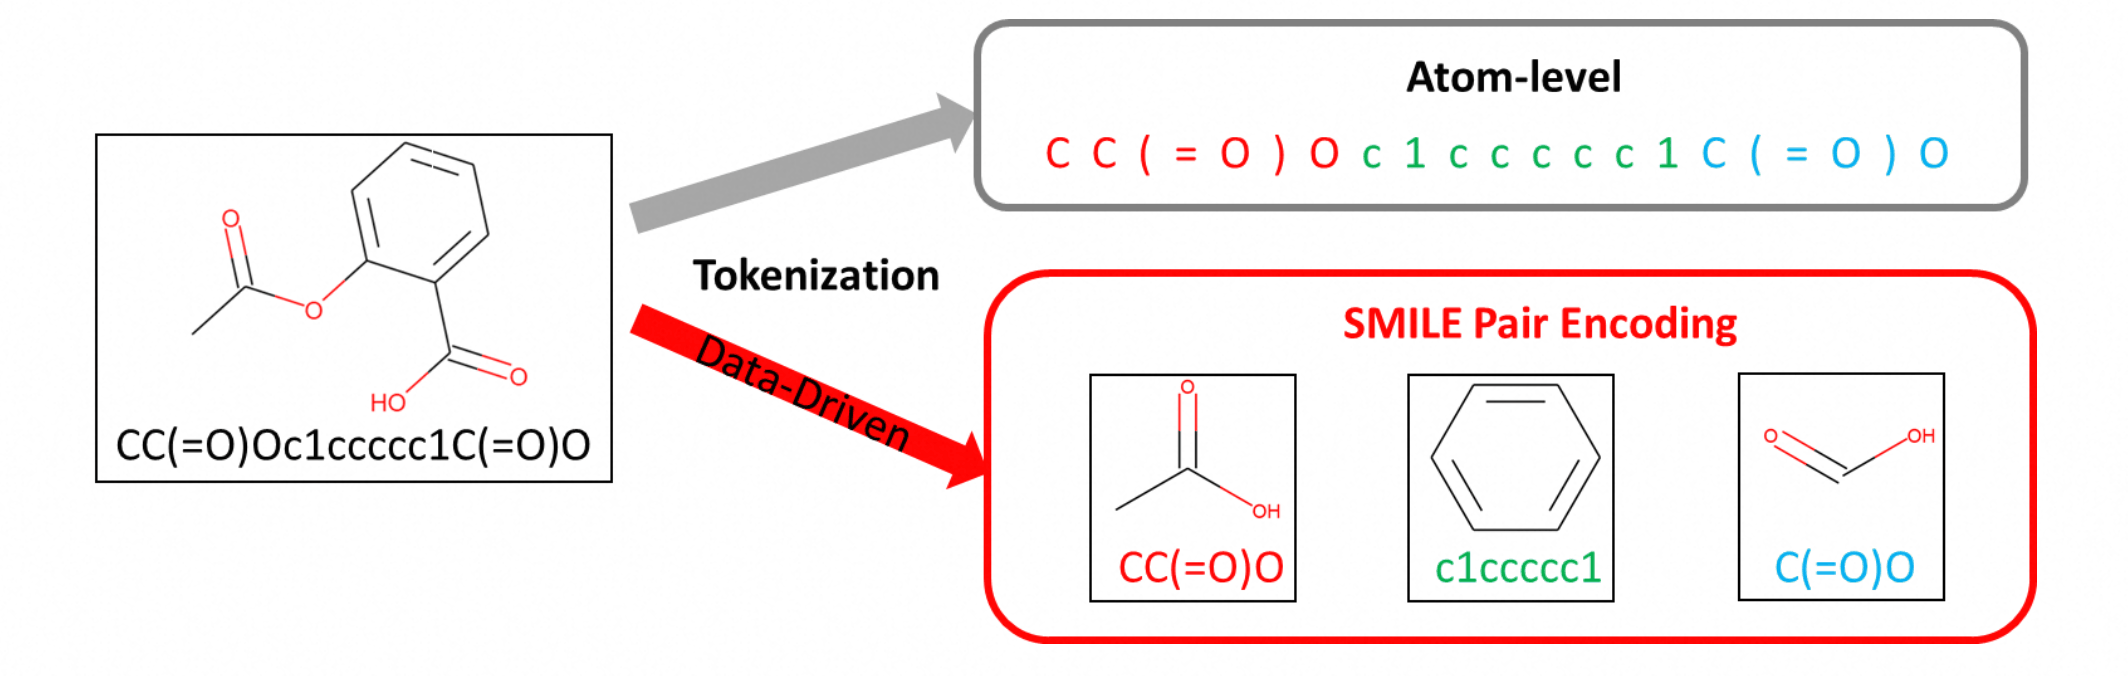
原子级标记的序列较长,单个标记(一个原子或一个键)的化学含义有限。SMILES Pair Encoding(SPE)把BPE的思想用于分子:
- 先用原子级正则把大规模分子库(如ChEMBL)中的SMILES切成原子级标记;
- 统计相邻标记对的频率,迭代地把最高频的一对合并为新标记,直到达到预设的词表大小或最高频对的频率低于阈值;
- 编码新分子时,按学习到的合并顺序依次应用合并规则。
合并产生的标记对应常见的化学子结构(如苯环片段c1ccccc1、羰基、常见的取代基组合),且保持人类可读。与原子级标记相比,SPE显著缩短了序列,在分子生成与分子性质预测(QSAR)任务上取得更好或相当的性能。
(2) 蛋白质
⚪ 蛋白质语言模型的氨基酸标记:ESM
- paper:Biological structure and function emerge from scaling unsupervised learning to 250 million protein sequences
- paper:Evolutionary-scale prediction of atomic-level protein structure with a language model
氨基酸字母表是最经典的“天然词表”:蛋白质序列由$20$种标准氨基酸组成,每个残基就是一个标记。ESM系列蛋白质语言模型的词表在$20$种标准氨基酸之外,还包含表示未知或模糊残基的X、B、Z与少见的U(硒代半胱氨酸)、O(吡咯赖氨酸),以及<cls>、<eos>、<pad>、<mask>、<unk>等特殊标记,ESM-2的词表共$33$个标记。这种标记化不做任何压缩:序列长度等于残基数(典型蛋白质为数百个残基)。
该工作在多达约$2.5$亿条蛋白质序列(来自UniParc)上以掩码语言建模训练Transformer,随机掩码约$15\%$的残基并预测其类型,最终的ESM-1b模型在高多样性的UniRef50序列上训练。论文发现,仅从序列中学习,模型的表示与注意力就涌现出蛋白质的结构与功能信息:残基表示按理化性质聚类,注意力图与残基间的空间接触高度相关,可用于二级结构、接触与突变效应预测。
ESM-2把模型扩展到$150$亿参数,并在其上构建ESMFold,仅从单条序列(无需多序列比对)以原子级精度预测三维结构,速度比基于多序列比对的方法快一个数量级以上,借此预测了超过$6$亿条宏基因组蛋白质的结构。
⚪ Foldseek:3Di结构字母表
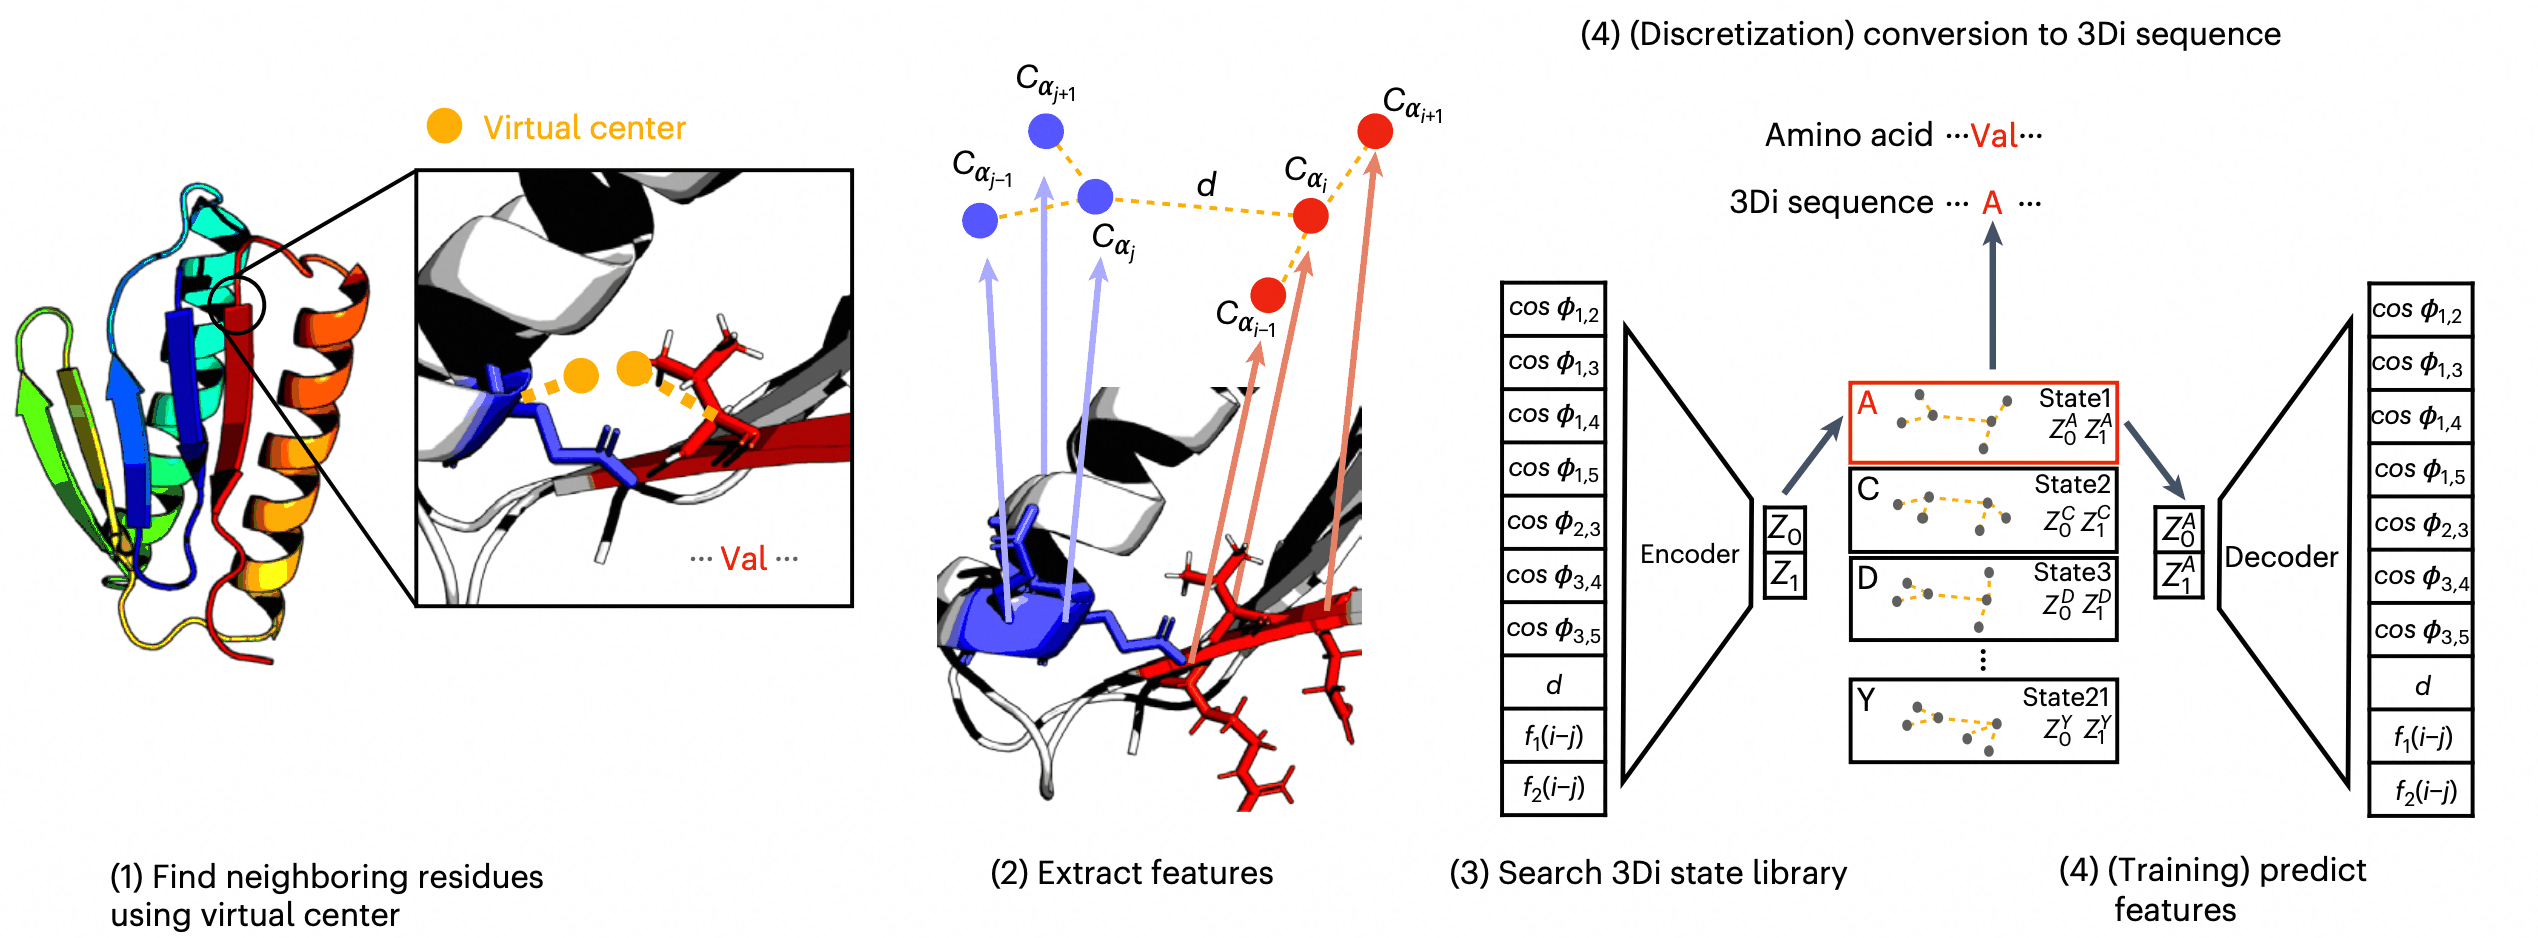
蛋白质结构是三维坐标,结构比对算法的计算量远高于序列比对。Foldseek把结构标记化为一条字母序列,从而复用高效的序列搜索技术。它学习了一个$20$态的3Di(3D interaction)字母表:对每个残基$i$,找出其在空间上最近的残基$j$(基于虚拟中心位置),用描述$i$与$j$的局部骨架构象与相对几何关系的特征(键角、二面角、距离、序列间隔等)构成一个向量;一个VQ-VAE把这个向量离散化为$20$个状态之一,训练目标是让离散状态足以重构相互作用残基的构象特征。于是一个结构被表示为与氨基酸序列等长的3Di序列,每个字母描述该残基与其空间邻居的三级相互作用。
搜索时,Foldseek用在结构相似蛋白质对上学到的3Di替换矩阵与氨基酸替换矩阵共同打分,并借用MMseqs2的$k$-mer预过滤与比对流程。与Dali、TM-align等传统结构比对工具相比,它在保持相当灵敏度的同时快四到五个数量级,使对数亿个预测结构的全库搜索成为可能。3Di标记随后也被用作蛋白质语言模型的输入:把每个残基的氨基酸与3Di字母组合为一个“结构感知”的标记,使序列模型同时获得结构信息。
⚪ ESM3的结构标记:多轨道的蛋白质生成
ESM3是一个同时推理蛋白质序列、结构与功能的多模态生成式语言模型,每种模态是一条与残基对齐的标记轨道(track):氨基酸序列、三维结构、二级结构($8$类)、溶剂可及表面积以及功能关键词。连续的三维结构通过专门的结构分词器离散化:一个VQ-VAE以每个残基的局部结构邻域为输入,编码器使用对旋转与平移不变的几何注意力,把邻域结构编码为一个离散的结构标记(码本大小约$4096$);解码器从结构标记序列重构全原子坐标。
所有轨道的标记嵌入相加后送入Transformer,以可变掩码率的掩码语言建模训练:模型在给定任意轨道子集的条件下预测其余被掩码的标记,因此可以从序列生成结构、从结构生成序列,或以部分功能与结构约束为提示生成完整蛋白质。
(3) 基因组DNA
DNA序列由四种碱基(A、C、G、T,以及表示未知碱基的N)组成,没有天然的“词”,且序列极长(人类基因组约$31$亿个碱基对)、功能信号可能取决于单个碱基的变化。
⚪ k-mer标记化:DNABERT与Nucleotide Transformer
- paper:DNABERT: pre-trained Bidirectional Encoder Representations from Transformers model for DNA-language in genome
- paper:The Nucleotide Transformer: Building and Evaluating Robust Foundation Models for Human Genomics
- paper:GENERator: A Long-Context Generative Genomic Foundation Model
k-mer把$k$个连续碱基作为一个标记,词表大小为$4^k$(加若干特殊标记)。按切分方式分为两种:
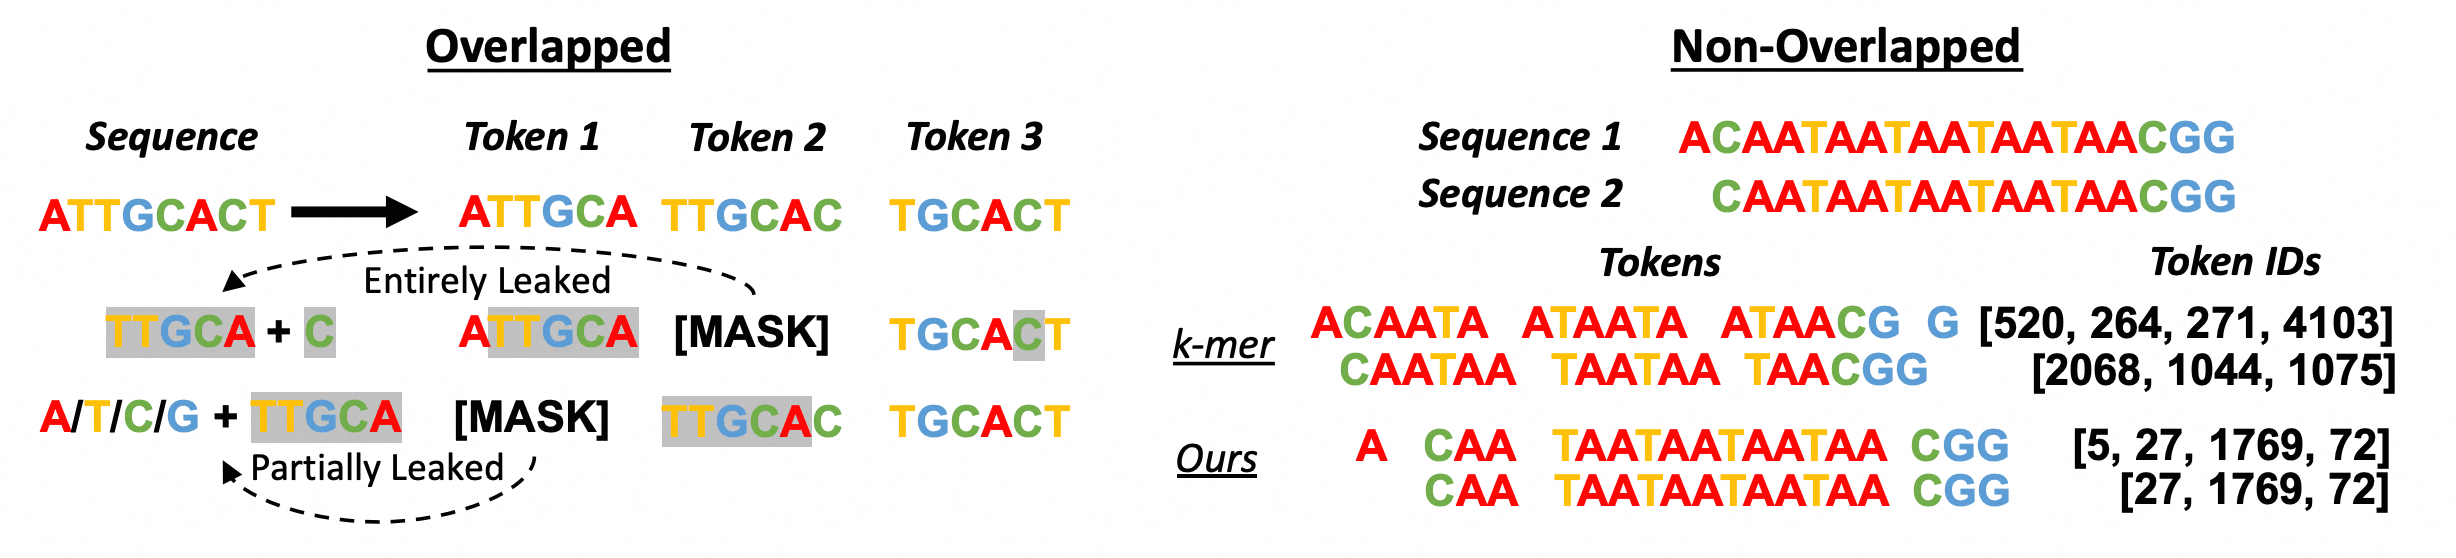
- 重叠k-mer(DNABERT):以步长$1$滑动窗口,长度为$L$的序列$x_1\cdots x_L$被切为$L-k+1$个标记$t_i=x_{i:i+k-1}$,例如$k=3$时
ATGGCT切为ATG、TGG、GGC、GCT。DNABERT支持$k=3,4,5,6$四种设置,对应$4^k+5$的词表,模型为$12$层BERT(隐藏维度$768$、$12$个注意力头),最大输入$512$个标记。由于相邻标记共享$k-1$个碱基,单独掩码一个标记时可以从左右邻居完全推出其内容,因此DNABERT在预训练中掩码连续的$k$个标记,以免信息泄露。重叠切分不压缩序列,但每个碱基都出现在$k$个标记中; - 非重叠k-mer(Nucleotide Transformer):以步长$k$切分,序列长度变为约$L/k$。NT采用$6$-mer(词表约为$4^6=4096$个$6$-mer加上单核苷酸与特殊标记,遇到N或长度不足$6$的片段时退回单核苷酸标记),在$5$亿到$25$亿参数的规模上、在人类参考基因组、$3202$个人类基因组与$850$个物种的基因组上做掩码语言建模预训练;非重叠切分使同样的上下文长度覆盖约$6$倍的碱基。
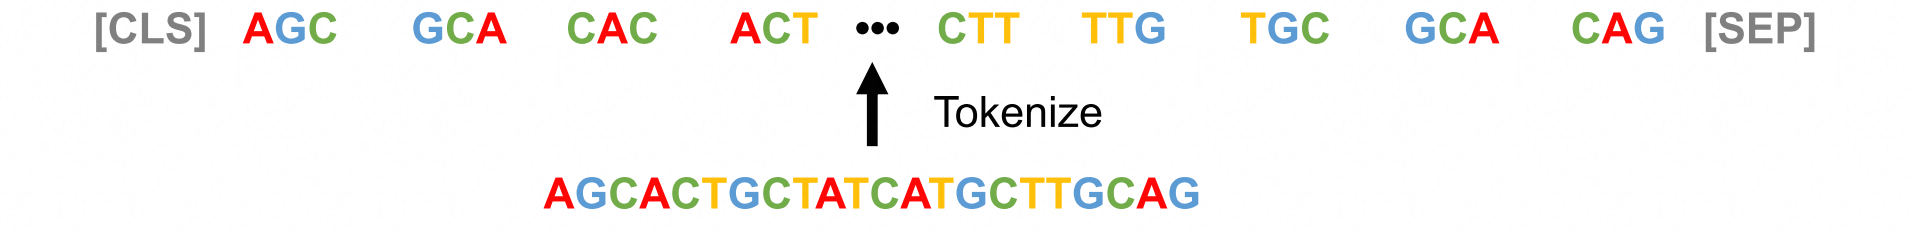
在因果生成式模型中,GENERator系统比较了单核苷酸、$k$-mer与BPE分词器,发现k-mer分词器在下一标记预测预训练中显著更好,其中$6$-mer在下一$k$-mer预测任务上表现最佳,且随输入标记数增加保持领先。
⚪ DNA的BPE:DNABERT-2与GROVER
- paper:DNABERT-2: Efficient Foundation Model and Benchmark For Multi-Species Genome
- paper:DNA language model GROVER learns sequence context in the human genome
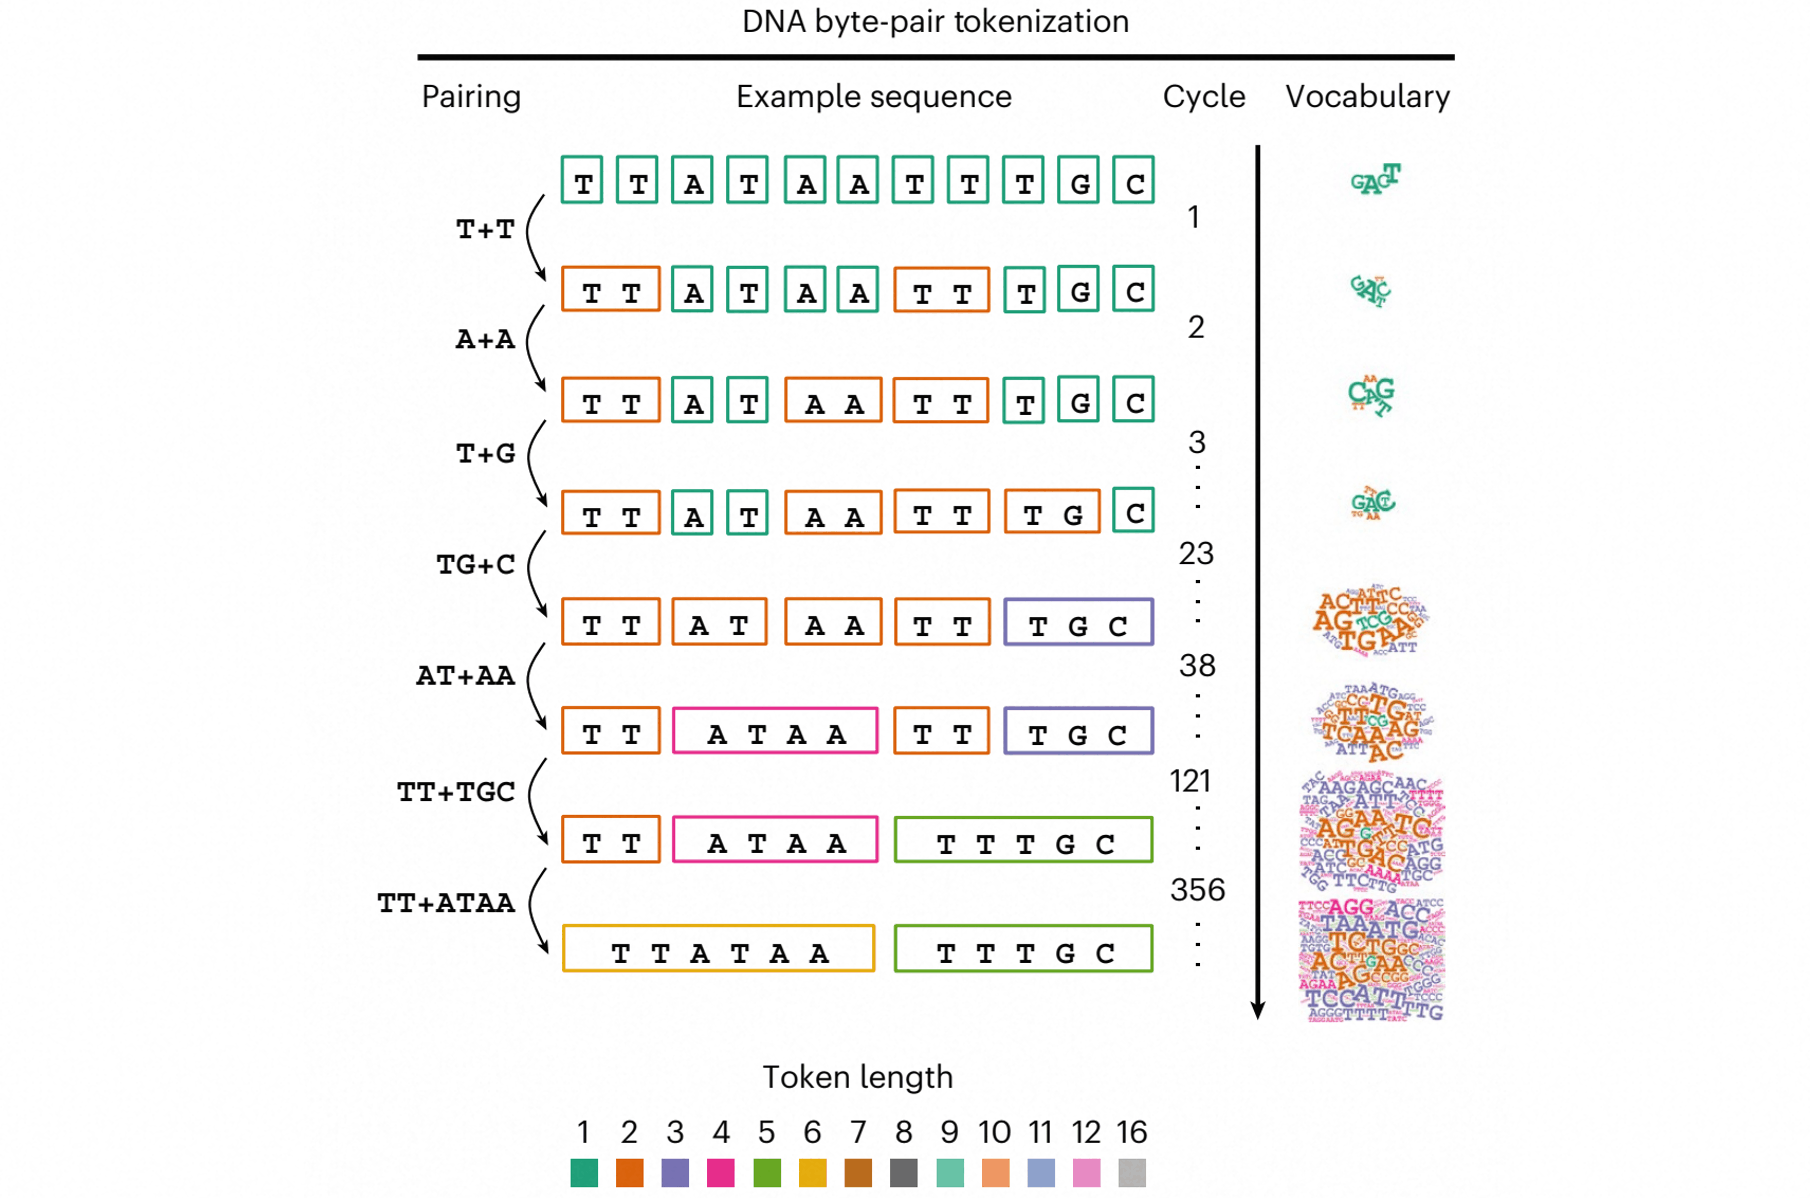
DNABERT-2认为$k$-mer标记化带来的计算与样本低效是构建大规模基因组基础模型的主要障碍:重叠$k$-mer存在信息泄露且不压缩序列,非重叠$k$-mer对序列平移极其敏感(在开头插入一个碱基,其后所有标记都会改变),使相同的序列片段在不同位置得到完全不同的标记。它用SentencePiece实现的BPE替换$k$-mer:从A、C、G、T四个字符出发,迭代合并语料中最频繁共现的片段,直到词表达到$4096$。BPE是非重叠的、变长的,长度为$L$的序列被切成约$L/5$个标记,既避免了信息泄露,又获得了非重叠切分的计算效率。
GROVER同样用BPE为人类基因组构建词表,强调频率平衡:基因组中不同核苷酸组合的频率高度不均衡,BPE的迭代合并使高频组合成为较长的标记、低频组合保持较短,标记频率趋于均衡。论文用“下一$k$-mer预测”任务选择最优的合并轮数,最终选定$600$轮合并得到的词表(共$601$个标记,涵盖从单核苷酸到$16$核苷酸的片段,大部分为$4$-mer与$5$-mer,标记长度与频率正相关)。分析训练后的标记嵌入发现,模型学到了标记频率、GC含量、AG含量等特征,并与基因组功能注释相关。
⚪ VQDNA:向量量化的基因组词表
- paper:VQDNA: Unleashing the Power of Vector Quantization for Multi-Species Genomic Sequence Modeling
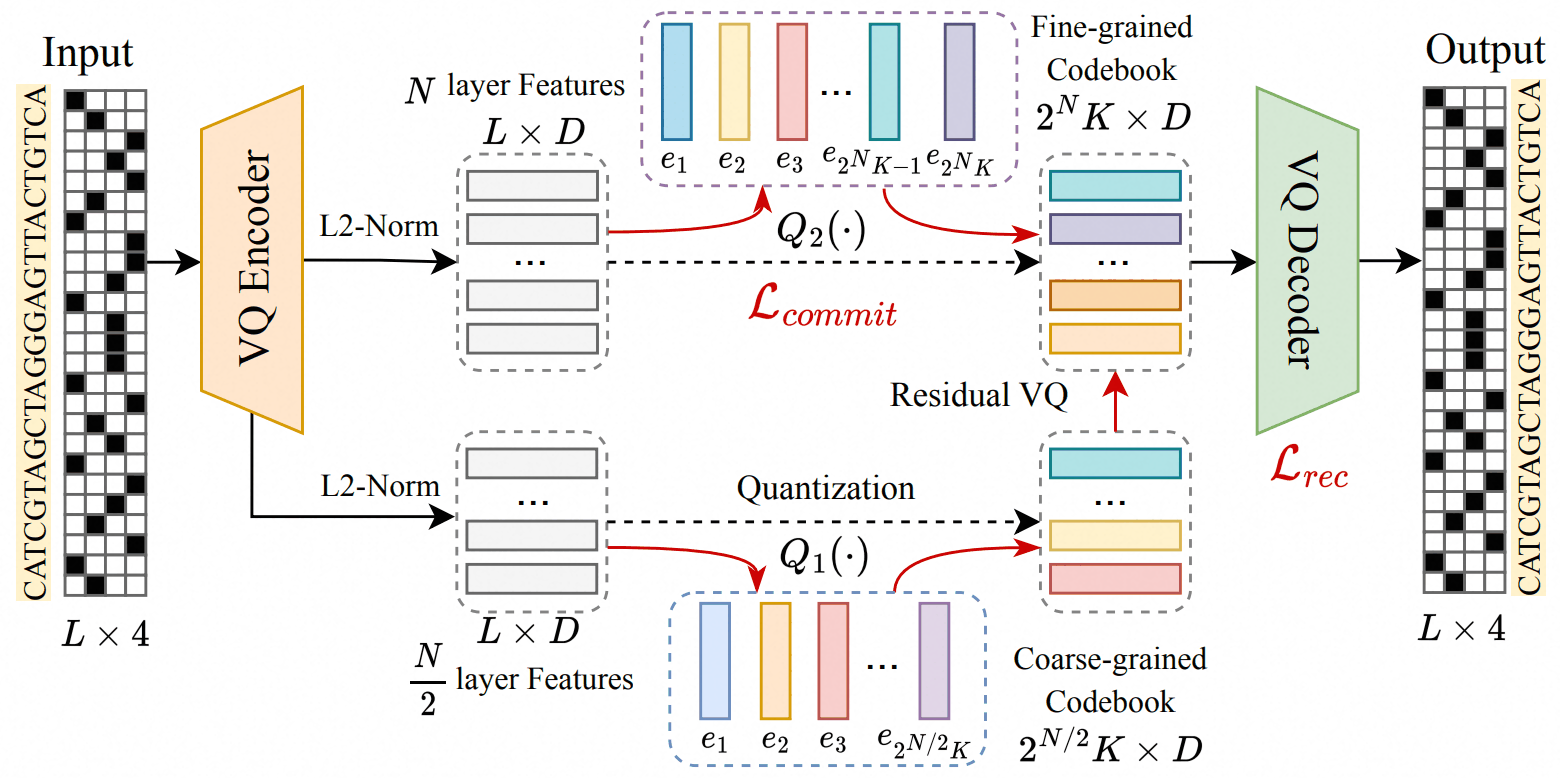
VQDNA把基因组标记化从手工规则($k$-mer、BPE)转变为词表学习问题:用VQ-VAE学习一个可区分的基因组码本,把序列自适应地标记化为具有模式感知能力的嵌入。给定输入序列$X\in\mathbb{R}^{L\times d}$(独热编码),编码器$E_\theta$输出$Z=E_\theta(X)\in\mathbb{R}^{L\times D}$,在码本${e(k)}{k=1}^{K}$上做最近邻量化$M_i=\mathop{\arg\min}{k}||Z_i-e(k)||2^2$,解码器$G\phi$从量化嵌入$\hat{Z}=e(M)$重构序列,损失为
\[\mathcal{L}_{\text{VQ}}=\mathcal{L}_{\text{CE}}(X,\hat{X})+\left\|\text{sg}[Z]-\hat{Z}\right\|_2^2+\beta\left\|Z-\text{sg}[\hat{Z}]\right\|_2^2\]其中重构项为碱基类别上的交叉熵。为了以由粗到细的方式丰富词表,论文提出层次残差量化(Hierarchical Residual Quantization, HRQ):在编码器第$n$层的输出$H^{(n)}$上使用规模逐层翻倍的码本$\mathcal{C}^{(n)}$(第$n$层码本大小为$2^nK$),量化后按
\[H^{(n+1)}_i=\begin{cases}e^{(1)}(M^{(1)}_i), & n=1\\ 2Z^{(n)}_i-e^{(n)}(M^{(n)}_i), & n\ge2\end{cases}\]计算下一层输入,最终的量化嵌入为各层嵌入的平均\(\hat{Z}_i=\frac{1}{N}\sum_{n=1}^{N}e^{(n)}(M^{(n)}_i)\)。浅层码本捕捉粗粒度模式,深层码本补充细粒度细节。学到的码本作为分词器,其后再以掩码语言建模(掩码比例$25\%$效果最好)预训练下游模型。消融显示码本大小为$512$时重构与区分能力的平衡最好。
7. 其他模态的标记化
时间序列、机器人动作、点云、图与推荐系统中的物品同样可以标记化,大多数方法是前文思想的直接迁移:图像块化、标量量化、频域变换$+$BPE、向量量化与残差量化。
(1) 时间序列
⚪ PatchTST与TimesFM:时间序列的图像块化
- paper:A Time Series is Worth 64 Words: Long-term Forecasting with Transformers
- paper:A decoder-only foundation model for time-series forecasting
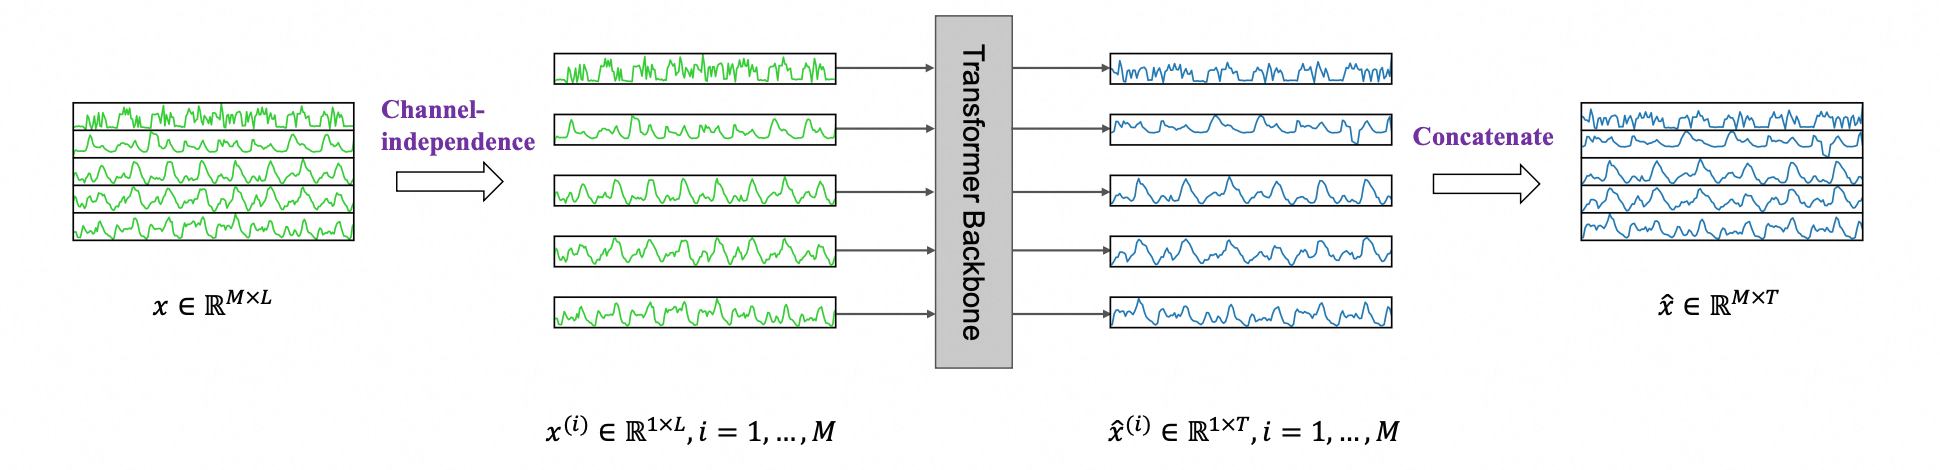
把时间序列的每个时间点作为一个标记,单个标记几乎没有语义,且注意力长度等于回看窗口长度。PatchTST借鉴ViT,把序列切成子序列级的图像块(patch)作为Transformer的输入标记。设单变量序列长度为$L$,块长为$P$、步长为$S$,在序列末尾重复填充$S$个最后的值后,块数为
\[N=\left\lfloor\frac{L-P}{S}\right\rfloor+2\]例如$L=336$、$P=16$、$S=8$时$N=42$,注意力的计算与显存大约降为逐点标记的$1/S^2$。每个块线性投影为$d$维标记并加上位置编码。另一个关键设计是通道独立:多变量序列的每个通道被视为一条单独的单变量序列,所有通道共享同一套嵌入与Transformer权重;输入先做逐实例归一化(减均值除标准差,预测后再还原)。块化同时带来三个好处:局部语义保留在标记嵌入中、注意力计算量随块化二次下降、同样算力下可以看更长的历史。PatchTST显著提升了长期预测的精度;在自监督预训练中(随机掩码不重叠的块并重构),其微调性能超过在大数据集上的监督训练,并能迁移到其他数据集。
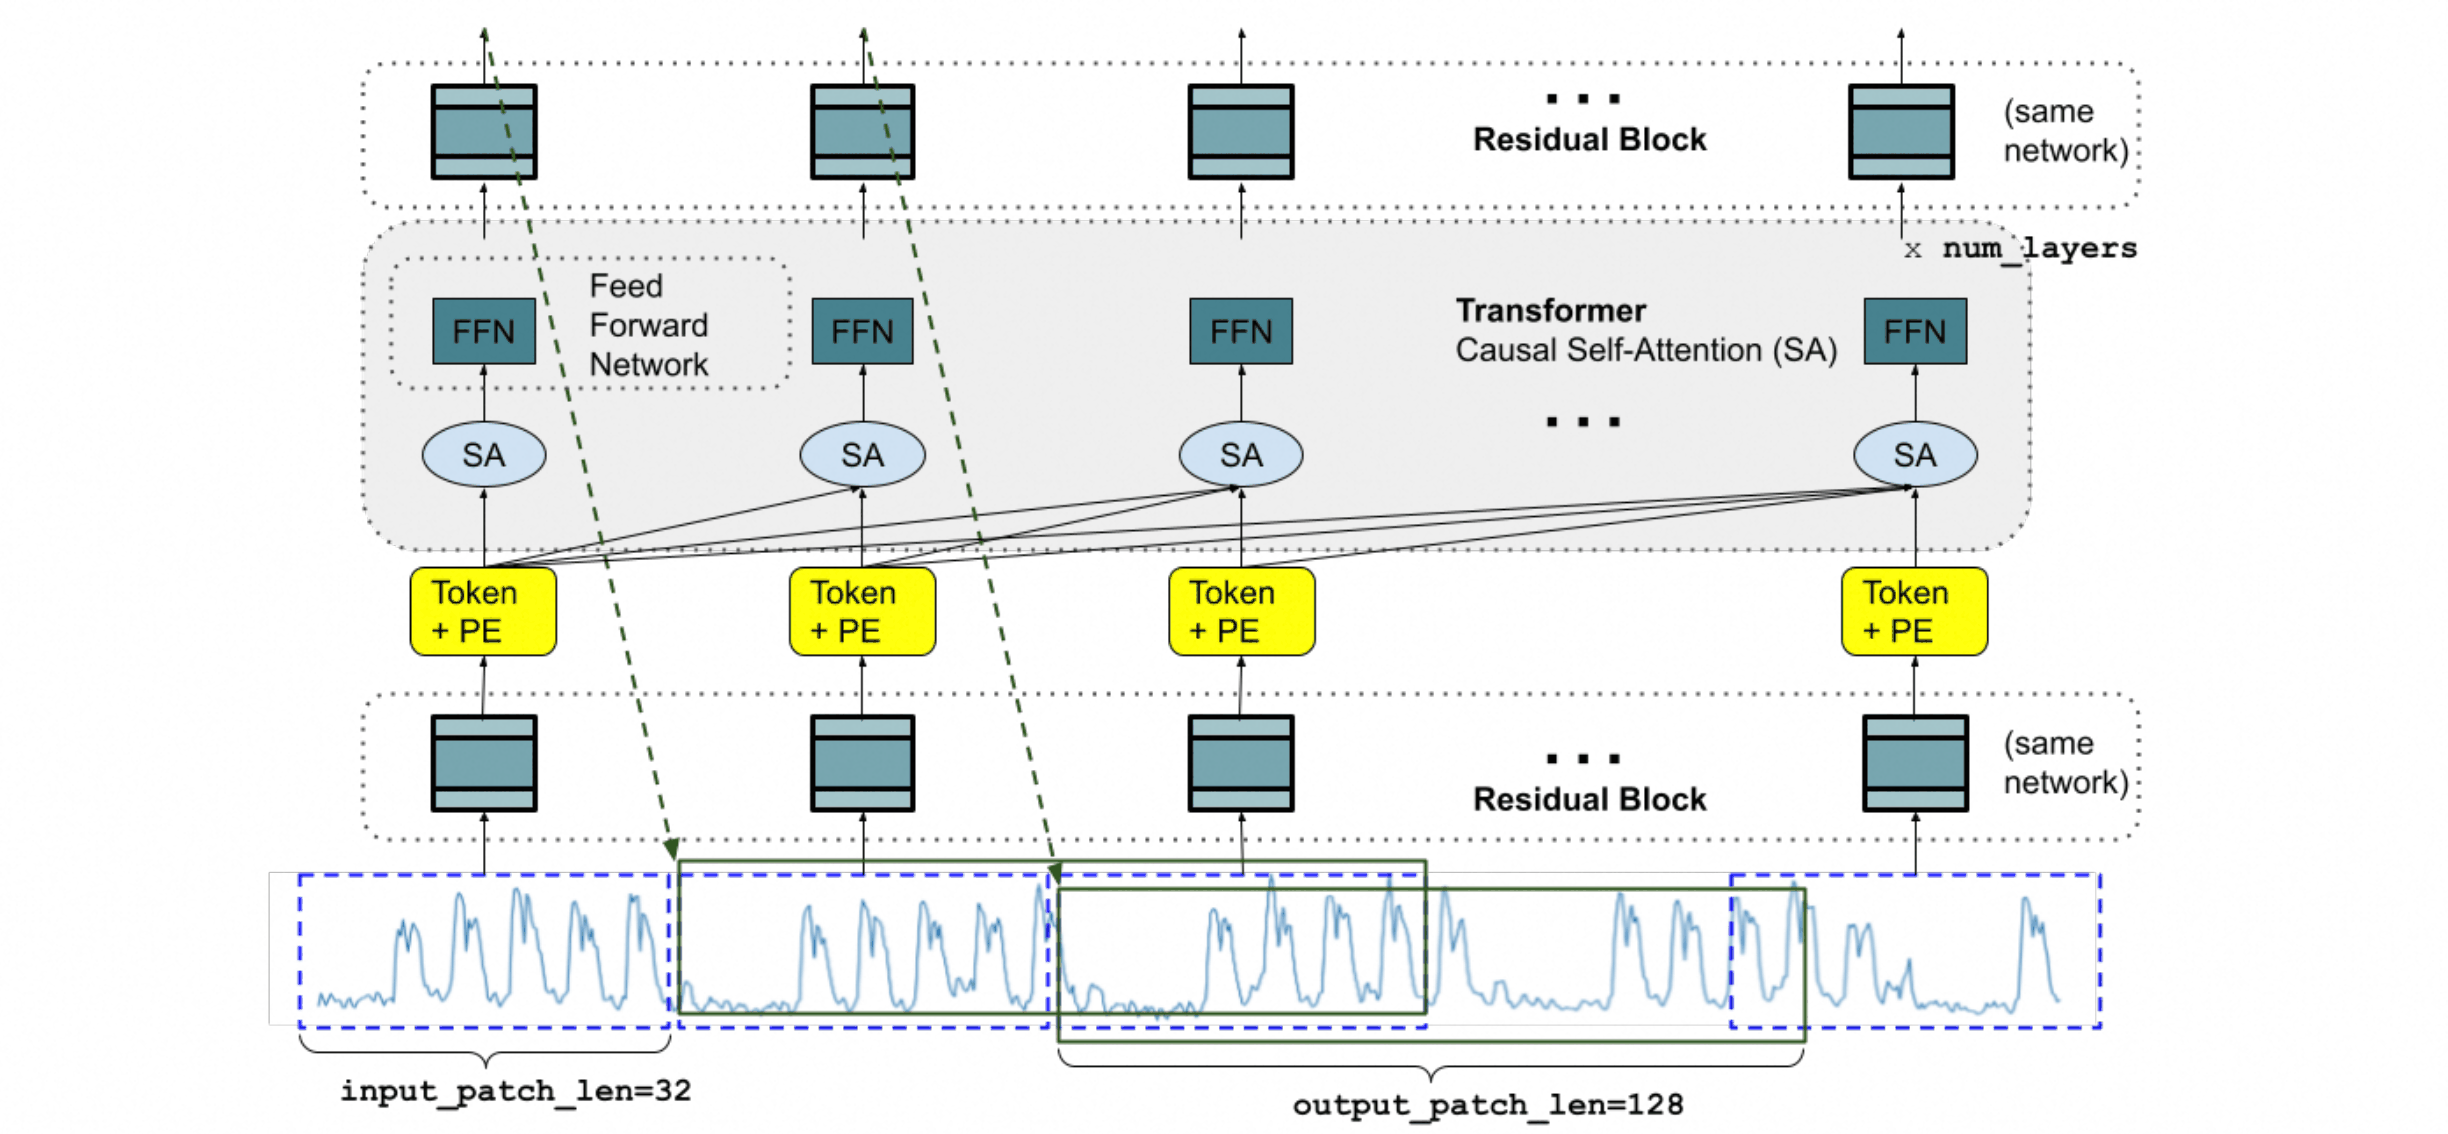
TimesFM把块化推广到仅解码器的时间序列基础模型:输入块长$32$,每个块经残差MLP嵌入为一个标记,模型以因果注意力在块序列上自回归,每个输出标记预测未来$128$个时间点(输出块长大于输入块长,以减少长预测时的自回归步数)。在大规模时间序列语料上预训练后,它对多种公开数据集的零样本预测精度接近针对每个数据集单独训练的监督模型,并能适应不同的历史长度、预测长度与时间粒度。
⚪ LLMTime:把时间序列写成数字字符串
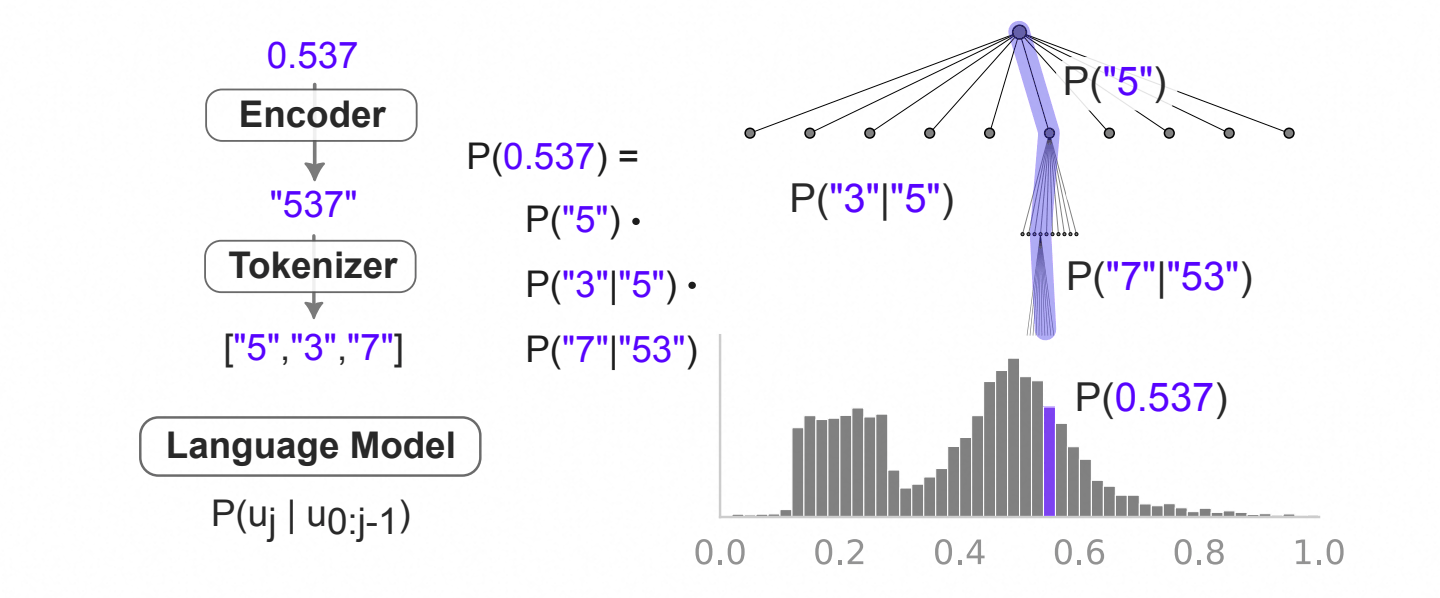
LLMTime把时间序列编码为数字字符串,从而把预测转化为文本的下一标记预测,直接用GPT-3、LLaMA-2等大语言模型做零样本预测。标记化的要点是:
- 缩放:对序列做平移与缩放,使其$\alpha$分位数映射到$1$附近,避免数值过大占用过多数字;
- 固定精度:保留固定的小数位数后去掉小数点,例如$0.123,1.23,12.3$在$2$位精度下写为
12、123、1230; - 数字切分:GPT-3的BPE会把数字串按频率任意合并(如
123可能是一个标记,1234被切为12与34),使相同位置的数字得到不一致的标记,因此在数字之间加入空格,强制逐位切分;LLaMA的分词器本身逐位切分数字,无需加空格; - 分隔:时间步之间用逗号分隔,如
1 2 3 , 1 3 0 , ...。
模型输出的是数字串上的离散分布,论文给出把它转换为连续密度的方法:以$B=10$为底、$n$位精度时,每个数字串对应宽度为$B^{-n}$(在缩放后的尺度上)的一个区间,在区间内取均匀分布,则连续密度为$p(x)=P(\text{digits}(x))\cdot B^{n}$,即$\log p(x)=\log P(\text{digits}(x))+n\log B$(再加上缩放变换的雅可比项)。按数位逐层展开,这是一个层级化的分箱均匀分布,可以灵活地表示多峰分布。
⚪ Chronos:缩放与量化的时间序列语言
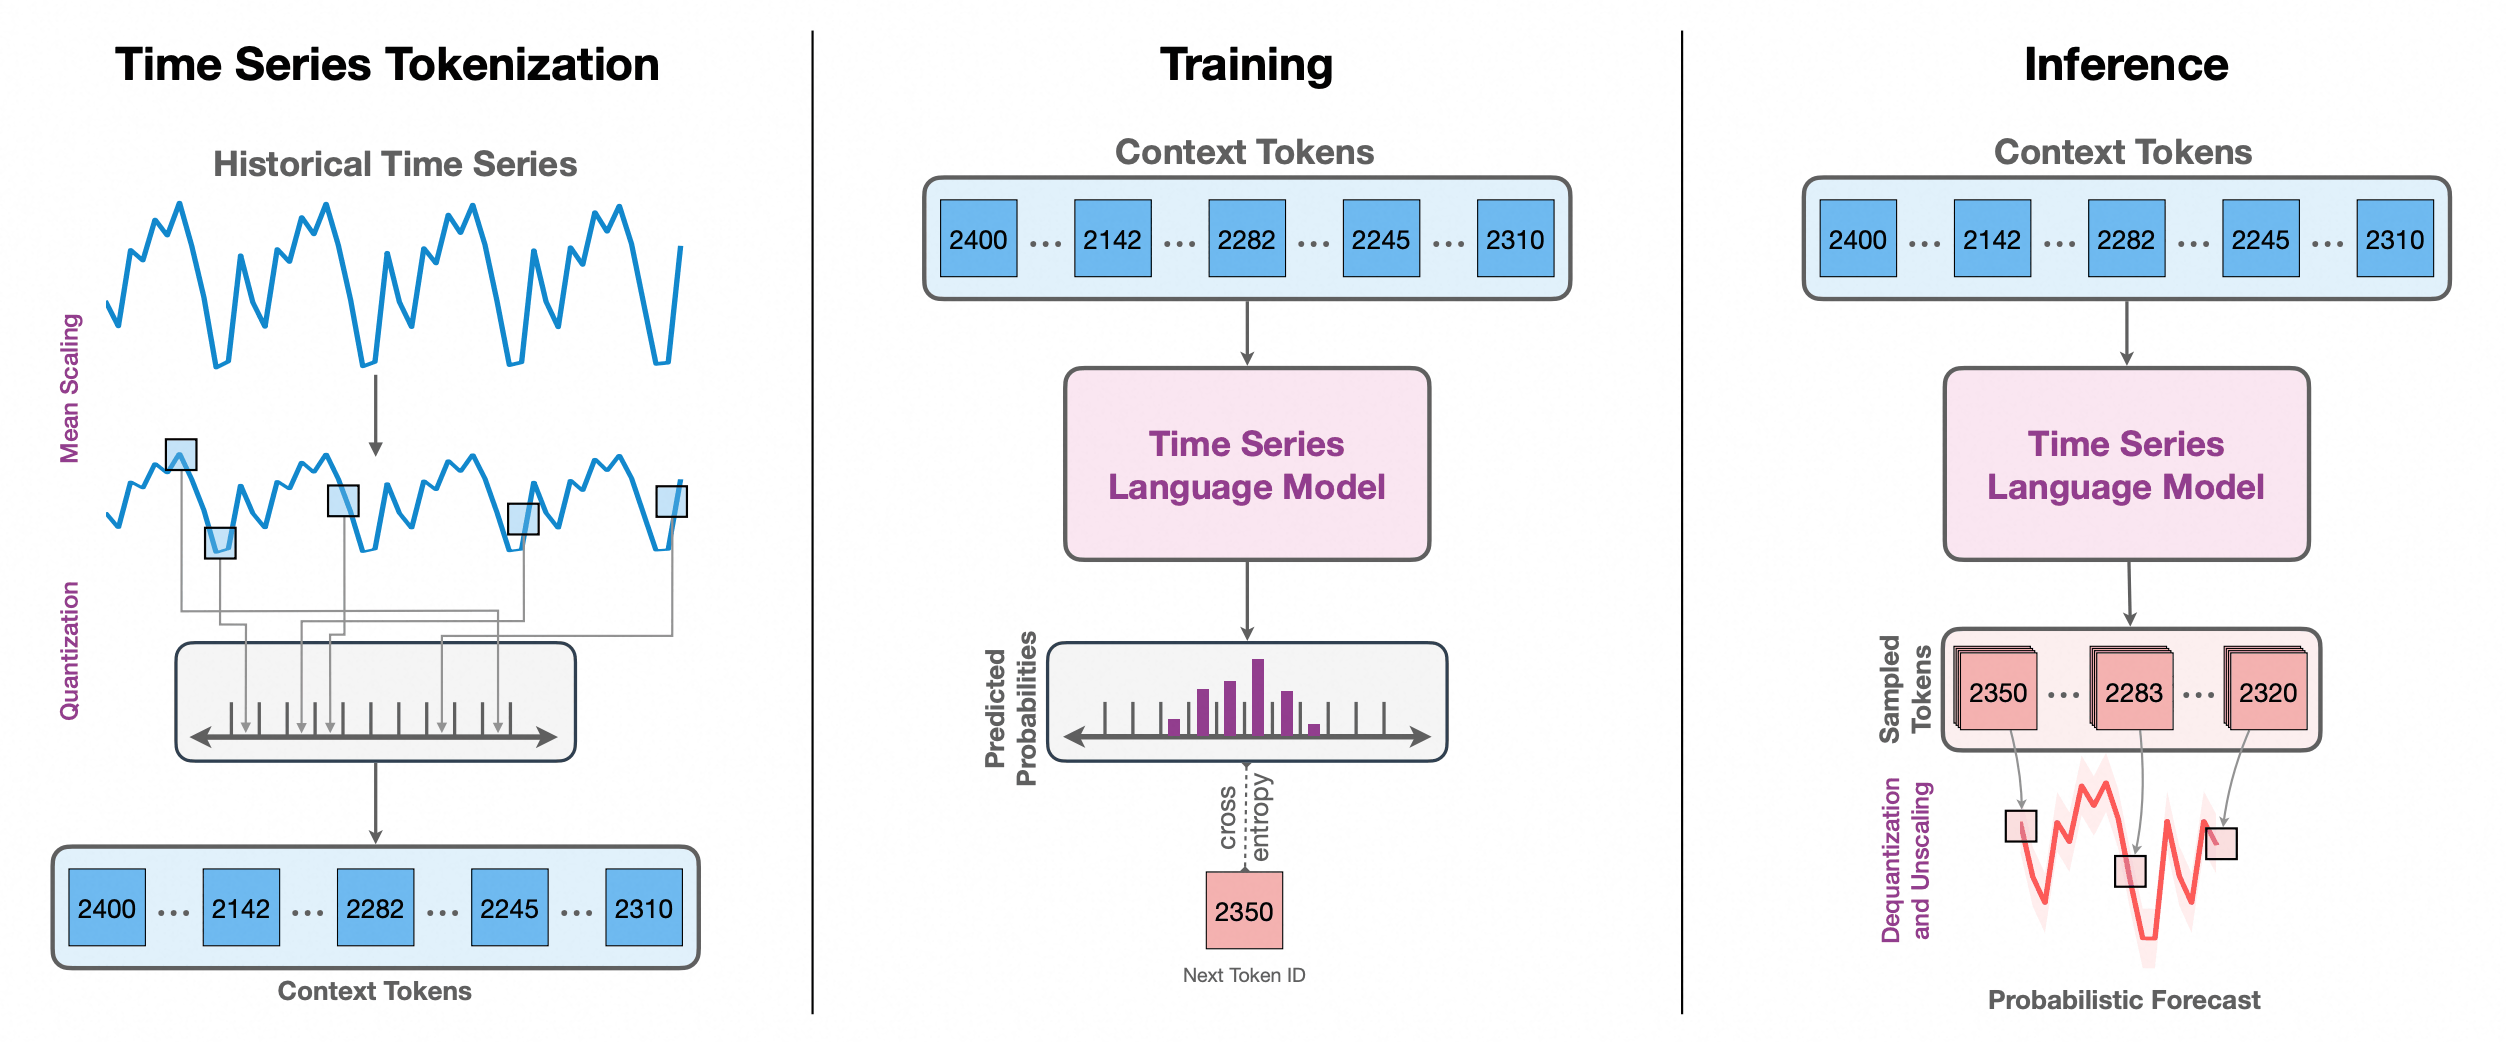
Chronos把时间序列值通过缩放与量化映射为固定词表中的标记,再用现成的语言模型结构(T5系列,$2000$万到$7.1$亿参数)以交叉熵训练:
- 均值缩放:对长度为$C$的上下文窗口,\(\tilde{x}_i=(x_i-m)/s\),取$m=0$、\(s=\frac{1}{C}\sum_{i=1}^{C}\vert x_i\vert\),使不同量纲的序列落在相近的范围;
- 均匀量化:在$[c_1,c_B]=[-15,15]$内设$B$个等宽箱,箱中心为$c_1<\cdots<c_B$、边界为$b_j=(c_j+c_{j+1})/2$,量化函数为$q(\tilde{x})=j$当且仅当$b_{j-1}\le\tilde{x}<b_j$($b_0=-\infty$、$b_B=\infty$);
- 词表:$4094$个数据箱加上
PAD(用于填充与缺失值)与EOS两个特殊标记,共$4096$个标记; - 反量化:预测的标记映射回箱中心再乘以缩放因子$s$,即$\hat{x}=c_j\cdot s$。
由于是在类别分布上做分类,模型可以表示任意形状(包括多峰)的预测分布;预测时自回归采样多条轨迹得到概率预测。
(2) 机器人动作
⚪ RT-2:把动作写成文本标记
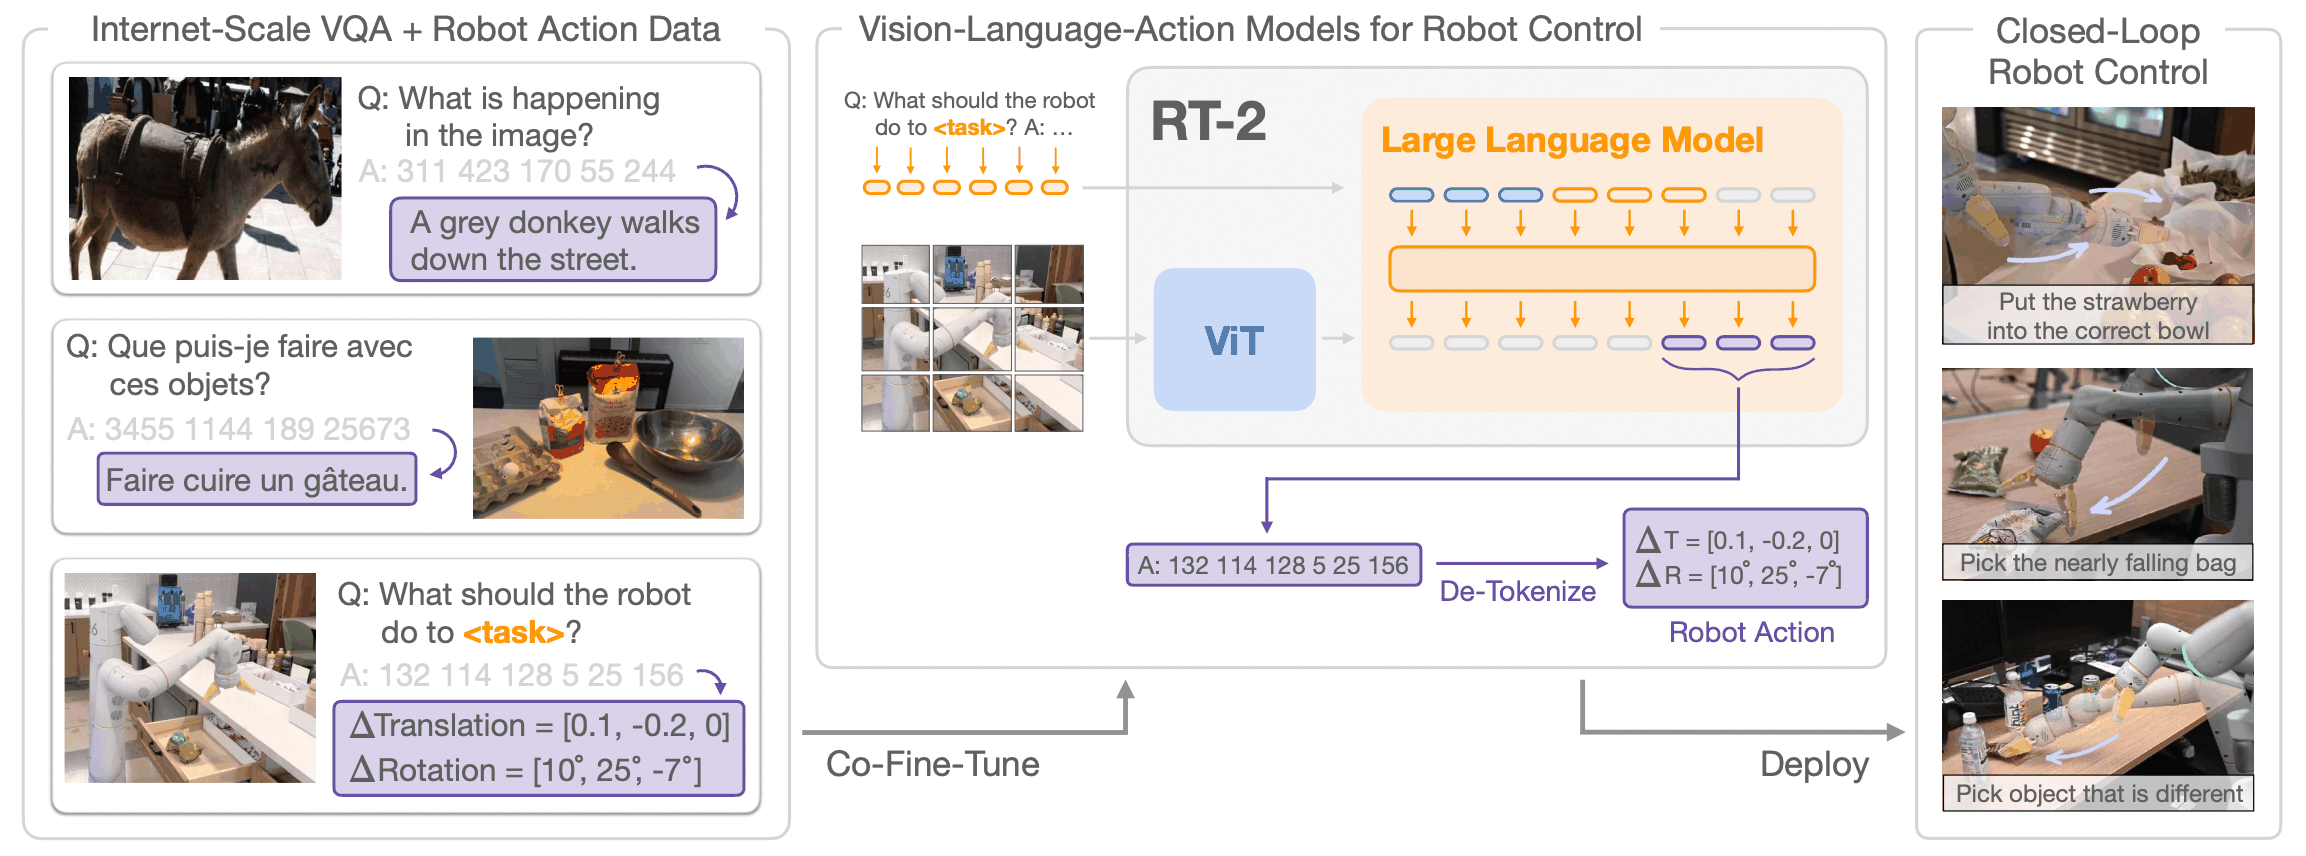
RT-2把互联网规模预训练的视觉-语言模型直接用于端到端的机器人控制。为了让自然语言回答与机器人动作使用相同的输出格式,它把动作表示为文本标记:机器人的动作空间包括位置与旋转的$6$自由度增量、夹爪开合程度以及一个表示是否结束本回合的标志;每个连续维度被均匀离散化为$256$个箱,于是一个动作就是$8$个整数,例如1 128 91 241 5 101 127 217。这些整数需要对应到语言模型的词表:对于词表中$0\sim1000$的整数各有独立标记的PaLI-X,直接用数字标记表示箱编号;对于PaLM-E,则把词表中$256$个使用频率最低的标记重新指派为动作箱。
训练时,RT-2在机器人轨迹数据与互联网规模的视觉-语言任务(如视觉问答)上联合微调,动作标记与自然语言标记以完全相同的方式进入训练集;推理时,当提示要求输出机器人动作时,把解码限制在合法的动作标记上。这类模型被称为视觉-语言-动作模型(VLA)。
⚪ FAST:基于离散余弦变换的动作标记化
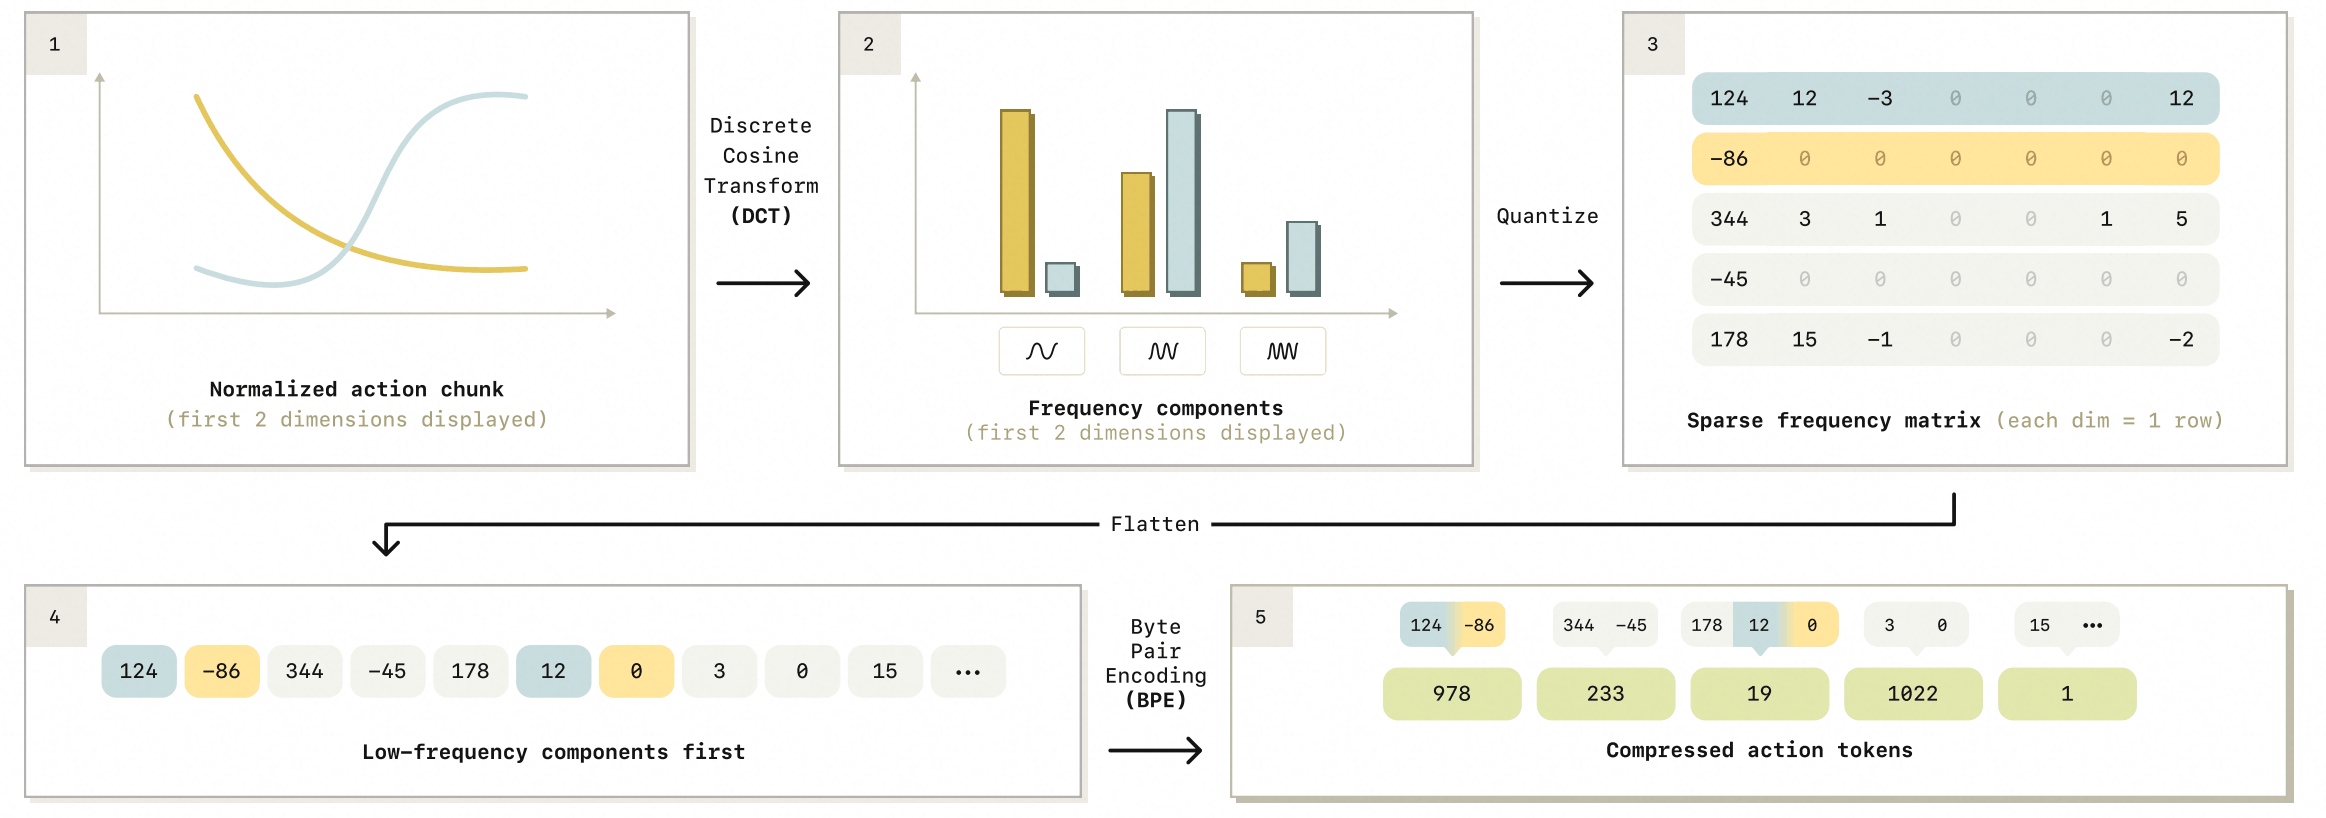
逐维度、逐时间步的简单分箱(通常$N=256$个箱)在高频、灵巧的机器人数据上表现不佳:控制频率高时相邻时间步的动作高度相关,逐步分箱得到的标记中,下一个标记几乎总能由前一个标记推出,每个标记携带的边际信息接近零,自回归模型难以从训练信号中学到有用的东西。
FAST(Frequency-space Action Sequence Tokenization)借鉴图像与视频压缩,把一段动作序列先变换到频域再压缩为标记。对一段$H$步、$D$维的动作块$a\in\mathbb{R}^{H\times D}$:
- 归一化:把每一维训练数据的第$1$与第$99$分位数映射到$[-1,1]$;
-
离散余弦变换:对每个动作维度$d$独立做DCT,
\[C^{d}_{k}=\sum_{t=0}^{H-1}a_{t,d}\cos\left[\frac{\pi}{H}\left(t+\frac{1}{2}\right)k\right],\quad k=0,\dots,H-1\]平滑的动作信号能量集中在少数低频系数上;
- 缩放取整:$\bar{C}^{d}_k=\text{round}(\gamma\cdot C^{d}_k)$,缩放系数$\gamma=10$控制有损压缩的精度,大量高频系数变为$0$,得到一个稀疏的整数矩阵;
- 展平:按低频优先、维度交错的顺序展平,即$[\bar{C}^{1}_0,\bar{C}^{2}_0,\dots,\bar{C}^{D}_0,\bar{C}^{1}_1,\dots]$,使最重要的信息排在序列前面;
- BPE压缩:在展平的整数序列上训练词表大小为$1024$的BPE,把常见的系数组合(尤其是大量的$0$)合并为单个标记,得到长度可变的紧凑标记序列。
解码时按相反顺序进行:BPE解码、反展平、除以$\gamma$、逆DCT、反归一化。FAST使自回归VLA能够完成标准离散化方法完全失败的高频灵巧任务。
(3) 点云、图与推荐系统
⚪ Point-BERT:点云的离散标记
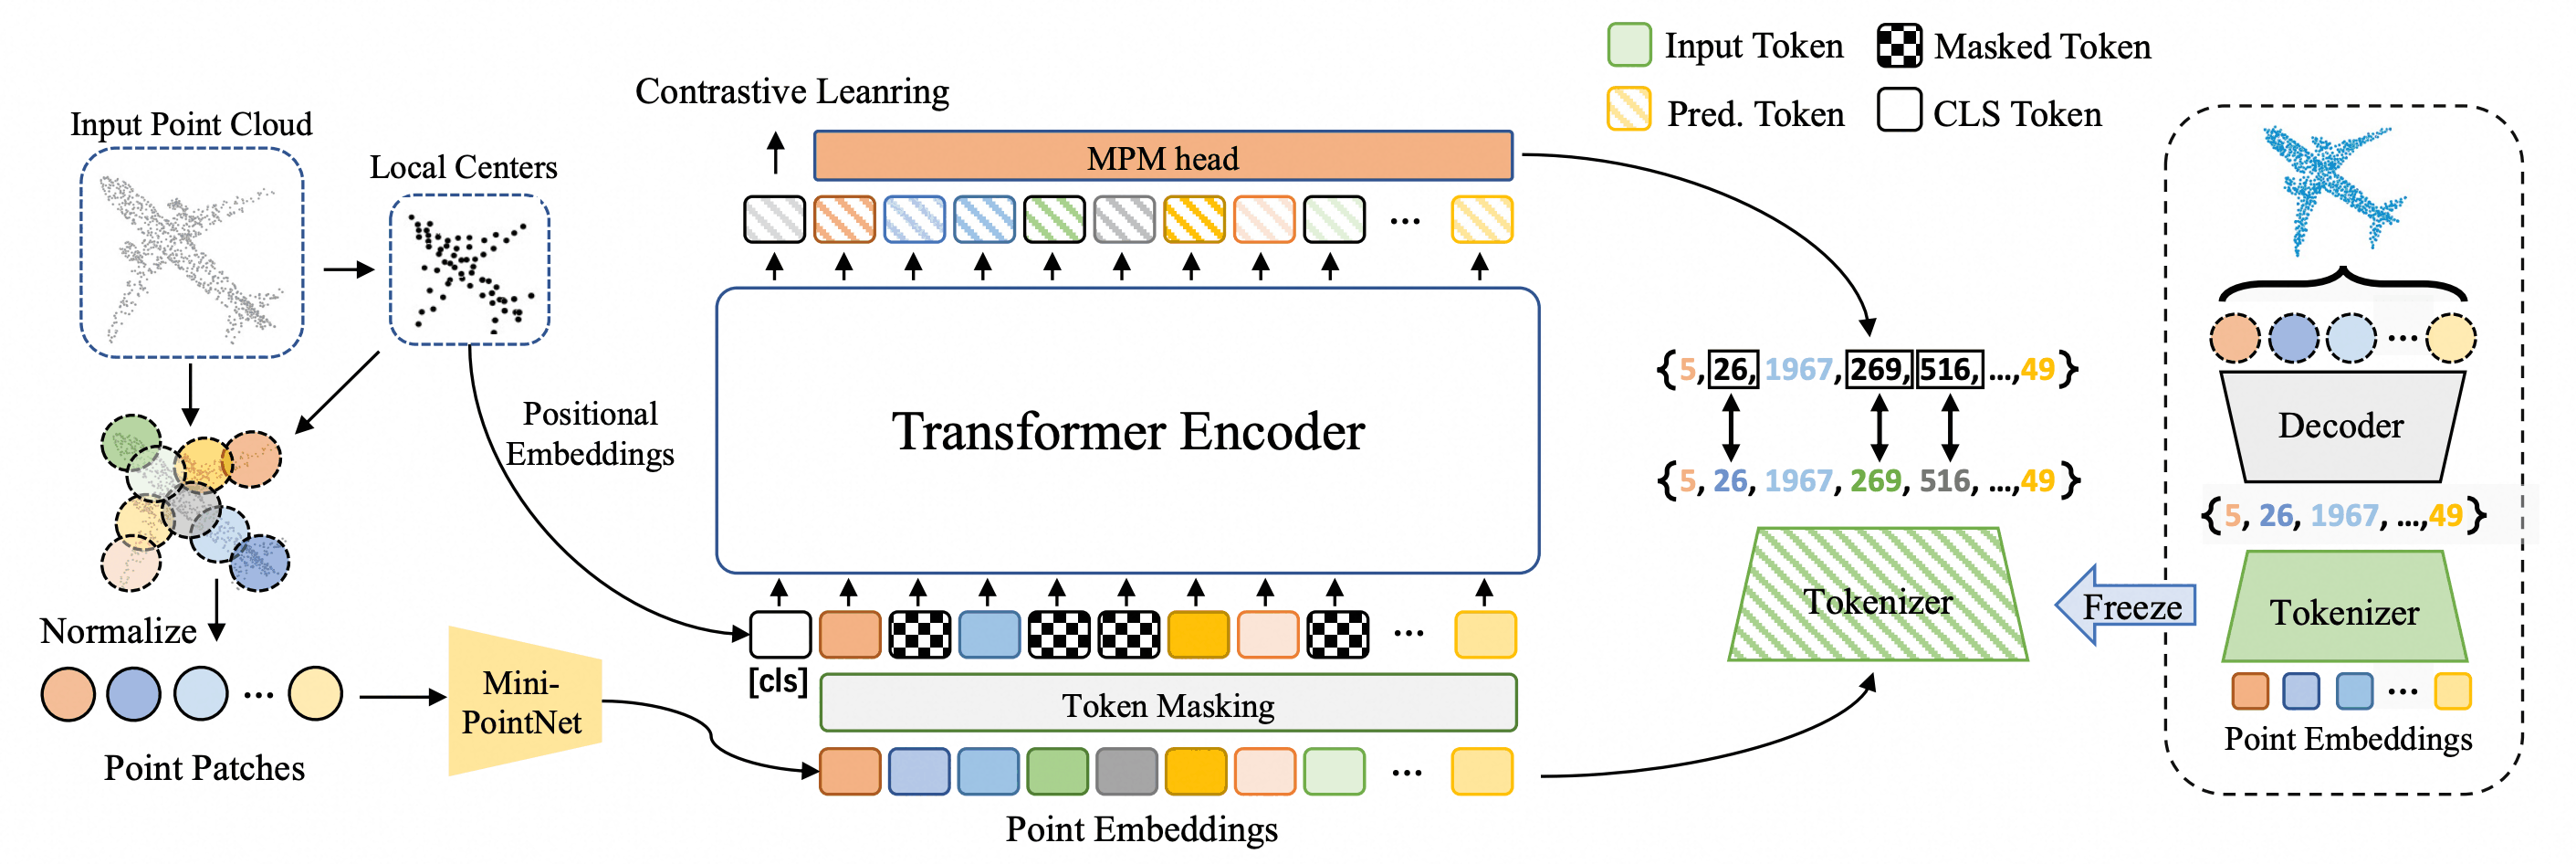
Point-BERT把BERT式预训练推广到三维点云,其关键是一个点云分词器:
- 点块划分:用最远点采样从点云中选出$g$个中心点,再以每个中心点的$k$近邻组成$g$个局部点块,块内坐标减去中心点坐标做归一化;
- 点块嵌入:一个小型PointNet把每个点块编码为一个嵌入向量;
- 离散分词器:一个dVAE把点块嵌入映射为码本(大小$8192$)上的离散点标记——编码器(DGCNN)输出每个点块在码本上的logits,训练时用Gumbel-Softmax松弛采样;解码器(DGCNN加FoldingNet)从点标记重构点块,以Chamfer距离为重构损失。
预训练任务为掩码点建模(Masked Point Modeling, MPM):随机遮住部分点块(按块状掩码遮住约$25\%\sim45\%$),把剩余点块送入骨干Transformer,在被遮位置上预测分词器给出的点标记;论文还加入点块混合与对比学习的辅助目标。
⚪ TokenGT:把节点与边都视为标记
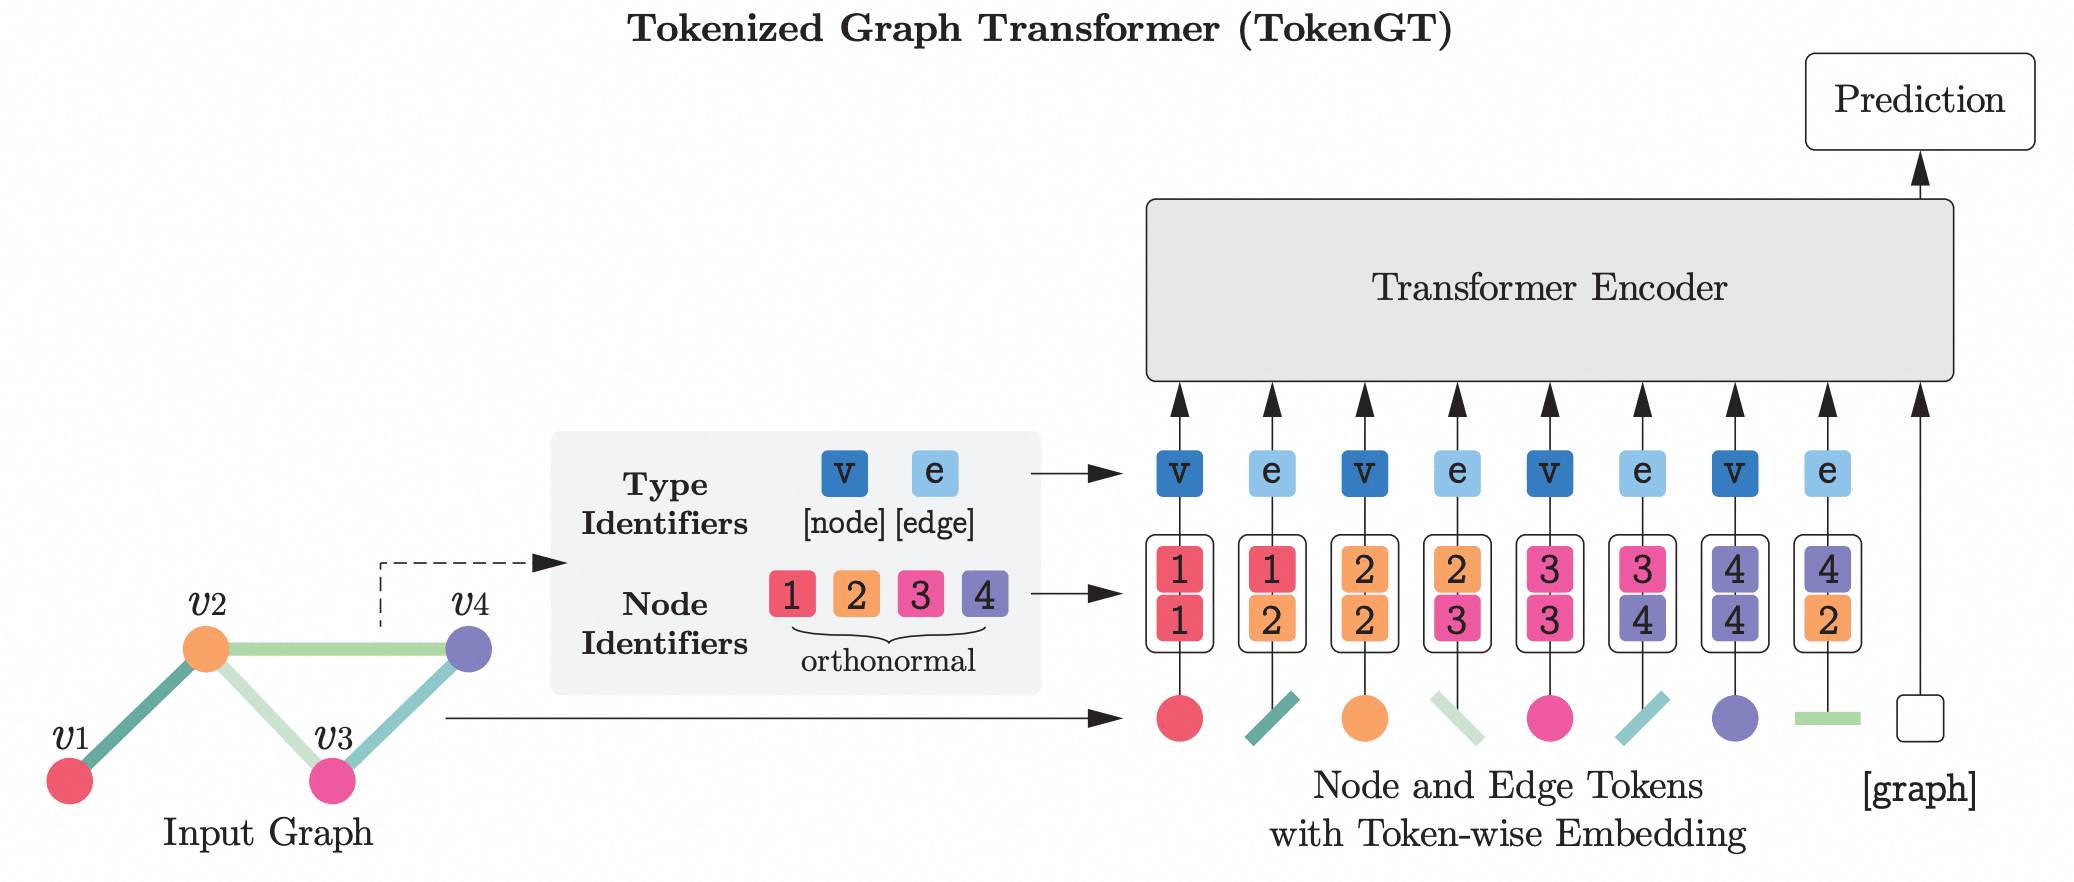
图的节点与边本身就是离散单元,GNN以节点为基本单元做消息传递,Graphormer等图Transformer把节点特征与最短路径编码等结构偏置加入注意力。TokenGT(Tokenized Graph Transformer)则表明,不加任何图专用修改的标准Transformer也能有效学习图:对一个有$n$个节点、$m$条边的图,把所有节点与边都作为独立的标记,共$n+m$个标记,并为其构造合适的标记嵌入:
- 节点标识符:为每个节点$v$分配一个标识向量$P_v\in\mathbb{R}^{d_p}$,取一组正交向量(如随机正交向量或图拉普拉斯矩阵的特征向量);
- 标记特征:节点$v$的标记为$[X_v,P_v,P_v]$,边$(u,v)$的标记为$[X_{(u,v)},P_u,P_v]$,其中$X$为原始特征;
- 类型标识符:再加上区分节点与边的可学习类型嵌入,经线性投影后送入Transformer。
由于标识符正交,注意力可以通过内积$P_u^{\top}P_v$识别“某条边连接哪两个节点”,从而在没有显式结构偏置的情况下恢复图的连接关系。论文证明,在适当的标记嵌入下,该方法的表达能力至少与由等变线性层构成的二阶不变图网络(2-IGN)相当。
⚪ TIGER:推荐系统的语义ID
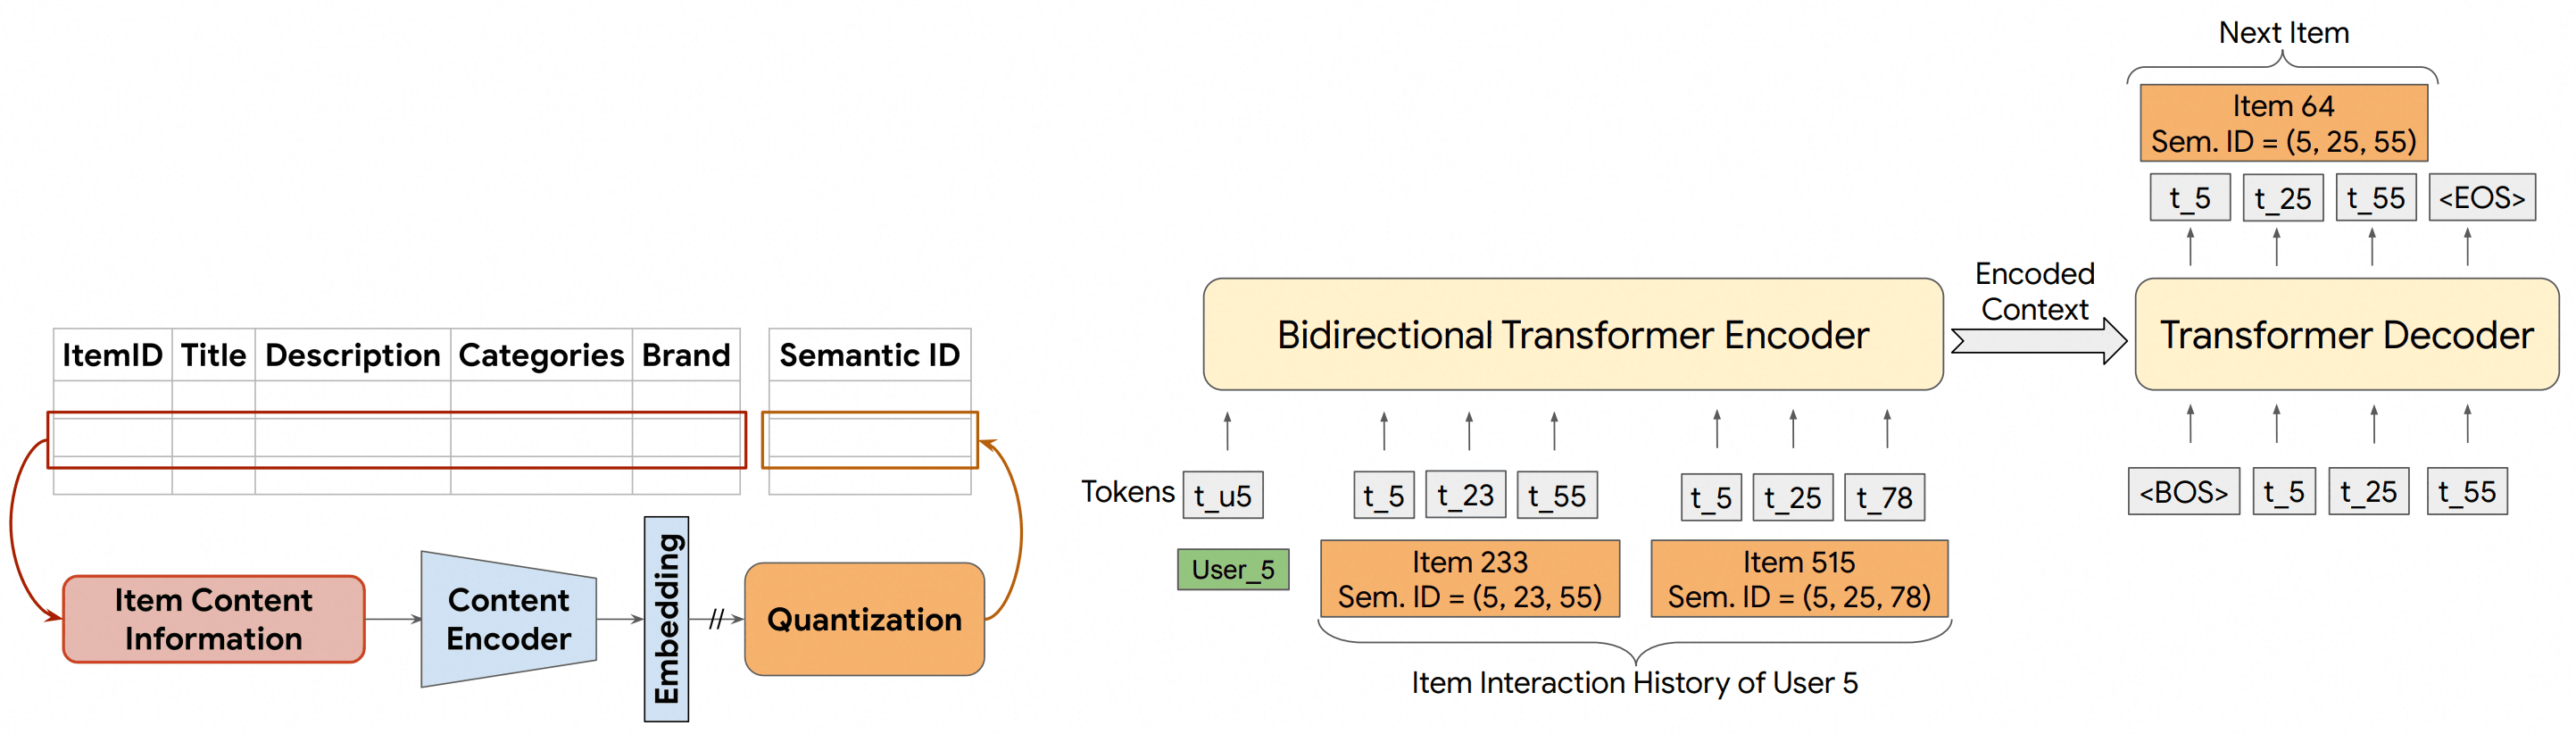
推荐系统中的物品ID天然就是标记,但随机分配的原子ID之间没有语义关系,新物品的ID也无法从内容中推断。TIGER提出生成式检索:为每个物品构造一个由多个码字组成的语义ID,再让序列模型直接自回归地“生成”下一个物品的语义ID。语义ID的构造是残差量化的又一次应用:
- 用预训练文本编码器(Sentence-T5)把物品的内容特征(标题、描述、类别、价格等)编码为语义嵌入;
- 用RQ-VAE对语义嵌入做$3$级残差量化,每级码本大小$256$,得到码字元组$(c_1,c_2,c_3)$;第一级码字刻画最粗的语义类别,后续各级逐级细化;
- 若多个物品的码字元组相同,追加第$4$个标记加以区分,保证每个物品的语义ID唯一。
用户的交互历史被表示为各物品语义ID拼接成的标记序列,一个Transformer序列到序列模型以此为输入,用束搜索解码下一个物品的语义ID。由于语义相近的物品共享前缀码字,模型能把知识迁移到交互很少甚至没有交互历史的物品上。
8. 多模态统一标记化
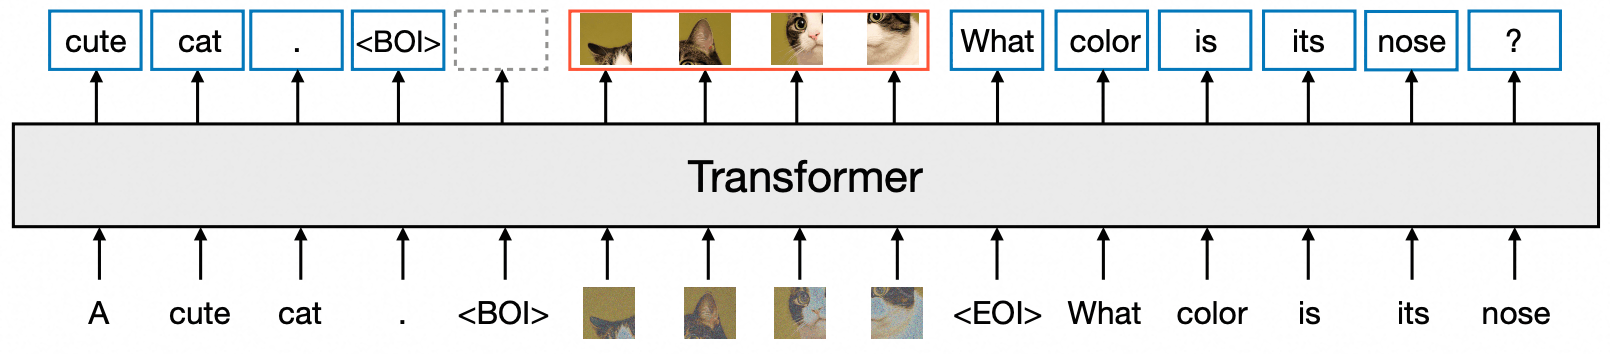
多模态学习的趋势是统一词表:把文本子词、图像VQ码与音频RVQ码放进同一个softmax,模型用特殊标记切换模态,从而用一个自回归Transformer处理任意模态的组合(如输入文本、输出图像与音频)。
标记化因此不再只是预处理,而是多模态统一模型的结构性接口。围绕这一接口有三条路线:早期融合直接把所有模态的离散标记拼成一个序列;统一视觉分词器让同一套视觉标记同时满足理解(需要语义)与生成(需要细节);混合接口让文本保持离散、图像使用连续标记,在同一个模型中分别用下一标记预测与扩散目标训练。
(1) 早期融合的统一词表
⚪ Gato:把一切序列化为标记
- paper:A Generalist Agent
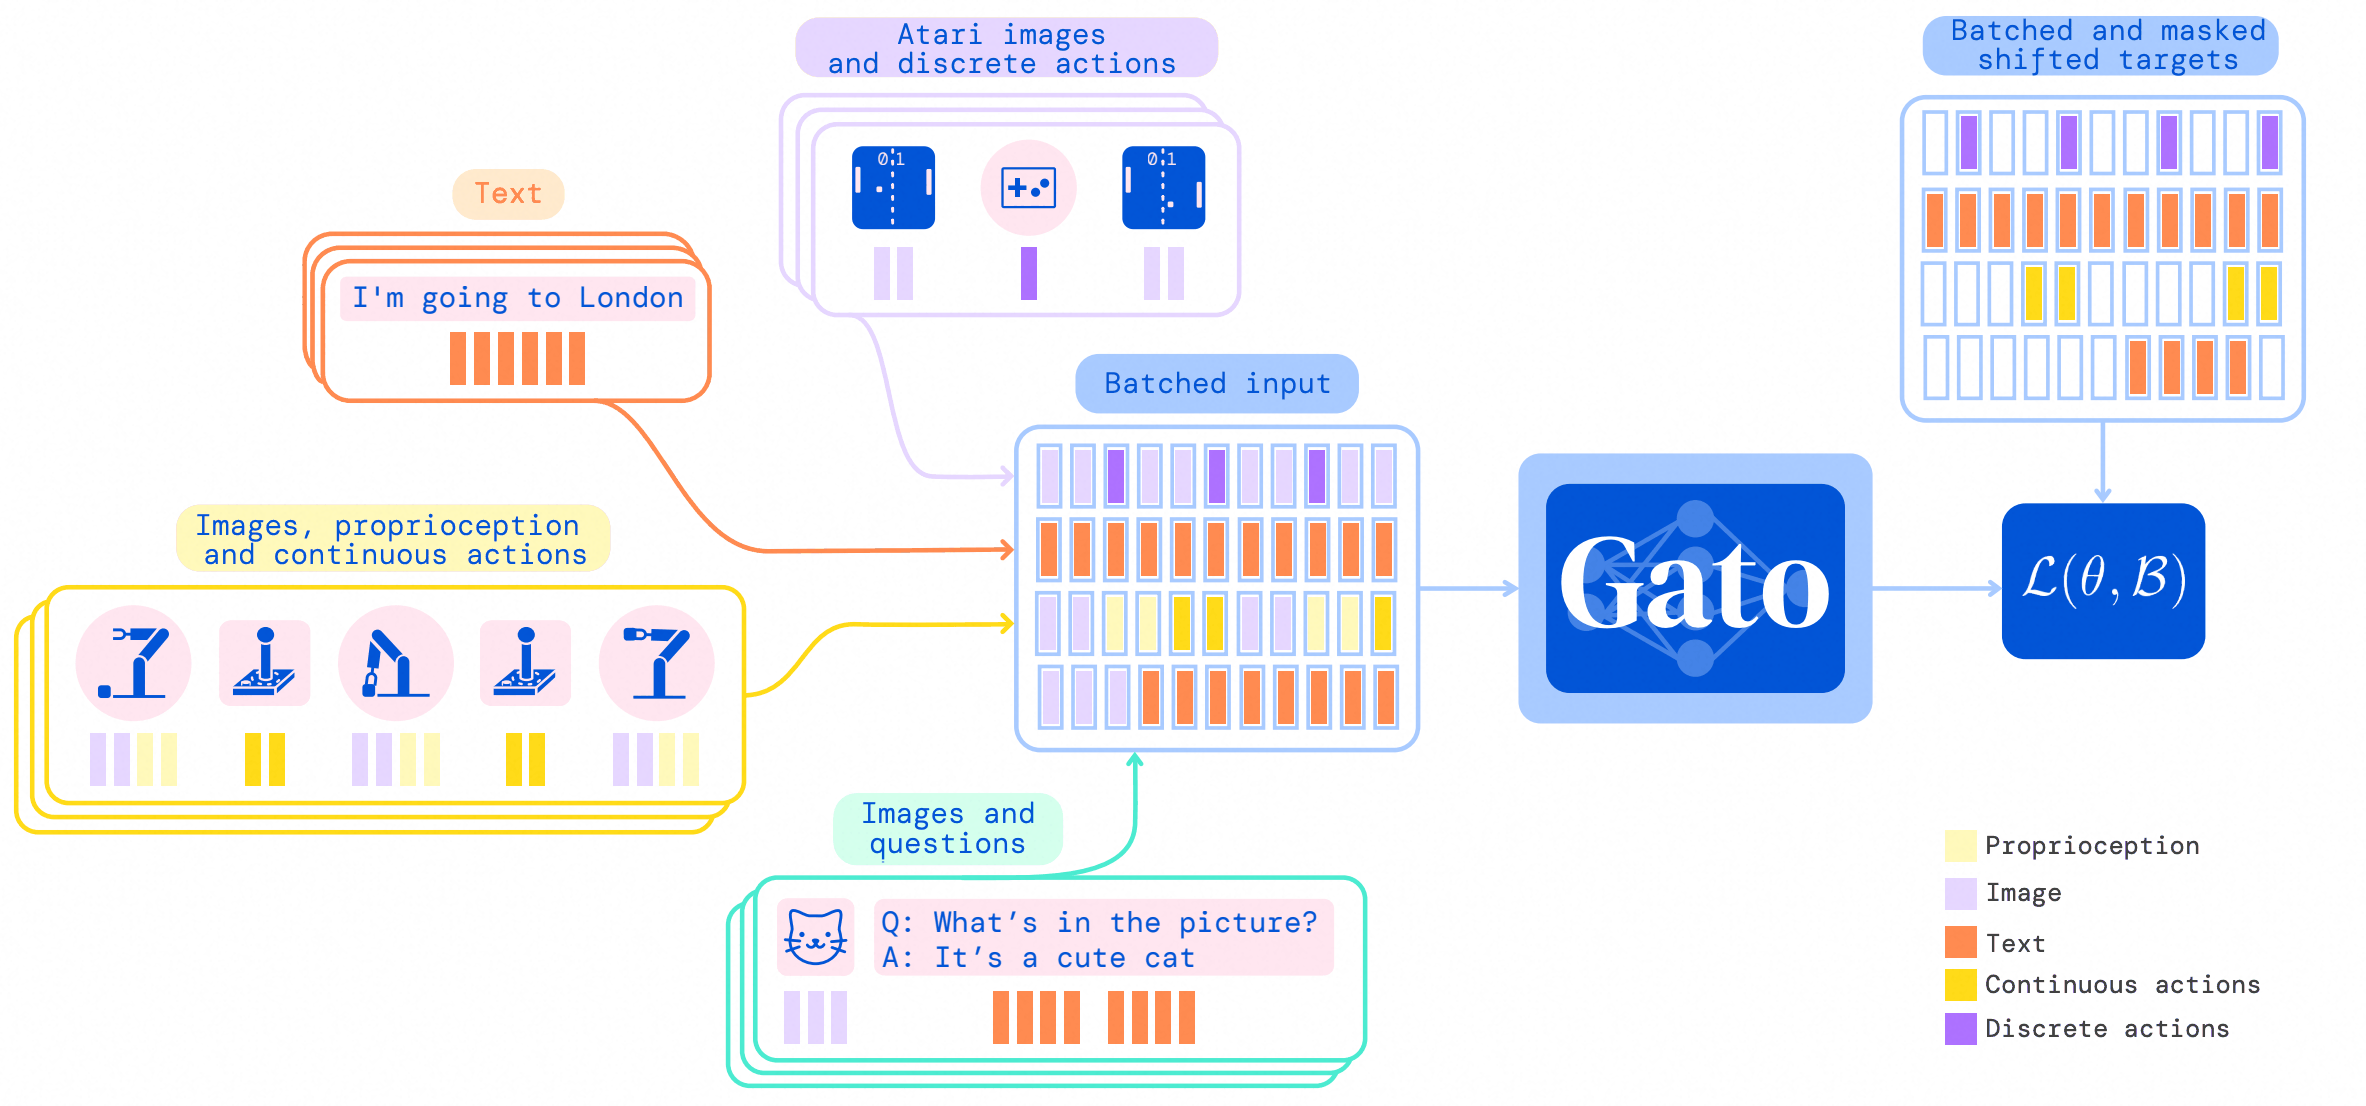
Gato是一个多模态、多任务、多具身的通用策略:同一个网络、同一组权重可以玩Atari游戏、给图像写描述、聊天、用真实机械臂堆积木,并根据上下文决定输出文本、关节力矩、按键还是其他标记。其基础是一套把所有数据扁平化为标记序列的规则:
- 文本:用SentencePiece编码为$32000$个子词,标记取值为$[0,32000)$;
- 图像:按ViT的方式切成不重叠的$16\times16$图像块(光栅顺序),像素归一化后经一个ResNet块嵌入,不做离散化;
- 离散值(如Atari按键):按行优先展平为$[0,1024)$内的整数序列;
- 连续值(如本体感觉、关节力矩):先展平,再用mu-law式压扩 \(F(x)=\text{sgn}(x)\frac{\log\left(|x|\mu+1\right)}{\log\left(M\mu+1\right)},\quad \mu=100,\ M=256\) 把取值压到$[-1,1]$,再均匀离散化为$1024$个桶,最后整体平移到$[32000,33024)$,与文本标记区分。
一个时间步的观测按“文本、图像块、离散值、连续值”的顺序排列,与动作之间用一个分隔标记隔开;多个时间步依次拼接为序列。训练时只对文本与动作标记计算自回归损失(观测标记作为条件)。
⚪ Chameleon:基于标记的早期融合
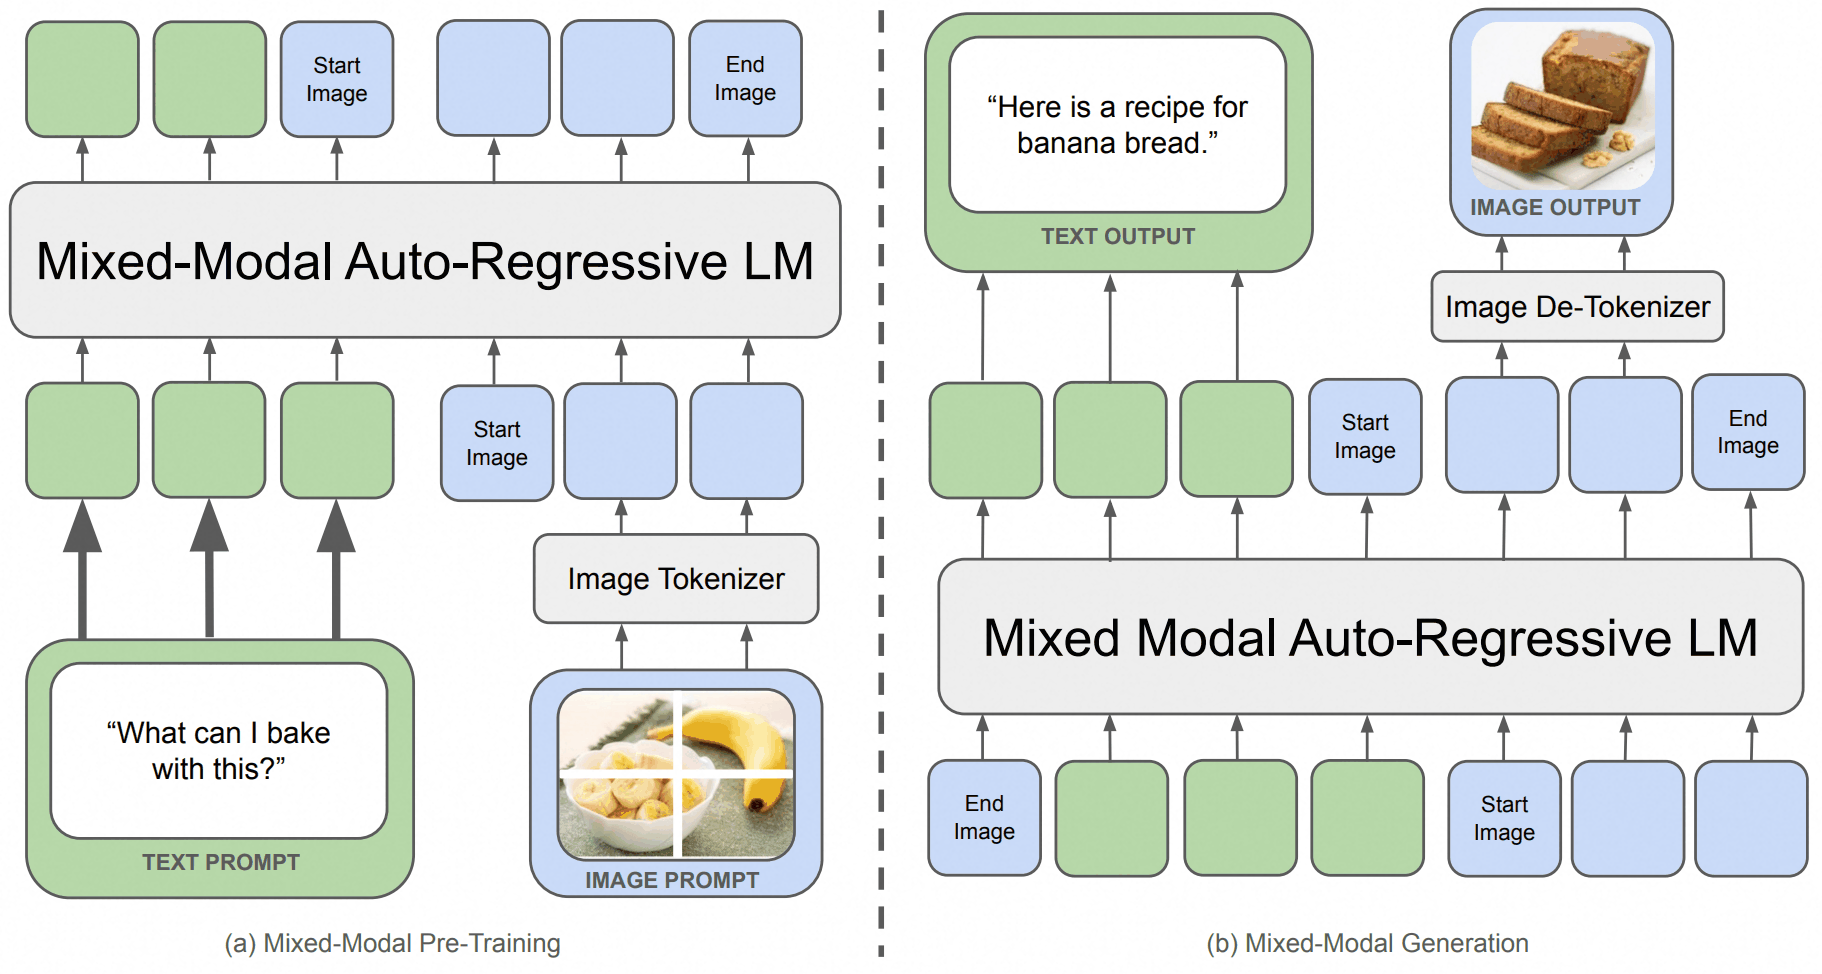
Chameleon是一族早期融合(early fusion)、完全基于标记的混合模态模型,可以理解并生成任意顺序交错的图像与文本。其标记化有两部分:
- 图像分词器:基于Make-A-Scene的VQ分词器,把$512\times512$的图像编码为$1024$个离散标记,码本大小为$8192$;训练数据中人脸图像被上采样以提升人脸生成质量;
- 文本分词器:用SentencePiece训练的BPE分词器,词表大小为$65536$,其中包含图像码本的$8192$个标记,即图像码与文本子词共享同一个词表与同一个输出softmax。
图像标记序列用开始/结束图像的哨兵标记包裹后与文本标记直接拼接,所有模态从预训练一开始就由同一个Transformer处理。为了在混合模态的大规模训练中保持稳定,Chameleon引入了QK-Norm(对注意力的查询与键做层归一化)、z-loss正则与重排的归一化位置。
⚪ Emu3:只用下一标记预测的多模态模型
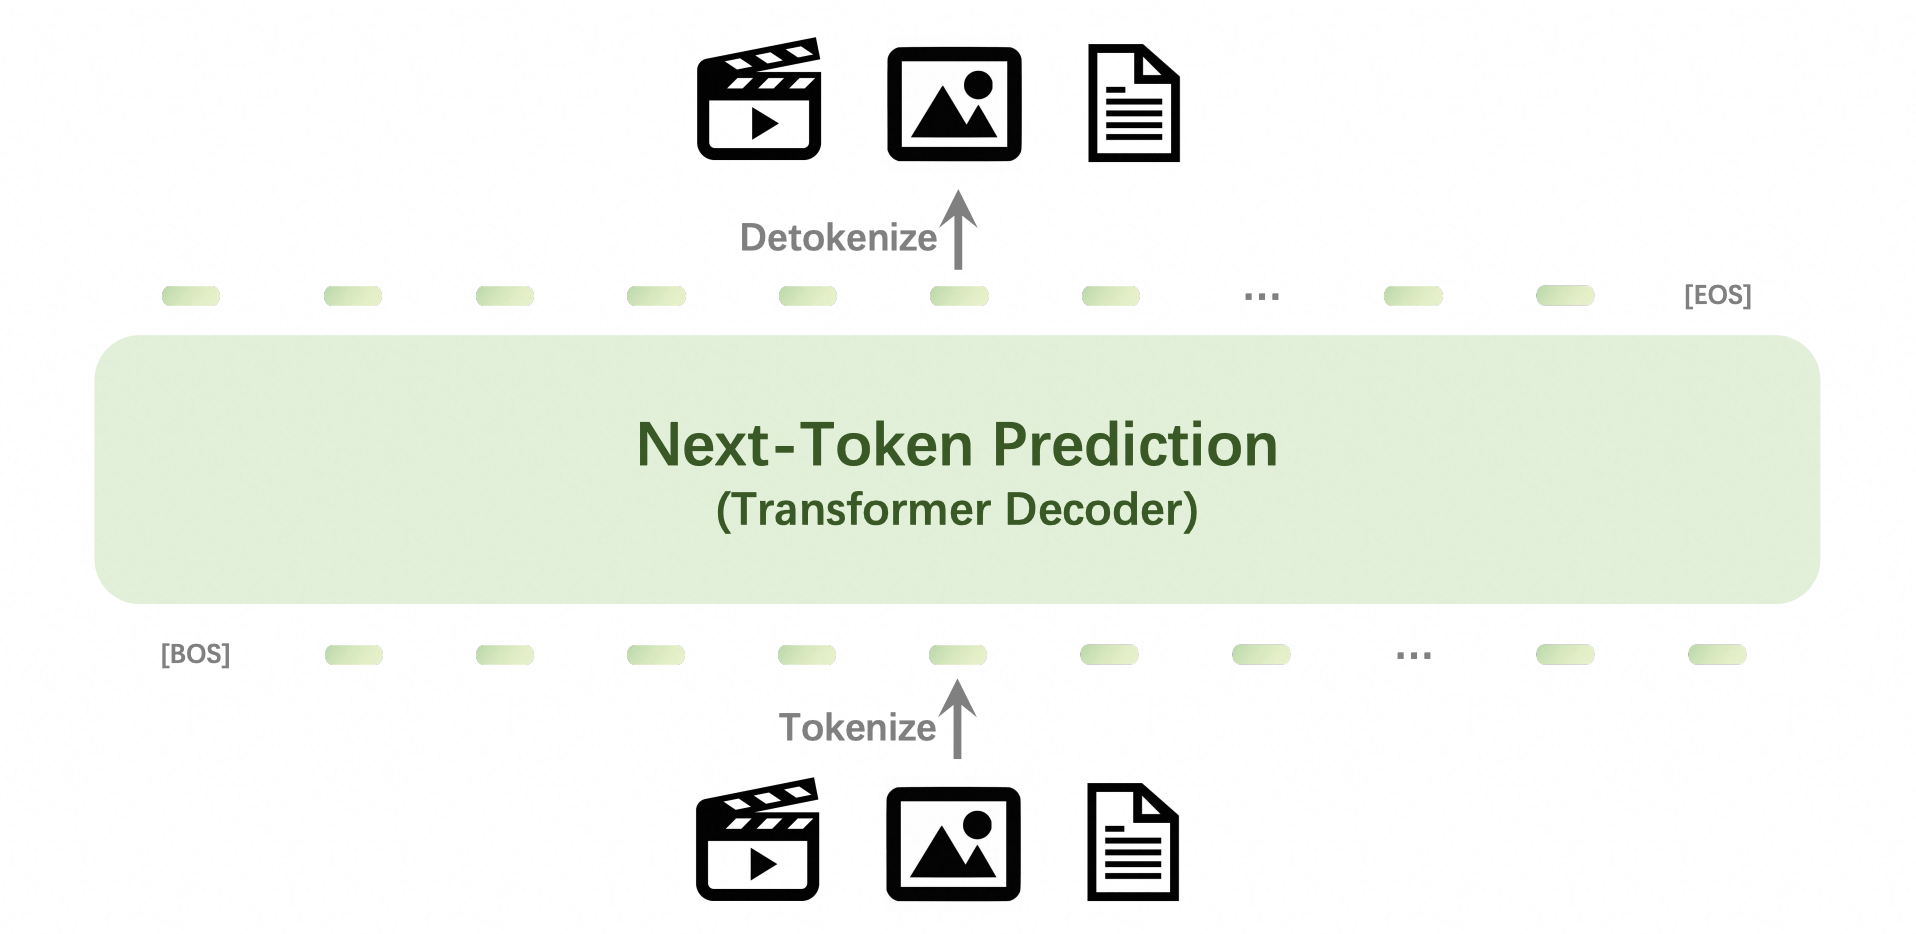
Emu3把图像、文本与视频都标记化到同一个离散空间,在混合多模态序列上从零训练一个Transformer,只使用下一标记预测目标。其视觉分词器基于SBER-MoVQGAN:码本大小为$32768$,空间压缩$8\times8$倍,时间压缩$4$倍,编码器与解码器中各加入两个使用三维卷积核的时间残差层以处理视频;一张$512\times512$的图像被编码为$64\times64=4096$个离散标记。文本使用QwenTokenizer,统一词表大小为$184622$。
视觉数据在序列中用特殊标记组织:[SOV]标记视觉输入的开始(其后先以文本形式给出分辨率等元信息),[SOT]标记视觉标记的开始,[EOV]标记视觉输入的结束;每一行视觉标记之后插入换行标记、每一帧之后插入帧结束标记,以保留二维与时间结构。
(2) 理解与生成统一的视觉分词器
为重构训练的VQ标记在多模态理解上通常不如CLIP类连续语义特征,而语义特征又难以重构像素。统一视觉分词器试图让一套离散标记同时具备语义性与可重构性。
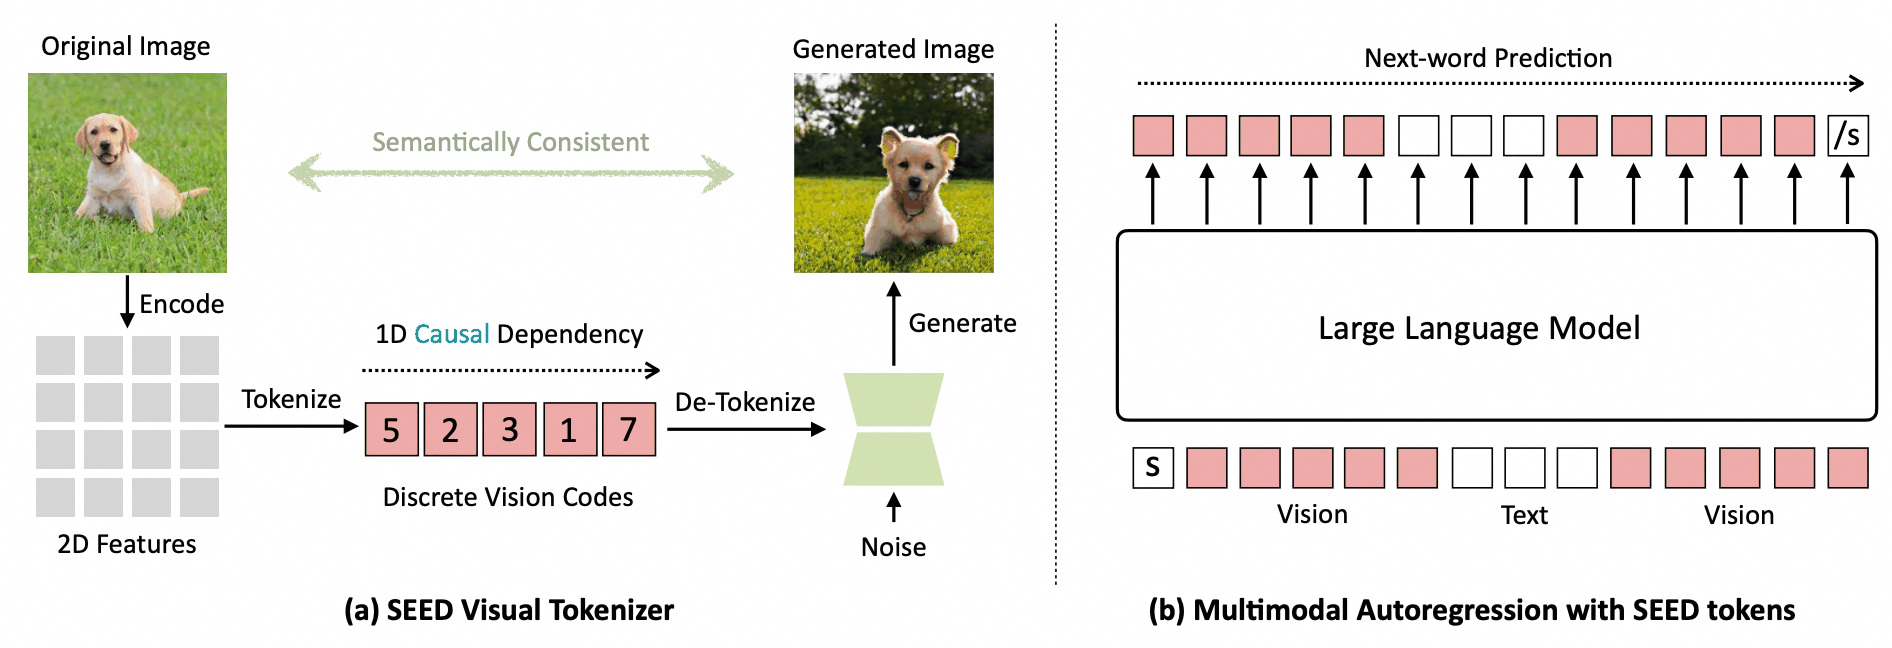
⚪ SEED:一维因果的语义视觉标记
SEED认为,为了让视觉标记便于与大语言模型对齐,分词器应满足两条原则:一是图像标记应独立于二维物理块位置,而以一维因果依赖产生,与语言模型从左到右的自回归机制一致;二是图像标记应捕捉与词语相当抽象程度的高层语义,并在分词器训练阶段同时为判别性与可重构性优化。其分词器由以下部分组成:
- ViT编码器(来自BLIP-2)提取图像特征;
- 因果Q-Former:$32$个可学习查询以因果注意力(第$i$个查询只能看到前$i-1$个查询)与图像特征交互,输出$32$个因果嵌入;第一阶段用这些嵌入与文本做对比学习,使其具备语义;
- VQ码本(大小$8192$)把$32$个因果嵌入量化为$32$个离散标记;
- 解码器:一个多层感知机把量化后的标记映射为unCLIP-Stable Diffusion的条件图像嵌入,由扩散模型生成图像。第二阶段同时用“重构因果嵌入”与“对齐生成嵌入”两个目标训练量化器与解码器。
⚪ VILA-U:对齐文本的统一视觉塔
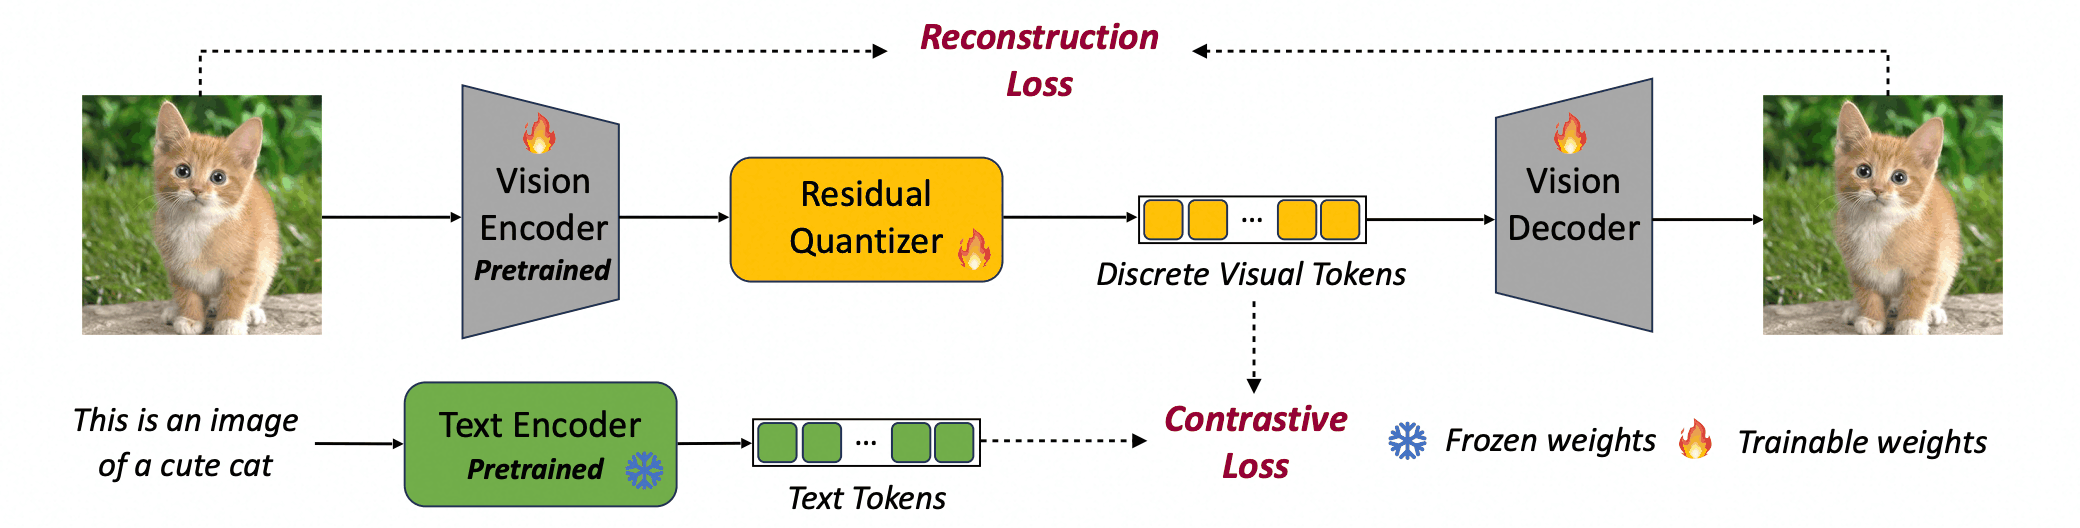
VILA-U用单一的自回归下一标记预测框架统一视频、图像与语言的理解与生成。其核心是统一视觉塔:编码器从SigLIP初始化,输出经残差量化(RQ)得到多级离散标记;训练目标同时包含图像-文本对比损失(使量化后的视觉特征与文本对齐,服务于理解)与重构损失(像素$L_2$、感知损失与对抗损失,服务于生成):
\[\mathcal{L}_{\text{total}}=w_{\text{contra}}\mathcal{L}_{\text{contra}}+w_{\text{recon}}\mathcal{L}_{\text{recon}}\]其中$w_{\text{contra}}$与$w_{\text{recon}}$为权重。为了稳定训练,视觉塔先加载CLIP式预训练权重、以对比目标为主,再逐步加入重构目标。语言模型端,每个空间位置的多级残差码由一个小的深度Transformer依次预测(类似RQ-Transformer)。VILA-U的成功归因于两点:预训练时与文本对齐的离散视觉标记提升了视觉感知能力;配合高质量数据,自回归图像生成可以达到与扩散模型相近的质量。
⚪ TokenFlow:共享索引的双码本
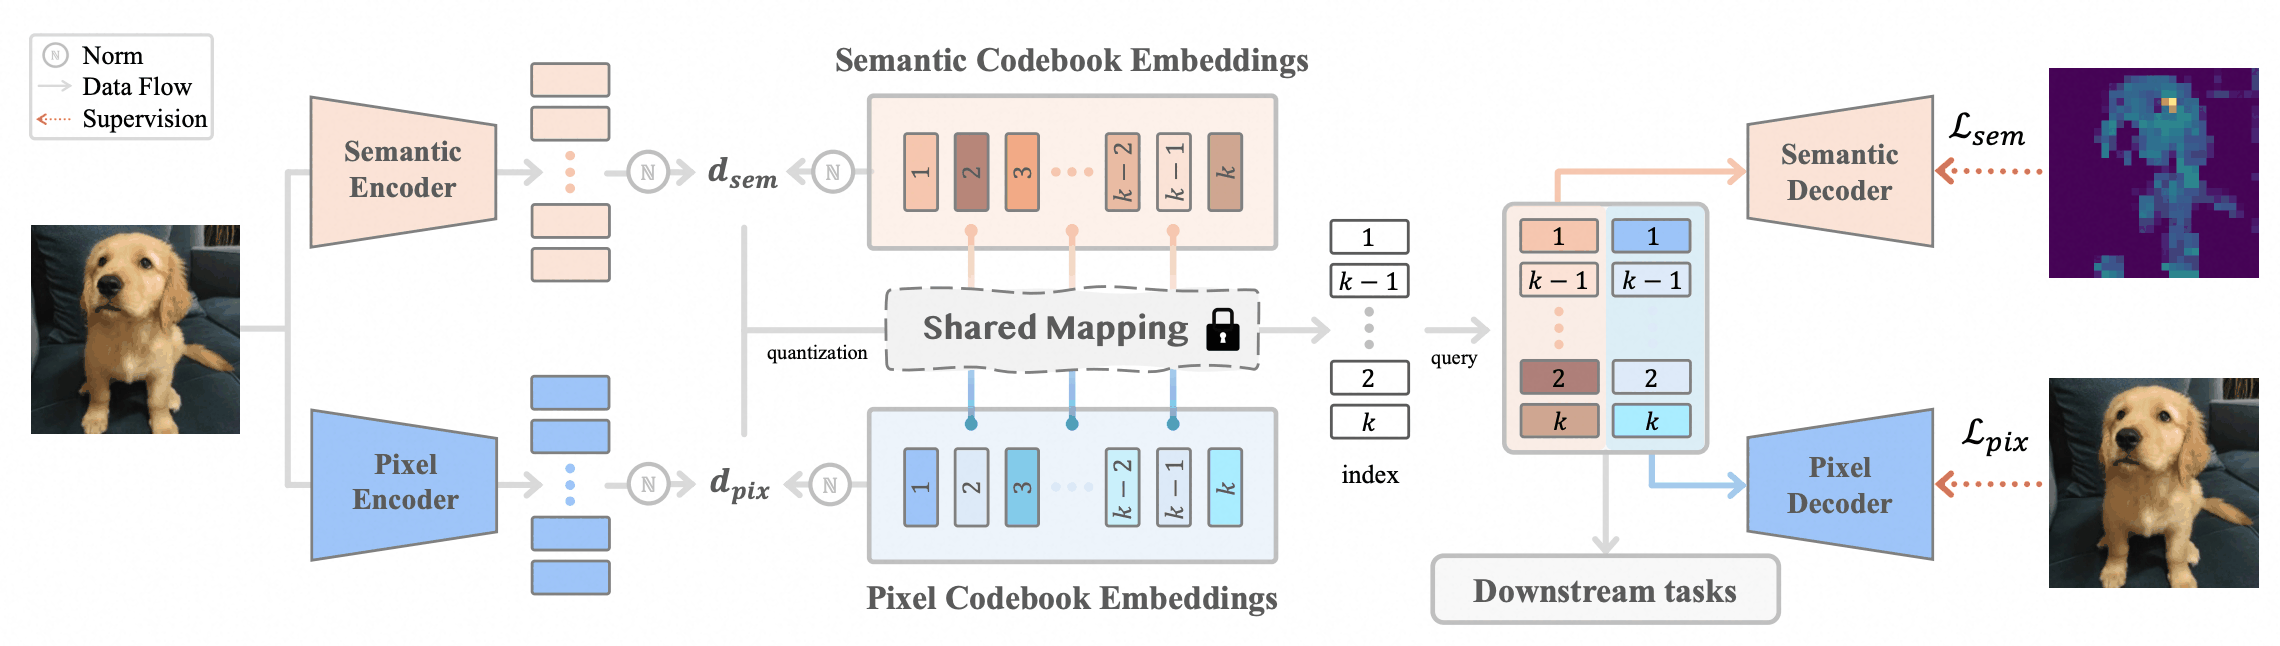
TokenFlow观察到理解与生成需要的视觉信息粒度根本不同,用单一的重构型VQ编码器统一两者会在理解任务上造成明显的取舍。它提出双码本结构,把语义特征与像素特征的学习解耦,同时用共享映射保持二者对齐:
- 双编码器:语义编码器(以SigLIP等为教师蒸馏)与像素编码器分别提取特征$\hat{z}{\text{sem}}$与$\hat{z}{\text{pix}}$;
- 双码本、共享索引:语义码本${e_{\text{sem},i}}$与像素码本${e_{\text{pix},i}}$大小相同($32768$),第$i$个语义码字与第$i$个像素码字绑定;量化时联合选择索引
其中$w_{\text{dis}}$为平衡两种距离的权重(取$1.0$);一个索引同时指向一对语义与像素码字;理解任务通过共享索引取用高层语义码字,生成任务同时取用细粒度的像素码字。
⚪ UniTok:多码本量化的统一分词器
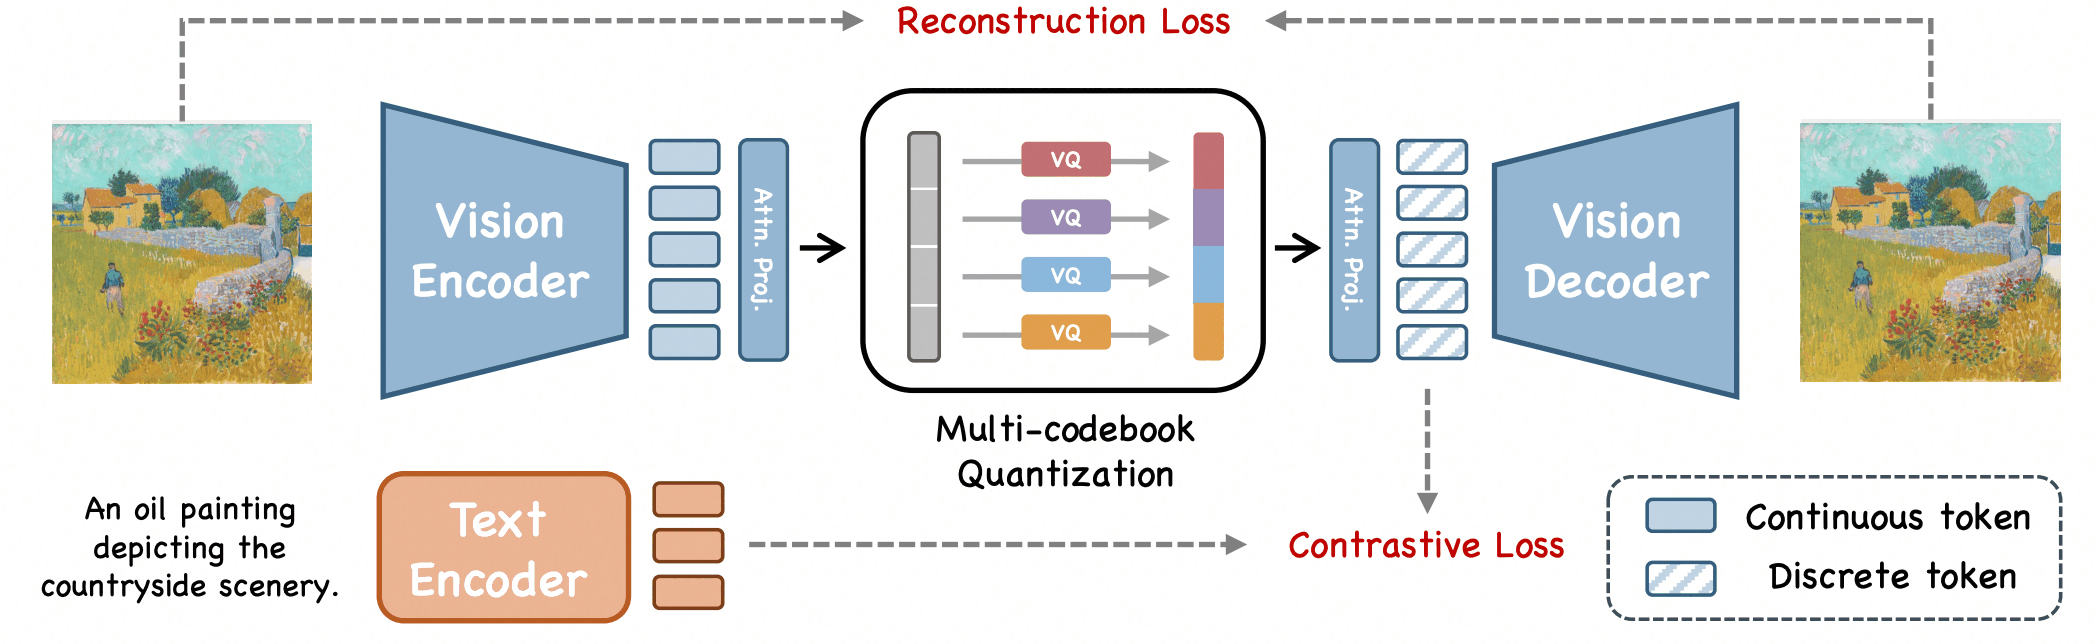
已有研究把VQVAE(服务生成)与CLIP(服务理解)的训练目标结合来构建统一分词器,但直接组合两种目标会出现严重的损失冲突。UniTok指出重构监督与语义监督本身并不冲突,真正的瓶颈在于离散标记空间的表示容量有限。为此它提出多码本量化:把每个位置的隐向量$z\in\mathbb{R}^{D}$切成$n$段$z=[z^{1};\dots;z^{n}]$,每段用各自独立的码本$\mathcal{C}^{j}$(大小$K$)量化后拼接:
\[\hat{z}=\left[Q_{\mathcal{C}^1}(z^1);\dots;Q_{\mathcal{C}^n}(z^n)\right],\quad |\mathcal{V}_{\text{eff}}|=K^{n}\]有效词表随段数指数增长,而每个子码本保持较小、易于充分利用;同时瓶颈维度$D$可以放大。论文还用多头注意力模块替代线性投影来做标记的维度分解,以更好地保留语义。训练目标为VQVAE的重构损失与CLIP的图文对比损失之和。
⚪ Janus:解耦理解与生成的视觉编码
Janus选择了与统一分词器相反的方向:既然理解与生成对视觉信息粒度的需求不同,就为两者使用不同的视觉编码路径,而共享同一个自回归Transformer。
理解路径使用SigLIP编码器提取连续的高层语义特征,经理解适配器映射到语言模型的输入空间;生成路径使用VQ分词器(来自LlamaGen,码本$16384$、下采样率$16$)把图像变为离散标记,经生成适配器嵌入,并由独立的图像预测头输出下一个视觉标记。
两条路径的特征序列都与文本标记拼接后由同一个语言模型处理。这种解耦缓解了单一视觉编码器在理解与生成之间的冲突,且每条路径可以独立选用最合适的编码方式。
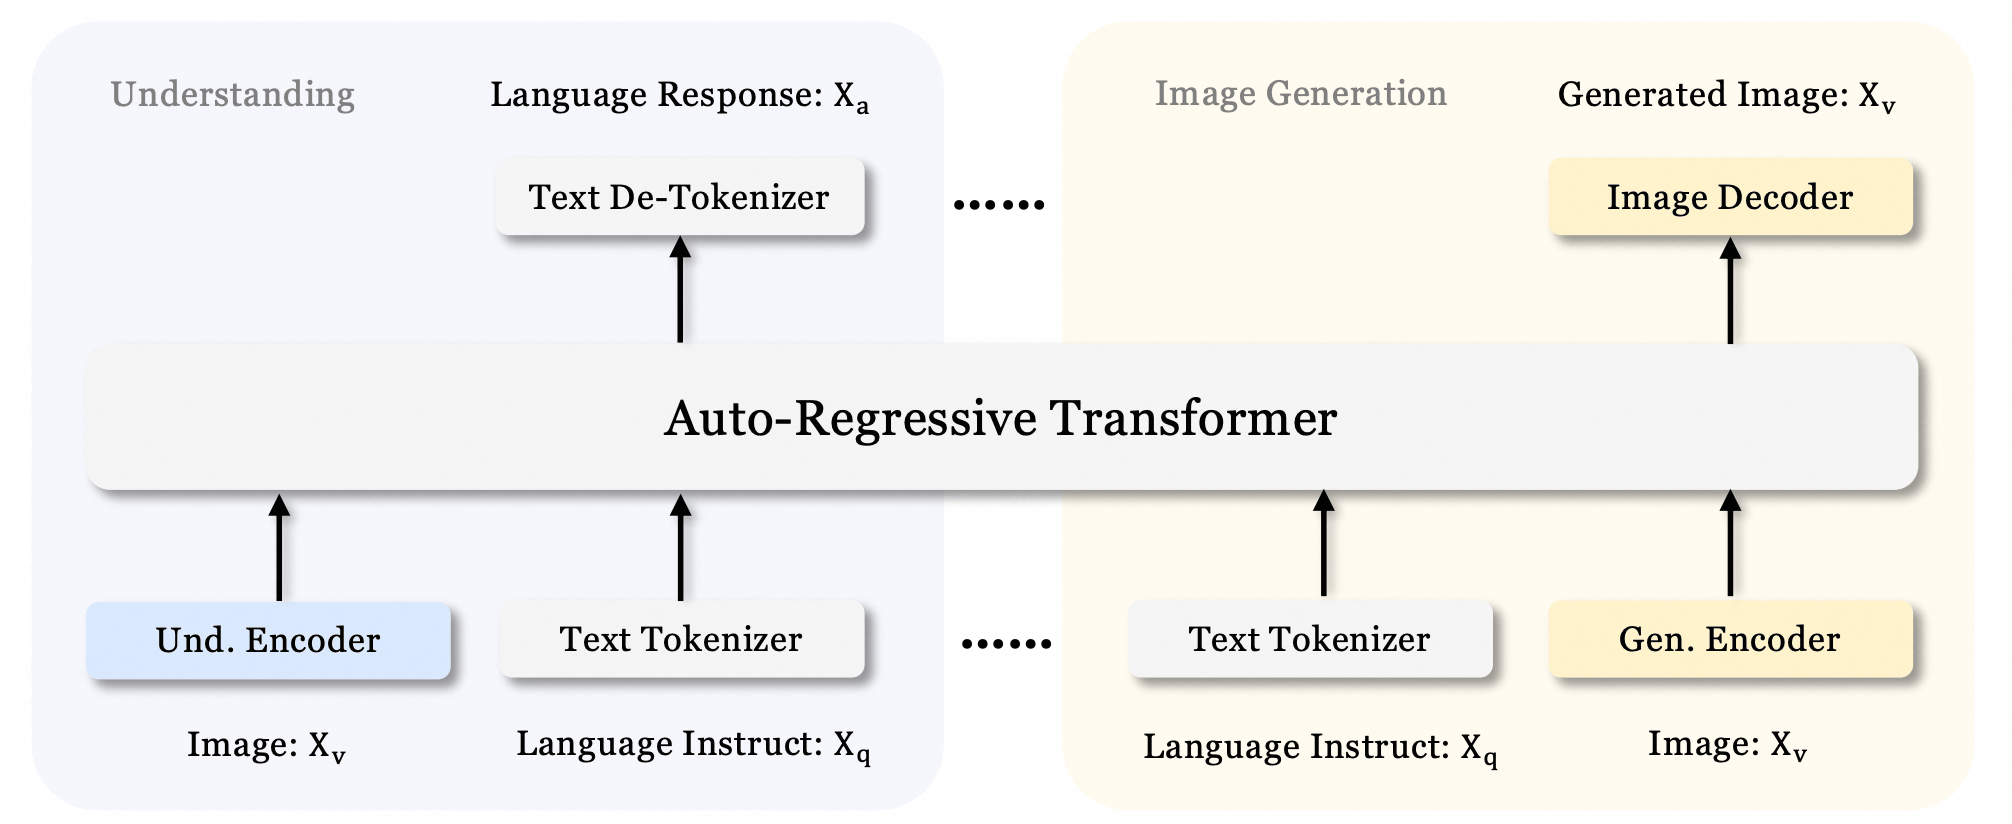
(3) 离散与连续混合接口
⚪ Transfusion:在一个模型中预测下一标记与扩散图像
Transfusion不对图像做离散化:文本保持离散标记、以下一标记预测训练,图像使用VAE的连续隐变量、以扩散目标训练,两者在同一个Transformer中共享参数。图像的标记化为:先用VAE把图像编码为空间下采样的连续隐变量,再把隐变量切成$2\times2$的小块,经线性层或U-Net下采样块投影为连续的图像块标记;图像块序列用开始/结束图像标记包裹,插入到文本序列中。注意力掩码在整体上是因果的,但同一图像内部的图像块之间使用双向注意力。训练目标为
\[\mathcal{L}_{\text{Transfusion}}=\mathcal{L}_{\text{LM}}+\lambda\cdot\mathcal{L}_{\text{DDPM}}\]其中\(\mathcal{L}_{\text{LM}}\)是文本标记上的交叉熵,\(\mathcal{L}_{\text{DDPM}}\)是图像块上的扩散去噪损失,$\lambda$平衡两者(论文取$5$)。在扩展实验中,Transfusion的扩展性明显优于把图像量化为离散标记再做语言建模的方法。