Asymptotic Theory I: Law of Large Numbers and Central Limit Theorem.
在经典数理统计的有限样本理论(Finite-Sample Theory)中,统计推断依赖于总体分布的精确先验假设。例如,当总体服从正态分布 $X_i \sim N(\mu, \sigma^2)$ 时,无论样本容量 $n$ 取何值,样本均值 $\bar{X}_n$ 的精确分布均为正态分布,样本方差的精确分布可由卡方分布刻画,进而可导出精确服从 $t(n-1)$ 分布的检验统计量。
然而,在实际的科学计算与工程建模中,精确有限样本理论面临两个根本性困难:
- 总体分布的未知性与复杂性:真实世界的数据分布往往呈现偏态、多峰或重尾特征,无法用单一的参数化分布族精确描述。
- 解析分布的不可计算性(Intractability):即使总体分布形式已知,当统计量涉及非线性变换或隐式方程求解(如极大似然估计)时,有限样本容量 $n$ 下的精确概率密度函数通常不存在初等解析表达式。
渐近理论(Asymptotic Theory,又称大样本理论 Large Sample Theory)旨在解决上述问题。其基本研究范式是:考察当样本容量 $n \to \infty$ 时统计量序列的极限行为,并利用结构简单的极限分布去近似有限样本下的复杂真实分布。
作为该系列的第 I 篇,本文将系统阐述渐近理论的理论基石:大数定律(LLN)与中心极限定理(CLT)。
本文目录:
1. 依概率收敛与大数定律
1.1 依概率收敛的定义
在实分析中,确定性数列 ${a_n}$ 收敛于常数 $a$ 是指距离 $\vert a_n - a\vert $ 随 $n\to\infty$ 趋于零。对于随机变量序列 ${X_n}$,由于其取值具有随机性,需要通过事件发生的概率来度量其与极限目标 $X$ 的接近程度。
定义 1.1(依概率收敛) 设 ${X_n}$ 与 $X$ 为定义在同一概率空间上的随机变量。若对任意正数 $\varepsilon > 0$,均有 \(\lim_{n\to\infty} P\left(\vert X_n - X\vert > \varepsilon\right) = 0 \quad \left(\text{等价地,}\lim_{n\to\infty} P\left(\vert X_n - X\vert \le \varepsilon\right) = 1\right)\) 则称序列 ${X_n}$ 依概率收敛(Convergence in Probability)于 $X$,记作 $X_n \xrightarrow{P} X$。
在参数估计理论中,设 $\theta$ 为未知总体参数,$\hat{\theta}_n = \hat{\theta}(X_1, \dots, X_n)$ 为基于样本构造的估计量。若 $\hat{\theta}_n \xrightarrow{P} \theta$,则称 $\hat{\theta}_n$ 为参数 $\theta$ 的弱相合估计量(Weakly Consistent Estimator)。
1.2 概率论中的尾概率不等式
为了严格证明依概率收敛,需要将形如 $P(\vert X_n - X\vert > \varepsilon)$ 的尾概率与随机变量的矩(数学期望、方差)建立联系。以下两个基础不等式是证明大数定律的核心工具。
引理 1.1(Markov 不等式) 设非负随机变量 $Y \ge 0$ 满足 $\mathbb{E}[Y]<\infty$,则对任意 $\varepsilon > 0$,有 \(P(Y \ge \varepsilon) \le \frac{\mathbb{E}[Y]}{\varepsilon}\)
证明:根据事件 ${Y\ge\varepsilon}$ 是否发生,分解数学期望: \(\mathbb{E}[Y]=\mathbb{E}\left[Y\mathbf{1}_{\{Y<\varepsilon\}}\right]+\mathbb{E}\left[Y\mathbf{1}_{\{Y\ge\varepsilon\}}\right]\) 第一项非负;第二项中 $Y\ge\varepsilon$,因此 \(\mathbb{E}[Y]\ge\mathbb{E}\left[Y\mathbf{1}_{\{Y\ge\varepsilon\}}\right]\ge\varepsilon\mathbb{E}\left[\mathbf{1}_{\{Y\ge\varepsilon\}}\right]=\varepsilon P(Y\ge\varepsilon)\) 两边同除以 $\varepsilon>0$ 即得结论。该证明不要求 $Y$ 存在概率密度,因此同时适用于离散、连续与其他分布。$\blacksquare$
引理 1.2(Chebyshev 不等式) 设随机变量 $X$ 的均值为 $\mu = \mathbb{E}[X]$,方差为 $\sigma^2 = \text{Var}(X) < \infty$。则对任意 $\varepsilon > 0$,有 \(P\left(\vert X - \mu\vert \ge \varepsilon\right) \le \frac{\text{Var}(X)}{\varepsilon^2}\)
证明:注意到事件 ${\vert X - \mu\vert \ge \varepsilon}$ 与事件 ${(X - \mu)^2 \ge \varepsilon^2}$ 完全等价。令非负随机变量 $Y = (X - \mu)^2$,对 $Y$ 应用引理 1.1(Markov 不等式),并代入 $\mathbb{E}[Y] = \mathbb{E}[(X-\mu)^2] = \text{Var}(X)$,可得:
\[P\left(\vert X - \mu\vert \ge \varepsilon\right) = P\left((X - \mu)^2 \ge \varepsilon^2\right) \le \frac{\mathbb{E}\left[(X - \mu)^2\right]}{\varepsilon^2} = \frac{\text{Var}(X)}{\varepsilon^2} \quad \blacksquare\]1.3 弱大数定律(Weak Law of Large Numbers)
大数定律揭示了算术平均值的稳定性:当试验次数无限增加时,样本均值依概率收敛于总体期望。下面依次讨论 Bernoulli、Chebyshev 与 Markov、Khinchin 三组经典结果,它们分别对应事件频率、二阶矩条件以及仅一阶矩存在的情形。
1.3.1 Bernoulli 弱大数定律(频率收敛于概率)
定理 1.1(Bernoulli 弱大数定律) 在 $n$ 重独立重复试验中,设事件 $A$ 在每次试验中发生的概率为 $p \in (0, 1)$。定义第 $i$ 次试验的指示随机变量 \(X_i = \mathbb{I}_A(\omega_i) \stackrel{\text{i.i.d.}}{\sim} \text{Bernoulli}(p)\)(事件发生取 $1$,不发生取 $0$),记 $S_n = \sum_{i=1}^n X_i$ 为事件 $A$ 发生的频数。则事件发生的频率依概率收敛于概率 $p$: \(\bar{X}_n = \frac{S_n}{n} \xrightarrow{P} p = \mu \quad (n \to \infty)\)
证明: 由于 $X_i \stackrel{\text{i.i.d.}}{\sim} \text{Bernoulli}(p)$,其总体均值为 $\mu = \mathbb{E}[X_i] = 1 \cdot p + 0 \cdot (1 - p) = p$,方差为 $\text{Var}(X_i) = p(1 - p)$。 从而样本均值(频率)\(\bar{X}_n = \frac{S_n}{n} = \frac{1}{n}\sum_{i=1}^n X_i\) 的期望与方差分别为:
\[\mathbb{E}[\bar{X}_n] = \mathbb{E}\left[\frac{S_n}{n}\right] = p, \quad \text{Var}(\bar{X}_n) = \text{Var}\left(\frac{S_n}{n}\right) = \frac{p(1 - p)}{n}\]对任意给定的 $\varepsilon > 0$,将引理 1.2(Chebyshev 不等式)直接应用于随机变量 $\bar{X}_n = \frac{S_n}{n}$(并注意均值不等式 $p(1-p) \le \frac{1}{4}$),可得:
\[0 \le P\left(\left\vert \frac{S_n}{n} - p\right\vert \ge \varepsilon\right) \le \frac{\text{Var}(S_n / n)}{\varepsilon^2} = \frac{p(1 - p)}{n\varepsilon^2} \le \frac{1}{4n\varepsilon^2}\]由夹逼准则($n\to\infty$时$1/n \to 0$),立得 $\bar{X}_n = \frac{S_n}{n} \xrightarrow{P} p$。$\blacksquare$
作为大数定律家族的历史起点,Bernoulli 大数定律其实就是一般大数定律 $\bar{X}_n \xrightarrow{P} \mu$ 在 0-1 分布(伯努利分布)下的特例:当每次试验的随机变量 $X_i \in {0, 1}$ 仅用于指示某事件 $A$ 是否发生时,样本均值 $\bar{X}_n$ 就退化为事件发生的频率 $\frac{S_n}{n}$,总体均值 $\mu$ 就退化为事件发生的概率 $p$。
1.3.2 Chebyshev 与 Markov 弱大数定律(二阶矩存在情形)
定理 1.2(Chebyshev 与 Markov 弱大数定律) 设随机变量序列 $X_1, X_2, \dots$ 具有有限二阶矩,记 $\mu_i = \mathbb{E}[X_i]$。
- Markov 条件(部分和方差条件):若部分和的方差满足 \(\lim_{n\to\infty} \frac{1}{n^2}\text{Var}\left(\sum_{i=1}^n X_i\right) = 0\) 则有 \(\bar{X}_n - \frac{1}{n}\sum_{i=1}^n \mu_i \xrightarrow{P} 0\)
- Chebyshev 条件(两两不相关且方差一致有界):特别地,若 $X_1, \dots, X_n$ 两两不相关($\text{Cov}(X_i, X_j) = 0,\ \forall i \neq j$),具有共同均值 $\mathbb{E}[X_i] = \mu$,且方差存在一致上界 $\text{Var}(X_i) \le C < \infty$,则 \(\bar{X}_n = \frac{1}{n}\sum_{i=1}^n X_i \xrightarrow{P} \mu \quad (n \to \infty)\)
证明:记 \(\bar{\mu}_n = \frac{1}{n}\sum_{i=1}^n \mu_i = \mathbb{E}[\bar{X}_n]\)。对任意给定的 $\varepsilon > 0$,将引理 1.2(Chebyshev 不等式) 应用于随机变量 $\bar{X}_n$,可得:
\[0 \le P\left(\left\vert \bar{X}_n - \bar{\mu}_n\right\vert \ge \varepsilon\right) \le \frac{\text{Var}(\bar{X}_n)}{\varepsilon^2} = \frac{1}{n^2 \varepsilon^2}\text{Var}\left(\sum_{i=1}^n X_i\right)\]在 Markov 条件下,令 $n \to \infty$,上式右端直接趋于 $0$,即得 $\bar{X}_n - \bar{\mu}_n \xrightarrow{P} 0$。
在 Chebyshev 条件下,由两两不相关性知方差可加,故有:
\[\frac{1}{n^2}\text{Var}\left(\sum_{i=1}^n X_i\right) = \frac{1}{n^2}\sum_{i=1}^n \text{Var}(X_i) \le \frac{nC}{n^2} = \frac{C}{n} \xrightarrow{n\to\infty} 0\]从而 Markov 条件自然满足,且 $\bar{\mu}_n = \mu$,故 $\bar{X}_n \xrightarrow{P} \mu$。$\blacksquare$
1.3.3 Khinchin 弱大数定律(仅一阶矩存在情形)
在实际应用中,某些重尾分布(如自由度为 2 的 $t$ 分布,或尾指数 $\alpha\in(1,2]$ 的 Pareto 分布)的方差不存在(即 $\text{Var}(X_i) = \infty$),此时 Chebyshev 不等式失效。Khinchin(辛钦)弱大数定律证明了:对于独立同分布序列,无需假设方差存在,只要一阶矩(数学期望)有限,弱大数定律依然成立。
为了给出完整证明,引入概率论中的特征函数(Characteristic Function)工具。
设随机变量 $X$ 的特征函数定义为 $\varphi_X(t) = \mathbb{E}[e^{\mathrm{i}tX}] = \mathbb{E}[\cos(tX)] + \mathrm{i}\mathbb{E}[\sin(tX)]$,其中 $\mathrm{i} = \sqrt{-1}$,$t \in \mathbb{R}$。特征函数具有以下基本性质:
- 线性变换性质:$\varphi_{aX+b}(t) = e^{\mathrm{i}tb}\varphi_X(at)$。
- 独立和性质:若 $X_1, \dots, X_n$ 相互独立,则 $\varphi_{\sum_{i=1}^n X_i}(t) = \prod_{i=1}^n \varphi_{X_i}(t)$。
- 可微性与泰勒展开:若 $\mathbb{E}[\vert X\vert ^k] < \infty$,则 $\varphi_X(t)$ 在 $t=0$ 处 $k$ 阶连续可导,且 $\varphi_X^{(k)}(0) = \mathrm{i}^k \mathbb{E}[X^k]$。由带 Peano 余项的泰勒公式,当 $t \to 0$ 时:
- 若 $\mathbb{E}[\vert X\vert ] < \infty$ 且 $\mathbb{E}[X] = \mu$,则 $\varphi_X(t) = 1 + \mathrm{i}\mu t + o(t)$;
- 若 $\mathbb{E}[X^2] < \infty$ 且 $\mathbb{E}[X] = 0,\ \text{Var}(X) = \sigma^2$,则 $\varphi_X(t) = 1 - \frac{1}{2}\sigma^2 t^2 + o(t^2)$。
定理 1.3(Khinchin 弱大数定律) 设 $X_1, X_2, \dots$ 独立同分布,且 $\mathbb{E}[\vert X_1\vert ] < \infty$,记 $\mathbb{E}[X_1] = \mu$,则有 \(\boxed{\bar{X}_n \xrightarrow{P} \mu \quad (n \to \infty)}\)
证明: 设 $X_i$ 的共同特征函数为 $\varphi(t) = \mathbb{E}[e^{\mathrm{i}tX_1}]$。由一阶矩存在性及带 Peano 余项的一阶泰勒展开,当 $t \to 0$ 时有:
\[\varphi(t) = 1 + \mathrm{i}\mu t + o(t)\]考察样本均值 \(\bar{X}_n = \frac{1}{n}\sum_{i=1}^n X_i\) 的特征函数 \(\varphi_{\bar{X}_n}(t)\)。由独立同分布性质与特征函数的缩放性质,对任意固定的 $t \in \mathbb{R}$,当 $n \to \infty$ 时 $\frac{t}{n} \to 0$,故有:
\[\begin{aligned} \varphi_{\bar{X}_n}(t) &= \mathbb{E}\left[\exp\left(\mathrm{i}t \cdot \frac{1}{n}\sum_{i=1}^n X_i\right)\right] \\&= \left[\varphi\left(\frac{t}{n}\right)\right]^n = \left[1 + \frac{\mathrm{i}\mu t}{n} + o\left(\frac{1}{n}\right)\right]^n \end{aligned}\]由基本极限公式 $\lim_{n\to\infty}\left(1 + \frac{z}{n} + o\left(\frac{1}{n}\right)\right)^n = e^z$,立即得到:
\[\lim_{n\to\infty} \varphi_{\bar{X}_n}(t) = e^{\mathrm{i}\mu t}, \quad \forall t \in \mathbb{R}\]注意到 $e^{\mathrm{i}\mu t}$ 恰好是退化于常数 $\mu$ 的随机变量的特征函数。由下文的 Lévy 连续性定理(见定理 2.2)可知,样本均值序列依分布收敛于常数 $\mu$,即 $\bar{X}_n \xrightarrow{d} \mu$。再由“依分布收敛于常数等价于依概率收敛于该常数”(将在第 2.3 节证明),立得 $\bar{X}_n \xrightarrow{P} \mu$。$\blacksquare$
1.4 强大数定律(Strong Law of Large Numbers)
弱大数定律($\bar{X}_n \xrightarrow{P} \mu$)仅保证在单个固定的大型时刻 $n$,样本均值偏离 $\mu$ 的概率很小;但它并不排除随着时间 $n$ 不断推移,样本轨道在未来的某些时刻再次发生大幅度偏离的可能性。为了刻画整条样本轨道随 $n \to \infty$ 的收敛性,需要引入更强的收敛概念。
定义 1.2(几乎处处收敛 / 以概率 1 收敛) 设 ${X_n}$ 与 $X$ 为定义在同一概率空间 $(\Omega, \mathcal{F}, P)$ 上的随机变量。若满足 \(P\left(\left\{\omega \in \Omega:\ \lim_{n\to\infty} X_n(\omega) = X(\omega)\right\}\right) = 1\) 则称序列 ${X_n}$ 几乎处处收敛(Almost Sure Convergence)于 $X$,记作 $X_n \xrightarrow{a.s.} X$。
强大数定律指出样本均值不仅会接近总体均值,而且几乎必然会在那附近稳定下来。
定理 1.4(Kolmogorov 强大数定律) 设 $X_1, X_2, \dots$ 为独立同分布的随机变量序列,$\mu$ 为有限常数。样本均值满足 \(\bar{X}_n = \frac{1}{n}\sum_{i=1}^n X_i \xrightarrow{a.s.} \mu\) 的充要条件是 $\mathbb{E}[\vert X_1\vert ] < \infty$ 且 $\mathbb{E}[X_1] = \mu$。
2. 依分布收敛与中心极限定理
2.1 依分布收敛的定义
大数定律表明估计误差满足 $\bar{X}_n - \mu \xrightarrow{P} 0$,但这仅给出了点估计的收敛性。为了进一步构造置信区间或进行假设检验,必须刻画估计量在逼近真值过程中的分布形态。
定义 2.1(依分布收敛) 设 ${X_n}$ 为随机变量序列,其累积分布函数(CDF)为 $F_{X_n}(x) = P(X_n \le x)$;设 $X$ 的分布函数为 $F_X(x) = P(X \le x)$。若在 $F_X$ 的所有连续点 $x \in C(F_X)$ 上,均有 \(\lim_{n\to\infty} F_{X_n}(x) = F_X(x)\) 则称序列 ${X_n}$ 依分布收敛(Convergence in Distribution,又称弱收敛 Weak Convergence)于 $X$,记作 $X_n \xrightarrow{d} X$。
注(为何仅要求在分布函数的连续点上收敛) 考察确定性退化序列 $X_n \equiv \frac{1}{n}$,其极限显然应当为常数 $X \equiv 0$。写出两者的分布函数:
\[F_{X_n}(x) = \begin{cases} 0, & x < \frac{1}{n} \\ 1, & x \ge \frac{1}{n} \end{cases}, \quad F_X(x) = \begin{cases} 0, & x < 0 \\ 1, & x \ge 0 \end{cases}\]
如上图所示:
- 对任意 $x < 0$,当 $n$ 充分大时 $\frac{1}{n} > 0 > x$,故 $\lim_{n\to\infty} F_{X_n}(x) = 0 = F_X(x)$;
- 对任意 $x > 0$,当 $n > \frac{1}{x}$ 时 $\frac{1}{n} < x$,故 $\lim_{n\to\infty} F_{X_n}(x) = 1 = F_X(x)$;
- 唯独在 $F_X(x)$ 的跳跃间断点 $x = 0$ 处,由于 $\frac{1}{n} > 0$ 恒成立,导致对任意有限的 $n$ 均有 $F_{X_n}(0) = P(\frac{1}{n} \le 0) = 0$,从而 $\lim_{n\to\infty} F_{X_n}(0) = 0 \neq F_X(0) = 1$。
由此可见,阶梯函数在水平平移逼近极限位置时,在跳跃边界点处可能出现极限值与函数值不相等的现象。由于单调有界函数的不连续点至多只有可数个,剔除不连续点既消除了这种边界伪反例,又唯一确定了极限分布函数。
在高等概率论中,判断依分布收敛的等价工具有以下两个基本定理:
定理 2.1(Portmanteau 定理) 对于随机变量序列 ${X_n}$ 与 $X$,下列命题完全等价:
- $X_n \xrightarrow{d} X$;
- 对任意有界连续函数 $h: \mathbb{R} \to \mathbb{R}$,有 $\lim_{n\to\infty} \mathbb{E}[h(X_n)] = \mathbb{E}[h(X)]$;
- 对任意闭集 $C \subset \mathbb{R}$,有 $\limsup_{n\to\infty} P(X_n \in C) \le P(X \in C)$;
- 对任意开集 $G \subset \mathbb{R}$,有 $\liminf_{n\to\infty} P(X_n \in G) \ge P(X \in G)$。
定理 2.2(Lévy 连续性定理) 设 $X_n$ 的特征函数为 $\varphi_{X_n}(t)$,$X$ 的特征函数为 $\varphi_X(t)$。则 $X_n \xrightarrow{d} X$ 的充要条件是:对任意 $t \in \mathbb{R}$,均有 $\lim_{n\to\infty} \varphi_{X_n}(t) = \varphi_X(t)$。
2.2 中心极限定理(Central Limit Theorem)
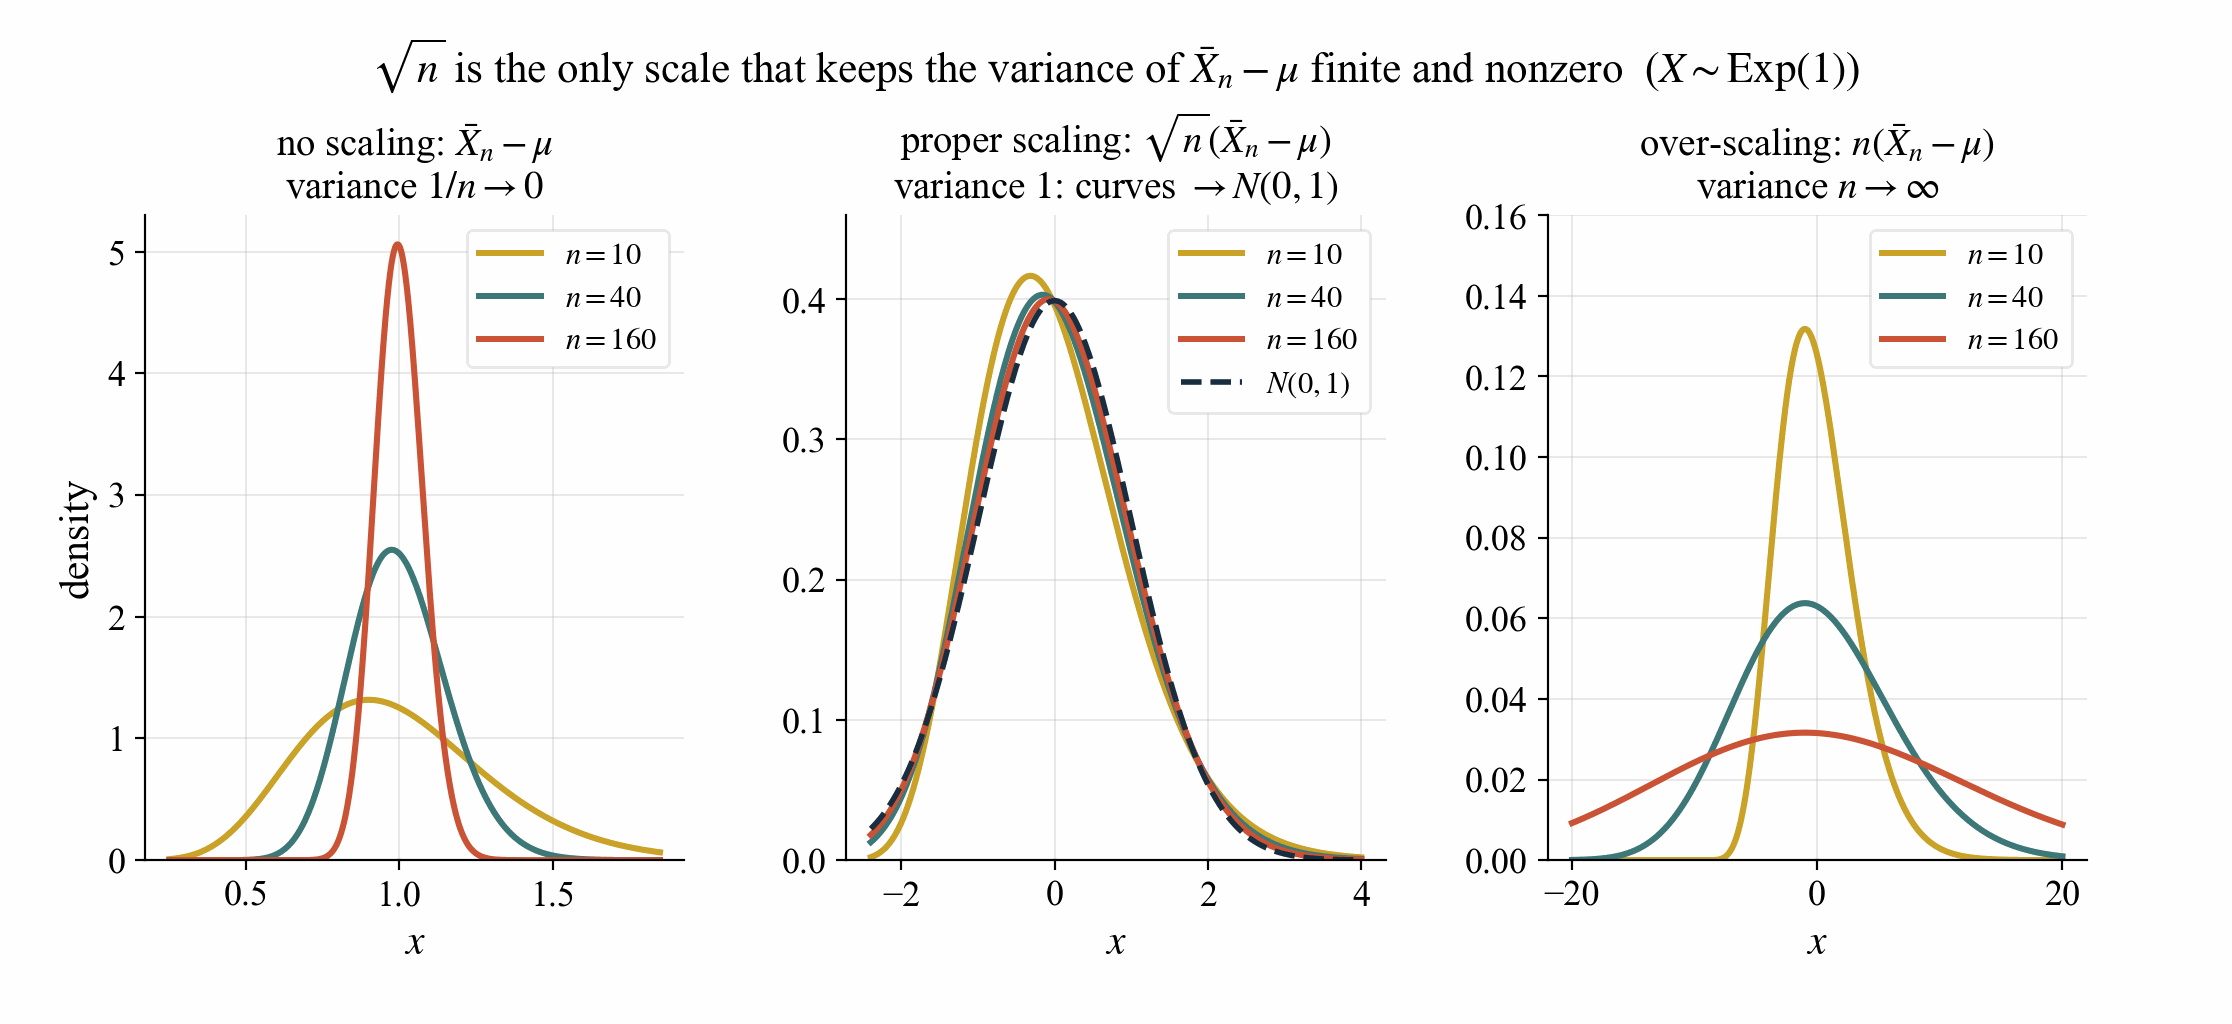
大数定律指出样本均值的误差满足 $\bar{X}_n - \mu \xrightarrow{P} 0$。若直接考察 $\bar{X}_n - \mu$ 的极限分布,只能得到退化于 $0$ 的单点分布。为了观察到非退化的误差分布形态,需要寻找恰当的放大因子 $a_n \to \infty$,使得 $a_n(\bar{X}_n - \mu)$ 的方差稳定在非零常数。
注意到 $\text{Var}\big(a_n(\bar{X}_n - \mu)\big) = a_n^2 \cdot \frac{\sigma^2}{n}$。要使该方差不随 $n\to\infty$ 退化为 $0$ 或发散至 $\infty$,放大因子必须与 $\sqrt{n}$ 同阶,即 $a_n \propto \sqrt{n}$;通常取 $a_n = \sqrt{n}$,使极限方差恰为 $\sigma^2$。
2.2.1 独立同分布的中心极限定理(Lindeberg-Lévy)
定理 2.3(Lindeberg-Lévy 中心极限定理) 设 $X_1, X_2, \dots$ 独立同分布,具有均值 $\mathbb{E}[X_i] = \mu$ 与有限的正方差 $\text{Var}(X_i) = \sigma^2 \in (0, \infty)$。则当 $n \to \infty$ 时, \(Z_n = \frac{\sqrt{n}\left(\bar{X}_n - \mu\right)}{\sigma} \xrightarrow{d} Z \sim N(0, 1)\) 等价地,$\sqrt{n}(\bar{X}_n - \mu) \xrightarrow{d} N(0, \sigma^2)$。
证明(利用特征函数与二阶泰勒展开):
(1) 标准化随机变量:令 $Y_i = \frac{X_i - \mu}{\sigma}$。由独立同分布假设知,$Y_1, \dots, Y_n$ 亦独立同分布,且满足:
\[\mathbb{E}[Y_i] = 0, \quad \text{Var}(Y_i) = \mathbb{E}[Y_i^2] = 1\]此时,目标统计量 $Z_n$ 可表示为标准化变量的算术和:
\[Z_n = \frac{\sqrt{n}(\bar{X}_n - \mu)}{\sigma} = \frac{1}{\sqrt{n}}\sum_{i=1}^n \left(\frac{X_i - \mu}{\sigma}\right) = \frac{1}{\sqrt{n}}\sum_{i=1}^n Y_i\](2) 对特征函数作二阶泰勒展开:设 $Y_i$ 的共同特征函数为 $\varphi_Y(t) = \mathbb{E}[e^{\mathrm{i}tY_1}]$。由于二阶矩 $\mathbb{E}[Y_1^2] = 1 < \infty$,特征函数 $\varphi_Y(t)$ 在 $t=0$ 处二阶连续可导,且有:
\[\varphi_Y(0) = 1, \quad \varphi_Y'(0) = \mathrm{i}\mathbb{E}[Y_1] = 0, \quad \varphi_Y''(0) = \mathrm{i}^2 \mathbb{E}[Y_1^2] = -1\]由带 Peano 余项的二阶泰勒公式,当 $s \to 0$ 时:
\[\varphi_Y(s) = \varphi_Y(0) + \varphi_Y'(0)s + \frac{\varphi_Y''(0)}{2}s^2 + o(s^2) = 1 - \frac{1}{2}s^2 + o(s^2)\](3) 计算 $Z_n$ 的特征函数并求极限:利用独立和的特征函数性质,将 $s = \frac{t}{\sqrt{n}}$ 代入上式。对任意固定的 $t \in \mathbb{R}$,当 $n \to \infty$ 时 $\frac{t}{\sqrt{n}} \to 0$,从而有:
\[\begin{aligned} \varphi_{Z_n}(t) &= \mathbb{E}\left[\exp\left(\mathrm{i}t \cdot \frac{1}{\sqrt{n}}\sum_{i=1}^n Y_i\right)\right] \\&= \left[\varphi_Y\left(\frac{t}{\sqrt{n}}\right)\right]^n = \left[1 - \frac{t^2}{2n} + o\left(\frac{t^2}{n}\right)\right]^n \end{aligned}\]对任意固定的 $t$,余项满足 $o\left(\frac{t^2}{n}\right) = o\left(\frac{1}{n}\right)$。由重要极限公式,当 $n \to \infty$ 时: \(\lim_{n\to\infty} \varphi_{Z_n}(t) = \lim_{n\to\infty} \left[1 + \frac{-t^2/2}{n} + o\left(\frac{1}{n}\right)\right]^n = e^{-t^2/2}, \quad \forall t \in \mathbb{R}\)
(4) 应用 Lévy 连续性定理:注意到 $e^{-t^2/2}$ 恰好是标准正态分布 $Z \sim N(0,1)$ 的特征函数。由定理 2.2(Lévy 连续性定理),得出 $Z_n \xrightarrow{d} Z \sim N(0,1)$。$\blacksquare$
2.2.2 二项分布的中心极限定理(De Moivre-Laplace)
作为定理 2.3(Lindeberg-Lévy CLT)在离散 Bernoulli 试验下的特例,De Moivre-Laplace 定理 是历史上第一个中心极限定理。
推论 2.1(De Moivre-Laplace 中心极限定理) 设 $S_n \sim \text{Binomial}(n, p)$ 表示 $n$ 重独立 Bernoulli 试验中成功的次数,其中 $p\in(0,1)$ 固定。则当 $n \to \infty$ 时, \(\frac{S_n - np}{\sqrt{np(1 - p)}} \xrightarrow{d} N(0, 1) \quad (n \to \infty)\)
证明:将 $S_n$ 表示为独立同分布变量之和 $S_n = \sum_{i=1}^n X_i$,其中 $X_i \stackrel{\text{i.i.d.}}{\sim} \text{Bernoulli}(p)$,均值为 $\mu = p$,方差为 $\sigma^2 = p(1 - p) > 0$。直接套用定理 2.3,即得 $\frac{\sqrt{n}(\bar{X}_n - p)}{\sqrt{p(1-p)}} = \frac{S_n - np}{\sqrt{np(1-p)}} \xrightarrow{d} N(0, 1)$。$\blacksquare$
2.3 两种收敛模式的关系证明
在渐近理论中,依概率收敛与依分布收敛存在紧密的逻辑关联。
定理 2.4(依概率收敛蕴含依分布收敛) 设 ${X_n}$ 与 $X$ 为同一概率空间上的随机变量。若 $X_n \xrightarrow{P} X$,则必有 $X_n \xrightarrow{d} X$。
证明: 设 $x$ 为极限分布函数 $F_X$ 的任意连续点,需证 $\lim_{n\to\infty} F_{X_n}(x) = F_X(x)$。 任取 $\varepsilon > 0$。考察事件 ${X_n \le x}$,依据事件 ${\vert X_n - X\vert \le \varepsilon}$ 是否发生,将其分解为两个互斥事件之并:
\[\{X_n \le x\} = \left(\{X_n \le x\} \cap \{\vert X_n - X\vert \le \varepsilon\}\right) \cup \left(\{X_n \le x\} \cap \{\vert X_n - X\vert > \varepsilon\}\right)\]- 对于第一个交事件:若 $X_n \le x$ 且 $\vert X_n - X\vert \le \varepsilon$ 同时成立,由三角不等式必有 $X = X_n + (X - X_n) \le x + \varepsilon$。故该交事件包含于事件 ${X \le x + \varepsilon}$。
- 对于第二个交事件:直接利用集合包含关系,它显然包含于其中一个事件 ${\vert X_n - X\vert > \varepsilon}$。
由概率的有限可加性与单调性,得到 $F_{X_n}(x)$ 的上界不等式:
\[\begin{aligned} F_{X_n}(x) = P(X_n \le x) &\le P(X \le x + \varepsilon) + P(\vert X_n - X\vert > \varepsilon) \\&= F_X(x + \varepsilon) + P(\vert X_n - X\vert > \varepsilon) \end{aligned}\]完全对称地,考察事件 ${X \le x - \varepsilon}$:
\[\{X \le x - \varepsilon\} = \left(\{X \le x - \varepsilon\} \cap \{\vert X_n - X\vert \le \varepsilon\}\right) \cup \left(\{X \le x - \varepsilon\} \cap \{\vert X_n - X\vert > \varepsilon\}\right)\]- 对于第一个交事件:若 $X \le x - \varepsilon$ 且 $\vert X_n - X\vert \le \varepsilon$ 同时成立,由三角不等式必有 $X_n = X + (X_n - X) \le x$。故该交事件包含于事件 ${X_n \le x}$。
- 对于第二个交事件:直接利用集合包含关系,它显然包含于其中一个事件 ${\vert X_n - X\vert \gt \varepsilon}$。
同理可得:
\[\begin{aligned}F_X(x - \varepsilon) = P(X \le x - \varepsilon) &\le P(X_n \le x) + P(\vert X_n - X\vert > \varepsilon) \\&= F_{X_n}(x) + P(\vert X_n - X\vert > \varepsilon) \end{aligned}\]将上式移项即得 $F_{X_n}(x)$ 的下界不等式。综合上下界,记尾概率误差项为 $\delta_n(\varepsilon) = P(\vert X_n - X\vert > \varepsilon)$,有:
\[F_X(x - \varepsilon) - \delta_n(\varepsilon) \le F_{X_n}(x) \le F_X(x + \varepsilon) + \delta_n(\varepsilon)\]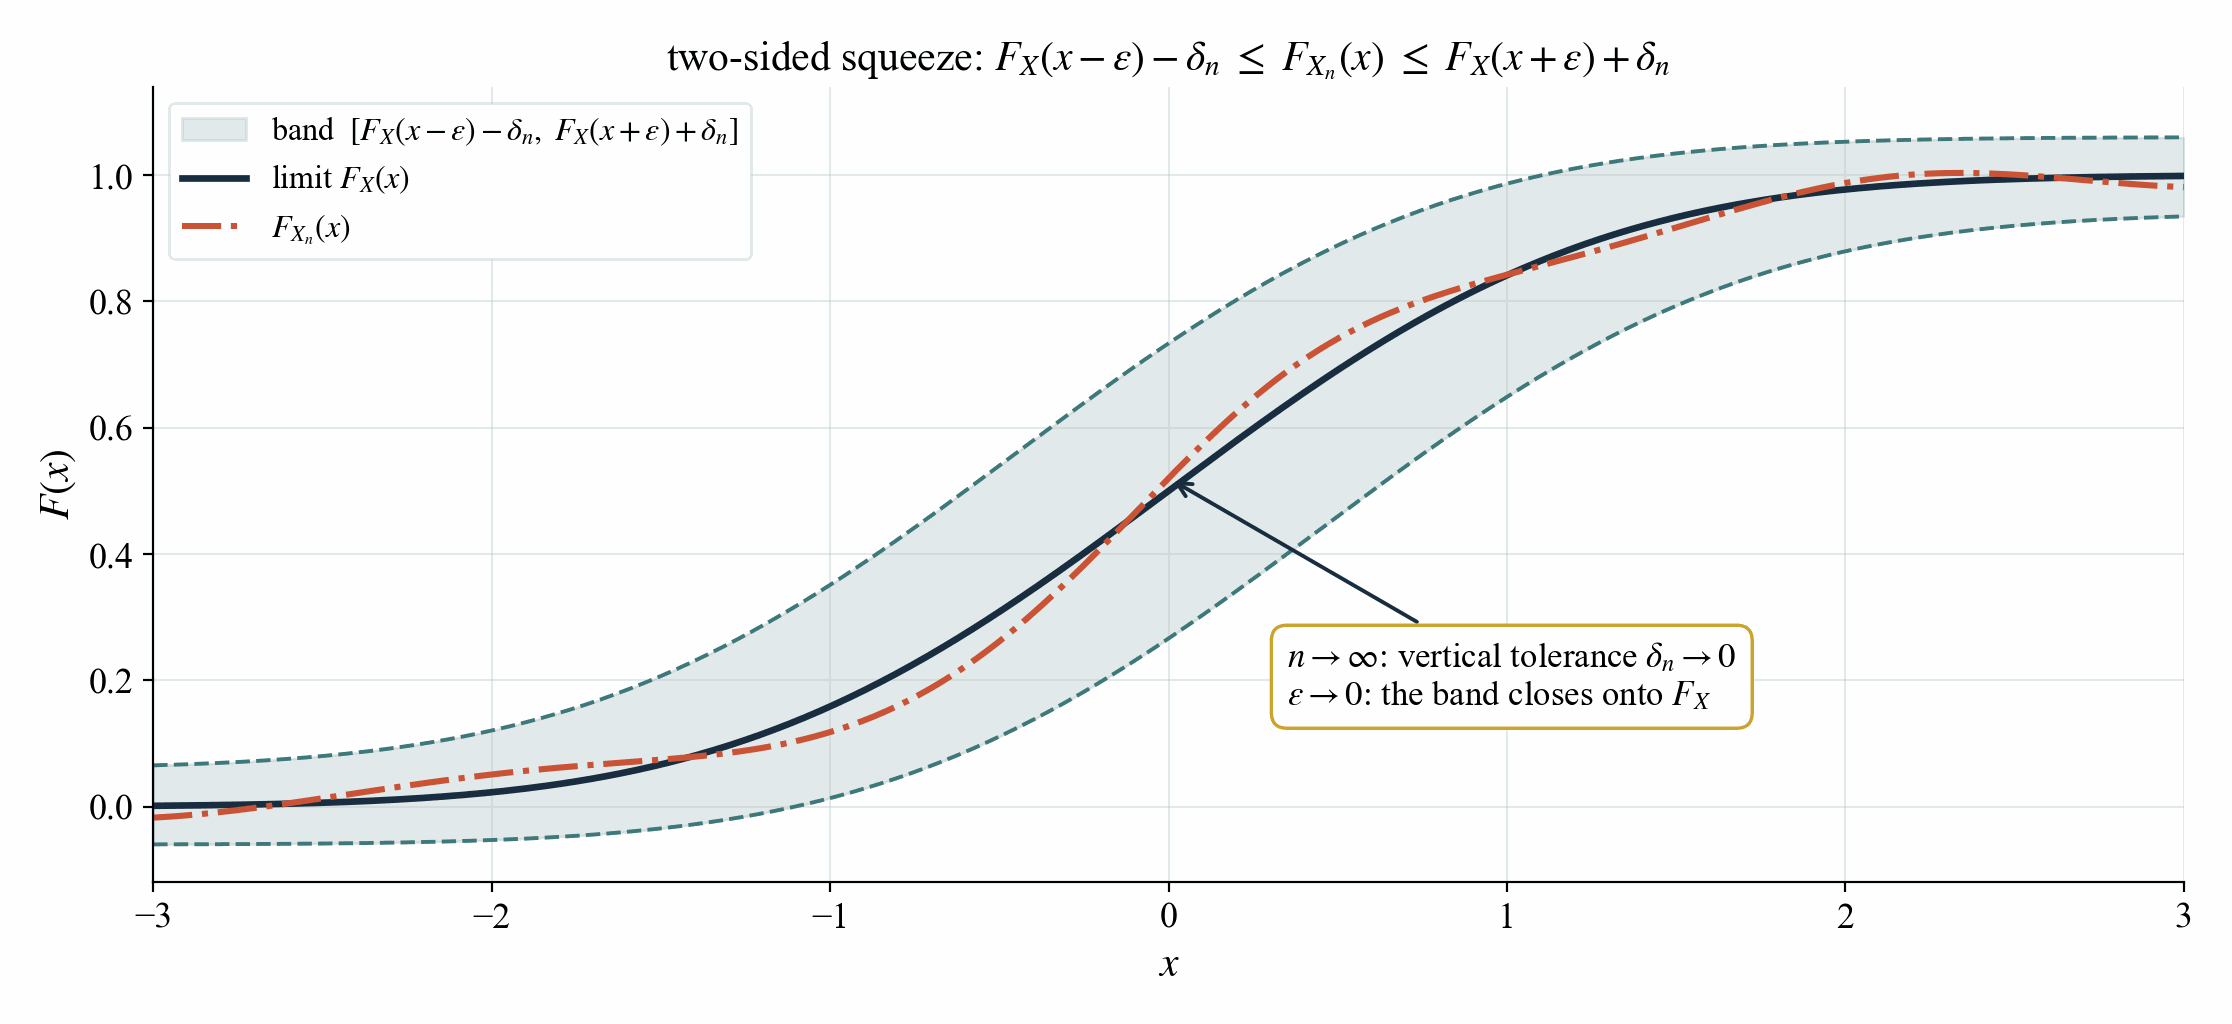
现在执行二次极限过程:
- 固定 $\varepsilon > 0$,令 $n \to \infty$:由已知条件 $X_n \xrightarrow{P} X$,有 $\lim_{n\to\infty} \delta_n(\varepsilon) = 0$。对不等式链取上极限与下极限,得: \(F_X(x - \varepsilon) \le \liminf_{n\to\infty} F_{X_n}(x) \le \limsup_{n\to\infty} F_{X_n}(x) \le F_X(x + \varepsilon)\)
- 令 $\varepsilon \to 0^+$:由于 $x$ 是 $F_X$ 的连续点,故有 $\lim_{\varepsilon\to 0^+} F_X(x - \varepsilon) = F_X(x)$ 以及 $\lim_{\varepsilon\to 0^+} F_X(x + \varepsilon) = F_X(x)$。由夹逼准则,上下极限相等且均为 $F_X(x)$,即 $\lim_{n\to\infty} F_{X_n}(x) = F_X(x)$。$\blacksquare$
注(逆命题不成立的反例):依分布收敛通常不能推出依概率收敛。例如,设随机变量 $Z \sim N(0,1)$,定义序列 $X_n \equiv -Z$ 且令极限目标 $X = Z$。由于对称性,$X_n$ 与 $X$ 同服从标准正态分布,故 $F_{X_n}(x) = F_X(x)$ 恒成立,显然有 $X_n \xrightarrow{d} X$。然而: \(P(\vert X_n - X\vert > \varepsilon) = P(\vert -Z - Z\vert > \varepsilon) = P\left(\vert Z\vert > \frac{\varepsilon}{2}\right) > 0\) 该概率是一个与 $n$ 无关的正数,不随 $n\to\infty$ 趋于 $0$,故 $X_n$ 不依概率收敛于 $X$。
然而,当极限目标退化为确定性常数时,上述逆命题成立:
定理 2.5(退化极限下的等价性) 设 $c$ 为常数,则 $X_n \xrightarrow{d} c \iff X_n \xrightarrow{P} c$。
证明:其中一个方向($\Leftarrow$)已由定理 2.4 给出,仅需证明另一方向($\Rightarrow$)。 设 $X_n \xrightarrow{d} c$,常数 $c$ 对应的退化分布函数为:
\[F_c(x) = \begin{cases} 0, & x < c \\ 1, & x \ge c \end{cases}\]显然,除点 $x = c$ 外,实轴上其余所有点均为 $F_c(x)$ 的连续点。对任意给定的 $\varepsilon > 0$,取 $x_1 = c - \varepsilon < c$ 与 $x_2 = c + \varepsilon > c$,则 $x_1, x_2$ 均为 $F_c$ 的连续点,故有:
\[\lim_{n\to\infty} F_{X_n}(c - \varepsilon) = F_c(c - \varepsilon) = 0\\ \lim_{n\to\infty} F_{X_n}(c + \varepsilon) = F_c(c + \varepsilon) = 1\]利用事件包含关系 ${\vert X_n - c\vert > \varepsilon} = {X_n < c - \varepsilon} \cup {X_n > c + \varepsilon} \subset {X_n \le c - \varepsilon} \cup {X_n > c + \varepsilon}$,可得:
\[\begin{aligned} 0 \le P\left(\vert X_n - c\vert > \varepsilon\right) &\le P\left(X_n \le c - \varepsilon\right) + P\left(X_n > c + \varepsilon\right) \\ &= F_{X_n}(c - \varepsilon) + \left[1 - F_{X_n}(c + \varepsilon)\right] \end{aligned}\]令 $n \to \infty$,上式右端收敛于 $0 + (1 - 1) = 0$。由夹逼准则知 $\lim_{n\to\infty} P(\vert X_n - c\vert > \varepsilon) = 0$,即 $X_n \xrightarrow{P} c$。$\blacksquare$
📖 例题(MC dropout 预测均值的蒙特卡洛误差)
论文背景:Dropout as a Bayesian Approximation: Representing Model Uncertainty in Deep Learning (ICML 2016)。
Gal 与 Ghahramani 提出在测试阶段保留 dropout 随机掩码,对同一输入重复 $T$ 次前向传播,用这 $T$ 个输出的样本均值近似预测均值,用样本二阶矩减去均值平方(再加上观测噪声项 $\tau^{-1}$)近似预测方差,论文把这一做法称为 MC dropout。给定输入与训练完成的权重后,这 $T$ 个输出由独立重采样的掩码生成,因而独立同分布:样本均值的收敛性由大数定律给出,其误差量级与置信区间由中心极限定理给出。
题目描述:固定输入 $x$ 与训练完成的权重,设 $T$ 次前向传播的标量输出 $Y_1, \dots, Y_T$ 独立同分布,记 \(\mu(x) = \mathbb{E}[Y_1], \qquad s^2(x) = \text{Var}(Y_1) \in (0, \infty)\) MC dropout 以 $\hat{\mu}T = \frac{1}{T}\sum{t=1}^T Y_t$ 作为预测均值的估计。
- 求 $\mu(x)$ 的渐近 $1 - \alpha$ 置信区间。
- 设 $s(x) = 0.2$,要使该置信区间(取 $\alpha = 0.05$)的半宽不超过 $0.01$,前向传播次数 $T$ 至少取多少?
解答:
(1) 由 $Y_t$ 独立同分布且 $0 < s^2(x) < \infty$,定理 2.3(Lindeberg-Lévy 中心极限定理)给出
\[\sqrt{T}\left(\hat{\mu}_T - \mu(x)\right) \xrightarrow{d} N\left(0,\ s^2(x)\right)\]记 $z_{\alpha/2}$ 为标准正态分布的上 $\alpha/2$ 分位数,则 $P\big(\vert \hat{\mu}T - \mu(x)\vert \le z{\alpha/2}s(x)/\sqrt{T}\big) \to 1 - \alpha$,故 $\mu(x)$ 的渐近 $1-\alpha$ 置信区间为
\[\hat{\mu}_T \pm z_{\alpha/2}\frac{s(x)}{\sqrt{T}}\](2) 置信区间的半宽为 $z_{\alpha/2}s(x)/\sqrt{T}$,要求它不超过 $\delta$ 即
\[z_{\alpha/2}\frac{s(x)}{\sqrt{T}} \le \delta \iff T \ge \left(\frac{z_{\alpha/2}\,s(x)}{\delta}\right)^2\]代入 $z_{0.025} \approx 1.96$、$s(x) = 0.2$、$\delta = 0.01$:
\[T \ge \left(\frac{1.96 \times 0.2}{0.01}\right)^2 \approx 1536.6 \quad \Longrightarrow \quad T \ge 1537\]由于半宽按 $T^{-1/2}$ 下降,精度每提高一个数量级,所需前向传播次数就要增加约 $100$ 倍,这是蒙特卡洛估计的固有代价。
3. 连续映射定理与随机渐近阶符号
3.1 连续映射定理(CMT)
在确定性微积分中,若数列 $a_n \to a$ 且函数 $g(x)$ 在点 $a$ 处连续,则有 $g(a_n) \to g(a)$。连续映射定理将这一性质完整推广至随机变量的收敛序列。
定理 3.1(连续映射定理,Continuous Mapping Theorem) 设 $g: \mathbb{R}^d \to \mathbb{R}^k$ 为 Borel 可测映射,其不连续点集合记为 $D_g$。若 $P(\mathbf{X}\in D_g)=0$,即 $g$ 相对于 $\mathbf{X}$ 的分布几乎处处连续,则:
- 若 $\mathbf{X}_n \xrightarrow{P} \mathbf{X}$,则 $g(\mathbf{X}_n) \xrightarrow{P} g(\mathbf{X})$;
- 若 $\mathbf{X}_n \xrightarrow{d} \mathbf{X}$,则 $g(\mathbf{X}_n) \xrightarrow{d} g(\mathbf{X})$。
证明(常数概率极限与处处连续映射两种情形): 设函数 $g$ 在常数点 $\mathbf{c}$ 处连续。由多元函数在一点连续的 $\varepsilon$-$\delta$ 定义:对任意给定的 $\varepsilon > 0$,存在 $\delta > 0$,使得对任意满足 $\Vert \mathbf{x} - \mathbf{c}\Vert \le \delta$ 的点 $\mathbf{x}$,均有 $\Vert g(\mathbf{x}) - g(\mathbf{c})\Vert \le \varepsilon$。 取其逆否命题:若随机事件 ${\Vert g(\mathbf{X}_n) - g(\mathbf{c})\Vert > \varepsilon}$ 发生,则必然有事件 ${\Vert \mathbf{X}_n - \mathbf{c}\Vert > \delta}$ 发生。由事件包含关系的概率单调性,得:
\[0 \le P\left(\Vert g(\mathbf{X}_n) - g(\mathbf{c})\Vert > \varepsilon\right) \le P\left(\Vert \mathbf{X}_n - \mathbf{c}\Vert > \delta\right)\]令 $n \to \infty$,由 $\mathbf{X}_n \xrightarrow{P} \mathbf{c}$ 知右端概率趋于 $0$,故 $g(\mathbf{X}_n) \xrightarrow{P} g(\mathbf{c})$。 对于依分布收敛情形,当 $g$ 处处连续时,任取有界连续函数 $h$,则复合函数 $h \circ g$ 仍为有界连续函数。由定理 2.1(Portmanteau 定理)的条件 2,直接有 $\mathbb{E}[h(g(\mathbf{X}_n))] = \mathbb{E}[(h\circ g)(\mathbf{X}_n)] \to \mathbb{E}[(h\circ g)(\mathbf{X})] = \mathbb{E}[h(g(\mathbf{X}))]$,故 $g(\mathbf{X}_n) \xrightarrow{d} g(\mathbf{X})$。$\blacksquare$
3.2 随机渐近阶符号:$o_p(\cdot)$ 与 $O_p(\cdot)$
在经典数学分析中,Landau 符号 $o(\cdot)$ 与 $O(\cdot)$ 被广泛用于表示无穷小量与有界量的渐近阶。在数理统计中,为了简化复杂随机展开式的书写,引入了对应的随机渐近阶符号(Stochastic Order Symbols)。
定义 3.1(依概率无穷小量 $o_p$) 设 ${X_n}$ 为随机变量序列,${a_n}$ 为正实数序列。
- 若 $X_n \xrightarrow{P} 0$,则记作 $X_n = o_p(1)$;
- 若 $X_n/a_n \xrightarrow{P} 0$,则记作 $X_n = o_p(a_n)$。
定义 3.2(依概率有界量 $O_p$) 设 ${X_n}$ 为随机变量序列,${a_n}$ 为正实数序列。
- 若对任意 $\eta>0$,存在有限常数 $M_\eta>0$ 和正整数 $N_\eta$,使得当 $n>N_\eta$ 时恒有 \(P\left(\vert X_n\vert > M_\eta\right) < \eta\) 则称序列 ${X_n}$ 依概率有界(Bounded in Probability),记作 $X_n=O_p(1)$;
- 若 $X_n/a_n=O_p(1)$,则记作 $X_n=O_p(a_n)$。
定理 3.2(依分布收敛必依概率有界) 若随机变量序列满足 $X_n \xrightarrow{d} X$,则必有 $X_n = O_p(1)$。
证明:任取 $\eta > 0$。由于极限随机变量 $X$ 的分布函数满足 $\lim_{x\to -\infty} F_X(x) = 0$ 及 $\lim_{x\to +\infty} F_X(x) = 1$,故存在充分大的正数 $M > 0$,使得 $-M$ 与 $M$ 均为 $F_X$ 的连续点,且满足:
\[P(\vert X\vert > M) \le F_X(-M) + \left[1 - F_X(M)\right] < \frac{\eta}{2}\]由 $X_n \xrightarrow{d} X$,在连续点 $\pm M$ 处有 $\lim_{n\to\infty} \left(F_{X_n}(-M) + 1 - F_{X_n}(M)\right) = F_X(-M) + 1 - F_X(M) < \frac{\eta}{2}$。由极限的保号性,存在正整数 $N$,当 $n > N$ 时恒有:
\[P(\vert X_n\vert > M) \le F_{X_n}(-M) + 1 - F_{X_n}(M) < \eta\]此即表明 $X_n = O_p(1)$。$\blacksquare$
应用示例(中心极限定理的渐近阶表示): 由中心极限定理知 $\sqrt{n}(\bar{X}_n - \mu) \xrightarrow{d} N(0, \sigma^2)$。根据定理 3.2,该收敛序列必依概率有界,即: \(\sqrt{n}(\bar{X}_n - \mu) = O_p(1) \iff \bar{X}_n - \mu = O_p\left(n^{-1/2}\right)\) 这表明样本均值逼近总体均值的收敛速率为 $n^{-1/2}$ 量级。由于 $n^{-1/2} \to 0$,故亦有 $\bar{X}_n - \mu = o_p(1)$(即弱大数定律)。