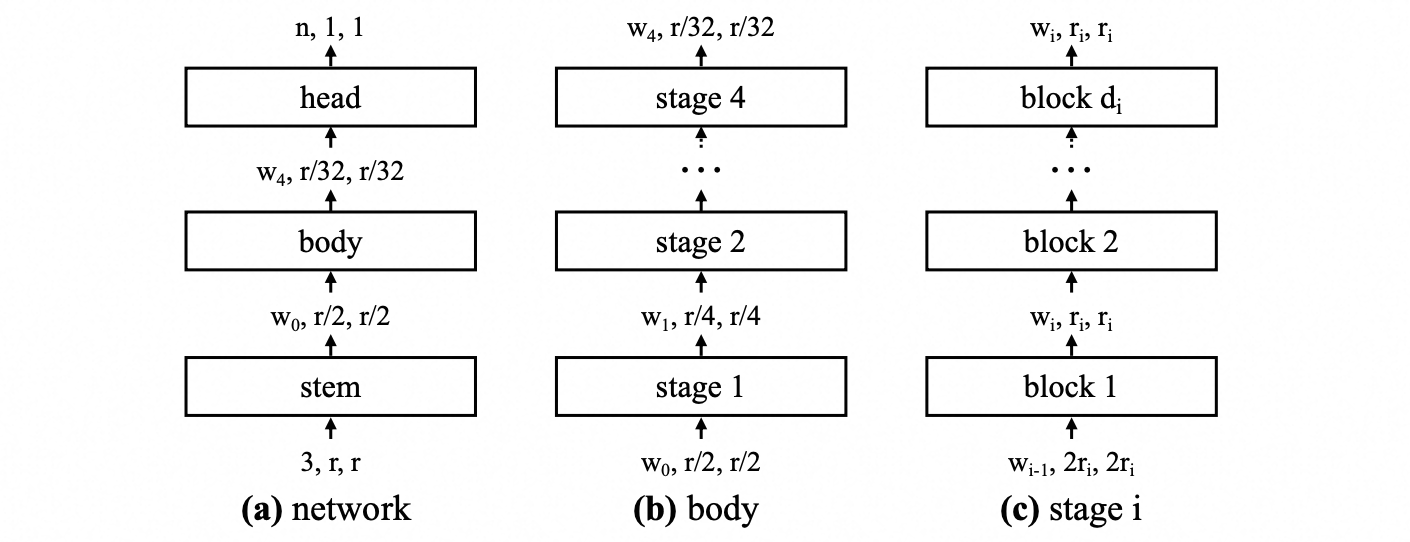
Image Recognition.
图像识别(Image Recognition)又称图像分类(Image Classification),是计算机视觉的基础任务,旨在根据图像内容判定其所属的预定义类别。
该任务的核心难点在于跨越语义鸿沟(semantic gap):由于视角、光照、遮挡及背景的变化,同类样本在底层视觉特征(low-level visual features)上可能呈现显著差异,而异类样本在局部底层特征上反而可能具有较高相似性,导致底层像素统计特性与高层语义概念(high-level concepts)之间缺乏直接的线性映射。
传统方法通常将特征提取(如 SIFT、HOG)与分类器训练(如 SVM)解耦;深度学习方法则通过卷积神经网络(CNN)构建端到端的层级表示学习框架。作为视觉表征学习的基准任务,主流卷积主干网络(Backbone)的设计通常率先在图像分类任务上验证,随后迁移至目标检测、语义分割与姿态估计等下游任务。
- 1. 早期探索
- 2. 深度与跨层连接
- 3. 模块化与多分支设计
- 4. 缩放与架构搜索
1. 早期探索
卷积神经网络的早期探索确立了“卷积特征提取—空间下采样—分类器”的设计范式,并通过实验与可视化分析确立了缩小卷积核尺寸、减小步幅以及增加网络深度的基本设计准则。
⚪ LeNet-5:局部连接与可学习下采样的手写字符识别网络
- paper:Gradient-based learning applied to document recognition(Proceedings of the IEEE 1998)
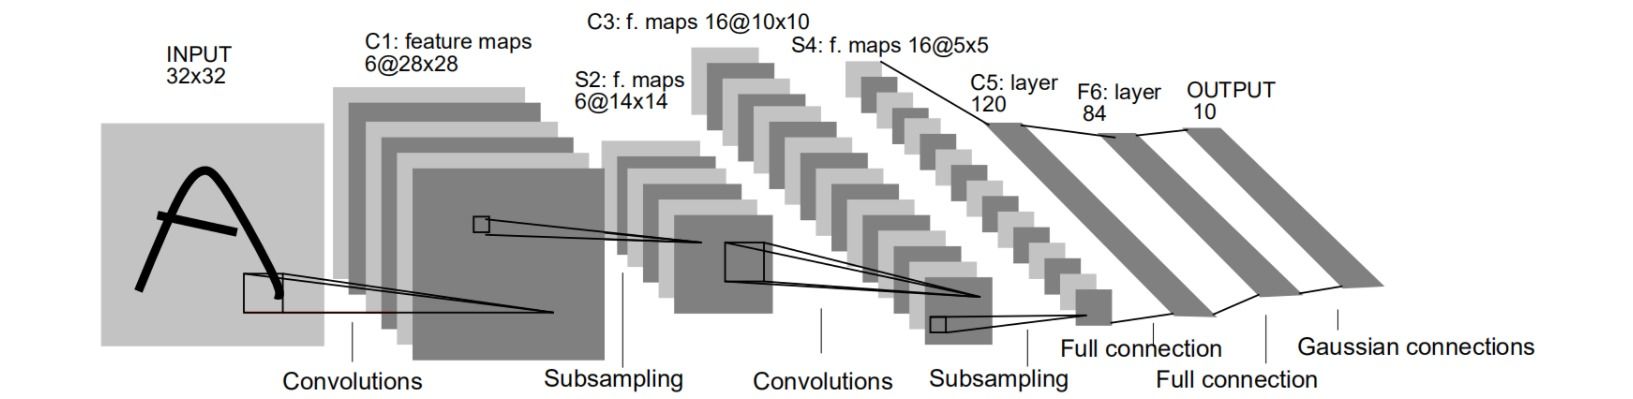
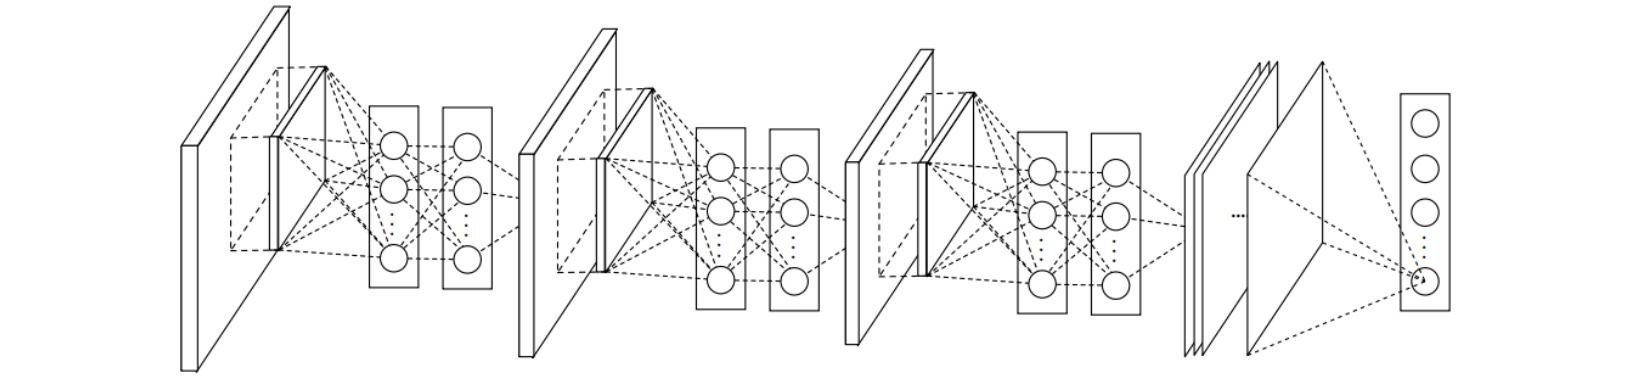
LeNet-5由LeCun等人于$1998$年提出,旨在解决文档手写字符识别问题。针对全连接多层感知机处理图像时参数量过大且忽略空间拓扑结构的问题,该网络引入局部感受野(local receptive fields)、权值共享(weight sharing)和空间子采样(spatial sub-sampling)三项核心机制。权值共享显著降低了模型自由度,空间子采样则赋予特征对局部平移、缩放和轻微形变的鲁棒性。
网络接收$32\times32$单通道图像,前馈结构依次为$C1(6@5\times5)$ $\to S2(2\times2)\to$ $C3(16@5\times5)\to S4(2\times2)$ $\to C5(120@5\times5)\to F6(84)\to10$类输出层,总参数量约$6\times 10^4$。其中,$S2$与$S4$是对$2\times2$邻域求和后乘以可学习标量并加偏置;$C3$层采用非对称的部分通道连接策略以打破对称性并限制计算开销。全网隐藏层使用缩放双曲正切激活函数$f(a) = A \tanh(Sa)$。输出层由欧氏径向基函数单元组成,每个单元对应一个预定义的$84$维字符编码原型,通过最小化特征向量与目标原型间的欧氏距离(配合最大后验准则)完成分类。
⚪ AlexNet:以 ReLU 与 GPU 并行训练实现大规模图像分类
- paper:ImageNet Classification with Deep Convolutional Neural Networks(NeurIPS 2012)
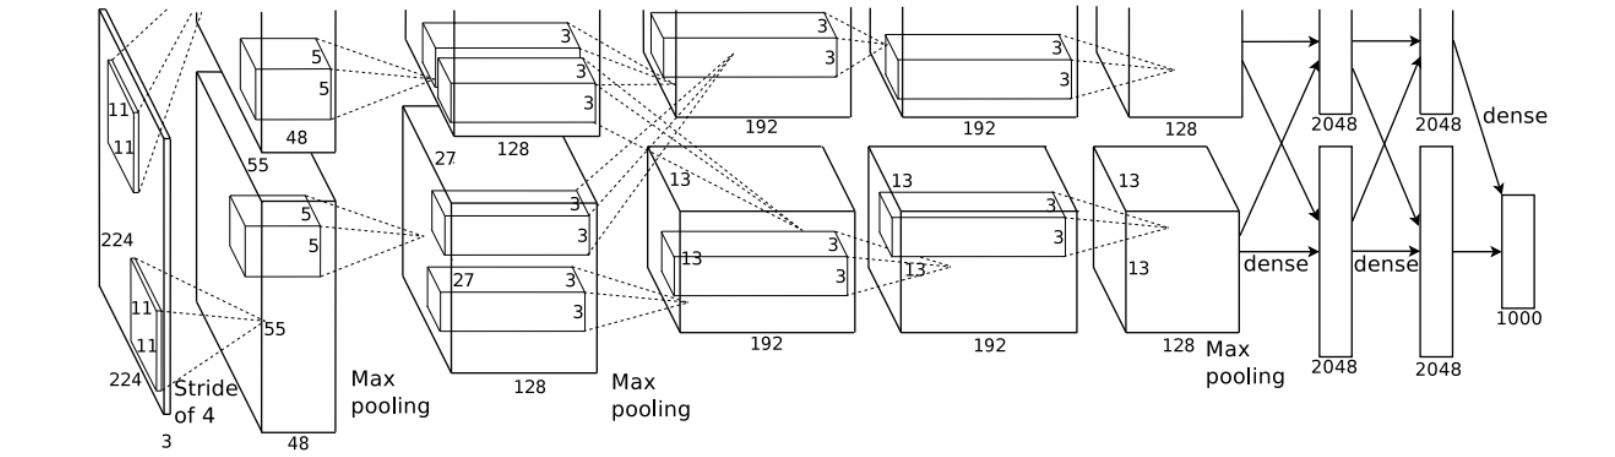
AlexNet将卷积神经网络扩展至百万级样本的大规模自然图像分类任务(ImageNet ILSVRC-2012)。为解决深层大模型在训练效率与过拟合方面的瓶颈,该工作引入非饱和激活函数ReLU以缓解梯度消失并加速收敛,采用局部响应归一化(Local Response Normalization, LRN)模拟生物神经元的侧抑制机制,并在全连接层引入Dropout正则化。受限于早期单卡显存容量,模型采用跨双GPU的模型并行策略(仅在特定层进行跨卡通信),这一分组计算机制成为后续分组卷积(group convolution)的雏形。
网络包含$5$个卷积层和$3$个全连接层,参数量约$6\times 10^7$。针对$224\times224\times3$输入(实际填充为$227\times227$),依次执行:$96$通道$11\times11/s4$卷积、$256$通道$5\times5$卷积、三层$3\times3$卷积(通道数分别为$384, 384, 256$),并在第$1, 2, 5$卷积层后配置核尺寸$3\times3$、步幅$2$的重叠最大池化;尾部连接两个$4096$维全连接层与$1000$维Softmax分类器。训练过程采用随机裁剪、水平翻转及基于PCA的RGB通道强度扰动进行数据增强;优化器采用带动量($0.9$)的小批量随机梯度下降(Batch Size 为$128$),配合权重衰减($5\times10^{-4}$)与阶梯式学习率衰减(初始值$10^{-2}$)。
⚪ ZFNet:基于反卷积特征可视化的卷积核与步幅调优
- paper:Visualizing and Understanding Convolutional Networks(ECCV 2014)
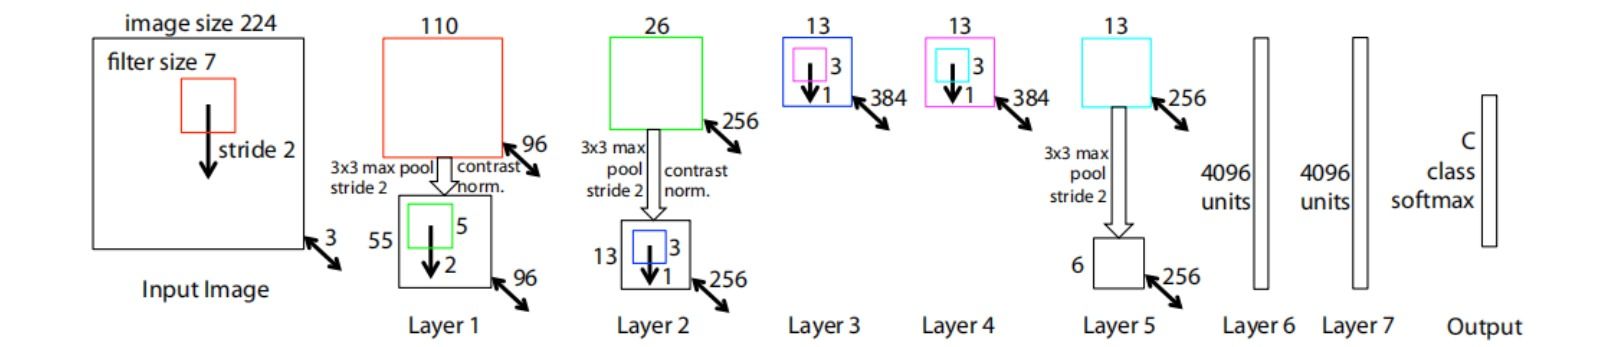
针对早期深层网络依赖经验性试错设定超参数的问题,Zeiler与Fergus提出一种基于反卷积网络(Deconvolutional Network, DeconvNet)的特征可视化方法,将任意中间层的特征激活映射回输入像素空间,以诊断网络的特征演化动力学与表示缺陷。可视化分析表明,AlexNet第一层过大的卷积核($11\times11$)与步幅($4$)导致中频信息缺失及第二层特征混叠(aliasing)。
反卷积映射机制是:可视化路径与前向传播探针层并联,依次执行三项逆操作:(1) 反池化(Unpooling):利用前向最大池化记录的激活位置索引将特征恢复至池化前分辨率;(2) 整流(Rectification):通过ReLU保证重构信号非负;(3) 滤波(Filtering):使用前向卷积核的转置对整流后的特征图进行卷积。此外,通过系统性遮挡输入图像的局部区域并观测分类概率变化,验证了网络对目标局部结构的空间敏感性。基于上述诊断,ZFNet将AlexNet首层卷积核由$11\times11/s4$缩小为$7\times7/s2$,并将第$3, 4, 5$层通道数扩展至$512, 1024, 512$,有效保留了底层高频与中频判别特征。
⚪ NIN:引入微网络结构与全局平均池化的分类架构
- paper:Network In Network(ICLR 2014)
传统卷积层通过线性滤波器与非线性激活函数提取特征,其隐含假设是潜在概念在局部感受野内线性可分。NIN提出两项结构改进:(1) 用微型多层感知机替代纯线性卷积核,以增强局部感受野内的非线性函数逼近能力;(2) 用全局平均池化(Global Average Pooling, GAP)替代尾部的全连接层,直接建立特征图通道与目标类别之间的对应关系,从而消除全连接层带来的大量参数与过拟合风险。
NIN的基本构建块mlpconv在标准空间卷积后级联多个$1\times1$卷积层(等价于在通道维度上共享参数的逐像素全连接层)与ReLU激活。整体网络由多层mlpconv与空间下采样层堆叠而成。末端mlpconv直接输出与类别数$K$相等的特征图,经无参数的全局空间平均池化生成$K$维逻辑值向量并输入Softmax计算交叉熵损失。该设计确立了$1\times1$跨通道交互卷积与全局池化分类头在现代卷积网络中的标准地位。
⚪ SPP-net:将多尺度空间特征汇聚为定长表示
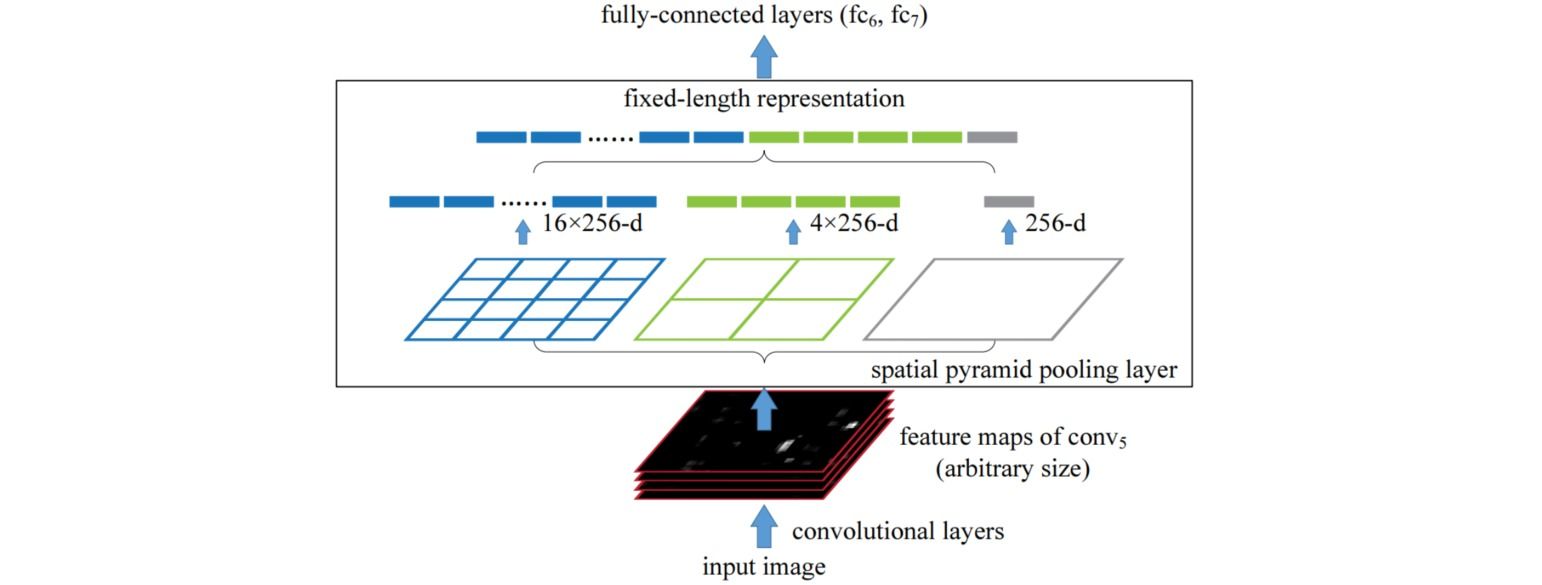
早期卷积网络的卷积层本身不限制输入尺寸,但尾部的全连接层要求固定维度的输入向量,迫使预处理阶段对图像进行裁剪(导致上下文信息丢失)或各向异性缩放(导致几何畸变)。SPP-net在末端卷积层与全连接层之间引入空间金字塔池化(Spatial Pyramid Pooling, SPP)层,通过对任意空间尺寸的特征图按固定网格比例进行多尺度汇聚,输出定长特征向量,从而解除了网络对输入图像分辨率与纵横比的限制。
设末端卷积层输出特征图维度为$H\times W\times C$,SPP 层预设$M$个金字塔层级(如$1\times1, 2\times2, 4\times4$网格)。对于$n\times n$级网格,池化窗口尺寸动态设定为$\lceil H/n \rceil \times \lceil W/n \rceil$,步幅设定为$\lfloor H/n \rfloor \times \lfloor W/n \rfloor$。各网格单元内的最大池化响应拼接为维度恒等于$C \sum_{m=1}^M n_m^2$(如$21C$)的定长向量并送入全连接层。训练阶段采用跨小批量的多尺度输入策略(如在$224\times224$与$180\times180$间交替)以提高尺度不变性。
⚪ VGGNet:通过堆叠小尺寸卷积核构建同构深层网络
- paper:Very Deep Convolutional Networks for Large-Scale Image Recognition(ICLR 2015)
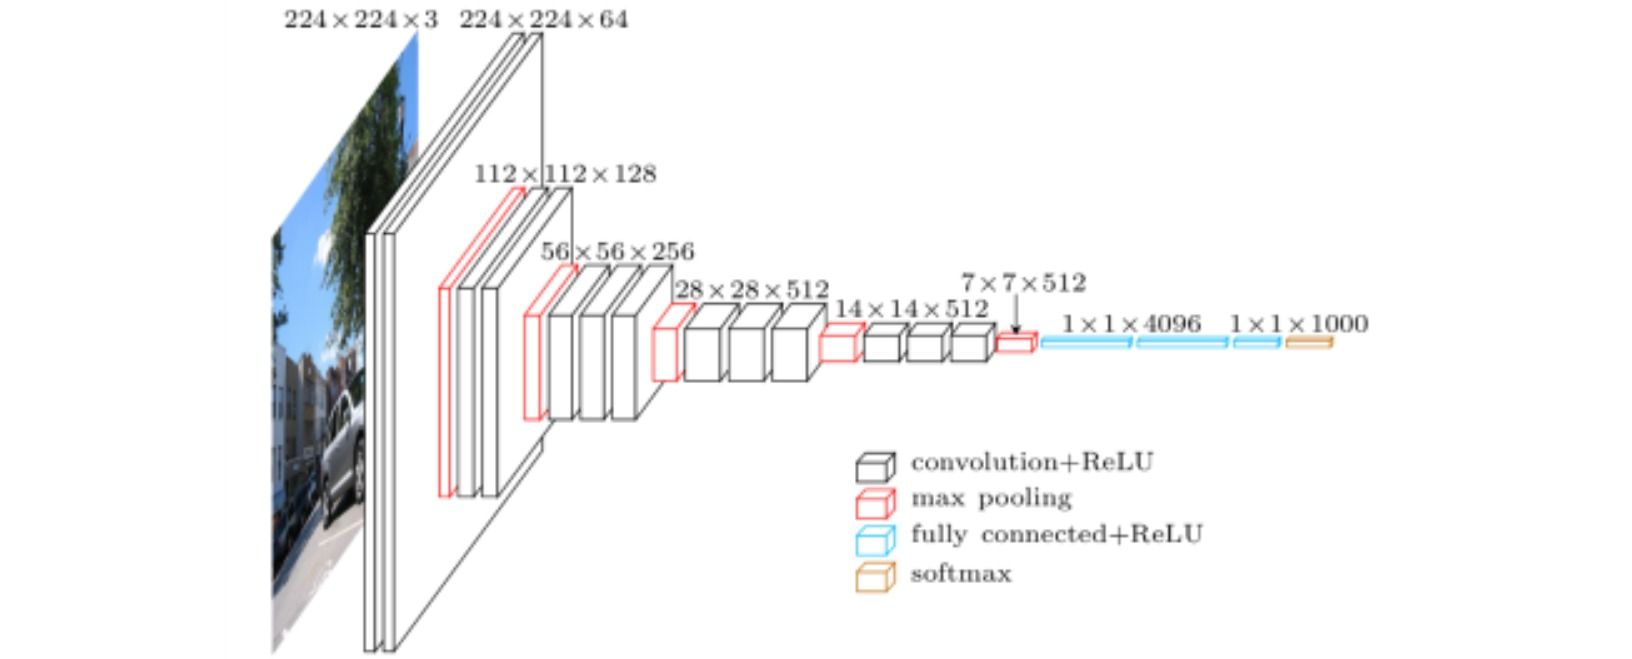
VGGNet系统性地探讨了卷积网络深度对分类性能的影响,确立了以单一小尺寸卷积核($3\times 3$)构建模块化深层网络的范式。理论分析表明,在保持通道数$C$不变的前提下,串联两层$3\times 3$卷积的有效感受野等价于单层$5\times 5$卷积,串联三层等价于单层$7\times 7$卷积;但多层小核堆叠不仅引入了更多非线性整流层以增强判别能力,还将参数量从$7^2 C^2 = 49C^2$压缩至$3 \times (3^2 C^2) = 27C^2$(减少约$45\%$),起到隐式正则化作用。
网络由五个卷积阶段和三个全连接层($4096\to4096\to1000$)组成。卷积层统一采用核尺寸$3\times3$、步幅$1$、填充$1$以保持空间分辨率,阶段间通过$2\times2/s2$最大池化将特征图分辨率减半,同时将通道数翻倍(由$64$依次递增至$128, 256, 512, 512$)。代表性配置VGG-16与VGG-19的五阶段卷积层数分别为$(2, 2, 3, 3, 3)$与$(2, 2, 4, 4, 4)$,其中VGG-16总参数量约$1.38\times 10^8$(主要集中于首个全连接层)。训练初期针对极深配置采用由浅层预训练模型(VGG-11)初始化权重的策略,后续证明使用Xavier均匀初始化配合批归一化即可直接收敛。
2. 深度与跨层连接
随着网络层数的进一步增加,单纯堆叠卷积层不仅面临梯度消失或爆炸问题,还会出现训练集与测试集误差同步上升的网络退化(degradation)现象。本节方法通过引入跨层跳跃连接(Skip Connections)、门控机制、特征级联及渐进式通道扩增,重构深层网络的前向信息流与反向梯度传播路径。
⚪ Highway Network:利用门控机制调节跨层信息传递
- paper:Highway Networks(arXiv 2015,预印本)
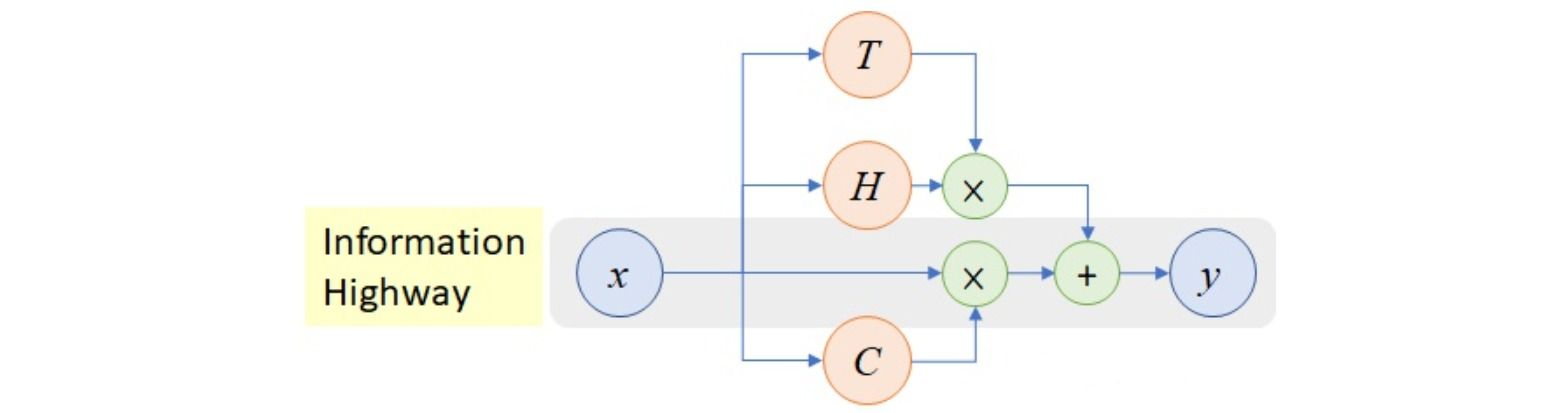
受长短期记忆网络门控机制的启发,Highway Network在前馈网络中引入可学习的跨层信息通路,以解决百层以上深度网络的优化困难。标准网络层仅执行非线性变换$y = H(x, W_H)$,而该网络定义了两个非线性门控函数:变换门(transform gate)$T(x, W_T)$与携带门(carry gate)$C(x, W_C)$,对非线性变换结果与原始输入进行自适应加权融合。
设门控激活函数为 Sigmoid 函数$\sigma(\cdot)$,为简化计算,通常将携带门耦合为$C = 1 - T$,单层前向传播公式表述为:
\[y = H(x, W_H) \odot T(x, W_T) + x \odot \left(1 - T(x, W_T)\right)\]其中$\odot$表示逐元素乘积,$T(x) = \sigma(W_T x + b_T)$。当$T(x)\to 0$时,输出近似为恒等映射$y \approx x$,对应雅可比矩阵趋近于单位矩阵,允许信息与梯度无损跨越多层;当$T(x)\to 1$时则退化为标准非线性层。训练时将变换门偏置$b_T$初始化为负值(如$-1$至$-3$),迫使网络在训练初期处于近似恒等传递状态,随后根据任务损失逐步开启非线性变换分支,成功实现了高达$900$层网络的端到端优化。
⚪ ResNet:基于恒等跳跃连接的残差映射学习
- paper:Deep Residual Learning for Image Recognition(CVPR 2016)
实验表明,当普通网络深度增加到一定程度时,训练准确率会出现饱和乃至下降的退化现象,说明多层非线性堆叠难以直接拟合恒等映射。ResNet提出残差学习(residual learning)框架:不再让堆叠层直接拟合潜在目标映射$H(x)$,而是通过引入无参数、非门控的恒等跳跃连接(identity shortcut connection),令非线性分支拟合残差映射$F(x) = H(x) - x$,则原映射重构为:
\[y = F(x, \{W_i\}) + x\]若恒等映射即为最优解,优化器只需将残差分支的权重推向零,这比用多层非线性层拟合恒等映射在优化上显著更容易,且恒等支路既不增加参数量也不引入额外计算开销。
针对不同深度规模,ResNet设计了两种残差单元:ResNet-18/34采用由两个$3\times3$卷积组成的基本块(BasicBlock);ResNet-50/101/152为控制计算复杂度,采用由“$1\times1$降维卷积—$3\times3$空间卷积—$1\times1$升维卷积(通道扩张倍数为$4$)”构成的瓶颈块(Bottleneck)。以ResNet-50为例,四个阶段的残差块堆叠数量为$(3, 4, 6, 3)$。当阶段转换处发生空间步幅下采样($s=2$)或通道维度改变时,快捷支路采用$1\times1$线性投影卷积$W_s x$对齐维度:
\[y = \operatorname{ReLU}\left(F(x, \{W_i\}) + W_s x\right)\]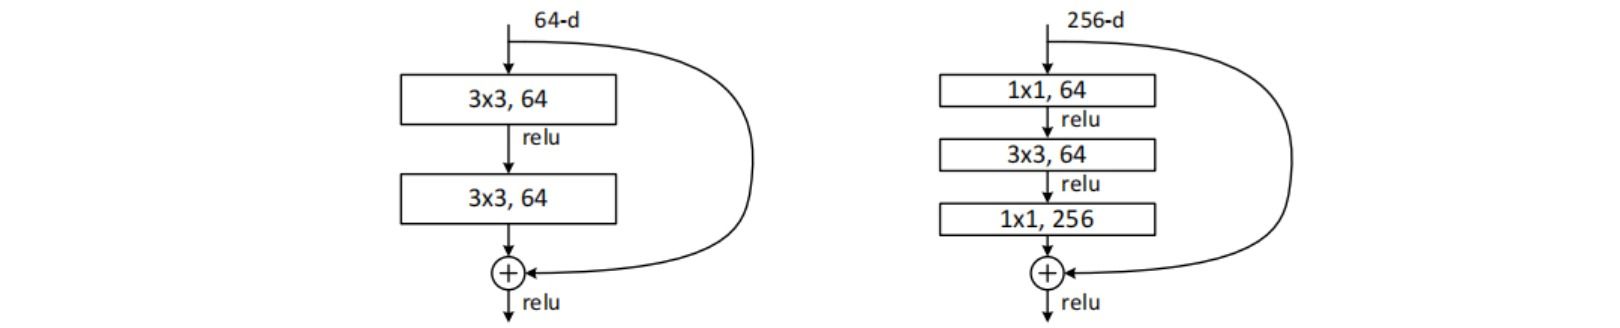
⚪ ResNet-v2:以预激活结构保障极深网络的恒等映射传播
- paper:Identity Mappings in Deep Residual Networks(ECCV 2016)
在原始ResNet-v1中,每个残差块的相加操作之后紧跟一个ReLU激活函数(即后激活 post-activation:$x_{l+1} = \operatorname{ReLU}(x_l + F(x_l))$),导致跳跃连接上的信号并非严格意义上的恒等映射,当网络扩展至上千层时仍会出现优化困难。ResNet-v2从理论上证明:当且仅当跳跃连接与相加后的传递函数均为恒等映射时,前向信号与反向梯度才能在任意浅层$l$与深层$L$之间直接无损传递。
ResNet-v2将批归一化(BN)与ReLU激活移至残差分支的卷积运算之前,构成预激活(pre-activation)结构(即$\text{BN}\to\text{ReLU}\to\text{Conv}$)。此时主干传递严格满足递推关系$x_{l+1} = x_l + F(x_l, W_l)$,展开至任意深层$L$可得:
\[x_L = x_l + \sum_{i=l}^{L-1} F(x_i, W_i)\]根据链式法则,损失函数$\mathcal{E}$对浅层特征$x_l$的梯度为:
\[\frac{\partial \mathcal{E}}{\partial x_l} = \frac{\partial \mathcal{E}}{\partial x_L} \left( 1 + \frac{\partial}{\partial x_l} \sum_{i=l}^{L-1} F(x_i, W_i) \right)\]括号中的常数项$1$确保了高层梯度$\frac{\partial \mathcal{E}}{\partial x_L}$能够不经任何权重矩阵衰减地直接回传至任意浅层$l$;同时,预激活中的BN层对残差分支的所有输入进行了标准化,起到了更强的正则化作用,使超过$1000$层的残差网络得以稳定收敛且泛化性能进一步提升。

⚪ Stochastic Depth:训练期随机旁路残差块的深层网络正则化
- paper:Deep Networks with Stochastic Depth(ECCV 2016)
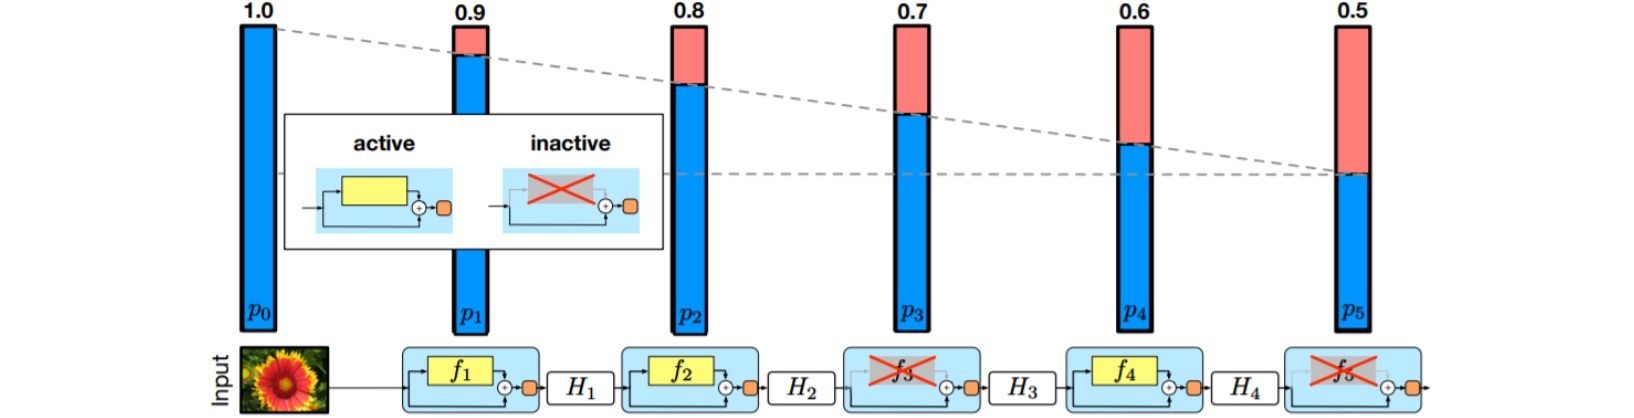
尽管残差连接缓解了优化难题,但极深网络仍面临训练耗时长、前向特征边际收益递减及过拟合问题。随机深度(Stochastic Depth)提出一种结构级正则化策略:在训练阶段,对每个小批量样本按预设概率随机将部分残差块的非线性分支旁路(仅保留恒等跳跃连接),从而动态构造一个期望深度较浅的子网络;在推理阶段,保留全部残差块并按存活概率缩放其输出,实现隐式的不同深度模型集成。
引入服从伯努利分布的二值随机变量$b_l \sim \operatorname{Bernoulli}(p_l)$,第$l$个残差块在训练时的前向更新公式为:
\[H_l = \operatorname{ReLU}\left(b_l F_l(H_{l-1}) + H_{l-1}\right)\]当$b_l=0$时,该块退化为恒等映射。鉴于浅层提取的低级视觉特征是后续各层的基础,应保持较高稳定性,因此各块的存活概率(survival probability)$p_l$通常沿网络深度配置为线性衰减日程:
\[p_l = 1 - \frac{l}{L}\left(1 - p_L\right)\]其中$L$为总残差块数,$p_L$为末端块存活率(经验值常取$0.5$),训练期的期望有效深度降至$\tilde{L} = \sum_{l=1}^L p_l = \frac{3}{4}L$。测试时去除随机变量,确定性计算$H_l^{\text{test}} = \operatorname{ReLU}(p_l F_l(H_{l-1}^{\text{test}}) + H_{l-1}^{\text{test}})$(现代实现中常采用 Inverted DropPath,即在训练期将存活分支除以$p_l$,测试期保持原权重不变)。
⚪ DenseNet:沿通道维级联跨层特征的密集连接机制
- paper:Densely Connected Convolutional Networks(CVPR 2017)
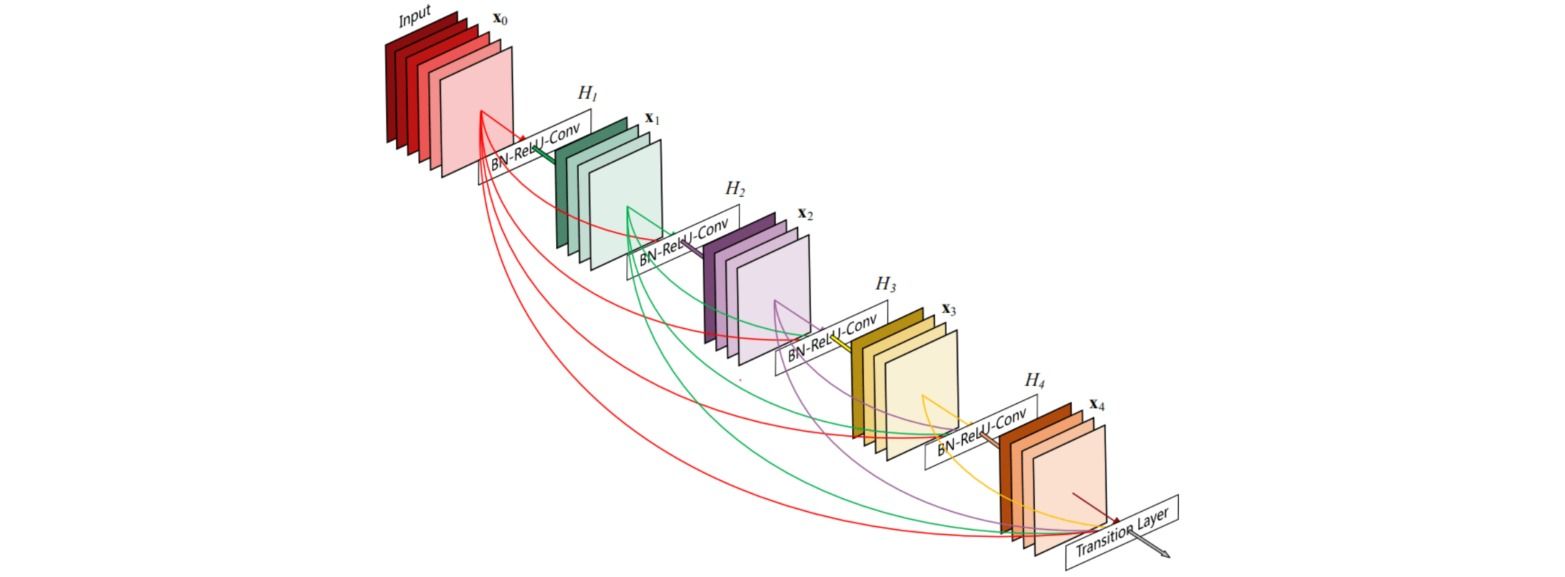
ResNet通过逐元素相加聚合跨层信息,但相加操作可能会模糊不同深度层级特征的独立性,且部分冗余层对最终表示贡献极小。DenseNet提出密集连接(dense connectivity)拓扑:在一个密集块(Dense Block)内,任意第$l$层均直接接收前面所有层$0, \dots, l-1$输出特征图在通道维度上的级联作为输入,共在$L$层间建立$\frac{L(L+1)}{2}$条直接连接:
\[x_l = H_l\left([x_0, x_1, \dots, x_{l-1}]\right)\]这种设计不仅使浅层直接获得来自损失函数的隐式深度监督(implicit deep supervision),还显式区分了“已提取的跨层复用特征”与“当前层新生成的特征”,从而允许单层卷积使用极窄的通道宽度。
设单层非线性变换$H_l(\cdot)$(采用\(\text{BN}\to\text{ReLU}\to\text{Conv}_{3\times3}\)预激活顺序)仅输出$k$个特征通道,则第$l$层的输入通道数为$k_0 + k(l-1)$,超参数$k$称为网络的增长率(growth rate)(通常取$12 \sim 48$)。为抑制深层输入通道累加带来的计算膨胀,DenseNet-BC变体引入两项压缩机制:(1) 瓶颈层(Bottleneck):在每个$3\times3$卷积前插入\(\text{BN}\to\text{ReLU}\to\text{Conv}_{1\times1}\)将输入通道统一压缩至$4k$;(2) 过渡层(Transition Layer):在相邻两个密集块之间,使用$1\times1$卷积按压缩系数$\theta \in (0, 1]$(常取$0.5$)缩减总通道数,并接$2\times2/s2$平均池化完成空间下采样。
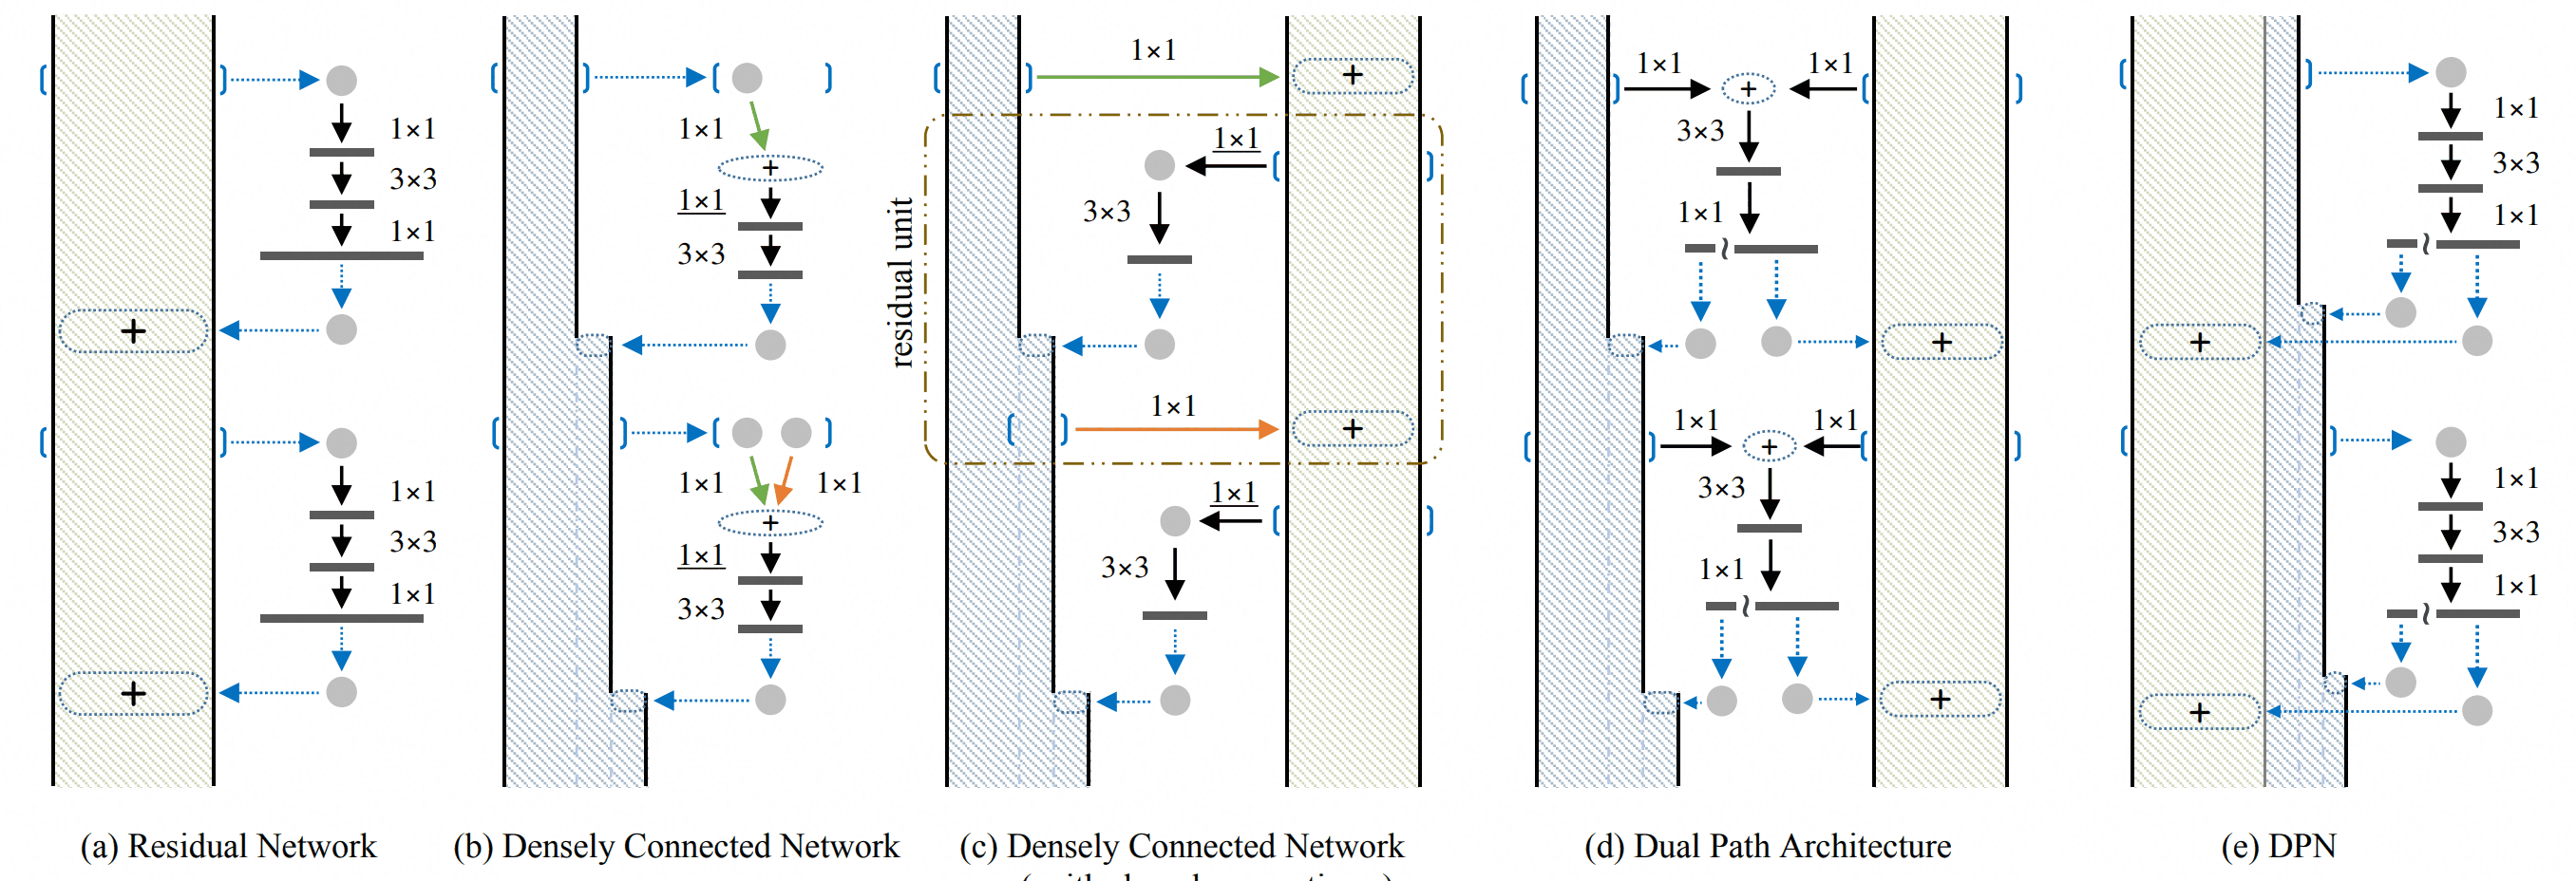
⚪ DPN:结合残差特征复用与密集特征探索的双路径网络
- paper:Dual Path Networks(NeurIPS 2017)
DPN在高阶循环神经网络(Higher-Order Recurrent Neural Network, HORNN)的数学框架下对ResNet与DenseNet进行了统一理论剖析:当高阶跨步连接权值在各步间共享时,HORNN 退化为ResNet,其逐元素相加机制有利于特征复用(feature re-usage),但难以发掘全新的特征表征;当跨步连接权值不共享时,HORNN 对应于DenseNet,其通道级联机制有利于探索新特征(new feature exploration),但存在较高的特征冗余。DPN将两种拓扑结合,在每个计算块中并行维护一条残差路径与一条密集路径。
设第$k$步的输入状态由残差分支特征$r_k$与密集分支特征$d_k$拼接而成,即$x_k = [r_k, d_k]$。经过由分组瓶颈结构($1\times1\to 3\times3\text{ GroupConv}\to 1\times1$)实现的特征变换$F_k(x_k)$后,将其输出沿通道维度拆分为两部分$F_k^r(x_k)$和$F_k^d(x_k)$,分别以相加和级联的方式更新两条路径:
\[r_{k+1} = r_k + F_k^r\left([r_k, d_k]\right), \quad d_{k+1} = \left[d_k, F_k^d\left([r_k, d_k]\right)\right]\]展开至第$k$步,网络总状态可表示为两条路径的通道拼接($\oplus$):
\[y_k = \underbrace{\left(r_0 + \sum_{t=1}^{k} F_t^r(x_{t-1})\right)}_{\text{残差路径:特征复用}} \ \oplus \ \underbrace{\left[d_0, F_1^d(x_0), \dots, F_k^d(x_{k-1})\right]}_{\text{密集路径:探索新特征}}\]在实际设计中,残差路径承载主体通道宽度,而密集路径每步仅递增少量通道(类似 DenseNet 的小增长率),从而在严格控制显存占用与计算复杂度的前提下兼顾了特征复用与表征扩展。
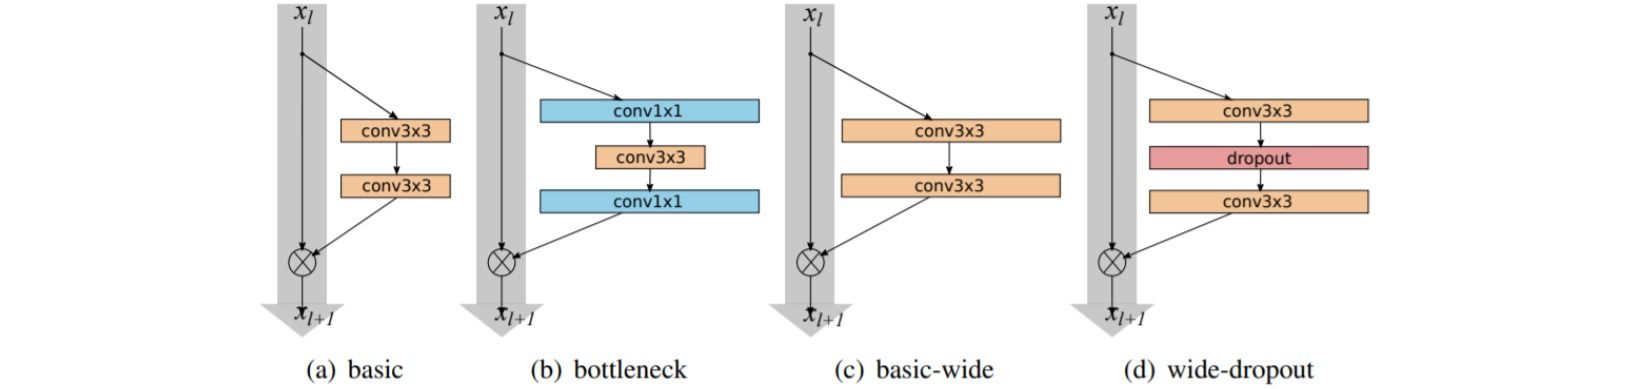
⚪ WideResNet:通过扩展残差块通道宽度提升表征能力
- paper:Wide Residual Networks(BMVC 2016)
针对原始残差网络依靠堆叠上百层甚至上千层来换取微小精度增益(平均每提升$1\%$精度需将层数翻倍)的收益递减(diminishing feature reuse)现象,WideResNet系统对比了残差网络的深度与宽度。研究表明,极深细长网络的梯度流倾向于主要通过恒等支路传递,迫使大量残差块仅贡献极少特征;相反,适当缩减层数并显著扩增卷积层的通道宽度,不仅能提升单块的特征容量,还能充分利用现代 GPU 对大张量密集矩阵运算的高并行吞吐特性,大幅提高训练效率。
WideResNet放弃了旨在压缩通道的瘦长瓶颈块,转而采用基于预激活($\text{BN}\to\text{ReLU}\to\text{Conv}$)的双层$3\times3$卷积基本块$B(3,3)$,并引入加宽因子$k$($k=1$对应原始宽度)扩展各阶段通道数(如将三阶段通道从$[16, 32, 64]$扩增为$[16k, 32k, 64k]$)。网络配置记为WRN-$d$-$k$,其中总深度$d = 6n + 4$($n$为每阶段块数)。为防止通道数成倍增加引发过拟合,该方法在残差块内部的两个$3\times3$卷积层之间直接插入Dropout层。实验表明,仅$28$层、加宽$10$倍的WRN-28-10在分类精度与训练速度上均超越了$1000$层的原始预激活 ResNet。
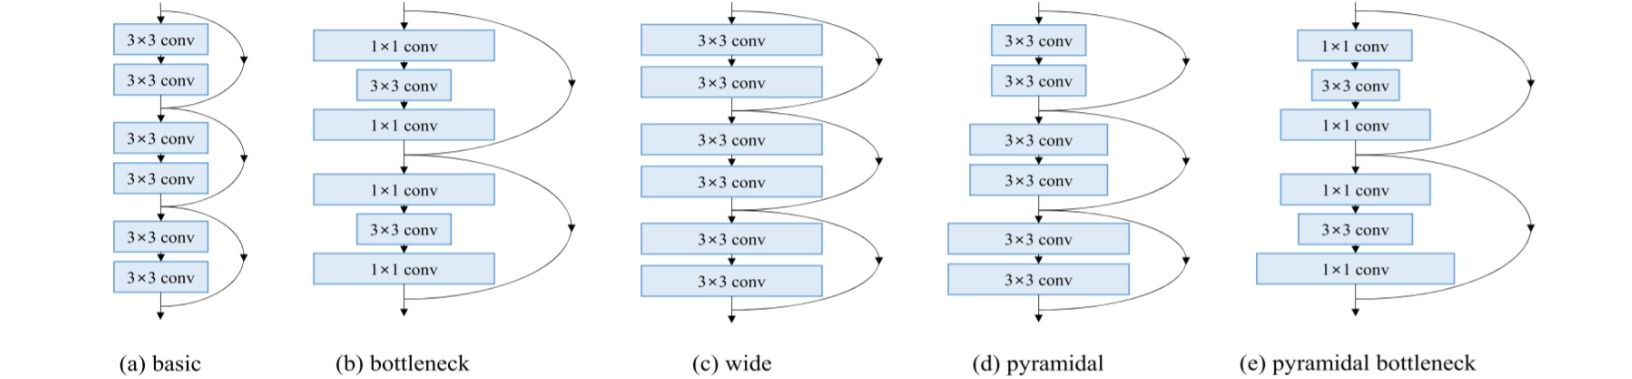
⚪ Pyramidal ResNet:沿网络深度逐层递增通道维度的金字塔结构
- paper:Deep Pyramidal Residual Networks(CVPR 2017)
标准卷积主干网络通常在空间分辨率保持不变的阶段内维持恒定通道数,仅在下采样层处将通道数阶跃式翻倍。先前研究(如 Stochastic Depth)指出,随机删除中间普通残差块对精度影响甚微,但删除通道翻倍处的下采样残差块则会导致性能剧烈下降。Pyramidal ResNet认为将特征维度的扩增负担集中在少数下采样点会限制表征的平滑演化,因而提出在全网所有残差单元上逐层递增通道维度,使网络宽度沿深度呈现平滑的金字塔形分布。
设全网共包含$N$个残差单元,初始通道数为$D_1$,全网总通道增量超参数为$\alpha$。在加法金字塔(Additive Pyramid)配置下,第$k$($1 \le k \le N$)个残差单元的通道维度$D_k$按线性规则递增(另有按几何级数递增的乘法配置):
\[D_k = \begin{cases} D_1, & k = 1 \\ \left\lfloor D_1 + \frac{\alpha (k-1)}{N} \right\rfloor, & 2 \le k \le N \end{cases}\]最终输出通道数为$D_N = D_1 + \alpha$。由于每个残差单元的输入与输出通道数均不相同($D_{k-1} < D_k$),若在每个块的跳跃连接上均使用$1\times1$投影卷积会引入过多参数与过拟合风险,因此该网络统一采用零填充跳跃连接(zero-padded identity mapping)对新增的$D_k - D_{k-1}$个通道维度进行补零对齐。同时,其提出的金字塔预激活单元移除了每个残差块首个卷积前的ReLU,仅保留末端的BN,进一步改善了特征分布表达。
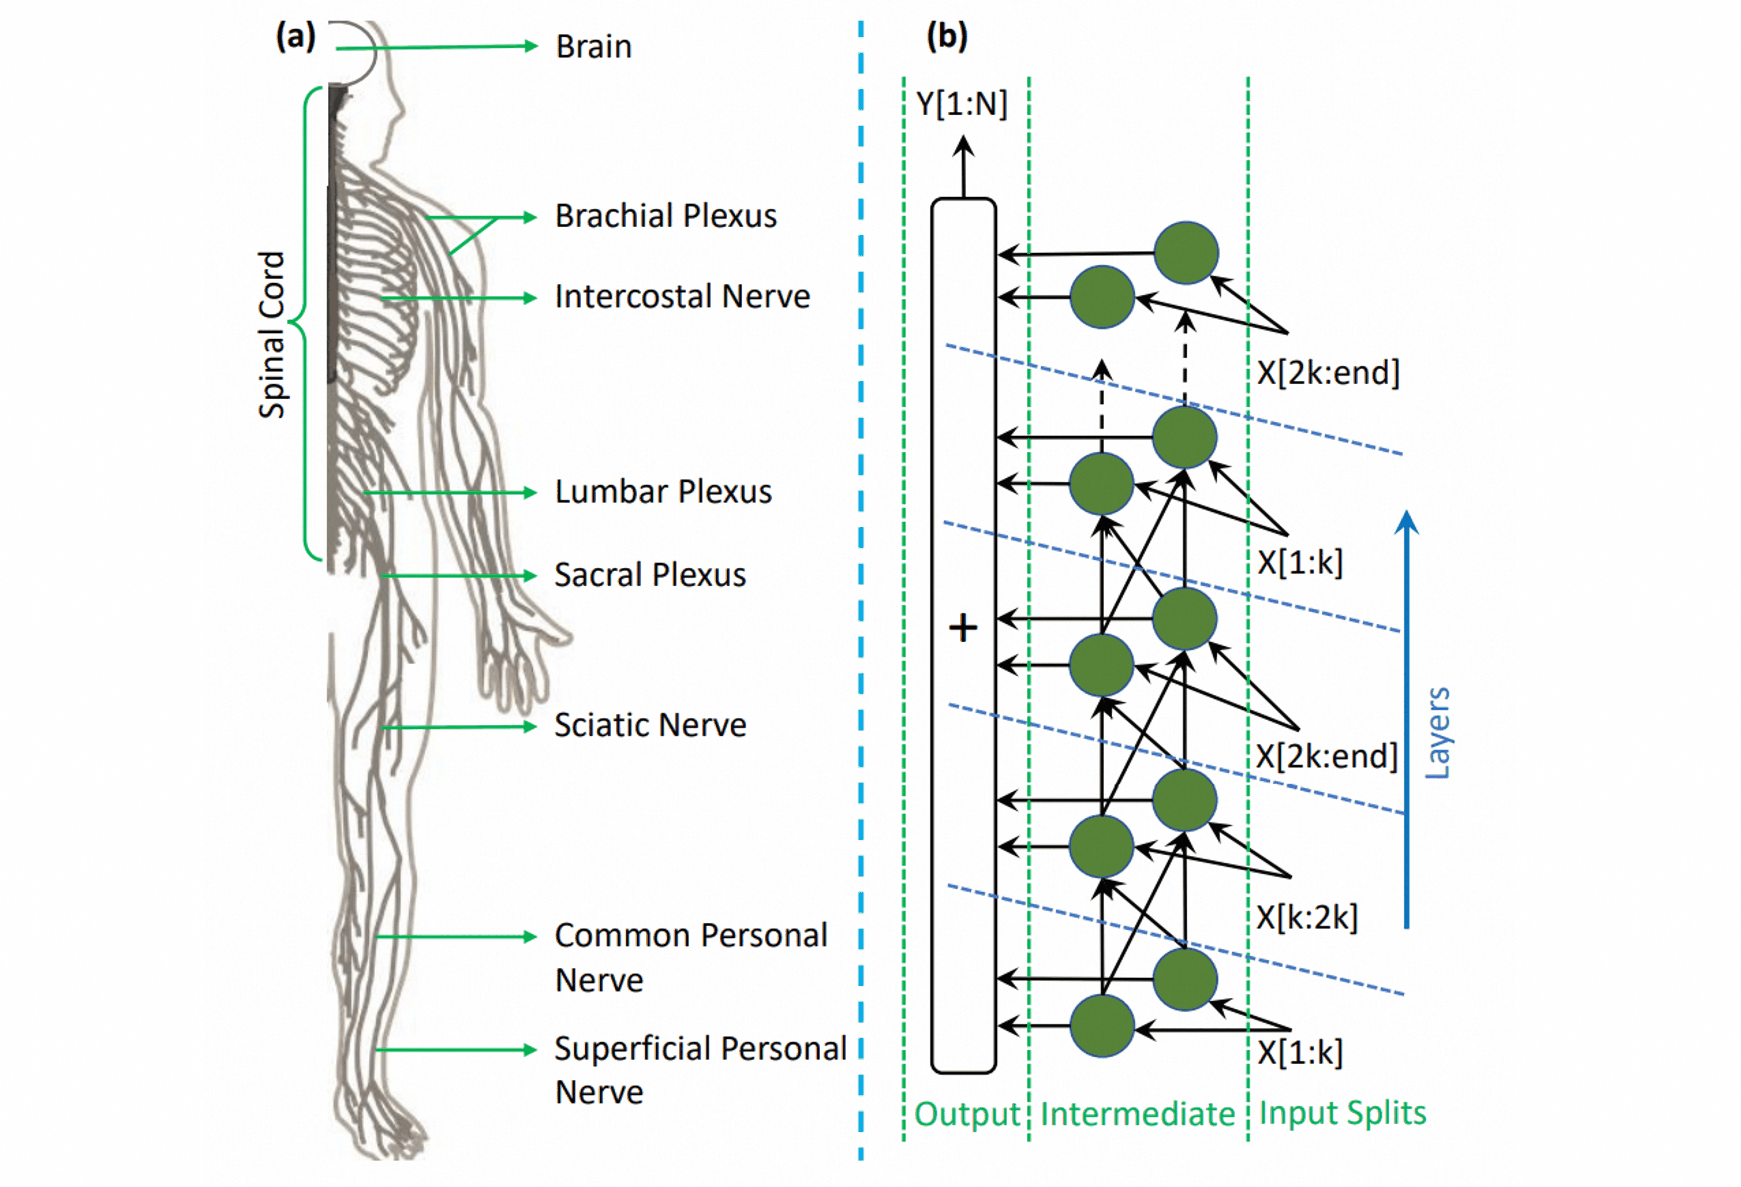
⚪ SpinalNet:采用分段输入与局部递推连接的分类头设计
- paper:SpinalNet: Deep Neural Network with Gradual Input(arXiv 2020,预印本)
受生物躯体感觉神经系统(脊髓分段接收外周神经输入并逐级向上传导整合)的启发,SpinalNet针对神经网络尾部的全连接分类器提出了一种渐进式输入与局部递推连接拓扑,旨在降低深层全连接网络的参数规模与梯度衰减问题。
设主干网络展平后的特征向量为$x \in \mathbb{R}^D$,将其均匀切分为$m$个子段$x = [x^{(1)}, x^{(2)}, \dots, x^{(m)}]$。SpinalNet由$m$个隐藏层串行组成,第$i$层隐藏状态$h_i \in \mathbb{R}^d$仅接收当前对应的局部输入子段$x^{(i)}$以及前一层隐藏状态$h_{i-1}$,递推公式为:
\[\begin{aligned} &h_1 = \phi\left(W_1 x^{(1)} + b_1\right), \\& h_i = \phi\left(W_i [x^{(i)}; h_{i-1}] + b_i\right), \quad i = 2, \dots, m \end{aligned}\]其中$\phi(\cdot)$为非线性激活函数。最终分类输出层汇总所有隐藏层的局部输出(等价于从输出层向各隐藏层建立直接跳跃连接):
\[y = \sum_{i=1}^m V_i h_i + b_y\]由于每层权重矩阵$W_i$的输入维度仅为$\frac{D}{m} + d$(远小于标准全连接层的$D$),在隐藏单元总数相同的情况下大幅削减了乘加运算量,且理论证明了任意宽度的单隐藏层全连接网络均可由足够深但极窄的SpinalNet等价逼近。
3. 模块化与多分支设计
模块化设计的核心思想是构建具备多尺度融合、空间与通道解耦或分组变换能力的局部拓扑单元(Module/Block),再通过同构堆叠形成完整网络。从早期的拆分-变换-融合(split-transform-merge)多分支结构,到后期的现代化大核深度可分离模块,该方向致力于在给定参数与计算预算下最大化单模块的表征效率。
⚪ Inception / GoogLeNet:并行聚合多尺度卷积与池化分支
- paper:Going Deeper with Convolutions(CVPR 2015)
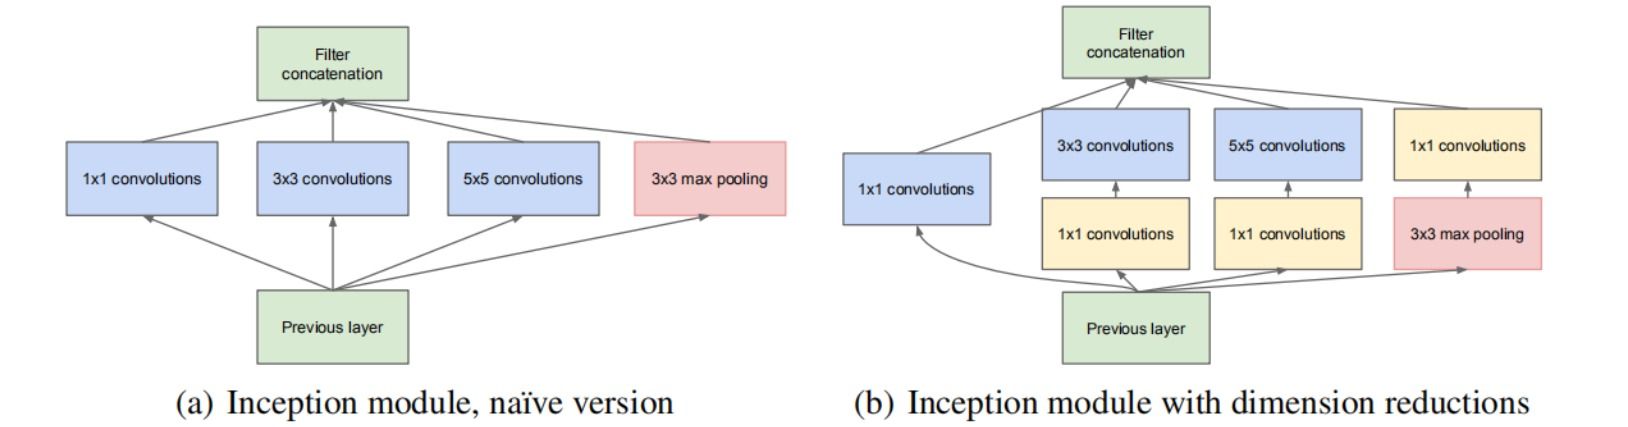
由于图像中目标物体的空间占比变化剧烈,单一尺寸的卷积核难以兼顾局部细节与全局上下文;同时,直接加宽或加深标准卷积层会导致计算量呈二次方增长。GoogLeNet提出基于赫布学习原理与稀疏矩阵稠密近似思想的Inception模块,在单层内并行配置多种尺度的滤波操作,并通过$1\times1$瓶颈卷积控制计算开销。
Inception模块将输入特征图并行分发至四条分支:(1) 单层$1\times1$卷积;(2) $1\times1$降维卷积后接$3\times3$卷积;(3) $1\times1$降维卷积后接$5\times5$卷积;(4) $3\times3/s1$最大池化后接$1\times1$投影卷积。四条分支的输出特征图沿通道维度级联。其中,前置$1\times1$卷积作为降维瓶颈,在大核空间卷积前显著压缩输入通道数。GoogLeNet主干共堆叠$9$个 Inception 模块(总计$22$个带权层),末端采用全局平均池化替代全连接层,参数量仅为AlexNet的$1/12$(约$5\times 10^6$)。为缓解无残差结构下的深层梯度消失,网络在中间第$3$与第$6$个 Inception 模块后引出两个辅助分类头(auxiliary classifiers),在训练期间以$0.3$的权重将其交叉熵损失累加至主损失,推理时则予以移除。
⚪ Inception-V2 / Inception-V3:引入批归一化与非对称卷积分解
- paper:Rethinking the Inception Architecture for Computer Vision(CVPR 2016)
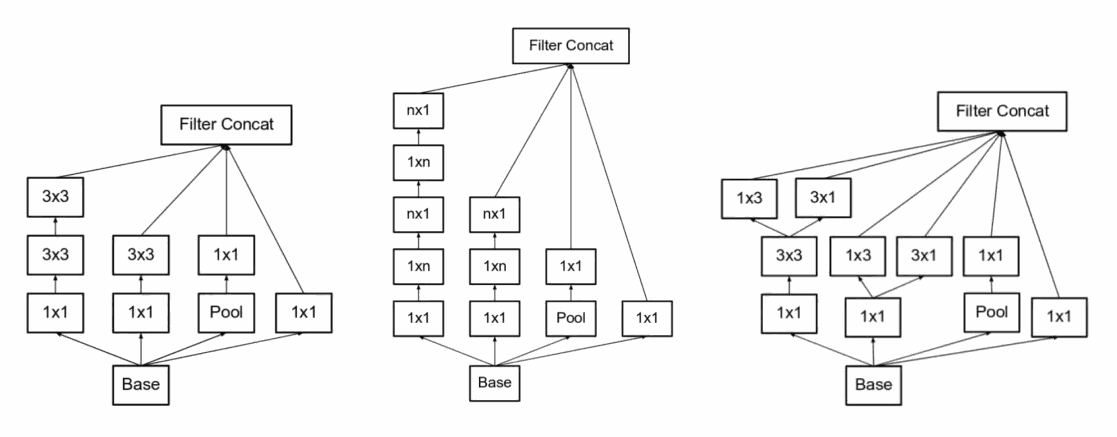
针对多分支架构的设计,该工作总结了避免早期发生信息压缩的表征瓶颈(representational bottleneck)及利用高维特征局部解耦加速收敛等四项设计准则。在引入Batch Normalization(对应 Inception-v2)的基础上,Inception-v3通过空间卷积分解与无损网格缩减进一步优化了计算效率。
模块改进主要体现在三方面:(1) 大核级联分解:在模块浅层,用两层串联的$3\times3$卷积完全替代单层$5\times5$卷积;(2) 非对称空间分解:在中层特征图(如$17\times17$网格)上,将$n\times n$对称卷积(原文取$n=7$)分解为串联的$1\times n$卷积与$n\times 1$卷积,使计算成本降低约$\frac{n^2 - 2n}{n^2}$;在最深层($8\times8$网格)则将$3\times3$分解为并联的$1\times3$与$3\times1$分支以扩展高维特征维度;(3) 高效网格缩减(Grid Size Reduction):为避免“先池化(产生空间瓶颈)或先扩通道(导致计算翻倍)”的两难问题,设计了将步幅为$2$的卷积分支与步幅为$2$的池化分支并行执行后再沿通道拼接的专用降采样模块。此外,训练中首次提出标签平滑正则化(Label Smoothing Regularization, LSR),将硬编码的独热标签分布软化为$(1-\epsilon)\delta_{k,y} + \frac{\epsilon}{K}$,防止分类器对单一类别过度自信。
⚪ Inception-V4 / Inception-ResNet:统一多分支模块并与残差连接融合
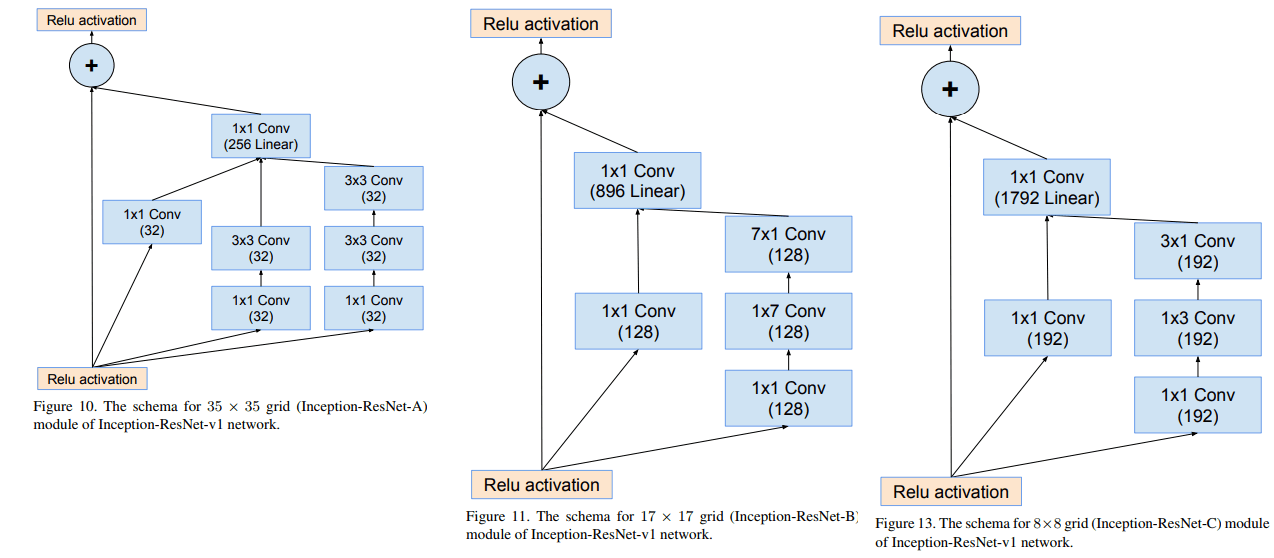
早期 Inception 系列为适应分布式训练对不同层做了大量非规整的定制化设计。Inception-v4将其重构为高度规整的阶段化架构(由专用 Stem、三类尺度特定的 Inception-A/B/C 模块和两类 Reduction-A/B 降采样模块组成)。在此基础上,Inception-ResNet探讨了将多分支 Inception 结构与残差跳跃连接相结合的正交性。
在 Inception-ResNet-v1/v2 模块中,多条分解卷积分支在拼接后,统一经过一个无激活函数的$1\times1$线性卷积将通道维度还原至与模块输入一致,随后与恒等快捷支路相加并经ReLU激活(同时省去了原 Inception 模块中的池化分支)。实验发现,当滤波器数量超过$1000$时,深层残差网络在训练早期极易发生数值不稳定(末端全局池化前输出全零)。为此,作者提出在残差相加前对非线性分支乘以一个常数残差缩放因子(residual scaling factor)$\lambda \in [0.1, 0.3]$:
\[y = \operatorname{ReLU}\left(x + \lambda F(x, \{W_i\})\right)\]对比实验证明,纯多分支的Inception-v4与融合残差的Inception-ResNet-v2在最终收敛精度上相近,表明残差连接并非提升精度的必要条件,但其核心价值在于显著加速了多分支深层网络的训练收敛过程。
⚪ Xception:基于深度可分离卷积解耦空间与通道相关性
- paper:Xception: Deep learning with depthwise separable convolutions(CVPR 2017)
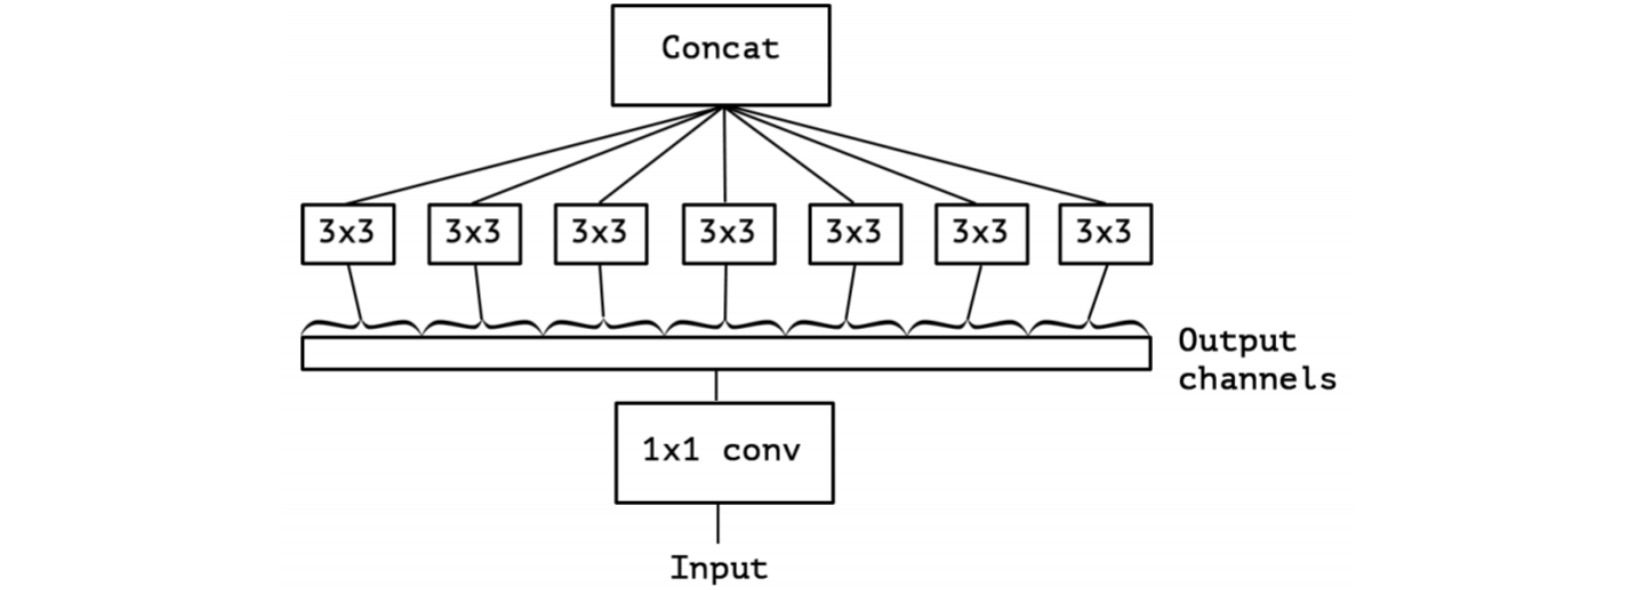
标准卷积核在三维特征张量上同时学习空间相关性(跨宽高维度)与跨通道相关性。Inception 模块通过前置$1\times1$卷积与后置多组空间卷积,隐式假设了这两种相关性可以部分解耦。Xception将这一假设推向极限(Extreme Inception):假设通道间相关性与空间相关性完全解耦,即对$1\times1$卷积映射后的每一个输出通道分别执行完全独立的空间卷积,该结构在数学上等价于深度可分离卷积(depthwise separable convolution)。
深度可分离卷积将标准卷积拆分为两步:首先执行逐通道空间卷积(depthwise convolution),对每个输入通道独立应用一个$k\times k$空间滤波器;随后执行逐点卷积(pointwise convolution),使用$1\times1$卷积线性组合各通道输出。设输入输出通道分别为$C_{in}, C_{out}$,空间尺寸为$H\times W$,其计算量与标准卷积之比为:
\[\frac{\text{FLOPs}_{\text{DW+PW}}}{\text{FLOPs}_{\text{Standard}}} = \frac{H W C_{in} k^2 + H W C_{in} C_{out}}{H W C_{in} C_{out} k^2} = \frac{1}{C_{out}} + \frac{1}{k^2}\]当$k=3$且$C_{out} \gg k^2$时,计算量与参数量均降至标准卷积的约$1/9$。此外,Xception证明在逐通道卷积与逐点卷积之间不插入ReLU非线性激活(保持线性中间表征)可避免低维流形上的信息损失。整个主干由入口流(Entry flow)、重复$8$次的中间流(Middle flow)和出口流(Exit flow)共$36$层可分离卷积串联而成,且除首尾模块外均配有线性残差连接。
⚪ ResNeXt:引入基数维度聚合多路同构分组变换
- paper:Aggregated Residual Transformations for Deep Neural Networks(CVPR 2017)
Inception 系列虽然通过多分支聚合获得了优异表征,但其每个分支的核尺寸与通道数需精细手工定制,导致超参数繁多且难以跨任务扩展。ResNeXt融合了VGG/ResNet的同构堆叠原则与Inception的拆分-变换-融合思想,提出所有并行分支均采用完全相同的拓扑结构,从而将分支数量抽象为一个独立于深度(depth)与宽度(width)的新结构维度:基数(cardinality)。
设基数为$C$,单个残差模块的数学形式定义为$C$个同构低维变换函数$T_i(x)$之和:
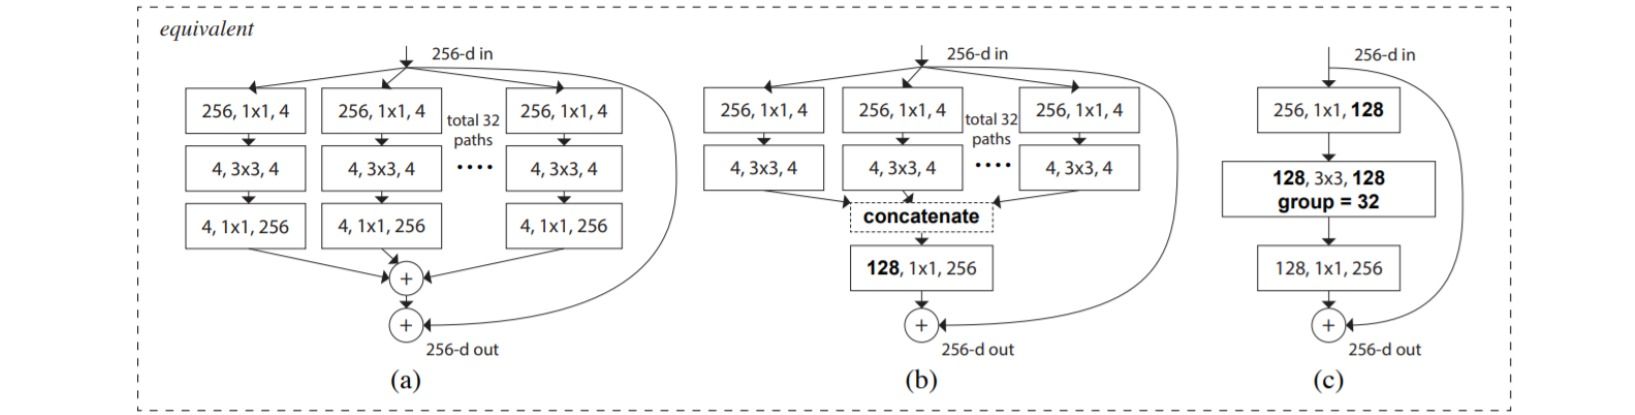
\[y = x + \sum_{i=1}^{C} T_i(x)\]其中每个$T_i(x)$均为“$1\times1$降维至$d$维$\to 3\times3$空间卷积$\to 1\times1$升维”的窄瓶颈结构。在算子实现层面,论文证明了三种形式完全等价:(a) 显式的多路分支相加;(b) 早期合并的 Inception 式拼接后接$1\times1$卷积;(c) 将中间的$3\times3$卷积直接实现为组数为$C$、总通道数为$C\cdot d$的分组卷积(grouped convolution)。标准配置ResNeXt-50 ($32\times 4d$)取基数$C=32$、单组瓶颈宽度$d=4$,在保持与ResNet-50(可视为$C=1, d=64$的特例)参数量和 FLOPs 严格相当的前提下,证明了增大基数$C$比单纯增加深度或宽度更能有效提升分类精度。
⚪ Res2Net:通过块内通道分组级联构建多尺度感受野
- paper:Res2Net: A New Multi-scale Backbone Architecture(TPAMI 2021)
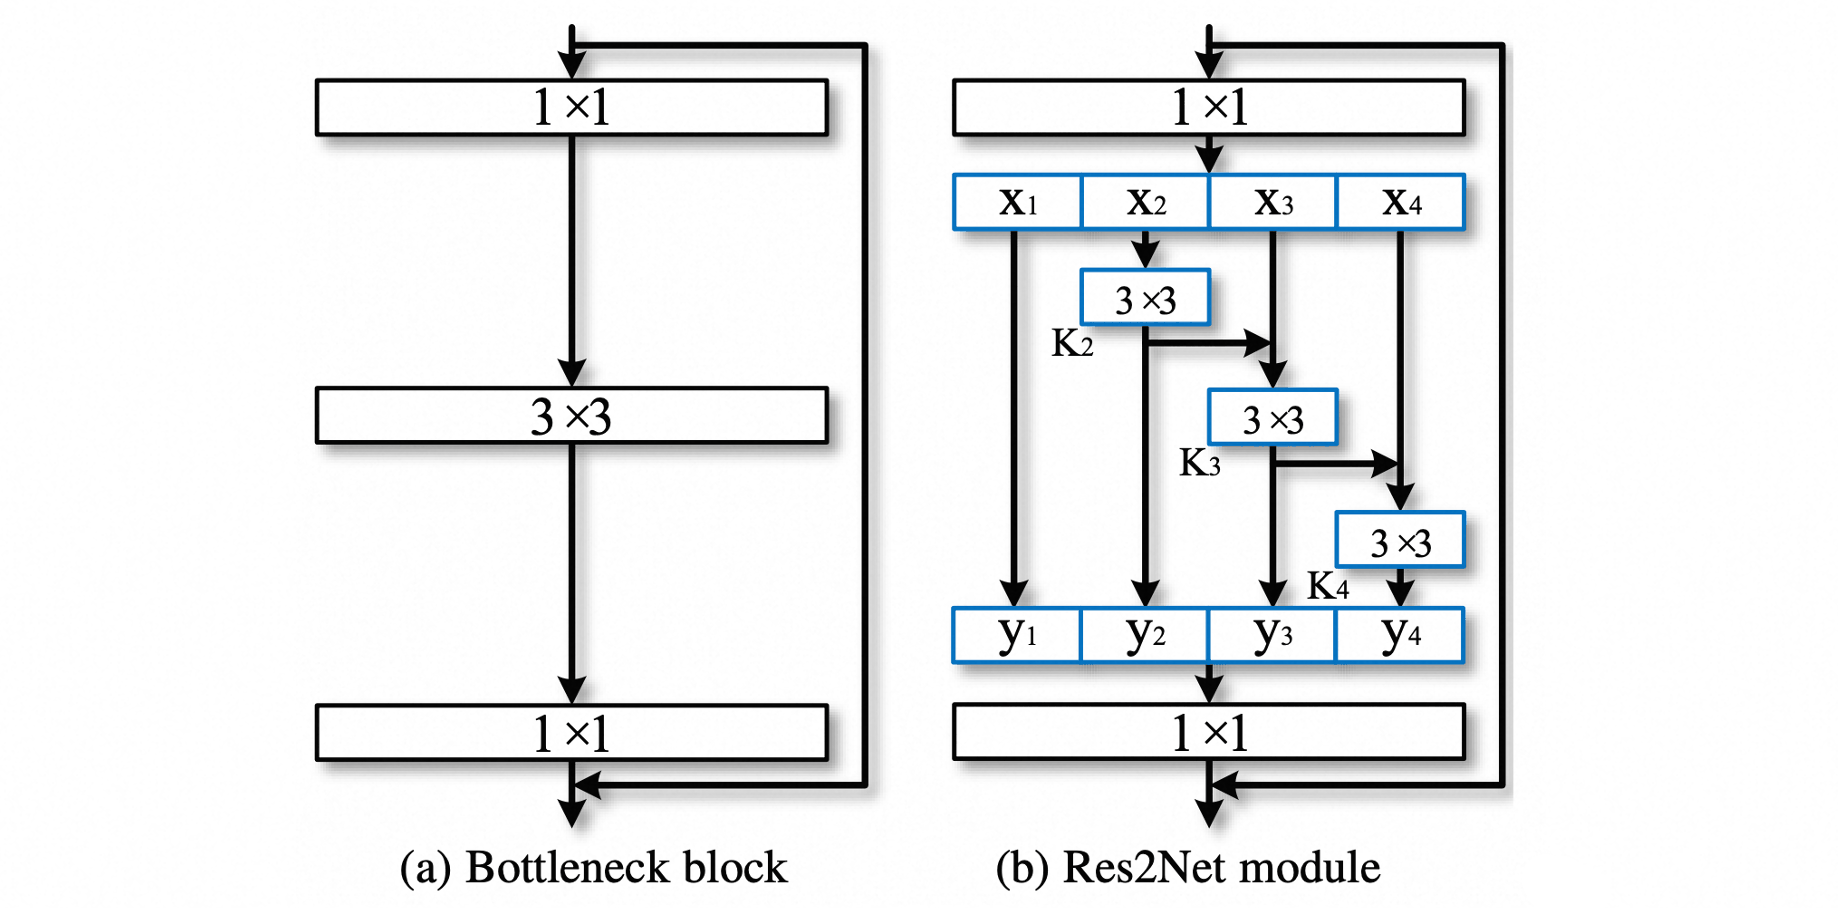
传统多尺度特征提取大多以“按层(layer-wise)”方式在网络不同阶段之间交互,而Res2Net旨在以更细粒度的“块内(block-wise)”方式增强单个残差块的多尺度表征能力。它在标准瓶颈块的中间$3\times3$卷积位置,用一组具有层级残差样式连接的更小滤波器组替代单一卷积层。
在经过前置$1\times1$卷积后,将特征图沿通道维度均匀切分为$s$个子集$x_1, x_2, \dots, x_s$(每组通道宽度为$w$)。除第一组$x_1$直接恒等跳过(一方面用于特征复用,另一方面减少参数以维持总计算量恒定)外,其余各组$x_i$在与前一组卷积输出$y_{i-1}$相加后,再送入对应的$3\times3$卷积算子$K_i(\cdot)$:
\[y_i = \begin{cases} x_1, & i=1 \\ K_2(x_2), & i=2 \\ K_i\left(x_i + y_{i-1}\right), & 2 < i \leq s \end{cases}\]随后将所有子输出$[y_1, y_2, \dots, y_s]$沿通道级联并送入后置$1\times1$卷积进行跨尺度通道信息融合。由于第$i$组输出$y_i$包含了经由$0$次至$i-1$次$3\times3$级联卷积的路径组合,其等效感受野随索引$i$逐级扩大。控制特征分组数的超参数$s$被称为尺度维度(scale dimension)(典型配置记为Res2Net-50 $26w\times 4s$)。
⚪ ResNeSt:结合多路径分组表示与跨分支拆分注意力
- paper:ResNeSt: Split-Attention Networks(CVPR Workshops 2022)
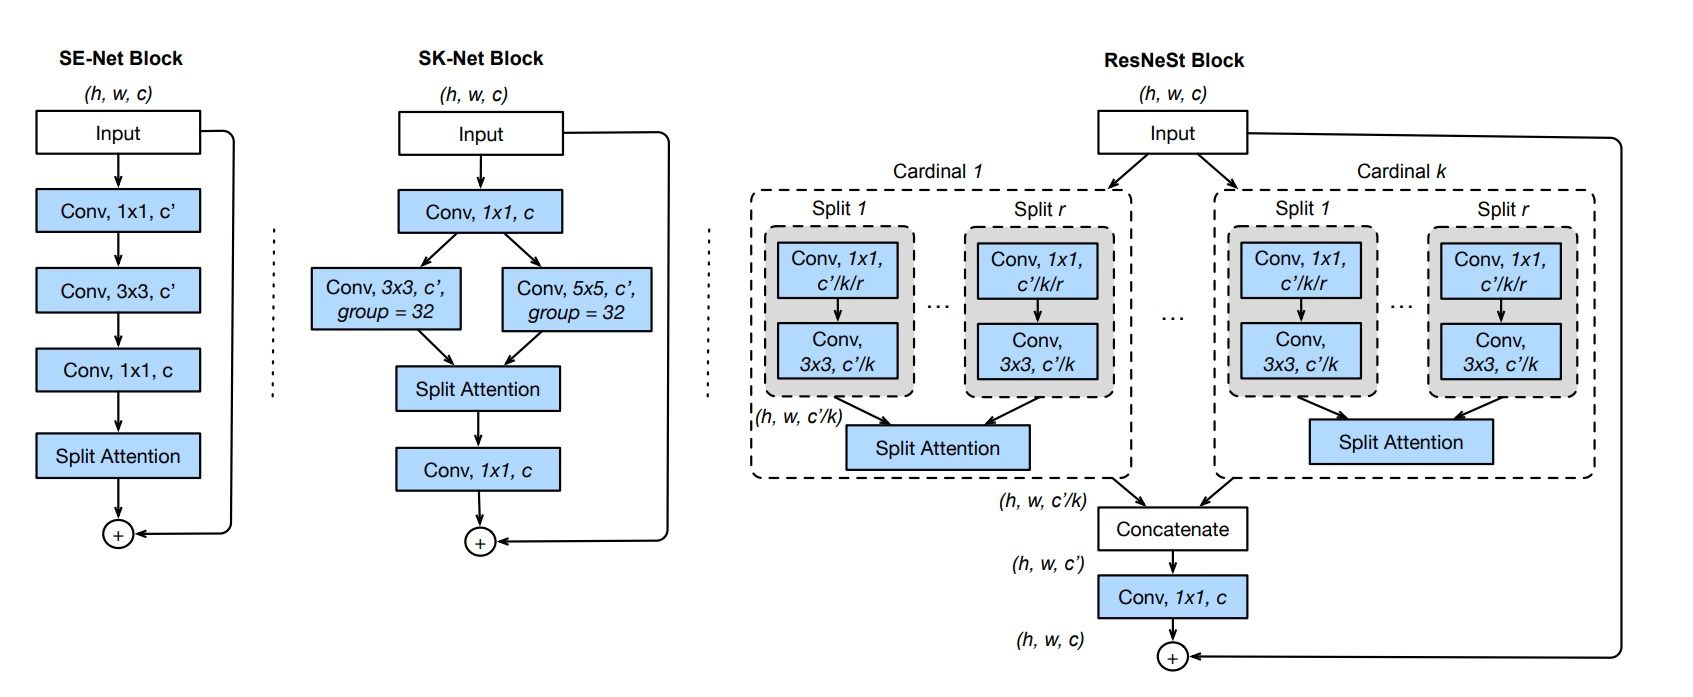
ResNeSt将ResNeXt的多路径分组表示与SENet/SKNet的动态通道注意力机制相结合,提出模块化的拆分注意力(Split-Attention)块,通过跨特征图组的软注意力加权,实现多路径特征的自适应融合。
模块将输入特征通道沿用基数超参数$K$划分为$K$个基数特征组(Cardinal Groups),随后在每个基数组内部进一步引入基数分裂因子(radix)$R$,将其细分为$R$个子分支,全层共计$G = K \times R$个特征组,分别执行$1\times1 \to 3\times3$卷积变换得到中间表示${U_1, \dots, U_G}$。在第$k$个基数组内(包含子分支$U_{k,1}, \dots, U_{k,R}$),首先通过逐元素求和与全局空间平均池化提取该组的全局上下文描述符$s^k \in \mathbb{R}^{C/K}$:
\[\hat{U}^k = \sum_{j=1}^{R} U_{k,j}, \quad s_c^k = \frac{1}{H \times W} \sum_{i=1}^{H} \sum_{j=1}^{W} \hat{U}_c^k(i,j)\]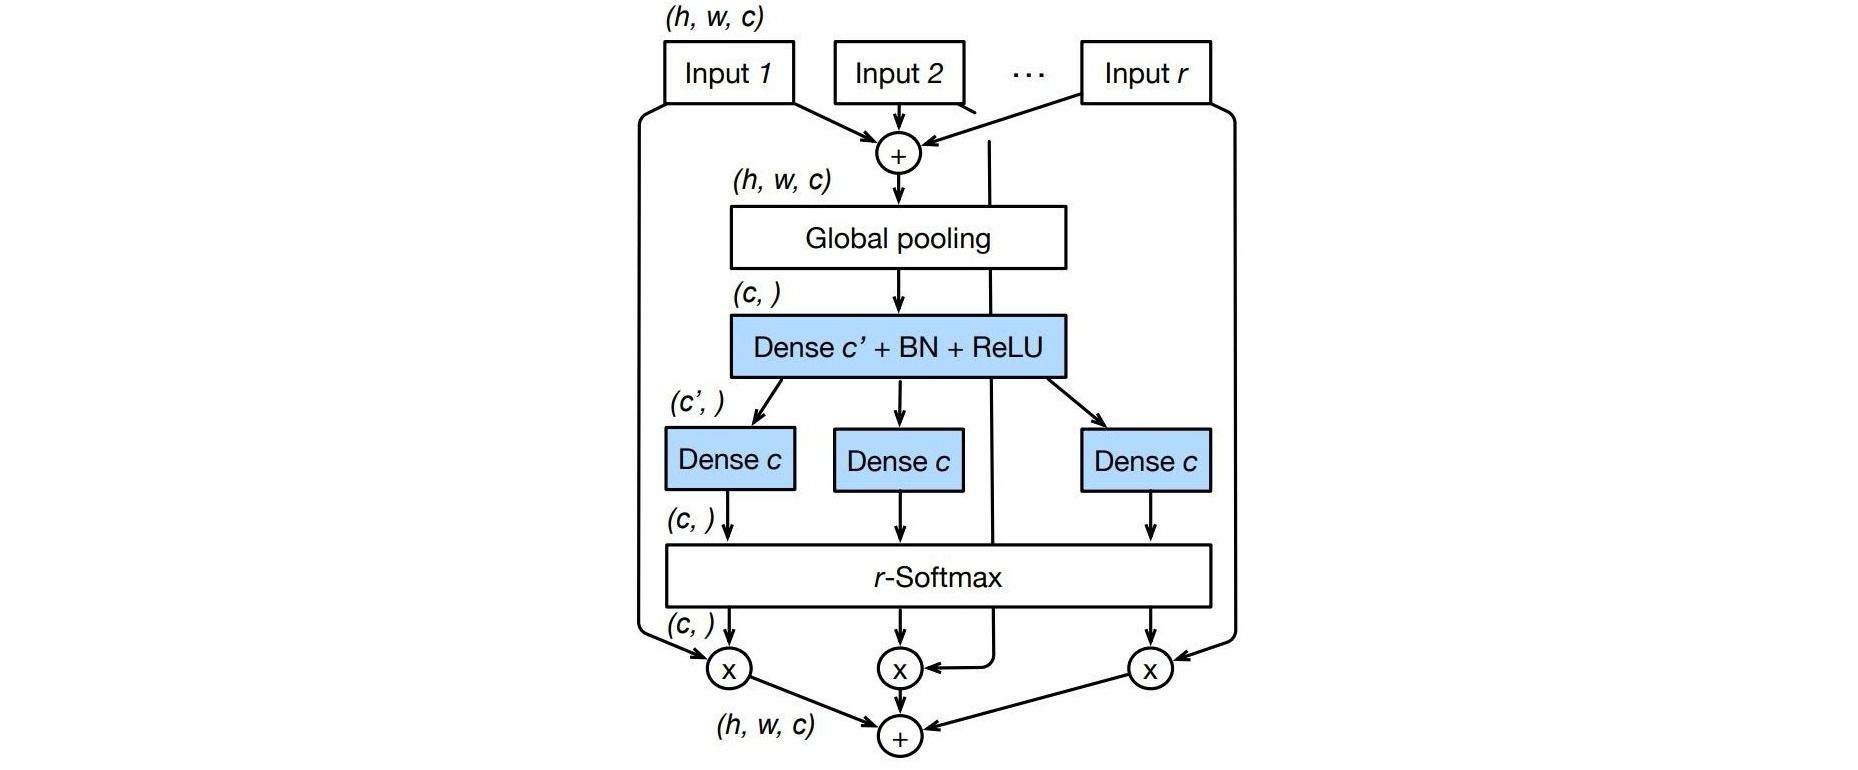
随后将$s^k$送入两层全连接层(中间含 BN 与 ReLU)生成$R$组通道权重,当$R>1$时沿 radix 维度应用r-Softmax归一化($R=1$时退化为 Sigmoid,对应标准 SE 块)计算软注意力系数$a_{k,r}^c$,并将子分支加权求和得到第$k$个基数组的聚合表示$V^k = \sum_{r=1}^R a_{k,r} \odot U_{k,r}$。最后将所有$K$个基数组的输出$V = [V^1, \dots, V^K]$拼接并经$1\times1$卷积与残差支路相加。通过采用radix-major的内存张量排布方式,所有分支与注意力计算均可合并为单一的分组卷积与矩阵张量算子并行执行。
4. 缩放与架构搜索
当局部计算模块的算子形式趋于成熟后,核心问题转向如何在给定的参数、算力(FLOPs)或硬件延迟预算下,确定网络的宏观拓扑连接以及深度、宽度与输入分辨率的最优配比。本节涵盖自动化神经架构搜索(Neural Architecture Search, NAS)、复合模型缩放定律以及参数化网络设计空间的统计构造方法。
⚪ NASNet:搜索可迁移的局部计算单元与降采样单元
- paper:Learning Transferable Architectures for Scalable Image Recognition(CVPR 2018)
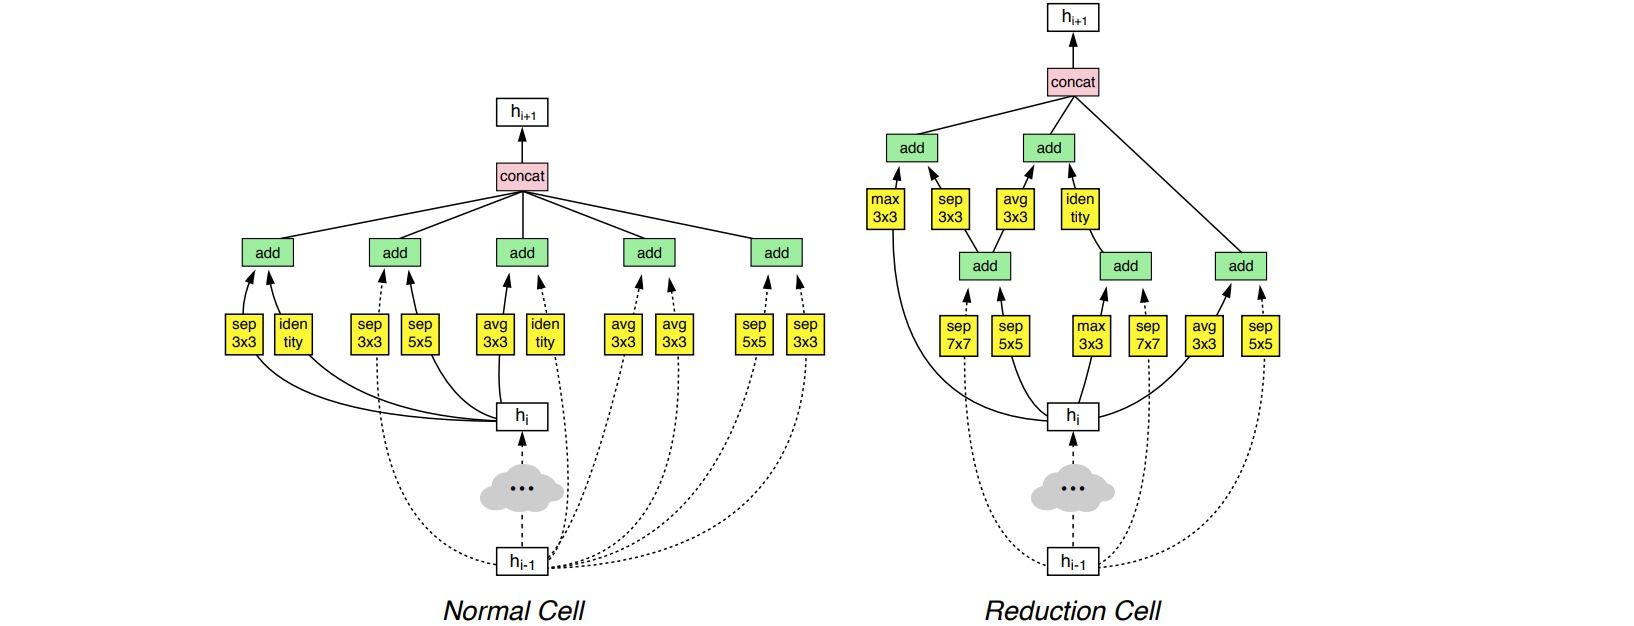
早期基于强化学习的架构搜索直接在目标数据集上逐层搜索整个网络,搜索空间过于庞大,无法直接应用于 ImageNet 等大规模数据集。NASNet借鉴手工网络模块化堆叠的思想,提出NASNet 搜索空间:将宏观网络骨架固定,仅在小规模代理数据集(CIFAR-10)上搜索两类具备跨数据集迁移能力的局部微架构:保持特征图空间维度的普通单元(Normal Cell)与将空间步幅设为$2$的降采样单元(Reduction Cell)。
每个单元被建模为一个包含$B$(原文取$B=5$)个内部组合块的有向无环图。一个基于循环神经网络的控制器按自回归方式为每个组合块依次做出$5$步离散决策:(1) 从前驱单元输出或当前单元已生成的组合块中选择隐藏状态$h_i$;(2) 选择隐藏状态$h_j$;(3) 从预定义算子库(包含不同核尺寸的深度可分离卷积、空洞卷积、恒等映射、最大/平均池化等$13$种操作)中为$h_i$选择操作$o_i$;(4) 为$h_j$选择操作$o_j$;(5) 选择合并方式(逐元素相加或通道级联)生成新状态。单元内所有未被其他块作为输入的自由状态在末端沿通道级联作为该单元输出。
训练时,控制器采样生成子网络并在 CIFAR-10 上训练至收敛,以其验证集准确率作为奖励信号,利用近端策略优化(PPO)更新控制器参数。搜索完成后,将最优的 Normal Cell(重复$N$次)与 Reduction Cell 交替堆叠并扩展初始通道数,直接迁移至 ImageNet 从头训练(配合 Scheduled DropPath 正则化)。
⚪ MnasNet:将硬件推理延迟纳入多目标奖励的移动端架构搜索
- paper:MnasNet: Platform-Aware Neural Architecture Search for Mobile(CVPR 2019)
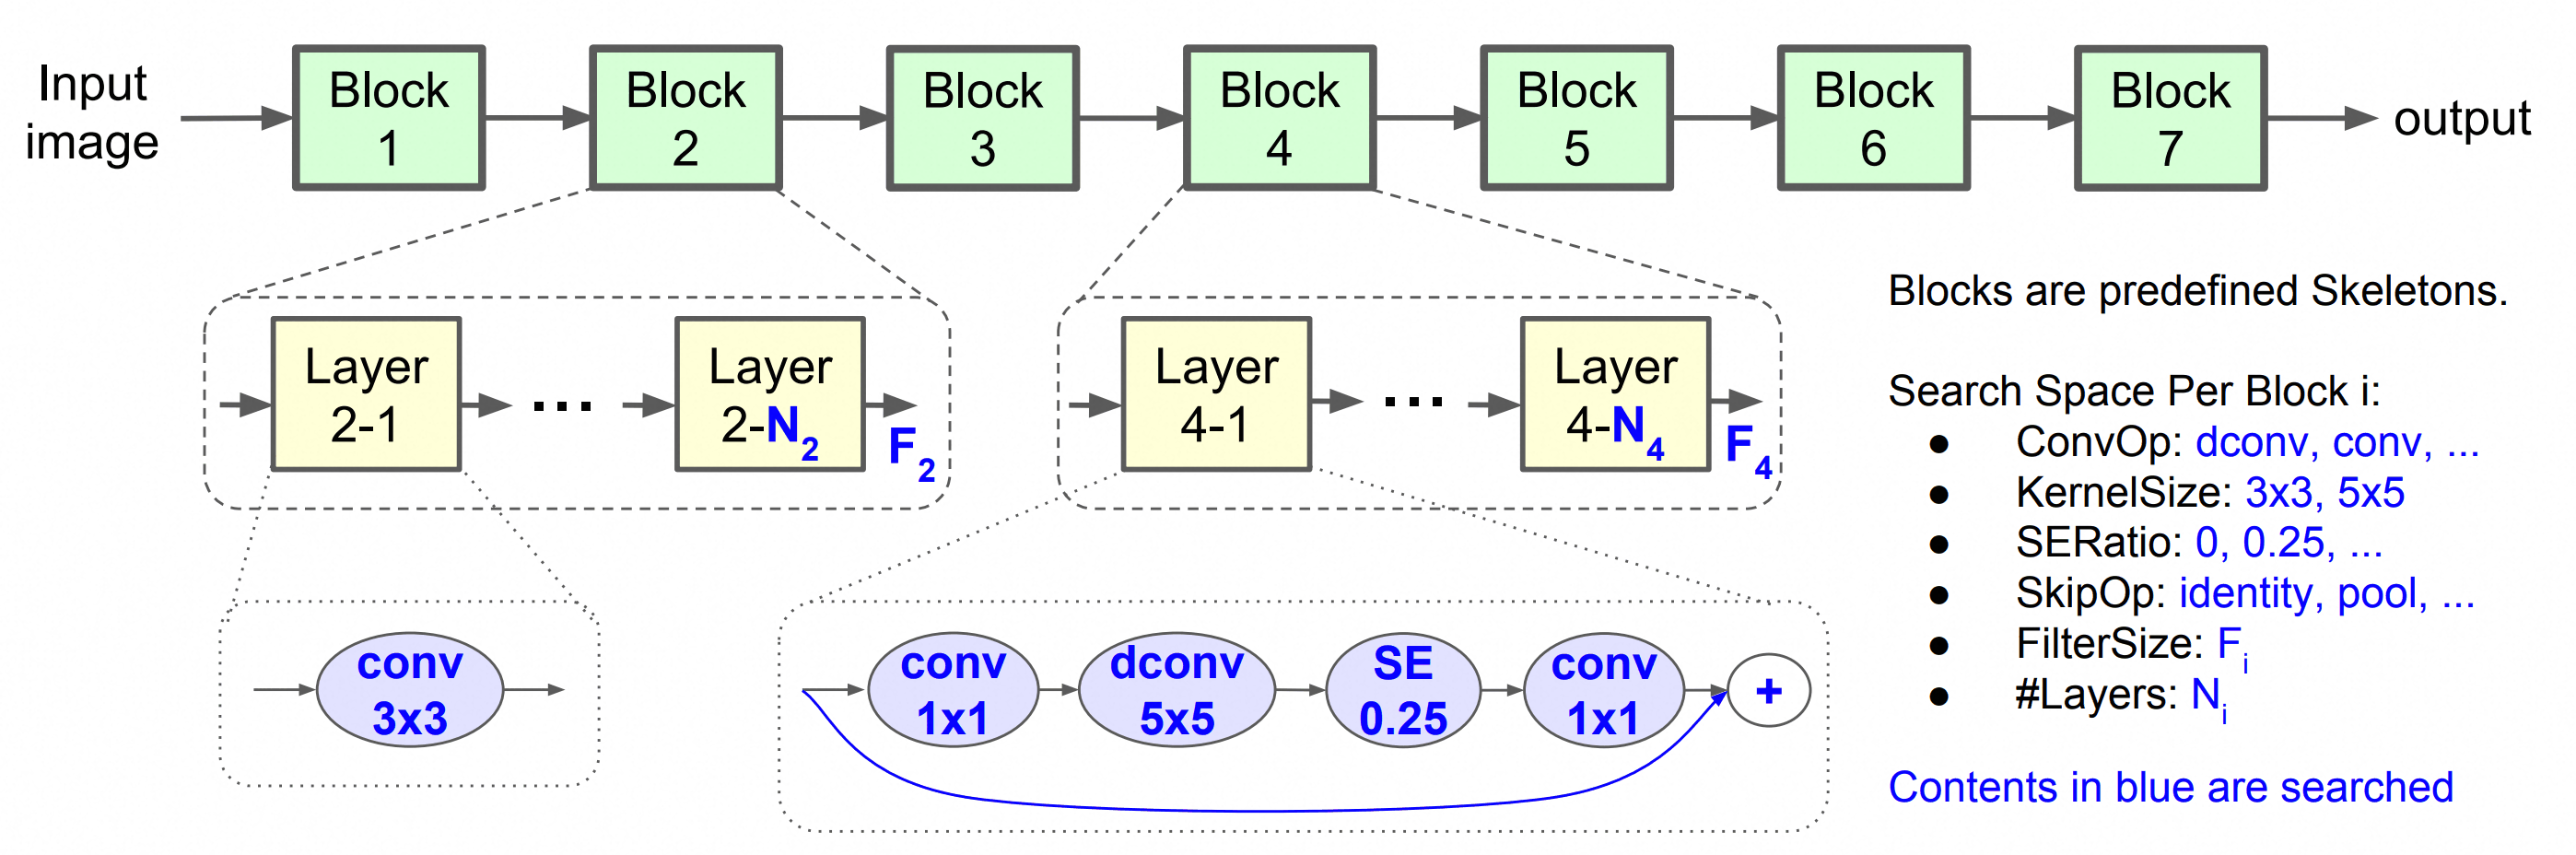
NASNet搜索出的单元内部拓扑极其复杂且碎片化,且全网共享单一单元结构;更重要的是,以乘加运算量(FLOPs)作为计算复杂度的间接代理往往与真实硬件上的推理速度严重脱节(受访存带宽与算子并行度影响)。MnasNet提出平台感知的多目标神经架构搜索:一方面直接将模型在真实移动设备(如 Pixel 手机)上实测的推理延迟(inference latency)纳入强化学习奖励函数;另一方面提出分解式分层搜索空间(factorized hierarchical search space),允许网络的不同阶段采用不同的算子与通道结构。
给定目标硬件延迟约束$T$,为在单次搜索中兼顾模型准确率$ACC(m)$与实测延迟$LAT(m)$并逼近帕累托前沿,定义加权乘积形式的软约束目标函数:
\[\mathop{\max}_{m} \ R(m) = ACC(m) \times \left[\frac{LAT(m)}{T}\right]^{w}, \quad w = \begin{cases} \alpha, & \text{if } LAT(m) \le T \\ \beta, & \text{otherwise} \end{cases}\]经验上常设$\alpha = \beta = -0.07$(使得延迟每降低约$2$倍对应于约$5\%$的相对精度增益权衡)。在搜索空间设计上,将整个网络预先划分为$7$个阶段,每个阶段内部堆叠相同结构的块,但控制器为每个阶段独立搜索以下$6$个超参数:卷积操作类型(普通卷积、深度可分离卷积、扩张率为$3$或$6$的 MobileNetV2 倒残差瓶颈块 MBConv)、卷积核尺寸($3\times3$或$5\times5$)、是否启用SE通道注意力模块、跳跃连接类型(残差连接、池化或无连接)、输出通道大小以及该阶段的块重复次数$N_i$。这种设计支持在浅层保留高并行度的计算而在深层使用大感受野核,显著提升了移动端的精度-延迟权衡比。
⚪ DARTS:基于连续松弛与双层优化的可微架构搜索
- paper:DARTS: Differentiable Architecture Search(ICLR 2019)
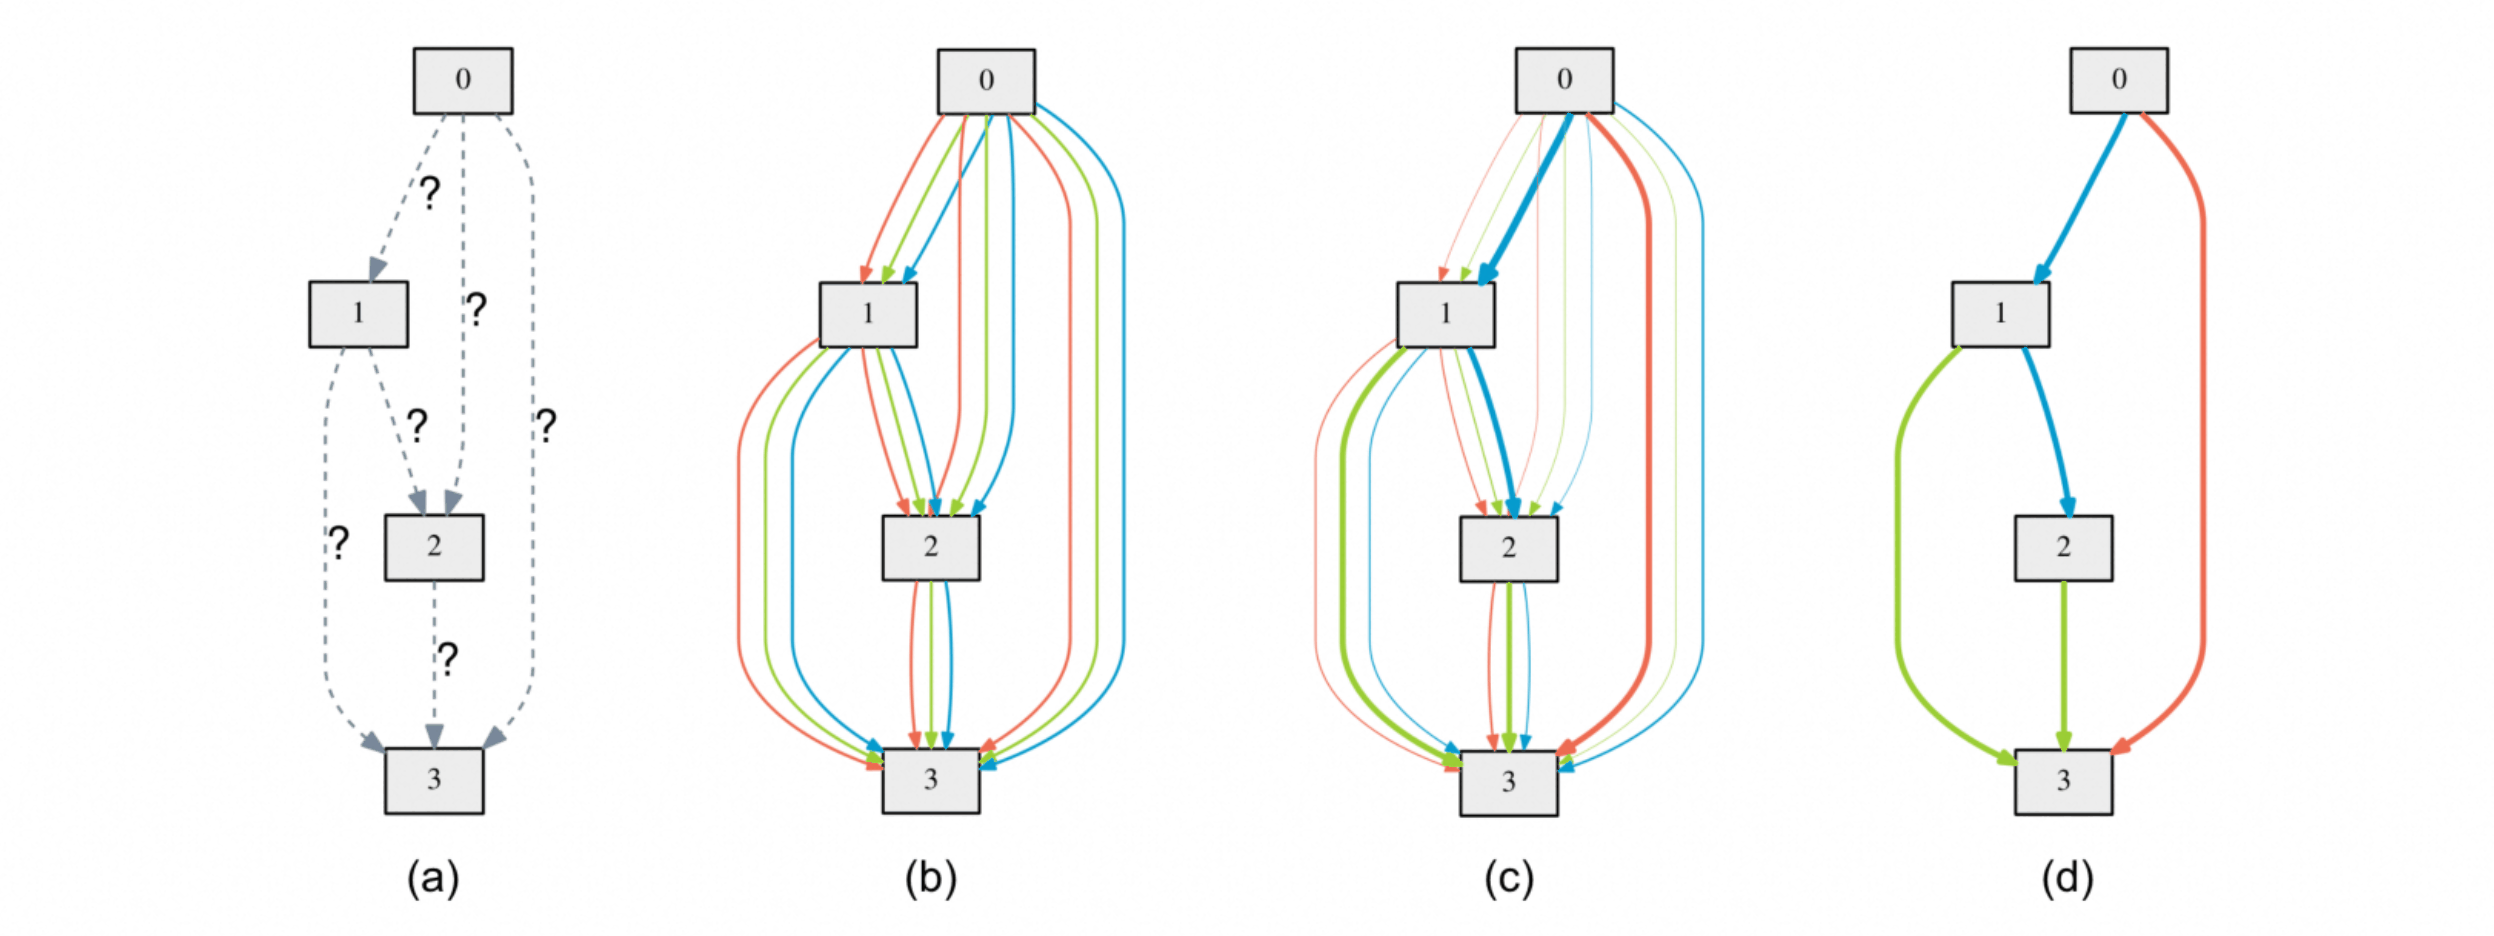
基于强化学习的架构搜索将结构选择视为黑盒离散优化问题,需独立训练数千个候选子网络,耗费数千 GPU 天。DARTS提出将离散的架构搜索空间通过连续松弛(continuous relaxation)转化为连续可微空间,从而利用标准梯度下降法在一个包含所有候选路径的超网络(Supernet)上联合优化架构参数与网络权重,将搜索成本降低至单卡数天量级。
将待搜索的计算单元表示为有向无环图,节点$x^{(i)}$代表特征张量,有向边$(i,j)$代表从节点$i$到$j$的特征变换。设候选算子集合为$\mathcal{O}$(含零操作、恒等映射、卷积与池化等),DARTS 为边$(i,j)$上的每个候选操作$o \in \mathcal{O}$分配一个连续的架构权重$\alpha_o^{(i,j)}$,并通过Softmax将其松弛为混合操作$\bar{o}^{(i,j)}$:
\[\bar{o}^{(i,j)}(x) = \sum_{o \in \mathcal{O}} \frac{\exp(\alpha_o^{(i,j)})}{\sum_{o' \in \mathcal{O}} \exp(\alpha_{o'}^{(i,j)})} o(x), \quad x^{(j)} = \sum_{i < j} \bar{o}^{(i,j)}(x^{(i)})\]由此,架构搜索转化为关于上层架构变量$\alpha$(在验证集损失\(\mathcal{L}_{\text{val}}\)上评估)与下层网络权重$w$(在训练集损失\(\mathcal{L}_{\text{train}}\)上评估)的双层优化问题(bi-level optimization):
\[\begin{aligned} &\min_{\alpha} \ \mathcal{L}_{\text{val}}\left(w^*(\alpha), \alpha\right) \\& \text{s.t.} \quad w^*(\alpha) = \arg\min_{w} \ \mathcal{L}_{\text{train}}(w, \alpha) \end{aligned}\]由于每次更新$\alpha$时精确求解内层最优解$w^{*}(\alpha)$不可行,DARTS 采用单步梯度下降近似:$w^{*}(\alpha) \approx w - \xi \nabla_w \mathcal{L}_{\text{train}}(w, \alpha)$,并在训练集与验证集上交替对$w$和$\alpha$求导更新(当$\xi=0$时为一阶近似,$\xi>0$时展开包含海森矩阵-向量积的二阶近似)。优化收敛后,将混合操作替换为权重$\alpha_o^{(i,j)}$最大的离散算子,并为每个节点仅保留权重最大的两条前驱输入边,导出最终离散架构。
⚪ SpineNet:通过架构搜索构建尺度置换与跨尺度连接主干
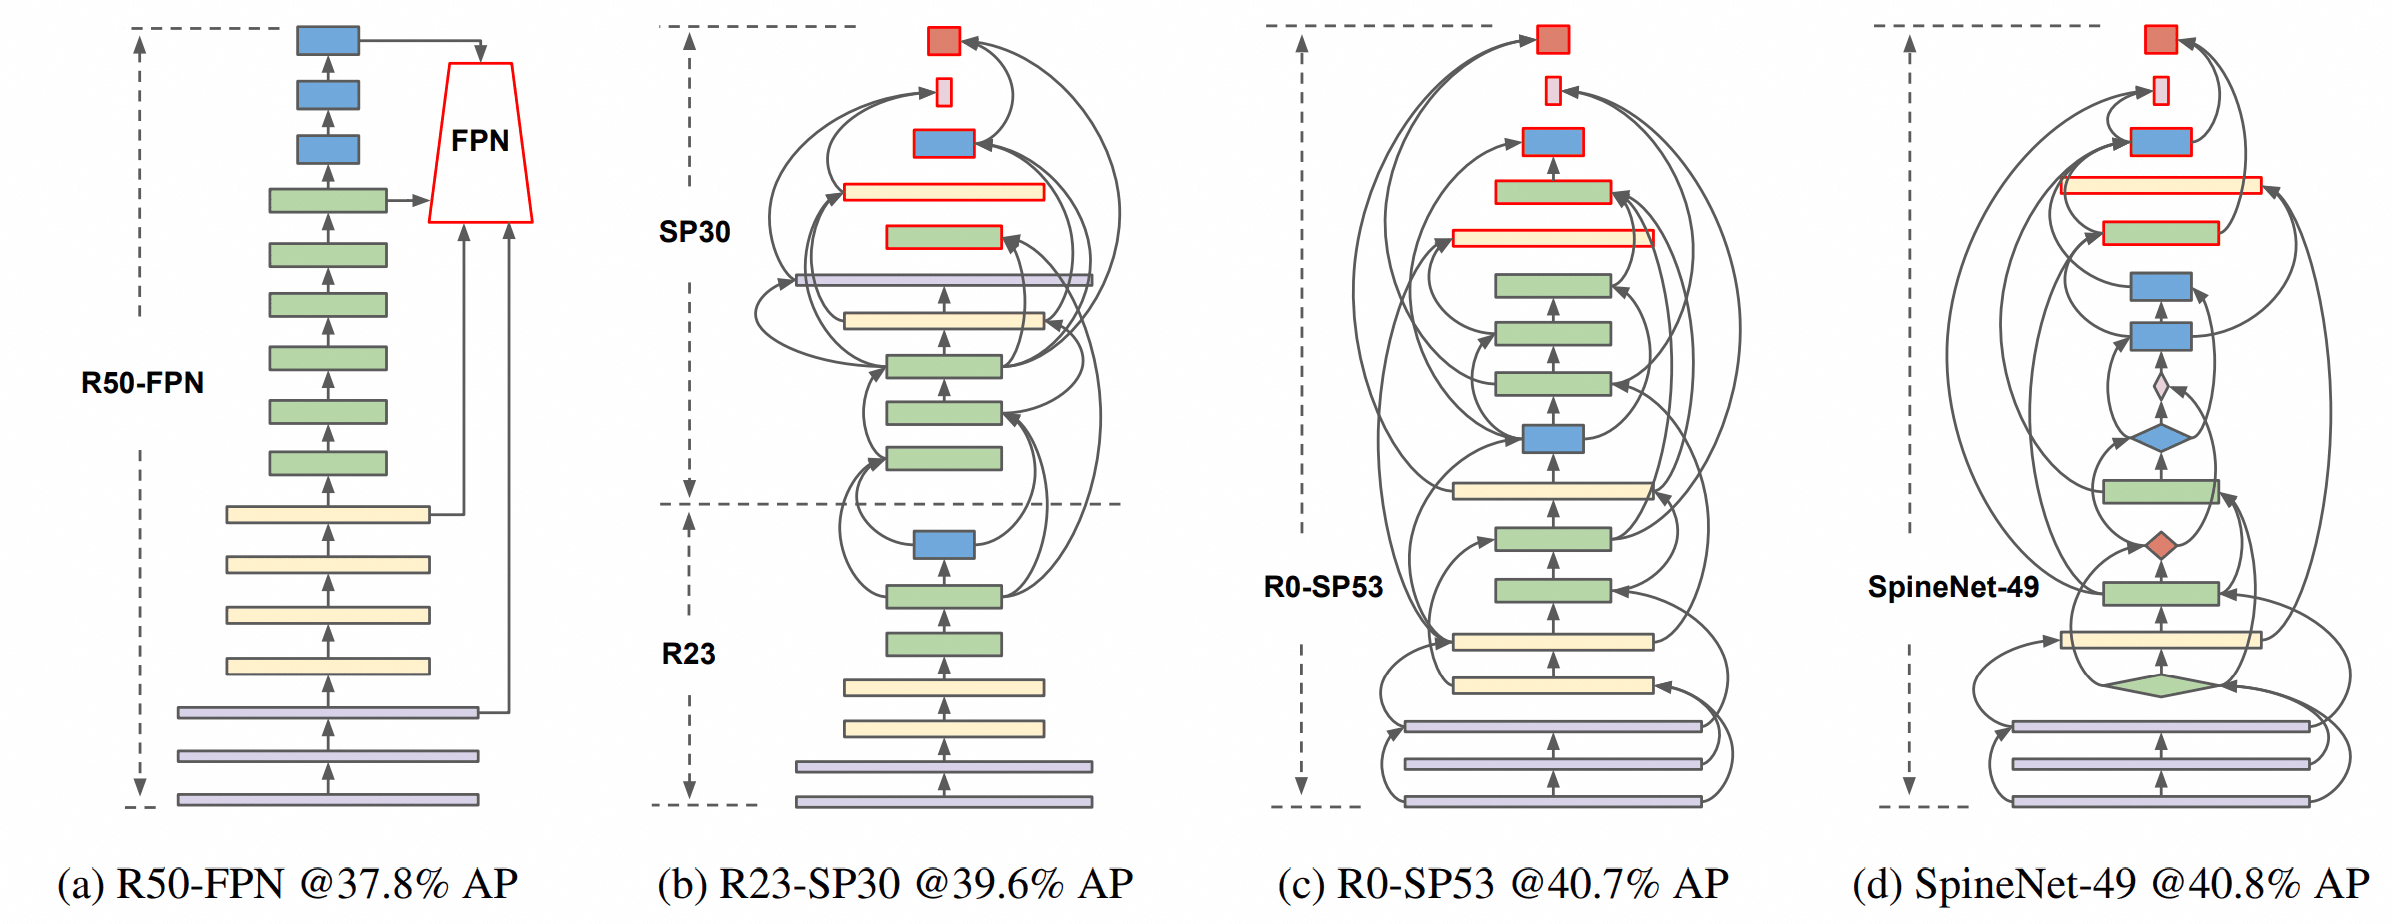
传统视觉主干网络普遍遵循尺度单调递减(scale-decreased)的编码器设计范式:特征图空间分辨率随网络深度逐级下采样,在末端保留强语义但丢失空间细节。SpineNet质疑了单调下采样的必要性,提出尺度置换(scale-permuted)元架构:允许主干网络中间层的特征尺度在任意深度随时增大(上采样)或减小(下采样),并在不同尺度的特征块之间建立灵活的跨尺度有向连接。
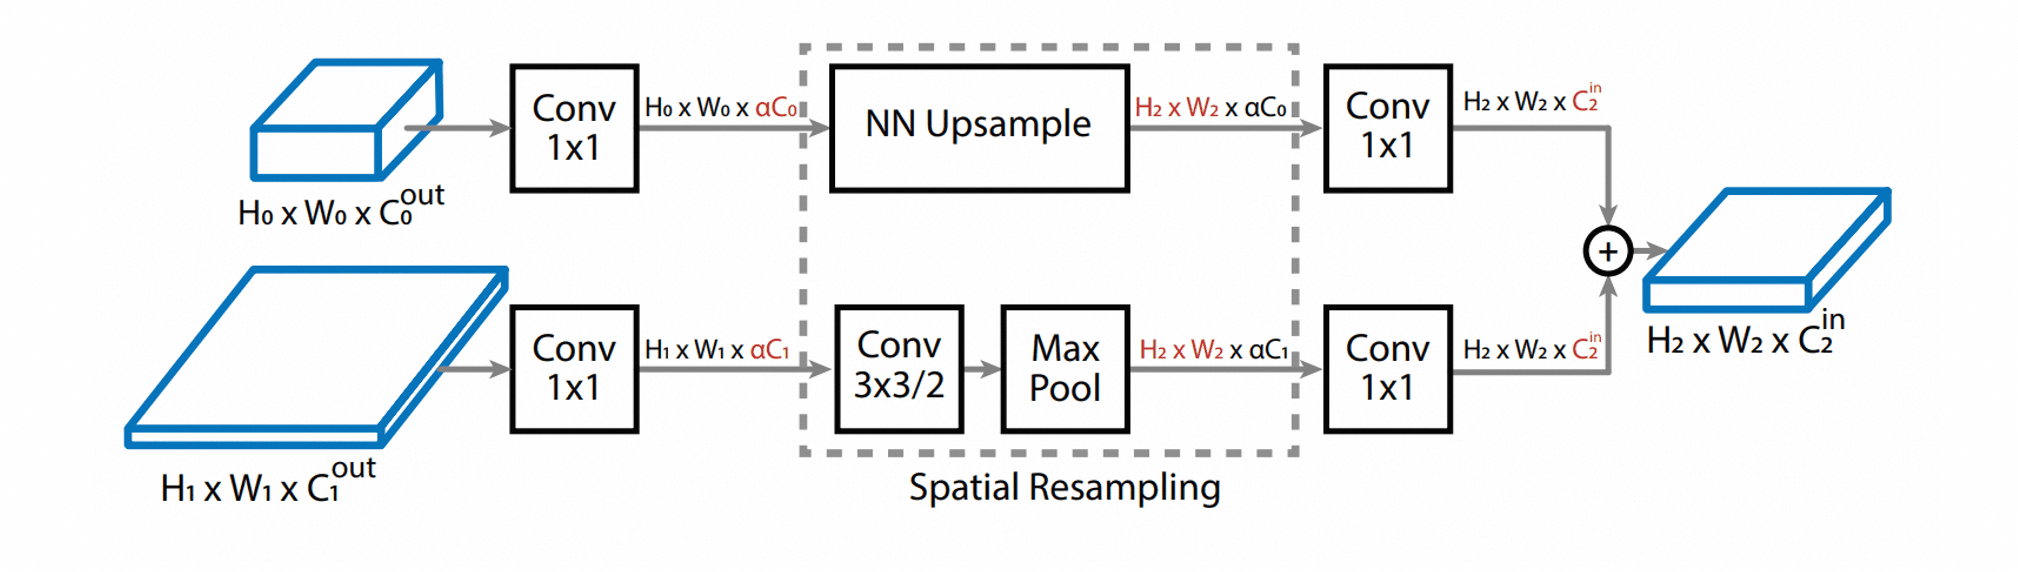
给定一个基准尺度递减网络(如 ResNet-50),保留其前两个阶段作为固定 Stem,将其余残差块作为候选节点集(每个块关联一个预定义的空间分辨率级别$L_3 \sim L_7$)。通过强化学习架构搜索同时优化三项配置:(1) 尺度排列顺序:对所有中间块及末端输出块(分别对应多尺度输出$P_3 \sim P_7$)的排列顺序进行随机置换搜索;(2) 跨尺度拓扑连接:为每个块从其前驱所有块中搜索两个输入父节点;(3) 块类型:为每个节点选择残差基本块或瓶颈块。由于父节点特征图与当前节点在空间分辨率与通道维度上通常不一致,连接处需执行显式的特征重采样对齐:空间上采样采用最近邻插值,空间下采样采用步幅为$2$的$3\times3$卷积(跨多个级别时后接最大池化),并先通过$1\times1$卷积将通道维度缩放$\alpha$倍(默认$\alpha=0.5$)再恢复至目标通道数,最后将两路对齐后的父节点特征逐元素相加。
搜索所得的SpineNet拓扑展现出频繁的中间层上下采样交替,不仅在目标检测上超越同量级 ResNet-FPN,在 ImageNet 与细粒度分类(iNaturalist)任务上同样以更少计算量取得了更高识别精度。
⚪ EfficientNet:以复合系数协同缩放网络深度、宽度与分辨率
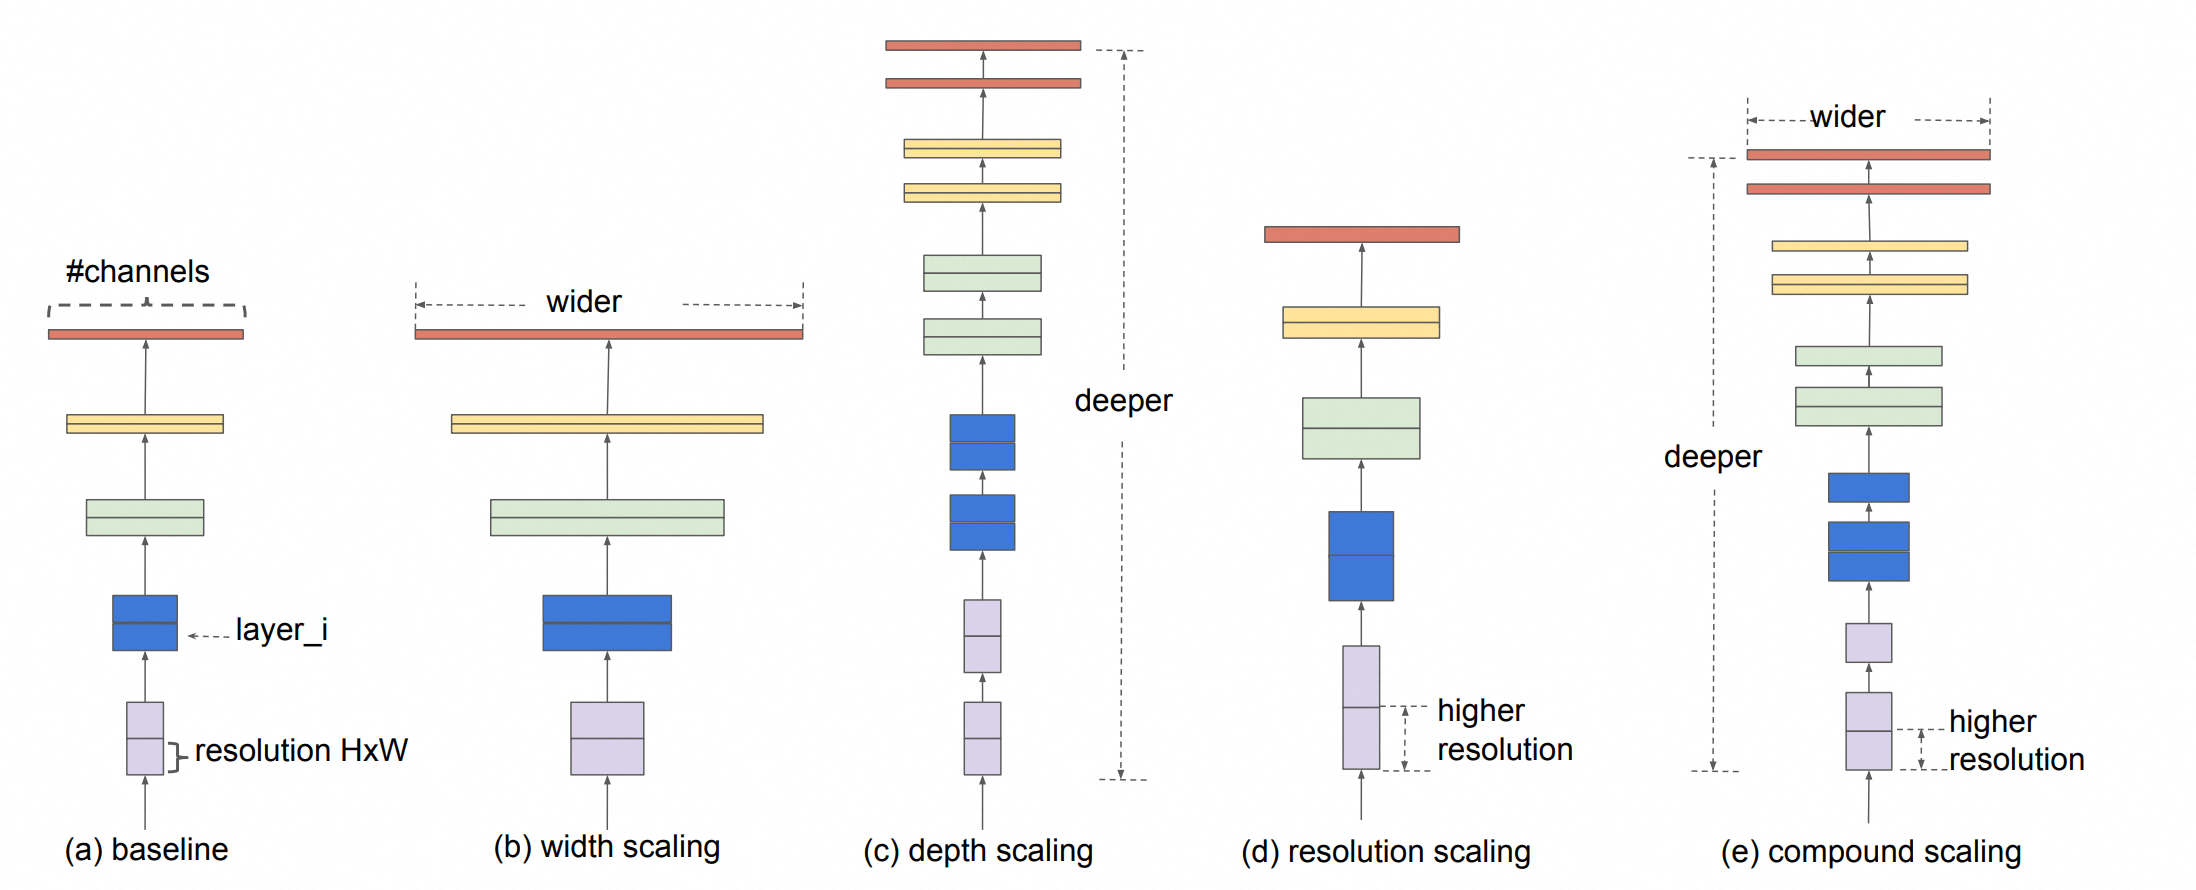
在将基准卷积网络扩展至更大算力预算时,以往工作通常孤立地放大单一维度:仅增加网络深度$d$(如 ResNet-18 至 ResNet-152)、仅增加通道宽度$w$(如 WideResNet)或仅提高输入图像分辨率$r$。EfficientNet通过实证分析指出,深度、宽度与分辨率三个维度之间存在内在耦合关系:更高分辨率的图像包含更丰富的细粒度像素信息,需要同步增加网络深度以扩大感受野来捕获大尺度目标结构,并同步增加通道宽度以编码更丰富的细粒度局部模式;单一维度的孤立放大均会在早期迅速遭遇精度饱和。
该方法提出复合缩放(compound scaling)法则,引入单一的复合系数$\phi$(代表用户可用的额外算力资源),按固定幂指数比例同步均匀地缩放深度、宽度与分辨率:
\[\text{depth: } d = \alpha^\phi, \quad \text{width: } w = \beta^\phi, \quad \text{resolution: } r = \gamma^\phi\] \[\text{s.t. } \alpha \cdot \beta^2 \cdot \gamma^2 \approx 2, \quad \alpha \ge 1, \ \beta \ge 1, \ \gamma \ge 1\]由于标准卷积层的计算量(FLOPs)与深度$d$呈线性正比,与宽度$w$及分辨率$r$的平方呈正比,约束条件$\alpha \cdot \beta^2 \cdot \gamma^2 \approx 2$确保了对于任意$\phi$,总计算量近似扩大为基准模型的$2^\phi$倍。具体构建分为两步:(1) 首先利用与 MnasNet 类似的多目标架构搜索(优化准确率与 FLOPs,不限制特定硬件延迟),搜索出基于倒残差块(MBConv)与 SE 注意力的轻量级基线模型EfficientNet-B0;(2) 固定$\phi=1$,在 B0 上通过小规模网格搜索确定最优比例常数$\alpha=1.2, \beta=1.1, \gamma=1.15$,随后固定$\alpha,\beta,\gamma$并逐步增大$\phi$,直接缩放生成EfficientNet-B1至B7系列。
⚪ EfficientNetV2:结合训练感知架构搜索与渐进式学习策略
- paper:EfficientNetV2: Smaller Models and Faster Training(ICML 2021)
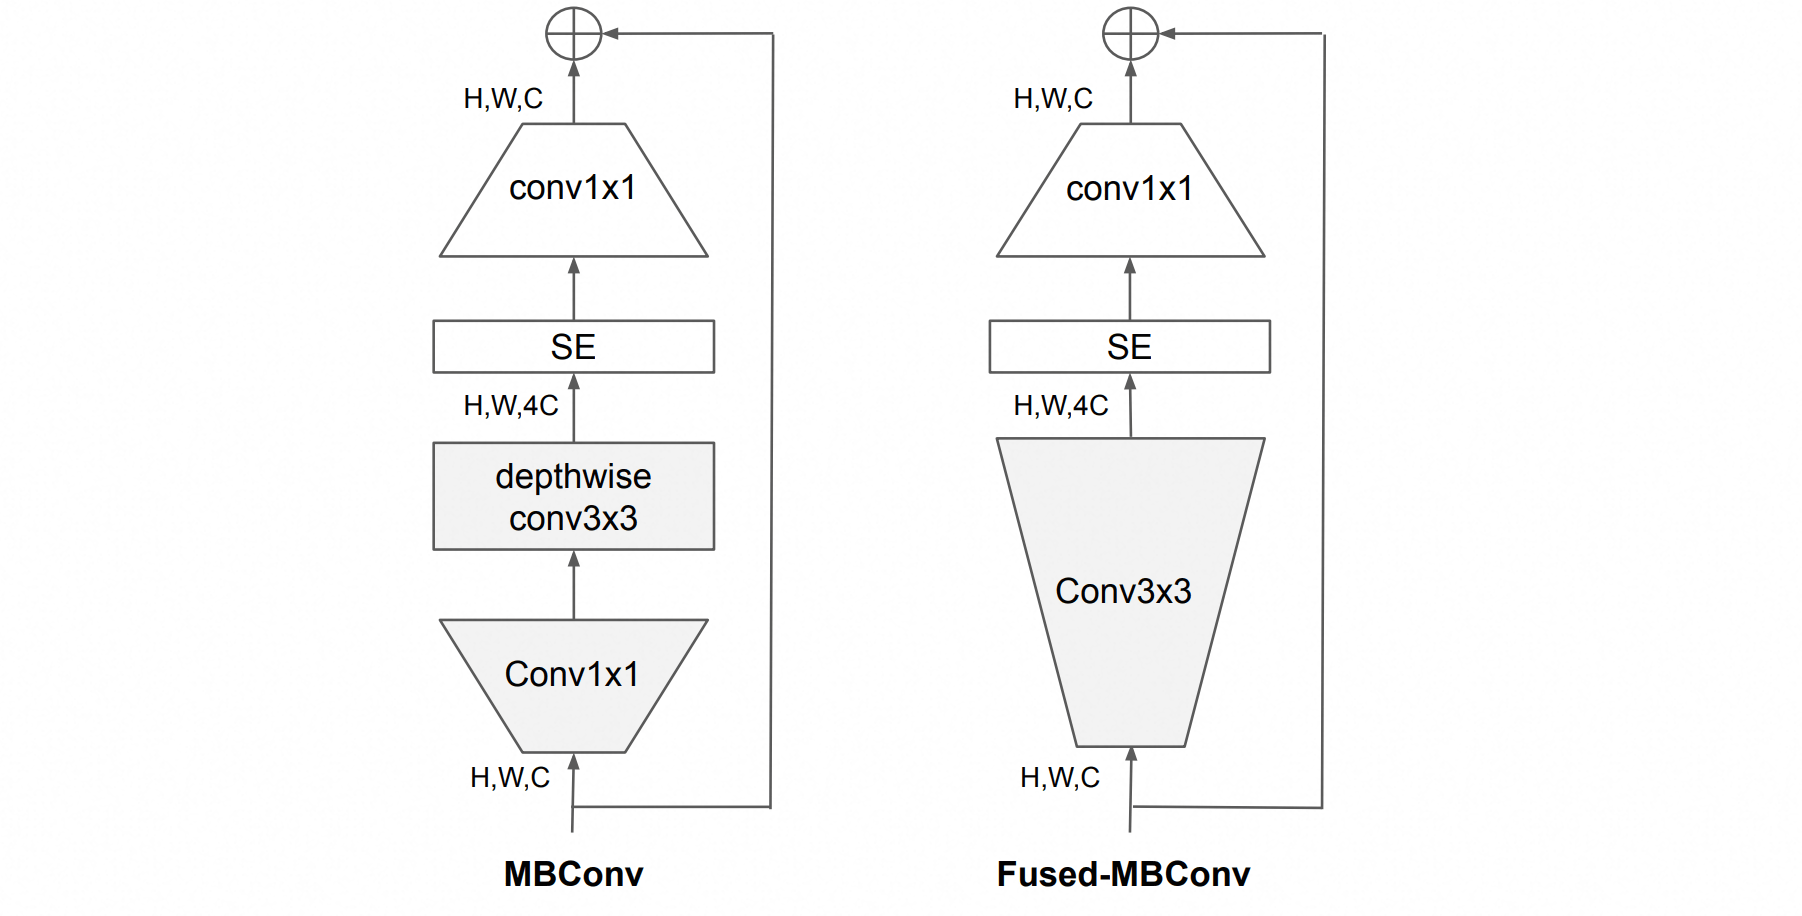
系统性剖析表明,初代EfficientNet在训练效率与模型扩展上存在三项瓶颈:(1) 在超大输入分辨率(如 B6/B7 的$528 \sim 600$)下训练占用极大显存,被迫使用极小批量从而拖慢训练;(2) 深度可分离卷积(MBConv)虽然参数与 FLOPs 少,但在网络浅层的高分辨率特征图上算术强度低、访存开销大,无法有效利用现代加速器单元,导致实际训练速度极慢;(3) 等比例复合缩放规则倾向于在所有阶段盲目增加层数与分辨率,并非最优。EfficientNetV2从算子搜索与训练日程两方面进行了改进。
在架构层面,提出Fused-MBConv模块:将原 MBConv 中的“$1\times1$扩张卷积 + $3\times3$深度可分离卷积”合并替换为单个标准的稠密$3\times3$扩张卷积,后接$1\times1$降维卷积。随后构建包含{MBConv, Fused-MBConv}的搜索空间,执行以验证精度$A$、真实训练步耗时$S$与参数量$P$为联合奖励($A \cdot S^w \cdot P^v$)的训练感知架构搜索。搜索结果自动在浅层(Stage 1–3)选择高吞吐的 Fused-MBConv,而在深层(Stage 4–6)保留低参数的 MBConv,同时将缩放时的最大推理分辨率限制在$480$以内并偏向于在深层阶段增加网络块。
在训练策略层面,提出自适应正则化的渐进式学习(Progressive Learning with Adaptive Regularization):针对以往渐进调整图像尺寸容易导致精度下降的问题,指出其根源在于不同图像尺寸需要匹配不同强度的正则化。因此,将整个训练周期划分为$M$个阶段,在将输入图像尺寸$S_i$从较小初始值线性递增至目标尺寸的同时,同步线性增强Dropout丢弃率、RandAugment幅度与Mixup混合比例,在大幅缩短训练时间的同时进一步提升了泛化精度。
⚪ RegNet:基于量化线性函数约束构造参数化网络设计空间
- paper:Designing Network Design Spaces(CVPR 2020)
传统手工网络设计或神经架构搜索(NAS)均聚焦于在特定配置下寻找“单个最优网络实例”,其结论往往缺乏可解释性与跨算力尺度的泛化规律。RegNet提出一种全新的研究范式:设计网络的设计空间(designing network design spaces):将整个候选网络集合视为一个总体,通过从包含所有可能残差网络的无约束初始空间(AnyNet)出发,每次随机采样一批模型训练,利用误差的经验分布函数进行假设检验,逐步发现统计规律并施加结构约束,最终收敛至一个仅由$6$个自由度参数化的低维高质量设计空间:RegNet。
从包含四阶段标准残差瓶颈块(带分组卷积,称为 X 块)的初始空间出发,经过逐步统计收缩得出三项核心结构准则:(1) 全网所有阶段共享相同的瓶颈压缩比$b$(常取$b=1$,即不压缩)与相同的分组卷积组宽$g$;(2) 网络通道宽度与阶段深度应随阶段推进单调递增;(3) 最优网络的逐块通道宽度演化规律可以用一个量化的线性函数(quantized linear function)精确参数化。具体生成过程为:首先给定总网络深度(总块数)$d$、初始宽度$w_0 > 0$和线性增长斜率$w_a > 0$,为每个块$j$($0 \le j < d$)生成连续线性宽度$u_j$:
\[u_j = w_0 + w_a \cdot j\]随后引入阶段宽度倍增公比$w_m > 0$(通常取$w_m \approx 2 \sim 2.5$),将$u_j$对数化并四舍五入取整,得到每个块所属的离散阶段索引$s_j$,进而确定量化后的分阶段常数宽度$w_j$:
\[s_j = \operatorname{round}\left( \log_{w_m}\left(\frac{u_j}{w_0}\right) \right), \quad w_j = w_0 \cdot w_m^{s_j}\]最后将具有相同$s_j$(即相同宽度$w_j$)的所有连续块归并为同一个阶段(Stage $i$),并将$w_j$微调至组宽$g$的整数倍。由此,整个网络四阶段的深度与宽度分布完全由$(d, w_0, w_a, w_m, b, g)$决定。在此基础上加入SE模块的变体记为RegNetY(无 SE 记为RegNetX),该空间下的模型在跨越移动端至百亿次计算量的宽广尺度上表现极其稳健,且因结构高度规整,在 GPU 上的实际训练与推理吞吐量远超同 FLOPs 的 EfficientNet。